Разбор готов
Трансформеры в поиске и рекламе: опыт Яндекса 2022 года
Когда человек вводит запрос в Поиске, системе нужно выбрать документы и решить, какую рекламу показать. Текущий запрос объясняет непосредственное намерение, а история действий помогает понять интересы пользователя. Первая модель Яндекса обрабатывала историю вместе с каждым кандидатом: это давало хорошее качество, но заставляло многократно повторять дорогие вычисления. В докладе DataFest 3.0 2022 года Кирилл Хрыльченко рассказывает, как команда разделила обработку пользователя и объекта, какие упрощения не сработали и чем удалось вернуть потерянный эффект. Далее разберём, как учитывать длинную историю без её полного пересчёта на каждом запросе и почему обучение по кликам требует различать релевантность, внимание пользователя и влияние остальных результатов выдачи.
Глава полезна инженерам поиска, рекламы и рекомендательных систем, которые выбирают между качеством взаимодействия признаков и стоимостью применения модели. На конкретных экспериментах видно, что можно вынести в предварительные расчёты, зачем нужны несколько состояний пользователя и как читать результаты обучения по шумной обратной связи.
Видео · на русском
Кирилл Хрыльченко | Яндекс Трансформеры для персонализацииКирилл Хрыльченко · Опубликовано: 23 июня 2022 г.
Исходный доклад · Открыть оригинал
Персонализация в трёх сервисах Яндекса
Основа главы — доклад Кирилла Хрыльченко «Трансформеры для персонализации» на DataFest 3.0 в 2022 году. На момент выступления команда около двух лет занималась персонализацией и внедряла модели в Поиск, поисковую рекламу и Рекламную сеть Яндекса, или РСЯ. Здесь рассматривается именно этот исторический опыт: разные модели и результаты относятся к этапам его развития, а не к одной неизменной системе.
Рассказ объединяет три задачи. Первая — сократить стоимость оценки кандидатов, не потеряв пользу от пользовательской истории. Вторая — расширить историю за пределы небольшого свежего фрагмента, который ещё можно обработать при обращении к сервису. Третья — использовать клики так, чтобы модель различала интерес к документу и другие причины реакции человека. Эти задачи связаны, но каждая имеет собственные эксперименты и основания сравнения.
Архитектурная часть — не история безусловного успеха любого упрощения. Удаление тяжёлого взаимодействия сначала заметно уменьшило прирост, и обычная дополнительная нейросеть не исправила положение. Чтобы понять итоговый выбор, важно пройти через эти неудачи, а затем отдельно разобрать обучение и применение готовой модели.
Доклад · 00:00:01Что выбирает система и что она знает о пользователе
В задаче персонализации есть пользователь и множество объектов, которые можно ему предложить. Объект до окончательного выбора называется кандидатом: в поиске это документ, в товарном сервисе — товар, в рекламе — баннер. Система должна не просто оценить привлекательность объекта вообще, а определить, насколько он подходит конкретному человеку в текущей ситуации.
Для этого используются два разных источника сведений о человеке. История содержит его прежние взаимодействия с сервисами. Текущий контекст появляется непосредственно при обращении: в поиске это запрос, а в РСЯ — веб-страница, на которой нужно разместить рекламу. История помогает понять интересы, но не заменяет запрос; контекст объясняет текущую ситуацию, но не содержит всей информации о пользователе.
Целевая величина зависит от продукта. Поиску нужны документы, релевантные запросу с учётом истории пользователя. Рекламе нужны вероятности клика и конверсии — целевого действия, ради которого размещается объявление. Прогноз клика обычно обозначают CTR, прогноз конверсии — CVR. Эта разница позже станет важной и для многозадачной модели, и для разбора шумного кликового сигнала: высокая вероятность клика не обязательно означает высокую релевантность.
Слайд 4 · 00:01:30. История, текущий контекст и кандидат — разные входы. Их нельзя заранее свести к одному неизменному профилю: способ их связывания определяет и выразительность модели, и повторяемость вычислений.
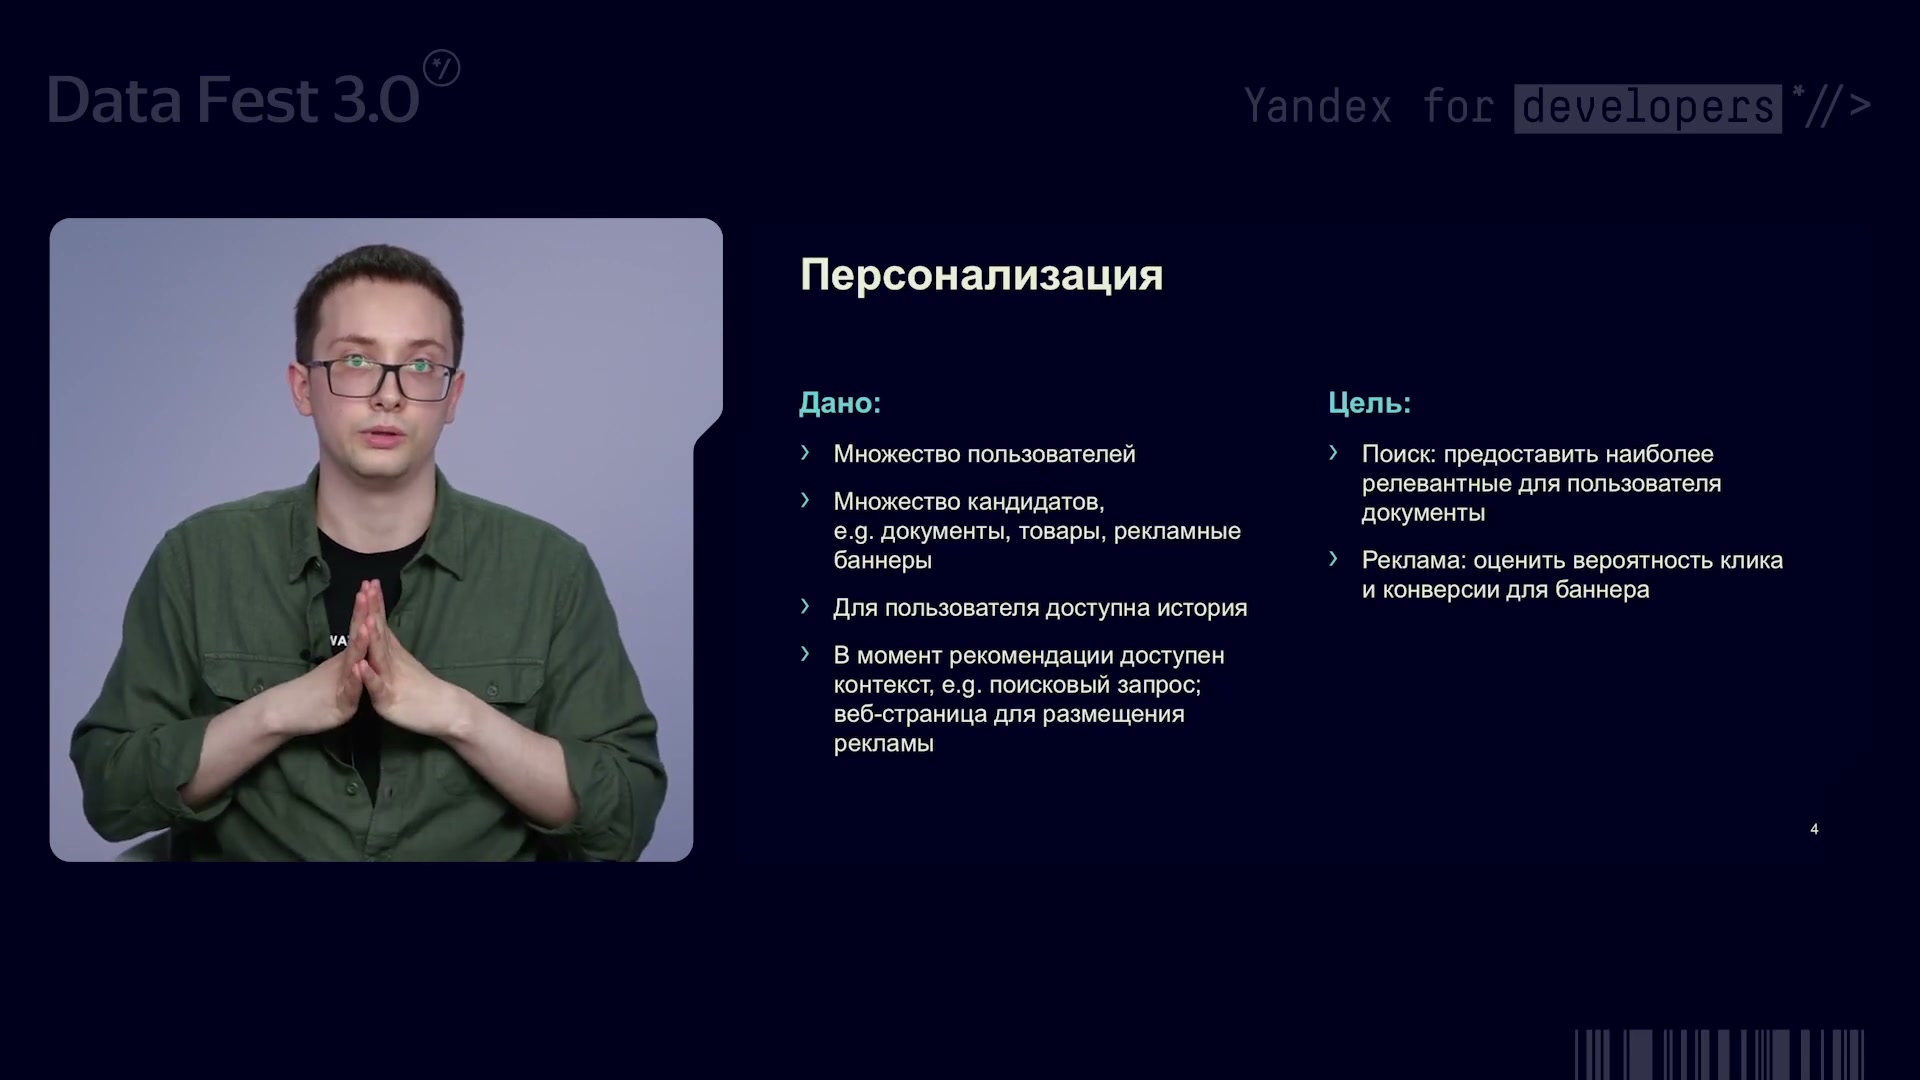
Постановка персонализации: пользователь, кандидаты, история и текущий контекст.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Как запрос превращается в несколько рекламных объявлений
На примере поисковой рекламы пользователь вводит «купить телевизор». Именно этот текст задаёт текущий контекст. Кандидатами выступают рекламные объявления, каждое со своим заголовком, текстом и URL — адресом страницы. Поэтому даже до добавления истории задача уже содержит две стороны: что сейчас ищет человек и что предлагает конкретное объявление.
Перед формированием показанного списка рекламные модели решают, стоит ли вообще показывать рекламу на этот запрос и сколько объявлений нужно. Затем из большого множества рекламных документов выбирают небольшой набор и ещё раз его сокращают. В иллюстрации остаются три баннера. Это конкретная выдача на слайде, а не правило, что любой запрос всегда получает ровно три объявления.
Таким образом, дорогая оценка отдельных кандидатов возникает внутри более длинного процесса отбора. История пользователя должна помочь выбрать подходящие объявления, но сначала нужно сделать множество кандидатов достаточно небольшим, чтобы подробное сравнение стало вычислительно доступным.
Слайд 5 · 00:02:30. Запрос «купить телевизор» — контекст, а выделенные объявления — кандидаты с текстом и URL. До этих трёх результатов система уже приняла решение о показе рекламы и несколько раз сузила набор.
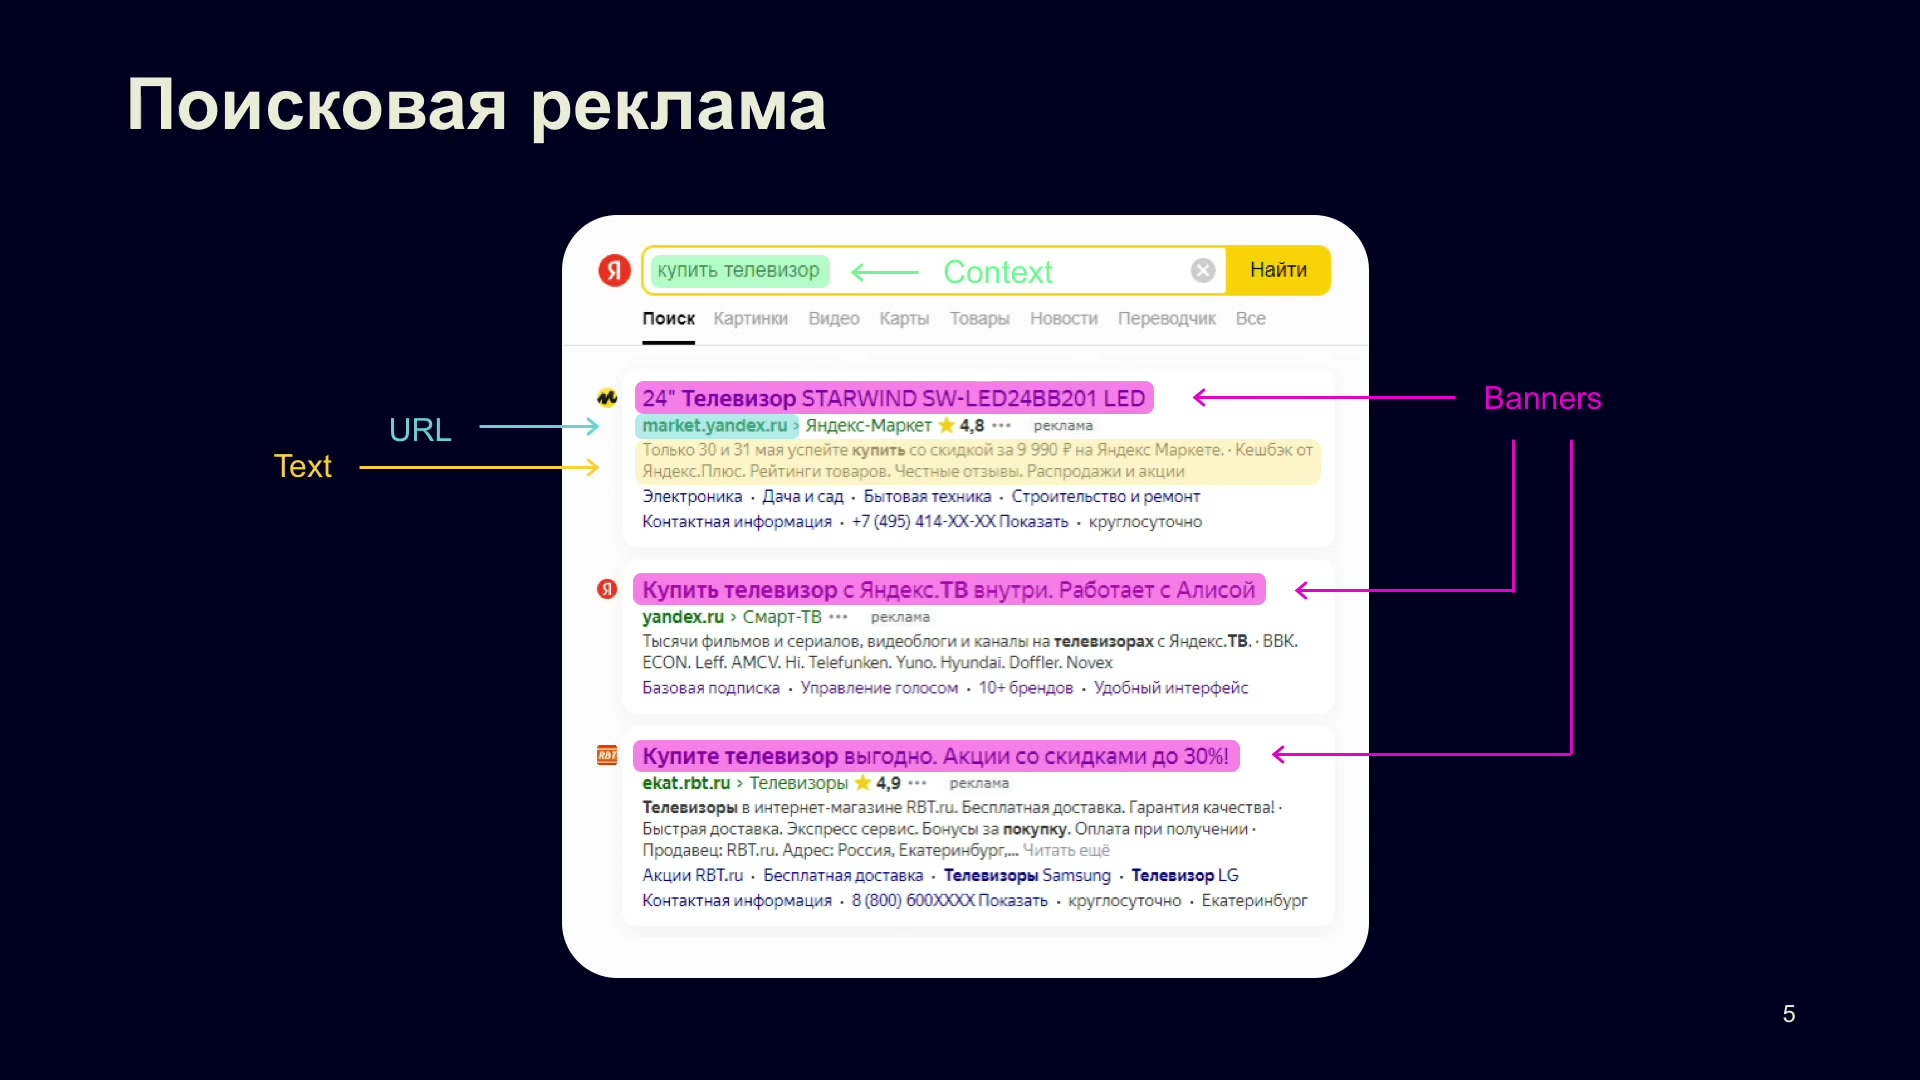
Поисковая реклама: запрос как контекст, текст и URL как атрибуты кандидатов.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022От ручных категорий к сходству и скрытым факторам
Исторический обзор начинается с системы, которой ещё не нужно учиться по большому потоку действий. Эксперты вручную разделяют контент на категории, пользователь отмечает предпочтения, и сервис предлагает соответствующие объекты. Связь между человеком и контентом здесь задаётся через заранее выбранные категории.
Следующий подход использует совместные действия пользователей и называется коллаборативной фильтрацией. В методах сходства можно сравнивать пользователей между собой или объекты между собой. Например, для текущего пользователя находят похожих людей, смотрят, с какими объектами они взаимодействовали, и агрегируют эту информацию в рекомендации. На слайде обе формы обозначены как user-to-user и item-to-item.
Другая группа представляет взаимодействия матрицей и раскладывает её на две более компактные матрицы скрытых факторов — представлений пользователей и объектов. Оценка пары тогда получается через скалярное произведение соответствующих векторов. Если в исходной матрице были рейтинги, модель пытается приблизить именно рейтинг. В качестве примеров матричных методов на слайде названы SVD и ALS.
Далее в обзор входят методы, которые используют содержание и признаки объектов. Однако автор не описывает это как полную замену одного поколения другим: коллаборативная фильтрация продолжала применяться, в том числе в гибридных моделях вместе с контентными признаками. Для последующего рассказа важна сама идея представлять пользователя и объект числами, а затем выбирать, как эти представления будут взаимодействовать.
Слайд 6 · 00:03:00. Методы сходства используют связи между пользователями или объектами, а матричное разложение сжимает взаимодействия в скрытые факторы. Переход к признакам содержания не отменяет эти источники информации.
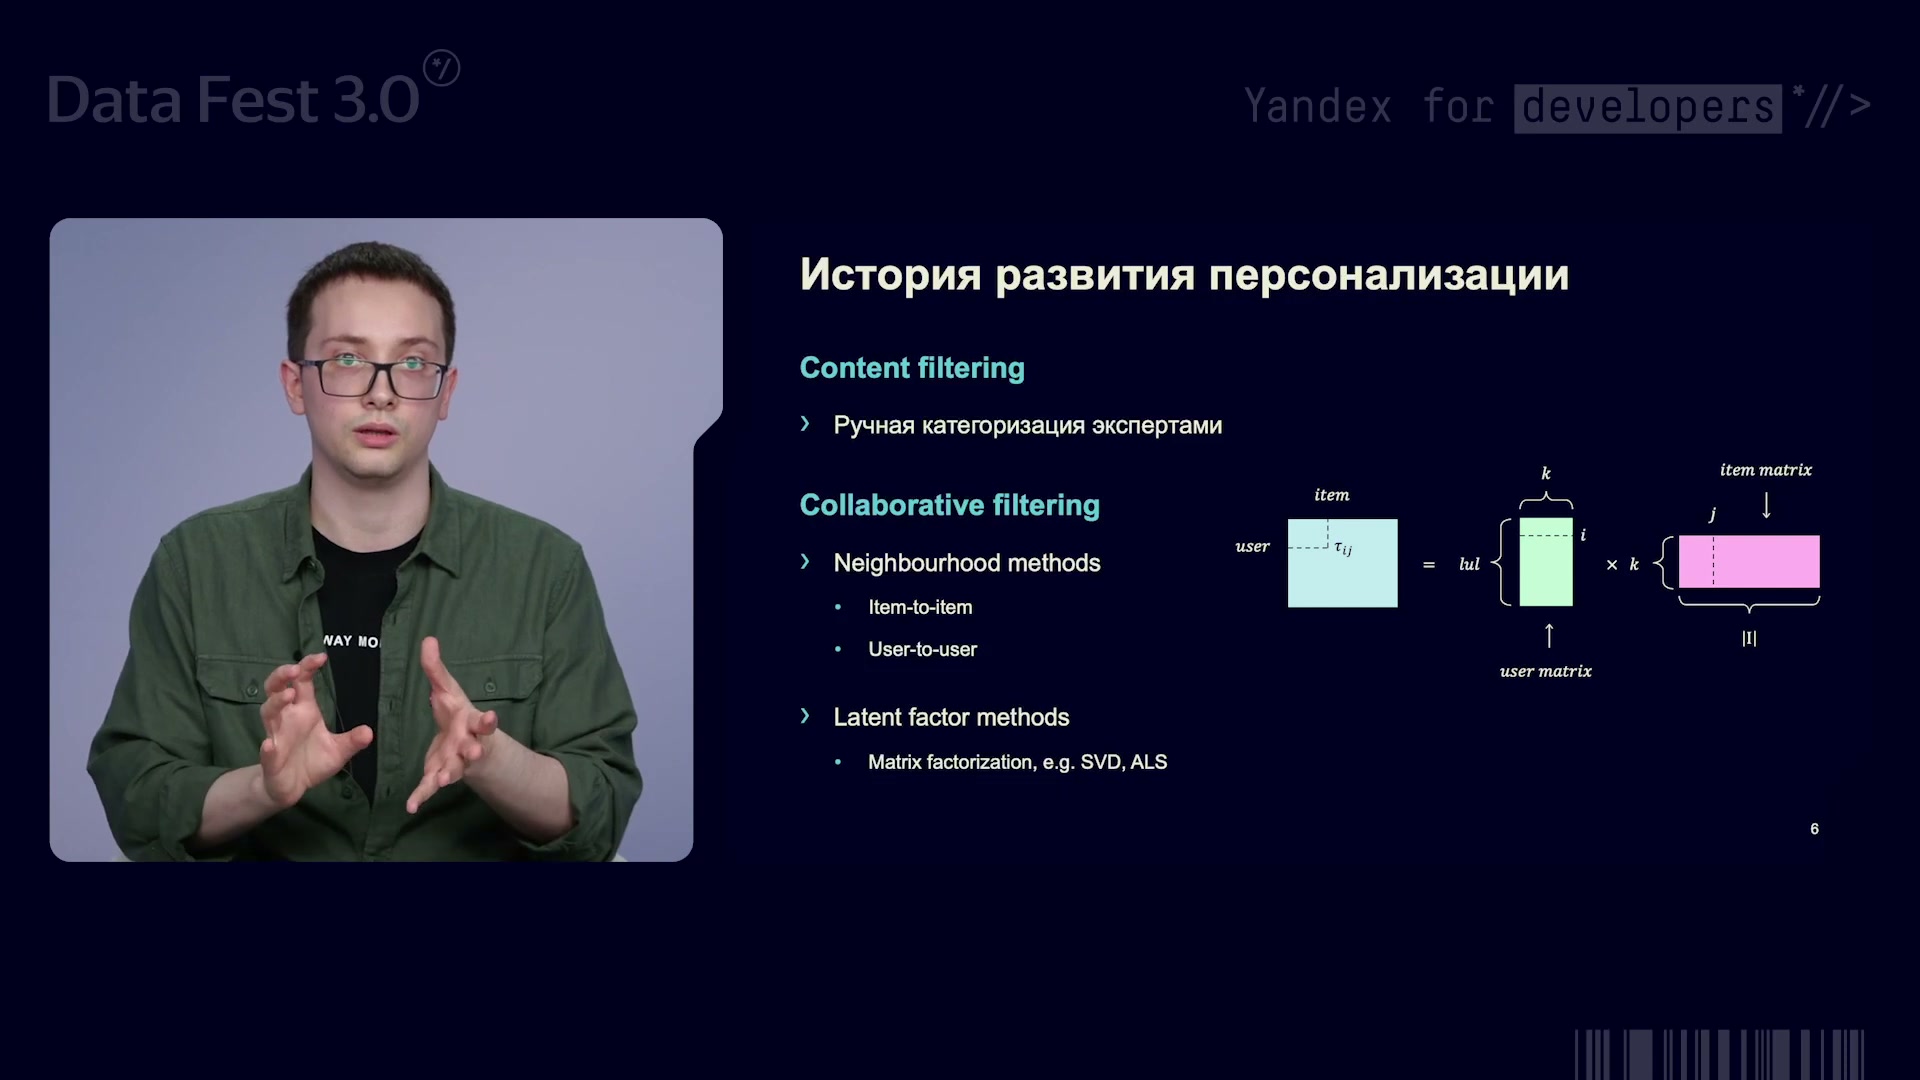
Исторические методы: содержательная и коллаборативная фильтрация, факторизация.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Как YouTube DNN собирала пользовательский вектор
Пример следующего шага взят из рекомендательной системы YouTube образца 2016 года. Это чужая историческая архитектура, которую автор приводит для объяснения развития персонализации; она не является описанием собственной модели Яндекса.
В схеме есть просмотренные пользователем видео и поисковые запросы, которые он раньше задавал. Видео и элементы запросов превращаются в векторные представления — наборы чисел, по которым модель может сопоставлять объекты. Представления просмотров усредняются отдельно от представлений запросов. В результате вместо двух последовательностей остаются два агрегированных вектора.
Остальные сведения о пользователе тоже переводятся в числа или векторы и объединяются с этими агрегатами в один длинный вектор. Полносвязная нейронная сеть, или MLP, последовательно преобразует его в более компактное пользовательское представление. На исходной схеме среди дополнительных входов видны географическое представление, возраст обучающего примера и пол; несколько слоёв используют функцию ReLU, обнуляющую отрицательные значения.
При обучении схема связывает пользовательский вектор с вероятностями классов через softmax — преобразование оценок кандидатов в распределение. При применении показан индекс ближайших соседей: он помогает искать видео с близкими представлениями. В речи автор объясняет сопоставление через скалярные произведения пользовательского вектора и векторов видео; последние могут строиться из признаков либо извлекаться как обученные представления идентификаторов.
Здесь уже виден важный компромисс: после усреднения история занимает мало места, но подробности отдельных событий должны уместиться в агрегатах. Дальнейшая часть доклада сосредоточена на другом представлении истории — последовательности, которую модель анализирует целиком, прежде чем сжимать её в состояния пользователя.
Слайд 7 · 00:04:30. YouTube DNN 2016: просмотры и запросы сначала усредняются, затем общая сеть строит вектор пользователя. На рисунке отдельно показаны обучение через softmax и применение через индекс ближайших соседей.
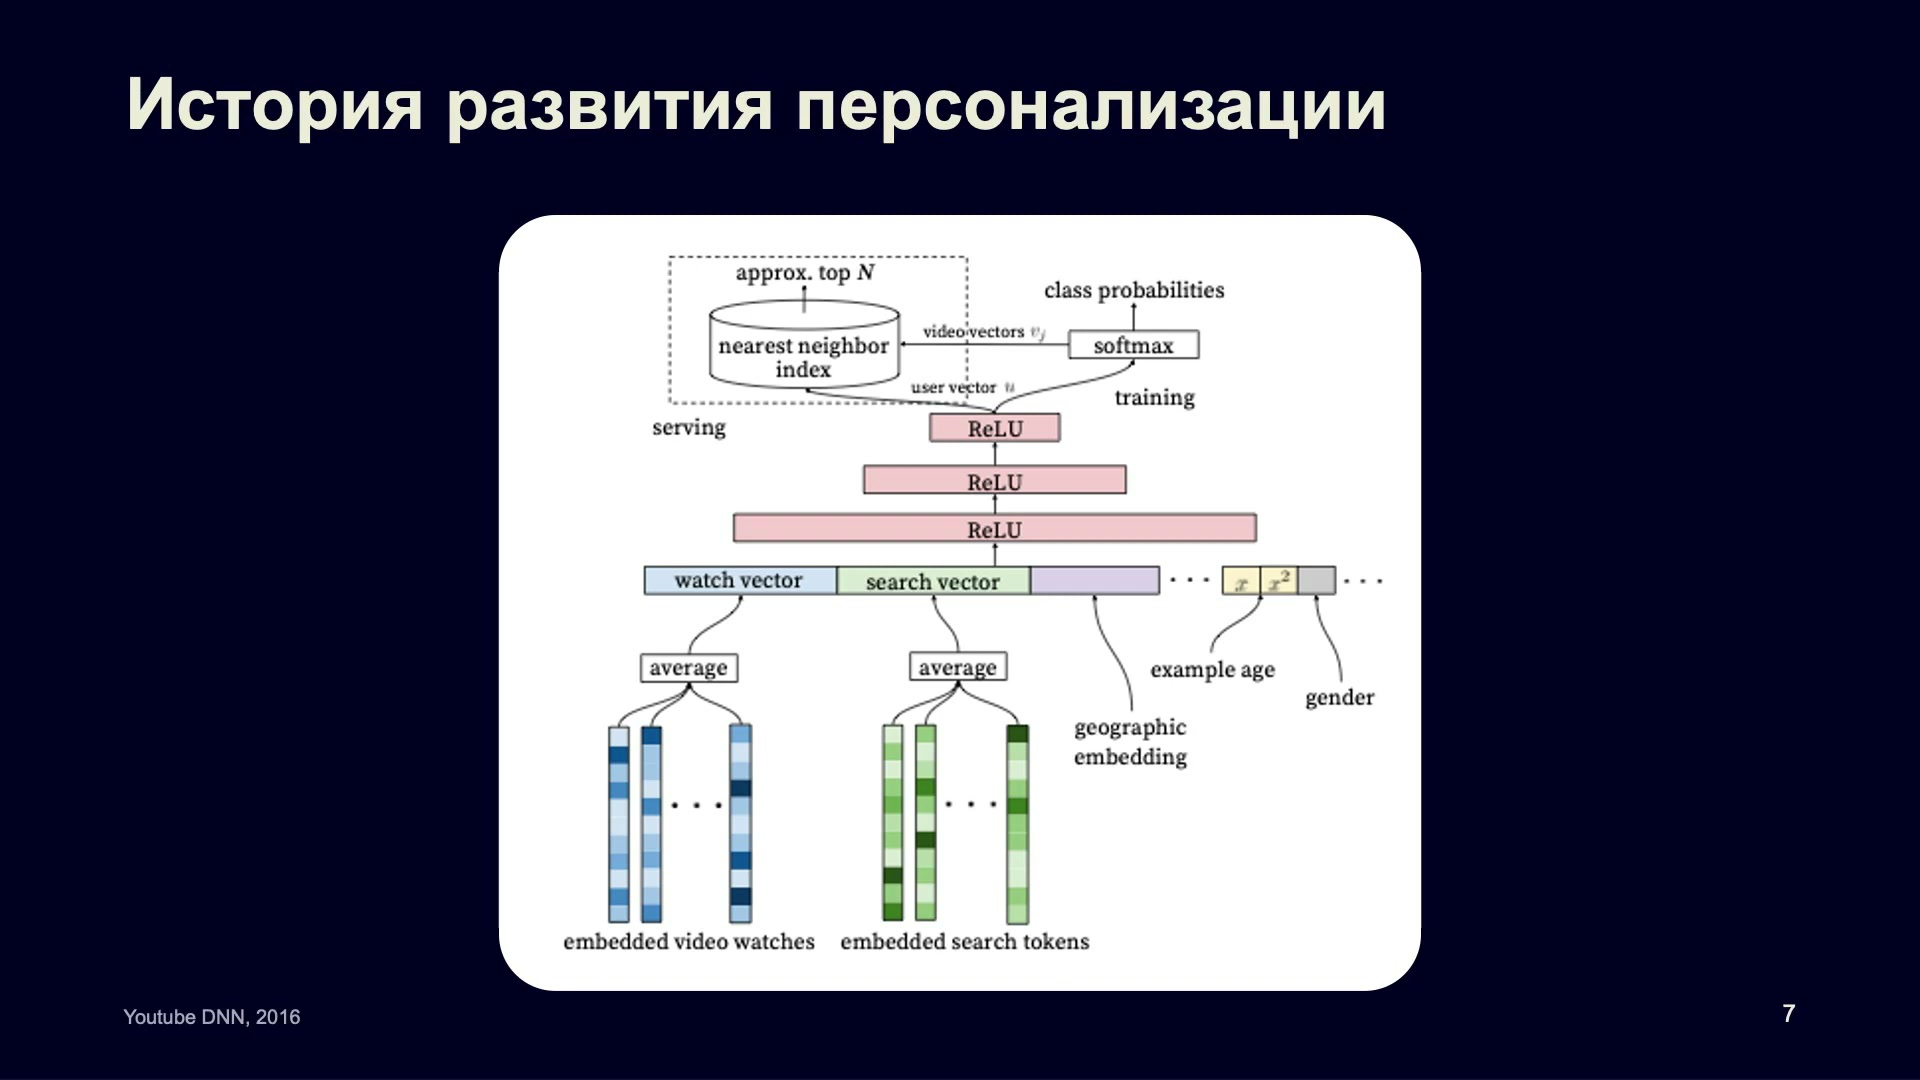
YouTube DNN 2016 приведена как чужой исторический пример, а не собственная модель Яндекса.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022От агрегатов к последовательности событий
В последовательной модели история не сводится заранее к одному среднему. Она подаётся как набор событий в порядке их появления, каждое из которых представлено вектором, и анализируется общей моделью. В этом докладе именно такой способ работы с историей становится основным.
Автор различает короткую историю одной или нескольких недавних сессий и длительную историю взаимодействий. Сессия здесь — связанная по времени группа действий; точное правило её границы не задаётся. Модели длительной истории на слайде названы lifelong: речь о стремлении использовать большой накопленный сигнал, а не о гарантированной обработке буквально всех событий жизни человека.
Для информационного поиска автор отдельно противопоставляет раздельное кодирование сущностей в плотные векторы и совместную обработку всей информации одной сетью. В первом случае сущности встречаются только в простой операции сравнения; во втором их признаки взаимодействуют раньше. Именно это различие, а не выбор одного названия из обзорного перечня, определит дальнейшую архитектурную историю.
Слайд 8 · 00:05:30. Основная тема находится на пересечении последовательного анализа истории и способов сопоставления пользователя с объектом. Другие семейства на слайде остаются фоном, без заявления, что все они внедрены в Яндексе.
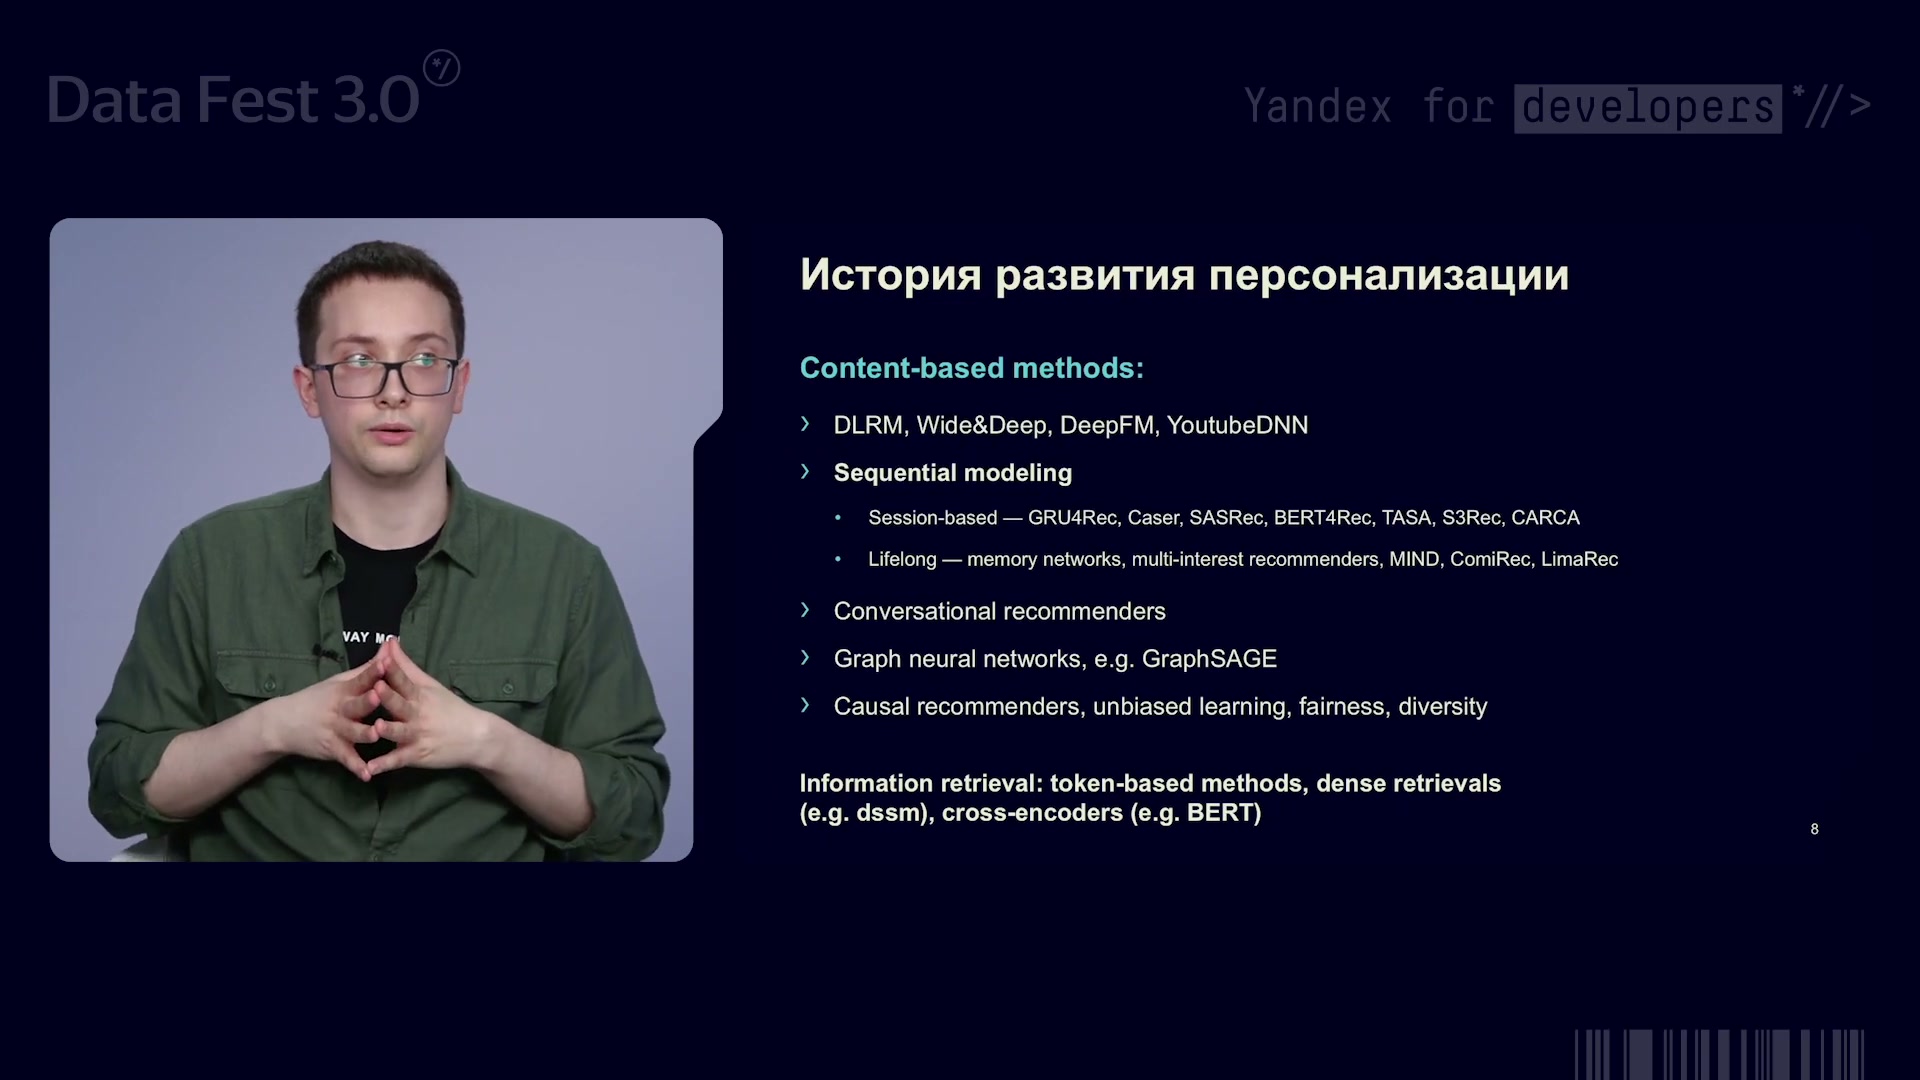
Обзор семейств рекомендателей и последовательных моделей; перечисление не означает внедрение каждого метода.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Почему персонализация работает внутри каскада
Даже хорошая модель бесполезна, если её нельзя достаточно быстро применить ко всем необходимым объектам. Поэтому множество кандидатов проходит через несколько стадий: сначала дешёвую проверку большого каталога, затем всё более подробную оценку всё меньшего списка. На ранних стадиях используются и более лёгкие модели, и меньше данных о пользователе и объекте.
Таблицу можно прокрутить по горизонтали.
Последняя стадия принципиально отличается от предыдущих: в представленной схеме она ничего не отбрасывает, а переставляет уже выбранные объекты. Причина — реакция на один результат зависит от остальных. Например, человек может решить задачу на одном документе и не перейти к другому похожему, хотя второй тоже релевантен. Позже это влияние будет разобрано как каннибализация.
Основная часть доклада относится к ранжированию: кандидатов уже сотни, но обработать большую пользовательскую историю отдельно для каждого всё ещё дорого. Автор допускает применение отдельных архитектурных приёмов и на других стадиях. Это не означает, что описанная далее модель целиком заменяет весь каскад.
Слайд 9 · 00:07:00. Сужение множества позволяет постепенно усложнять модель. Переранжирование в этой схеме не фильтрует объекты: оно учитывает то, как выбранные результаты влияют друг на друга.
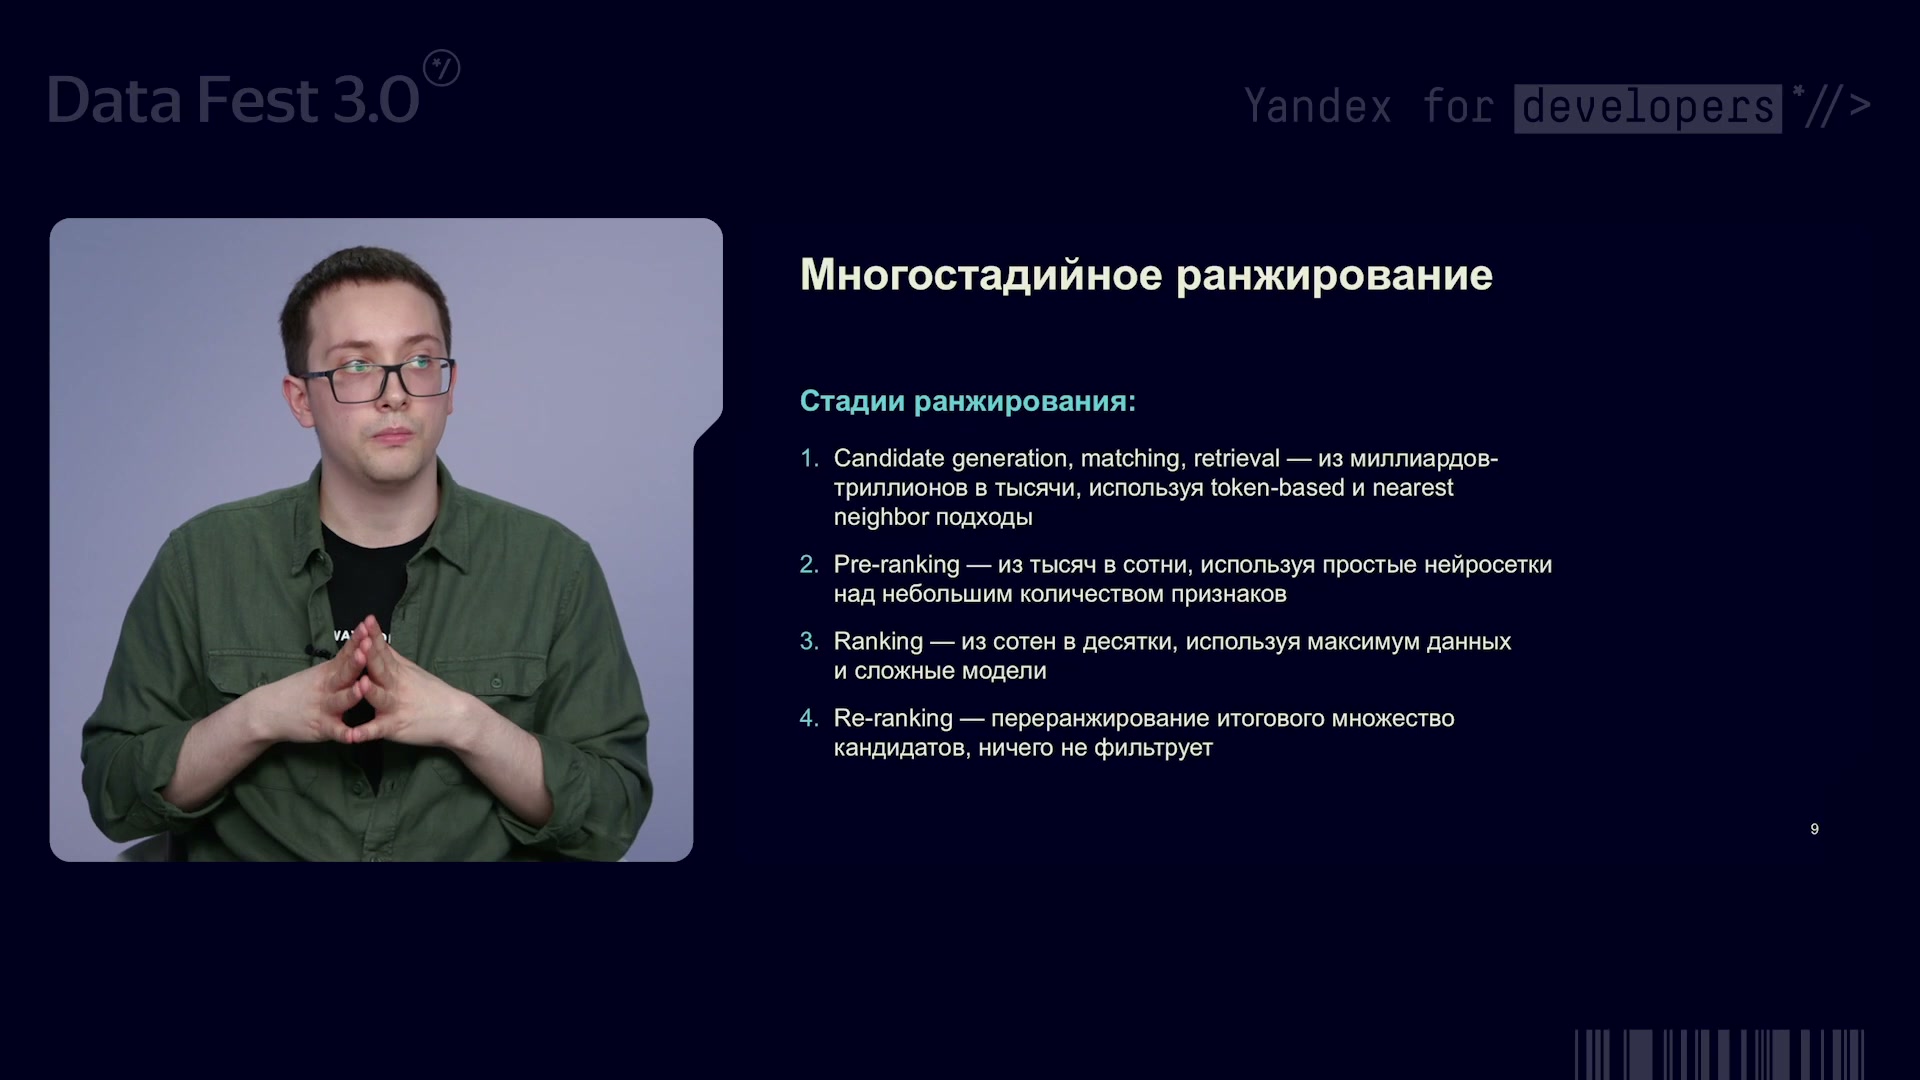
Четыре стадии: отбор, предварительное ранжирование, тяжёлое ранжирование и перестановка итогового списка.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Где должны встретиться пользователь и кандидат
Модель, которая преобразует входные данные в векторные представления, называется энкодером. Совместный энкодер, или cross-encoder, получает историю пользователя, контекст и кандидата вместе. Признаки одной стороны могут влиять на обработку другой уже внутри сети. Для персонализации это привлекательное свойство: модель не обязана сначала упаковать все интересы человека в представление, одинаковое для любого объекта.
В двухбашенной модели, или bi-encoder, эти вычисления разделены. Одна сеть кодирует пользователя вместе с текущим контекстом, другая — кандидата. На выходе выполняется дешёвое сравнение, например скалярное произведение или косинусная близость. Такая архитектура ограничивает способ взаимодействия сторон, зато позволяет независимо выполнять основную часть работы.
Пользовательская башня применяется один раз на текущий запрос. Кандидатная не зависит от этого пользователя и запроса, поэтому векторы объектов можно регулярно рассчитывать заранее и хранить по идентификаторам. Такое хранилище «ключ — значение» обычно обозначают KV. Во время запроса система извлекает готовые векторы, а не снова запускает кандидатную сеть.
У совместного энкодера этой независимости нет. Когда меняется кандидат, меняется вход общей модели, и пользовательская история обрабатывается заново. Таким образом, выбор между архитектурами — это выбор места, где начинается взаимодействие данных. Раннее взаимодействие в опыте команды давало больше качества, а раздельное кодирование было значительно удобнее для внедрения под нагрузкой.
Слайд 10 · 00:09:00. Слева пользователь, контекст и кандидат взаимодействуют внутри общей сети. Справа дорогие преобразования разделены, поэтому пользователь считается один раз на запрос, а кандидатные представления можно хранить заранее.
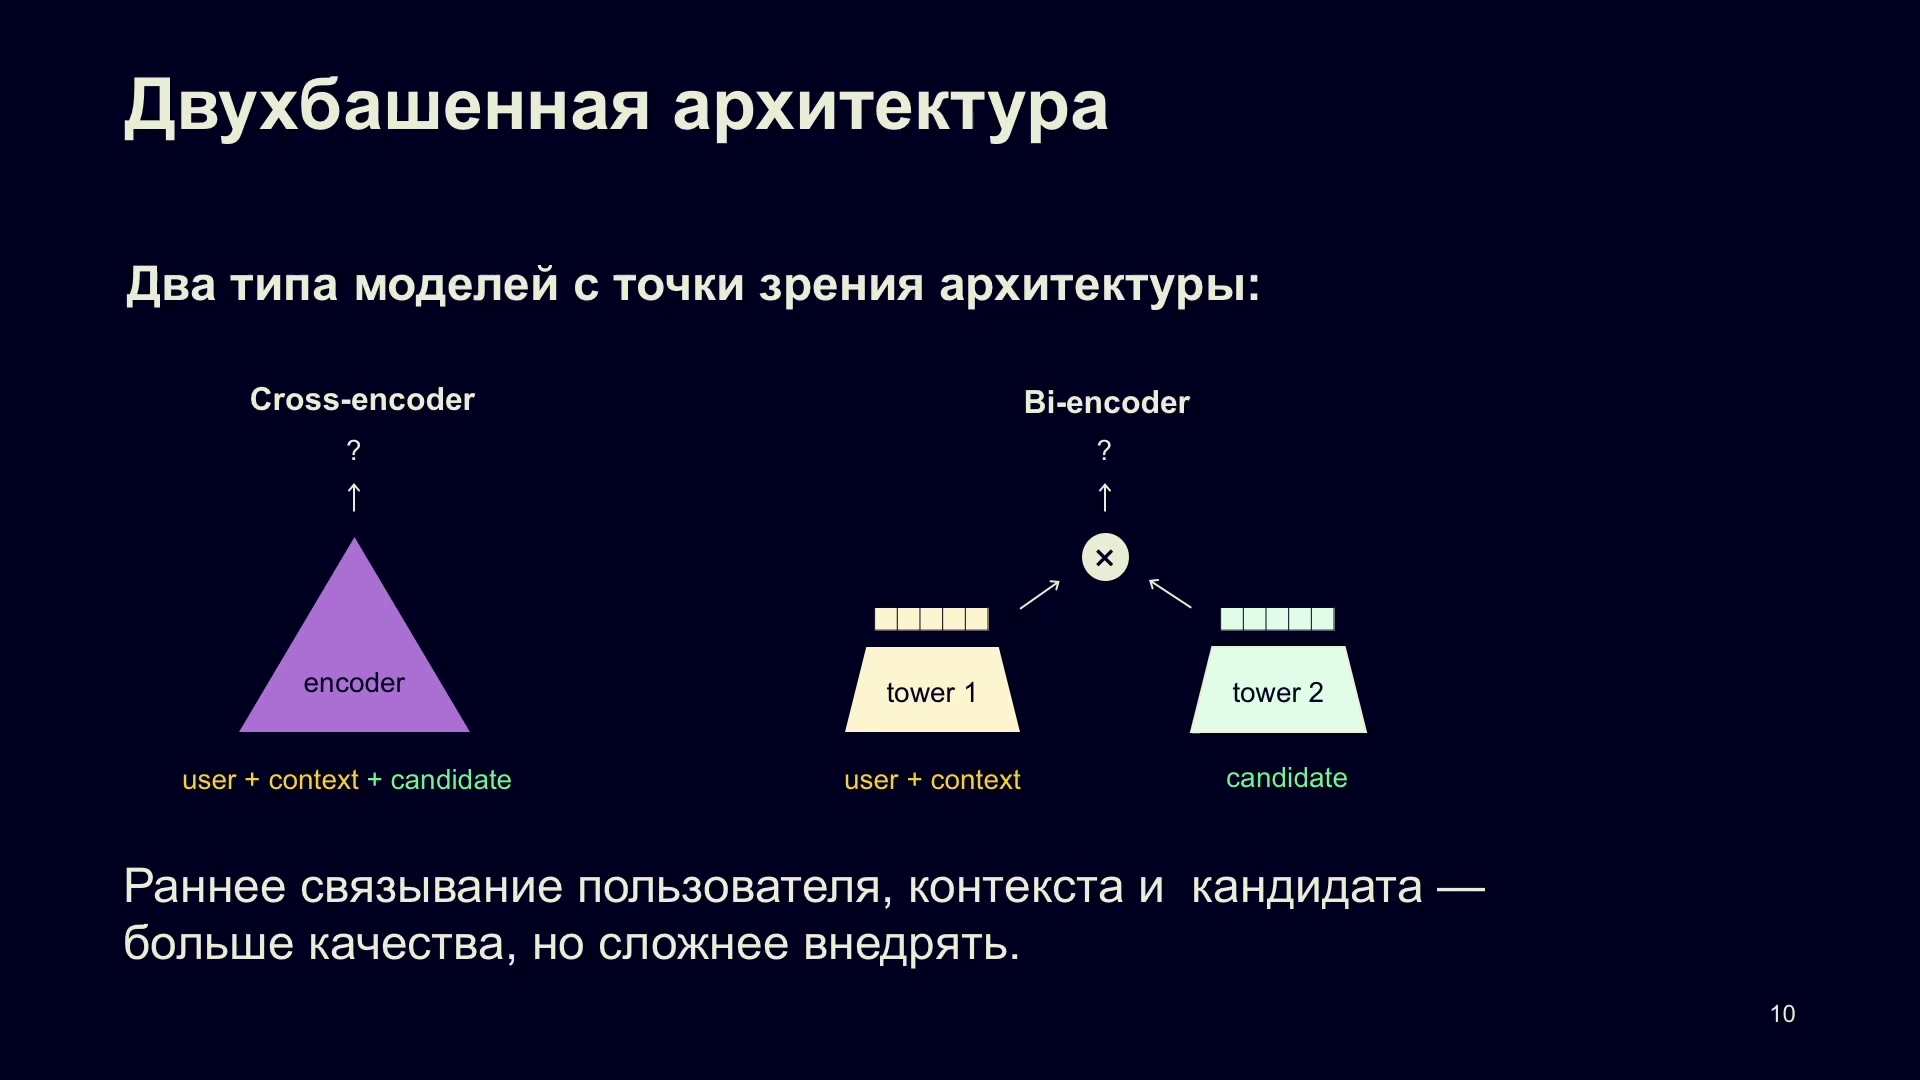
Совместный энкодер против двух башен: качество раннего взаимодействия требует дорогих вычислений.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Первая поисковая модель: вся история для каждого документа
Первая внедрявшаяся в Поиск модель использовала раннее связывание: пользователь, контекст и кандидат сразу попадали в один трансформер. Пользователь был представлен последовательностью прежних запросов и документов, на которые он кликал. Каждое событие, текущий контекст и кандидат достаточно простым способом превращались в векторы. Полный рецепт этого начального кодирования в докладе не раскрывается.
К входу добавляли ещё один обучаемый служебный вектор — CLS. Это не событие истории и не слово запроса: он предназначен для сбора информации, нужной итоговому предсказанию. Трансформер связывает входные позиции механизмом внимания, после чего модель берёт выходное представление CLS и получает оценку через простой линейный слой.
Такая модель хорошо работала по качеству. Её ограничение возникало при применении: для следующего кандидата нужно было заново пропустить через трансформер всю ту же историю. Автор приводит пример тысячи исторических событий. Если оценивается много кандидатов, эта тысяча обрабатывается многократно, хотя сама история в пределах запроса не меняется.
Далее результаты упрощений будут сравниваться с приростом именно этой исходной модели относительно базового варианта. Автор называет такой прирост «профитом». Сохранить 90% прироста — значит сохранить большую часть эффекта раннего связывания, а не получить качество 90% или увеличить выручку на 90%. Само название целевой метрики для этого архитектурного сравнения не раскрыто.
Слайд 11 · 00:10:30. Вектор кандидата включён до общей обработки истории, поэтому заменить кандидата без повторного запуска энкодера нельзя. CLS собирает сведения для оценки пары, но не устраняет повторяемость вычислений.
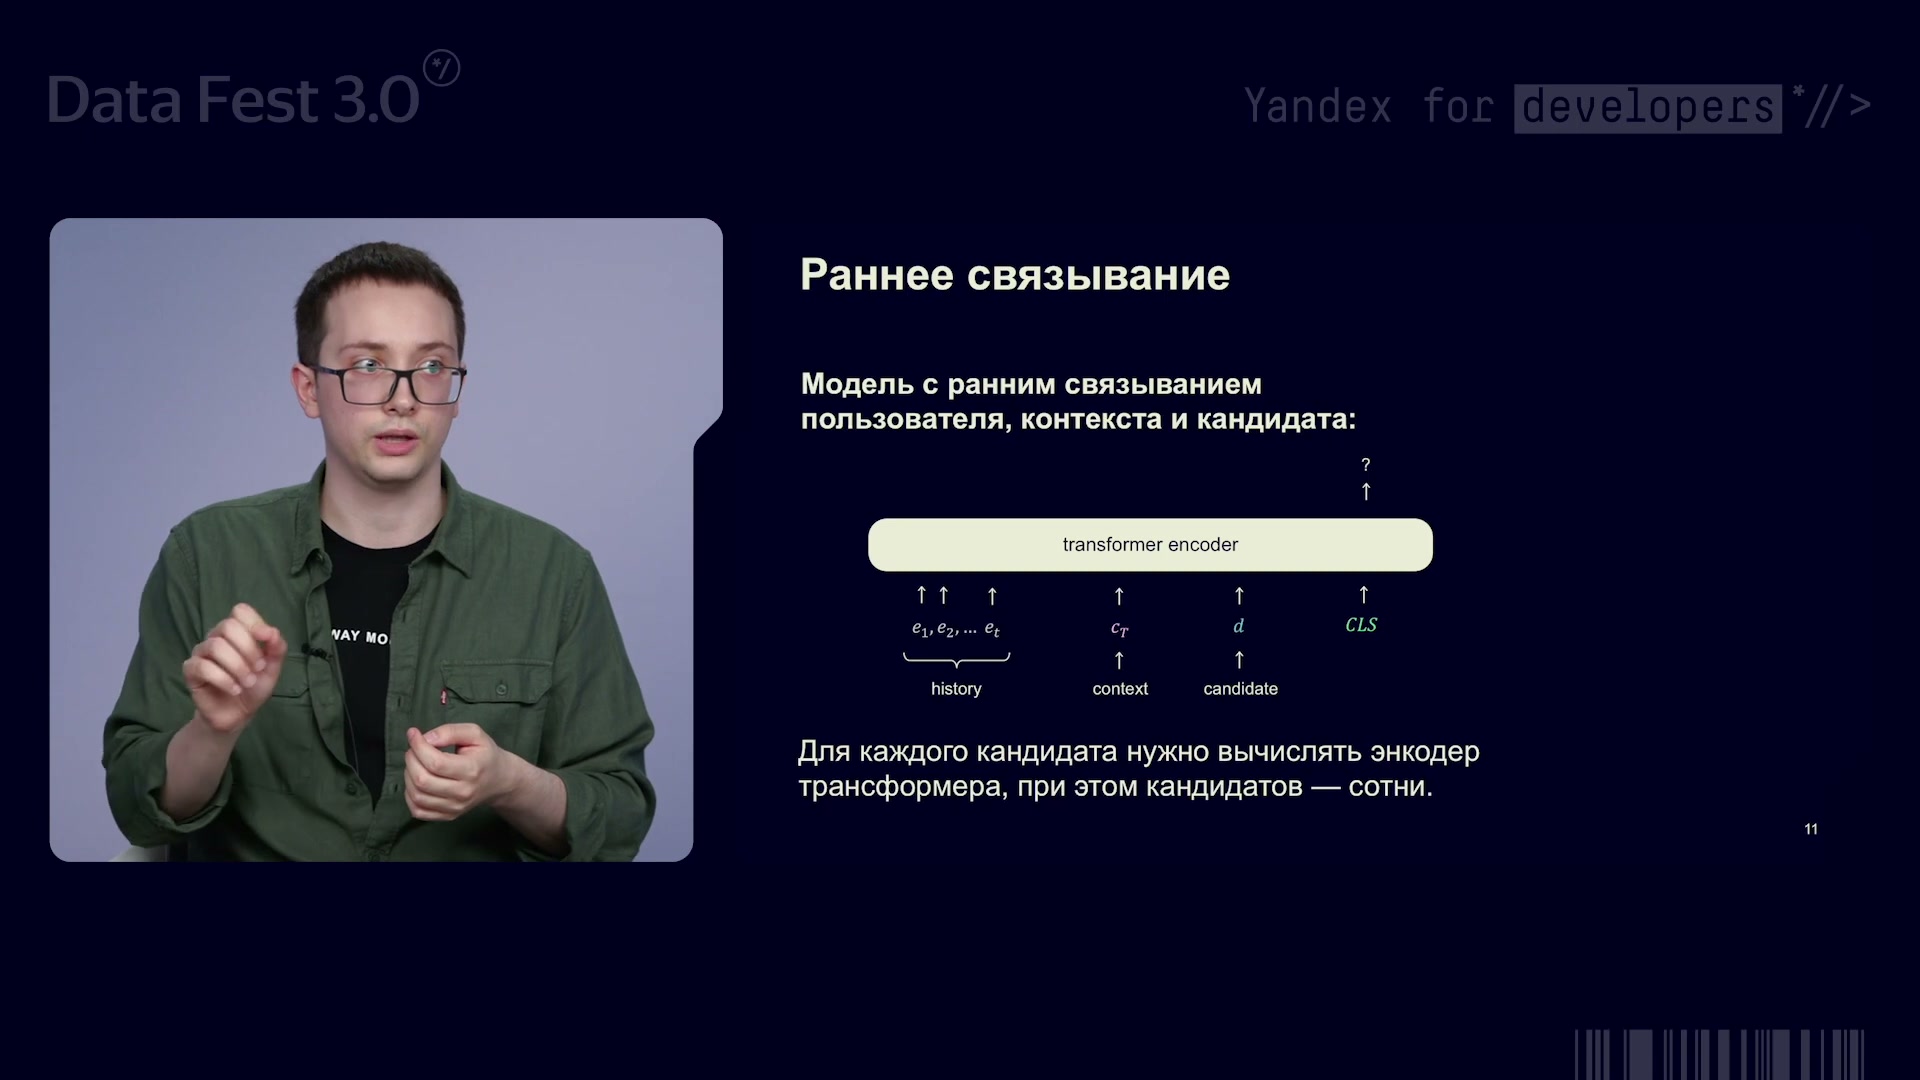
Раннее связывание истории, контекста и кандидата: энкодер считают для каждого объекта.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Позднее связывание: сначала сжать историю
При разработке модели для поисковой рекламы команда разделила обработку на исторический и кандидатный трансформеры. Историческая часть один раз за запрос получает историю и текущий контекст. Вместо единственного служебного CLS к ним добавляется небольшая группа обучаемых векторов. Их выходные представления становятся состояниями пользователя — компактным результатом анализа всей последовательности.
Автор приводит диапазон от 6 до 10 состояний и отмечает, что в крайнем случае можно оставить один вектор. Число состояний выбирает, насколько сильно будет сжата история. Здесь важна не одна универсальная настройка, а смена масштаба: сотни или тысячи событий заменяются небольшим набором представлений.
Кандидатная часть получает готовые состояния, вектор конкретного объекта и новый служебный CLS, из которого формируется предсказание. При шести состояниях вход содержит восемь токенов: шесть пользовательских, один кандидатный и один CLS. Токен в этой схеме означает входную позицию трансформера с вектором, а не обязательно слово текста.
Взаимодействие пользователя и кандидата не исчезло, но переместилось после сжатия истории. Поэтому второй трансформер всё ещё запускается для каждого объекта, однако работает с гораздо более короткой последовательностью. В речи автор сообщает о сохранении более 90% исходного прироста и о внедрении этой схемы в поисковой рекламе. Позднее связывание стало компромиссом между совместной обработкой и полностью раздельными башнями.
Слайд 12 · 00:11:30. Исторический энкодер общий для запроса; кандидатный работает с компактными состояниями. При шести состояниях его последовательность равна восьми токенам, поэтому повторная обработка становится существенно дешевле.
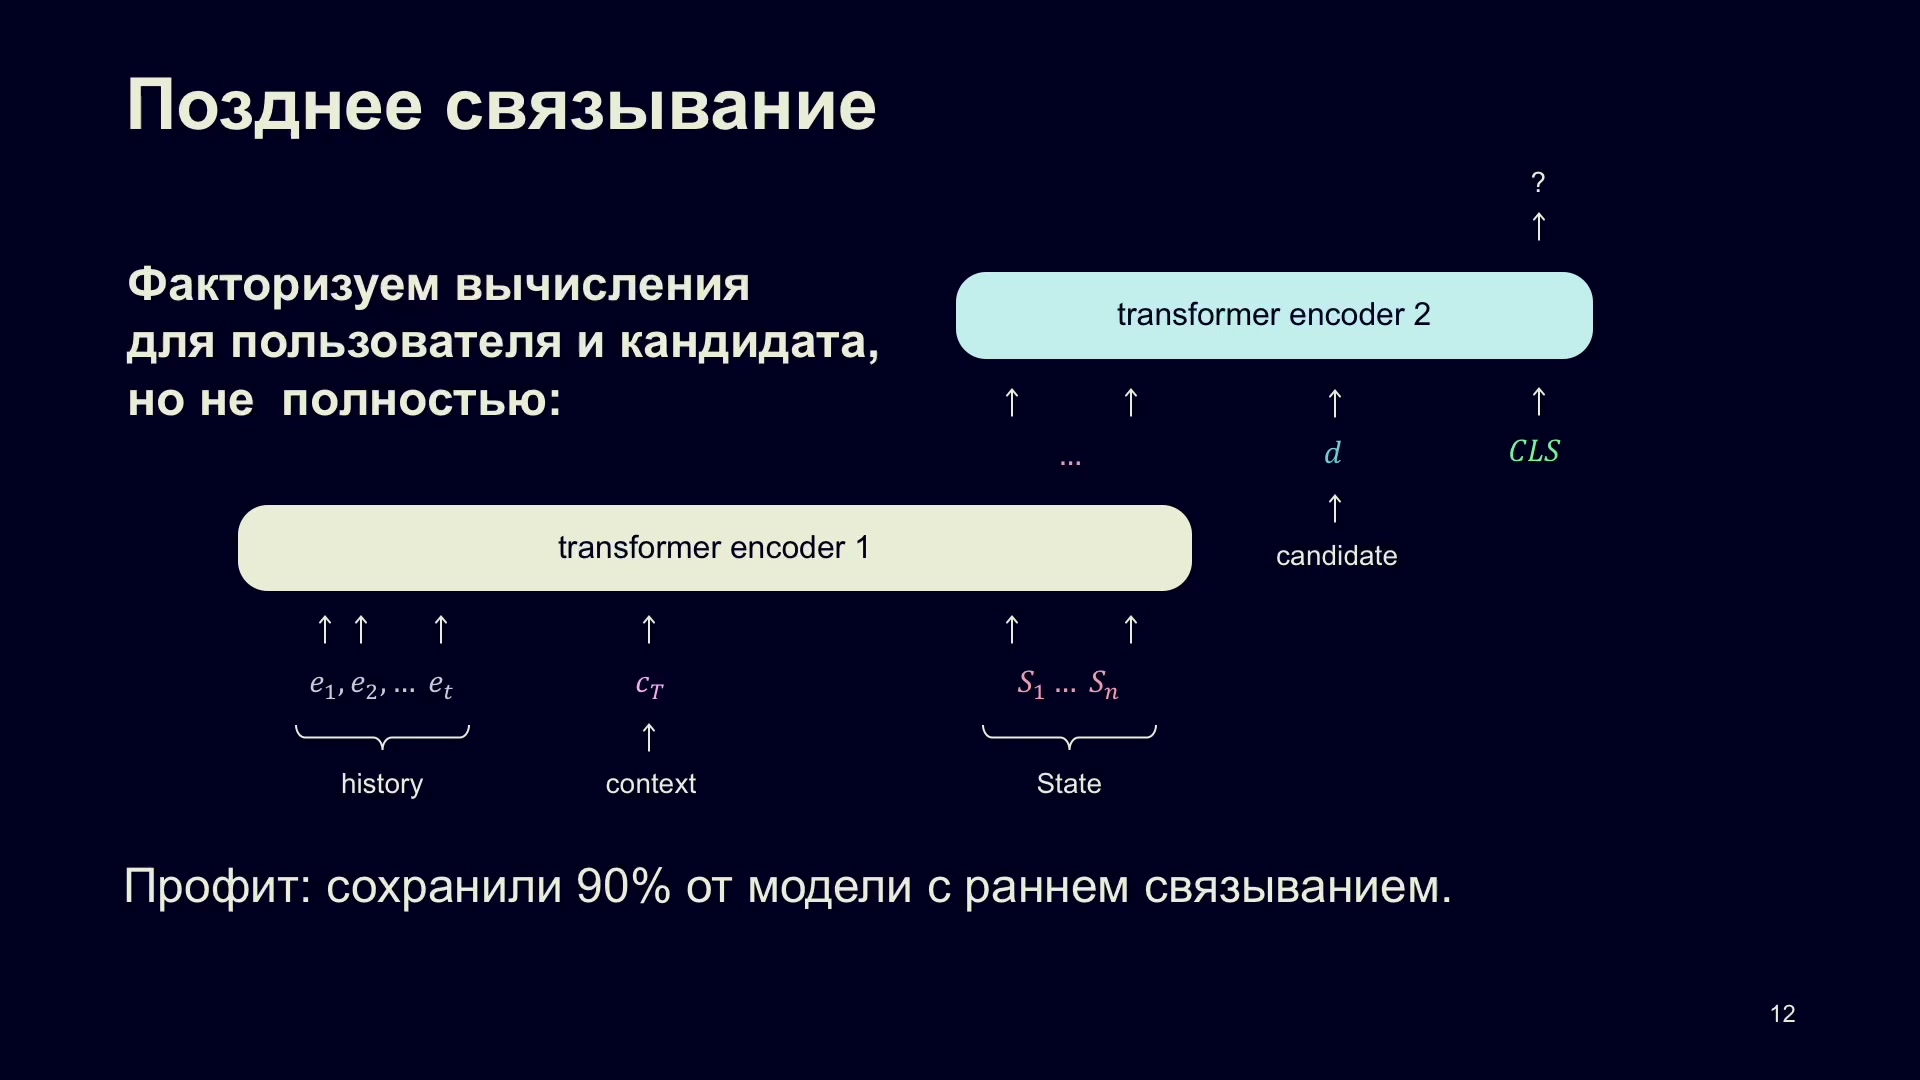
Позднее связывание через состояния истории сохраняет около90% исходного прироста в описанном опыте.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Почему короткая кандидатная сеть осталась дорогой
После поисковой рекламы команда перешла к РСЯ, где нагрузка была выше. В конкретной зафиксированной конфигурации — с выбранным числом кандидатов, длиной истории и архитектурой — оказалось, что основную работу всё ещё выполняет поздняя часть модели.
На исторический трансформер приходилось x умножений, а на совокупность кандидатных трансформеров — 35x. Причина не в том, что один маленький трансформер обязательно тяжелее большого. Историческая часть запускается один раз, а кандидатная повторяется для всего списка. Поэтому сумма коротких вычислений оказывается гораздо больше общей обработки истории.
В речи это соотношение также описано как примерно 35/36 всей вычислительной работы, приходящейся на позднюю часть. Основное сравнение на схеме — число умножений. Оно показывает, где находится узкое место, но не задаёт ни количество кандидатов, ни универсальную долю измеренной задержки любой системы.
Следующая цель поэтому состояла не просто в уменьшении второй сети. Команда хотела совсем убрать дорогое совместное преобразование состояний пользователя и кандидата, оставив их встречу только в дешёвой операции над готовыми векторами. Но перенос этой границы немедленно затронул качество.
Слайд 13 · 00:13:00. x относится к одному анализу истории, 35x — ко всем вызовам поздней части в выбранной конфигурации. После первого упрощения основная стоимость переместилась туда, где обработка всё ещё повторяется по кандидатам.
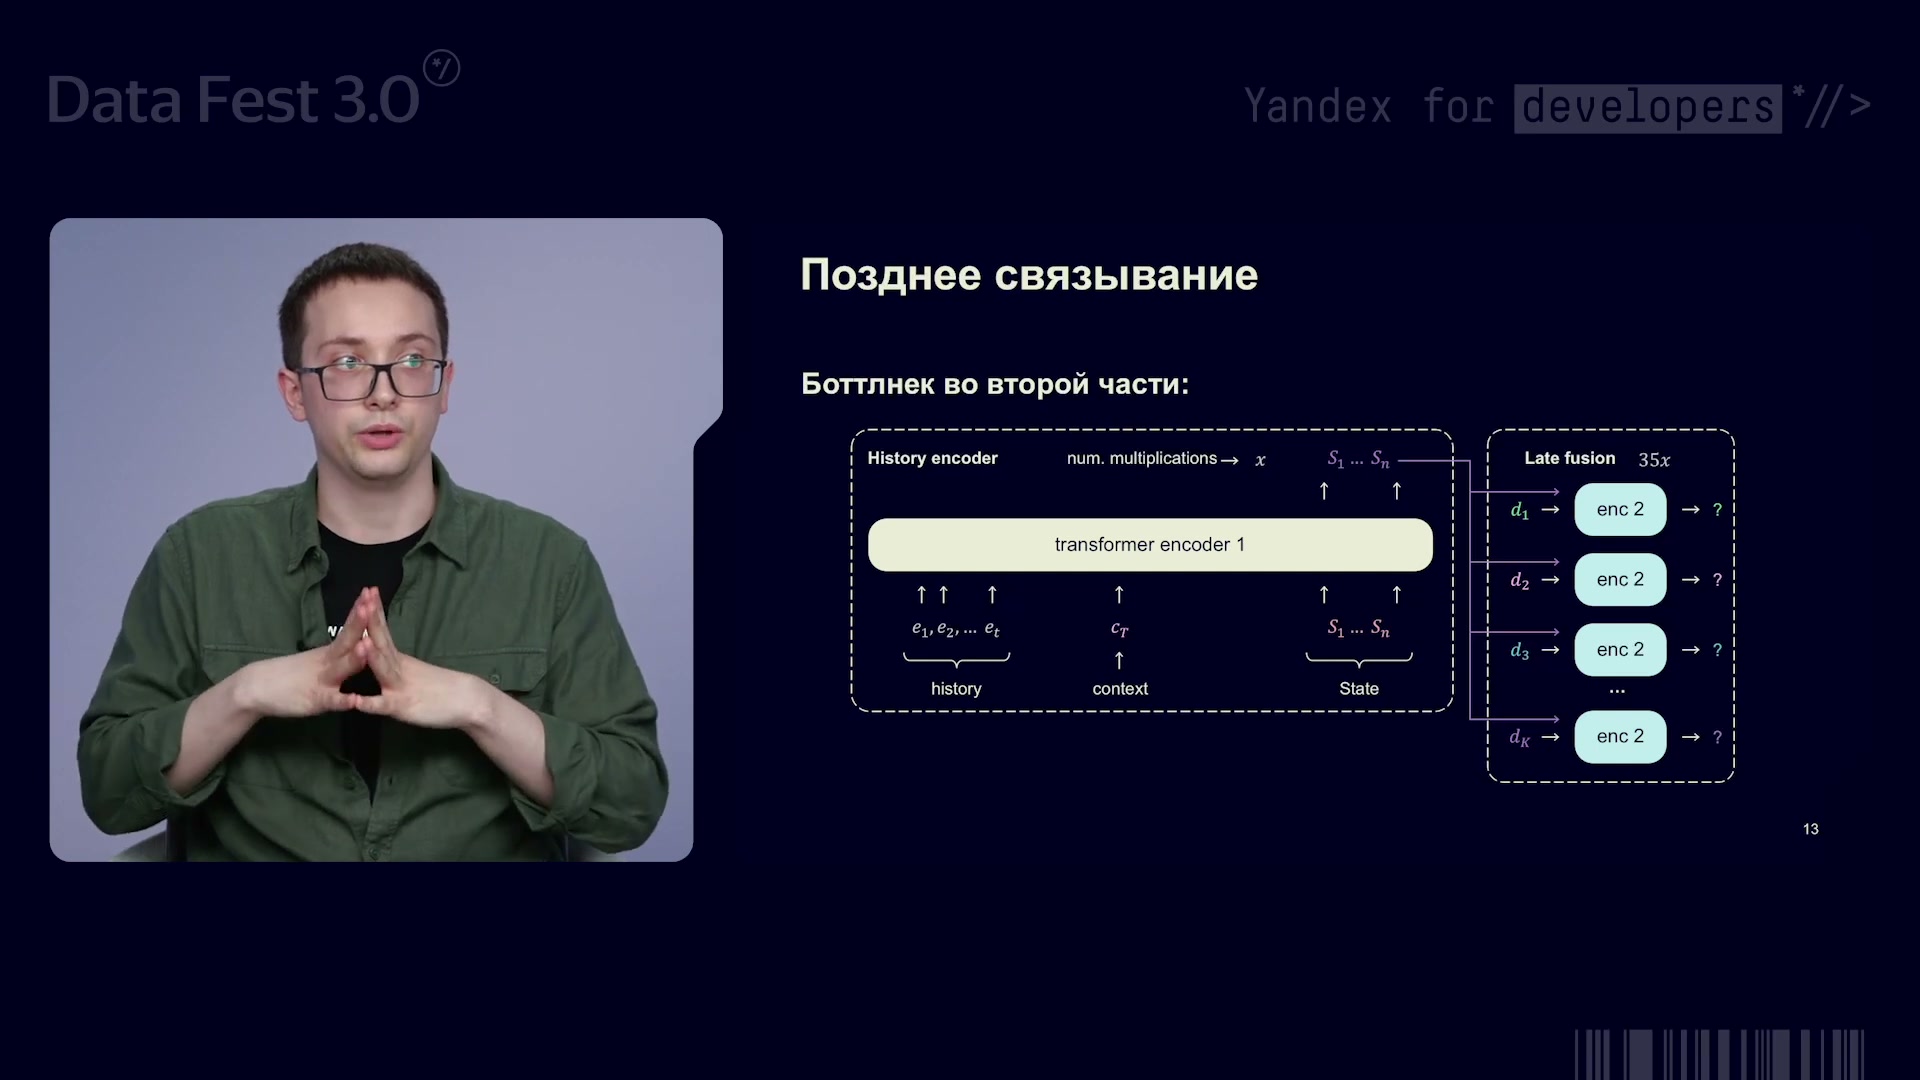
После факторизации узким местом остаётся вторая сеть, которая выполняется на каждого кандидата.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Почему произведения векторов и обычного MLP оказалось мало
Первая попытка была прямой: убрать второй трансформер и сравнивать пользовательские состояния с кандидатным вектором скалярными произведениями. Вычисления действительно разделились, но осталось только 50% прироста модели с ранним связыванием. Значит, сама возможность предварительно рассчитать кандидата ещё не гарантировала достаточной выразительности полученной модели.
Команда сформулировала объясняющую гипотезу. Исходные векторы событий и кандидатов строились сходным простым способом, но затем пользовательские состояния проходили через полноценный трансформер. Кандидатный вектор сопоставимой обработки не получал. После этого модель пыталась сравнивать их так, будто оба представления уже одинаково хорошо подготовлены к общей задаче.
Чтобы усилить кандидатную сторону, к ней добавили собственную полносвязную нейронную сеть с ReLU. Небольшое улучшение внутренней ошибки действительно появилось. Однако по используемой командой процедуре оценки сохранилось всё те же примерно 50% исходного прироста. Подробности этой процедуры в данном фрагменте не раскрыты.
Это существенная неудача, а не промежуточная победа: улучшение обучаемой внутренней величины не вернуло нужный эффект. Поэтому дальнейший поиск касался не просто числа слоёв, а формы обработки кандидата и пользовательских состояний. Дешёвое сравнение нужно было снабдить представлениями, которые сохранят полезное содержание прежней поздней модели.
Слайд 14 · 00:13:30. Сначала поздний трансформер заменили произведениями векторов, затем усилили кандидата MLP. Обе попытки оставили около половины исходного прироста; небольшое улучшение внутренней ошибки не решило основную задачу.
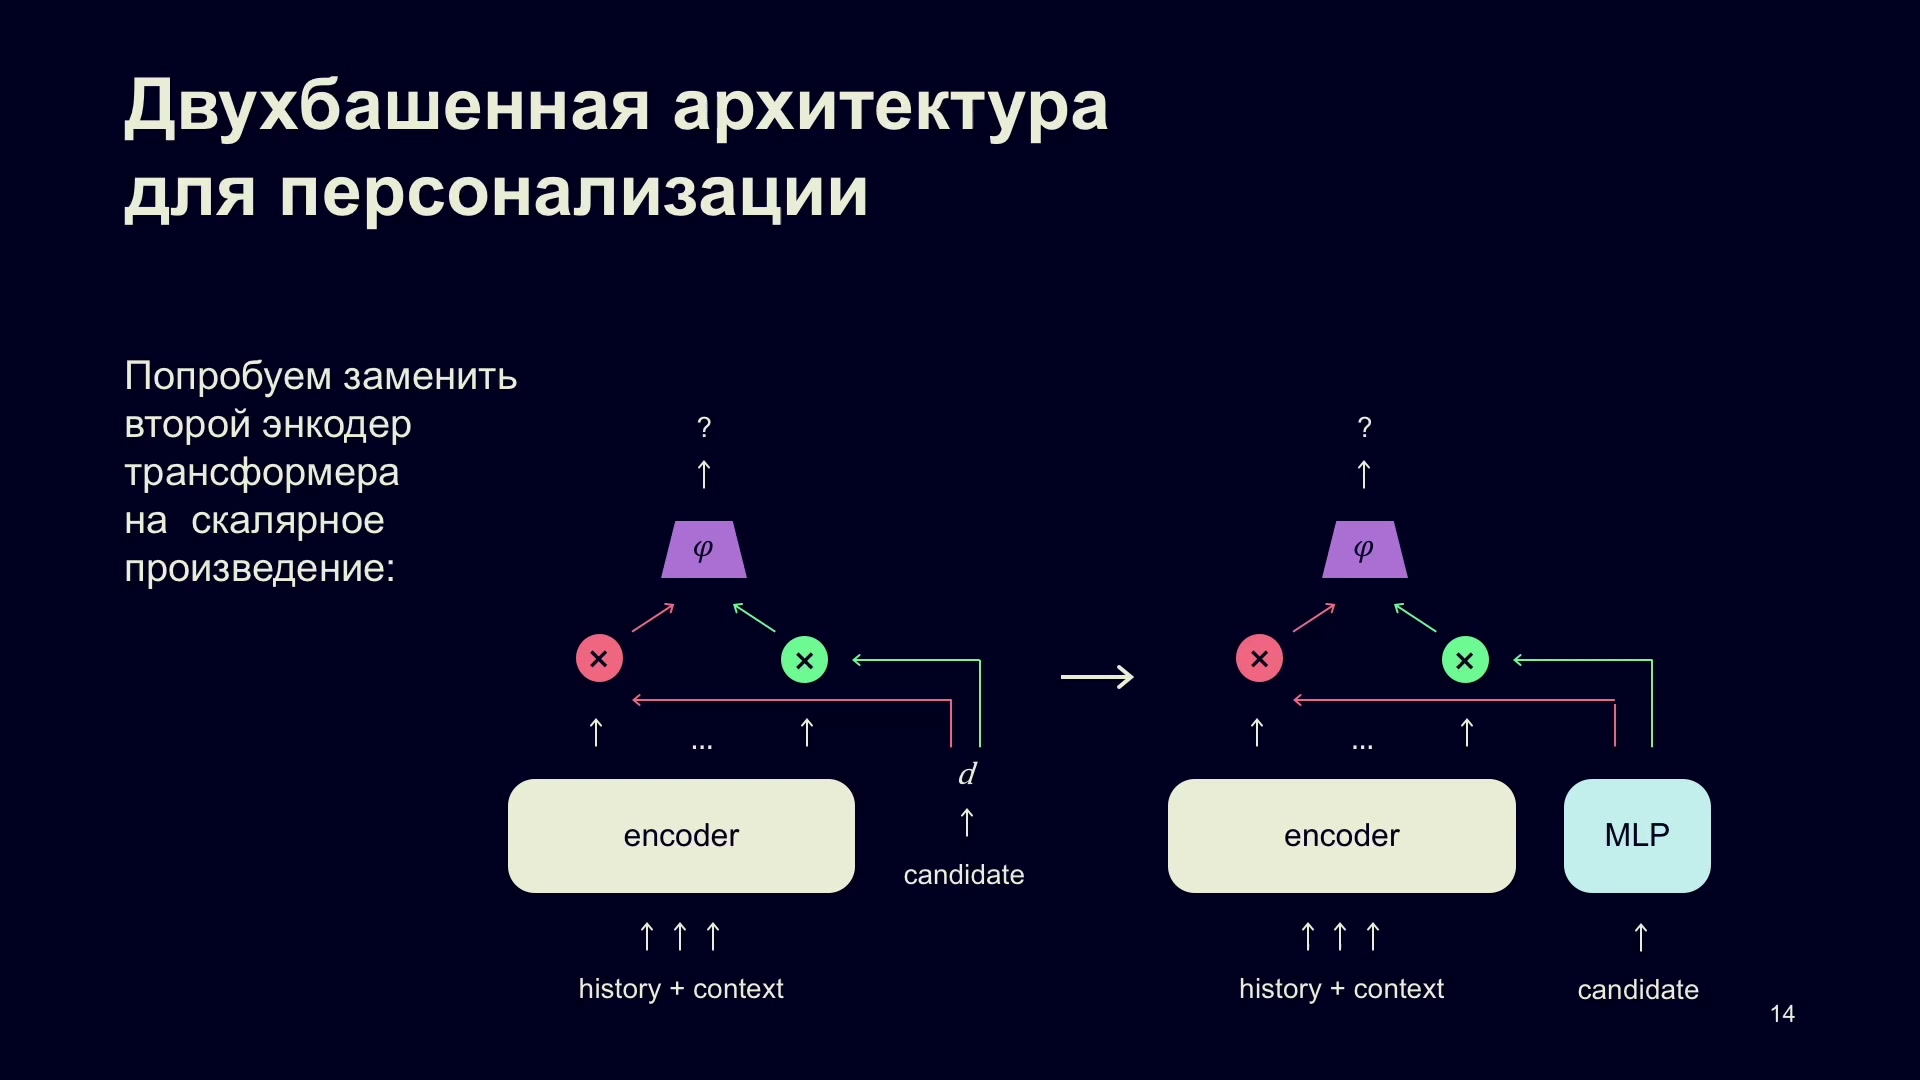
Первые попытки заменить вторую сеть произведением векторов; кандидат можно кодировать отдельно.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Разделить позднее связывание, сохранив сложность преобразований
После неудачи с обычной полносвязной сетью команда вернулась к позднему связыванию и разделила сам этот модуль. Исторический энкодер по-прежнему создаёт состояния пользователя. Дальше один новый трансформер обрабатывает только эти состояния, а другой — только единственный вектор кандидата. Их выходы встречаются уже в скалярных произведениях, поверх которых формируется итоговая оценка.
На промежуточной схеме поэтому видны исторический энкодер и две раздельные части вместо прежнего совместного кандидатного трансформера. Служебный CLS, собиравший совместную информацию пользователя и кандидата в поздней части, больше не нужен. Пользовательская обработка может оставаться общей для запроса, а кандидатная теперь независима от него.
Автор описывает этот шаг как повторное «развязывание» без изменения ёмкости модели. В отличие от прямой замены на произведение или обычный MLP, новый вариант сохранил уже 80% прироста раннего связывания. Отдельное число параметров для проверки одинаковой ёмкости на слайде не приводится; главное наблюдение — эффект удалось вернуть, изменив архитектуру преобразования представлений.
Остаётся разобраться, зачем вообще применять трансформер к одному кандидатному вектору. Ответ приводит к более простой форме этой башни: при единственной входной позиции из механизма внимания исчезает выбор между разными токенами, но сохраняются другие полезные преобразования.
Слайд 15 · 00:15:00. Взаимодействие заменяется двумя раздельными преобразованиями, а не одним удалением поздней сети. Именно такой вариант сохраняет 80% исходного прироста и открывает возможность независимого расчёта кандидатов.
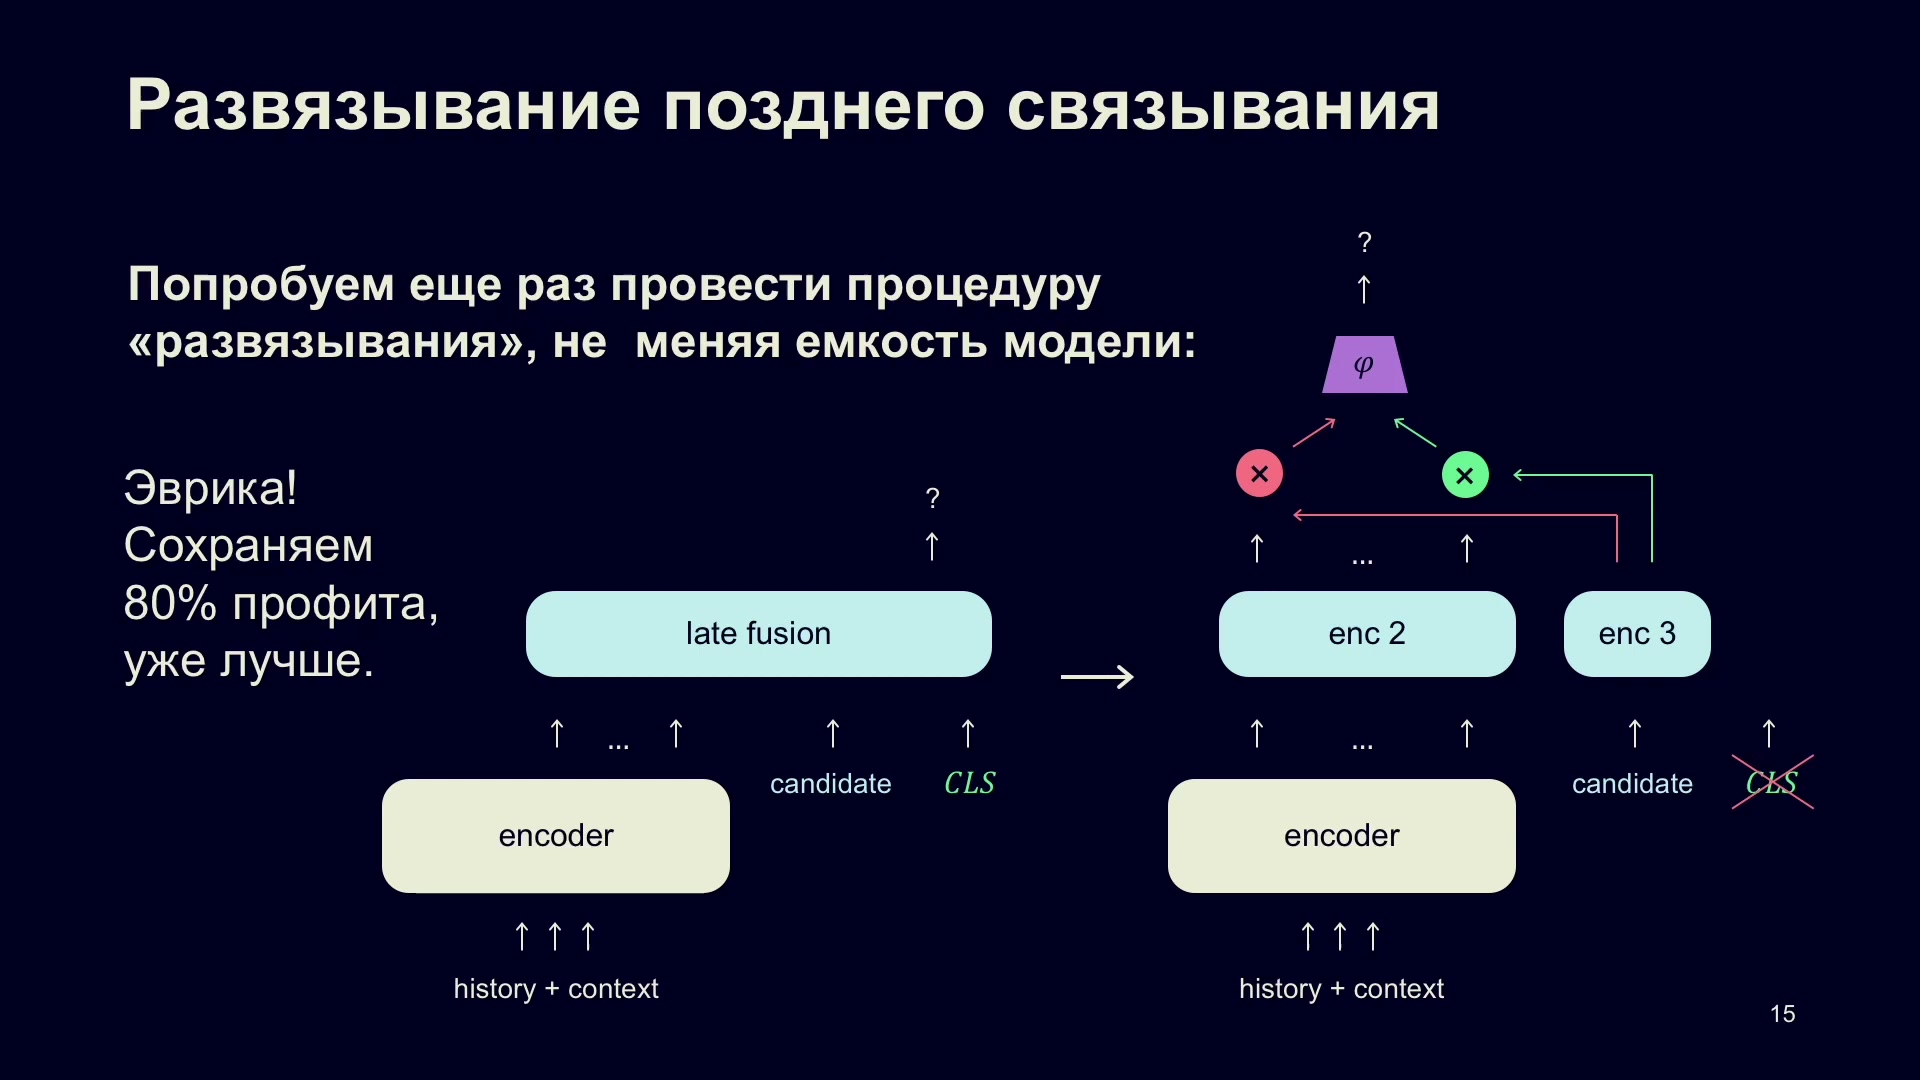
Дополнительное разделение сети сохраняет около80% прироста без прежней стоимости взаимодействия.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Как трансформер над одним токеном превращается в остаточную сеть
В обычном трансформере механизм самовнимания связывает разные входные позиции. При единственном кандидатном токене связывать его с другими позициями уже не требуется. В показанном автором преобразовании многоголовое внимание вырождается в последовательность двух линейных слоёв: проекцию значений и выходную проекцию после объединения результатов голов внимания.
Но это ещё не превращает весь блок в один линейный слой. В исходной схеме остаются остаточные связи — прибавление входа к выходу преобразования — и нормализация представления LayerNorm. Также остаётся полносвязная часть с нелинейностью ReLU между линейными слоями. На слайде её промежуточная размерность увеличивается с x до 4x. Поэтому отсутствие выбора между токенами не означает отсутствия нелинейного преобразования кандидата.
Затем команда дополнительно упрощает архитектуру. Получается блок остаточной сети ResNet: линейное преобразование, ReLU, прибавление входного вектора и LayerNorm. Следующая запись разворачивает показанную схему; это не отдельная формула, напечатанная автором. Обозначим вход блока h, его обучаемое линейное преобразование — Linear, а выход — h_next.
Алгебраическая запись схемы остаточного блока со слайда 17: вход прибавляется после нелинейного преобразования, затем выполняется нормализация.
Автор называет два таких блока примерно эквивалентными одному блоку энкодера трансформера и приводит пример 8–10 блоков в зависимости от модели. Это описание выбранного упрощения, а не строгая эквивалентность любых двух сетей после всех замен. В отличие от неудачного обычного MLP здесь сохраняются остаточный путь и нормализация.
Так кандидатная башня получает достаточно содержательное преобразование, но не несёт лишней структуры внимания над последовательностью, которой на её входе нет. Её можно применять заранее к объектам, а результат хранить для дальнейшего сравнения с пользовательскими состояниями.
Слайд 17 · 00:16:00. При одном токене внимание даёт два линейных преобразования, но остаточные связи, нормализация и нелинейность остаются. Последующее упрощение приводит к ResNet, а не к произвольной замене всей башни обычным MLP.
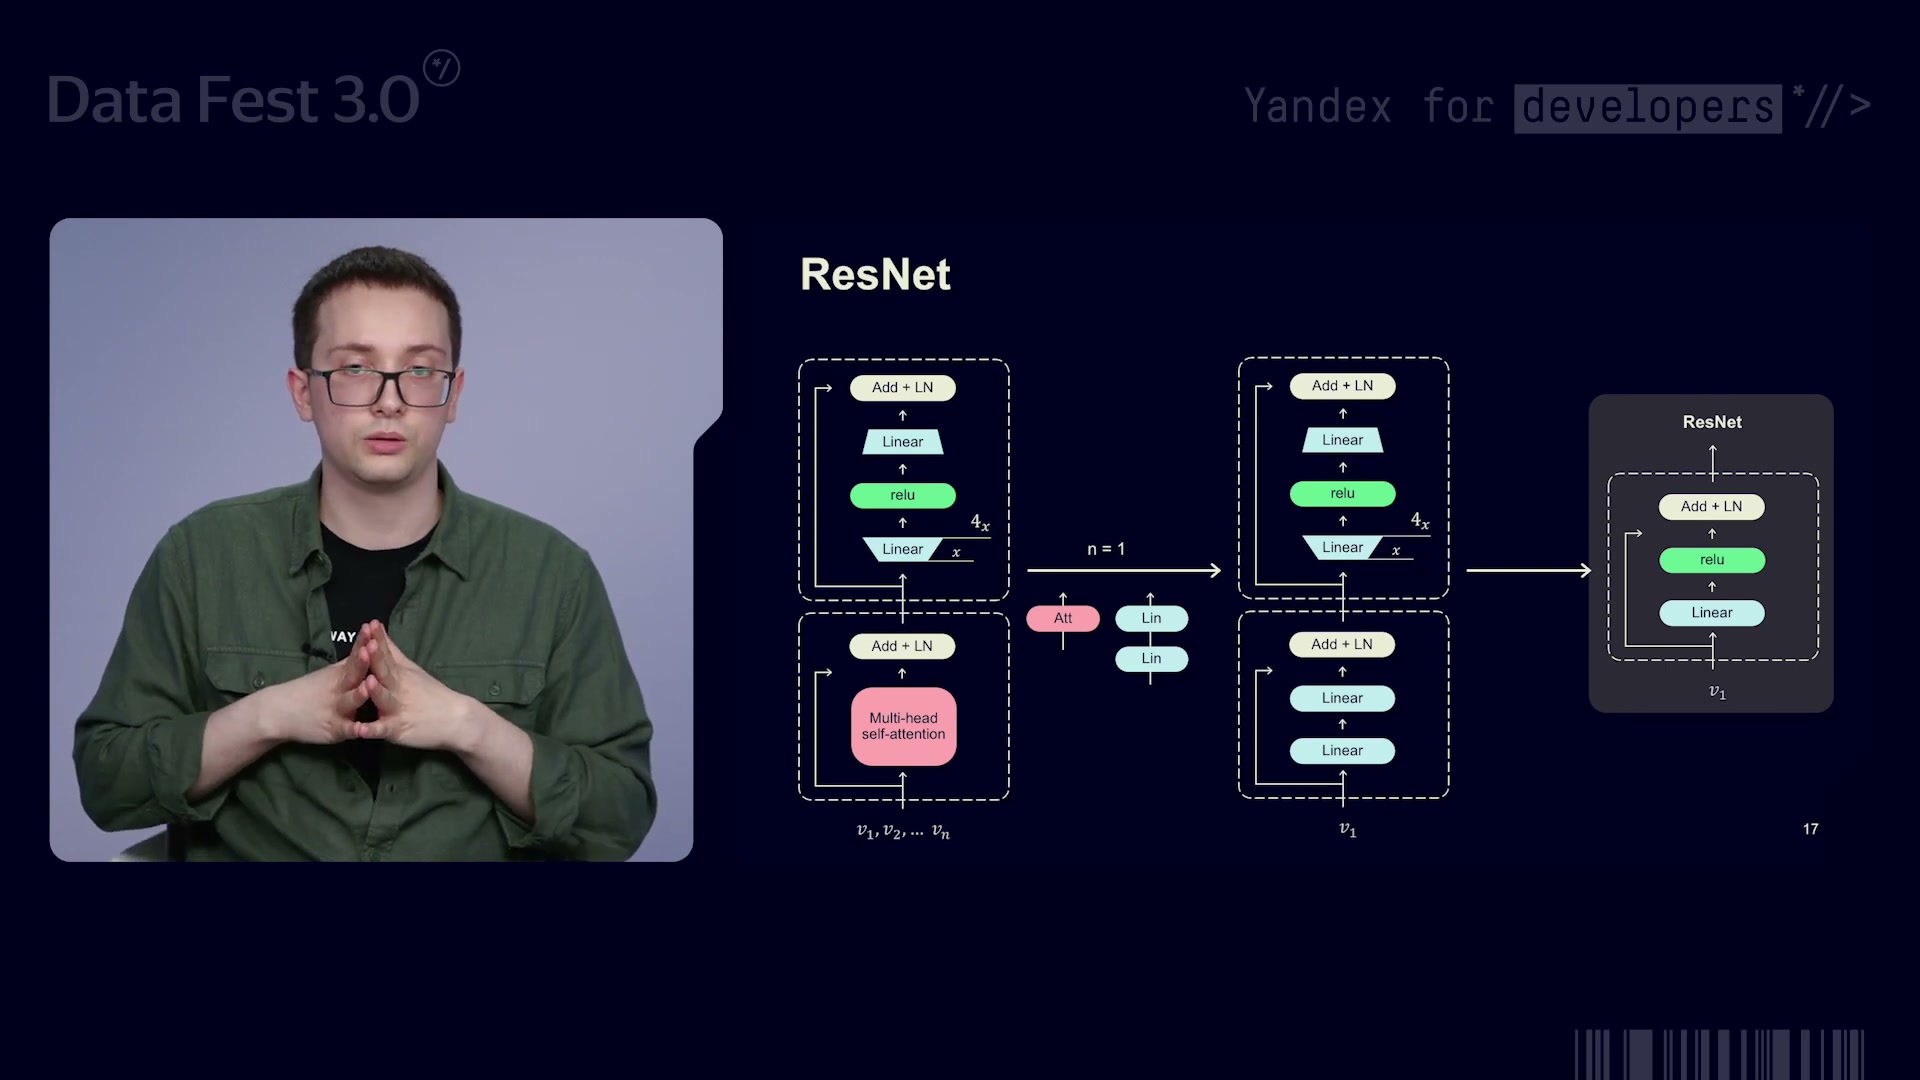
При одном входном векторе блок внимания упрощается; кандидатная башня использует остаточную сеть.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Один компактный кандидат и несколько интересов пользователя
Разделение башен не требует, чтобы каждая сторона была представлена одинаковым количеством векторов. У кандидата и пользователя разные ограничения. Готовые кандидатные представления нужно хранить для большого множества объектов, и память хранилища дорогая и конечная. Поэтому кандидату отводят один сравнительно небольшой вектор; в речи приведён пример размерности 256.
Для заголовка, URL и текста одного кандидата такое сжатие может быть приемлемым. Но пользовательская сторона должна сохранить содержание большой истории, в которой отражено несколько интересов. Сжимать всё это до того же единственного вектора означало бы гораздо более жёсткое ограничение. Поэтому исторический трансформер выдаёт несколько состояний: вместе они образуют более ёмкое представление пользователя.
Для оценки конкретного объекта каждое состояние сравнивают с его вектором. Скалярное произведение даёт отдельное число. Затем к каждому числу применяется сигмоида — функция, переводящая его в диапазон от нуля до единицы. Только после этого оценки усредняются. Если состояний шесть, сначала получаются шесть отдельных оценок, а не одно произведение заранее усреднённых представлений.
Развёрнутая запись операции со слайда 19 и устного объяснения: sₖ — пользовательское состояние, d — кандидатный вектор, n — число состояний. В оригинальной схеме функция активации обозначена δ; в речи обсуждается сигмоида.
Порядок операций проверяли экспериментально. Максимум по отдельным оценкам работал хуже. Усреднение до сигмоиды тоже проигрывало выбранному варианту. Не помог и dropout на пользовательских векторах — случайное обнуление части сигнала при обучении. Поэтому итоговая операция осталась простой: скалярные произведения, отдельные сигмоиды, среднее.
Несколько состояний мотивированы несколькими интересами, однако из этого не следует, что каждому состоянию заранее назначена понятная человеку категория. В докладе нет такой разметки или доказательства однозначного соответствия. Практический результат здесь архитектурный: пользователь может иметь более ёмкое представление, не увеличивая во столько же раз объём хранения каждого кандидата.
Слайд 19 · 00:17:30. Маленький вектор кандидата хранится заранее, а несколько пользовательских состояний сравниваются с ним независимо. Выбранный порядок — произведение, сигмоида, затем среднее — важен: показанные альтернативы работали хуже.
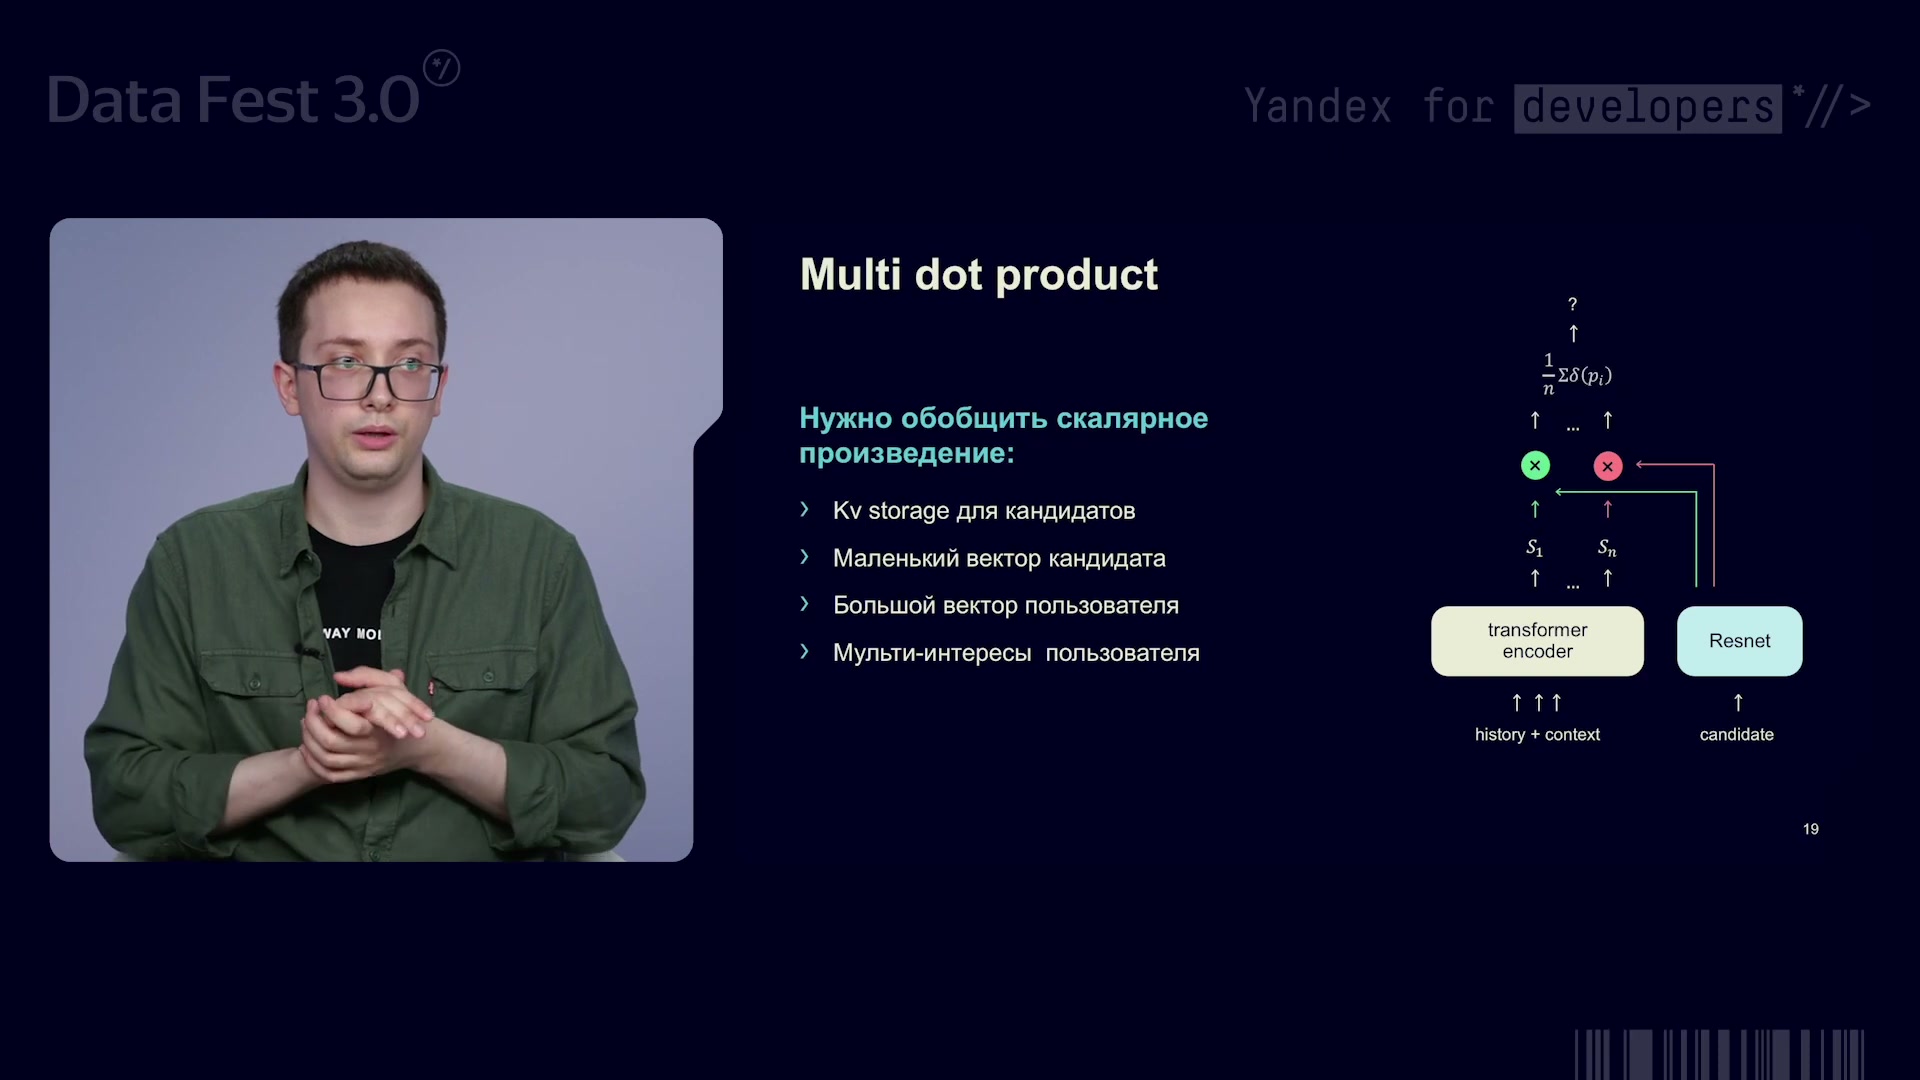
Несколько произведений векторов представляют разные интересы; небольшой кандидат хранится заранее.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Почему рекламному выбору нужны ставка, клик и конверсия
В рекламной системе баннеры конкурируют за возможность быть показанными. Рекламодатель оценивает выгоду от реакции пользователя и задаёт ставку — bid: сколько он готов заплатить за показ, клик либо конверсию. Это экономический вход в систему, а не предсказание нейронной сети.
Со стороны сервиса можно оценить вероятность конверсии, CVR, и на её основе скорректировать ставку. Автор говорит как о повышении, так и о снижении исходной ставки. Далее нужен прогноз клика, CTR: особенно явно эта потребность возникает при оплате за клик. Выбор победителя опирается на исходную ставку, её коррекцию и вероятность клика.
В этой постановке модель персонализации должна возвращать не одно универсальное число полезности, а несколько разных прогнозов. Высокая вероятность клика и высокая вероятность целевого действия отвечают на разные вопросы. Это объясняет, зачем двухбашенной модели понадобилось совместное обучение на нескольких задачах.
Доклад не задаёт полной формулы рекламного аукциона, расчёта платежа или всех ограничений показа. Поэтому описанную логику нельзя заменить придуманным единым произведением ставки и вероятностей. Здесь существенна связь продуктовой задачи с необходимостью отдельных CTR- и CVR-предсказаний.
Слайд 20 · 00:19:00. Ставка поступает от рекламодателя, а вероятности оценивает модель. CTR и CVR используются для разных частей рекламного выбора; слайд объясняет мотивацию двух целей, а не спецификацию всего аукциона.
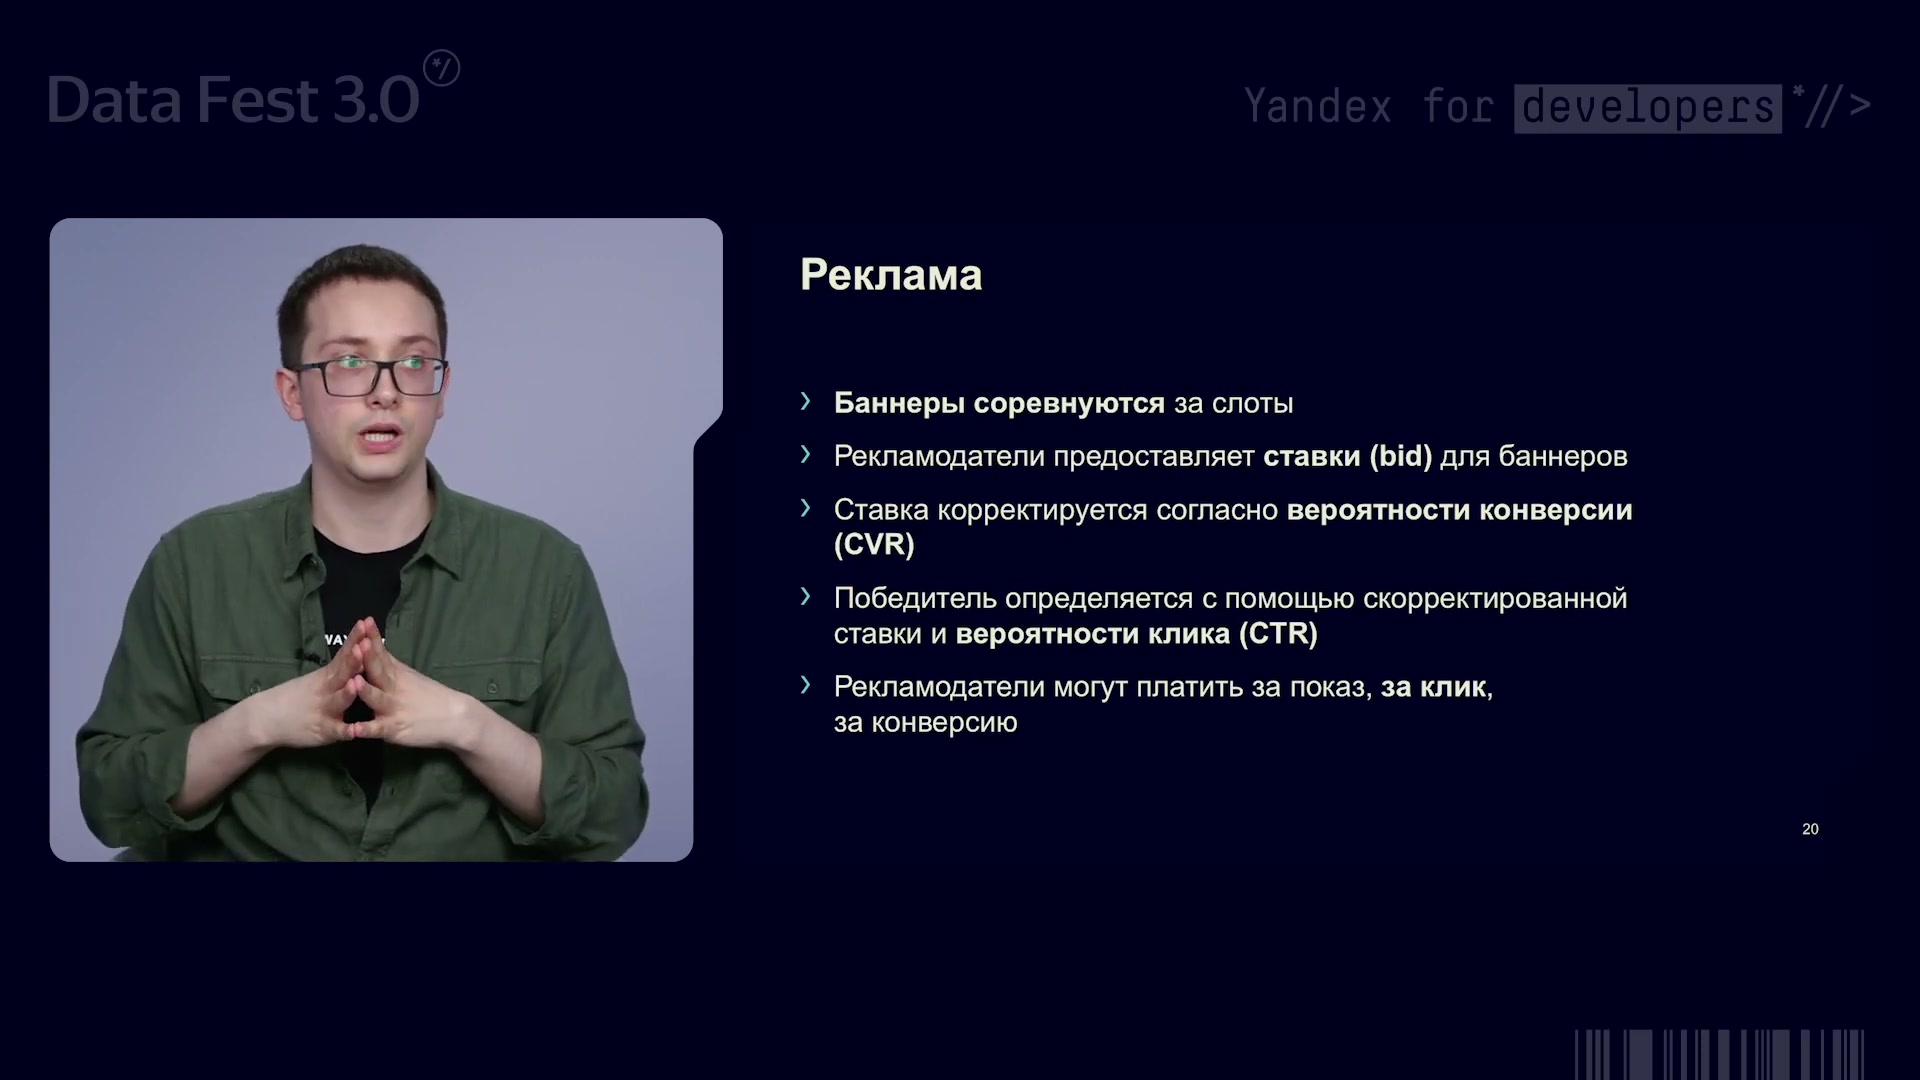
Рекламный выбор использует ставки, вероятности клика и конверсии; это разные показатели.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Две задачи через отдельные группы служебных состояний
Совместное обучение одной модели на нескольких целевых величинах называют многозадачным. В данном случае речь о CTR и CVR. Пользовательская история нужна обеим задачам, поэтому нет необходимости обязательно повторять весь её анализ в двух независимых сетях.
Выбранное решение — выделить отдельную группу обучаемых CLS-векторов для каждой цели. Одна группа после общего трансформера формирует состояния для клика, другая — для конверсии. В каждой выходной ветви эти состояния участвуют в своей операции сопоставления с кандидатной стороной. Такие отдельные выходные ветви часто называют головами модели.
Общая сеть при этом может учиться извлекать разные аспекты одной истории: цели используют общие вычисления, но не обязаны опираться на одну и ту же группу состояний. Кандидатная сторона остаётся раздельной от обработки пользователя. Схема не возвращает дорогое совместное внимание истории и каждого баннера.
Команда пробовала усложнить разделение: сначала сделать общие слои энкодера, а затем отдельные слои под каждую задачу. Существенного дополнительного прироста это не принесло. Поэтому остановились на более простом решении с отдельными CLS-группами. По словам автора, удалось сохранить эффект по CTR и добавить эффект по CVR; отдельной численной таблицы этого сравнения нет.
Слайд 21 · 00:19:30. История проходит общую обработку, но CTR и CVR получают разные группы служебных состояний. Более сложные отдельные слои под каждую задачу не дали существенного выигрыша.
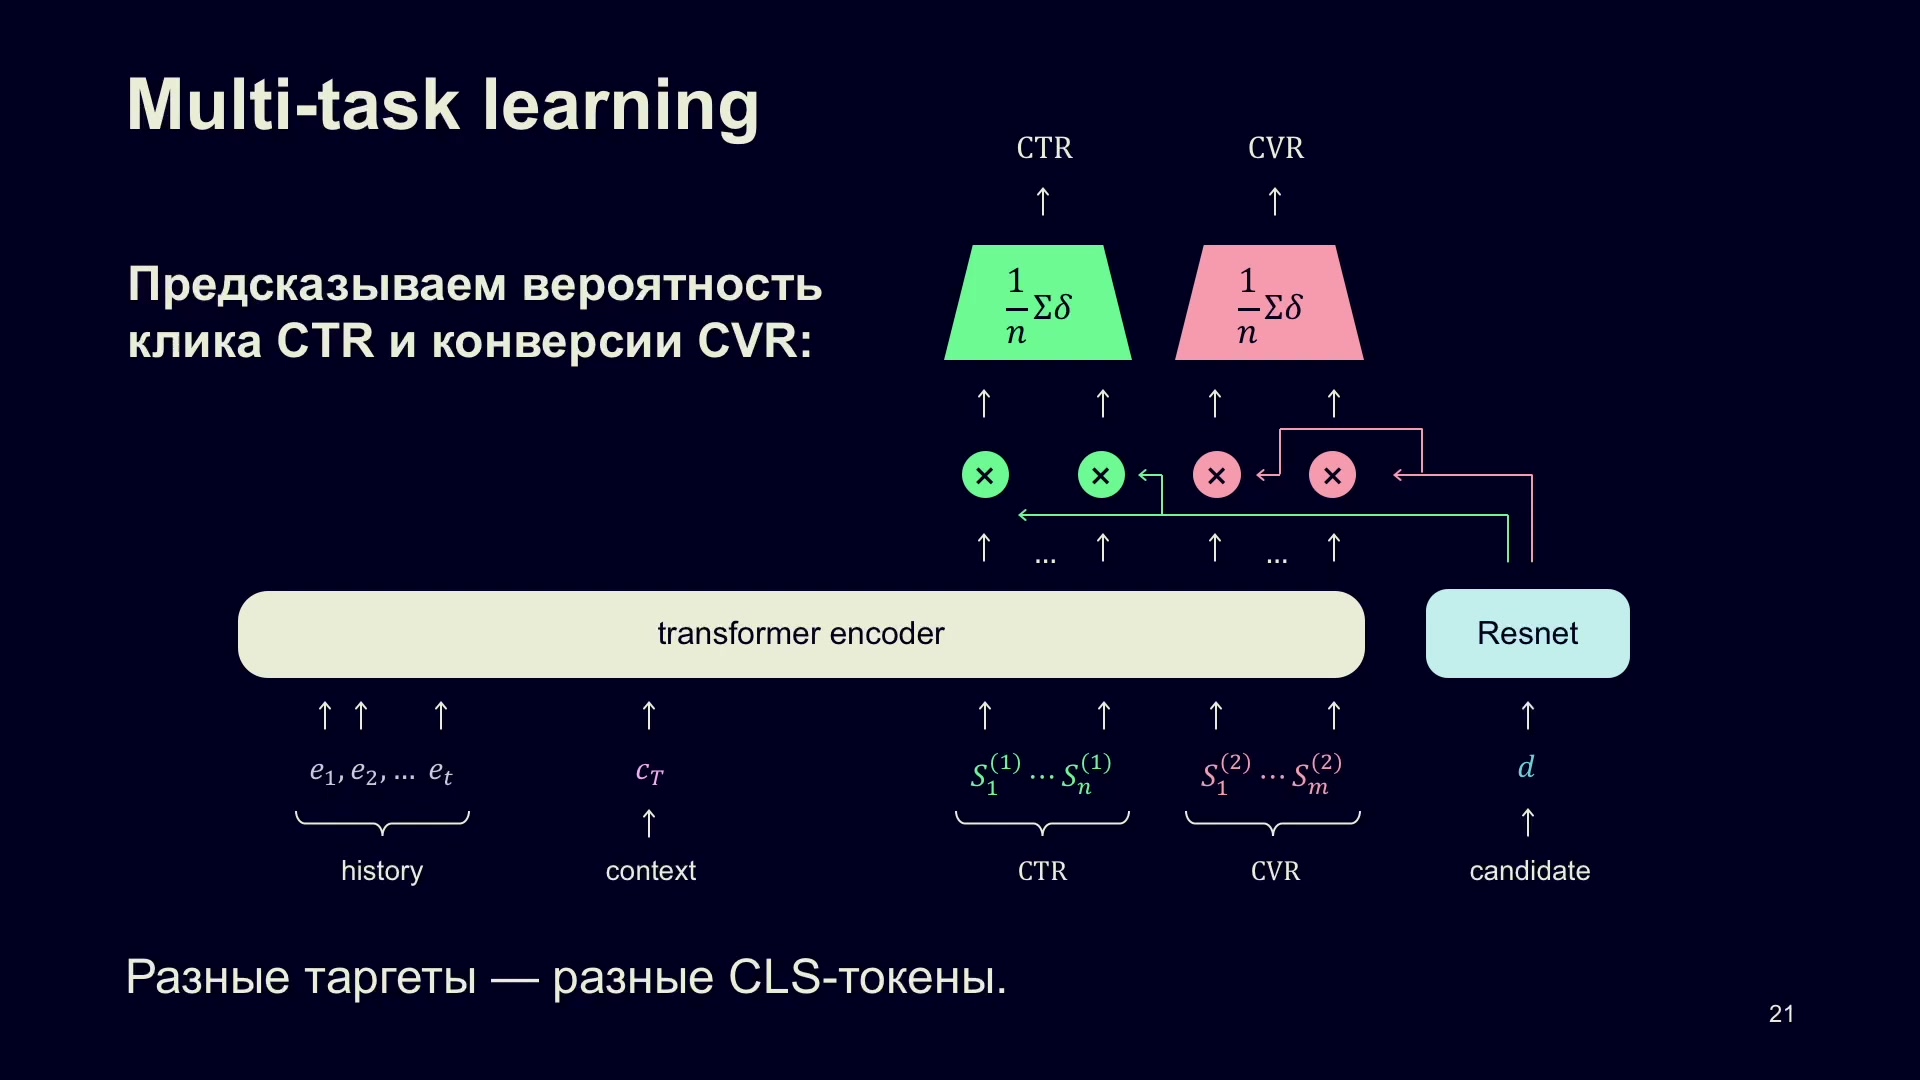
Общие параметры истории и отдельные состояния для предсказания CTR и CVR.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Зачем предварительное обучение при миллиардах примеров
До этого менялось устройство модели и место выполнения её частей. Следующий способ вернуть эффект относится к обучению. Предварительное обучение даёт начальные параметры на дополнительной задаче, после чего модель дообучают под целевые предсказания. Оно не запускается заново при каждом обращении пользователя.
У команды уже были миллиарды обучающих примеров. Они получались из неявной обратной связи — прежде всего кликов, — поэтому не требовали специальной ручной разметки каждого примера. Но большое количество наблюдений не делает задачу простой: модели велики, целевые зависимости сложны, а сам сигнал шумный. Автор выделяет четыре содержательных мотива предварительного этапа.
Первый мотив — сходимость. Большой трансформер на сложной целевой задаче может обучаться неустойчиво. Более простая предварительная задача позволяет начать дообучение с уже содержательных параметров, а не со случайной точки. Автор связывает это с уменьшением риска расходимости, взрыва или затухания градиентов.
Второй мотив — скорость экспериментов. Один дорогой предварительный этап можно выполнить заранее, а затем проверять изменения архитектуры или процедуры обучения через сравнительно короткие дообучения. Тогда для содержательного сравнения вариантов не обязательно каждый раз проходить весь путь с нуля.
Третий мотив — обобщение, то есть способность переносить выученные закономерности на новые примеры. Особенно хорошо этот эффект заметен, когда целевой набор невелик: предварительное обучение уже дало модели полезную структуру, которую небольшого набора могло бы не хватить выучить самостоятельно.
Четвёртый мотив сохраняется даже при миллиардах примеров. Большой кликовый набор содержит много неоднозначности и шума, а правильно выбранная предварительная задача помогает получить полезный сигнал и в таком режиме. На слайде отдельно перечислены обобщение, большой эффект на маленьких наборах и эффект на больших; в речи они раскрываются через общую проблему качества обучения, а не только нехватку данных.
Слайд 22 · 00:20:30. Предварительный этап нужен не только маленьким наборам. Он помогает устойчивости, ускоряет последующие эксперименты и улучшает обобщение даже при очень большом, но шумном кликовом сигнале.
Предобучение помогает сходимости, экспериментам и переносу на небольшие целевые наборы.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Научить модель отличать подходящий объект от остальных
В качестве предварительной задачи для двухбашенной модели команда выбрала контрастивное обучение: модель сравнивает подходящий объект с другими и учится выделять его среди них. Начальная единица данных — положительная пара «пользователь — заинтересовавший его кандидат». Автор иллюстрирует интерес положительной оценкой, кликом или полным просмотром видео. Это примеры возможного сигнала, а не утверждение, что все эти типы событий одновременно использовались во всех сервисах.
К положительному объекту подбирают несколько других, которые в данной задаче считаются отрицательными примерами. Базовый обсуждаемый способ — равномерно выбрать их из набора данных без индивидуального подбора под пользователя. Значит, отрицательная роль здесь задаётся процедурой обучения: она не обязательно основана на явном отказе этого человека от объекта.
Пользовательское представление сравнивают с каждым выбранным объектом. Оценки проходят через softmax, который превращает их в распределение по кандидатам. Затем берут вероятность именно положительного объекта, её логарифм и максимизируют его. Чем лучше модель отделяет этот объект от остальных, тем больше нужная вероятность.
Автор объясняет задачу как многоклассовый выбор внутри сформированного набора: отдельные кандидаты играют роль классов, и для текущего обучающего примера известен один положительный. Это не процедура показа рекламы и не оценка вероятности того, что любой другой объект человеку никогда не понравится. На пользовательском запросе такой случайный учебный набор не формируется.
Слайд 24 · 00:22:30. Положительный объект должен получить большую относительную оценку среди выбранных кандидатов. Softmax нормирует именно этот учебный набор, поэтому процедура отличается от двух рекламных предсказаний при применении модели.
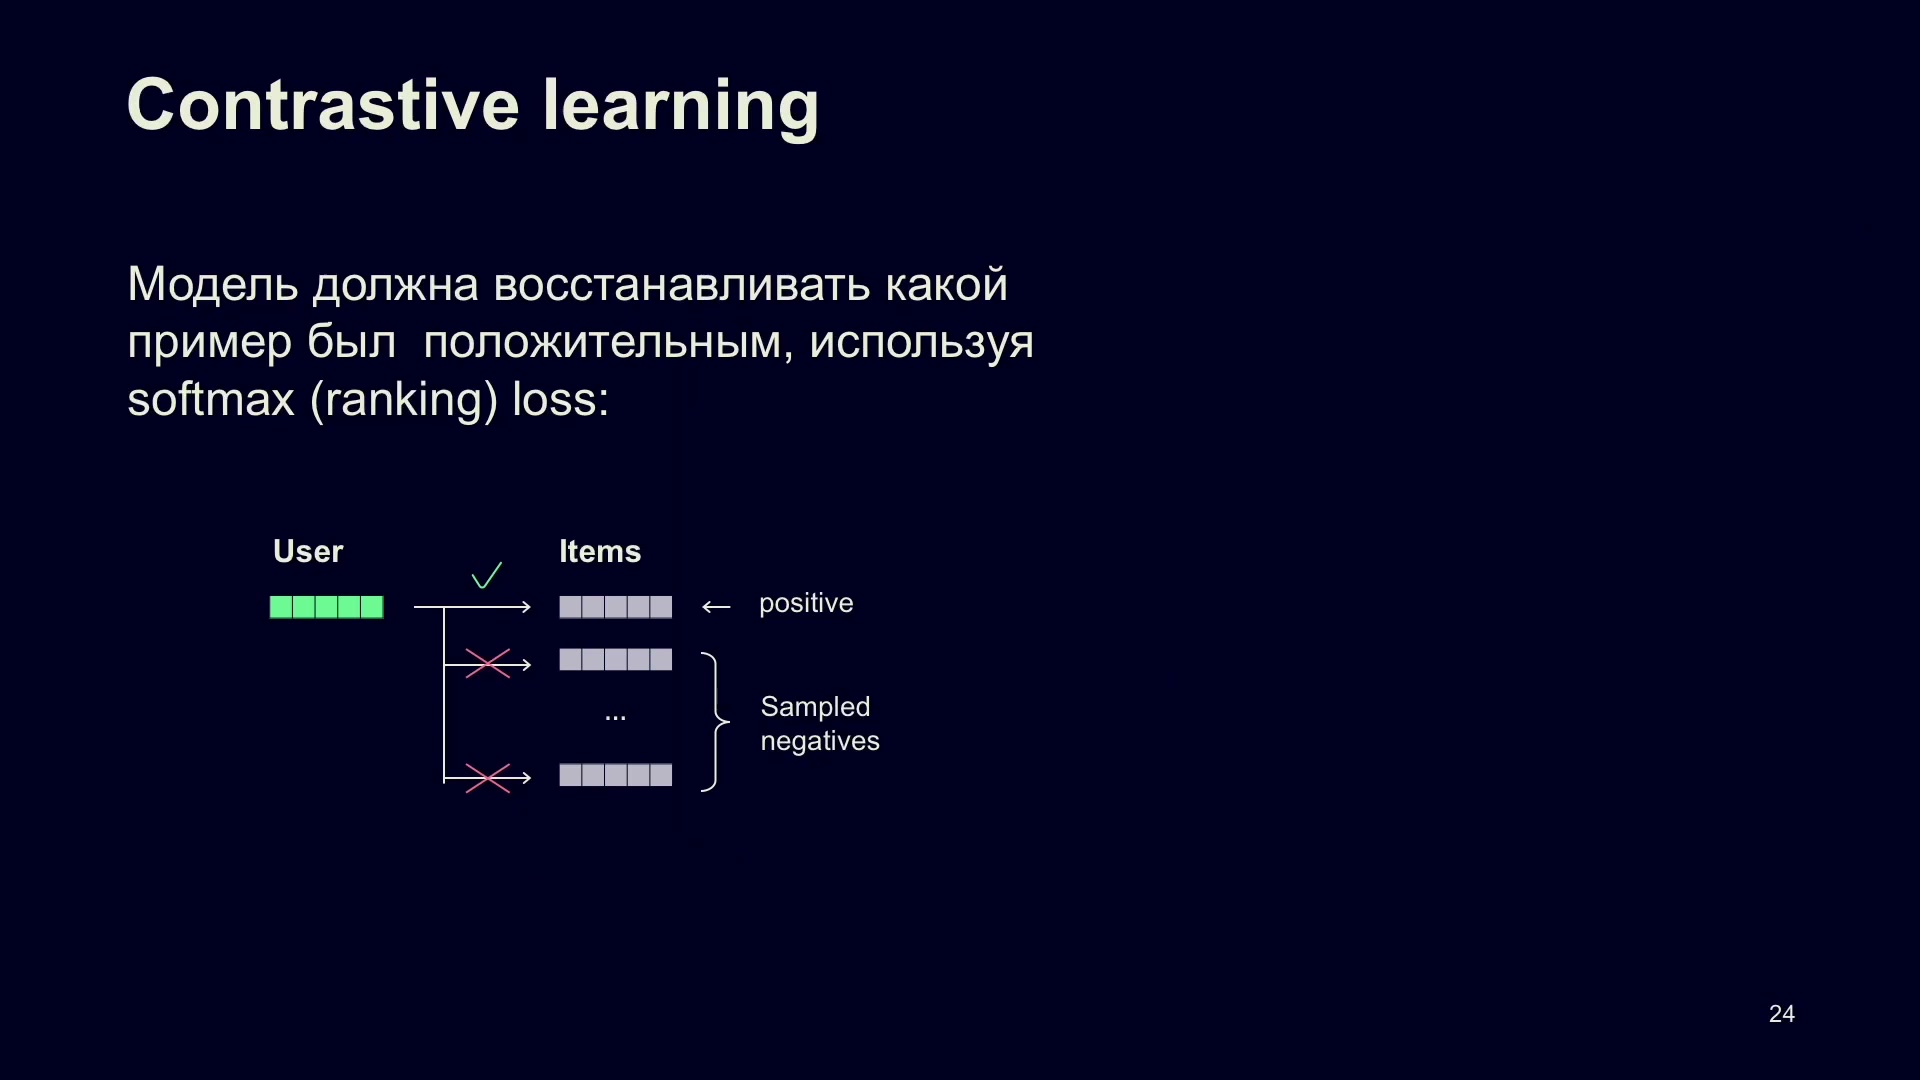
Контрастивное обучение различает положительный объект и выбранные отрицательные.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Отрицательные примеры уже есть в обучающем пакете
Отдельный выбор отрицательных примеров можно убрать. Для этого в обучающий пакет помещают положительные пары разных пользователей. Для текущего пользователя его собственный объект остаётся положительным, а положительные объекты остальных пар используются как отрицательные. Это и есть отрицательные примеры из того же пакета, или in-batch negatives.
Так объект не нужно отдельно выбирать и обрабатывать только ради отрицательного сравнения: он уже находится в пакете из-за своей положительной пары. Одна и та же коллекция представлений используется для большого числа сопоставлений. Экономия возникает из организации вычислений, а не из добавления новой сети.
При распределённом обучении набор можно расширить за пределы одной видеокарты. Автор предлагает наладить обмен между GPU и вычислительными узлами, чтобы пользователь сравнивался также с объектами из пакетов других участников обучения. Тогда эффективный пакет объединяет доступные объекты со всех участвующих устройств, а не ограничивается локальной частью.
Конкретный размер такого пакета, схема коммуникации и обработка случаев, когда чужой положительный объект подходит и текущему пользователю, не раскрыты. Не показан и отдельный численный эффект обмена между GPU. Следующий результат относится к добавлению всей процедуры контрастивного предварительного обучения.
Слайд 25 · 00:23:30. Один объект является положительным для своей пары и отрицательным для других пар пакета. При обмене между устройствами матрица сравнений может охватывать не только локальные данные.
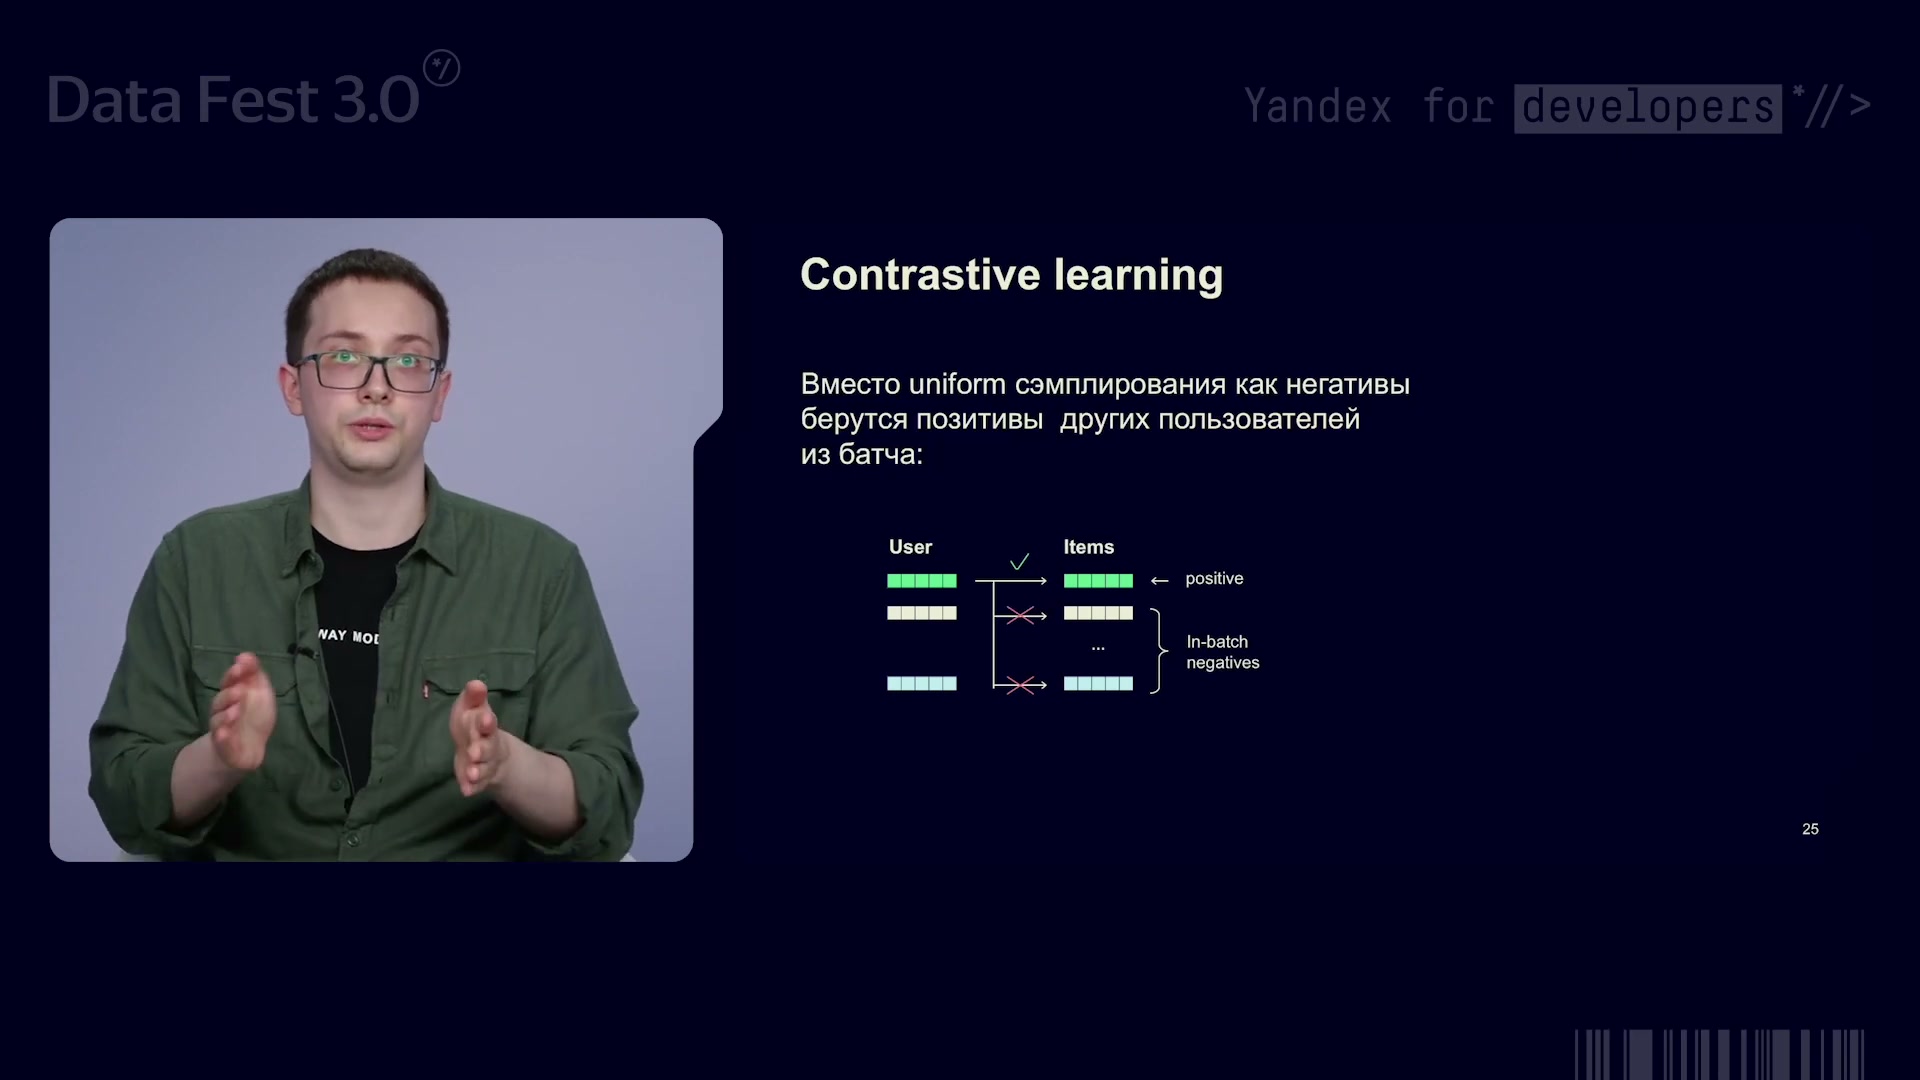
Положительные объекты других пользователей в пакете используются как отрицательные.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Формула контрастивной задачи и её матричная реализация
Для кликового предварительного обучения в наборе оставляют только положительные пары, то есть пары с кликом. Обозначим вектор пользователя u, его положительный объект i⁺, остальные объекты пакета — N. В выражении ниже угловые скобки обозначают скалярное произведение представлений. Авторская целевая величина — логарифм вероятности положительного объекта после нормировки по всему выбранному набору.
Целевая величина со слайда 26: τ умножает скалярное произведение; N содержит остальные объекты пакета. J введено здесь как имя максимизируемого выражения.
На слайде коэффициент τ назван температурой и именно умножает оценку. Эту конвенцию важно сохранить: запись через деление на температуру была бы другой записью параметра. Значение τ в докладе не указано. Также исходная формула максимизируется — знак минус в её числителе или перед логарифмом отсутствует.
Для пакета из B положительных пар можно собрать матрицу Z. В строке a стоят сравнения пользователя uₐ со всеми объектами i_b, а его собственный положительный объект расположен на диагонали. После logsoftmax по каждой строке остаётся выбрать диагональные элементы. Следующая матричная запись разворачивает устное объяснение автора; усреднение по пакету — явная форма объединения этих целевых величин.
Алгебраическое пояснение устного описания в 00:24:22–00:24:29: перемножение матриц, logsoftmax по строкам и диагональ положительных пар.
Если программная реализация принимает минимизируемую функцию потерь, можно ввести L = −J_batch и минимизировать L. Это только алгебраический переход от максимизации к минимизации, а не исправление авторской формулы. Он меняет направление оптимизации вместе со знаком, не меняя задачу.
Наше алгебраическое пояснение перехода к минимизируемой функции потерь. В исходном слайде максимизируется логарифм softmax-вероятности без этого минуса.
После добавления такого предварительного этапа двухбашенная модель дала больше прироста, чем исходная модель с ранним связыванием: на слайде результат обозначен 100+%. Значит, потерю от ограничения взаимодействия удалось компенсировать обучением. Дорогая совместная обработка каждого кандидата при применении при этом не вернулась.
Формула в докладе записана через одну пару представлений u и i. Подробной отдельной развёртки для всех групп пользовательских состояний, весов CTR/CVR-задач и их сочетания с предварительным этапом автор не приводит. Из неё поэтому не следует полный готовый рецепт всех вариантов многозадачного обучения.
Слайд 26 · 00:24:30. Положительная пара стоит в числителе, остальные кандидаты — в знаменателе. τ умножает произведение, а логарифм максимизируется; 100+% характеризует возвращённый прирост, не удвоение бизнес-показателя.
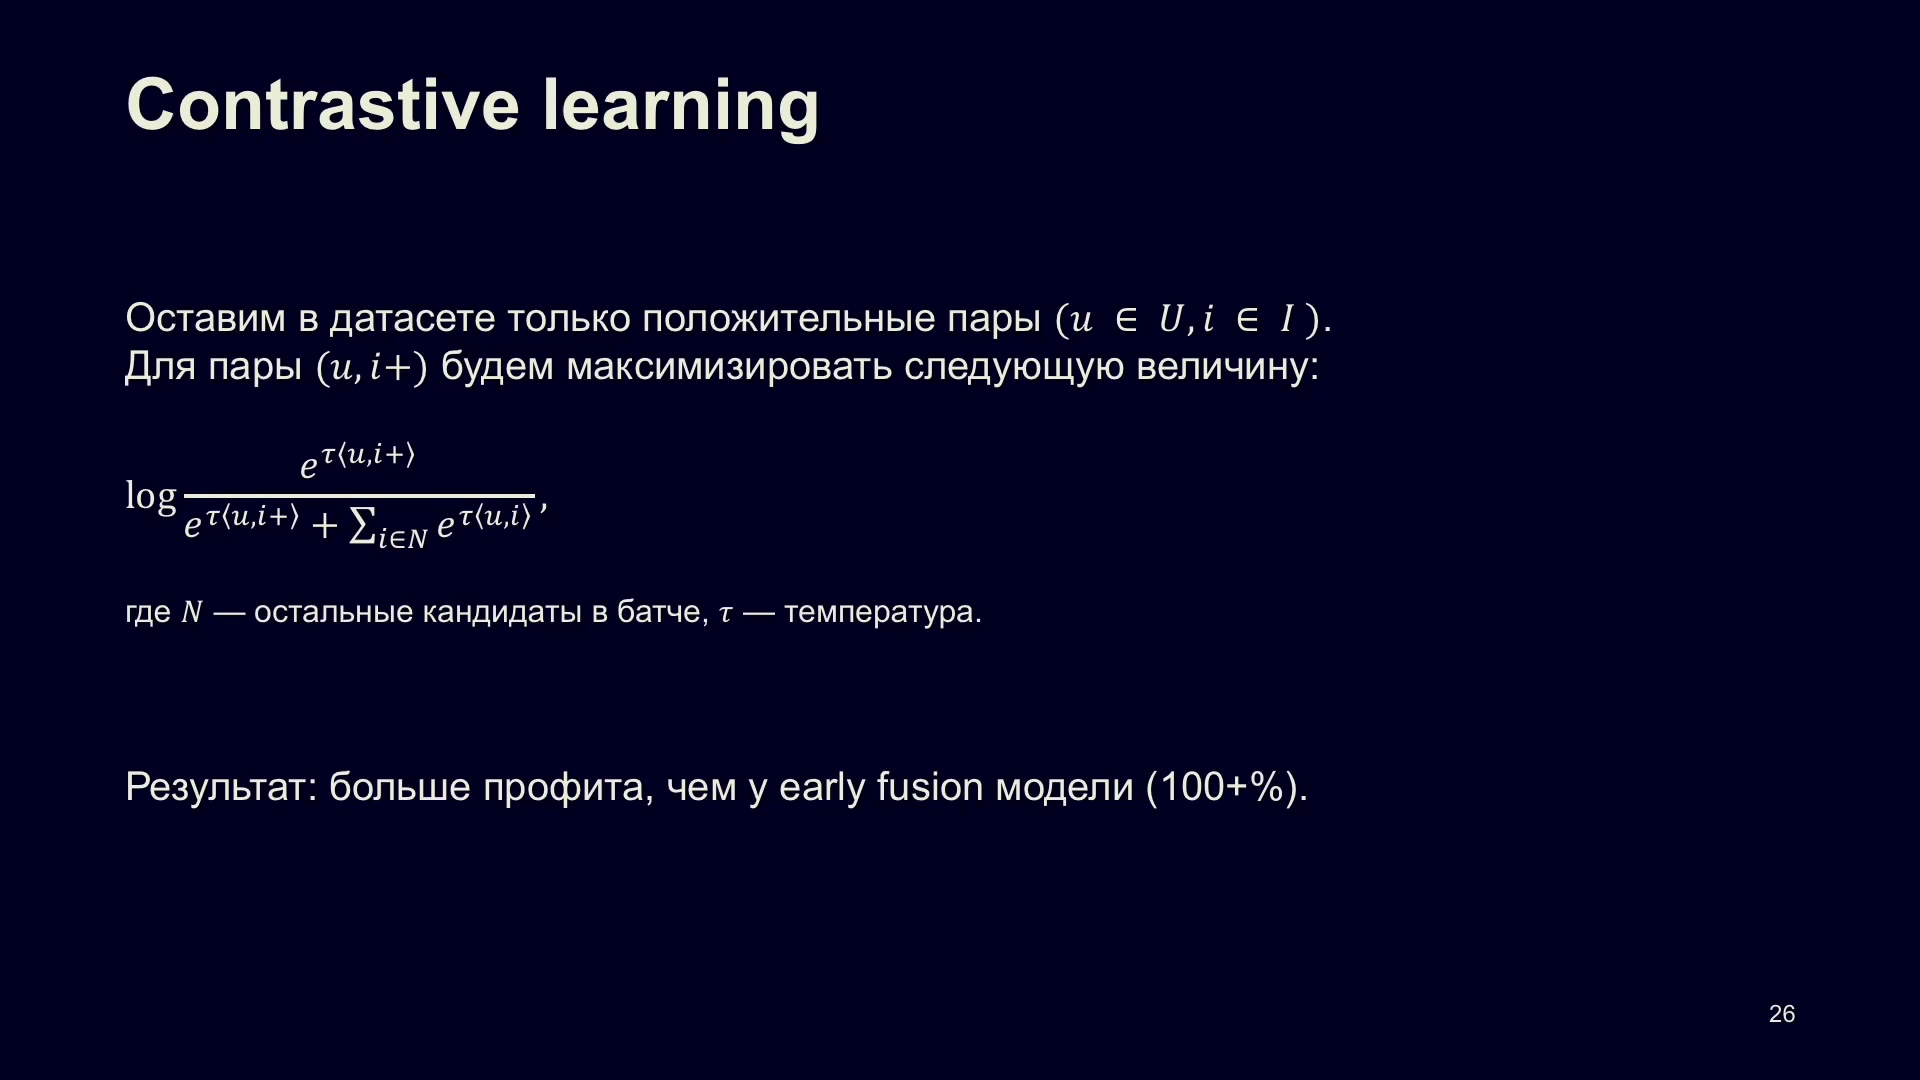
Исходная формула контрастивной задачи: коэффициентτ умножает скалярное произведение, а не делит его.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Скорость и сохранённый прирост в разных версиях сервисов
Сводная таблица соединяет всю архитектурную историю. Время показано в миллисекундах: отдельно среднее и p99 — значение на 99-м перцентиле измерений. Столбец complexity оставлен в авторской записи сложности вычислений. Последний столбец показывает долю прироста исходного раннего связывания, а не абсолютное значение качества.
Таблицу можно прокрутить по горизонтали.
Сноски оригинала связывают строки с версиями сервисов: ¹ — Поиск v1; ² — Поиск v2 и поисковая реклама v1; ³ — Contrastive Learning, то есть контрастивное обучение; ⁴ — РСЯ v1 и поисковая реклама v2. Для обычной двухбашенной строки отдельной сноски с привязкой к сервису нет.
Из таблицы видны два разных достижения. Разделение вычислений уменьшило повторную работу при оценке кандидатов. Затем предварительное обучение повысило сохранённый прирост без изменения показанных значений задержки у двухбашенного варианта: 0,8 мс в среднем и 1,2 мс на p99 в обеих нижних строках.
Однако строки относятся к разным итерациям Поиска и рекламы. Доклад не задаёт для них полный единый протокол замера на одинаковом оборудовании. Поэтому отношение 139 и 0,8 нельзя превращать в универсальное обещание ускорения любой системы, а p99 — в гарантию задержки всего пользовательского запроса. Так же и O(256n), O(16n), O(n) здесь остаются авторским способом сопоставить варианты, а не общим выводом асимптотики всех операций трансформера.
Содержательный итог сравнения — не выбор самой короткой сети любой ценой. Наивные варианты теряли половину эффекта; правильно устроенная кандидатная башня и контрастивный сигнал позволили сохранить дешёвое применение и вернуть весь исходный прирост.
Слайд 27 · 00:25:00. Первые изменения сокращают стоимость повторных вычислений, последнее возвращает прирост через обучение. Сноски показывают историю разных версий сервисов, поэтому таблица не является единым аппаратным тестом.
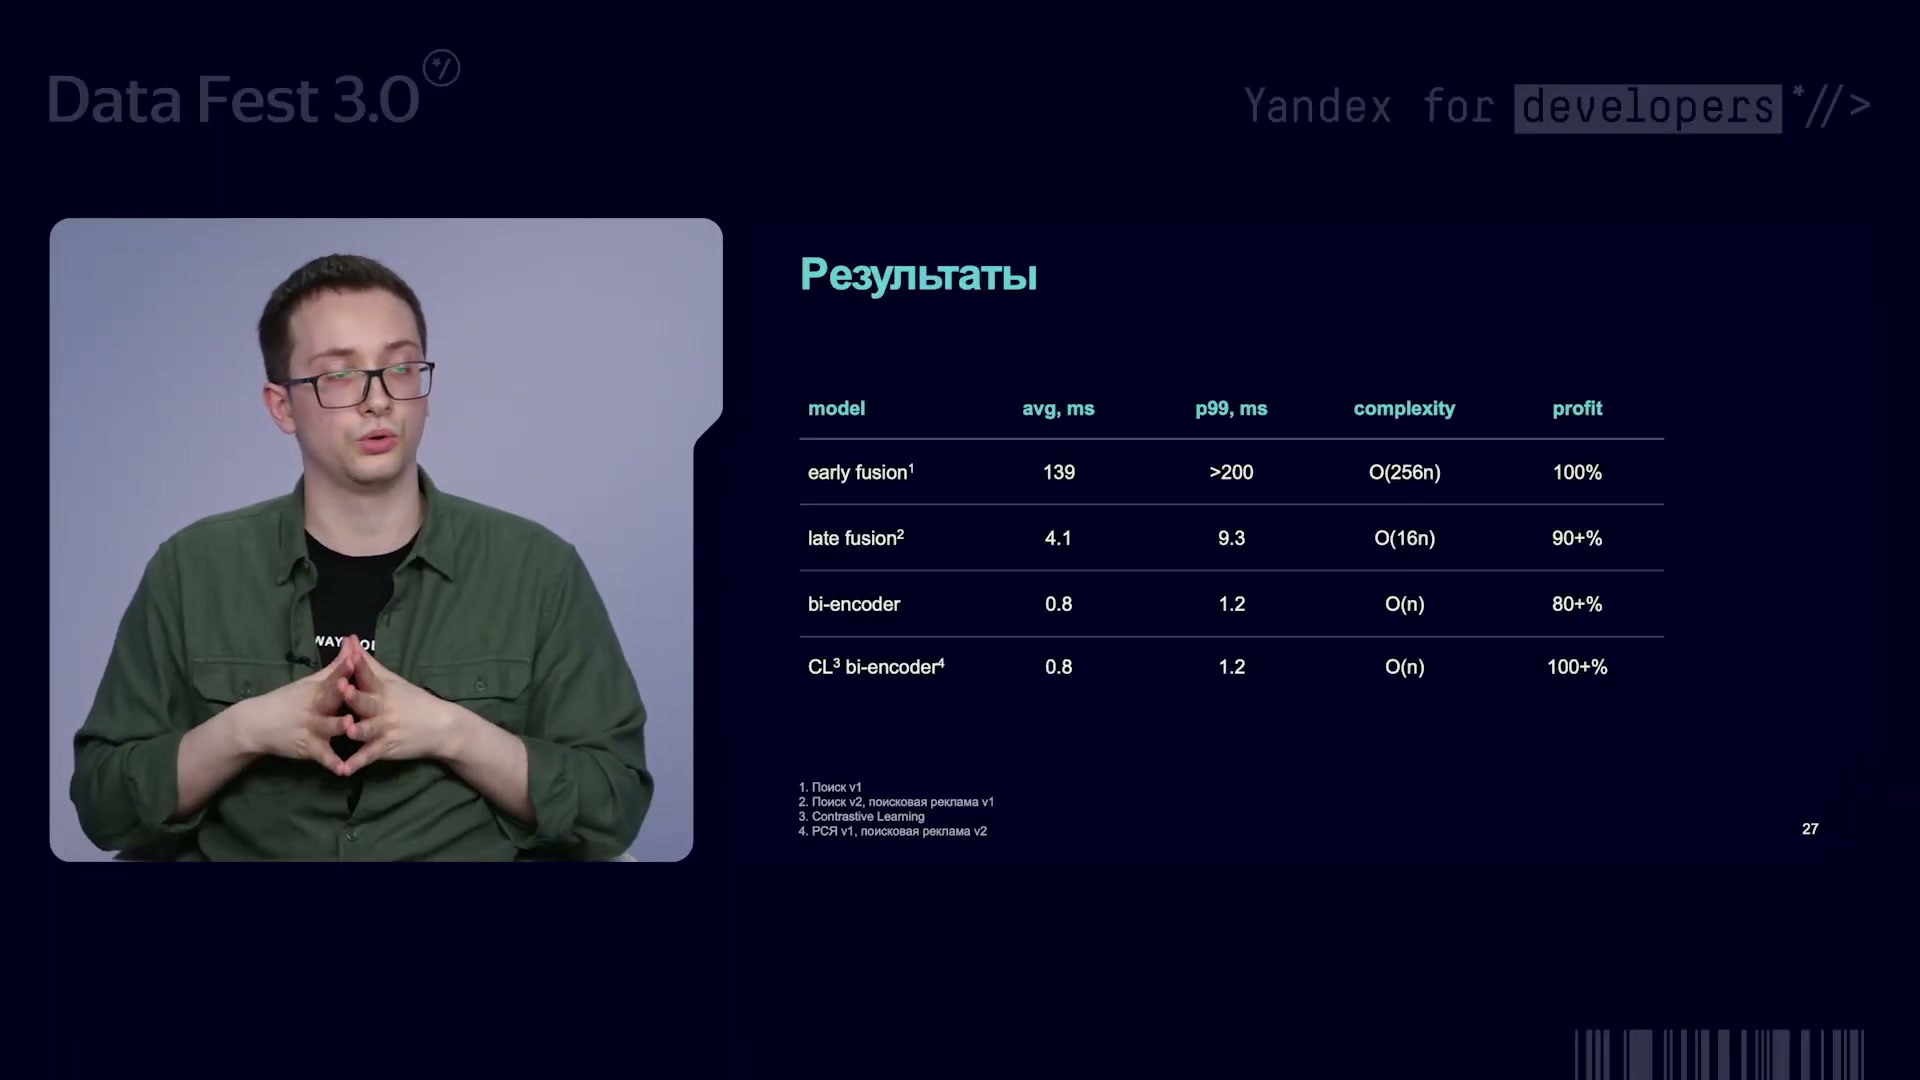
Задержка и доля сохранённого прироста для четырёх архитектур; это разные итерации сервисов.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Двух башен недостаточно для всей годовой истории
После разделения пользовательской и кандидатной частей остаётся другая причина высокой стоимости — длина самой истории. По словам автора, в Поиске у четверти пользователей за год накапливается более тысячи новых запросов и кликов по документам. Их полезно учитывать, но даже единственный проход большой истории на каждом запросе слишком дорог.
На графике автор фиксирует размерность скрытого представления 512 и сравнивает время обработки разных длин. За единицу принято время для 128 событий. Поэтому значения ниже не имеют единицы «миллисекунды»: они показывают отношение времени для данной длины к времени для 128 событий.
При переходе от 128 к 2048 событиям значение на графике достигает 19,8 — почти двадцатикратной нагрузки по этой оценке времени. В речи автор объясняет рост через число умножений и необходимость значительно расширять ресурсы сервиса. Ключевая проблема уже не в повторении одного пользователя для разных кандидатов: даже общая пользовательская часть становится слишком большой.
Выходом не обязательно должно быть сокращение истории до последних действий. Дальняя история несёт другой сигнал, поэтому следующая архитектура меняет не только её размер, но и момент обработки: часть сведений можно подготовить до того, как пользователь придёт с новым запросом.
Слайд 28 · 00:25:30. За единицу взята обработка 128 событий при скрытой размерности 512. Почти двадцатикратный рост к 2048 событиям объясняет, почему раздельные башни ещё не позволяют бесплатно расширять историю.
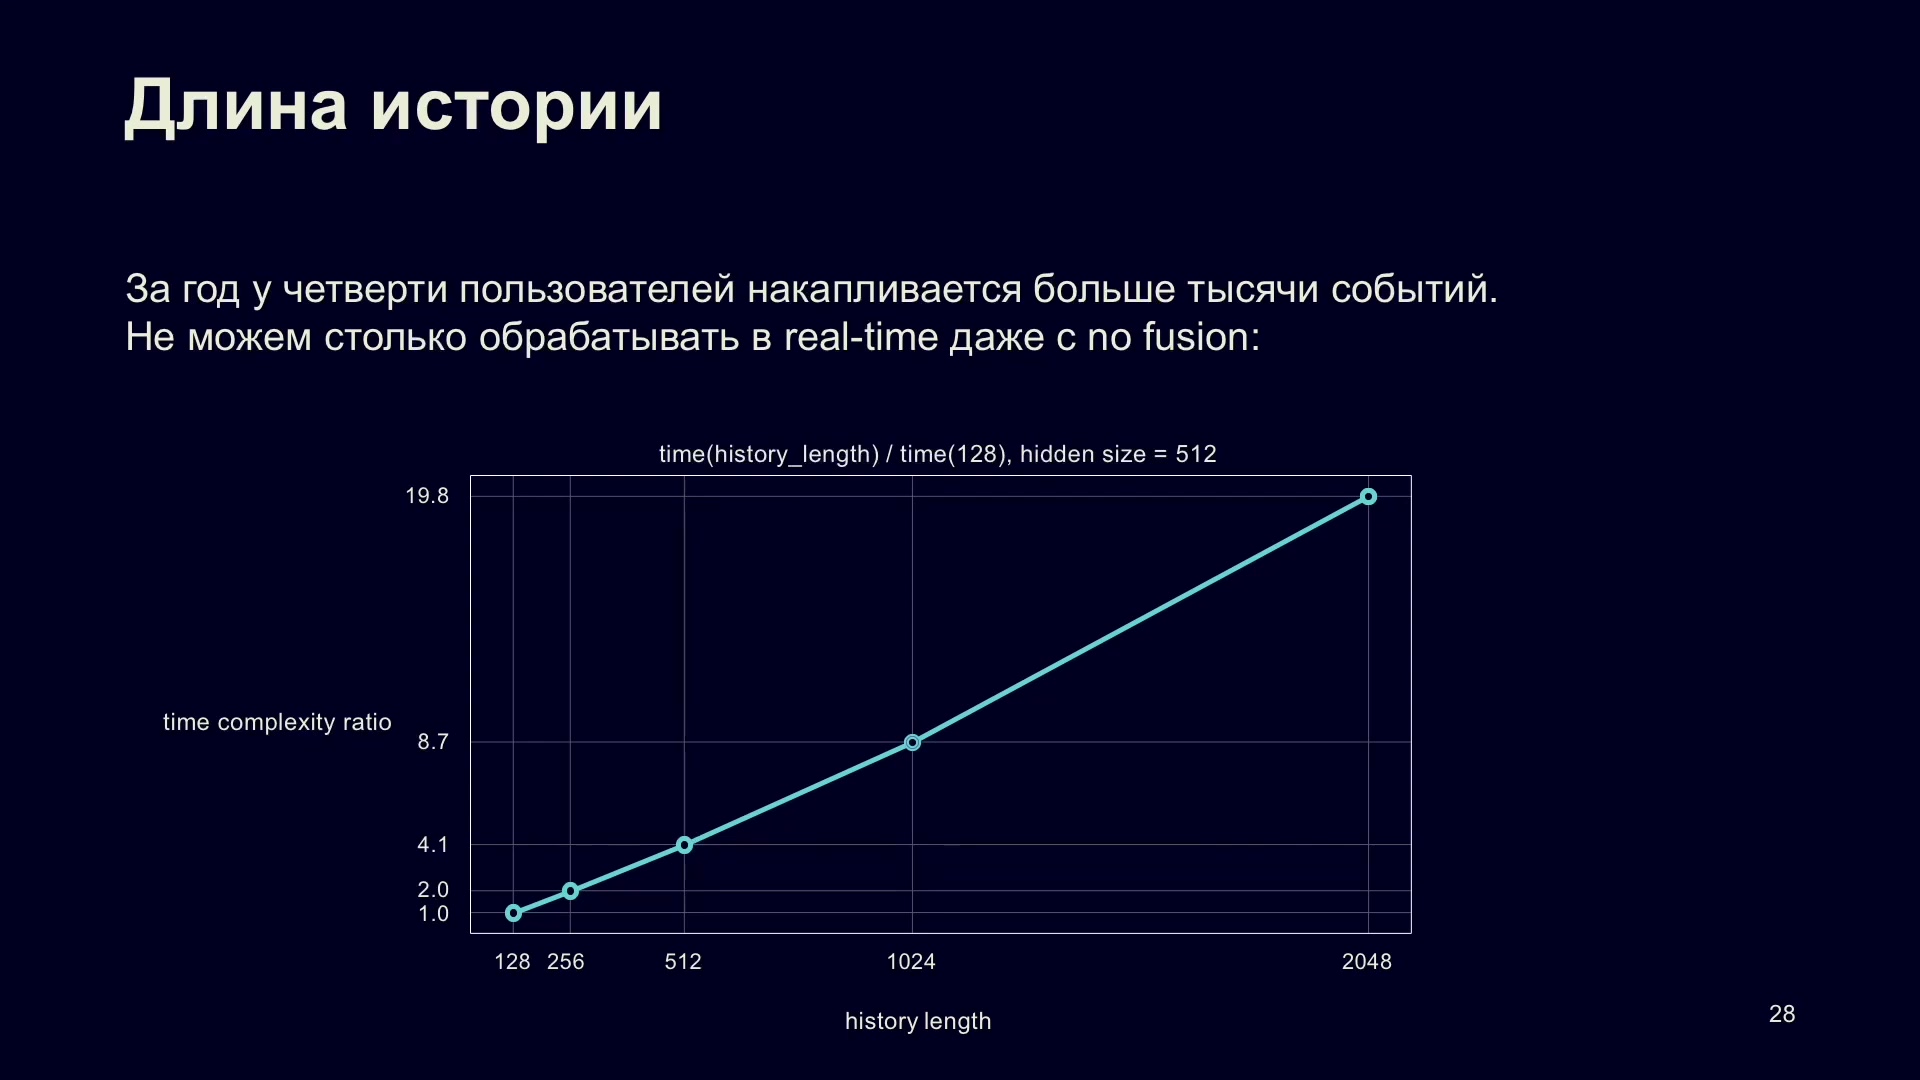
Зависимость времени от длины истории при hidden size512; время нормировано на128 событий.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Свежие действия и устойчивые интересы отвечают на разные вопросы
Короткий фрагмент истории помогает понять, зачем человек сейчас пришёл в сервис. В пределах одной или нескольких сессий у него часто есть конкретное намерение. Автор иллюстрирует такой фрагмент последними 50 событиями: они отражают недавние действия, но не исчерпывают все интересы человека.
Длительная история даёт более широкий взгляд. В ней накоплены разные темы и повторяющиеся предпочтения, которые могли не проявляться в последней сессии. Поэтому короткий и длинный сигналы не являются просто двумя взаимозаменяемыми окнами: увеличение окна позволяет получить сведения о других временных масштабах интереса.
По опыту автора, долгосрочный сигнал приносит существенный эффект персонализации. Вместо того чтобы каждый раз заново анализировать всю историю, команда решает разделить вычисления на предварительную обработку давних событий и обработку недавних событий во время запроса. В дальнейшем эти два представления снова соединяются, но уже после сжатия длинной последовательности.
Слово «офлайн» в этой части означает «заранее, вне обработки текущего запроса». Оно не обозначает само обучение. Обученная модель может регулярно применять свои параметры к истории, записывать новые состояния и при этом не менять веса. Именно такой предварительный расчёт позволяет переносить часть нагрузки за пределы ответа пользователю.
Слайд 29 · 00:26:00. Свежая история описывает текущее намерение, длинная — более устойчивые и разнообразные интересы. Их разделяют по моменту вычисления, а не объявляют один сигнал заменой другого.
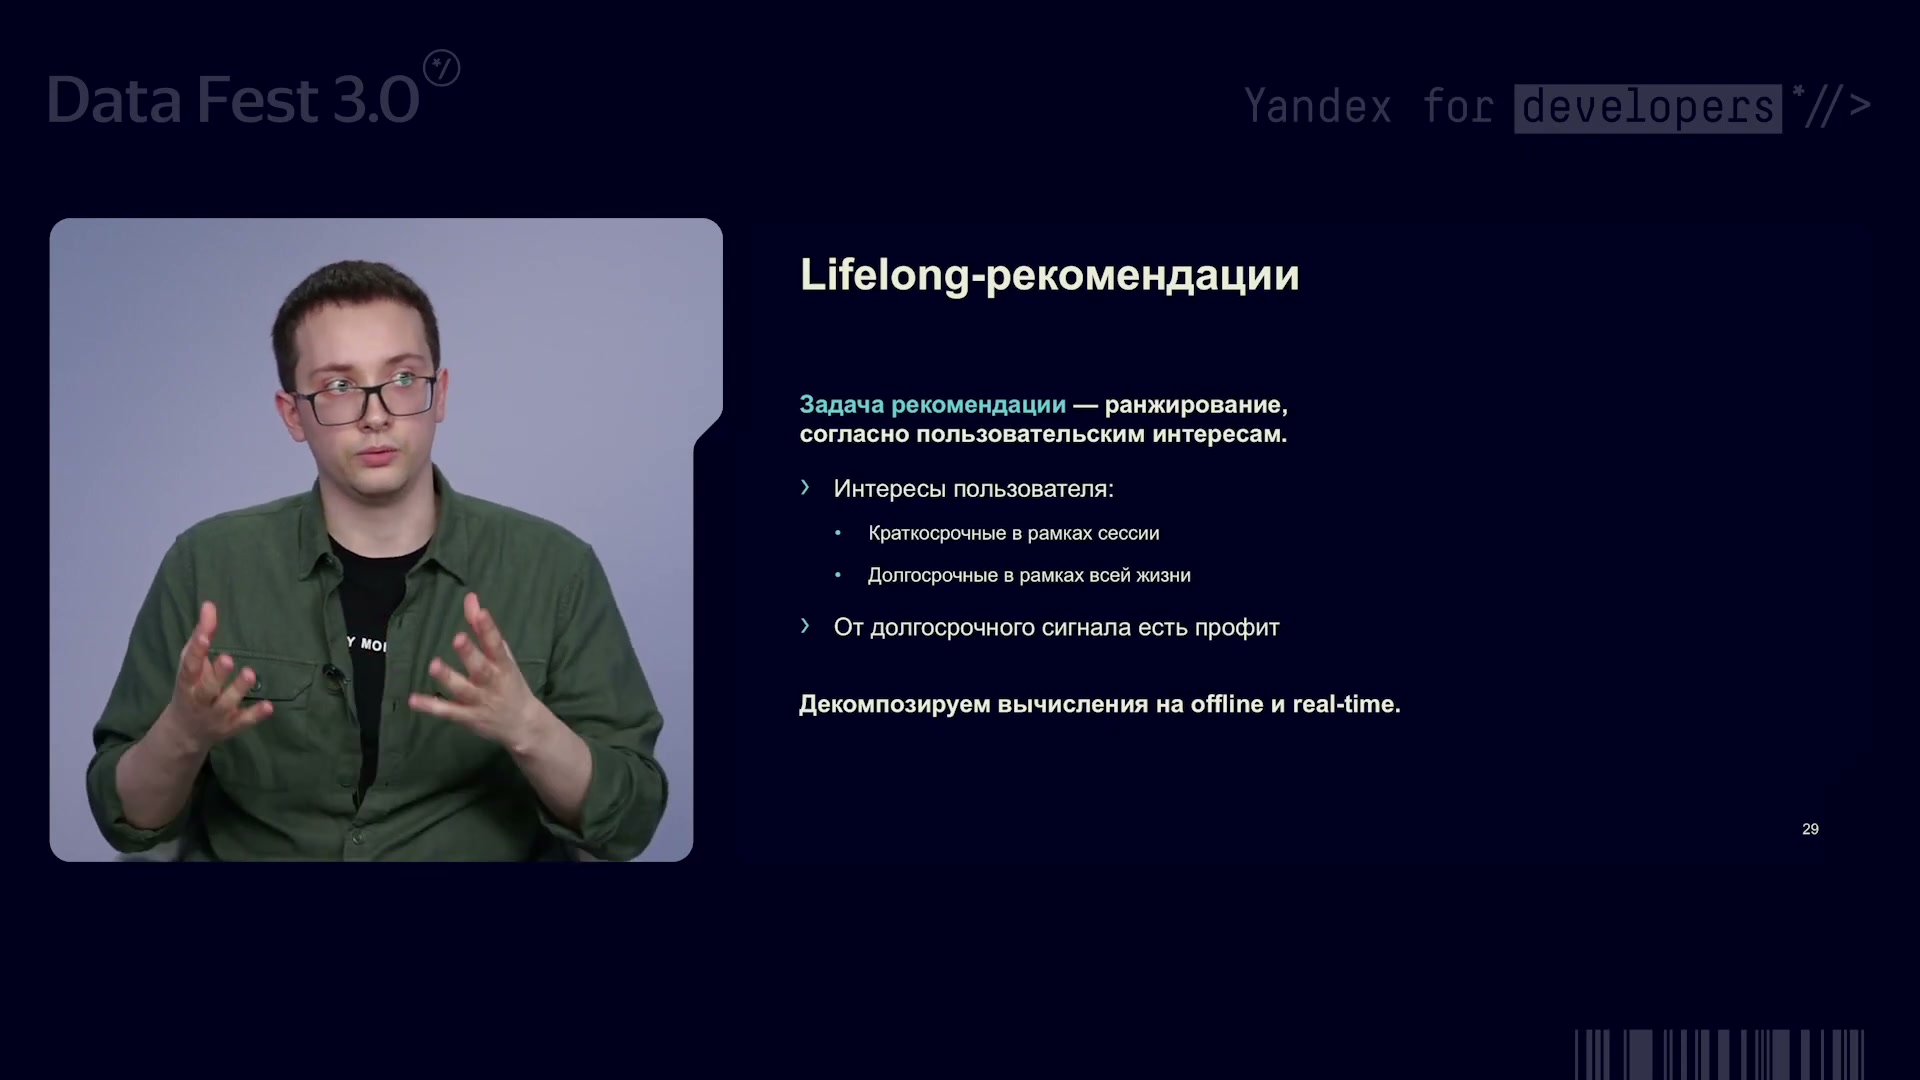
Краткосрочные и долгосрочные интересы требуют разделения вычислений.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Как заранее подготовленные состояния входят в текущий запрос
Длинную историю обрабатывает отдельный трансформер. Он получает большую последовательность событий и группу обучаемых служебных векторов. На выходе берутся новые представления этих векторов — небольшой набор состояний, в который сжата история. В речи возможный масштаб входа иллюстрируется 500 событиями, тысячей и даже десятками тысяч; это примеры возможностей схемы, а не одна обязательная длина всех внедрений.
Этот трансформер применяют вне пользовательского запроса. Готовые состояния по пользователям кладутся в KV-хранилище. Автор приводит ежедневный и еженедельный пересчёт как примеры регулярности. Конкретного общего графика для всех сервисов из этих слов не следует: важна сама возможность обновлять длинное представление отдельно от каждого обращения.
Во время запроса система получает свежую историю — в речи это, например, 100 или 60 событий — и текущий контекст. К ним добавляются группы служебных CLS-векторов для нужных целевых предсказаний и готовые состояния длинной истории из хранилища. Всё вместе поступает в пользовательский трансформер, который работает непосредственно на запросе.
На выходе этого трансформера получаются актуальные пользовательские состояния: они учитывают одновременно текущую ситуацию, недавние действия и предварительно сжатый дальний сигнал. Для варианта с двумя рекламными целями разные группы состояний обслуживают CTR и CVR. Их сопоставляют с кандидатной стороной через уже рассмотренные произведения, сигмоиды и объединение оценок.
Кандидатная ResNet остаётся независимой от пользователя. Её готовые выходы, как и в двухбашенной схеме, можно извлекать из KV, не повторяя обработку объекта на запросе. Таким образом, предварительно рассчитываются два разных вида сведений: представления объектов и состояния давней пользовательской истории. Свежая история и текущий контекст всё равно обрабатываются сейчас, поэтому пользовательская часть не превращается в один устаревающий профиль.
Слайд 30 · 00:27:00. Заранее рассчитанный трансформер сжимает давнюю историю в состояния; текущий трансформер соединяет их со свежими событиями, контекстом и CLS-группами двух целей. Получить состояния из KV — не то же самое, что заново обучить модель.
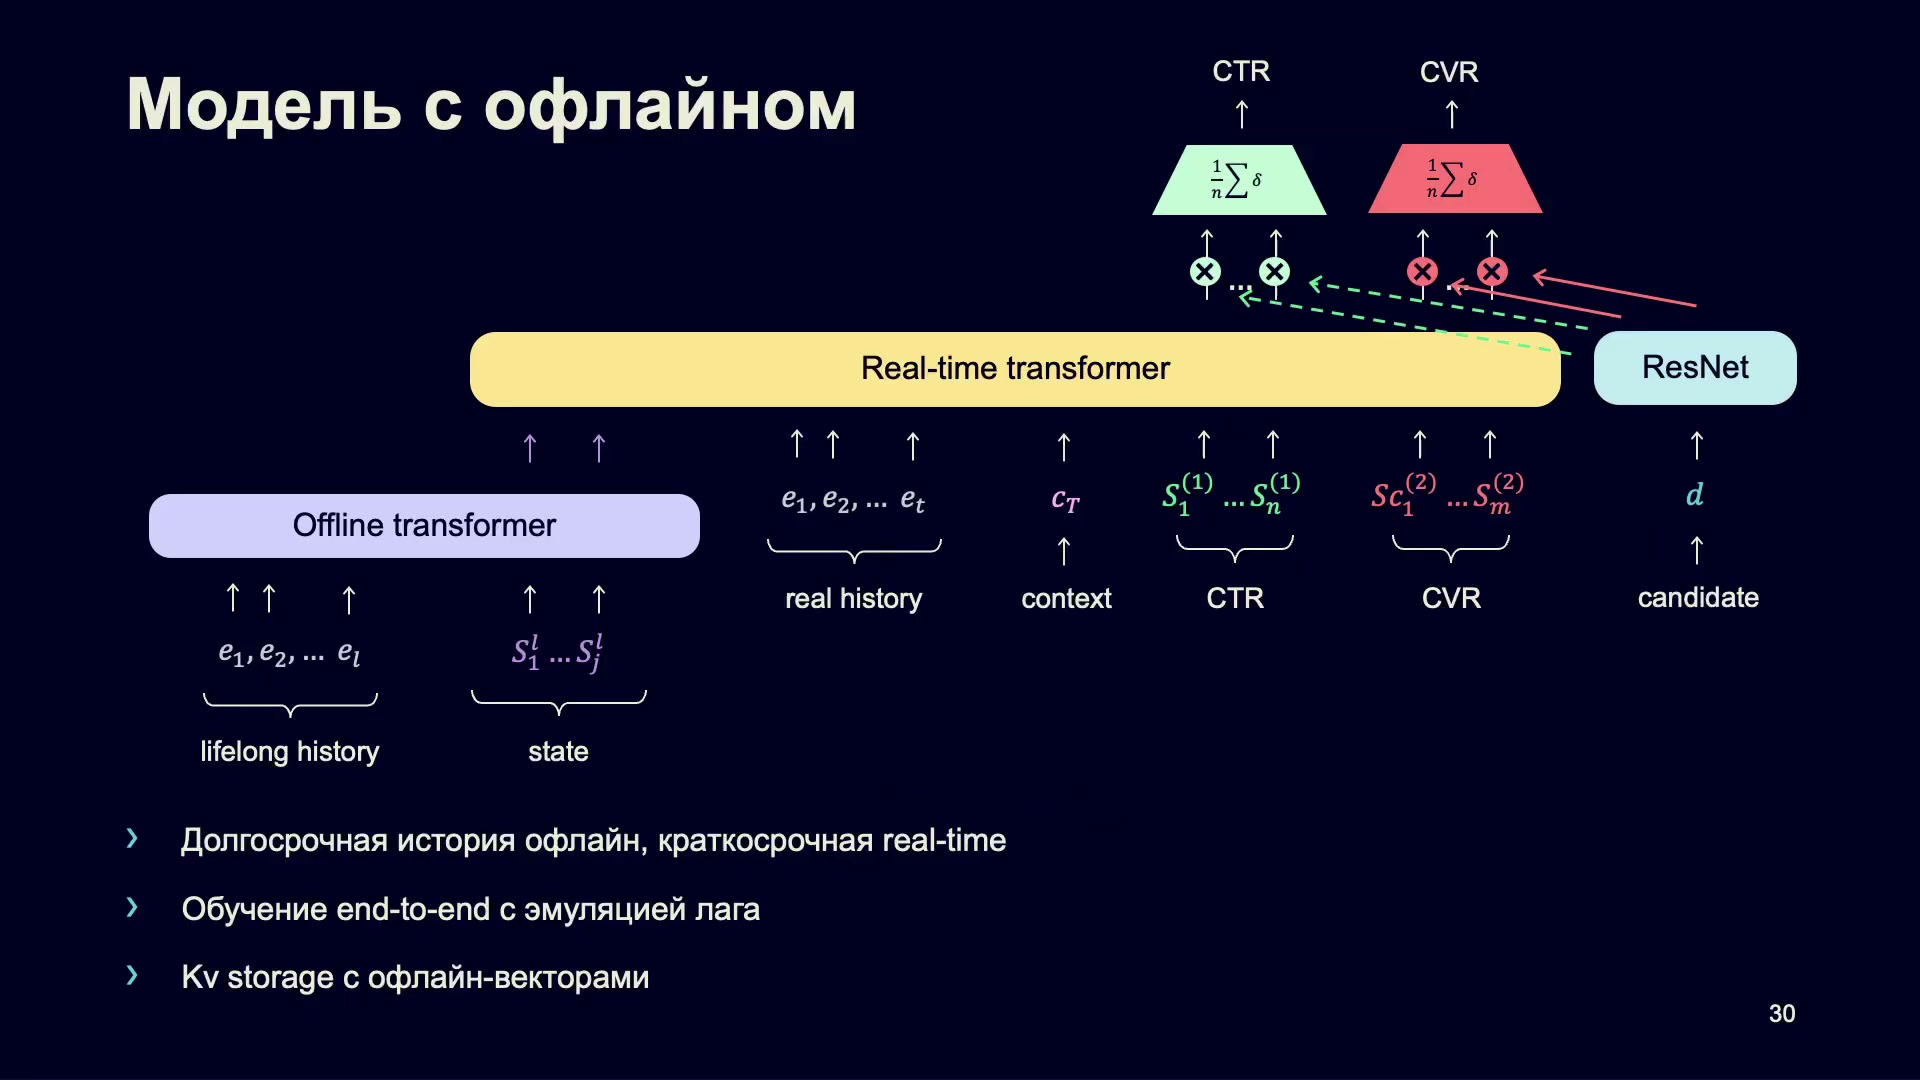
Длинная история считается заранее, свежие события — на запросе; обучение эмулирует задержку данных.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Совместное обучение должно видеть ту же задержку истории
У предварительной и текущей частей одна общая задача, поэтому их можно обучать совместно: ошибка конечного предсказания влияет на параметры обеих частей. Такое обучение называют сквозным, или end-to-end. Оно происходит отдельно от регулярного вычисления готовых состояний и отдельно от обработки пользовательского запроса.
При этом нельзя обучать модель так, будто предварительные состояния всегда построены по самой свежей истории. В реальном применении они имеют задержку, зависящую от частоты пересчёта. Поэтому автор требует эмулировать нужный лаг — временное отставание длинной истории — уже при формировании обучающих примеров.
Конкретный пример в речи: если длинный трансформер рассчитывается раз в неделю, для текущей пары «пользователь — кандидат» в его ветвь берут исторические события с недельным лагом. Текущая часть учится работать с таким отстающим представлением вместе со свежими событиями. Иначе условия обучения дали бы ей доступ к информации в длинном состоянии, которой в момент применения ещё нет.
Недельный лаг здесь объясняет принцип согласования данных, а не задаёт неизменный режим всех сервисов. Главное ограничение сформулировано явно: совместное обучение не отменяет границу доступности данных между предварительными и текущими вычислениями.
Доклад · 00:28:16Что дали длинные состояния и сколько прироста удалось сохранить
Верхняя таблица результатов сравнивает, сколько событий обрабатывается заранее и сколько — во время запроса. В ячейках показан прирост целевой метрики относительно базового варианта. Название метрики здесь не сообщается. Первая строка не использует предварительную историю; остальные показанные значения сочетают её с 64 событиями на запросе.
Таблицу можно прокрутить по горизонтали.
Пустые ячейки не означают ноль и не доказывают неудачу соответствующей конфигурации: результатов для них на слайде нет. Среди показанных вариантов без предварительной истории прирост растёт от 8,17% при 64 событиях до 11,11% при 512. При фиксированных 64 событиях на запросе увеличение заранее обработанной истории до 512 событий даёт 10,69%.
Два крайних для этого сравнения варианта — все 512 событий на запросе и сочетание 512 предварительных с 64 текущими — дают близкий прирост. Отношение результатов объясняет надпись о сохранении 96% эффекта:
Арифметическое пояснение слайда 31: доля сохранённого прироста при 512 офлайн-событиях и 64 событиях на запросе относительно 512 событий целиком на запросе.
Здесь 96% — не точность предсказаний и не доля довольных пользователей. Автор одновременно сообщает об уменьшении вычислений во время запроса примерно в восемь раз. Это не оценка общей стоимости системы: обработка длинной истории и хранение её состояний перенесены за пределы запроса, а не исчезли.
Нижняя таблица отвечает на другой вопрос: насколько усилился уже имевшийся эффект в сервисах, которые до этого использовали короткую текущую историю. К ним добавили 512 заранее обработанных событий:
Таблицу можно прокрутить по горизонтали.
В РСЯ это ещё примерно половина прежнего эффекта, в поисковой рекламе — почти его удвоение. Значения +45% и +92% не означают такой же рост CTR, выручки или товарного оборота. Они характеризуют увеличение прироста от персонализации в своих сравнениях. Поэтому их нельзя складывать с 90+%, 80+% и 100+% из архитектурной таблицы.
Обе части слайда поддерживают одну техническую мысль с двух сторон. Предварительная история почти воспроизводит эффект большой текущей истории, но требует меньше работы на запросе. А для сервиса с короткой историей она добавляет сведения, которых раньше у модели просто не было.
Слайд 31 · 00:29:00. Верхняя таблица показывает сохранение около 96% прироста при переносе длинной истории из запроса; нижняя — усиление прежнего эффекта в двух сервисах. Это разные основания сравнения, а не проценты одной бизнес-метрики.
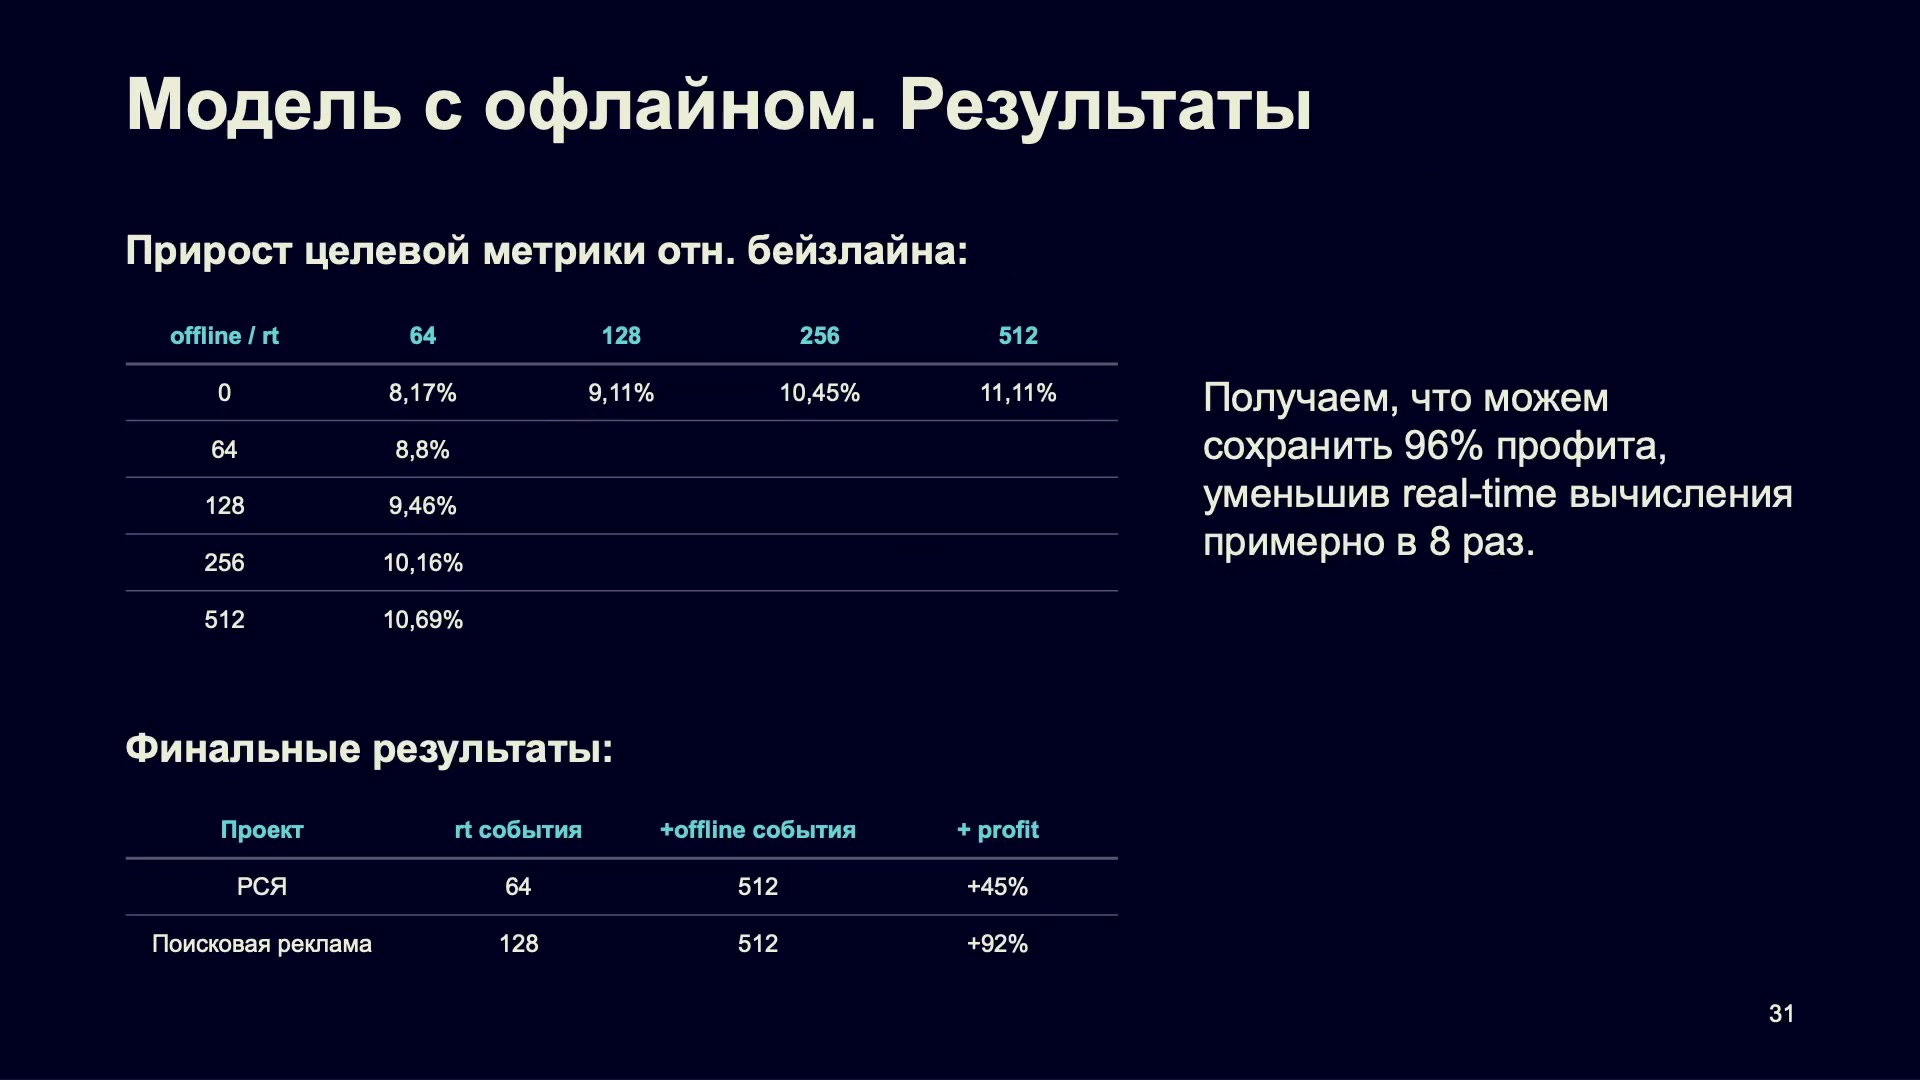
Таблица длины офлайн- и онлайн-истории; пустые ячейки не означают ноль.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Документ может быть релевантным и не получить клик
Последняя большая часть доклада возвращается к тому, чему модель вообще учится по действиям пользователя. Кликов много, но факт клика не является чистой оценкой релевантности. Для поиска это особенно важно: сервис должен находить подходящую человеку информацию, а не просто воспроизводить вероятность перехода при прежнем устройстве выдачи.
Первое препятствие — объект мог не попасть во внимание пользователя. Верхнюю часть результатов замечают чаще нижней, а до других страниц человек может не дойти. Второе препятствие остаётся даже у увиденного и релевантного документа: другой похожий результат выше уже решил задачу. Отсутствие перехода к следующему документу тогда ничего не говорит о том, насколько он сам подходил запросу.
Таблицу можно прокрутить по горизонтали.
В примере объект 2 находится выше и получает преимущество перед тоже релевантным объектом 5. Если человеку уже хватило второго результата, пятый не получает клик. Для обычной кликовой разметки это отрицательный пример, и модель может уменьшать его близость к пользователю, хотя причина была в окружении выдачи, а не в содержании самого объекта.
Далее автор разбирает шесть связанных механизмов: попадание объекта во внимание, позиционное смещение, доверие к системе, популярность объекта, индивидуальную склонность реагировать на популярное и каннибализацию другими результатами. Они не объявляются шестью независимо измеренными причинами. Напротив, задача — задать модель, в которой общий кликовый сигнал складывается из более содержательных частей.
Слайд 32 · 00:29:30. Два релевантных объекта могут иметь разную вероятность клика из-за позиции и решения задачи на предыдущем результате. Поэтому отсутствие клика по пятому объекту не равно доказанной нерелевантности.
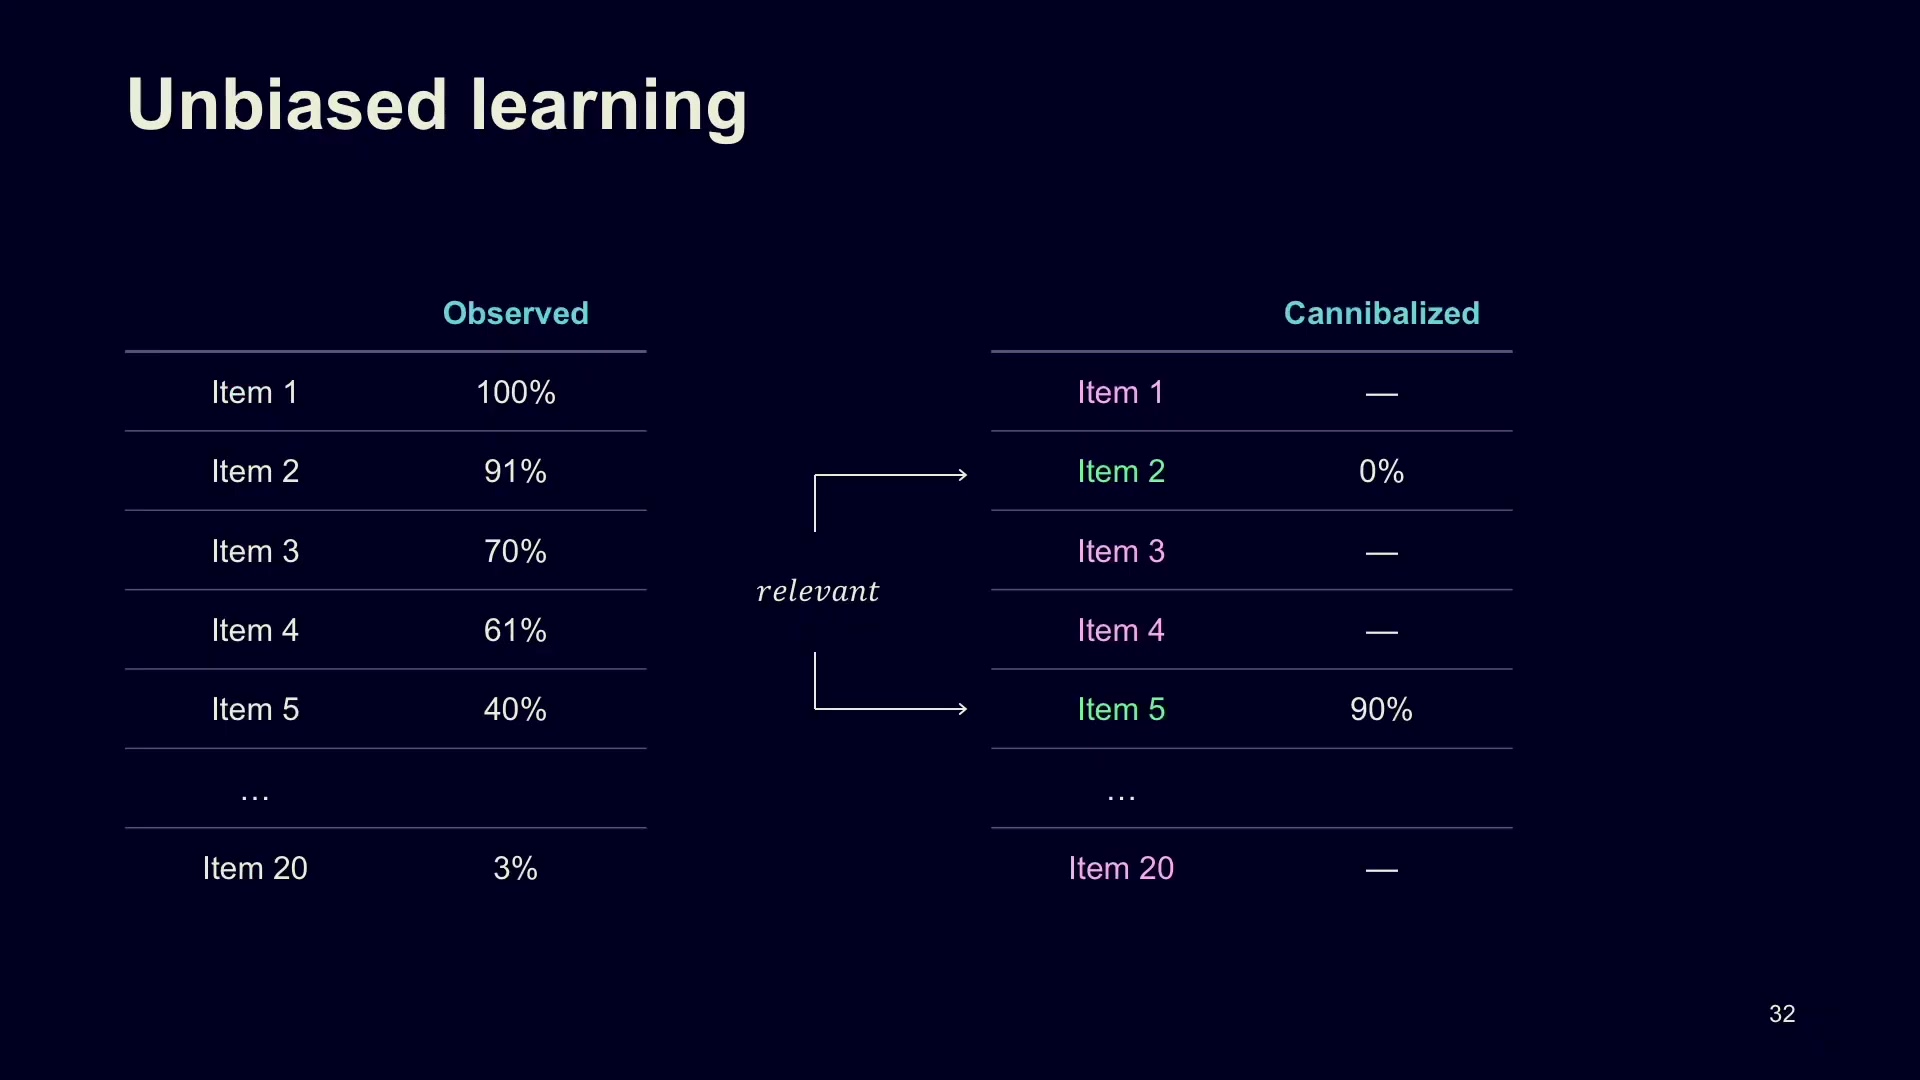
Иллюстрация наблюдения и конкуренции показанных объектов; проценты — учебный пример.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Позиция влияет на то, увидит ли объект именно этот человек
Начать разложение можно с самого простого различия: вероятность клика по документу на конкретной позиции не равна вероятности его релевантности пользователю. В обозначениях автора user — пользователь, item — объект, pos — позиционная информация. Условие текущего запроса присутствует в общей постановке, но в данной формуле отдельно не выписано.
Исходное различие со слайда 33: клик зависит от условий показа и не отождествляется с релевантностью.
Обозначим через obs событие, что пользователь увидел документ. Тогда модель раскладывает кликовую вероятность на вероятность перехода при условии наблюдения и вероятность самого наблюдения. Эта часть на слайде названа Exposure, position biases — эффекты видимости объекта и его позиции.
Декомпозиция со слайда 33. В авторской параметризации наблюдение зависит от пользователя и позиции.
Персонализация нужна и множителю наблюдения. Один человек подробно просматривает выдачу, другой ограничивается несколькими верхними результатами. Поэтому одна общая поправка только на номер позиции не отражала бы описанное различие поведения. В предложенной записи вероятность увидеть документ учитывает пользователя.
Модель может сразу предсказывать обе составляющие, перемножать их и сопоставлять конечную вероятность с фактом клика или его отсутствия. Отдельная известная метка наблюдения для каждого показа здесь не заявлена: обучение использует общий сигнал через выбранную декомпозицию. Это принципиально отличается от ситуации, в которой все внутренние компоненты уже размечены независимо.
Доклад · 00:31:43Доверие и привлекательность объясняют клик без релевантности
Обратная неоднозначность тоже возможна: клик происходит, хотя объект не отвечает исходному намерению. Первый объясняющий механизм — доверие к системе. Пользователь может перейти к верхнему результату, предполагая, что сложная рекомендательная модель уже выбрала подходящее. Автор также описывает ситуацию, когда грань релевантности неочевидна и сам факт рекомендации убеждает человека в полезности объекта.
Второй механизм связан с привлекательностью, не совпадающей с запросом. Кликбейтный заголовок или акция могут заинтересовать человека независимо от того, что он собирался найти. Популярный бренд действует сходным образом, если пользователь любит такие бренды. Автор отдельно замечает, что полный просмотр видео тоже неоднозначен: короткое видео легче досмотреть до конца, даже если оно не особенно релевантно.
Поэтому модель различает свойство объекта и свойство пользователя. Популярность относится к самому документу, склонность реагировать на популярное — к человеку. В английской терминологии слайда это popularity и conformity. Вместе с доверием, trust, они описывают одну из ветвей кликовой вероятности при нерелевантности.
Формула со слайда 33 для клика при нерелевантности: irr — нерелевантность, o — наблюдение, u — пользователь, i — объект, p — позиция. Trust, user conformity и item popularity — предсказываемые составляющие.
Сначала эта запись допускает клик за счёт доверия. В оставшейся части вероятность определяется сочетанием привлекательного объекта и склонного к нему пользователя. Это не утверждение, что каждый отдельный клик имеет единственную доказанную причину. Модель задаёт структуру, через которую можно распределить общий обучающий сигнал.
Две части одного исходного слайда дополняют друг друга: сверху учитывается, увидел ли человек документ, снизу — почему увиденный документ может получить клик даже без релевантности. Для полноты ещё нужно добавить противоположный случай — релевантный объект без клика из-за других результатов.
Слайд 33 · 00:32:00. Наблюдение, релевантность и клик разделены. Доверие к ранжированию и сочетание популярности объекта со склонностью пользователя образуют отдельный путь к клику, поэтому один высокий прогноз клика ещё не объясняет полезность документа.
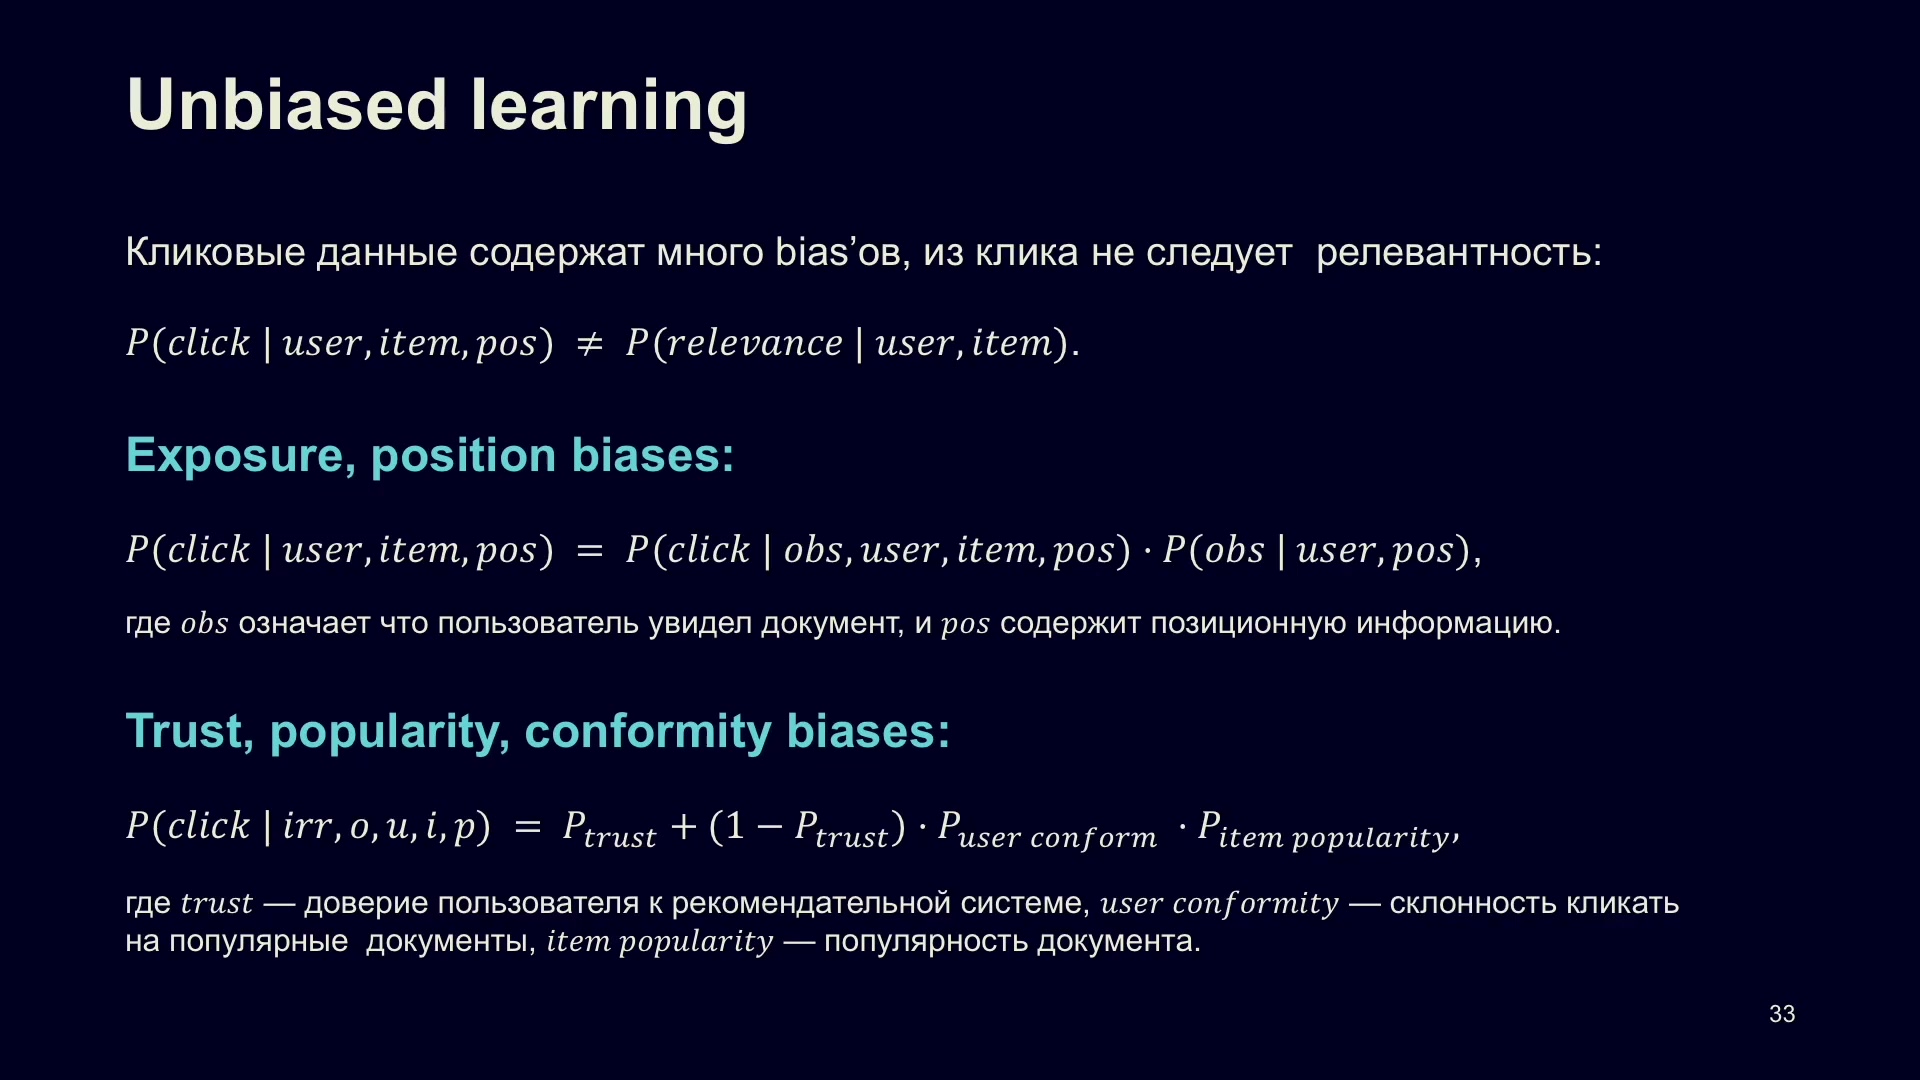
Клик не равен релевантности: наблюдение, позиция, доверие и популярность моделируются отдельно.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Почему модель должна видеть остальные показанные документы
Релевантный и замеченный объект тоже может остаться без клика, если пользователь уже нашёл нужную информацию выше. Такое отсутствие реакции из-за других показанных объектов в докладе называется каннибализацией. На соответствующей части слайда автор использует заголовок Examination bias; здесь сохраняется именно его объяснение этого термина.
Для описания эффекта недостаточно только пользователя, одного объекта и его позиции. Нужен состав всего показанного списка. В формуле impression означает все показанные документы вместе с их позициями, rel — релевантность, obs — наблюдение. Вероятность клика при релевантности и наблюдении записана через дополнение вероятности каннибализации:
Формула со слайда 34: impression включает остальные показанные документы и их позиции; cannib. означает отсутствие клика из-за их влияния.
Автор предлагает оценивать такой эффект трансформером или простым слоем внимания над векторами всех показанных объектов с учётом позиций. Это локальное взаимодействие внутри выдачи: модель может учитывать наличие другого похожего результата, который уже закрыл потребность пользователя.
Эта часть объясняет, зачем в начале доклада отдельно упоминалось переранжирование. Даже если индивидуальные оценки кандидатов уже посчитаны, их совместное появление меняет вероятность реакции. Однако из предложения моделировать каннибализацию не следует, что именно такой дополнительный модуль одновременно присутствовал во всех описанных двухбашенных внедрениях.
Доклад · 00:34:25Как обучать составляющие через общий кликовый сигнал
Теперь описанные механизмы можно собрать в одну модель. Объект сначала должен попасть во внимание пользователя. Если он релевантен, клик зависит от того, не помешало ли влияние других результатов. Если нерелевантен, остаются доверие к системе и сочетание популярности объекта со склонностью пользователя к популярному.
В сокращённой записи автора obs — вероятность наблюдения, rel — релевантности, can — каннибализации, trust — доверия, conf — склонности реагировать на популярное, pop — популярности объекта. Слово click в левой части обозначает моделируемую вероятность клика. Позиция входит в условия соответствующих компонентов, прежде всего наблюдения, а не добавляется ещё одним независимым множителем.
Полная авторская декомпозиция со слайда 34. Это параметризация кликовой вероятности с принятыми моделью допущениями, не универсальная причинная формула поведения.
Компоненты предсказываются самой моделью и объединяются в итоговую кликовую вероятность, которая обучается по факту клика. Например, для вероятности наблюдения автор предлагает сигмоиду от скалярного произведения пользовательского вектора и обучаемого вектора позиции. Ниже a(u) обозначает пользовательское представление, а rⱼ — представление позиции j; эти обозначения введены для записи устного примера.
Алгебраическая запись устного примера 00:35:52–00:36:04: персональное наблюдение через пользовательский вектор и обучаемый вектор позиции.
Другие компоненты автор тоже предлагает выражать отдельными скалярными произведениями или их комбинациями. Тем самым внутри модели задаются предположения о структуре кликового сигнала. Обучение не просто получает новую метку «чистая релевантность», которой раньше не было; оно учится распределять информацию общего наблюдаемого клика между выбранными составляющими.
На слайде сообщается о +1% целевой метрики. Её название и протокол эксперимента здесь не раскрыты. В речи отдельно рассматривается связка, где нейросеть формирует признаки для итогового градиентного бустинга. Если тот сам умеет учитывать позицию, согласование нейросетевого обучения с этой структурой может быть полезным. Это сценарий использования признаков, а не доказательство, что нейросеть всегда является единственным итоговым ранжировщиком.
Главное ограничение такого объяснения — возможность однозначно восстановить внутренние составляющие, или идентифицируемость. По одному общему сигналу нельзя считать любую красивую декомпозицию независимо доказанным описанием причин. В докладе нет доказательства уникальности восстановленных компонентов и полного устранения всех смещений. Поэтому далее полезно смотреть на интерпретации модели, но не превращать их в причинную истину о пользователе.
Слайд 34 · 00:34:30. Итоговая вероятность объединяет наблюдение, релевантность, влияние других результатов и пути к клику без релевантности. +1% относится к неназванной целевой метрике; интерпретируемая структура не заменяет доказательства причин и идентифицируемости.
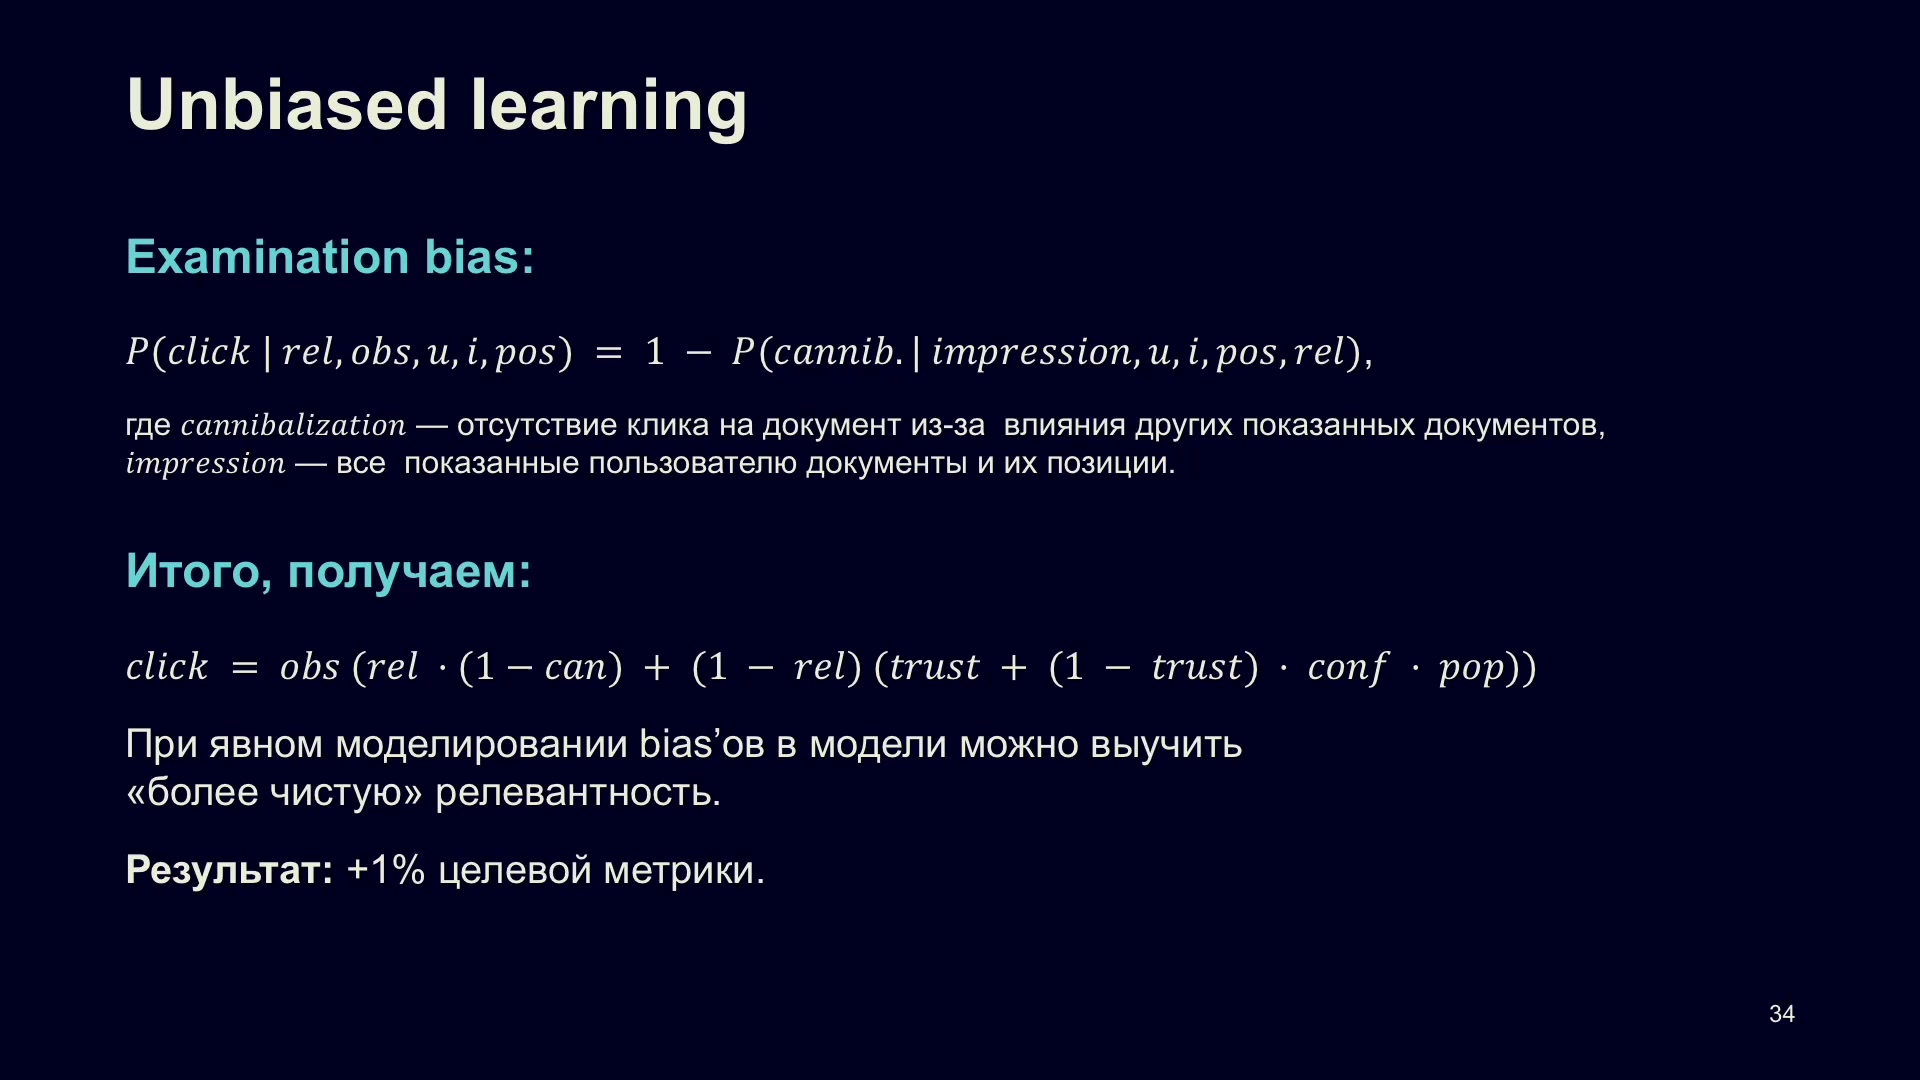
Конкуренция документов и итоговая кликовая модель. +1% целевой метрики без уточнённого здесь протокола.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Что предсказывают компоненты на разных позициях
Чтобы посмотреть на поведение обученной модели, автор берёт данные поисковой рекламы и группирует её предсказания по четырём позициям показа. Для каждого показа можно получить оценки составляющих кликового сигнала, а затем усреднить их в соответствующем срезе. Поэтому приведённые числа — средние предсказания, не непосредственно измеренная частота кликов по каждой позиции.
В таблице click обозначает итоговый прогноз клика, obs click — прогноз клика при условии наблюдения, relev — компонент релевантности, obs — наблюдение, trust — доверие, irr click — клик при нерелевантности. Эти шесть столбцов не являются шестью одинаково устроенными причинами: среди них есть как внутренние составляющие, так и полученные из них кликовые вероятности.
Таблицу можно прокрутить по горизонтали.
Итоговый прогноз клика уменьшается от 0,173 на первой позиции до 0,088 на четвёртой. Но при условии наблюдения значения гораздо ближе друг к другу: от 0,243 до 0,253 в показанных строках. Это соответствует идее, что часть позиционного падения связана с вероятностью увидеть документ, а не обязательно с его меньшей полезностью.
Компонент релевантности максимален на первой позиции, но на второй, третьей и четвёртой нет такого же монотонного порядка. Автор интерпретирует это как частичное согласие модели с прежним ранжированием: верхний результат выглядит более подходящим, а различия ниже могут быть хуже объяснены релевантностью. В речи звучит сравнение статистической различимости, однако формального теста и доверительных интервалов не приведено.
Вероятность наблюдения тоже падает с позицией, причём даже для первой она равна 0,656, а не единице. Автор предлагает объяснение: часть пользователей сознательно пропускает рекламу и сразу переходит к органической, то есть нерекламной, поисковой выдаче. Персональная модель наблюдения может выражать такое поведение, но сама таблица не доказывает причину пропуска.
Компонент доверия уменьшается, а прогноз клика при нерелевантности, напротив, растёт от 0,0257 до 0,0443. Последнее автор связывает с возможным влиянием популярности объекта и склонности пользователя к таким объектам на нижних позициях. Это объяснения после обучения — интерпретации предсказаний, а не независимые причинные измерения.
Все столбцы нужно сохранять как отдельные средние. Нельзя «восстановить» средний click, просто перемножив средние obs и obs click: усреднение произведения по показам и произведение отдельных средних — разные операции. Поэтому значения таблицы не пересчитываются друг из друга и не исправляются под такую проверку.
Слайд 35 · 00:38:00. Верхняя таблица разделяет позиционное падение клика и предсказанные компоненты, нижняя показывает два запроса с разными объяснениями высокого клика. Обе части содержат выходы модели, а не доказанные причины поведения.
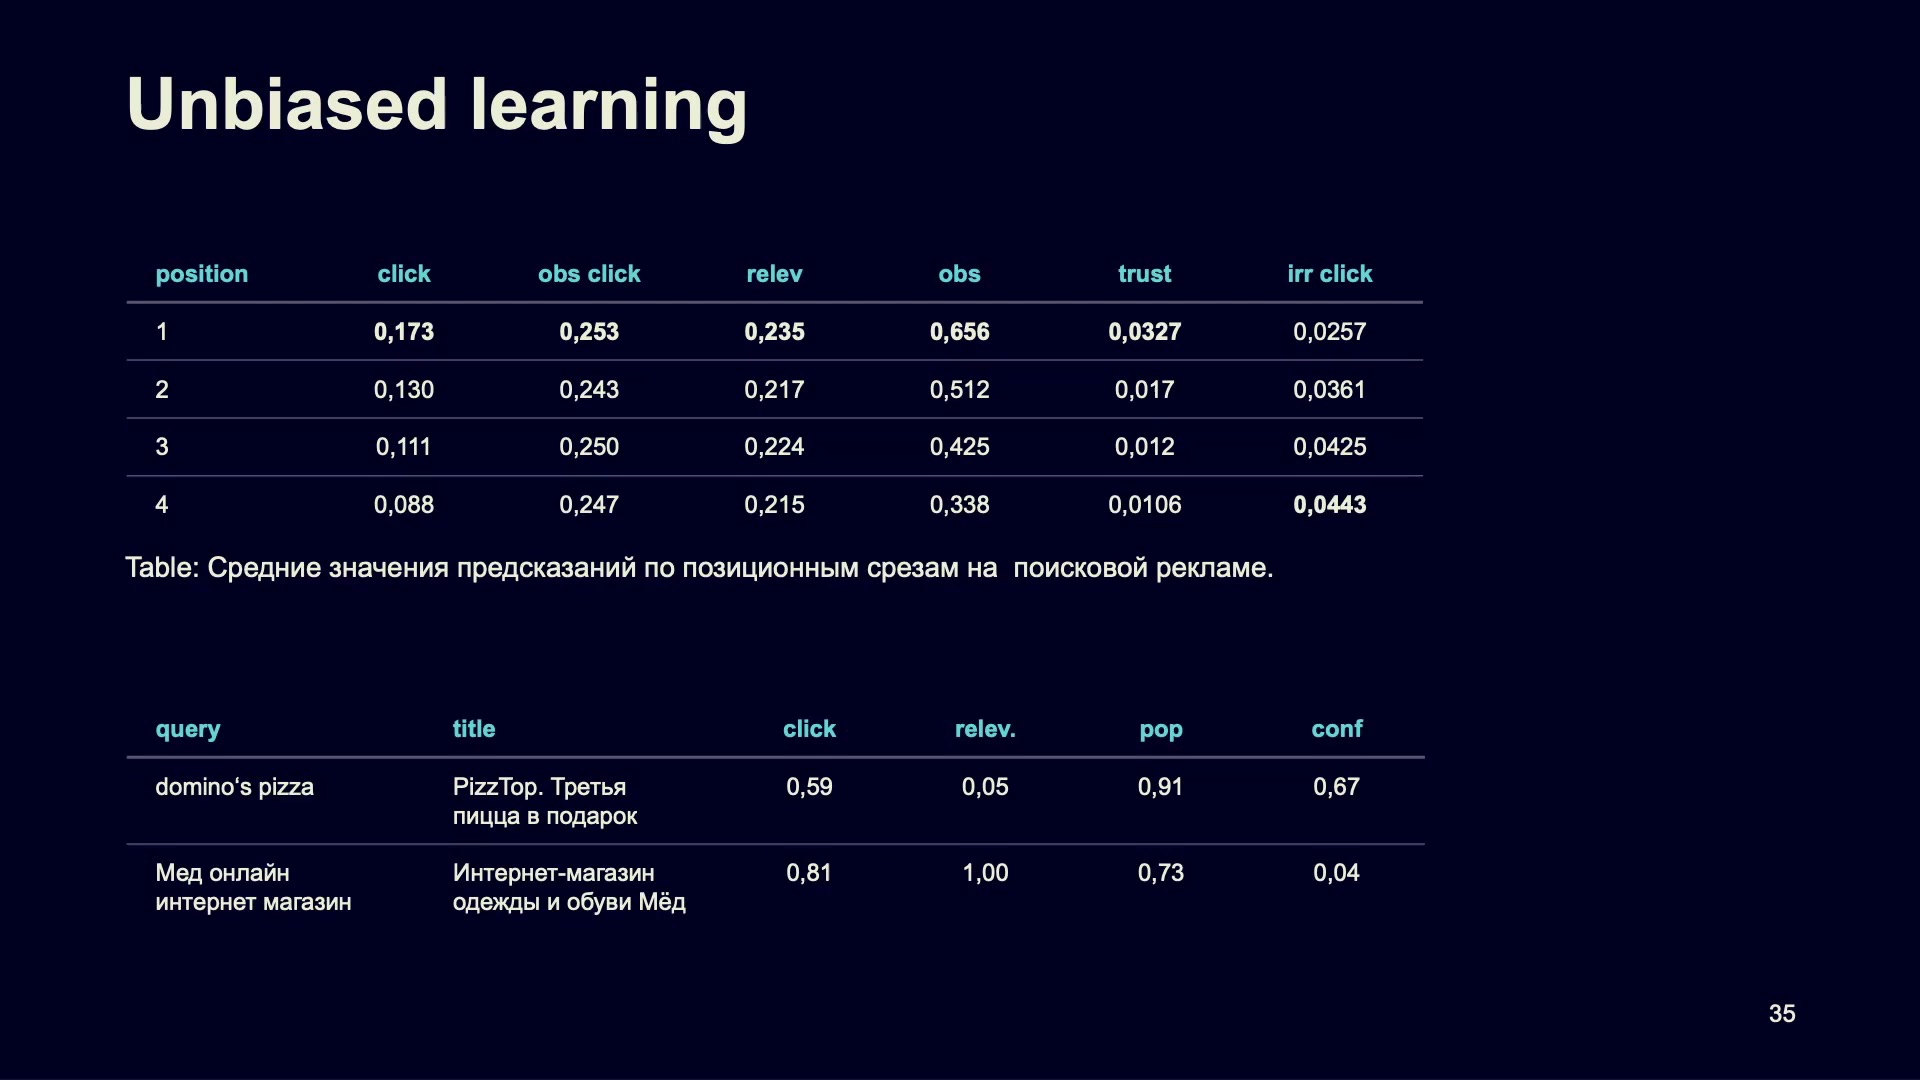
Предсказания компонентов модели по позициям и два запроса; это не измеренный CTR каждого места.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Два похожих прогноза клика и разные объяснения
Нижняя часть того же слайда сравнивает две пары «запрос — рекламный баннер». В обеих модель предсказывает достаточно высокую вероятность клика, но её внутренние составляющие сильно различаются. Это наглядный пример того, зачем не сводить всю полезность объекта к одной кликовой вероятности.
Таблицу можно прокрутить по горизонтали.
Для запроса domino’s pizza показан другой рекламный заголовок с акцией: «PizzTop. Третья пицца в подарок». Прогноз клика равен 0,59, но компонент релевантности — только 0,05. Высокие значения популярности 0,91 и склонности пользователя 0,67 автор связывает с привлекательностью предложения. С его точки зрения, баннер мог заинтересовать акцией, хотя не совпадал с исходным запросом.
Во втором случае человек ищет интернет-магазин «Мёд», и баннер предлагает именно магазин одежды и обуви с таким названием. Прогноз клика 0,81 сопровождается релевантностью 1,00, популярностью 0,73 и небольшой склонностью к популярному 0,04. Автор трактует это как соответствие запросу, а не прежде всего как реакцию на привлекательную, но постороннюю акцию.
Значение 1,00 остаётся выходом модели и не означает доказанную абсолютную релевантность. Так же низкая релевантность первого баннера не является внешней экспертной разметкой. Польза примеров в том, что одна декомпозиция позволяет содержательно сравнить два прогноза; истинность объяснения каждого отдельного действия по этим числам не установлена.
Доклад · 00:39:05Шесть выводов из пройденных экспериментов
В финале автор связывает архитектурные изменения, обучение и работу с данными в несколько выводов. Их объединяет не идея заменить любую сложную модель маленькой, а последовательное выяснение, какая часть сложности действительно нужна задаче. Тяжёлое взаимодействие можно переносить или убирать лишь тогда, когда представления и способ обучения позволяют вернуть потерянный эффект.
Таблицу можно прокрутить по горизонтали.
Формулировки об ускорении в десятки и сотни раз относятся к описанному опыту. Сводная таблица уже показала, что речь о разных версиях сервисов, а не об одном полном аппаратном испытании. Аналогично увеличение прироста в 1,5–2 раза за счёт длинной истории не означает увеличение самой бизнес-метрики во столько же раз.
Особенно важно сохранить неудачные шаги между удачными. Без них легко сделать неправильный вывод, будто достаточно вынести кандидата в простую полносвязную сеть. На практике именно такой вариант не вернул качество. Помогли более подходящее остаточное преобразование, несколько пользовательских состояний и дополнительный сигнал предварительного обучения.
С кликами логика иная: там команда не только меняет вычислительную форму, но и задаёт предположения о наблюдаемом поведении. Это позволяет получать более интерпретируемые составляющие. Однако сами предположения остаются частью модели, а прирост метрики не превращает их в доказанный полный перечень причин каждого клика.
Слайд 36 · 00:41:00. Архитектура уменьшает повторную работу, обучение возвращает эффект, длинная история добавляет сигнал, а декомпозиция клика меняет его интерпретацию. Эти результаты связаны общей задачей, но не имеют одного суммируемого процента.
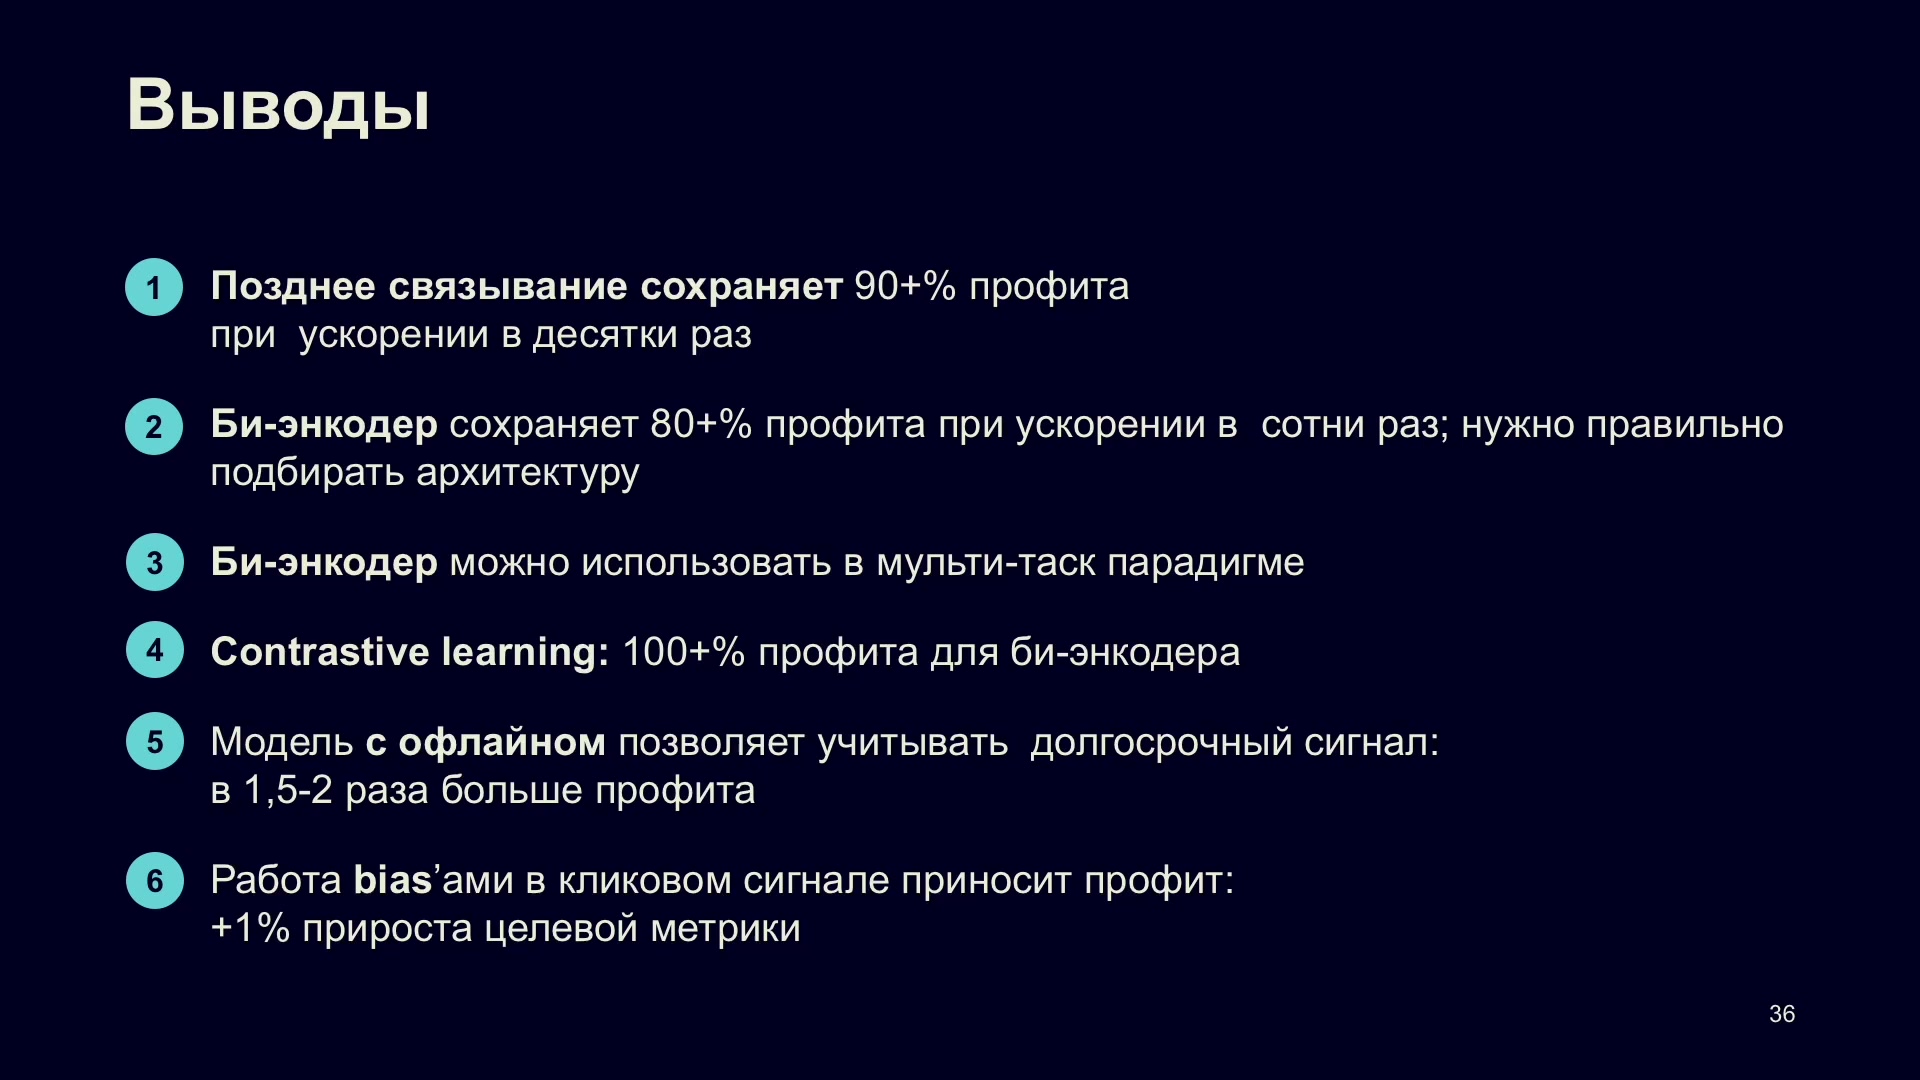
Итоговые авторские сравнения: сохранённый прирост и скорость относятся к указанным конфигурациям.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Попарное обучение и дистилляция: дополнительные наблюдения
Последние замечания выходят за пределы подробно разобранных экспериментов. Первое касается обучения упорядочивать пары кандидатов. Вместо отдельного предсказания для каждого примера модель учится отдавать предпочтение одному объекту пары перед другим. Автор обращает внимание на случай, когда нейросеть лишь создаёт признаки, а окончательный порядок строит градиентный бустинг.
Если итоговый бустинг сам обучается попарному ранжированию, аналогичная задача для нейросети может лучше согласовать её признаки с последующим использованием. На слайде указан результат +3% целевой метрики в ранжирующем CatBoost. Название метрики, подробные условия и протокол этого сравнения не приводятся; это отдельный результат, не добавка к процентам архитектурной таблицы или длинной истории.
Второе замечание — дистилляция, то есть передача поведения одной модели другой при обучении. Для двухбашенных трансформерных моделей персонализации автор говорит о возможности сжаться примерно вдвое почти без потери прироста. Выражение «почти бесплатно» здесь описывает выгодный компромисс, а не нулевую стоимость обучения, оборудования или эксплуатации.
В докладе не уточняется, что именно измерялось при двукратном сжатии: число параметров, размер сохранённой модели, память или иной объём. Поэтому нельзя автоматически заменить эту формулировку двукратным ускорением. Сам рецепт дистилляции, размеры учителя и ученика и отдельная численная оценка остаточной потери не раскрыты.
В самом конце автор добавляет многозадачный случай с разным покрытием целей. Для одной целевой величины наблюдений много, для другой мало; дистилляция на разных срезах может приносить эффект по отдельным задачам. Подробности остаются за рамками выступления. Запись заканчивается благодарностью в 00:43:03, без последующего содержательного обсуждения вопросов.
Слайд 37 · 00:42:30. Попарная задача полезна, когда нейросетевые признаки идут в ранжирующий CatBoost. Дистилляция описана как способ примерно двукратного сжатия с малой потерей эффекта, но без точной метрики сжатия и полного рецепта.
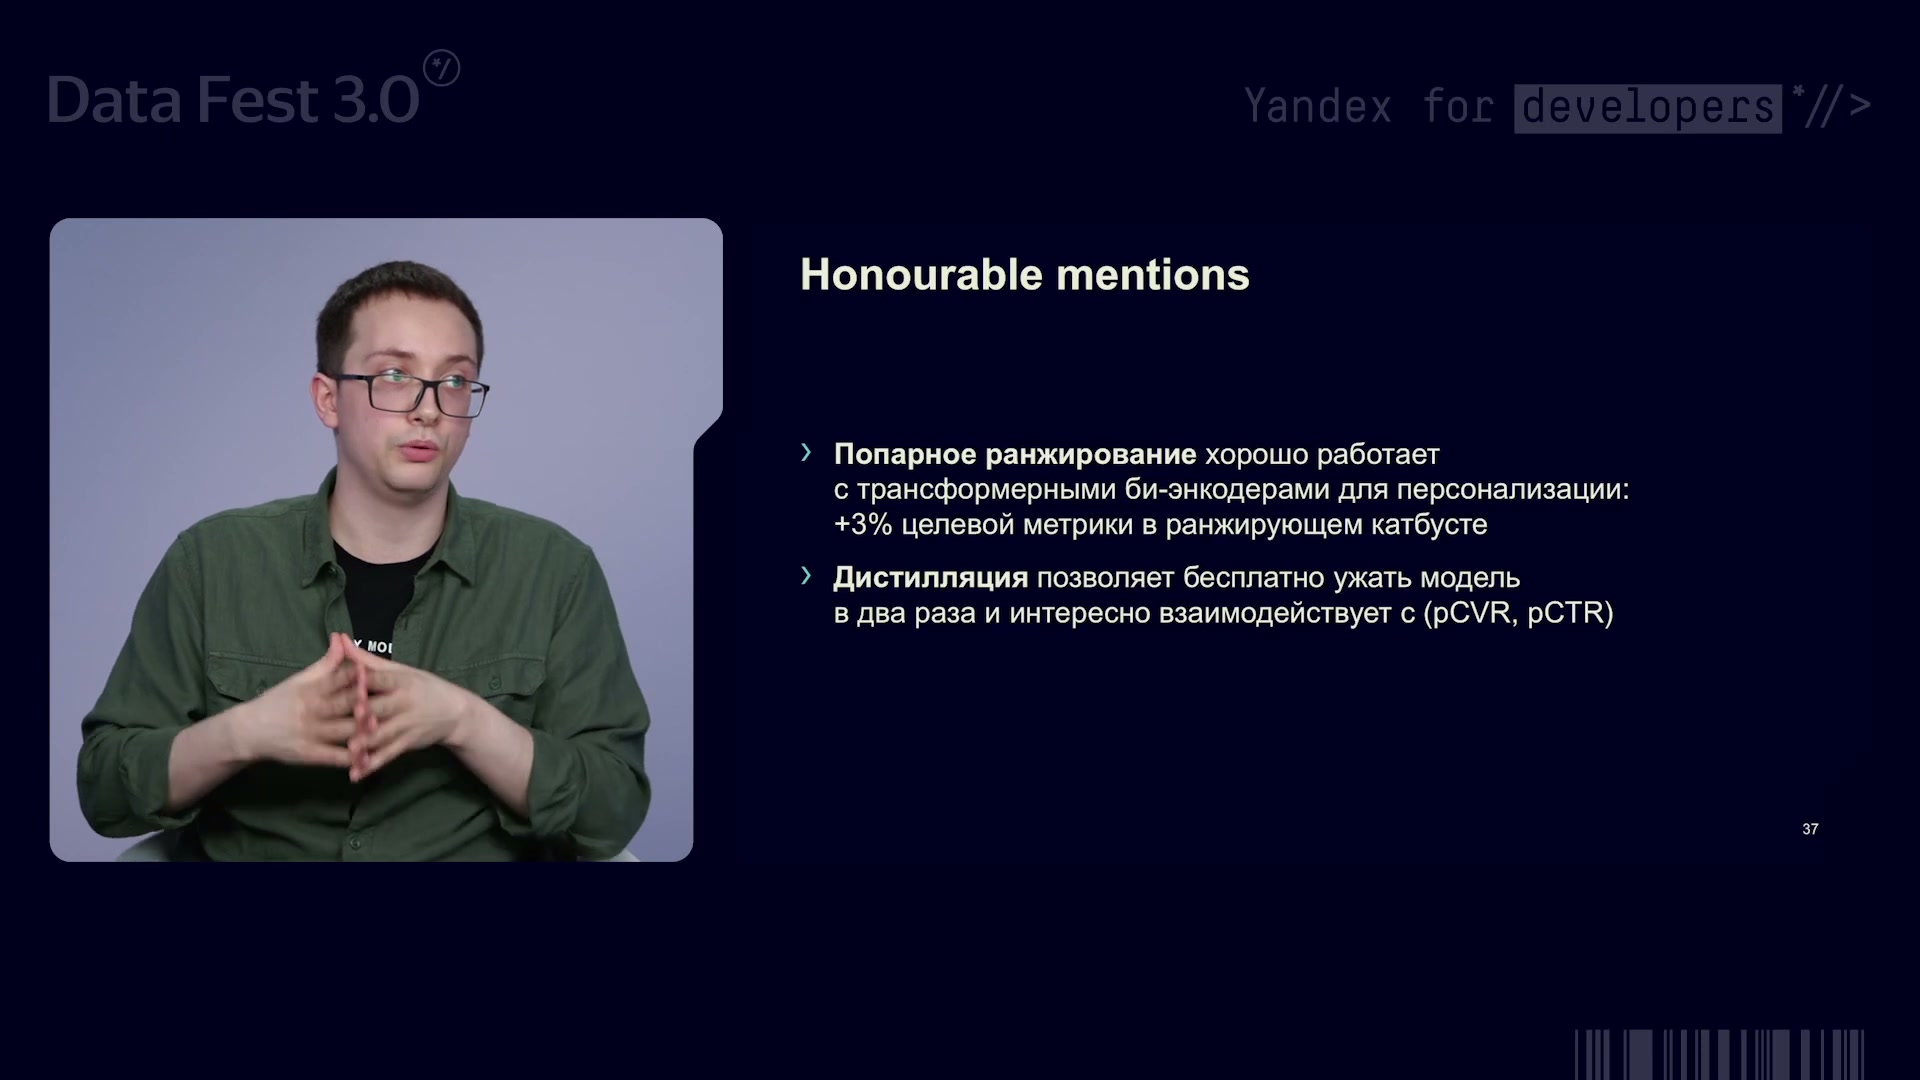
Дополнительные результаты: попарное обучение и дистилляция; общие численные условия не раскрыты.
Источник: Кирилл Хрыльченко · DataFest 3.0, 2022Итог: что остаётся на запросе и что удалось сохранить
Команда прошла путь от совместного анализа истории и каждого кандидата к раздельным башням. Наивное упрощение теряло половину прироста; остаточная кандидатная сеть, несколько интересов и контрастивное предварительное обучение помогли вернуть эффект. Следующий шаг разделил давнюю и свежую историю, сохранив актуальность пользовательского представления без полного пересчёта прошлого на каждом запросе.
В варианте с длинной историей отдельный трансформер заранее сжимает давние события, а кандидатная ResNet заранее готовит представления объектов. Результаты хранятся в KV. Обучение выполняется отдельно и эмулирует задержку длинных состояний. Во время запроса модель работает так:
- 01
Контекст и свежая история
Система получает текущий запрос или контекст страницы и небольшой фрагмент недавних действий пользователя.
- 02
Долгие состояния из KV
Из хранилища извлекаются готовые состояния давней истории; длинный трансформер сейчас не запускается.
- 03
Текущий трансформер
Контекст, свежие события, долгие состояния и группы CLS совместно формируют актуальные пользовательские представления.
- 04
Готовые векторы кандидатов
По объектам извлекаются из KV представления, ранее рассчитанные кандидатной ResNet.
- 05
Отдельные CTR- и CVR-ветви
Для каждой цели вычисляются скалярные произведения её состояний с кандидатными векторами, затем сигмоиды и среднее.
- 06
Оценки для ранжирования
Прогнозы передаются дальнейшему рекламному выбору и ранжированию; полной формулы аукциона доклад не задаёт.
Архитектурная сводка показывает 100+% исходного прироста после предварительного обучения. В сравнении длинной истории сохранено около 96% прироста при примерно восьмикратном сокращении вычислений на запросе. Это не точность и не экономия всей инфраструктуры; замеры относятся к описанным конфигурациям.
Отдельная декомпозиция клика дала +1% неназванной целевой метрики, но не доказала истинность всех причинных объяснений. Разные эксперименты не складываются в один процент или единое внедрение. Сильная сторона доклада — проверяемый путь архитектурных решений; пределы задают нераскрытые протоколы, параметры и идентифицируемость компонентов.
Доклад · 00:39:53