Разбор готов
Uber DeepETA: нейросетевая поправка к времени поездки
В Uber оценка времени прибытия нужна не только для интерфейса поездки: от ETA зависят расчёт тарифа, время подачи, сопоставление водителя и пассажира и доставка. Маршрутный движок умеет найти путь по дорожному графу и сложить времена прохождения сегментов, но такой граф не полностью отражает реальные условия, а фактический маршрут заранее не всегда известен. Несколько лет Uber исправлял базовый прогноз большими ансамблями XGBoost, однако по мере роста данных и модели этот путь стало трудно масштабировать. В DeepETA команда сохранила маршрутизацию как физическую основу, а поверх неё поставила глубокую модель, которая предсказывает поправку к ETA. Разберём, почему выбрали такую гибридную схему, как табличные и географические признаки превращаются в эмбеддинги, зачем механизм внимания сделали линейным, как модель учитывает разные сегменты поездок и как она обучается и обслуживает онлайн-запросы.
Глава полезна ML-инженерам и специалистам по табличным моделям, которым важно совместить качество нейросети с очень жёсткой задержкой ответа. Особенно полезны разделы про геопризнаки, разреженное обращение к большим таблицам эмбеддингов и разделение маршрутизации и ML-поправки.
Статья · на английском
DeepETA: How Uber Predicts Arrival Times Using Deep LearningTanmay Binaykiya, Xinyu Hu, Olcay Cirit, Ramit Hora · Опубликовано: 10 февраля 2022 г.
Почему понадобилась новая модель
Традиционный маршрутный движок представляет дорожную сеть графом: дороги разбиваются на небольшие сегменты, каждому ребру назначается вес, затем алгоритм кратчайшего пути выбирает маршрут и суммирует времена прохождения. Но дорожный граф остаётся моделью мира: он не может полностью учесть происходящее на дороге, а система заранее не всегда знает, какой путь реально выберут водитель и пассажир.
Поэтому Uber уже несколько лет использовал машинное обучение поверх прогноза маршрутизатора. До DeepETA эту роль выполняли ансамбли градиентного бустинга XGBoost. Датасет и сама модель росли от релиза к релизу; команда даже вносила изменения в XGBoost, чтобы поддерживать всё более глубокие модели. В какой-то момент дальнейшее увеличение модели и данных стало непрактичным, и команда обратилась к глубокому обучению, которое проще масштабировать на большие выборки через параллельный по данным стохастический градиентный спуск, data-parallel SGD.
Переход имел три условия. Во-первых, модель должна была укладываться максимум в несколько миллисекунд — это именно требование к задержке, а не опубликованное измерение DeepETA. Во-вторых, средняя абсолютная ошибка, MAE, должна была заметно улучшиться относительно действующего XGBoost. В-третьих, архитектуру хотели сделать общей для разных линий бизнеса Uber по всему миру.
DeepETA: How Uber Predicts Arrival Times Using Deep Learning — opening paragraphsМаршрутизация остаётся основой
DeepETA не строит маршрут вместо маршрутизатора. Физическая часть системы по карте и измерениям трафика оценивает лучший путь и получает базовый ETA как сумму времени прохождения его сегментов. Нейросеть решает более узкую задачу: предсказывает остаточную ошибку, или residual, между этим базовым ETA и реально наблюдаемым временем.
Авторы называют такую схему постобработкой ETA, ETA post-processing. Практическое преимущество разделения в том, что новые источники данных и быстро меняющиеся продуктовые требования можно добавлять в модель-поправку, не перестраивая сам маршрутный движок. На вход модели поступают пространственные и временные признаки — например, точка отправления, назначение и время запроса, — а также сведения о текущем трафике и типе запроса, например доставка или поездка.
Эта модель постобработки названа в статье моделью Uber с самым высоким QPS, то есть числом запросов в секунду, но численное значение QPS не приведено. Качество требуется улучшать по MAE для разных сегментов данных, сохраняя очень малую добавочную задержку.
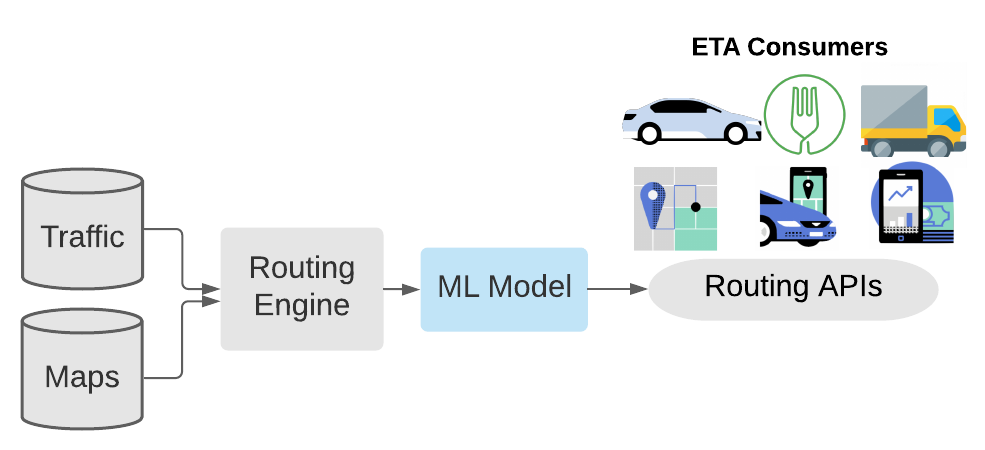
Маршрутный движок оценивает время по физическим данным, а DeepETA предсказывает ошибку базового прогноза.
Источник: Uber Engineering · DeepETAСемь архитектур и выбор направления
Команда протестировала и настраивала семь нейросетевых архитектур: MLP, NODE, TabNet, Sparsely Gated Mixture-of-Experts, HyperNetworks, Transformer и Linear Transformer. Статья не публикует для каждого варианта отдельные значения MAE, задержки или размера модели, поэтому сравнить их по численным метрикам из этого источника нельзя.
Лучшей по точности оказалась архитектура «энкодер–декодер» с механизмом самовнимания (self-attention). Отдельно команда сравнивала способы кодирования признаков и получила заметный, но не выраженный числом выигрыш от дискретизации и перевода всех входов в эмбеддинги.
How We Made It AccurateМеханизм самовнимания связывает табличные признаки
В языковой модели механизм самовнимания (self-attention) связывает токены последовательности. В DeepETA роль элементов последовательности играют признаки таблицы: например, начало поездки, конец поездки или время суток. Для K признаков обычный механизм самовнимания явно вычисляет попарные взаимодействия в матрице K × K, а затем использует нормированные веса, чтобы пересчитать представление каждого признака с учётом остальных.
Так модель может менять важность одного признака в зависимости от сочетания времени, координат, дорожной ситуации и других входов. Позиционное кодирование здесь не используется: в отличие от слов в тексте, порядок признаков не должен нести самостоятельный смысл.
На иллюстрации механизма внимания в исходной статье показаны восемь голов, но доли цветов соответствуют случайно сгенерированным весам. Поэтому рисунок демонстрирует механику многоголового внимания, а не измеренные зависимости в реальных поездках.
Encoder with Self-AttentionНепрерывные признаки сначала разбиваются на интервалы
Категориальные признаки DeepETA сразу переводит в обучаемые векторные представления — эмбеддинги. Непрерывные признаки сначала разбиваются на интервалы, то есть выполняется bucketization, и уже номер интервала превращается в эмбеддинг. По экспериментам команды такой вариант оказался точнее прямой подачи непрерывных значений.
Авторы объясняют это тем, что после предварительного разбиения модели не приходится тратить часть параметров на самостоятельное разделение входного пространства. Это интерпретация авторов, а не отдельное измерение стоимости параметров.
Для границ интервалов сравнивались равные по ширине корзины и квантильные корзины. Квантильный вариант оказался точнее. Авторы предполагают, что причина связана с энтропией: при фиксированном числе корзин квантильное разбиение передаёт больше информации об исходном значении, чем другие схемы разбиения. Число корзин и величина выигрыша в статье не указаны.
Feature Encoding > Continuous and Categorical FeaturesГеокодирование: несколько масштабов и независимые хеши
Координаты начала и конца поездки особенно важны для ETA, поэтому их кодируют отдельно от обычных непрерывных признаков. Географические данные распределены по миру неравномерно и содержат полезную информацию на разных масштабах. DeepETA накладывает на широту и долготу несколько сеток разного разрешения. При увеличении разрешения число возможных ячеек растёт экспоненциально, а средний объём данных внутри одной ячейки пропорционально уменьшается.
Команда сравнила три способа связать ячейку сетки с эмбеддингом. Точная индексация, exact indexing, выделяет каждой ячейке собственную строку таблицы и требует больше всего памяти. Хеширование признаков, feature hashing, отображает множество ячеек в меньший набор корзин одной хеш-функцией и экономит память, но создаёт коллизии. Множественное хеширование признаков, multiple feature hashing, отправляет одну ячейку сразу в несколько компактных диапазонов с помощью независимых хеш-функций.
Обычный feature hashing давал ту же или немного худшую точность, чем точная индексация, в зависимости от разрешения сетки. Multiple feature hashing показал лучшую точность и задержку, сохранив экономию памяти относительно exact indexing. Авторы связывают это с тем, что сеть может объединять несколько независимых хеш-представлений и тем самым уменьшать ущерб от одиночных коллизий.
На схеме показаны две функции h1 и h2 как иллюстрация метода. Точное число хеш-функций, сеток и корзин в рабочей конфигурации статья не указывает.
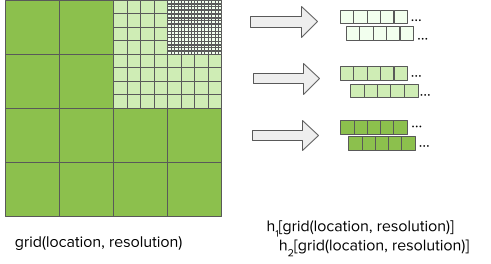
Координаты кодируются на нескольких масштабах; независимые хеши сокращают таблицы представлений и уменьшают последствия коллизий.
Источник: Uber Engineering · DeepETAЛинейный механизм внимания убирает квадратичную матрицу
Механизм самовнимания дал нужную точность, но исходный Transformer оказался слишком медленным для онлайн-обслуживания с требованием ответа максимум за несколько миллисекунд. В этом разделе статьи авторы рассматривают архитектурное ускорение, отдельно от специализированного оборудования и оптимизаций после обучения.
Обычный механизм внимания строит матрицу всех пар между K входами. Команда изучила линейные варианты, среди них Linear Transformer, Linformer и Performer, и после экспериментов выбрала Linear Transformer. Он использует ядровое преобразование (kernel trick) и позволяет избежать явного вычисления полной матрицы внимания.
Иллюстративный расчёт из статьи: если K = 40 признаков и размерность каждого представления d = 8, то K²d = 12 800, а Kd² = 2 560. Эти значения K и d нужны только для объяснения разницы между сложностью O(K²d) у исходного Transformer и O(Kd²) у Linear Transformer; статья не утверждает, что это конфигурация рабочей модели. В таком сравнении линейный вариант быстрее, когда K больше d.
How We Made It Fast > Fast TransformerБольшая модель вычисляет только малую часть параметров
Ещё одно решение для скорости — сделать сеть относительно неглубокой и вынести подавляющую часть параметров в таблицы эмбеддингов. В статье говорится о сотнях миллионов параметров, но один прогноз затрагивает лишь примерно 0,25% из них. Это доля параметров, к которым обращается конкретный запрос, а не доля «активных нейронов» и не процент ускорения.
После дискретизации модель читает только нужные строки таблиц и не вычисляет остальные параметры. Для географического признака координаты сначала квантуются, затем нужная запись находится хеш-поиском. В асимптотическом сравнении авторов такой поиск занимает O(1), поиск в древовидной структуре — O(log N), а использование полносвязных слоёв для того же отображения в приведённом сравнении — O(N²).
Авторы описывают это как обмен памяти на время: во время обучения модель заранее формирует большие таблицы представлений, а во время запроса быстро извлекает лишь небольшую их часть. Источник не приводит точное число параметров, размер таблиц или фактическую задержку каждого варианта.
More Embeddings, Fewer LayersОдна архитектура для разных типов запросов
Проектная цель DeepETA — общая ETA-модель для разных линий бизнеса Uber и регионов, несмотря на различия в распределениях данных и требованиях. Это цель архитектуры; подтверждённый в заключении запуск уже и относится к оценке времени прибытия для четырёхколёсного транспорта по всему миру.
Общая схема связывает предыдущие решения в один поток. Непрерывные признаки квантуются и вместе с дискретными признаками превращаются в эмбеддинги, затем представления объединяются и проходят через Linear Transformer. После полносвязного слоя декодер учитывает тип сегмента, а результат модели остаётся поправкой к исходному ETA маршрутизатора, а не независимым временем поездки.
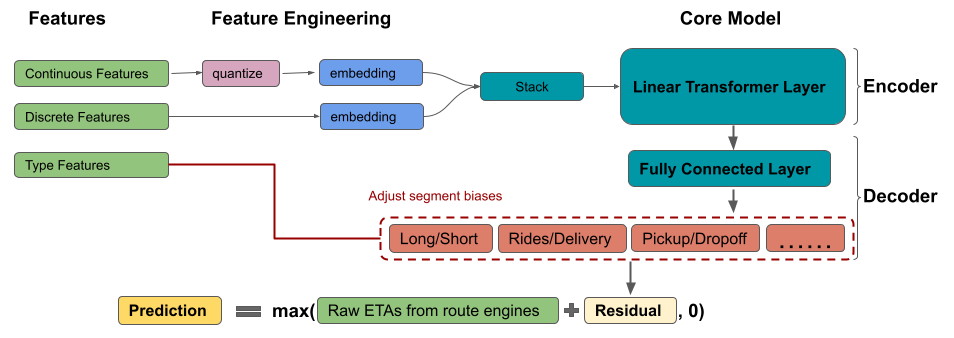
Общая схема DeepETA. Внимание связывает признаки поездки, а декодер учитывает различия между сегментами запросов.
Источник: Uber Engineering · DeepETAСегментный декодер корректирует систематические различия
После энкодера DeepETA использует полносвязный декодер с отдельным слоем корректировки смещения для сегментов. Мотивация в том, что распределение абсолютных ошибок заметно различается между доставками и поездками, короткими и длинными маршрутами, посадкой и высадкой, а также между крупными регионами.
Вместо того чтобы только добавить идентификатор сегмента как ещё один признак, модель отдельно корректирует сырой прогноз для соответствующей группы. По словам авторов, такая корректировка смещения, bias adjustment, работает лучше простого добавления сегментных признаков. От многозадачного декодера команда отказалась из-за ограничений по задержке.
На выходе также применяется ReLU, чтобы предсказанное ETA оставалось положительным, и ограничение экстремальных значений, clamping, чтобы уменьшить их влияние. Размер декодера, список всех сегментов и пороги clamping в статье не раскрыты.
Bias Adjustment DecoderАсимметричная Huber loss подстраивается под бизнес-цель
Одинаковая точечная оценка ETA подходит не всем потребителям. Для расчёта тарифа, например, нужен прогноз, близкий к среднему времени, но устойчивый к выбросам; в других сценариях может понадобиться определённый квантиль распределения. Поэтому DeepETA использует параметризованную асимметричную функцию потерь Huber — asymmetric Huber loss.
В статье названы два управляющих параметра. Delta задаёт степень устойчивости к выбросам: изменяя его, можно плавно переходить между поведением квадратичной и абсолютной ошибки, причём абсолютная ошибка менее чувствительна к выбросам. Omega задаёт асимметрию, то есть относительную цену недооценки и переоценки времени.
Пример из статьи: в некотором сценарии опоздать на минуту может быть хуже, чем приехать на минуту раньше. Тогда штраф за недооценку ETA можно сделать выше, чем за переоценку. За счёт delta и omega одна семья функций потерь может поддерживать разные типы точечных оценок и разные бизнес-цели.
Asymmetric Huber LossОбучение и развёртывание через Canvas и Michelangelo
Для обучения и выпуска DeepETA команда использовала Canvas — фреймворк внутри ML-платформы Uber Michelangelo. После обучения модель разворачивается в Michelangelo, откуда становится доступна для онлайн-предсказаний.
Отдельно настроены периодические автоматические процессы переобучения и проверки модели. Статья не сообщает их частоту, размер обучающей выборки, конфигурацию вычислительных ресурсов или точную схему разделения данных на обучение и проверку.
Обучение и проверка качества происходят вне последовательности обработки отдельного пользовательского запроса. В самой статье основным критерием точности назван MAE относительно действующего XGBoost, а для отдельных архитектур и приёмов приводятся только качественные выводы — без таблицы абсолютных MAE и без точного процента улучшения.
How We Train and Serve the ModelКак DeepETA обслуживает онлайн-запрос
Во время пользовательского запроса центральным входом в маршрутизацию служит uRoute. Он является фронтендом для запросов к маршрутизации: получает запрос от сервисов Uber, обращается к маршрутизатору за линией маршрута и базовым ETA, затем использует этот ETA вместе с другими признаками для запроса к Michelangelo Online Prediction Service.
- 01
Запрос приходит в uRoute
Продуктовые сервисы Uber передают запрос на маршрутизацию в uRoute.
- 02
Routing Engine строит базу
Маршрутизатор возвращает линию маршрута и исходный ETA.
- 03
uRoute собирает признаки
Базовый ETA объединяется с другими признаками, необходимыми DeepETA.
- 04
Michelangelo применяет DeepETA
Онлайн-сервис прогнозирования вычисляет ML-поправку к базовой оценке.
- 05
ETA уточняется
Поправка используется вместе с исходным ETA, чтобы получить итоговый прогноз для потребителя.
Схема показывает разделение ответственности: Routing Engine отвечает за маршрут и физический базовый прогноз, Michelangelo — за применение модели, а uRoute связывает их в одном запросе. Статья не публикует p50, p95 или p99 задержки этой цепочки.
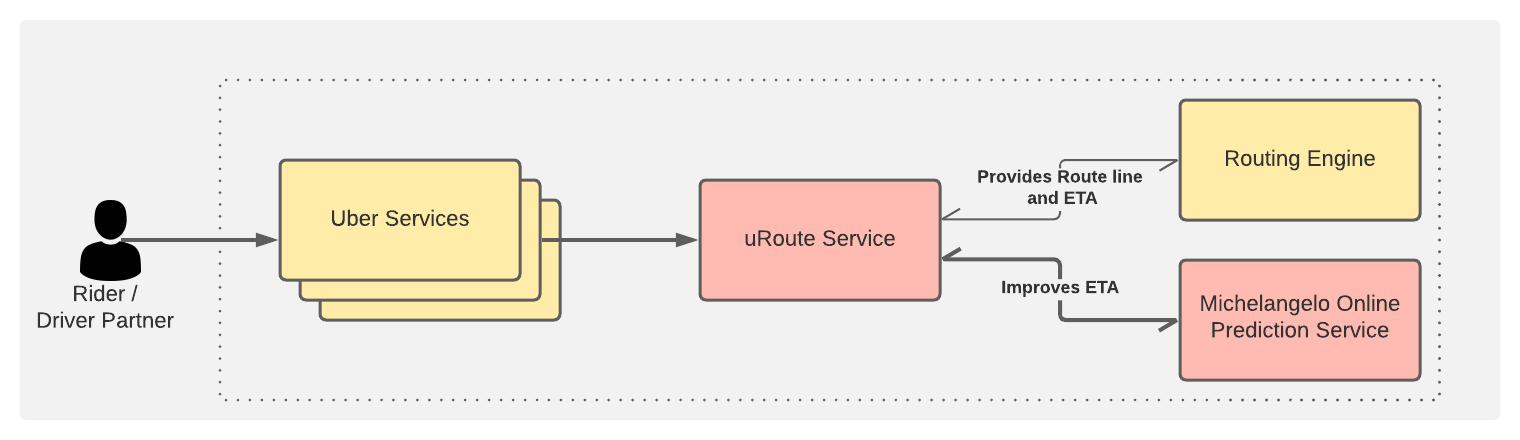
В рабочем запросе uRoute получает маршрут и базовое время, затем вызывает DeepETA через Michelangelo Online.
Источник: Uber Engineering · DeepETAИтог: маршрутизатор остаётся базой, DeepETA исправляет ETA
DeepETA выросла из практического ограничения: маршрутизатор хорошо задаёт структуру пути, но не полностью отражает реальные условия, а всё более крупный XGBoost стало трудно масштабировать вместе с данными. Uber сохранил физический прогноз маршрута и перенёс его уточнение в глубокую модель. Табличные признаки дискретизируются и превращаются в эмбеддинги, географические координаты кодируются несколькими сетками и независимыми хешами, а взаимодействия признаков обрабатывает Linear Transformer. Большая часть параметров хранится в таблицах, поэтому один прогноз затрагивает лишь около 0,25% параметров.
- 01
Запрос приходит в uRoute
Продуктовые сервисы передают запрос на маршрутизацию в uRoute.
- 02
Routing Engine строит маршрут
Маршрутизатор возвращает линию маршрута и базовый ETA.
- 03
uRoute собирает признаки
Базовый ETA объединяется с остальными входами DeepETA.
- 04
Michelangelo применяет модель
Онлайн-сервис вычисляет остаточную поправку к ETA.
- 05
Итоговый ETA уточняется
Поправка добавляется к базовому прогнозу маршрутизатора.
Обучение и оценка находятся вне последовательности обработки отдельного онлайн-запроса. Модель обучают и разворачивают через Canvas и Michelangelo; периодические процессы автоматически переобучают и валидируют её. Главный заявленный критерий качества — MAE относительно действующего XGBoost. Статья описывает направления улучшений, но не публикует абсолютный MAE, точный процент прироста или отдельный дизайн A/B-теста.
Авторы сообщают о запуске DeepETA в рабочей системе для оценки времени прибытия четырёхколёсного транспорта по всему миру и об улучшении производственных метрик без численной величины эффекта. Это не подтверждает запуск для всех линий бизнеса Uber. Архитектура рассматривается как основа для нескольких вариантов ETA под разных потребителей. Дальнейшая работа включает данные, признаки, преобразования, архитектуры, обучение, функции потерь и инфраструктуру; отдельно упомянуто непрерывное инкрементальное обучение на более свежих данных.
Problem Statement; How We Train and Serve the Model; Conclusions and Future Work