Разбор готов
YouTube 2016: от миллионов видео к сотням кандидатов и ранжированию по времени просмотра
В огромном видеокаталоге нельзя для каждого запроса прогнать тяжёлую модель по всем роликам: даже хороший алгоритм становится бесполезным, если не укладывается в задержку выдачи. Но одного быстрого отбора тоже мало. Клик ещё не означает, что рекомендация оказалась полезной: пользователь может открыть ролик по привлекательной обложке и почти сразу уйти. В статье Google 2016 года эти проблемы разделены на два этапа. Сначала нейросеть быстро сокращает миллионы видео до сотен кандидатов, затем отдельная модель подробно оценивает небольшой список и упорядочивает его по величине, связанной с ожидаемым временем просмотра. Это историческая промышленная система RecSys 2016, а не описание современного YouTube 2026.
Материал полезен тем, кто изучает многоэтапные рекомендательные системы и хочет понять, как связать обучение на огромном каталоге, быстрый поиск кандидатов, богатое ранжирование и живые A/B-тесты. Особенно полезны детали о выборе обучающей задачи и о том, почему офлайн-метрика не заменяет проверку в продукте.
Публикация · на английском
Deep Neural Networks for YouTube RecommendationsОткрыть оригинальную статью (PDF)Paul Covington, Jay Adams, Emre Sargin · Опубликовано: 15 сентября 2016 г.
Три сложности: масштаб, свежесть и шум
Работа описывает YouTube середины 2010-х. Авторы называют сервис одной из крупнейших промышленных рекомендательных систем, пишут более чем о миллиарде пользователей и о постоянно растущем каталоге. В той системе модели имели примерно миллиард параметров и обучались на сотнях миллиардов примеров с использованием инфраструктуры Google Brain и TensorFlow. Эти сведения задают исторический масштаб статьи; они не описывают архитектуру, модели или инфраструктуру YouTube в 2026 году.
Первое ограничение — масштаб. Алгоритм должен работать не на небольшом экспериментальном каталоге, а на огромном числе пользователей и видео, поэтому важны и распределённое обучение, и дешёвое применение модели. Второе — свежесть. Новые ролики появляются непрерывно, а интерес пользователя меняется после последних действий. Система должна подхватывать новое, не теряя релевантность уже известного контента; авторы связывают это с компромиссом между исследованием нового и использованием уже надёжных вариантов.
Третье ограничение — шум. История просмотров разрежена, на поведение влияют внешние факторы, которые модель не наблюдает, а точной метки удовлетворённости почти нет. Поэтому система учится в основном на неявной обратной связи. Дополнительную сложность создают плохо структурированные метаданные без единой аккуратной онтологии. В начале статьи авторы также помещают работу в контекст матричного разложения и ранних нейросетевых рекомендателей; это исторический фон, а не отдельное сравнение всех этих методов на одном эксперименте.
Статья · стр. 1–2 — ABSTRACT; раздел 1 INTRODUCTIONПочему систему разделили на отбор кандидатов и ранжирование
Одна тяжёлая модель не может подробно оценивать каждый ролик из миллионного каталога за один пользовательский запрос. Поэтому система устроена как воронка. На первом этапе отбор кандидатов (candidate generation) использует историю YouTube и контекст пользователя, чтобы сократить миллионы видео до нескольких сотен в целом подходящих. Это грубая персонализация: сходство пользователей выражается через такие сигналы, как ID просмотренных видео, токены поисковых запросов и демографические признаки.
На втором этапе ранжирование получает уже небольшой набор и может позволить себе гораздо более богатое описание пользователя, ролика и их отношений. Оно присваивает каждому кандидату оценку по выбранной цели и оставляет несколько десятков лучших. В эту же точку могут поступать кандидаты из других источников, поэтому ранжирование одновременно приводит разнородные источники к одной сопоставимой шкале.
Предшественником нейросетевого отбора была модель матричного разложения, обученная с функцией потерь для ранжирования. Первые DNN-версии были неглубокими и использовали только векторы предыдущих просмотров, то есть ещё были близки к факторизации. Авторы рассматривают последующую сеть как её нелинейное обобщение: к истории можно добавить разнородные признаки и моделировать их взаимодействия скрытыми слоями.
При разработке команда активно смотрела на офлайн-метрики — точность, полноту и ошибку ранжирования (precision, recall, ranking loss). Но окончательную эффективность изменения определяли живыми A/B-тестами по кликам, времени просмотра и другим метрикам вовлечённости. Авторы специально предупреждают: улучшение офлайн не всегда совпадает с улучшением онлайн. Численного бизнес-прироста для всей системы в статье нет.
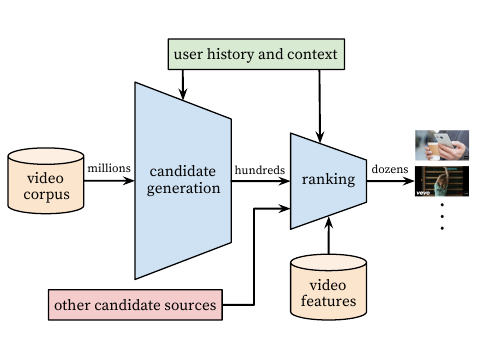
Архитектура YouTube 2016: миллионы видео → сотни кандидатов → десятки рекомендаций. Ранжирование использует также другие источники кандидатов. PDF, страница 2.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 2Отбор кандидатов как классификация среди миллионов видео
Первый этап авторы формулируют как экстремальную многоклассовую классификацию: классов не десятки и не тысячи, а миллионы видео. Для пользователя U и контекста C сеть строит плотный вектор u. Каждому видео i соответствует плотный вектор v_i. Чем больше их скалярное произведение, тем выше модель ставит это видео.
V — множество видео-классов, u — представление пользователя и контекста, v_i — представление видео. Полный softmax задаёт учебную постановку; при выдаче его по миллионам классов не вычисляют.
В качестве положительного сигнала используются просмотры. В исходном тексте это сформулировано как «user completing a video is a positive example». Статья не задаёт здесь порог длительности или правило «досмотрено ровно 100%», поэтому такое уточнение добавлять нельзя. Мотивация в другом: неявных просмотров на порядки больше, чем лайков, дизлайков и ответов на опросы, и на них можно учиться даже для длинного хвоста каталога.
Полный softmax по миллионам видео слишком дорог для обучения. Поэтому для каждого примера выбирают отрицательные классы из фонового распределения и минимизируют кросс-энтропию только по правильному классу и этой выборке. Такой sampled softmax создаёт смещение, поэтому авторы вводят поправку на вероятность отбора отрицательных классов (importance weighting). На практике брали несколько тысяч отрицательных классов, что дало более чем 100-кратное ускорение обучения относительно традиционного полного softmax. Это число относится именно к обучению, а не к ускорению пользовательского запроса.
Альтернативой был hierarchical softmax, где путь к классу проходит через дерево промежуточных решений. Сопоставимой точности получить не удалось. Объяснение авторов: на внутренних узлах приходится различать группы видео, которые часто мало связаны между собой, и такая декомпозиция делает классификацию труднее.
При работе системы задача другая: нужны только N наиболее подходящих видео. Строго вычислять нормированные softmax-вероятности для миллионов классов не требуется. Оценка сводится к поиску больших скалярных произведений между u и векторами видео, поэтому используется приближённый поиск ближайших соседей (ANN). Авторы упоминают жёсткую задержку порядка десятков миллисекунд и пишут, что A/B-результаты не были особенно чувствительны к конкретному алгоритму такого поиска. Предыдущие системы YouTube использовали суб-линейный поиск на основе hashing; для описываемого классификатора точную структуру индекса статья не раскрывает.
Статья · стр. 2–3 — раздел 3.1 Recommendation as ClassificationКак из истории и контекста получается вектор пользователя
История просмотров имеет переменную длину, а полносвязной сети нужен вход фиксированного размера. Поэтому каждый ID видео сначала превращается в обучаемый вектор, после чего векторы истории агрегируются. Авторы сравнивали несколько простых способов, включая сумму и поэлементный максимум; лучше всего сработало обычное среднее. Эти представления не фиксированы заранее: они учатся совместно со всей сетью обратным распространением ошибки.
Поисковая история обрабатывается похоже. Запрос разбивается на униграммы и биграммы, у каждого токена есть обучаемый вектор, а затем токены усредняются в одно представление истории поиска. Так модель получает два компактных блока: что человек недавно смотрел и что искал.
К ним добавляются другие сигналы. Географический регион и устройство кодируются обучаемыми векторами. Простые бинарные и числовые признаки, например пол, состояние входа в аккаунт и возраст пользователя, подаются как значения, нормализованные в диапазон [0, 1]. Демографические признаки дают разумные начальные предположения там, где пользовательская история ещё бедна.
После объединения признаков идут несколько полностью связанных слоёв ReLU. На обучении верх сети связан с sampled softmax. При работе системы тот же выходной пользовательский вектор направляется в индекс ближайших видео и возвращает сотни кандидатов. Figure 3 важна именно этим разделением: softmax — часть учебной постановки, ANN-поиск — часть выдачи.
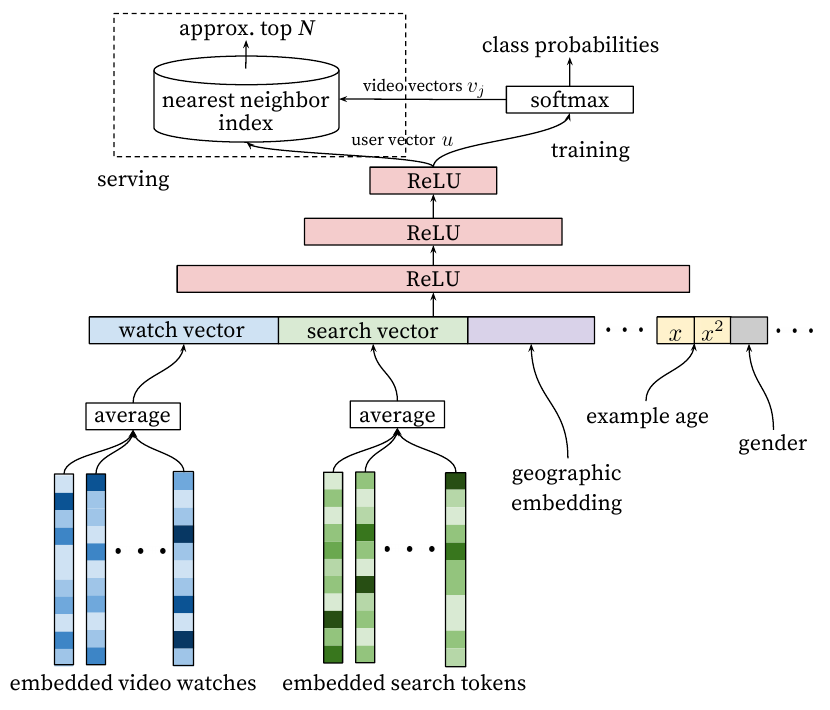
Отбор кандидатов: усреднённые векторы просмотров и поисковых токенов вместе с контекстом проходят полносвязные слои. Softmax — обучение; поиск ближайших векторов — применение. PDF, страница 4.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 4Свежесть и правильная обучающая задача важнее лишнего сигнала
Популярность видео меняется во времени, а модель учится на историческом окне длительностью в несколько недель. Без специального признака она склонна усреднять вероятность просмотра по этому окну и запаздывать относительно текущего момента. Для YouTube это важно дважды: пользователи ценят свежий контент, если он остаётся релевантным, а ранний показ может помочь новому вирусному ролику быстро распространиться. Для коррекции авторы вводят возраст обучающего примера (example age).
t_max — максимальное время, наблюдавшееся в обучающих данных, t_N — время целевого просмотра конкретного обучающего примера. Это возраст обучающего примера относительно конца окна, а не возраст видео с момента загрузки.
Во время обучения этот временной сдвиг подаётся в сеть как признак. При выдаче его устанавливают в 0 или немного отрицательное значение: запрос делается на самом конце обучающего окна или чуть позже. Конкретное отрицательное число статья не сообщает. На Figure 4 показан один произвольно выбранный ролик: модель с example age лучше воспроизводит временной всплеск его популярности, тогда как базовая модель ближе к среднему уровню за окно. Это иллюстрация поведения модели, а не график A/B-прироста.
Ещё одно решение касается того, какие события вообще превращать в учебные примеры. Авторы берут все просмотры YouTube, включая ролики, просмотренные во встроенных плеерах на других сайтах, а не только просмотры после собственных рекомендаций. Иначе система училась бы главным образом на том, что сама уже показала, и новым объектам было бы труднее выйти на поверхность. Кроме того, для каждого пользователя генерируют фиксированное число примеров, чтобы небольшая группа очень активных пользователей не доминировала в функции потерь. Авторы отдельно отмечают, что это решение улучшило live-метрики.
Авторы показывают и более контринтуитивный принцип: полезную информацию иногда надо скрыть. Если человек только что искал «taylor swift», модель следующего просмотра может просто научиться воспроизводить ролики из только что показанной поисковой страницы. Для главной страницы такой перенос работает плохо. Поэтому последовательность поисковых запросов превращают в неупорядоченный набор токенов: модель сохраняет тематику поиска, но хуже видит происхождение целевой метки.
Наконец, случайно скрывать просмотр внутри полной истории тоже опасно. События после выбранной метки тогда попадают во вход и дают утечку будущего. Кроме того, совместные просмотры асимметричны: серии обычно смотрят по порядку, а знакомство с артистом или жанром может двигаться от массового к более нишевому. Поэтому команда выбирает некоторый просмотр как цель и откатывает историю к нему, оставляя только действия до этого момента. Предсказание будущего просмотра показало лучшие A/B-результаты, чем случайный held-out просмотр.
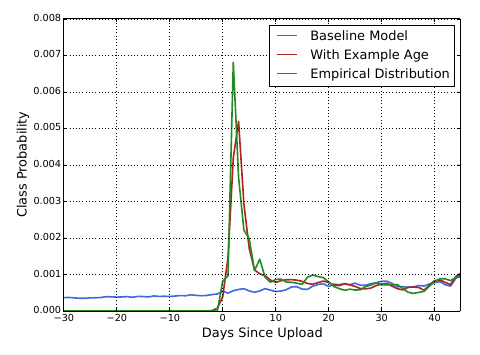
Пример одного видео: признак возраста обучающего примера помогает отражать всплеск после загрузки. Это демонстрационный график, не бизнес-метрика и не просто возраст видео. PDF, страница 3.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 3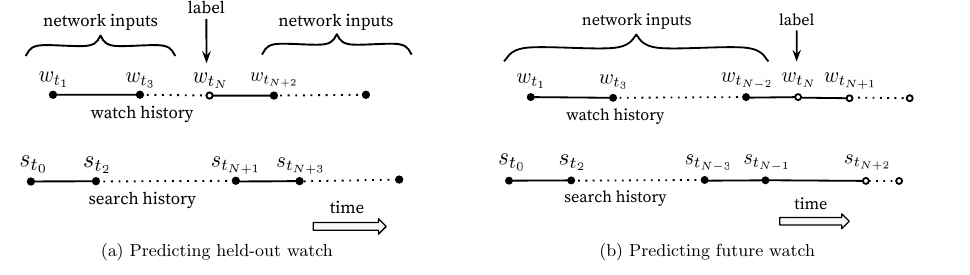
Контекст только до целевого просмотра сохраняет направление времени. Случайно исключённый просмотр с будущими входными событиями приводит к утечке. PDF, страница 5.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 5Эксперимент с признаками и глубиной кандидатной сети
Числа этого раздела относятся к конкретному эксперименту 3.5, а не к обязательным размерам всей системы YouTube. В эксперименте использовались словарь из 1 млн видео и словарь из 1 млн поисковых токенов. Их представления имели по 256 чисел. Во входе сохраняли не более 50 последних просмотров и 50 последних поисков. Выходной softmax содержал те же 1 млн видео-классов; размер отдельного выходного представления видео также был 256.
Модели обучали до сходимости на данных всех пользователей YouTube, что соответствовало нескольким проходам по данным. Сеть строилась башней: нижний слой самый широкий, затем ширина примерно уменьшается вдвое. Глубину увеличивали, пока дополнительная польза не стала уменьшаться, а сходимость — усложняться.
Глубина 0 фактически близка к линейной факторизационной схеме и работала примерно как система-предшественник. Figure 6 показывает две устойчивые тенденции: дополнительные сигналы поверх истории просмотров повышают holdout MAP, а более глубокая сеть лучше использует их совместно. На графике сравниваются наборы Watches Only, Watches & Searches, Watches, Searches & Example Age и All Features при глубине от 0 до 4. Отдельные точки не подписаны точными значениями, поэтому восстанавливать проценты по пикселям графика нельзя.
В итоговых выводах авторы пишут, что глубокая коллаборативная модель превзошла использовавшийся ранее подход на основе матричного разложения. Однако отдельной таблицы с численным сравнением этих двух систем в статье нет, поэтому Figure 6 нельзя превращать в такую оценку: он показывает только варианты самой нейросетевой кандидатной модели.
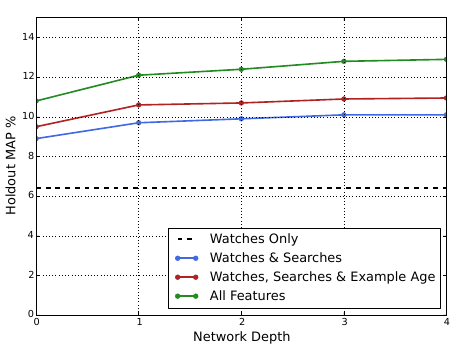
Глубина и дополнительные признаки улучшают holdout MAP в показанном эксперименте. Точные неподписанные значения точек не восстанавливаются по графику. PDF, страница 5.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 5Ранжирование: почему клик — недостаточная цель
После отбора остаётся несколько сотен видео, и теперь можно учитывать детали конкретного показа. Например, человек в целом может с высокой вероятностью посмотреть ролик, но проигнорировать его на главной странице из-за конкретной миниатюры. Такая информация слишком дорога для полного каталога, но доступна на маленьком наборе кандидатов.
Ранжировщик независимо оценивает каждый показ глубокой полносвязной сетью и затем сортирует кандидатов. Его конечная цель постоянно настраивалась по A/B-тестам, но в статье она описана как простая функция ожидаемого времени просмотра на один показ. Оптимизировать только вероятность клика опасно: броская обложка может вызвать клик на ролик, который пользователь почти сразу закроет. Время просмотра лучше отражает продолжившееся взаимодействие.
Этап ранжирования также нужен для объединения разных источников кандидатов. Их внутренние оценки могут быть несопоставимы, зато общий ранжировщик получает признаки каждого кандидата и решает, какое место он должен занять уже в едином списке.
Статья · стр. 5 — раздел 4 RANKING; начало раздела 4.1 Feature RepresentationСотни признаков: история отношений, общие таблицы ID и нормализация
В статье признаки ранжирования сначала делятся на категориальные и числовые или порядковые. Категориальный признак может содержать одно значение (univalent), например ID оцениваемого видео, или набор значений (multivalent), например последние N просмотренных видео. Ещё одно разделение — признаки самого показа (impression) и признаки пользователя или контекста запроса (query). Последние можно посчитать один раз на запрос, тогда как признаки показа вычисляются для каждого кандидата.
Авторы пишут о сотнях признаков, примерно поровну категориальных и числовых. Нейросеть не убрала ручную работу с данными: особенно важно представить временную историю и отношение пользователя к оцениваемому ролику. Сильными оказались, например, число просмотренных видео того же канала и время с последнего просмотра похожей темы. Такие агрегаты обобщаются между разными конкретными роликами лучше, чем одно запоминание ID.
В ранжирование обязательно передают информацию от этапа отбора: какой источник предложил этот ролик и какую оценку он ему назначил. Другой критичный блок — частота предыдущих показов. Если ролик только что показывали, но человек его не посмотрел, следующий запрос должен естественно понизить его. Так система создаёт сменяемость списка, или churn, вместо постоянного повторения одних и тех же рекомендаций. Инженерная система, которая подаёт почти мгновенно обновлённую историю показов и просмотров, названа важной, но её устройство вынесено за пределы статьи.
Высококардинальные категориальные признаки превращают в обучаемые векторы. Для каждого пространства ID есть свой словарь, а размерность его векторов растёт примерно пропорционально логарифму числа уникальных значений. Словари строят отдельным проходом по данным перед обучением. Очень большие пространства, например video ID или поисковые термины, обрезают до top-N по частоте в кликнутых показах; значение вне словаря получает нулевой вектор. Если признак содержит несколько ID, их векторы усредняют.
Признаки из одного ID-пространства используют общую таблицу представлений. Один глобальный video embedding может обслуживать ID текущего показа, последнее просмотренное видео и video ID, который послужил seed рекомендации. При этом после lookup каждый признак остаётся отдельным входом сети, поэтому верхние слои могут использовать один и тот же ID по-разному. Общая таблица улучшает обобщение, ускоряет обучение и экономит память. Для масштаба авторы приводят пример: 1 млн ID в 32 измерениях дают в семь раз больше параметров, чем полностью связанные слои шириной 2048.
Числовые признаки требуют отдельной обработки: авторы называют правильную нормализацию критичной для сходимости. Их распределения преобразуют через накопленную функцию распределения так, чтобы значения приблизительно равномерно заполняли [0, 1). На практике CDF аппроксимируют квантилями, посчитанными одним проходом до обучения, и линейной интерполяцией между соседними квантилями. Затем в сеть подают не только нормализованное значение x̃, но также x̃² и √x̃, чтобы полносвязной сети было проще выражать сверхлинейные и сублинейные зависимости.
Сначала числовой признак переводится в приближённый квантиль, затем вместе с ним подаются квадрат и квадратный корень. Статья сообщает, что степени улучшали офлайн-точность.
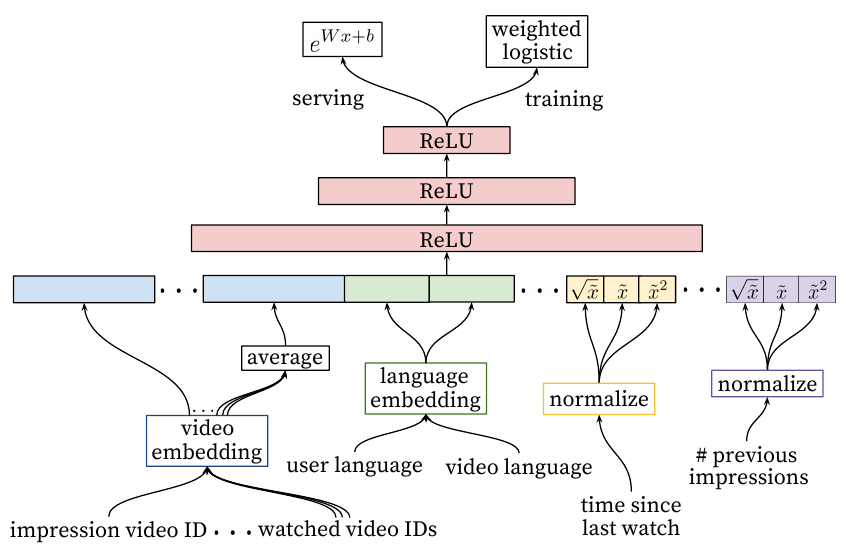
Ранжирование: общие таблицы категориальных представлений, нормализованные числовые признаки и их степени. Обучение — взвешенная логистическая регрессия; применение — экспонента оценки. PDF, страница 6.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 6Как взвешенная логистическая регрессия приближает время просмотра
Обучающие показы делятся на положительные, когда по ролику кликнули, и отрицательные, когда клика не было. У положительного примера дополнительно известна длительность просмотра T_i. Сеть обучается с логистической кросс-энтропией, но вес положительного примера равен T_i, а вес каждого отрицательного — 1. Тем самым долгий просмотр влияет на функцию потерь сильнее короткого. В результате логистическая модель учит отношение шансов (odds) положительного исхода к отрицательному, но из-за весов это отношение получает связь с временем просмотра.
N — число показов, k — число положительных показов. Сумма T_i идёт по положительным примерам; у некликнутых показов watch time в среднем на impression можно считать нулевым.
Чтобы понять связь с ожидаемым временем, обозначим P = k/N и определим E[T] как среднее время просмотра на один показ, включая ноль для некликнутого показа: E[T] = ΣT_i/N. Тогда формула авторов даёт odds = E[T]/(1−P). При малом P это примерно ET, а значит близко к E[T]. Вероятность клика здесь уже входит в среднее по всем показам; умножать E[T] на P ещё раз нельзя.
E[T] здесь — watch time на impression, а не среднее только среди кликов. Поэтому дополнительный множитель P был бы двойным учётом вероятности клика.
То же можно переписать через условное среднее μ = E[T | click]. Тогда E[T] = Pμ и odds = Pμ/(1−P). Это лишь алгебраическое пояснение той же формулы, а не отдельная модель из статьи. При применении сеть берёт exp(logit), где logit — выход сети до финального преобразования, то есть переводит логит в odds, которые при малом P близки к ожидаемому времени просмотра. Это не откалиброванная вероятность клика и не CTR. В выводах авторы пишут, что такая постановка заметно лучше на watch-time-weighted ranking evaluation, чем прямое предсказание click-through rate; численного размера этого преимущества не приводят.
Статья · стр. 7 — раздел 4.2 Modeling Expected Watch TimeГлубина ранжировщика: офлайн-ошибка и цена CPU
Результаты ранжирования измерялись на выборке следующего дня. Метрика называется weighted, per-user loss. Для пользователя берут положительный и отрицательный показ с одной страницы и сравнивают их оценки. Если отрицательный показ оказался выше положительного, время просмотра положительного считается ошибочно упорядоченным. Итоговая величина — доля такого времени в общем времени просмотра по удержанным парам. Это офлайн-ошибка попарного порядка, взвешенная watch time, а не CTR, рост удержания или бизнес-uplift.
И ширина, и глубина снижают эту ошибку, но требуют больше процессорного времени при выдаче. Конфигурация 1024 → 512 → 256 дала лучший из показанных результатов, который при этом укладывался в CPU-бюджет сервиса. Численного значения этого бюджета статья не сообщает.
Для той же сети авторы провели две дополнительные проверки. Если подавать только нормализованный числовой признак без √x̃ и x̃², loss увеличивается на 0.2%. Если положительные и отрицательные примеры взвешивать одинаково, watch-time-weighted loss увеличивается на 4.1%. Источник говорит именно «increased loss by 0.2%» и «by 4.1%» и не уточняет, считать это относительным изменением или процентными пунктами. Поэтому пересчитывать эти значения нельзя.
В разделе выводов авторы также утверждают, что глубокий ранжировщик превзошёл использовавшиеся ранее линейные и древовидные методы предсказания watch time. Численного сравнения с этими базовыми моделями в Table 1 нет: семь строк таблицы сравнивают только конфигурации скрытых слоёв нейросети.
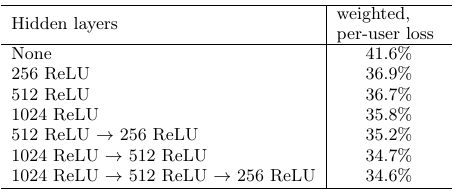
Полная таблица ошибок ранжирования, взвешенных временем просмотра: 41,6%; 36,9%; 36,7%; 35,8%; 35,2%; 34,7%; 34,6%. Это офлайн-доля ошибочно упорядоченного времени, не CTR и не прирост удержания. PDF, страница 7.
Источник: Covington, Adams, Sargin · YouTube 2016 · стр. 7Итог: как работала двухэтапная система YouTube 2016
Статья проходит путь от ограничения масштаба к разделению ответственности. Кандидатная DNN объединяет просмотры, поиск и контекст, а обучающая постановка следующего просмотра помогает сохранить направление времени и избежать утечки будущего. Example age уменьшает смещение к прошлому. Затем отдельная DNN использует сотни более дорогих признаков и оптимизируется под величину, связанную с ожидаемым временем просмотра. Sampled softmax, importance correction, выбор отрицательных классов и функции потерь относятся к обучению и не входят в путь одного готового пользовательского запроса.
- 01
История и контекст
Система получает недавние просмотры, поисковые сигналы и доступный контекст пользователя.
- 02
Представление пользователя
Кандидатная сеть усредняет векторы историй, объединяет признаки и строит один вектор u.
- 03
Быстрый отбор
ANN-поиск по скалярному произведению находит сотни близких видео без вычисления полного softmax по миллионам классов.
- 04
Богатые признаки
Для каждого кандидата добавляются признаки ролика, отношений с пользователем, предыдущих показов и источника кандидата.
- 05
Точная оценка
Ранжирующая DNN выдаёт logit; exp(logit) интерпретируется как odds, близкие к ожидаемому watch time при малой вероятности клика.
- 06
Сортировка списка
Кандидаты сортируются по оценке, и несколько десятков лучших возвращаются пользователю.
Офлайн авторы показывают пользу дополнительных признаков и глубины в candidate generation и снижение next-day watch-time-weighted pairwise loss в ranking. Но главный критерий выбора — живой A/B-тест: офлайн и онлайн могут расходиться. Статья сообщает лучшие live-результаты для предсказания будущего просмотра и качественный рост watch time на свежих видео с example age, не публикуя численных бизнес-дельт. Она также не раскрывает точный ANN-алгоритм, размер индекса, полный список признаков, hardware-конфигурацию или современную архитектуру YouTube. Поэтому доказанный вывод ограничен системой 2016 года: двухэтапная схема позволяла совместить масштабный поиск, богатое ранжирование и продуктовую проверку, но её численные параметры нельзя переносить на YouTube 2026 как текущие.
Статья · стр. 7 — раздел 5 CONCLUSIONS; итог по разделам 2–4