Разбор готов
Яндекс: выбор истории, архитектуры и обучения для трансформерной персонализации
Персонализация в Яндекс Маркете должна учитывать и свежие действия, и долгосрочные интересы человека. Для подбора похожих товаров особенно важна последняя сессия, а для знакомства с ассортиментом на главной странице — более глубокая история. Сводные показатели активности не сохраняют всех различий между тем, что пользователь делал, в каком порядке и в каком контексте. Трансформер позволяет анализировать последовательность событий, но его полезность зависит не только от архитектуры. В докладе «Тайны трансформерной персонализации» на Turbo ML Conf 2024 Кирилл Хрыльченко объяснил, как команда Яндекса выбирала события, кодировала содержание, сокращала повторные вычисления и согласовывала обучение с ранжированием и отбором кандидатов. Разберём эти решения, результаты сравнений и ограничения.
Глава полезна разработчикам рекомендательных и поисковых систем, которые добавляют анализ пользовательской истории или улучшают существующую модель. Она помогает связать выбор данных с устройством модели, её обучением и способом применения в продукте.
Видео · на русском
Тайны трансформерной персонализации — Кирилл Хрыльченко, ЯндексКирилл Хрыльченко · Опубликовано: 13 августа 2024 г.
Исходный доклад · Открыть оригинал
От анализа текста к последовательности действий
Кирилл Хрыльченко рассказывал об опыте команды, которая одновременно исследовала и разрабатывала рекомендательные технологии для разных сервисов Яндекса. В отличие от выступлений об отдельном внедрении, этот доклад был посвящён решениям, общим для нескольких продуктов: какие данные давать модели, как их представлять и какую задачу ставить при обучении. Дальше речь идёт именно об этом опыте, представленном в 2024 году, а не о текущем устройстве всех рекомендаций Яндекса.
Отправной точкой стал 2020 год. Трансформеры уже активно применялись к текстам в машинном переводе и Поиске. Возник естественный вопрос: можно ли так же анализировать не слова, а события пользовательской истории? В экосистеме уже было много рекомендательных алгоритмов, однако сложный анализ последовательного сигнала оставался возможностью для улучшения.
Технологию начали развивать для веб-поиска, а затем перенесли в Рекламу, Музыку, Маркет, Алису, Лавку и Кинопоиск. Она пригодилась в двух разных местах. При ранжировании, то есть упорядочивании выбранных объектов, нейросеть давала сильный дополнительный признак. При отборе кандидатов она выступала основным источником объектов из каталога для дальнейшей обработки. Эти роли используют историю одного человека, но требуют разных обучающих задач.
Технология начиналась в Поиске и распространялась на другие сервисы Яндекса; исторический статус 2024 года.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Четыре решения, которые важнее готовой архитектуры
Перенести готовую модель из обработки естественного языка недостаточно. В тексте уже определено, из каких единиц состоит последовательность. В рекомендациях её ещё предстоит собрать: пользователь вводил запросы, видел предложения, переходил к объектам, покупал товары или пропускал треки. Каждый из этих следов означает разное, а часть отражает решения самой системы, а не самостоятельный интерес человека.
Поэтому автор последовательно разбирает четыре вопроса. Как сформировать историю: что оставить и насколько далеко смотреть назад? Как закодировать события: представить содержание, действие и время численно? Где связать историю с конкретным кандидатом: внутри трансформера или после отдельной обработки? Наконец, чему учить модель, чтобы её выход помогал именно на выбранном этапе рекомендаций?
Порядок вопросов существенен. Сначала определяется информация, доступная модели, затем способ её обработки, и только после этого — соответствие предсказания продуктовой задаче. Более сложная нейросеть не возвращает полезные события, вытесненные из истории, и сама по себе не исправляет несовпадение цели обучения с задачей ранжирования.
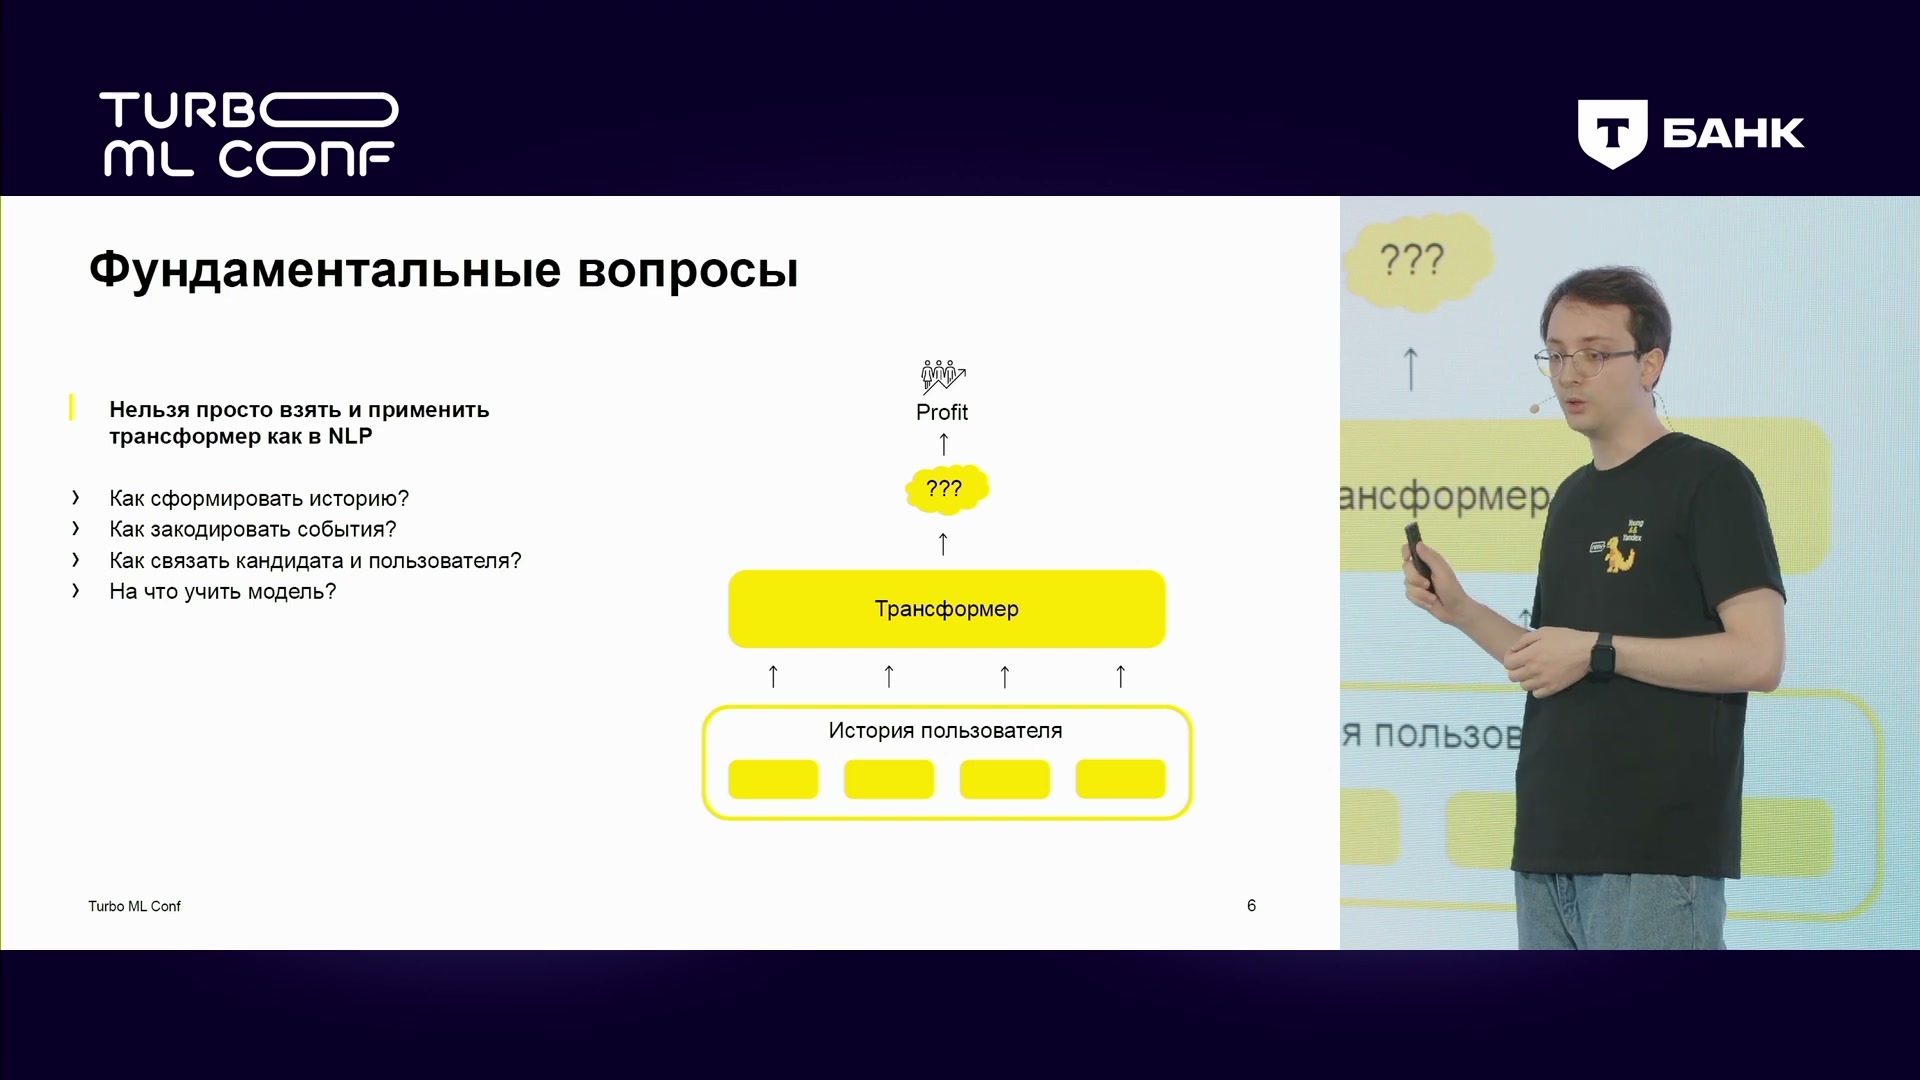
Четыре решения: выбор истории, кодирование событий, связь пользователя с кандидатом и цель обучения.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Почему события нельзя считать равноценными
Даже привычный «клик» обозначает неоднородные взаимодействия. После одного перехода человек задерживается на объекте, после другого сразу уходит: возможно, его привлекло лишь оформление. Клики совершаются на разных страницах приложения и по разным сущностям. Объединить их в одну категорию удобно технически, но при выборе истории нужно понимать, какую информацию такое объединение сохраняет.
Автор предлагает смотреть на частоту события, его шумность и связь с тем действием, которое предстоит предсказать. Клики встречаются гораздо чаще покупок. Клик может быть случайным, тогда как ввод поискового запроса обычно требует более явного намерения. Если модель предсказывает покупку, частое событие не обязательно полезнее редкой, но непосредственно связанной с покупкой активности.
Ещё две характеристики — насколько действие задано самим человеком и насколько оно зависит от рекомендательной системы. Запрос пользователь формулирует сам. Показ возникает потому, что система решила что-то предложить. Органическим автор называет сигнал, на появление которого рекомендации влияют мало; он интересен именно как менее зависимый от предыдущей выдачи источник информации.
Из этих различий вытекают отдельные задачи: выбрать допустимые типы событий, определить их количество, решить, как смешивать их между собой и какие временные участки истории сохранять. Включать всё доступное — не нейтральная исходная точка: наиболее многочисленные события способны изменить сам состав входа модели.
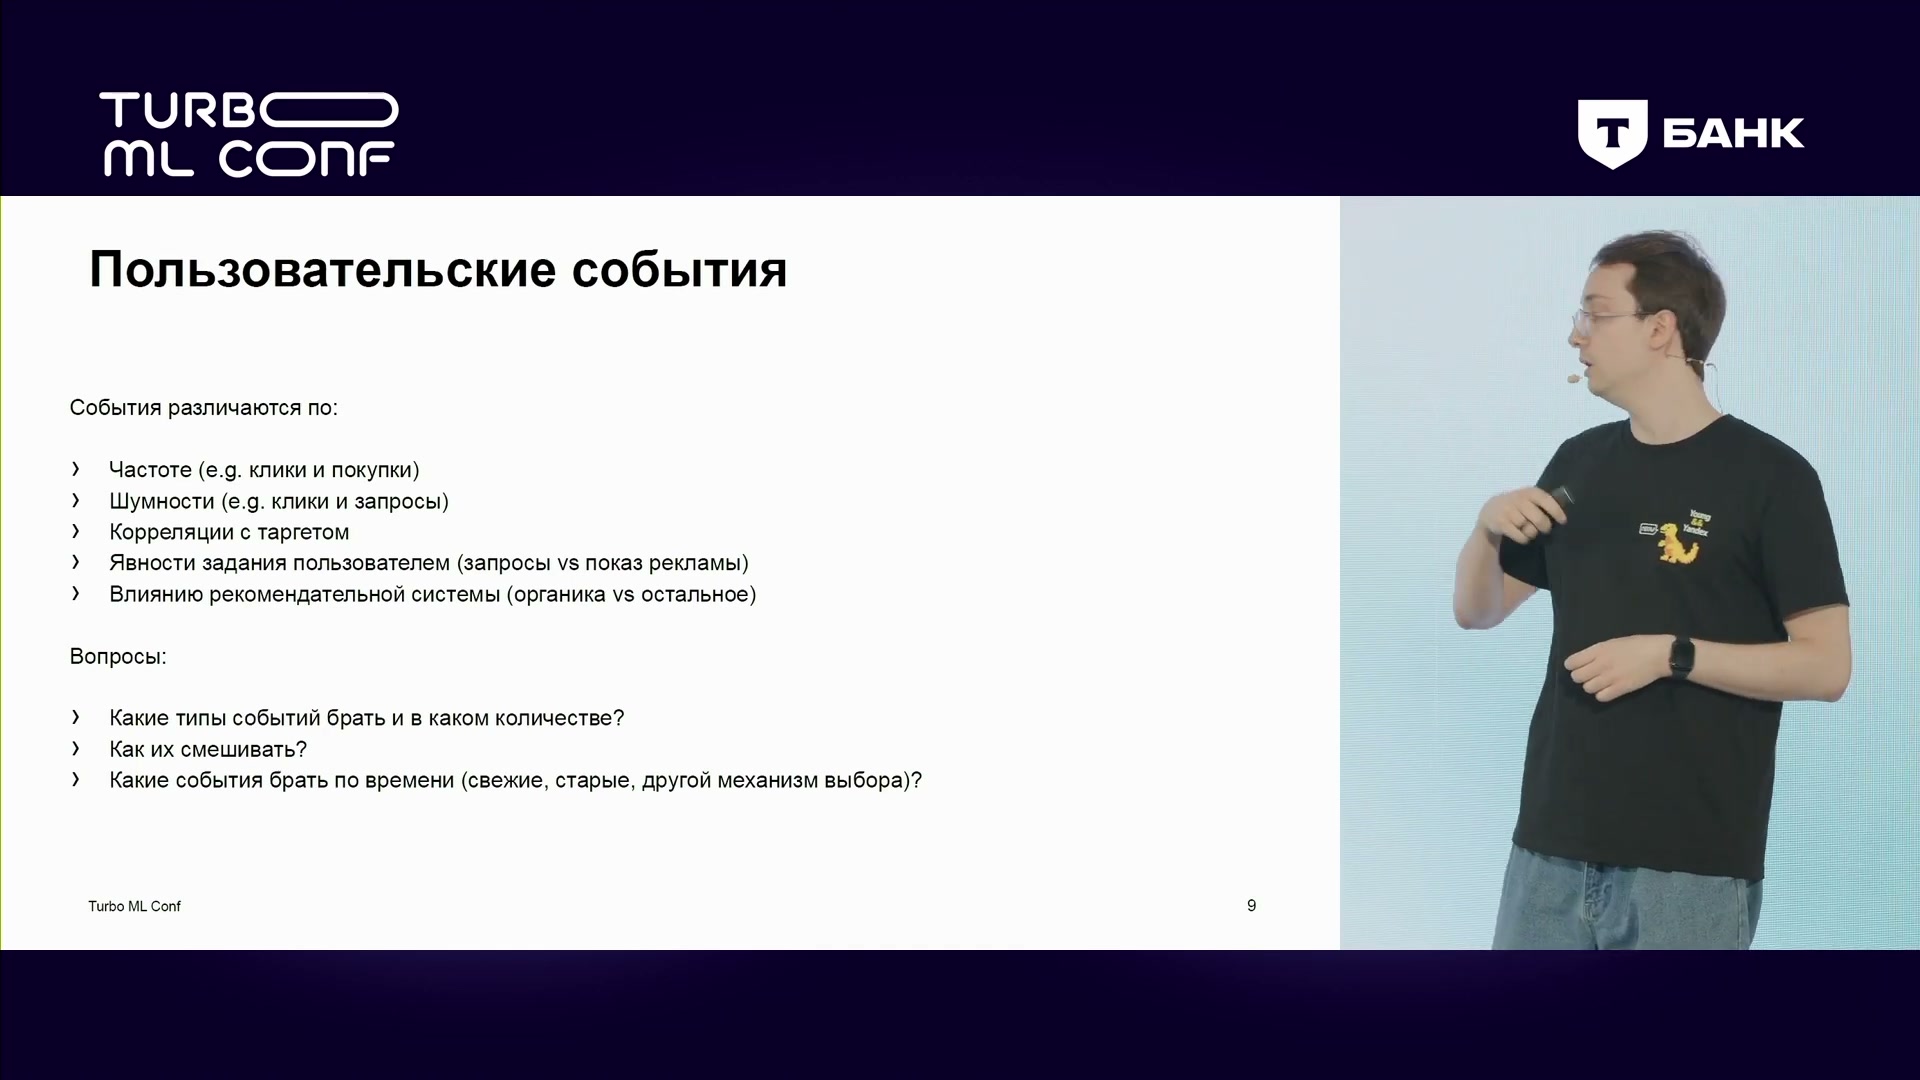
События различаются частотой, шумом, связью с целью и зависимостью от рекомендаций.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Показы вытесняют историю, целевые действия уточняют интерес
Показы рекомендаций выглядят привлекательным источником: их много и они хорошо фиксируются системой. Но именно количество становится проблемой. В последовательности ограниченной длины многочисленные показы занимают места, которые могли бы достаться более содержательным действиям. Модель получает длинный рассказ о том, что система предлагала человеку, вместо истории того, что он действительно выбирал.
Кроме того, показы шумны, слабо связаны с желаемым будущим действием и сильно зависят от качества прежних рекомендаций. Пользователь не обязательно проявил интерес к тому, что оказалось перед ним. По опыту автора, простое добавление показов в историю обычно приносило мало пользы: дополнительный объём данных не компенсировал слабость сигнала.
Прошлые целевые действия устроены иначе. Если нужно предсказывать покупки, покупки следует включать в историю: это один из наиболее прямых источников информации о пользователе. Здесь речь именно о прошлых событиях, доступных к моменту предсказания. Выбор полезного содержимого истории не следует смешивать с выбором обучающих примеров: позднее показы понадобятся как основа задачи ранжирования, даже если они не вошли в последовательность событий.
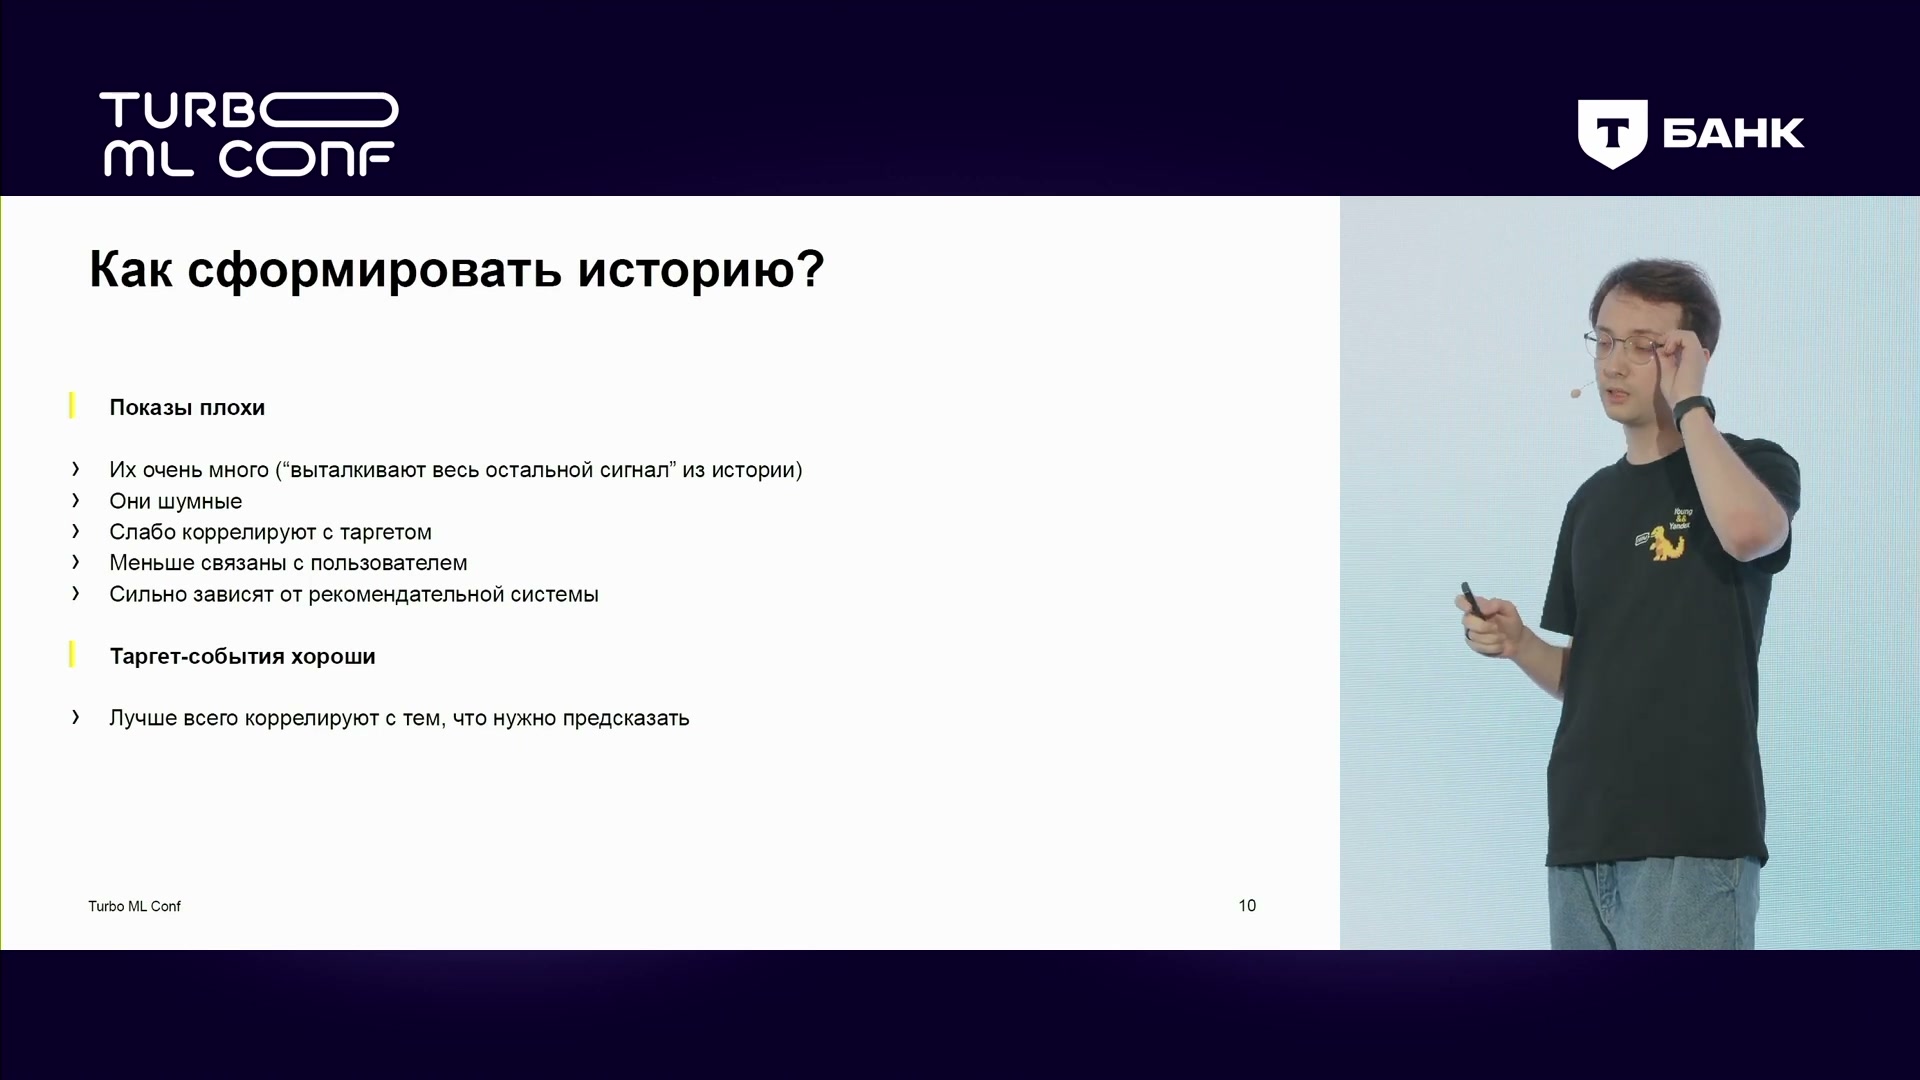
Многочисленные показы могут вытеснить более полезные события; целевые действия лучше связаны с задачей.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Запросы и история другого сервиса: почему Маркет выигрывает, а Музыка — исключение
После целевых действий автор выделяет поисковые запросы. Человек сам формулирует, что его интересует, поэтому запрос несёт более явный сигнал, чем показ или случайный переход. В докладе запросы названы практически нешумными и мало зависящими от рекомендательной системы. Смысл этого сравнения — в степени выраженности намерения пользователя, а не в обещании, что любой введённый текст безошибочно описывает его интерес.
В Яндексе оказалось полезно брать события одного продукта и включать их в историю трансформера для другого. Это перенос между доменами: например, веб-поисковые запросы используются при персонализации Маркета. Особенно важен такой источник для холодных пользователей — людей, о которых в целевом сервисе ещё мало истории. Другой продукт уже может содержать полезный след их интересов.
Перенос также помогает ослабить петлю обратной связи. Когда рекомендации учатся только на действиях после собственных показов, прежняя выдача влияет на будущие данные, а те — на следующую выдачу. События другого сервиса, в частности явно введённые запросы, добавляют сигнал, не созданный тем же самым рекомендательным механизмом.
В этом сравнении история самого Маркета уже полезна, а добавление веб-запросов усиливает результат. Однако перенос не является обязательным для каждого продукта. В Яндекс Музыке, по словам автора, собственная история взаимодействий уже давала достаточно содержательный сигнал, поэтому подключать события других сервисов не требовалось.
Для всех трёх численных сравнений в этой главе действует одна граница интерпретации: автор показывает приросты качества ранжирования, но не раскрывает названия метрик, полный протокол, выборки и доверительные интервалы. Детальное устройство исходного ранжировщика также не описано. Числа не следует считать изменением выручки или подтверждёнными результатами A/B-тестов. Это отдельные сравнения вариантов, а не эффекты, которые можно складывать между собой.
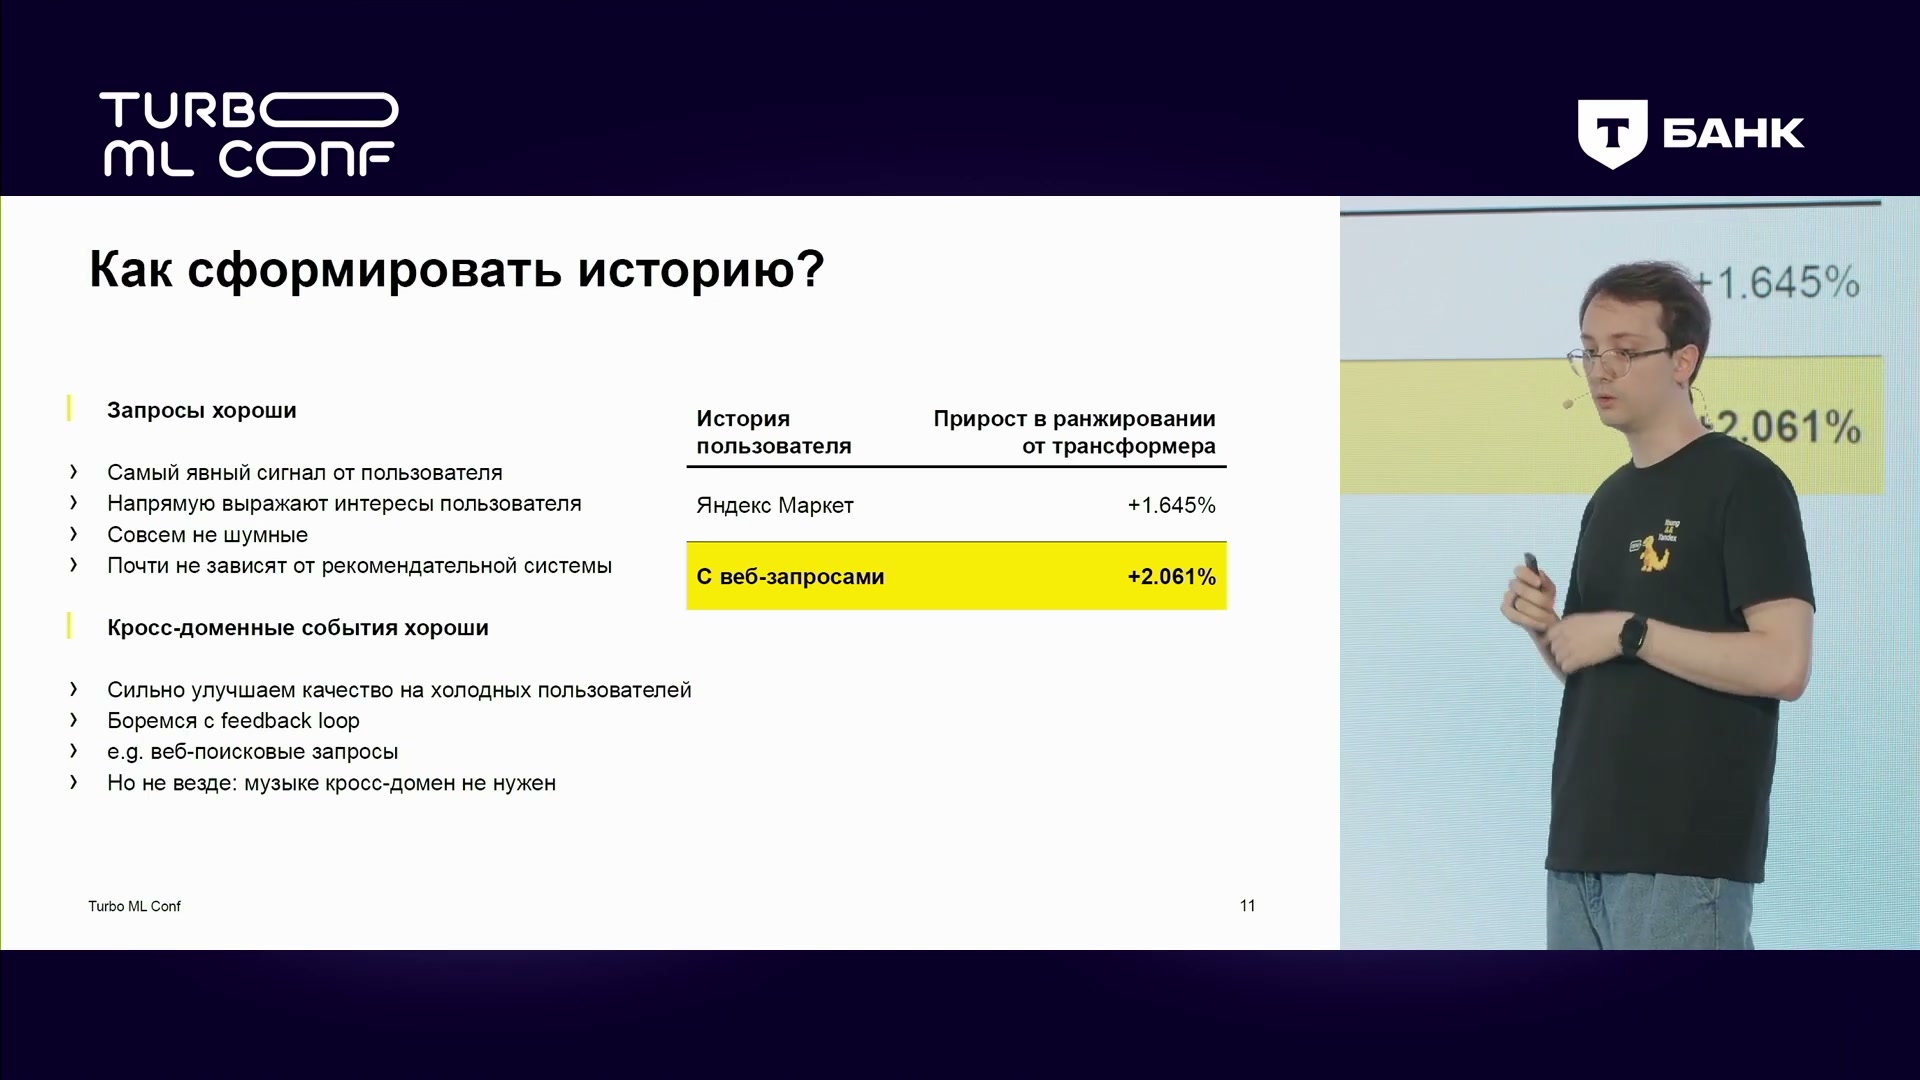
Ранжирование Маркета: история Маркета +1,645%, с веб-запросами +2,061%. Это качество ранжирования в указанном сравнении.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Длина истории: свежая сессия и долгосрочные интересы
Когда типы событий выбраны, нужно определить, сколько их попадёт в модель. На слайде перечислены проверяемые длины: 64, 128, 256, 512, 1024 и 1536 событий. Это набор вариантов для экспериментов, а не одна конфигурация, рекомендованная всем продуктам. Выбор зависит и от задачи, и от количества действий, которое вообще доступно у пользователей.
Автор сравнивает два товарных сценария. При персонализированном подборе похожих товаров особенно важны недавние действия последней сессии. На главной странице, где человеку помогают знакомиться с ассортиментом, полезны и долгосрочные интересы. Поэтому вопрос «какую длину поставить?» нельзя отделить от вопроса «какое решение сейчас принимает система?».
Увеличение истории в показанном сравнении помогает, но следующий прирост требует всё большего расширения входа. Автор описывает это как убывающую отдачу и использует выражение «профит затухает экспоненциально». График иллюстрирует наблюдение, а не задаёт формальный закон, по которому можно вычислить результат для любой следующей длины. Сам домен этого сравнения не назван.
Каждая строка относится к варианту с указанной длиной. Это не добавочный эффект поверх предыдущей строки: значения нельзя последовательно суммировать. Практический вывод здесь связан с выбором информации — более глубокая история может быть полезна, но не заменяет понимания того, нужны ли задаче давние интересы или прежде всего свежая активность.
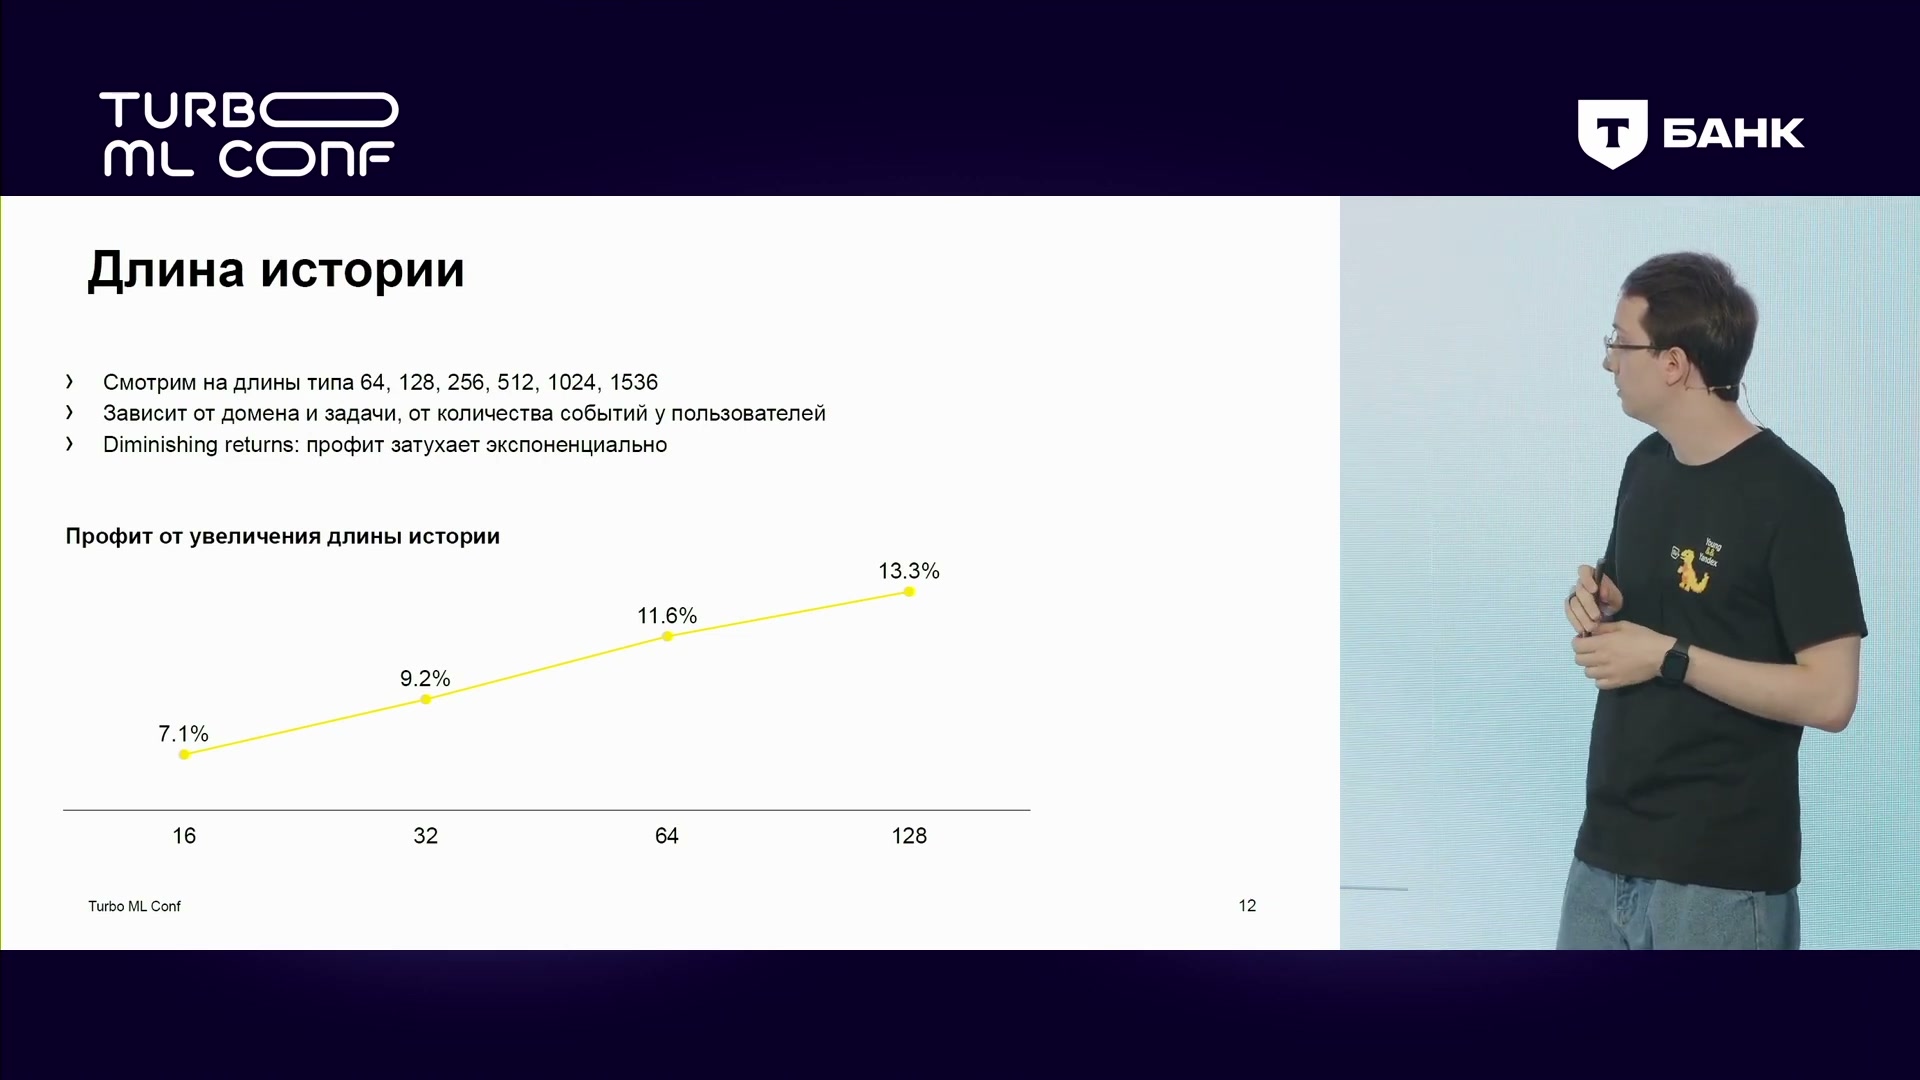
Пример влияния длины истории:16/32/64/128 событий и прирост7,1/9,2/11,6/13,3%.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Последние N событий вместо квот — с оглядкой на домен
После выбора длины остаётся решить, как разделить доступные места между типами действий. Кажется естественным выделить редким событиям отдельную квоту. В музыкальной истории можно сначала набрать фиксированное количество лайков, а затем дополнить их прослушиваниями: так редкий сигнал точно не потеряется среди частого.
Однако в опыте команды чаще выигрывал более простой подход: взять последние N событий среди выбранных типов и сохранить их временной порядок. Различная частота лайков и прослушиваний сама по себе не доказывает пользу заранее установленных квот. Такой отбор оставляет в модели свежий контекст, вместо того чтобы подчинять историю искусственному распределению по типам.
Простота не объявляется окончательным решением для любой глубины. Автор отмечает, что более сложные способы выбирать события из глубокой истории тоже работают. Но конкретного алгоритма такого отбора в докладе нет. Главный результат этого фрагмента — сильный простой вариант не стоит отбрасывать только потому, что история содержит неодинаково частые действия.
Значение отрицательной обратной связи также зависит от продукта. Пропуск трека — действие слушателя: вместо предложенной музыки он хочет перейти дальше. В Музыке это важный сигнал и для входной истории, и для того, что модель учится предсказывать. В торговле показ без клика не столь однозначен: человек просто не взаимодействовал с предложением. Поэтому полезность музыкальных пропусков не является аргументом автоматически включать все товарные показы без кликов.
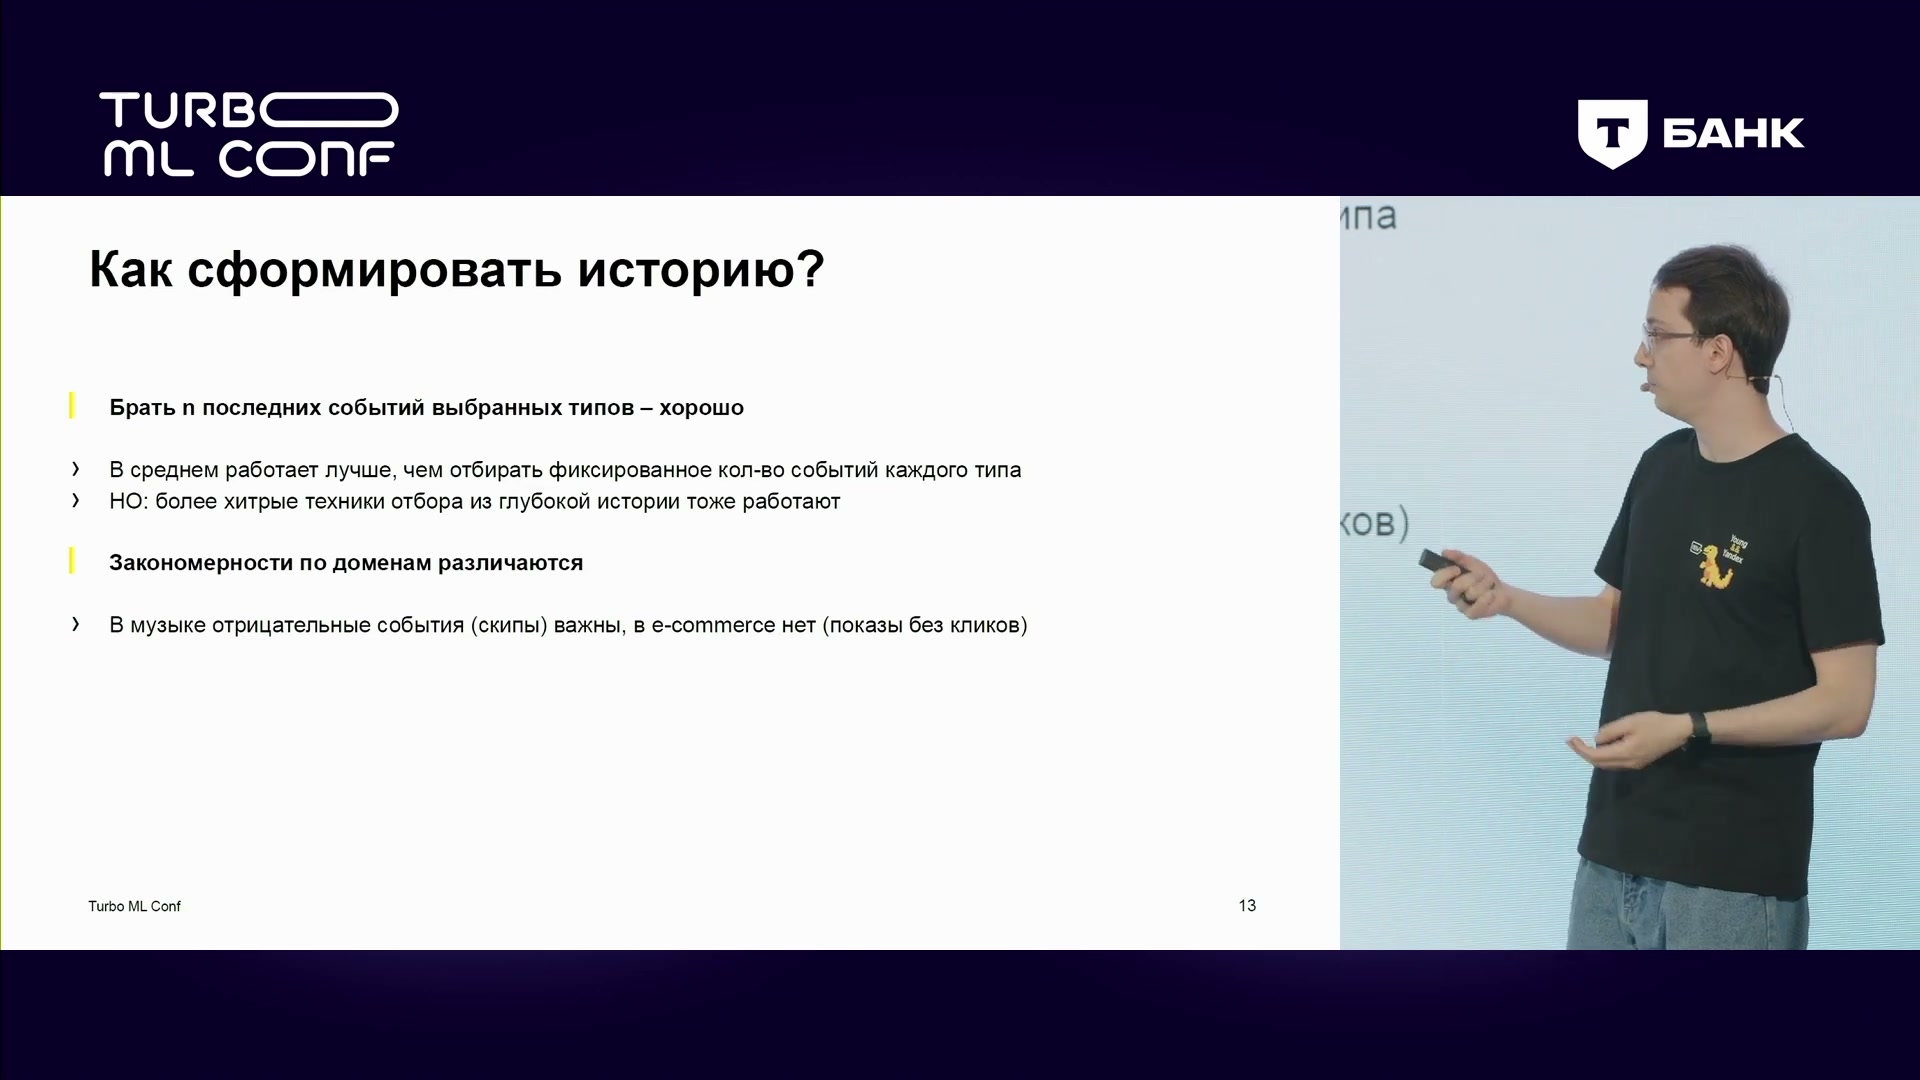
Выбор последних событий и особенности домена: пропуски в музыке важны иначе, чем показы без кликов в торговле.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Из чего складывается представление события
Выбранная последовательность ещё не является входом нейросети. Трансформеру нужны векторы — числовые представления событий. Нужно решить, какие сведения о каждом действии попадут в эти числа и как разные источники информации будут объединены.
О событии известно содержание объекта: его идентификатор, название, описание и другие доступные свойства. Есть контекст взаимодействия, например устройство или регион. Наконец, известно, когда событие произошло и какое место занимает в истории. Это разные стороны одного наблюдения: сам объект не объясняет, какое действие совершил пользователь и насколько оно свежее.
Полезно различать два уровня обработки. Сначала поля отдельного события превращаются в общее представление. Затем последовательность таких представлений поступает в пользовательский трансформер. Поэтому текст запроса или название документа не обязательно нужно разворачивать в длинную текстовую последовательность внутри той же модели: его можно заранее свернуть в вектор лёгким кодировщиком.
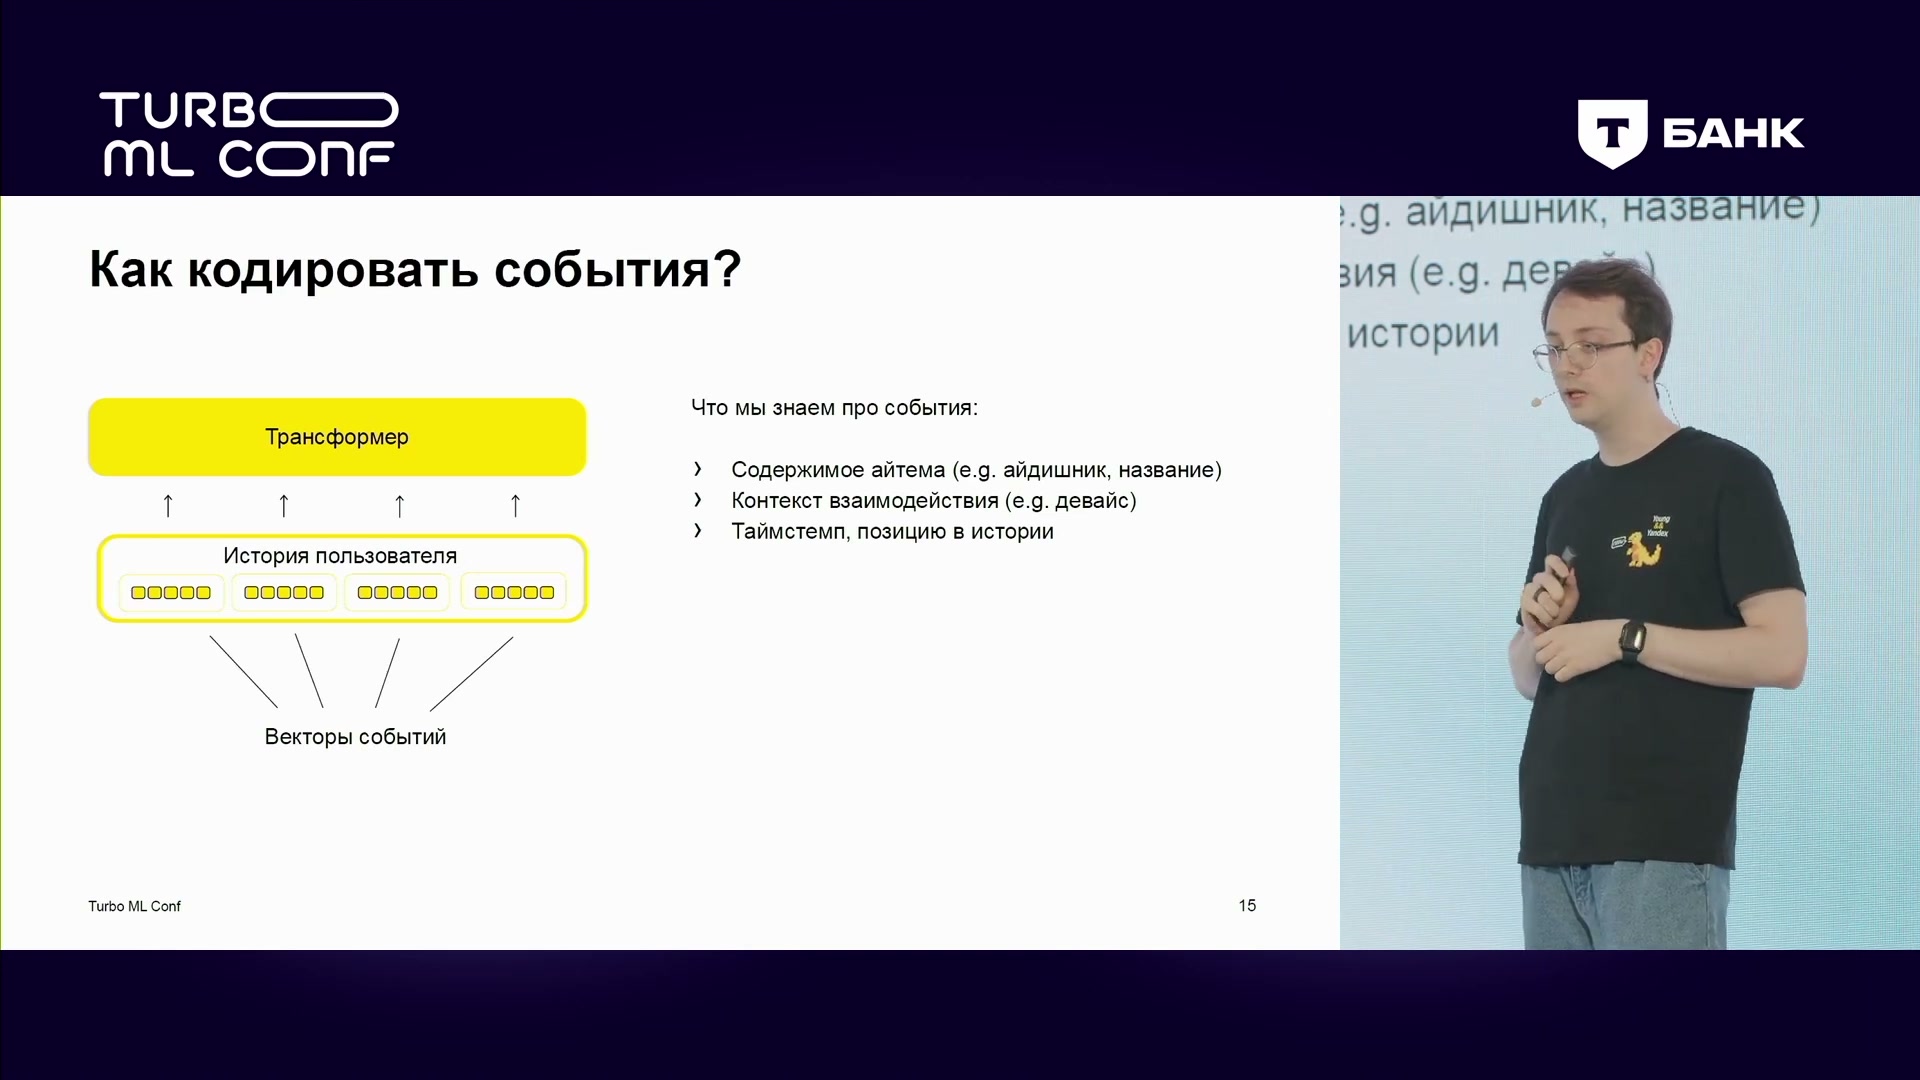
Вектор события объединяет содержание объекта, контекст, время и позицию.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Почему для текста выбрали лёгкое кодирование
Простой способ представить объект — завести обучаемый вектор для его идентификатора, ID. Во время обучения модель постепенно настраивает числовое представление каждого известного объекта. В академических задачах это распространённая отправная точка, но в крупных сервисах сама таблица становится инфраструктурной задачей: автор говорит о каталогах с миллионами и даже миллиардами объектов.
Кроме масштаба, есть проблема смысла идентификатора. У поисковых запросов множество уникальных формулировок. Создавать для каждой отдельный обучаемый вектор неудобно: такая схема не использует общие части текстов. Когда технология начиналась в веб-поиске, запросы уже были важнейшим сигналом, поэтому требовалось представлять их по содержанию.
Большая языковая модель, LLM, могла бы превратить запрос в вектор, но здесь возникают две разные статьи затрат. Первая — вычисления. Для истории примерно из тысячи событий нужно многократно применить текстовую модель, причём это история лишь одного обучающего примера. Вторая — хранение. Даже если заранее посчитать представления, их нужно сохранить для огромного массива событий. Автор упоминает объёмы от миллионов и миллиардов вплоть до триллионов событий как масштаб, на котором хранение отдельных векторов становится дорогим.
Поэтому команда выбрала лёгкий текстовый кодировщик, который обучается вместе с остальной моделью. Текст разбивается на небольшие единицы — токены. Каждому токену соответствует обучаемый вектор, а вектор поля получается объединением этих представлений. Так содержание события кодируется без запуска отдельной большой языковой модели.
Начальная схема была похожа на DSSM: использовались униграммы, биграммы и символьные триграммы — отдельные слова, пары соседних слов и тройки символов. Векторы этих элементов можно просто сложить. Позднее перешли к WordPiece, способу разбиения текста на части слов, со словарём, построенным по своему домену. Автор отмечает, что таблица обучаемых векторов стала меньше: в первоначальной схеме элементов словаря были миллионы.
Переход к WordPiece меняет единицы текста и размер словаря, но не превращает кодировщик каждого события в полноценную языковую модель. Сохраняется лёгкая схема: разбиение текста, извлечение векторов токенов и их объединение. Для других объектов истории применяется тот же принцип: у веб-документа можно отдельно закодировать название, URL и описание. В результате запросы и документы получают пригодные для общей модели представления.
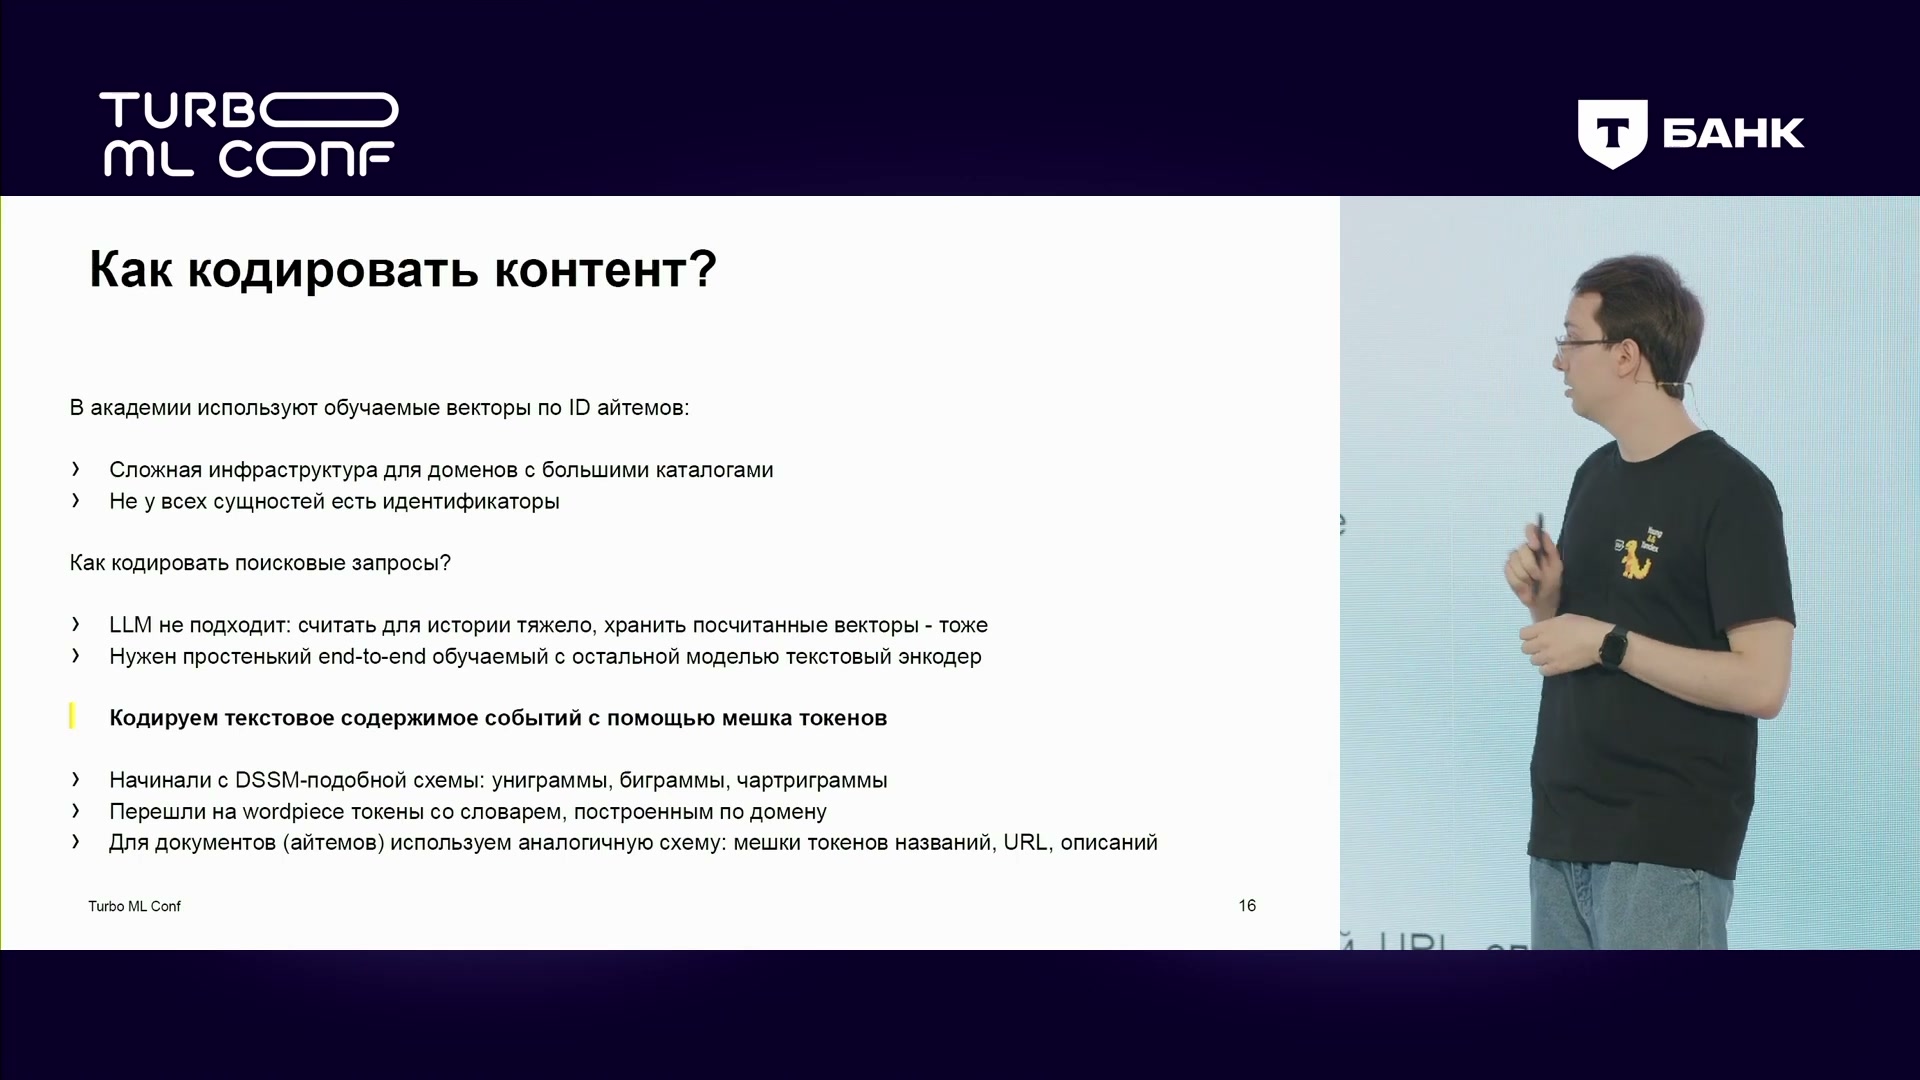
Лёгкое кодирование текстов: от DSSM-подобных токенов к словарю WordPiece, построенному по домену.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Текст помогает не только понять, но и различить объект
На исходной схеме текст «Очень большой розовый лампас» разбивается на токены. Для каждого извлекается вектор из обучаемой таблицы, после чего векторы объединяются сложением. Таким образом, одна фраза превращается в одно числовое представление; сама схема подчёркивает лёгкость операции, а не сложный анализ каждого предложения.
Автор предлагает смотреть на токенизированное поле и как на составной идентификатор. Отдельные элементы могут встречаться у многих объектов, но их сочетание помогает различать конкретные документы. Поэтому польза текстового представления не ограничивается смысловой похожестью. В частности, токенизированный URL веб-документа давал дополнительную пользу поверх его названия: адрес приносил ещё один способ распознавать объект.
Для объяснения этой идеи в докладе упомянута другая промышленная техника — несколько хешей одного ID. От идентификатора вычисляют несколько разных хешей, для каждого получают обучаемое представление, затем результаты объединяют. Вместо единственного номера модель получает несколько компонентов, совместно описывающих объект.
Текстовое кодирование и несколько хешей решают сходную задачу составного представления, но остаются разными техниками. Сравнение объясняет, почему сочетание частей полезно даже без богатого смыслового содержания. В рассматриваемом решении таким источником частей служат текстовые токены, в том числе токены URL; отдельную внедрённую схему хеширования автор здесь не описывает.
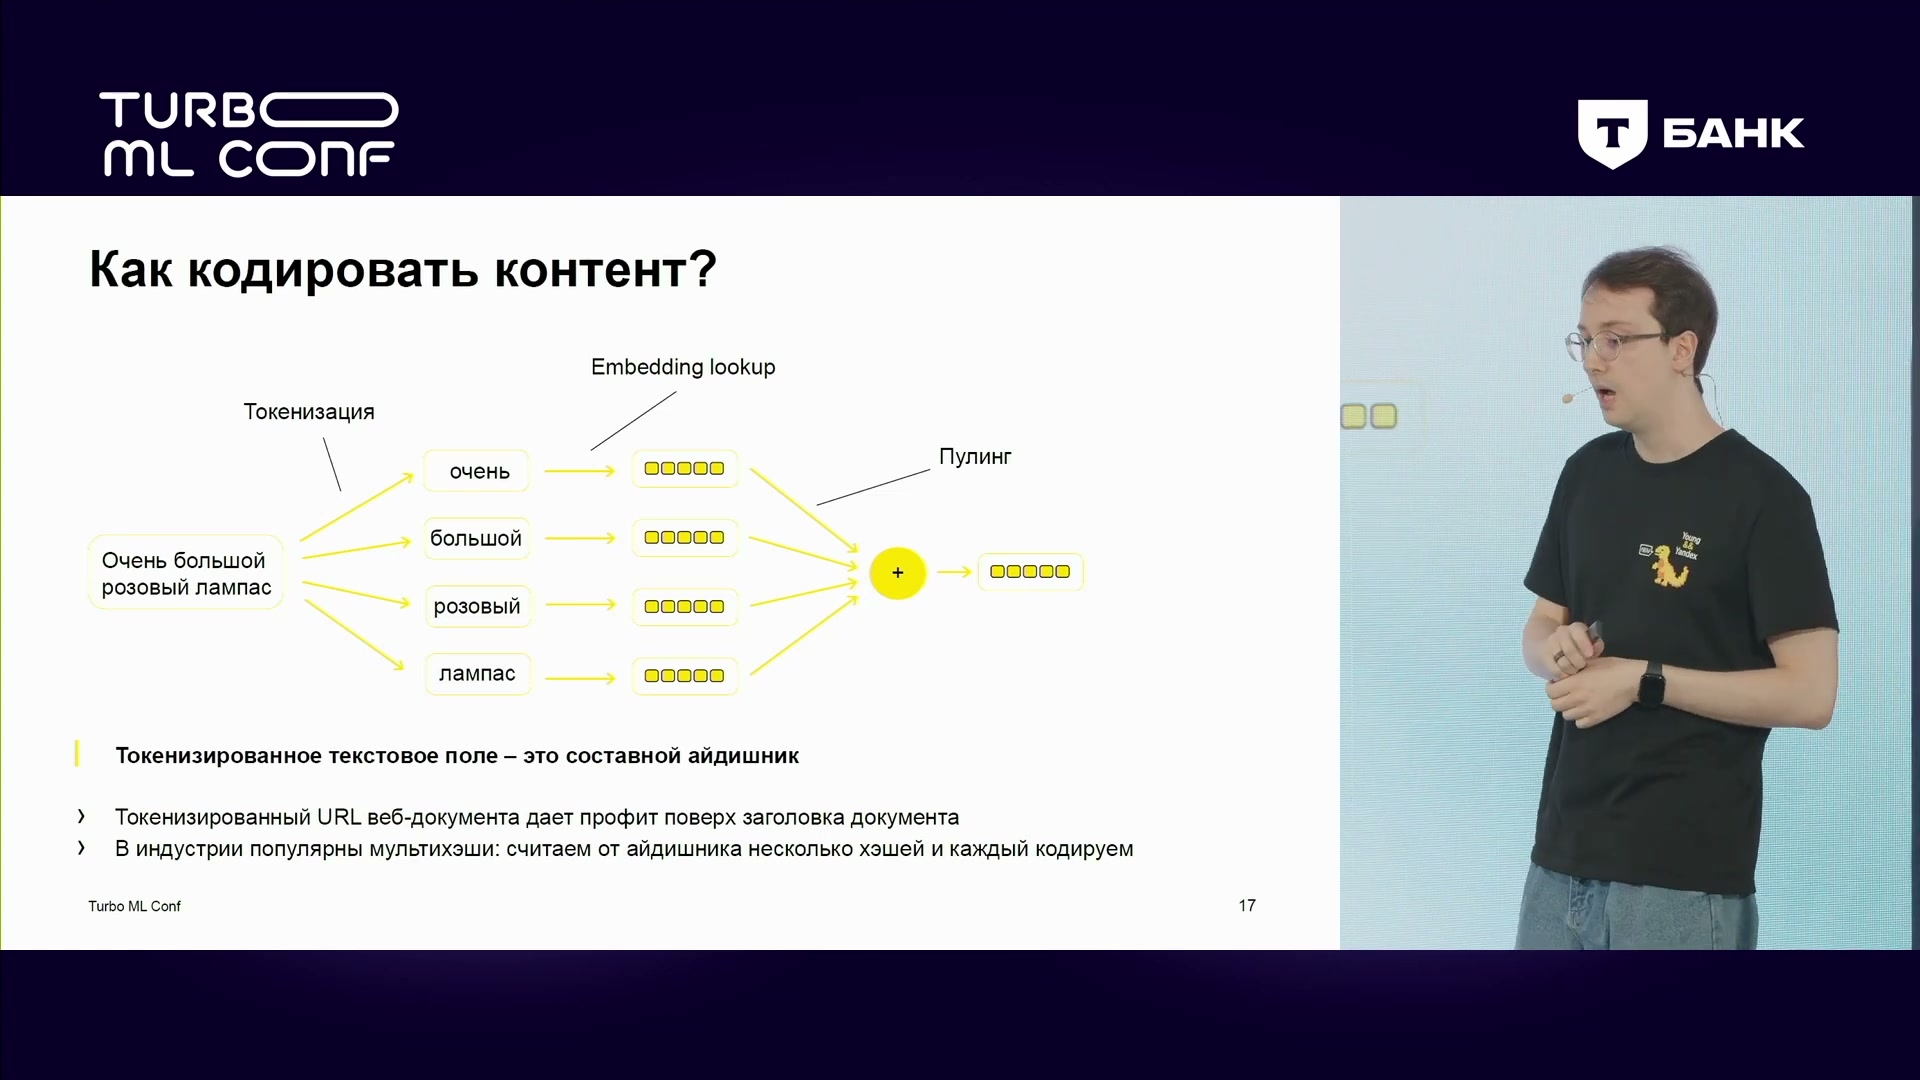
Токены превращаются в обучаемые векторы и объединяются; URL добавляет информацию к названию.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Как собрать название, описание и другие поля в один вектор
Представление отдельного текстового поля ещё не равно представлению события. У объекта могут быть название, описание и изображение; на схеме каждому из них соответствует собственный вектор. Теперь нужно объединить эти векторы так, чтобы трансформер получил одно представление события.
Простой вариант — сложить векторы разных атрибутов. Устно автор также упоминает усреднение. Для сложения все поля приводятся к одной размерности, поэтому её не приходится независимо подбирать для названия, описания и каждого дополнительного признака. Простота касается не только вычислений, но и числа решений при настройке модели.
Альтернатива — конкатенация: векторы полей ставятся рядом и образуют один более длинный вектор. Затем его обрабатывает полносвязная нейронная сеть, MLP, либо указанная на слайде сеть DCN-v2. Автор рассматривает такую обработку как возможность получить больше качества, но предупреждает о вычислительной цене. Если оставить каждому полю одинаково большой вектор, их объединённое представление может оказаться слишком тяжёлым.
Поэтому при конкатенации приходится отдельно выбирать размерности атрибутов и устройство следующего модуля. Это уже более сложная настройка, чем выбор одной общей размерности для суммы. Выбор между суммой и дополнительной сетью становится компромиссом: простота объединения против большей свободы обработки полей, за которую нужно платить вычислениями и подбором параметров.
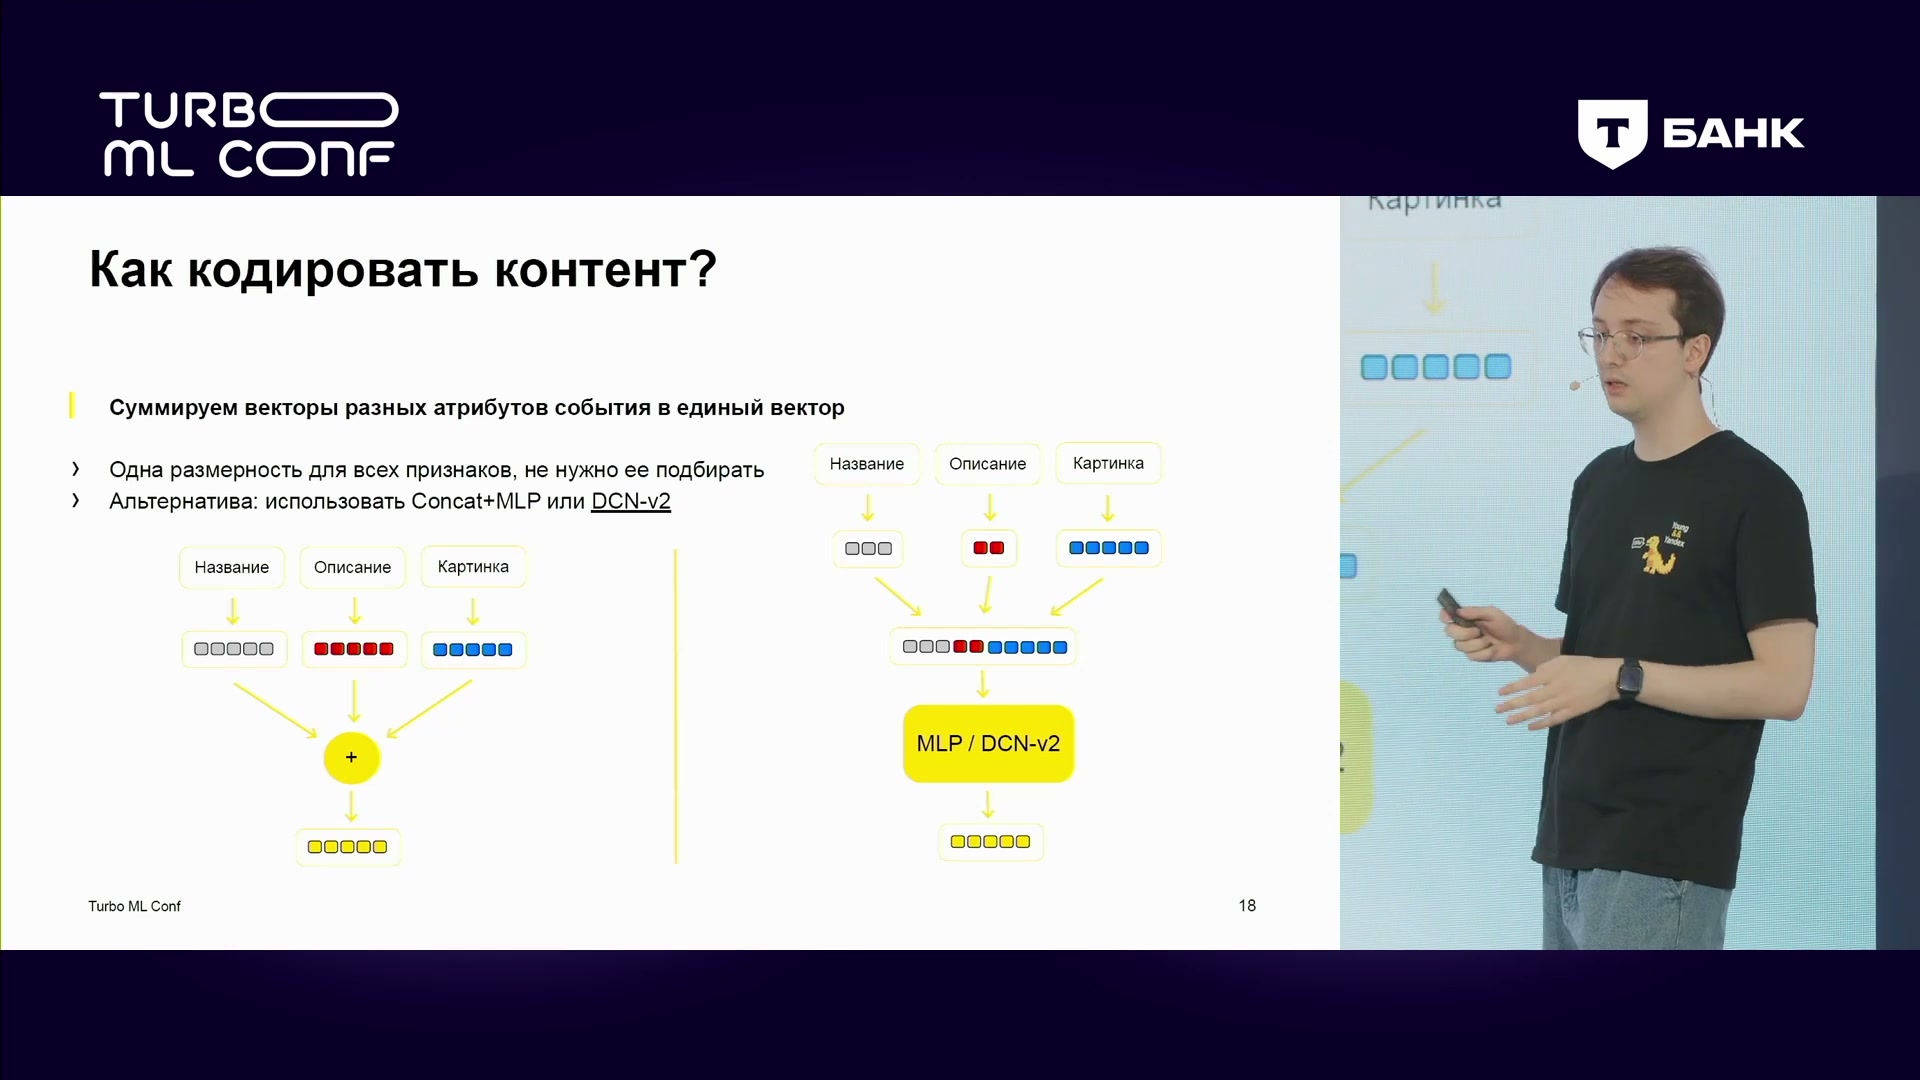
Сложение атрибутов и альтернативы: объединение с MLP или DCN-v2.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Содержание помогает новым объектам, а ID дополняет его
Кодирование по содержанию даёт свойство, важность которого команда не сразу оценила: для нового объекта можно получить вектор ещё до накопления собственной истории взаимодействий. Такая способность применять обученную функцию к новым объектам по их признакам называется индуктивностью. Она помогает при холодном старте, когда объект только появился.
По словам автора, тот же подход полезен в длинном хвосте каталога — среди множества редко встречающихся объектов. Представление не обязано целиком выучиваться из небольшого числа взаимодействий с конкретным ID. Кроме того, содержание помогает при изменении данных и трендов: модель опирается не только на запомненные идентификаторы.
Но из этого не следует, что ID нужно исключить. Его обучаемый вектор сохраняет сведения именно о данном объекте, которые могут дополнять содержание. На одном из доменов команда сравнила три варианта представления объектов в трансформере для ранжирования.
В показанном сравнении сочетание содержания и ID оказалось лучше каждого источника отдельно. Индуктивное представление и запоминание конкретного объекта здесь не конкурируют за право быть единственным способом кодирования: они дополняют друг друга. Домен этого эксперимента не назван, поэтому результат не следует автоматически приписывать Маркету из сравнения разных историй.
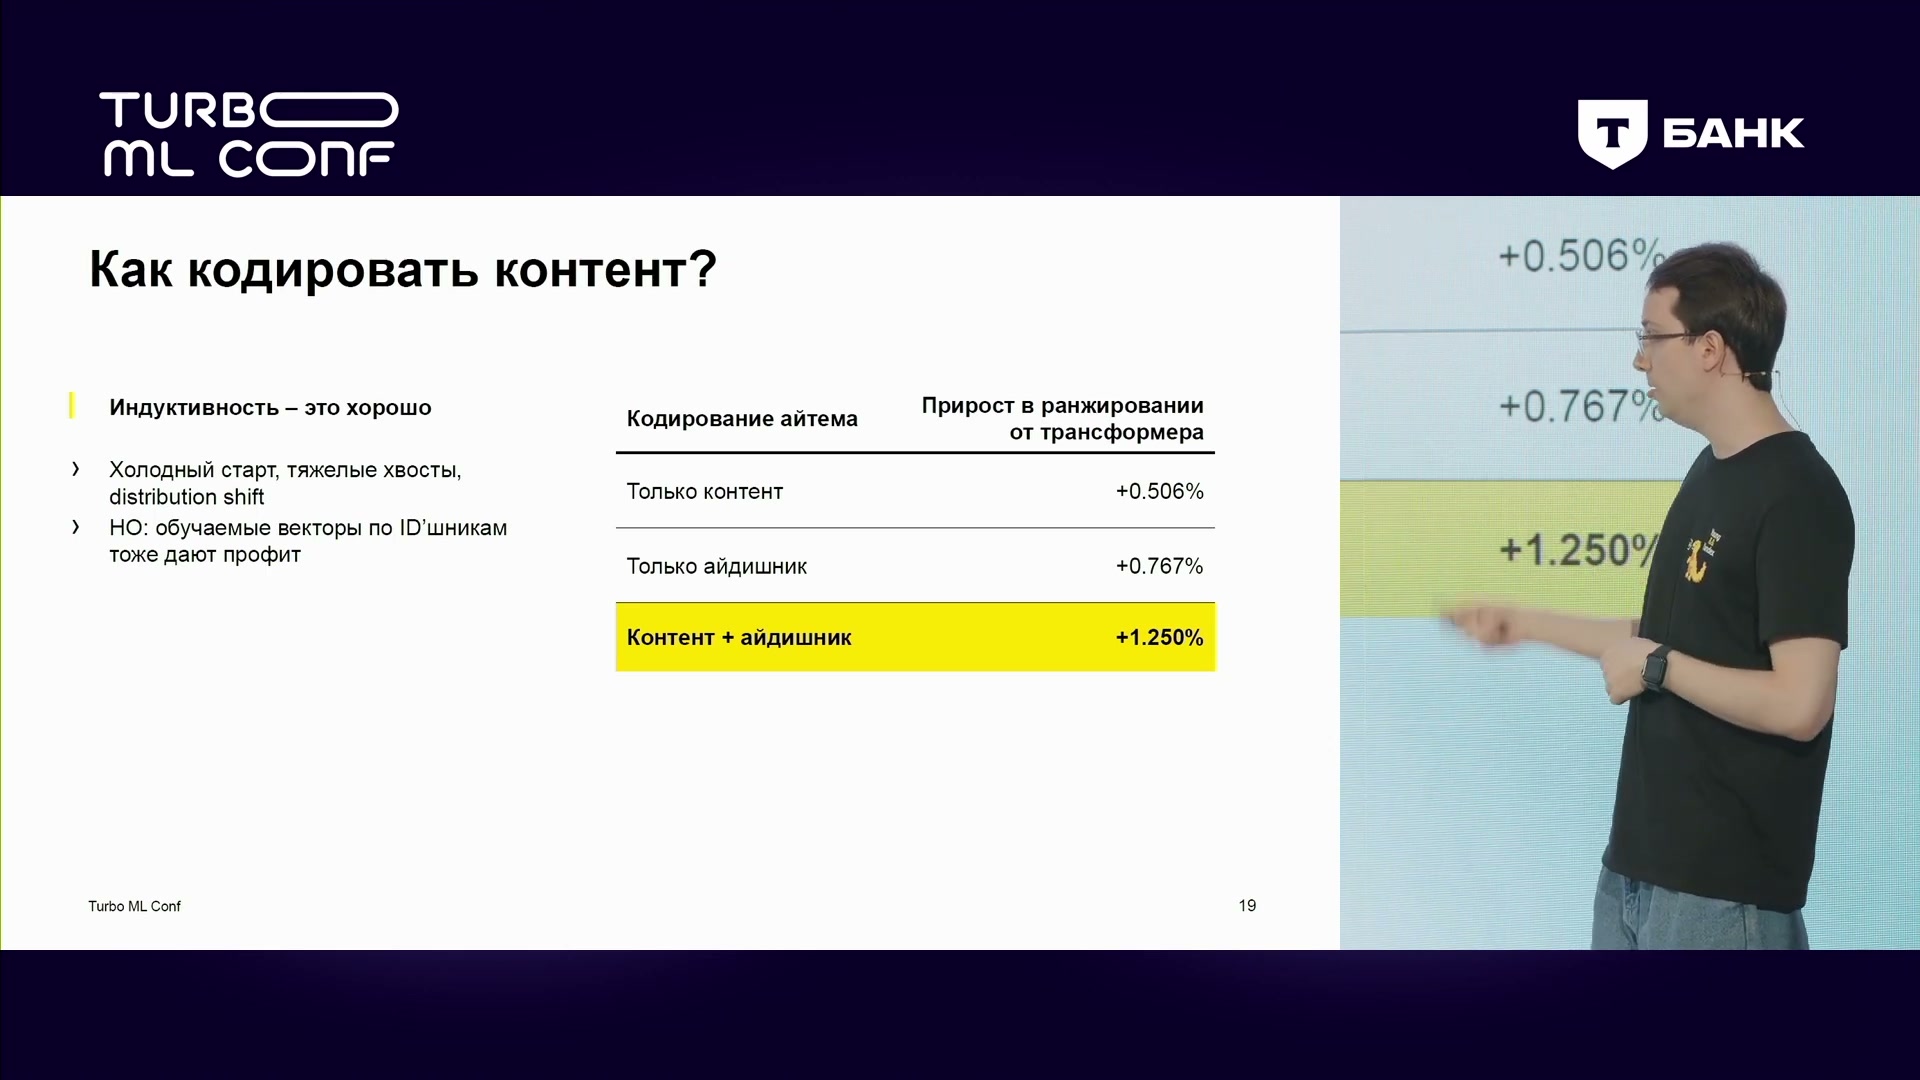
Ранжирование: контент +0,506%,ID +0,767%,совместно+1,250%; не метрики выручки.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Тип действия и позиция: отсчитывать от свежих событий
Содержание объекта не объясняет, что именно сделал с ним человек. Один и тот же товар можно открыть, добавить в корзину или купить. В музыкальной истории взаимодействие может быть положительным или отрицательным. Поэтому тип события кодируется собственным обучаемым вектором и добавляется к остальным сведениям о событии — простым сложением либо более сложным объединением.
Для положения события можно использовать обучаемые абсолютные позиционные представления: каждому номеру позиции соответствует вектор. Однако в истории рекомендаций автор советует нумеровать позиции в обратном порядке относительно привычного отсчёта от начала текста. Самые свежие события получают меньшие номера. Так номер описывает удалённость от актуального конца истории, а не только место в давно начавшейся последовательности.
Это правило относится к позиционному признаку. Оно само по себе не требует переворачивать порядок событий или менять направление внимания. Более сложные варианты также возможны: относительные позиции описывают взаимное расположение событий, а временные отметки дают информацию о том, когда взаимодействия произошли. На некоторых доменах такая информация приносила дополнительное качество.
Есть и обратное наблюдение: отдельные позиционные векторы нужны не всегда. При наличии каузальной маски, которая запрещает позиции обращаться к будущим событиям, в некоторых задачах от них можно отказаться. Это доменная оговорка, а не общее правило о бесполезности позиций для любого трансформера.
Чувствительность к позициям связана и со способом применения модели. Если представление пользователя рассчитали заранее и затем используют целый день, точность положения самых свежих событий уже не определяет предсказание так же, как при обработке актуальной истории на каждом запросе. Автор отмечает, что такие офлайн-модели менее чувствительны к позиционной информации. К этой разнице вернёмся при выборе архитектуры.
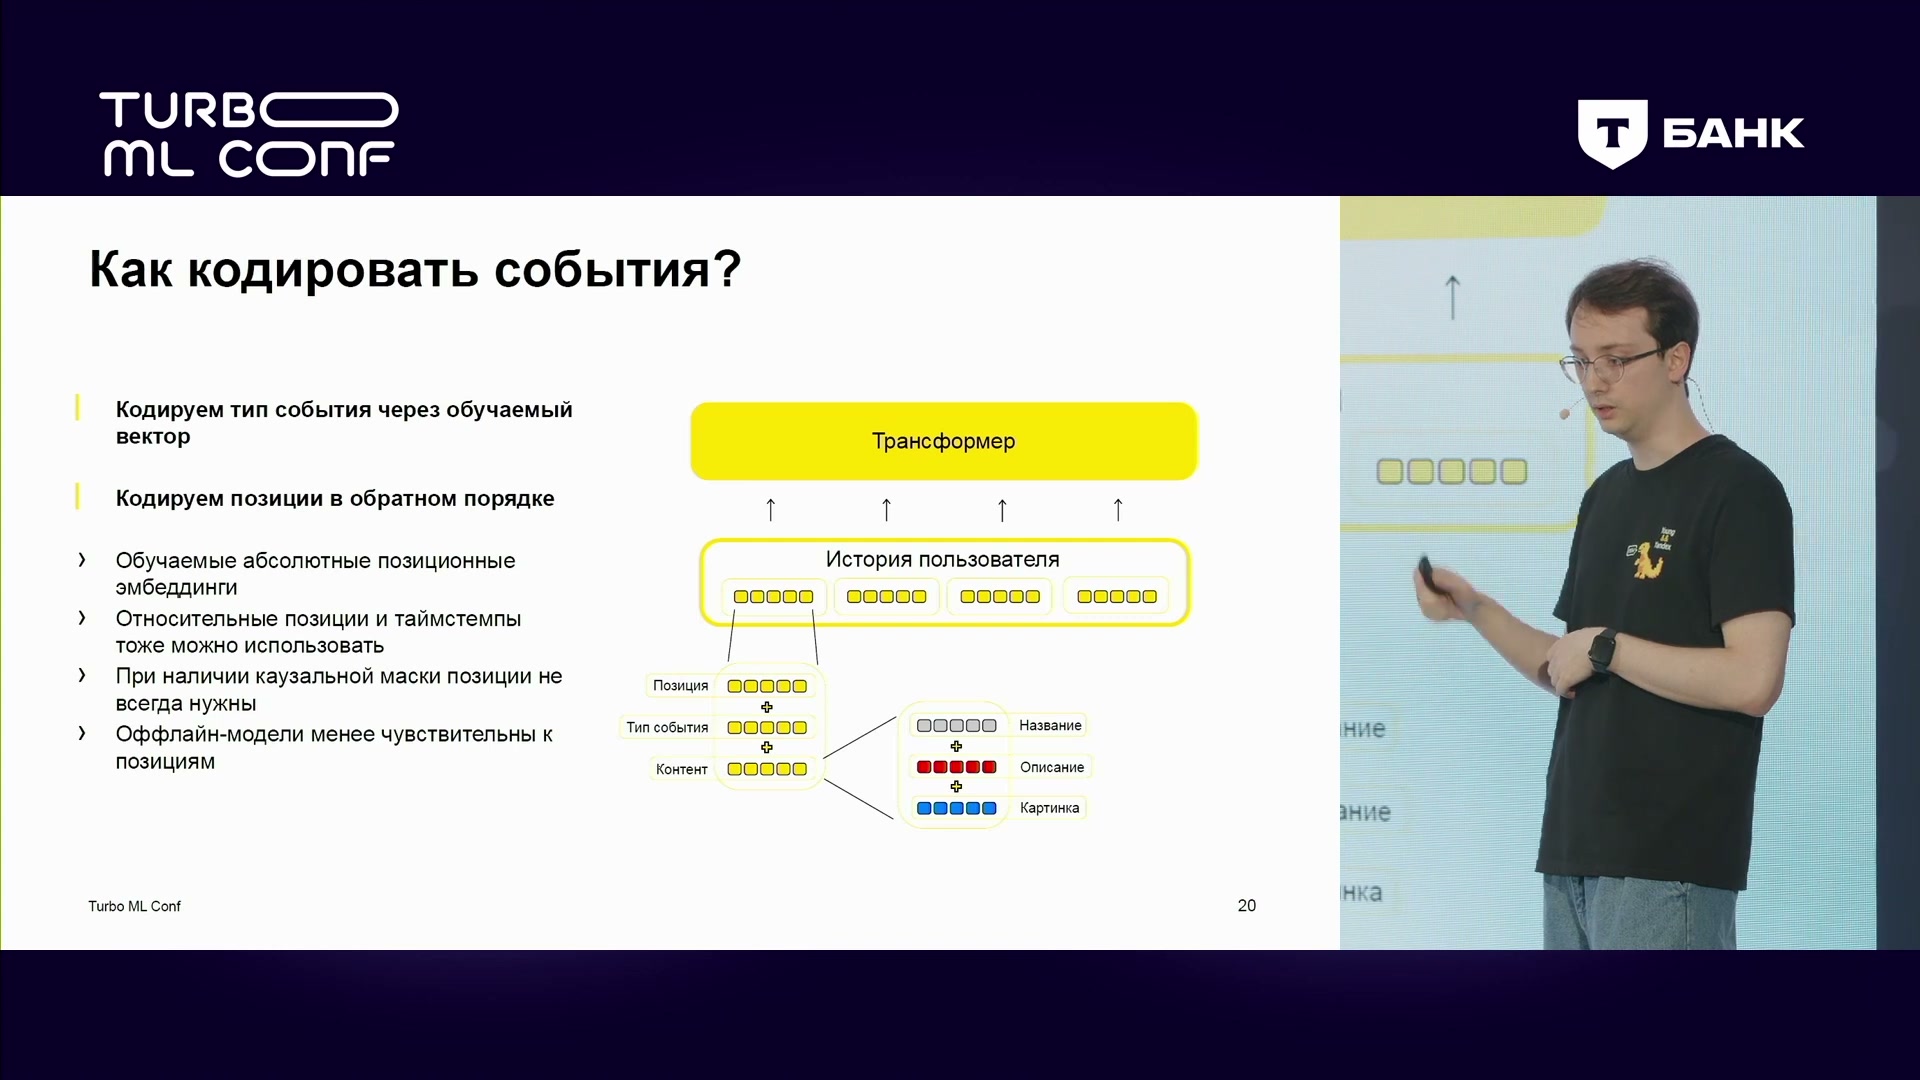
Тип события и обратные позиции; время, относительные позиции и каузальная маска имеют отдельные оговорки.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Кандидат внутри трансформера: полное взаимодействие, повторные вычисления
После построения векторов событий остаётся решить, где в модели появится объект, который нужно оценить. Начальный вариант команды был прямолинейным: закодировать историю пользователя, аналогично закодировать кандидата и передать всё в один трансформер. Тогда история обрабатывается уже с учётом того, для какого объекта требуется предсказание.
На схеме есть и служебный элемент CLS. Это не действие пользователя и не ещё один товар, а обучаемый вектор, добавленный в последовательность. После обработки трансформером из соответствующего выходного представления получают предсказание. Таким способом задаётся удобное место, откуда модель забирает итоговый сигнал для рассматриваемой пары пользователя и кандидата.
Архитектура называется кросс-энкодером, или моделью с ранним связыванием: кандидат и история взаимодействуют внутри общей нейросети. Цена такого устройства — необходимость повторять обработку для каждого нового кандидата. Если нужно ранжировать 3000 объектов, как в примере автора, трансформер запускается для каждого из них. История одного человека участвует в дорогостоящем вычислении снова и снова.
Именно повторение тяжёлой части, а не отказ от анализа истории, стало причиной следующего изменения. Нужно было отделить представление пользователя от конкретного кандидата настолько, чтобы его можно было использовать многократно при обработке одного запроса.
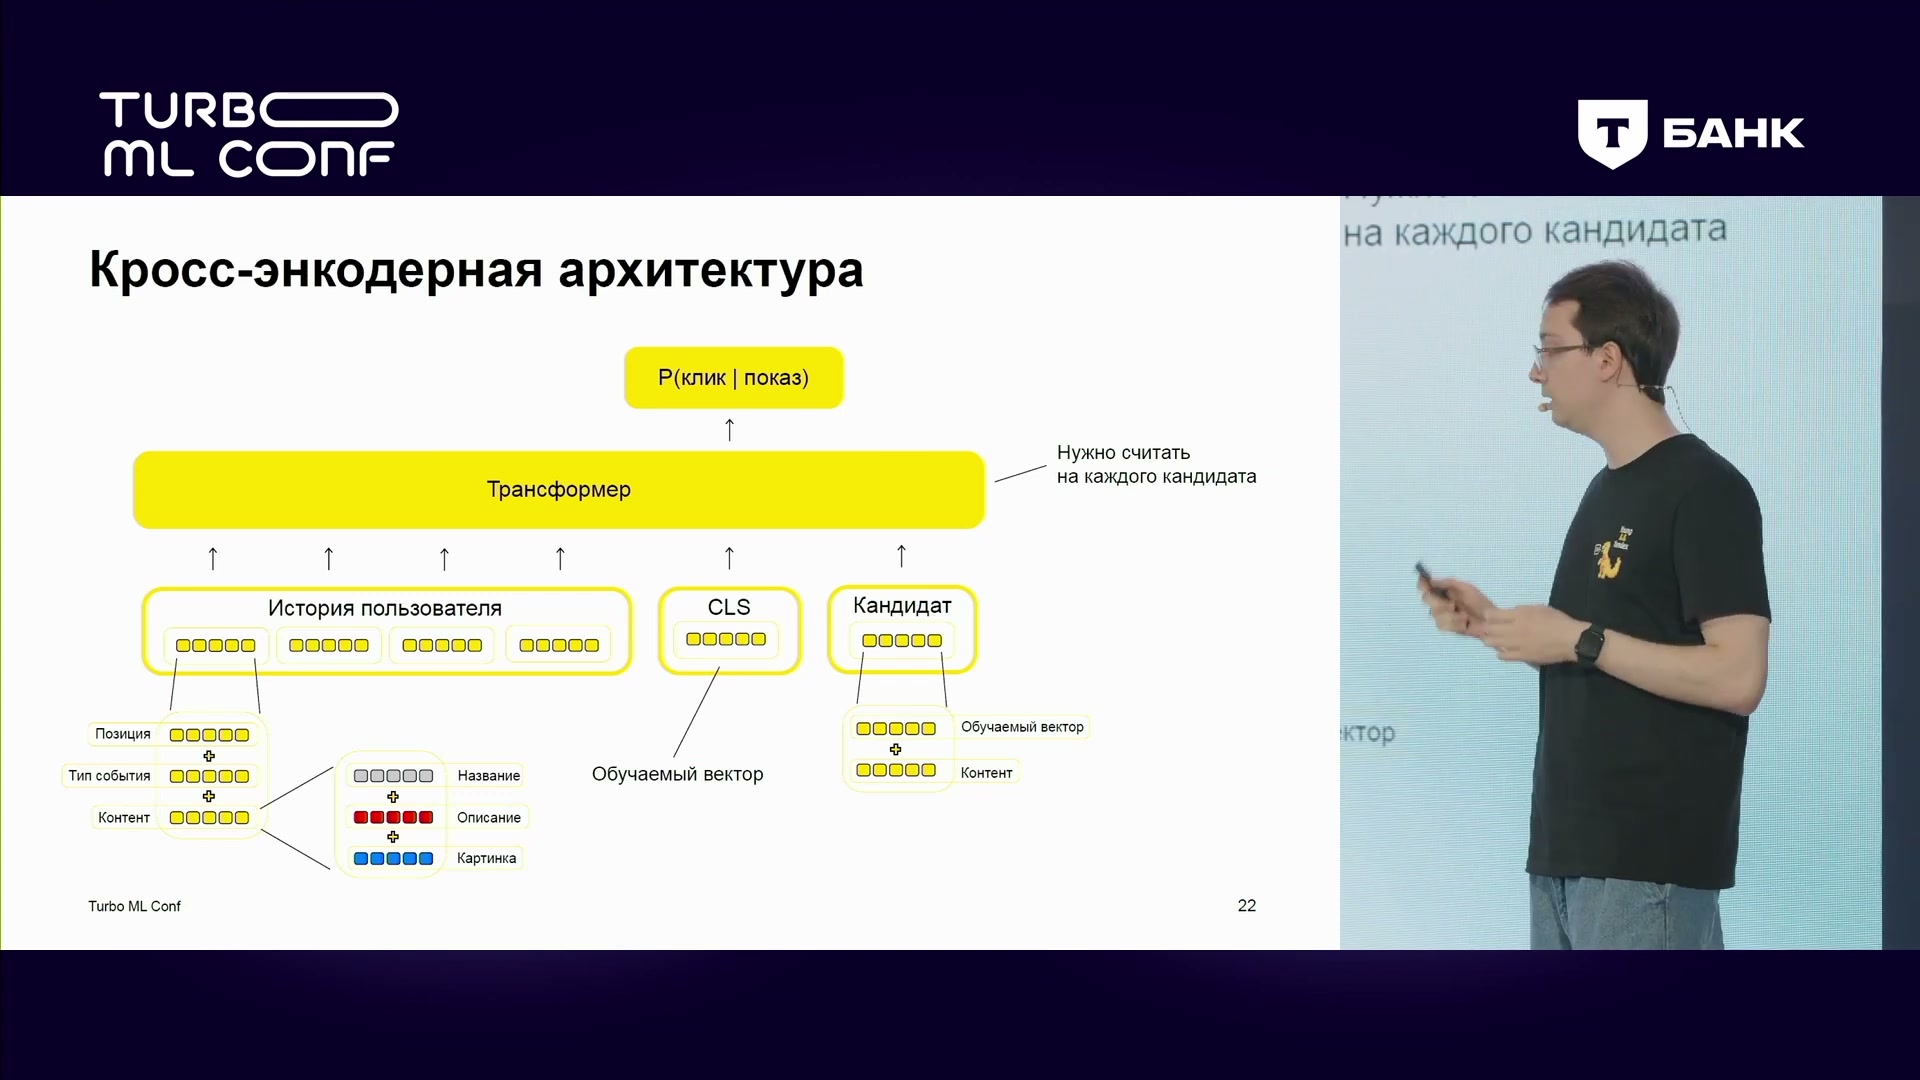
Кросс-энкодер совместно обрабатывает историю и конкретного кандидата, требуя вычислений на каждого кандидата.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Две башни: историю считать на запросе, кандидатов — заранее
В двухбашенной модели пользователя и кандидата обрабатывают разные части нейросети. Кандидата убрали из пользовательского трансформера: теперь тот получает историю и обучаемый CLS, а затем строит представление пользователя. Важнейшая граница на схеме — эта обработка происходит один раз на пользовательский запрос, с доступной в этот момент историей.
Кандидат проходит отдельную полносвязную сеть MLP. Его вектор можно вычислить заранее, вне обработки запроса, и положить в хранилище «ключ — значение», обозначенное на слайде как KV-storage. При оценивании объектов система получает уже готовые представления. Таким образом, офлайн-расчёт кандидатов не означает, что вектор пользователя тоже рассчитан заранее: в этом варианте пользовательская часть остаётся в запросе.
После единственного запуска трансформера полученное представление сопоставляется с векторами кандидатов. Автор называет скалярные произведения: они дают числовую оценку соответствия двух представлений без повторного анализа всей истории для каждого объекта. На исходной схеме результат используется для предсказания реакции при условии показа.
Для примера с 3000 кандидатами меняется число запусков пользовательского трансформера: вместо 3000 нужен один. Это сокращение конкретной повторяющейся операции, а не измеренное ускорение всего запроса в 3000 раз. Получение готовых векторов, сопоставление с кандидатами и дальнейшее ранжирование остаются частью работы. По словам автора, разделение заметно облегчило вычисления, сохранив большую пользу для качества.
Смысл двух башен — перенести независимые от пользователя вычисления в предварительную обработку и не повторять общую историю внутри одного запроса. Такой разрез архитектуры сохраняет возможность реагировать на свежие действия человека, потому что пользовательский трансформер всё ещё выполняется при обращении к системе.
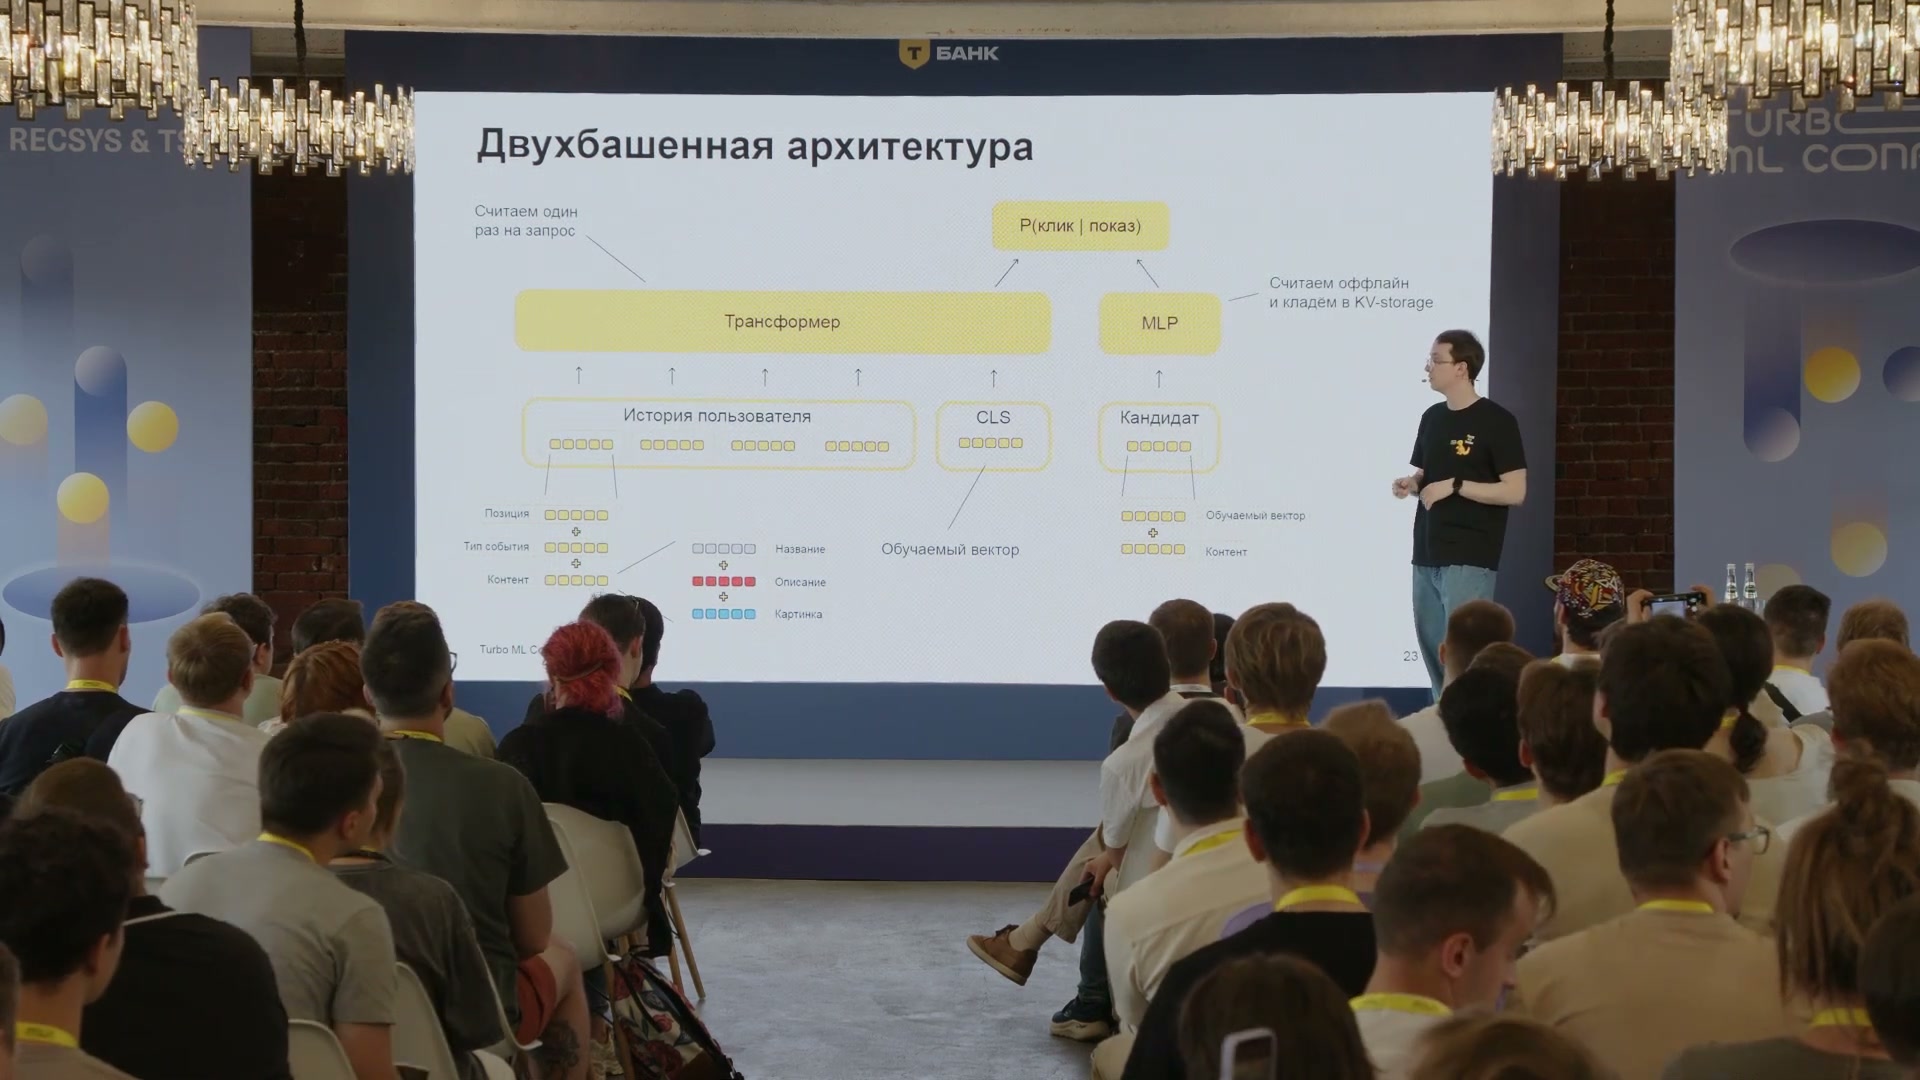
Две башни: история — один раз на запрос; кандидаты — заранее в KV-хранилище. CLS обучается.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Отдельный компромисс: заранее считать и пользователя
Следующий вариант меняет уже не только обработку кандидатов. Вектор пользователя тоже рассчитывается заранее и некоторое время используется без пересчёта. Во время запроса модель опирается на подготовленное представление, в котором отсутствуют самые свежие события. Это отдельная офлайн-модель, а не другое название двухбашенной схемы с единственным запуском трансформера на запросе.
Возникающую задержку данных, или лаг, эмулируют при обучении. Учебная история должна воспроизводить то запаздывание, с которым представление будет доступно при применении. Иначе модель обучалась бы на более свежей информации, чем та, которую получает в выбранном рабочем режиме. На схеме задержка отделяет доступную историю от последующих событий и оцениваемого взаимодействия.
Переход упрощает внедрение и снижает требования к вычислениям во время запроса, но свежесть сигнала ухудшается. Автор предлагает приблизительную оценку: такой вариант «в два раза хуже» модели с актуальными данными, зато «в десять раз легче» внедряется. Эти выражения описывают его опыт выбора компромисса. Они не привязаны к единой метрике качества, формальному измерителю трудоёмкости или гарантированному времени ответа.
Тем, кто только начинает применять трансформерную персонализацию в компании, автор советует рассматривать офлайн-вариант как исходную точку. Идея не в том, что свежие действия не нужны, а в возможности сначала получить пользу от истории при более простом применении модели. Дальнейший переход к расчёту на запросе возвращает актуальность данных, но требует другой организации вычислений.
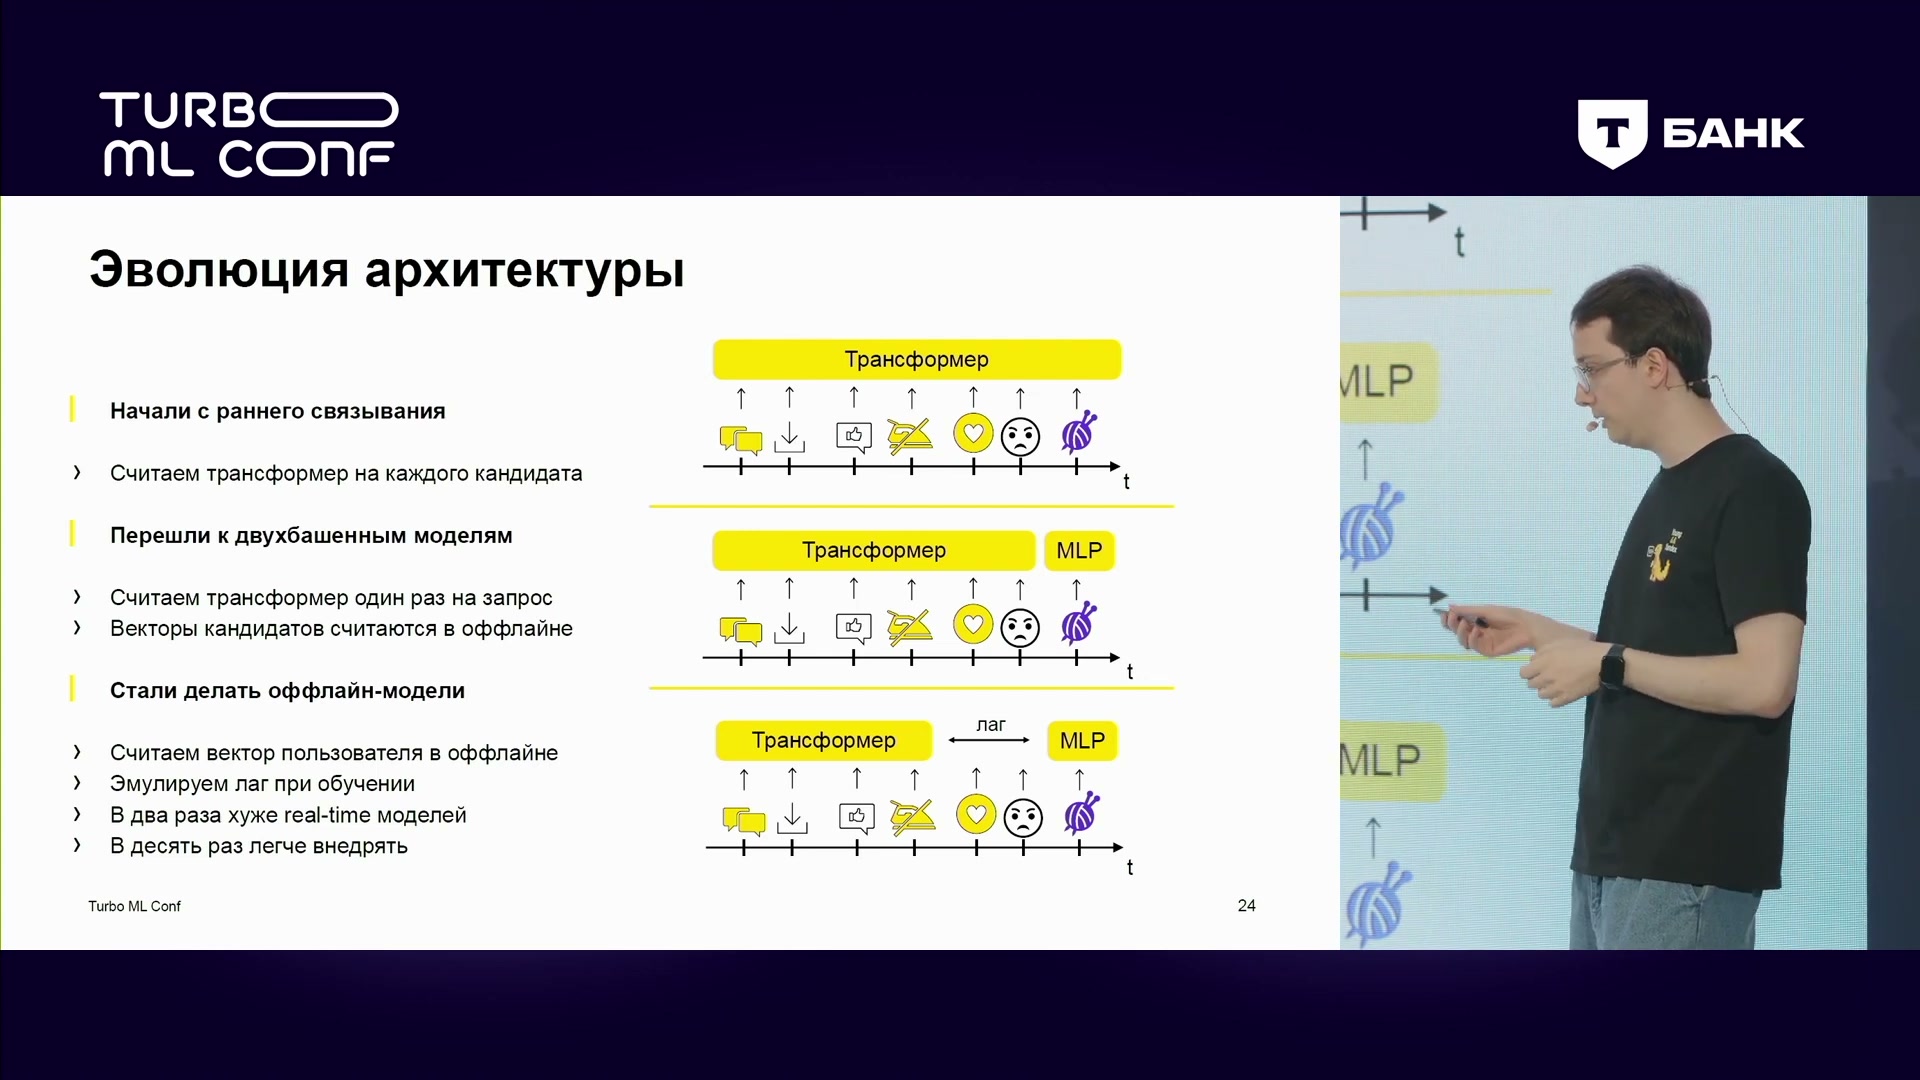
От раннего связывания к двум башням и офлайн-моделям с эмуляцией задержки данных.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Учить признак той задаче, которую решает ранжировщик
Первой задачей трансформера в этом развитии было не самостоятельное формирование всей выдачи, а создание сильного признака для градиентного бустинга. На схемах основной ранжировщик — CatBoost. Он получает множество признаков кандидата, и к ним добавляется оценка нейросети, проанализировавшей историю пользователя.
Если нейросеть готовит признак для ранжирования, её нужно учить задаче ранжирования. Автор подчёркивает, что такие модели обычно обучаются на объектах, непосредственно показанных пользователю. Они оценивают не просто будущее действие, а реакцию при условии, что рекомендация попала в показ. Для клика эта разница записана как P(клик | показ) в противопоставлении P(клик). Условие показа меняет постановку, даже если история пользователя остаётся той же.
Популярное предсказание следующего объекта, Next Item Prediction, отвечает на другой вопрос: с каким объектом человек будет взаимодействовать дальше. В описанном сравнении такая модель не учится непосредственно оценивать реакцию при заданном показе. Её оценку всё ещё можно добавить в ранжирование и получить некоторую пользу, но автор сообщает о меньшем эффекте, чем при обучении нейросети именно ранжированию.
Согласование не заканчивается названием функции потерь. Для нейросети нужны та же цель и то же распределение объектов, на которых обучается ранжировщик. При пообъектном обучении качество предсказания проверяется для отдельных примеров, при попарном — модель учится правильно упорядочивать пары. Если CatBoost обучается на парах, пары для нейросети следует образовывать тем же способом. Иначе даже одинаковая функция потерь будет решать отличающуюся задачу.
Здесь становится ясно, почему рекомендация не добавлять все показы в историю не противоречит обучению на показах. История — прошлые сведения, по которым модель понимает человека. Обучающий пример — показанный объект и реакция на него, которую требуется предсказать. Можно исключить шумные показы из входной последовательности и при этом использовать именно показанные объекты для обучения ранжирующего признака.
Так трансформер встраивается в уже существующую систему не только через формат выхода. Он получает задачу, согласованную с тем, как этот выход будет использоваться. Следующий вопрос — сколько информации о человеке можно передать бустингу через одну такую оценку.
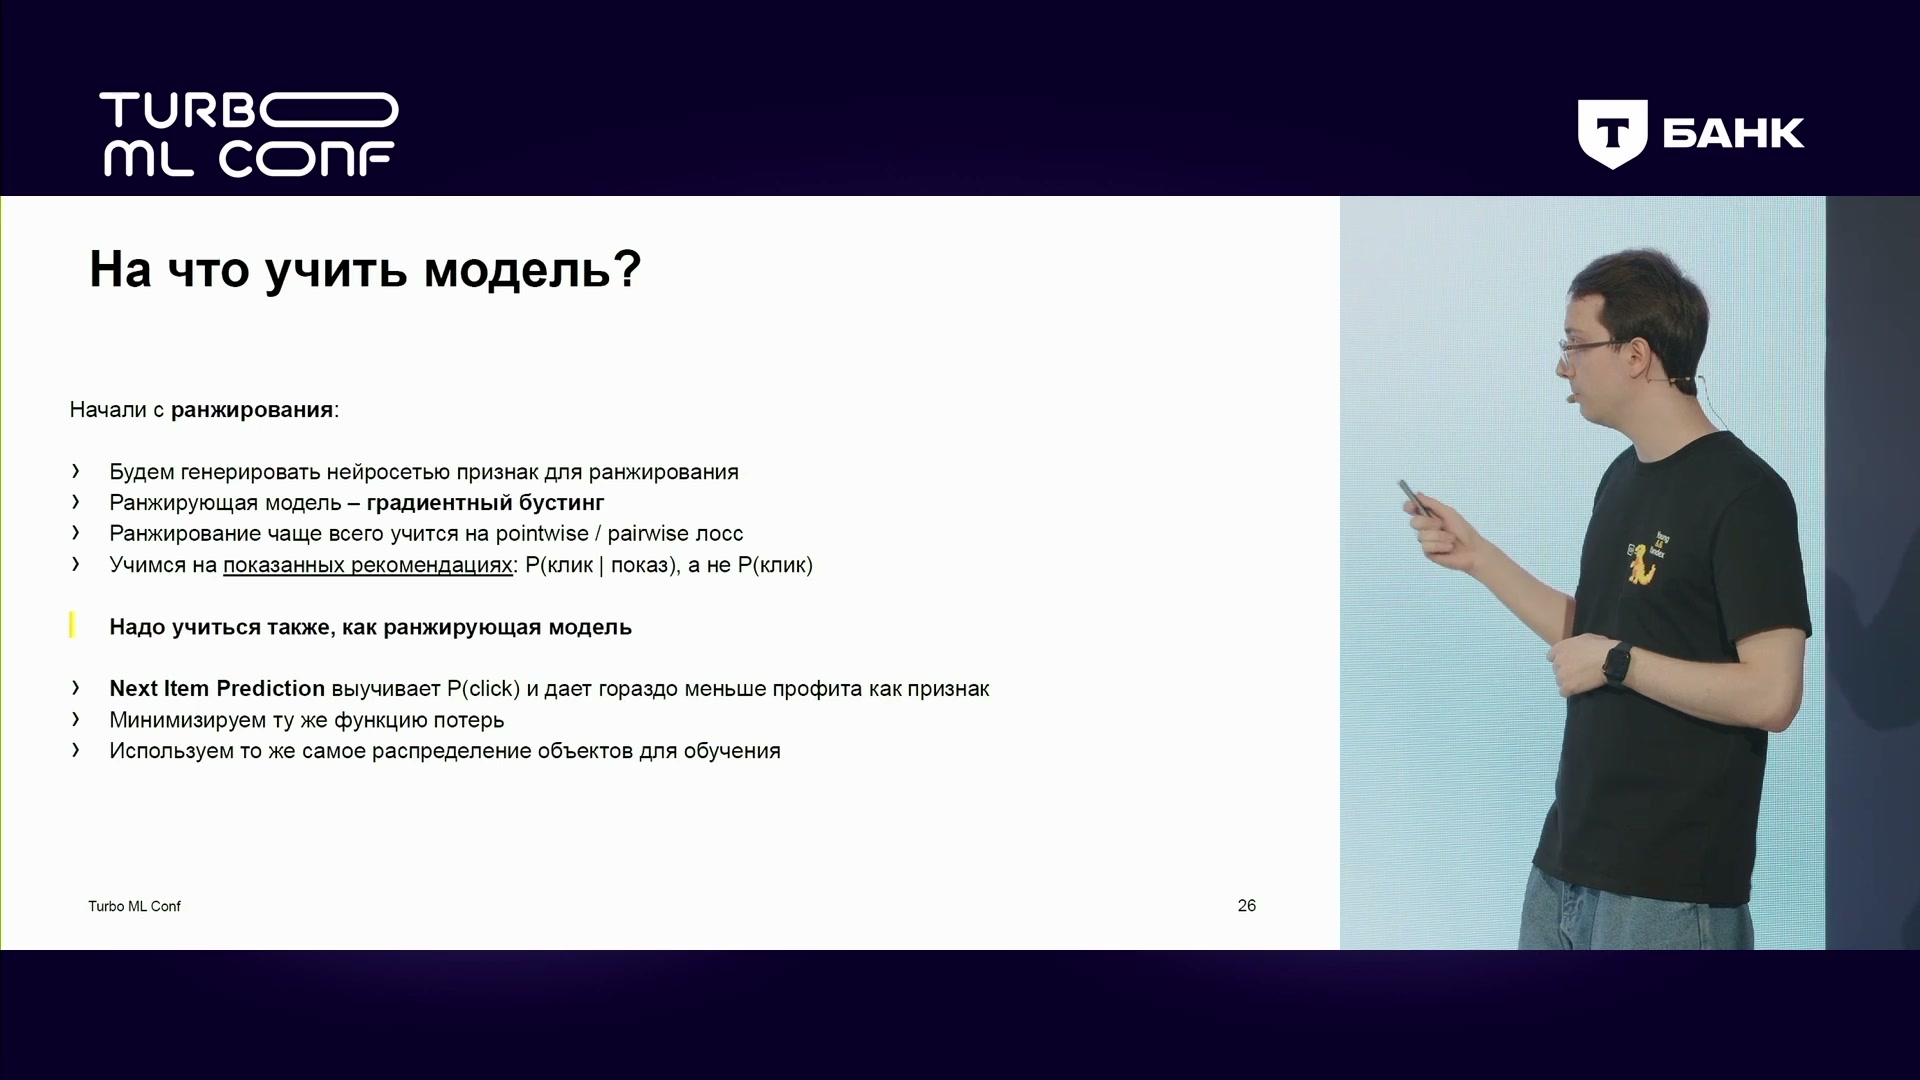
Признак для ранжирования учится на показанных объектах и цели ранжировщика, а не просто на следующем объекте.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Полезный признак ещё не обязан быть откалиброванной вероятностью
Добавление нейросетевой оценки в CatBoost вызывает понятное опасение: останется ли её масштаб удобным для бустинга? Попарное обучение не гарантирует одинаковую шкалу между разными запросами. Кроме того, нейросеть дообучается, и её выходы могут меняться вместе с весами.
Калибровкой здесь называют дополнительное согласование оценок; для вероятностей это означает соответствие прогнозируемых значений наблюдаемым частотам. Казалось бы, без такого шага новый признак может стать неудобным для ранжировщика. Однако автор сообщает, что в практике команды явная калибровка часто не требовалась: признак хорошо работал и после попарного обучения, и при дальнейшем дообучении нейросети.
Это наблюдение относится к пользе выхода как входного признака CatBoost. Оно не означает, что число автоматически стало корректной вероятностью или что калибровка вообще не бывает нужна. На схеме задача бустинга — использовать оценку вместе с остальными признаками для ранжирования, а не обязательно трактовать её как самостоятельный точный прогноз частоты клика.
При этом схема обнаруживает другую границу: из большой нейросети, обработавшей глубокую историю, в CatBoost попадает всего один скаляр. Даже пригодная по масштабу оценка может передавать слишком мало информации. Поэтому дальнейшие изменения расширяют не историю и не бустинг, а набор выходных сигналов нейросети.
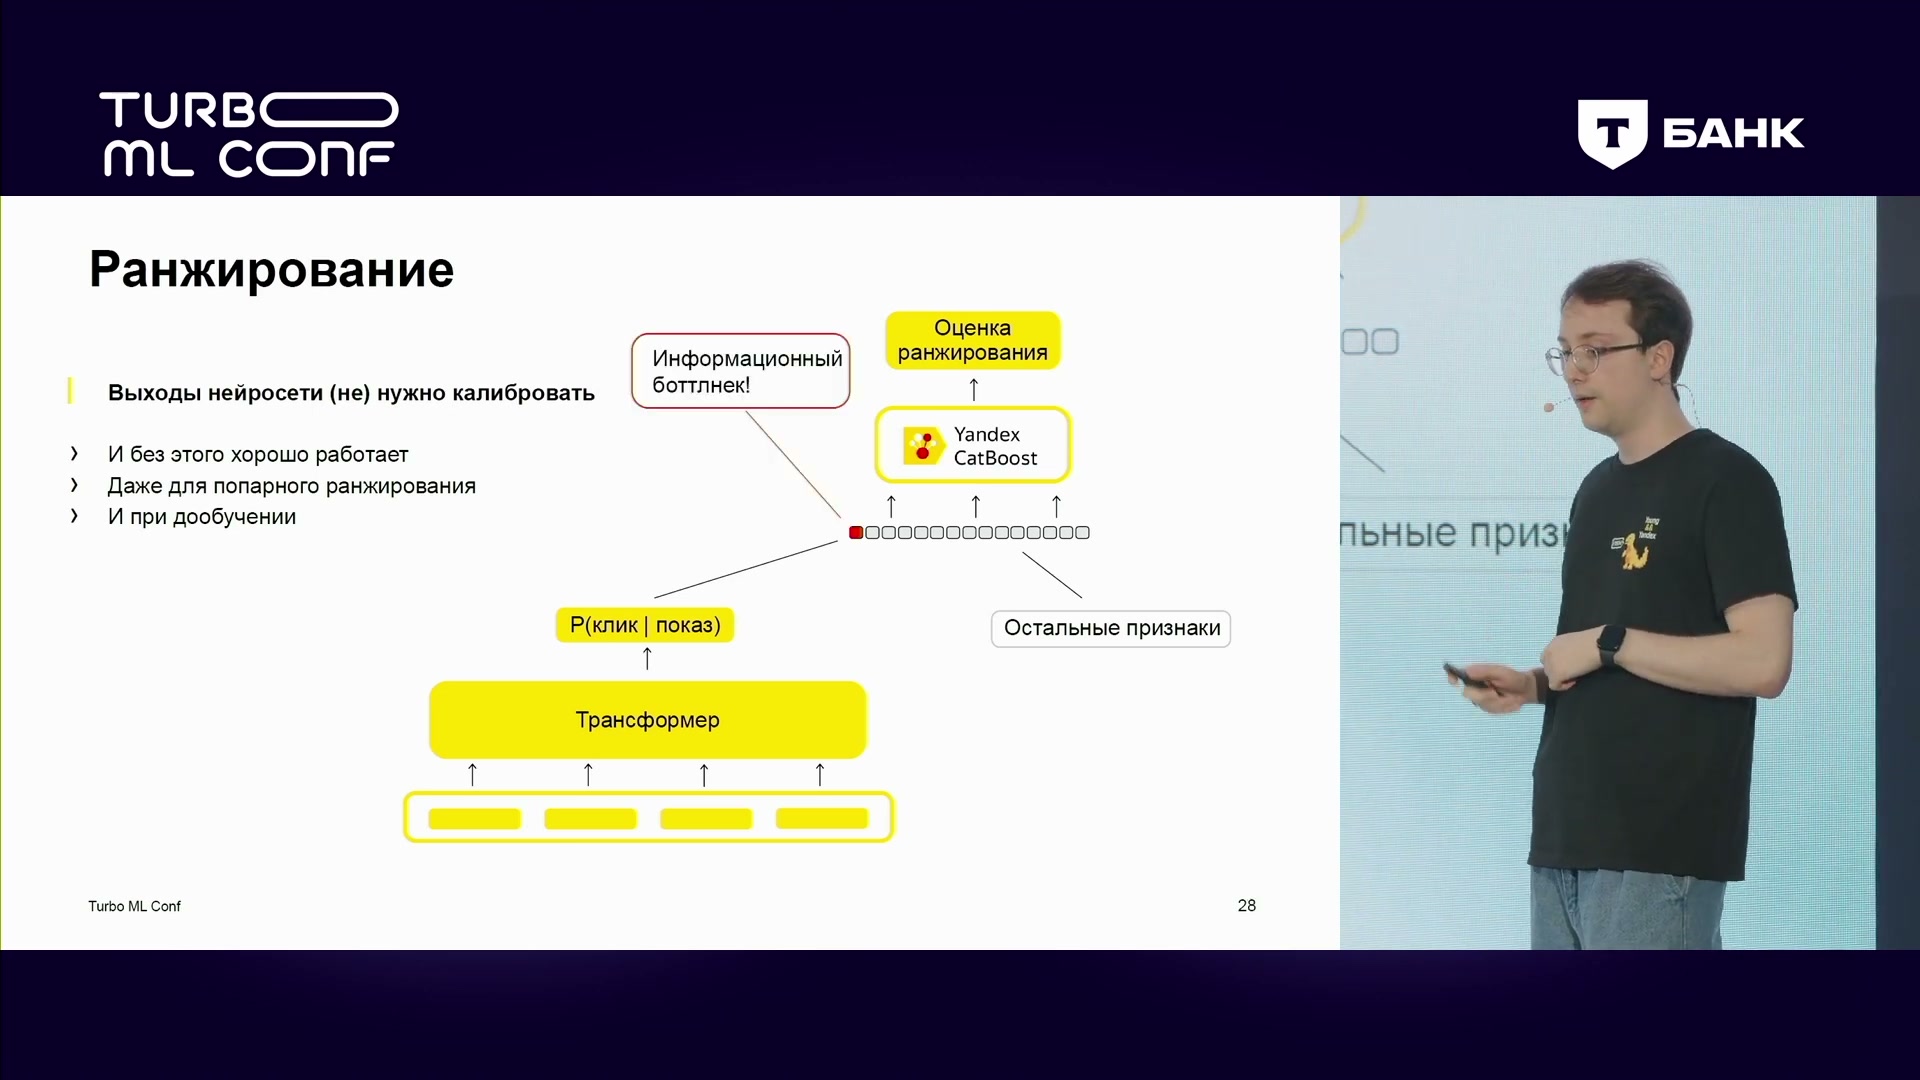
Одна нейросетевая оценка ограничивает информацию для CatBoost; явная калибровка не всегда нужна.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Несколько действий — несколько признаков вместо одного числа
Одно число — очень сильное сжатие результатов анализа истории. Автор называет эту границу информационным узким местом: большая модель могла обнаружить разные стороны интереса пользователя, но бустинг видит только их единственную итоговую оценку. Увеличение самой нейросети не обязательно решит проблему передачи информации дальше.
В сервисе обычно наблюдаются разные действия: клики, добавления в корзину, покупки. Для ранжирования их могут объединять в одну целевую метку. На уровне нейросети автор предлагает разъединить сигналы: добавить отдельные выходные модули, или головы, которые предсказывают разные типы действий на основе общей обработки истории. Такое совместное обучение нескольким задачам называют многозадачным.
На исходной схеме показаны две оценки: P(клик | показ) и P(покупка | показ). Обе поступают в CatBoost отдельными признаками, вместе с остальными данными кандидата. Бустинг получает возможность учитывать их по отдельности, а не только через заранее смешанную нейросетью величину. По опыту автора, такое разделение обычно приносило больше пользы.
Надпись об уменьшении узкого места «в 2 раза» иллюстрирует переход от одного выходного сигнала к двум. Это не измеренное удвоение качества и не количественная оценка объёма информации. Существенное изменение здесь устроено проще: разные цели получают разные выходы, а следующий ранжировщик сам использует их сочетание.
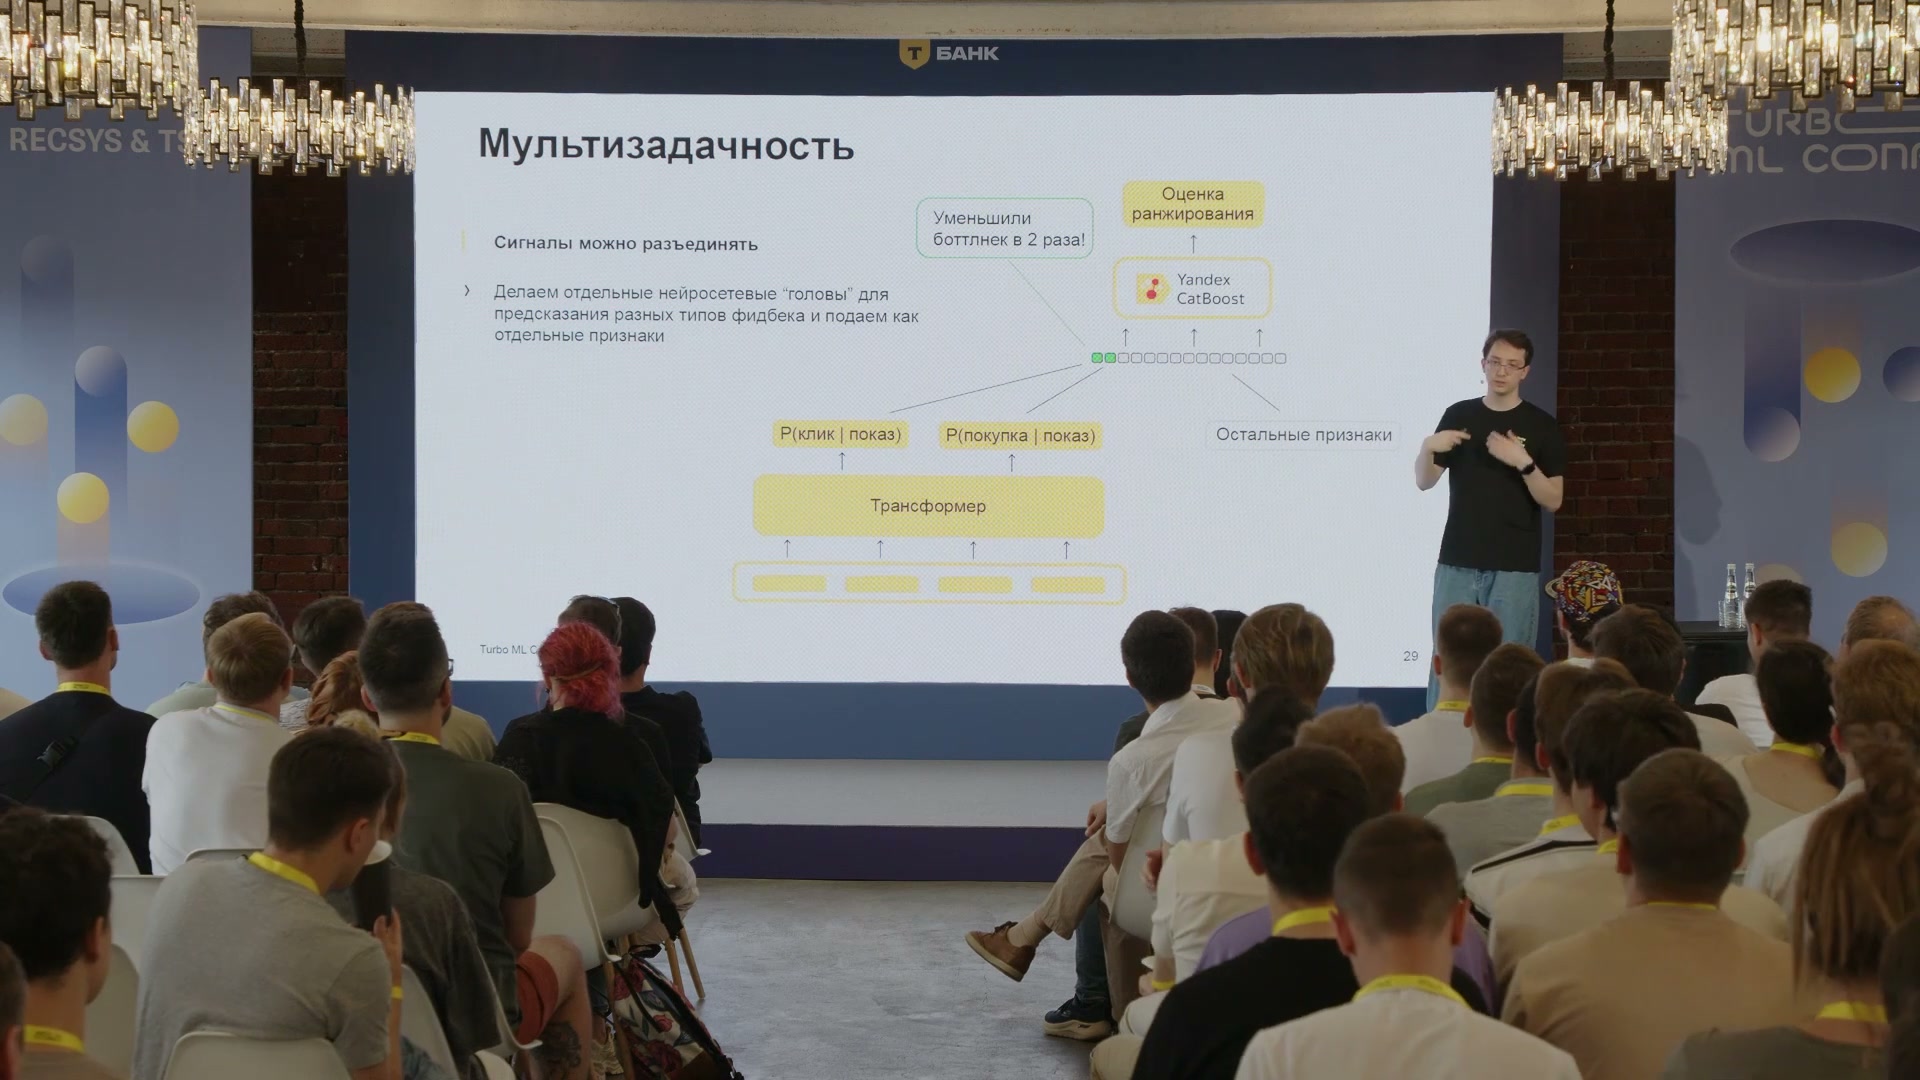
Многозадачное обучение: отдельные головы для клика и покупки передают разные признаки.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Даже для одной цели можно передать несколько оценок
Разделить клики и покупки удобно, когда продукт действительно содержит несколько целевых действий. Но иногда требуется предсказывать только одну характеристику. Автор предлагает и в этом случае не ограничивать выход трансформера одним числом: можно получить несколько оценок и объединять их в итоговое предсказание при обучении.
На схеме этот подход назван смесью экспертов, Mixture of Experts. Над общим трансформером показаны несколько выходов E1, E2 и E3. Их объединённое предсказание используется в функции потерь, а отдельные выходы можно передавать бустингу самостоятельными признаками. Получается другой способ расширить связь нейросети с ранжировщиком: не разные типы действий, а несколько сигналов для одной задачи.
Важная деталь касается объединения выходов. Логит — это оценка до преобразования в вероятность. Автор отмечает, что при усреднении лучше использовать уже вероятности, а не логиты: в описанном подходе это давало больше пользы. Поэтому нельзя незаметно заменить показанное объединение вероятностей средним по исходным оценкам.
Описанная смесь работает на уровне выходных сигналов. При обучении они участвуют в одном итоговом прогнозе, но для следующего ранжировщика сохраняются раздельными. Это продолжает идею многозадачной схемы: передать бустингу больше результатов анализа истории, только теперь несколько признаков получаются не из разных целевых действий, а из нескольких выходов для одной цели.
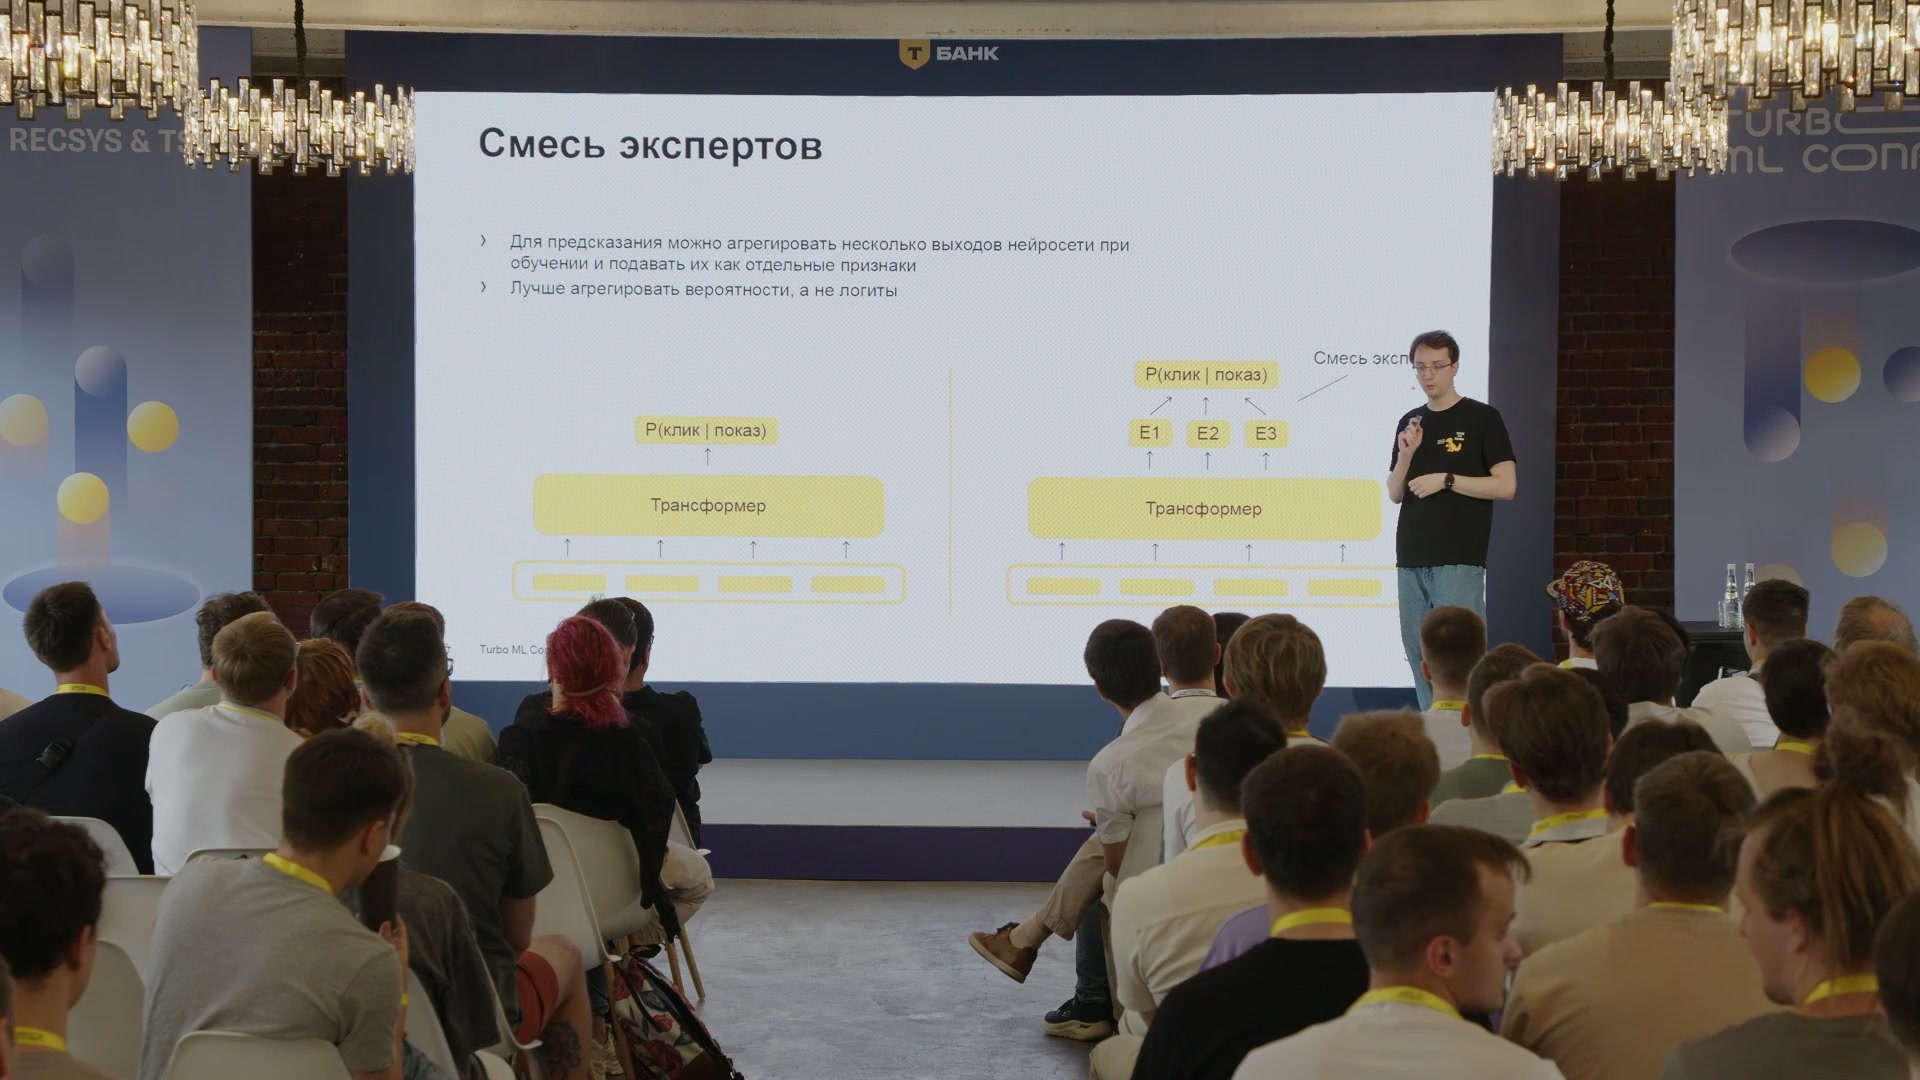
Смесь экспертов: агрегирование вероятностей показало себя лучше агрегирования логитов в описанном подходе.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Отбор из каталога требует другого сравнения объектов
Трансформеры стали использовать для отбора кандидатов позже, чем для признаков ранжирования. Здесь изменяется не только место модели в системе, но и набор объектов, среди которых она должна принимать решение. Ранжировщик учился на показанных рекомендациях — особом срезе каталога. При отборе нужно находить подходящее среди гораздо более широкого множества.
Автор предупреждает: если просто взять модель с ранжирующей функцией потерь и оценить ею весь каталог, можно получить много неподходящих кандидатов. В каталоге есть объекты, которые обычно не доходят до показа и выглядят «лёгкими» с точки зрения задачи отбора. Обучение только на срезе показов не гарантирует, что модель будет правильно оценивать и их. Поэтому цель ранжирования не переносится на отбор автоматически.
Для отбора предлагается сравнивать положительный объект со всей коллекцией через softmax — нормирование оценок, превращающее их в распределение по сравниваемым вариантам. Обучение должно повышать значение для объекта, с которым пользователь положительно взаимодействовал. Если каталог невелик, полный расчёт возможен; автор приводит пример с 10–20 тысячами объектов. Для крупных каталогов сравнение с каждым объектом становится слишком дорогим.
Тогда используют sampled softmax: положительный объект сравнивается не со всей коллекцией, а с выбранным набором отрицательных примеров — объектов, которые в данном обучающем сравнении нужно оценить ниже. Пусть u — вектор пользователя, i — вектор положительного объекта, N — набор отрицательных объектов. Скалярное произведение двух векторов задаёт оценку их соответствия, а экспонента превращает её в положительный вес. На слайде показано следующее нормирование.
Запись со слайда: вероятность положительного объекта среди него самого и выбранных отрицательных объектов. Обозначение L сохранено.
В числителе находится вес положительного объекта, в знаменателе — суммарный вес всех сравниваемых вариантов. Несмотря на букву L, эта запись показывает вероятность, которую хотят увеличить, а не полную минимизируемую функцию потерь: минус-логарифма в ней нет. Поэтому читать её как предписание минимизировать показанную дробь было бы неверно. Для смысла метода достаточно различать нормированную вероятность и функцию потерь, через которую её оптимизируют.
Отрицательные примеры команда собирает из общего обучающего пакета — это приём in-batch negatives. Для данного примера другие объекты пакета становятся участниками сравнения. Существенная деталь исходного слайда: объекты собираются со всех GPU, то есть со всех видеокарт, участвующих в обучении, а не только из локального пакета одной карты.
Отдельно применяется поправка logQ, учитывающая вероятность попадания объекта в выборку отрицательных примеров. Автор отмечает её пользу для качества отбора. На слайде поправка перечислена отдельным пунктом, но не включена в показанную дробь. Поэтому исходное выражение иллюстрирует нормирование оценок без раскрытия расчёта Q и способа внесения этой поправки.
Такую задачу используют и для предварительного обучения модели ранжирования. По объяснению автора, она проще непосредственного ранжирования и для неё обычно доступно больше данных. Противоречия с требованием учить ранжирующий признак правильной цели нет: предварительная подготовка представлений и готовая оценка, которую без дальнейшего согласования подают в CatBoost, — разные способы использовать модель.
Для офлайн-отбора возникает ещё один вариант цели — предсказание будущего положительного взаимодействия, Future Item Prediction. Нужно предсказать не обязательно следующий объект сразу после доступной истории, а то, с чем человек будет взаимодействовать на более отдалённом горизонте. Автор приводит действие через день или через больший промежуток времени. Один день здесь пример, а не обязательная настройка всех моделей.
Так обучение снова связывается со способом применения: для оценки показанных кандидатов важна условная реакция, для отбора из каталога — сравнение с широким набором альтернатив, для заранее подготовленных рекомендаций — подходящий горизонт будущего действия. Одна и та же идея анализа истории не делает эти задачи взаимозаменяемыми.
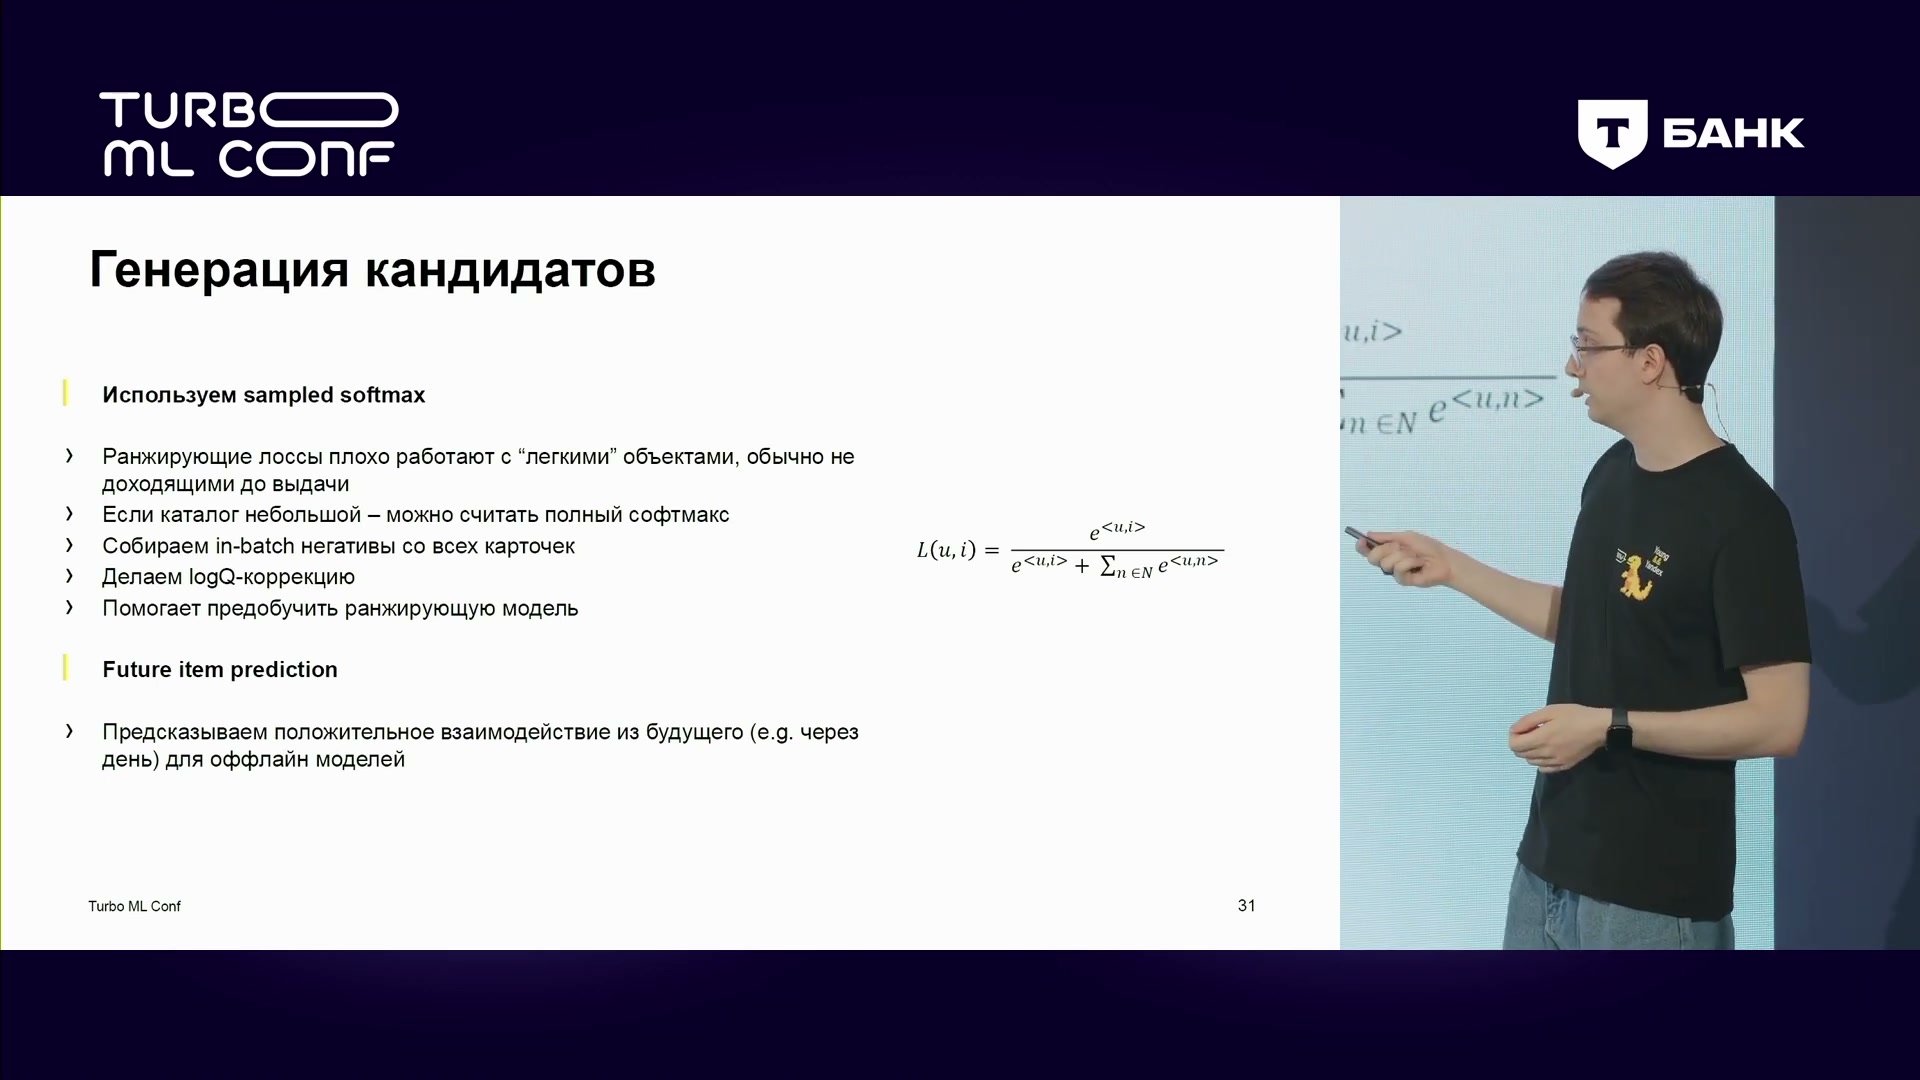
Отбор кандидатов: sampled softmax, отрицательные примеры из общего пакета и logQ-поправка; отдельно — прогноз будущего действия.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Свежие веса, контекст запроса и одинаковая история в данных
После выбора истории, архитектуры и цели остаётся поддерживать модель в рабочем состоянии. Автор отмечает, что дообучение необходимо, хотя более индуктивная модель, сильнее опирающаяся на содержание, меньше теряет от устаревания, чем модель с большой зависимостью от конкретных ID. Способность представить новый объект не означает, что поведение пользователей перестаёт меняться.
На слайде указан еженедельный цикл дообучения на новых данных. Используется продолжение с предыдущих весов, warm start, а не новая случайная инициализация. Это обновление параметров нейросети: накопленные представления постепенно изменяются с учётом следующих данных.
От него нужно отделять ежедневный пересчёт офлайн-моделей. В контексте заранее подготовленных представлений это применение готовой модели для получения свежих векторов, а не ежедневное обучение её весов. У системы два разных вида обновления: еженедельно продолжается обучение, ежедневно обновляются результаты офлайн-применения. Их смешение скрывает, откуда именно берётся свежесть информации.
Для модели, выполняемой при запросе, важен и текущий контекст рекомендации. В Поиске это прежде всего запрос, который человек ввёл сейчас. Его кодируют по тем же принципам и передают в трансформер отдельным событием, то есть отдельным токеном последовательности событий. Текущий запрос дополняет прошлую историю; он не заменяется тем, что какие-то запросы уже встречались раньше.
Наконец, пользовательская история — сложный составной вход. Автор советует сразу сохранять в логах то, что подаётся модели, и то, что она предсказывает, а затем выполнять перекрёстные проверки. Особенно важно согласовать историю в работающей системе с историей, доступной в сохранённых данных. Если они различаются, можно проверять один вход, а применять модель к другому, не замечая расхождения.
Поэтому проверка модели не сводится к правильности вычисления нейросети. Нужно убедиться, что сама последовательность, её поля и контекст соответствуют ожидаемым данным. На этом акценте автор завершает доклад: полезность трансформера зависит не только от выбранной функции потерь, но и от того, что реальная история пользователя доходит до него без незаметной подмены.
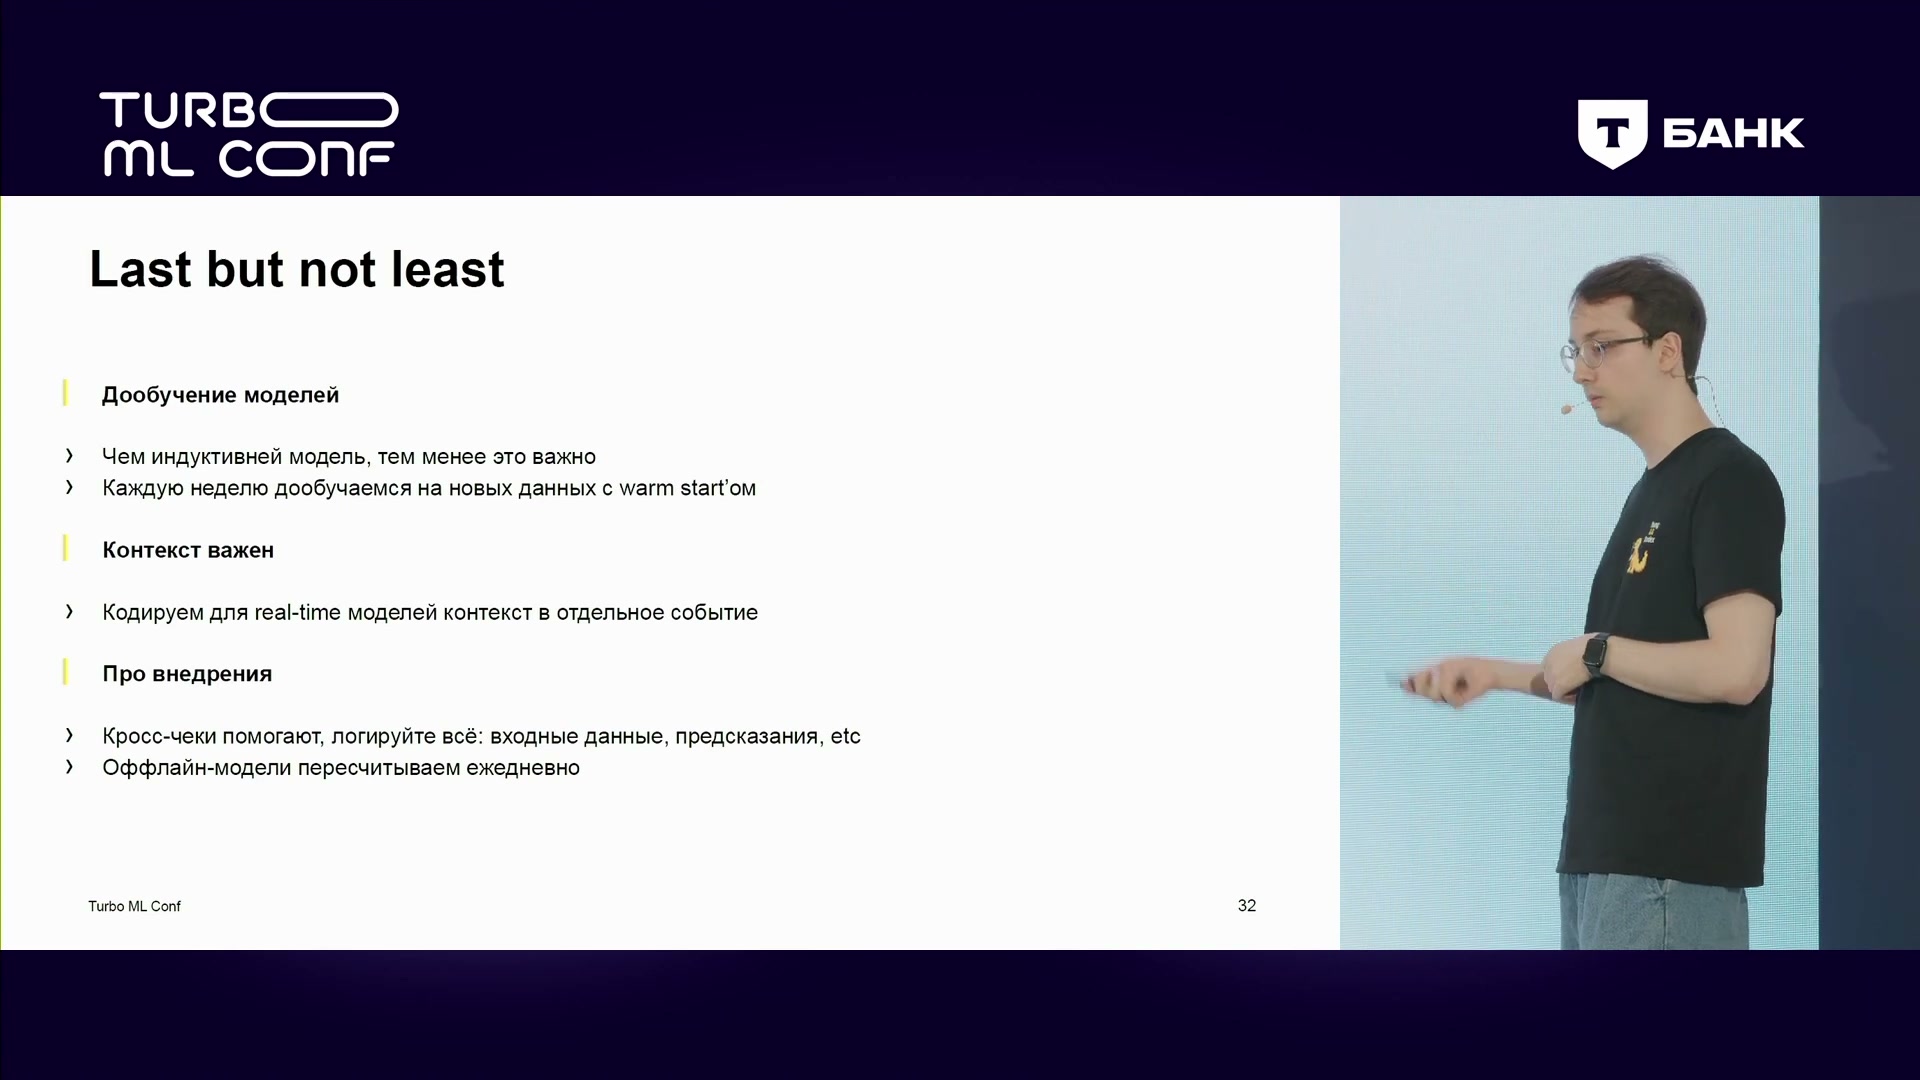
Практика эксплуатации: еженедельное дообучение, отдельное событие контекста, сверка входов и предсказаний, ежедневный пересчёт офлайн-моделей.
Источник: Кирилл Хрыльченко · Turbo ML Conf 2024Итог: от выбранной истории к признакам ранжирования
Опыт Яндекса показывает последовательность решений: сначала выбрать содержательные события, затем дёшево представить их, отделить общие вычисления от обработки кандидата и согласовать обучение с назначением модели. Трансформер не заменяет все рекомендации автоматически: он может готовить признаки для CatBoost или решать отдельную задачу отбора из каталога.
- 01
История и текущий контекст
Система получает выбранные прошлые события и добавляет контекст текущего запроса отдельным событием.
- 02
Кодирование событий
Содержание, тип действия и позиционная информация превращаются в векторы, пригодные для общей обработки.
- 03
Один запуск пользовательского трансформера
История вместе с контекстом и обучаемым CLS обрабатывается один раз на запрос.
- 04
Готовые векторы кандидатов
Для оцениваемых объектов извлекаются представления, заранее рассчитанные MLP и сохранённые в KV-хранилище.
- 05
Отдельные нейросетевые оценки
По представлениям пользователя и кандидатов формируются признаки, например отдельные оценки клика и покупки.
- 06
Ранжирование в CatBoost
Бустинг получает нейросетевые оценки вместе с остальными признаками и определяет порядок кандидатов.
В отдельном офлайн-варианте вектор пользователя тоже рассчитывают заранее, с ежедневным обновлением. Лаг воспроизводят при обучении. Еженедельное продолжение обучения весов и проверка согласованности историй происходят отдельно: это не шаги обработки каждого запроса.
Качество в докладе сопоставлялось по приросту ранжирования. Веб-запросы усилили вариант с историей Маркета; более длинная история улучшила результат относительно короткой; сочетание содержания и ID превзошло каждый из этих источников отдельно. Это три разных сравнения, а не общий измеренный эффект всей системы. Деталей экспериментов недостаточно, чтобы обещать те же числа другому продукту. Главный переносимый вывод — согласовывать данные, вычисления и учебную цель, сохраняя различие между свежестью представлений, качеством ранжирования и сложностью внедрения.
Доклад · 00:00:03