Разбор готов
Три доклада Turbo ML Conf 2024: персонализация, T-lite и синтетические временные ряды
Эта глава разбирает одну статью-обзор о трёх разных докладах Turbo ML Conf 2024, а не одну систему Т-Банка. Первый доклад показывает, как трансформер превращает историю действий пользователя в признаки для рекомендаций. Второй — как адаптировать открытую большую языковую модель (LLM) к русскому языку и где проходит граница между исследовательской T-lite и реально опубликованной версией 0.1. Третий — как генерировать временные ряды с заранее известными аномалиями, когда реальной разметки мало. По каждому сюжету разберём постановку, неудачные или ограниченные варианты, архитектуру, обучение, оценку и то, чего источник не позволяет утверждать. Такой формат помогает видеть не только красивую модель, но и происхождение каждого результата, его измерение и пределы переноса.
Материал полезен ML-инженерам и дата-сайентистам, которые хотят видеть не только идею модели, но и границы публичных результатов: что действительно показано на слайдах, какие числа имеют неизвестный протокол и где автор обзора уже переходит от доклада к собственной гипотезе.
Одна статья, три независимых доклада
Статья устроена как обзор трёх выступлений Turbo ML Conf 2024. Это не описание одной системы Т-Банка и не три полные стенограммы. Первый сюжет — о том, как представить историю пользователя трансформером и дать её сигналы ранжирующей модели. Второй — о продолжении обучения открытой LLM для русского языка и о T-lite. Третий — о синтетических временных рядах для проверки и обучения детекторов аномалий. После каждого сюжета автор статьи отдельно предлагает возможную аналогию с кибербезопасностью; эти идеи нужно отличать от результатов самих докладов.
Введение статьи: «В формате разбора содержания докладов…»Сюжет 1. Из истории действий — в признак для ранжирования
Кирилл Хрыльченко разбирает задачу персонализации: последовательность действий пользователя нужно превратить в числовое представление, которое поможет ранжировать уже отобранные товары, треки или другие объекты. В обзоре выделены четыре вопроса: какие события оставлять в истории, как кодировать каждое событие, как связать историю с конкретным кандидатом и на какой цели обучать нейросеть.
История может включать клики, показы и поисковые запросы; лайки, просмотры, прослушивания и пропуски; покупки, добавления в корзину и избранное; отзывы, комментарии и подписки. Сам автор обзора сознательно не пересказывает все детали фильтрации исходного доклада, поэтому пропущенные правила обработки показов или запросов нельзя восстанавливать по догадке.
Для длины истории сравнивали 64, 128 и более событий; в тексте приведён пример 1536. По пересказу, польза от удлинения истории постепенно затухала. Простой выбор последних n событий нужных типов в среднем работал лучше фиксированной квоты на каждый тип, хотя автор оставляет место для более сложного отбора. Эффект сигналов зависит от домена: в музыке пропуски треков важны, а в электронной торговле (e-commerce) показы без клика в приведённом сравнении не дали такой же пользы.
1. NLP в RecSys («Тайны трансформерной персонализации») → «Прикладной кейс доклада» → «Содержание»Как кодировать объект и событие
Для текста искали середину между двумя крайностями. Большая языковая модель оказалась слишком тяжёлой, а униграммы, биграммы и символьные триграммы — слишком простыми. В итоге использовали WordPiece: текст делится на части слов по словарю, обученному на данных нужного домена. Для веб-документа автор обзора отмечает дополнительную пользу токенизированного URL поверх заголовка. Для файла полезно сочетать признаки содержания с обучаемым вектором его ID. Если у объекта несколько атрибутов — например, название, описание и изображение, — их векторы можно объединить простым агрегированием (pooling): суммированием или усреднением, либо небольшой нейросетью.
Эти варианты дополняют друг друга. Контент помогает работать с новыми и редкими объектами, потому что модель может опереться на название, описание или изображение. Обучаемый ID, наоборот, даёт возможность запомнить свойства конкретного объекта, которые не выводятся из содержания. На слайде сочетание двух источников даёт лучший из трёх показанных результатов.
Само событие собирается сложением трёх частей: позиции в истории, обучаемого вектора типа события и представления контента. Позиции кодируют в обратном порядке, чтобы недавние события имели устойчивые индексы при росте истории. В качестве альтернатив на слайде перечислены относительные позиции и временные метки. При каузальной маске внимания — запрете позиции видеть будущие события — отдельная позиционная информация нужна не всегда; это термин про доступность контекста в последовательности, а не про причинный анализ. Офлайн-модели, по замечанию доклада, менее чувствительны к точным позициям.
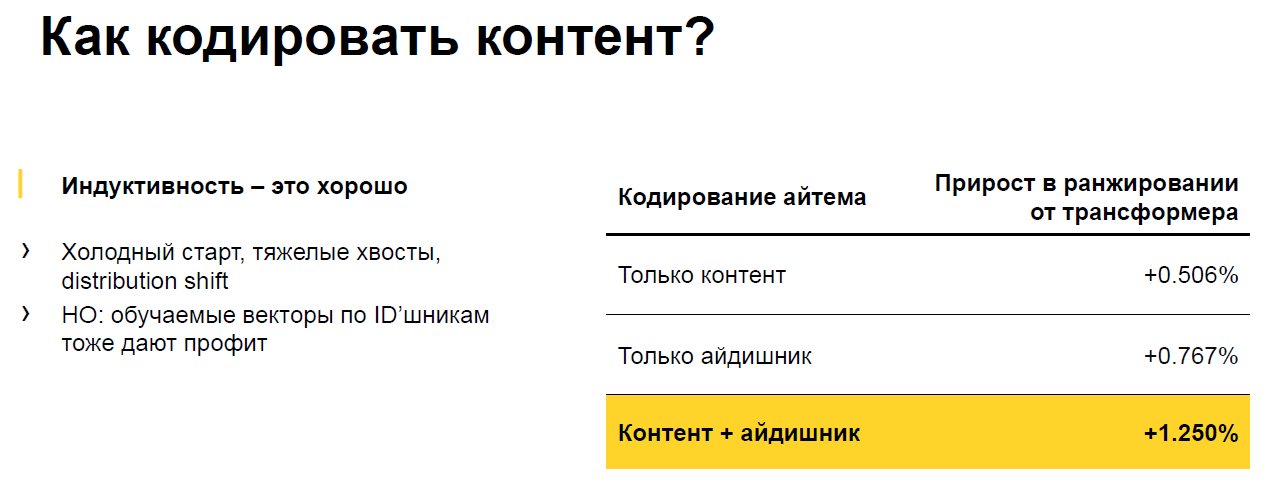
Яндекс: качество ранжирования при кодировании контента, ID и их сочетания. +0,506% / +0,767% / +1,250% — показатели этого сравнения, не выручка кибербезопасности.
Источник: Оригинальный материал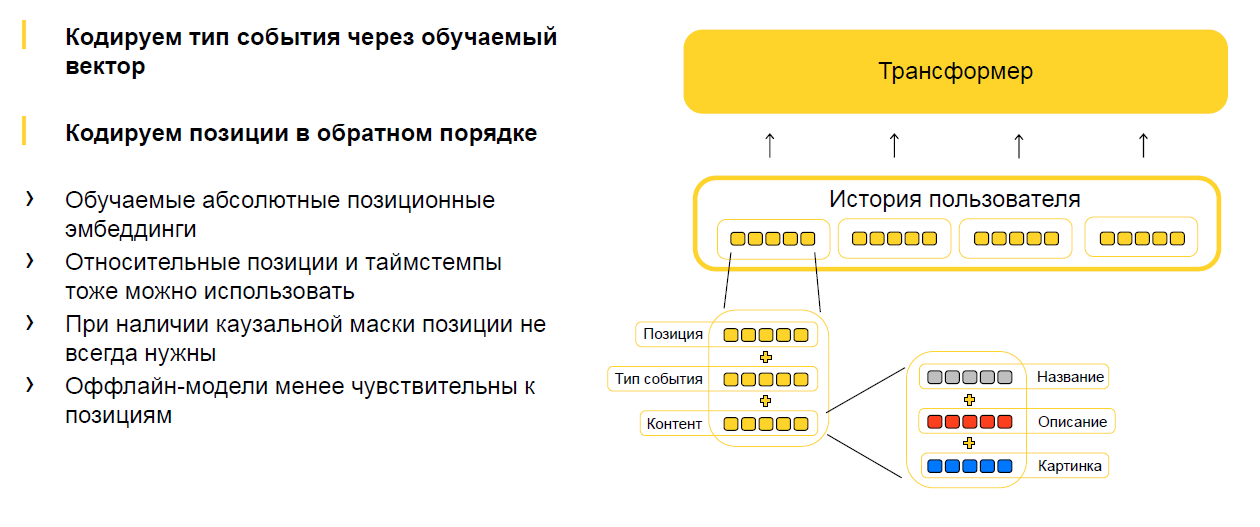
Событие складывается из позиции, обучаемого типа и содержания. Относительные позиции и время указаны как возможные дополнения.
Источник: Оригинальный материалДвухбашенная архитектура: история онлайн, кандидат заранее
На слайде две стороны модели вычисляются по-разному. История пользователя проходит через трансформер один раз на запрос. В последовательность добавлен CLS — специальный обучаемый вектор, который участвует в получении общего представления истории. Это важно: его нельзя описывать как новый случайный вектор, создаваемый заново при каждом запросе.
Кандидатная сторона устроена дешевле во время запроса. Обучаемый ID-вектор кандидата складывается с признаками контента, затем проходит через MLP — небольшую полносвязную нейронную сеть. Этот вектор вычисляют заранее, вне пользовательского запроса, и кладут в KV-storage — хранилище «ключ — значение», откуда готовое представление можно быстро получить по ключу кандидата. Поэтому тяжёлая обработка истории выполняется один раз на запрос, а не повторяется для каждого кандидата.
В тексте обзора есть фраза о вычислении «вектора пользователя в офлайне», но исходная схема конкретнее и имеет приоритет: пользовательский трансформер подписан как вычисляемый один раз на запрос, офлайн относится к стороне кандидата. Обе стороны затем используются для оценки реакции на показанный объект.
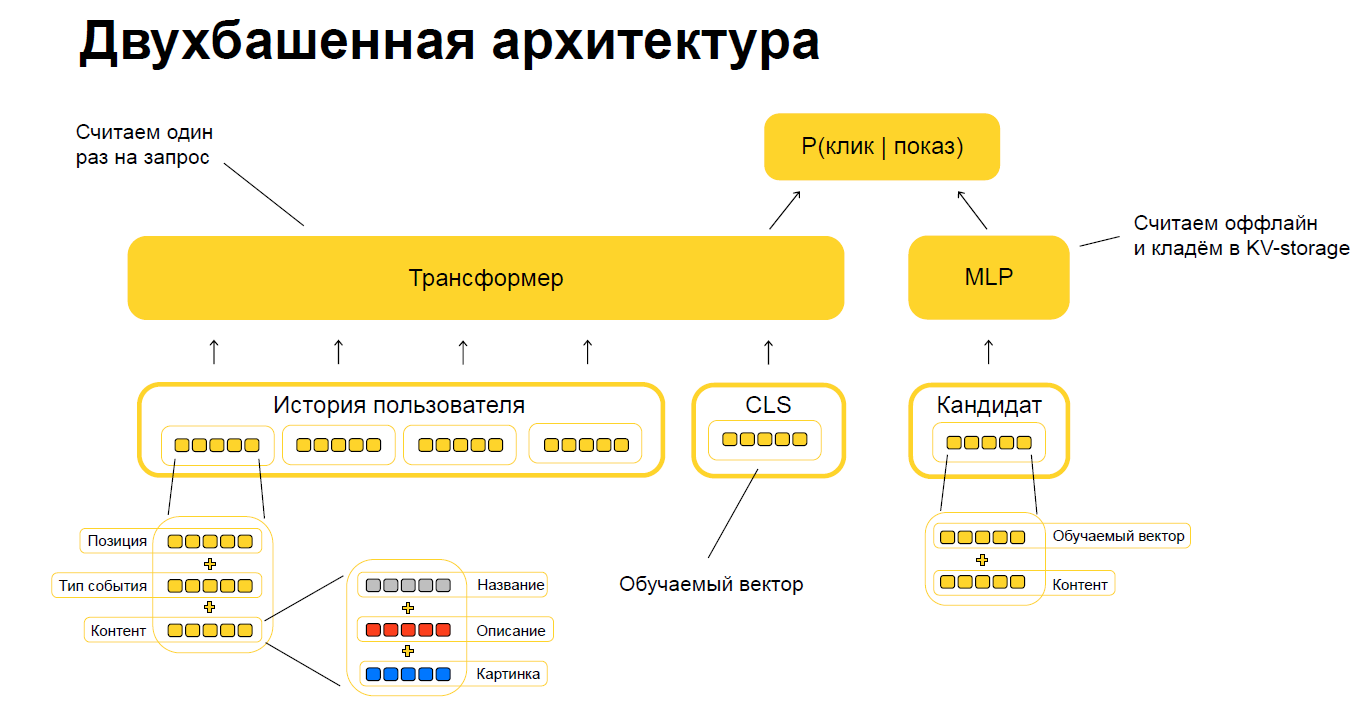
На исходном слайде пользовательский трансформер считается один раз на запрос; вектор кандидата — заранее и хранится в KV-storage. CLS явно подписан как обучаемый.
Источник: Оригинальный материалУчить нейросеть так, как её будет использовать ранжировщик
Нейросеть здесь не обязана заменять итоговый ранжировщик. Её выход становится дополнительным признаком для CatBoost вместе с другими признаками. Поэтому цель обучения трансформера стараются приблизить к цели самой ранжирующей модели: работать с показанными рекомендациями и оценивать условную вероятность P(клик | показ), а не абстрактную P(клик). В обзоре отдельно сказано, что обычное предсказание следующего объекта изучает другое распределение и даёт заметно меньше пользы именно как признак для ранжирования.
Один нейросетевой выход становится информационным узким местом: сложная история пользователя схлопывается в одно число, которое затем видит CatBoost. На слайде также обсуждается калибровка вероятностей — соответствие, например, прогноза 0.2 реальной частоте кликов около 20%. Авторы отмечают, что для их использования такого признака калибровка не обязательна: схема работала и без неё, включая попарное ранжирование и последующее дообучение. Это эмпирическое наблюдение конкретного подхода, а не универсальное правило.
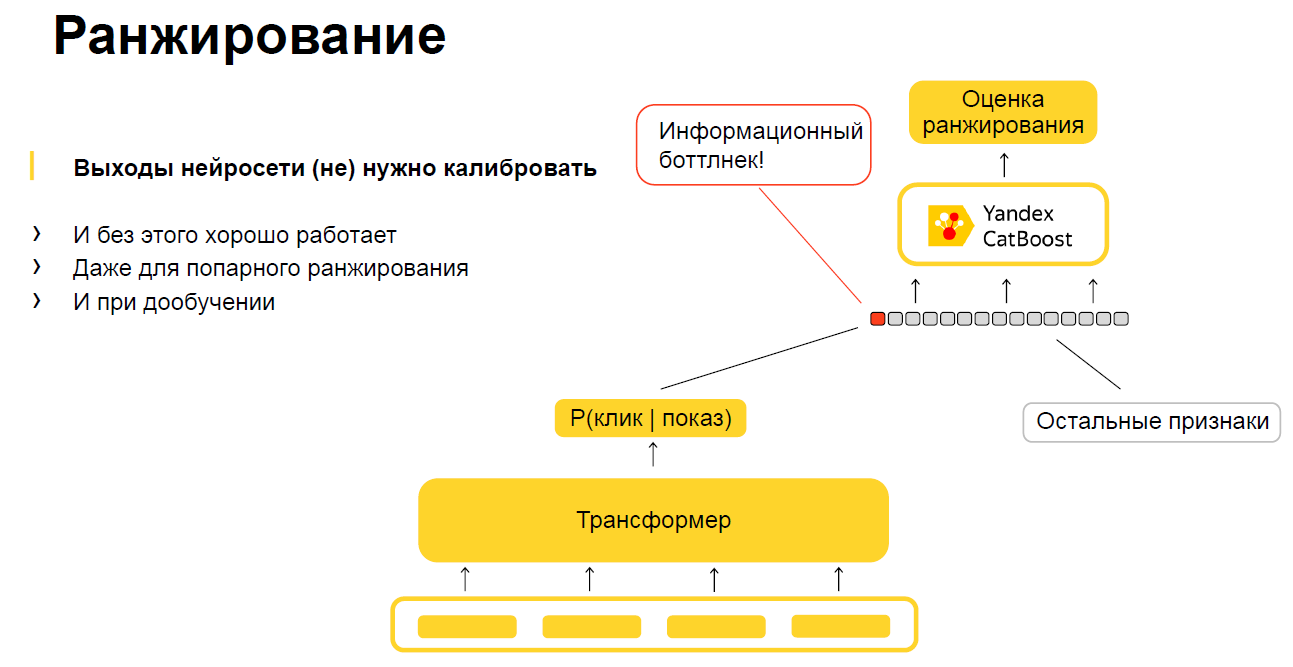
Передача одной нейросетевой оценки в CatBoost создаёт информационное ограничение. Необходимость калибровки обсуждается в этом контексте.
Источник: Оригинальный материалНесколько сигналов вместо одного
Чтобы не передавать в CatBoost только одну оценку, сигналы разделяют. На показанном варианте одна голова предсказывает P(клик | показ), другая — P(покупка | показ). Каждая оценка становится отдельным признаком ранжировщика. На слайде это сформулировано как уменьшение информационного узкого места «в 2 раза»: речь идёт о двух выходных сигналах, а не об удвоении бизнес-метрики.
Следующий рисунок показывает общий трансформер и несколько экспертов E1, E2 и E3. Их выходы можно агрегировать при обучении, а затем передавать в CatBoost раздельно. В обзоре отмечено, что лучше агрегировать вероятности, а не логиты — ненормированные оценки до преобразования в вероятность. При этом рисунок не раскрывает полную архитектуру смеси экспертов (MoE): в нём нет описания маршрутизации между экспертами, их размеров или полной схемы обучения.
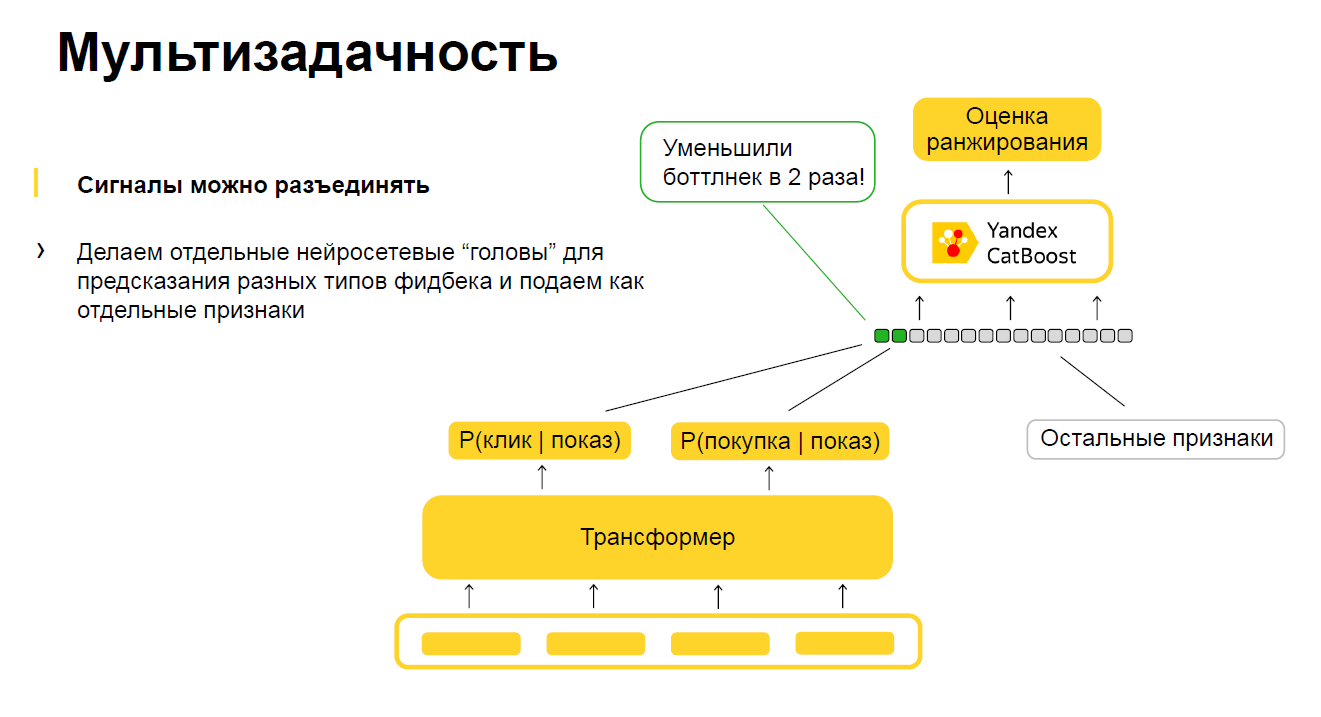
Две головы для клика и покупки передают два отдельных признака в CatBoost. Это разные сигналы, а не общий измеренный бизнес-прирост.
Источник: Оригинальный материал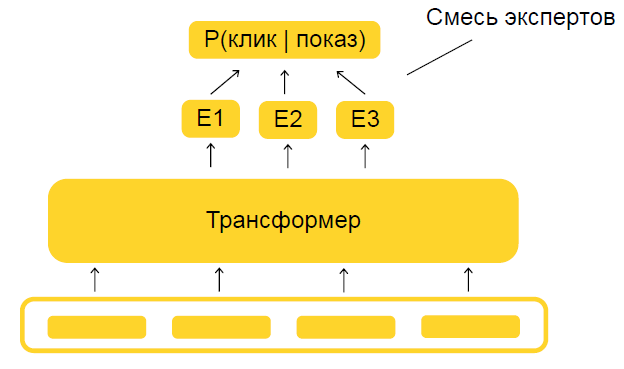
Несколько экспертов модели — схема получения разных выходных сигналов. Она не задаёт полный универсальный MoE-сервис.
Источник: Оригинальный материалОтбор кандидатов: sampled softmax, отрицательные примеры и LogQ
Для отбора кандидатов нужно научить модель отличать подходящий объект от множества неподходящих. На слайде отдельно объясняется, почему обычные ранжирующие функции потерь здесь неудобны: они плохо обучают модель на «лёгких» объектах, которые обычно вообще не доходят до финальной выдачи. Если каталог небольшой, можно считать softmax по всему каталогу. При большом каталоге используют sampled softmax: положительный объект сравнивают только с выбранным набором отрицательных. Отрицательные объекты берут из общего обучающего пакета сразу со всех GPU-видеокарт — это in-batch negatives, то есть положительные объекты других примеров того же распределённого пакета становятся отрицательными для текущего примера.
На слайде выражение подписано L(u,i), но математически это нормированная вероятность положительного объекта относительно набора отрицательных N. Полная функция потерь, например с внешним −log, на рисунке не выписана.
Выбор отрицательных объектов меняет их частоты относительно полного каталога, поэтому добавляют LogQ-коррекцию — поправку на вероятность попадания объекта в выборку. Слайд также предлагает предсказание будущего положительного взаимодействия (future item prediction) для офлайн-моделей: положительным примером может стать действие, которое случится позже, например через день. Идея помогает предварительно обучить модель отбора, но не отменяет отдельную проверку качества финального ранжирования.
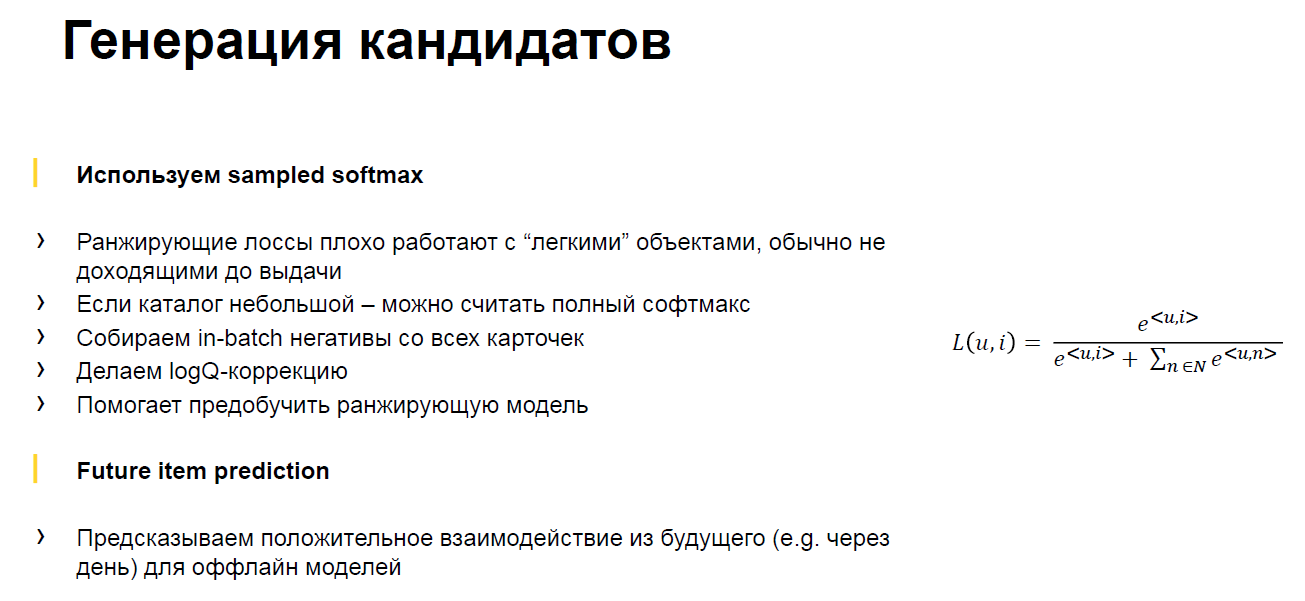
Отбор кандидатов с sampled softmax, in-batch negatives и logQ-коррекцией. Формула показывает вероятность; полная функция потерь не выписана.
Источник: Оригинальный материалОбновление моделей и авторская аналогия с кибербезопасностью
В конце обзора перечислены практические режимы работы. Модели можно еженедельно дообучать на новых данных, начиная с прошлых весов (warm start), а не обучать заново. Чем более индуктивна модель, то есть чем лучше она обобщает по содержанию и другим признакам вместо запоминания ID, тем меньше зависимость от такого обновления. Контекст для модели, работающей в реальном времени, предлагается кодировать отдельным событием. Для внедрения автор пересказывает советы делать перекрёстные проверки, логировать входы и предсказания; офлайн-модели пересчитывать ежедневно.
Далее начинается уже не производственный результат Яндекса, а комментарий автора статьи. Он предлагает представить Windows Security Log или Sysmon как историю событий пользователя: Process Creation/Exit, Account Logon/Logoff могут играть роль, похожую на клики, прослушивания или пропуски. Такое представление можно использовать как вход для кластеризации или другой модели поведения. В статье нет внедрения SOC, A/B-теста или численной оценки этого переноса.
1. NLP в RecSys → «Дообучение моделей» → «Контекст важен» → «Про внедрения» → «Толк для кибербезопасности»Сюжет 2. Зачем дообучать открытую большую языковую модель под русский язык
Анатолий Потапов рассматривает, как усилить открытую Llama 3 для русского языка и прикладных задач. В обзоре перечислены три проблемы: грамматические ошибки на русском, недостаток специальных доменных знаний и небольшая доля русского текста в предварительном обучении — 0.1–4%. Одна из гипотез касается плотности токенизации: токенизация — это разбиение текста на единицы, которые видит модель; если один токен покрывает мало символов русского текста, на тот же лимит токенов помещается меньше информации.
Два рисунка про плотность токенизации заимствованы из внешнего исследования. Первый сопоставляет размер словаря и число символов на токен на MC4 ru для нескольких моделей; второй показывает время и память для исходной и Unigram-токенизации при разной длине текста. Это не собственные тесты T-lite. Автор обзора также приводит диапазон 20–100% экономии или ускорения применения модели для вариантов, обученных с нуля под русский язык, но не раскрывает оборудование, методику и базу сравнения.
Для маленькой команды статья перечисляет три более доступных способа. Инструкции прямо в запросе к готовой модели называют prompting. Дообучение на парах «запрос — правильный ответ» — это Supervised Fine-Tuning (SFT). RAG означает, что система сначала находит подходящие фрагменты во внешних материалах, а затем даёт их модели перед ответом. Для команды среднего масштаба добавляются продолжение предварительного обучения на языке и домене и собственная настройка поведения модели (alignment). Полное обучение с нуля вынесено в отдельную, гораздо более дорогую категорию. Рассматриваемый путь T-lite находится между этими крайностями: взять сильную открытую основу и глубоко адаптировать её.
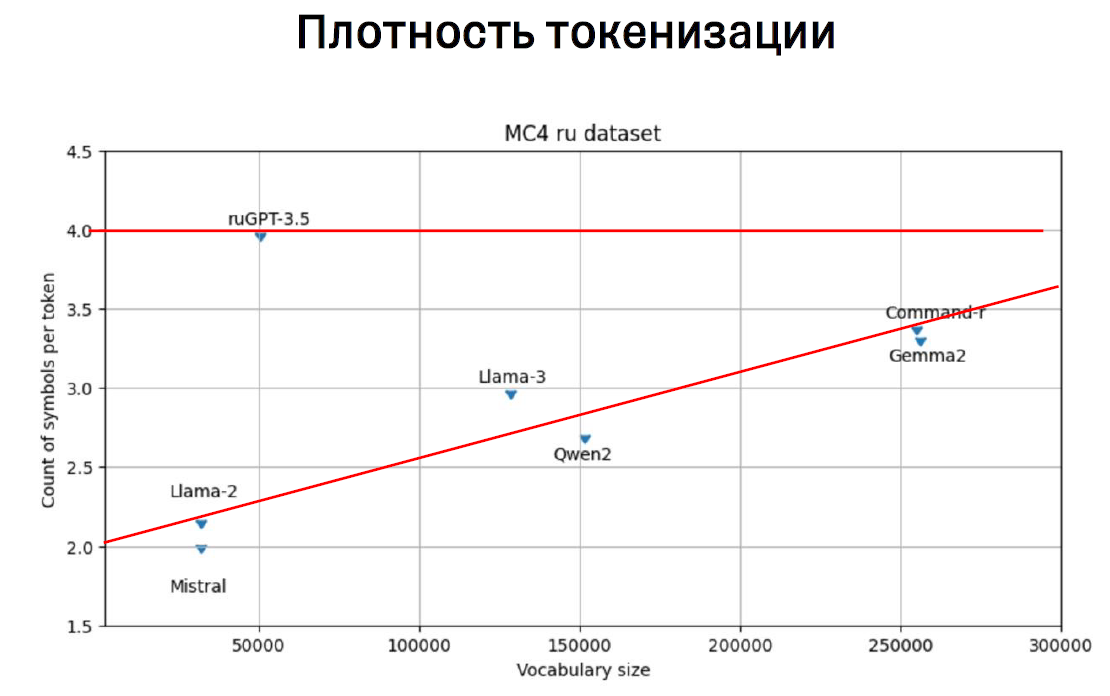
Символов на токен и размер словаря на русскоязычном MC4. Сравниваются разные модели; это не готовая оценка качества T-lite.
Источник: Оригинальный материал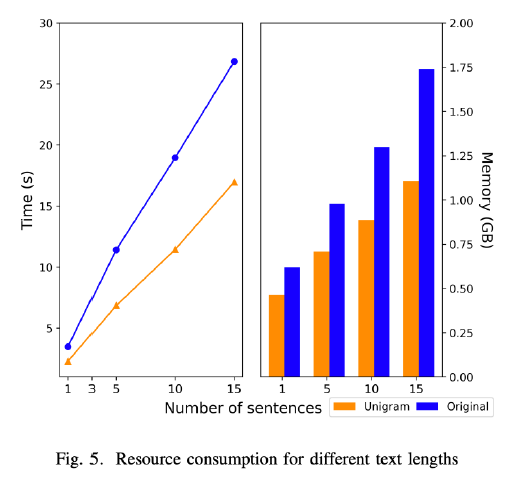
Рисунок из внешнего исследования токенизации: время и память для Unigram и Original. Его нельзя считать собственным benchmark T-lite или безусловным рейтингом языков.
Источник: Оригинальный материалИсследовательский план T-lite и границы заявленных результатов
В обзоре исследовательский план выглядит так: обучить более ёмкий для русского токенизатор — правило, которое разбивает текст на токены, — адаптировать под него модель, продолжить предварительное обучение на русском, затем на доменном корпусе, выполнить обучение выполнению инструкций (instruction tuning) и после этого обучение на предпочтениях между вариантами ответов (preference tuning). Важно воспринимать это как последовательность идей, показанных в докладе, а не как описание одной опубликованной конфигурации без оговорок.
Автор обзора сообщает три итоговых тезиса: эффективность применения модели выросла на 60%, русский язык стал заметно чище, а попарное сравнение с GPT-3.5 Turbo дало 55/45. Для 60% не указаны точное определение «эффективности», оборудование и вариант сравнения; для 55/45 не раскрыты состав запросов, число сравнений и критерий победы. Эти числа нельзя отождествлять ни с задержкой ответа, ни с экономией стоимости, ни с Ru-arena-general.
2. Презентация T-lite → «Как можно самостоятельно доработать открытую модель?» → «Результаты реализации описанного выше подхода»Очистка корпуса и баланс стилей
Перед продолжением обучения корпус очищают. В статье для иллюстрации показан конвейер FineWeb: фильтрация URL, извлечение текста, определение языка, Gopher-фильтры, удаление дублей MinHash, C4-фильтры, пользовательские фильтры и удаление персональных данных. Это заимствованная схема FineWeb, а не доказательство, что внутренний конвейер Т-Банка полностью совпадал с ней.
Таблицу можно прокрутить по горизонтали.
Смысл ребалансировки — не просто собрать много текста, а управлять тем, какие стили чаще видит модель. На показанном распределении особенно заметно снижение доли рекламы и рост долей статей, инструктивных и образовательных материалов. Это описание смеси данных, а не само по себе доказательство прироста качества.
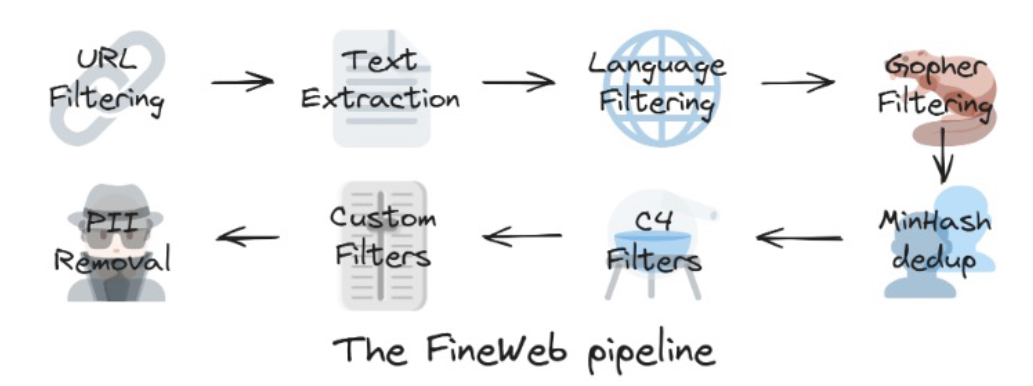
Иллюстрация FineWeb pipeline, на которую ссылается автор обзора. Это пример очистки корпуса, не полная точная схема Т-Банка.
Источник: Оригинальный материал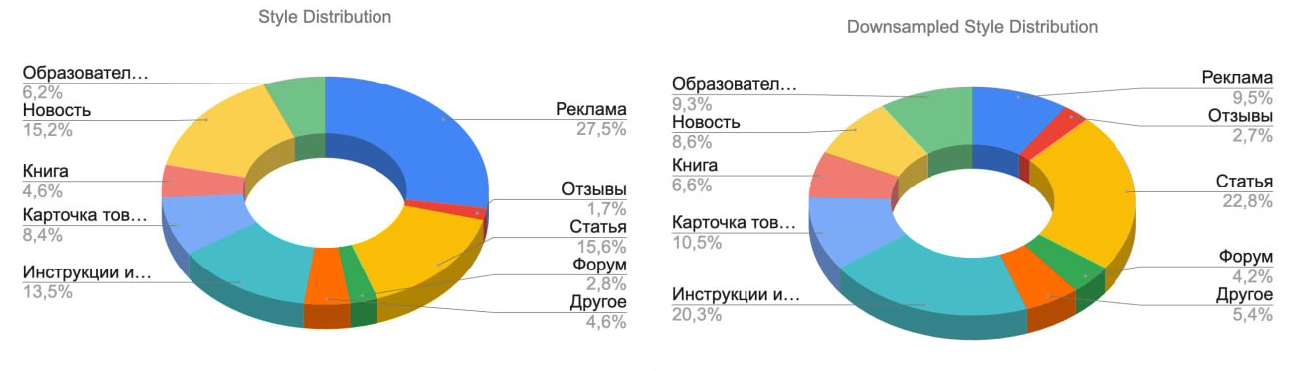
Стилевое распределение до и после снижения доли отдельных источников. Укораченные подписи нельзя дополнять по догадке.
Источник: Оригинальный материалДве стадии данных и оценка образовательной ценности
Команда разделяет продолжение обучения на две смеси. Первая максимально широкая: основной объём занимает русскоязычный Common Crawl, к нему добавляются книги, Wikipedia, научные, форумные, доменные, кодовые и английские данные. Вторая смесь заметно разнообразнее и содержит больше инструктивных, образовательных и синтетических источников. Проценты ниже относятся именно к двум показанным смесям; из-за округления их не нужно насильно сводить к ровно 100%.
Образовательную ценность веб-текста оценивали отдельной большой языковой моделью по пятибалльной шкале. На слайде видна инструкция для модели (промпт) с накопительными критериями: от базовой полезной информации до материала, который хорошо подходит для обучения и даёт глубокое объяснение. В конце требуется краткое обоснование до 100 слов и итоговая строка с образовательным баллом. Правая часть нескольких строк на исходном изображении обрезана, поэтому полный промпт нельзя реконструировать.
В обзоре перечислены источники второй стадии: школьные учебники по STEM и гуманитарным предметам, Common Crawl после такой фильтрации, английские и переведённые наборы инструкций, книги и Wikipedia, математические наборы, код и задачи по программированию, параллельные тексты и синтетические наборы типа Cosmopedia.
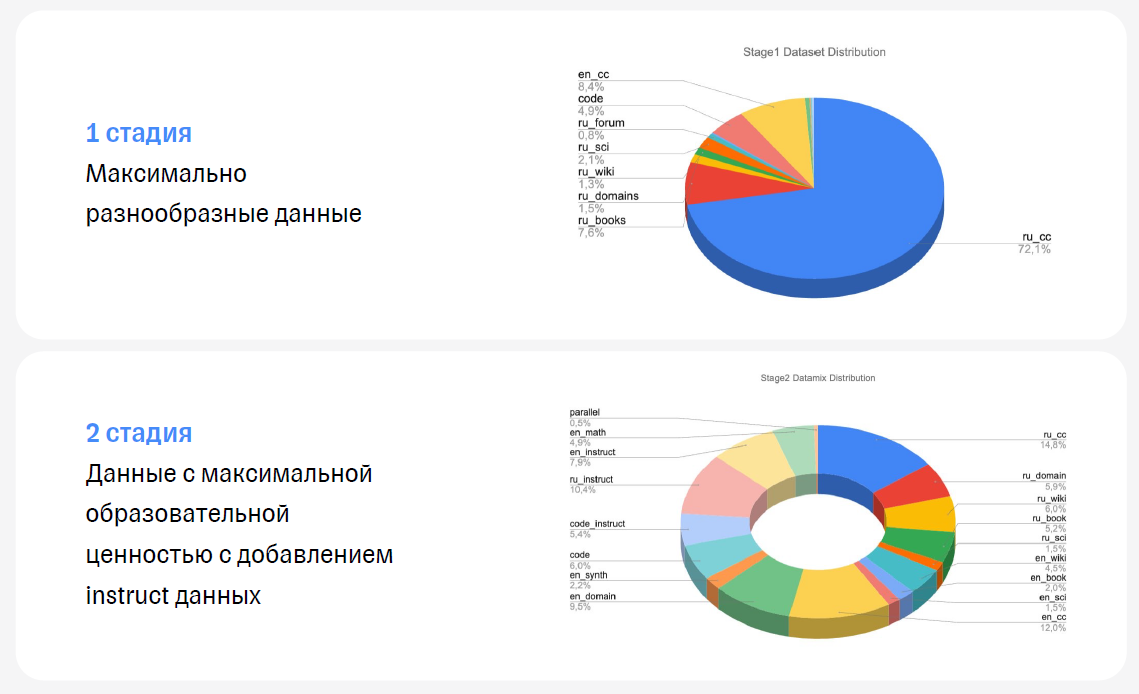
Два этапа обучения: разнообразные данные, затем образовательные и инструктивные материалы. Числа на диаграмме относятся к показанным смесям.
Источник: Оригинальный материал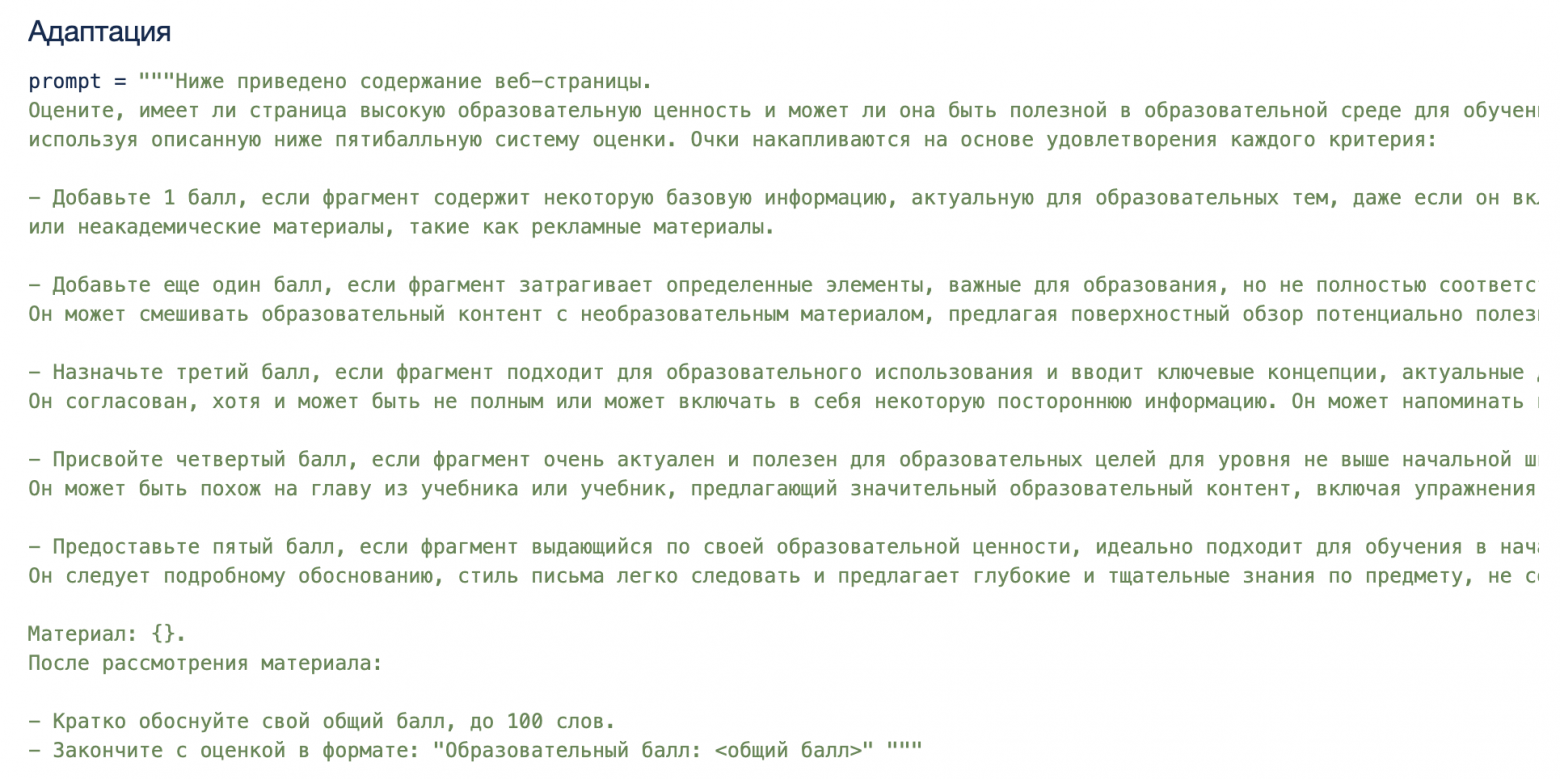
Часть изображения промпта оценки образовательной ценности по пяти критериям. Правые окончания ряда строк в исходнике обрезаны; полного исполняемого промпта рисунок не даёт.
Источник: Оригинальный материалПродолжение обучения: меньший шаг и маска для упакованных примеров
При продолжении обучения нужно адаптироваться к русскому, не разрушив уже выученные возможности. В обзоре это связывают с меньшим шагом обновления весов (learning rate). На рисунке повторный большой разогрев и спад шага обучения перечёркнуты, а выбранная зелёная кривая подписана LR = 1e-5. Это одно видимое значение на схеме, а не полная конфигурация обучения: не указаны алгоритм обновления весов (optimizer), размер пакета примеров (batch size) и расписание изменения шага (scheduler).
Следующий рисунок — не «новая голова внимания». Он показывает упаковку нескольких независимых примеров в одну длинную последовательность. Блочно-диагональная маска внимания разрешает токенам смотреть только внутрь своего примера и запрещает внимание между соседними упакованными примерами. Так можно эффективнее использовать вычисления, не смешивая контекст разных текстов.
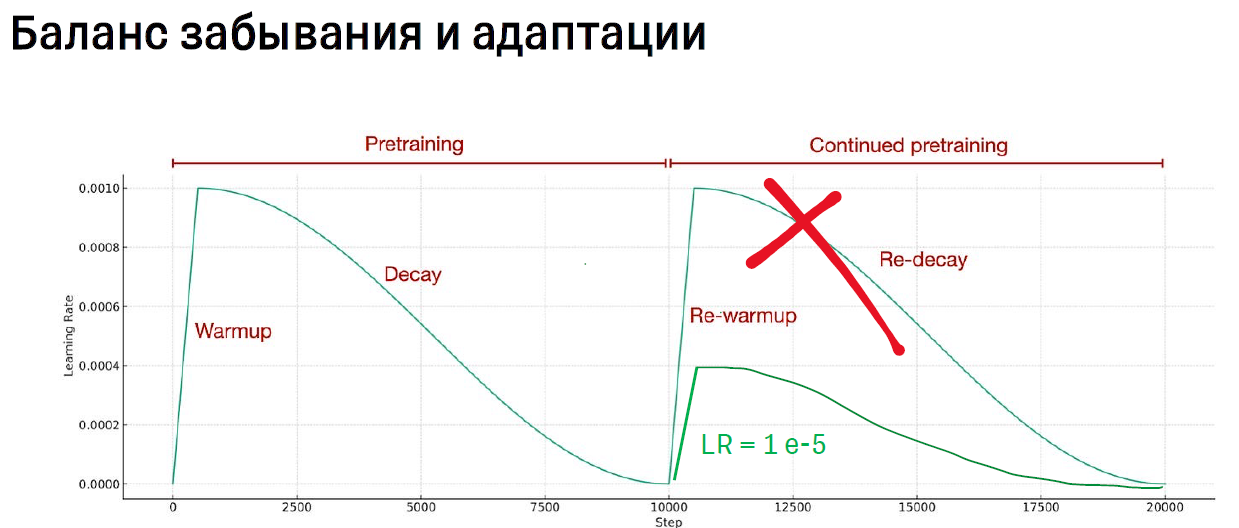
Малый шаг при продолжении обучения противопоставляется повторному большому разогреву. LR=1e-5 — подпись иллюстрации, не полная конфигурация обучения.
Источник: Оригинальный материал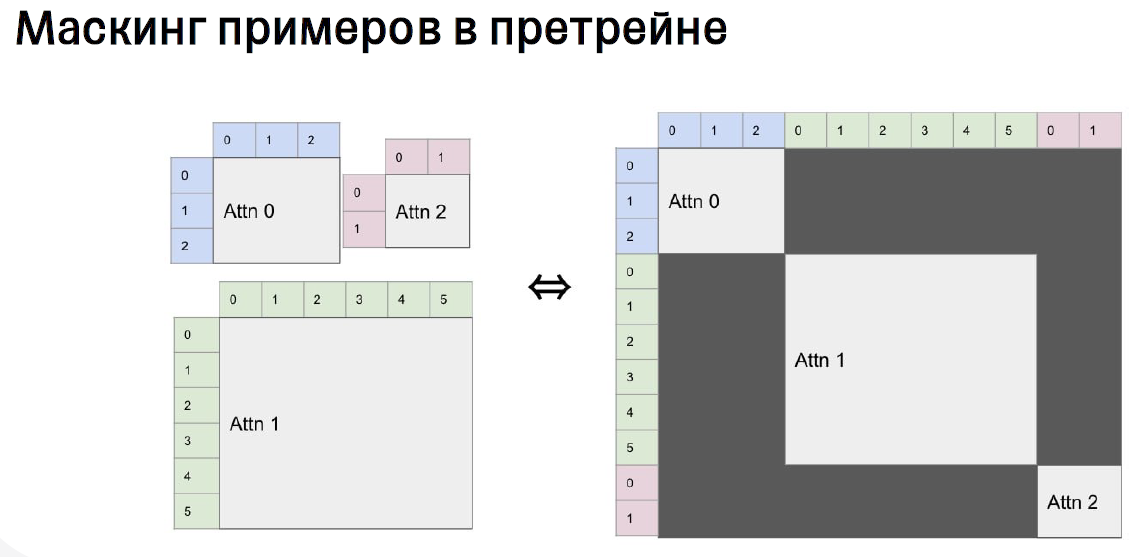
Блочная маска изолирует независимые примеры при упаковке в одну последовательность. Это не доказательство добавления новой attention-головы.
Источник: Оригинальный материалРасширение токенизатора и обучение новых эмбеддингов
Для русского языка в обзоре описан собственный более плотный токенизатор на базе TikToken. Указано число 50 000 для нового русского словаря до объединения с исходным. Далее словари объединяют процедурой, связанной в обзоре с Qwen, а новые векторные представления токенов (эмбеддинги) инициализируют через усреднение старых токенов. Точный итоговый размер объединённого словаря на графике не подписан, поэтому 50 000 нельзя выдавать за финальный размер словаря модели.
Для объяснения постепенного обучения новых параметров показана схема EEVE со стадиями 0–7. На ней отдельно отмечаются входной Embedding, Transformer Layers и выходная LM Head, которая выдаёт оценки токенов словаря. Замораживание и размораживание этих блоков меняется по стадиям. Важно не спутать LM Head с головой механизма внимания: рисунок показывает входные эмбеддинги и выход по словарю, а не добавление новых голов самовнимания (self-attention). Кроме того, эта заимствованная схема не доказывает точную последовательность всех стадий обучения T-lite.
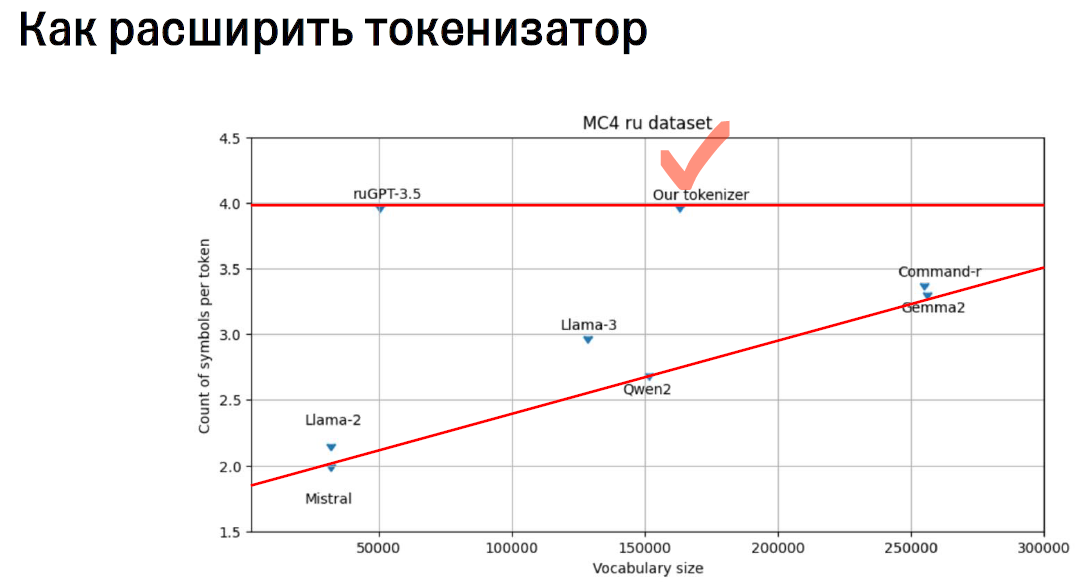
Расширение токенизатора: число 50 тыс. из текста нельзя объявлять итоговым объединённым словарём; точное итоговое число на графике не подписано.
Источник: Оригинальный материал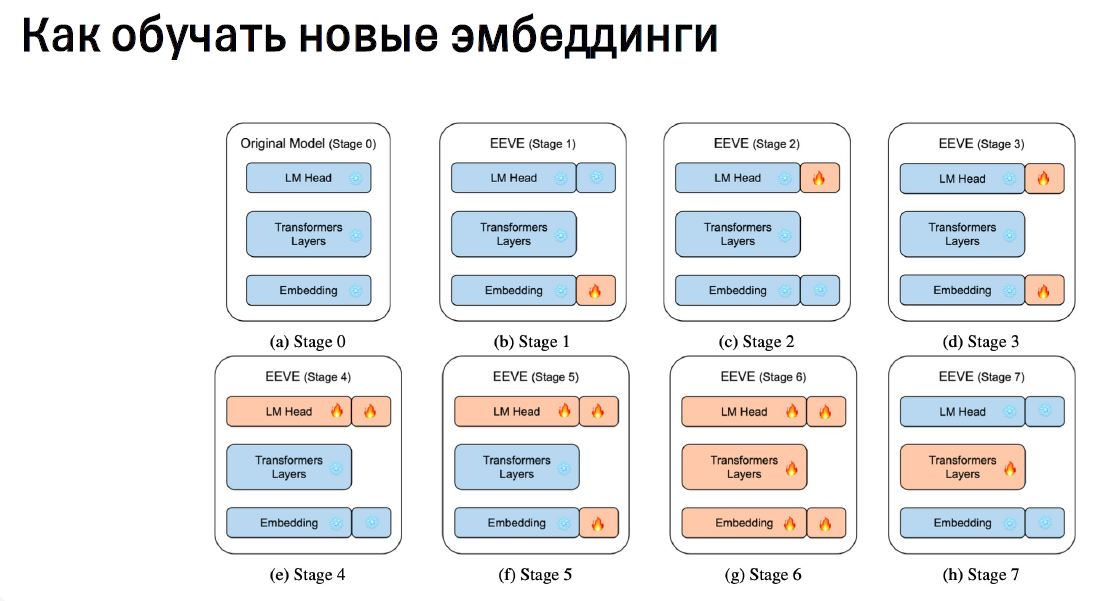
Заимствованная схема EEVE: замораживаются и обучаются входные embedding и выходная LM Head, а не «новые головы внимания». Точная схема всех стадий T-lite не раскрыта.
Источник: Оригинальный материалДлинный контекст как исследовательская ветвь, а не свойство релиза 0.1
Для позиционной информации обсуждается RoPE. Его корректнее понимать так: положение токена кодируется вращением векторов запросов Q и ключей K внутри механизма самовнимания (self-attention). Это не четвёртая независимая обучаемая матрица рядом с Q, K и V. В обзоре рядом упомянуты PoSe, Theta Scaling/LongRoPE и YaRN, но деталей недостаточно, чтобы объявить их одной и той же конфигурацией или восстановить точный рецепт обучения.
В тесте Needle-in-a-Haystack («иголка в стоге сена») проверяется извлечение факта, помещённого на разную глубину контекста. Показаны длины 2k, 4k, 8k, 16k, 32k, 65k и 131k токенов. Почти все клетки равны 1.00, однако для 131k при глубине факта 40% есть 0.00. Поэтому результат сильный, но не «идеальный до 131k».
Ещё важнее отделить исследовательский вариант от того, что реально выложили пользователям. В официальном релизе AI Центра Т-Банк от 20 июля 2024 года прямо сказано, что команда решила не ждать версии с расширенным токенизатором и длинным контекстом и сначала поделилась моделью после продолжения предварительного обучения. Расширенный токенизатор и длинный контекст обещаны позже — это зафиксировано в официальном релизе T-lite.
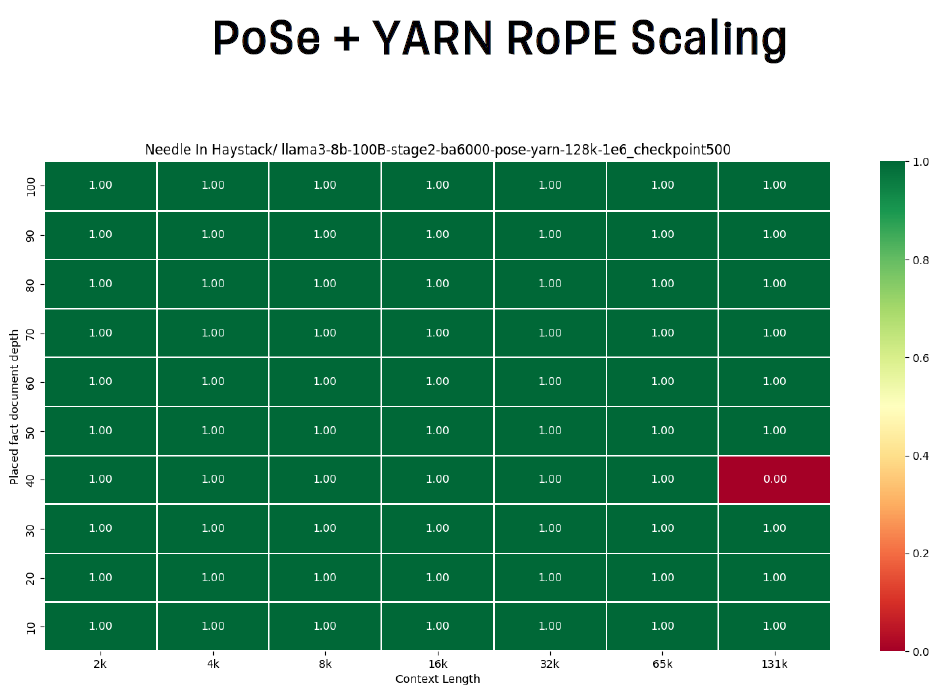
Тест извлечения факта с PoSe + YaRN до 131k. В ячейке 131k/40% глубины есть 0,00; это не идеальное прохождение всех случаев и не доказательство наличия функции в опубликованной версии0.1.
Источник: Оригинальный материалНастройка поведения: что говорит обзор и что подтверждает опубликованная версия
В обзоре настройка поведения модели (alignment) описана широкими мазками: из данных предварительного обучения генерируют синтетические инструкции, плохие примеры фильтруют классификатором, обученным на человеческих оценках, затем подбирают пропорции и гиперпараметры. Далее перечислены DPO, IPO, ORPO, TR-DPO, SLIC-HF и другие названия техник обучения на предпочтениях. Само перечисление показывает круг исследованных или обсуждавшихся методов, но не доказывает, что каждый из них вошёл в конкретную опубликованную модель.
Дополнительная официальная карточка T-lite-instruct-0.1 уточняет этап обучения на предпочтениях уже для опубликованного набора весов: сначала использован SPiN с моделью-учителем, затем SLiC-HF с моделью оценки предпочтений (reward model). Поэтому список DPO, IPO, ORPO, TR-DPO и SLIC-HF из доклада нельзя автоматически считать полным рецептом версии 0.1.
2. Презентация T-lite → «Еще был проведен алайнмент…» → «И последнее — она же опенсорс, где скачать?»Как оценивали T-lite: диалоговые и продуктовые таблицы
На диалоговом слайде используются две разные шкалы — Ru-mt-bench и Ru-arena-general. Их значения нельзя читать как проценты правильных ответов. Для опубликованной T-lite-instruct-0.1 официальная карточка подтверждает основные значения 6.458 и 57.26. В дополнительном описании карточки указано, что MT-Bench перевели на русский и ответы оценивала модель-судья gpt-4-1106-preview; для Arena в качестве модели, с которой сравнивали ответы, использовали gpt-3.5-turbo-0125, а судьёй оставалась та же модель.
Таблицу можно прокрутить по горизонтали.
Отдельный продуктовый слайд сравнивает только T-lite-instruct-0.1 и Llama3-8b-instruct по трём направлениям. На нём нет определения шкалы, размера выборки, способа выставления оценки или доверительных интервалов, поэтому числа нужно сохранять как оценки и не переводить их в процент правильных ответов.
Таблицу можно прокрутить по горизонтали.
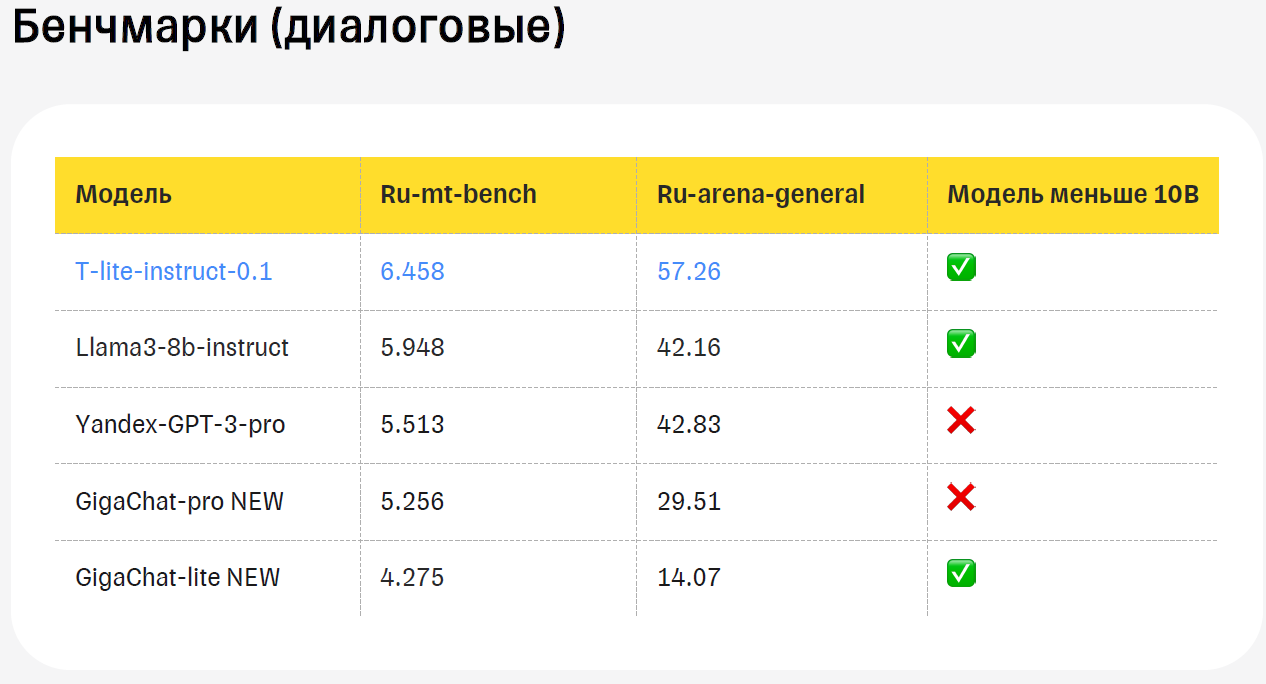
Диалоговые оценки T-lite-instruct0.1: 6,458 MT-Bench и57,26 Arena; те же основные значения подтверждает первичная модельная карточка. Это разные шкалы, не проценты точности.
Источник: Оригинальный материал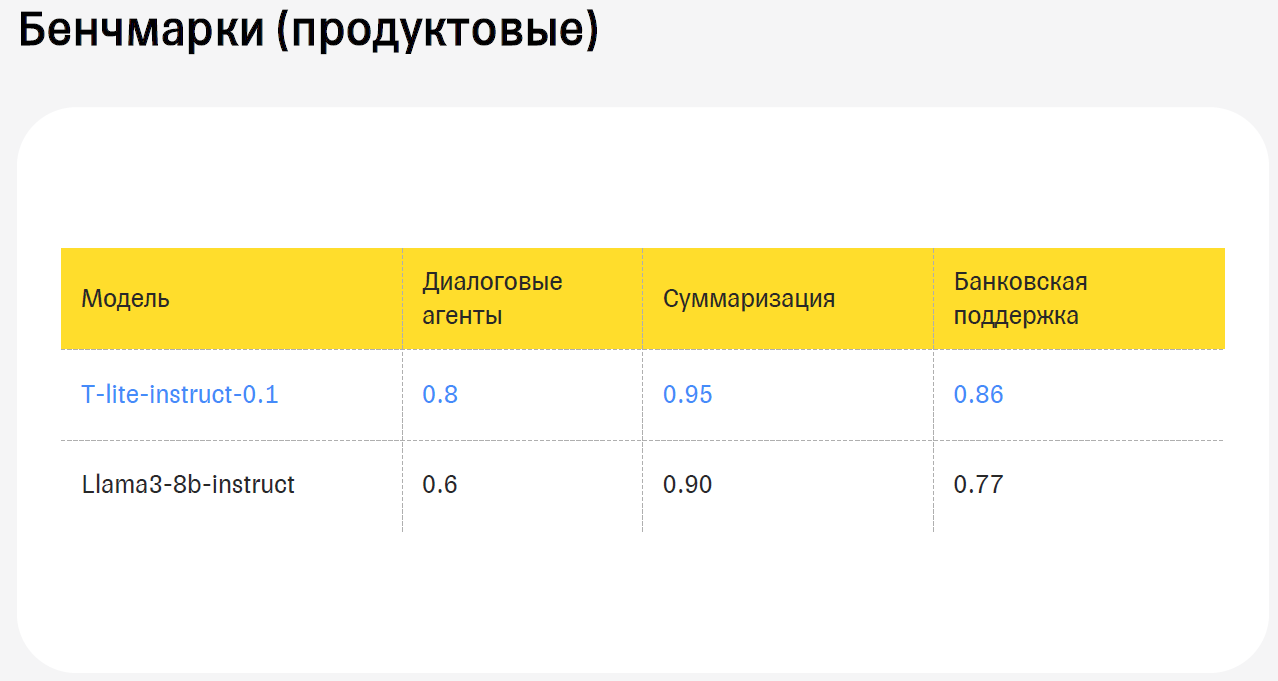
Продуктовые оценки:0,8/0,95/0,86 против0,6/0,90/0,77. Полный протокол и смысл шкалы на слайде не раскрыты.
Источник: Оригинальный материалЧто автор обзора предлагает перенести в кибербезопасность
После T-lite автор статьи переключается на собственную интерпретацию. Он пишет, что общая большая языковая модель может плохо знать специфические связи и различия из информационной безопасности: например, контекст PowerShell и commandline, различия между APT29 и APT39 или локальные требования реагирования и информирования. Отсюда предложение — продолжить обучение модели на доменных данных и при необходимости добавить RAG, то есть поиск актуальных фрагментов перед формированием ответа.
Эту часть нельзя превращать в доказанный производственный кейс Т-Банка. В статье нет описанной работающей SOC-системы, метрик аналитиков или A/B-теста. Фраза о существующих эффективных русскоязычных системах приводится как утверждение автора обзора без открытых условий оценки.
2. Презентация T-lite → «Толк для кибербезопасности»Сюжет 3. Зачем синтетические временные ряды нужны для аномалий
Владислав Власов разбирает задачу, где число временных рядов меняет сам способ работы. Для единиц или десятков рядов можно вручную задать эвристики и быстро получить экспертную обратную связь. Для сотен или тысяч уже приходится группировать типы рядов и дольше собирать оценки экспертов. Для сотен тысяч или миллионов ряды могут сильно различаться, требования к скорости оповещения становятся жёсткими, а самой трудной частью оказывается оценка качества.
В обзоре сравниваются три способа синтеза. Смесь авторегрессионных моделей (Mixture autoregressive model) даёт разнообразие, но требует трудного подбора параметров под нужный шаблон и плохо контролирует место аномалии. GAN — генеративная состязательная сеть — проще использовать поверх существующих рядов, но синтетические ряды могут быть слишком похожи на исходные примеры, а положение аномалии также трудно задавать. Послойное моделирование (Layer Modelling) строит ряд из отдельных компонентов и даёт большую вариативность.
В раннем перечне минусов автор обзора пишет, что и для Layer Modelling «сложно контролировать положение аномалии». Позже тот же текст показывает противоположное практическое преимущество: аномалия задаётся отдельным слоем, поэтому её место известно при генерации. Источники не дают условия, которое примирило бы эти формулировки, поэтому противоречие лучше сохранить, а не придумывать объяснение.
3. «Генерация синтетических временных рядов для решения задачи поиска аномалий» → «Прикладной кейс доклада» → «Содержание»Неоднозначная разметка и четыре слоя генератора
Первый рисунок показывает один и тот же временной ряд с двумя разными наборами отмеченных точек. Это иллюстрация того, что экспертное понятие аномалии может быть неоднозначным: без формального критерия разные разметчики или правила выберут разные участки. Рисунок не сравнивает две точности модели.
Послойное моделирование (Layer Modelling) решает другую часть проблемы: вместо попытки обнаружить аномалию в уже сгенерированном ряду её добавляют как известный компонент. Синтетический ряд складывается из четырёх слоёв: тренда, сезонности, шума и аномалии. Поскольку последний слой создаётся самим генератором, для синтетических данных заранее известны положение и тип аномалии.
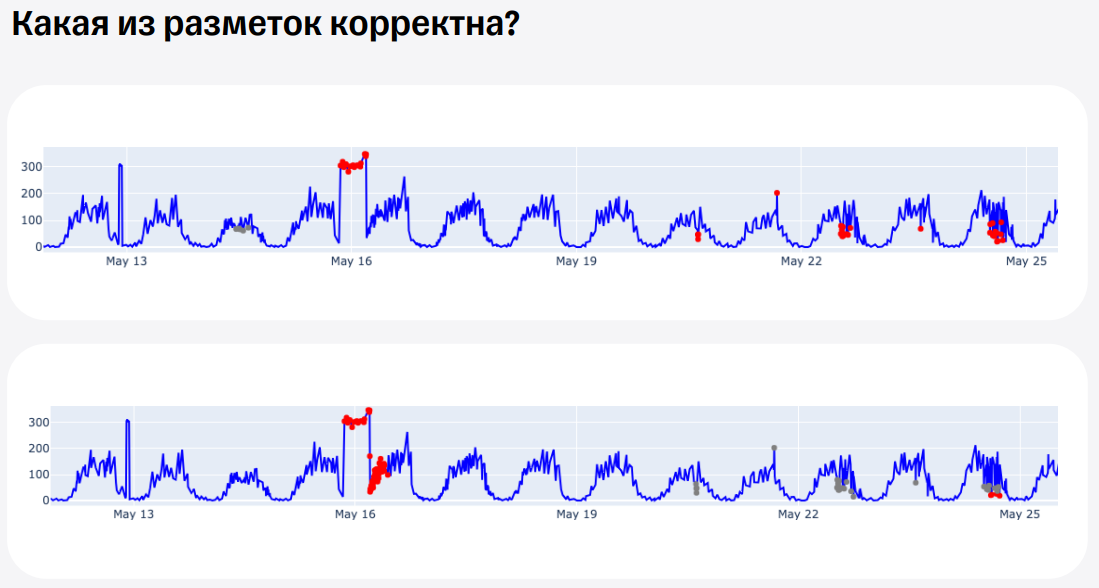
Две разные разметки одного временного ряда показывают неоднозначность определения аномалии, а не две измеренные точности.
Источник: Оригинальный материал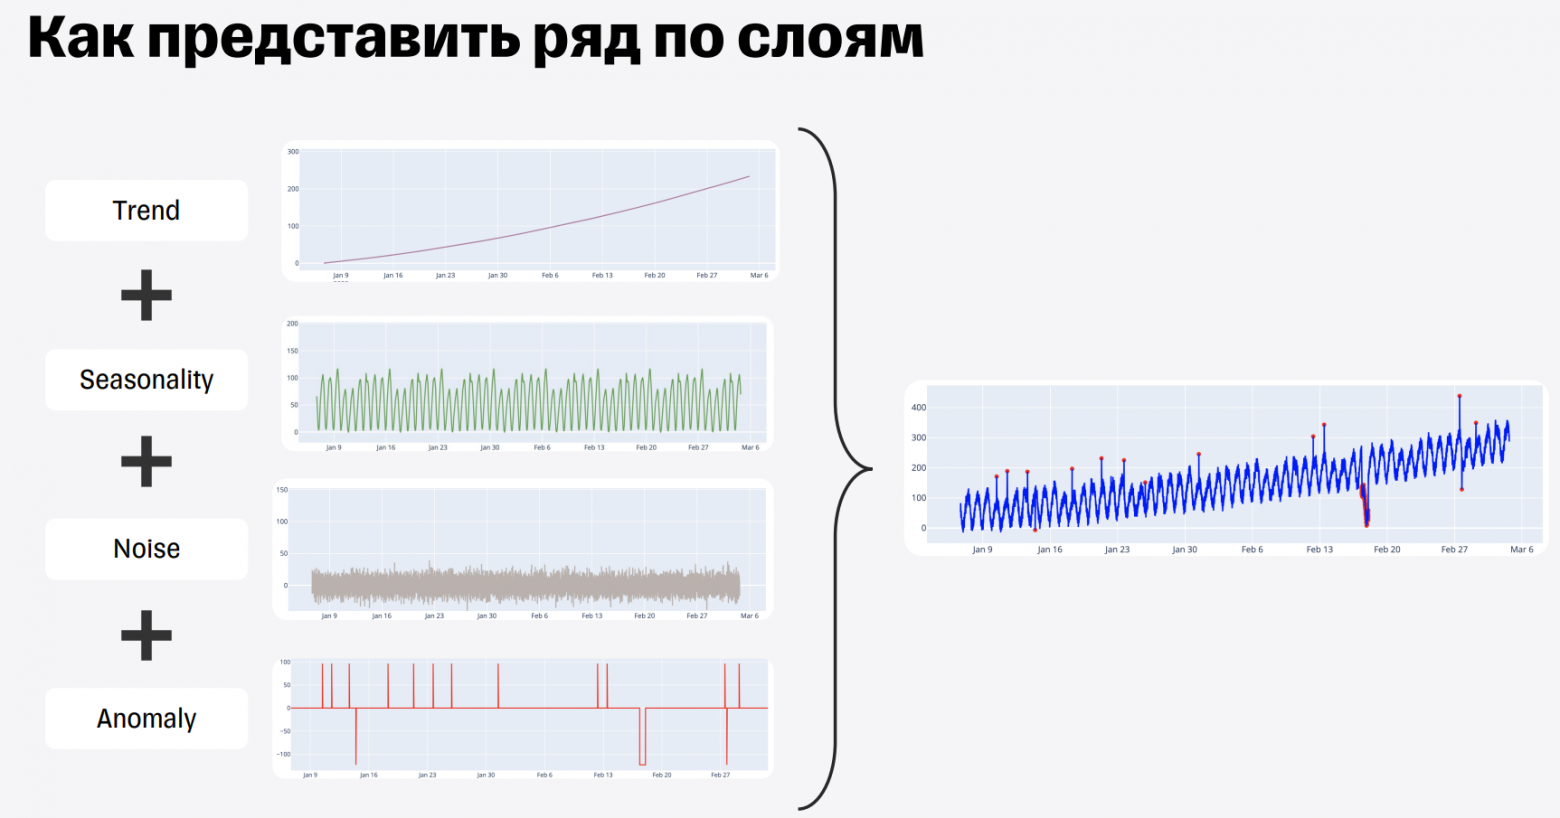
Синтетический ряд складывается из тренда, сезонности, шума и заранее заданных аномалий.
Источник: Оригинальный материалКакие блоки входят в генератор
По пересказу статьи, в их прикладной задаче почти все случаи шума покрывали первые два варианта — Gaussian Noise и Binomial Noise. Это локальное наблюдение, а не утверждение, что этих распределений достаточно для любых промышленных временных рядов.
Список можно расширять итеративно. Когда появляется новый тип аномалии, его алгоритмически добавляют в генератор, после чего заново создают синтетический набор и переобучают детекторы. Так экспертное описание нового паттерна превращается в размеченные обучающие примеры.
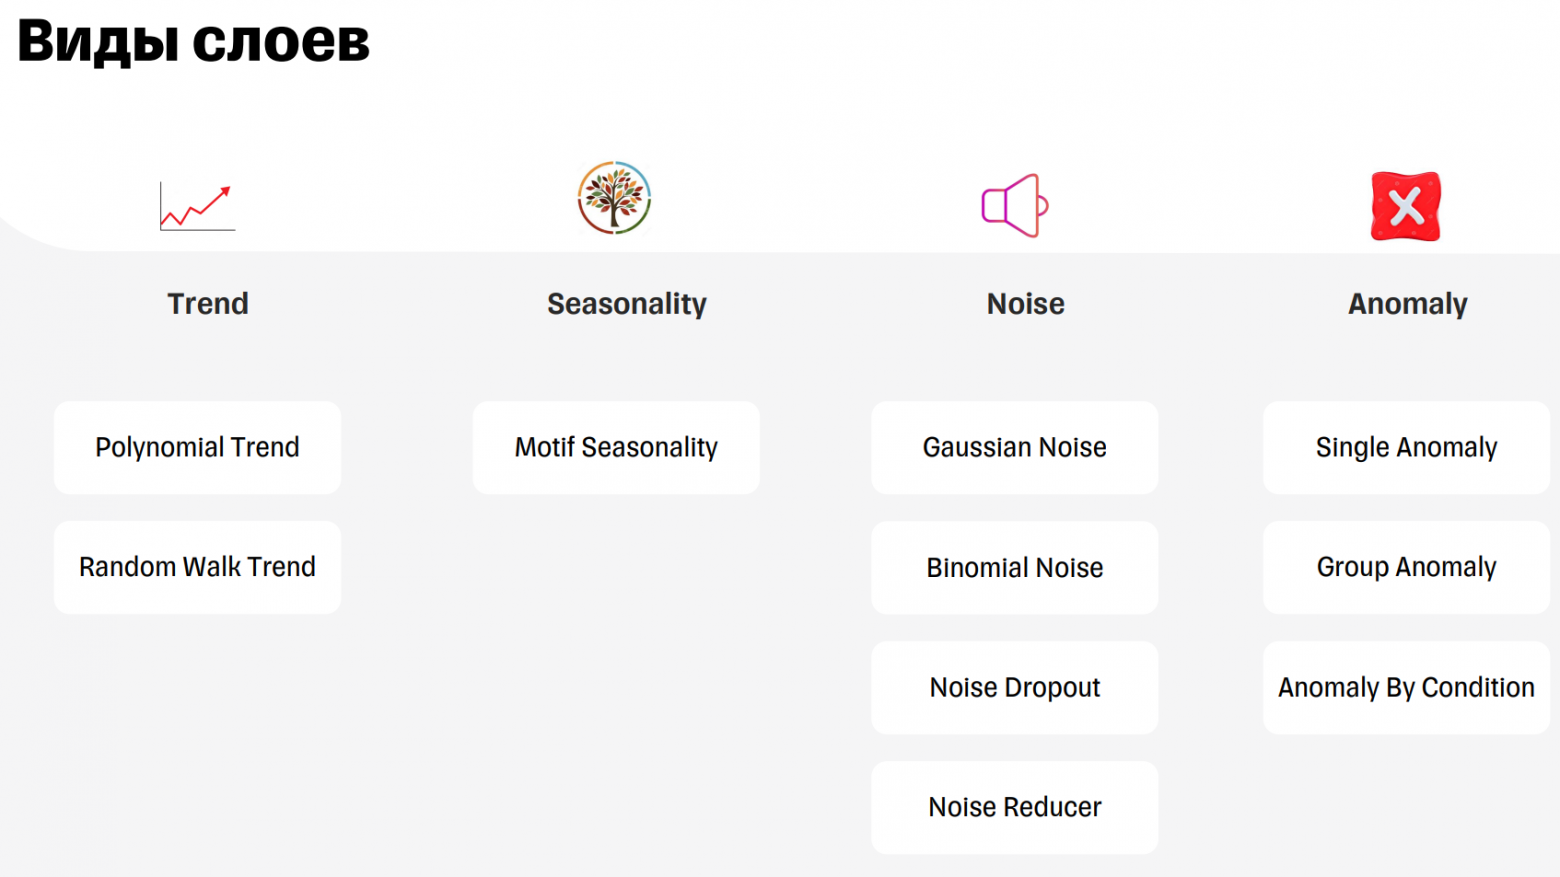
Каталог слоёв генератора: разновидности тренда, сезонности, шума и аномалий. Это описанный набор, не универсальный минимум всех промышленных рядов.
Источник: Оригинальный материалСетка параметров: пример, а не готовая библиотека
На слайде показан пример конфигурации шаблона. Для Polynomial Trend перебираются тройки коэффициентов из range(3); масштаб Gaussian Noise берётся из np.arange(0.015, 0.2, 0.05); для одиночной аномалии перебираются p из np.arange(0.001, 0.01, 0.001) и k из набора 5, 7, 9, 11.
seasonal_noise_trend_pattern = {
    PolynomialTrend: [
        {"coef": (x, y, z)}
        for x, y, z in product(range(3), range(3), range(3))
    ],
    MotifSeasonality: get_motif_seasonality_params(),
    GaussianNoise: [
        {"scale": x, "seed": None}
        for x in np.arange(0.015, 0.2, 0.05)
    ],
    NoiseReducer: NoiseReducer_params,
    BaseAnomaly: [
        {"mapper": single_random_anomaly, "p": p, "k": k, "seed": None}
        for p, k in product(np.arange(0.001, 0.01, 0.001), (5, 7, 9, 11))
    ],
}
Этот фрагмент нельзя копировать как самодостаточный запускаемый код. На слайде не определены get_motif_seasonality_params, NoiseReducer_params, single_random_anomaly и сами классы слоёв. Его ценность — показать принцип: генератор задаётся комбинацией блоков и сеток параметров, из которых можно получать много размеченных рядов.
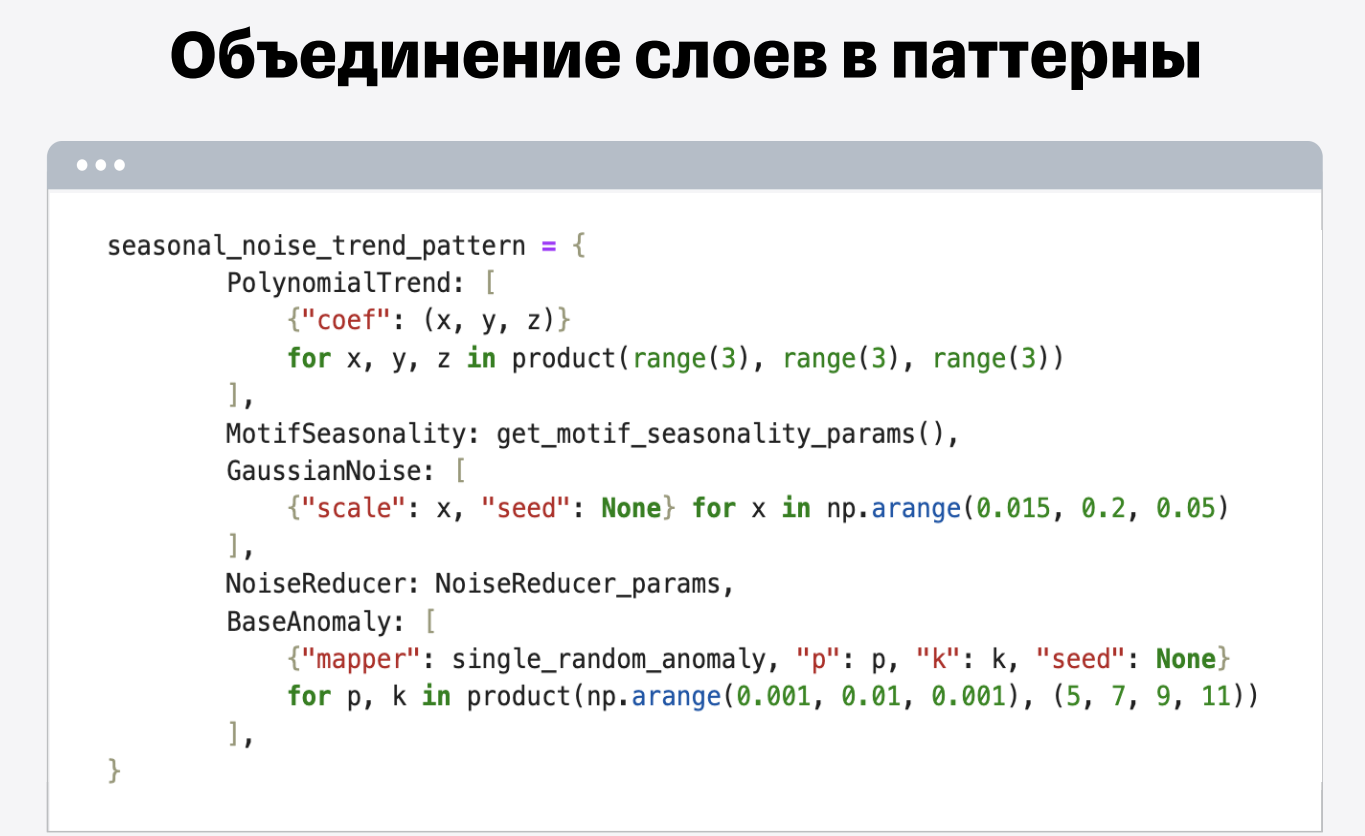
Пример параметров генерации: сетки коэффициентов, масштаба шума и аномалий. Для исполнения нужны внешние определения; код иллюстративный.
Источник: Оригинальный материалРезультат и границы третьего сюжета
По итогам автор обзора пишет, что синтетика дала возможность валидировать модели, перейти к обучению с размеченными примерами на большом объёме данных и применять подход в разных задачах. Для одной задачи классификации сообщён рост F1 с 0.57 до 0.88. Но в доступном обзоре нет набора данных, правила разделения на обучение и проверку, варианта F1, размера теста, числа запусков и доверительных интервалов. Поэтому число можно передать только как авторский отчёт, а не как переносимый ориентир качества.
Доступный обзор не содержит полного протокола оценки F1, поэтому по нему нельзя восстановить условия эксперимента или оценить статистическую устойчивость результата.
В разделе про кибербезопасность автор обзора предлагает попробовать тот же принцип для сетевого трафика и системных событий: формализовать экспертные типы аномалий, синтезировать размеченные примеры и обучать детекторы. Это гипотеза о переносе метода. F1 0.57→0.88 не относится к SOC и не доказывает эффективность такой работающей системы в безопасности.
3. Генерация синтетических временных рядов → «Как итог…» → «Толк для кибербезопасности»Итог: три разных способа построить обучаемый сигнал
Три истории в статье объединяет не одна архитектура, а идея отделять подготовку модели от её применения и честно связывать результат с тем, что действительно измерялось. В рекомендациях трансформер учится представлять историю пользователя, а кандидатные векторы заранее рассчитываются; при применении эти сигналы становятся признаками для CatBoost. В T-lite до применения отдельно очищают и балансируют корпус, продолжают предварительное обучение, настраивают поведение и проверяют разные варианты токенизации и контекста. Во временных рядах генератор заранее создаёт разметку через известный слой аномалии, после чего на таких данных обучают детектор. Всё это — подготовка, а не шаги схемы ниже.
- 01
Рекомендации: история пользователя
Во время запроса трансформер один раз обрабатывает последовательность событий и получает представление истории.
- 02
Рекомендации: оценки кандидатов
Готовые представления кандидатов сопоставляются с историей, а нейросетевые оценки вместе с другими признаками поступают в CatBoost для ранжирования.
- 03
T-lite: запрос
Готовая опубликованная модель получает пользовательский запрос и доступный ей контекст.
- 04
T-lite: ответ
Модель генерирует ответ; исследовательские 131k и расширенный токенизатор нельзя автоматически считать возможностями версии 0.1.
- 05
Аномалии: измерения ряда
Готовый детектор получает последовательность измерений временного ряда.
- 06
Аномалии: оценка
Детектор вычисляет, какие точки или участки считать аномальными в рамках своей заданной постановки.
Границы результатов различаются. Для RecSys показаны локальные приросты ранжирования и архитектурные наблюдения, а не выручка. Для T-lite числа 20–100%, 60% и 55/45 приведены без полного описания условий, а официальный июльский релиз 0.1 ещё не включал расширенный токенизатор и длинный контекст. Для аномалий F1 0.57→0.88 дан без полного протокола оценки. Во всех трёх сюжетах обучение, синтетическая разметка и контроль качества происходят вне схемы применения. И наконец, предложения о кибербезопасности принадлежат автору обзора: это направления возможного переноса идей, а не подтверждённые внедрения в работающих SOC-системах.
Итоги трёх частей статьи и три раздела «Толк для кибербезопасности»