Разбор готов
Островок: что работает между запросом и выбором номера
Пользователь открывает сервис бронирования с простой целью: найти подходящий отель и выбрать номер. За этой короткой цепочкой скрывается много небольших решений. У разных поставщиков разная скорость и качество обновления данных, цены могут устаревать, один и тот же отель или номер может называться по-разному, а фотографии и описания иногда противоречат друг другу. Поэтому ещё до появления привычного экрана с вариантами система решает, что подсказать в поиске, кого спросить о наличии, что взять из кэша, как упорядочить результаты и как объединить разрозненные сведения. В статье Островка этот путь показан через пять экранов пользователя — от ввода направления до свойств выбранного номера.
Материал полезен ML- и DS-инженерам, которые хотят увидеть, как в одном продукте сочетаются эвристики, классические модели, компьютерное зрение (Computer Vision, CV), языковая модель и ручные проверки. Особенно полезно различать реальные результаты, иллюстрации интерфейса и планы команды.
Статья · на русском
Data Science в travel-tech. Часть 1. Поиск и бронированиеИван Елфимов · Опубликовано: 24 июля 2024 г.
Пять экранов вместо одной «большой модели»
В статье Островка от 24 июля 2024 года Иван Елфимов начинает с важной оговорки: Data Science здесь понимается широко. Это не только нейронные сети, но и классические модели, эвристики и обработка разных типов данных. Команда Data Science появилась в Островке в 2014 году и за это время работала с изображениями, текстом, табличными данными, компьютерным зрением (Computer Vision, CV) и обработкой естественного языка (NLP). Поэтому пять авторских загадок лучше читать не как перечень нейросетей, а как карту решений, которые помогают пользователю дойти до бронирования.
Таблицу можно прокрутить по горизонтали.
В сумме получается 13 ролей. Это число описывает функции продукта, а не количество отдельных моделей, сервисов или нейросетей: часть ролей основана на эвристиках, часть — на классическом машинном обучении, часть — на компьютерном зрении или языковых моделях. Точное разбиение на модули и время выполнения каждой части статья не раскрывает.
Текст до «Загадка №1»; «Загадка №1»–«Загадка №5»Сначала понять, куда хочет поехать пользователь
Путь начинается с формы поиска. Если человек вводит «Мос», наиболее вероятный вариант — Москва, но запрос может означать и Московский вокзал. Аналогично латинское «Mos» скорее ведёт к «Moscow». По мере ввода система уточняет список, сортирует направления по популярности и старается сохранить полезный результат даже при опечатке вроде «москвский возкал».
Здесь автор специально показывает DS-продукт без ML-модели. Пока строка пуста, сервис предлагает популярные направления. После появления текста список упорядочивается на основе B-tree — древовидной структуры для быстрого поиска по упорядоченным ключам — и учитывает то, что пользователь искал раньше. Статья не описывает отдельную модель исправления опечаток, формулу популярности или точный способ персонализации, поэтому их не следует достраивать.
На первом оригинальном экране видны Москва, вокзалы и конкретные отели в выпадающем списке. Сам скриншот подтверждает пользовательский сценарий подсказок, но не является доказательством нейросетевой архитектуры или качества поиска.
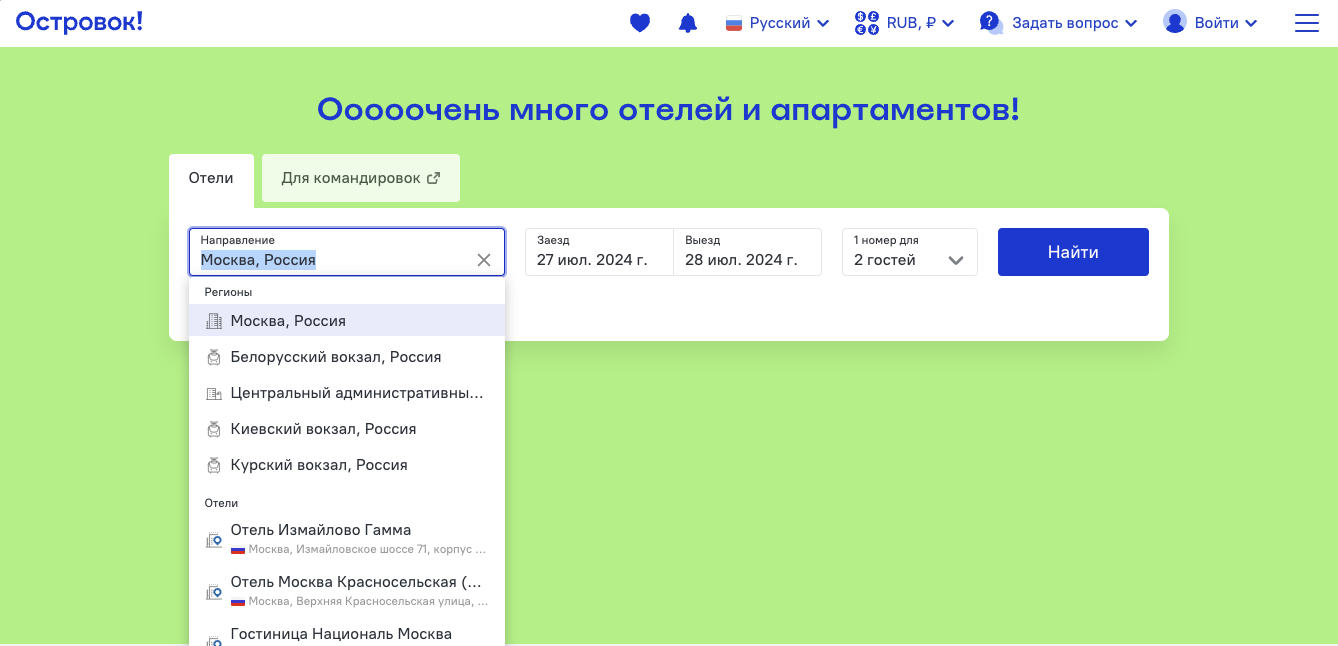
Подсказки направлений в форме поиска. Автор описывает эвристики и B-tree, а не нейросеть для каждой подсказки.
Источник: Оригинальный материалПока идёт поиск: кого спрашивать о наличии
После нажатия «Найти» одна из задач — определить, в каком порядке искать варианты у поставщиков. Они различаются по скорости, качеству инфраструктуры и свежести данных: у кого-то кодовая база и инфраструктура тянутся ещё из 1990-х, а кто-то работает на более современном стеке; часть поставщиков быстро обновляет наличие, другие передают информацию через посредников и с задержкой. Если поставщик медленный и редко даёт привлекательный результат, его можно отодвинуть на вторую или третью страницу и запросить в фоне.
Автор называет этот этап офлайн-ранжированием, потому что для него используются сохранённые сведения об отелях, которые редко меняются. Слово «офлайн» здесь объясняет источник данных, но не доказывает, что все оценки пересчитываются одной ежедневной пакетной задачей. Расписание пересчёта, точная граница между ранжированием отелей и порядком опроса поставщиков и время выполнения в статье не названы.
Для выбора привлекательных вариантов используется CatBoost — классическая модель градиентного бустинга по деревьям. Она обучается на 10 млн пользовательских сессий за последние 30 дней, охватывающих 1000 регионов, в каждом из которых может быть до 5000 отелей. Среди названных признаков — количество отзывов, рейтинг, звёздность, интересные удобства, то, как отель показывал себя раньше, и отклонение его цены от средней по региону. Цель автор описывает простыми словами: найти баланс между привлекательностью объекта и его стоимостью.
Второй оригинальный экран показывает только загрузку выдачи и карту. Пустые карточки — элемент интерфейса, а не измерение задержки поиска или скорости CatBoost.
Пока результаты загружаются, работают ранжирование поставщиков, выбор срока кеша, оценка конверсии и уточнение цен. Пустые карточки — интерфейсный пример, не метрика задержки.
Источник: Оригинальный материалСвежесть данных: кэш и вероятность бронирования
Островок обрабатывает 1,5 миллиона поисковых запросов в минуту. Если каждый запрос сразу пересылать поставщикам, часть их систем не выдержит нагрузку. Поэтому ответы приходится кэшировать, то есть временно хранить и повторно использовать. При этом поток данных достигает до 100 GiB в минуту, поэтому невозможно без разбора хранить всё одинаково долго.
Dynamic Cache TTL решает именно эту задачу. TTL — срок жизни записи в кэше: модель прогнозирует, сколько времени можно хранить информацию конкретного поставщика. Она обучена с учителем на исторических данных поставщиков. Источник не называет конкретные значения TTL, тип кэша, Redis, долю запросов, обслуженных из кэша, признаки модели или её архитектуру — эти детали нельзя восстанавливать по общему описанию.
Другая модель — Look-to-book optimization — оценивает вероятность того, что отдельный поиск закончится бронированием. Автор сравнивает задачу с поиском видео: привлекательная обложка ещё не означает, что ролик будут смотреть, так же как привлекательная карточка отеля ещё не гарантирует бронирование. Модель использует историю бронирований и параметры пользователя, поставщика и отеля. Ещё один названный сигнал — победа на репрайсе, то есть ситуация, когда повторная проверка цены или поставщика дала лучший вариант.
Автор пишет, что увеличение конверсии на 3–4% команда могла бы считать хорошим успехом при настройке моделей. Это ориентир, а не опубликованный прирост конкретного релиза Look-to-book и не результат описанного здесь A/B-теста. Связать Look-to-book с Dynamic Cache TTL, чтобы прогревать кэши для перспективных запросов, команда только планирует.
«Dynamic Cache TTL»; «Look-to-book optimization»Повторно проверить цену и поставщика
Одна из составляющих ценообразования — репрайс: повторный уточнённый запрос поставщикам. Он нужен, чтобы проверить, не успела ли измениться цена и нет ли того же номера у другого поставщика на лучших условиях.
Автор приводит две иллюстрации. Первая: вместо номера «Стандарт, двухместная кровать» за 5000 ₽ может обнаружиться «Люкс, двухместная кровать» за те же 5000 ₽. Вторая: тот же номер может найтись у другого поставщика дешевле, и тогда пользователю показывают более дешёвый вариант. Сумма 5000 ₽ — цена из примера, а не средний чек или бизнес-метрика.
Результаты репрайса могут влиять и на последующие поиски других пользователей. При этом статья не раскрывает, когда именно в техническом запросе запускается репрайс, сколько поставщиков повторно опрашивается, как хранится результат и сколько времени занимает проверка.
«Ценообразование»Когда выдача уже есть: уточнить порядок и представление
После большого поиска система работает уже с заметно меньшим набором. Автор описывает точечное, или point-wise, ранжирование: каждому отелю вычисляется отдельная оценка, после чего список сортируется. Повторно ранжируется выборка из 100–200 отелей; на ней можно учесть больше параметров и поднять более подходящий вариант выше.
Мотивация здесь не только в привлекательности карточки, но и в реальной возможности забронировать отель. Автор приводит условный контраст: один отель может не принять запрос на бронирование, а другой успешно завершать 99% таких запросов. Эти 99% относятся к примеру отеля, а не к точности модели, не к общей успешности бронирований и не к эффекту онлайн-ранжирования.
Отдельно учитываются программы лояльности. GURU предназначена для пользователей, Top Stays — для объектов размещения; автор связывает доверие к Top Stays с высоким рейтингом, большим числом отзывов и бронирований. Чтобы сочетать выгоду для пользователя и качество объектов, команда использует линейную регрессию. Она прогнозирует число просмотров: сколько отель получает сейчас и сколько мог бы получить, оказавшись выше в списке. Это не модель, которая определяет сам бейдж Top Stays, и статья не публикует показатели точности или полноты такой классификации.
Ещё одна роль — «умная галерея». Одни пользователи хотят сначала увидеть фасад, другим важнее интерьер. CV-модель, то есть модель компьютерного зрения, распознаёт содержание фотографии, после чего изображения получают оценки и сортируются. Выбор первого кадра зависит от интересов пользователя и контекста страницы: например, в поисковой выдаче можно показать интерьер, а на странице отеля — фасад, или наоборот. Речь в этом примере о контексте поверхности продукта, а не о доказанной персонализации по физической геолокации.
На третьем оригинальном экране видны реальные карточки, рейтинги, цены и множество точек на карте. Они помогают понять интерфейс, но цены, оценки и число доступных вариантов на конкретном скриншоте не являются метриками качества моделей.
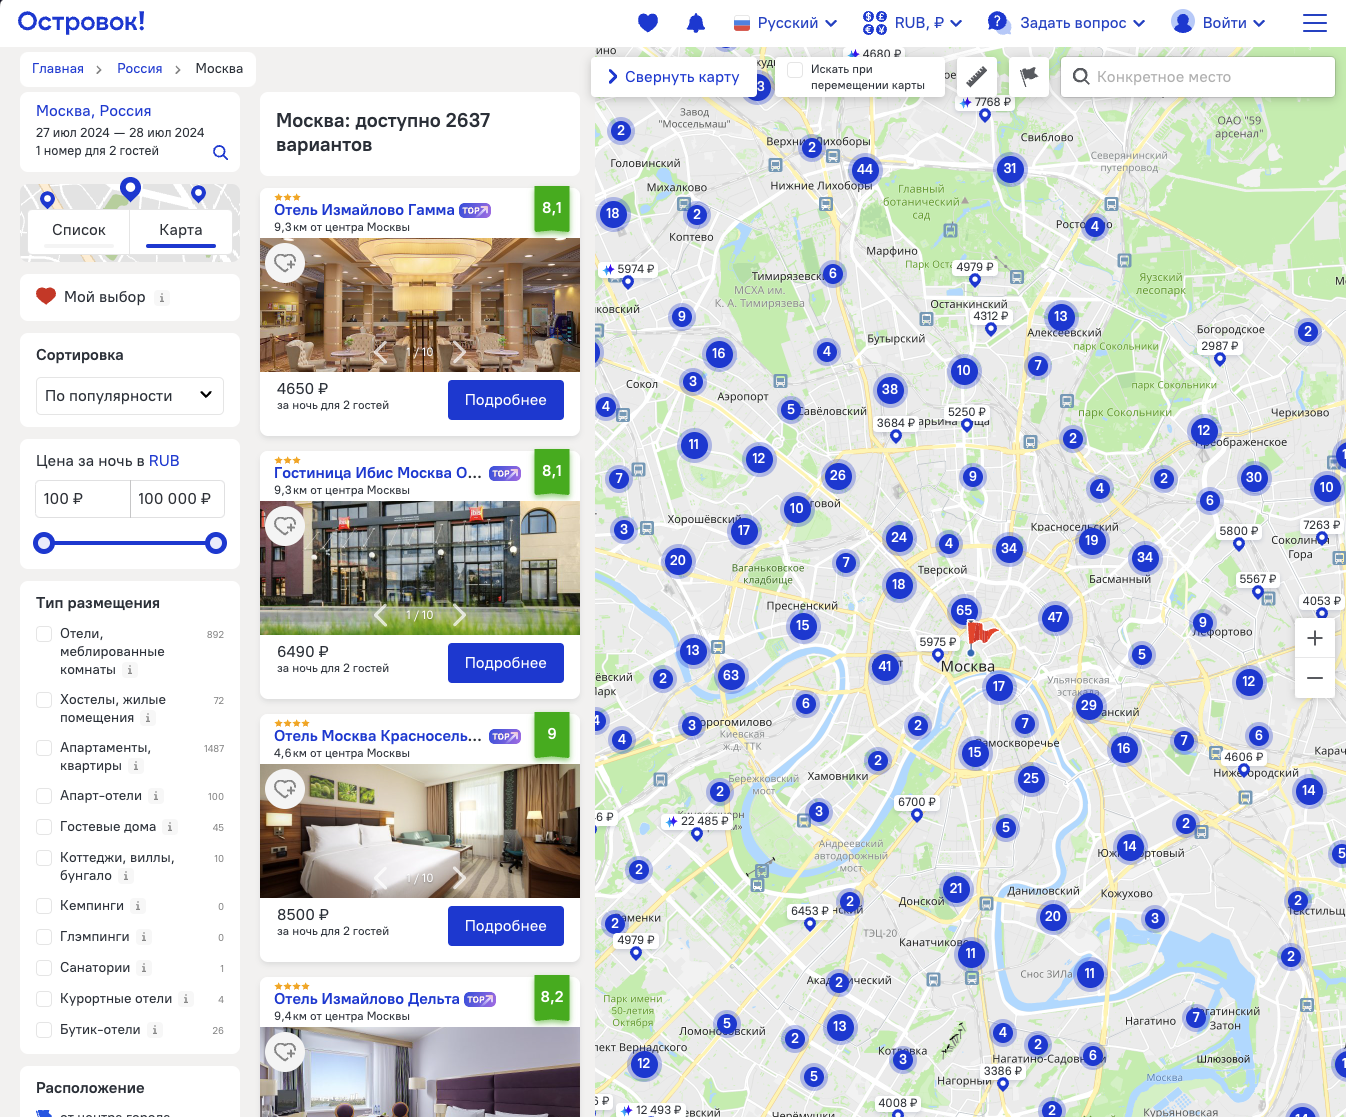
Выдача после загрузки: повторное ранжирование небольшой выборки, учёт программ лояльности и выбор изображения отеля.
Источник: Оригинальный материалСтраница отеля: собрать одну сущность из разрозненных данных
На странице конкретного отеля возникает другая проблема: один физический объект может приходить из нескольких источников. У Островка 230 поставщиков и 100 000 прямых контрактов с отелями. Координаты, адреса и названия одного места могут различаться, поэтому записи нужно сопоставить и объединить в один метаотель.
Автор описывает три шага матчинга: поиск ближайших соседей, фильтрацию ненужных пар и классификацию. При сопоставлении учитываются координаты, адрес, название, класс отеля и тип объекта размещения. Точный алгоритм поиска соседей, вид индекса, модель классификации, пороги и метрики качества в статье не названы.
Ошибки данных бывают очень приземлёнными. Один поставщик однажды перепутал широту и долготу, из-за чего система принимала запись за другой отель. Другие поставщики могли дословно переводить названия: в статье встречаются варианты вроде «Коробка на улице бесплатная» и «Будь счастлив на улице, Жадный». Если автоматический матчинг не справляется, название разбирает команда редакторов. Это важная часть процесса: модель не закрывает все случаи без человека.
Отзывы тоже приводятся к единому виду. В статье указано 50 млн отзывов, которые переводятся на 20 языков продукта небольшой LLM — языковой моделью. Её название, размер, архитектура, качество перевода и задержка не раскрыты. Персонализировать подбор отзыва по истории просмотров и бронирований команда только планирует.
В ответе к четвёртой загадке автор считает распознавание объектов на фотографиях ещё одной отдельной DS-ролью на странице отеля. Отдельной архитектуры для неё здесь не описано; более наглядные примеры распознавания предметов появляются ниже, уже на фотографиях комнаты.
Четвёртый оригинальный экран показывает страницу конкретного отеля: галерею, рейтинг, отзыв, цену и удобства. Это пример того, как сопоставленные данные, отзывы и содержимое фотографий сходятся в одной карточке. Значения цены, рейтинга и текста отзыва относятся к историческому интерфейсу и не являются бизнес-метриками.
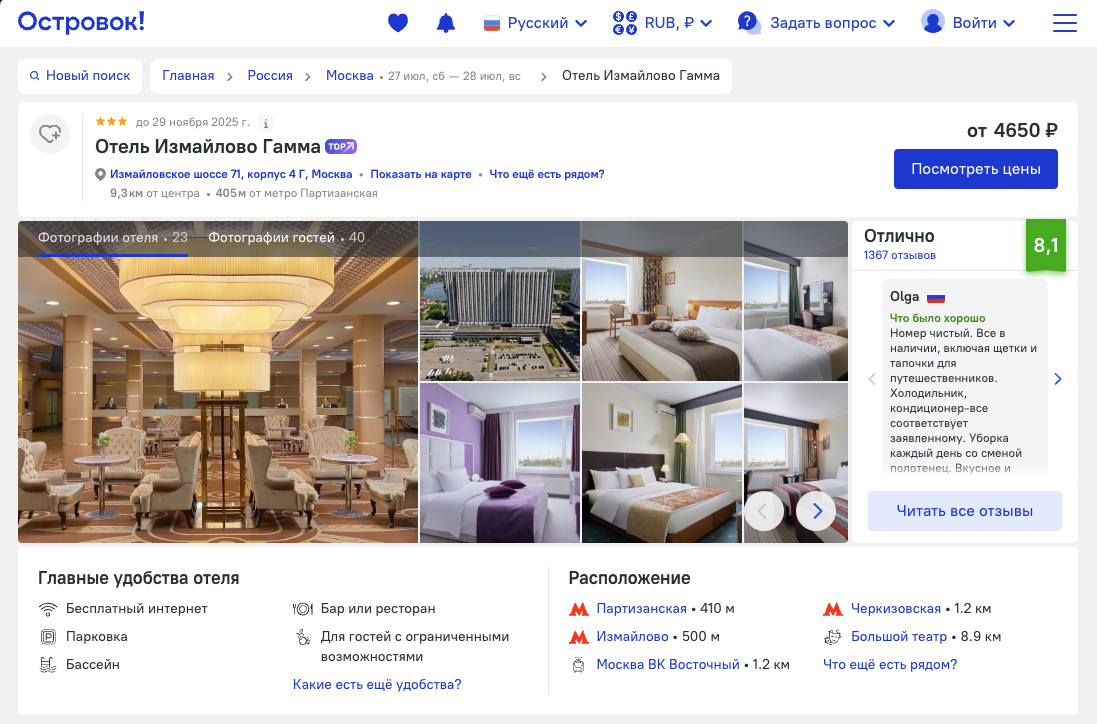
Карточка отеля использует сопоставленные данные поставщиков, отзывы и распознанное содержание фотографий. Цены, даты и отзывы на скриншоте — исторический пример интерфейса.
Источник: Оригинальный материалНомер: убрать дубли и подтвердить свойства по фотографии
На уровне комнат повторяется проблема метаотеля. Одна и та же комната одного отеля у разных поставщиков может иметь разные фотографии и описания. Островок использует многошаговую мультимодальную модель — модель, которая совместно работает с несколькими видами данных, — чтобы убрать дубли и собрать одну «метакомнату» для каждого типа номера.
Статья не раскрывает архитектуру этой модели. Нельзя из общего слова «мультимодальная» делать вывод о конкретных энкодерах, эмбеддингах, векторной базе, косинусной близости, количестве шагов, порогах сопоставления или задержке. Из первоисточника известно только назначение: сопоставить разные описания и фотографии одной комнаты.
Есть и отдельная проверка содержимого фотографий. Поставщик может прислать описание номера и изображения, которые не совпадают. CV-модель распознаёт объекты на фото, а затем её теги объединяются с описанием поставщика. Так формируется список подтверждённых параметров комнаты.
Пятый оригинальный экран показывает несколько тарифов одного номера. Следующие два изображения демонстрируют рамки вокруг кровати, ламп, телевизора, телефона, зеркал, раковин, полотенец и других объектов. Это примеры выхода CV-модели, а не опубликованный тест её точности и полноты. Последний оригинал показывает итоговый список свойств комнаты: площадь и удобства относятся к одному конкретному примеру, а не к агрегированным показателям системы.
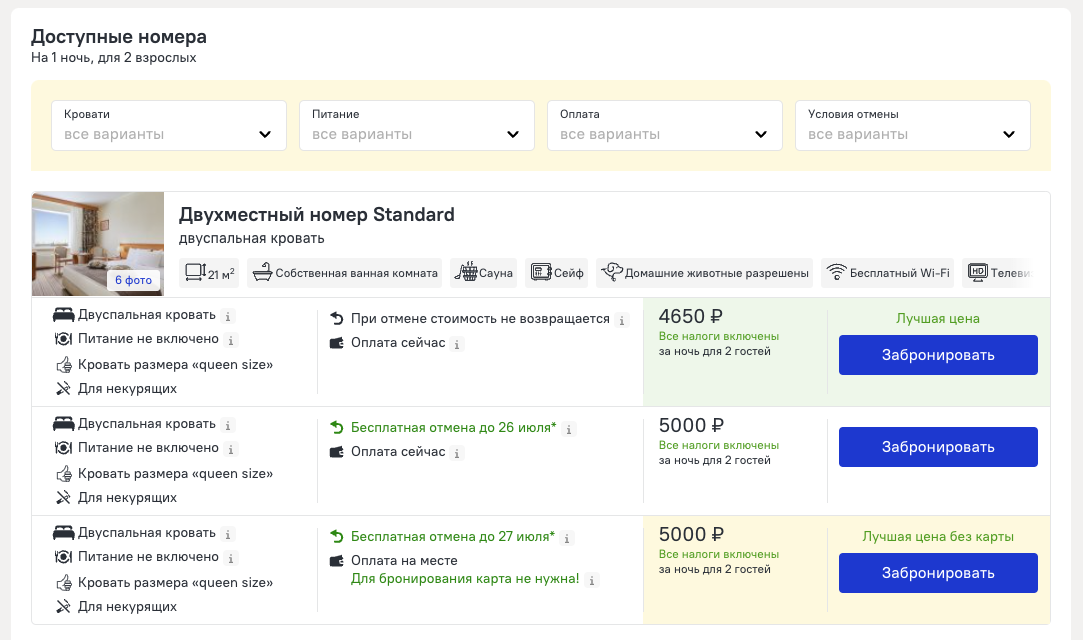
Блок номеров: объединение вариантов от разных поставщиков и уточнение свойств по изображениям.
Источник: Оригинальный материал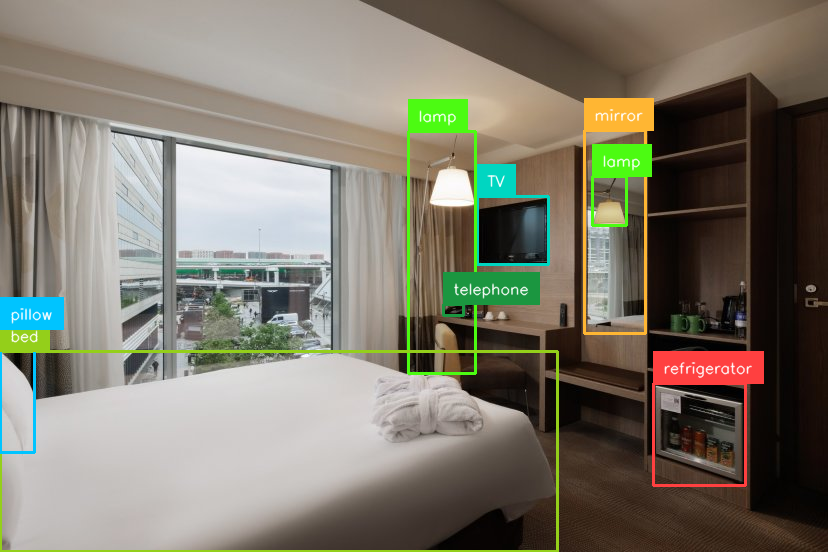
Пример распознавания объектов в номере. Рамки — выход CV-модели, а не опубликованный тест её точности.
Источник: Оригинальный материал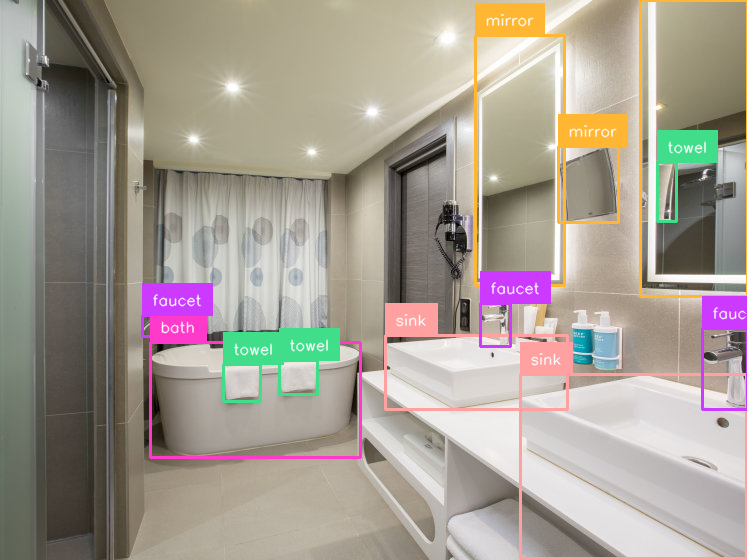
Пример распознавания предметов в ванной комнате. Ошибки распознавания автор отдельно обсуждает в статье.
Источник: Оригинальный материал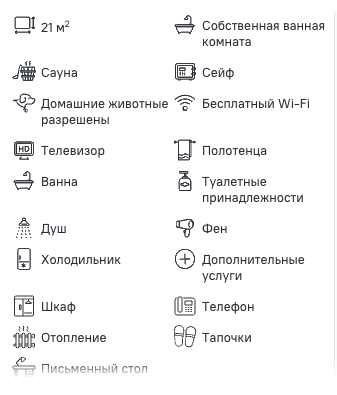
Параметры номера объединяют сведения поставщика и распознанные теги. Значение площади и набор удобств относятся к одному показанному примеру.
Источник: Оригинальный материалПочему хороший офлайн-результат ещё не заканчивает работу
Автор отдельно предупреждает: предпочтения пользователей трудно угадывать, а модель, которая хорошо выглядит во время обучения, после релиза может работать плохо. Новый DS-продукт способен пройти 3–4–5 итераций до ожидаемого результата — или вовсе его не дать. Поэтому для поиска и бронирования важна инфраструктура, в которой можно регулярно проверять новые гипотезы.
В статье приведены и конкретные промахи. Фотографии туалетов иногда определялись как столовая. Другой случай — совсем плохой отель всплывал на самый верх выдачи. Эти примеры важнее общего утверждения о качестве работающей системы: они показывают, что сложный продукт остаётся уязвимым к неожиданным сочетаниям данных и расчётов.
Часть ошибок обнаруживается людьми. Отельеры проверяют свои страницы после размещения, команда контента выборочно смотрит, как выглядят объекты, а аккаунт-менеджеры могут проверять, что участник Top Stays действительно появляется высоко в списках. Из этого нельзя делать вывод, что все ошибки гарантированно ловятся или что у команды опубликована формальная схема мониторинга: источник описывает ручные проверки как практический контур контроля.
«Про частые итерации и проверки гипотез»; «Не всегда всё идёт гладко»Граница этой части: после бронирования есть другие модели
Эта статья заканчивается на этапе до бронирования. Автор упоминает ещё примерно десяток DS-продуктов после бронирования: служба поддержки использует модели и ML-инструменты для выявления высокорисковых бронирований, распознавания входящих обращений и подготовки шаблонов ответов по e-mail.
На этом подробности заканчиваются. Архитектура, обучение, данные и метрики задач после бронирования в текущем источнике не раскрыты, поэтому их нельзя включать в техническое описание как продолжение уже разобранной системы.
«Продолжение — во второй части»Итог: путь от поисковой строки до подтверждённых свойств номера
Главная идея статьи — путь до номера складывается не из одной универсальной модели, а из набора решений для разных источников неопределённости: что имел в виду пользователь, какие поставщики дадут полезный ответ, насколько свежи цена и наличие, какой отель поднять выше, какие записи относятся к одному объекту и чему можно доверять в описании комнаты.
- 01
Запрос направления
Подсказки помогают уточнить город, вокзал или другой объект. Здесь достаточно эвристик, B-tree и истории предыдущих поисков.
- 02
Получение вариантов
Система решает, каких поставщиков спрашивать раньше и какие данные можно временно взять из кэша. Цена и поставщик также могут уточняться репрайсом.
- 03
Упорядочение выдачи
Из уже найденного набора повторно ранжируются 100–200 отелей, учитываются вероятность успешного бронирования, программы лояльности и выбор фотографии.
- 04
Подготовка страницы отеля
Записи поставщиков сопоставляются в метаотель, отзывы приводятся к единому виду и переводятся, фотографии получают содержательные теги.
- 05
Выбор номера
Разные описания и фото одного типа комнаты объединяются в метакомнату, а CV помогает подтвердить свойства, которые затем показываются пользователю.
Обучение находится вне этого пользовательского пути. Для CatBoost автор называет 10 млн сессий за 30 дней, 1000 регионов и до 5000 отелей в регионе; для Dynamic Cache TTL — обучение с учителем по истории поставщиков. Другие архитектурные детали в статье не раскрыты.
Числа нужно читать только в их контексте: 1,5 млн запросов и до 100 GiB относятся к минуте, 99% — пример одного отеля, а 3–4% — ориентир хорошего роста конверсии, не измеренный результат описанного релиза.
Проблемы качества в статье показаны прямо: туалет мог быть принят за столовую, а плохой отель — оказаться наверху выдачи. Поэтому система требует повторных итераций и ручной проверки со стороны отельеров, контент-команды и аккаунт-менеджеров.
Планы также отделены от внедрённого: связка Look-to-book с Dynamic Cache TTL для прогрева кэша и персональный выбор отзывов по истории пользователя на момент статьи ещё только задуманы.
«Загадка №1»–«Продолжение — во второй части»