Разбор готов
Как находят накрутку товарных рейтингов во ВкусВилле
Покупатель открывает карточку товара и видит высокий рейтинг. Если часть оценок накручена, цифра начинает описывать не качество продукта, а действия тех, кто пытается на неё повлиять. Для ВкусВилла это особенно чувствительно: рейтинг используется как один из сигналов качества, а товар с низкой оценкой могут вывести из ассортимента на доработку и затем вернуть. Команда «ДатаЛаб» ГК «Автомакон» построила для ВкусВилла антифрод-систему, которая анализирует не только сам отзыв, но и поведение вокруг него. Задача — не спутать любое необычное действие с мошенничеством, а собрать несколько разных оснований. В этой главе разберём данные, поведенческие представления, поиск аномалий, объединение сигналов и роль ручной перепроверки.
Материал полезен тем, кто строит антифрод, системы доверия и другие решения на поведенческих данных. Особенно показательно, как авторы отделяют необычный объект от окончательного решения о фроде и связывают ML с продуктовым процессом.
Статья · на русском
Честные рейтинги и отзывы: роль машинного обучения в борьбе с фродом рейтинга и отзывов товаров в ритейлеАндрей Шелюх · ДатаЛаб · Опубликовано: 22 мая 2024 г.
Почему накрутка рейтинга становится продуктовой проблемой
Онлайн-рейтинг помогает покупателю выбирать товар, поэтому искусственные оценки и отзывы меняют не просто красивую цифру на странице. Они способны создать ложное впечатление о качестве продукта. Для ВкусВилла связь ещё прямее: отзывы и оценки из приложения и сайта участвуют в формировании рейтинга, а его падение служит сигналом, что с товаром может быть проблема. Товар с низким рейтингом могут вывести из ассортимента на доработку; после изменений он может вернуться.
Компания собирает обратную связь через разные каналы — в том числе социальные сети, горячую линию и упоминания в медиа. Рейтинг же формируется по оценкам и отзывам в мобильном приложении и на сайте. В статье также сказано, что специалисты ВкусВилла проверяют оставленные отзывы, но не раскрыто, какая часть этой проверки выполняется вручную для каждого отзыва. Отдельно и явно описана ручная перепроверка карт покупателей, которые уже были заблокированы антифродом.
Отсюда и постановка антифрода: защитить нужно не только публикацию отдельного отзыва, но и сам сигнал качества, на который опирается продуктовый процесс. Авторы описывают разработанную для ВкусВилла систему распознавания и блокировки поддельных отзывов, но статья не публикует полный экспериментальный протокол с размеченной тестовой выборкой и обычными метриками классификации. Поэтому дальше важно разделять устройство подхода, заявленные продуктовые ориентиры и то, что реально измерено.
Честные рейтинги и отзывы: роль машинного обучения в борьбе с фродом рейтинга и отзывов товаров в ритейлеКакие данные нужны кроме текста отзыва
Антифрод начинается с данных. В статье перечислены текстовые отзывы и оценки, поставленные после покупки, история покупок и сведения о покупателе, полученные при регистрации бонусной карты. Отдельно предлагается проверять, есть ли другие покупатели, использующие тот же телефон, валидировать адрес электронной почты и смотреть агрегированные данные по поставщикам товаров. Так один отзыв оказывается связан с историей действий, идентификаторами покупателя, товаром и поставщиком.
Перед моделированием данные очищают от дублей, выбросов и других аномалий. Источник не раскрывает точный окончательный набор признаков, правила очистки или способ разметки фрода. Это важно: перечисление доступных полей ещё не означает, что каждое из них одинаково используется в каждой модели или в каждом сценарии.
Сбор и подготовка данныхОт поиска необычного поведения к нескольким моделям
Задача первого машинного слоя — найти объекты, поведение которых заметно отличается от основной массы. Такой объект называют аномалией. Аномалия полезна как сигнал для проверки, но сама по себе не доказывает мошенничество: необычное поведение может иметь и нормальное объяснение.
Автор перечисляет несколько возможных методов: поиск k ближайших соседей (k-NN), Isolation Forest, автоэнкодеры, свёрточные нейронные сети и другие модели. Этот список нельзя читать как перечень всего, что было внедрено в рабочую систему. Дальше статья уже явно показывает применение конкретных подходов: PyTorch Lifestream для представлений поведения, K-means, Isolation Forest, их совместное использование и оценку ошибки реконструкции автоэнкодера.
Идея ансамбля появляется именно из различий между моделями: разные методы обращают внимание на разные структуры данных. Если несколько разных сигналов указывают на один и тот же объект, это может дать более сильное основание для дальнейшей проверки, чем одиночное срабатывание.
Выявление аномалий и неестественных паттерновКак временное поведение превращают в вектор
Обычные признаки можно подать в модель после нормализации, то есть привести их масштабы к сопоставимому виду. Другой путь — построить компактное числовое представление, или эмбеддинг. Для данных, где важен порядок событий во времени, авторы используют PyTorch Lifestream. В статье этот инструмент связывается с изменяющимися во времени рейтингами для пар «товар — поставщик» и с последовательностями оценок и отзывов отдельных пользователей.
Авторы прямо пишут, что с помощью PyTorch Lifestream сформировали эмбеддинги и уже на этом представлении применяли методы поиска фрода. При этом статья не раскрывает архитектуру модели, размер эмбеддинга, длину истории или конкретную учебную задачу. Эти детали нельзя восстанавливать по общим знаниям о библиотеке.
Обучение моделей для выявления фродаK-means: искать отдельные группы в пространстве поведения
K-means разбивает объекты на группы так, чтобы точки внутри одной группы были ближе друг к другу, чем к центрам других групп. В этом кейсе метод применён к представлениям, полученным после PyTorch Lifestream. Для рисунка авторы сжали эмбеддинги до двух координат, но способ такого сжатия не назван. Поэтому нельзя приписывать визуализации t-SNE, UMAP, PCA или другой конкретный алгоритм.
На исходном рисунке светло-зелёным выделены несколько пространственно отделённых областей, тогда как большая левая масса точек остаётся синей. Из рисунка следует только то, что K-means разделяет это двумерное представление на отличающиеся группы. На нём нет эталонной разметки, precision или recall, поэтому цвет нельзя трактовать как доказанный класс «фрод».
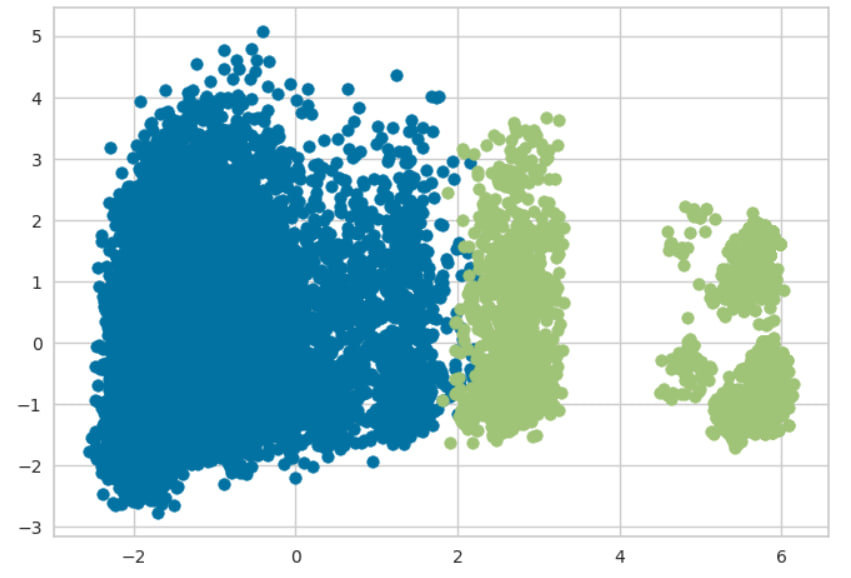
K-means на двумерной иллюстрации представлений Pytorch Lifestream. Выделенные группы показывают реакцию метода, а не доказанные классы фрода с опубликованной точностью.
Источник: Оригинальный материалIsolation Forest: выделять отдельные необычные объекты
Isolation Forest ищет объекты, которые легче отделить от остальных случайными разбиениями пространства. Интуитивно редкий или стоящий особняком объект обычно изолируется быстрее. На тех же двумерных представлениях этот метод выделяет точки иначе, чем K-means: подозрительные точки распределены по нескольким областям и встречаются даже внутри большого общего облака.
Сравнение двух рисунков и поддерживает авторский тезис, что модели замечают разные факторы. Но граница аномальности и параметры Isolation Forest не опубликованы. Так же как и в случае K-means, на визуализации нет истинных меток фрода. Следовательно, рисунок иллюстрирует реакцию алгоритма, а не измеренную точность антифрода.
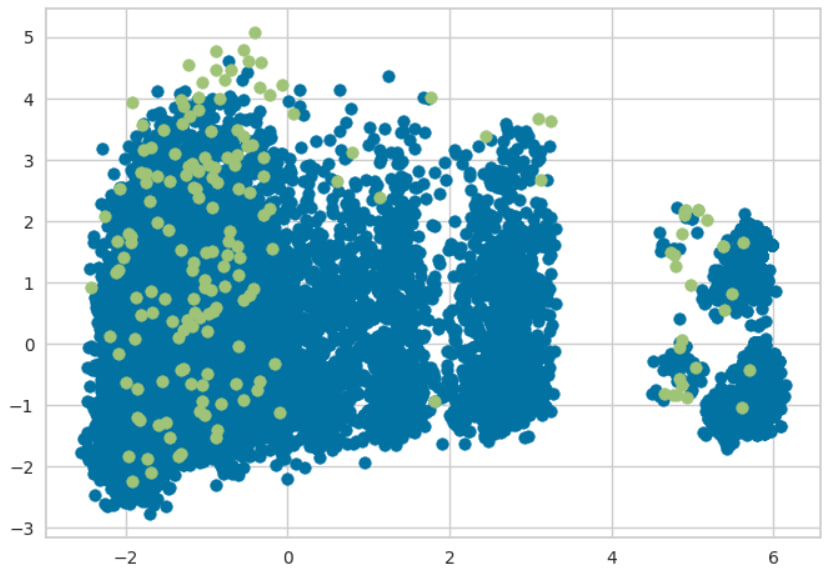
Isolation Forest выделяет другие подозрительные объекты на тех же представлениях. Полная методика снижения размерности и порог аномалии не раскрыты.
Источник: Оригинальный материалАнсамбль: использовать совпадение разных сигналов
После отдельных результатов авторы показывают совместное применение K-means и Isolation Forest. Ансамблем называют сочетание нескольких моделей или правил, когда итоговое решение использует больше одного источника сигнала. В статье мотивация простая: если методы реагируют на разные особенности данных, их совместное мнение может быть полезнее одиночного срабатывания.
На рисунке красным отмечен небольшой поднабор точек, особенно заметный на отдельных правых группах. Это показывает, как пересечение или совмещение сигналов сужает множество кандидатов. Но статья не даёт формулы объединения, порогов и численного сравнения качества ансамбля с каждой моделью по отдельности. Нельзя утверждать, что каждая красная точка автоматически блокируется или что ансамбль имеет опубликованный прирост precision либо recall.
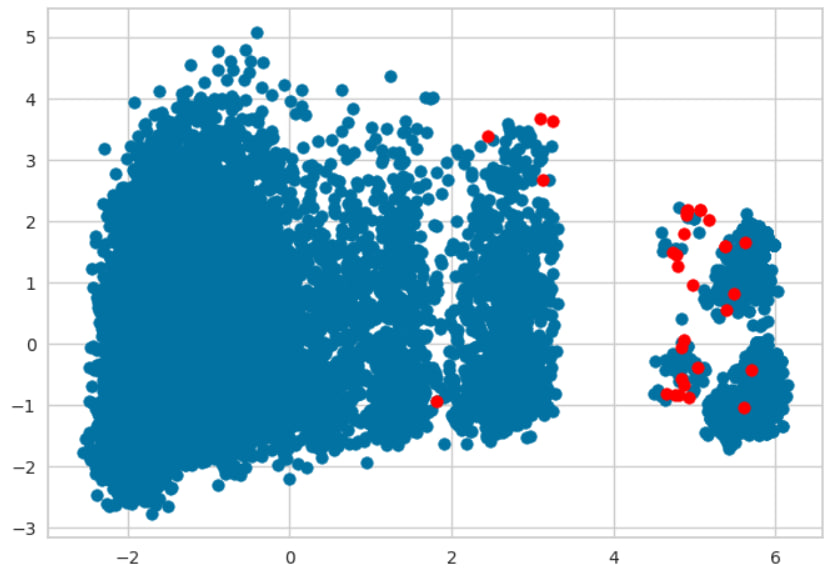
Совместное применение K-means и Isolation Forest: отмеченные точки иллюстрируют совмещение сигналов. На рисунке нет эталонной разметки или измеренной precision/recall.
Источник: Оригинальный материалАвтоэнкодер: аномалия через ошибку восстановления
Другой реально использованный подход — автоэнкодер. Это нейросеть, которая пытается восстановить входные данные после прохождения через внутреннее представление. Если объект сильно отличается от типичных примеров, восстановление может оказаться хуже. Разница между исходным объектом и реконструкцией становится оценкой необычности.
Авторы прямо указывают, что использовали ошибку реконструкции автоэнкодера. На двумерной иллюстрации выделенные точки появляются и в отдельных правых группах, и внутри большого левого облака. Из этого нельзя восстановить архитектуру сети, функцию потерь или порог решения: статья их не публикует. И здесь выделенная точка означает лишь модельный сигнал, а не обязательную блокировку покупателя.
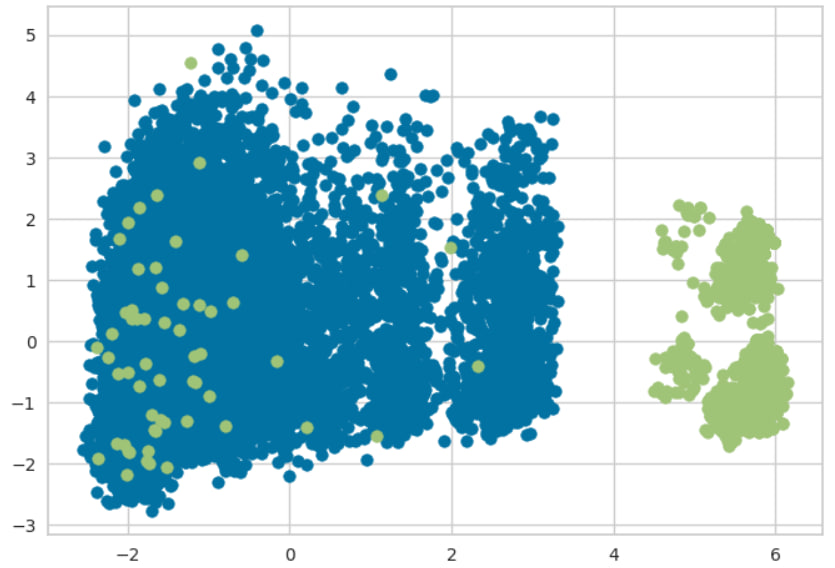
Автоэнкодер оценивает отклонения через ошибку восстановления. Показанные точки не означают автоматическую блокировку всех выделенных покупателей.
Источник: Оригинальный материалПочему один необычный признак ещё не означает фрод
После модельных примеров статья возвращается к более важной для системы мысли: финальное решение принимается в комбинации с другими сопутствующими факторами. Антифрод во ВкусВилле охватывает не только манипуляции рейтингами, но также возвраты товаров, чрезмерное использование бонусов и другие виды недобросовестного поведения. Для разных сценариев используются разные наборы признаков.
Сигнал может сработать один раз или повторяться несколько раз в течение дня. Само одиночное срабатывание не обязательно означает фрод. Поэтому системе важны контекст, сочетание признаков и частота повторений. В описании автора каждому признаку присваивается вес, а затем контролируется накопленный вес. Когда он достигает заданного порога, ситуация считается подозрительной и получает фродовый статус.
Статья не связывает формально каждый выход K-means, Isolation Forest и автоэнкодера с этим накопителем. Поэтому корректно говорить, что модели дают сигналы для более широкого решения, а система в целом умеет учитывать взвешенную совокупность признаков. Утверждение, будто все показанные модельные выходы обязательно входят в один и тот же аккумулятор по единой формуле, источник не подтверждает.
«Антифрод» в компанииТекстовые отзывы: направление, которое авторы оставляют на будущее
Обработка естественного языка, или NLP, может искать в текстах повторяющиеся фразы, шаблоны и другие смысловые признаки. Автор упоминает такой анализ как отдельное направление и обещает подробнее разобрать его в другой статье. В текущем источнике нет описания внедрённой NLP-модели, языковой модели или LLM-детектора, встроенного в показанную антифрод-систему.
Использование алгоритмов обработки естественного языка (NLP)Почему модели и признаки приходится обновлять
Фрод меняется вместе с правилами продукта и поведением тех, кто пытается эти правила обойти. Поэтому авторы считают необходимыми постоянный мониторинг результатов моделей и добавление новых данных для обучения. Однако точная частота переобучения в статье не приведена: нельзя превращать общий принцип обновления в выдуманный ежедневный, еженедельный или другой график.
То же относится к признакам. Некоторые перестают работать, когда мошенническая схема исчезает, другие требуют постоянной доработки. Таким образом, антифрод здесь — не фиксированный классификатор, а изменяемая система сигналов. Её эффективность зависит от того, насколько быстро команда замечает новые схемы и обновляет способы их обнаружения.
Обновление моделей и системыКак читать планку 90% и зачем остаётся ручная перепроверка
После запуска система должна соответствовать продуктовым обещаниям. Представитель ВкусВилла формулирует два ориентира: рейтинг должен оставаться честным, а честный покупатель не должен быть заблокирован как мошенник. При этом заблокированные карты покупателей сохраняют ручной контроль и перепроверку. Это важная часть процесса: решение модели не объявляется безусловной истиной.
Ключевая заявленная планка сформулирована как «доля выявленного фрода системой 90%», то есть ручных блокировок должно быть 10% или меньше. В статье нет опубликованной тестовой выборки, знаменателя, confusion matrix или измеренного recall. Поэтому число 90% нельзя переписывать как accuracy, precision или recall модели и нельзя выдавать за уже доказанное фактическое качество.
«Плохая прибыль»: бизнес-сигнал вокруг проблемного продукта
Кроме доли системного выявления, команда использует понятие «плохой прибыли». Логика такая: найденный фейковый отзыв по товару может означать попытку скрыть реальную картину мнений о его качестве. За выявленный период вся прибыль и выручка по такому продукту относятся к «плохим», а команда ежемесячно смотрит на долю «плохой прибыли» в общей прибыли компании.
Это не оценка денежного ущерба от одного фейкового отзыва. Мера относится к продукту целиком за период, в котором обнаружена проблема. В статье также упомянут показатель «плохой» выручки в 10 000 рублей, но база этого числа не раскрыта достаточно ясно. Поэтому его нельзя трактовать как ежемесячный убыток на 10 000 рублей или как стоимость одного эпизода фрода.
Авторы пишут, что текущая величина этого показателя составляет лишь небольшую долю и что нулевого значения, вероятно, достичь не удастся. Практический смысл такой метрики — следить за динамикой потенциально проблемной выручки, а не заменять ею обычные метрики качества классификации.
Метрики эффективностиЦель антифрода, поставщики и цена инфраструктуры
Представитель ВкусВилла подчёркивает, что задача системы не сводится к наказанию нарушителя. Продуктовая цель — создать безопасный путь для покупателя: он должен иметь возможность купить товар, оставить мнение и рассчитывать, что его обратная связь будет услышана. Вторая сторона той же системы — добросовестная конкуренция между поставщиками.
Экономический эффект в статье сформулирован осторожнее, чем иногда пересказывают этот кейс. Авторы пишут, что антифрод может приносить значительные выгоды и помогать экономить сотни миллионов в год. Но опубликованного расчёта фактически достигнутой экономии, контрольной группы или причинного измерения нет. Поэтому «сотни миллионов» нужно читать как заявленный потенциал, а не как доказанный реализованный эффект этой конкретной версии системы.
Отдельный инженерный вывод статьи: для антифрода не всегда нужны самые сложные модели. Иногда важнее иметь актуальные данные и точно понимать, какую схему нужно искать. Поэтому сильная поддержка data-инженеров названа ключевым фактором. При этом источник не раскрывает конкретные хранилища, очереди, сервисы применения моделей, online/batch-режимы или задержки обработки, и их нельзя достраивать.
«Антифрод» в компанииИстория поведения и персональные данные
Чем длиннее история поведения, тем больше сигналов можно использовать для анализа, но одновременно сложнее работа с персональными данными. Автор отдельно отмечает необходимость удалить информацию о пользователе по соответствующему запросу и упоминает хеширование персональных данных как один из способов защиты.
Этого недостаточно, чтобы делать более сильные выводы. Статья не описывает, какие именно поля хешируются, как управляются ключи или соль, какие производные данные сохраняются, как устроены сроки хранения и полное удаление. Поэтому хеширование нельзя объявлять автоматически доказанной анонимизацией или готовой гарантией соответствия требованиям по удалению данных. Источник лишь фиксирует техническое противоречие: для анализа хочется сохранять историю, а персональные данные требуют отдельной защиты и политики удаления.
«Антифрод» в компанииИтог: от отзыва до подозрительной ситуации
В разобранном кейсе антифрод начинается не с выбора одной «лучшей» модели, а с расширения контекста вокруг отзыва. Команда связывает оценку с историей покупок, данными покупателя, повторным использованием телефона, проверкой электронной почты и агрегатами поставщика. Для временного поведения строятся эмбеддинги через PyTorch Lifestream, после чего разные методы ищут необычные объекты. K-means, Isolation Forest и автоэнкодер дают разные сигналы; совпадение методов можно использовать как дополнительное основание для проверки.
- 01
Собрать контекст
К отзыву и оценке добавляются покупки, сведения о покупателе, связи по телефону, проверка электронной почты и агрегированные признаки поставщика.
- 02
Построить представление поведения
Последовательности действий превращаются в числовые представления; в показанном кейсе для этого использован PyTorch Lifestream.
- 03
Получить сигналы аномальности
K-means, Isolation Forest, автоэнкодер и другие доступные признаки отмечают необычные объекты с разных сторон.
- 04
Сопоставить сигналы с контекстом
Одиночное срабатывание не считается достаточным: учитываются сочетания, частота появления и веса признаков.
- 05
Принять решение и перепроверить
Накопленный вес сравнивается с порогом; подозрительные случаи получают фродовый статус, а заблокированные карты сохраняют ручную перепроверку.
Обучение и обновление моделей находятся вне этого пути применения: статья отдельно говорит о новых данных, мониторинге и адаптации признаков к меняющимся схемам, но не раскрывает частоту переобучения. Так же не описана точная online/batch-обвязка: неизвестно, какие шаги выполняются во время появления конкретного отзыва, какие считаются заранее пакетно и как устроены сервисы вокруг моделей.
Наконец, источник не доказывает, что выходы K-means, Isolation Forest и автоэнкодера буквально все входят в один общий аккумулятор весов. Связь между модельными иллюстрациями и финальным правилом накопления сигналов описана концептуально. Планка 90% — целевая доля системного выявления против ручных блокировок, а не опубликованный recall. «Плохая прибыль» относится к продукту целиком за выявленный период, показатель 10 000 рублей имеет неясную базу, а сотни миллионов названы потенциальной экономией. Поэтому главный результат статьи — архитектурная логика многофакторного антифрода и необходимость постоянной перепроверки и адаптации, а не набор доказанных универсальных чисел.
Честные рейтинги и отзывы: роль машинного обучения в борьбе с фродом рейтинга и отзывов товаров в ритейле