Разбор готов
ByteDance Monolith: как устроить непрерывное обучение рекомендаций с динамическими разреженными признаками
В промышленной рекомендательной системе большая часть признаков — разреженные категориальные идентификаторы пользователей, объектов и контекста. Их множество растёт со временем, частоты сильно различаются, а интересы пользователей меняются быстрее, чем успевает переобучаться модель в старом пакетном цикле. Monolith решает обе проблемы на уровне системы: хранит разреженные параметры в динамической таблице эмбеддингов без коллизий и после запуска продолжает обучаться на свежих событиях, периодически перенося обновлённые параметры из обучающих серверов параметров в отдельные серверы параметров, обслуживающие запросы. В этой главе разберём не только общую схему, но и инженерные причины каждого решения: Cuckoo HashMap, допуск и удаление редких или устаревших ID, потоковую сборку обучающих примеров с поздними метками, разные режимы синхронизации разреженных и плотных параметров, а также компромисс между частотой снимков состояния и стоимостью восстановления. Затем разнесём по отдельности четыре типа доказательств из статьи: MovieLens, внутренний рекомендательный эксперимент, офлайн-симуляцию непрерывного обучения на Criteo и живой A/B-тест одной Ads-модели. Статья подтверждает внедрение Monolith в BytePlus Recommend; остальные результаты ниже относятся только к явно описанным внутренним и рекламным экспериментам.
Глава полезна ML-инженерам и разработчикам рекомендательных систем, которые уже понимают базовое обучение нейросетей и хотят разобраться, как хранить огромные динамические таблицы эмбеддингов, замыкать петлю обратной связи между выдачей и обучением и обновлять модель без остановки пользовательского сервиса.
Публикация · на английском
Monolith: Real Time Recommendation System With Collisionless Embedding TableZhuoran Liu и соавторы · Опубликовано: 16 сентября 2022 г.
Почему обычный цикл обучения не подходит
Авторы начинают с двух свойств промышленных рекомендаций. Во-первых, признаки в основном разреженные, категориальные и динамические: пользователь, объект или другой ID встречается лишь в части примеров, а само множество ID растёт после запуска. Для такого ID модель хранит обучаемое векторное представление — эмбеддинг. В отличие от словаря языковой модели, число пользователей и объектов может быть огромным и не иметь удобной фиксированной верхней границы. Во-вторых, распределение данных нестационарно: интересы и поведение меняются со временем. Это изменение распределения называют дрейфом данных (concept drift).
В старой схеме пакетное обучение и применение модели были разведены во времени: модель сначала обучалась на накопленной истории, затем долго обслуживала запросы без свежих обновлений. Для рекомендаций такая задержка особенно заметна, потому что последние действия пользователя могут лучше отражать его текущий интерес. Поэтому Monolith строит короткую петлю: свежие события попадают в обучение, а обновлённые параметры периодически передаются в отдельный контур применения модели. На рисунок 1 обучающий сервер параметров (PS обучения) отделён от сервера параметров для применения модели (PS обслуживания); пользовательский запрос не ждёт вычисления градиентов.
Подтверждённый продуктовый факт в статье ограничен формулировкой о внедрении Monolith в BytePlus Recommend. Упоминание short-video ranking в мотивации — пример класса задач с чувствительной ко времени обратной связью, а не доказательство повсеместного внедрения во всех продуктах ByteDance.
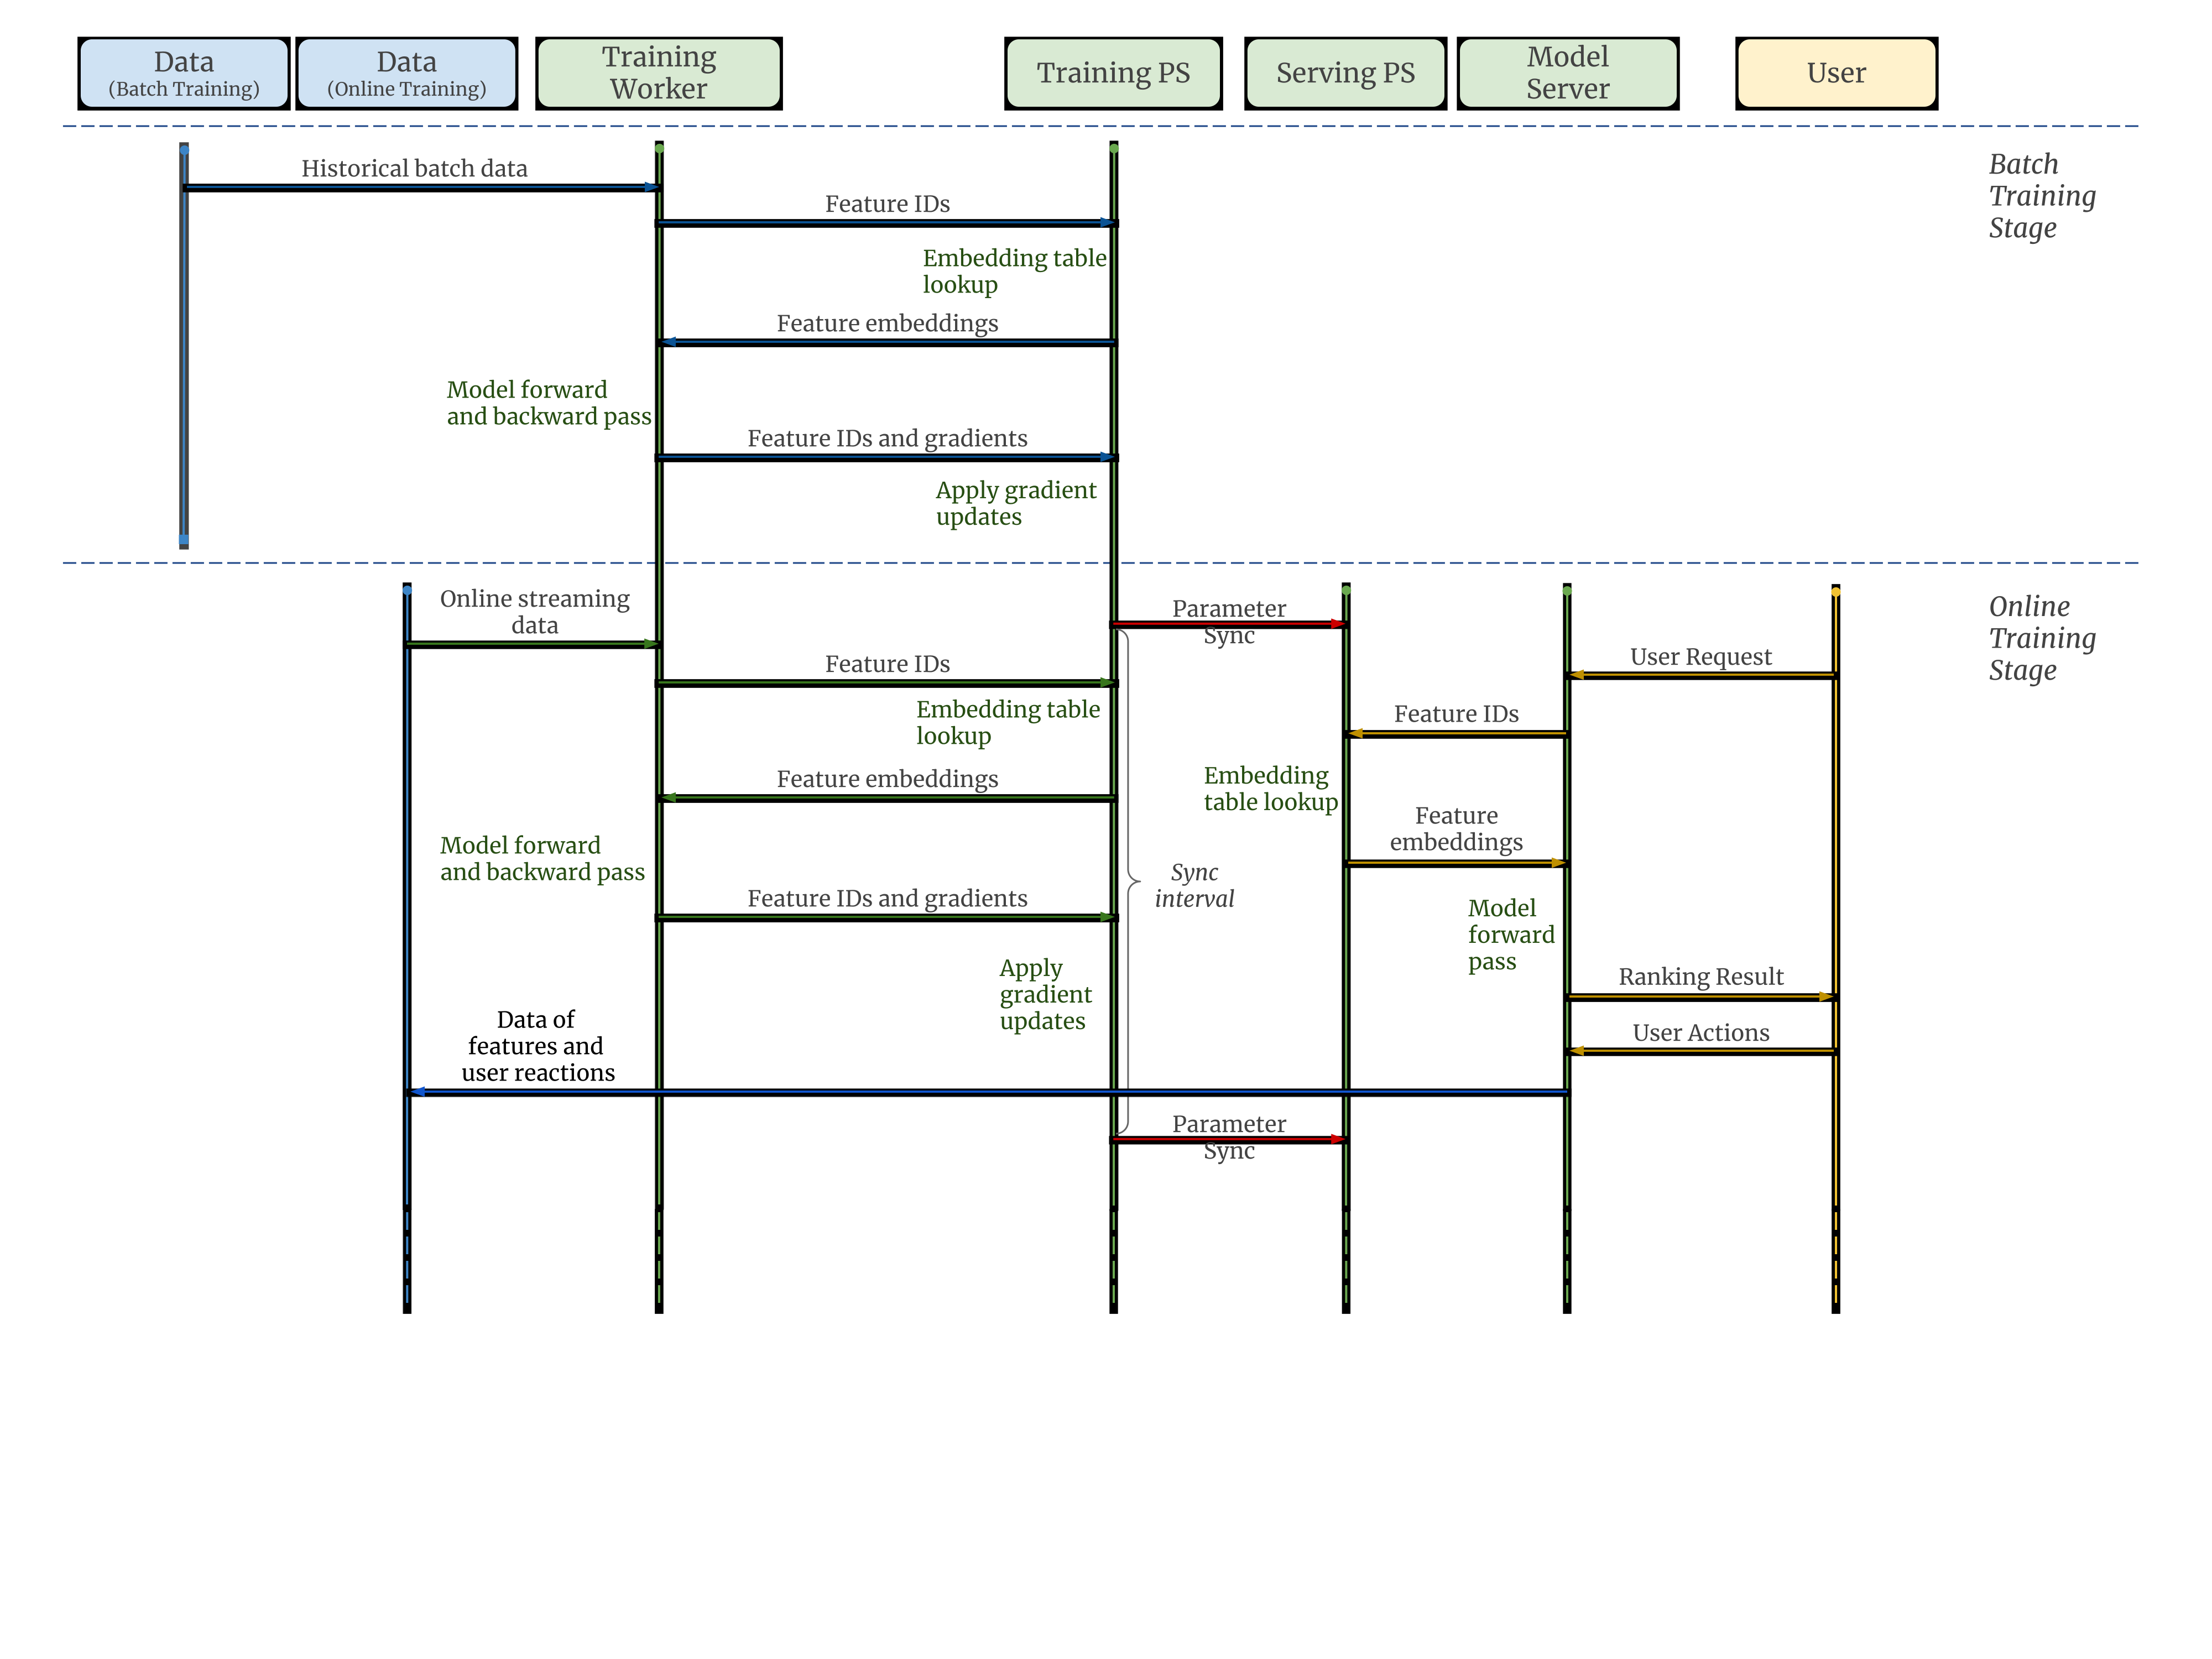
Рисунок 1. Обучающий и обслуживающий контуры разделены; обновления передаются из training PS в serving PS.
Источник: ByteDance · MonolithWorker–PS как основа, но не путь пользовательского запроса
Monolith опирается на распределённую схему Worker–Parameter Server из TensorFlow. Рабочий процесс обучения, или Worker, выполняет прямой и обратный проходы и считает градиенты. Сервер параметров, или PS, хранит параметры и применяет полученные обновления. В рекомендательной модели параметры разделены на плотные и разреженные. Плотные — обычные веса нейросети; разреженные — таблицы эмбеддингов для категориальных ID.
Важно не склеивать эту тренировочную схему с обработкой пользовательского запроса. В Monolith есть PS обучения, куда Worker передаёт градиентные обновления, и отдельный PS обслуживания, из которого Model Server читает параметры при выдаче. Между ними работает синхронизация. Такое разделение позволяет обновлять модель независимо от запросов и не останавливать работающий сервис при каждом изменении параметров.
p. 3, §2 Design, Figure 2Таблица эмбеддингов без коллизий
Обычное хеширование в фиксированное пространство (hash trick) сжимает множество ID до заданного числа ячеек. Тогда два разных ID иногда попадают в одну ячейку и вынуждены делить один эмбеддинг. Авторы считают это нежелательным для длиннохвостых данных: популярные и редкие ID имеют очень разные частоты, а вероятность коллизий растёт вместе с количеством ключей. Поэтому Monolith использует динамическую таблицу «ключ–значение», где каждому принятому ID соответствует собственное значение.
Внутри используется Cuckoo HashMap. Для ключа вычисляются две возможные позиции в двух таблицах. Если первая позиция занята, новый ключ не делит значение со старым: он вытесняет находившийся там ключ, а вытесненный ключ пробует свою альтернативную позицию. Процесс продолжается, пока записи не стабилизируются; при цикле таблица перестраивается. В статье для поиска и удаления заявлена худшая сложность O(1), для вставки — ожидаемая амортизированная O(1). рисунок 3 полезен тем, что визуально отличает вытеснение записи от совместного хранения одного эмбеддинга двумя ID.
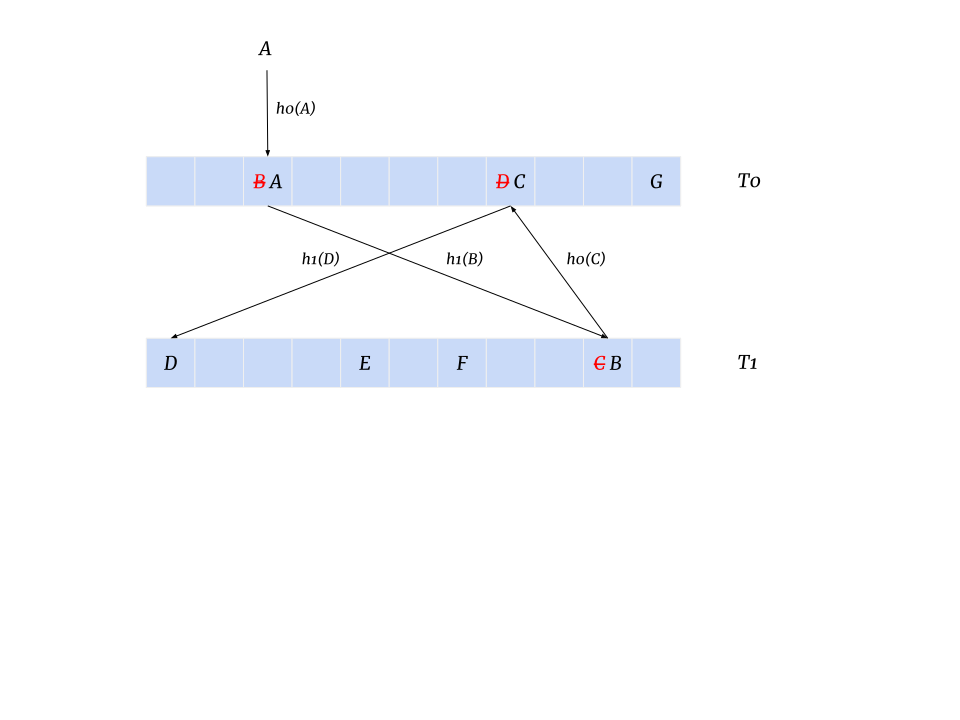
Рисунок 3. Ключ может занять место в одной из двух таблиц; при конфликте запись перемещается, а не делит один эмбеддинг с другим ключом.
Источник: ByteDance · MonolithКак ограничить память: допуск, фильтрация и срок жизни
Динамическая таблица без коллизий решает проблему качества, но создаёт другую: если добавлять каждый новый ID, память будет расти без ограничения. Авторы опираются на наблюдение из своих промышленных моделей: множество ID встречается лишь несколько раз и остаётся плохо обученным, а часть старых ID больше никогда не используется. Поэтому память контролируется не сжатием нескольких ID в одну ячейку, а правилами того, какие ID вообще хранить.
Перед попаданием в таблицу ID проходит правило допуска (admission). Первый фильтр использует число появлений: порог настраивается отдельно для модели. Дополнительно применяется вероятностный фильтр, детали которого в статье не раскрыты. Уже принятые эмбеддинги получают срок неактивности: если ID не используется дольше заданного времени, запись может истечь и быть удалена. Период тоже настраивается по таблице, потому что разным признакам нужна разная глубина истории.
Статья не даёт отдельной численной абляции для каждого механизма памяти: нельзя из неё вывести, сколько мегабайт сэкономил частотный фильтр, сколько — вероятностный, и как отдельно удаление устаревших записей влияет на AUC. Корректный вывод уже: Monolith совмещает хранение без коллизий с управляемым допуском и удалением неактивных ключей.
pp. 3–4, §2.1 Hash TableПакетное и непрерывное обучение работают вместе
Обучение в Monolith делится на две стадии. Пакетная стадия похожа на обычный TensorFlow-цикл: Worker читает пакет примеров, запрашивает параметры у PS обучения, считает прямой и обратный проход и отправляет обновления. Авторы отдельно отмечают, что исторический датасет проходят один раз. Пакетное обучение остаётся нужным, например, когда меняют архитектуру и требуется переобучить модель на накопленной истории.
После развёртывания обучение не заканчивается. В непрерывной стадии Worker читает свежие примеры из потока и продолжает обновлять PS обучения. Затем часть этих параметров переносится на PS обслуживания, после чего новые значения участвуют в последующих пользовательских запросах. Это не обучение внутри одного запроса: обновление модели идёт отдельным асинхронным контуром.
p. 4, §2.2 Online Training, Figure 1Поток данных: Kafka, Flink и общий источник для непрерывного и пакетного обучения
Потоковый движок соединяет выдачу и обучение. Одна Kafka-очередь хранит действия пользователя — например, клик, лайк или конверсию, — другая Kafka-очередь содержит признаки, сформированные при показе. В центре схемы работает Flink-задача Online Joiner: она соединяет признаки с пришедшими позднее метками и формирует обучающие примеры. Готовые примеры записываются ещё в одну Kafka-очередь.
Дальше один и тот же поток поддерживает два режима. Для непрерывного обучения Worker читает примеры прямо из Kafka. Для пакетного обучения данные сначала выгружаются в HDFS, накапливаются и затем читаются оттуда. рисунок 4 полезен тем, что показывает не две независимые системы данных, а общий поток с быстрым путём непрерывного обучения и более медленным пакетным путём.
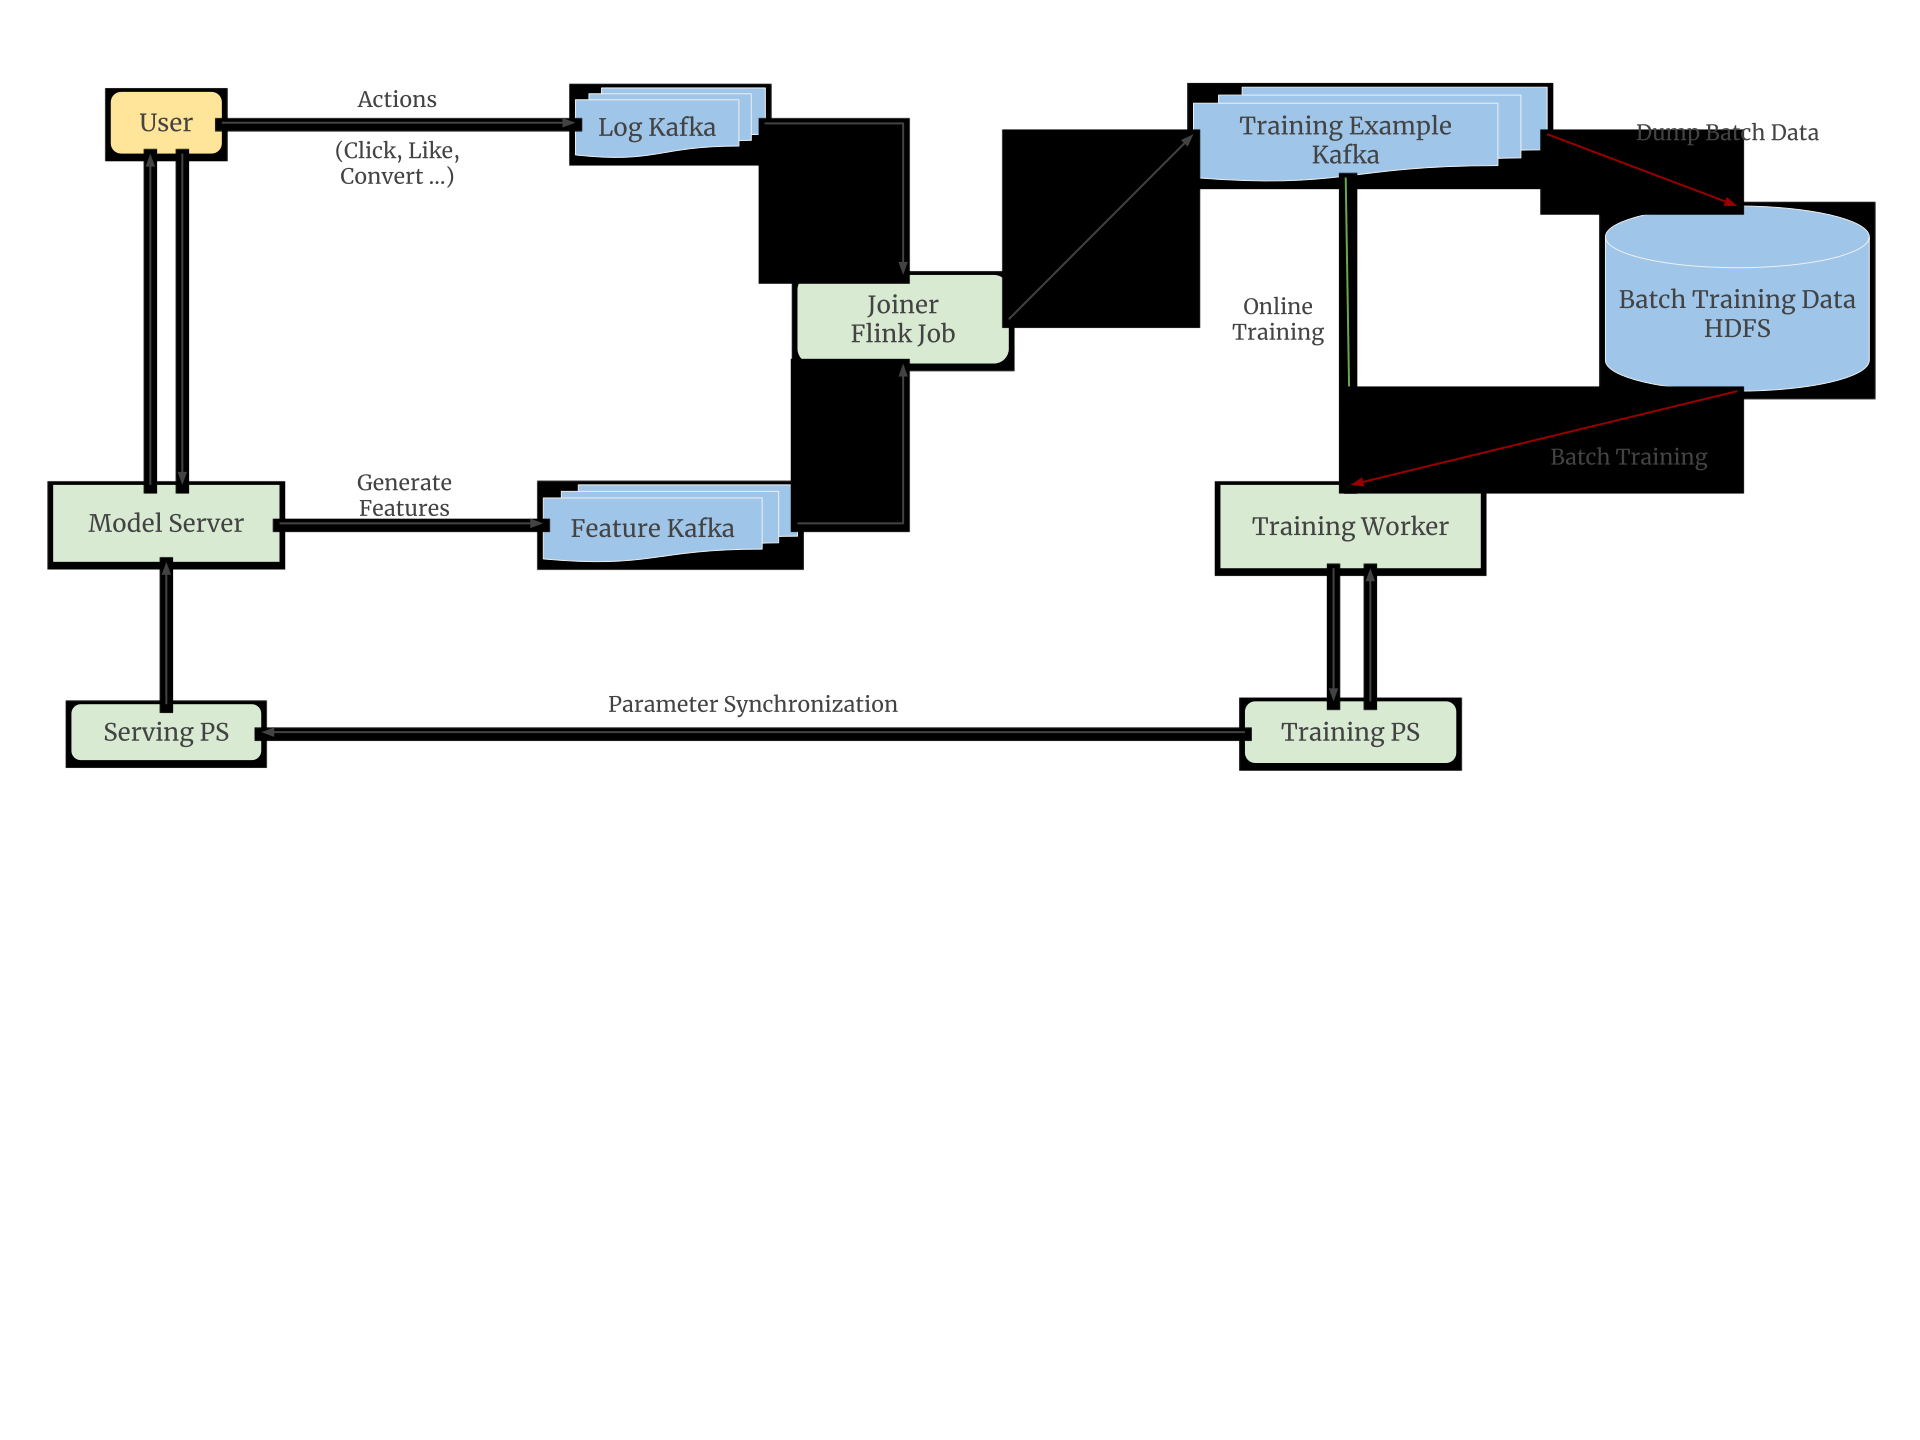
Рисунок 4. Потоковые события сокращают задержку обратной связи; исторические данные остаются отдельным источником обучения.
Источник: ByteDance · MonolithOnline Joiner: как дождаться поздней метки
Событие показа и действие пользователя не обязаны приходить по порядку. Поэтому каждому запросу назначается уникальный ключ, по которому признаки можно сопоставить с будущей меткой. Метка может запоздать существенно: в примере статьи покупка происходит через несколько дней после показа. Хранить все ожидающие признаки только в оперативной памяти слишком дорого.
Online Joiner использует два уровня хранения. Сначала ожидающие признаки находятся в кеше в памяти. Если нужной записи там уже нет, система обращается к дисковому хранилищу «ключ–значение», рассчитанному на более долгое ожидание. рисунок 5 показывает этот резервный путь до объединения признаков и метки, после которого формируется обучающий пример. Статья не раскрывает срок хранения, долю попаданий в кеш или долю потерянных сопоставлений, поэтому эти показатели нельзя достраивать.
После объединения система выбирает отрицательные примеры, потому что отрицательных событий может быть на порядки больше, чем положительных. Такой отбор меняет наблюдаемое распределение меток. При применении модели авторы используют поправку логарифма шансов (log-odds correction), чтобы компенсировать это смещение и вернуть оценки к исходному распределению.
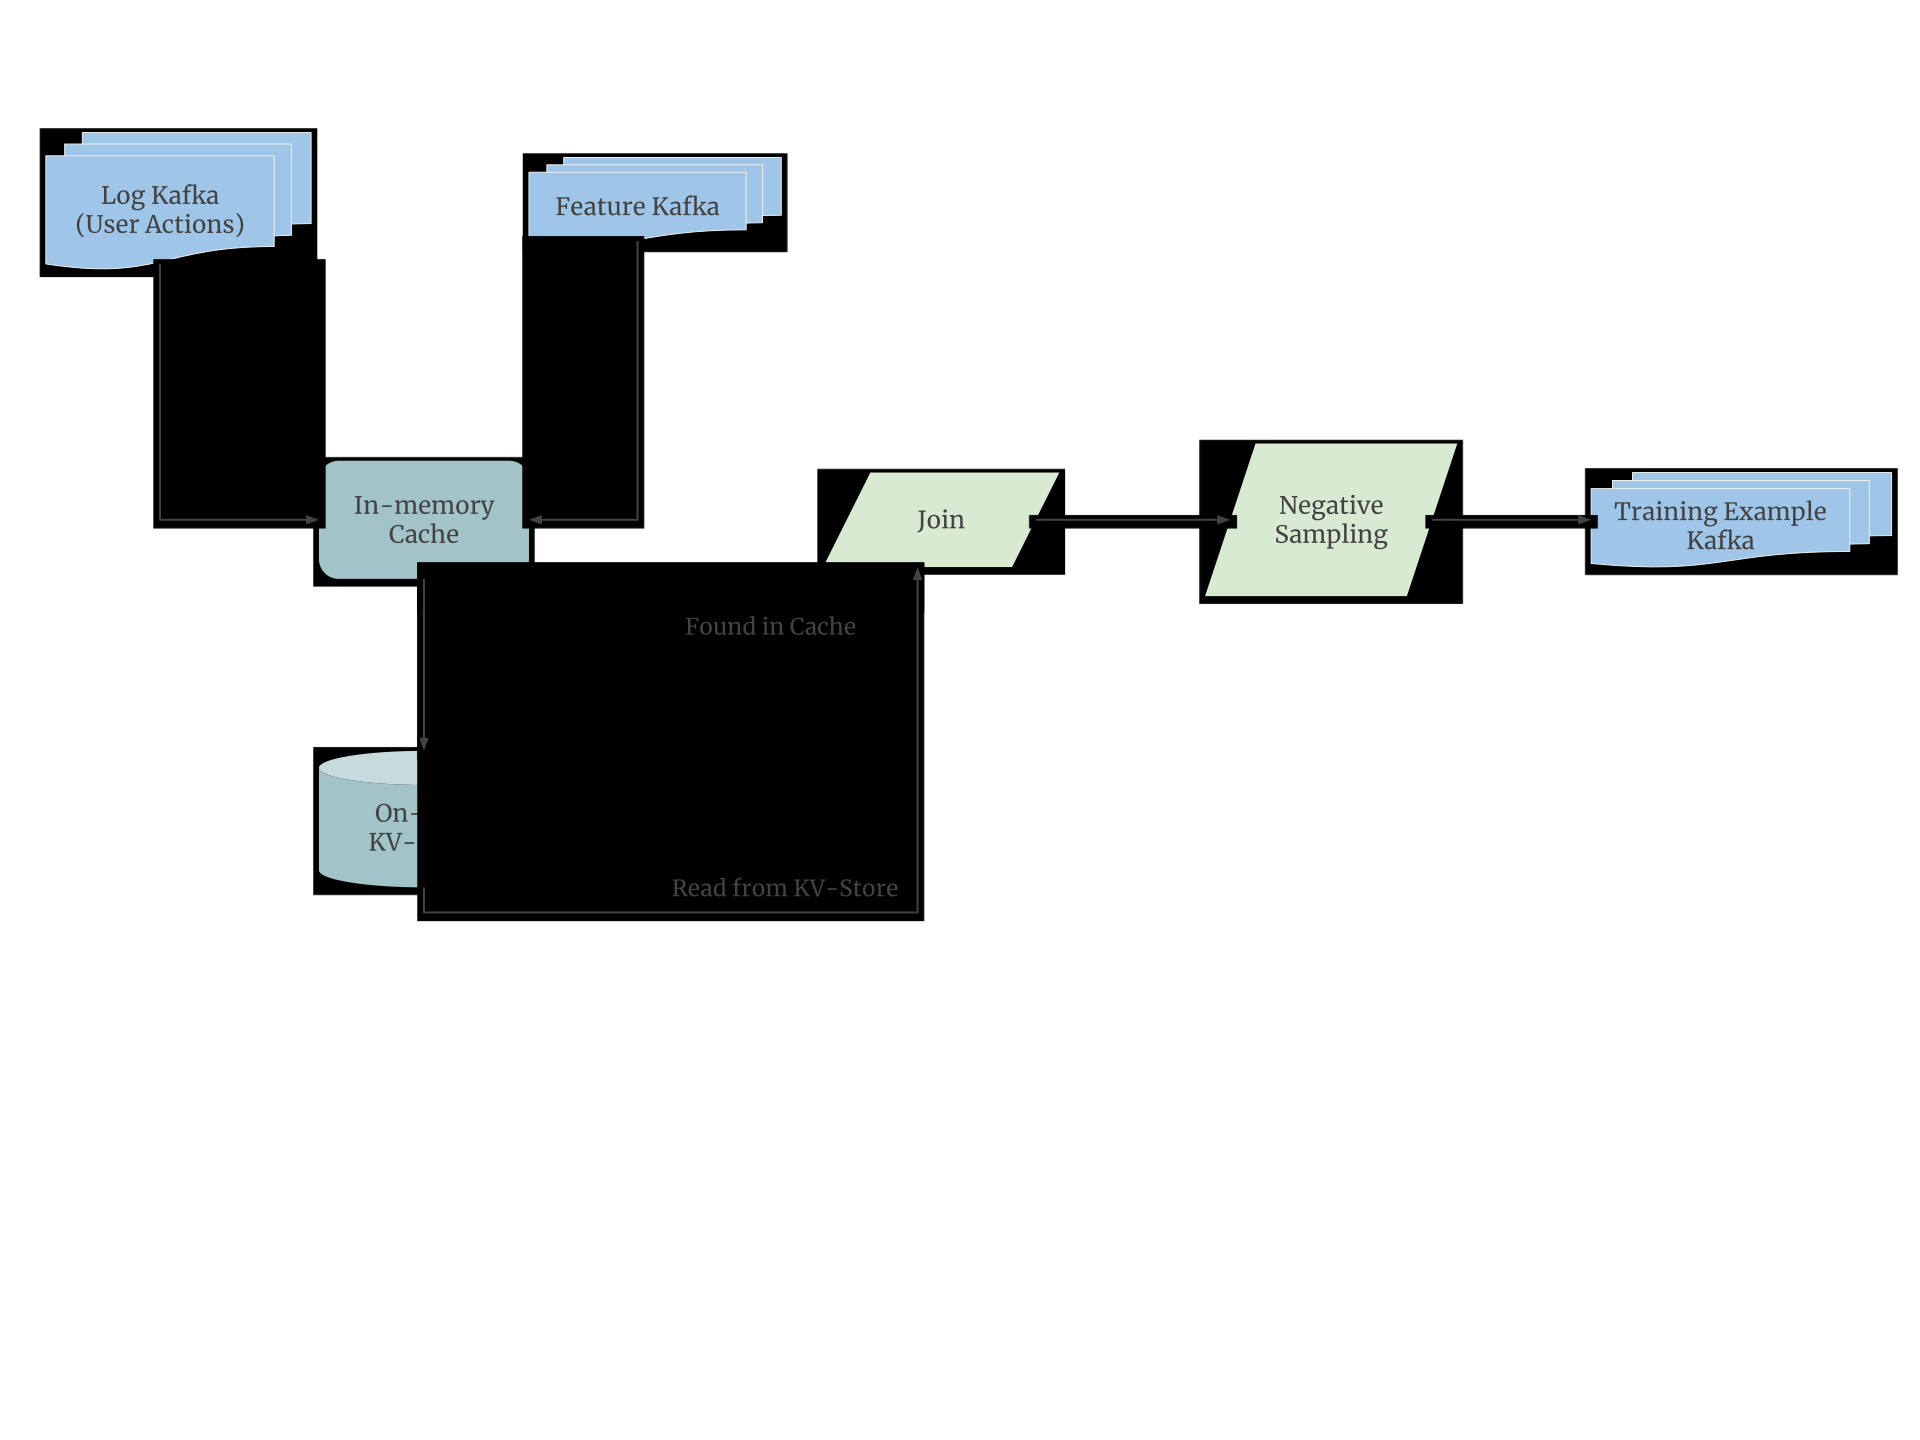
Рисунок 5. Online Joiner связывает признаки и метки из разных потоков, используя память и более длительное хранение.
Источник: ByteDance · MonolithПочему разреженные и плотные параметры синхронизируются по-разному
Полностью заменить модель на PS обслуживания при каждом обновлении нельзя: промышленные модели авторов могут занимать несколько терабайт, а полная передача создаёт большой сетевой трафик и временно требует дополнительной памяти. Monolith использует инкрементальную синхронизацию на ходу, не прекращая обслуживание запросов.
Разреженные параметры занимают основную часть объёма, но за короткое время меняется лишь небольшая доля ID. PS обучения поддерживает множество изменённых ключей — ID, чьи эмбеддинги обновились после прошлой синхронизации, — и отправляет только их. Для разреженных параметров в промышленном режиме статья указывает синхронизацию на уровне минут. Плотные параметры меняются медленнее, поэтому их передают значительно реже; далее в статье конкретизирован режим раз в день.
Следствие — PS обслуживания может одновременно содержать более свежие разреженные параметры и более старые плотные. Авторы сообщают, что заметной потери качества от такой несогласованности не наблюдали, но отдельной численной абляции не приводят. Это локальный инженерный компромисс данной системы, а не универсальное правило о допустимой рассинхронизации любых моделей.
p. 5, §2.2.3 Parameter Synchronization; p. 9, production sync scheduleСнимки состояния: что именно можно потерять при сбое
Для восстановления PS обучения Monolith периодически сохраняет снимок состояния модели. Более частые снимки уменьшают объём последних обновлений, которые исчезнут при сбое, но копирование многотерабайтной модели создаёт заметные расходы на копирование памяти и дисковый ввод-вывод. В описанной конфигурации состояние всех PS обучения сохраняется раз в день.
Если отдельный PS выходит из строя, он восстанавливается из последнего снимка и теряет обновления, накопленные после него. Авторы сообщают, что при увеличении интервала до одного дня почти не увидели потери качества. На стр. 9 они поясняют это расчётным примером: при 1000 PS, 15 млн DAU, равномерном распределении ID пользователей и частоте отказов 0.01% на один PS в день один PS в среднем выходит из строя раз в 10 дней, а суточная обратная связь теряется примерно для 15 000 пользователей этого сегмента.
Это не доказательство, что данные «не важны» или что можно без последствий терять произвольные обучающие примеры. Расчёт зависит от шардирования, частоты отказов, того, что разреженные параметры локальны конкретным пользователям, и от более медленного изменения плотных параметров. В статье нет общего эксперимента, который переносил бы этот вывод на другие архитектуры или профили отказов.
pp. 5–6, §2.3 Fault Tolerance; p. 9, The Effect of PS reliabilityЭксперимент 1: как проверяли вред коллизий
Первую группу экспериментов проводят на MovieLens ml-25m. В наборе 25 млн оценок, примерно 162 тыс. пользователей и 62 тыс. фильмов. Исходные рейтинги 0.5–5.0 превращают в бинарную метку: значения не ниже 3.5 считаются положительными, остальные — отрицательными. Модель — стандартный DeepFM, качество измеряется AUC.
Чтобы получить вариант с коллизиями, ID предварительно MD5-хешируют в меньшее пространство. Поэтому таблица 1 описывает искусственно созданный уровень столкновений для сравнения, а не естественную долю коллизий Monolith.
Таблицу можно прокрутить по горизонтали.
Второй вариант проверки проходит уже на внутренней промышленной рекомендательной модели с многобашенной архитектурой (multi-tower) и примерно 1000 таблиц эмбеддингов. Исходное пространство ID имеет размер 2^48. Базовый вариант раскладывает ID на две меньшие таблицы и складывает два эмбеддинга; авторы пишут, что это уменьшает потенциальный размер с 2^48 до 2^25. Качество этого эксперимента измеряется AUC на реальном трафике.
Базовая схема хеширования внутренней модели: один исходный ID представляется суммой двух эмбеддингов из меньших таблиц.
Результаты без восстановления точек графика
На MovieLens модель с таблицей без коллизий имеет более высокий AUC на тестовой части уже с первой эпохи и сходится к более высокому значению. Авторы также отмечают, что после сходимости дополнительная разреженность отдельных эмбеддингов не приводит к видимому переобучению. рисунок 7 нужен для качественного сравнения траекторий; точные точки кривых по пикселям не восстанавливаются.
На внутренней рекомендательной модели рисунок 8 сравнивает AUC на реальном трафике по дням. Обе кривые заметно меняются, что соответствует нестационарности данных, но вариант без коллизий остаётся выше варианта с коллизиями на показанном периоде. Это отдельный промышленный эксперимент; он не является тем же опытом, что MovieLens, и в статье не приведена таблица точных дневных значений или интервалов неопределённости.
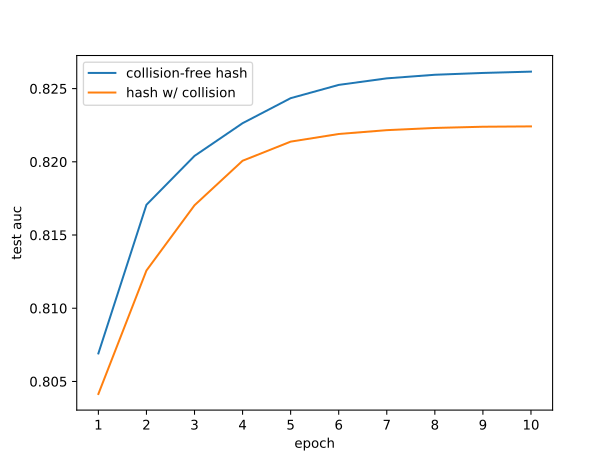
Рисунок 7. Офлайн-эксперимент на MovieLens показывает более высокий test AUC у модели с таблицей без коллизий.
Источник: ByteDance · Monolith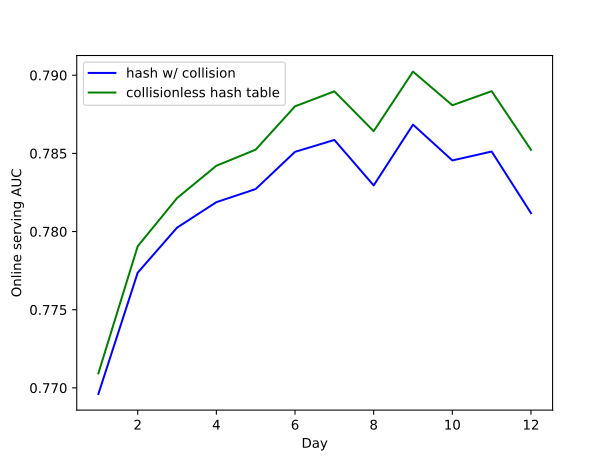
Рисунок 8. Промышленный эксперимент с таблицами эмбеддингов; колебания качества по дням связаны с изменением данных.
Источник: ByteDance · MonolithЭксперимент 2: симуляция непрерывного обучения на Criteo
Для проверки частоты обновлений авторы используют Criteo Display Ads Challenge и DeepFM. Данные содержат семь хронологически упорядоченных дней. Первые пять идут в пакетное обучение, последние два имитируют непрерывное обучение. Эти два дня последовательно делят на N частей; перед обработкой очередной части текущие параметры обучения копируются в применяемую модель, затем эта модель оценивается на новых данных, после чего обучающая версия обновляется на той же части.
При N = 10, 50 и 100 авторы получают приблизительные интервалы синхронизации 5 часов, 1 час и 30 минут. Это именно офлайн-симуляция на Criteo. Её нельзя путать с промышленной синхронизацией разреженных параметров на уровне минут, описанной позднее. рисунок 9c показывает вариант 30 минут и нужен как пример того, что обновляемая модель сравнивается с замороженной пакетной моделью на последовательном потоке данных.
Таблицу можно прокрутить по горизонтали.
Во всех трёх настройках вариант с непрерывным обучением имеет более высокий средний AUC, а меньший интервал синхронизации связан с немного лучшим результатом. рисунок 10 сравнивает эти три кривые; его вывод следует читать только в условиях данной симуляции, не как универсальный закон о конкретном оптимальном интервале.
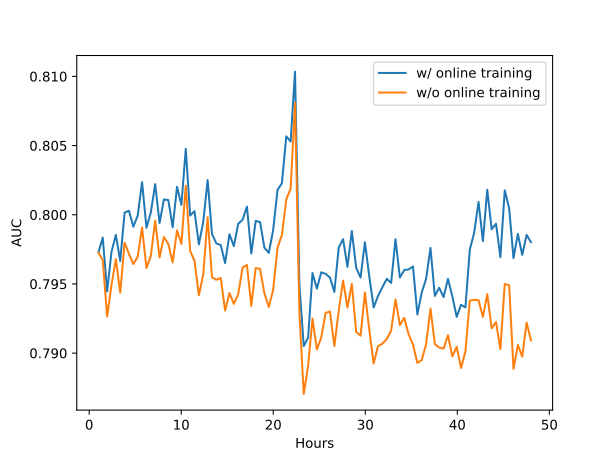
Рисунок 9c. Последовательная офлайн-симуляция на Criteo сравнивает обновляемую модель и замороженный пакетный вариант; это не пользовательский A/B-тест.
Источник: ByteDance · Monolith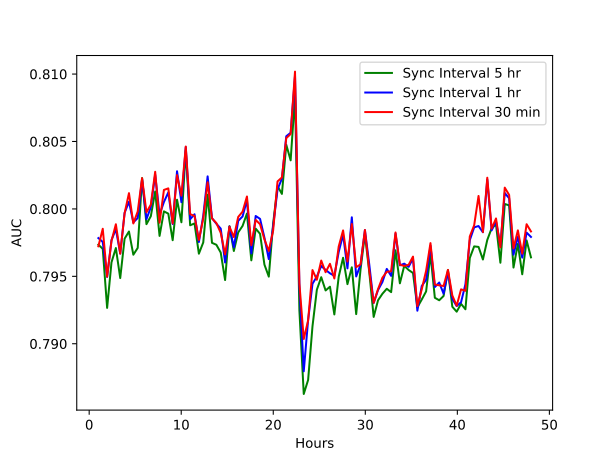
Рисунок 10. AUC в симуляции Criteo при разных интервалах синхронизации; более частое обновление выигрывает в этом эксперименте.
Источник: ByteDance · MonolithЭксперимент 3: живой A/B-тест Ads-модели
Отдельно от Criteo авторы проводят живой A/B-тест на одной промышленной Ads-модели, сравнивая непрерывное обучение с пакетным. Это другая постановка и другой уровень доказательств: здесь используется реальный трафик, но статья раскрывает меньше деталей экспериментального протокола.
Авторы описывают результат как заметный рост AUC на реальном трафике. Однако формула показателя «AUC Improvement %», размер групп, единица рандомизации, длительность до этих семи дневных срезов и интервалы неопределённости не раскрыты. Поэтому числа можно воспроизводить только под исходным названием метрики и нельзя переименовывать в рост CTR, GMV или конверсии либо считать доказательством такого же эффекта в другом продукте.
p. 7 live experiment description; p. 9 Table 3Промышленный режим: разреженные параметры — минуты, плотные — сутки
После экспериментов авторы описывают выбранный производственный режим. Разреженные параметры синхронизируют с PS обслуживания настолько часто, насколько позволяют стоимость и надёжность системы; текущий уровень в статье — минуты. Плотные параметры обновляют раз в день и стараются делать это при минимальном трафике, например около полуночи.
Для оценки порядка сетевой нагрузки приводится расчётный пример, а не измеренная метрика конкретного кластера: если за минуту обновились 100 000 ID, размер эмбеддинга равен 1024, а одно такое представление занимает 4 KB, нужно передать примерно 400 MB за минуту. Смысл примера — показать, почему перенос только изменившихся эмбеддингов гораздо дешевле передачи многотерабайтной модели целиком.
p. 9, §3.2.2 continuation after Table 3 and Figure 10Что именно доказывает статья и где проходят границы
В разделе Related Work Monolith сравнивают с фиксированными таблицами с хешированием, улучшенными вариантами хеширования, динамическими таблицами «ключ–значение» и системами непрерывного обучения. Отличие, которое подчёркивают авторы, — нативная операция TensorFlow HashTable и сравнительно лёгкая инкрементальная синхронизация. Формулировки об удобстве для разработчика и пригодности для ToB — позиционирование авторов, а не отдельный количественный эксперимент.
Сильные выводы заключения — важность таблицы эмбеддингов без коллизий, польза короткого интервала синхронизации и возможность частично обменять строгую согласованность и частоту сохранения состояния на стоимость — основаны на описанных выше постановках. Их не следует превращать в универсальные правила. Criteo проверяет частоту синхронизации в симуляции, внутренний рекомендательный эксперимент — хранение без коллизий на своём трафике, а Ads A/B — непрерывное обучение против пакетного на одной рекламной модели.
Из внедрения статья прямо подтверждает BytePlus Recommend. Она не даёт основания писать, что Monolith целиком обслуживает TikTok, что таблица 3 показывает CTR или рост GMV, либо что ежедневные снимки состояния безопасны при любом профиле отказов. Корректная граница вывода — архитектура и компромиссы Monolith плюс результаты конкретных публичных, внутренних и Ads-экспериментов.
p. 9, §4 Related Work; p. 10, §5 Conclusion; p. 1 AbstractИтог: как текущая модель отвечает на запрос и что показали проверки
Monolith отделяет применение модели от её обновления. Во время запроса используется уже опубликованная версия параметров на PS обслуживания; вычисление градиентов и Worker не входят в критический путь.
- 01
Получить запрос
Model Server принимает запрос и собирает доступные в этот момент признаки и ID.
- 02
Прочитать эмбеддинги
По нужным ID система получает текущие векторные представления из таблиц на PS обслуживания.
- 03
Прочитать плотные веса
Модель использует опубликованную версию обычных весов нейросети; она может быть старше части эмбеддингов.
- 04
Выполнить прямой проход
Model Server вычисляет оценки без обратного прохода и без изменения параметров обучения.
- 05
Вернуть ранжирование
Оценки задают результат текущей выдачи; дальнейшее обучение происходит уже вне этого запроса.
Обратная связь появляется после выдачи. Действия пользователя и признаки показа идут в Kafka, а Online Joiner связывает их по ключу запроса; для поздних меток он может обратиться сначала к памяти, затем к дисковому хранилищу «ключ–значение».
Обучение идёт отдельно: Worker читает сформированные примеры и обновляет PS обучения. Обновлённые эмбеддинги передаются на PS обслуживания по множеству изменённых ключей на минутном уровне, а плотные веса в описанном промышленном режиме — раз в день.
Проверки показывают разные вещи. На MovieLens и на внутренней рекомендательной модели вариант без коллизий имеет более высокий AUC, чем вариант с коллизиями. В последовательной симуляции Criteo непрерывное обучение превосходит пакетное для интервалов 5 часов, 1 час и 30 минут; это не промышленный график синхронизации. В отдельном живом A/B-тесте Ads-модели таблица 3 даёт семь дневных значений AUC Improvement % от 14.028 до 18.081. Методика вычисления этого процента, размер групп и интервалы неопределённости не раскрыты, поэтому это нельзя называть ростом CTR, GMV или конверсии.
Статья подтверждает внедрение Monolith в BytePlus Recommend. Суточные снимки состояния PS — отдельный компромисс между стоимостью сохранения и потерей последних обновлений при отказе: расчёт с 1000 PS, 15 млн DAU и 0.01% отказов в день — иллюстрация авторов, а не универсальная гарантия.
pp. 2–5, Figures 1, 4, 5 and §2.2–2.2.3; p. 10 §5 Conclusion