Разбор готов
Яндекс Картинки: автоматизация разметки новостных запросов
Запрос «Дюна» после выхода фильма должен находить другие картинки: пользователю становятся важны кадры, постеры и сопутствующие материалы, а не только песчаные пейзажи. Строка запроса не изменилась, но новость изменила ожидаемый ответ. Для Яндекс Картинок это задача не только быстрого обновления изображений: нужно получить данные, на которых модель научится правильно сочетать свежие и несвежие результаты. Таких запросов мало, пользовательские сигналы запаздывают, а ручная проверка требует чтения новостей. Арсений Михайлов рассказывает, как команда автоматизировала эту разметку: Поиск с Алисой собирает новостной контекст для запроса и даты, а отдельная языковая модель проверяет значимость событий и выносит вердикт. Далее разметку проверяют, используют для обучения ранжирования и продолжают ежедневно контролировать её качество.
Материал полезен тем, кто развивает поиск, готовит данные для ранжирования или заменяет сложную ручную разметку языковыми моделями. Особенно важны разделение поиска фактов и принятия решения, согласование двух промптов и проверка того, что хорошие метки действительно пригодны для следующей модели.
Видео · на русском
Как автоматизировать разметку новостных запросов с RAG / Арсений МихайловАрсений Михайлов · Опубликовано: 1 ноября 2025 г.
Исходный доклад · Открыть оригинал
Когда новость меняет ожидаемые картинки
Поисковая система должна понять не только слова запроса, но и намерение человека — то, что он хочет найти. Это намерение называют интентом. У одного запроса их может быть несколько: в докладе приведён пример с животным, маркой автомобиля и энергетиком. Хорошая выдача учитывает основные вероятные трактовки, а не объявляет любую из них единственно правильной.
У намерения есть и временное измерение. Песчаная дюна действительно соответствует запросу «Дюна», поэтому отдельную картинку нельзя назвать нерелевантной просто из-за выхода фильма. Однако релевантность — соответствие запросу — ещё не определяет, какие изображения должны занимать заметное место в выдаче именно сейчас. Новостное событие меняет соотношение ожиданий: в момент премьеры возрастает важность материалов о фильме.
Арсений Михайлов рассматривает эту проблему в работе команды базового качества Яндекс Картинок. Команда занимается ранжированием с учётом текста и изображений, международными проектами и предоставлением картинок для Поиска с Алисой. У сервиса есть и другие задачи, включая поиск связанных изображений и формирование тегов, но здесь речь о картинках по текстовому запросу.
Особенно сложно реагировать на событие без предварительного анонса. По постановке автора, выдача должна перестраиваться за десятки минут. Это требование к реакции поискового сервиса на изменение мира, а не измеренная задержка ответа языковой модели. Для такой реакции нужно одновременно иметь новые изображения и понимать, по каким запросам они сейчас важны.
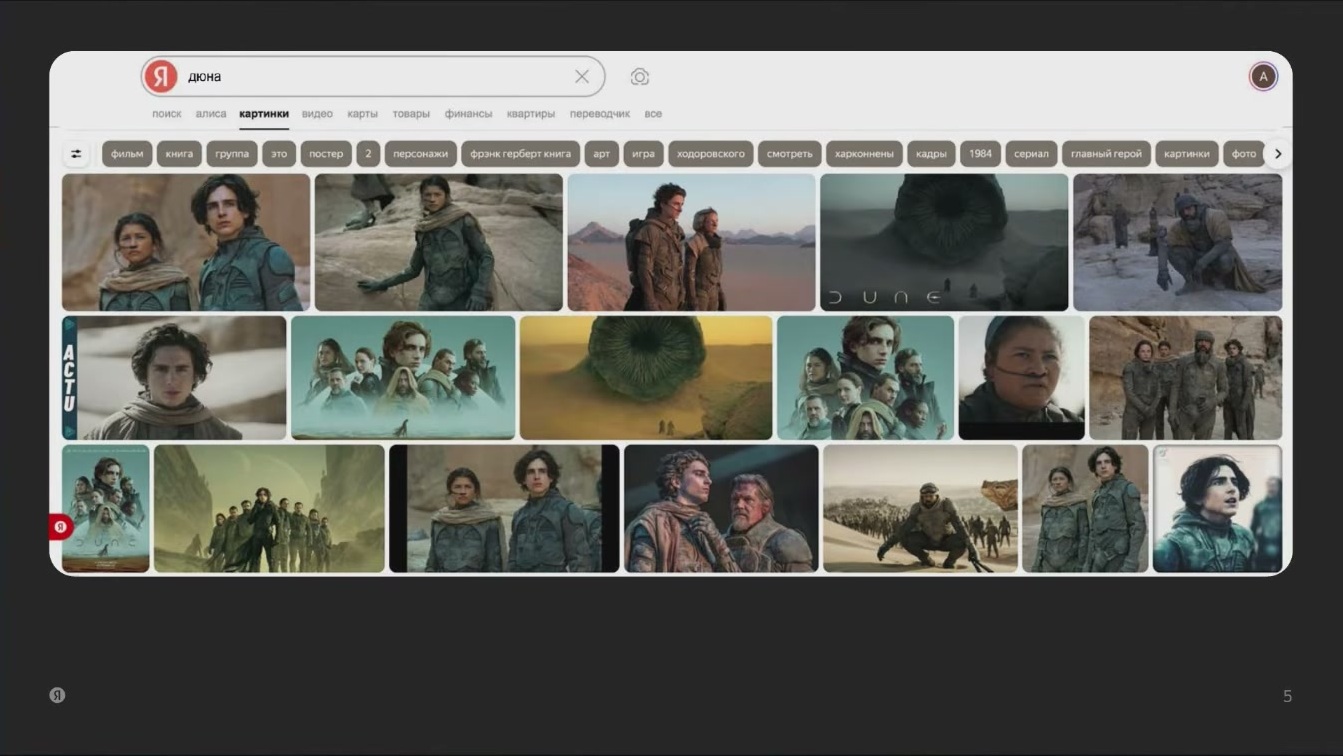
После выхода фильма запрос «Дюна» должен приводить к новым изображениям; постоянной релевантности для этого недостаточно.
Источник: Арсений Михайлов · ЯндексДве базы изображений сходятся в общем ранжировании
Для работы со свежим содержимым команда использует две базы документов: свежих и несвежих. На схеме свежая база выделена высокой скоростью обновления. Из каждой базы сначала отбирают кандидатов — изображения, которые стоит рассмотреть для ответа, — а затем предварительно упорядочивают их. Такое упорядочивание по оценке полезности называется ранжированием.
Предварительное ранжирование у двух источников независимое. После него кандидаты поступают в общую финальную модель, которая объединяет свежие и несвежие картинки в одну выдачу. Разделение баз помогает получать свежие документы, но само по себе не решает, какой источник должен оказаться важнее для конкретного запроса.
Финальной модели нужно различать ситуации, в которых человек ожидает новые изображения, и ситуации, в которых возраст картинки не является главным условием. Рабочее предположение команды: свежий запрос означает повышенную потребность в свежих картинках. Автор подчёркивает, что это предположение о пользовательском намерении, а не безусловная закономерность для любого человека.
Здесь речь пока только об источниках изображений и их ранжировании. Позднее в решении появится другой поиск — по новостным текстам, нужным для разметки запроса. Он не заменяет эти две базы: у него другая роль, получить факты о событии для автоматического разметчика.
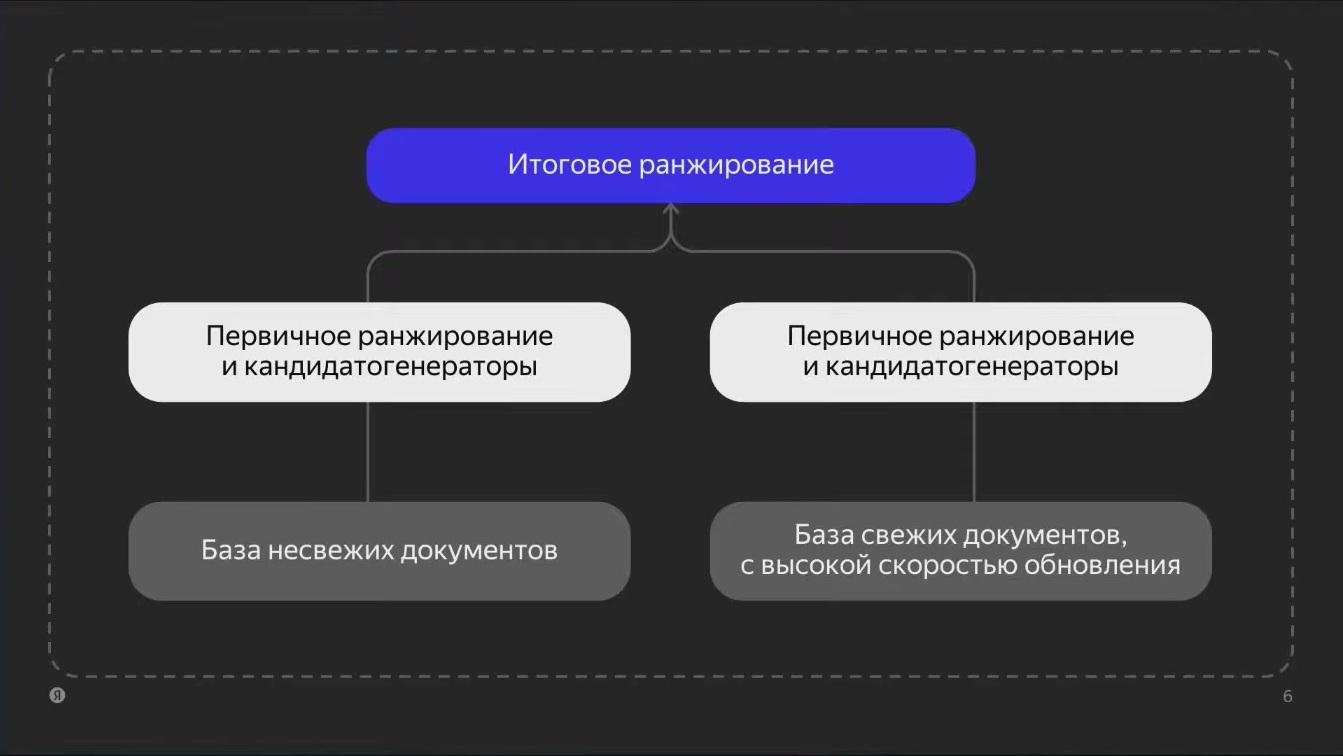
Кандидаты из свежих и несвежих документов ранжируются отдельно, затем объединяются.
Источник: Арсений Михайлов · ЯндексПочему обычных обучающих данных недостаточно
После построения двух источников возникает следующий вопрос: на чём обучать финальное ранжирование? Недостаточно взять обычную выборку запросов и документов. В ней одновременно нарушены несколько условий, от которых зависит пригодность обучения.
В итоге не хватает не только положительных примеров. Проблема затрагивает и целевую метку — правильный ответ для обучения, — и условия, в которых модель видит документы. Улучшать сам алгоритм ранжирования, не исправляя эти данные, недостаточно. Поэтому команда переходит к специальному поиску свежих запросов именно тогда, когда они связаны с событием.
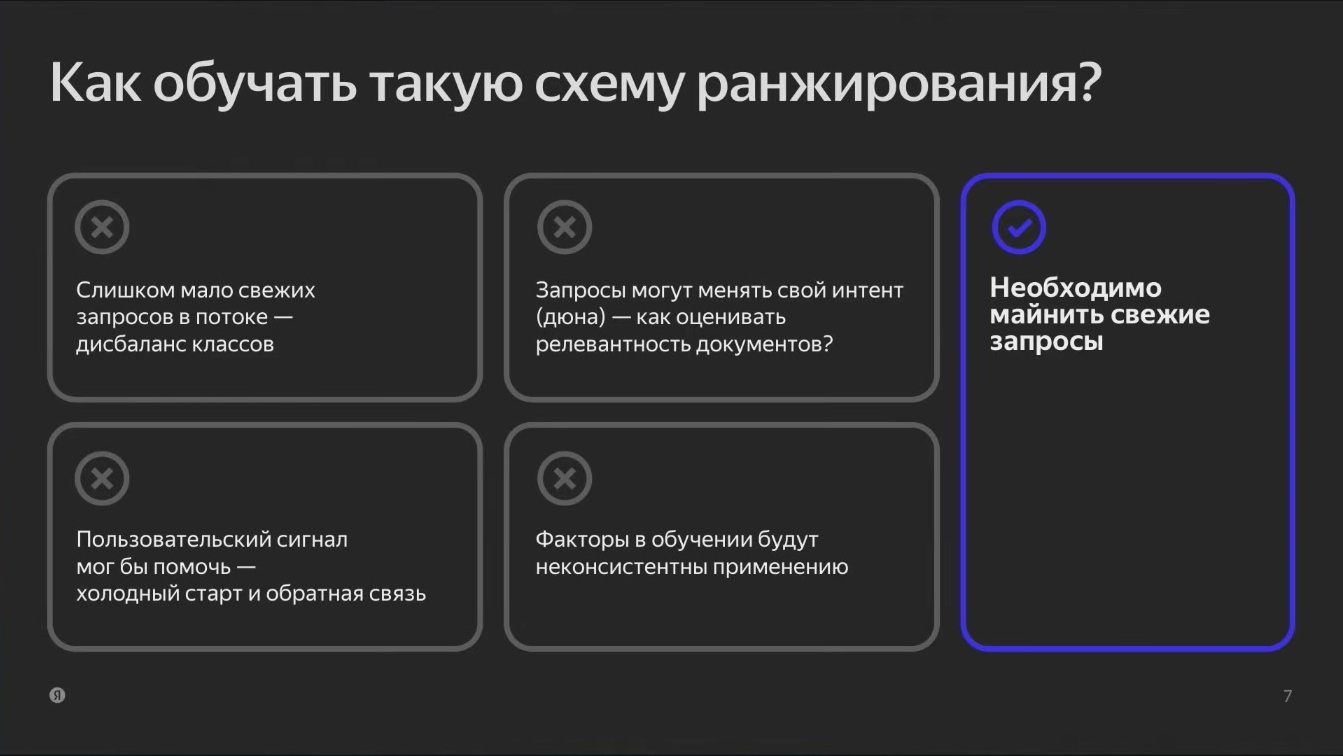
Свежих запросов мало, их смысл меняется, пользовательские сигналы запаздывают, а признаки в обучении расходятся с моментом применения.
Источник: Арсений Михайлов · ЯндексНужно поймать запрос вместе с его датой
Специальный поиск подходящих примеров автор называет майнингом запросов. Событие произошло, пользователи начали о нём спрашивать, и система должна оперативно поймать такие запросы и сохранить связанные с ними документы. Так данные привязываются к моменту, когда свежесть действительно важна, а не восстанавливаются только по более позднему состоянию.
Отбор должен быть несмещённым: систематические перекосы в том, какие запросы удаётся поймать, перейдут в обученную модель. В докладе это сформулировано как требование; конкретный алгоритм поиска кандидатов и проверка отсутствия смещения не раскрыты. Кандидатов получается много, и среди них ещё нужно выделить действительно свежие.
Единица разметки — не строка сама по себе, а запрос вместе с датой. Возможна дополнительная информация, например регион пользователя. Вопрос к разметчику звучит так: связан ли этот запрос со значимым свежим событием в указанный момент? Одна строка может получать разные ответы в разные даты.
Таблицу можно прокрутить по горизонтали.
Эта таблица показывает зависимость метки от времени, а не задаёт универсальный календарь свежести. Автор продолжает пример чемпионата мира: при следующем событии тот же запрос снова может стать свежим. Для решения нужны дата и новостной контекст; ни наличие знакомого названия, ни дата, написанная внутри строки, сами по себе не заменяют проверку.
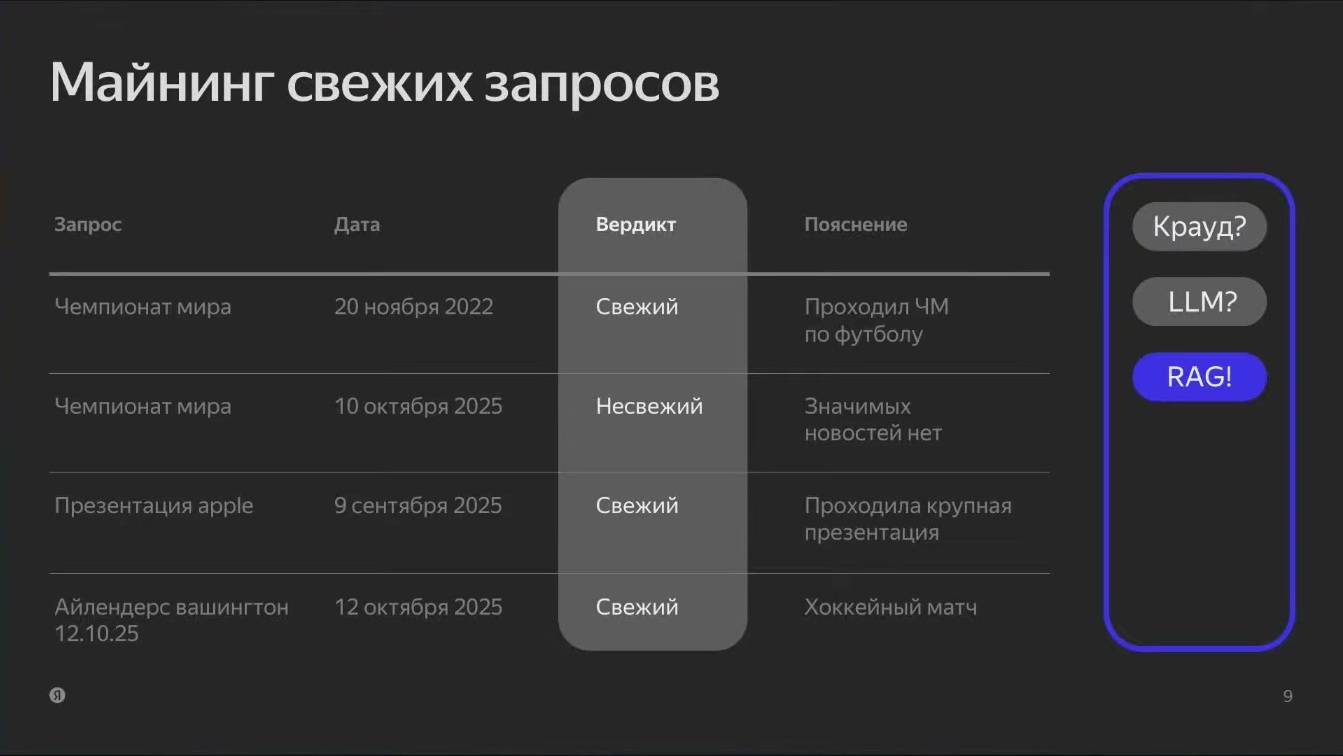
Одинаковая строка может быть свежей в одну дату и несвежей в другую. Примеры на слайде — иллюстрация разметки, а не универсальный календарь событий.
Источник: Арсений Михайлов · ЯндексПочему крауд дорог, а одной языковой модели не хватает
Прежний способ — поручить задачу людям-разметчикам, то есть крауду. Но это не быстрая проверка очевидного признака. Человеку нужно открыть новостные источники, прочитать их, понять связь с запросом и только затем решить, является ли запрос свежим. Большое число кандидатов сочетается с высокой трудоёмкостью каждого решения.
Естественная попытка автоматизации — передать запрос большой языковой модели, или LLM. Однако её знания, полученные при обучении, не гарантируют осведомлённости о событии, которое произошло недавно. Модель может хорошо понимать формулировку запроса и всё же не иметь фактов, необходимых для разметки на конкретную дату.
Поэтому проблема не сводится к выбору более убедительно отвечающей модели. Сначала нужно дать ей сведения о произошедшем. В этой задаче статичность знаний мешает не потому, что модель вообще не умеет классифицировать запросы, а потому, что нужный класс зависит от текущего новостного контекста. Получение такого контекста становится отдельной частью решения.
Доклад · 00:06:53Поиск с Алисой приносит модели недостающие факты
Команда использует подход RAG: перед генерацией ответа система ищет подходящие материалы и передаёт их модели как контекст. В докладе его объясняют на устройстве Поиска с Алисой. Исходный вопрос перефразируется в несколько связанных поисковых запросов, по ним находятся релевантные страницы, а из страниц выбираются подходящие текстовые фрагменты.
Фрагменты объединяются и поступают в генеративную модель, которая составляет ответ. В показанной схеме генератор подписан YandexGPT; также показаны исходный вопрос и весь диалог. Это объяснение работы поискового ответа: оно не означает, что конвейер разметки свежести обязательно получает историю диалога каждого пользователя.
На схеме присутствуют пять страниц, содержащих текстовый ответ, и пять фрагментов текста для генератора. Эти количества относятся к показанному примеру. Из них нельзя вывести постоянное число документов во всём конвейере или универсальное правило для систем RAG.
Для разметки свежести ценен не сам разговорный ответ Алисы, а собранный с помощью поиска новостной материал. Теперь модель может рассматривать запрос на фоне событий соответствующего времени, а не пытаться восстановить их из своих обученных знаний. В отличие от двух баз изображений, этот поиск нужен для получения текстовых свидетельств о новостях.
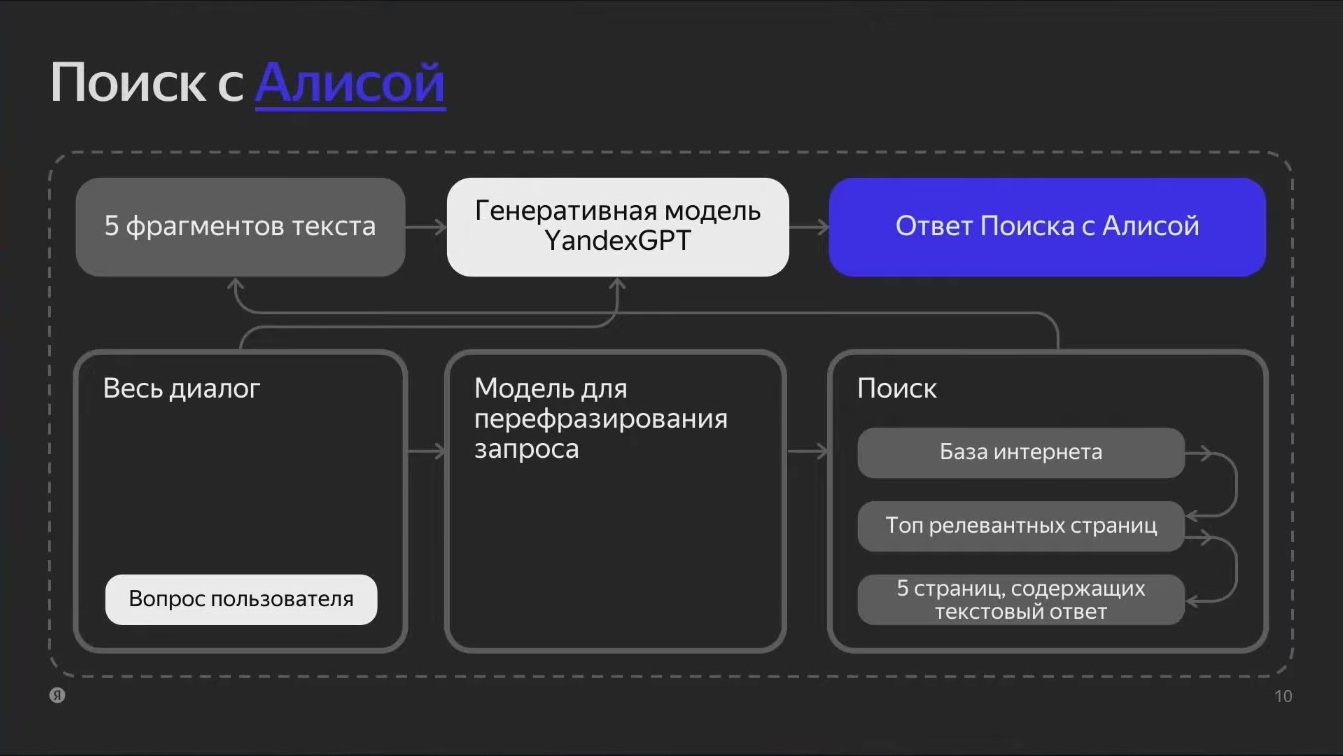
На схеме показаны пять страниц и пять фрагментов текста для YandexGPT. Это устройство показанного примера, не правило для всех RAG-систем.
Источник: Арсений Михайлов · ЯндексНайденная новость ещё не делает запрос свежим
После добавления поиска обнаружилась более тонкая проблема. По запросу о новостях Новосибирска можно получить развёрнутую сводку, но наличие такой сводки не означает, что все перечисленные сообщения должны менять выдачу по широкому запросу «Новосибирск». Для него важно не любое упоминание города, а событие достаточной значимости.
Поиск способен собрать много малозначительных новостей. Небольшой модели трудно одновременно отбирать их и оценивать, достаточно ли они важны для изменения ожидаемых картинок. Полезность поиска здесь не отменяется: он нашёл материалы. Не сработало объединение получения материалов и сложного итогового суждения в одной перегруженной стадии.
Автор перечисляет обязанности, возложенные на небольшую YandexGPT: кратко изложить источник, проверить дату и попадание во временное окно, оценить значимость каждой новости, её связь с исходным запросом и затем принять общее решение. Для иллюстрации он говорит о десятке новостей; это не фиксированное число документов. По его оценке, модель с таким набором обязанностей не справлялась. Следующий шаг — разделить их.
Доклад · 00:08:53Отделить сбор новостей от решения о свежести
Первой стадии оставляют отбор и краткое изложение релевантных новостных источников. Этим занимается Поиск с Алисой: он формирует новостной контекст, который будет использовать следующая модель. Его задача теперь не состоит в том, чтобы заодно окончательно решить все вопросы о свежести запроса.
Вторая стадия получает этот контекст и оценивает значимость событий, соответствие критериям и финальную свежесть запроса. Для неё подходит модель без собственного доступа к свежим новостям: нужные сведения уже переданы на вход. Более крупная модель, по объяснению автора, использует более широкие знания о мире, чтобы лучше оценивать значимость найденных событий.
В обозначениях разметки положительный вердикт — 1, отрицательный — 0. Однако решение зависит от содержания контекста и критериев, а не от самого факта, что поиск что-то вернул. Наличие новостей и достаточность оснований для положительной метки — разные вопросы.
Разделение позволяет отдельно настраивать инструкции и входной контекст для каждой обязанности. Инструкция, которую вместе с данными передают языковой модели, называется промптом. Здесь нужны два согласованных промпта: один управляет поиском и подготовкой новостей, другой — оценкой и классификацией. Точная модель финальной стадии в этом кейсе не названа; смысл решения не в конкретном названии, а в разделении ролей.
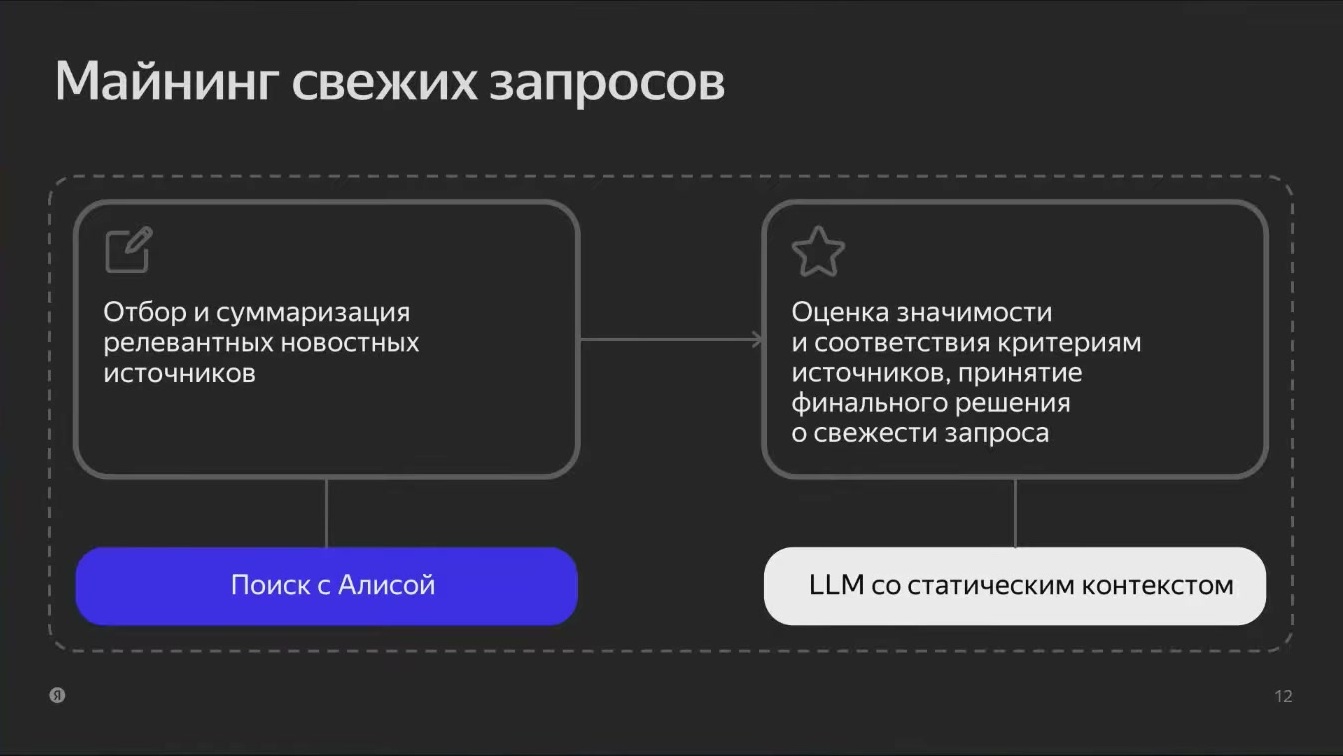
Поиск с Алисой отбирает и суммирует источники; отдельная LLM оценивает значимость и соответствие критериям свежести.
Источник: Арсений Михайлов · ЯндексПочему ошибки нужно разбирать по стадиям
У разделения есть цена: становится больше способов получить неправильную метку. Теперь недостаточно заметить ошибочный итоговый ответ. Нужно установить, что пришло из поиска и как этим воспользовался классификатор. В докладе выделены шесть основных ситуаций.
Таблицу можно прокрутить по горизонтали.
Особенно часто команда работала над второй и шестой ситуациями — теми, которые объясняет пример Новосибирска. На первой стадии легко получить материалы по теме, которая сейчас не должна считаться свежей; на второй — переоценить их значение. В обоих случаях итоговая метка может выглядеть обоснованной, потому что рядом действительно есть новости.
Разные причины требуют разных изменений. Отсутствующий или неподходящий контекст нельзя исправить только более строгой формулировкой финального ответа. А правильные новости не помогут, если классификатор недостаточно строго проверяет критерии. Перечень ошибок служит диагностикой; частоты категорий и их количественный вклад в итоговую ошибку не приведены.
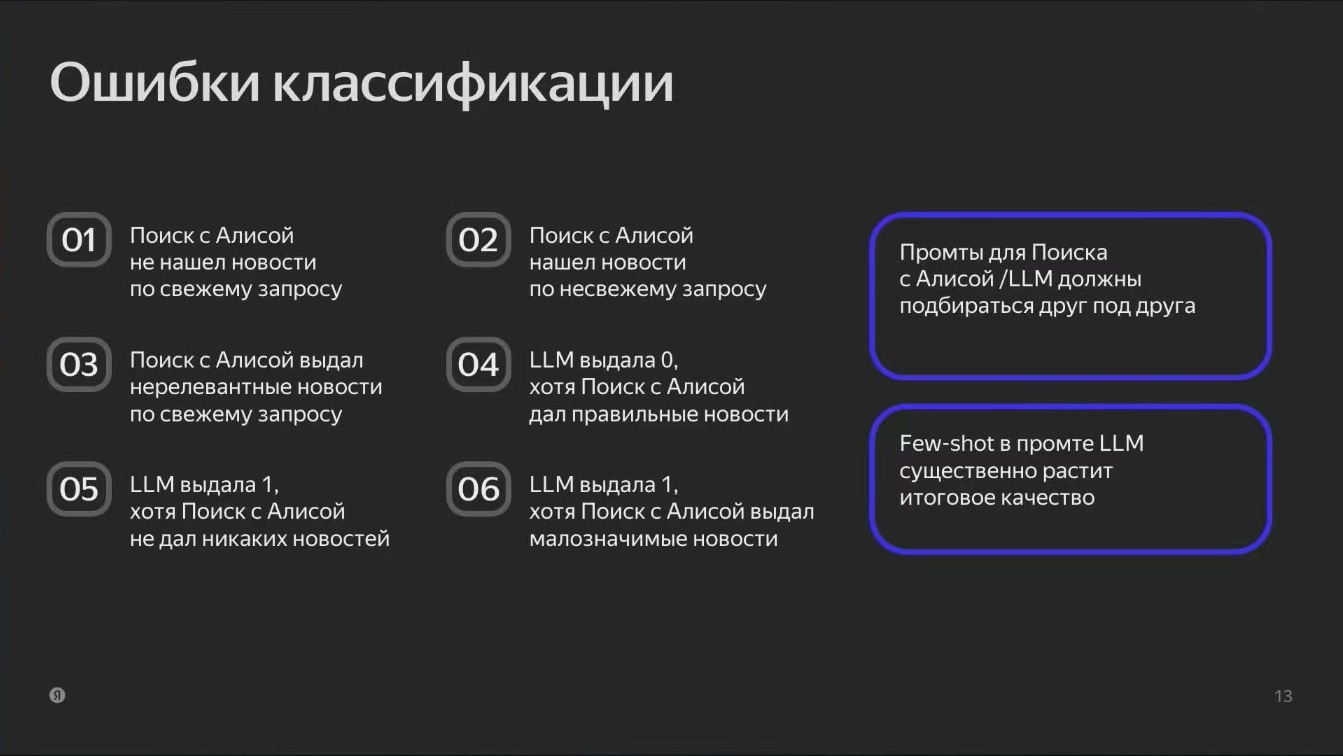
Шесть типов ошибок требуют совместной настройки промптов обеих стадий, а не только замены одной модели.
Источник: Арсений Михайлов · ЯндексПервый промпт: явные даты и право не найти новости
Первое практическое изменение касается дат. Поиску с Алисой лучше передавать их явным списком, например перечислить 12, 13, 14 октября и продолжить список нужного периода. Так временное условие становится конкретным, а не остаётся только относительной формулировкой.
Автор поясняет этот совет опытом с Perplexity. Инструкция учитывать новости за последние пять дней приводила к ответу, в котором событие представлялось свежим, хотя при уточнении выяснялось, что оно произошло год назад. Это пример проблемы при работе с другим поисковым инструментом, а не установленная поломка Поиска с Алисой. Пять дней также не названы постоянным окном разметки данной системы.
Второе изменение — явно разрешить модели сообщать, что новостей нет, и признавать неуверенность. Без такой инструкции она может пытаться обязательно заполнить ответ и выдумывать сведения. Отсутствие подходящих новостей должно стать нормальным результатом первой стадии, а не выглядеть как невыполненное задание, которое требуется любой ценой дополнить.
Этот выбор сразу влияет на вторую стадию: она теперь может получить не сводку событий, а сообщение об их отсутствии. Поэтому настройка поискового промпта не заканчивается в точке выдачи текста. Нужно подготовить классификатор к тем видам ответа, которые поиск действительно будет возвращать.
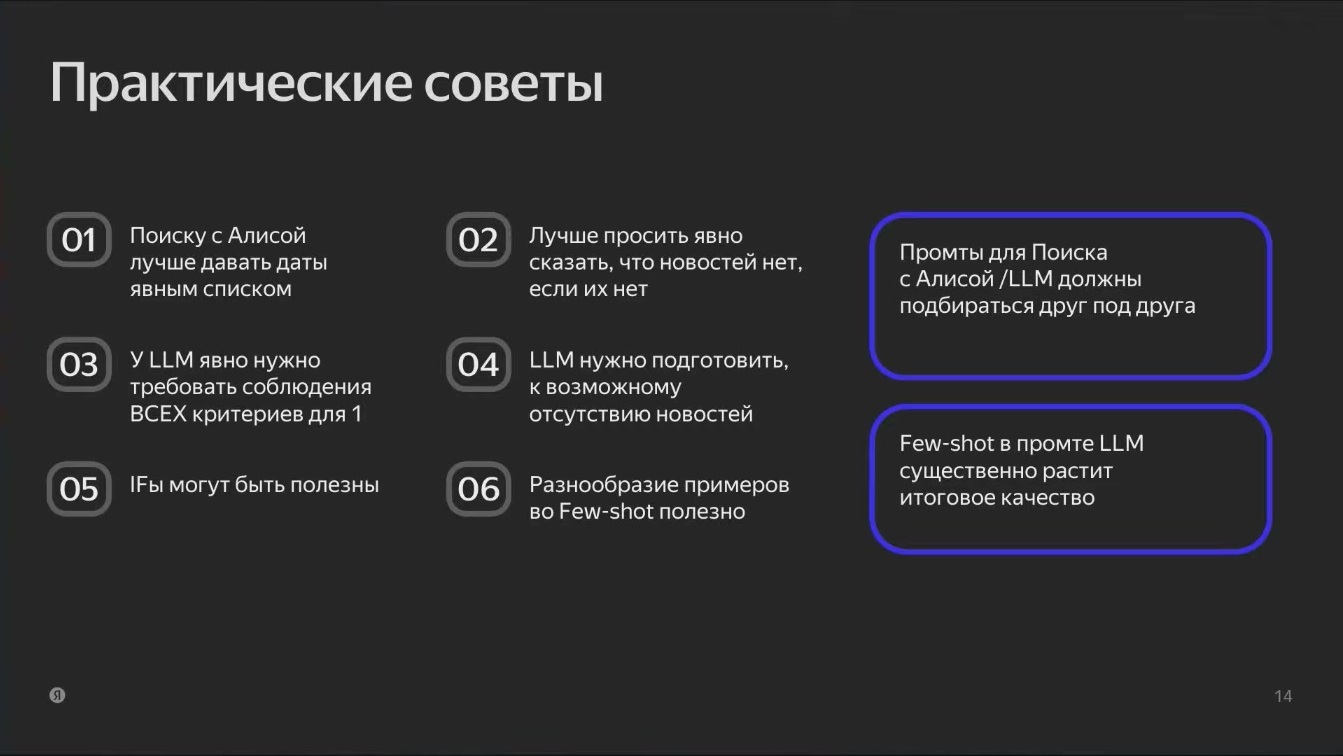
Даты задают явно; отсутствие новостей — допустимый результат. Примеры в промпте помогают следующей стадии правильно понимать выход предыдущей.
Источник: Арсений Михайлов · ЯндексВторой промпт: положительная метка требует всех критериев
В инструкции финальной модели нужно явно требовать соблюдения всех критериев для положительного решения. По рекомендации автора, сомнение хотя бы в одном из них должно склонять ответ к 0. Иначе модель может достроить недостающие основания и выдать 1 по контексту, который на самом деле не подтверждает свежесть.
Речь идёт о правиле принятия решения в промпте, а не о показанном численном пороге вероятности. Из предыдущего разбора понятны виды проверок: связь с запросом, дата, нужное временное окно и значимость новости. Но полная инструкция с точными условиями и формальным определением достаточной значимости в докладе не приведена.
Отдельно модель готовят к отсутствию новостей. Если в примерах и инструкции всегда была содержательная сводка, пустой вход оказывается неожиданным случаем. Классификатор не должен отвечать произвольно только потому, что первая стадия ничего не нашла. Право поиска вернуть отсутствие сведений и готовность классификатора обработать такой результат — две части одного решения.
После общих изменений промптов команда добавила и специальные условные правила. Автор приводит фильмы и сериалы: для проблемных случаев в финальном промпте явно прописали дополнительные условия. Точное содержание этих условий не раскрывается. Поэтому из доклада следует польза адресных правил для конкретных ошибок, но не готовый алгоритм, по которому следует классифицировать любой запрос о кино.
Доклад · 00:12:31Примеры связывают выход поиска с решением классификатора
Главным выводом настройки автор называет готовность следующей стадии к выходу предыдущей. Одного общего указания «оцени новости» недостаточно: важно, чтобы классификатор понимал фактические ответы Поиска с Алисой, а не только идеальную сводку, которую предполагали при разработке.
Для этого в финальный промпт помещали несколько примеров работы Поиска с Алисой вместе с правильными ответами. Такой способ называется few-shot: модель получает несколько разобранных примеров прямо в контексте текущего обращения. В этом месте не описано дообучение весов. Модель ориентируется на показанные образцы входа и правильного решения.
На слайде отдельно отмечена польза разнообразия примеров. Их задача — подготовить модель к разным результатам предыдущей стадии, а не только показать один удачный ответ. Точное число и полный состав примеров не названы.
Таким образом, разделение обязанностей упрощает настройку каждой модели, но не делает промпты независимыми по смыслу. Изменение того, как поиск сообщает об отсутствии или значимости новостей, влияет на поведение классификатора. Команда согласовывала оба промпта, а few-shot помогал закрепить это согласование. Польза такого подхода заявлена качественно: отдельный численный эффект каждого изменения не измерен в представленном материале.
Доклад · 00:13:24Первая проверка: сравнение с краудом на эталонной разметке
Настроенная система ещё не считается принятой только потому, что хорошо отвечает на выбранные примеры. Первый этап приёмки — оценить Precision и Recall и сопоставить качество с уже работающим краудом.
Precision, или точность положительных решений, отвечает на вопрос: какая доля запросов, помеченных свежими, действительно свежая по эталону? Recall, или полнота, показывает, какую долю всех свежих запросов из проверочного набора удалось найти. Первая метрика важна для чистоты отобранных данных, вторая — для того, чтобы не пропустить слишком много нужных примеров. Это оценки разметки запросов, а не релевантности отдельных картинок.
Качество крауда проверяли на эталонном наборе — golden set, который размечали более квалифицированные люди, включая менеджеров и разработчиков. Следовательно, существующая крауд-разметка не выступала автоматически безошибочной истиной. Для сравнения использовалась более квалифицированная проверка.
Число эталонных примеров и доверительные интервалы, показывающие неопределённость оценок, неизвестны. Также не описана подробная процедура согласования ответов экспертов. После того как автоматизация показала большее или сопоставимое качество относительно крауда, команда перешла к следующим проверкам. Одних этих двух метрик для принятия решения оказалось недостаточно.
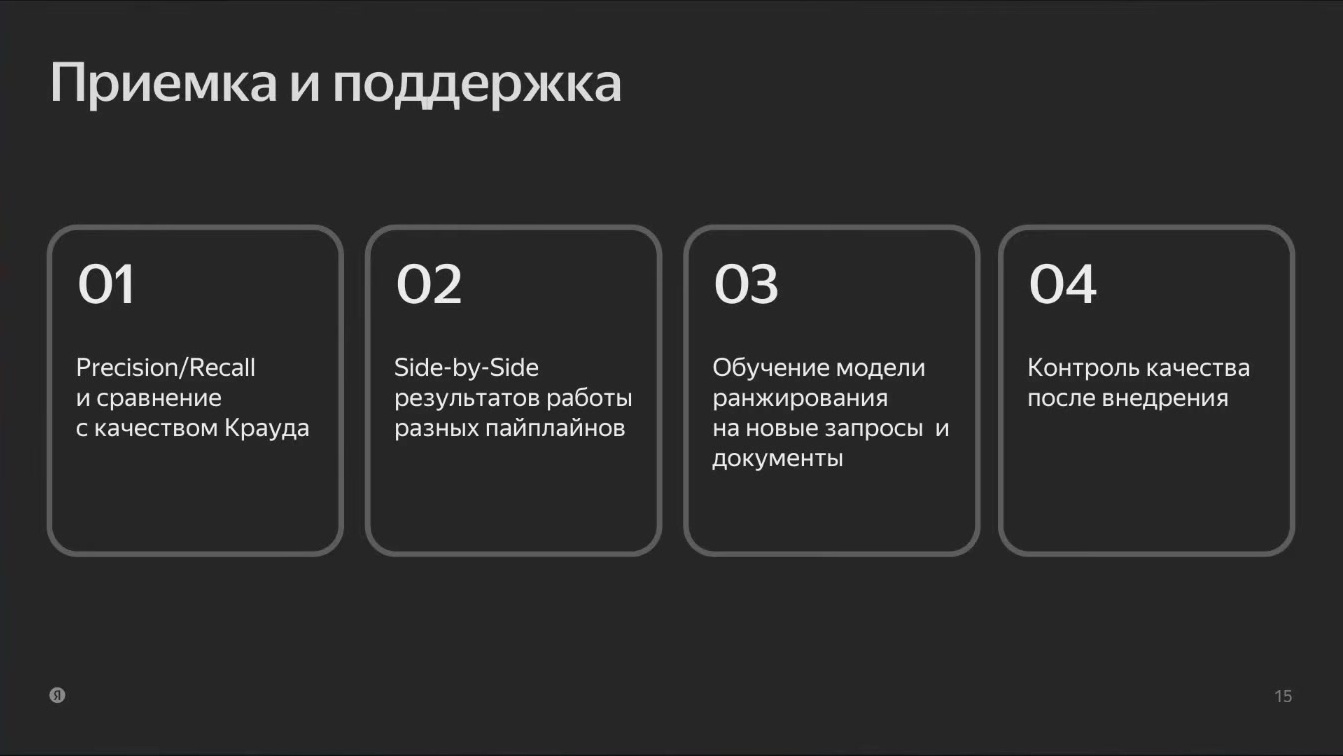
Precision/Recall сравнивают с краудом, результаты смотрят попарно, затем проверяют модель ранжирования и продолжают контроль качества.
Источник: Арсений Михайлов · ЯндексСравнить отобранные запросы, затем проверить обучение ранжирования
Следующий этап — сопоставить результаты двух способов отбора непосредственно. Такое сравнение называют Side-by-Side, или SbS: результаты показывают рядом и разбирают содержательные различия. В этом кейсе смотрели на запросы, которые свежими считал прежний процесс, и на запросы, отобранные новым конвейером.
Смысл проверки не в повторном вычислении тех же Precision и Recall. У нового отбора могут быть характерные ошибки, которые плохо заметны в агрегированных показателях. По словам автора, непосредственное сравнение позволило найти несколько критичных проблем, способных проявиться позднее. Конкретные примеры этих находок он не раскрывает.
После этого команда вернулась к исходной цели. Свежие запросы собирали не ради самого классификатора, а чтобы обучить модель, которая правильно ранжирует свежие и несвежие картинки. Поэтому запросы, отобранные новым способом, действительно использовали для обучения ранжирующей модели и провели сравнительную проверку её качества.
Автор оценивает полученный сравнительный результат как подходящий для этой задачи. Но точное численное значение, название метрики и подробный протокол сравнения не установлены. Оснований превращать этот результат в численный прирост качества выдачи или доказанную статистическую эквивалентность нет.
Обучение ранжирования — отдельная проверка пригодности подготовленных данных. Оно не является шагом, который заново выполняется при разметке каждого запроса. Так же и SbS здесь относится к результатам отбора, а не к описанному A/B-тесту поведения пользователей поиска.
Доклад · 00:14:20После запуска часть запросов продолжают проверять люди
Даже успешно принятый конвейер может со временем изменить поведение без правок со стороны команды разметки. Поиск с Алисой и большая языковая модель развиваются независимо: меняются их версии, ответы и свойства. Согласованные вчера промпты не гарантируют, что после такого обновления вся последовательность будет работать так же.
Поэтому часть запросов по-прежнему размечает крауд. Из этой разметки каждый день формируется небольшой проверочный набор — бенчмарк. На нём строят графики качества, используют автоматические предупреждения об ухудшении и ежедневно проверяют, что система продолжает работать правильно.
Ручной контроль здесь не означает возвращение к полной ручной обработке потока. Его задача — сохранить независимую проверку автоматической разметки и замечать изменение качества. Размер ежедневного набора и точные условия срабатывания предупреждений не названы.
Важно разделять три процесса: разметку отдельного запроса, обучение ранжирующей модели на собранных данных и контроль качества работающего разметчика. Ежедневная периодичность относится к последнему. Из неё нельзя вывести расписание всего майнинга, частоту переобучения ранжирования или интервалы обновления двух баз изображений.
Доклад · 00:15:23Результат: качество разметки и экономия на крауде
В итоговом сравнении автоматическая разметка показывает более высокие Precision и Recall, чем крауд. Значения автоматического процесса зафиксированы на слайде; ориентир для крауда автор называет в речи приблизительно.
Таблицу можно прокрутить по горизонтали.
Это не общая доля правильных ответов по всем классам и не качество картинок в выдаче. Число эталонных примеров и доверительные интервалы неизвестны, поэтому по приведённым значениям нельзя установить статистическую значимость различий. Результат поддерживает вывод автора о пригодности автоматизации в его задаче, но не обещает те же показатели на другом потоке.
На момент выступления процесс был внедрён и работал более шести месяцев. По словам автора, за описанный период не происходило критических поломок и не требовался серьёзный ремонт. При этом ежедневная проверка качества сохранялась: длительность работы не заменяла мониторинг.
Таблицу можно прокрутить по горизонтали.
Эти проценты нельзя складывать или считать изменением одной и той же величины: 25% относится ко всему крауд-бюджету сервиса, а около 95% и оставшиеся 5% — к расходам на конкретную задачу. Последние 5% также не означают автоматически, что люди проверяют ровно 5% запросов: названа денежная доля, а не доля потока.
Стоимость работы всех моделей и полная экономика автоматизации не раскрыты. Поэтому 25% нельзя трактовать как сокращение общего бюджета машинного обучения, повышение качества на 25 процентных пунктов или A/B-прирост пользовательских метрик. Измеренные результаты этого рассказа — качество разметки и экономия расходов на крауд.
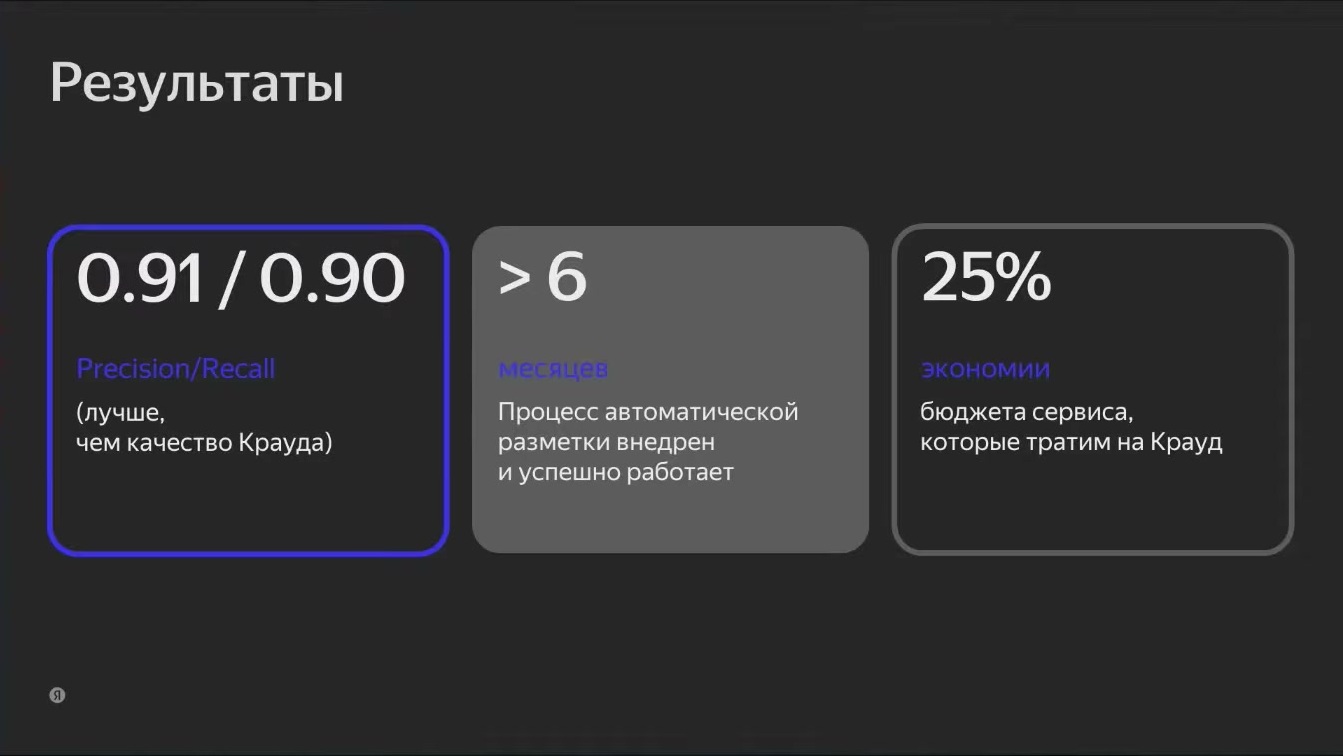
На слайде Precision/Recall 0,91/0,90, работа более шести месяцев и 25% экономии бюджета всего сервиса на крауд. Это не рост пользовательских метрик поиска.
Источник: Арсений Михайлов · ЯндексОбщие инструменты не означают общее внедрение
Вопрос из зала возвращает обсуждение к значимости новостей: использовала ли команда опыт подразделения, которое борется с преувеличением важности небольших событий? По ответу Арсения, прямого взаимодействия с названной спрашивающим командой новостей в рамках этой задачи скорее не было. Использовали общие инструменты Яндекса, в том числе Поиск с Алисой.
Автор допускает общие компоненты и пересечения в проблемах разных систем. Но это не заявление о конкретном подключении готового новостного классификатора или передаче этой команде финального решения. Малозначительные новости всё равно пришлось разбирать как собственный источник ошибок конвейера.
Другой вопрос касается повторного использования разметки: почему не встроиться в общий процесс поиска, вместо того чтобы строить решение поверх поискового инструмента? Автор объясняет, что задача свежести возникает в нескольких направлениях, или вертикалях, — большом веб-поиске, поиске картинок и видеопоиске. Способы решения похожи; крауд, с которым сравнивались, по его формулировке был примерно общим для этих трёх вертикалей.
Новый подход тоже может использоваться другими сервисами, если им понадобится такая разметка. Но в ответе описана возможность переноса, а не состоявшееся внедрение одного конвейера во все виды поиска. Общая постановка задачи делает повторное использование осмысленным, не отменяя различий в конкретном применении.
Доклад · 00:17:31До устойчивого результата дошли через множество исправлений
На вопрос о самом интересном результате проекта автор сначала отвечает не названием модели или метрикой. Важным оказалось довести работу до конца: итераций было много, на каждой что-то переставало работать и требовало исправления. Этот опыт объясняет, почему в докладе так много внимания уделено ошибкам, согласованию стадий и последовательной приёмке.
Второй вывод — такую сложную разметку удалось в значительной степени передать языковым моделям с поиском, используя относительно ограниченные силы. Это оценка опыта команды. Численность участников, затраты времени и бюджет разработки не названы, поэтому превращать её в обещание дешёвого запуска за определённый срок нельзя.
Множество исправлений до получения рабочего решения не противоречит более чем шестимесячной устойчивой эксплуатации после внедрения. Это разные части истории проекта. И автоматизация основной работы не означает исчезновения людей из процесса: они остаются в эталонной оценке, содержательной приёмке и ежедневном мониторинге.
Доклад · 00:19:56Свежесть запроса и личные интересы пользователя — разные сигналы
Ещё один вопрос связывает новости с личными интересами. Например, человек ищет новости Новосибирска, а перед этим часто интересовался театрами и мероприятиями. Должна ли история таких интересов менять решение разметчика?
Автор разделяет два уровня. При определении, свежий запрос или нет, личные предпочтения, по его словам, скорее не используются: команда считает этот признак не зависящим от конкретного пользователя. А при формировании окончательной выдачи персонализация используется и является важным фактором.
Предпочтения помогают выбрать, что показать, но не должны механически подменять запрос. Автор иллюстрирует это картинками котиков: любовь пользователя к таким изображениям полезна для персонализации, однако показывать их в ответ на каждый запрос было бы странно.
Упомянутый ранее регион как возможная дополнительная информация — не то же самое, что история личных интересов. Поэтому из ответа нельзя сделать вывод, что пользовательские сведения вообще нигде не учитываются. В данном кейсе отдельно рассматриваются разметка свежести пары «запрос — дата» и персонализированное ранжирование итоговых картинок.
Доклад · 00:20:58Почему в ответе звучат несколько семейств моделей
Последний технический вопрос — какая большая модель использовалась. Автор объясняет, что представил один кейс автоматизации свежих запросов, но команда уже запустила несколько похожих конвейеров для разных задач. В одном используется DeepSeek, в другом GPT, в третьем YandexGPT.
Это перечисление нельзя читать как состав одного ансамбля или последовательность всех моделей внутри описанного решения. Точная модель финального классификатора свежести и её версия остаются неустановленными. YandexGPT на схеме Поиска с Алисой подписывает генератор поискового ответа и также не раскрывает автоматически модель следующей стадии.
Ранее, объясняя разделение обязанностей, автор приводил GPT-4o, DeepSeek и YandexGPT как возможные варианты модели, которой уже передали новостной контекст. Оба фрагмента поддерживают одну мысль: структура задачи допускает разные модели. Они не содержат сравнительного испытания этих семейств и не позволяют приписать каждой из них итоговые Precision и Recall данного кейса.
Доклад · 00:22:12Итог: автоматизировать разметку, сохранив проверку результата
Проблема начиналась с выдачи изображений: после новости прежнее понимание запроса может перестать соответствовать ожиданиям пользователя. Две базы обеспечивают доступ к свежим и несвежим картинкам, но ранжированию нужны правильно собранные данные. Команда пришла к разметке запроса вместе с датой и разделила её на получение новостного контекста и оценку значимости.
- 01
Поймать запрос
В момент актуальности события зафиксировать запрос-кандидат, его дату и связанные документы.
- 02
Найти новости
Передать Поиску с Алисой запрос и явно заданные даты, чтобы получить релевантные новостные материалы.
- 03
Подготовить контекст
Кратко изложить найденные источники либо явно сообщить, что подходящих новостей нет.
- 04
Проверить основания
Отдельная языковая модель оценивает значимость и выполнение критериев, ориентируясь на согласованный промпт и примеры.
- 05
Выдать метку
Принять решение о свежести запроса; наличие материалов само по себе не является основанием для положительного ответа.
Приёмка и обучение происходят отдельно от этих шагов. Разметку сравнивают с квалифицированным эталоном по Precision и Recall, содержательно сопоставляют отборы рядом и проверяют пригодность данных обучением ранжирующей модели. После внедрения часть запросов продолжает проверять крауд: небольшой ежедневный набор, графики и предупреждения помогают замечать изменения качества.
Результат — Precision 0,91 и Recall 0,90, более шести месяцев работы на момент выступления. Экономия составила 25% крауд-бюджета всего сервиса и около 95% прежних расходов на крауд именно в этой задаче; оставшиеся 5% поддерживают мониторинг. Это не экономия стоимости всех моделей и не измеренный рост пользовательских метрик. Размер эталона и доверительные интервалы неизвестны, численный эффект на ранжирование не установлен. Практический итог — автоматизация основной разметки с сохранённой проверкой качества, а не отказ от человеческого контроля.
Доклад · 00:16:02