Разбор готов
A-vibe: как Авито адаптировало Qwen3 под русский язык, обучение и быстрый инференс
Авито нужна языковая модель, которую можно приспосабливать к задачам пользователей и сотрудников. Простые варианты не устраивали команду по разным причинам: проприетарные API ограничивали контроль и гибкость, готовые открытые модели хуже работали с русским языком и неэкономно его токенизировали, а собственное обучение с нуля требовал слишком много данных, вычислений и времени. Поэтому команда выбрала промежуточный путь: сохранить знания сильной открытой модели Qwen3-8B-Base, заменить проблемную часть токенизации, затем дообучить модель на инструкциях, задачах с вызовом функций, математике и предпочтениях по безопасности и качеству ответа. Разберём, как меняли токенизатор, готовили данные, проверяли способности модели и ускоряли её работу под нагрузкой.
Материал полезен ML/LLM-инженерам, которые адаптируют открытую языковую модель под русский язык, меняют токенизатор у уже предобученной сети, строят SFT/RL-пайплайн, готовят function-calling данные или оптимизируют инференс под реальную параллельную нагрузку. Глава особенно полезна как разбор компромиссов: улучшение одной группы метрик здесь не означает улучшение всех остальных.
Статья · на русском
Как мы в Авито сделали свою LLM — A-vibeАнастасия Рысьмятова · Опубликовано: 27 октября 2025 г.
Почему не стали обучать языковую модель с нуля
LLM-юнит Авито на момент статьи — команда из 25 человек, которая делает общую core-модель и затем адаптирует её под разные бизнес-кейсы. За два года команда пишет о более чем 60 продуктовых сервисах, более 50 A/B-тестах и более 12 внедрённых и масштабированных продуктах. Эти числа описывают деятельность юнита в целом, а не эффект A-vibe. Контекст компании также велик: в статье названы 72+ млн уникальных пользователей, более 220 млн активных объявлений и около 12 тысяч сотрудников.
Первый вариант — использовать проприетарные модели через API. От него отказались из-за вопросов безопасности, ограниченной гибкости и желания развивать экспертизу внутри компании. Второй — брать готовые открытые модели как есть. Они показывали хорошие общие метрики, но на русском языке результаты были слабее английских, а токенизаторы часто неэффективно разбивали русский текст. Третий — делать собственный pretrain, то есть предварительное обучение модели с нуля на огромном корпусе. Этот путь сочли слишком дорогим и долгим.
Команда выбрала адаптацию открытой модели: взять сильную OS-модель, заменить или перестроить её токенизатор, затем провести инструктивное дообучение и обучение по предпочтениям/вознаграждению. Такой выбор сохраняет значительную часть уже выученных представлений и вычислительных инвестиций исходной модели, но позволяет изменить те части, которые мешают русскоязычным задачам.
Как мы обучали модель AvibeС чего началась адаптация токенизатора
Токенизатор делит текст на токены — единицы, с которыми работает модель. Плотность токенизации в статье измеряется как число символов на один токен: чем оно выше на фиксированном корпусе, тем меньше токенов требуется для представления того же текста. Это важно и для длины входного контекста, и для количества шагов генерации.
Таблицу можно прокрутить по горизонтали.
Внутренние токенизаторы имели меньший словарь и заметно больше кириллических элементов. Авторы связывают это с двумя эффектами: русский текст занимает меньше токенов, а меньший словарь сокращает число параметров в слоях, зависящих от размера vocabulary. Но полная замена словаря создаёт новую проблему: старые веса модели были обучены вместе со старым набором токенов.
У команды уже был двухэтапный способ подмены токенизатора. Сначала на этапе freeze замораживали всю сеть, кроме слоя эмбеддингов, то есть таблицы векторов токенов. Затем на этапе unfreeze размораживали все параметры и продолжали обучение на тех же данных. После этого шли SFT и DPO. Позже в текущем проекте между SFT и DPO появился отдельный GRPO-этап.
Адаптация токенизатораПочему полную подмену словаря заменили объединением двух токенизаторов
У старого способа было слабое место: пересечение токенов открытой модели и собственного словаря обычно составляло около двух тысяч токенов. Большинство новых строк таблицы эмбеддингов приходилось инициализировать заново, поэтому они плохо согласовывались с уже обученными слоями модели. Для эксперимента команда взяла Qwen3-8B-Base и решила сохранить сильную английскую и кодовую часть её словаря, а русскую часть получить из собственного ver6_60k.
Сначала из Qwen3 выделяли кандидатов, состоящих из латинских символов. Этого недостаточно: латиницей пользуются многие языки. Поэтому токены дополнительно ранжировали по частотности на чистом английском корпусе DCLM и сохраняли область до 99-го перцентиля. Отдельно оставили кодовые токены, статистику которых посчитали на внутренней кодовой базе Авито. В тексте этот этап описан как примерно 80 тысяч английских и кодовых токенов.
Для русского ver6_60k использовали похожий отбор, но частотности считали на fineweb_ru. После pruning получился словарь примерно на 36 тысяч токенов с высокой плотностью на русском. Ver6 был заранее обучен в совместимом с Qwen сетапе: совпадали pre-tokenizer и normalizer. Поэтому итоговый merge технически сводился к добавлению новых элементов в vocabulary и соответствующих правил merges.
Таблицу можно прокрутить по горизонтали.
Итоговый объединённый токенизатор почти сохраняет английскую плотность исходного Qwen3: 4,65 → 4,59 символа на токен. На русском изменение намного заметнее: 2,91 → 4,47. Это и было целью merge: не обменять хороший английский на хороший русский, а сохранить обе целевые области достаточно плотными.
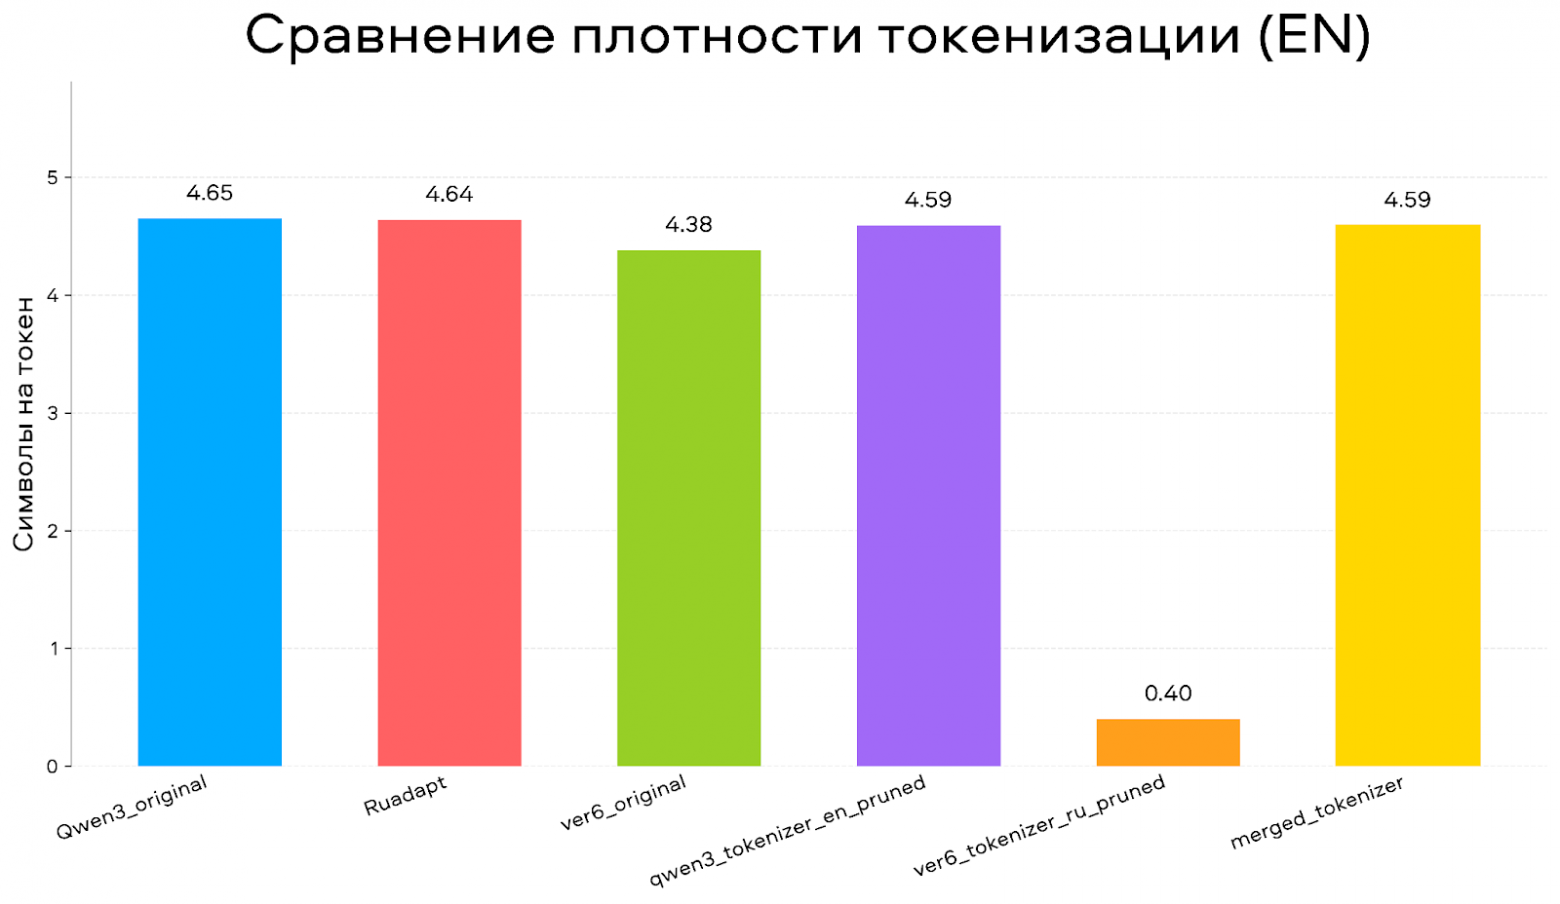
Объединённый токенизатор даёт 4,59 символа на токен на английском корпусе; Qwen3_original — 4,65. Это сравнение токенизации, не качества ответов.
Источник: Анастасия Рысьмятова · Авито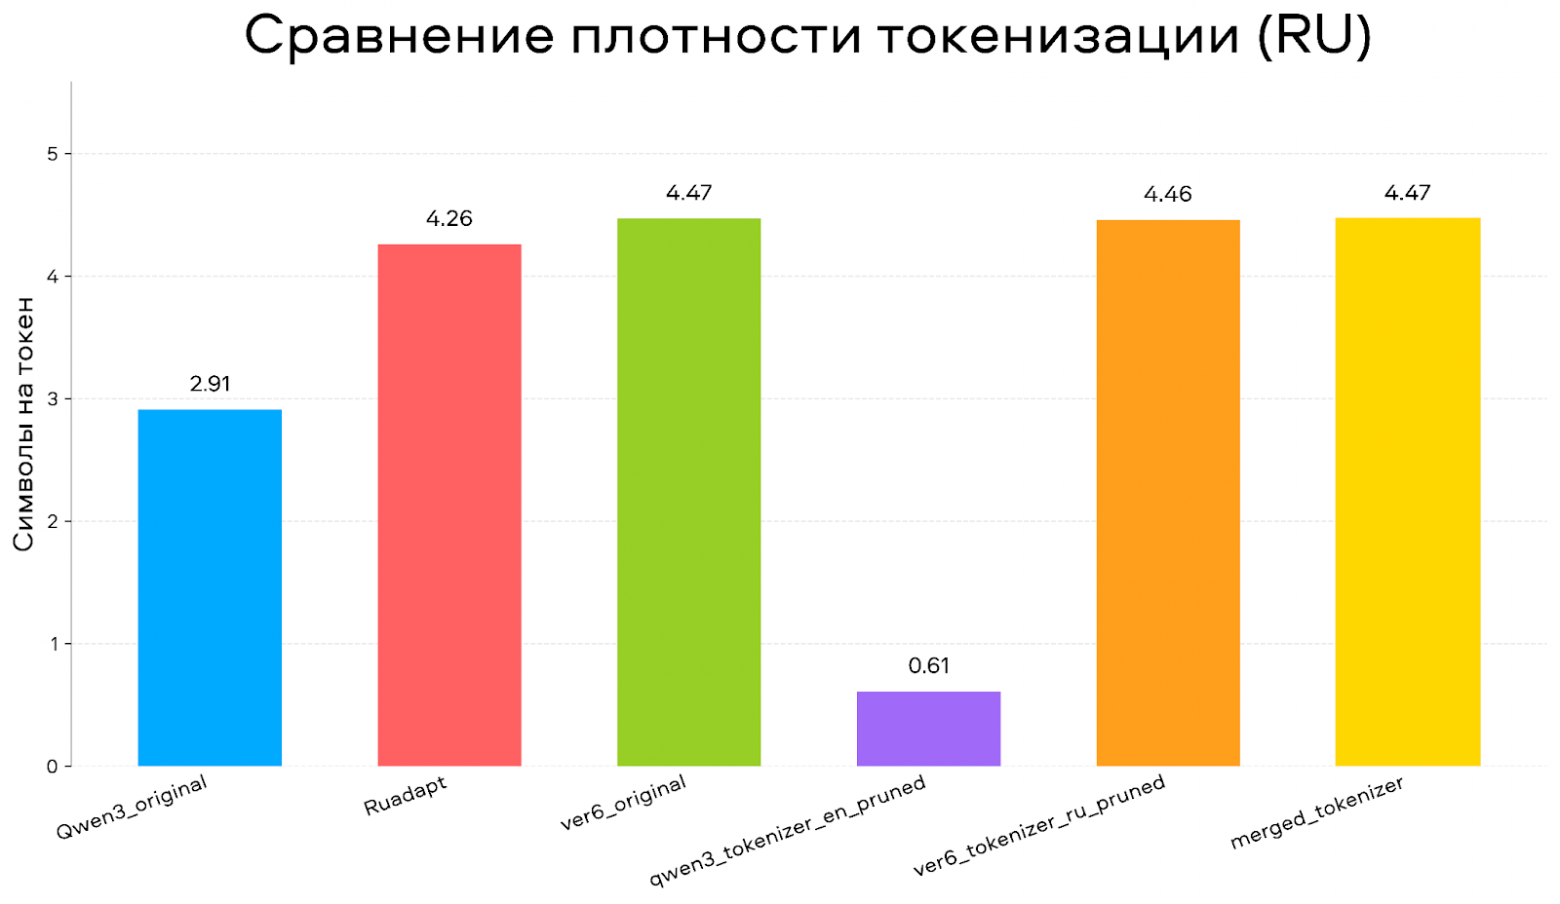
Для merged_tokenizer показано 4,47 символа на токен против 2,91 у Qwen3_original на русском корпусе.
Источник: Анастасия Рысьмятова · Авито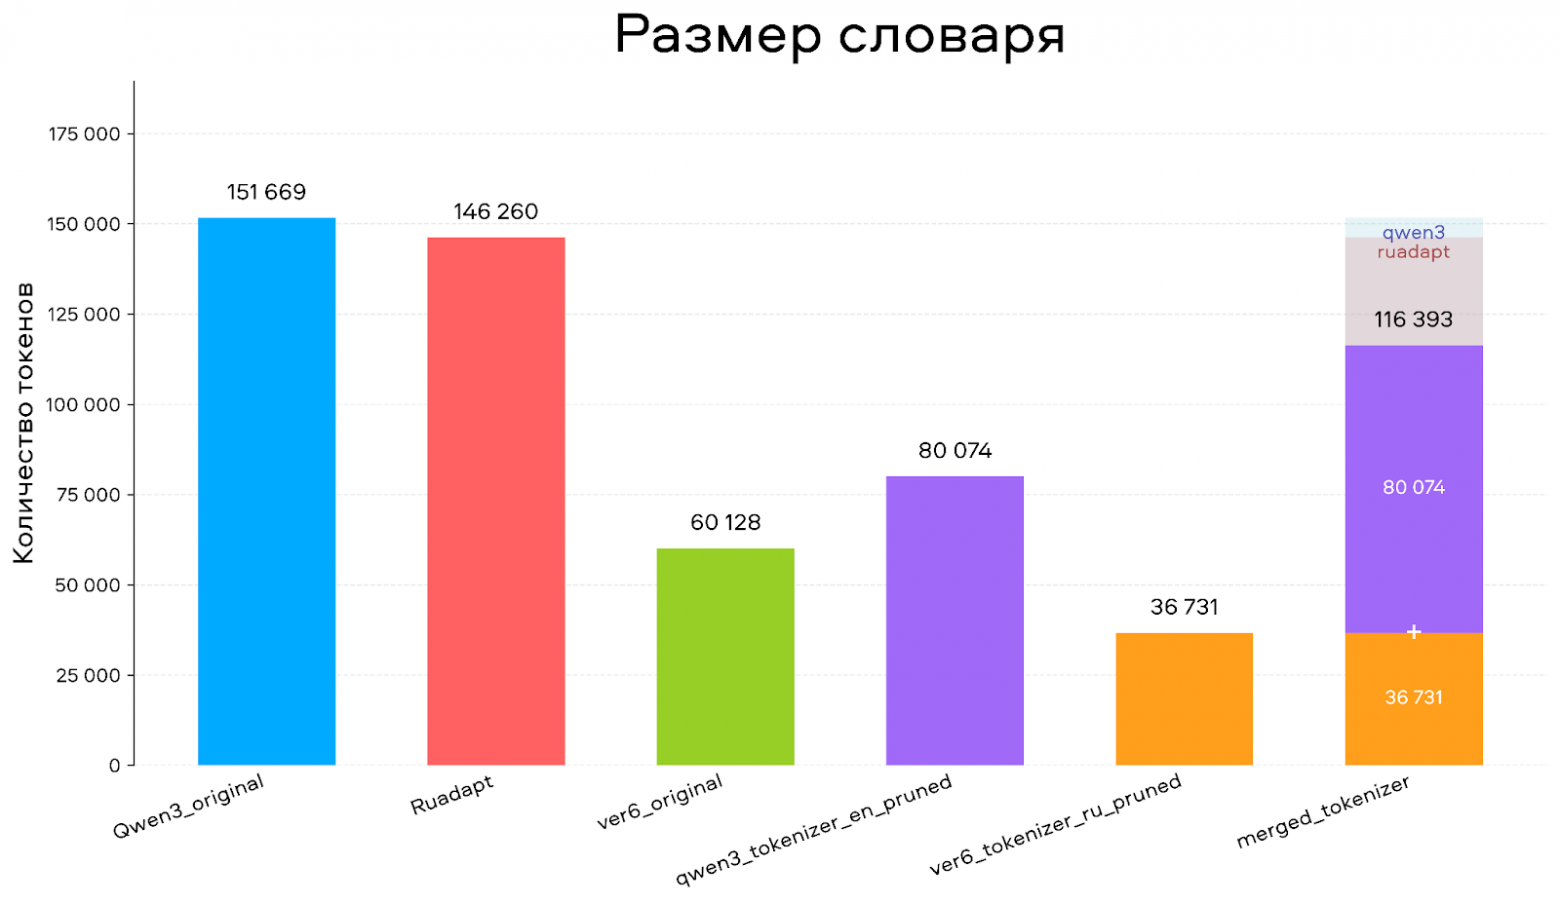
На графике итоговый словарь подписан 116 393; части — 80 074 и 36 731. Не складываем подписи в новый итог: их несогласованность источник не поясняет.
Источник: Анастасия Рысьмятова · АвитоКак сохранить старые эмбеддинги и обучить только новые строки
После merge токены, пришедшие из исходного Qwen3, можно инициализировать его же эмбеддингами. Эти векторы уже согласованы с остальными весами сети, поэтому на freeze-этапе их важно не испортить. Новые русские токены, наоборот, должны получить новые векторы и адаптироваться под существующую модель. Та же логика относится к lm_head — выходному слою, который превращает скрытое представление в оценки токенов словаря.
Обычное requires_grad=False здесь не решает задачу. В PyTorch вся таблица эмбеддингов хранится одним параметром-матрицей, а requires_grad переключается для параметра целиком. Команде же нужно оставить обучаемыми новые строки и зафиксировать старые.
Первый механизм — gradient hook: функция, которую PyTorch вызывает во время backward. Hook получает градиент матрицы и зануляет строки с ID старых токенов. Это предотвращает обычное градиентное обновление выбранных строк. В практическом описании hook ставят и на input embeddings, и на lm_head.
# Псевдокод из статьи: идея частичной заморозки строк, не универсальная готовая реализация
def make_row_zero_hook(token_ids):
    def hook(grad):
        idx = to_device(token_ids, grad.device)
        return zero_rows(grad, idx)
    return hook

def install_freeze_hooks(model, token_ids, include_lm_head=True):
    hook = make_row_zero_hook(unique_sorted(token_ids))
    get_input_embeddings(model).weight.register_hook(hook)
    # В рабочей схеме статьи hook также ставится на lm_head.
Но нулевого градиента недостаточно из-за AdamW. Этот оптимизатор отдельно применяет weight decay — усадку веса, не являющуюся частью градиента функции потерь. Поэтому строка может двигаться даже при нулевом gradient.
В записи статьи первый вычитаемый член — обычный шаг оптимизатора, второй — отдельный weight decay. Нулевой gradient устраняет не все изменения веса.
Отсюда нужны две защиты старых строк. Hook обнуляет их градиент и не даёт обычному шагу оптимизатора менять векторы. Отдельно Trainer исключает embedding weights из списка параметров, к которым применяется weight decay. Без второго шага старые строки всё равно постепенно сдвигались бы.
# Псевдокод из статьи: отключение weight decay для эмбеддингов
class NoDecayEmbeddingsTrainer(Trainer):
    def get_decay_parameter_names(self, model):
        decay = base_decay_list(model)
        decay -= all_embedding_weight_names(model)
        return sorted(decay)

old_token_ids = collect_old_token_ids(tokenizer, old_tokenizer)
install_freeze_hooks(model, old_token_ids, include_lm_head=True)
trainer = NoDecayEmbeddingsTrainer(model=model, args=training_args, ...)
trainer.train()
После этого freeze действительно концентрируется на новых токенах, не размывая уже выученные представления старых. Затем на unfreeze-этапе модель можно обучать целиком. Важно, что это решение относится к стадии адаптации весов; оно не является частью выполнения уже готовой модели на пользовательском запросе.
Адаптация токенизатораКорпус для адаптации токенизатора: объём, языки и тематики
Для адаптации команда собрала около 700 млрд токенов, но в итоговом запуске и экспериментах использовала выборку 150 млрд. По словам авторов, это заметно сокращало время адаптации без значимого ухудшения метрик. Все данные проходили внутренний пайплайн фильтрации и дедупликации.
Баланс нужен не только между русским и английским. Авторы отдельно сохраняют код и другие языки, чтобы адаптация под русский не превратилась в узкое дообучение, которое забывает прежние способности. В корпус также подмешивали SFT-датасет.
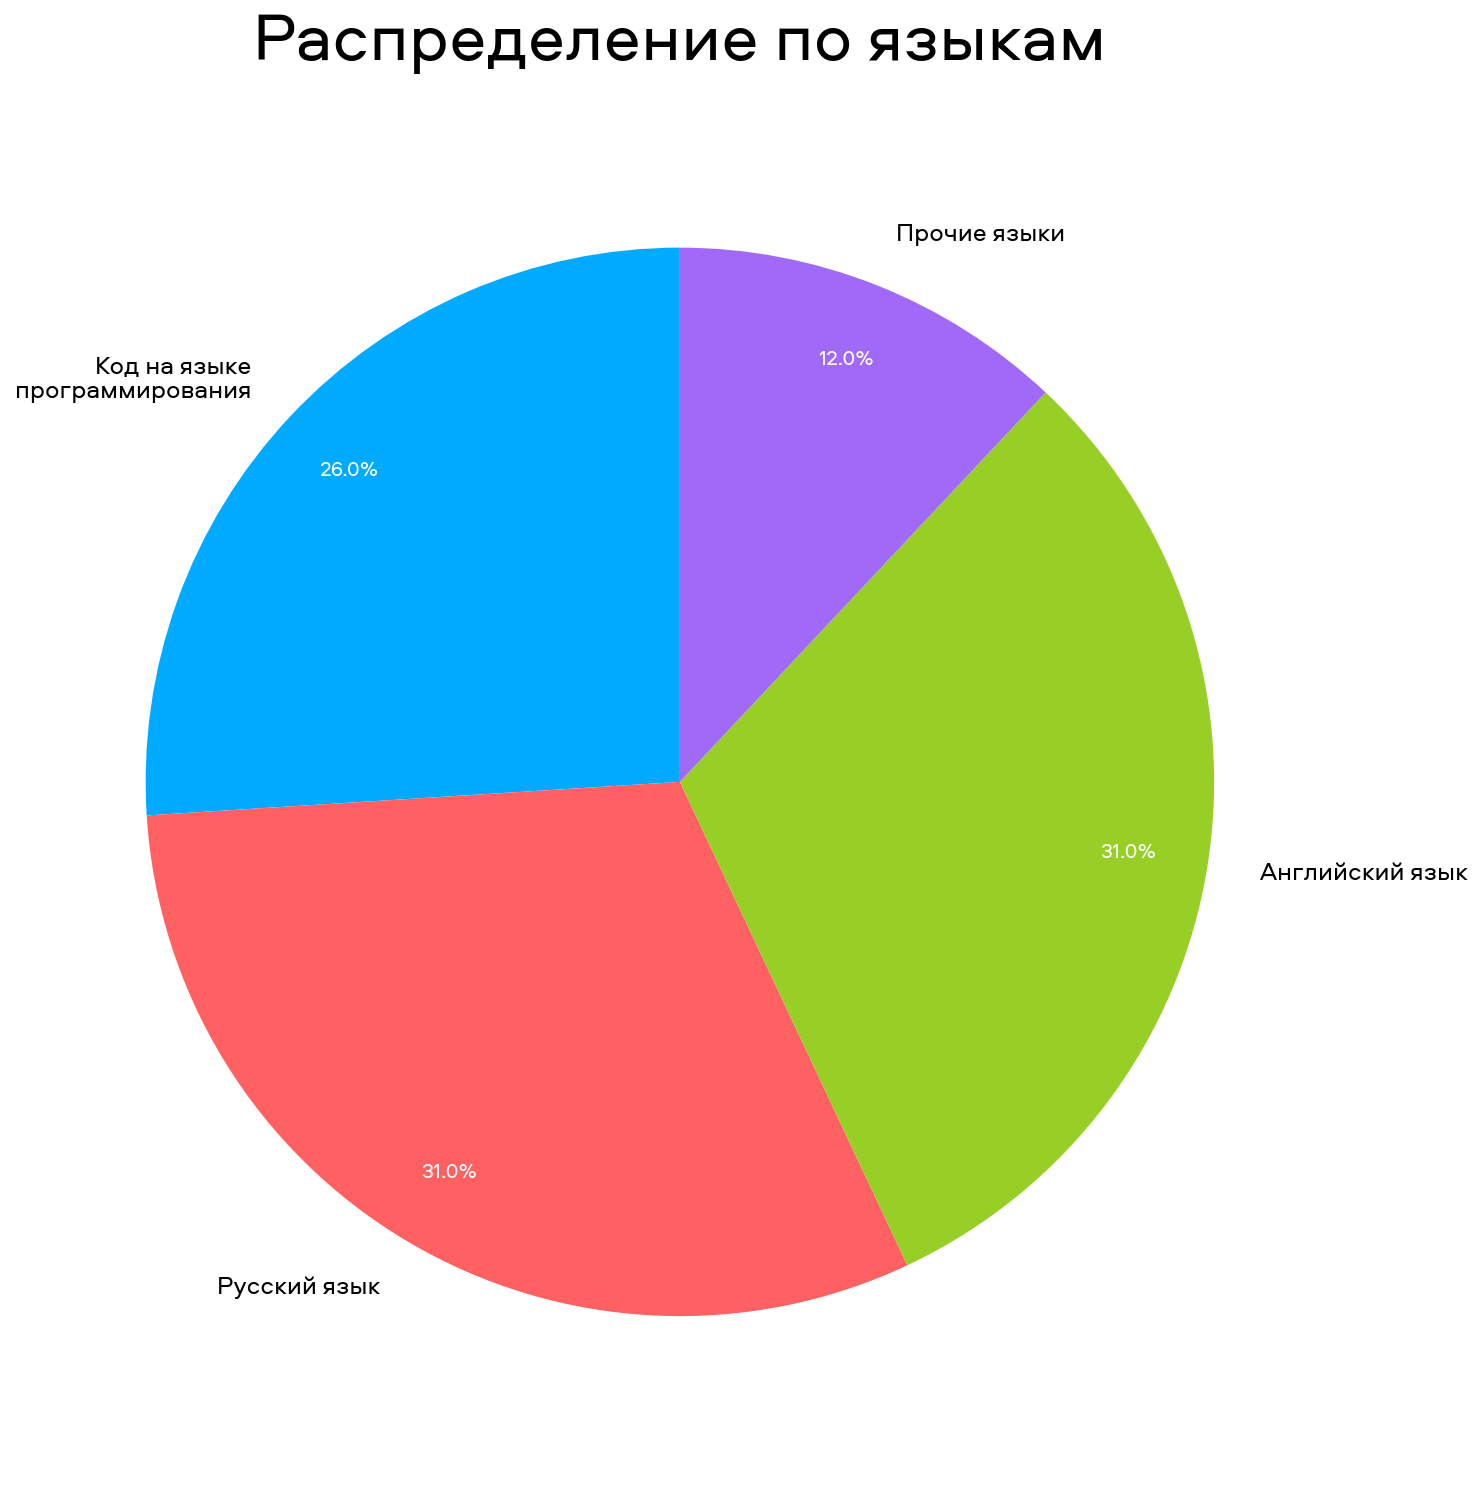
31% русского, 31% английского, 26% кода и 12% прочих языков — распределение на исходном графике.
Источник: Анастасия Рысьмятова · Авито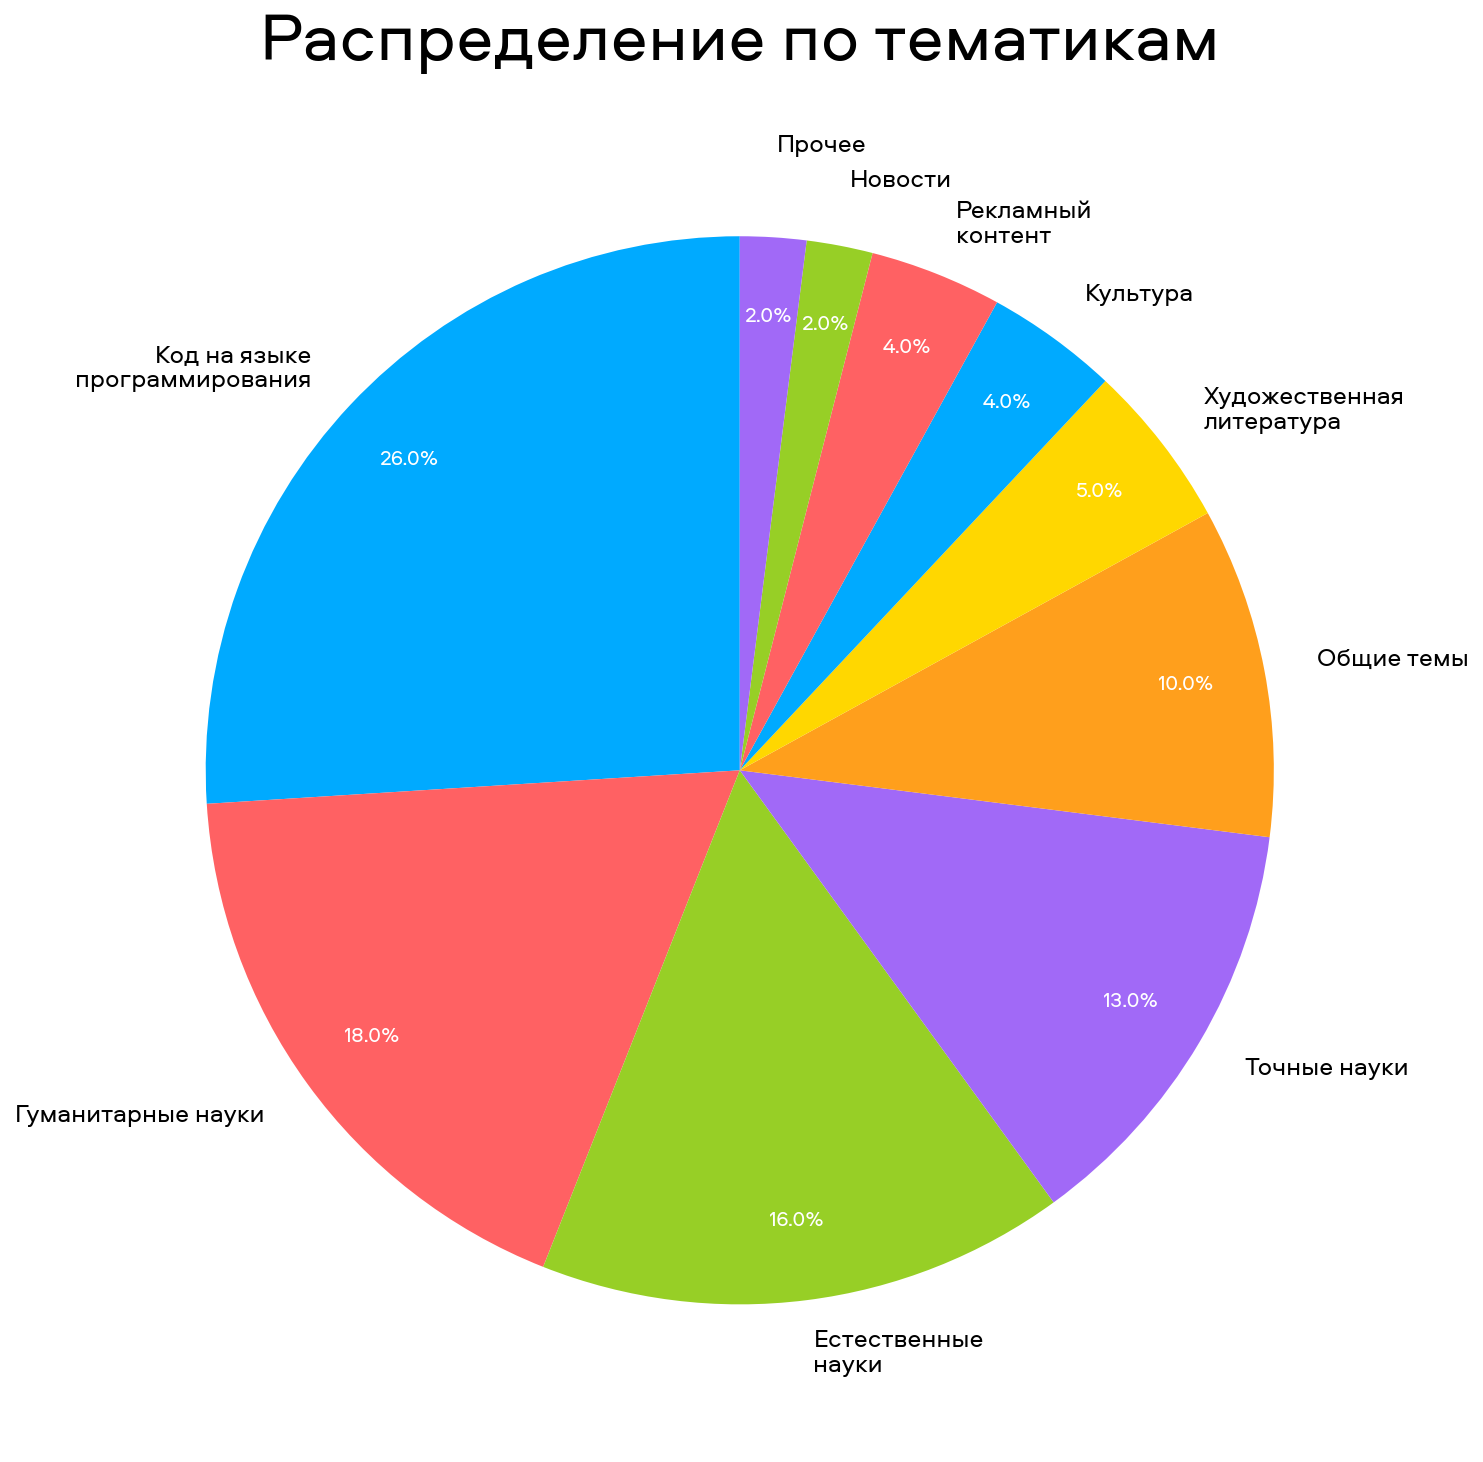
Код, гуманитарные, естественные и точные науки, общие и другие темы входят в корпус адаптации. График описывает данные, не пользовательский трафик.
Источник: Анастасия Рысьмятова · АвитоSFT: научить модель следовать инструкции и вести диалог
SFT, supervised fine-tuning, — дообучение на примерах, где модели показывают желаемый ответ. Здесь его задача была базовой: научить A-vibe отвечать на вопросы, вести диалог и понимать system prompt. Набор содержал более 800 тысяч примеров.
Качество SFT-данных контролировали через LLM as a judge — другую языковую модель, которая по заданным критериям оценивает сгенерированный пример. Особенно много внимания уделили function calling: способности модели не только написать текст, но и сформировать структурированный вызов разрешённого инструмента.
SFT этапКак генерировали синтетические multi-turn диалоги с инструментами
Для function calling команда не ограничилась одиночными парами «запрос — вызов функции». Целью были многоходовые, или multi-turn, диалоги, где пользователь уточняет задачу, агент выбирает инструменты, получает результаты API и продолжает разговор. Подход опирался на APIGen-MT и на идею разнообразия через большое множество персон.
- 01
Описание инструментов
Команда парсит описания ручек сервисов Авито.
- 02
Формат tools
LLM переводит описания ручек в OpenAI-формат описания инструментов.
- 03
Проверка схемы
Для каждого описания выполняется запрос в OpenAI API; отсутствие ошибки считается валидацией формата.
- 04
Персона и набор инструментов
Сэмплируются несколько tools и персона из набора, использованного авторами идеи 1,000,000,000 Personas.
- 05
Среда и политика
LLM создаёт домен, роли, возможности инструментов, ограничения их использования, описание данных и правила поведения агента с персонализацией.
- 06
План конкретного диалога
LLM создаёт system prompt агента, цель пользователя и ожидаемый план развития разговора.
Полученную конфигурацию проверяет LLM-судья. Он даёт фидбек, конфигурация переписывается и снова оценивается. Цикл повторяют до пяти раз; если после пятой итерации judge всё ещё считает конфигурацию некачественной, пример отбрасывается.
Сам разговор генерируется по одной реплике за запрос, а не целиком одним длинным ответом. Авторы используют это, чтобы уменьшить галлюцинации и сделать полноту и сложность диалога ближе к реальным взаимодействиям.
- 01
Модель пользователя
Получает персону и цель пользователя и генерирует следующую пользовательскую реплику.
- 02
Модель ассистента
Отвечает и при необходимости формирует вызов инструмента.
- 03
API-эмулятор
Принимает описание инструмента и запрос, затем возвращает синтетический результат вызова API.
- 04
Модель остановки
Решает, достигнута ли цель и пора ли завершать диалог.
- 05
Финальный LLM-судья
После завершения проверяет корректность использования tools и соответствие диалога заранее заданному плану.
GRPO: три отдельные цели вместо одного общего «улучшения»
GRPO здесь используется как этап обучения с вознаграждением: модель генерирует несколько ответов, получает вознаграждение (reward) по правилам конкретной задачи, а обучение повышает вероятность более удачных вариантов. Команда отдельно работала с function calling, кодом и математикой.
По наблюдению авторов, GRPO на одном из этих доменов не давал значимого ухудшения метрик в других доменах, поэтому запуски проводили последовательно. Это эмпирическое наблюдение именно их экспериментов; итоговые таблицы всё равно показывают, что отдельные метрики после GRPO и DPO могут снижаться.
GRPO этапGRPO для function calling: строгий бинарный reward
Из синтетических multi-turn диалогов делали пары «префикс диалога → следующий ответ ассистента». Добавляли irrelevant-примеры, где вызов функции не нужен, чтобы модель училась не только правильно вызывать инструмент, но и вовремя отказываться от вызова.
Reward был rule-based, то есть вычислялся правилами, без LLM-судьи: 1 только при полном совпадении вызова функций с эталоном и 0 при любом несовпадении. Авторы специально не дают частичную награду только за правильный формат или отдельные поля, чтобы модель обучалась полностью корректному действию.
Таблицу можно прокрутить по горизонтали.
Эти два агрегата показывают сильный локальный эффект GRPO, но не означают, что каждая подзадача BFCL выросла. В полном разрезе ниже есть, например, просадки в multi-turn сценариях и разные направления изменений relevance/irrelevance detection.
Function CallingGRPO для кода: большой запуск без заметного выигрыша
Для кода собрали 120 тысяч алгоритмических задач на Python. В каждой было от 3 до 450 тестов. Сгенерированное решение запускали на тестах: пройденные тесты давали положительную награду, а ошибки, таймауты и непройденные проверки — штраф.
Несмотря на объём запуска, значимого улучшения на выбранных бенчмарках авторы не зафиксировали. Они перечисляют HumanEval, MBPP, MERA Code RuHumanEval, MERA Code CodeCorrectness и MERA Code StruCom. Поэтому этот эксперимент нельзя описывать как успешный GRPO для программирования: отрицательный результат — часть итоговой картины.
GRPO этап — КодGRPO для математики: почему слишком простые задачи мешают обучению
Для математики использовали 10 тысяч задач на английском и ещё 10 тысяч, переведённых на русский. Reward был бинарным: 1, если финальный ответ совпал с golden answer, и 0 иначе. Кандидатов генерировали через vLLM в colocated-режиме; по словам авторов, это ускорило обучение в несколько раз.
Большие значения temperature делали обучение сильно нестабильным; в диапазоне примерно 0,3–0,7 авторы существенной разницы не увидели. Увеличение num_generations, то есть числа кандидатов на пример, заметно улучшало качество.
Ключевой приём — убрать слишком лёгкие задачи. Для каждой задачи считали pass rate по восьми генерациям. Если модель решала задачу 8 раз из 8, пример исключали. Причина связана с advantage: когда все варианты получают одинаково высокий reward, разница между ними почти нулевая и обучению нечем направленно обновлять политику.
Таблицу можно прокрутить по горизонтали.
DPO: пары предпочтений для безопасности и качества ответа
DPO, Direct Preference Optimization, — дообучение по парам ответов, где один выбран как предпочтительный (chosen), а другой как хуже подходящий (rejected). В A-vibe этим этапом хотели повысить безопасность, структурированность и понятность ответов.
Таблицу можно прокрутить по горизонтали.
- 01
Восемь ответов целевой модели
Для каждого вопроса собирали 8 генераций A-vibe с конфигурацией, подобранной под полноту и разнообразие ответов.
- 02
Выбор лучшего и худшего
Большая открытая модель с отдельным промптом и критериями для каждого набора выбирала chosen и rejected.
- 03
Баланс длин
Количество пар с длинными и короткими ответами уравновешивали по коэффициенту разницы длин.
Команда также проверила более простой способ: брать ответ большой открытой модели как chosen, а ответ целевой модели как rejected. Этот вариант, по словам авторов, качественных результатов не дал. Поэтому финальная схема строит предпочтение между несколькими ответами самой целевой модели, а внешняя модель используется как разметчик.
DPO этапКак оценивали DPO и где уже видна неоднозначность
Помимо общих бенчмарков команда сделала два доменных набора с LLM as a judge: safe и unsafe. Для каждого были свои промпты и подробные критерии качества. Эти наборы использовали для наблюдения за обучением и выбора конфигурации DPO.
В тексте статьи результат RU_ARENA сформулирован как рост с 77,7 до 79,2 на arena-hard-v0.1 с судьёй gpt-4-1106-preview. Однако ниже в таблице для того же судьи указано 79,9 у avibe_dpo_final. Источник не объясняет расхождение, поэтому обе версии нужно сохранять: 79,2 — в описании этапа DPO, 79,9 — в итоговой таблице.
ОЦЕНКА МОДЕЛИКак читать бенчмарки A-vibe
Замеры проводились с жадными параметрами генерации. Qwen3-8B и RuadaptQwen3-8B-Hybrid измеряли в режиме no_think. Авторы отдельно предупреждают: методика конкретного бенчмарка может отличаться от чужих публикаций из-за версии данных, формулировки system prompt и числа few-shot примеров.
Для воспроизводимости команда прикладывает часть данных для GPQA Diamond RU, Math500 RU, RuDROP и RU BFCL, а также изменения в lm-evaluation-harness. Поэтому сравнивать числа лучше внутри одной таблицы статьи и одной методики, а не механически с внешними лидербордами.
Ни одна из следующих таблиц сама по себе не доказывает внедрение соответствующей способности во все продукты Авито. Это офлайн-измерения моделей. В частности, наличие внутренних бенчмарков по объявлениям, поиску и параметрам товара не является заявлением об отдельном бизнес-эффекте A-vibe.
Метрики качества AvibeОбщие знания и внутренние задачи Авито: рост не монотонный
Таблицу можно прокрутить по горизонтали.
Здесь post-training не даёт равномерного роста. Например, GPQA Diamond RU снижается с 0,364 после SFT до 0,343 после GRPO и остаётся там после DPO; GPQA Diamond EN падает до 0,318. Baby MMLU в статье считается через перплексию: question и варианты ответов объединяются, а выбирается вариант с минимальной perplexity.
Таблицу можно прокрутить по горизонтали.
На внутренних задачах видно тот же компромисс: I2P растёт заметно, но OKK после SFT проседает на GRPO и не возвращается к исходному значению после DPO; relevance после DPO немного ниже 0,962. Поэтому корректный вывод — улучшение части целевых способностей при сохранении отдельных регрессий, а не «каждый этап делал модель лучше по всем метрикам».
Общие знания о миреSTEM, DOoM и русский язык: что улучшилось, а что просело
В STEM-таблице pass@10 — метрика кодовых задач, а avito_stash измеряется через perplexity (ppl): авторы маскировали часть внутреннего кода и оценивали способность модели предсказывать скрытый фрагмент. Для perplexity меньшее значение лучше.
Таблицу можно прокрутить по горизонтали.
Математический GRPO действительно отражается в Math500 RU: 0,602 → 0,692. Но кодовая картина обратная: RuHumanEval падает 0,445 → 0,390 → 0,378, а perplexity внутреннего stash ухудшается относительно SFT 2,211 → 2,335 → 2,385. Это согласуется с отдельным выводом авторов, что code-GRPO не дал значимого выигрыша.
Таблицу можно прокрутить по горизонтали.
Для DOoM в статье нет промежуточных SFT/GRPO значений A-vibe, поэтому по этому набору нельзя приписать прирост конкретному этапу post-training. Видно только сравнение финальной модели с двумя внешними базами в рамках этой методики.
Таблицу можно прокрутить по горизонтали.
RuDROP растёт после GRPO 0,407 → 0,426, а затем падает после DPO до 0,394. RU Facts у финальной A-vibe — 0,718, то есть ниже как SFT-версии, так и исходного Qwen3-8B 0,724. Эти просадки важны для честного чтения итогов.
Математические и кодовые способности моделей (STEM)Function calling: высокий общий прирост и слабые места multi-turn
GRPO прибавляет почти десять процентных пунктов относительно A-vibe SFT, но финальная DPO-версия немного откатывается, а исходный Qwen3-8B в этой таблице всё ещё выше финальной A-vibe. Поэтому корректное утверждение — GRPO сильно улучшил FC относительно собственного SFT-бейзлайна.
Таблицу можно прокрутить по горизонтали.
Overall растёт 40,22% → 49,25% после GRPO, а irrelevance detection почти удваивается. Но multi-turn accuracy падает 4,88% → 3,50% → 3,12%, Multi Turn Miss Func после GRPO тоже резко ниже, а relevance detection после DPO снижается до 88,89%. Один общий процент скрывает разные режимы поведения.
Работа с функциямиMERA и RU_ARENA: разные судьи дают разную картину
Таблицу можно прокрутить по горизонтали.
После GRPO растут MERA text, общий CODE и оба индустриальных столбца, но private CODE снижается. После DPO text и общий CODE немного откатываются, медицина падает 0,612 → 0,565, сельское хозяйство 0,521 → 0,483, а private CODE возвращается к 0,367. Это ещё один пример немонотонного post-training.
Таблицу можно прокрутить по горизонтали.
Для этого судьи итоговая таблица показывает рост A-vibe SFT 77,7 → DPO 79,9. Но в прозе раздела DPO автор отдельно пишет 77,7 → 79,2. Это внутреннее расхождение исходника; выбирать одну цифру вместо другой без объяснения нельзя.
Таблицу можно прокрутить по горизонтали.
С другим судьёй картина меняется: GRPO-версия A-vibe получает 93,3 и заметно выше DPO 89,7. Поэтому нельзя говорить, что DPO «улучшил RU_ARENA вообще» — вывод зависит от judge и конкретной методики измерения.
MERAПочему A-vibe быстрее Qwen3 ещё до спекулятивного декодинга
Скорость измеряли на примерах из SFT-датасета, состоящего преимущественно из русскоязычных текстов. У A-vibe более плотный русский токенизатор, поэтому один и тот же текст требует меньше входных и выходных токенов. Кроме того, размер модели после изменения словаря указан как 7,9B параметров против 8,2B у Qwen3-8B.
На одинаковых русскоязычных примерах авторы сообщают в среднем 15–25% ускорения относительно исходной Qwen3-8B; на отдельных задачах — до двух раз. Это результат их данных и конфигурации, а не универсальная скорость модели на любом трафике.
Бенчмарки скорости AvibeEAGLE-3: ускорение зависит от размера параллельной нагрузки
Спекулятивный декодинг ускоряет генерацию с помощью небольшой draft-модели. Она заранее предлагает несколько следующих токенов, а основная модель проверяет эти предложения. Чем больше предложений принимается, тем больше шагов последовательной генерации удаётся сэкономить.
В статье используется EAGLE-3. По объяснению авторов, в отличие от EAGLE-2 он прямо генерирует токены вместо предсказания будущих hidden states и объединяет признаки нескольких слоёв target-модели — ранних, средних и поздних. Для исполнения команда использовала реализации в vLLM и SGLang; на момент написания статьи EAGLE-3 у них быстрее работал через SGLang.
Draft-модель обучали на примерно 100 млн токенов из SFT-данных, преимущественно русских и близких основной модели по домену и стилю. Средняя acceptance length — число корректно предложенных draft-моделью токенов — составила 2,4 против 2,1 у EAGLE-2.
Таблицу можно прокрутить по горизонтали.
Авторы отдельно отмечают расхождение между своими максимумами до 2,7× и внешним заявлением до ~6,5×. Их гипотеза: очень большие ускорения легче получить в узком домене со специально переобученной draft-моделью и высокой acceptance length. Внутренний замер Авито показывает, что с ростом батча дополнительный проход небольшой модели перестал давать ускорение. Это наблюдение данного сценария, а не универсальный предел спекулятивного декодирования.
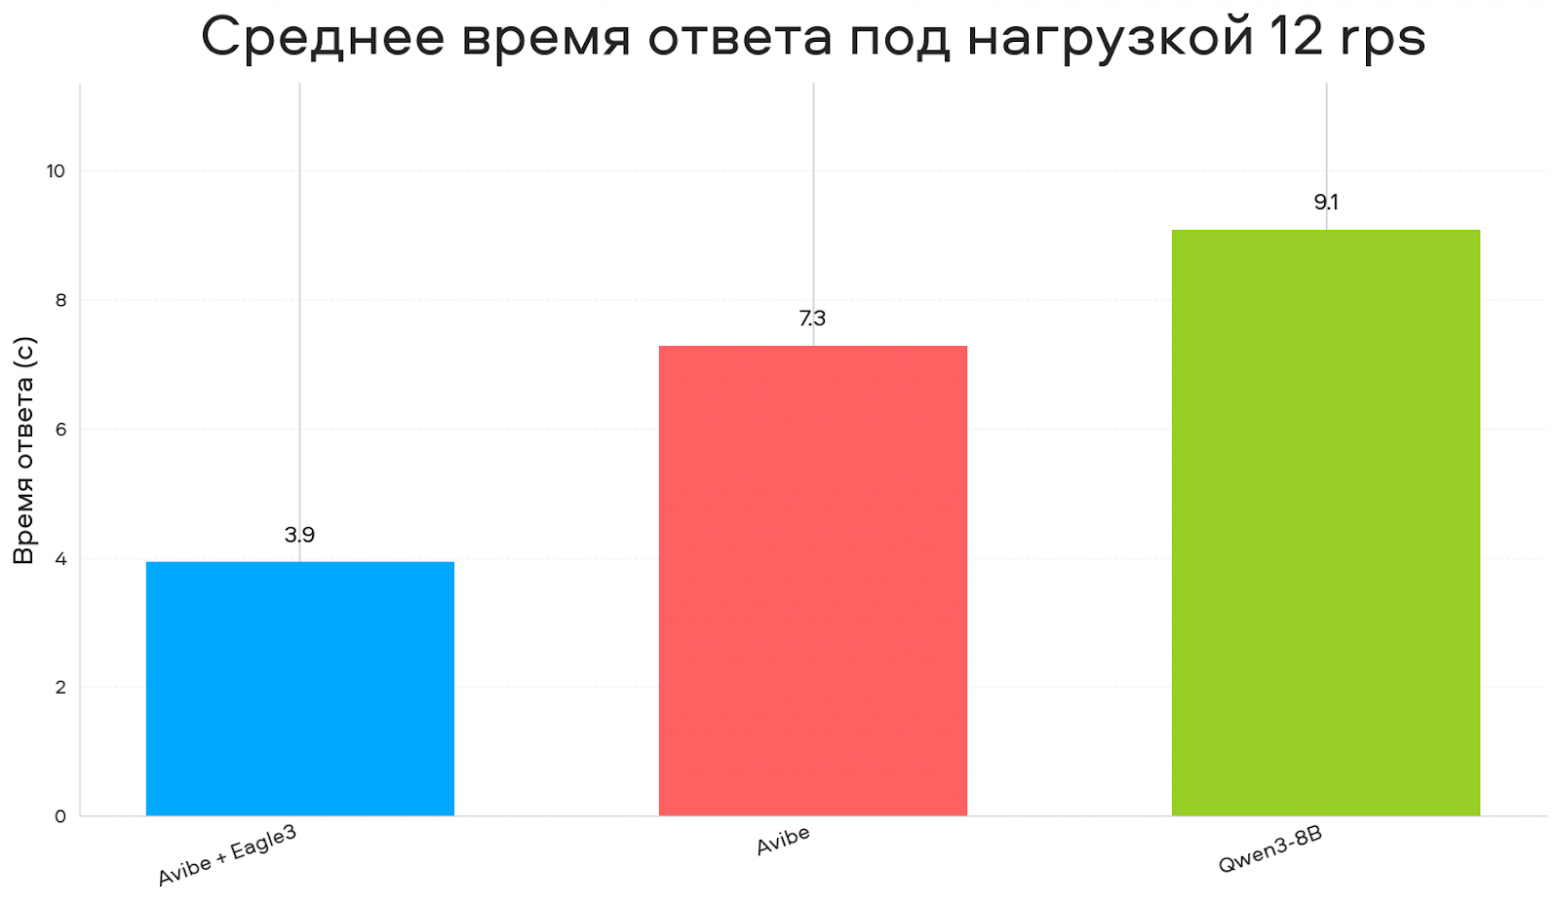
На примерах преимущественно русского SFT-датасета: Avibe + Eagle3 — 3,9 с, Avibe — 7,3 с, Qwen3-8B — 9,1 с. Это среднее полное время ответа, не задержка первого токена и не универсальная гарантия.
Источник: Анастасия Рысьмятова · АвитоИтог: от адаптации Qwen3 до применения готовой A-vibe
A-vibe появилась не из идеи обучить LLM с нуля, а из более узкого выбора: сохранить pretrain Qwen3 и исправить неэффективную работу с русским. Полная подмена токенизатора плохо сохраняла уже выученные представления, поэтому команда объединила английские и кодовые токены Qwen3 с русской частью своего словаря. Старые embeddings и lm_head на freeze-этапе защищали двумя способами: зануляли их градиенты hook-ом и отдельно исключали embeddings из AdamW weight decay.
- 01
Запрос
Сервис получает текст, system prompt и при необходимости описания доступных инструментов.
- 02
Токенизация
Объединённый словарь переводит вход в токены; на русском их обычно меньше, чем у исходного Qwen3.
- 03
Применение модели
Готовая A-vibe обрабатывает вход и определяет продолжение с использованием уже подготовленных весов.
- 04
Получение продолжения
При обычной генерации модель выдаёт токены последовательно; при EAGLE-3 небольшая модель предлагает токены, а A-vibe проверяет их. Выигрыш зависит от нагрузки.
- 05
Результат
Вызывающий сервис получает ответ или function call и применяет собственную прикладную логику.
Обучение происходило заранее. Токенизатор адаптировали на 150 млрд токенов, затем провели SFT на более чем 800 тыс. примеров, включая синтетические multi-turn диалоги с API-эмуляцией и LLM-судьёй. GRPO отдельно улучшал function calling и математику, но кодовый запуск не дал значимого выигрыша. DPO строился на chosen/rejected парах для безопасных и небезопасных вопросов; упрощённый вариант с ответом большой модели как chosen не сработал.
Результаты остаются компромиссными: часть русских, FC и математических метрик растёт, но отдельные языковые, кодовые, multi-turn и индустриальные показатели проседают. RU_ARENA зависит от судьи, а текст статьи расходится с таблицей: 79,2 против 79,9. На русскоязычных SFT-примерах A-vibe быстрее Qwen3; EAGLE-3 даёт до 2,7× на одиночном запросе и около 1,9× при 12 rps, но теряет выигрыш к batch 64. Отдельного A/B-бизнес-эффекта именно A-vibe статья не измеряет.
Бенчмарки скорости Avibe