Разбор готов
Яндекс Музыка: как кандидат выбирает важные события из истории слушателя
Слушатель меняет поведение: пропускает трек, ставит лайк или переключает настройки «Моей волны». Вектор предпочтений, рассчитанный раз в сутки, ещё не знает об этой реакции. Но даже пересчёт на каждый запрос не устраняет вторую проблему: один общий вектор сжимает всю историю одинаково, хотя для оценки конкретного трека важны разные её части. При выборе рок-композиции, например, полезно внимательнее посмотреть на прежние прослушивания рока. В докладе Пётр Зайдель рассказывает, как команда Яндекс Музыки добавила к реалтайм-ARGUS механизм, позволяющий каждому кандидату обращаться к состояниям истории. Дорогая обработка истории выполняется один раз, а дополнительный слой выбирает полезную информацию отдельно для каждого трека. Такой подход называется target-aware: представление, используемое при оценке, учитывает именно того кандидата, которого сейчас ранжируют. Разберём, как это изменение связано с предварительным обучением, попарным ранжированием, устройством сервиса и результатами A/B-тестов.
Глава полезна разработчикам рекомендательных систем и инженерам, которые применяют последовательные модели при ограниченном времени ответа. Особенно важны связь обучающих задач с архитектурой, различие между свежестью истории и свежестью весов, а также цена взаимодействия длинной истории с тысячами кандидатов. Достаточно понимать, что нейросеть превращает входные данные в числовые векторы; специальные термины объясняются по ходу разбора.
Видео · на русском
Ранжирование в реалтайме: target-aware-архитектура Яндекс Музыки / Пётр ЗайдельПётр Зайдель · Опубликовано: 23 октября 2025 г.
Исходный доклад · Открыть оригинал
Почему «Моей волне» нужна последняя реакция слушателя
«Моя волна» — персональный музыкальный поток, который подстраивается под интересы пользователя во время прослушивания. Её можно настроить на знакомые или незнакомые треки, запустить по артисту, отдельной композиции или жанру. Поэтому системе мало знать, какую музыку человек любит вообще: нужен ещё контекст текущего выбора.
Когда пользователь включает волну, приложение обращается к бэкенду Музыки — серверной части продукта. Там собирают последнюю историю, настройки волны и служебные сведения: наличие подписки, геопозицию, версию приложения. С этими данными вызывают сервис рекомендаций. Он возвращает пять треков, которые могут включиться следующими. Наличие сведений в запросе сервиса само по себе не означает, что каждый такой признак входит в ARGUS: состав входного события модели будет описан отдельно.
Лайк или пропуск трека запускает новый запрос за следующей пачкой. Следующий включаемый трек уже может учитывать только что полученную обратную связь. Таким образом, пачка из пяти треков не превращает выдачу в неизменную очередь, которую нужно дослушать прежде, чем алгоритм отреагирует на пользователя.
Рядом работает офлайн-контур: в нём заранее готовят данные, обучают модели и выполняют вычисления, которые не должны задерживать пользовательский запрос. В частности, тяжёлые офлайн-трансформеры обычно пересчитывают представления пользователей раз в день. Результаты сохраняют в хранилище «ключ — значение», откуда их можно быстро получить при ранжировании. Предварительная подготовка и обучение отделены от непосредственного выбора следующих треков.
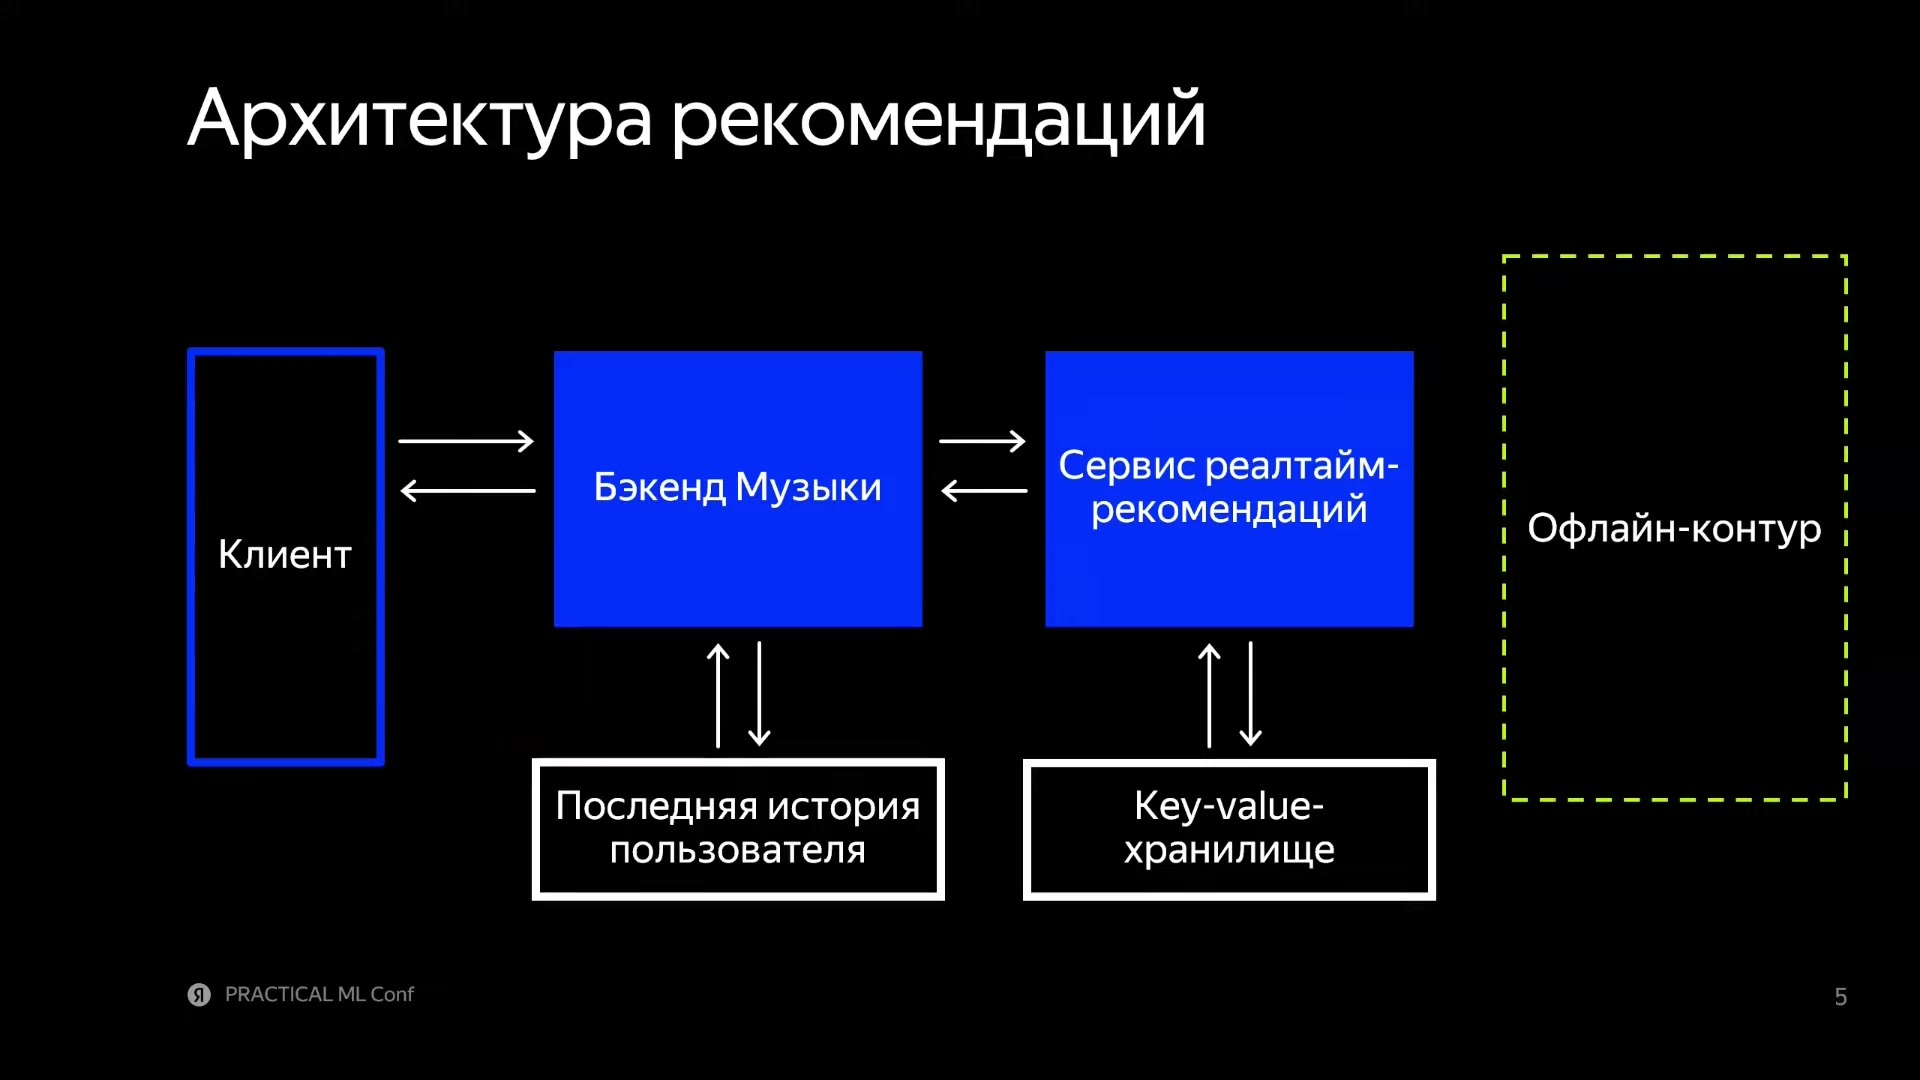
Онлайн-сервис использует свежую историю слушателя и key-value-хранилище; офлайн-контур готовит часть данных заранее.
Источник: Пётр Зайдель · Яндекс МузыкаКак сто миллионов треков превращаются в пять
Прежде чем применять дорогую модель, система несколько раз сокращает число вариантов. Это многоэтапная воронка: ранние стадии работают с большим каталогом и должны быть дешёвыми, поздние могут позволить себе более сложную оценку. Ранжирование здесь означает упорядочивание треков по тому, насколько они подходят пользователю.
Таблицу можно прокрутить по горизонтали.
У источников кандидатов разная сложность. Можно вернуть часть недавно прослушанного или подобрать композиции артистов, которых пользователь отмечал лайками. Можно использовать матричное разложение — модель, представляющую взаимодействия слушателей и треков через векторы, — либо трансформер. Смысл этой стадии не в окончательном порядке, а в получении достаточно небольшого набора подходящих вариантов.
Облегчённый CatBoost быстро оставляет 3000 треков. CatBoost строит оценку с помощью ансамбля деревьев решений; у финальной версии больше деревьев и признаков, включая результаты тяжёлых нейросетей. Затем система последовательно набирает пять треков, учитывая ограничения выдачи. Пример автора — не повторять в пачке треки одного артиста.
Нейросетевые модели в описанной системе служат источником сильных признаков для финального ранжирования. По словам автора, так проще внедрять новые модели и сохранять гибкость. Поэтому улучшение ARGUS не означает, что он заменил источники кандидатов, оба CatBoost и правила выдачи. Его место — внутри уже существующей системы оценки треков.
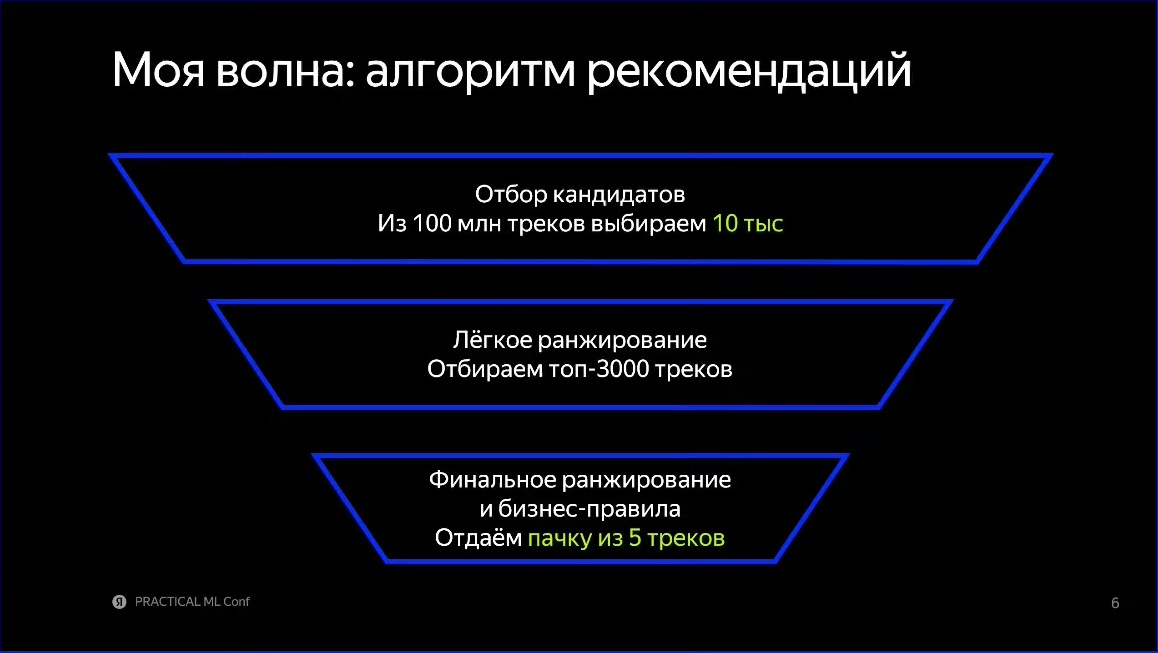
Из 100 млн треков выбирают 10 тысяч кандидатов, лёгкое ранжирование оставляет 3 000, финальное ранжирование и правила возвращают 5 треков. Это схема на момент доклада.
Источник: Пётр Зайдель · Яндекс МузыкаДве башни ARGUS: почему независимые векторы удобны
Основой изменения стала архитектура ARGUS, разработанная командой R&D рекомендаций Музыки. В рассматриваемом варианте это двухбашенная модель: одна часть обрабатывает пользователя, другая — трек-кандидат. «Башня» здесь означает отдельную нейросеть, а не отдельный сервер.
Пользовательская башня — трансформер, то есть модель, которая связывает события последовательности через механизм внимания. Она получает историю и строит вектор предпочтений пользователя в данный момент. Такой числовой вектор называют эмбеддингом: он представляет информацию о входе в форме, с которой дальше удобно работать модели.
Башня трека состоит из нескольких полносвязных слоёв. На вход поступают признаки кандидата; автор называет идентификаторы трека и артиста. На выходе получается вектор в том же пространстве, что и пользовательский. Итоговую оценку вычисляют скалярным произведением: соответствующие координаты двух векторов перемножают и складывают.
Этот способ называют поздним связыванием, потому что информация о пользователе и кандидате соединяется только в конце. Его сильная сторона — независимость вычислений. Векторы треков и пользователей можно заранее рассчитать и сохранить, а при запросе лишь прочитать их и получить оценки. Для офлайн-пользовательского вектора автор описывает обновление раз в сутки.
Экономия возникает не из-за отсутствия сложной модели, а из-за переноса её работы за пределы запроса. Внутри пользовательской башни может быть большой трансформер. Но при ранжировании уже не нужно заново пропускать через него историю для каждого трека. Дальнейшее развитие должно сохранить эту полезную общую обработку, одновременно сделав взаимодействие с кандидатом выразительнее.
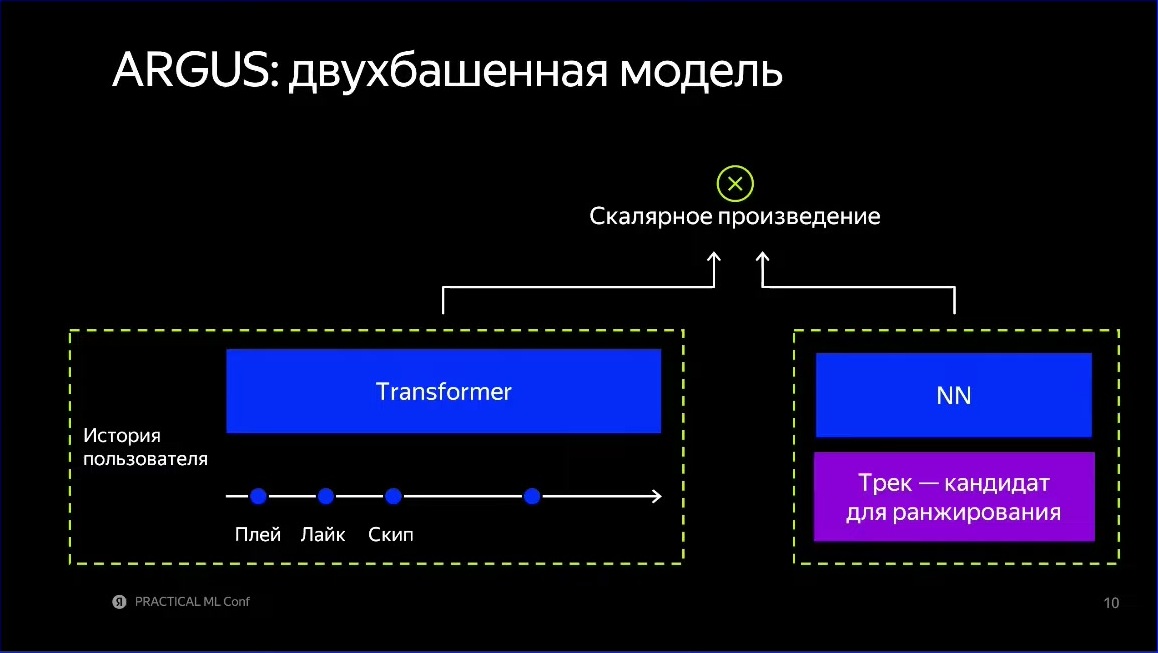
Трансформер кодирует историю, нейросеть — трек; итоговая оценка получается скалярным произведением. Кандидат ещё не выбирает важные события истории.
Источник: Пётр Зайдель · Яндекс МузыкаПредварительное обучение начинается с представления события
Обучение ARGUS состоит из двух стадий. Сначала модель получает общие знания о треках и поведении слушателей — это предварительное обучение, или pretrain. Затем её дообучают непосредственно под ранжирование «Моей волны». Разделение важно: умение предсказать продолжение истории и умение правильно упорядочить предложенные кандидаты связаны, но это не одна и та же обучающая задача.
Для трансформера историю нужно представить как последовательность единиц входа — токенов. В этой системе токеном служит событие прослушивания, а не слово из текстового описания. Вектор события получается сложением четырёх составляющих: представления трека, реакции пользователя, контекста и позиции.
Сложение означает, что на вход трансформера для каждого события поступает единое представление, в котором одновременно присутствуют сведения о композиции, поведении и обстоятельствах включения. Контекст позволяет различать два внешне похожих прослушивания: самостоятельный выбор человека и трек, который ему предложила система.
История проходит через трансформер-декодер с треугольной маской внимания. Маска запрещает позиции обращаться к будущим событиям. На выходе получаются состояния пользователя в разные моменты истории — отдельные векторы, описывающие доступное к этим моментам прошлое. Именно наличие целой последовательности состояний, а не только последнего вектора, затем помогает и обучению, и target-aware-ранжированию.
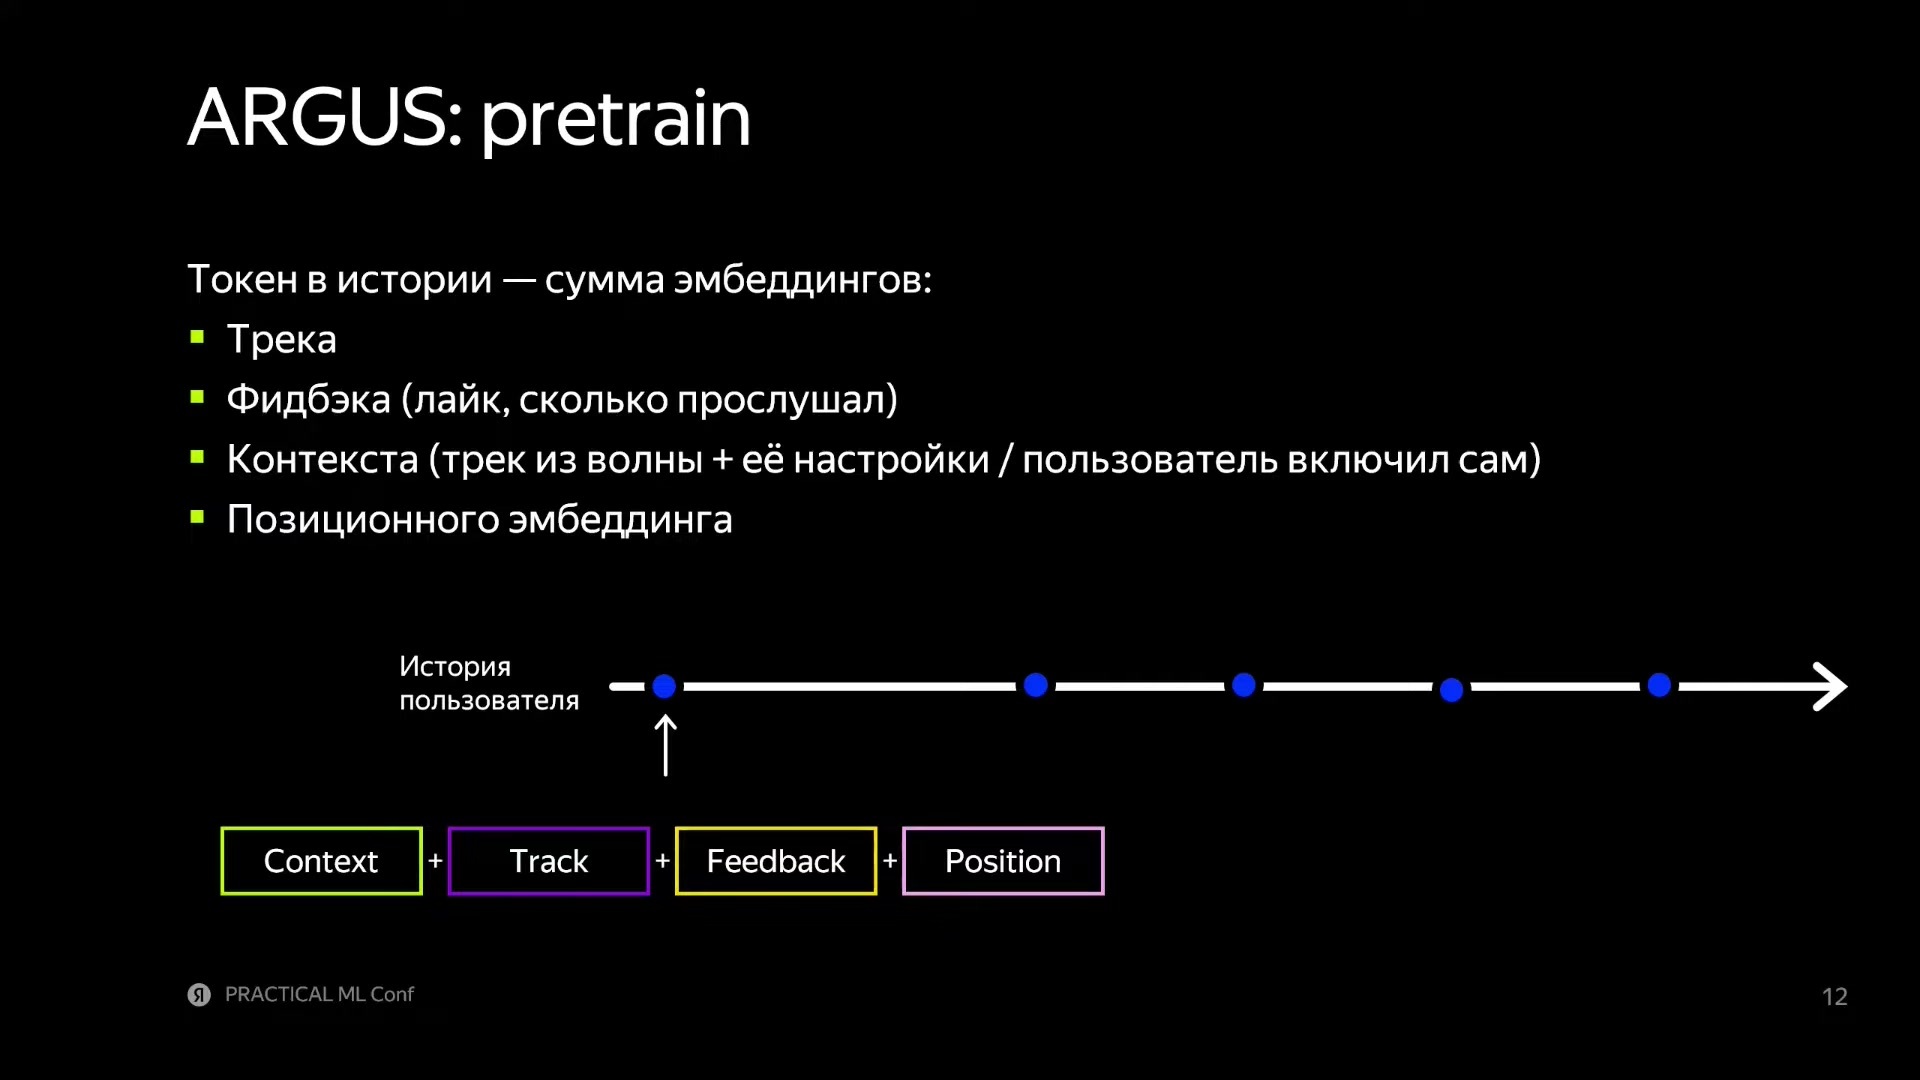
Представление события суммирует трек, реакцию пользователя, контекст и позицию.
Источник: Пётр Зайдель · Яндекс МузыкаДве задачи pretrain: следующий трек и следующая реакция
Первая задача — предсказать, какой трек появится в истории следующим. На схеме она названа Next Item Prediction, а в объяснении автора — также предсказанием следующего трека. Если этот трек был рекомендован, модель учится воспроизводить выбор действующей рекомендательной системы. Если пользователь сам нашёл его через поиск, модель изучает самостоятельное поведение слушателя. Поэтому предварительное обучение не ограничивается реакциями на «Мою волну».
Для предсказания следующего трека берут состояние пользователя и контекст. Обучение должно выделить следующий трек среди каталога, но считать нормировку по всем 100 млн композиций слишком дорого. Автор сравнивает масштаб с предсказанием следующего слова и приводит около 100 тыс. элементов языкового словаря как иллюстрацию. Это сравнение масштабов в докладе, а не размер входного словаря ARGUS.
Используется Sampled Softmax Loss: вместо сравнения с целым каталогом модель сопоставляет следующий трек с выбранными отрицательными примерами. Отрицательный пример в этой задаче — альтернативный трек для сравнения, а не обязательно композиция, которую пользователь явно отверг. Автор называет смесь примеров из текущего обучающего пакета и случайно выбранных треков. Точная формула упомянутой поправки и подробные параметры выборки в доступном описании не раскрыты.
Вторая задача — Next Feedback Prediction, предсказание реакции на следующий трек. Здесь модель уже получает представление этого трека вместе с состоянием пользователя и контекстом. Несколько полносвязных слоёв прогнозируют, поставит ли слушатель лайк и какую долю композиции прослушает. Это именно прогноз поведения на заданном треке, а не ещё один способ выбрать идентификатор из каталога.
Таблицу можно прокрутить по горизонтали.
Cross Entropy, или кросс-энтропия, штрафует модель, когда она приписывает низкую вероятность правильному ответу. Автор описывает прогноз реакции как классификацию; конкретные границы классов доли прослушивания не приведены. Также не раскрыто, с какими весами объединяются две задачи предварительного обучения.
Треугольная маска даёт важную вычислительную экономию. За один проход трансформера по истории можно получить состояния разных моментов и рассчитать обучающие ошибки сразу для множества событий. Нет необходимости заново обрабатывать один и тот же префикс ради каждого следующего трека. Это свойство обучения: оно не означает, что веса модели обновляются при каждом запросе слушателя.
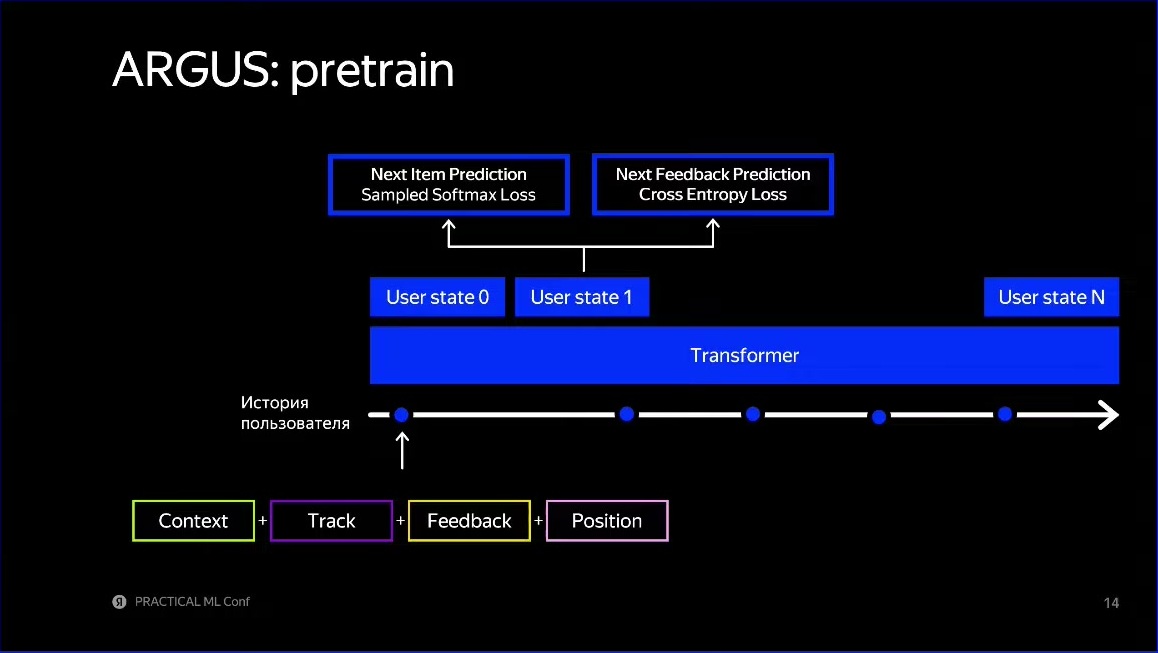
Для следующего трека используется Sampled Softmax Loss, для реакции — Cross Entropy Loss. Эти задачи обучают представления, но не выполняются при каждом запросе.
Источник: Пётр Зайдель · Яндекс МузыкаДообучение: понравившийся трек должен оказаться выше пропущенного
После pretrain модель знает многое о каталоге и последовательностях действий, но её конечная задача — помогать ранжировать треки «Моей волны». Для этого проводится finetune, дообучение под конкретную цель. Из истории собирают пары последовательных треков с разной обратной связью. В примере автора один трек понравился пользователю, а второй он пропустил.
Из пары выбирают положительный и отрицательный трек. Положительный должен получить большую оценку. Это уже другой смысл отрицательного примера, чем случайная альтернатива при Sampled Softmax: здесь предпочтение задаётся различием наблюдавшихся реакций. Полный порядок всех видов обратной связи и правила разрешения неоднозначных случаев в докладе не перечислены.
Пусть s_positive — оценка положительного трека, а s_negative — отрицательного. Дообучение минимизирует попарную кросс-энтропию, которую автор также называет BPR loss. Сигмоида σ преобразует разность оценок в число между нулём и единицей; чем увереннее положительный трек стоит выше отрицательного, тем меньше штраф.
Попарная кросс-энтропия, или BPR loss: функция потерь зависит от разности оценок двух треков, а не от их абсолютного значения.
Для каждой пары выбирают состояние пользователя, соответствующее ей по времени, и рассчитывают оценки треков. Поскольку трансформер уже выдал состояния разных моментов, функции потерь для большого количества пар можно вычислять после одного общего прохода по истории. Преимущество предварительного обучения на множестве позиций переносится и на ранжирование.
Для офлайн-версии важно воспроизвести возраст представления, с которым модель столкнётся в работе. Пользовательские векторы рассчитываются раз в день, поэтому при дообучении берут состояние, отстающее от времени пары на сутки. Указанная в конфигурации задержка на finetune в один день — это возраст состояния, а не длительность обучения и не время ответа сервиса.
Отдельную башню треков-кандидатов добавляют именно на finetune. Она состоит из нескольких полносвязных слоёв и строит представления объектов из ранжируемых пар. Отсутствие этой башни на pretrain не означает отсутствия знаний о треках: представления идентификаторов уже участвуют в предварительном обучении. В ответах на вопросы автор отдельно объясняет, как их переиспользуют.
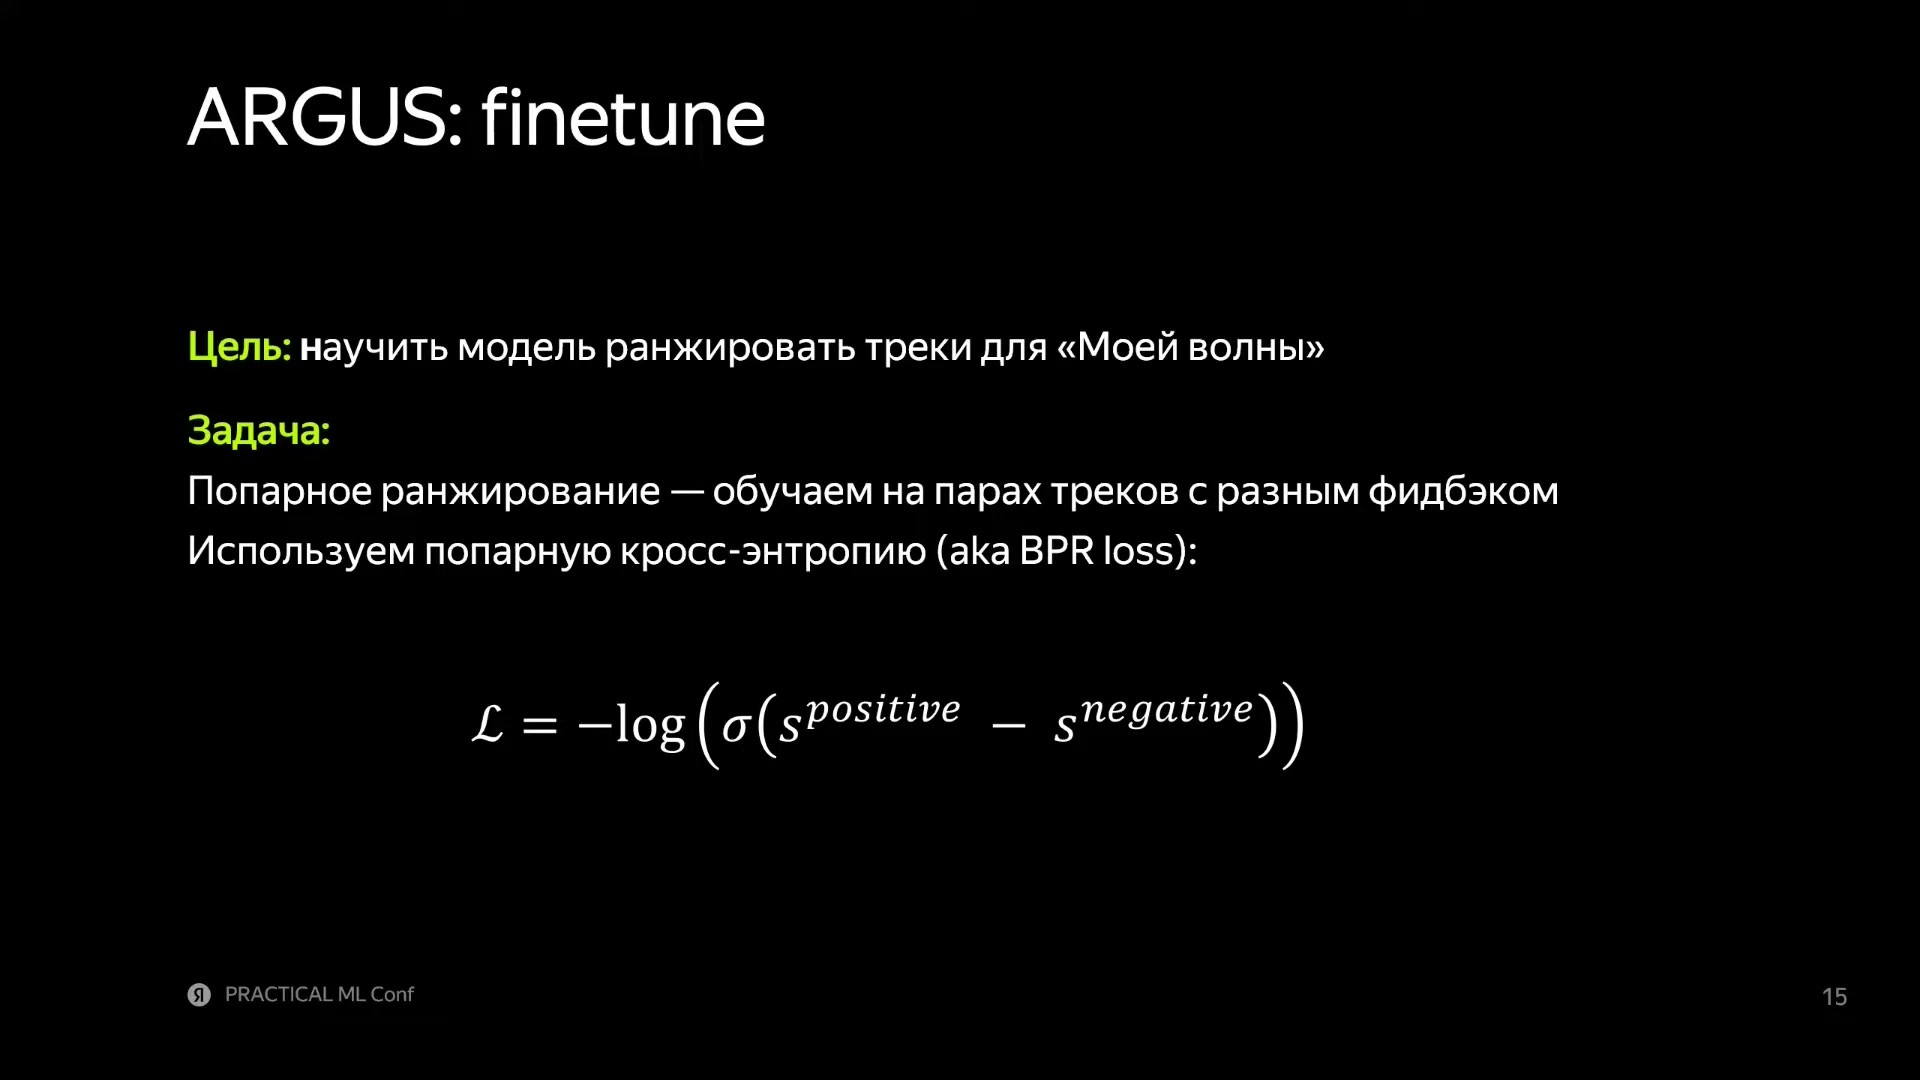
На слайде попарная кросс-энтропия/BPR: −log σ(s_positive−s_negative). Модель учится ставить трек с более подходящей реакцией выше другого.
Источник: Пётр Зайдель · Яндекс МузыкаСвежесть вместо размера: две конфигурации ARGUS
Офлайн-ARGUS улучшил рекомендации, но прежде всего описывал долгосрочные интересы. Сохранённый вчера вектор не может сам обновиться после только что поставленного лайка. Команда начала развивать реалтайм-версию в дополнение к офлайн-модели: её пользовательское представление рассчитывается прямо во время запроса.
Просто перенести большую модель в обработку запроса не получилось бы: она не укладывалась в доступное время инференса, то есть применения уже обученной сети. Поэтому уменьшили длину входной истории, глубину трансформера и внутреннюю размерность его представлений.
Таблицу можно прокрутить по горизонтали.
Это обмен вычислительной ёмкости на свежесть. Реалтайм-модель видит более короткую историю и обрабатывает её меньшей сетью, зато реагирует на последний фидбэк. Под фидбэком здесь понимается обратная связь слушателя: лайк, пропуск, доля прослушивания. Такое дополнение не требует объявлять офлайн-представления бесполезными или считать онлайн-модель их полной заменой.
Пока архитектура остаётся двухбашенной: на каждый запрос получаем один новый вектор пользователя и сравниваем его с представлениями треков. Устаревание сохранённого состояния удалось обойти, но способ соединения истории с кандидатом ещё не изменился. Именно это становится следующим ограничением.
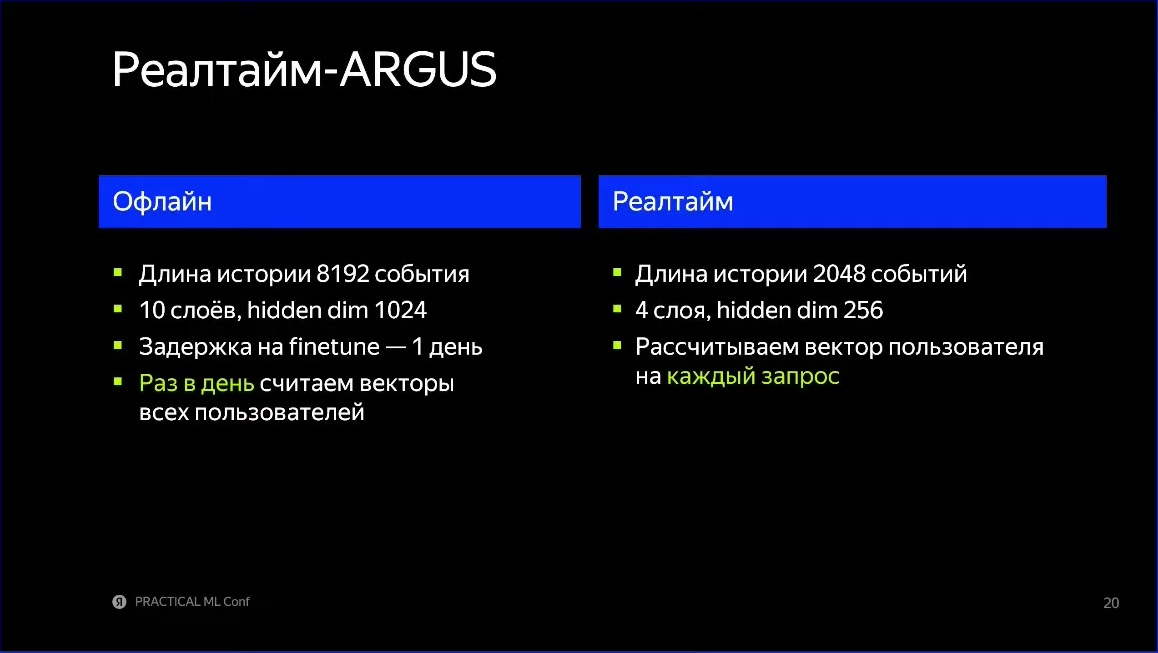
Офлайн: 8 192 события, 10 слоёв, 1 024 измерения, расчёт раз в день. Онлайн: 2 048 событий, 4 слоя, 256 измерений, пересчёт на каждый запрос.
Источник: Пётр Зайдель · Яндекс МузыкаПочему одного свежего вектора всё ещё мало
Двухбашенная модель сжимает все предпочтения и всю доступную историю в один небольшой вектор до того, как узнаёт, какой трек нужно оценить. Автор указывает на потенциальную потерю информации: в одном представлении должны ужиться интересы к разным артистам, жанрам и режимам прослушивания. Пересчёт этого вектора чаще не меняет сам принцип сжатия.
В реальном времени уже доступны и входная история, и все 3000 кандидатов финального ранжирования. Возникает естественная идея: позволить модели оценивать историю с учётом конкретного трека. Тогда один и тот же прошлый эпизод может оказаться важным для одного кандидата и второстепенным для другого.
Автор иллюстрирует это рок-музыкой. Если пользователь раньше слушал много рока, а теперь рассматривается рок-трек, полезно сильнее опереться на соответствующую часть истории, чем на прослушивания других жанров. Это объяснение возможного поведения модели, а не отдельный измеренный эксперимент по жанрам.
Полное раннее связывание реализовало бы эту идею через общий трансформер. На вход подаются история и кандидат, например как дополнительный токен. Внутри сети история может обращаться к кандидату, а кандидат — к истории. В отличие от позднего скалярного произведения, взаимодействия между ними возникают уже при построении представлений. Выразительность выше, но цена такого изменения оказывается критической.
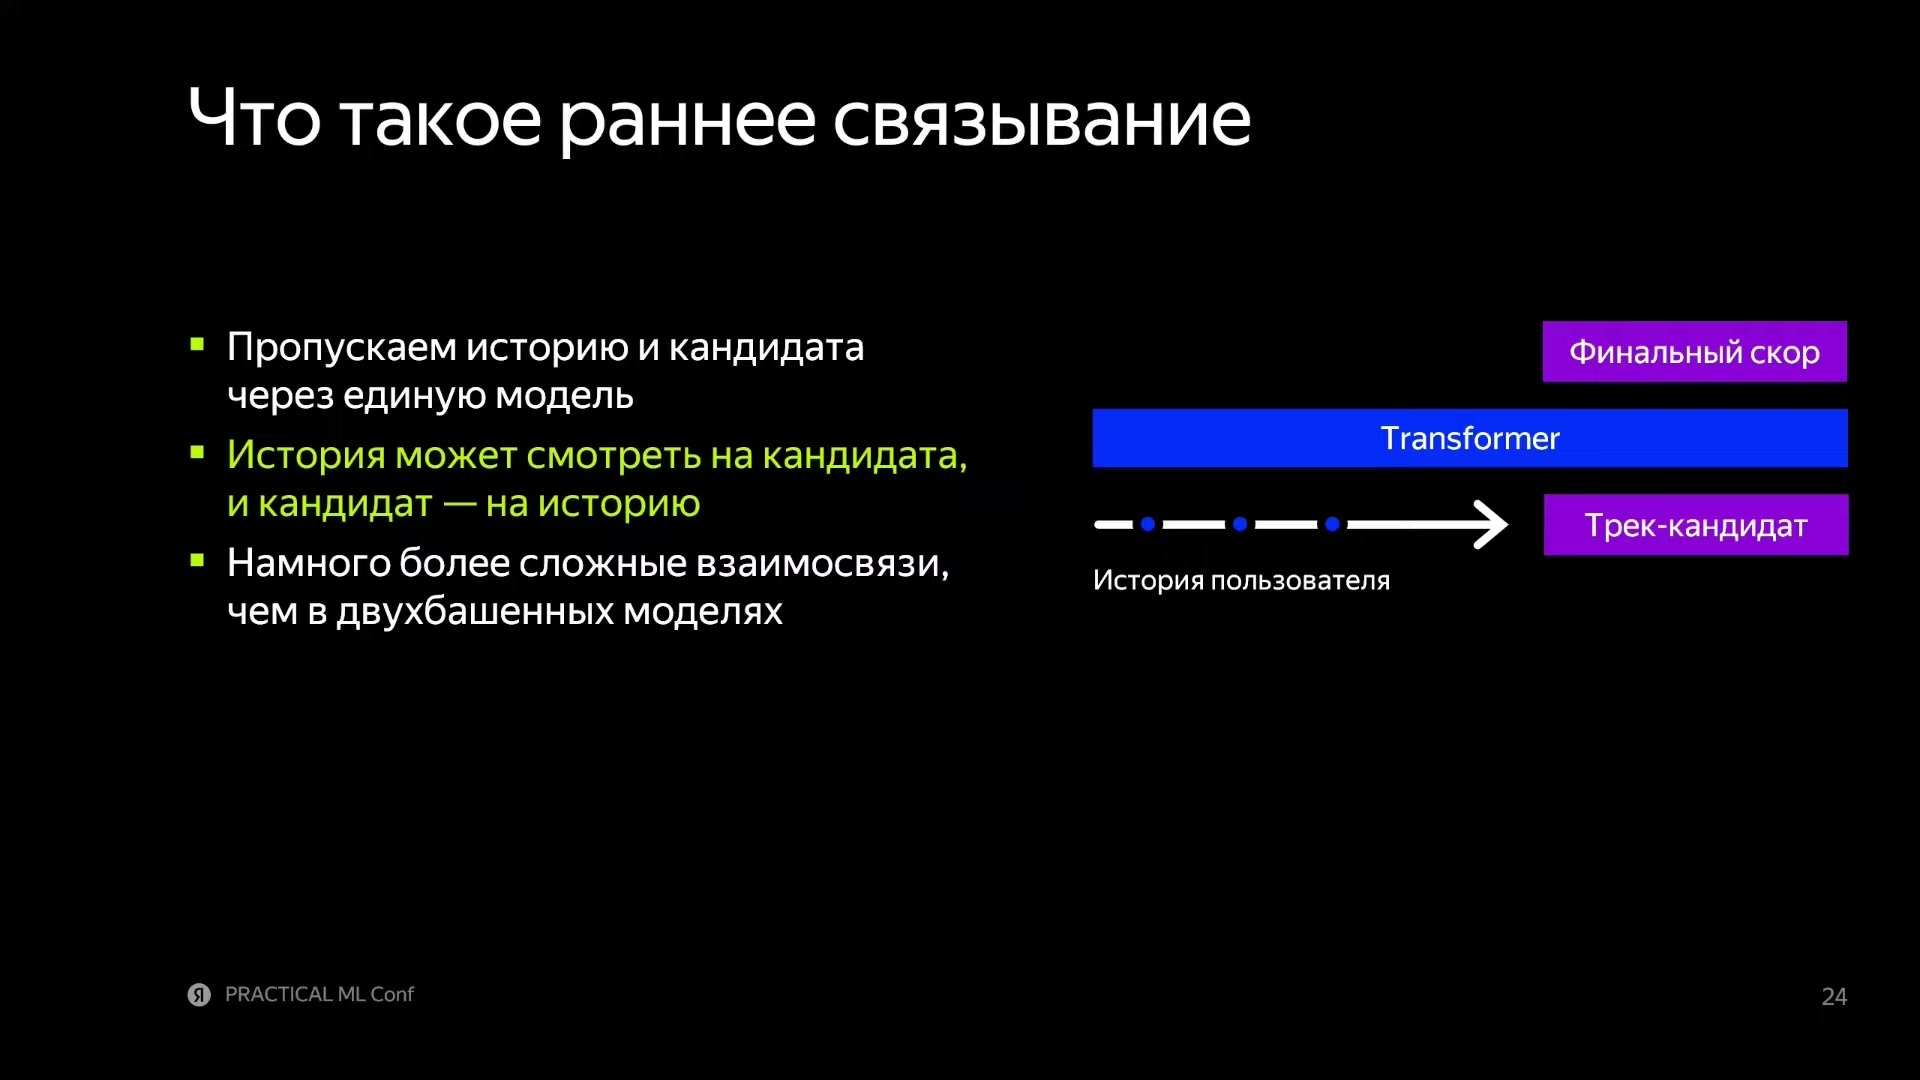
Общий трансформер позволяет кандидату и истории взаимодействовать; повторять обработку истории для каждого трека дорого.
Источник: Пётр Зайдель · Яндекс МузыкаПочему полный общий трансформер слишком дорог
Если состояния истории зависят от добавленного кандидата, их нельзя один раз вычислить и одинаково использовать для всех остальных треков. Для каждого кандидата требуется новый проход по последовательности «история плюс трек». При тысячах вариантов это многократно повторяет самую тяжёлую часть работы.
Обозначим длину истории через N, число кандидатов через M, размерность представлений через d, а количество слоёв через L. В последовательности с добавленным кандидатом N + 1 позиций. Для обсуждаемых вычислений на слайде приведена следующая оценка сложности:
Оценка вычислений полного раннего связывания в докладе: история с кандидатом повторно обрабатывается для каждого из M треков через L слоёв.
Квадрат длины последовательности отражает рассмотренное взаимодействие её позиций, а множитель M — повторение для каждого кандидата. Это оценка показанных операций, не полный подсчёт всех операций с плавающей точкой в модели и тем более не профиль сервиса. Из неё нельзя вывести точную задержку в миллисекундах.
Проблема затрагивает и обучение. Исчезает прежняя возможность получить общие состояния истории за один проход и использовать их для большого количества пар. Дообучение становится длиннее и требует больше ресурсов. По этим причинам команда отвергает полный вариант как неподходящий для своих ограничений; отдельного промышленного результата для него в докладе нет.
Следующий шаг поэтому состоит не в отказе от взаимодействия с кандидатом, а в ограничении его направления. История должна остаться общей, а индивидуальную работу нужно перенести в более дешёвый модуль поверх уже вычисленных состояний.
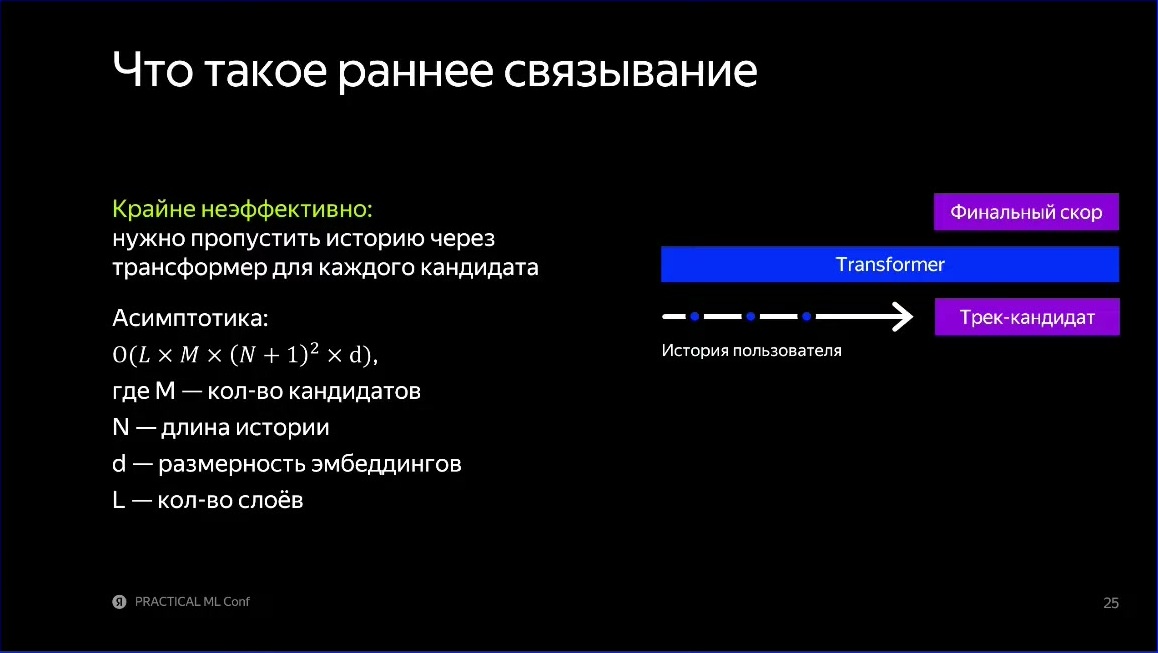
Слайд оценивает вычисления как O(L·M·(N+1)²·d), где M — кандидаты, N — история, d — размерность, L — слои. Это оценка показанной операции, не точный профиль всего сервиса.
Источник: Пётр Зайдель · Яндекс МузыкаКандидат обращается к истории, но не заставляет её пересчитываться
В предложенной архитектуре трансформер по-прежнему один раз обрабатывает историю без привязки к конкретному кандидату. Полученные состояния пользователя сохраняются как общая основа для оценивания. Кандидат может посмотреть на эти состояния, но его добавление не меняет саму обработку истории. Это упрощение полного раннего связывания и делает модель target-aware без тысяч повторных проходов.
Для взаимодействия используется cross-attention — механизм внимания между двумя наборами представлений. Запросы, Query, задают треки-кандидаты. Ключи и значения, Key и Value, берутся из состояний пользователя. Запрос помогает определить, какие состояния релевантны данному треку; ключи участвуют в вычислении весов, а значения передают информацию, которую нужно объединить.
Для каждого кандидата модель получает оценки совместимости с состояниями истории. Softmax превращает их в нормированные веса, после чего считается взвешенная сумма значений. Поэтому разные треки могут использовать одну и ту же историю с разными весами. Дорогой общий анализ прошлого остаётся один, а выбор полезных частей становится индивидуальным.
Формула в конвенции доклада: совместимость обозначена через QᵀK. Q относится к кандидатам, K и V — к состояниям истории. Это математическая схема, не выражение из программного кода.
Размерности этой записи можно согласовать следующей математической конвенцией: поместить запросы в столбцы Q размера d × M, ключи — в столбцы K размера d × N, а значения — в строки V размера N × d. Тогда QᵀK имеет размер M × N; нормировка по N состояниям и умножение на V дают по одному вектору размерности d для каждого кандидата. Это пояснение того, как читать формулу, а не раскрытые размеры тензоров в реализации Яндекс Музыки. Порядок хранения, проекции и остальные детали реализации в докладе не расписаны.
Для показанной операции cross-attention автор приводит оценку, линейную отдельно по числу кандидатов и длине истории:
Стоимость рассматриваемого взаимодействия M кандидатов с N состояниями истории размерности d. Она не включает всю модель и весь путь пользовательского запроса.
Это не означает, что весь ARGUS стал линейным по длине истории: основной трансформер и прочие операции никуда не исчезли. Меняется добавочная стоимость связи с кандидатами. Автор замечает, что при сопоставимых длине истории и числе кандидатов такая добавка по порядку вычислений похожа на ещё один слой трансформера истории. В описанной онлайн-конфигурации это 2048 событий и 3000 кандидатов, а не точное равенство двух размеров или времени работы.
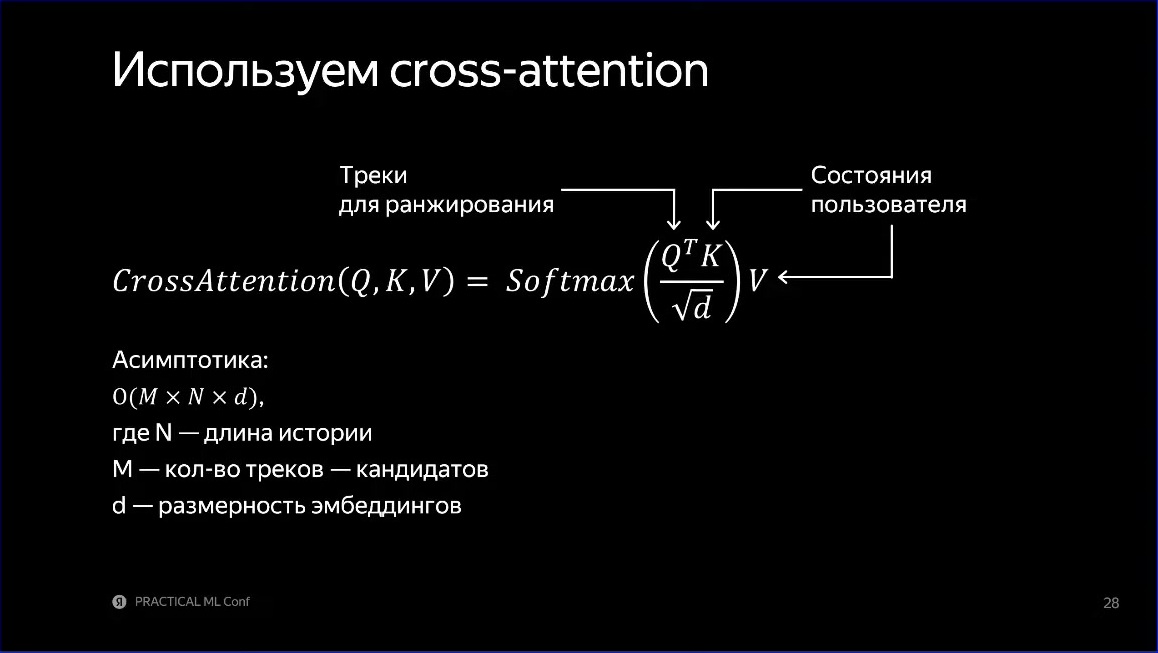
Query задаёт трек, Key/Value — состояния слушателя. На слайде CrossAttention(Q,K,V)=Softmax(QᵀK/√d)V и оценка O(M·N·d). Сохраняем обозначения источника.
Источник: Пётр Зайдель · Яндекс МузыкаОдной операции внимания недостаточно: нужен слой
Cross-attention включают в полноценный вычислительный блок. К нему добавляют нормализацию, полносвязный блок FFN и остаточные связи. Нормализация приводит значения представления к сопоставимому масштабу. FFN преобразует собранную информацию. Остаточная связь прибавляет вход соответствующей части блока к результату её преобразования.
На схеме блоки расположены в порядке Norm → Cross-attention → Add & Norm → FFN → Add. Кандидат задаёт запрос, а состояния пользователя поступают как ключи и значения. Остаточные связи сохраняют путь исходного представления через блок. Здесь важен состав слоя; тип нормализации, функции активации и все размеры промежуточных преобразований отдельно не раскрыты.
На выходе получается новый вектор трека, обогащённый сведениями из истории данного пользователя. Затем его скалярно умножают на состояние пользователя, соответствующее моменту оценивания. Операция в самом конце формально остаётся простой, но её аргумент уже другой: представление кандидата зависит от истории. Поэтому это не возврат к прежнему позднему связыванию независимых башен.
В показанной итоговой конфигурации к четырёхслойному реалтайм-ARGUS с внутренней размерностью 256 добавлен один cross-attention-слой размерности 256. История при этом не проходит весь основной трансформер заново для каждого трека.
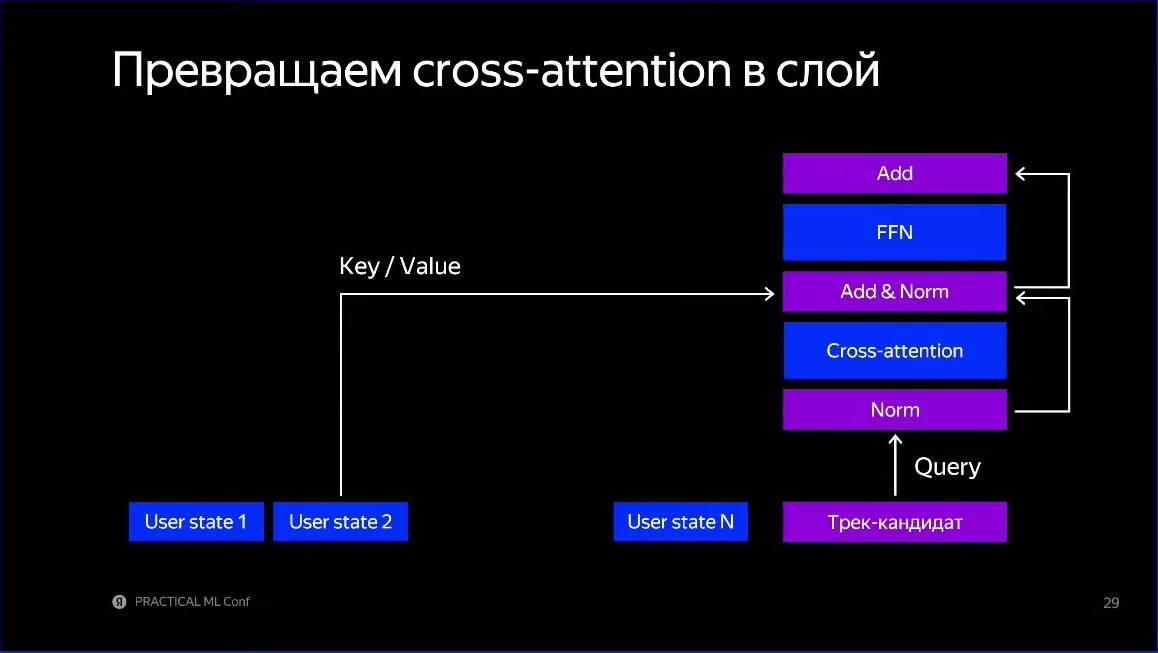
К cross-attention добавлены нормализация, остаточные связи и FFN. История не проходит весь трансформер заново для каждого кандидата.
Источник: Пётр Зайдель · Яндекс МузыкаКак сохранить эффективное обучение и получить оценки всех кандидатов
Полученные оценки подставляются в ту же задачу попарного ранжирования. Для обучающих кандидатов выбираются соответствующие по времени состояния пользователя. История остаётся общей: после прохода основного трансформера можно рассчитывать ошибки для множества пар, не строя её представления заново под каждый трек.
По смыслу описанной схемы кандидат обращается к состояниям пользователя в прошлом. Это согласуется с исходным ограничением на доступ к будущим событиям. Однако конкретная реализация временных масок в добавленном cross-attention и способ упаковки пар не раскрыты. Схема обучения объясняет переиспользование состояний, но не является готовой спецификацией кода.
При применении модели вместе с историей передают сразу список всех 3000 кандидатов. Основной трансформер обрабатывает историю один раз. Затем слой cross-attention получает представления кандидатов, обращается к общим состояниям и помогает рассчитать оценку каждого трека. Один общий проход по истории не означает отсутствия дальнейшей работы для кандидатов: она вынесена в добавленный слой.
Меняется и результат вызова модели. Раньше реалтайм-ARGUS отдавал один пользовательский эмбеддинг, который затем сравнивали с треками. Теперь версия с cross-attention возвращает сразу оценки кандидатов. Эти оценки поступают обратно в рекомендательный сервис, а дальнейшие решения остаются частью описанной воронки с финальным ранжированием и правилами.
Весь этот путь относится к применению уже обученных весов. Ни предварительные задачи предсказания, ни минимизация BPR не запускаются заново для каждого запроса слушателя. Свежая история изменяет результат вычисления, а обновление самих весов происходит отдельным процессом.
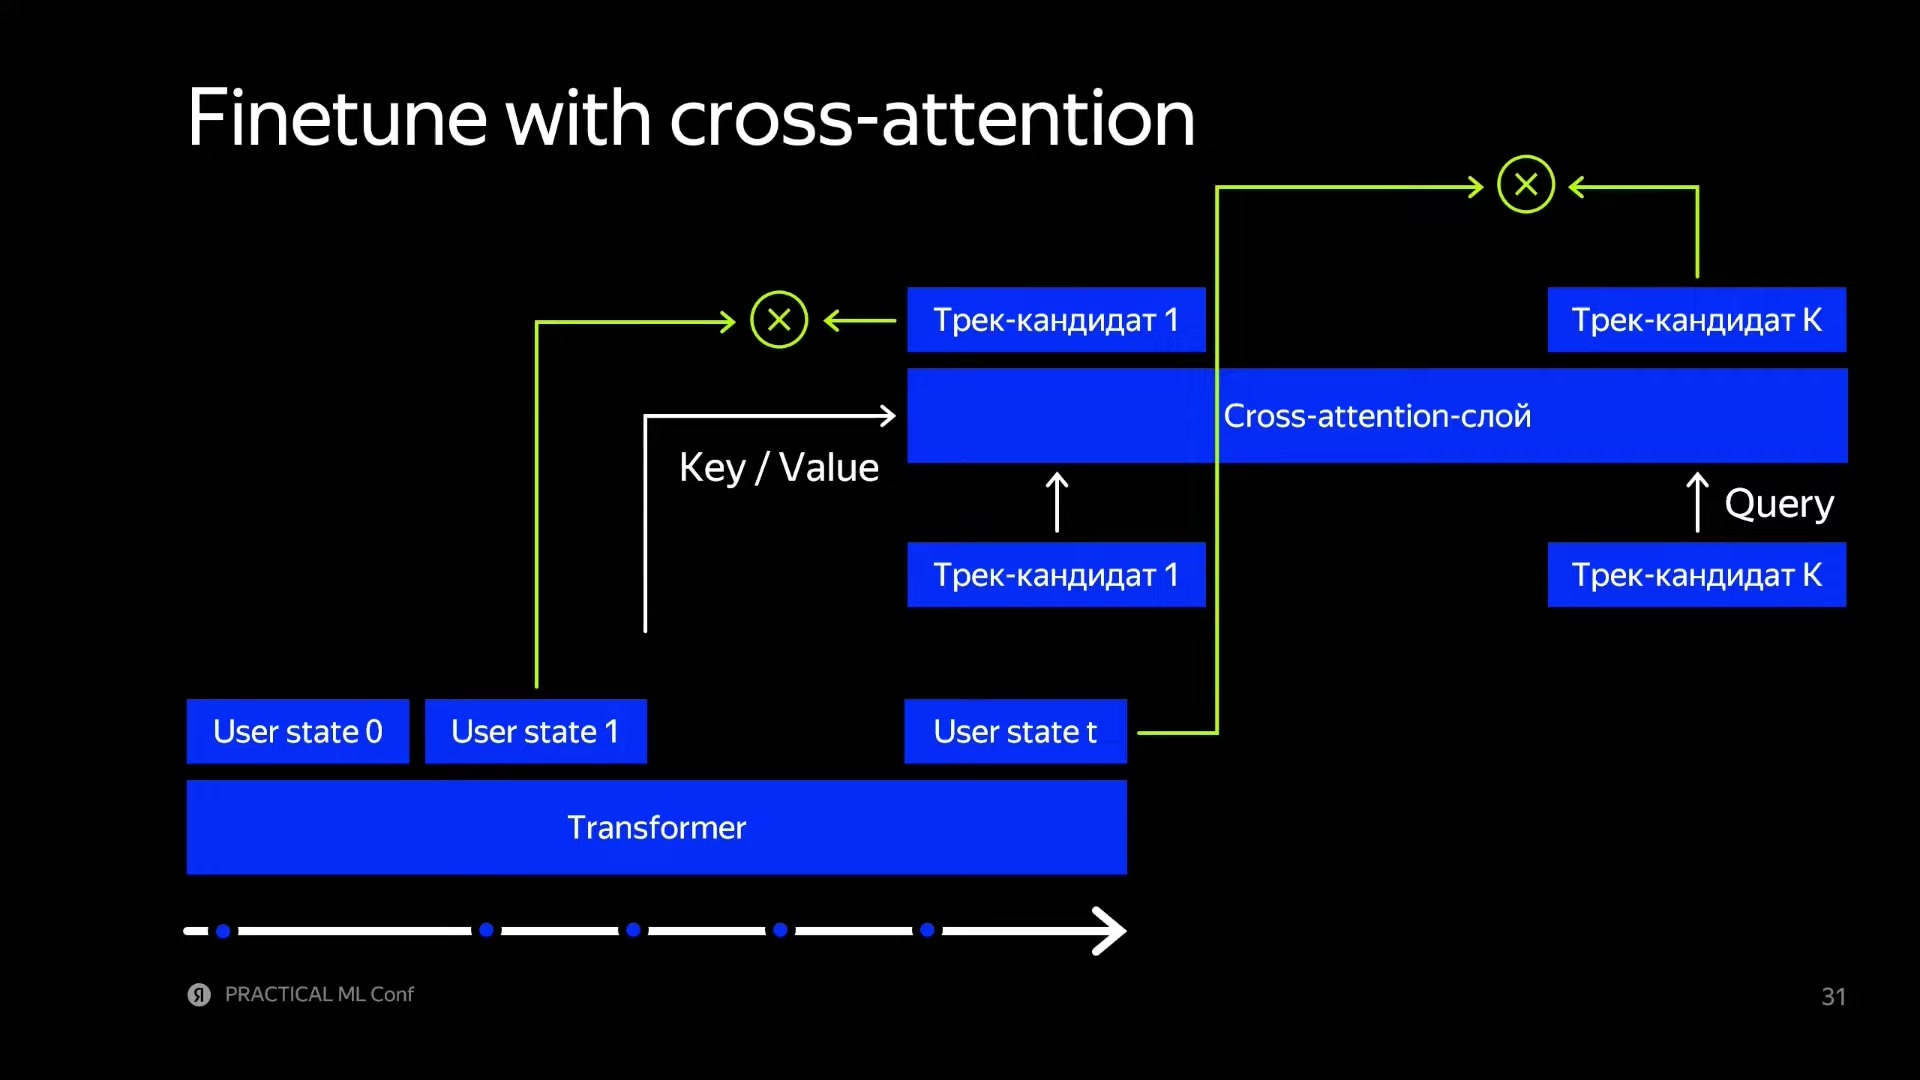
Общие состояния истории служат Key/Value, кандидаты — Query; выход слоя используется в оценке треков.
Источник: Пётр Зайдель · Яндекс МузыкаЧто показали последовательные внедрения
Автор описывает развитие системы последовательно: сначала внедрили офлайн-ARGUS, затем получили дополнительный эффект от реалтайм-версии, затем — от реалтайм-ARGUS с cross-attention. В таблице приведены изменения трёх пользовательских показателей: времени в «Моей волне», вероятности дослушать трек до конца и вероятности лайка рекомендации.
Таблицу можно прокрутить по горизонтали.
Единый контрольный вариант для всех трёх строк не раскрыт. Поэтому нельзя складывать проценты в суммарный прирост или вычитать одну строку из другой и объявлять разность отдельно измеренным эффектом cross-attention. Последовательный рассказ о внедрениях не даёт полной спецификации контрольных групп каждого эксперимента.
Значения обозначают приросты в процентах, а не абсолютные уровни вероятностей и не процентные пункты. Например, +2,68% в строке вероятности лайка не означает, что лайкнули 2,68% рекомендаций. Для восстановления исходного уровня вероятности и её нового значения понадобилась бы контрольная величина, которой в таблице нет.
Докладчик характеризует полученный эффект как существенный и статистически значимый. При этом не приведены размеры выборок, длительности экспериментов, доверительные интервалы и подробный статистический протокол. Также не раскрыты охват всех поверхностей продукта и доля всего сервиса в каждом тесте. Результаты относятся к показанным экспериментам рекомендаций «Моей волны», а не автоматически ко всей активности Яндекс Музыки.
Подтверждённый вывод уже достаточно содержателен: команда сообщает о положительном эффекте последовательных изменений и отдельно показывает строку для варианта с cross-attention. Но таблица не позволяет восстановить единый суммарный эффект всей цепочки или обещать такие же проценты при переносе архитектуры в другой продукт.
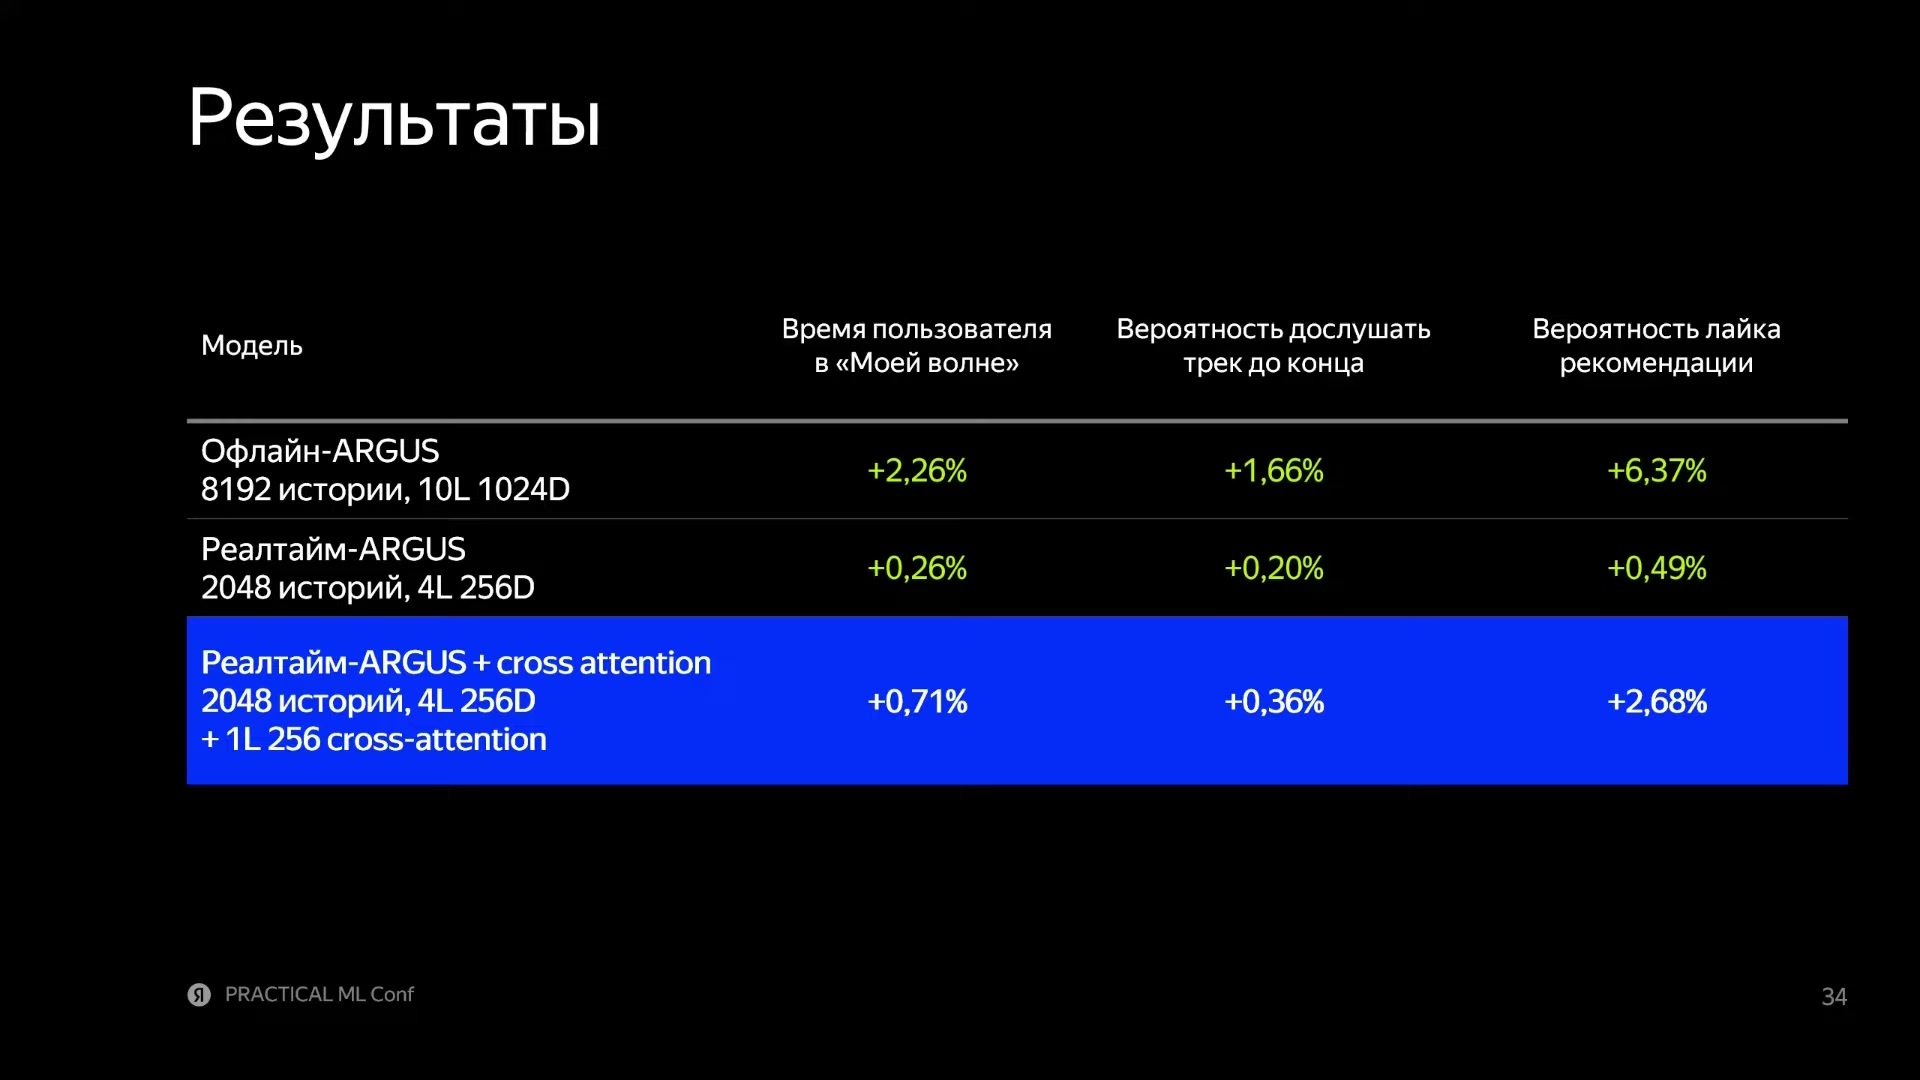
Время слушания, дослушивания и лайки показаны отдельно. Автор описывает последовательные внедрения; проценты разных строк не складываем и не объявляем сравнением с единой раскрытой базой.
Источник: Пётр Зайдель · Яндекс МузыкаПочему историю готовят на CPU, а модель считают на GPU
Для применения нейросетевой модели команда использует отдельный GPU-сервис. Он получает уже подготовленные данные в виде тензоров — многомерных массивов чисел, — объединяет запросы в пакеты, или батчи, и выполняет модель. Обработка нескольких запросов вместе помогает лучше загрузить GPU. Подготовка истории вынесена в другой сервис, работающий на CPU.
- 01
Сервис рекомендаций
Обращается за оценками треков к сервису обработки истории.
- 02
CPU-сервис истории
Получает актуальную историю из хранилища «ключ — значение», подготавливает её, добавляет необходимые метаданные и формирует вход для модели.
- 03
GPU-сервис модели
Принимает тензоры, объединяет запросы в батчи и рассчитывает оценки кандидатов.
- 04
Возврат оценок
Результаты проходят обратно через сервис истории в сервис реалтайм-рекомендаций.
Ключевое основание для выделения CPU-сервиса — согласованность данных. При обучении и при применении модели история должна получаться одинаковым способом. Если одна и та же последовательность действий превращается в разные входы, качество может заметно ухудшиться, даже когда веса сети не изменились.
Поэтому команда использует один и тот же код обработки истории для подготовки обучающих данных и для инференса. Общей является логика преобразования, а не время выполнения: обучение остаётся отдельным процессом. Такая организация уменьшает риск расхождения входов между двумя режимами, но сама по себе не доказывает отсутствие любых ошибок в данных.
Для сервиса поддерживается актуальная история пользователя в хранилище «ключ — значение». Это хранилище событий не следует смешивать с Key и Value механизма внимания: совпадающие английские слова обозначают разные сущности. В одном случае речь о доступе к сохранённой истории, в другом — о представлениях внутри нейросетевой операции.
Автор отмечает, что выделенный сервис обработки истории можно использовать и в других командах Яндекса. Конкретные сторонние внедрения не перечислены. В описанной системе его роль ясна: CPU занимается сбором и подготовкой данных, GPU — пакетным вычислением модели.
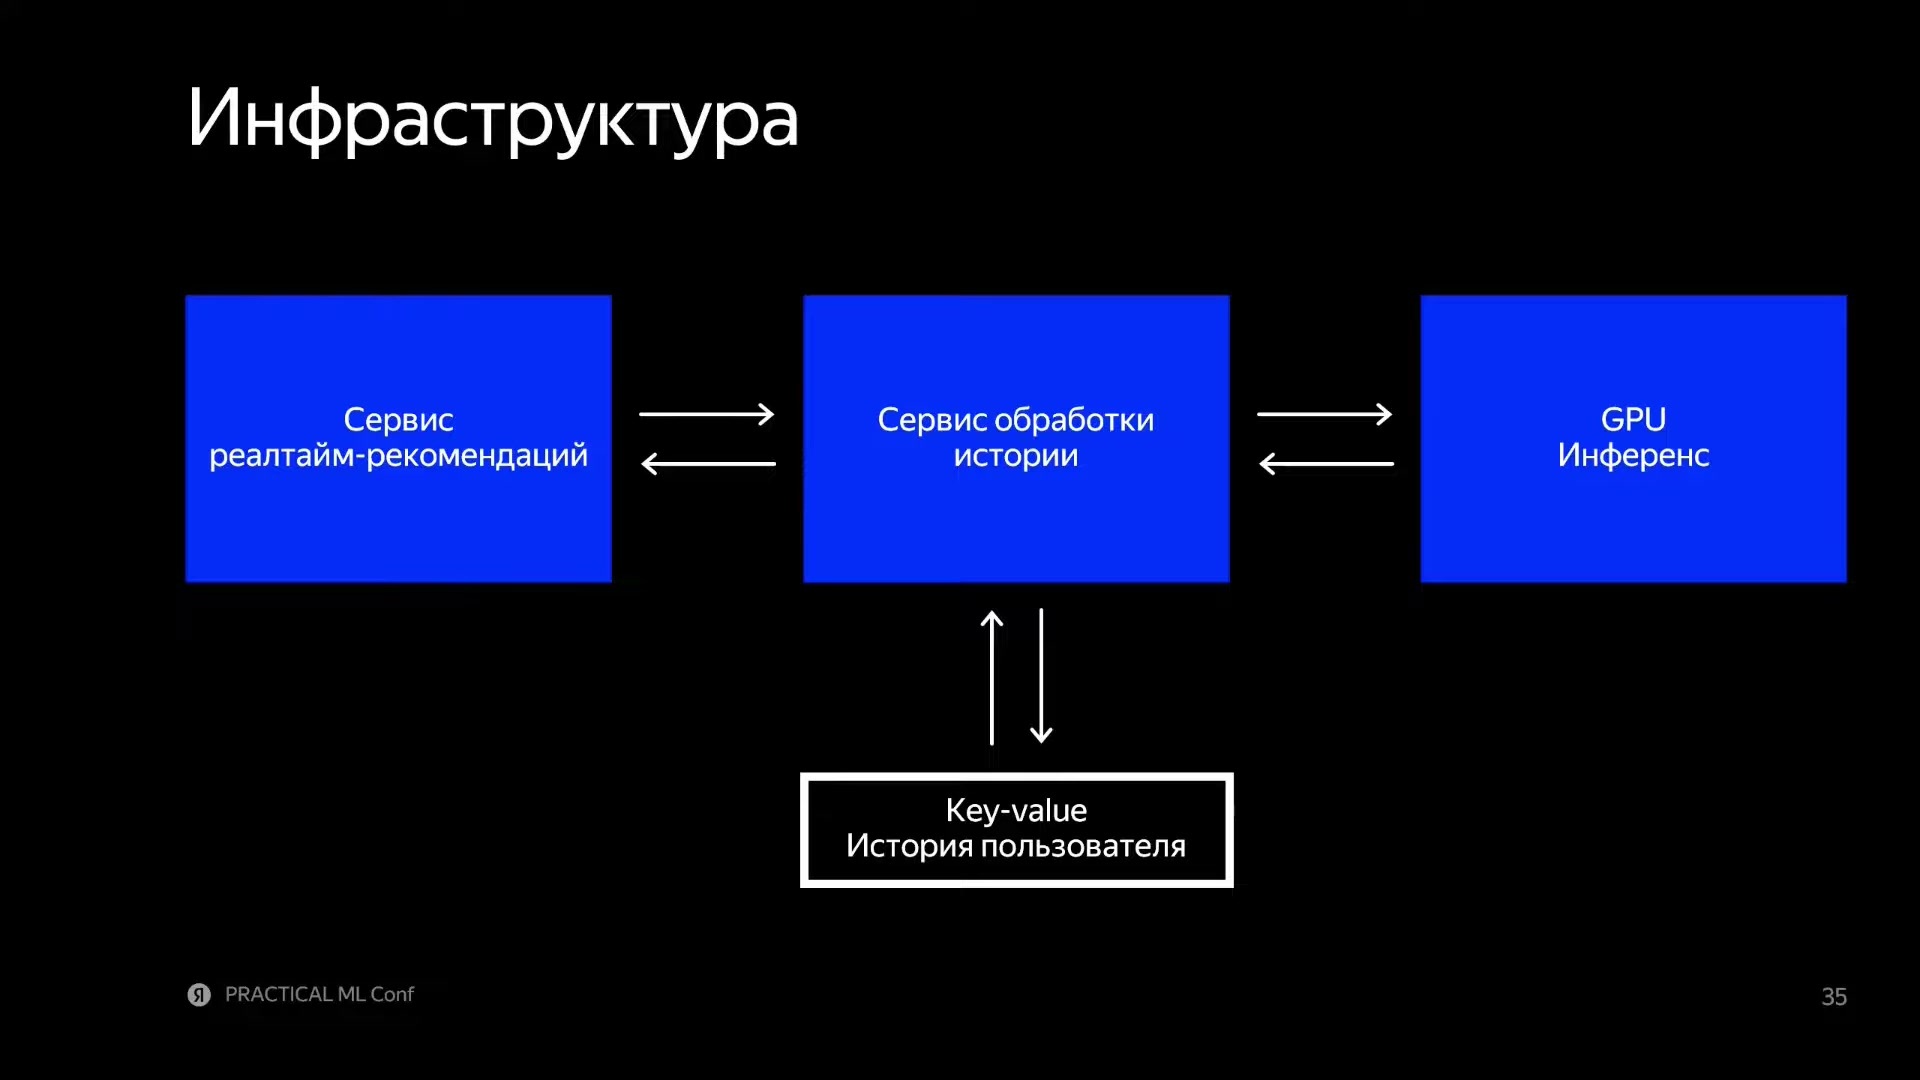
CPU-сервис готовит историю и тензоры, GPU-сервис объединяет запросы в батчи. Один код обработки истории используется в обучении и применении.
Источник: Пётр Зайдель · Яндекс МузыкаЧто означают 28 миллисекунд, 75 миллисекунд и тысяча запросов в секунду
Добавление cross-attention увеличило время инференса модели на 10% относительно реалтайм-ARGUS без этого слоя. Это сравнение двух вариантов модели, а не утверждение, что вся система рекомендаций стала на 10% медленнее. Далее автор приводит несколько измерений с разными границами.
Таблицу можно прокрутить по горизонтали.
28 мс — время модельного вычисления при названном размере батча. 75 мс охватывают более широкий путь, где есть подготовка истории и сетевые передачи. Второе число нельзя заменить первым при оценке задержки интеграции. При этом не раскрыто, что 75 мс включают вообще весь путь от нажатия кнопки в приложении, весь поиск кандидатов и все стадии выдачи.
RPS означает количество запросов в секунду. Эта величина описывает пропускную способность, а не число треков, возвращённых одному слушателю. Батч из запросов также не следует путать с пачкой из пяти треков для пользователя: это пакет вычислений на GPU, а не форма музыкальной очереди.
Для указанных времён не назван перцентиль. Следовательно, это не обещание p95 — границы, в которую укладываются 95% запросов. Модель GPU, точная конфигурация оборудования и подробные условия нагрузки также неизвестны. Из приведённых чисел нельзя вывести гарантию задержки под любой нагрузкой или воспроизводимость на произвольной видеокарте.
Практический смысл результата в другом: в конфигурации команды более содержательное взаимодействие кандидатов с историей добавило умеренные расходы к уже работающей онлайн-модели. Возможность один раз обработать историю оказалась важнее, чем попытка получить максимальную выразительность через полный общий трансформер для каждого трека.
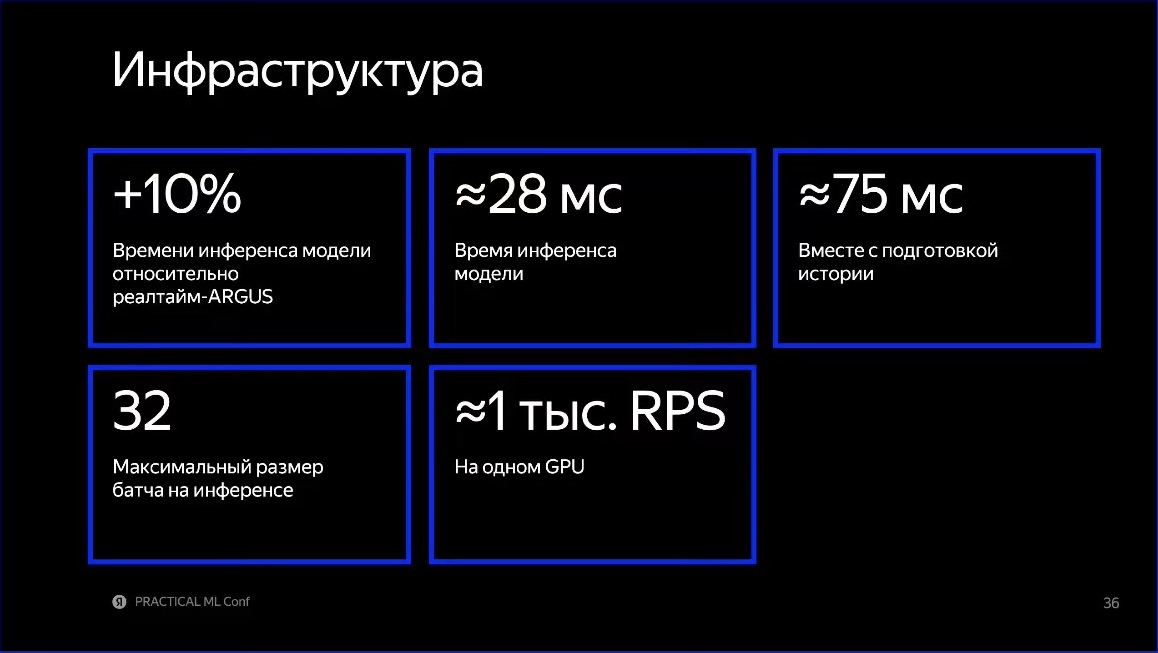
Добавление cross-attention даёт +10% времени относительно онлайн-ARGUS; около 28 мс на модель при батче 32, около 75 мс с подготовкой истории и передачей данных, около 1 000 RPS на GPU. Перцентиль и модель GPU не раскрыты.
Источник: Пётр Зайдель · Яндекс МузыкаКак часто обновляют веса, если история меняется на каждом запросе
После основной части из зала спрашивают о ещё одном виде устаревания. Даже если на каждый запрос брать свежую историю, параметры модели остаются теми, которые были получены на обучении. Как быстро они теряют актуальность и насколько часто нужно запускать дообучение?
Пётр отвечает, что рассматриваемые реалтайм-модели на момент выступления обучают примерно раз в неделю. Если не обновлять их несколько недель, команда уже видит просадку качества. Ежедневное обучение, по его словам, было бы слишком накладным по ресурсам, поэтому недельный режим выбран как практический компромисс. Численная зависимость качества от возраста весов и отдельный результат сравнения ежедневного и недельного режимов не приведены.
Здесь полезно различать три расписания. Офлайн-пользовательский вектор пересчитывается раз в день. Онлайн-представление пользователя получается на каждый запрос. Веса описанных реалтайм-моделей обновляются примерно раз в неделю. Только последнее относится к обучению параметров; первые два определяют, когда уже обученная сеть обрабатывает пользовательскую историю.
Так объясняется, почему система может реагировать на новый лайк, не переобучаясь после него. Лайк меняет входные данные следующего запроса, и существующие веса вычисляют другой результат. Но этот механизм не отменяет постепенного устаревания самой модели, которое и требует отдельного цикла обновления.
Доклад · 00:28:51Когда появляется башня треков и что она получает от pretrain
Следующий вопрос уточняет схему обучения: существует ли отдельная башня кандидатов уже на pretrain или её добавляют позже? Автор подтверждает, что на предварительной стадии такой башни нет. Её вводят только при дообучении под ранжирование. Поэтому финальную двухбашенную схему нельзя без оговорок считать схемой всех стадий обучения.
Продолжение вопроса — как использовать знания о треках, выученные до появления башни. Ответ связан с входными представлениями. Команда использует подход Unified Embeddings: общую матрицу эмбеддингов для разных типов идентификаторов, в частности треков и артистов. Эти же представления становятся входом для кандидатов на следующей стадии.
Получается разделение двух вещей: уже обученных представлений идентификаторов и добавляемой полносвязной башни. Переиспользование первых раскрыто явно; из ответа не следует, что все слои новой башни существовали или были предобучены раньше. Точная процедура инициализации всех её параметров не описана.
По словам Петра, добавление башни треков существенно влияет на качество финальной ранжирующей модели. Но отдельной численной абляции — эксперимента, где меняется только наличие этой башни, — в докладе не показано. Это содержательное наблюдение автора, а не ещё одна строка общей таблицы A/B-эффектов.
Доклад · 00:30:27На каких событиях обучаются и что ещё знают о пользователе
Из зала спрашивают, ограничено ли обучение «Моей волной» или используются другие сценарии Музыки. Ответ разделяет вход модели и целевые примеры, на которых рассчитывается ошибка. При finetune целевыми служат рекомендованные треки. Но в пользовательскую историю входят все прослушанные треки, в том числе найденные через поиск и включённые из собственного плейлиста.
На предварительном обучении используются и такие самостоятельные действия. Команда называет их органическими событиями: трек появляется в истории не потому, что его выбрала волна, а потому, что его включил пользователь. Это согласуется с исходной постановкой Next Item Prediction, где часть примеров учит воспроизводить рекомендательную выдачу, а часть — самостоятельный выбор слушателя.
Следовательно, фраза «дообучаем на рекомендованных треках» не означает «выбрасываем из входа все остальные прослушивания». Цель ранжирования остаётся специализированной, но описание интересов опирается на более широкую историю. Это одна из важных границ между подготовкой входа и выбором обучающей метки.
Вопрос о данных других сервисов получает более осторожный ответ. Автор предполагает, что они вряд ли дадут большой дополнительный выигрыш, потому что Музыка уже располагает плотным и большим собственным потоком событий. Сравнительного эксперимента с такими данными он не приводит. Поэтому это оценка перспективы, а не доказанная бесполезность межсервисной информации.
Ещё один вопрос касается сведений, не сводящихся к временной последовательности: например, текущего избранного и других характеристик состояния пользователя. Пётр подчёркивает, что описанные модели на основе ARGUS сосредоточены на истории прослушивания. О дополнительных сведениях он говорит неуверенно: скорее всего, они используются среди признаков финальной ранжирующей модели.
Такой ответ нельзя превращать ни в полный список входов финального CatBoost, ни в заявление, что вся рекомендательная система игнорирует пользовательское состояние за пределами прослушиваний. Уверенно раскрыта граница именно рассматриваемой модели ARGUS; устройство остальных признаков здесь подробно не разбирается.
Доклад · 00:32:19Как устроены эксперименты и могут ли они мешать друг другу
На вопрос о дополнительных подходах к оценке эффекта автор отвечает, что команда использует обычные A/B-тесты: пользователей случайно распределяют по группам и сравнивают варианты ранжирования. Отдельные методы анализа, о которых спрашивали, в описанном процессе не применялись. Это описание выбранной процедуры, а не утверждение, что рандомизированный эксперимент не измеряет причинный эффект.
В качестве примера Пётр говорит о новой модели, на которую направляют 10% пользователей. Это иллюстрация распределения трафика в ответе на вопрос. Она не задаёт долю аудитории, размер контроля или длительность каждого из трёх экспериментов с ARGUS в таблице результатов.
Другой вопрос — что происходит при параллельном проведении нескольких экспериментов. Автор признаёт, что тесты иногда влияют друг на друга. Но у Музыки много пользователей, а экспериментальных групп обычно не настолько много, поэтому команда не наблюдает большого количества таких эффектов.
Если станет сложно обнаруживать изменения или потребуется более точная оценка, команда может усложнить подход к измерению. На момент выступления Пётр описывает обычные эксперименты. Его ответ не даёт гарантии независимости всех тестов и не раскрывает полную схему управления пересечениями групп.
Доклад · 00:34:32Единая модель вместо воронки — пока направление дальнейшей работы
В конце обсуждения задают более широкий вопрос: можно ли заменить отбор кандидатов и несколько стадий ранжирования одной моделью, которая получает историю и сразу выдаёт рекомендации? Такой подход называют end-to-end, то есть сквозным: несколько функций системы объединяются внутри общей обучаемой архитектуры.
Пётр считает направление перспективным. Его аргумент связан не только с качеством, но и с вычислениями: отдельные стадии ранжирования и расчёт многочисленных признаков требуют ресурсов, а единая модель потенциально может использовать их эффективнее. При этом он говорит о возможных будущих экспериментах. В системе, о которой идёт речь в докладе, остаётся стандартная многоэтапная воронка.
Модератор дополняет ответ идеей генерации кодов кандидатов. Вместо обычного оценивания огромного множества объектов модель могла бы непосредственно выдавать коды рекомендаций. Это обозначено как возможный следующий этап. Способ кодирования, обучение генератора и промышленный результат такого решения здесь не раскрыты.
Важно не смешивать это обсуждение с уже показанным target-aware-ARGUS. Он не генерирует кандидатов вместо всей воронки: получает готовые 3000 треков, использует общую историю и возвращает их оценки. Подтверждённый результат доклада относится к этому расширению ранжирования, а единая система остаётся перспективой, высказанной в ответах на вопросы.
Доклад · 00:35:59Итог: общая история, отдельное внимание к каждому треку
У задачи было два ограничения: суточный вектор запаздывал за реакциями слушателя, а один общий вектор не выделял полезные события для конкретного трека. Команда сначала перенесла уменьшенный ARGUS в обработку каждого запроса, затем добавила cross-attention. В отличие от полного раннего связывания, история осталась общей для всех кандидатов.
- 01
Запрос и свежая реакция
Приложение запрашивает продолжение волны; бэкенд передаёт последние действия пользователя и настройки.
- 02
Отбор кандидатов
Система сокращает каталог из 100 млн треков до 10 тысяч, затем лёгкое ранжирование оставляет 3000.
- 03
Подготовка на CPU
Сервис истории собирает актуальные события и метаданные, формирует тензоры; GPU-сервис объединяет запросы в батчи.
- 04
Общая обработка истории
Четырёхслойный трансформер с размерностью 256 один раз обрабатывает историю до 2048 событий и выдаёт её состояния.
- 05
Оценки с учётом кандидата
Треки задают Query, состояния — Key/Value. Один cross-attention-слой обогащает кандидатов; скалярные произведения дают их оценки.
- 06
Финальная выдача
Оценки возвращаются в рекомендательный сервис. Финальный CatBoost и бизнес-правила помогают выбрать пять следующих треков.
Обучение происходит отдельно: pretrain использует предсказание следующего трека с Sampled Softmax и реакции с Cross Entropy; finetune учит попарному порядку через BPR. Один код подготовки истории используется при обучении и применении. Веса реалтайм-моделей обновляют примерно раз в неделю, а не на каждый запрос.
В строке A/B для cross-attention показаны +0,71% времени в «Моей волне», +0,36% вероятности дослушивания и +2,68% вероятности лайка; время модели выросло на 10% к реалтайм-ARGUS. Это результат описанного этапа, не сумма последовательных внедрений. Общая база их сравнения не раскрыта. Около 28 мс относятся к модели при батче 32, около 75 мс — к подготовке, сети и модели; перцентиль и оборудование неизвестны.
Доклад · 00:23:36