Разбор готов
Wildberries: как UniSRec превратили в модель общих поведенческих представлений
Команда рекомендаций и команда обнаружения мошенничества смотрят на одни и те же действия покупателей, но каждая заново извлекает из них закономерности. Одновременно в каталог приходят новые товары: идентификатор у карточки уже есть, а истории взаимодействий, на которой можно обучить его полезное представление, ещё нет. В Wildberries захотели получить общие векторы товаров и поведения пользователей, которые можно использовать в разных задачах, не начиная анализ истории с нуля. Карина Романова рассказывает о годе адаптации UniSRec — от текстовых описаний, доменных адаптеров и обучения на последовательностях до внутреннего текстового энкодера, изображений и стабилизации обучения. Путь оказался не прямым: усложнение смеси экспертов ухудшило результат, а жёсткое подавление популярности повредило другим метрикам. Разберём, как готовили данные, чему учили модель, какие изменения действительно видны в сравнительных таблицах и где заканчивается подтверждённая универсальность полученных представлений.
Глава полезна инженерам рекомендательных систем и командам, которые строят общие поведенческие признаки для нескольких продуктов или задач. Особенно — тем, кто переносит исследовательскую модель на большой каталог и хочет понять роль подготовки событий, содержания карточек, отрицательных примеров и противоречащих друг другу метрик.
Видео · на русском
Как менялся UniSRec / Карина РомановаКарина Романова · Опубликовано: 23 октября 2025 г.
Исходный доклад · Открыть оригинал
Общие представления вместо повторного анализа одних событий
На момент доклада масштаб платформы описывался тремя величинами: более 79 млн уникальных пользователей в месяц, более 100 млн товаров в каталоге и более 2,5 млрд пользовательских событий в день. Это характеристики Wildberries, а не объём одного обучающего набора и не нагрузка, которую непосредственно измерили для новой модели. Персонализация в реальном времени обозначена как продуктовый вызов; конкретного времени ответа системы доклад не задаёт.
Первая причина строить общие представления — разобщённость команд. Рекомендации ищут закономерности выбора товаров, а обнаружение мошенничества — подозрительные последовательности действий. Данные поведения пересекаются, поэтому одна обученная модель могла бы дать обеим командам полезные признаки. Векторное представление, или эмбеддинг, здесь — набор чисел, в котором модель сохраняет информацию о товаре либо последовательности действий. Общим должен стать этот слой описания поведения, а не обязательно все прикладные решения поверх него.
Вторая причина — нехватка данных о новом товаре, то есть холодный старт. Если представление связано только с выученным идентификатором, новая карточка ещё не имеет полезного вектора. Автор описывает такой товар как невидимый для рекомендаций и связывает проблему с потерей миллионов рублей в день. Расчёта этой оценки нет: она объясняет важность задачи, но не измеряет финансовый эффект UniSRec.
Третье направление — обнаружение аномалий: согласованные накрутки, подозрительные отзывы, использование одного аккаунта несколькими людьми. Здесь у поведения двойная роль. Оно может быть предметом отдельной проверки на мошенничество, а может оказаться шумом, который следует убрать из данных обычной модели. Доклад раскрывает работу над представлениями, но не показывает отдельного результата антифрода: ни точности обнаружения, ни числа предотвращённых нарушений.
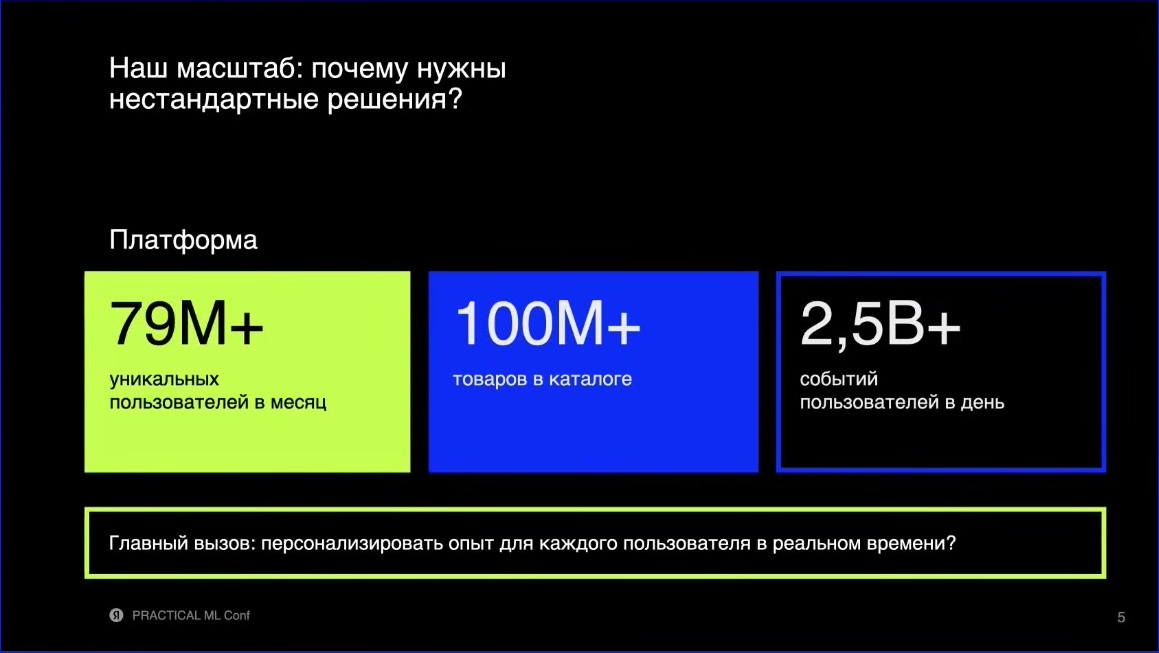
Более 79 млн уникальных пользователей в месяц,более 100 млн товаров,более 2,5 млрд событий в день описывают платформу. Стартовый эксперимент ниже использует гораздо меньшую выборку.
Источник: Карина Романова · Wildberries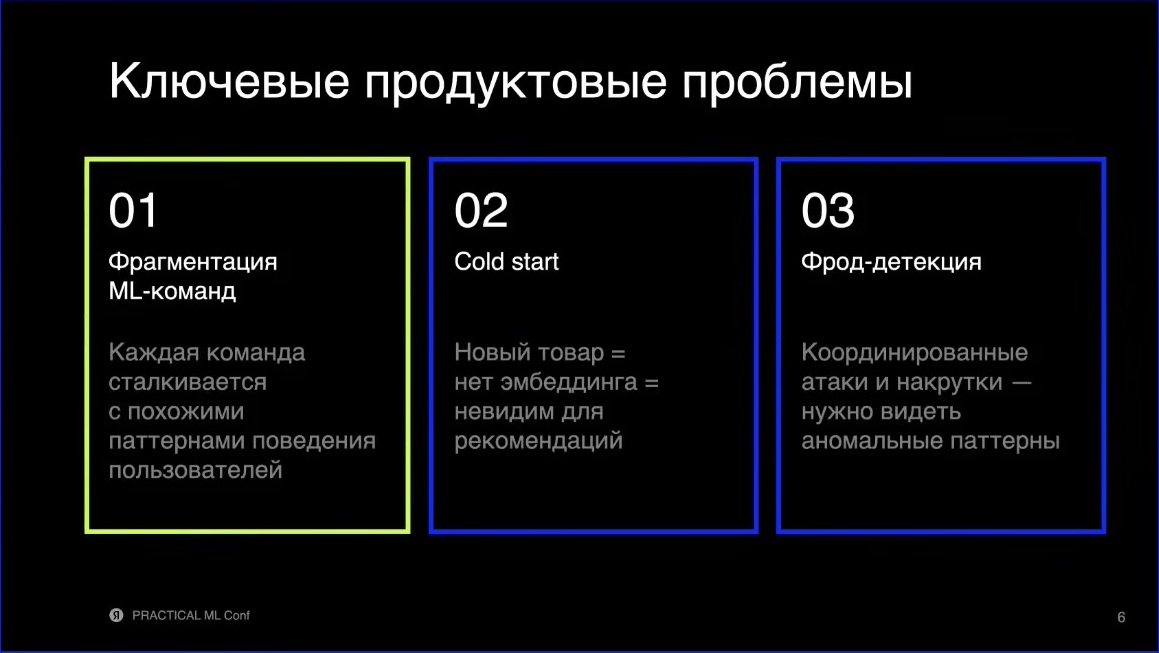
Фрагментация команд, новые товары без истории и выявление аномалий задают направления применения; отдельный эффект антифрода здесь не измерен.
Источник: Карина Романова · WildberriesСначала привести события в порядок
Чтобы объяснить, что модель должна извлечь из поведения, Карина показывает обезличенный пример. В 09:15 человек открывает iPhone 14 Pro, в 09:17 нажимает «Похожие товары», в 09:18 смотрит Samsung Galaxy S23, в 09:25 добавляет iPhone 14 Pro в корзину, а в 09:27 покупает. Такая сессия связывает события в осмысленную историю выбора. Указанные часы — время внутри иллюстрации, а не измеренная воронка или норматив длительности покупки.
Вектор сессии должен отражать не просто перечень карточек, а намерение, которое связывает действия. Однако иллюстрация шире фактических входов разобранной модели. В ответах на вопросы автор отдельно подтверждает: в выбранной конфигурации и целевые действия, и история ограничены покупками. Просмотры и добавления в корзину из примера нельзя автоматически переносить в её входную последовательность.
До обучения приходится разобраться с тремя видами проблем. Один и тот же товар встречается под разными идентификаторами. Длинные сессии содержат 1000 и более событий и не помещаются в доступный контекст модели. Общие аккаунты и случайные клики вносят шум. Для дублей на слайде названы методы хеширования и поиска похожих объектов MinHash+LSH; длинные сессии разбивают на фрагменты, шум фильтруют. Размер фрагмента, перекрытие между ними и пороги фильтрации не раскрыты.
- 01
Сырые события
Собрать события из доступных источников. В речи упоминаются источники с SQL и без него; конкретный набор хранилищ не перечислен.
- 02
Фильтрация
Отсеять шумные данные. Общие аккаунты и случайные клики приведены как примеры проблем, но точные правила отбора не названы.
- 03
Удаление дубликатов
Найти повторяющиеся или похожие карточки с разными идентификаторами. Для этого указаны MinHash+LSH, без параметров и порога совпадения.
- 04
Сессии и фрагменты
Организовать события в последовательности, а слишком длинные сессии разделить на части. Правило временной границы сессии не приведено.
- 05
Векторы товаров
Подготовить представления товаров, из которых затем строится вход последовательной модели.
Таким образом, подготовка данных — не техническая приписка к нейросети. Она определяет, какие события модель увидит как связанную историю и какие повторения или аномалии примет за пользовательское предпочтение. При этом обозначение проблемы не означает, что доклад раскрыл полный алгоритм её решения: воспроизводимых правил для каждого фильтра здесь нет.
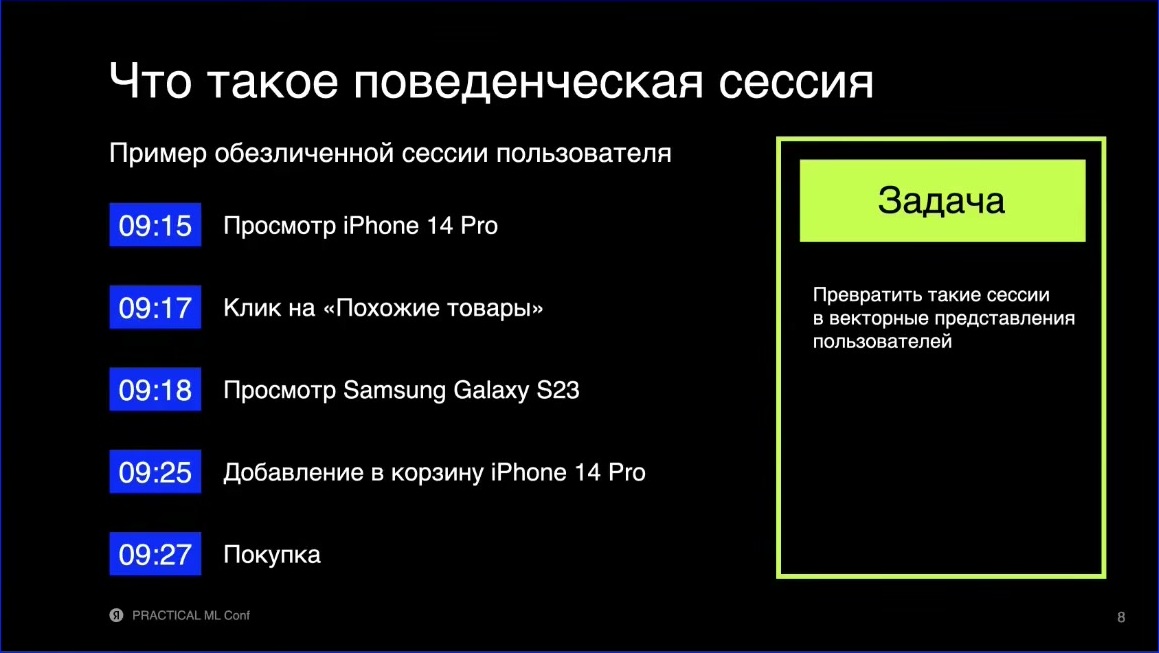
Просмотры, сравнение, корзина и покупка образуют последовательность. Это обезличенный иллюстративный пример, не измеренная пользовательская воронка.
Источник: Карина Романова · Wildberries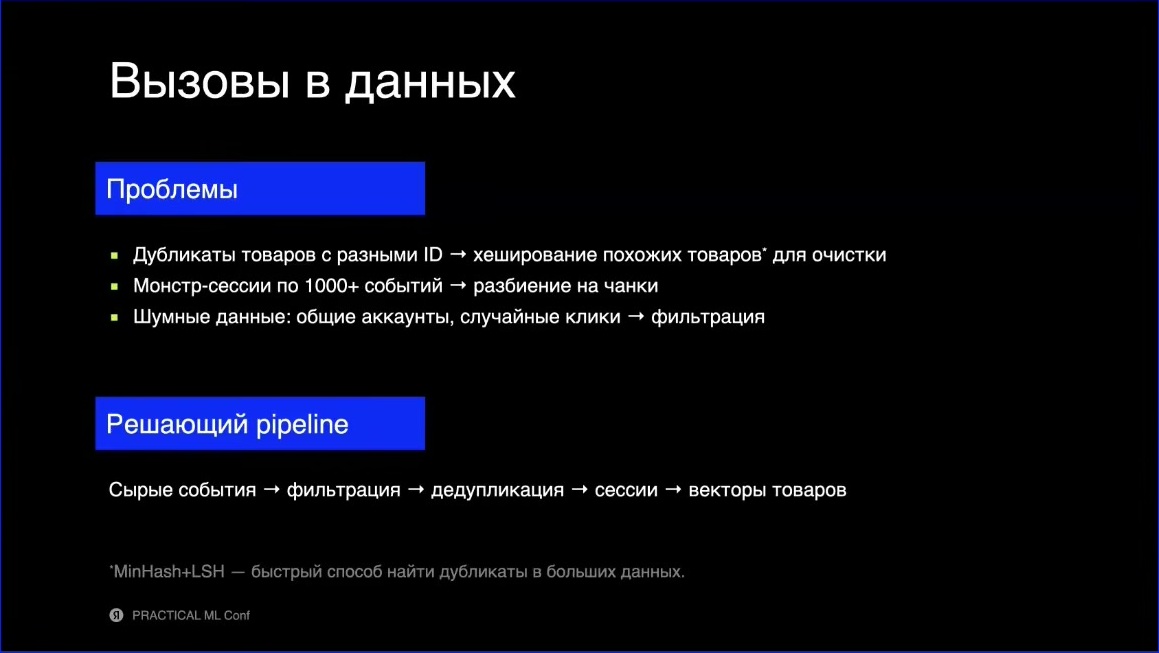
Фильтрация, дедупликация, разбиение длинных сессий и представления товаров предшествуют обучению. MinHash+LSH названы для поиска похожих дубликатов.
Источник: Карина Романова · WildberriesОписание товара даёт сигнал до появления истории покупок
Основная учебная задача — предсказать следующий товар по предыдущим покупкам. Автор объясняет её на продуктовом примере: после хлеба, молока и масла возможным продолжением могут быть яйца. Это сопоставление последовательности с товаром, или sequence-to-item. В реальном каталоге пространство выбора насчитывает около 100 млн товаров. Из этого не следует, что рабочая система перебирает весь каталог при каждом запросе: способ поиска по нему не описан.
Модель, опирающаяся на идентификаторы товаров, обучает представление конкретного номера по истории взаимодействий. Сам номер ничего не сообщает о содержании новой карточки. Поэтому проблема не в отсутствии идентификатора как такового, а в отсутствии накопленного опыта, который сделал бы его вектор полезным.
UniSRec добавляет другой источник информации — текст продавца. Модель-кодировщик, или энкодер, превращает описание товара в числовое представление. В исходном варианте эту роль выполняет трансформерный энкодер BERT. Новый товар можно описать через его содержание, не дожидаясь покупок именно этой карточки. Слова автора о работе «с первой минуты» относятся к такой возможности, а не к измеренному времени появления товара во всех рекомендательных интерфейсах.
Это уменьшает зависимость от накопленной ID-истории, но не доказывает одинаковое качество для всех новых товаров. В докладе нет отдельной таблицы качества на холодных карточках и нет описания того, как в выбранном позднее сочетании текста с ID обрабатывается совершенно новый идентификатор. Точная максимальная длина истории тоже не установлена: соответствующее число в автоматической расшифровке повреждено.
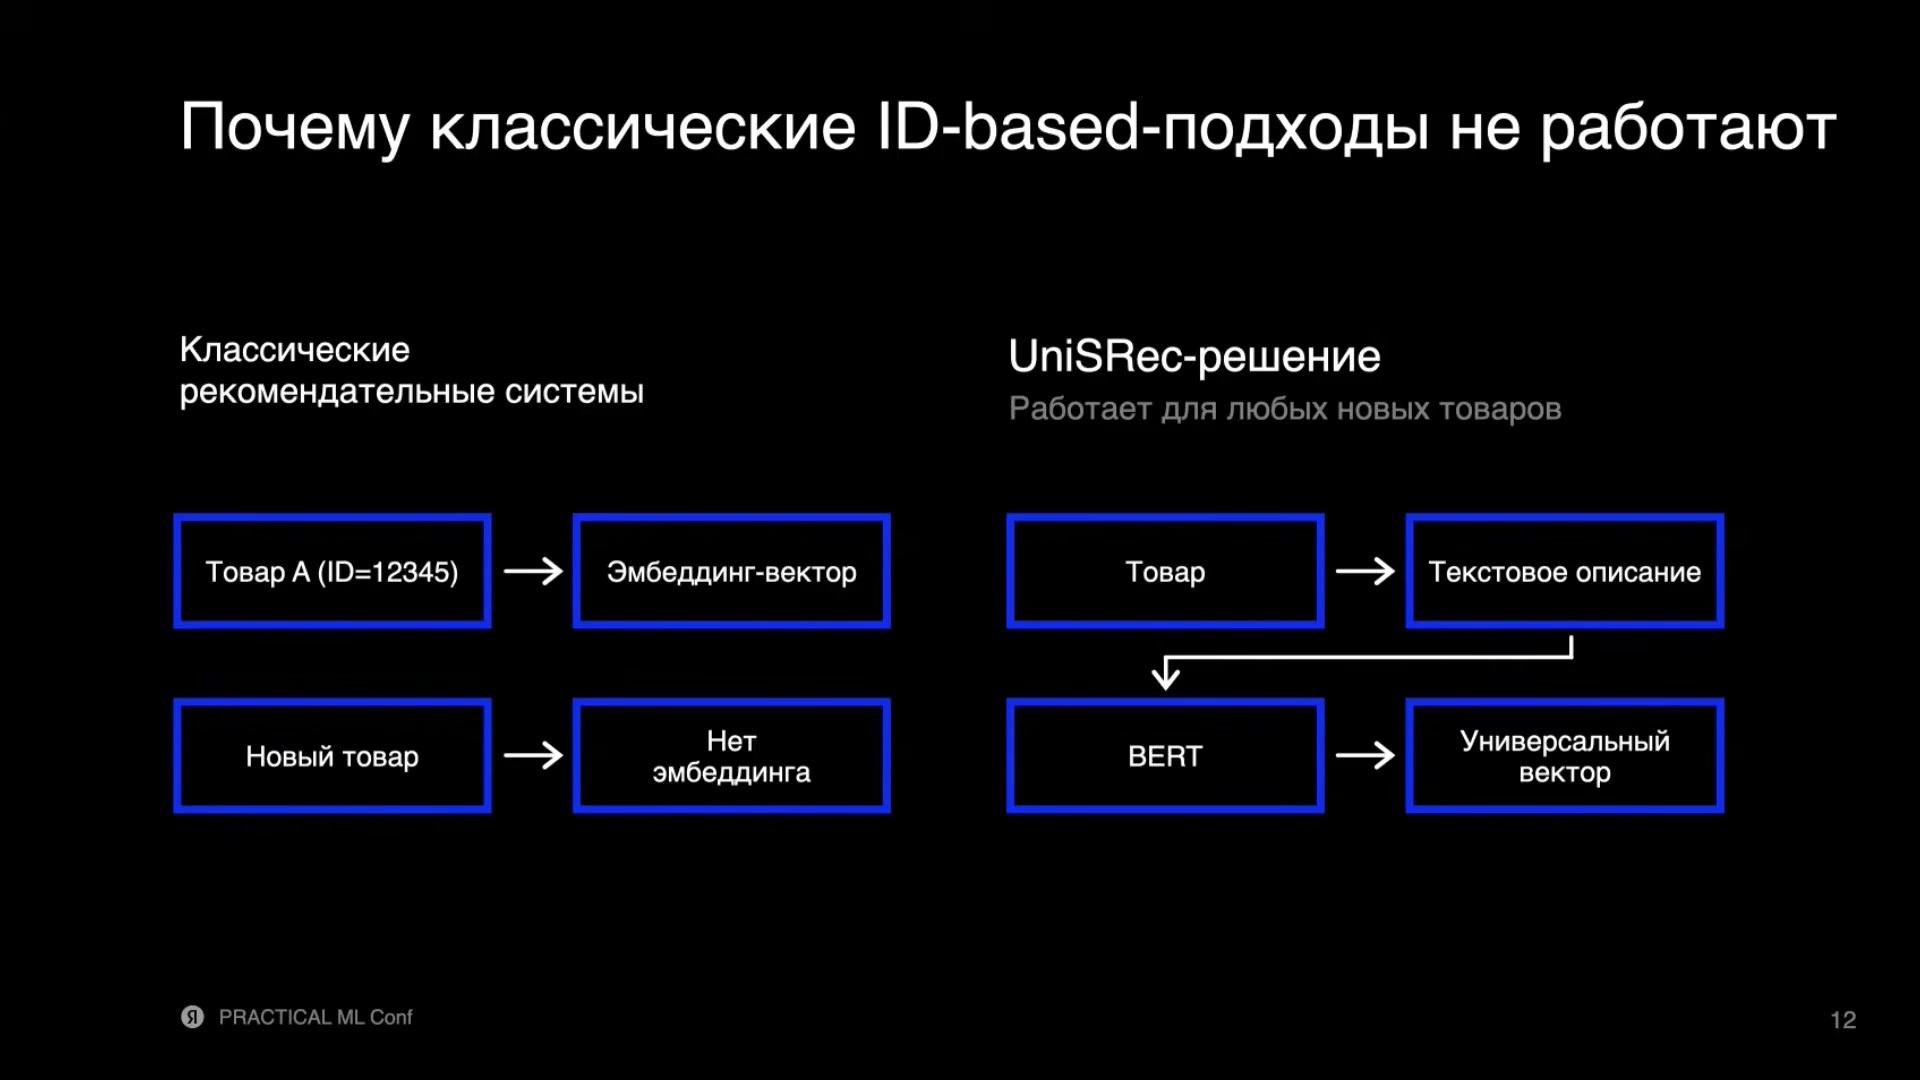
Текстовый энкодер позволяет получить представление нового товара из описания. Это уменьшает зависимость от обученного ID, но не доказывает одинаковое качество для любых новых карточек.
Источник: Карина Романова · WildberriesПочему текстовый вектор пришлось адаптировать к товарному домену
Одного универсального текстового энкодера оказалось недостаточно. Смартфон и корм для кошек принадлежат разным товарным областям: полезные различия внутри электроники не совпадают с различиями внутри зоотоваров. По словам автора, без дополнительной специализации модель путала контексты, представления плохо разделялись на группы, а популярные товары перетягивали обучение на себя.
Первый шаг после BERT — обучаемое преобразование, выравнивающее геометрию векторов, на слайде parametric whitening. Его задача — уменьшить анизотропию: ситуацию, когда представления чрезмерно сосредоточены в некоторых направлениях. Автор объясняет это как получение более равномерного пространства. Это не просто произвольное «взвешивание»: на исходном слайде явно указано преобразование для устранения анизотропии BERT.
Далее используется смесь экспертов, или mixture of experts (MoE). Эксперты-адаптеры — обучаемые преобразования, которые специализируются на разных доменах. Маршрутизатор (gating router) выбирает нужных экспертов по содержанию товара, а их результаты соединяются взвешенной комбинацией. Вектор после такой адаптации должен лучше передавать различия, важные именно для соответствующей товарной области.
Поясняющая схема показывает цепочку BERT → выравнивание представления → маршрутизатор → эксперты → взвешенная комбинация. Входной BERT-вектор имеет 768 координат. Число экспертов обозначено буквой G, а электроника, одежда и продукты на рисунке иллюстрируют специализации: три нарисованные ветви не устанавливают число экспертов в рабочем запуске. Не раскрыты также число одновременно выбираемых экспертов, глубина адаптеров и коэффициенты их смешивания.
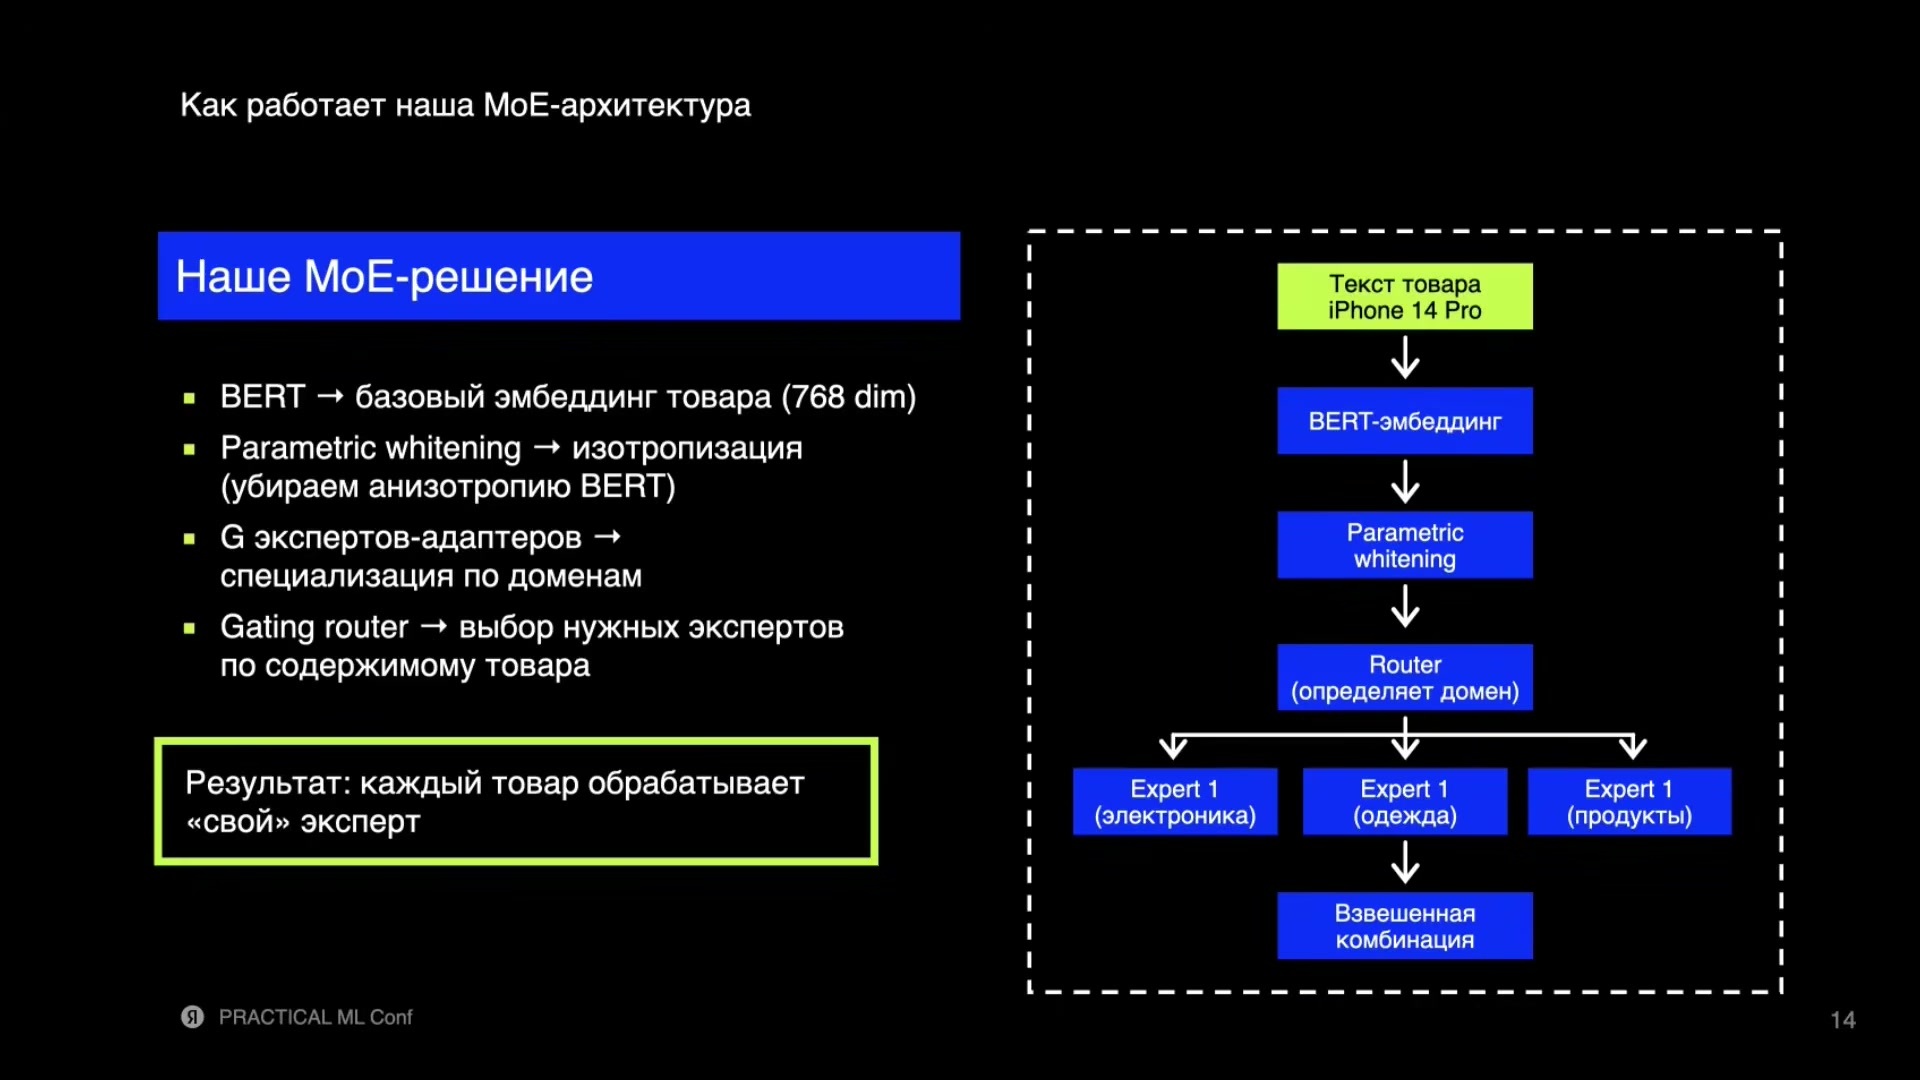
BERT-вектор, обучаемое преобразование и эксперты-адаптеры соединяются через маршрутизатор. Число экспертов в рабочем запуске не выводим из условного рисунка.
Источник: Карина Романова · WildberriesДве задачи связывают содержание товаров с поведением
Содержательно близкие товары ещё не образуют хорошую модель поведения. Нужно научиться различать подходящее продолжение истории и неподходящее, а также близкие по смыслу пользовательские последовательности. Для этого используется контрастивное обучение: модель сопоставляет положительные пары с отрицательными и учится различать их.
В задаче «последовательность — товар» история iPhone и чехла соединяется с AirPods как с положительным примером продолжения. Молоток в том же примере — отрицательное продолжение, которое модель должна оценивать ниже. Это иллюстрация устройства учебной пары, а не правило, что каждый покупатель телефона обязательно захочет наушники.
Во второй задаче сравниваются две истории — sequence-to-sequence. Последовательности «iPhone, чехол, AirPods» и «iPhone, зарядка, AirPods» показаны как похожие, а «хлеб, молоко, масло» — как отличающаяся. На академической схеме положительный партнёр обозначен как изменённая версия последовательности. Конкретные способы такого изменения в реализации Wildberries не описаны.
Автор связывает вторую задачу с добавлением коллаборативной информации — закономерностей совместного поведения, а не только сходства текстов. Название sequence-to-sequence здесь не означает, что модель генерирует новую историю покупок по токенам: показано контрастивное сопоставление представлений. Формулы двух потерь, их относительные веса и полный способ формирования положительных и отрицательных пар не раскрыты.
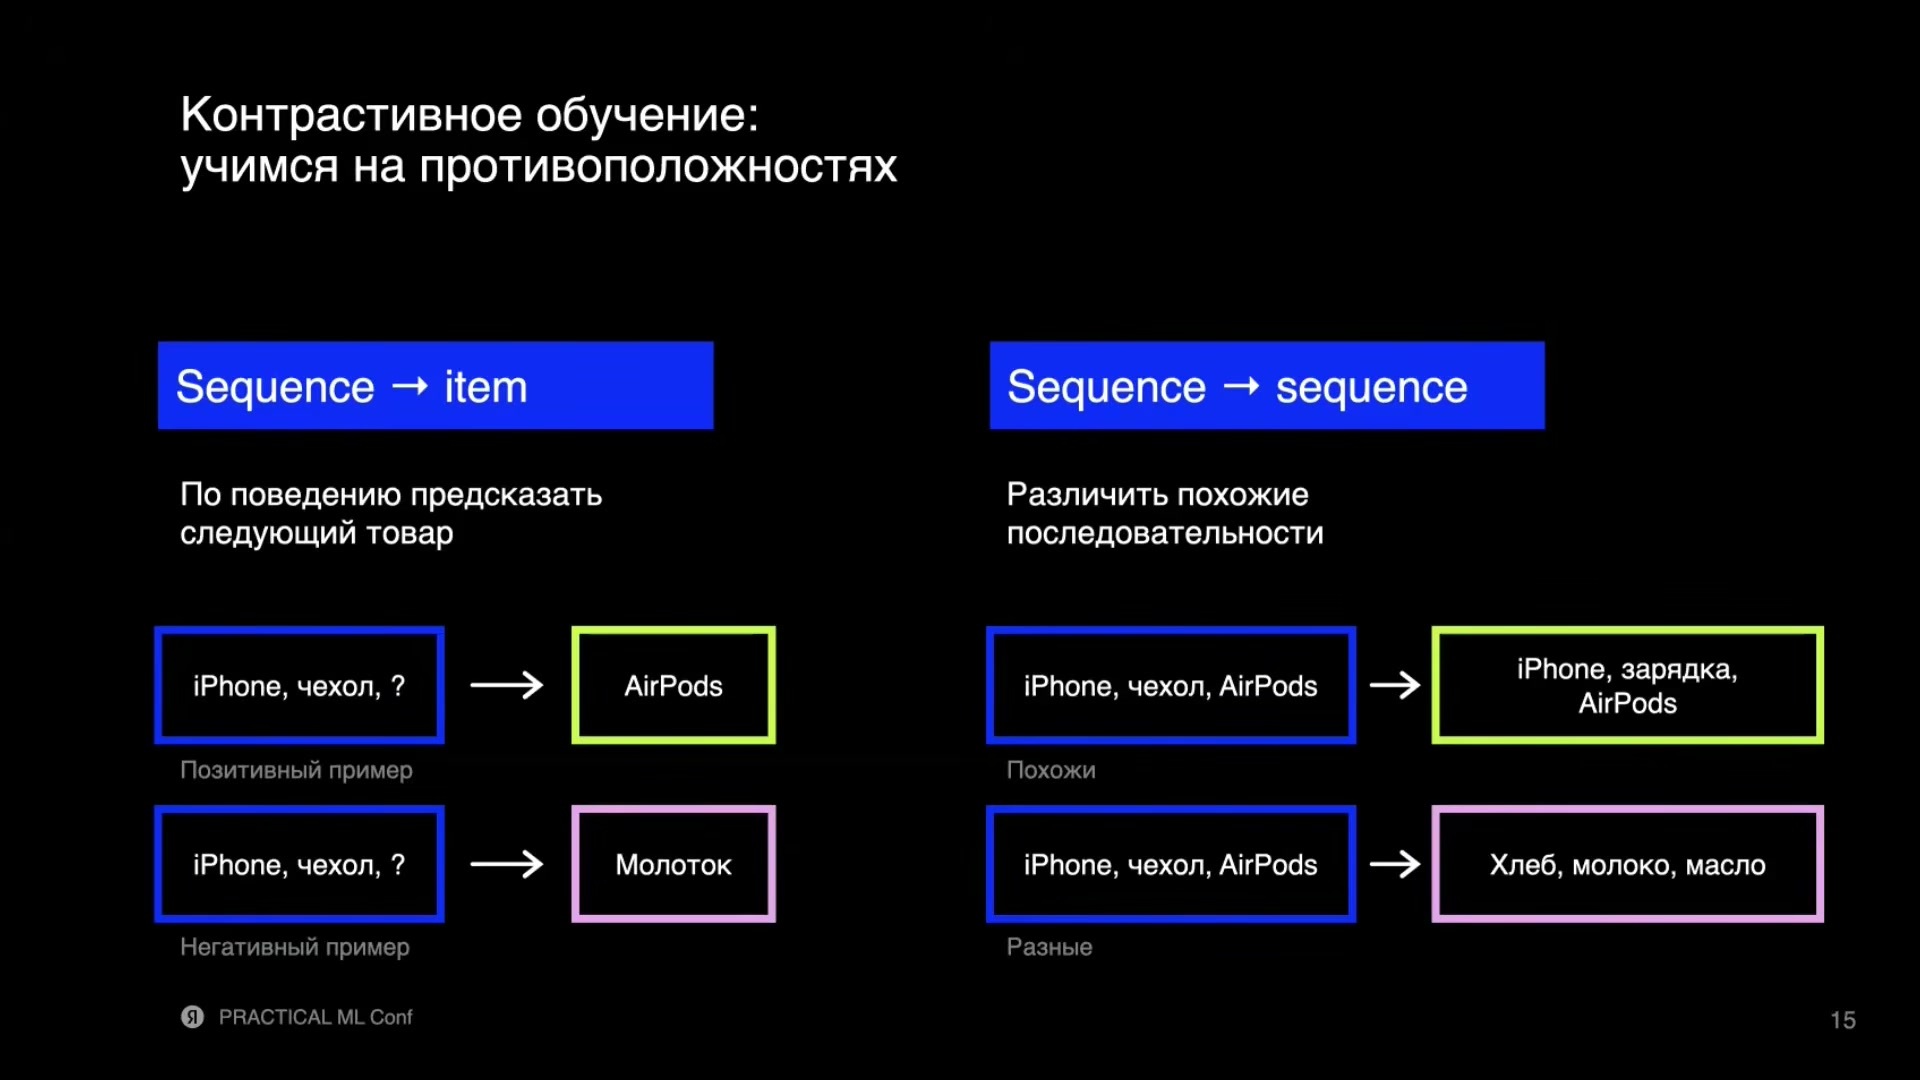
Последовательность сопоставляют с будущим товаром и с другой последовательностью. Телефон, AirPods и молоток на слайде иллюстрируют положительные и отрицательные примеры.
Источник: Карина Романова · WildberriesКак собрать модель и что означает дообучение с идентификаторами
После адаптации отдельных товаров их векторы поступают в последовательную модель на основе SASRec. Это трансформерное ядро, которое превращает историю товаров в представление поведения. Отдельный выходной модуль для контрастивного обучения, на слайде contrastive head, сравнивает положительные и отрицательные примеры. Здесь разделяются две функции: понять содержание отдельной карточки и получить представление всей истории.
В объяснении применения Карина начинает с идентификаторов товаров, которые покупал пользователь. К ним добавляются текстовые представления, затем работают адаптеры и последовательностное ядро. Однако в этой же реплике автор возвращается к двум учебным задачам. Это не основание считать, что при каждом пользовательском запросе заново строятся контрастивные пары и обновляются веса. Доклад задаёт общую цепочку получения представления, но не полный протокол обслуживания запросов.
Обучение делится на предварительное обучение по текстовым представлениям и дообучение под конкретную постановку, или fine-tuning. Показанная академическая схема различает два режима. В первом используются только текстовые представления: такой режим назван индуктивным (inductive), поскольку он допускает получение представления нового товара из его текста. Во втором к тексту добавляются обучаемые представления конкретных ID: этот режим назван трансдуктивным (transductive).
На академической схеме исходный предварительно обученный текстовый энкодер помечен как фиксированный. В обоих изображённых режимах дообучения кодировщик поведения также имеет пометку «parameters fixed». Эти подписи описывают показанную схему UniSRec, а не доказывают полный набор правил замораживания для каждого эксперимента Wildberries. Какие параметры команда реально обновляла на всех стадиях и после замены текстового энкодера, не перечислено.
Решение команды в речи определено однозначнее: для дообучения выбрали текст вместе с идентификаторами. Таким образом, содержание не заменяет всю информацию о конкретном товаре, а сочетается с ней. Знак сложения на академическом рисунке не позволяет восстановить все детали объединения в производственной версии. Количество слоёв SASRec, размер итогового поведенческого вектора и схема работы с отсутствующим обученным ID остаются неизвестными.
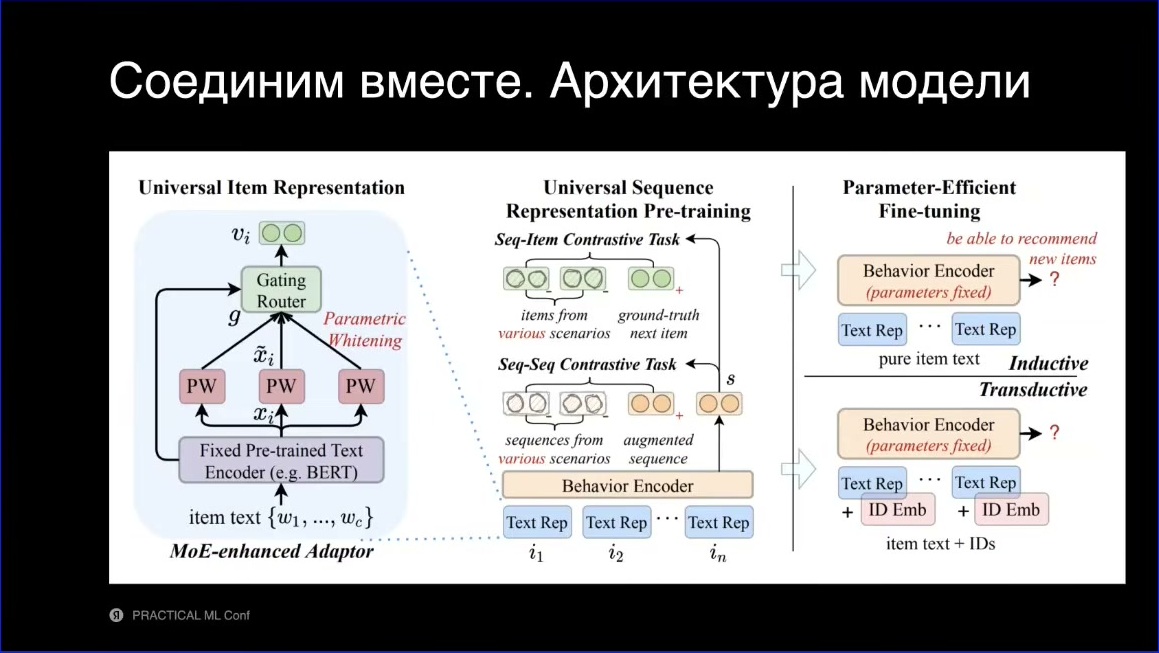
Показаны представление товара, предварительное обучение последовательностей и режимы дообучения. Схему из работы необходимо отличать от всех деталей конкретного запуска Wildberries.
Источник: Карина Романова · WildberriesПервый запуск не дал полезного качества сам по себе
Стартовали не со всего каталога. В первом эксперименте использовали 250 тысяч пользователей и 850 тысяч товаров, а текстовые представления получали с помощью BERT-base-multilingual-uncased с размерностью 768. Сравнивать эти объёмы с масштабом платформы важно: работа с более чем 100 млн карточек в продукте не означает, что именно столько товаров участвовало в этом обучении.
Качество оценивали по попаданиям целевых товаров в первые 200 результатов — HitRate@200, и точности состава этой части списка — Precision@200. Отдельно смотрели на разделимость групп в пространстве представлений, которую характеризует силуэтный коэффициент (Silhouette score). Последний описывает геометрию векторов, а не покупки пользователей. Подробные правила усреднения метрик и формирования проверочного набора не приведены.
Таблицу можно прокрутить по горизонтали.
Отрицательная оценка разделимости и слабые показатели списка означали, что перенос архитектурной идеи ещё не решил задачу. Значение −0,12 автор упоминает и при объяснении проблем без доменной специализации. Это согласуется с мотивацией адаптеров, но не заменяет отдельного контролируемого сравнения всех компонентов. После такого старта команда сначала попыталась повысить качество усложнением смеси экспертов.
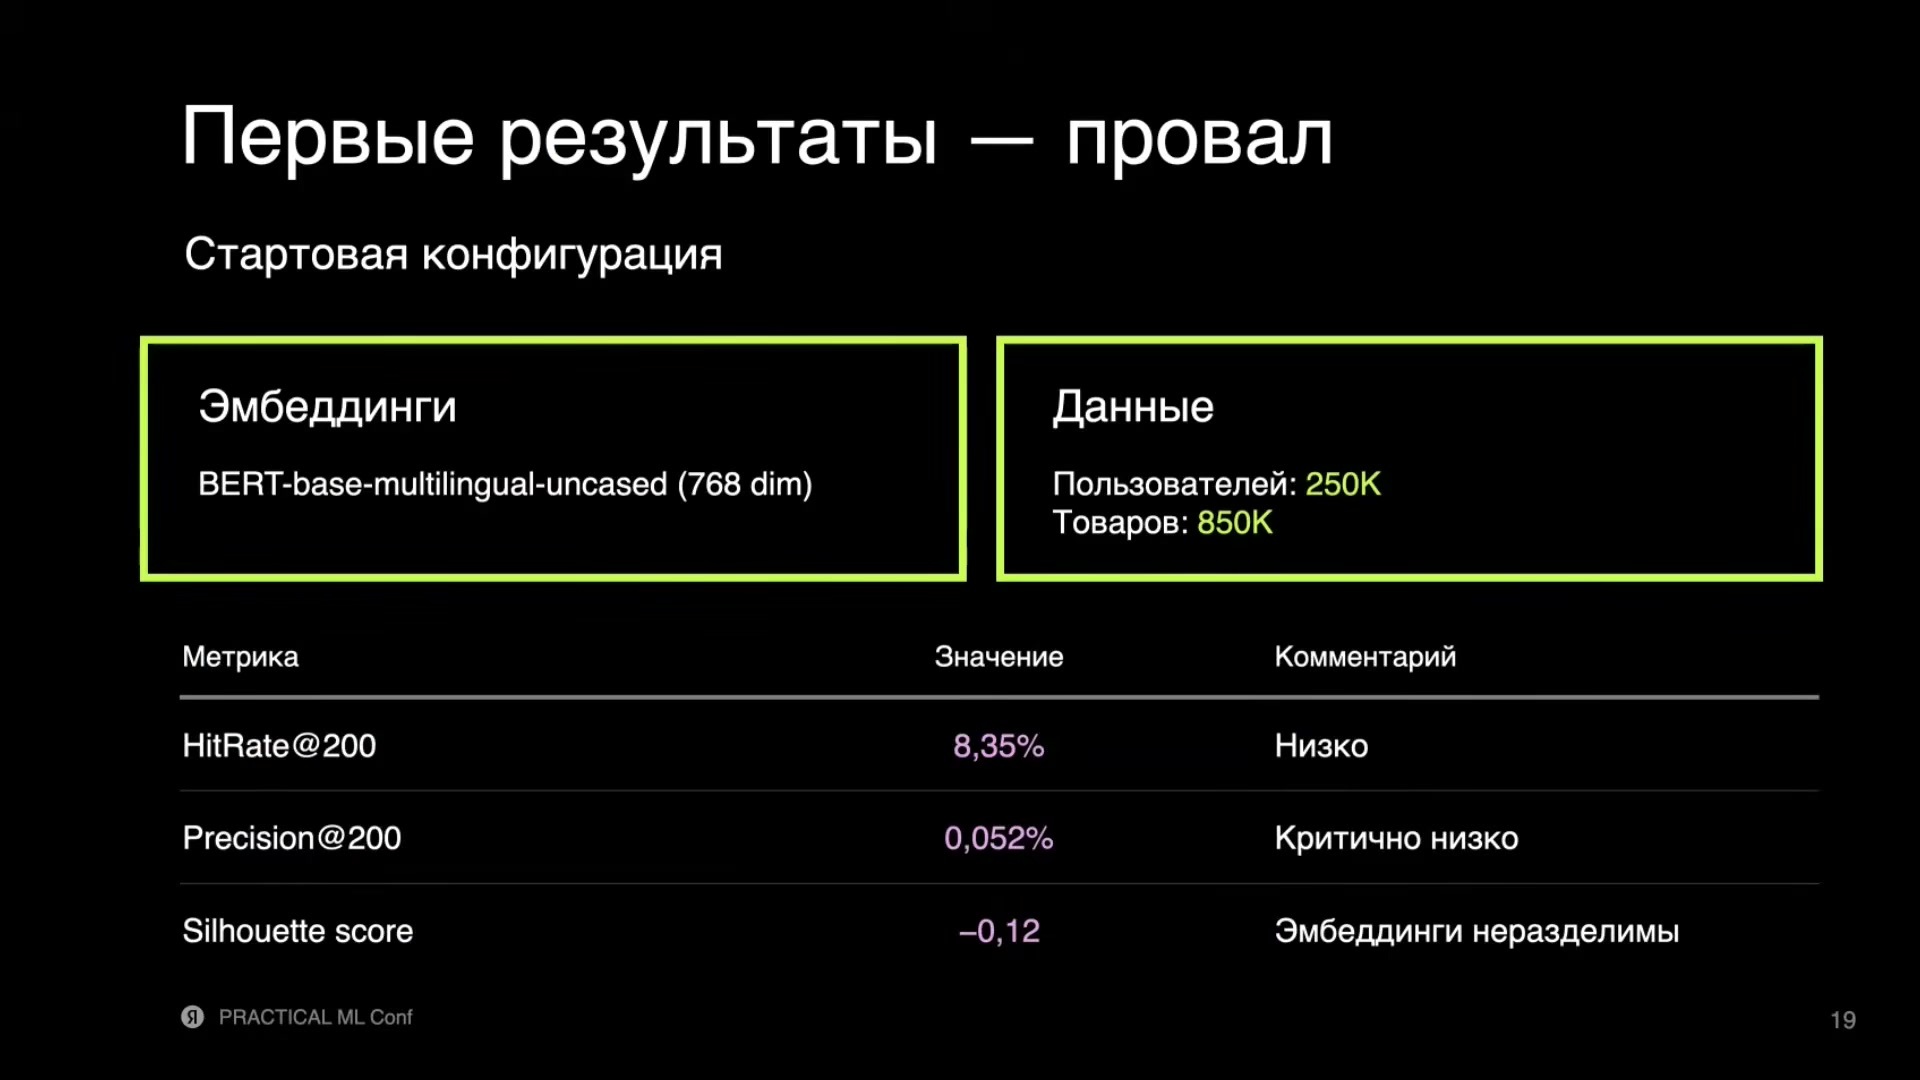
BERT с размерностью 768, 250 тысяч пользователей и 850 тысяч товаров: HitRate@200 — 8,35%,Precision@200 — 0,052%,Silhouette — −0,12. Это отдельный исходный эксперимент.
Источник: Карина Романова · WildberriesЗаимствованная идея сложного MoE проиграла базовой смеси
Гипотеза была понятной: если эксперты дают полезную специализацию, более развитая организация экспертов должна помочь ещё сильнее. Команда обратилась к идее MoE из работ DeepSeek. Это адаптация архитектурного принципа к представлениям товаров, а не установка готовой большой языковой модели DeepSeek в рекомендательную систему.
В показанном варианте есть общие эксперты, которые хранят информацию для всех доменов, и специализированные эксперты, подключаемые в зависимости от входа. Для общих экспертов указан диапазон 2–4, для маршрутизируемых — 6–8. Сеть выбора подключает K наиболее подходящих экспертов, но значение K не названо. Эти диапазоны относятся к описанию усложнённой архитектуры, а не устанавливают число экспертов финальной модели.
В речи механизм выбора объясняется как диспетчер, который может учитывать входной контекст и общую нагрузку, чтобы не направлять всё к одним экспертам. Предполагалось, что общая часть уменьшит дублирование знаний, а специализированная сохранит разнообразие. Фактическое сравнение оказалось противоположным ожиданию.
Таблицу можно прокрутить по горизонтали.
Сложная модель проиграла по обеим показанным величинам. При этом базовый HitRate здесь равен 9,35%, а не 8,35% из стартового эксперимента: это другая точка сравнения. Показатель Revenue автор называет выручкой, но его определение, нормировка и охват не раскрыты. Разница −10,1 п.п. относится к двум значениям этой таблицы; она не доказывает падения всей выручки Wildberries и не снабжена протоколом A/B-теста.
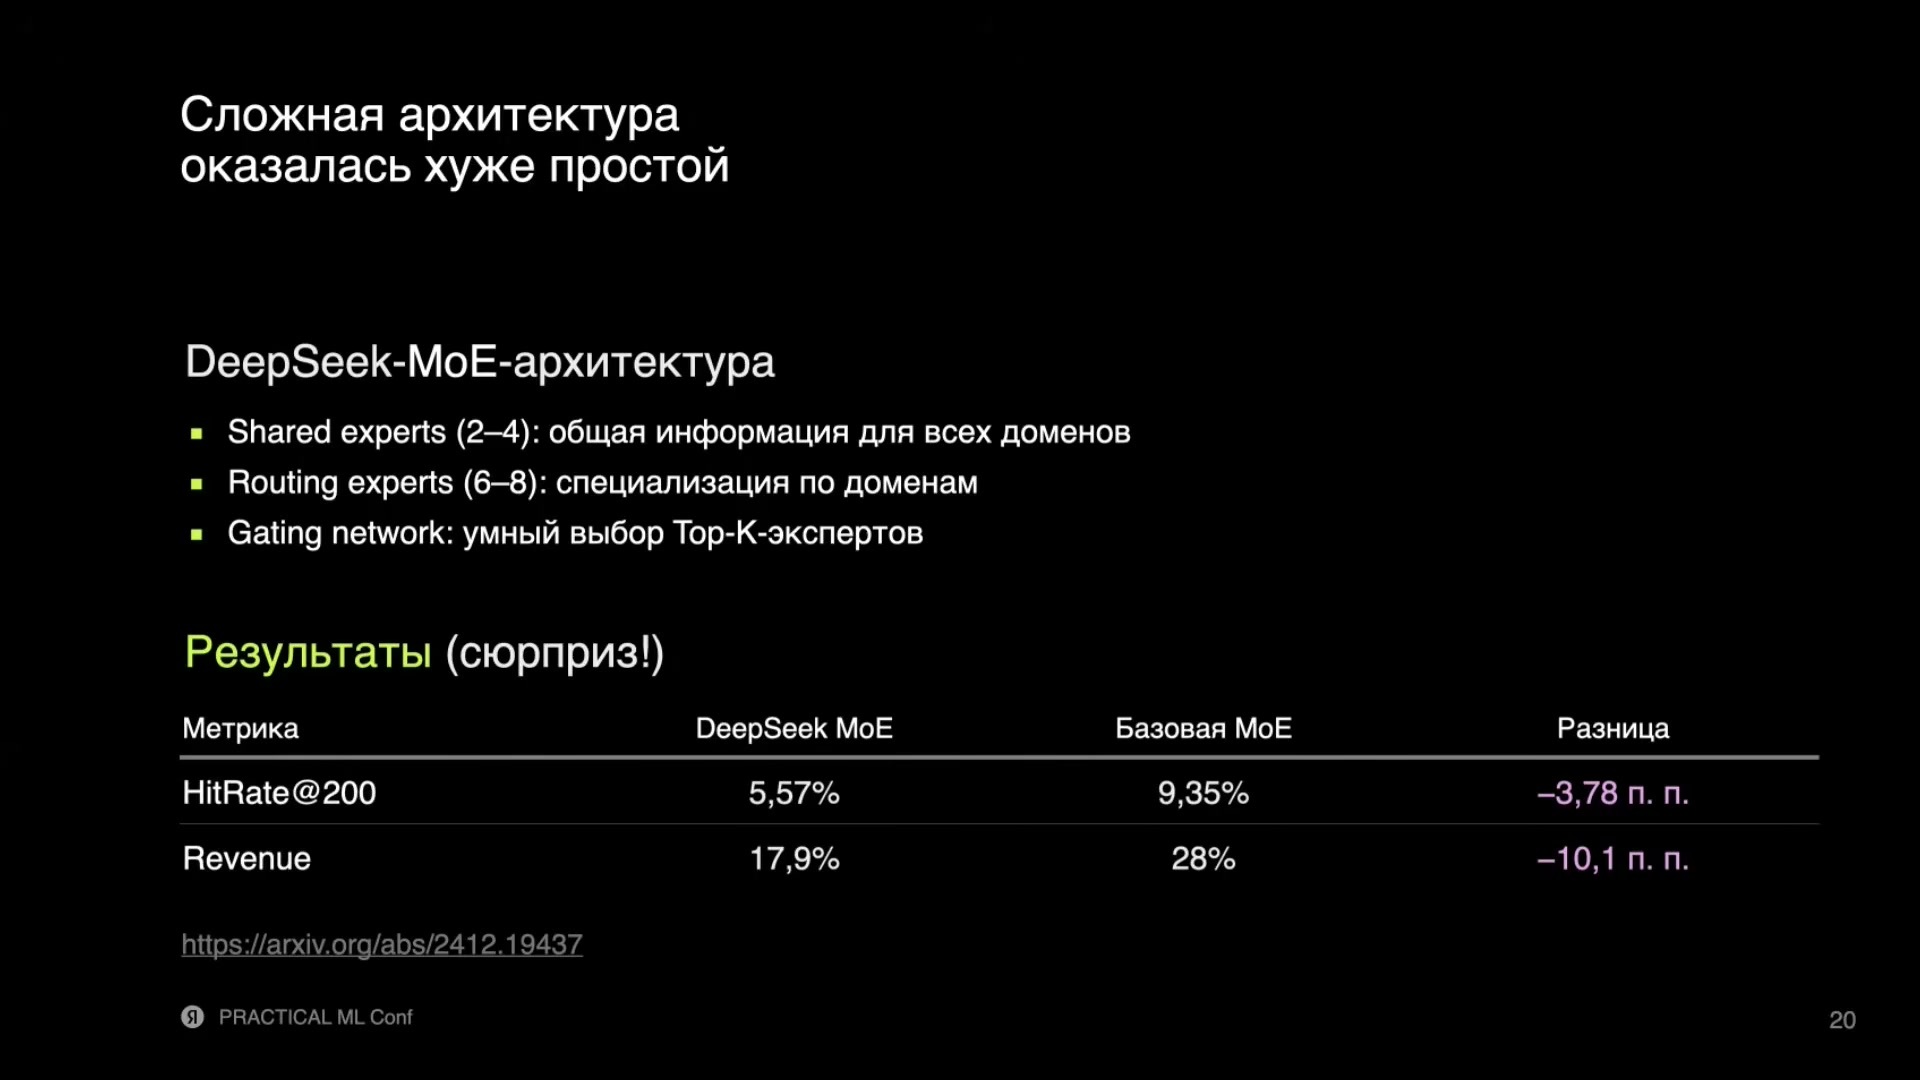
На слайде DeepSeek-MoE — 5,57% против базовой MoE — 9,35% по HitRate@200; Revenue — 17,9% против 28%. Определение Revenue и полный протокол сравнения не раскрыты.
Источник: Карина Романова · WildberriesСтабилизировать обучение оказалось полезнее, чем усложнять архитектуру
После неудачи команда сместила внимание с устройства экспертов на численное поведение обучения. Добавили дополнительный штраф при обучении — регуляризацию Z-Loss. Автор описывает её как ограничение слишком больших логитов. Логиты — числовые оценки до преобразования в вероятности. Чрезмерные значения могут приводить к переполнению при вычислении экспоненты; именно этот риск обозначен на слайде.
По объяснению Карины, регуляризация предотвращает численную нестабильность, улучшает прохождение градиентов и делает обучение более плавным. В сравнении показываются характер сходимости, качество порядка первых 200 результатов с учётом их позиций (NDCG@200) и силуэтный коэффициент.
Таблицу можно прокрутить по горизонтали.
В показанном сравнении NDCG увеличилась на 0,2 процентного пункта, а силуэтный коэффициент — на 0,09 в абсолютных единицах. Это арифметические разности значений таблицы, не отдельные измерения. Формулы Z-Loss, её коэффициента и точного места приложения в модели нет. Поэтому описание нельзя дополнять привычной формулой из другой работы или утверждением, что штраф действовал именно на определённый маршрутизатор.
Автор формулирует вывод как преимущество стабильности над сложностью в их эксперименте. Причины провала сложного MoE обсуждаются осторожнее: у команды могли отличаться размерные соотношения по сравнению с исходной работой, а товарные данные были более узконаправленными. Какое именно соотношение размеров имелось в виду, расшифровка не позволяет надёжно восстановить.
Эти объяснения остались гипотезами. Карина прямо говорит, что команда могла продолжить их проверку, но сосредоточилась на ключевых метриках. Значит, доклад показывает практический выбор более удачного решения, а не доказательство универсальной причины, по которой сложные смеси экспертов должны проигрывать в рекомендациях.
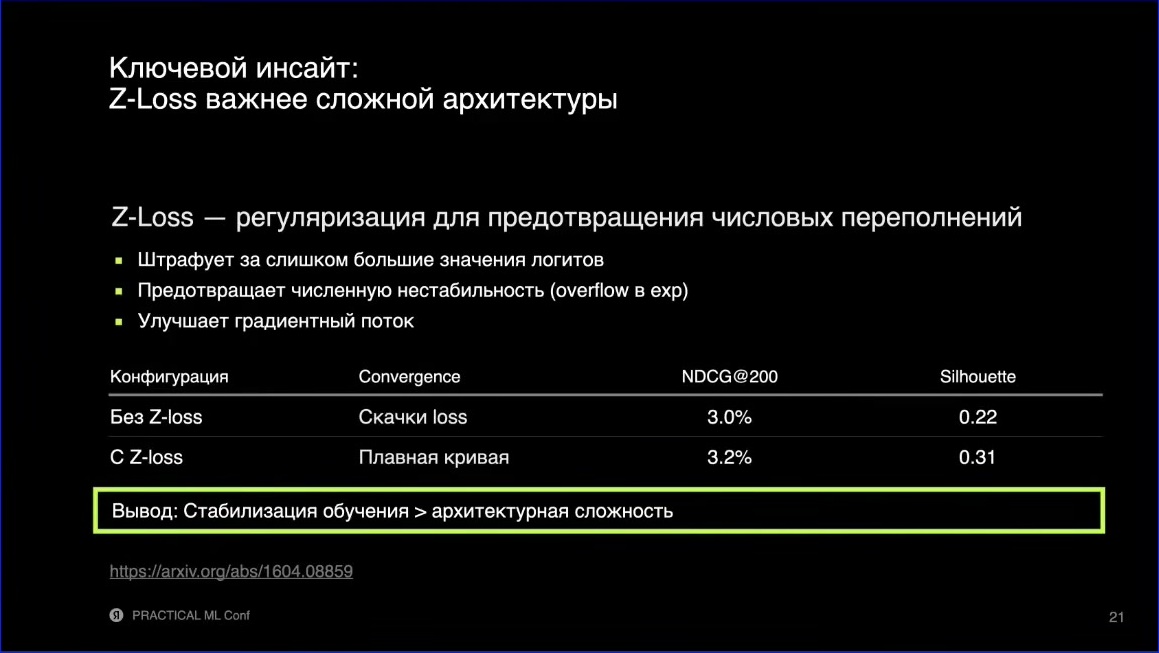
Z-Loss сопоставлен со скачущим loss: NDCG@200 — 3,0% → 3,2%,Silhouette — 0,22 → 0,31. Формулу регуляризации и её коэффициент слайд не задаёт.
Источник: Карина Романова · WildberriesКомпактный текстовый энкодер и изображения меняют представление товара
Ещё одной линией развития стала замена базового текстового представления. В итоговой ретроспективе после BERT-768 появляется вариант Matryoshka-64. В речи соответствующий шаг описан как переход к внутреннему текстовому энкодеру вместо BERT, который дал компактность и небольшой прирост качества. Название этапа известно, но подробности архитектуры и обучения этого энкодера не раскрыты; восстанавливать их по одному имени нельзя.
Более заметное изменение связано с изображениями. Текстовые формулировки вроде «смартфон Apple iPhone» и «телефон Apple iPhone» могут слабо передавать различия в дизайне, цвете и внешнем виде. Автор в речи упрощает это до одинаковых векторов, но технический смысл аргумента — потеря визуальной информации. Из него не следует, что энкодер обязан выдавать буквально одинаковые числа для любых похожих описаний.
Команда сравнила текст, изображения и их сочетание. Представления изображений обозначены как CV — признаки компьютерного зрения. Такой подход с несколькими видами исходных данных называют мультимодальным. Для сочетания автор описывает усреднение нормализованных векторов. Конкретный визуальный энкодер, способ согласования размерностей и полный порядок преобразований относительно адаптеров не названы.
Таблицу можно прокрутить по горизонтали.
Последняя колонка содержит качественное описание групп на визуализации векторов после уменьшения размерности методом UMAP. Это помогает понять наблюдение автора о разделимости, но не является ещё одной метрикой пользовательского или финансового эффекта.
Главный прирост в этой таблице относится к HitRate@200: от 9,03% у текста до 13,47% у сочетания модальностей. Разность равна 4,44 п.п.; относительно исходных 9,03% это около 49%, что и вынесено в вывод слайда. Иными словами, «в полтора раза» здесь получает конкретное основание: почти в полтора раза выше значение данной метрики по сравнению с текстовым вариантом. Это не рост выручки на 49%.
Название Matryoshka-64 и результат мультимодального сравнения не дают основания придумать точную формулу смешивания или заявить, что вся модель стала 64-мерной. Известны смысл замены текстового энкодера и способ сочетания на уровне речи; все остальные размерности и детали реализации остаются за пределами доклада.
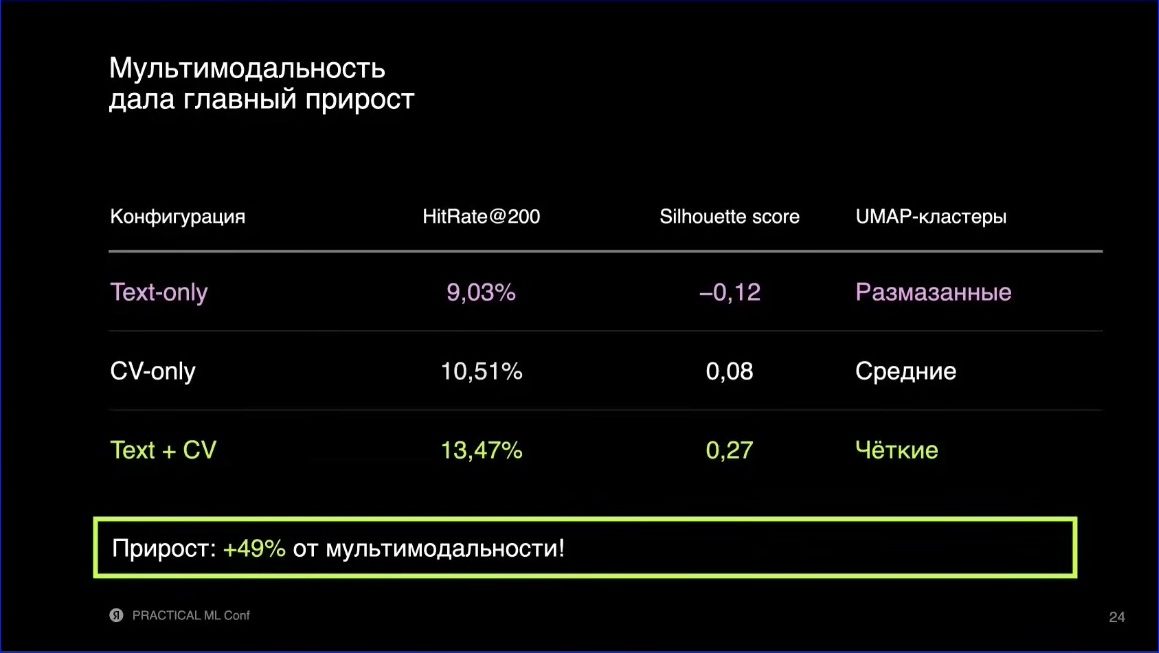
В этой таблице HitRate@200: Text-only — 9,03%, CV-only — 10,51%, Text + CV — 13,47%. +49% относительно текста относится к этому сравнению, не к выручке.
Источник: Карина Романова · WildberriesПохожий товар учит большему, чем очевидно неподходящий
Если положительный пример — iPhone, а отрицательный — лопата, задача различения слишком проста. Она мало требует от способности модели замечать тонкие различия между товарами. Поэтому команда добавила сложные отрицательные примеры (hard negatives): в иллюстрации покупке iPhone 14 Pro противопоставляется iPhone 14.
Практическая схема отбора описана довольно конкретно. Сначала находят семантически близкие товары и сохраняют соответствия в таблицу. Затем, когда товар встречается как целевой в обучающем примере, к нему подтягивают связанные сложные отрицательные примеры. Это подготовка учебных сопоставлений, а не дополнительный поиск неподходящих товаров при каждом запросе покупателя.
В отдельном сравнении измеряются полнота первых десяти результатов (Recall@10) и разброс представлений внутри групп (intra-cluster variance). Автор характеризует полученные улучшения как скромные, но стабильные.
Таблицу можно прокрутить по горизонтали.
По таблице вырос Recall@10, а внутригрупповой разброс уменьшился. Относительное увеличение Recall, рассчитанное из этих значений, составляет около 7,8%. Оно не равно заявлению «до +55%», которое появится в заключительном слайде: там автор не указывает ни метрику, ни базу сравнения.
Число соседей, алгоритм их поиска и частота обновления таблицы не названы. Остаётся и содержательное ограничение: похожий непокупавшийся товар не обязательно неинтересен пользователю. Поиск по близости сам по себе этого не доказывает; процедура исключения ошибочно отрицательных примеров в докладе не описана. Поэтому известный приём нельзя считать полностью раскрытым рецептом отбора.
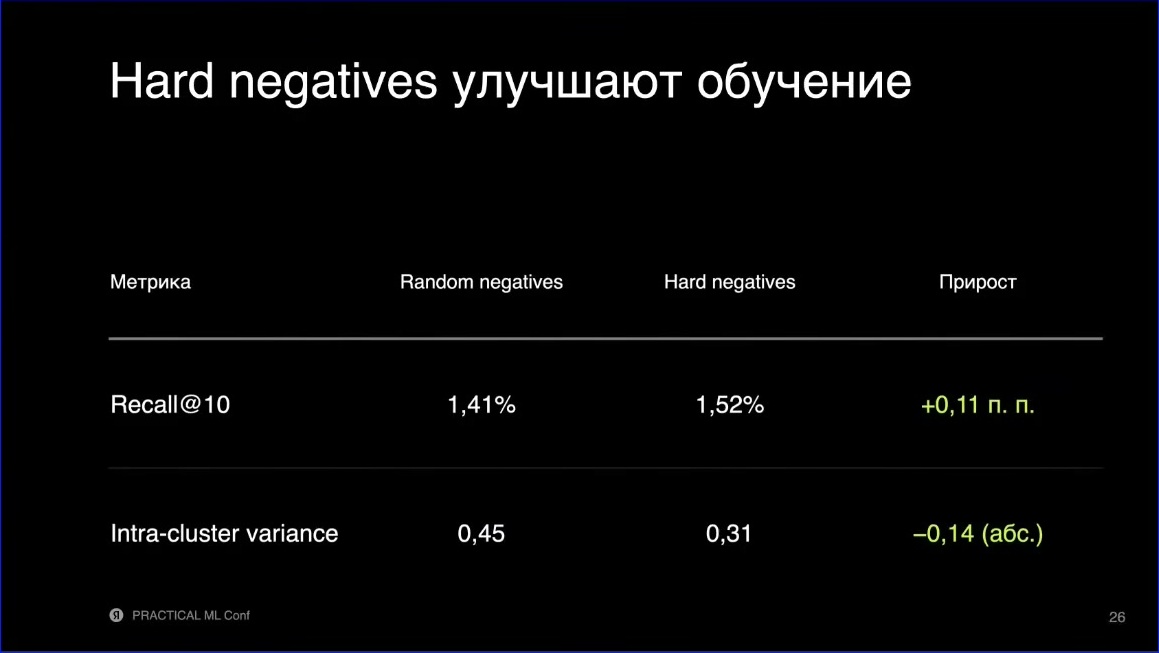
Recall@10 — 1,41% со случайными и 1,52% со сложными отрицательными примерами; внутригрупповой разброс — 0,45 против 0,31. Это отдельное сравнение, его нельзя подменять таблицей смещения к популярному или заявлением до +55%.
Источник: Карина Романова · WildberriesМеньше перекоса к популярному — не обязательно лучше по остальным метрикам
Популярность способна подменить персонализацию. Автор приводит пример человека, который интересуется винтажной одеждой, но получает iPhone вместо подходящих джинсов. Такой перекос к часто встречающимся объектам называют смещением к популярному (popularity bias). В экспериментах его характеризует отдельная величина Top bias; формальное определение этой метрики в материале не приведено.
Команда обсуждает три способа вмешательства. Первый — балансировать обучающую выборку по популярности, то есть применять стратифицированный отбор (stratified sampling). Второй — повышать вес редких товаров при обучении; в речи это названо IPS-подобным подходом, без точной формулы весов. Третий — использовать популярные товары как сложные отрицательные примеры. Общая цель — ослабить преимущество объектов, которое связано с их частотой, а не с соответствием конкретной истории.
Таблицу можно прокрутить по горизонтали.
Первое противоречие видно уже в строке сложных отрицательных примеров. Комментарий «Slight improvement» означает небольшое улучшение, однако HitRate снижается с 11,56% до 11,22% — на 0,34 п.п. Top bias уменьшается на 1 п.п., а Revenue остаётся 38,3%. Поэтому корректный вывод — ослабление перекоса при небольшом ухудшении попаданий и неизменной Revenue, а не общий рост качества. Это отдельное сравнение, его нельзя подменять ростом Recall@10 в предыдущей таблице.
Стратификация даёт гораздо более сильное снижение Top bias, но цена в остальных колонках тоже выше. При добавлении стратифицированного отбора HitRate становится 8,02%, а Revenue — 20,5%. Самый жёсткий вариант Pure stratified снижает Top bias до 4,5%, но одновременно даёт только 4,38% HitRate и 11,0% Revenue. Именно этот неудобный результат показывает, почему минимизация одного перекоса не может автоматически считаться победой всей системы.
Словесный перечень гипотез и строки таблицы не совпадают один к одному. В частности, отдельной строки с результатом IPS-подобного перевзвешивания нет; приписывать ему результат Pure stratified нельзя. В речи автор почти пропускает обсуждение одной неудачной гипотезы, но отрицательные результаты жёсткой стратификации на слайде представлены явно.
Карина называет это компромиссом между справедливостью и выручкой и говорит о выборе не слишком жёстких условий. При этом справедливость отдельно не определена: измерено изменение Top bias, а не соответствие формальному критерию справедливого распределения показов. Revenue также остаётся названием неопределённой метрики. Таблица показывает её ухудшение в данном сравнении, но не устанавливает потери всей платформы в деньгах и не раскрывает конкретные коэффициенты выбранного рабочего компромисса.
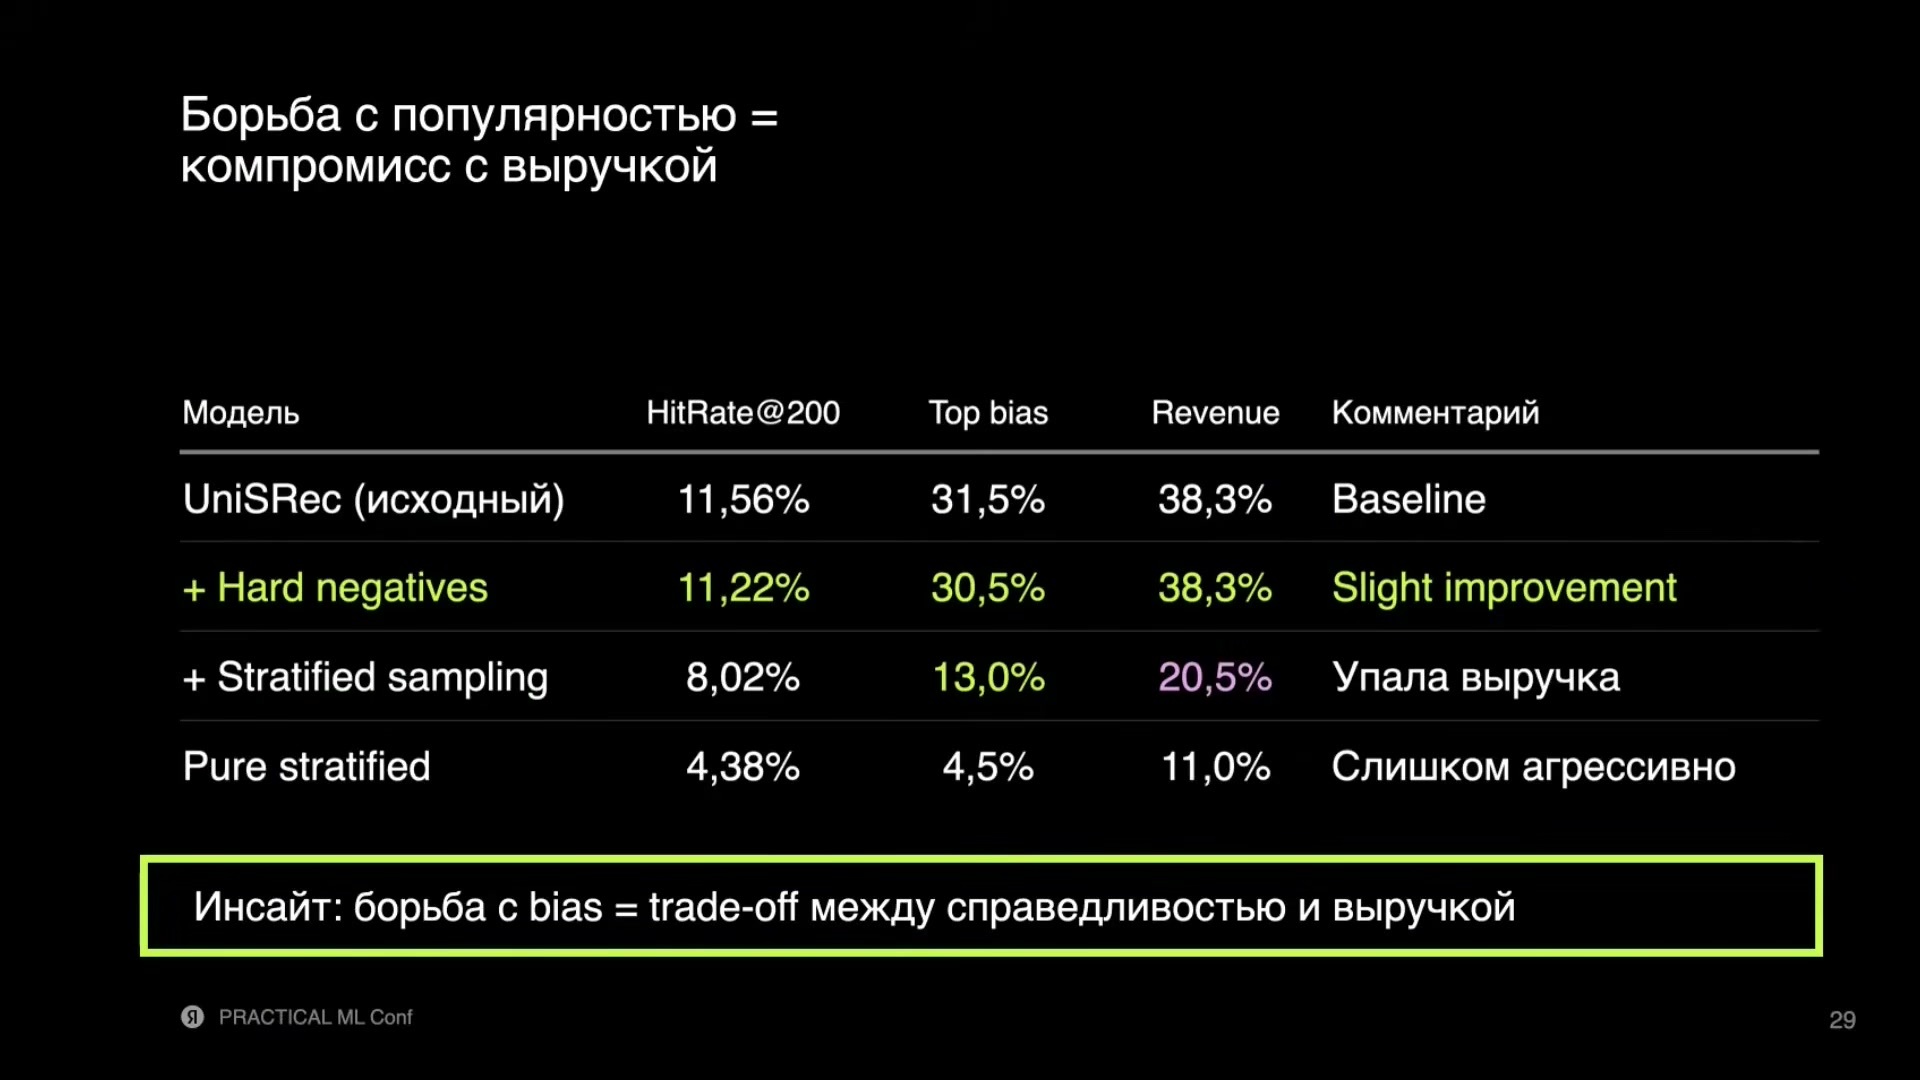
Снижение Top bias сопровождается падением HitRate и Revenue; у строки Hard negatives HitRate 11,22% ниже baseline 11,56%, хотя подпись говорит об улучшении. Сохраняем неоднозначность источника.
Источник: Карина Романова · WildberriesИтоговый путь улучшил попадания, но не все показатели одновременно
В итоговой ретроспективе автор возвращается к минимальной рабочей версии (MVP) и показывает последовательность изменений за год. После BERT-768 идёт компактный текстовый вариант Matryoshka-64, затем визуальные представления, сочетание текста с изображениями и, наконец, стабилизация вместе с распределённым обучением.
Последняя строка обозначена «Z-Loss + DDP». DDP здесь — распределённое обучение с параллельной обработкой данных. Из таблицы нельзя узнать число устройств, время обучения или отделить вклад DDP от вклада регуляризации: два изменения указаны вместе.
Таблицу можно прокрутить по горизонтали.
Внутри этой таблицы переход от первой строки к последней даёт +4,6 п.п. по HitRate@200: 8,4% → 13%. Precision@200 увеличивается с 0,05% до 0,08%, то есть на 0,03 п.п. Именно +0,03 п.п. написано и в итоговой подписи. В автоматической расшифровке речи, напротив, стоит +0,3 п.п. Это расхождение источника сохраняется явно; для численного результата здесь используется согласованная со значениями таблицы запись слайда.
Не менее важна последняя колонка метрик. При переходе от сочетания текста с изображениями к финальной модели Revenue уменьшается с 4,1% до 3,9%, хотя HitRate и Precision растут. Поэтому финальный вариант нельзя описать как одновременное улучшение всех показателей. Из доклада неясно, какой полный набор критериев определил этот выбор.
Разные таблицы нельзя собрать в одну общую шкалу прогресса. Базовый HitRate равен 9,35% в сравнении MoE, 9,03% в сравнении модальностей и 11,56% в эксперименте с популярностью; итоговая ретроспектива начинается с 8,4%. Результат 13,47% у сочетания модальностей и финальные 13% также не доказывают ухудшения одной и той же конфигурации: одинаковый протокол для этих таблиц не установлен.
Особенно заметно различие масштаба Revenue: в сравнении MoE фигурируют 17,9% и 28%, при коррекции популярности — 38,3% у базового варианта, а итоговый путь лежит в диапазоне 2,8–4,1%. Ни пересчитывать их через придуманную нормировку, ни объявлять проценты долей всей выручки нельзя. Определение Revenue, разбиение данных, размеры оценочных выборок, периоды, доверительные интервалы и протокол A/B-теста не раскрыты. История изменений также не заменяет полного исследования с изолированной проверкой каждого компонента.
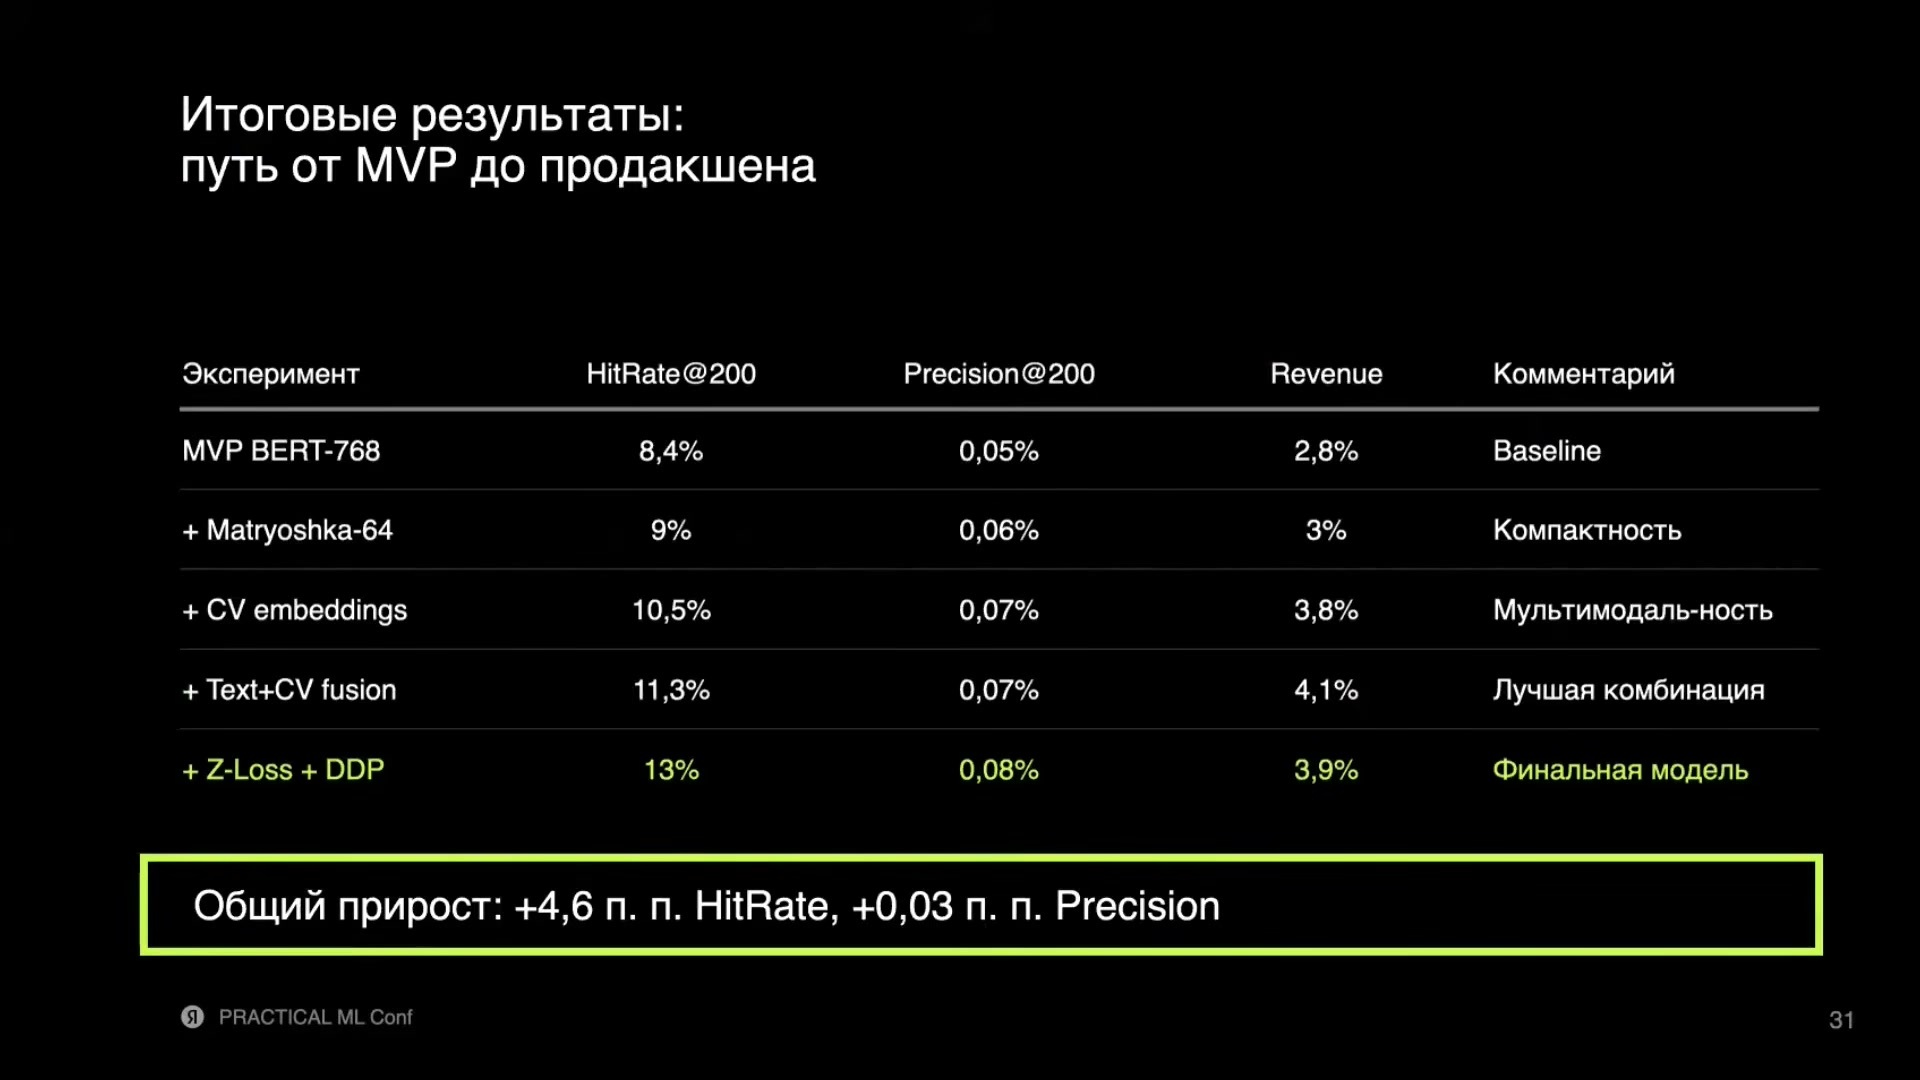
В итоговой таблице 8,4% → 13% HitRate и 0,05% → 0,08% Precision; слайд указывает +0,03 п.п., речь — +0,3 п.п. Revenue разных таблиц не считаем сопоставимым ростом всей платформы.
Источник: Карина Романова · WildberriesЧто подтверждено в трёх заключительных тезисах автора
Карина завершает основную часть тремя выводами: не игнорировать изображения, предпочитать устойчивое обучение неоправданному усложнению и вкладываться в качество отрицательных примеров. Первые два тезиса имеют понятную опору в разобранных сравнениях. Сочетание модальностей получило примерно +49% по HitRate относительно текста в своей таблице, а более сложная смесь экспертов не стала лучшим вариантом.
Третий тезис требует отдельной оговорки. На финальном слайде действительно написано «до +55%» при правильном подборе сложных отрицательных примеров. Это не просто неразборчивое число из автоматической расшифровки. Однако метрика, базовое значение и подтверждающее сравнение для него не приведены. Таблица с Recall@10 показывает 1,41% → 1,52%, а таблица борьбы с популярностью вообще содержит небольшое снижение HitRate после добавления отрицательных примеров.
Следовательно, «до +55%» остаётся утверждением автора с нераскрытыми условиями, а не проверенным эффектом представленной конфигурации. Ни заменять его на догаданное 5,5%, ни переносить на Revenue или итоговый HitRate оснований нет. Сам ход экспериментов показывает более содержательный вывод: полезность приёма зависит от того, что именно измеряют и какой компромисс готовы принять.
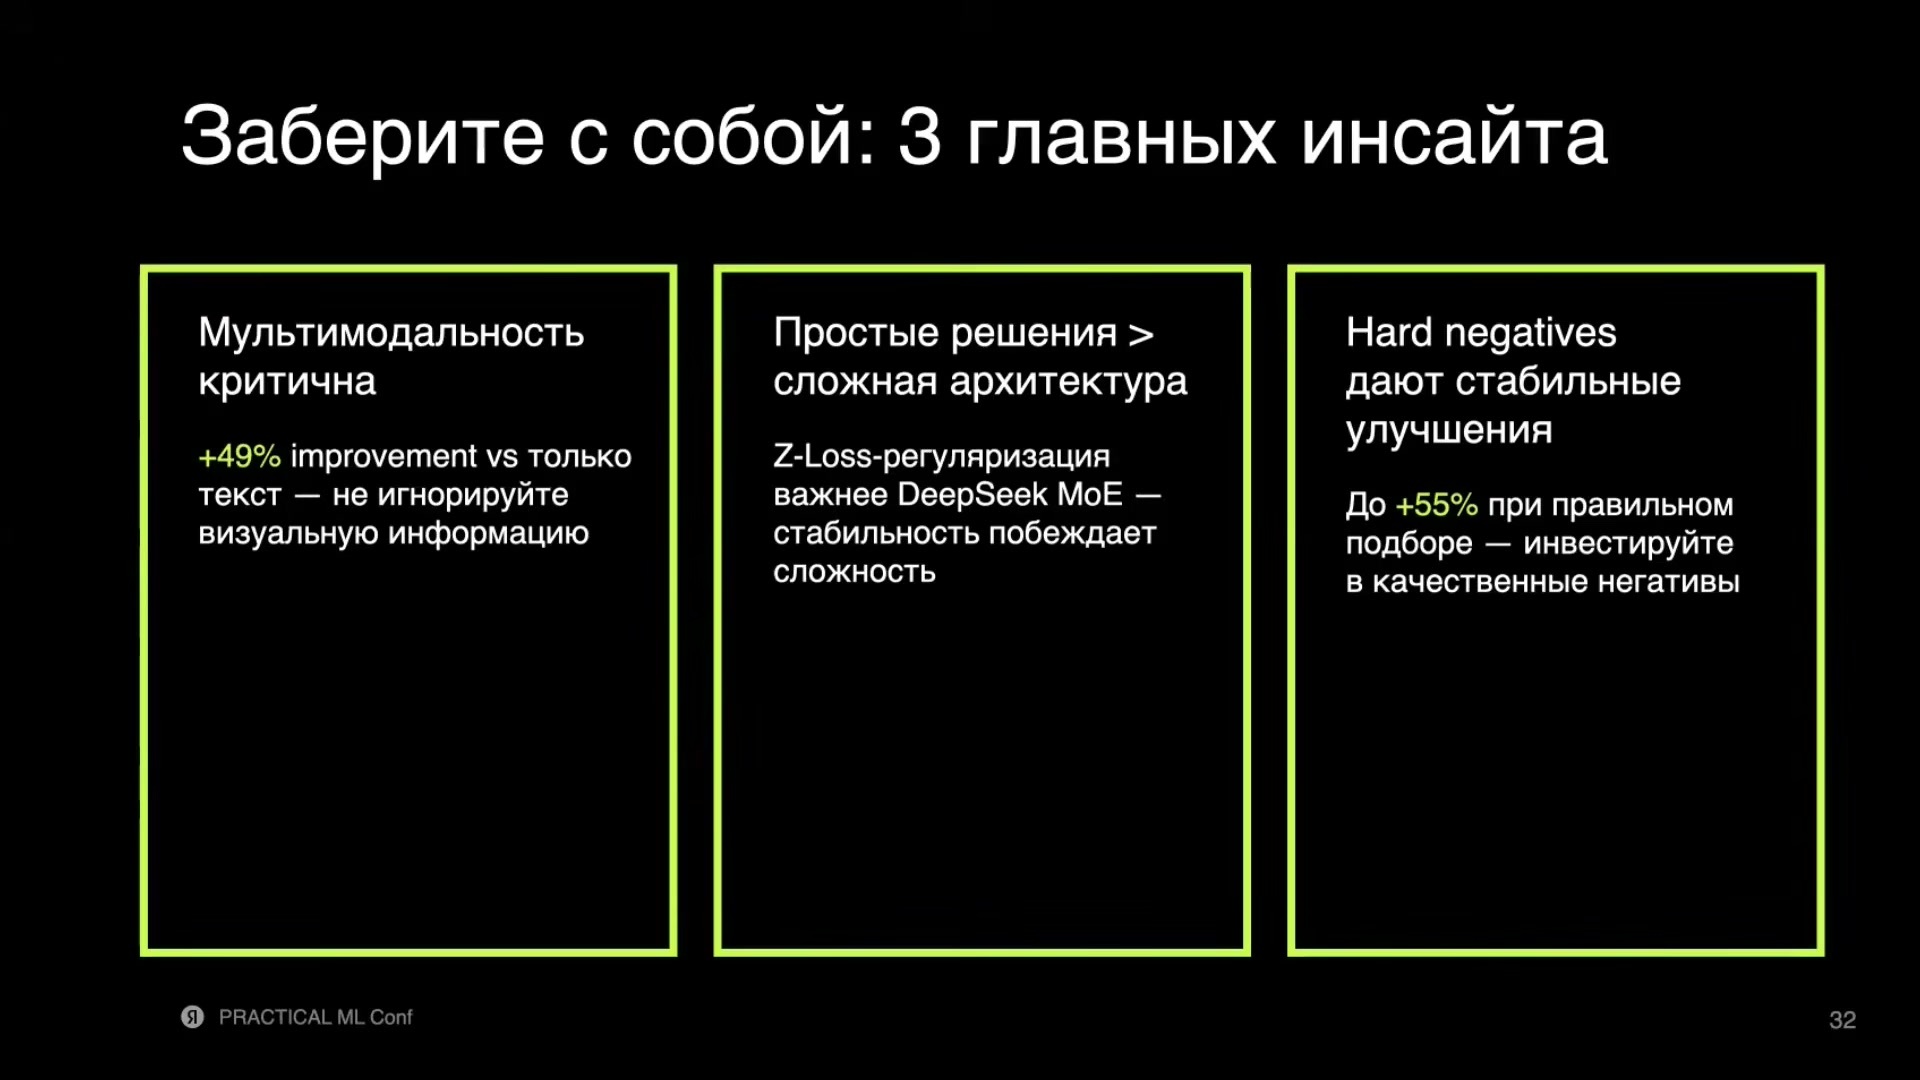
Автор выделяет мультимодальность и стабильность обучения. Заявление до +55% от hard negatives не снабжено здесь метрикой, базой и подтверждающим сравнением; не переносим его в доказанный результат.
Источник: Карина Романова · WildberriesПочему во входе остались покупки, хотя событий гораздо больше
Обсуждение после доклада возвращает архитектуру к конкретному составу данных. Первый вопрос касается того, учитываются ли кроме покупок просмотры, избранное и другие взаимодействия. Автор отвечает, что команда экспериментировала с разными целевыми действиями, но в этой модели остановилась на покупках: такой вариант сработал лучше. В ответе упоминаются уже сформированные корзины, однако отдельное включение события «добавление в корзину» этим не подтверждается.
Ведущий затем специально разделяет две вещи. Покупка может оставаться тем, что модель предсказывает, а её входная история при этом могла бы содержать просмотры и другие действия. Команда пробовала и такой вариант. По ответу Карины, результат зависит от модели; в разобранной конфигурации во входе тоже остались только покупки. Численного сравнения вариантов и причины, по которой более широкая история здесь проиграла, нет.
Это уточнение меняет прочтение вводной сессии. Слайд с просмотром телефона, переходом к похожим товарам и корзиной объяснял общую идею поведенческого представления, но не перечислял поля финального входа. Нельзя задним числом приписывать модели всю доступную пользовательскую активность только потому, что она есть в иллюстрации.
Следующий вопрос — о времени, проведённом на карточке. Пять секунд и минута приводятся как примеры разных взаимодействий, а не как пороги разметки. Карина считает длительность полезным косвенным сигналом, который можно включать в признаки; с ним экспериментировали, но не в рамках этой модели. Поэтому доклад не даёт ни измеренного прироста UniSRec от такого признака, ни способа его кодирования.
Доклад · 00:18:36Почему графовые связи не стали главным источником улучшения
Другой вопрос касается связей между товарами, которые можно получить не из покупательских сессий. Например, ингредиенты связаны рецептом независимо от того, покупал ли их кто-то вместе. Ведущий спрашивает о внешних графовых источниках: товар можно считать вершиной графа, а известную связь между товарами — ребром.
Карина отвечает, что команда пробовала такие подходы в разных постановках при работе над общими представлениями и строила большой набор проверок по косвенным показателям. Но решение с нейронными сетями для графов дало намного меньший эффект, чем сочетание разных представлений, поведения, текста и изображений.
В конце ответа автор формулирует результат ещё жёстче: в их случае графы не повлияли, хотя проверять подход всё равно нужно. Обе части важны: графы не стали удачным направлением в данном опыте, но универсального запрета на их использование не следует. Не названы архитектура графовой сети, размеры проверочного набора, численные метрики и конкретные внешние источники. Рецепты остаются примером из вопроса, а не подтверждённым набором данных Wildberries.
Доклад · 00:20:52Где заканчиваются общие векторы и начинаются прикладные рекомендации
Последний содержательный вопрос — о различиях между местами, где пользователь взаимодействует с каталогом: десктопом, мобильным приложением и другими интерфейсами. Карина подтверждает, что поведенческие паттерны немного различаются. Но эксперименты с такими особенностями в работающих рекомендациях ведёт другая, отдельная команда.
Команда общих представлений не специализирует свою модель на особенностях конкретного устройства. Автор допускает полезность анализа таких срезов, но предупреждает о противоположном эффекте: узкая специализация иногда ухудшает представления, предназначенные для разных команд. Улучшение под один интерфейс и улучшение универсального вектора — не одно и то же.
Так становится точнее и исходное обещание универсальности. Цель — переиспользуемые признаки поведения, которыми можно дополнить прикладные системы, а не одна полностью описанная модель, заменяющая все рекомендации и антифрод. Для обнаружения мошенничества не показаны отдельные результаты, правила решения или пороги; для рекомендательных интерфейсов нет сопоставления по устройствам.
Раскрыта история получения и улучшения общих векторов, но не полная инфраструктура их использования. Не названы поисковый индекс, последующие стадии ранжирования, частота обновления представлений, аппаратная конфигурация или гарантированная задержка ответа. Отсутствие этих деталей не отменяет архитектурного результата, но ограничивает то, что можно утверждать о работе системы на всём трафике.
Доклад · 00:22:31Итог: как общая модель превращает покупки в представление поведения
Путь Wildberries начался с общего запроса нескольких команд и слабого запуска академической модели. Усложнение экспертов не помогло; полезнее оказались стабилизация обучения, компактный текстовый энкодер и изображения. Сложные отрицательные примеры добавили возможности для улучшения, но борьба с популярностью потребовала компромисса. Итоговая система строит представление поведения, а не подменяет собой все прикладные сервисы.
- 01
Получить историю покупок
На вход поступает подготовленная последовательность купленных товаров. Очистка событий и разбиение длинных сессий обеспечивают подходящий вход.
- 02
Связать товары с их содержанием
С товарами истории связываются текстовые и визуальные представления. В выбранном режиме информация о содержании сочетается с идентификаторами.
- 03
Адаптировать представления
Заранее обученные преобразования и смесь экспертов учитывают товарные домены, сохраняя важные различия между объектами разных категорий.
- 04
Построить вектор поведения
Последовательностное ядро на основе SASRec объединяет представления товаров в описание истории пользователя. Это применение готовых весов, не новое обучение.
- 05
Использовать результат в задаче
Представление служит основой предсказания следующего товара и задумано как общий сигнал для других команд. Конечные прикладные решения остаются отдельным уровнем.
Обучение проводится отдельно: сопоставляются история и следующий товар, а также пары последовательностей; при дообучении добавляются ID. Для сравнения вариантов использованы метрики рекомендательных списков, геометрии представлений и популярности. Их изменения не равнозначны доказанному эффекту на поведение всех покупателей.
Итоговая таблица показывает +4,6 п.п. HitRate@200 и +0,03 п.п. Precision@200; в расшифровке для Precision стоит противоречащее слайду +0,3 п.п. Revenue на последнем шаге снижается. Её определение и протокол A/B не раскрыты, отдельный эффект антифрода не измерен. Поэтому результат — улучшенная модель общих представлений с известными компромиссами, а не подтверждённый рост всей выручки маркетплейса.
Доклад · 00:10:10