Разбор готов
Яндекс: как развивали ARGUS и переходили к генеративным рекомендациям
В поиске и рекламе недостаточно знать, чем человек интересовался вчера: выбор зависит и от того, что он делает сейчас. Первые внедрения ARGUS обрабатывали историю раз в сутки и сжимали её в один вектор, а текущий контекст добавляли уже после основной нейросети. Модель помогала существующему ранжированию, но пропускала свежие события и не использовала знания других сервисов. В докладе «Генеративные рекомендательные технологии в Яндексе» Николай Савушкин показывает, как команда меняла представление истории, проверяла необходимость предварительного обучения и масштабировала выбор отрицательных примеров. Этот путь приводит к двум разным результатам: улучшенному ARGUS внутри работающего каскада и экспериментам с единой моделью, которая должна сама формировать рекомендации.
Глава полезна разработчикам рекомендательных и поисковых моделей, которые работают с историями действий, несколькими источниками данных и ограничениями распределённого обучения. На конкретных сравнениях видно, почему улучшение вспомогательной задачи, эффект в последующем ранжировании и готовность заменить весь каскад — разные результаты.
Видео · на русском
Генеративные рекомендательные технологии в Яндексе / Николай СавушкинНиколай Савушкин · Опубликовано: 20 октября 2025 г.
Исходный доклад · Открыть оригинал
Почему зрелым рекомендациям понадобился другой подход
Музыка, Маркет и реклама уже имели развитые рекомендательные технологии. Задача команды базовых рекомендательных технологий Яндекса состояла не в создании персонализации с нуля, а в дальнейшем развитии таких систем. Савушкин описывает работу команды как сочетание исследований, общей платформы и рекомендательных сервисов; её разработки используются во многих продуктах компании.
Традиционный подход опирался на большое число вручную подготовленных признаков и специализированные модели, которые их объединяли. Объектами рекомендации здесь могут быть треки, товары или рекламные объявления; в докладе для них также используется слово «документы». Прежде чем показать объект, система последовательно отбирает и оценивает кандидатов. Такой набор этапов называется каскадом.
Первая причина искать замену — отдача от дальнейшего увеличения данных и вычислений. По оценке докладчика, прежний признаковый подход быстро насыщается. Команда хотела получить для рекомендаций ту возможность улучшать модели масштабированием, которую наблюдала в соседних областях. Здесь это мотивация разработки, а не предъявленный закон зависимости качества ARGUS от числа параметров.
Вторая причина — эксплуатация. Многочисленные признаки, модели и микросервисы нужно поддерживать совместно. Даже сохранение качества при уменьшении числа компонентов могло бы быть полезным результатом. Третья причина связана с данными: отдельная модель сервиса видит в основном его собственную историю. Общая модель могла бы усваивать закономерности из нескольких сервисов и затем использовать их в конкретной задаче. Именно эти три мотива связывают последующие архитектурные и обучающие эксперименты.
Доклад · 00:01:44Что в этом докладе называется генеративной моделью
Прежде чем сравнивать модели, Савушкин оговаривает терминологию. В рамках этого выступления генеративной называется модель, которая задаёт распределение на пользователях. Пользователь при этом описан не своим именем или номером, а последовательностью событий. Поэтому речь идёт о моделировании возможных историй: какие объекты в них встречаются и какие действия следуют.
Противопоставление строится на том, что именно моделируется. Дискриминативная модель отвечает, например, как пользователь отреагирует на уже заданный объект при известной истории. Генеративная в выбранном определении должна описывать и саму историю. Это рамка докладчика, а не универсальная классификация, которой обязаны следовать авторы других работ.
Историю нужно разбить на единицы входа нейросети — токены. В рекомендациях токен не обязательно соответствует слову: это может быть объект, реакция или целое событие с признаками. Трансформер обрабатывает последовательность таких представлений и связывает её позиции механизмом внимания. Далее сравнение проводится по четырём вопросам: из каких токенов состоит история, чему модель учится, как устроена и какую роль выполняет после обучения.
Доклад · 00:03:47HSTU и TIGER: похожая работа с историей, разные задачи и выходы
В изложении Савушкина HSTU получает полную историю: и положительные, и отрицательные взаимодействия. На каждое событие приходятся два токена — документ и реакция на него. Документ описывается идентификатором item ID. Для каждого такого идентификатора модель использует обучаемое векторное представление, или эмбеддинг.
С этим связано замечание о масштабе HSTU. Докладчик упоминает триллион параметров из описания этой внешней работы, но подчёркивает, что практически все они находятся в таблицах эмбеддингов. Это не характеристика трансформерной части ARGUS и не размер модели, выбранной Яндексом.
HSTU обучается либо предсказывать следующий положительный документ, либо оценивать реакцию на заданный документ с учётом истории. В определении этого доклада обе задачи дискриминативны, хотя архитектура на основе внимания допускает другую постановку обучения. Описанное применение HSTU — ранжирование вместо прежней модели обработки ручных признаков.
TIGER от Google иначе представляет и историю, и объект. В историю входят только положительные взаимодействия. Объект получает семантический идентификатор — последовательность кодов, связанную с его представлением. Савушкин объясняет кодирование через иерархическую кластеризацию: последовательность чисел описывает путь по дереву групп объектов.
Кодировщик, или энкодер, обрабатывает историю, а декодировщик последовательно предсказывает код следующего положительного объекта. Поэтому TIGER выступает источником кандидатов: предлагает объекты для дальнейшего выбора, а не заменяет автоматически всё ранжирование. На схеме для пользователя User 5 показаны Item 233 с кодом (5, 23, 55), Item 515 с кодом (5, 25, 78) и предсказываемый Item 64 с кодом (5, 25, 55). Это иллюстрация кодирования, а не размеры каталога или словаря кодов.
Таблицу можно прокрутить по горизонтали.
Обе модели автор относит к дискриминативным именно по их обучающим задачам в принятой рамке. Сам факт последовательной генерации кодов в TIGER этому авторскому определению не противоречит: способ получения ответа и то, какое распределение учат, здесь рассматриваются отдельно.
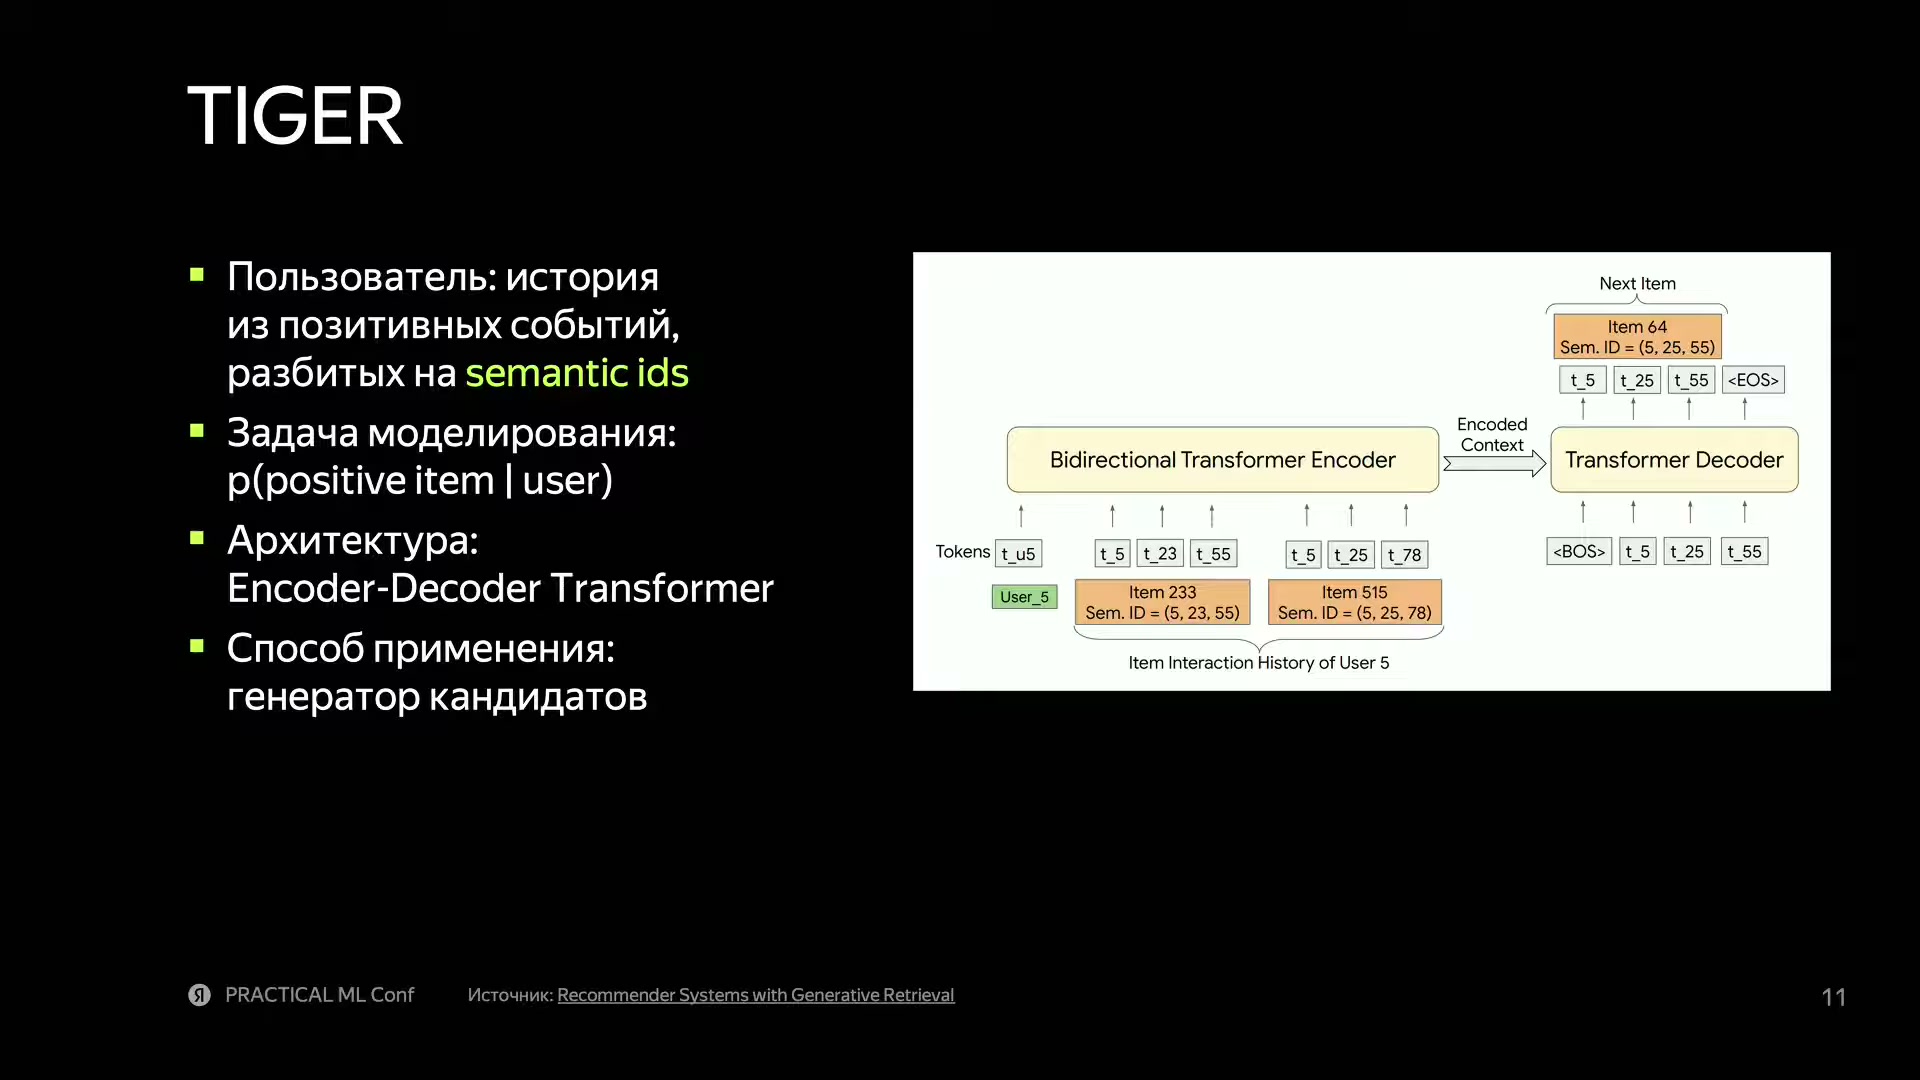
История положительных взаимодействий кодируется semantic IDs; encoder–decoder предсказывает код следующего объекта. Это обзор внешней работы Google.
Источник: Николай Савушкин · Яндекс · Practical ML ConfИсходный ARGUS: сначала моделировать историю, затем решать задачу сервиса
ARGUS, как и HSTU, не ограничивает историю удачными взаимодействиями. Каждое событие описывается тройкой: контекст, объект и действие. Контекст задаёт обстоятельства взаимодействия, объект определяет, с чем встретился пользователь, действие сохраняет его отклик. Все компоненты представлены признаками, а не только номерами объектов.
В исходном описании есть две схемы разбиения истории. В полной схеме контекст, объект и действие разделены. На практике команда преимущественно использовала упрощённую схему simplified: информацию всей тройки объединяли в один токен. На показанной схеме векторные представления контекста, объекта и реакции суммируются на входе трансформера.
Описание объекта включает и item ID, и сведения о содержании. По опыту команды, контентная информация существенно увеличивала пользу ARGUS. Однако отдельной численной абляции этих признаков в выступлении нет: нельзя приписать им конкретную долю последующих улучшений.
Обучение разделено на два этапа. На предварительном обучении, или pretrain, модель учится продолжать историю: предсказывает следующий документ независимо от того, была реакция положительной или отрицательной, а в исходном рецепте ещё и саму реакцию. Предсказания строятся последовательно по уже известной части истории — это авторегрессионная постановка. На слайде задача обозначена как p(user).
Для следующего документа на схеме указана sampled softmax loss — функция потерь, сравнивающая целевой документ с выбранными альтернативами. Для реакции показана классификация с несколькими выходами. Обе задачи используют небольшие полносвязные нейросети, MLP, после трансформера. Подробности выбора альтернатив будут важны при пересмотре обучения.
Второй этап — дообучение под задачу сервиса, или finetune. Здесь модель либо предсказывает действие при известных пользователе, контексте и объекте — p(action | user, context, item), либо следующий положительный объект — p(positive item | user, context). Это уже дискриминативные задачи. Такое разделение позволяет сначала учить представление поведения, а затем приспосабливать его к отбору кандидатов или ранжированию.
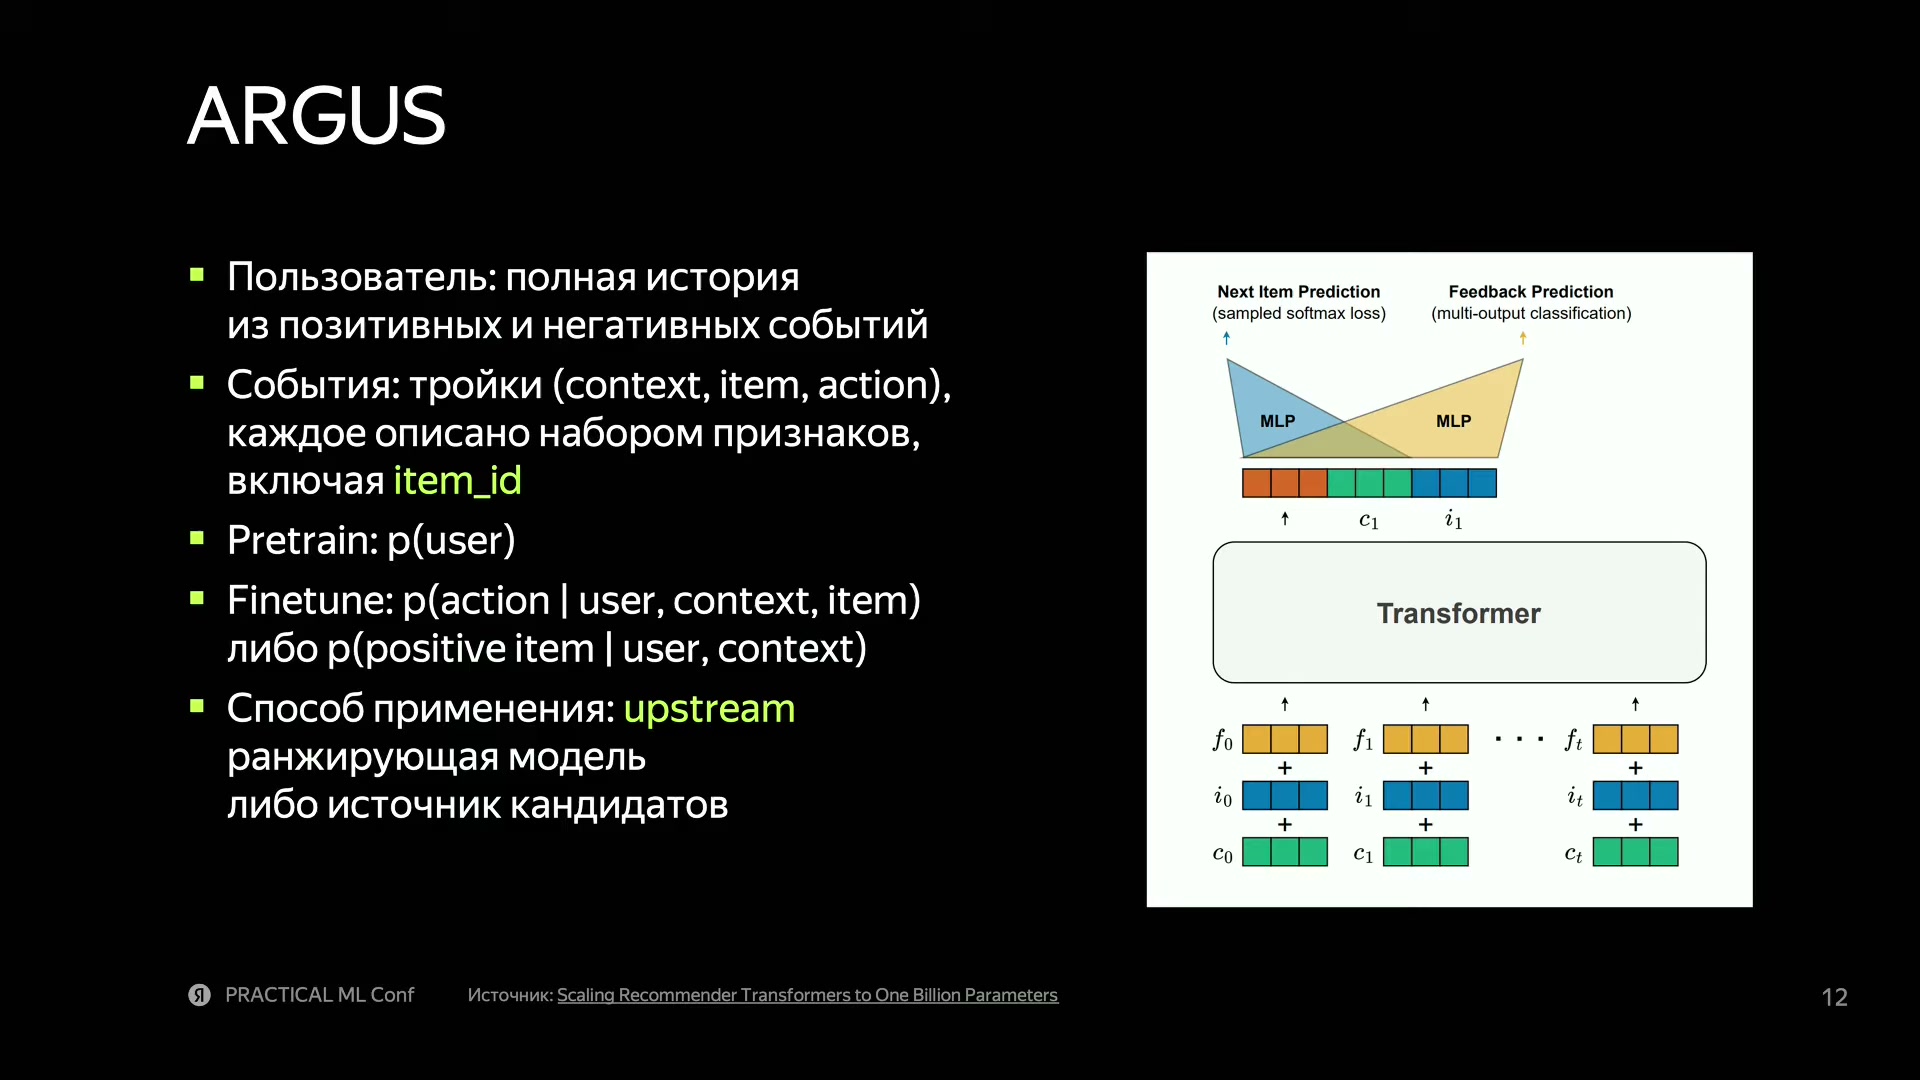
Предварительное обучение истории, затем дообучение на целевой задаче. Применение — признак для последующего ранкера или источник кандидатов.
Источник: Николай Савушкин · Яндекс · Practical ML ConfПервые внедрения: полезный компонент, но ещё не замена каскада
Первые варианты ARGUS запускали заранее, пакетно, раз в сутки. Использовали двухбашенную постановку: история пользователя и документ получали отдельные представления, которые затем связывались скалярным произведением или очень лёгкой моделью. Дорогая обработка истории таким образом была отделена от конкретного выбора.
Далее у ARGUS было две роли. Его оценка могла становиться признаком для следующей ранжирующей модели. Либо он давал дополнительный набор кандидатов, который обрабатывал существующий каскад. Поэтому слово «генеративный» в описании предварительного обучения ещё не означало генеративную замену всех этапов сервиса.
При внедрении проявились три группы ограничений. Суточное выполнение не учитывало самые свежие действия, а сжатие истории в один вектор теряло детали. Модель продолжала работать в пределах одного домена, хотя одной из целей были знания разных сервисов. Наконец, сам рецепт предварительного обучения оставался исследовательским: ещё предстояло понять, какие задачи и вычисления действительно полезны.
Эти ограничения требуют разных изменений. Более частое применение решает вопрос свежести, но само по себе не устраняет потерю информации при сжатии. Добавление данных другого сервиса расширяет вход, но не отвечает на вопрос, нужно ли предсказывать его события. Именно поэтому команда проверяет представление истории, обучающие задачи и способ применения по отдельности.
Доклад · 00:09:11Почему позднее добавление контекста ограничивает модель
Исходный ARGUS формально уже предсказывает документ с учётом текущего контекста. Но важно не только наличие контекста среди аргументов модели, а место, где он участвует в вычислении. Сначала история из троек проходит через трансформер. Только после этого к его выходному вектору добавляется контекст следующего взаимодействия, а MLP формирует предсказание. Такое объединение называется поздним связыванием, или late fusion.
При этой схеме трансформер должен заранее сохранить в одном векторе всё, что понадобится для разных будущих контекстов. Когда конкретный контекст становится известен, вернуться к подробностям истории через этот единственный вектор уже нельзя. Для поиска и рекомендаций «объект к объекту» это особенно существенно: текущий запрос или документ меняет то, какая часть прошлого поведения полезна сейчас.
Команда хочет перенести связывание раньше: позволить текущему контексту участвовать в обработке истории, а не только в последнем небольшом преобразовании. Это другая архитектурная задача, чем простая замена суточного запуска на выполнение при запросе.
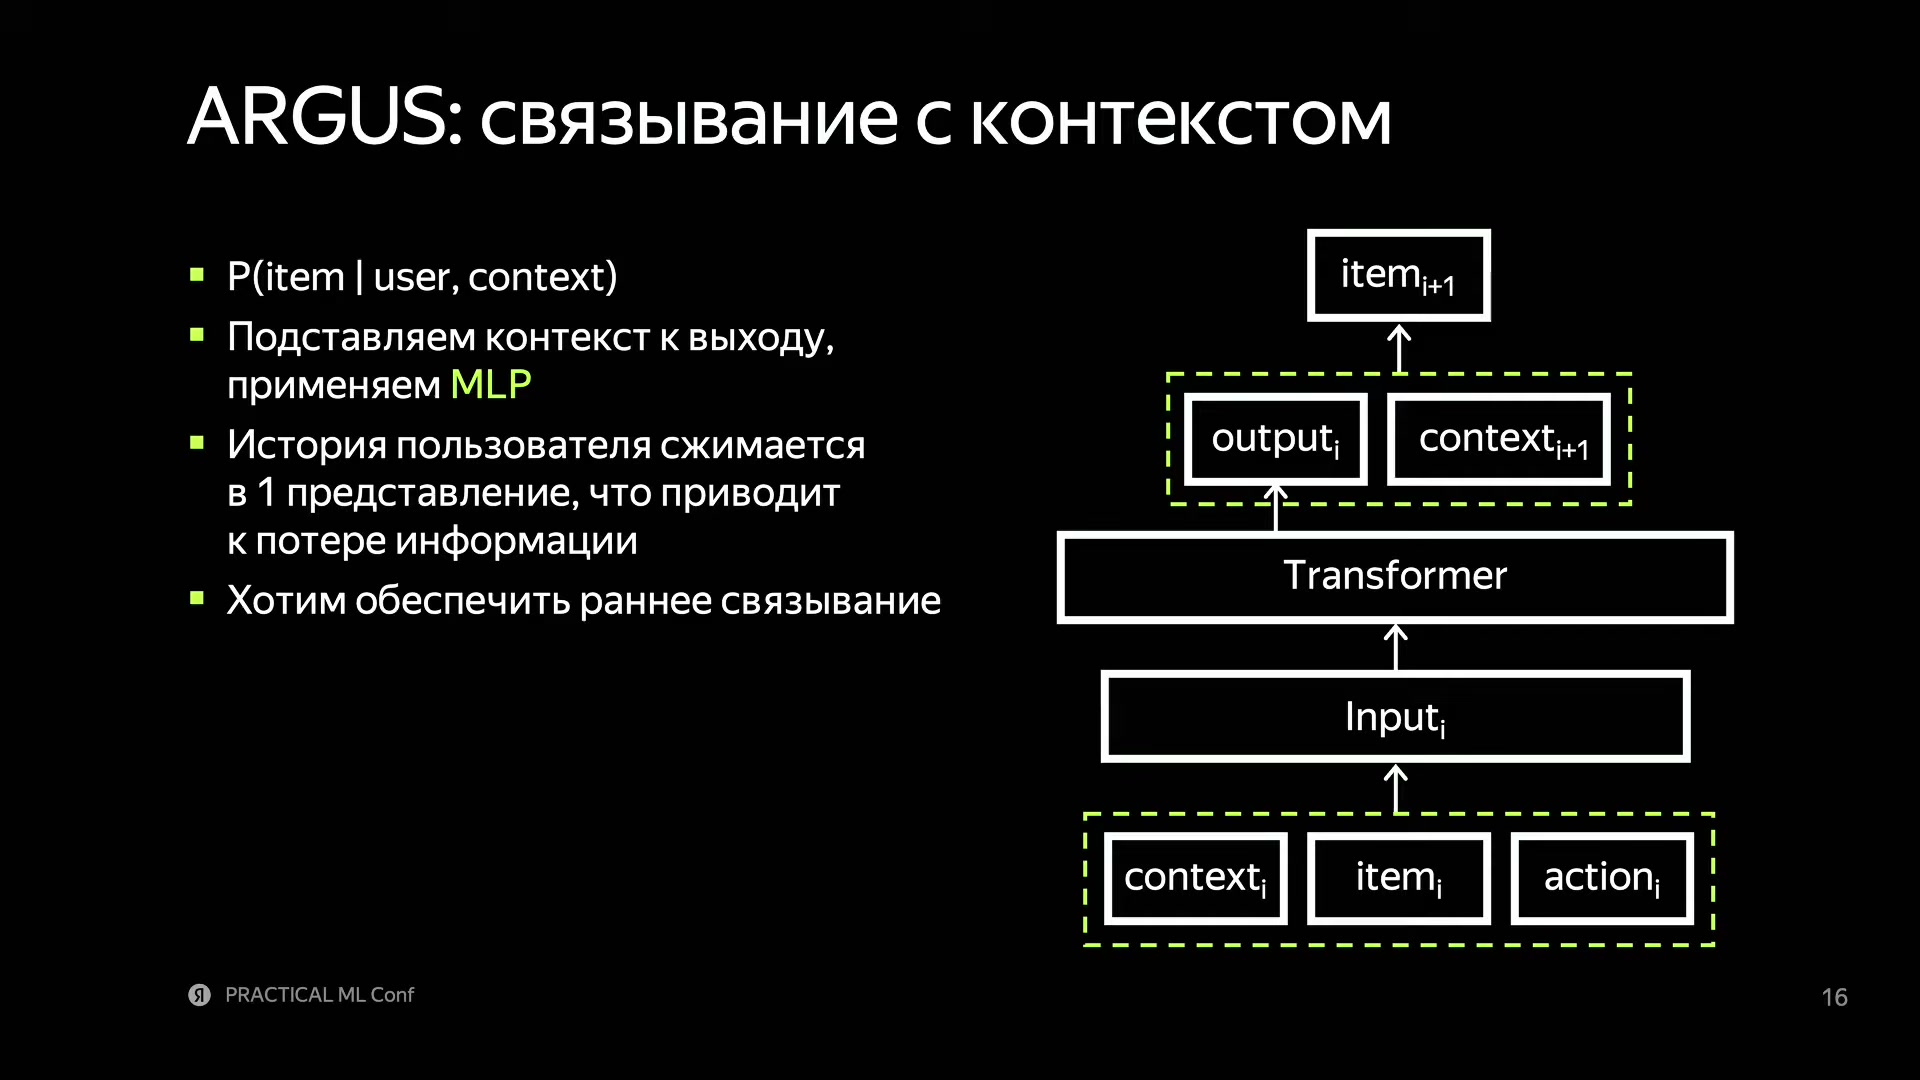
Контекст добавляется после трансформера через MLP; вся история заранее сжата в одно представление.
Источник: Николай Савушкин · Яндекс · Practical ML ConfКонтекстный токен меняет обработку истории
В Context-aware ARGUS контекст выделен в отдельный входной токен. За ним идут события, произошедшие в этом контексте, причём объект и реакция продолжают объединяться в один токен. Следующий объект предсказывается из состояния контекстного токена после обработки трансформером. Теперь это состояние может учитывать историю именно для заданного контекста.
Такое изменение требует выполнять трансформер во время запроса: текущий контекст должен попасть на его вход. Заранее рассчитанного вчера представления недостаточно. Доклад не приводит задержку этого выполнения, поэтому выигрыш в качестве нельзя одновременно считать доказанным ускорением обслуживания.
Цена нового представления — более длинная последовательность. По сравнению с упрощённой схемой «одно событие — один токен» длина увеличивается не более чем вдвое. На практике рост меньше: если контекст не изменился, его не нужно повторять перед каждым событием. Для сравнения, у разобранного HSTU на событие приходятся два токена, а в полной схеме ARGUS — три. Это числа токенов, а не измеренные множители памяти или времени.
При дообучении кандидаты связываются с соответствующим контекстным токеном. Они не обязаны все присутствовать во входной истории. В рекламе и Маркете показов очень много, поэтому историю прореживают, но исключённый из неё показ всё ещё можно использовать как обучающего кандидата. Так разделяются две вещи: какие события модель читает и какие объекты учится оценивать. Конкретный набор функций потерь для этого связывания автор не фиксирует.
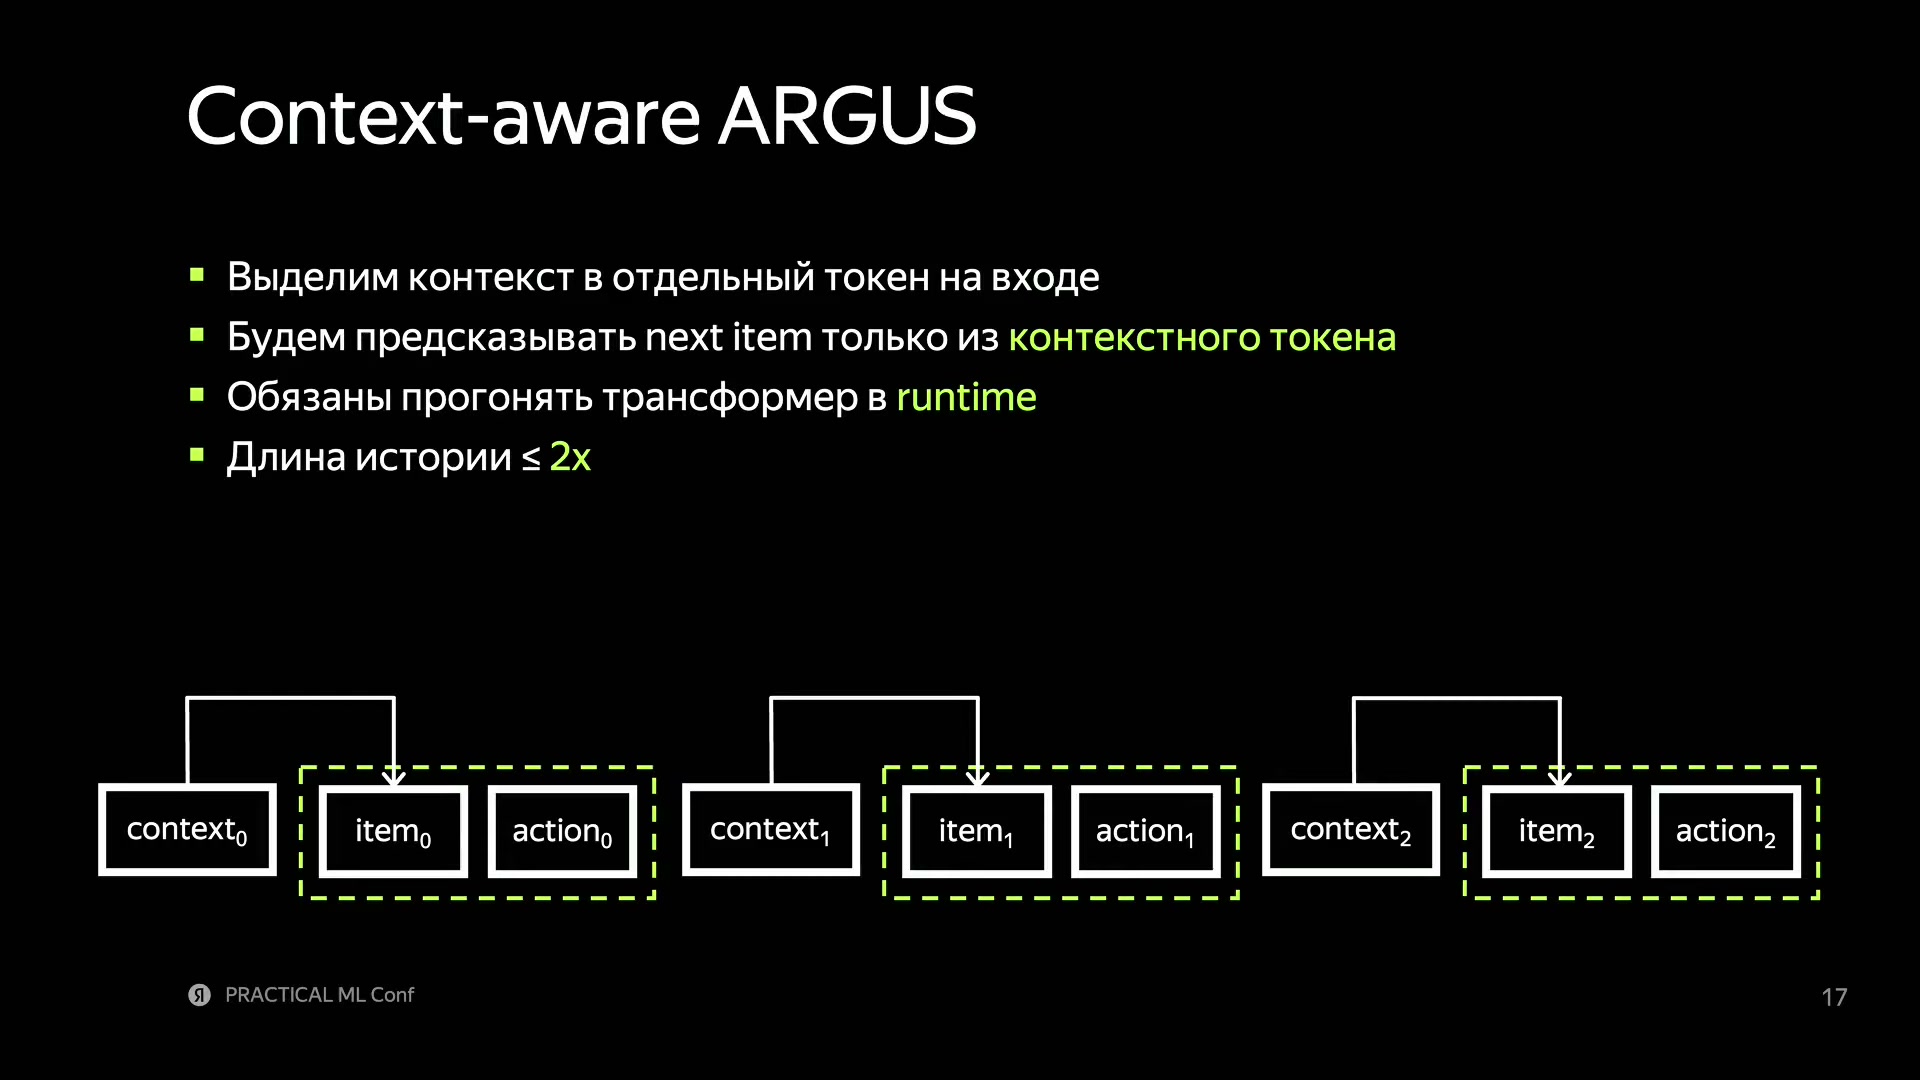
Следующий объект предсказывается из контекстного токена. Модель требуется выполнять во время запроса; длина последовательности растёт не более чем вдвое относительно показанной упрощённой схемы.
Источник: Николай Савушкин · Яндекс · Practical ML ConfРеальная история запаздывает: почему пришлось менять обучение
Событие происходит в продукте раньше, чем запись о нём появляется в доступном модели профиле пользователя. Это задержка доставки данных в распределённой системе, а не время вычисления ответа нейросети. Если обучать модель на полностью собранной истории, она увидит события, которые при реальном запросе ещё не были бы доступны.
Поэтому при обучении команда воспроизводит временной разрыв: часть недавних событий нужно скрыть. Для контекстной схемы возникает неудобное сочетание требований. Текущий контекст должен остаться видимым, а несколько непосредственно предшествующих ему событий — нет. Обычного правила «не смотреть в будущее» недостаточно; нужна специальная маска доступности позиций в механизме внимания.
Использованная библиотечная реализация FlashAttention такую маску не поддерживала. В сравнении на слайде FlexAttention работает медленнее fa2. Собственное вычислительное ядро на Triton обсуждается как ещё один путь, но автор подчёркивает, насколько трудно сравняться со скоростью библиотечной реализации. Успешное внедрение собственного Triton Kernel здесь не заявлено.
Сработало другое разделение ответственности. Основную модель обучают без этого временного разрыва, а задержку воспроизводят при обучении следующей модели, использующей ARGUS. В терминологии доклада это downstream-модель — последующий потребитель его представлений или оценок. Разрыв между доступными событиями и текущим моментом не исчезает из продукта; меняется стадия обучения, на которой его учитывают.
Такой обход сохраняет более быстрый путь предварительного обучения, не требуя сложной маски в его основном вычислительном ядре. При этом перенос моделирования задержки — конкретный опыт команды, а не доказательство, что свежесть данных можно игнорировать в любом последовательном рекомендателе.
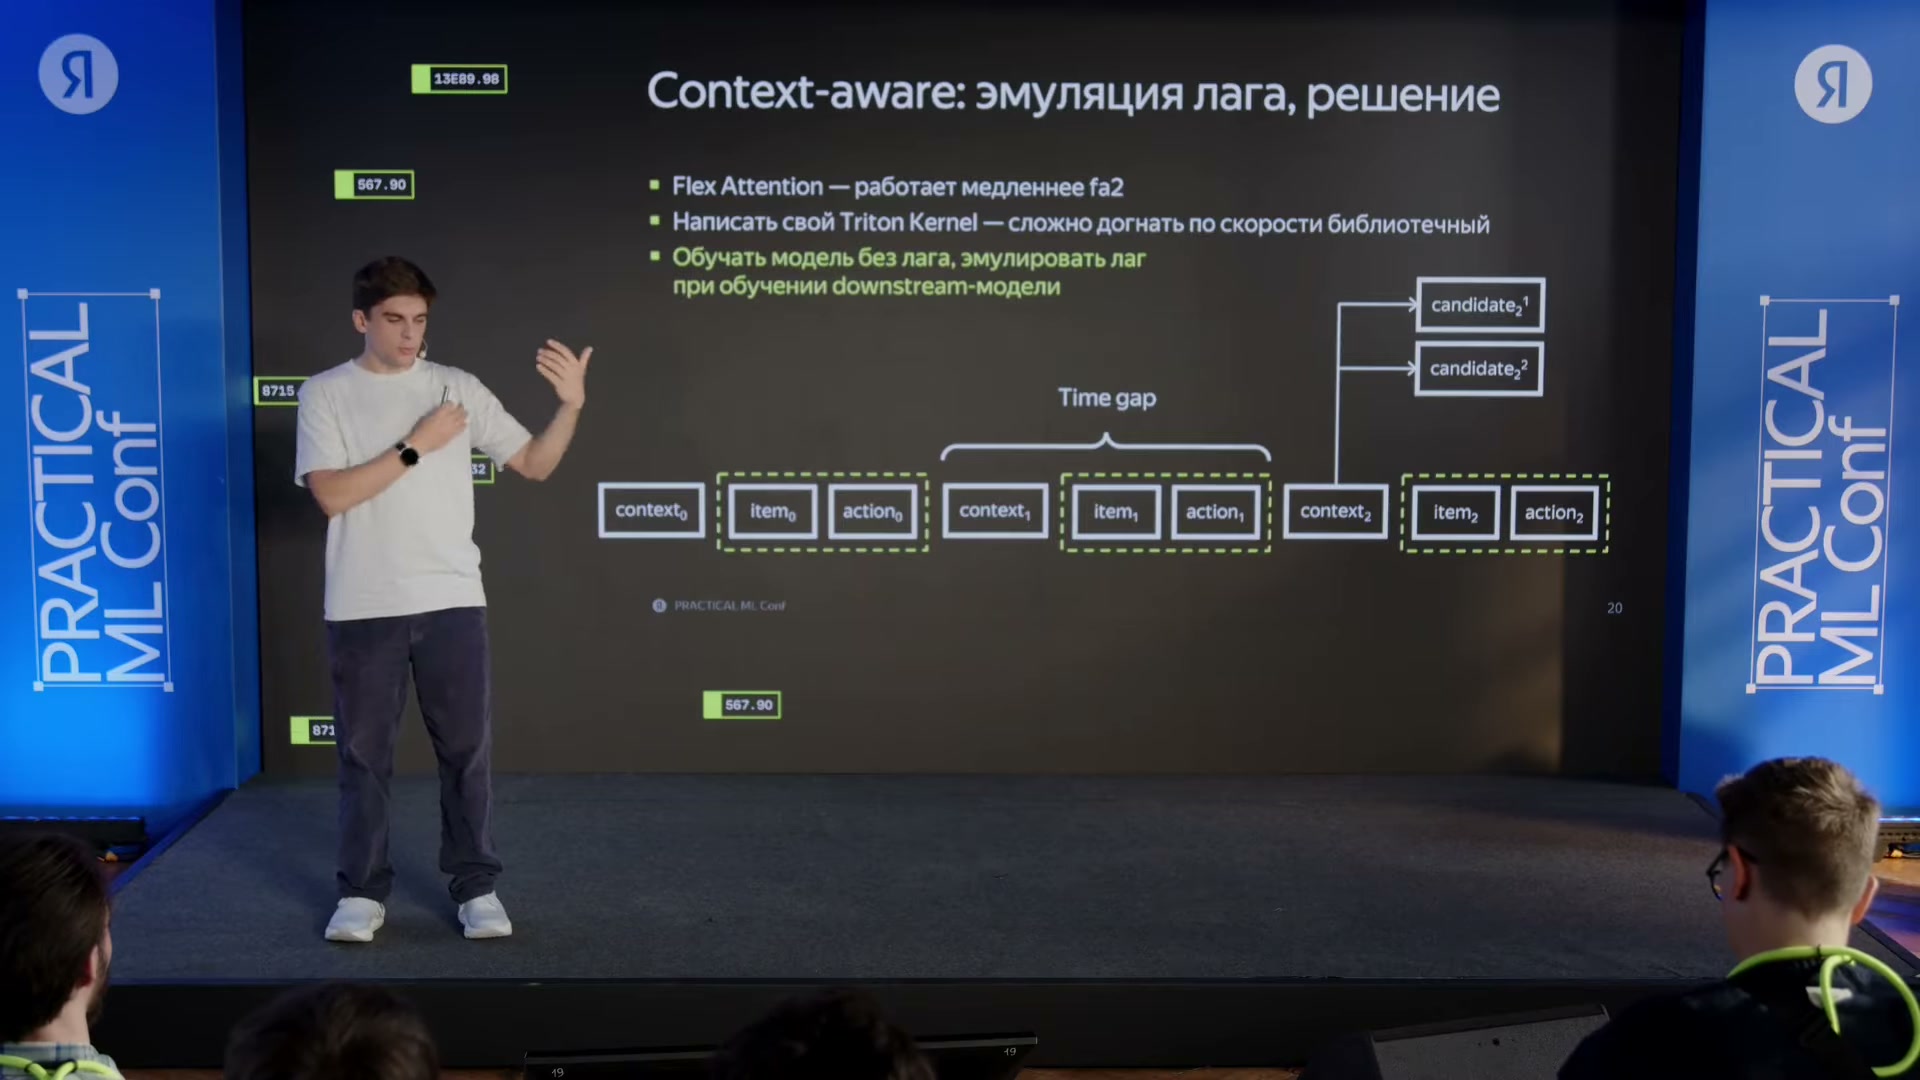
Flex Attention медленнее использованного fa2; собственное Triton-ядро трудно довести до той же скорости. Выбран обход: предварительное обучение без лага, имитация задержки в downstream-модели.
Источник: Николай Савушкин · Яндекс · Practical ML ConfСвежесть помогает, а ранний контекст — не каждому домену
Команда сравнивает три варианта: заранее рассчитанный ARGUS с поздним связыванием, выполнение при запросе с тем же поздним связыванием и контекстный вариант. Измеряется не изолированная точность трансформера, а эффект после добавления ARGUS в финальную ранжирующую модель.
В таблицах с обозначением x базовый эффект внутри данного сравнения принят за x, а остальные строки показывают его множители. Это не абсолютное значение качества, не увеличение выручки во столько раз и не процентные пункты. Более того, x в разных экспериментах и доменах не означает одну и ту же величину.
Таблицу можно прокрутить по горизонтали.
Реклама показывает две ступени улучшения: выполнение при запросе даёт 2,65x, а контекстная схема — 4,78x относительно исходной базы. Именно сравнение этих двух онлайн-вариантов стоит за словами автора о почти удвоенном выигрыше. Это удвоение эффекта от компонента ARGUS, не всей метрики сервиса.
В Музыке картина другая. Вариант с поздним связыванием при запросе даёт 1,41x, а контекстный — 1,24x. Следовательно, в этой таблице раннее связывание не превосходит более простой онлайн-вариант. Нельзя заменить этот результат общим обещанием, что контекстный токен всегда улучшает рекомендации.
В ответе на вопрос автор связывает различие со сценарием потребления. В «Моей волне» человек часто просто включает свою музыку, без отдельного запроса или выбранного объекта, задающего условие. Текущее время может учитываться, но специализированный контекст выражен слабее, чем в поиске или рекомендациях к текущему документу. Это не означает отсутствия истории и свежих действий в музыкальных рекомендациях.
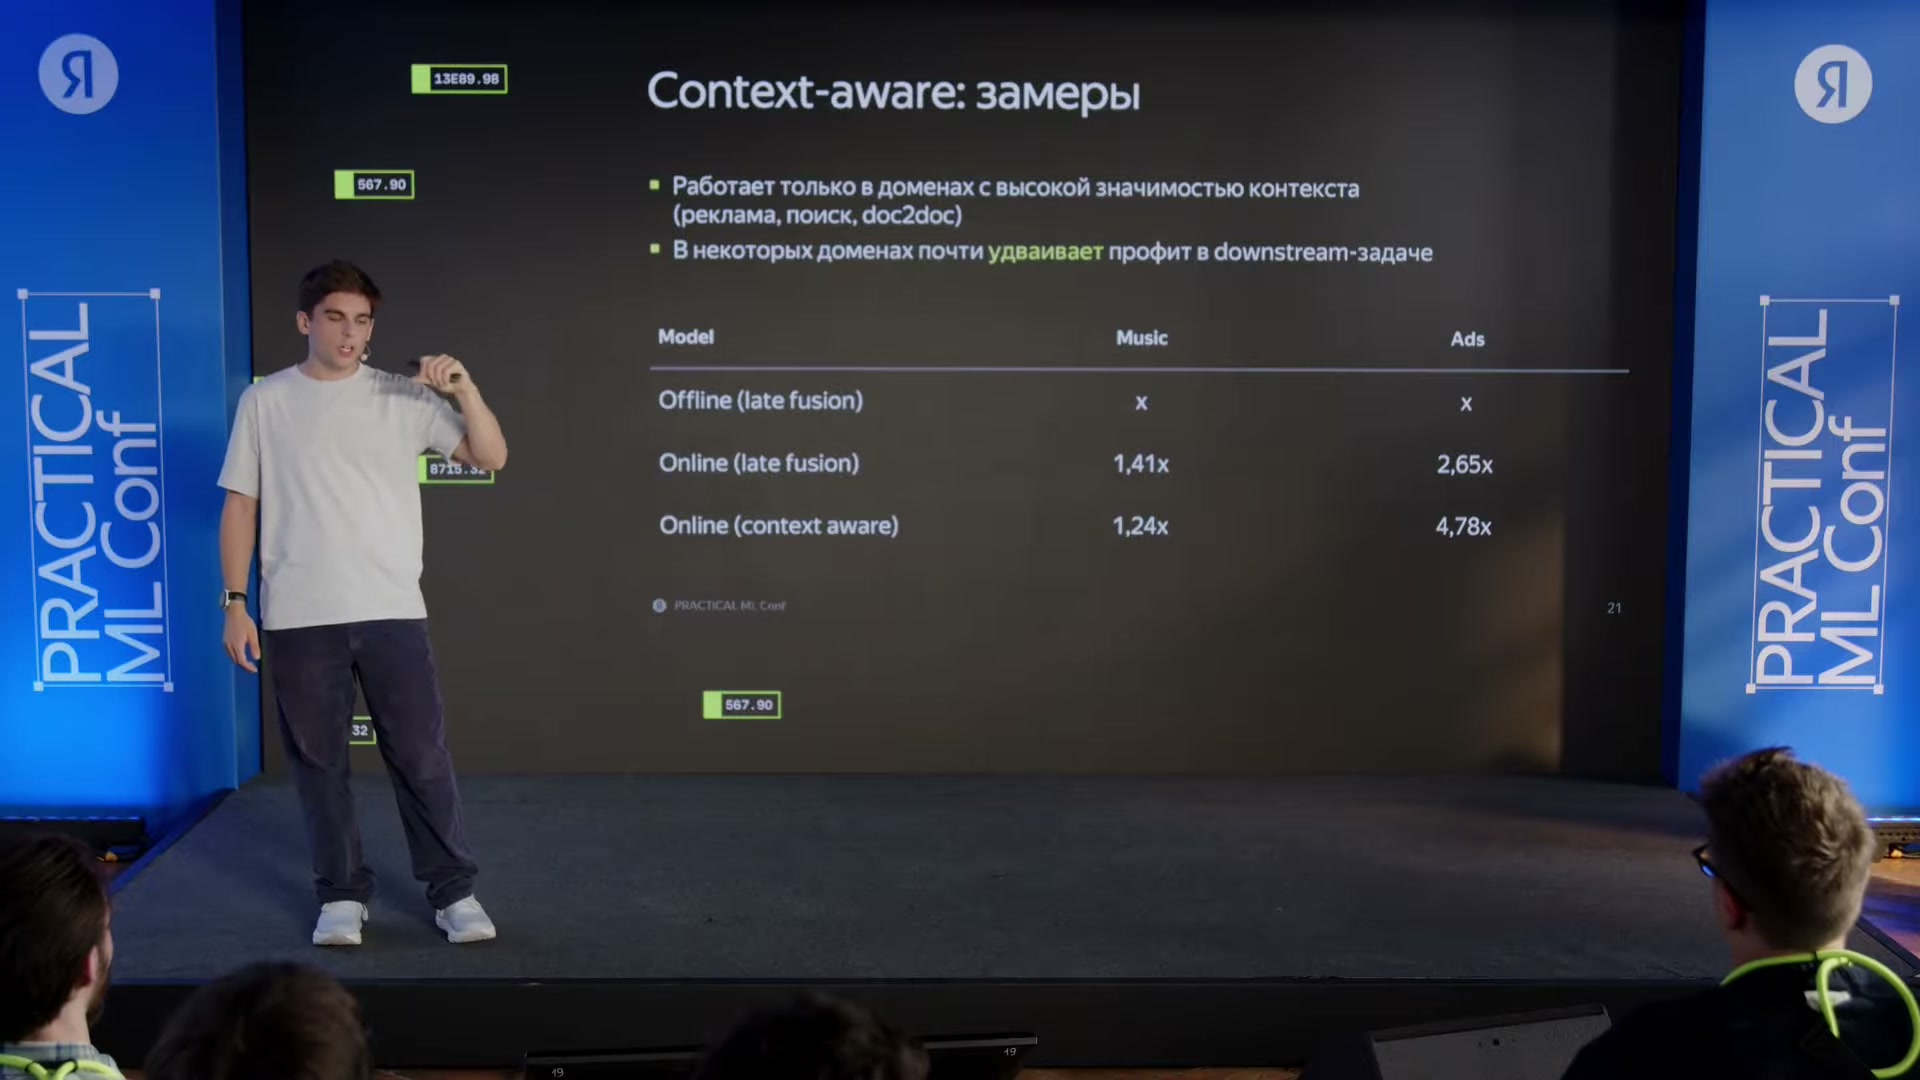
Offline late fusion — x. Online late fusion: Music 1,41x, Ads 2,65x. Online context aware: Music 1,24x, Ads 4,78x. Это множители выигрыша в downstream-задаче; абсолютная метрика и протокол не названы.
Источник: Николай Савушкин · Яндекс · Practical ML ConfКак события разных сервисов попадают в одну последовательность
Следующее ограничение первых внедрений — изоляция данных по сервисам. Раньше знания из другого продукта приходилось переносить через простые ручные признаки. ARGUS позволяет поставить задачу иначе: объединить события пользователя в одну последовательность и обработать её общей моделью. Однако события разных типов сначала нужно привести к совместимым представлениям.
Для категориальных признаков, например идентификатора объекта, автора или категории, используется мультихэширование. На схеме это путь Multi Hash → Unified Embedding Table: признаки через несколько хеш-преобразований обращаются к общей таблице обучаемых векторов. Таблица используется для разных доменов. Число хешей и размеры таблицы в докладе не названы.
Для текста показан другой путь. Заголовок разбивается на части с помощью BPE, а затем представления этих частей объединяются компонентом Embedding Bag. Так получается «мешок BPE-токенов», а не отдельный текстовый трансформер. В речи автор также объясняет, что текстовые признаки вручную группируют по смыслу и обрабатывают соответствующими представлениями.
Выходы категориальной и текстовой ветвей объединяются через DCNv2, затем MLP формирует представление события. Схема содержит отдельные энкодеры для разных типов событий; в речи они описаны как отдельные башни доменов. Эти энкодеры обучаются совместно с основной моделью. Общая последовательность поэтому не требует считать все входные события одинаковыми: различается их кодирование, а анализ истории становится общим.
Важно, что здесь ещё не определена новая задача обучения. Мы только расширили то, что модель может прочитать. Следующий эксперимент проверяет пользу такого расширения при прежней цели, а уже после него команда меняет набор предсказываемых событий.
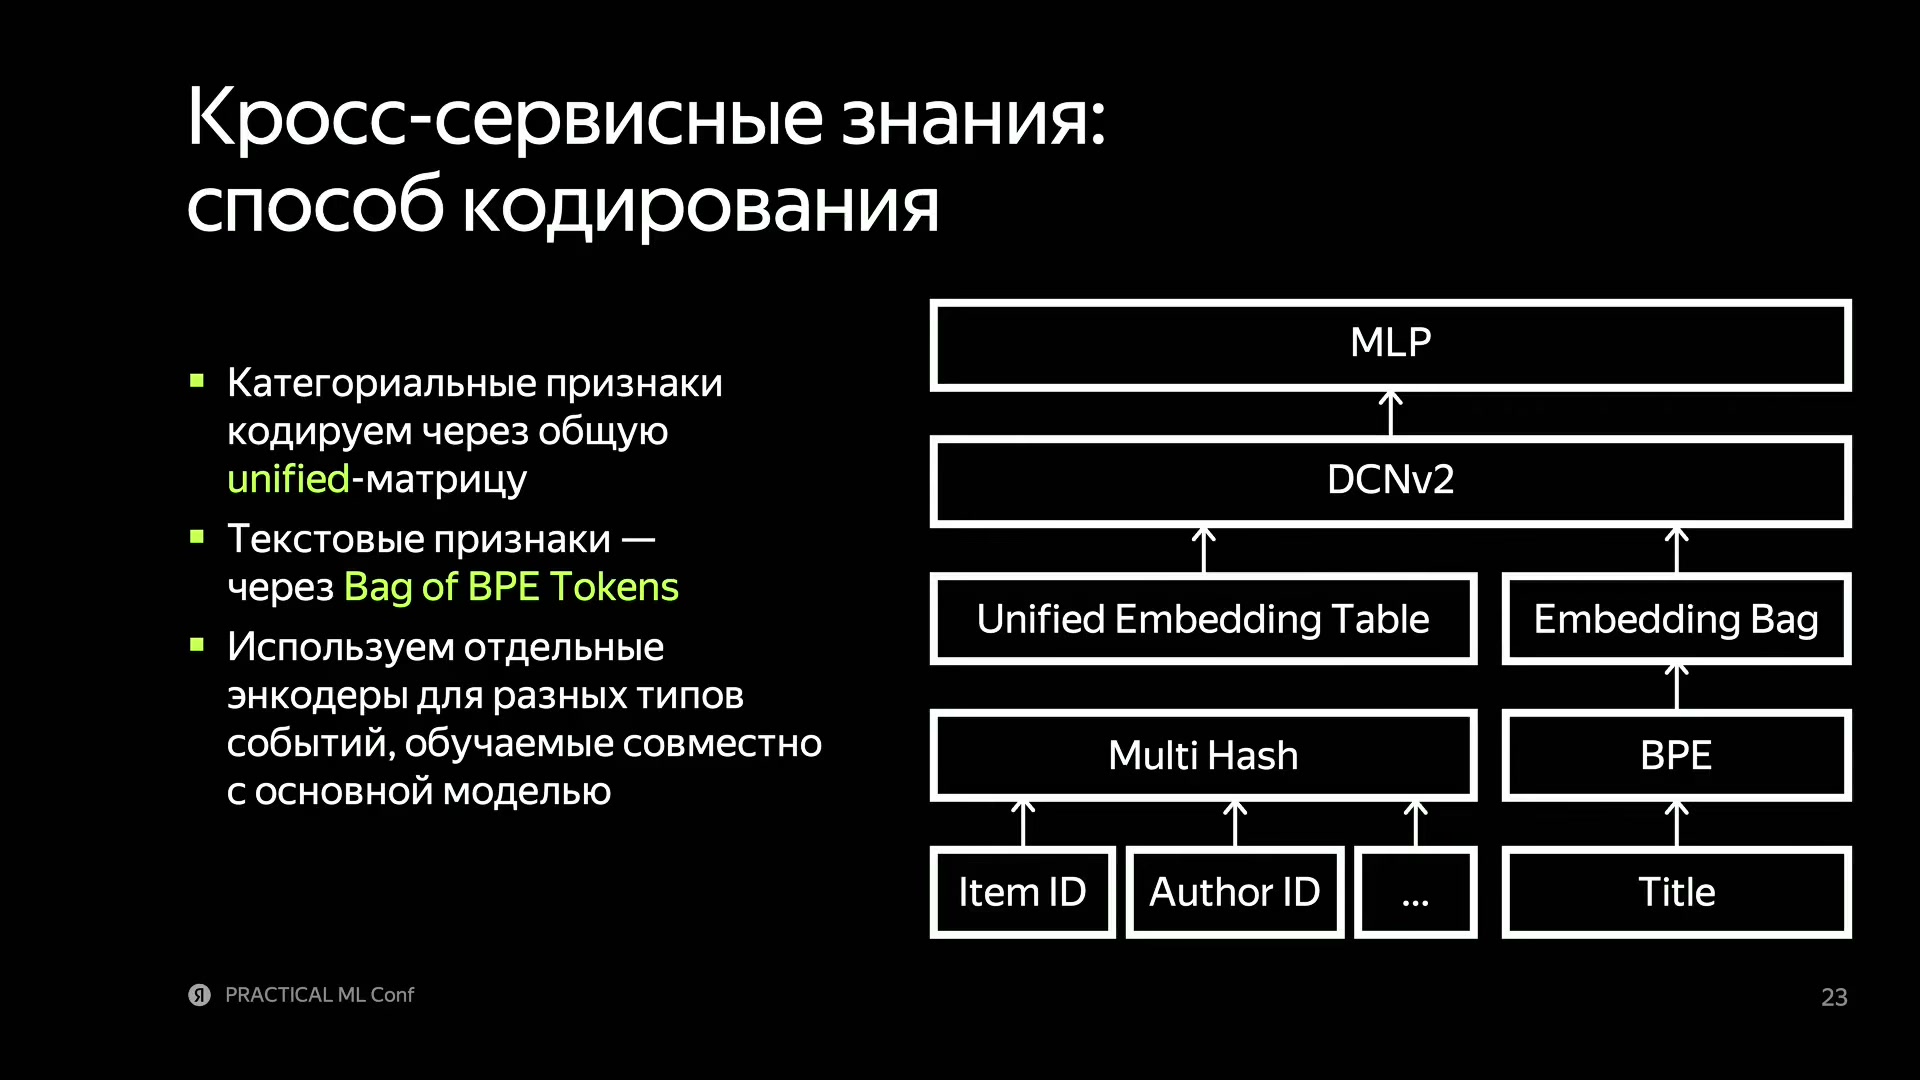
Категориальные признаки: Multi Hash → Unified Embedding Table; текст: BPE → Embedding Bag. Далее DCNv2 и MLP, отдельные энкодеры типов событий.
Источник: Николай Савушкин · Яндекс · Practical ML ConfДополнительная история помогает ещё до изменения обучающей задачи
Первый опыт с кросссервисными данными не требует учить модель решать задачи всех добавленных сервисов. В историю включают дополнительные события, но продолжают предсказывать следующий объект целевого домена. Новые события служат входной информацией, а не самостоятельными целями предсказания.
Оба варианта повышают показанный эффект относительно модели одного домена. Но таблица не говорит, что сначала добавили показы, затем поверх них запросы. Строки сравнивают раздельные расширения базы. Их множители нельзя складывать, перемножать или трактовать как измерение совместного добавления двух источников.
Причина результата в формулировке автора — больше доступных знаний о пользователе при той же функции потерь. Это первый уровень переноса между сервисами. Второй потребует заставить модель не только читать чужие события, но и предсказывать их. Перед этим команда проверяет более базовый вопрос: оправдан ли отдельный этап предварительного обучения вообще.
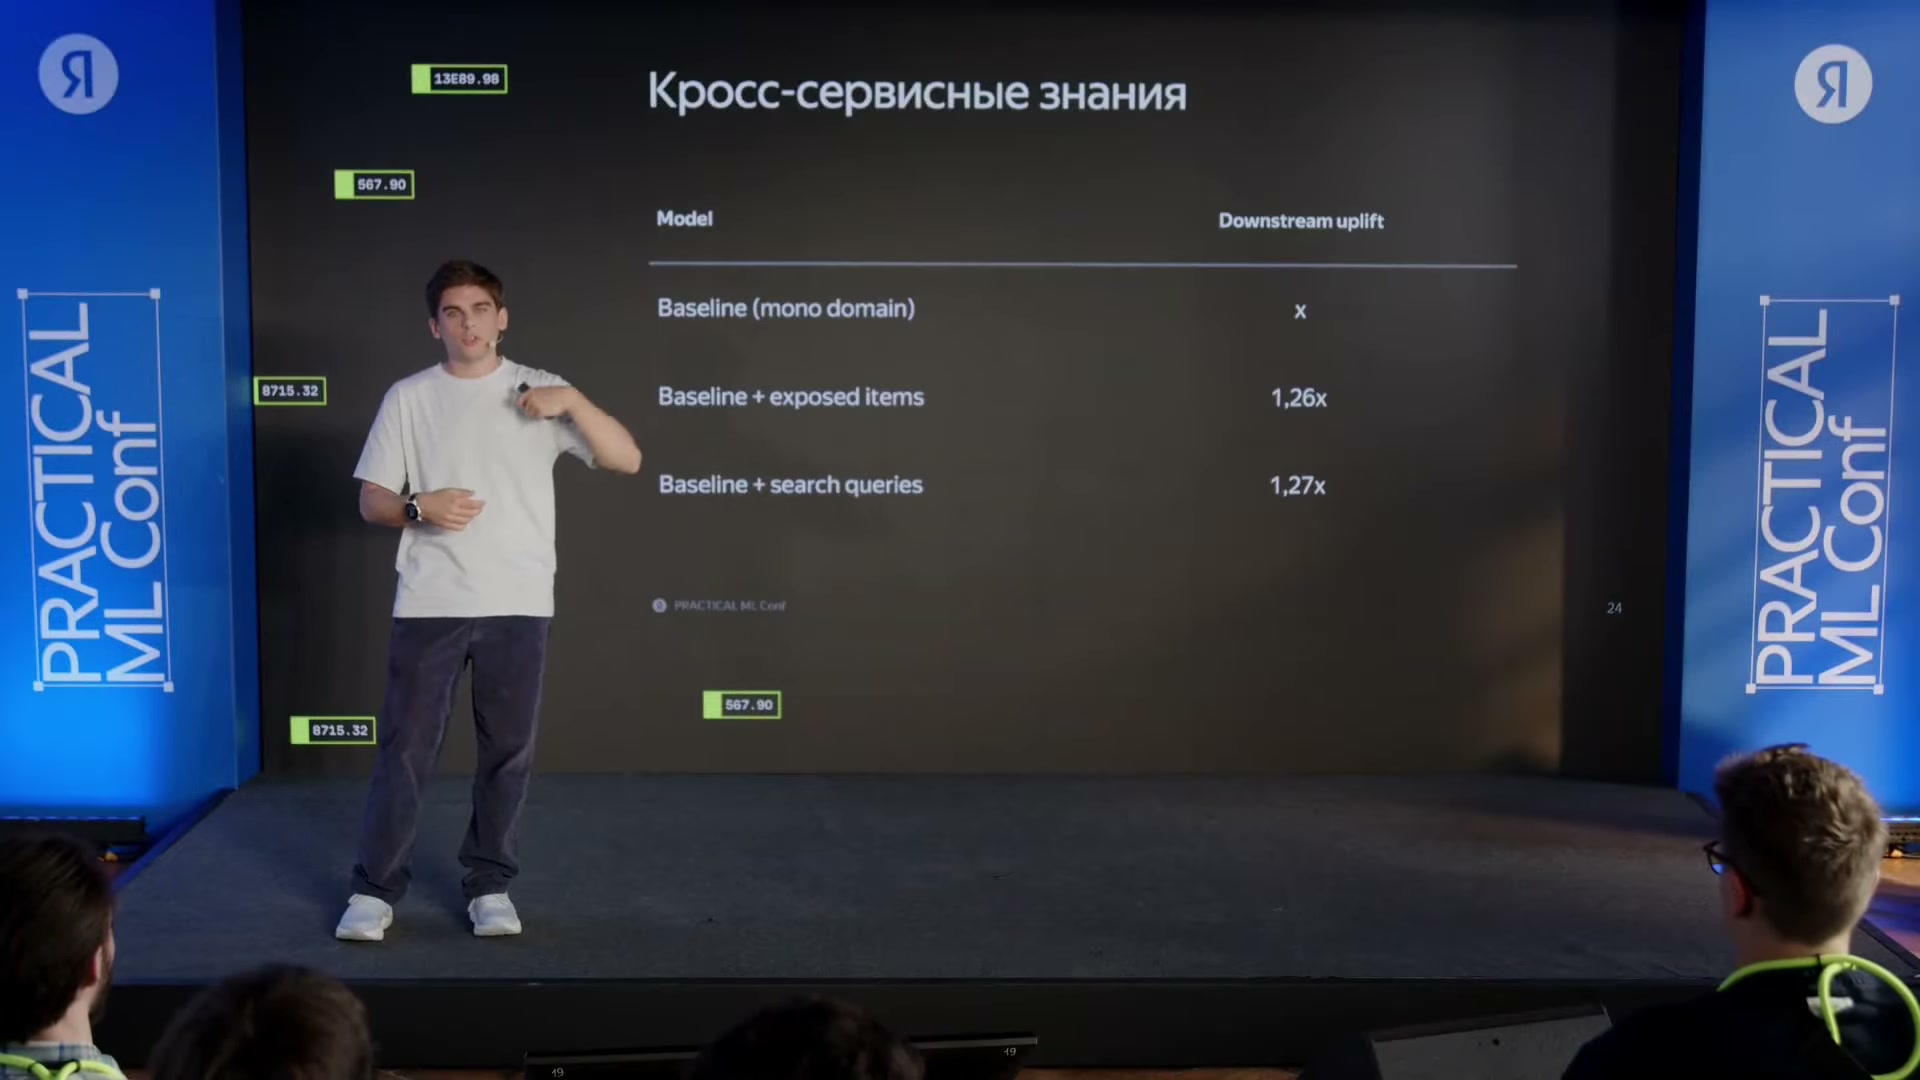
Baseline mono domain — x; добавление exposed items — 1,26x, search queries — 1,27x по Downstream uplift. Это отдельные варианты, их эффекты не складываются.
Источник: Николай Савушкин · Яндекс · Practical ML ConfМожно ли заменить предварительное обучение более долгим дообучением
В рассмотренных внешних моделях автор не выделяет такой же отдельный предварительный этап, как в ARGUS. Поэтому двухступенчатую процедуру нельзя считать полезной только по аналогии с языковыми моделями: её нужно сравнить с обучением сразу под целевую задачу.
Савушкин разделяет два вопроса. Первый — куда выгоднее потратить фиксированный бюджет GPU-часов: на предварительное обучение с дообучением или только на целевое обучение. Второй — сможет ли обучение только под целевую задачу догнать предварительно обученную модель, если запускать его дольше. Они связаны, но не тождественны: одна эпоха разных задач не обязана стоить одинаково.
Таблицу можно прокрутить по горизонтали.
При увеличении числа эпох одного дообучения эффект сначала растёт, а затем почти перестаёт меняться: после 1,83x получается 1,86x. Одна эпоха предварительного обучения и три эпохи дообучения дают 2,04x — выше всех показанных вариантов без первого этапа. Это и есть наблюдаемое основание сохранить предварительное обучение.
При этом четыре эпохи дообучения и сочетание «одна плюс три» нельзя объявлять экспериментом с одинаковыми вычислительными затратами: времени разных этапов нет. Таблица также не доказывает, что любое сколь угодно долгое целевое обучение обязательно уступит. Она показывает насыщение конкретных запусков и преимущество двухэтапного рецепта в представленном сравнении.
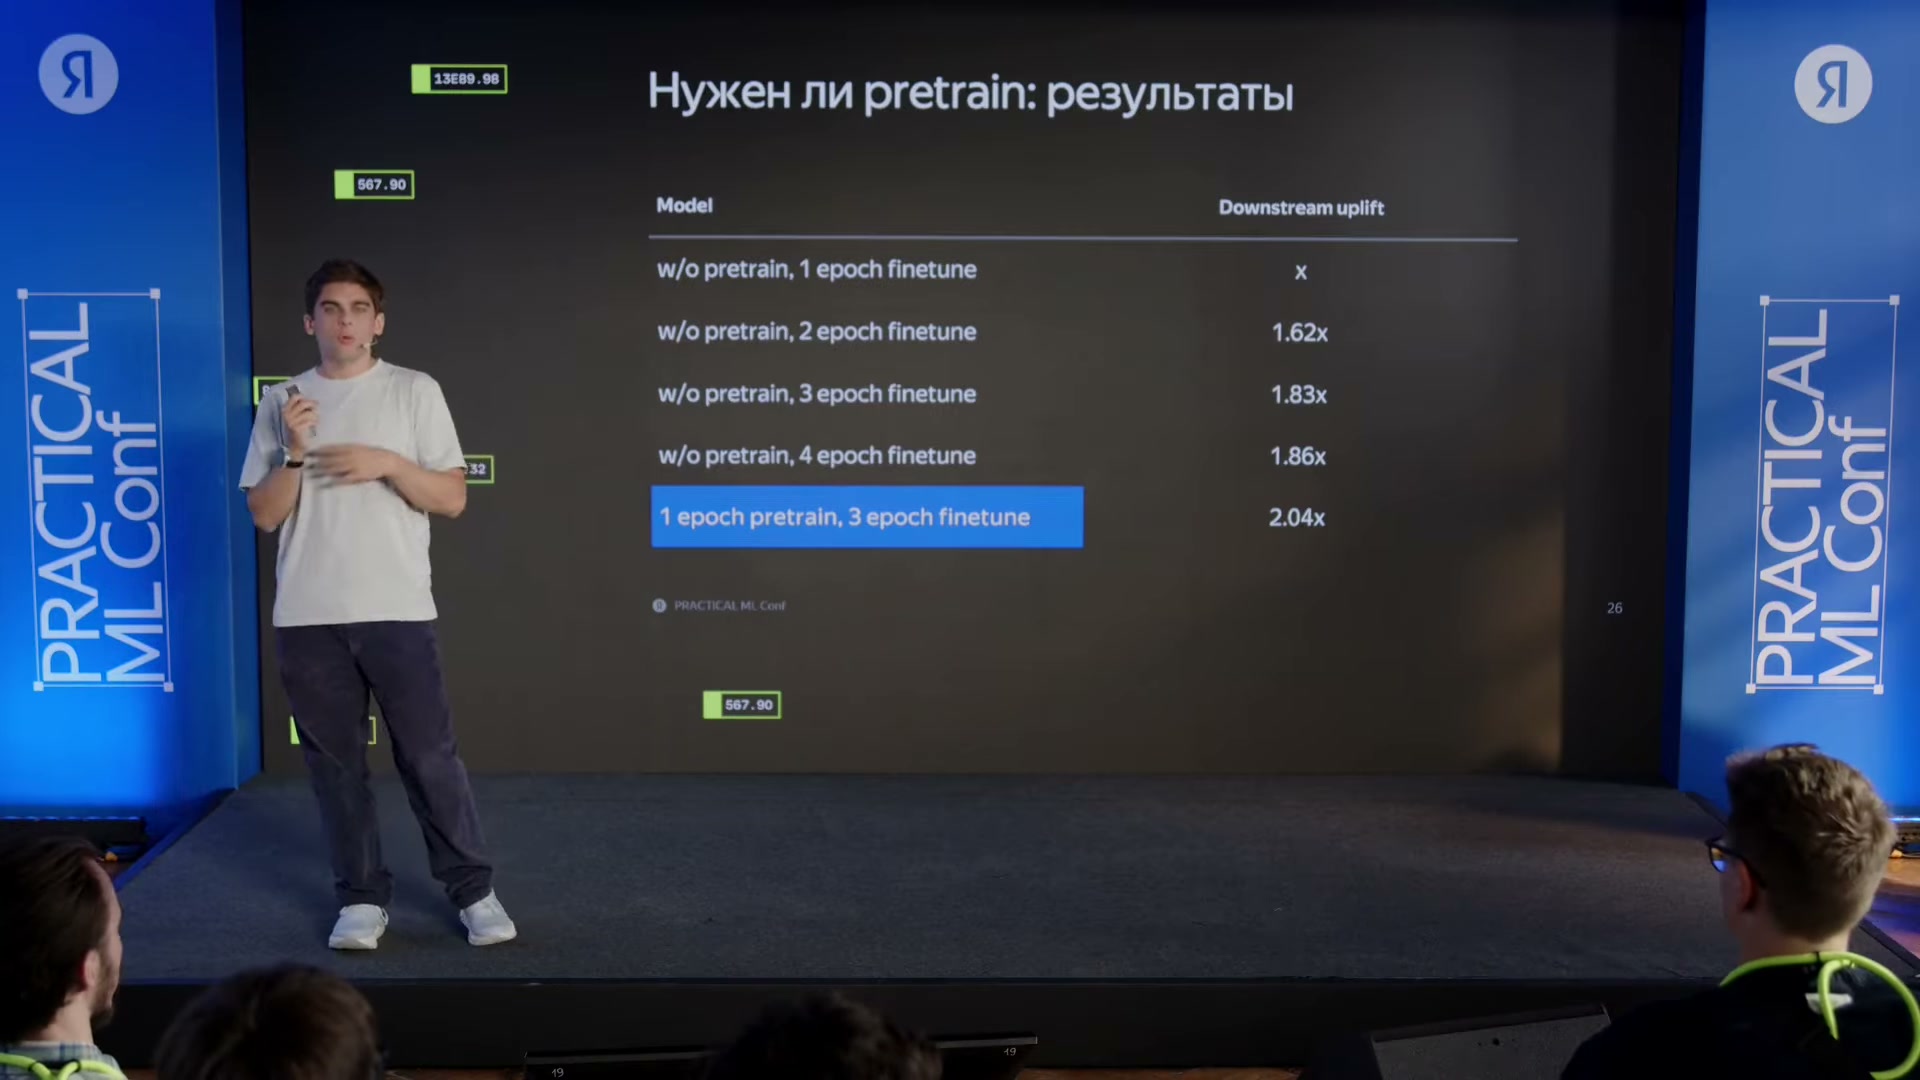
Без pretrain: 1/2/3/4 эпохи finetune — x/1,62x/1,83x/1,86x. 1 эпоха pretrain + 3 finetune — 2,04x. GPU-часы и абсолютная downstream-метрика не раскрыты.
Источник: Николай Савушкин · Яндекс · Practical ML ConfПредсказывать события других доменов: sampled softmax и поправка на выборку
После проверки предварительного обучения возникает следующая гипотеза. Если общая история уже содержит события нескольких сервисов, возможно, полезно предсказывать следующий объект каждого из них. Конечное применение при этом может оставаться в одном сервисе. Новая задача должна сделать общие представления полезнее для этого целевого применения.
Функция потерь — величина, уменьшение которой направляет обучение. В исходном рецепте используется sampled softmax: вместо сравнения со всем каталогом целевой объект сопоставляется с выбранными отрицательными примерами. Здесь «положительный пример» в вычислении потери означает документ, который действительно был следующим. Его не следует путать с положительной реакцией: ARGUS на предварительном этапе восстанавливает и документы с отрицательным откликом.
Отрицательные примеры получают двумя путями. Можно взять случайные документы из базы. Можно использовать документы других примеров в том же пакете обучения — in-batch negatives. Во втором случае набор альтернатив зависит от того, что встретилось в данных, и уже не соответствует равномерному перебору каталога.
Чтобы учитывать смещение такой выборки, используется поправка LogQ. Q описывает вероятность попадания объекта в выборку; поправка к оценкам учитывает, что одни объекты оказываются среди сравниваемых альтернатив чаще других. По смыслу это коррекция процедуры выбора примеров, а не утверждение, что часто встречающийся документ обязательно неинтересен пользователю.
В записи на исходном слайде есть существенная особенность: в числителе стоит exp(f(u,p)), без вычитания log Q(p), а в положительном слагаемом знаменателя — exp(f(u,p) − log Q(p)). Отрицательные слагаемые знаменателя также скорректированы на log Q. Поэтому эту асимметричную дробь нельзя без оговорки читать как обычную нормированную softmax-вероятность. Слайд показывает авторскую запись, но не позволяет восстановить по ней точную реализацию потери в коде.
Для каждого добавленного домена вводится своя аналогичная задача предсказания. Её отрицательные примеры выбираются внутри этого же домена, а итоговая функция потерь складывается из доменных. Таким образом, общая модель учится на нескольких задачах, но объекты разных каталогов не превращаются автоматически в один неразличимый пул альтернатив.
Краткая запись описанного суммирования: D — набор доменов, L_d — потеря домена. Это не полная формула реализации; нормировка и дополнительные коэффициенты не раскрыты.
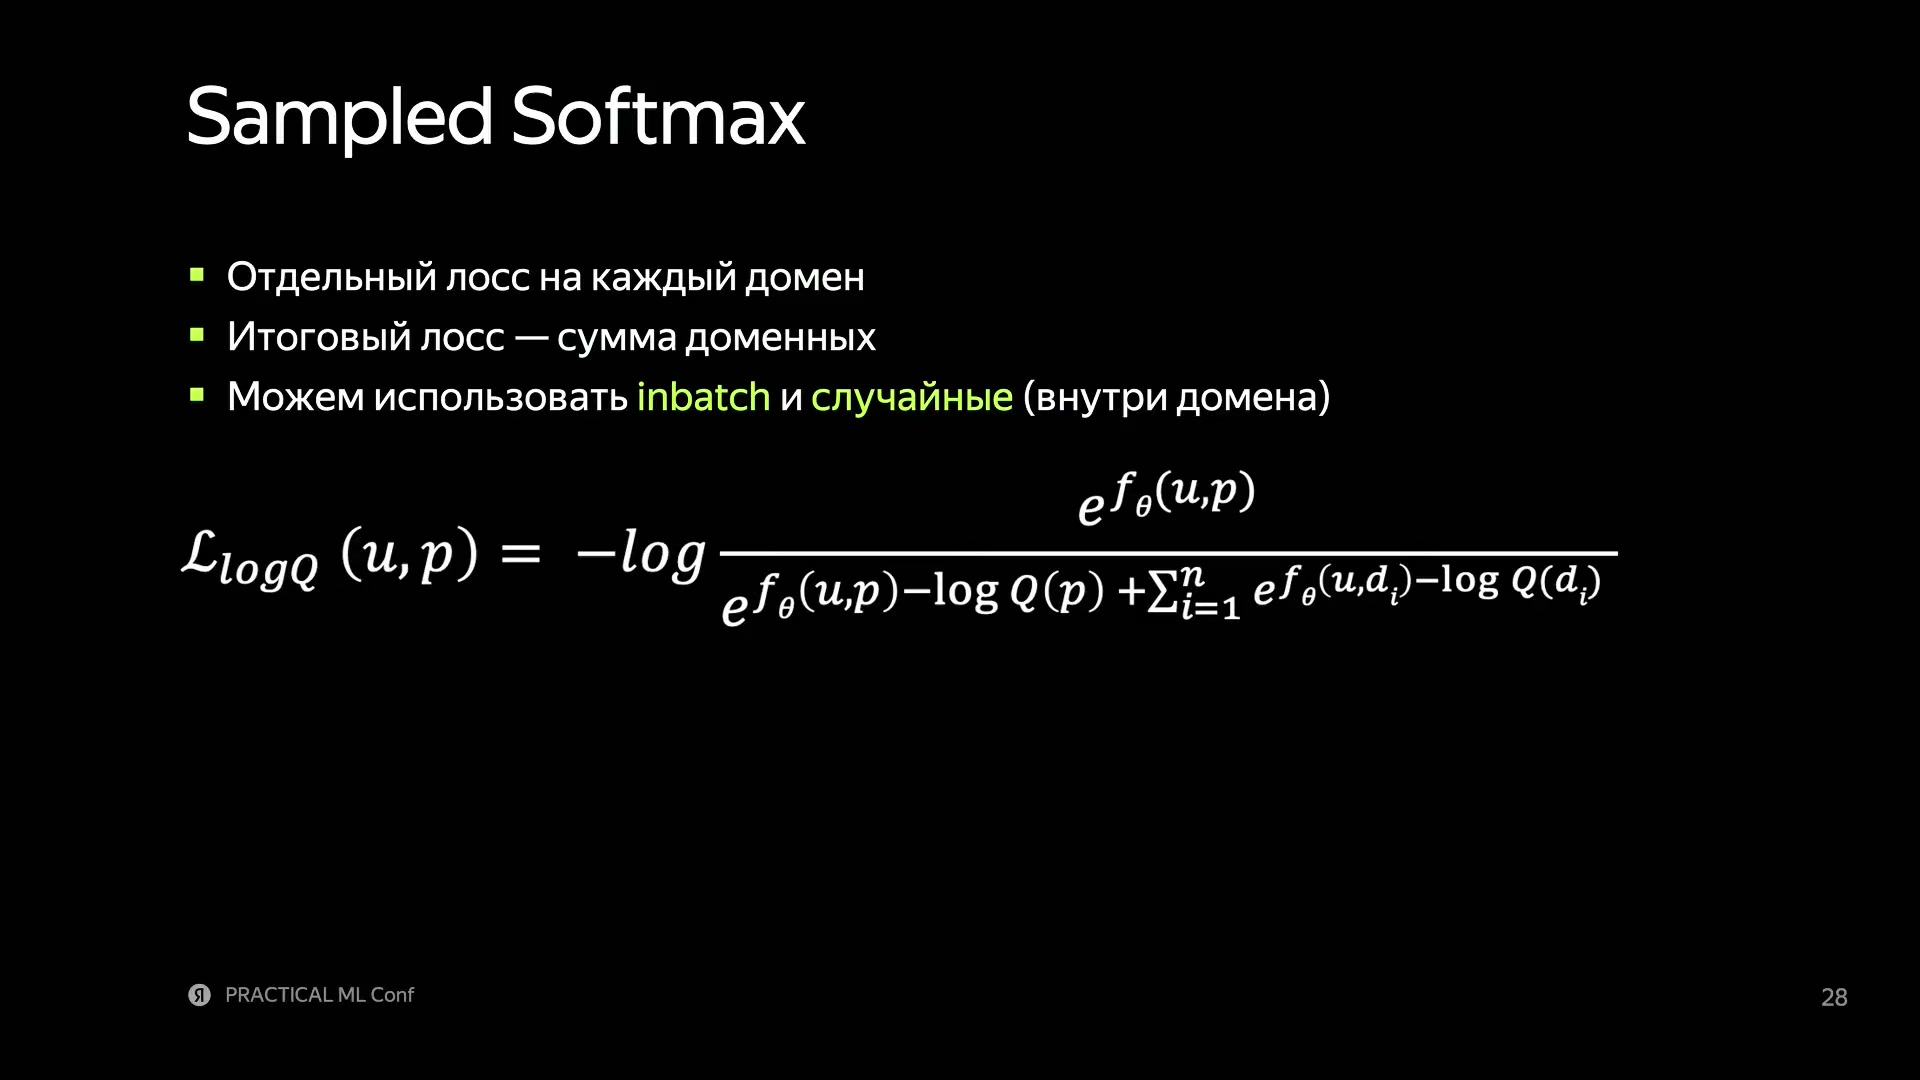
Итоговая потеря — сумма доменных, негативы внутри домена. Формула на слайде асимметрична: в числителе у положительного логита отсутствует -log Q(p), в знаменателе есть. Не превращаем её без пояснения в корректную нормированную вероятность.
Источник: Николай Савушкин · Яндекс · Practical ML ConfЧто даёт обучение на задачах нескольких сервисов
Теперь эксперимент меняет не только доступную историю, но и то, что требуется предсказывать на предварительном этапе. На слайде сравниваются отсутствие этого этапа, предварительное обучение на рекламе и его последовательное расширение задачами search и gallery.
Каждое показанное расширение увеличивает эффект относительно одной и той же базы без предварительного обучения. Значение 1,51x не означает отдельную прибавку от gallery поверх 1,37x. Названия search и gallery сохранены как обозначения доменных задач на слайде: более подробный состав данных не раскрыт.
Существенна точка измерения. ARGUS сначала предварительно обучили, затем дообучили под целевую задачу, после чего его выход включили в следующую модель. Результат оценили уже там. Это более сильное свидетельство полезности общих представлений, чем одно лишь снижение вспомогательной потери. Но конкретная метрика, размер выборки и процедура проверки пользовательского эффекта здесь не названы.
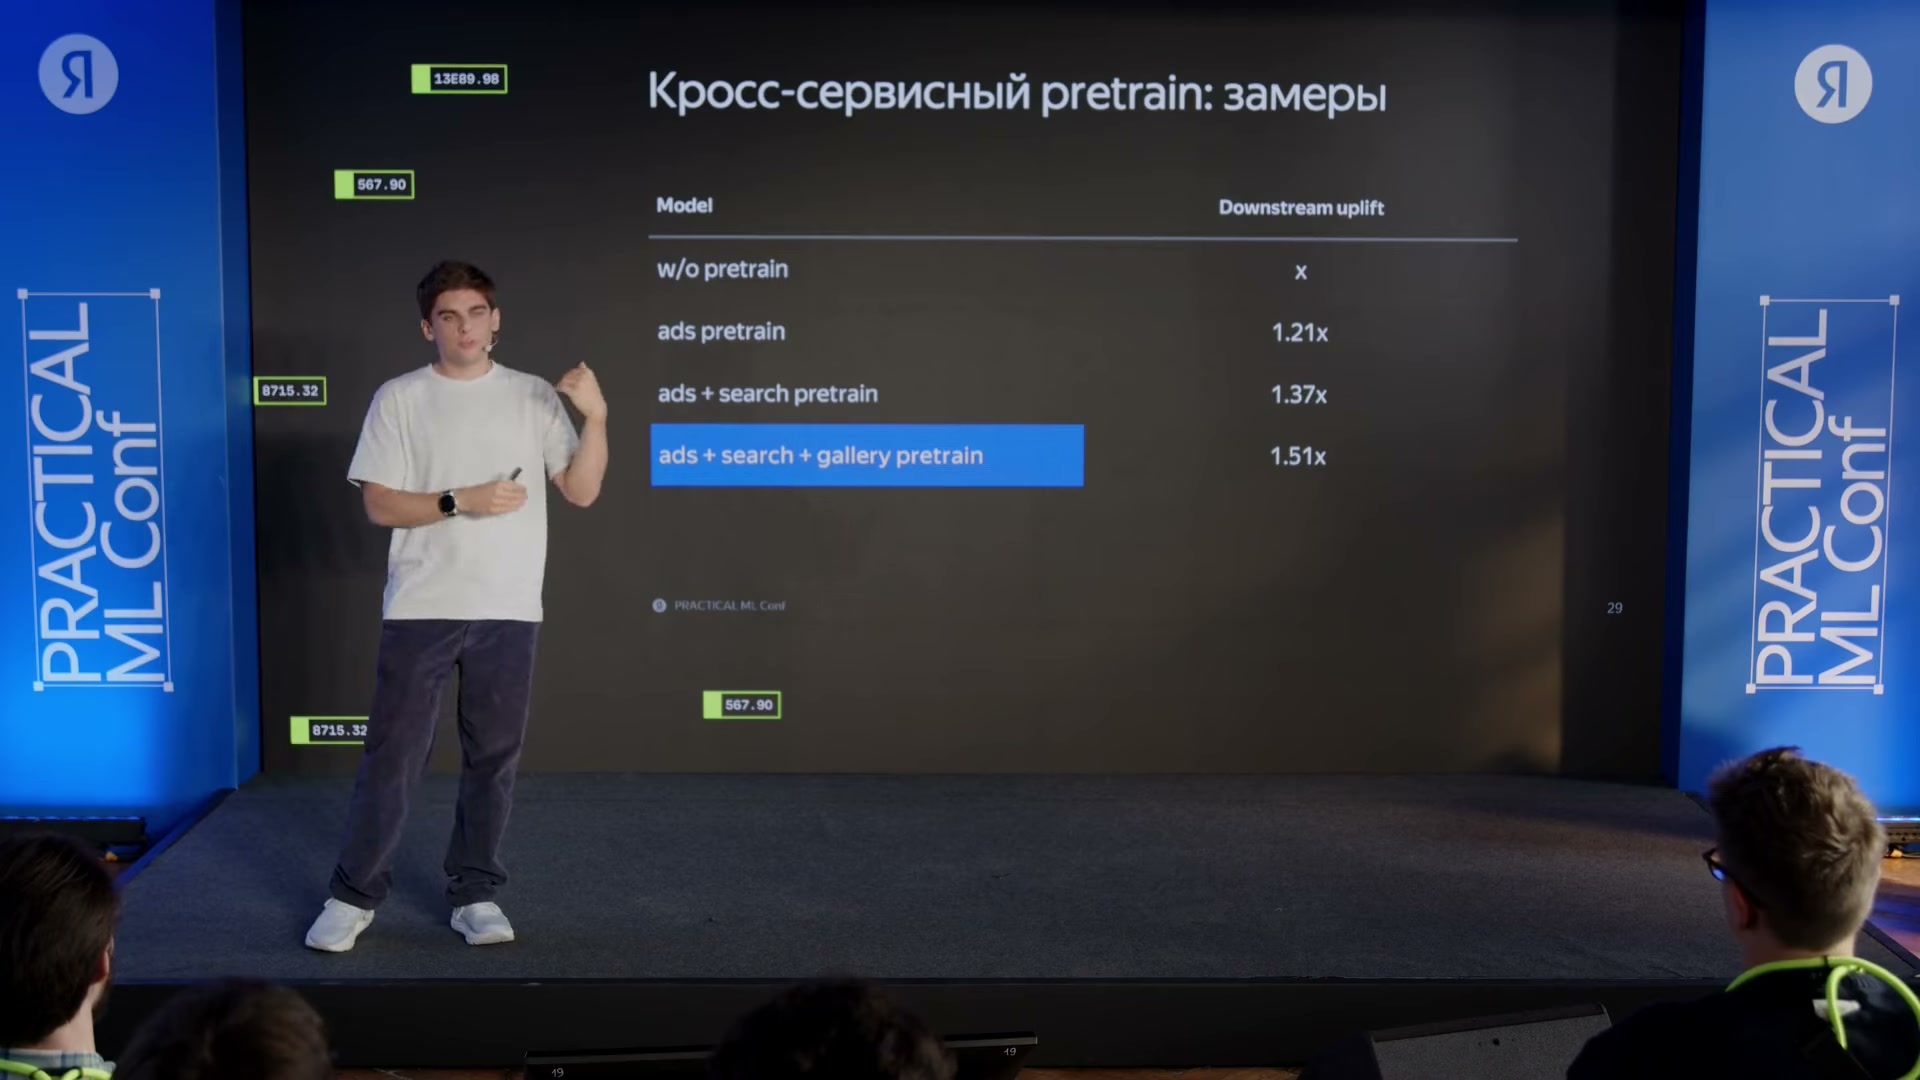
Без pretrain — x; ads — 1,21x; ads + search — 1,37x; ads + search + gallery — 1,51x по Downstream uplift. Результат измерен после дообучения и включения модели в ранкер.
Источник: Николай Савушкин · Яндекс · Practical ML ConfПочему отказались от отдельного предсказания реакции
В исходном ARGUS две задачи выполняли разные роли. Предсказание следующего документа восстанавливало поведение прежней системы: какие объекты пользователь вообще встретит. Эти правила прошлой выдачи автор называет логирующей политикой. Вторая задача по документу, текущему контексту и представлению истории предсказывала реакцию пользователя. Её отдельная функция потерь называется feedback loss.
Команда проверила, нужен ли второй сигнал именно на предварительном этапе. Результаты показаны для рекламы и Музыки; в речи сказано о проверках в нескольких доменах. Основанием решения стало качество последующих моделей, а не только успешность предсказания самой реакции.
Таблицу можно прокрутить по горизонтали.
Без отдельного предсказания реакции сохраняется 0,98x показанного эффекта в рекламе и 0,92x в Музыке. Поэтому результат нельзя назвать буквально без потерь. Автор считает вклад задачи небольшим относительно её цены: она усложняет код и вносит нестабильность в обучение. В обновлённом рецепте от неё отказываются.
Удаляется обучающая цель, а не информация о реакции во входной истории. Объект и действие по-прежнему могут входить в токен события; отрицательные взаимодействия также не объявлены исключёнными. Не следует переносить это решение и на все целевые задачи дообучения: ранжирование реакции и вспомогательная feedback loss на предварительном этапе — разные вещи.
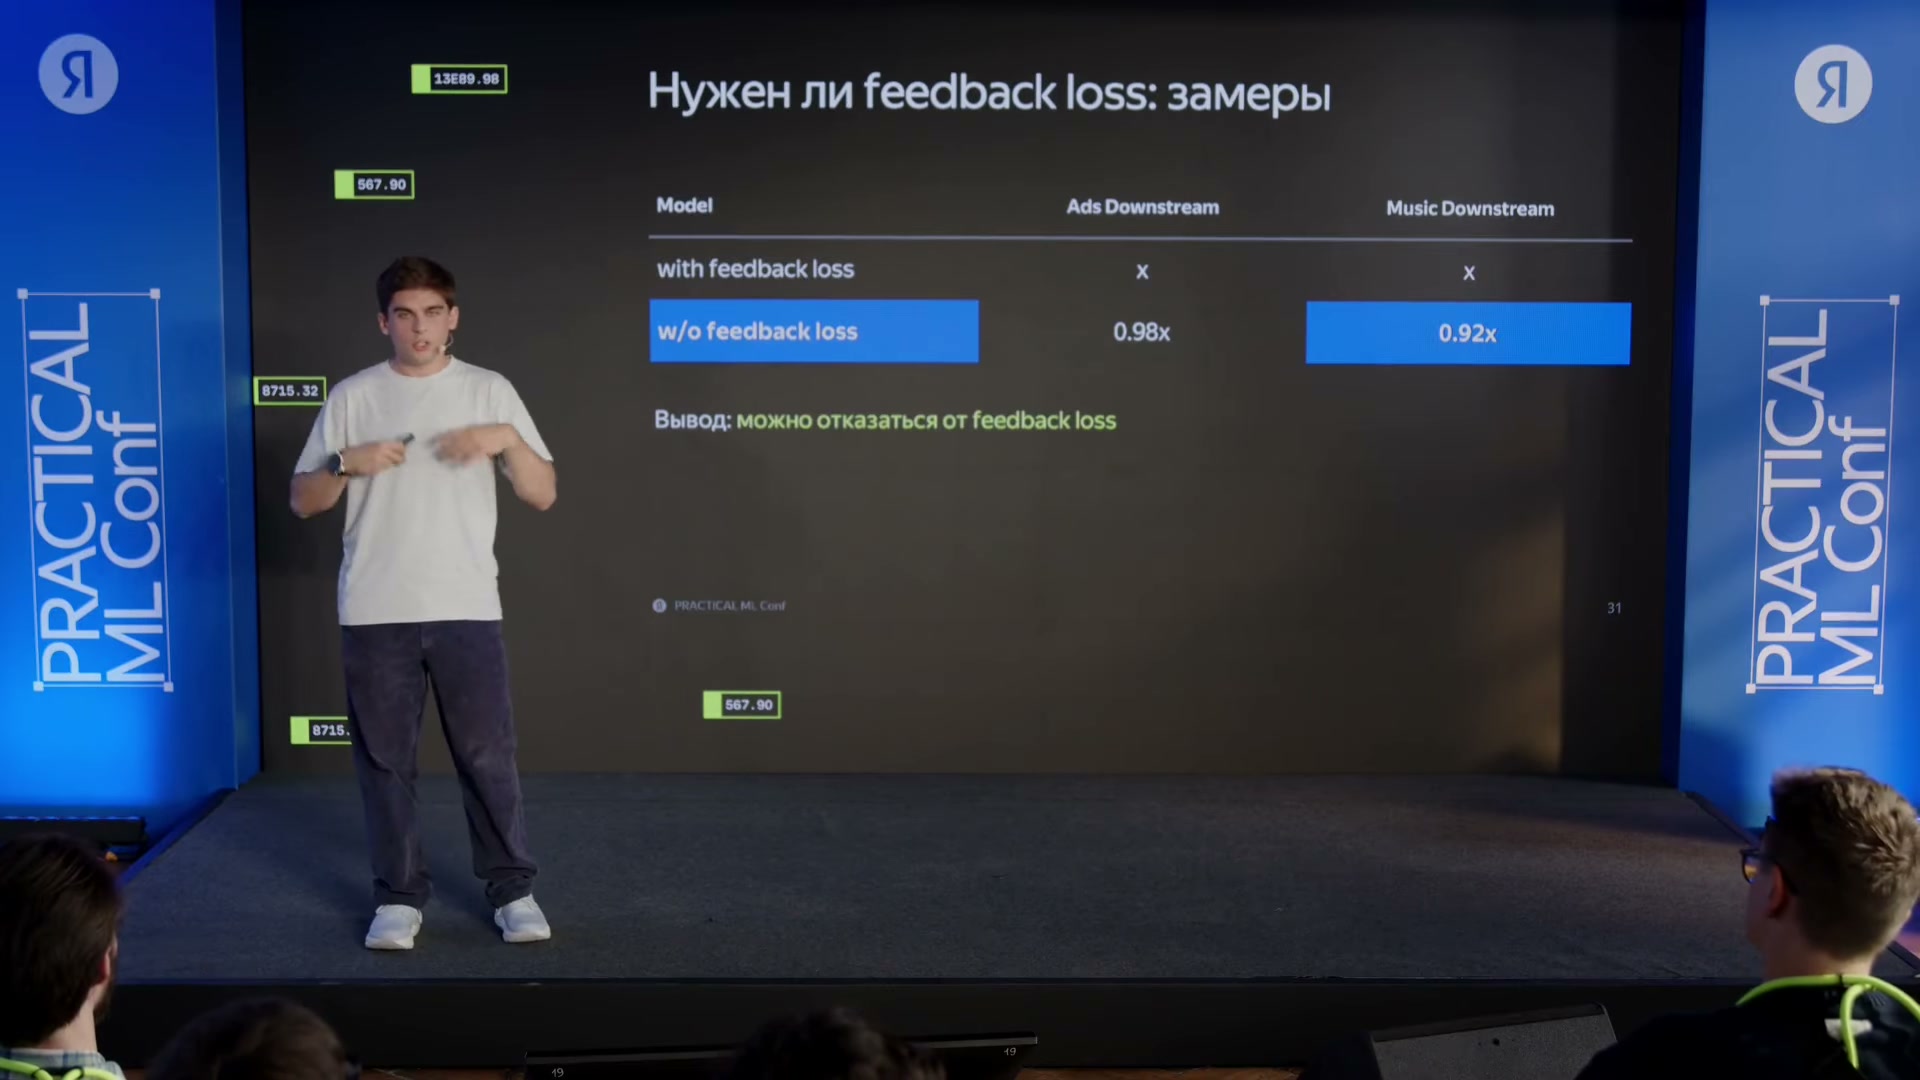
Без feedback loss: Ads Downstream 0,98x, Music Downstream 0,92x относительно варианта с потерей. Это отношение показанного эффекта, не проценты падения всей бизнес-метрики.
Источник: Николай Савушкин · Яндекс · Practical ML ConfБольше отрицательных примеров: обмен между GPU и цена матрицы логитов
Следующий вопрос касается не архитектуры трансформера, а того, с какими альтернативами он сравнивает правильный следующий документ. Нужно ли сохранять смешанный набор отрицательных примеров? Поможет ли увеличить их число? И как сделать это, не исчерпав видеопамять?
Команда обучает модели на сотнях GPU, используя параллельную обработку данных с DDP или FSDP. Каждый рабочий процесс получает свой локальный пакет примеров и локально выбранные отрицательные документы. Их можно собрать между устройствами. Это даёт два разных преимущества: выбор из более разнообразного общего пула и возможность увеличить количество альтернатив для каждого целевого объекта. По словам автора, приём применим уже при двух GPU; сотни устройств не являются обязательным условием самой идеи.
Но простой обмен данными ещё не решает вычислительную проблему. Обычная реализация sampled softmax сохраняет большую промежуточную матрицу логитов — числовых оценок до нормировки. Её размер определяется числом целевых, или положительных, примеров и числом сравниваемых отрицательных. Если второй множитель растёт, матрица тоже растёт и занимает значительную часть видеопамяти.
Размер большой матрицы логитов в описанной реализации. Это число её элементов, а не формула полного расхода памяти модели.
В наивной межустройственной схеме приходится уменьшать пакет обучения, чтобы поместить новые альтернативы. Для обхода используют объединённую реализацию вычислений — fused cross-entropy, которая не материализует всю большую матрицу. Автор говорит о готовом вычислительном ядре от LinkedIn.
В опыте команды fused-реализация немного медленнее исходной кросс-энтропии. Её достоинство здесь не в ускорении одного и того же расчёта, а в возможности использовать значительно больше отрицательных примеров. Вместе с обменом между устройствами это меняет доступный режим обучения. Точные числа примеров, типы GPU, объём сэкономленной памяти и скорость в единицах времени не приведены.
Это масштабирование обучающего сравнения, а не заявленное ускорение ответа рекомендательного сервиса. Его полезность нужно смотреть по качеству модели, что команда и делает в следующей абляции.
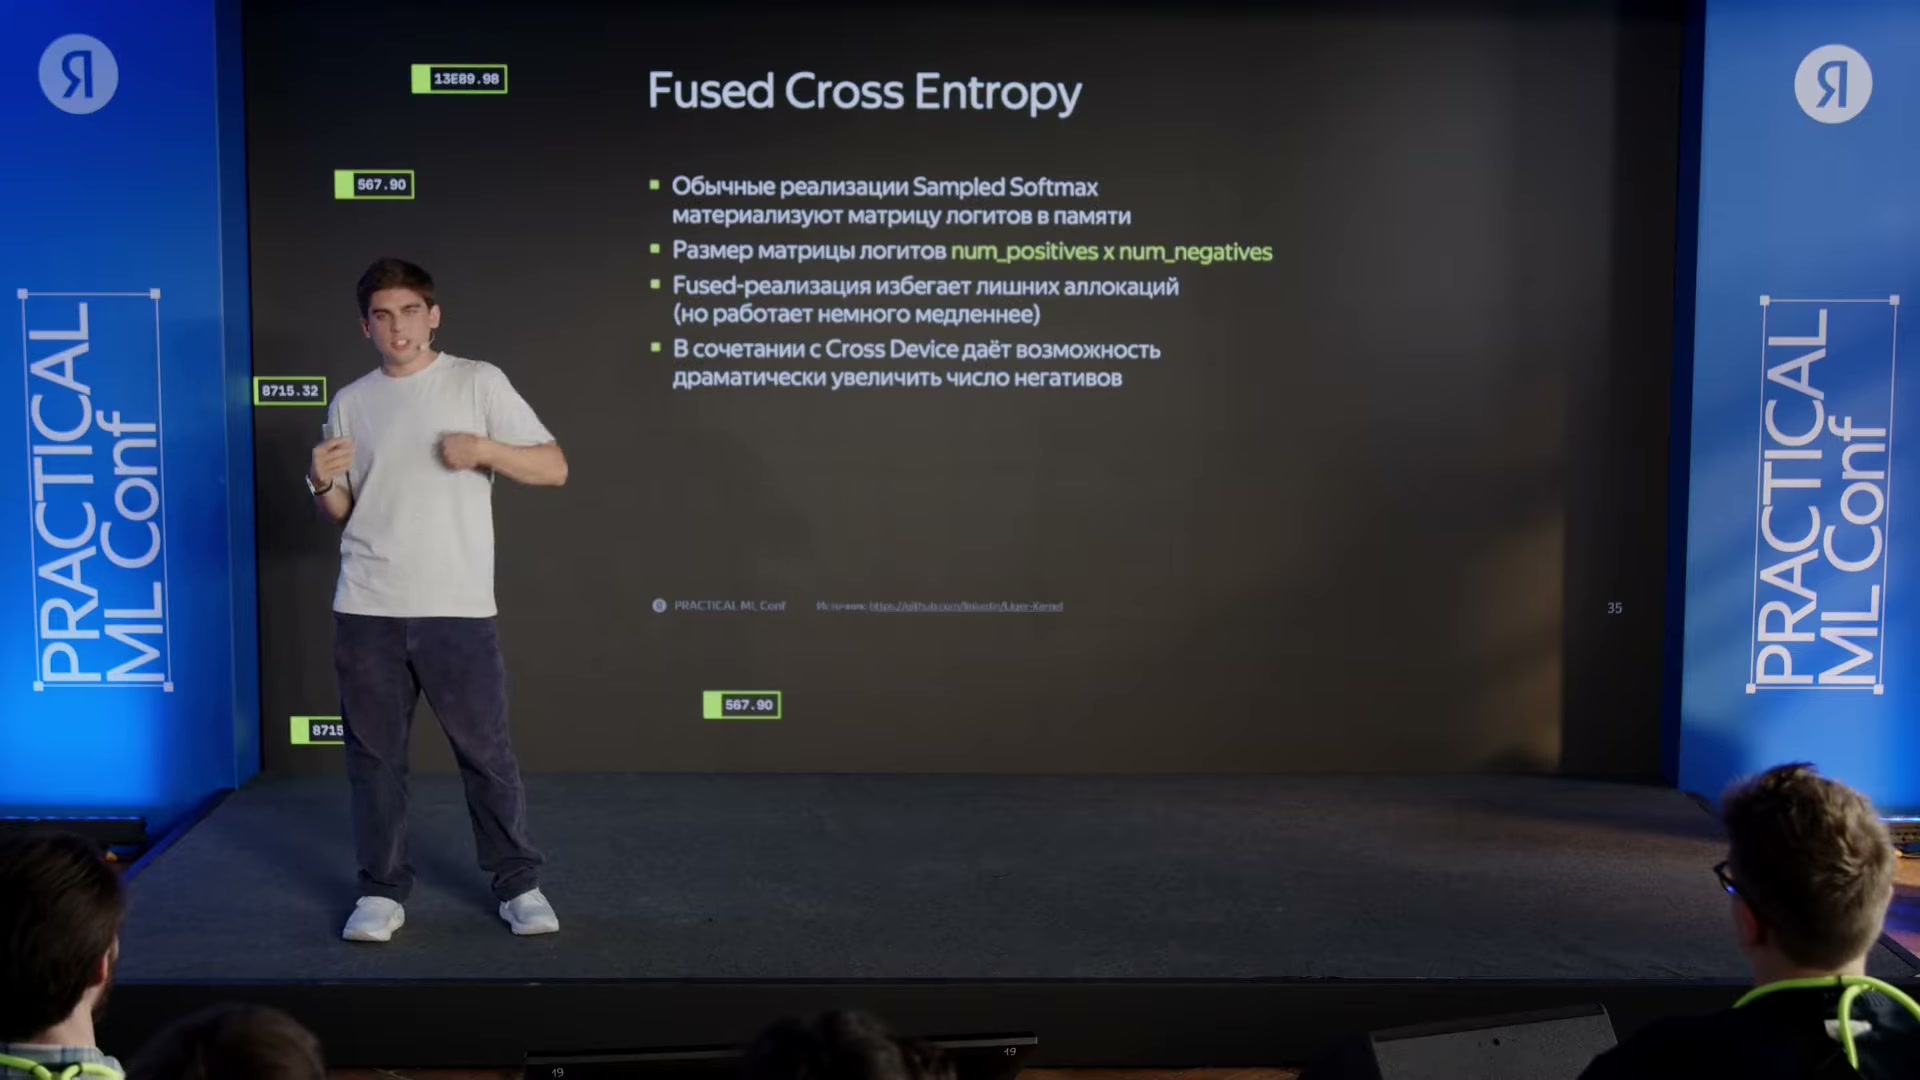
Обычный подход материализует num_positives × num_negatives логитов. Fused избегает большой промежуточной матрицы, но в опыте автора немного медленнее; вместе с cross-device позволяет увеличить число негативов.
Источник: Николай Савушкин · Яндекс · Practical ML ConfКакие отрицательные примеры действительно повлияли на качество
Базовый вариант использует смешанную выборку: документы из текущего пакета обучения и случайные документы из базы. В абляциях отдельные части этого рецепта выключают или меняют. Так можно проверить, какой компонент отвечает за наблюдаемое качество, вместо того чтобы оценивать все изменения одним числом.
На слайде показаны метрики hitrate@10, hitrate@100 и hitrate@1000 — оценки попадания целевого объекта в верхнюю часть списка на разных глубинах. В речи автор местами говорит о recall, но численные столбцы этого эксперимента подписаны именно hitrate. Отдельно дан эффект в последующей модели, Downstream.
Таблицу можно прокрутить по горизонтали.
Самый сильный отрицательный результат — удаление примеров из пакета. Все три hitrate снижаются, а показанный downstream-эффект составляет 0,51x. Поэтому автор считает эту часть выборки принципиальной для рассматриваемого рецепта. Это вывод из конкретного сравнения, а не запрет на любые другие способы обучения.
Отказ от случайных примеров из базы не даёт такого провала: hitrate@10 немного ниже базы, а остальные показанные значения и downstream-множитель выше. Вариант Uniform popular улучшает hitrate на всех трёх глубинах, но имеет лишь 1,01x по Downstream. Строка Fused даёт наибольшие показанные hitrate и 1,05x эффекта в следующей модели. Эти различия хорошо показывают, почему качество вспомогательного предсказания и польза для ранжирования не движутся одинаково.
В описании Fused объединены межустройственный подход и реализация, позволяющая увеличивать набор альтернатив. Таблица не изолирует эффект одной замены вычислительного ядра при неизменных данных. Поэтому её результат нельзя объяснить тем, что сама по себе другая реализация кросс-энтропии улучшает модель.
Для документов из базы автор обсуждает несколько распределений: равномерное по каталогу, выбор из популярных объектов и учёт затухающей со временем популярности. В последнем случае объект, популярный сейчас, выбирается чаще, чем объект с давно прошедшим всплеском интереса. При этом в речи вся группа продолжает называться uniform negatives, даже когда выборка уже неравномерна. Здесь полезнее различать источник примеров и конкретное распределение их выбора.
Итог зависит от назначения модели. На предварительном обучении можно отказаться от случайных документов из базы, если улучшение этой задачи почти не передаётся в последующее ранжирование. Для непосредственного отбора кандидатов команда их сохраняет, меняет стратегию выборки и увеличивает число альтернатив. Одна обучающая процедура поэтому не объявляется лучшей сразу для всех ролей ARGUS.
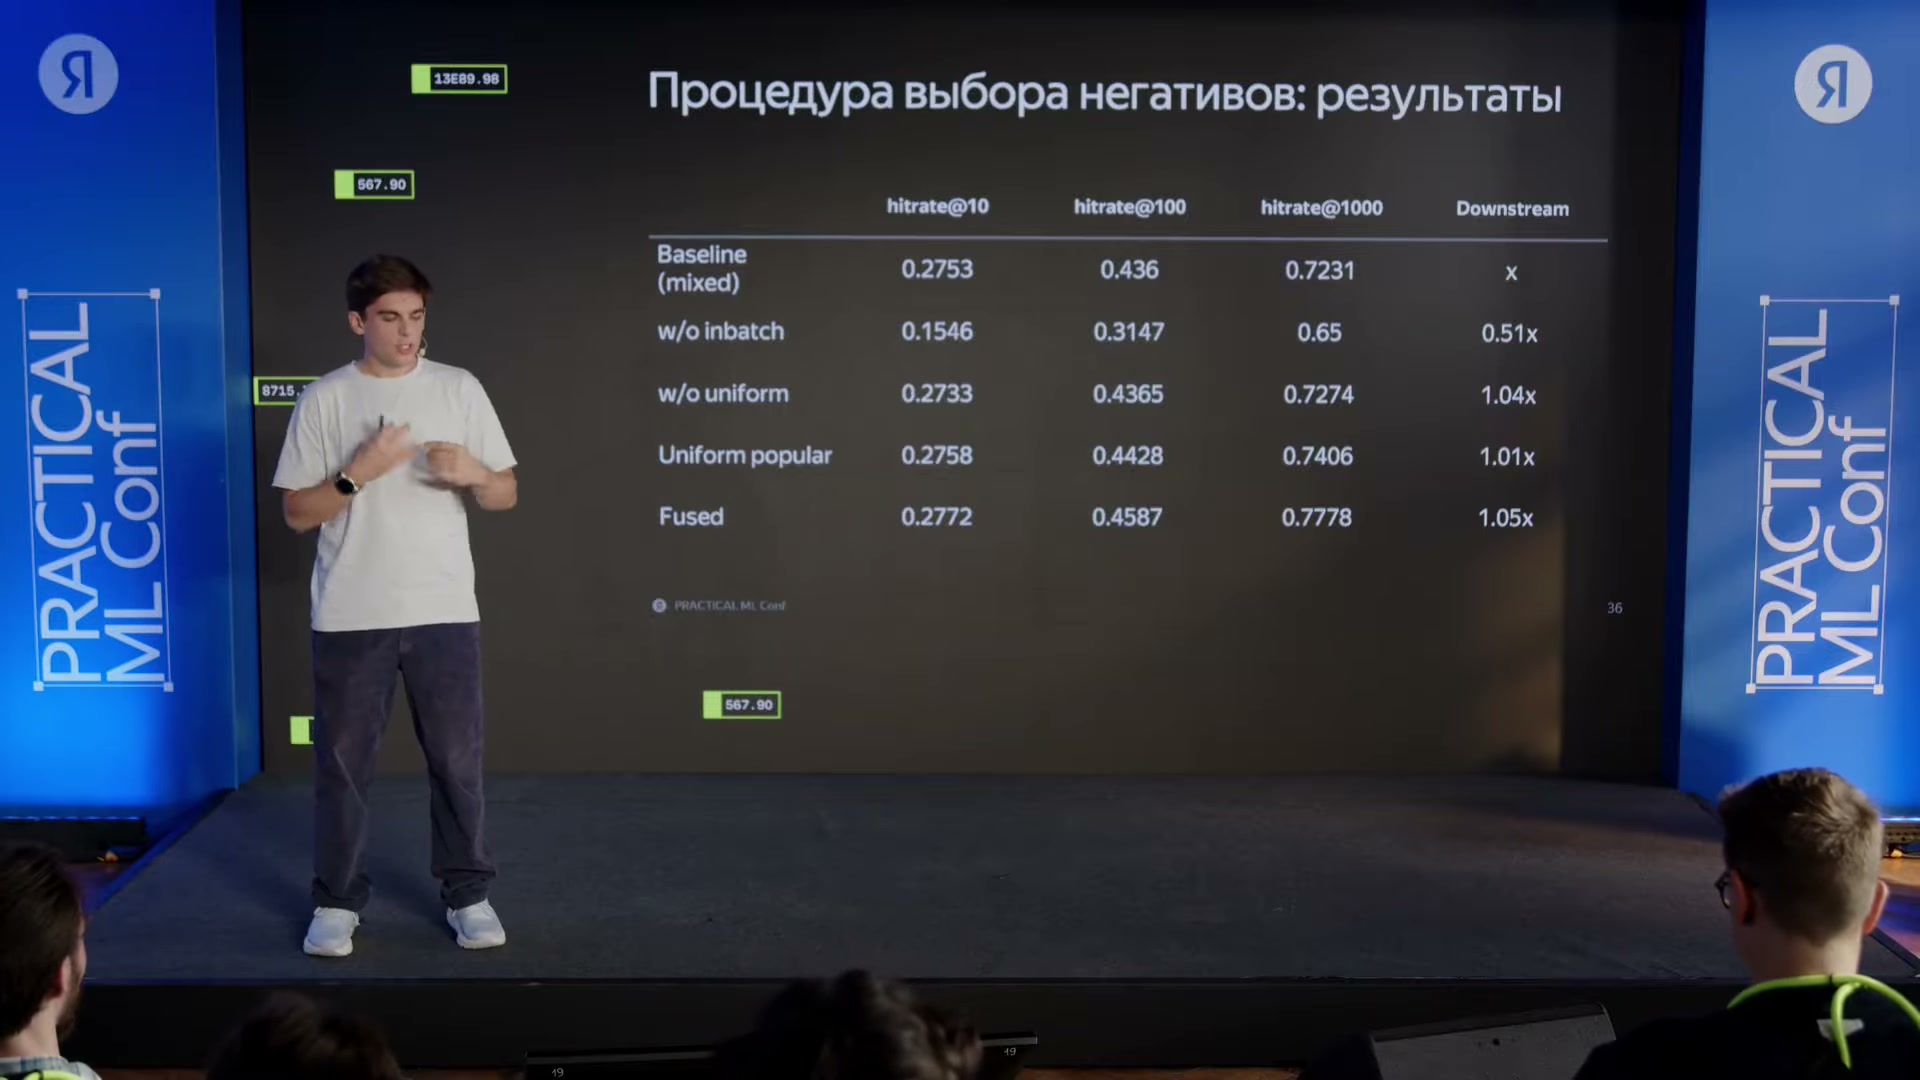
Показаны hitrate@10/@100/@1000 и Downstream. Без inbatch downstream 0,51x; без uniform 1,04x; Uniform popular 1,01x; Fused 1,05x. Множители downstream не равны абсолютной метрике или бизнес-росту.
Источник: Николай Савушкин · Яндекс · Practical ML ConfОбновлённый рецепт: что сохраняется, что убирается и где
Обновление ARGUS не сводится к одному новому слою. Меняются источники информации, обучающие цели и размер сравниваемого набора объектов. При этом автор сохраняет основную двухэтапную логику: предварительно учить представление истории, а затем приспосабливать его к целевому применению.
- 01
Объединить доступные события
Представить историю через признаки контекста, объектов и действий; при кросссервисном варианте добавить события других доменов с соответствующими энкодерами.
- 02
Предварительно обучить историю
Предсказывать следующие документы прежней выдачи, включая документы с отрицательной реакцией. Для добавленных доменов использовать собственные задачи и складывать доменные потери.
- 03
Упростить вспомогательные цели
Не использовать отдельную feedback loss в обновлённом предварительном обучении. Сохранять различие между удалённой целью и реакциями, входящими в историю.
- 04
Дообучить под роль в сервисе
Настроить модель на целевое ранжирование или отбор кандидатов. Для отбора сохранить выбор документов из базы и использовать более крупные наборы альтернатив там, где они полезны.
В этом рецепте важно не превратить сводный слайд в список обязательных приёмов для каждого запуска. Fused cross-entropy и изменённые стратегии выбора документов из базы автор относит к обучению отбора кандидатов; на предварительном этапе они используются не обязательно. Для контекстного варианта моделирование задержки поступления событий перенесено в обучение downstream-модели.
Полученная модель всё ещё может быть компонентом прежнего каскада. Пересмотр обучения повышает полезность её оценок и кандидатов, но не устраняет автоматически все остальные модели. Следующая часть доклада ставит уже другую цель: научиться формировать рекомендации единой генеративной системой.
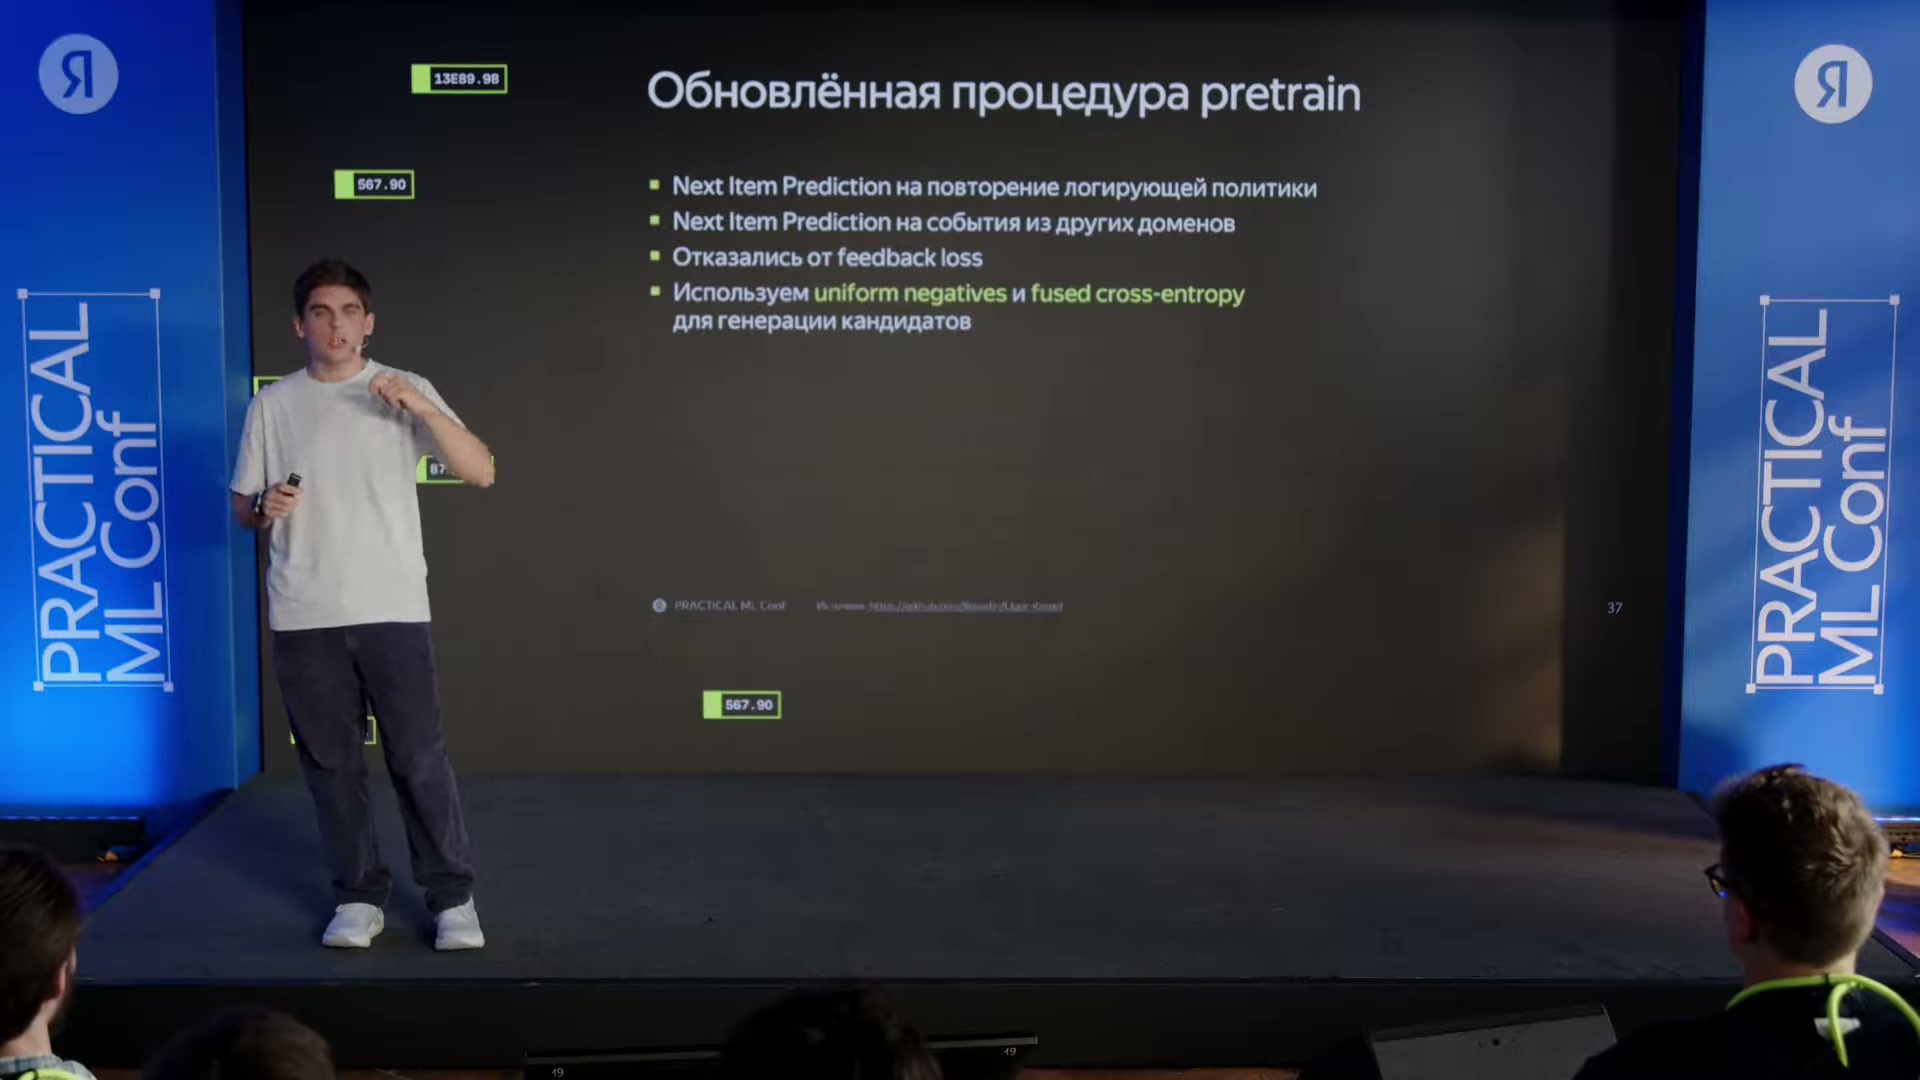
Предсказание документов логирующей политики и других доменов; отдельную feedback loss убрали. Uniform negatives и fused cross-entropy сохранены для генерации кандидатов.
Источник: Николай Савушкин · Яндекс · Practical ML ConfОт компонента каскада к одной модели: новая цель, а не уже завершённый переход
До этого момента ARGUS предварительно обучался в генеративной постановке, затем дообучался и применялся в дискриминативной задаче внутри каскада. Савушкин специально обозначает эту границу. Дальнейшая цель — заменить прежний рекомендательный стек единой моделью, а не просто передать ещё один признак существующему ранжировщику.
Самый прямой путь — научить модель повторять логирующую политику, то есть воспроизводить выбор прежней системы. От простой имитации трудно ожидать существенного улучшения рекомендаций. Но если удастся сохранить качество с меньшим количеством ручных признаков и компонентов, это само по себе может сократить эксплуатационную сложность. В докладе это аргумент в пользу исследования, а не измеренная экономия уже заменённой системы.
Для улучшения относительно прежней выдачи рассматривается обучение на её удачных примерах. Автор называет его SFT, supervised fine-tuning: трансформер дообучают на хорошие выдачи, чтобы он воспроизводил не всё поведение старой системы, а выбранную полезную часть. Точное правило отбора таких примеров здесь не задано.
Другой путь — сообщить модели желаемый результат до выбора документов. Это обусловливание, или conditioning: вместо предсказания реакции после документа нужно восстановить документы при известном условии о реакции или вознаграждении. Таким образом, можно учить зависимость между результатом сессии и тем, какие объекты в ней встречались, а при применении задавать желаемый вариант результата.
Наконец, упомянуты DPO и методы обучения с подкреплением. Докладчик считает их многообещающими, но более сложными в реализации и внедрении. В описываемых экспериментах команда останавливается на обусловливании. Полная функция вознаграждения, реализация DPO или процедура обучения с подкреплением для этой системы не представлены.
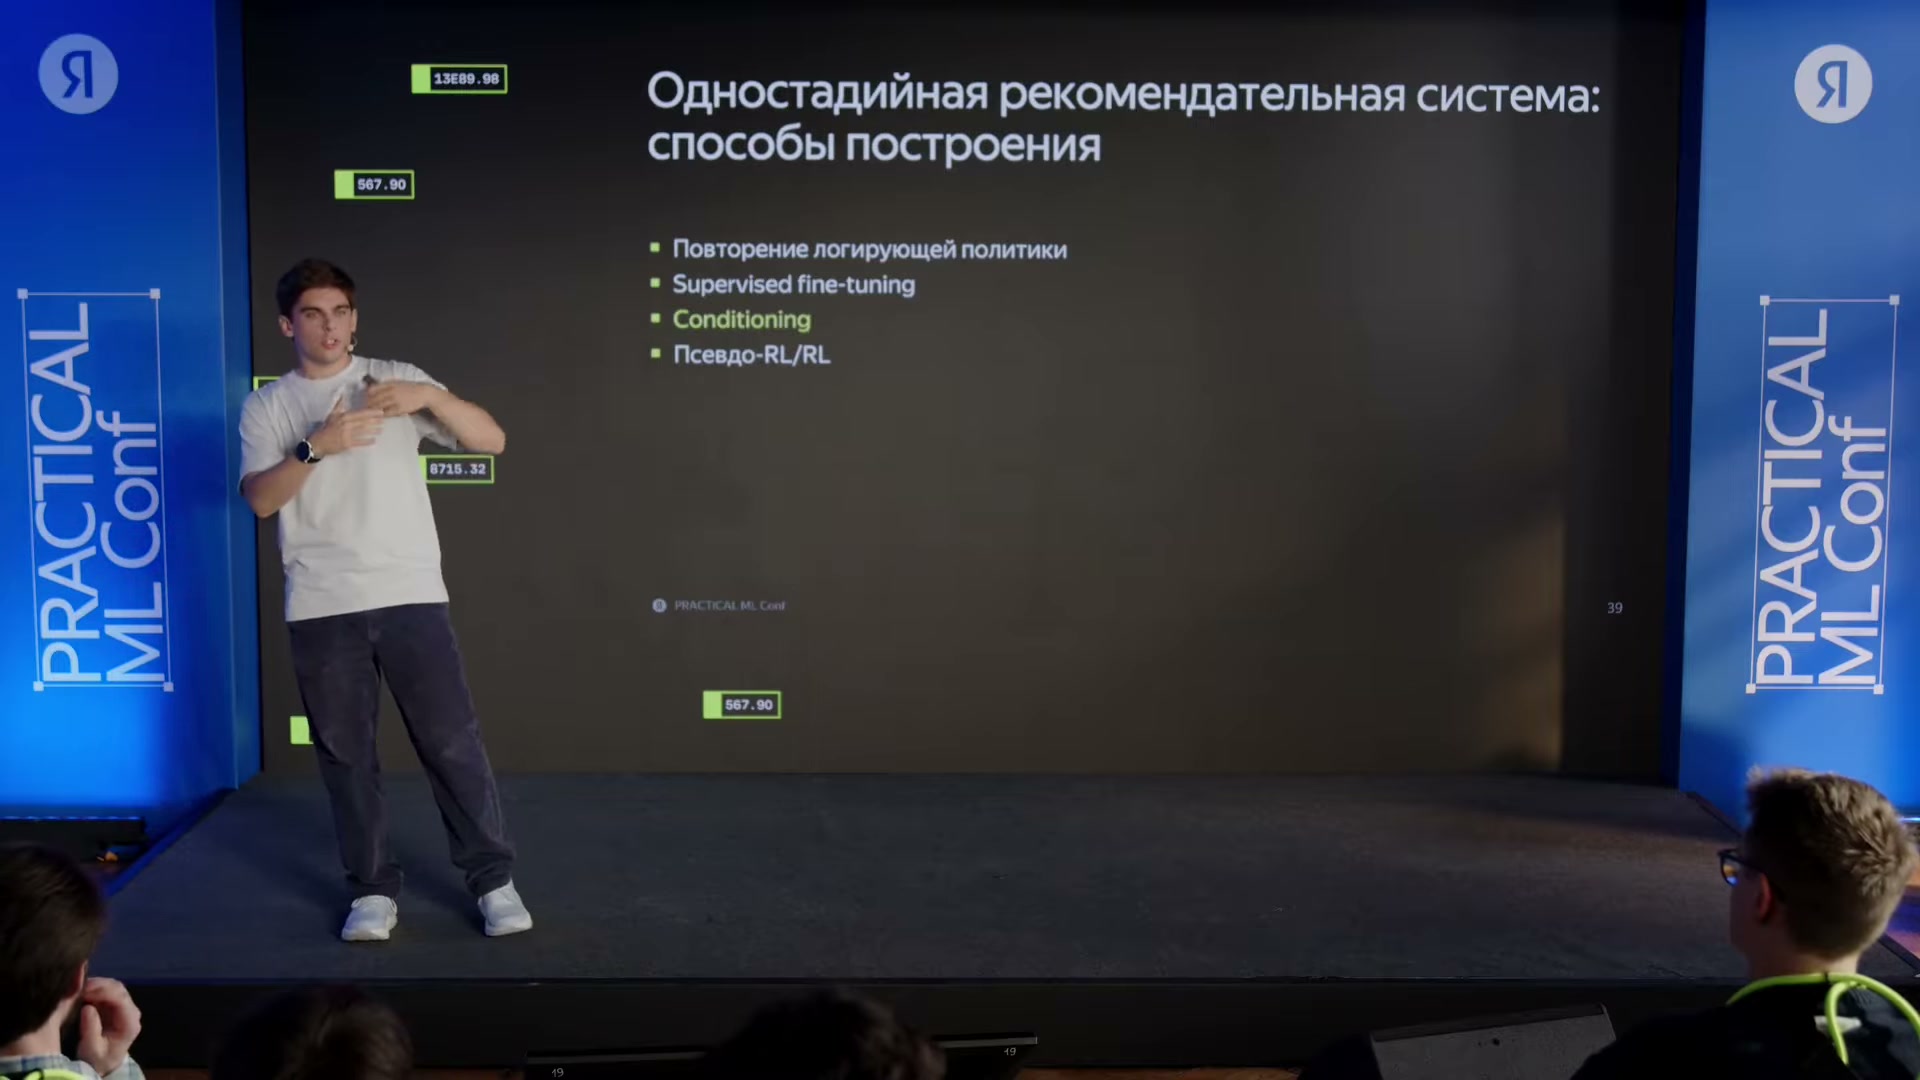
Повторение прежней политики, SFT, conditioning и псевдо-RL/RL — разные подходы. В докладе исследуется обусловливание, а не объявляется внедрение всех вариантов.
Источник: Николай Савушкин · Яндекс · Practical ML ConfУсловие во входном токене: простой замысел и три дорогих последствия
Первый вариант вводит условие прямо в последовательность. Перед хорошей сессией в обучающих данных вставляется специальный токен. Для разных видов хороших сессий можно использовать разные токены. Модель учится продолжать историю, видя такое условие; во время применения нужный токен добавляют в конец известной истории и получают рекомендации.
На схеме показана последовательность play → condition → play → like → skip. Она иллюстрирует место условного токена среди событий, а не определяет, сколько лайков или пропусков делает сессию хорошей. Порогов, формулы вознаграждения и точных правил завершения сессии доклад не даёт.
Первая проблема обнаруживается при исследованиях. Пока команда выбирает, какую сессию считать хорошей, меняются и вставляемые в историю условия. В описанном подходе это не удаётся решить простым использованием готового предварительно обученного варианта: при изменении правила обучение начинается со случайной инициализации. Поэтому даже небольшая продуктовая гипотеза может потребовать дорогой новой итерации.
Вторая проблема возникает в обработке событий. Определить результат сессии можно после её завершения, но токен должен стоять перед ней. Значит, историю приходится дополнять задним числом. Это усложняет не только подготовку обучающего набора, но и обработку пользовательских событий в работающей системе.
Третья проблема связана с незавершённой сессией. При обучении её итог уже известен, и перед хорошей сессией стоит соответствующий токен. Во время применения такого знания ещё нет. Можно подставить хороший токен перед сессией, которая в итоге хорошей не окажется, либо не подставить его там, где обучение его предполагало. Автор называет это расхождение между обучением и применением exposure bias.
Все три недостатка возникают из одного решения — включить оценку будущего результата в саму входную историю. Поэтому следующая попытка меняет не только форму токена, а место, где условие взаимодействует с моделью.
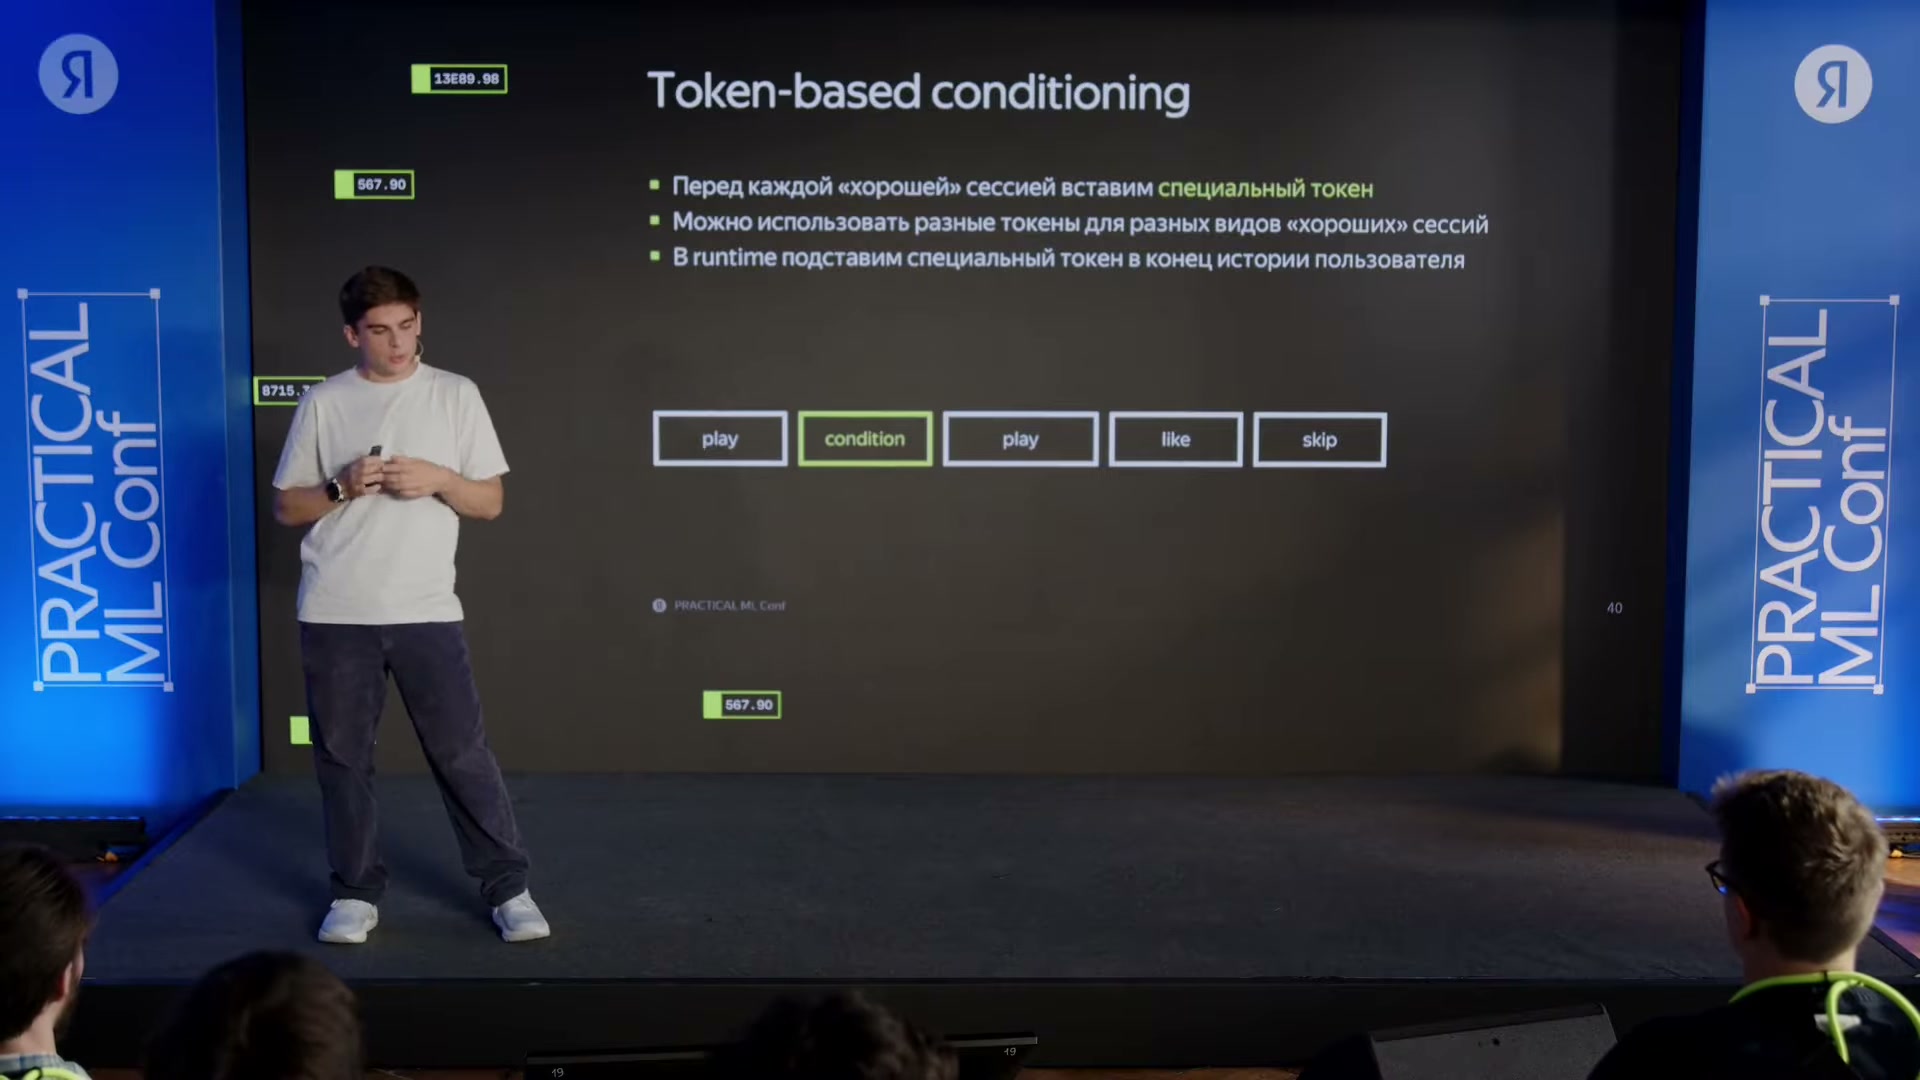
Перед хорошей сессией вставляется специальный токен; при применении его добавляют в конец истории. Требуется определить хорошесть сессии, что создаёт инженерные трудности.
Источник: Николай Савушкин · Яндекс · Practical ML ConfУсловие после энкодера: перекрёстное внимание вместо разметки истории
Альтернатива развивает идею PinRec от Pinterest, на которую ссылается Савушкин. Вместо специального токена внутри истории условие передаётся модельному компоненту после трансформера. В пересказе докладчика подход Pinterest использует MLP; команда Яндекса предлагает механизм перекрёстного внимания, или cross-attention.
На схеме последовательность событий сначала проходит через энкодер и становится набором выходных представлений. Условие condition обращается к этим представлениям через cross-attention, после чего формируется предсказание объекта. Условие связывается с уже обработанной историей, а не меняет последовательность входных событий задним числом.
Это не оценка заданного кандидата через внимание к истории. Докладчик подчёркивает: на вход условного компонента подаётся именно желаемое условие, а не документ-кандидат. При одинаковом названии механизма внимания вопросы различаются: «какой объект предложить при таком условии» и «как пользователь отреагирует на этот объект» — не одна задача.
Перенос условия за энкодер отделяет представление истории от способа задавать хороший результат. Автор сообщает, что новый подход не имеет перечисленных инфраструктурных недостатков входных условных токенов. Однако точная схема заморозки или дообучения частей модели, число слоёв внимания и порядок переиспользования весов не раскрыты. Их нельзя восстановить по одной архитектурной схеме.
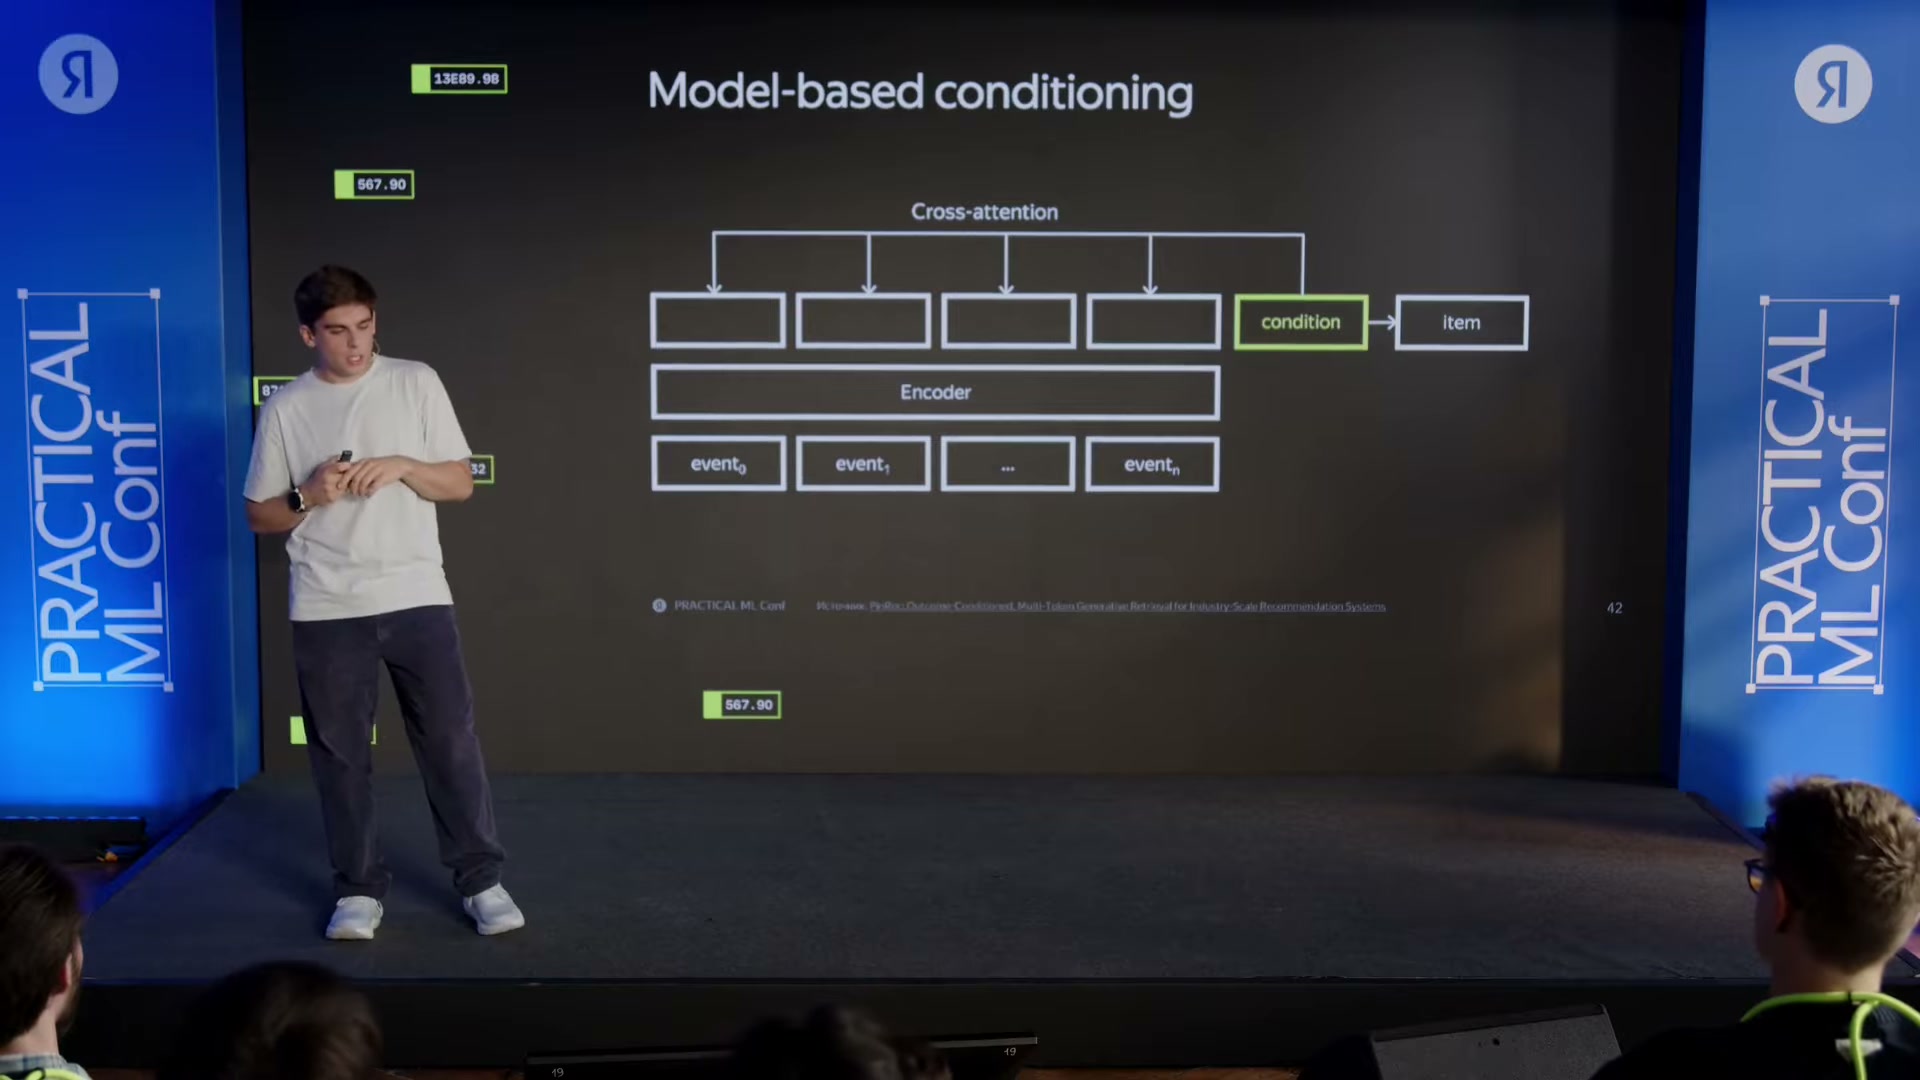
В механизм cross-attention подаётся condition, а не кандидат. Нижняя ссылка — PinRec: Outcome-Conditioned, Multi-Token Generative Retrieval for Industry-Scale Recommendation Systems.
Источник: Николай Савушкин · Яндекс · Practical ML ConfРезультат обусловливания: улучшение зависит и от усреднения потери
Для нового способа обусловливания команда дополнительно меняет усреднение функции потерь. Вместо неуточнённого в докладе исходного усреднения используется вариант по пользователям, обозначенный per-user loss mean. Точная формула и порядок агрегации внутри пользовательской истории не приведены, поэтому объяснение ограничивается этим различием.
Результаты сравниваются по Like Recall — так на слайде названа оценка полноты по лайкам — в двух столбцах Alice и Non-Alice. Обозначение не сопровождается глубиной K, описанием выборки или полным протоколом. По нему нельзя самостоятельно восстановить ни метод расчёта, ни состав обеих групп.
Таблицу можно прокрутить по горизонтали.
Одна замена входного токена модельным компонентом не даёт улучшения в обоих столбцах: Alice снижается с 0,1463 до 0,1441, тогда как Non-Alice повышается с 0,0933 до 0,1011. После добавления пользовательского усреднения получаются 0,1464 и 0,1052 — наибольшие показанные значения в каждом столбце.
Следовательно, итоговое сравнение относится к сочетанию двух изменений, а не к безусловному превосходству одного только cross-attention. Таблица позволяет увидеть отдельную строку без пользовательского усреднения, но не устанавливает статистическую значимость различий. Особенно осторожно нужно читать близкие значения 0,1463 и 0,1464.
Вместе с устранением неудобств входных токенов это поддерживает выбранное направление экспериментов. Но Like Recall не является сообщением о росте бизнес-метрик в A/B-тесте и не доказывает завершённую замену всего рекомендательного каскада. В заключении основной части автор называет эти результаты последними экспериментами в генеративной постановке.
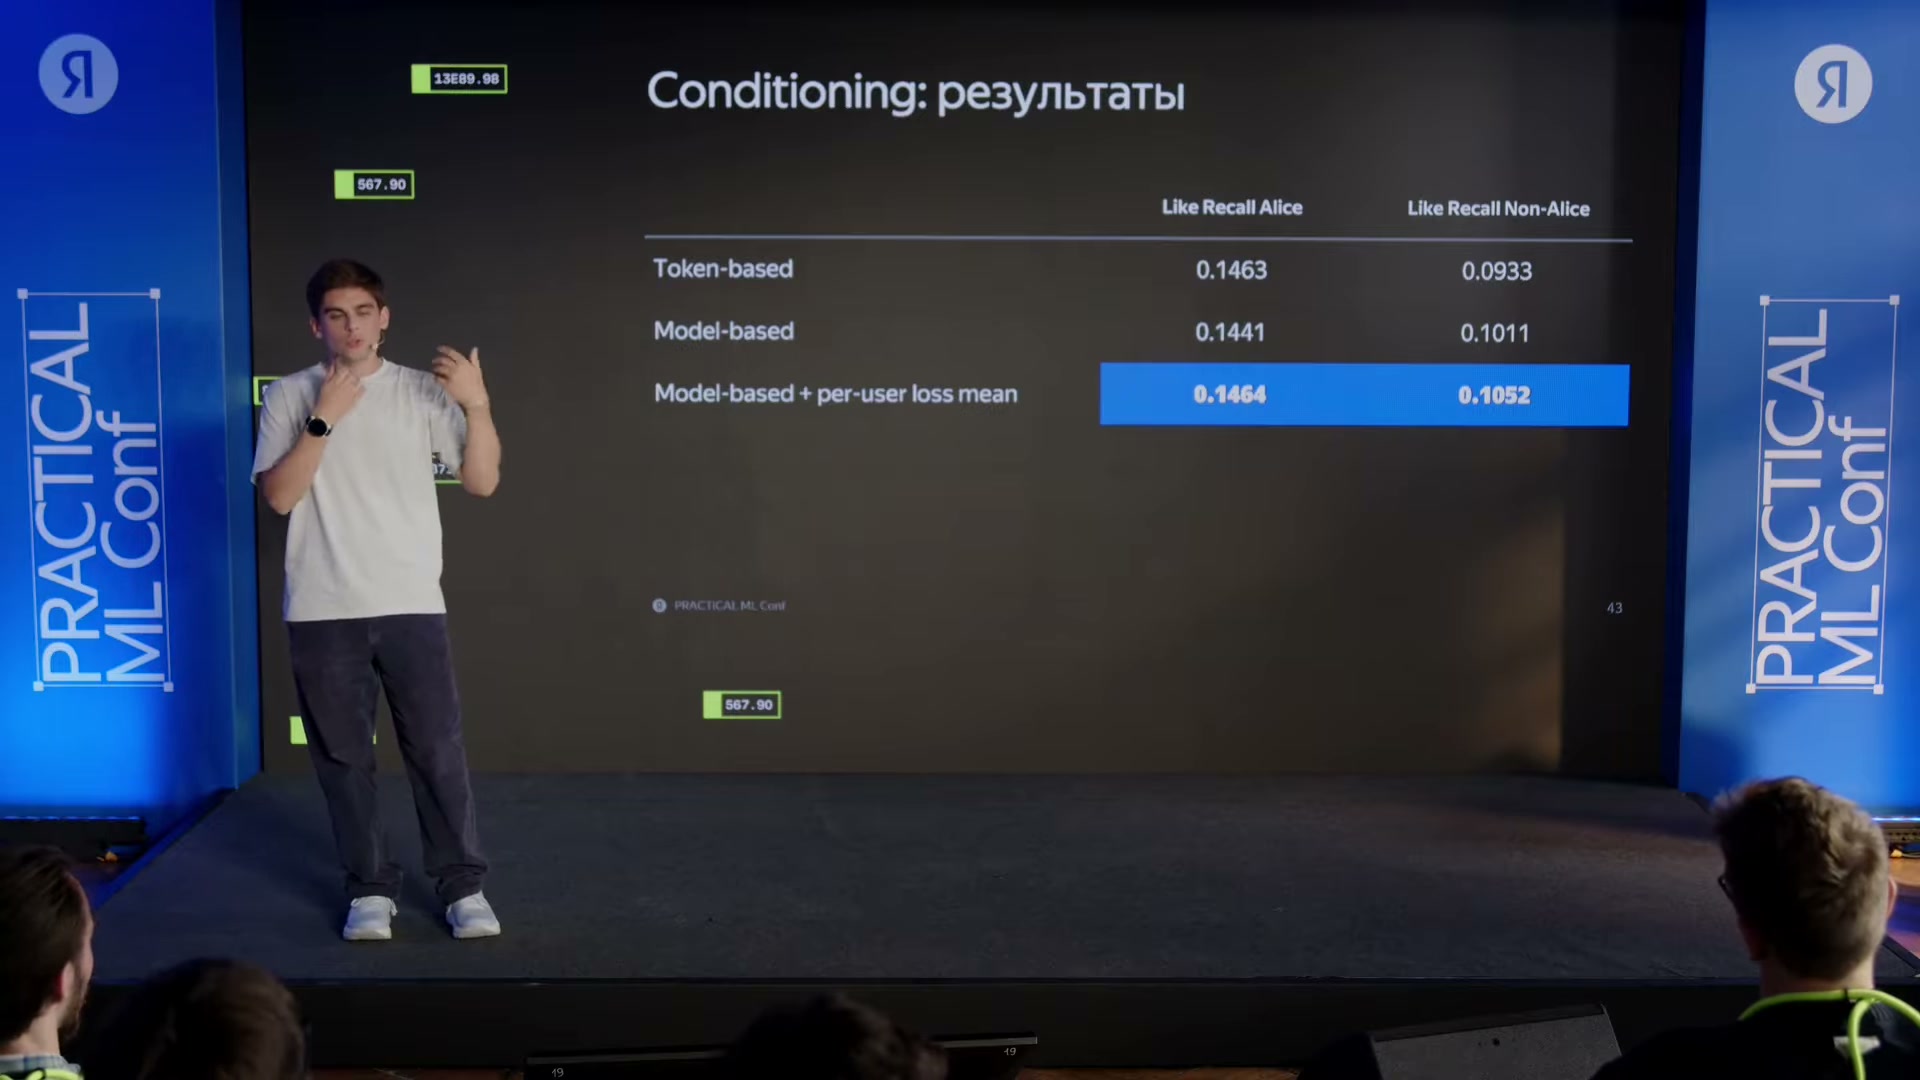
Token-based: Like Recall Alice 0,1463 / Non-Alice 0,0933. Model-based: 0,1441 / 0,1011. Model-based + per-user loss mean: 0,1464 / 0,1052. K, размер выборки и A/B-протокол не указаны; это эксперимент, не подтверждение замены всего каскада.
Источник: Николай Савушкин · Яндекс · Practical ML ConfЧто известно о внедрениях и почему ARGUS здесь не look-alike
После выступления автору задают два связанных вопроса: какой сервис получил наибольший рост бизнес-метрик после доработок ARGUS и окупились ли разработка с внедрением. Савушкин отвечает, что внедрения дают существенные улучшения, сопоставимые с лучшими нейросетевыми внедрениями команды. Особенно полезна контекстная постановка в поиске, рекламе и рекомендациях к текущему документу.
Подтверждено большое количество внедрений ARGUS, в том числе доработанных вариантов. Но сервис-победитель не назван, конкретных бизнес-метрик в ответе нет. Не раскрыты затраты и срок окупаемости. Поэтому успешное использование модели — подтверждённый статус, а количественный расчёт финансовой отдачи из этого ответа не получается.
Другой вопрос касается поиска аудитории, похожей на существующих клиентов, — look-alike. Ответ ограничен ролями ARGUS: он используется как источник кандидатов и ранжирующая модель, но не как look-alike-модель. Какая технология обслуживает названный слушателем рекламный инструмент, автор не уточняет. Из этого ответа нельзя делать вывод, что look-alike не существует в других частях рекламной системы.
Доклад · 00:33:23Дрейф данных и пределы переноса между сервисами
Вопрос об обновлении данных содержит сразу несколько частей: как часто добавляют данные в предварительное обучение, как быстро меняется их распределение и в каких пропорциях смешивают сервисы. Автор объясняет, что дополнительные данные вводят ради улучшения качества, а распределение меняется постоянно и достаточно сильно. Поэтому модели необходимо регулярно дообучать.
Это изменение статистики и поведения со временем — дрейф данных, в речи distribution shift. Конкретного расписания, порога существенного изменения и пропорций доменной смеси в ответе нет. Суточное применение первых версий ARGUS не задаёт частоту обновления весов: выполнение модели и её дообучение — разные процессы.
Следующее уточнение проверяет границы утверждения о кросссервисной пользе: означает ли оно, например, что историю Музыки стоит добавлять в Лавку? Савушкин различает естественно связанные и менее связанные домены. В качестве первых названы Лавка с Маркетом и Кинопоиск с Музыкой. На момент выступления эксперименты сосредоточены на более связанных продуктах.
Объединение слабо связанных доменов остаётся перспективой. Автор приводит конкретную аналогию: добавление китайскоязычных данных в предварительное обучение русскоязычной модели может помочь ей лучше отвечать на часть вопросов по-русски. В рекомендациях он предполагает похожий перенос общих зависимостей потребления. Это объяснение исследовательской гипотезы, а не представленный результат эксперимента «Музыка улучшила Лавку».
Доклад · 00:35:04Почему сложные примеры из пакета полезны даже с поправкой LogQ
Последний технический вопрос возвращается к выбору отрицательных примеров. Если LogQ исправляет смещение батчевой выборки, зачем она вообще нужна и почему работает лучше равномерных документов из каталога? Ответ автора связан с трудностью обучающего сравнения.
Случайный документ из большого каталога часто легко отличить от того, с которым пользователь действительно взаимодействовал. Примеры из пакета имеют частотное, в речи «униграммное», распределение и оказываются заметно сложнее. Модель должна лучше различать правдоподобные альтернативы, а не просто отсеивать очевидно неподходящие случайные объекты.
По объяснению Савушкина, именно усложнение задачи помогает обучению. Но неравномерность выборки при этом остаётся, поэтому нужна коррекция. Сложность примеров и поправка на вероятность их попадания решают разные вопросы. Отдельного поиска трудных отрицательных примеров специальной моделью автор не описывает: речь о свойствах самой выборки из пакета обучения.
Доклад · 00:36:56Итог: улучшенный ARGUS в каскаде и отдельная генеративная перспектива
Путь ARGUS начинается с модели истории, которая помогает существующему отбору и ранжированию. Команда последовательно устраняет её ограничения: позднее добавление контекста, отсутствие данных других сервисов и неопределённость обучающего рецепта. Получившаяся система не обязательно заменяет каскад: меняются качество его входных сигналов и возможности источника кандидатов.
- 01
Получить доступную историю
Система использует записанные события пользователя и текущий контекст. Самые свежие события могут ещё не попасть в профиль.
- 02
Представить события
Контекст, объект и действие превращаются в токены; кросссервисный вариант использует соответствующие энкодеры для разных типов событий.
- 03
Обработать историю
В первых внедрениях представление рассчитывалось заранее раз в сутки. Контекстный ARGUS выполняется при запросе, получая актуальный контекст на вход.
- 04
Передать результат ARGUS
В зависимости от роли модель предоставляет признаки для следующего ранжировщика либо дополнительный набор кандидатов. Это альтернативные способы включения.
- 05
Завершить выбор в каскаде
Последующие компоненты используют выход ARGUS для отбора и упорядочивания объектов, после чего сервис формирует рекомендации.
Обучение происходит отдельно: предсказание документов прежней выдачи и дополнительных доменов, затем настройка под целевую задачу. Отдельную feedback loss убрали ради упрощения и стабильности; более крупные наборы отрицательных примеров особенно полезны для отбора кандидатов.
Оценка показывает неодинаковую пользу изменений. В рекламе контекстный вариант даёт 4,78x эффекта исходного офлайн-варианта, но в Музыке уступает онлайн-модели с поздним связыванием. Предварительное и кросссервисное обучение повышают показанный downstream-эффект. Это множители вклада модели, не всей бизнес-метрики.
Промышленные внедрения ARGUS подтверждены, однако полные протоколы оценки и окупаемость не раскрыты. Одностадийная генеративная система с обусловливанием остаётся экспериментальным направлением. Её Like Recall и удобство обработки истории ещё не доказывают завершённой замены всех этапов рекомендаций.
Доклад · 00:32:34