Разбор готов
Ошибки рекомендательной системы, которые не видны по одной метрике
Полка с записями конференции сначала показывает всем один и тот же порядок: выше стоят объекты с большей средней пользовательской оценкой. За несколько месяцев накапливаются показы и клики, и возникает естественная идея — научиться персонализировать этот порядок. Но новая модель может принять особенности старых показов за предпочтения людей, а после переобучения её составные части могут перестать одинаково понимать числовые оценки друг друга. Сергей Кузнецов из МТС разбирает эти ошибки на синтетическом примере со стажёрским решением из трёх рекомендательных моделей и бустинга. Проследим весь путь: как устроены данные и проверка качества, почему возникает перевёрнутая зависимость от рейтинга и что действительно показывает исправление обучающей выборки.
Материал полезен разработчикам рекомендательных систем, которые объединяют несколько моделей и обучают их на поведении пользователей. На конкретном примере видно, как различать проблему шкалы оценок, смещение обучающих пар и хорошее предсказание, не приносящее пользы в выдаче.
Видео · на русском
Разбор ошибок при проектировании рекомендательной системы / Сергей КузнецовСергей Кузнецов · Опубликовано: 8 октября 2025 г.
Исходный доклад · Открыть оригинал
От общей полки к персональному порядку
Исходное решение не пытается понять отдельного зрителя. В постановке автор предлагает полку с записями конференции, а последующие учебные признаки и примеры описывает через фильмы и жанры. Пользователи когда-то оценили объекты, оценки усреднили, а затем расположили их по убыванию среднего. Такой порядок легко запустить: достаточно одного признака объекта. Но одинаковая высокая оценка для всех ещё не отвечает на вопрос, что подходит конкретному человеку.
По условиям примера полка работает несколько месяцев. При запросе сохраняется то, что было известно системе в этот момент: признаки и предыдущие действия пользователя. Затем добавляется его реакция на выдачу. Получается журнал, в котором можно связать ситуацию показа с последующим кликом. На первый взгляд, обучающая выборка уже готова — остаётся подобрать более сильную модель.
Именно это предположение предстоит проверить. Журнал фиксирует не все возможные отношения между людьми и каталогом, а только поведение при конкретном прежнем порядке объектов. Новая модель наследует способ отбора этих наблюдений. Кроме того, несколько моделей внутри одного решения могут обновляться так, что их выходные числа меняют смысл для следующего уровня.
Кузнецов представляет опыт рекомендательной и поисковой платформы МТС, работающей более чем для десяти сервисов экосистемы. Однако разбираемая полка — выдуманный учебный пример, собранный по мотивам ошибок автора, его коллег и знакомых. Это мастер-класс по поиску проблем в готовом ноутбуке, а не отчёт о внедрении именно такой системы в МТС.
Автор предлагает рассматривать решение с точки зрения будущего применения: не просто добиться выполнения ячеек, а понять, что произойдёт после запуска и последующих обновлений. Поэтому подбор гиперпараметров здесь вторичен. Основные вопросы относятся к устройству данных, связи между моделями и смыслу проверки качества.
Доклад · 00:02:18Что известно о пользователях, объектах и времени
Единица взаимодействия связывает пользователя, объект, действие и момент времени. Клик обозначен как click. Запись show в объяснении автора означает показ, после которого человек не совершил целевого действия. Это различие дальше превращается в целевую метку: что модель должна научиться предсказывать.
Таблицу можно прокрутить по горизонтали.
Каталог специально ограничен 100 объектами. В большой системе, как объясняет автор, из миллионов объектов сначала отбирают несколько тысяч кандидатов — небольшой набор для более тщательной оценки. Затем кандидатов упорядочивают, то есть ранжируют. В мастер-классе отдельный отбор исключён: рассматривается ранжирование маленького каталога. Это упрощение позднее позволит перебрать все пары пользователей и объектов.
В журнале примерно 4 млн записанных действий, из них около 80 тыс. положительных кликов. Это числа событий, а не размер аудитории. Объекты распределены примерно равномерно между пятью жанрами. На показанном фрагменте таблицы встречаются комедия, триллер, драма, мелодрама и фантастика. Распределение пользователей по полу автор также описывает как примерно равномерное.
Работа начинается с исследовательского анализа данных: прежде чем обучать модель, нужно увидеть, как устроены наблюдения. На графике количества целевых событий во времени автор замечает рост без дополнительных сезонных колебаний. Временной тренд важен для разбиения выборки, а позднее выясняется, что он специально заложен в генератор данных. При этом ровное распределение жанров и понятный график кликов ещё не доказывают корректность обучающих примеров.
Для применения рекомендательных методов и повторяемой проверки на временных разбиениях используется RecTools. Библиотека упрощает экспериментальную часть, но не определяет за разработчика, какие пары нужно считать обучающими и что означает отсутствие клика.
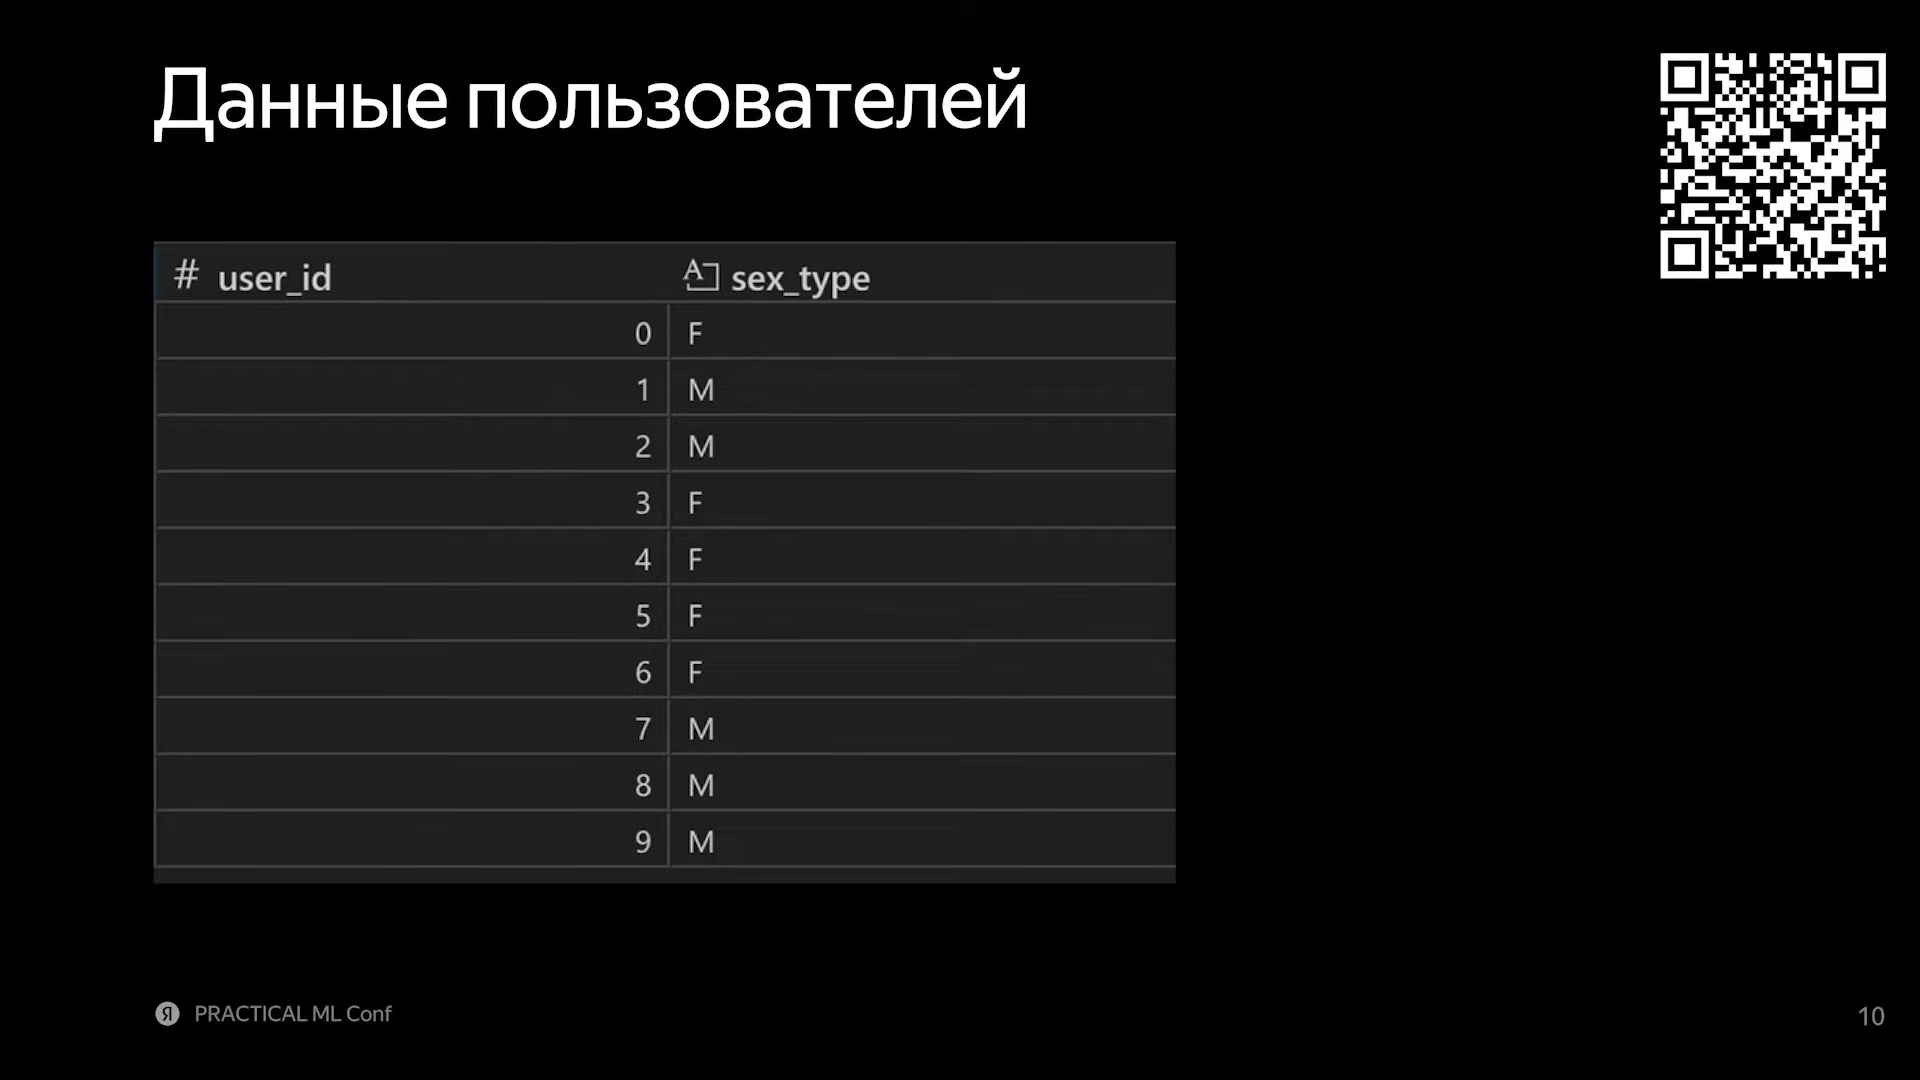
В демонстрации есть user_id и sex_type; это искусственные данные учебного генератора.
Источник: Сергей Кузнецов · МТС · Practical ML Conf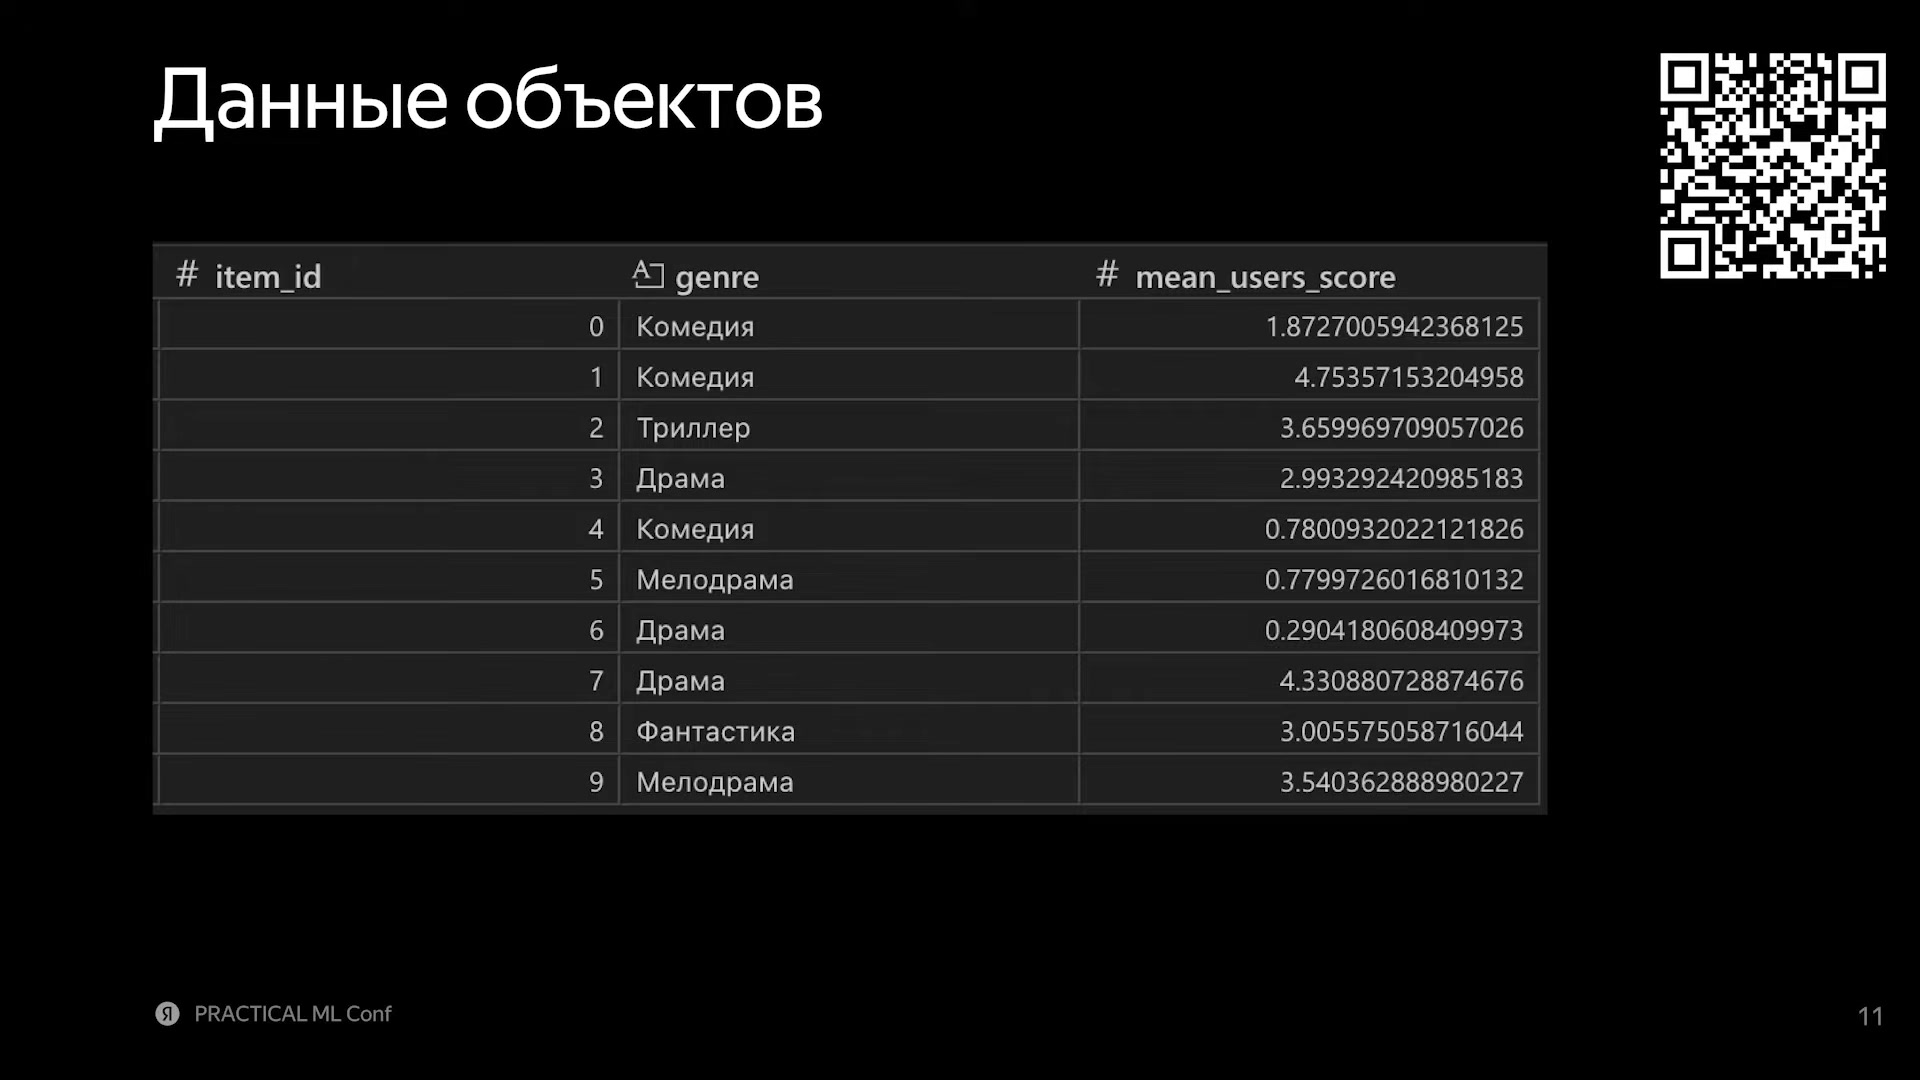
Жанр и mean_users_score используются как признаки учебных объектов. Средняя оценка исходно задаёт порядок полки.
Источник: Сергей Кузнецов · МТС · Practical ML ConfТри рекомендательные модели становятся признаками четвёртой
Стажёр предлагает не одну модель вместо прежней сортировки, а два уровня. На первом работают ALS, EASE и SASRec. Каждая вычисляет числовую оценку того, насколько объект подходит пользователю. Такую оценку часто называют скором. На втором уровне эти три числа становятся входными признаками бустинга — модели, которая объединяет их с другими сведениями и формирует итоговую оценку.
Обучаемое объединение предсказаний других моделей называется стекингом. Здесь бустинг не просто усредняет три ответа. Он может по-разному использовать их в разных сочетаниях с жанром, средней оценкой объекта и признаком пользователя. Поэтому важно не только качество каждой базовой модели отдельно, но и то, какие значения она передаёт следующему уровню.
Для разделения обучения двух уровней данные делят по времени на две половины. ALS, EASE и SASRec обучают на первом периоде, затем их предсказания используют при подготовке примеров второго периода. Бустинг, таким образом, не должен учиться на тех же событиях, по которым базовые модели уже подбирали свои параметры. Речь идёт о половинах временного периода; равенство числа строк в них не установлено.
Такое разделение учитывает изменение поведения во времени и уменьшает риск утечки — ситуации, когда оценка качества получает преимущество за счёт информации, которой не должно быть в соответствующем обучающем или проверочном шаге. Но автор сразу подчёркивает ограниченность этой защиты. Развести события двух периодов ещё не значит устранить смещение старых показов или обеспечить одинаковое распределение оценок после нового обучения.
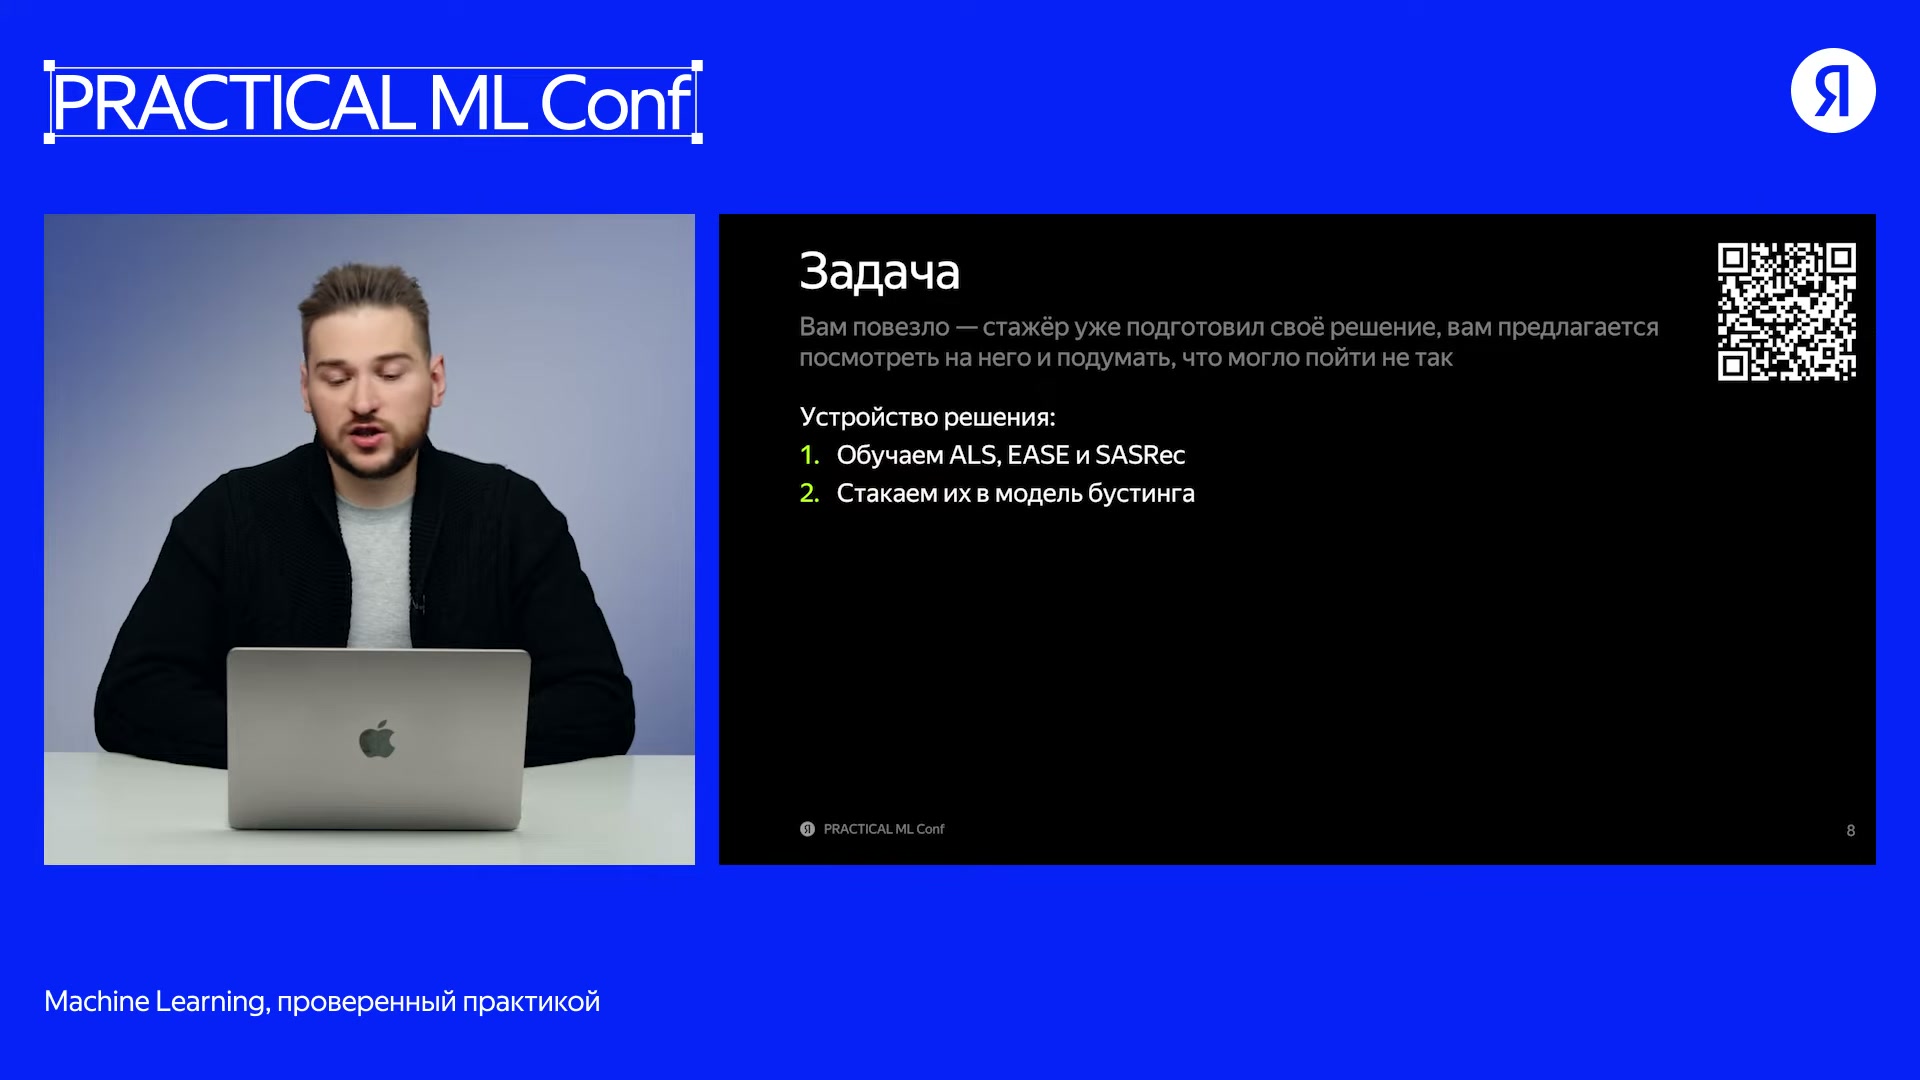
Стажёр предлагает скоры ALS, EASE и SASRec как признаки для бустинга. Это синтетический пример мастер-класса, не доказанное внедрение МТС.
Источник: Сергей Кузнецов · МТС · Practical ML ConfПочему проверяют не только попадание в клик
Перед объединением моделей автор сравнивает их на нескольких временных разбиениях. Повторение проверки на таких разбиениях — временная кросс-валидация. В показанном коде TimeRangeSplitter задан с test_size="14D", n_splits=5 и filter_already_seen=True: используются пять разбиений с тестовым интервалом 14 дней и включённой фильтрацией уже встречавшихся объектов. Полная схема расположения обучающих окон в кадре не раскрыта.
Все шесть показанных метрик рассчитываются для первых шести рекомендаций, то есть с k=6. Отдельно в ячейке стоит K_RECS=10. Эта переменная задана отдельно и не переопределяет явно указанную глубину метрик: здесь NDCG@6, а не NDCG@10.
Дополнительные характеристики нужны не для увеличения числа столбцов в отчёте. У платформы есть не только зрители, но и авторы контента. Если рекомендательная система постоянно показывает небольшой набор записей, создатели остальных могут не получить аудиторию и уйти. Именно этим примером Кузнецов объясняет необходимость смотреть на покрытие каталога, даже когда попадания в клики выглядят неплохо.
Средняя популярность и пересечение с популярной выдачей помогают понять, приносят ли персональные модели что-то кроме повторения общего рейтинга востребованности. В сравнении есть отдельный PopularModel. Его нельзя автоматически отождествлять с первоначальной полкой: та сортировалась по средней пользовательской оценке, а здесь используется база сравнения по популярности. Точный способ расчёта этой популярности в выступлении не раскрыт.
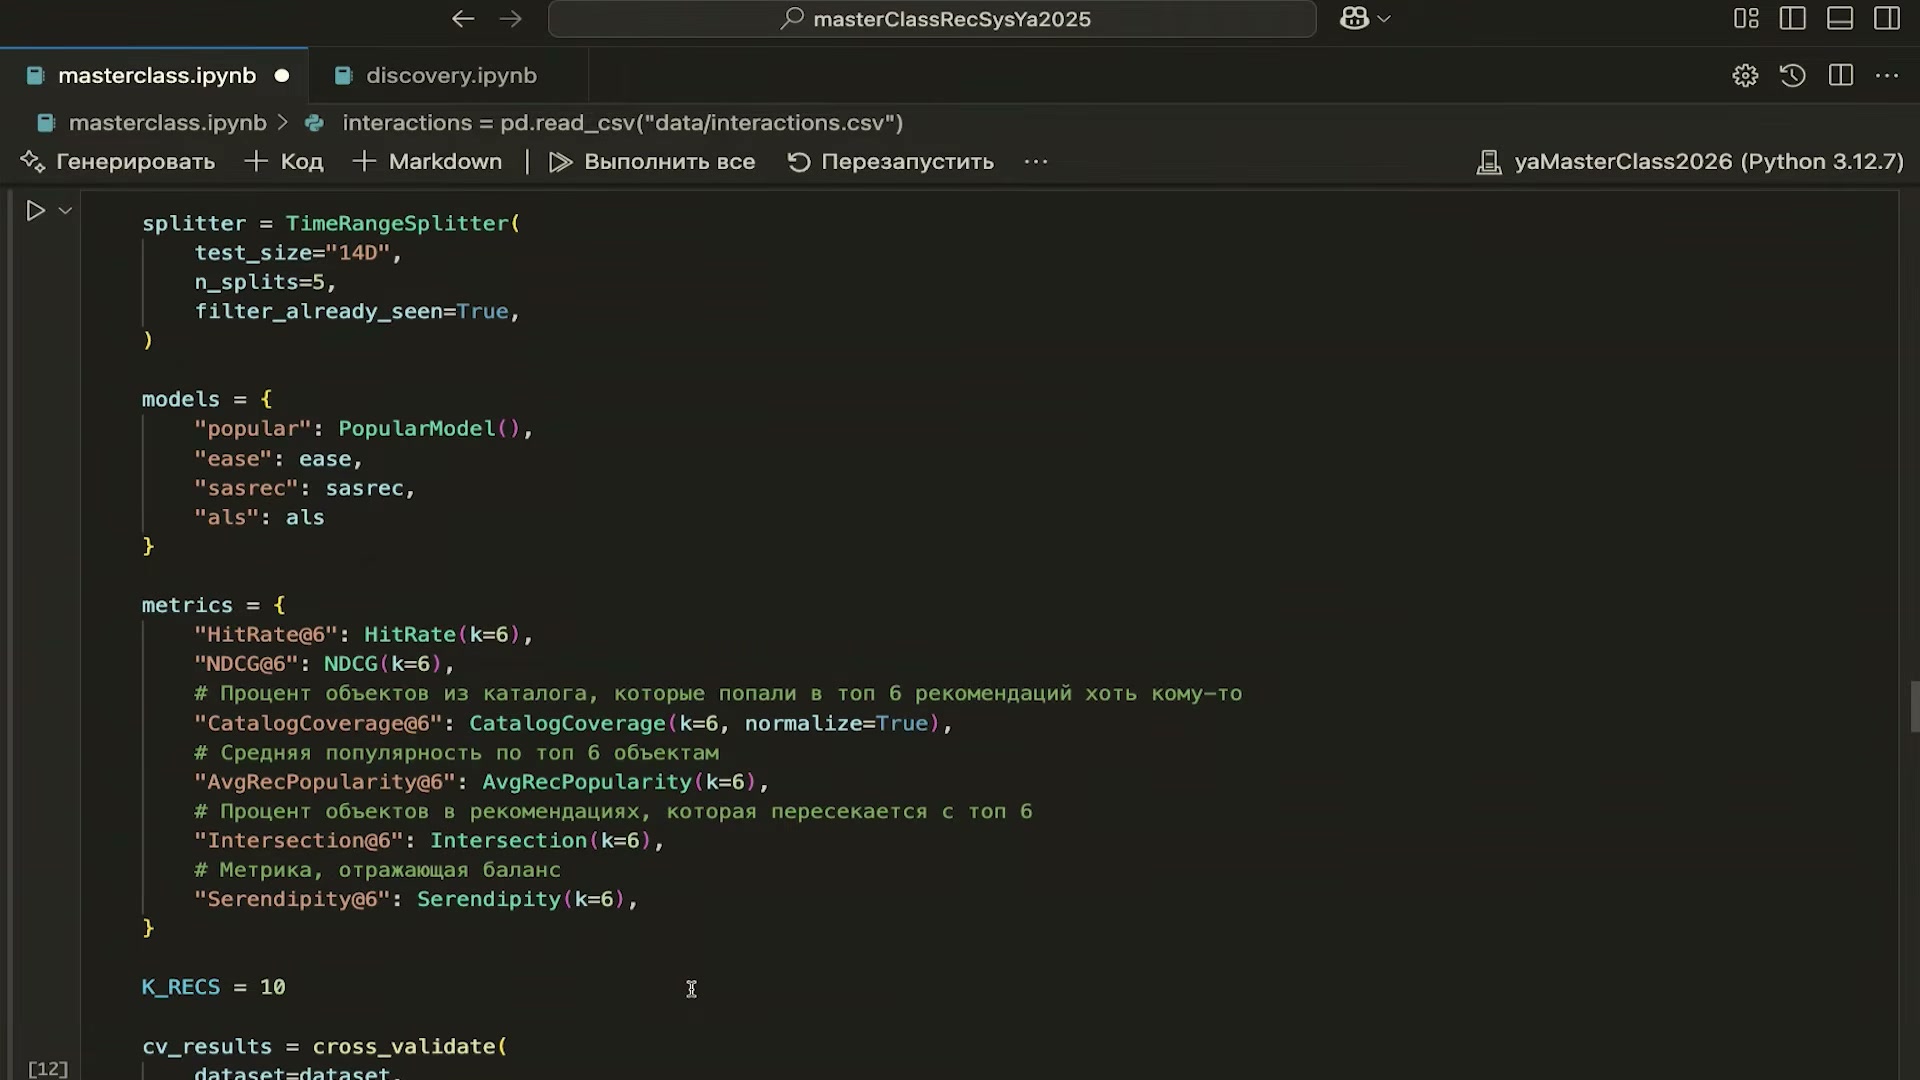
TimeRangeSplitter: test_size="14D", n_splits=5, filter_already_seen=True. Все показанные метрики заданы с k=6; отдельно K_RECS=10.
Источник: Сергей Кузнецов · МТС · Practical ML ConfЧто показала первая таблица — и чего она не доказывает
Первоначальное сравнение оценивает, насколько рекомендации воспроизводят исторические клики, собранные прежней полкой. Это ещё не проверка по известной истинной релевантности симулятора: такая проверка появится в конце. Поэтому значения NDCG из этой таблицы нельзя напрямую сопоставлять с финальным результатом: у проверок различаются эталон и состав оцениваемых пар.
Таблицу можно прокрутить по горизонтали.
В этом выводе EASE выше PopularModel по HitRate@6 и NDCG@6, а ALS — лишь немного выше. SASRec по этим двум метрикам ниже популярной базы. При этом выдачи отличаются по охвату объектов и средней популярности: например, у EASE показано покрытие 1,000, у PopularModel — 0,090. Это характеристика рекомендаций на выбранной проверке, а не доказательство роста реальных просмотров или дохода авторов.
Кузнецов делает ограниченный вывод: некоторые методы дают дополнительные сигналы, которых нет у ранжирования по популярности, поэтому их оценки имеет смысл рассмотреть для объединения. Из таблицы не следует, что каждая из трёх моделей обязательно улучшает итоговый бустинг. Численные результаты Intersection@6 и Serendipity@6 в предоставленном кадре не видны, хотя их расчёт настроен.
У демонстрации есть и явная техническая неопределённость. Над таблицей в выводе обучения SASRec показано train_loss=nan.0, а остановка связана с достижением max_epochs=1. Причина такой записи в выводе не объяснена. По этой записи нельзя ни подтвердить численно корректное успешное обучение, ни установить, чем именно вызвана проблема и как она повлияла на итоговые метрики. Значения в таблице сохраняются как показанный результат ноутбука, а не как независимо воспроизведённый надёжный эксперимент.
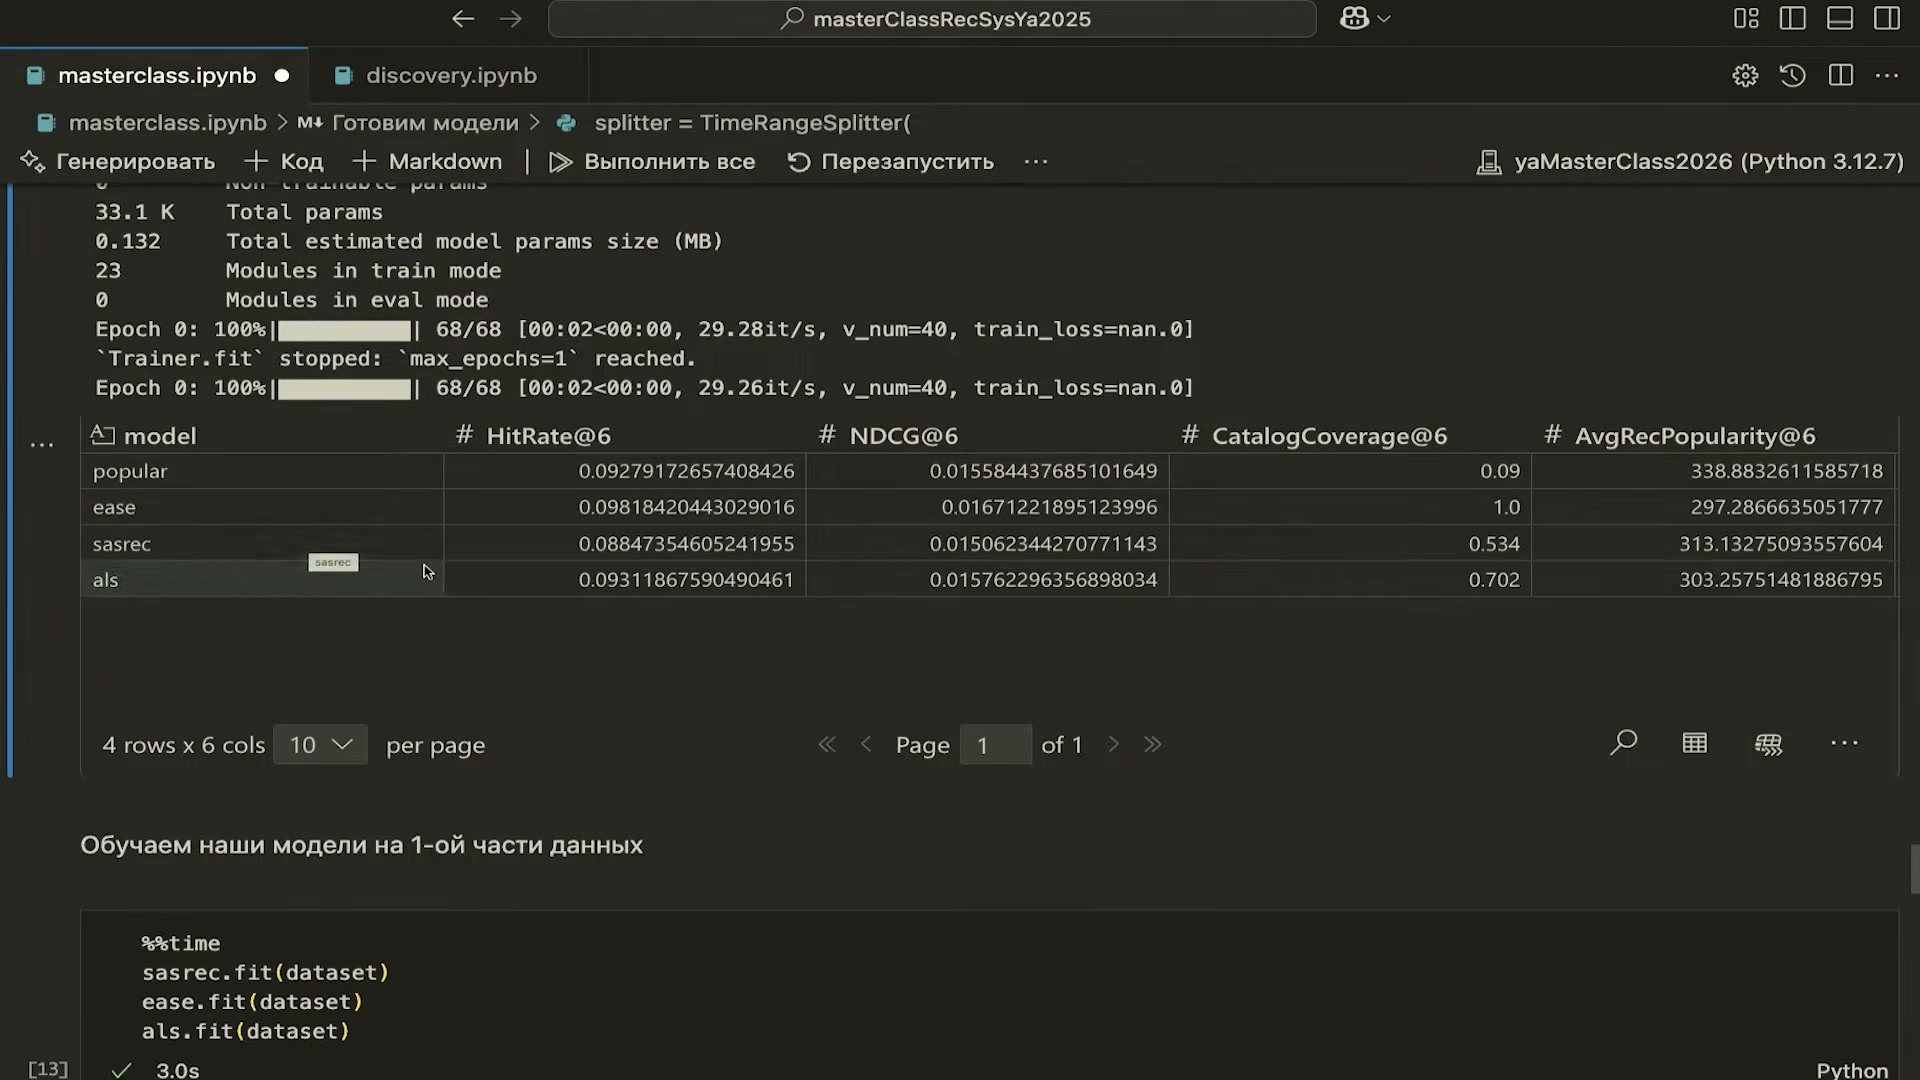
Сравниваются popular, EASE, SASRec и ALS по историческим кликам. В выводе обучения SASRec виден train_loss=nan.0: запись не поясняет причину, поэтому успешное численно корректное обучение не утверждаем.
Источник: Сергей Кузнецов · МТС · Practical ML ConfКак собирается выборка для бустинга
После обучения на первом временном периоде базовые модели рассчитывают оценки для подготовки второго. В вызовах recommend используются известные модели идентификаторы пользователей, filter_viewed=True и k=100. Столбец rank удаляется, а score переименовывается в sasrec_score, ease_score или als_score. Таким образом, бустинг получает сами оценки, а не готовые места объектов в трёх списках.
Параметр k=100 относится к запросу рекомендаций у базовых моделей. Из-за фильтрации просмотренного его нельзя читать как обещание ста реально рассчитанных оценок для каждого пользователя. Это также не k=6 из метрик и не отдельно объявленный K_RECS=10.
Изначально основой общей таблицы служат только пары из журнала второго периода. Из них выбирают user_id и item_id, удаляют повторы, затем присваивают целевую метку: click превращается в 1, show — в 0. Положительный пример здесь означает целевой клик, отрицательный — зарегистрированный показ без него. Непопавшие в журнал пары вообще не задают строки этой первоначальной выборки.
target_df = interactions_second_period[["user_id", "item_id"]].drop_duplicates()
target_df["target"] = interactions_second_period["action"].map({"click": 1, "show": 0})
К target_df слева присоединяются таблицы пользователей, объектов и оценок каждой модели, затем пропуски заполняются нулями. В результате рядом с меткой оказываются sex_type, genre, mean_users_score и три модельных скора. Левое объединение сохраняет исходное множество пар; добавление новых столбцов само по себе его не расширяет. Эта деталь оказывается важнее сложности моделей.
В двух строках подготовки метки есть отдельная неоднозначность, которую нельзя скрывать за содержательным выводом мастер-класса. Таблица пар уже прошла drop_duplicates, а столбец action берётся из исходной таблицы событий. Корректность присваивания требует понять, как соотносятся индексы и какое действие должно представлять повторяющуюся пару. По кадру не установлено ни фактическое нарушение выравнивания, ни правило разрешения разных действий одной пары. Поэтому этот фрагмент — иллюстрация замысла, а не проверенная реализация для промышленного использования.
При обсуждении признаков автор приводит ещё один конкретный пример. Можно передать бустингу пол человека и две отдельные конверсии — для мужчин и женщин — и рассчитывать, что модель сама выберет нужную. По опыту Кузнецова, полезнее заранее вычислить конверсию среди людей того же пола, что и текущий пользователь. В первом описании звучит переход к просмотру, затем к клику; точное определение конверсии и её временное окно не раскрыты. Это иллюстрация подготовки совместного признака пользователя и объекта, не отдельный измеренный прирост и не подтверждение наличия такого столбца в показанной модели.
Вторую временную часть дополнительно делят на обучение и валидацию для ранней остановки. Все взаимодействия одного пользователя должны целиком попасть в одну из этих частей. Модель обучается на первой, а на второй отслеживают улучшение: когда оно прекращается, обучение останавливают. CatBoost помогает обрабатывать категориальные признаки встроенными счётчиками. Точный класс модели, функция потерь и доля валидации в источнике не указаны.
Получается вполне осмысленная исходная конструкция: временное разделение уровней, дополнительная проверка по пользователям, несколько источников сигнала и удобная обработка категорий. Дальнейшие ошибки возникают не потому, что всё это отсутствовало. Они находятся в предположениях, которые такой порядок обучения сам по себе не проверяет.
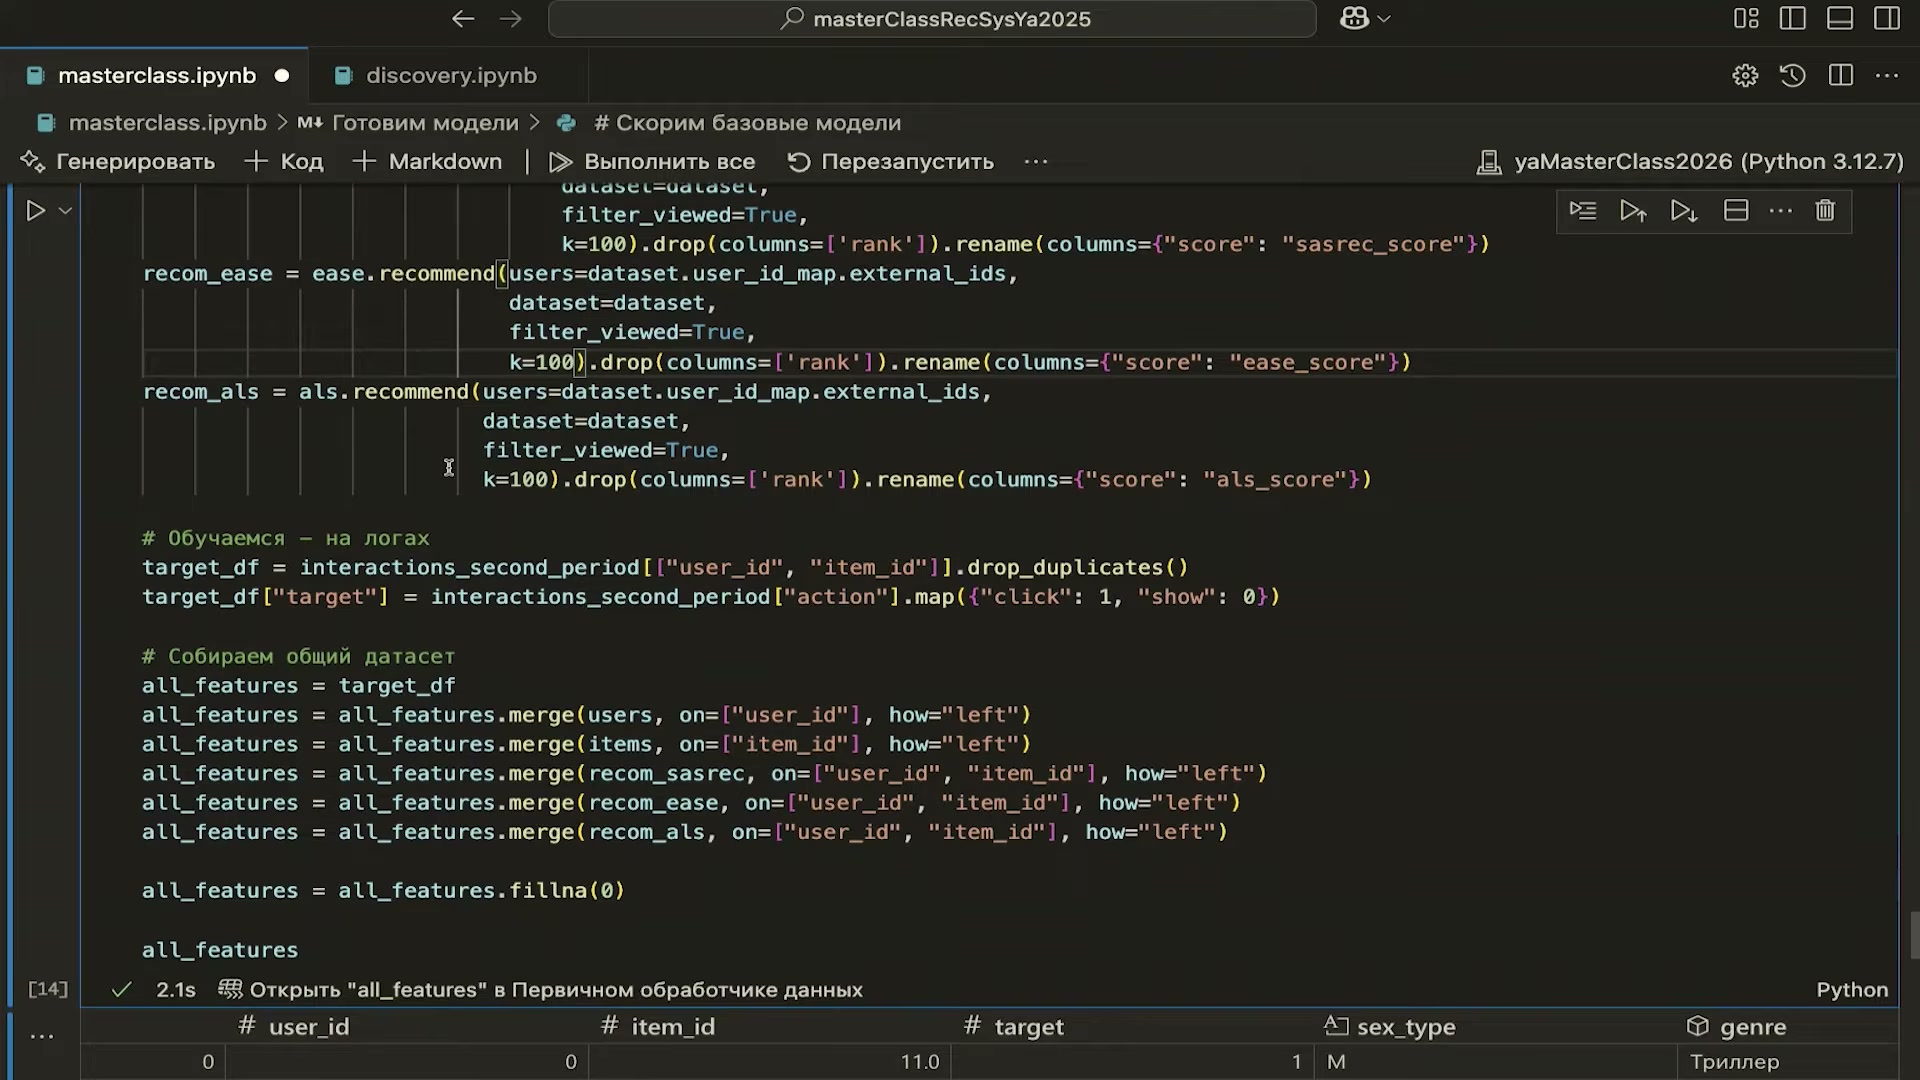
Признаки присоединяются к парам из журнала: click→1, show→0. Такие пары сохраняют отбор аудитории прошлой полкой.
Источник: Сергей Кузнецов · МТС · Practical ML ConfОбщие истории пользователей и идея ALS
Чтобы понять, зачем объединять разные модели, автор на время возвращается к источникам рекомендательного сигнала. Один из них — сходство действий разных людей. Допустим, первый зритель посмотрел фильмы 1, 2 и 4, а Петя — 1, 2 и 5. Общая часть историй позволяет предположить близость интересов: первому можно предложить фильм 5, а Пете — фильм 4. Такой перенос сведений между похожими историями называется коллаборативной фильтрацией.
В объяснении автора взаимодействия записываются в матрицу: строки соответствуют пользователям, столбцы — объектам. Единица отмечает наличие взаимодействия, ноль — его отсутствие. Это способ представить историю для модели. Само по себе нулевое значение не даёт универсального правила разметки отрицательных примеров: смысл отсутствующего события ещё зависит от того, как объект мог попасть к человеку.
ALS пытается приблизить матрицу взаимодействий произведением двух матриц — представлений пользователей и объектов. Представление здесь означает набор числовых весов, который модель подбирает по данным. Вместо независимого запоминания каждого сочетания она ищет общую структуру взаимодействий.
Обучение происходит поочерёдно. Сначала фиксируются пользовательские веса и подбираются объектные, затем фиксируются объектные и подбираются пользовательские. Для обсуждаемой квадратичной ошибки соответствующая подзадача имеет аналитическое решение: не требуется заменять её отдельным шагом градиентного спуска. Слайд иллюстрирует произведение матриц, но не задаёт полную функцию потерь, размеры представлений или настройки конкретного запуска.
Обновление модели — отдельная задача, не часть расчёта каждой рекомендации. Если после обучения появились новые взаимодействия, они не окажутся в уже подобранных весах автоматически. В описанном автором варианте методы регулярно переобучают или дообучают; ориентир из речи — раз в день или чаще. Это пояснение необходимости учитывать свежие данные, а не раскрытый регламент сервисов МТС.
Для двухуровневой системы регулярное обновление имеет дополнительное следствие. Даже если базовая модель лучше учла новые действия, следующему уровню предстоит работать с её новыми выходными числами. Улучшение или обновление одного компонента ещё не гарантирует согласованность всего решения.
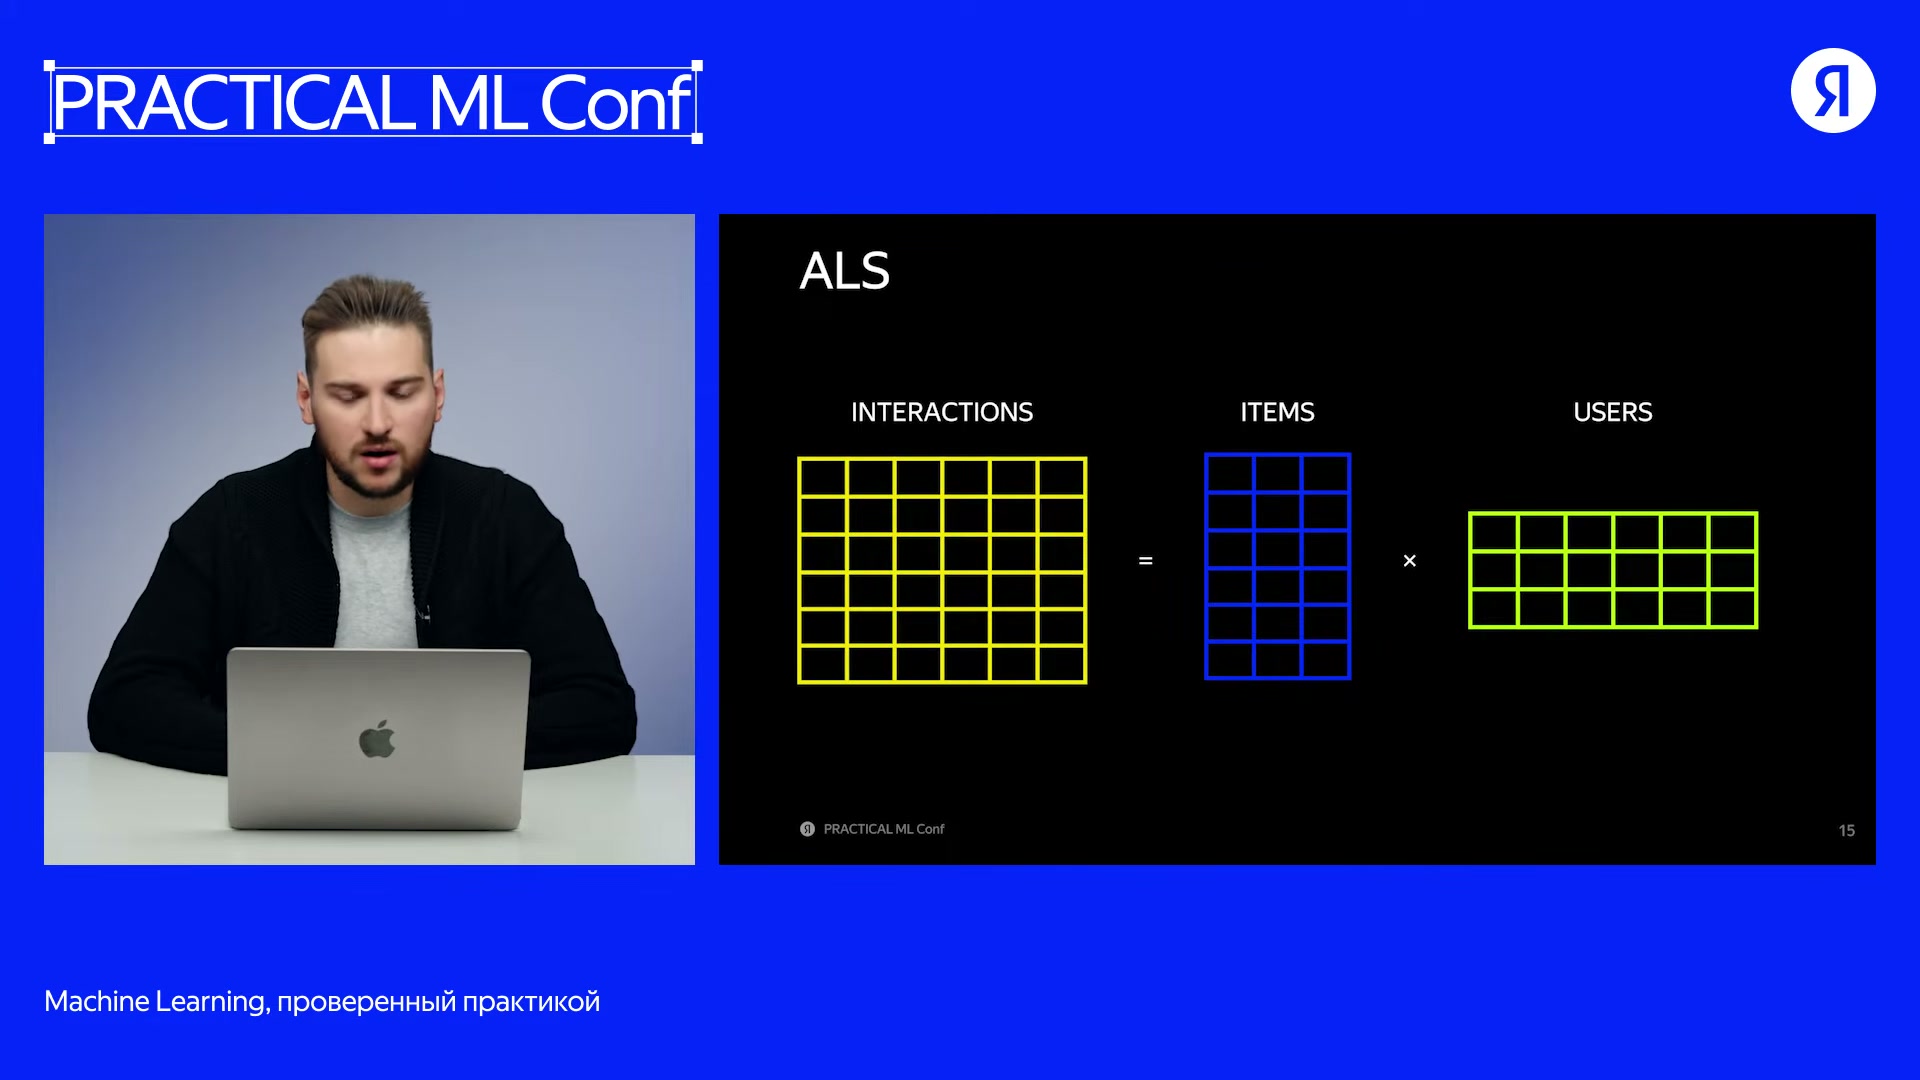
Матрица взаимодействий приближается произведением двух матриц; поочерёдное обучение обсуждается отдельно от обработки запроса.
Источник: Сергей Кузнецов · МТС · Practical ML ConfEASE: восстановить взаимодействия, не скопировав их
EASE решает похожую задачу другим способом. Пусть X — матрица взаимодействий, а B — подбираемая матрица весов. Нужно сделать произведение XB похожим на исходную X. Дополнительный штраф за величину B ограничивает рост весов. Но одного сходства с исходной матрицей недостаточно: простое копирование уже наблюдавшихся действий не создаёт полезной рекомендации.
Поэтому на диагонали B должны стоять нули. Диагональный вес связывал бы объект с ним самим; запрет такого веса не позволяет использовать прямой путь копирования. Автор объясняет проблему на единичной матрице: она воспроизводит X без ошибки, но возвращает человеку то, что тот уже посмотрел. Нулевая ошибка восстановления здесь не означает автоматически минимум всей суммы со штрафом.
Математическое пояснение квадратов норм Фробениуса на слайде EASE: восстановление X через XB и штраф на B. На слайде F² напечатано как нижний индекс; здесь используется обычная запись квадрата нормы. Отдельный коэффициент регуляризации в источнике не указан.
Норма Фробениуса описывает общий размер матрицы через её элементы. В показанной постановке первый член отвечает за отличие восстановления от исходных взаимодействий, второй — за величину весов. Конкретный коэффициент регуляризации в реализации не раскрыт: отсутствие отдельного коэффициента на слайде не позволяет приписать ноутбуку выбранное значение параметра.
В обзоре упомянут и более быстрый вариант EASE, название которого в речи звучит как SANSA. Автор характеризует его как близкий по качеству при более быстром обучении, но не приводит величину ускорения или отдельную таблицу сравнения. Точное написание этого названия на предоставленных кадрах не показано. В подтверждённую тройку моделей стажёрского решения входят ALS, EASE и SASRec, а не этот дополнительный вариант.
Общий вывод автора — не объявлять один метод победителем заранее. На разных задачах лучше работают разные подходы; их можно сравнить, выбрать один или передать несколько оценок в общую модель. Те же методы могут предлагать кандидатов для большого каталога, но такой этап в текущем упражнении не реализуется.
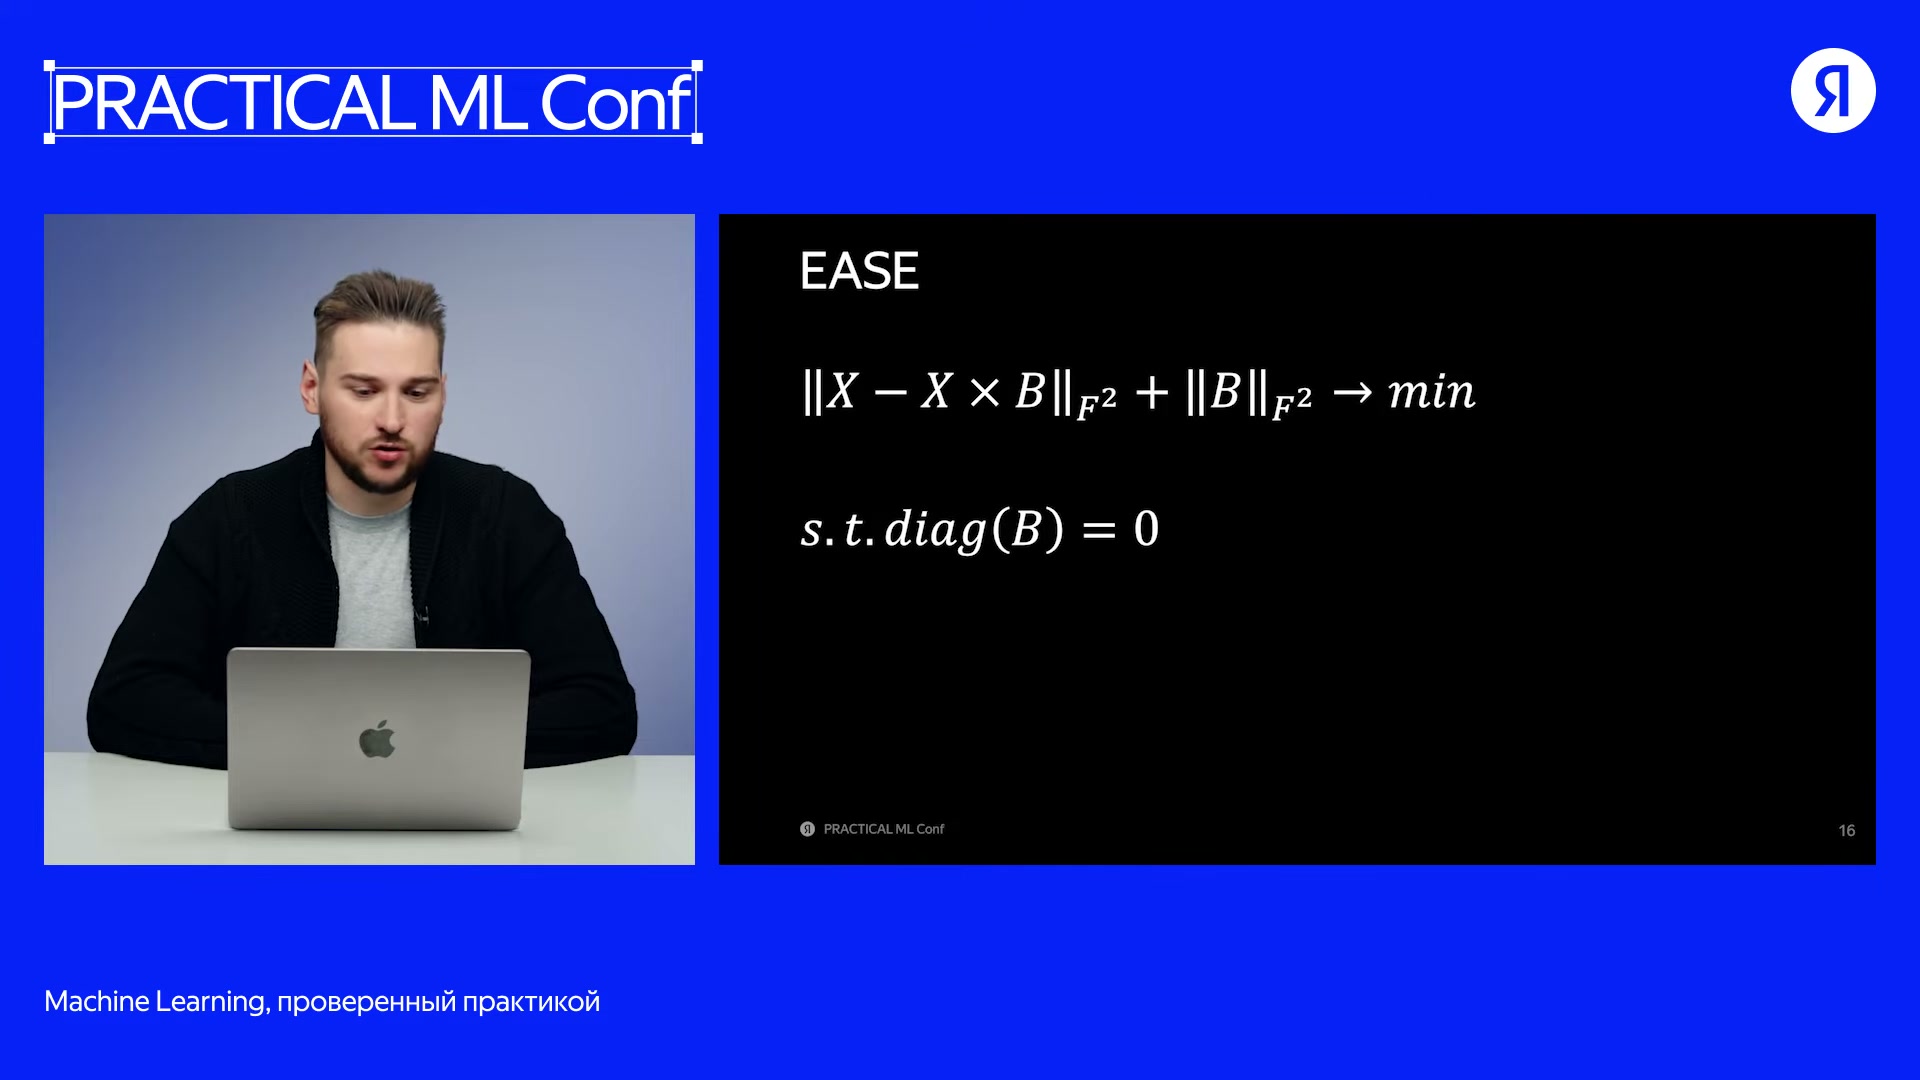
Реконструкция X через XB и штраф на B при diag(B)=0. На слайде коэффициент регуляризации отдельно не указан.
Источник: Сергей Кузнецов · МТС · Practical ML ConfСвойства объектов и порядок действий дополняют общие предпочтения
История совместных действий — не единственный доступный сигнал. О фильме можно знать жанр, среднюю оценку, актёров и описание. Для структурированных признаков автор обсуждает счётчики, а для неструктурированного содержания — векторные представления, или эмбеддинги: наборы чисел, которыми модель описывает содержание. Это обзор возможных источников информации, а не утверждение, что все они есть в демонстрационном наборе.
О пользователе также могут быть известны пол, возраст и другие характеристики. Но особенно важна его история в сервисе: она отражает уже проявленные интересы и позволяет строить совместные признаки человека и объекта. В конкретном учебном наборе показан sex_type; дополнительные свойства из общего обзора не следует автоматически добавлять в фактический состав модели.
Порядок действий несёт информацию, которую трудно передать одной общей оценкой популярности. Автор предлагает пример: человек смотрел «Леди Баг», «Три кота» и «Синий трактор». По такой истории «Маша и Медведь» выглядит более подходящим продолжением, чем «Душегубы». Рекомендательная модель должна превратить это понятное человеку различие в числовое сравнение кандидатов.
На этом основан интерес к моделям последовательностей. В обработке языка модель анализирует последовательность слов, а в рекомендациях — последовательность действий. Кузнецов вспоминает, как ещё в конце 2010-х перенос методов из обработки языка оказался полезен для рекомендаций, а затем связывает с той же идеей использование трансформеров. Точное название упомянутого раннего языкового метода в расшифровке не сохранилось.
SASRec в исходном решении выступает именно как источник сигнала из последовательности. Подробности её архитектуры, длина истории, функция потерь и другие настройки в этом объяснении не раскрываются. Поэтому смысл сочетания моделей здесь — разные способы извлечь сведения из поведения, а не доказанный выигрыш конкретной архитектурной конфигурации трансформера.
Доклад · 00:17:31Первая ошибка: после переобучения скор означает другое
Вернувшись к ноутбуку, автор показывает проблему, которую не устраняет разделение данных по времени. ALS обучается сначала на событиях с первого по шестидесятый день, затем — с первого по сто двадцатый. Второй период накопительный: это не только дни с 61-го по 120-й. Распределение выходных оценок меняется вместе с объёмом истории.
Таблицу можно прокрутить по горизонтали.
На экране средние равны 0,012428 и 0,022839, а не 0,12 и 0,22 из устного объяснения. Изменяется не только среднее, но и разброс. Отрицательные значения также показывают, почему эти скоры нельзя без дополнительного обоснования читать как вероятности клика. При этом количество рассчитанных значений между запусками различается: таблица не подтверждает сравнение одного и того же фиксированного набора пар.
Для бустинга важен смысл диапазонов входного признака. На обучении он обнаружил, какие значения базовой модели соответствуют более перспективным объектам. После обновления ALS прежний диапазон может стать гораздо более обычным. Бустинг продолжает применять выученные зависимости к числам, но числам уже соответствует другое распределение.
Это не обязательно проявляется как техническая авария. Автор описывает возможный сценарий: первоначальная онлайн-проверка прошла хорошо, модель запущена, затем через месяц, два или позже постепенно расходятся распределения. Сервис продолжает отвечать, ничего не падает, но пользовательские или бизнес-показатели могут ухудшаться. В докладе это предупреждение о характере ошибки, а не измеренный результат такого запуска в МТС.
Причина находится между уровнями системы. Базовая модель сама по себе может продолжать выдавать разумный порядок, но её оценка одновременно служит признаком другой модели. Поэтому обновление первого уровня требует учитывать не только его собственное качество, но и то, как второй уровень интерпретирует новые значения.
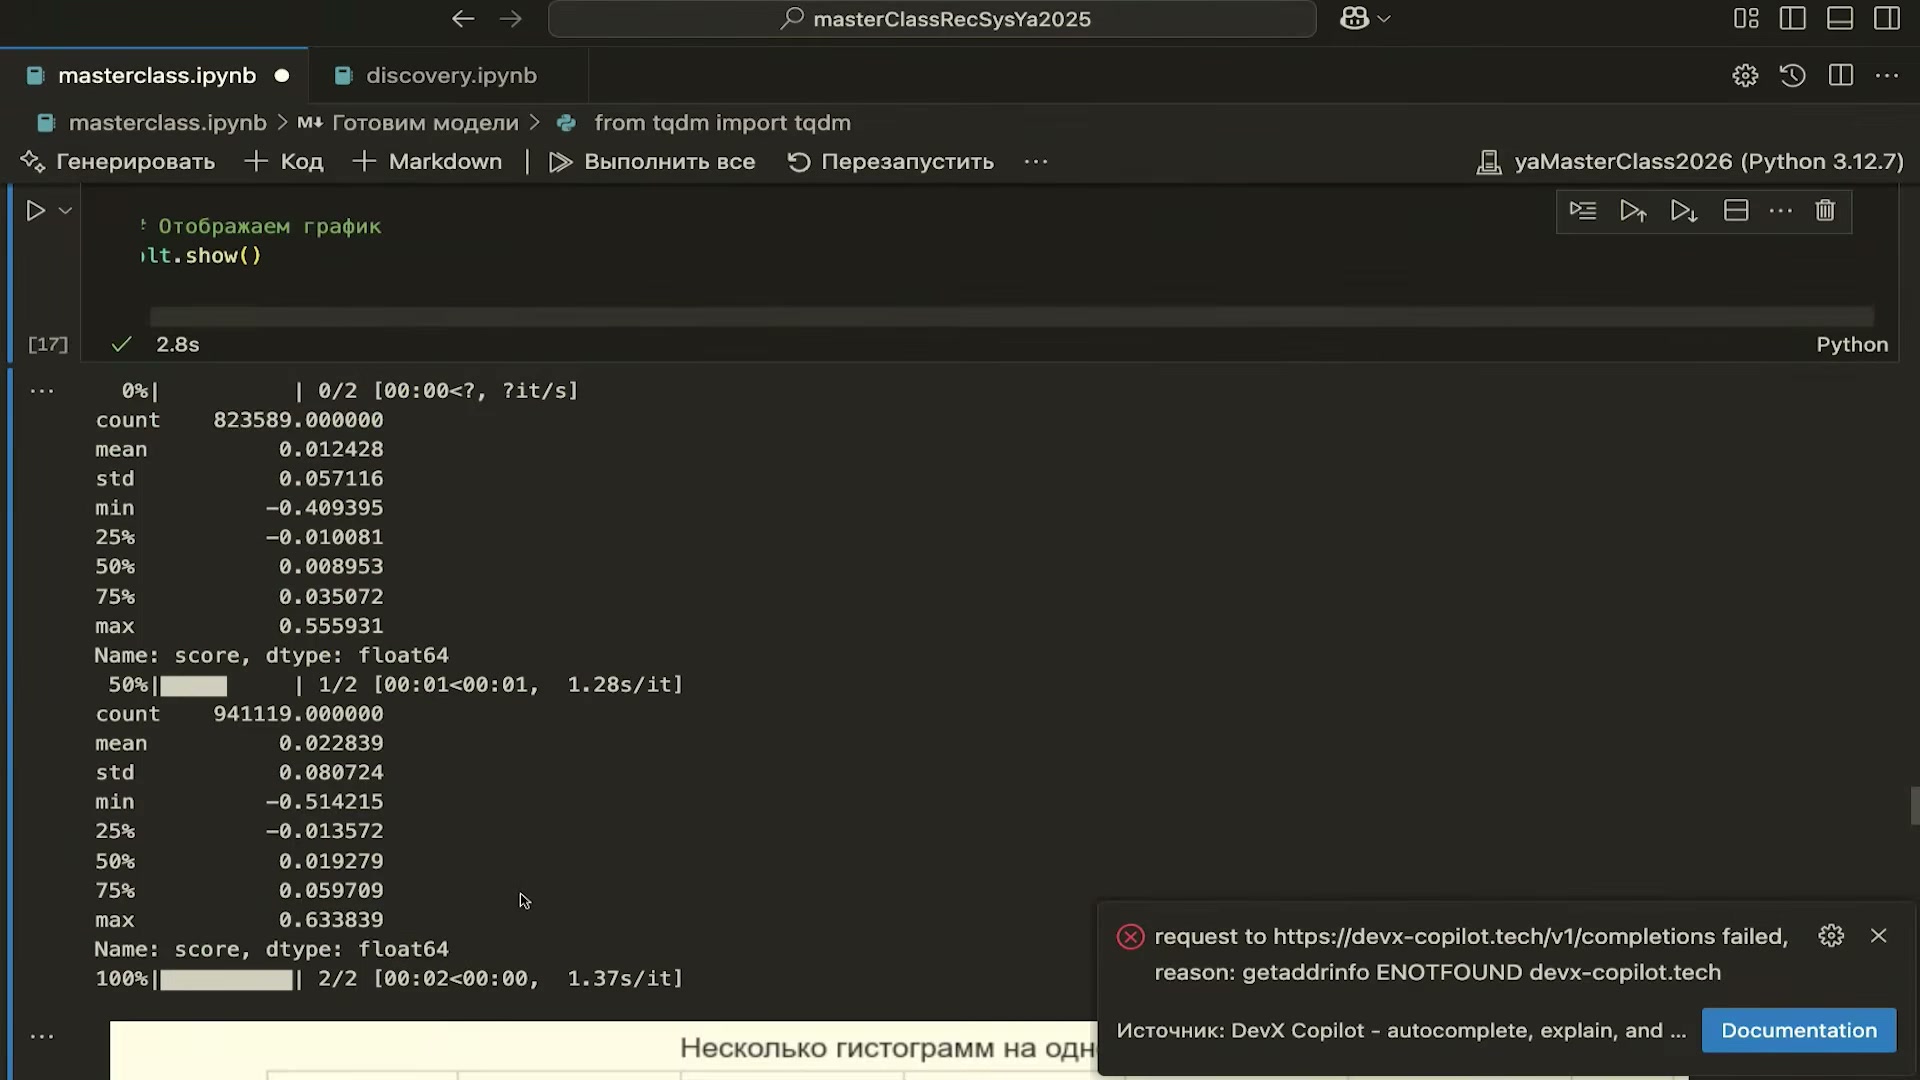
На экране mean=0,012428 и 0,022839, std=0,057116 и 0,080724. Числа 0,12/0,22 из речи не совпадают с выводом ноутбука.
Источник: Сергей Кузнецов · МТС · Practical ML ConfНормировка согласует масштаб, но не исправляет смысл данных
В качестве исправления Кузнецов вычитает из оценок среднее и делит результат на стандартное отклонение — величину, характеризующую разброс. После такого преобразования бустинг получает оценку относительно центра и масштаба соответствующего распределения, а не исходное число в произвольной шкале.
Sₘ — весь переданный столбец оценок модели m. Среднее и стандартное отклонение вычисляются отдельно для столбца каждой модели; запись соответствует показанной функции normalize.
def normalize(data):
    return (data - data.mean()) / data.std()

recom_sasrec["sasrec_score"] = normalize(recom_sasrec["sasrec_score"])
recom_ease["ease_score"] = normalize(recom_ease["ease_score"])
recom_als["als_score"] = normalize(recom_als["als_score"])
Здесь нет группировки по пользователю. Функция получает целиком столбец sasrec_score, ease_score или als_score и считает статистики по этому столбцу. Нормировка каждого пользовательского списка по отдельности была бы другим преобразованием. Она не показана в ноутбуке и не должна приписываться этому решению.
Автор связывает изменение со стабильностью объединения моделей, но не приводит отдельного численного эффекта одной нормировки. Не показаны и правила применения статистик в работающем сервисе: где их сохранять, когда пересчитывать и как согласовывать с версиями моделей. Поэтому фрагмент объясняет предложенный способ выравнивания шкал, но не доказывает устойчивость системы на длительном эксплуатационном периоде.
Нормировка меняет представление входного признака. Она сама по себе не проверяет, правильно ли выбраны обучающие пары и почему к ним присвоены конкретные метки. Именно поэтому после выравнивания скоров автор продолжает разбор: следующая проблема относится уже не к масштабу чисел, а к выученной зависимости.
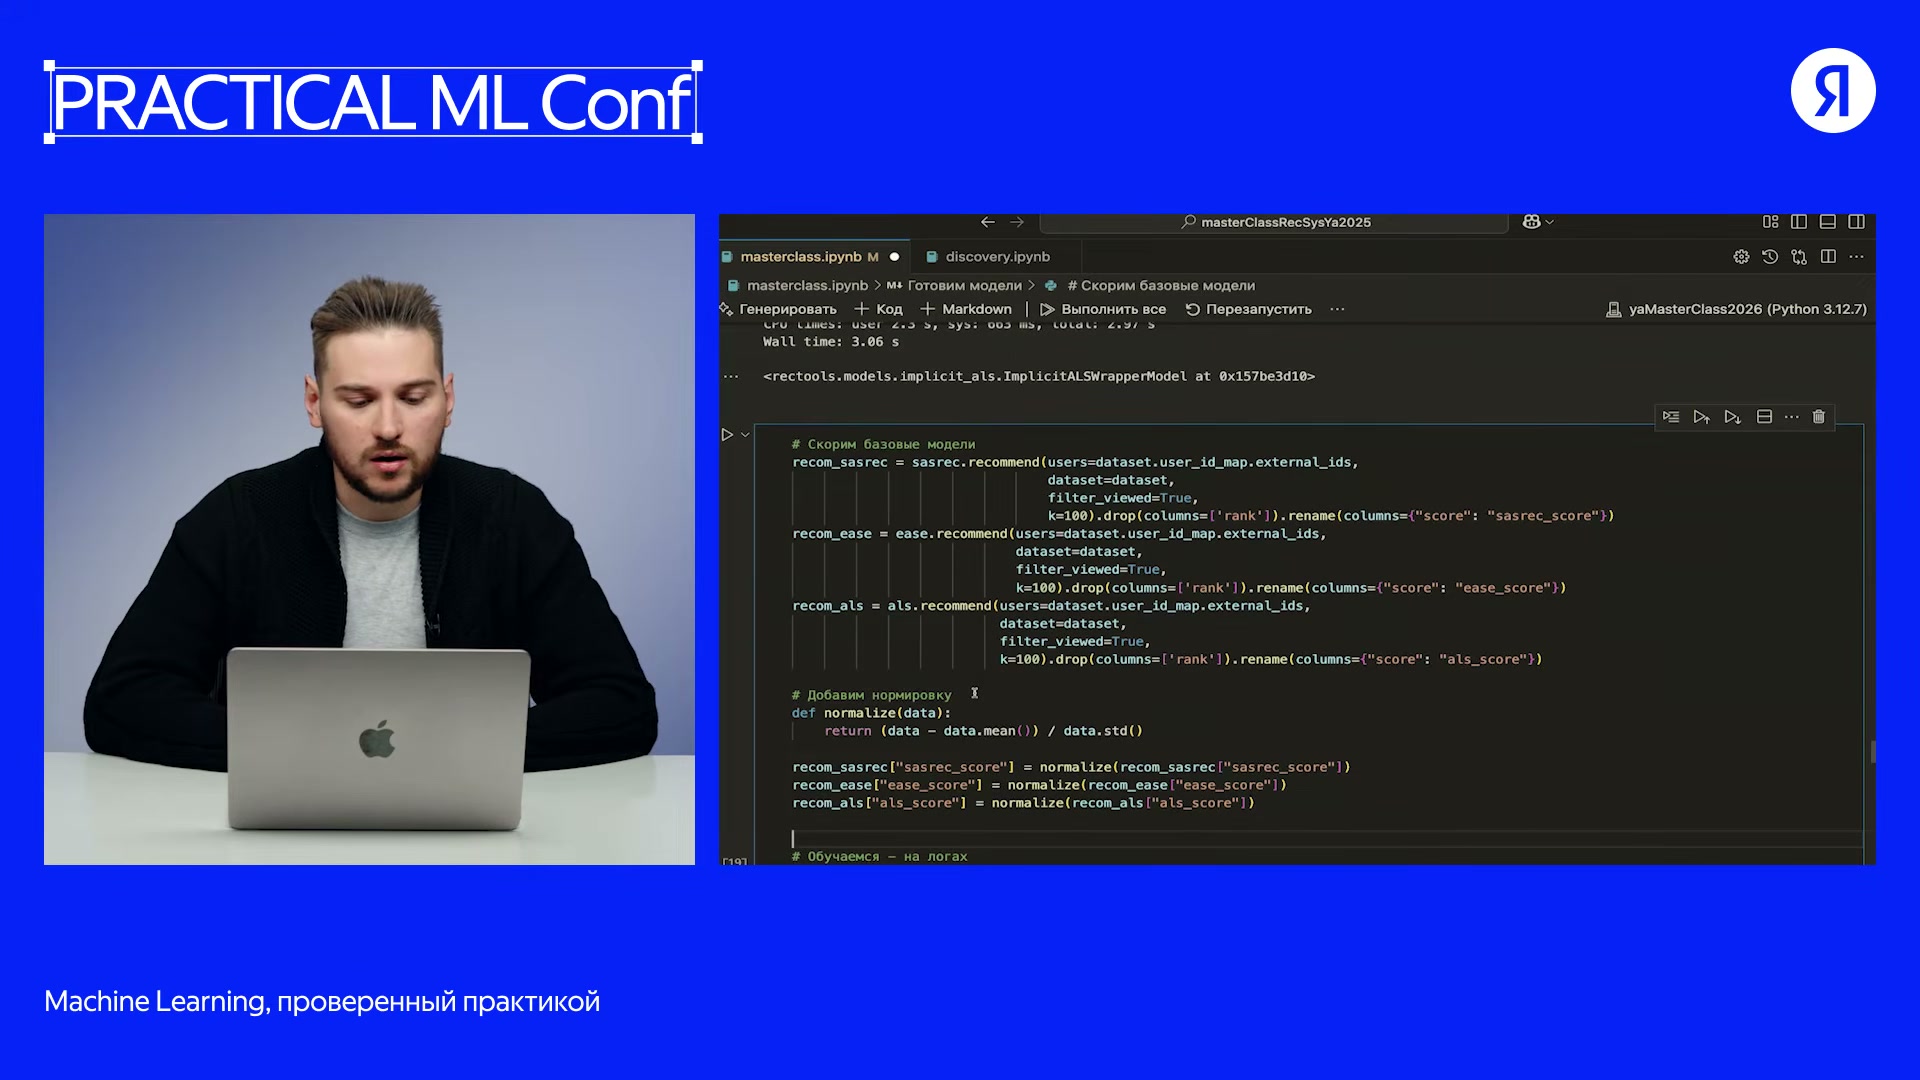
Для каждого столбца скор модели нормируется как (data-data.mean())/data.std(). Статистики считаются по переданному столбцу, не отдельно для каждого пользователя.
Источник: Сергей Кузнецов · МТС · Practical ML ConfВторая ошибка: модель наказывает объект за высокую оценку
Стажёр проверял качество, но не посмотрел, какие закономерности использует итоговая модель. Чтобы сделать их видимыми, автор заново запускает обучение CatBoost и добавляет анализ вкладов признаков — SHAP. Важна не только величина предсказания, но и то, какие свойства связаны с его увеличением или уменьшением.
На показанном графике каждая строка относится к одному признаку. Цвет обозначает величину признака: высокие значения выделены розовым, низкие — синим. Горизонтальная координата показывает вклад в выход модели: справа от нуля вклад положительный, слева — отрицательный. Это чтение отображённых вкладов, а не доказательство причинного эффекта искусственного изменения признака у реального пользователя.
В верхней строке стоит mean_users_score — средняя пользовательская оценка объекта. Высокие значения находятся преимущественно слева от нуля, а низкие образуют длинную область положительных вкладов справа. То есть показанная модель использует низкую среднюю оценку как довод повысить собственный прогноз, а высокую — как довод его понизить. Имя признака и направление связи видны непосредственно на графике.
Ниже расположены sasrec_score, ease_score, als_score, genre и sex_type. Этот состав помогает связать интерпретацию с предыдущей сборкой таблицы: бустинг действительно получает оценки рекомендательных моделей и признаки исходных данных. Но центральная находка — не список важных столбцов, а обратная связь у mean_users_score.
Одна лишь неожиданность ещё не доказывала бы ошибку: в реальных данных привычная интуиция может оказаться неверной. Здесь есть более сильное основание для проверки. Автор сам построил симулятор и знает, что повышение средней оценки увеличивает истинную склонность к клику. Следовательно, нужно объяснить, почему обучение по наблюдаемым показам привело к противоположной зависимости. График становится средством поиска причины, а не заменой её анализа.
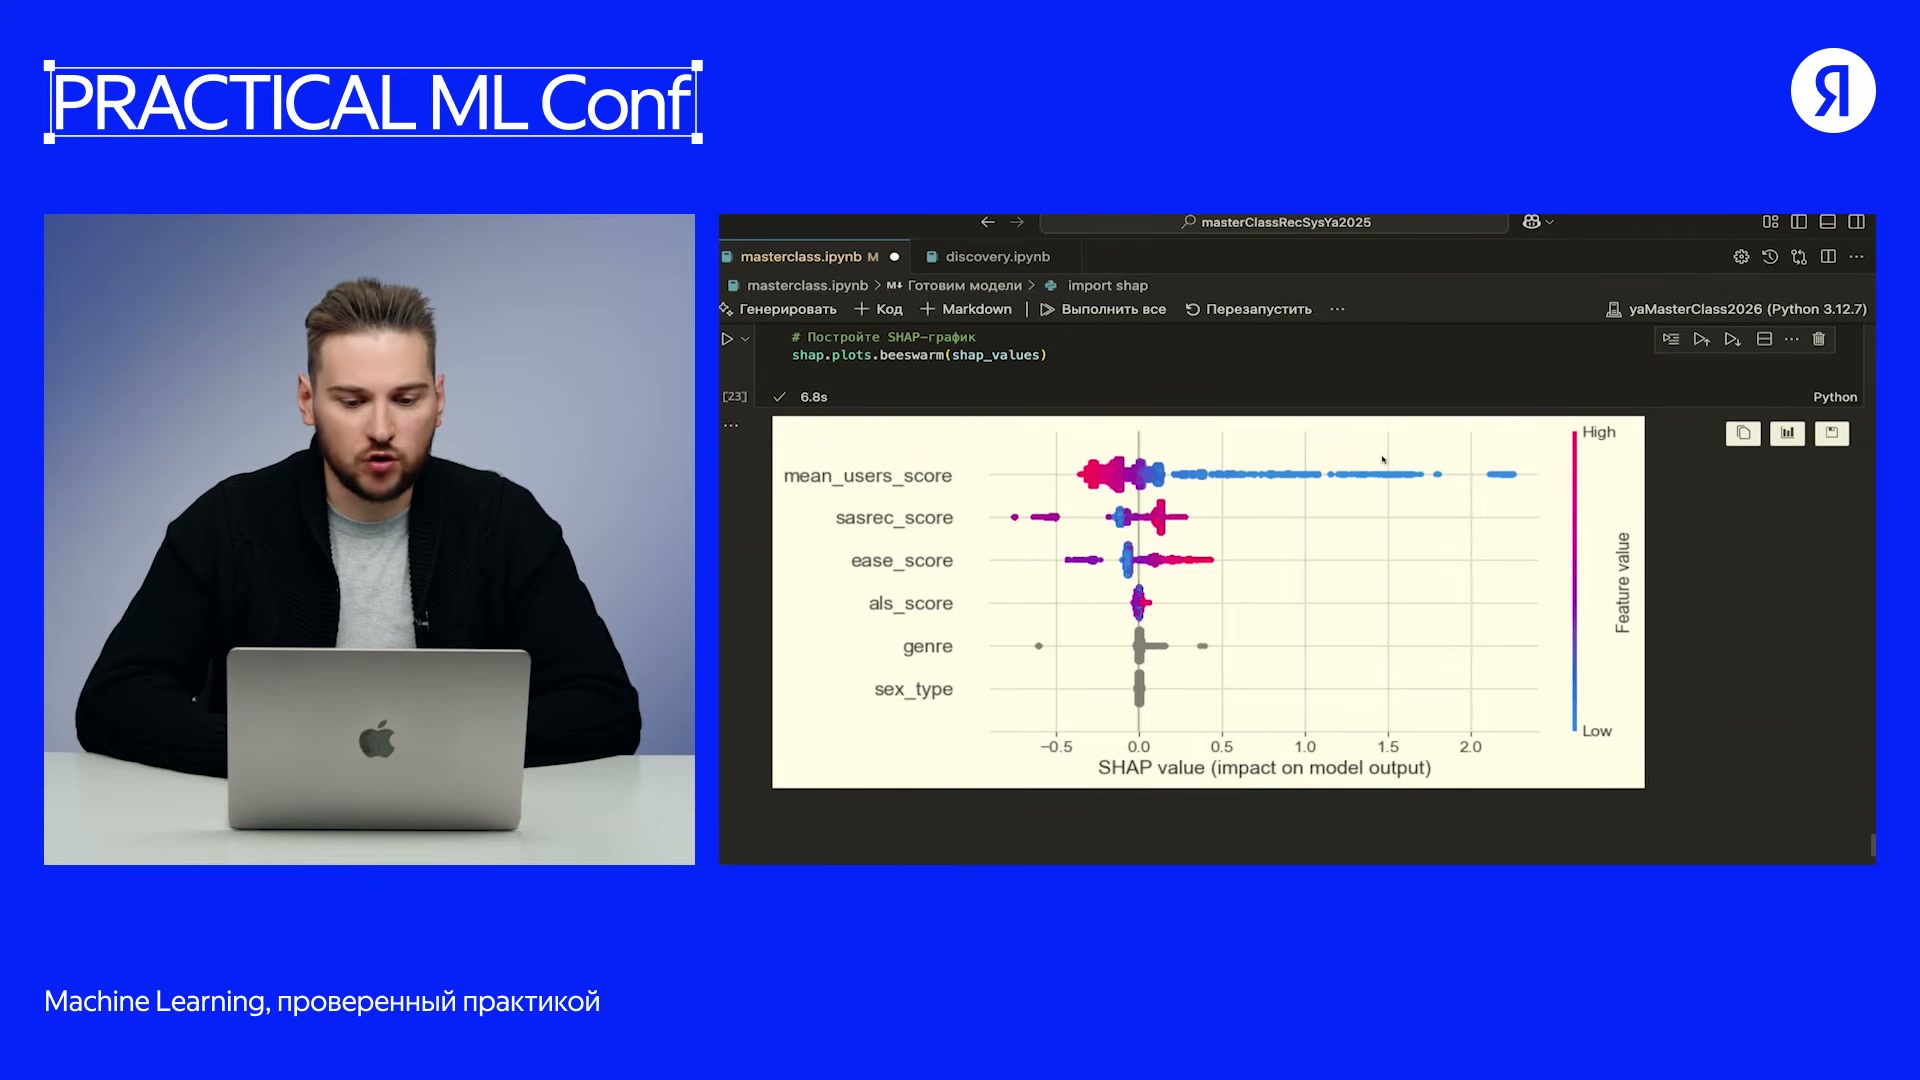
Высокие mean_users_score слева от нуля по SHAP, низкие справа: более высокая средняя оценка уменьшает предсказание модели в этом примере.
Источник: Сергей Кузнецов · МТС · Practical ML ConfКак прежняя полка переворачивает наблюдаемую зависимость
Синтетические данные позволяют отделить истинную склонность человека к действию от того, что попало в журнал. В генераторе вероятность клика положительно зависит от средней пользовательской оценки. Дополнительно действуют интересы пользователя, целевая аудитория фильма и временной рост числа кликов.
Хотя слайд представляет устройство истинной релевантности, он перечисляет факторы, а не даёт численную формулу. Не раскрыто, как именно они объединяются, какие имеют коэффициенты и как результат превращается в вероятность. Восстанавливать отсюда конкретное линейное или логистическое уравнение нельзя.
Механизм инверсии связан с тем, кто до какого объекта доходит. Первые позиции полки видит широкая аудитория. Среди этих людей много тех, кому сейчас не подходит данный объект, даже если его средняя оценка высока. Их показы без клика попадают в журнал и становятся отрицательными примерами для верхних объектов.
Часть пользователей ищет что-то конкретное и продолжает просматривать полку, пока не найдёт подходящее. До дальних объектов доходит уже отобранная группа. В описанном автором поведении доля кликов среди людей, увидевших дальний объект, может оказаться выше, чем среди всей широкой аудитории первых позиций. Это свойство состава аудитории показов, а не доказательство, что дальние объекты лучше подходят всем.
Теперь свяжем механизм с исходной сортировкой. Выше стояли объекты с большим mean_users_score; они получили много показов самым разным людям. Ниже стояли объекты с меньшим mean_users_score; их реакции наблюдались у более узкой, отобранной аудитории. Если обучать модель только на этих парах, высокая средняя оценка может начать ассоциироваться с отрицательной меткой, а низкая — с положительной. Так прежние правила выдачи превращаются в ложную зависимость новой модели.
Поэтому объяснение не сводится к тому, что популярный объект просто видело больше людей. Существенно, что люди в разных частях списка различаются и отобраны предыдущим поведением. Наблюдаемая конверсия считается на разных аудиториях. Перенести её напрямую в универсальную оценку релевантности пары — значит перепутать результат отбора с предпочтением пользователя.
Автор отмечает, что подобная ситуация может возникнуть и при сортировке по другому признаку: популярности, конверсии в просмотр или иной характеристике. Но он не утверждает, что дальние позиции всегда конвертируют лучше. В мастер-классе разобран конкретный механизм, который объясняет инверсию на графике и указывает на построение отрицательных примеров как на место исправления.
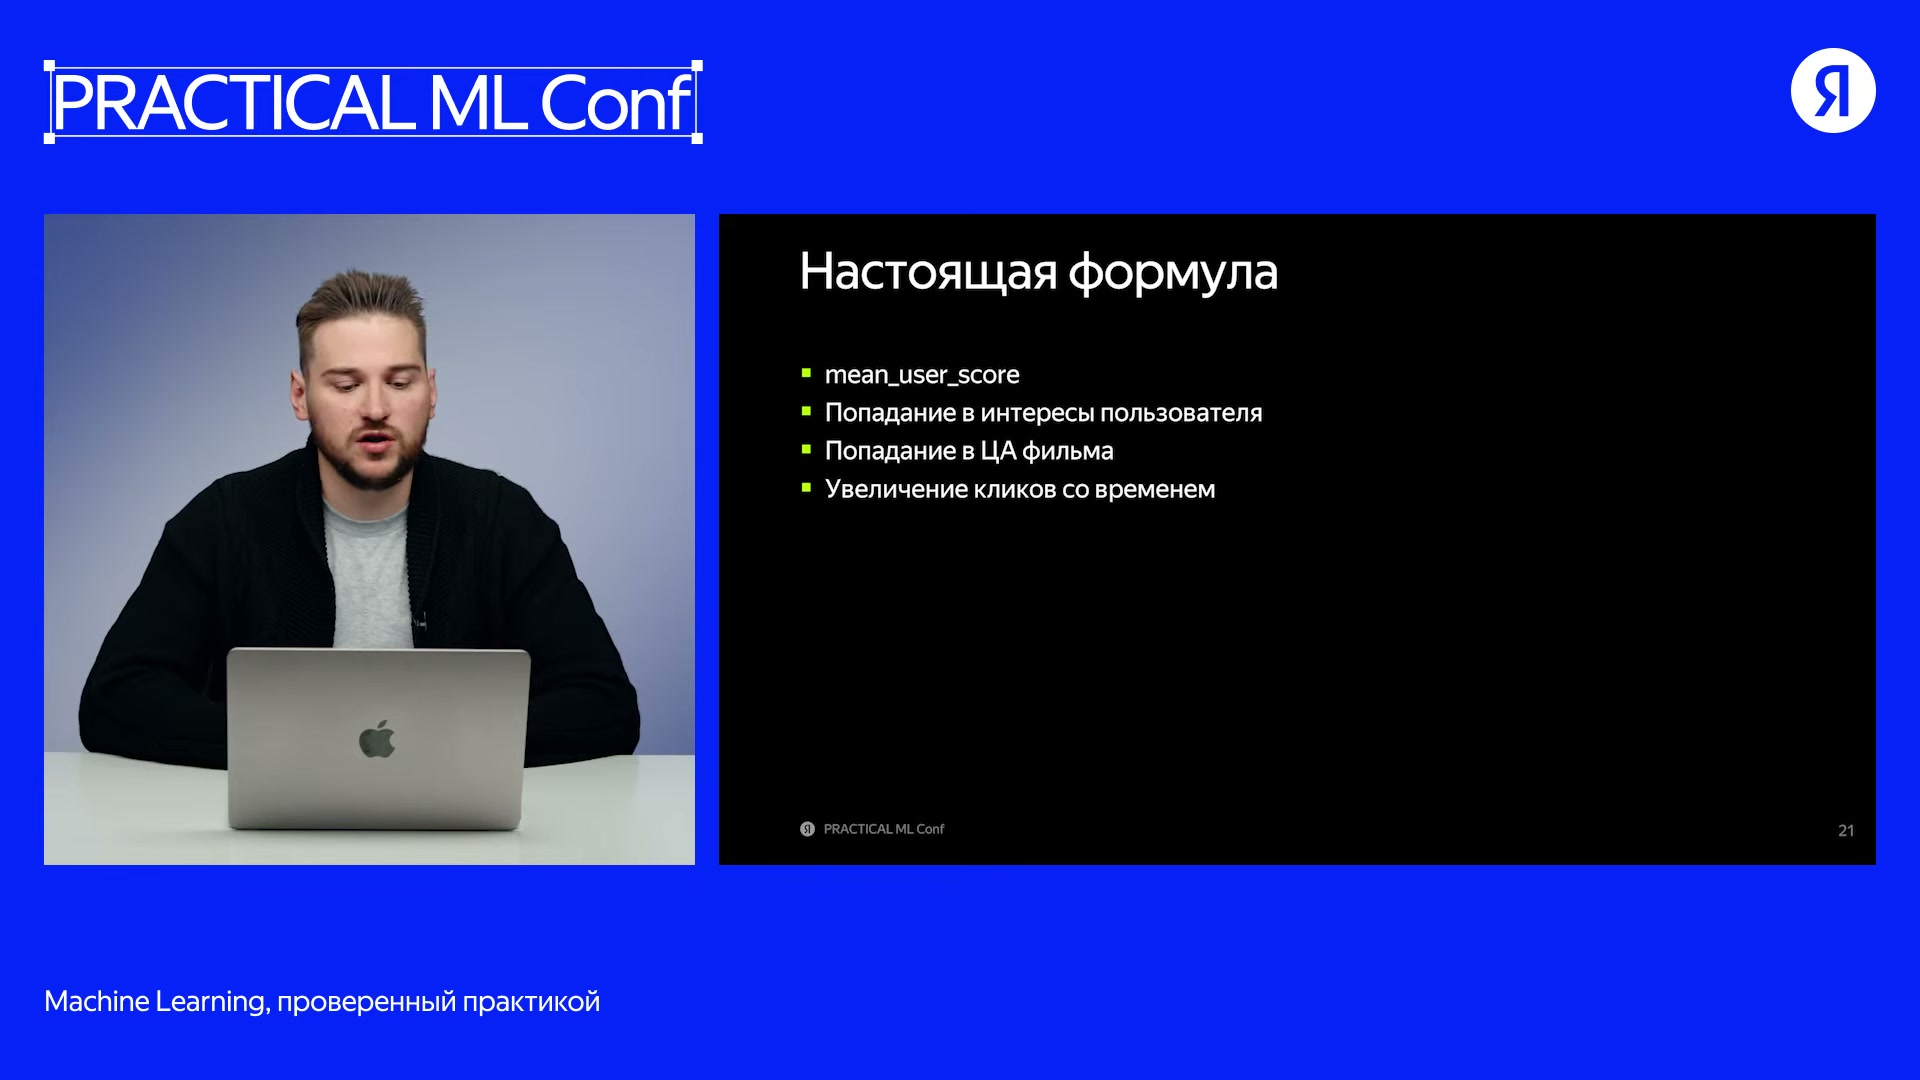
Симулятор учитывает среднюю оценку, интересы, целевую аудиторию и рост кликов со временем. Полное уравнение на слайде не дано.
Источник: Сергей Кузнецов · МТС · Practical ML ConfИсправление: изменить множество пар, а не только признаки
Первоначальная таблица начиналась с зарегистрированных взаимодействий. Значит, именно прошлая полка решала, какие пары вообще станут обучающими примерами. В небольшом синтетическом каталоге автор меняет эту основу: теперь каждому пользователю сопоставляют каждый объект. Такое объединение называется декартовым произведением, или cross join.
К полученному множеству пар слева присоединяют target_df, а отсутствующие значения заменяют нулями. Пары, которые раньше не появлялись в журнале, теперь тоже входят в таблицу и получают нулевую метку. Потом добавляются признаки пользователей и объектов, а также нормированные оценки SASRec, EASE и ALS. В конце оставшиеся пропуски снова заполняются нулями.
all_features = pd.merge(users["user_id"], items["item_id"], how="cross")
all_features = all_features.merge(target_df, on=["user_id", "item_id"], how="left")
all_features = all_features.fillna(0)

all_features = all_features.merge(users, on=["user_id"], how="left")
all_features = all_features.merge(items, on=["item_id"], how="left")
all_features = all_features.merge(recom_sasrec, on=["user_id", "item_id"], how="left")
all_features = all_features.merge(recom_ease, on=["user_id", "item_id"], how="left")
all_features = all_features.merge(recom_als, on=["user_id", "item_id"], how="left")

all_features = all_features.fillna(0)
Метка берётся из того же журнала; источник истинной релевантности не используется для этой разметки. Изменение состоит в расширении множества строк, а не в замене кликов на известные ответы симулятора. При этом подготовка target_df с удалением повторов и последующим присваиванием action остаётся отдельным местом неопределённости, описанным выше.
Нельзя считать, что любой ноль в итоговой таблице — настоящий рассчитанный моделью скор. У базовых recommend включена фильтрация просмотренного, а после объединения пропуски тоже заменяются нулями. Полная таблица пар и таблица фактически возвращённых оценок — не одно и то же. Демонстрационный код не сопровождается проверками всех таких случаев.
После перестроения данных автор сообщает, что средняя пользовательская оценка больше не оказывает прежнего странного отрицательного влияния, а главную роль начинают играть оценки SASRec и ALS. Это результат интерпретационного анализа по речи автора. Предоставленный SHAP-кадр показывает исходную инверсию; отдельного кадра исправленного графика в наборе нет.
Причина, по которой такое изменение вообще удобно попробовать, — каталог из 100 объектов. Для более крупного случая Кузнецов обсуждает использование кандидатов, отобранных для конкретного пользователя, но не показывает законченный вариант этой реализации. Перебирать весь промышленный каталог в рассматриваемом упражнении не требуется.
Важно не превратить исправление симулятора в универсальное правило. Отсутствие показа не доказывает, что объект человеку не подходит. Здесь добавление нулевых меток меняет перекошенное множество примеров в конкретной искусственной среде. Оно не даёт общего разрешения считать все непоказанные объекты достоверно отрицательными во всякой рекомендательной системе. Дальше автор использует особое преимущество симуляции — известную истинную релевантность — и проверяет, что получилось.
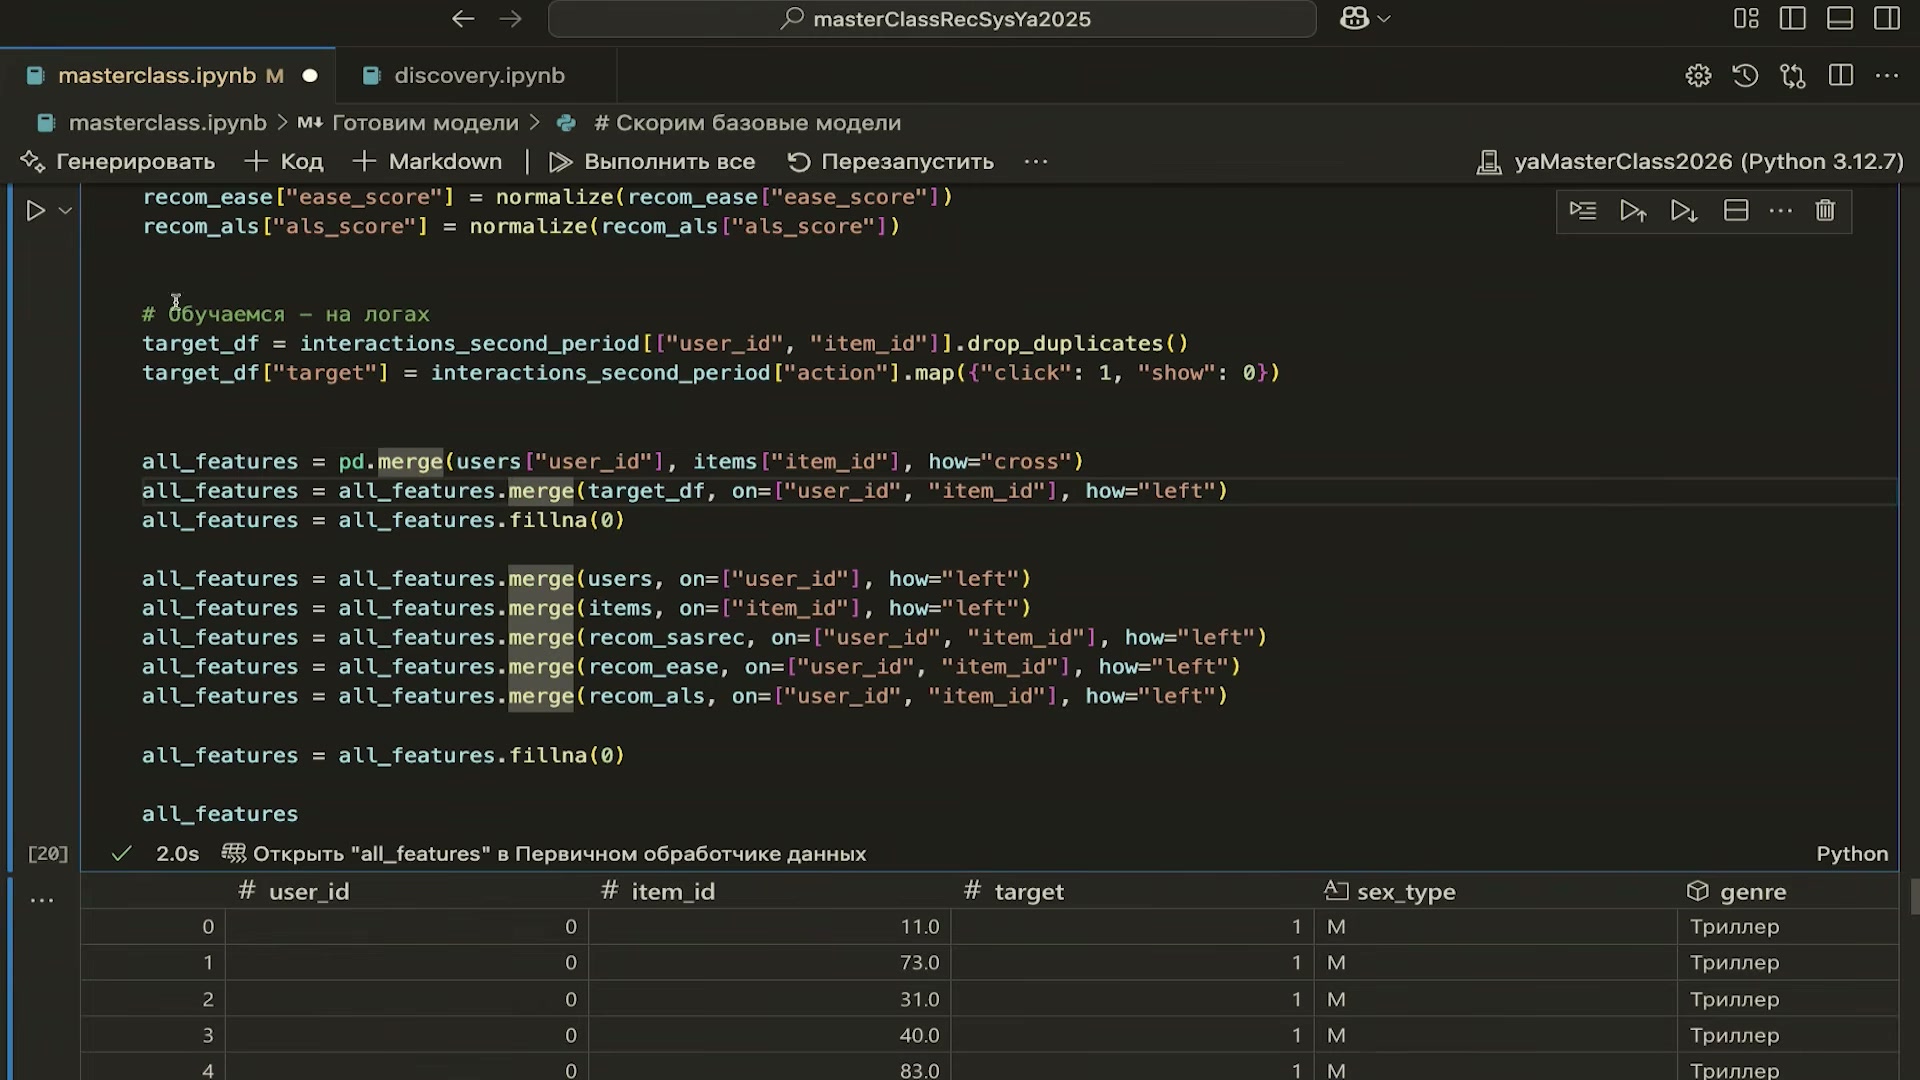
Декартово произведение пользователей и объектов расширяет множество пар; target присоединяется слева, пропуски заполняются нулём. Это решение для маленького искусственного каталога, не универсальная разметка непоказанных объектов.
Источник: Сергей Кузнецов · МТС · Practical ML ConfФинальная проверка: истинная релевантность, но разные множества пар
В обычном журнале видны только совершённые действия. В этом упражнении дополнительно известна величина, по которой симулятор порождал реакцию: true_relevance для пары пользователя и объекта. Её можно использовать как отдельный ориентир качества ранжирования. Чем лучше порядок модели согласуется с этой релевантностью, тем выше оцениваемый NDCG.
Проверка начинается с пар из X_val, к которым добавляется выход model.predict(val_pool). Затем эти строки объединяют с таблицей истинной релевантности по user_id и item_id. Для каждого пользователя берут только строки, сохранившиеся после объединения. Если их больше одной, вызывают ndcg_score(true_rel, model_pred, k=6), а результаты усредняют обычным np.mean.
val_scores = X_val[["user_id", "item_id"]]
val_scores["prediction"] = model.predict(val_pool)
all_scores = val_scores.merge(true_relevance, on=["user_id", "item_id"])

all_ndcg = []
for user in tqdm(all_scores["user_id"].unique()):
    if all_scores[all_scores["user_id"] == user].shape[0] > 1:
        true_rel = all_scores.loc[all_scores["user_id"] == user, "true_relevance"].to_numpy().reshape(1, -1)
        model_pred = all_scores.loc[all_scores["user_id"] == user, "prediction"].to_numpy().reshape(1, -1)
        sc = ndcg_score(true_rel, model_pred, k=6)
        all_ndcg.append(sc)

print(np.mean(all_ndcg))
В коде используется ndcg_score из sklearn.metrics. Здесь показан сам способ применения к уже подготовленным данным: X_val, val_pool и таблица true_relevance должны существовать заранее. Это не полный воспроизводимый эксперимент. Существенны глубина k=6, отбор пользователей с более чем одной парой и усреднение пользовательских значений, а не метрика по одному общему списку всех объектов.
Таблицу можно прокрутить по горизонтали.
Эта проверка отличается от первой таблицы сразу по двум существенным основаниям. Вместо исторического клика эталоном служит true_relevance, а оценивается итоговая модель второго уровня, не отдельные базовые рекомендатели. Нельзя считать изменение масштаба NDCG между таблицами приростом качества одного и того же эксперимента.
Даже два финальных значения требуют осторожного сравнения. На экране видно 2500 пользователей в цикле исправленного варианта и 2452 после отката. Кроме того, входом оценки служат пары текущего X_val. Когда основу датасета заменяют на декартово произведение, изменяется и доступное множество проверяемых пар. Источник не подтверждает, что обе версии оценивались на одном зафиксированном полном наборе кандидатов и одинаковых пользователях.
Условие больше одной пары находится внутри цикла. Поэтому число его итераций нельзя автоматически объявить точным количеством пользовательских значений, вошедших в среднее: отдельный размер all_ndcg не напечатан. Эта деталь не отменяет показанных результатов, но задаёт границу точности их интерпретации.
Разница между округлёнными результатами составляет около 0,100 единицы NDCG, а не относительные 10%. Она иллюстрирует существенную чувствительность результата к построению пар в симуляторе. Однако это не чистая оценка эффекта одного изменения на неизменной контрольной выборке, не доказанная статистическая значимость и не A/B-результат МТС. Повторные запуски, доверительные интервалы и промышленный бизнес-эффект не приведены.
Содержательный итог остаётся важным: после изменения данных автор видит более разумное использование признаков и более высокий показатель относительно известной истинной релевантности в показанном варианте проверки. Это основание внимательнее относиться к происхождению обучающих пар, но не обещание конкретного прироста для другого продукта.
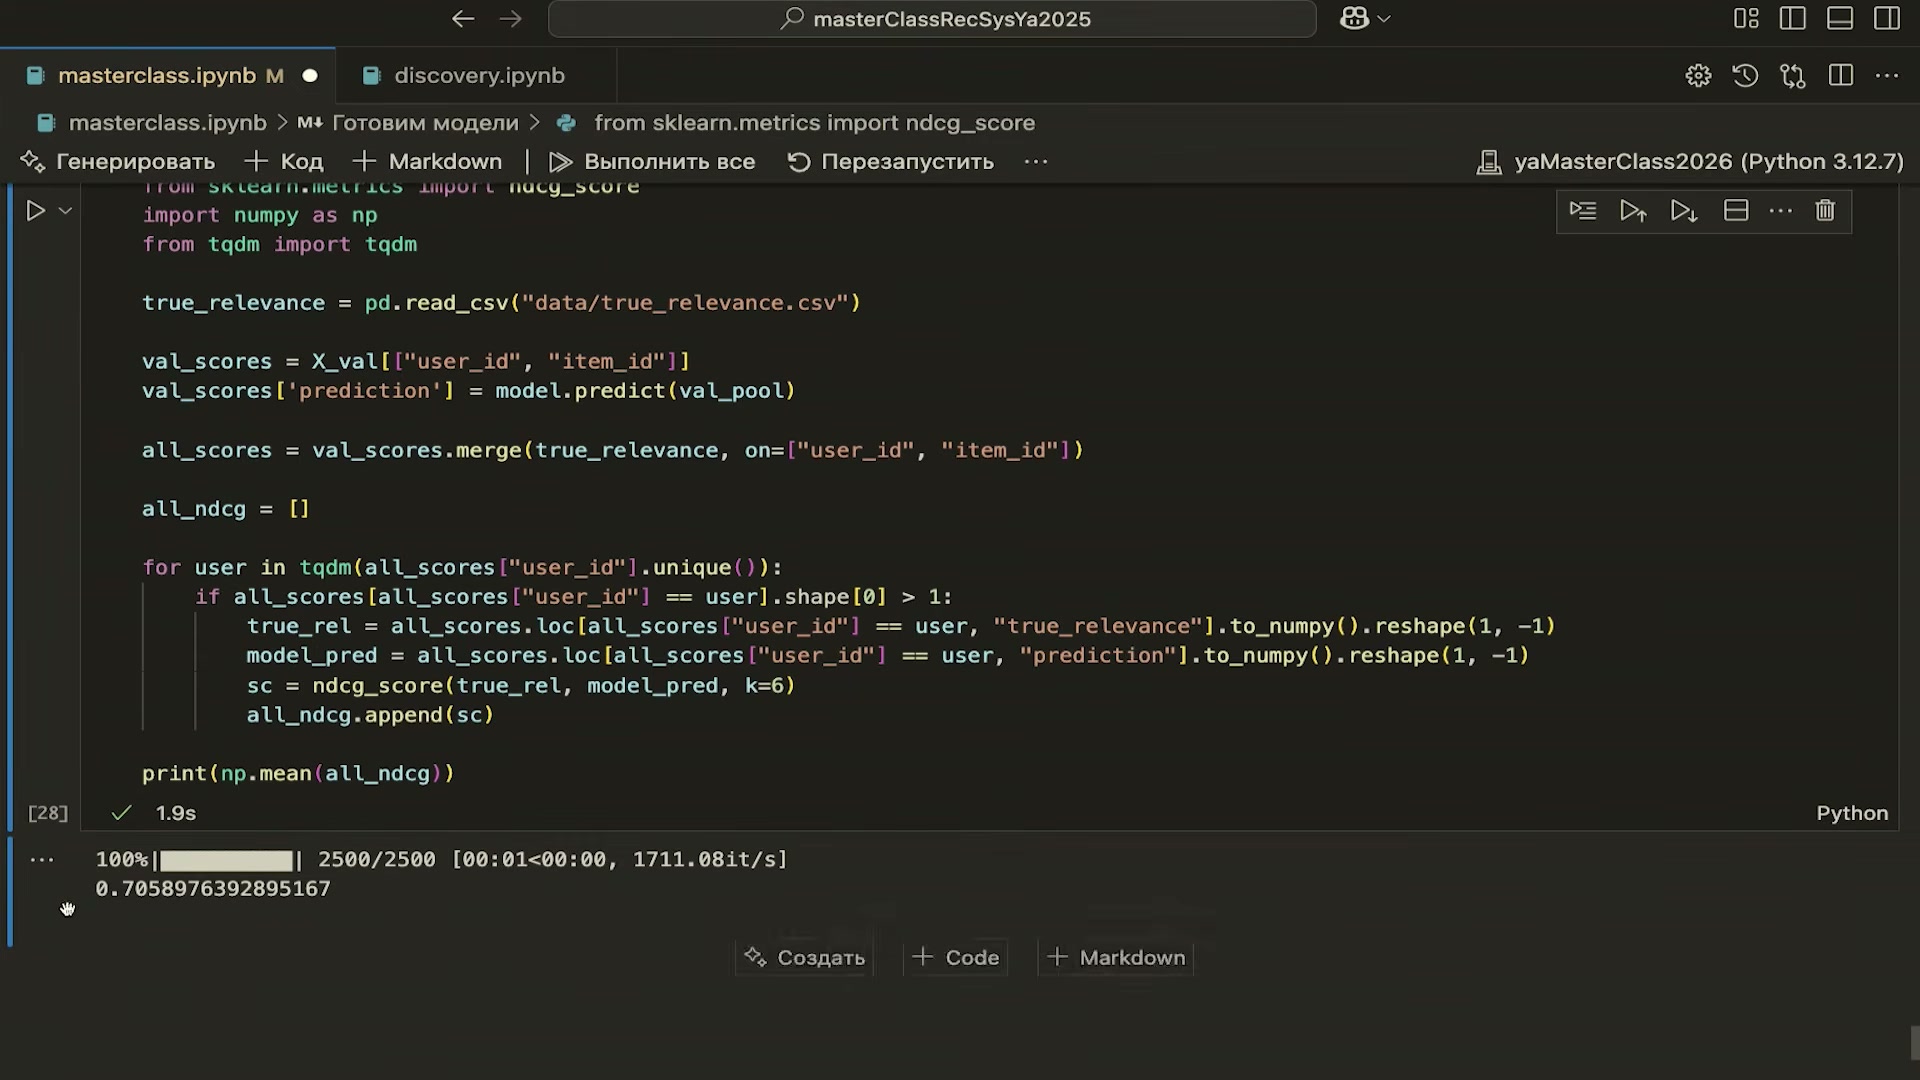
На экране 0,7058976392895167, k=6. Скоры сравнивают с true_relevance, считают по пользователям с более одной парой и усредняют; цикл показывает 2500 пользователей.
Источник: Сергей Кузнецов · МТС · Practical ML Conf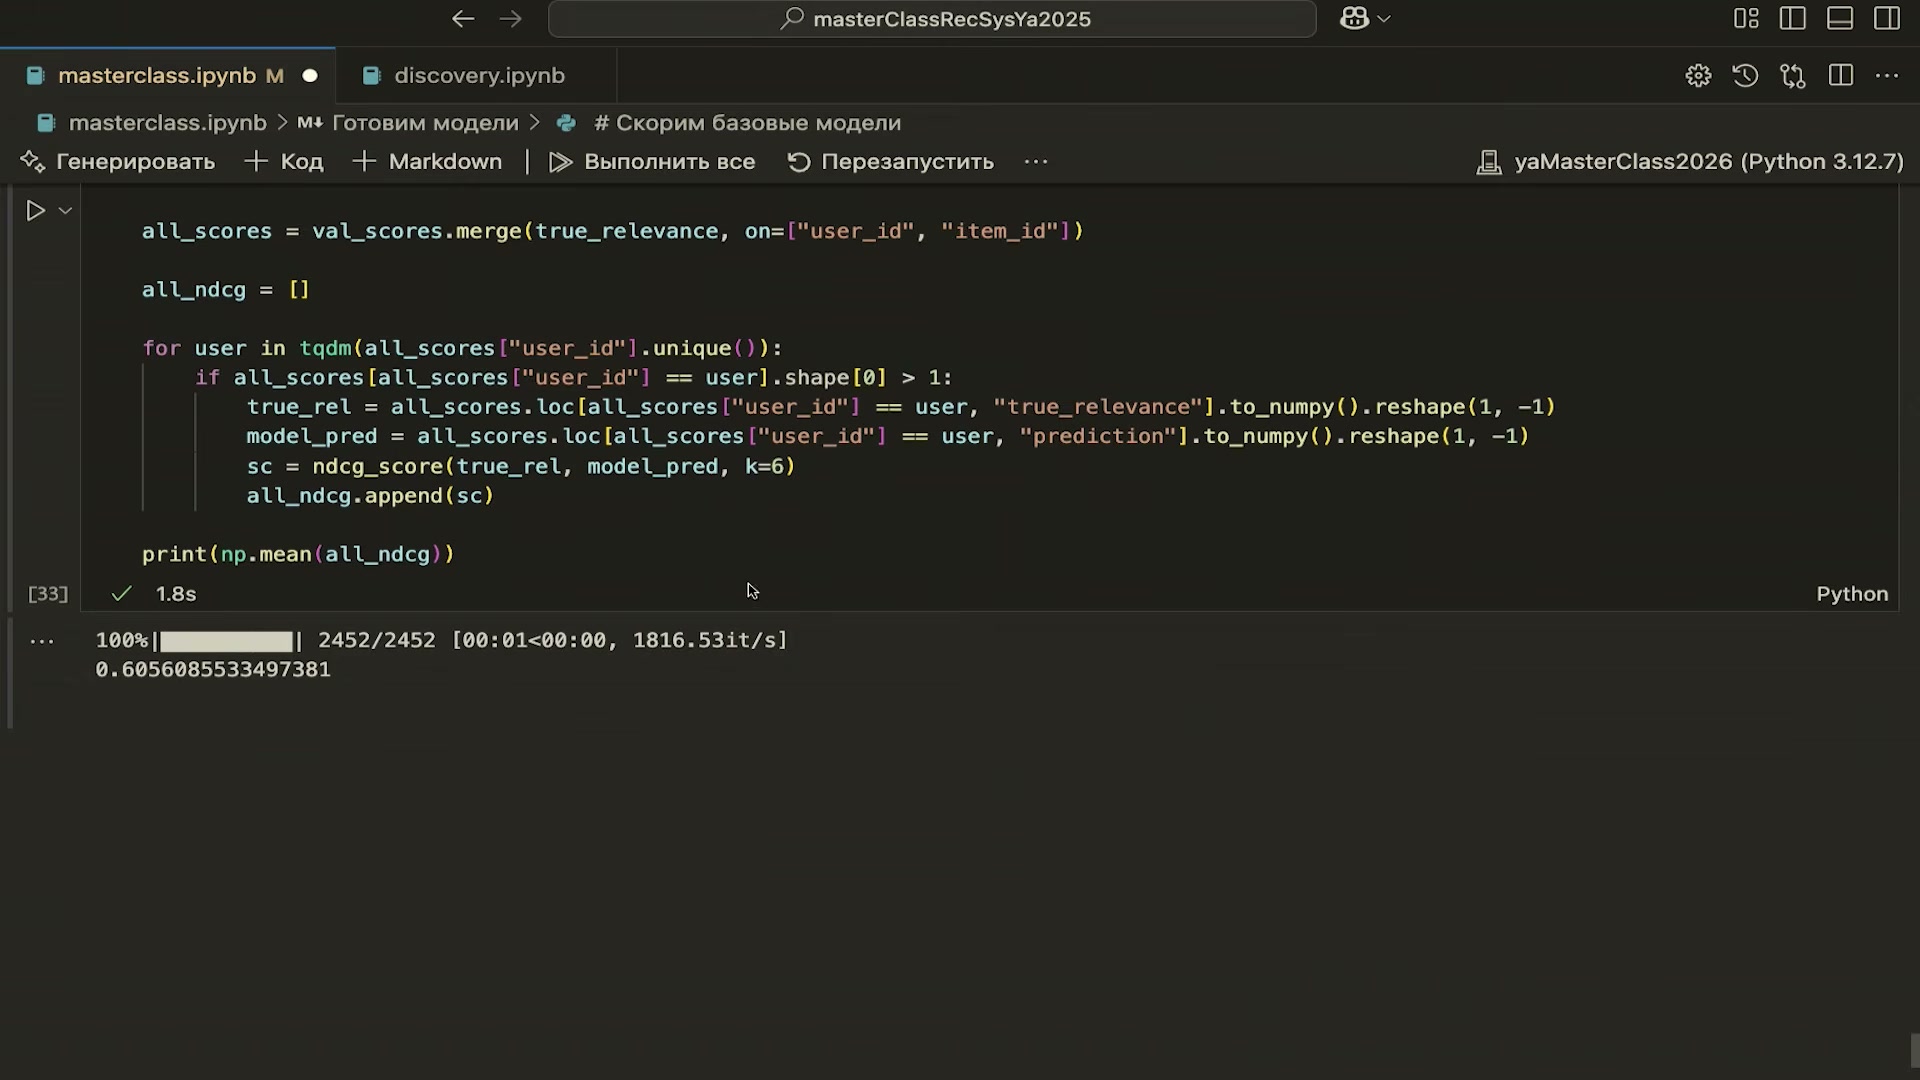
На экране 0,6056085533497381, k=6; цикл показывает 2452 пользователя. Это сравнение двух вариантов построения пар, не одинаковая полная выборка и не бизнес-рост на 10%.
Источник: Сергей Кузнецов · МТС · Practical ML ConfОтдельная история: предсказать покупку, которую человек уже выбрал
В конце выступления Кузнецов приводит другой случай, произошедший со знакомыми. Они обучали трансформер на последовательностях пользовательских действий и предсказывали следующую покупку. Офлайн-проверка, то есть проверка на сохранённых данных без включения новой выдачи пользователям, показывала отличные результаты. Но онлайн-тест оказался настолько плохим, что его остановили уже на следующий день.
Причина обнаружилась в устройстве последовательности. Чтобы купить товар, пользователь сначала переходил в его карточку. Поэтому перед событием покупки в данных всегда находился клик по тому же объекту. Модель выучила простой признак: после перехода в карточку высока вероятность покупки именно этого товара. Для хорошей офлайн-метрики такого правила оказалось достаточно.
Для полезной рекомендации этого было недостаточно. Человек уже выбрал товар и двигался к покупке; предложение того же объекта не помогало найти что-то ещё подходящее. Модель хорошо распознавала уже сформированное намерение, но задача рекомендаций требовала большей пользы, чем повторение этого намерения. Сильный показатель предсказания события скрывал слабую полезность выдачи.
Здесь не нужно придумывать утечку будущего: автор объясняет эффект кликом, который действительно предшествовал покупке. Ошибка связана с доступной лёгкой подсказкой и тем, какую закономерность вознаграждала проверка. Вопрос не только в том, законно ли модель видит событие по времени, но и в том, решает ли выученное правило нужную задачу.
Эта история отличается от инверсии средней оценки на синтетической полке. Там прежняя выдача исказила состав наблюдаемых пар; здесь целевое событие оказалось легко предсказать по уже проявленному намерению. Общая причина для проверки поведения модели одна: высокая агрегированная метрика не объясняет, за счёт какого правила она получена.
Компания, точный размер ухудшения, распределение аудитории и статистический протокол онлайн-теста не названы. Не показаны и исправленная версия модели с повторным результатом. Поэтому из истории нельзя вывести универсальный запрет на недавние клики или приписать автору конкретное решение. Она показывает необходимость сопоставлять выученную зависимость с тем, какую пользу должна приносить рекомендация.
Доклад · 00:30:29Итог: согласовать оценки моделей и не перепутать показы с предпочтениями
Путь начался с общей сортировки по средней оценке и привёл к персональному ранжированию через ALS, EASE, SASRec и бустинг. Исправлять пришлось не только модель: нормировка согласовала шкалы её входов, а расширение обучающих пар изменило зависимость, навязанную старой полкой. Это результат учебного разбора, а не описание внедрённого сервиса МТС.
- 01
История и объекты
Связать пользователя с известной историей и объектами каталога. В упражнении каталог содержит 100 объектов, отдельного отбора кандидатов нет.
- 02
Оценки базовых моделей
Получить оценки ALS, EASE и SASRec для рассматриваемых объектов. В показанных вызовах базовых моделей включена фильтрация просмотренного.
- 03
Общая шкала
Использовать нормированные оценки каждой модели. В демонстрации преобразование рассчитывается по целому переданному столбцу, а не отдельно по пользователю.
- 04
Признаки для бустинга
Объединить оценки с жанром, средней пользовательской оценкой объекта и признаком пользователя в строки пар, пригодные для итоговой модели.
- 05
Порядок полки
Применить бустинг, сравнить итоговые оценки объектов и расположить рекомендации в соответствующем порядке. Обучение не повторяется для каждого запроса.
Качество проверяли по историческим кликам, характеристикам выдачи, SHAP и отдельно по true_relevance. В последней проверке NDCG@6 равен 0,706 после исправления и 0,606 после отката; циклы охватывают 2500 и 2452 пользователя, среднее учитывает только пользователей с более одной парой. Это разные наборы проверки, не относительный прирост на 10% и не A/B-тест МТС.
Нормировка не доказывает долгосрочную стабильность: правила применения её статистик в сервисе не раскрыты. Нули для непоказанных объектов не становятся универсально достоверными отрицательными метками. Неопределённости численного обучения и присваивания меток также остаются. История с покупкой добавляет последний критерий: даже хорошо предсказанное действие может не означать полезной рекомендации.
Доклад · 00:31:54