Разбор готов
От SASRec к RecTools: что именно учится предсказывать рекомендательная модель
Пользователь посмотрел несколько фильмов, и сервису нужно решить, что показать следующим. На первый взгляд достаточно выбрать известную последовательную модель — например SASRec или BERT4Rec. Но одно название архитектуры почти ничего не говорит о конкретном эксперименте: меняются цель обучения, маски, отрицательные примеры, функция связи пользователя с объектом, признаки и даже способ валидации. В этой главе разберём базовую механику SASRec, затем проследим, как постановка расширялась до будущих окон, действий и масштабируемых генеративных моделей. После этого посмотрим, как RecTools позволяет собирать и сравнивать такие варианты на открытых данных, не смешивая офлайн-эксперименты библиотеки с результатами внешних промышленных работ.
Материал полезен тем, кто уже знает базовые идеи рекомендательных систем и хочет понять, чем на практике различаются трансформерные последовательные модели. Он также пригодится для воспроизводимых офлайн-сравнений через RecTools, но не описывает A/B-внедрение рекомендаций МТС.
Статья · на русском
Трансформерные архитектуры для рекомендаций: от SASRec до сегодняшнего дня. Сравниваем с помощью RecToolsНикита Зелинский · Опубликовано: 18 сентября 2025 г.
От истории действий к следующему объекту
Самая простая постановка в статье — предсказание следующего объекта (next-item prediction). У пользователя есть упорядоченная история взаимодействий с каталогом, а модель должна определить, какой объект окажется следующим. Учебный пример построен на фильмах KION: в базовой версии сигнал только один — факт просмотра. Автор подчёркивает, что такая постановка с одним типом взаимодействия долго была обычной и примерно до 2022 года не включала в одну последовательную цель дизлайки, рейтинги и другие реакции. Это историческое наблюдение автора, а не описание всего современного стека KION.
Названия фильмов для модели заменяются идентификаторами. В иллюстративном каталоге их 14: сам номер ничего не говорит о содержании фильма, но позволяет завести обучаемую строку в таблице эмбеддингов. Истории пользователей имеют разную длину, поэтому их приводят к общему размеру служебными токенами дополнения. В примере с окном из 100 событий пользователь с 98 событиями получает два таких токена в начале. Это не «реальные нули», а специальные позиции, которые не должны интерпретироваться как просмотр объекта.
На математическом слайде вход обозначен как матрица X из пользовательских последовательностей, а Y — как следующие объекты, которые нужно предсказать. Позиции истории нумеруются справа налево: последняя доступная позиция имеет номер 1, более старая — больший номер. Такая нумерация нужна дальше для позиционных представлений: модель должна отличать один и тот же объект, увиденный недавно, от объекта в далёкой части истории.
Упрощённая запись постановки со слайда: x_u — история пользователя в порядке позиций, y_u — следующий объект. Служебные позиции дополнения не являются объектами каталога.
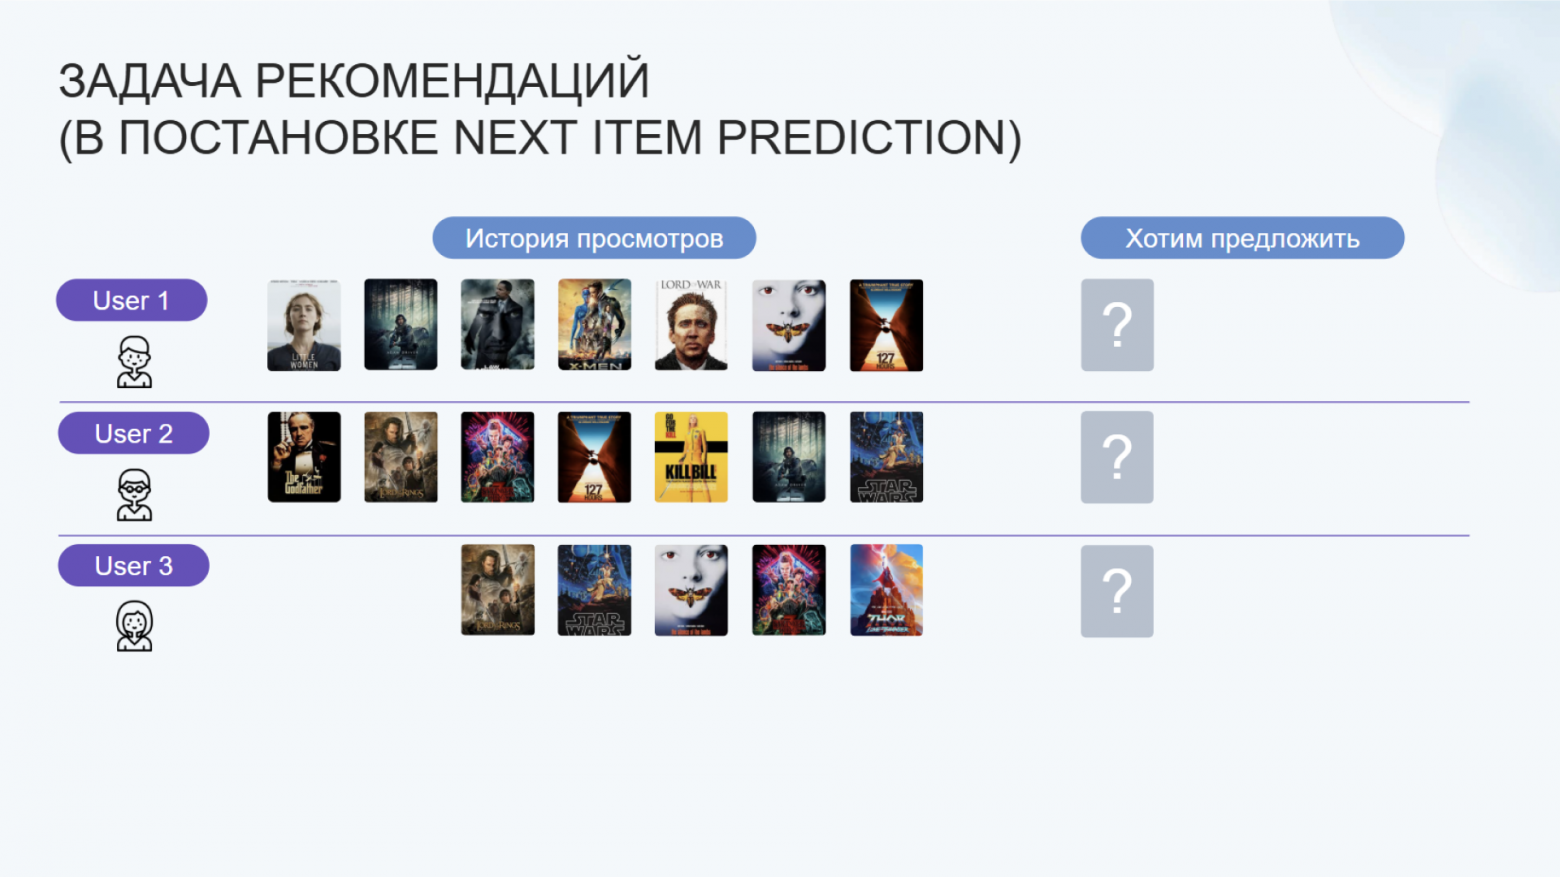
История просмотров используется для выбора следующего объекта. Иллюстрация задаёт учебную задачу, а не описывает весь продакшен KION.
Источник: Никита Зелинский · МТС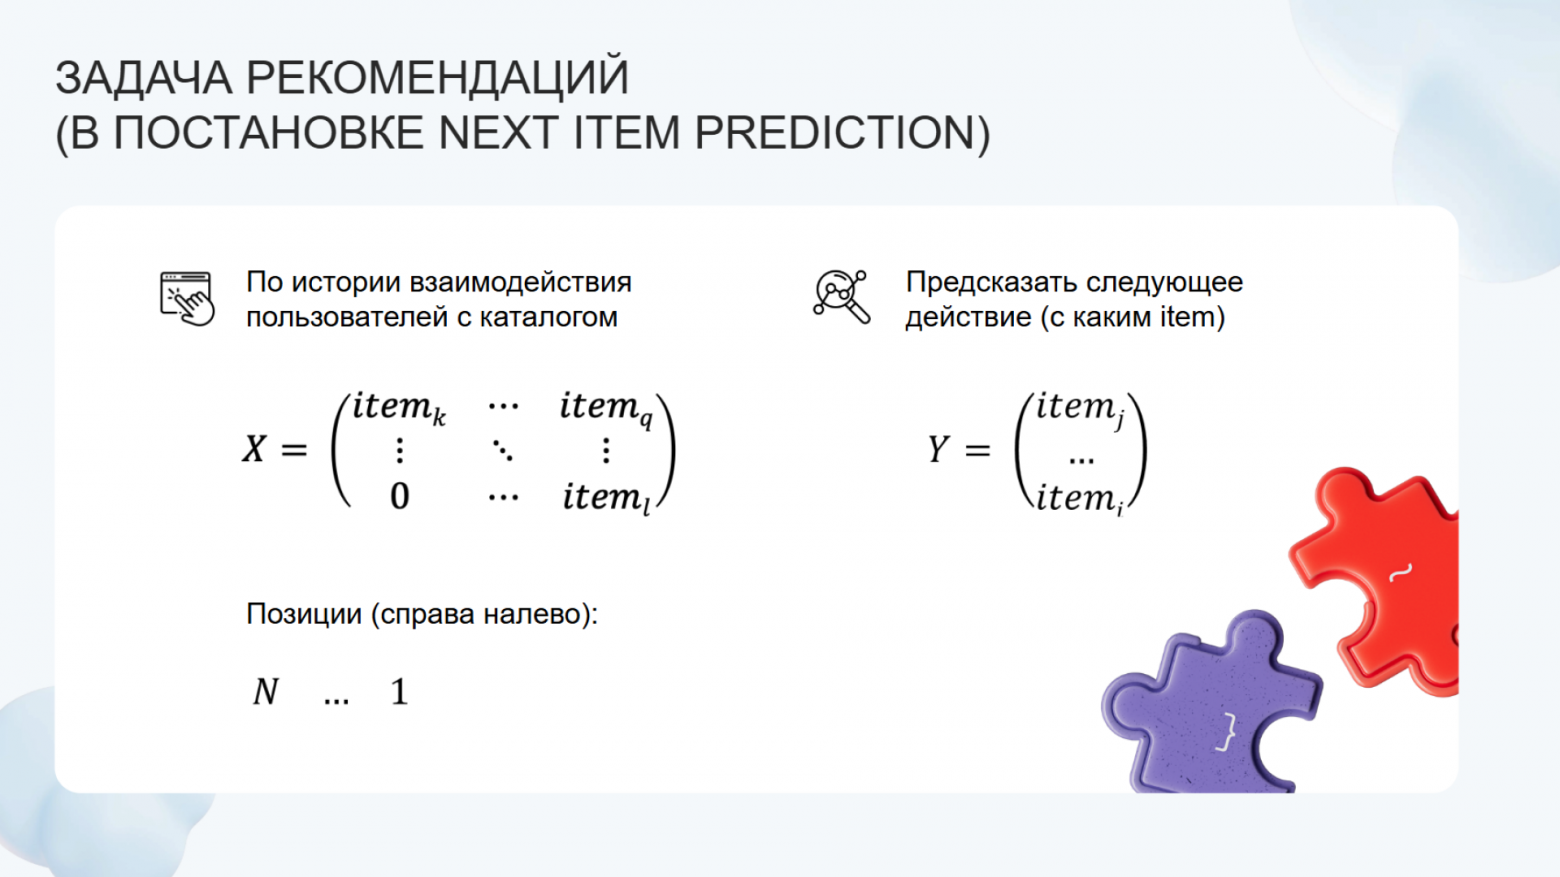
ID объектов заменяют названия фильмов; специальные токены выравнивают длину историй.
Источник: Никита Зелинский · МТСSASRec: как история превращается в состояние пользователя
SASRec 2018 года используется как базовая точка всей статьи. Сначала каждому объекту сопоставляется обучаемый вектор. Таблица эмбеддингов инициализируется случайно; в тексте размерность 256 приведена только как пример возможного значения, которое на практике подбирают. Отдельная таблица хранит позиционные эмбеддинги: она кодирует не конкретный фильм, а место события в истории. Поэтому один и тот же объект на разных позициях получает одинаковый объектный вектор, но разную позиционную добавку.
Для каждой позиции складываются объектный и позиционный векторы. Затем применяется dropout. Здесь важно читать операцию корректно: dropout во время обучения случайно зануляет часть активаций представления, а не «часть весов модели». После этого представления поступают в self-attention. Линейные проекции создают query, key и value, каузальная маска запрещает текущей позиции использовать будущие события, softmax превращает оценки совместимости в веса, а взвешивание V собирает контекст.
Упрощённая формула внимания с исходного слайда. На схеме показана одна голова для объяснения; реальная SASRec использует multi-head attention.
После внимания идут полносвязные преобразования. На каждой позиции получается своё скрытое состояние пользователя: после четырёх событий оно одно, после пятого уже другое. В полной схеме SASRec добавляются остаточные связи, LayerNorm и несколько трансформерных блоков. Положение нормализации тоже является архитектурным выбором: в статье отдельно упоминаются варианты Pre Layer Norm и Post Layer Norm. Двухбашенное изображение SASRec используется как наглядная абстракция, но его нельзя читать как доказательство полностью независимых башен: трансформер строит пользовательское состояние из эмбеддингов объектов истории.
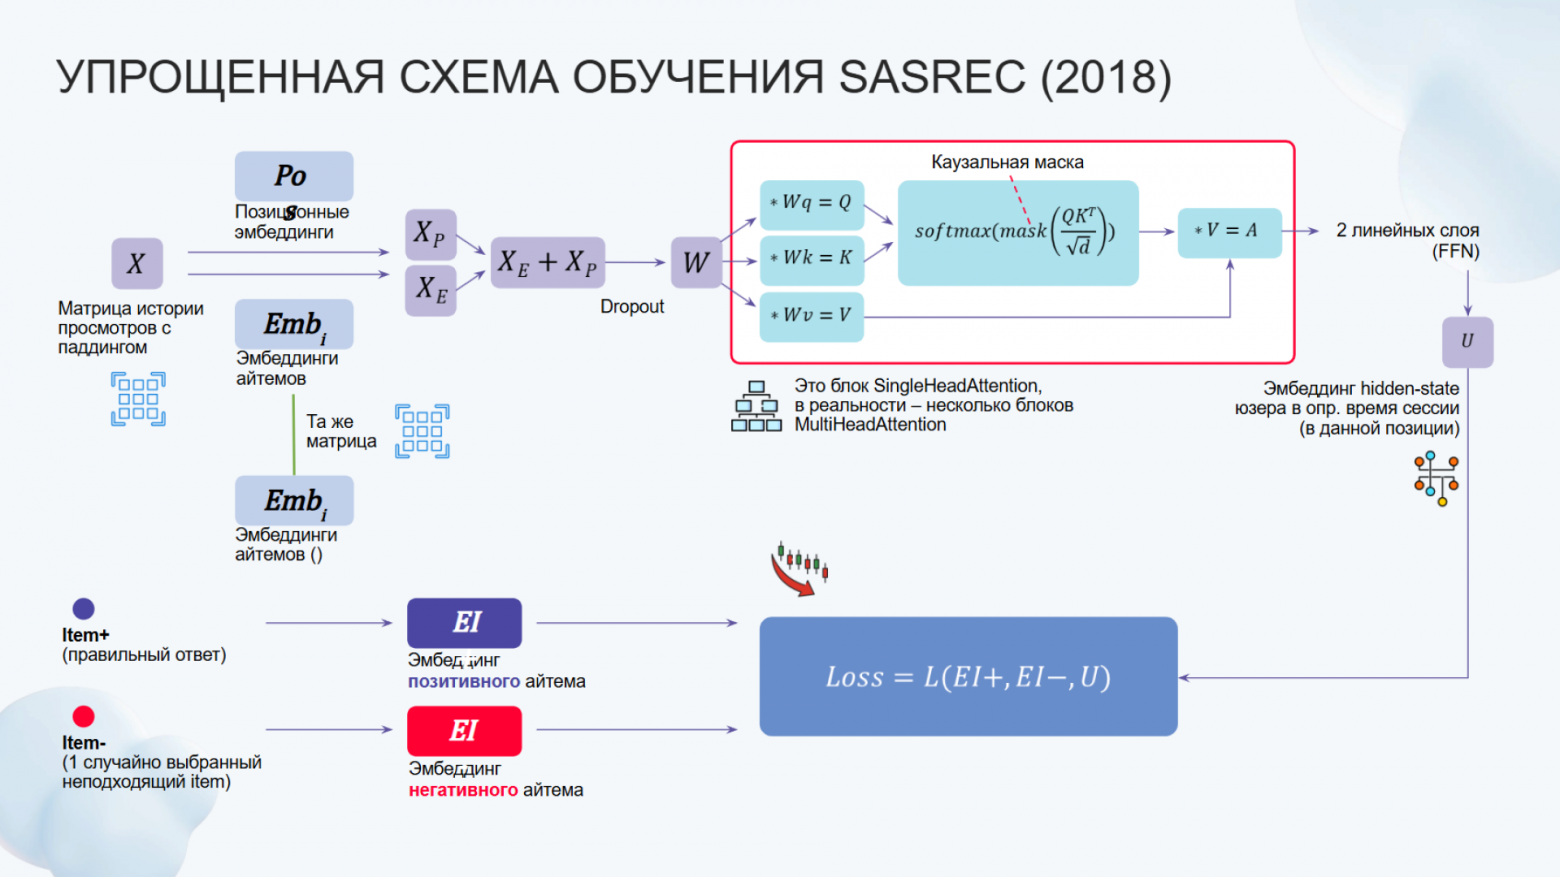
Каузальное внимание строит представление истории; положительный объект и один случайный отрицательный пример задают обучение. На схеме показана одна голова внимания для простоты.
Источник: Никита Зелинский · МТСОтдельно про обучение SASRec: shifted sequence, негатив и BCE
Одна пользовательская история превращается сразу в несколько обучающих примеров через shifted sequence. Если наблюдались item1, item2, item3, то после item1 правильной целью становится item2, после item2 — item3 и так далее. То есть модель учится не только на последнем переходе истории: каждая допустимая позиция даёт собственный положительный следующий объект.
В оригинальной постановке SASRec, как её пересказывает статья, к каждому положительному объекту выбирается один случайный отрицательный объект, с которым пользователь не взаимодействовал. Представление пользователя u_t скалярно умножается с эмбеддингом положительного e_t^+ и отрицательного e_t^-. Эти скалярные произведения являются логитами. Логит сам по себе не является вероятностью и не обязан численно стремиться к 1 или 0. В BCE через sigmoid положительный логит должен давать вероятность ближе к 1, а отрицательный — ближе к 0.
Базовая функция связи на слайде shifted sequence. В статье также упомянут вариант, где соответствие пользователя и объекта вычисляет небольшой двух- или трёхслойный MLP.
Та же BCE, что в исходном TensorFlow-коде статьи: m_t соответствует istarget и исключает служебные позиции; 10^-24 добавлено для численной устойчивости.
После суммирования потерь по доступным сдвинутым позициям backpropagation обновляет таблицы эмбеддингов и остальные параметры сети. Поэтому negative sampling — не вспомогательная деталь: то, какие объекты модель видит как отрицательные, непосредственно меняет обучающий сигнал. Поздние работы из статьи экспериментируют уже не только с одним равномерно случайным отрицательным объектом, но и с in-batch, популярностными, скорректированными и более сложными вариантами.
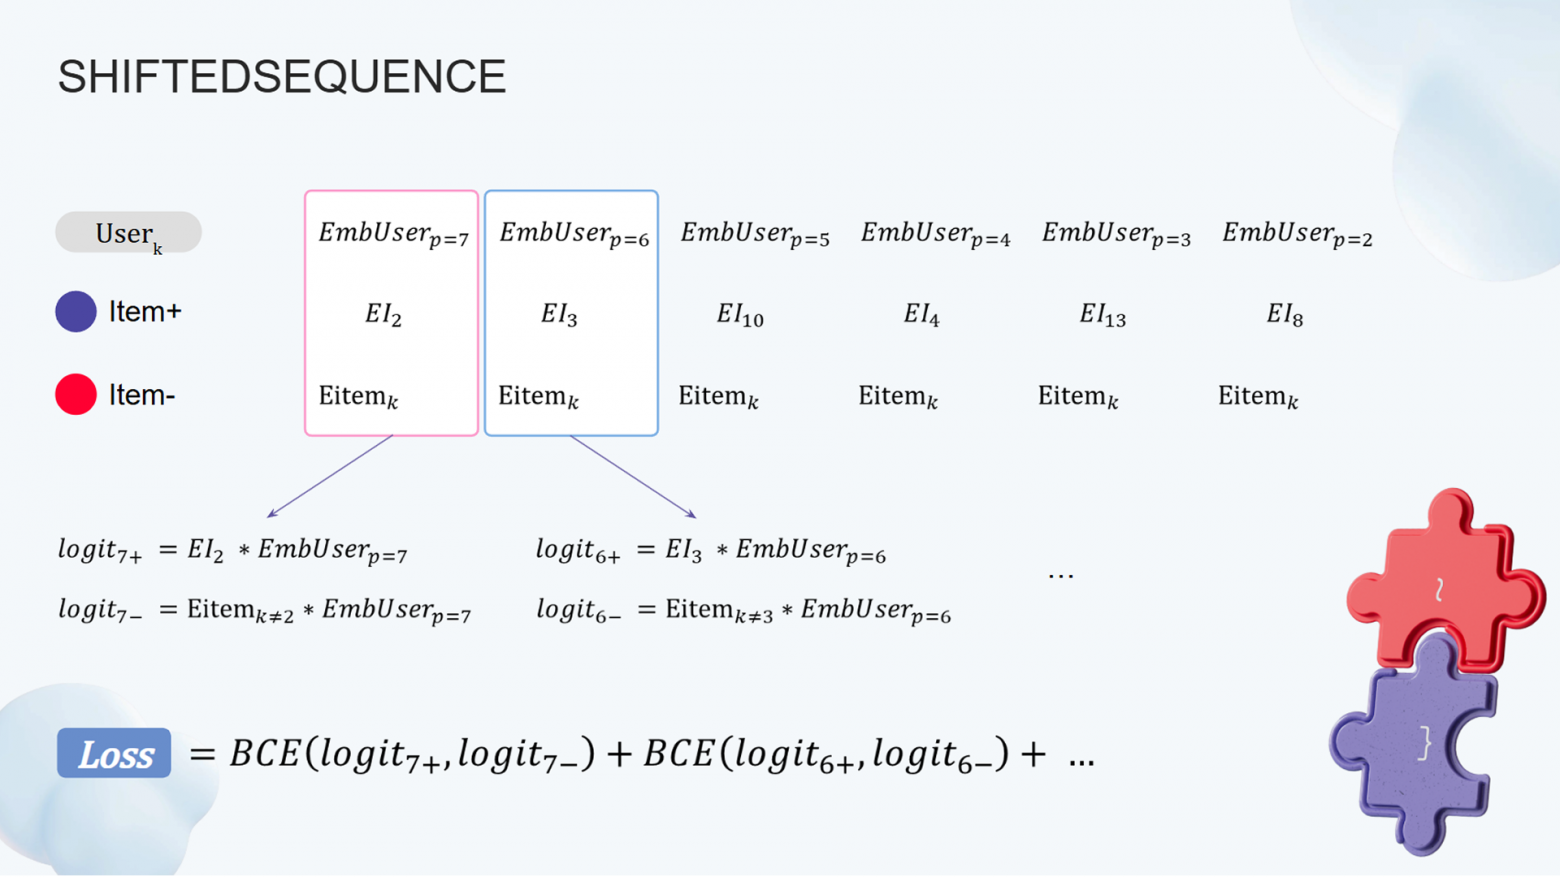
Каждая позиция истории даёт отдельную пару для предсказания следующего объекта. Скалярные произведения — логиты, не вероятности.
Источник: Никита Зелинский · МТСBERT4Rec: похожий трансформер, другая учебная задача
BERT4Rec показывает, почему сравнение нельзя сводить к слову «трансформер». Архитектурный каркас остаётся похожим, но меняются три принципиальные вещи. SASRec учится на сдвинутой последовательности, использует каузальную маску и в разобранной реализации оптимизирует BCE на положительном и выбранном отрицательном объекте. BERT4Rec скрывает отдельные элементы истории и восстанавливает их по оставшемуся контексту — это masked language modeling для объектов рекомендаций.
Из-за такой цели BERT4Rec может использовать контекст и слева, и справа от скрытой позиции. На исходном сравнительном слайде противопоставлены каузальная маска SASRec и маскирование служебного padding у BERT4Rec; в тексте это описано как bidirectional-доступ. Функция потерь на слайде обозначена как SoftMax против BCE у SASRec. Следовательно, выигрыш конкретной реализации нельзя приписать только расположению слоёв: одновременно меняются целевая задача и способ нормировки оценок.
Таблицу можно прокрутить по горизонтали.
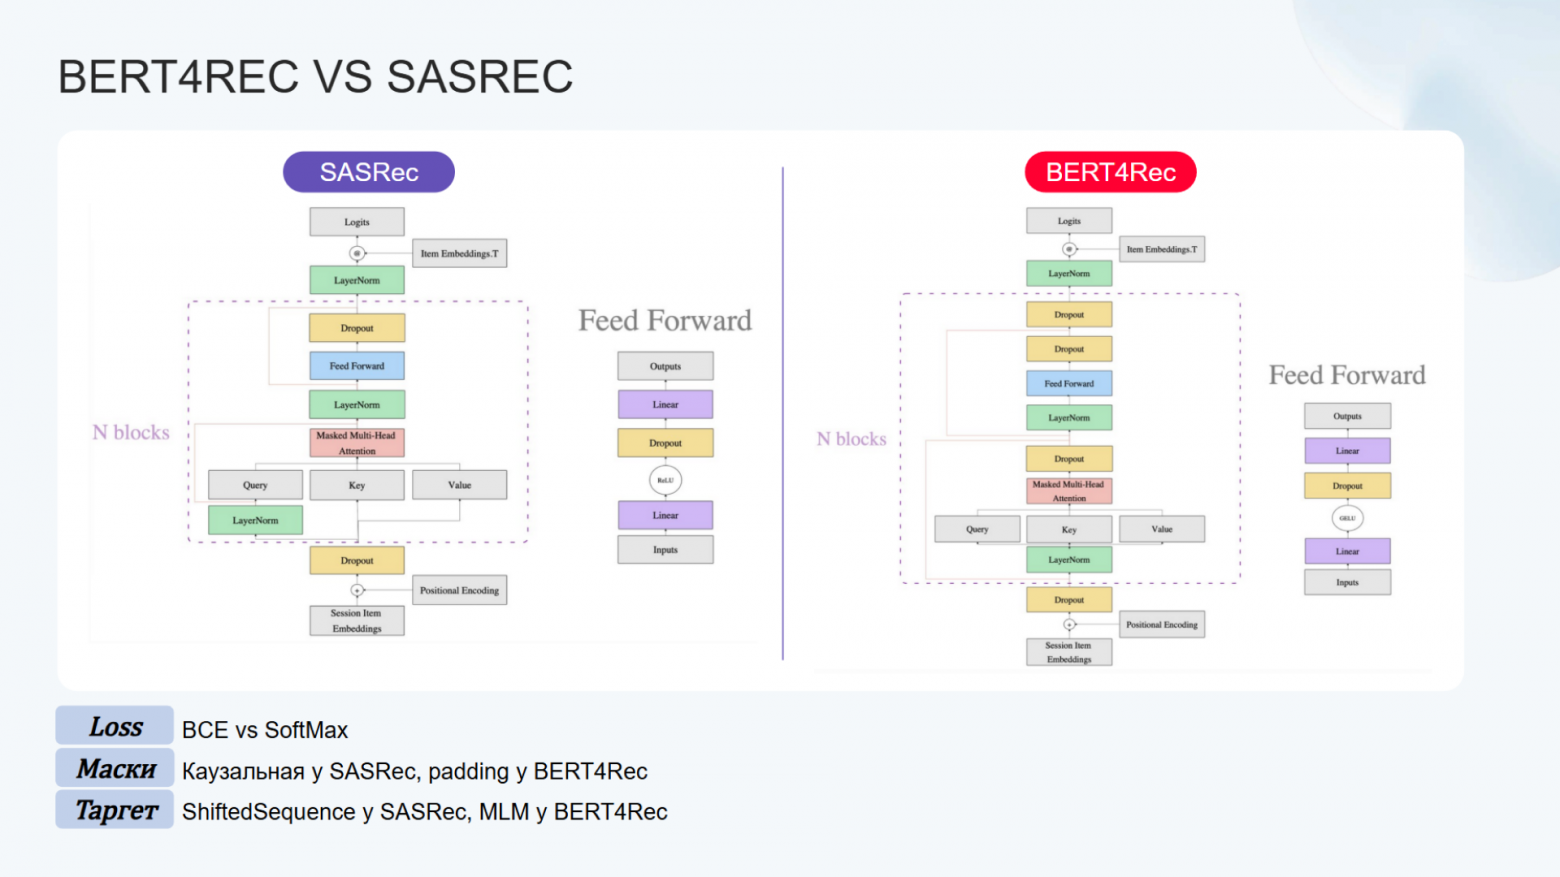
Меняются маска внимания, функция потерь и учебная цель: следующий объект или восстановление скрытых объектов.
Источник: Никита Зелинский · МТСПочему известного имени модели всё ещё недостаточно
После SASRec и BERT4Rec развитие идёт не по одной оси. Таймлайн статьи показывает рост числа вариантов: SASRec в 2018 году; BERT4Rec и FDSA в 2019; S³-Rec и CL4SRec в 2020; LSAN и DuoRec в 2021; PinnerFormer и CBiT в 2022; TIGER, SASRec++, gSASRec и SASRec_MoL в 2023; ELMRec и HSTU в 2024; ActionPiece, FuXi-α, LiGR и RAILS в 2025. Сам слайд отдельно предупреждает, что история RecSys этим не исчерпывается: параллельно развивались RQ-VAE и semantic ID, LLM4Rec и foundation-модели вроде OneRec.
Параллельно расширяется и сам набор наблюдаемых реакций. В начале статьи объектом обучения был только просмотр фильма; дальше автор перечисляет просмотр, дизлайк, оценку, пропуск и частичный просмотр. В такой постановке модель может строить отдельные оценки для разных типов действий над объектом. Это промежуточный шаг между простым next-item prediction и более поздними схемами, где action становится самостоятельным токеном последовательности.
Таблицу можно прокрутить по горизонтали.
Причина такого количества вариантов — масштаб задачи. В статье приводятся порядки величин: словари мультиязычных языковых моделей — сотни тысяч токенов, тогда как каталоги рекомендательных сервисов могут насчитывать сотни миллионов объектов; крупный стриминговый сервис может генерировать десятки миллиардов событий в день. Эти числа используются как мотивация, а не как характеристики МТС. К 2024 году автор смещает акцент к архитектурам, которые продолжают улучшаться при росте глубины вплоть до десятков слоёв, в тексте упомянуто 40+.
Поэтому «взять SASRec» — лишь начало спецификации. Нужно зафиксировать как минимум функцию потерь, формирование целей, распределение отрицательных примеров, функцию связи user–item, токенизацию, признаки и глубину. Именно эту мысль позже поддерживает RecTools: библиотека старается сделать такие компоненты явными и заменяемыми, чтобы сравнивать не названия статей, а конкретные конфигурации.
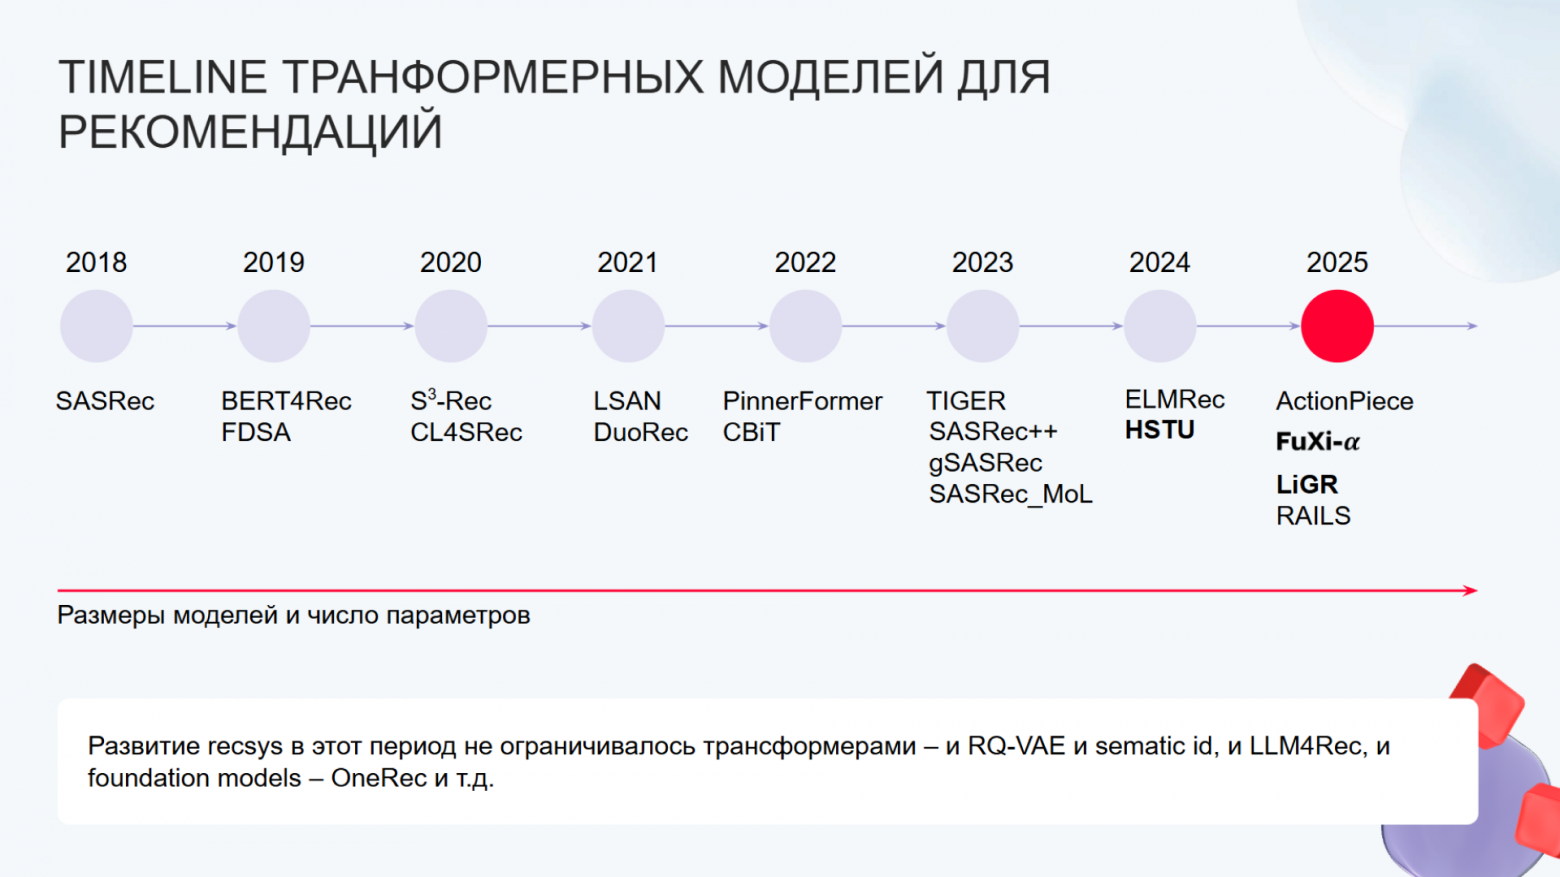
Обзор направлений развития до сентября 2025 года; перечисленные модели не образуют единый контролируемый эксперимент RecTools.
Источник: Никита Зелинский · МТС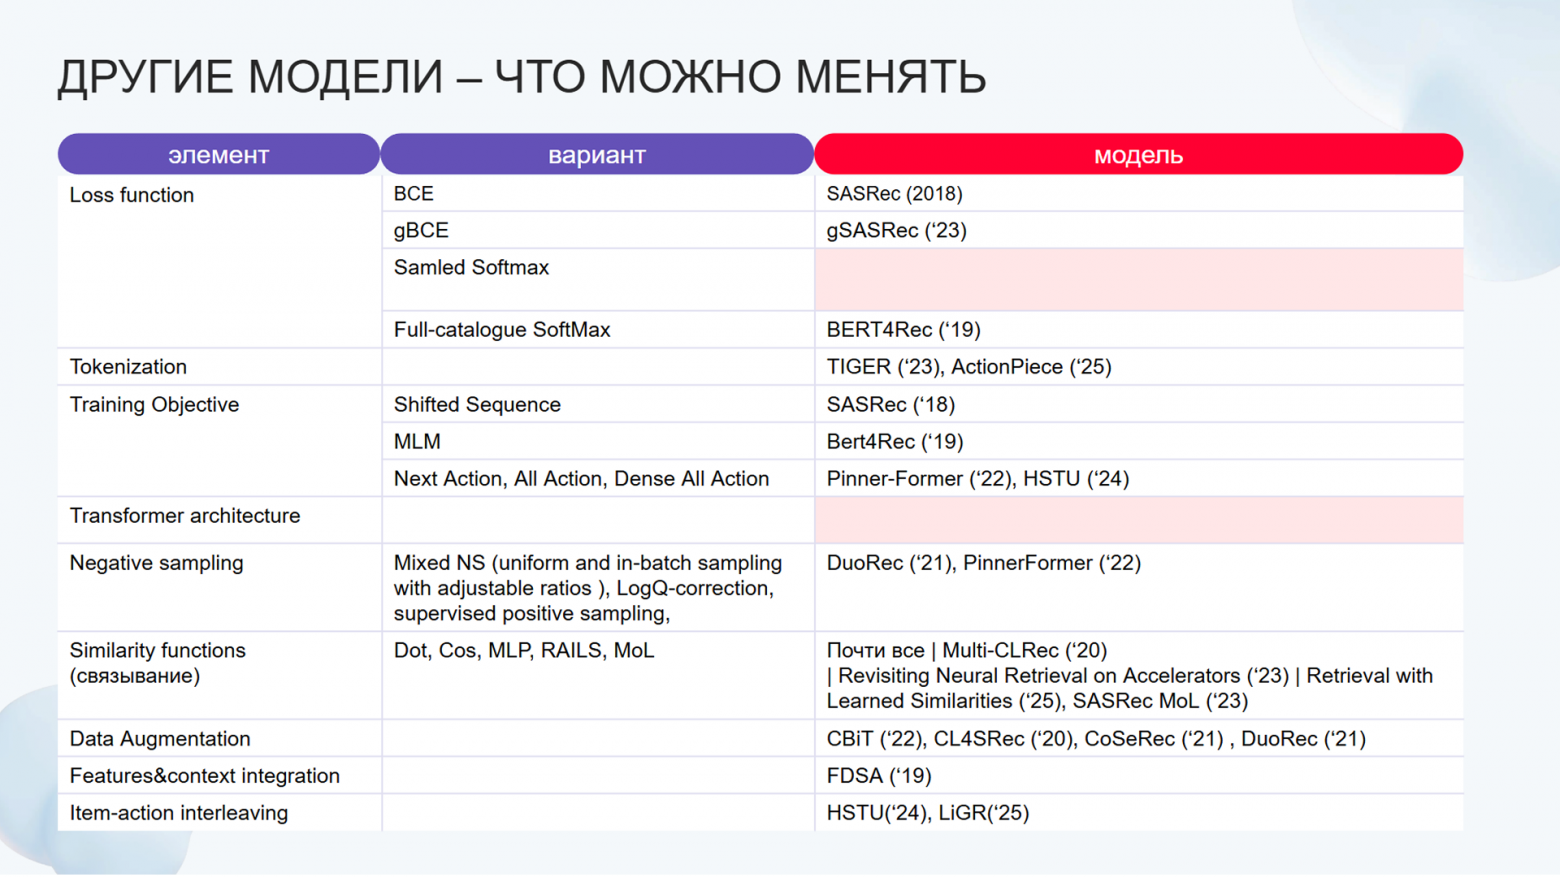
Цель, негативные примеры, функция потерь и токенизация — независимые решения, которые нельзя восстановить только по названию модели.
Источник: Никита Зелинский · МТСPinnerFormer: вместо одного следующего объекта — окно будущего
PinnerFormer 2022 года меняет прежде всего цель обучения. Предсказание одного следующего объекта оказалось слишком локальным, если представление пользователя должно сохранять более устойчивые интересы. В примере статьи берут до года истории, ограничивают её 400 элементами и учат модель предсказывать множество объектов, с которыми пользователь будет взаимодействовать в следующем месяце. Эти значения относятся к объясняющему примеру автора, а не к настройкам RecTools.
Исходный слайд показывает четыре способа формировать связи между историей и будущим K-day window: Next Action связывает историю только со следующим положительным действием; схема SASRec строит последовательные локальные переходы; All Action связывает последнее состояние истории со всеми положительными действиями будущего окна; Dense All Action даёт такие будущие цели нескольким состояниям истории. Синим отмечен positive engagement, красным — non-positive engagement.
Причинная идея здесь важнее названия модели: если обучать представление только на том, что произойдёт непосредственно следующим, оно может переоценивать краткосрочный контекст. Будущее окно заставляет модель учитывать более длинный горизонт. Автор отдельно замечает, что явное моделирование того, что пользователь с высокой вероятностью проигнорирует, в 2022 году ещё не было распространённой постановкой; это его историческое обобщение, а не измеренный результат эксперимента МТС.
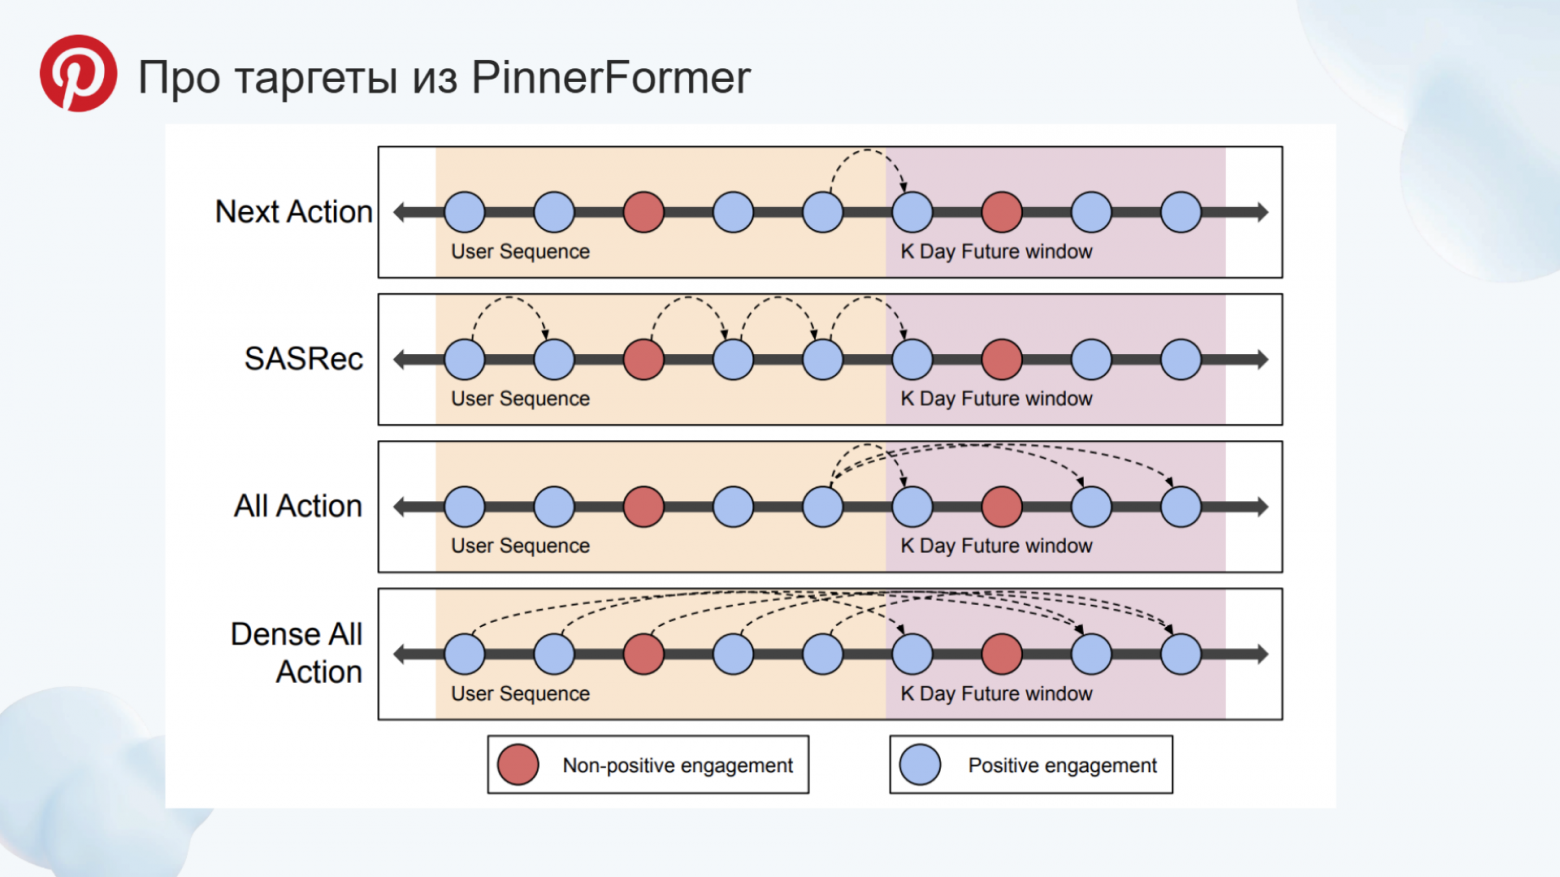
Окно будущих взаимодействий расширяет задачу относительно одного следующего действия. Это внешняя работа Pinterest, не результат внедрения МТС.
Источник: Никита Зелинский · МТСHSTU: объект и действие становятся отдельными токенами
В изложении статьи HSTU из работы Actions Speak Louder переносит рекомендации к более генеративной постановке. Вместо записи, где действие пользователя либо теряется, либо прячется внутри признаков объекта, строится чередующаяся последовательность item–action–item–action. Объект и реакция на него получают отдельные токены. Это позволяет одной истории содержать не только «что было показано или выбрано», но и «что пользователь с этим сделал»: посмотрел, поставил лайк, купил и так далее.
Такой формат связывает две классические стадии. Для отбора кандидатов модель должна предсказывать токены объектов, а для ранжирования полезно моделировать последующие действия. Это не означает, что отбор и ранжирование автоматически становятся одной и той же операцией; меняется общее представление данных, из которого можно сформулировать обе цели.
HSTU также противопоставляется большому feature-based конвейеру, где отдельно считаются многочисленные численные и категориальные признаки и затем вручную организуются их взаимодействия. В статье это описано как перенос большей части этой работы в длинную последовательность поведения. Фраза про «пять событий» приведена как иллюстрация достаточной истории, а не как универсальный нижний порог применимости трансформеров.
Формулы со схемы HSTU. U участвует в обучаемом поэлементном взаимодействии с нормированным выходом внимания; его не следует интерпретировать как жёсткий фильтр по знаку.
На слайде стек HSTU повторяет блоки представления и взаимодействия, использует относительное смещение в attention и обучаемую компоненту U. В тексте статьи U упрощённо названа gating-функцией, но оригинальная формула показывает именно поэлементное умножение. Поэтому корректнее говорить об обучаемом управлении потоком признаков, а не о буквальном правиле «положительное проходит, отрицательное блокируется».
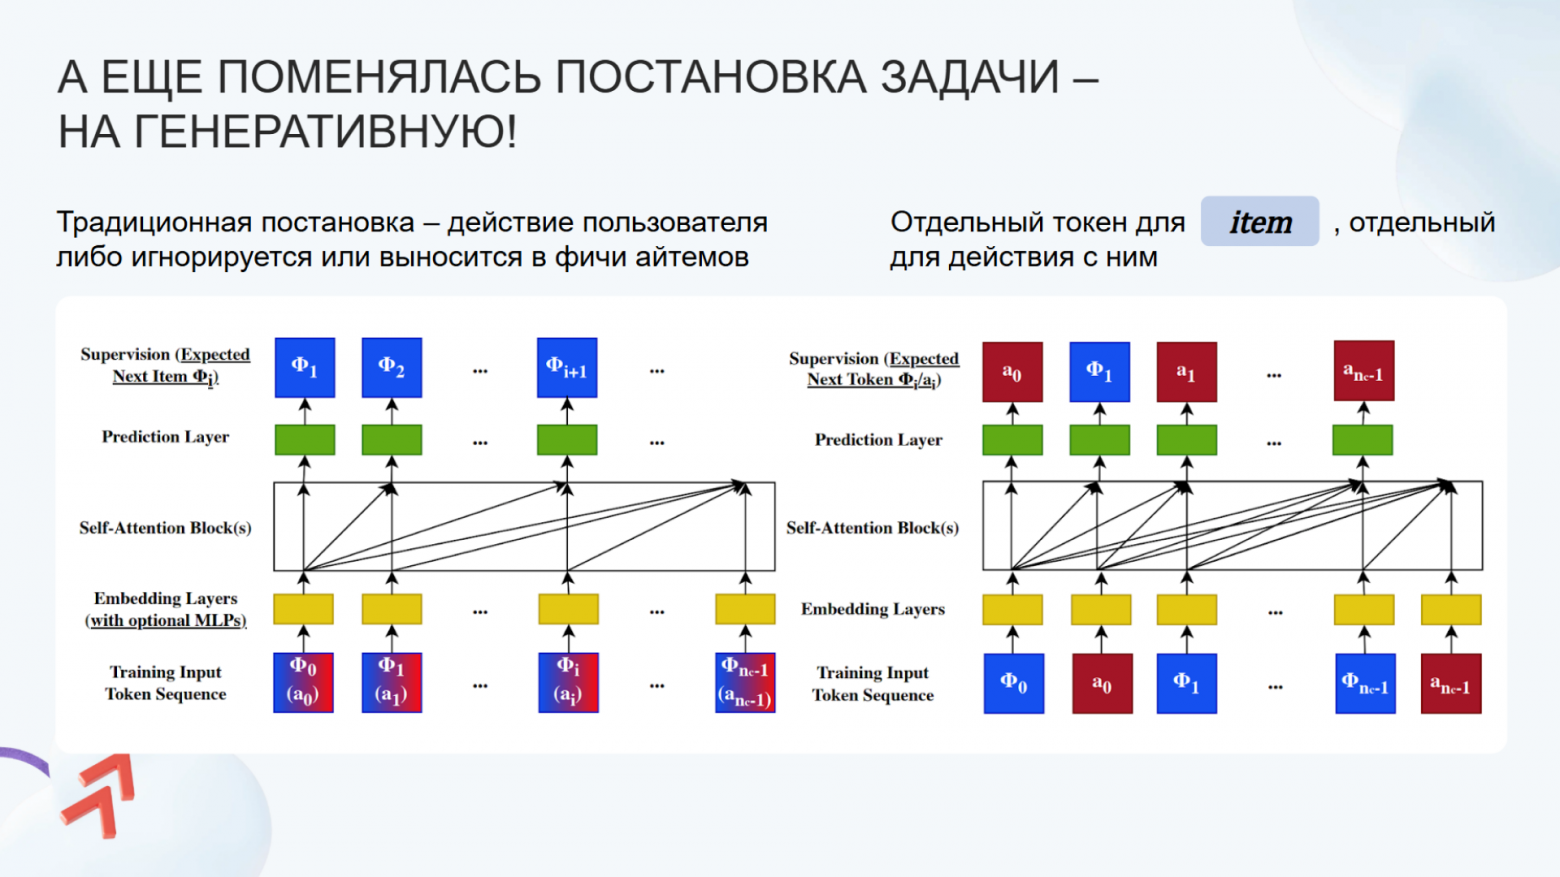
Чередование item–action позволяет моделировать и объект, и реакцию пользователя.
Источник: Никита Зелинский · МТС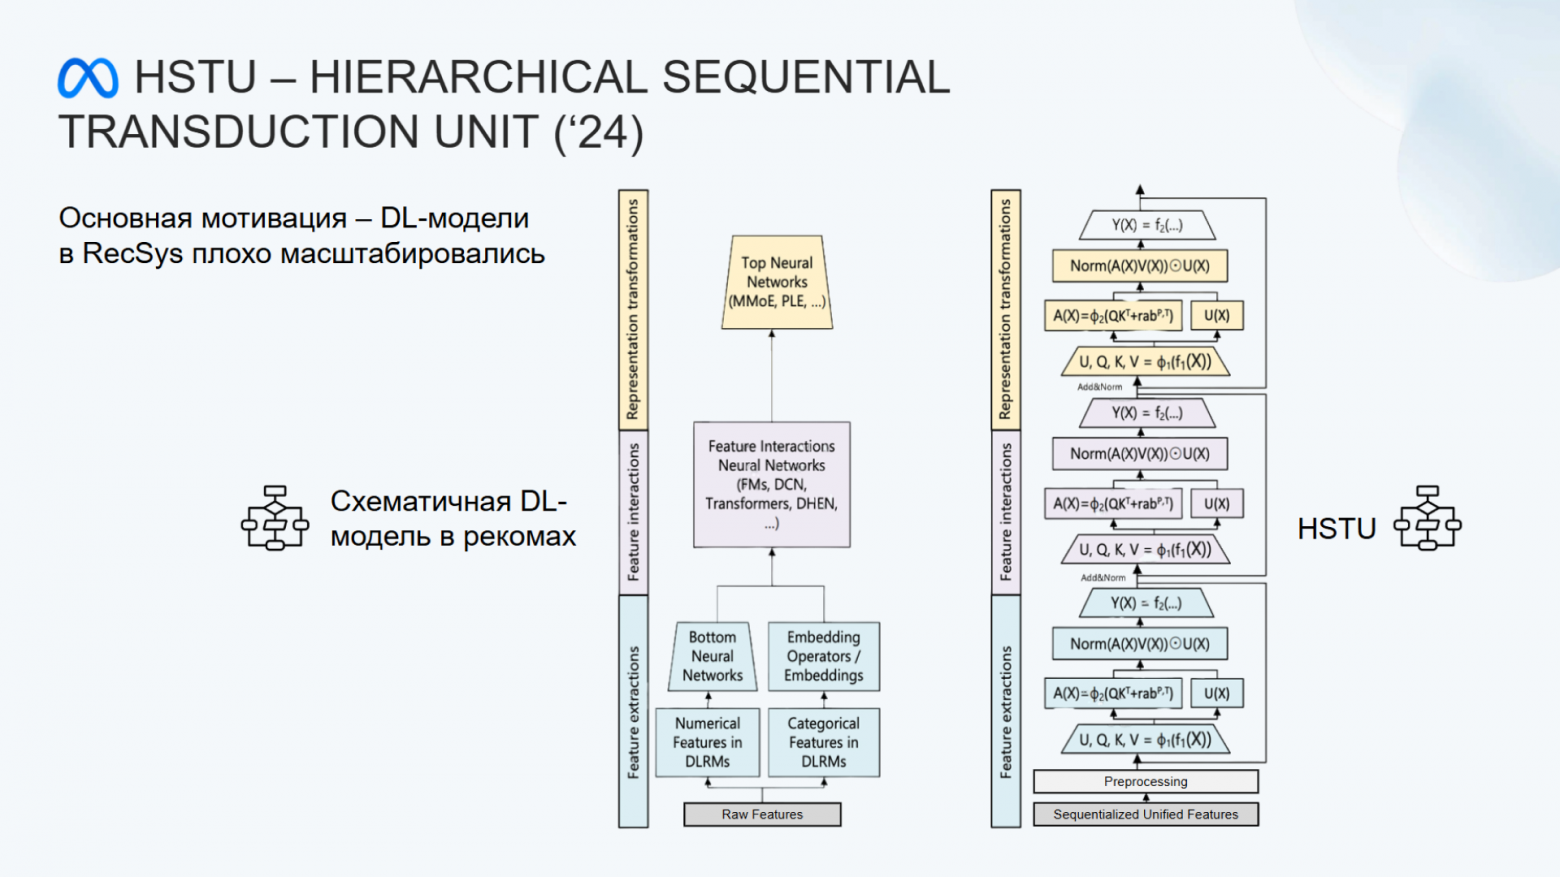
Схема внешней работы Meta: проекции, относительные смещения и управляемое поэлементное взаимодействие. Результаты HSTU не относятся к RecTools.
Источник: Никита Зелинский · МТСЧто значит «HSTU скейлится» на показанном графике
На графике сравниваются Traditional DLRMs, отмеченные красными ромбами, и Generative Recommenders, отмеченные синими звёздами. По горизонтали — Training PetaFLOPs per day. Слева показан Eval NE, причём подпись оси прямо указывает «lower is better»; справа — Eval Hit Rate@100. С ростом вычислительного бюджета синие точки продолжают двигаться в желаемую сторону: Eval NE уменьшается, Hit Rate@100 растёт, тогда как красные точки выглядят заметно более плоско.
Подпись линии на левом графике HSTU. C соответствует вычислительному бюджету по оси Training PetaFLOPs per day; численные координаты отдельных точек из изображения не восстанавливаются.
Подпись линии на правом графике HSTU для Hit Rate@100. Это внешний результат HSTU, а не эксперимент RecTools или МТС.
Именно отсутствие раннего насыщения на этих графиках автор статьи называет scaling law. В тексте это пересказано более общо как снижение loss и рост Hit Rate, но исходный слайд конкретнее: левая ось называется Eval NE. На слайде также есть ремарка «1,5T параметров», однако её не связывают с конкретной точкой или отдельной конфигурацией, поэтому использовать это число как измеренный benchmark этой главы нельзя.
Здесь особенно важно сохранить границу доказательства. HSTU — внешняя работа; графики не являются A/B-тестом МТС и не сравнивают модели RecTools по единому протоколу. Из них можно вынести только показанную зависимость качества внешней архитектуры от вычислительного масштаба при условиях той работы.
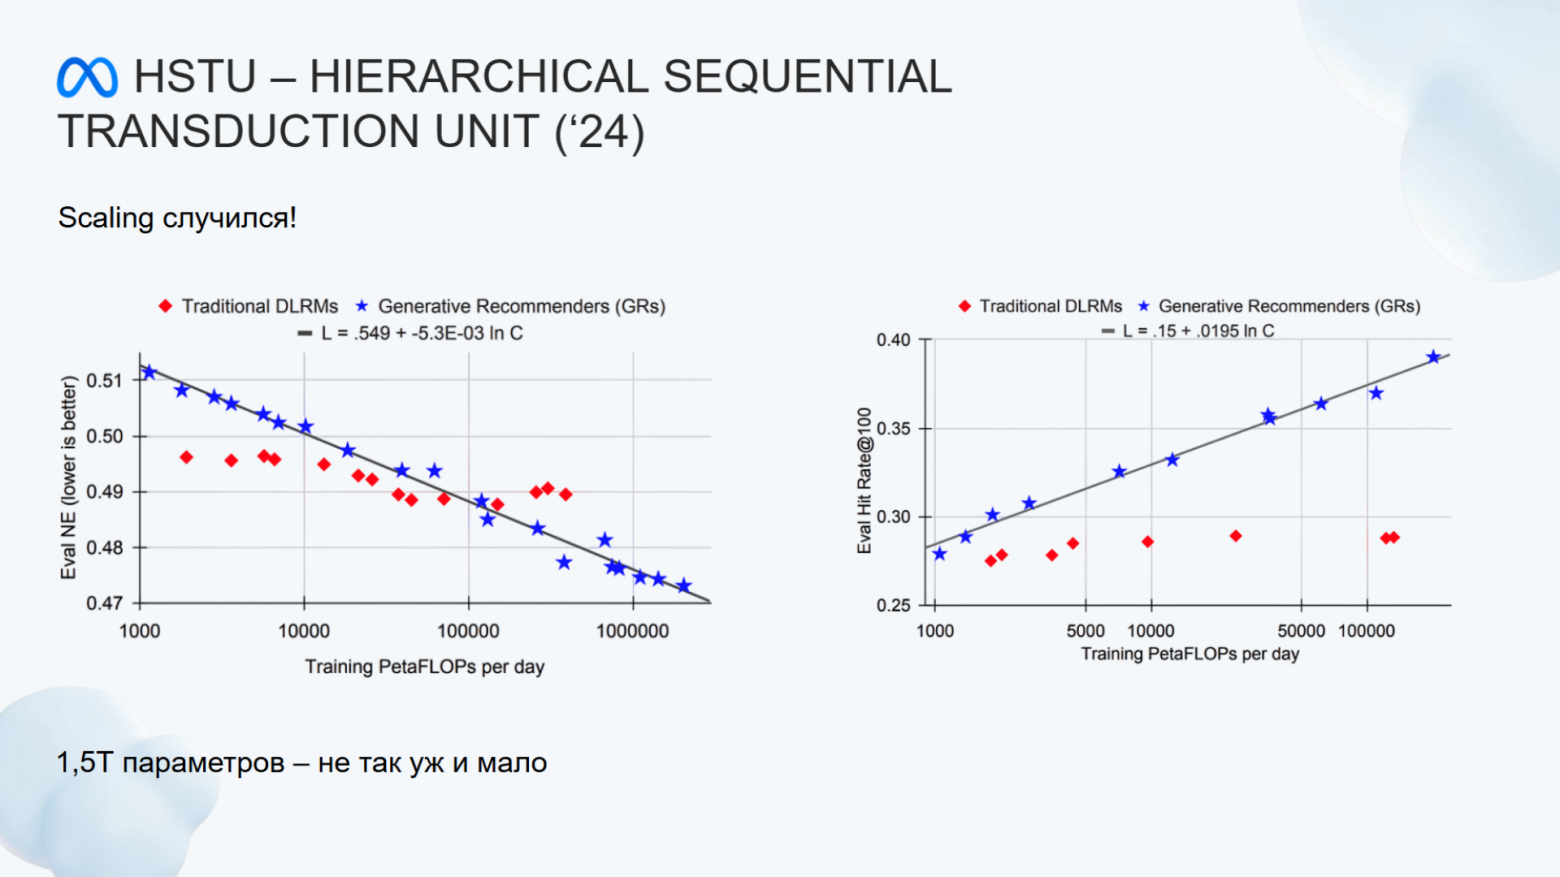
Графики внешней работы связывают вычислительный бюджет с Eval NE и Hit Rate@100. Это разные метрики; точные точки с кривых не восстанавливаем.
Источник: Никита Зелинский · МТСFuXi-α: разнести семантику, позицию и время
FuXi-α меняет внутреннюю организацию внимания. На проверенном оригинальном слайде Adaptive Multi-channel Self-attention разделяет три канала: Semantic, Positional и Temporal. Семантический канал отвечает за взаимодействие содержания объектов; в тексте статьи отдельно отмечено, что такое представление можно предварительно строить из item embeddings и дополнительных признаков через вспомогательную сеть. Позиционный канал использует положение события в последовательности, временной — timestamp. Позиционная и временная информация получают собственные относительные представления вместо того, чтобы быть смешанными с семантикой в одном механизме.
Результаты каналов затем объединяются внутри слоя, а на выходе схемы отдельно показано поэлементное умножение — Hadamard product. Поэтому здесь не вводится отдельный «timeless»-канал: для этой главы сохраняются названия с исходной архитектурной схемы — Semantic, Positional и Temporal.
Внешний эксперимент FuXi-α показывает масштабирование по глубине на Industrial Dataset. На оси числа слоёв стоят 2, 4, 8, 16 и 32; две линии — NDCG@10 и HR@10 — растут на каждом показанном шаге. Мы не считываем и не вычисляем значения отдельных точек с графика: существенный вывод источника состоит в том, что улучшение сохранялось вплоть до 32 слоёв. HR@10 измеряет попадание нужного объекта в первые 10 позиций, а NDCG@10 дополнительно учитывает, насколько высоко он оказался в ранжированном списке.
В тексте статьи также сказано, что обучение такой тяжёлой конфигурации в экспериментальных условиях занимало месяцы, а промышленная система FuXi обновлялась потоково по поступающим блокам данных. Это описание внешней модели, не RecTools и не МТС. Оно объясняет, почему более новые архитектуры нельзя просто добавить в тот же учебный benchmark и считать прямым продолжением SASRec.
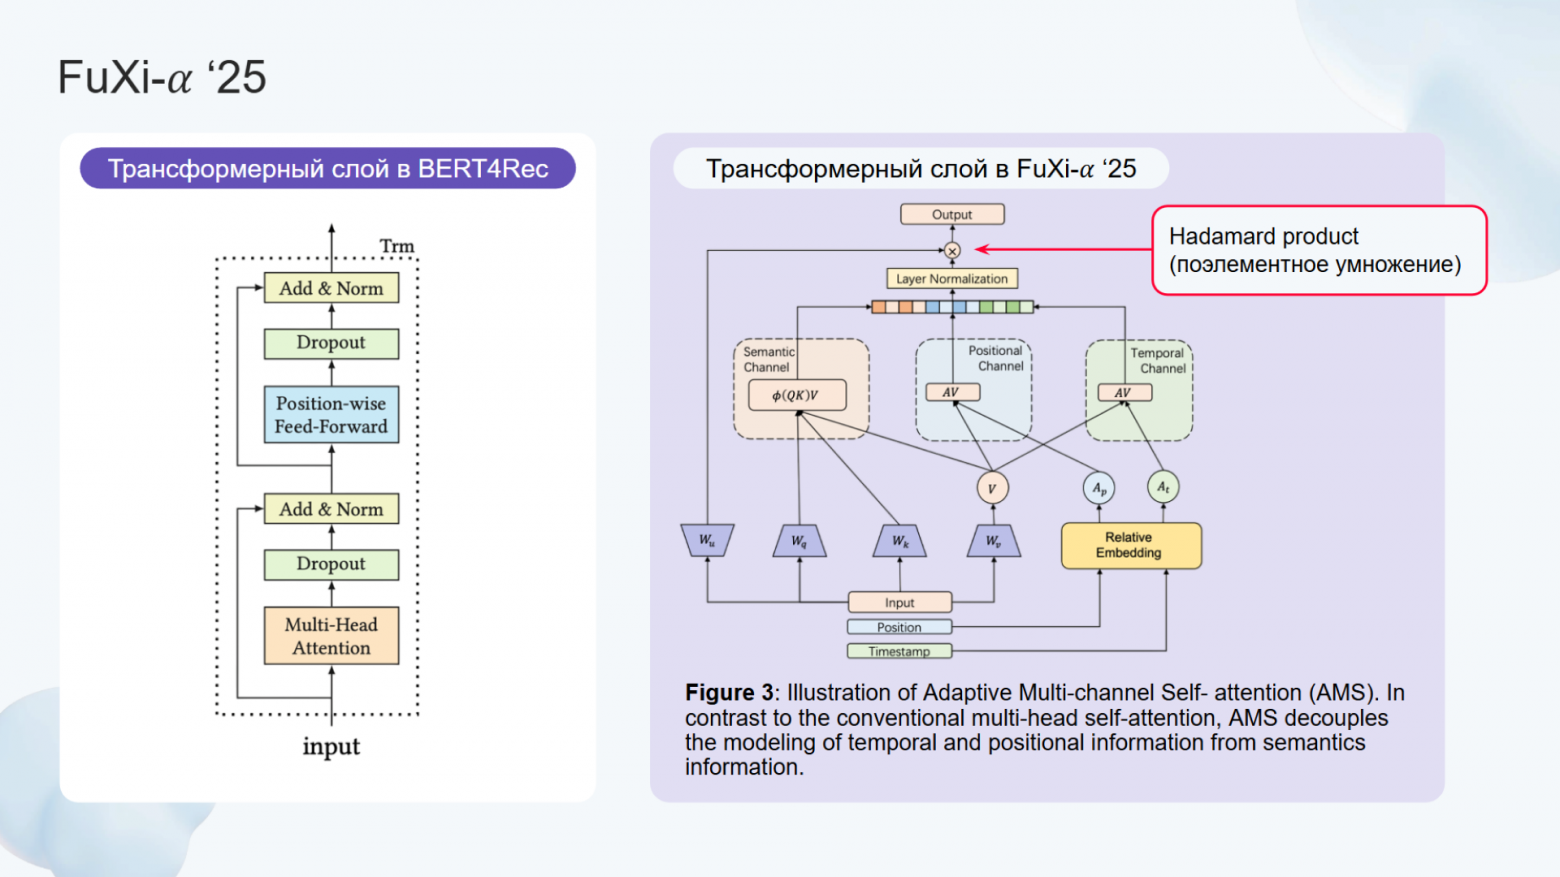
На исходной схеме разделены Semantic, Positional и Temporal channels. Используем эти обозначения, а не неточный пересказ про timeless.
Источник: Никита Зелинский · МТС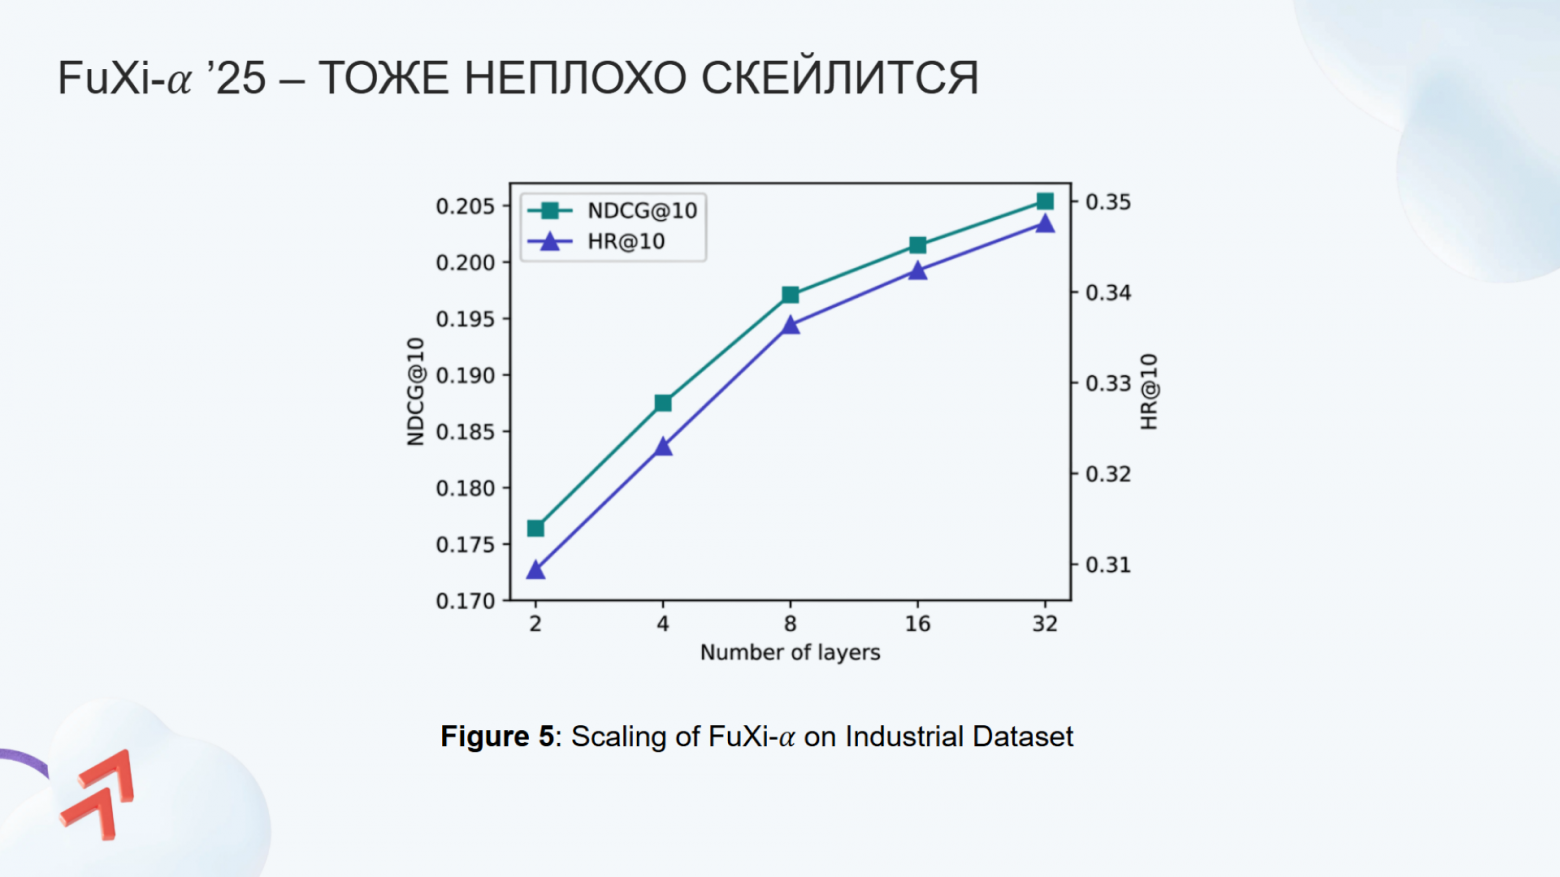
Внешний эксперимент: при увеличении числа слоёв от 2 до 32 растут NDCG@10 и HR@10. Это не A/B-тест МТС.
Источник: Никита Зелинский · МТСRecTools: данные и минимальный путь до рекомендаций
После обзора архитектур статья переходит к RecTools — open-source-библиотеке МТС для построения и сравнения рекомендательных моделей. На момент публикации автор отмечал почти 400 GitHub stars. В библиотеке рядом с трансформерами доступны и более классические подходы, включая матричные разложения и двухбашенные модели. Это важно для честного эксперимента: трансформер должен сравниваться не только с другим трансформером, но и с более простыми базовыми вариантами.
Таблицу можно прокрутить по горизонтали.
Контраст между наборами показывает, почему длина истории важна для последовательной модели. В KION средняя последовательность содержит 5,69 события, в MovieLens 10M — 143,11. Автор утверждает, что на более длинных последовательностях эффект трансформеров заметнее. Это наблюдение статьи, а не универсальный порог: сама средняя длина не говорит о распределении историй, разбиении данных или статистической значимости выигрыша.
sasrec = SASRecModel()
bert4rec = BERT4RecModel()

dataset = Dataset.construct(
    interactions_df=interactions,
    item_features_df=item_features,
    cat_item_features=["genre"],
)

sasrec.fit(dataset)

recos = sasrec.recommend(
    users=test_user,
    dataset=dataset,
    k=3,
    filter_viewed=True,
)
Этот код переписан с исходного слайда без добавления импортов, которых там нет. Он показывает API версии статьи 2025 года: создать модель, собрать Dataset, вызвать fit и затем recommend. В примере рекомендаций запрашиваются три объекта и включена фильтрация уже просмотренных. Это исторический интерфейс из статьи, а не гарантия совместимости с будущими версиями RecTools.
Таблицу можно прокрутить по горизонтали.
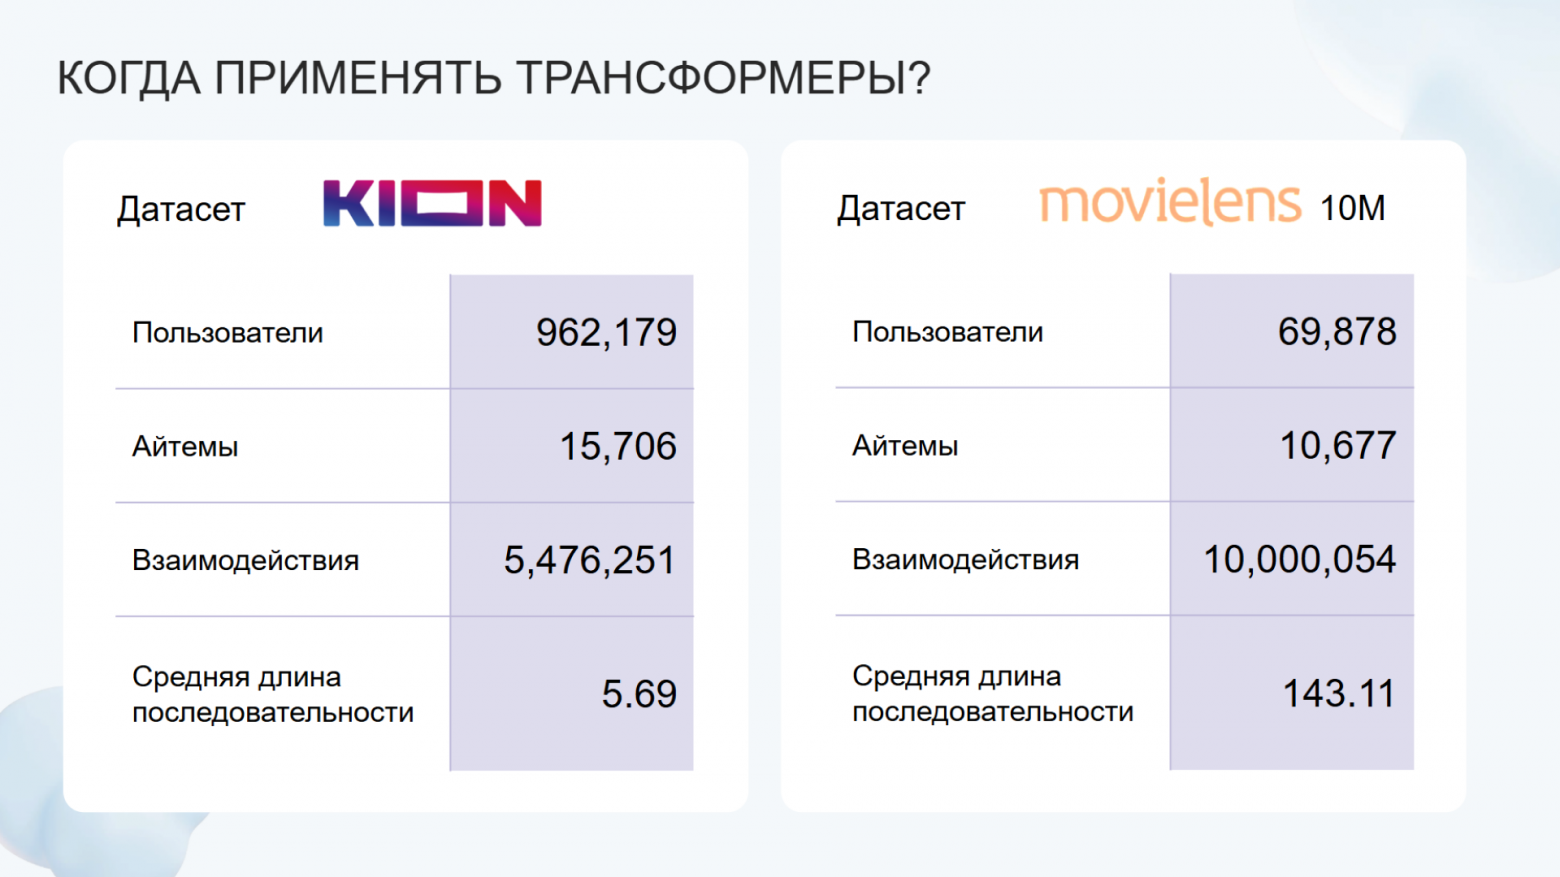
KION: 962 179 пользователей, 15 706 объектов, 5 476 251 взаимодействие, средняя длина 5,69. MovieLens 10M: 69 878, 10 677, 10 000 054 и 143,11 соответственно.
Источник: Никита Зелинский · МТС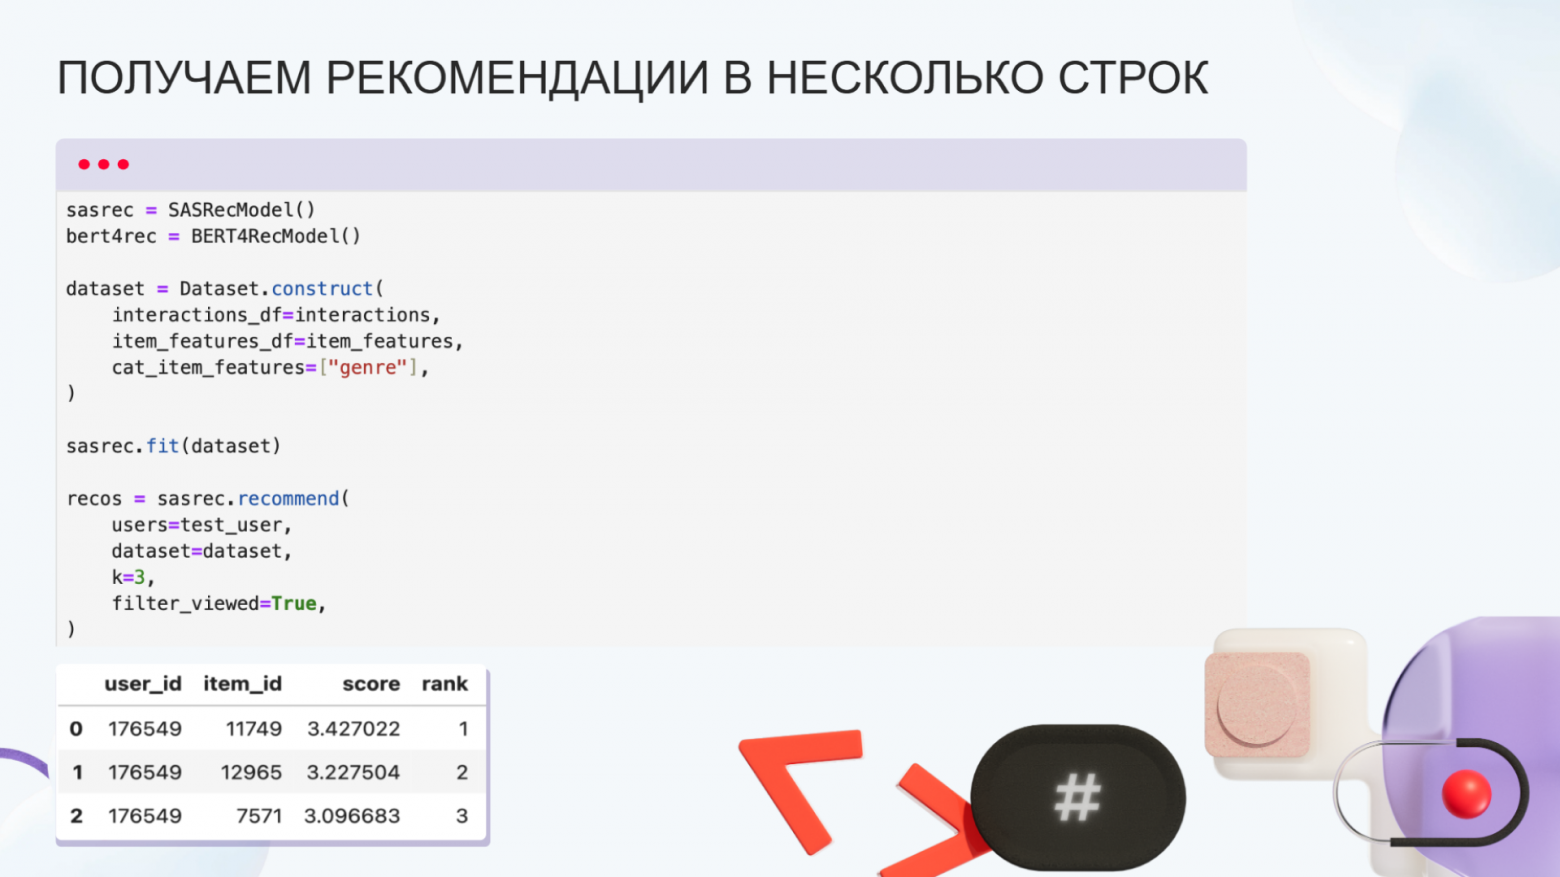
Создание Dataset, fit и recommend показаны для версии из статьи 2025 года. Пример не гарантирует совместимость с будущими версиями библиотеки.
Источник: Никита Зелинский · МТСЧто показывает офлайн-график реализаций — и чего он не доказывает
Одна и та же статья модели может иметь несколько реализаций: различаться порядком операций, длиной последовательности, деталями слоёв и оптимизацией кода. Поэтому автор показывает отдельный офлайн-график open-source реализаций. На двух панелях используются MovieLens 1M и MovieLens 20M; по вертикали — NDCG@10, по горизонтали — Training time. Единица времени на слайде не указана, поэтому значения по оси нельзя переводить в секунды, минуты или часы. NDCG@10 — метрика качества ранжирования первых десяти позиций: более высокий результат означает, что релевантные объекты стоят выше.
Это исправляет важную неоднозначность текста статьи: фраза «звёздочка — это мы. Наш BERT4Rec в топе» не согласуется с легендой. По легенде звезда — SASRec RecTools, а BERT4Rec RecTools — розовый квадрат. Обе реализации находятся среди сильных точек на показанных графиках, но мы не вычисляем их координаты с изображения и не превращаем визуальный результат в новые числа.
Кроме того, источник не раскрывает здесь train/validation/test split, число повторов, seed, аппаратную конфигурацию, доверительные интервалы или статистическую значимость. Поэтому график годится как демонстрация качества и скорости конкретных open-source реализаций в условиях автора, но не как единый строгий benchmark всех архитектур из таймлайна. HSTU и FuXi на этих панелях вообще не сравниваются.
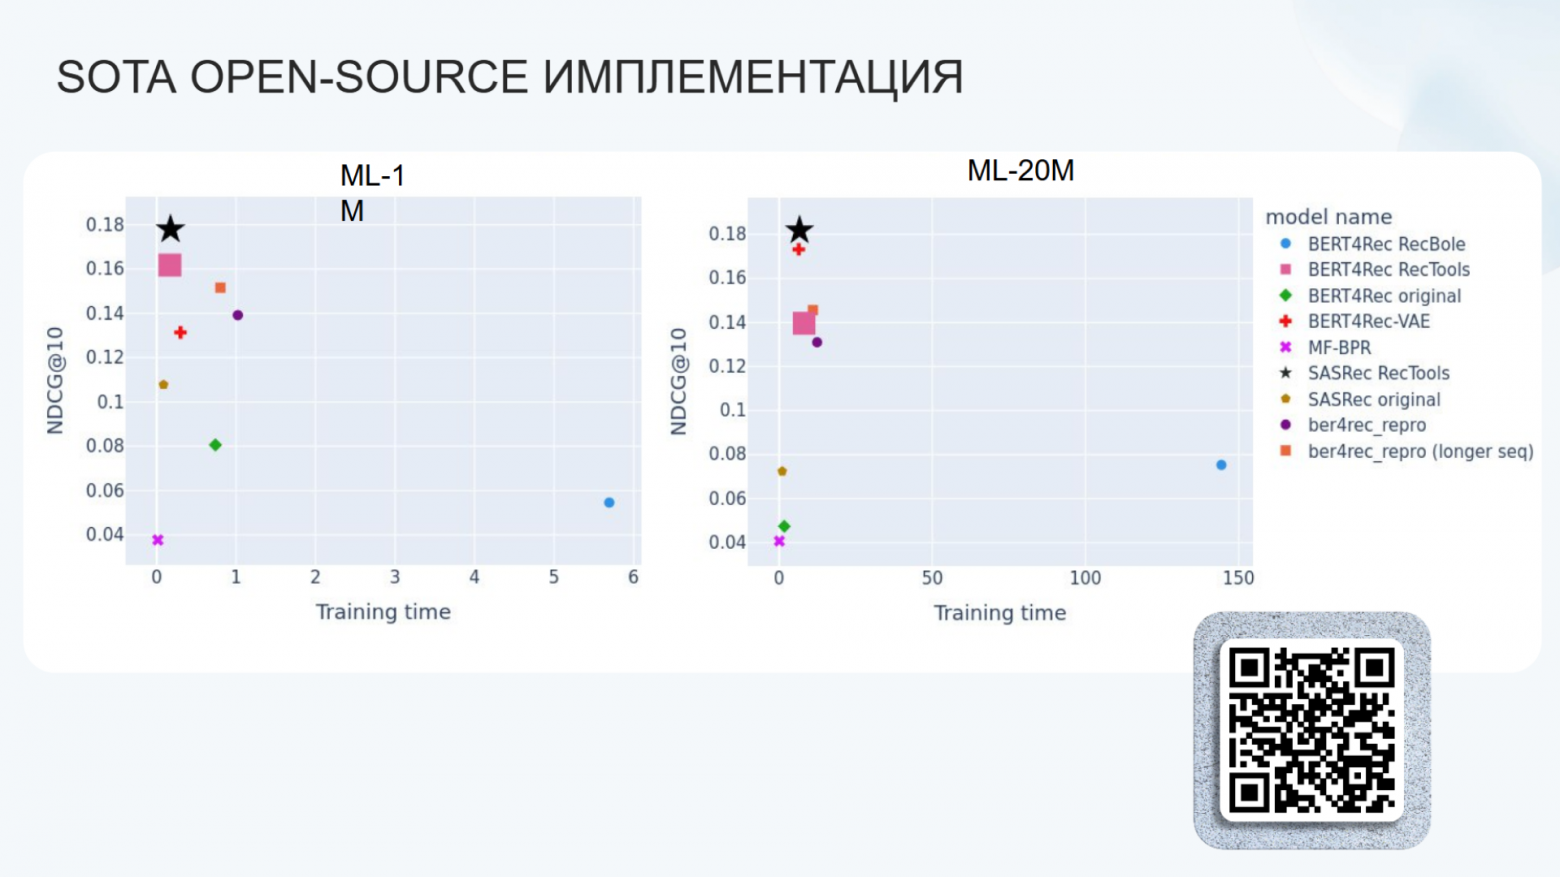
По легенде чёрная звезда обозначает SASRec RecTools, розовый квадрат — BERT4Rec RecTools. Подпись статьи про звезду и BERT4Rec не согласуется с легендой. Единица Training time не указана.
Источник: Никита Зелинский · МТСПризнаки и конфигурация — часть модели, а не скрытые детали
Базовая схема использует ID объектов, но RecTools позволяет менять способ построения объектного представления. На слайде показаны три варианта SASRec: только ID-эмбеддинги, ID вместе с категориальными признаками и только категориальные признаки. Это делает дополнительную информацию каталога — например жанр — явной частью архитектуры, а не внешней обработкой, которую легко забыть при сравнении.
sasrec_ids_only = SASRecModel(
    item_net_block_types=(IdEmbeddingsItemNet,)
)

sasrec_ids_and_categories = SASRecModel(
    item_net_block_types=(IdEmbeddingsItemNet, CatFeaturesItemNet)
)

sasrec_categories_only = SASRecModel(
    item_net_block_types=(CatFeaturesItemNet,)
)
На рисунке справа та же идея показана геометрически: к ID-эмбеддингам добавляются категориальные представления и позиционная информация, трансформер строит результирующие состояния, а кандидаты сравниваются с ними скалярным произведением. Такой эксперимент позволяет отдельно проверить, нужен ли модели сам ID, достаточно ли категорий или полезно их сочетание.
Вторая часть конфигурации относится уже к размеру и процедуре обучения. Исходный слайд показывает epochs=2, n_blocks=1, n_heads=1, n_factors=64 и train_min_user_interactions=2. Это значения конкретного примера, а не defaults и не рекомендованные настройки для production. На том же слайде конфиг может принимать пользовательские функции для validation mask и trainer, а также строковый путь к классу трансформерных слоёв.
config = {
    "epochs": 2,
    "n_blocks": 1,
    "n_heads": 1,
    "n_factors": 64,
    "train_min_user_interactions": 2,
}

config = {
    "get_val_mask_func": get_val_mask_func,
    "get_trainer_func": get_custom_trainer,
    "transformer_layers_type":
        "rectools.models.nn.transformers.sasrec.SASRecTransformerLayers",
}
Именно поэтому сравнение «SASRec против BERT4Rec» без конфига неполно. Число блоков и голов, размерность представлений, фильтрация коротких историй, состав признаков и пользовательские компоненты меняют конкретную модель не меньше, чем её имя в статье.
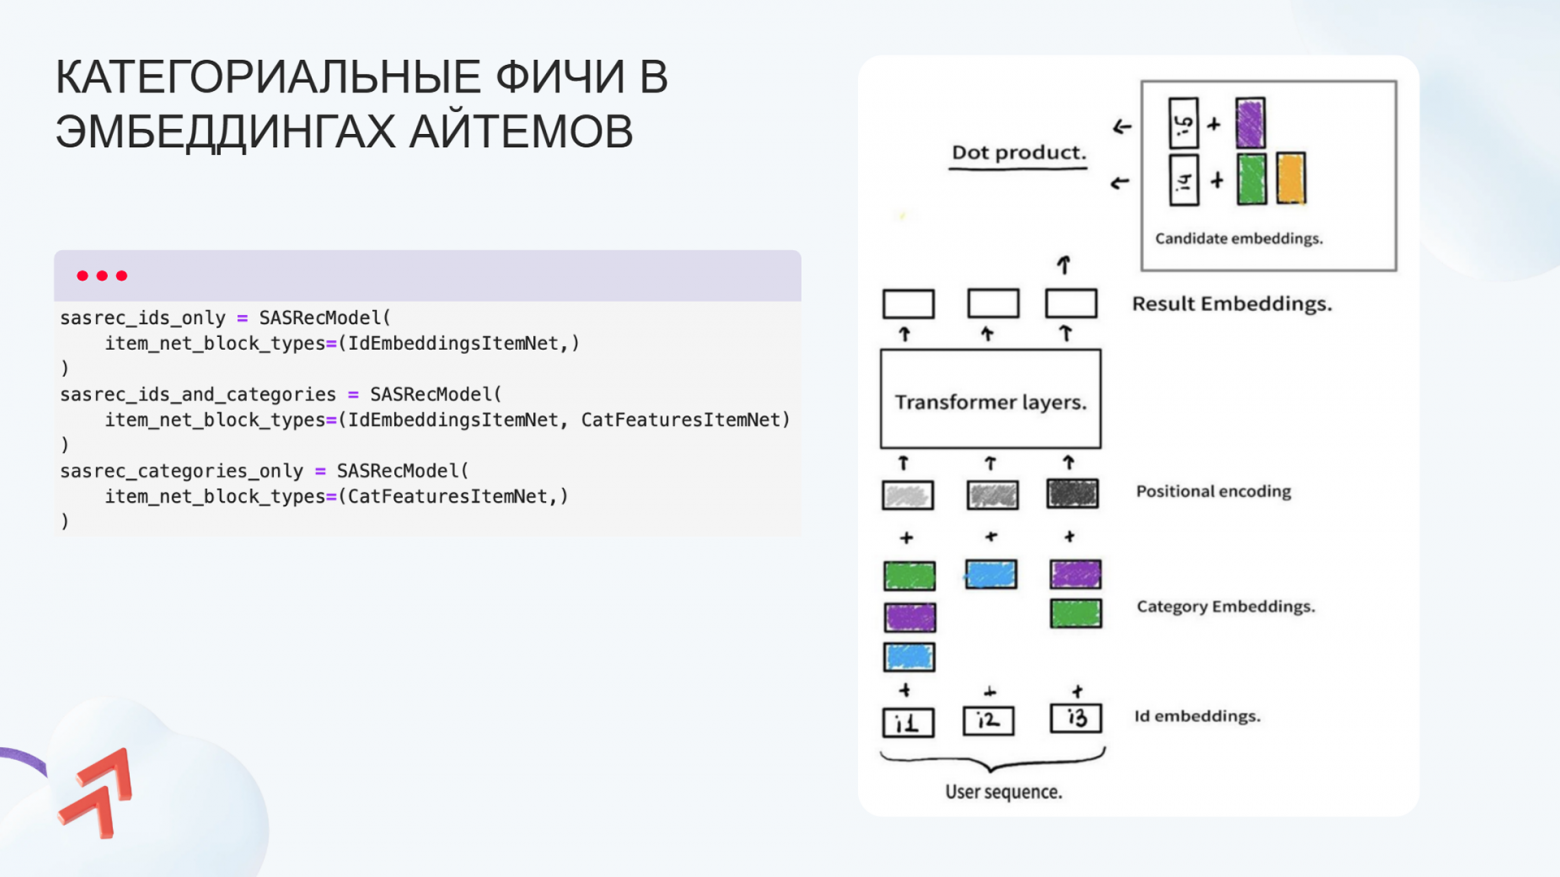
В примерах отдельно задаются ID-признаки, категории или их сочетание. Код иллюстрирует конфигурацию библиотеки на момент статьи.
Источник: Никита Зелинский · МТС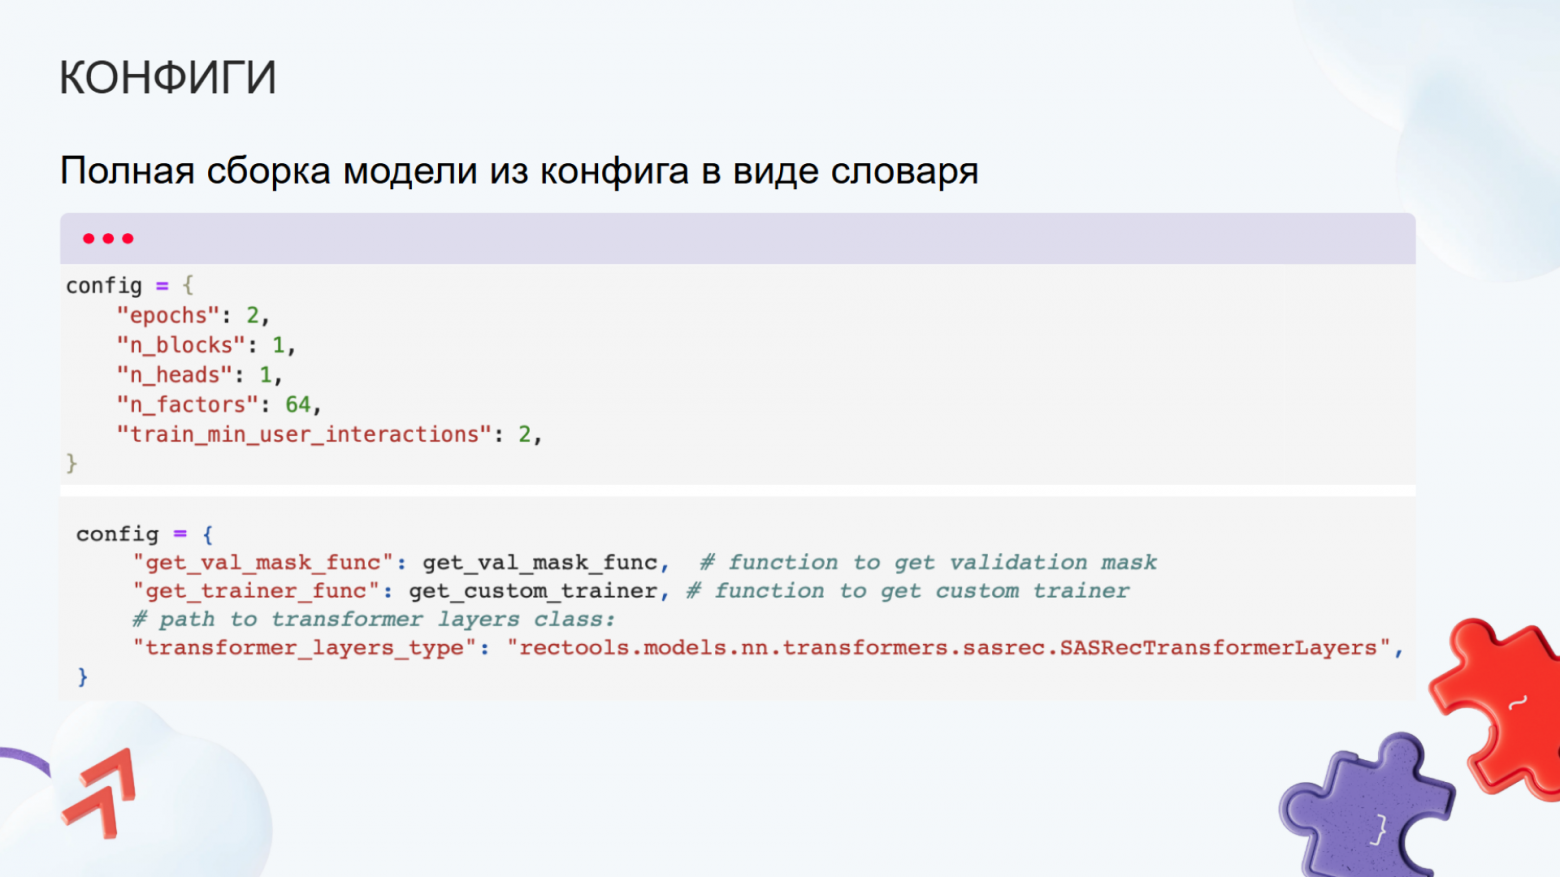
epochs=2, n_blocks=1, n_heads=1, n_factors=64 и train_min_user_interactions=2 — значения показанного примера, а не обязательные настройки или defaults.
Источник: Никита Зелинский · МТСВалидация, beyond-accuracy и границы RecTools
Точность попадания в следующий объект — не единственный способ оценивать рекомендации. Статья отдельно вводит beyond-accuracy характеристики: разнообразие списка, новизну и serendipity — неожиданно полезные рекомендации. Мотивация простая: алгоритм может хорошо угадывать очевидные популярные объекты, но выдавать однообразный список. De-biased-валидация в статье должна помогать видеть этот компромисс, особенно когда релевантным оказывается непопулярный объект.
RecTools встроил расчёт метрик в процесс эксперимента. Автор приводит сценарий, где перебираются 20–30 моделей и параметры, а callbacks позволяют считать показатели на каждой эпохе. Часть логики построена поверх PyTorch Lightning; также используются Torch Native и Pandas. В статье прямо сказано, что TensorFlow- и Keras-версий этих трансформерных моделей нет.
from rectools.visuals import MetricsApp

MetricsApp.construct(
    metrics_df,
    model_params_df
)
Виджет MetricsApp строит плоскость по двум выбранным метрикам и помогает искать компромисс или Парето-оптимальные варианты. Но конкретный статичный кадр из статьи нельзя использовать как доказательство diversity: на нём ось X — prec@1, ось Y — prec@10. Чтобы сравнивать точность с разнообразием или новизной, одну из выбранных метрик действительно нужно заменить соответствующей beyond-accuracy метрикой.
Финальная граница библиотеки на момент статьи принципиальна. Автор говорит, что распространённые модификации функций потерь, negative sampling, функции связи и числа слоёв уже можно комбинировать как конструктор, и широко формулирует это как возможность воспроизводить практически любые работы до 2024 года. Однако HSTU, FuXi и LiGR он отдельно называет тяжёлыми моделями, которые в RecTools тогда ещё не были реализованы. Значит, внешние графики этих моделей нельзя смешивать с офлайн-сравнением RecTools в один benchmark.
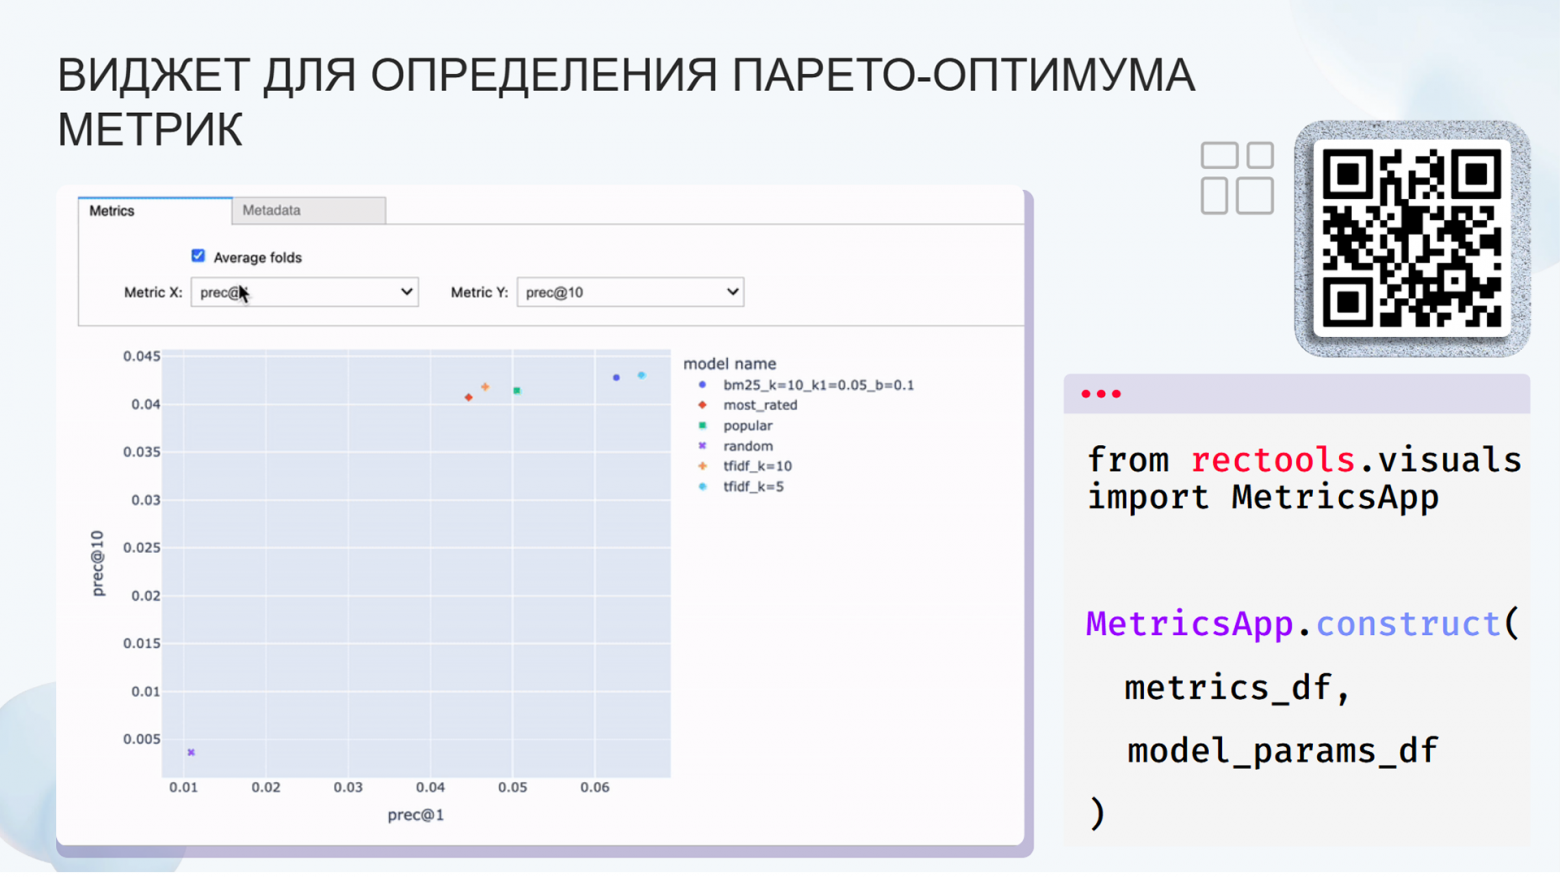
На статическом кадре оси prec@1 и prec@10. Сам этот кадр не доказывает измерение разнообразия; выбор метрик и анализ компромиссов нужно задавать отдельно.
Источник: Никита Зелинский · МТСИтог: путь рекомендации и границы сравнения
Главный вывод статьи — выбирать последовательную рекомендательную модель только по её названию бессмысленно. SASRec задаёт понятную базу: история объектов превращается в позиционные состояния, каузальное внимание не видит будущее, а shifted sequence даёт много обучающих переходов. BERT4Rec меняет маску и цель на восстановление скрытых объектов. PinnerFormer расширяет горизонт до будущего окна. HSTU вводит отдельные токены объектов и действий, а FuXi-α разделяет семантический, позиционный и временной каналы. Это разные способы определить, какую информацию модель должна извлечь из одной и той же истории.
- 01
Получить историю
Сервис собирает упорядоченные доступные действия пользователя и приводит историю к допустимой длине; служебные позиции дополнения не считаются реальными объектами.
- 02
Построить входные представления
ID объектов, позиции и, если конфигурация это предусматривает, категориальные признаки превращаются в векторы.
- 03
Обработать последовательность
Обученный трансформер строит скрытые состояния истории с тем типом маски и архитектуры, которые были зафиксированы при обучении.
- 04
Оценить объекты
Состояние пользователя сопоставляется с доступными объектами выбранной функцией связи — например скалярным произведением — и получает численные оценки.
- 05
Сформировать выдачу
Система применяет нужные фильтры, например исключает уже просмотренное, выбирает top-K и возвращает item_id, score и rank.
RecTools ценен тем, что делает многие из этих решений явными: можно менять представление объекта, глубину, головы внимания, отрицательные примеры, функцию потерь и метрики, а затем сравнивать варианты одним интерфейсом. Но показанные результаты остаются офлайн-экспериментами и внешними исследованиями. В источнике нет единого split для всех моделей, A/B-теста МТС, доверительных интервалов или доказанной статистической значимости. На графике реализаций единица Training time не указана; статичный MetricsApp показывает prec@1 против prec@10, а не diversity. HSTU, FuXi и LiGR на момент статьи не входили в RecTools. Поэтому итоговая проверка должна разделять три вопроса: чему модель учится, насколько корректен офлайн-протокол и можно ли вообще сравнивать приведённые числа между собой.
— «В завершение — краткое саммари» и все предыдущие разделы; итог по source-0—source-35 из approved-figures