Разбор готов
Wildberries: почему Semantic IDs строят снизу вверх
На Wildberries одно и то же бежевое худи может существовать в нескольких карточках разных продавцов. Для рекомендательной модели это разные объекты: покупки и просмотры распределяются между ними, а новая карточка начинает без истории. Объединить всё по категории нельзя — внутри неё слишком разные вещи. Александр Тришин рассказывает, как команда искала более точную единицу для обучения и рекомендаций: семантический код, который связывает близкие товары и сохраняет разные уровни сходства. Путь оказался не прямым: методы квантизации давали нестабильные и неудобные группы, поэтому команда построила адаптивную иерархию снизу вверх. Разберём этот выбор, обновление кодов, первые внедрения и вопросы, на которые визуальное сходство само по себе не отвечает.
Глава полезна разработчикам рекомендаций и представлений товаров, которые работают с дублями, новыми карточками и разреженной историей. На конкретном внедрении видно, почему качество кодирования, удобство иерархии и результат рекомендательной модели нужно рассматривать отдельно.
Видео · на русском
«Semantic IDs: архитектура и наш опыт внедрения» — Александр ТришинАлександр Тришин · Опубликовано: 1 сентября 2025 г.
Исходный доклад · Открыть оригинал
Почему карточка товара — не всегда удачная единица для модели
Обычный товарный идентификатор позволяет различать карточки, но сам по себе ничего не сообщает об их сходстве. Для маркетплейса это существенно: продавцы независимо заводят карточки и могут физически продавать один и тот же товар под разными ID. Даже внутри ассортимента одного продавца одинаковые вещи могут иметь разные названия и отдельные карточки.
В примере из доклада рядом стоят бежевые худи. Они заметно похожи, однако описанные автором рекомендательные процессы работают с ними по отдельности. Модель не получает из самих идентификаторов указания, что опыт взаимодействия с одной карточкой может быть полезен для другой. Поэтому задача не сводится к уменьшению числа строк в каталоге: нужно явно передать моделям содержательную близость товаров.
Недостаток общего представления особенно болезнен для новых и редко выбираемых карточек. Холодный старт означает, что товар уже появился на площадке, но взаимодействий с ним ещё нет или почти нет. Длинный хвост — множество товаров, на которые приходится мало действий пользователей, тогда как небольшая популярная часть каталога собирает основную историю. Дубли дополнительно дробят и без того редкий сигнал.
Отсюда возникает требование к новой единице учёта: она должна объединять достаточно похожие товары, но не стирать различия между далёкими вещами. Категории уже существуют, однако их детализации для этого недостаточно. Дальнейший выбор алгоритма подчинён именно этому требованию, а не желанию получить короткий код любой ценой.
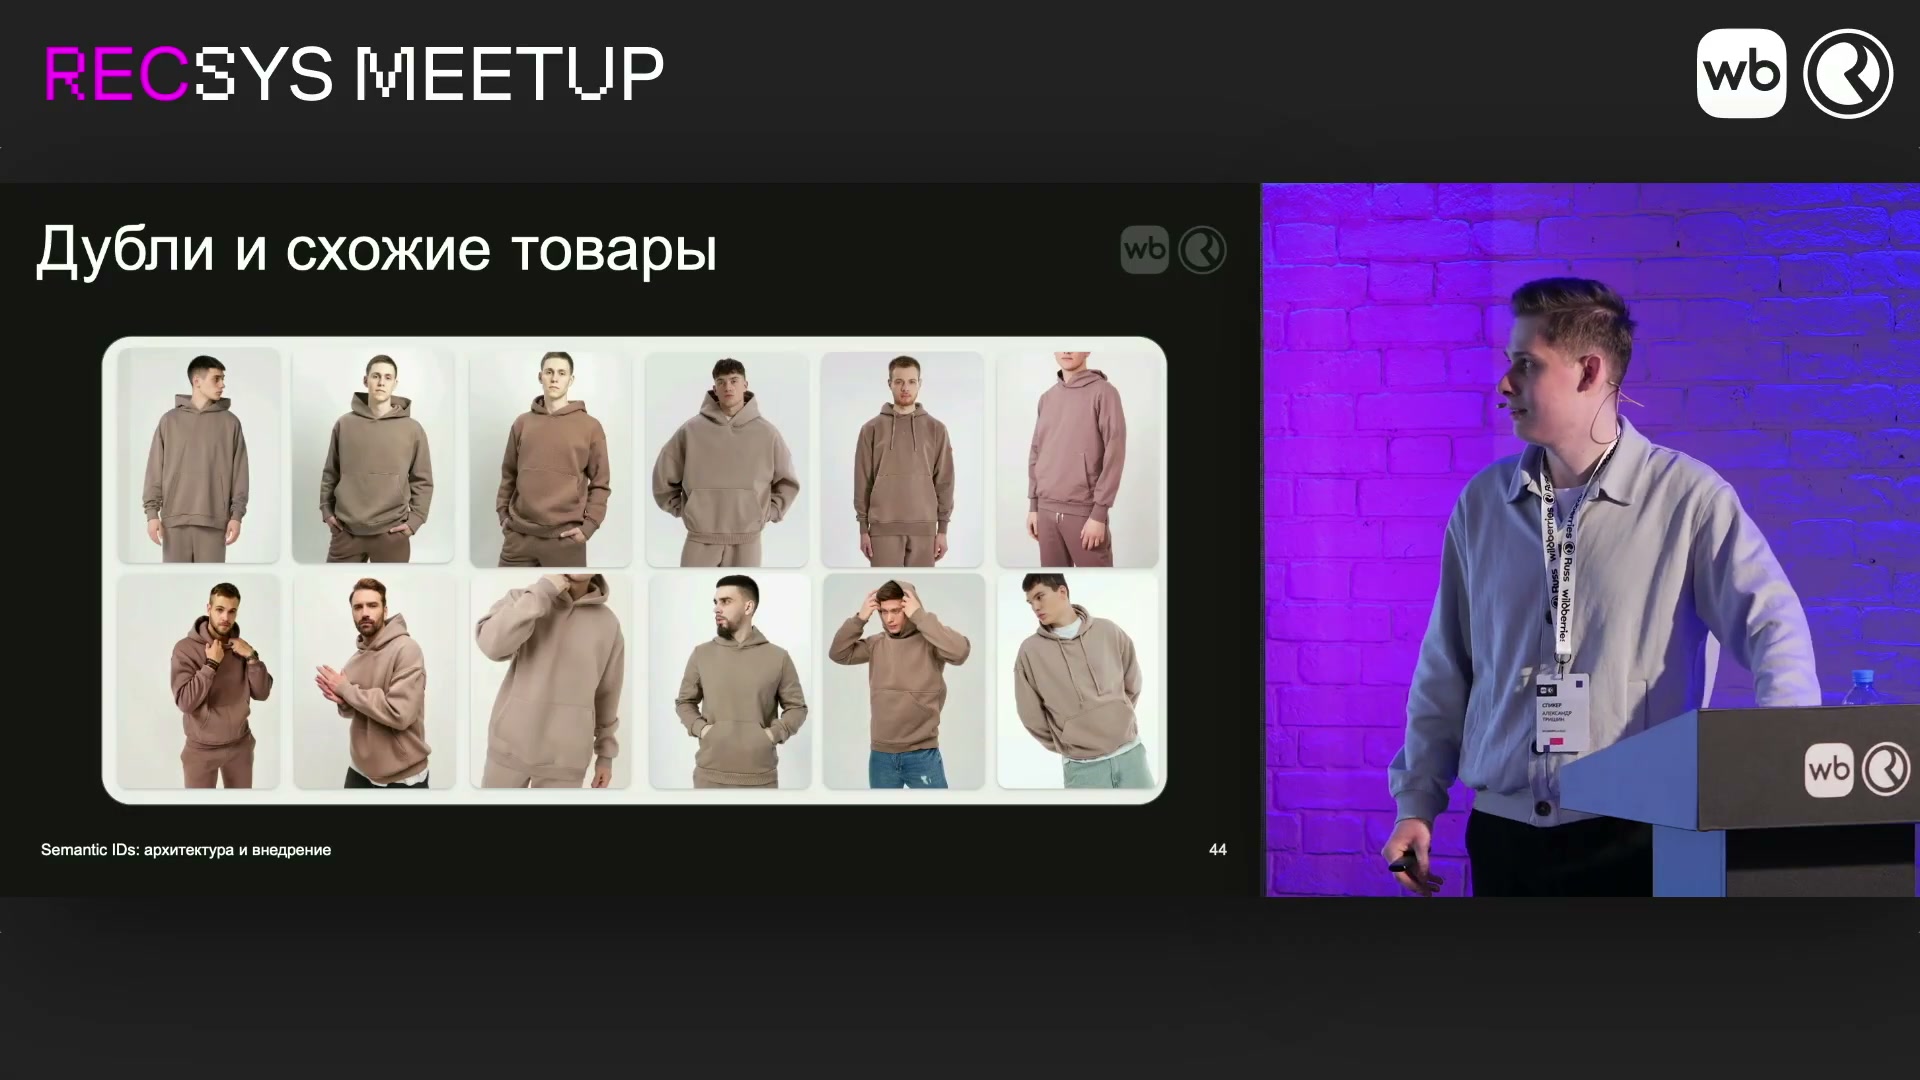
Разные карточки визуально близких товаров делят между собой пользовательские взаимодействия.
Источник: Александр Тришин · Wildberries · RecSys MeetupЧто меняется, когда взаимодействия собираются на группе
На графике обычных товарных ID почти половина объектов имеет меньше десяти взаимодействий. Это наблюдение автора для показанного распределения; период накопления истории и состав выборки не раскрыты. По таким карточкам трудно независимо получить устойчивое представление предпочтений пользователей.
На соседнем графике единицей становится семантическая группа, а не отдельная карточка. Взаимодействия её товаров собираются вместе, поэтому малонаполненных единиц оказывается заметно меньше. В этой части выступления автор называет около четырёх миллионов Semantic IDs. При этом товары не исчезают из каталога: меняется то, на каком уровне объединяется информация для модели.
Графики нельзя сравнивать как две кривые на одинаковой числовой сетке. На горизонтальной оси обычных ID указан масштаб 10⁸, а на оси Semantic ID — 10⁶; вертикальные оси логарифмические. Иллюстрация показывает разреженность истории и эффект её объединения, но не задаёт универсальный коэффициент сжатия каталога и не измеряет качество рекомендаций. Точная доля групп с малым числом взаимодействий справа не приведена.
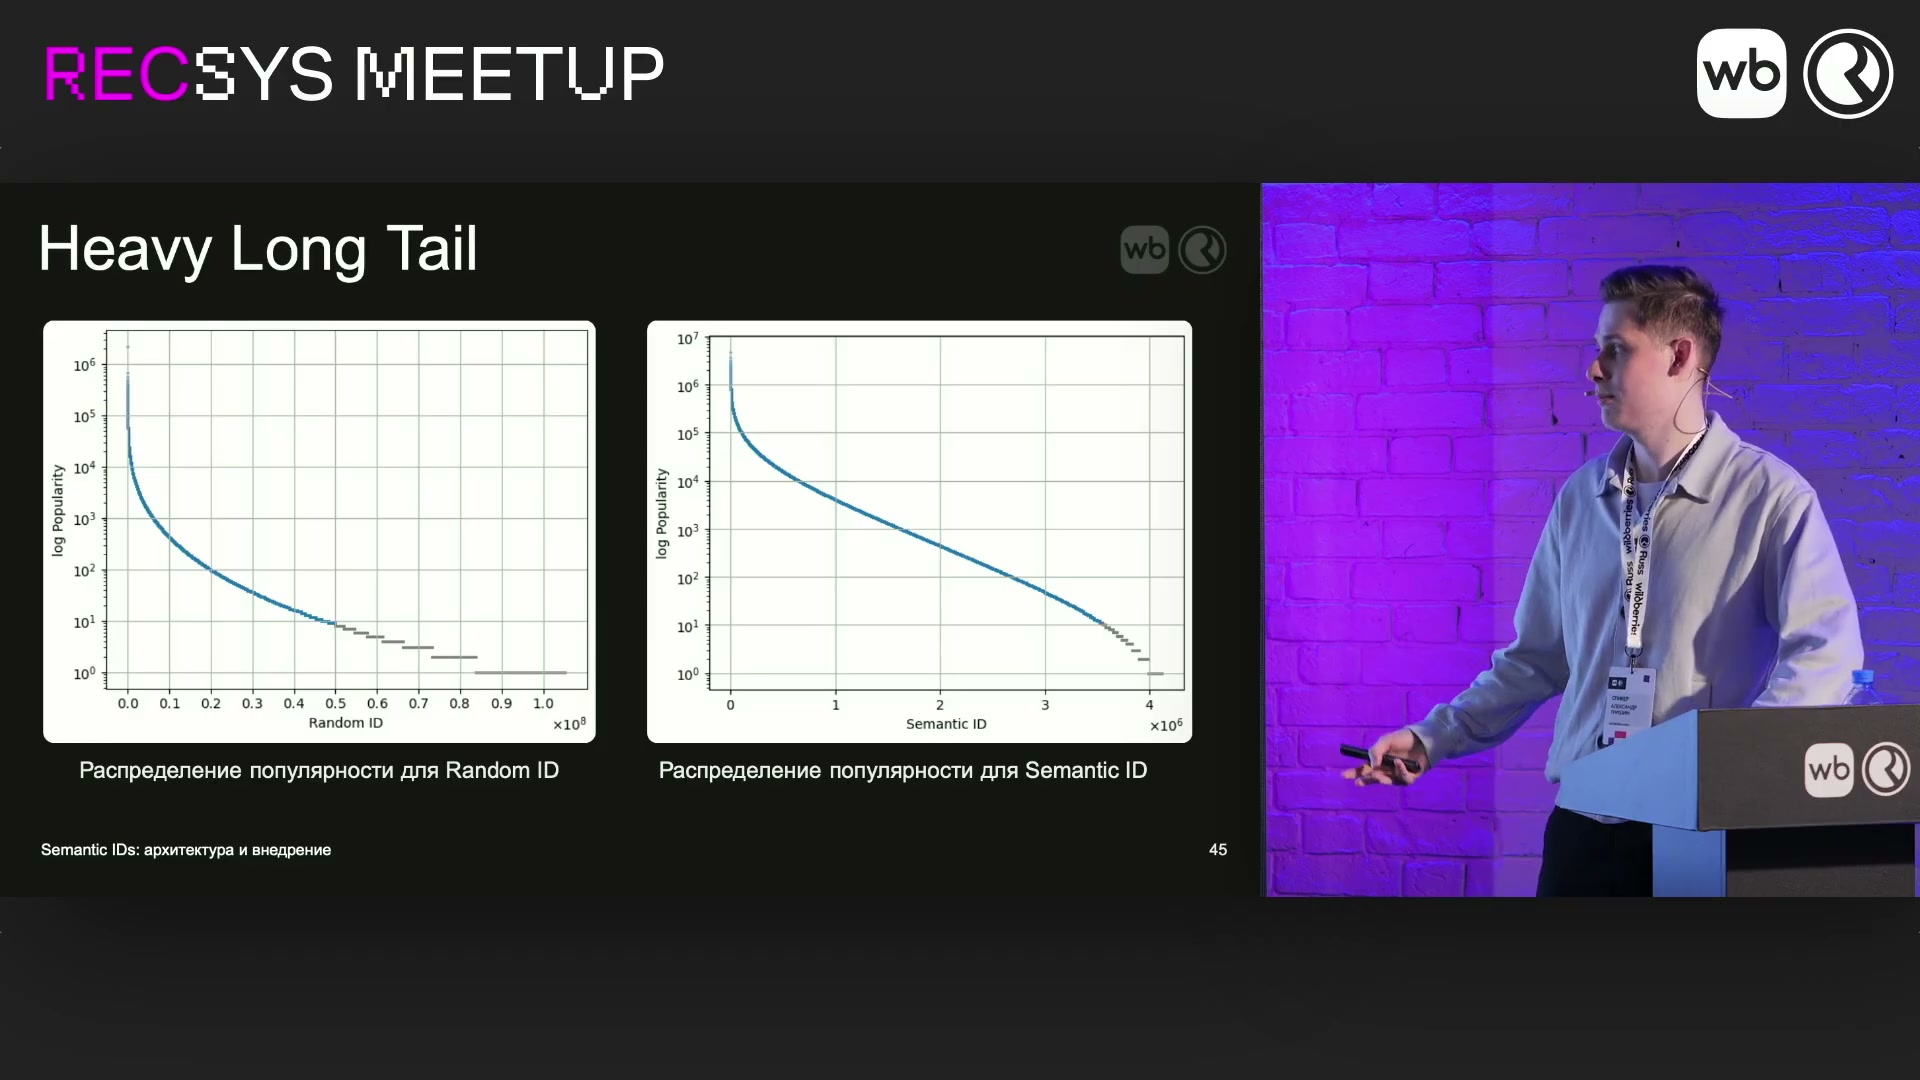
Графики популярности Random ID и Semantic ID показаны с разными масштабами оси X. Они иллюстрируют распределение, а не гарантируют фиксированный коэффициент сжатия.
Источник: Александр Тришин · Wildberries · RecSys MeetupСемантический код: сходство выражается общим началом
Готовая каталожная группа слишком груба для переноса поведения между близкими вещами. В примере Subject ID = 255 объединяет женские кардиганы и пиджаки, которые заметно различаются. Рядом показан ещё более широкий Parent ID = 1. Эти числа обозначают конкретные иллюстративные группы, а не размеры словаря или число уровней будущего дерева.
Семантический идентификатор, Semantic ID или SID, — последовательность дискретных чисел, описывающая содержание карточки. Главное желаемое свойство: у похожих товаров должно совпадать длинное начало кода. Это начало называется общим префиксом. В иерархическом представлении оно соответствует общей части пути от крупной группы к более узкой.
Для вечерних чёрных платьев с разрезом в презентации показано начало (12, 95, 104, 7788), после которого код продолжается. Для коротких чёрных зимних курток — (12, 20, 474, 1228). Внутри каждой показанной группы совпадают четыре компонента, а у платья и куртки — только первая. Так код различает сильное и слабое сходство, не требуя отдельного названия для каждой промежуточной группы. Автор позднее уточняет, что реальные ID в презентации не показывал: значения служат объяснению свойства префикса.
Для дублей команда хочет одинаковый SID, для близких вариантов — длинный общий префикс. У нового товара код можно построить по содержанию и отнести карточку к группе, о которой уже накоплена история. Тем же способом предполагается объединять одинаковые товары разных продавцов и карточки с различающимися названиями. Это мотивация подхода, а не отдельные измеренные гарантии качества каждого такого объединения.
Здесь важно различать три объекта. Карточка остаётся конкретным товаром для показа и покупки. Нижний кластер объединяет близкие карточки. Более короткий префикс обозначает более широкую группу. Выбирая длину префикса, модель может менять детализацию, не возвращаясь к чрезмерно широкой исходной категории.
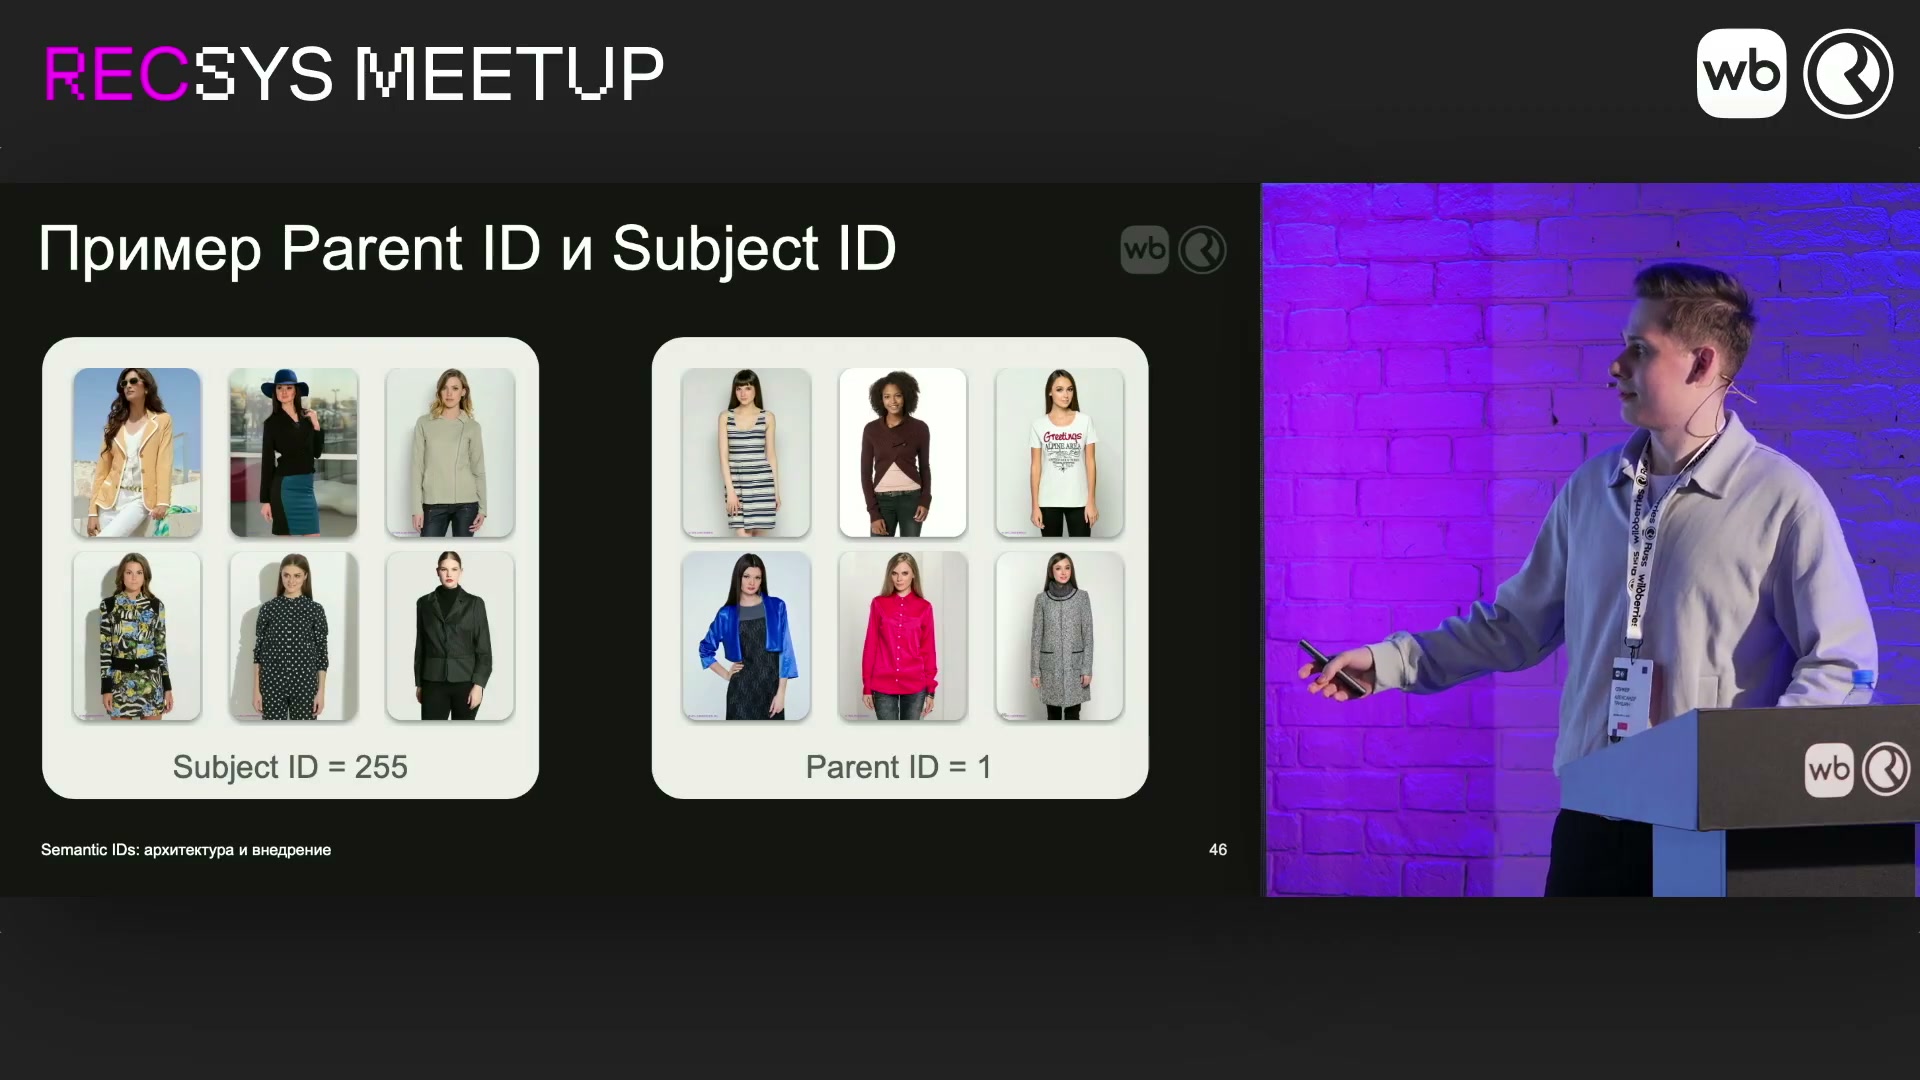
На примере Subject ID=255 и Parent ID=1 показаны уровни каталожной группировки; это не полный словарь категорий.
Источник: Александр Тришин · Wildberries · RecSys Meetup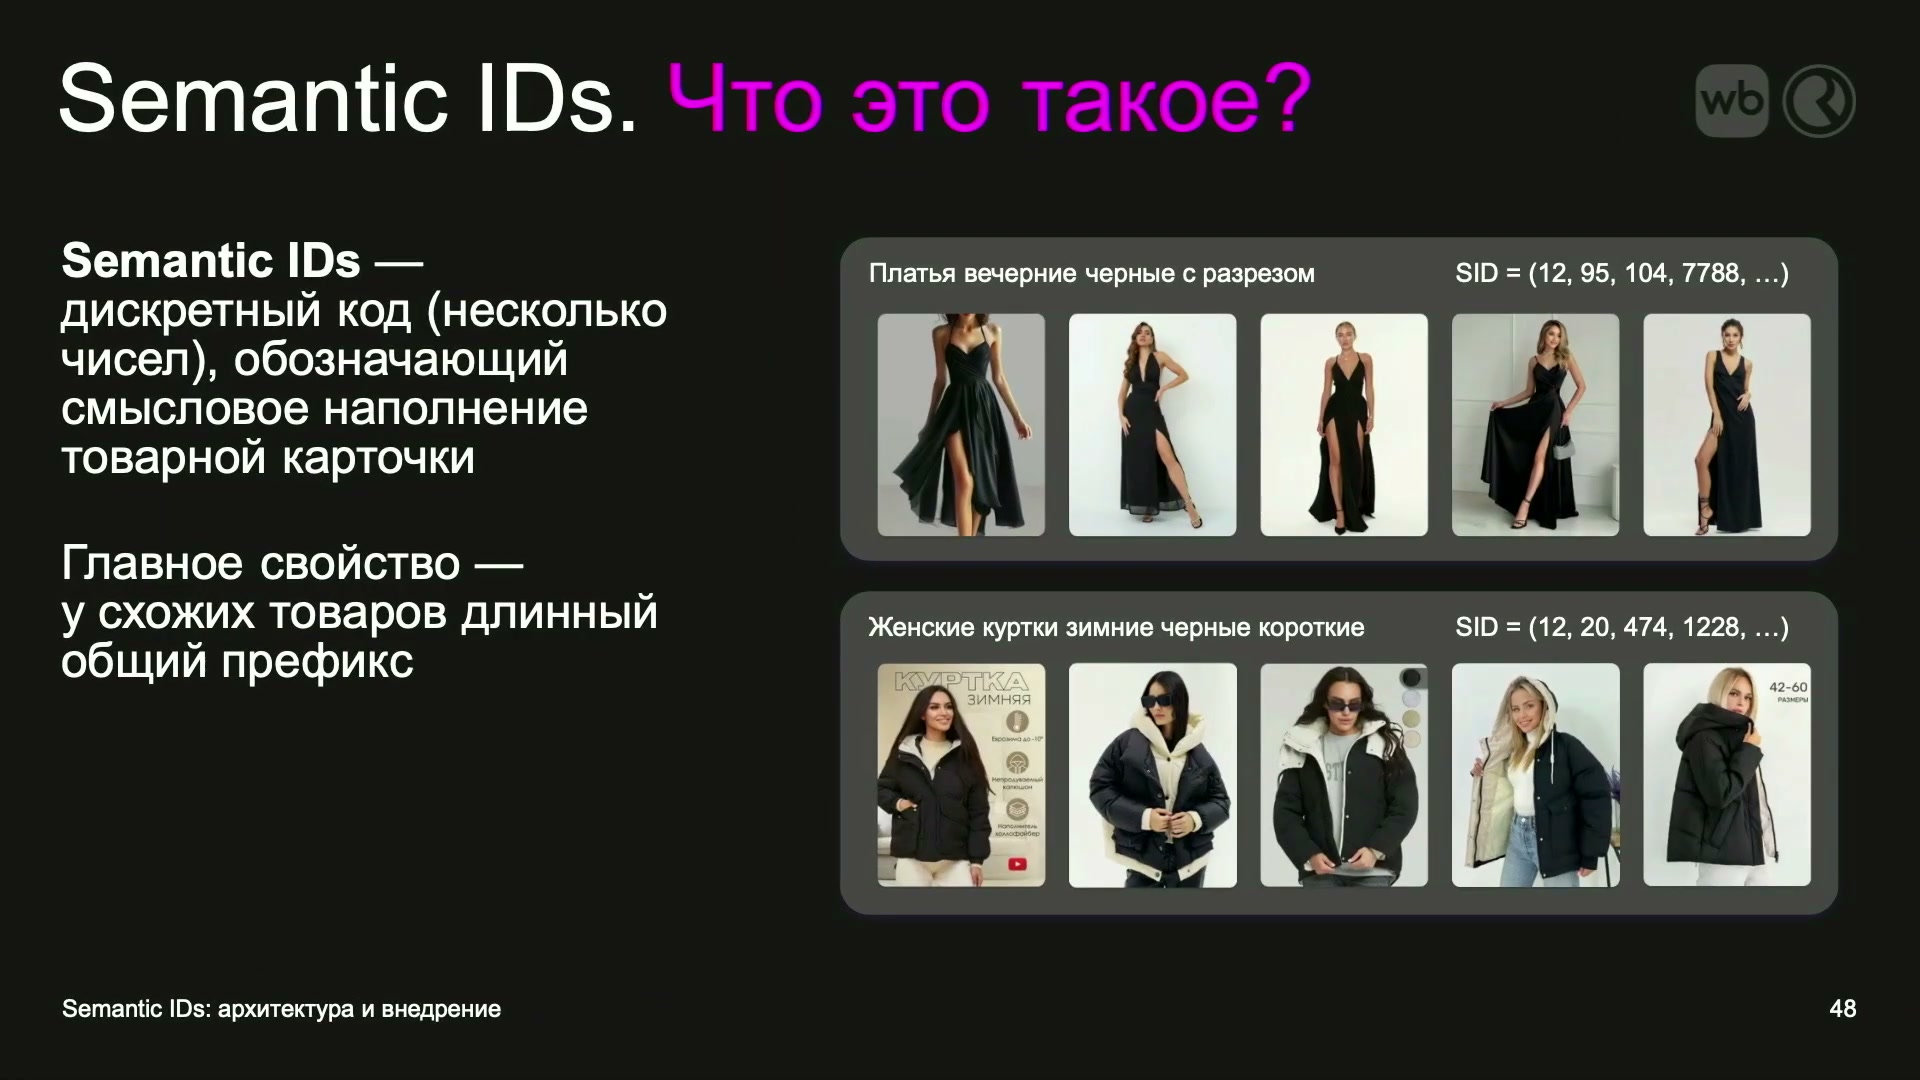
Код описывает путь в иерархии. Длинный общий префикс должен связывать близкие товары.
Источник: Александр Тришин · Wildberries · RecSys MeetupПочему основу кодов составляют изображения
Чтобы сгруппировать карточки по содержанию, сначала нужно превратить это содержание в числовое представление — эмбеддинг. Модель, которая получает изображение и выдаёт такой вектор, называется энкодером. Уже к его векторам применяют алгоритм построения дискретных кодов. Поэтому полезность будущих групп начинается с того, какое сходство отражает исходное представление.
В этой работе используются только изображения. Подтверждённая конфигурация — SigLIP2 с головой, дообученной на домене Wildberries командой поиска по фото. Голова здесь означает дополнительный модуль поверх представления базовой модели. Текст карточки в построении этих SID не используется. Размер варианта SigLIP2, размерность итогового вектора и полный режим дообучения не раскрыты.
На исходном рисунке рядом с описанием решения приведена схема внешней модели SigLIP2: там есть текстовый энкодер и несколько обучающих задач. Это не доказательство того, что команда воспроизвела все эти задачи или использует текст при назначении товарных кодов. Для собственной системы автор сообщает только о дообученной голове и визуальных представлениях.
Вопрос из зала уточняет, не выбрали ли картинки просто потому, что готовые векторы уже были. Автор отвечает, что выбор осмысленный. Разные продавцы могут по-разному назвать одно и то же платье, тогда как фотография чаще показывает саму вещь. В его оценке название оказывается более шумным источником, а изображение лучше подходит для такого объединения.
Это объяснение выбора модальности, не универсальное утверждение о бесполезности текста. Отдельных результатов сравнения изображений, названий, описаний и отзывов в докладе нет. Из наличия визуальных векторов также не следует, что они описывают все свойства, важные покупателю: к этому ограничению обсуждение вернётся на примере похожих платьев.
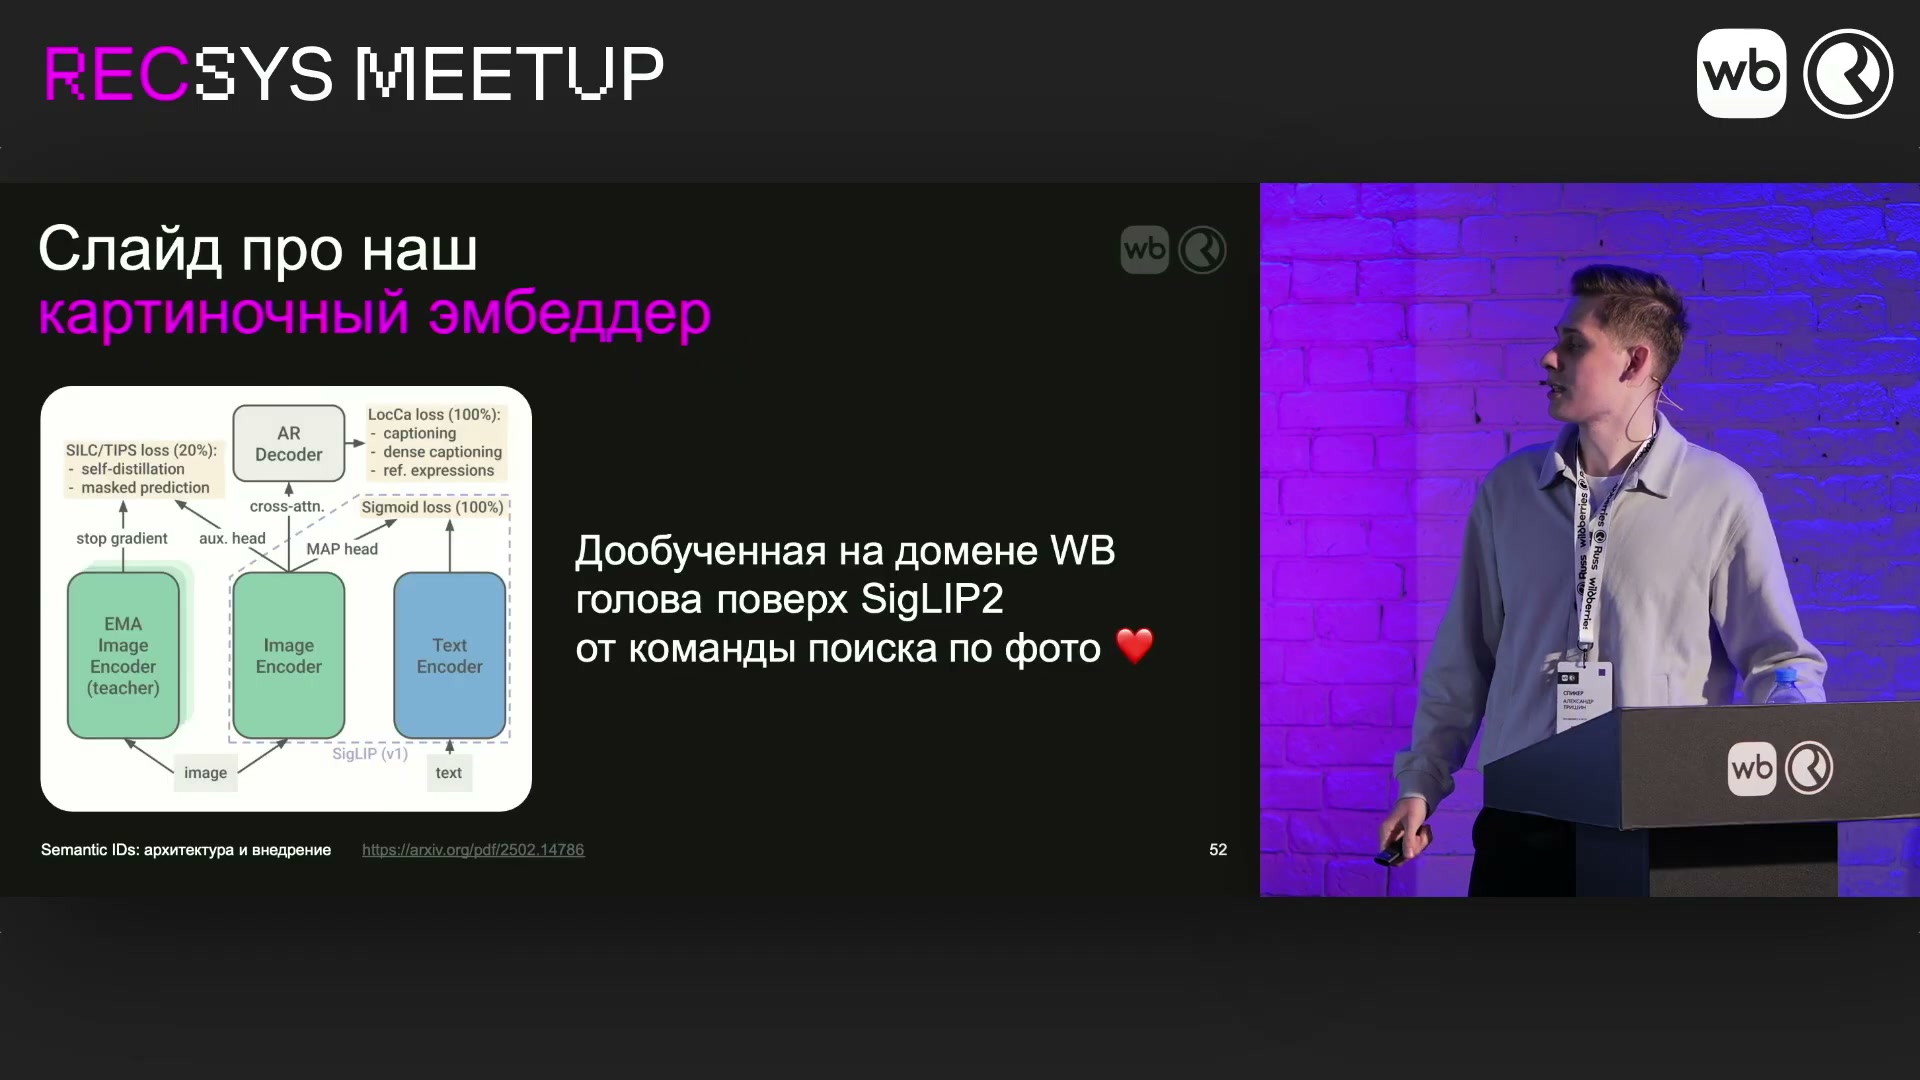
Команда использует дообученную на домене WB голову поверх SigLIP2. Схема SigLIP2 — иллюстрация исходной внешней модели, не полный рецепт дообучения WB.
Источник: Александр Тришин · Wildberries · RecSys MeetupПервый вариант: заменить вектор ближайшим представителем
Первый рассмотренный способ — векторная квантизация, VQ. Вместо хранения произвольного входного вектора выбирают один из заранее заданного числа векторов-представителей. Их набор называется кодбуком. Результат кодирования — индекс ближайшего представителя; карточки, выбравшие один индекс, получают общее дискретное обозначение.
Математически эту идею можно записать следующим образом. Пусть h — входной вектор товара, cⱼ — представитель из кодбука, а d — выбранная мера расстояния. Это поясняющая запись действия «найти ближайший», а не опубликованная формула реализации Wildberries: конкретную меру расстояния в этом фрагменте автор не задаёт.
Математическое пояснение VQ: индекс k становится кодом, а cₖ — приближением входного вектора. Не описание выбранного алгоритма WB.
Автор описывает обучение через повторение простых операций: инициализировать представителей, найти ближайшие к ним товары, пересчитать центроиды и повторить цикл. Центроида — центр полученной группы в векторном пространстве. В такой постановке кодбук постепенно приспосабливается к расположению входных данных.
Однако выразительность упирается в размер кодбука. Чтобы различать много содержательных вариантов товара, представителей нужно много, и их число требуется выбрать заранее. В докладе это сформулировано через вполне прикладной вопрос: сколько на Wildberries различных платьев? Заранее зафиксировать разумный ответ для всего каталога трудно. VQ открывает обзор альтернатив; она не является выбранной системой Semantic IDs.
Доклад · 00:06:21Остаточная квантизация: следующий код уточняет предыдущий
Остаточная квантизация, RQ, заменяет один огромный кодбук несколькими небольшими. Первый даёт грубое приближение входного вектора. Затем вычисляют невязку — то, что осталось неописанным. Следующий кодбук приближает уже эту невязку, а не заново весь исходный вектор. Процедура повторяется, и результатом становится последовательность индексов.
Для пояснения обозначим исходный вектор через h, невязку после уровня m через rₘ, а выбранный на этом уровне вектор через c⁽ᵐ⁾ₖₘ. Следующая запись раскрывает смысл последовательного уточнения. Число уровней M и размеры кодбуков здесь — символы, а не настройки эксперимента команды.
Собственное математическое пояснение устной идеи RQ: каждый выбранный вектор вычитается из текущей невязки. Эта схема не выбрана для итоговой иерархии WB.
Преимущество автор называет комбинаторной выразительностью: сочетания нескольких небольших словарей позволяют описать больше вариантов, чем один отдельный словарь. Для ясности математического смысла можно отдельно посчитать возможные последовательности. Если в кодбуке m имеется Kₘ индексов, число их сочетаний равно произведению размеров словарей. Не каждое сочетание обязательно будет использовано на реальных данных.
Отдельный комбинаторный подсчёт, не цитата формулы докладчика и не размер пространства кодов WB. Устный фрагмент 00:07:48–00:07:56 не даёт надёжной записи формулы; на предоставленном кадре её нет.
Самой возможности составить много кодов недостаточно. Для рекомендаций последовательные уточнения должны ещё создавать полезные уровни сходства. Если почти вся информация попадёт в первый кодбук, следующие индексы могут формально увеличивать длину кода, но мало помогать содержательному объединению товаров.
На каждом уровне новый кодбук приближает остаток после предыдущих уровней.
Источник: Александр Тришин · Wildberries · RecSys MeetupVQ-VAE: учить представление вместе с дискретным кодированием
Следующий рассмотренный шаг — встроить VQ в автоэнкодер. Автоэнкодер сначала преобразует вход в скрытое представление, а затем пытается восстановить исходные данные. В VQ-VAE между этими частями появляется дискретный выбор: вместо произвольного скрытого вектора декодер получает выбранный вектор кодбука. Так модель должна одновременно научиться представлять данные и приспосабливать их к ограниченному словарю.
В презентации названы три функции потерь. Reconstruction Loss отвечает за восстановление. Codebook Loss подстраивает представителей кодбука к выходам энкодера. Commitment Loss, наоборот, удерживает выход энкодера рядом с выбранным представителем, чтобы кодирование и формирование скрытого вектора не расходились. Это объясняет, почему одной ошибки восстановления недостаточно для описанной схемы обучения.
В формулах используется stop-gradient, обозначенный sg: численное значение аргумента сохраняется, но через эту ветвь не передаётся градиент. Благодаря этому можно отдельно двигать векторы кодбука к выходу энкодера и выход энкодера к выбранным векторам, не смешивая роли соответствующих слагаемых.
У исходного рисунка есть несогласованность обозначений. Схема показывает x → encoder → x′ → codebook → eₖ → decoder → y, но ошибку реконструкции печатает как ||x′ − y||²₂. При этом x′ подписывает именно скрытое представление. Поэтому эту запись нельзя принимать за проверенную формулу реализации или молча исправлять от имени автора.
Далее — отдельное математическое объяснение ролей потерь с собственными согласованными обозначениями. Пусть h — вход автоэнкодера, z = E(h) — скрытый вектор, cₖ — выбранный представитель, а ĥ = D(cₖ) — восстановленный вход. В такой учебной записи сравнение h и ĥ описывает реконструкцию, а два оставшихся слагаемых направляют обновления в разные части модели.
Собственное математическое пояснение трёх ролей потерь. Первое слагаемое не воспроизводит спорную реконструкцию со слайда; второе и третье соответствуют показанному разделению через stop-gradient. Коэффициенты суммирования и реализация WB не заданы.
Размеры кодбука на схеме обозначены символически, а не конкретной конфигурацией эксперимента. Ни эти обозначения, ни обзор трёх потерь не означают, что автоэнкодер вошёл в итоговое решение: далее команда откажется от рассмотренных вариантов квантизации.
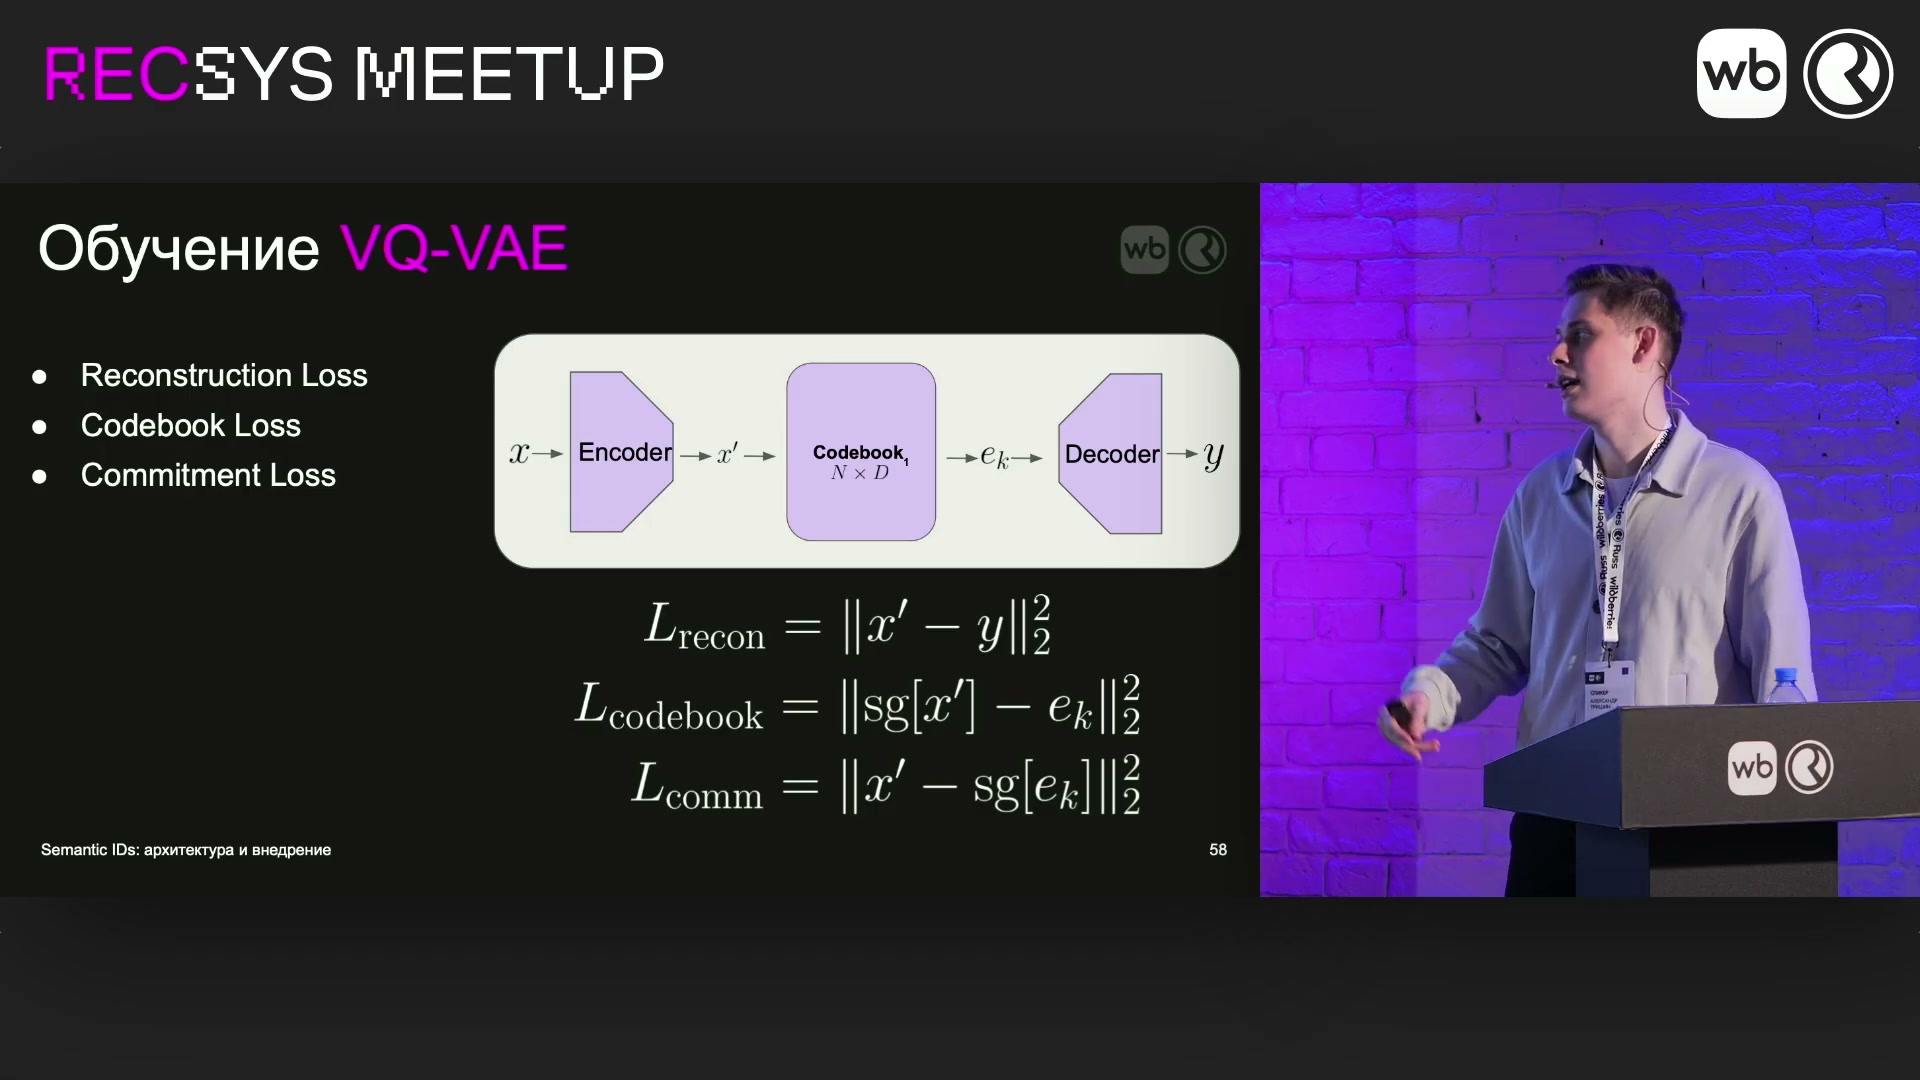
Показаны reconstruction, codebook и commitment loss со stop-gradient. В реконструкции на слайде x′ сравнивается с y, хотя x′ подписывает скрытое представление: обозначения не согласованы, не переносим их как проверенную формулу реализации.
Источник: Александр Тришин · Wildberries · RecSys MeetupПочему дискретный выбор мешает градиенту и что делает STE
Выбор ближайшего элемента кодбука — дискретная операция. Небольшое изменение входа может оставить выбранный индекс прежним, а пересечение границы между областями выбора переключает его. Обычное обратное распространение ошибки через такой выбор не даёт нужного обучающего сигнала энкодеру. Наличие функции потерь само по себе эту трудность не устраняет.
Прямой перенос градиента, Straight-Through Estimator или STE, обходит проблему приближённо. В прямом проходе по-прежнему берут выбранный дискретный вектор. В обратном градиент со входа декодера передают на выход энкодера, минуя блок квантизации. Именно такое направление показано на исходной схеме.
Для обратного прохода это эквивалентно замене квантизации тождественным преобразованием: как будто значение прошло через блок без изменения. Но фактически в прямом проходе изменение было. Поэтому STE — договорённость о передаче градиента, а не доказательство дифференцируемости самого argmin. Автор связывает такое приближение с неоптимальностью обучения и дальше рассматривает способы изменить этот участок.
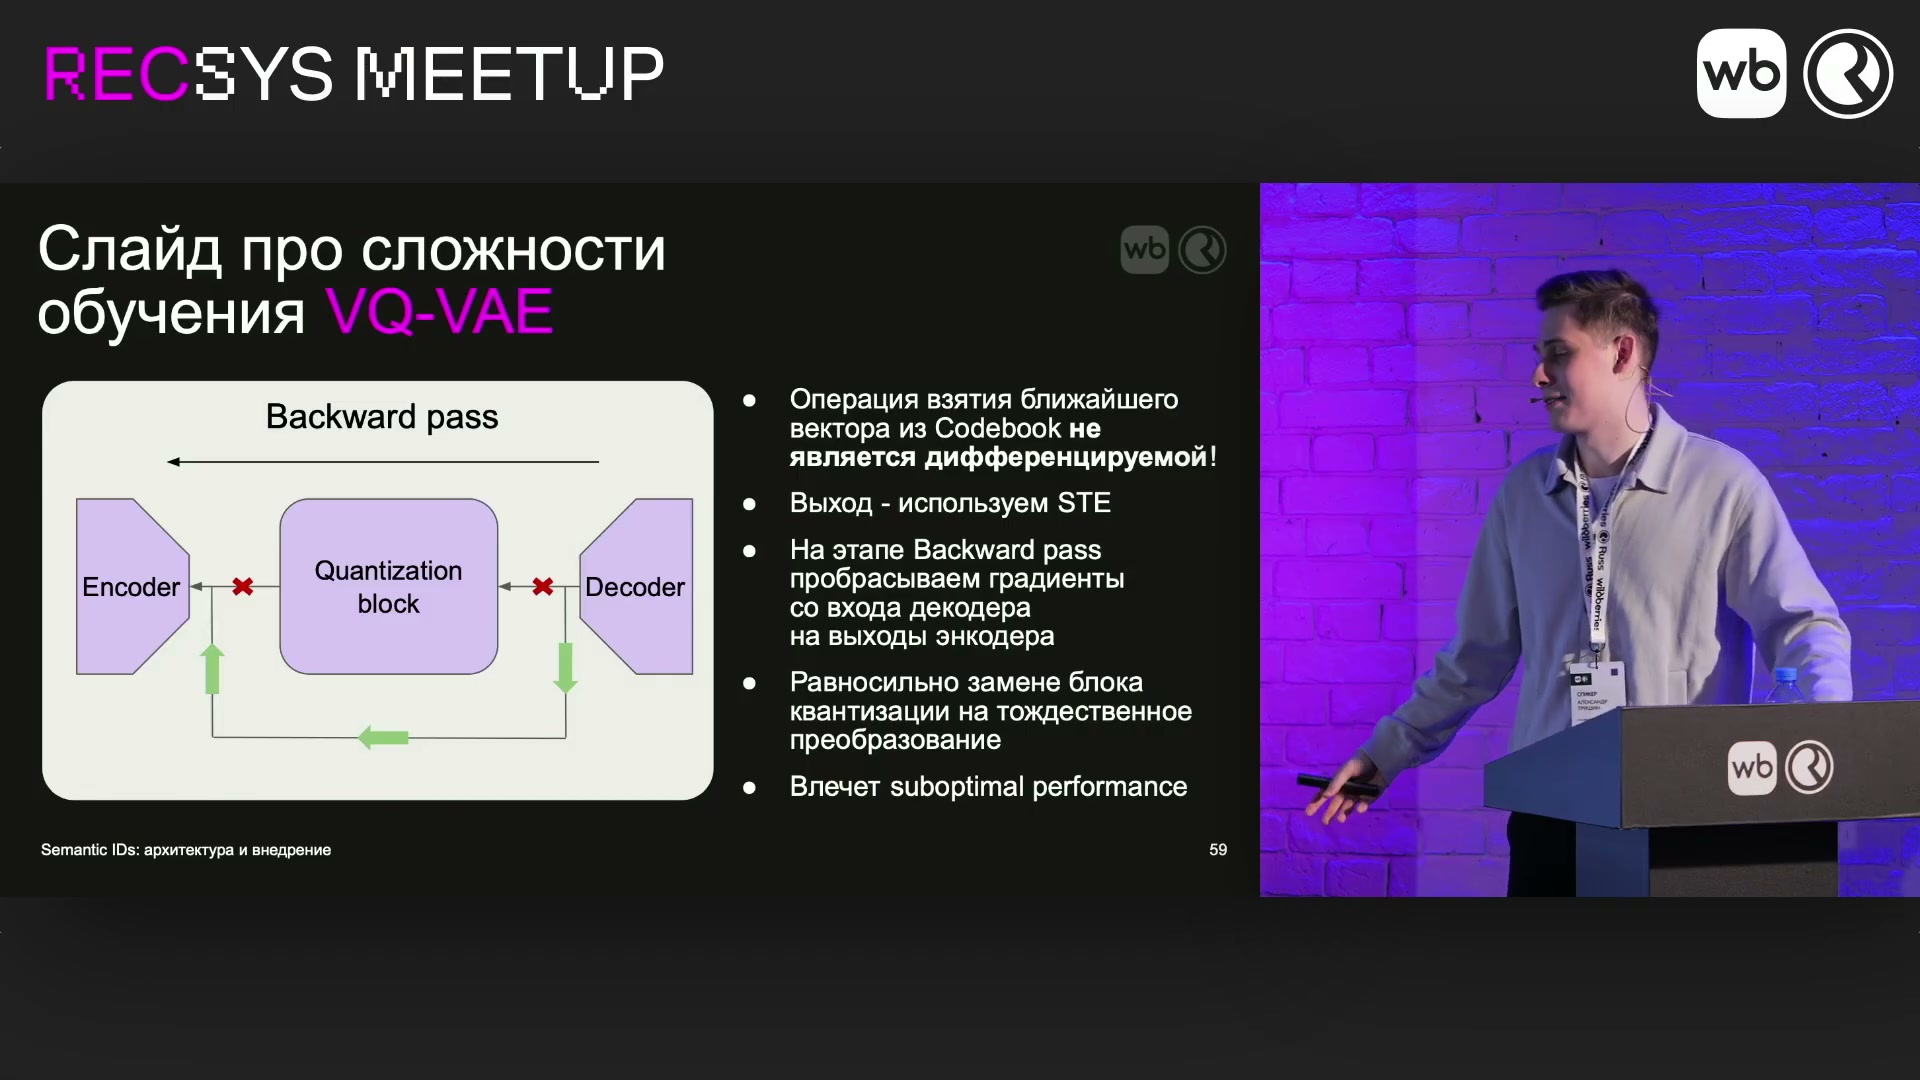
Выбор ближайшего кода не дифференцируем. STE переносит градиент через квантование приближённо, не делает сам argmin дифференцируемым.
Источник: Александр Тришин · Wildberries · RecSys MeetupRQ-VAE: больше уровней не гарантирует полезных групп
В RQ-VAE внутри автоэнкодера вместо одного кодбука используется последовательность остаточных уточнений. Такая конструкция совмещает обучение скрытого представления и составной дискретный код. Проблема передачи градиента через выбор ближайшего представителя при этом сохраняется: дополнительные уровни её не отменяют.
Для задачи Wildberries существенен и дисбаланс размеров полученных кластеров. Автор описывает группы из одного товара. С точки зрения различения объектов это допустимый результат, но с точки зрения объединения разреженной истории он мало помогает: у одиночной карточки не появляется дополнительного опыта соседних товаров.
Другая проблема — коллапс кодбука, codebook collapse. Под этим автор понимает ситуацию, когда при обучении и применении выбирается только небольшая часть его векторов. Формально словарь большой, однако фактическая выразительность ограничена активной частью. Остальные представители практически не участвуют в описании данных.
Важно не смешивать эти симптомы. Одиночные кластеры говорят о недостаточном объединении товаров, а неактивные векторы — о неиспользованной ёмкости словаря. Вместе с трудностью обучения они делают такой код неудобным для исходной задачи, хотя он всё ещё остаётся корректным дискретным обозначением объектов.
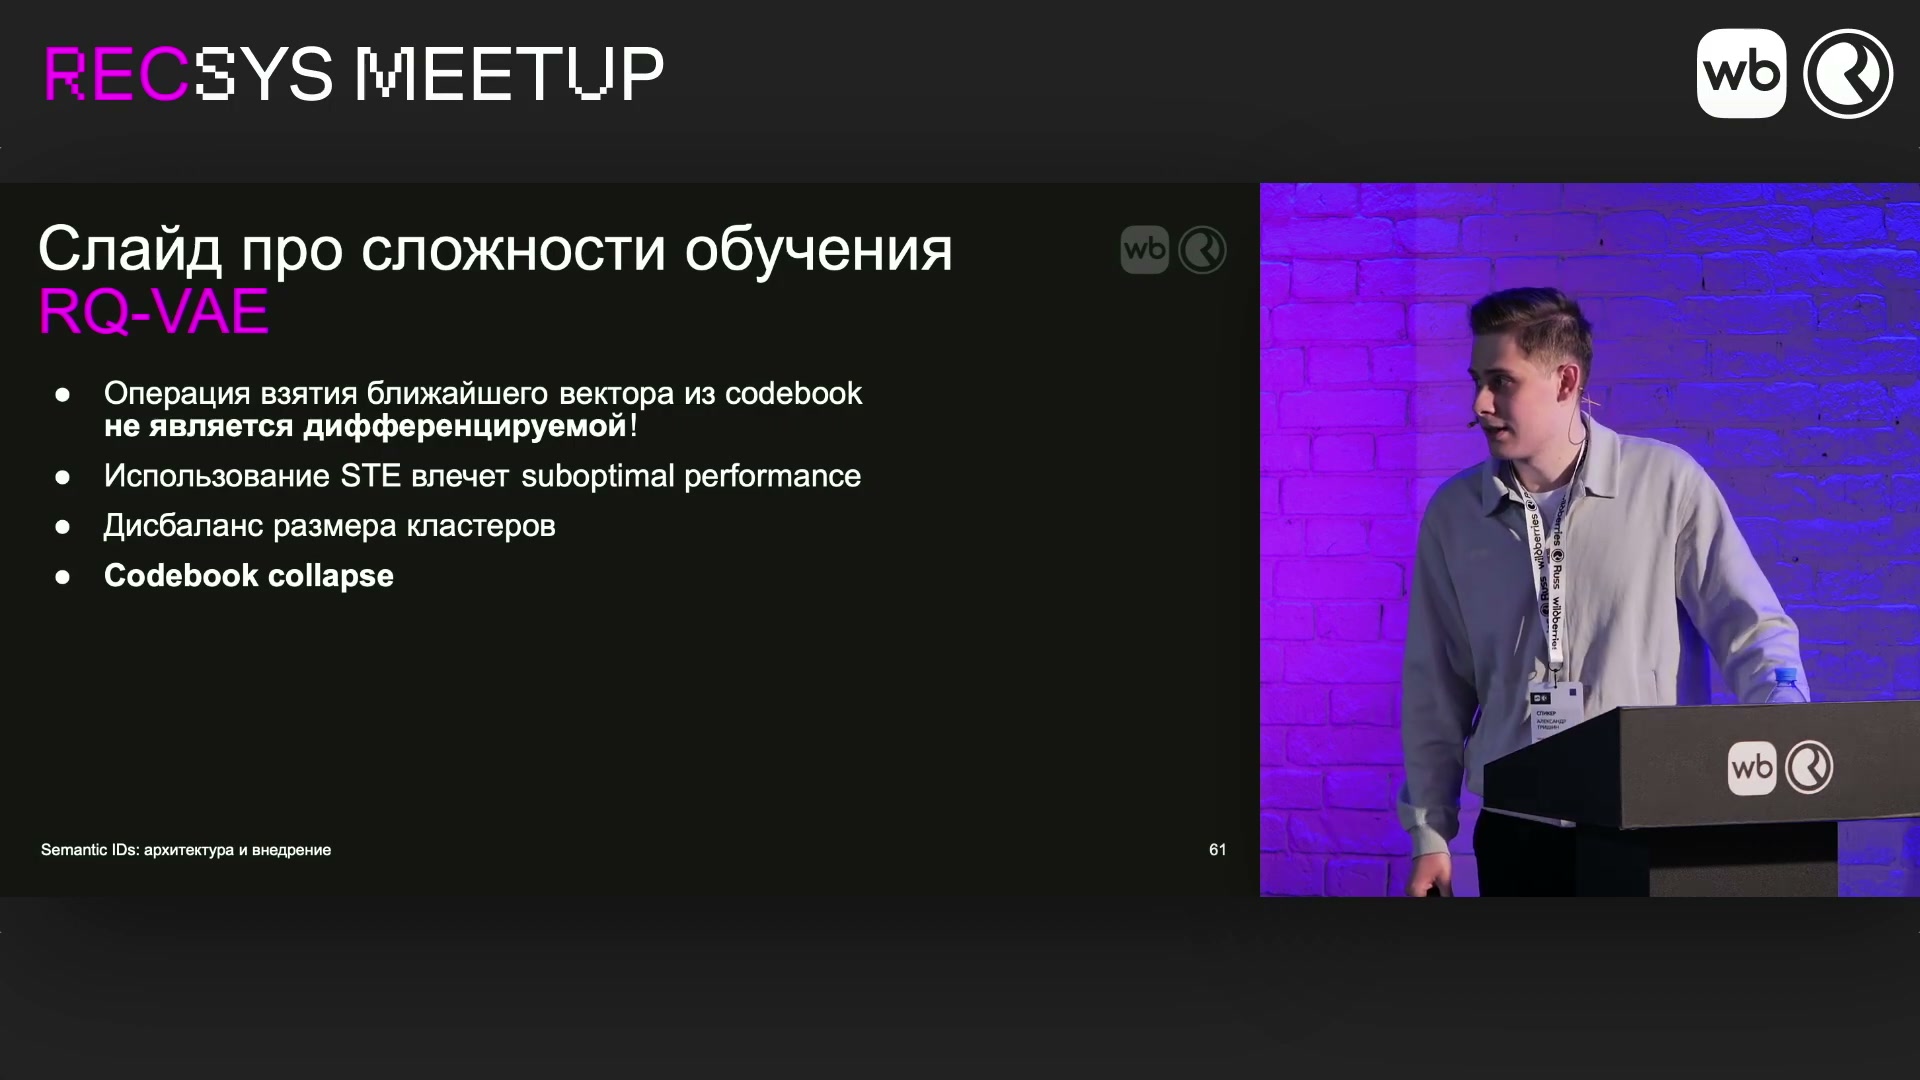
Автор перечисляет нестабильность, дисбаланс размеров кластеров и codebook collapse. Это опыт задачи WB, не универсальное отрицание метода.
Источник: Александр Тришин · Wildberries · RecSys MeetupКак пытались оживить неиспользуемые коды
Коллапс можно пытаться исправить на нескольких уровнях. Самый прямой вариант — заново случайно инициализировать неактивные векторы. Другой — заменить обновление через Codebook Loss на экспоненциальное скользящее среднее, EMA: обновлять представителей через сглаженное накопление информации. На слайде также названа регуляризация ортогональности векторов кодбука — дополнительное ограничение на их взаимные направления.
Отдельно автор выделяет SimVQ. По его объяснению, вместо одной матрицы кодбука используют произведение двух. Такая параметризация позволяет неактивным весам изменяться за счёт активных и тем самым помогает бороться с «мёртвыми» представителями. Это та степень детализации, которая есть в выступлении: размеры матриц, их инициализация и режимы фиксации или обучения не раскрыты.
Все эти варианты направлены на использование словаря, но не обязательно решают другую задачу — получение удобной иерархии товаров. Даже активно используемый кодбук может создавать слишком мелкие или слишком крупные группы. И наоборот, устойчивость отдельного обучающего шага не доказывает, что соседние уровни будут различаться на полезную величину.
Перечень способов борьбы с коллапсом не сопровождается таблицей отдельных экспериментов. В нём нельзя прочитать, какой именно приём сколько добавил к метрике или какая комбинация оказалась лучшей. Дальнейший вывод автора относится к совокупному опыту команды: несмотря на попытки исправления, рассмотренные подходы не стали основой внедрения.
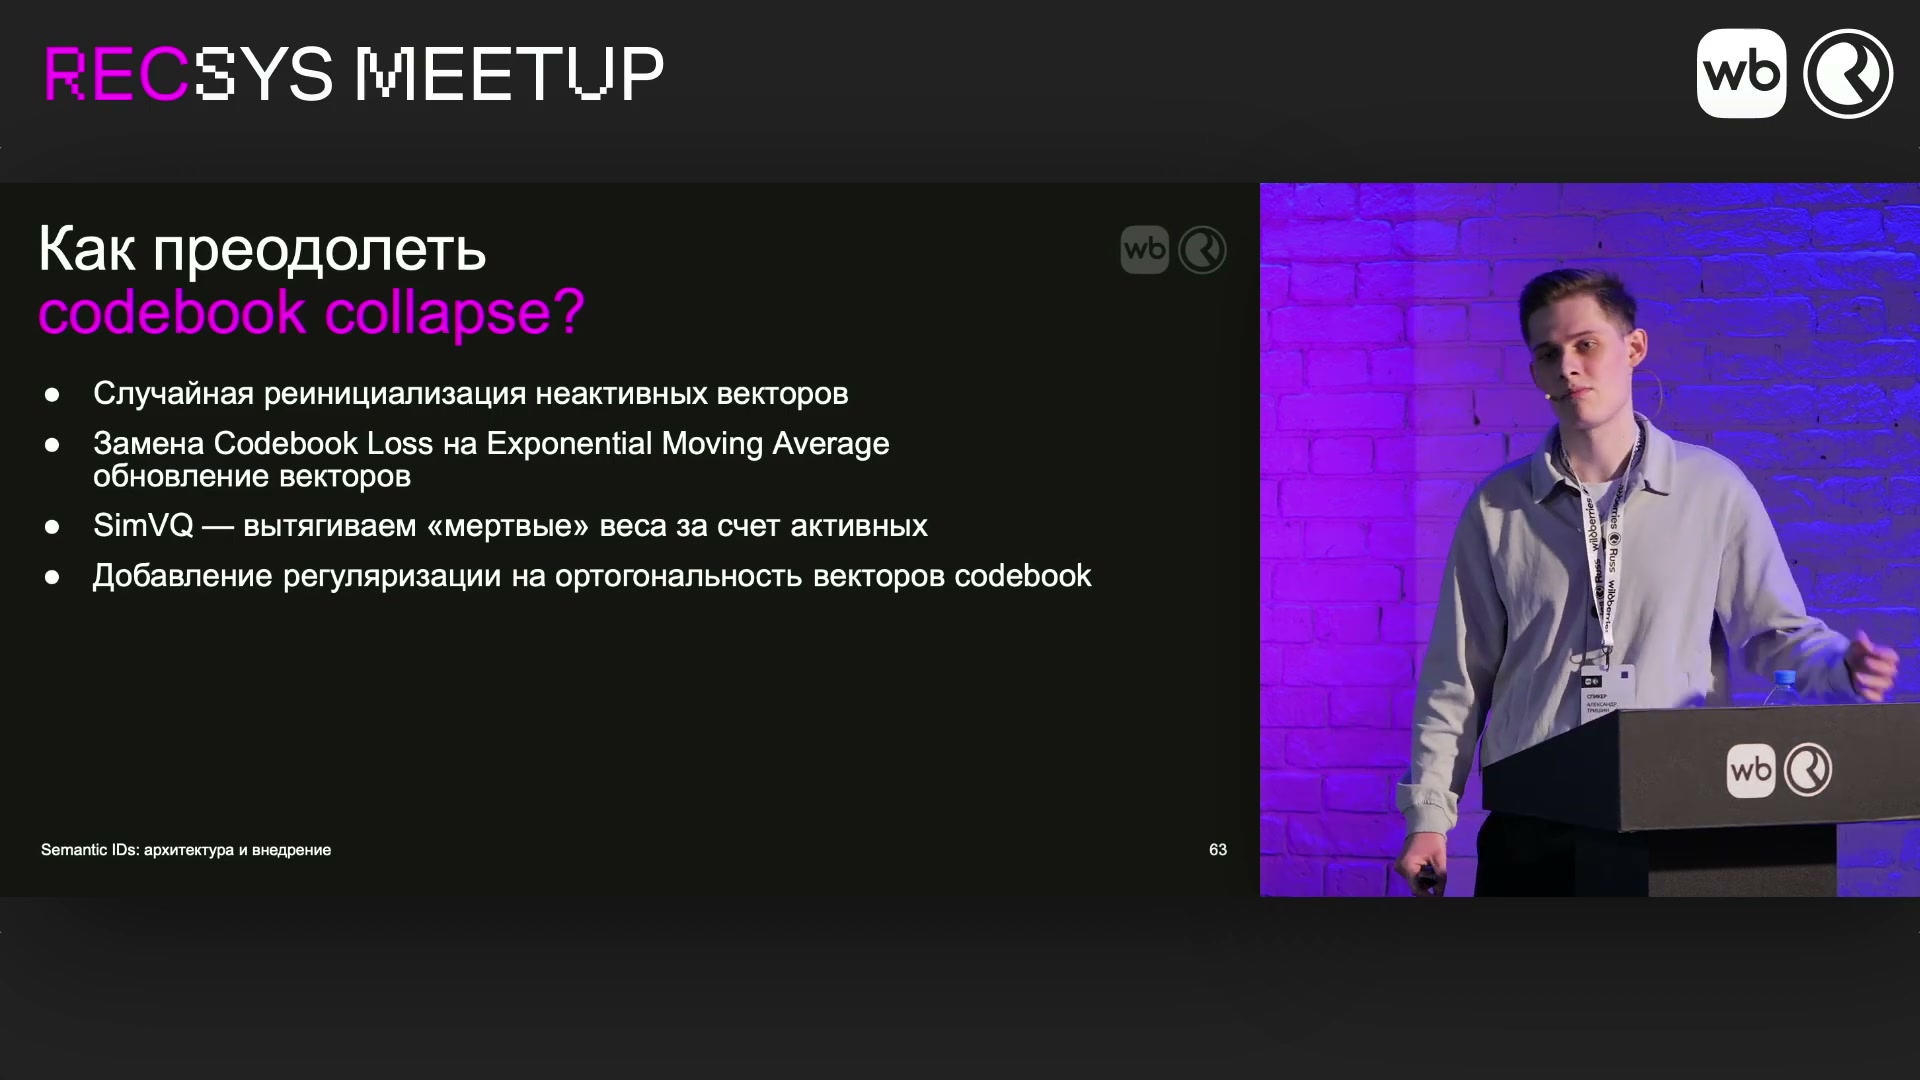
Реинициализация, EMA, SimVQ и регуляризация ортогональности рассмотрены как варианты; их наличие на слайде не означает успех каждого в WB.
Источник: Александр Тришин · Wildberries · RecSys MeetupАльтернативы жёсткому обходу: Gumbel-Softmax и rotation trick
Другая линия изменений касается не активности кодов, а передачи обучающего сигнала через дискретный выбор. Вместо простого STE автор рассматривает Gumbel-Softmax и rotation trick. Эти методы обсуждаются как альтернативы внутри обзора, а не как компоненты выбранной иерархии Wildberries.
В объяснении Gumbel-Softmax сначала появляется эквивалентность способов случайного выбора. Пусть xᵢ — исходные числовые оценки вариантов, а softmax превращает их в вероятности π. Вместо непосредственного выбора по этим вероятностям можно добавить к оценкам шум из стандартного распределения Гумбеля и выбрать максимальную сумму. Это формула, читаемая на исходном кадре.
Формула Gumbel-выбора с исходного кадра 00:12:00. j — выбранный индекс; 0 и 1 — параметры указанного распределения, а не настройки модели WB.
Затем жёсткий индекс заменяют приближённым one-hot-вектором. В точном one-hot единица стоит только у выбранного варианта, остальные координаты нулевые. Для мягкого приближения к зашумлённым оценкам применяют softmax с температурой τ: она регулирует, насколько распределён или сосредоточен результат.
Формула мягкого приближения с исходного кадра 00:12:00. При положительной τ используется непрерывный softmax; уменьшение τ приближает выбор к one-hot.
При стремлении положительной температуры к нулю масса сосредотачивается на максимальном варианте, если максимум единственный. Здесь важно различать мягкое приближение и его предел: гладкость выражения при τ > 0 не означает, что жёсткий argmax стал гладким. Устную формулировку о «дифференцируемом argmax» поэтому следует понимать через замену операции на приближение, а не как свойство самого дискретного выбора. Расписание температуры и результат отдельного эксперимента в докладе отсутствуют.
Идея rotation trick в изложении автора геометрическая: выбранный вектор Q получают из исходного E сочетанием поворота и изменения масштаба, описанного как сжатие. Поскольку такие преобразования гладкие, их используют для представления перехода между векторами. Это объяснение альтернативного способа работы с градиентом; оно не делает дискретный поиск ближайшей центроиды дифференцируемым. Полная формула, условия преобразования и устройство обратного прохода в предоставленных материалах не раскрыты.
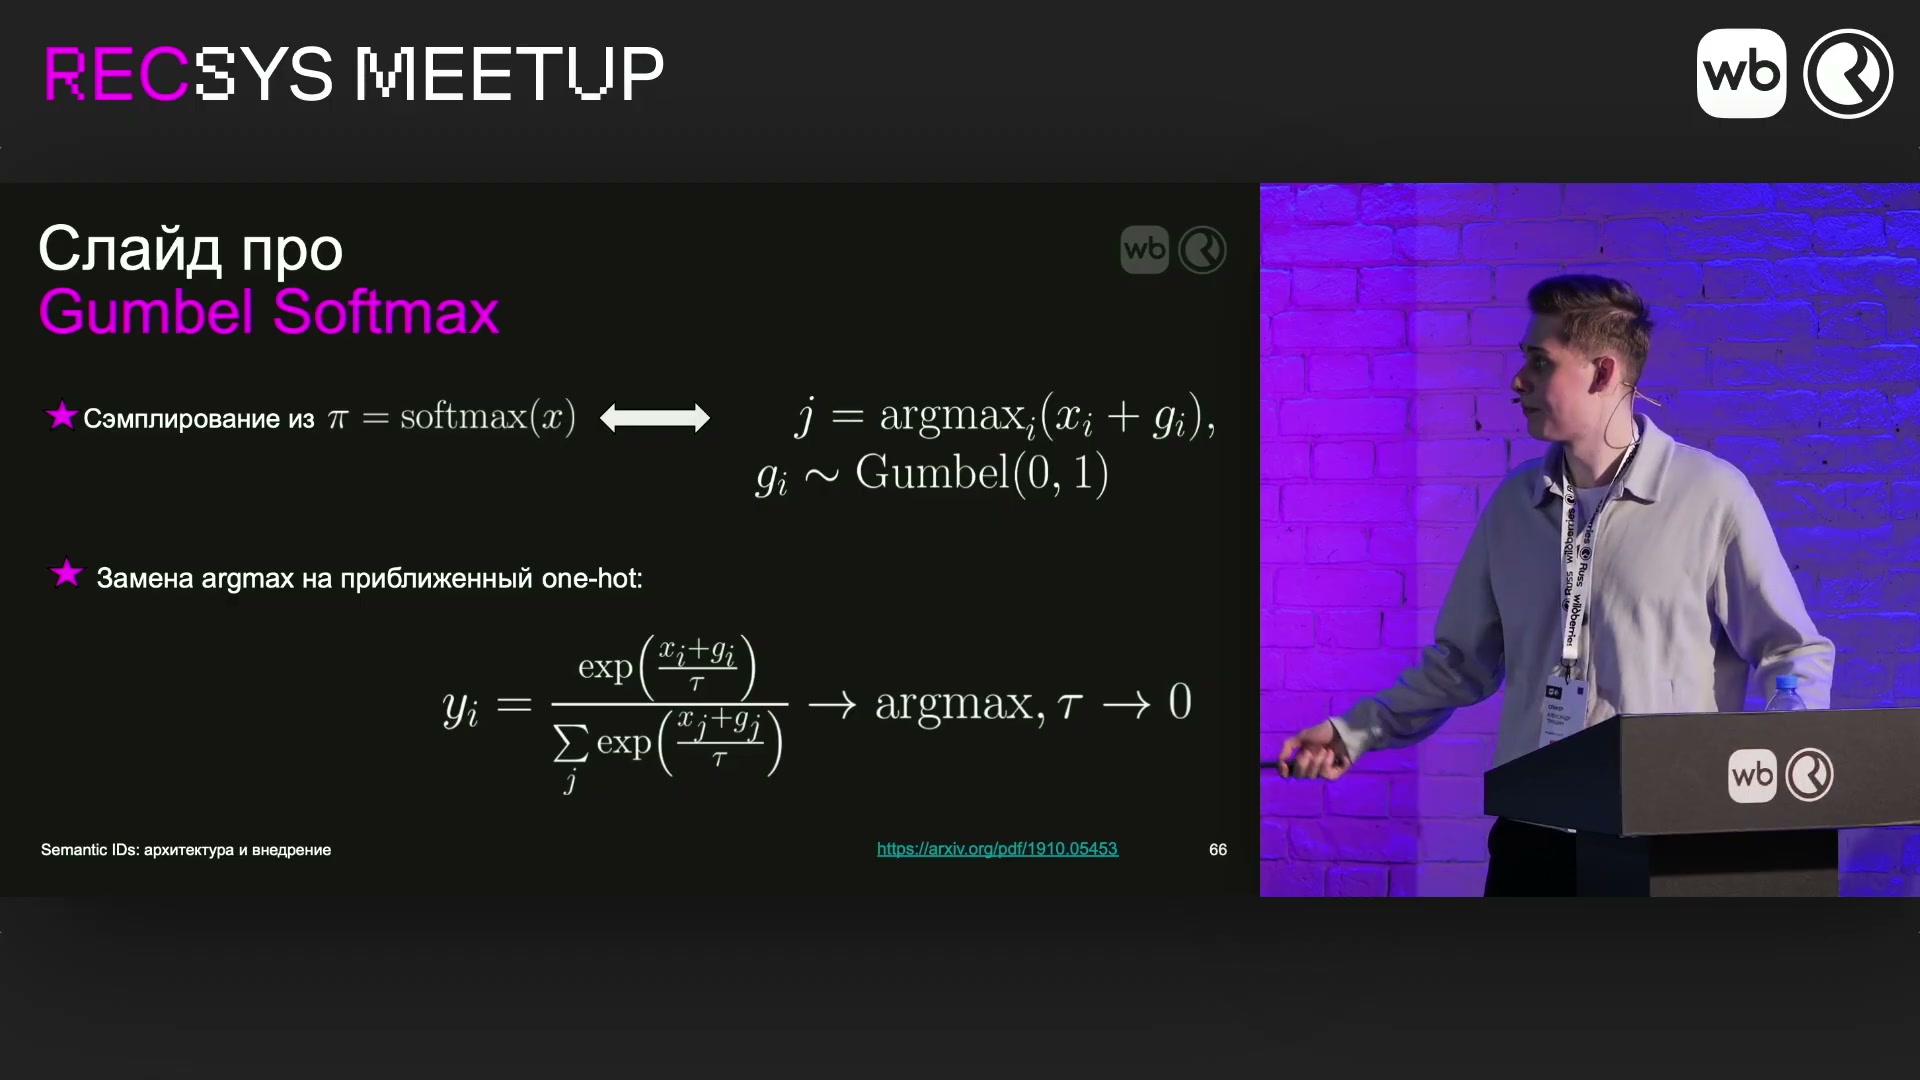
Сэмплирование через Gumbel-шум и непрерывное приближение one-hot объясняют альтернативу жёсткому выбору. Не утверждаем промышленное применение WB.
Источник: Александр Тришин · Wildberries · RecSys MeetupRQ-KMeans: получать кодбуки через кластеризацию
RQ-KMeans стоит в обзоре несколько отдельно. Последовательность остаточных уточнений сохраняется: каждый следующий этап квантует текущую невязку. Меняется способ получения представителей — их находят кластеризацией K-means, а не описанной выше схемой нейросетевого обучения кодбука.
В K-means представитель является центроидой группы. Именно этим автор объясняет заявленное преимущество RQ-KMeans: отсутствие «мёртвых» векторов в рассматриваемом подходе, поскольку представители получаются из кластеризации данных. Это аргумент докладчика, а не универсальная гарантия для любой реализации и любых входных данных.
Отдельные размеры кодбуков, число остаточных этапов, настройки K-means и количественное сравнение в записи не приведены. Метод не нужно путать с итоговой адаптивной иерархией: наличие кластеризации в обоих описаниях не делает их одним алгоритмом. В RQ-KMeans последовательно кодируют невязки; в выбранной системе объединяют группы товаров снизу вверх.
Доклад · 00:12:28Почему команда отказалась от рассмотренных вариантов
После обзора автор делает ключевое уточнение: ни один из перечисленных алгоритмов команда не использует. Причина не в том, что коды невозможно получить. Они не обеспечили нужного сочетания устойчивости и содержательной детализации. Обучение оставалось крайне нестабильным, коллапс не удалось устранить, а единичные кластеры не решали задачу объединения истории.
Отдельная проблема — резкий скачок гранулярности, то есть размера и смысловой детализации групп. На нижнем уровне могло оказаться много очень маленьких кластеров, а непосредственно выше — уже мало огромных. У рекомендательной модели не оставалось удобной промежуточной единицы: либо почти отдельная карточка, либо слишком широкое объединение.
Диагностический график показывает нормы векторов разных кодбуков. Норма характеризует величину вектора. Для первого кодбука она близка к единице, для остальных — к нулю. В легенде приведены Codebook 0, 1, 2 и 3; это четыре серии конкретной иллюстрации, а не число уровней итоговой иерархии.
Интерпретация автора такова: первый кодбук захватил почти всю информацию о товарах, последующим осталось в основном описывать шум. Поэтому увеличение длины кода не превратилось в последовательное полезное уточнение. Сам график норм не даёт таблицы качества групп, но в рассказе служит подтверждением того, почему команда не увидела нужной иерархии.
Это вывод из задачи и экспериментов Wildberries, не универсальное отрицание VQ, RQ или автоэнкодеров. По записи нельзя восстановить точную конфигурацию каждого опыта и отделить вклад всех модификаций. Зато ясно, какое требование не было выполнено: управляемые, осмысленные уровни объединения товаров важнее одной только формальной ёмкости дискретного кода.
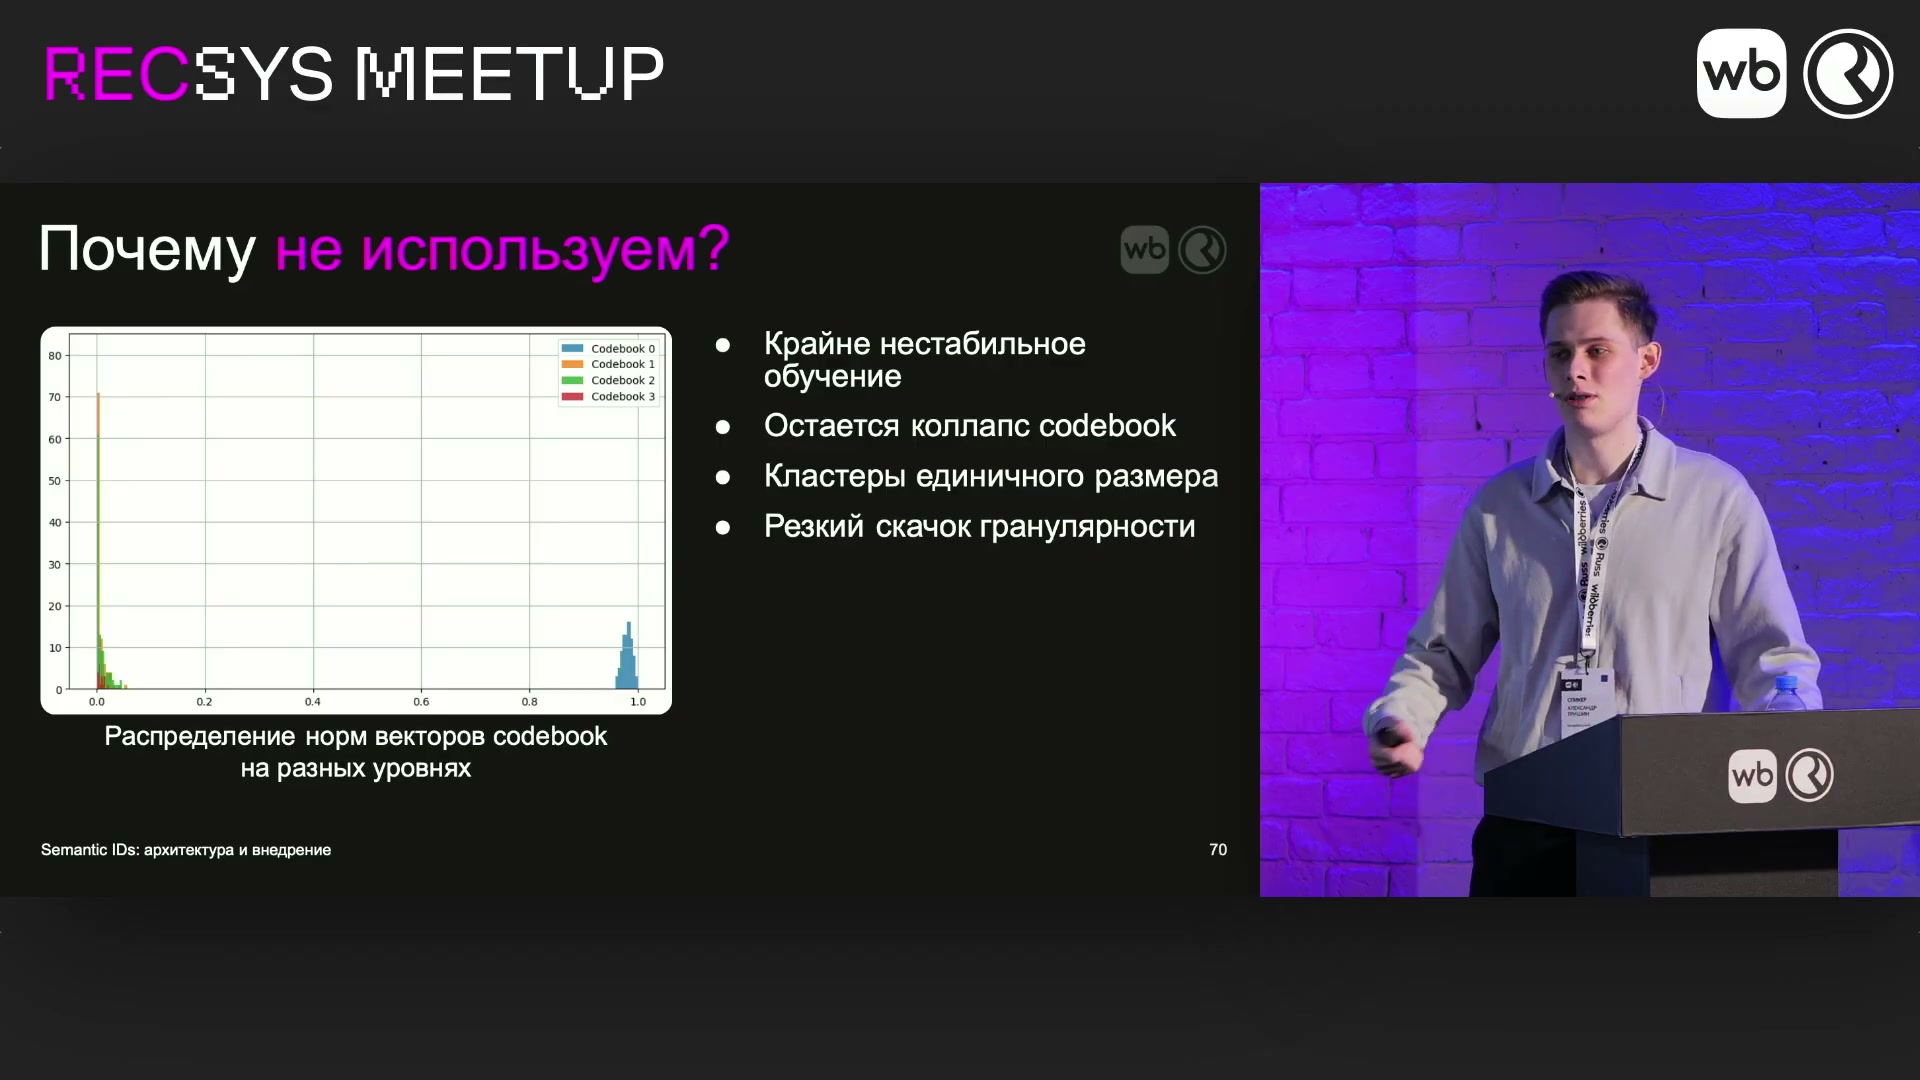
Нестабильность, неактивные коды, единичные кластеры и резкие изменения гранулярности побудили искать другой способ построения иерархии.
Источник: Александр Тришин · Wildberries · RecSys MeetupИзменить направление: не дробить крупное, а объединять близкое
В объяснении автора рассмотренные способы сначала задают грубое описание, а затем уточняют его. Он интерпретирует это как построение иерархии сверху вниз: сначала выделить большую сущность, например платья, затем продолжать детализацию внутри неё. Эта интерпретация помогает сформулировать опасность ранней ошибки.
Сразу выделить хорошие крупные группы из огромного каталога трудно. Если на верхнем шаге платье попало к блузкам, а следующие шаги продолжают работать только внутри выбранной ветви, оно уже не вернётся к платьям. Ошибка первого разбиения ограничивает все последующие уточнения. Это конкретный пример того, почему удобная схема декомпозиции ещё не гарантирует пригодную структуру каталога.
Команда меняет направление. Сначала получает много небольших групп с максимально близкими товарами, затем объединяет их в более крупные. Построение идёт снизу вверх, хотя готовый код по-прежнему можно читать от общей группы к частной. Не следует смешивать направление создания дерева и направление чтения префикса.
Такой подход позволяет использовать уже имеющиеся сущности на нижних уровнях и отдельно регулировать детализацию последующих объединений. Если несколько почти одинаковых платьев сначала разъехались по мелким группам, это ещё можно исправить слиянием. Вопрос теперь не в том, как заранее угадать весь словарь крупных сущностей, а в том, какие уже содержательные небольшие группы разумно объединить.
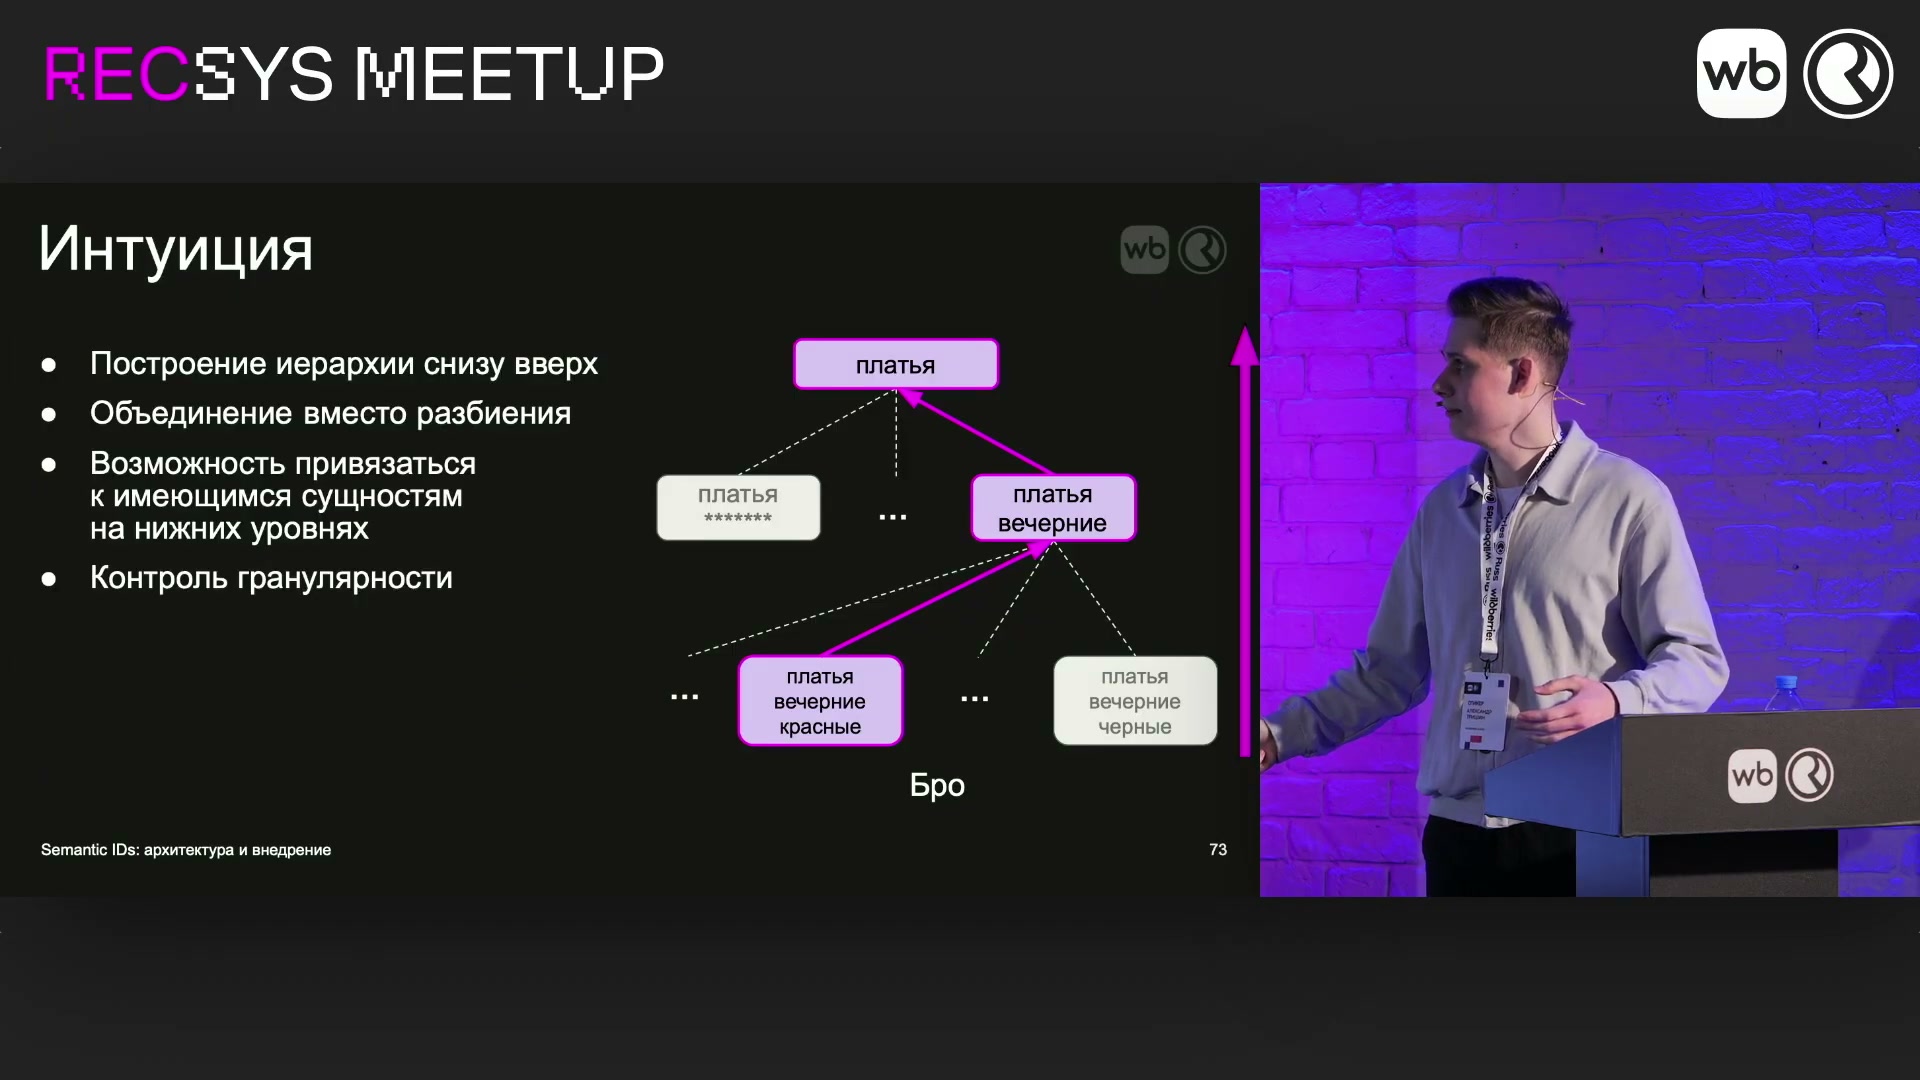
Вместо многократного разбиения крупных групп объединяют небольшие; можно опираться на существующие сущности и контролировать гранулярность.
Источник: Александр Тришин · Wildberries · RecSys MeetupКак устроено адаптивное объединение кластеров
На самом нижнем уровне требуется много маленьких кластеров с максимально похожими товарами внутри. Приоритет — внутренняя согласованность группы, а не немедленный сбор всех похожих вещей во всём каталоге. В примере длинные чёрные платья с разрезом могут оказаться в нескольких кластерах: для этого этапа автор считает такое избыточное дробление допустимым.
Первое объединение исправляет именно эту мелкость разбиения. Оно собирает близкие нижние кластеры и передаёт более крупные группы на следующий уровень. При этом работа ещё ограничена существующей сущностью — в описанном случае Subject ID. То есть сравниваются и объединяются группы внутри одной такой категории.
Следующие объединения выполняются уже вне границ исходных сущностей. Параметры могут отличаться, но идея остаётся прежней: из более мелких групп строить более крупные. Благодаря этому итоговая иерархия не обязана повторять готовый каталог категорий. Схема показывает, что группы из разных исходных сущностей могут участвовать в последующем объединении.
- 01
Получить мелкие согласованные группы
Работать с визуальными представлениями; внутри нижнего кластера собирать максимально похожие товары, допуская избыточное разделение похожих вещей.
- 02
Исправить дробление внутри Subject ID
Объединить близкие нижние кластеры в рамках имеющейся сущности, например собрать разнесённые группы сходных чёрных платьев.
- 03
Продолжить объединение вне сущностей
Применить объединение к полученным группам уже без прежних категориальных границ; параметры на следующем этапе могут быть другими.
- 04
Получить уровни для составного кода
Использовать полученную иерархию для разных степеней детализации: нижние группы обозначаются полным кодом, более широкие — его префиксом.
Ключевая операция называется в докладе merge — объединение. Её реализация описана как кластеризация с адаптивным подбором числа кластеров и набором эвристик. Конкретный базовый алгоритм, критерий выбора числа групп, пороги и сами эвристики не названы. Поэтому из этого описания нельзя сделать вывод о применении какого-либо конкретного стандартного алгоритма агломерации или дописать готовый рецепт настройки.
Главное отличие от RQ-KMeans — объект следующего шага. Здесь объединяются кластеры товаров, чтобы получить полезный уровень обобщения. Речь не идёт о повторном квантовании остатка вектора. Именно контроль такой детализации и становится центральным свойством выбранного решения.
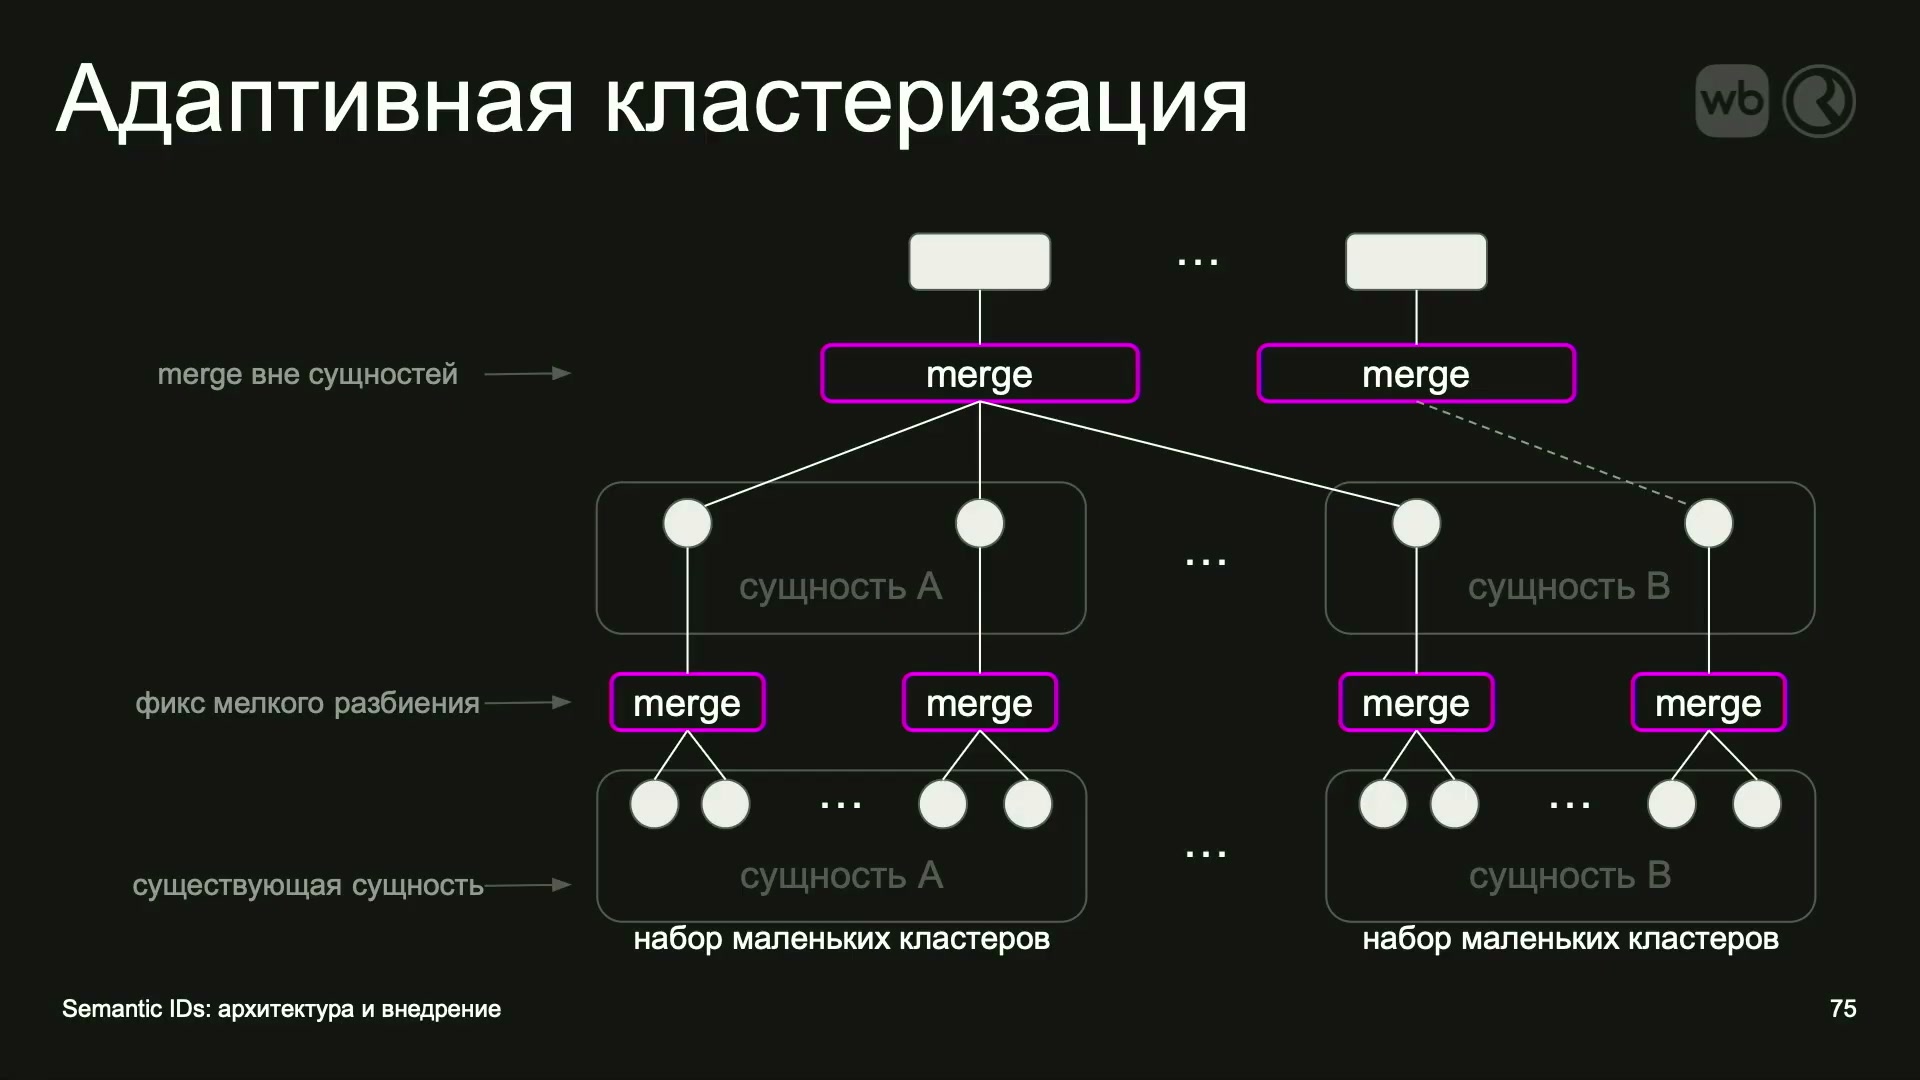
Сначала исправляют слишком мелкое разбиение внутри сущностей, затем объединяют группы между сущностями.
Источник: Александр Тришин · Wildberries · RecSys MeetupКак читать получившееся дерево обуви
Пример с обувью показывает, ради чего нужны промежуточные уровни. В одной ветви из широкой группы обуви выделяются тапки, затем Crocs, а ниже — серые варианты с красной надписью, серые с серой надписью и чёрные. Получается не просто группа «обувь» и не набор независимых карточек, а несколько последовательных степеней сходства.
В другой ветви показана группа с подписью Nike Air Force, внутри которой выделены Nike Air Force Low и Nike Air Force Venom. Это иллюстративные подписи ветвей, показывающие переход от общей модели обуви к более узким группам.
Подъём по дереву объединяет более разнообразные варианты, спуск оставляет более узкий набор. Это и делает разные длины префикса потенциально полезными для разных задач. Однако несколько удачных поддеревьев ещё не измеряют качество всей иерархии: остаётся отдельно проверить, нет ли чужих товаров внутри группы и собраны ли туда все подходящие карточки.
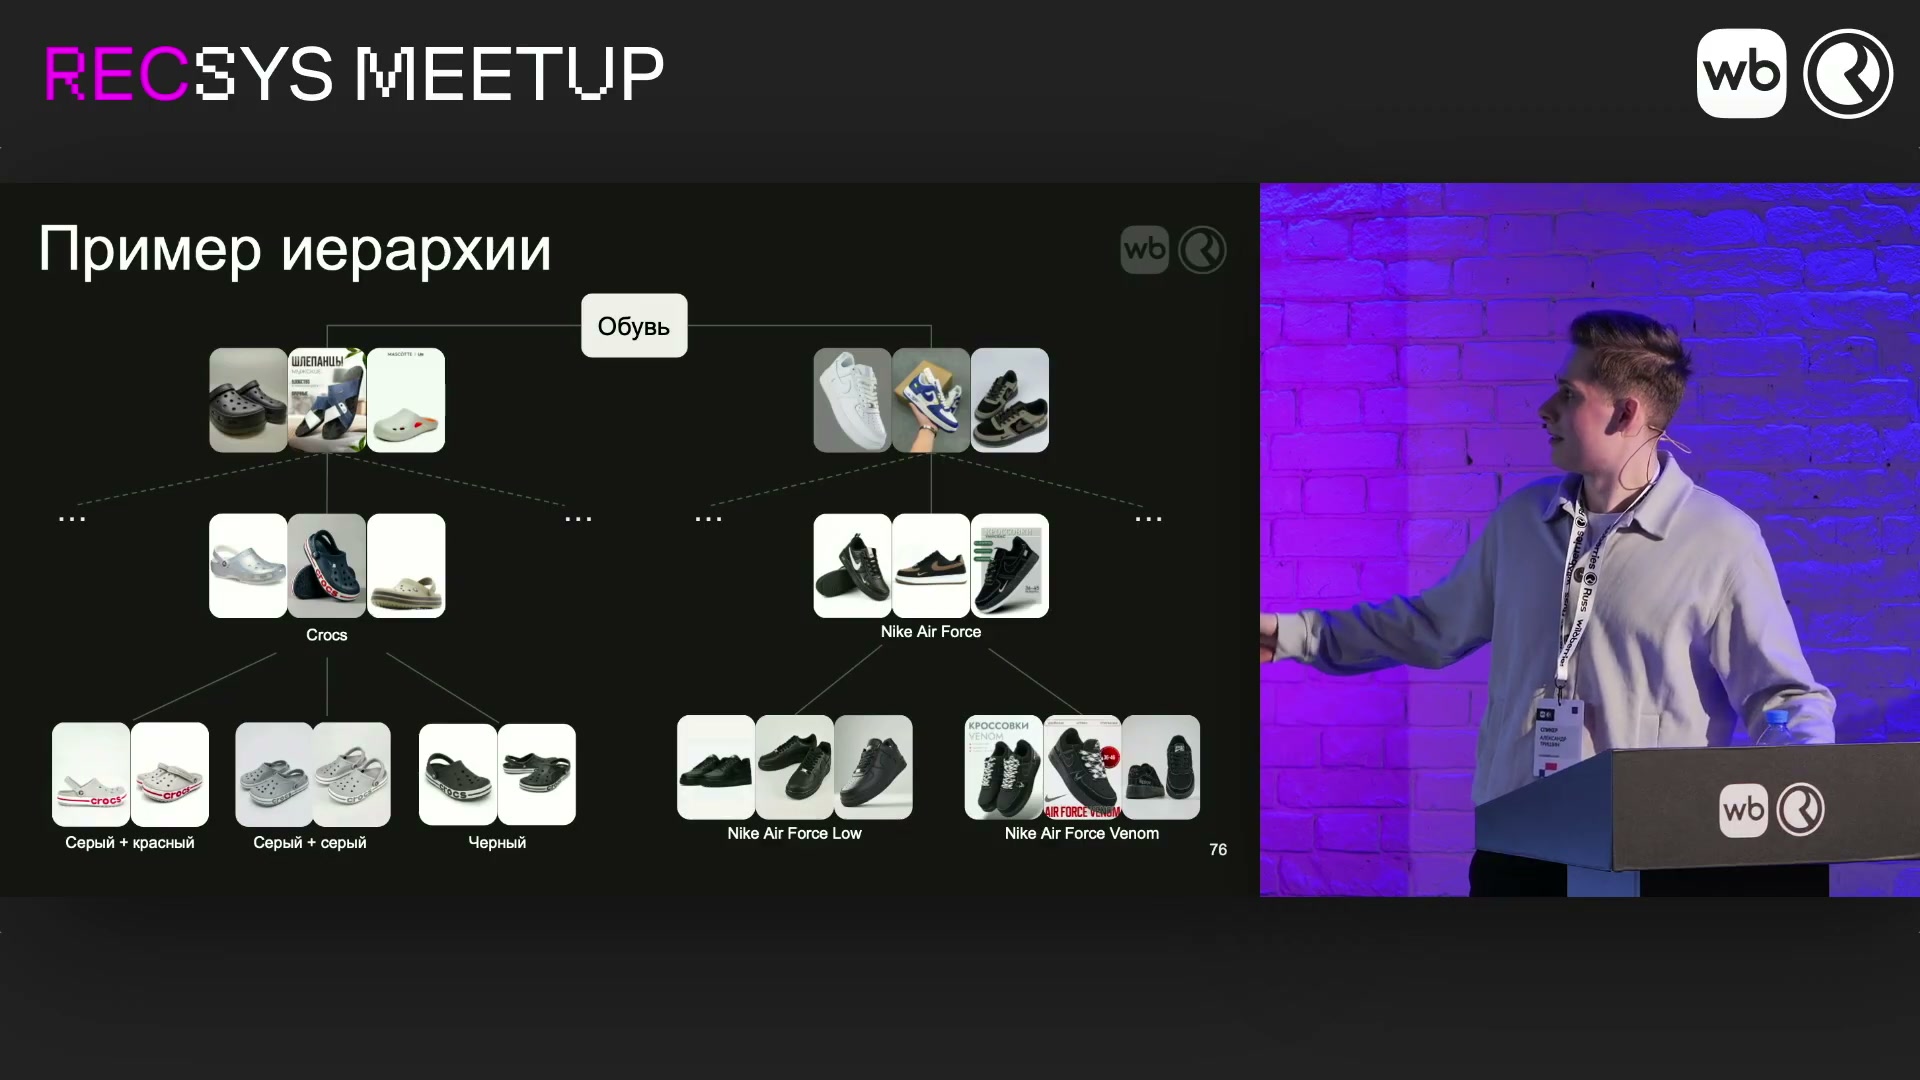
Иерархия уточняет обувь до конкретных групп. На слайде действительно написано Nike Air Force Low и Venom; это названия иллюстрации, не проверка подлинности товаров.
Источник: Александр Тришин · Wildberries · RecSys MeetupСколько в дереве кодов и почему длина зависит от задачи
В ответах на вопросы автор приводит характеристики дерева, которых не было в основной схеме. Здесь важно отличать полную длину кода от числа компонентов, реально полезных конкретной модели. Нижний уровень очень подробный, а часть наиболее общего описания уже известна из существующей крупной сущности.
Таблицу можно прокрутить по горизонтали.
Числа 4,6 млн кодов и 4,5 млн нижних узлов произнесены в разных репликах. Источник не объясняет различие, поэтому их нельзя согласовать придуманным округлением, иной выборкой или разными версиями дерева. Раннее «около четырёх миллионов» также остаётся отдельной приблизительной характеристикой графика популярности.
Ветвление неоднородно. По объяснению автора, разнообразная женская одежда образует более широкое дерево, а менее разнообразная группа посуды — более узкое. Уменьшение общего числа узлов при подъёме не означает, что каждый родитель обязан иметь одинаковое число детей.
В том же ответе уточняется, что большие числовые значения из примеров на слайдах не являются реальными ID. Название целочисленного типа в расшифровке читается ненадёжно, поэтому разрядность хранения из выступления установить нельзя. Семь компонентов кода — не семь байтов и не опубликованный размер записи в памяти.
Доклад · 00:26:29Каталог меняется: новое не всегда помещается в старые группы
Построить понятное дерево один раз недостаточно. На маркетплейсе появляются новые карточки, исчезают старые и возникают новые типы товаров. Поэтому сопровождение включает и работу с содержимым каталога, и обновление самой иерархии. Это связанные, но разные задачи.
Назначение новому платью кода уже известной группы — один случай. Появление принципиально новой для каталога сущности — другой: подходящего кластера раньше могло не быть. В презентации таким примером служат лабубу. Автор использует их, чтобы объяснить потребность создавать новые группы, а не только добавлять карточки к существующим.
Из доклада не следует готовый режим непрерывного обновления. Не названы частота пересборки дерева, срок назначения кода новой карточке и конкретное правило открытия нового кластера. Заявлено требование учитывать динамику каталога; более подробно раскрыт следующий вопрос — как после обновления сохранить осмысленность прежних кодов.
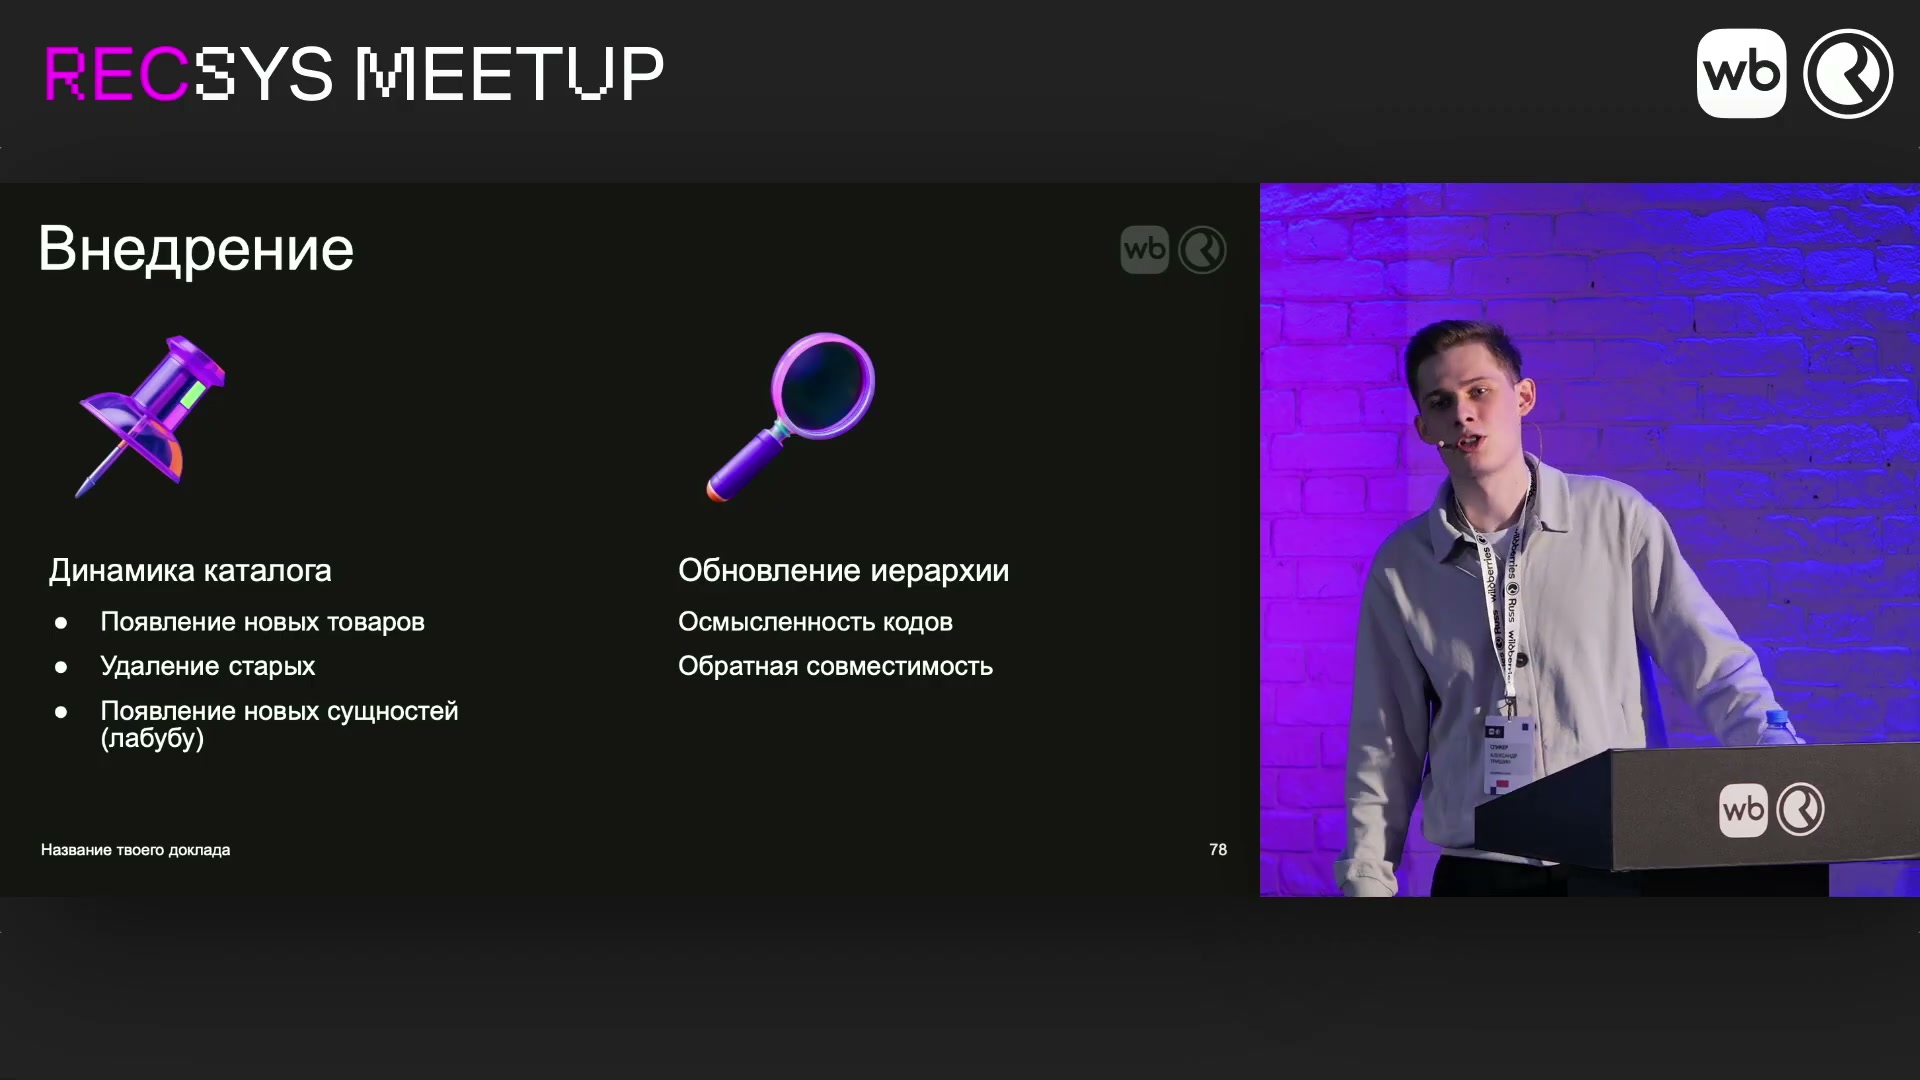
Новые товары и сущности, удаление старых, осмысленность кодов и обратная совместимость — отдельные задачи сопровождения.
Источник: Александр Тришин · Wildberries · RecSys MeetupКак согласуют старую и новую нумерацию
Даже если два независимо построенных дерева содержательно похожи, одинаковый номер в них не обязан обозначать одно и то же. Для модели-потребителя это опасно: она могла научиться работать с определённым кодом, а после обновления под ним окажется другая группа. Поэтому требуется не только хорошее новое разбиение, но и преемственность его обозначений.
На иллюстрации синие куртки и другая группа одежды имеют одинаково напечатанное начало (12, 2591, 48), после которого код продолжается. В речи автор объясняет это примером независимых обучений: общий префикс длины три меняет смысл. Рисунок нужно читать как иллюстрацию неоднозначности нумерации между версиями, не как публикацию реального одинакового кода этих двух групп в одной действующей системе.
Решение — перенумеровать новое дерево с учётом предыдущего. На уровнях иерархии сопоставляют вершины старой и новой версий с помощью Linear Sum Assignment, задачи назначения соответствий. По смыслу нужно найти согласованное сопоставление узлов на основе их сходства, а не просто оставить те номера, которые случайно появились после нового построения.
Сходство узлов можно оценивать по их векторным представлениям или по совпадению входящих в поддеревья товаров. Для второго варианта названо intersection over union, IoU: размер пересечения наборов относительно размера их объединения. По словам автора, в их задаче лучше сработало сходство эмбеддингов. Численного сравнения вариантов и точного способа вычисления представления узла нет.
Такое сопоставление направлено на стабильность смыслов кодов, но не даёт из записи гарантии сохранения каждого ID. Не раскрыты все правила для появления, исчезновения, разделения и объединения групп. Следовательно, обратная совместимость здесь — цель и конкретный механизм её поддержки, а не обещание полной неизменности словаря.
В Q&A слушатель связывает преемственность с возможностью не переобучать большие модели-потребители. Отдельного развёрнутого ответа с условиями такой гарантии в записи нет. Поэтому нельзя утверждать, что введённая перенумерация безусловно отменяет переобучение всех использующих SID моделей.
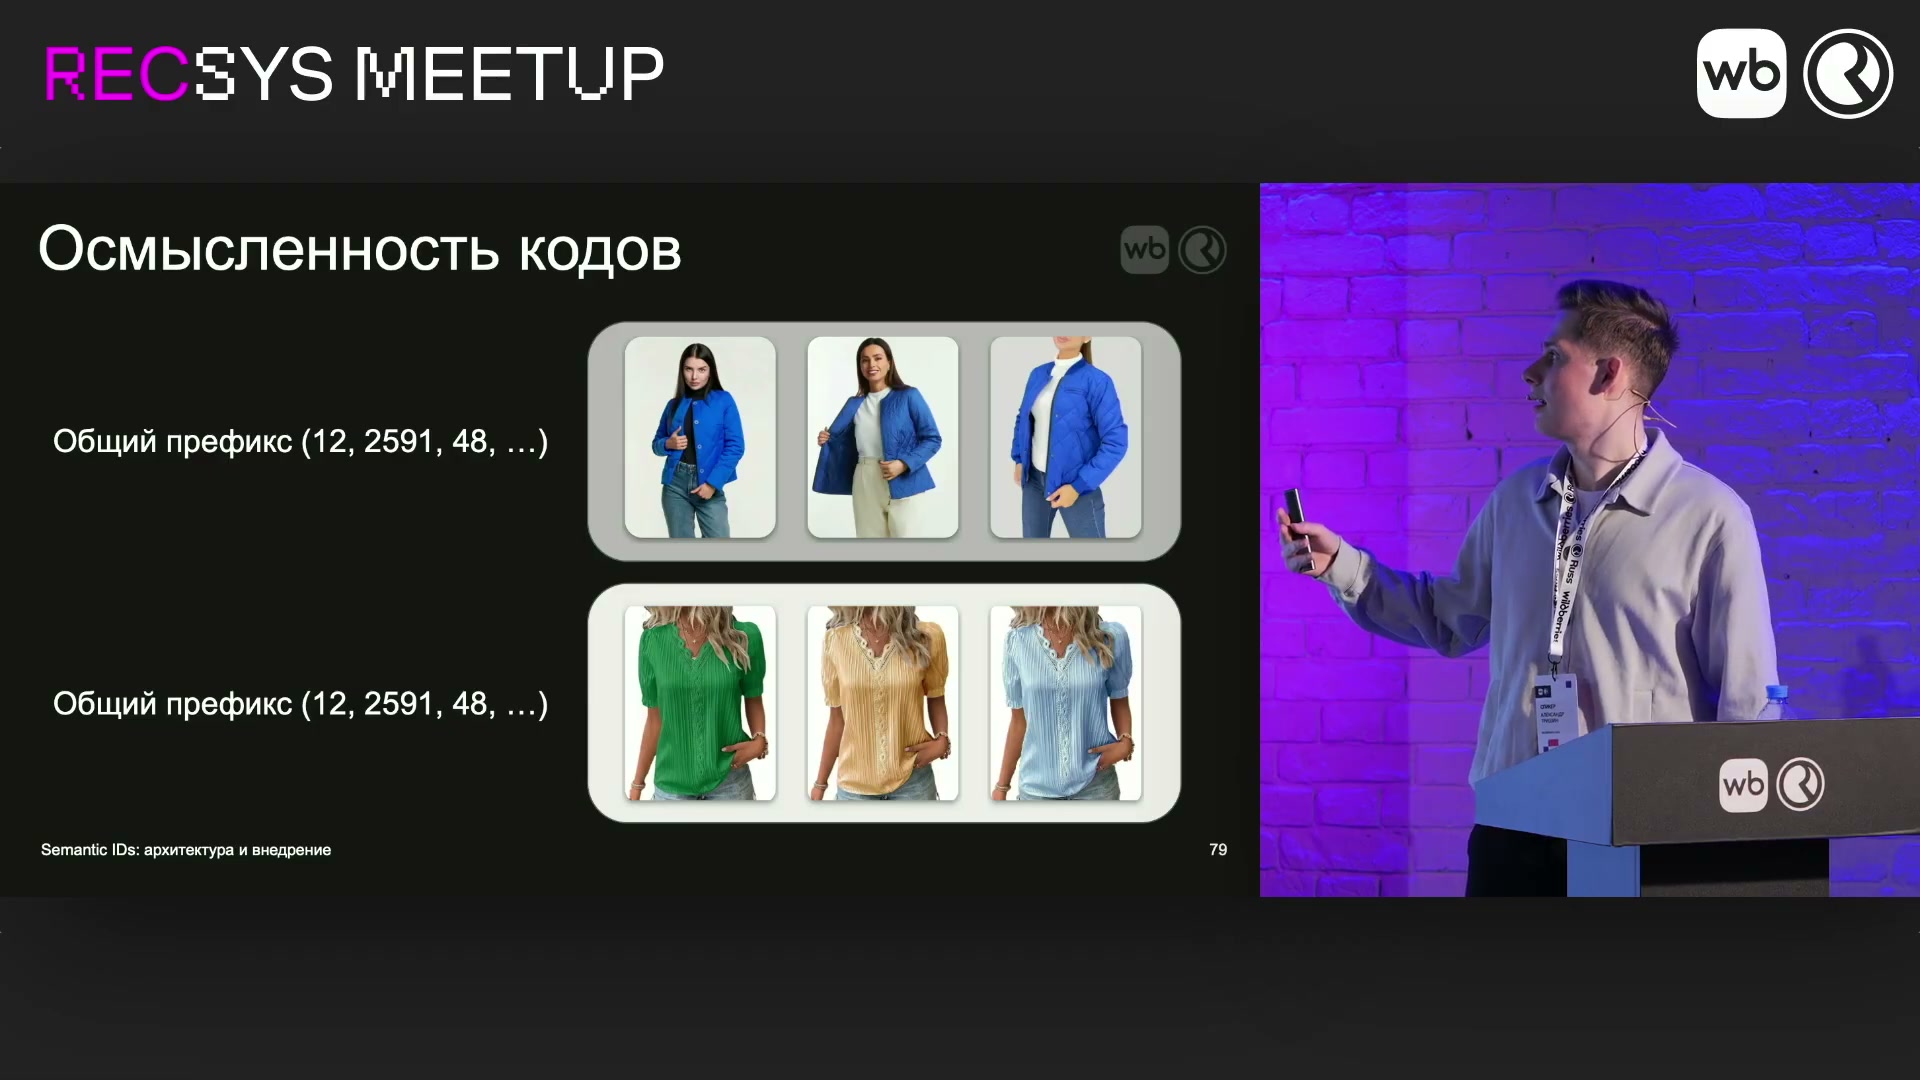
Иллюстрация обсуждения свойств общих префиксов. На кадре две разные группы имеют одинаково напечатанный пример префикса; не используем его как точный опубликованный код обеих групп.
Источник: Александр Тришин · Wildberries · RecSys Meetup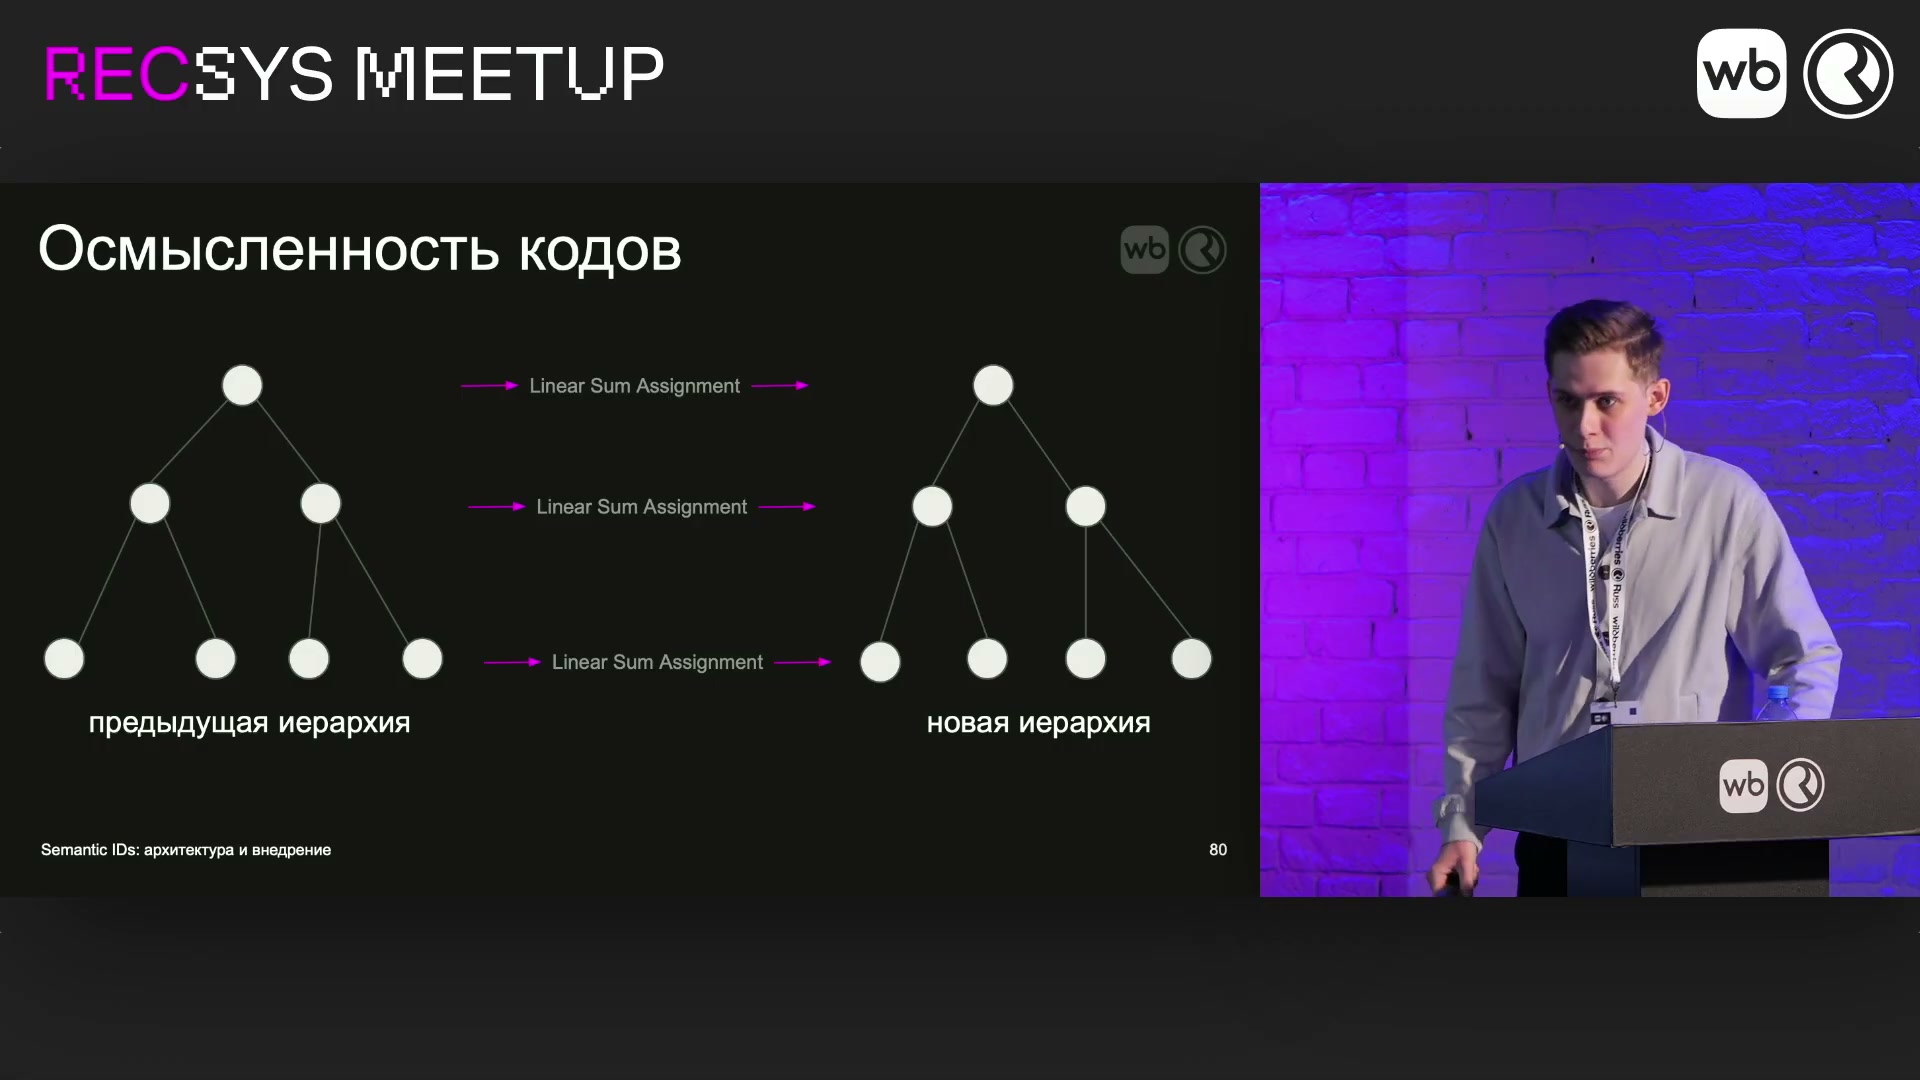
Linear Sum Assignment сопоставляет узлы на разных уровнях. По словам автора, сходство эмбеддингов работало лучше пересечения наборов товаров; без гарантии сохранения каждого ID.
Источник: Александр Тришин · Wildberries · RecSys MeetupЧто уже внедрили: покрытие и более компактные коллаборативные модели
Первое применение — увеличить покрытие товаров представлениями, обученными по взаимодействиям. Визуальный вектор уже помогает построить группу, а объединённая история её товаров позволяет получить коллаборативный эмбеддинг: представление, основанное на поведении пользователей. Это разные роли векторов, и их нельзя смешивать. Контент связывает карточки, а накопленные действия дают сигнал для рекомендательной модели.
Автор иллюстрирует проблему карточкой, которую не покупали год или купили только два раза. Эти значения — примеры разреженной истории, не пороги отбора. В кластерной схеме не обязательно независимо учить всё по такой карточке: можно использовать информацию группы. В речи применение связано с доранжированием похожих товаров в сценарии, названном «КТ».
Таблицу можно прокрутить по горизонтали.
Число +4% относится именно к Ads Revenue. Автор связывает улучшение с покрытием прежде трудных для модели товаров. Но в материалах нет исходного значения выручки, размера выборки, длительности проверки, единицы рандомизации или доверительных интервалов. Нельзя ни распространять этот процент на весь бизнес, ни восстанавливать отсутствующий экспериментальный протокол. Точная доля покрытия до и после также не приведена.
Второе применение идёт дальше: обучать коллаборативные модели не на отдельных товарах, а на нижних кластерах. Мотивация связана со сценарием главной страницы. По оценке автора, текущие модели не настолько тонко различают почти одинаковые вещи разных продавцов, чтобы обязательно сохранять отдельную единицу обучения для каждой карточки. Значит, можно попробовать более компактное представление без заведомо полезной потери детализации.
Команда собрала две модели, добавила их в ранжирующую модель и получила результат, который в речи назван «серым». Из этого не следует ни положительный прирост качества, ни статистически доказанная неухудшаемость. Условия проверки и достаточность её чувствительности неизвестны. Названия самих двух моделей также не раскрыты.
На слайде экономия измеряется бакетами: их стало в десять раз меньше. Что именно представляет собой бакет в этой системе, автор отдельно не определяет. Устное объяснение связывает экономию с хранением ссылки на кластер вместо множества отдельных товаров для пользователя. Это нельзя переименовать в десятикратное сокращение обучающих батчей, ускорение ответа или уменьшение всех расходов рекомендательного сервиса.
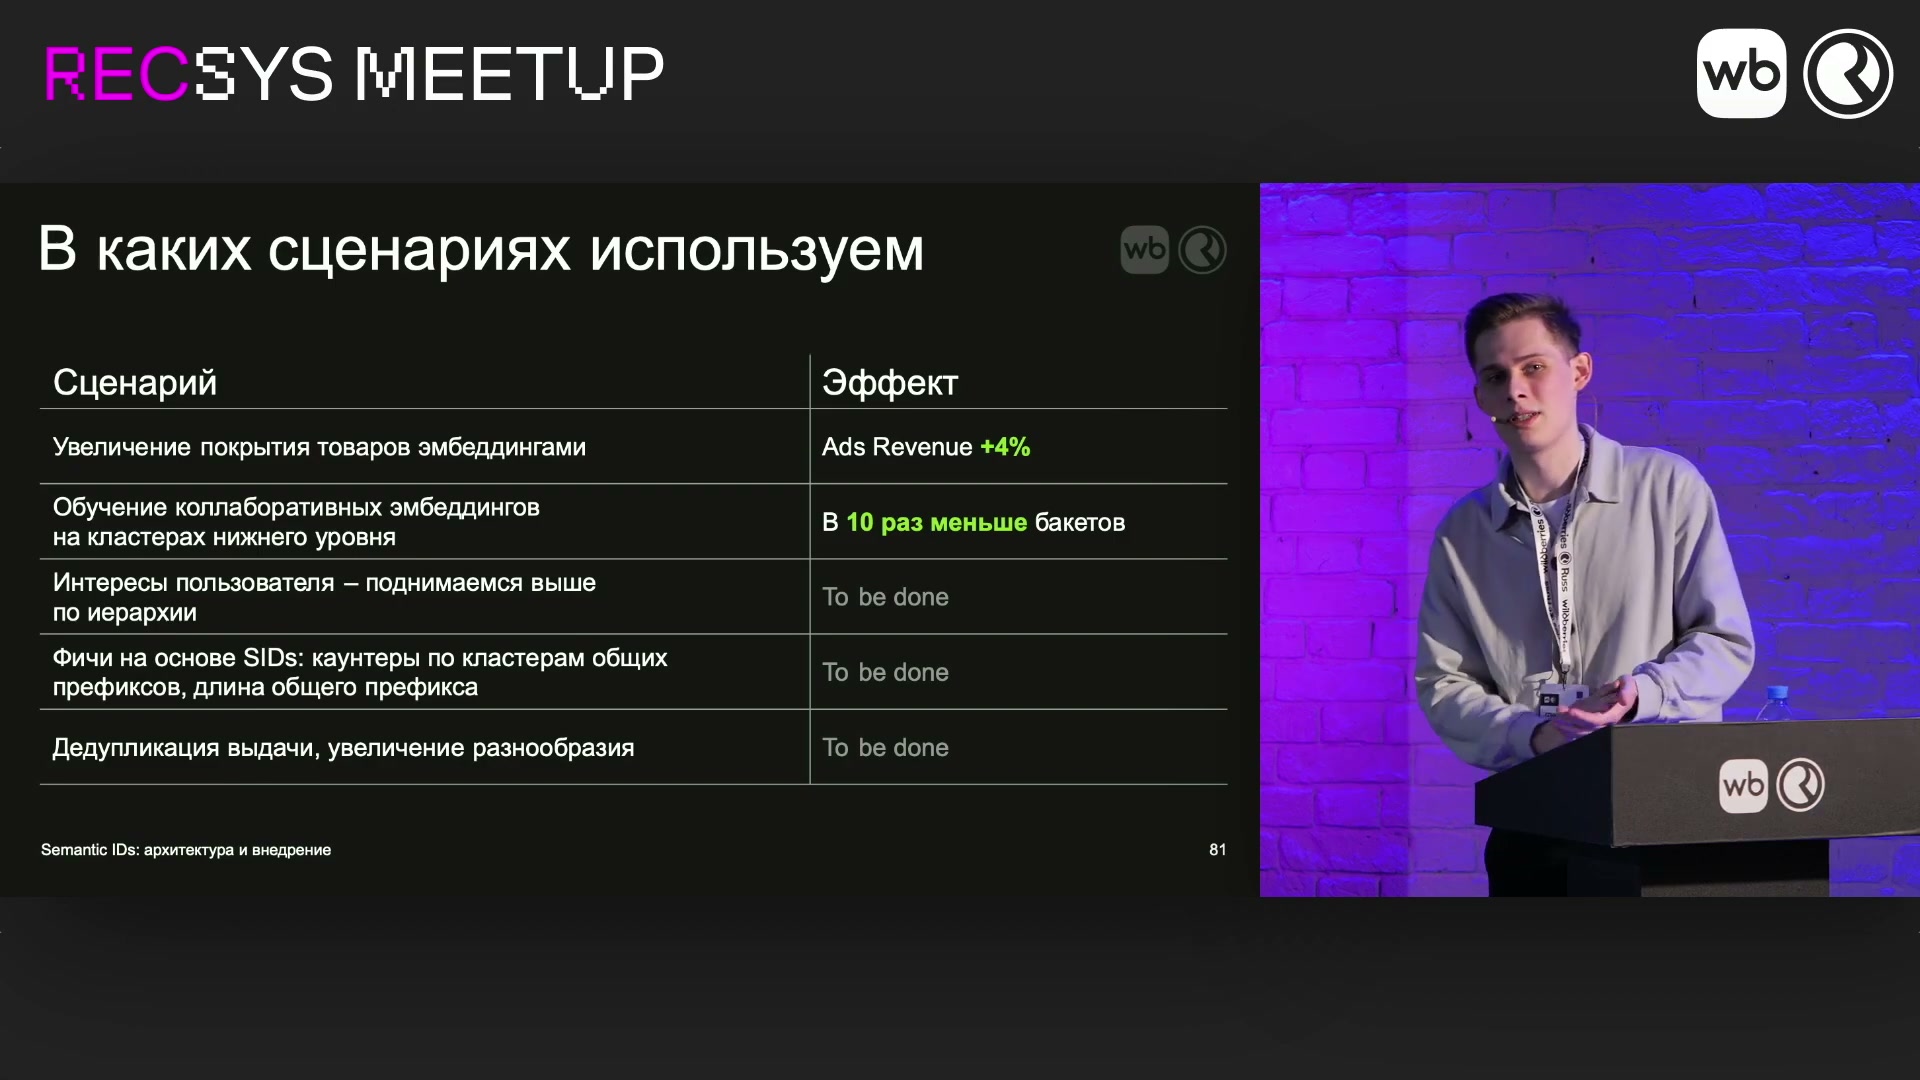
Увеличение покрытия эмбеддингами: Ads Revenue +4%; коллаборативные эмбеддинги нижних кластеров: в 10 раз меньше бакетов. Интересы по иерархии, SID-признаки и дедупликация/разнообразие помечены To be done. База и протокол +4% здесь не раскрыты.
Источник: Александр Тришин · Wildberries · RecSys MeetupЧто осталось в планах и что даёт сам префикс
На момент выступления внедрение, по словам автора, ещё шло. После первых двух применений он перечисляет следующие направления. В исходной таблице они прямо помечены To be done — предстоит сделать. Наличие для них подходящего представления не означает, что соответствующий продуктовый эффект уже получен.
Таблицу можно прокрутить по горизонтали.
Отдельная вычислительная возможность связана с тем, что код уже содержит иерархическую близость. Чтобы получить такую оценку сходства пары товаров, можно посмотреть на длину общего начала. Для этой операции не нужно дополнительно запрашивать эмбеддинги из хранилищ и считать близость двух полных векторов.
Автор называет это получением оценки «за бесплатно». Смысл — в отсутствии перечисленных дополнительных обращений и вычислений, а не в буквально нулевой стоимости. В докладе нет измерения задержки, нагрузки или согласия такой оценки с векторной метрикой. Возможность вычислить признак по коду также не превращает запланированное внедрение SID-признаков в уже завершённое.
Доклад · 00:23:31Как из рекомендованной группы выбирают конкретную карточку
Семантический код не завершает рекомендацию. Пользователь увидит конкретную карточку, поэтому после выбора группы нужно определить её представителя. Вопрос из зала формулирует это через условный пример: SID соответствует двадцати пяти товарам — какой именно будет показан? Двадцать пять здесь не средний размер кластера и не ограничение системы.
Автор отвечает, что группа похожих товаров даёт пространство для оптимизации: конкретную карточку можно выбирать с учётом бизнес-метрик и разнообразия. Он не раскрывает точную функцию выбора и не описывает обязательное равномерное случайное сэмплирование. Поэтому «модель рекомендовала кластер» не следует понимать как «система всегда показывает произвольный товар без дополнительных правил».
Для главной страницы есть конкретное ограничение: по словам автора, пользователи неохотно покупают товары без отзывов. Поэтому карточку с нулём отзывов там, вероятно, не покажут. При этом представление позволяет технически рекомендовать её в другом сценарии, если такое решение понадобится. Покрытие карточки эмбеддингом и фактический допуск к показу — разные свойства системы.
Ответ также не отменяет статусы дальнейших планов. Возможность учитывать разнообразие при выборе представителя ещё не является сообщением о завершённом внедрении дедупликации всей выдачи по SID. В докладе раскрыты свобода выбора и пример ограничения по отзывам, но не полный алгоритм формирования финального списка.
Доклад · 00:25:06Почему похожие платья не обязательно взаимозаменяемы
Другое возражение из зала касается уже не выбора представителя, а самого основания объединения. Визуально похожие чёрные платья могут иметь широкие или узкие бретельки и подходить разным покупателям. Следовательно, близость в изображениях ещё не доказывает одинаковую аудиторию и безразличие пользователя к замене одной карточки другой.
В вопросе также звучат условные 45 и 60 кг. Это иллюстрация слушателя, не сведения об исследованной аудитории, не используемые признаки системы и не установленная связь между весом и предпочтением фасона. Содержательное возражение остаётся справедливым без такого предположения: товарные отличия могут быть важны человеку, даже если группа выглядит однородной.
Автор не подтверждает конкретное утверждение о ширине бретелек. Он говорит, что полученные кластеры достаточно согласованны, и ссылается на проверку, но её название в расшифровке не восстановлено, а численные результаты не приведены. Поэтому ответ не даёт измеренного доказательства полной взаимозаменяемости всех товаров группы.
При этом он явно признаёт границу подхода. Если бы модель действительно знала тонкие предпочтения пользователя и точно выбирала подходящую карточку, замена такого предсказания случайным товаром из SID могла бы ухудшить результат. Но, по его словам, текущие модели в обсуждаемом сценарии такими знаниями не располагают. Выбор уровня обобщения оправдывается возможностями конкретной системы, а не равенством всех похожих товаров.
Есть и особенность главной страницы: первая показанная карточка не обязана стать финальной покупкой. Пользователь может перейти в похожие, найти платье с другими бретельками и купить уже его. Автор считает это ожидаемой воронкой, а не неудачей исходного показа. Так обсуждение связывает гранулярность представления с задачей поверхности: привлечь к подходящей группе может быть полезно, даже если окончательный выбор точнее.
Доклад · 00:29:29Не сводится ли новая иерархия к готовым категориям?
Следующий вопрос проверяет роль визуального содержания. Если алгоритм начинает внутри Subject ID, не воспроизводит ли он просто уже заданные категории? Слушатель предлагает контрольную замену: убрать содержательные векторы и дать алгоритму случайные эмбеддинги. Такой эксперимент позволил бы отделить пользу изображения от эффекта исходных категориальных ограничений.
После уточнения вопроса автор отвечает через устройство алгоритма. На первых уровнях товары уже находятся внутри одной сущности. Её конкретное значение не помогает разделить их: для всех этих карточек Subject ID одинаков. Следовательно, одна только метка категории не объясняет содержательное разбиение внутри неё. Но сама граница категории на этом этапе действительно используется — это не алгоритм, полностью независимый от каталожных сущностей.
Далее объединение выполняется вне этих границ и без использования конкретизации сущности как объяснения полученных групп. Автор добавляет количественный аргумент: число кластеров, которые отправляются на объединение вне сущностей, примерно на два порядка больше числа самих сущностей. Воспроизведение исходных категорий было бы слишком грубым результатом по сравнению с заявленной детализацией.
Однако архитектурный аргумент не заменяет предложенную случайную абляцию — контрольный эксперимент с изменением одного компонента. В ответе не сообщено о проведении такой проверки и не приведено сравнение со случайными эмбеддингами. Поэтому корректный итог Q&A ограничен: объяснено, почему механизм не должен просто копировать метки, но экспериментально отделённый вклад визуальных представлений этой абляцией в докладе не показан.
Доклад · 00:31:58Как проверять точность групп и почему полнота остаётся трудной
Последний содержательный вопрос касается валидации объединений: как проверяют качество кластеризации и подбирают параметры, особенно на верхних уровнях, где уже нет опоры на категории? Автор разделяет качество иерархии на две стороны. Это разделение важно и для интерпретации примеров, и для оценки того, что система действительно решает.
Первая сторона — точность в смысле внутренней согласованности. Если взять один кластер, не окажутся ли внутри непохожие товары? Автор предлагает считать метрики кластеризации, в том числе силуэт — оценку компактности и отделимости групп, — и смотреть на сходство товарных эмбеддингов внутри кластера. Он считает такую проверку относительно простой. Численных значений, порогов приёмки и состава проверяемой выборки не приводит.
Вторая сторона — полнота. Допустим, кластер содержит чёрные платья определённого фасона с бантом. Нужно понять, попали ли туда все остальные платья такого фасона с таким бантом, имеющиеся на площадке. Внутри группы может не быть ничего лишнего, но подходящие вещи при этом могут оставаться в других ветвях. Поэтому внутренняя согласованность не доказывает полноту объединения.
Таблицу можно прокрутить по горизонтали.
Именно в этом позднем ответе, в 00:36:49, автор говорит о каталоге из 300 млн товаров, который постоянно растёт. Это отдельное утверждение о масштабе; оно не уточняет автоматически ранний график популярности или неполную раннюю реплику о числе карточек. Для проверки полноты важно не только большое количество объектов, но и отсутствие полного предварительного знания об их содержимом.
Автор противопоставляет активную часть каталога, по которой есть покупки и другие действия, остальному большому и малоизученному массиву. В нём находятся новые карточки, товары без взаимодействий и потенциально фейковые карточки. По ним команда не имеет готового полного эталона: какие группы уже существуют, что появилось, что исчезло и все ли подходящие вещи найдены.
Иерархия помогает лучше понять эту часть каталога, но сама по себе не создаёт независимую правильную разметку для проверки собственной полноты. Поэтому автор выражает сомнение в возможности хорошо провалидировать её целиком в таких условиях. Это описание ограничения их оценки, а не доказательство невозможности любой оценки полноты. Конкретный рецепт выбора параметров верхних объединений остаётся нераскрытым.
Доклад · 00:35:07Итог: что дают готовые коды и где заканчиваются доказанные результаты
Wildberries пришёл от независимых карточек с разреженной историей к группам, на которых можно объединять пользовательский опыт. Варианты квантизации не дали нужной устойчивости и детализации, поэтому команда выбрала адаптивную иерархию снизу вверх. Визуальные векторы получают через SigLIP2 с дообученной головой. Построение дерева, согласование новой нумерации со старой и обучение коллаборативных моделей происходят отдельно от применения готовых кодов.
- 01
Получить код карточки
Использовать уже назначенный SID, связывающий конкретный товар с его местом в подготовленной иерархии.
- 02
Выбрать детализацию
Обратиться к нижнему кластеру или подходящему префиксу, а не обязательно работать с отдельной карточкой.
- 03
Применить модель
Использовать представление группы и накопленную по её товарам информацию в рекомендательной модели и ранжировании.
- 04
Выбрать конкретный товар
Перейти от рекомендованной группы к карточке с учётом целей сценария; для главной учитывать ограничение по отзывам.
- 05
Показать рекомендацию
Предложить карточку пользователю; на главной дальнейший переход в похожие тоже может привести к ожидаемой покупке.
Для внутренней согласованности кластеров названы силуэт и сходство эмбеддингов; полноценная проверка полноты затруднена масштабом и неизвестной частью каталога. Увеличение покрытия представлениями сопровождается Ads Revenue +4%, но база и протокол не раскрыты. Для моделей на нижних кластерах показано в десять раз меньше бакетов; устный «серый» результат не доказывает статистическую неухудшаемость.
Сходство не означает взаимозаменяемость товаров, перенумерация не гарантирует сохранения всех ID, а абляция со случайными векторами не предъявлена. Выделение интересов, SID-признаки и дедупликация с разнообразием остаются планами. Итог — внедряемое общее представление с конкретными первыми результатами, а не законченная замена всей рекомендательной системы.
Доклад · 00:16:22