Разбор готов
Иннотех: как «Сфера» объединила поиск по документам и генерацию ответов
Специалист поддержки получает типовое обращение, но для ответа ему всё равно приходится искать подходящую статью, разбираться во вложениях и собирать решение из найденных материалов. В продуктах «Сферы» простой лексический поиск справлялся с этим недостаточно хорошо. Команда Иннотеха построила помощника, который ищет по корпоративной базе знаний и составляет ответ с указанием источников. В докладе Make Retrieval Smarter Дмитрий Баканов показывает весь путь: от ограничений на обновление документов и ожидание ответа до подготовки текстов, адаптации поисковой модели и сравнения готовых конфигураций. Важна не только языковая модель: качество зависит от того, какие фрагменты удалось найти, как их объединили и насколько ответ действительно опирается на полученный контекст.
Глава полезна инженерам, которые развивают поиск по документам или помощника поддержки. На одном внедрении видно, зачем разделять подготовку корпуса, обучение поисковой модели и обработку запроса, а также почему качество поиска и качество ответа нужно оценивать отдельно.
Видео · на русском
Дмитрий Баканов | Make Retrieval Smarter: как мы делали умный поиск по базе документовДмитрий Баканов · Опубликовано: 13 августа 2025 г.
Исходный доклад · Открыть оригинал
От списка документов к ответу для специалиста поддержки
Исходная задача связана с обработкой типовых запросов, обращений и инцидентов. Специалисту нужно найти документы, на основании которых можно решить проблему, а затем сформулировать ответ. Баканов характеризует прежний лексический поиск как недостаточно качественный. Поэтому команда поставила более широкую цель, чем переставить ссылки в выдаче: помощник должен и находить источники, и составлять ответ по их содержанию.
Лексический поиск сопоставляет слова запроса с текстом документов. В новой системе его не просто заменили нейросетью: поиск по словам остался одним из способов отбора материалов. К нему добавили поиск по векторным представлениям текста, позволяющим сравнивать запрос и документы не только по буквальному совпадению формулировок. Конкретных ошибочных запросов прежнего поиска и отдельной численной оценки именно этого старого сервиса в докладе нет.
Поиск материалов перед генерацией ответа называется RAG. В объяснении автора это три связанные функции: найти подходящий контент, дополнить им запрос и передать запрос с найденным контекстом языковой модели. Контекст здесь — тексты, которые модель получает вместе с вопросом и использует для ответа. Новые сведения можно предоставить таким способом без переобучения самого генератора.
Позднее команда действительно дообучает другую часть системы — модель, которая превращает статьи и запросы в векторы для поиска. Противоречия нет: обновление знаний генератора через контекст и адаптация поискового кодировщика решают разные задачи. Снижение нагрузки на все линии поддержки остаётся назначением проекта; отдельного измерения сэкономленного времени сотрудников автор не приводит.
В публичном выступлении Дмитрий Баканов разбирает внедрение в продукте «Сфера» компании Иннотех. Здесь приведены только сведения и примеры, раскрытые в докладе.
Доклад · 00:00:10Свежесть документов, ожидание ответа и ресурсный бюджет
Помощник должен работать с обновляющейся базой знаний и отвечать достаточно быстро для повседневной работы поддержки. Поэтому ограничения задавались и на подготовку новых материалов, и на обработку запроса. Эти два времени относятся к разным процессам: появление статьи в поиске не равно времени генерации ответа.
Таблицу можно прокрутить по горизонтали.
В корпус входят статьи с разметкой и документы разных форматов. В речи автор также сообщает о недавнем расширении поиска на базу стандартных решений и базу самопомощи. Это уже описываемое расширение охвата, а не будущая мультимодальность, к которой команда вернётся в конце выступления.
В итогах Баканов говорит, что реализованный помощник удовлетворяет требованиям. Однако распределение задержек, число одновременных запросов и отдельные измерения индексации не показаны. Значения 15 минут и 10 секунд поэтому остаются требованиями, а не опубликованным тестом производительности.
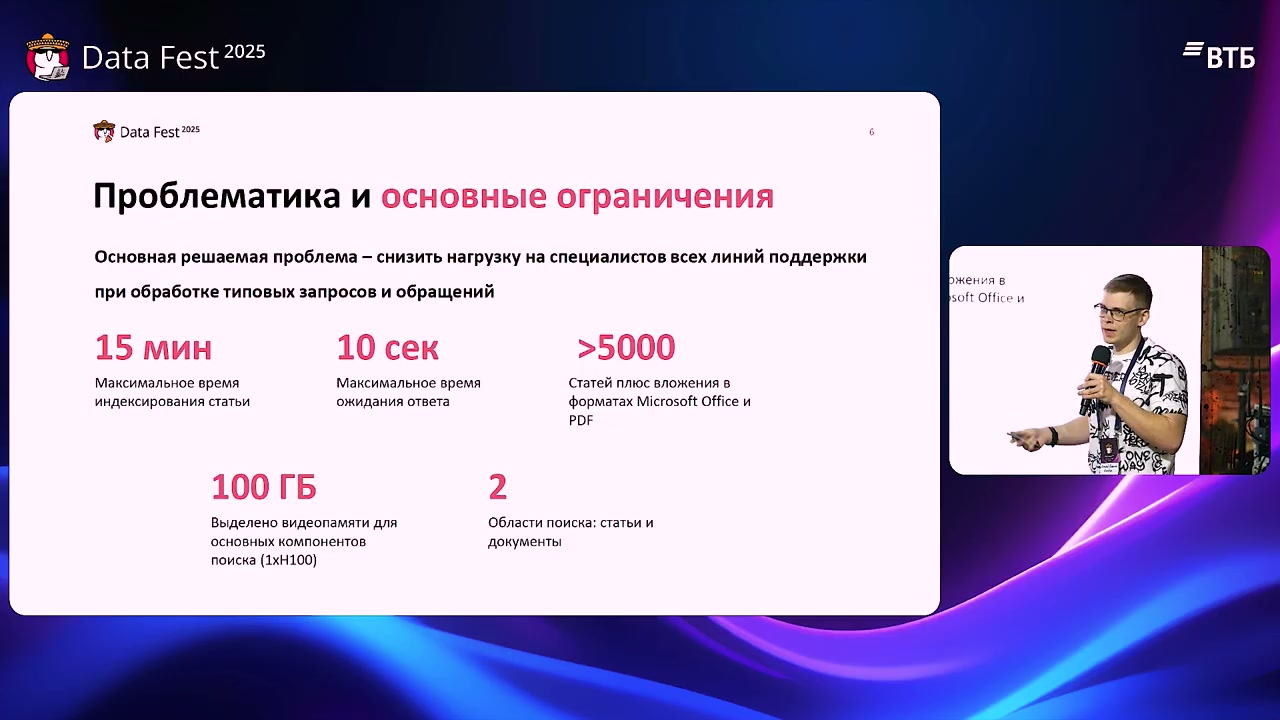
Новая статья должна индексироваться максимум за 15 минут, ответ — за 10 секунд; более 5000 статей с вложениями, две области поиска. Подпись ресурса «100 ГБ (1xH100)» приводится как указание автора, не паспортная спецификация GPU.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Два рабочих контура и отдельная подготовка моделей
В архитектуре разделены поступление документов и обращение пользователя. Пользователь работает во внешней системе ведения знаний: открывает форму поиска и отправляет вопрос. Документы поступают из файлового хранилища заказчика через отдельный механизм загрузки. Оба пути сходятся в OpenSearch — хранилище документов и векторов, по которому выполняется поиск.
Подготовкой документов занимается сервис извлечения, преобразования и загрузки данных, или ETL. Агент загрузки подготавливает материалы и формирует задания, брокер Apache Kafka передаёт задания и метаданные, а ETL-сервис скачивает и обрабатывает сами документы. Это важное различие: наличие Kafka на схеме не означает, что каждый файл целиком пересылается в сообщении.
Сервис поиска реализован на Python с FastAPI и LangChain. FastAPI показан в том числе в программном входе сервиса, API Gateway, а LangChain используется в компонентах поисковой и генеративной обработки. Рядом находятся модель векторизации TextEmbedder, генератор ответа LLM и, в одной из комплектаций, отдельная ранжирующая модель. Поэтому в речи автор говорит о двух или трёх моделях в системе.
Таблицу можно прокрутить по горизонтали.
Такое разделение позволяет рассматривать ошибки по месту возникновения. Неудачно разобранный документ, плохо найденный фрагмент и неподтверждённый ответ генератора — разные проблемы даже тогда, когда пользователь видит один и тот же неудовлетворительный результат. В докладе каждому из этих участков посвящён отдельный разбор.
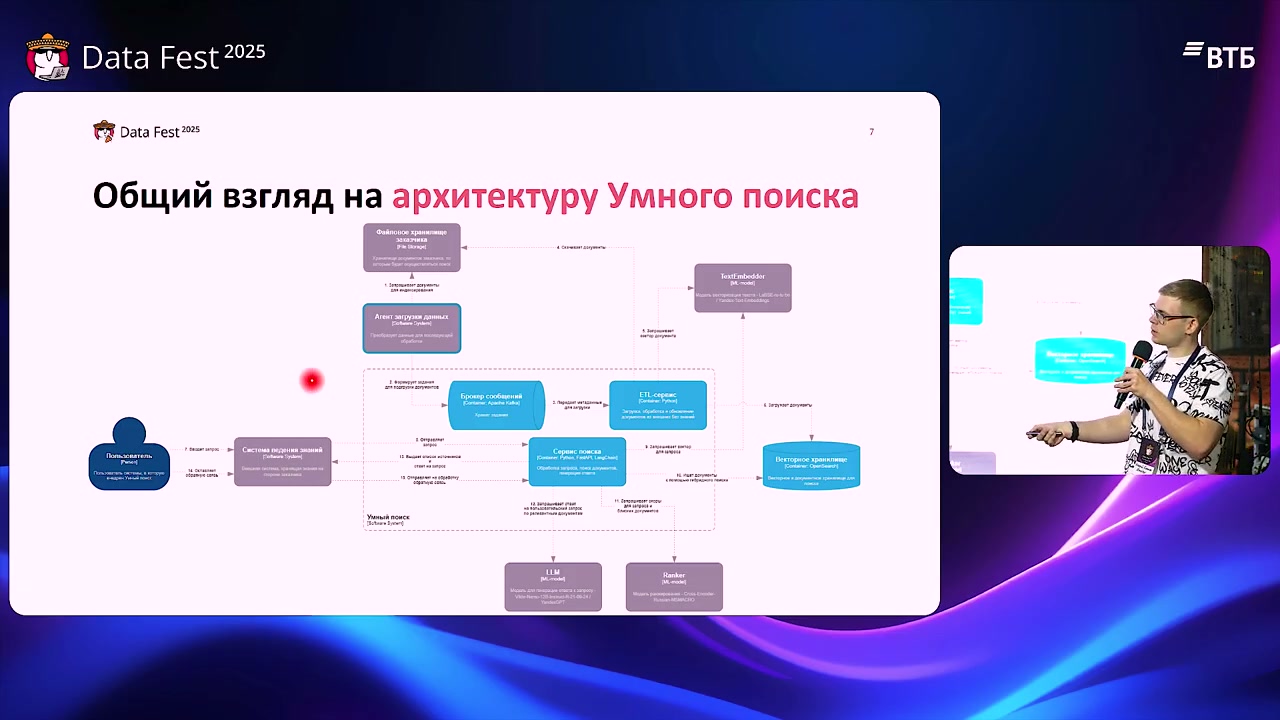
Загрузка и индексация документов отделены от запроса пользователя. Kafka, ETL, модели и OpenSearch образуют разные части системы.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Как документы превращаются в поисковый корпус
Документы неоднородны, поэтому ETL не сводится к чтению одного текстового поля. После получения задания сервис скачивает материал из хранилища заказчика и направляет его в обработчик подходящего формата. На схеме это три альтернативные ветки, а не три преобразования, через которые обязательно проходит каждый документ.
Таблицу можно прокрутить по горизонтали.
Markdown — текст с обозначениями структуры, например заголовков и списков. В этом контуре он служит формой, к которой приводят разные исходные документы. Наличие обработки изображений внутри PDF ещё не означает, что поиск уже сравнивает запрос с самостоятельными визуальными представлениями: действующий сервис описан преимущественно как текстовый.
- 01
Задание на загрузку
Apache Kafka передаёт задание и метаданные модулю загрузки документов.
- 02
Получение исходного материала
Модуль на Python скачивает документ из файлового хранилища заказчика.
- 03
Обработка формата
Выбранная ветка извлекает содержание и подготавливает текстовое представление документа.
- 04
Индексация
Модуль на Python с opensearch-py извлекает метаданные, разбивает материал на фрагменты, запрашивает их векторы у TextEmbedder и отправляет подготовленные данные в OpenSearch.
Сведения о соседних фрагментах нужны для дальнейшего расширения контекста по Small2Big. При запросе пользователь уже обращается к этому подготовленному корпусу: система не скачивает и не разбирает все исходные документы заново. Собственные парсеры и предварительная обработка дополняют библиотеки; в ответах на вопросы автор отдельно подчёркивает роль этой собственной части.
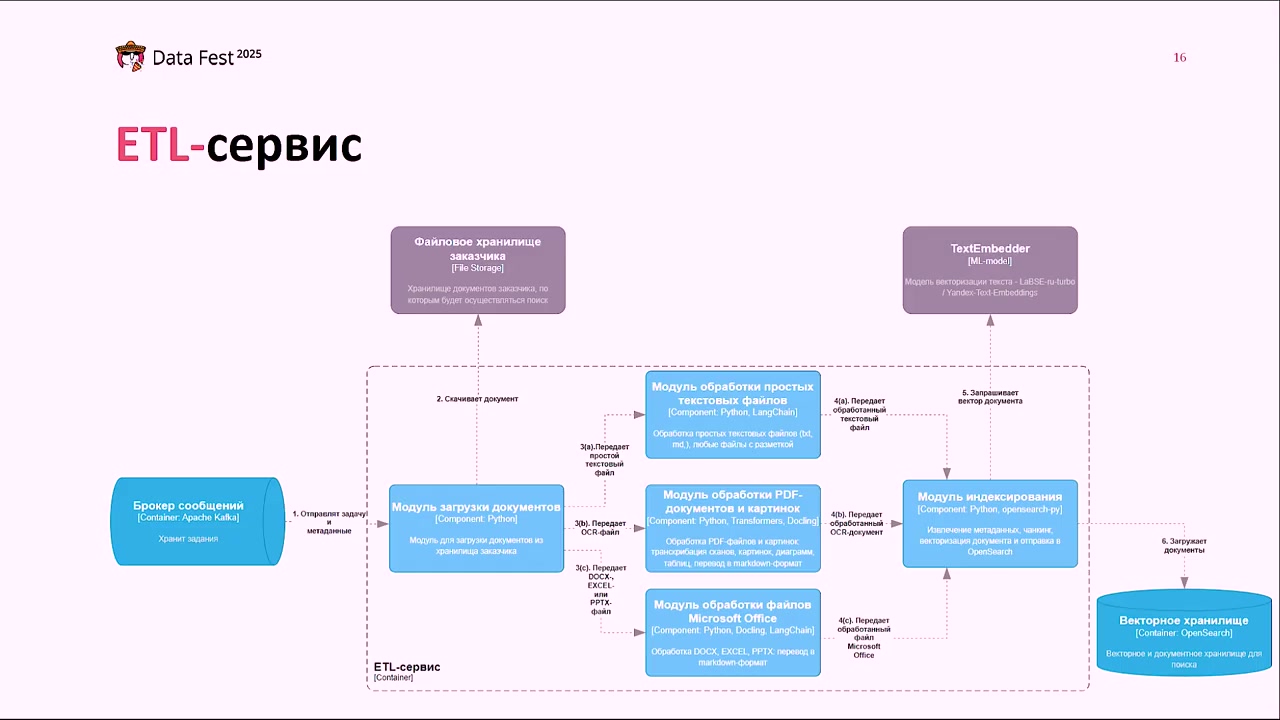
Разные обработчики для обычного текста, PDF/картинок и Microsoft Office; метаданные, фрагменты и векторы загружают в OpenSearch.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Что происходит после отправки вопроса
Первым содержательным действием становится переформулировка запроса. Пользователь может описать потребность в свободной форме, а сервис превращает её в более понятный вопрос и расширяет формулировку. Для этого используются тезаурусы из контура заказчика: словарные сведения помогают раскрывать используемые обозначения и преобразовывать запрос. Конкретных словарных записей и текстов промптов автор не публикует.
На подробной схеме есть отдельный модуль формирования промпта — инструкции и входных данных для языковой модели. Он участвует в подготовке обращения для переформулировки и в формировании запроса для генерации. Это не повод приписывать системе неизвестные шаблоны: из материалов устанавливаются роли компонентов, но не буквальный текст инструкций.
Расширенный запрос поступает в гибридный поиск. Модель векторизации строит его числовое представление, а OpenSearch возвращает найденные материалы. После объединения каналов документы переупорядочиваются по соответствию вопросу. Отобранный и подготовленный контекст передаётся генератору вместе с запросом пользователя. Подробности объединения, выбора документов и расширения контекста рассматриваются далее отдельно.
Ответ выводится потоково: пользователь видит текст по мере генерации. Под ответом показываются источники. Таким образом, выход сервиса — не только список документов и не только свободный ответ модели, а ответ, связанный с материалами базы знаний.
Лайк или дизлайк поступает в модуль обработки обратной связи и сохраняется. На схеме также нарисована адаптация вектора запроса с использованием этих данных. Но в финальной части выступления автор уточняет её статус: модуль только проходит эксперимент. Сбор оценок пользователей нельзя отождествлять с уже работающим непрерывным обучением с подкреплением или обновлением модели после каждого обращения.
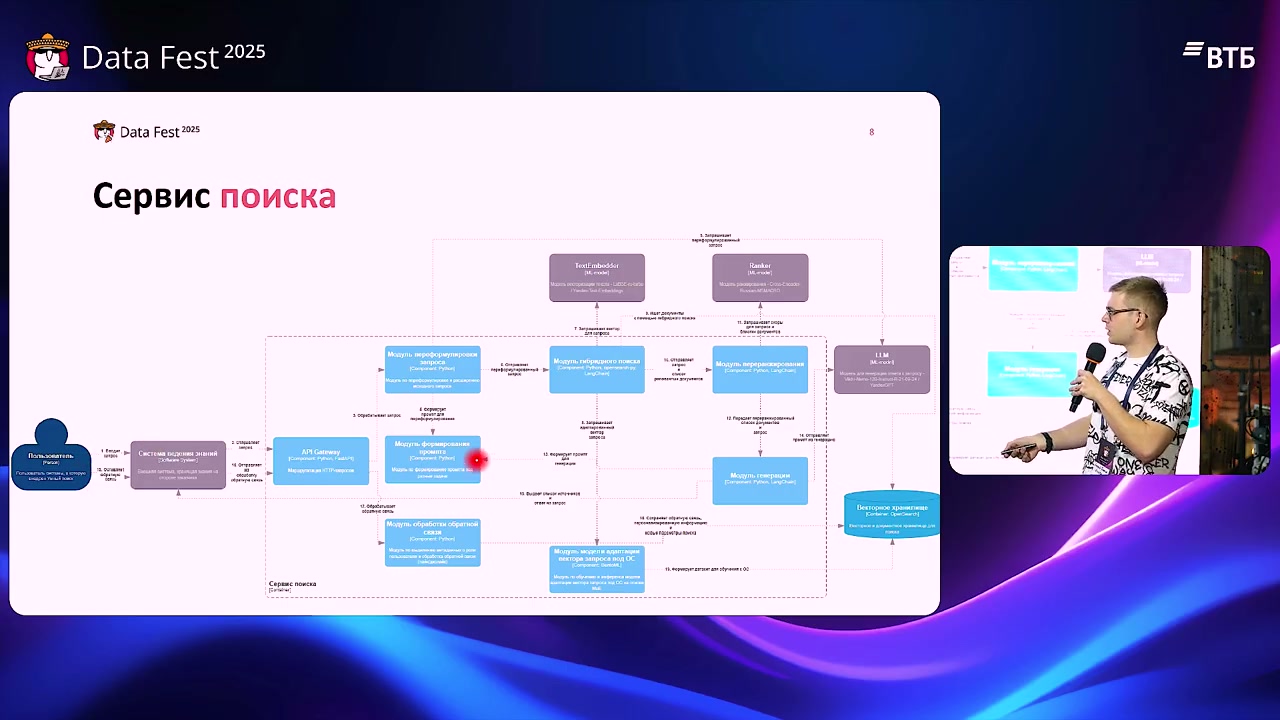
Переформулировка → гибридный поиск → переранжирование → формирование контекста и генерация. Обратная связь предусмотрена отдельным контуром, а адаптация по ней описана в планах.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Две комплектации генератора: открытая модель и поставка Яндекса
Команда рассматривает два способа комплектации. Открытые модели можно изменять и дообучать под свою задачу. В другом варианте используются технологии Яндекса, предоставленные в контуре заказчика: их параметры команда в описанной поставке менять не может. Это ограничение конкретного способа использования, а не утверждение о любых продуктах Яндекса.
Для открытой ветки выбран генератор Vikhr-Nemo-12B-Instruct-R-21-09-24. Баканов объясняет выбор качеством на задачах ответа по найденным материалам и подходящим соотношением размера и качества. Контекстное окно — это объём входного текста, который модель может обработать; он ограничивает совместный размер вопроса, инструкций и предоставленных материалов.
Таблицу можно прокрутить по горизонтали.
Токены — единицы, на которые модель делит текст; они не равны автоматически словам. Указанные объёмы памяти и контекста относятся к представленным вариантам. Доклад не раскрывает точность хранения весов, параметры одновременной обработки запросов и режим выделения памяти, поэтому из приблизительных 40 ГБ нельзя вывести универсальные требования к любой установке Vikhr.
На слайде Vikhr также отнесена к топ-15 LLM Arena Ru. Это историческое заявление автора на момент выступления, без независимой проверки и без раскрытия конкретного среза рейтинга. Выбор для корпоративного корпуса подтверждается не этим местом само по себе, а последующим сравнением комплектаций на задаче команды.
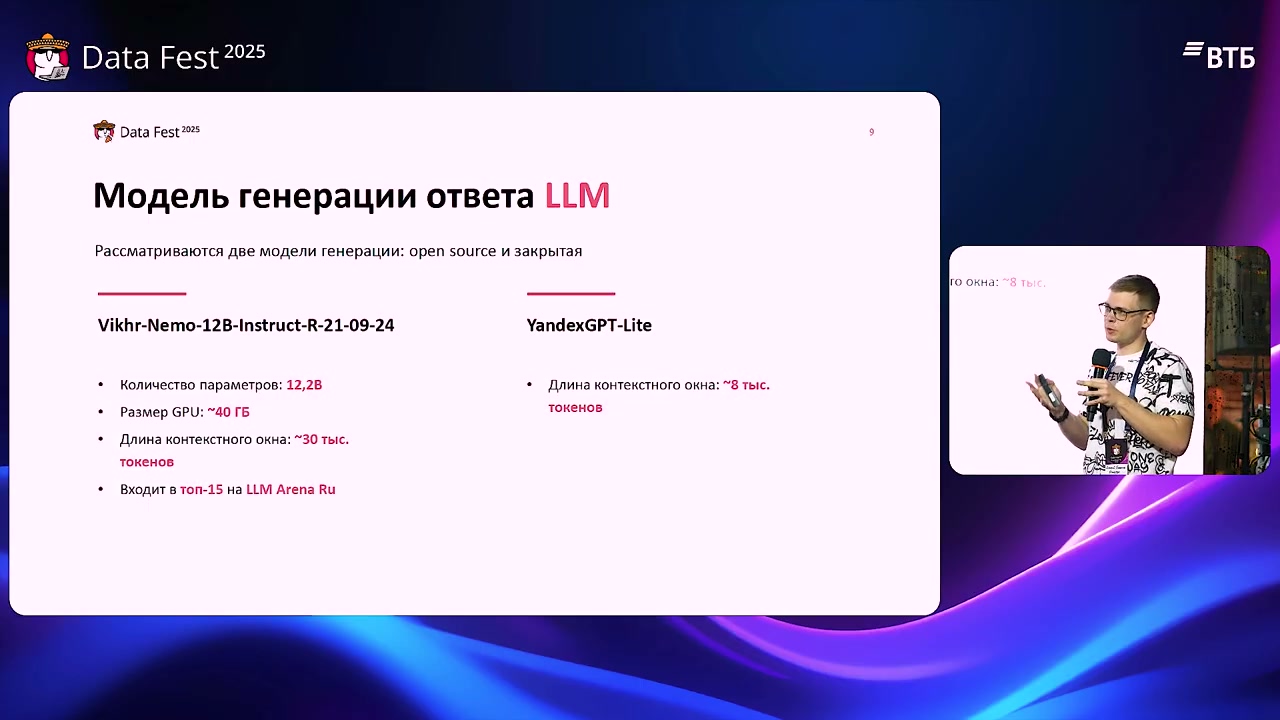
Vikhr-Nemo-12B-Instruct-R-21-09-24: 12,2B параметров, около 40 ГБ GPU и около 30 тыс. токенов контекста; YandexGPT-Lite — около 8 тыс. токенов. Это конфигурации и оценки на момент доклада.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Какие модели строят векторы запросов и документов
Для поиска по смысловой близости текст сначала превращают в вектор — последовательность чисел, по которой можно сопоставлять запрос и документы. Компонент TextEmbedder обслуживает обе стороны: заранее представляет материалы корпуса и во время поиска представляет поступивший вопрос.
Таблицу можно прокрутить по горизонтали.
Открытую LaBSE-ru-turbo автор выбирает в том числе из-за небольшого расхода памяти: в речи названо около 2 ГБ. Это оценка кодировщика, не размер всей системы и не требование генератора. На слайде также указано попадание в топ-20 бенчмарка MTEB. Как и рейтинг генератора, это историческая характеристика из выступления, без независимой проверки или указанного набора задач.
Небольшая модель общего назначения ещё не обязана хорошо различать специализированные корпоративные статьи. Именно поэтому следующий шаг — дообучение LaBSE-ru-turbo на предметной области заказчика. Для предоставленной модели Yandex-Text-Embeddings такой адаптации в описываемой комплектации нет.
Ограничение LaBSE в 512 токенов влияет на подготовку корпуса: длинную статью нельзя безоговорочно считать одним поисковым фрагментом. Но оно не превращается в такой же предел для генерации ответа. Кодировщик и языковая модель работают с разными объёмами текста, что и используется в Small2Big.
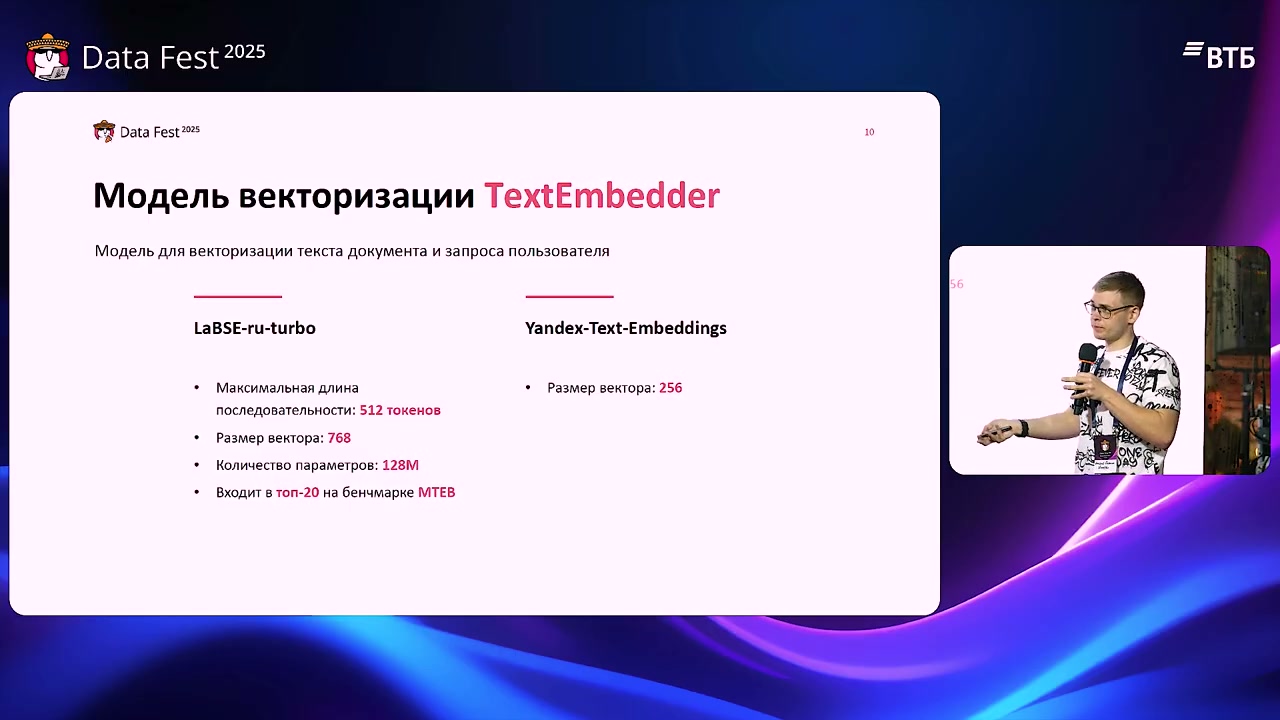
LaBSE-ru-turbo: 512 токенов, вектор 768, 128M параметров; Yandex-Text-Embeddings — вектор 256. Места в рейтингах относятся к моменту доклада.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Первый этап обучения: восстановить смысл зашумлённой статьи
LaBSE-ru-turbo изначально обучалась на более общем материале, чем статьи заказчика. По объяснению Баканова, ей нужно лучше освоить специфику тех документов, среди которых она будет искать. Для этого используется двухэтапная подготовка. Сначала модель учится на самих текстах, затем — на поисковой задаче с автоматически подготовленными запросами и оценками.
Первый метод — восстановление исходного текста из зашумлённого, TSDAE, Transformer-based Sequential Denoising Auto-Encoder. На вход подают изменённый текст статьи, а целью служит текст без шума. В показанной схеме кодировщик строит представления, операция pooling собирает их в общее представление, а декодер по нему восстанавливает текст. Так модель учится сохранять сведения, нужные для восстановления документа, а не только реагировать на отдельные поверхностные совпадения.
Функция потерь измеряет, насколько восстановление расходится с исходным текстом, а оптимизатор обновляет параметры модели. Слайд даёт названия этих компонентов и основные настройки, но не описывает способ и интенсивность внесения шума, размер обучающего набора, инициализацию декодера или полный режим обновления параметров.
Это подготовка поискового кодировщика вне пользовательского запроса. Восстанавливающий декодер на обучающей схеме не следует путать с Vikhr, которая составляет ответ в рабочем сервисе. Доклад не показывает отдельного результата только TSDAE: влияние адаптации затем рассматривается в составе готовых поисковых комплектаций.
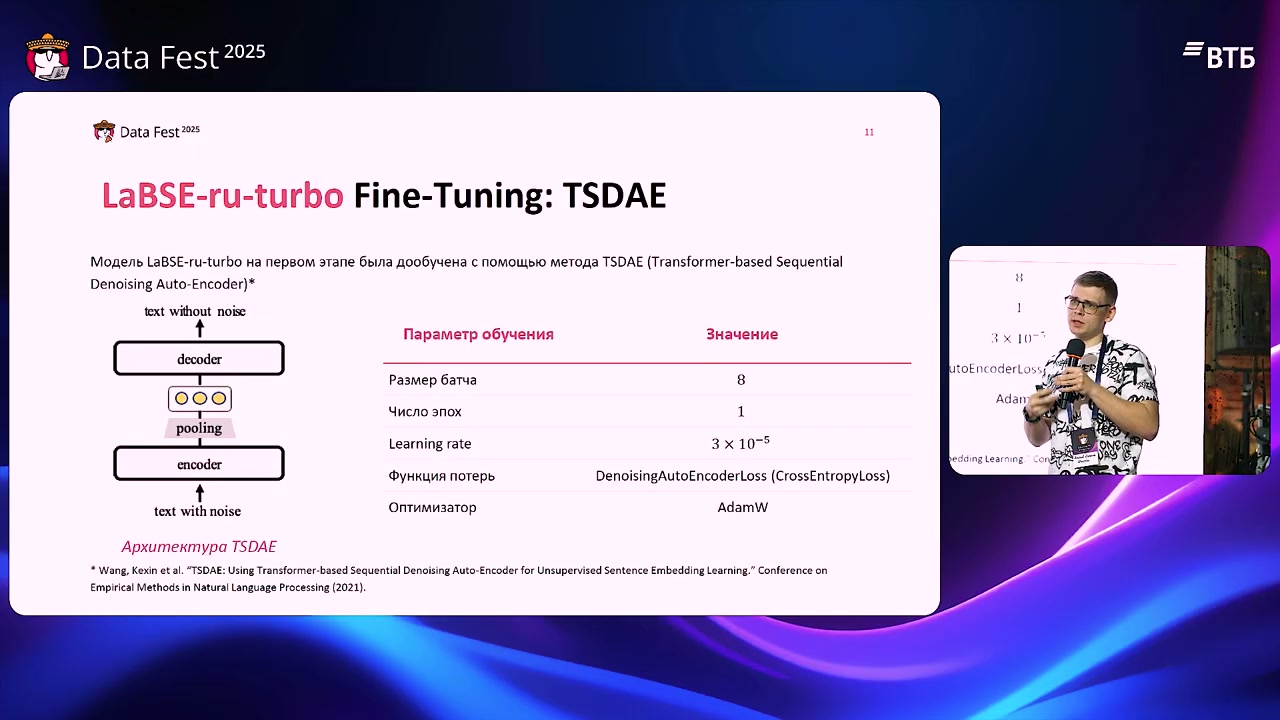
Восстановление текста из зашумлённого: batch 8, одна эпоха, learning rate 3×10⁻⁵, DenoisingAutoEncoderLoss и AdamW.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Второй этап обучения: синтетические запросы и оценки учителя
После освоения текстов модель нужно приблизить к реальной форме поиска: есть вопрос, несколько документов и различия в их полезности. Для этого применяется генеративная псевдоразметка, GPL, Generative Pseudo Labeling. Обучающие запросы и оценки создаются моделями, а не считаются результатом ручной разметки каждой пары.
- 01
Запросы к статьям
Модель Vikhr генерирует поисковые запросы по имеющимся статьям.
- 02
Отрицательные примеры
Поиск в OpenSearch используется для создания негативных примеров — документов, противопоставляемых подходящему материалу в обучающей задаче.
- 03
Псевдооценки
Модель cross-encoder оценивает пары запроса и документа. Эти автоматически полученные значения становятся обучающим сигналом для кодировщика.
Cross-encoder рассматривает запрос вместе с документом и выдаёт оценку их соответствия. В этой части он служит учителем: более компактная поисковая модель учится воспроизводить его оценки. Получается переход от знания о структуре корпоративных текстов к различению материалов по запросу. Совпадение конкретного учителя GPL с моделью переранжирования рабочего сервиса в докладе отдельно не установлено.
Названная функция потерь используется для переноса сигнала учителя. Её точная математическая запись и устройство всех обучающих пар в выступлении не раскрыты. Не указаны число запросов на статью, количество негативных примеров, режим их отбора и ручная проверка псевдоразметки. Поэтому схема показывает происхождение сигнала, но не является полным рецептом воспроизведения обучения.
TSDAE и GPL выполняются последовательно при подготовке модели. Генерация синтетических вопросов и получение псевдооценок не запускаются заново для каждого вопроса сотрудника. В рабочем поиске используется уже адаптированная LaBSE, а новый документ поступает через отдельный контур индексации.
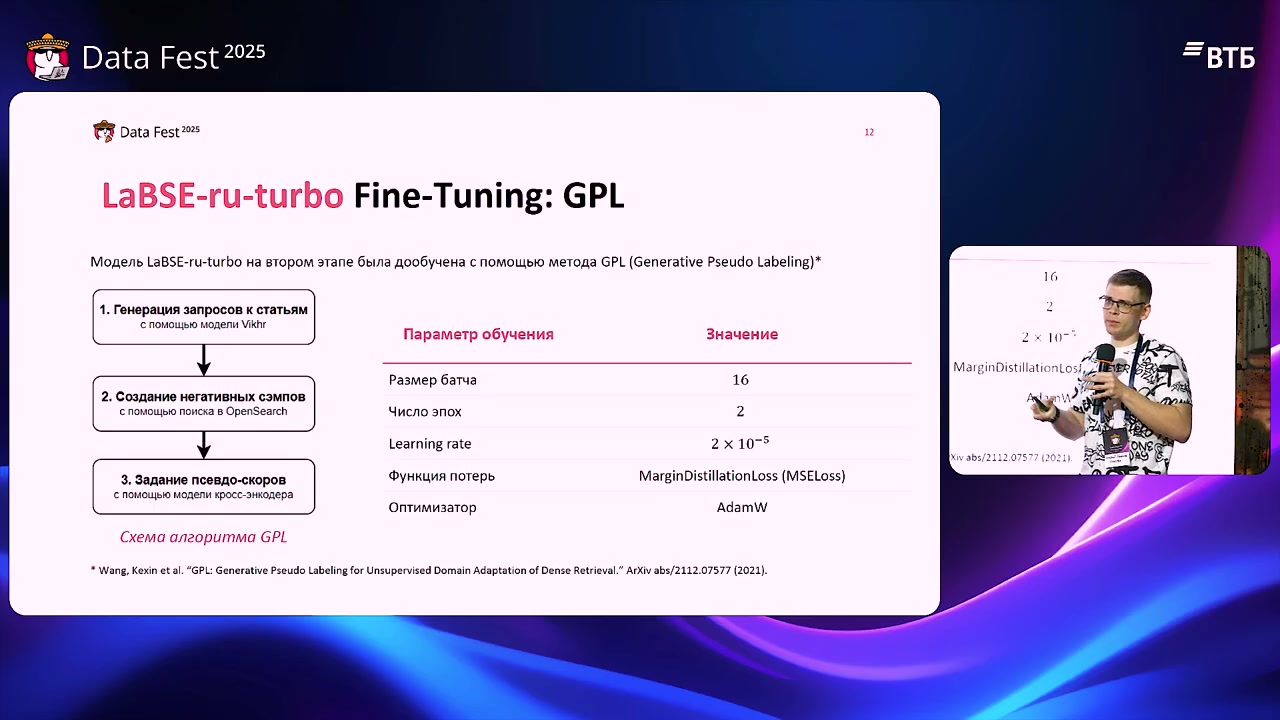
Vikhr генерирует запросы, OpenSearch даёт негативные примеры, cross-encoder — псевдоскоры. Batch 16, две эпохи, learning rate 2×10⁻⁵, MarginDistillationLoss и AdamW.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Четыре канала поиска и отказ от смешивания исходных оценок
Для статьи доступны по меньшей мере название, в речи также называемое темой, и содержимое. По каждому полю запускаются два способа поиска: лексический BM25 и векторный. Поэтому речь идёт не об одном общем векторном списке, дополненном одним лексическим, а о четырёх отдельно ранжированных списках.
Таблицу можно прокрутить по горизонтали.
На схеме у каждого канала есть вес. Автор говорит, что веса можно подбирать, в том числе автоматически. Но итоговые значения и надёжно установленное название инструмента подбора не раскрыты. Наличие весов не даёт основания считать их равными или подставлять типовые коэффициенты.
Следующая проблема — разные числовые шкалы. Баканов описывает векторные оценки своей схемы как нормированные, а оценки BM25 — как неудобные для непосредственного сопоставления с ними. Он пробовал преобразовать оценки с помощью сигмоиды, но получил очень низкие метрики. Конкретные значения, параметры сигмоиды и полный состав той проверки не приведены. Это неудачная попытка в данном проекте, а не доказательство непригодности такого преобразования вообще.
Вместо прямого смешивания исходных чисел команда использовала объединение по позициям документов в списках — RRF. Алгоритм получает ранги кандидатов от разных каналов и по ним строит общую оценку. Поэтому высокая оценка BM25 в собственной шкале не должна напрямую конкурировать с числом из векторного поиска. Формула используемого варианта, её константы и значения весов не показаны; важен подтверждённый переход от значений к рангам.
В разделе результатов автор ещё раз уточняет историю: до RRF применялось взвешенное объединение. В действующую комплектацию вошёл RRF вместе с дообученным кодировщиком и отдельной моделью переранжирования. Их совместный результат нельзя автоматически разложить на независимые прибавки каждого изменения.
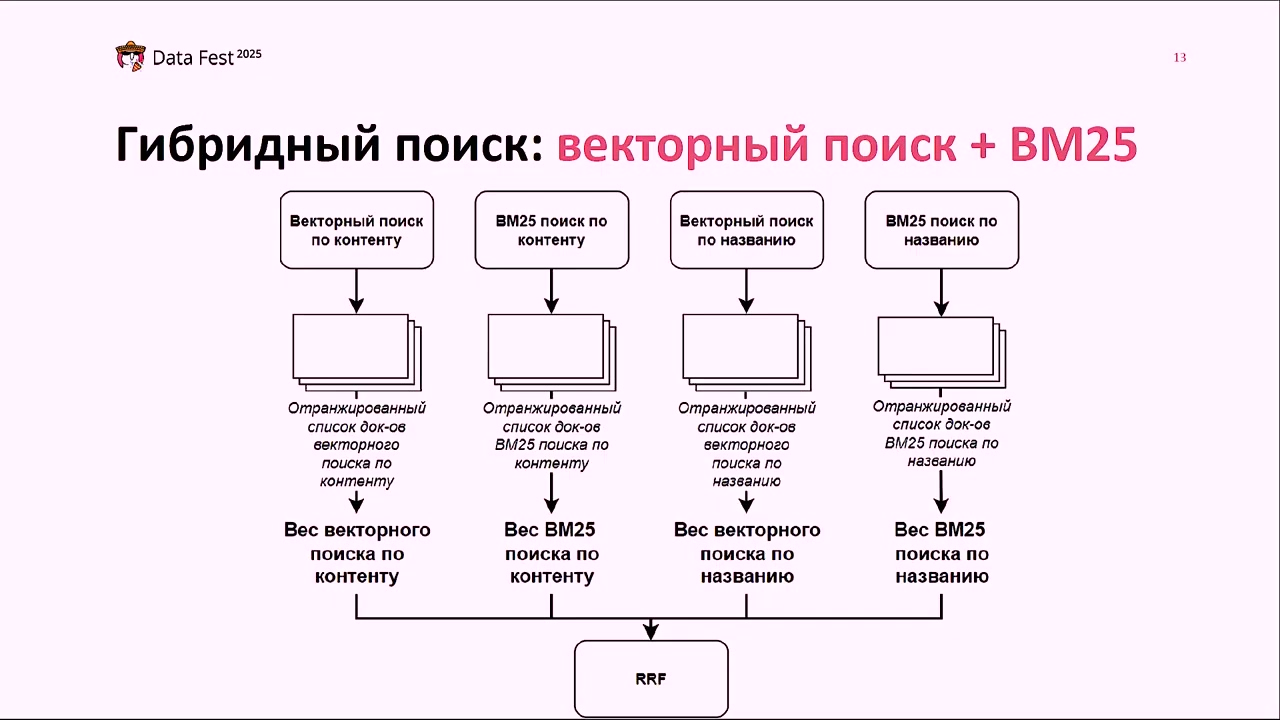
Векторный поиск и BM25 отдельно по содержимому и названию; ранжированные списки объединяют через RRF.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Small2Big: искать по небольшому фрагменту, отвечать по расширенному
Большой документ удобен как источник полного объяснения, но содержит много постороннего относительно конкретного запроса текста. Кроме того, выбранный кодировщик принимает ограниченную последовательность. Небольшой фрагмент проще сопоставить с вопросом, однако его может не хватить для ответа: нужные пояснения остаются в соседней части статьи.
Стратегия Small2Big разделяет эти требования. Для поиска используются маленькие фрагменты, а для генератора найденный материал расширяется соседним текстом. Поэтому размер единицы поиска не обязан совпадать с объёмом контекста, который в итоге увидит языковая модель.
- 01
Разбиение документа
При индексации документ делят с учётом допустимой длины входа TextEmbedder.
- 02
Сохранение соседства
Для каждого фрагмента сохраняют сведения о его соседях и их индексах.
- 03
Поиск по небольшим фрагментам
При пользовательском запросе OpenSearch возвращает найденные небольшие части документа.
- 04
Увеличение контекста
Перед передачей материала генератору к найденному фрагменту добавляют контекст левых и правых соседей.
В объяснении автор упоминает 512 токенов базовой BERT-подобной модели и оговаривает существование моделей с большим входом. Для выбранной LaBSE-ru-turbo предел 512 подтверждён отдельно. Но из этого не следует, что каждый фактический фрагмент содержит ровно 512 токенов: точный размер разбиения не опубликован.
Число соседей с каждой стороны, перекрытие фрагментов, объединение пересекающихся окон и итоговый бюджет контекста не названы. Не установлен и точный порядок расширения относительно отдельного cross-encoder-переранжирования. Подтверждена граница: поиск идёт по маленьким фрагментам, а расширенный текст должен быть подготовлен до генерации.
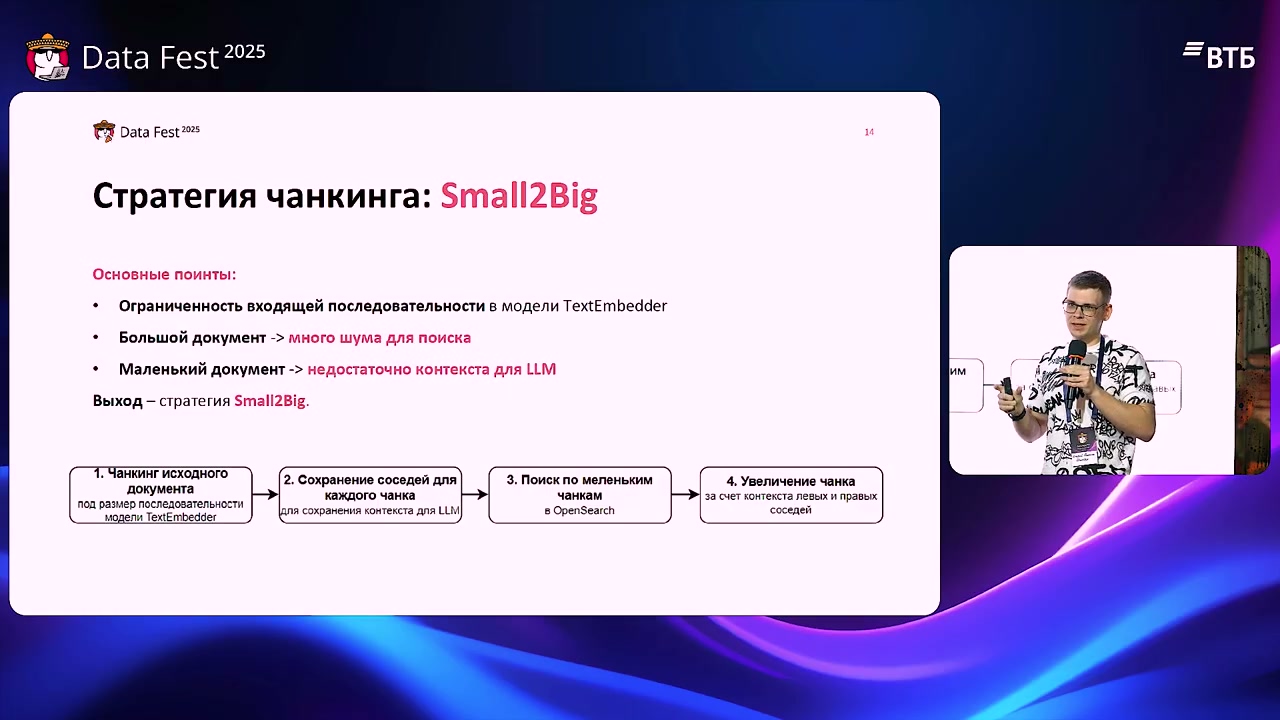
Поиск работает по маленьким фрагментам, контекст генерации расширяют левыми и правыми соседями. Это разделяет требования эмбеддера и языковой модели.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Переранжирование: уточнить соответствие или уменьшить повторяемость
После гибридного поиска остаётся список кандидатов, порядок которого можно уточнить. В докладе рассмотрены две переключаемые стратегии: отдельная модель соответствия запросу и отбор с учётом разнообразия. Это альтернативы под потребности заказчика, а не обязательное последовательное применение обеих.
Первый вариант — Cross-Encoder-Russian-MSMARCO. В отличие от поиска по заранее вычисленному представлению документа, cross-encoder оценивает запрос и документ совместно. Баканов описывает эту BERT-подобную модель как более трудоёмкий и ресурсозатратный способ переранжирования. На слайде указаны максимальная последовательность 512 токенов и 178 млн параметров. Там же подписан «размер вектора 768»; при этом роль компонента в сервисе — оценка пары, а не замена поискового кодировщика.
Второй вариант — MMR: при выборе следующего документа учитываются одновременно его соответствие вопросу и сходство с уже выбранными документами. Это помогает не заполнять весь контекст почти одинаковыми фрагментами. Чем сильнее предпочтение разнообразия, тем больше значение имеет новая информация относительно уже отобранной; чем сильнее предпочтение релевантности, тем важнее непосредственное соответствие вопросу.
Математическая запись и пояснение коэффициента λ на исходной иллюстрации неточны. Коэффициент поставлен перед общей скобкой, а подпись описывает рост разнообразия от 0 к 1, что не согласуется с обычной трактовкой веса релевантности в MMR. Поэтому эту иллюстрацию нельзя использовать как готовую формулу для реализации. Указанный рядом диапазон 0,3–0,7 также не подтверждает конкретную настройку работающего сервиса.
Для понимания решения достаточно содержательного правила: отбирать полезное для вопроса и одновременно учитывать повторяемость относительно уже выбранного. Корректную формулу именно авторского кода, выбранное значение λ и функции сходства запись не устанавливает. В итоговом сравнении выигрывает комплектация с cross-encoder; MMR остаётся показанной альтернативой, в том числе в варианте с моделями Яндекса.
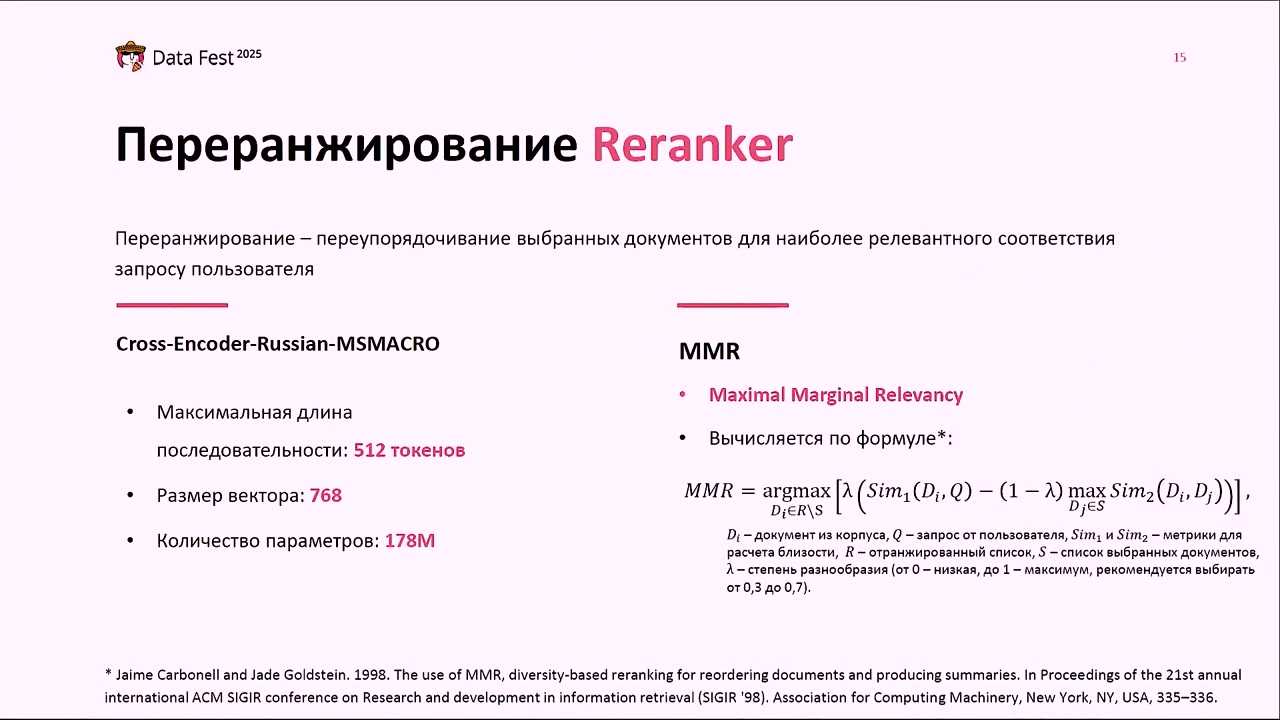
Cross-Encoder-Russian-MSMARCO: 512 токенов, 178M параметров. MMR балансирует релевантность и сходство уже выбранных документов. Формула и объяснение λ на слайде неточны; не копируем их как проверенную реализацию.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Как проверить документы и собранный для ответа контекст
Одна оценка не описывает всю систему: можно найти подходящий документ, но передать генератору неполный контекст; можно подготовить полезный контекст, но получить неудачный ответ. Поэтому команда отдельно проверяет поиск, полезность контекста и генерацию.
Для оценки найденных документов аналитики подготовили разметку релевантности. Основная метрика поиска — MRR@5, средняя обратная позиция первого релевантного документа среди первых пяти результатов. Она вознаграждает выдачу, в которой первый подходящий материал расположен выше. Автор объясняет выбор понятной интерпретацией и удобством обсуждения качества.
Недостаток MRR@5 назван прямо: метрика учитывает только первый релевантный документ. Наличие других нужных материалов и качество оставшейся части списка она не описывает. Поэтому хорошая позиция одного источника ещё не говорит, насколько полон контекст для ответа на вопрос.
Для этого введена отдельная оценка релевантности контекста — Contextual Relevancy. Языковая модель получает специальную инструкцию и выступает судьёй: оценивает, насколько найденный контекст помогает ответить на заданный вопрос. Автор говорит о небольшой адаптации используемого оценочного подхода под свою задачу. Это проверка полезности материалов, а не верности уже сгенерированных утверждений.
Число размеченных запросов, подробное правило подготовки тестовой части и согласие модели-судьи с человеческими оценками не раскрыты. Поэтому можно восстановить назначение метрик и роль аналитиков, но не полностью воспроизводимый протокол оценки. MRR@5 также не является долей безошибочно решённых обращений поддержки.
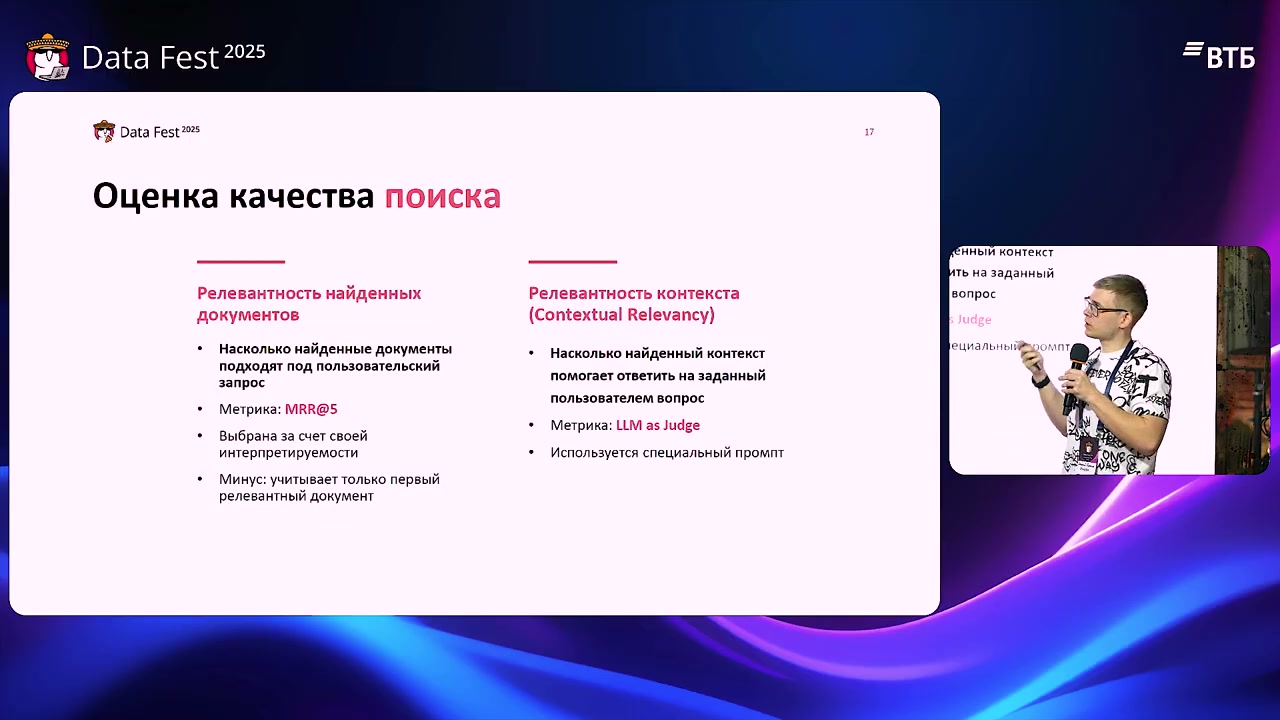
MRR@5 оценивает позицию первого релевантного документа; Contextual Relevancy — отдельная оценка найденного контекста моделью-судьёй.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Текстовое совпадение, правильность и опора на источники
Для проверки генерации аналитиков попросили подготовить вопрос и подобрать контекст, в котором содержится ответ. На первом этапе команда сравнивала ответ модели с ожидаемым фрагментом документа по текстовому совпадению. Такая проверка проста, но не отличает все смысловые случаи: один и тот же ответ можно выразить разными словами.
Таблицу можно прокрутить по горизонтали.
Причина дополнения chrF++ смысловыми оценками раскрыта в речи: модель может передать правильное содержание, используя другие слова. Позже Баканов показывает, что ответы различаются и по структуре — где-то повторяют ожидаемые пункты, а где-то становятся связным текстом. Такое расхождение способно ухудшать текстовое совпадение без однозначного вывода о смысле.
Correctness и Faithfulness нельзя объединять в одну «правильность». Первая сопоставляет ответ с ожидаемым, вторая проверяет его опору на выданные источники. По смыслу этих критериев фактически верное утверждение ещё не обязательно обосновано тем контекстом, который получила модель. И наоборот, аккуратная передача предоставленного текста сама по себе не устанавливает полноту ответа относительно эталона.
Точные инструкции судье, его модель, версия, шкалы оценок и степень совпадения с аналитиками не опубликованы. Поэтому значения итоговой таблицы нужно читать как показатели указанной оценки, а не как установленный процент полностью правильных ответов или доказанную частоту неподтверждённых утверждений.
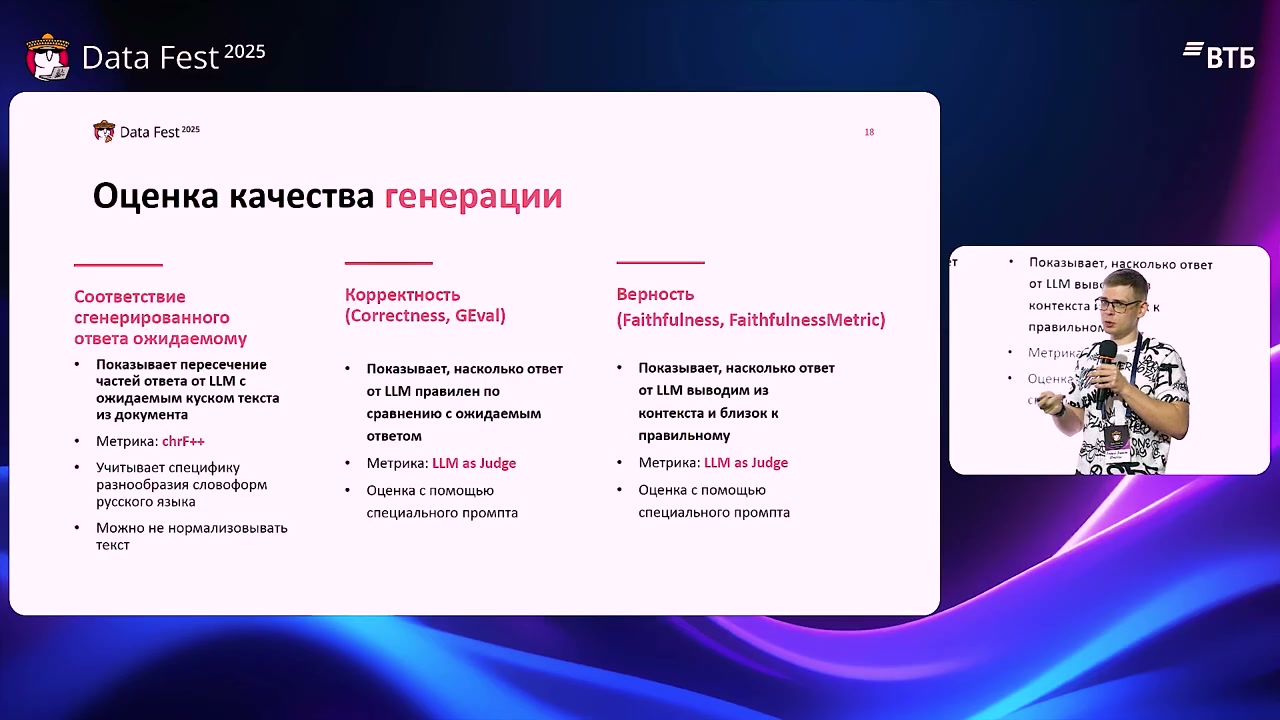
chrF++ сравнивает текст с ожидаемым; Correctness и Faithfulness оцениваются отдельно с помощью LLM as Judge.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Результаты: сравнение шести полных комплектаций
В итоговой таблице сопоставлены комплектации системы, а не только отдельные языковые модели. Zero-shot означает исходный кодировщик без описанной доменной адаптации, Fine-tuned — дообученный вариант. Названия LaBSE и Vikhr в строках сокращены относительно ранее показанных LaBSE-ru-turbo и Vikhr-Nemo-12B-Instruct-R-21-09-24; YaGPT обозначает ветку генерации Яндекса, представленную до этого как YandexGPT-Lite.
Таблицу можно прокрутить по горизонтали.
Работающая комплектация — Fine-tuned LaBSE + Cross-Encoder + RRF + Vikhr. Среди показанных вариантов она имеет максимальные MRR@5 и chrF++; среди двух строк с полным набором оценок — также наибольшие Contextual Relevancy, Correctness и Faithfulness. В речи автор прямо связывает выбор с этими результатами и говорит, что именно эта комплектация уже используется в умном поиске.
Первая строка не является численной оценкой прежнего простого лексического поиска: в ней уже присутствуют LaBSE, cross-encoder и Vikhr. Поэтому переход от 0,22 к 0,802 нельзя подписывать как измеренное улучшение старого лексического сервиса. Это сравнение указанных в таблице комплектаций на оценке команды.
Нельзя и приписать каждую разность одному изменению. Между первой и второй строками меняются не только адаптация кодировщика, но и стратегия переранжирования. В последней строке одновременно другие кодировщик, переранжирование и генератор. Строки с RRF показывают результаты соответствующих сочетаний, однако полный протокол изолированных экспериментов и неизменность всех остальных настроек не раскрыты. Таблица не является отдельной абляцией каждого компонента.
Все пять метрик приведены только для двух последних комплектаций. Дефисы в остальных строках нельзя заменять нулями или считать доказательством того, что эти варианты вообще не способны давать обоснованные ответы. Размер выборки, разделение обучающих и тестовых данных, доверительные интервалы и согласие модели-судьи с человеком неизвестны.
Бизнес-эффект отдельно не измерен в опубликованном материале: нет A/B-теста нагрузки на поддержку, экономии времени, доли закрытых обращений или роста пользовательских показателей. Подтверждённый результат — выбор и применение комплектации с указанными оценками на корпоративном корпусе авторов, а не универсальная гарантия качества или экономии.
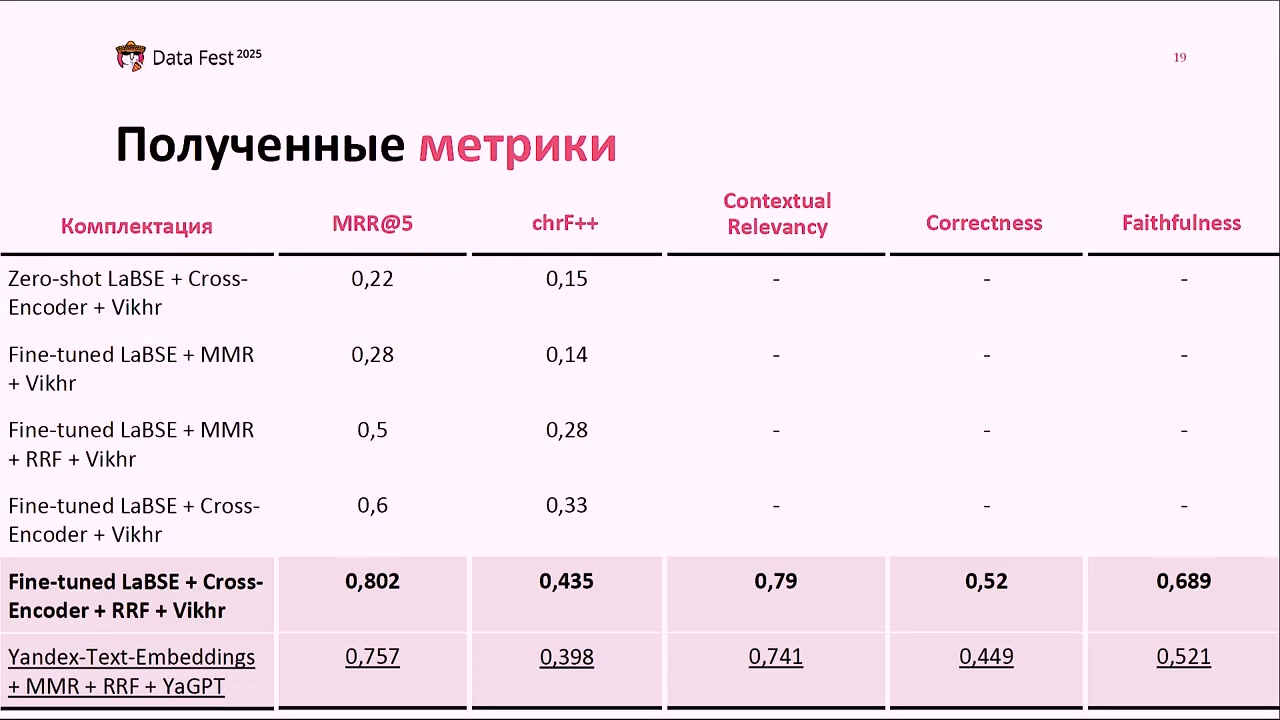
Fine-tuned LaBSE + Cross-Encoder + RRF + Vikhr: MRR@5 0,802; chrF++ 0,435; Contextual Relevancy 0,79; Correctness 0,52; Faithfulness 0,689. Последняя строка — другой полный стек, не изолированная абляция LLM.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Развёртывание и показанный пользователю ответ
После таблицы автор обсуждает реальные различия формы ответа: иногда система воспроизводит ожидаемое содержание по пунктам, иногда излагает его сплошным текстом. Этим он объясняет часть просадки chrF++. Подробное содержимое промежуточного сравнения в речи не зачитано, поэтому из него устанавливается наблюдение о структуре, а не новый численный результат.
Развёртывание организовано в Kubernetes. На схеме внутри кластера показаны search-api, ETL-service, proxy-encoder, text-embedder и reranker. Рядом отдельно изображены OpenSearch, S3 и Kafka. S3 используется для хранения артефактов, а proxy-encoder обеспечивает переключение между вариантами кодировщика. Из этой схемы нельзя вывести число рабочих реплик, подробную топологию оборудования или местоположение каждого экземпляра генератора.
Пользовательский интерфейс встроен в продукт «Сфера». В форме можно ввести запрос в свободном виде, после чего система переформулирует его и выводит ответ по мере генерации. На демонстрации есть области «Статьи Знаний» и «Индекс с файлами», а внизу ответа — ссылки на источники.
Показанный запрос звучит так: «какие есть методики нагрузочного тестирования». В ответе выделены поиск максимальной производительности, тест стабильности и стресс-тестирование. Первый описан как постепенное повышение нагрузки до деградации. Для теста стабильности в тексте ответа указаны не менее 24 часов и нагрузка 80% от найденной максимальной производительности. Для стресс-тестирования ответ оговаривает, что конкретные сценарии в контексте документа не описаны.
Эти 24 часа и 80% — содержание публично показанного ответа по найденным материалам, не параметры тестирования самого умного поиска и не установленная этой главой методика нагрузочных испытаний. Под демонстрационным ответом указано четыре источника; это характеристика данного примера, а не обязательное число документов для любого запроса. Полный текст исходных корпоративных материалов и независимая проверка всех утверждений ответа не предоставлены.
Такой пример показывает конечную форму продукта: не абстрактный вызов модели, а ответ в рабочем интерфейсе, связанный с найденными документами. При этом само наличие ссылок не заменяет оценку обоснованности ответа: для этого команда и ввела отдельную Faithfulness.
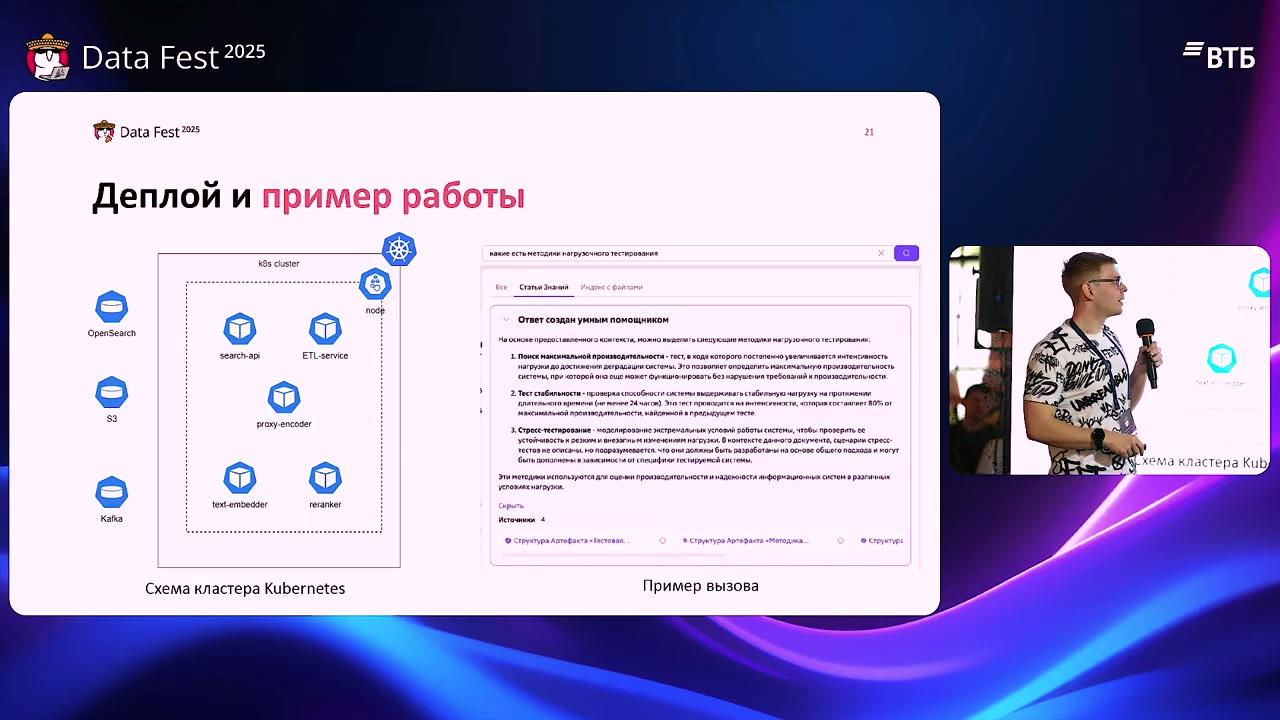
В Kubernetes показаны search-api, ETL-service, proxy-encoder, text-embedder и reranker; OpenSearch, S3 и Kafka — отдельные сервисы. Ответ содержит ссылки на источники.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Что уже работает, что проверили и что осталось направлением развития
К моменту выступления реализованы поисковый движок на основе RAG и модуль автоматической оценки на данных корпоративной базы знаний. Баканов говорит о соответствии помощника требованиям. При этом перечисление дальнейших шагов неоднородно: там соседствуют текущий эксперимент, уже отвергнутая попытка и более дальние направления.
Таблицу можно прокрутить по горизонтали.
Особенно важен результат попытки с Chain of Thoughts, то есть генерацией с промежуточными рассуждениями. Итоговая подпись слайда ещё выглядит как план, но устное уточнение меняет её смысл: подход уже попробовали, результат не удовлетворил команду, и возможность пока отменили. Числа, задачи сравнения и причина ухудшения не приведены; нельзя утверждать, что проблема была именно в задержке, стоимости или каком-либо конкретном типе ошибок.
С обратной связью граница другая: сбор лайков и дизлайков предусмотрен, а адаптация поискового вектора ещё проверяется. Полноценный агент также остаётся целью, а не скрытой частью уже внедрённого помощника. Возможность извлекать текст из PDF и изображений при загрузке не снимает этой границы между сегодняшним текстовым поиском и будущим мультимодальным.
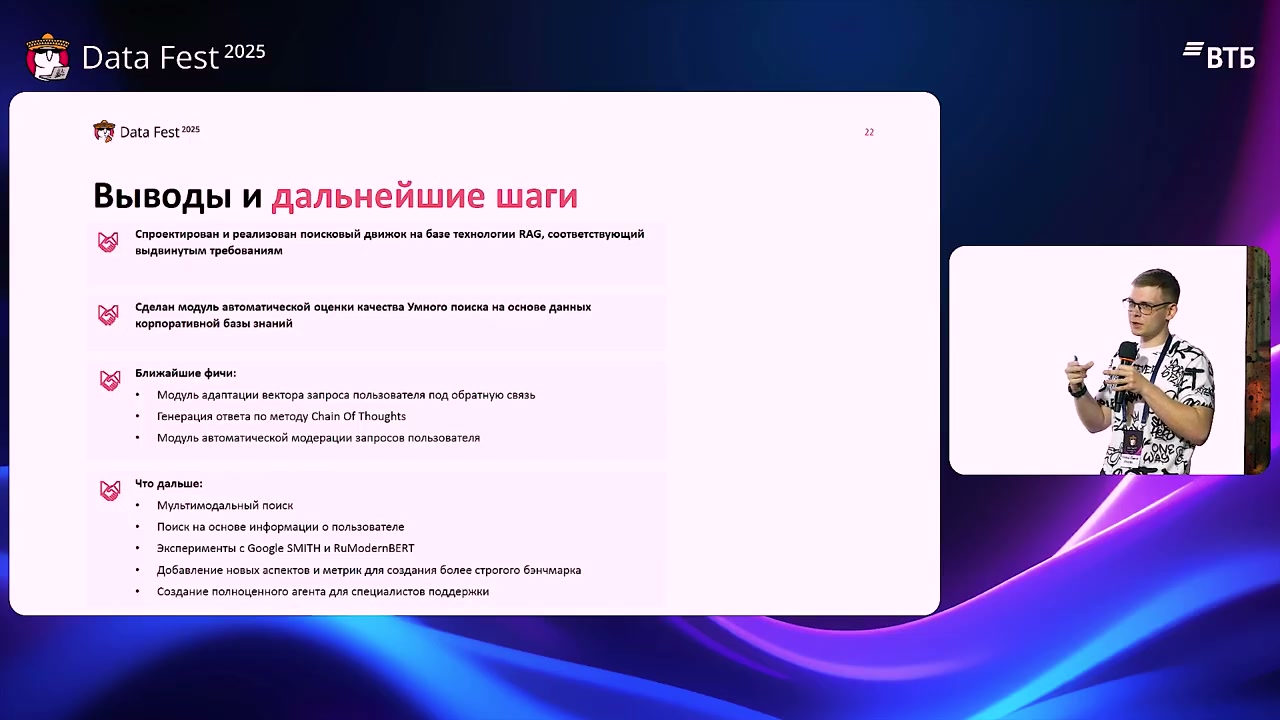
Поисковый движок и модуль оценки реализованы. Адаптация по обратной связи экспериментальна; генерацию с Chain of Thoughts испытали и пока отменили по словам автора. Модерация, мультимодальность, новые модели/метрики и полноценный агент — направления развития.
Источник: Дмитрий Баканов · Иннотех · Data Fest 2025Вопрос из зала: есть ли жанровая и лингвистическая разметка
Первый содержательный вопрос касается исходного массива документов. Участник спрашивает, маркируются ли тексты по жанрам и лингвистическим признакам. В качестве идеи он приводит различение юридических и других текстов по особенностям употребления букв или звуков, в частности шипящих.
Баканов отвечает, что такой разметки пока нет. На предложение рассмотреть идею он соглашается её принять. Это не описание уже работающего классификатора, не объявление установленной методики и не подробный план внедрения. Само предположение о признаках юридических текстов принадлежит задающему вопрос: результаты его проверки в докладе не приводятся.
Уточнение дополняет картину данных: публично раскрыты форматная обработка, текстовые поля и метаданные, но не специальный жанровый или лингвистический слой, используемый при поиске. Нельзя достраивать такой слой по общей архитектурной схеме.
Доклад · 00:22:20Вопрос из зала: что дало использование Docling и собственных парсеров
Следующий участник просит подробнее рассказать о выборе инструментов распознавания документов. Он ссылается на болезненный опыт своей команды и спрашивает, с чем экспериментировали и как показала себя Docling. Высказанное в вопросе мнение о популярности библиотеки на соревнованиях не является сравнительным результатом команды Иннотеха.
В ответ Баканов уточняет, что используются не только готовые библиотеки, но и собственные парсеры с небольшой предварительной обработкой. Он упоминает парсер LangChain для работы с разметкой и оговаривает «насколько я помню». Название ещё одного инструмента предварительной обработки в записи неразборчиво; конкретная библиотека по созвучию не устанавливается.
Docling применяется с некоторыми нюансами и вместе с собственной обработкой. Автор положительно оценивает именно получившееся сочетание. Ему удобно, что документы переводятся в Markdown; отдельно упоминается работа с презентациями. Это согласуется с ранее показанными отдельными обработчиками PDF и Microsoft Office.
Ответ не содержит таблицы качества распознавания, списка проигравших альтернатив, параметров распознавания сканов или классификации оставшихся ошибок. Поэтому вывод ограничен опытом этого контура: подход сработал у команды в сочетании с собственным кодом, но универсальное превосходство одного парсера не доказано.
Доклад · 00:23:20Вопрос из зала: будут ли открыты код и обучение
Последний участник спрашивает о публикации кода последовательности обработки и обучения, включая дообучение и возможное обучение с подкреплением. Он отдельно говорит, что сами данные пользователям пришлось бы собирать самостоятельно. Часть других вопросов участник оставляет для кулуаров; их содержания в записи нет.
Баканов отвечает, что планирует написать научную статью. Он не обещает открыть код, выложить репозиторий или опубликовать датасеты. Реакция собеседника с ожиданием препринта также не устанавливает площадку и срок публикации со стороны автора. Итог этого ответа — план научного описания, а не обещание публичного программного продукта.
Доклад · 00:25:12Итог: как вопрос превращается в ответ и что подтверждено оценкой
Иннотех пришёл от недостаточно удобного лексического поиска к помощнику, который соединяет поиск материалов и подготовку ответа. Изменение затронуло не только генератор: команда организовала обработку разных документов, адаптировала поисковый кодировщик, объединила каналы и разделила оценку поиска, контекста и ответа. Подготовка LaBSE через TSDAE и GPL, как и индексация документов, выполняется отдельно от обращения сотрудника.
- 01
Понять вопрос
Сервис принимает свободную формулировку, переформулирует её и расширяет с помощью сведений из тезаурусов заказчика.
- 02
Найти материалы
Дообученная LaBSE строит представление запроса. Векторный поиск и BM25 работают по названию и содержимому, а RRF объединяет списки.
- 03
Подготовить контекст
Cross-encoder уточняет порядок кандидатов. Small2Big позволяет дополнить найденные фрагменты левыми и правыми соседями перед генерацией.
- 04
Составить ответ
Vikhr получает вопрос с подготовленным контекстом и генерирует ответ, который показывается пользователю потоково.
- 05
Показать опору и собрать оценку
Интерфейс приводит источники; пользователь может оставить лайк или дизлайк. Адаптация по этой обратной связи пока экспериментальна.
На оценке авторов выбранная комплектация получила MRR@5 0,802 и chrF++ 0,435. Полезность контекста, правильность относительно ожидаемого ответа и обоснованность источниками проверялись отдельно моделью-судьёй. Таблица сравнивает полные комплектации и не доказывает независимый вклад каждого изменения.
Результат — работающий поиск в «Сфере» и модуль оценки, а не измеренная экономия поддержки. Требования 15 минут на индексацию и 10 секунд на ответ не заменяют нагрузочный тест; размер выборки и согласие судьи с человеком не раскрыты. Chain of Thoughts уже попробовали и пока отменили. Модерация, мультимодальность, персонализация и единый агент остаются направлениями развития.
Доклад · 00:20:04