Разбор готов
Поиск в Яндекс Лавке: зачем одновременно нужны BM25, DSSM и CatBoost
Пользователь вводит в Лавке «овощи для борща», «полезные перекусы» или название товара, который появился всего пару дней назад. Один и тот же алгоритм ведёт себя на таких запросах по-разному: лексический поиск хорошо цепляется за свежие названия, а нейронные модели лучше понимают смысл и поведение покупателей. Николай Смирнов показывает, как команда прошла от Ахо — Корасика, общего SaaS и движка Маркета к собственному поисковому сервису на C++ и userver. Разберём не только модели, но и весь путь запроса: выбор склада, проверку наличия, поставку товарных данных, сбор обучающего датасета, объединение трёх генераторов кандидатов, отдельную фильтрацию и персональное ранжирование.
Материал полезен ML-инженерам и разработчикам поиска, которым важно увидеть связь между моделями, индексами, товарной доступностью и данными для обучения. Особенно показательно, почему семантический поиск не отменяет BM25 и зачем после генерации кандидатов нужны отдельные фильтрация и персональное ранжирование.
Статья · на русском
Разбираем на запчасти поисковый сервис в Яндекс ЛавкеНиколай Смирнов · Опубликовано: 10 июля 2025 г.
От Ахо — Корасика до собственного сервиса
Поиск Лавки начинался в 2020 году с модифицированного алгоритма Ахо — Корасика. Он искал по названию, категориям и синонимам, причём название имело больший вес. Простые опечатки удавалось обработать, но сложные быстро становились проблемой: автор приводит пример «вожв», где в четырёхбуквенном слове «вода» сразу две ошибки. Такой поиск хорошо опирался на форму текста, но не давал всей семантики, которая нужна товарному сервису.
В 2021 году команда перешла на общеяндексовый Search as a Service. Он был универсальным и не учитывал специфику Лавки, но оказался достаточно сильным, чтобы сохраниться как базовый вариант для измерения интегральных улучшений поисковых моделей. В статье нет численного значения этого базового качества и нет величины улучшения относительно него.
Следующим шагом в том же 2021 году стал движок Яндекс Маркета: инвертированный индекс плюс ранжирующий CatBoost. Лавка построила поставку товарных данных в индекс и сервис, который проксировал вызов поиска в контур Маркета. Маркет умел учитывать CTR и покупаемость, позволял встраивать кастомные модели и давал зрелую инфраструктуру масштабирования. Тем не менее команда постепенно перешла на собственный сервис. Источник описывает это как эволюцию архитектуры, а не как эксперимент, где Маркет количественно проиграл.
Хроники поиска истинного пути — история 2020–2021 годовКакие требования определяют архитектуру поиска
Автор сначала отделяет три контура такой ML-системы: обработка пользовательских запросов, сбор данных и обучение моделей. Пользователь получает ответ при обработке запроса; его действия и вычисленные признаки превращаются в датасет; новые модели после обучения возвращаются в сервис. Эта петля важна для всей статьи: качество поиска зависит не только от архитектуры модели, но и от того, как быстро обновляются данные, индексы и веса.
Таблицу можно прокрутить по горизонтали.
Функционально поиск должен работать и по неполному запросу — например, «моло» должно приводить к «молоко» — и персонализировать широкие запросы. Для «сметаны» недостаточно найти все подходящие товары: в верхней части списка желательно поставить ту сметану, которую вероятнее выберет конкретный пользователь.
Запрос из приложений Лавки, Еды, Go, Маркета или web-клиента приходит в client-api. Там определяется склад заказа, затем вызывается search, который возвращает идентификаторы релевантных товаров. В search собираются пользовательские данные из kv-user-storage, нормализуется запрос и вычисляются его представления, генерируются кандидаты, проверяется наличие, считаются признаки, применяются модели и правила итоговой выдачи. После этого данные каталога нужны уже для карточек: изображения, названия, цены и скидки.
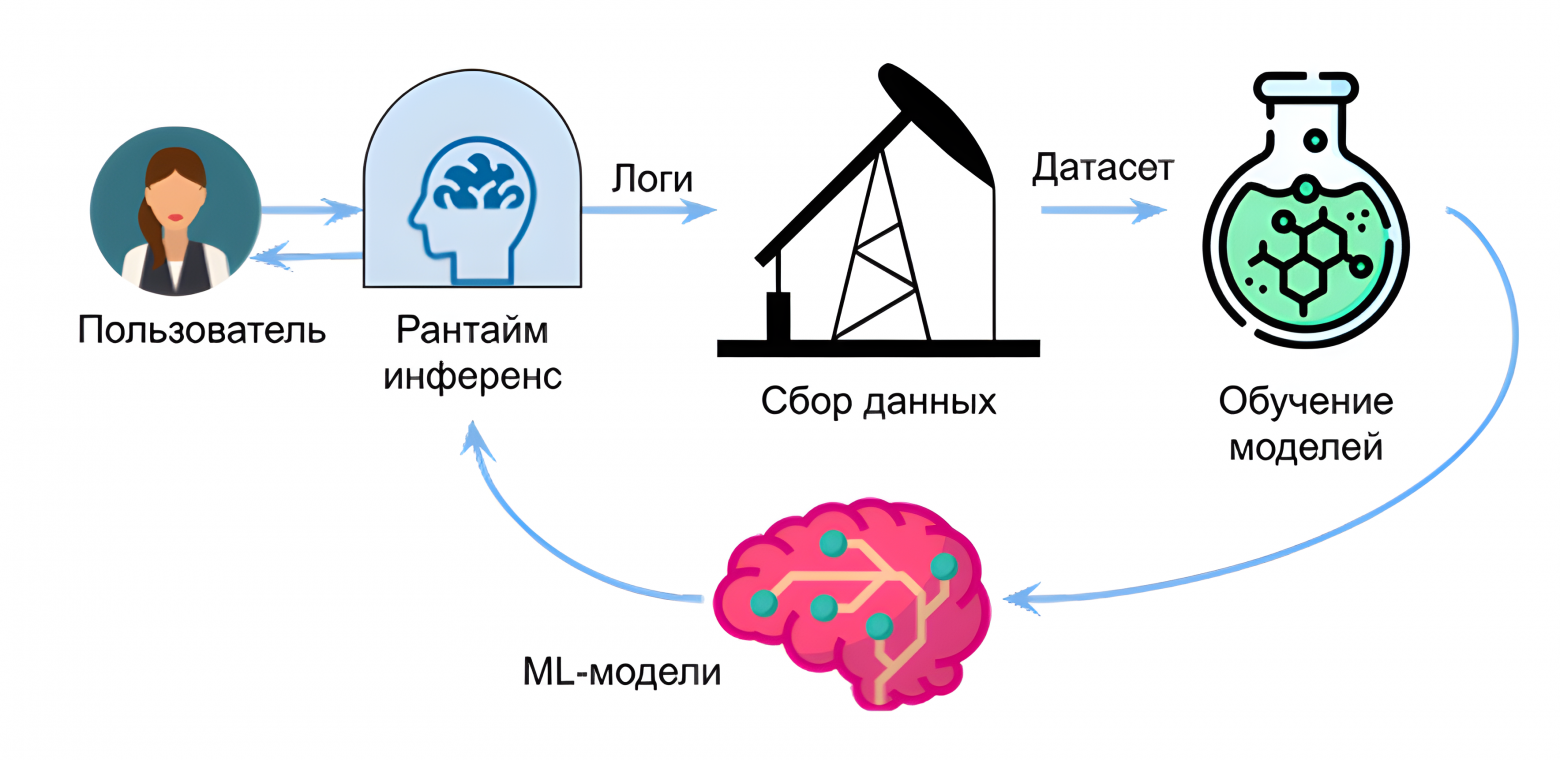
Применение моделей, сбор данных и обучение разделены; новые веса возвращаются в поисковый сервис.
Источник: Николай Смирнов · Яндекс Лавка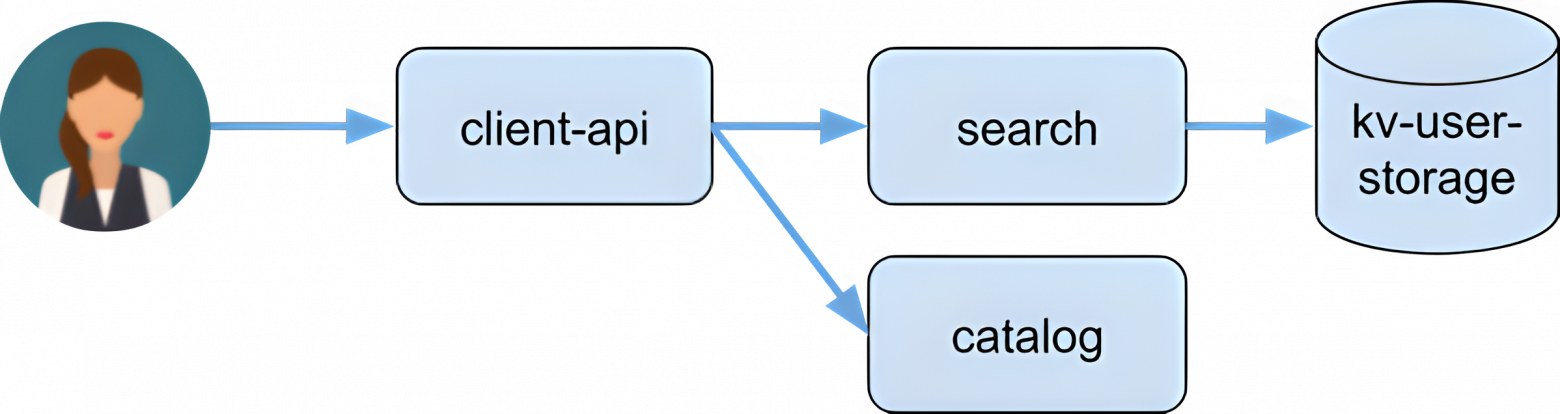
client-api определяет склад, search получает профиль пользователя и возвращает идентификаторы; catalog помогает собрать товарные карточки.
Источник: Николай Смирнов · Яндекс ЛавкаПочему проверку наличия ставят до тяжёлого ранжирования
На складе в среднем доступно около 5К товаров из ассортимента примерно 20К. Поэтому команда старается как можно раньше убрать кандидатов, которых нельзя купить именно с выбранного склада. Смысл инженерного решения простой: нет причины вычислять дорогие признаки ранжирования для большого числа товаров, которые всё равно должны исчезнуть из выдачи. Это объяснение экономии вычислений, а не измеренный в статье выигрыш задержки на 75%.
Для каждого склада search хранит асинхронно обновляемый Quotient filter — компактную вероятностную структуру для проверки идентификаторов товаров. В статье указан порядок хранения около 10 КБ на склад. Это отдельная величина и не имеет отношения к примерно 10 КБ пользовательского профиля.
Фразу об отсутствии false negative важно читать на уровне операции membership: если идентификатор был добавлен в фильтр, проверка не должна отвергнуть его как отсутствующий. Это не гарантия, что товар окажется в конечной выдаче пользователю: после проверки наличия остаются фильтрация, ранжирование и правила итогового списка. Кроме того, кеш обновляется асинхронно, поэтому сама схема не означает идеально синхронное состояние с реальным складом в каждый момент времени.
Рядом с описанием false-positive в исходнике стоит число 0,99, но по формулировке статьи нельзя надёжно установить, к какой именно вероятности оно относится. Поэтому его нельзя превращать ни в «1% false positive», ни в «99% accuracy», ни в другую восстановленную метрику.
Сервис поиска с высоты птичьего полёта — абзац о фильтрации товаров по наличиюЧто живёт внутри поискового пода и как это обновляется
Сервис search написан на C++ и использует REST-подход и open-source-фреймворк userver. Во время запроса модели получают признаки из текста запроса, товарных данных и пользовательского профиля. Товарная часть хранится в бинарном shard-файле: там есть заранее рассчитанные статистики, например число заказов, доля кликов по показам (CTR), покупаемость в географии, а также другие данные, нужные поиску. Пользовательские счётчики по истории покупок читаются из быстрого key-value-хранилища.
Признаки, использованные при обработке запроса, записываются в features log, проходят через Message broker и попадают в долгосрочные MapReduce Tables. То есть работающий поиск одновременно создаёт материал для следующего цикла обучения.
Таблицу можно прокрутить по горизонтали.
Источник называет близкие, но разные механизмы доставки: товарный shard обновляется несколько раз в сутки, HNSW-индекс подкладывается раз в несколько часов, а веса моделей имеют свои циклы. Не стоит превращать эти интервалы в одну общую частоту свежести всей системы.
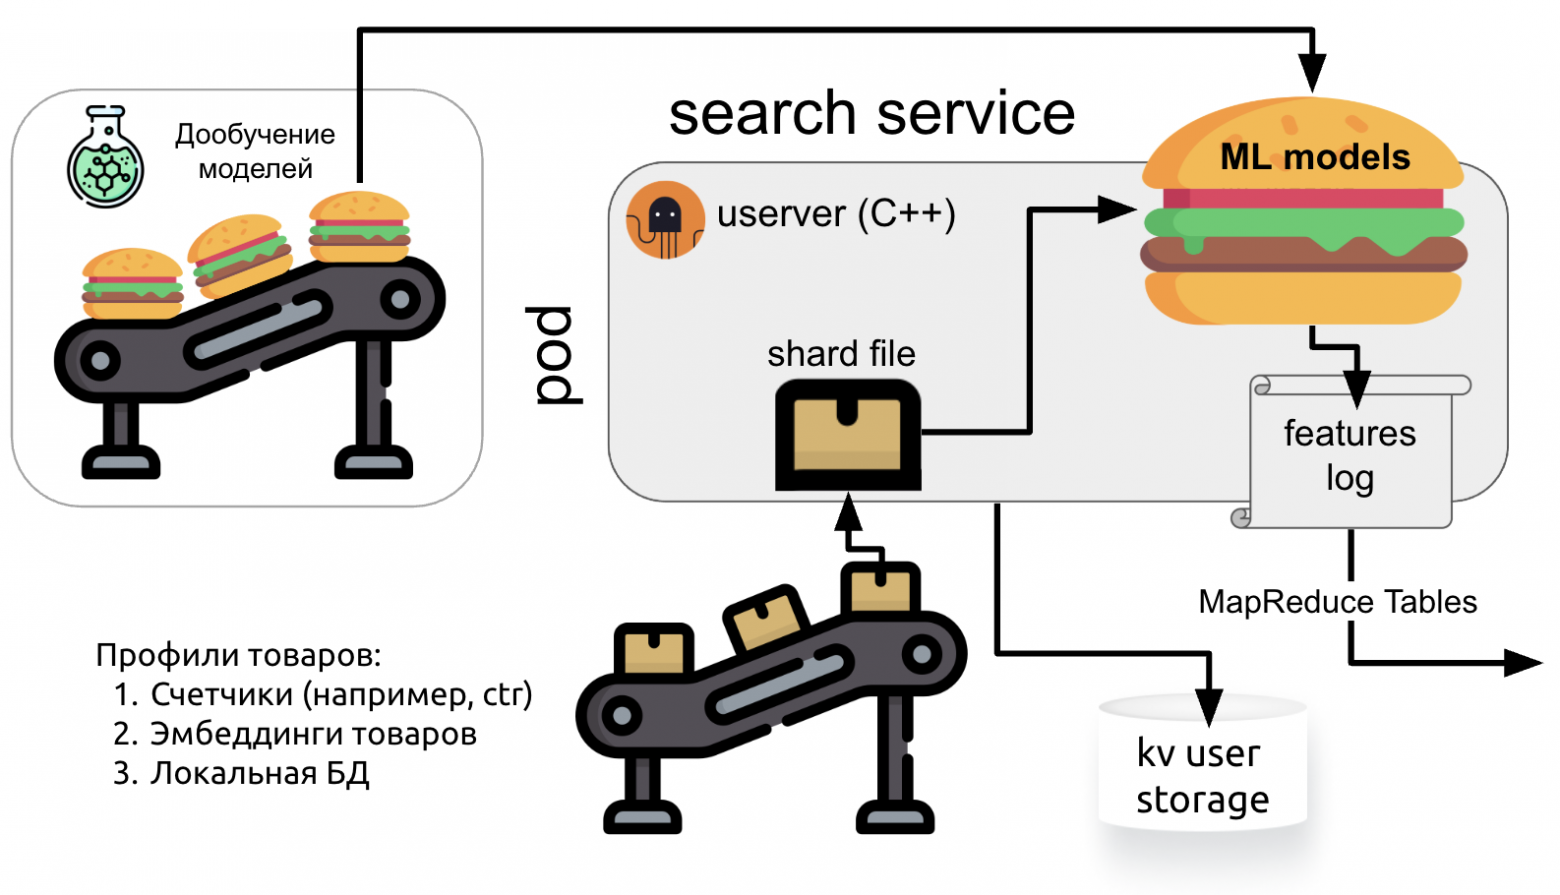
C++/userver использует товарный shard-файл и пользовательское key-value-хранилище. Признаки запроса логируются для последующего обучения.
Источник: Николай Смирнов · Яндекс ЛавкаКак из пользовательского запроса получается обучающий датасет
Клик по товару, открытие карточки, добавление в корзину, покупка и пролистывание становятся фронтенд-событиями. Они попадают в User Frontend Logs, а затем в подготовленную таблицу User Actions с типом действия. Параллельно backend при том же запросе вычисляет признаки каждого товара и пишет их в features log.
Ключевой технический мост — идентификатор запроса. По request ID команда связывает действия пользователя с теми признаками товаров, которые реально использовались при выдаче. На схеме у обеих частей есть timestamp, reqId, userId и itemId; у пользовательской таблицы добавляется action_type, у таблицы признаков — сами features. После соединения получается датасет, где известно, как пользователь взаимодействовал с конкретным показанным товаром.
Цели обучения у разных моделей не совпадают. Для ранжирующего CatBoost статья называет целевой меткой факт обновления корзины. Дальше автор связывает высокий ранжирующий скор с большей вероятностью покупки, но не сообщает, что этот скор откалиброван как вероятность; корректнее читать его как оценку для упорядочивания кандидатов.
У CartUpdate DSSM в описании обучения другая формулировка: модель получает пары «запрос — купленный по нему товар». Несмотря на название CartUpdate, эти пары нельзя автоматически отождествлять с cart update ранжировщика. У фильтрующего CatBoost будет ещё одна цель — разметка релевантности пары «запрос — товар».
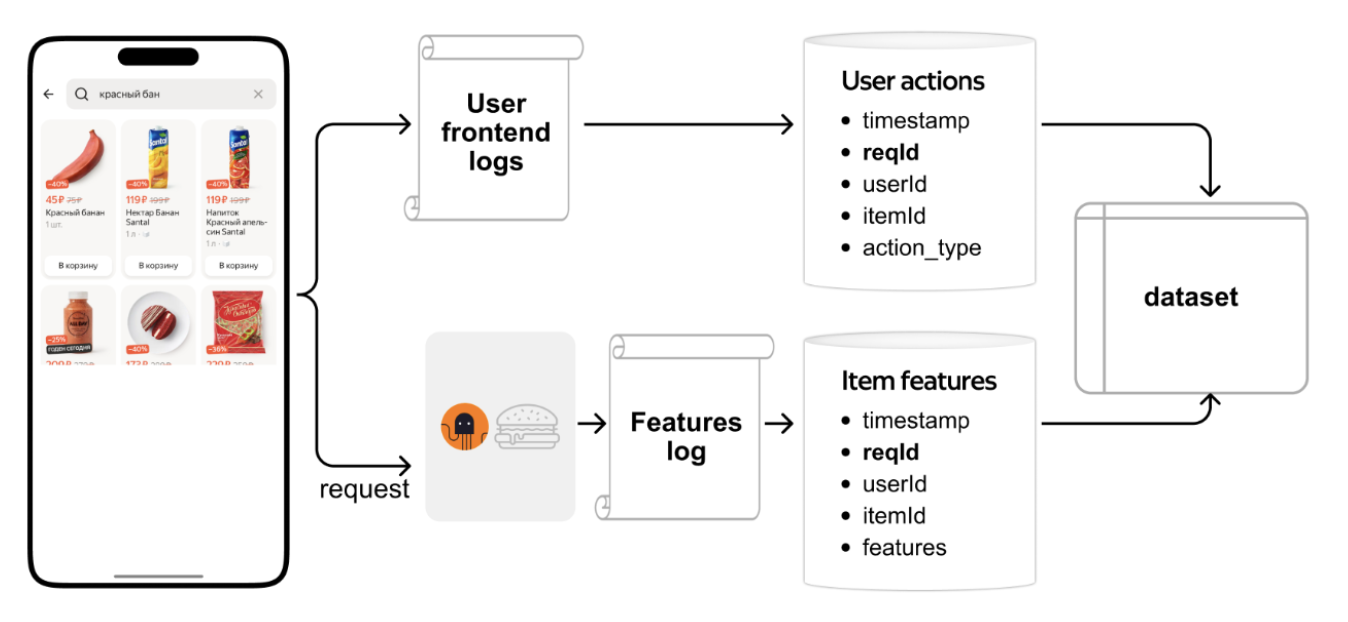
Фронтенд-события и признаки товаров соединяют по request ID. События покупки и изменение корзины нельзя автоматически считать одной меткой.
Источник: Николай Смирнов · Яндекс ЛавкаТри генератора кандидатов: поведение, смысл и точное совпадение
Первый слой «бургера» — генерация кандидатов. Вместо попытки выбрать одну универсальную модель Лавка объединяет три источника с разными сильными сторонами: CartUpdate DSSM, BERT→DSSM и BM25. Две нейронные модели используют собственные HNSW-индексы товарных эмбеддингов, а BM25 — инвертированный индекс текстовых термов. Эмбеддинг — числовой вектор, в котором близость отражает сходство товаров или запросов. HNSW — индекс для быстрого приближённого поиска ближайших таких векторов; инвертированный индекс связывает слова и их части с товарами, где они встречаются.
Таблицу можно прокрутить по горизонтали.
У CartUpdate DSSM документная башня заранее считает товарные векторы, которые складываются в HNSW. Во время запроса вычисляется только вектор текста, после чего индекс возвращает близкие товары. Такой подход некоторое время был основным генератором и, по словам автора, хорошо показал себя относительно полнотекстового поиска Маркета, но численной величины этого сравнения статья не приводит.
BERT→DSSM решает другую часть задачи. BERT сначала адаптировали к ассортименту Лавки, затем его знания дистиллировали в DSSM, чтобы получать семантические эмбеддинги. При обработке запроса работают DSSM и HNSW; cross-encoder для каждой пары «запрос — товар» статья не описывает.
BM25 строится на текстовых термах. Автор приводит буквенные триграммы для «красный» — «кра-рас-асн-сны-ный» — и словарную биграмму «красный банан». Эта лексическая природа затем объясняет и слабость на абстрактных запросах, и преимущество на свежих названиях.
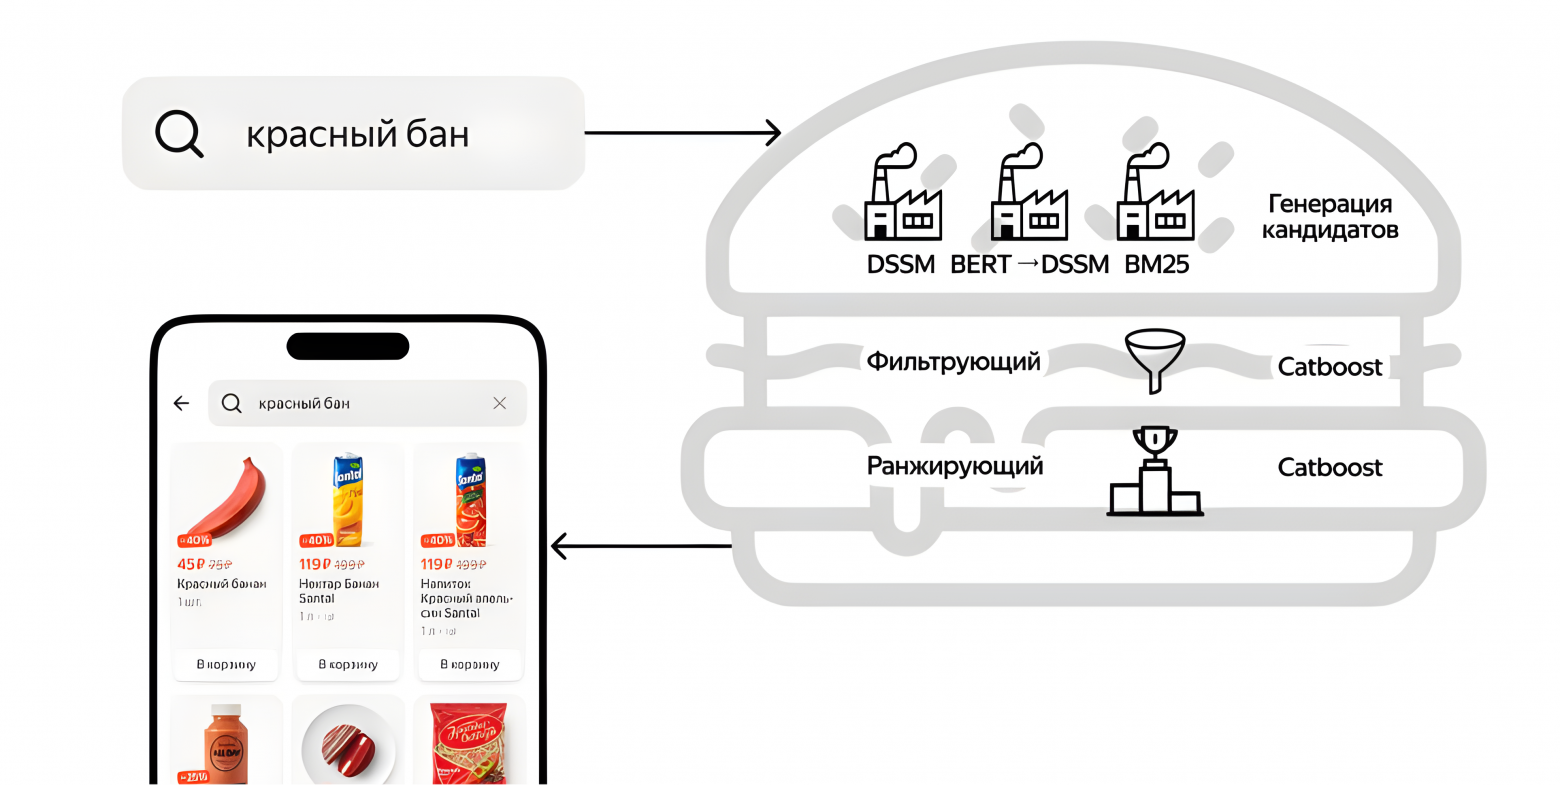
BM25, CartUpdate DSSM и BERT DSSM предлагают кандидатов; CatBoost отдельно фильтрует нерелевантное и ранжирует оставшееся.
Источник: Николай Смирнов · Яндекс Лавка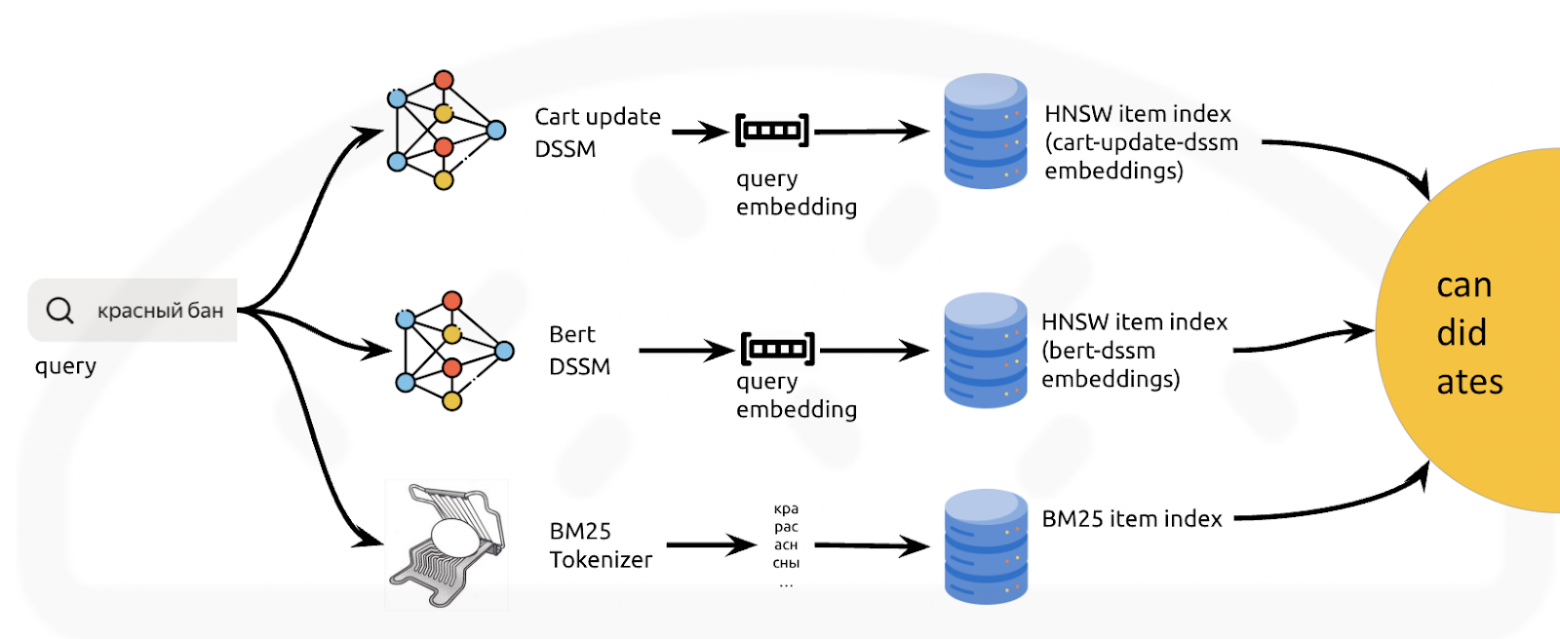
Два HNSW-индекса содержат разные нейронные представления товаров; BM25 использует инвертированный индекс термов.
Источник: Николай Смирнов · Яндекс ЛавкаПочему ни один генератор нельзя просто выбросить
Автор сравнивает источники кандидатов на отдельных запросах, временно оставляя по одному генератору. Это иллюстрации характерных ошибок, а не общий benchmark: нет единой тестовой выборки, агрегированной метрики или статистической оценки превосходства одной модели над другой.
Таблицу можно прокрутить по горизонтали.
Случай с BERT→DSSM требует аккуратности. Модель в описанной системе обучена однократно, потому что постоянное дообучение сочли дорогим по вычислениям и человеческим ресурсам. Однако новый товар всё равно можно пропустить через прежнюю документную башню, посчитать для него эмбеддинг и добавить его в shard и индекс. Это позволяет модели технически видеть новинки, но не означает, что её обученное пространство уже хорошо понимает новый бренд или новый тип товара.
CartUpdate DSSM обновляется чаще: каждые несколько дней модель дообучают на новом ассортименте. И всё же в показанном примере с «Арбуз бруски» и она не подняла точную новинку. Именно сочетание разных ошибок приводит автора к главному выводу раздела: генераторы дополняют друг друга.
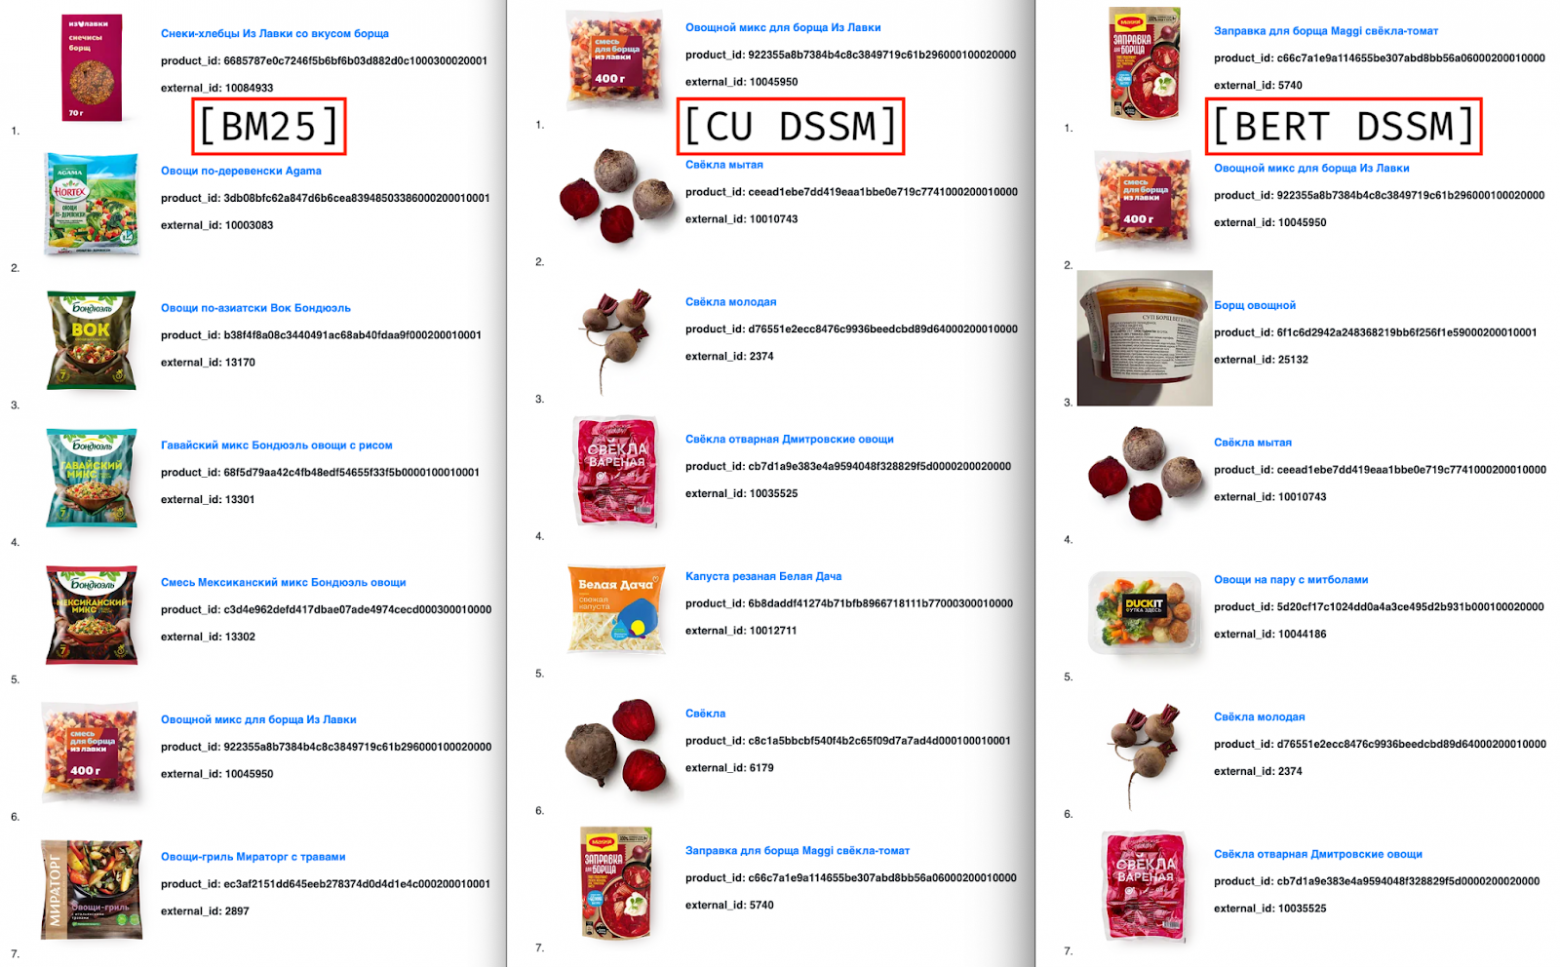
Примеры показывают разницу словарного и семантического поиска. Это несколько конкретных выдач, не численная оценка всего качества.
Источник: Николай Смирнов · Яндекс Лавка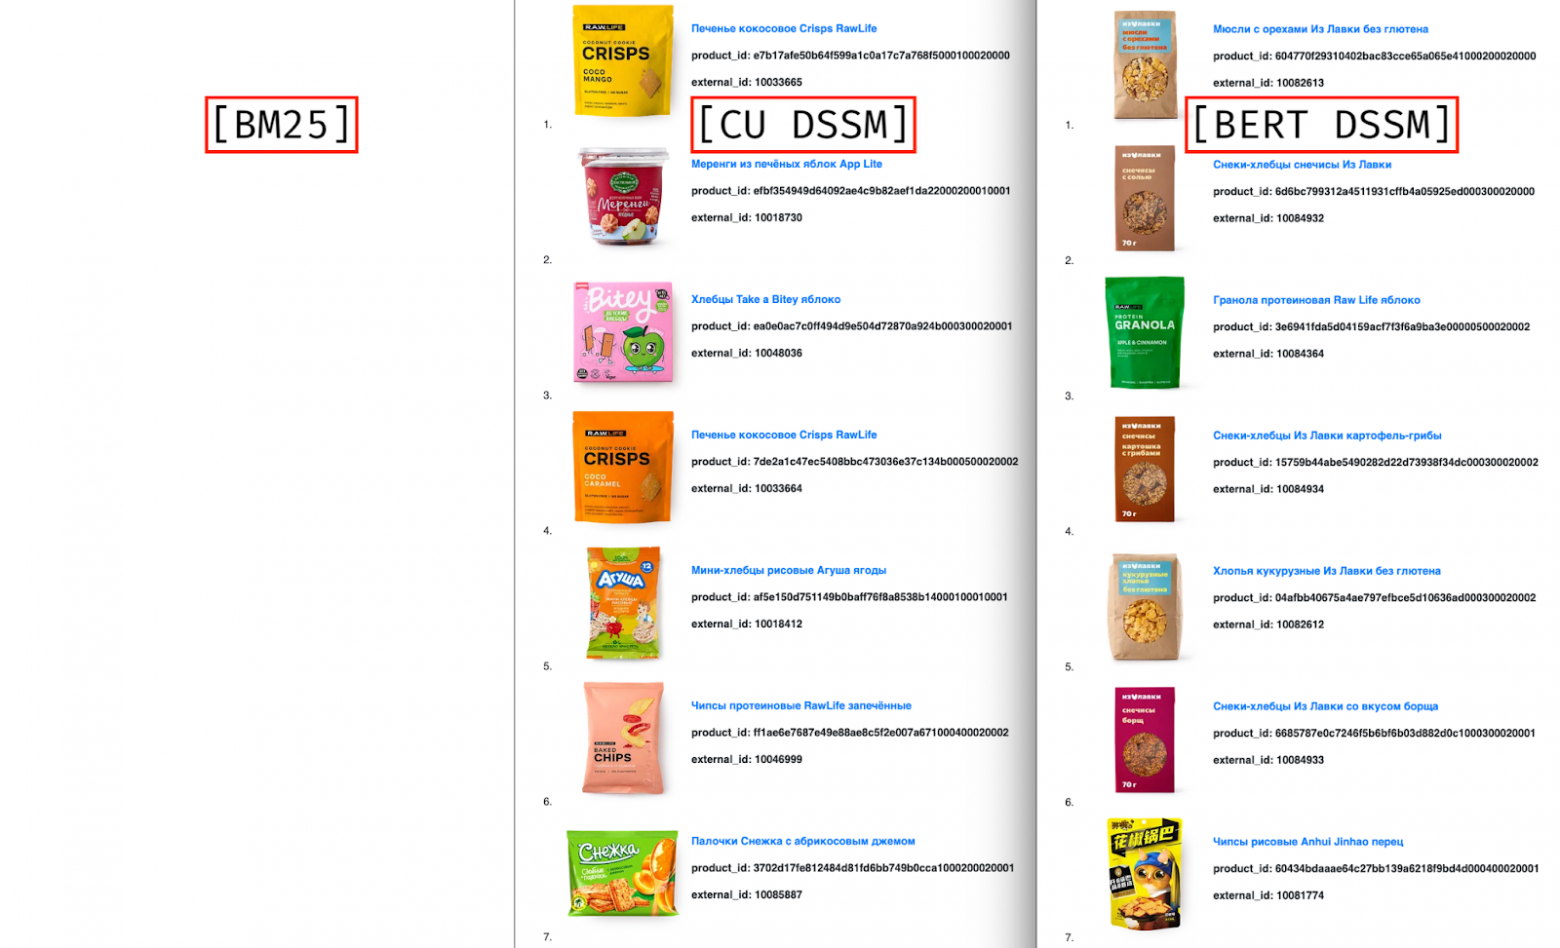
Нейронные модели находят связь со смыслом запроса, которой недостаточно для полнотекстового совпадения.
Источник: Николай Смирнов · Яндекс Лавка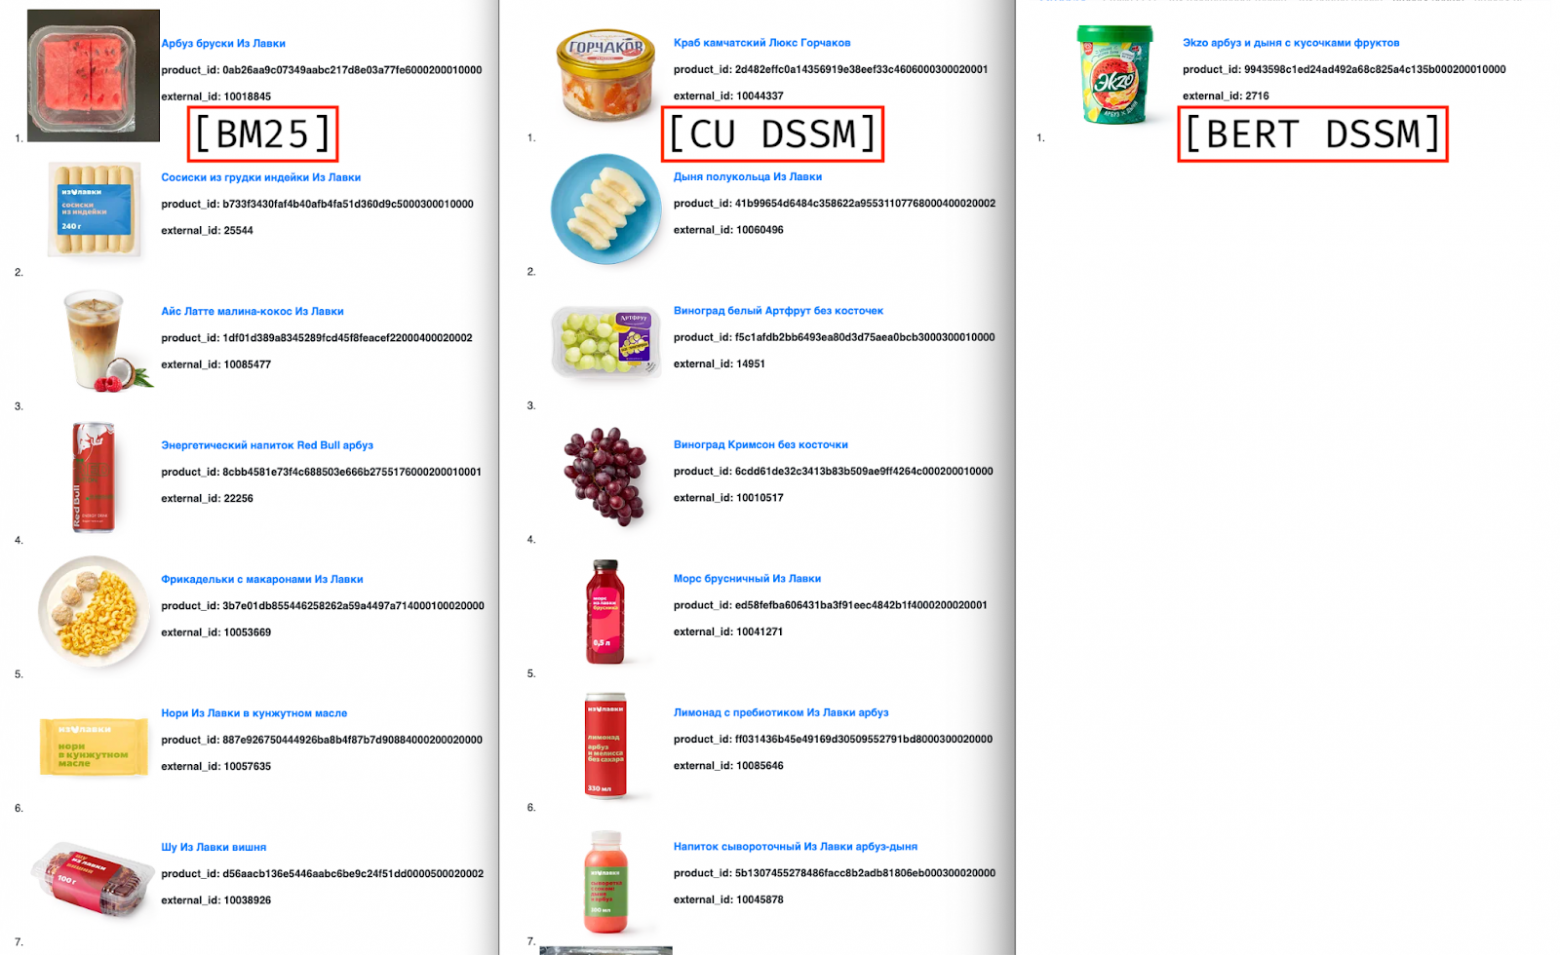
В показанном примере BM25 находит новинку, которую обе нейронные модели не подняли. Новые векторы можно считать старыми весами, но это не заменяет дообучение.
Источник: Николай Смирнов · Яндекс Лавка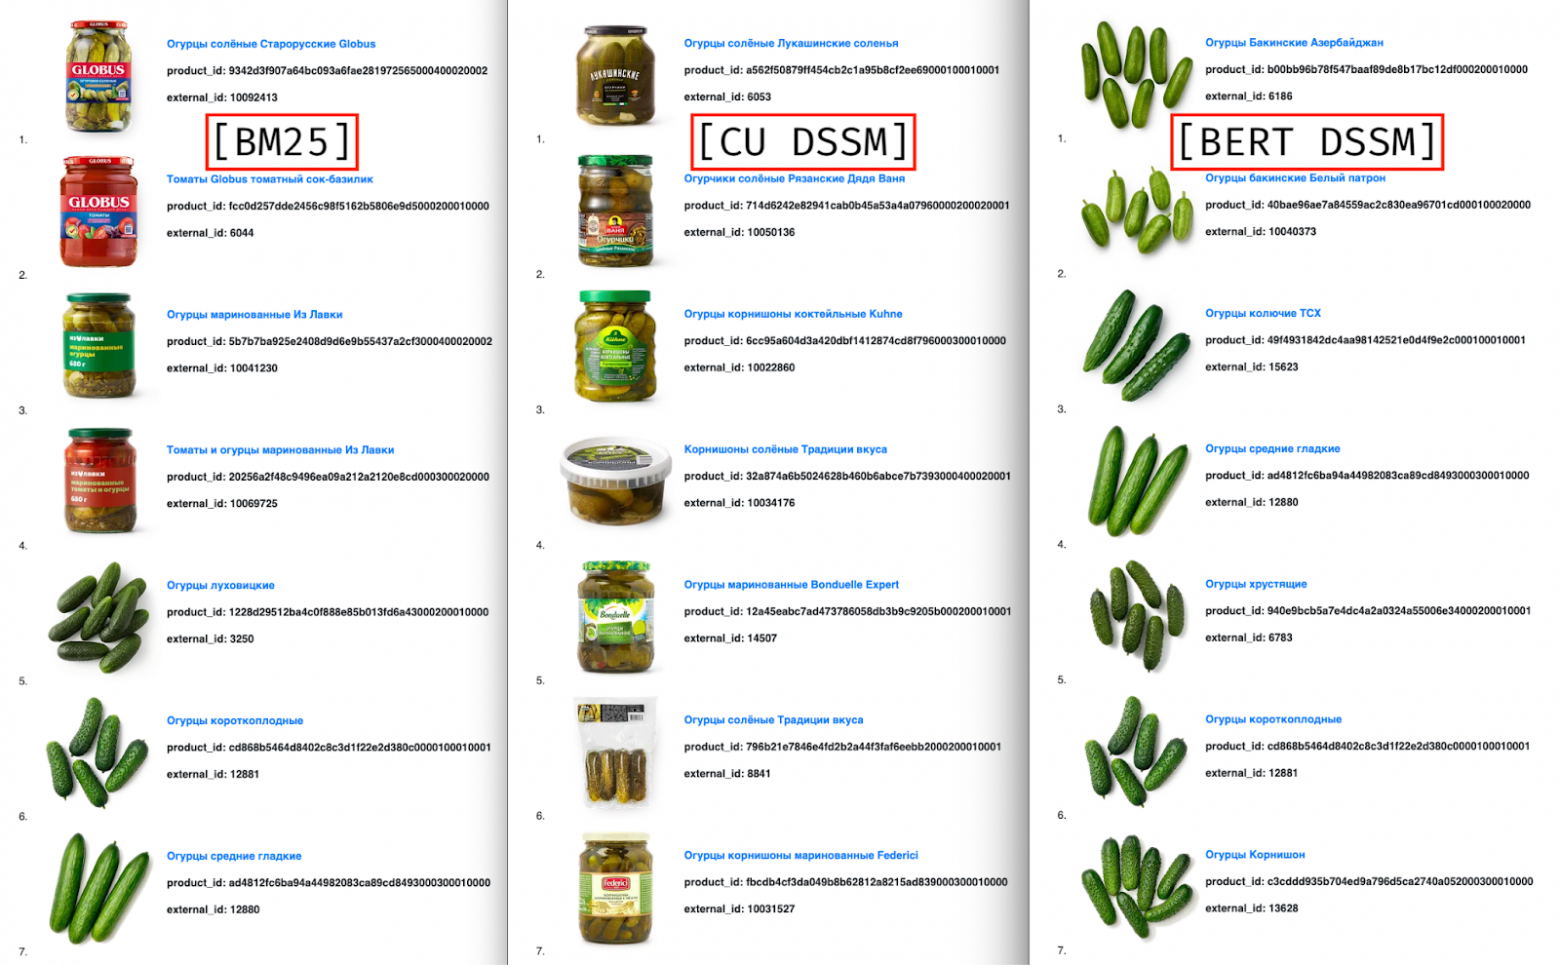
BM25 находит точное название; CartUpdate DSSM предлагает другие солёные огурцы, BERT DSSM не справляется с данным запросом.
Источник: Николай Смирнов · Яндекс ЛавкаФильтрация — отдельная задача после объединения кандидатов
После того как три генератора собрали общее множество кандидатов, каждый из них выставляет кандидатам собственную оценку. CartUpdate DSSM несёт поведенческий сигнал, BERT→DSSM — смысловую близость, BM25 — лексическое совпадение. Эти оценки становятся признаками следующего этапа.
Фильтрующий CatBoost обучен отличать релевантные пары «запрос — товар» от нерелевантных. Его целевая разметка идёт по шкале от rel+ до non-rel и создаётся людьми и роботами. Автор отмечает, что роботы догоняют людей по качеству разметки, но численной метрики этого сравнения не приводит.
Причина для отдельной фильтрации видна на запросе «лего»: среди конструкторов в выдачу может попасть «говяжье лёгкое для собак» из-за близкой формы слова. Автор называет такие очевидно нерелевантные ответы «стьюпидами». Ещё чувствительнее запросы «без глютена», «халяль» и «постное»: здесь нерелевантность касается уже свойства товара, важного для выбора пользователя.
Статья не утверждает, что проблема полностью решена. Напротив, фильтрация названа точкой роста, а дальнейшие улучшения обещаны отдельно. Поэтому из этой архитектуры нельзя выводить доказанную безопасность или отсутствие таких ошибок в работающем поиске.
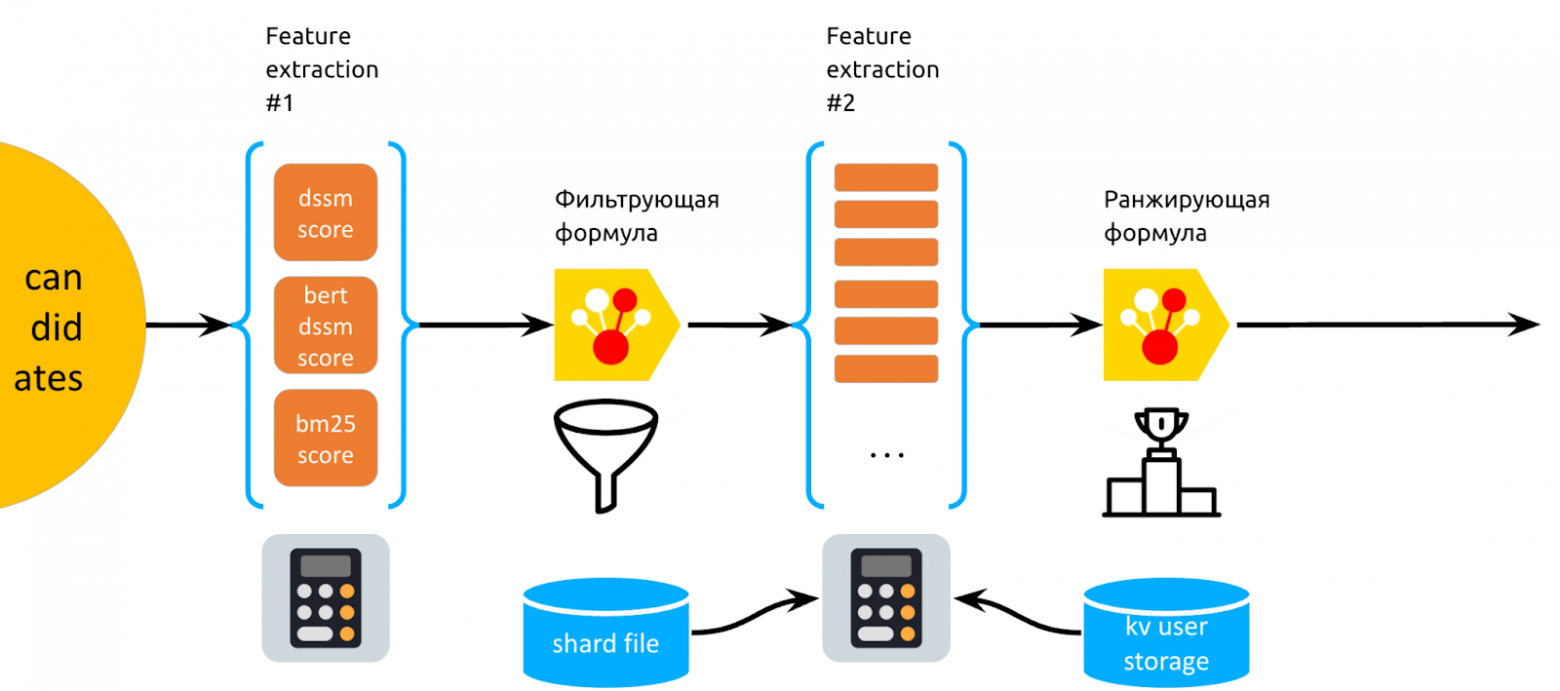
Каждый генератор оценивает объединённое множество кандидатов. Первая CatBoost-модель использует разметку релевантности, вторая — поведенческий целевой сигнал и признаки пользователя.
Источник: Николай Смирнов · Яндекс Лавка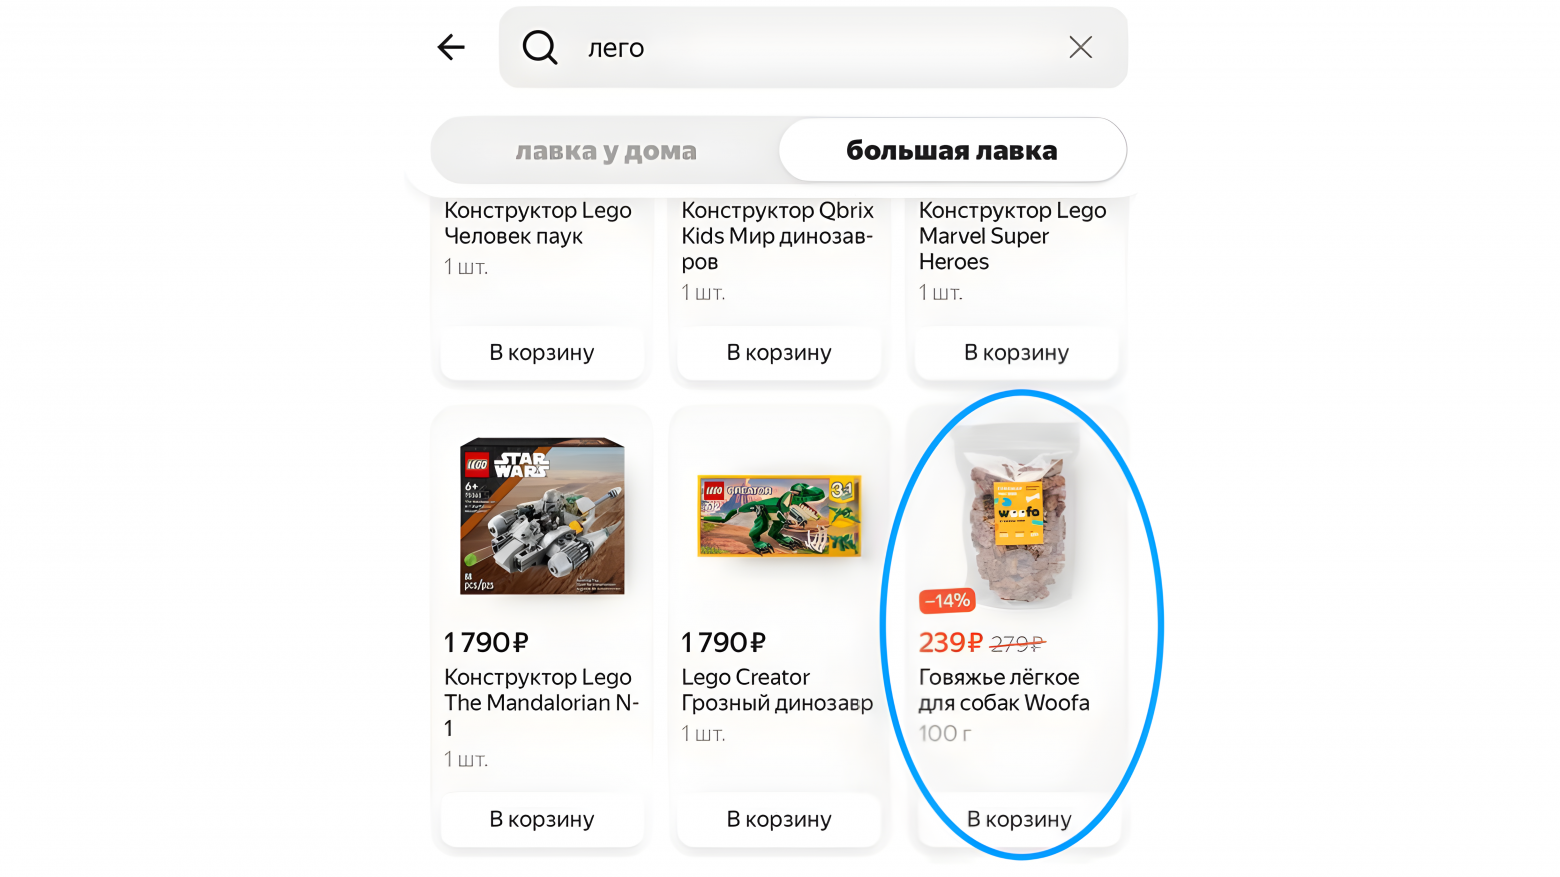
Фонетически или лексически близкое «лёгкое» может попасть в кандидаты, хотя не соответствует запросу; фильтрация имеет самостоятельную задачу.
Источник: Николай Смирнов · Яндекс ЛавкаПерсональный CatBoost меняет порядок уже подходящих товаров
После фильтрации остаётся задача порядка. Ранжирующий CatBoost должен поднять выше те товары, которые по доступным сигналам вероятнее окажутся полезными конкретному пользователю. Для персонализации в модель подаются заранее рассчитанные статистики по истории покупок. Во время запроса они извлекаются из kv-user-storage вместе с другими признаками.
На схеме это отдельный этап: сначала оценки трёх генераторов помогают фильтрующему CatBoost, затем вычисляется ещё один набор признаков из shard-файла и пользовательского хранилища, после чего работает ранжирующий CatBoost. Фильтр и ранжировщик — не одна и та же модель и не одна и та же цель обучения.
Пример со сметаной показывает сам эффект персонализации: в общей выдаче сверху стоят одни товары, а в выдаче конкретного пользователя — другие. Автор предлагает сравнить поиск под своим аккаунтом и в режиме инкогнито. Это наглядная демонстрация различия порядка, но статья не публикует для персонализации A/B-цифр, прироста покупок, GMV, NDCG или иной агрегированной метрики.
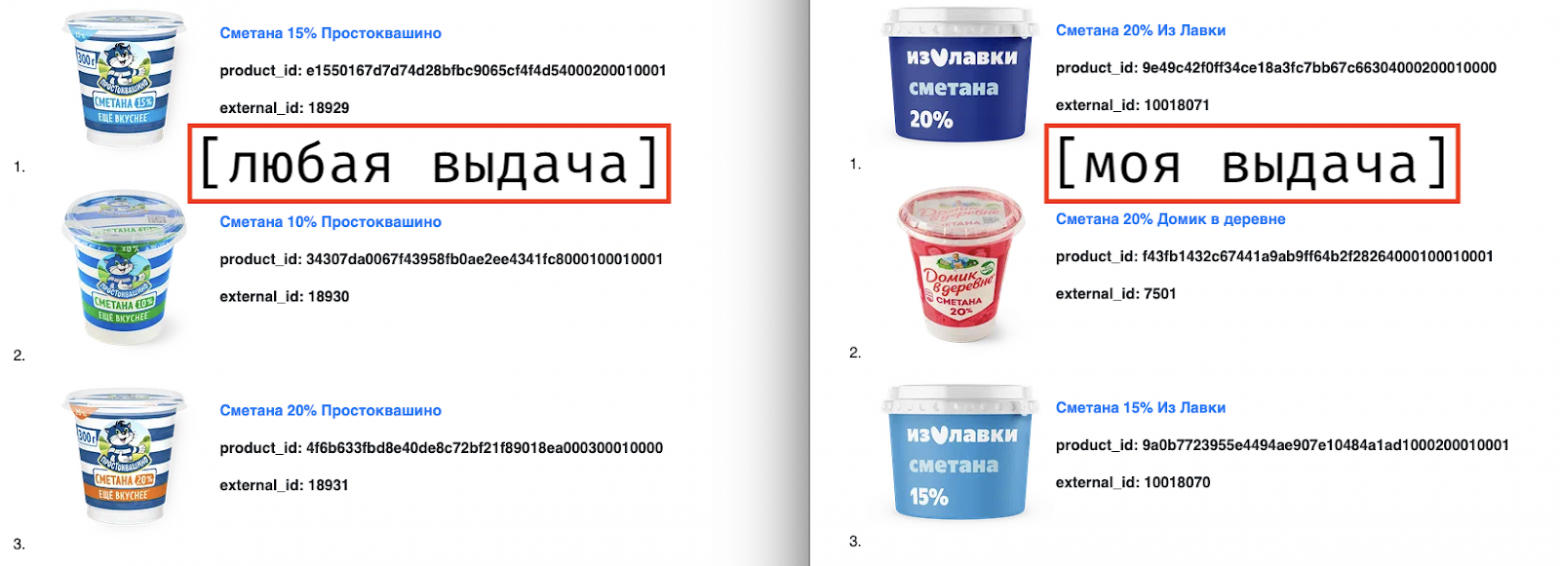
В примере со сметаной порядок меняется для конкретного пользователя. У статьи нет численного A/B-результата персонализации.
Источник: Николай Смирнов · Яндекс ЛавкаИтог: многоэтапный поиск, где модели закрывают разные ошибки
История поиска Лавки идёт от лексического Ахо — Корасика через универсальный SaaS и движок Маркета к собственной многоэтапной системе. Главный результат статьи не в том, что одна новая модель победила старую, а в разделении ответственности. BM25 быстро реагирует на свежие названия и бренды; CartUpdate DSSM использует поведенческие пары; BERT→DSSM добавляет смысловую близость. После объединения кандидатов отдельный CatBoost отсеивает нерелевантное, а другой CatBoost персонально упорядочивает оставшиеся товары.
- 01
Определить контекст заказа
client-api принимает запрос и определяет склад, из которого пользователь будет заказывать.
- 02
Собрать кандидатов
search подготавливает запрос и объединяет товары от BM25, CartUpdate DSSM и BERT→DSSM.
- 03
Проверить наличие
Кандидаты рано проходят проверку складского кеша, чтобы не считать тяжёлые признаки для явно недоступных товаров.
- 04
Отфильтровать нерелевантное
Фильтрующий CatBoost использует оценки генераторов и разметку релевантности, чтобы убрать плохие совпадения.
- 05
Персонально ранжировать и собрать карточки
Ранжирующий CatBoost учитывает пользовательские признаки, после чего каталог добавляет данные для отображения товаров.
Обучение и обновление живут отдельно от этого пользовательского пути. Фронтенд-события соединяются с features log по request ID; товарный shard обновляется несколько раз в сутки, HNSW-индекс — раз в несколько часов, CartUpdate DSSM дообучается каждые несколько дней, а CatBoost-модели поставляются через CI по запросу разработчиков. Разные циклы свежести нельзя смешивать в одну частоту.
Качество в статье показано главным образом через конкретные выдачи: смысловые запросы лучше раскрывают нейронные модели, а две новинки точнее поднимает BM25. Это не общий benchmark и не A/B-доказательство бизнес-эффекта. SaaS остаётся базовым вариантом сравнения, но чисел A/B, GMV или агрегированных метрик статья не даёт. Открыты и ограничения: асинхронное наличие не означает идеальной синхронности, BERT→DSSM не переобучается регулярно, а фильтрация прямо названа точкой роста.
Выходим из ML-норы и оглядываемся: выводы из статьи