Разбор готов
Языковая модель для банковских задач на узбекском
Клиент банка может говорить по-узбекски или по-русски, писать узбекский кириллицей или латиницей и при этом спрашивать о кредитах, счетах и других банковских продуктах. TBC Uzbekistan и Aiphoria хотели, чтобы такой помощник работал локально в инфраструктуре банка и в будущем подходил для голосовых звонков. Готового решения для низкоресурсного узбекского и банковской лексики не было, а обучение модели с нуля оказалось слишком дорогим вариантом. Команда сравнила открытые модели, выбрала Gemma-2-9B-IT, сначала укрепила её владение узбекским и русским, а затем обучила работе с банковскими инструкциями. Переводы проверяли носители языка, синтетические данные дополняли обезличенными настоящими диалогами. После офлайн-проверок модель сначала вынесли во внутренний Telegram-прототип для сотрудников банка, а затем отдельно применили в Sales Pro для общения с потенциальными клиентами.
Материал полезен ML- и LLM-инженерам, которые адаптируют открытую модель под низкоресурсный язык и узкий предметный домен. Здесь видно, как выбрать базовую модель, собрать данные из переводов, синтетики и реальных диалогов, организовать два этапа дообучения и отделить внутреннюю проверку от коммерческого внедрения.
Статья · на английском
When Languages Lack Data: Making Open-Source LLMs Work for Banking in UzbekistanAiphoria NLP team — Ivan Pastukhov, Nikita Pustovoytov, Anton Voronov, Denis Kirianov · Опубликовано: 2 июня 2025 г.
Зачем банку своя двуязычная LLM
Проект продолжал более широкую работу TBC Uzbekistan и Aiphoria со speech-технологиями для узбекского. Одного распознавания и синтеза речи недостаточно: банковский помощник должен понимать смысл запроса и отвечать по делу. Для этого ему нужны не только общий язык, но и банковская лексика — кредиты, задолженности, платежи и связанные с ними сценарии.
Условия сразу делали задачу нетипичной. Решение должно работать на узбекском и русском, учитывать смешение языков и диалектов в реальных разговорах, разворачиваться on-premise из-за требований к безопасности данных и отвечать достаточно быстро для телефонного общения, где люди перебивают друг друга, переспрашивают и говорят неидеально.
Проект был совместным не только на уровне данных. Команда TBC Uzbekistan делилась знаниями о местных банковских практиках и привычках клиентов, а техническая команда банка участвовала во внедрении и согласовании решения с существующими системами и требованиями безопасности. Статья не раскрывает устройство этой интеграции, но подчёркивает её как отдельную часть проекта.
source(20261003-165453).txt lines 22-46 — introduction before “What we had to keep in mind”Почему не стали обучать модель с нуля
Обучение собственной модели с нуля авторы сочли коммерчески неразумным: для этого потребовались бы огромные многоязычные корпуса и существенно больше вычислений. Поэтому задача свелась к выбору подходящей открытой LLM и её адаптации под язык и банковский домен.
Целевой диапазон авторы определили примерно как 7–9 млрд параметров. Модель должна быть достаточно маленькой для экономически приемлемого оборудования клиента, достаточно быстрой для будущей голосовой работы и при этом достаточно сильной для двуязычной генерации. Этот диапазон — инженерная цель проекта, а не универсальная граница между «маленькими» и «большими» моделями.
source(20261003-165453).txt lines 48-86 — “What we had to keep in mind”Какие стратегии адаптации рассматривали
Сначала нужно было выбрать исходный тип модели. Базовая модель после предварительного обучения умеет продолжать текст, но сама по себе не обязана выполнять команды пользователя — в статье это pretrained, или -pt. Instruction-tuned, или -it, — модель, которую дополнительно научили работать с инструкциями: отвечать на вопросы, выполнять задания и соблюдать уже заложенные правила безопасного поведения. Дальше предстояло решить, нужно ли сначала дополнительно учить модель продолжать текст на целевых языках — completion training, — а затем обучать на парах «инструкция — ответ» — instruction fine-tuning, — или сразу переходить ко второму этапу.
Отдельный выбор — сколько параметров модели менять. Полное дообучение затрагивает всю модель или выбранные слои и требует больше времени и данных. Параметрически эффективное дообучение, PEFT, оставляет основную модель почти неизменной и обучает небольшую добавочную часть параметров. К этому семейству относятся LoRA и использованный далее QLoRA. Такой путь экономнее, но авторы учитывали риск: если исходная модель плохо знает целевой язык и родственные ему языки, небольшого числа изменяемых параметров может не хватить.
source(20261003-165453).txt lines 88-104 — “Choosing the Right Model”Сравнение семейств и выбор Gemma-2-9B-IT
Команда тестировала семейства LLaMa-3.x, Gemma-2 и Qwen размером от 8B до 72B на четырёх языках. Узбекский и русский были целевыми, английский служил ориентиром зрелости модели, а турецкий — высокоресурсным родственником узбекского, позволяющим понять, как семейство справляется с тюркскими языками.
На приложенном графике результаты на переведённых турецких тестах нормированы относительно лучшей модели. Большие модели оказываются выше, поэтому рисунок не доказывает, что 9B-модель сильнее всех альтернатив. Его практический смысл другой: среди вариантов меньше 10B Gemma-2-9B заметно опережает сопоставимые LLaMa-3-8B и LLaMa-3.1-8B. Именно это, вместе с ограничением на размер, поддержало выбор семейства Gemma для дальнейшей работы. График не измеряет готовность модели к банковскому продукту.
Для дальнейшей работы выбрали именно Gemma-2-9B-IT — версию, уже обученную выполнять инструкции. Одновременно команда сравнивала расширение словаря и сохранение исходного, полное и параметрически эффективное дообучение, один и два этапа обучения, общие и банковские инструкции, а также базовые и уже обученные на инструкциях версии моделей. Точные результаты этих отдельных сравнений в тексте статьи не приведены.
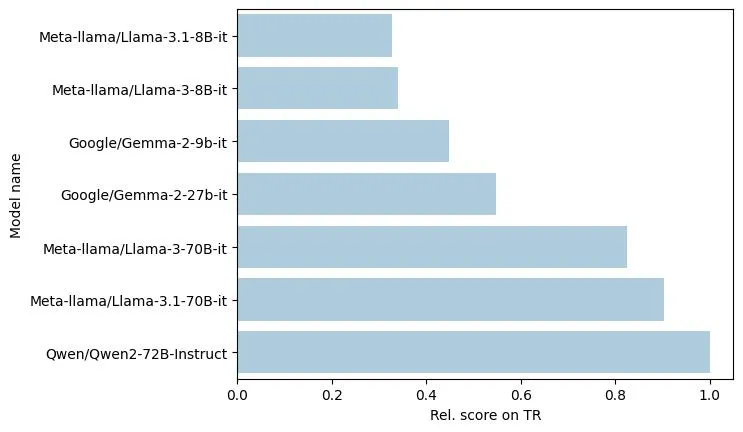
Сравнение моделей на турецких переводных тестах: взвешенная оценка, нормированная на лучший результат. Это не замер готовой банковской модели.
Источник: График из статьи Aiphoria / TBC UzbekistanФинальная схема: две стадии и QLoRA
В итоговой схеме Gemma-2-9B-IT обучали дважды. Сначала модель дополнительно училась продолжать узбекский и русский текст — это completion training. Затем её учили выполнять конкретные банковские инструкции на примерах «задание — ответ» — instruction fine-tuning. На обоих этапах использовали QLoRA, выбранный командой вариант параметрически эффективного дообучения.
Разделение на два этапа соответствовало двум разным проблемам. Первый должен был укрепить владение языками, словарём и естественными текстовыми конструкциями. Второй — научить модель правильно выполнять задания в банковских сценариях. Статья не раскрывает параметры адаптеров, список изменяемых модулей, скорость обучения, число эпох и другие настройки QLoRA, поэтому конкретную конфигурацию по этому источнику восстановить нельзя.
source(20261003-165453).txt lines 118-120 — selected strategy in “Experimental Approach”Первая стадия: учим язык на смеси источников
С русским корпусом проблем было меньше, а для узбекского пришлось собирать смесь из нескольких источников: публичных узбекских датасетов с Hugging Face, открытых английских и русских наборов, переведённых на узбекский, и собственных обезличенных данных банковского партнёра.
Авторы сознательно не хотели строить корпус только из машинных переводов. Такой текст легко перенимает гладкие, но неестественные шаблоны переводчика. Настоящие диалоги поддержки давали сразу две вещи: банковскую лексику и живую манеру общения. По словам авторов, это заметно сокращало объём работы, который иначе пришлось бы компенсировать дополнительным обучением.
source(20261003-165453).txt lines 122-126 — “Completion Training: Learning a Low-Resource Language”Вторая стадия: общие и банковские инструкции
Для второго этапа понадобились пары «инструкция — ответ» сразу на узбекском и русском. Общие задания — например, переформулировать предложение, придумать вопрос или написать короткий рассказ — в основном переводили из существующих наборов. Банковские примеры строили иначе: часть синтетически создавали более крупные открытые модели, часть формулировали специалисты TBC Uzbekistan.
Банковские инструкции подгоняли под будущие сценарии работы, в том числе поддержку, где перед ответом предполагался поиск нужной информации через RAG. Это объясняет требования к обучающим примерам, но не раскрывает устройство самого поиска: статья не описывает индекс, нарезку документов или способ передачи найденного контекста модели.
source(20261003-165453).txt lines 128-138 — beginning of “Instruction Fine-Tuning: Teaching Command Following”Почему перевод инструкций пришлось проверять вручную
Обычный перевод instruction datasets оказался ненадёжным не только из-за грамматики. Некоторые задания завязаны на свойства исходного языка: например, задача на снятие неоднозначности может потерять смысл, если при переводе исчезает омонимия. Поэтому носители узбекского проверяли, сохранилась ли сама учебная задача.
Авторы сообщают, что примерно 70% переведённых инструкций сохраняли исходный смысл и были корректны по грамматике и синтаксису. Проблемные примерно 30% языковые эксперты пытались переформулировать; часть примеров пришлось удалить, потому что сохранить исходный смысл не удавалось.
Приложенный график показывает отдельную автоматическую оценку тяжести ошибок перевода: чаще встречаются категории «no mistakes» и «minor», реже — «moderate» и «major». Точные доли по высоте столбцов здесь не восстанавливаются. Этот график нельзя смешивать с ручным выводом 70%/30%: это два разных способа оценки качества перевода.
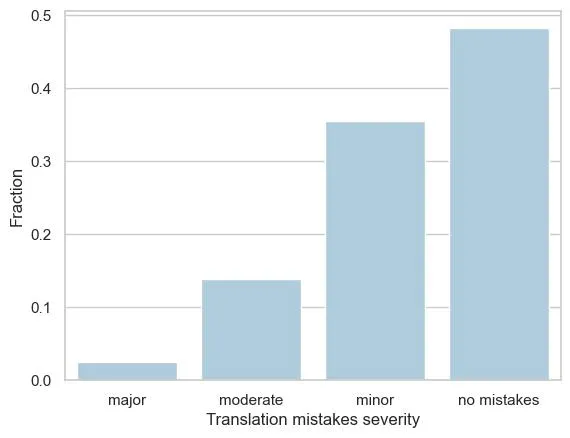
Автоматическая оценка тяжести ошибок перевода английских инструкций на узбекский. Этот график и ручная проверка 70%/30% — разные оценки.
Источник: График из статьи Aiphoria / TBC UzbekistanПочему одной синтетики не хватило
Синтетические банковские инструкции хорошо работали на похожих синтетических входах, но раннее живое тестирование выявило разрыв: настоящие люди пишут и говорят менее аккуратно, чем генератор учебных примеров. Модель, хорошо выглядевшая в симуляции, заметно хуже справлялась с реальными разговорами.
Поэтому обезличенные реальные диалоги использовали не только на первом этапе, где модель осваивала язык и банковскую лексику, но и на втором, где она училась отвечать на инструкции. Банковские специалисты проверяли финансовую корректность, языковые — естественность формулировок. Авторы отмечают, что похожую проблему можно было бы исправлять дополнительным обучением после основных стадий, но это потребовало бы больше времени и денег.
source(20261003-165453).txt lines 148-150 — synthetic data and real customer dialoguesКак проверяли модель, когда полный прогон слишком дорог
Оценка охватывала сразу несколько свойств: понимание инструкций, качество ответа, фактическую корректность, грамматику, соблюдение узбекского языка, работу с контекстом и безопасность. За основу брали MMLU, Truthful-QA и Halu-Eval, удаляли нерелевантные для задачи области вроде медицины, права и истории, а примеры группировали по длине входа и ожидаемой длине ответа.
Языково специфичные примеры удаляли, остальные переводили на узбекский с дополнительными приёмами для снижения шума перевода. Полные тестовые наборы насчитывали тысячи или десятки тысяч примеров, поэтому вместо ежедневного полного прогона команда делала случайную стратифицированную выборку примерно из 2000 примеров. Safety-тесты в эти 2000 не входили и оценивались отдельно.
Чтобы проверить саму идею агрегированной метрики, её посчитали на известных англоязычных моделях и сравнили с Elo из LM-Arena. Авторы получили положительную статистически значимую корреляцию с p-value < 0,01 и использовали это как аргумент в пользу методики. Это остаётся переносом методики по аналогии: статья не приводит отдельной валидации того же критерия на большой независимой узбекской выборке.
На графике prompt-injection-relevance показаны распределения для AiphoriaTech/gemma-2-9b-it-pre, AiphoriaTech/gemma-2-9b-it-rev01, AiphoriaTech/gemma-2-9b-it-rev02 и OpenAI/gpt-4o. Распределение pre находится заметно левее, а rev01 и rev02 смещены к более высоким значениям ожидаемого улучшения релевантности; их диапазоны частично перекрываются с GPT-4o. Из рисунка нельзя заключать общий паритет с GPT-4o, а названия rev01 и rev02 нельзя без дополнительного источника привязать к первой и второй стадиям обучения.
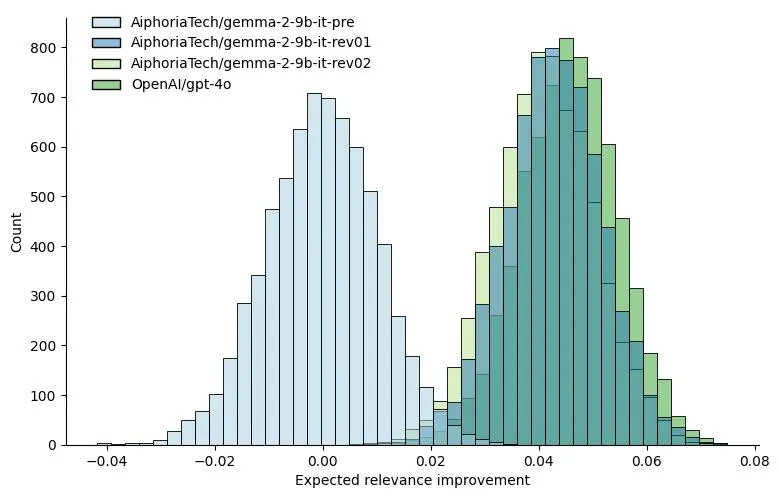
Распределение ожидаемого улучшения релевантности ответов в проверке prompt injection. Обозначения rev01/rev02 сохранены из оригинала; общий паритет с GPT-4o из этого не следует.
Источник: График из статьи Aiphoria / TBC UzbekistanTelegram-прототип: сначала проверка на сотрудниках, потом продукт
После офлайн-обучения команде нужен был не финальный канал продаж, а быстрый реальный контур проверки. Telegram выбрали из-за простого асинхронного API, удобства подключения разных моделей и сценариев, доступности на web, desktop и мобильных устройствах и высокой популярности в Узбекистане.
Через несколько недель обучения и тестов двуязычную LLM развернули как Telegram-бот для пользователей со стороны банка. Он проводил их через банковские сценарии вроде подачи заявки на кредит и управления счётом, а сотрудники и носители узбекского со стороны клиента могли быстро возвращать ошибки разработчикам. Так, ранние версии иногда путали числительные; прототип позволил быстро обнаружить и исправить проблему.
Отдельно проявилась полезная способность работать с двумя письменностями узбекского. Пользователь мог написать узбекский текст кириллицей, а бот ответить на узбекском латиницей и продолжить разговор. Это наблюдение из прототипа, а не количественная метрика качества и не доказательство универсального переключения между русским и узбекским.
source(20261003-165453).txt lines 162-174 — “Field Test: A Bilingual Banking Assistant in Telegram”Что команда вынесла из экспериментов
Первый вывод — низкоресурсный язык требует смеси источников. Машинный перевод помогает быстро увеличить корпус, но не заменяет натуральные тексты, носителей языка и реальные взаимодействия. Второй — синтетика полезна как старт, однако без настоящих диалогов модель плохо учится неровной человеческой речи.
Третий вывод касается процесса разработки: как можно раньше стоит дать модель безопасной реальной аудитории и собирать обратную связь короткими циклами. Четвёртый — в их задаче лучше работали более простые варианты с меньшим числом обучаемых параметров. Когда дообучали больше параметров, шум в данных сильнее портил результат.
Последний пункт статьи уже скорее бизнесовый: авторы связывают вложения TBC Uzbekistan в собственную языковую и AI-экспертизу с технологической независимостью в локальном рынке. Это позиция авторов о стратегии компании, а не отдельный эксперимент над моделью.
source(20261003-165453).txt lines 176-198 — “Lessons Learned”Sales Pro: отдельное коммерческое применение
После внутренней проверки обученные LLM применили в Sales Pro — «цифровом сотруднике», который общается уже не с тестировщиками банка, а с потенциальными клиентами и предлагает банковские продукты, например кредиты. Здесь языковая модель работает вместе с GOAL framework, который статья называет управляющей архитектурой. Внутренние компоненты GOAL, его состояние, инструменты и правила маршрутизации в источнике не раскрыты.
В продажах задача бота шире простого ответа на вопрос: он должен обсуждать потребности клиента, объяснять, как продукт может помочь, работать с возражениями и мягко вести разговор к заявке. Именно этот сценарий относится к бизнес-результатам ниже; его нельзя смешивать с предыдущим Telegram-прототипом для сотрудников.
Таблицу можно прокрутить по горизонтали.
Эти числа описывают авторское сравнение каналов за первый месяц работы Sales Pro. Рандомизация и протокол A/B-теста в статье не описаны, поэтому разницу нельзя представлять как измеренный причинный эффект.
Авторы также подчёркивают, что новый автоматизированный канал не требует участия сотрудников в каждом диалоге. При этом статья не приводит отдельного расчёта затрат труда или стоимости привлечения, поэтому этот тезис нельзя превращать в количественный вывод об экономии.
source(20261003-165453).txt lines 200-214 — “Business implementations and what’s next”Следующий шаг — холодные звонки, а не уже решённый инференс
Следующей целью TBC Uzbekistan авторы называют cold calling: цифровой продавец должен брать на себя первичный контакт с незнакомыми потенциальными клиентами и освобождать сотрудников для более сложных разговоров. Это план дальнейшего применения, а не уже измеренный результат текущей статьи.
В конце авторы отдельно обещают следующую публикацию об ускорении LLM и связки ASR/TTS для телефонных сценариев. Значит, из текущего материала нельзя достраивать serving-архитектуру, конкретные latency, throughput, квантизацию на инференсе или аппаратную конфигурацию: эти детали здесь сознательно оставлены за рамками.
source(20261003-165453).txt lines 216-220 — end of “Business implementations and what’s next”Итог: от низкоресурсного языка к работающему банковскому сценарию
Путь начался не с архитектуры чат-бота, а с ограничений языка и инфраструктуры. Банку требовалась локально разворачиваемая модель для узбекского и русского, поэтому обучение с нуля отбросили и выбрали компактную Gemma-2-9B-IT. Её дообучили в две стадии с QLoRA: сначала укрепили владение языками на смешанном корпусе, затем обучили выполнять общие и банковские инструкции. Машинный перевод и синтетика дали масштаб, но настоящие обезличенные диалоги оказались нужны для банковской лексики и естественного общения. После офлайн-проверки модель сначала испытали во внутреннем Telegram-прототипе, а уже затем использовали в Sales Pro.
- 01
Сообщение клиента
Потенциальный клиент пишет на узбекском или русском и формулирует вопрос, потребность или возражение.
- 02
Цель разговора
Sales Pro использует GOAL как управляющую архитектуру, чтобы вести диалог к заданной бизнес-цели; внутреннее устройство GOAL в статье не раскрыто.
- 03
Ответ языковой модели
Дообученная двуязычная LLM формирует банковский ответ с учётом текущего разговора и профильной лексики.
- 04
Продолжение диалога
Система обсуждает потребности, объясняет продукт и отвечает на возражения, а не ограничивается выдачей справочной фразы.
- 05
Переход к заявке
Если разговор успешно развивается, бот мягко ведёт клиента к оформлению заявки на банковский продукт.
Главный технический результат статьи — практичная схема адаптации небольшой открытой LLM к низкоресурсному языку и узкому домену без полного переобучения модели. Главный продуктовый результат авторы относят уже к Sales Pro: за первый месяц они сообщают о конверсии в заявки примерно на треть выше и о вдвое большей вовлечённости относительно других каналов. Но статья не раскрывает A/B-дизайн, размеры групп, доверительные интервалы или точное определение вовлечённости. Не раскрыты также размеры обучающих корпусов, параметры QLoRA, детали GOAL, RAG-контур и инференс для телефонных звонков. Поэтому сильнейшая часть кейса — причинная цепочка «выбор модели → данные → две стадии адаптации → оценка → реальный прототип → отдельное коммерческое применение», а не возможность воспроизвести систему по одной статье.
source(20261003-165453).txt lines 22-220 — synthesis of the full article