Разбор готов
Яндекс Лавка: как трансформер начал учитывать свежую историю покупателя
Пользователь листает рекомендации Лавки, добавляет товар в корзину и продолжает выбирать. Содержание текущего заказа уже изменилось, а его векторное представление, рассчитанное вчера, ещё об этом не знает. При этом ежедневные векторы уже помогали рекомендациям: задача состояла не в замене бесполезной модели, а в использовании более свежих сигналов. Команда перенесла расчёт представлений пользователя в обработку запроса, сохранив финальное ранжирование за градиентным бустингом. В главе разберём, как модель описывает товары и действия, чему её обучают, откуда она получает историю и как укладывается в работу сервиса. Отдельно рассмотрим ошибки чтения истории и асинхронного выполнения, а также два этапа экспериментов, без которых новые признаки не дали желаемого роста выручки.
Глава полезна разработчикам рекомендательных систем и инженерам, которые переносят последовательные модели в работающий сервис. На одном внедрении видно, как связаны свежесть данных, подготовка входа, задержка ответа и обучение финального ранжирования.
Видео · на русском
Рантайм-трансформер в персональных рекомендациях Яндекс Лавки / Марк НарусовМарк Нарусов · Опубликовано: 30 мая 2025 г.
Исходный доклад · Открыть оригинал
Почему корзина требует рекомендаций по ходу сессии
У рекомендательных поверхностей Лавки разные задачи. На главной странице помогают открыть то, чего человек ещё не пробовал. В карточке товара предлагают похожие товары. На корзине цель более непосредственная: увеличить добавления и денежный объём покупок, который в докладе обозначен как GMV. Поиском занимается соседняя команда на похожем стеке; результаты внедрения в рекомендации не следует автоматически переносить на поиск.
На момент доклада рекомендации обеспечивали более 20% GMV Лавки и работали примерно на десяти поверхностях. Это масштаб исходного продукта, а не прирост от нового трансформера. В пике сервис обрабатывал около 1100 запросов в секунду. На формирование ответа отводилось 300 мс, а бэкенду — серверной части приложения — нужно было вернуть двадцать товаров. Дедлайн относится ко всему ответу, а не только к нейросети.
Бесконечная лента не является одним списком, который навсегда отсортировали при открытии экрана. Она собирается отдельными порциями. Бэкенд присылает пользователя и его корзину, получает двадцать товаров и служебную информацию о показанной части. Для следующей порции отправляется новый запрос; уже показанные товары исключаются. Такое разбиение выдачи на страницы называется пагинацией.
Между запросами человек может добавить товар в корзину. Поэтому следующую часть ленты система формирует уже в другом контексте. История прежних покупок всё ещё важна, но она не заменяет сведения о том, что человек выбирает прямо сейчас. Именно этот разрыв между устойчивыми предпочтениями и текущим выбором становится причиной перехода к более свежим представлениям.
Раньше Лавка использовала привычную многоэтапную схему: сначала выбирала сотни или тысячи кандидатов, затем собирала для них подробные признаки и упорядочивала ранжирующей моделью. Однако на корзине к моменту выступления уже перешли к ранжированию всего ассортимента конкретного даркстора — склада, из которого собирают заказ. Это несколько тысяч товаров, а не глобальный каталог Лавки. Причины самого перехода автор оставляет за пределами доклада.
На исходном слайде собраны ограничения, в которых происходило внедрение. Новая модель должна была помогать заметной части бизнеса, но при этом оставаться внутри короткого цикла выдачи очередных двадцати товаров. Ранжирование всего ассортимента и выдача порциями не противоречат друг другу: первое определяет множество оцениваемых товаров, второе — сколько из них возвращают за запрос.
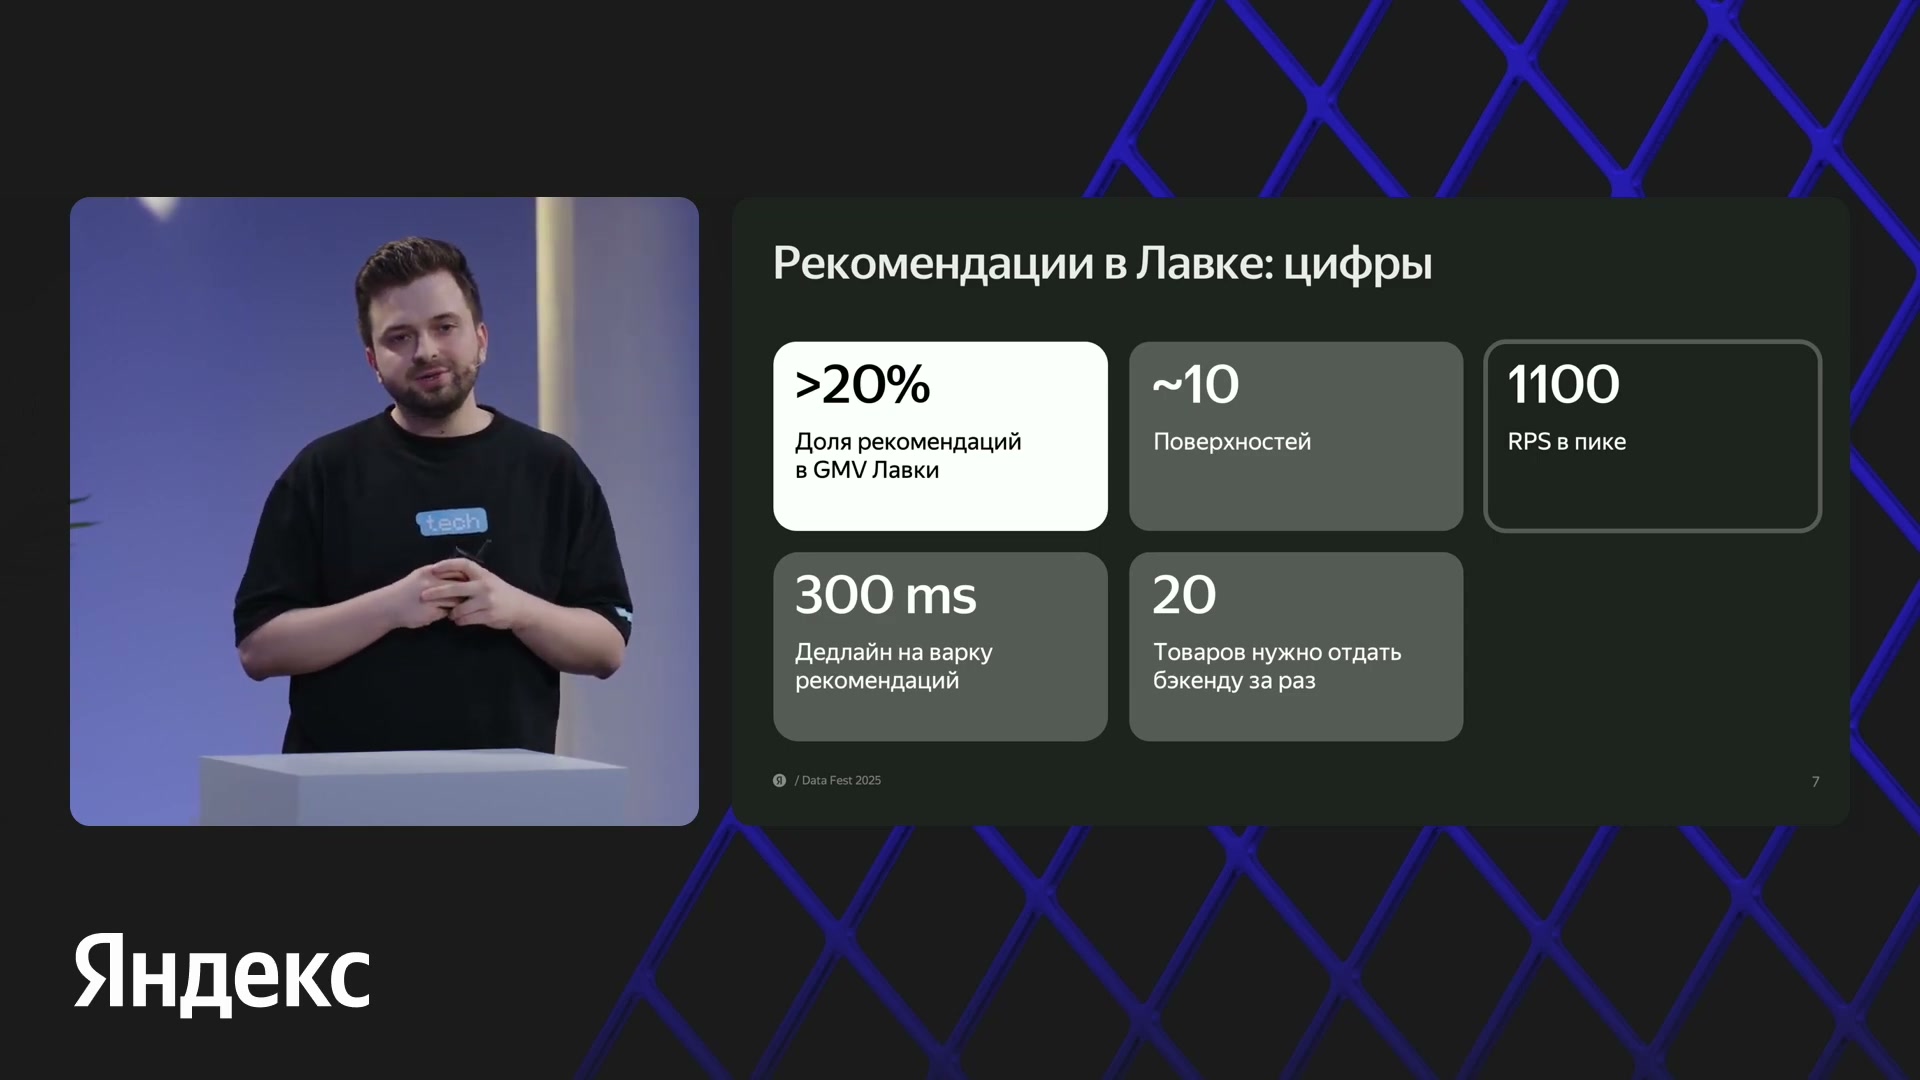
Более 20% GMV Лавки приходится на рекомендации; около 10 поверхностей, 1100 RPS в пике, дедлайн 300 мс и 20 товаров в ответе. Доля GMV — характеристика сервиса, не прирост от трансформера.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Как получить вектор товара, которого раньше не было
Модель строит отдельные числовые представления пользователя и товара, а затем сравнивает их. Такое представление — вектор, или эмбеддинг. Две части модели обычно называют башнями. В этой архитектуре они связываются поздно: пользователь и оцениваемый товар не проходят совместно через все слои трансформера. Это позволяет разделить расчёт товарных представлений и обработку меняющейся истории человека.
Для товара можно было бы выучить вектор его идентификатора, но команда выбрала другой путь: строить представление из содержания. Причина — новые товары. Когда товар появляется на складе, для него ещё нет собственной накопленной истории взаимодействий. Команда хотела получать его вектор без дообучения всей архитектуры ради нового идентификатора. Способность уже обученной модели обрабатывать новый объект по доступным признакам здесь называется индуктивностью.
Вход товарной башни — текстовые атрибуты: название, категория и страна. Тексты разбивают на небольшие единицы, в том числе части слов, методом WordPiece. Из выученных представлений этих единиц собирают «мешок эмбеддингов». Автор не уточняет в этом докладе, какой именно операцией объединяют токены внутри каждого атрибута, поэтому приписывать реализации конкретное суммирование или усреднение не стоит.
Представления атрибутов соединяют в один вектор — это конкатенация. Затем его обрабатывает полносвязная нейронная сеть, или многослойный перцептрон. В ней есть остаточные связи, передающие вход блока дальше вместе с его преобразованием, и нормализация слоя. На выходе получается представление товара, которое можно сопоставить с пользовательским. Число слоёв и подробная конфигурация этой сети не приведены.
Схема показывает главное отличие от таблицы выученных товарных ID: вектор возникает из названия, категории и страны. Новый товар получает доступ к уже выученным закономерностям текста. Это решает задачу построения представления, но само по себе ещё не гарантирует высокий ранг или покупку: окончательное место определяет другая модель, учитывающая дополнительные признаки.
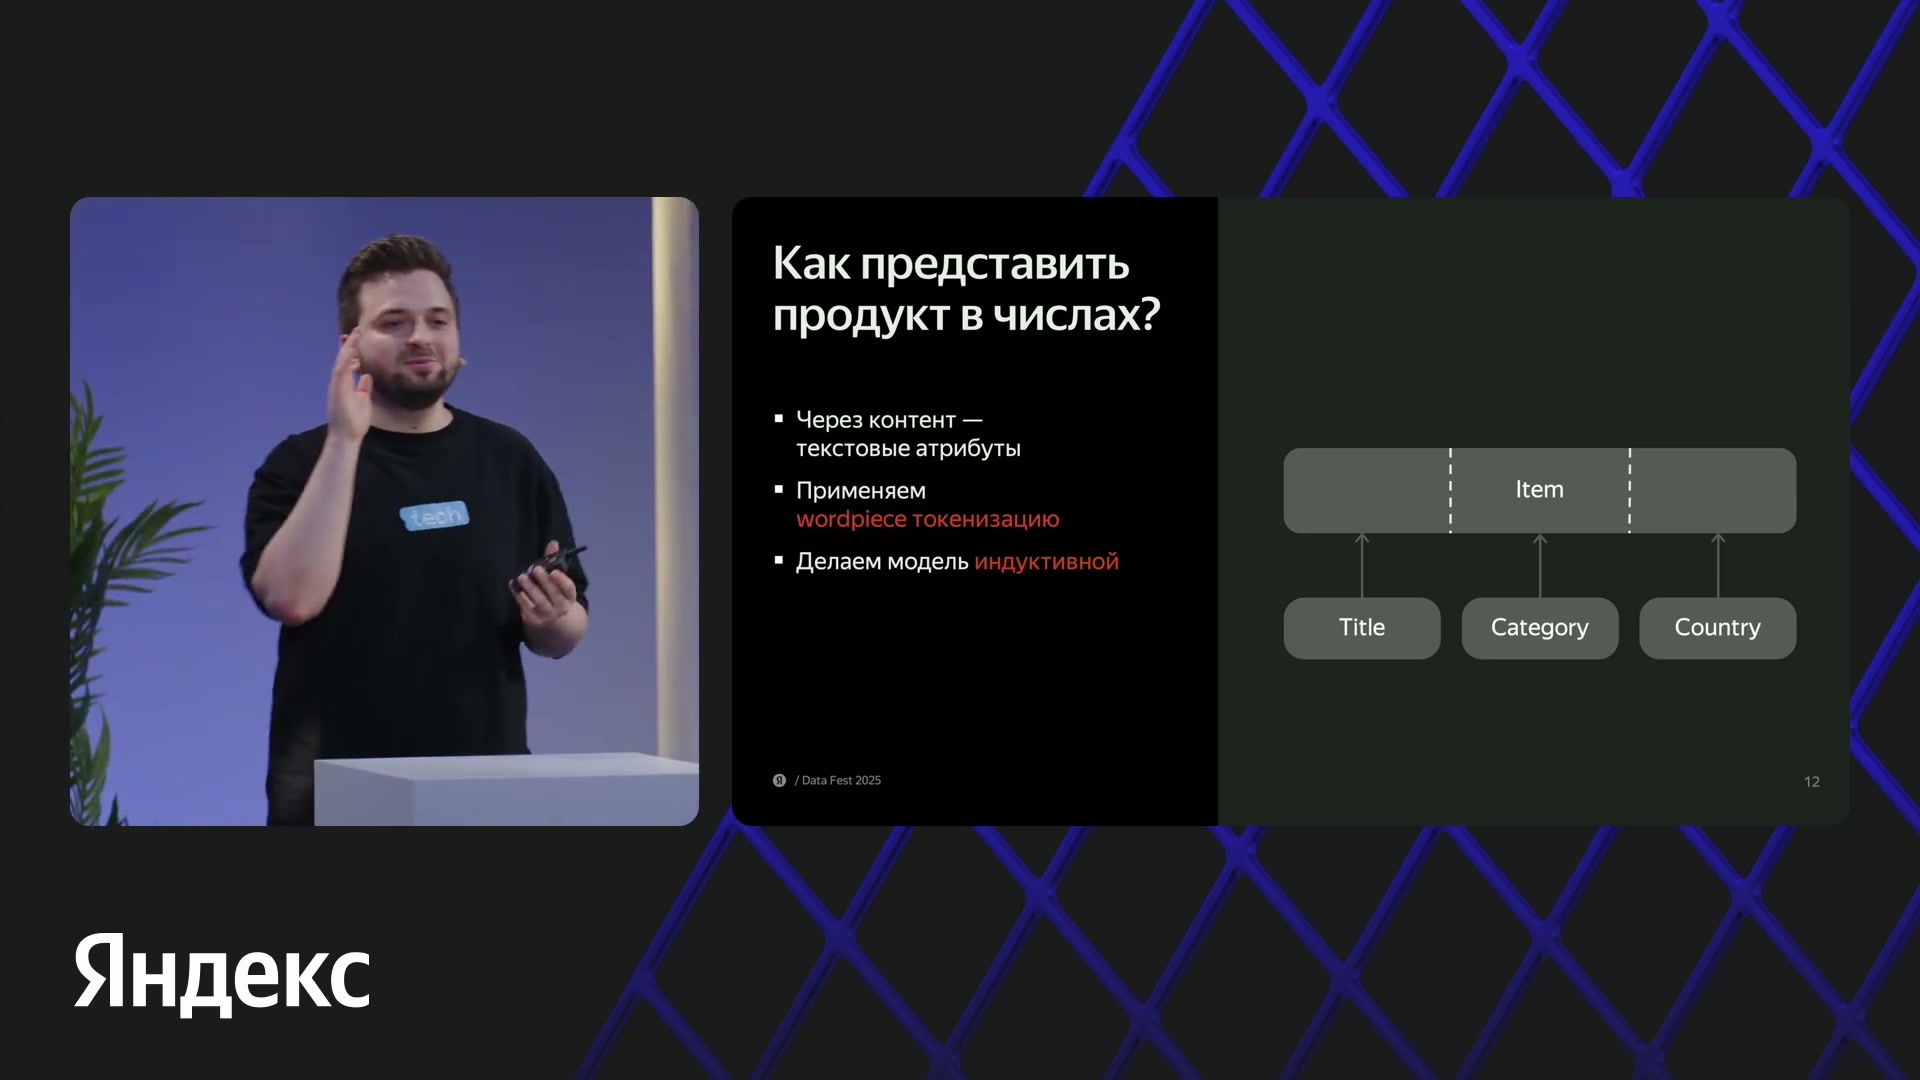
Название, категория и страна проходят WordPiece-токенизацию. Контентный энкодер может обработать новый товар без создания отдельной обученной строки для его ID.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025История действий и несколько представлений пользователя
Пользовательскую башню интересуют не только покупки. В последовательность входят действия с товарами: просмотры, клики, добавления в корзину и покупки. Один и тот же товар получает разный смысл в зависимости от того, что человек с ним сделал и где это событие находится в истории. Поэтому одного товарного вектора для описания события недостаточно.
Каждое событие складывается из представления товара, обучаемого представления типа действия и представления позиции в последовательности. Товарная часть отвечает на вопрос «с чем взаимодействовали», действие — «что сделали», позиция — «где это находится в истории». Словесное описание автора можно кратко записать следующим образом.
Запись описанного в докладе сложения: xₜ — входное представление события на позиции t; vᵢₜ — вектор его товара; aₑₜ — представление типа действия; pₜ — представление позиции. Обозначения введены для объяснения, это не отдельная формула со слайда.
Чтобы собрать информацию из последовательности в представление пользователя, добавляют служебный токен CLS. Он имеет доступ ко всей поданной истории и учится извлекать из неё полезную информацию. Служебный токен не является ещё одним купленным товаром: его задача — дать выходное представление истории. В докладе не раскрыта полная схема доступа между остальными позициями.
Вместо одного такого токена используют несколько CLS. Это даёт несколько представлений одного пользователя и повышает выразительность модели; автор сообщает об улучшении качества, но не приводит отдельной численной оценки этого изменения. Количество токенов обозначено как n. Каждому из них не назначают в объяснении фиксированную категорию или намерение: такой специализации источник не устанавливает.
Для оцениваемого товара вычисляют сходство с каждым пользовательским вектором. На исходном слайде это именно косинусные сходства: cos_similarity_1, cos_similarity_2 и так далее до cos_similarity_{n}. Они описывают согласованность направлений векторов и поступают в ранжирование отдельными числовыми признаками. Несколько выходов пользователя здесь не сводятся к одной объявленной автором средней или максимальной оценке.
На схеме использования модели указаны размеры [512, n] для пользовательских представлений и [512, 1] для товарного. Значит, один вектор содержит 512 координат, пользователь получает n таких векторов, а товар — один. Позже в рассказе появится ещё одно число 512 — количество выбранных действий. Это другой параметр: длина входной истории, а не размерность её выходного представления.
Вывод из схемы сходств: трансформер обрабатывает историю и предоставляет несколько способов сравнить её с товаром, но не выносит единственный окончательный вердикт о месте товара. Разделение особенно важно при большом ассортименте: одни и те же пользовательские представления участвуют в оценивании разных товаров.
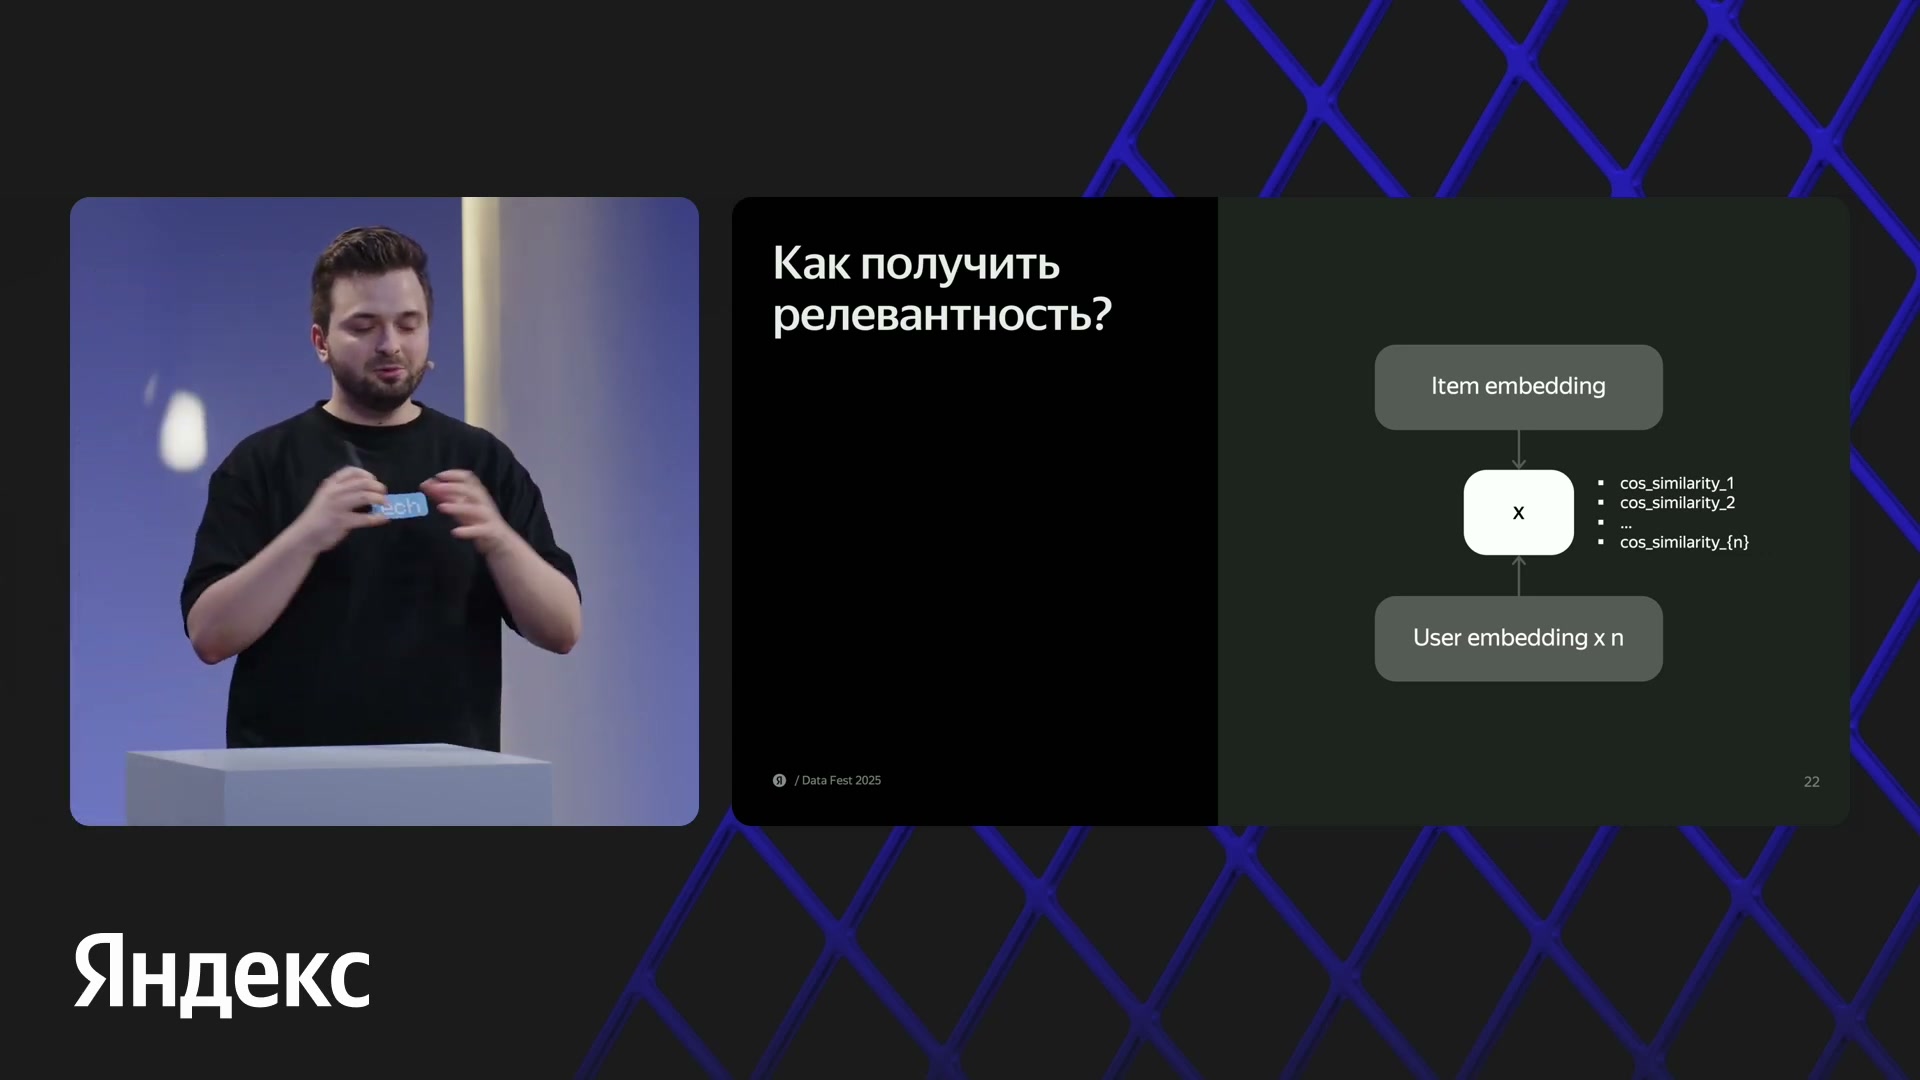
Косинусное сходство товара с несколькими представлениями пользователя даёт разные числовые признаки для ранжирования.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Сначала предсказать следующую корзину, затем помочь ранжированию
Архитектура определяет, как получить векторы, но ещё не объясняет, почему подходящий пользователю товар должен оказаться близко. Это задаёт обучение. В Лавке оно состоит из двух стадий, которые решают разные задачи и не выполняются заново при каждом запросе рекомендаций.
На предварительной стадии модель предсказывает следующую корзину — Next-basket prediction. В речи автор поясняет задачу как предсказание того, что человек купит в следующей сессии. Такая постановка ориентирует представления на поиск будущих покупок по предшествующей истории. Речь идёт о следующей корзине, а не об обязательной генерации одного следующего идентификатора товара.
Затем модель дообучают под использование в финальном ранжировании. На слайде названы классификация и обучение упорядочиванию объектов — Learning to Rank. Идея в том, чтобы её оценки были полезны модели, которая выбирает порядок выдачи. Точные метки классификации, функции потерь, способ выбора отрицательных примеров и соотношение задач в этом докладе не раскрыты.
Это обучение самой нейросети нужно отличать от обучения градиентного бустинга. Трансформер выдаёт признаки сходства; бустинг использует их вместе с другими сведениями о пользователе и товаре. Позднее команде пришлось повторно обучить именно бустинг на обратной связи от изменившейся выдачи. Эти два этапа внедрения — не то же самое, что предварительное обучение и дообучение трансформера.
Слайд объясняет направление перехода: сначала представления учатся предсказывать будущую корзину, затем их приспосабливают к задаче упорядочивания. Названий конкретных функций потерь здесь нет. Поэтому важен раскрытый смысл стадий, а не предполагаемый набор популярных рецептов обучения.
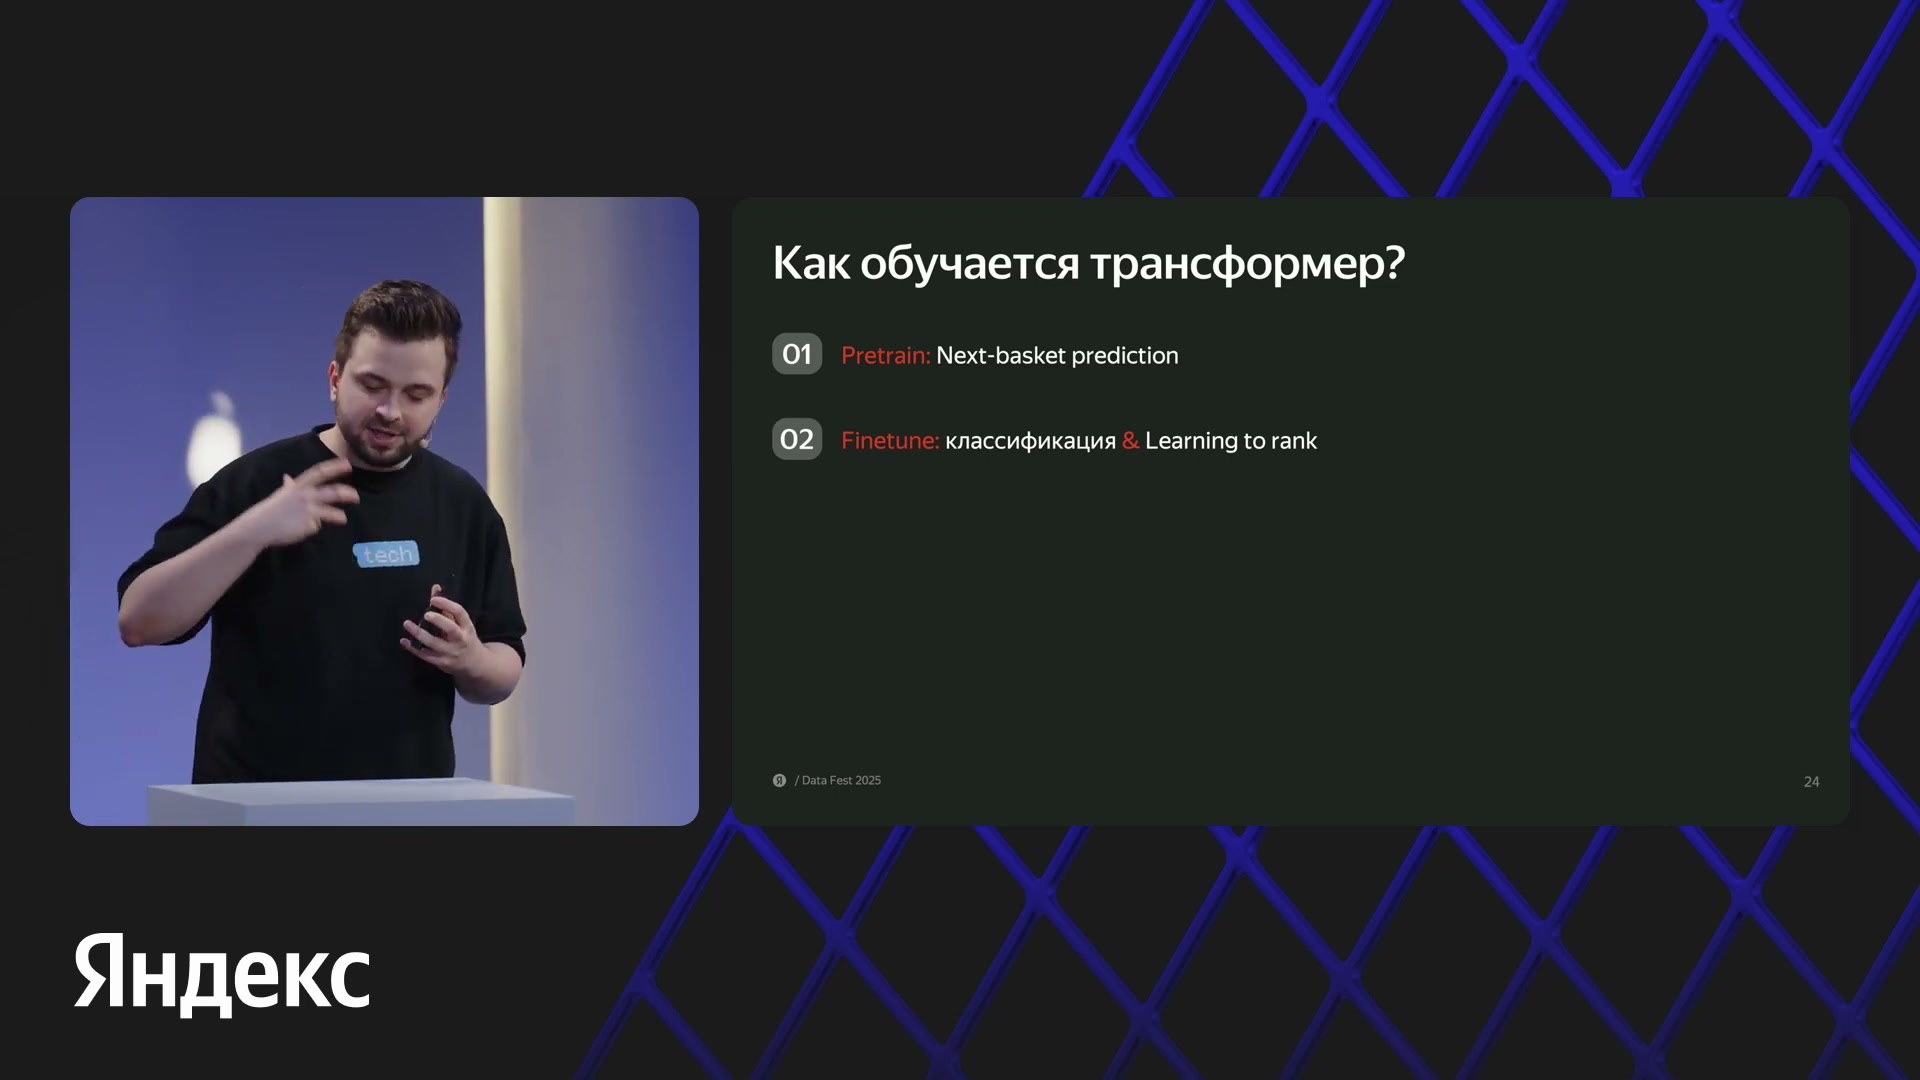
Предварительное обучение — предсказание следующей корзины; дообучение — классификация и Learning to Rank. Эти этапы отделены от применения при каждом запросе.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Исходный вариант: обе башни рассчитываются заранее
Финальный порядок товаров определяет градиентный бустинг, в схеме Лавки — CatBoost. Это отдельная модель, которая соединяет множество признаков. Векторы трансформера не заменили все прежние сигналы: рядом с ними сохранились счётчики взаимодействий, оценки других рекомендательных моделей и товарные показатели.
В исходной схеме обе башни применяли примерно раз в день. Пользовательские представления сохраняли в хранилище «ключ — значение», откуда данные можно получить по пользователю. Товарные представления помещали в базу товаров в памяти. При запросе сервис извлекал готовые данные, рассчитывал признаки для пары «пользователь — товар» и передавал их в бустинг.
Ежедневный расчёт позволял использовать нейросеть без выполнения пользовательской башни на каждом запросе. Но информация в её векторах приходила с отставанием примерно на сутки или больше. Это не значит, что все признаки сервиса были суточными: текущая корзина отдельно присутствовала в запросе. Устаревало именно представление, заранее рассчитанное трансформером.
Даже этот вариант, по словам автора, уже давал заметную пользу в A/B-экспериментах; её величина не названа. Поэтому следующий шаг был попыткой улучшить работающий компонент, а не отказом от провалившейся исходной модели. Частота ежедневного расчёта векторов также ничего не говорит о частоте переобучения весов.
На схеме косинусные сходства добавляются в общий набор признаков перед CatBoost. Это объясняет, почему успех трансформера зависит от финального ранжирования: улучшить пользовательский вектор недостаточно, если бустинг не умеет извлечь из новых оценок пользу для всей выдачи.
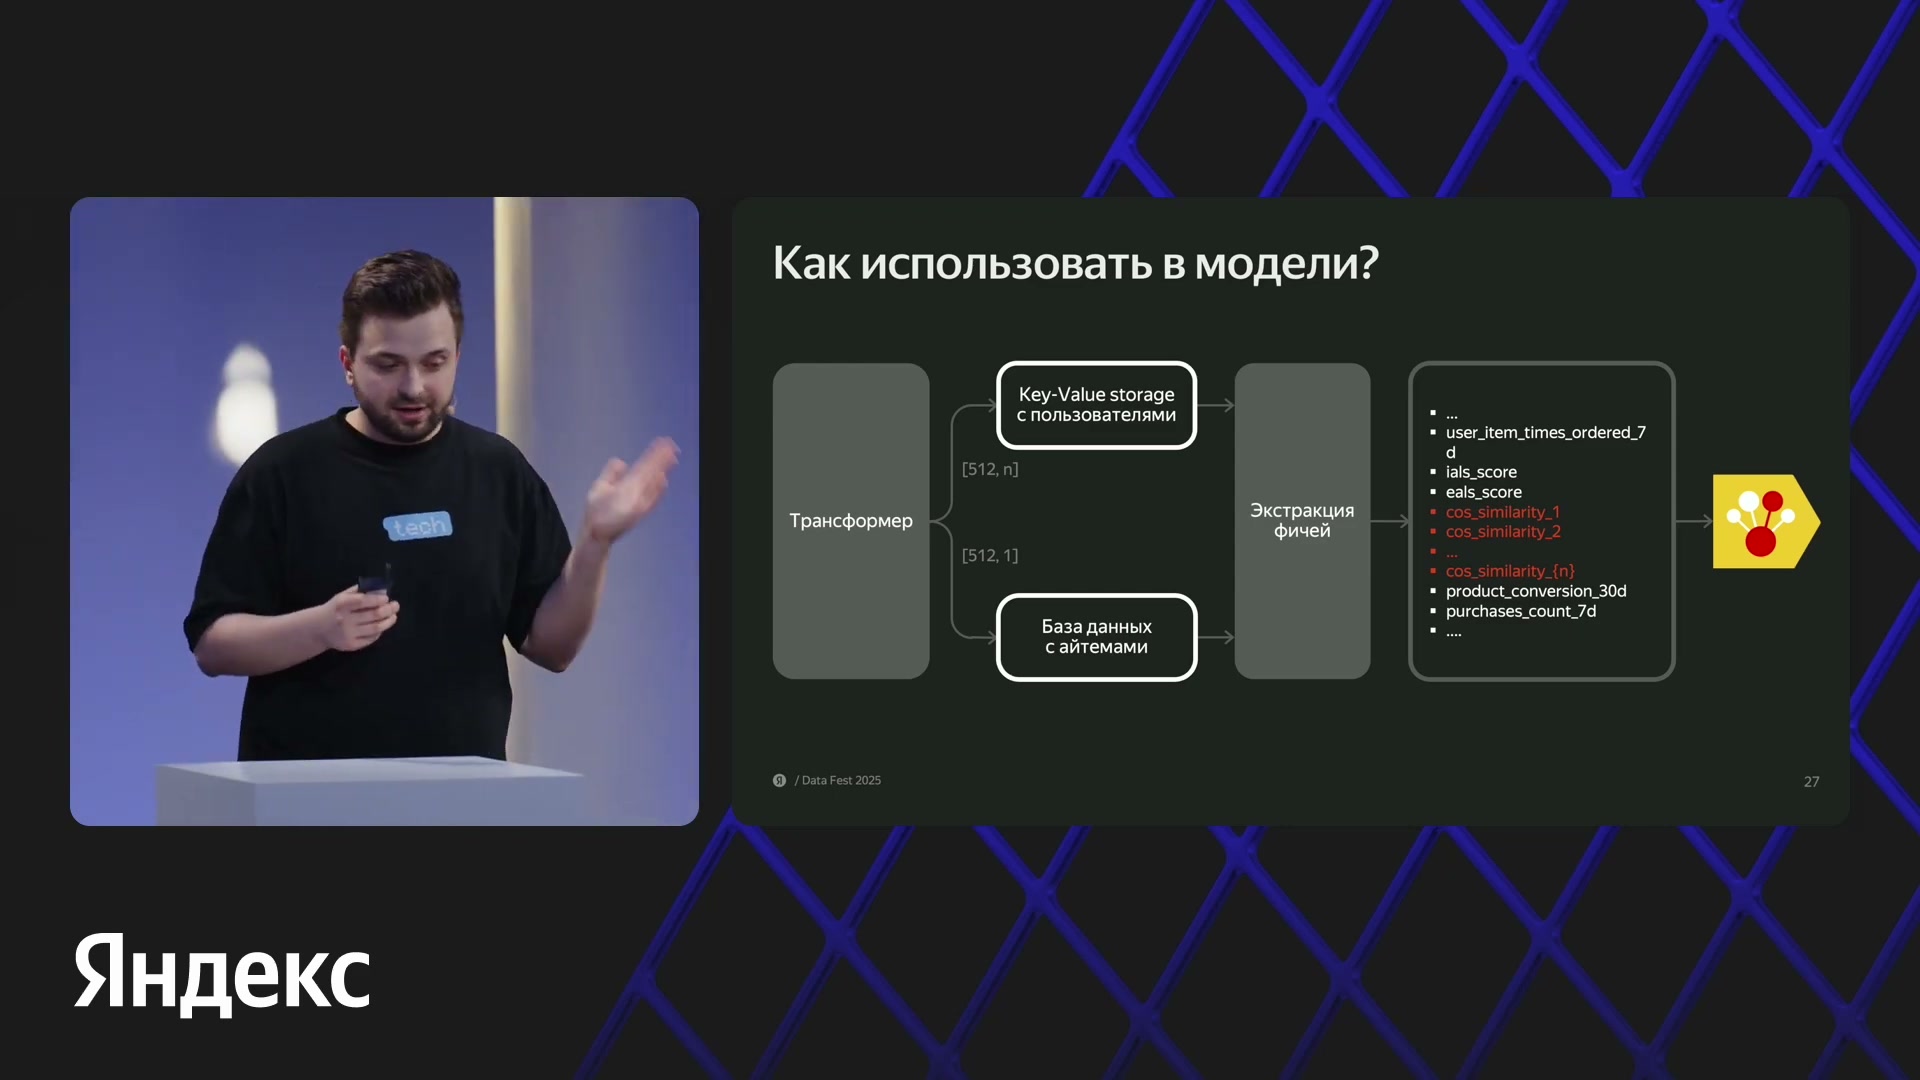
Представления пользователей готовят заранее и сохраняют. Данные из хранилищ используются для признаков CatBoost. Это начальный вариант с суточной свежестью.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Два аргумента в пользу свежей истории
Первый аргумент команда получила в проверке на данных, вне работающего приложения. Когда доступная трансформеру история отставала от текущего момента на 90 секунд, а не примерно на день, наблюдали +2% по офлайн-метрикам. Это показывает потенциал более свежей истории, но ещё не измеряет изменение покупок в реальном продукте.
На исходном слайде результат подписан только как «по оффлайн-метрикам». Название метрики, глубина оцениваемого списка и подробный протокол не приведены. Поэтому +2% нельзя превращать в значение конкретной метрики ранжирования, а 90 секунд — во время выполнения трансформера. Это отставание истории в проверяемом сценарии, не задержка ответа.
Второй аргумент связан с устройством ленты. Автор описывает график конверсии из показа в добавление в корзину в зависимости от позиции товара. Обычно конверсия снижается при продвижении вниз, но на графике видны всплески с шагом в двадцать позиций. Этот шаг совпадает с количеством товаров, которые сервис отдаёт за один запрос.
Объяснение автора опирается на действия внутри сессии. Человек видит первую порцию рекомендаций и может что-то добавить. Следующий запрос уже содержит обновлённую корзину. Признаки близости товара к её содержимому важны для ранжирования, поэтому начало очередной страницы получает более актуальный контекст, чем продолжение предыдущей.
Для продуктового ритейла, где люди часто повторяют прошлые заказы, это существенная деталь. Устойчивые предпочтения не делают текущую сессию бесполезной. Команда увидела, что свежие действия помогают рекомендациям, и захотела использовать их также в нейросетевом представлении пользователя.
Эти два аргумента дополняют друг друга, но не являются одним экспериментом. Слайд с +2% относится к офлайн-проверке свежести. Объяснение всплесков связывает пагинацию и контекст корзины; это не отдельная проверка, которая изолированно измерила эффект нового трансформера. Бизнес-результат потребовалось проверять после внедрения всей связки с ранкером.
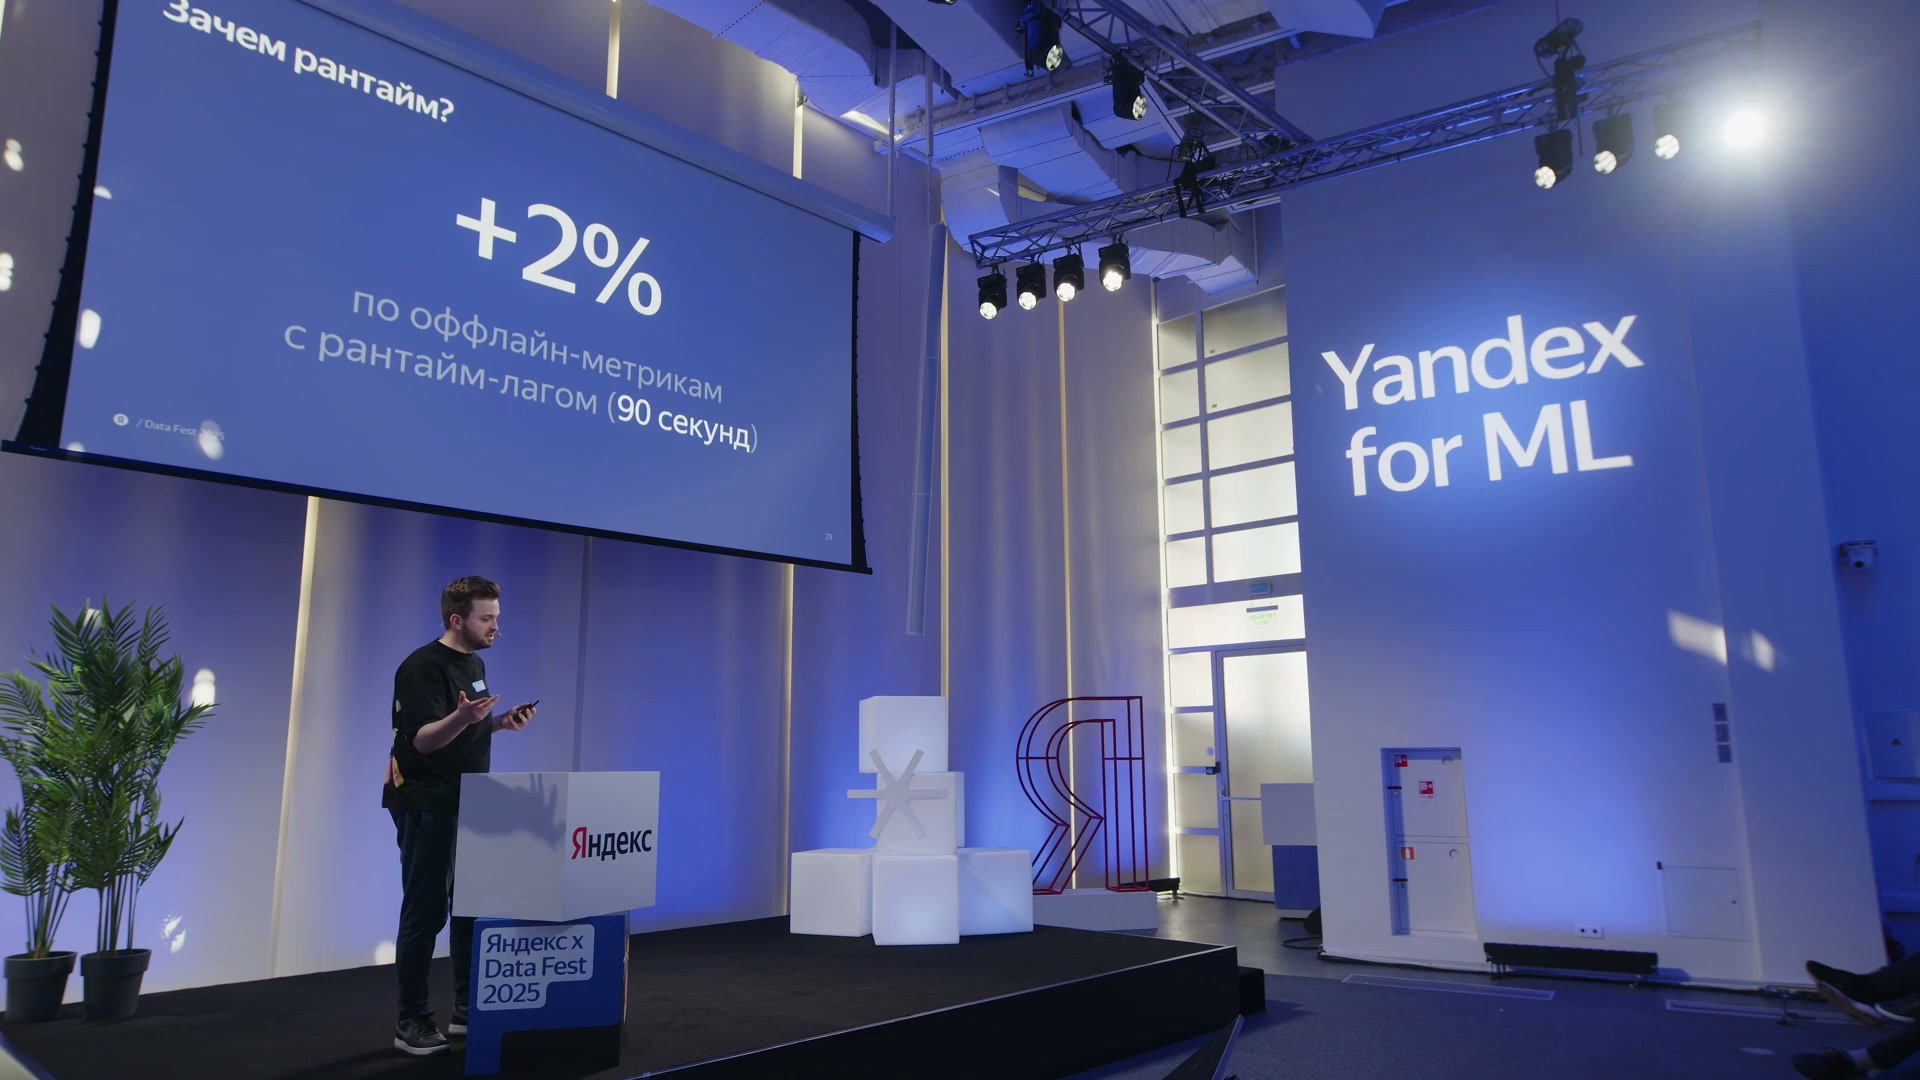
Слайд показывает +2% по офлайн-метрикам при лаге 90 секунд. Это отдельная проверка, не бизнес-результат A/B-теста; глубина метрики и полный протокол не приведены.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Что пришлось изменить при переходе к расчёту на запросе
Расчёт при запросе, или runtime, означает применение уже обученной модели к актуально доступной истории пользователя. Вместо чтения только вчерашнего вектора система должна прочитать события и заново построить представления. Пользовательскую часть меняют, а товарные векторы по-прежнему могут поступать из заранее подготовленного хранилища.
Команда не хотела решать задачу постоянным перестроением индекса пользовательских представлений в хранилище «ключ — значение» при каждом обновлении. На схеме перехода старое место хранения пользовательского вектора заменено вопросом: нужен новый способ получать этот результат. Ответом стала цепочка сервисов, которая возвращает представления непосредственно для текущего запроса.
Первое условие — одинаковая подготовка входа при обучении и применении. Даже сильная модель не поможет, если при работе ей подают данные, преобразованные не так, как в обучении. Автор иллюстрирует это изменением токенизации: один и тот же текст после разных правил разбиения уже не является для модели одинаковым входом.
Второе условие — правильное использование результата бустингом. Он остаётся финальной моделью и может как реализовать пользу новых признаков, так и нивелировать её. Третье условие, отдельно проговорённое автором, — время ответа. Пользователь должен продолжать скроллить, а не ожидать уведомления о том, что рекомендации когда-нибудь будут готовы.
Две исходные схемы фиксируют разные части задачи. Первая показывает, какой элемент ежедневной архитектуры нужно заменить. Вторая напоминает, что совпадение подготовки данных и поведение финального ранкера — самостоятельные вопросы. Быстро посчитать правильный тензор ещё не означает правильно упорядочить весь ассортимент.
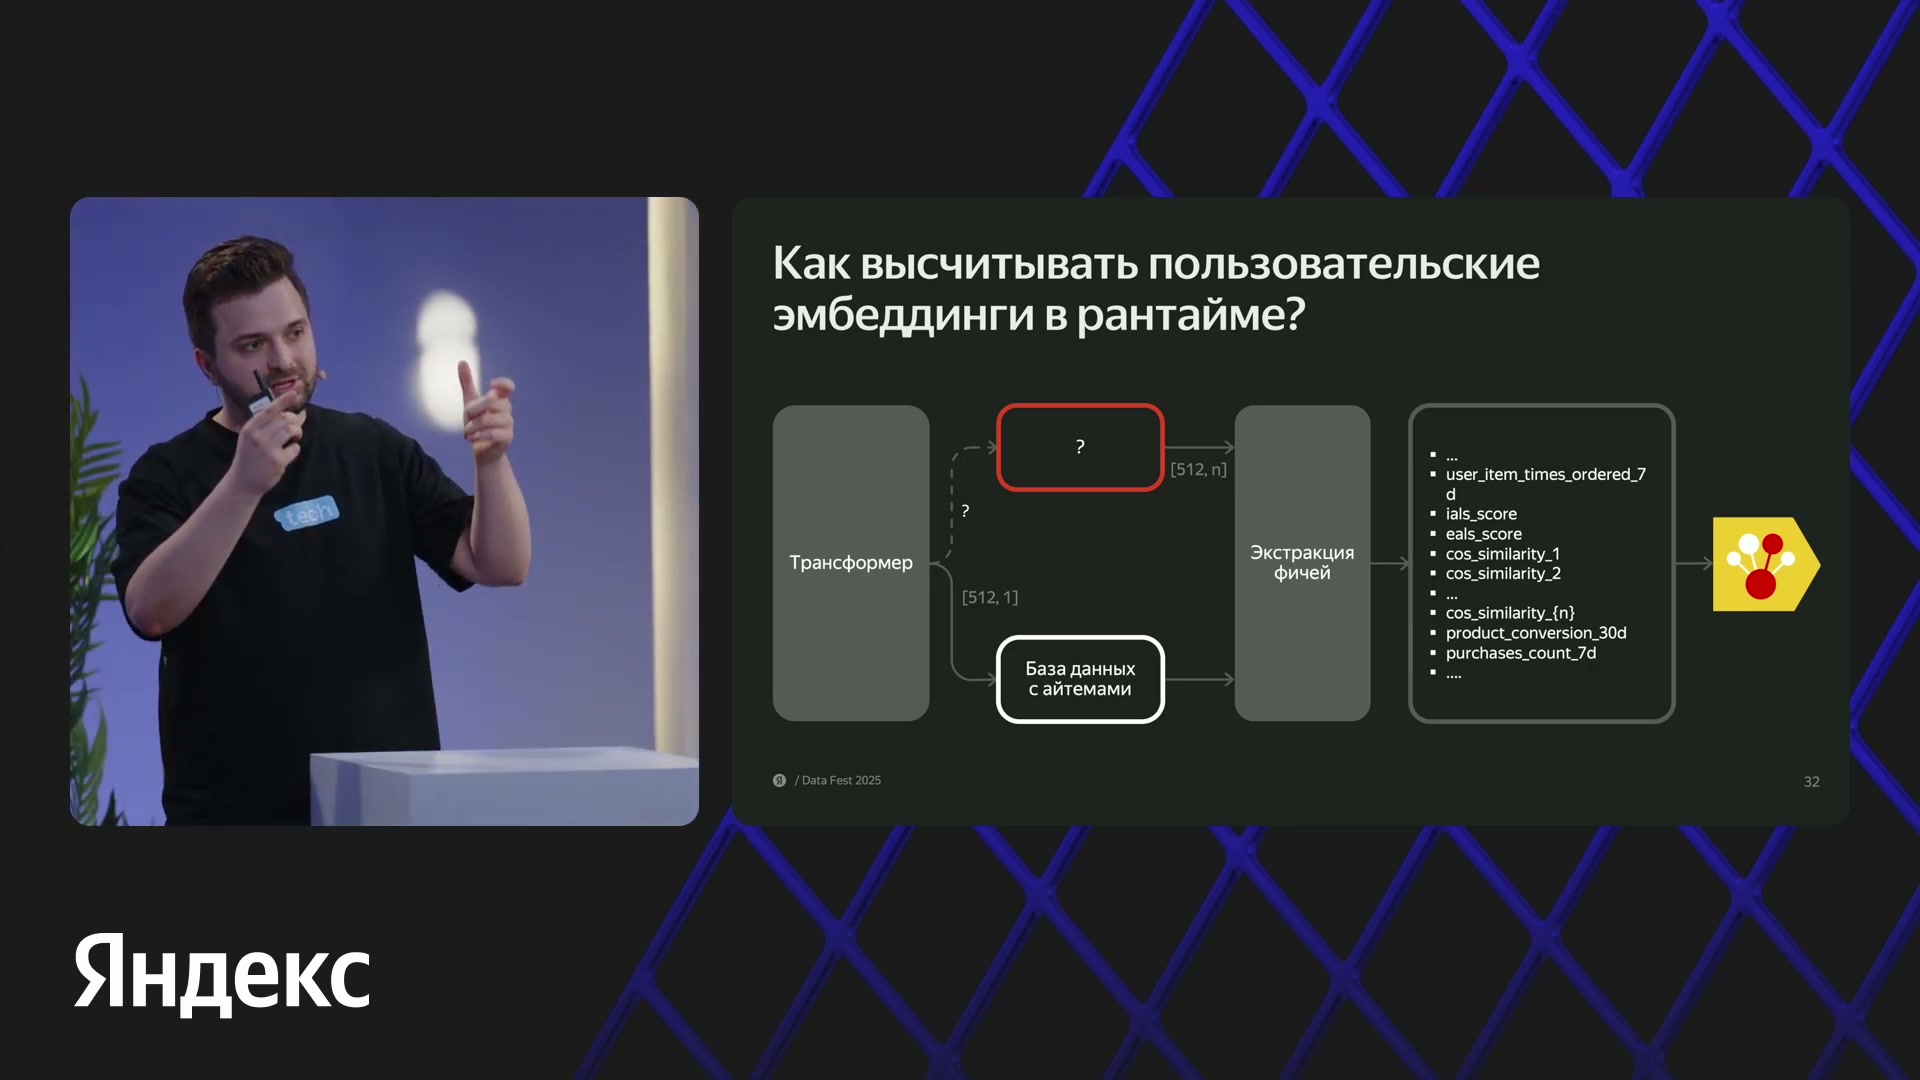
Свежая история должна пройти через модель при запросе, вместо чтения только заранее готового эмбеддинга.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025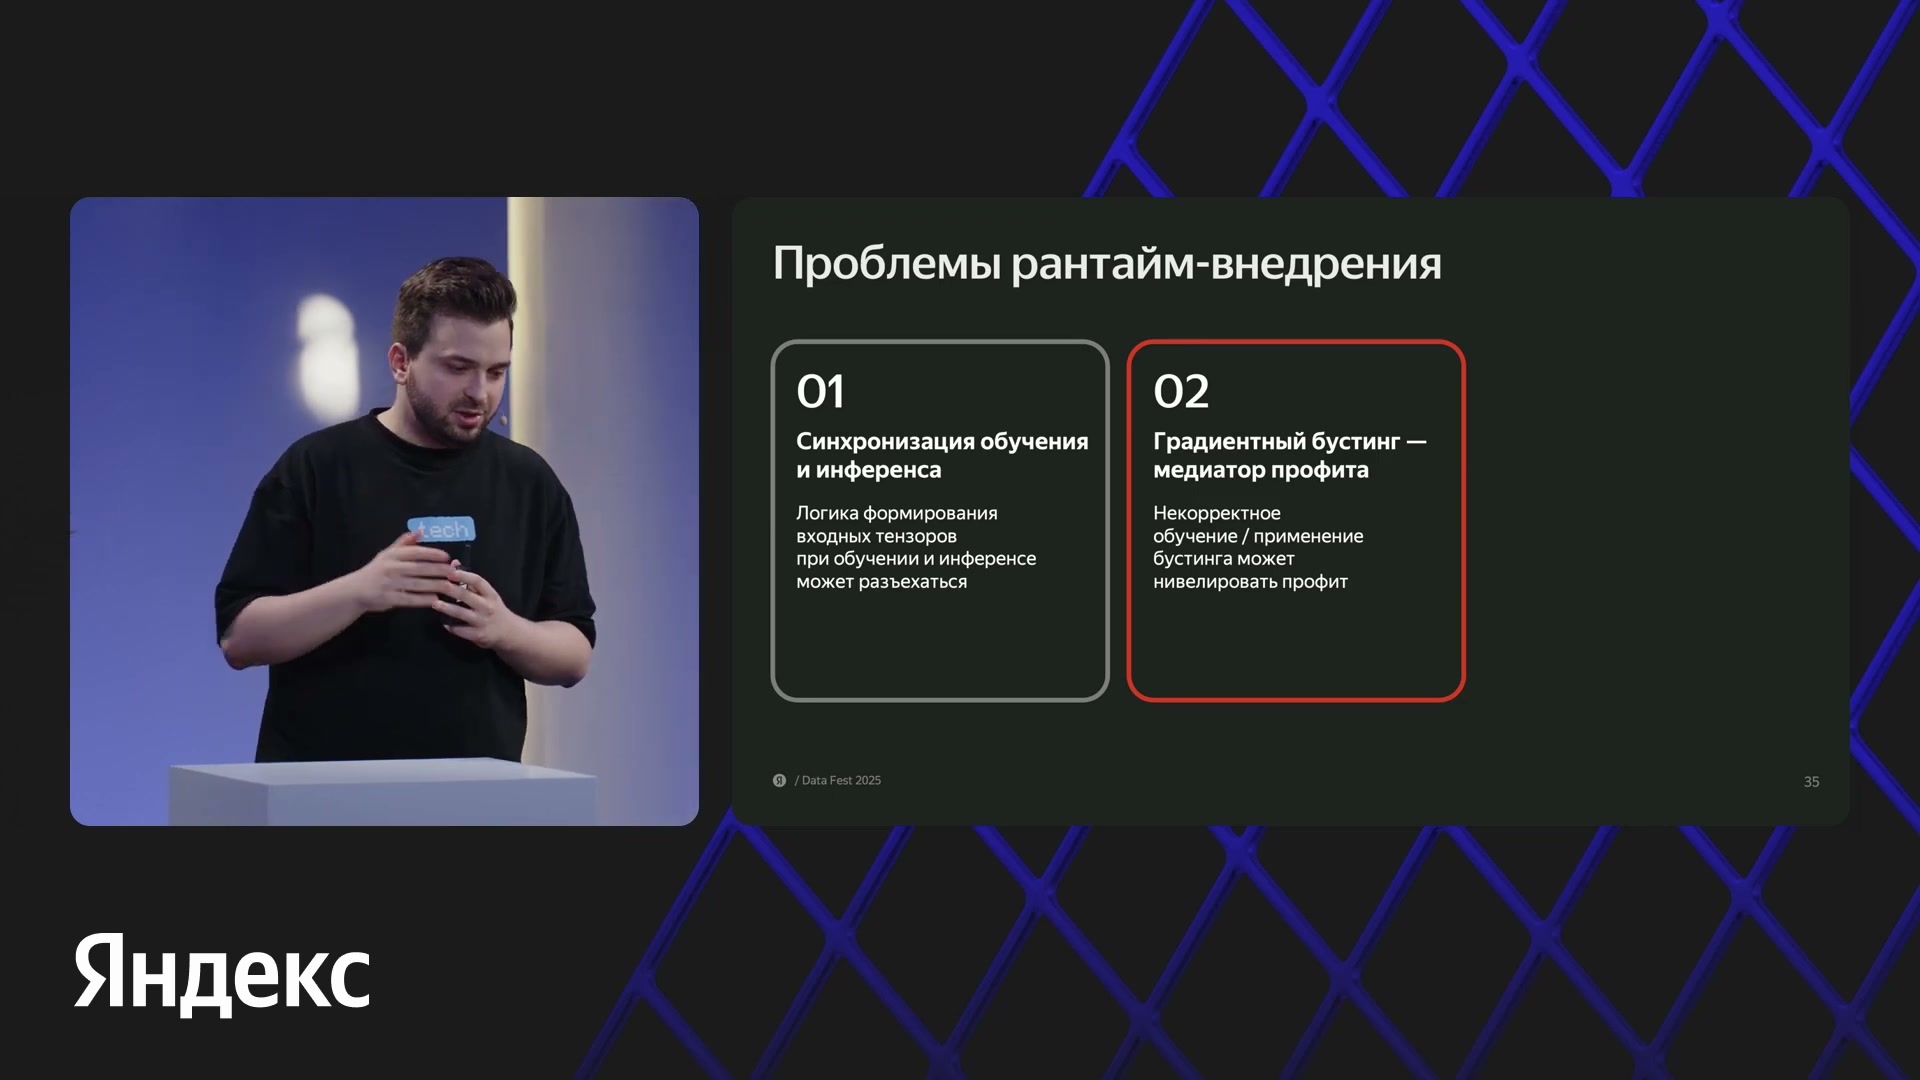
Нужны одинаковая подготовка тензоров при обучении и применении и правильное использование признаков градиентным бустингом.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Где хранить события, которые нужны прямо сейчас
Для обучения и ежедневного расчёта историю можно читать из статических таблиц. Там работа организована заранее и не обязана завершаться внутри ответа пользователю. При расчёте на запросе хранилище должно одновременно принимать новые действия и быстро отдавать нужную историю. Обычный ежедневный снимок не решает задачу её свежести.
Команда выбрала динамическую таблицу YTsaurus. Название системы указано на итоговой сервисной схеме. Сервис рекомендаций обращается к этой таблице за историей, в которой записаны действия пользователя с товарами. Полученные записи затем нужно подготовить для модели: сами идентификаторы товаров не являются достаточным входом контентной башни.
Хранилище истории нельзя путать ни с прежним хранилищем готовых пользовательских векторов, ни со словарём товарных атрибутов в памяти. В первом случае нужны события, из которых ещё предстоит получить представление; во втором — уже вычисленный результат; в третьем — данные, которыми обогащают события. Разделение этих ролей объясняет, почему перенос одной только нейросети не завершает внедрение.
Выбор динамической таблицы подтверждает способ хранения, но не раскрывает весь путь доставки событий. В докладе нет измерения задержки от действия в приложении до его доступности модели, полного описания ключей таблицы или гарантий согласованности. Поэтому слово «свежая» здесь не означает, что каждое действие гарантированно видно без задержки.
Доклад · 00:14:07Одна подготовка данных для обучения и работающего сервиса
Между чтением истории и применением трансформера есть полноценная обработка данных. Сначала события обогащают товарными атрибутами. Затем выбирают наиболее полезные действия. Наконец, результат превращают в тензоры — числовые массивы нужной для нейросети формы. Слишком медленная реализация этих шагов могла бы израсходовать время ещё до запуска модели.
Для обогащения сервис использует базу данных в оперативной памяти. Атрибуты товаров токенизируют заранее и сохраняют в словаре, который по ID товара возвращает токенизированные название, категорию и страну. Во время обработки истории не требуется заново разбирать эти тексты. Наличие ID в словаре не делает модель основанной на ID: идентификатор служит ключом для получения содержания, а не отдельным выученным вектором товара.
Отбор событий тоже является частью подготовки, а не случайным усечением массива. Просмотров намного больше, чем покупок и добавлений, но последние несут особенно полезную информацию. Значит, ограниченная история должна учитывать важность типа действия, а не только количество доступных строк. Конкретная ошибка чтения истории покажет, почему это решение нельзя отложить до самого конца.
Команда использовала фреймворк препроцессинга, разработанный коллегами из Яндекс Музыки. Последовательность преобразований задаётся конфигурацией. Одни и те же функции и классы можно оформить как микросервис для применения модели и как шаг графа обучения. Речь не о двух похожих реализациях, написанных по одной спецификации, а об использовании одного и того же кода.
В офлайн-задаче более медленную подготовку можно выполнить заранее. В работающем сервисе она повторяется при запросах, поэтому скорость становится отдельным требованием. Общее происхождение кода помогает сохранить одинаковую семантику входа после оптимизаций. При этом оно не устраняет другой источник расхождений: товары, на которых учился ранкер, могут отличаться от ассортимента, который он оценивает.
На первом слайде подготовка разложена на три действия: обогащение, приоритизацию и формирование тензоров. На втором показано, откуда процессинг берёт товарные данные. Вывод из обеих схем один: до трансформера есть самостоятельный вычислительный этап, и его корректность должна совпадать в обучении и при обработке запросов.
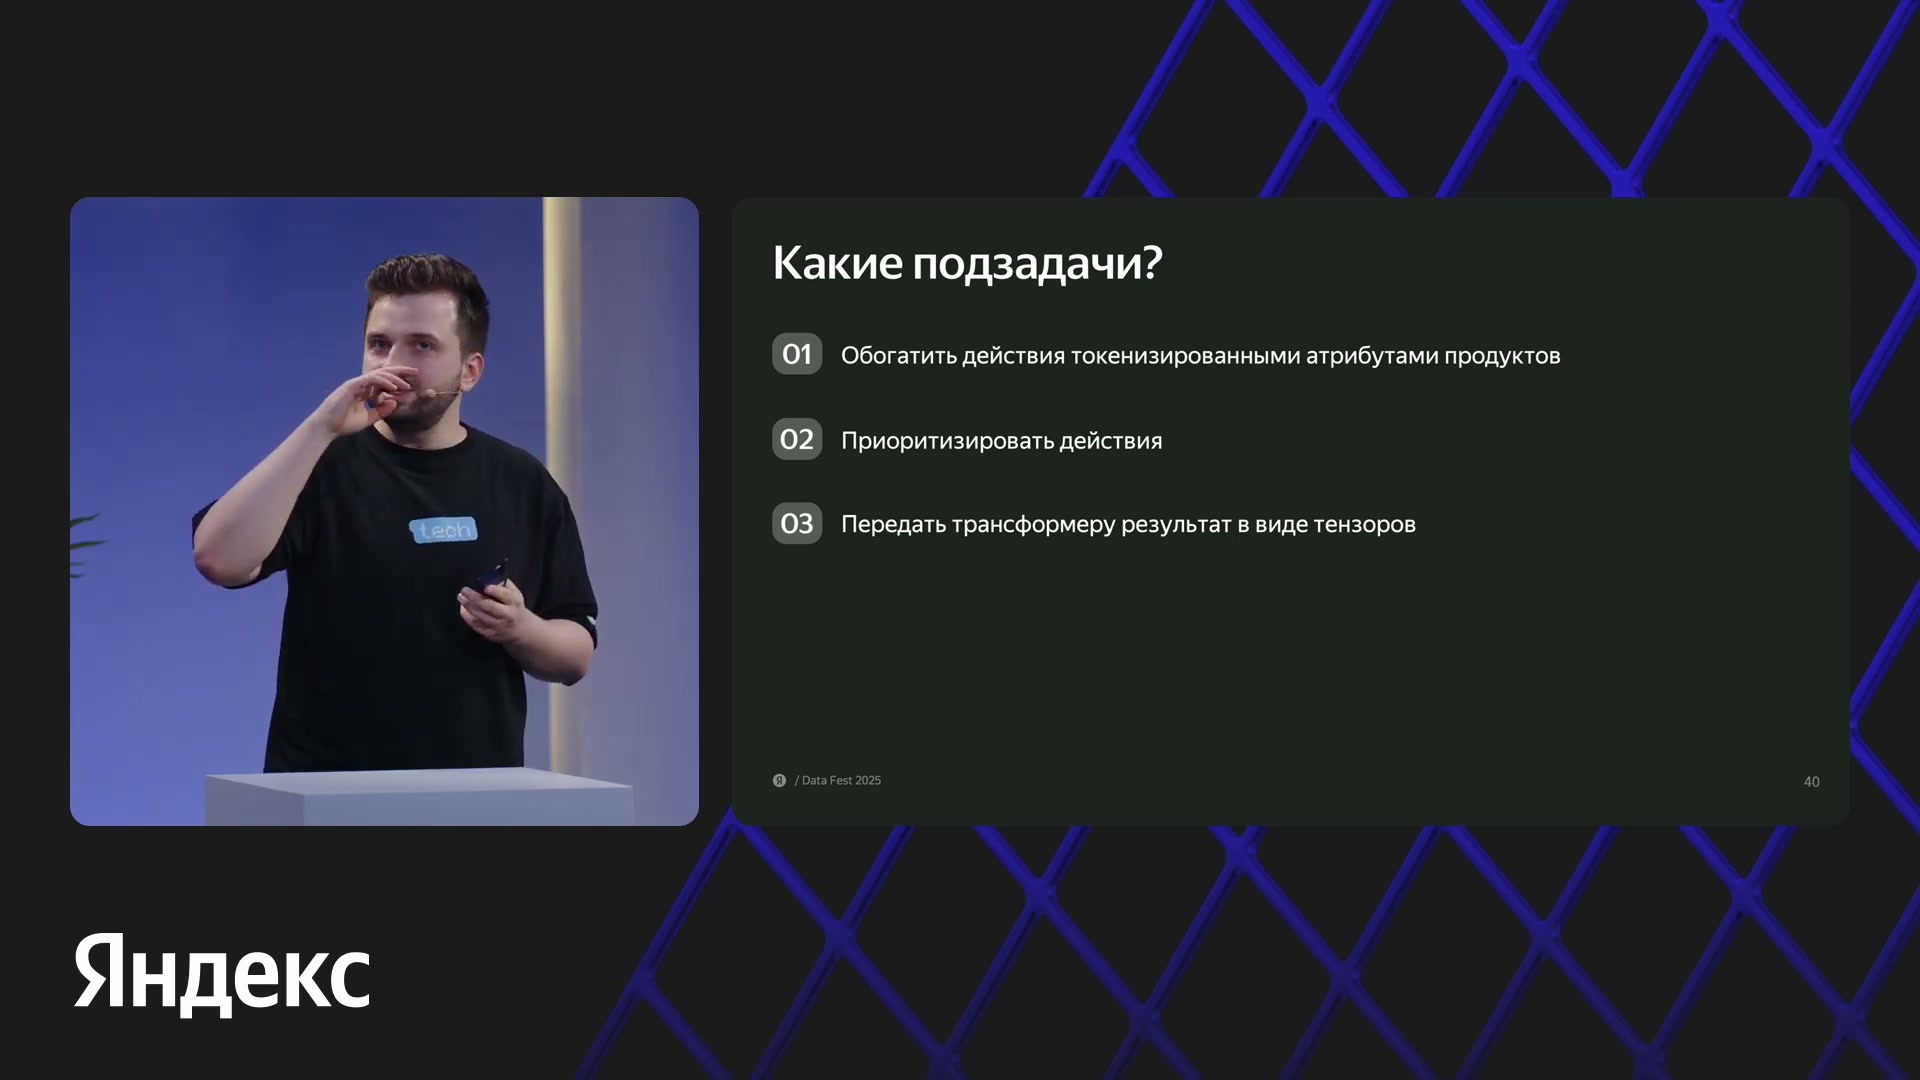
Действия обогащают атрибутами товара, приоритизируют и преобразуют в тензоры. Это отдельная работа до расчёта трансформера.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025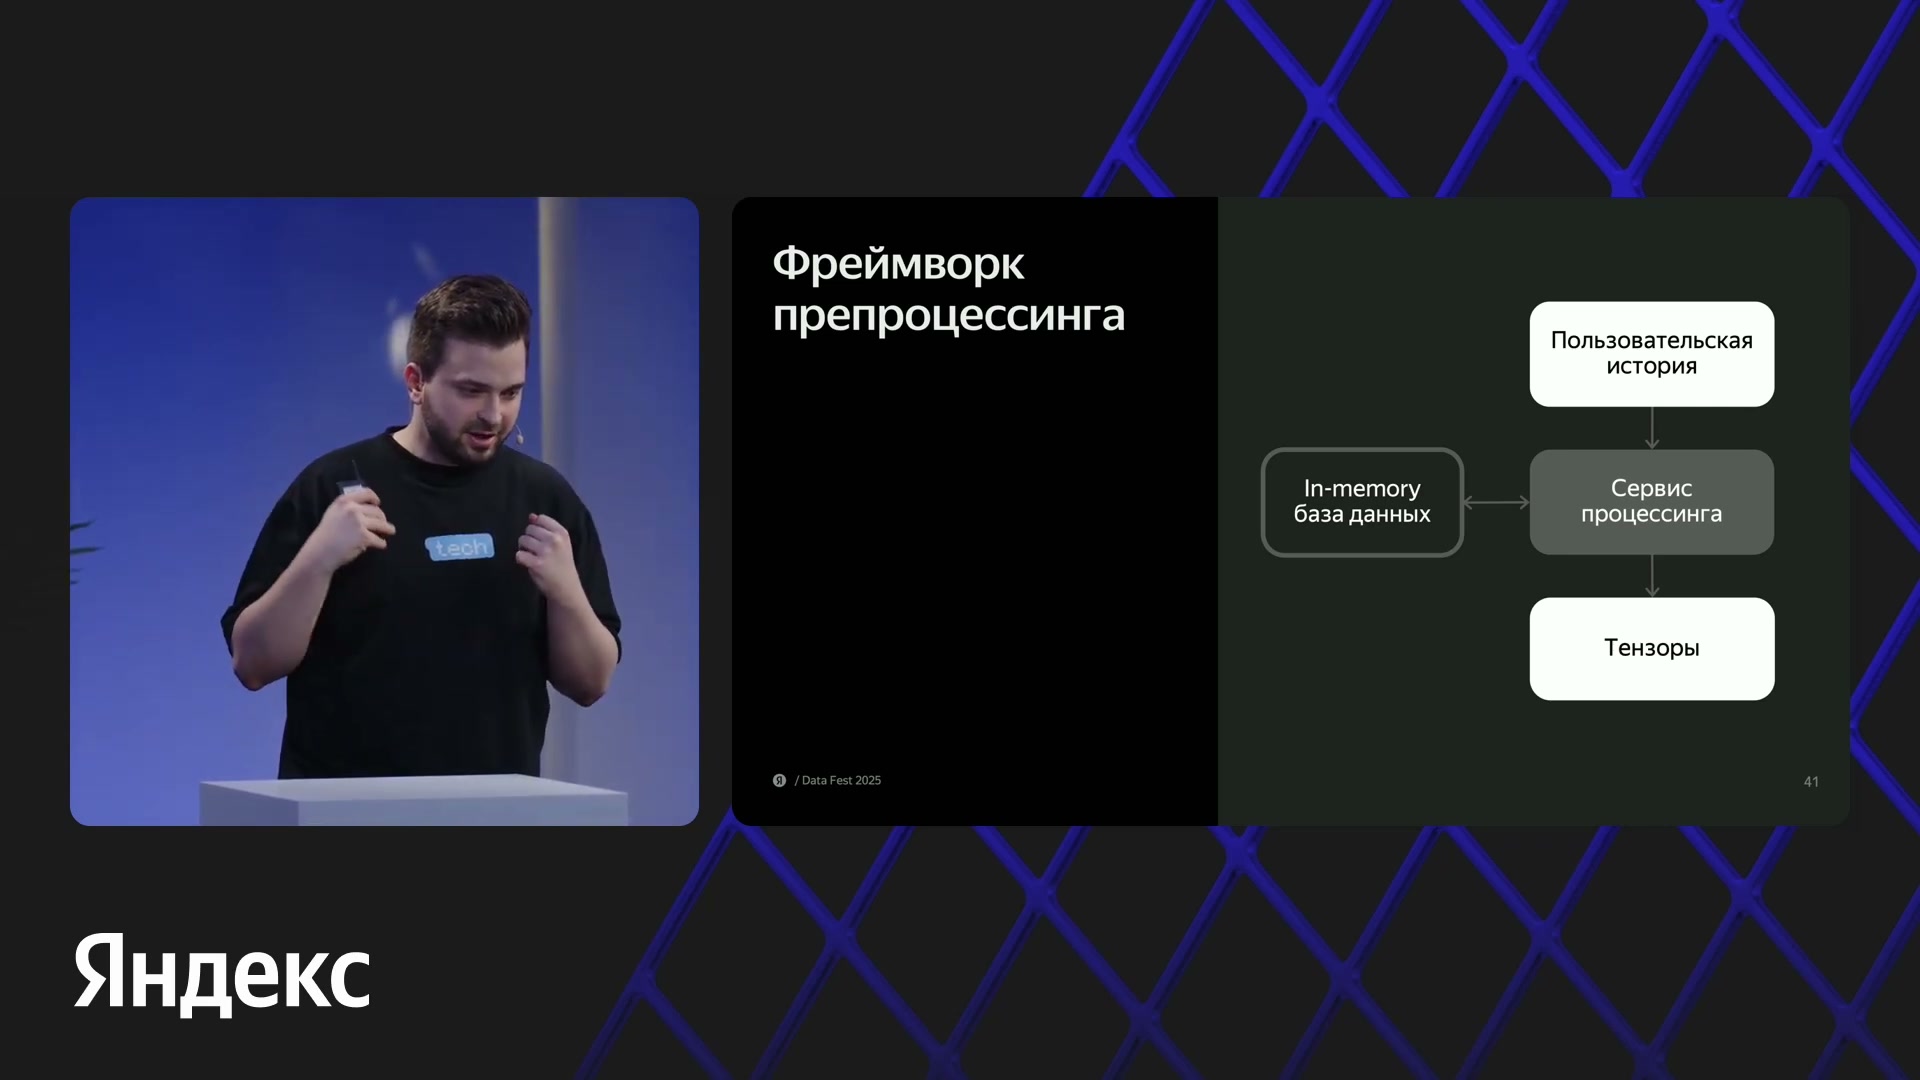
Сервис процессинга использует данные товаров в памяти и формирует тензоры истории; та же логика требуется для обучения.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Процессинг сам вызывает модель, а сервис не ждёт без дела
После выделения процессинга напрашивался такой маршрут: вернуть подготовленные тензоры в сервис рекомендаций, а затем из него отдельно вызвать пользовательскую башню. Автор рассматривает этот вариант, но выбирает другой. Сервису рекомендаций промежуточный вход модели не нужен; для признаков ему требуются готовые пользовательские представления.
Поэтому сервис рекомендаций передаёт историю в процессинг в структурированном сообщении Protocol Buffers. Процессинг получает товарные атрибуты из базы в памяти, собирает тензоры и сам обращается к сервису применения модели — сервису инференса. Там находится пользовательская башня трансформера. Результат возвращается через процессинг в сервис рекомендаций уже как набор эмбеддингов.
При объяснении автор отдельно исправляет ошибку на одном из слайдов. Его устное уточнение важно для чтения архитектуры: именно процессинг ходит в сервис инференса, а обратно сервису рекомендаций передаёт эмбеддинги, не исходные тензоры истории. Это не дополнительный вызов модели из сервиса рекомендаций после получения подготовленного входа.
Получение представлений запускают асинхронно сразу после прихода запроса бэкенда. Пока эта работа идёт, сервис выполняет независимые действия, в частности собирает товары, которые предстоит ранжировать. К пользовательским векторам обращаются позднее, когда они действительно потребуются. По словам автора, к этому моменту они обычно уже готовы, поэтому дополнительного ожидания часто нет.
Здесь слово «кандидаты» в описании подготовки товаров не означает возвращения к прежней архитектуре раннего отбора. На корзине оценивается весь ассортимент конкретного даркстора. Параллельность касается организации вычислений вокруг этого ранжирования, а не замены полного множества товаров небольшим набором.
У асинхронности оказалась и неприятная сторона. Автор рассказывает об ошибке в C++-коде: он неаккуратно синхронизировал асинхронные задачи, и сервис пришлось откатывать. Откат совпал с прослушиванием лекции о двухбашенных трансформерах. Конкретный дефект синхронизации и его исправление не разобраны, поэтому эту историю нельзя превращать в описание определённой гонки или аварии памяти.
Итоговая схема показывает непрерывный путь: история из динамической таблицы, подготовка, применение модели и возврат представлений для расчёта признаков. Экономия ожидания возникает от перекрытия независимых работ, а не от отсутствия стоимости у нейросети. В докладе нет точных задержек отдельных сервисов, перцентилей времени ответа или конфигурации оборудования.
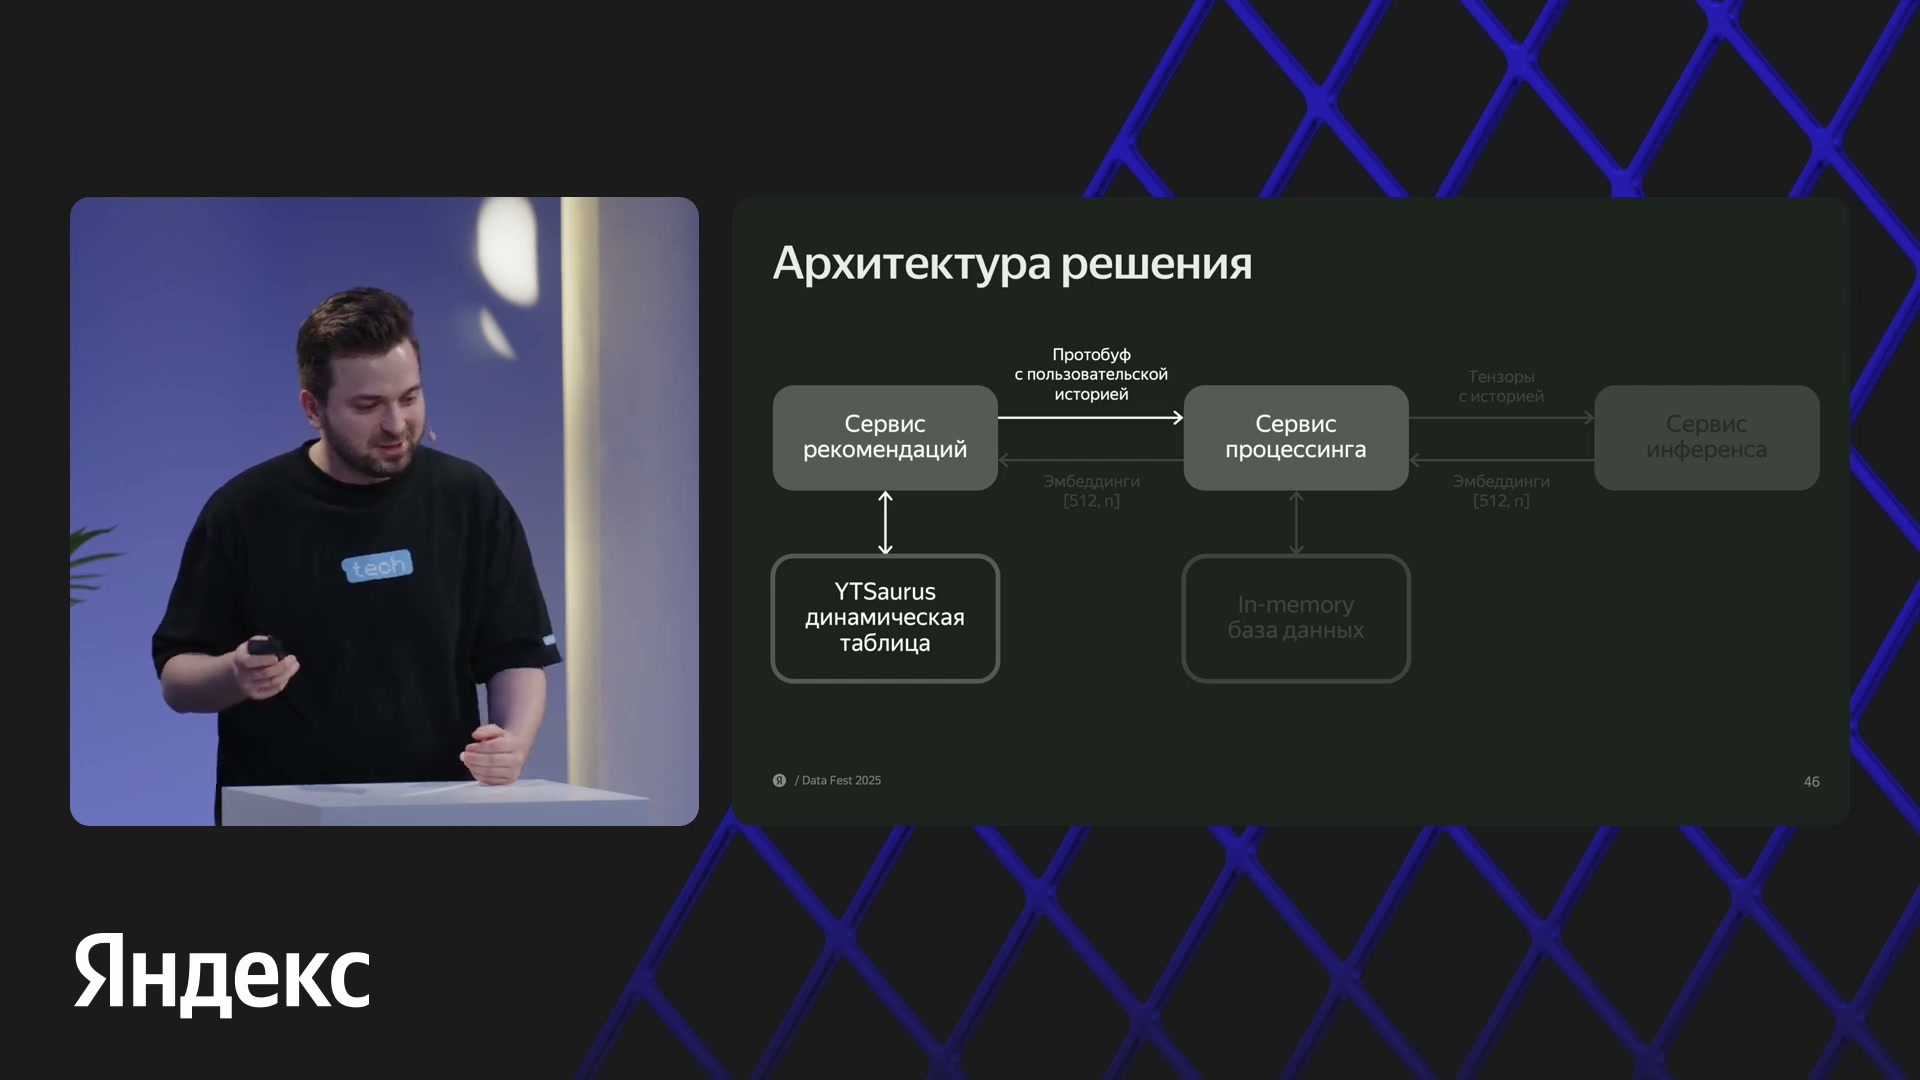
Сервис рекомендаций читает историю из динамической таблицы YTsaurus; процессинг готовит тензоры для инференса, эмбеддинги возвращаются для расчёта признаков. Затем работает ранжирование.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Почему последние 3000 событий не заменяют нужные 512
На первом этапе внедрения для модели выбирали историю из 512 действий. С более длинными последовательностями команда уже экспериментировала, но начала с меньшего объёма, чтобы реализовать рабочий путь данных. Здесь 512 — число событий. Оно независимо от 512 координат каждого вектора, показанных на архитектурной схеме.
Действия попадали в историю с учётом двух факторов: насколько недавно они произошли и насколько важен их тип. Клик или добавление в корзину информативнее простого просмотра; покупки также выделены автором как особенно полезный сигнал. Полный алгоритм сочетания свежести и типа в докладе не приведён.
Прочитать всю историю и потом выбрать нужное тоже оказалось неудобно. У пользователя могут накопиться десятки тысяч строк, передача которых нагружает сеть. Команда попыталась сократить чтение общим ограничением на число строк. На слайде показан запрос по пользователю с сортировкой по времени события от новых к старым и LIMIT 3000.
SELECT ...
FROM [//table]
WHERE user_id = "{user_id}"
ORDER BY event_timestamp DESC
LIMIT 3000
Это схема неудачного запроса из доклада: список полей и путь таблицы обозначены условно. Он действительно уменьшает объём получаемых данных, но ничего не гарантирует о составе этих данных. Если последние события в основном являются просмотрами, более редкие добавления и клики могут не попасть в прочитанный фрагмент.
Ошибка возникает раньше, чем приоритизация. Нельзя выбрать полезное событие из 512 мест для модели, если его уже отсёк запрос к хранилищу. Поэтому аргумент «3000 заметно больше 512» не решает проблему: важен не запас строк сам по себе, а присутствие нужных типов действий среди прочитанного.
Исправление — четыре асинхронных запроса к динамической таблице, в которых количество событий задаётся отдельно по типам действий. Такой способ чтения позволяет получить нужный состав истории до окончательного формирования входа модели. Это не четыре вызова трансформера: меняется извлечение событий из хранилища.
Слайд с LIMIT показывает конкретный провал простого ограничения по свежести. Исправленную логику автор объясняет словами; полный SQL четырёх запросов, перечень их квот и подробное правило объединения не раскрыты. Из рассказа следует необходимость сохранить важные типы событий при чтении, но не готовый универсальный рецепт отбора истории для любого сервиса.
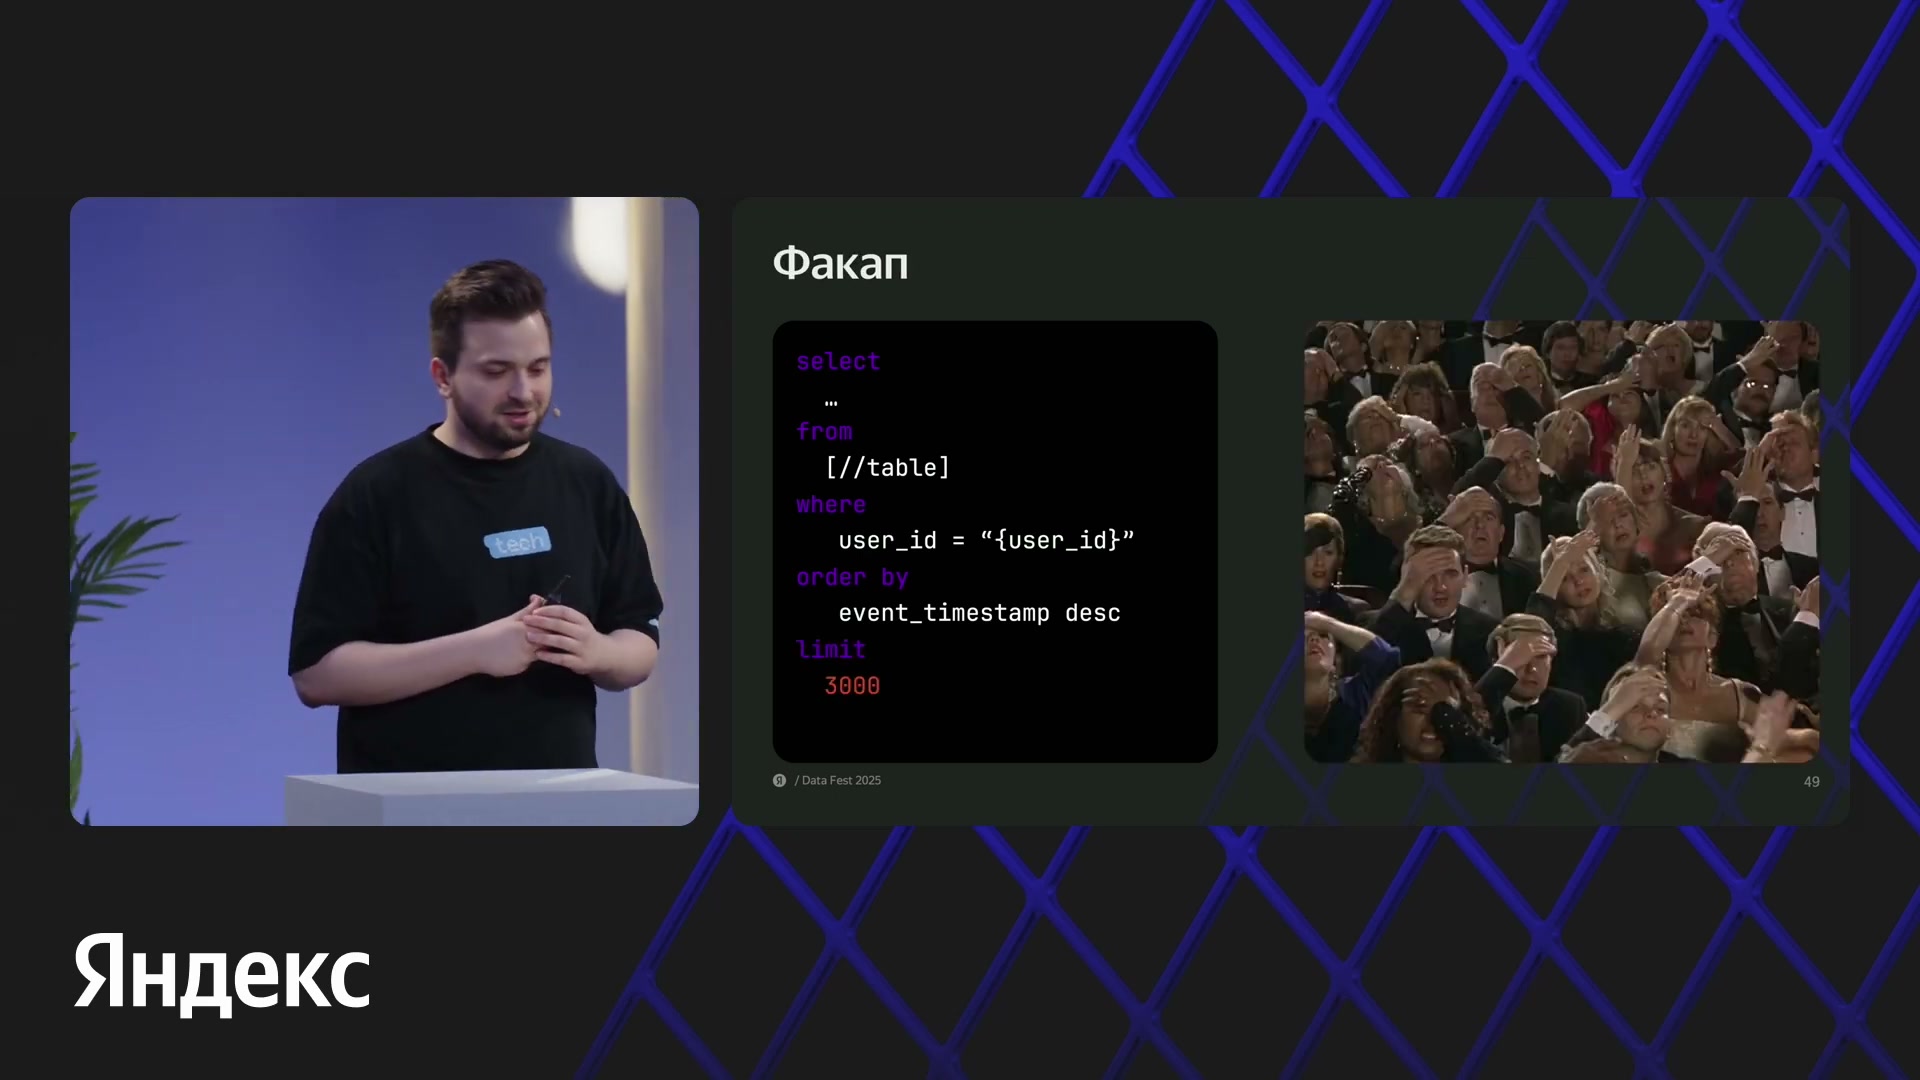
Последние 3000 событий могут состоять главным образом из показов. Значимые покупки и добавления в корзину при таком отборе могут не попасть в ограниченную историю; полные правила приоритизации не раскрыты.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Ранкер учится на показах, а сортирует весь даркстор
Даже при одинаковой подготовке тензоров остаётся другое расхождение между обучением и применением. Бустинг учится на неявной обратной связи: пользователь не ставит оценку каждому товару, но его просмотры и добавления дают обучающий сигнал. Модель должна поставить товары с целевым действием выше остальных в рассматриваемой группе.
На слайде приведён пример такой группы: 7–9 просмотров используются как отрицательные примеры, а 1–3 добавления в корзину — как положительные. Всего иллюстрация предлагает отранжировать примерно десять товаров. Это схема формирования обучающей группы, а не утверждение о точном среднем размере или полном распределении классов во всём наборе данных.
Таблицу можно прокрутить по горизонтали.
Для обучения минимизируют ранжирующую функцию потерь — величину, штрафующую неправильный порядок объектов. Но обратная связь есть только по тому, что прежняя система показала человеку. Непоказанный товар не становится от этого подтверждённо плохим: у модели просто нет такой же наблюдаемой реакции на него в этой группе.
При запросе бустинг получает другую задачу: оценить несколько тысяч товаров, включая те, которые редко попадали в прежнюю выдачу. Признак может отлично разделять просмотренное и добавленное внутри старых показов, но давать неудачный порядок на всём ассортименте. Здесь различается не способ вычисления признака, а множество объектов, к которым применяется выученная зависимость.
Сопоставление двух исходных слайдов делает проблему видимой: небольшой набор наблюдавшихся товаров на обучении и весь даркстор при применении. Общий код процессинга не исправляет этот сдвиг. Именно из-за него внедрение потребовало двух основных этапов, а не одного добавления нейросетевых оценок в бустинг.
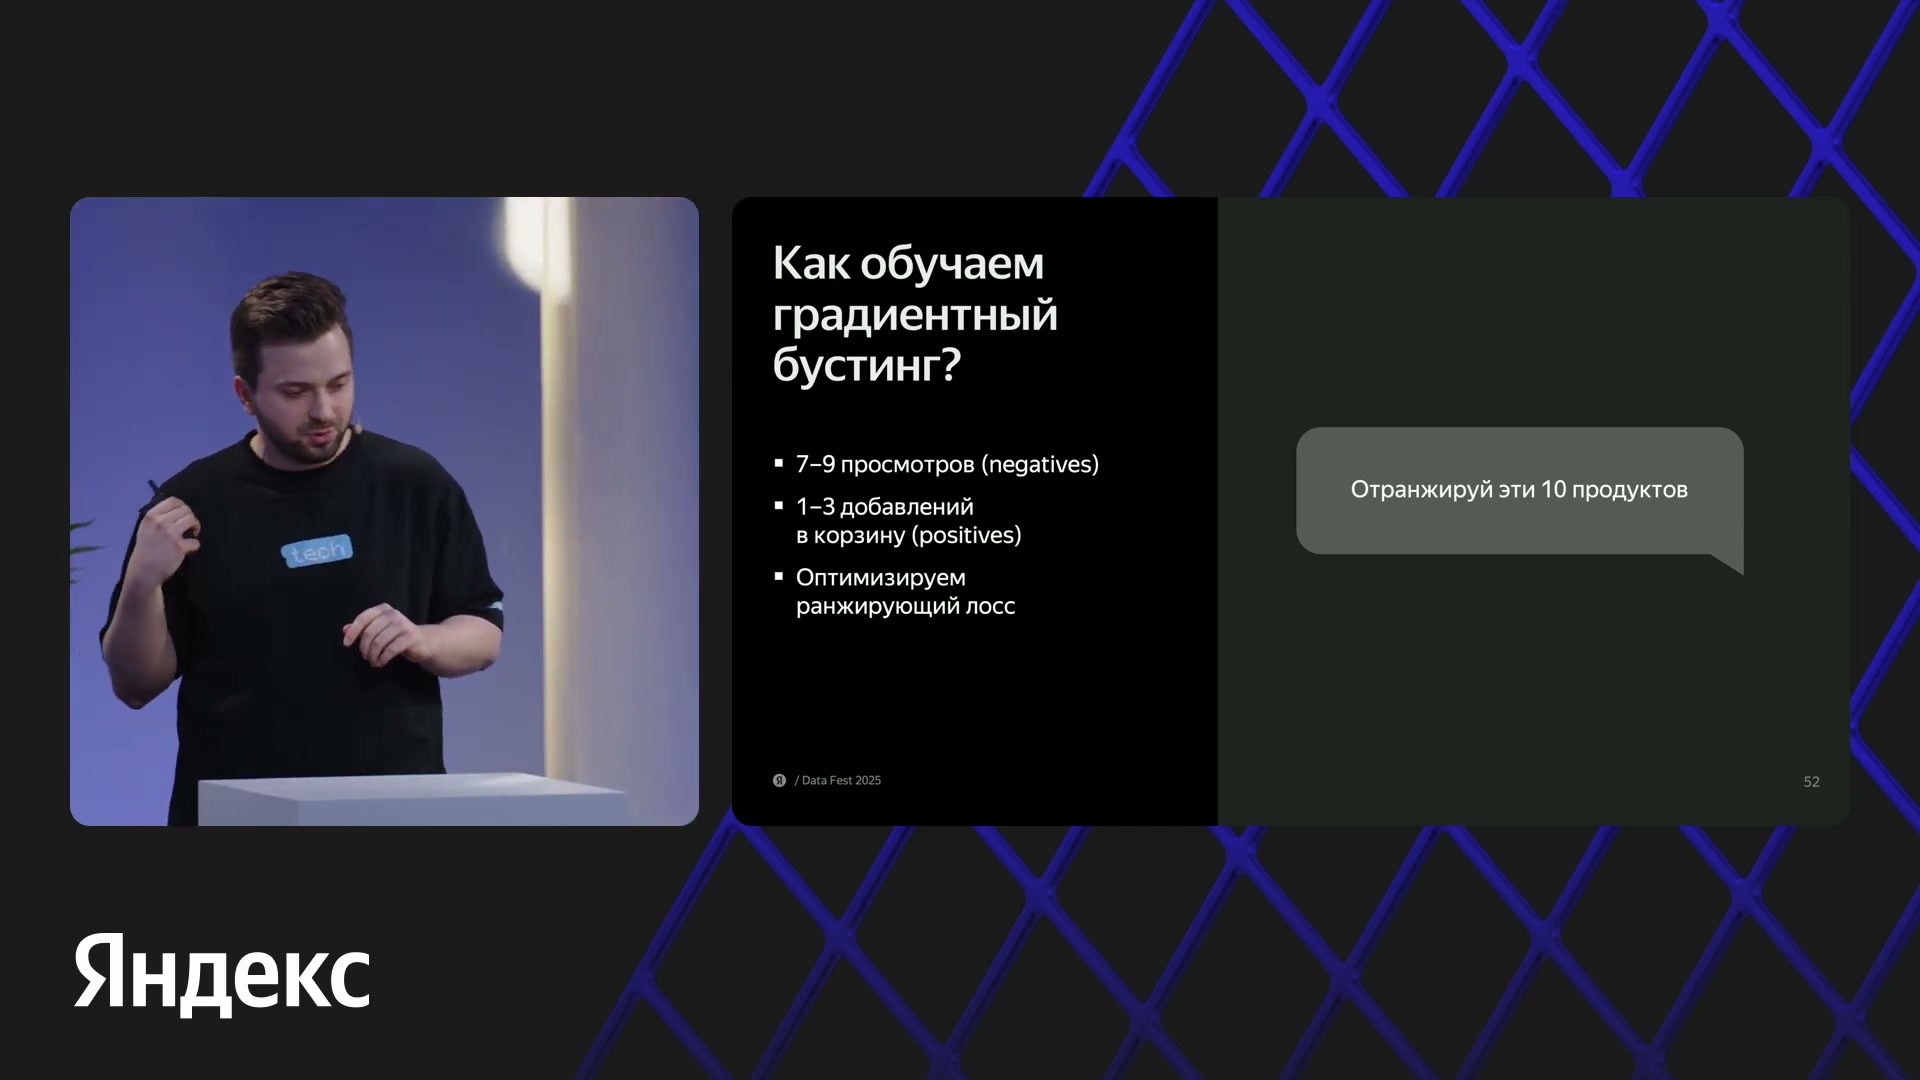
На обучении пример содержит 7–9 просмотров и 1–3 добавления в корзину, всего около 10 товаров. При применении ранжируют тысячи товаров даркстора.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025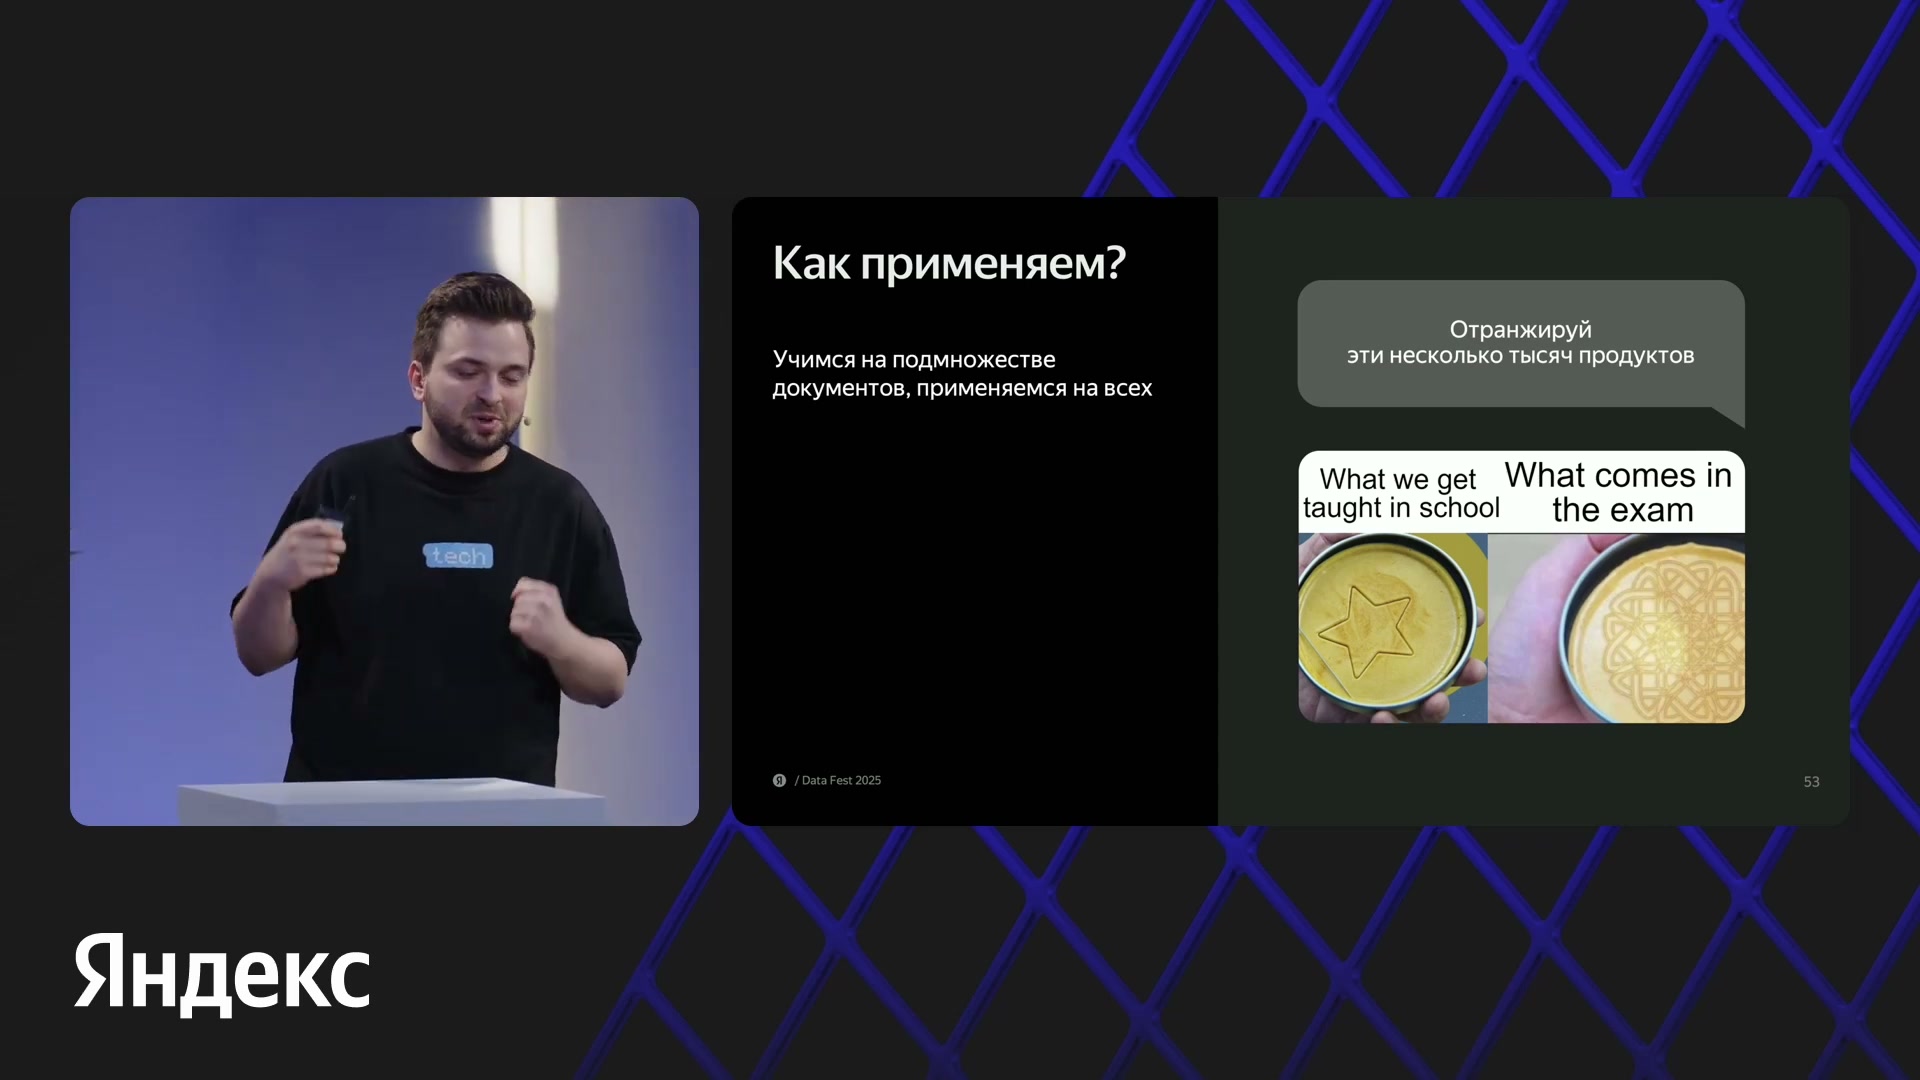
Обучение на показанном подмножестве не равнозначно оценке всего ассортимента. Это повлияло на первые онлайн-эксперименты.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Почему первая выкатка изменила выдачу, а вторая — выручку
На первом этапе оценки сходства трансформера стали новыми признаками бустинга. В обучающей выборке они хорошо отличали товары, которые заинтересовали пользователя, от остальных показанных товаров. Бустинг выучил, что этим сигналам полезно доверять. Но проверка на старых показах не показывала полностью, что произойдёт при оценивании всего ассортимента.
При применении новые зависимости начали поднимать менее популярные и менее привычные для истории пользователя товары. Это расширяло выдачу за пределы обычных повторных покупок. Выросла метрика знакомства с новым — Discovery. Однако, по словам автора, выручка с поверхности и качество в смысле конверсии значимо не выросли. Изменение состава рекомендаций оказалось недостаточным для желаемого бизнес-результата.
На втором этапе бустинг обучили повторно, уже получив обратную связь о товарах, которые новые признаки вывели в верх выдачи. Теперь модель могла увидеть не только то, что сходство полезно, но и условия его полезности: с какими другими признаками оно сочетается, когда новый товар стоит поднимать, а когда не стоит.
Автор описывает это как обучение на результатах собственного применения. Речь не об автоматическом изменении весов после каждого пользовательского действия. Между выкатками меняются доступные примеры и обучение ранкера. Подробности сбора новых логов, смешивания их со старыми и расписания переобучения не сообщаются.
После этого вырос не только Discovery, но и GMV. Важен весь переход: новые признаки меняют выдачу, выдача создаёт другую обратную связь, а повторное обучение помогает использовать признаки точнее. Сам по себе второй запуск того же эксперимента не объяснял бы улучшение.
Для пояснения автор сравнивает ситуацию с добавлением нового источника кандидатов в рекомендательную систему. Ранжирующей модели нужно познакомиться с товарами, которые этот источник приносит. В Лавке на корзине новый генератор здесь не вводили: аналогия объясняет необходимость адаптации ранкера к изменившемуся составу показов.
На слайде цепочка заканчивается повторным обучением на результатах новой выдачи и ростом GMV. Это существенное ограничение первого подхода: полезный на старых данных признак нельзя считать готовым бизнес-улучшением без проверки всего ранжирования. При этом доклад не показывает отдельную проверку вклада каждого изменения при неизменности остальных компонентов.
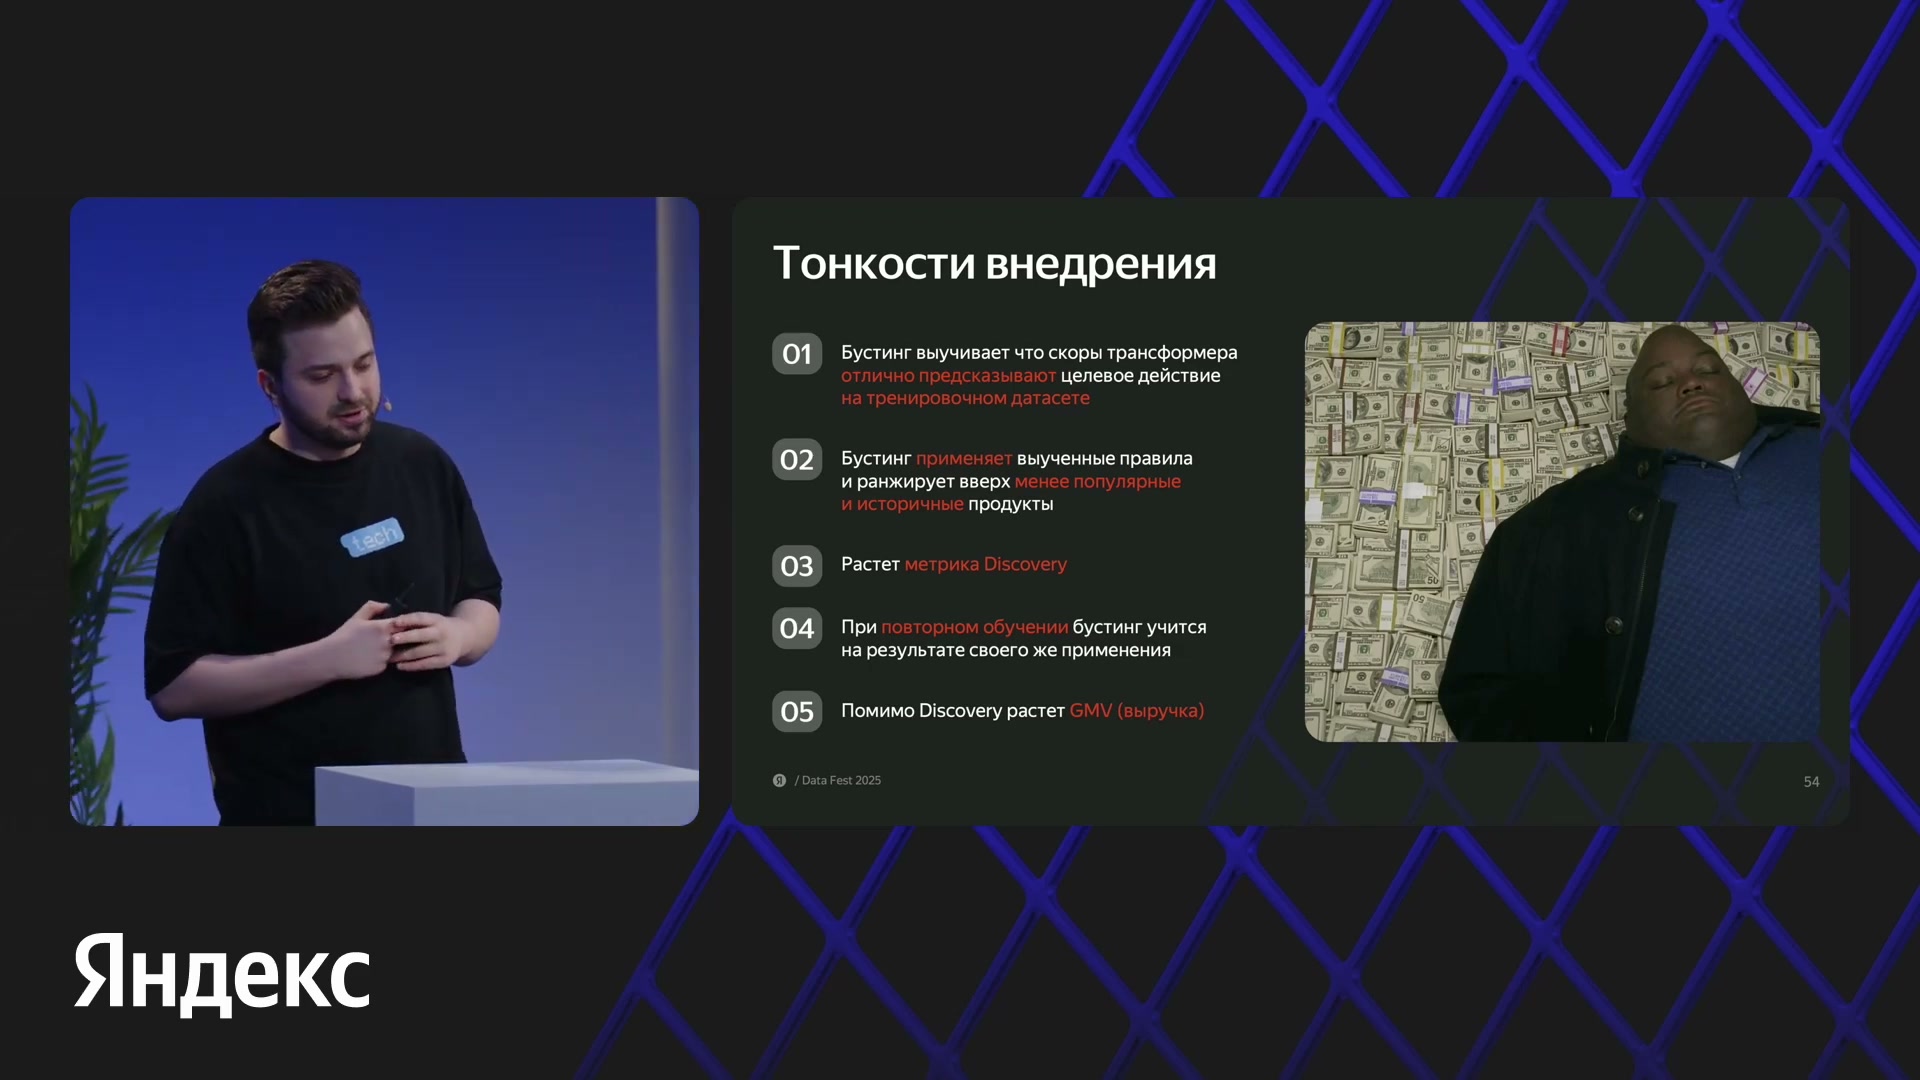
Сначала бустинг поднимает непопулярные продукты; после переобучения на новой выдаче учится точнее использовать сходства. Растёт не только Discovery.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Результаты двух этапов: разные подписи GMV
Итоговый слайд сопоставляет первую и вторую выкатки. Для первой указан рост примерно на 2–3% у показателя «GMV с рекомендаций к корзине» и +1,3% Discovery. Для второй — примерно на 6–8% у показателя «GMV с корзины» и +1,5% Discovery. Подписи денежных показателей различаются; они сохранены в таблице.
Таблицу можно прокрутить по горизонтали.
Устный комментарий не позволяет назвать первый этап значимым ростом всей выручки. Автор говорит, что выручка с поверхности значимо не выросла, а позднее характеризует увеличение GMV с рекомендаций как небольшое. Величина из первой строки относится к более узко подписанному показателю. Слайд не раскрывает его статистическую значимость и не даёт оснований заменить этой строкой весь комментарий о результате первой выкатки.
Второй этап автор называет желаемым результатом: выручка с корзины выросла на 6–8%, а Discovery всей Лавки — на 1,5%. Это не заявление о росте общего GMV всей Лавки на 6–8%. Нельзя также сложить диапазоны двух этапов, вычесть один из другого или перемножить их как последовательные приросты одной и той же величины: подписи и полные условия сравнения этого не допускают.
Для обоих этапов не приведены абсолютные значения метрик, точный состав контрольных вариантов, длительность тестов, размеры групп и доверительные интервалы. Диапазоны 2–3% и 6–8% нельзя автоматически считать такими интервалами. Изменения Discovery записаны в процентах; преобразовывать их в процентные пункты или в количество новых покупателей без базы расчёта нельзя.
Вывод из слайда — не сумма процентов, а различие двух состояний системы. Сначала новые признаки помогли открыть больше непривычных товаров, но не дали желаемого значимого роста выручки с поверхности. Затем ранкер адаптировали к изменившимся показам и получили заявленный рост GMV с корзины. Офлайн-результат +2% при лаге 90 секунд относится к другой проверке и в эти величины не входит.
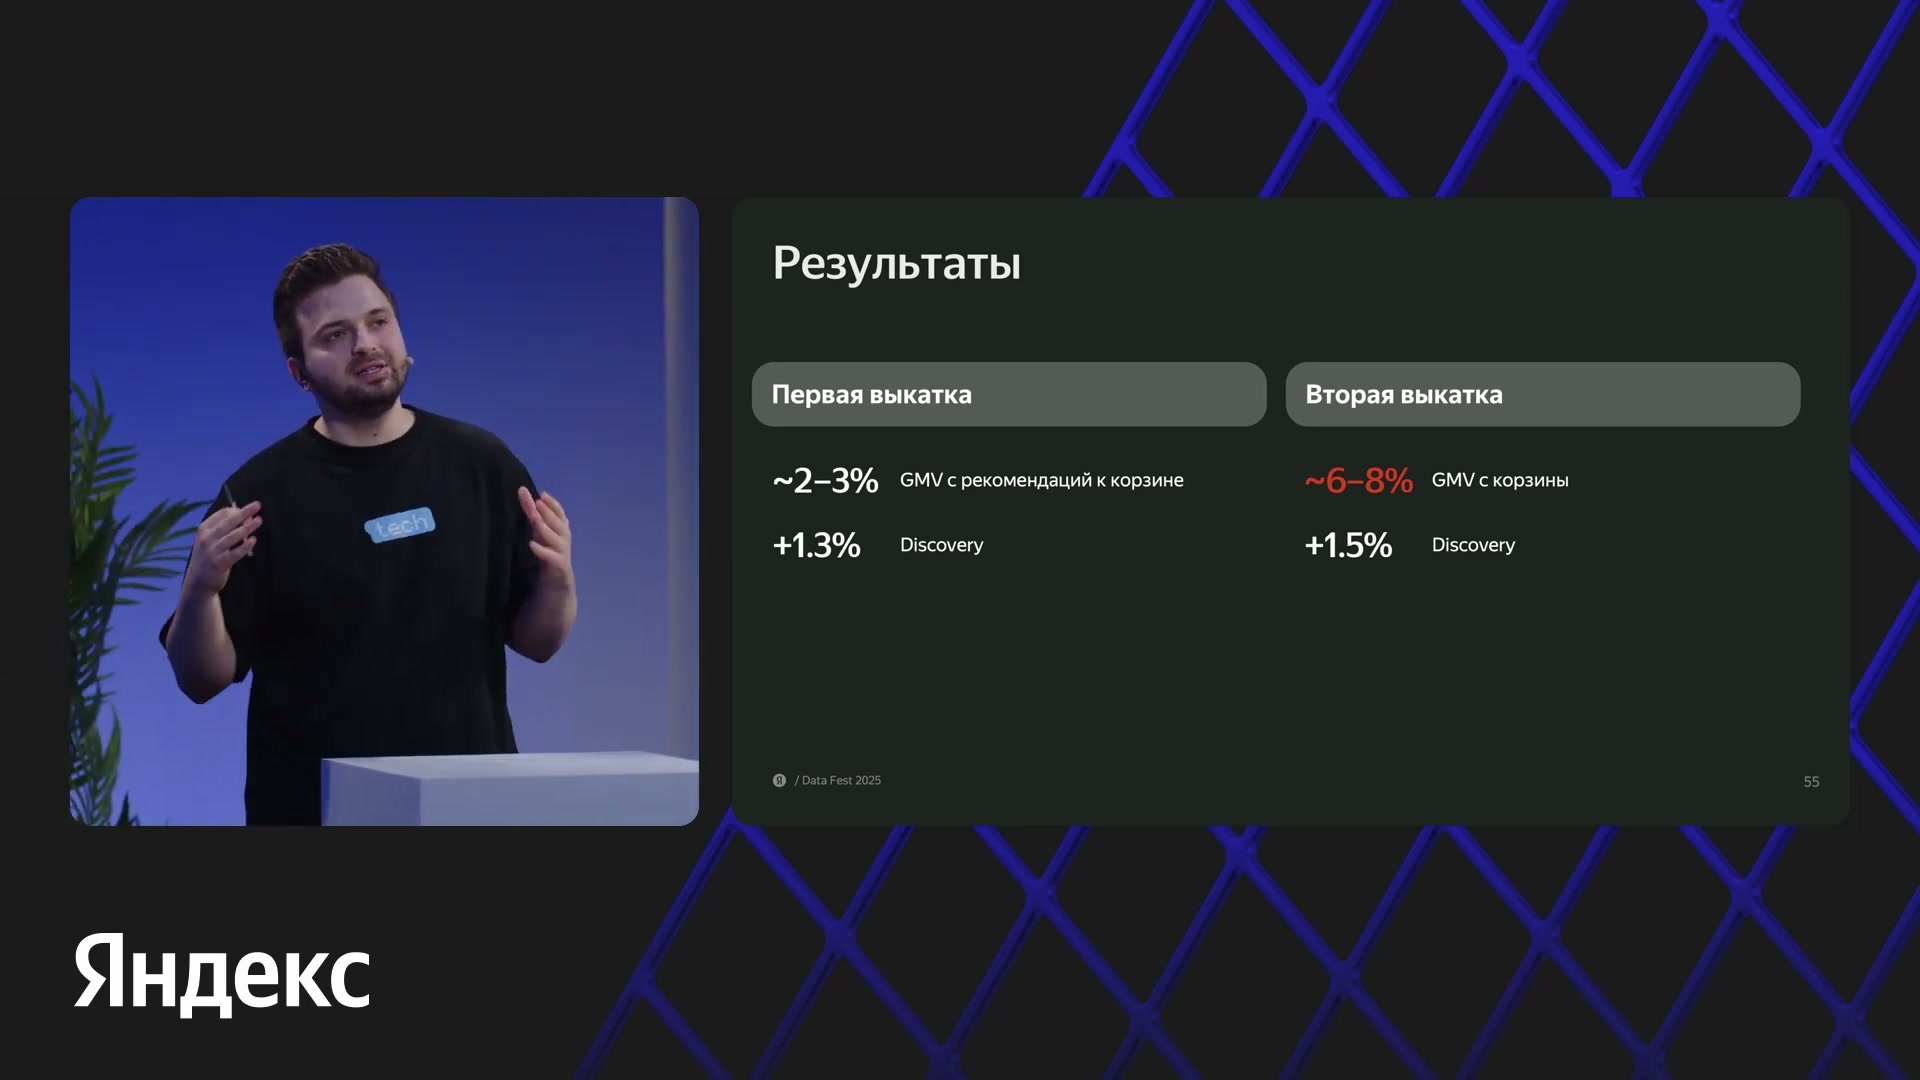
Первая выкатка: GMV с рекомендаций к корзине ~2–3%, Discovery +1,3%. Вторая: GMV с корзины ~6–8%, Discovery +1,5%. Названия показателей сохранены; эффекты не складываем, выборка и протокол не раскрыты.
Источник: Марк Нарусов · Яндекс Лавка · Data Fest 2025Что именно стало новым для покупателя
Discovery в объяснении автора — доля покупок, в которых человек приобретает что-то из категории, ранее им не покупавшейся. Это не просто показ незнакомой карточки. Связь с покупкой делает результат содержательнее, чем одно разнообразие списка, но подробная формула остаётся за рамками доклада: не уточнены единица подсчёта, окно пользовательской истории и уровень категорий.
Команда также стала чаще выводить товары из длинного хвоста — менее популярных позиций, которые обычно получают меньше внимания. Индуктивная товарная башня помогает не ждать накопления индивидуальной истории нового товара. Автор приводит практический ориентир: товар появился на складе, и уже на следующий день его можно начинать рекомендовать. Это пример работы подхода, а не формально заданный срок обновления каталога для каждого случая.
Отдельно упомянут рост показателей продаж товаров, новых именно для даркстора. Название этого показателя в доступной речи неразборчиво, численного результата автор не приводит. Его смысл нужно сохранить отдельно от Discovery: новая позиция на складе может относиться к давно знакомой пользователю категории, а новую для себя категорию пользователь может открыть через давно существующий товар.
Ещё один результат касается способности предложить неочевидное, но интересное человеку. В вопросах после доклада автор объясняет эту идею как обнаружение скрытых интересов: система предлагает то, о желании чего пользователь раньше мог не знать. Для этого свойства используется название Serendipity.
На прямой вопрос о расчёте Serendipity в Лавке автор отвечает, что не воспроизведёт формулу. Он только отмечает её интуитивную близость к Discovery и то, что эти показатели обычно растут вместе с метриками новизны. Это сообщение о связанных наблюдениях, а не определение одной метрики через другую. Числа прироста Serendipity в докладе нет.
Таким образом, здесь есть разные основания говорить о новизне: новая категория для покупателя, новый товар для склада и обнаруженный неочевидный интерес. Их рост поддерживает продуктовую интерпретацию результата, но не позволяет объединить их в один показатель или присвоить всем +1,5% из строки Discovery.
Доклад · 00:25:50Как связали обучение с денежной целью
Последний содержательный вопрос касается аукциона после ранжирования: у товаров разный вклад в GMV, и слушатель спрашивает, пробовали ли учитывать это отдельным механизмом. Автор уточняет, идёт ли речь о рекламе; в разговоре также возникает версия про способ решения оптимизационной задачи. Однозначно установить смысл предложенного аукциона участники не успевают.
Подтверждённая часть ответа — цену уже учитывают в целевой величине обучения. Поскольку в продукте хотят улучшать GMV, в офлайн-обучении стараются моделировать оптимизацию этой денежной метрики. Следовательно, постановка не ограничивается утверждением «любое добавление любого товара одинаково полезно», хотя точный способ ценового учёта не раскрыт.
Из этого нельзя вывести формулу вида «вероятность покупки, умноженная на цену», наличие рекламного аукциона или отдельного денежного переранжирования. Доклад подтверждает учёт цены в обучающей цели, но не реализацию предложенного слушателем механизма. Оставшиеся вопросы ведущий предлагает разобрать текстом; их ответов в записи нет.
Доклад · 00:29:40Что установлено о системе, а что остаётся неизвестным
Публичный доклад Марка Нарусова на Data Fest 2025 посвящён командному внедрению, а не только устройству нейросети. Автор отдельно отмечает работу коллег над обучением трансформера, бустингом и настройкой сервера инференса. Поэтому итог нельзя приписать одному удачному архитектурному элементу: понадобились модель, данные, сервисная интеграция и адаптация финального ранжирования.
Из архитектуры раскрыты содержание товарных признаков, устройство входного события, несколько пользовательских представлений и их использование в бустинге. Однако нет полной конфигурации слоёв, количества CLS, подробных функций потерь или режима обновления весов. Возможность рассчитать представление нового товара не равна гарантии немедленно получить для него качественную выдачу.
Из инфраструктуры известны динамическая таблица YTsaurus, база токенизированных атрибутов в памяти, общий процессинг и цепочка вызовов модели. При этом не описаны полный путь событий, обработка пропусков атрибутов, запасной ответ при недоступности сервисов и точные задержки. Отсутствие обычного ожидания в асинхронной схеме не заменяет измерений времени всей системы.
Наконец, 512 действий — исходный рабочий выбор, а более длинные истории на момент выступления ещё исследовались. Две выкатки показывают, почему обратная связь новой выдачи важна для ранкера, но не раскрывают полный экспериментальный протокол. Сильная сторона кейса — объяснённый путь от устаревающих векторов к работающей связке; его граница — невозможность восстановить из доклада все настройки и независимый вклад каждой из них.
Доклад · 00:00:09Итог: свежая история полезна только в работающей цепочке
Лавка начала с полезного, но запаздывающего решения: представления пользователей и товаров рассчитывались заранее. Переход к свежей истории потребовал не только переноса пользовательской башни в обработку запроса. Команда согласовала подготовку данных, изменила чтение событий, распараллелила вычисления и адаптировала бустинг к новой выдаче. Неудачи с ограничением истории и синхронизацией показали, где модель зависит от окружающего кода.
- 01
Получить контекст
Бэкенд передаёт пользователя, текущую корзину и сведения о предыдущей части выдачи. Сервис начинает получение пользовательских представлений параллельно с подготовкой товаров.
- 02
Прочитать историю
Четыре запроса по типам действий извлекают события из динамической таблицы YTsaurus, не ограничивая всё одним общим LIMIT.
- 03
Подготовить вход
Процессинг обогащает события токенизированными атрибутами из памяти, учитывает приоритеты и формирует тензоры выбранной истории из 512 действий.
- 04
Получить представления
Процессинг сам вызывает пользовательскую башню. Несколько готовых векторов возвращаются через него в сервис рекомендаций.
- 05
Упорядочить и ответить
Сходства с товарными векторами и другие признаки поступают в бустинг. Из ассортимента даркстора формируется очередная порция из двадцати товаров без повторов уже показанного.
Предварительное обучение и дообучение трансформера, а также повторное обучение бустинга происходят отдельно от этих шагов. Офлайн-проверка дала +2% по неназванным метрикам при лаге истории 90 секунд. Первая выкатка показала около +2–3% GMV с рекомендаций к корзине и +1,3% Discovery, но не желаемый значимый рост выручки с поверхности.
После повторного обучения заявлены +6–8% GMV с корзины и +1,5% Discovery. Разные подписи GMV не позволяют складывать эффекты. Полные условия A/B-тестов, точные задержки и формула Serendipity неизвестны; поэтому результат описывает конкретное внедрение, а не обещает такие же проценты для любой рекомендательной системы.
Доклад · 00:03:14