Разбор готов
hh.ru: эволюция рекомендаций от фильтров и DSSM к трансформерам по поведению
Пользователь hh.ru открывает рекомендации из своего резюме и ждёт не просто список «похожих» вакансий, а выдачу, где подходящие позиции не потерялись на раннем фильтре, свежие и проблемные вакансии обработаны осознанно, а система остаётся быстрой при большом каталоге. В ранней схеме эту задачу решали каскадом эвристик, линейных и древесных моделей. Дальше команда добавляла новые источники кандидатов, текстовые представления вакансий и резюме, поведенческие сигналы и последовательностные модели. В этой главе разберём весь путь из презентации: как устроен каскад «Ангары», зачем понадобились LSH, Prefilter, ALS и SASRec, как развивалась DSSM, где появились BERT и multitask-обучение, как в выдачу встроены продуктовые поправки и как изменения проверяют экспериментами.
Материал полезен ML-инженерам и специалистам по рекомендациям, которые строят многоэтапную систему с несколькими источниками кандидатов, текстовыми и поведенческими признаками. Особенно полезны инженерные детали: пороговый отбор вместо фиксированного top-K, продуктовые поправки поверх ранкера, разные решения для каталогов разного масштаба и общий граф признаков для обучения и продакшена.
Слайды · на русском
Эволюция рекомендательной системы hh.ru: от линейной регрессии к трансформерам по тексту и поведениюОткрыть оригинальные слайдыСтанислав Яркин · Опубликовано: 16 мая 2025 г.
От «подходящих вакансий» к системе, влияющей на большую часть откликов
Презентация начинается не с модели, а с продукта. На слайде «Ангара» показан переход из резюме к списку подходящих вакансий: рекомендация должна превратить информацию о соискателе в конкретный набор позиций, на которые имеет смысл откликнуться. Поэтому качество здесь нельзя свести к одной нейросети. Ошибка раннего фильтра способна навсегда убрать хорошую вакансию, а хорошая оценка ранкера не исправит ситуацию, если нужный объект вообще не попал в набор кандидатов.
Масштаб продукта хорошо виден на историческом графике. В 2016 году на слайде подписано 10% откликов из рекомендаций, в 2024 году — 69%. Рядом есть столбец 2025 года, но точной подписи у него нет, поэтому число для 2025-го по высоте столбца не восстанавливаем. Этот рост относится к развитию системы за много лет и не является эффектом одной модели или одного A/B-теста.
Дальше презентация идёт примерно по той же временной линии, по которой усложнялась система: сначала архитектура и A/B-проверки, затем поведенческие сигналы, BERT и трансформеры. Важно читать эту историю как накопление слоёв и инструментов. Новая модель не обязательно заменяет всё предыдущее: иногда она становится дополнительным источником кандидатов, иногда — новым признаком, иногда — отдельной головой общей текстовой модели.
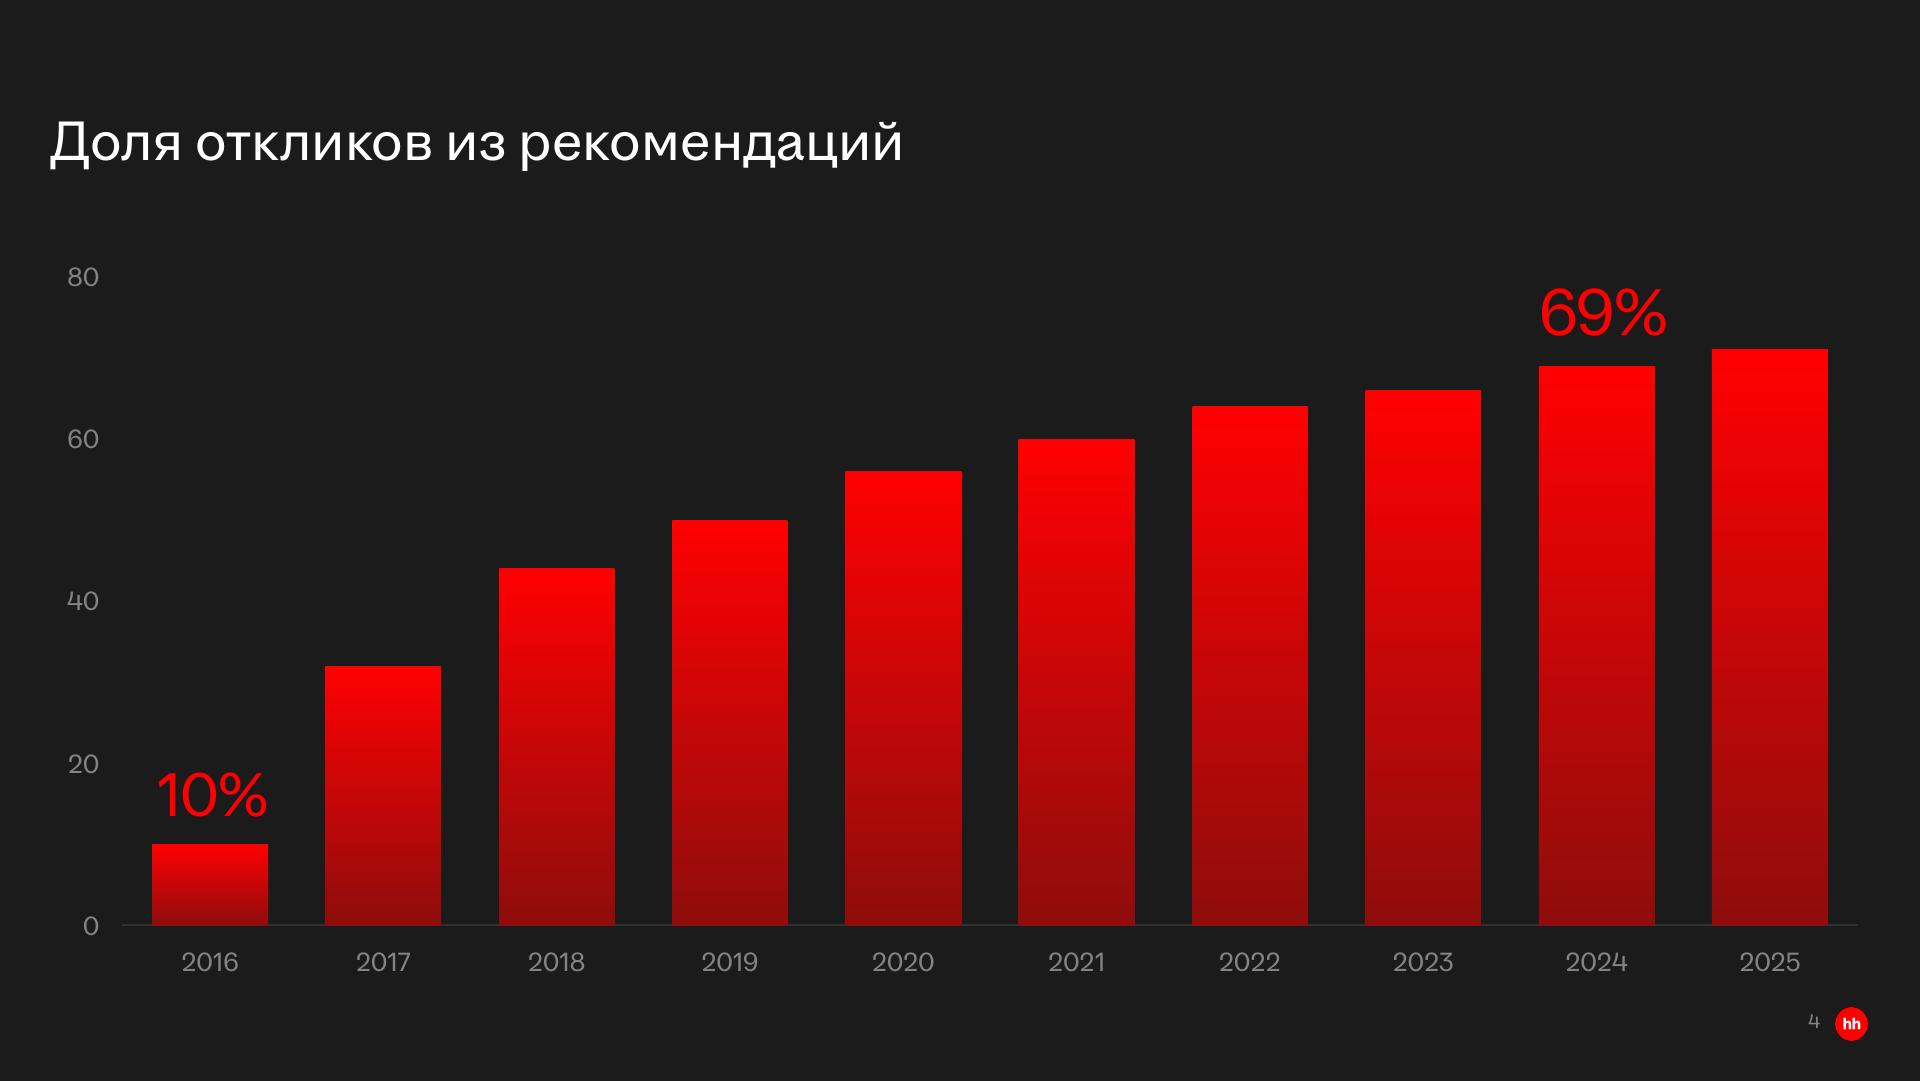
На графике 10% относится к 2016 году, 69% — к 2024-му. Рост доли за годы не является эффектом одной модели или одного A/B-теста.
Источник: Станислав Яркин · hh.ru · слайд 4Каскад: сначала найти кандидатов, потом ранжировать
Базовая архитектура разделена на две крупные части. Первая — отбор кандидатов: из большого каталога нужно быстро оставить вакансии, которые вообще стоит рассматривать. На схеме здесь есть эвристический фильтр, LSH, ANN, Prefilter, линейный и древесный фильтры, а также поведенческие источники ALS и SASRec. Вторая часть — ранжирование уже сокращённого набора: Tree Ranker, затем дополнительные стадии Reranker, Boosting и Blender. Такое разделение объясняет, почему улучшение одной модели не равно улучшению всей выдачи. ANN означает приближённый поиск близких объектов; LSH — хеширование, которое помогает быстрее отбирать похожие объекты. Tree Ranker сортирует кандидатов, Reranker меняет порядок верхней части списка, Boosting применяет поправки, Blender смешивает выдачи.
У фильтров сразу несколько целей. Полнота означает не потерять интересные вакансии; точность — убрать явно нерелевантные; третья задача — удерживать вычислительную нагрузку. На слайде линейному фильтру отведена более грубая работа: удалить самое нерелевантное. Древесный фильтр делает более точный матч. Для этого этапа автор указывает оптимизацию mauc по откликам.
Порог фильтра выбирают через компромисс между полнотой и размером очереди, которая пойдёт дальше по каскаду. Чем мягче порог, тем больше подходящих вакансий сохраняется, но тем выше последующая нагрузка. В таблице показаны пять вариантов конкретного подбора; параметры справа на слайде — снимок конфигурации, а не универсальные значения для любого сегмента.
LSH в этой системе показан как простой способ ускорить работу, особенно рядом с инвертированным индексом. Автор сообщает примерно о 10% уменьшения загрузки процессора и примерно о 20% уменьшения времени ответа. На слайде не указаны исходная нагрузка, железо, конкретный перцентиль задержки или методика замера, поэтому эти проценты нельзя переносить на другую систему.
Отдельный инженерный выбор — ANN против Prefilter. Здесь Prefilter прямо определён как полный перебор с заданным порогом: объект проходит, если его оценка достаточно высока. Фиксированный top-K команде не подходит, потому что вакансии живут в разных микрорынках: где-то подходящих объектов много, где-то мало. Одинаковое K в таком случае либо обрежет насыщенный рынок, либо заставит брать слабые варианты в узком. Поэтому пороговый отбор лучше согласуется с неодинаковой плотностью каталогов.
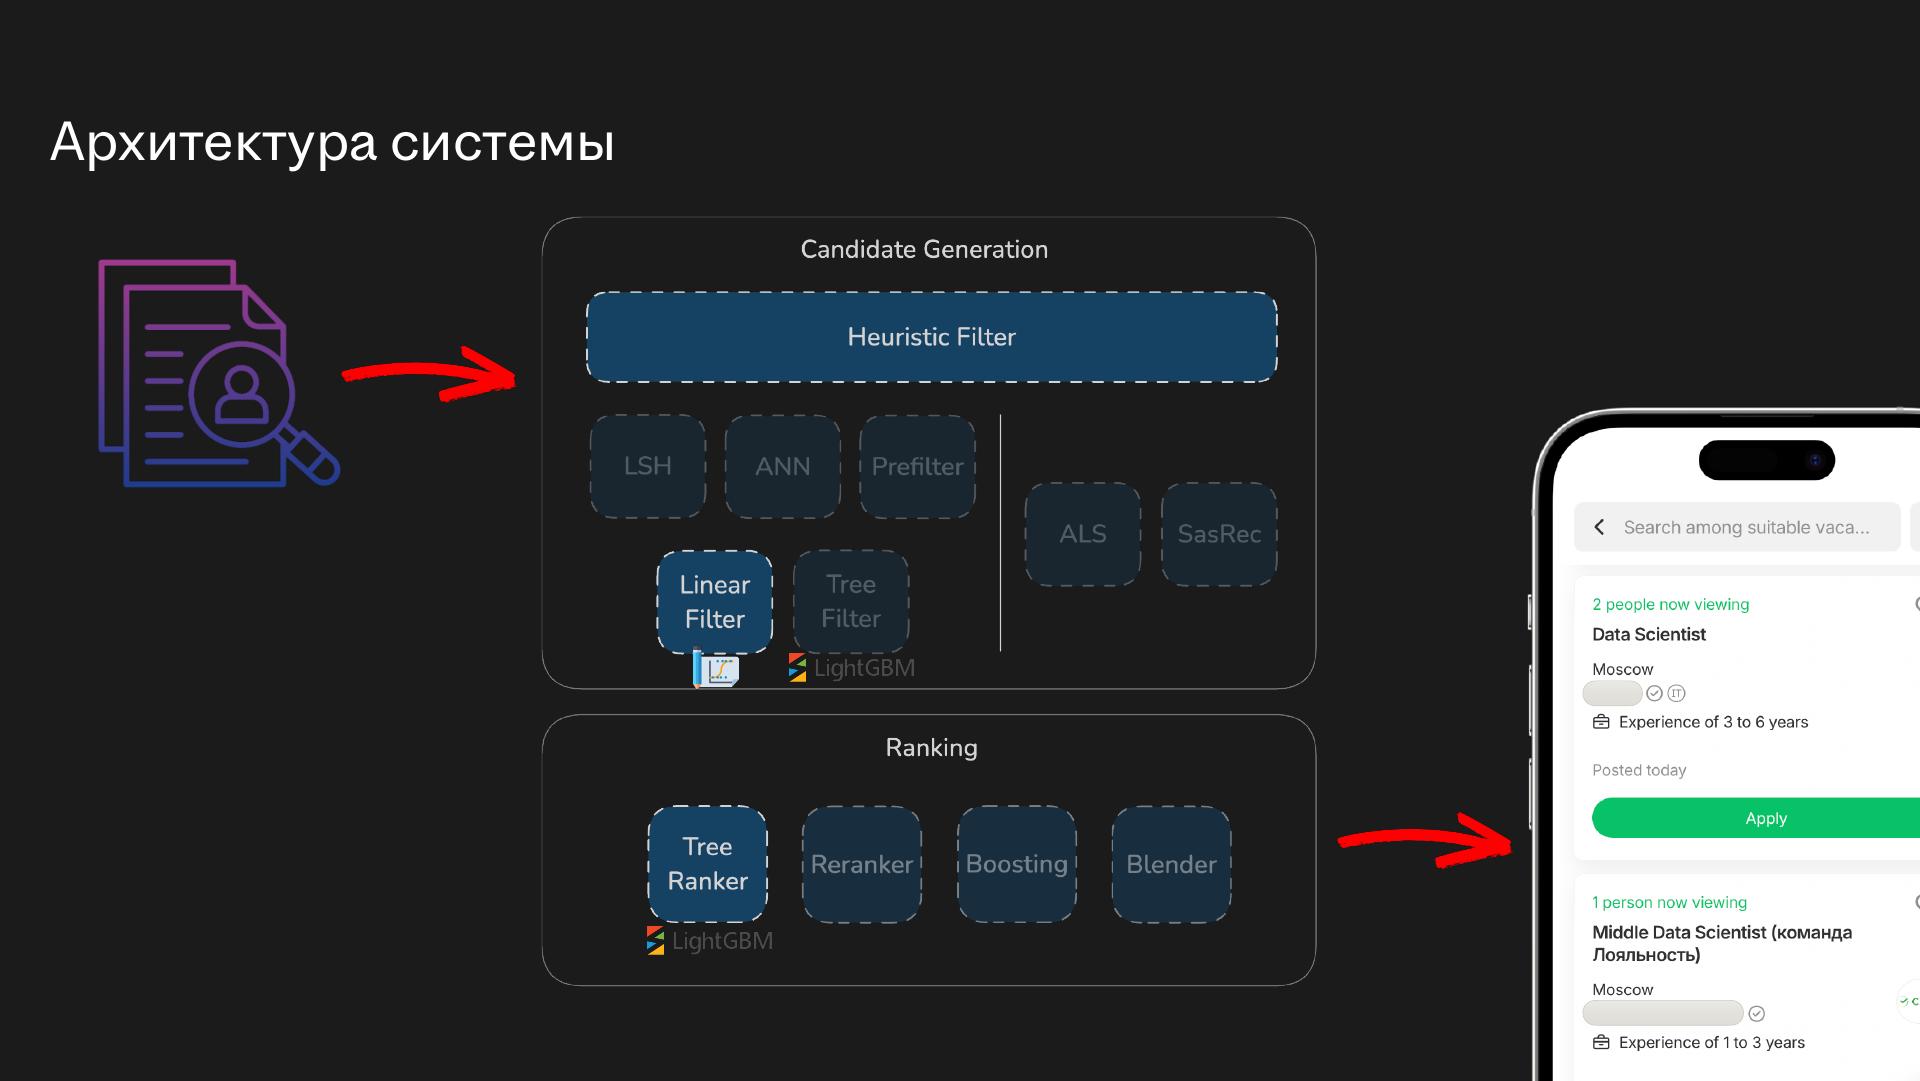
Разные способы отбора кандидатов и фильтры предшествуют ранжированию. На схеме выделены линейный фильтр и LightGBM; затем рассматриваются другие части каскада.
Источник: Станислав Яркин · hh.ru · слайд 7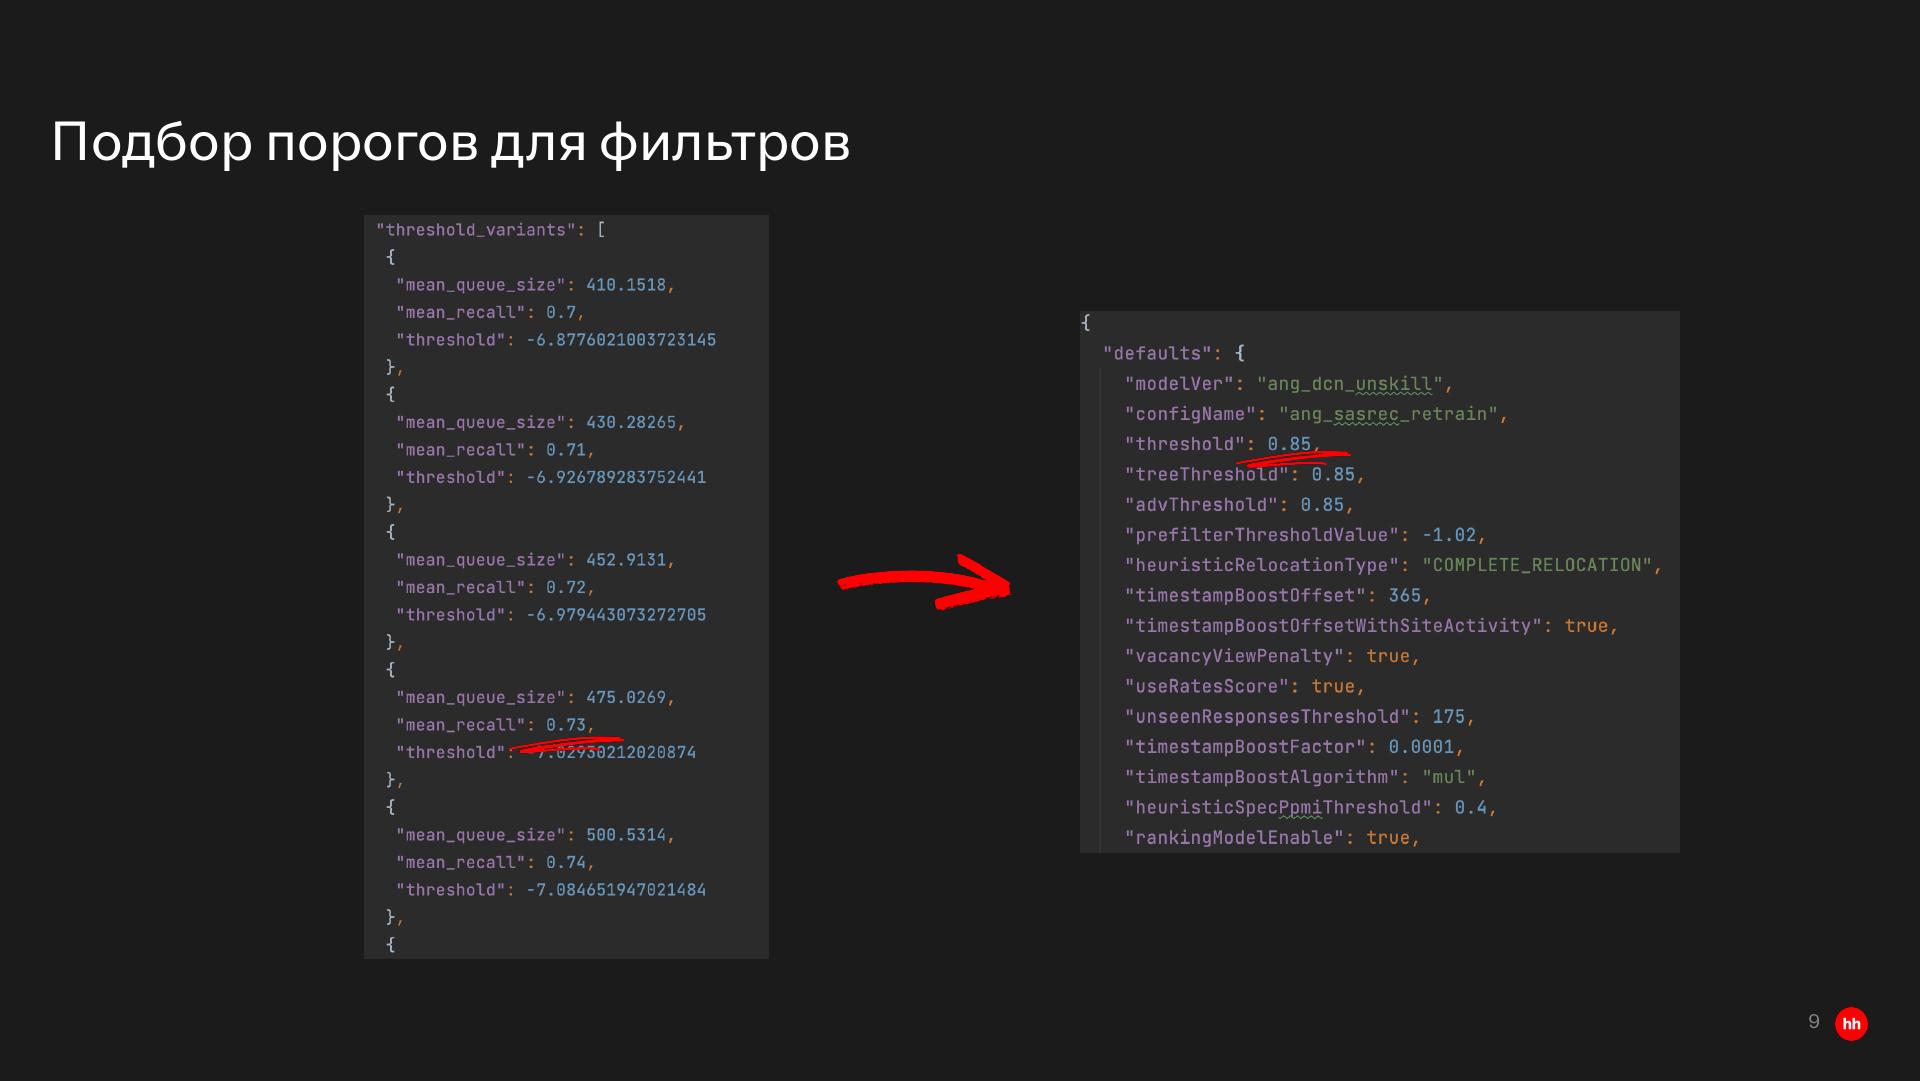
Показаны варианты компромисса между средним размером очереди и recall. Числа конфигурации — пример, не универсальные пороги для любого микрорынка.
Источник: Станислав Яркин · hh.ru · слайд 9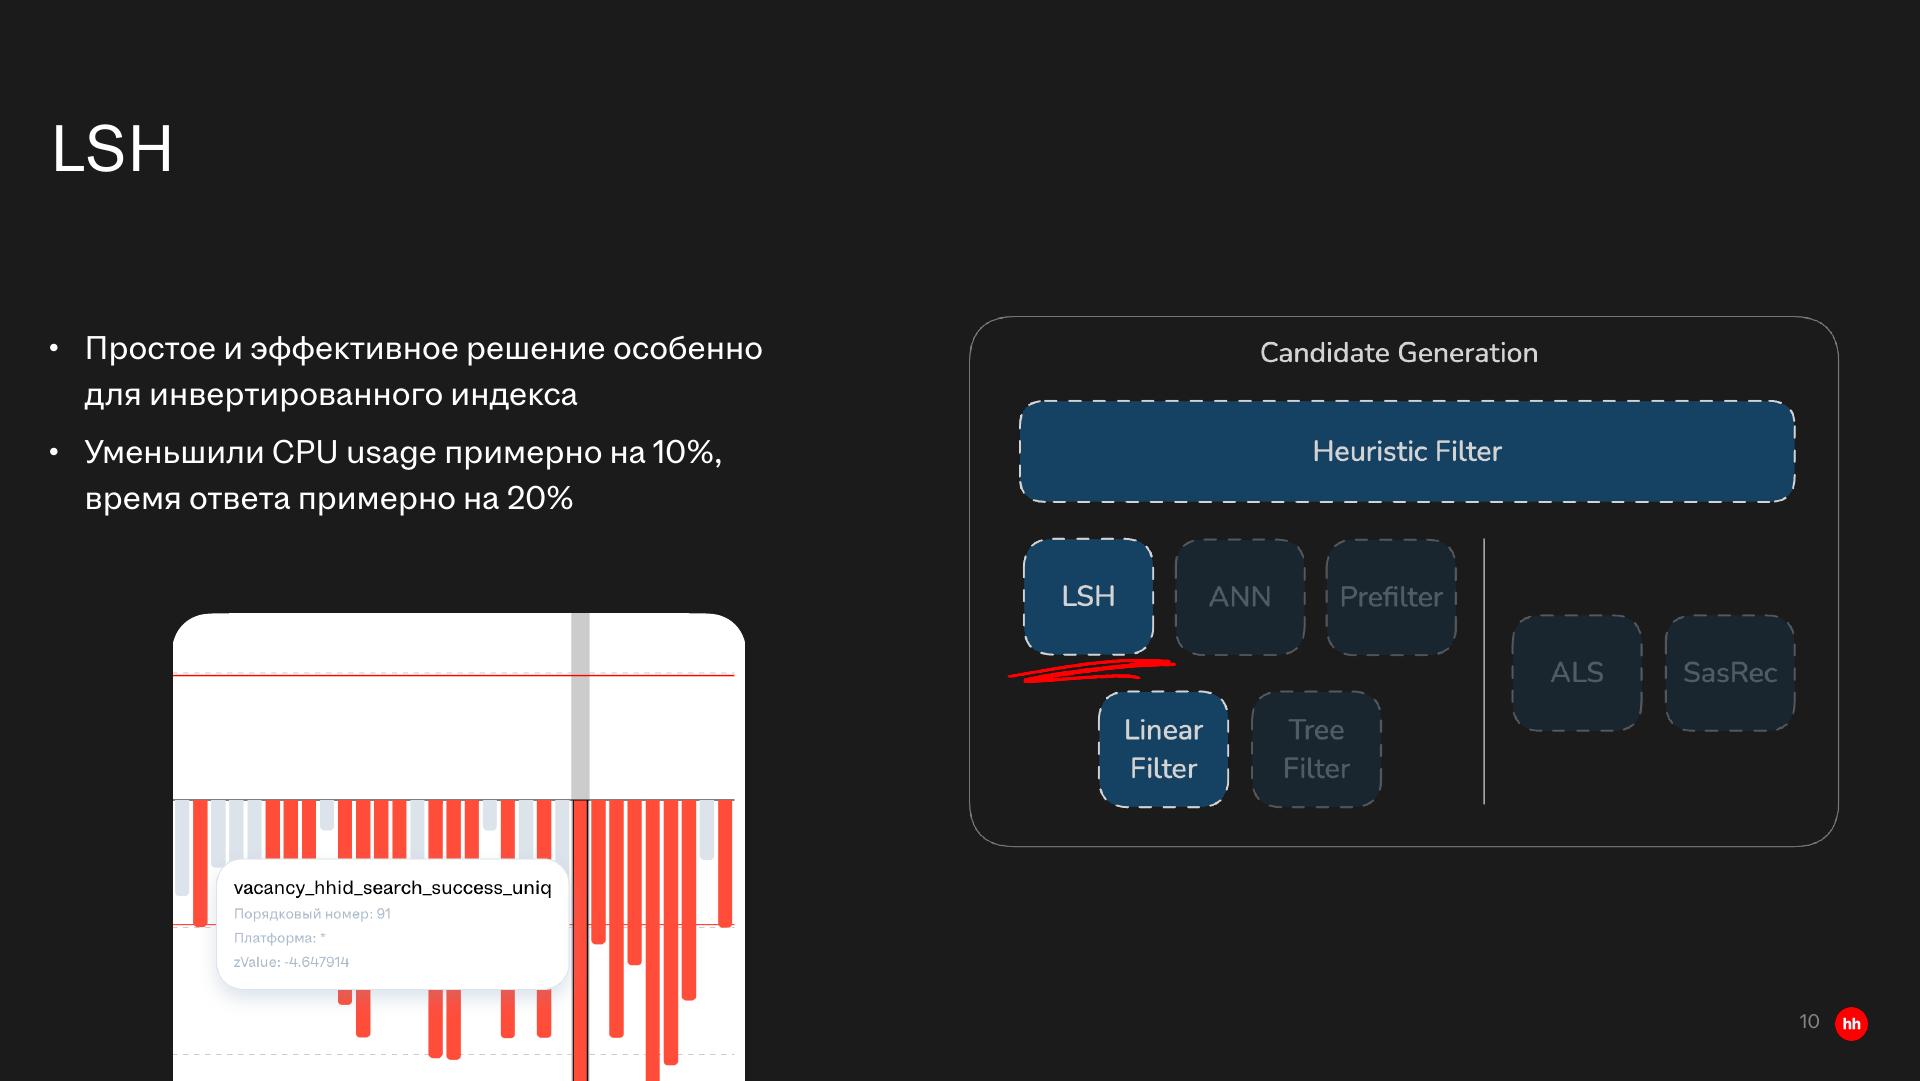
Автор сообщает уменьшение CPU usage примерно на 10%, времени ответа — примерно на 20%. База, нагрузка и перцентиль задержки на слайде не раскрыты.
Источник: Станислав Яркин · hh.ru · слайд 10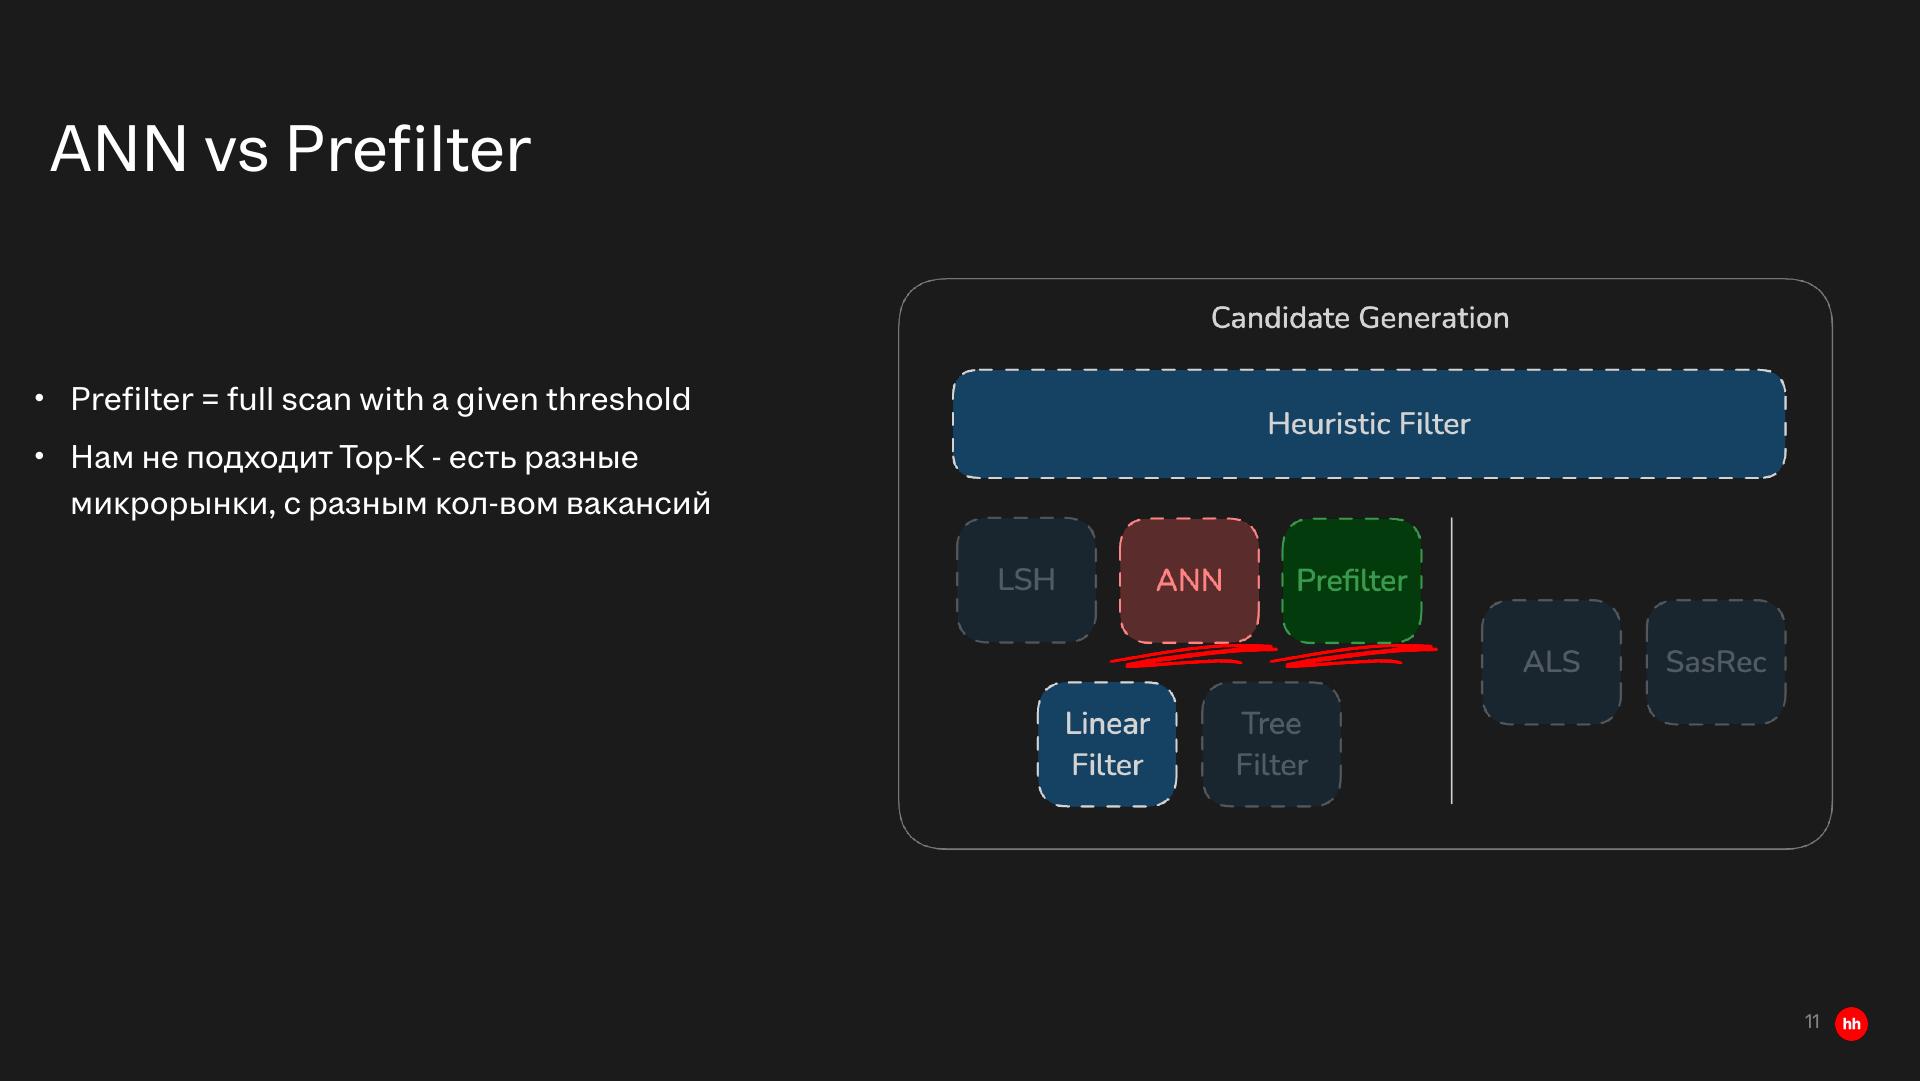
Prefilter описан как full scan with a given threshold. Разные микрорынки имеют разное количество вакансий.
Источник: Станислав Яркин · hh.ru · слайд 11Поведение входит в отбор кандидатов: ALS, SASRec и пулы
Поведенческие модели появились на стороне фильтров не сразу. Причина, указанная на слайде, продуктовая: исторически в сервисе было много «белых воротничков» с хорошо заполненными резюме, поэтому содержательных признаков долго хватало для разумного отбора. Когда бизнес и аудитория начали меняться, пришлось адаптировать модели, включая фильтры. Дополнительная сложность hh.ru — у одного пользователя может быть несколько резюме, то есть один аккаунт не сводится к одному профилю интересов.
К классическим каналам добавляются ALS — модель по истории взаимодействий — и SASRec, которая учитывает их последовательность. Здесь важно не воспринимать их как единственный новый ранкер. По архитектурной схеме это дополнительные способы получить кандидатов наряду с фильтрами и другими моделями отбора кандидатов. Позже презентация отдельно покажет, что SASRec действительно оказался особенно полезен именно как дополнительный источник кандидатов.
Следующий шаг — управлять не одной общей массой вакансий, а пулами. На схеме приведены примеры: вакансии с малым числом откликов (LPV), новые вакансии и весь каталог. Разные модели отбора кандидатов могут работать с разными пулами; у каналов отбора свои настройки и гиперпараметры; набор каналов может зависеть от группы пользователя. В примерах групп названы белые воротнички, синие воротнички и студенты. Это превращает отбор кандидатов из одной формулы в конфигурируемый слой.
Следующий слайд показывает уже конфигурационный фрагмент с типами пулов, моделями отбора кандидатов, квотами и порогами. Он важен как доказательство того, что архитектура действительно допускает разные каналы и настройки, но конкретные числа на этом снимке — параметры отдельной конфигурации. Их нельзя выдавать за универсальный рецепт, например как фиксированную квоту для любого сегмента.
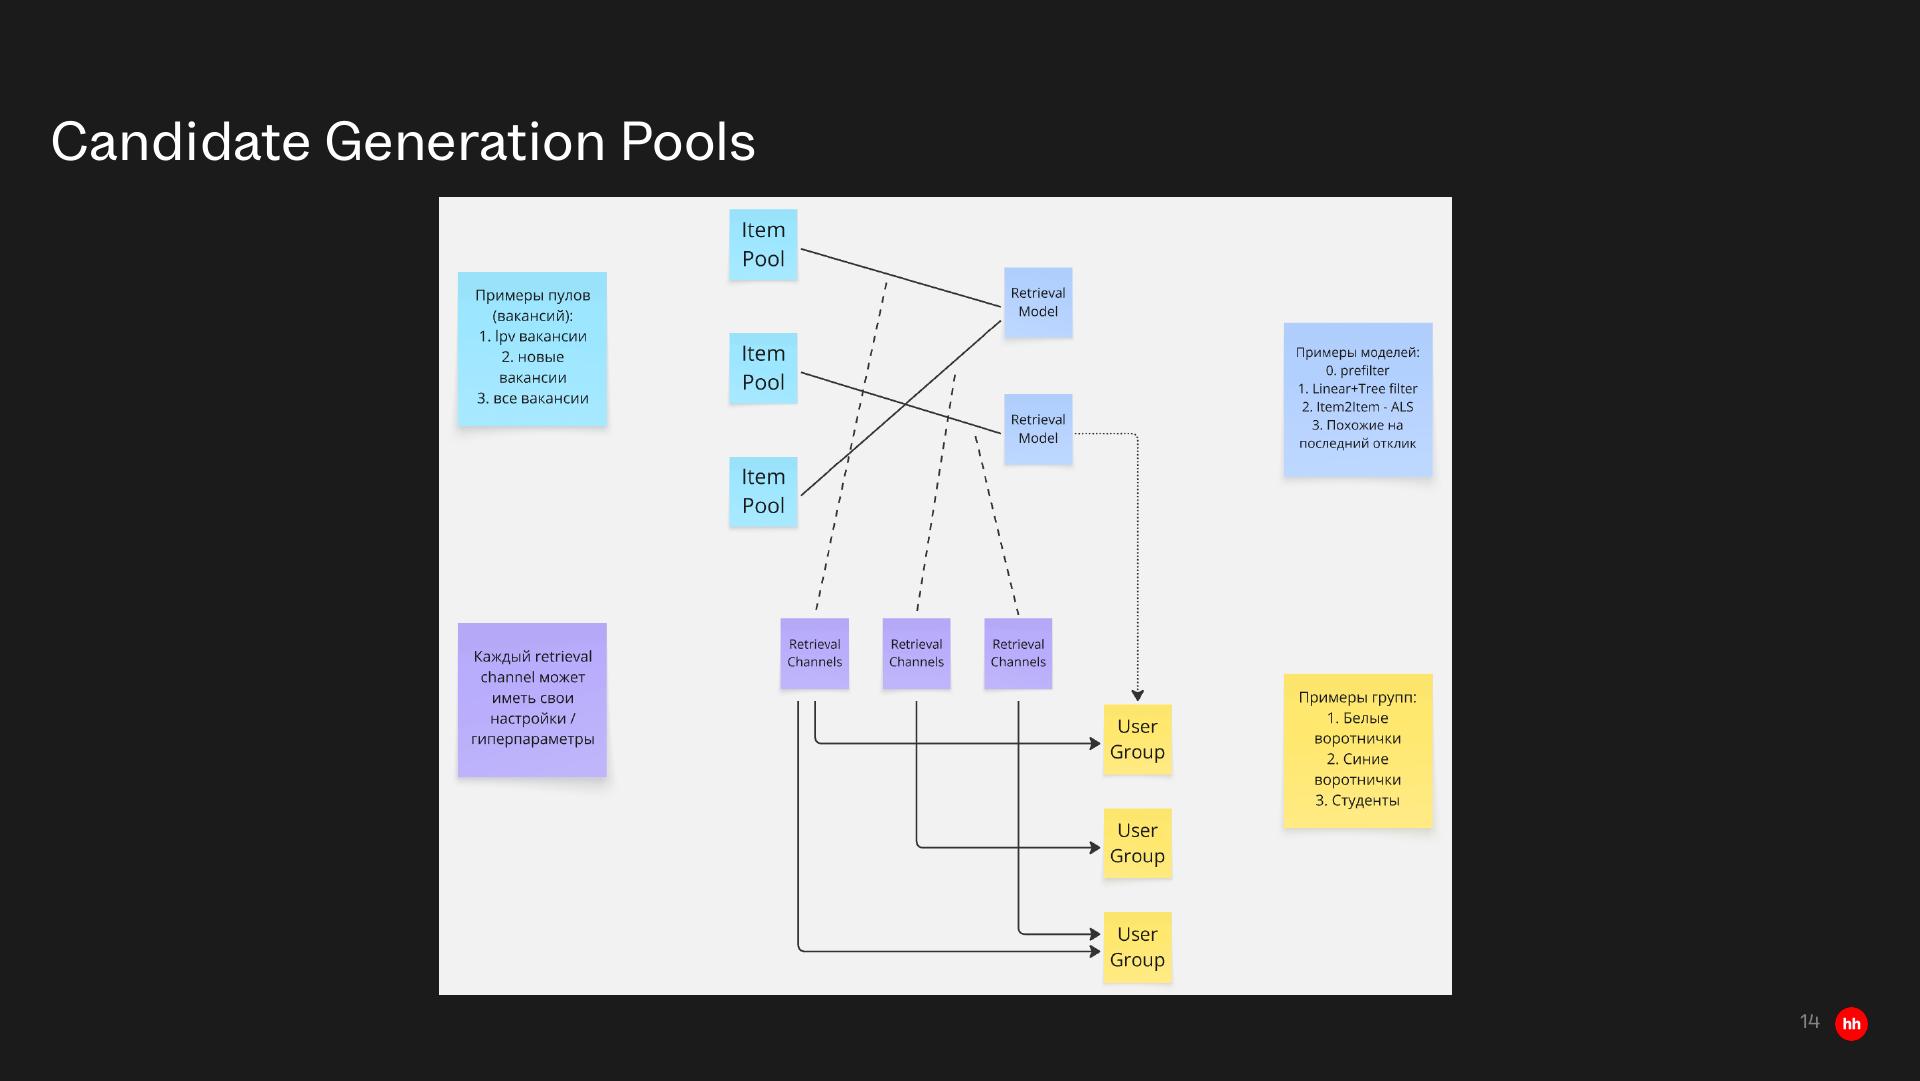
Отдельные пулы новых и LPV-вакансий сочетаются с каналами отбора и настройками для групп пользователей.
Источник: Станислав Яркин · hh.ru · слайд 14После ранкера остаются продуктовые задачи: boosting, LPV и ликвидность
На стадии ранжирования система уже работает с подготовленным набором кандидатов. Презентация подчёркивает, что основное усложнение ранжирующей модели происходило через добавление признаков, а не через постоянную замену самой модели. Нейросетевую функцию ранжирования пробовали, но локального прироста качества не увидели. На этом этапе автор указывает NDCG как оптимизируемую метрику.
Но итоговая выдача должна решать больше, чем задача сортировки по релевантности. В презентации перечислены отдельные продуктовые цели: поднять новые вакансии, опустить вакансии, по которым работодатель не разбирает отклики, удалить дубли и управлять другими ограничениями. Для таких изменений используется переранжирование уже верхней части списка. Автор отдельно предупреждает: правила стоит изначально держать под контролем и оформлять через понятную логику и общий фреймворк, иначе набор поправок быстро становится неуправляемым.
На примере видно, как поверх исходной оценки ранкера накладываются дополнительные преобразования. В одном показанном примере original score равен −0.96469206, после sigmoid — 0.25449282, временной коэффициент — 0.97962385, а результирующая оценка — 0.24930723. Там же фигурируют штраф за непросмотренные отклики и boostFactor из настроек. Это трассировка одного расчёта и иллюстрация механизма поправок, а не доказательство того, что sigmoid откалиброван как вероятность.
Отдельная продуктовая проблема — LPV, Low Performance Vacancy. В презентации LPV определяется конкретно: меньше пяти откликов за первую неделю жизни вакансии. На следующем слайде показана формула скидки и сравнение нескольких вариантов параметров. Смысл такой поправки — не просто максимизировать текущий скор, а управлять тем, какие вакансии получают шанс на показ.
lpv_discount = self.alpha * mean_pred * (1 - lpv_count / (k + 1) / self.beta)
if self.pos_bias:
    lpv_discount *= (1 - self.pos_biases[k])
best_lpv_pred += lpv_discount
Фрагмент выше — пример реализации из презентации. Слайд сравнивает несколько комбинаций параметров alpha, beta, keep и pos-bias, но не объявляет одну универсально лучшей конфигурацией. Поэтому безопасный вывод здесь не «ставить такой коэффициент», а сам принцип: вклад LPV регулируется отдельной управляемой поправкой и проверяется на данных.
На уровне всего каталога проблема формулируется как ликвидность: 20% вакансий получают 80% откликов, при этом доля LPV растёт. В Blender предлагается резервировать позиции под pre-LPV — вакансии, которые, вероятно, станут LPV. Отдельные места в выдаче делают вмешательство наблюдаемым: можно понять, что происходило именно с продвигаемыми вакансиями, и не смешивать эту бизнес-цель с исходной оценкой ранкера.
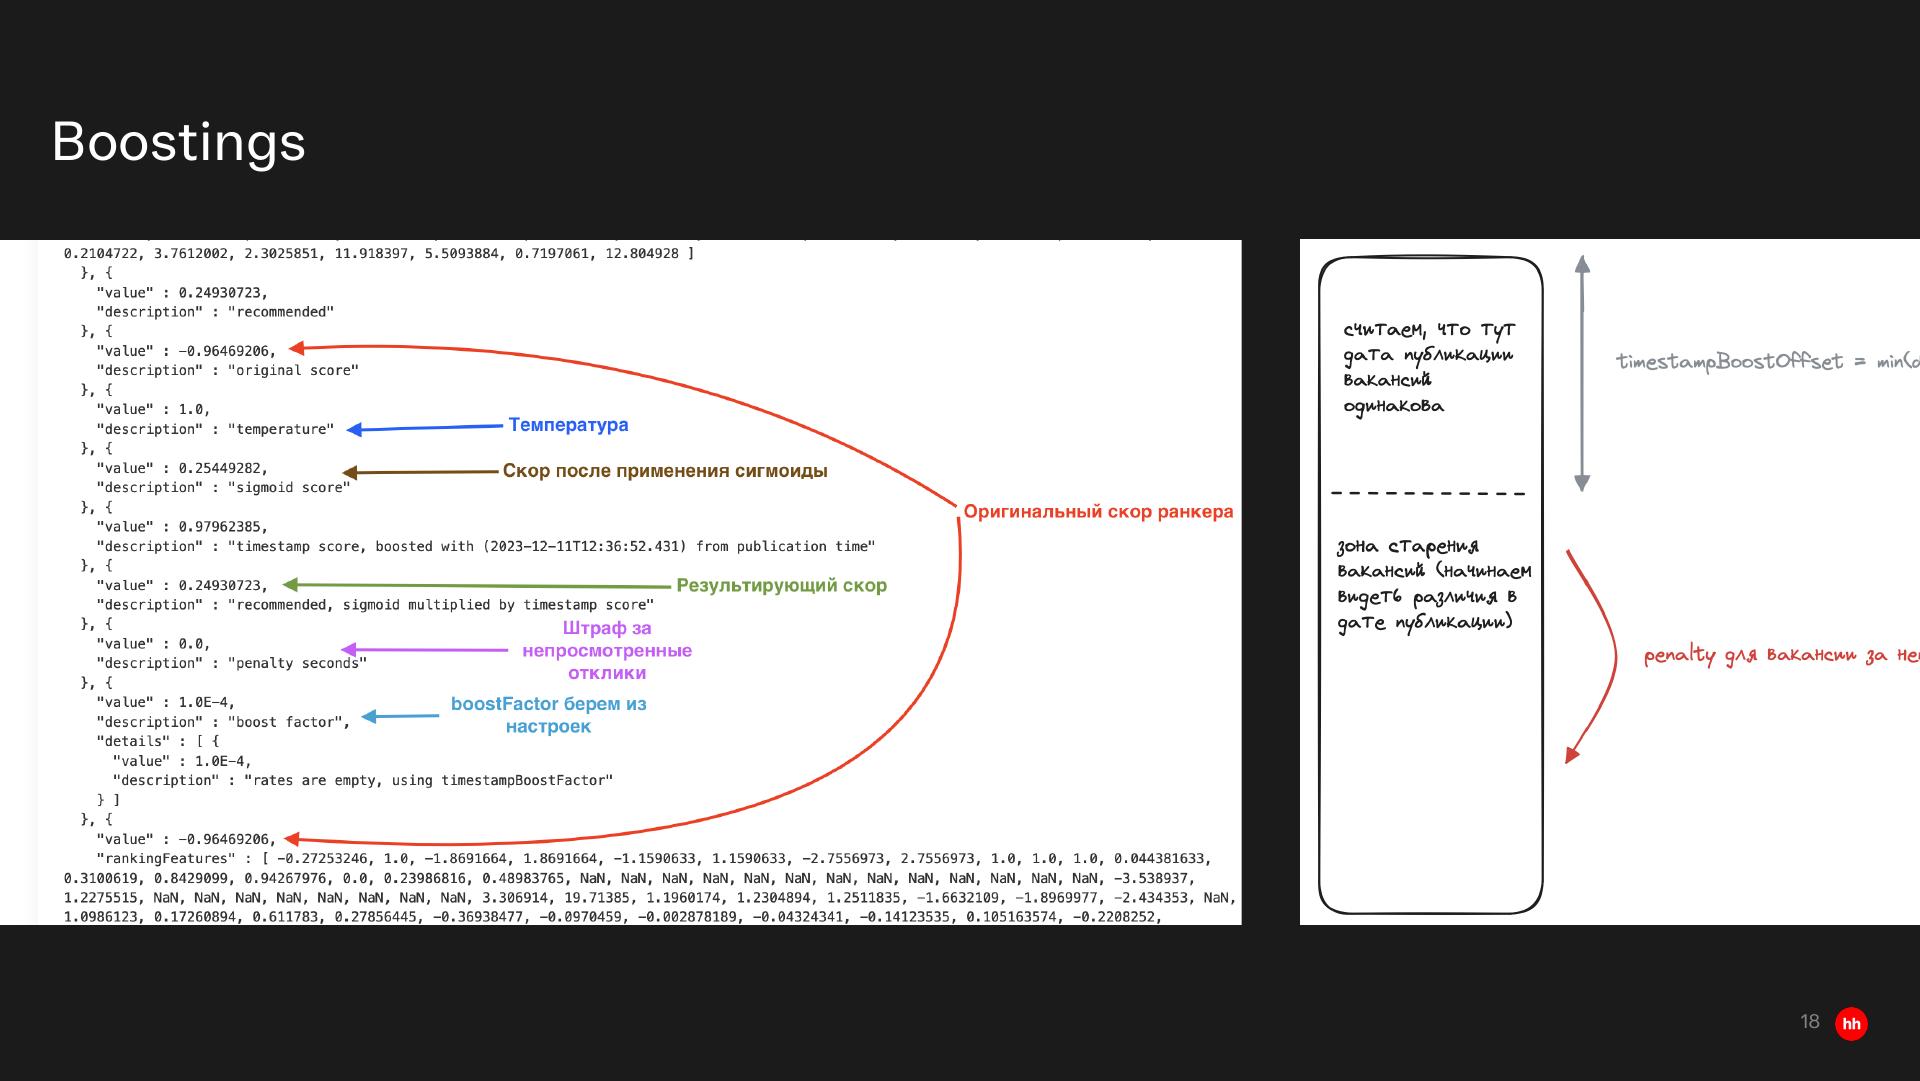
Показаны original score, температура, sigmoid, временной коэффициент и итоговый скор. Частные значения — иллюстрация расчёта, не доказательство вероятностной калибровки.
Источник: Станислав Яркин · hh.ru · слайд 18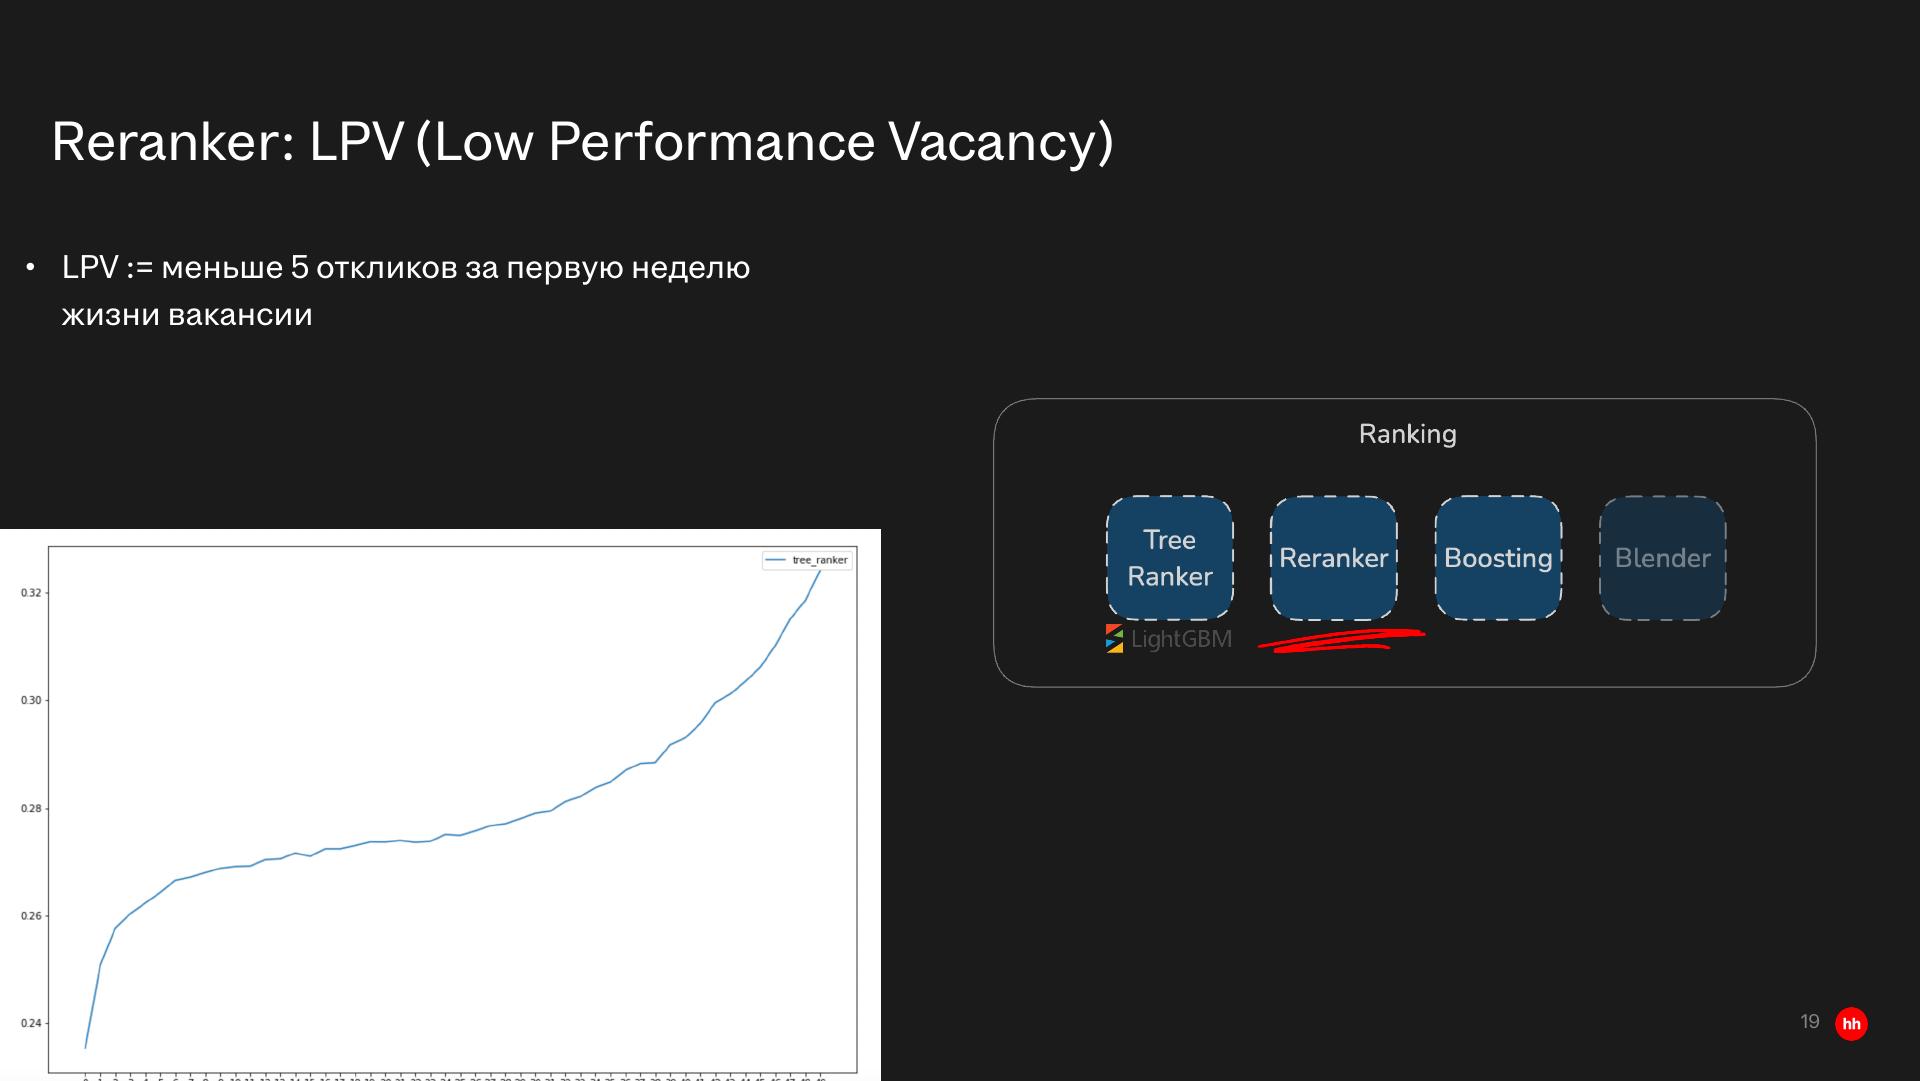
LPV — меньше пяти откликов за первую неделю вакансии. Это продуктовый критерий, отдельный от NDCG.
Источник: Станислав Яркин · hh.ru · слайд 19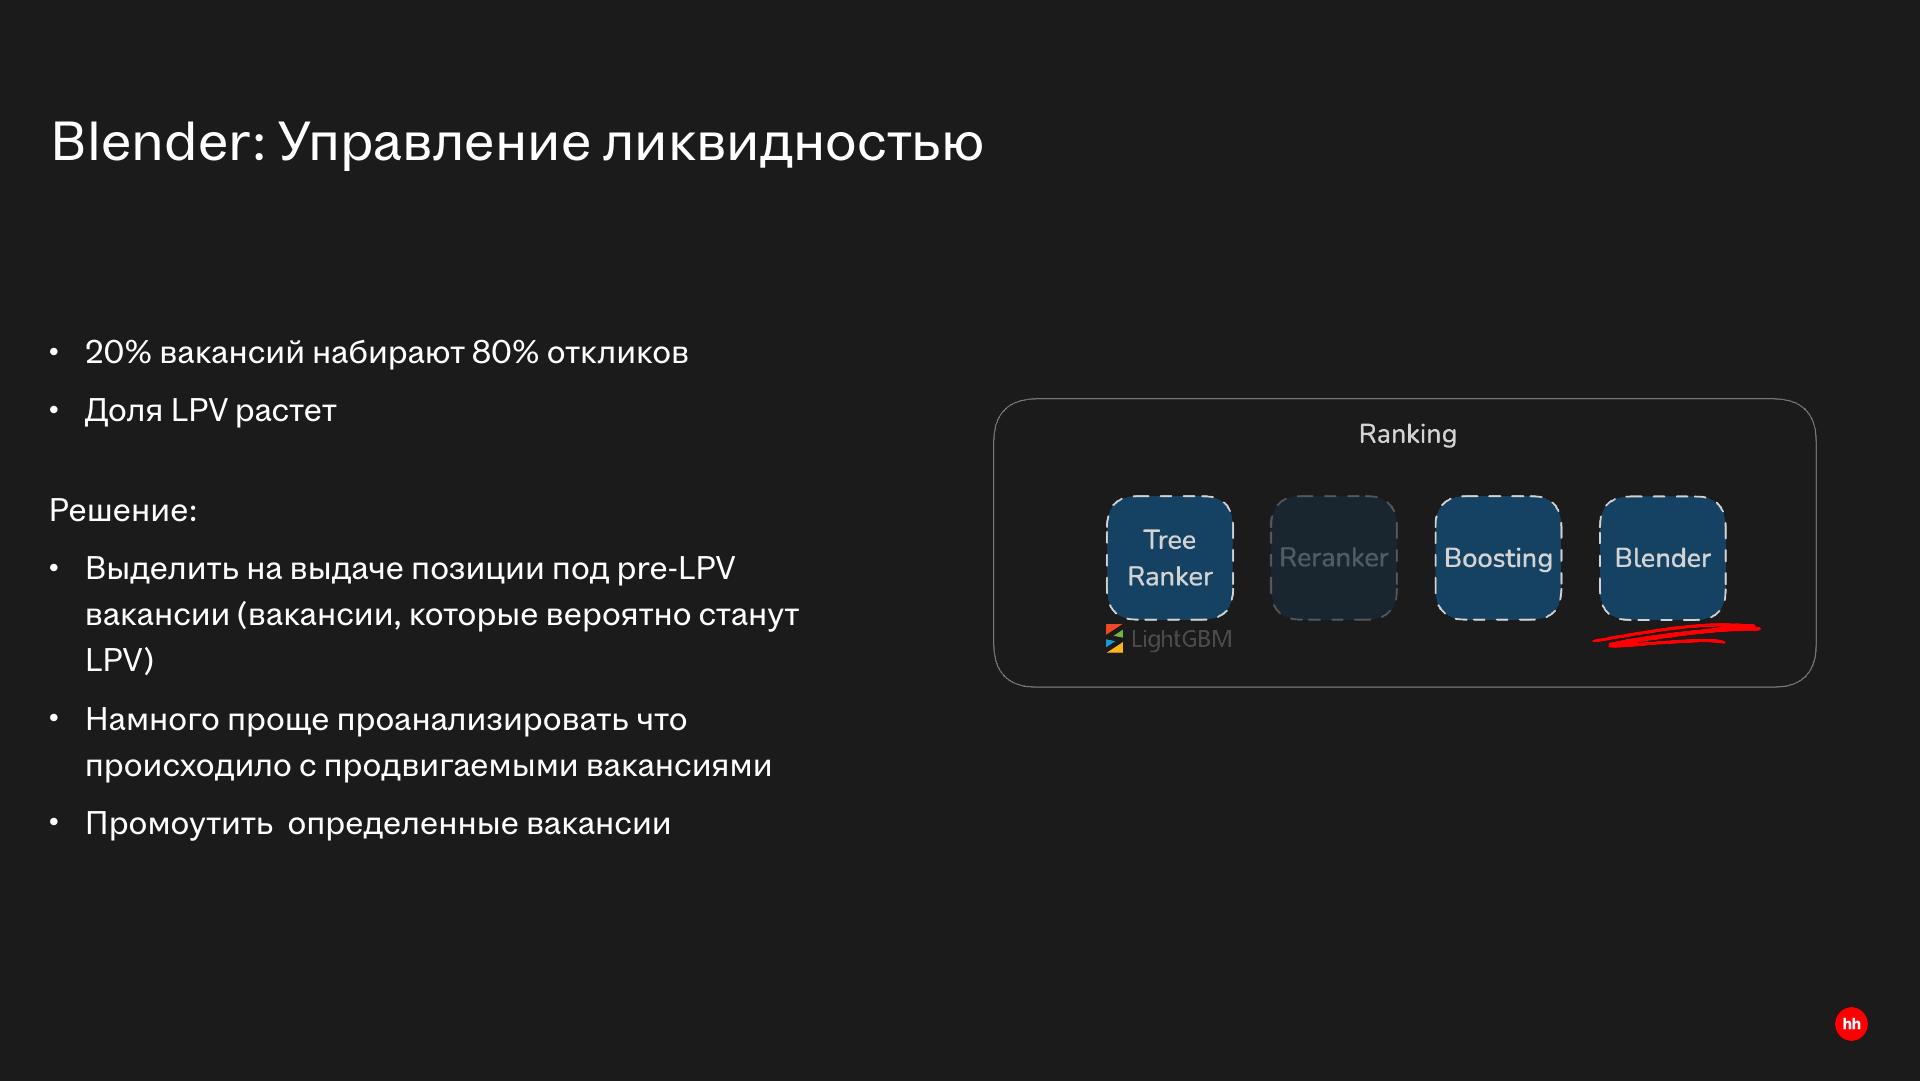
20% вакансий получают 80% откликов; для потенциальных pre-LPV выделяют позиции в выдаче. Период этого наблюдения не указан.
Источник: Станислав Яркин · hh.ru · слайд 21DSSM v1: единое пространство вакансий и резюме
Следующая линия развития — научиться сравнивать вакансию и резюме не только по вручную подготовленным признакам, а через общие векторные представления — эмбеддинги, наборы чисел, которыми модель описывает содержание. DSSM в этой презентации строит по одному вектору для вакансии и резюме, после чего их совместимость оценивается скалярным произведением и сигмоидой, переводящей числовую оценку в диапазон от нуля до единицы. Такая схема удобна тем, что дорогую часть представления каждой стороны можно использовать повторно в разных задачах.
Первая версия DSSM сочетает текст и структурированные поля. Из Title / Description берутся только первые 300 токенов, текст проходит через рекуррентную сеть (RNN) и механизм внимания (attention), выделяющий важные фрагменты и даёт представление размерности 256. Категориальные признаки — area, employment, work_experience, work_schedule, specializations, prof_area — кодируются отдельно; на схеме их объединение имеет размер 156, затем сжимается до 128. Вместе с числовыми зарплатными признаками всё собирается в вектор 387, проходит Dense 256 и Dense 128. Итоговый вектор каждой стороны имеет размер 128.
Следующий слайд показывает визуализацию attention для DSSM и отдельной salary-задачи. Один и тот же текст подсвечивается по-разному: для разных целевых задач полезны разные фрагменты. Этот рисунок помогает понять мотивацию дальнейшего перехода к более общим текстовым представлениям и нескольким головам, но сам по себе не является количественной оценкой качества внимания.
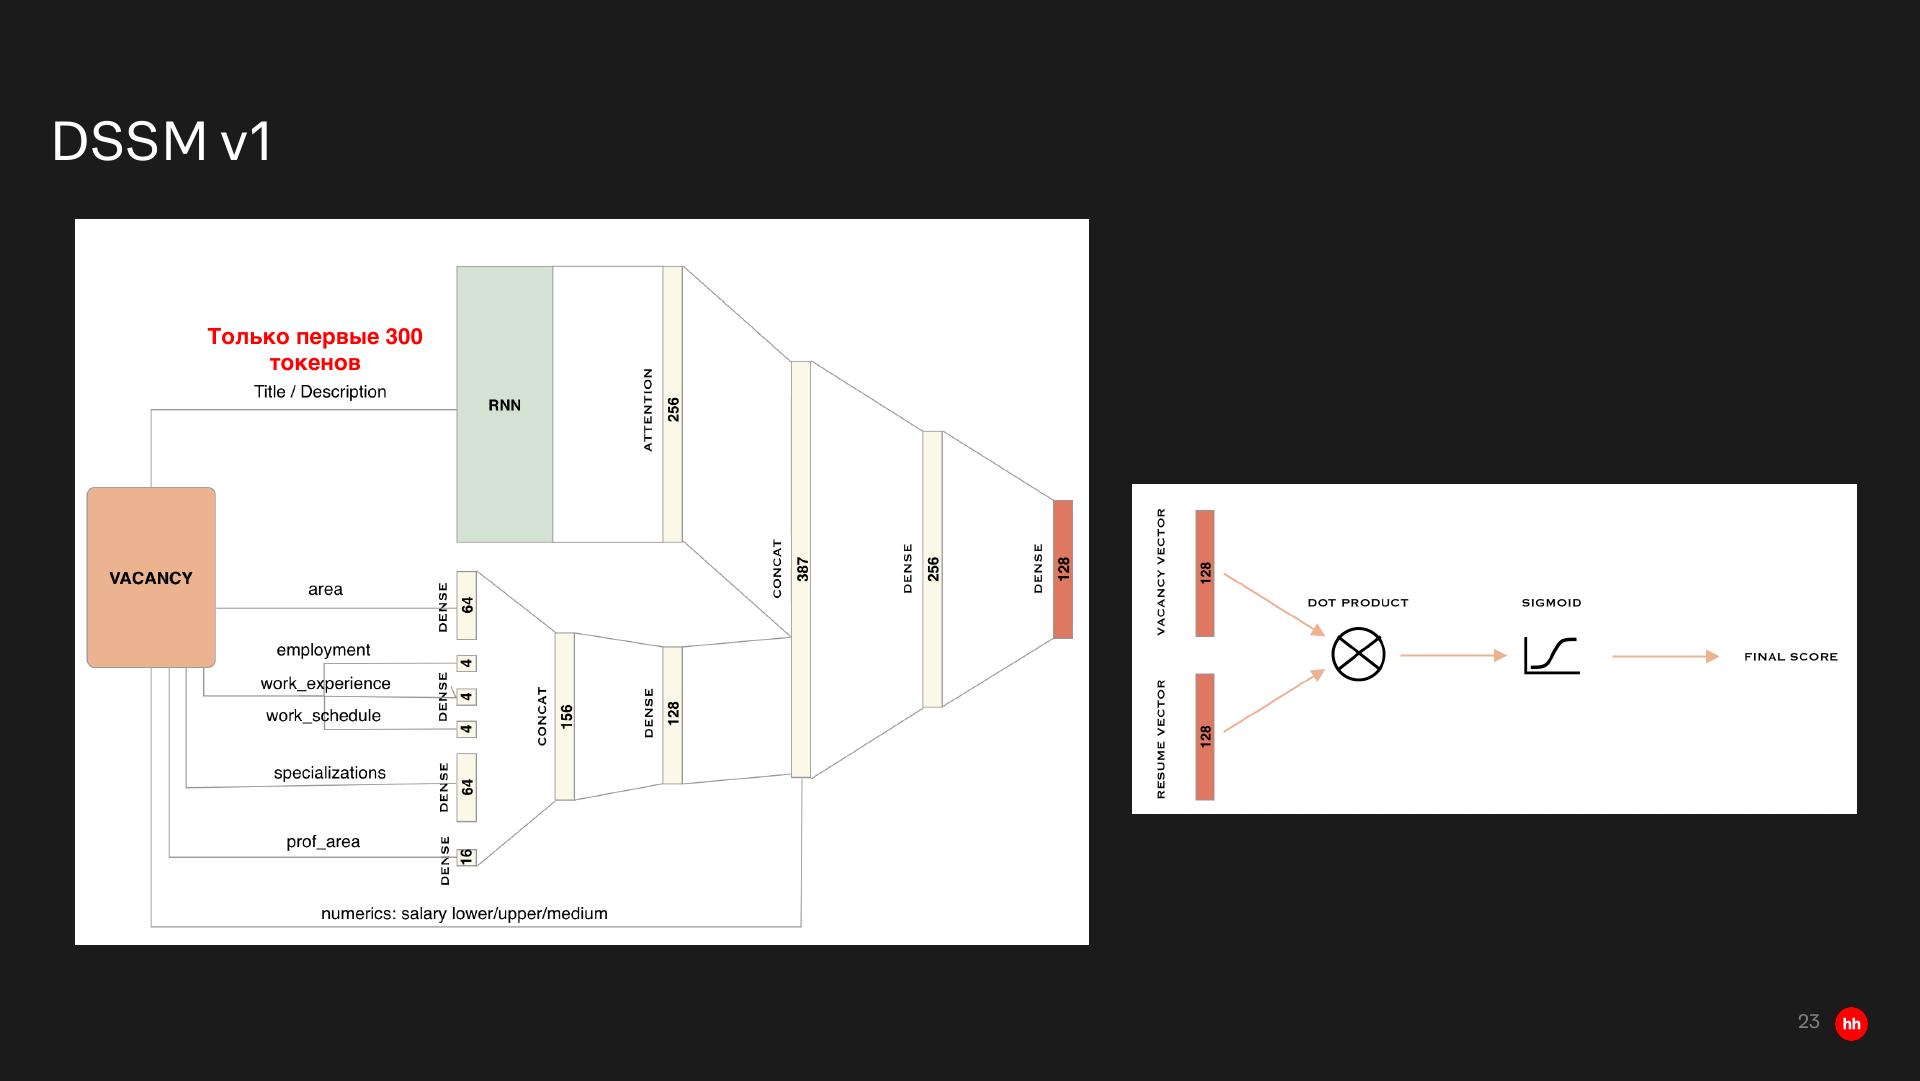
Текст: первые 300 токенов, RNN с attention. Контент и структурированные признаки дают вектор128; скалярное произведение векторов вакансии и резюме проходит через sigmoid.
Источник: Станислав Яркин · hh.ru · слайд 23От RNN к BERT: общая текстовая модель, взаимодействия признаков и несколько задач
В ветке текстового трансформера BERT команда не ограничилась стандартным fine-tuning готовой модели. На слайде зафиксированы четыре решения и наблюдения: своя токенизация дала меньшую модель и лучшее качество, чем вариант с fine-tuning; для вакансий и резюме использовали одну общую сеть, а раздельные сети работали хуже; для предварительного обучения упомянуты MLM и ELECTRA; отдельные Segment Embeddings для сегментов текста тоже пробовали, но получили хуже. Численных абляций этих сравнений презентация не даёт, поэтому можно сохранить только направление результата.
В показанной архитектуре текстовая сеть даёт представление, которое объединяется с категориальными признаками и дальше используется несколькими задачами. Это продолжает идею DSSM: текст и структура вакансии не живут в разных независимых системах, а становятся общей основой, которую можно переиспользовать.
Два слайда Summarization показывают попытку сокращать длинный текст до более содержательных частей и отдельно — списки позитивных и негативных токенов для вакансий и резюме. По презентации нельзя заключить, что это генеративная LLM-суммаризация: алгоритм, модель генерации и отдельный A/B-эффект не раскрыты. Поэтому здесь корректно говорить только о ветке сокращённого текстового представления и анализе того, какие токены оказываются полезными или вредными.
Дальше в модель добавляют Deep & Cross Network v2. Слева вставлена внешняя схема DCN-V2 из статьи, справа показано место блока взаимодействия inter в архитектуре hh.ru. Это не собственный benchmark hh.ru против DCN-V2: левая часть объясняет механизм, правая — интеграцию идеи в модель.
Формула показана в подписи внешней схемы DCN-V2. Она объясняет cross-слой; презентация не приводит отдельной численной оценки эффекта этого блока в hh.ru. x₀ — исходный набор признаков, xₗ — текущий; Wₗ и bₗ — обучаемые параметры, ⊙ — умножение координат.
Далее архитектура развивается в многозадачное обучение. Общая текстовая часть и общие представления категорий питают разные ветви взаимодействия признаков: одна ведёт к прогнозу зарплаты, другая — к DSSM-представлению. Смысл не в том, что все задачи имеют один выход, а в том, что дорогие энкодеры можно обучать и использовать совместно, оставляя отдельные головы под разные цели.
ArcFace добавляется для задачи «похожая вакансия на вакансию». На слайде необычная постановка описана прямо: в качестве классов используют пользователей, откликнувшихся на вакансию. Эта стадия обучается отдельно; энкодеры текста и категорий общие с основной DSSM, а слои взаимодействия признаков разные. Автор пишет, что стадия занимает мало времени на обучение и даёт хороший прирост качества, но численного значения этого прироста на слайде нет.
К концу этого блока DSSM уже выступает не одной моделью для одного списка, а базовой технологией. В презентации перечислены query2vacancy, query2resume, vacancy2vacancy, resume2resume, персонализированный поиск по вакансиям и резюме, а также ctr_nn, salary_nn, uplift, unskilled и сторонние продукты. Это важный архитектурный итог: вложение в общий текстовый энкодер окупается тем, что его представления начинают обслуживать несколько задач.
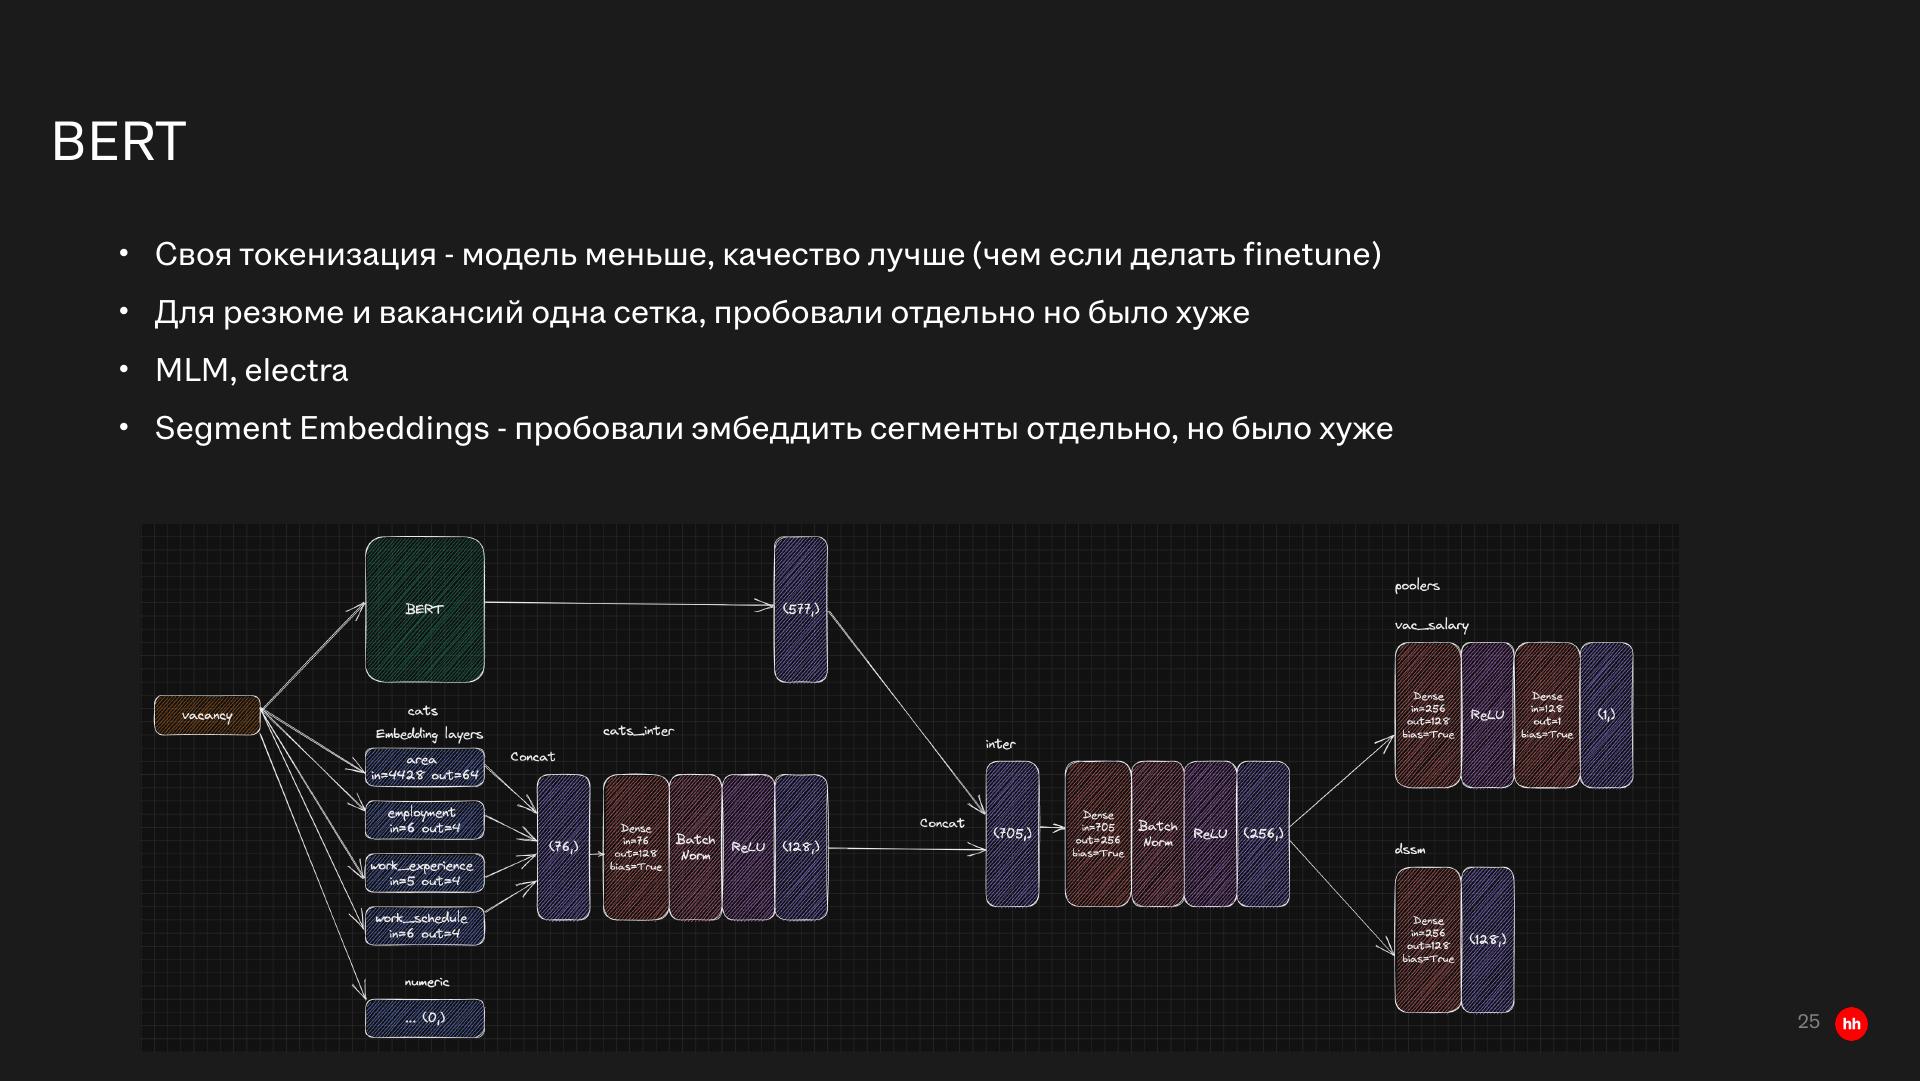
Собственная токенизация и общая сеть для резюме и вакансий. Раздельные сети и отдельное кодирование сегментов по словам автора работали хуже; численная абляция не дана.
Источник: Станислав Яркин · hh.ru · слайд 25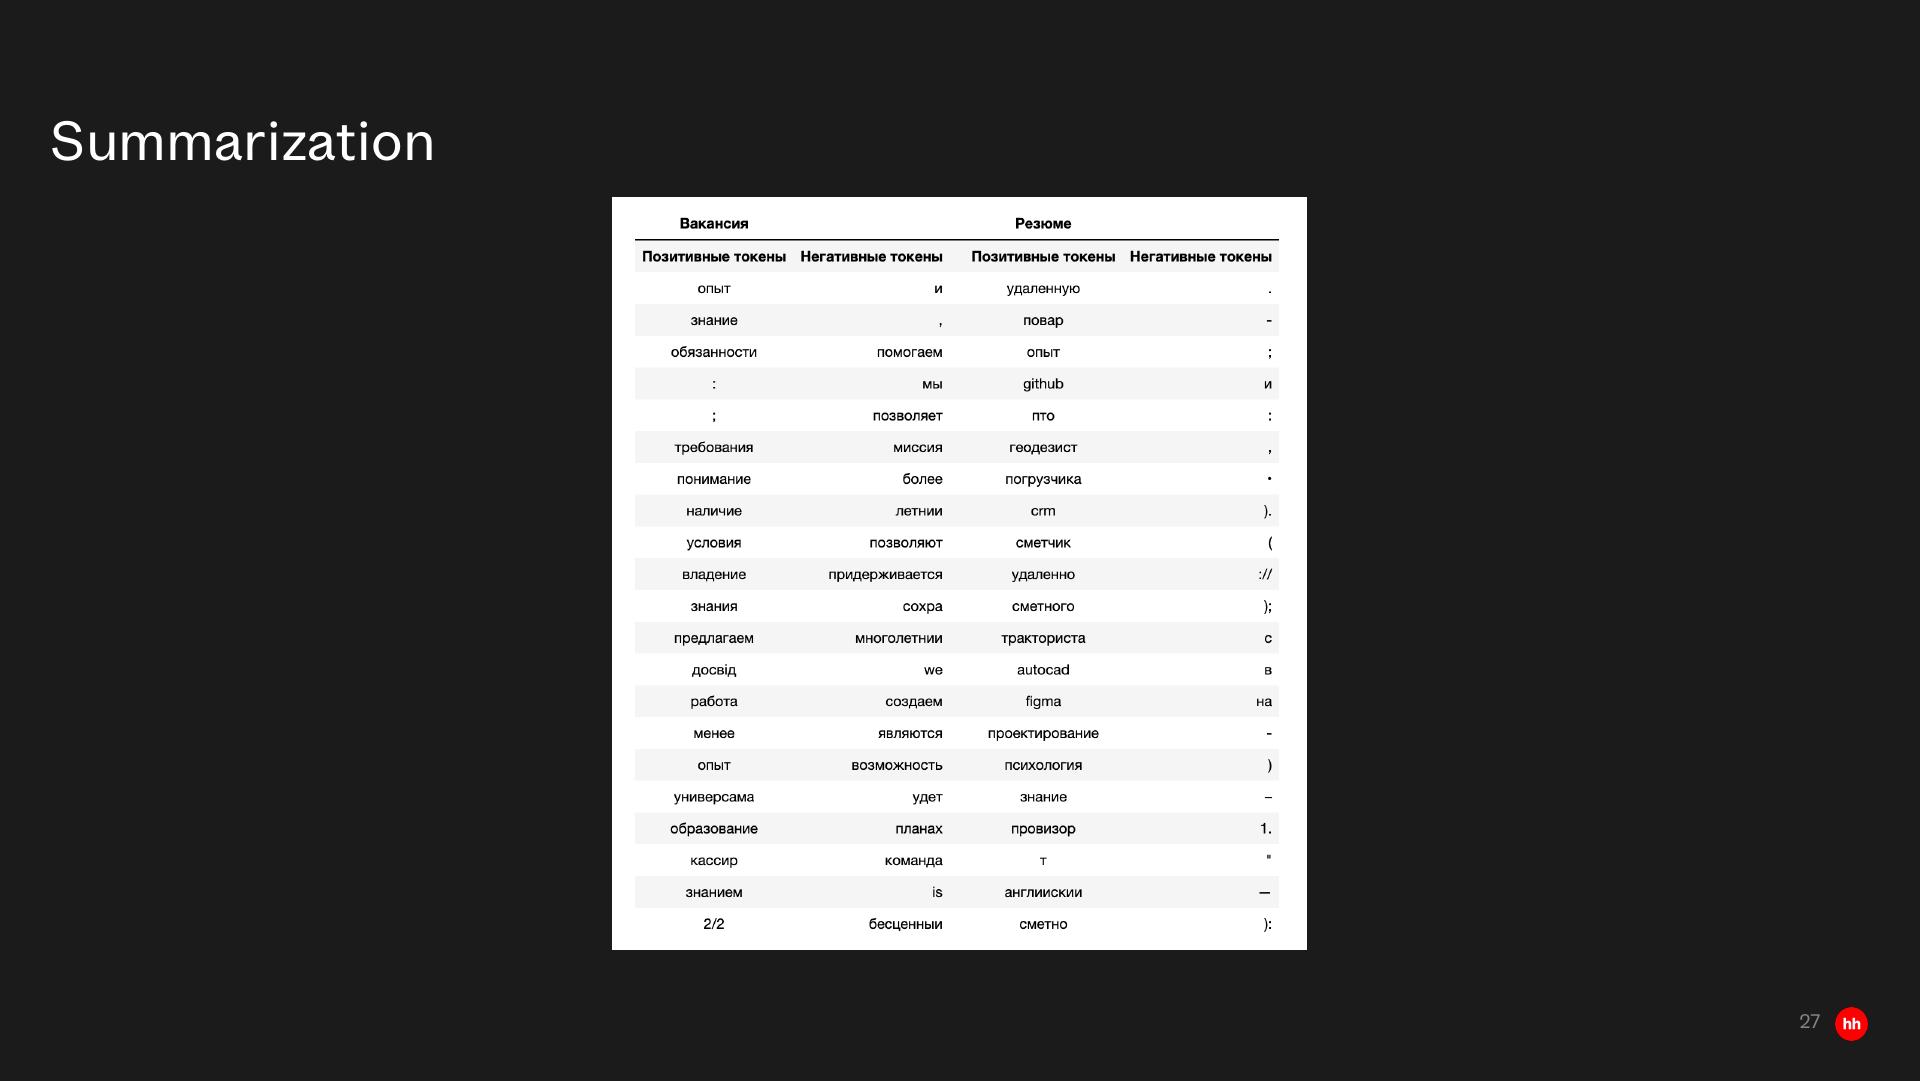
Показаны списки позитивных и негативных токенов для вакансий и резюме. Слайд не раскрывает полный алгоритм генерации суммаризации или её отдельный A/B-эффект.
Источник: Станислав Яркин · hh.ru · слайд 27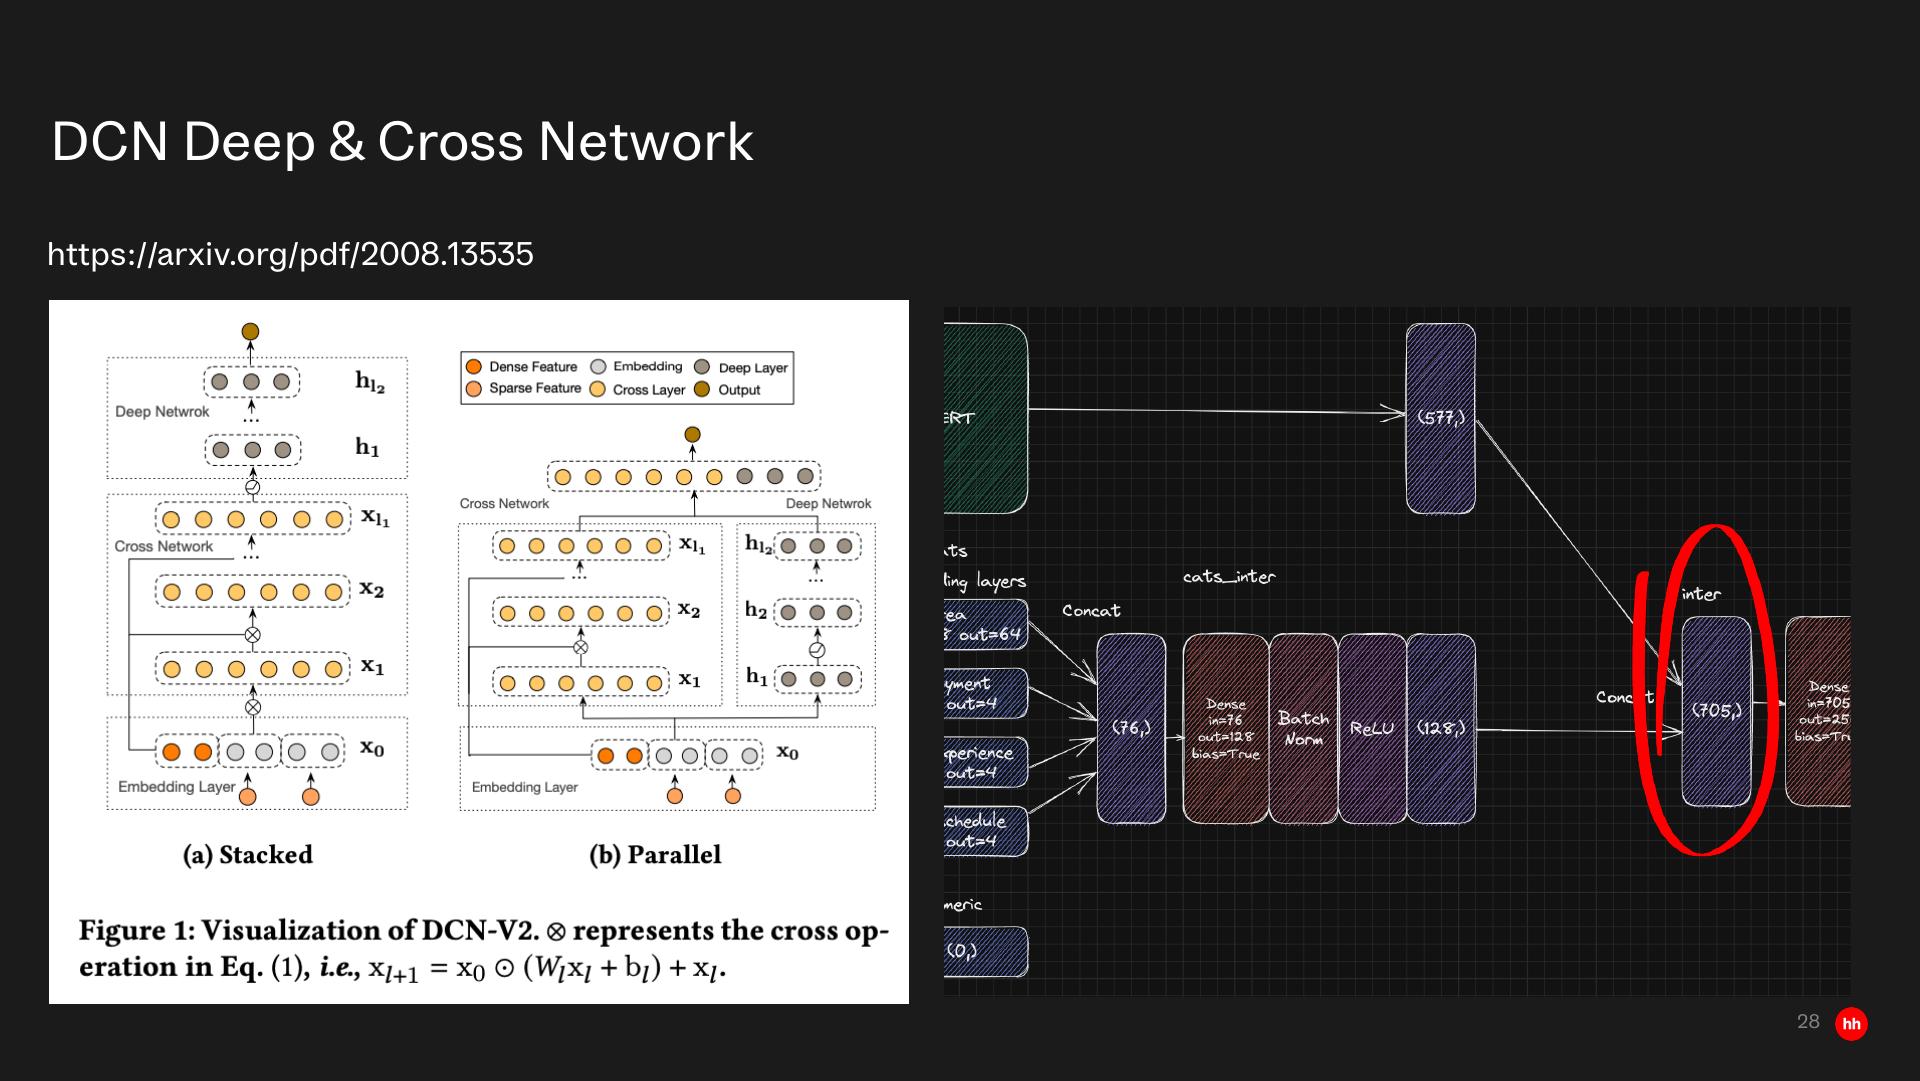
Слева схема внешней работы DCN-V2, справа место взаимодействия признаков в архитектуре hh.ru; их результаты не смешиваются.
Источник: Станислав Яркин · hh.ru · слайд 28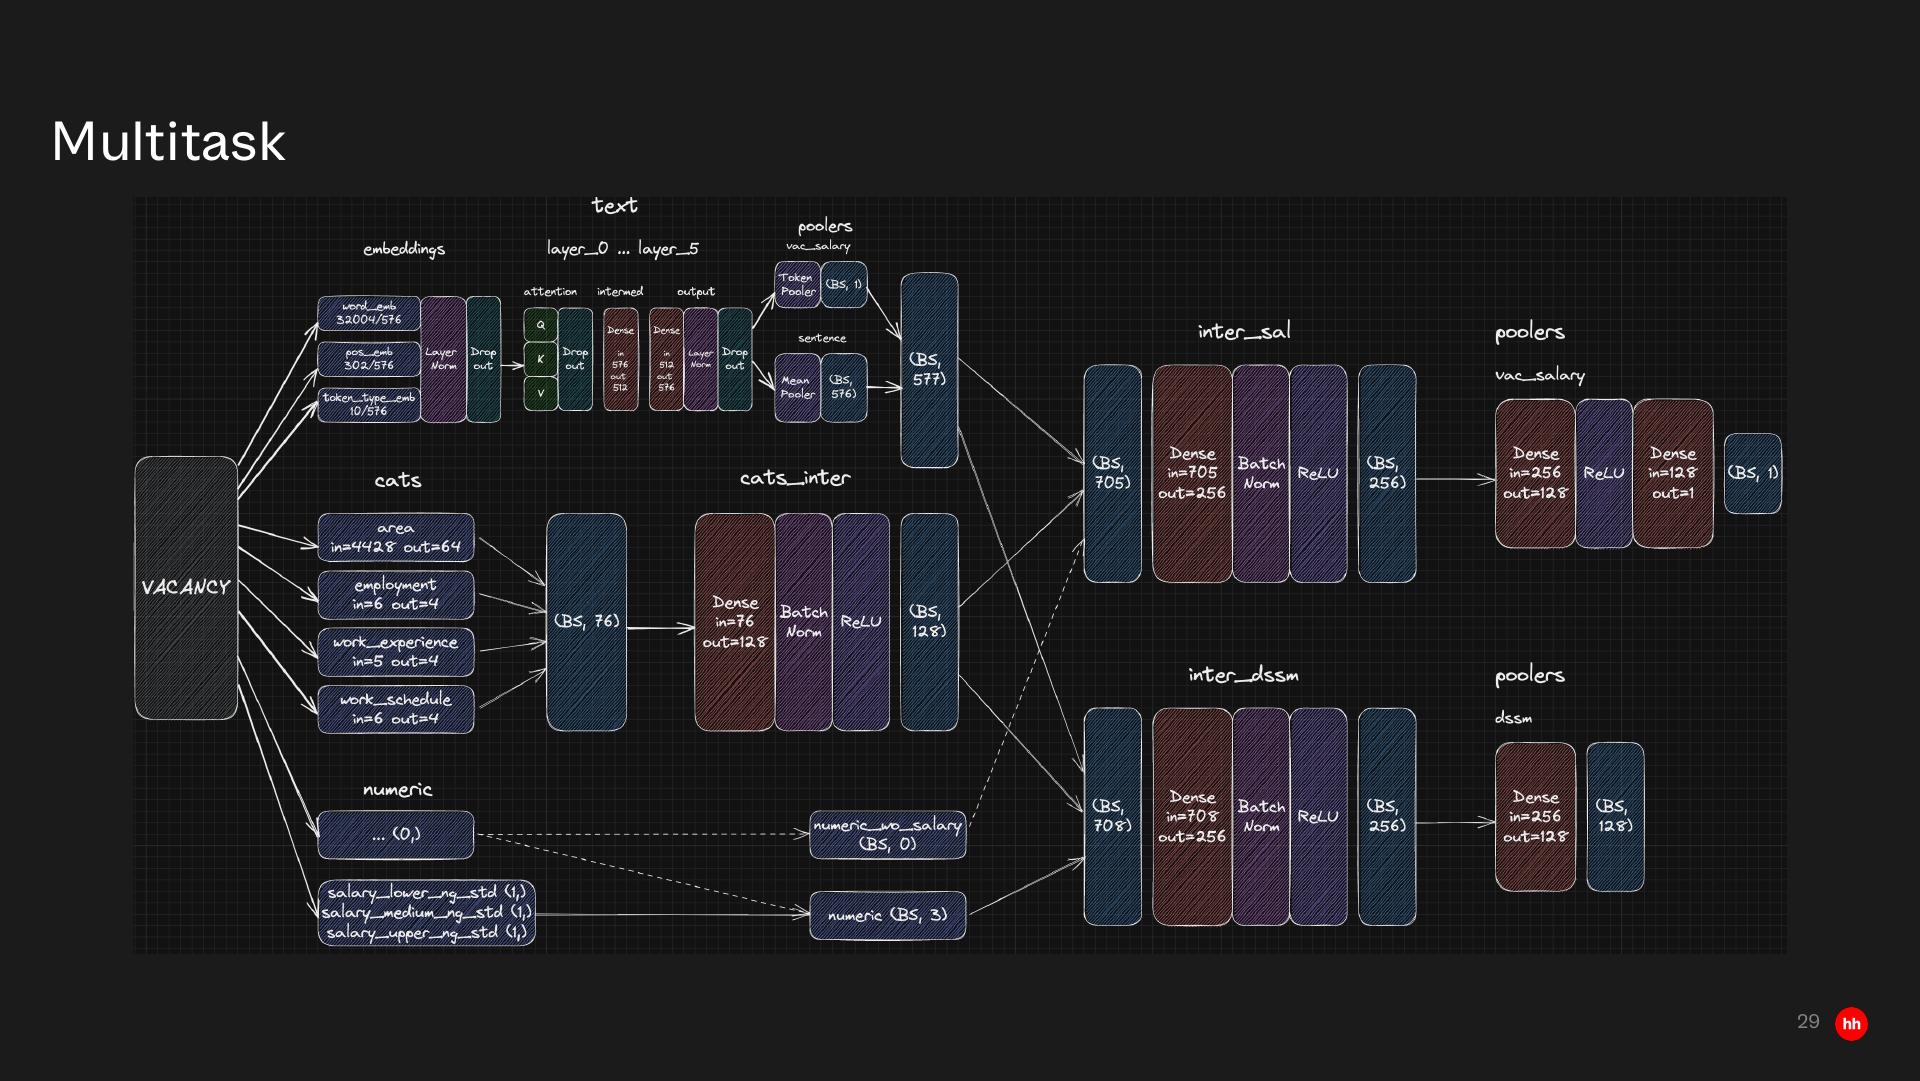
Общее кодирование текста и категорий питает разные головы, включая salary и dssm. Обучение и применение задач нужно различать.
Источник: Станислав Яркин · hh.ru · слайд 29Поведенческие признаки: от CTR до трансформеров
Контент вакансии и резюме описывает, что в них написано, но не показывает, как пользователи реально выбирают. Поэтому отдельная линия эволюции — поведенческие признаки. В презентации перечислена последовательность сигналов: доля кликов по показам (CTR); история откликов, из которой можно брать среднюю зарплату и DSSM-представления вакансий; ALS; нейросетевая матричная факторизация; SASRec; трансформеры. Это не утверждение, что каждый следующий метод полностью заменяет предыдущий: часть сигналов остаётся признаками, часть становится источниками кандидатов.
Поведение требует собственной инфраструктуры. На схеме события идут из Kafka в Kardinal Cluster, после обработки результаты сохраняются в S3. Точная задержка обновления не указана. Следующий слайд подчёркивает эксплуатационные требования: мониторинг, логирование, автотесты, тестовое окружение, запись рассчитанных признаков (Feature Logging) и принцип «чем чаще, тем лучше». То есть качество поведенческого признака зависит не только от модели, но и от того, насколько свежо и одинаково он рассчитывается.
Особенно показателен следующий пример: один и тот же класс последовательностных моделей используется по-разному из-за масштаба каталога. Для рекомендаций вакансий каталог — около 1,5 млн объектов. Там обучают практически классический SASRec: эмбеддинги объектов стартуют с нуля и являются чисто коллаборативными. Как признак ранжирования SASRec добавил уже немного, зато оказался полезнее как дополнительный генератор кандидатов.
В задаче рекомендаций резюме к вакансии каталог уже больше 40 млн объектов. Здесь используется другое решение: двухбашенная модель, где вакансия представляется последовательностью предобученных DSSM-эмбеддингов резюме, которые с ней взаимодействовали, а последовательность агрегируется трансформером. Это не «тот же SASRec на большем каталоге», а другая конструкция, использующая уже выученные содержательные представления.
Таблицу можно прокрутить по горизонтали.
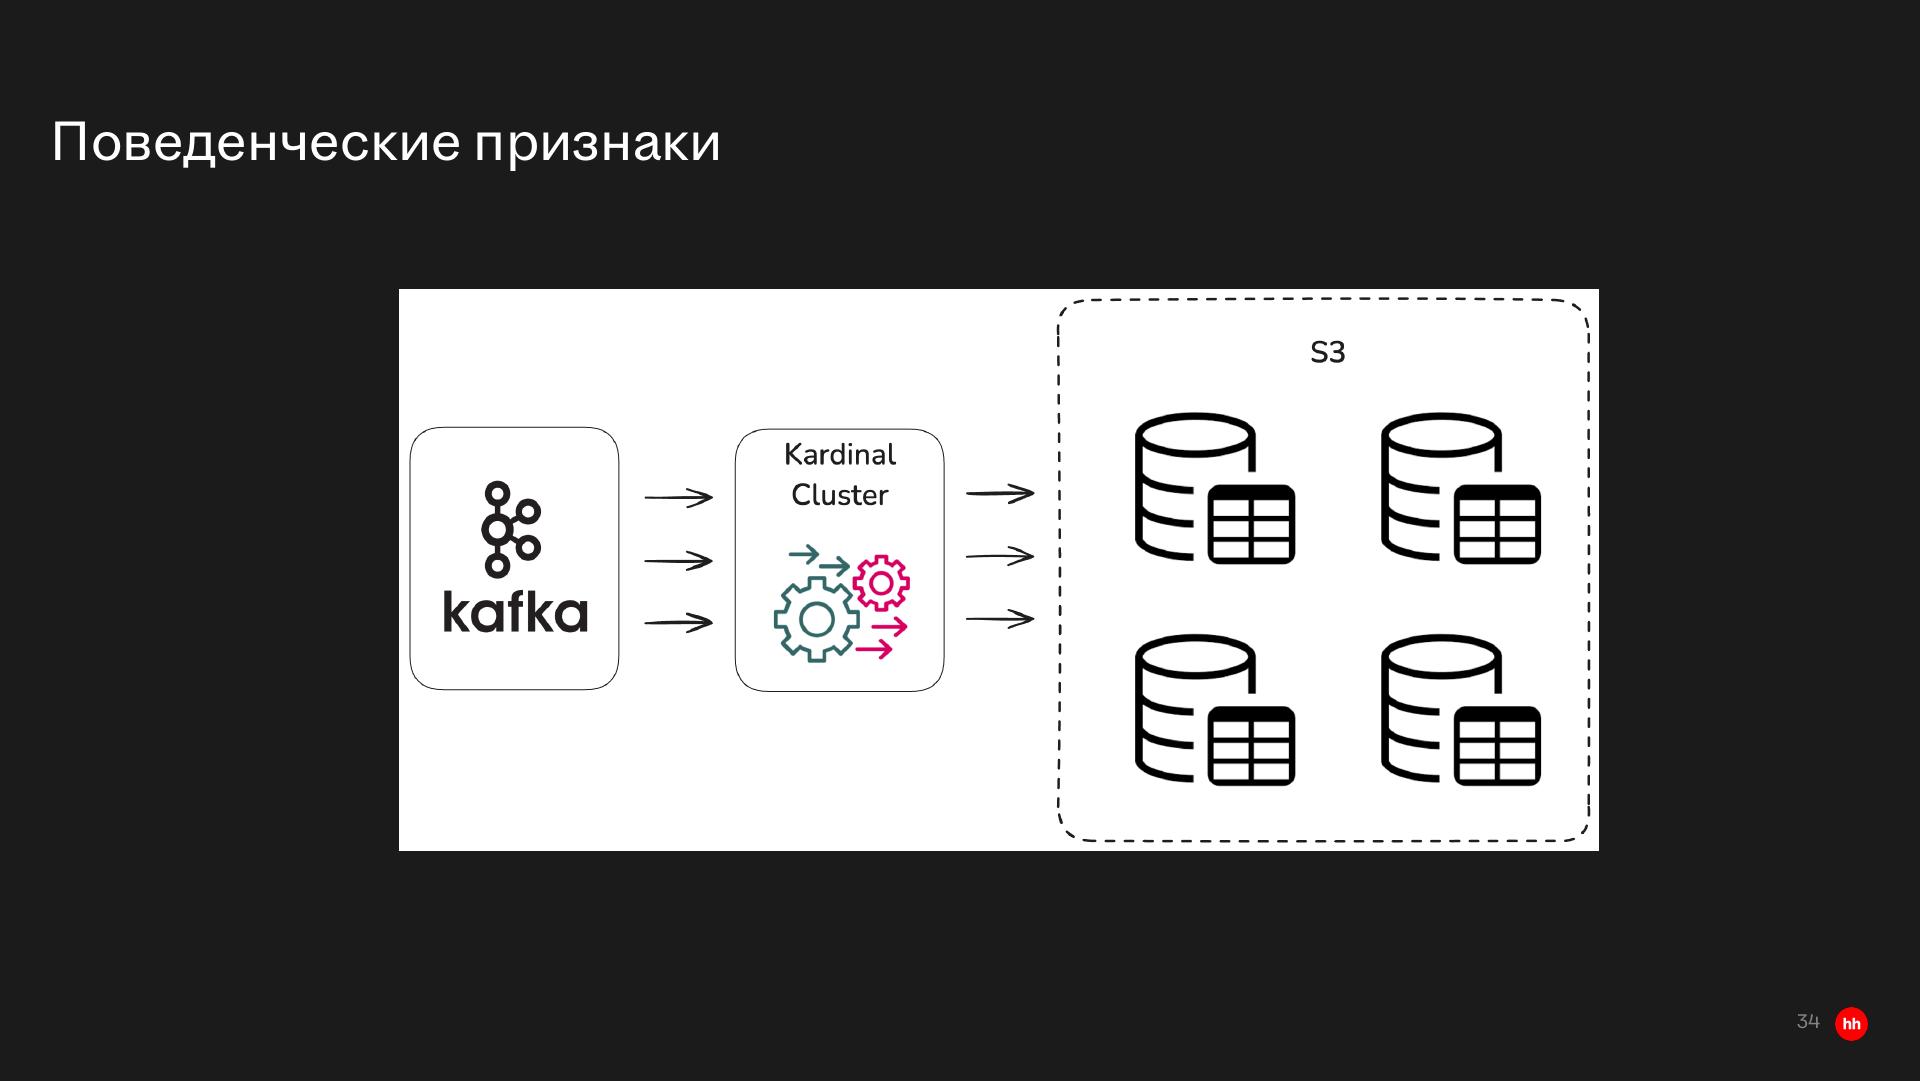
На схеме Kafka → Kardinal Cluster → S3. Период обновления не раскрыт; автор подчёркивает важность свежести признаков отдельно.
Источник: Станислав Яркин · hh.ru · слайд 34
Вакансии: около1,5млн объектов, SASRec полезнее как дополнительный генератор кандидатов. Резюме: более40млн, двухбашенная модель агрегирует DSSM-векторы взаимодействовавших резюме трансформером.
Источник: Станислав Яркин · hh.ru · слайд 36Как изменения доходят до A/B-теста и зачем нужна метрика «stupids»
Новая модель в этой системе включается не как замена кода «для всех сразу», а через конфигурацию эксперимента. В конфигурационном примере показан override для angara_2024_12_02_fixed_fair_adj: в нём отдельно задаются версия модели angara_2024_12_02, конфигурация ang24_fixed_fair, пороги 0.89 и экспериментальный индекс ANGARA_2024_12_02. Эти числа относятся к конкретному тесту. Рядом показаны другие значения defaults, что дополнительно подчёркивает: конфигурация меняется по версии, а не является набором постоянных параметров системы.
В отдельной карточке приведён эксперимент angara_2024_12_02_fixed_fair_adj. Описание говорит об обновлении «Ангары» на датасет октября 2024 года, использовании исправленного fair (replace=False) и повторном подборе порогов фильтров. Тест шёл с 22.04.2025 по 06.05.2025. Экспериментальные сплиты 0, 4, 7, 8 занимали 33%, контрольные 1, 5, 9, 11 — тоже 33%. В ожиданиях указаны зелёные метрики рекомендаций и снижение stupids.
Следующий слайд показывает другой эксперимент — angara_electra_salary_ctr_vs21. Подзаголовок говорит: общая модель dssm_salary + ctr, angara_2023, сравнивается с electra_base 2021. График содержит множество метрик, агрегированных по платформам, и отклонение от контрольной группы. Точные значения небольших неподписанных столбцов по высоте не восстанавливаем.
Почему одной общей метрики мало, объясняют слайды Stupids. Рекомендация может статистически выглядеть успешной, но содержать очевидно странные результаты. В качестве примера приведена вакансия «Курьер»: среди откликающихся на вакансию «Курьер» водители составляют 13,7%, сами курьеры — 13,0%, менеджеры по продажам и работе с клиентами — 7,9%, администраторы — 4,1%. Реальное поведение шире формального названия позиции, поэтому диагностировать «глупые» результаты нужно отдельно.
В сводных результатах среди метрик angara_electra_salary_ctr_vs21 отдельно выделена метрика AVG(stupids_SERP). Презентация не раскрывает её точную формулу, знаменатель и правило разметки stupid, поэтому придумывать определение нельзя. Надёжный вывод другой: команда держит отдельную диагностическую метрику, чтобы улучшение агрегированных показателей не скрывало рост явно нерелевантных результатов.
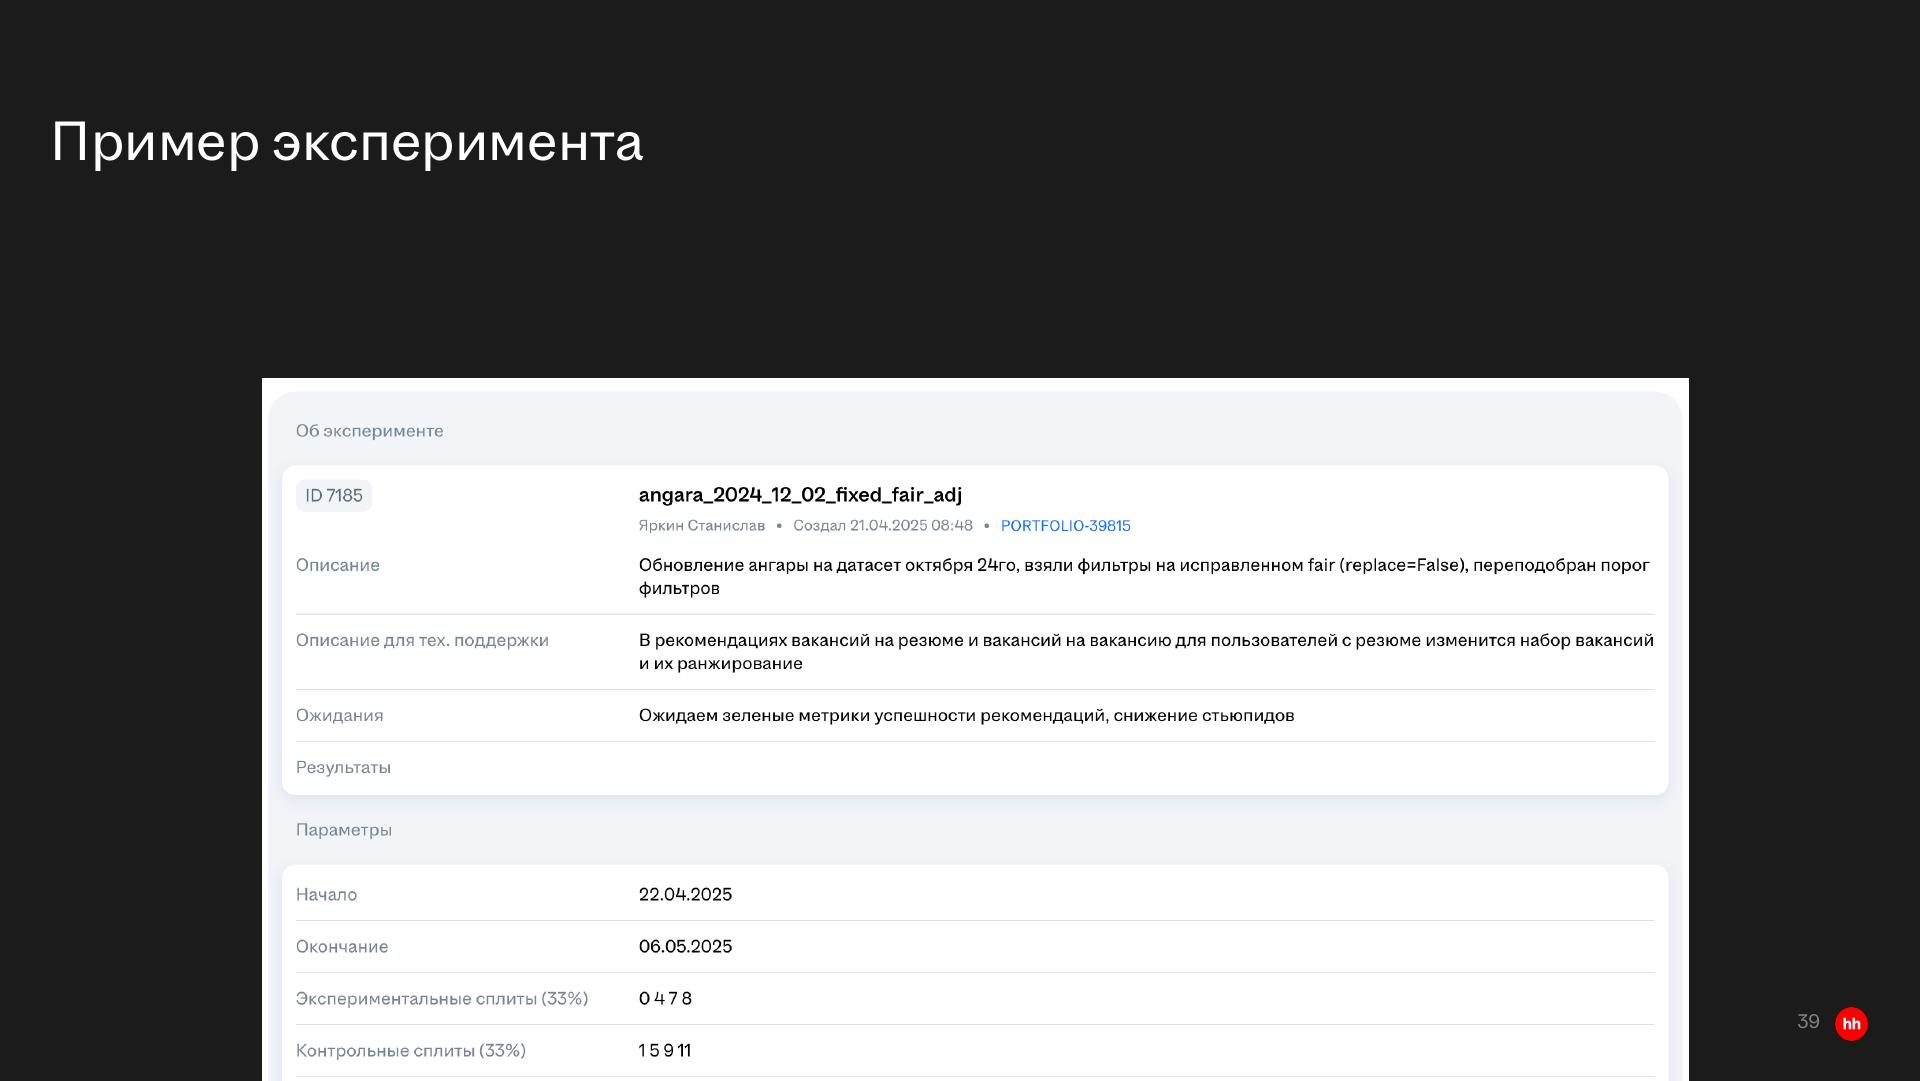
Тест angara_2024_12_02_fixed_fair_adj: 22.04–06.05.2025, эксперимент и контроль по33%. Это карточка одного эксперимента; следующий слайд показывает другой эксперимент.
Источник: Станислав Яркин · hh.ru · слайд 39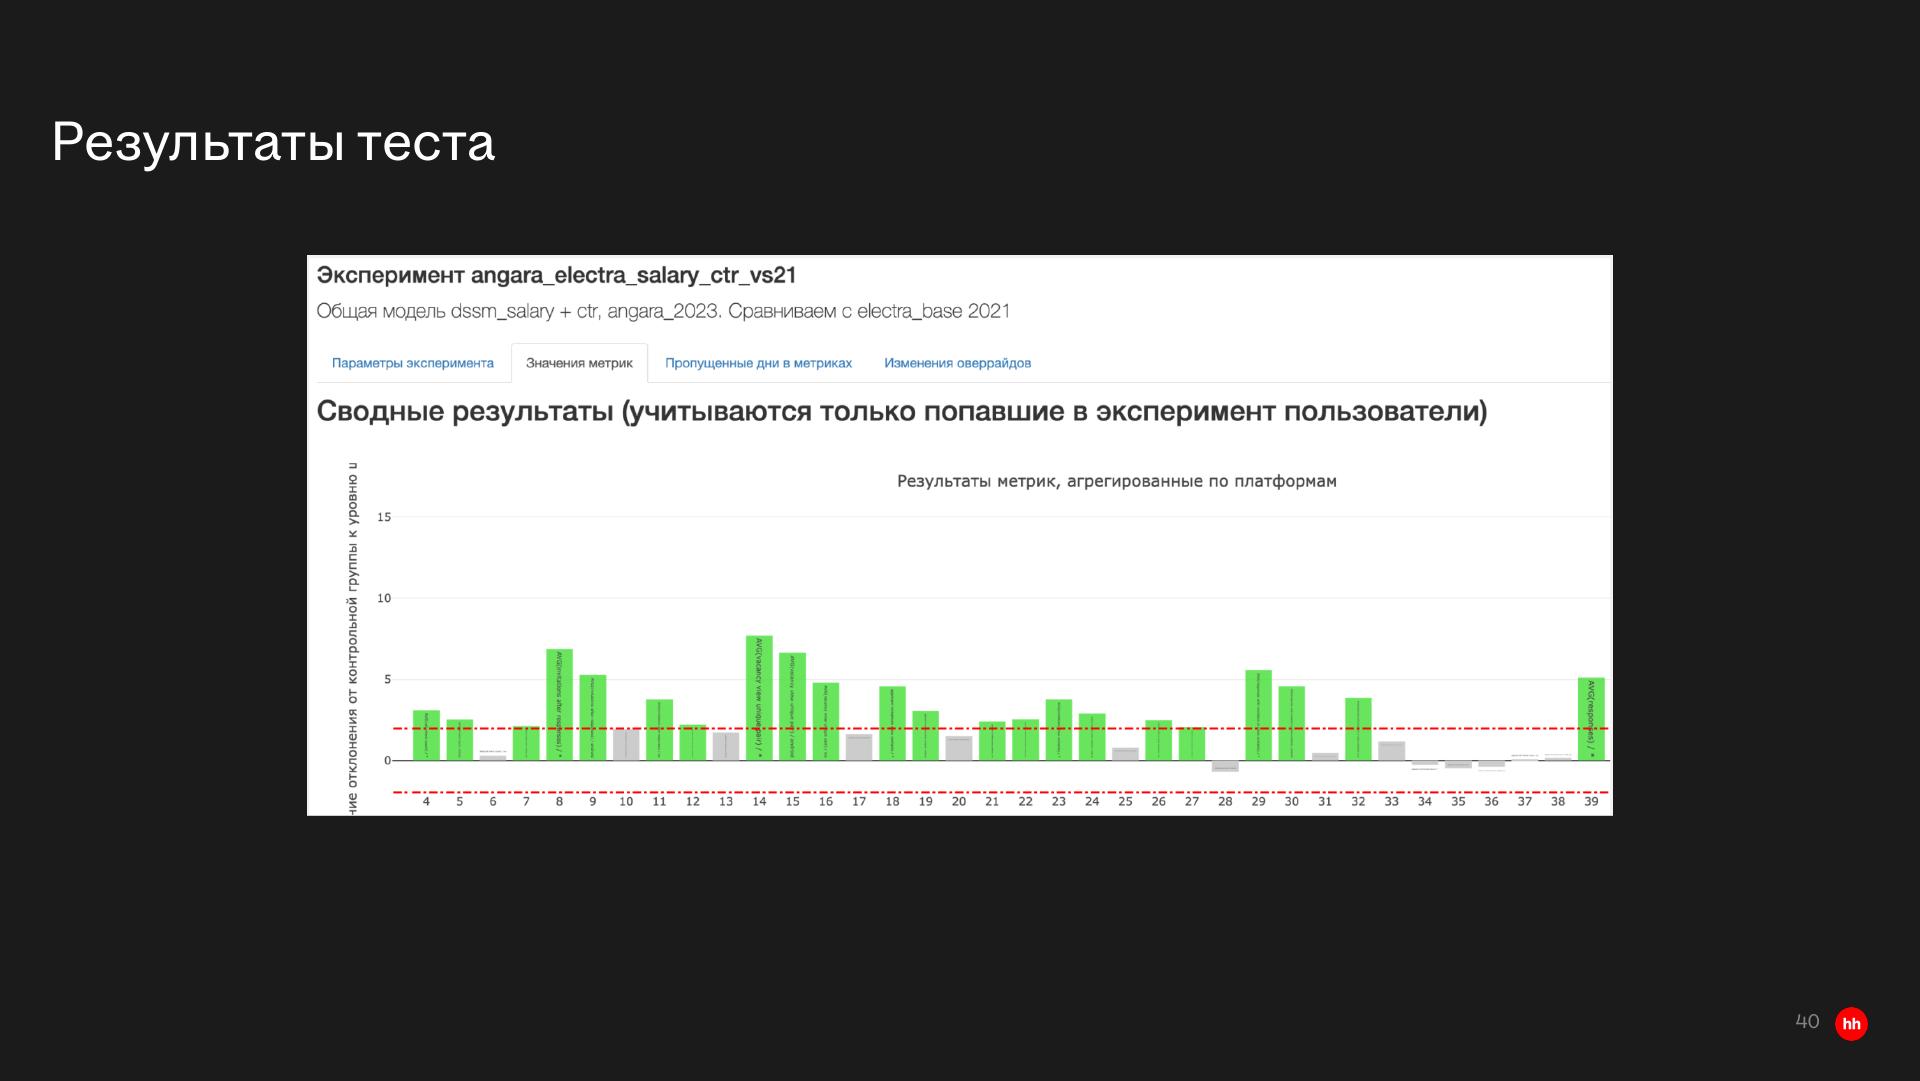
Тест angara_electra_salary_ctr_vs21 сравнивает общую dssm_salary+ctr, angara_2023 с electra_base2021. Его нельзя приписать карточке на предыдущей странице; точные значения малых столбцов не восстанавливаем.
Источник: Станислав Яркин · hh.ru · слайд 40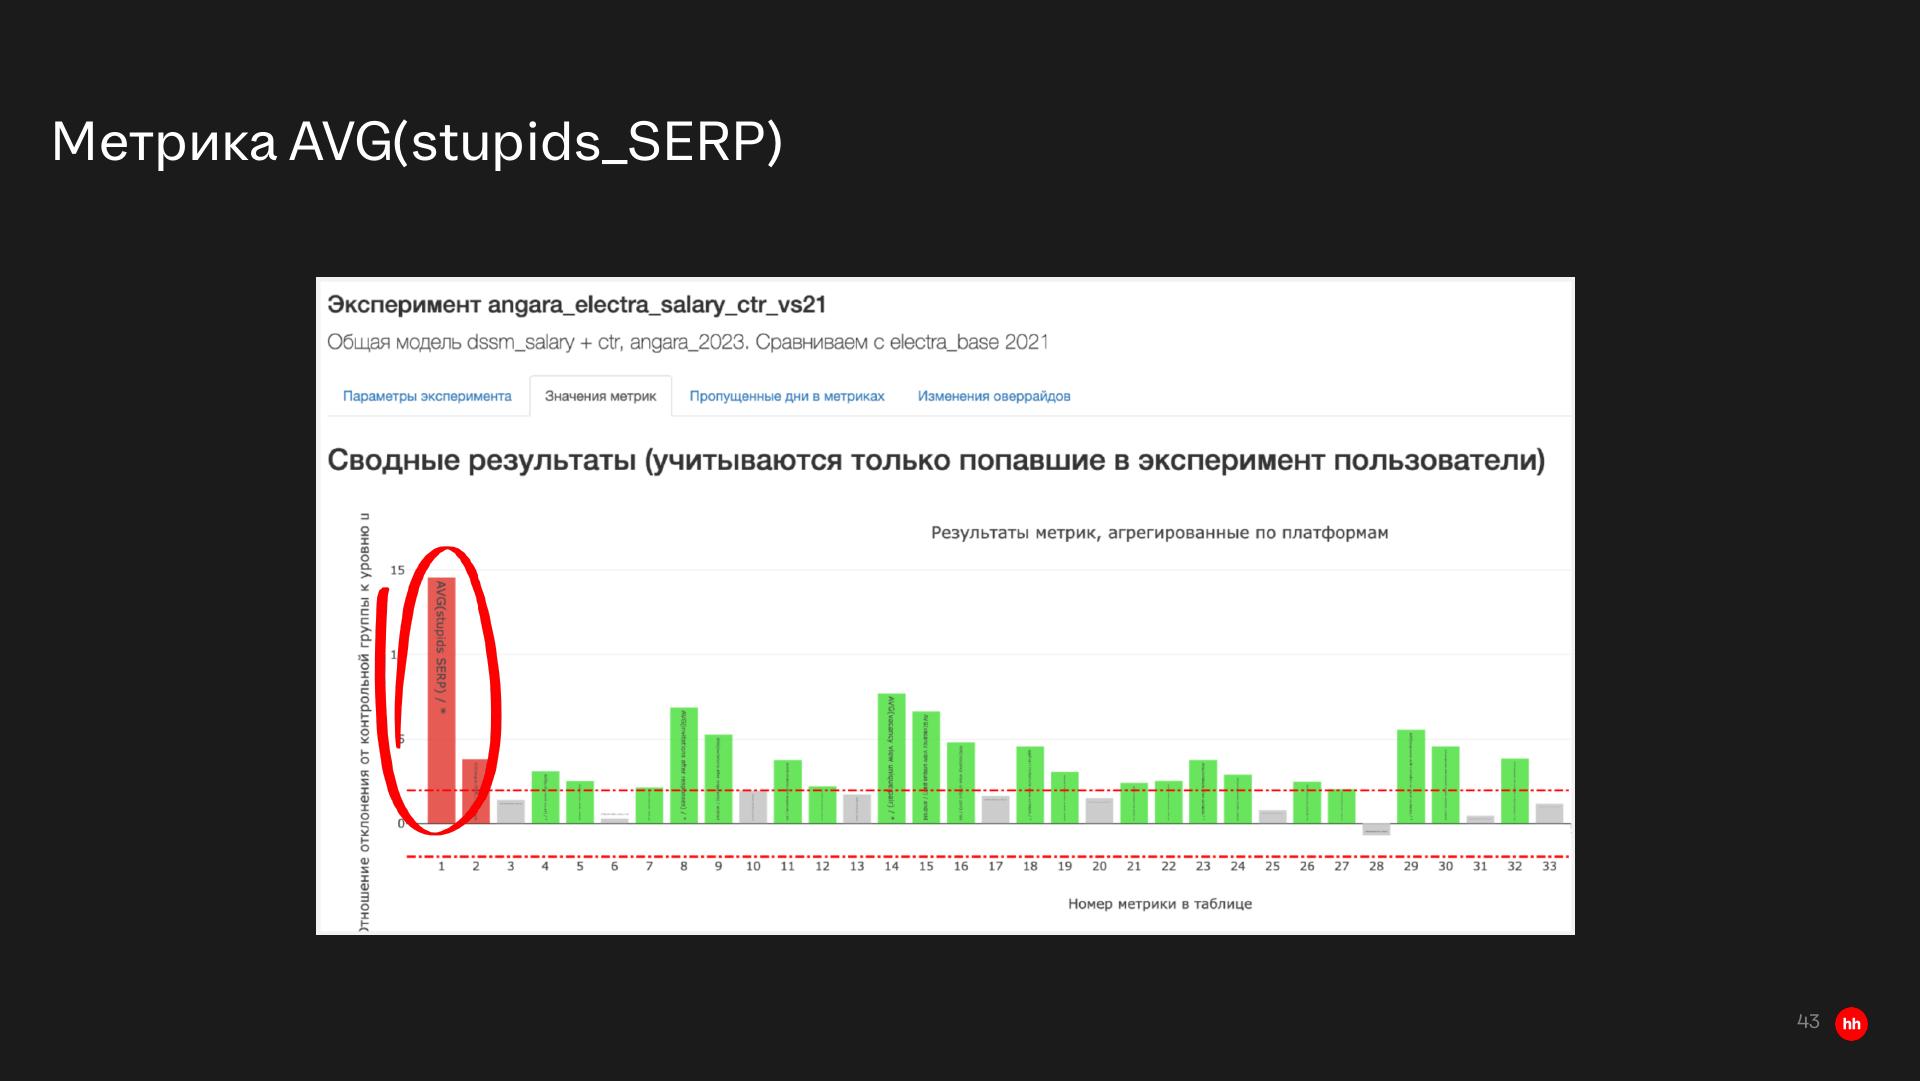
AVG(stupids_SERP) показана отдельно среди метрик теста angara_electra_salary_ctr_vs21. Точная формула и правило разметки на этом кадре не даны.
Источник: Станислав Яркин · hh.ru · слайд 43Приложение: Team-Draft Interleaving для быстрых сравнений ранжировщиков
После основного доклада идёт приложение про интерливинг — способ сравнить два ранжирования внутри одной смешанной выдачи. В приложении приведён алгоритм Team-Draft Interleaving (TDI) из работы Radlinski и соавторов. Есть два списка A и B. Система поочерёдно добавляет в общий список лучший ещё не использованный результат одной из «команд», стараясь сохранять баланс числа выбранных элементов. Одновременно запоминается, какому ранжировщику принадлежит каждый добавленный объект, чтобы затем зачесть клики.
- 01
Получить два ранжирования
Два алгоритма строят списки A и B для одного запроса или пользователя.
- 02
Собрать общий список
Команды по очереди добавляют лучший ещё не использованный объект; при равенстве размеров выбор команды рандомизируется.
- 03
Запомнить происхождение
Для каждого добавленного результата сохраняется, из какого ранжирования он пришёл.
- 04
Наблюдать клики
Клик засчитывается команде, которая добавила этот результат, и сравнение показывает относительное предпочтение ранжировщиков.
По слайду TDI гораздо чувствительнее обычного A/B-теста для такого сравнительного вопроса, требует меньшего пользовательского сплита и позволяет быстро перебирать множество однотипных гипотез. Но это не способ измерить абсолютный бизнес-эффект. Он отвечает скорее на вопрос «какое ранжирование пользователь предпочитает в прямом сравнении», а не «на сколько процентов выросла целевая метрика продукта».
Ограничения этого подхода принципиальны. TDI не стоит использовать, если меняются фильтры: тогда два варианта могут работать уже с разными множествами кандидатов, и интерпретация смешанной выдачи ломается. Автор также фиксирует случаи, когда знак результата TDI и последующего A/B-теста расходился. Поэтому TDI — быстрый фильтр гипотез, а не замена полноценному онлайн-эксперименту.
Правая иллюстрация подписана Balanced Interleaving: a Problem. Она иллюстрирует проблему другого способа интерливинга: почти одинаковые ранжирования могут дать смещённый результат из-за того, кому засчитываются позиции. Эту картинку нельзя описывать как сам алгоритм TDI; алгоритм TDI находится на предыдущем слайде.
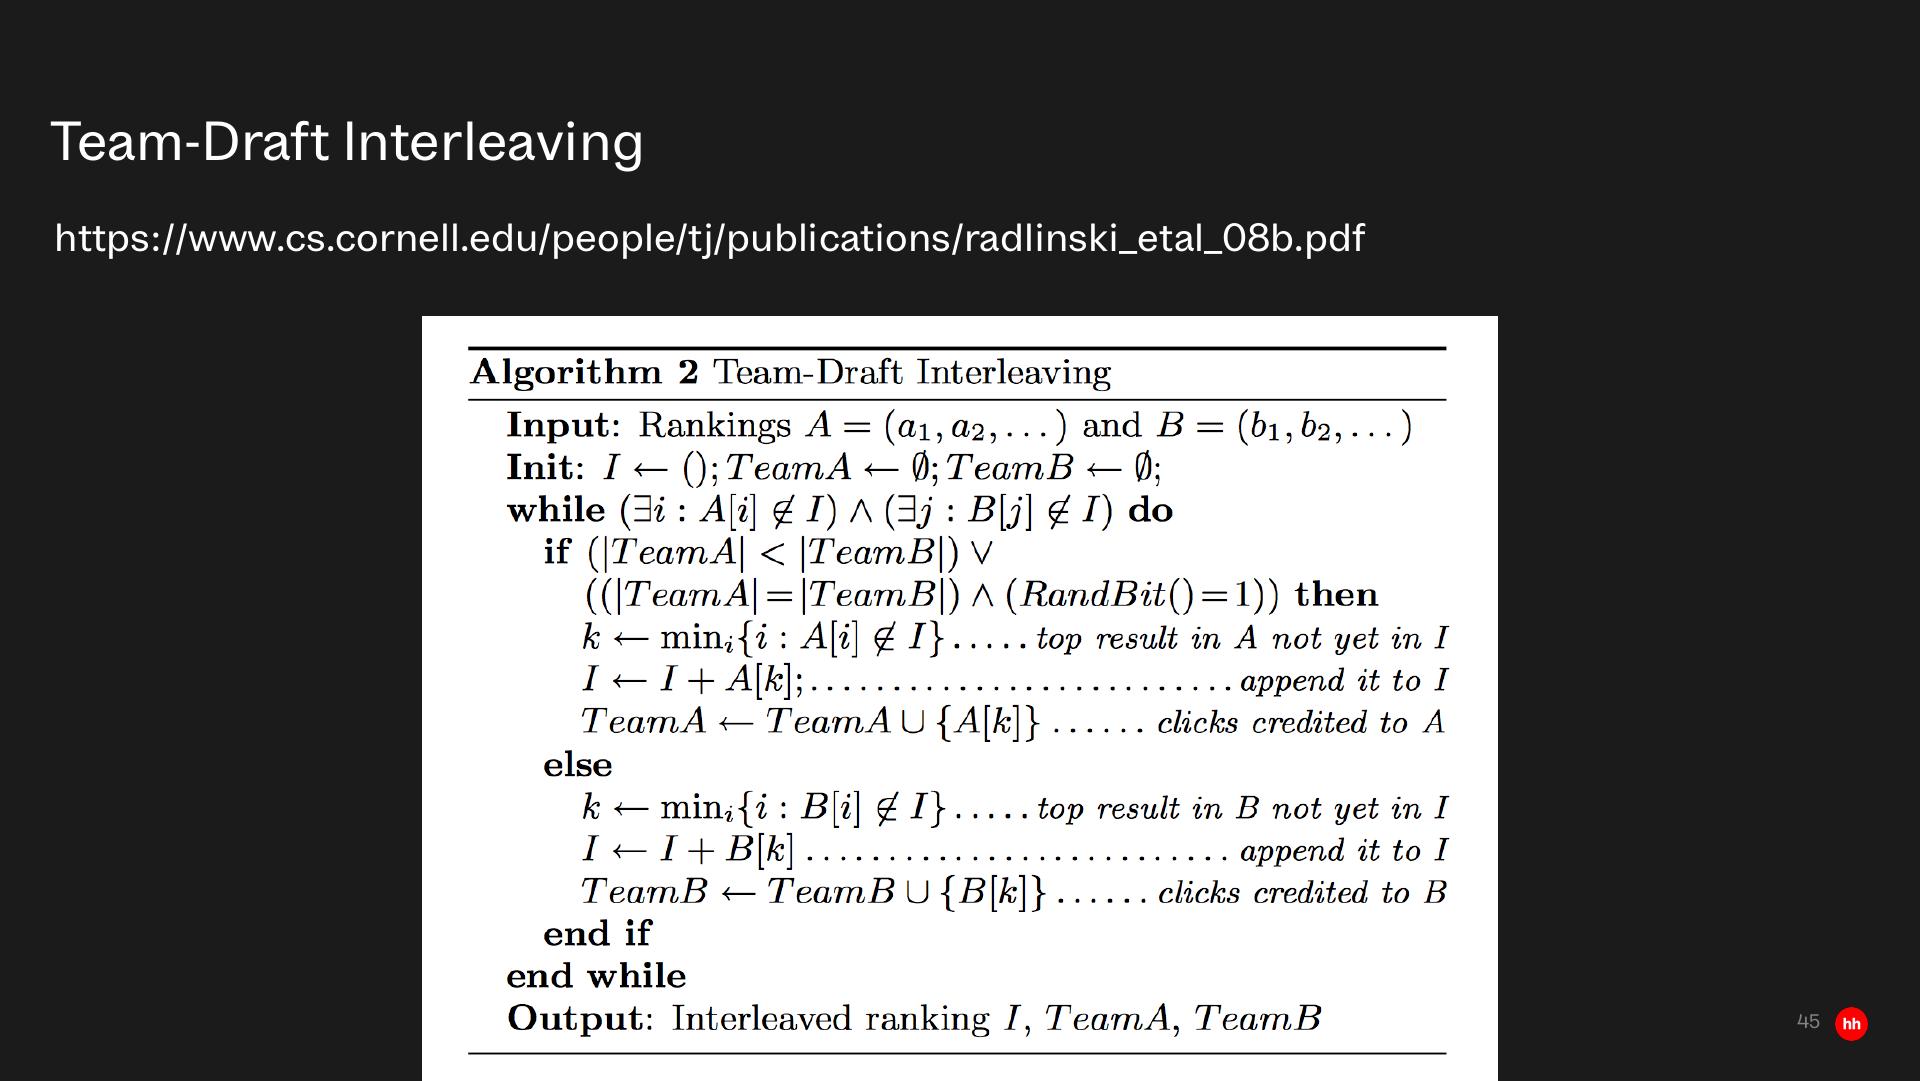
Исходный алгоритм смешивает два ранжирования и сохраняет принадлежность объектов командам для зачёта кликов. Дубликаты в смешанной выдаче пропускают.
Источник: Станислав Яркин · hh.ru · слайд 45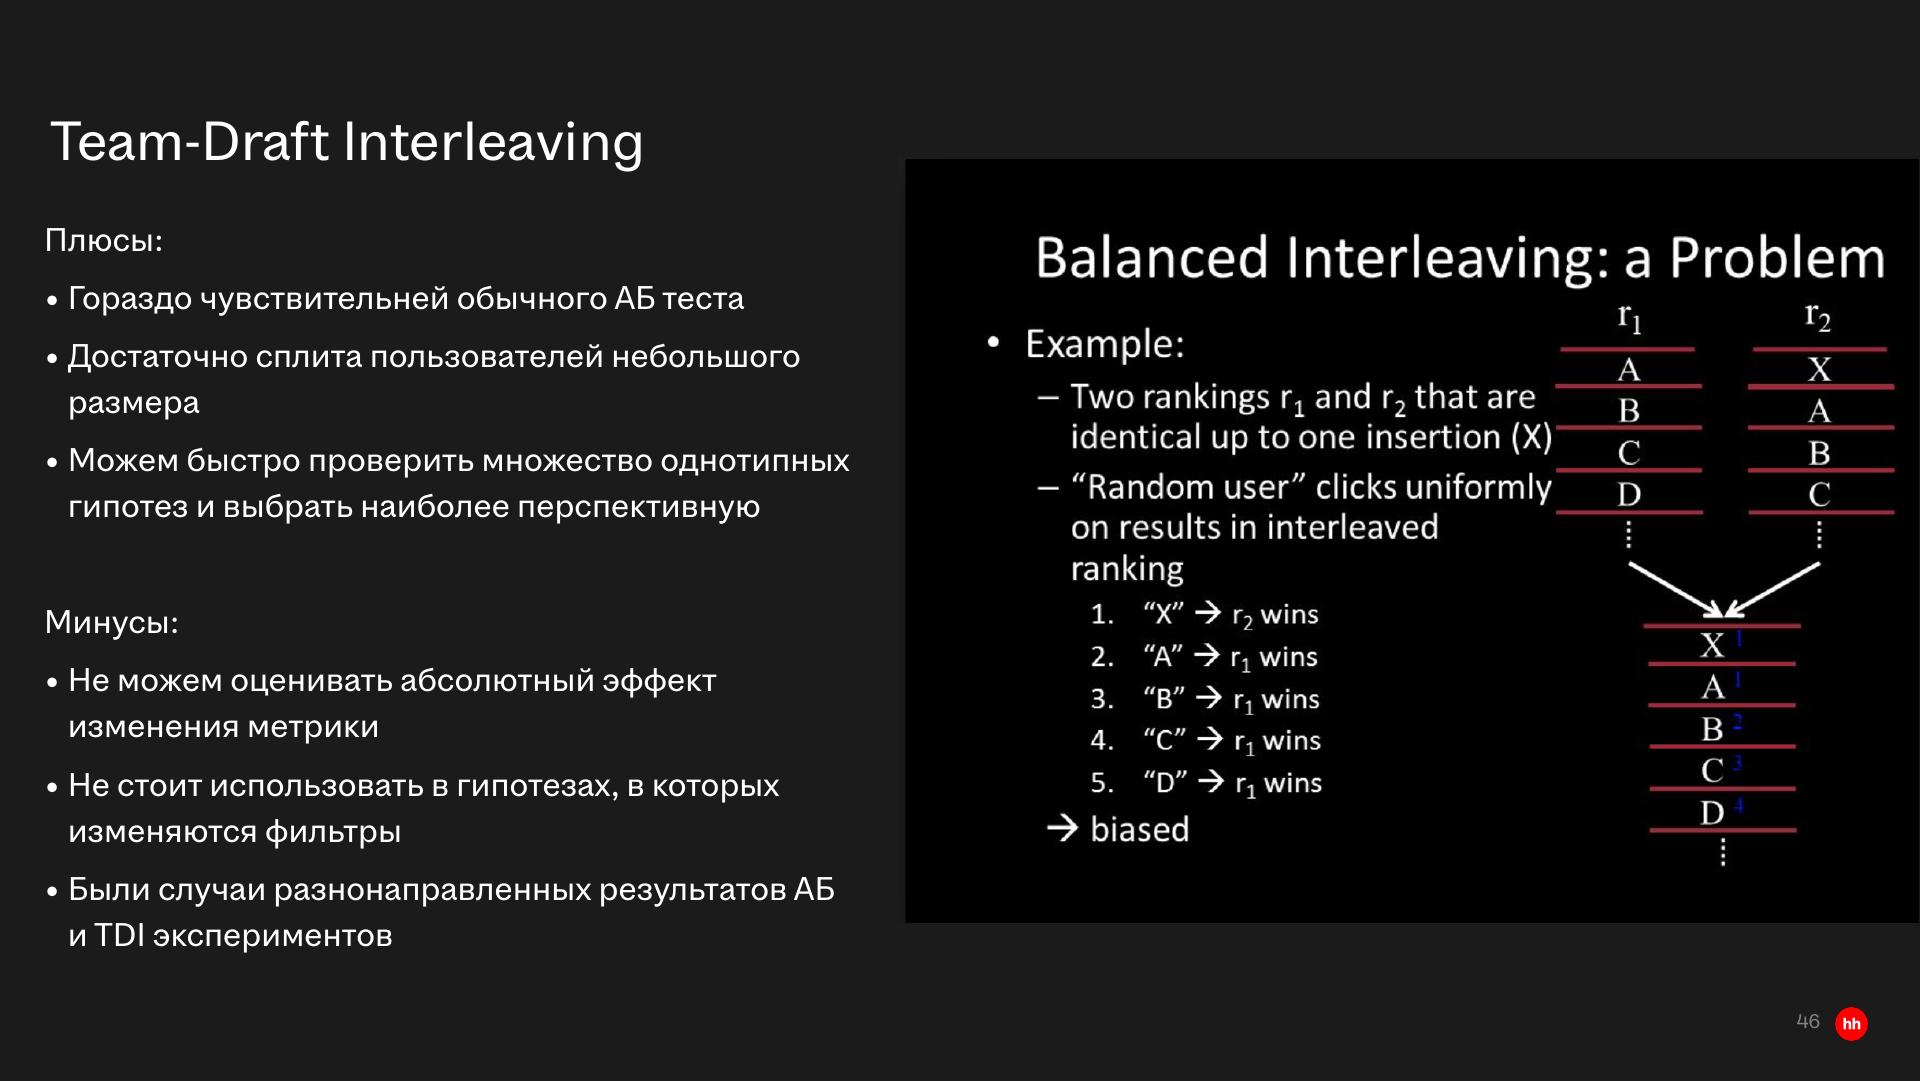
По опыту автора TDI чувствителен для быстрых сравнений, но не измеряет абсолютный эффект и не подходит для смены фильтров. Правая картинка иллюстрирует проблему Balanced Interleaving, а не алгоритм TDI.
Источник: Станислав Яркин · hh.ru · слайд 46Приложение: FeatureGroup и общий граф признаков
Последнее приложение возвращает разговор от моделей к инфраструктуре признаков. Класс FeatureGroup инкапсулирует всё, что нужно для расчёта и хранения признака. В объекте есть имя, тип сущности, для которой признак считается — например, резюме, вакансия или запрос, — и путь локального кэша. Meta хранит дополнительную информацию для вычисления: словарь токенов, веса нейросети, курсы валют. Computer задаёт способ получить признак из входных данных и этой метаинформации.
На кодовом примере сначала определяется res_salary, который извлекает зарплату из JSON резюме. Затем res_salary_sqrt зависит уже от результата первого признака и применяет квадратный корень. При входе salary = 9 итоговый зависимый признак равен 3. Важен не сам квадратный корень, а механизм зависимости: система понимает, какие промежуточные признаки нужно вычислить, чтобы получить конечный.
res_salary = FeatureGroup(
    'res_salary', resume_entity, ('salary',),
    computer=RowComputer(resume_node, get_resume_salary),
    level=Level.ALL, meta_persistable=False, pretrained=True,
)

res_salary_sqrt = FeatureGroup(
    'res_salary_sqrt', resume_entity, ('salary', 'sqrt'),
    computer=RowComputer(res_salary, np.sqrt),
    level=Level.ALL, meta_persistable=False, pretrained=True,
)
Финальный слайд показывает эту идею как полный граф зависимостей: например, vacancy_json → vac.compensation → vac.salary.lower / vac.salary.upper → vac.salary.medium. На слайде сформулированы три преимущества: код признака пишется один раз и переиспользуется во всех моделях; можно проверять больше гипотез по добавлению признаков без изменения бэкенда и индексации; один и тот же код используется при обучении и в продакшене. Последний пункт особенно важен, потому что уменьшает риск, что модель обучалась на одном вычислении признака, а онлайн получает другое.
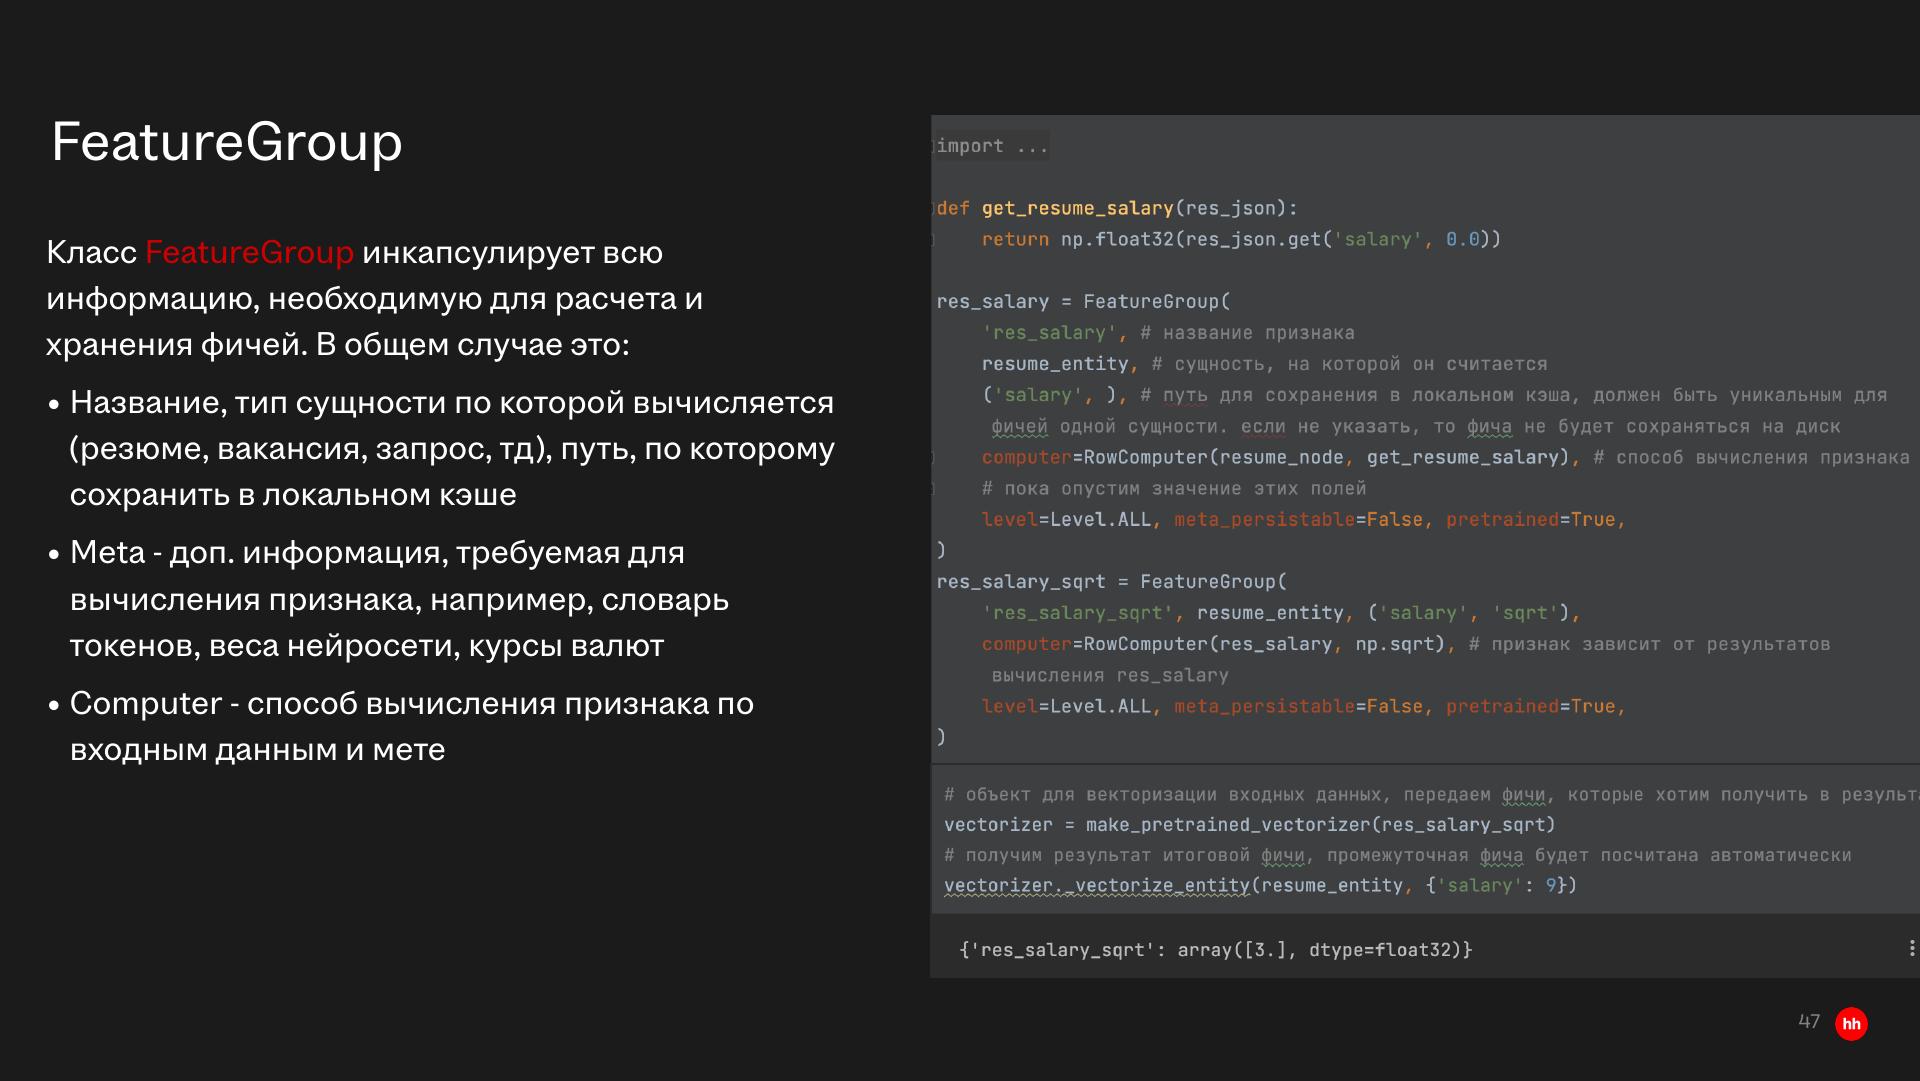
Название/сущность/кэш, метаданные и способ вычисления объединены в объект признака. На иллюстрации salary=9 даёт sqrt=3; это учебный пример API.
Источник: Станислав Яркин · hh.ru · слайд 47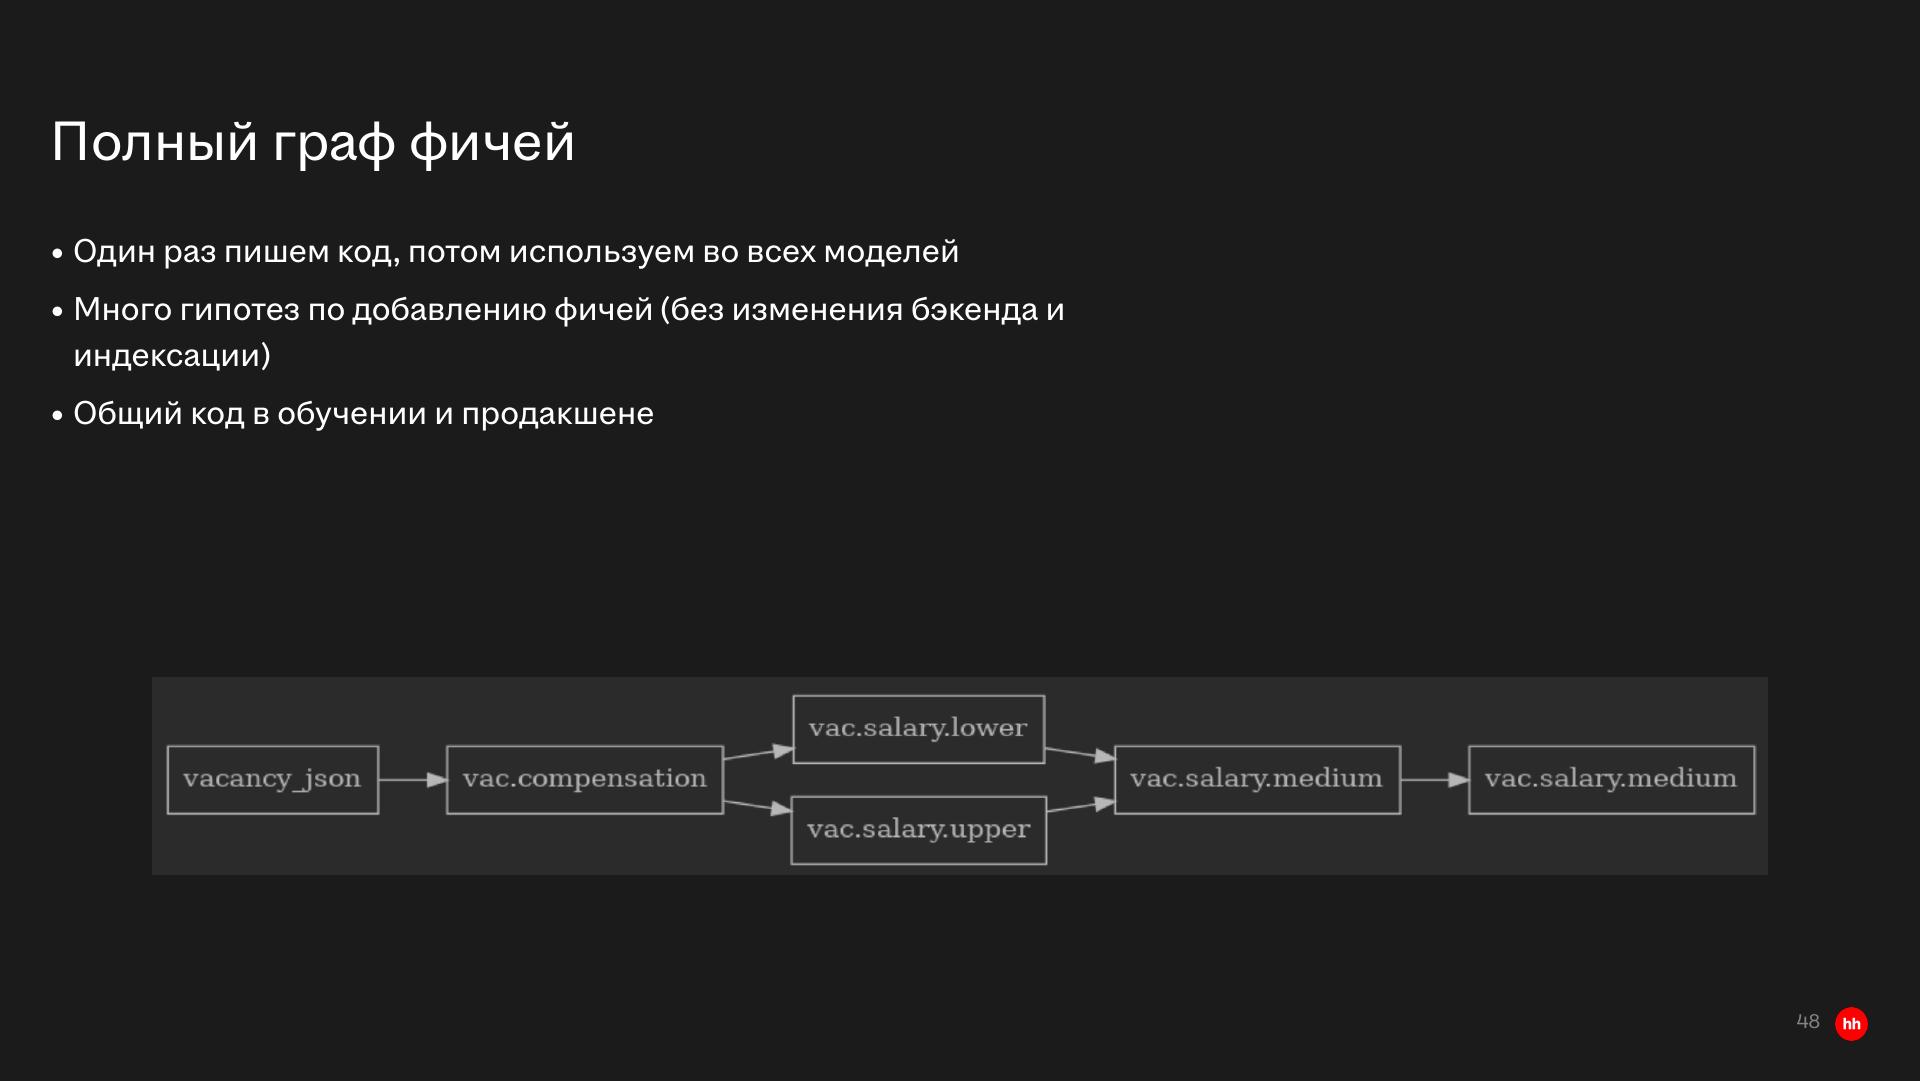
Один код расчёта используется при обучении и в продакшене; пример показывает зависимости признаков зарплаты.
Источник: Станислав Яркин · hh.ru · слайд 48Итог: как устроена рекомендация и что важно не перепутать
Эволюция рекомендаций hh.ru в этой презентации — не история одной «победившей» модели. Система растёт слоями. Каскад фильтров обеспечивает полноту, точность и приемлемую нагрузку; LSH ускоряет ранний этап, а пороговый Prefilter лучше фиксированного top-K приспосабливается к разным микрорынкам. Затем появляются дополнительные источники кандидатов, поведенческие модели и управляемые пулы. После отбора древесный ранкер сортирует вакансии, а отдельные стадии переранжирования решают продуктовые задачи: свежесть, LPV и ликвидность. Параллельно DSSM, BERT, multitask и ArcFace создают переиспользуемые текстовые представления, а поведенческая ветка развивается до SASRec и трансформеров.
- 01
Получить контекст пользователя
Система использует выбранное резюме, доступные признаки и поведенческую историю.
- 02
Собрать кандидатов
Эвристики, фильтры и источники вроде ALS или SASRec формируют набор вакансий из нужных пулов; пороги ограничивают объём следующего этапа.
- 03
Отранжировать
Tree Ranker оценивает оставшиеся вакансии по содержательным, поведенческим и другим признакам и упорядочивает список.
- 04
Применить продуктовые поправки
Reranker, Boosting и Blender корректируют верх выдачи с учётом свежести, LPV, ликвидности, дублей и других целей.
- 05
Показать итоговый список
Пользователь получает готовую выдачу; действия после показа становятся новыми поведенческими данными для будущих обновлений моделей.
Для готового запроса обучение не запускается заново: пользователь получает результат от уже обученных моделей и подготовленных признаков. Подбор порогов, обучение DSSM/BERT/SASRec и A/B-проверки относятся к отдельному контуру развития системы.
Качество контролируется на нескольких уровнях. Для фильтров указана mauc, для ранжирования — NDCG; продуктовые поправки вынесены в отдельные стадии. В 2024 году на графике подписано 69% откликов из рекомендаций, но это итог многолетней эволюции, а не uplift одной модели. Два показанных A/B-примера относятся к разным экспериментам, а точные значения неподписанных баров презентация не даёт. TDI помогает быстрее сравнивать похожие ранжировщики, но не измеряет абсолютный бизнес-эффект и не предназначен для изменений фильтров. FeatureGroup и общий граф признаков связывают исследования с эксплуатацией: один расчёт признака используется при обучении и в продакшене.