Разбор готов
Data Fusion 2025: хранение рекомендаций, новая главная Lamoda и проверка порядка действий
Рекомендательная система может столкнуться с разными ограничениями. В Wildberries персональные подборки для растущей аудитории занимают всё больше места, а попытка заменить их общими списками ухудшает покупки. В Lamoda небольшой товарный виджет превращается в основу главной страницы: теперь нужно улучшать порядок товаров и перестать заранее рассчитывать каждую готовую выдачу. Исследователи Sber AI Lab задают другой вопрос: действительно ли порядок действий в выбранных данных важен для последовательной модели? Анастасия Никулина разбирает эти три выступления Data Fusion 2025, останавливает записи и обсуждает решения, метрики и недостающие проверки. Глава сохраняет этот формат: отдельно объясняет каждое решение, его неудачные шаги и результаты, а замечания автора обзора связывает с конкретными местами докладов.
Материал полезен разработчикам рекомендательных систем, аналитикам и ML-инженерам, которым важно связать модели с хранением, показом товаров и оценкой данных. Он помогает различать инфраструктурный выигрыш, офлайн-качество и изменение поведения пользователей.
Видео · на русском
Как работают алгоритмы рекомендаций? Обзор на доклады с Data Fusion 2025Анастасия Никулина · Опубликовано: 3 мая 2025 г.
Исходный доклад · Открыть оригинал
Три выступления внутри одного обзора
Основа главы — обзор Анастасии Никулиной. В нём показаны фрагменты выступлений Евгения Иванова из Wildberries, Данила Комарова из Lamoda и Анны Володкевич из Sber AI Lab. Состав участников и принадлежность третьего доклада Сберу подтверждает официальная программа Data Fusion. Связанная с исследовательским выступлением первичная работа — Does It Look Sequential? An Analysis of Datasets for Evaluation of Sequential Recommendations, среди авторов которой указана Anna Volodkevich.
Никулина выбрала понравившиеся ей технические доклады одной рекомендательной секции, а не пересказывает всю конференцию. У этих историй нет общей производственной архитектуры: первая посвящена хранению подборок, вторая — развитию главной страницы и её рекомендательного каскада, третья — методике исследования данных. Дальше слова спикеров, комментарии Никулиной и наши пояснения различаются по смыслу и атрибуции.
Доклад · 00:00:00Wildberries: почему готовая выдача стала дорогой единицей хранения
Евгений Иванов начинает с устройства главной Wildberries. В неё поступает заранее рассчитанная персональная подборка: кандидаты от разных моделей проходят бустинговое ранжирование, то есть упорядочиваются обученной моделью. Эту ветку пересчитывают раз в день. Рядом работает реактивная ветка: она подбирает товары по последним взаимодействиям пользователя с другими товарами. Эти источники смешиваются, а затем проходят правила итоговой выдачи.
На схеме в правилах названы MMR и уже купленные товары. MMR — способ разнообразить список, не отказываясь от релевантности; подробнее он появляется в истории Lamoda. Главное здесь — не перепутать уровни схемы. Никулина специально поясняет: ранжирование не отсутствует, оно уже находится внутри офлайн-ветки. Схема всей главной и схема построения одной персональной подборки показывают разные этапы.
Готовый список товаров спикер называет пресетом. Его сохраняют по идентификатору пользователя во внутренний бакет — инфраструктурный шард, или часть распределённого хранилища. Это не просто файл со списком: внутри бакета есть индекс с обновляемыми сведениями о товарах, скидках, логистике и признаках, доступных при финальной обработке. На старте работы десятки миллионов персональных выдач были распределены по сотням таких бакетов.
Наше пояснение: ограничение возникает из-за самой единицы хранения. Если каждому пользователю соответствует отдельный готовый список, рост аудитории добавляет новые списки, которые нужно рассчитывать, загружать и обслуживать. Поэтому следующая попытка меняет не только модель предпочтений, но и то, что система считает самостоятельным объектом хранения.
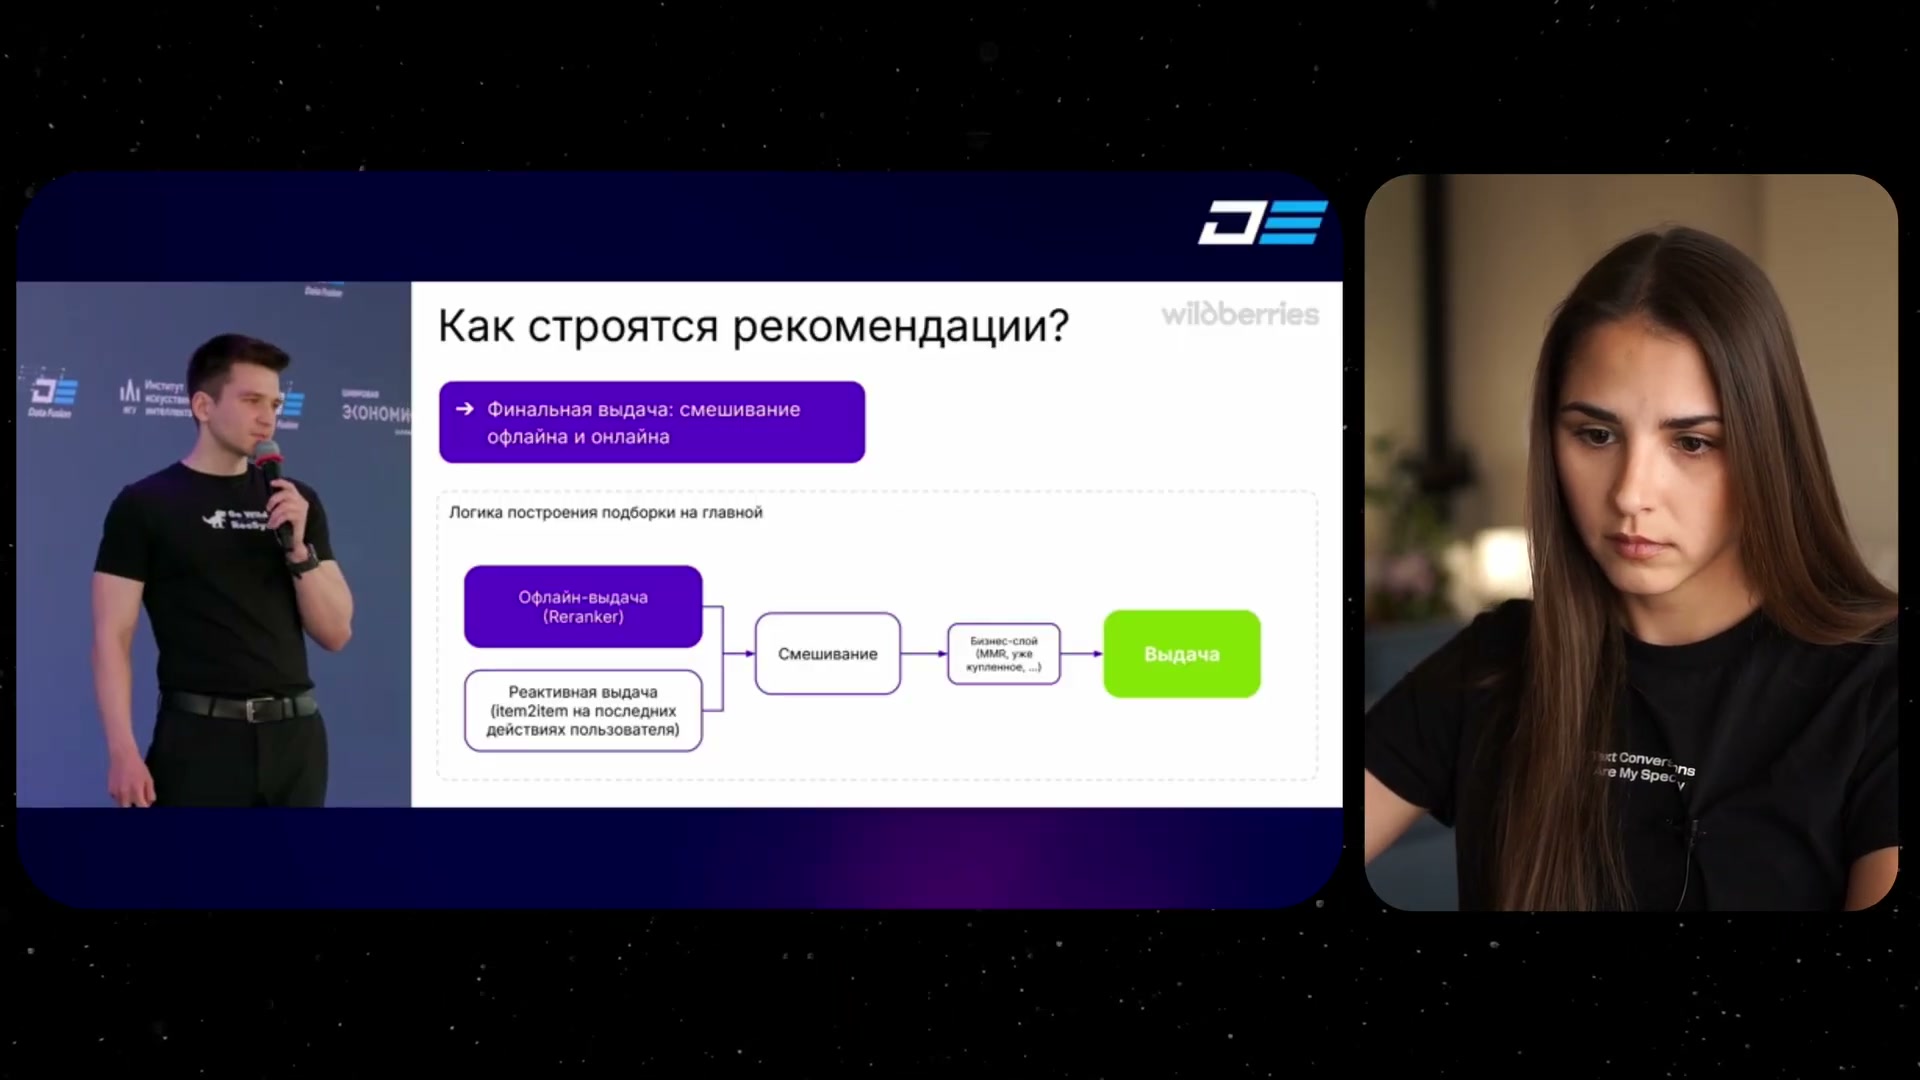
На показанном фрагменте доклада Евгения Иванова смешиваются заранее рассчитанная и реактивная подборки, затем применяется бизнес-слой. Комментарии справа принадлежат автору обзора.
Источник: Анастасия Никулина · обзор Data Fusion 2025Кому оставить персональную подборку
Первое приближение — не рассчитывать и не хранить одинаково дорогой результат для всех. Команда выделяет активных пользователей: они регулярно приходят на главную и совершают целевые действия, например добавляют товары в корзину, заказывают или долго просматривают предложения. Таких пользователей оказалось около 48% среди тех, для кого раньше считали персональные подборки. При этом они обеспечивали примерно 97% GMV рекомендательной полки — денежного объёма покупок, учитываемого в этой метрике.
Обе доли относятся к названной полке и к аудитории с рассчитанными подборками. Это не доля всех пользователей Wildberries и не вклад в оборот всей компании. Точные пороги активности и период подсчёта в рассматриваемом фрагменте не раскрыты. Для активных решили сохранить индивидуальные списки; остальных объединить в группы и хранить один список на группу.
Никулина одобряет, что сегментацию связывают с деньгами, а не только с количеством действий. Она проводит аналогию с сегментацией запросов в поиске и одновременно спрашивает, не слишком ли грубо описано поведение неактивной аудитории. Пользователь может перейти между сегментами, снова открыть главную и начать покупать. Частота таких переходов и техническое обновление сегмента остаются открытыми вопросами обзора.
Раньше, обсуждая рост нагрузки, Никулина замечает, что заранее предусмотреть подобное ограничение без опыта работы на таком масштабе трудно. Приведённая в разговоре цепочка от десятков миллионов пользователей к гораздо большей аудитории иллюстрирует проблему, а не сообщает фактическую динамику Wildberries. Наше пояснение: выделение малодоходного сегмента уменьшает ожидаемый риск, но не делает потерю качества внутри него бесплатной.
Доклад · 00:02:13Первая кластеризация: места меньше, покупок тоже
Для каждого пользователя уже есть векторное представление — набор чисел, описывающий его поведение. Большую матрицу таких векторов разбивают на части, чтобы упростить кластеризацию. В каждой части находят группы похожих пользователей, а рекомендации рассчитывают для центра группы, или центроида. Так одна подборка заменяет множество индивидуальных. На слайде число кластерных подборок составляет около 8% исходного числа персональных списков; это характеристика сжатия, а не доля оборота.
Никулина ещё до результатов называет этот вариант разумной отправной точкой, но ожидает, что грубое усреднение предпочтений ухудшит качество. В A/B проверяют сочетание индивидуальных подборок для активных и кластерных для остальных. Экономия действительно появляется, однако вместе с ней снижается GMV главной.
Таблицу можно прокрутить по горизонтали.
Даже неактивные пользователи иногда приходят на главную и покупают. Когда это происходит, общий список хуже соответствует их намерению. Особенно важно различить два перехода воронки: кликнувший пользователь добавлял товар в корзину с прежней конверсией, но переход из корзины в покупку оказался заметно хуже. Именно поэтому неизменная промежуточная конверсия не спасла денежный результат.
Длительность теста, объём групп и доверительные интервалы не приведены. Диагностику кластерных выдач нельзя переносить на всю аудиторию главной, а снижение GMV главной — на весь оборот Wildberries. Полученная просадка становится причиной следующего шага: приблизить общий список к персональным рекомендациям, не возвращая прежний объём хранения.
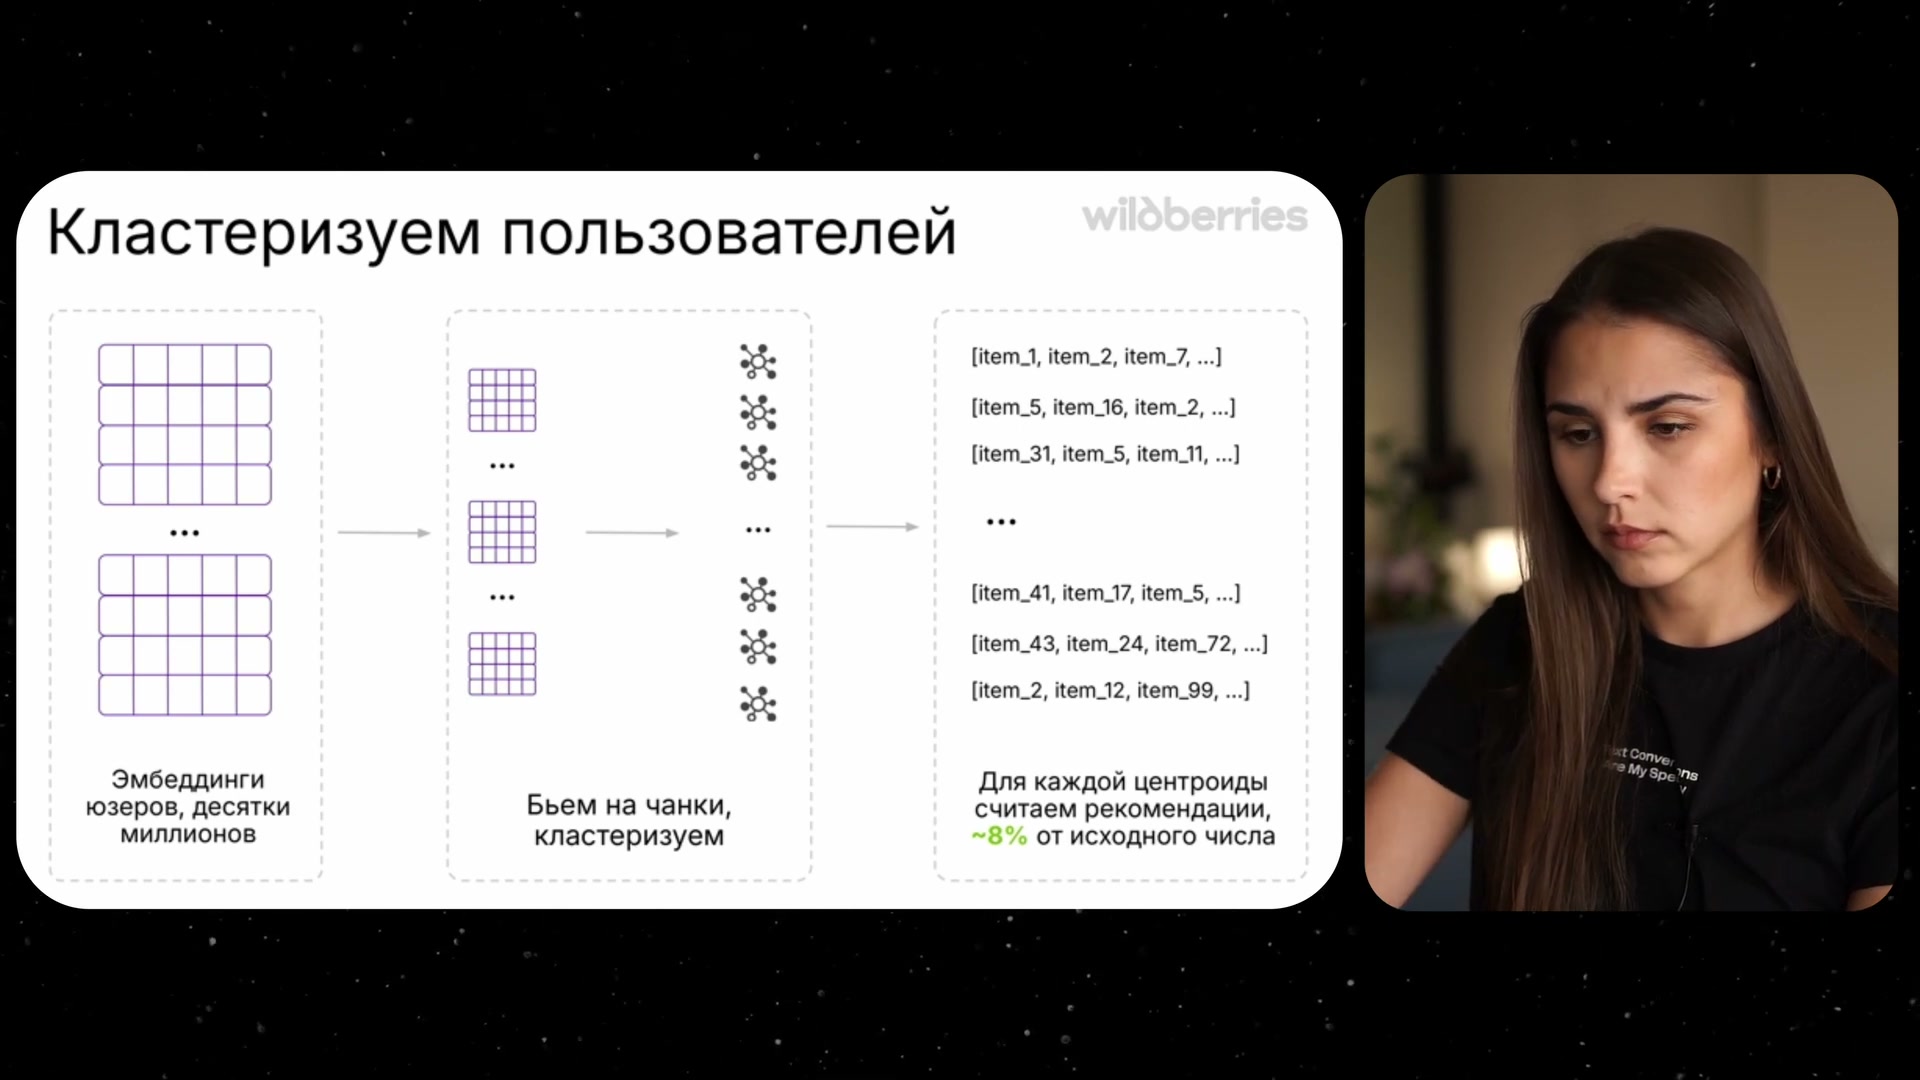
Векторы десятков миллионов пользователей делят на части и кластеризуют, для центров считают рекомендации. ~8% относится к числу кластерных подборок относительно исходного, не к доле GMV.
Источник: Анастасия Никулина · обзор Data Fusion 2025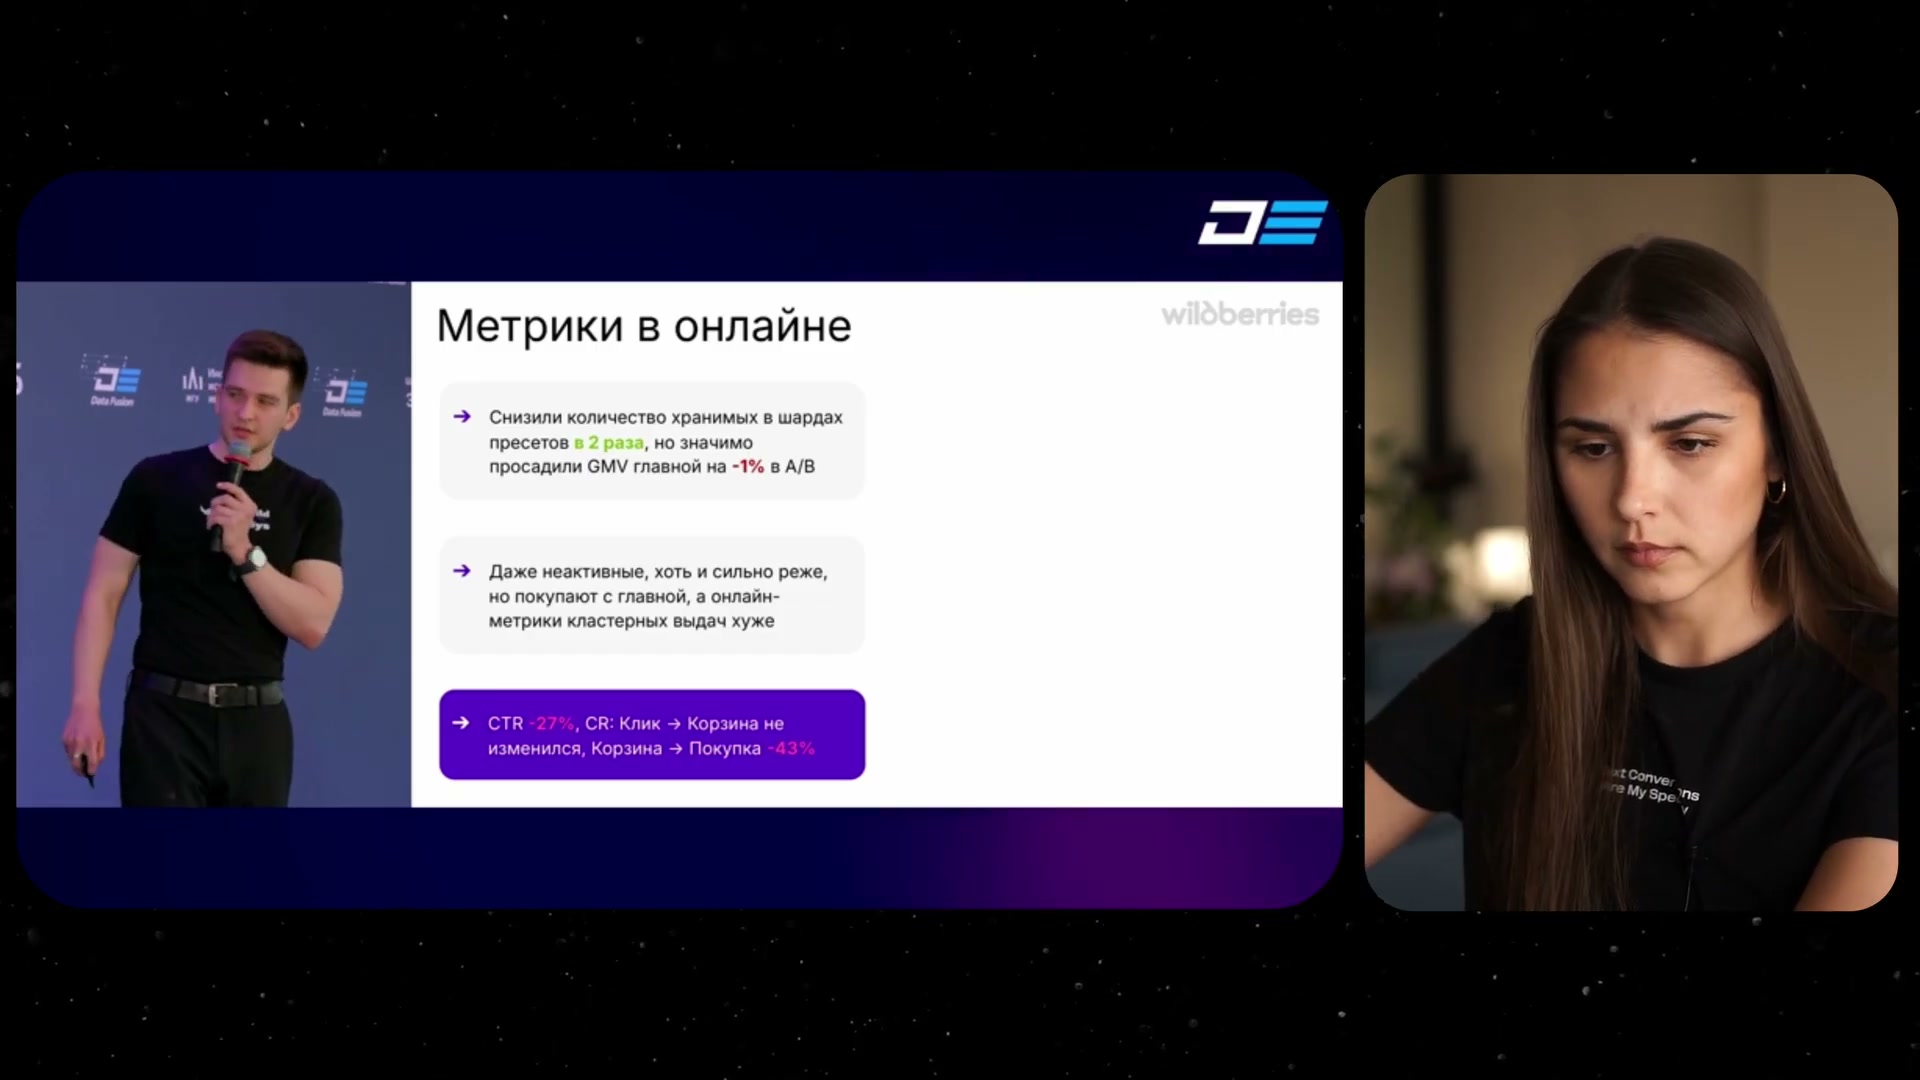
Количество хранимых пресетов уменьшили вдвое, но GMV главной снизился примерно на1%. Для кластерных выдач отдельно показаны CTR−27% и корзина→покупка−43%. Это разные группы показателей.
Источник: Анастасия Никулина · обзор Data Fusion 2025Почему улучшали не только границы кластеров
Команда меняет сразу несколько элементов представления. Простое разбиение большой матрицы на произвольные части заменяют двухуровневой кластеризацией с опорными пользователями. Социально-демографические признаки помогают уменьшить выбросы: рядом с поведенческим вектором используют пол, возраст, покупательскую способность и другие характеристики. Но самое сильное из показанных улучшений связано не с границами группы, а со способом получения её выдачи.
Таблицу можно прокрутить по горизонтали.
Агрегирование означает, что сначала получают персональные рекомендации для участников группы, а затем сводят их в общий список с учётом позиций товаров. На этом этапе персональные вычисления не исчезли: изменился способ сохранения их результата. Точная формула весов и устройство двух уровней кластеризации не раскрыты.
Никулина выделяет два содержательных изменения: вместо одного среднего пользователя используется информация о рекомендациях всей группы, а вместо жёсткой принадлежности к одному кластеру — несколько близких групп. Однако на слайде прямо сказано, что суммарный GMV главной ещё не показывает улучшения. Промежуточные проценты не складываются: это разные изменения и сравнения, а их независимый вклад и единая база не установлены.
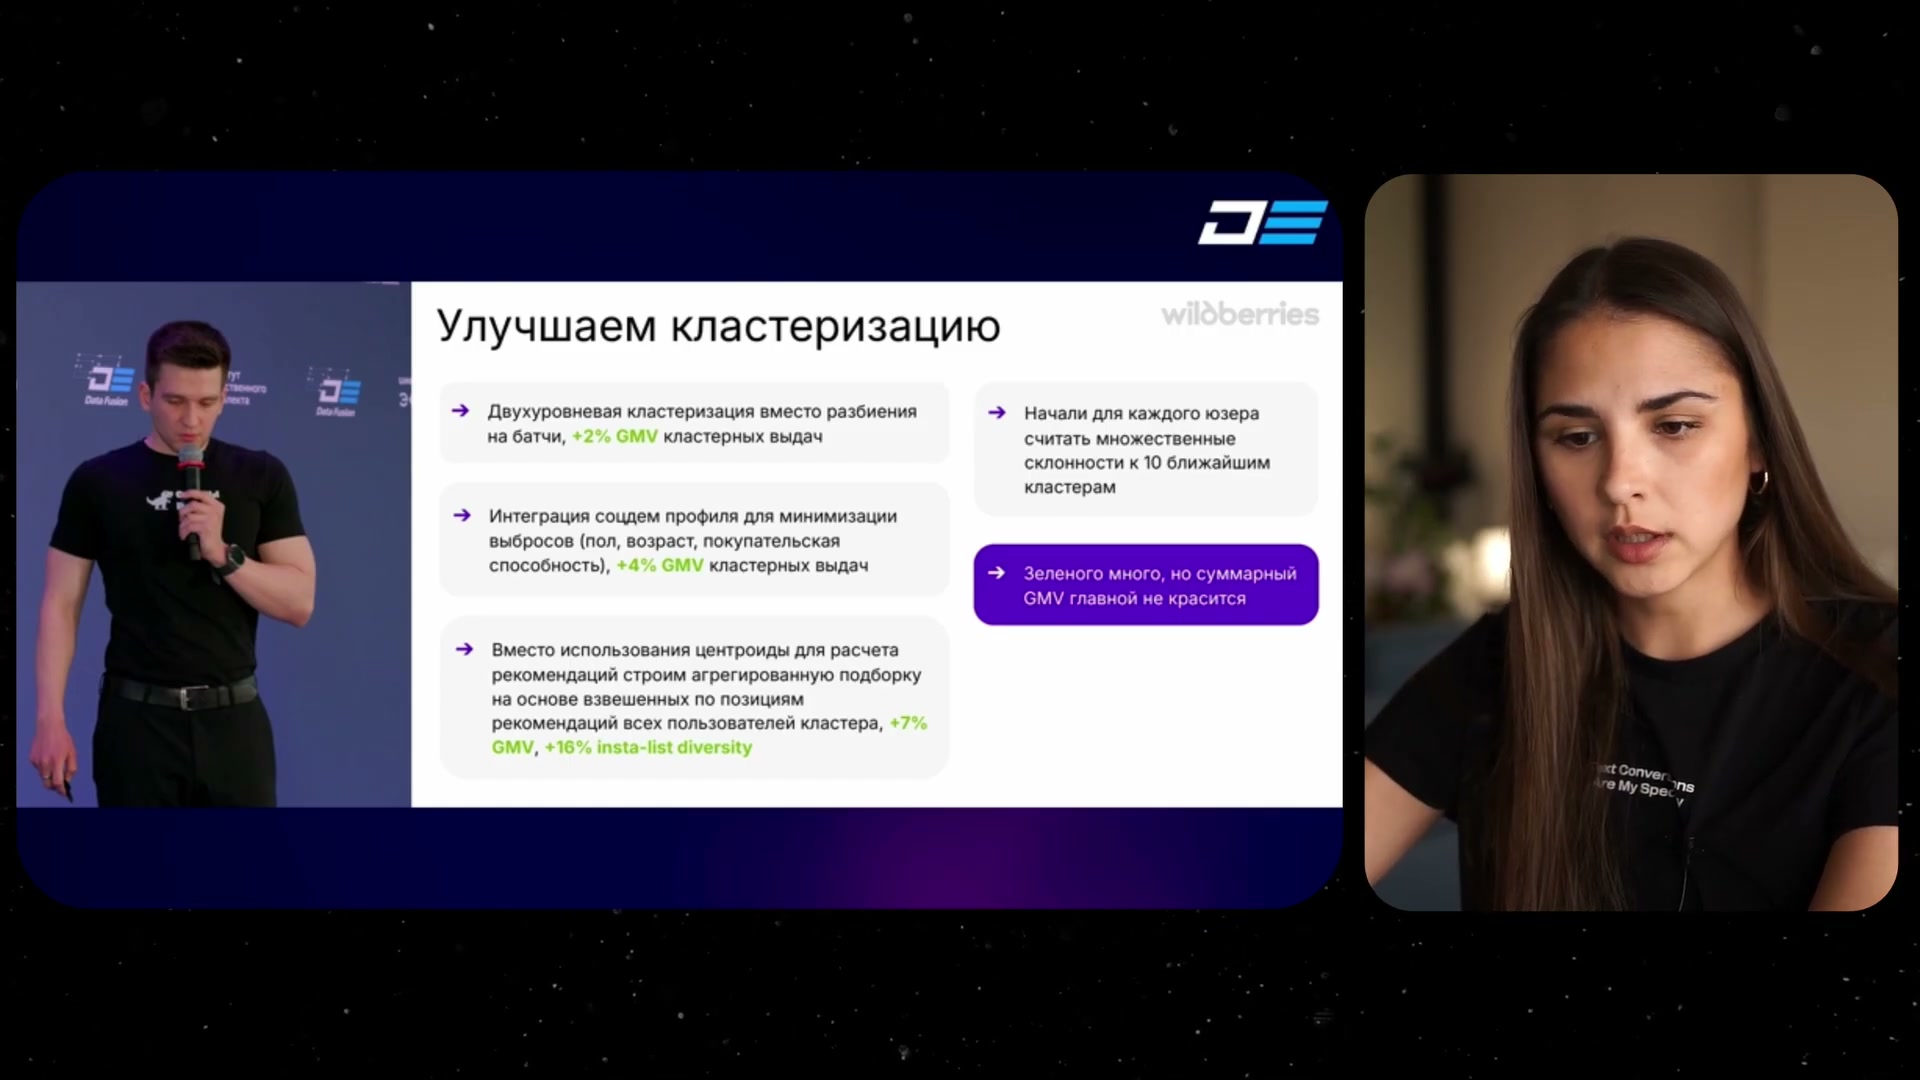
Двухуровневая кластеризация +2% GMV кластерных выдач, социально-демографические признаки +4%, агрегация персональных рекомендаций +7% GMV и +16% insta-list diversity. Эффекты не складываются; суммарный GMV главной здесь ещё не улучшился.
Источник: Анастасия Никулина · обзор Data Fusion 2025Как вернуть персональный порядок общему списку
Следующая цель — хранить общую подборку, но при запросе восстанавливать различия между пользователями. Спикер сравнивает это с архиватором: индивидуальные выдачи «сжимают» в один список, а во время показа «разжимают». Технически описан персональный пересчёт оценок товаров внутри общего набора, а не обратимое сжатие, которое гарантированно возвращает прежнюю выдачу.
Сервис берёт подборку кластера и сравнивает вектор пользователя с вектором каждого её товара. Более высокая оценка поднимает товар в списке. Для пояснения обозначим эти векторы eᵤ и eᵢ: описанная операция — их скалярное произведение, то есть сумма произведений соответствующих координат.
eᵤ — вектор пользователя, eᵢ — вектор товара; по оценке s(u,i) пересортировывают товары выбранной кластерной подборки.
Такое применение оказалось возможным благодаря предыдущему проекту векторного переранжирования. Векторы товаров начали хранить в бакетах, а пользовательские векторы — пересчитывать раз в день и помещать в векторное хранилище. Сайт или приложение синхронизирует пользовательский вектор и может добавлять его к запросу выдачи. Поэтому сервис, который отдаёт рекомендации, располагает представлениями обеих сторон — пользователя и товара.
В собственном пояснении Никулина сначала говорит об эмбеддингах кластеров. Техническая реплика Иванова конкретизирует операцию иначе: из кластера берут набор товаров, а затем используют пользовательский и товарные векторы. Наше пояснение: общий набор ограничивает, что вообще можно показать, а персональный пересчёт меняет порядок внутри него. Он сам по себе не возвращает товар, которого в наборе нет.
Подобное векторное переранжирование команда уже проверяла на разных поверхностях, но результаты тех отдельных релизов в этом обзоре не раскрываются. Для рассматриваемой кластерной задачи сообщается, что удалось отыграть примерно половину потери GMV. Это не рост GMV на половину и не основание вычислять итог простым вычитанием из первой просадки: состав последовательных сравнений полностью не описан.
Доклад · 00:06:46От суточного вектора к обновлению в сессии
После возврата персонального порядка важна свежесть самого пользовательского вектора. Суточное обновление заменяют сессионным. Взаимодействия обрабатываются отдельной цепочкой с небольшой задержкой — nearline: запрос рекомендаций не должен сам заново готовить историю и выполнять весь расчёт вектора.
- 01
События пользователя
Платформа отправляет взаимодействия в очередь сообщений. Конкретная технология очереди на схеме не названа.
- 02
Подготовка пакетов
Сервис-потребитель на Go читает взаимодействия и формирует готовые пакеты для применения модели.
- 03
Расчёт вектора
Балансировщик направляет пакеты в серверы Triton внутри сервиса применения модели.
- 04
Хранение и синхронизация
Обновлённые векторы поступают в распределённое хранилище. Платформа забирает новую версию раз в сессию и передаёт её дальше с запросами выдачи.
Пометка «раз в сессию» на схеме относится к обмену платформы с хранилищем; в речи переход также описан как обновление пользовательского представления в сессионном масштабе. Это не обещание синхронного пересчёта после каждого клика. Размеры пакетов, задержка от события до нового вектора и частота обучения самой модели не названы. Обновление вектора при применении модели не следует путать с обновлением её весов.
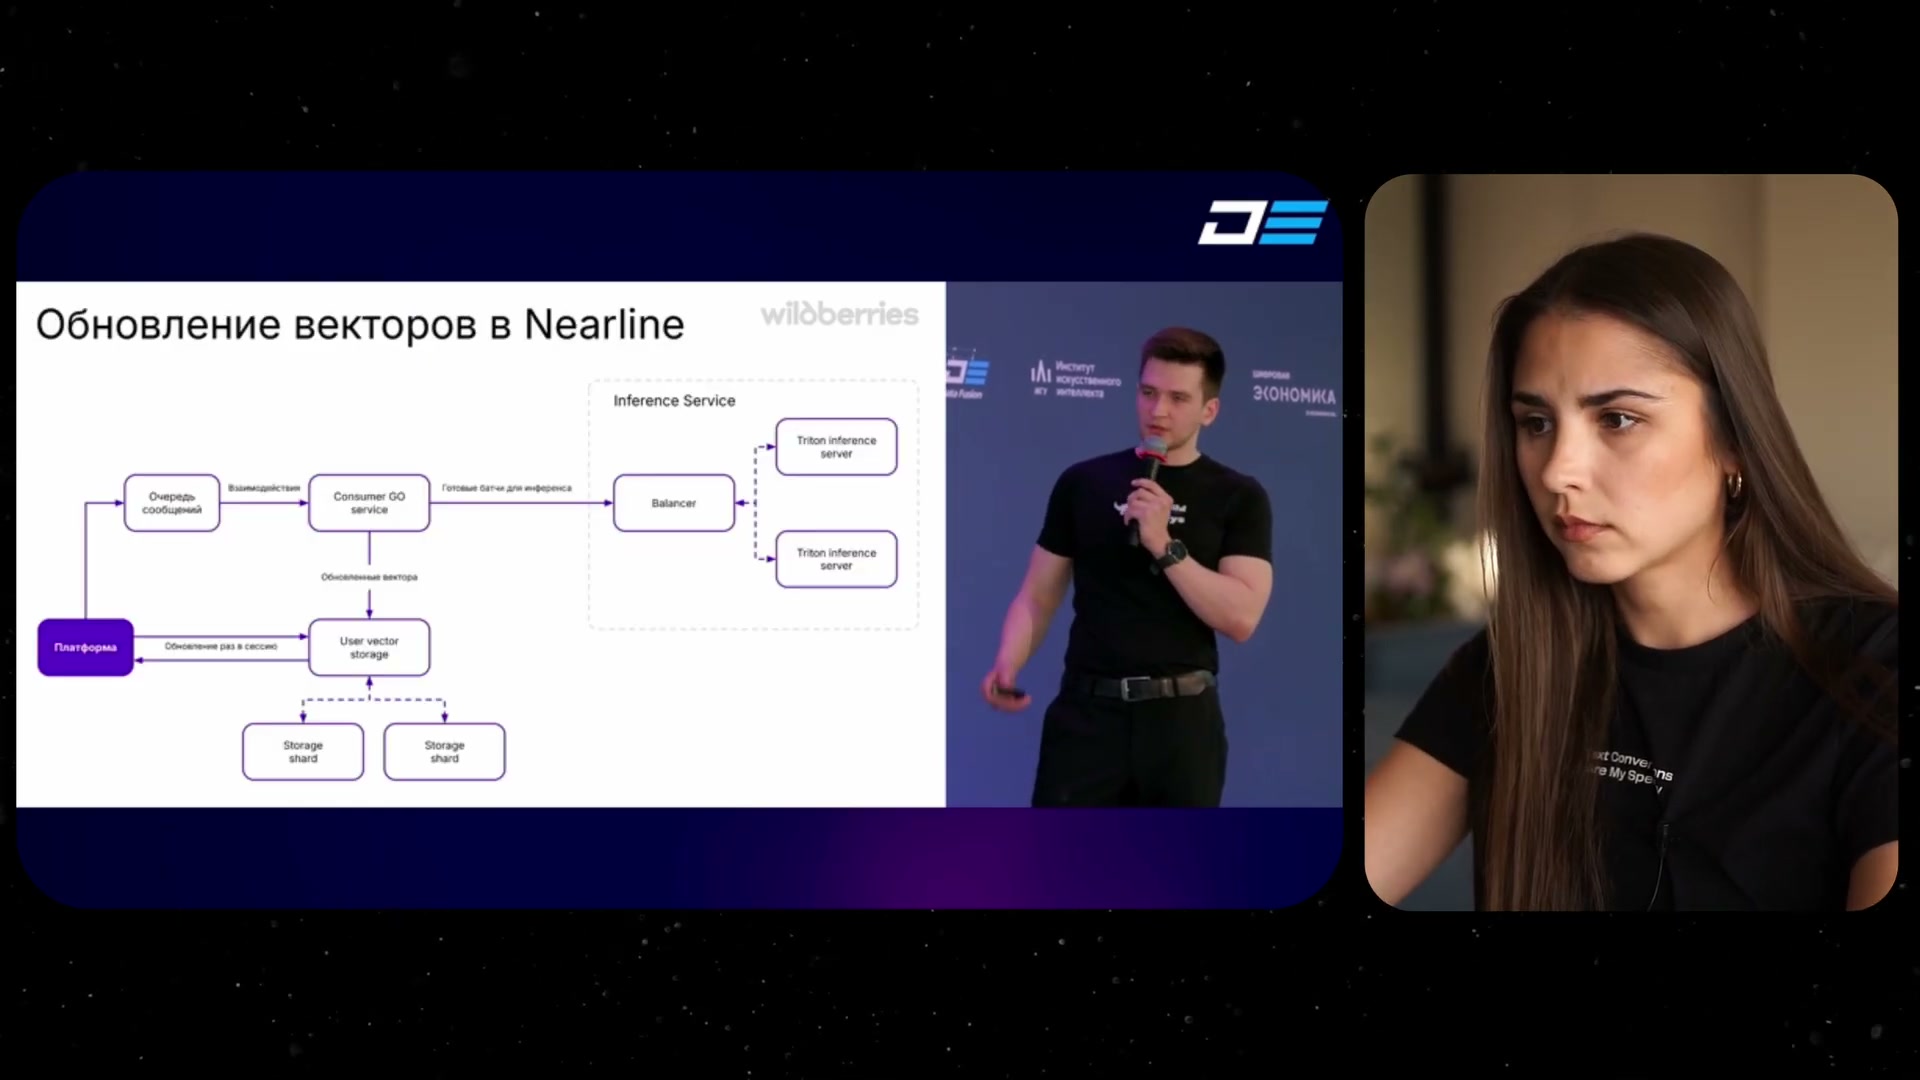
Очередь событий → Go consumer → балансировщик и Triton → хранилище векторов. На схеме обновление раз в сессию, не синхронный расчёт после каждого события.
Источник: Анастасия Никулина · обзор Data Fusion 2025Другой способ группировки: товарные интересы
До этого группировали пользователей. Теперь Иванов предлагает отдельную ветку — группировать сами товары. Текст карточки обогащают теми характеристиками, которые можно представить текстом: принадлежностью товара к полу, цветом, размером, ценовым диапазоном, диапазоном отзывов и другими сведениями. Полученные представления иерархически кластеризуют.
Результат похож на дерево каталога, но его узлы не обязаны иметь понятные человеку названия. Такую товарную группу команда называет интересом. Спикер противопоставляет её каталожной структуре, на которую может влиять поставщик: здесь используются содержательные признаки. Наше пояснение: это аргумент в пользу способа группировки, а не доказательство полной защиты от манипуляций описаниями карточек.
Интересов получается порядка сотен тысяч, но для конкретного пользователя значимы десятки или сотни. При запросе система выбирает близкие ему интересы, берёт из них товары, объединяет и персонально доранжирует по векторам. Пользователь по-прежнему получает конкретные товары, а не название кластера или абстрактную категорию.
Никулина отдельно спрашивает, как эта структура меняется при появлении новых товаров и категорий, как выбирается число кластеров и какие методы сравнивались. В показанном фрагменте нет ответов о перестроении дерева, критерии оптимального числа групп и обработке новых категорий. Поэтому описание объясняет устройство представления, но не даёт полной процедуры его сопровождения.
Доклад · 00:08:55Сравнение: товарные кластеры, пользовательские и их сочетание
В итоговой серии сравнений условие меняется: пользователей больше не делят на активных и неактивных. Для всех используют кластерные представления, сохраняют общие подборки и строят персональную выдачу из подходящих кластеров с онлайн-ранжированием. Поэтому эту таблицу нельзя читать как продолжение первого теста с неизменным составом сегментов.
Таблицу можно прокрутить по горизонтали.
Просмотры КТ — просмотры карточек товаров. Обозначение SPU сохранено без расшифровки: источник не даёт надёжного определения этой метрики. Таблица показывает все опубликованные столбцы, но не сообщает длительность опытов, размеры групп и доверительные интервалы. Маленькую положительную дельту нельзя автоматически считать доказанным статистически значимым эффектом.
Только товарные интересы дают самую сильную экономию хранения, но ухудшают каждую показанную метрику поведения и GMV. Пользовательские кластеры лучше сохраняют релевантность: корзины и заказы растут, однако GMV всё ещё снижается. Иванов связывает это со снижением среднего чека. Сам размер изменения среднего чека не приведён.
Финальный вариант сочетает 50 товарных интересов и 5 пользовательских кластеров. Из их подборок получают товары и пересортировывают их под конкретного пользователя. В таблице остаётся около 6% исходного числа пресетов, а GMV увеличивается на 1,8%. Никулина связывает удачный результат с тем, что решение учитывает и пользовательское поведение, и сведения о товарах, сохраняя инфраструктурную экономию.
Наше пояснение: сильная сторона смешанного решения видна не в максимальном росте каждого промежуточного показателя. Пользовательские кластеры отдельно дают больший прирост корзин и заказов, но проигрывают по GMV. Выбор отражает компромисс между хранением и конечным денежным результатом, а не оптимизацию одного клика или одной конверсии.
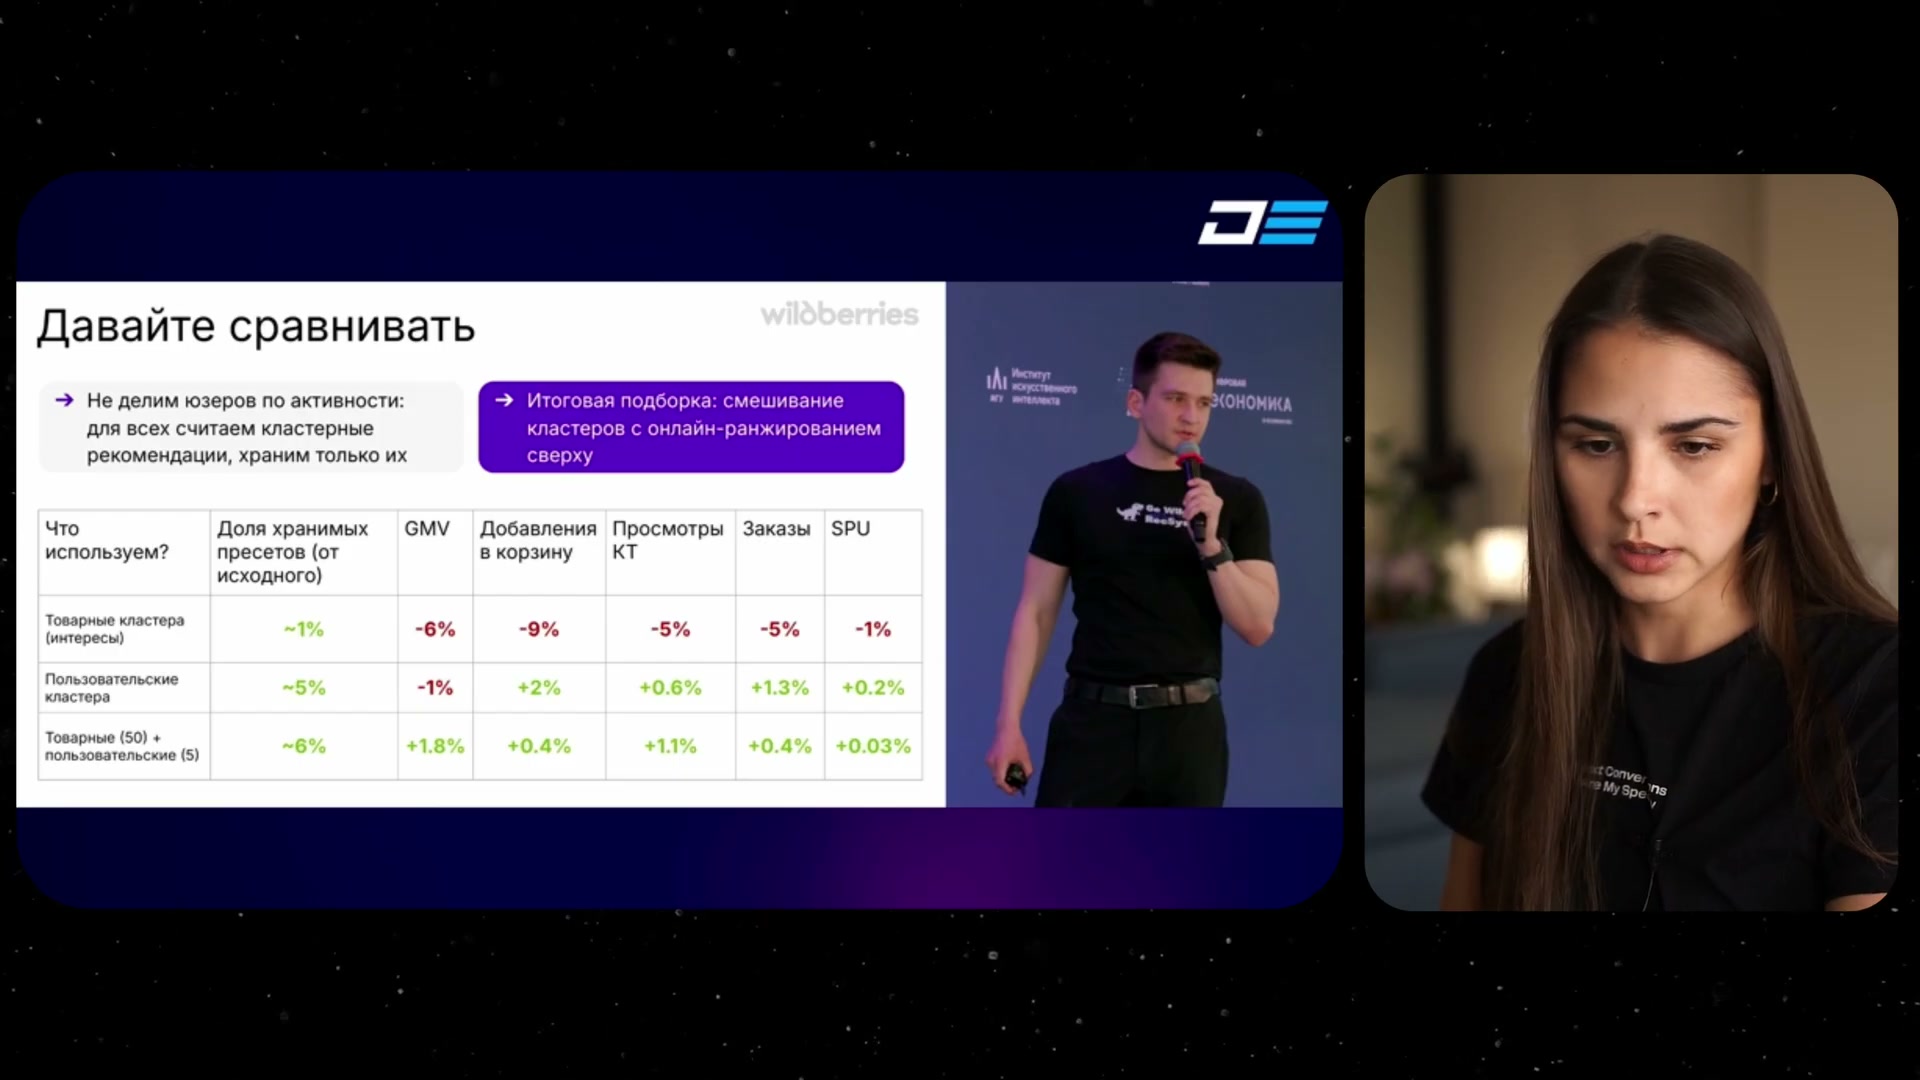
Товарные кластеры, пользовательские и смесь50+5 дают разные компромиссы. В смеси хранят~6% исходных пресетов, GMV+1,8%; состав и база сохраняются, масштаб всех затрат не выводим.
Источник: Анастасия Никулина · обзор Data Fusion 2025Что удалось сэкономить и какие вопросы остались
Итог Иванова — в 15 раз меньше обслуживаемых шардов соответствующих выдач. Это измерение инфраструктуры, а не пятнадцатикратное снижение всех затрат компании. Около 6% в предыдущей таблице относится к числу хранимых пресетов; число пресетов и число шардов — разные показатели, поэтому округлённые значения не нужно превращать в точное взаимно обратное равенство.
Более важным концептуальным результатом спикер считает возможность отобразить нового пользователя в уже существующие группы пользователей и товарные интересы. Для каждого нового человека больше не требуется отдельная сохранённая товарная выдача. Наше пояснение: это снимает конкретную зависимость объёма пресетов от аудитории, но не отменяет рост числа запросов, пользовательских векторов и остальных данных.
Дальнейший план — рассчитывать склонности к кластерам непосредственно в онлайн-инфраструктуре, чтобы быстрее реагировать на намерение пользователя. Этот план отличается от уже показанного nearline-обновления вектора: свежий вектор и новый способ выбора кластеров — не одна и та же операция. Ожидаемое улучшение реактивности ещё не сопровождается измеренным результатом.
В финальном комментарии Никулина отмечает необычный для привычного каскада взгляд на рекомендации: кластеризация здесь становится способом изменить эксплуатацию системы. Ей хотелось бы больше исследования выбора алгоритмов. Она обсуждает удобство k-means на больших объёмах и его ограничения для сложной структуры данных, но обзор не даёт сравнительной таблицы методов и не позволяет приписать Wildberries все обсуждаемые варианты.
Ещё один её вопрос — можно ли было решить проблему иначе, изменив архитектуру без такого кластерного представления. Это приглашение к обсуждению, а не показанный проигрыш альтернативного решения. Остаются также вопросы о переходах между сегментами, обновлении товарных кластеров и параметрах алгоритмов. Секцию вопросов исходного выступления Никулина пропускает; эти замечания принадлежат автору обзора, а не восстановленному обсуждению со спикером.
Доклад · 00:13:04Lamoda: персонализация начинается с небольшого виджета
Данил Комаров рассказывает о другой задаче: как рекомендации меняли главную страницу Lamoda. Вводные числа задают масштаб на момент выступления: десятки миллионов пользователей в месяц, более 100 тысяч заказов ежедневно, свыше 670 тысяч товаров в стоке и более тысячи сотрудников Lamoda Tech. Последнее число относится к технологическому подразделению, а не к команде специалистов по данным.
Никулина просит обращать внимание на такие вводные: от размера аудитории и каталога зависят подходящие алгоритмы и ограничения. Но сами эти числа ещё ничего не говорят о размере групп последующих A/B-тестов или о нагрузке конкретного рекомендательного сервиса.
До мая 2024 года показанная главная состояла из баннеров, неперсональных подборок, подборок стилистов и сторис. В мае команда тестирует персональный товарный виджет на женской и мужской главных. В нём объединены товары разных категорий. Это начало рассматриваемой истории главной, а не доказательство отсутствия любых рекомендаций в других частях Lamoda до этой даты.
Никулина положительно оценивает межкатегорийную подборку: посетитель может искать не только футболку, но и брюки, кроссовки или аксессуары. Это её продуктовый комментарий, не утверждение о специальной модели совместимости вещей. Виджет добавляет персональные предложения в прежнюю страницу; превращение всей главной в рекомендательную ленту произойдёт следующим шагом.
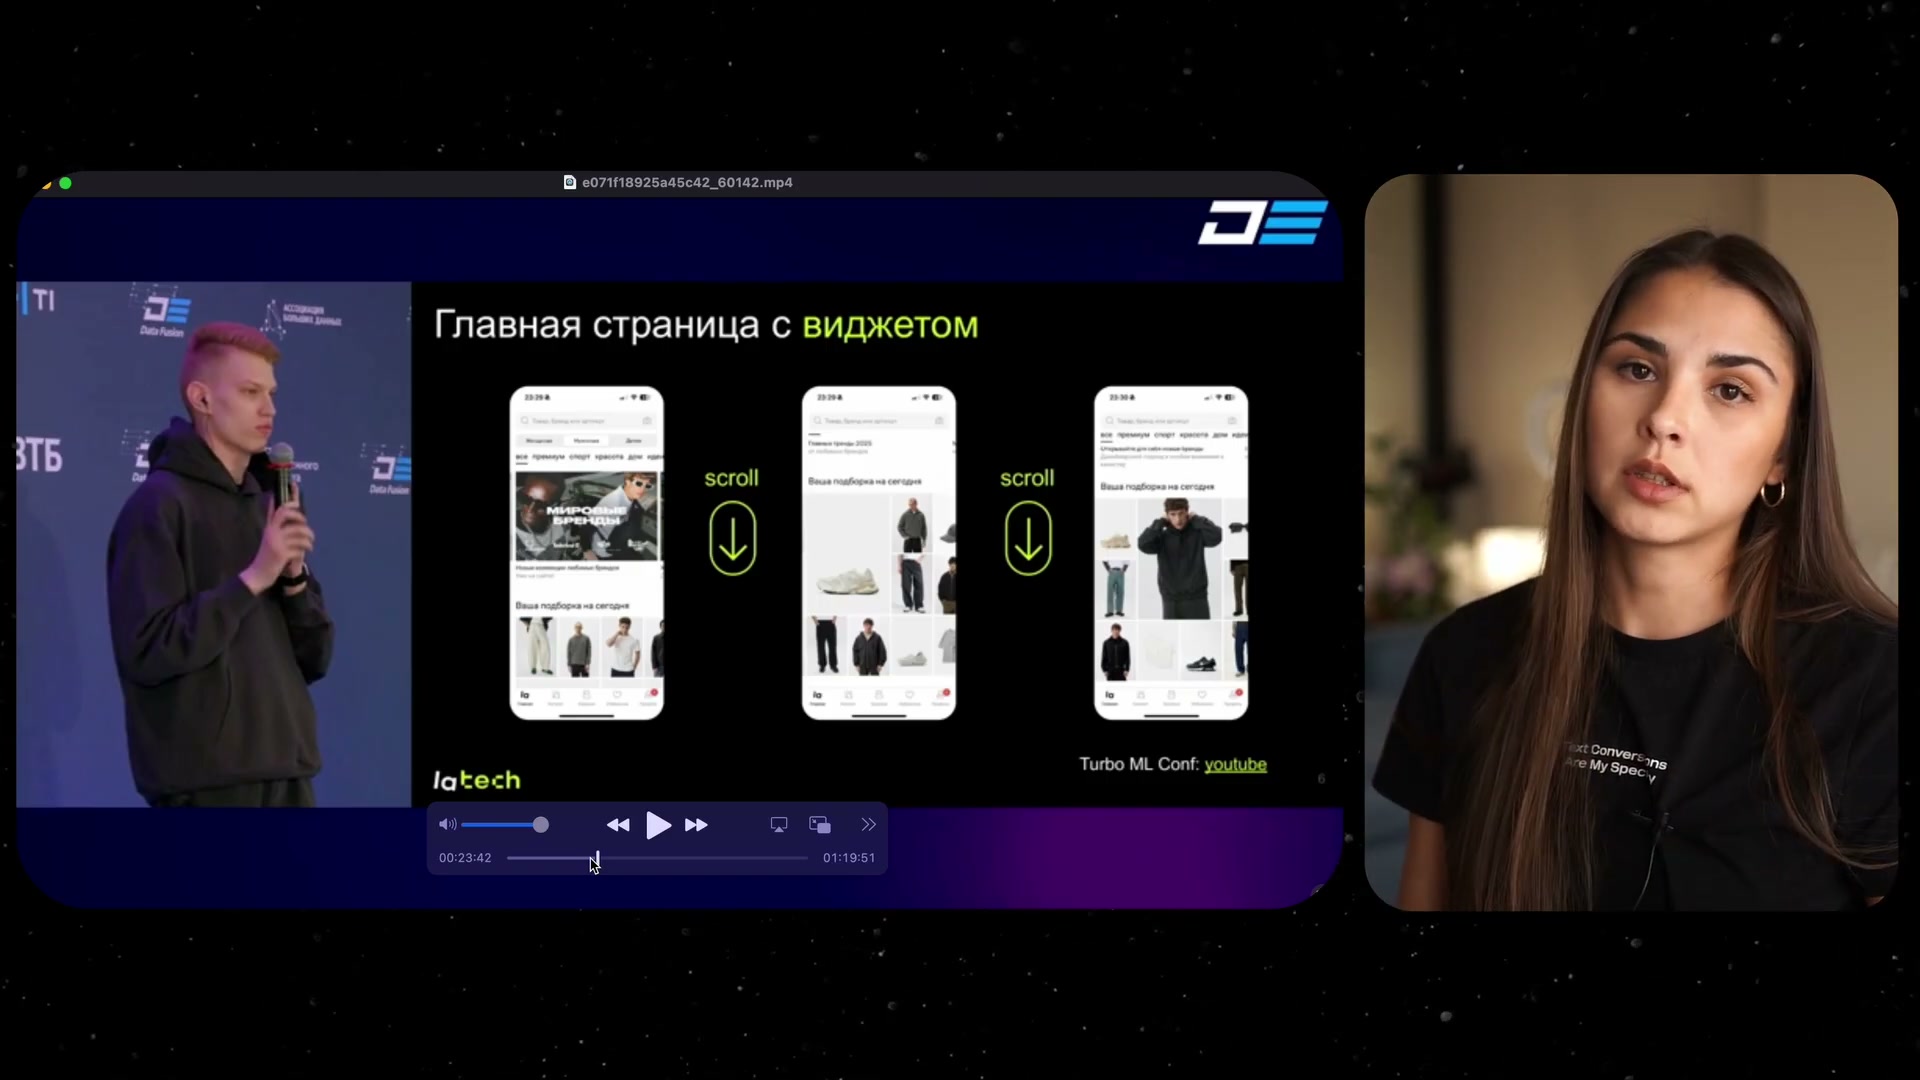
Показан новый товарный виджет вместо только редакционных блоков; это интерфейсный контекст, а не результат конкретной ML-метрики.
Источник: Анастасия Никулина · обзор Data Fusion 2025Первый подбор товаров: ALS, HNSW и разнообразие
Первая версия начинает с двух источников кандидатов — небольшого набора товаров, который отбирают из всего каталога до показа. Один источник использует совместные действия пользователей, то есть коллаборативную фильтрацию; второй предлагает бестселлеры. На схеме первый источник назван ALS. Наше пояснение: ALS получает векторные представления пользователей и товаров из матрицы взаимодействий, чтобы оценивать подходящие сочетания.
Обучение ALS учитывает четыре вида действий: просмотр карточки, добавление в избранное, добавление в корзину и заказ. Действия взвешиваются с учётом давности: старые получают меньший вес. Точные коэффициенты и вид затухающей функции не приведены. Для применения ALS используют приближённый поиск соседей по векторам через HNSW. Это способ быстро найти кандидатов, а не отдельная обучаемая модель предпочтений.
Бестселлеры на слайде определены как лидеры продаж за последние N дней; конкретное N не названо. Простого объединения результатов недостаточно: список может оказаться однообразным. Поэтому после источников работает слой правил — разнообразие через MMR и отдельная бизнес-логика для некоторых позиций ленты.
Наше пояснение MMR: очередной товар выбирается с учётом его релевантности и сходства с тем, что уже попало в список. Так уменьшается повторение однотипных предложений. В докладе не раскрыты коэффициент такого компромисса и используемая мера сходства. MMR здесь не следует путать с появившимся позже обучаемым ранкером CatBoost.
В этой версии всю подборку рассчитывают заранее, сохраняют в хранилище, а бэкенд получает готовый список. Никулина называет ALS с популярными товарами хорошей базовой схемой и замечает отсутствие отдельной тяжёлой ранжирующей модели. Это исходная стадия развития продукта, а не итоговая архитектура Lamoda.
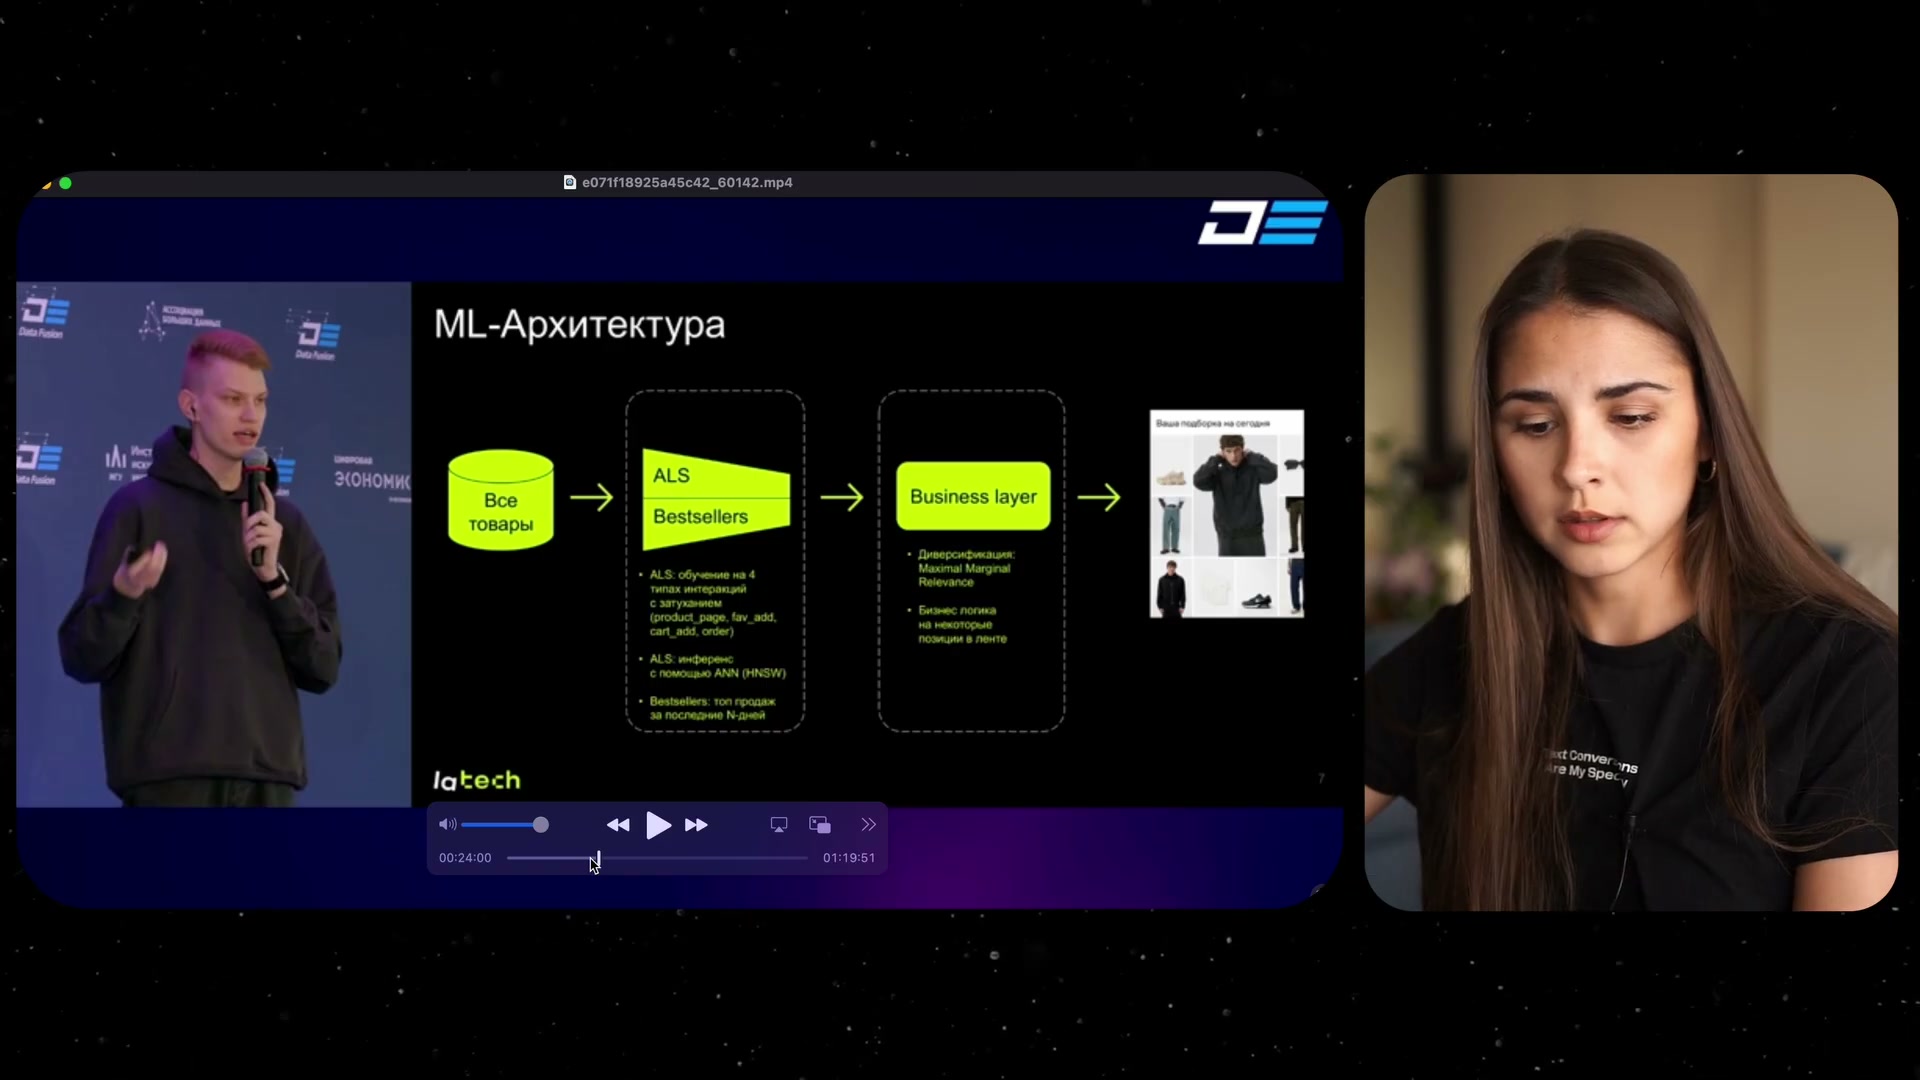
ALS и бестселлеры → MMR и бизнес-правила. ALS учитывает четыре вида взаимодействий и давность; HNSW используется для приближённого поиска кандидатов.
Источник: Анастасия Никулина · обзор Data Fusion 2025Почему заменили виджет полноценной лентой
Первый тест показывает улучшение конверсии в добавление в корзину и интерес пользователей к виджету. Но у решения остаются продуктовые ограничения. В виджете только 72 товара; хотелось показывать больше. Горизонтальная прокрутка и карточки разных размеров делают взаимодействие неочевидным. Развитие рекомендаций упирается уже не только в подбор кандидатов, но и в устройство самой страницы.
Одновременно в компании идёт большой проект новой главной. Теперь её основу составляет лента персональных товарных рекомендаций, а баннеры и сторис размещаются между ними. Это изменение поверхности показа: рекомендациям достаётся гораздо большая часть пользовательского пути.
Комаров интерпретирует уменьшение времени между сессиями как более частое возвращение пользователей. При этом на слайде нет конкретного показателя удержания за выбранное число дней. Дельты относятся к тесту новой главной; их нельзя суммировать с дальнейшим улучшением ранкера или источника кандидатов. Абсолютные значения конверсий, точные знаменатели, длительность и размеры групп не раскрыты.
Никулина дважды возвращается к денежной оценке. После первого теста она напоминает, что корзина не равна совершённой покупке. После новой ленты — что даже больше покупок не обязательно означает больше выручки или прибыли: может уменьшиться средний чек. Это запрос дополнительных результатов, а не сообщение о реально упавшем чеке Lamoda. Денежных дельт для этих тестов в обзоре нет.
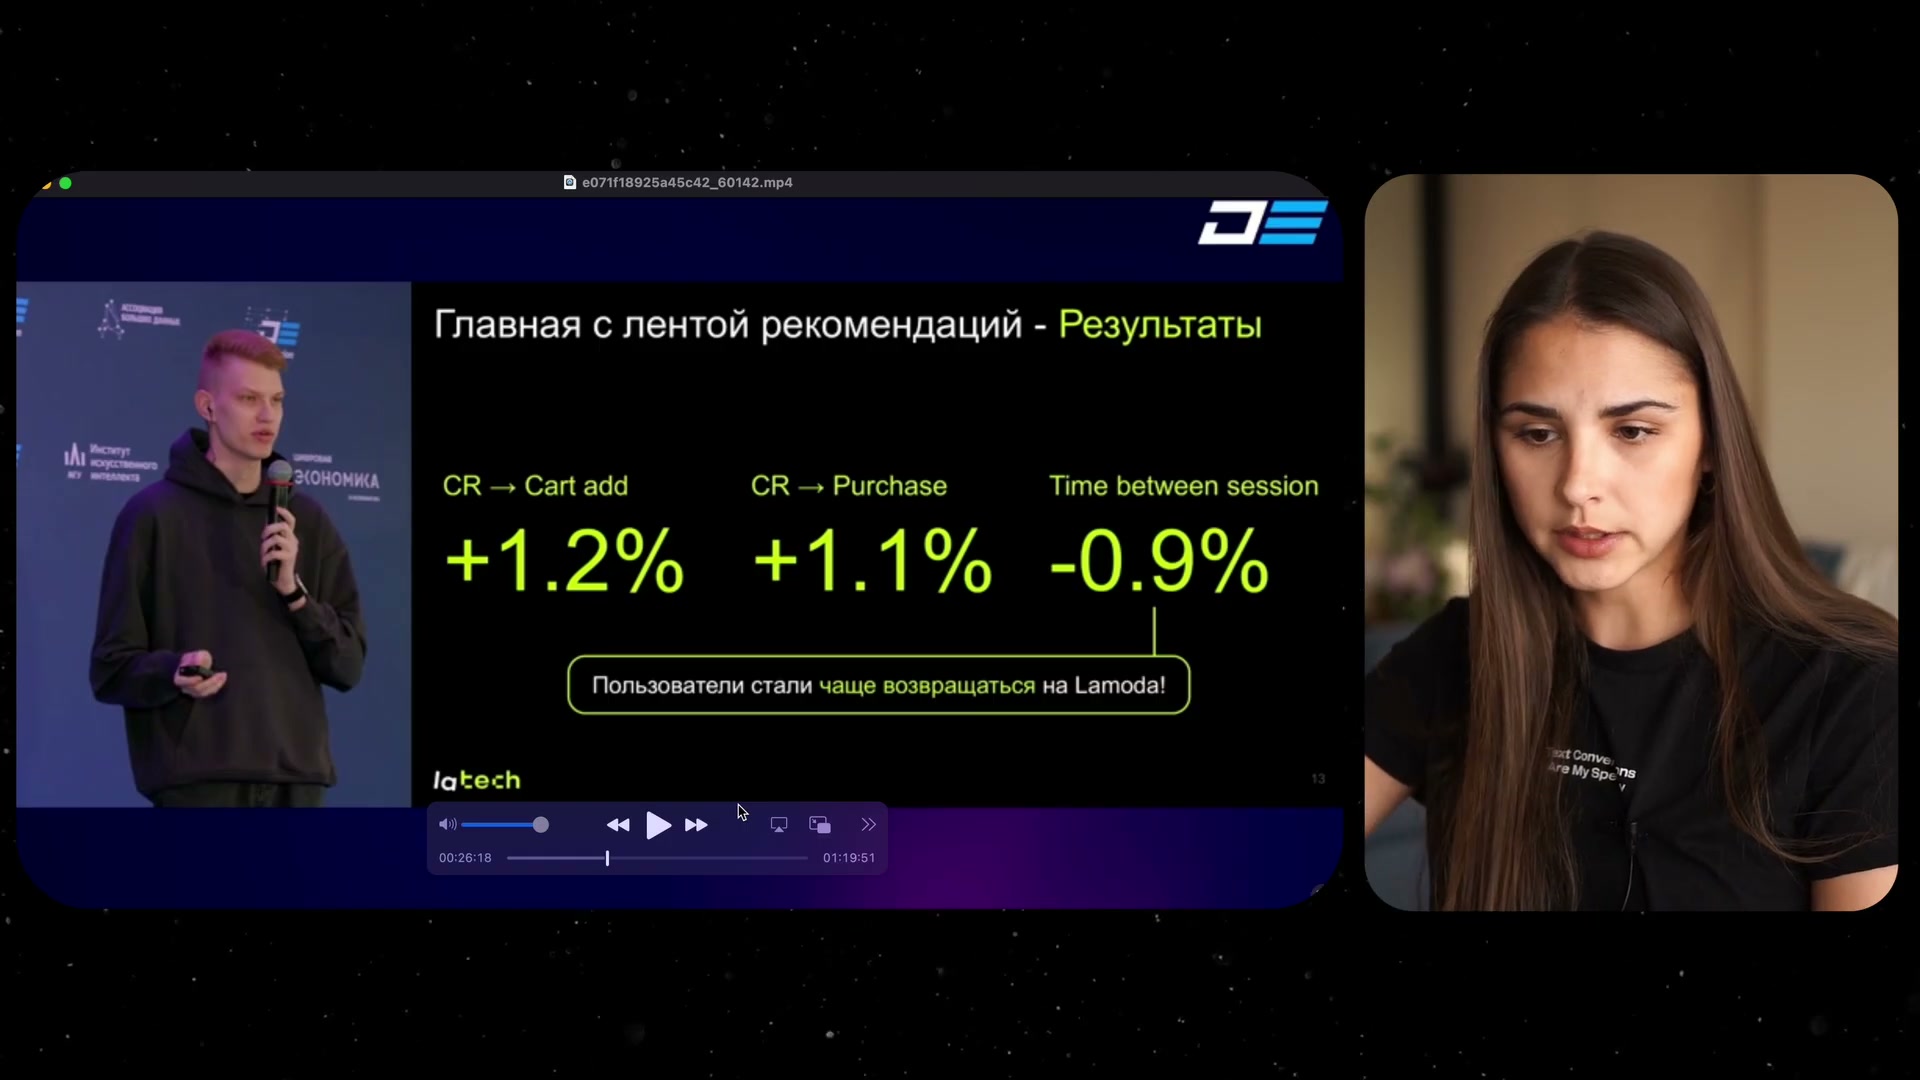
CR→Cart add +1,2%, CR→Purchase +1,1%, Time between session−0,9%. Это сравнение главных страниц, а не эффект всех последующих изменений вместе.
Источник: Анастасия Никулина · обзор Data Fusion 2025CatBoost: научиться упорядочивать показанные товары
На следующем этапе источники кандидатов и правила разнообразия уже работают, но система ещё не использует богатые признаки при определении общего порядка товаров. Команда добавляет CatBoost — обучаемую ранжирующую модель на деревьях. Сначала она применяется офлайн, внутри предварительного расчёта подборок.
Для обучения собирают реальные просмотры рекомендаций на главной. Эти показы образуют будущие группы ранжирования. Модель получает товарные, пользовательские и парные признаки: последние описывают связь конкретного пользователя с конкретным товаром. Целевое действие — добавление в корзину. Комаров объясняет выбор большим количеством такого сигнала и его связью с будущими заказами.
Для офлайн-проверки используют NDCG@60: метрику, которая учитывает, насколько высоко в первых 60 позициях стоят релевантные объекты. Слайд показывает +22% относительно тогдашней производственной выдачи. В речи результат округлён примерно до 20%; это одно сравнение, а не два улучшения. Рост NDCG не означает роста заказов, денег или конверсии на 22%.
Порядок предварительного расчёта становится таким: источники кандидатов, затем CatBoost, затем бизнес-правила и сохранение готовой выдачи. Формула потерь, конкретные гиперпараметры и правила построения отрицательных примеров в обзоре не описаны. Никулина спрашивает, что произойдёт с новым пользователем или с запросом без заранее рассчитанной подборки. Отдельный механизм холодного старта здесь не показан; наличие бестселлеров само по себе не раскрывает его устройство.
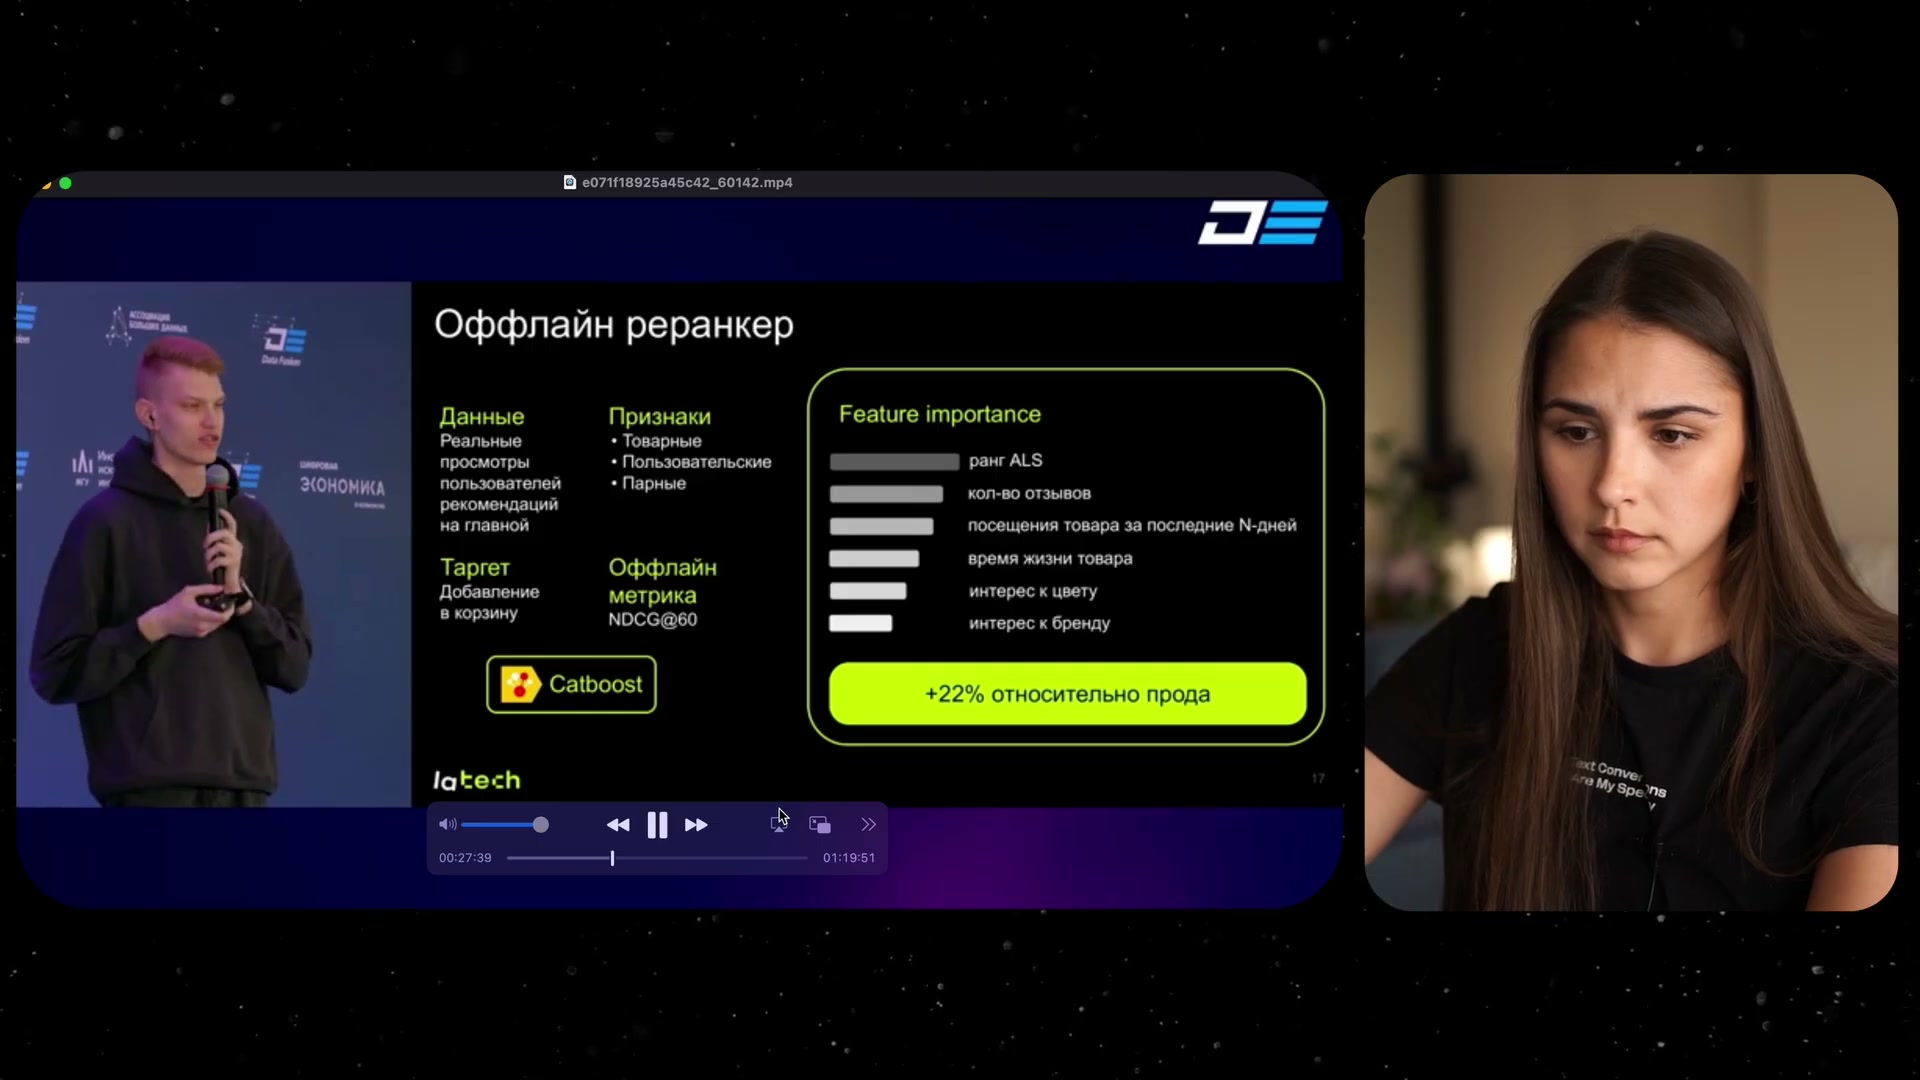
CatBoost обучают на добавлении в корзину; офлайн NDCG@60 +22% относительно тогдашнего продакшена. Это не рост продаж на22%.
Источник: Анастасия Никулина · обзор Data Fusion 2025Что перенесли в запрос, а что оставили ежедневным
Онлайн-тест ранкера Комаров описывает как сильный и сопоставимый с запуском новой главной. В верхней части выдачи появляются более релевантные товары, новые категории и новинки. Этот отдельный тест в обзоре описан без точных дельт; цифры теста новой страницы не являются его результатом.
Следующая задача — перестать заранее рассчитывать весь окончательный порядок. У Lamoda не одна главная: для каждого гендера их пять. Ежедневный расчёт персональных подборок для всех этих страниц обходится дорого и ограничен заранее известным контекстом. Кроме того, у команды уже есть опыт онлайн-ранжирования каталога и других рекомендательных полок.
До изменения сервис получал сохранённую подборку, проверял доступность товаров и отдавал её пользователю. Теперь между получением кандидатов и ответом появляется отдельный рекомендательный ранкер. На итоговой схеме оба сервиса написаны на Go; кандидаты и признаки находятся в Aerospike. В новом сервисе применяются CatBoost и MMR.
- 01
Запрос главной
Сервис рекомендаций на Go получает запрос и обращается к подготовленным данным в Aerospike.
- 02
Передача кандидатов
Отобранный набор товаров передаётся отдельному сервису рекомендательного ранкера; для оценивания доступны признаки кандидатов.
- 03
Персональный порядок
Сервис ранкера на Go применяет заранее обученный CatBoost к кандидатам и их признакам.
- 04
Разнообразие и ответ
MMR меняет порядок с учётом разнообразия, после чего результат возвращается сервису рекомендаций и пользователю.
Подготовка данных и обучение происходят отдельно от этого запроса. В Hadoop-кластере с помощью Spark рассчитывают пользовательские, товарные и парные признаки, готовят кандидатов и обучают ранкеры. Airflow управляет заданиями и загрузками. Кандидаты и признаки обновляются в хранилище ежедневно; для весов моделей и конфигурации на схеме отдельно показаны S3 и etcd. Онлайн-сервис использует опубликованные артефакты, а не запускает обучение при открытии страницы.
Таким образом, онлайн здесь означает применение CatBoost и правил разнообразия во время запроса. Это не переход всего отбора кандидатов в реальное время: кандидатный уровень остаётся офлайн. Никулина спрашивает о частоте обновлений и предполагает, что при дальнейшем росте аудитории могли бы возникнуть ограничения хранения, похожие на историю Wildberries. Она сразу оговаривает, что необходимость переделки зависит от реального темпа роста; это не установленный дефект системы Lamoda.
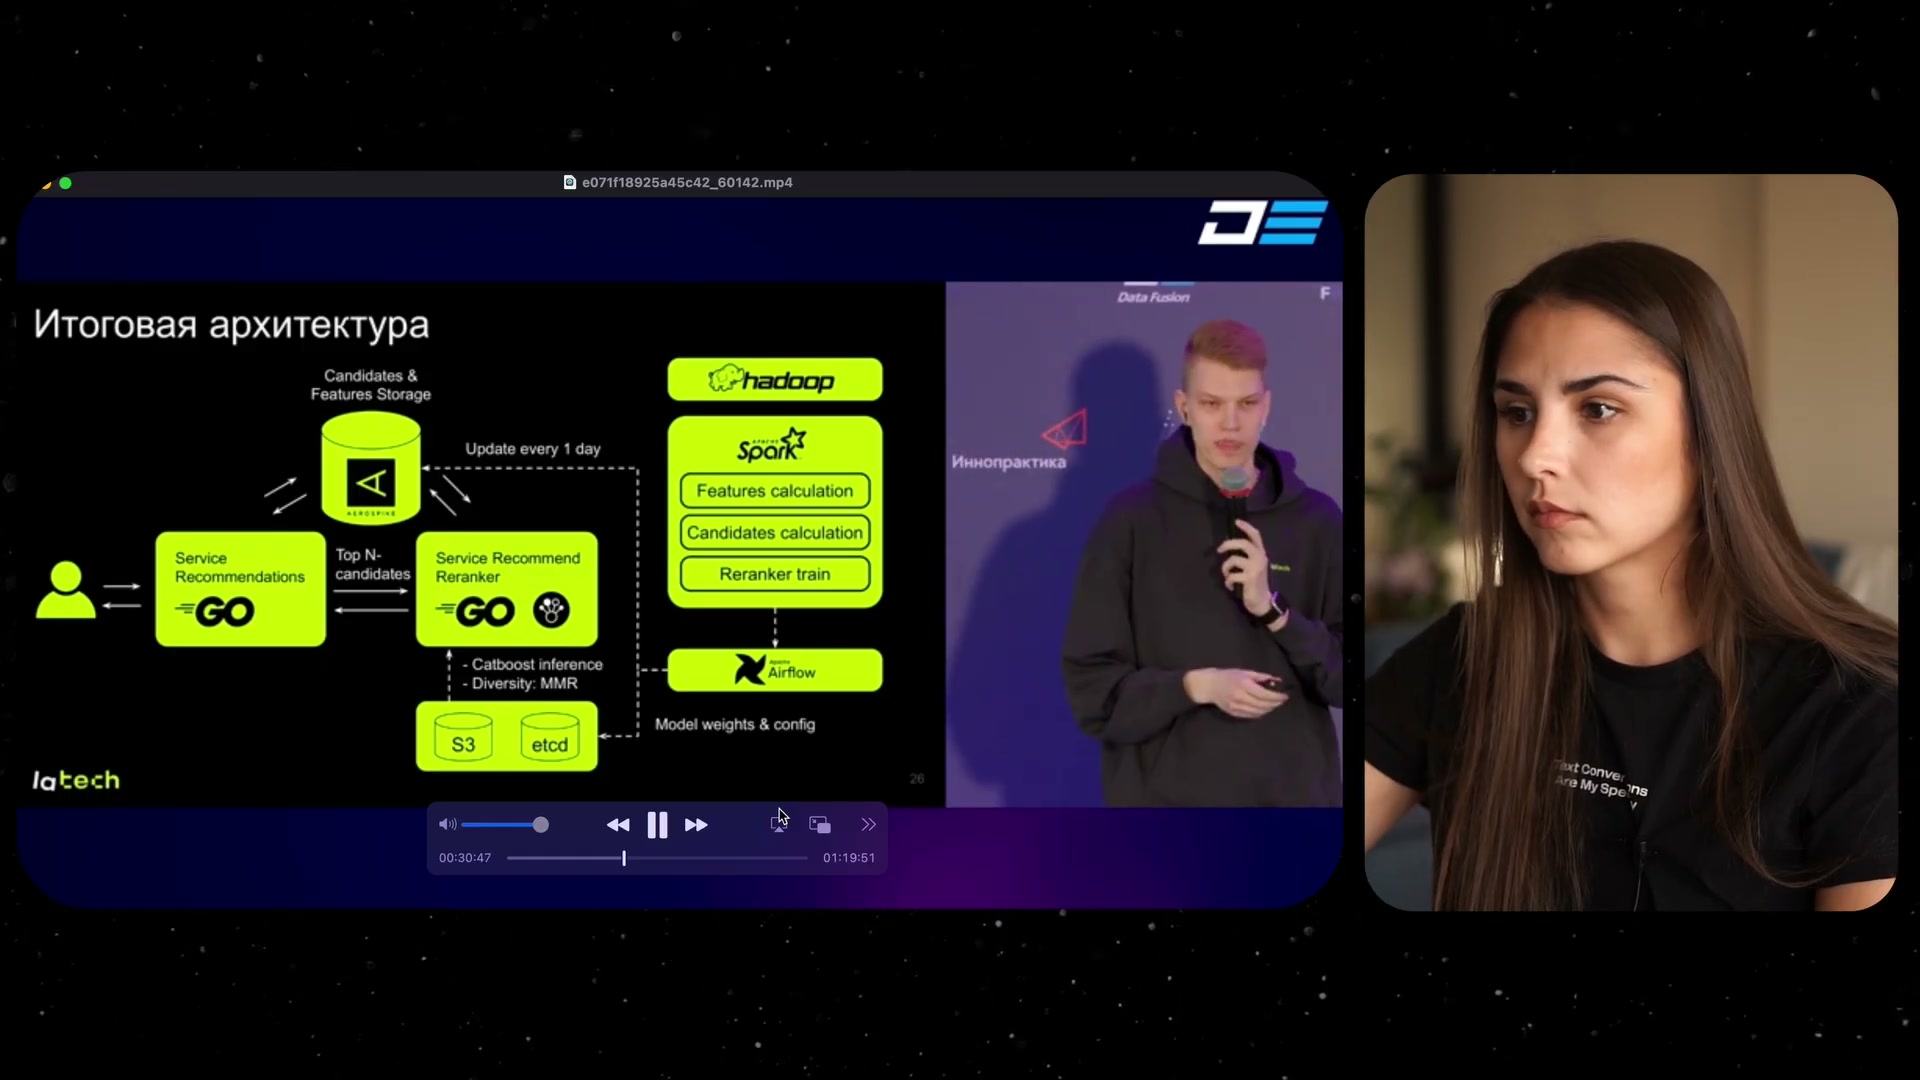
Go-сервисы читают кандидатов/признаки из Aerospike; CatBoost и MMR применяются при запросе. Spark/Hadoop/Airflow готовят ежедневные данные и веса, S3/etcd — модели и конфигурация.
Источник: Анастасия Никулина · обзор Data Fusion 2025Почему обучающие признаки должны совпадать с признаками показа
После переноса ранкера в запрос команда замечает расхождение между обучением и применением. Обучающая выборка строится из фронтовых событий: к группам показов присоединяют офлайн-признаки на выбранную дату. Но в реальном запросе ранкер получает значения из хранилища. В течение дня могут приехать новые загрузки, измениться признаки или не доехать часть значений, оставив пропуски.
В итоге обучающий пример не обязательно описывает то состояние, которое модель действительно видела при показе. Наше пояснение: одного совпадения названий признаков недостаточно. Для корректного обучения важны их фактические значения и наличие в конкретный момент — иначе модель учится по информации, отличающейся от её рабочей среды.
Решение разделяет две задачи сбора данных. Показы и реакции пользователя продолжают получать с фронта. Признаки, реально использованные ранкером, логируют на бэкенде. Сервис ранкера отправляет сообщения в Kafka; Spark Streaming читает их и переносит в Hadoop, где эти данные доступны для обучения. Поток логов дополняет ежедневную подготовку кандидатов и признаков, а не заменяет её.
Никулина спрашивает, как раньше контролировали этот эффект в A/B: сохраняли ли фиксированный набор признаков и одинаковую процедуру их получения. Ответа в показанном фрагменте нет. Комаров говорит, что решение подготовлено и его скоро будут тестировать. Поэтому описанная схема логирования — конкретная инженерная мера, но её собственный подтверждённый онлайн-прирост ещё не назван.
Доклад · 00:23:30Зачем понадобилась SANSA, когда уже есть ALS
После изменений в ранжировании команда возвращается к офлайн-источникам кандидатов. Здесь обсуждаются SANSA и SASRec. Про SASRec Комаров прямо говорит, что эксперименты продолжаются и подробности будут позже. Никулина предполагает, что последовательные модели могли бы хорошо сработать на данных маркетплейса, предлагает посмотреть на BERT4Rec и другие варианты, а также на дополнительные статистические источники. Это её ожидания и предложения, не перечень доказанных улучшений Lamoda.
SANSA появляется как ответ на размер каталога. Комаров начинает с EASE — неглубокой модели восстановления взаимодействий, известной как сильный вариант коллаборативной фильтрации. Но в обсуждаемой реализации большой каталог становится препятствием: у Lamoda более 600 тысяч товаров. Оставлять только частые позиции не хотят, поскольку вместе с ними можно потерять редкие, но ценные товары.
Никулина связывает это ограничение с аналитическим решением EASE и размером работающих с каталогом матриц. Комаров говорит о практической работе на каталогах до десятков тысяч объектов. Это описание мотивации команды, а не универсальный предел метода независимо от реализации и оборудования. В обзоре нет замеров памяти и времени, которые позволили бы перенести такой предел на любую систему.
Полное название SANSA на слайде — Scalable Approximate NonSymmetric Autoencoder. Она представлена как масштабируемая модификация EASE, рассчитанная на каталоги с миллионами объектов. Иллюстрация показывает разреженную несимметричную схему кодирования и декодирования: преобразование Wᵀ, затем Z. Здесь нет основания приписывать Lamoda дополнительную нейросетевую глубину, конкретную разреженность или размеры этих матриц.
Подпись к заимствованной схеме SANSA отдельно упоминает способы не рекомендовать объекты, уже присутствующие на входе: маскирование вектора предсказаний либо остаточную связь между входом и выходом. Это варианты из описания самой модели. Слайд не устанавливает, какой из них использован в системе Lamoda, и не задаёт общее продуктовое правило запрета повторных рекомендаций.
Наше пояснение: в этой истории SANSA — отдельный способ получить товарных кандидатов до ранжирования. Она не заменяет CatBoost и MMR, которые уже перенесены в запрос. Упоминание миллионов объектов относится к заявленной масштабируемости подхода на слайде, а не к фактическому размеру каталога, на котором Lamoda получила следующий результат. Подробности аппроксимации и сравнительные ресурсные замеры здесь не раскрыты.
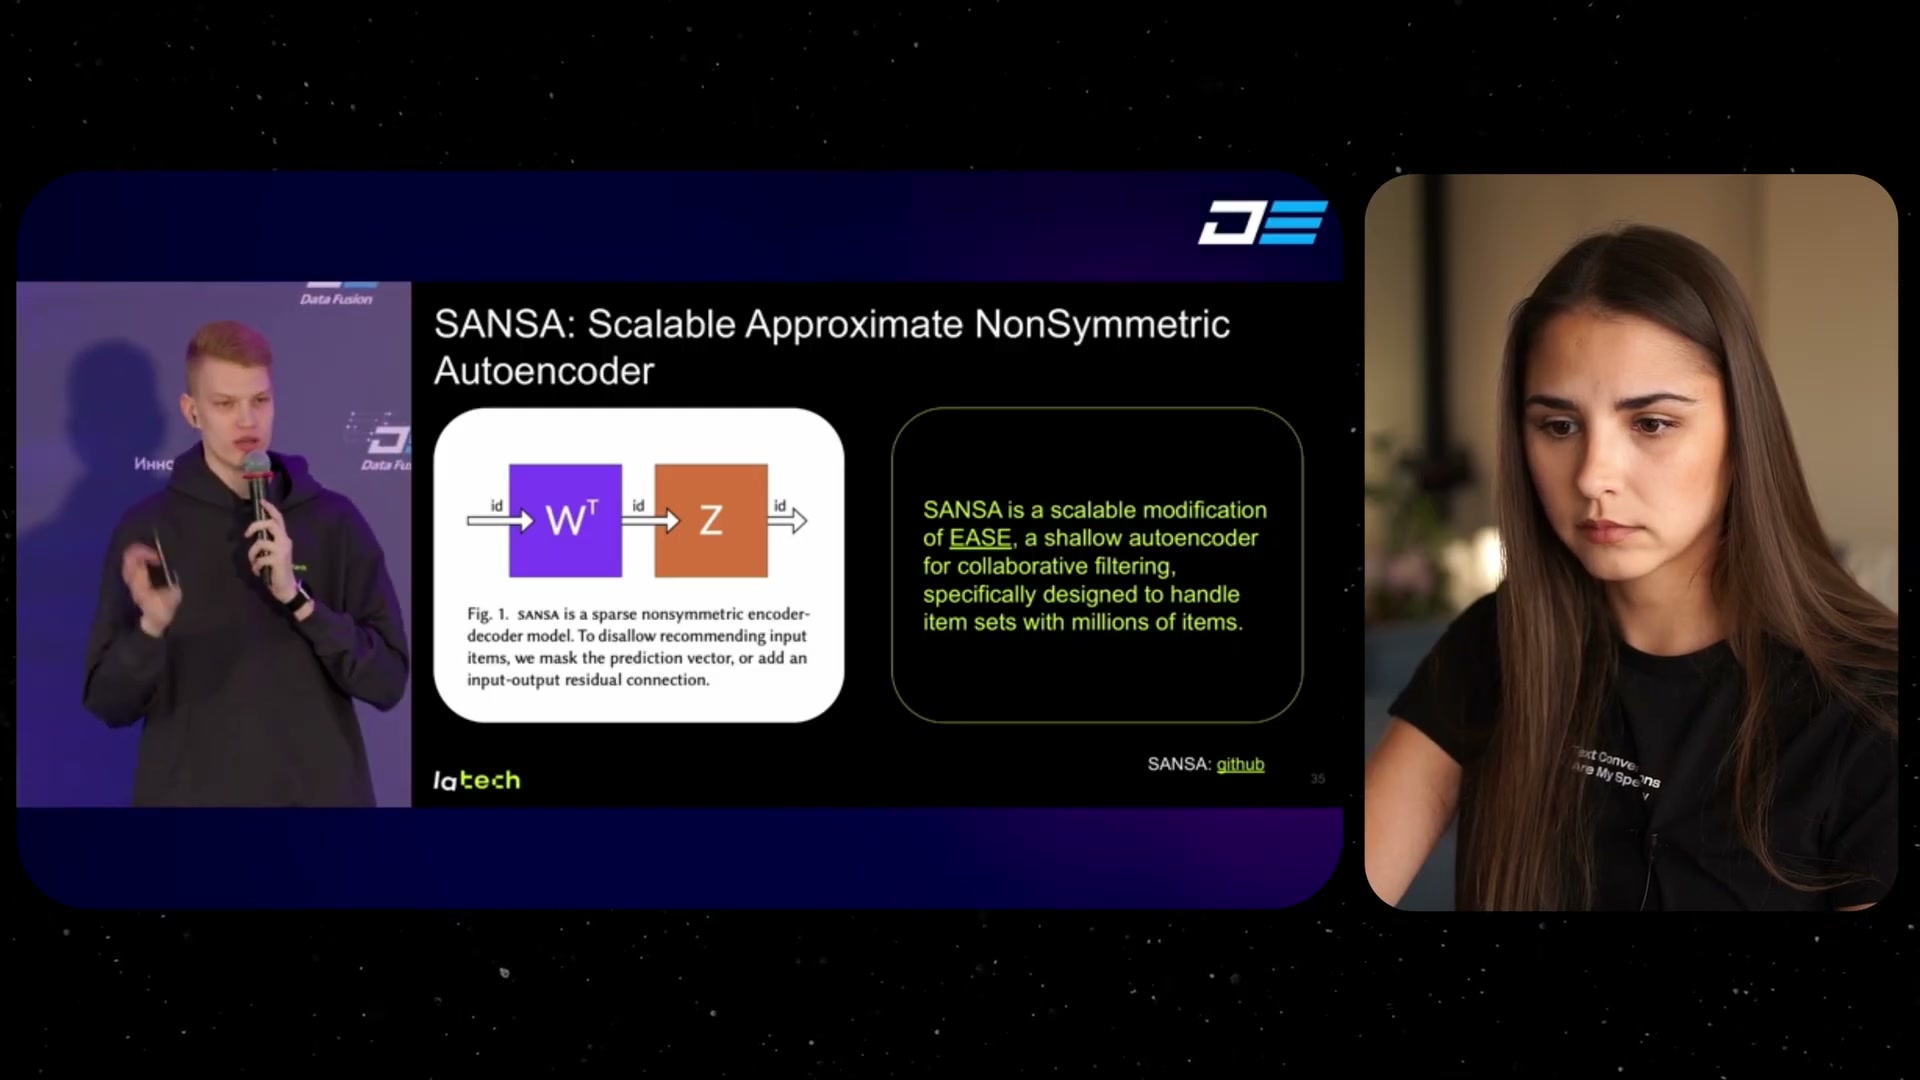
SANSA — масштабируемый вариант неглубокого автоэнкодера EASE; схема Wᵀ→Z относится к этой модели. Это отдельный источник кандидатов.
Источник: Анастасия Никулина · обзор Data Fusion 2025Как проверяли SANSA и почему офлайн-сравнение смещено
Для SANSA используют отдельную, чётко описанную подготовку данных. Модель обучают в разрезах пол × страна на шести месяцах добавлений в корзину. Вход — бинарная разреженная матрица пользователь × товар: фиксируется факт взаимодействия, а не сумма взвешенных событий разных видов. Эту схему нельзя подменять первоначальным обучением ALS на просмотрах, избранном, корзинах и заказах с временным затуханием.
Recall@200 проверяет, какая доля целевых объектов попала в первые 200 кандидатов. В этом сравнении SANSA улучшает офлайн-метрику на 10% относительно ALS. Абсолютные значения Recall и завершённый численный A/B-результат SANSA не приведены. Комаров говорит о намерении проверить модель онлайн; более ранняя реплика о запуске в обзоре обрывается, поэтому точный статус внедрения по ней не устанавливается.
Затем спикер объясняет смещение офлайн-проверки. Действующая система сама выбирает товары, которые пользователи увидят, кликнут или добавят в корзину. Её кандидаты поэтому имеют преимущество при оценке на накопленных реакциях. Комаров считает, что даже близкий к производственному источнику результат нового подхода может быть достаточным основанием для A/B. Это не правило автоматического внедрения без теста.
Никулина хочет видеть не только Recall, но и разнообразие категорий, распределение популярности и отличие новых предложений от ALS. Её вопрос важен для интерпретации: одна и та же итоговая полнота не раскрывает, какие именно товары система стала находить. Измерений этих дополнительных свойств в рассматриваемом фрагменте нет.
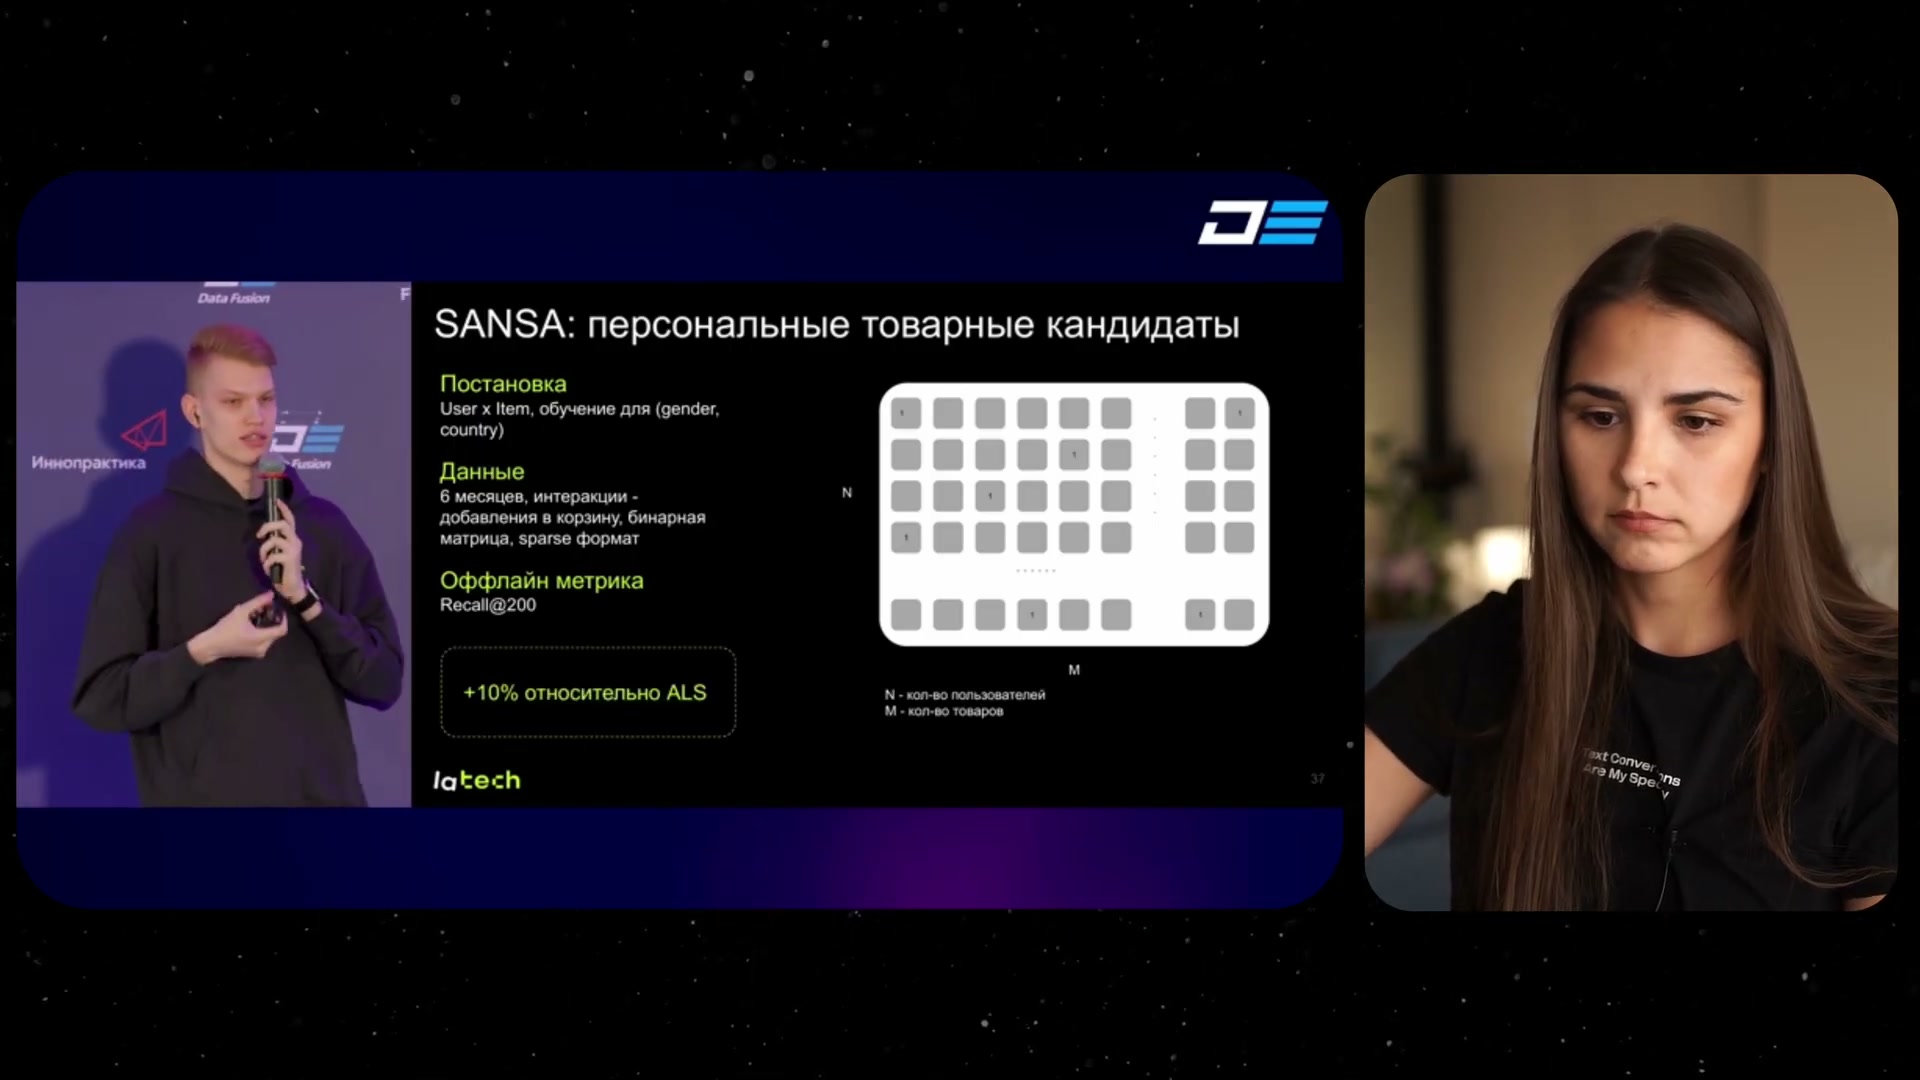
Шесть месяцев добавлений в корзину, бинарная разреженная матрица user×item; модели по gender/country. Recall@200 +10% относительно ALS — офлайн-сравнение.
Источник: Анастасия Никулина · обзор Data Fusion 2025Открытые вопросы к истории Lamoda
Подводя итог, Никулина одобряет старт с базовых моделей и постепенное развитие персонализации. Ей не хватает глобальных бизнес-метрик, в том числе GMV, а также подробного исследования SANSA и будущих результатов SASRec. Эти замечания дополняют её прежние вопросы о холодном старте, обновлении признаков и масштабе хранения.
Обзор не досматривает оставшуюся часть исходного выступления Lamoda. Поэтому описанный путь заканчивается там, где есть данные: интерфейсные A/B-результаты, офлайн-оценки ранкера и SANSA, архитектура онлайн-ранжирования и подготовленное логирование признаков. Подтверждённого общего денежного эффекта всех этих изменений вместе источник не даёт.
Доклад · 00:27:35Sber AI Lab: подходит ли датасет для проверки последовательной модели
Анна Володкевич из Sber AI Lab переводит обсуждение с устройства продукта на свойства данных. Команда занимается прикладными исследованиями, публикует статьи и развивает открытую библиотеку рекомендательных моделей. В этом выступлении её интересует не новая промышленная выдача, а то, насколько используемые в исследованиях данные действительно содержат последовательные закономерности.
Изучение данных нужно в нескольких ситуациях. Продуктовая команда хочет понять собственную аудиторию и улучшить обработку взаимодействий. Читатель научной статьи — оценить, похожи ли использованные там данные на его задачу и стоит ли ожидать переноса результата. Исследователю нужны наборы, на которых предполагаемое достоинство нового метода вообще можно проверить.
Володкевич приводит пример из соседних докладов: свойства данных могут подсказать, что разные группы пользователей лучше обслуживать отдельными моделями. Это мотивация анализа, а не описание системы Сбера с таким разделением. Результатом данного исследования станет диагностика наборов данных, а не утверждение о внедрённой сегментации.
Никулина поддерживает постановку: выводы о последовательной модели трудно переносить, если природа данных не соответствует задаче. Её акцент — сначала понять, что записано в истории пользователя и как эти события получены. Наше пояснение: хорошая метрика на датасете ещё не показывает, за счёт чего она достигнута — использования порядка или просто запоминания состава интересов.
Доклад · 00:28:13Что именно должен давать порядок действий
В обычном представлении истории можно знать, с какими объектами человек взаимодействовал, но не учитывать порядок. Последовательная рекомендация использует ещё и то, что произошло раньше, что позже и какое намерение актуально сейчас. Володкевич иллюстрирует это продолжением книжной серии или просмотром следующей серии сериала; исследование, конечно, не ограничивается такими очевидными цепочками.
Основная модель, которую спикер объясняет в речи, — SASRec. Она использует трансформер с причинным ограничением внимания: при предсказании следующего действия нельзя смотреть на будущие события истории. Обучение использует предыдущую часть последовательности для предсказания продолжения. Это описание задачи обучения, а не операция переобучения при каждом запросе.
Никулина добавляет два различия. Во-первых, следующим объектом может быть отдельный товар, а другой постановкой бывает предсказание следующей корзины — набора товаров. Во-вторых, запрет видеть будущее в SASRec отличается от восстановления скрытых элементов внутри последовательности, которое она обсуждает на примере BERT4Rec. В этом исследовании её комментарий не превращает следующую корзину или BERT4Rec в дополнительно проверенные эксперименты.
Исходная гипотеза проста: если полезная закономерность заключена в порядке действий, случайное перемешивание должно её нарушить. Тогда обученная последовательная модель может выдать другие рекомендации или показать худшее качество. Если ничего существенного не меняется, это повод усомниться в выраженности полезного порядка для данной проверки, а не автоматически считать модель плохой.
Доклад · 00:30:35Основной эксперимент: обучение одно, входов два
Модель сначала обучают на исходных упорядоченных историях. Затем фиксируют её параметры и применяют к двум вариантам входа: к настоящему порядку действий и к случайно перемешанным действиям внутри каждой пользовательской последовательности. Перемешивают именно входную историю, а не уже построенный список рекомендаций. Переобучение не входит в этот основной протокол.
- 01
Обучить на исходных историях
Для выбранного набора данных обучают последовательную модель на оригинальном порядке взаимодействий.
- 02
Получить исходные рекомендации
С фиксированными параметрами строят список по упорядоченной входной истории.
- 03
Изменить только порядок входа
Внутри истории случайно переставляют события и той же моделью получают второй список.
- 04
Сопоставить результаты
Сравнивают состав списков и изменение качества относительно целевых взаимодействий.
Для сходства используется мера Жаккара. Наше пояснение: пусть A и B — множества объектов в двух верхних частях выдачи одинаковой выбранной длины. Мера делит количество общих объектов на количество разных объектов, встретившихся хотя бы в одном списке. Порядок внутри самих списков в этой мере не учитывается.
A — объекты рекомендаций по исходной истории, B — по перемешанной. Это сходство двух наборов, а не доля правильных рекомендаций.
Вторая проверка — изменение метрик качества. Сильное падение NDCG или HitRate после перемешивания указывает, что порядок был полезен модели в выбранной постановке. Сходство списков и качество отвечают на разные вопросы: список может поменяться, не став хуже. Поэтому авторы рассматривают несколько показателей, а не одно совпадение рекомендаций.
Никулина спрашивает, что именно принято за историю: одна сессия или события за некоторый период, внутри которого могут находиться разные сессии даже одного дня. Правило сессионного разбиения, длина входа и число случайных перестановок в данном фрагменте не раскрыты. Володкевич интерпретирует похожие выдачи как слабое использование последовательного сигнала, сравнивая поведение с поиском соседей. Наше уточнение: это не доказательство архитектурной эквивалентности модели такому поиску и не доказательство отсутствия любых временных связей.
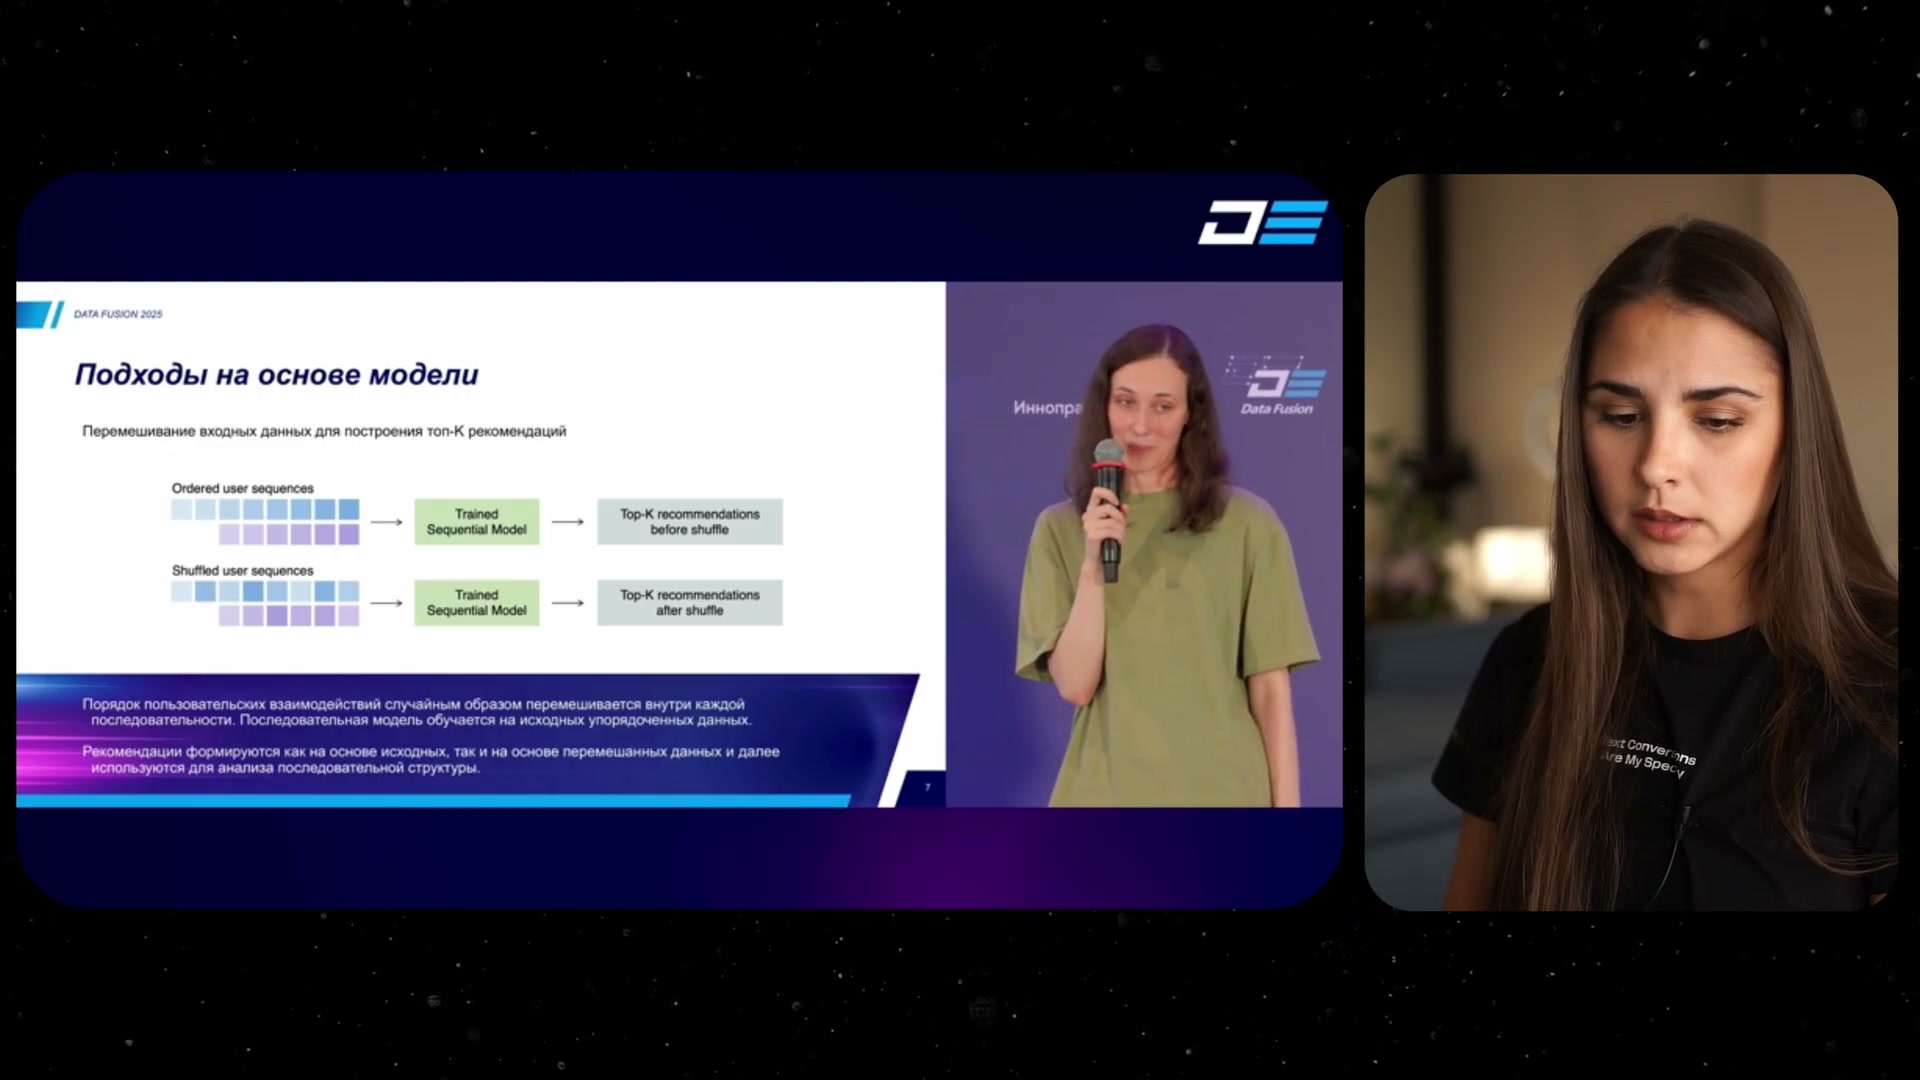
Последовательная модель обучена на исходных данных. Рекомендации получают по исходным и перемешанным историям, затем сравнивают; это проверка роли порядка, не промышленное внедрение нового ранкера.
Источник: Анастасия Никулина · обзор Data Fusion 2025Проверка без модели: сколько последовательных правил переживает перемешивание
Дополнительный подход не требует обучать рекомендательную модель. В данных ищут достаточно часто встречающиеся последовательные пары и тройки объектов, а затем смотрят, сколько таких правил остаётся после перемешивания. Это анализ порядка, а не просто подсчёт неупорядоченных совместных появлений товаров.
На слайде с результатами уточнено, что речь идёт о правилах длины два и три — 2-grams и 3-grams — при заданных порогах support и confidence. Для понимания: support характеризует распространённость правила, confidence — устойчивость его продолжения при выполнении условия. До и после перемешивания правила нужно сравнивать при фиксированных условиях отбора. Численные значения этих порогов в показанном описании не названы.
Не раскрыты также точное правило соседства событий, допустимые промежутки и обработка повторов при извлечении правил. Поэтому далее можно воспроизвести опубликованное сравнение, но не восстановить весь алгоритм подсчёта по одному описанию пар и троек.
Доклад · 00:33:24Популярность датасета не доказывает полезность его порядка
Чтобы понять практику оценки последовательных моделей, авторы посмотрели, на каких наборах данных их проверяют в научных статьях последних лет. На слайде приведено число работ, использовавших каждый набор, и процент от общего числа просмотренных статей. Это частота использования в выбранном обзоре литературы, не размер датасета и не его качество.
Таблицу можно прокрутить по горизонтали.
Звёздочки здесь отмечают семейство Amazon Reviews — данные с отзывами. Володкевич обращает внимание на сходную природу таких наборов: последовательность отзывов не обязательно даёт именно тот сигнал, ради которого строится модель последовательных взаимодействий. Кроме них, в литературе встречаются MovieLens и данные маркетплейсов, которые авторы также хотят исследовать.
Никулина согласна с необходимостью смотреть на природу данных прежде, чем переносить выводы статьи. Наше пояснение к таблице: одна работа может использовать несколько наборов, поэтому доли строк не следует складывать как части одного распределения. Общее число рассмотренных статей и точное окно отбора в этом фрагменте не указаны; восстанавливать их делением округлённых процентов не нужно.
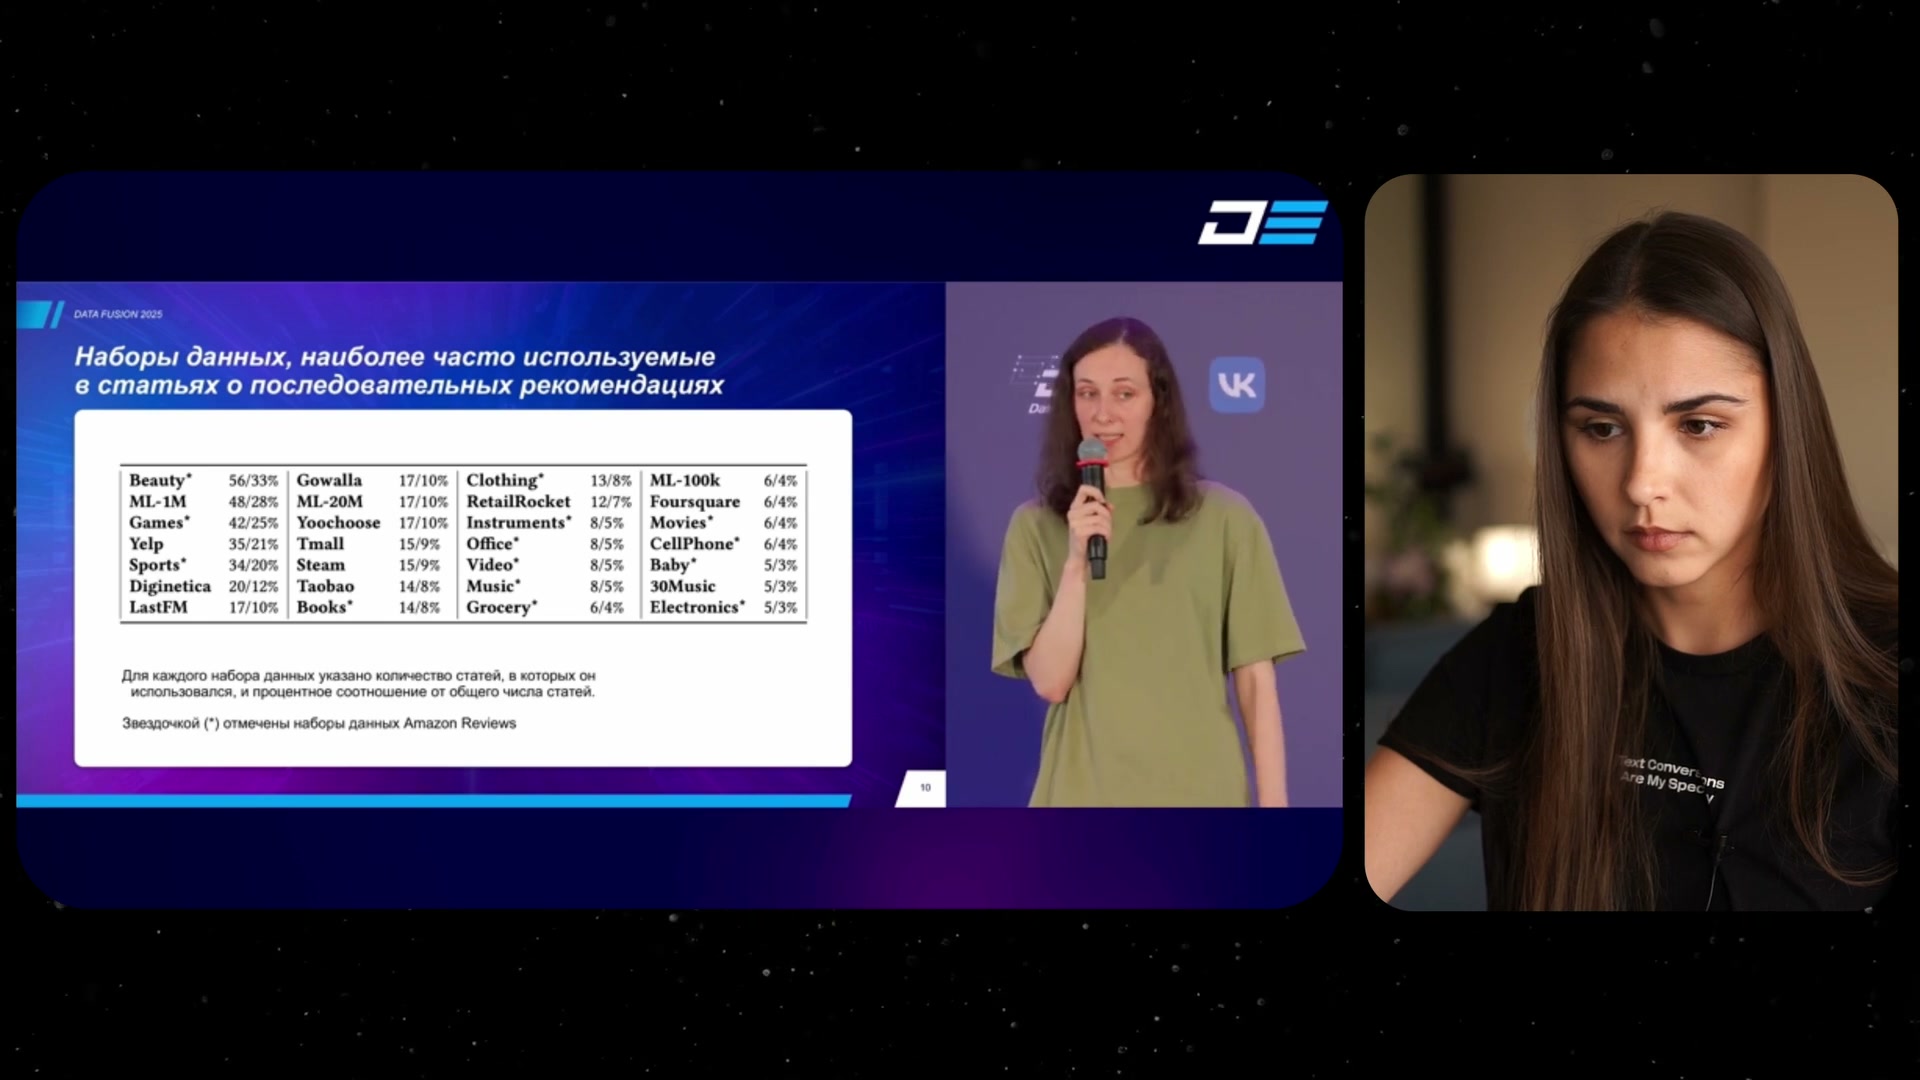
Таблица показывает частоту использования наборов в исследовательских статьях. Звёздочка здесь означает Amazon Reviews, не новые промышленные наборы.
Источник: Анастасия Никулина · обзор Data Fusion 2025Какие данные реально вошли в эксперимент
Для самой проверки составлен набор из разных доменов: электронная торговля, игры, фильмы, музыка и социальные данные. Следующая таблица описывает уже не частоту упоминаний в статьях, а выборки после предварительной обработки. В ней восемнадцать строк. Размеры и средняя длина истории относятся именно к этим подготовленным данным, а не ко всей аудитории соответствующих сервисов.
Таблицу можно прокрутить по горизонтали.
Значение звёздочки изменилось: в этой таблице она выделяет недавно опубликованные промышленные наборы, а не Amazon Reviews. Так, звёздочки у Dressipi, MegaMarket, OTTO и Zvuk нельзя читать как указание на отзывы Amazon. Числа в названии MovieLens тоже не заменяют фактическое число взаимодействий после обработки.
Разброс характеристик велик: средняя длина равна 7,9 у Diginetica, 144,3 у ML-20m и 516,5 у 30Music. Это среднее по подготовленным историям, а не среднее поведение любого посетителя продукта. Плотность приведена в обозначении слайда; подробное правило её расчёта с учётом повторов в обзоре не объясняется. Ни большая длина, ни высокая плотность сами по себе не являются измерением последовательной структуры — для этого и нужны следующие проверки.
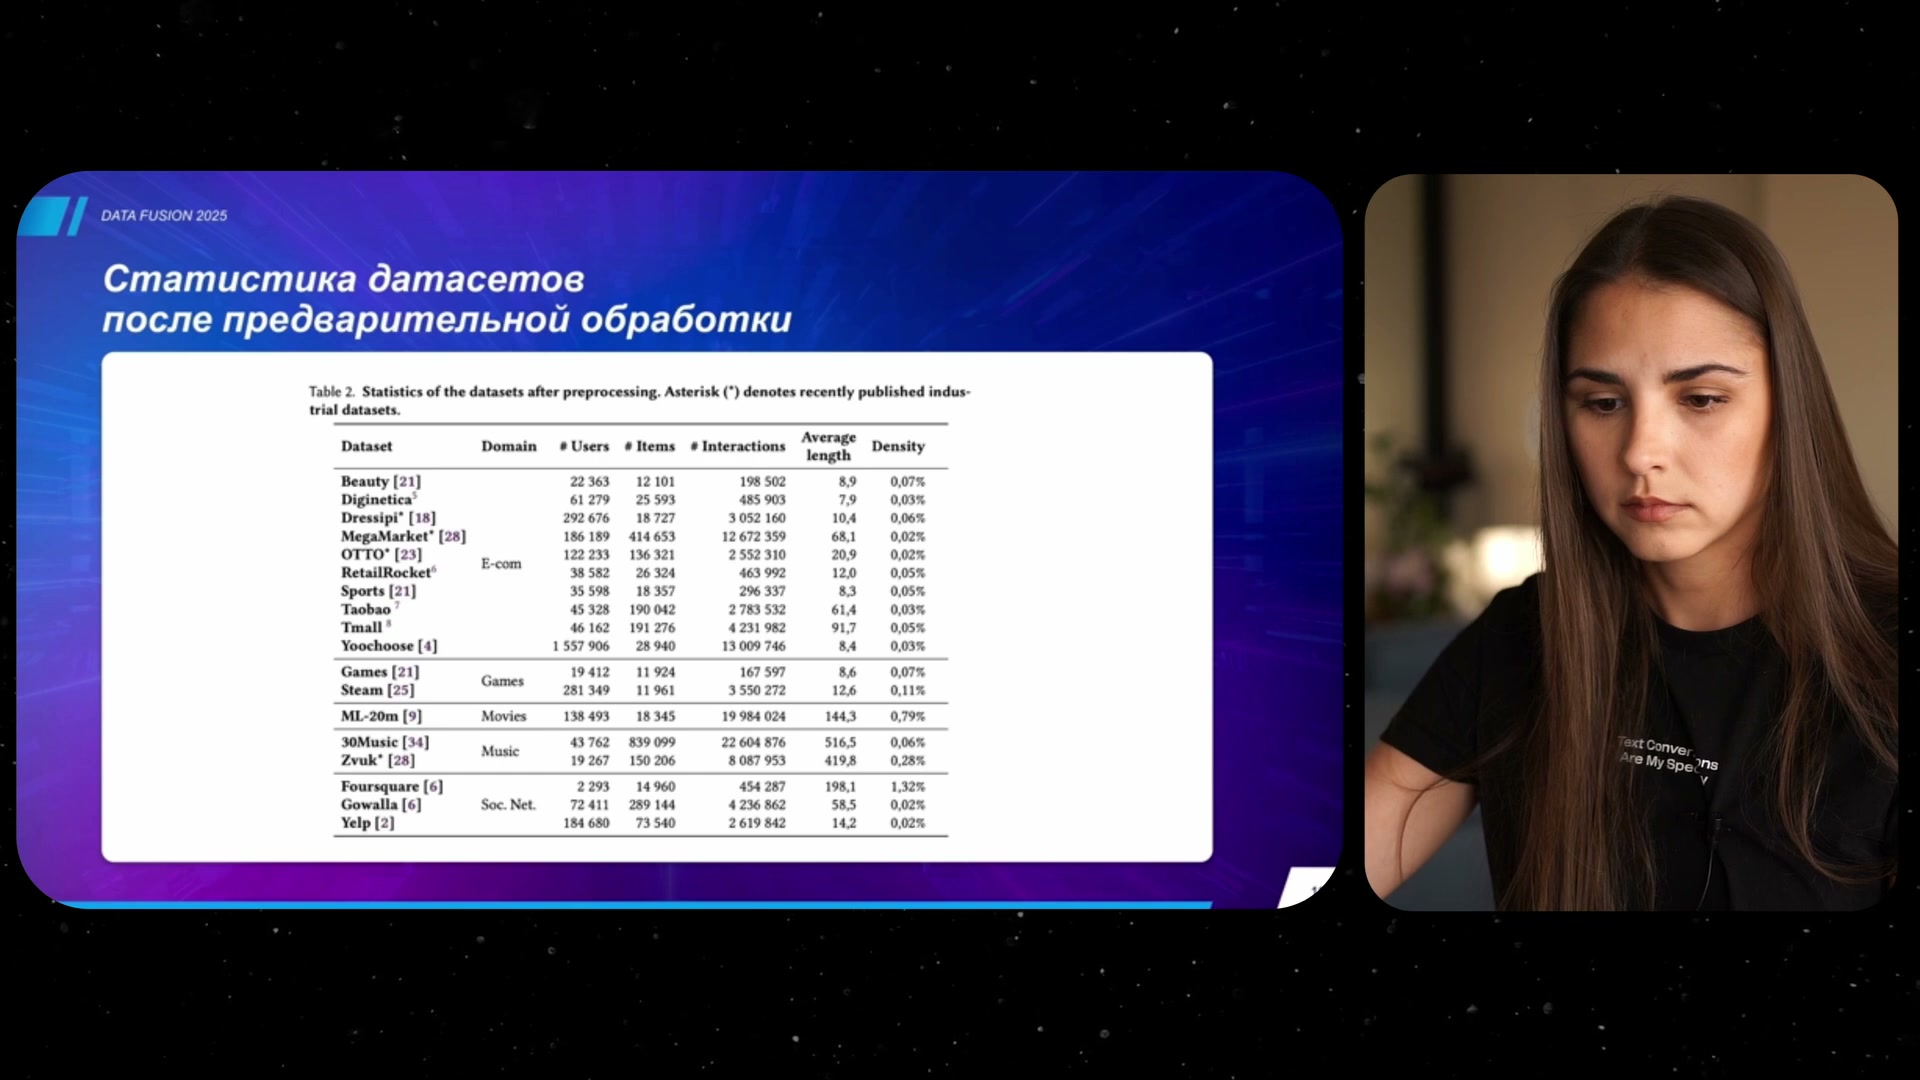
Характеристики разных наборов показывают длину историй и плотность. Звёздочка в этой таблице обозначает недавно опубликованные промышленные данные — другой смысл, чем на предыдущем слайде.
Источник: Анастасия Никулина · обзор Data Fusion 2025Как отделили будущее от обучающих данных
Перед результатами Володкевич обсуждает временную утечку. Распространённый приём — отложить последнее действие каждого пользователя в тест — сам по себе ещё не задаёт общую границу времени. Без неё обучение может содержать события, которые произошли позже части тестовых событий. Наше пояснение: персональное «последнее» и единое для всех «будущее» — разные условия разделения.
В эксперименте тест отделяют по общей временной отметке, global timestamp, а затем используют последний объект как целевой. Валидацию также выделяют по времени и используют для ранней остановки обучения. Сначала формируются обучающая, валидационная и тестовая части; сравнение исходного и перемешанного входа проводится уже в этой постановке оценки.
Никулина сначала возражает против общей формулировки проблемы, говоря, что корректное разбиение должно быть временным. Когда спикер показывает свой протокол, она его одобряет. Здесь нет двух конкурирующих реализованных разбиений: различаются критика неудачной практики и выбранное авторами исправление.
Конкретные даты границ, правила обработки новых пользователей и объектов и полный состав доступной истории на оценке в обзоре не раскрыты. Известное условие — общая временная граница вместе с последним целевым объектом — нужно сохранять; заменять его просто случайным разбиением или только исключением последнего действия нельзя.
Доклад · 00:34:37Результаты правил: как правильно читать границу −90%
Сначала авторы сравнивают число последовательных правил до и после перемешивания при фиксированных условиях support и confidence. В таблице отдельно показаны правила длины два и три. Для чтения относительного изменения обозначим исходное число правил C₀, а число после перемешивания Cₛ. Следующая запись лишь поясняет процентное сравнение, а не восстанавливает отсутствующие параметры алгоритма.
Отрицательная дельта означает уменьшение числа правил. Сравнение выполняется отдельно для пар и троек при неизменных условиях отбора правил.
Таблицу можно прокрутить по горизонтали.
Подпись слайда связывает слабую структуру с относительным изменением, которое больше −90%. Важно направление: −54% больше −90%, потому что правило изменилось менее сильно; −97% меньше −90%, потому что почти все прежние закономерности перестали проходить условия отбора. При ровно −90% строгая формулировка «больше» не выполнена. Это диагностическая эвристика данного сравнения, не универсальный закон для всех данных.
Процентные значения округлены: строка −100% не всегда означает буквальное отсутствие оставшихся правил. Например, на слайде у Steam число пар после перемешивания указано как 0,8, хотя относительное изменение округлено до −100%. Дробные значения в таблице не позволяют сами по себе установить число повторений эксперимента или способ усреднения — эти детали не проговорены.
Никулина интерпретирует Beauty как пример заметных паттернов по этой проверке, противопоставляет ему RetailRocket и отдельно обсуждает географическую природу Foursquare. Объяснение через геометки принадлежит автору обзора. Оно не доказывает невозможность последовательного предсказания для любых данных о местоположениях. Уже различие столбцов пар и троек показывает, что результат зависит и от выбранного измерителя.
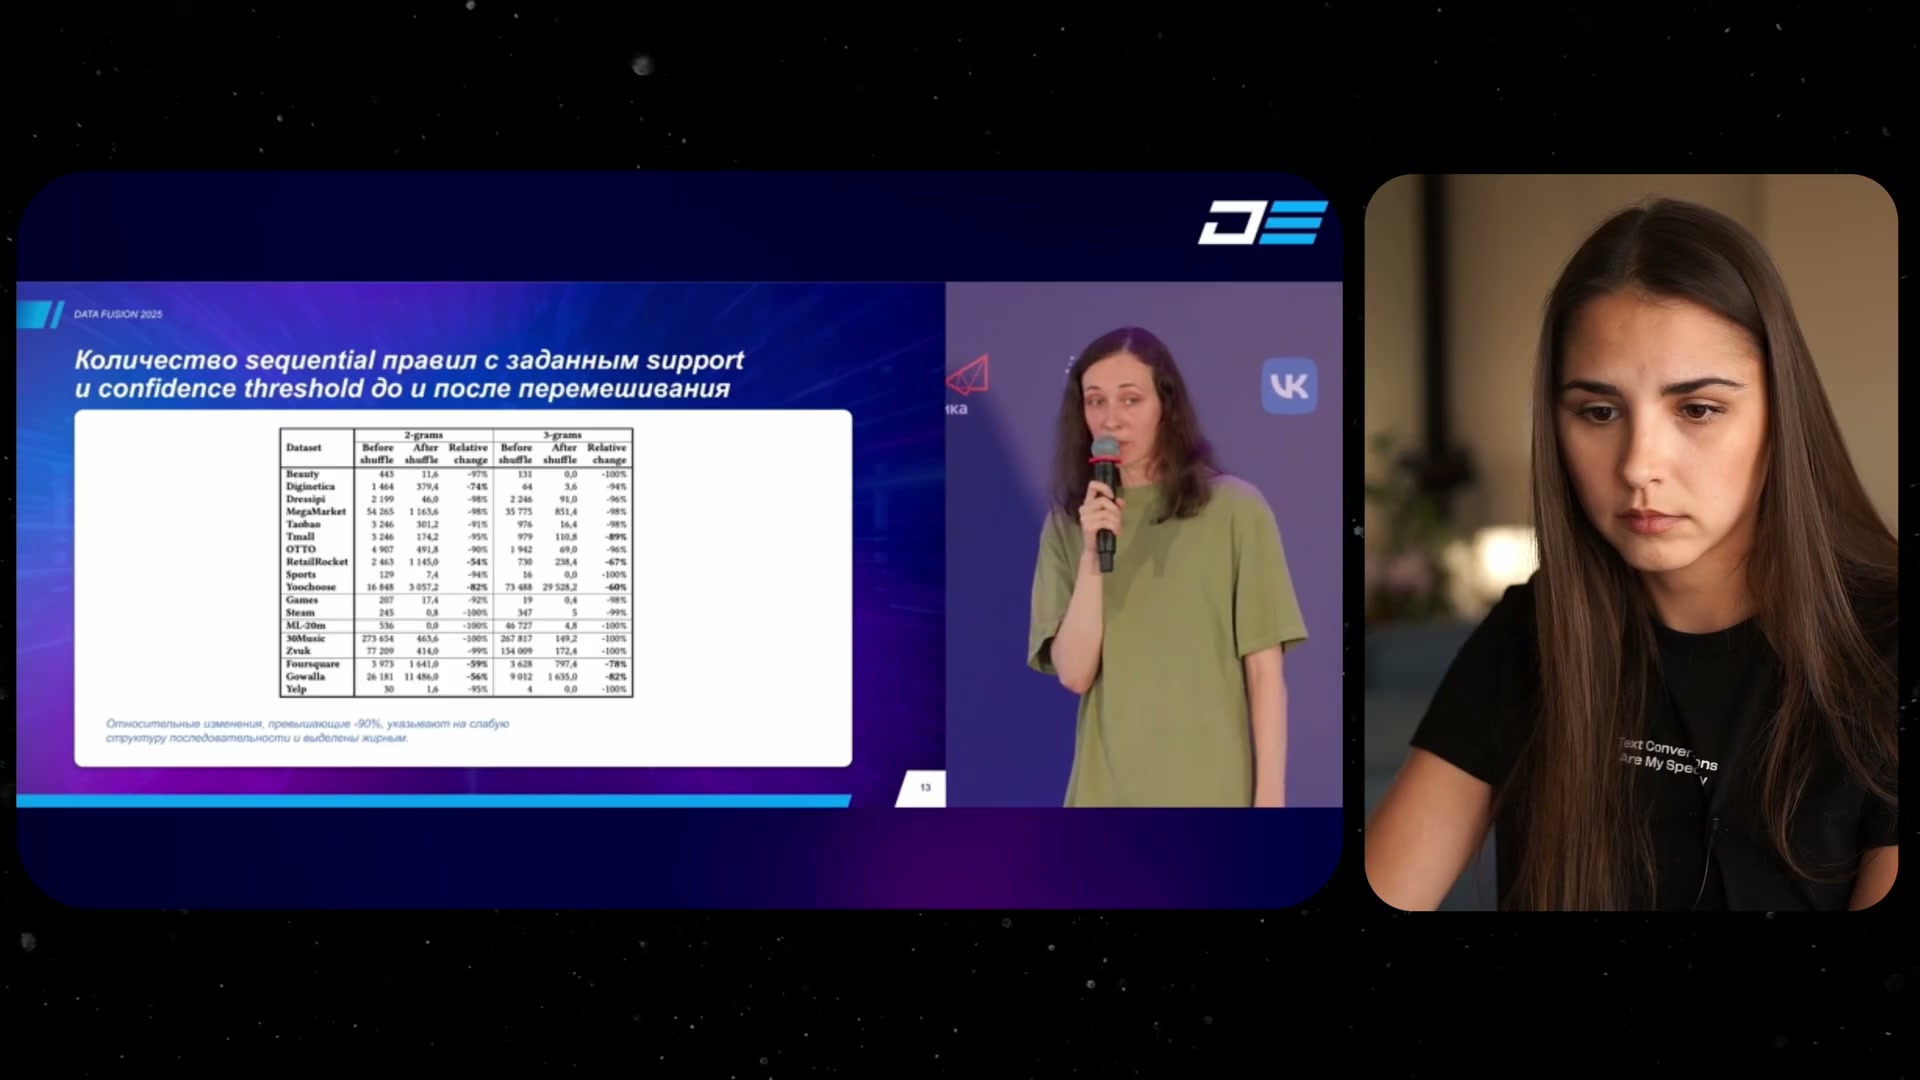
Число двух- и трёхэлементных последовательных правил сравнивается при заданных support/confidence. Пороги и нечитаемые значения не восстанавливаем догадкой.
Источник: Анастасия Никулина · обзор Data Fusion 2025Что меняется после перемешивания: результаты SASRec и GRU4Rec
Непосредственная модельная проверка отвечает на вопрос: насколько рекомендации зависят от порядка действий во входной истории? Володкевич показывает результаты отдельно для SASRec и GRU4Rec. База сравнения для каждой модели — её работа с исходной, упорядоченной историей; второй вариант — работа той же обученной модели с перемешанной историей. Обучение на исходных последовательностях выполняют заранее, а между этими двумя вариантами оценки параметры не переобучают. Поэтому столбцы «до» и «после» не означают качество до и после обучения.
Во всех показанных модельных метриках K = 10. HitRate@10 проверяет попадание целевого следующего объекта в первые десять рекомендаций, а NDCG@10 учитывает также его позицию. Отдельная мера Жаккара, Jaccard@10, сравнивает состав двух наборов из десяти рекомендаций: число общих объектов делится на число объектов в их объединении. Она не оценивает правильность рекомендаций и не учитывает перестановки внутри самих списков. Таким образом, падение качества и изменение состава выдачи — два разных наблюдения.
В таблице ниже оставлены три показательных набора для каждой модели. В ячейках «до → после» слева стоит результат на исходной истории, справа — на перемешанной. RC — напечатанное на слайде относительное изменение соответствующей метрики относительно исходного варианта, в процентах, а не в процентных пунктах. Для Jaccard приведено одно значение сходства между двумя выдачами, а не отдельные оценки «до» и «после».
Таблицу можно прокрутить по горизонтали.
Значения после знака ± сохранены буквально. Слайды не объясняют, обозначают ли они стандартное отклонение, стандартную ошибку или доверительный интервал; число повторений и правило усреднения здесь также не раскрыты. По этим записям нельзя установить статистическую значимость различий. Проценты RC не пересчитаны по отображённым округлённым значениям: такая арифметика может дать другой результат. В частности, положительное изменение NDCG@10 для SASRec на Yelp оставлено в записи слайда «4%».
Подписи под обеими модельными таблицами задают ориентиры слабой последовательной структуры: RC точностной метрики больше −10% и Jaccard@10 больше 1/3. Соответствующие значения выделены жирным. «Больше −10%» означает меньшую потерю качества либо его рост: например, −4% удовлетворяет этому условию, а −82% — нет. Это признаки по отдельным измерителям, а не повод автоматически считать все показатели строки согласованными. Их нельзя смешивать с границей −90% из проверки числа последовательных правил: там измеряется изменение количества правил, здесь — качество рекомендаций и сходство выдач.
На 30Music обе модели резко реагируют на перемешивание. У SASRec HitRate@10 снижается на 82%, NDCG@10 — на 86%; у GRU4Rec напечатаны снижения на 89% и 92% соответственно. Низкий Jaccard@10 — 0,11 у SASRec и 0,03 у GRU4Rec — показывает, что меняется и состав рекомендаций. Поскольку перестановка сохраняет сами события истории, но разрушает их порядок, совместное падение качества и сходства согласуется с полезностью исходного порядка для этих моделей на этом подготовленном наборе.
Объясняя музыкальные результаты, Володкевич обращает внимание на порядок прослушивания и допускает роль жанра и времени суток. Это содержательная интерпретация результата: порядок может помогать понять актуальное намерение слушателя. Наше уточнение: приведённое сравнение не выделяет влияние жанра или времени суток отдельными экспериментами, поэтому нельзя объявлять какой-либо из этих факторов доказанной причиной падения на 30Music.
RetailRocket и Yelp дают другой результат: точностные метрики обеих моделей меняются намного слабее. На RetailRocket все показанные потери HitRate@10 и NDCG@10 меньше 10%. На Yelp у SASRec HitRate@10 немного падает, а NDCG@10 даже немного растёт; у GRU4Rec обе метрики снижаются на 6%. В этой проверке нарушение порядка, следовательно, не лишает модели такой же большой части полезного сигнала, как на 30Music. Однако сами таблицы не устанавливают, какая особенность событий или подготовки данных объясняет эту разницу: меньшая чувствительность — наблюдение, а не установленная причина поведения RetailRocket или Yelp.
Сходство выдач уточняет этот вывод. У SASRec на RetailRocket и Yelp Jaccard@10 равен 0,50 и 0,42 — оба значения выше 1/3. У GRU4Rec на тех же наборах он равен 0,32 и 0,27 — оба ниже указанной границы, хотя потери точностных метрик невелики. Здесь признаки по разным измерителям расходятся. Наше пояснение: слабое изменение качества не требует почти неизменного списка рекомендаций. Поэтому вывод «после перемешивания ничего не поменялось» был бы слишком сильным даже для этих двух примеров.
Оговорка о точности исходника: десятичные записи NDCG после перемешивания для Dressipi, Taobao и Zvuk в таблице SASRec отмечены как спорные. Эти ячейки не включены в компактную таблицу, и предполагаемые исправления по RC здесь не подставляются. Остальные строки остаются на исходных иллюстрациях; их наличие не означает, что неоднозначные записи можно использовать без дополнительной сверки.
Итог модельной проверки относится к сочетанию подготовленного набора данных, обученной модели и выбранного способа перемешивания. Сильная реакция на 30Music не доказывает полезность порядка на любых музыкальных данных; слабая реакция на RetailRocket или Yelp не доказывает отсутствия любых временных закономерностей. Это также не бизнес-результат и не универсальное сравнение качества SASRec с GRU4Rec. Теперь можно сопоставлять согласованность диагностик между наборами, не подменяя конкретные наблюдения одним коэффициентом корреляции.
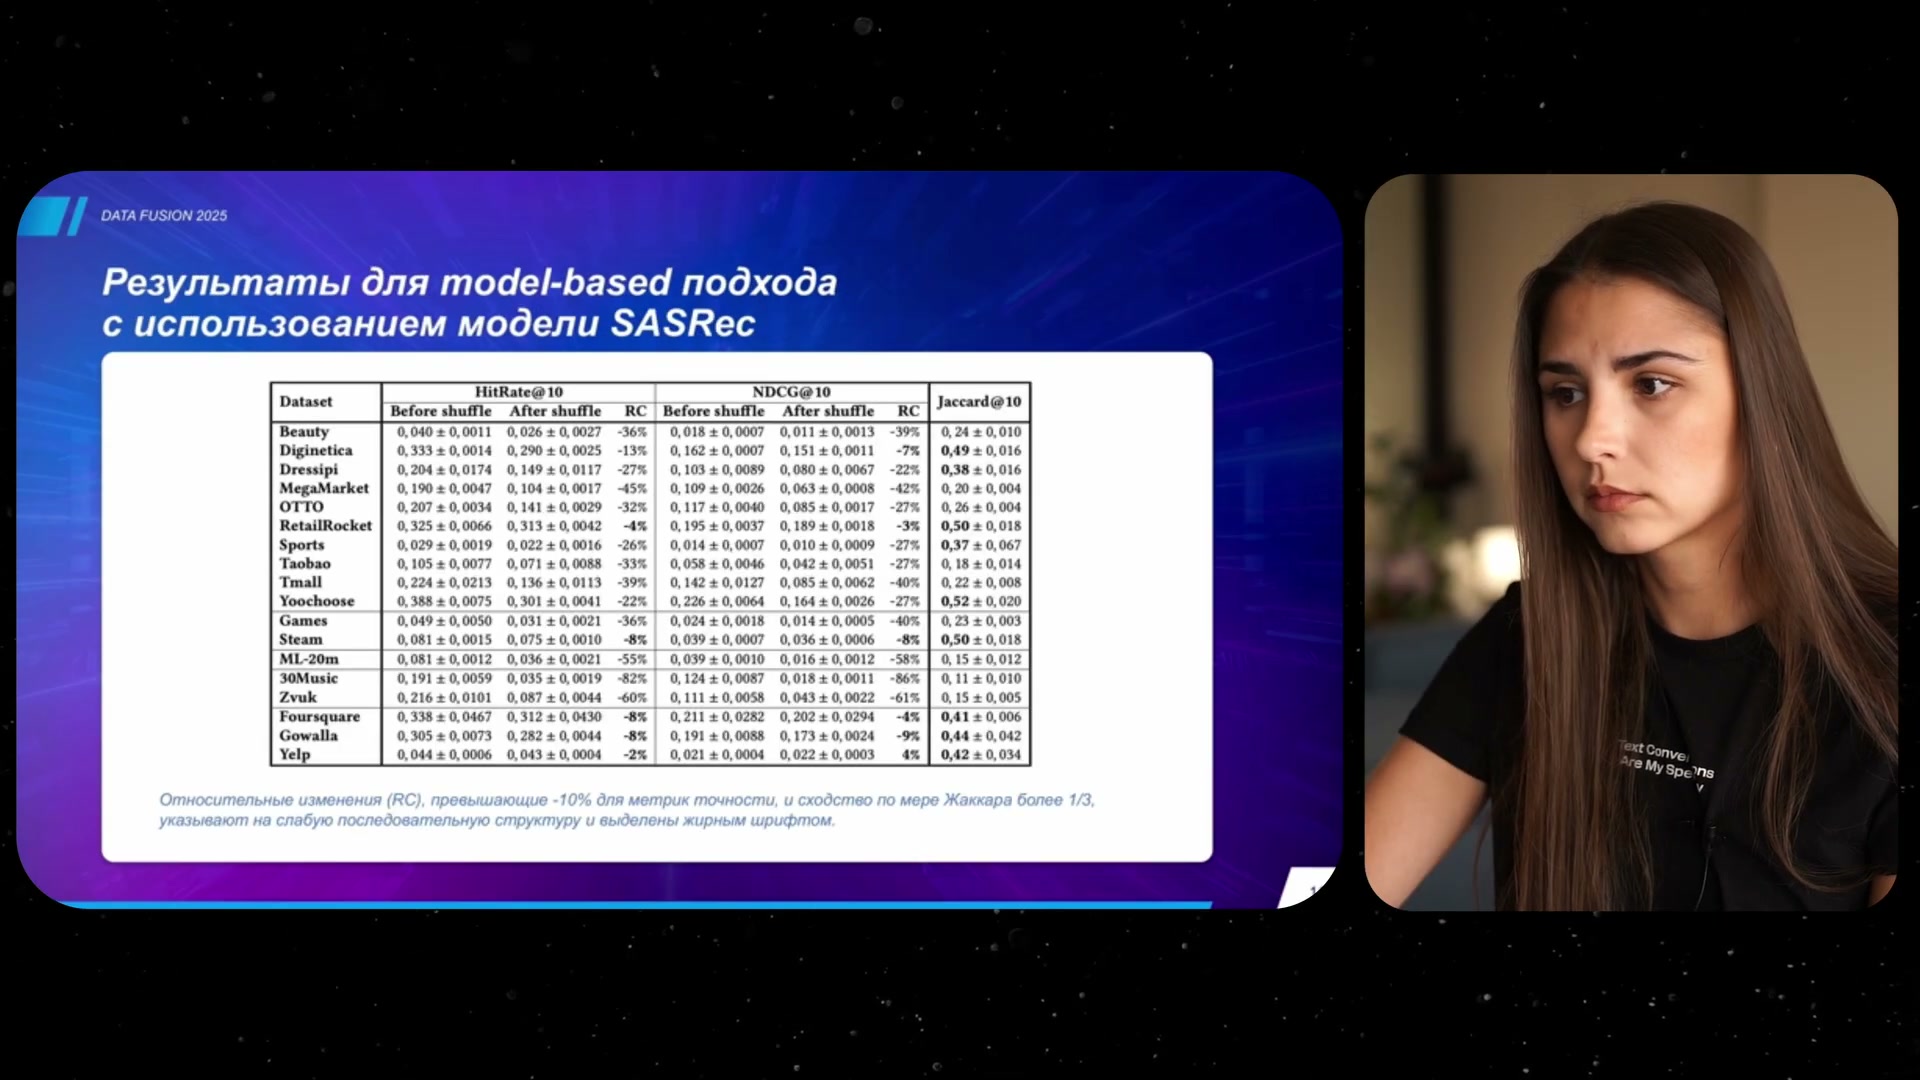
HitRate@10, NDCG@10 и Jaccard@10 на исходной и перемешанной истории. Таблица содержит неоднозначные десятичные записи в отдельных ячейках; их нельзя молча исправлять или выдавать за проверенные значения. Полезно сравнить читаемые строки 30Music, RetailRocket и Yelp.
Источник: Анастасия Никулина · Data Fusion 2025 · исходный кадр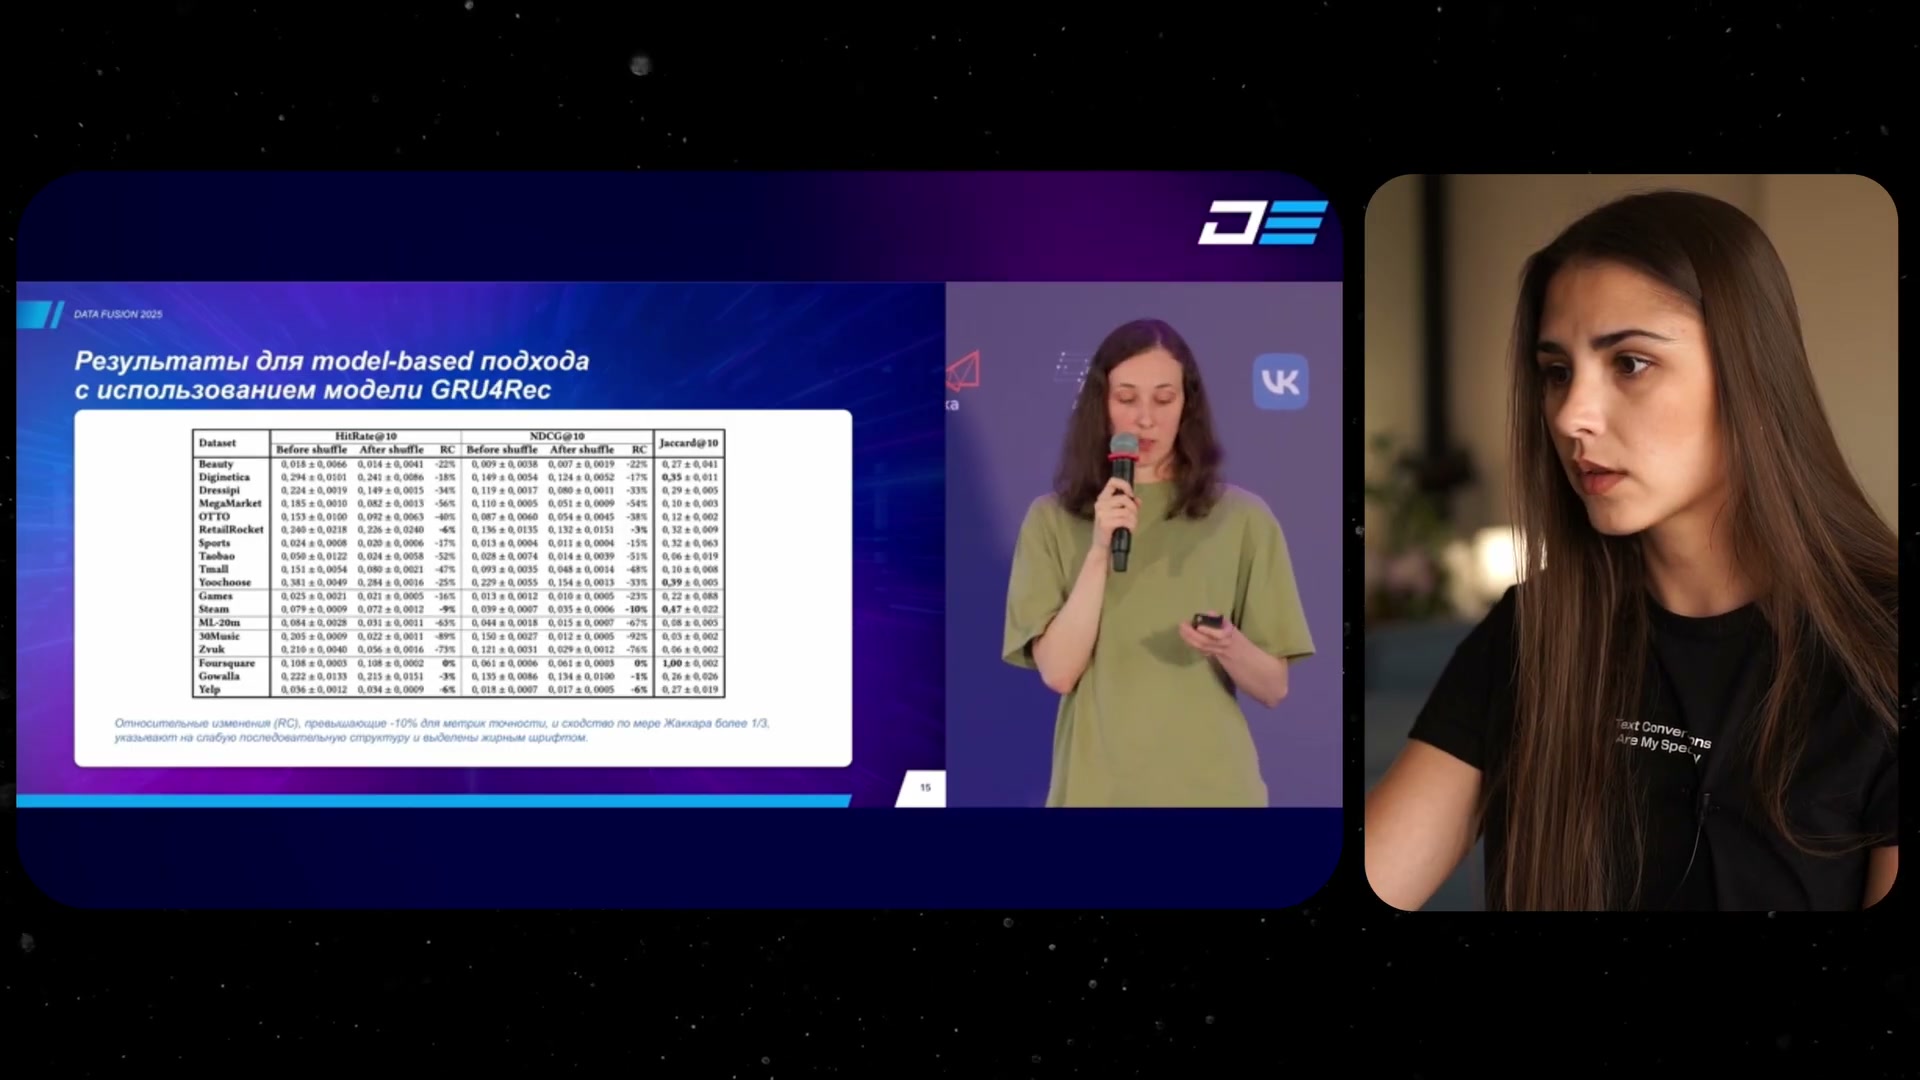
Проверка на исходной и перемешанной истории для GRU4Rec. Изменения отражают чувствительность к порядку, а не бизнес-результат или абсолютный рейтинг качества двух архитектур.
Источник: Анастасия Никулина · Data Fusion 2025 · исходный кадрМодельные показатели и согласованность измерителей
В отдельной модельной проверке у части наборов после перемешивания качество падает мало, а рекомендательные списки сильно пересекаются. Это и есть наблюдаемая устойчивость к нарушению порядка. Она не означает, что рекомендации стали хорошими или плохими в абсолютном смысле: сравниваются два входа при одном выбранном способе обучения.
Хотя речь подробно объясняет SASRec, матрица корреляций содержит также GRU4Rec. Для обеих моделей показаны HitRate@10, NDCG@10 и Jaccard@10. HitRate проверяет попадание целевого объекта в первые десять рекомендаций, NDCG учитывает ещё и его позицию, а Жаккар сравнивает состав двух списков. Матрица показывает согласованность измерителей, а не абсолютные значения качества по каждому набору; вычислить из неё такие значения нельзя.
Для сопоставления разных диагностик используют корреляцию Спирмена — согласованность рангов. Здесь сравнивается, насколько измерители сходным образом располагают наборы данных по реакции на перемешивание. Высокая корреляция не равна совпадению самих численных значений показателей.
Володкевич делает умеренный вывод: модельные подходы хорошо согласуются между собой, правила также связаны друг с другом, а связь правил с моделями слабее. Наше пояснение: это не причинный эффект и не доказательство взаимозаменяемости методов. В частности, сильная корреляция двух диагностик не доказывает, что они одинаково оценивают каждый датасет. Доверительные интервалы и проверка значимости коэффициентов в обзоре не показаны.
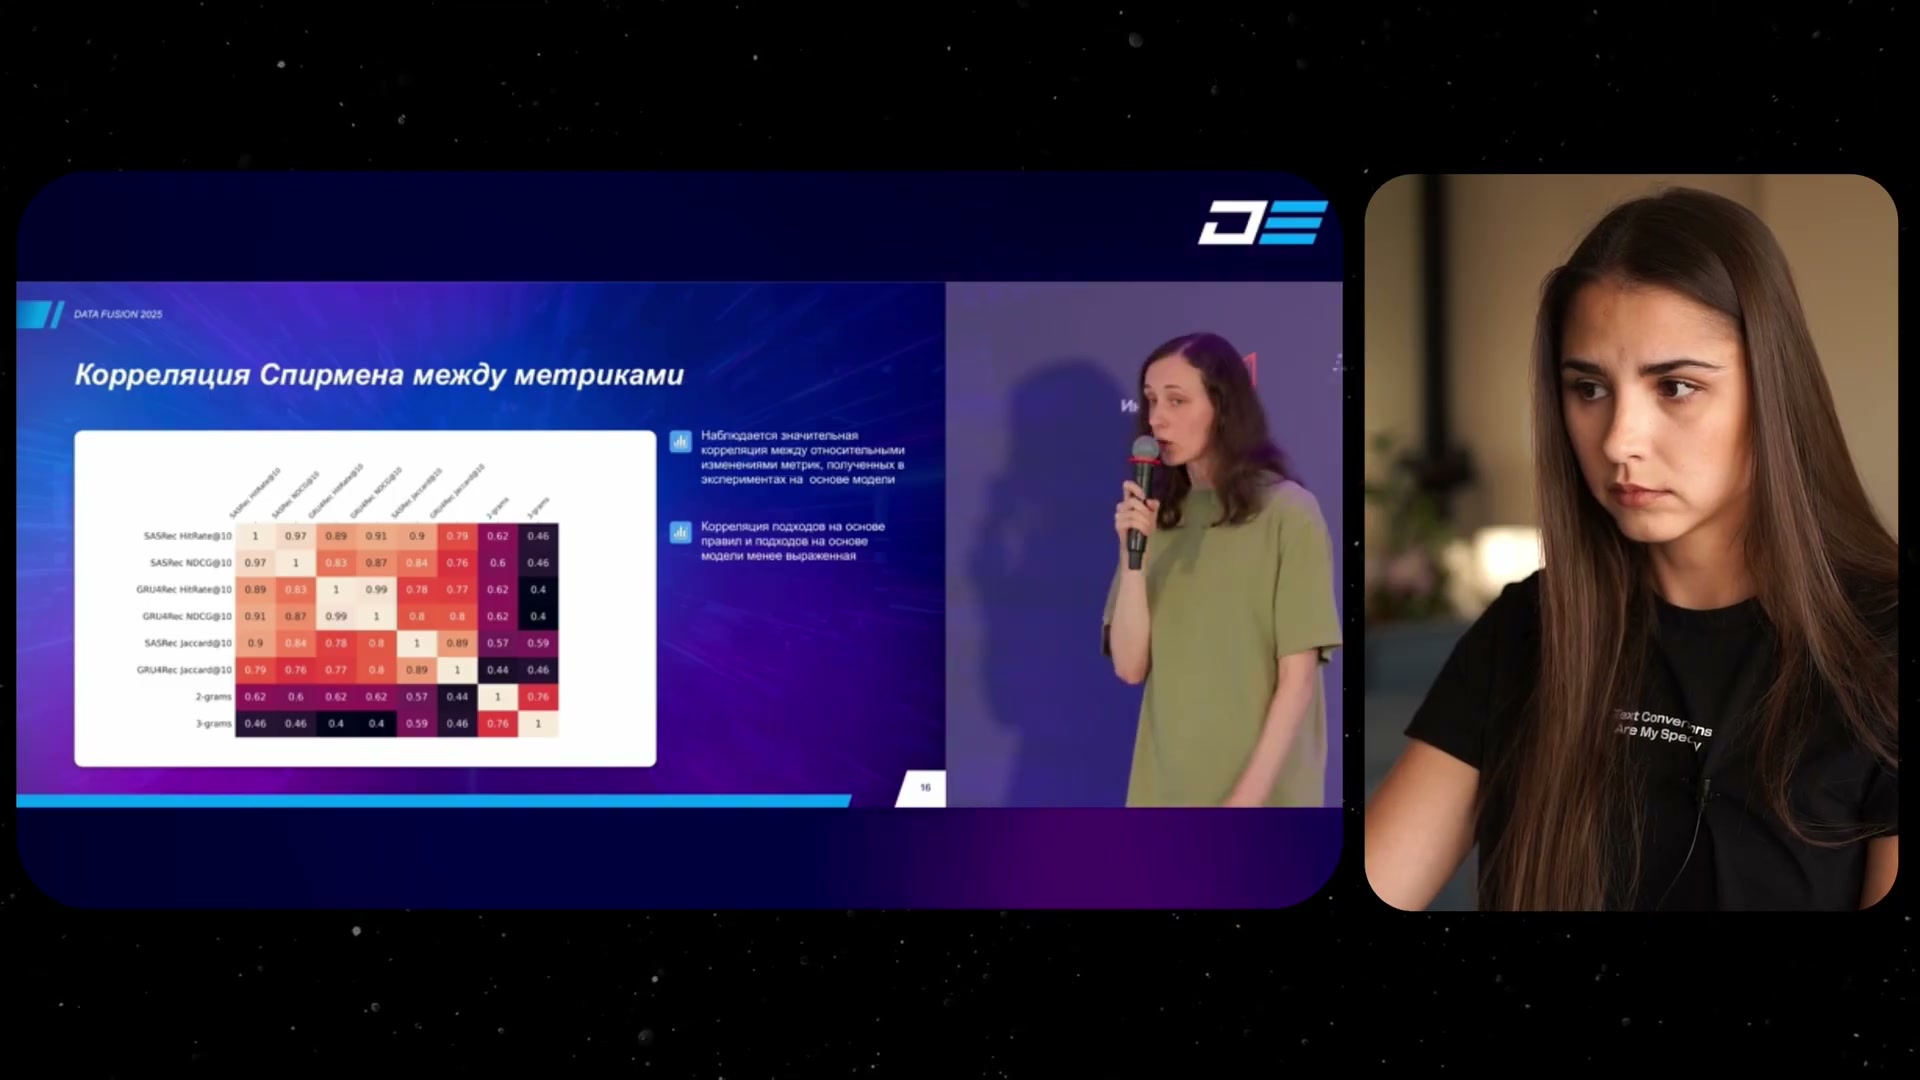
Корреляция Спирмена между относительными изменениями модельных метрик сильнее, чем связь модельных методов с правилами. Корреляция не доказывает причинность или универсальную пригодность датасета.
Источник: Анастасия Никулина · обзор Data Fusion 2025Ранг здесь означает чувствительность к порядку, а не качество модели
На следующем графике каждому набору присвоены ранги по нескольким измерителям. Подпись задаёт направление: чем больше ранг, тем слабее влияние перемешивания и слабее последовательная структура по данной проверке. Это не рейтинг моделей по качеству и не список продуктов с лучшими рекомендациями.
Среди наиболее выраженно последовательных данных оказываются 30Music и Zvuk, затем ML-20m. Для музыки Володкевич обсуждает естественные причины: порядок прослушивания, жанровые переходы и время суток могут быть связаны с намерением слушателя. Про MovieLens она делает оговорку, что обнаруженная структура имеет свои не вполне «органические» особенности, но не раскрывает их механизм. Подменять эту оговорку догадкой о конкретной причине нельзя.
Далее спикер выделяет данные маркетплейсов, где посетитель может действовать в рамках конкретного намерения. На графике представлены, среди прочих, MegaMarket, Tmall, Taobao и OTTO. Но это не общий вердикт всему домену электронной торговли: другие наборы того же домена ведут себя иначе, а ранги зависят от метрики. Показаны несколько диагностических упорядочиваний, не одна универсальная шкала.
Расхождения между правилами и моделями тоже содержательны. Например, для Steam и Yelp положение по правилам заметно отличается от положения по модельным показателям. Никулина обращает на это внимание и считает итоговые модельные проверки более убедительным ориентиром, чем только простые подсчёты. Это её оценка полезности методов, а не доказательство, что правила никогда не нужны.
Общий исследовательский результат: некоторые часто используемые наборы слабо реагируют на перемешивание, хотя на них принято проверять последовательные модели. Наше пояснение: успех модели на таком наборе ещё не доказывает успех именно её механизма работы с порядком. При переносе в другой продукт полезно сначала сопоставить природу событий и полученную диагностику, а не только итоговый балл из статьи.
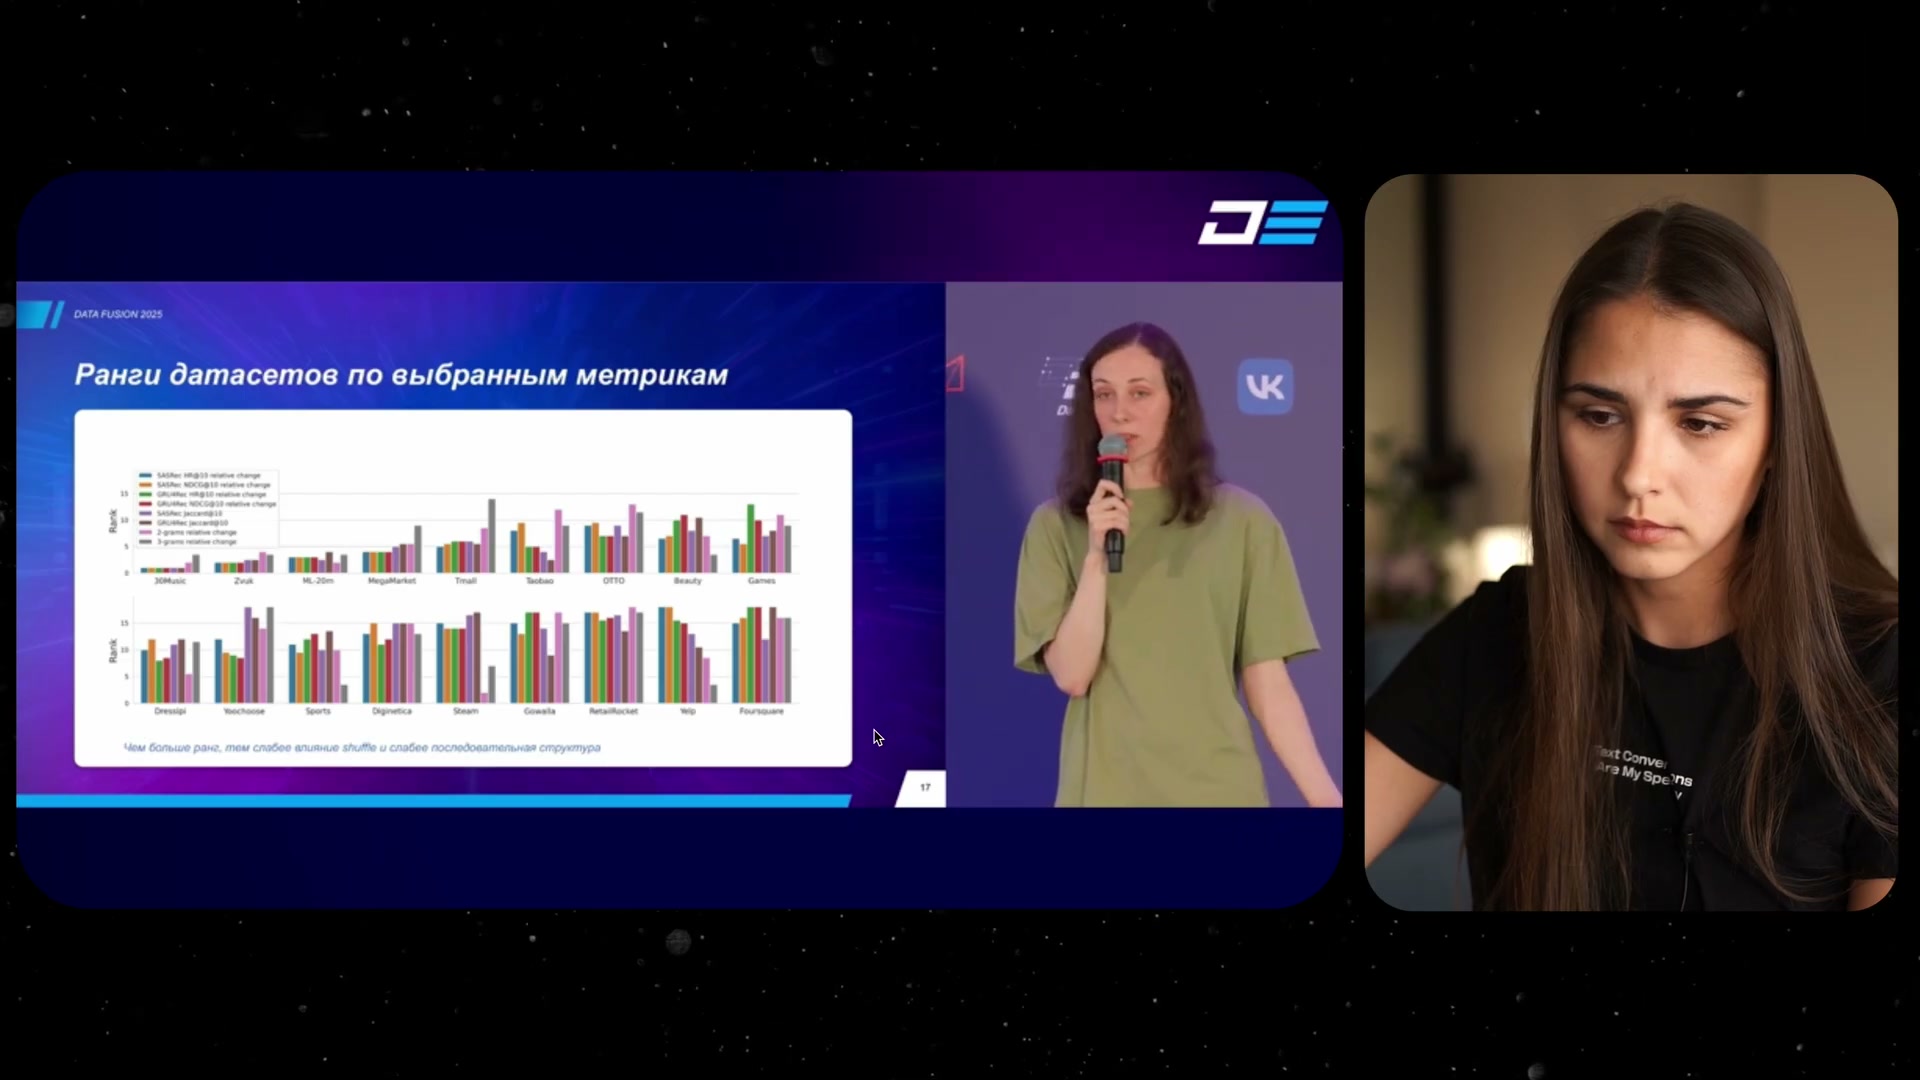
Более высокий ранг соответствует меньшему влиянию перемешивания и более слабой последовательной структуре в этой проверке. Это не рейтинг бизнес-качества рекомендаций.
Источник: Анастасия Никулина · обзор Data Fusion 2025Ранее встречавшиеся объекты: ограничение или часть задачи
Первое дополнительное исследование касается исключения объектов, с которыми пользователь уже взаимодействовал. Володкевич приводит книги: прочитанную книгу часто не хотят рекомендовать повторно. Авторы проверяют, как такое исключение влияет на измеряемую последовательную структуру.
Для повторяемого потребления вывод другой. Если пользователь снова слушает знакомую музыку, повторные взаимодействия являются частью настоящей задачи, и спикер говорит, что такие повторы необходимо сохранять. Иначе проверяется уже изменённый сценарий, из которого убрана существенная часть поведения.
Никулина спорит с возможным продуктовым прочтением этого вывода. Она не хочет замыкать человека на уже знакомых товарах и однообразной ленте: новизна и разнообразие тоже важны. Её пример покупки, которая может быть не нужна повторно через две недели, — иллюстрация рассуждения, а не окно исследования или установленная периодичность повторного спроса. Возможное влияние на деньги и возвращаемость она обсуждает без измеренных дельт.
Наше пояснение: здесь обсуждаются разные вопросы. Исследование спрашивает, что случится с диагностикой данных при исключении ранее встречавшихся объектов. Продуктовый комментарий спрашивает, когда такие объекты стоит показывать. Полезность знакомой музыки и необходимость разнообразия торговой ленты не обязаны приводить к одному правилу фильтрации.
Техническая точка исключения в обзоре не детализирована. Поэтому нельзя утверждать, что авторы обязательно удаляли повторы из обучающих историй: речь идёт о проверке влияния ранее встречавшихся объектов на результаты. Без полного протокола её не следует переименовывать в конкретную процедуру дедупликации обучения.
Доклад · 00:37:53Отдельный эксперимент: что изменится, если всё-таки переобучить модель
Второй дополнительный эксперимент проверяет важное допущение основной методики. До этого модель обучалась только на исходных последовательностях, а перемешивание применялось к входу во время оценки. Авторы спрашивают, достаточно ли этого, или выводы зависят от отсутствия переобучения.
Для проверки выполняют два отдельных обучения: одно на исходных данных, другое на перемешанных. Затем сравнивают полученные результаты. По словам Володкевич, они практически не меняются; это поддерживает более простой основной протокол, в котором достаточно перемешивать историю при применении модели.
Это самостоятельная дополнительная проверка, а не уточнение, будто во всех предыдущих опытах модель каждый раз обучали заново. В обзоре нет численных дельт этого сравнения, доверительных интервалов и точного допуска для выражения «практически не меняются». Поэтому результат нельзя превращать в доказанную одинаковость любых последовательных моделей на исходном и перемешанном обучении.
Доклад · 00:39:01Что исследование позволяет заключить — и чего не обещает
Володкевич завершает доклад выводом, что часть популярных датасетов имеет слабую последовательную структуру. Полученные на них результаты могут плохо переноситься на другую задачу. Предложенную диагностику можно применить и к собственным данным, чтобы лучше понимать, какие свойства действительно доступны последовательной модели.
Наше пояснение: проверка перемешиванием измеряет реакцию конкретной модели и выбранных правил на изменение порядка при определённой подготовке данных. Она не даёт универсального разрешения или запрета на использование трансформеров, не устанавливает отсутствие любых временных закономерностей и не прогнозирует точный прирост бизнеса. Для таких выводов нужны другие сравнения.
Никулина высоко оценивает внимание к данным, но хотела бы более простой критерий, который не требует обязательного обучения модели. Она подчёркивает, что правила не всегда совпадают с модельной диагностикой, снова возвращается к границам пользовательских сессий и к предсказанию следующей корзины вместо отдельного объекта. Это направления для дальнейшего исследования, а не уже полученная «формула последовательности».
В открытой части описания остаются конкретные пороги правил, подробности подготовки историй, число перемешиваний, полные настройки моделей и численная неопределённость результатов. При этом основной протокол, различие модельных и безмодельных проверок, свойства использованных выборок и обе дополнительные проверки уже позволяют понять содержание работы. Обзор заканчивается приглашением Никулиной обсудить выводы и предложить улучшения.
Доклад · 00:39:21Итог: три разных пути развития рекомендаций
Три выступления показывают разные причины менять рекомендательную систему. Wildberries начал с роста объёма сохранённых подборок и через неудачную кластеризацию пришёл к общим спискам с персональным порядком. Lamoda развивала поверхность показа: от виджета к ленте, затем к более сильному ранжированию и новым кандидатам. Sber AI Lab исследовал, есть ли в данных полезный порядок, ради которого стоит оценивать последовательные модели.
- 01
Wildberries — общие наборы
Пользователь связан с товарными и пользовательскими кластерами; вместо отдельной выдачи хранятся общие подборки.
- 02
Wildberries — персональный показ
Товары объединяются и доранжируются по пользовательскому и товарным векторам; пользовательское представление обновляется в сессионном масштабе.
- 03
Lamoda — готовые данные
Go-сервис получает опубликованные кандидаты и признаки из Aerospike. Их подготовка и обучение модели выполнялись отдельно от текущего запроса.
- 04
Lamoda — обработка запроса
Go-сервисы получают данные из Aerospike, применяют CatBoost и MMR, после чего возвращают персональную ленту.
- 05
Сбер — два вида входа
Уже обученная модель получает оригинальную и перемешанную истории при заранее выбранном временном разделении данных.
- 06
Сбер — сравнительная оценка
Авторы сопоставляют состав списков и качество, а отдельно проверяют изменение числа последовательных правил.
У Wildberries смешанный вариант сохраняет около 6% пресетов и даёт +1,8% GMV; итоговое сокращение шардов в 15 раз не равно снижению всех затрат. У Lamoda новая лента улучшает конверсии, а NDCG@60 +22% и Recall@200 +10% относятся к разным офлайн-сравнениям. У Сбера результат — различие датасетов по чувствительности к порядку, а не бизнес-прирост.
Замечания Никулиной сохраняют важные границы: денежная оценка не заменяется корзинами, выбор кластеризации требует объяснения, а перенос исследования зависит от природы данных. Во всех историях остаются непоказанные параметры и проверки. Поэтому выводы помогают понять конкретные решения, но не обещают тех же эффектов в другом продукте.
Доклад · 00:00:00