Разбор готов
FastVideo V1: общий конвейер для ускорения видеомоделей
Инженер хочет получить несколько секунд видео, но даже на H100 генерация может занимать больше пятнадцати минут. Отдельные способы ускорения уже существуют, однако их приходится собирать вместе, а работа на нескольких GPU требует дополнительной настройки. Команда FastVideo V1 предложила общую библиотеку компонентов: простой Python API, переиспользуемые стадии генерации и возможность менять низкоуровневые реализации, сохраняя логику модели. В главе разберём, что скрывается за одним параметром num_gpus, как разделены загрузка модели и настройки запроса, чем этот подход отличается от приведённых примеров Diffusers и xDiT. Затем посмотрим на реальные графики Wan2.1: с какой системой сравнивали скорость, что ускорилось и каких данных не хватает для оценки качества.
Материал полезен инженерам, которые запускают диффузионные видеомодели, разбираются с несколькими GPU или проектируют общую библиотеку для разных моделей. Особенно полезно различие между удобным API, распараллеливанием, оптимизацией вычислительных ядер и реально измеренным ускорением.
Статья · на английском
FastVideo V1: A Unified Framework for Accelerated Video GenerationFastVideo Team · Опубликовано: 24 апреля 2025 г.
Почему понадобился общий фреймворк
Авторы начинают не с нового алгоритма генерации, а с эксплуатационной проблемы. К апрелю 2025 года открытые видеомодели вроде HunyuanVideo и Wan2.1 уже давали высокое визуальное качество, но практический запуск оставался дорогим: несколько секунд видео могли генерироваться более 15 минут даже на H100. Одновременно работа на нескольких GPU в привычных инструментах требовала отдельного управления запуском, а ускорения появлялись в разных исследовательских проектах. В источнике среди таких направлений названы Sliding Tile Attention, SageAttention, TeaCache и xDiT.
FastVideo V1 позиционируется как объединяющий инженерный каркас. Его три заявленные цели: единый Python API, набор совместимых оптимизаций производительности и понятный способ описывать модели так, чтобы автор модели не переписывал всю распределённую и низкоуровневую часть. В сравнительной таблице статьи также заявлены 2–3× ускорение поддерживаемых моделей при сохранении качества, более экономное внимание и разбиение модели по GPU, а для загрузки — ускорение до 7×. Эти формулировки задают обещание V1; точные измерения появляются позже только для конкретного сравнения производительности Wan2.1.
Важно не смешивать разные уровни. SageAttention и TeaCache — техники ускорения вычислений внутри генерации. xDiT — отдельный фреймворк с более развитым распараллеливанием, чем показанный пример Diffusers. FastVideo V1 пытается сделать такие оптимизации составными частями общей системы, а не представить их как один новый алгоритм видеогенерации.
What’s NewМинимальный API V1: исторический пример 2025 года
В статье минимальный запуск строится вокруг VideoGenerator: пользователь передаёт идентификатор модели и число GPU, затем вызывает generate_video. Для примера берётся Wan-AI/Wan2.1-T2V-1.3B-Diffusers. Это важно отделить от сравнения производительности ниже, где измеряется Wan2.1 T2V 14B.
from fastvideo import VideoGenerator

generator = VideoGenerator.from_pretrained(
    "Wan-AI/Wan2.1-T2V-1.3B-Diffusers",
    num_gpus=1,
)
video = generator.generate_video("a person walking in a forest")
Публикация указывает для этого Quick Start CUDA 12.4, Python 3.10–3.12 и обычный запуск Python-файла без torchrun или accelerate. Но это снимок интерфейса FastVideo V1 на апрель 2025 года, а не актуальная инструкция по установке на 2026 год. Код полезен для понимания замысла API; перед реальным запуском текущую сигнатуру и зависимости нужно брать из актуальной документации проекта.
Quick StartКонфигурация и несколько GPU: что именно упрощает FastVideo
FastVideo разделяет параметры, которые задаются при создании конвейера, и параметры конкретной генерации. PipelineConfig отвечает за инициализацию: например, сколько GPU использовать и с какой точностью запускать кодировщик и декодер кадров VAE. SamplingParam описывает сам процесс генерации: число шагов, коэффициент усиления текстового условия (guidance scale) и размер кадра. Отдельные аргументы generate_video могут переопределить поля SamplingParam. В исходном примере SamplingParam задаёт 30 шагов, а прямой аргумент вызова меняет их на 35.
from fastvideo import VideoGenerator, SamplingParam, PipelineConfig

model_name = "Wan-AI/Wan2.1-T2V-1.3B-Diffusers"
config = PipelineConfig.from_pretrained(model_name)
config.num_gpus = 2
config.vae_config.vae_precision = "fp32"

generator = VideoGenerator.from_pretrained(
    model_name, pipeline_config=config
)

param = SamplingParam.from_pretrained(model_name)
param.num_inference_steps = 30
param.guidance_scale = 7.5
param.width = 1024
param.height = 576

video = generator.generate_video(
    "fox in the forest close-up quickly turned its head to the left",
    sampling_param=param,
    num_inference_steps=35,  # override: 30 -> 35
)
Значения 2 GPU, fp32 для VAE, 30/35 шагов, guidance 7.5 и 1024×576 относятся только к демонстрации API. Источник не связывает их с графиком производительности. Его важная идея — сохранить подходящие значения по умолчанию, но дать продвинутому пользователю доступ к точной настройке компонентов.
Дальше статья противопоставляет два вида использования нескольких GPU. В показанном Diffusers-примере PartialState делит разные текстовые запросы между разными процессами: одна GPU может обрабатывать «a dog», другая — «a cat». Это параллельная обработка нескольких независимых заданий, то есть параллелизм по данным; одно конкретное задание от такого разделения само по себе быстрее не становится. Формулировку статьи о Diffusers нужно читать исторически: это сравнение с приведённым авторами примером и архитектурой на дату V1, а не утверждение о возможностях любой версии библиотеки в будущем.
distributed_state = PartialState()

with distributed_state.split_between_processes(["a dog", "a cat"]) as prompt:
    result = pipeline(prompt).images[0]
xDiT, также названный в статье xFusers, принципиально сильнее этого Diffusers-примера: он поддерживает параллелизм по тензорам и последовательности для диффузионной модели, то есть способен разносить вычисления одной модели или длинного представления между устройствами. Претензия FastVideo здесь не в отсутствии возможностей, а в интерфейсе: пример xDiT требует torchrun и большого набора shell-параметров для PipeFusion, Ulysses, Ring, CFG-параллелизма, parallel VAE, cache и compile-опций.
# В комментарии источника: pp=2, ulysses=2, ring=1, cfg_parallel=2
N_GPUS=8
PARALLEL_ARGS="--pipefusion_parallel_degree 2 --ulysses_degree 2 --ring_degree 2"

torchrun --nproc_per_node=N_GPUS ./examples/SCRIPT
  --model MODEL_ID
  PARALLEL_ARGS
  --num_inference_steps INFERENCE_STEP
В этом shell-фрагменте есть внутренняя нестыковка: комментарий говорит ring=1, а фактический аргумент задаёт --ring_degree 2. Источник её не объясняет, поэтому исправлять значение по догадке нельзя. Сам фрагмент нужен как иллюстрация количества ручной оркестрации, а не как рекомендованная конфигурация.
FastVideo заявляет более высокий уровень абстракции: при num_gpus > 1 фреймворк сам выбирает стратегию параллелизма и не требует отдельного torchrun или accelerate. Статья, однако, не раскрывает правило выбора параметров распараллеливания для конкретной модели и числа GPU. Поэтому «автоматически выбирает стратегию» — подтверждённый тезис, а конкретную таблицу того, как FastVideo делит Wan2.1 на 2, 4 или 8 H100, из источника восстановить нельзя.
Simple, Unified Python API with Multi-GPU SupportМодель отдельно, kernel-реализация отдельно
Следующий слой V1 — разделение архитектуры модели и конкретного способа выполнять её операции. Простая интуиция такая: автор модели описывает, какие преобразования нужны, а фреймворк решает, как эти преобразования выполнить на доступных GPU и какие оптимизированные вычислительные ядра использовать. Это позволяет добавить низкоуровневую оптимизацию один раз и затем переиспользовать её во всех совместимых моделях, не переписывая их основную логику.
В демонстрационном CustomEncoderModel используется QKVParallelLinear. Он строит три проекции для механизма внимания: запрос Q, ключ K и значение V. Затем get_rope добавляет позиционную информацию к Q и K через RoPE, а LocalAttention выполняет внимание. Число локальных голов делится на get_tensor_model_parallel_world_size(), то есть пример показывает связь слоя с разделением модельных тензоров между GPU.
self.qkv_proj = QKVParallelLinear(
    hidden_size=1024,
    head_size=64,
    total_num_heads=16,
    total_num_kv_heads=16,
)
self.rotary_emb = get_rope(64, rotary_dim=64, max_position=8192)
self.attn = LocalAttention(
    num_heads=16 // get_tensor_model_parallel_world_size(),
    head_dim=64,
    num_kv_heads=16 // get_tensor_model_parallel_world_size(),
    causal=True,
)
Параметры hidden_size=1024, 16 голов, head_dim=64, max_position=8192 и causal=True — только параметры учебного фрагмента. Это не конфигурация Wan2.1 T2V 14B и не условия сравнения производительности. Более того, показанный CustomEncoderModel не является самодостаточным запускаемым скриптом: в нём опущены окружающие определения, а комментарий прямо говорит, что фактическая реализация зависит от конфигурации пользователя и доступных оптимизаций.
Именно здесь проходит важная граница V1. Название LocalAttention описывает используемую абстракцию слоя, но не фиксирует навсегда одно CUDA-ядро. На другом уровне конфигурации фреймворк может выбрать другую реализацию, сохранив архитектурный код модели.
Modular Architecture with Clean SeparationWan2.1 как композиция семи стадий
Модульность распространяется не только на отдельные слои. FastVideo разбивает весь диффузионный конвейер на переиспользуемые PipelineStage. Для Wan2.1 сам конвейер требует пять модулей — text_encoder, tokenizer, vae, transformer и scheduler — и связывает их в семь последовательных стадий.
- 01
InputValidationStage
Проверяет входные параметры до начала дорогих вычислений.
- 02
TextEncodingStage
Токенизирует и кодирует текстовый запрос через tokenizer и text_encoder.
- 03
ConditioningStage
Формирует условия, которые понадобятся дальнейшей генерации.
- 04
TimestepPreparationStage
Через scheduler подготавливает последовательность шагов удаления шума.
- 05
LatentPreparationStage
Готовит начальные скрытые представления для генерации с учётом scheduler и transformer.
- 06
DenoisingStage
Многократно вызывает transformer и scheduler, постепенно переводя шумные скрытые представления к результату.
- 07
DecodingStage
Передаёт итоговые скрытые представления в VAE и получает видео.
Авторы подчёркивают, что файл FastVideo с Wan2.1 Pipeline целиком занимает 63 строки. Для контраста они приводят сильно сокращённый фрагмент Diffusers Wan2.1: в статье оставлен в основном __call__, тогда как исходный файл авторы описывают как почти 600 строк и отмечают повторение похожей логики для вариантов I2V и V2V. Это сравнение размера и структуры управляющего кода, а не самостоятельное доказательство скорости.
Даже сокращённый фрагмент Diffusers показывает обязанности монолитного вызова: проверку входа, приведение числа кадров к требованиям VAE, выбор размера пакета, кодирование текста и отрицательного условия, подготовку шагов и скрытых представлений. Далее идут цикл удаления шума, усиление текстового условия, scheduler.step, дополнительные вызовы функций, декодирование, постобработка и освобождение ресурсов. FastVideo выносит эти обязанности в отдельные стадии, чтобы их можно было заменять и переиспользовать.
В источнике сказано, что такие Stage в будущем можно компоновать и для обучения или дистилляции, но рядом стоит пометка coming soon. Поэтому модульная архитектура уже есть, а обучение/дистилляция на её основе в этом материале остаются планом, а не показанным функционалом.
ComposablePipeline and PipelineStage AbstractionЧто именно ускоряет сравнение производительности и как читать график
В итоговом сравнении производительности FastVideo сравнивается не с Diffusers-примером из раздела про API, а с официальной реализацией Wan2.1 T2V 14B. Для каждой конфигурации число GPU совпадает у FastVideo и у базы: FastVideo на 4 H100 сравнивается с Official Wan2.1 на 4 H100, а не с одной H100. Поэтому столбцы показывают относительное ускорение фреймворка при одинаковом числе GPU, а не масштабирование одного запуска при добавлении GPU.
Таблицу можно прокрутить по горизонтали.
Максимум на графике — 3,1× для генерации на 2 H100 и 7,3× для загрузки на 1 H100. В тексте статьи эти результаты округлены до «up to 3x» и «up to 7x». Нельзя переводить столбцы в секунды: абсолютное время генерации и загрузки на этом графике не приведено. Нельзя и заключать, что 8 H100 дают лишь 1,8× относительно одной H100: такой эксперимент график не показывает.
Авторы связывают показанное ускорение с прозрачным переключением механизма внимания на вычислительные ядра SageAttention и включением TeaCache. SageAttention здесь выступает низкоуровневой реализацией внимания, а TeaCache — дополнительной оптимизацией вычислений между шагами. Отдельной абляции, которая разделяла бы вклад этих двух методов, источник не даёт.
Sliding Tile Attention нужно держать отдельно. В начале статьи STA перечислен среди техник ускорения, а в списке вкладов команды сказано, что поддержка STA добавлена для Wan2.1. Но раздел с результатами производительности не приписывает числа 2,2–3,1× связке SageAttention + TeaCache + STA. Поэтому эти числа скорости нельзя использовать как абляцию STA.
Качество измерено гораздо слабее, чем скорость. Авторы заявляют, что ускорение сохраняет качество, но исходный график содержит только относительное ускорение генерации и загрузки. В материале рядом нет численной метрики качества, размера набора, доверительных интервалов, слепой оценки людьми или разбивки качества по оптимизациям. Корректная формулировка результата — «авторы заявляют сохранение качества», а не «качество доказано числом».
Из раздела о производительности также нельзя восстановить точное число шагов удаления шума, коэффициент усиления текстового условия, точность вычислений, размер пакета, набор текстовых запросов, версию ПО, тип соединения между GPU, число повторов или разброс результатов. Значения 30/35 шагов, 1024×576 и другие параметры из API-примера не являются пропущенными условиями сравнение производительности и не должны туда переноситься.
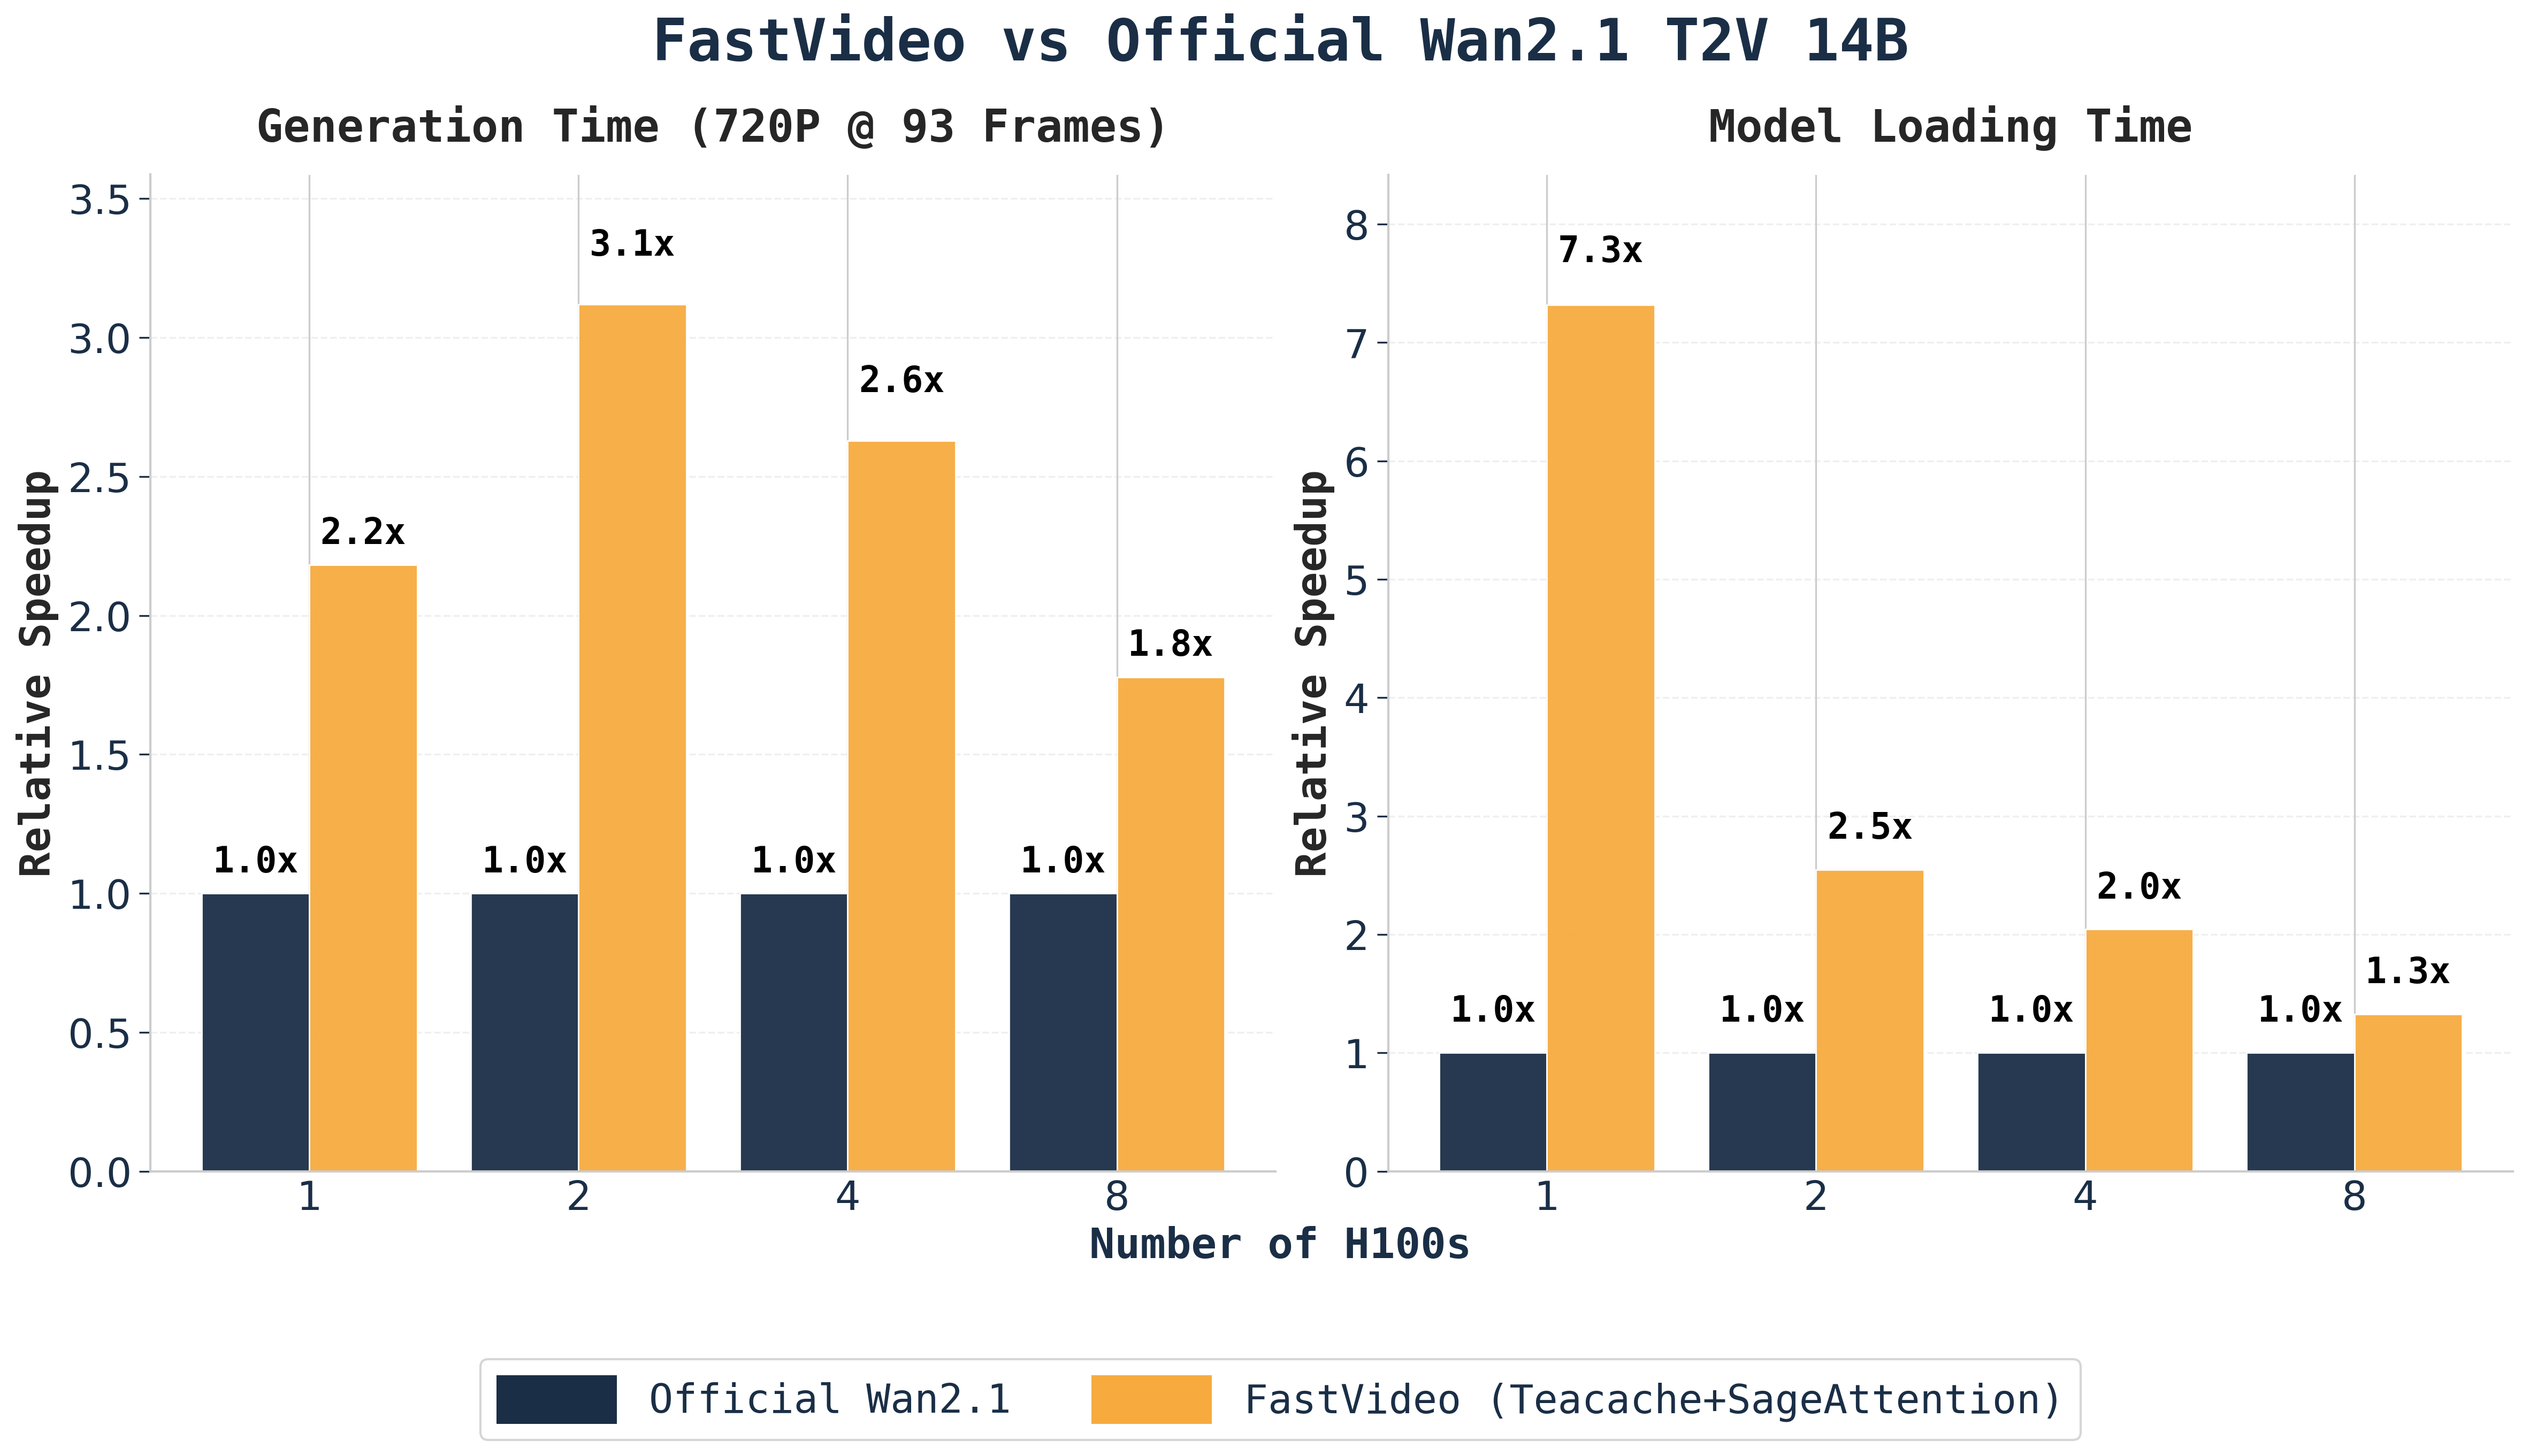
Для генерации 720p, 93 кадра: 2,2× / 3,1× / 2,6× / 1,8× на 1 / 2 / 4 / 8 H100. Загрузка модели: 7,3× / 2,5× / 2,0× / 1,3×. База каждой пары — официальный Wan2.1 на том же числе GPU, а не однокарточная скорость. Качество заявлено авторами; отдельной численной оценки качества на графике нет.
Источник: FastVideo Team · исходный графикГде заканчивается статья и начинается документация проекта
После сравнения производительности статья отправляет читателя в GitHub-репозиторий и документацию для разработчиков, отдельно упоминает материал по Sliding Tile Attention и сообщества Slack и Discord. Для главы это граница источника: статья объясняет устройство V1 и показывает одно сравнение производительности, но не заменяет текущую документацию по установке, поддерживаемым конфигурациям и API.
Это особенно важно из-за возраста материала. Любой код выше нужен для понимания V1 на апрель 2025 года; его нельзя выдавать как проверенный текущий рецепт запуска без отдельной сверки с современным репозиторием.
Getting StartedЧто в V1 уже показано, а что осталось в планах
Планы в статье делится на три направления: поддержать больше видеомоделей, ускорить обучение и дообучение собственных моделей и расширить интеграции с прикладными инструментами вроде ComfyUI и A1111. Ранее в тексте отдельно сказано о планах добавить обучение и дистилляцию поверх той же модульной архитектуры. Следовательно, библиотека для применения моделей и её компоненты конвейера — содержание V1, а обучение, дообучение и дистилляция в этой публикации не показаны как готовая измеренная возможность.
Поддержку моделей тоже нельзя расширять по косвенным упоминаниям. Quick Start использует Wan2.1 T2V 1.3B, сравнение производительности — Wan2.1 T2V 14B, а в описании вкладов участников сказано о добавлении StepVideo Pipeline. HunyuanVideo упоминается в обзоре современных open-source моделей, но эта фраза сама по себе не доказывает его поддержку FastVideo V1. Полного списка поддерживаемых конфигураций статья не приводит.
С ComfyUI есть отдельная оговорка. В планах интеграции с ComfyUI и A1111 ещё обсуждаются как направление развития, но в списке команды одновременно указана работа Kevin Lin и Wenting Zhang над интеграцией с ComfyUI. По одному тексту нельзя определить полноту и статус выпуска этой интеграции, поэтому корректно говорить только о том, что работа над ней уже велась, а расширение интеграций с другими инструментами оставалось частью плана.
What’s Next for FastVideo?На чьих работах построен FastVideo V1
FastVideo V1 представлен как открытый исследовательский и инженерный фреймворк, а не как кейс коммерческого внедрения с пользовательским трафиком, SLA и бизнес-метриками. В благодарностях команда прямо перечисляет проекты, у которых училась или переиспользовала код: PCM, diffusers, OpenSoraPlan, xDiT, vLLM, SGLang и Wan2.1. Разработка V1 была частично поддержана Anyscale и MBZUAI.
Авторы также благодарят ранних тестировщиков и участников сообщества, отдельно называя Jiao Dong и Yusuf Ozuysal. Это помогает правильно читать результат: перед нами фреймворк, собравший идеи распределённого применения моделей и оптимизаций из нескольких экосистем, а не полностью изолированная реализация всех методов с нуля.
AcknowledgementsКакие части V1 привязаны к конкретным вкладам команды
Внутри самой FastVideo Team роли распределены по слоям системы. Will Lin и Peiyuan Zhang названы руководителями проекта и архитекторами. Wei Zhou добавлял Pipeline и Model Configs, Wan2.1 Pipeline и Torch compile. Kevin Lin работал над CI/CD, тестами, интеграцией с ComfyUI и CLI; Yongqi Chen — над поддержкой STA для Wan2.1; Zihang He — над StepVideo Pipeline.
You Zhou указан с вкладом в CD, Wenting Zhang — в интеграции с ComfyUI, Cody Yu помогал проектировать архитектуру V1, Richard Liaw — API и архитектуру, Hao Zhang консультировал проект в целом. Перечень показывает распределение работы между участниками; сам по себе он не устанавливает готовность каждой функции.
FastVideo TeamИтог: что происходит при одной генерации и что действительно измерено
FastVideo V1 решает не одну локальную проблему скорости, а задачу сборки видеогенерации в общий инженерный каркас. До запроса модель и её компоненты инициализируются по PipelineConfig: выбираются устройства, точности и доступные реализации. Это отдельный этап от самой генерации. Обучение, дообучение и дистилляция в статье остаются направлениями развития и не входят в показанный процесс применения модели.
- 01
Принять текст и SamplingParam
Запрос задаёт текст и параметры генерации; прямые аргументы вызова могут переопределить поля SamplingParam.
- 02
Подготовить условие
Конвейер проверяет вход, кодирует текст и подготавливает условия для модели.
- 03
Подготовить шаги и скрытые представления
Планировщик scheduler задаёт шаги удаления шума, а конвейер создаёт начальные скрытые представления.
- 04
Постепенно удалить шум
Трансформер и scheduler многократно обновляют скрытые представления; используются выбранный режим нескольких GPU и оптимизированные ядра внимания.
- 05
Декодировать видео
Декодер VAE переводит итоговое скрытое представление в кадры, после чего конвейер возвращает видео.
Архитектурно V1 отделяет модель от её низкоуровневой реализации и раскладывает Wan2.1 на семь переиспользуемых стадий. В сравнении производительности авторы сравнивают FastVideo с официальным Wan2.1 T2V 14B на одинаковом числе H100. Для 720p и 93 кадров ускорение генерации составляет 2,2×, 3,1×, 2,6× и 1,8× на 1, 2, 4 и 8 H100; загрузки — 7,3×, 2,5×, 2,0× и 1,3×. Эти числа связываются с SageAttention и TeaCache, но отдельной абляции нет; STA к этим измерениям не отнесена. Абсолютного времени и численной оценки качества график не даёт. Поэтому основной результат публикации — удобное объединение нескольких уровней оптимизации и заметное ускорение в конкретном сравнении Wan2.1, а не универсальная гарантия ускорения, качества или линейного масштабирования для любой видеомодели.
Performance and Results