Разбор готов
Adobe Firefly: как TensorRT ускорял генерацию видео
Генерация короткого ролика диффузионной моделью заметно тяжелее генерации одного изображения: нужно обработать гораздо больше данных, поэтому растут задержка, загрузка GPU и стоимость сервиса. В 2024 году Adobe и NVIDIA готовили Firefly Video к запуску и параллельно ускоряли применение модели, обучение которой ещё завершалось. Сначала её экспортировали в ONNX и запустили через TensorRT в BF16, затем добавили смешанные вычисления BF16/FP8 и квантизацию после обучения, отдельно проверяя влияние снижения точности. В главе разберём три вида входа, путь до готового ролика, проверку качества, профилирование механизма внимания, работу на AWS, заявленные ускорения и ограничения измерений. Отдельно аккуратно разберём неточную математику FP8 из исходной статьи.
Материал полезен инженерам, которые ускоряют тяжёлые трансформерные и диффузионные модели после обучения. На примере Firefly видно, как связаны форматы чисел, профилирование GPU, проверка качества и стоимость применения модели. Это исторический разбор внедрения 2024 года по статье NVIDIA/Adobe, опубликованной в апреле 2025-го, а не инструкция по версиям TensorRT, библиотекам и пакетам 2026 года.
Статья · на английском
Optimizing Transformer-Based Diffusion Models for Video Generation with NVIDIA TensorRTMaximilian Müller и соавторы · NVIDIA / Adobe · Опубликовано: 21 апреля 2025 г.
От финализации модели до беты — меньше четырёх месяцев
Для Firefly генерация видео была не только задачей качества: один ролик требует заметно больше вычислений, чем одно изображение, поэтому применять модель нужно было достаточно быстро и экономно. Работу над ускорением начали ещё до окончательного завершения обучения. На исходном временном графике в июле 2024 года стоит «Model training finalizing», в августе — TensorRT BF16, в начале сентября — TensorRT FP8, в конце сентября — финальный чекпойнт и дополнительные эксперименты с квантизацией, а в октябре — Adobe MAX и бета. Подпись к рисунку говорит, что путь от исследовательского этапа до беты занял меньше четырёх месяцев. Это историческая последовательность работ, но не свидетельство формального жёсткого срока внутри команды.
Таблицу можно прокрутить по горизонтали.
В двух официальных материалах октябрьский этап назван по-разному. На исходном рисунке стоит подпись «Private beta», и она остаётся частью оригинальной иллюстрации. В то же время в официальном анонсе Adobe от 14 октября 2024 года Firefly Video Model назван «limited public beta». Это расхождение в формулировках двух материалов Adobe; оно не меняет последовательность технических работ на рисунке.
Числа о масштабе Firefly тоже нужно привязывать к правильному запуску. Более 70 млн изображений за первый месяц относятся к ранней бете Firefly 2023 года, что подтверждает официальный пресс-релиз Adobe от 10 мая 2023 года, а не к видеомодели октября 2024-го. Упомянутые в статье «более 20 млрд assets» — это совокупный объём созданных в экосистеме Firefly материалов, а не число сгенерированных видео. Поэтому обе величины дают общий продуктовый контекст Firefly, но не измеряют масштаб запуска Firefly Video. Интеграции с Photoshop, Premiere Pro, Express и Illustrator также показывают широту продукта, а не скорость основной диффузионной части модели.
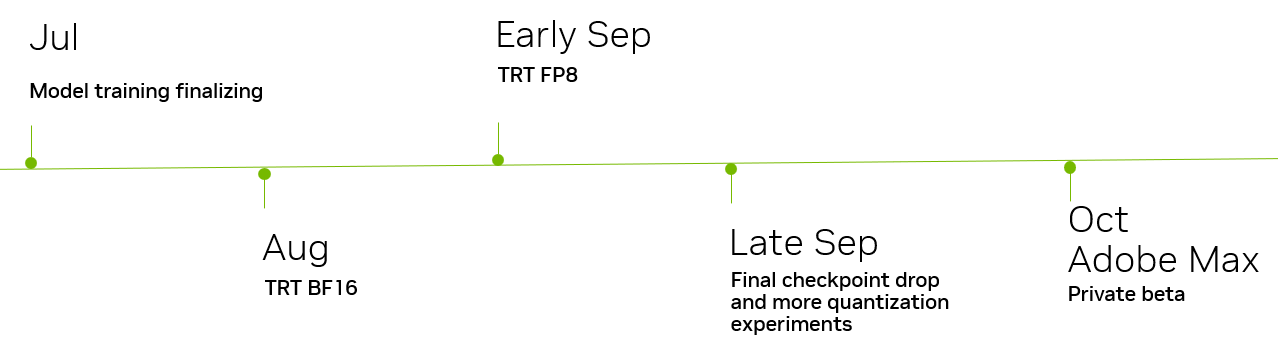
Путь от завершения обучения в июле 2024 до приватной беты Adobe Max в октябре: сначала TensorRT BF16, затем FP8 и дополнительные эксперименты с финальными весами.
Источник: NVIDIA / Adobe · исходная иллюстрацияТри вида входа сходятся в общей диффузионной модели (DiT)
Схема Firefly показывает три альтернативных способа задать исходные данные. При генерации по тексту (T2V, text-to-video) запрос обрабатывает текстовый энкодер. При генерации по изображению (I2V, image-to-video) используется энкодер LDM (LDM encoder), а при преобразовании уже имеющегося видео (V2V, video-to-video) — латентный энкодер (Latent encoder). Для одного запроса выбирается одна такая ветвь. Все три приводят разные исходные данные к представлению, которое затем поступает в общую основную часть диффузионной модели — DiT.
На оригинальной схеме основная диффузионная модель (Diffusion DiT) отмечена как работающая на H100. Остальные показанные GPU-компоненты — входные энкодеры, декодер латентного представления (Latent decoder) и увеличение разрешения (UpSample) — отмечены цветом A100. Финальная постобработка видео (Video postprocessing) выполняется на CPU. Это устройство конкретной опубликованной схемы, а не правило для любого варианта развёртывания Firefly.
После DiT получается латентное представление — компактный внутренний код будущих кадров: его декодируют, увеличивают до нужного разрешения и затем постобрабатывают. На выходе рисунка написано «5s / 24 fps / 1080p». Это параметры готового ролика: пять секунд видео, 24 кадра в секунду и разрешение 1080p. Число 5 s здесь не обозначает время вычисления. Публикация также не говорит, что все последующие измерения производительности проводились именно для такого выходного ролика.
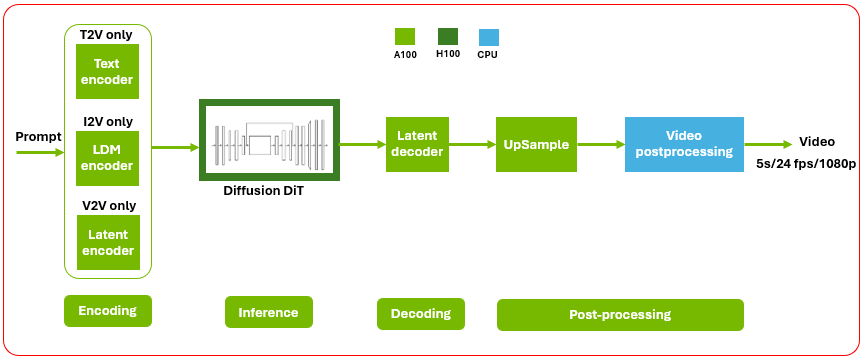
Три альтернативных входа T2V / I2V / V2V сходятся в diffusion DiT на H100. Другие GPU-компоненты показаны на A100, постобработка — на CPU. Выход подписан 5 секунд, 24 кадра/с, 1080p.
Источник: NVIDIA / Adobe · исходная иллюстрацияЗачем понадобился ONNX и почему сначала использовали BF16
Первый инженерный шаг — перенести модель из исследовательской среды в систему быстрого выполнения без отдельной ручной реализации вычислительного графа. Для этого Adobe экспортировала модель в ONNX. В статье мотив сформулирован практично: такой формат позволял передавать модель от разработки к развёртыванию и переиспользовать один и тот же граф. TensorRT затем получает этот граф и строит для GPU более эффективный вариант выполнения.
Сначала команда получила вариант TensorRT в BF16. BF16 хранит число меньшим количеством битов, чем FP32, но сохраняет широкий диапазон экспоненты; благодаря этому уменьшается объём данных, а формат хорошо поддерживается ускорителями. Только следующим этапом появились совместные вычисления в BF16 и FP8 — смешанная точность. Поэтому историю Firefly нельзя сводить к мгновенному переводу всей модели в FP8: временной график отдельно показывает BF16, а статья описывает итоговый вариант именно как сочетание двух форматов.
FP8 используют не просто ради более короткой записи числа. Меньший формат сокращает объём весов и активаций, снижает обмен данными с памятью и позволяет задействовать быстрые операции Tensor Core. При этом более грубое числовое представление может сильнее искажать значения, особенно если в распределении встречаются редкие большие выбросы. Поэтому часть вычислений оставляют в BF16, часть переводят в FP8, а влияние снижения точности на результат проверяют отдельно от ускорения.
Статья также отмечает, что TensorRT работает с моделями из PyTorch и TensorFlow и поддерживает ONNX. В конкретной истории Firefly именно ONNX стал связующим форматом между исследовательской моделью и её развёртыванием. Причинная цепочка здесь важна: команда сначала получила переносимый вычислительный граф, а затем ускоряла его средствами TensorRT, вместо того чтобы заново реализовывать видеомодель для каждой версии системы выполнения.
Leveraging TensorRT for efficient deployment; Step 1: ONNX export; Step 2: TensorRT implementationКвантизация после обучения: сначала проверить влияние на качество
Здесь точность чисел снижают уже после завершения обучения модели — это квантизация после обучения (PTQ). Команда использовала NVIDIA TensorRT Model Optimizer через PyTorch API. Так можно было сохранить существующий контур оценки и быстро проверить, как имитация FP8 влияет на результат, не собирая для каждой проверки готовый оптимизированный движок TensorRT.
Статья отдельно подчёркивает важное ограничение: режим имитации FP8 в PyTorch помогает оценивать влияние низкой точности на качество, но не показывает фактическое ускорение вычислений в FP8. Имитация воспроизводит численные эффекты более грубого формата, тогда как выигрыш по времени появляется только при реальном низкоточном выполнении на поддерживаемом оборудовании. Поэтому проверка качества и измерение скорости — два разных этапа.
Для настройки квантизованной диффузионной модели авторы упоминают анализ распределений и автоматический подбор квантизации в TensorRT Model Optimizer. Смысл анализа в том, чтобы увидеть, как распределены веса и активации, насколько велики редкие выбросы и где переход к FP8 даёт слишком заметную ошибку. При этом статья не раскрывает размер калибровочной выборки, конкретные пороги, список слоёв, оставленных в BF16, или точный алгоритм выбора смешанной точности. Эти параметры публичного эксперимента остаются неизвестными.
Step 3: Quantization techniques; Overcoming deployment challenges with quantized diffusersКак понимать масштабирование FP8 — и почему формулу статьи нельзя копировать буквально
Масштаб нужен для того, чтобы привести значения тензора к диапазону, который может представить FP8. Значения за границей диапазона ограничиваются, остальные переводятся в ближайшие представимые числа, а при обратном преобразовании масштаб возвращает их примерно в исходную шкалу. В статье этот процесс записан несогласованно: рядом приведены q = round(Sx), x′ = qS и S = max(|X|)/qmax. Если S во всех трёх выражениях означает одно и то же, первая и вторая формулы не являются взаимно согласованными. Кроме того, round здесь выглядит как округление к целому, хотя FP8 — формат с плавающей точкой.
Поэтому следующая запись — не «правильная формула из статьи Adobe», а отдельное пояснение по официальной документации TensorRT 10.x. NVIDIA сейчас помечает эту страницу как архивную. Здесь она нужна для проверки математики исторического материала, а не как руководство по установке, выбору версии или использованию API в 2026 году.
Согласованная запись из документации TensorRT для FP8E4M3: сначала значение делят на масштаб s и ограничивают допустимым диапазоном, затем castToFp8 округляет его к ближайшему представимому числу FP8 с плавающей точкой. При точном равенстве выбирается вариант ties-to-even. Это не целочисленное округление, как в INT8.
При такой записи простое масштабирование по максимуму (max-based scaling) можно понимать как выбор s, при котором наибольшее по модулю значение помещается около верхней границы формата. Это полезная иллюстрация, но публикация не показывает, что Adobe применяла одну и ту же схему ко всем тензорам. В самой статье упомянуты как один масштаб на весь тензор (per-tensor), так и отдельные масштабы по каналам (per-channel), а фактическая конфигурация модели не раскрыта.
Ошибка квантизации — разница между исходным и восстановленным значением. Для FP8 её распределение в общем случае не является равномерным: расстояние между соседними представимыми числами меняется с экспонентой, а ограничение диапазона создаёт дополнительную ошибку для выбросов.
Статья сравнивает два формата FP8 — E4M3 и E5M2. В E4M3 один бит отведён под знак, четыре — под экспоненту и три — под дробную часть: это даёт более высокую относительную точность, но меньший диапазон. В E5M2 экспонента занимает пять битов, а дробная часть — два, поэтому диапазон шире, а представление грубее. Авторы пишут, что для рассматриваемого применения Firefly выбрали E4M3. Напечатанные в статье нижние границы диапазонов E4M3 и E5M2 не подходят в качестве спецификации: они не дают надёжного описания всех представимых значений, включая нормальные и субнормальные числа. Поэтому для разбора достаточно устройства форматов и подтверждённой для TensorRT E4M3 верхней границы ±448; спорные нижние пределы не используются.
Quantization; Dequantization; Scaling factor selection; Error analysis (quantization noise); Handling FP8 formats — форматы и масштабирование; отдельное пояснение по официальной документации TensorRTПрофилирование показало главное узкое место
После переноса модели одного итогового времени недостаточно: нужно понять, какие именно операции определяют задержку. Команда использовала NVIDIA Nsight Deep Learning Designer, чтобы сопоставить участки ONNX-графа с работой GPU и увидеть, где уходит основная часть времени. Главным вычислительным узким местом в статье назван механизм внимания по масштабированному скалярному произведению — Scaled Dot Product Attention (SDPA).
На исходном скриншоте профилировщика слой _gemm_mha_v2_myl0_3 занимает 70,569% в колонке Inference Time (%). Это число объясняет, почему в показанном запуске команда сосредоточилась на механизме внимания. Но оно относится именно к этому слою и этому исходному ONNX-профилю. Конфигурация модели, размер входа, версия системы выполнения и другие условия могут изменить распределение времени, поэтому 70,569% не является общей долей внимания во всех запусках Firefly.
После нахождения узкого места статья говорит, что команда fine-tuned the Transformer backbone, чтобы ускорить выполнение и уменьшить расход памяти. Публичный материал не уточняет, что именно было изменено: веса модели, структура графа, используемые операции, выбор GPU-ядер или несколько вещей сразу. Поэтому из источника следует только дальнейшая оптимизация основной трансформерной части модели после профилирования; считать эту фразу подтверждением отдельного ML-дообучения нельзя.
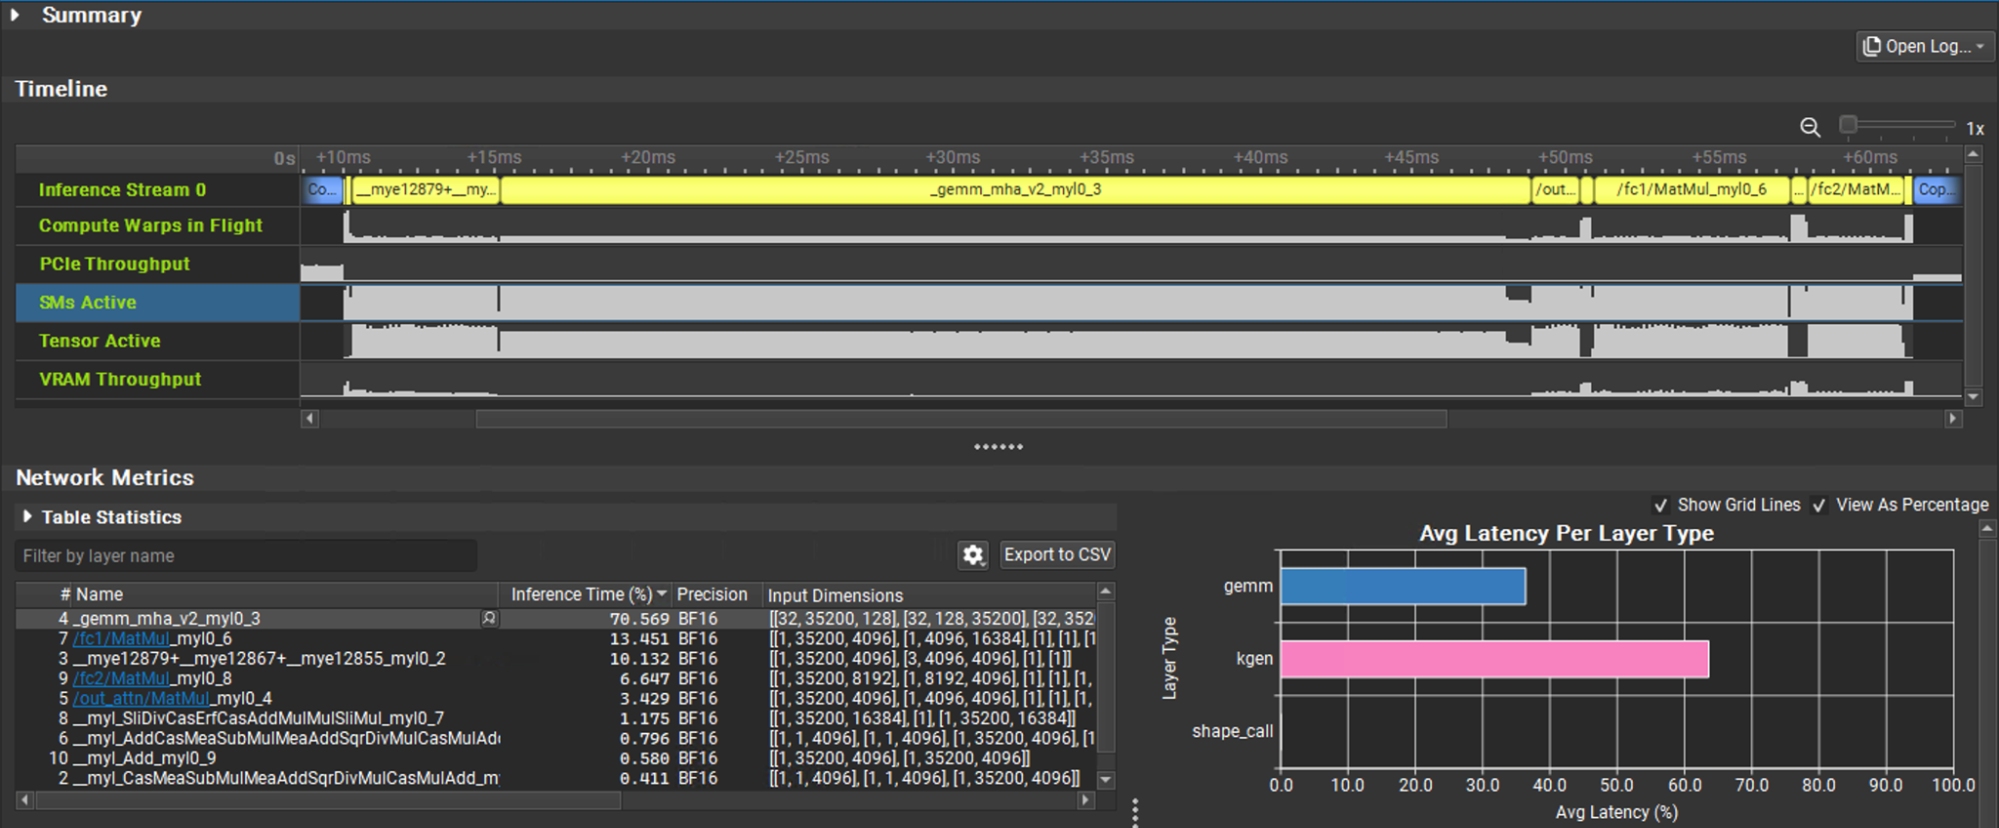
Профилирование исходной ONNX-модели: слой attention занимает около 70,6% времени в показанном профиле. Это конкретный снимок, не доля во всех конфигурациях Firefly.
Источник: NVIDIA / Adobe · исходная иллюстрацияЧто именно ускорилось и как читать результаты
Оптимизированная модель работала в AWS: статья называет экземпляры EC2 P5/P5en и GPU семейства Hopper. Авторы связывают эту конфигурацию с возможностью обслуживать больше запросов меньшим числом GPU. Это важный инфраструктурный контекст, но публикация не раскрывает распределение нагрузки, среднюю загрузку GPU, размер пакета запросов или полный расчёт стоимости.
Таблицу можно прокрутить по горизонтали.
Figure 4 особенно легко прочитать слишком широко. Столбцы показывают относительное время работы основной диффузионной части модели: TensorRT BF16 быстрее PyTorch в 1,6 раза, а сочетание BF16 и FP8 — до 2,5 раза. У оси Runtime нет единиц измерения, поэтому по графику нельзя восстановить ни абсолютное время генерации, ни задержку для пятисекундного ролика. Математически ускорение 2,5× соответствует примерно 60%-ному сокращению времени, однако статья не подтверждает, что заявленное в тексте снижение задержки на 60% и конкретный график получены в одном и том же измерении.
Так же осторожно нужно читать совокупную стоимость владения, TCO. В начале статьи говорится о снижении почти на 40%, а ближе к финалу — на 40%. Это округлённая оценка авторов, для которой не приведён полный расчёт с ценами, периодом и загрузкой оборудования. Надёжный вывод ограничен самим материалом: после оптимизации системе требовалось меньше вычислительных ресурсов, а авторы сообщают о заметном снижении TCO. По этим данным нельзя вычислить экономию для другой инфраструктуры.
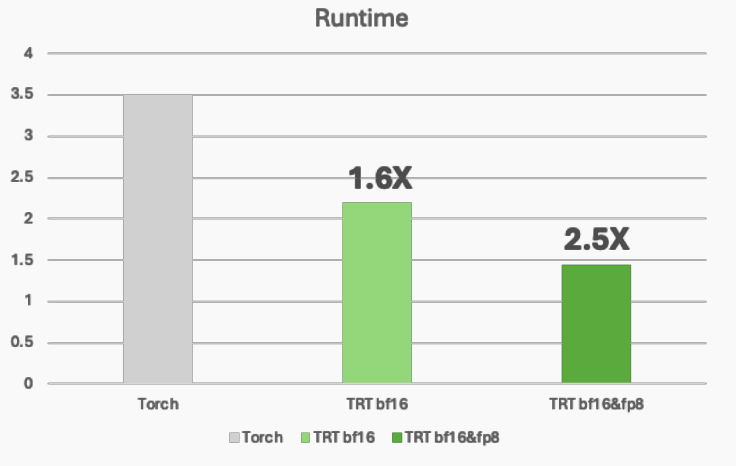
Diffusion backbone относительно PyTorch: TensorRT BF16 — 1,6×, BF16 с FP8 — 2,5×. Единицы оси Runtime не указаны; график не позволяет восстановить абсолютное время генерации.
Источник: NVIDIA / Adobe · исходная иллюстрацияКаких данных не хватает для полного воспроизведения
Статья хорошо показывает последовательность инженерных решений, но не даёт всех данных для полного воспроизведения эксперимента. Не указаны размер и устройство DiT, число шагов диффузии, точный список слоёв в FP8 и BF16, калибровочная выборка для PTQ, численная метрика визуального качества, допустимый порог его ухудшения, размер пакета, число одновременно обрабатываемых запросов, абсолютная задержка и точная конфигурация каждого измерения производительности.
Нет и отдельного сравнения, где на одном фиксированном стенде последовательно измерены только ONNX, только TensorRT BF16, только добавление FP8 и только изменения после профилирования. Поэтому 1,6×, 2,5×, −60% задержки и около −40% TCO следует воспринимать как заявленные результаты разных уровней, а не как точные вклады каждого шага оптимизации.
Качество описано через процедуру проверки, а не через итоговую численную таблицу. В материале есть имитация FP8 и анализ распределений, но нет сопоставления визуального качества до и после квантизации. Не раскрыто, одинаково ли меняется качество для T2V, I2V и V2V, и не показано, измерялась ли производительность именно для выхода 5 секунд, 24 fps и 1080p. Финальный раздел статьи говорит о дальнейшем развитии оптимизации и сотрудничества, но не добавляет нового измеренного эксперимента.
Наконец, это исторический пример промышленного внедрения: оптимизация происходила в 2024 году, а статья вышла в апреле 2025-го. Ссылка на архивную документацию TensorRT 10.x выше нужна только для проверки смысла операций FP8 и для отдельного математического пояснения к несогласованным формулам публикации. Эта архивная страница не служит руководством по выбору версий библиотек, API или способу установки TensorRT в 2026 году.
Future steps; Step 3: Quantization techniques; Overcoming deployment challenges with quantized diffusers; Figure 4Итог: ускорение Firefly с отдельной проверкой качества и скорости
История Firefly показывает последовательное удешевление применения видеомодели. Пока финальные веса ещё готовились, команда выстроила путь ONNX → TensorRT, получила вариант в BF16, затем добавила FP8 через квантизацию после обучения (PTQ) и отдельно проверяла влияние снижения точности. Профилирование GPU показало SDPA как главное узкое место, после чего основную трансформерную часть модели дополнительно оптимизировали. Экспорт, квантизация, выбор точности и проверка качества выполняются заранее, вне пользовательского запроса; во время генерации работает уже подготовленный оптимизированный вариант модели.
- 01
Подготовить выбранный вход
Текст, изображение или видео проходит через энкодер T2V, I2V или V2V и превращается в представление для общей модели.
- 02
Выполнить основную диффузионную модель
DiT обрабатывает представление; на исходной схеме этот самый тяжёлый этап расположен на H100.
- 03
Декодировать латентное представление
Декодер (`Latent decoder`) переводит внутреннее представление в данные для будущих кадров; на рисунке он относится к A100.
- 04
Увеличить разрешение
Блок `UpSample` доводит кадры до целевого разрешения; на схеме он также отмечен как A100.
- 05
Постобработать видео
CPU-блок `Video postprocessing` формирует ролик. 5 s, 24 fps и 1080p — параметры результата, а не задержка.
Результат оценивается по двум разным направлениям. Влияние FP8 на качество сначала проверяют с помощью имитации низкой точности и анализа распределений; ускорение измеряют уже при реальном выполнении TensorRT и профилировании GPU. Авторы сообщают о снижении задержки диффузионной части на 60% и TCO почти на 40%, а Figure 4 показывает для основной части модели ускорение в 1,6 раза относительно PyTorch при BF16 и до 2,5 раза при добавлении FP8. При этом публикация не даёт абсолютного времени генерации, полного сравнения вклада каждого изменения и численной таблицы визуального качества. Поэтому главный вывод этого примера — не универсальный коэффициент ускорения, а порядок работы: отдельно проверять влияние квантизации на качество, измерять производительность на реальном графе и после профилирования оптимизировать фактическое узкое место.
Article opening summary; Figure 1; Figure 2; Step 1: ONNX export; Step 2: TensorRT implementation; Step 3: Quantization techniques; Identifying bottlenecks with NVIDIA Nsight Deep Learning Designer; Scalability and cost benefits for AI workloads; Figure 4; Future steps