Разбор готов
Пакетный инференс: как обработать большую таблицу и пережить сбои
Командам с готовыми ML-моделями регулярно нужно прогонять большие таблицы: пересчитать признаки, сравнить новую версию модели с предыдущей или получить прогнозы для всего набора данных. Если каждая команда строит для этого собственную обвязку, инфраструктура дублируется. При этом пакетная работа может идти днями и неделями, зависеть от облака и YTsaurus, переживать падения отдельных экземпляров модели, а один ответ модели иногда оказывается намного тяжелее исходной строки. В VK эти задачи собрали в общий BatchWorker. Ниже разберём общий формат запросов OIP, упаковку моделей в MLServer и Triton, а затем три слоя BatchWorker — чтение, инференс и запись — вместе с повторной обработкой, контролем памяти и оставшимися узкими местами.
Материал полезен инженерам, которые строят пакетный инференс поверх больших таблиц и нескольких экземпляров одной модели. Особенно полезен разбор границ между форматом запросов, сервисом модели, очередями работы и записью результатов.
Статья · на русском
Эффективный пакетный инференс моделей. Опыт инженеров VKАртём Петров · Опубликовано: 15 апреля 2025 г.
Один формат запросов для разных моделей
Первый уровень унификации — не конкретная модель и не конкретный сервер, а форма запроса. Автор начинает с того, что у отдельных библиотек, например CatBoost, есть собственные специализированные форматы, а OIP нужен как общий способ записывать входы разных моделей, включая векторные представления. У каждого входа есть имя, размерность, тип данных и сами данные: name, shape, datatype, data. В ответе дополнительно присутствуют сведения о модели и массив outputs с такой же логикой описания тензоров.
{
  "inputs": [
    {
      "name": "IAB_TEXT",
      "shape": [1],
      "datatype": "BYTES",
      "data": [""]
    }
  ]
}
В показанном ответе модель называется banner-classifier-python, имеет версию 1, а выход SCORE имеет форму [1, 34] и тип FP64. Там же есть второй выход PRED_IDX. Смысл примера не в конкретных числах предсказания, а в том, что BatchWorker может читать метаданные тензора и его значения независимо от внутреннего кода модели. Автор также отмечает, что при необходимости формат можно расширять дополнительными полями.
{
  "model_name": "banner-classifier-python",
  "model_version": "1",
  "outputs": [
    {
      "name": "SCORE",
      "shape": [
        1,
        34
      ],
      "datatype": "FP64",
      "data": [
        0.16790169891977166,
        0.12961032360575966,
        0.05175606230880863,
        0.04470961327023595,
        0.1444450118377472,
        0.09656370402784009,
        0.1787367952925338,
        0.19052070898630957,
        0.22135750180980127,
        0.05315560371866009,
        0.058228992477796775,
        0.10493222226161725,
        0.07665099811086777,
        0.05640374156249024,
        0.03818363270376569,
        0.06162369427523705,
        0.08013533940834351,
        0.12504546550503864,
        0.017400716033072968,
        0.05009478320309705,
        0.0784720983460859,
        0.11254104392238658,
        0.15487643434177747,
        0.07010075919855611,
        0.06598170891575378,
        0.028824552053010277,
        0.13164396641373022,
        0.15785238316985242,
        0.09407360275114268,
        0.20113965508675122,
        0.09949341314285333,
        0.156285839927019,
        0.21333526549889067,
        0.1807703644287332
      ]
    },
    {
      "name": "PRED_IDX",
      "shape": [
        1,
        0
      ],
      "datatype": "FP64"
    }
  ]
}
Дальше этот же контракт используется для пакетирования нескольких строк. BatchWorker сохраняет имена и типы, кладёт несколько примеров в data и меняет shape. То есть пакетирование здесь означает собрать несколько исходных запросов в один OIP-запрос, а не изменить саму обученную модель. Конкретные JSON-примеры и API-детали ниже относятся к инженерному материалу 2025 года; их стоит читать как устройство показанной системы, а не как проверенную на 2026 год документацию библиотек. В описанной системе команда использует две основные реализации этого контракта — MLServer и Triton.
MLServer: как упакована модель и где находится predict
Одна из двух реализаций OIP в статье — MLServer. Пользователь присылает модель в .tar-архиве. В показанной структуре есть requirements.txt, каталог assets и каталог модели models/spam. Внутри лежат файл CatBoost spam.cbm, базовый settings.json, подробный model-settings.json и Python-пакет с реализацией класса модели. requirements.txt нужен для Python-зависимостей, если при запуске требуется установить дополнительные пакеты.
assets/
models/
 spam/
     model-settings.json
     package/
        init.py
        models.py
     settings.json
     spam.cbm
requirements.txtВ model-settings.json пример задаёт name: spam, реализацию package.CatboostModel, URI spam.cbm, платформу python3.10, вход value с shape: [-1] и FP32, а также выход predict с shape: [2, 1] и FP64. Эта метаинформация говорит серверу модели, какой класс вызвать и какие тензоры ожидать. Автор также упоминает отдельную HTTP-ручку обращения к модели по имени, но полный API в статье не специфицирован.
{
  "name": "spam",
  "implementation": "package.CatboostModel",
  "parameters": {"uri": "spam.cbm"},
  "platform": "python3.10",
  "inputs": [{"name": "value", "shape": [-1], "datatype": "FP32"}],
  "outputs": [{"name": "predict", "shape": [2, 1], "datatype": "FP64"}]
}
WELLKNOWN_MODEL_FILENAMES = ["model.cbm", "model.bin"]
class CatboostModel(MLModel):
async def load(self) -> bool:
model_uri = await get_model_uri(
self._settings,
wellknown_filenames=WELLKNOWN_MODEL_FILENAMES,
)
self._model = CatBoostClassifier()
self._model.load_model(model_uri)
self.ready = True
return self.ready
async def predict(self, payload: types.InferenceRequest) -> types.InferenceResponse:
decoded = self.decode_request(payload, default_codec=NumpyRequestCodec)
prediction = np.array(
self._model.predict(decoded, prediction_type="Probability")
)
return types.InferenceResponse(
model_name=self.name,
model_version=self.version,
outputs=[NumpyCodec.encode_output(name="predict", payload=prediction)],
)load() находит файл модели, создаёт CatBoostClassifier, загружает веса и отмечает модель готовой. predict() декодирует общий запрос, вызывает CatBoost и снова упаковывает ответ в OIP-совместимую структуру. Таким образом, MLServer берёт на себя оболочку сервиса, а пользовательский класс связывает общий контракт с конкретной библиотекой модели.
В статье сказано, что MLServer «позволяет загружать лишь одну модель одновременно». В этом разборе эту фразу относим только к показанной авторами упаковке и способу использования: из материала нельзя делать универсальный вывод о возможностях всех версий MLServer как продукта.
— «MLServer»Triton: контейнер цепочки из токенизатора и эмбеддера
Второй вариант — Triton Inference Server. В статье он описан как сервер с ядром на C++ и поддержкой бэкендов или форматов Python, ONNX, TensorRT, PyTorch и TensorFlow. Здесь он нужен прежде всего там, где хочется собрать несколько моделей или стадий в единый вызываемый конвейер. Показанный репозиторий содержит три модельных каталога: tokenizer, embed64 и me5_ensemble. Важно читать их правильно: me5_ensemble — не третья вычислительная стадия после tokenizer → embed64, а описание ансамбля, которое связывает эти две стадии в одну внешнюю модель.
tokenizer реализован через Python-модель и использует файл sentencepiece.bpe.model. embed64 содержит ONNX-модель. В его config.pbtxt задана платформа onnxruntime_onnx, max_batch_size: 16, вход inp типа TYPE_INT64 с dims: [-1], выход out типа TYPE_FP32 с dims: [-1], а также один экземпляр на GPU 0. Отдельно присутствует пустой блок dynamic_batching {}, который в описании автора отвечает за динамическое пакетирование и эффективное использование GPU.
# embed64/config.pbtxt
name: "embed64"
platform: "onnxruntime_onnx"
max_batch_size: 16
instance_group [{ count: 1, kind: KIND_GPU, gpus: [0] }]
dynamic_batching {}

# me5_ensemble/config.pbtxt
name: "me5_ensemble"
platform: "ensemble"
max_batch_size: 0
У самого me5_ensemble стоит max_batch_size: 0. Это другая конфигурация, чем у embed64, и её нельзя пересказывать как «батчинг выключен в Triton». В одном и том же примере внутренняя ONNX-модель допускает пакет до 16 элементов и имеет dynamic_batching, тогда как внешний ensemble настроен иначе.
Ансамбль принимает query типа TYPE_STRING, а также id и version типа TYPE_INT64; у всех трёх входов в показанном фрагменте конфигурации dims: [1]. Его внешний выход community_embed_e5 имеет TYPE_FP32 и dims: [-1]. Сначала входы передаются модели tokenizer; её выход inp становится входом embed64. Затем out эмбеддера переименовывается в внешний результат community_embed_e5. Так одна точка вызова скрывает внутреннюю цепочку tokenizer → embed64 и позволяет BatchWorker не знать детали каждого шага.
Здесь есть два разных уровня пакетирования, которые полезно не смешивать. BatchWorker сам может собрать несколько строк таблицы в один OIP-запрос, меняя data и shape. Triton, в свою очередь, имеет серверную настройку dynamic_batching для embed64. Они решают связанные, но не одинаковые задачи и находятся по разные стороны интерфейса.
Почему BatchWorker стал отдельной платформенной задачей
Главная пользовательская идея BatchWorker проста: команде не нужно строить собственный механизм чтения таблиц, распределения запросов и сохранения результатов. Пользователь разворачивает уже готовую модель на платформе с нужным количеством экземпляров и ресурсов, указывает входную и выходную таблицы и запускает пакетный инференс. BatchWorker знает, какие данные прочитать, как представить их через OIP и куда записать ответ.
Но универсальная обвязка быстро сталкивается с несовместимостью реального мира. Проект команды написан на Go, а готовой подходящей OIP-библиотеки для Go у авторов не было, поэтому реализацию пришлось писать самим. В статье это сопровождается резкой оценкой Python для высоких нагрузок. Её нельзя превращать в общий запрет: из источника следует только инженерный выбор конкретной команды и конкретного сервиса.
Кроме формата данных приходится учитывать транспорт. Автор перечисляет REST, gRPC и бинарный вариант поверх REST и подчёркивает, что они устроены по-разному. Ещё одна сложность — вложенные массивы OIP, а в перспективе и тензоры: их нужно корректно представить при чтении и записи в YTsaurus, которое в этой системе играет роль map-reduce-хранилища.
Пакетное задание нельзя проектировать как короткий HTTP-запрос. По словам автора, отдельный запуск должен уметь работать минимум несколько дней, а иногда пользователи ждут результат неделями: таблицы могут измеряться терабайтами, и модель не обязана отвечать за миллисекунды. На таком горизонте внешние сбои становятся нормальным сценарием, а не исключением.
В статье приведены примеры: транзакции однажды не работали больше получаса; модель могла проработать в облаке пару дней, после чего возникали проблемы с заполнением диска и падениями по OOM; иногда сама модель начинала возвращать множество ошибок. Источник не раскрывает точную причинную связь между диском и OOM, поэтому её не додумываем. Инженерное требование другое: после сбоя процесс должен перезапуститься так, чтобы уже накопленный результат не потерялся.
— «Я и мой бро Batch-worker»Три слоя: чтение, инференс и запись
Текущую реализацию автор делит на три слоя: чтение, инференс и запись. Слева читатели получают строки из YT input_table и складывают работу в reader chan. В центре пул клиентов моделей забирает запросы, распределяет их по экземплярам модели и кладёт ответы в writer chan. Справа потоки записи (writers) параллельно записывают результаты во временные таблицы, после чего выполняется merge в итоговую YT output_table.
На общей схеме также есть два управляющих контура. readers controller опрашивает обновления и при необходимости меняет конфигурацию чтения. pool’s controller управляет пулом клиентов модели. На исходной схеме оба управляющих компонента связаны с Database; для readers controller прямо подписано Polls updates. Поток самих данных при этом идёт отдельно через каналы.
Вывод из схемы: BatchWorker не является одним большим циклом «прочитал → вызвал модель → записал». Между стадиями стоят каналы, поэтому чтение, модель и запись могут работать с разной скоростью и иметь собственную логику восстановления. Именно это разделение дальше позволяет отдельно решать обновление размера пакета, отказ модели и дорогой merge YT-таблиц.
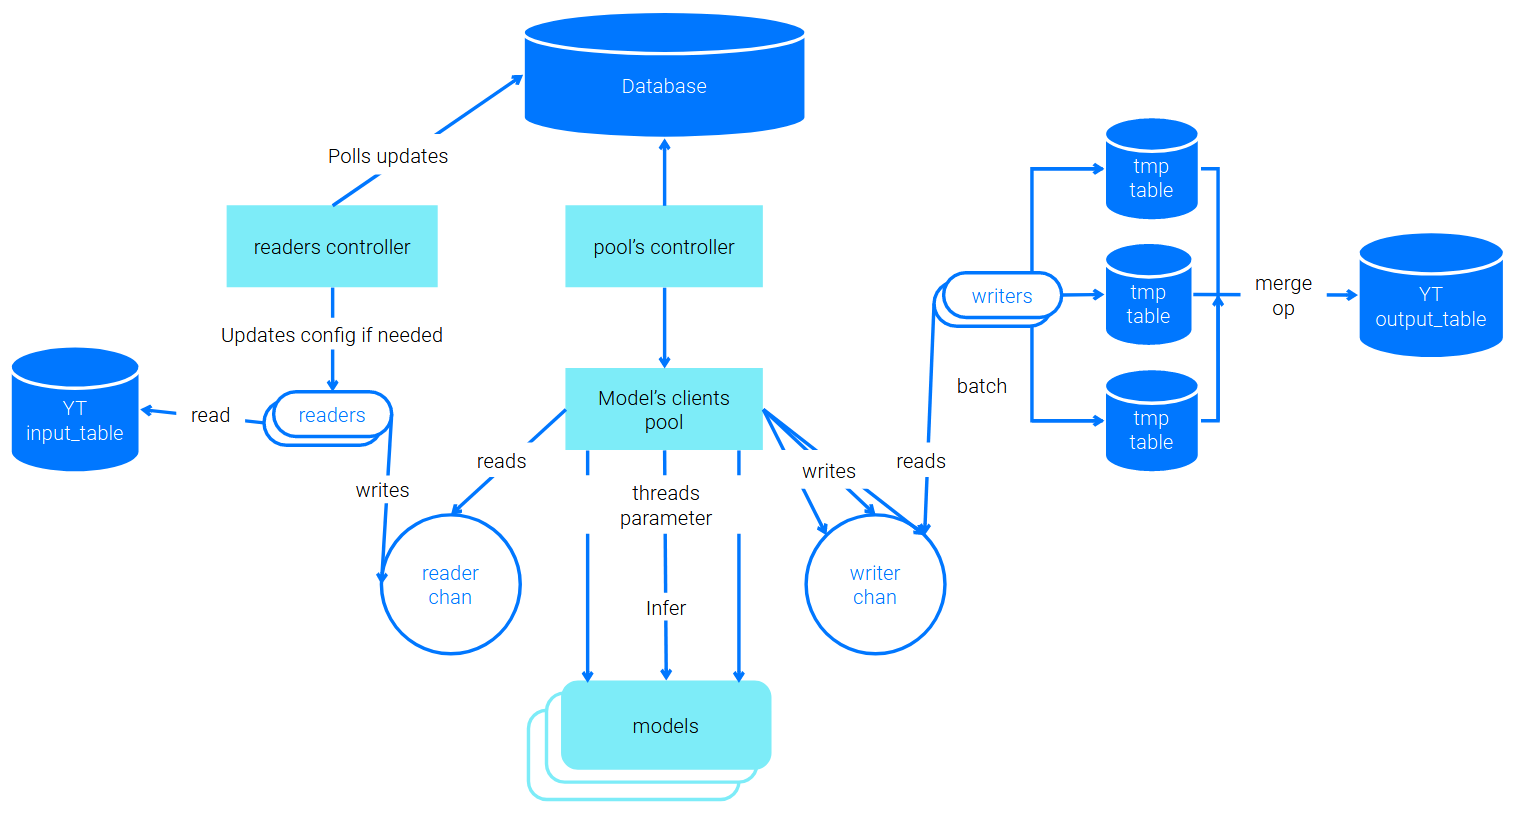
Общий конвейер VK: читатели YT → входной канал → пул клиентов модели → выходной канал → параллельная запись во временные таблицы и слияние в выходную. Контроллеры обновляют конфигурацию читателей и пул хостов.
Источник: Артём Петров / VK · исходная схемаЧтение: сформировать пакет и не связываться с состоянием моделей
Слой чтения автор называет почти безотказным, потому что у него мало внешних зависимостей. Читатель берёт небольшую строку или порцию данных из YT, превращает её в запрос и отправляет в reader chan. Он не выбирает конкретную модель и не ждёт завершения инференса: задача чтения — подготовить работу и передать её дальше.
Во время долгого задания пользователь может менять параметры пакетирования. readers controller опрашивает обновления конфигурации и при необходимости меняет настройки readers. В OIP пакетирование означает сохранить имена и типы входов, положить в data сразу несколько строк и скорректировать shape. Так размер пакета можно менять без переписывания формата каждого типа модели.
Вывод из схемы: чтение специально заканчивается общим каналом. Если пул моделей замедляется или отдельный host становится недоступен, читателю не нужно знать его адрес и логику восстановления. Эта граница делает дальнейшее распределение работы задачей отдельного слоя.
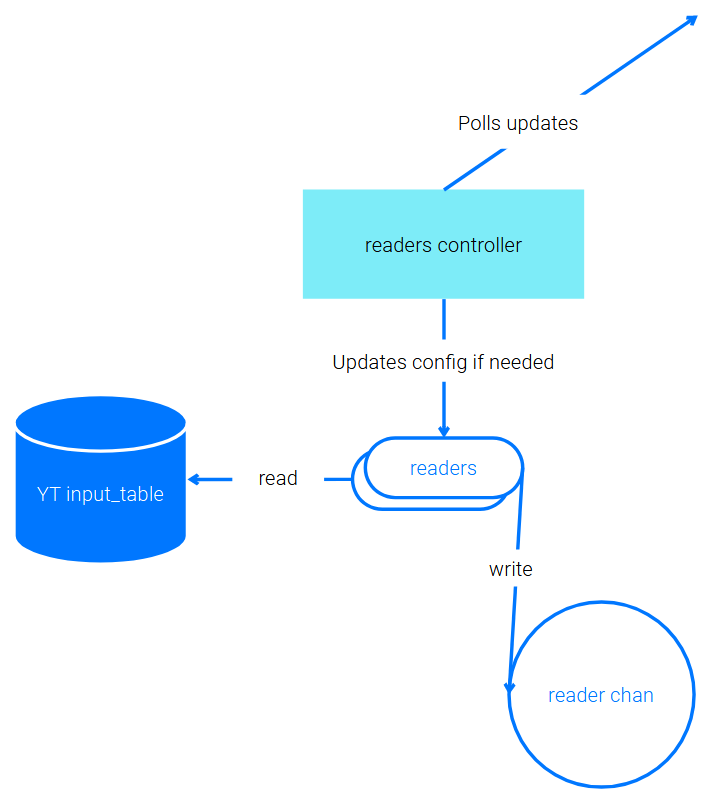
Чтение из YT отделено от инференса каналом; настройки размера пакета могут обновляться во время задания.
Источник: Артём Петров / VK · исходная схемаИнференс: пул клиентов, проверки здоровья и возврат работы
В центре системы находится пул клиентов моделей. Для каждого сервера модели есть свой обработчик (worker): он читает запросы из общего reader chan, вызывает свой экземпляр модели и при успехе отправляет ответ в writer chan. Так общий канал естественным образом раздаёт работу нескольким экземплярам, но одного этого недостаточно для долгого задания: нужно понимать, какие серверы ещё доступны. На исходной схеме число параллельных потоков к моделям вынесено отдельным threads parameter.
Если worker уже снял запрос из общего канала, а затем выяснилось, что его модель «мёртвая», нельзя просто потерять эту работу. Проблемный host нужно исключить из обработки, а незавершённый запрос вернуть в общий пул. Это и есть причина, по которой обычного однонаправленного канала оказывается мало: сообщение должно уметь вернуться на повтор.
Автор отдельно отмечает стохастический режим деградации: модель может не упасть полностью, а начать троттлить. В качестве примера он пишет, что такой host может отдавать примерно один плохой ответ из трёх; что именно считается «плохим ответом», источник не уточняет. Здесь трудно выбрать момент снижения нагрузки: это может помочь конкретному host, но одновременно уменьшит общую скорость обработки. В статье такой адаптивная балансировка нагрузки остаётся нерешённой задачей.
Вывод из схемы: пул клиентов отделяет общую очередь работы от конкретных экземпляров модели. Он позволяет подключать несколько workers и выводить из обращения неисправные hosts, но сам по себе общий канал не решает вопрос частичного троттлинга и не задаёт готовый алгоритм балансировки.
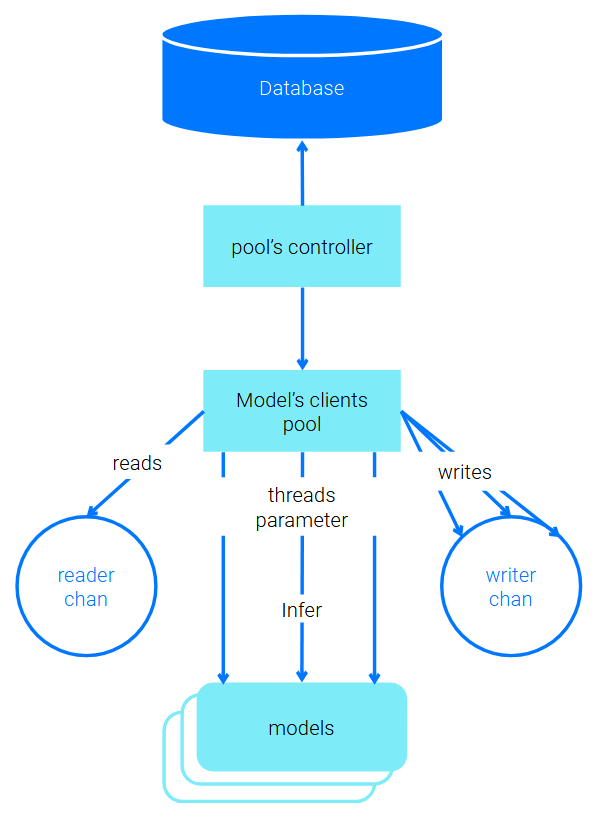
Пул клиентов читает общую очередь, распределяет работу по экземплярам модели и передаёт ответы в выходной канал. Неисправный хост отключается, незавершённая работа возвращается на повтор.
Источник: Артём Петров / VK · исходная схемаПовторная отправка без преждевременного закрытия канала
Для возврата незавершённой работы команда оборачивает обычный Go-канал. Базовая структура хранит chan *Request и отдельный done, а наружу предоставляет операции отправки, чтения, закрытия и проверки длины и ёмкости. Output использует эту обёртку для ответов модели. Input добавляет sync.WaitGroup, потому что входной канал должен учитывать работу, которая уже была выдана worker, но ещё может вернуться на повтор.
В описанном сценарии несколько обработчиков забрали сообщения, столкнулись с замедлением моделей и одновременно пытаются вернуть работу в тот же входной канал. Читатель таблицы продолжает поставлять новые сообщения. Наше пояснение: при синхронном возврате в заполненный канал все обработчики могут ждать отправки, а свободного получателя уже не останется. Поэтому в опубликованном интерфейсе Retry обозначен как асинхронная операция. Учёт незавершённой работы и безопасное закрытие канала — отдельная задача WaitGroup.
При выдаче запроса в обработку незавершённая работа учитывается в WaitGroup. Если инференс завершился успешно, worker вызывает Done(). Если запрос нужно вернуть, Done() не вызывается до завершения соответствующего жизненного цикла, чтобы Close() не закрыл вход, пока туда ещё возвращается сообщение. Асинхронный Retry нужен именно для повторной постановки работы, а не для изменения результата модели.
Здесь важны границы доказанного. WaitGroup сам по себе не является механизмом исправления всех дедлоков и не даёт гарантии exactly-once. В опубликованном коде тела Send, Retry, Close и других методов заменены пустыми заглушками, поэтому по статье нельзя восстановить полную реализацию, порядок блокировок, обработку дублей или формальную семантику доставки. Источник подтверждает идею учёта незавершённой работы и защиты закрытия канала.
Запись: сначала ограничить память, затем бороться с дорогими чанками
После модели размер данных может резко вырасти. Входом бывает короткая строка, а пример большого ответа в статье — тензор 512 × 512 типа float32. Это пример размера одного ответа модели, а не размер всей модели. Если без ограничения складывать такие ответы в очередь, буфер может привести процесс к OOM.
Поэтому ещё до запуска BatchWorker оценивает размер сообщения функцией RequestSize(). В конфигурации размер буфера задаётся в гигабайтах; зная оценку одного сообщения, система вычисляет, сколько ответов можно одновременно держать в памяти. Так ограничение памяти превращается из случайного падения во входной параметр конфигурации.
Дальше появляется специфика YTsaurus. В статических таблицах данные хранятся чанками, и запись пакета меньше одного чанка оказывается дорогой. Полупустые чанки нужно объединять через merge. Но во время merge другие операции над этой таблицей блокируются; на большой таблице такое объединение, по словам автора, может занимать часы.
Чтобы запись не простаивала на одном merge, система создаёт n временных таблиц. Несколько потоков записи работают с ними параллельно по схеме N:N: у каждой временной таблицы свой поток. После того как в каждую записано заданное число m пакетов, временные таблицы сливаются в итоговую, а writers получают новый набор временных таблиц и продолжают работу.
Автор сообщает, что такое изменение кратно ускорило BatchWorker и что в их системе после этого «буфер на записи всегда простаивает», какими бы тяжёлыми ни были ответы моделей. В статье нет численного коэффициента ускорения и отдельного воспроизводимого бенчмарка, поэтому это следует читать как наблюдение конкретной эксплуатации, а не как обещание для любой нагрузки.
Вывод из схемы: текущая реализация использует параллельную запись во временные таблицы и затем обычный merge в выходную таблицу. Древовидного слияния на этой схеме ещё нет — оно появляется только в разделе дальнейших планов.
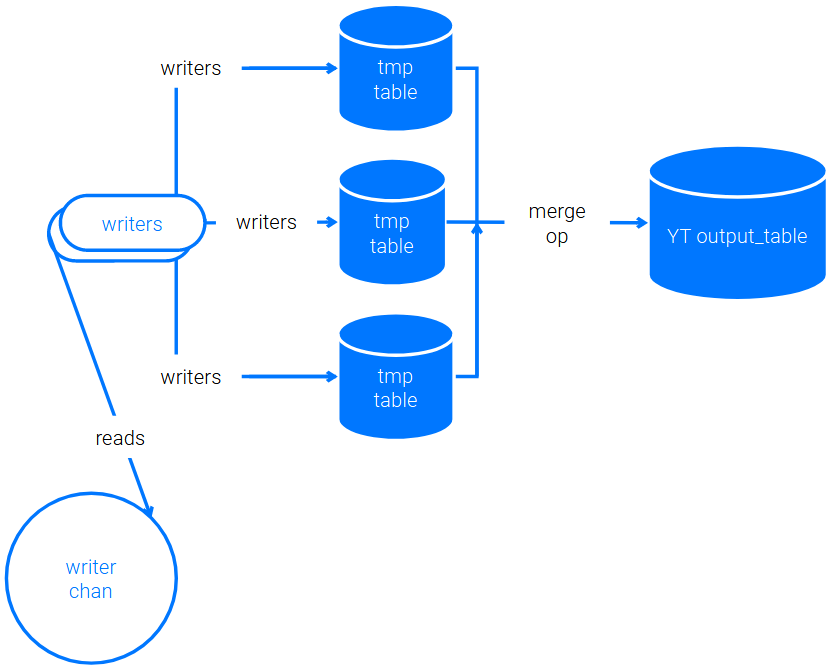
Запись разделена по временным таблицам с собственными потоками, затем выполняется merge в выходную YT-таблицу. Древовидное слияние в статье ещё планируется.
Источник: Артём Петров / VK · исходная схемаЧто осталось узким местом и что команда хотела добавить
Параллельные временные таблицы не устраняют очередь полностью. Если, например, несколько временных таблиц уже заполнены, а одна ещё пишется, готовые таблицы ждут общего merge и продолжают занимать буфер. Следующий план — древовидное слияние: объединять готовые части по мере появления, а не ждать полного набора. В статье это ожидаемое улучшение производительности и масштабируемости, а не уже реализованный результат.
Вторая нерешённая задача — балансировка при частичном троттлинге. Полностью мёртвый host относительно легко исключить, а медленный host может продолжать отвечать и портить общую динамику очереди. Авторы хотели научиться точнее добавлять и убирать workers в зависимости от состояния моделей, но готового алгоритма в статье нет.
Третье направление — наблюдаемость. На момент статьи пользователь в основном мог следить за изменениями своей выходной таблицы. В планах — дашборды, статистика и визуализации, которые сделали бы долгие задания понятнее без ручного наблюдения за таблицей.
Команда также хотела добавить поддержку vLLM для работы с большими языковыми моделями. Автор замечает, что OIP тоже позволяет обращаться к таким моделям, но считает это неудобным. В исходном тексте vLLM назван «протоколом», но технически корректнее рассматривать его как средство сервинга LLM. Для этой главы важно состояние проекта: интеграция с vLLM обозначена в планах, а не как готовая функция BatchWorker.
Ещё один план — поддержать gRPC и бинарный формат OIP. Автор мотивирует это скоростью и пишет, что выигрыш на больших наборах данных и моделях хотелось бы довести до 10–30%. Эти 10–30% не являются показанным результатом эксперимента: в статье нет измерения «до/после», это потенциальный эффект, ради которого команда собиралась реализовать новые транспорты.
— «Результаты и планы»Итог: как проходит одно пакетное задание с готовой моделью
BatchWorker начинает работу уже с готовой моделью и заданными входной и выходной таблицами. Его задача — одинаково обращаться к разным моделям, выдерживать долгие запуски, возвращать незавершённые запросы после отказа host и не переполнять память крупными ответами. OIP задаёт общий формат данных, а MLServer или Triton скрывают конкретную реализацию модели за этим интерфейсом.
- 01
Прочитать данные и собрать пакет
Читатели берут строки из YT, при необходимости объединяют их в один OIP-запрос и отправляют в общий входной канал. Размер пакета можно менять во время запуска.
- 02
Выдать работу экземпляру модели
Пул клиентов распределяет запросы между обработчиками моделей. Состояние серверов проверяется по расписанию и дополнительно при всплеске ошибок.
- 03
Вернуть незавершённую работу
Если сервер модели перестал работать, запрос асинхронно возвращается во входной канал. WaitGroup учитывает незавершённую работу и защищает момент закрытия входа.
- 04
Ограничить буфер ответов
RequestSize помогает оценить размер ответа и подобрать вместимость буфера в рамках заданного числа гигабайт, чтобы крупные тензоры не копились без ограничения.
- 05
Записать и объединить результат
Потоки записи параллельно пишут ответы во временные YT-таблицы, после чего merge формирует итоговую таблицу.
Количественная оценка в статье ограничена. Автор сообщает о кратном ускорении записи после перехода к временным таблицам, но не приводит отдельный воспроизводимый бенчмарк. Упомянутые 10–30% — желаемый эффект будущих gRPC и бинарного OIP, а не полученный результат.
Ограничения остаются: текущий merge всё ещё создаёт очередь, древовидное слияние только запланировано, а частичный троттлинг усложняет балансировку workers. WaitGroup не доказывает exactly-once, потому что полные тела retry и close в статье не опубликованы. vLLM, дашборды и новые транспорты тоже перечислены как планы. Главный результат — ясное разделение чтения, применения модели и записи с отдельными механизмами восстановления.
— синтез «Я и мой бро Batch-worker», «Наша реализация Open Inference Protocol», «Чтение», «Inference», «Кастомные каналы», «Запись», «Результаты и планы»