Разбор готов
Databricks Quick Fix: как маленькую Llama учат исправлять код на реальных взаимодействиях
Человек запускает SQL-ячейку в Databricks Notebook и получает ошибку: например, запрос обращается к несуществующему столбцу. Общая языковая модель способна предложить правку, но может сделать это в непривычном для команды стиле, переписать SQL в другой интерфейс или слишком буквально последовать подсказке ошибки и не учесть реальную схему таблицы. В Quick Fix команда Databricks проверяет другой путь: дообучает небольшую Llama 3.1 8B Instruct на истории реальной работы сотрудников. Разберём, как из неудачного и следующего успешного запуска одной ячейки получают обучающий пример, какие пары отбрасывают, как сравнивают полный код и только изменения, чем отличаются офлайн-проверка и внутренний A/B-тест и что именно показали два качественных примера.
Материал полезен тем, кто строит LLM-помощников для кода и располагает журналами реальных взаимодействий. На примере Quick Fix видно, как связать локальные данные, дообучение, задержку ответа и продуктовую проверку, не подменяя принятие правки гарантией корректности программы.
Статья · на английском
The Power of Fine-Tuning on Your Data: Quick Fixing Bugs with LLMs via Never Ending Learning (NEL)Samantha Banchik и соавторы · Databricks · Опубликовано: 8 апреля 2025 г.
Что исправляет Quick Fix
Quick Fix решает задачу исправления уже упавшего кода. В Databricks Workspace это один из нескольких LLM-помощников: рядом есть автодополнение кода и чатовый помощник AI assistant, а Quick Fix работает именно с ошибкой выполнения и предлагает правку прямо в ячейке. Ошибки бывают разными: от синтаксиса и неверного имени столбца до более тонкой смысловой проблемы. На исходном кадре запрос группирует данные по несуществующему pickup, а интерфейс предлагает заменить его на доступный pickup_zip; пользователь может принять правку и сразу запустить ячейку либо отклонить её.
Авторы исследуют не универсальное программирование, а внутренний сценарий Databricks. Для дообучения используется код сотрудников, которые анализируют телеметрию компании. Поэтому главный вопрос исследования уже, чем «какая модель лучше пишет код»: можно ли приспособить небольшую открытую модель к знаниям, соглашениям и рабочим данным одной организации так, чтобы она успевала помочь раньше, чем человек исправит ошибку сам.
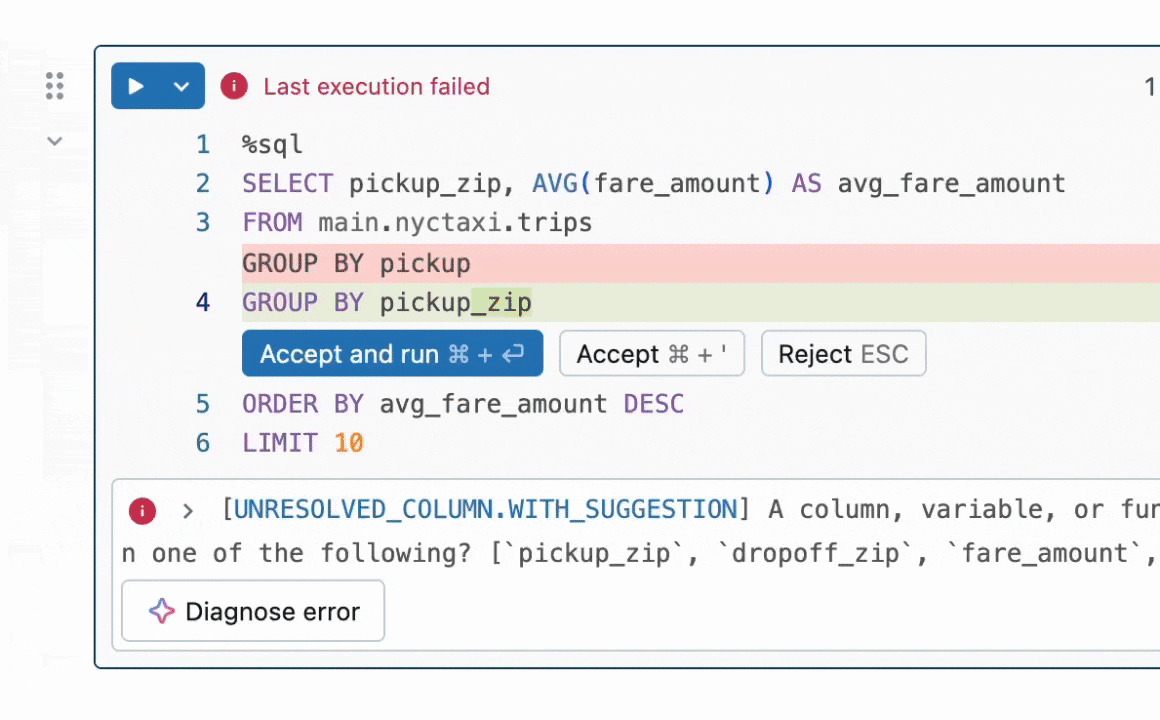
Кадр 135 оригинальной анимации: Quick Fix предлагает заменить неизвестную колонку pickup на pickup_zip; пользователь может принять правку и запустить код или отклонить её.
Источник: Databricks · исходный материалПочему не ограничились большой моделью и промптом
В исправлении кода важен не только факт устранения ошибки, но и форма правки. Авторы приводят характерное ограничение: пользователи Databricks обычно пишут стандартный ANSI SQL или Spark SQL, а не PL/SQL. Если помощник без необходимости меняет стиль или интерфейс, человеку приходится разбирать и откатывать лишние изменения. Похожая проблема возникает со знаниями о конкретных таблицах, API и внутренних соглашениях: общая модель могла видеть много кода вообще, но не обязана знать локальный контекст организации.
Можно пытаться компенсировать это настройкой запроса к модели — prompt engineering: подробно описывать правила, добавлять несколько примеров в контекст или просить модель перепроверить себя. Но авторы подчёркивают два ограничения. Во-первых, для небольших моделей такая настройка уступает дообучению по их результатам. Во-вторых, дополнительные примеры и самопроверка увеличивают задержку, а для Quick Fix важно показать исправление до того, как пользователь сделает его вручную. У крупных закрытых моделей также есть стоимость и вопрос размещения данных у внешнего провайдера. Небольшую открытую модель организация может разместить сама или у доверенной стороны, получая больше контроля над стоимостью, надёжностью и правилами работы с данными компании; конкретных денежных оценок статья не приводит.
В качестве более лёгкого класса альтернатив в статье названы Llama 8B, Gemma 4B, R1 Distill Llama 8B и Qwen 7B. Они потенциально дешевле и быстрее и могут размещаться самой организацией или доверенной стороной. По тексту статьи исходная Llama 3.1 8B Instruct была худшей среди протестированных вариантов до адаптации, поэтому задача не сводилась к простой замене крупной модели на малую. Детальное дообучение дальше проводится именно для Llama 3.1 8B Instruct; перечень других моделей не является отдельным полноценным сравнительным исследованием каждой из них.
Details of Our StudyКак из работы пользователя получается обучающий пример
Главная идея — не заказывать отдельную ручную разметку исправлений, а использовать историю реальных запусков. Когда пользователь впервые выполняет ячейку и получает ошибку, система сохраняет ошибочный код y. Вместе с ним сохраняется контекст x: сообщение об ошибке, соседние ячейки и доступные метаданные, например список таблиц и API.
После этого система ждёт следующее успешное выполнение той же первоначально ошибочной ячейки и сохраняет получившийся код как y′. Источник правки заранее не фиксирован: код мог исправить сам человек, Quick Fix или человек вместе с агентом. В датасет попадает тройка (x, y, y′), а задача дообучения формулируется просто: по контексту x и ошибочному коду y сгенерировать успешный вариант y′.
Такой сигнал привлекателен тем, что возникает естественно в продукте и отражает реальные ошибки. Авторы отдельно отмечают отсутствие дополнительной работы по разметке и то, что даже умеренное количество подобных примеров может быть полезно, потому что они приходят из фактической эксплуатации. При этом статья не раскрывает размер собранного датасета или период, за который он накоплен.
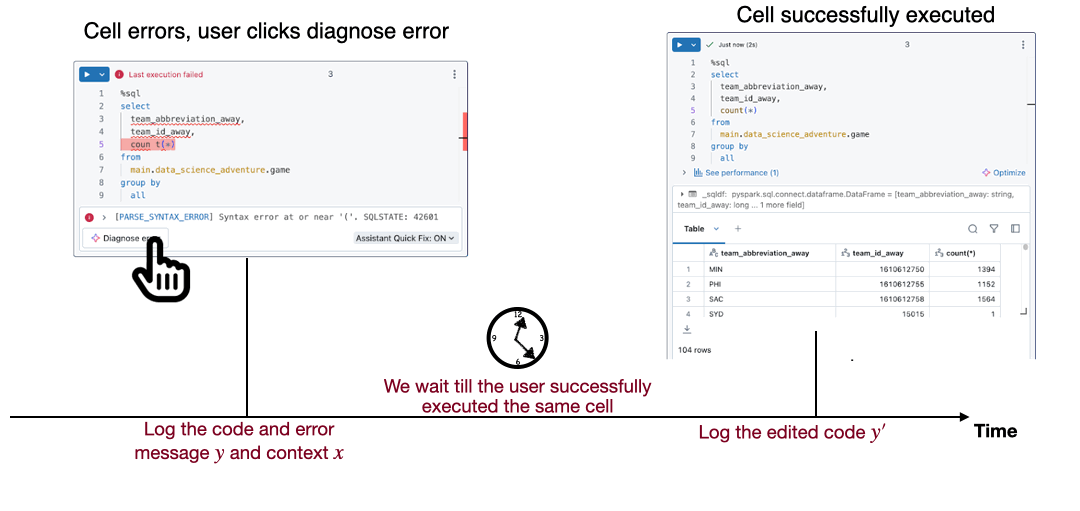
Кадр 330 исходной анимации сбора данных: ошибка и контекст при неудачном выполнении ячейки; исправленный код при следующем успешном выполнении той же ячейки. Правку мог сделать человек, агент или оба.
Источник: Databricks · исходный материалПочему не каждое успешное выполнение становится эталоном
Следующий успешный запуск — удобный, но шумный сигнал. Поэтому авторы отбрасывают два крайних случая. Первый: y′ полностью совпадает с y. Тогда код, вероятно, не менялся, а ошибка исчезла из-за внешней причины — например, разрешение или конфигурацию поправили в другом месте. Такой пример не учит локальному исправлению кода.
Второй случай — y′ существенно отличается от y. Это может быть не точечное исправление, а переписывание ячейки, поэтому такую пару тоже удаляют. Как именно измеряется «существенное отличие» и где проходит порог, источник не сообщает. Это важное ограничение: из статьи нельзя восстановить правило фильтрации в виде готового численного рецепта.
Что дообучают: полный код или только изменения
После фильтрации Databricks дообучает Llama 3.1 8B Instruct на внутренних взаимодействиях. Авторы пробуют два формата выхода. В первом модель генерирует весь исправленный код — полный код (full). Во втором выдаёт только изменения относительно ошибочной версии — формат изменений (diff).
Формат изменений обычно требует сгенерировать меньше токенов и потому может работать быстрее, но сама задача сложнее: модель должна точно указать локальную правку, а не заново воспроизвести всю ячейку. Команда использует сервис дообучения Databricks и перебирает разные значения шага обновления весов (learning rate) и число итераций. Конкретные значения этих параметров и итоговый размер обучающей выборки в статье не опубликованы.
Fine-tuning Llama 8b using your Interaction DataОфлайн-проверка: совпало ли исправление с сохранённым вариантом
Для выбора параметров обучения авторы сначала используют отложенную часть данных взаимодействий, которая не участвовала в соответствующем обучении. Метрика — точное совпадение с сохранённым исправлением. Для каждого примера оценка равна 1, если модель по (x, y) сгенерировала ровно y′, и 0 — если результат отличается. Среднее этих нулей и единиц образует 0–1 exact match. Это строгая проверка совпадения текста исправления, а не универсальная проверка смысла программы.
На исходном графике результаты нормированы относительно GPT-4o Full. Отдельно проверяется добавление примеров в запрос к готовой модели: для ICL используется пять примеров без обновления её весов. Базовая Llama заметно слабее GPT-4o, ICL улучшает её результат, а дообученные QuickFix Llama показывают лучший результат среди показанных вариантов. Авторы используют эту офлайн-метрику как сигнал для выбора гиперпараметров, но прямо называют её более шумной, чем A/B-тест.
Точные значения неподписанных столбцов на Figure 4 в источнике не опубликованы, поэтому их не следует восстанавливать по высоте графика. Из рисунка здесь важен порядок и условия сравнения: GPT-4o Full служит нормировочной базой, ICL использует пять примеров, а дообучение даёт более сильный результат, чем одна только настройка контекста.
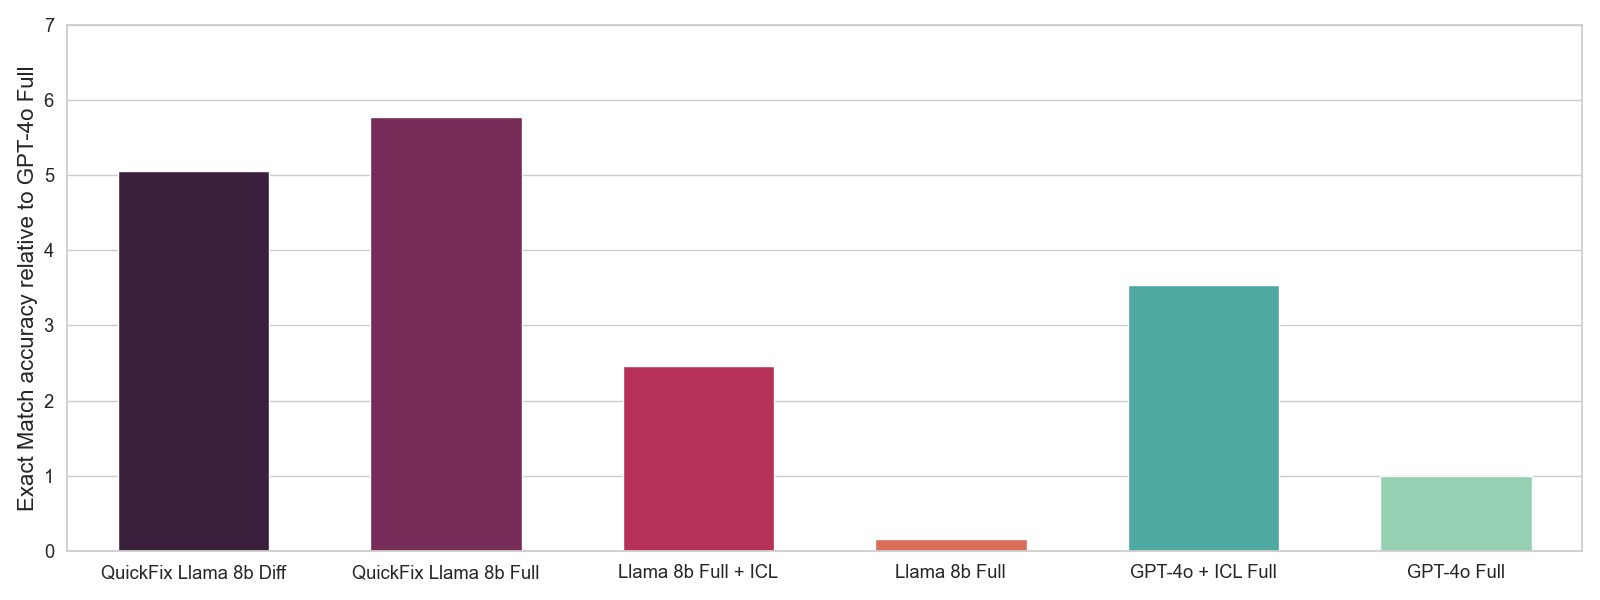
Офлайн exact-match относительно GPT-4o Full. Для ICL использовано пять примеров; точные неподписанные высоты столбцов не восстанавливаются. Совпадение с эталонной правкой — иной критерий, чем принятие пользователем в A/B.
Источник: Databricks · исходный материалОнлайн-проверка: принимают ли сотрудники предложенную правку
После офлайн-отбора модель проверяют на внутренних пользователях Databricks. Здесь метрика уже другая: смотрят долю предложенных исправлений, которые пользователи приняли. Она измеряет полезность предложения в рабочем интерфейсе, но не означает, что вся программа после принятия гарантированно корректна во всех смыслах.
Таблицу можно прокрутить по горизонтали.
На графиках нет абсолютной доли принятых исправлений и нет абсолютной задержки в миллисекундах. Не опубликованы также размер A/B-теста, его длительность, единица рандомизации и доверительные интервалы. Поэтому результат следует читать узко: в этом внутреннем сценарии QuickFix Llama 8B Diff получила более высокое принятие предложений и меньшую задержку, чем GPT-4o Diff. Это не доказательство превосходства Llama 8B в любой задаче программирования.
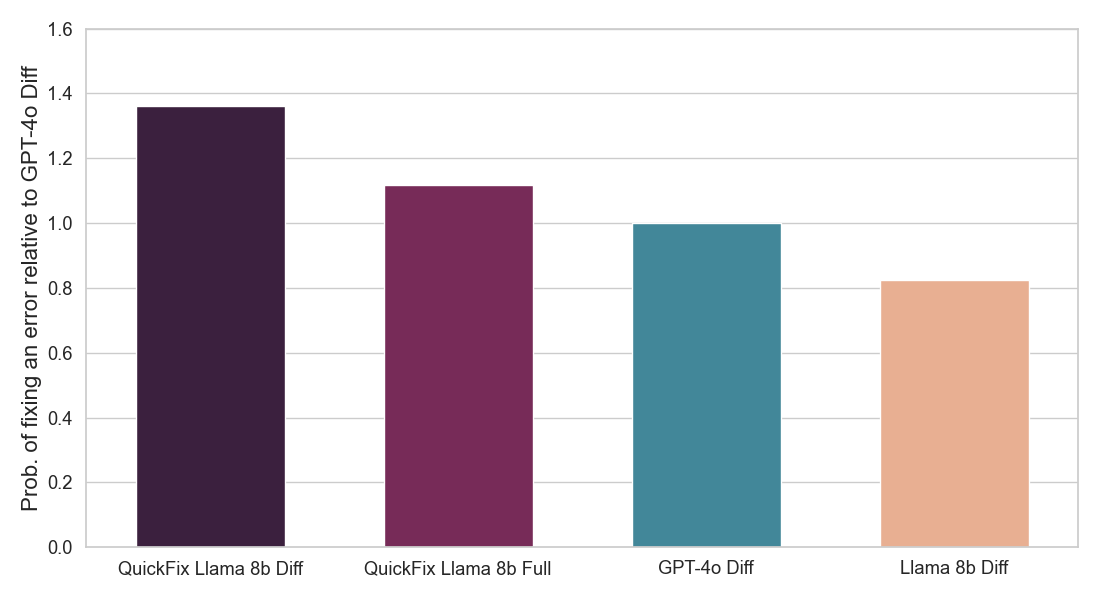
A/B на сотрудниках Databricks: доля принятых исправлений относительно GPT-4o Diff. Текст статьи сообщает примерно 1,4× для дообученной Llama 8B Diff; график не публикует абсолютные доли, это не число ошибок вообще.
Источник: Databricks · исходный материал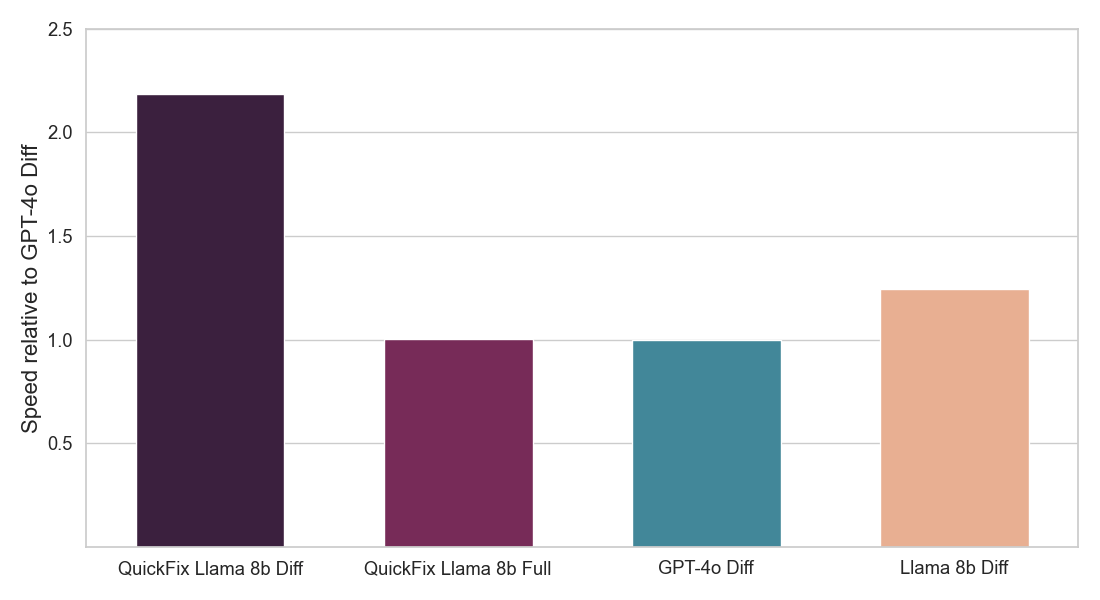
Скорость относительно GPT-4o Diff. Дообученная Llama8B Diff быстрее полного вывода исправленного кода; текст сообщает примерно двукратное снижение задержки. Абсолютные миллисекунды не раскрыты.
Источник: Databricks · исходный материалПример 1: исправить ошибку и не переписать SQL в другой стиль
Первый качественный пример показывает не только исправление, но и сохранение формы кода. GPT-4o превращает SQL-ячейку в PySpark-вызовы и тем самым создаёт большой лишний diff. QuickFix Llama сохраняет исходный SQL-стиль и меняет локальную часть запроса. Авторы считают это полезным свойством: даже корректная по смыслу широкая переработка заставляет пользователя тратить время на просмотр и откат ненужных изменений.
При этом пример нельзя описывать как буквальное воспроизведение пользовательского исправления. В показанном фрагменте пользователь подставляет константу 10, а QuickFix Llama — 30. Следовательно, рисунок подтверждает прежде всего сохранение SQL-стиля и локального характера правки, а не идентичность двух исправленных программ и не полную семантическую корректность. Реальные имена таблиц и константы авторами скрыты; фрагмент с ошибочным выражением из иллюстрации не является проверенной инструкцией по написанию SQL.
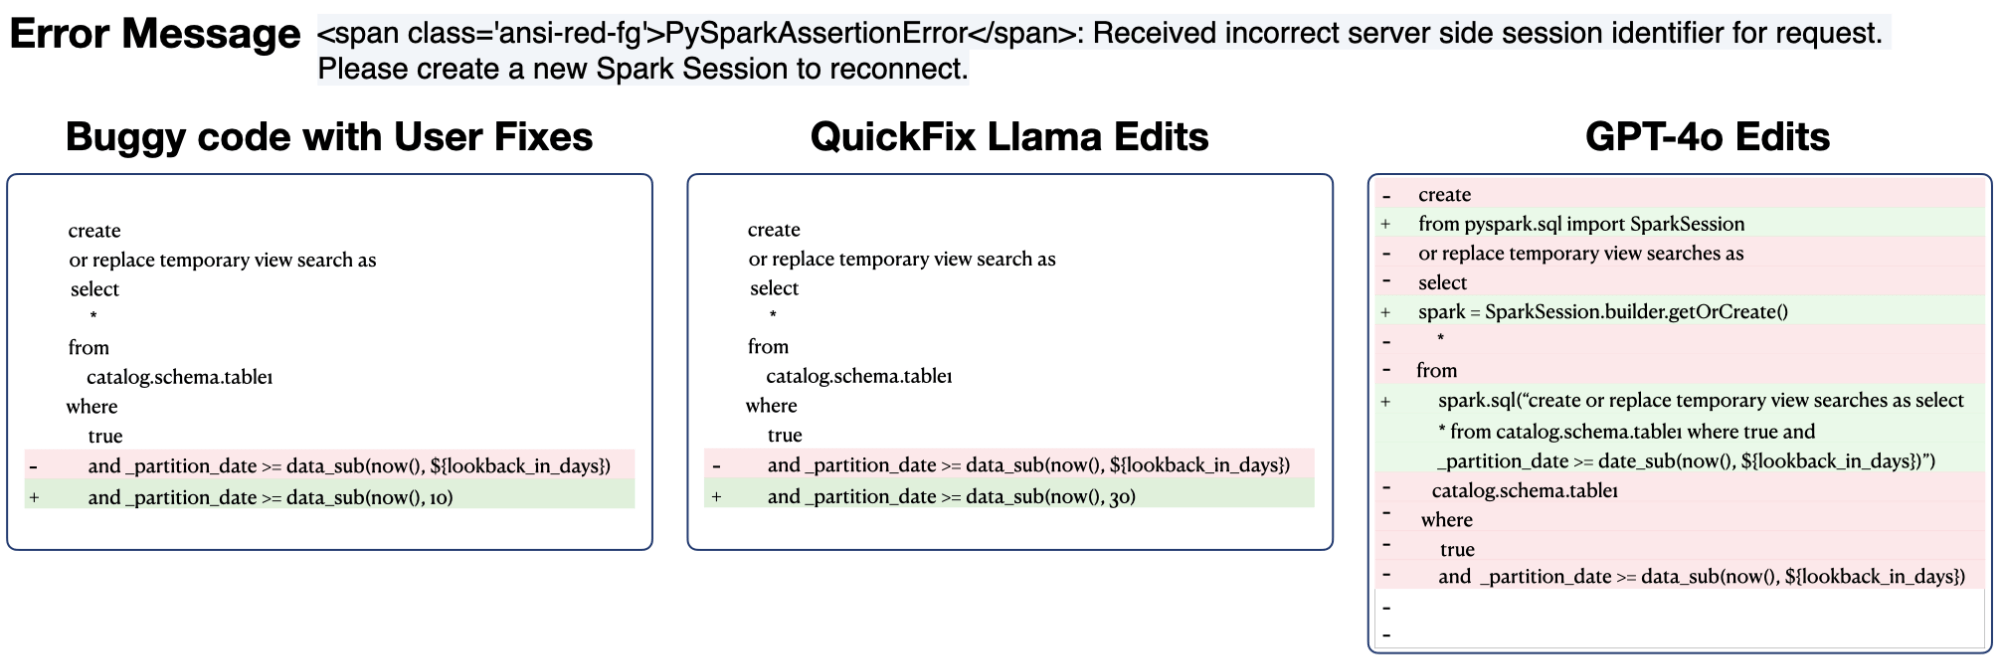
Пример сохранения SQL вместо перехода на PySpark. На рисунке пользователь подставляет 10, QuickFix — 30:это не буквально одинаковые исправления и не доказательство полной семантической корректности. Реальные имена таблиц и константы скрыты авторами.
Источник: Databricks · исходный материалПример 2: смотреть на схему, а не только на подсказку ошибки
Во втором примере запрос обращается к отсутствующему столбцу date. Сообщение SQL-движка перечисляет похожие доступные имена, среди которых есть _event_time. GPT-4o выбирает именно _event_time, то есть слишком сильно опирается на подсказку из текста ошибки.
Но в переданном контексте таблицы присутствует _partition_date. И пользователь, и QuickFix Llama заменяют date именно на _partition_date. Это пример того, что локальные данные организации могут быть важнее поверхностно правдоподобной подсказки: модель должна учитывать не только ошибку, но и схему, доступную в x. Контекст целиком на рисунке не показан, а реальные имена таблиц и константы авторами скрыты.
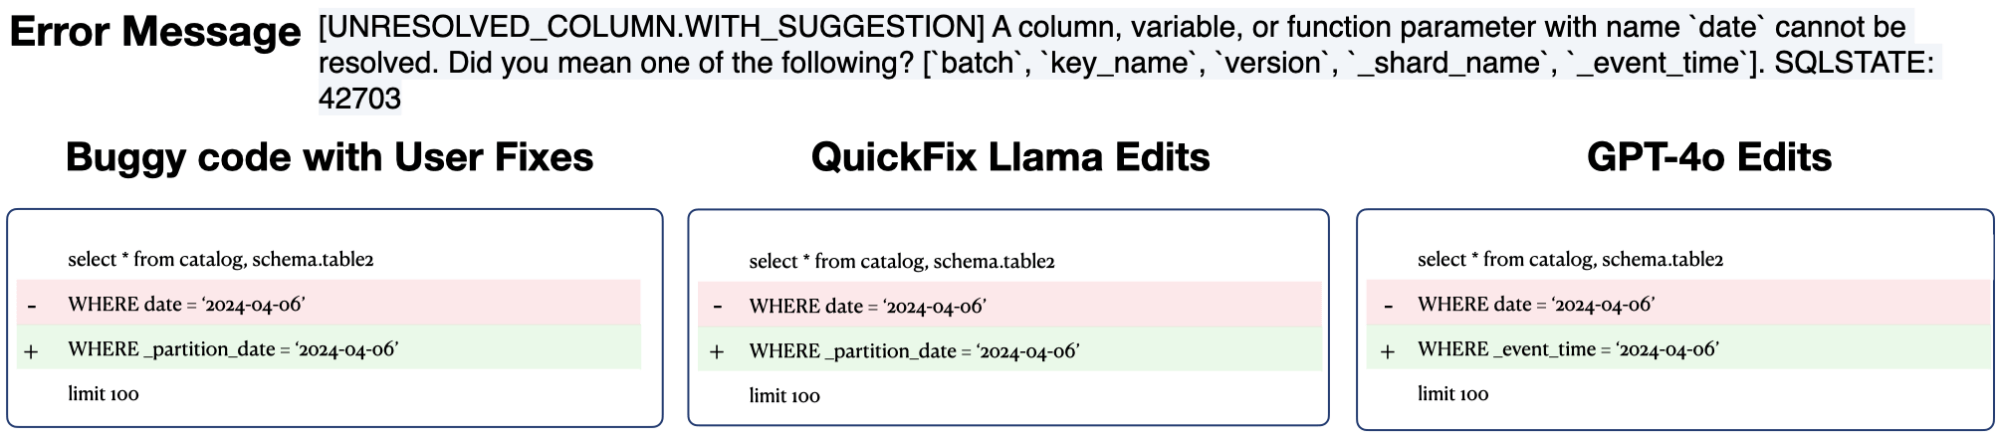
Второй пример: GPT-4o выбирает _event_time из подсказки ошибки, пользователь и QuickFix — _partition_date из доступного контекста. Имена таблиц и константы заменены авторами.
Источник: Databricks · исходный материалКак новые взаимодействия могут снова становиться данными
Поскольку новые ошибки и успешные исправления продолжают появляться во время работы помощника, тот же механизм сбора может снова давать пары (x, y, y′) для следующего цикла дообучения. Авторы называют такую идею Never Ending Learning (NEL) — постоянным пополнением обучающих данных из новых взаимодействий и повторным дообучением модели.
Источник не описывает уже работающий полностью автономный цикл, который без участия команды сам собирает данные, обучает модель, проверяет качество и выпускает её в продукт. Не раскрыты расписание переобучения, критерии выпуска, защитные проверки и откат. Поэтому NEL здесь — направление, которое становится возможным благодаря потоку новых взаимодействий, а не доказанная безошибочная автоматизация.
Авторы также пишут, что исследуют возможность персонализировать Quick Fix на данных конкретных клиентов. Это план, а не уже опубликованный результат. В статье Databricks предлагает свой сервис дообучения и развёртывания открытых моделей, но подробности инфраструктуры этого пути не разбираются. Организация может размещать небольшую открытую модель у себя или у доверенной стороны; источник не сообщает данных всех клиентов и не даёт численного расчёта стоимости или окупаемости.
Why does it matter?; What’s next?Итог: от рабочей ошибки к локально обученному Quick Fix
История Quick Fix начинается с практического ограничения: общая модель может знать программирование, но не обязана знать схему таблиц, принятый SQL-стиль и другие привычки конкретной организации. Databricks использует внутренние взаимодействия сотрудников как обучающий сигнал: сохраняет ошибочный запуск, контекст и следующее успешное выполнение той же ячейки, отбрасывает очевидно внешние исправления и большие переписывания, а затем дообучает Llama 3.1 8B Instruct. Этот сбор датасета и обучение происходят отдельно от работы готового Quick Fix.
- 01
Ошибка выполнения
Пользователь запускает ячейку, а среда возвращает ошибку выполнения.
- 02
Контекст для модели
Quick Fix получает ошибочный код и доступный контекст: сообщение об ошибке, соседний код и метаданные.
- 03
Предложение правки
Выбранная QuickFix Llama 8B Diff генерирует только необходимые изменения; полный код был отдельным сравниваемым форматом.
- 04
Решение пользователя
Пользователь просматривает предложение и принимает его с запуском либо отклоняет; принятие не гарантирует полную корректность программы.
- 05
Повторное выполнение
После принятой или ручной правки ячейка выполняется снова, и среда показывает новый результат.
Параметры обучения сначала выбирают по 0–1 exact match на отложенных данных: это проверка буквального совпадения с сохранённым y′, а не доказательство смысловой правильности. В Figure 4 результаты нормированы к GPT-4o Full, а ICL использует пять примеров; неподписанные высоты столбцов не дают точных чисел. Затем полезность проверяют на внутренних пользователях: QuickFix Llama 8B Diff показала около 1,4× по принятию правок и примерно вдвое меньшую задержку относительно GPT-4o Diff.
Два примера объясняют, что именно могла перенять модель: сохранять SQL-стиль вместо лишнего перехода в PySpark и выбирать _partition_date из реального контекста вместо _event_time из подсказки ошибки. Но источник не раскрывает размер данных, пороги фильтрации, параметры A/B-теста или абсолютную задержку и не доказывает универсальное превосходство модели. Постоянное повторное дообучение и персонализация для клиентов обозначены как возможности дальнейшего развития, а не как полностью автономная уже работающая система.