Разбор готов
Авито: автомодерация изображений с исправлением нарушений
Пользователь загружает в объявление фотографию, а на ней оказывается телефон, QR-код, адрес сайта или другой запрещённый контакт. Самый простой ответ модерации — отклонить снимок или заблокировать публикацию, но тогда площадка теряет полезный контент, а пользователь должен исправлять объявление вручную. Команда Авито попробовала другой путь: сначала находить нарушение, затем менять только проблемную область изображения и сохранять остальную фотографию. История началась с размытия контактов, а затем привела к восстановлению фона с помощью inpainting. Разберём, как под высокой нагрузкой построили каскад классификатора и детектора, как ускоряли сервис, почему размытия оказалось недостаточно, как сравнивали модели восстановления и где система всё ещё требует запасного сценария.
Материал полезен ML- и CV-инженерам, которые запускают модерацию изображений в высоконагруженном сервисе и должны одновременно учитывать качество, задержку и стоимость ручной проверки. Отдельно полезен разбор границ автоматического исправления: какие ошибки остаются у детектора, подготовки изображения и inpainting.
Статья · на русском
Автомодерация изображений: как исправлять нарушения, сохраняя количество и качество контентаВладимир Морозов · Опубликовано: 16 февраля 2025 г.
Почему модерации недостаточно просто найти нарушение
До проекта автоисправлений фотография могла пройти по одному из трёх путей. Если система была уверена, что нарушений нет, снимок публиковали. Если уверенности не хватало, его отправляли человеку. Если нарушение считалось очевидным, фотографию блокировали или просили заменить — в зависимости от критичности случая. Такая схема хорошо отвечает на вопрос «можно ли публиковать?», но не решает следующий вопрос: можно ли сохранить полезную часть фотографии и автоматически убрать только то, что нарушает правила.
У ручной проверки две практические цены. Во-первых, она сама стоит денег и требует контроля качества. Во-вторых, решение может занимать часы, тогда как автоматическая проверка работает за секунды. Жёсткое отклонение тоже имеет побочный эффект: не каждый пользователь возвращается, исправляет публикацию и загружает фото заново. Поэтому команда сформулировала новую цель — не только обнаружить нарушение, но и там, где это безопасно, автоматически исправить изображение.
Важно не превращать эту цель в обещание «исправлять всё». В исходной системе остаются ручная модерация и блокировка для сложных или критичных случаев. Автоисправление — ещё один путь внутри модерации, который подходит лишь тем нарушениям, где можно локально изменить фотографию, не уничтожив её смысл.
Дано: зачем Авито модерация изображений; Проблемы классической модерации: долго, дорого, неудобноПервая версия: убрать контакт, но оставить фотографию
Первый очевидный вариант — удалить всю фотографию с нарушением. Он прост, но в объявлении может быть всего один снимок. Тогда формально объявление сохраняется, а пользователь теряет всю визуальную часть. Команда поэтому перешла к локальному исправлению: найти область с контактом и размыть только её. Размытие, или blur, не пытается восстановить фон — оно просто делает выбранные пиксели нечитаемыми.
Такой компромисс решает главную продуктовую проблему первого этапа: остальная фотография остаётся на месте, а телефон, QR-код или адрес сайта перестаёт читаться. Но у метода сразу появляется цена: прямоугольная размытая полоса заметна и может закрывать полезные детали. На раннем этапе команда принимает этот дефект ради возможности автоматически исправлять публикацию вместо полного удаления.
Иллюстрация показывает именно этот компромисс: контакт скрыт, человек и большая часть сцены остаются видимыми, но вмешательство хорошо заметно. Позже именно визуальные дефекты размытия станут причиной перейти к восстановлению изображения.
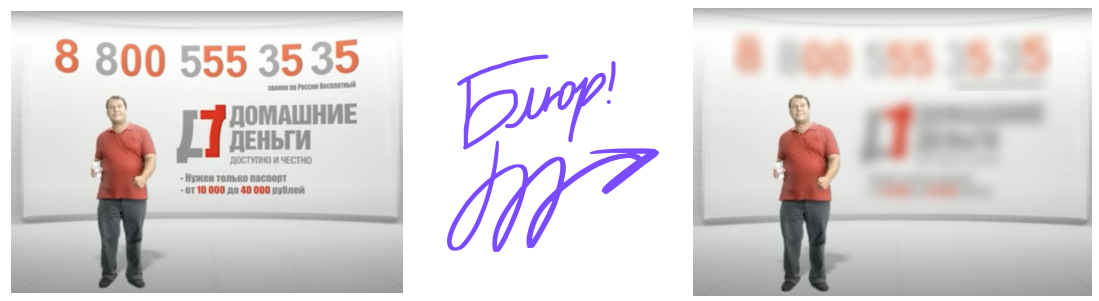
Размытие скрывает контакт и сохраняет остальное фото, но заметно портит его внешний вид.
Источник: Владимир Морозов · Авито · исходный материалПочему понадобился каскад из классификатора и детектора
Для первого запуска выбрали контакты на фотографиях: это относительно некритичный тип нарушения, а пользователи нередко размещают его без намерения обойти модерацию. По данным автора, контакты встречаются примерно на 1% фотографий. При этом в одном объявлении в среднем пять изображений. Средняя нагрузка на модерационные сервисы — около 1 500 запросов в секунду (RPS), в пике — до 10 000 RPS, а желаемый порядок времени модерации — около одной секунды.
Запускать тяжёлый детектор на каждом изображении было бы расточительно: подавляющее большинство снимков не содержит контактов. Поэтому поток разделили на два этапа. Сначала быстрый классификатор отвечает только на вопрос «есть ли здесь подозрение на контакт?». Для него важнее полнота, или recall: какую долю настоящих нарушений он не пропустил. Команда ориентировалась на то, чтобы подготовка изображения и применение классификатора укладывались менее чем примерно в 100 мс.
Только подозрительные фотографии идут в детектор. Детектор уже решает другую задачу: возвращает прямоугольные области — боксы — в которых расположен контакт. Эти боксы затем можно размыть или передать следующему модулю. На этом этапе автор делает акцент на precision, то есть на доле срабатываний, которые действительно соответствуют нужному объекту. Так требования разделяются: ранний этап старается не пропустить нарушение, поздний — точнее локализовать его на существенно меньшем потоке.
Шаг 1. Планируем архитектуру.Данные: реальные контакты, боксы и синтетика
Разметка нужна разная для двух частей каскада. Классификатору достаточно знать, есть ли нарушение на фотографии. Детектору требуется точнее: где именно оно расположено. На фотографиях с нарушениями размечали QR-коды, логины, телефоны и email, а также прямоугольные области вокруг них. Чистые публикации использовали ещё и как основу для синтетических примеров: на фотографии программно добавляли телефоны, email и другие контакты.
Таблицу можно прокрутить по горизонтали.
Синтетика помогает увеличить разнообразие расположений и форматов контактов, но не заменяет реальные фотографии. В источнике она показана отдельным потоком данных, а не как весь датасет детектора. Также статья не даёт подробностей о долях классов, разделении по времени или защите от похожих изображений между обучением и проверкой — эти параметры нельзя восстанавливать по одной схеме.
Есть и случаи, которые плохо ложатся в обычную детекцию прямоугольника: цифры выкладывают предметами, рисуют на поверхности или вписывают в необычный фон. Классификатор может понять, что фотография подозрительная, но детектор не обязательно найдёт аккуратный бокс. Такие примеры автор отправляет на ручную модерацию или в блокировку. Это важный запасной путь: высокий recall первого этапа сам по себе ещё не означает, что нарушение можно автоматически исправить.
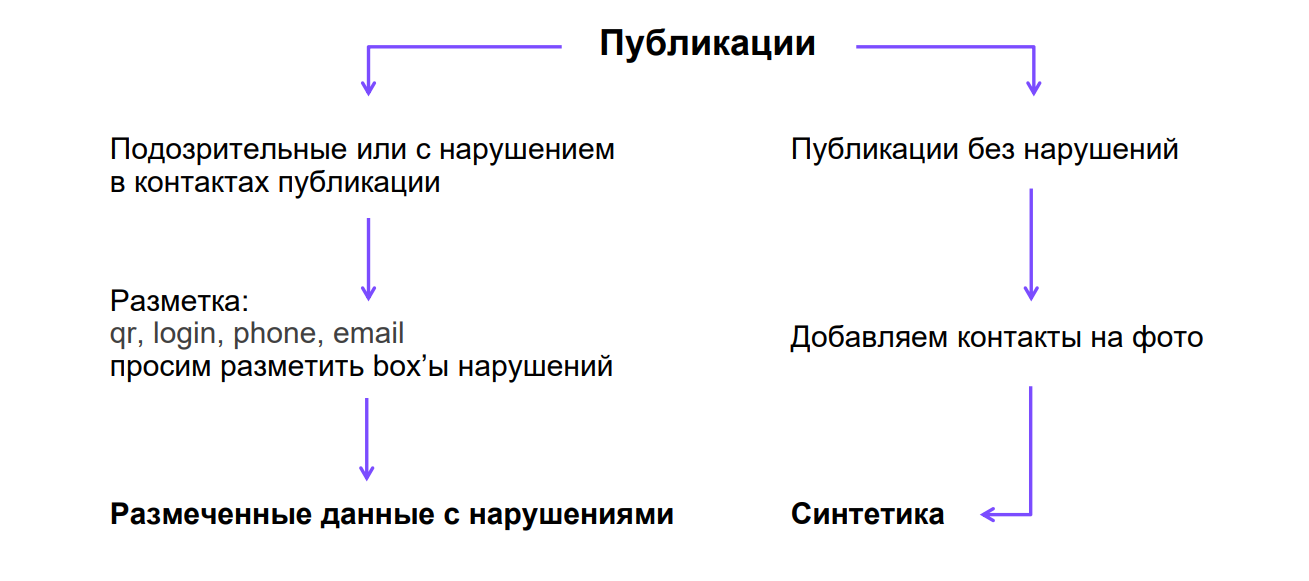
Контакты размечают вместе с прямоугольными областями. Чистые фотографии дополнительно используют для синтетического добавления контактов.
Источник: Владимир Морозов · Авито · исходный материал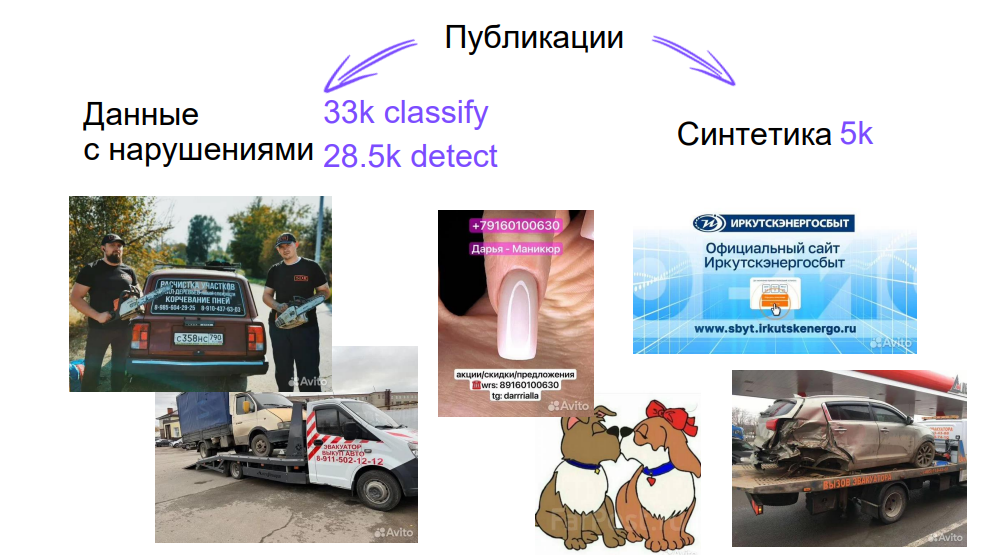
По иллюстрации: 33 тыс. фотографий для классификатора, 28,5 тыс. для детектора и 5 тыс. синтетических примеров. Условия разделения на обучение и проверку не раскрыты.
Источник: Владимир Морозов · Авито · исходный материал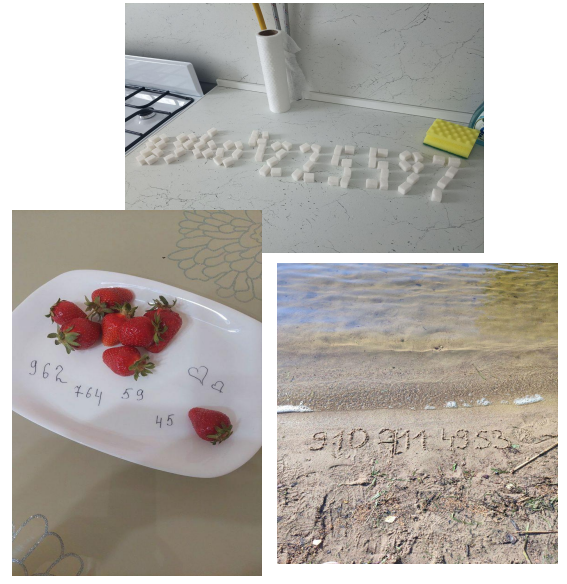
Контакты могут быть выложены предметами, нарисованы или написаны на необычном фоне. Автор направляет такие сложные случаи на ручную проверку или в блокировку.
Источник: Владимир Морозов · Авито · исходный материалКакие модели выбрали и что на самом деле показано в метриках
Для классификатора команда сравнивала несколько архитектур. На своих данных свёрточные модели оказались сильнее трансформерного ViT по сочетанию качества и скорости, поэтому выбрали EfficientNetV2 Small. На слайде сравнение классификаторов дано по двум столбцам: wmAP и бинарному AUC-ROC. wmAP здесь нельзя переименовывать в precision: источник не раскрывает схему взвешивания этой метрики.
Таблицу можно прокрутить по горизонтали.
Для локализации контактов использовали YOLO v6. Это историческая версия, указанная на исходном слайде, а не «последняя YOLO» в современном смысле. В тексте автор формулирует основную цель как высокий recall при precision 0,995, а на слайде метрика записана как Recall@0.995. Чтобы не смешивать показатели, ниже сохраняем именно числа и подписи источника.
Таблицу можно прокрутить по горизонтали.
После каскада поток резко сужается. На вход классификатора приходит около 1 500 RPS, после него — около 20 RPS на детектор, а до блока размытия доходит около 10 RPS. Эти числа особенно хорошо объясняют архитектурный выбор: дорогие операции выполняются не над всем потоком. Часть подозрительных фотографий при этом не становится автоматически исправленной — сложные случаи по-прежнему могут уйти человеку или в блок.
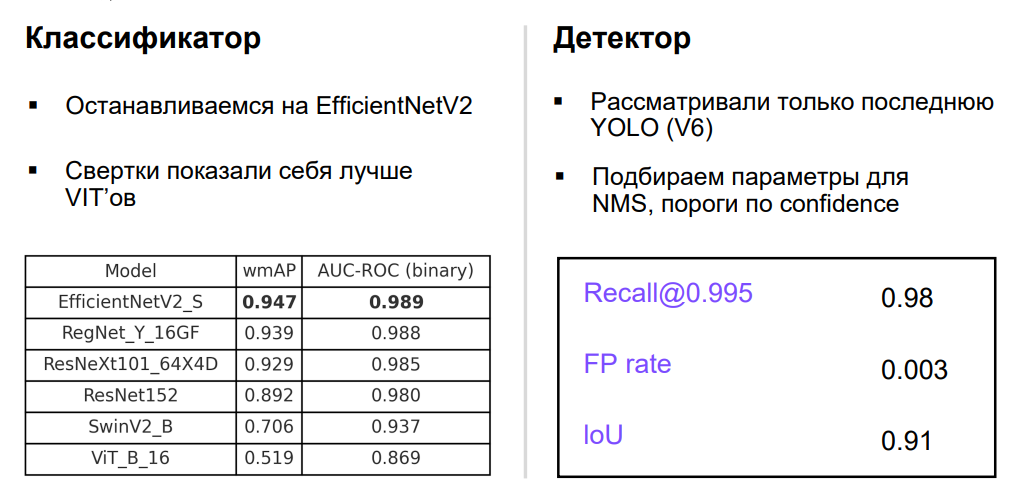
Слева — сравнение классификаторов по wmAP и бинарному AUC-ROC; справа — Recall@0.995, FP rate и IoU для детекции. Эти показатели не следует смешивать с одной общей точностью всего сервиса.
Источник: Владимир Морозов · Авито · исходный материал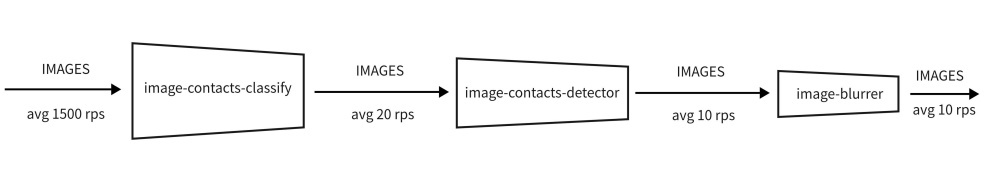
Исходный каскад: классификатор принимает около 1500 RPS, детектор около 20, размытие около 10. Это условные ветви обработки, а не применение каждой модели ко всему потоку.
Источник: Владимир Морозов · Авито · исходный материалКак устроили сервис: кеш, очередь и четыре обработчика
После обучения моделей основная задача меняется: теперь нужно дешёво и устойчиво применять их на потоке изображений. Вокруг моделей появляется обычная сервисная обвязка. Сначала система проверяет кеш по image_id. Если предсказание уже есть, одинаковую фотографию не нужно прогонять повторно. Дубликаты возникают не только при повторной загрузке картинки: изменение текста объявления тоже может заново запустить модерацию того же изображения.
Внутри сервиса команда использует Aqueduct — открытую библиотеку Авито для серверного инференса. В простом представлении это очередь, которая накапливает задания и передаёт их обработчикам пакетами. Пакетная обработка, или batching, позволяет эффективнее использовать CPU/GPU, когда много запросов приходят рядом по времени. Для шага можно задавать число процессов nprocs, размер пакета batch_size и максимальное ожидание batch_timeout: последний параметр не даёт редкому потоку ждать бесконечно ради полного пакета.
- 01
DownloadHandler
Скачивает изображение по URL через HTTPX. Задержка сети поэтому является отдельной частью времени классификатора.
- 02
PreprocessorHandler
Приводит изображение к форме и масштабу, которые ожидает модель.
- 03
ModelHandler
Запускает подготовленную модель в выбранном runtime.
- 04
PostprocessorHandler
Преобразует выход модели в результат сервиса: класс, бокс или другой формат, после чего результат можно положить в кеш.
Кеш находится по обе стороны вычислительного блока: перед обработкой выполняется проверка, после неё — сохранение результата. Это не часть нейросети, но именно такие детали позволяют не тратить GPU на работу, которую система уже делала для того же изображения.
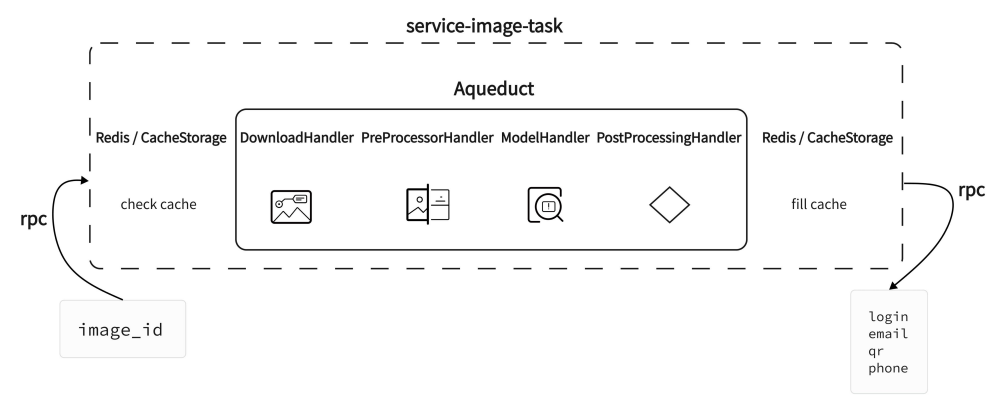
Кеш по image_id → Aqueduct → скачивание, подготовка, модель, обработка результата → запись предсказания в кеш. Кеш помогает не проверять повторно одинаковые изображения.
Источник: Владимир Морозов · Авито · исходный материал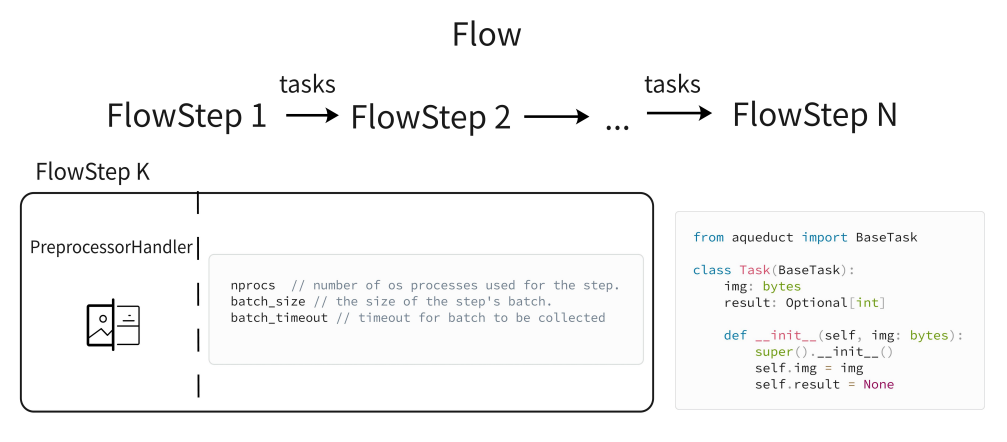
Aqueduct связывает обработчики в Flow. Для шага задаются число процессов nprocs, размер пакета batch_size и время ожидания batch_timeout.
Источник: Владимир Морозов · Авито · исходный материалПочему ускорение подготовки изображения может сломать качество
На обучении изображения часто случайно преобразуют, чтобы модель меньше зависела от частных деталей; такие преобразования называют аугментациями. Автор приводит TorchVision как базовый вариант и связывает его преобразования с Pillow, а в своих рабочих контурах команда предпочитает Albumentations на обучении и OpenCV в продакшене. На больших изображениях заметная часть времени уходит ещё до нейросети: обрезка и изменение размера. На внутреннем графике OpenCV быстрее Pillow, особенно на resize при больших разрешениях. Неподписанные точки нельзя превращать в точные числа, но направление сравнения ясно: выбор библиотеки подготовки изображения влияет на задержку.
В команде на обучении используют Albumentations, а в рабочем сервисе — OpenCV. Однако просто заменить библиотеку недостаточно: одинаково звучащая операция может иметь разные параметры и численно давать другой вход модели. Если сеть обучалась на одной подготовке, а в продакшене видит систематически другую, распределение входных пикселей меняется и качество может ухудшиться.
Здесь важна поправка к исходной подписи. На показанном примере сравниваются Pillow Image.BILINEAR и OpenCV INTER_AREA — это разные алгоритмы интерполяции. Поэтому картинка не доказывает, что две библиотеки обязательно по-разному реализуют одну и ту же билинейную операцию. Практический вывод уже: при переносе подготовки изображения нужно сверять не только библиотеку, но и конкретный способ изменения размера, порядок каналов, нормализацию и остальные параметры.
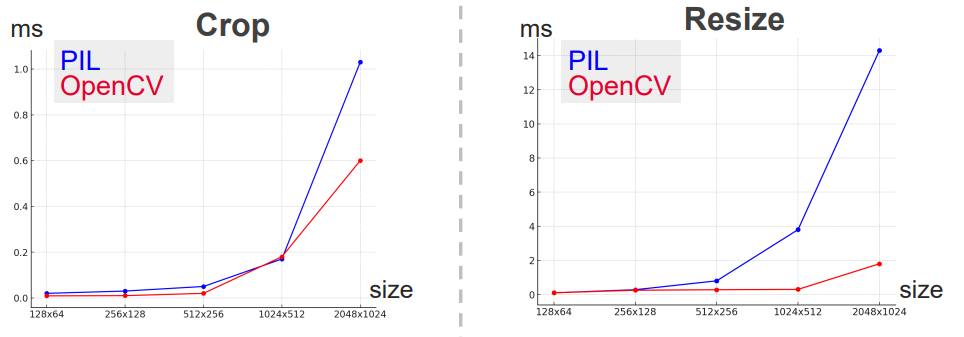
В опыте автора OpenCV быстрее Pillow на обрезке и изменении размера, особенно при больших изображениях. Неподписанные точки не воспроизводятся как точные замеры.
Источник: Владимир Морозов · Авито · исходный материал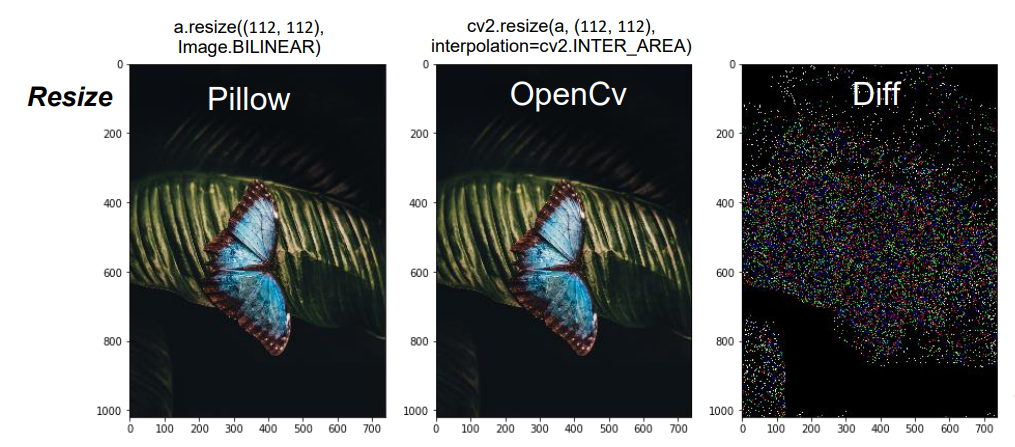
В подписи фактически сравниваются Pillow BILINEAR и OpenCV INTER_AREA — разные способы интерполяции. Разница не доказывает разные результаты одной и той же операции; подготовку входа при обучении и применении нужно согласовывать.
Источник: Владимир Морозов · Авито · исходный материалЭкспорт моделей: где ускорение стоит инженерного времени
Обучать удобно в PyTorch/Lightning, но рабочему сервису не нужны все возможности обучающего фреймворка. Поэтому команда конвертирует модели в более узкие форматы выполнения. На одном из слайдов приведён общий опыт автора по ускорениям: TorchScript — примерно 1,2–1,5×, ONNX — 1,2–2×, TensorRT FP32 — 1,5–3×, TensorRT FP16 — 3–5× относительно PyTorch/Lightning. Это ориентиры из разных оптимизаций, а не единый сравнительный замер одной и той же модели автомодерации на фиксированном железе.
Главная инженерная оговорка — конвертация не всегда проходит автоматически. В статье это показано на Python-ветвлении, которое зависит от входных данных. В левой версии код проходит по элементам батча и выбирает if для каждой строки; в правой то же решение для двумерного входа выражено тензорными масками. Для x формы [B, D] обе версии возвращают [B, D]: слева благодаря torch.stack(result), справа — потому что маска [B, 1] автоматически расширяется по второй размерности.
import torch

class BadModel(torch.nn.Module):
    def forward(self, x):
        result = []
        for i in range(x.size(0)):
            if x[i].sum() > 0:
                result.append(x[i] * 2)
            else:
                result.append(x[i] - 2)
        return torch.stack(result)

model = BadModel()


class FixedModel(torch.nn.Module):
    def forward(self, x):
        positive_mask = (x.sum(dim=1, keepdim=True) > 0).float()
        negative_mask = 1 - positive_mask
        result = x * 2 * positive_mask + (x - 2) * negative_mask
        return result

model = FixedModel()
Этот пример нельзя превращать в универсальный рецепт для любой размерности. Слева x[i].sum() суммирует весь элемент батча, а справа явно задана ось dim=1; при входах выше двух измерений семантика уже может разойтись. И главное: это не доказательство, что ONNX «в принципе не умеет динамику». В стандарте ONNX есть операторы управления потоком, включая If и Loop; проблема примера — в том, как ветвление Python попадает в конкретную трассировку и экспорт. См. первичную документацию ONNX: If.
Для контактов EfficientNetV2 и YOLO удалось перевести в TensorRT. Но автор отдельно подчёркивает инженерную стоимость: если модель требует долгой переработки, на старте бывает разумнее остановиться на TorchScript. Это решение не про «лучшую технологию вообще», а про баланс времени разработки и выигрыша в конкретном сервисе.
Таблицу можно прокрутить по горизонтали.
Складывать 240 + 280 + 500 мс и называть результат общей задержкой нельзя: разные блоки работают на разных ветвях и потоках, а источник не даёт распределение сквозной задержки. Сам blur-блок на схеме самый долгий; автор связывает это с тем, что он не только считает результат, но и обновляет фотографии в публикации. После запуска автор качественно сообщает о большом числе успешных срабатываний, малом числе жалоб и заметном сокращении потока ручной модерации. Процент сокращения, экономия денег или другая бизнес-дельта в материале не приведены.
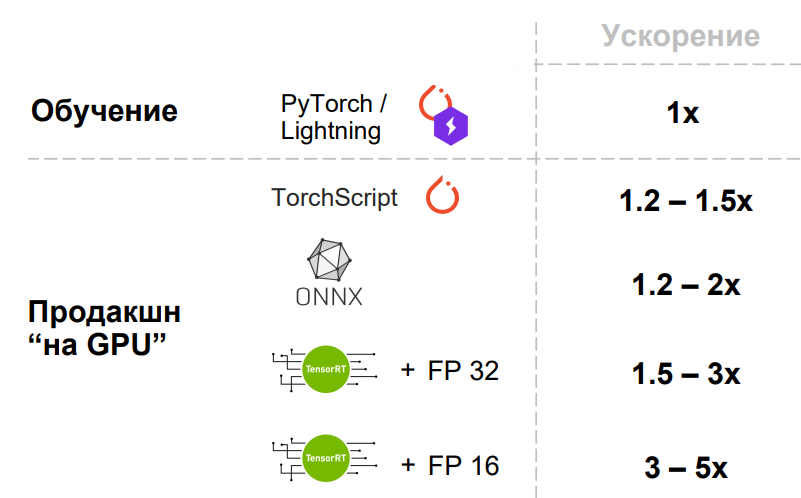
Обобщённый опыт оптимизаций автора: TorchScript 1,2–1,5×,ONNX 1,2–2×,TensorRT FP32 1,5–3×,FP16 3–5× относительно PyTorch/Lightning. Это не единый замер всех моделей автомодерации.
Источник: Владимир Морозов · Авито · исходный материал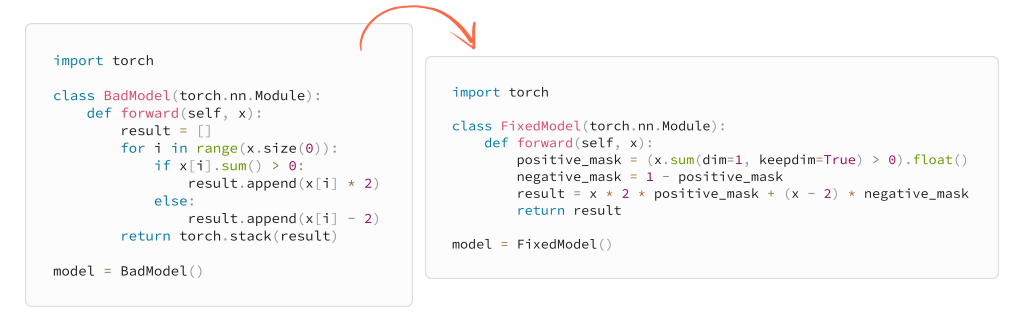
Python-ветвление заменено тензорной маской. Слева возвращается torch.stack(result), справа — результат операций над массивом; для двумерного входа обе формы [B,D] совпадают. Это иллюстрация принципа, а не универсальное доказательство экспорта любой модели.
Источник: Владимир Морозов · Авито · исходный материал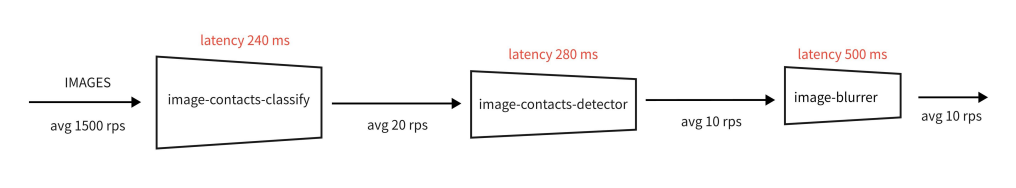
После оптимизации: классификатор 240 мс, детектор 280 мс, размытие 500 мс; потоки 1500→20→10RPS. Время классификатора включает скачивание; сумма не устанавливает общий p95 или среднюю задержку всей площадки.
Источник: Владимир Морозов · Авито · исходный материалПочему blur перестал устраивать и появился inpainting
После контактов систему начали расширять на другие причины. Текстовые нарушения — например, мат или вводящие в заблуждение слова — можно сначала найти распознаванием текста на изображении, OCR. Для части нарушений авторского права используется отдельный детектор логотипов. Такие модели дают локализацию, поэтому технически их результаты тоже можно было передавать в блок размытия.
Проблема проявилась в Авито Услугах на кейсе «Частный мастер»: некоторые компании маскировались под частных исполнителей, а соответствующую надпись нужно было убрать с фотографии. Blur действительно скрывал текст, но оставлял крупную размытую полосу. Нарушение исчезало, однако само изображение выглядело заметно испорченным. Это не редкая косметическая мелочь, а сигнал, что действие «спрятать пиксели» плохо соответствует новой задаче.
Вместо размытия команда попробовала восстановление закрытой области — inpainting. Модели дают фотографию и маску: внутри маски часть пикселей считается неизвестной, и сеть дорисовывает продолжение окружающего изображения. Если маска полностью закрывает надпись, хороший результат выглядит так, будто текста там не было. На примерах из статьи модель восстанавливает тёмный фон рядом с человеком, участок пола и другие текстуры без характерной размытой полосы.
Это не означает, что inpainting гарантированно сохраняет исходную фотографию без дефектов. Модель генерирует содержимое закрытой области и может ошибаться. Поэтому переход потребовал отдельного сравнения качества, скорости и визуальных артефактов.
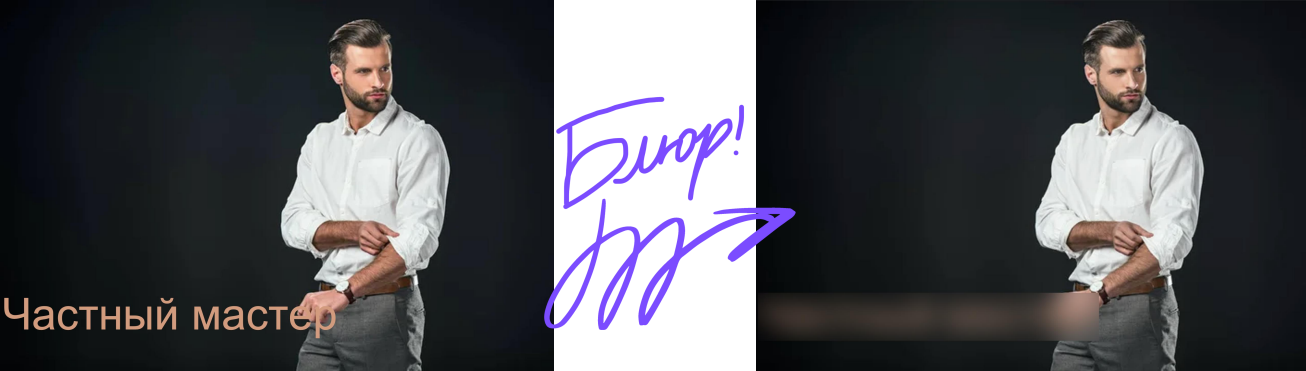
Размытие надписи «Частный мастер» оставляет заметную полосу: исправление нарушения ухудшает саму фотографию.
Источник: Владимир Морозов · Авито · исходный материал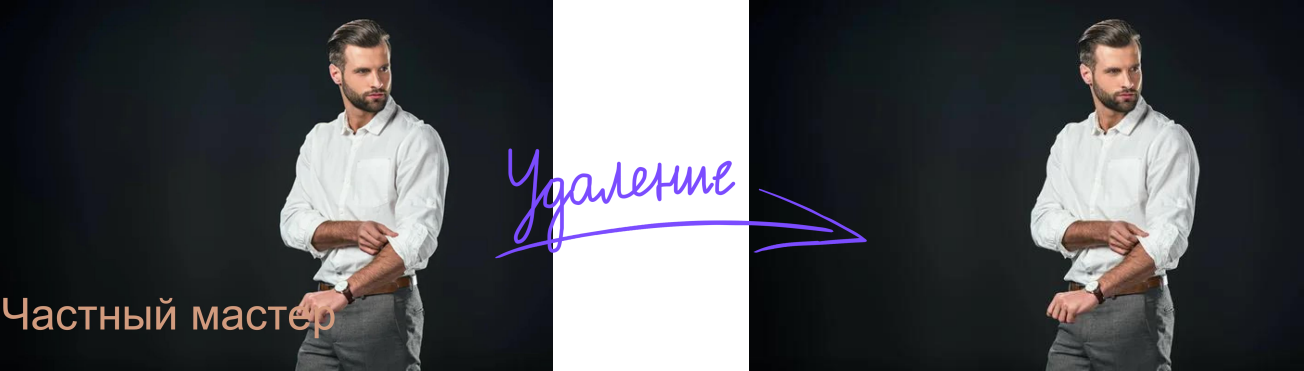
Восстановление области изображения убирает надпись без размытой полосы. Это визуальный пример автора, не общий процент качества.
Источник: Владимир Морозов · Авито · исходный материал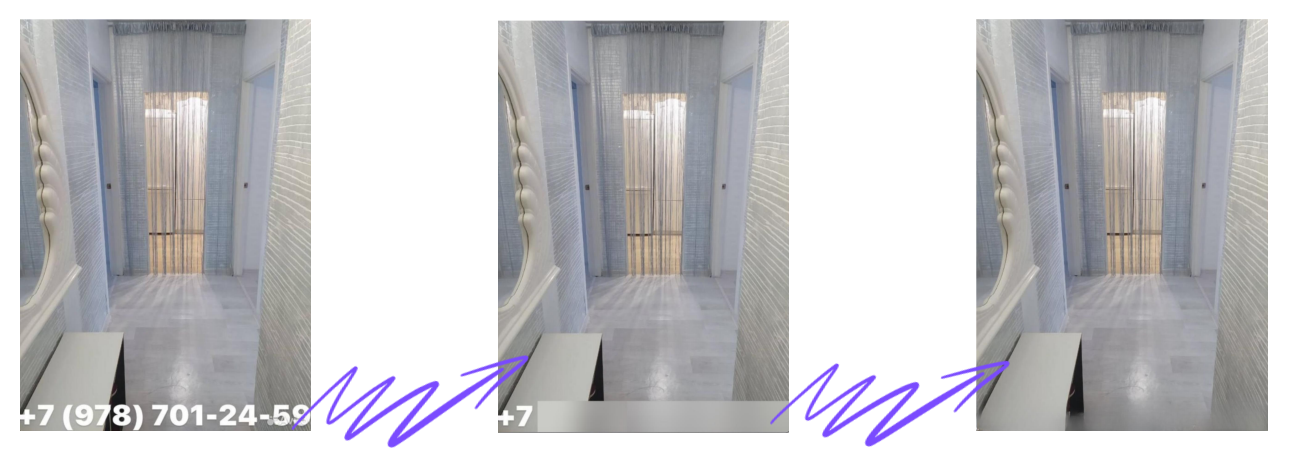
Размытие скрывает телефон, восстановление достраивает фон в области контакта. Исходный текст не утверждает безошибочность для любого изображения.
Источник: Владимир Морозов · Авито · исходный материалКак сравнивали восстановление: четыре метрики и просмотр глазами
Для inpainting трудно выбрать одну метрику, которая полностью совпадает с человеческим восприятием. Поэтому команда смотрела на PSNR, SSIM, FID и LPIPS вместе и дополнительно просматривала изображения глазами. Это важнее списка аббревиатур: каждая метрика чувствительна к своему виду отличий и может пропустить дефект, который заметит другая.
PSNR начинается со средней квадратичной ошибки пикселей, MSE: чем сильнее восстановленное изображение отличается от эталона по значениям пикселей, тем выше MSE и тем ниже PSNR. В статье формула описана упрощённо. Для точного определения используем стандартную запись из документации PyTorch-Ignite, отдельно от слов автора.
Стандартная формула при MSE > 0; data_range — диапазон допустимых значений изображения. При MSE = 0 изображения совпадают и PSNR стремится к +∞. Первичный источник: PyTorch-Ignite PSNR.
PSNR не учитывает структуру изображения так, как её воспринимает человек. SSIM дополняет попиксельную ошибку локальными статистиками яркости, контраста и структуры. На иллюстрации три искажённые версии имеют одинаковый PSNR 26,547, но SSIM падает с 0,988 до 0,840 и 0,694 по мере визуального ухудшения. Это хороший пример того, почему одинаковая попиксельная ошибка не означает одинаковое качество.
С FID нужна отдельная редакционная оговорка. Статья описывает его как работу с парами изображений и упоминает CLIP, но это не стандартное определение Fréchet Inception Distance. В исходной работе FID сравнивает распределения признаков двух наборов изображений: признаки извлекаются Inception-сетью, затем сравниваются оценённые средние и ковариации. Какая именно реализация FID и какой feature extractor использовались в эксперименте Авито, материал полностью не раскрывает, поэтому это нельзя угадывать. Первичная работа: Heusel et al., 2017.
LPIPS оценивает различие уже в признаках нейросети на нескольких уровнях и лучше отражает некоторые перцептивные изменения. На примере из статьи две версии почти совпадают по PSNR и SSIM: 32,106 / 0,839 против 32,105 / 0,831, но LPIPS различается сильнее — 0,174 против 0,015. И это всё равно не делает LPIPS идеальным судьёй: автор прямо предупреждает, что визуальная проверка остаётся необходимой.
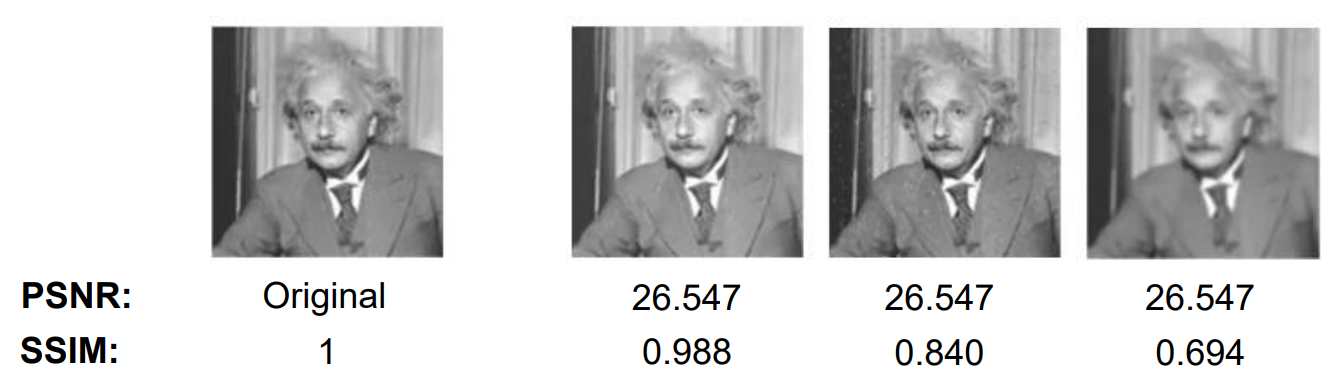
При одинаковом PSNR 26,547 у показанных искажений SSIM отличается: 0,988 / 0,840 / 0,694. Иллюстрация показывает ограниченность попиксельной ошибки.
Источник: Владимир Морозов · Авито · исходный материал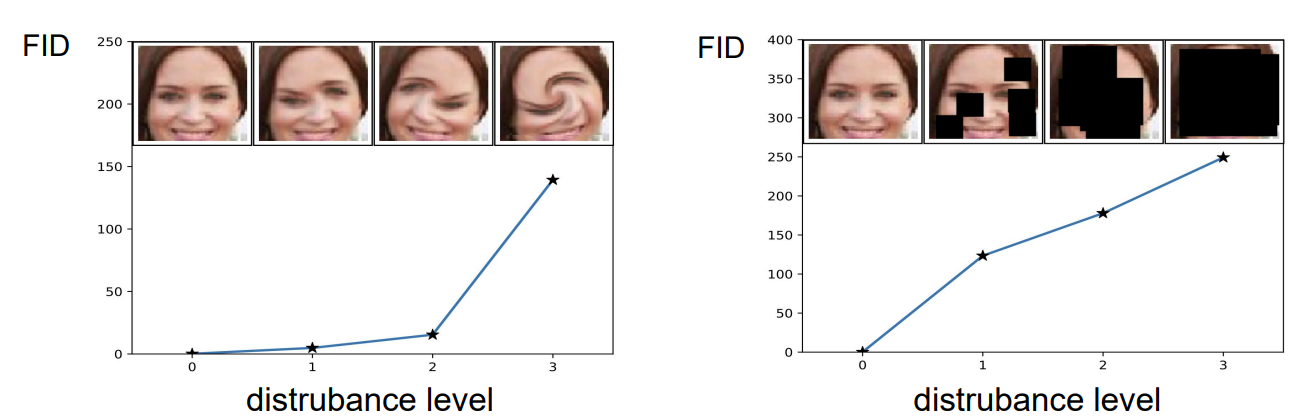
Пример роста FID при искажении набора изображений. Стандартный FID сравнивает распределения признаков, а показанные лица иллюстрируют тип искажения; это не отдельная попиксельная дистанция одной пары.
Источник: Владимир Морозов · Авито · исходный материал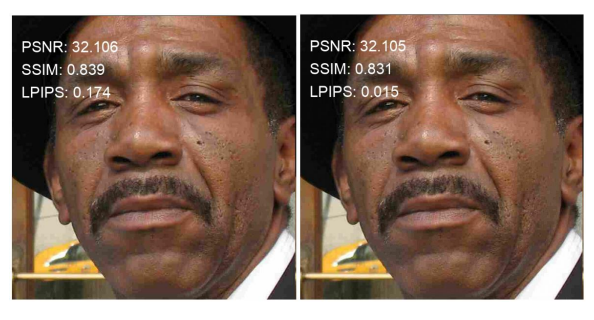
Два искажения почти совпадают по PSNR/SSIM, но отличаются по LPIPS 0,174 vs 0,015. Перцептивная оценка дополняет сравнение пикселей.
Источник: Владимир Морозов · Авито · исходный материалПочему лучшая по качеству модель не стала рабочей
Кандидатов искали среди готовых моделей для редактирования изображений. Команду заинтересовал репозиторий IOPaint с набором inpainting-моделей; дальше потенциальные варианты фильтровали по опубликованным результатам, ориентируясь в том числе на Papers with Code. Сначала выделили LaMa, ZITS и MAT; в итоговом сравнении присутствует и более новая ZITS++. На тесте с масками ZITS++ получает лучшие числа по всем четырём показанным метрикам. Но это ещё не финальный выбор: модерационная система должна обрабатывать поток изображений, поэтому качество нужно сопоставлять со скоростью.
Таблицу можно прокрутить по горизонтали.
По визуальным примерам MAT иногда создаёт заметные артефакты; LaMa выглядит стабильнее, хотя способна слегка размывать участок. ZITS и особенно ZITS++ выигрывают по таблице качества, но разница между ними и LaMa существенно меньше, чем разница в скорости.
Таблицу можно прокрутить по горизонтали.
LaMa оказывается примерно в отдельном классе по производительности: 103,8 мс на изображение и 9,63 изображения в секунду в показанном сравнении. Команда выбирает её несмотря на то, что ZITS++ лучше по качественным метрикам. Автор также отмечает удобство и качество репозитория LaMa и, как дополнительный человеческий фактор, российских авторов модели. Главная техническая причина выбора при этом — компромисс между качеством и скоростью, а не победа в одной метрике.
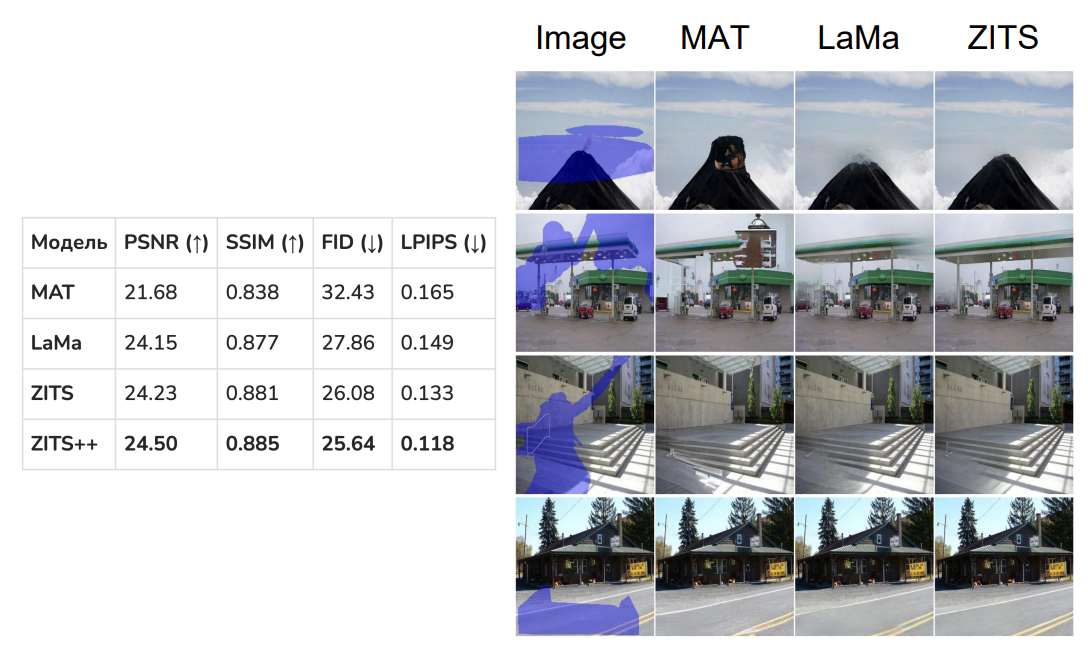
Сравнение качества MAT, LaMa, ZITS, ZITS++ по PSNR/SSIM/FID/LPIPS. ZITS++ лидирует в таблице,но LaMa выбрана с учётом скорости; полная методика набора и масок не раскрыта.
Источник: Владимир Морозов · Авито · исходный материал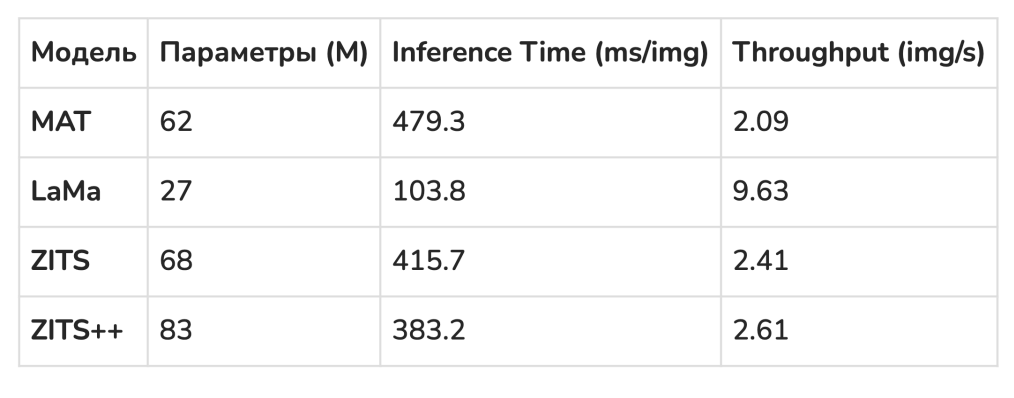
В сравнении моделей LaMa: 27 млн параметров, 103,8 мс/изображение, 9,63 изображения/с. Условия позднейшего теста A100 1920×1440 не следует автоматически переносить сюда.
Источник: Владимир Морозов · Авито · исходный материалLaMa, свёртки Фурье и осторожная оптимизация
LaMa должна восстанавливать большие закрытые области, поэтому ей важно учитывать контекст далеко за пределами небольшой локальной окрестности. В архитектуре используются Fast Fourier Convolution (FFC): признаки разделяются на локальную и глобальную части, а спектральная ветвь применяет прямое и обратное двумерное преобразование Фурье. Интуитивно это помогает слою учитывать информацию на более широком поле зрения. Показанная схема — архитектура LaMa из исходной работы, а не свидетельство того, что Авито обучало эту модель с нуля.
Именно Fourier-операции усложнили привычный путь конвертации в ONNX/TensorRT. По словам автора, попытка такой конвертации давала нежелательный для них граф, поэтому для рабочей оптимизации остановились на TorchScript. Здесь снова проявляется общий принцип статьи: самый агрессивный runtime не обязан быть лучшим, если его поддержка требует непропорциональной инженерной работы.
Таблицу можно прокрутить по горизонтали.
В исходной таблице столбец Throughput Diff для TorchScript равен +27%. При этом отношение показанных скоростей 7,7 / 5,6 даёт другой процент, и статья не объясняет, относительно какой базы рассчитаны +27%. Поэтому корректно сохранить все три опубликованных числа и отметить несогласованность, а не молча заменять авторский процент пересчитанным. Также этот benchmark относится именно к LaMa на A100 и разрешению 1920×1440; он не описывает условия более раннего сравнения MAT/LaMa/ZITS/ZITS++.
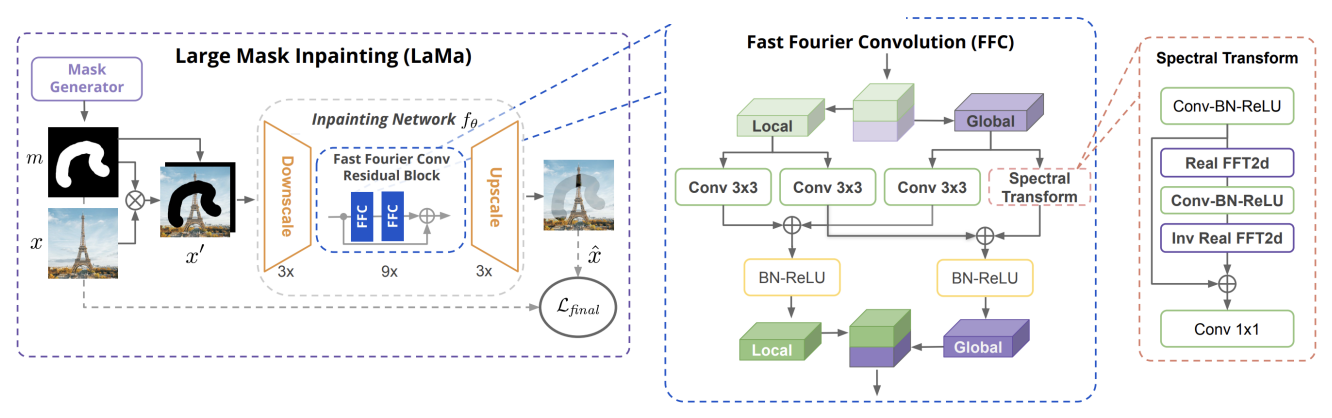
Заимствованная схема LaMa и Fast Fourier Convolution: локальная и глобальная ветви, прямое и обратное FFT. Это архитектура выбранного подхода, не сообщение о самостоятельном обучении Авито с нуля.
Источник: Владимир Морозов · Авито · исходный материал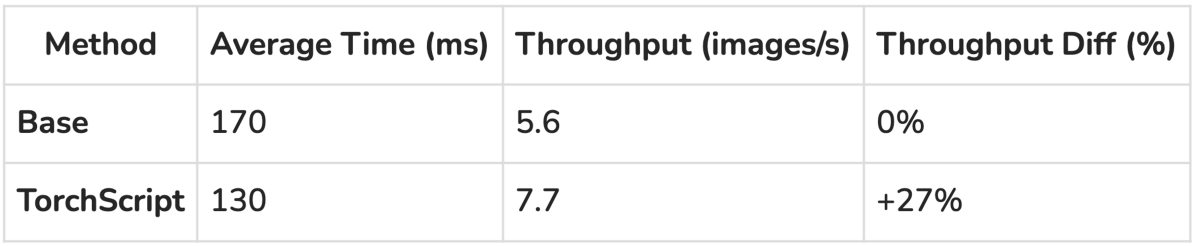
LaMa на A100, 1920×1440: Base170мс/5,6изобр./с;TorchScript 130мс/7,7изобр./с; в столбце изменения напечатано +27%. Процент не согласуется с арифметикой показанных скоростей; иной базы автор не объясняет.
Источник: Владимир Морозов · Авито · исходный материалВо что превратилась система после перехода на inpainting
После экспериментов часть причин, которые раньше приводили к отклонению или блокировке, перевели на автоматическое восстановление изображения. Но финальная схема не означает, что все виды нарушений теперь чинит одна модель. В ней остаются самостоятельные ветви: контакты проходят через классификатор и детектор; OCR ищет текстовые нарушения и на схеме может вести как к inpainting, так и к блокировке; детектор логотипов продолжает вести к блокировке. На схеме также остаётся Blurrer как отдельное действие для части случаев.
Новая ветвь дороже старого размытия. На схеме поток контактов выглядит так: около 1 500 RPS поступают в классификатор, около 20 RPS — в детектор и около 10 RPS после него идут дальше. Параллельная OCR-ветвь также получает изображения и выдаёт в среднем около 16 RPS. Потоки порядка 10 и 16 RPS сходятся в image-inpainter; после него на схеме подписано около 26 RPS и задержка 550 мс.
550 мс — задержка блока inpainting, а не сквозная задержка всей модерации. Время OCR отдельно не указано, поэтому складывать 240 мс классификатора, 280 мс детектора, OCR и 550 мс и объявлять сумму общим p95 нельзя. Схема показывает устройство ветвей и порядок нагрузки, но не полное распределение времени от входа до результата.
Визуальные примеры показывают, зачем был нужен переход: модель убирает телефон с двери автомобиля и дорисовывает фон, удаляет адрес сайта и восстанавливает участок кузова. Это конкретные успешные случаи, а не статистическая гарантия качества на любом изображении.
Автор качественно формулирует результат как сохранение контента при автоматическом удалении части нарушений. Для первой версии с blur он также говорит о малом числе жалоб и заметном сокращении ручного потока. Однако источник не приводит GMV, стоимость модерации, процент сохранённых объявлений, точный прирост публикаций или единую продуктовую KPI. Поэтому вывод главы ограничен тем, что действительно измерено или показано: модельные метрики, задержки отдельных блоков, потоки RPS и визуальные примеры.
За пределами этого кейса автор коротко упоминает другие направления команды автоматической модерации: блокировку дублей, применение LLM и few-shot-подходов, а также модерацию более сложных форматов, например видео. В статье эти проекты не раскрываются технически, поэтому глава не приписывает им архитектуру или результаты.
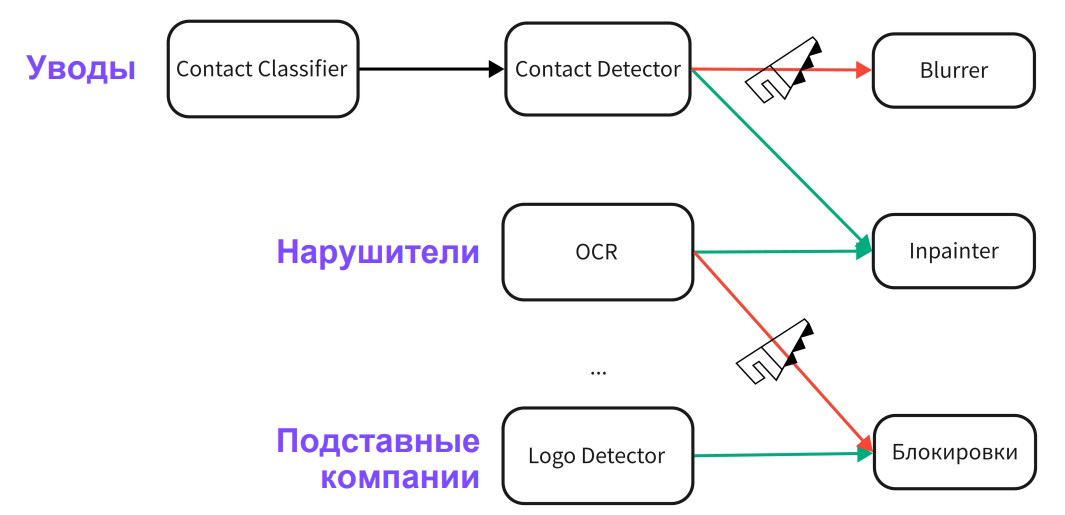
Контакты и часть нарушений текста направляются на inpainting. Ветвь Logo Detector на итоговой схеме продолжает идти к блокировке; автоматическое исправление не отменяет остальные решения модерации.
Источник: Владимир Морозов · Авито · исходный материал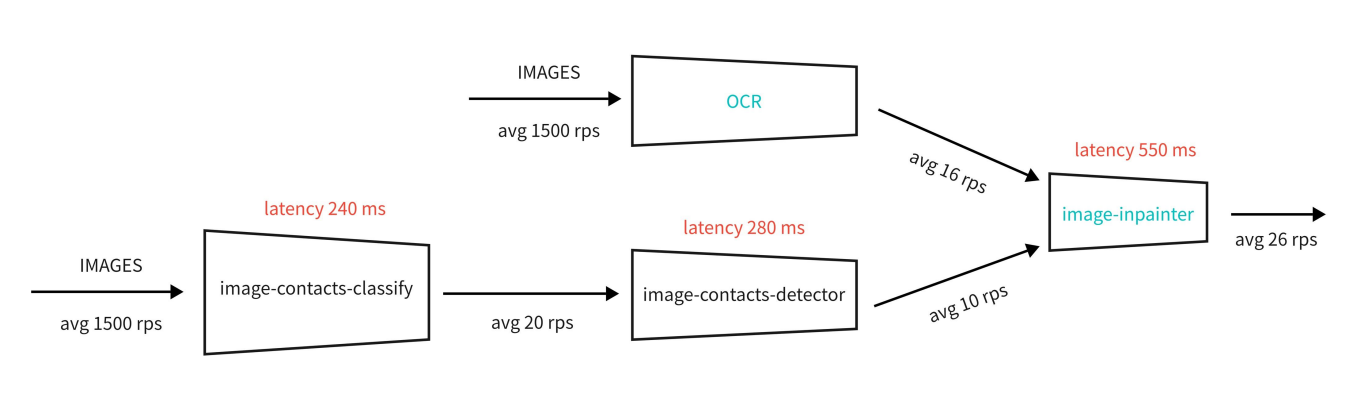
К ветви контактов добавлена OCR-ветвь 16RPS; inpainting принимает около 26RPS и подписан 550мс. Задержка OCR и полная пользовательская задержка не указаны.
Источник: Владимир Морозов · Авито · исходный материал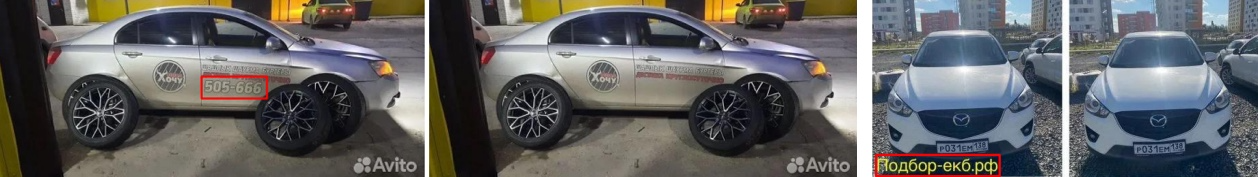
Примеры удаления телефона и сайта с восстановлением фона автомобиля. Иллюстрации показывают конкретные результаты, а не универсальную гарантию точности.
Источник: Владимир Морозов · Авито · исходный материалПоследняя ошибка происходит ещё до LaMa: неполная маска
Даже сильный inpainting не удалит то, чего нет внутри маски. На проблемном примере прямоугольник детектора не захватил буквы целиком, поэтому LaMa восстановила только отмеченную область, а фрагменты текста остались на фотографии. Это важная диагностика: видимый артефакт после генерации не обязательно означает, что ошиблась сама генеративная модель. Причина может быть в локализации до неё.
Предложенное исправление — превратить грубый бокс в более точную маску. Бокс можно передать как подсказку сегментатору SAM (Segment Anything Model), получить контур объекта и уже эту маску отдать LaMa. Так система пытается удалить именно текст или объект, а не весь прямоугольник вокруг него.
Статус здесь нужно читать буквально относительно даты источника. Статья опубликована 16 февраля 2025 года, и автор пишет, что решение с SAM «внедряем в Авито прямо сейчас». Это означает работу над внедрением на момент публикации, но не подтверждает, что схема позже полностью раскатана, насколько она улучшила метрики или что именно работает в Авито в 2026 году.
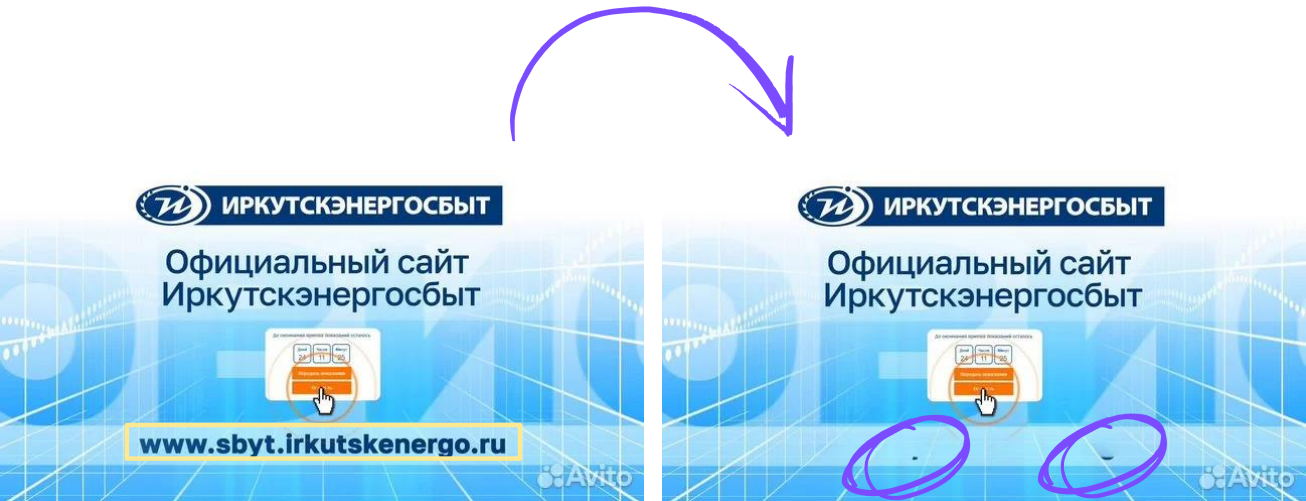
Рамка не захватила все буквы, после восстановления остались фрагменты текста. Автор описывает внедрение уточнения маски через SAM на момент публикации, без подтверждения завершённого эффекта.
Источник: Владимир Морозов · Авито · исходный материалИтог: как фотография проходит автоматическое исправление
Путь Авито начинается не с выбора нейросети, а с изменения цели модерации. Вместо правила «нашли нарушение — удалили фотографию» команда захотела сохранить полезную часть контента и автоматически убрать только запрещённый фрагмент. Для контактов сначала подошёл blur: он оказался достаточно простым для запуска под высокой нагрузкой. Но при расширении на крупные текстовые области размытие стало заметно портить фотографию, поэтому действие заменили на inpainting — восстановление фона внутри маски.
- 01
Проверить фотографию
Быстрый классификатор контактов обрабатывает основной поток и отбирает подозрительные изображения; другие причины могут идти по собственной ветви, например через OCR или детектор логотипов.
- 02
Локализовать нарушение
Детектор контактов или другой локализующий модуль возвращает бокс. Сложные случаи, которые нельзя надёжно локализовать, остаются кандидатами на ручную проверку или блокировку.
- 03
Выбрать действие
Для исправляемых причин система может использовать blur или inpainting; для части причин, например ветви логотипов на итоговой схеме, сохраняется блокировка.
- 04
Восстановить область
LaMa получает изображение и маску, дорисовывает закрытый участок и возвращает исправленную фотографию. В финальной схеме этот блок подписан как 550 мс и около 26 RPS.
- 05
Сохранить результат
Исправленная фотография возвращается в публикацию, а предсказания сервисных моделей могут кешироваться по image_id, чтобы не выполнять повторную работу.
Качество выбирали не по одной цифре: ZITS++ была лучшей в таблице PSNR/SSIM/FID/LPIPS, но LaMa оказалась намного быстрее в отдельном сравнении и удобнее для эксплуатации. TorchScript затем сократил показанное время LaMa на A100 с 170 до 130 мс при 1920×1440; напечатанные +27% не согласуются напрямую с отношением 7,7 и 5,6 изображения/с, поэтому этот столбец нельзя пересчитывать молча. Продуктовый эффект в источнике описан качественно: ручной поток снизился, жалоб было мало, а фотографии удавалось сохранять. Численных бизнес-KPI нет. Главное оставшееся ограничение — качество маски: если бокс не накрывает весь текст, его фрагменты переживают inpainting. SAM описан как внедряемое на дату статьи улучшение, а не как уже измеренный финальный результат.
Резюме