Разбор готов
Яндекс Музыка: как «Незнакомое» помогает открывать интересную музыку
Слушатель включает «Незнакомое», потому что хочет найти музыку, которую ещё не знает, но захочет слушать дальше. Удалить из рекомендаций уже слышанные песни недостаточно: новая для него запись любимого артиста может не стать открытием, а случайный незнакомый трек — не понравиться. Команда Яндекс Музыки изменила и способы поиска подходящих треков, и модель, которая определяет их порядок. Важными оказались не только удачные решения, но и неудачи: популярность внутри любимых жанров, соседство в плейлистах и обучение исключительно на данных этого режима. Разберём, как система использует историю слушателя, находит новых артистов, учитывает разные реакции и проверяет, стало ли больше приятных открытий без потери желания вернуться.
Глава полезна разработчикам рекомендательных систем, которые добавляют режим открытия нового контента в уже работающий продукт. Продуктовым аналитикам она поможет различать отсутствие повторов, разнообразие, положительную реакцию на первое знакомство и возвращение пользователей.
Видео · на русском
Как мы улучшили алгоритм рекомендаций в настройке «Незнакомое» в Яндекс Музыке | Савва СтепуринСавва Степурин · Опубликовано: 24 января 2025 г.
Исходный доклад · Открыть оригинал
Новая песня и новое открытие — не одно и то же
«Моя волна» — персональный поток музыки, в котором знакомые любимые песни чередуются с новыми треками, артистами и жанрами. Система опирается на то, что человек слушал и отмечал лайками, и пытается подобрать музыку под его интерес в данный момент. Постоянно воспроизводить только знакомое тоже недостаточно: тогда поток превращается в повтор собственной подборки.
Кроме настроения и языка музыки, пользователь может выбрать настройку «Незнакомое». Она меняет задачу: нужны треки, которых человек ещё не слышал на сервисе. Здесь «новый» означает новый для конкретного слушателя, а не обязательно недавно выпущенный. История сервиса также не позволяет утверждать, что человек никогда не встречал эту песню за его пределами.
В этом режиме слушатель активнее решает, нравится ли ему песня: оценивает первые секунды, пропускает, перематывает, ставит лайки. Цель команды — неожиданное приятное открытие, или серендипность. Савва Степурин описывает её так: человек не искал песню, но рекомендация настолько понравилась, что захотелось послушать другие работы этого артиста. Это описание переживания; его измеримое приближение разберём отдельно.
Этот кейс Савва Степурин, разработчик команды рекомендаций Яндекс Музыки, представил на DataFest 2024. Запись опубликована 24 января 2025 года. Описанные решения и их статус относятся к моменту выступления, а не к дате публикации видео.
Настройка на иллюстрации объединяет новизну и активную оценку музыки. Её успех — не просто отсутствие повторов: незнакомый трек должен оказаться достаточно интересным, чтобы слушатель захотел продолжить знакомство.
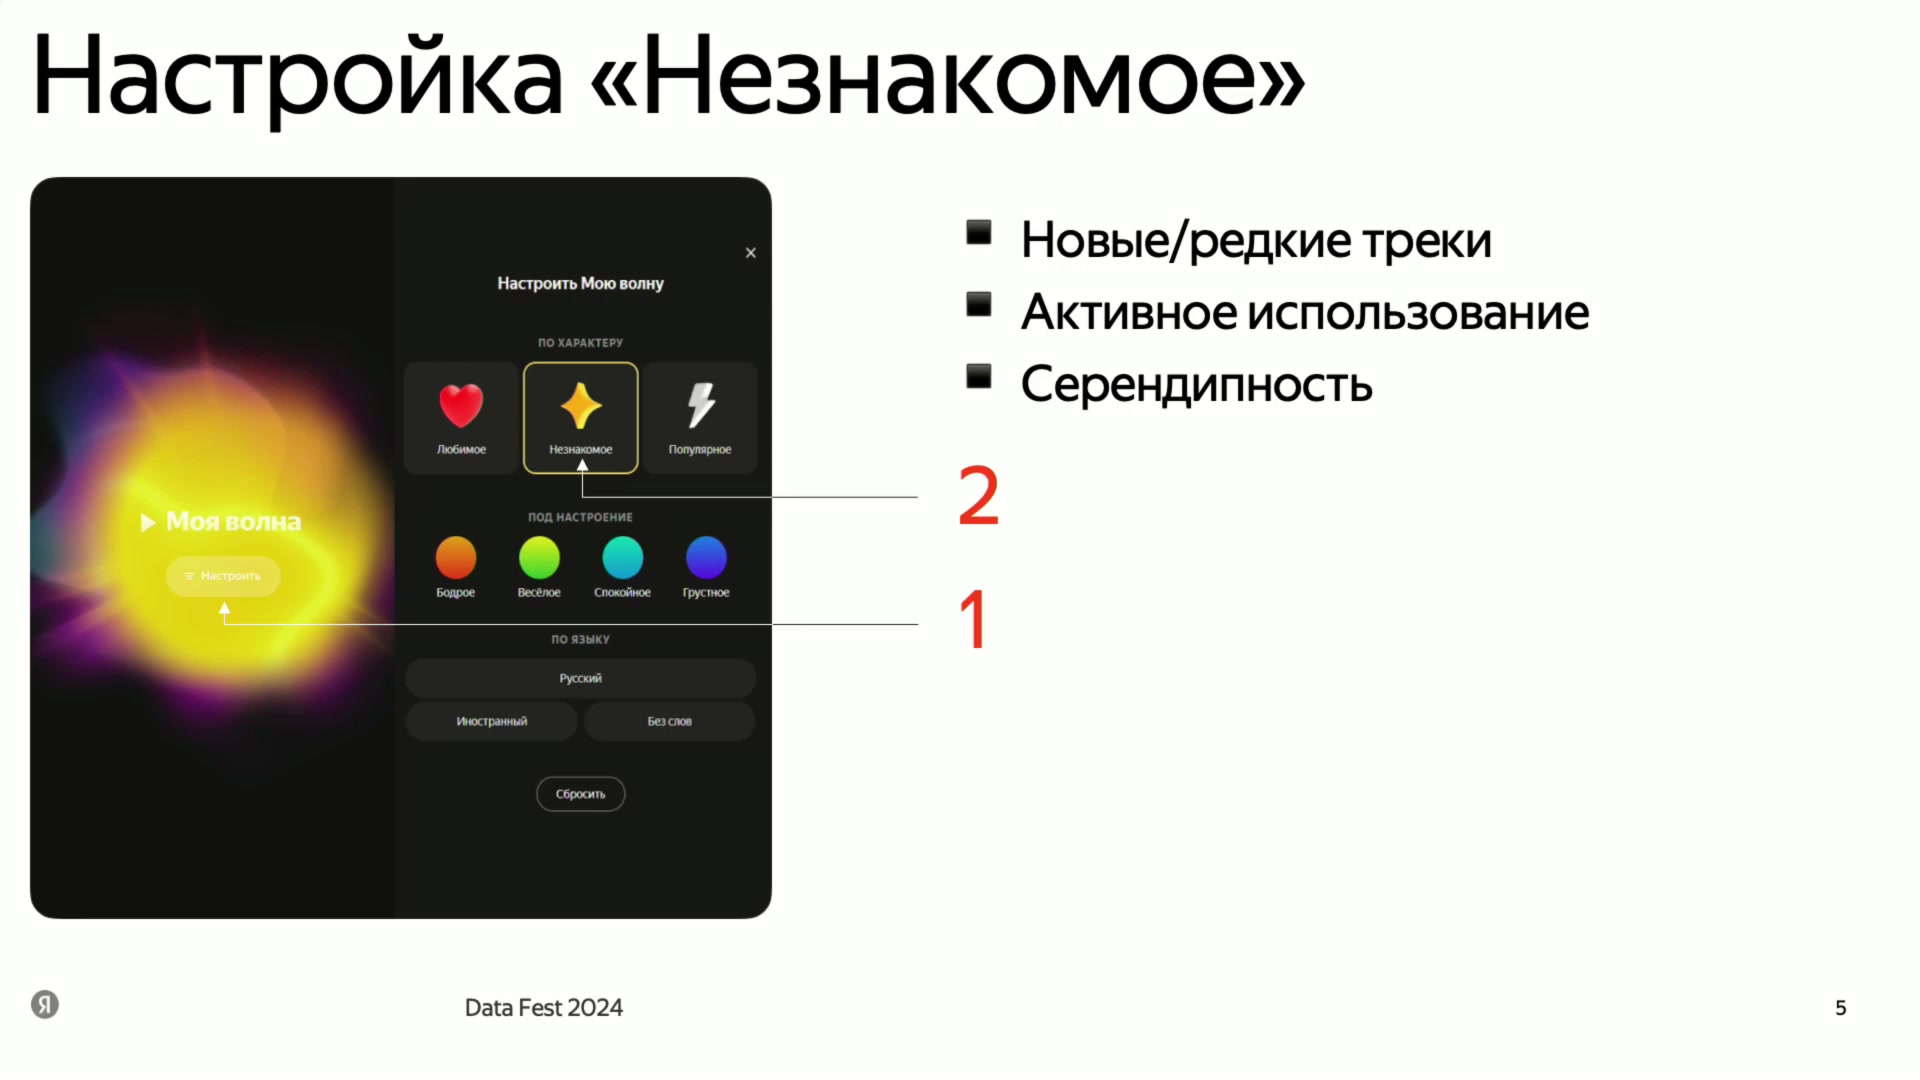
Настройка «Незнакомое» рассчитана на новые и редкие треки; цель — полезные неожиданные открытия, а не случайный незнакомый контент.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Какие треки считаются незнакомыми
Проверка одного трека не решает задачу. Пользователь может впервые услышать конкретную песню, но давно знать и любить её исполнителя. Для режима открытия это не то же самое, что знакомство с новым артистом. Поэтому команда учитывает не только историю трека, но и знакомство с артистом и альбомами, а также лайки.
Условие по альбомам важно читать буквально: достаточно, чтобы ограничению соответствовал хотя бы один альбом; требования ко всем альбомам здесь нет. Для счётчиков появлений не названо временное окно. Формулировка про другие треки также не раскрывает подробный способ объединения их счётчиков, поэтому из неё нельзя восстановить готовый алгоритм фильтрации.
Эти ограничения определяют допустимость рекомендации в показанной настройке, но ещё не выбирают наиболее интересную музыку. Они также не дают полного определения «редкого трека» в итоговой экспериментальной метрике: способ её расчёта отдельно не раскрыт.
Главный вывод из условий на иллюстрации: незнакомость оценивается шире одной записи. Даже ещё не показанная песня может оказаться слишком близкой к уже освоенному пользователем каталогу артиста или альбома.
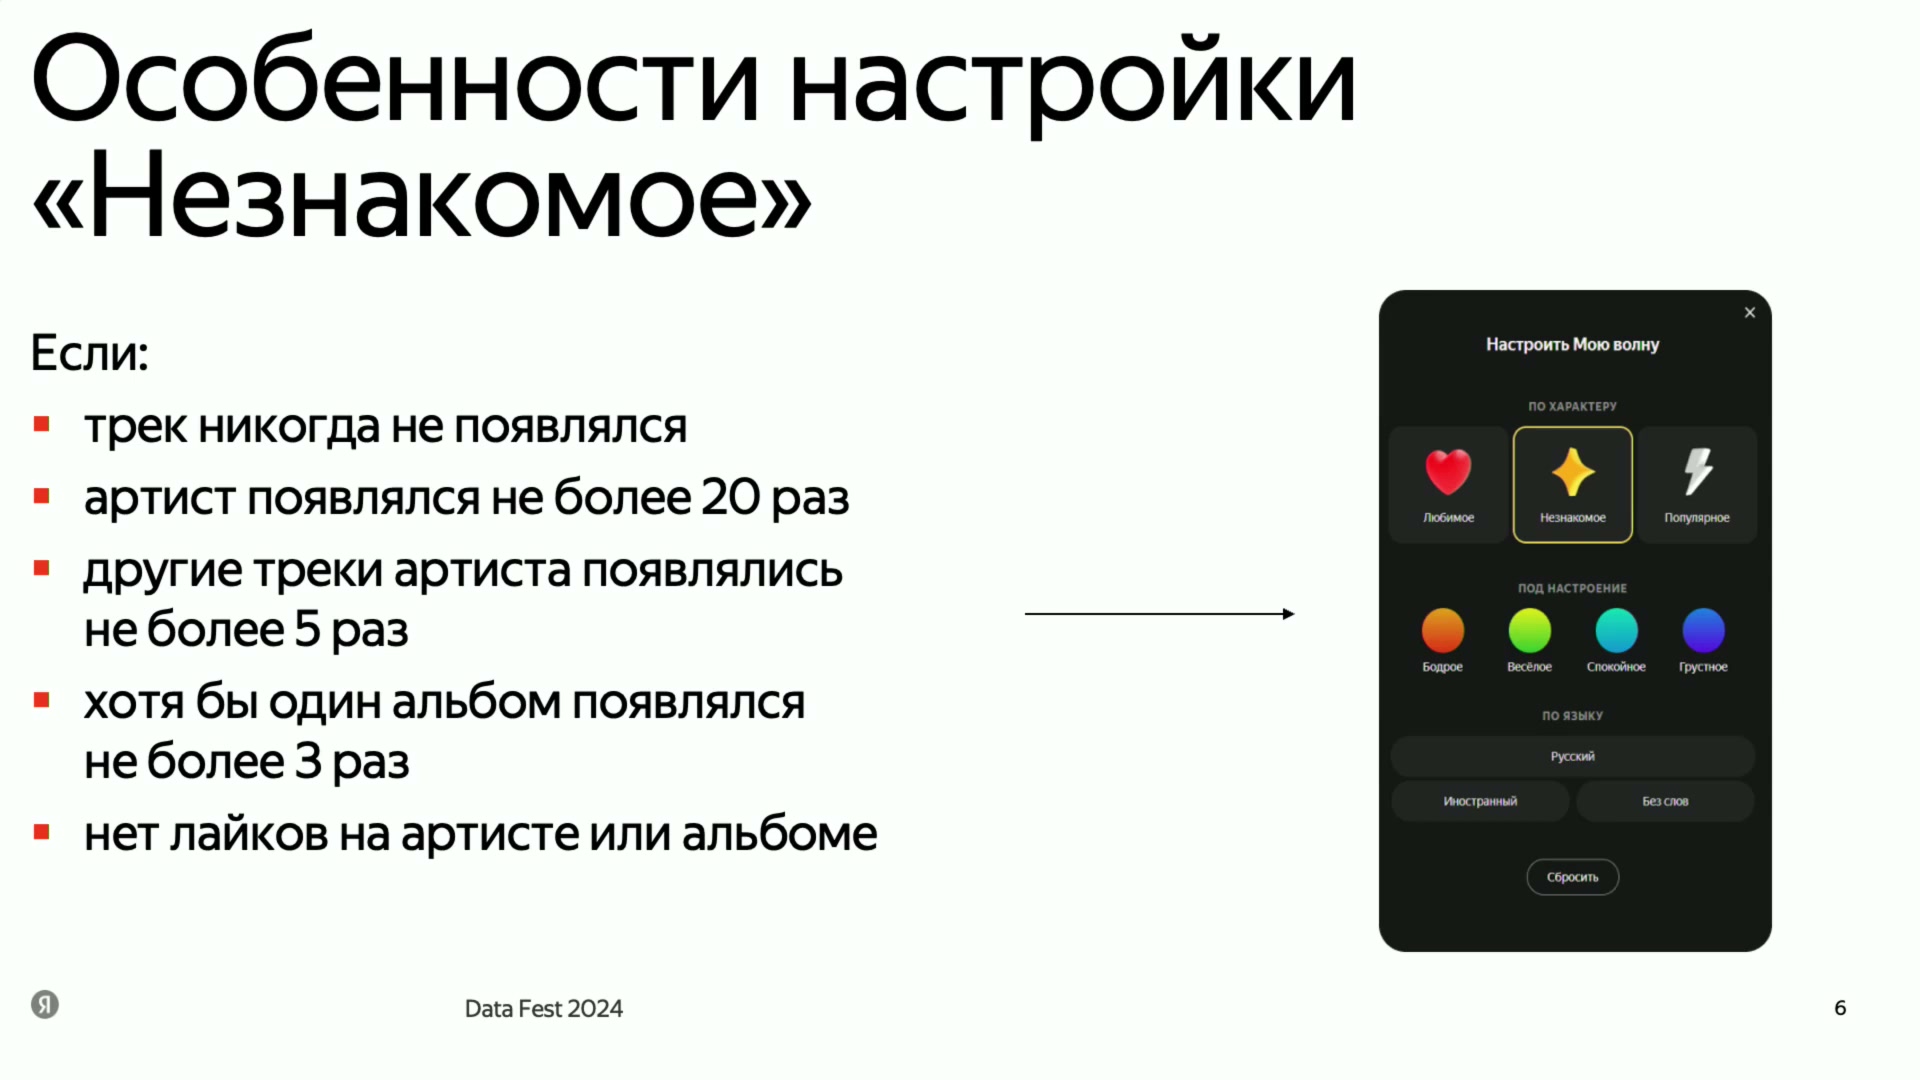
Пример правил незнакомости: трек не появлялся; артист ≤20 раз; другие его треки ≤5; хотя бы один альбом ≤3; нет лайков на артисте или альбоме. Это правила показанной настройки, не абсолютный общий алгоритм Музыки.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Как запрос превращается в пять рекомендаций
При включении волны приложение отправляет серверу сведения о пользователе, выбранной настройке и дополнительном контексте; среди примеров автор называет подписку. Сервер Музыки добавляет последнюю историю пользователя и передаёт запрос рекомендательной системе. Та дополняет его всей доступной историей на сервисе и данными, подготовленными заранее.
На схеме отдельно показано хранилище типа «ключ — значение», KeyValue Storage, из которого получают нужные данные, и офлайн-контур — часть системы, работающая вне обработки текущего запроса. Из него поступают дополнительные сведения о пользователе и результаты работы моделей. Название конкретного продукта для хранения и полный состав заранее вычисленных данных в докладе не раскрыты.
После подготовки контекста начинается многоэтапный выбор, или каскад. Сначала система быстро находит кандидатов — небольшое множество потенциально подходящих треков. Затем ранжирование упорядочивает их по оценке модели. Большую модель нельзя применить ко всему каталогу при каждом обращении: автор называет ориентир ответа около 500 мс. Это требование к скорости, а не опубликованное распределение фактических задержек.
Обе стадии ранжирования используют CatBoost — ансамбль деревьев решений, которые последовательно обучаются исправлять ошибки предыдущих. Такой способ обучения называют градиентным бустингом. Лёгкий вариант содержит меньше деревьев и признаков, то есть входных характеристик для оценки трека. Тяжёлый использует больше деревьев, статистик и результатов других моделей. Он получает меньше кандидатов, поэтому может позволить себе более дорогую оценку каждого из них.
Финальная пачка не обязана совпадать с первыми позициями рейтинга без изменений. Дополнительные правила, например, не дают поставить подряд два трека одного артиста. В общем описании волны автор также упоминает ограничение на «два лайка подряд»; это не означает, что в «Незнакомое» возвращают уже прослушанные и лайкнутые песни. Готовые пять треков отправляются обратно через сервер в приложение.
Схема показывает, как система совмещает большой каталог и быстрый ответ: дорогая модель работает только с сокращённым набором. Часть данных готовится заранее, а при запросе отбор, оценка и сборка пачки остаются разными задачами.
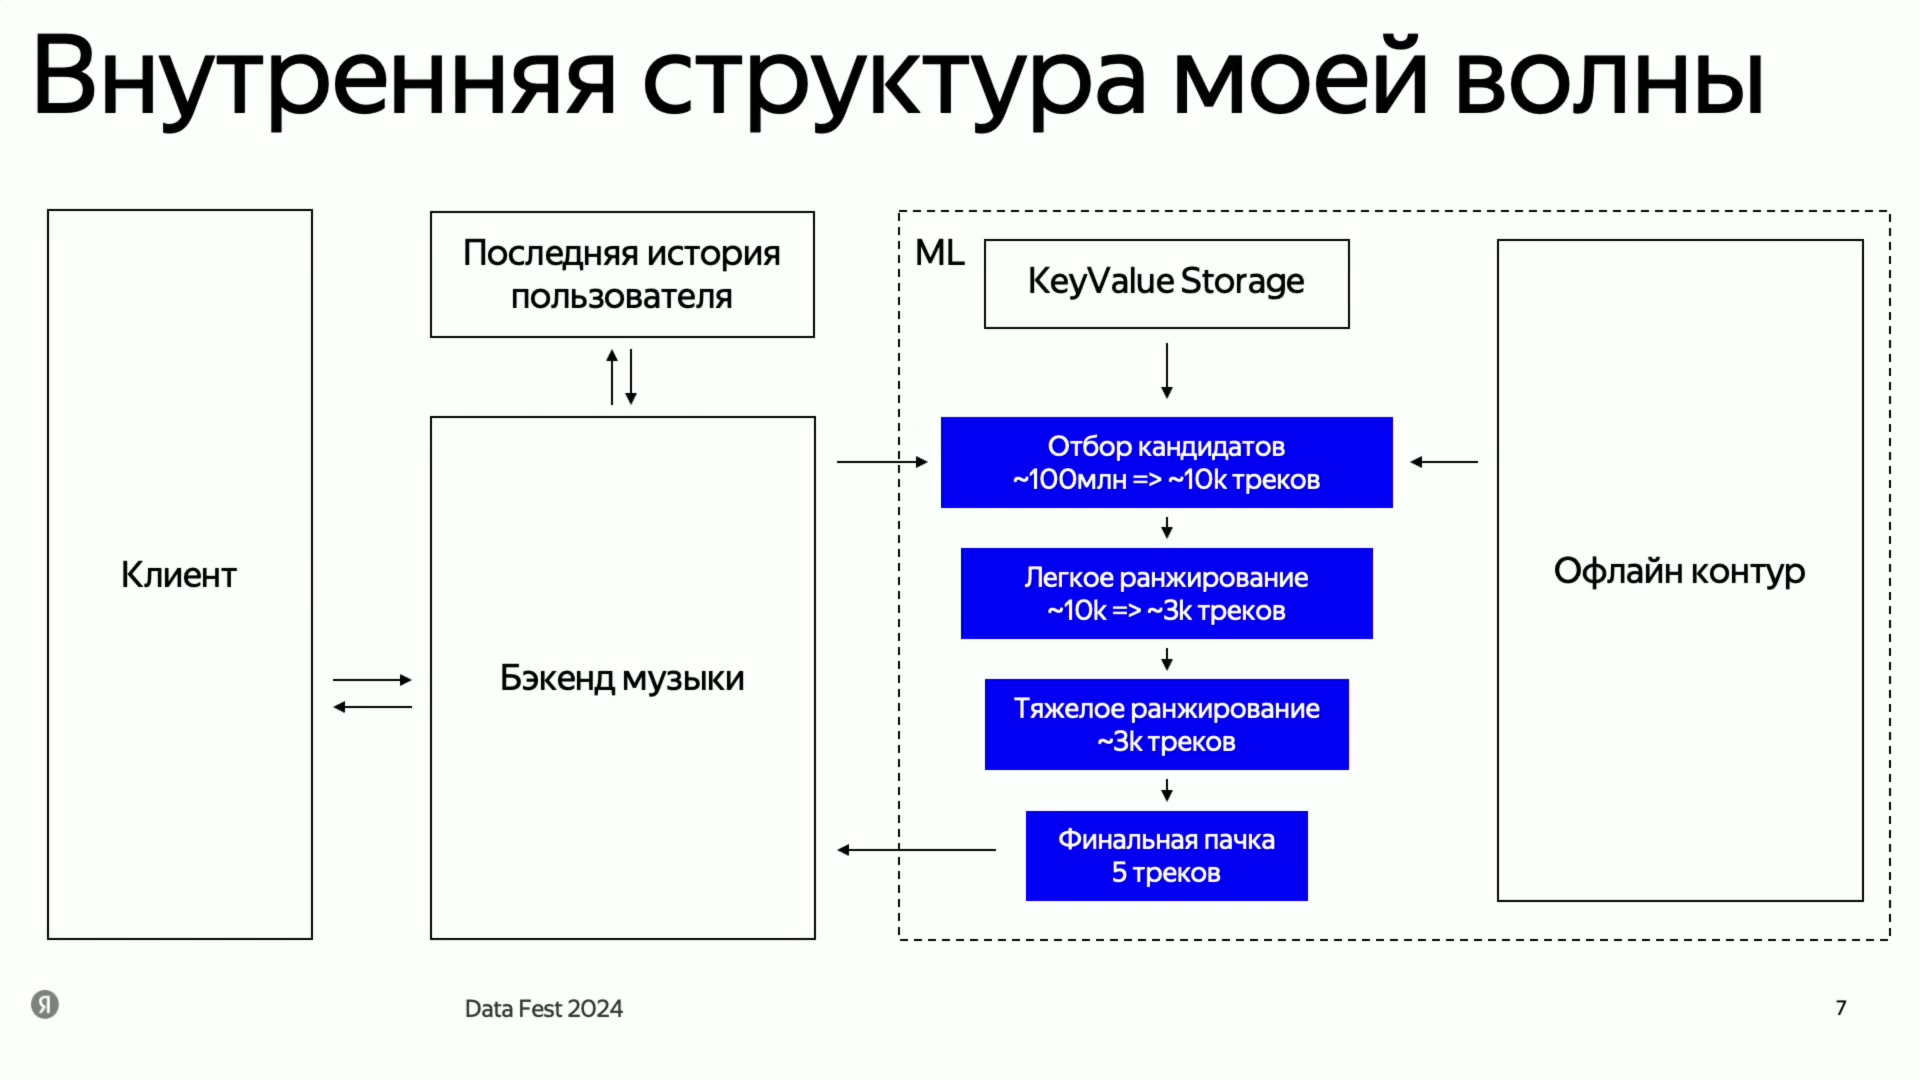
Каскад «Моей волны»: около 100 млн → около 10 тыс. кандидатов → около 3 тыс. после лёгкого ранжирования → тяжёлое ранжирование → пачка из пяти треков. Это схема Data Fest 2024, а не архитектура Sona 2026.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Почему после лайка оставшиеся треки заменяют
Пачка из пяти треков — не неизменная очередь до конца прослушивания. Как только пользователь совершает активное действие, например ставит лайк, ещё не прослушанный остаток отбрасывают. В систему рекомендаций приходит новый запрос, уже учитывающий эту реакцию, и она выдаёт новые пять треков. Если в прежней пачке оставались песни, дослушивать их до обновления не требуется.
Такой механизм действует и в обычной волне, и в «Незнакомом». Он позволяет учитывать свежую обратную связь при следующем выборе музыки. Речь идёт о повторном применении системы к обновлённому контексту, а не об обучении CatBoost после каждого лайка: обновление весов модели в этой части доклада не описывается.
Первоначально «Незнакомое» использовало примерно тот же каскад, отличаясь дополнительной фильтрацией уже слышанного. Но одинаковая обработка запроса ещё не означает одинаковой задачи. Здесь пользователь активнее оценивает новую музыку, а успех связан с приятным открытием. Команда поэтому изменила и отбор кандидатов, и обучение ранжирующей модели: фильтр оставили ограничением допустимости, но перестали считать его достаточной адаптацией режима.
Доклад · 00:07:01Откуда берутся кандидаты до специальных изменений
Около 10 тыс. кандидатов появляются не в результате одного поиска. Несколько алгоритмов предлагают свои небольшие наборы, после чего система их объединяет. Такой отдельный алгоритм отбора в докладе называется селектором. Чтобы понять пользу нового селектора, нужно сначала увидеть, какую музыку уже находят существующие.
Самый простой источник — популярные треки всего сервиса. Он не требует сложного описания личного вкуса, но может предложить музыку, которая нравится многим. Другая группа селекторов использует векторные представления: наборы чисел, с помощью которых модель сопоставляет пользователя и треки. По вектору пользователя ищут близкие векторы треков.
Такие представления могут строиться разными моделями. Матричное разложение, в докладе названное SVD, описывает взаимодействия через векторы пользователей и треков. Трансформер обрабатывает историю взаимодействий и также может получать представление пользователя. Двухбашенная модель отдельно строит представление пользователя и представление трека, чтобы их можно было сравнить. Здесь важно общее действие этих подходов — найти подходящих кандидатов по близости представлений; конкретные архитектуры не разбираются.
Есть и вариант без отдельного вектора, напрямую выданного пользовательской моделью: усреднить векторы последних прослушиваний или лайков, возможно придав им разные веса. Полученное представление также используют для поиска близких треков. Автор упоминает поиск соседей и возможность заранее рассчитывать похожести, но надёжно установленного названия конкретного поискового индекса в материалах нет.
Наконец, в обычную волну можно напрямую добавлять треки из истории пользователя — то, что он уже слушал и лайкал. Для «Незнакомого» такой источник готовых рекомендаций не подходит по определению. Это не запрет использовать историю вообще: она по-прежнему помогает понять вкус, только найденный по ней результат должен быть новым для слушателя.
В обсуждении после выступления прозвучало предложение находить похожих пользователей и рекомендовать их любимые треки. Автор объяснил, что эта идея уже представлена рекомендациями по совместным действиям людей — коллаборативной фильтрацией, в том числе SVD. В описанной системе сходство выражается через векторы пользователей и треков, а не обязательно через явно хранимый список ближайших слушателей.
Доклад · 00:08:14Первая неудача: популярное внутри любимого жанра
Первый дополнительный селектор выглядел естественно: определить любимые жанры пользователя по прослушиваниям и лайкам, затем предложить наиболее популярные треки этих жанров. Предпочтение жанра вроде бы сохраняет персонализацию, а популярность помогает выбирать музыку, уже понравившуюся другим. Однако эксперимент не дал нужного эффекта.
Автор предлагает несколько объяснений. Во-первых, персонализация остаётся грубой: для любого слушателя с интересом к одному жанру набор его популярных треков будет одинаковым. Конкретные любимые артисты и отдельные личные предпочтения такой список отражает слабо.
Во-вторых, в системе уже был селектор общей популярности. Новый способ мог сильно пересекаться с ним и предлагать ту же музыку. В-третьих, популярные треки имеют много прослушиваний и других взаимодействий. Моделям с такими данными проще понять, кому они подходят, поэтому эти треки и без нового селектора могли попадать в кандидаты.
Таким образом, логичный алгоритм не обязательно приносит полезное дополнение к работающему отбору. Если хорошие треки уже найдены другими способами, ещё один путь к ним мало меняет доступный ранжированию набор. При этом доклад не приводит измерений пересечения селекторов или отдельной проверки каждого из объяснений: это версии причин неудачи, а не их количественное разложение.
Вывод из схемы эксперимента — оценивать не правдоподобность нового источника саму по себе, а его вклад сверх существующих. В этом случае уточнение популярности жанром не обеспечило нужного дополнения.
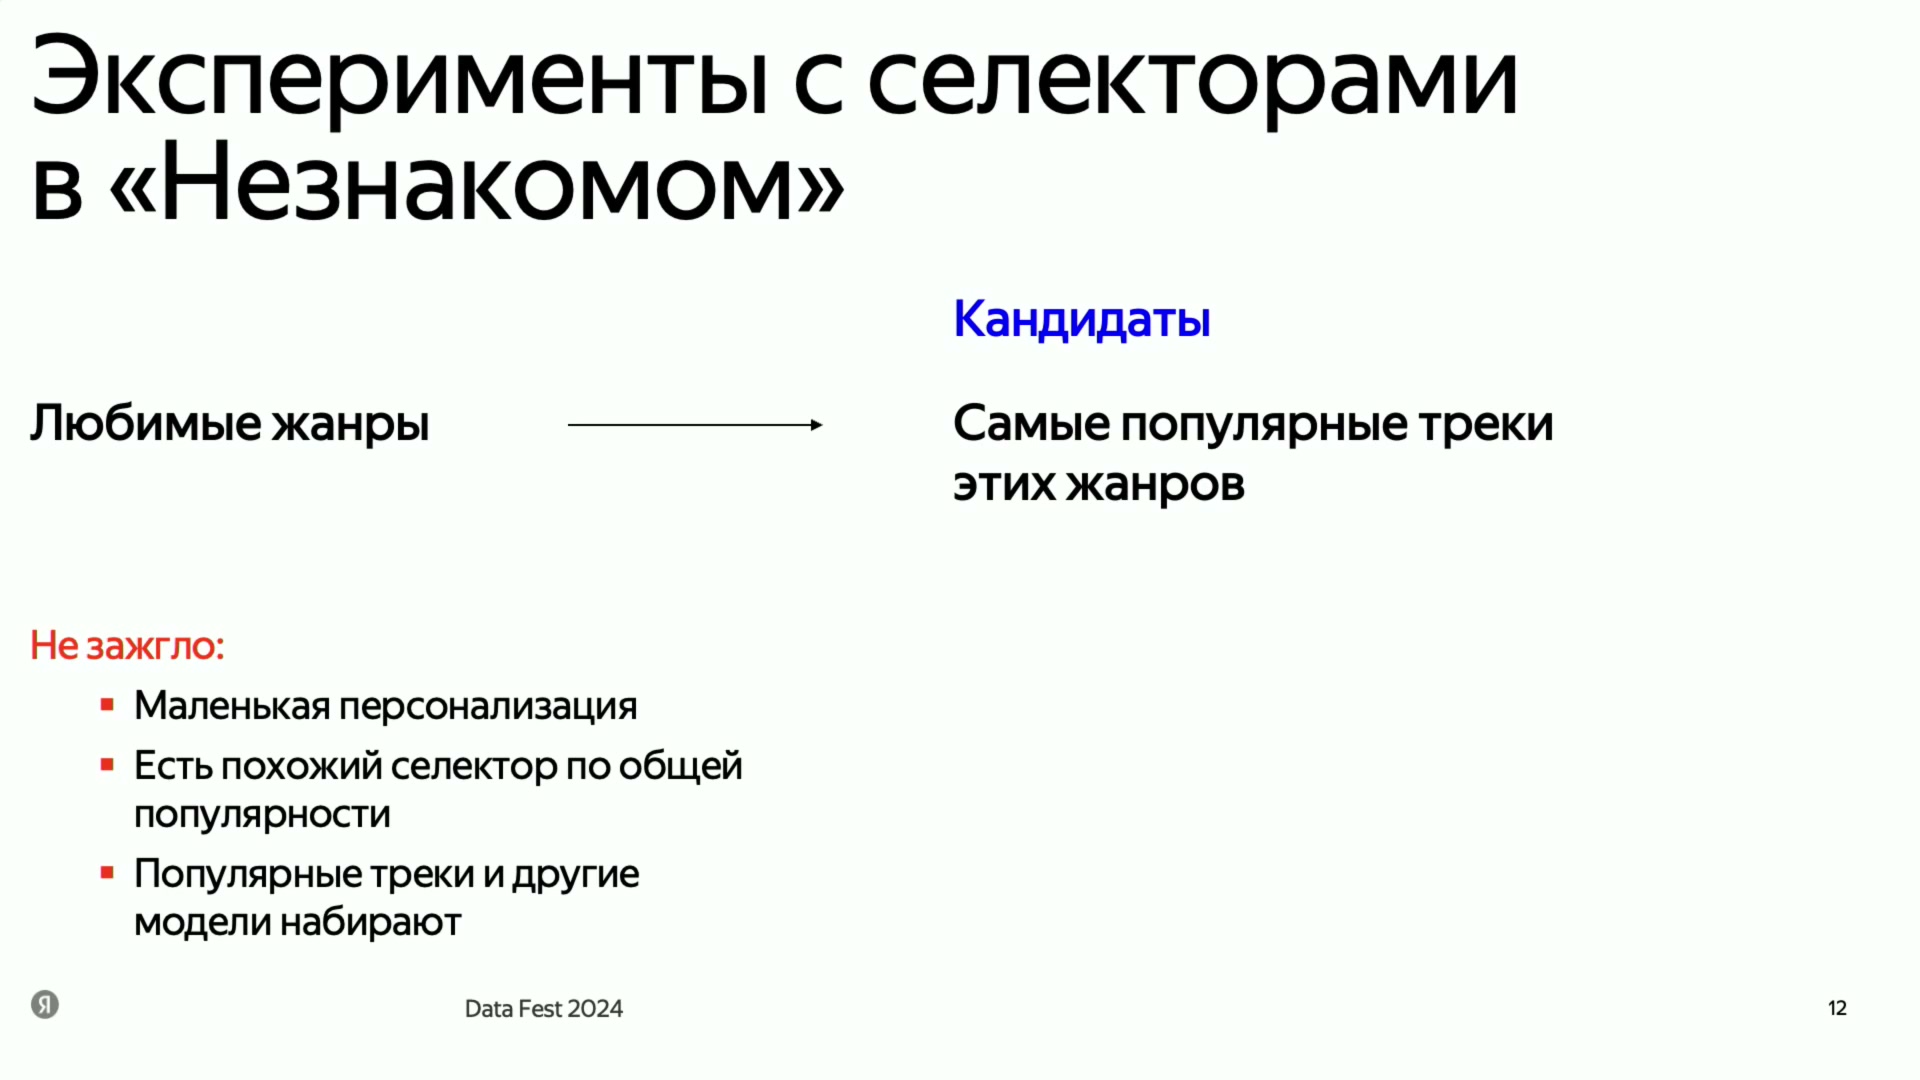
Популярные треки любимых жанров не дали нужного эффекта: мало персонализации, похожий канал уже существовал и популярные треки находили другие модели.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Вторая неудача: соседи по плейлисту
Следующая гипотеза использовала плейлисты — подборки треков, созданные редакторами сервиса или самими пользователями. Селектор брал последние прослушивания человека, находил плейлисты с этими треками и добавлял остальные песни из найденных подборок в кандидаты. Предположение простое: если треки оказались вместе, между ними может быть полезная связь.
Этот вариант тоже не сработал. У редакторских плейлистов оказалось ограниченное покрытие: по ним удавалось охватить недостаточно музыки. Само по себе более аккуратное составление подборки не решало проблему масштаба доступных кандидатов.
Добавление пользовательских плейлистов сталкивалось с другой трудностью. Человек может собрать в одном месте совершенно разную музыку, поэтому совместное присутствие не гарантирует похожести звучания или совпадения вкусов. Из того, что слушателю понравилась одна песня подборки, не следует, что понравятся остальные.
Даже редакторская работа не делает любую связь музыкальной похожестью. Подборка может быть посвящена эпохе, стране или периоду и содержать треки разных жанров и разного звучания. Тогда принадлежность к одной теме объясняет соседство, но слабо отвечает на вопрос, какую музыку стоит предложить конкретному слушателю.
Схема показывает направление поиска: от известных прослушиваний через плейлисты к новым кандидатам. Неудача объясняется двумя разными ограничениями — недостаточным покрытием и неоднозначностью связи внутри подборки. Это результат конкретного селектора, а не доказательство бесполезности плейлистов для рекомендаций вообще.
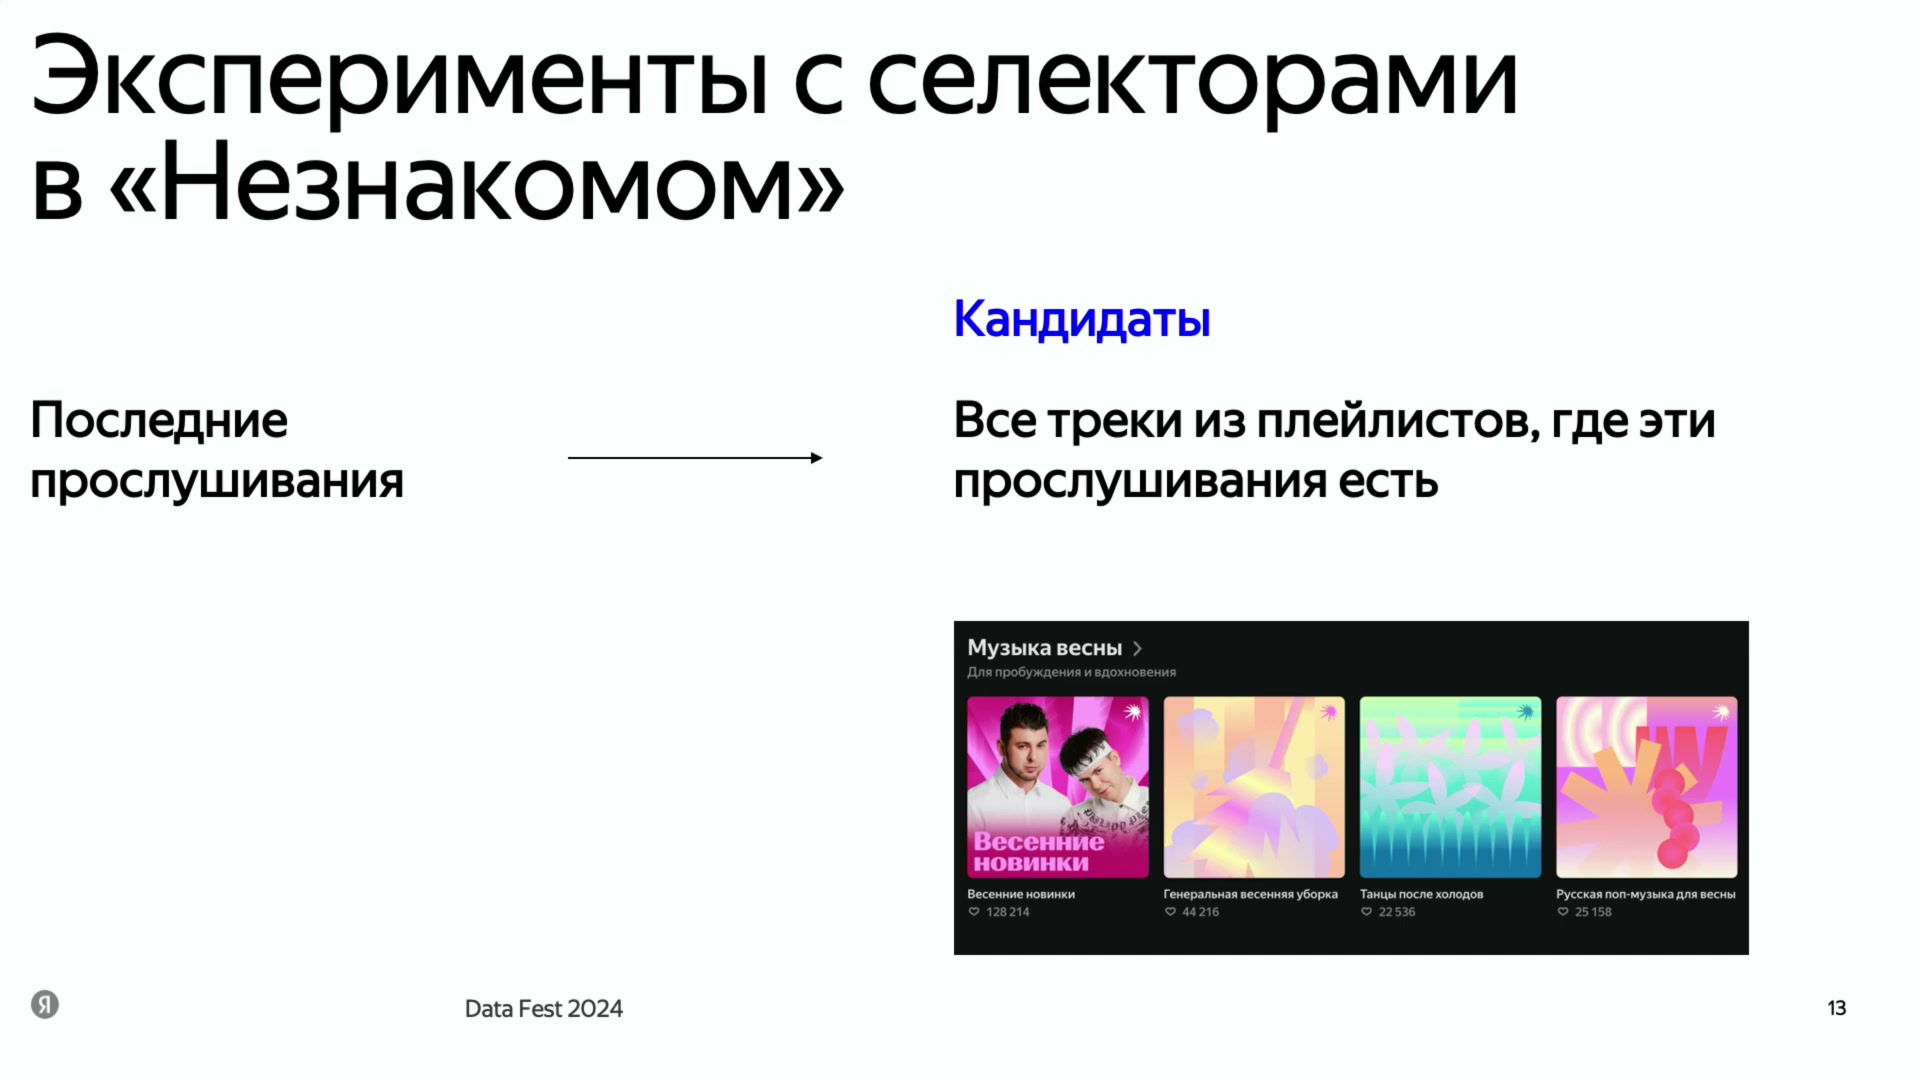
Кандидаты из плейлистов, где есть последние прослушивания пользователя. Иллюстрация объясняет направление селектора; лайки отдельных плейлистов на картинке не метрики эксперимента.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Что сработало: от личного лайка к новому артисту
Удачный вариант сместил поиск с похожести треков на похожесть артистов. Система случайно выбирает лайки пользователя, берёт артистов соответствующих треков, находит похожих незнакомых исполнителей и предлагает их популярные песни в кандидаты. Исходная точка — явное личное предпочтение: человек уже отметил, что музыка этого артиста ему нравится.
Случайный выбор лайков не ограничивается последними событиями. Он может вернуть старый интерес: пользователь давно не слушал какую-то песню и почти забыл о ней, но похожий на её исполнителя новый артист снова оказывается уместным. В отличие от выдачи случайной музыки из каталога, здесь случайность выбирает опору внутри собственных предпочтений слушателя.
Похожесть артистов получают не из одного источника. Звучание может связывать одних исполнителей, а поведение аудитории — других. Внешние сведения дают ещё один вид связи, который не обязан совпадать с первыми двумя.
Разные связи и разные исходные лайки расширяют разнообразие кандидатов. При этом персонализация остаётся конкретной: набор похожих артистов зависит от музыки, которую отметил именно этот пользователь. Выбираются новые для него артисты, поэтому отбор лучше согласован с правилами «Незнакомого»: меньше риска набрать множество песен, которые затем придётся отбросить из-за уже знакомого исполнителя. Точная доля отсева и способ объединения похожестей не приведены.
Популярность здесь не повторяет неудачный жанровый эксперимент. Сначала персональный лайк помогает выбрать нового артиста, а уже внутри его каталога берут популярные треки. Это не общий список главных хитов жанра. Селектор добавляет кандидатов к остальным источникам; окончательный выбор по-прежнему делает каскад ранжирования.
В последнем вопросе доклада автор отдельно объяснил, почему этот способ особенно уместен именно здесь. Обычная волна должна давать и знакомую любимую музыку для переслушивания. «Незнакомому» нужны новые редкие артисты, поэтому выбранный путь лучше соответствует его задаче. Численного сравнения пользы селектора между настройками в докладе нет.
На схеме важна вся цепочка: личный лайк → похожий незнакомый артист → популярный трек этого артиста. Она одновременно сохраняет связь со вкусом слушателя и меняет область поиска, в которой система ищет следующее открытие.
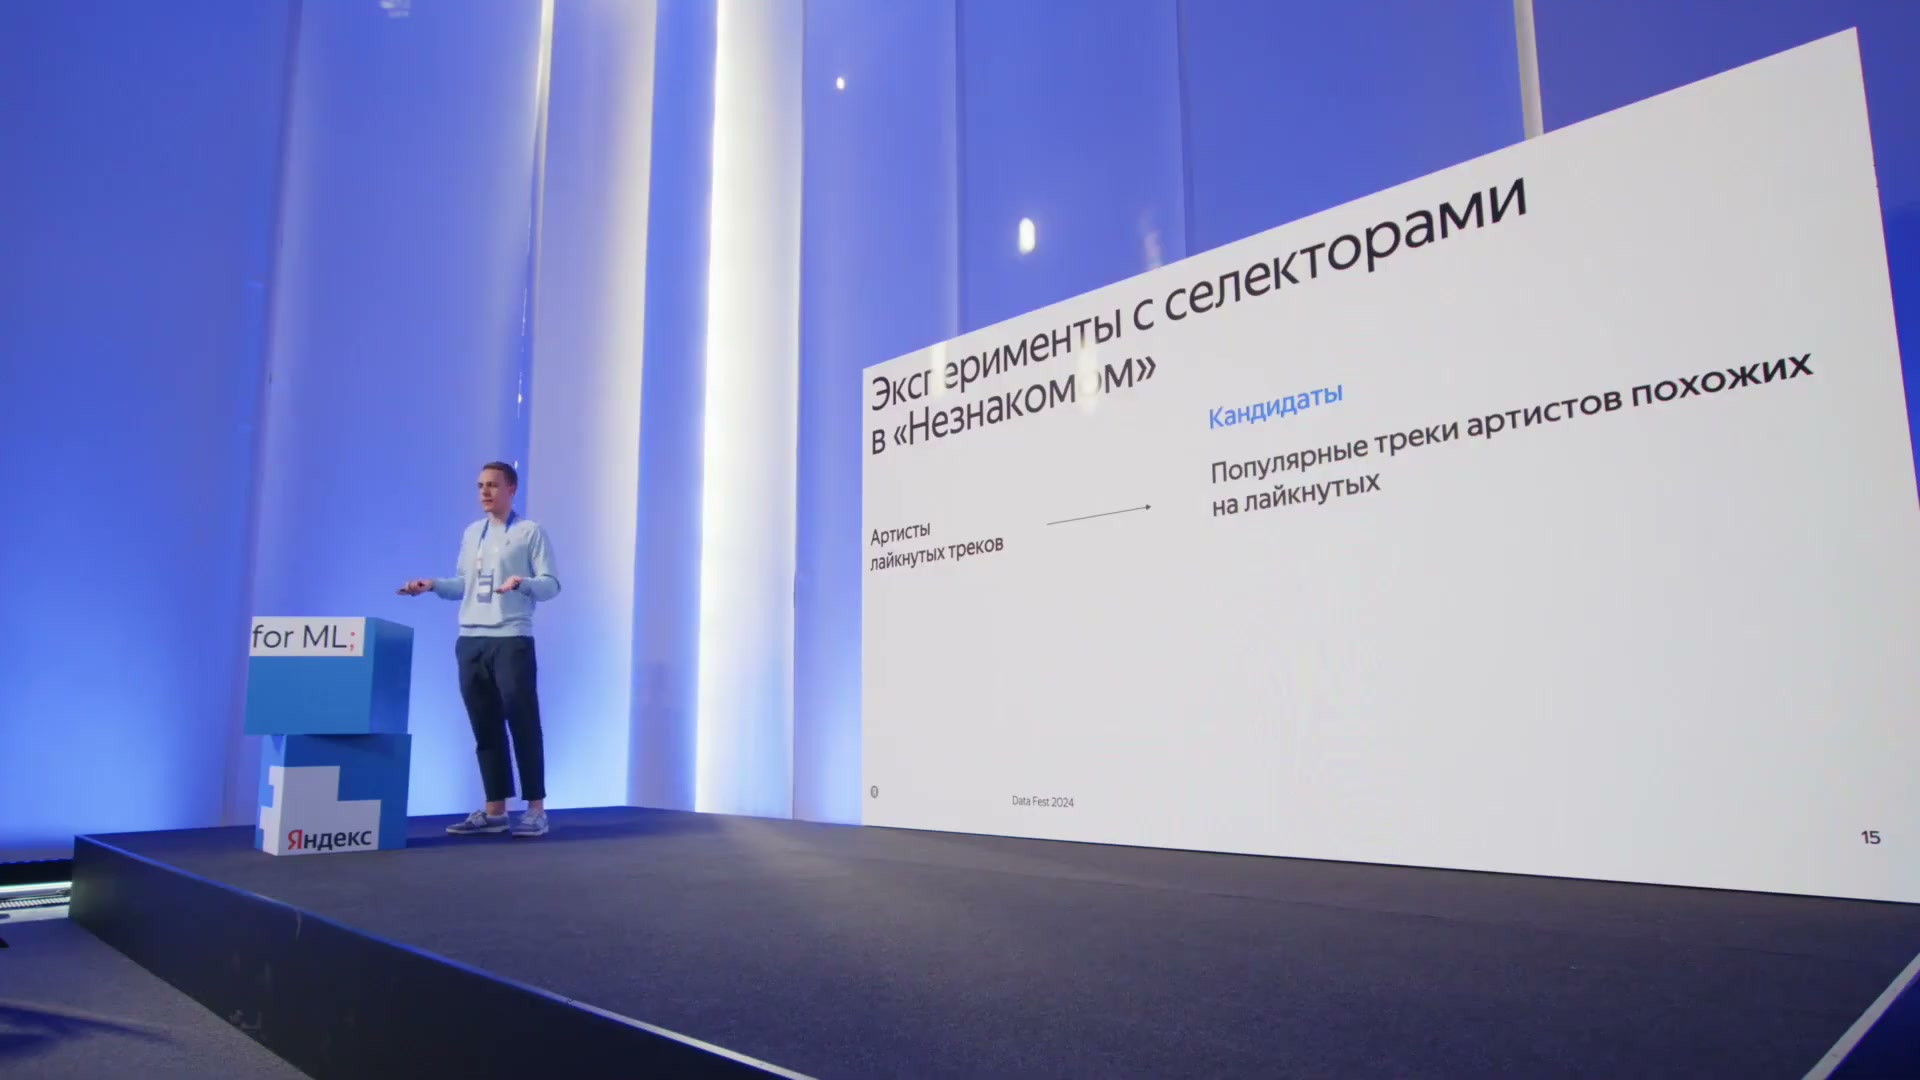
Кандидаты — популярные треки артистов, похожих на артистов лайкнутых треков. Это отдельный селектор, не окончательное решение всей системы.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Как CatBoost учится на парах пользовательских реакций
Отбор определяет, какую музыку система вообще сможет рассмотреть, но не решает, что поставить первым. За это отвечает ранжирующая модель. В докладе её основа — CatBoost, который получает статистики и предсказания других моделей и по ним оценивает трек для пользователя. Тяжёлое ранжирование объединяет больше таких сигналов и использует больше деревьев, чем лёгкое.
Для обучения берут пары соседних различных взаимодействий одного пользователя. Модель должна правильно упорядочить соответствующие треки: более положительная реакция служит основанием поставить один выше другого. Это попарное обучение — задача о сравнении двух объектов, а не просто отдельный прогноз для каждого прослушивания.
Разные события при этом неравноценны. Лайк выражает интерес яснее, чем простое прослушивание; пропуск — менее положительная реакция, чем прослушивание. Событиям назначают разные веса. Таким образом, обучение учитывает не только факт взаимодействия, но и силу заключённого в нём сигнала. Конкретная шкала весов и способ получения веса пары из весов её событий не раскрыты.
В качестве функции потерь — величины, по которой обучение оценивает ошибку, — используется PairLogit. Автор объясняет её через разность предсказаний для более положительного и менее положительного взаимодействия. Для плавного преобразования этой разности используется сигмоида, после которой берут логарифм. Практический смысл сравнения: модель должна давать более высокую оценку предпочтительному треку, а не путать порядок пары. Полной формулы с правилами взвешивания в материалах нет.
Для оценки используют PairAccuracy — долю пар, которым модель назначила правильный порядок. Это не доля точно предсказанных лайков и не доля довольных пользователей. Такая метрика проверяет сравнение объектов на данных; реальную реакцию слушателей затем оценивают отдельно в эксперименте.
Признаки объединяют статистические сведения и предсказания других рекомендательных моделей, среди которых автор упоминает трансформеры и двухбашенные модели. Поэтому CatBoost не заменяет все остальные модели: он использует их результаты как входные сигналы для окончательного сравнения кандидатов. Полный перечень статистик, число деревьев, размеры обучающих наборов и значения PairAccuracy не названы.
Иллюстрация разделяет три части обучения: пары взаимодействий задают сравнение, веса отражают различие реакций, а статистики и модельные предсказания дают информацию для решения. Последующие изменения касаются обучающих примеров и их значимости, а не отказа от этого принципа.
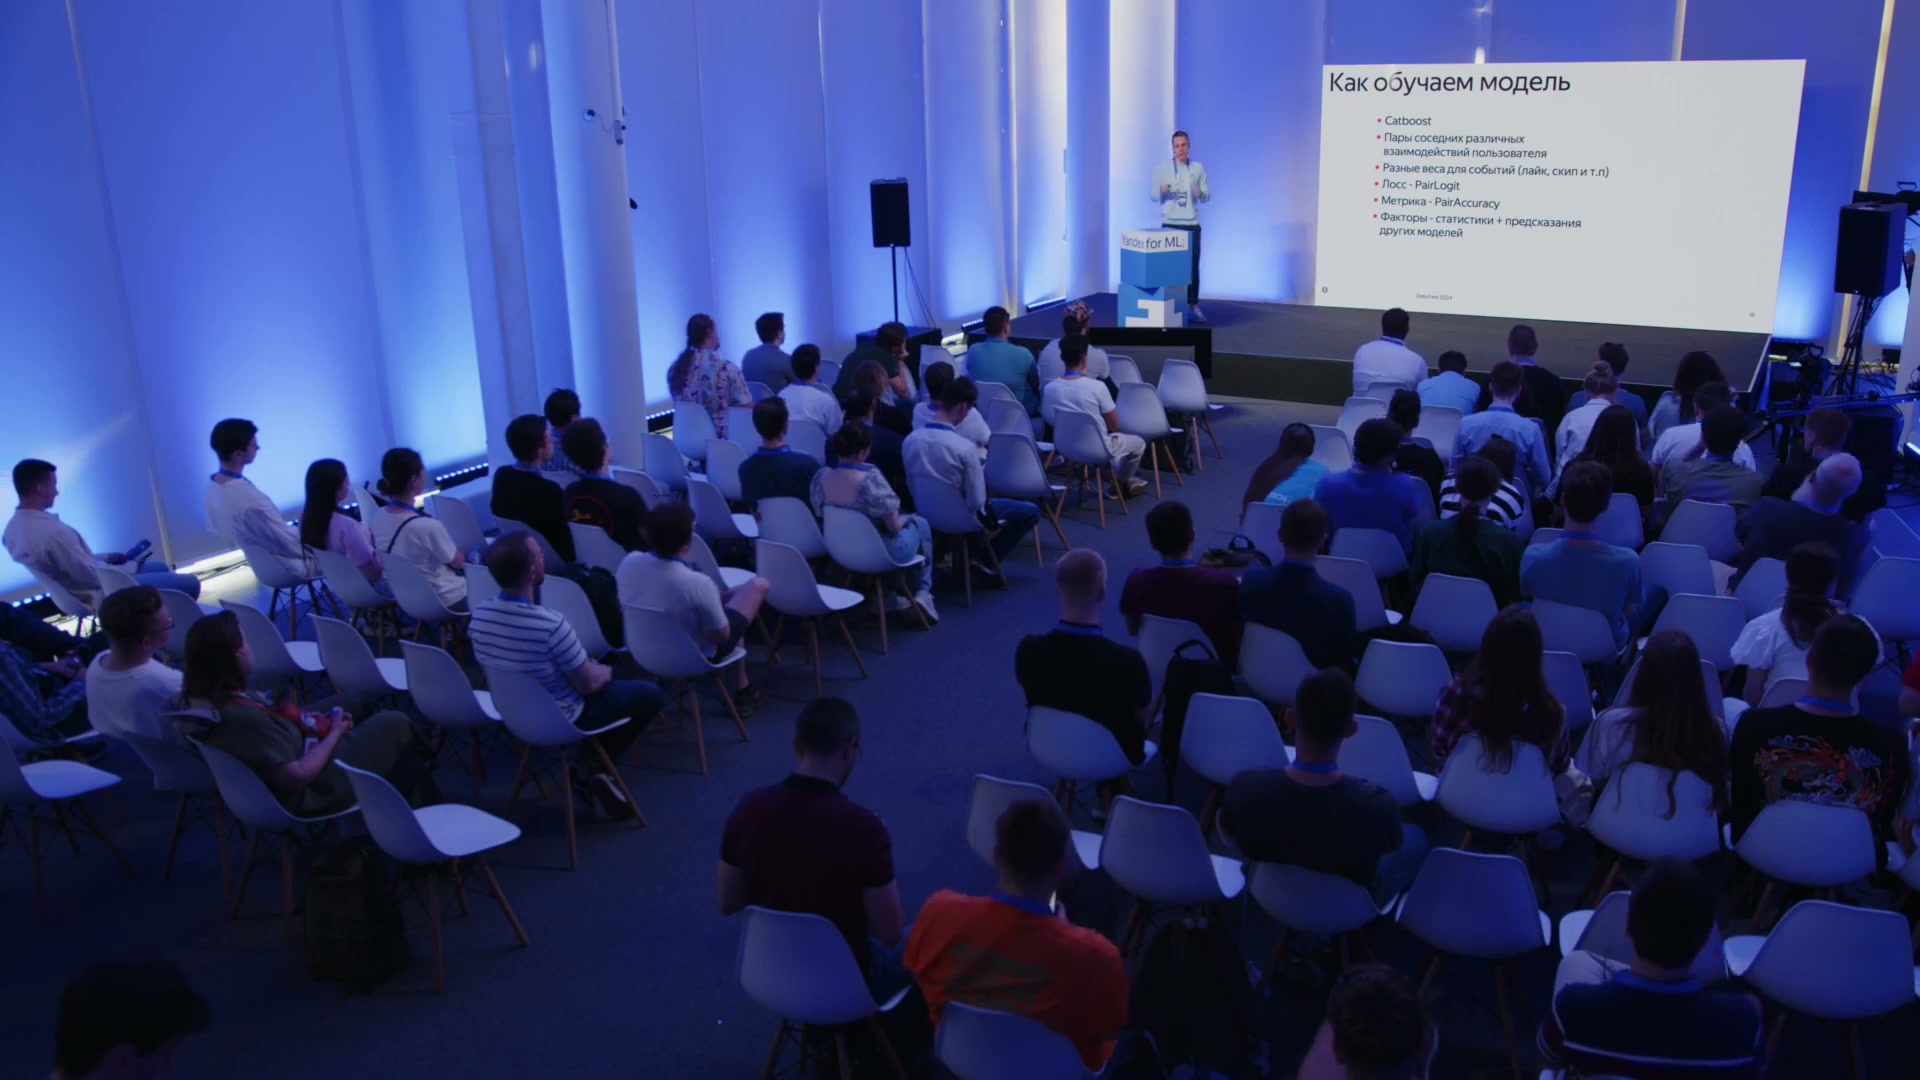
Обучение CatBoost: пары разных пользовательских взаимодействий, разные веса событий, PairLogit, оценка PairAccuracy. Признаки — статистики и предсказания других моделей.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Почему обучение только на «Незнакомом» не сработало
Первой попыткой специализации было обучение CatBoost только на примерах из «Незнакомого». Логика казалась прямой: если модель предназначена для отдельной настройки, пусть учится именно на её взаимодействиях. Модель обучили и проверили в эксперименте, но нужного эффекта не получили.
Одна причина — объём данных. Обычную волну слушают больше, поэтому отказ от её примеров заметно сокращает обучающий набор. Однако проблема не исчерпывается количеством: данные режима открытия по своей природе хуже показывают устойчивые предпочтения.
Трек в «Незнакомом» не должен повторно появляться у того же пользователя. Если человек прослушал песню, трудно понять, действительно ли она понравилась или он просто отвлёкся и не пропустил её. Возможна и обратная ситуация: интерес проявился бы после повторных встреч, но в этой настройке их не будет. Автор приводит повторные показы как объяснение неоднозначности реакции, а не как проведённый эксперимент.
Из однократных знакомств поэтому сложнее восстановить любимые жанры, настроения и устойчивые вкусы. Обычная волна даёт дополнительный контекст: что человек повторно включает, продолжает слушать, лайкает или часто перематывает. Удаляя эти примеры, модель теряет информацию, полезную даже тогда, когда конечная рекомендация должна быть незнакомой.
Иллюстрация показывает ограничение этой попытки, а не невозможность отдельной модели: специализация через отказ от общих данных оставила слишком мало примеров и слишком неоднозначный сигнал о предпочтениях.
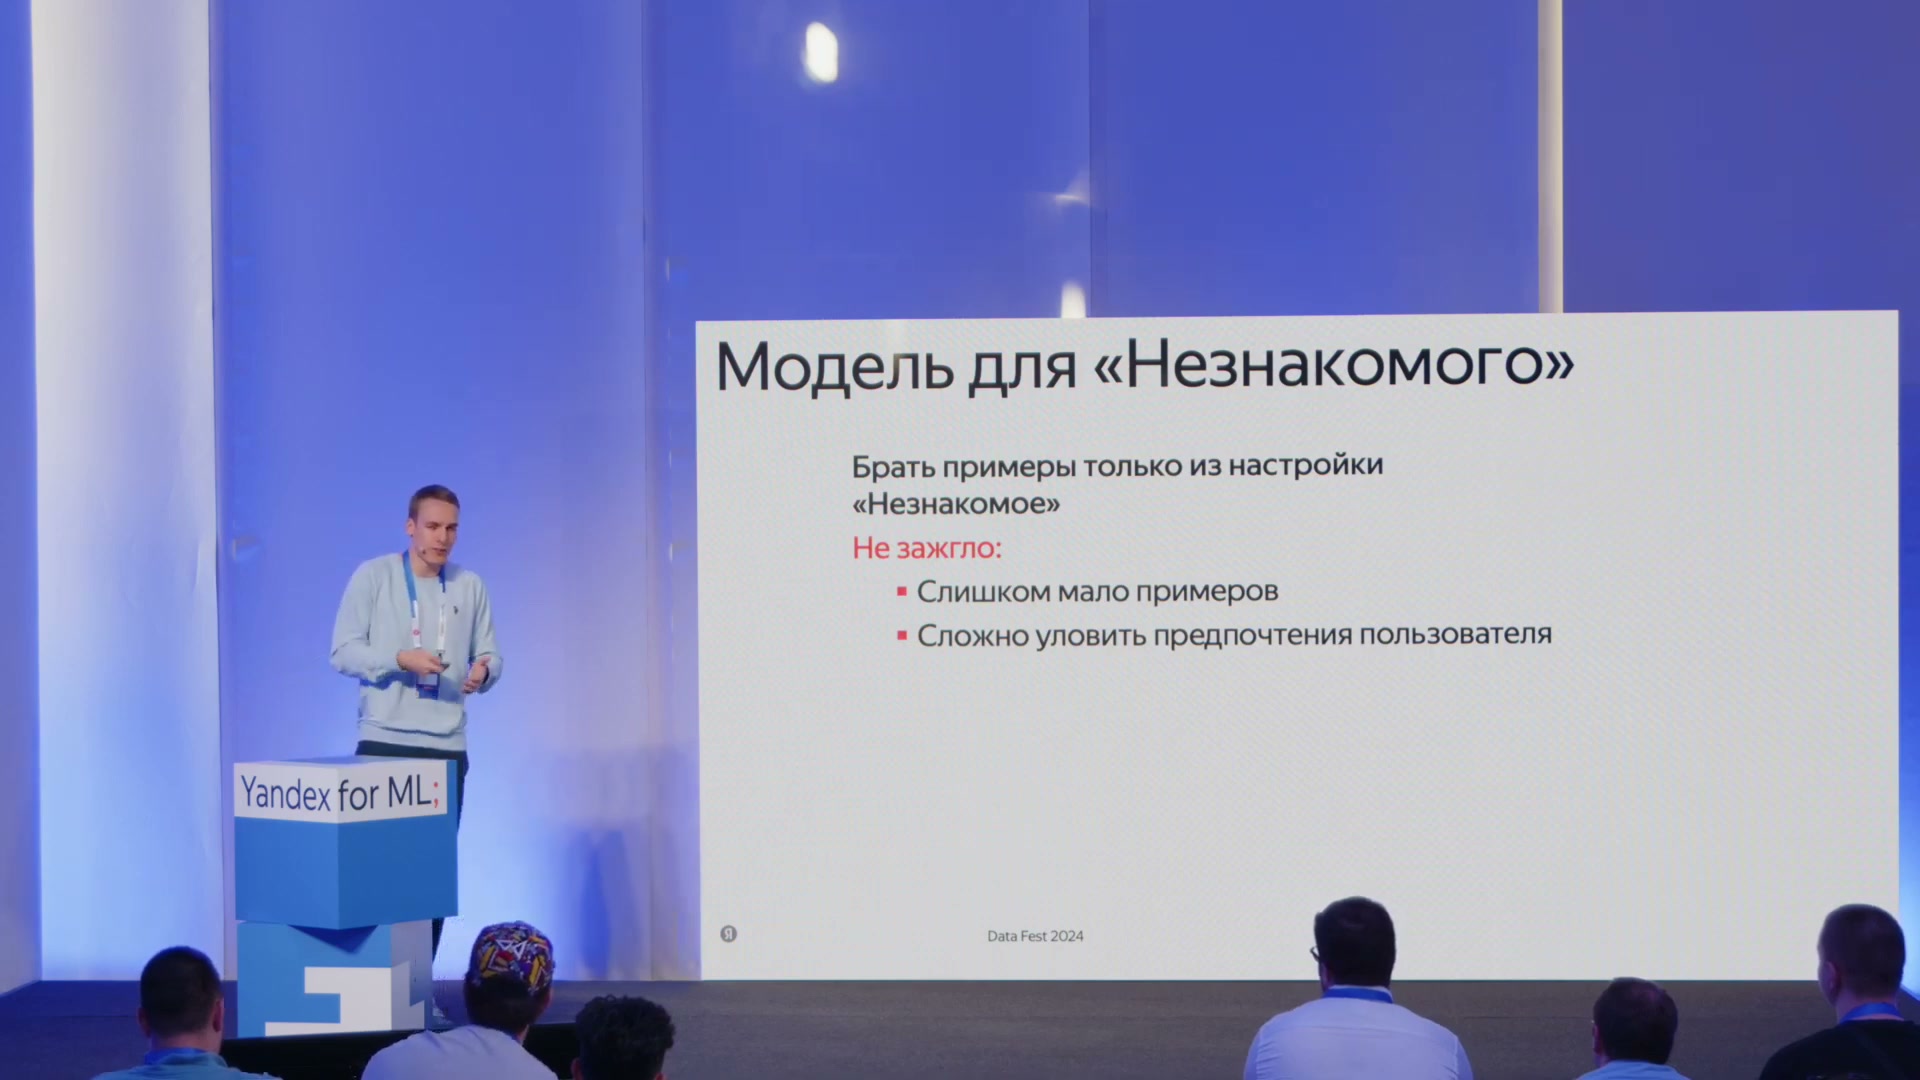
Попытка обучать модель только на данных настройки «Незнакомое» не сработала: мало примеров и трудно уловить предпочтения пользователя.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Общий обучающий пул сохранили, вес целевого режима увеличили
Рабочий вариант сохранил прежний общий набор обучающих примеров CatBoost, но назначил примерам «Незнакомого» больший вес. Модель продолжила видеть поведение в обычной волне, а ошибки на целевом режиме стали важнее для обучения. По словам автора, этот подход сработал.
Он решает обе проблемы предыдущего эксперимента одновременно. Общий пул сохраняет достаточное количество данных. Прослушивания, лайки, перемотки и переслушивания в обычной волне помогают уловить устойчивый вкус. Повышенный вес примеров настройки усиливает её влияние на обучение, не требуя отказаться от этого большего массива.
Важно различать данные для обучения и ограничения выдачи. Наличие знакомых и повторно прослушанных песен в общем обучающем пуле не означает, что их теперь можно рекомендовать в «Незнакомом». Они помогают понять предпочтения, а правила настройки всё так же ограничивают допустимые треки. Специализация достигается изменением влияния примеров, а не обязательным исключением полезной информации.
Численный коэффициент повышения веса не приведён. Не раскрыты также доли примеров разных режимов и техническая реализация перевзвешивания. Из доклада можно восстановить принцип выбора, но не готовую конфигурацию обучения.
Доклад · 00:18:07Отдельное изменение: больше значения явному лайку
После повышения веса примеров режима команда отдельно увеличила вес лайка. Это другое изменение: первое связано с тем, откуда пришёл обучающий пример, второе — с тем, какое действие совершил человек. Смешивать их в одно неопределённое «повысили веса» нельзя, потому что они решают разные задачи.
Мотив связан с использованием «Незнакомого». Слушатель здесь чаще активно оценивает новую музыку, поэтому явная положительная реакция особенно важна. По словам автора, повышение веса лайка тоже сработало: модель стала смелее предлагать редкие незнакомые треки, которые могут вызвать такую реакцию, и при этом не потеряла в качестве.
Редкость в этом объяснении — свойство изменившейся выдачи, а не названный отдельный вес обучения. В докладе нет прямого коэффициента редкости, штрафа за популярность или специальной функции потерь для серендипности. Описано попарное обучение CatBoost с изменённой значимостью примеров режима и лайков.
Эта последовательность связывает изменения модели с продуктовой целью: сохранить информацию о вкусах, сильнее учитывать нужную ситуацию использования и ценить выраженный интерес к новой музыке. Точные веса и независимые численные эффекты каждого изменения не опубликованы; окончательные результаты представлены для проведённых улучшений в совокупности.
Доклад · 00:18:46Как проверяли, что изменение действительно помогает
На вопрос, как отличали удачные эксперименты от неудачных, автор ответил: пользователей разделяли на две группы и сравнивали поведение. Такая проверка называется A/B-тестированием. В числе наблюдаемых сигналов он назвал реакции на музыку, возвращение в сервис и положительные взаимодействия с редкими треками. Шутливое предложение записывать слушателей на камеру не было методом оценки.
Здесь важно не смешивать два уровня проверки. PairAccuracy показывает, насколько хорошо модель упорядочивает пары на имеющихся данных. Пользовательский эксперимент отвечает на другой вопрос: стало ли людям интереснее слушать рекомендации и возвращаться за ними. Правильный порядок обучающих пар сам по себе не измеряет это поведение.
В докладе известен общий принцип проверки, но не полный протокол. Не названы размеры и пропорции групп, механизм их формирования, длительность отдельных тестов, исходные значения метрик, статистические критерии и доверительные интервалы. Поэтому формулировки «сработало» и «не сработало» передают выводы команды, но не позволяют независимо пересчитать значимость результатов.
Доклад · 00:25:40Что именно измеряет серендипность в этом эксперименте
Неожиданное приятное открытие — внутреннее переживание слушателя. Напрямую посчитать его по действиям в приложении нельзя, и в ответе на вопрос автор специально называет используемую метрику приближением. Его формулировка события: «пользователь впервые услышал артиста и сразу же его лайкнул». Измеряется вероятность такого события.
В этом приближении соединены знакомство с новым артистом и немедленная явная положительная реакция. Одного первого прослушивания недостаточно. Обычный лайк тоже не равнозначен этому событию, если артист был знаком раньше. Поэтому показатель серендипности не совпадает ни с долей непрослушанных треков, ни с общей вероятностью лайка.
У определения остаются существенные границы. Не уточнено, какое время означает «сразу же», какое множество событий или пользователей образует знаменатель вероятности и как результаты объединяют. Точная запись события лайка на уровне данных также не раскрыта. Формулировку автора нельзя без дополнительных сведений заменить правилом «лайк треку в той же сессии» или самостоятельно назначить ей временной порог.
Такое событие согласуется с целью приятного открытия, но не доказывает, что человек затем долго слушал нового артиста. В начале выступления желание открыть другие его песни служит объяснением чувства; в экспериментальном определении обязательного последующего изучения каталога нет. При чтении результатов важно сохранить различие между целью продукта и наблюдаемым приближением этой цели.
Доклад · 00:26:43Что изменилось в «Незнакомом»: пять результатов A/B
Итоговые значения объединяют результаты улучшений отбора кандидатов и ранжирования. Все они показаны в разрезе настройки «Незнакомое». Проценты означают относительное изменение метрик, а не процентные пункты. Они не описывают рост всей Яндекс Музыки, её аудитории или бизнеса.
Таблицу можно прокрутить по горизонтали.
Автор связывает увеличение разнообразия в основном с новым селектором: тот находит больше незнакомых похожих артистов. Улучшение реакции слушателей он объясняет изменённым ранжированием, которое сильнее ориентируется на лайки и задачу режима. Это содержательное объяснение, но не отдельная таблица эффектов каждого компонента. Из общих процентов нельзя вычислить точную прибавку от одного селектора или одного веса.
Возвращение пользователей автор выделяет как главную метрику. В этой части доклада речь идёт именно о возвращении в «Незнакомое» на следующий день. Точная когортная формула, календарные правила и границы окна не названы. Значение +1% поэтому следует сохранять вместе с данным словесным определением, а не переносить на другой горизонт или весь сервис.
На итоговой иллюстрации выросли и показатели состава рекомендаций, и показатели реакции на них. Это важнее, чем просто увеличить долю неизвестных песен: более разнообразная выдача сопровождалась ростом явного интереса и возвращения в выбранную настройку.
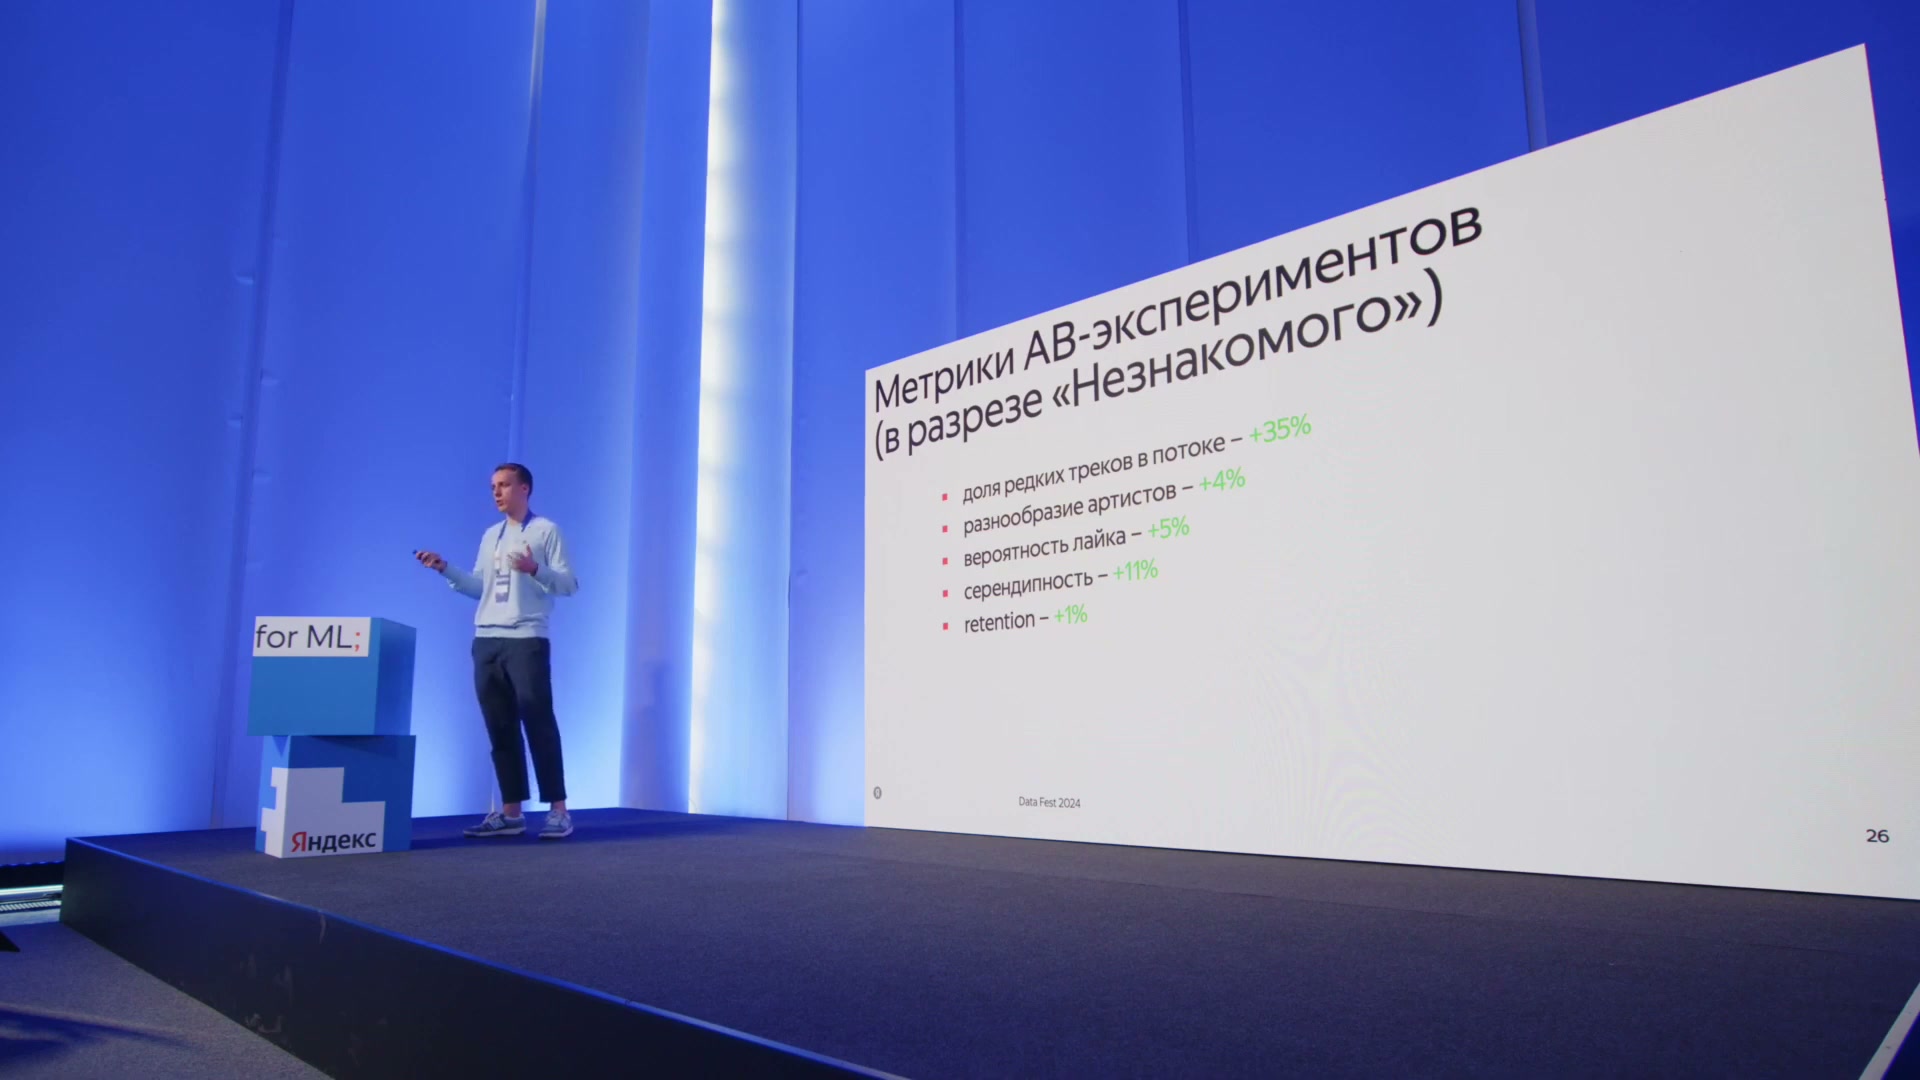
A/B в разрезе «Незнакомого»: доля редких треков +35%, разнообразие артистов +4%, вероятность лайка +5%, серендипность +11%, retention +1%. База, группы, длительность, доверительные интервалы и формулы не раскрыты; это не процентные пункты и не рост всего сервиса.
Источник: Савва Степурин · Яндекс Музыка · Data Fest 2024Что проверили за пределами режима и что уже работало
Положительный результат внутри «Незнакомого» мог бы скрывать ухудшение остальной волны: например, люди чаще выбирали бы новую настройку, но в целом реже возвращались за музыкой. В ответе на этот вопрос автор пояснил, что команда смотрит также на метрики всей «Моей волны». Нужен как минимум результат без ухудшения; об улучшении в других срезах он не сообщает как о количественном итоге.
По словам автора, просадок не было. Команду интересует возвращение в сервис независимо от того, какую настройку выбрал пользователь или слушает ли волну вообще без дополнительных настроек. Это качественный результат проверки всей волны, а не основание приписать ей проценты из таблицы «Незнакомого».
Более долгосрочное удержание также проверяли, и падения автор не отмечает. Он объясняет, что эксперименты идут постепенно с весны, а настройку улучшают каждую неделю. Это последовательная работа, не единоразовый выпуск всех изменений. Точные длинные горизонты, численные эффекты и состав наблюдаемых групп не названы. Упомянутая в вопросе неделя не превращается в опубликованную метрику D7.
К моменту выступления описанные улучшения отбора и ранжирования уже были внедрены: автор прямо предложил слушателям попробовать настройку. Точные даты отдельных запусков не приведены. Этот статус относится к разобранным изменениям; следующая специальная модель, о которой спросили в обсуждении, ещё находилась в эксперименте.
Доклад · 00:27:10Специальная двухбашенная модель: ещё эксперимент
Вопрос о двухбашенной модели для новых пользователю треков описывает следующий шаг работы. Автор сообщил, что команда уже занимается таким вариантом, но на момент выступления он ещё экспериментальный. Для обучения используют первые встречи пользователя с треками в настройке «Незнакомое».
Модель планируют проверять в двух ролях: как способ отбора кандидатов и как дополнительный признак ранжирования. Во втором случае её предсказание станет одним из входных сигналов для модели, которая сравнивает кандидатов. Подробная архитектура, правила выбора обучающих объектов и результаты этой проверки не раскрыты.
Это не следует смешивать ни с уже существующими двухбашенными моделями в общем наборе сигналов, ни с неудачной попыткой обучить CatBoost исключительно на данных режима. В том эксперименте ограничивали обучающий пул ранжирующей модели; здесь обсуждается другая модель и возможное использование её результата. Доклад не даёт основания заранее объявить новую попытку успешной или неуспешной.
Пять итоговых процентов не относятся к этой разработке. Подтверждённый результат кейса — новый селектор похожих артистов и изменения обучения ранжирования. Специальная двухбашенная модель остаётся обозначенным направлением дальнейшей проверки, а не частью доказанного эффекта уже внедрённых решений.
Доклад · 00:24:58Вопросы о каталоге, повторах и цвете волны
На вопрос о пополнении зарубежного каталога автор ответил утвердительно, оговорив, что объём, вероятно, меньше прежнего. Это ответ о состоянии сервиса на момент выступления, без количественной статистики. Когда слушатель пожаловался на повторение одних и тех же зарубежных треков, автор предложил попробовать «Незнакомое», где уже слышанная песня исключается. Причину конкретной жалобы в обсуждении не расследовали.
Отдельный вопрос касался цвета волны: не определяется ли он частыми цветами обложек недавно прослушанных альбомов? Автор ответил, что, насколько ему известно, цвет связан с настроением музыки. Спокойные мелодичные треки он соотнёс с синим или голубым, более весёлые и энергичные — с красным.
В этом ответе есть важная оговорка: цвет делала другая команда, и автор знаком с решением лишь частично. Поэтому это пояснение интерфейса, а не раскрытая формула или ещё одна подтверждённая модель из рекомендательного каскада. Обсуждение цвета не устанавливает дополнительных признаков, которыми обучали ранжирование «Незнакомого».
Доклад · 00:22:48Какие данные других сервисов обсуждали
Слушатели спросили, помогают ли рекомендовать музыку другие действия человека: поисковые запросы, поездки в Такси, покупки в Маркете или Лавке. Автор сказал, что такие данные можно пробовать, но собственные музыкальные сигналы дают больше пользы. По его оценке, внешняя активность не настолько сильна для этой задачи, как прослушивания и реакции внутри Музыки.
Этот ответ не описывает действующую систему, которая обязательно объединяет все перечисленные источники. Он также не означает запрета на их использование. Конкретный работающий пример автор привёл в обратном направлении: Яндекс Афиша рекомендует концерты с учётом того, какие треки и каких артистов человек слушает и лайкает в Музыке.
Идею определять настроение по сладостям из Лавки и менять цвет волны обсуждали шутливо. Автоматическое включение личных музыкальных рекомендаций при посадке в такси прозвучало как пожелание, после которого участники пошутили о неловкости перед водителем. Ни одна из этих реплик не подтверждает внедрение соответствующей функции.
Для основного кейса из обсуждения важен выбор опоры: команда улучшает рекомендации прежде всего на подробной музыкальной истории. Возможность получить ещё один вид пользовательских данных сама по себе не делает его сильным сигналом для выбора следующего трека.
Доклад · 00:28:23Итог: открытие музыки требует согласованного отбора и ранжирования
Команда прошла путь от общего каскада с фильтром повторов к настройке, ориентированной на интересное знакомство. Жанровая популярность и соседство в плейлистах не помогли; сработал поиск незнакомых артистов по личным лайкам и разным видам похожести. При обучении сохранили общий пул, усилили влияние примеров «Незнакомого» и отдельно повысили вес лайка.
- 01
Контекст слушателя
Сервер получает настройку и добавляет последнюю историю; рекомендательная система дополняет контекст доступной историей и заранее подготовленными данными.
- 02
Отбор кандидатов
Селекторы, включая поиск похожих незнакомых артистов, предлагают около 10 тыс. треков из каталога примерно в 100 млн.
- 03
Лёгкое ранжирование
Более компактный CatBoost сокращает набор примерно до 3 тыс. кандидатов.
- 04
Тяжёлое ранжирование
Более сложный CatBoost сравнивает оставшиеся треки по статистикам и предсказаниям других моделей.
- 05
Пачка и новая реакция
Правила выдачи помогают выбрать пять треков. После лайка оставшаяся пачка отбрасывается, и новый запрос учитывает реакцию.
Качество сравнения пар оценивали через PairAccuracy, а поведение слушателей — в A/B-тестах. В «Незнакомом» доля редких треков выросла на 35%, разнообразие артистов — на 4%, вероятность лайка — на 5%, серендипность — на 11%, возвращение — на 1%. Это относительные изменения только данного режима. Серендипность приближённо означает первое знакомство с артистом и немедленный лайк, а не непосредственно измеренную радость.
Описанные изменения уже работали на момент доклада. Для всей волны и более долгого удержания сообщено лишь отсутствие просадок; специальная двухбашенная модель оставалась экспериментальной. Не раскрыты коэффициенты весов, полные определения метрик, размеры групп, длительность тестов и интервалы неопределённости. Кейс показывает логику улучшения открытия музыки, но не даёт готовых настроек и обещаний такого же эффекта в другой системе.
Доклад · 00:19:24