Разбор готов
Как Wildberries находит одинаковые товары у разных продавцов
Покупателю маркетплейса полезно увидеть не просто похожую вещь, а тот же самый товар у другого продавца — например, дешевле или с более быстрой доставкой. Но одинаковые товары могут быть заведены как разные карточки с отличающимися фотографиями, текстами и характеристиками, поэтому системе приходится сопоставлять их по содержимому. Команда Wildberries построила многоэтапный офлайн-расчёт: сначала быстро ищет возможные пары по тексту и изображению, затем точнее проверяет их двумя моделями и в конце исправляет часть ошибок с помощью графового анализа. Разберём, почему одного сходства недостаточно, как устроен этот каскад, как он запускается в инфраструктуре и какие компромиссы между точностью, покрытием, выручкой и временем итерации показали последовательные версии системы.
Материал полезен инженерам поиска, рекомендаций и ML, которым нужно сопоставлять одинаковые сущности в большом каталоге. На конкретном промышленном примере видно, как разделить быстрый отбор кандидатов и дорогую проверку пар, сформировать сложные отрицательные примеры, учесть графовые ошибки и не переносить тяжёлые модели в пользовательский HTTP-запрос.
Статья · на русском
Быстрый матчинг товаров на маркетплейсе WildberriesПавел Саликов · Опубликовано: 24 января 2025 г.
Одинаковый товар, а не просто похожий
В этой задаче матчинг означает поиск идентичных товаров, размещённых разными продавцами. Цель — дать покупателю возможность сравнить предложения того же товара и выбрать, например, более низкую цену или более быструю доставку. Это принципиально отличается от блока похожих рекомендаций: две футболки могут выглядеть почти одинаково, но матчинг должен подтвердить, что это один и тот же товар, а не просто соседние позиции категории.
Для такого сопоставления команда использует четыре группы данных карточки: изображение, название, описание и характеристики. Размеры товара иногда применяют в похожих задачах, но в описанной версии Wildberries они не используются. В продукте результат показывается как блок предложений от других продавцов; версия этого блока для iOS стала доступна всем пользователям 20 декабря 2024 года. Иллюстрация интерфейса показывает именно продуктовую роль матчинга: цены на ней — примеры карточек, а не результаты эксперимента.
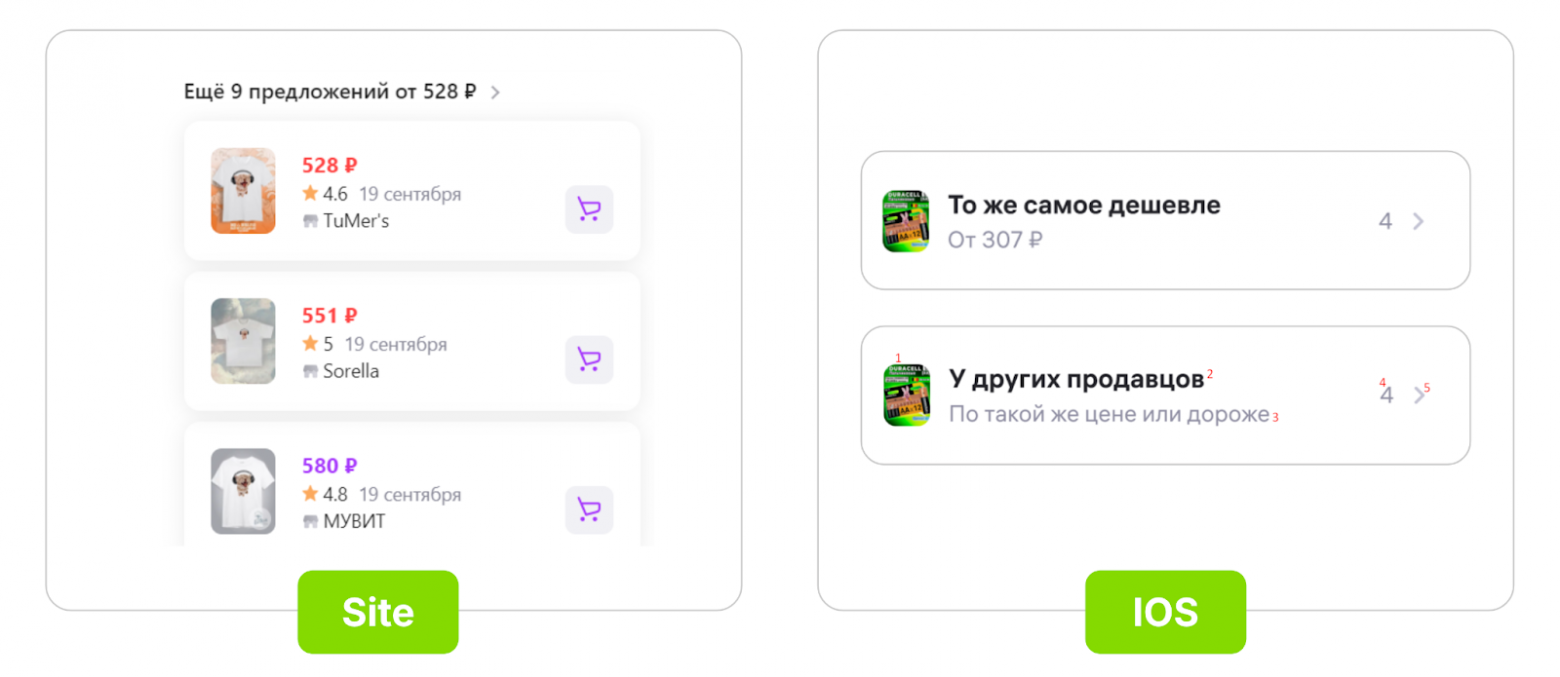
Блоки одинаковых товаров разных продавцов на сайте и в iOS. Пример интерфейса, цены на картинке не результаты эксперимента. Общедоступная iOS-версия — с 20 декабря 2024 по статье.
Источник: Павел Саликов · Wildberries · исходный материалТри этапа: кандидаты, проверка пар и группы
Сравнивать каждый товар со всеми остальными слишком дорого, поэтому система последовательно сужает пространство поиска. На первом этапе важнее не пропустить настоящий дубль: текстовая и визуальная модели строят векторные представления карточек, а быстрый поиск ближайших объектов возвращает ограниченный набор кандидатов. Такое векторное представление, или эмбеддинг, — это набор чисел, в котором близкие по содержанию объекты должны оказаться близко друг к другу.
На втором этапе кандидаты проверяются точнее: сначала моделью, которая сравнивает пару по заранее рассчитанным представлениям (Bi-encoder), затем для оставшихся пар — более дорогой моделью, совместно рассматривающей два текста (Cross-encoder). Здесь цель уже обратная: не сохранить как можно больше возможных совпадений, а убрать похожие, но не идентичные товары. На третьем этапе пары рассматриваются как рёбра графа, а товары — как вершины. Алгоритм выделения сообществ помогает собрать устойчивые группы дублей и одновременно отсечь часть слабых связей между разными группами.
Схема подчёркивает саму логику каскада: тяжёлая проверка применяется не ко всему каталогу, а только к парам, прошедшим быстрый отбор. Именно это разделение позволяет сочетать полноту на ранней стадии и высокую точность ближе к финалу.
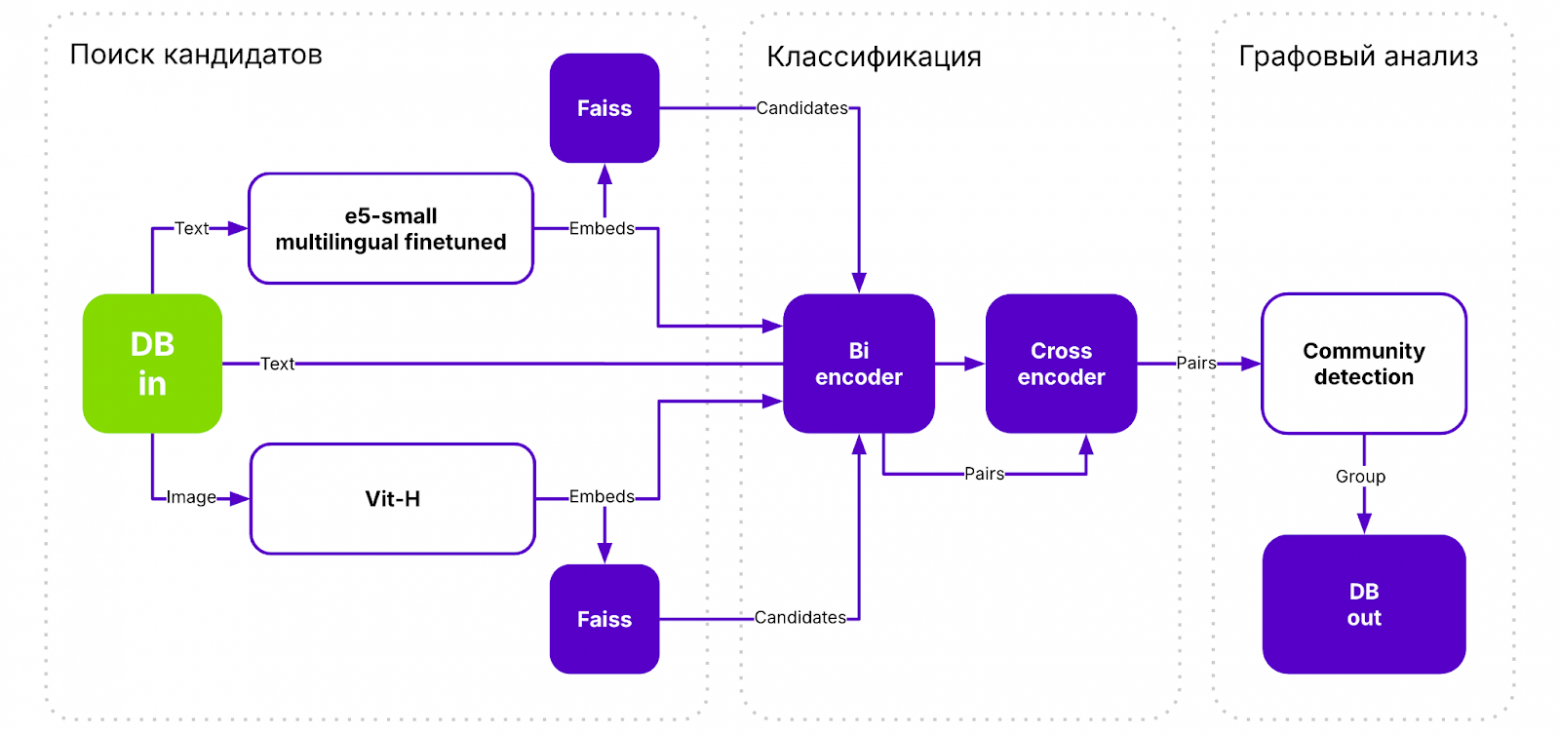
Три этапа: кандидаты из текстовых и визуальных векторов через Faiss, последовательная проверка Bi-encoder/Cross-encoder, графовые сообщества. Тяжёлая проверка применяется к отобранным парам.
Источник: Павел Саликов · Wildberries · исходный материалКак офлайн-расчёт встроен в промышленную систему
Основной расчёт запускается пакетно, а не внутри пользовательского запроса. Задачи конвейера выполняются на кластере под управлением Prefect. Отдельный контур заранее считает визуальные эмбеддинги; основной процесс синхронизируется с ним через S3. После завершения расчёта найденные дубликаты записываются в Greenplum. На схеме также показана резервная выгрузка в S3.
Greenplum служит точкой выдачи готового результата другим сервисам. Go API, которым пользуются сайт и iOS-приложение, не запускает E5, ViT-H, Faiss, Bi-encoder и Cross-encoder заново: он читает уже рассчитанные данные из базы. Отдельный аналитический сервис также обращается к результатам и поставляет команде онлайн-метрики и целевую разметку.
Скорость поддерживается итеративным режимом. Вместо полного пересчёта всего каталога на каждой итерации система смотрит, какие карточки появились или изменились, и ищет дубликаты именно для них среди текущих товаров. Иллюстрация промышленного контура поэтому важна не только как список технологий: она показывает границу между тяжёлым офлайн-матчингом и лёгким чтением готового ответа во время показа.
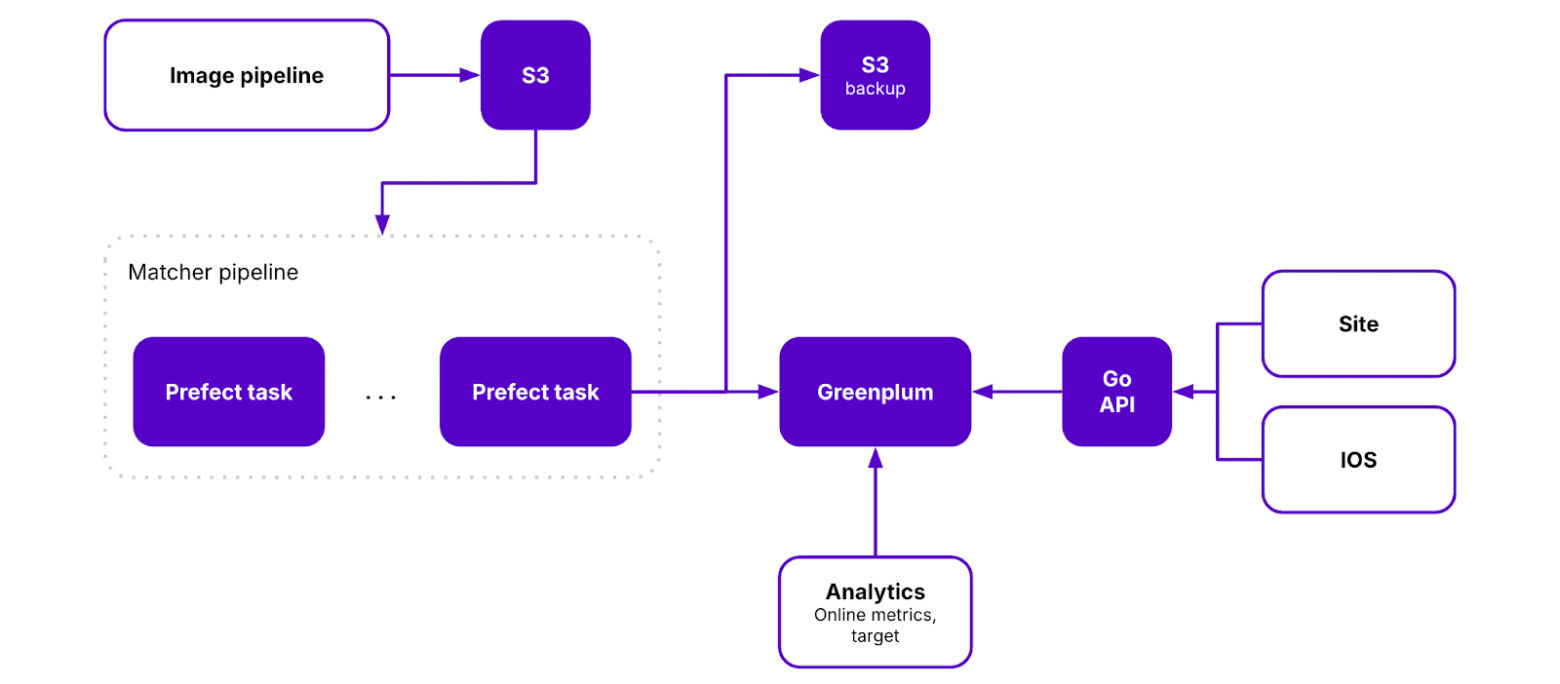
Офлайн-контур: Prefect запускает задачи, отдельный расчёт визуальных векторов синхронизируется через S3, результаты попадают в Greenplum; Go API отдаёт их сайту и iOS.
Источник: Павел Саликов · Wildberries · исходный материалОт миллионов потенциальных пар к тысячам кандидатов
На старте у каждого товара есть миллионы потенциальных партнёров по сравнению. Задача отбора кандидатов — сократить это множество примерно на три порядка, до тысяч наиболее правдоподобных вариантов. На этом этапе полнота важнее точности: ложные кандидаты ещё можно удалить позже, а пропущенный настоящий дубль следующие стадии уже не восстановят.
Для текста выбрали e5-small-multilingual. Команда ориентировалась одновременно на качество и скорость, а также хотела менять состав текста и экспериментировать с его аугментацией. Модель мультиязычная и дообучена на данных Wildberries. В её вход входят название, бренд, характеристики вместе с их значениями и описание товара. Именно здесь шумное описание всё ещё полезно: оно может добавить сигнал и повысить полноту поиска кандидатов.
Для изображений используется ViT-H. В источнике она описана как модель, предварительно обученная на LAION-2B и затем дообученная на товарах из соревнования Google Universal Image Embedding. Команда переиспользует уже рассчитываемые в Wildberries визуальные эмбеддинги. На вход берётся только первая картинка товара после масштабирования и нормализации. На момент материала эксперименты с дальнейшей настройкой самой модели и входного изображения ещё были планом. Иллюстрация с карточкой подчёркивает разделение ролей: текстовая ветвь читает поля карточки, визуальная — первую фотографию.
После получения текстовых и визуальных эмбеддингов кандидаты ищутся в Faiss на GPU. Это приближённый поиск ближайших соседей (ANN): он не перебирает все объекты один за другим, а быстрее находит близкие векторы с допустимым приближением. Автор объясняет выбор GPU-реализации Faiss тем, что она давала наиболее быстро обновляемый индекс товаров по сравнению с другими ANN-вариантами. Для быстрого доступа к самим эмбеддингам и их хранения команда сделала собственную структуру на основе mmap — механизма отображения файла в память процесса. Конкретный тип индекса Faiss в источнике не раскрыт, поэтому его нельзя восстанавливать по общим практикам библиотеки.
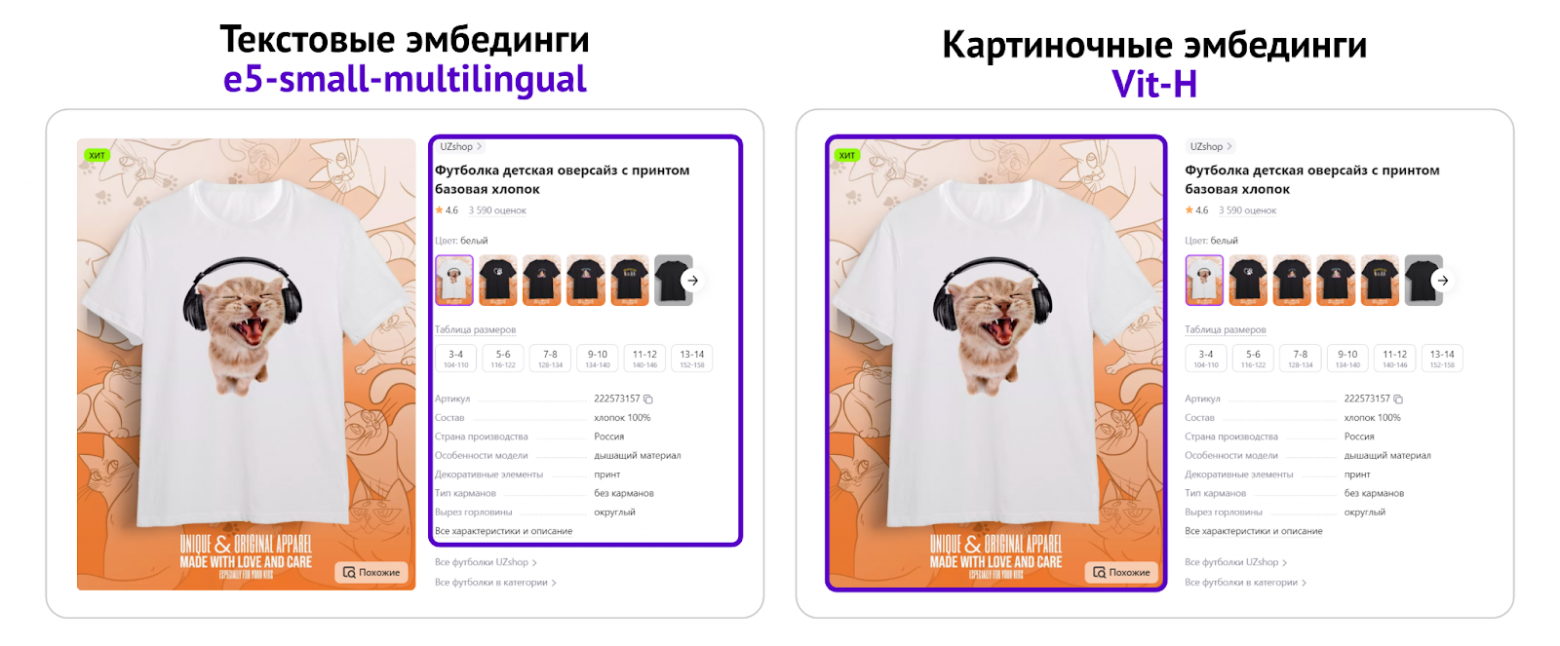
Текстовая башня получает название, бренд, характеристики и описание. Визуальная — первую картинку; размеры товара не используются для матчинга в этой версии.
Источник: Павел Саликов · Wildberries · исходный материалПервая проверка пар: Bi-encoder и сложные отрицательные примеры
После быстрого поиска остаются тысячи потенциальных пар, и их нужно сократить до единиц настоящих дублей. Первая модель точности получает уже рассчитанные представления обоих товаров. На схеме для каждого товара показан текстовый вектор размерности 384 и визуальный вектор размерности 1024. В материале этот блок называется Bi-encoder; по описанию это достаточно простая полносвязная нейронная сеть (MLP) с линейными слоями, dropout — случайным отключением части промежуточных сигналов при обучении — и нормализацией. Такие модели обучаются отдельно для каждой категории.
Важнейшей частью оказалась не сложность самой модели, а состав обучающего пакета. Положительные пары — товары из одной группы дублей. Отрицательные пары выбираются среди разных товаров той же категории, то есть модель учат отличать идентичную футболку от очень похожей футболки, а не от заведомо далёкого холодильника. Такие похожие, но неверные пары называют сложными отрицательными примерами.
Целевая разметка собирается из двух источников. Есть прежнее решение на основе SKU — товарных позиций, которые размечают продавцы; оно постепенно дополняется разметкой асессоров, чтобы поддерживать более актуальный набор пар. Источник не раскрывает доли этих источников, объём разметки или процедуру разрешения конфликтов, поэтому эти детали нельзя придумывать.
Первая неудача была в попытке оставить только Bi-encoder. Такой вариант работал быстрее, но качество оказалось хуже. Поэтому простой классификатор сохранили как дешёвый фильтр, а для небольшой части лучших кандидатов добавили более дорогую совместную проверку. Схема Bi-encoder/Cross-encoder показывает именно этот каскад: второй этап не заменяет первый, а уточняет его результат.
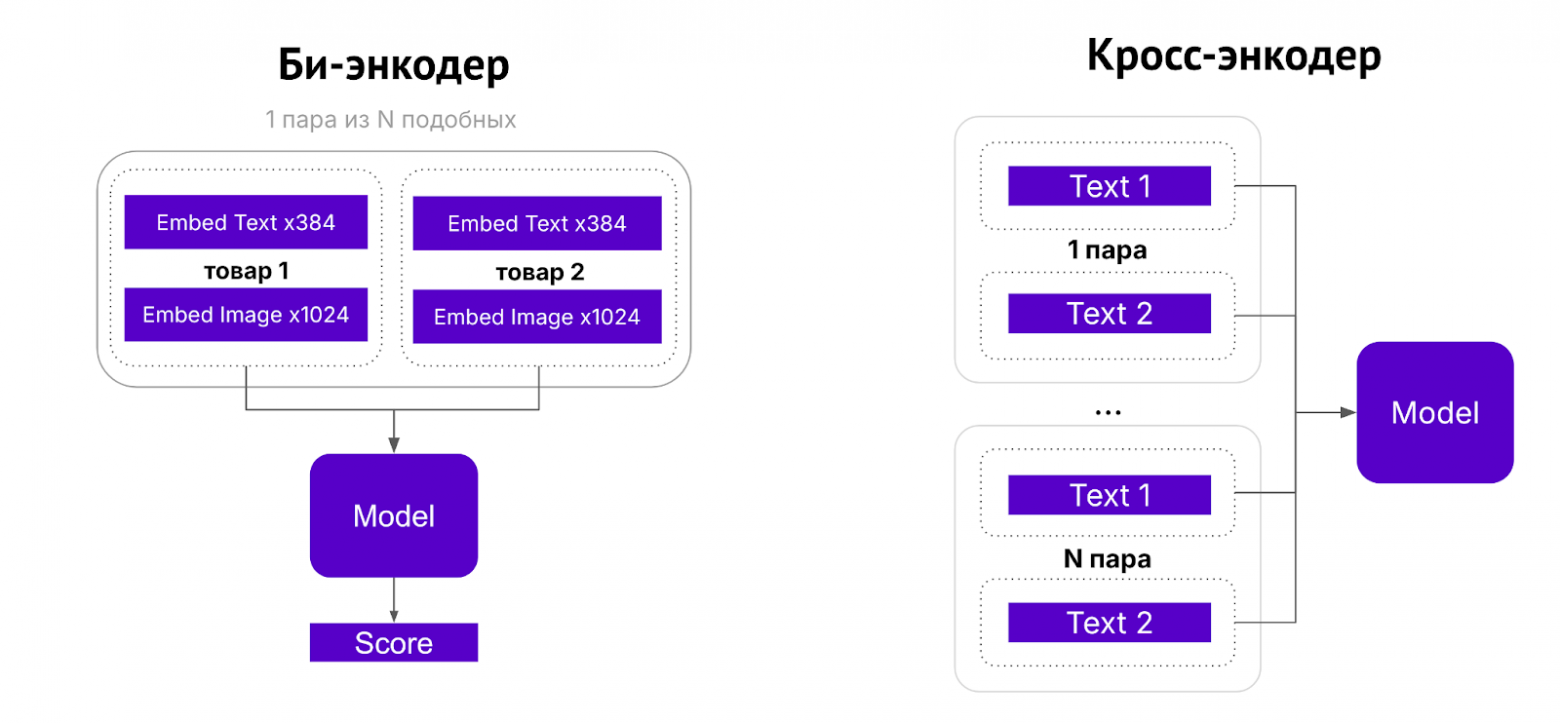
Bi-encoder принимает текстовый вектор размерности 384 и визуальный 1024 для каждого товара. Cross-encoder совместно проверяет тексты пары; точная внутренняя архитектура в статье не раскрыта.
Источник: Павел Саликов · Wildberries · исходный материалПочему один Cross-encoder тоже не подходит
Cross-encoder рассматривает сразу два текстовых описания пары и может строить более точное совместное решение. Но прогонять через него все кандидаты слишком дорого: в источнике сказано, что вариант только с Cross-encoder в несколько раз замедлял бы работу конвейера, чего команда не могла себе позволить. Это вторая неудачная крайность — высокая точность без приемлемой стоимости.
Поэтому Cross-encoder стоит после Bi-encoder и получает только уже отобранные пары. Под капотом используется та же E5 Small Finetuned, но состав текста отличается от стадии поиска кандидатов: здесь подаются название, бренд и характеристики, а описание исключается. Причина практическая: описание помогает на раннем поиске повысить полноту, но на точной классификации оказывается достаточно шумным и снижает точность.
Эта разница входов важнее, чем кажется. Один и тот же текстовый источник не обязан быть одинаково полезен на всех стадиях системы: поиск кандидатов допускает больше шума, если он помогает не потерять правильный товар, а финальная проверка пары сильнее наказывает ложные совпадения. В результате архитектура специально использует более широкий текст на поиске и более строгий — в Cross-encoder.
Cross-encoderОт отдельных пар к устойчивым группам
После классификации уже есть пары товаров, признанные дублями. Если связи безошибочны, одинаковость транзитивна: если товар 1 идентичен товару 2 и товару 3, то 2 и 3 тоже должны быть одним товаром. Иллюстрация с треугольником показывает, как из двух подтверждённых связей можно достроить третью и получить целую группу.
Проблема появляется при одной ошибочной связи. В учебном примере есть две независимые тройки настоящих дублей и один ложный мост между ними. До полного объединения граф содержит шесть истинных рёбер и одно ложное, поэтому условная точность рёбер равна 6/7. Если без проверки замкнуть все связи внутри объединённой шестёрки, появится 15 пар, из которых истинными останутся только шесть: 6/15. Это иллюстрация механизма падения precision, а не фактическая метрика промышленной модели Wildberries.
Учебный пример со слайда: один ложный мост между двумя тройками превращает безопасное транзитивное объединение в большое число ложных пар. Значения 6/7 и 6/15 не являются измерением качества продакшен-системы.
Чтобы уменьшить этот риск, команда применяет выделение сообществ на графе — community detection. Интуиция такая: внутри настоящей группы дублей связи должны быть плотными, а между разными группами их мало. Алгоритм может объединить отдельные внутренние связи в цельную группу и одновременно обрезать слабые межгрупповые рёбра. На соответствующей иллюстрации именно слабый мост между двумя плотными тройками удаляется. Конкретный алгоритм и его пороги в источнике не названы.
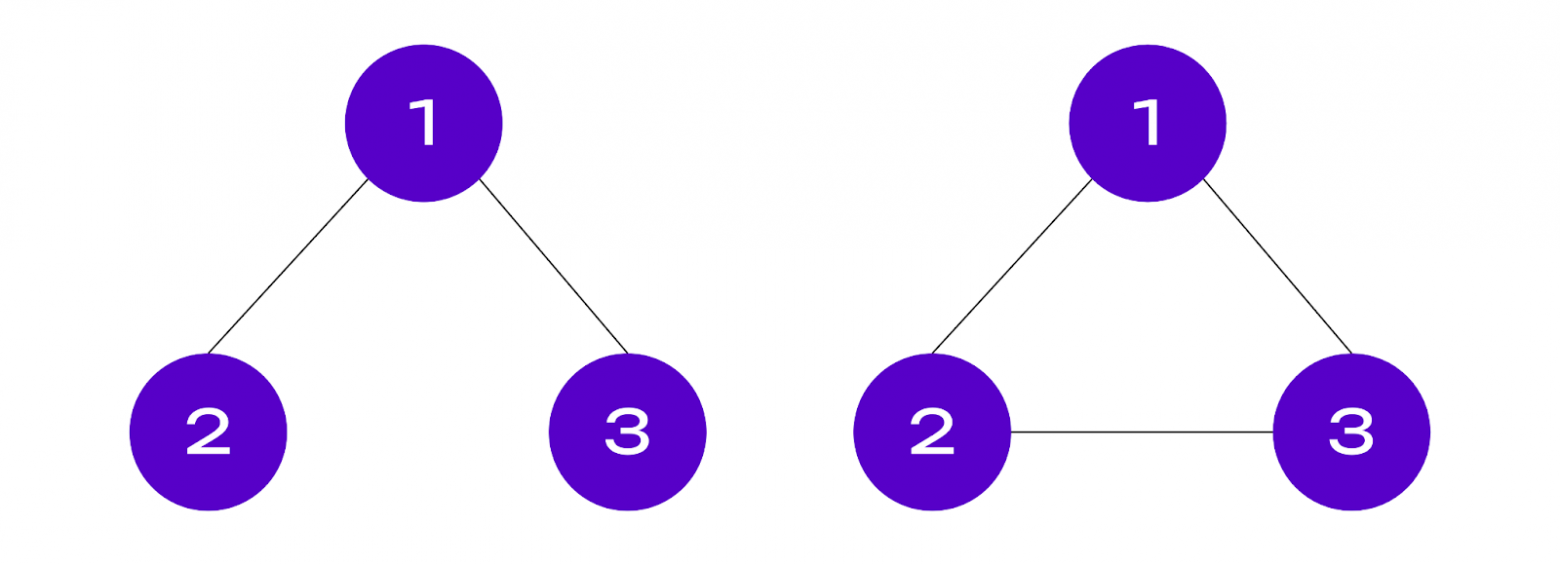
Транзитивность одинаковости: при верных связях 1–2 и 1–3 можно достроить 2–3. Это учебный пример; надёжность такого дополнения зависит от ошибок исходных пар.
Источник: Павел Саликов · Wildberries · исходный материал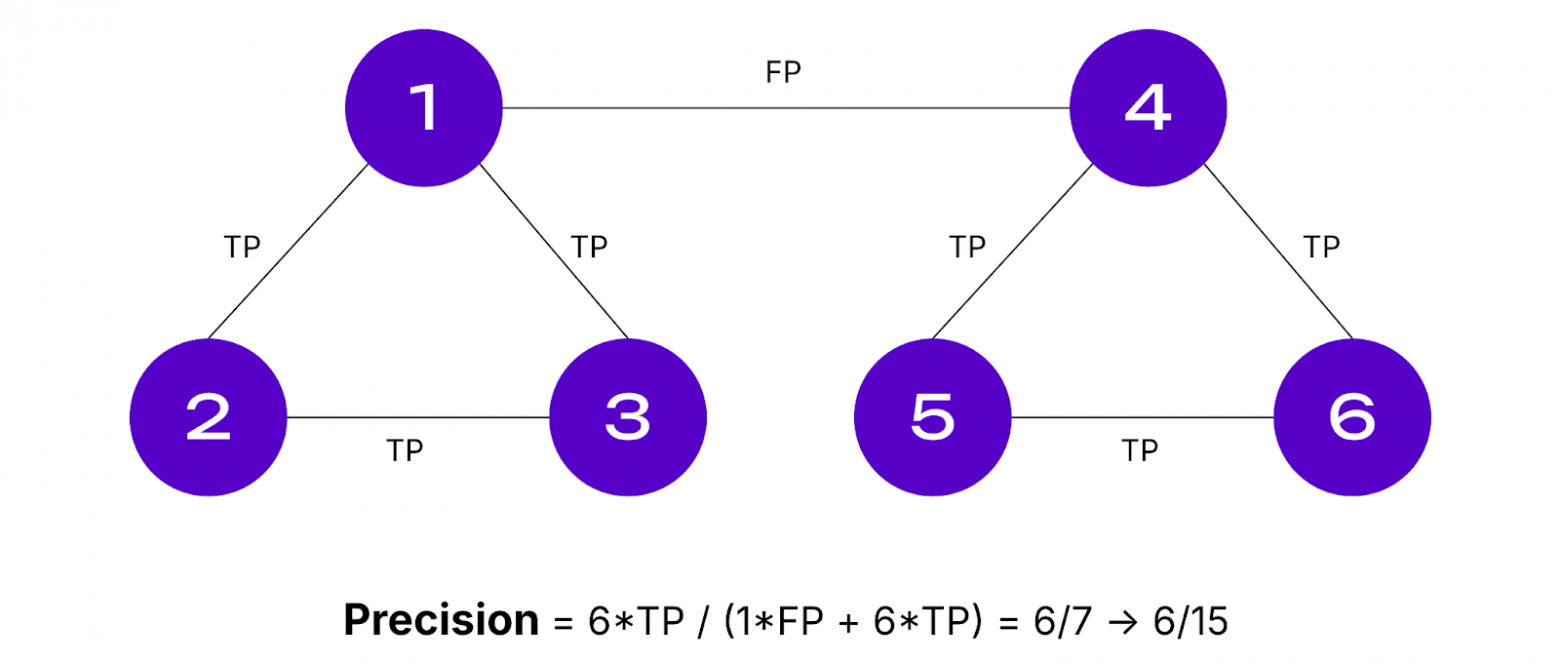
Одна ошибочная связь объединяет две тройки: шесть истинных пар среди семи исходных превращаются в шесть среди 15 после полного замыкания. Это иллюстрация потери precision, не измерение качества промышленной модели.
Источник: Павел Саликов · Wildberries · исходный материал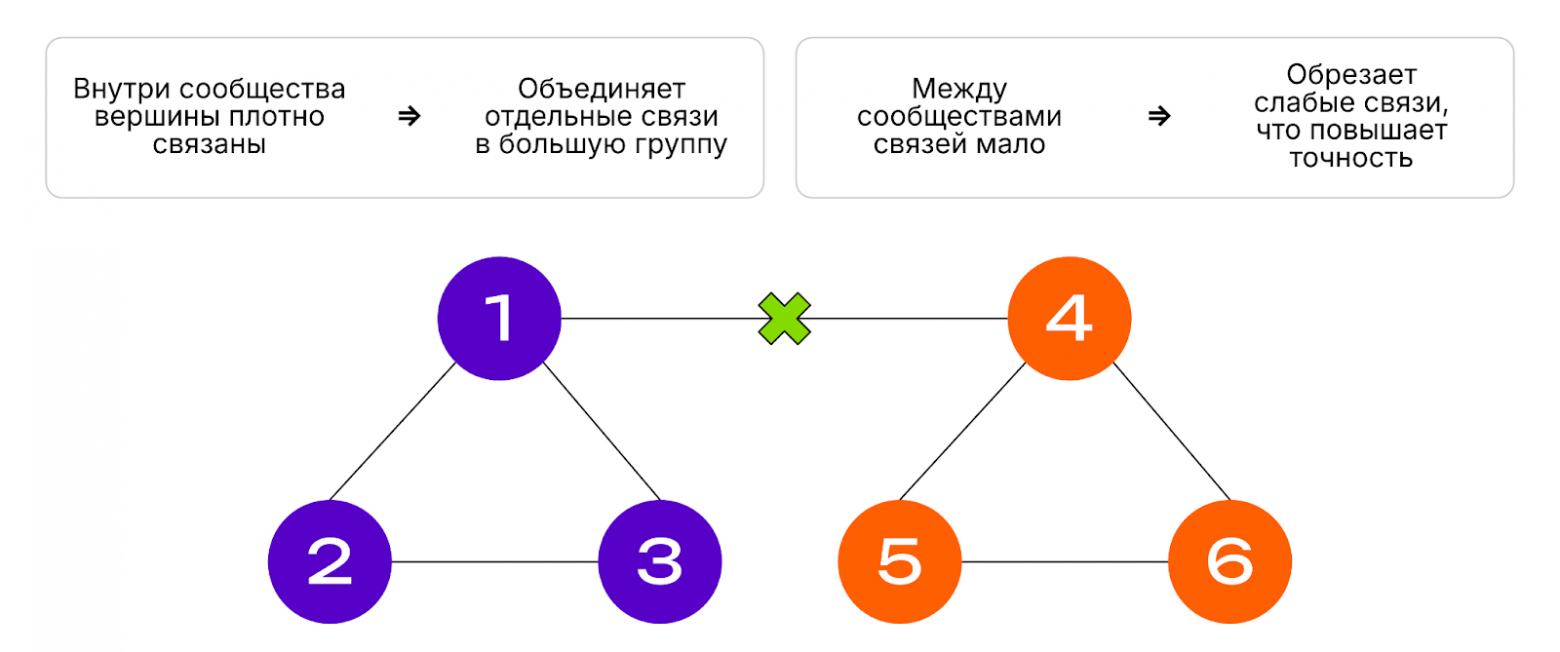
Выделение сообществ должно сохранять плотные группы и отсекать слабые связи между ними. Конкретный алгоритм и пороги сообществ не названы.
Источник: Павел Саликов · Wildberries · исходный материалЧто измеряют: точность, покрытие, выручку и время
Конвейер обрабатывает порядка 130 миллионов товаров, и более чем для трети из них система находит дубликаты. Но одного числа найденных групп недостаточно: улучшение модели может одновременно менять точность совпадений, долю каталога с дублями, поведение покупателей и стоимость пересчёта. Поэтому автор разделяет четыре показателя.
Precision — доля верных пар среди всех пар, которые система назвала дублями. Покрытие по GMV — выручка всех товаров, для которых найдены дубли, делённая на выручку по всем товарам. Эти показатели оцениваются офлайн по целевой разметке и онлайн с помощью асессоров. Отдельно онлайн смотрят выручку товаров, купленных через блок дубликатов, и скорость — время одной итерации конвейера.
Графовый этап дал показательный компромисс: после community detection покрытие заметно снизилось, потому что часть связей была обрезана, но выручка выросла. После этого релиза онлайн-точность, ранее немного отстававшая от офлайн-уровня около 90%, тоже стала держаться примерно на 90%. Это пример того, почему максимальное покрытие не является единственной целью матчинга.
Результаты матчингаШесть версий системы и их компромиссы
Финальная таблица источника показывает шесть последовательных конфигураций. Процентные изменения покрытия по GMV и выручки сохранены ровно в том виде, как они указаны на слайде. База этих дельт описана недостаточно явно, поэтому значения нельзя складывать между столбцами или превращать в накопленный эффект.
Таблицу можно прокрутить по горизонтали.
Переход к MMap + Faiss в тексте статьи описан как ускорение более чем в 10 раз. При этом сама таблица показывает изменение времени с 15 часов до 1 часа 45 минут, то есть примерно в 8,6 раза. Источник не объясняет расхождение, поэтому нельзя придумывать разные объёмы данных, железо или режимы измерения, чтобы согласовать эти две формулировки.
Автор отдельно отмечает, что переход от CatBoost к Bi-encoder с правильно сформированным обучающим пакетом в сочетании с E5 заметно добавил качества. Но в таблице между версиями одновременно меняются несколько компонентов, поэтому из неё нельзя восстановить отдельный численный вклад CatBoost, E5 или способа формирования отрицательных примеров.
Замена визуальной модели SWINv2 на ViT-H подняла указанную точность с 80% до 90% без потери продуктовых метрик по описанию автора. Community detection затем дал важный обмен: в таблице для соответствующей версии показаны -9% покрытия по GMV и +6% выручки. Дообучение E5 сопровождается значениями +3% и +3%, а последняя конфигурация Bi+CE+CD — +10% покрытия по GMV, +30% выручки и 4 часа на итерацию.
Последний релиз с Cross-encoder и улучшениями стабильности на момент выступления ещё находился в A/B-тесте. Он замедлил конвейер относительно предыдущих двухчасовых версий, но автор счёл прирост остальных метрик достаточно большим, чтобы не отказываться от изменения. Команда при этом продолжала работать над ускорением, поэтому эту строку нельзя описывать как давно завершённое и окончательно оптимизированное внедрение.
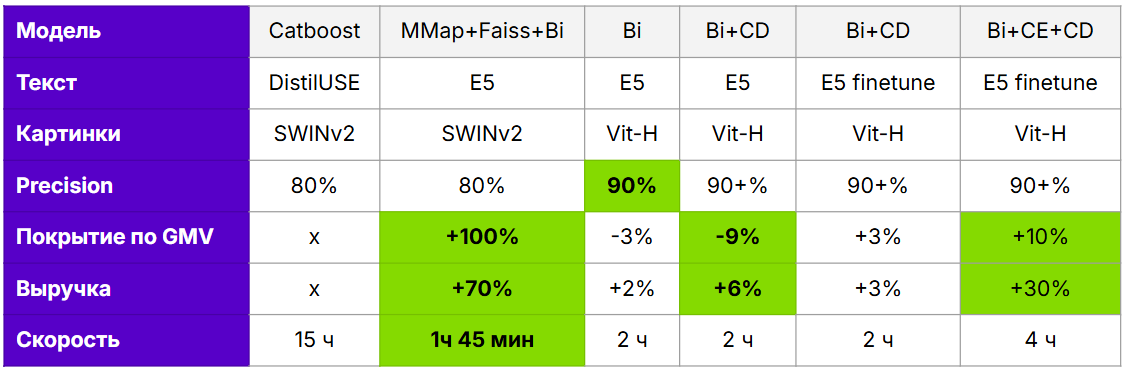
История версий с точностью, GMV-покрытием, выручкой блока и временем итерации. База процентных дельт не определена достаточно явно; их нельзя складывать. 15 ч → 1 ч 45 мин в таблице — около 8,6×, хотя текст заявляет более 10×: условия расхождения не раскрыты.
Источник: Павел Саликов · Wildberries · исходный материалИтог: как считаются дубликаты для новых и изменённых карточек
Система разделяет полноту и точность по стадиям: ранний поиск старается не потерять настоящий дубль, классификаторы отсеивают похожие, но разные товары, а графовый анализ защищает группы от отдельных ложных связей. Тяжёлый расчёт выполняется заранее только для новых и обновлённых карточек.
- 01
Выбрать изменившиеся карточки
На итерации берутся товары, которые появились или были обновлены, без полного пересчёта каталога.
- 02
Построить эмбеддинги
E5 кодирует текст карточки, а отдельный контур расчёта изображений предоставляет эмбеддинг первой картинки от ViT-H.
- 03
Найти кандидатов
Faiss на GPU ищет ближайшие векторы; mmap даёт быстрый доступ к эмбеддингам. Миллионы возможных сравнений сокращаются до тысяч.
- 04
Проверить пары
Bi-encoder быстро фильтрует кандидатов, затем Cross-encoder уточняет оставшиеся пары по названию, бренду и характеристикам без описания.
- 05
Собрать группы
Графовый анализ объединяет плотные сообщества, обрезает слабые связи, после чего готовые группы сохраняются в Greenplum.
Во время пользовательского HTTP-запроса этот каскад не запускается: Go API сайта и iOS читает готовые данные из Greenplum. Обучение тоже не является шагом обработки карточки. Модели подготовлены заранее; для Bi-encoder положительные пары берутся из групп дублей, а сложные отрицательные — из той же категории. Целевая разметка приходит из SKU-разметки продавцов и от асессоров.
История версий показывает цену улучшений. Замена визуальной модели подняла указанную precision с 80% до 90%. Community detection уменьшил покрытие, но увеличил выручку. Добавление Cross-encoder в последней строке таблицы связано с 90+% precision, +10% покрытия по GMV, +30% выручки и ростом времени итерации до 4 часов. На момент выступления этот релиз ещё находился в A/B-тесте, а команда продолжала ускорять конвейер. Поэтому итог — не одна «лучшая модель», а офлайн-каскад, где полнота, точность, продуктовый эффект и стоимость пересчёта контролируются на разных стадиях.
Результаты матчинга