Разбор готов
Яндекс: когда нейросетевой ранжировщик может заменить CatBoost
Рекомендательный каскад уже нашёл хорошие товары, треки или фильмы. Теперь нужно решить, какие из них показать выше: отличить явно подходящий объект от случайного проще, чем выбрать лучший среди нескольких подходящих. Для этого этапа в описываемых системах Яндекса привычен CatBoost. Команда Кирилла Хрыльченко проверила, сможет ли нейросеть лучше использовать сочетания признаков, историю пользователя и большой объём данных, сохранив приемлемую стоимость работы. Разберём, почему одной полносвязной сети оказалось недостаточно, как кодировали категории и числа, зачем добавили явные взаимодействия и несколько выходных задач. Затем посмотрим на конфигурацию обучения, результаты на трёх доменах и масштабирование данных — и отделим эти офлайн-сравнения от первых шагов внедрения в сервис.
Глава полезна разработчикам рекомендательных систем, которые уже используют бустинг и рассматривают нейросеть для ранжирования. Она поможет связать выбор представлений, архитектуры и режима обучения с измеренным качеством, вычислительными ограничениями и риском изменения пользовательской обратной связи.
Видео · на русском
Нейросетевое ранжирование для рекомендательных систем / Кирилл ХрыльченкоКирилл Хрыльченко · Опубликовано: 14 января 2025 г.
Исходный доклад · Открыть оригинал
Почему ранжирование сложнее отбора кандидатов
Основа главы — доклад Кирилла Хрыльченко «Нейросетевое ранжирование для рекомендательных систем» на ML Party. Автор представляет исследовательскую команду Яндекса, которая разрабатывает трансформеры для персонализации, графовые нейросети, технологии отбора кандидатов и ранжирования. Команда работала с поиском, рекламой, Музыкой, Маркетом, Алисой и Кинопоиском. Этот перечень описывает её опыт, а не распространение одного ранжировщика по всем сервисам. Запись опубликована 14 января 2025 года; год самого мероприятия по представленным сведениям не установлен.
Рекомендации помогают человеку разобраться в большом каталоге. Слушателю нужны подходящие треки, покупателю — товары, удовлетворяющие его потребностям. Проверять каждый объект самой сложной моделью слишком дорого, поэтому обработку разделяют на этапы. Такой последовательный отбор называют каскадом. В докладе важны две его функции: сначала найти кандидатов, затем упорядочить полученный набор.
Отбор кандидатов должен обеспечить присутствие хороших объектов в сравнительно небольшом списке. Автор объясняет его обучение через различение хороших объектов и относительно простых плохих примеров. Ранжирование начинается позже: перед ним уже набор неплохих объектов, и требуется понять, кто заслуживает более высокой позиции. Для этого используется больше признаков и более сложное совместное рассмотрение пользователя и конкретного кандидата. Такое соединение информации до получения окончательной оценки называют ранним связыванием.
Дополнительная трудность — шум в наблюдаемом поведении. Пользователь мог нажать на объект не потому, что тот лучше остальных, а потому, что он стоял выше. Ранжировщик учится на реакции, которая зависит и от интереса человека, и от прежнего порядка выдачи. Поэтому задача не сводится к поиску очевидно релевантного объекта.
Схема ранжирования подчёркивает именно эту границу: нейросеть в данном докладе меняет способ оценки уже пришедших кандидатов. Она не заменяет автоматически поиск по каталогу. Линейные модели, градиентный бустинг и нейросети здесь рассматриваются как варианты решения одной и той же поздней задачи.
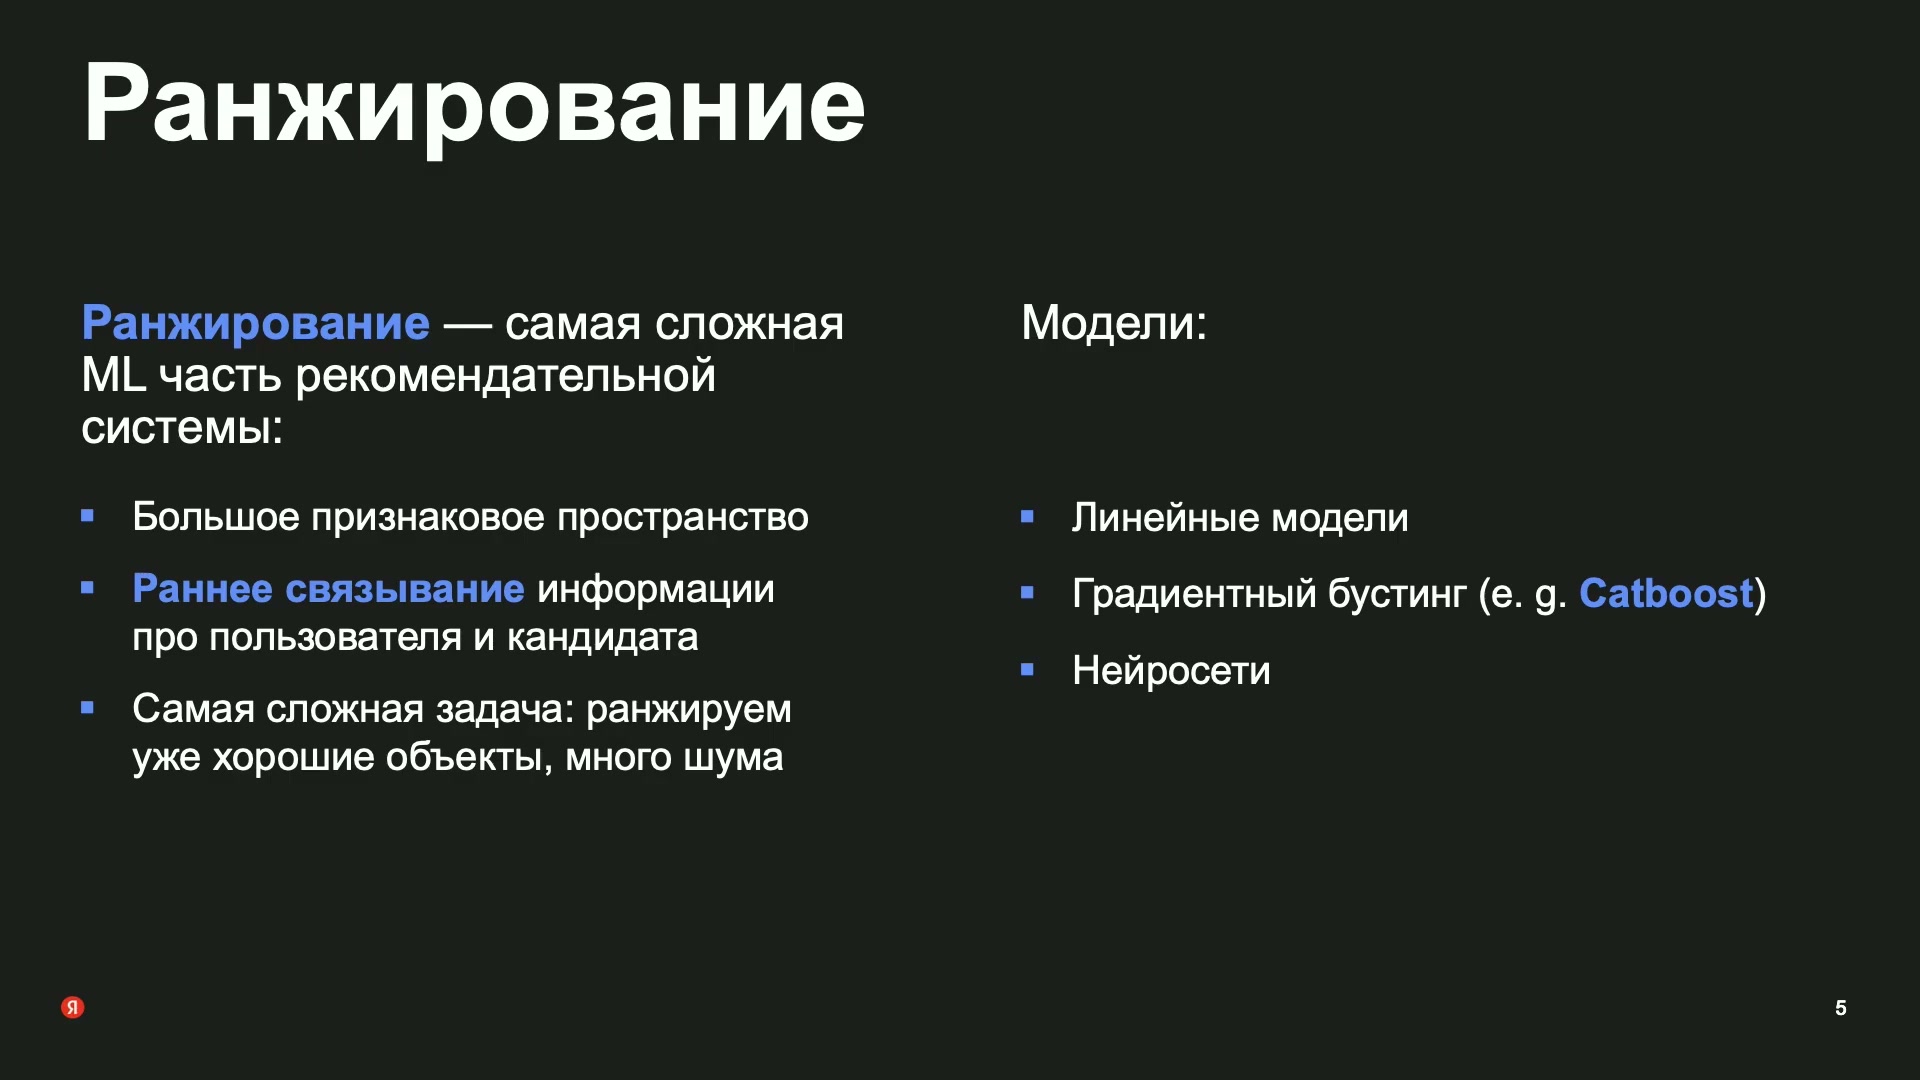
Ранжирование объединяет сведения о пользователе и кандидате, работает с большим числом признаков и уже относительно хорошими кандидатами. В докладе сравнивается нейросетевой подход с привычным бустингом.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyПочему привычного ответа «CatBoost достаточно» оказалось мало
Сложность ранжирования сама по себе ещё не доказывает, что для него нужна нейросеть. В описываемой автором практике Яндекса привычным решением был градиентный бустинг, прежде всего CatBoost. К тому же исследования нейросетей на табличных данных не давали однозначного довода за замену: по пересказу докладчика, бустинг часто выигрывал либо модели показывали сопоставимое качество. Данные рекомендаций по форме похожи на таблицы, поэтому это возражение нельзя было просто проигнорировать.
Но промышленные публикации давали другой повод для проверки. Автор различает компании, которые перешли к нейросетям прямо от линейных моделей, и компании, которые сначала успели использовать бустинг. Первую траекторию он иллюстрирует Google и YouTube, вторую — Airbnb. На слайде также приведены ShareChat и ByteDance: в пересказе этих внешних работ глубокие модели успешно используются в ранжировании, а ShareChat сообщает о преимуществе нейросетевых ранжировщиков в своих экспериментах.
Эти примеры — мотивация, а не результаты Яндекса и не доказательство превосходства нейросетей в любом сервисе. Команда поставила более узкий вопрос: какие свойства нейросетевого ранжировщика удастся использовать на собственных рекомендательных данных и почему выводы могут отличаться от академических сравнений. Дальнейший рассказ последовательно разбирает входы модели, взаимодействия признаков, обработку истории, обучение и масштаб данных.
Смысл промышленного сопоставления не в списке известных компаний. Он в том, что решение зависит не только от названия класса моделей: важно, какие сигналы модель получает и на каком объёме данных способна ими воспользоваться. Проверять это автор предлагает через конкретную архитектуру и собственные эксперименты.
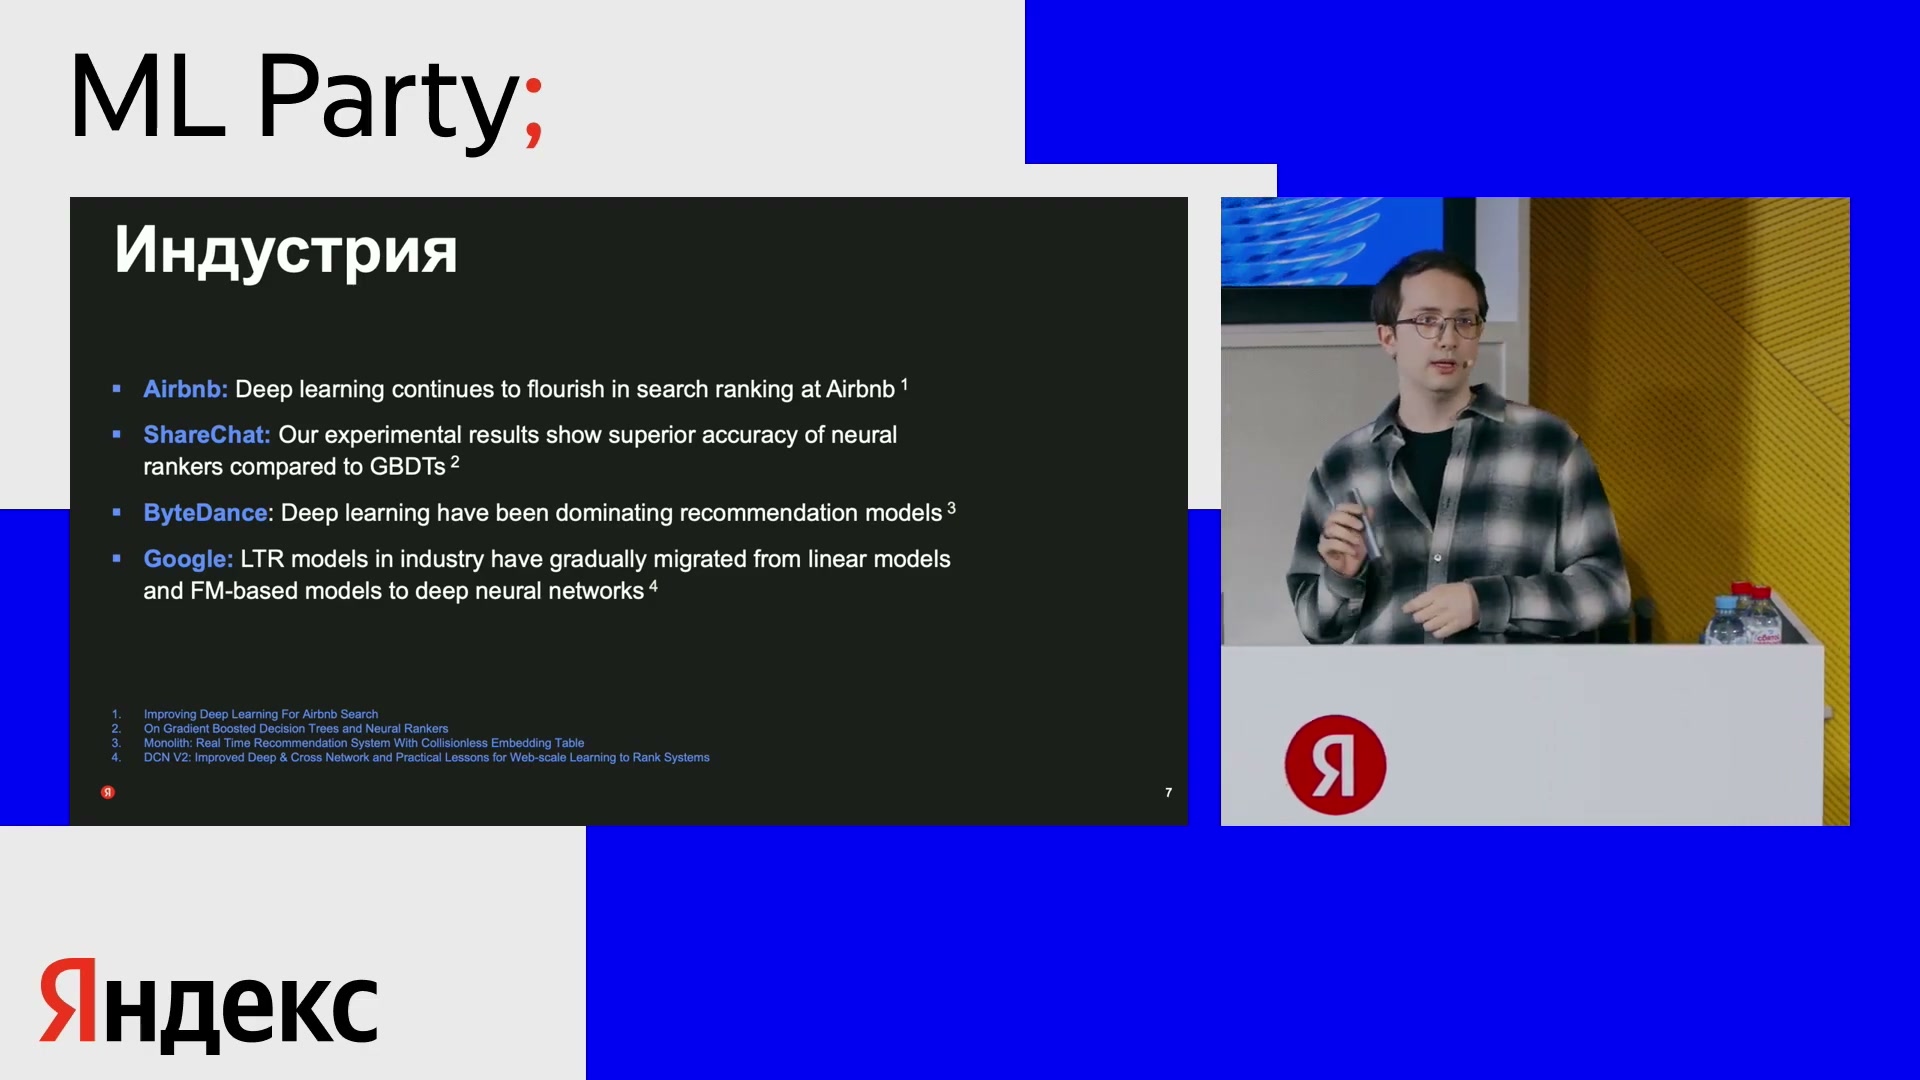
Отдельные внешние промышленные работы Airbnb, ShareChat, ByteDance и Google служат мотивацией. Это не результаты собственных экспериментов Яндекса.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyОбщий вход, два вида взаимодействий и выходные головы
Нейросетевой ранжировщик собирает три вида информации: категориальные признаки, числовые признаки и выходы других нейросетей. Категория может обозначать страну, язык или идентификатор объекта; число — некоторую количественную характеристику; внешний нейросетевой выход уже представляет сведения о пользователе или объекте в виде вектора. После кодирования эти части соединяются в один длинный вектор, который получает основная модель.
Внутри модели автор разделяет явные и неявные взаимодействия. В первом случае сам слой устроен так, чтобы перемножать и связывать признаки. Для этого используется семейство Deep & Cross Network, далее DCN. Во втором случае зависимости выучиваются последовательностью полносвязных преобразований — полносвязной нейронной сетью, или MLP. На общей схеме DCN идёт перед MLP; позже автор объясняет, почему порядок важен и какой ещё способ соединения возможен.
На выходе находятся отдельные модули, каждый со своей предсказываемой характеристикой. Их называют головами модели. Общие вычисления выполняются до разделения на головы, поэтому разные задачи могут пользоваться одним представлением. Это не набор независимых ранжировщиков и не генератор новых объектов: входом остаются признаки конкретного кандидата и пользователя.
Из схемы следует план дальнейшего разбора. Сначала нужно сохранить полезную информацию при превращении входов в числа. Затем — обеспечить подходящие взаимодействия этих чисел. И только после этого общие представления используются для предсказания разных реакций.
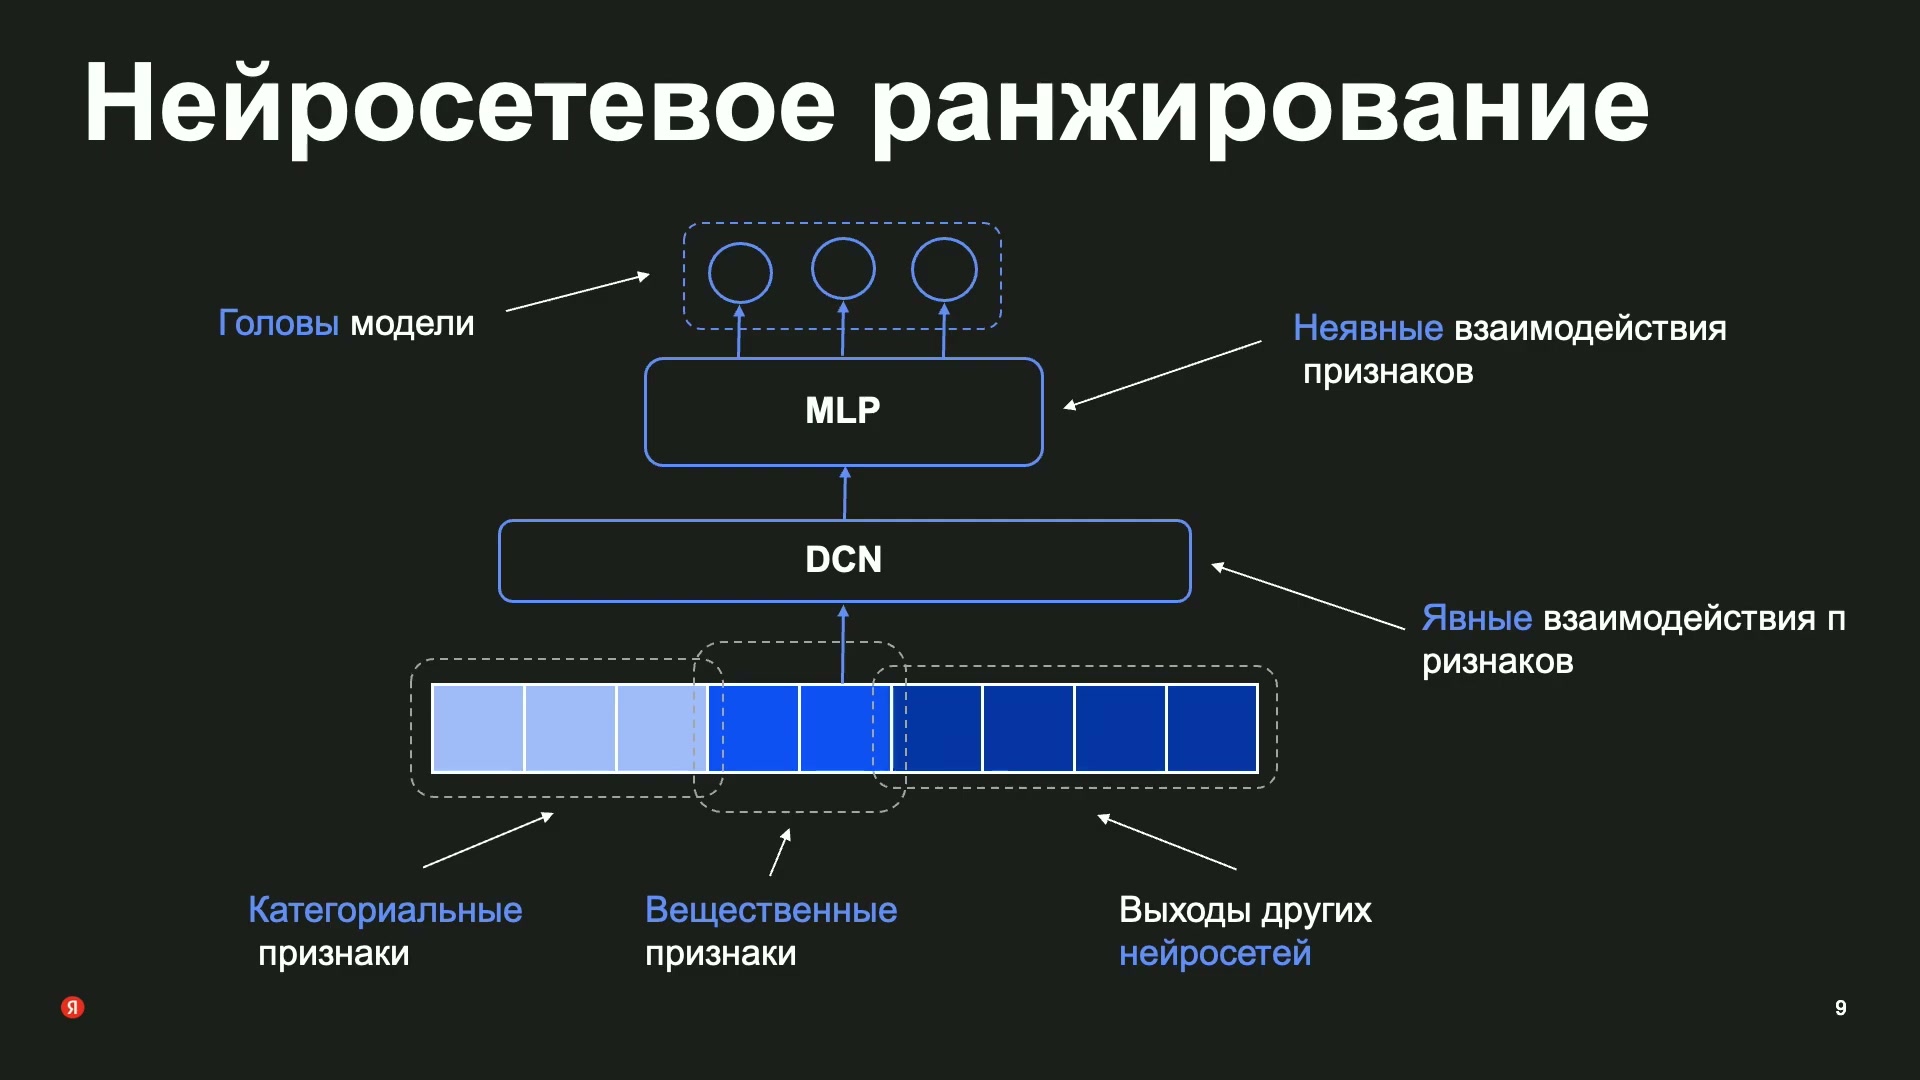
Категориальные, числовые и внешние нейросетевые признаки → явные взаимодействия DCN → неявные взаимодействия MLP → головы модели.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyКатегории и общая таблица векторных представлений
В общей схеме сначала важно сохранить информацию отдельных признаков. Для категории нейросеть использует обучаемый вектор — эмбеддинг. Его координаты подбираются при обучении, а значение категории служит способом выбрать нужную строку таблицы. Благодаря этому идентификатор объекта может участвовать в общей нейросетевой обработке вместе с другими признаками, а не оставаться просто номером.
Автор выделяет признаки с очень большим числом возможных значений. Это свойство называют высокой кардинальностью; типичный пример — идентификатор рекомендуемого объекта. Миллионы и миллиарды объектов в речи иллюстрируют масштаб возможного словаря, но не задают размер каталога в показанных экспериментах. Преимущество обсуждается относительно привычной для команды схемы с бустингом, а не как абсолютный запрет использовать большие категориальные признаки в других моделях.
На слайде отдельно показано переиспользование одной матрицы эмбеддингов для разных признаков — Unified embeddings. Это именно общая обучаемая таблица категориальных представлений. Её не следует путать с универсальной моделью, которая заранее рассчитывает пользовательские или объектные векторы: такие выходы появятся далее как другая группа входов.
Иллюстрация показывает возможность разделять параметры кодирования между признаками. Но она не определяет, какие именно поля разделяют таблицу в конкретном сервисе, как согласованы их идентификаторы и что происходит с новым значением. Эти детали автор не раскрывает. Важная для общей архитектуры мысль уже ясна: категории можно представить непосредственно обучаемыми векторами и передать дальше без сведения всей информации к одному ручному числовому признаку.
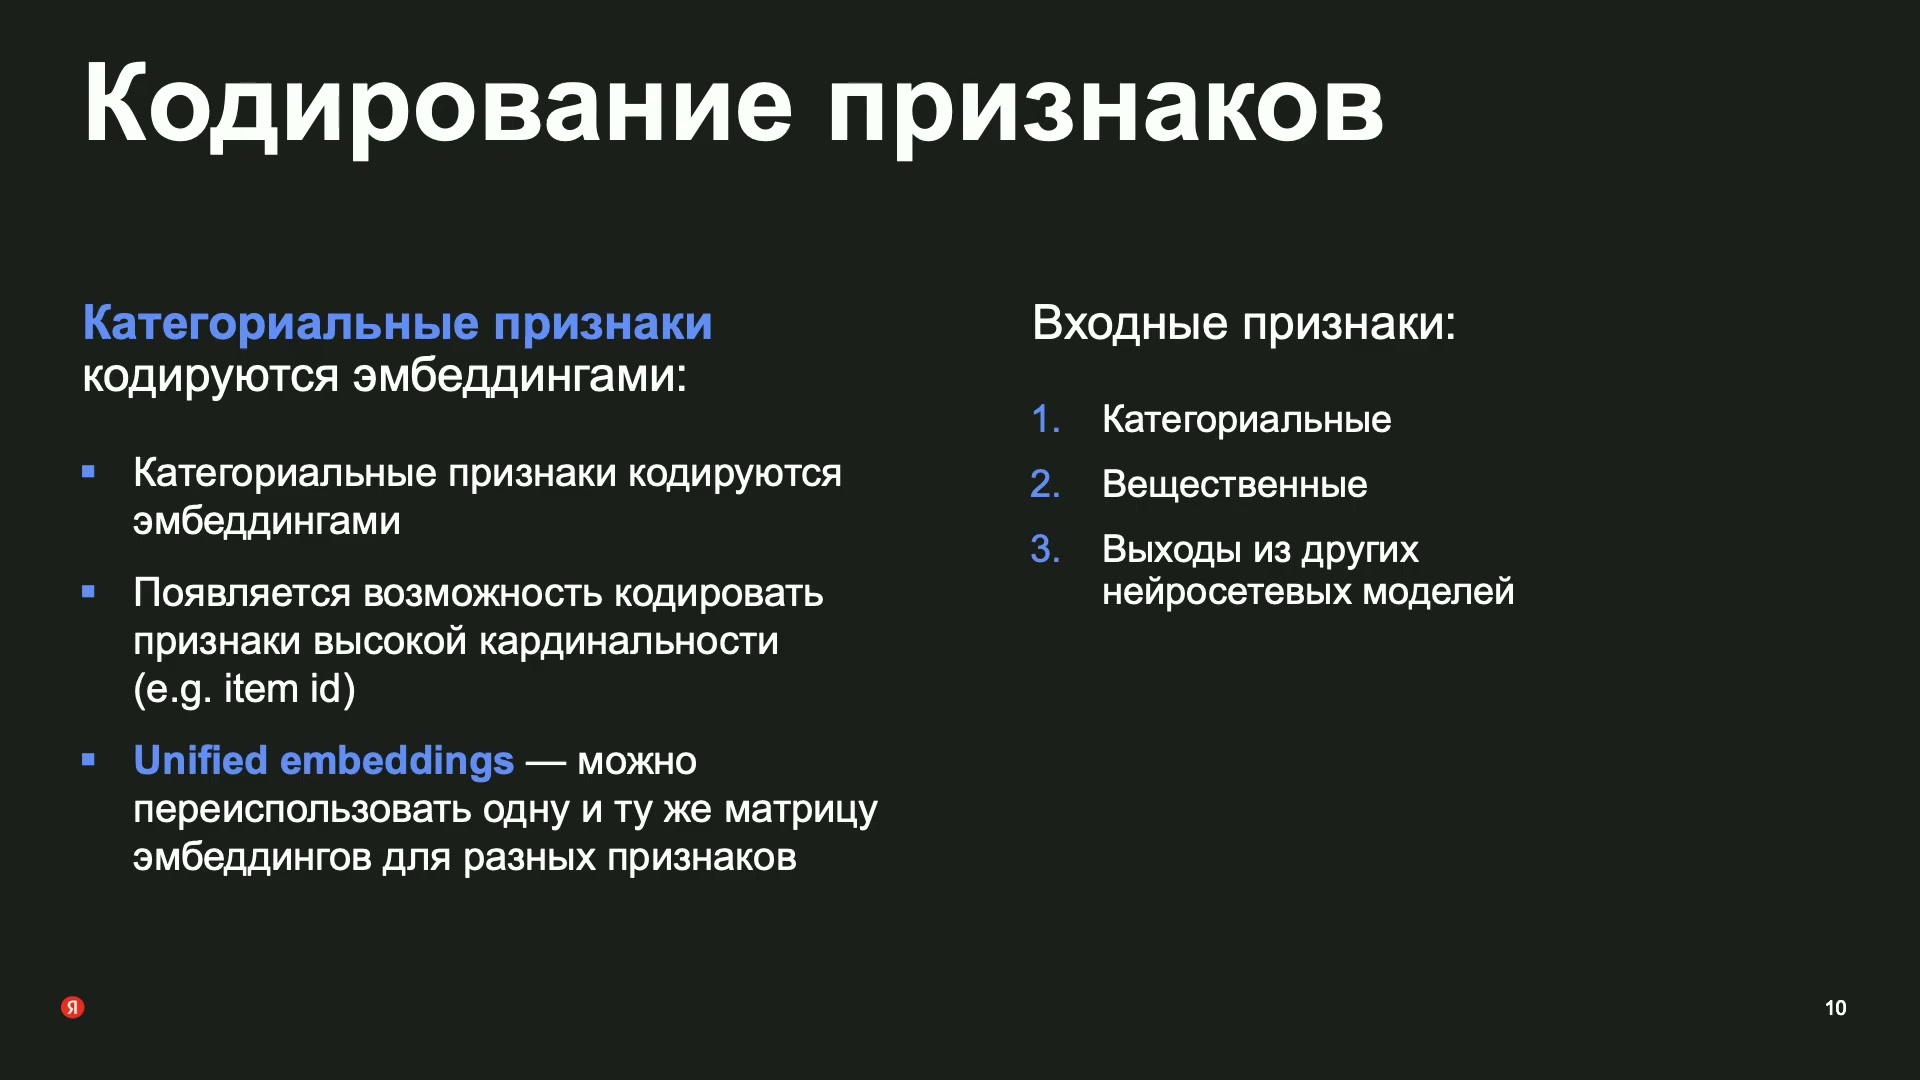
Категории кодируются векторами; матрицу представлений можно переиспользовать для разных признаков. Выходы других моделей остаются отдельной группой входов.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyЧисла: нормализация, интервалы и первый сигмоидный вариант
С числовыми признаками такого прямого решения нет. Их распределения могут быть неравномерными, содержать пропуски и аномальные значения. Автор связывает это с трудностями и обучения, и последующего применения. Поэтому сначала обсуждает подготовку распределения: нормализацию, логарифмирование и обработку аномалий. Здесь меняется представление числа, чтобы модели было удобнее с ним работать.
Другой путь — дискретизация, то есть разбиение значений порогами на интервалы. Для каждого числа определяется интервал, после чего его номер можно обрабатывать как категорию и сопоставлять ему обучаемый вектор. Это удобно, но одно только обозначение интервала теряет часть исходной информации: все значения внутри него получают одинаковый код.
Первым собственным вариантом команды был сквошинг — сжатие нормализованного значения сигмоидой. Сигмоида плавно ограничивает выход; перед ней используются обучаемые масштаб и сдвиг. По объяснению автора, такая обработка нужна прежде всего для уменьшения влияния аномалий. Можно использовать несколько сигмоид с разными обучаемыми параметрами и получить из одного числового признака небольшой вектор.
Однако этот вариант не оказался окончательным. На слайде прямо сказано, что кусочно-линейное кодирование работает лучше. Отдельного численного сравнения с сигмоидой автор не показывает, поэтому речь о выборе по опыту команды, а не о доказательстве полной непригодности первого подхода. Следующее изменение возвращает информацию, которую теряла обычная дискретизация.
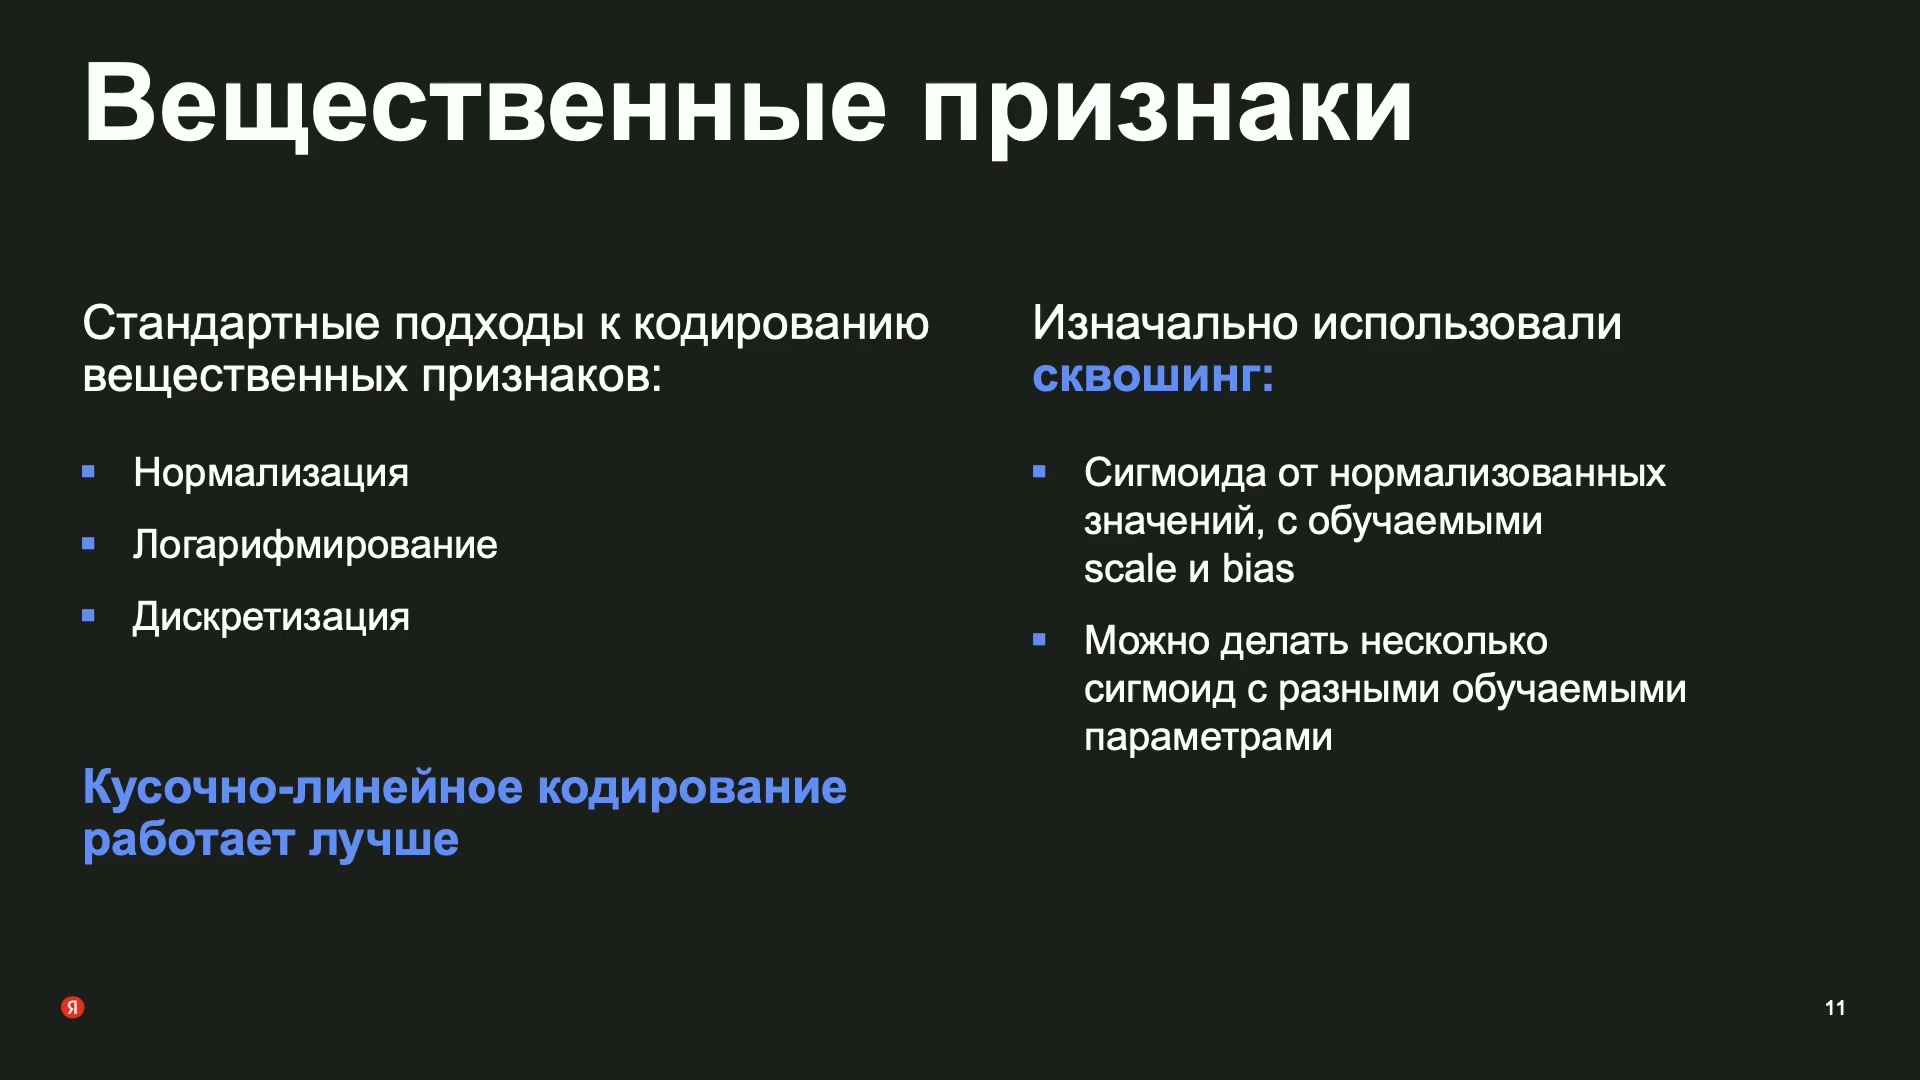
Сначала числовые признаки кодировали сигмоидой с обучаемыми масштабом и сдвигом. Автор предпочитает кусочно-линейное кодирование; численная абляция этого решения не приведена.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyИсходное кусочно-линейное кодирование: сохранить порядок и положение
У обычного кода интервала есть два недостатка. Во-первых, он не показывает, где именно лежит число: у левой границы, у правой или между ними. Во-вторых, из отдельных категориальных кодов напрямую не следует порядок интервалов. Для рекомендательной модели оба различия могут быть полезны: число несёт больше информации, чем просто принадлежность к некоторой группе.
Кусочно-линейное кодирование, или PLE, дополняет номер интервала положением внутри него. Автор описывает идею так: пройденные интервалы отмечаются единицами, а текущая координата показывает долю уже пройденной ширины интервала. В примере на слайде заданы пороги b₀, b₁, b₂, b₃; значение x находится между b₁ и b₂. Знаменатель дроби — ширина этого интервала, числитель — расстояние от его левой границы до x.
Именно этот четырёхкомпонентный пример показан на слайде 12. Это не общая формула всех координат кодировщика.
Две единицы в данном примере сохраняют информацию о пройденной части шкалы, дробная координата уточняет положение x между соседними порогами, а последняя координата остаётся нулевой. В отличие от одного номера интервала, представление различает значения внутри него. Это и есть смысл иллюстрации: вернуть порядок и локальное положение числа, а не просто увеличить длину входа.
По этому рисунку нельзя установить полную индексацию произвольного числа интервалов, выбор порогов или обработку значений за крайними границами. Следующий шаг команды также важно рассматривать отдельно: для быстрого применения автор описывает изменённый способ получения вектора, а не дословное повторение этого рисунка.
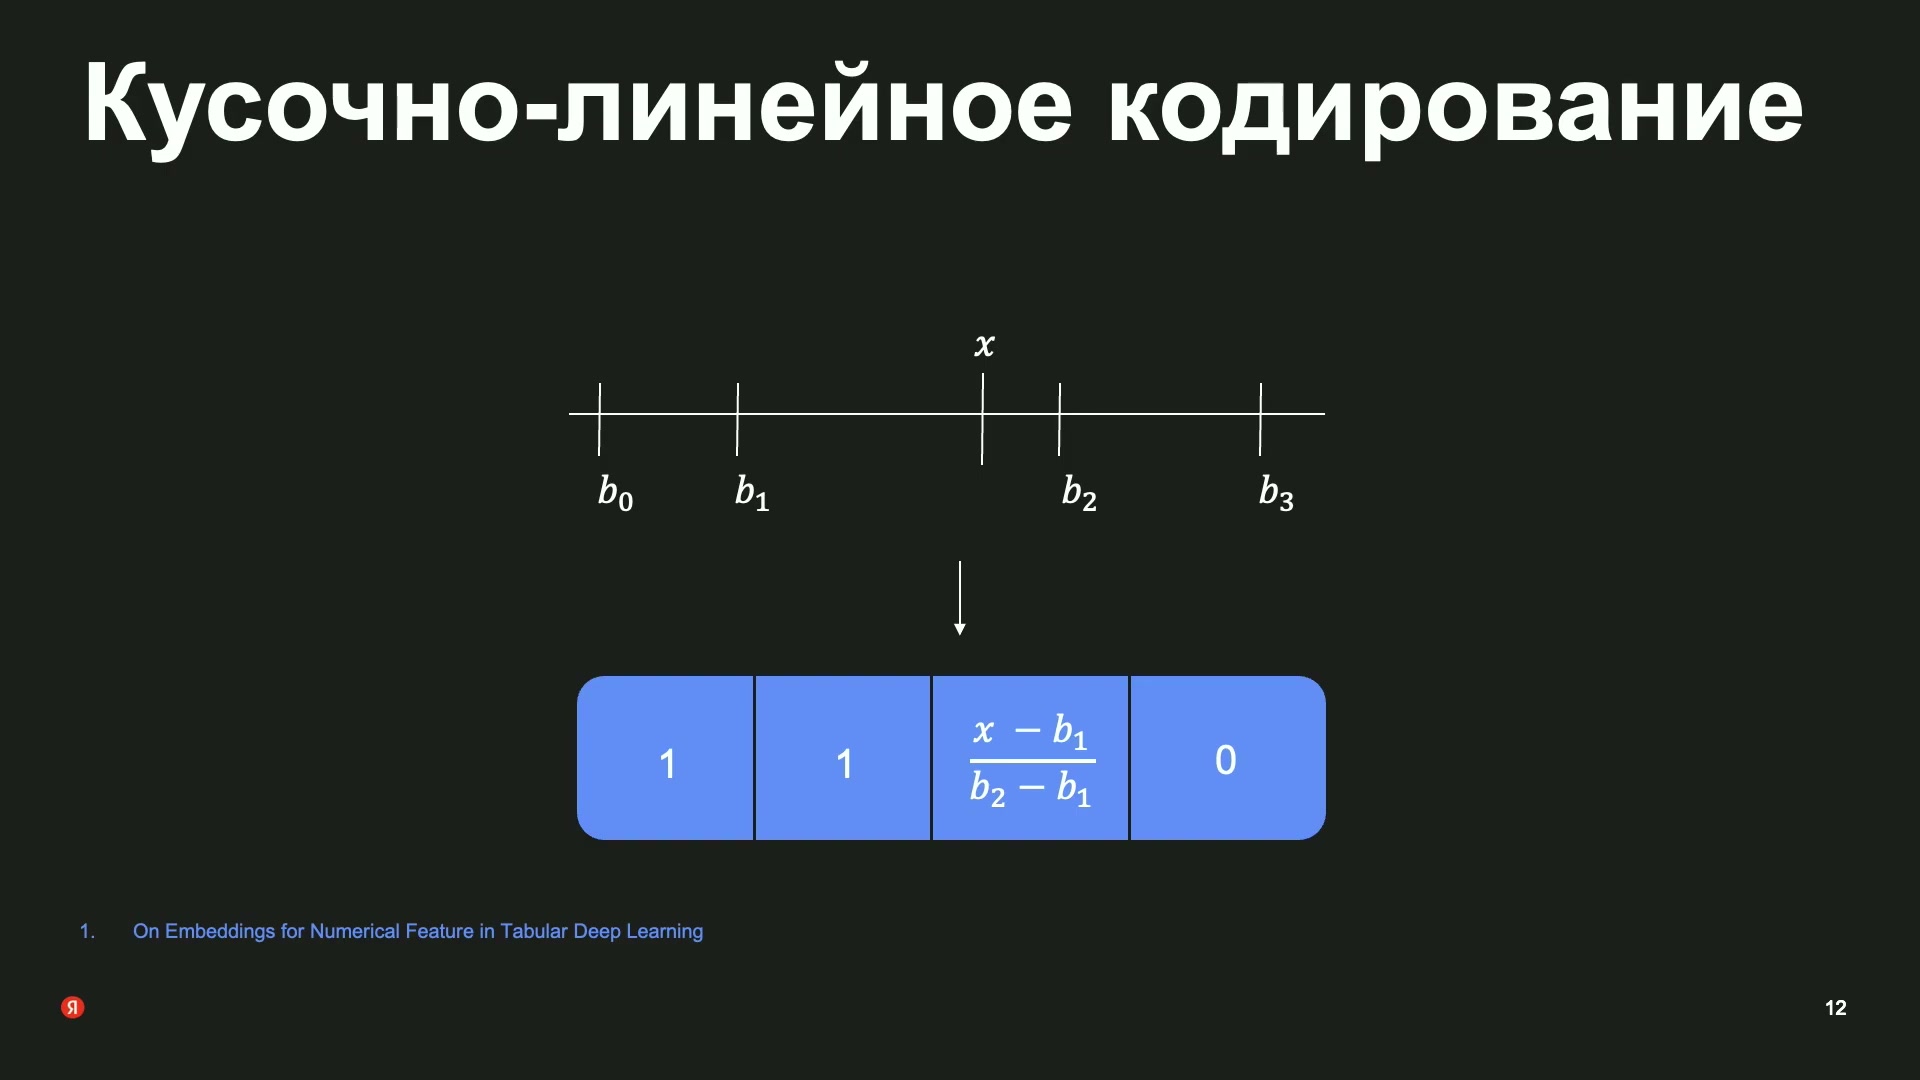
Показанный пример кусочно-линейного кодирования: x между b₁ и b₂ → [1,1,(x−b₁)/(b₂−b₁),0]. Общую конфигурацию интервалов не следует восстанавливать по одному рисунку.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyУскоренный вариант: интерполяция соседних обучаемых векторов
Исходная схема сохраняет полезные свойства числа, но для большого сервиса важна и стоимость её применения. Поэтому после объяснения PLE автор переходит к собственному упрощению. В устном описании он начинает с замены единиц нулями, а затем формулирует практическую конструкцию через обучаемые векторы порогов. Эти два уровня рассказа нельзя смешивать: рисунок показывает исходный пример, последующая речь — адаптацию.
Каждому порогу сопоставляется обучаемый вектор нужной размерности. Для конкретного числа определяют интервал, в который оно попало, и берут векторы двух соседних порогов — границ этого интервала. Затем получают их выпуклую комбинацию: взвешенную сумму, в которой веса неотрицательны и в сумме равны единице. Положение числа определяет, как распределяется вклад между левым и правым векторами.
Такую операцию называют интерполяцией. Чем ближе значение к одному из порогов, тем больше в итоговом представлении вклад соответствующего вектора. Модель по-прежнему получает информацию о положении числа внутри интервала, но вычисление описано уже через два соседних представления, а не через построение всего иллюстративного кода с накопленными единицами.
Причина изменения — возможность быстрее применять кодирование в высоконагруженных сервисах. Полного алгебраического перехода от первой схемы ко второй и отдельного измерения ускорения автор не приводит. Поэтому здесь сохраняется именно раскрытая конструкция: соседние обучаемые векторы, положение между порогами и их интерполяция. Правила выбора границ и обработки пропусков по-прежнему не определены.
Доклад · 00:07:33Почему одной полносвязной сети не хватило
После кодирования кажется естественным соединить все векторы и передать их обычной полносвязной сети. Но, по словам автора, такой вариант теряет заметную часть качества. В рекомендациях важны не только значения отдельных признаков, но и их сочетания. Полносвязным слоям приходится учиться этим сочетаниям неявно, и в рассмотренной задаче это оказалось недостаточно эффективным.
Пример на слайде — страна и язык. Можно обучить отдельный вектор страны, отдельный вектор языка, а затем добавить представление их пары. Пара несёт информацию, которой нет в простом перечислении двух независимых значений. Однако при сотнях или тысячах исходных признаков попытка отдельно завести представления всех пар, троек и более сложных комбинаций становится непрактичной.
Отсюда возникает требование к специальному слою: он должен выражать взаимодействия, не заставляя вручную перечислять все возможные составные признаки. На слайде названы DCN-V2, MaskNet и FibiNet. Это альтернативные способы моделирования взаимодействий, а не три последовательных блока одной системы. Команда выбирает не по качеству в отрыве от ресурсов, а по соотношению качества и скорости.
Рисунок со страной и языком объясняет, зачем добавлять такой слой перед общей нелинейной обработкой. Он не утверждает, что MLP математически неспособна представить взаимодействия. Речь о том, что явная структура делает их обучение полезнее в описанном сравнении. Дальше автор подробно разбирает выбранный cross-слой семейства DCN.
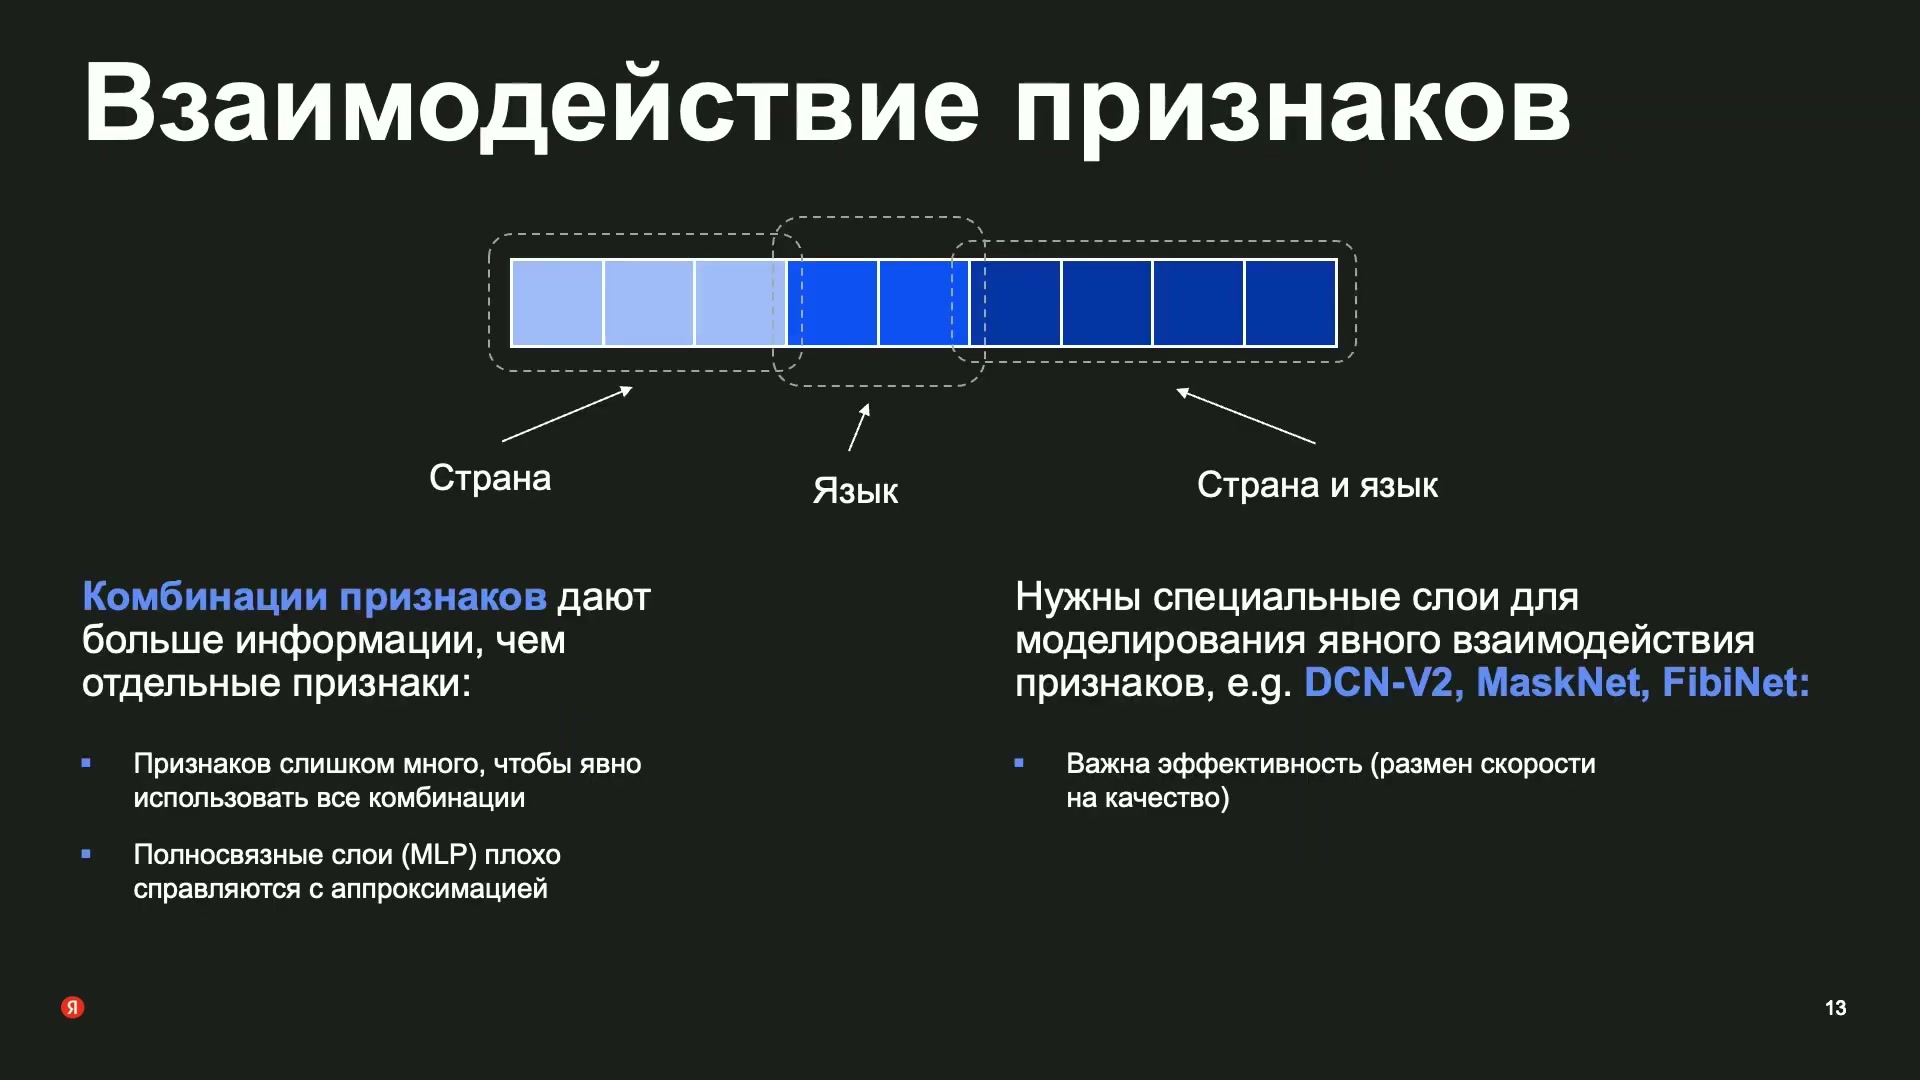
Явные сочетания признаков дополняют их отдельные значения. DCN-V2, MaskNet и FibiNet названы альтернативами; не все перечисленные модели объявлены внедрёнными.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyDCN: явные взаимодействия и цена большой матрицы
Слой явных взаимодействий, который автор называет cross-слоем, связывает текущее представление с исходным вектором признаков. Обозначим исходный вектор через x₀, а выход предыдущего слоя — через xᵢ. Сначала к xᵢ применяется линейное преобразование: умножение на обучаемую матрицу W и прибавление обучаемого вектора b. Затем результат покоординатно умножается на x₀. Именно здесь исходные признаки непосредственно участвуют во взаимодействиях.
Наконец, к полученному результату прибавляется xᵢ. Такой прямой путь от предыдущего представления называют остаточной связью. Она входит в показанную формулу, а не является отдельным необязательным дополнением:
Формула со слайда 14: x₀ — исходные признаки, xᵢ — предыдущее представление, W и b — обучаемые параметры, ⊙ — покоординатное умножение.
Важная особенность схемы — повторное обращение к исходному x₀. Автор связывает последовательность из L таких слоёв с моделированием сочетаний порядка L+1. На практике большую часть выигрыша у команды дал один слой. Второй немного улучшал качество, но увеличивал вычислительную стоимость; точные значения сравнения глубины не показаны.
Для объяснения стоимости автор предлагает пример: есть 1 000 признаков, каждый представлен вектором размерности 4. После соединения получается вектор длины 4 000. Полная квадратная матрица линейного преобразования тогда имеет размер 4 000 × 4 000. Поэтому даже один дополнительный слой может оказаться дорогим. Это иллюстрация вычислений, а не точное число признаков в итоговой модели.
Из формулы и рисунка видно, что плата за явные взаимодействия сосредоточена в большом матричном умножении. Отказ от всех взаимодействий вернул бы потерю качества, а простое наращивание глубины увеличило бы задержку. Следующий шаг сохраняет роль слоя, но меняет способ выполнения его линейной части.
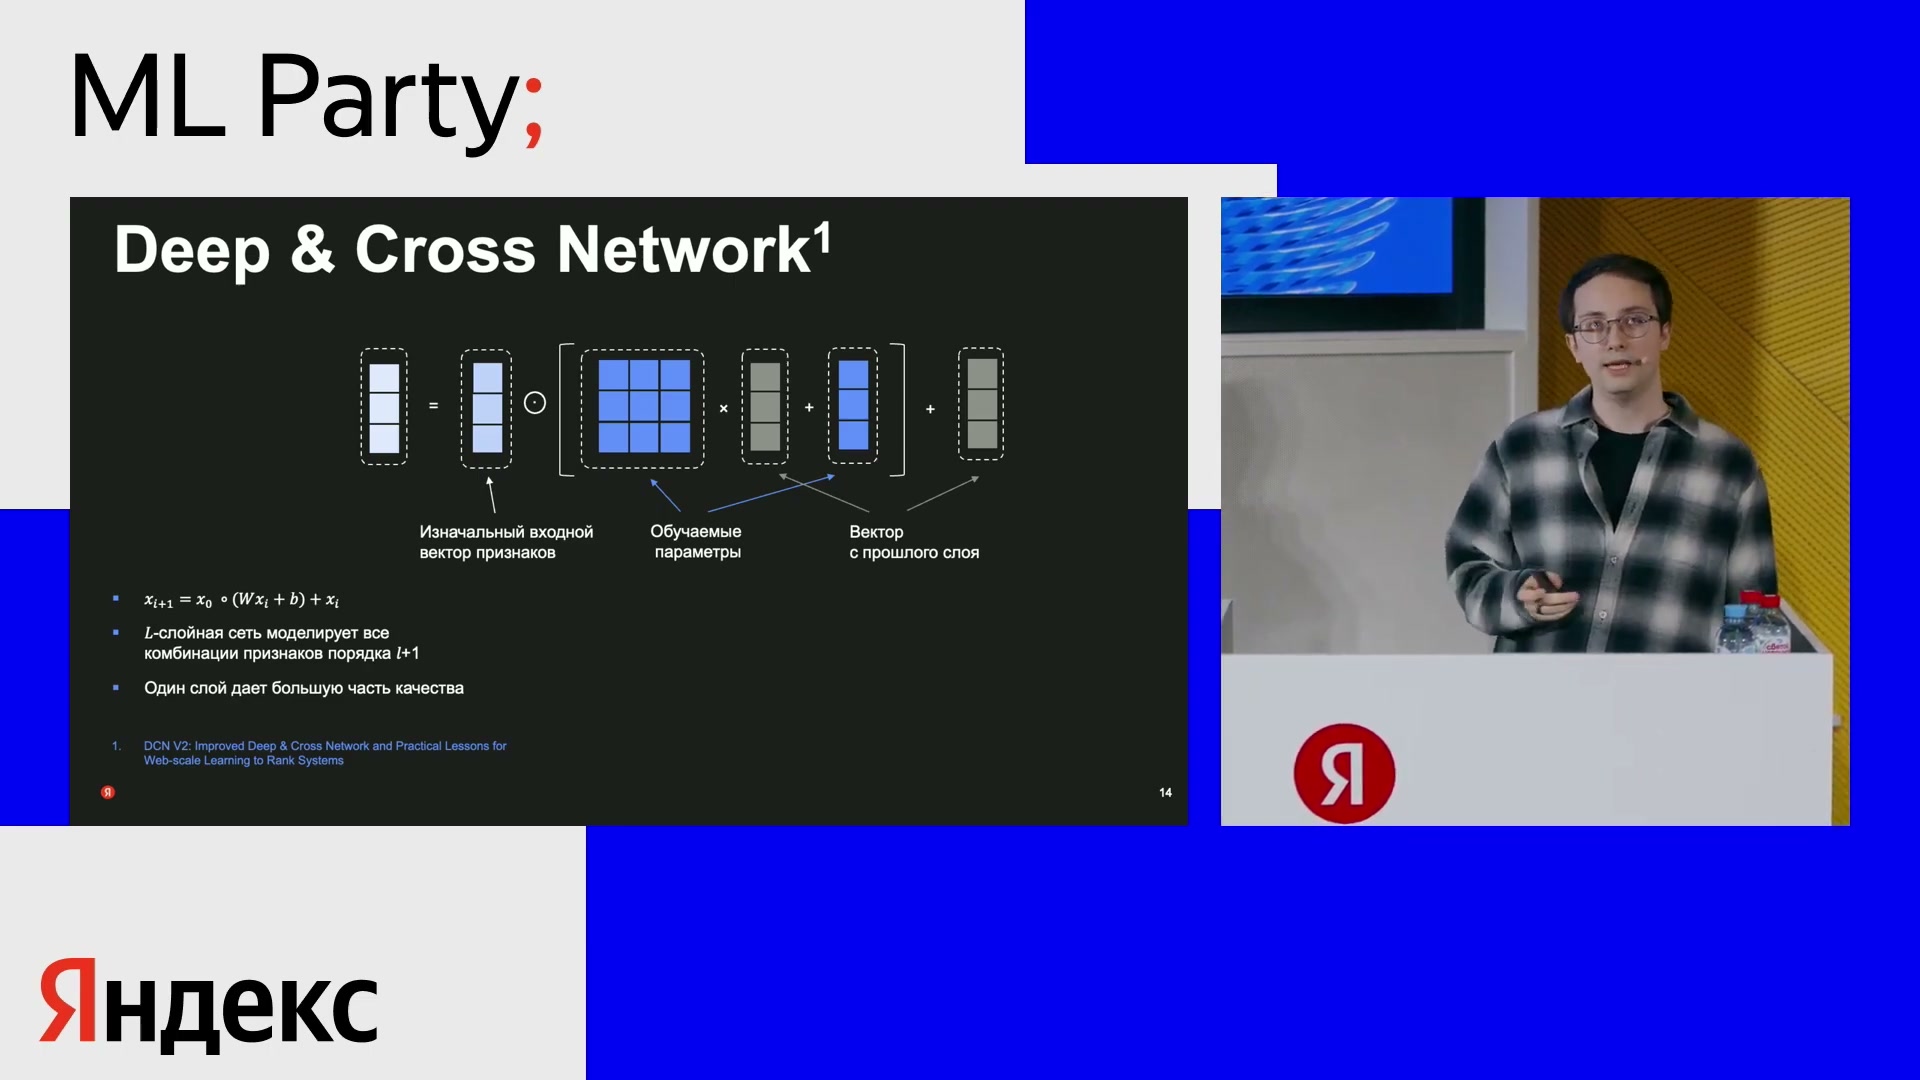
Cross-слой: xᵢ₊₁ = x₀ ⊙ (W xᵢ + b) + xᵢ. Формула и схема заимствованы из объяснения DCN-V2; источник отдельно говорит о пользе одного слоя.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyНизкий ранг: заменить большое умножение двумя меньшими
Узкое место большого cross-слоя — умножение на квадратную матрицу. Автор заменяет её двумя прямоугольными множителями с небольшой внутренней размерностью. Это низкоранговое разложение: преобразование проходит через промежуточный вектор существенно короче исходного.
На рисунке длина исходного вектора обозначена m, а малая внутренняя размерность — d, причём d намного меньше m. Первый множитель по порядку применения сжимает вектор до d координат, второй возвращает его к длине m. Если обозначить эти матрицы V и U, показанную конструкцию можно записать так:
Запись схемы со слайда 15; буквы U и V введены для двух изображённых множителей. Это пояснение низкоранговой параметризации, не описание отдельного алгоритма разложения уже обученной матрицы.
По размерам матриц видно, откуда берётся экономия: полное умножение требует объёма вычислений порядка m², а два узких — порядка md. Это оценка по изображённым размерам, не измеренный коэффициент ускорения сервиса. Конкретный выигрыш зависит от выбранного ранга и выполнения операций.
На слайде также отмечено переиспользование результата умножения, дающего низкоразмерную проекцию. Автор говорит, что это оказалось полезно на практике. Но точное место её дополнительного подключения не раскрыто достаточно подробно. Из этой реплики нельзя вывести отдельный кеш между пользовательскими запросами или срок хранения проекции.
Главный вывод схемы — явные взаимодействия не обязательно требуют полной большой матрицы. Команда сохраняет cross-слой, ограничивая его внутреннюю размерность, а не заменяет весь ранжировщик простым скалярным сравнением.
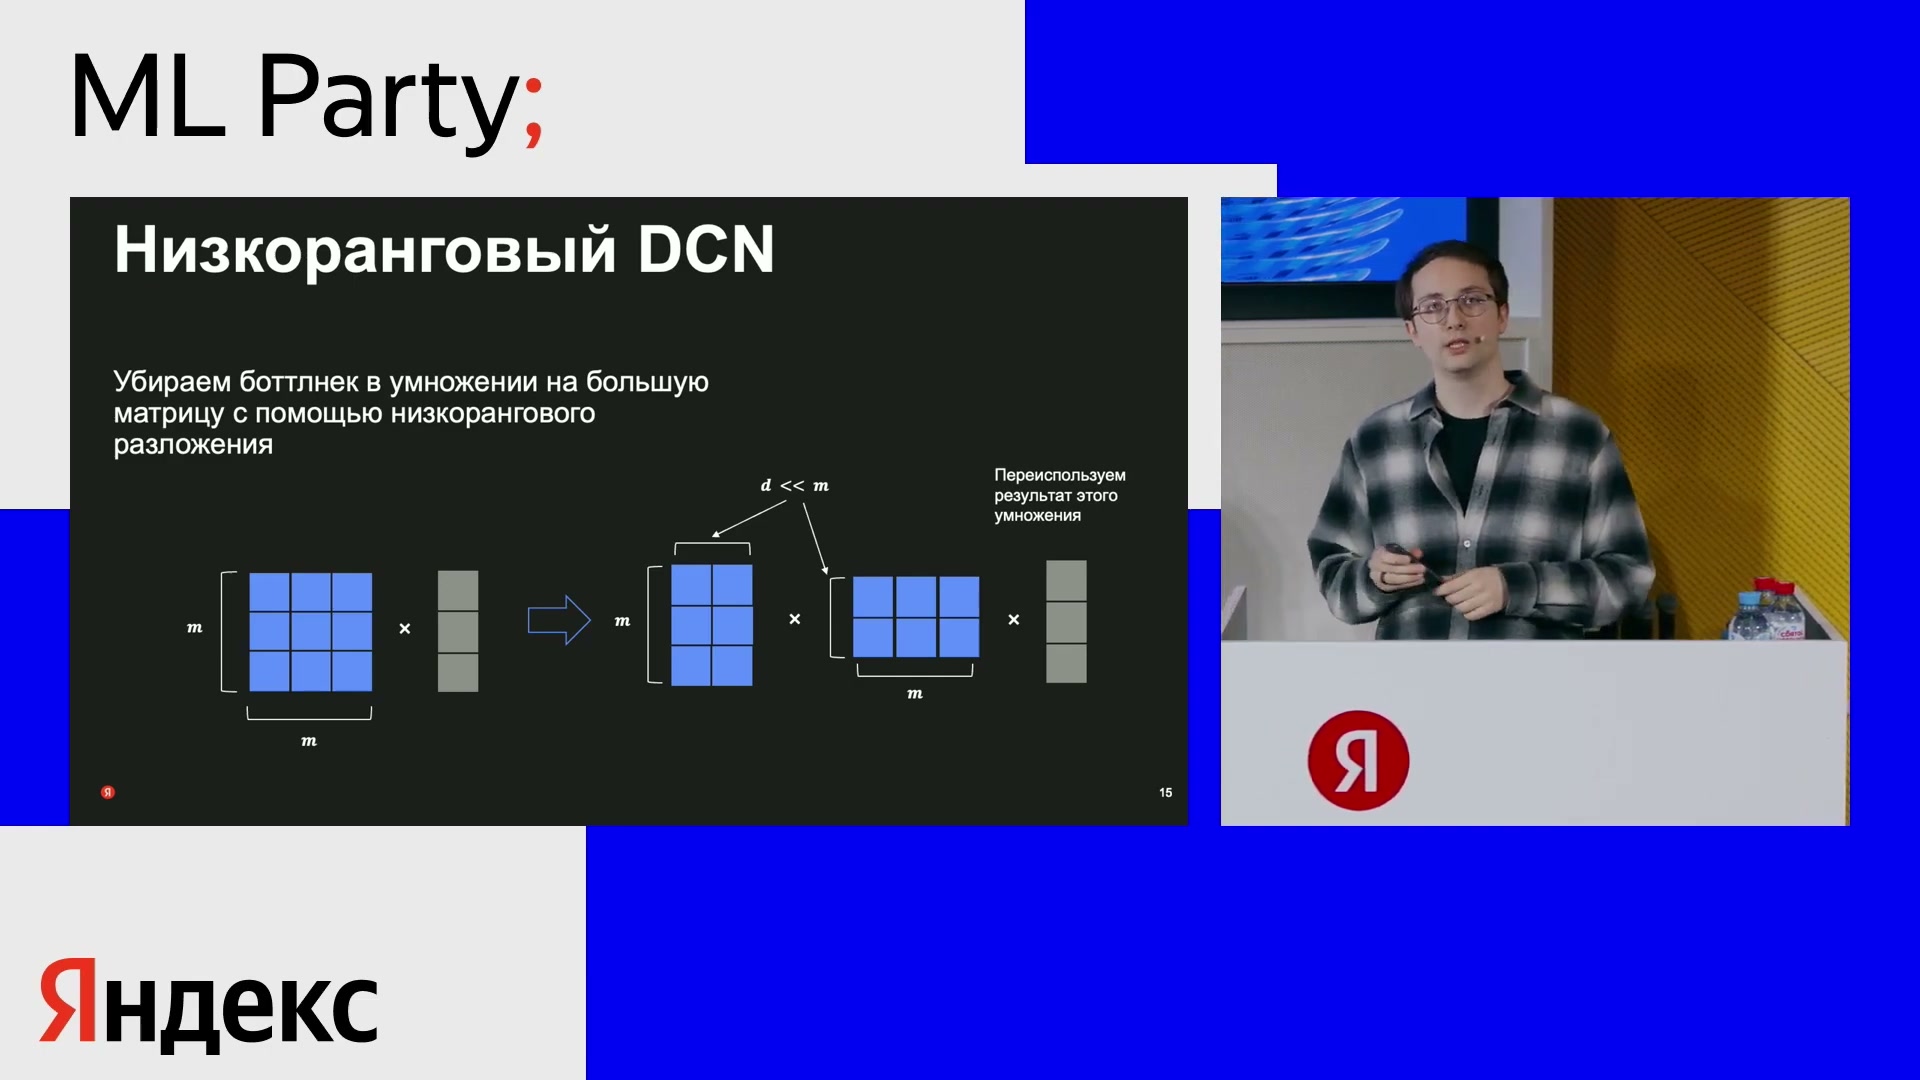
Большую матрицу заменяют низкоранговыми множителями с d≪m. Слайд отмечает переиспользование проекции; полного режима кеширования между запросами не раскрывает.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyПочему DCN не заменяет MLP и почему важен порядок слоёв
Низкий ранг делает слой дешевле, но не меняет его специализацию. DCN хорошо моделирует сочетания признаков; для других, более сложных нелинейных зависимостей автор оставляет полносвязные слои. Поэтому выбор между DCN и MLP здесь ложный: в описываемом ранжировщике они дополняют друг друга.
Автор называет два способа соединения. При параллельной схеме исходное представление отдельно обрабатывается DCN и MLP, после чего результаты объединяются. При последовательной сначала применяется DCN, затем MLP. Именно последовательная схема показана в общем изображении ранжировщика. Возможность параллельного варианта не означает, что оба одновременно используются в итоговой конфигурации.
Обратная последовательность — DCN поверх уже преобразованного нейросетевого выхода — в опыте автора работала хуже. Его объяснение состоит в том, что cross-слою важно получать вектор с интерпретацией в терминах исходных признаков. Поэтому он помещается до общей полносвязной обработки. Это не запрет использовать готовые внешние эмбеддинги: они, как и раньше, входят отдельными частями в исходный вектор. Замечание относится к порядку преобразований всего представления.
Низкоранговые преобразования команда затем стала использовать и в полносвязных слоях. По словам автора, это тоже ускоряло модель без наблюдаемой потери качества. Отдельного численного сравнения не приведено. В результате задача проектирования сводится не к максимальному числу слоёв, а к подходящему сочетанию явных взаимодействий, общей нелинейной обработки и экономичных матричных операций.
Доклад · 00:10:46Готовые представления и обучение обработки истории под ранжирование
Помимо категорий и чисел, модель может получать уже рассчитанные нейросетевые представления. Автор различает универсальные модели, которые готовят пользовательские или объектные векторы для многих задач экосистемы, и прикладные модели конкретного ранжирования. Первые он называет upstream-моделями, вторые — downstream-моделями. По-русски это различие между общим источником представлений и задачей, которая их использует.
Первое направление — переиспользовать результат универсальной модели. Она формирует единый вектор пользователя или объекта, а разные ранжировщики получают этот вектор как вход. В таком варианте не требуется заново извлекать всю информацию из исходной истории для каждого прикладного обучения.
Второе направление — обучать обработку исходных данных специально под ранжирование. Модуль, превращающий историю в представление, можно включить в общую обучаемую систему. Тогда он подстраивается под задачу вместе с последующими слоями. Такое совместное обучение от входного сигнала до конечной цели называют сквозным, или end-to-end.
На слайде перечислены YouTubeDNN, DIN, BST и TransAct как примеры подходов к анализу пользовательской истории. Они не составляют единый собственный стек Яндекса. Там же обозначено ограничение: на небольших наборах данных сквозная обработка может переобучаться, то есть подстраиваться под обучающие примеры без сопоставимого улучшения на новых данных.
Иллюстрация противопоставляет не «старый» и «новый» обязательные этапы, а способы использовать нейросетевую информацию. Готовые представления и обучение под прикладную задачу можно сочетать. Следующая схема делает это различие особенно наглядным, разделяя историю на длинную и свежую части.
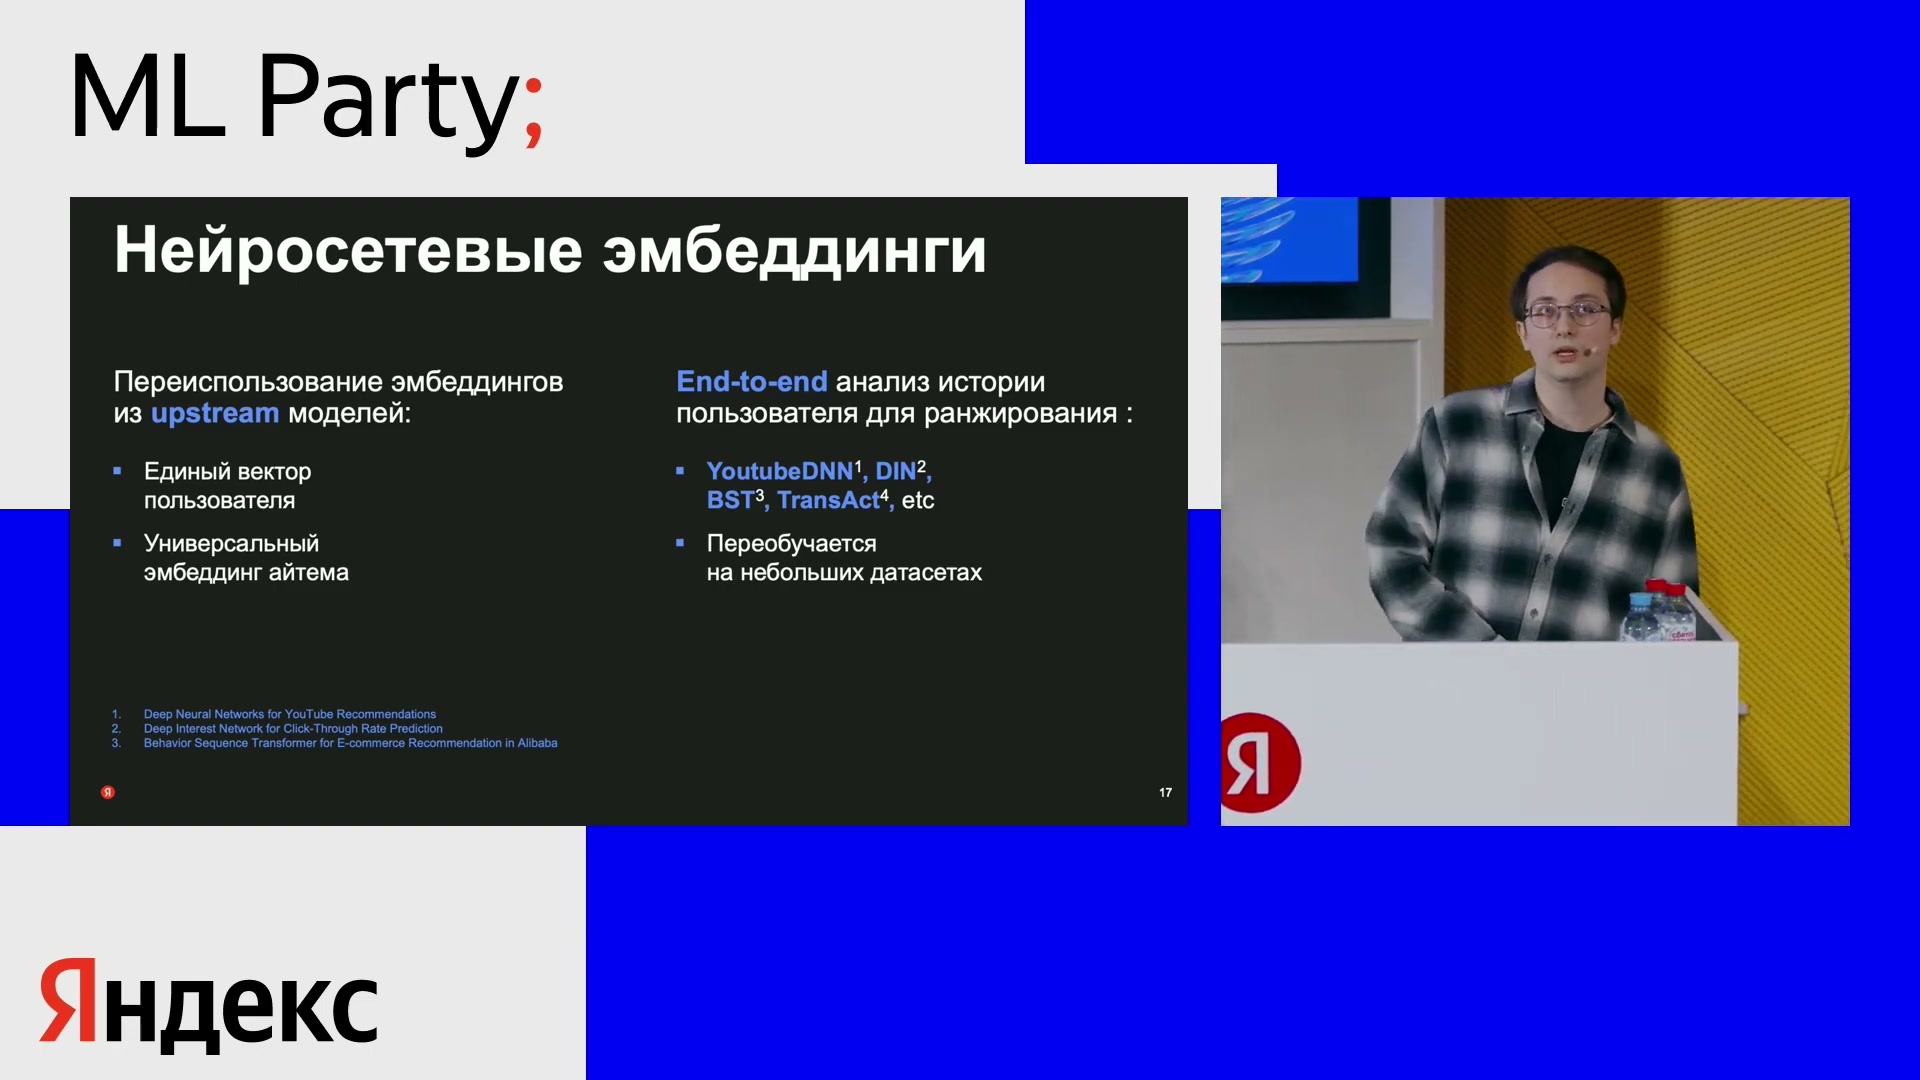
Готовые пользовательские и товарные векторы сравниваются с отдельным обучением истории целиком. YouTubeDNN/DIN/BST/TransAct — упомянутые внешние подходы, не единый собственный стек Яндекса.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyДлинная история — заранее, свежая — при запросе
Разделение на два вида представлений даёт способ совместить большой объём прошлого поведения со свежими действиями. Автор предлагает представить длинную историю пользователя: например, события за последний год, порядка тысячи событий. Эти числа — объясняющий пример, а не объявленные ограничения рабочего ранжировщика.
Длинную историю можно обрабатывать отдельной моделью, сжимать в пользовательский вектор и пересчитывать заранее, вне обслуживания запроса. Такой режим называют офлайн-обработкой. На схеме её выполняет Offline encoder — модель-кодировщик длинной истории. Во время ранжирования нужен уже готовый результат; повторно запускать эту тяжёлую обработку для каждого ответа не требуется.
Свежую короткую историю, напротив, анализирует небольшая модель во время запроса. На слайде она названа Real-time encoder. Её можно обучать совместно со всем ранжированием, чтобы она извлекала сведения, полезные именно для предсказания реакции на кандидатов. Представления обеих частей истории соединяются с остальными признаками и поступают в DCN и MLP.
Автор связывает такую обработку с возможностью заменить часть ручных признаков. Например, в обычном ранжировщике есть счётчики того, сколько раз объект или его атрибут встречался в истории пользователя. Обучаемый анализ последовательности, особенно при раннем взаимодействии с кандидатом, может извлекать подобные зависимости сам. Это возможность сократить ручную подготовку, а не утверждение, что все счётчики в описанной системе уже удалены.
Главный смысл схемы — не компромисс «либо длинная, либо свежая история», а два разных места вычисления. Заранее можно позволить себе больше истории; в запросе — быстро учесть недавнее поведение. Конкретные длины обеих последовательностей, частота пересчёта длинного вектора и внутреннее устройство взаимодействия с кандидатом здесь не раскрыты.
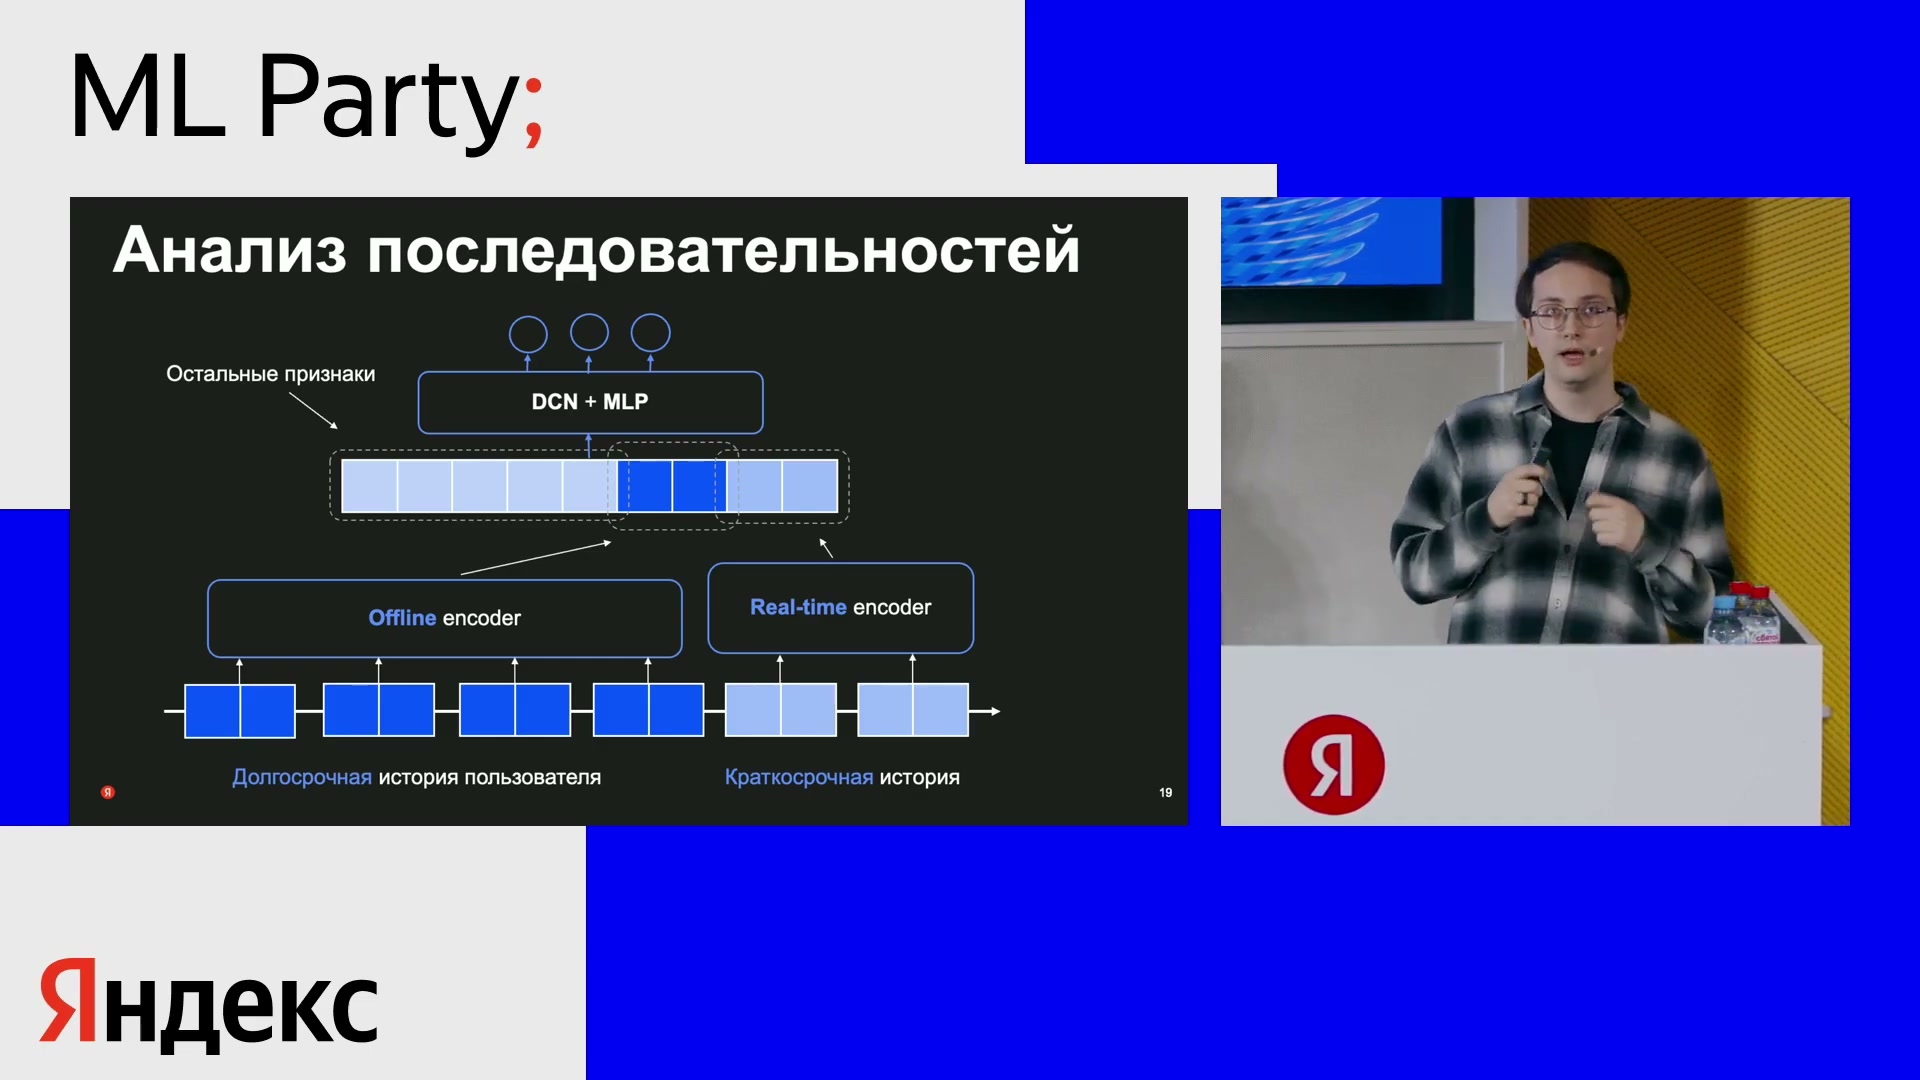
Длинная история обрабатывается заранее, короткая — при запросе. Их представления объединяются с другими признаками в DCN+MLP.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyНесколько реакций: общая модель и разные выходные задачи
Представление пользователя и кандидата может быть полезно сразу для нескольких прогнозов. В торговом сервисе автор приводит клик и покупку, в музыкальном — лайк и прослушивание. Если следовать привычной для команды схеме с CatBoost, для этих задач обычно готовятся разные модели. Нейросеть позволяет оставить общие слои и разделить только выходные модули — головы.
Такое совместное обучение на нескольких задачах называют многозадачным, или multitask learning. Его первое преимущество — экономия ресурсов: часть вычислений выполняется один раз. На слайде две отдельные модели для клика и покупки заменяются общей сетью, у которой есть также выход для дополнительного сигнала. Название этого сигнала не уточняется.
Второе преимущество — перенос полезной информации между задачами. Событий одного вида может быть мало, либо они могут быть слишком шумными для самостоятельного обучения. Более частый и простой сигнал помогает общей части модели сформировать представление, которое затем использует и сложная задача. Автор описывает ситуацию, когда отдельный CatBoost почти не обучается на некоторой цели, но объединение этой цели с другой внутри нейросети даёт заметно лучший результат.
Схема объясняет, почему несколько голов — не просто удобный способ вернуть несколько чисел. Их обучение связано через общие параметры. При этом в докладе нет полного набора голов для каждого экспериментального сервиса, весов их функций потерь или формулы, которая превращает прогнозы разных реакций в итоговый порядок. Клик, покупка, лайк и прослушивание остаются отдельными целями, а не одной автоматически сопоставимой шкалой.
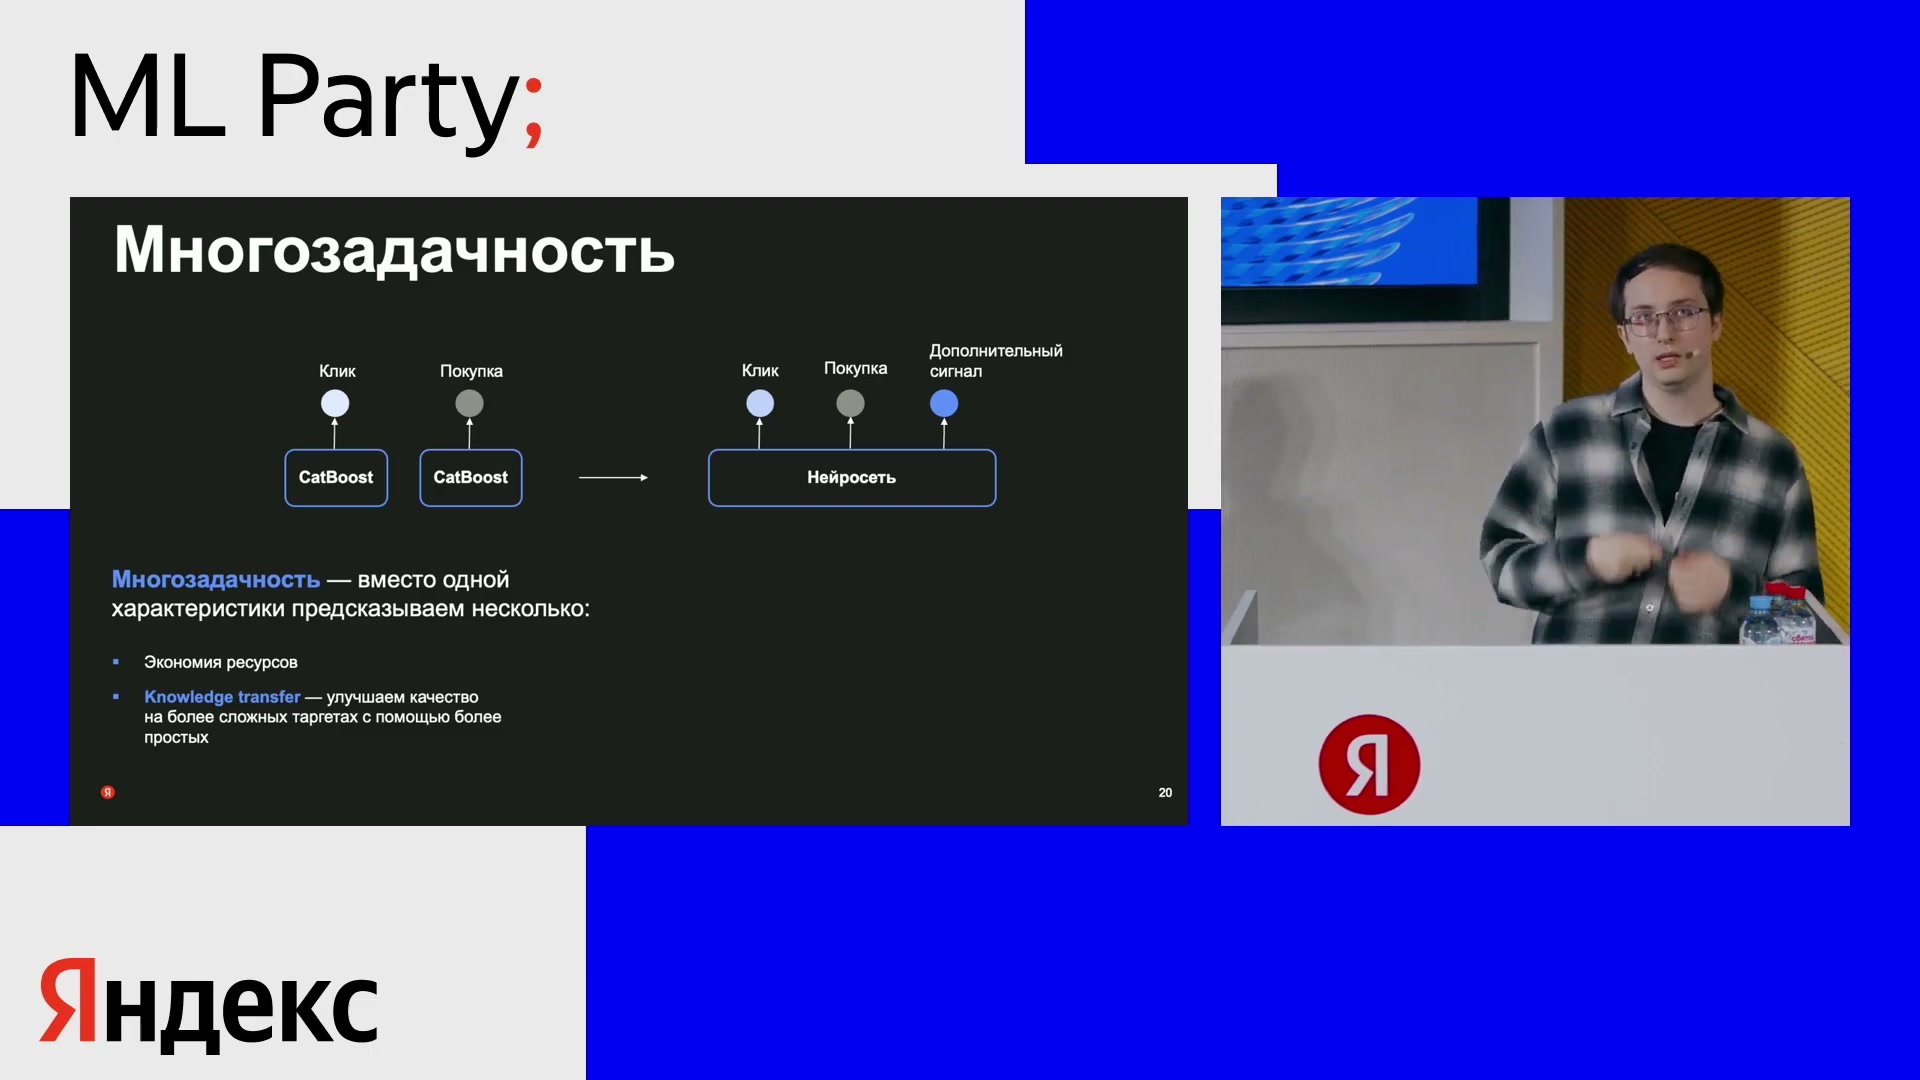
Общие слои и разные головы для разных целей. Обучение нескольких задач не означает единой метрики или одинаковой шкалы их выходов.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyПочему преимущества архитектуры зависят от количества данных
После обработки признаков, истории и разных целей автор возвращается к исходному вопросу о бустинге. Все перечисленные возможности повышают выразительность модели — её способность описывать разнообразные зависимости. Но наличие такой способности не означает, что она реализуется на любом обучающем наборе.
Большой объём данных позволяет использовать более сложную модель и учить богатые представления. При недостатке данных та же сложность увеличивает риск переобучения. Поэтому у нейросетевого ранжирования, в авторской формулировке, есть одновременно большой потенциал масштабирования и высокая потребность в примерах. Увеличение модели само по себе не заменяет достаточного обучающего сигнала.
Так автор объясняет часть различий между академическими и промышленными результатами. Он говорит, что используемые в академических сравнениях наборы могут быть в десятки или сотни тысяч раз меньше доступных промышленным рекомендательным сервисам. Это его оценка масштаба, а не представленная таблица сопоставимых наборов. Аналогия с языковым моделированием, где используются нейросети, также служит иллюстрацией выразительности, но не отдельным экспериментальным доказательством в пользу данного ранжировщика.
На слайде приведено и внешнее наблюдение ShareChat о более сильном улучшении нейросетевого ранжировщика при росте данных. Его нельзя считать измерением Яндекса. Собственная проверка команды будет показана дальше. Из иллюстрации следует условие применимости идеи: архитектуру и размер данных нужно рассматривать вместе, а не переносить вывод о качестве между произвольными задачами.
Перед экспериментами автор ещё раз собирает решение: обучаемые категории, кусочно-линейные числовые представления, явные взаимодействия DCN, неявные зависимости MLP, готовые и прикладные представления истории, несколько выходных задач. Масштабирование по данным связывает эти части: без него значительная часть возможностей может остаться невостребованной.
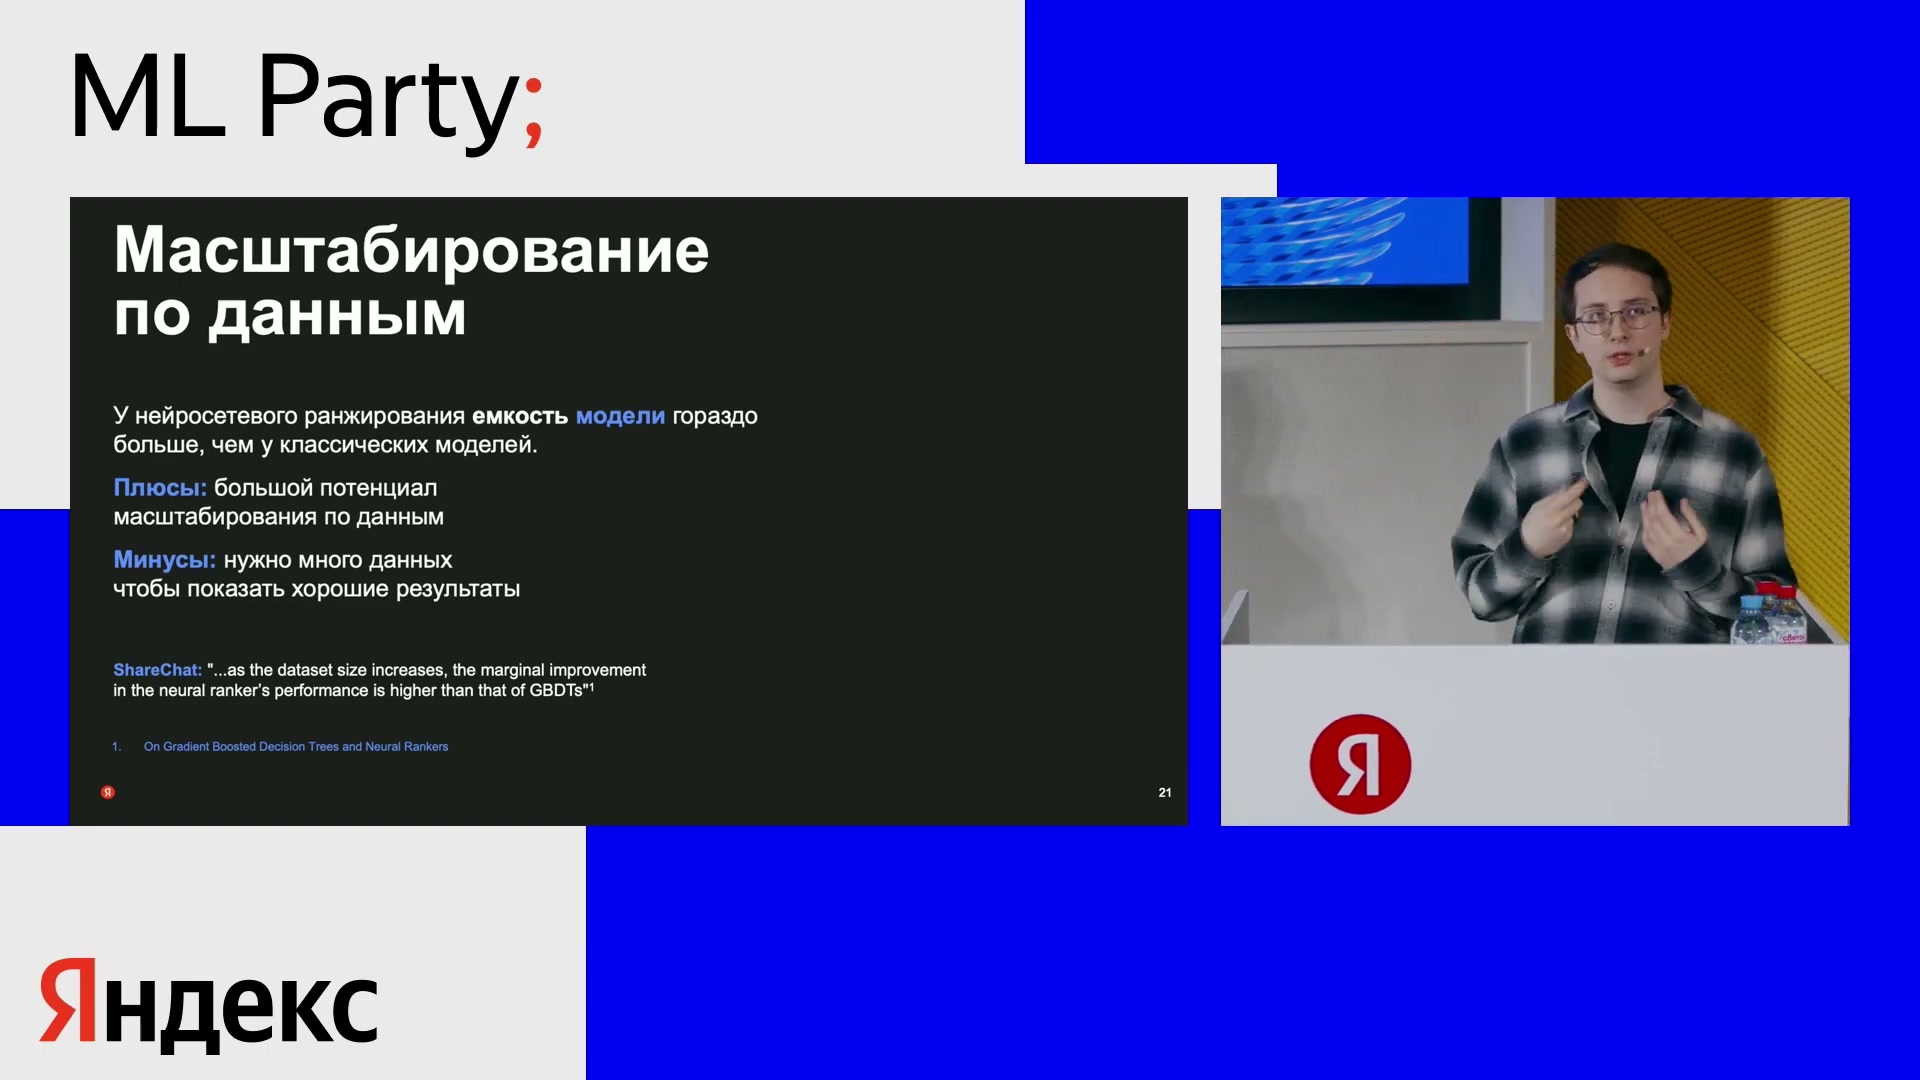
Для нейросети автор рассматривает больше эпох и увеличение объёма обучающих данных, с которыми взаимодействует размер модели.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyВыбранная конфигурация и стоимость обучения
Несмотря на разнообразие обсуждённых идей, выбранная для внедрения основная сеть оказалась сравнительно небольшой по глубине. Один слой явных взаимодействий дополняется пятью полносвязными слоями. Числовые признаки получают короткое представление, а низкий ранг ограничивает стоимость cross-преобразования.
Параметры обучения нужно читать отдельно от структуры модели. Размер пакета — число примеров, обрабатываемых вместе при обучении. Шаг обучения определяет масштаб обновления параметров. Эпоха означает проход по обучающему набору; автор говорит о десятках таких проходов. Dropout — случайное отключение части промежуточных компонентов при обучении — в итоговом варианте небольшой. Его точная величина не указана.
Таблицу можно прокрутить по горизонтали.
В устном пояснении автор уточняет привычное оборудование: CatBoost обычно учат на GPU-хосте — одной машине с восемью графическими картами. Затем он говорит, что архитектуры нового ранжировщика учатся в той же конфигурации оборудования и на тех же данных, даже немного быстрее. Это уточнение поясняет, какое оборудование автор имеет в виду под одним хостом. Однако тип GPU, их память и способ распределения вычислений между ними не названы.
Таблица фиксирует выбранную конфигурацию, но не полную инструкцию для воспроизведения. Размерность 4 относится к выходу числового кодирования, а не автоматически к числу интервалов или ко всем категориям. Значения 1e-3 и 1e-4 не задают расписание изменения шага. Ширины MLP, оптимизатор, точное число эпох и критерий остановки также не раскрыты.
Практический смысл результата — более выразительную обработку удалось совместить с привычным порядком затрат на обучение. Пять часов относятся к указанному автором набору и оборудованию, а не являются обещанным временем для любого рекомендательного сервиса.
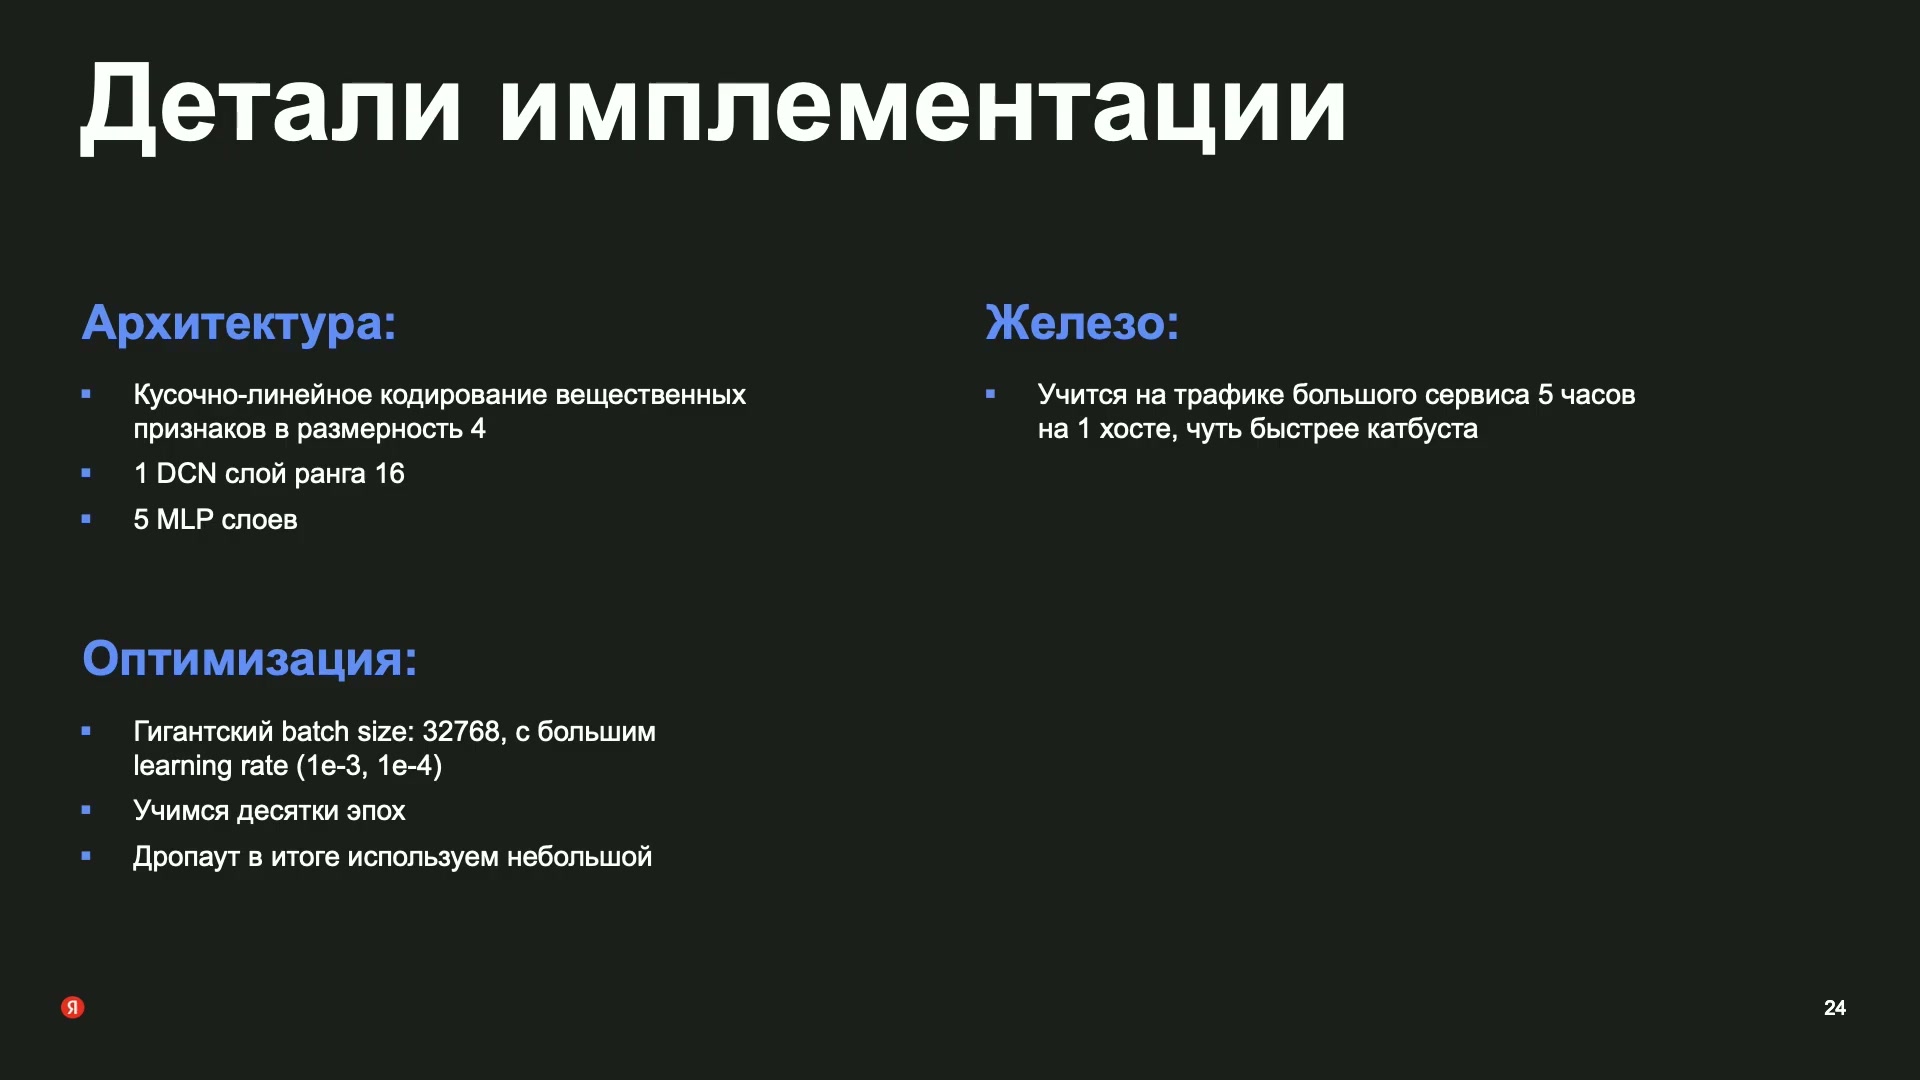
Показанная конфигурация: числовое кодирование размерности 4; один DCN-слой ранга 16; пять MLP-слоёв; пакет 32768; шаг обучения 1e−3/1e−4; десятки эпох. На трафике большого сервиса обучение занимает пять часов на одном хосте; детали оборудования не названы.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyРезультаты в трёх доменах: только офлайн-метрики ранжирования
Проверив архитектуру на нескольких задачах, команда получила положительные изменения качества ранжирования. Автор сразу оговаривает способ оценки: это офлайн-сравнение, то есть измерение на подготовленных данных, а не результат наблюдения за пользователями после включения новой модели. В трёх доменах используются разные метрики.
Все три строки показывают улучшение выбранного показателя внутри своей задачи. Но они не образуют единой шкалы, по которой можно сказать, что один сервис улучшился для пользователя сильнее другого. Точное название и формула метрики для каждого домена не раскрыты. Автор упоминает разные способы оценки, в том числе попарную точность, но не задаёт надёжного соответствия «сервис — метрика».
Числа выражают относительное изменение, а не процентные пункты. Они не означают рост кликов, покупок, времени прослушивания или GMV — денежного объёма продаж. Автор считает эти офлайн-приросты серьёзными и ожидает, что они могут перейти в бизнес-эффект, однако ожидание не равно измеренному результату работающего сервиса. Сервис рекомендаций фильмов отдельно не назван.
Таблица обосновывает дальнейшую проверку нейросетевого ранжирования в нескольких доменах. Она не содержит полных протоколов: неизвестны исходные значения метрик, разбиение данных, неопределённость измерений и подробная конфигурация сравнения. Базовую модель на 46 миллионах записей из следующего исследования нельзя автоматически считать протоколом всех трёх строк.
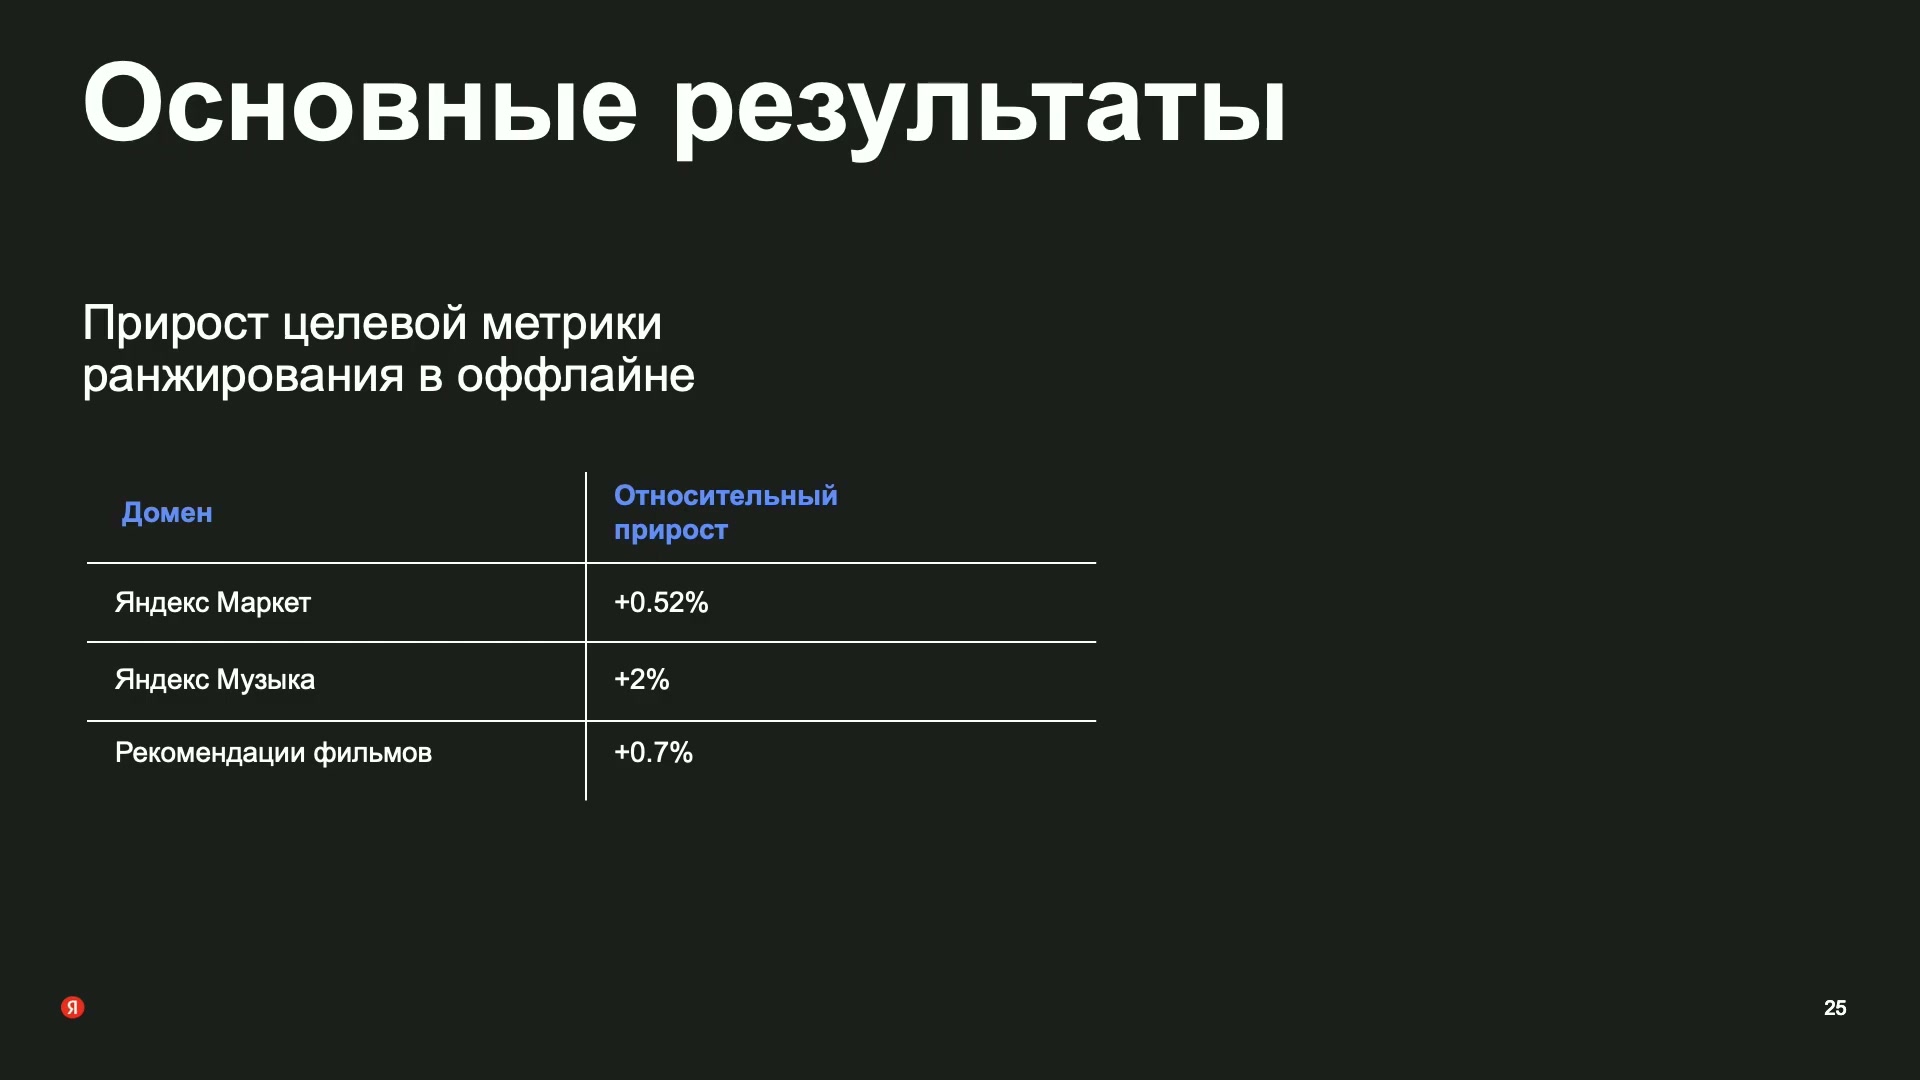
Офлайн-прирост целевой метрики ранжирования: Яндекс Маркет +0,52%, Музыка +2%, рекомендации фильмов +0,7%. Название метрики, база и протокол не раскрыты; это не GMV или A/B-бизнесрезультат.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyМасштабирование: качество растёт, CatBoost упирается в память
После результатов по доменам автор показывает исследование зависимости от размера набора. Сам он сразу оговаривает: это не вполне чистое исследование вклада одного изменения. На части строк увеличивается количество данных, а в последней появляется и более сильная нейросетевая архитектура. Поэтому таблица одновременно показывает возможности масштабирования и границы причинных выводов.
Базой именно этого сравнения служит CatBoost на наборе 46kk, для которого записано +0,00%. Обозначение kk на слайде означает миллионы. Что именно является одной единицей набора — показ, пара объектов или иная обучающая запись, — автор не уточняет. Заголовок Catboost w.o transformers означает вариант без трансформерных признаков.
Таблицу можно прокрутить по горизонтали.
Пустая клетка означает, что значение не опубликовано. Это не нулевой эффект и не доказательство, что соответствующий вариант вообще не запускался. OOM, от out of memory, означает нехватку памяти при обучении в рассматриваемой конфигурации. Автор говорит о невозможности вместить увеличенный набор; это не отказ ранжировщика при пользовательском запросе.
На 46kk нейросеть уже показывает +0,47% к выбранной базе. При увеличении набора до 116kk качество растёт и у CatBoost, и у нейросети: в таблице стоят +0,57% и +1,10%. На 185kk и 215kk для CatBoost указана нехватка памяти, тогда как нейросеть получает +1,23% и +1,39%. Автор объясняет возможность дальнейшего обучения нейросети обработкой данных частями. Это наблюдение в доступной конфигурации, а не общий предел размера данных для любого бустинга.
Позже команда вернулась к исследованию с улучшенной архитектурой. Ей соответствует «Нейросеть++» на 230kk и результат +2,09%. Приписывать всё отличие только росту данных нельзя: одновременно изменена модель. Подробное устройство этой версии не раскрыто.
Смысл таблицы — в сочетании двух наблюдений: нейросеть использовала увеличение обучающего набора, а у базового подхода возникло ресурсное ограничение. Но таблица не даёт отдельной численной оценки вклада каждой архитектурной идеи, одинакового ресурсного бюджета всех вариантов или полного протокола для переноса результата на другой сервис.
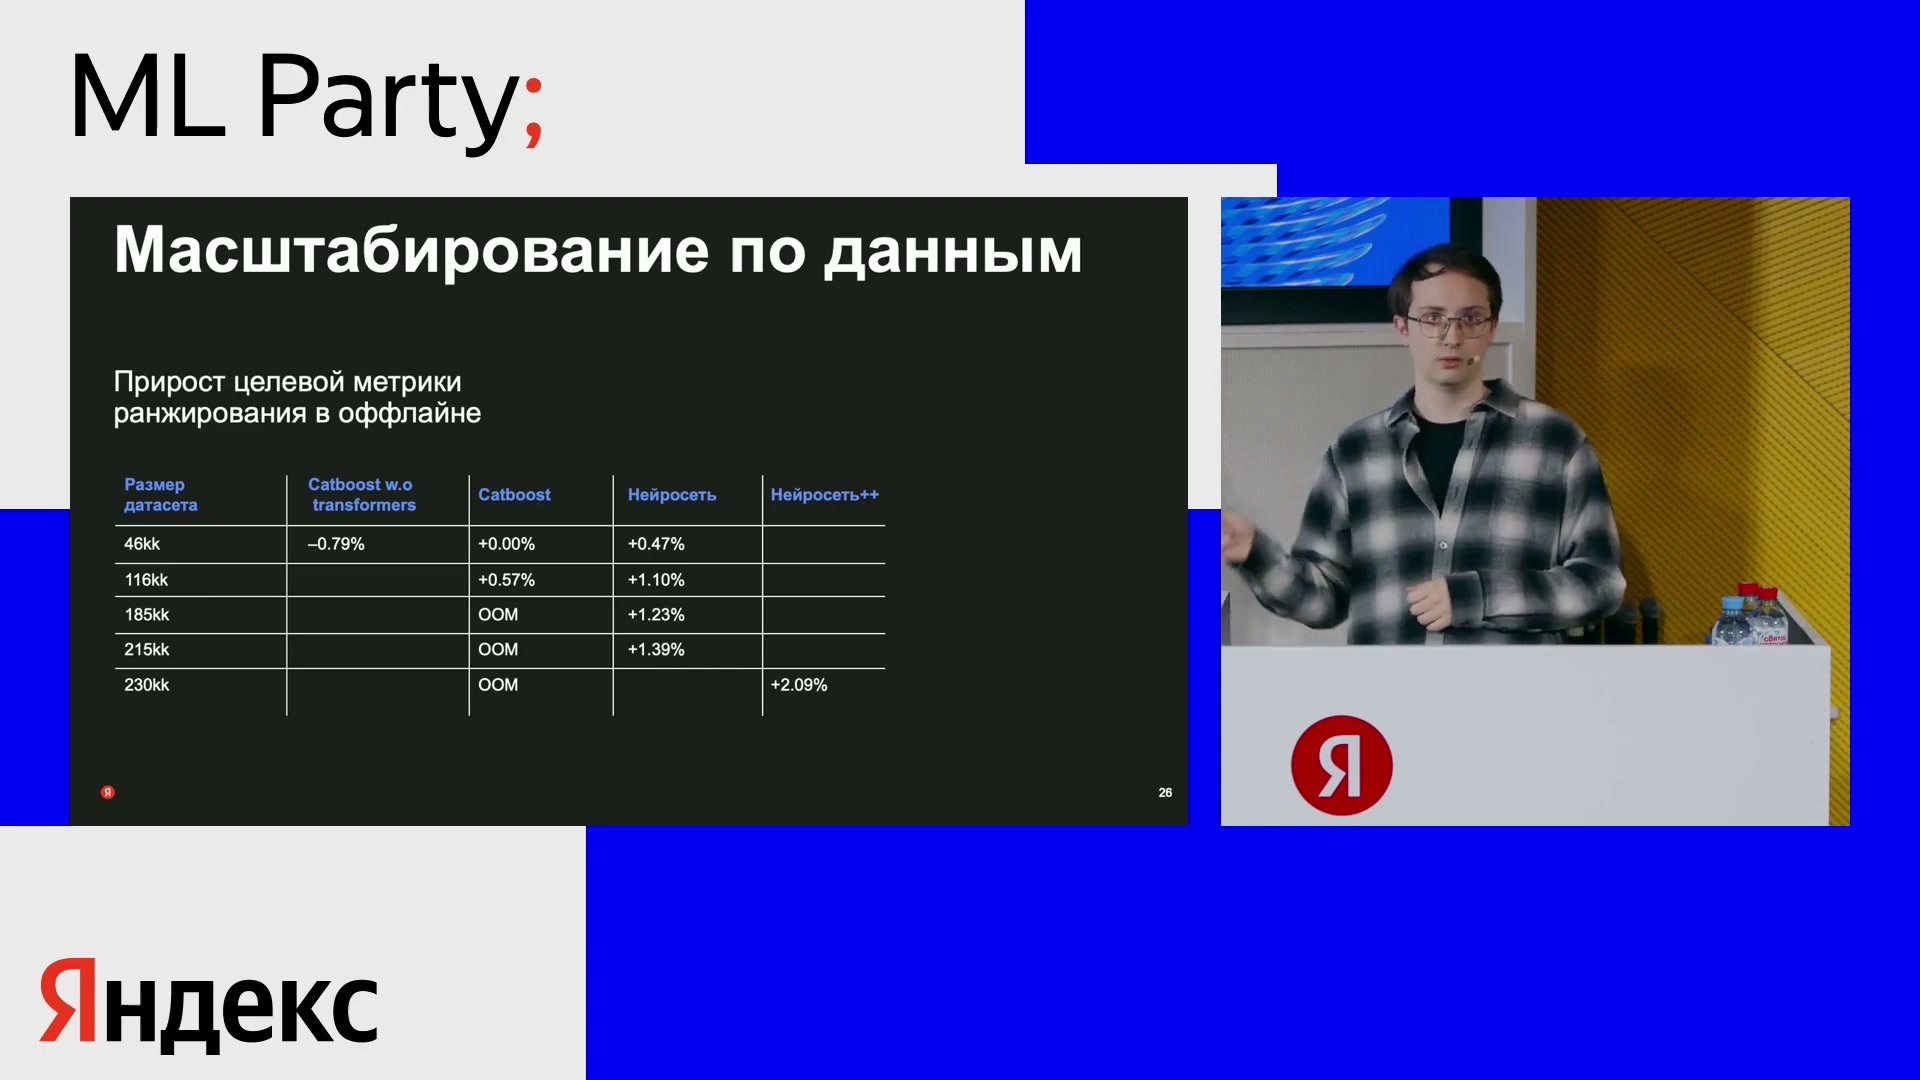
Масштабирование данных: 46/116/185/215/230kk (миллионов). база — CatBoost 46kk = +0%; нейросеть 46kk +0,47%, 116kk +1,10%, 185kk +1,23%, 215kk +1,39%; нейросеть++ 230kk +2,09%. OOM и пустые ячейки не заменяются нулём.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyЧто объясняет строка без трансформерных признаков
Первая модельная колонка предыдущей таблицы нужна не только для сравнения семейства моделей. Автор отдельно объясняет, что произойдёт при удалении из ранжирования Яндекс Музыки признаков, связанных с трансформерами персонализации. На 46kk такой CatBoost получает −0,79% относительно базового CatBoost той же строки. Это значение показано на оригинальном слайде.
Почему небольшое по записи изменение заслуживает внимания? Автор напоминает, что прежние внедрения трансформеров в Музыке давали заметные эффекты по времени прослушивания, лайкам и другим пользовательским показателям. Точных чисел этих эффектов он здесь не приводит. Число прежних итераций также не фиксируется однозначно: в речи звучит сначала «дважды», затем «примерно даже трижды».
Таким сравнением автор показывает, что изменения офлайн-метрики такого масштаба могут быть содержательно важными для зрелой системы. Но это не позволяет пересчитать −0,79% в конкретный бизнес-эффект. Тем более нельзя приписать новому нейросетевому ранжировщику онлайн-результаты, которые раньше получили от другого изменения — добавления трансформерных признаков.
Показанная строка подтверждает полезность этой группы признаков для выбранной модели и набора. Она не изолирует вклад всех частей нового ранжировщика и не объясняет, какая доля его выигрыша возникает от истории, взаимодействий, числового кодирования или совместного обучения задач.
Доклад · 00:17:35Первый эксперимент в сервисе: применение на CPU
Офлайн-результаты привели к следующему шагу — попытке заменить действующее ранжирование в сервисе. Для начала команда подготовила применение модели на центральных процессорах, CPU. Причина в совместимости с существующей системой: бустинговые модели уже применялись на CPU, поэтому такой вариант было проще поставить на их место. Обучение на GPU и применение на CPU здесь относятся к разным этапам жизни модели.
На момент выступления нейросетевое ранжирование находилось в эксперименте в одном крупном сервисе. Автор не объявляет полный переход всех перечисленных во вступлении продуктов. Название этого конкретного сервиса в сообщении о внедрении не раскрыто.
Слайд качественно описывает компромисс: удалось сохранить примерно весь выигрыш ценой небольшого замедления. Числа задержки и проценты пользовательских метрик не опубликованы. Поэтому «примерно весь выигрыш» нельзя превращать в новый измеренный онлайн-прирост или в обещание, что CPU-версия в любых условиях почти бесплатна.
Иллюстрация показывает достигнутую стадию работы: модель уже не только сравнивают на данных, её начинают проверять внутри сервиса. Но главный вывод слайда связан и с осторожностью. Смена ранжировщика меняет не только вычисления, но и будущие показы, а значит, данные для следующего обучения.
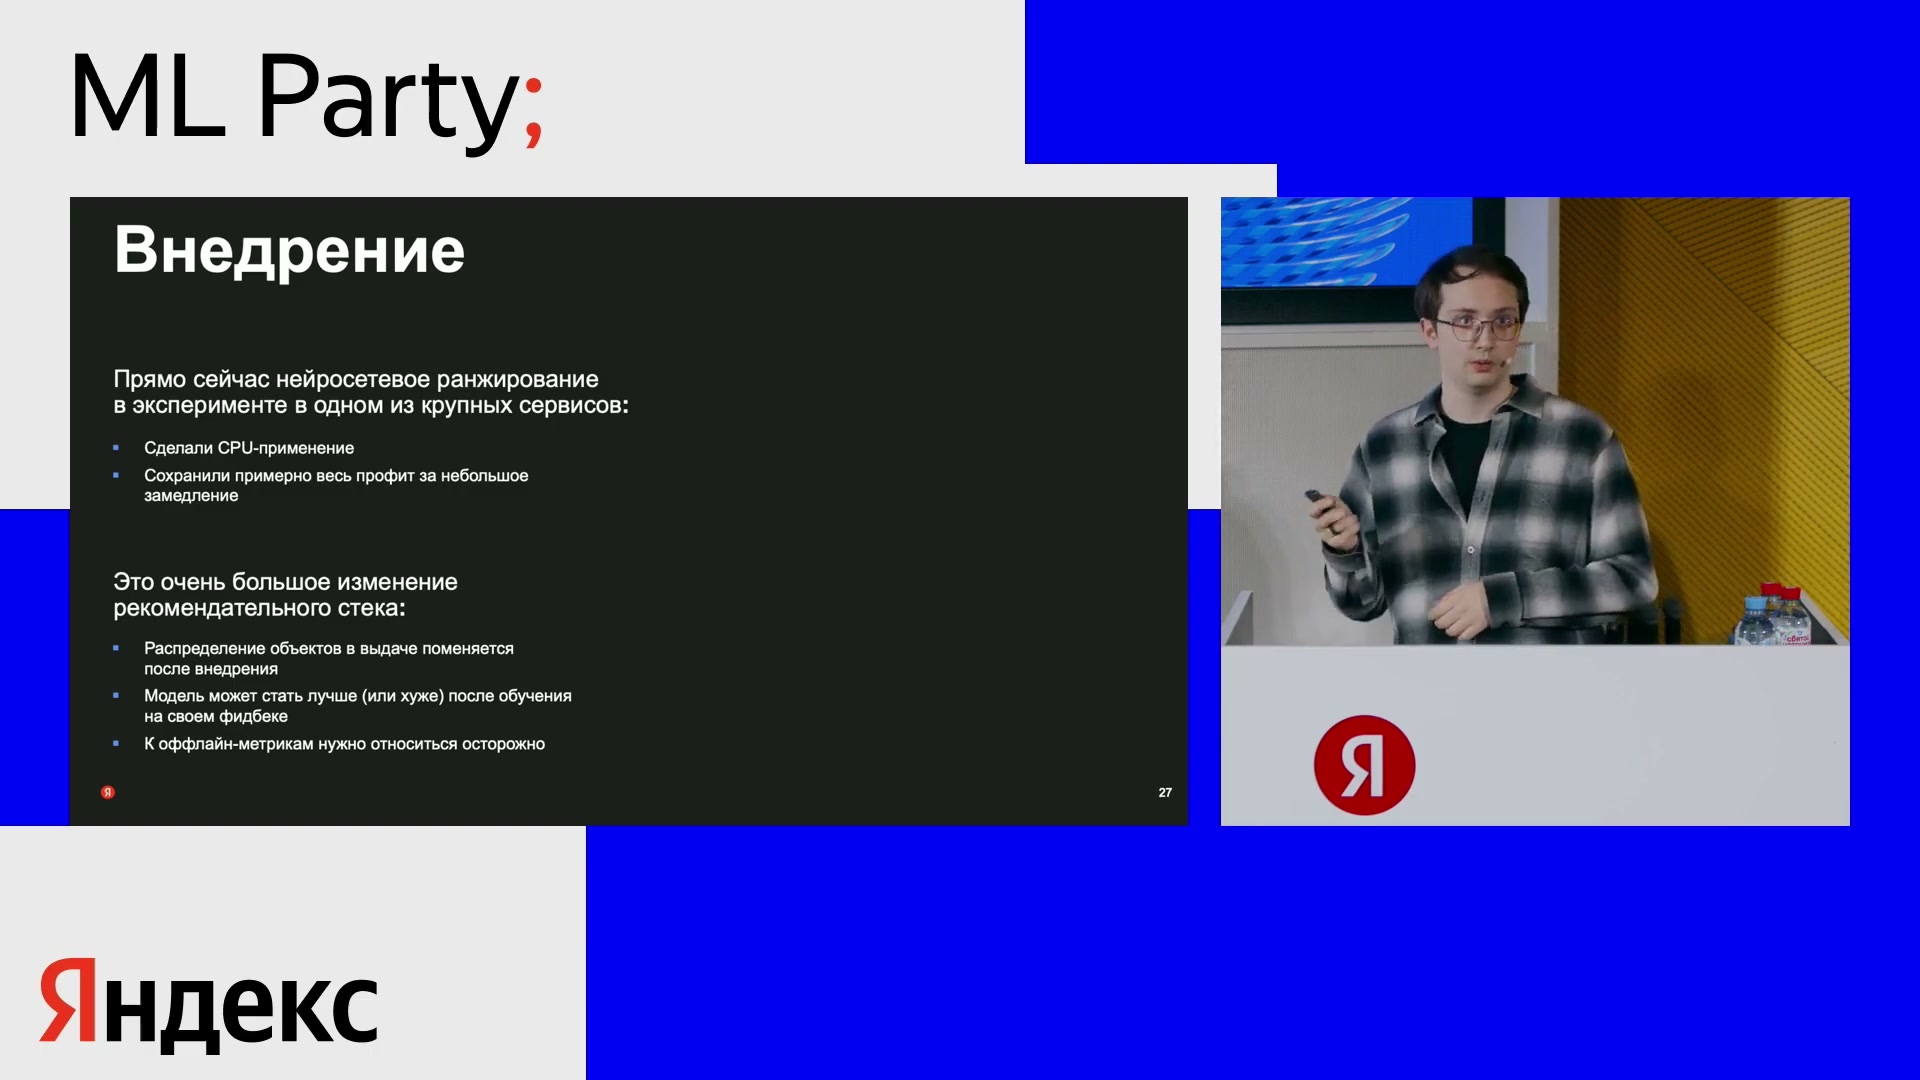
На момент выступления — эксперимент в одном крупном сервисе. CPU-применение сохранило примерно весь выигрыш ценой небольшого замедления; проценты A/B и точная задержка не опубликованы.
Источник: Кирилл Хрыльченко · Яндекс · ML PartyПочему новая выдача меняет данные и собственные ошибки модели
Предупреждение на слайде о внедрении возвращает нас к шуму ранжирования. Офлайн-метрики измерены на выдачах, сформированных работающим CatBoost. Именно прежняя модель решала, какие объекты показать и на каких позициях; наблюдаемая реакция относится к этим решениям. Автор называет такой порядок формирования показов прежней политикой сбора данных.
Нейросетевой ранжировщик меняет порядок и состав показываемых объектов. В результате меняются реакции, доступные для обучения, и характер ошибок. Модель может предложить то, чего старая система почти не показывала, или чаще ошибаться на другой группе кандидатов. Поэтому качество, измеренное по старым выдачам, не даёт исчерпывающего ответа о следующем состоянии системы.
Автор подчёркивает необходимость учить новую модель на её собственной обратной связи — реакциях на выдачи, которые сформировала уже она. При благоприятном исходе эти данные помогают увидеть и исправить новые ошибки. Но возможен и обратный эффект: если модель имеет устойчивые перекосы, новые показы могут усилить их, а следующее обучение — дополнительно закрепить.
Это ограничение не отменяет показанных офлайн-результатов. Оно определяет их роль: выбрать перспективную архитектуру и обосновать проверку в продукте, но не заменить эту проверку. Доклад не предлагает завершённого способа устранить все смещения и не показывает численный долгосрочный результат обучения на собственной выдаче. Дальнейшие ответы автора уточняют, что именно проверяли, как обучали модель и какие возможности пока остаются только направлениями работы.
Доклад · 00:18:24Проверяли ли передачу знаний от CatBoost к нейросети
В обсуждении автора спрашивают, пробовала ли команда подавать выходы CatBoost как признаки в нейросетевой ранжировщик. Ответ прямой: нет. Поэтому показанные результаты нельзя объяснять обучением нейросети на предсказаниях бустинга или использованием этих предсказаний как дополнительного входа.
Привычная схема команды была обратной: в CatBoost передавали признаки, полученные из нейросетей. Обычно это не сами многомерные векторы, а производные числовые характеристики. Автор приводит скалярное произведение двух векторов — одну числовую оценку их совместимости. Так нейросетевая информация попадала в бустинг в уже обработанном виде.
В этом и состоит одно из отличий нового ранжировщика. Он может получать сами представления и учиться их взаимодействиям внутри общей сети, а не использовать только заранее выбранную скалярную функцию. При этом ответ описывает практику команды, а не универсальный запрет передавать векторы другим моделям.
Автор также упоминает возможную идею: использовать разбиения обученных деревьев CatBoost, чтобы сформировать явные признаки для нейросети. Такой вариант команда тоже не применяла. Это направление обсуждения, а не скрытый этап построения модели или отдельный эксперимент с положительным результатом.
Доклад · 00:19:33Использовались ли решения Yandex Cup
На вопрос об использовании разработок соревнования Yandex Cup автор также отвечает отрицательно. Затем он поясняет устройство работы: у Яндекс Музыки есть собственная продуктовая рекомендательная команда. Она участвовала в организации соревнования, формулировке задачи и изучает появившиеся решения.
Исследовательская команда автора активно взаимодействует с этой командой, но не совпадает с ней по роли. Поэтому ответ «не использовали» относится к описываемой работе, а не ко всем сотрудникам Яндекса. Обратный вывод тоже был бы неверным: участие Музыки в соревновании не делает конкурсные решения установленной основой показанного нейросетевого ранжировщика. Конкретные решения, заимствованные компоненты или сравнительные результаты здесь не названы.
Доклад · 00:20:30Сколько выигрыша даёт свежесть, а сколько — объём истории
Следующий вопрос касается способов включения истории в модель: совместной обработки внутри общей сети и отдельного получения представлений. В ответе автор не даёт полной таблицы вариантов и прямо меняет акцент на другую полезную зависимость — соотношение свежести сигнала и объёма доступной истории.
Сначала он уточняет, что команда не кластеризует нейросетевые векторы ради построения такого входа. Можно подать на вход сами векторы, не заменяя их номером группы. Это продолжает основной принцип доклада: использовать богатое представление непосредственно, а не обязательно предварительно сжимать его в отдельный ручной признак.
Затем автор описывает наблюдение из опыта. Примерно половину выигрыша от анализа свежего краткосрочного сигнала нередко удаётся получить офлайн-архитектурой, которая обрабатывает историю с задержкой в один-два дня. Это оценка доли дополнительного выигрыша, а не половина абсолютного качества рекомендаций и не универсальное улучшение на 50%. Размер эффекта зависит от задачи; гарантировать это соотношение для любого сервиса нельзя.
Почему запаздывающая модель вообще может быть полезна? При офлайн-обработке можно взять существенно больше истории, не увеличивая время ответа на запрос. У свежего модуля преимущество другое — недавно произошедшие действия. Поэтому эффекты частично пересекаются, но могут и дополнять друг друга. Автор не сводит выбор к обязательной замене одного модуля другим.
Этот ответ уточняет смысл двухконтурной схемы: отдельно важны доступная длина истории и её свежесть. Но он не раскрывает контролируемого сравнения всех сочетаний общей и раздельной подготовки, точных длин последовательностей или одинакового ресурсного бюджета вариантов.
Доклад · 00:21:18Как устроен обучающий сигнал для ранжирования
На вопрос о функции потерь — величине, которую минимизируют при обучении, — автор отвечает через попарное ранжирование. Он говорит, что это привычная для команды постановка и при использовании CatBoost, а в нейросети сохраняется примерно тот же принцип.
Для сравнения берутся два объекта, попавшие вместе в одну выдачу. У одного есть положительная пользовательская реакция, у другого её нет. Модель учится увеличивать разность их оценок в пользу первого. Цель здесь — улучшать взаимный порядок объектов, а не только независимо предсказывать характеристику каждого из них.
Такой ответ также уточняет происхождение обучающего сигнала. Он связан с наблюдавшимися показами и реакциями, а не с произвольным набором случайных объектов каталога. При этом отсутствие положительной реакции остаётся именно наблюдаемой меткой: основная часть доклада уже предупредила, что поведение может зависеть от позиции. Отдельного способа исправления этого смещения в ответе нет.
Далее автор кратко упоминает эксперименты с комбинированием функций потерь и заменой экспоненты на сигмоиду в одном выражении. Полную формулу по этому фрагменту установить нельзя. Поэтому конкретное название дополнительной функции не приписывается модели; надёжно раскрыт только попарный принцип и использование объектов одной выдачи.
Для воспроизведения обучения этого недостаточно. Не заданы правила отбора пар, число пар на выдачу, веса разных реакций и голов, временное разбиение данных или точное определение одной записи в таблице масштабирования. Эти пробелы ограничивают переносимость численных результатов, но не меняют объяснённую постановку: предпочитаемый по наблюдаемому отклику объект должен получать более высокую оценку.
Доклад · 00:23:01Что известно об обучении модели длинной истории
Отдельный вопрос посвящён обучению офлайн-трансформера: что подаётся на вход помимо длинной истории и что получается на выходе. Вместо технического разбора автор отсылает к двум другим своим докладам. Подробного ответа об устройстве обучения в этом выступлении нет.
Из основной части известно, что отдельная модель сжимает историю в пользовательский вектор, который пересчитывается заранее и используется в ранжировании. Но это описание применения представления не определяет обучающую цель. Здесь не раскрыты формат события, конкретная функция потерь для длинной истории, способ предварительного обучения, длина входа и параметры трансформера.
Поэтому схема двух историй остаётся описанием ролей и мест вычисления. Она не превращается в полную спецификацию модели последовательности. Детали из других выступлений нельзя автоматически переносить на эту архитектуру: автор не устанавливает их здесь.
Доклад · 00:24:04Какие данные можно добавить кроме обычных признаков
Вопрос о неструктурированных данных помогает понять, откуда берутся внешние нейросетевые векторы. Первым таким сигналом автор называет историю пользователя: это последовательность действий, которую не обязательно заранее сводить к набору счётчиков. Специальная модель может извлекать из неё представление для ранжирования.
Затем обсуждение переходит к самому объекту. У товара, например в Маркете, есть изображение и текст. Для них можно получить векторные представления и передать эти векторы на вход нейросетевому ранжировщику. Так признаки содержания становятся частью того же общего входа, где уже находятся категории, числа и сведения о пользователе.
Это описанная возможность архитектуры, а не подтверждение, что все три доменных эксперимента обязательно использовали одновременно текст и изображения. Не названы конкретные модели обработки этих данных, их обучение или отдельный прирост. Сравнение с CatBoost дано в контексте привычной практики команды, а не как доказательство невозможности использовать содержательные признаки в бустинге.
В ответе также упоминаются исследования Яндекс Research с успешными результатами на структурированных данных. Конкретные наборы и значения не приводятся, поэтому это дополнительная отсылка автора, а не новая часть собственной таблицы результатов. Основной содержательный вывод ответа — к ранжированию можно подвести информацию из истории, текста и изображения через их представления, не ограничиваясь заранее составленными скалярными характеристиками.
Доклад · 00:24:41Как проверять важность признака и чего это не объясняет
Вопрос об интерпретируемости возвращает сильную сторону исходного решения. Автор признаёт, что у бустинга понятнее структура деревьев и доступны привычные способы оценки важности признаков. Для нейросетевого ранжировщика объяснять внутренние решения сложнее, и это существенно при разборе нежелательных перекосов.
Один из названных приёмов — случайно перемешать значения определённого признака после обучения, уже при проверке применения модели. Такое перемешивание называют пермутацией. Затем смотрят, изменилось ли поведение модели. В авторском объяснении заметное изменение указывает, что признак был важен; отсутствие изменения позволяет предположить, что модель им не пользуется, и рассмотреть его удаление.
Это диагностическая идея, а не готовая система объяснения каждой рекомендации. В докладе нет численного эксперимента с пермутацией, списка удалённых признаков или доказательства, что таким способом устраняются все смещения. Метод помогает поставить вопрос о зависимости модели от входа, но не заменяет весь анализ её поведения.
Итоговая позиция автора осторожна: объяснимость важна, но отсутствие привычного уровня прозрачности CatBoost не обязательно запрещает использование нейросети. Он не утверждает, что проблема решена; скорее обозначает один доступный способ проверки и признаёт оставшееся ограничение.
Доклад · 00:25:37Почему остановились на DCN и что пробовали вместо него
На вопрос об улучшениях вместо DCN автор сообщает об экспериментах с трансформерными архитектурами ранжирования. Он упоминает новые работы авторов DCN и интерес к исследованиям Meta. Но не приводит для этих вариантов ни законченного сравнения, ни производственного результата. Название одной из новых работ в доступной записи нельзя надёжно установить.
DCN для автора на момент выступления остаётся более проверенной отправной точкой. Чтобы считать новый подход лучшим, недостаточно появления одной статьи: нужны дополнительные измерения и независимые сравнения. Это позиция в контексте данного доклада, а не актуальный рейтинг архитектур на произвольную последующую дату.
Для альтернатив, названных также в основной части, ответ конкретнее. MaskNet в экспериментах команды работала хуже по качеству; автор добавляет с оговоркой, что, кажется, она была и медленнее. FibiNet, по его словам, ещё медленнее и не даёт заметной прибавки качества. Для последующего упоминания версии с «+» точное обозначение не установлено, поэтому отдельное имя модели не добавляется.
Эти результаты качественные: чисел, настроек и отдельной таблицы сравнений нет. Они объясняют выбор команды по соотношению качества и скорости, но не доказывают, что MaskNet или FibiNet всегда уступают. В общей истории доклада это ещё одна граница: хороший ранжировщик получился не из выбора самого нового названия, а из согласования полезных взаимодействий, удобного представления данных и допустимой вычислительной стоимости.
Доклад · 00:26:45Итог: как готовая модель ранжирует кандидатов и что доказано
Команда искала замену привычному CatBoost на этапе, где каскад уже нашёл хорошие объекты. Решение складывается из сохранения информации в признаках, явных взаимодействий DCN, нелинейной обработки MLP, двух режимов анализа истории и нескольких выходных задач. Низкоранговые преобразования помогли удержать стоимость вычислений, а увеличение данных позволило использовать возможности нейросети.
- 01
Принять кандидатов
Получить готовый набор объектов и доступные признаки пользователя и каждого кандидата. Поиск по каталогу уже выполнен.
- 02
Подготовить представления
Закодировать категории и числа, добавить готовый вектор длинной истории и предусмотренные внешние нейросетевые представления.
- 03
Учесть свежие действия
Небольшой моделью обработать короткую историю во время запроса и объединить результат с остальными признаками.
- 04
Вычислить взаимодействия
Применить DCN для явных сочетаний признаков, затем MLP для остальных нелинейных зависимостей.
- 05
Получить оценки и порядок
Рассчитать выходы голов для нужных реакций и использовать оценки для ранжирования. Конкретная формула объединения целей не раскрыта.
Обучение происходит отдельно от этих шагов: модель использует попарный сигнал из выдач, общие представления помогают нескольким задачам. После включения важно обучаться и проверяться на собственной обратной связи, которая может как исправить ошибки, так и усилить перекосы.
Относительные офлайн-приросты составили +0,52% для Маркета, +2% для Музыки и +0,7% для рекомендаций фильмов; метрики в доменах разные. Таблица масштабирования показывает дальнейший рост, но последняя версия одновременно меняет архитектуру и данные. Это не численные онлайн-результаты. На момент доклада шёл эксперимент в одном крупном сервисе с применением на CPU: выигрыш описан как почти сохранённый при небольшом замедлении. Точные задержки, полный протокол сравнения и долгосрочный эффект не опубликованы.
Доклад · 00:04:34