Разбор готов
hh.ru: почему хорошей оценки модели недостаточно для рекомендаций навыков
Соискатель заполняет резюме, а система снова предлагает однотипные навыки. По отдельности они могут выглядеть уместно, но весь список плохо раскрывает профессиональный профиль. Хорошая оценка на заранее собранных данных — офлайн-оценка — ещё не гарантирует полезности работодателю. В hh.ru разбирали три связанные проблемы: несогласованность метрик модели с бизнес-целями, узкий фокус рекомендаций и нехватку разметки — примеров с заданными правильными ответами. Команда сопоставляла изменения метрик в экспериментах, сочетала оценки навыков с профессиями и категориями, а подготовку данных строила вокруг совместной работы инженеров и методологов — специалистов по организации предметной разметки. Разберём устройство решения, обе бизнес-цели, смысл опубликованных чисел и ограничения, уточнённые в ответах на вопросы.
Глава полезна инженерам машинного обучения и аналитикам, которые выбирают метрики рекомендаций, отвечают за разнообразие выдачи или организуют предметную разметку. На одном кейсе видно, как различать пользовательский выбор и полезность рекомендации, соединять модель с экспертными категориями и проверять качество данных, не подменяя бизнес-результат удобным показателем.
Видео · на русском
Рекомендательные системы: сложности разработки и пути решения | Пётр Чуйков, HeadHunterПётр Чуйков · Опубликовано: 23 декабря 2024 г.
Исходный доклад · Открыть оригинал
Задача hh.ru и границы доклада
В основе главы — доклад Петра Чуйкова «Рекомендательные системы: сложности разработки и пути решения» на Practical ML Conf 2024. В начале выступления он представляется руководителем команды анализа данных и машинного обучения HeadHunter, или Data Science (далее DS). Дата загрузки видеозаписи — 23 декабря 2024 года; точная дата выступления не установлена. Все описания использования моделей относятся к моменту доклада, а не к текущему состоянию hh.ru.
Основной пример — рекомендации навыков при работе с резюме и вакансиями. Автор связывает эту модель с реальными сценариями соискателей и работодателей. Рассказ последовательно проходит от бизнес-целей к проверке метрик, затем к разнообразию рекомендаций и подготовке размеченных данных. Масштаб задачи он предваряет характеристиками всей платформы.
Таблицу можно прокрутить по горизонтали.
Эти числа задают контекст, но не позволяют восстановить требования к отдельной модели. В частности, 2 млн нельзя называть суточными откликами, а 40 тыс. запросов в секунду — нагрузкой сервиса навыков. Сам автор подчёркивает ещё одну границу: решения подобраны под конкретную задачу и данные HeadHunter, поэтому их полезность в другом продукте нужно устанавливать отдельно.
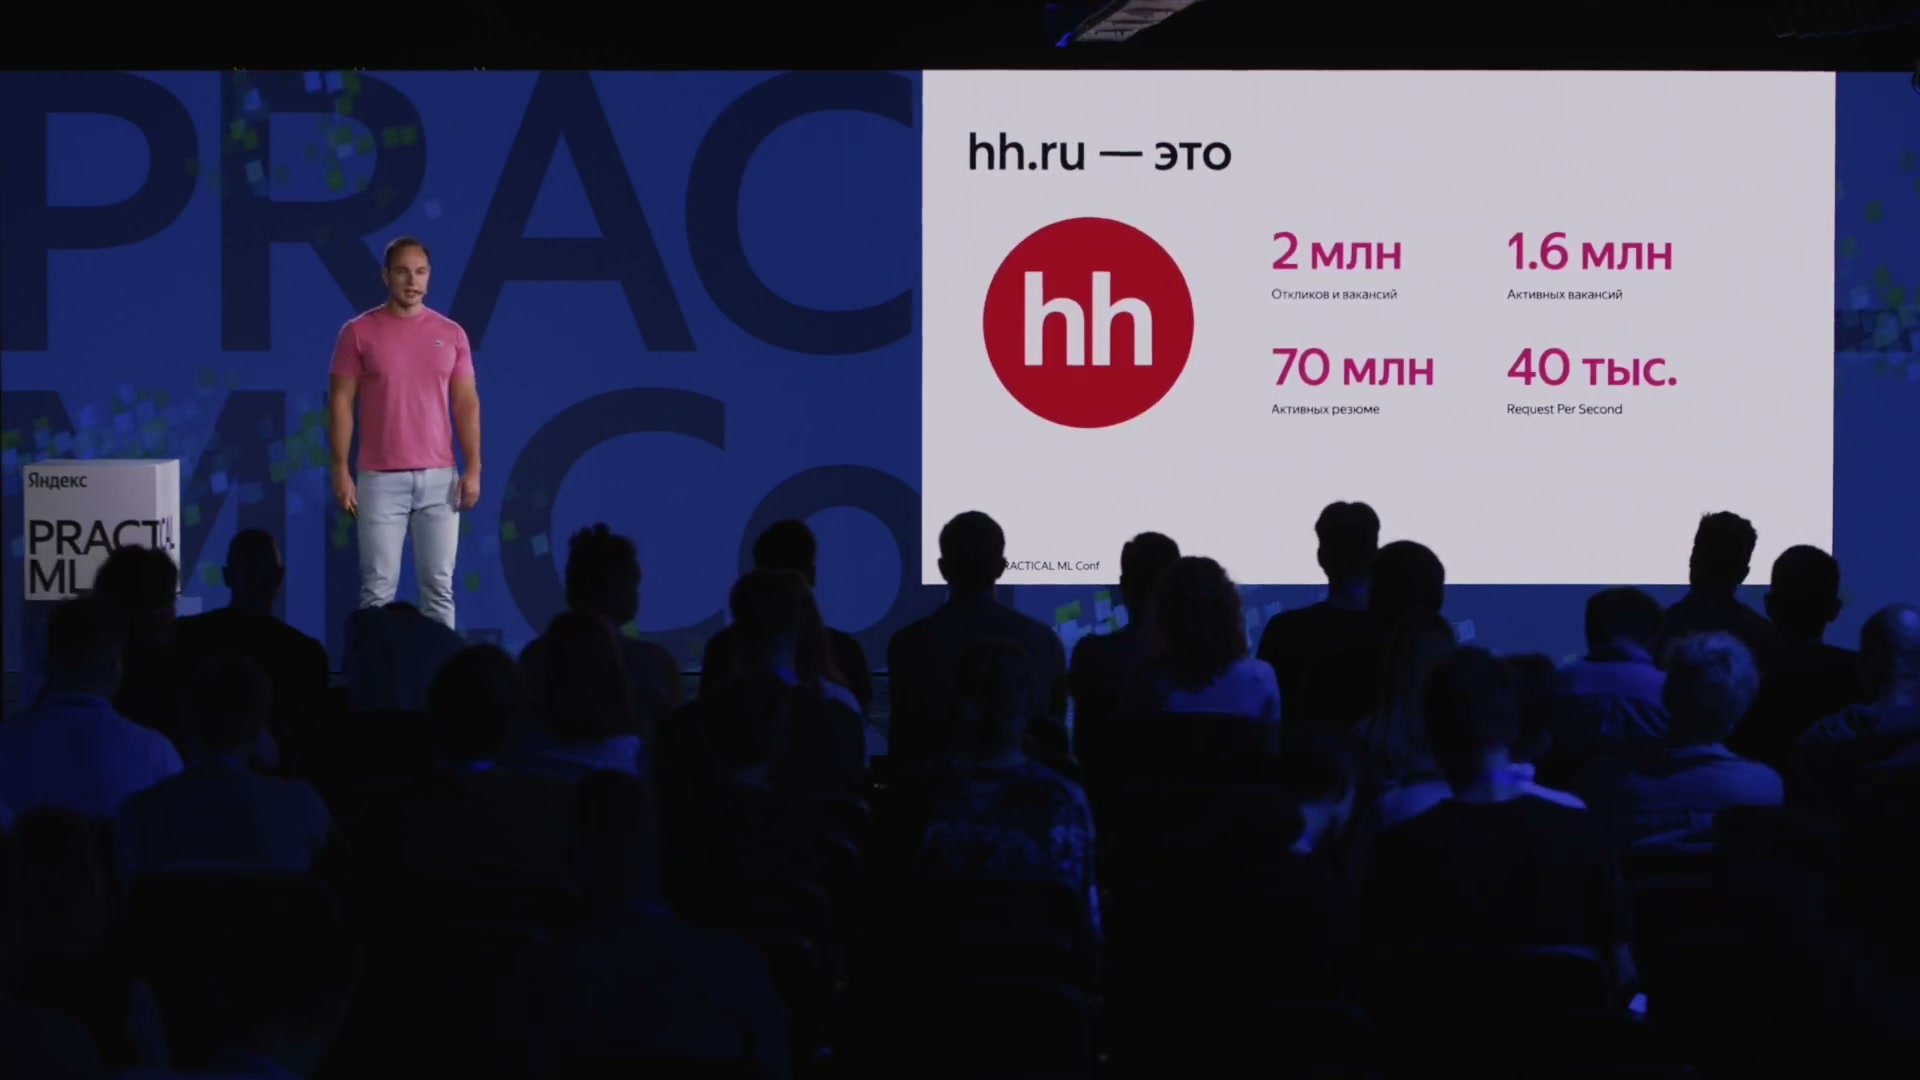
Масштаб hh.ru на момент доклада: 70 млн активных резюме, 1,6 млн активных вакансий, 40 тыс. запросов в секунду. У 2 млн на слайде подпись «откликов и вакансий» без периода; это не нагрузка модели навыков.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfДве бизнес-цели: закончить резюме и сделать его информативнее
Первая цель — упростить заполнение резюме. Когда человеку легче описать свои навыки, он с большей вероятностью завершит работу и опубликует резюме. В докладе эту сторону продукта описывают метрики масштаба: сколько соискателей публикует резюме в рассматриваемой группе. В этой цепочке рекомендации помогают пройти пользовательский сценарий до конца.
Вторая цель — повысить качество навыков в базе. Здесь важно не просто заполнить поле, а получить сведения, с которыми резюме и вакансии становятся эффективнее. Это другая группа показателей — метрики эффективности. Позже в качестве конкретного бизнес-показателя автор использует приглашения из базы. Публикация и приглашение отражают разные результаты, поэтому один нельзя считать заменой другого.
На исходной схеме две цепочки разделены: упрощение заполнения ведёт к большему числу публикаций, а повышение качества навыков — к более эффективным резюме и вакансиям. Такое разделение понадобится в конце главы. Общие слова о трудолюбии могут мало помогать работодателю различать кандидатов, но их удаление способно затруднить завершение резюме. Значит, оценивать рекомендации только по информативности или только по удобству заполнения недостаточно.
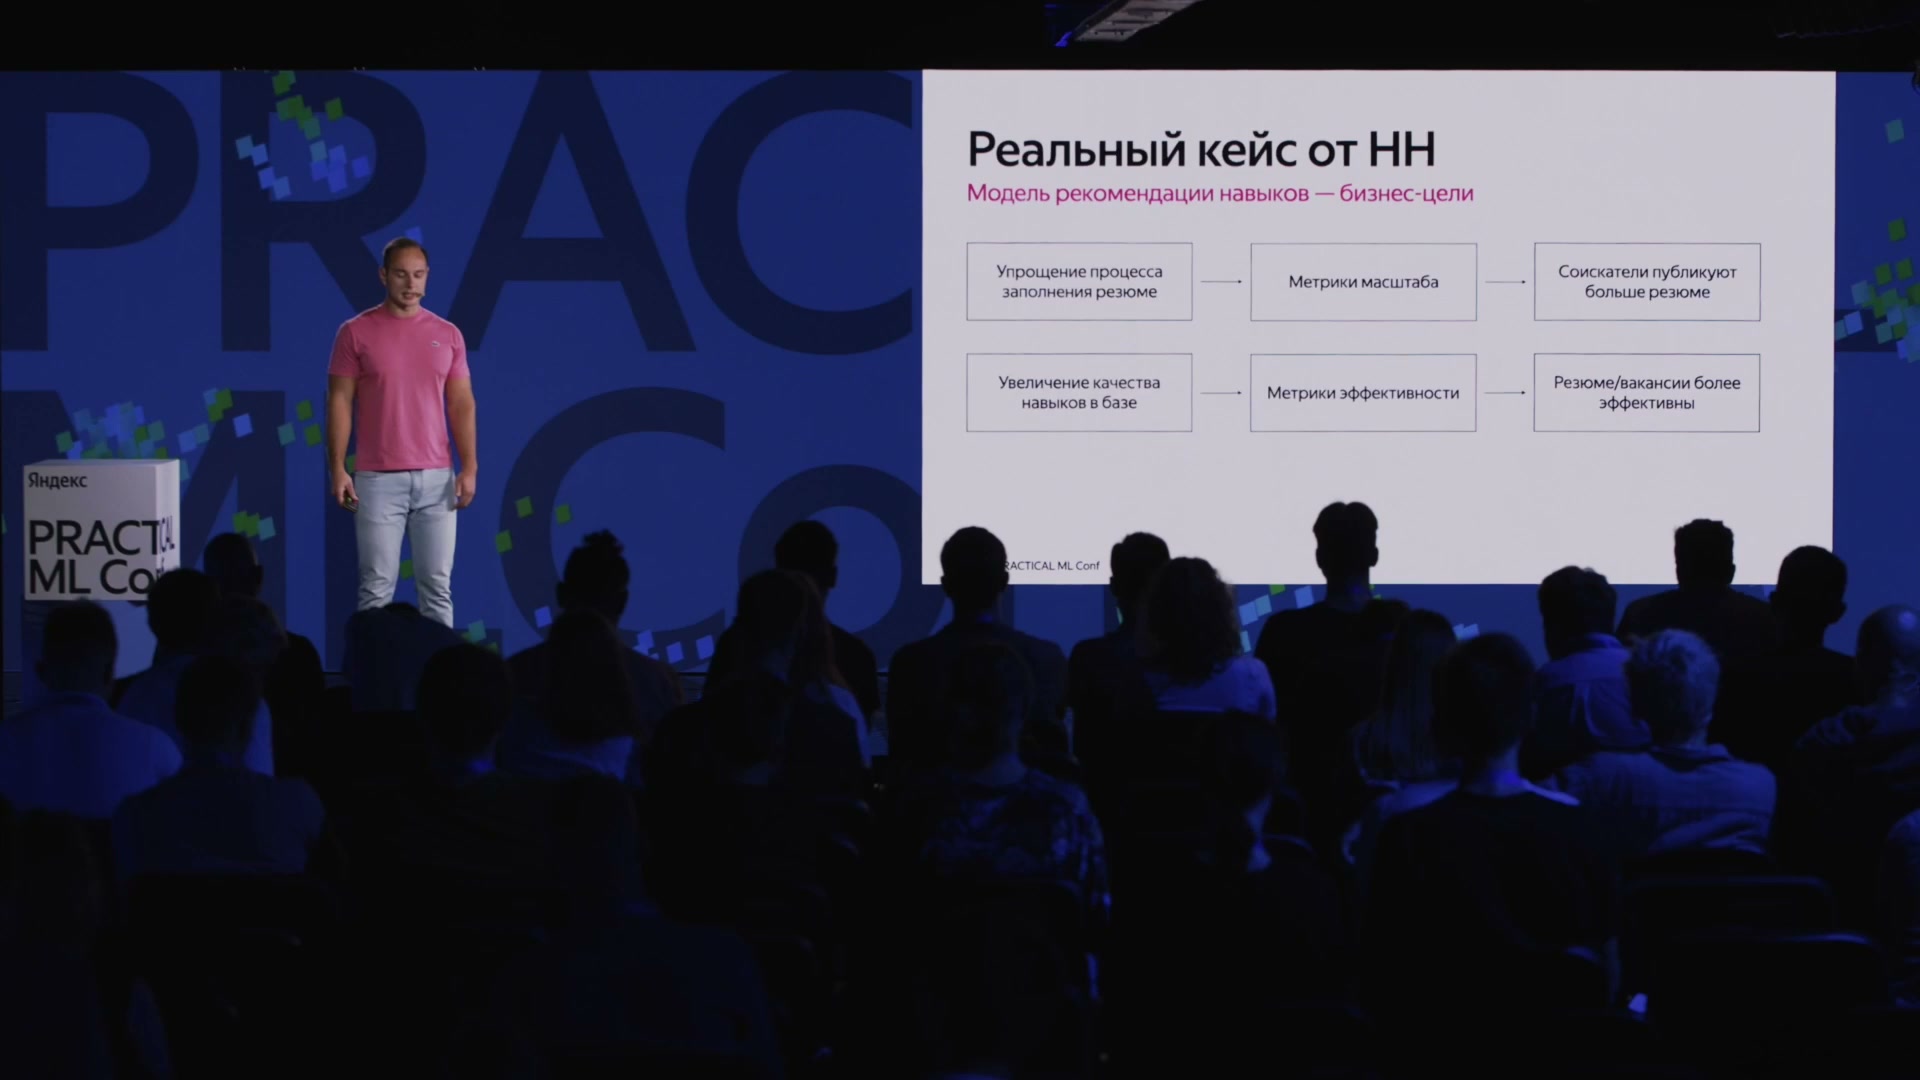
Две бизнес-цели рекомендаций навыков: упростить заполнение и увеличить число опубликованных резюме; повысить информативность навыков и эффективность резюме и вакансий.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfПочему метрика модели — ещё не бизнес-результат
Первая сложность возникает, когда показатели качества модели улучшаются, а нужное изменение в продукте не следует за ними. Автор отмечает, что такое несовпадение встречается не только в рекомендациях. В задаче навыков особенно важно понять, что именно предсказывает выбранный показатель: поведение пользователя, качество заполнения или полезность резюме.
Числовой показатель качества машинного обучения будем называть ML-метрикой. Автор предлагает относиться к нему как к возможной замене целевого бизнес-показателя — прокси-метрике. Прокси используют, когда целевую величину нельзя измерить напрямую. Но удобство измерения само по себе не делает замену хорошей: нужно проверить, насколько она связана с тем результатом, который требуется продукту.
Полезно различать три уровня. Бизнес-метрика отвечает на вопрос, достигнута ли цель продукта. ML-метрика описывает качество модели в выбранной постановке. Оценка пригодности этой ML-метрики в качестве прокси называется proxy score. Это уже характеристика связи между показателями, а не качество отдельной рекомендации и не прирост бизнеса.
Так меняется вопрос к экспериментам: вместо «у какой модели выше привычная метрика?» сначала нужно спросить «помогает ли изменение этой метрики предсказывать изменение публикаций или приглашений?». Для ответа в докладе используется подход, сравнивающий результаты нескольких экспериментов.
Доклад · 00:04:05Сопоставлять эффекты экспериментов, а не сырые значения
A/B-тест сравнивает вариант продукта с изменением и контрольный вариант. Различие измеренной метрики между этими группами называют эффектом эксперимента; на слайде он подписан Treatment_effect. В описываемом подходе для одного теста нужны два таких результата: эффект по бизнес-метрике и эффект по выбранной прокси-метрике.
На схеме показаны M тестов с такими парами. По связи между эффектами хотят оценить бизнес-результат нового эксперимента через изменение прокси. M здесь обозначает количество тестов вообще: автор не сообщает, сколько реальных экспериментов hh.ru вошло в расчёт, как долго они шли и какие изменения моделей сравнивались.
Смысл схемы — проверять, согласуются ли результаты разных изменений продукта. Это не то же самое, что найти пользователей, у которых одновременно высоки две метрики, и назвать такую связь доказательством эффективности модели. Даже в экспериментальном сравнении остаётся вопрос точности измерения каждого эффекта. Именно к нему относится следующий слайд.
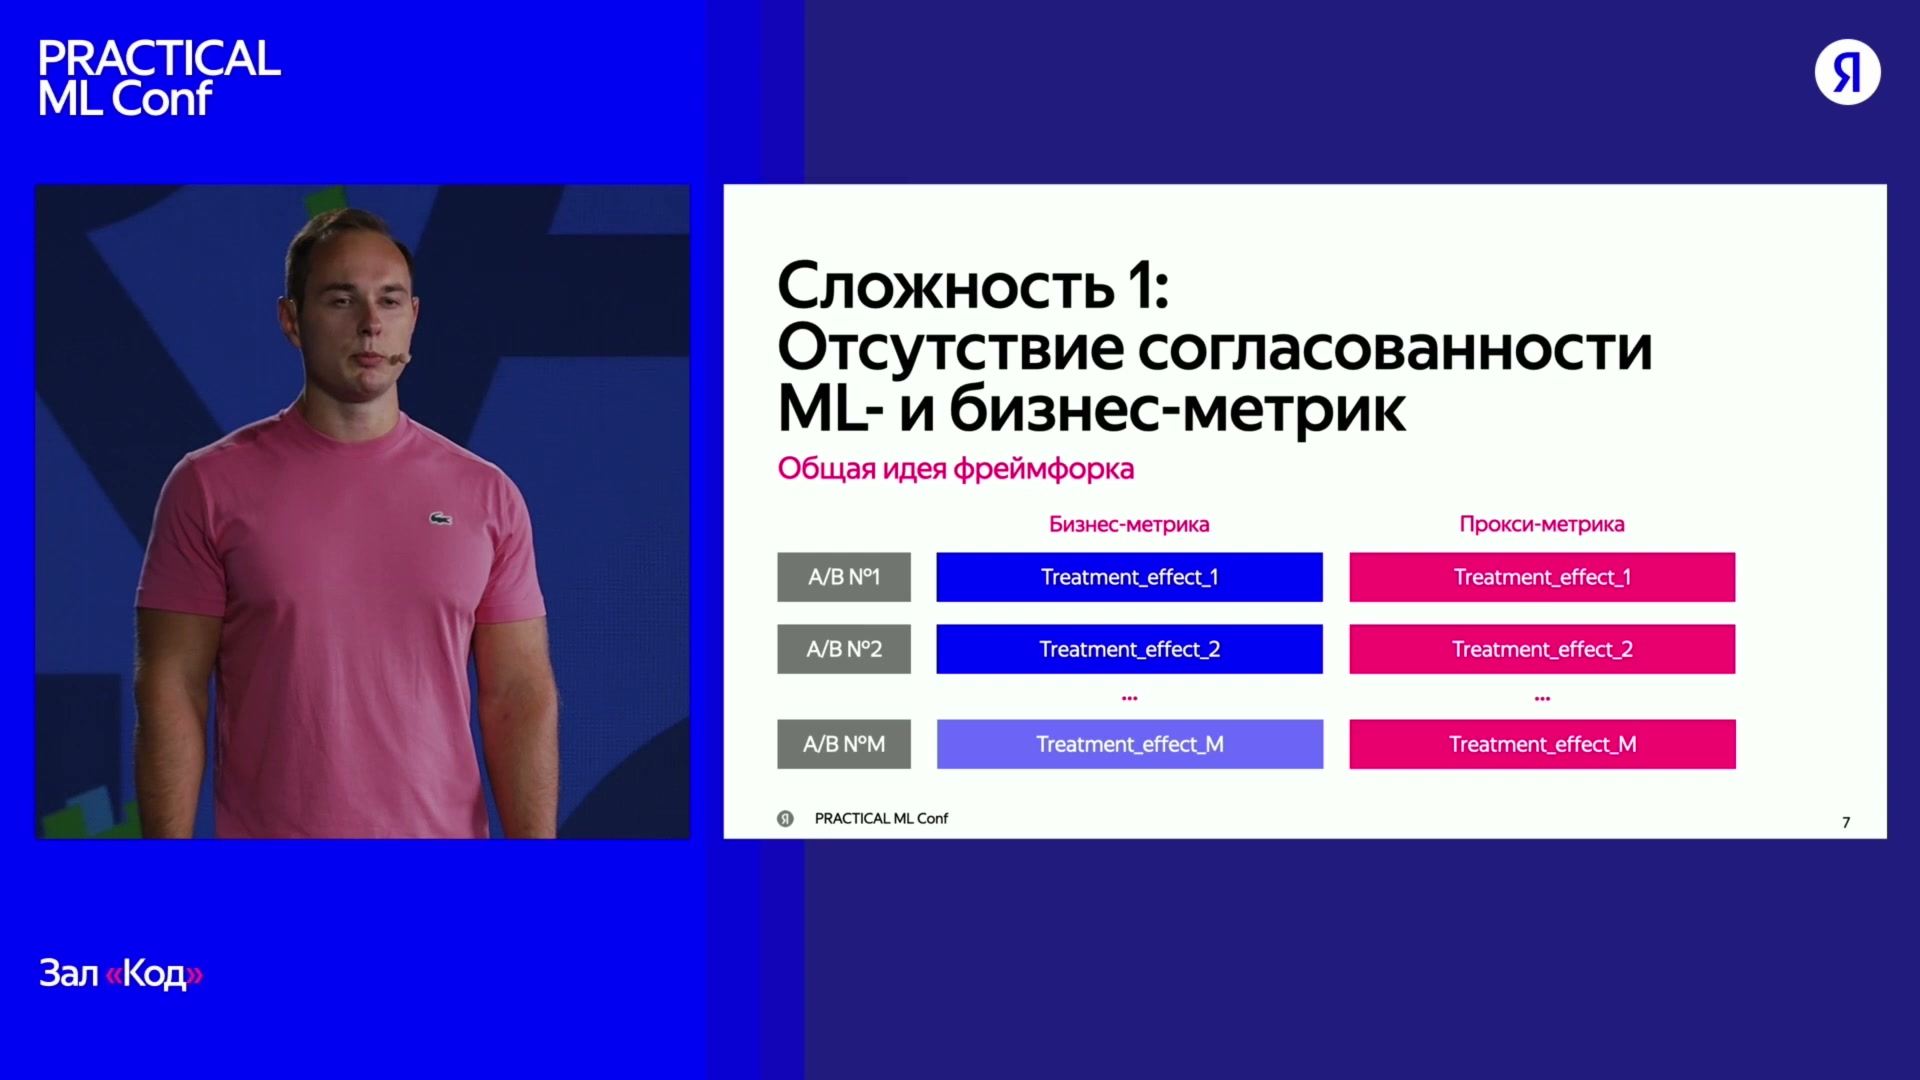
Связь прокси- и бизнес-метрик проверяют на эффектах нескольких A/B-тестов, а не только по значениям качества модели.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfПочему при оценке прокси нужно учитывать шум
Эффект эксперимента приходится оценивать по данным, поэтому его наблюдаемое значение содержит случайные колебания. На исходном слайде автор различает эффекты без шляпок и их шумные оценки со шляпками. Корреляция описывает, насколько согласованно меняются две величины; в данном случае речь идёт об эффектах по бизнес- и прокси-метрике, а не просто об их значениях у пользователей.
Формула справа связывает корреляцию бизнес-эффекта с наблюдаемой оценкой прокси-эффекта с корреляцией самих эффектов и поправкой на шум. Ниже сохранена запись со слайда. Она нужна, чтобы увидеть роль шума, а не как готовая инструкция расчёта на любых данных.
Исходная формула: N и P различают бизнес- и прокси-эффекты, шляпка обозначает оценку по эксперименту, Var — меру разброса. Член с обозначением Ξ входит в шумовую поправку; его точное определение и способ оценивания в докладе не раскрыты.
Автор сознательно оставляет формальные предположения, определения и вывод за рамками выступления. Из слайда нельзя восстановить полный статистический метод. Но содержательное ограничение ясно: оценка пригодности прокси зависит не только от связи эффектов, но и от того, насколько шумно они измерены.
Поэтому proxy score нельзя пересказывать как доказательство, что любое увеличение выбранной ML-метрики причинно увеличит публикации или приглашения. Формула также не определяет разнообразие рекомендаций и не описывает пользовательскую конверсию — долю пользователей, совершивших нужное действие. Она относится к оценке связи экспериментальных эффектов.
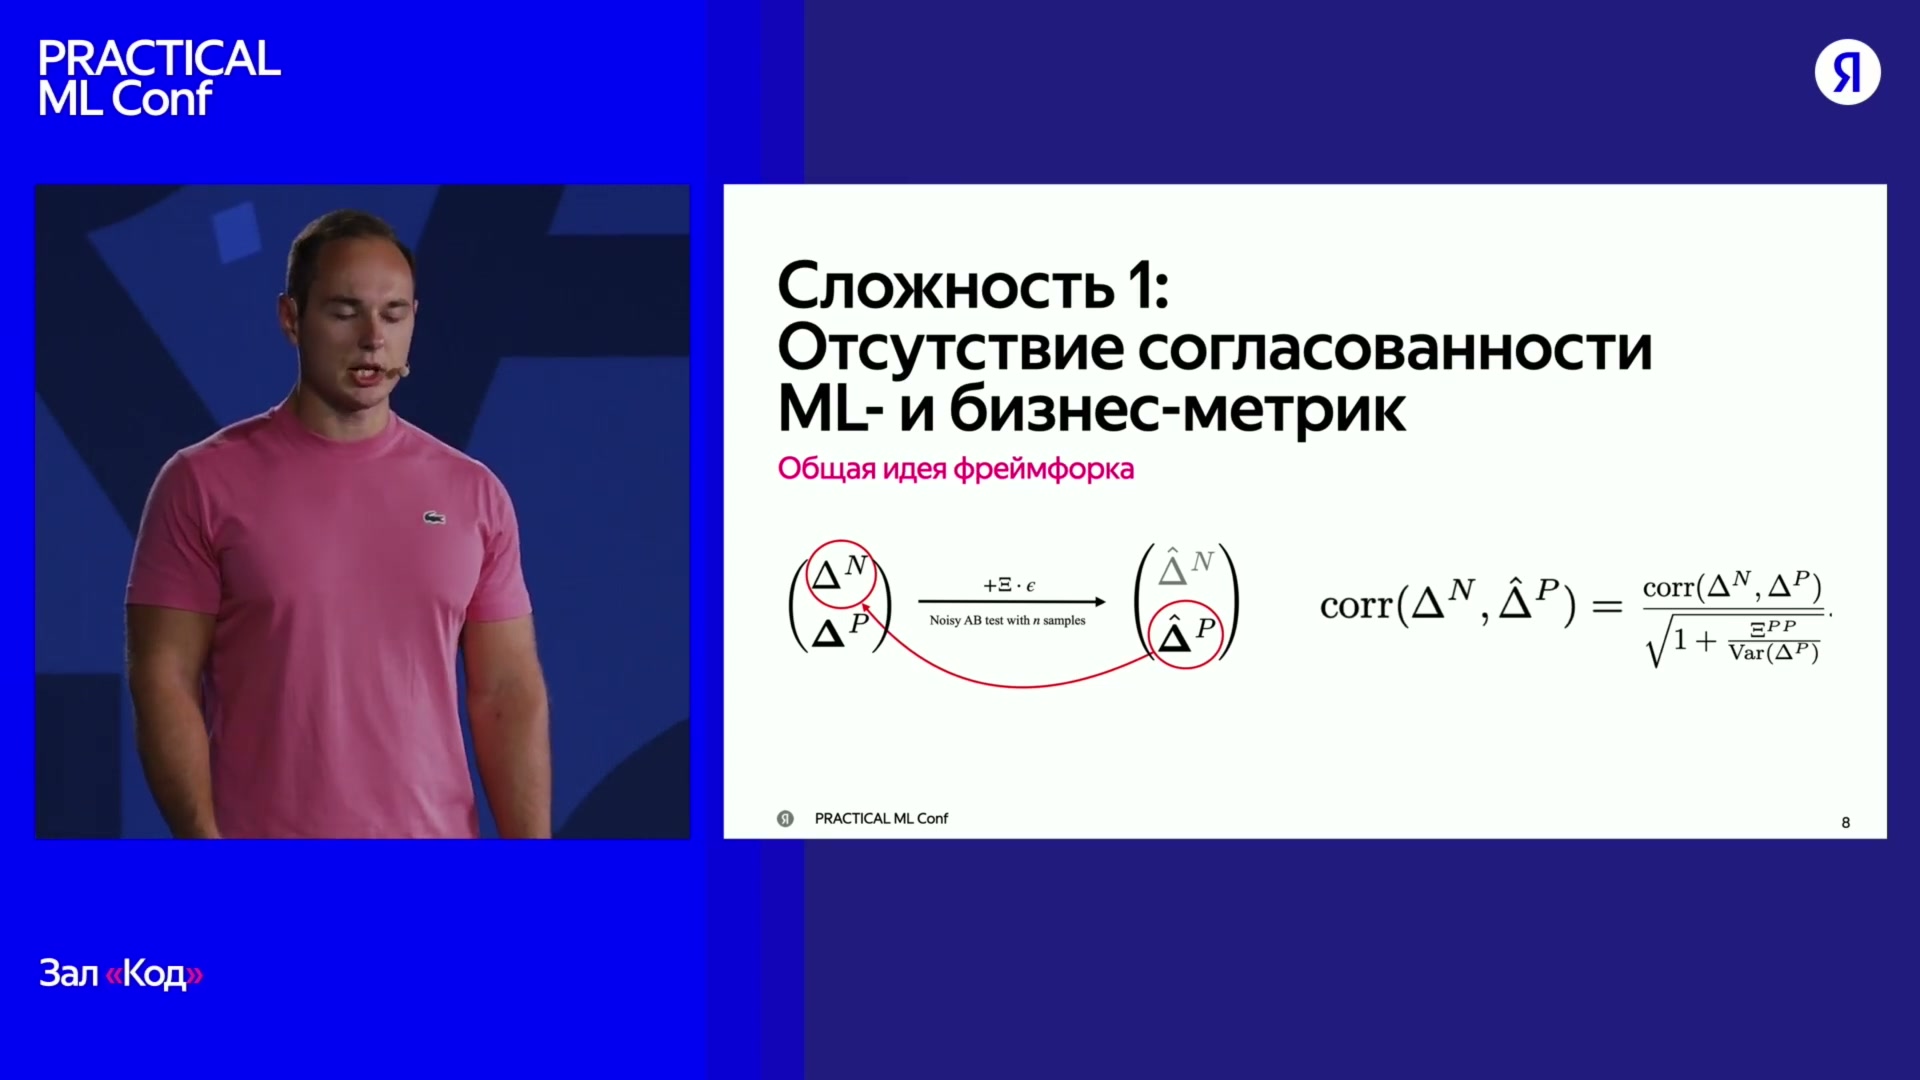
Формула из упомянутого в докладе подхода к оценке прокси-метрик учитывает шум экспериментов. Это не опубликованная формула diversity или пользовательской конверсии hh.ru.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfЧто показала проверка пяти ML-метрик
В первом столбце бизнес-метрик стоит applicant_resume_publication. Автор описывает её как среднее количество опубликованных резюме в рассматриваемой группе соискателей: это показатель масштаба. Второй столбец, applicant_base_invitation, относится к приглашениям из базы и представляет эффективность. Окна наблюдения и точные правила агрегации этих показателей не сообщаются.
Сокращения pr и re обозначают точность и полноту — precision и recall. В общем смысле точность отвечает на вопрос, какая доля предложенного соответствует эталону, а полнота — какая доля эталонного набора найдена. Числа после @ задают глубину списка: первые 5 или 20 позиций. Это объясняет названия строк, но не восстанавливает протокол hh.ru: какие навыки считались эталонными и как усреднялись результаты, не раскрыто.
Diversity — числовая характеристика широты и разнообразия рекомендаций. Её конкретной формулы для этого кейса нет. Каждая ячейка следующей таблицы показывает не саму ML-метрику, а её proxy score для соответствующей бизнес-метрики.
Таблицу можно прокрутить по горизонтали.
Разнообразие получило заметно более высокую оценку пригодности, чем проверенные варианты точности и полноты. Именно это сравнение поддерживает дальнейший интерес к разнообразию. При этом 62,4% не означает рост числа публикаций на 62,4%, а 78,1% — рост приглашений на 78,1%. Все десять значений — proxy score, а не точность модели, доля успешных рекомендаций или эффект её замены в A/B-тесте.
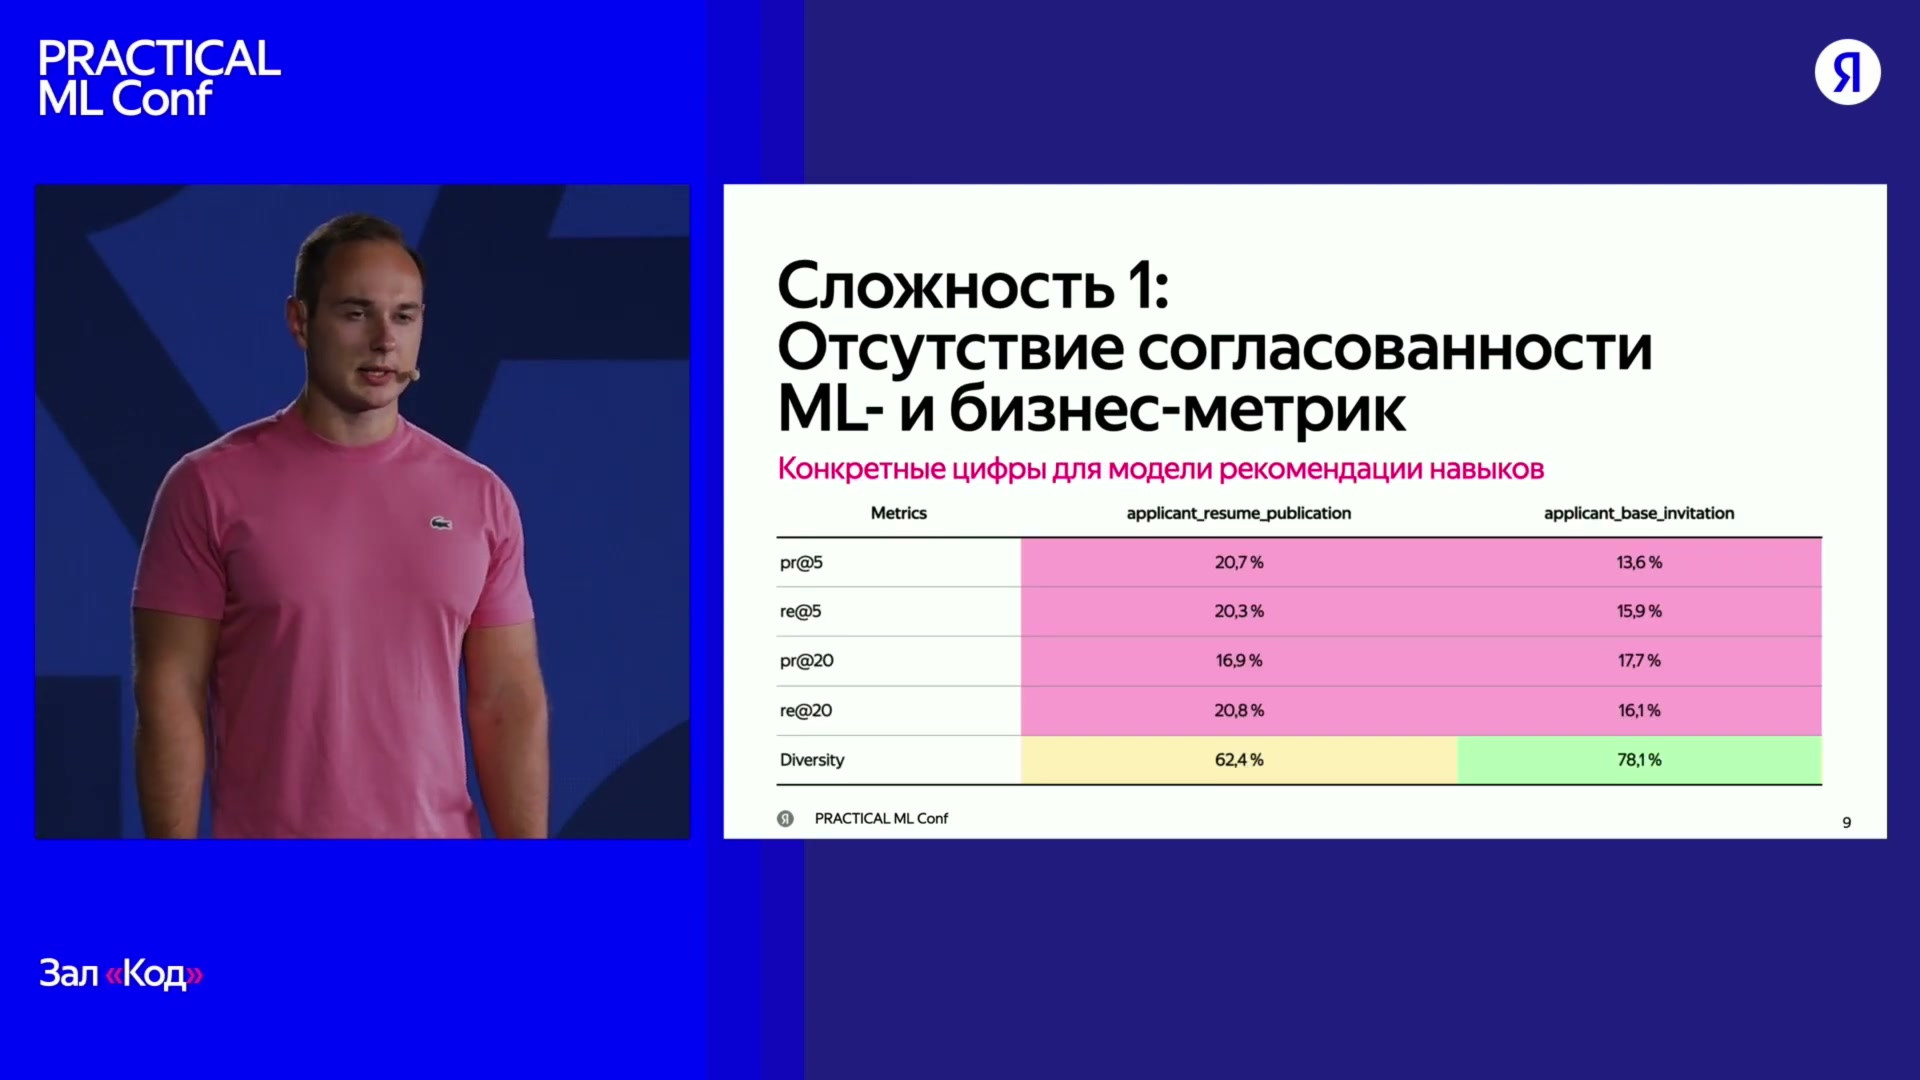
Показанные proxy score: pr@5 — 20,7%/13,6%; re@5 — 20,3%/15,9%; pr@20 — 16,9%/17,7%; re@20 — 20,8%/16,1%; Diversity — 62,4%/78,1%. Столбцы: applicant_resume_publication и applicant_base_invitation. Числа не означают прирост этих бизнес-метрик.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfКакие решения можно принимать по этой таблице
Для модели навыков автор делает жёсткий, но локальный вывод: проверенные ML-метрики почти бесполезны для предсказания бизнес-метрик, за исключением Diversity. «Локальный» здесь важно: речь о конкретных показателях, данных и продуктовой задаче, а не о запрете использовать офлайн-оценку в рекомендациях.
Изменения модели приходится проверять прямыми A/B-тестами. Автор отдельно подчёркивает необходимость тщательно проработать их методологию. Таблица пригодности прокси не заменяет сравнение нового варианта с контрольным и не сообщает величину эффекта какой-либо конкретной архитектурной доработки.
В докладе нет размеров экспериментальных групп, длительности тестов и интервалов неопределённости оценок. Поэтому опубликованный результат позволяет понять выбор способа оценки, но не повторить весь экспериментальный расчёт. Diversity становится полезным ориентиром внутри этой задачи, а не обещанием, что любое разнообразие автоматически улучшает бизнес.
Доклад · 00:08:29Узкий фокус: хорошие отдельные навыки могут дать плохой список
Вторая сложность — однородность рекомендаций. Пузырём рекомендаций автор называет ситуацию, когда система всё чаще предлагает похожий контент, опираясь на прошлые предпочтения и взаимодействия пользователя. Узкий фокус — частный случай такого пузыря: выдача сосредоточена на одной области или категории и оставляет без внимания остальные возможные интересы.
Для навыков важно качество всего списка, а не только каждой позиции по отдельности. Высокие оценки нескольких однотипных навыков ещё не обеспечивают широкое описание профессионального профиля. Поэтому задачу нельзя свести к выбору самых высоких индивидуальных оценок без учёта того, какие области они представляют.
Здесь соединяются три темы выступления. Разнообразие оказалось более полезной прокси-метрикой, поэтому узкий фокус важен не только как внешнее свойство выдачи. А качественная разметка может дать категории, через которые это разнообразие организуют. Дальше автор показывает именно такое решение: содержание резюме или вакансии превращается в признаки, модель оценивает навыки и определяет профессию, а категории помогают собрать неоднородный верх списка.
Исходные определения отделяют пузырь вообще от более узкой задачи этого кейса. Показанное далее смешивание категорий направлено на узкий фокус; оно не объявляется универсальным решением всех проблем рекомендательной обратной связи.
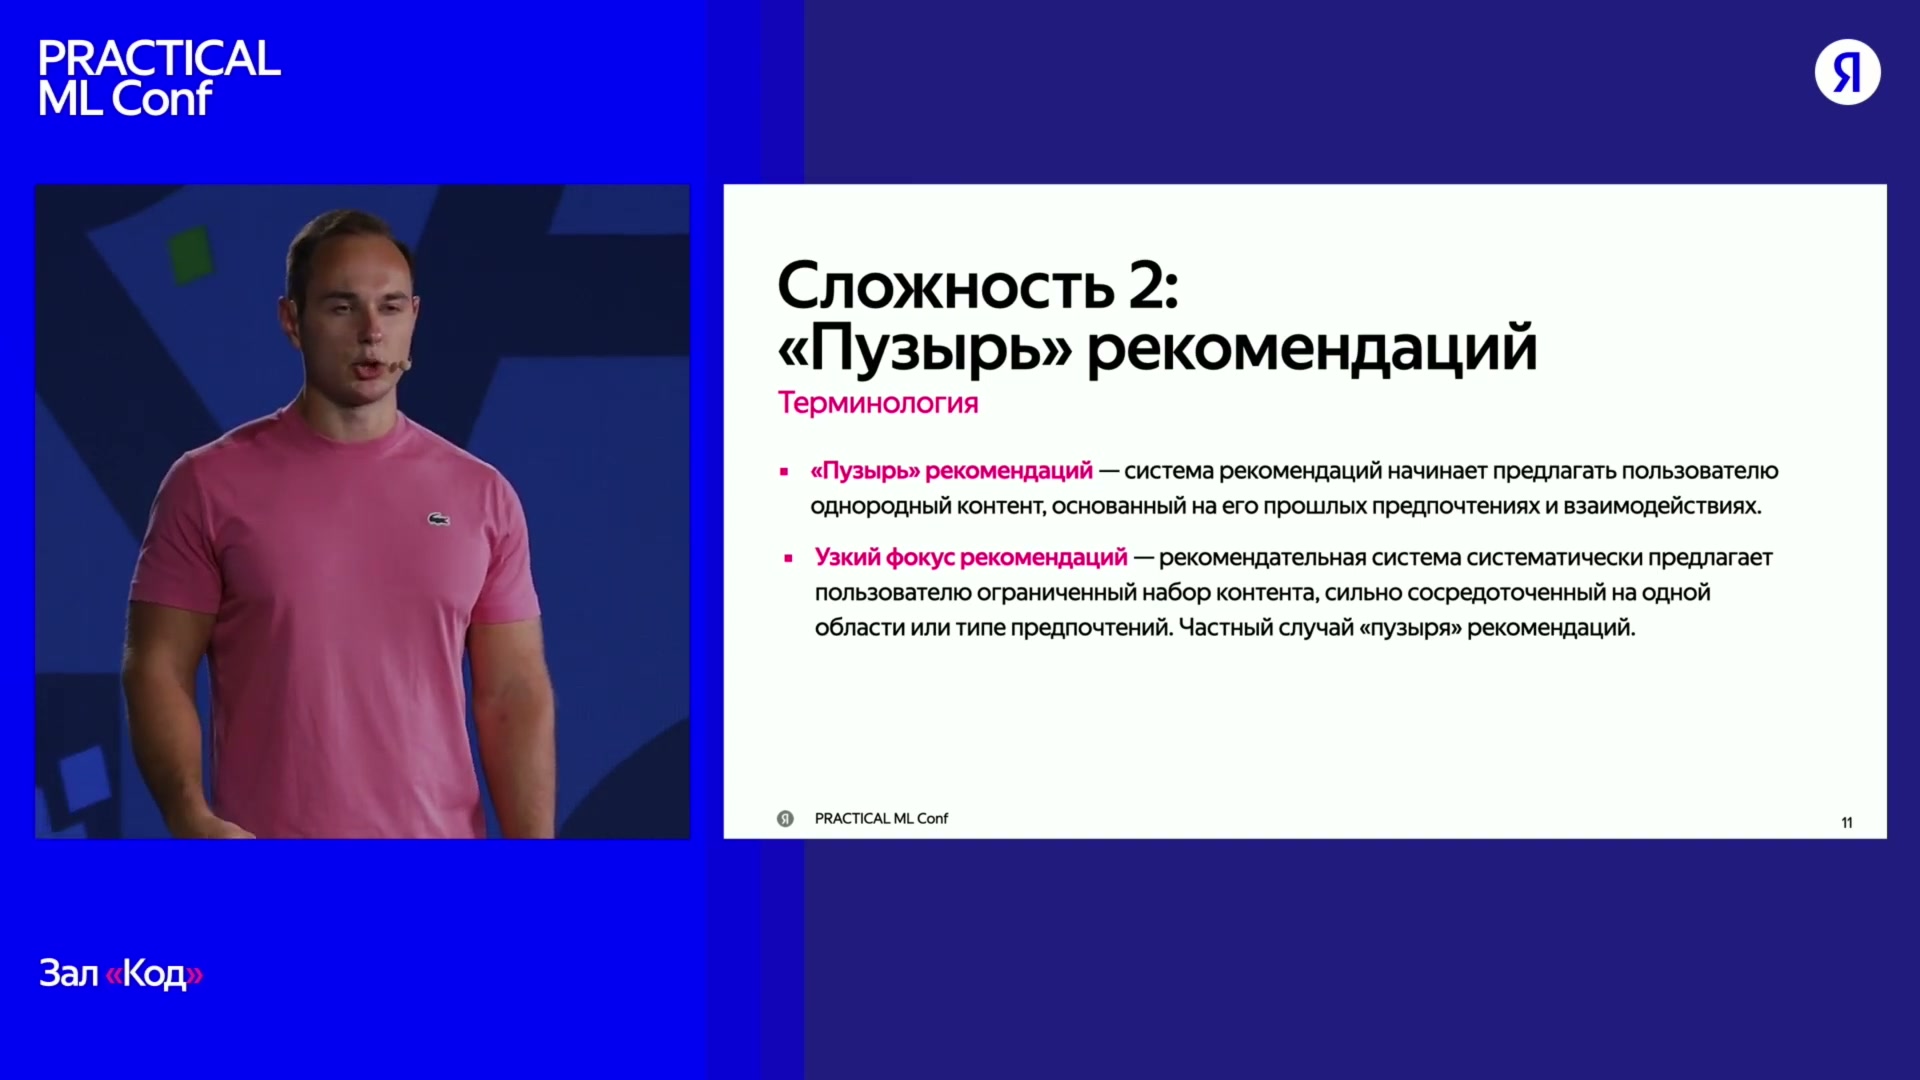
Узкий фокус — частный случай пузыря рекомендаций: система сосредоточивается на одной области и игнорирует остальные интересы.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfКак заголовок, навыки и обязанности превращаются в признаки
Для расчёта признаков автор рассматривает резюме и вакансию как похожие объекты: у каждого есть заголовок, набор навыков и набор обязанностей. Признаки — числовое описание содержания, которое затем получает модель. Векторное представление, или эмбеддинг, хранит такое описание в виде набора чисел.
Заголовок преобразуют в вектор, повторно используя DSSM — уже имеющуюся у hh.ru модель, которая в этом фрагменте выступает именно преобразователем заголовка. Название DSSM здесь не обозначает всю систему рекомендаций. Как она обучена и как устроена внутри, автор не объясняет.
Для навыков на схеме показано индикаторное кодирование OHE, от one-hot encoding: элементу словаря соответствует отдельная позиция, в которой можно отметить его наличие. После OHE строится векторное представление. Для обязанностей сначала указана нормализация — приведение к согласованному виду, — а затем также построение вектора. Конкретные операции нормализации не названы.
Таблицу можно прокрутить по горизонтали.
В результате получается вектор признаков резюме или вакансии. Размерности, способы объединения представлений и модели для кодирования навыков и обязанностей не раскрыты. Существенный вывод схемы — разные виды содержания проходят разные преобразования, после чего служат общим входом для оценки навыков и определения профессии.
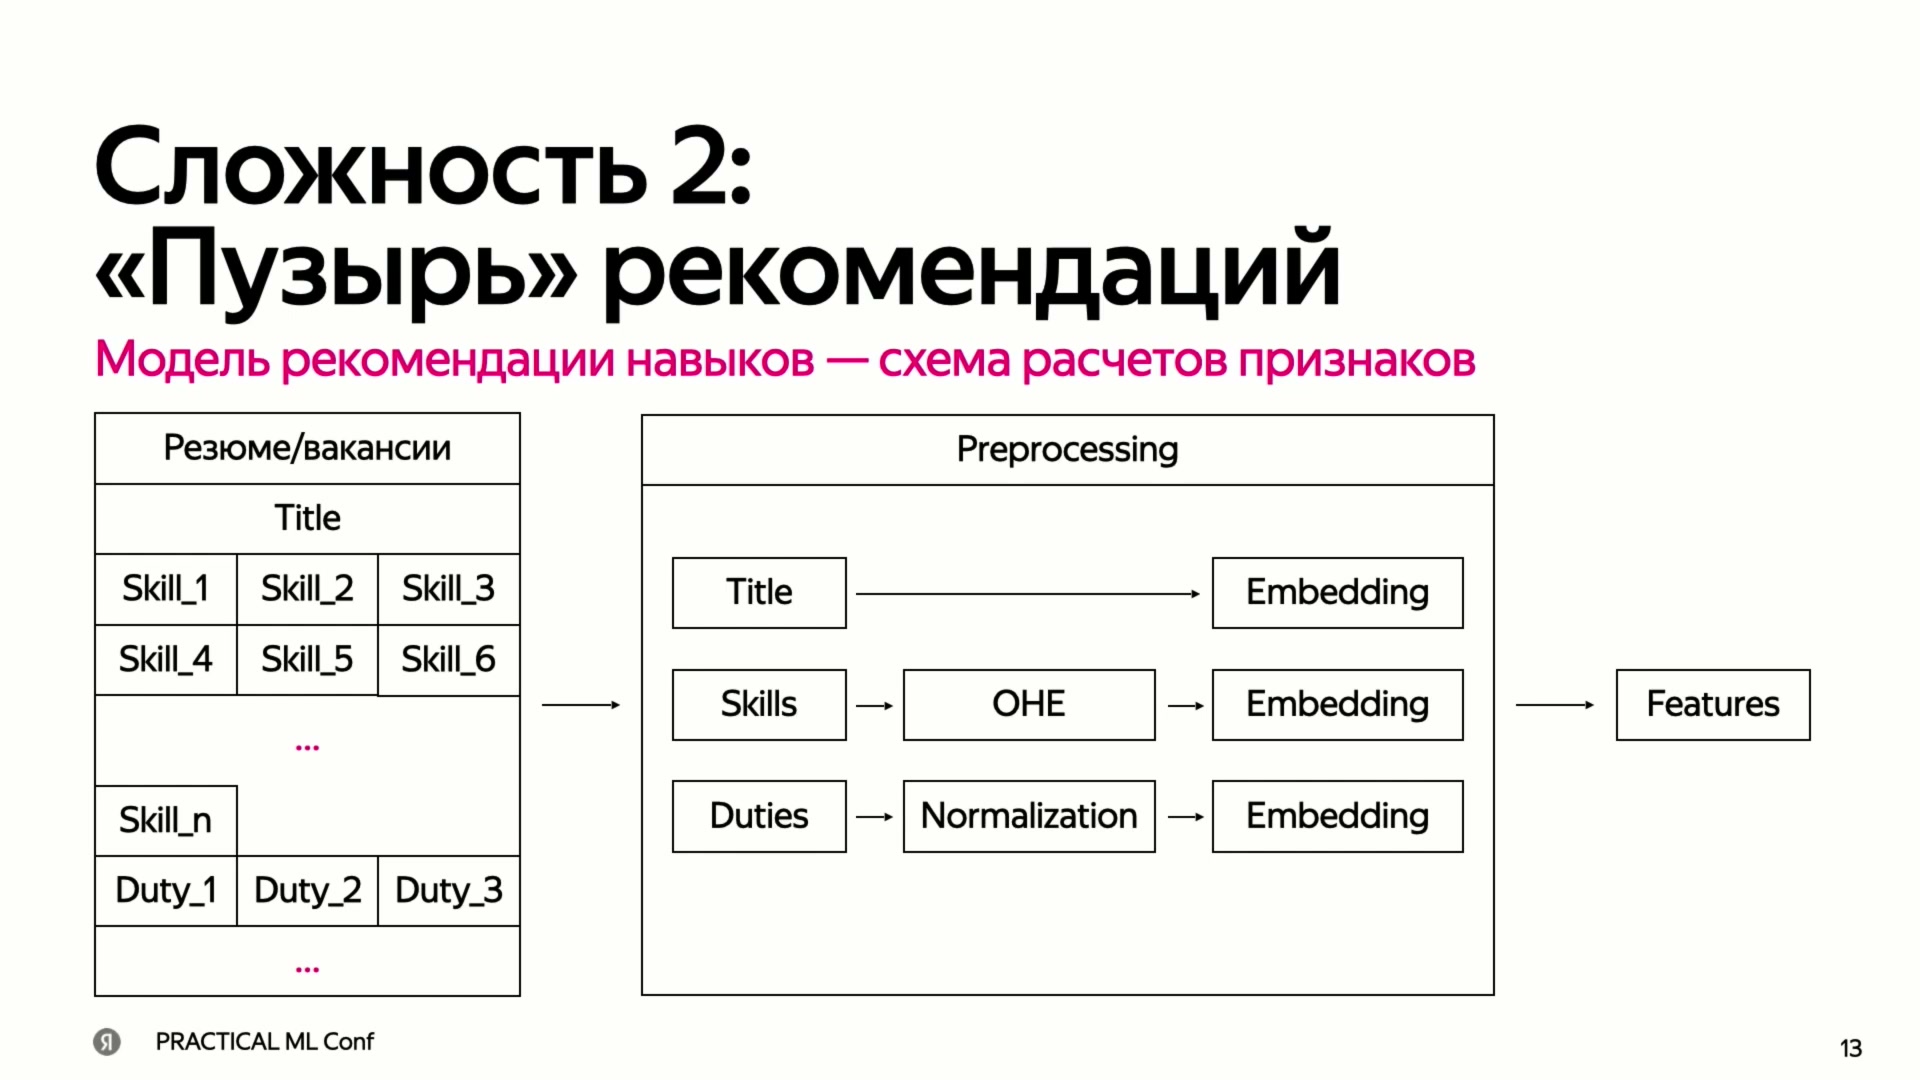
Признаки резюме или вакансии: заголовок → вектор; навыки → OHE → вектор; обязанности → нормализация → вектор. Возраст и весь трудовой стаж в этот набор не входят, как поясняет автор в ответах.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfДве задачи на одних признаках: следующий навык и профессия
Подготовленный вектор направляется в две ветви. Первая оценивает каждый навык отдельно: насколько вероятно, что следующим пользователь выберет именно его. Такое пообъектное оценивание называется point-wise: модель выдаёт значение для отдельного навыка, а не непосредственно сравнивает пару навыков.
Постановка с отдельным предсказанием для каждого навыка называется «один против остальных», или OvA. На исходной схеме ветвь подписана Point-wise OvA. Важно не подменить её другой задачей: в докладе речь идёт о вероятности следующего выбора, а не о прямом прогнозе приглашения работодателя. Это различие объясняет, почему даже хорошая модель пользовательского выбора нуждается в проверке через бизнес-метрики.
Вторая ветвь — модель профессий. Она определяет, к какой профессии относится резюме или вакансия. Задача отнесения объектов к заданным классам ответов называется классификацией. Таким образом, система получает и оценки конкретных навыков, и профессиональный контекст, в котором их нужно предлагать. Эти результаты используются вместе при формировании списка.
Схема раскрывает назначение ветвей, но не их конкретную реализацию. В речи повреждено название семейства базовых моделей; по нему нельзя надёжно восстановить тип алгоритма. Архитектура классификатора профессий, параметры обучения и способ подготовки обучающих примеров также не сообщаются. Наличие DSSM в обработке заголовка не определяет устройство остальных моделей.
Доклад также не сообщает, как делили данные для обучения и проверки, как часто обновляли модели и какой была задержка ответа. Инфраструктура отдельного сервиса не описана. Эти параметры нельзя вывести из масштаба всей платформы или из общей схемы двух ветвей.
Доклад · 00:11:17Категории и смешивание: как не заполнить верх списка одной областью
Одних индивидуальных оценок недостаточно, чтобы управлять разнообразием. В описанном решении каждому навыку назначена категория, а для профессии задан набор возможных категорий. Это предметная структура, связывающая профессиональный профиль с разными областями навыков. На слайде она названа картами компетенций.
Компонент смешивания, который автор называет блендером, получает профессию объекта и оценки навыков. Он выбирает наиболее вероятные навыки внутри категорий и объединяет их в верхней части списка рекомендаций. Ранжирование — упорядочивание по оценке — тем самым используется внутри категорий, а итоговая выдача учитывает ещё и их представительство.
Таблицу можно прокрутить по горизонтали.
В общем порядке оценок верх таблицы занимают Python, R и Numba из DS1. Но выделены Python, PyTorch и Pandas: они представляют DS1, DS2 и DS3. На этом примере видно, зачем учитывать категории, а не только общую сортировку. Числа показывают механику выбора; они не являются результатами эксперимента, приростом публикаций или проверкой точности предсказанных вероятностей.
Из иллюстрации не следует, что промышленный алгоритм всегда берёт ровно по одному навыку из каждой категории. Автор не раскрывает квоты, размер итогового списка, веса смешивания и правила для неоднозначной профессии. Подтверждён общий принцип: высоко оценённые навыки выбираются с учётом категорий и затем смешиваются, чтобы выдача не замыкалась на одной области.
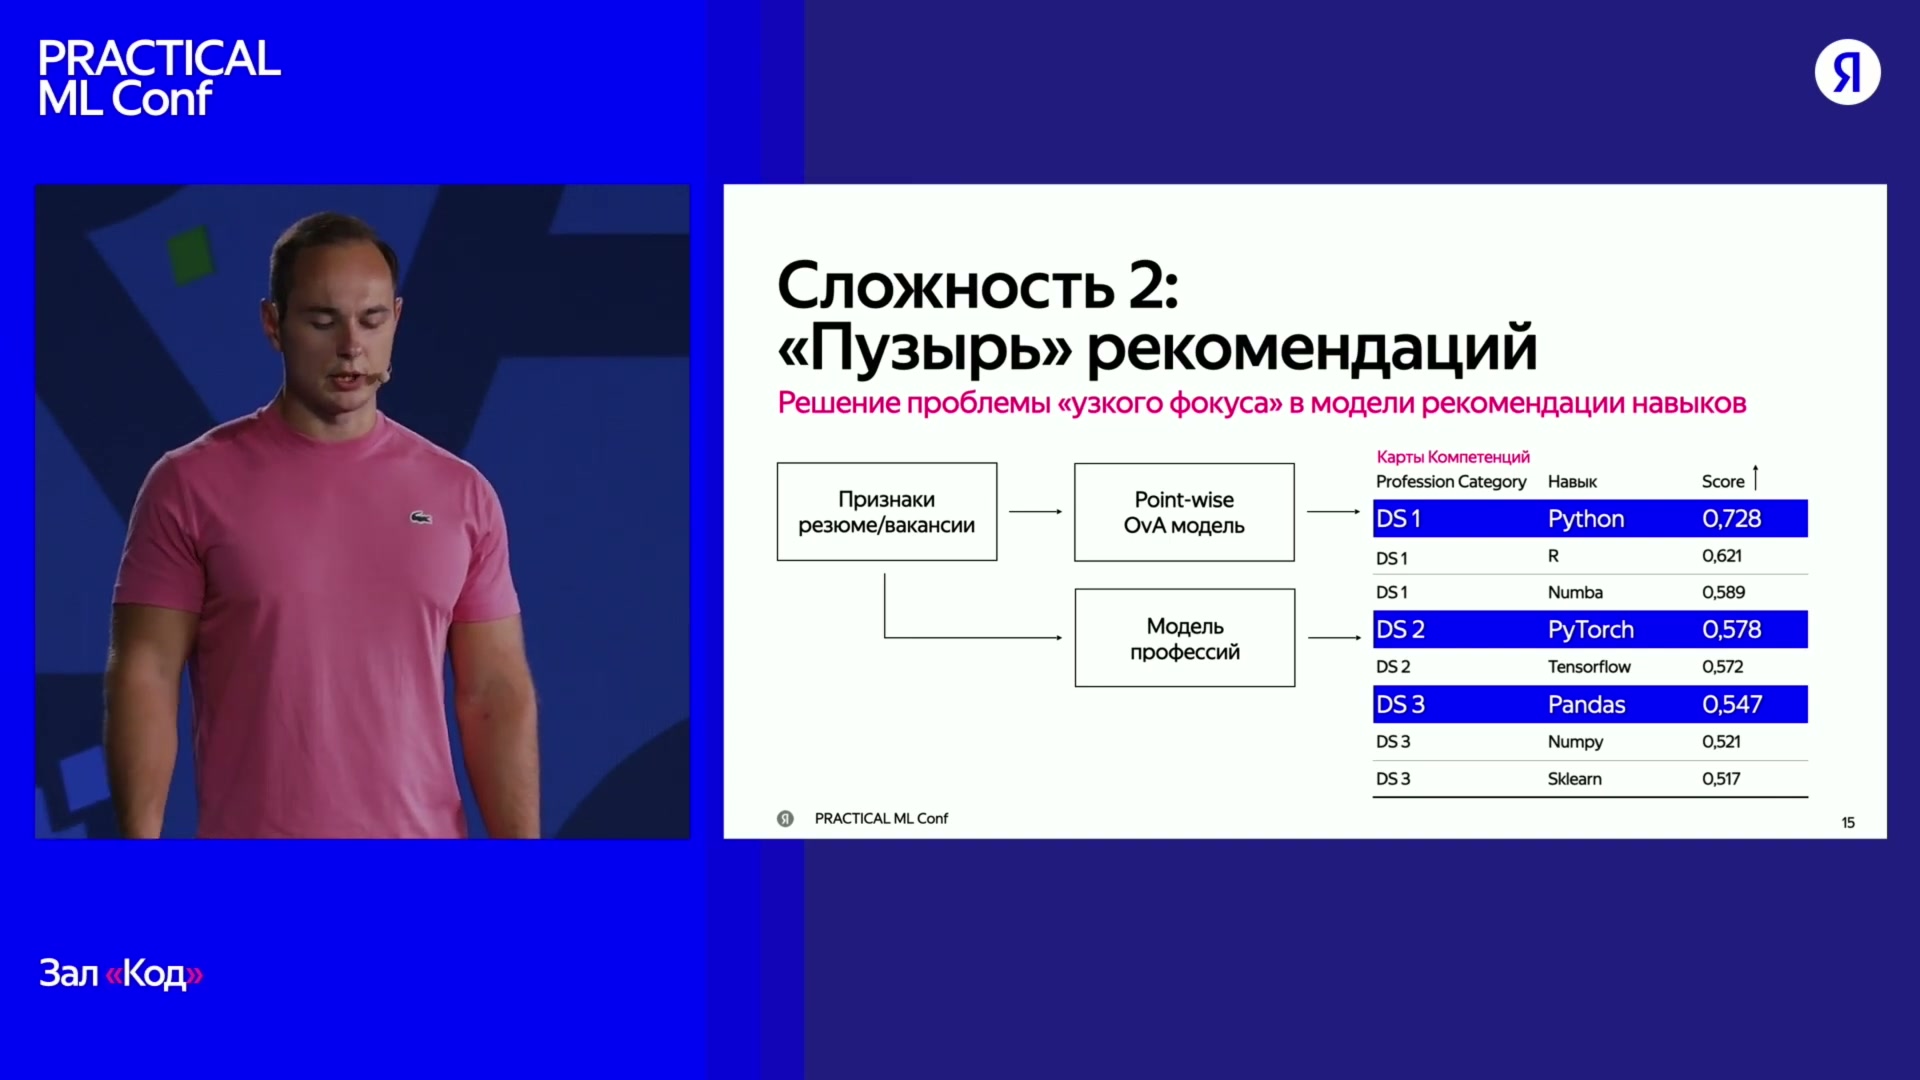
Оценки навыков сочетаются с моделью профессий и картами компетенций. Пример DS1/DS2/DS3 с оценками — схема смешивания категорий, не измеренный бизнес-эффект.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfЧто известно об эксперименте с узким фокусом
После описания смешивания автор прямо говорит, что не смог поделиться численными результатами. Далее упоминается A/B-сравнение, однако фраза с его итогом повреждена в расшифровке. По доступной речи нельзя надёжно установить даже точную качественную формулировку результата.
Поэтому описанную архитектуру нельзя сопровождать утверждением о доказанном положительном A/B-эффекте. Не раскрыты ни величина изменения, ни точный базовый вариант, с которым сравнивали модель, ни статистическая значимость результата. Значимость здесь означает обоснованность отличия от случайных колебаний; сведений для её проверки нет.
Таблица proxy score отвечает на другой вопрос — какие метрики лучше подходят для оценки бизнес-эффекта. А оценки навыков в карте компетенций иллюстрируют смешивание категорий. Ни одна из этих таблиц не восполняет отсутствующие результаты A/B-теста. Устройство решения и доказательства его эффекта необходимо держать раздельно.
Доклад · 00:12:21Когда нужны размеченные данные
Третья сложность — отсутствие размеченных данных. Разметка означает, что объекту сопоставлен нужный ответ: например, резюме отнесено к профессии. Но автор начинает эту тему не с заказа большой разметки, а с вопроса, нужна ли она выбранному методу вообще.
В докладе различаются рекомендации по содержанию объектов, то есть контентная фильтрация; рекомендации по совместным действиям пользователей, то есть коллаборативная фильтрация; и гибридные подходы, объединяющие разные источники информации. Потребность в предметной разметке у этих методов неодинакова. Автор допускает ситуации, в которых можно обойтись без неё, и одновременно отмечает, что качественная разметка способна повысить эффективность системы.
Для рассматриваемого решения связь с разметкой конкретна: модели профессий нужны подготовленные примеры профессий, а смешиванию — содержательная структура категорий навыков. Это не утверждение, что каждый пользовательский выбор должен быть вручную проверен. Речь о тех знаниях, которых недостаточно получить из самого факта выбора.
Так замыкается переход от узкого фокуса к данным. Чтобы управлять разнообразием через профессии и категории, нужно не только оценить вероятности, но и организовать надёжную предметную подготовку. Следующие разделы показывают, кому поручают эту работу и как уменьшают её трудоёмкость.
Доклад · 00:12:36Почему время и бюджет ещё не гарантируют качество разметки
Ожидания от разметки автор изображает через схему «быстро, качественно, дёшево», которую называет треугольником Хопкинса. В его изложении приходится выбирать не более двух свойств, жертвуя третьим. Для разметки он предлагает ещё более осторожную версию — собственный «грустный треугольник».
На правой части слайда большие затраты времени и денег ведут к качеству со знаком вопроса. Автор формулирует это жёстко: «долго и дорого» — необходимые, но не достаточные условия. Содержательная мысль здесь в том, что сама оплата труда и длительность проекта не обеспечивают правильных ответов.
Это авторская метафора сложной предметной разметки, а не универсальная теорема о любых данных. Практический акцент — на организации работы: кто понимает предметную область, кто пишет правила, как разбирают трудные случаи и как проверяют результат. Именно эти действия, а не расходы сами по себе, далее становятся центром процесса.
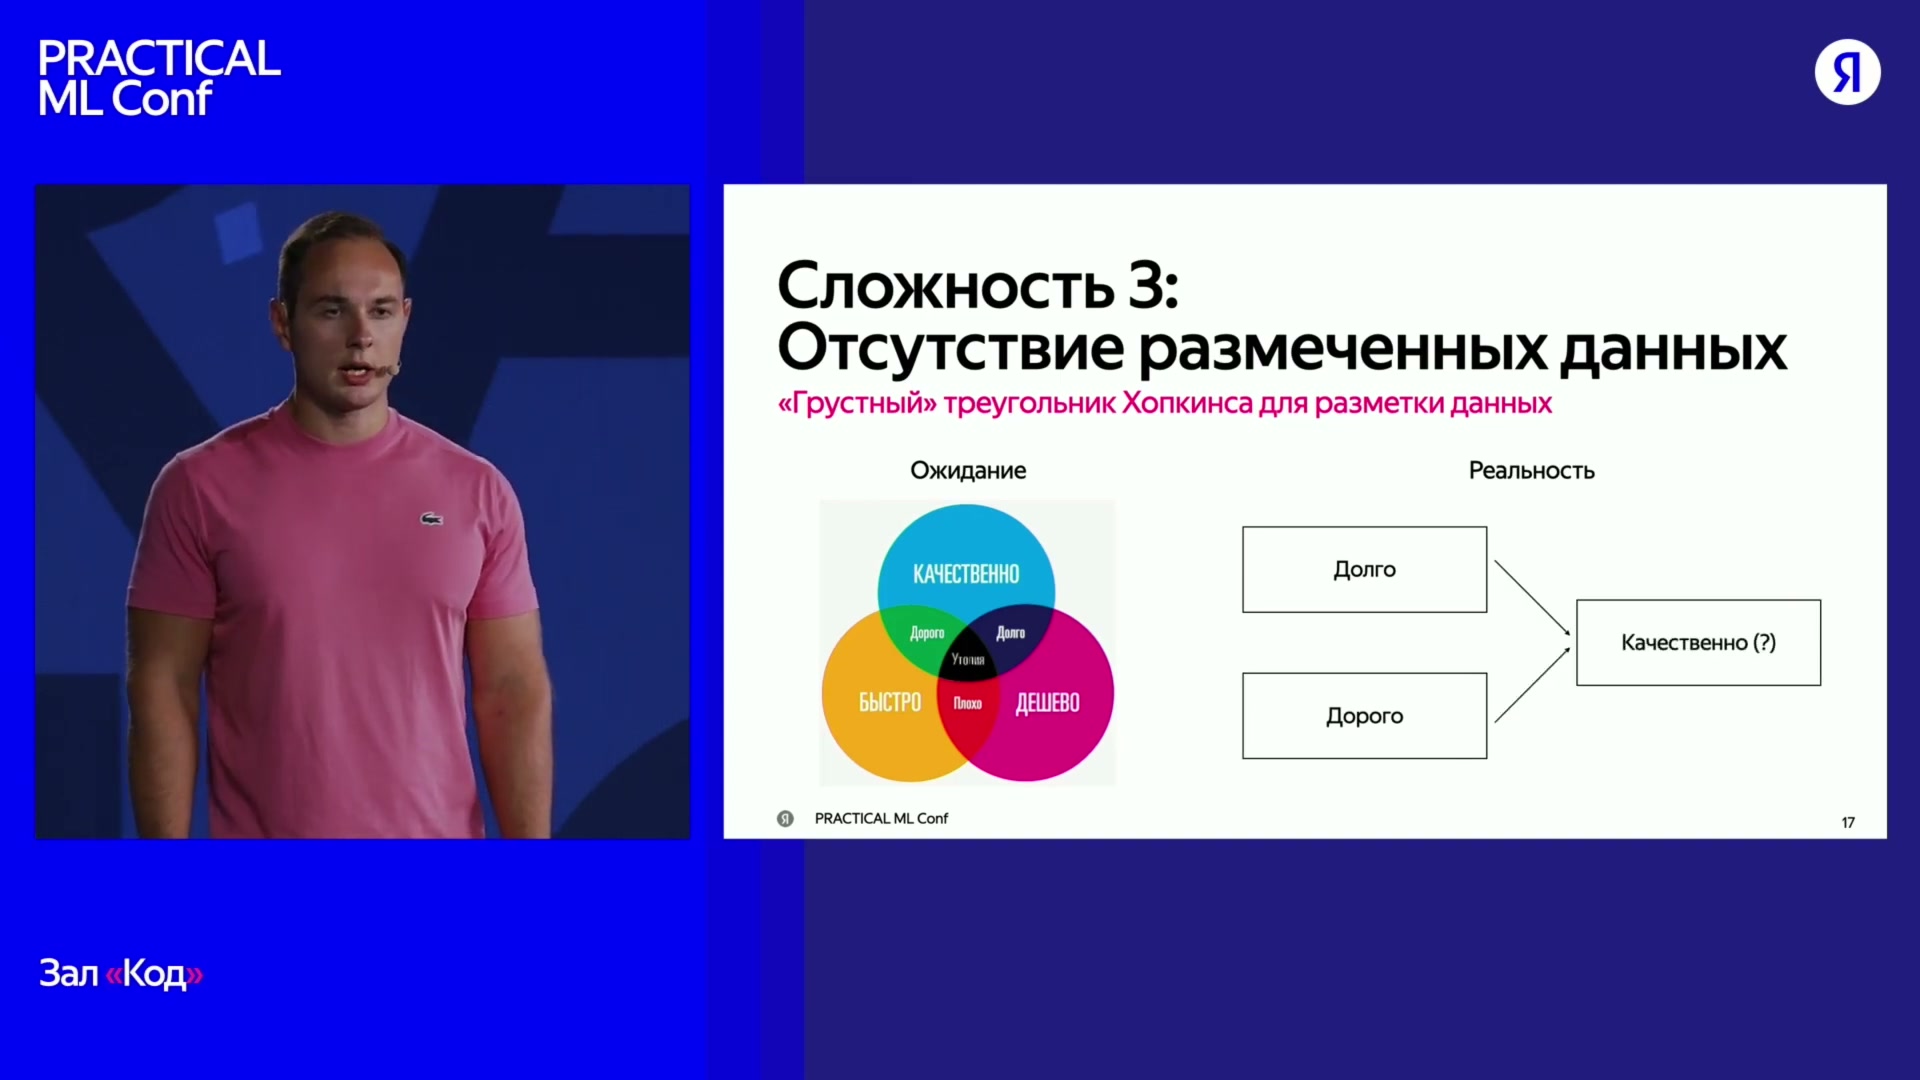
Авторская иллюстрация ограничений разметки: большие затраты и время сами по себе не гарантируют качество.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfЧто должен решить разметчик профессий
Модель профессий получает признаки резюме или вакансии и оценивает вероятности принадлежности к профессиям. Такой выбор из набора возможных ответов называется классификацией, а сами ответы — классами. Эта задача поддерживает рекомендации навыков, но не совпадает с оценкой следующего навыка или уровня позиции.
Для обучения нужны примеры, которым сопоставлена профессия. На исходном слайде показаны резюме с заголовками Software Java Engineer — разработчик программного обеспечения на Java — и ML engineer — инженер машинного обучения. В первом техническом примере среди навыков видны Java, Spring Framework и SQL; во втором — Python, C++, PyTorch, CUDA и компьютерное зрение. Это содержание помогает рассматривать объект шире его заголовка.
Задача разметчика — прочитать заголовок, навыки и обязанности с последнего места работы и сопоставить резюме с профессией. Под обоими примерами на слайде стоят вопросительные знаки, а не готовые эталонные классы. Поэтому название позиции нельзя просто принять за уже размеченный правильный ответ.
Смысл иллюстрации — показать необходимость предметной экспертизы. Количество профессий, полный справочник классов и правильные ответы для этих примеров не приводятся. Качество классификатора также не выражено числом: слайд раскрывает постановку задания, а не результаты его автоматического решения.
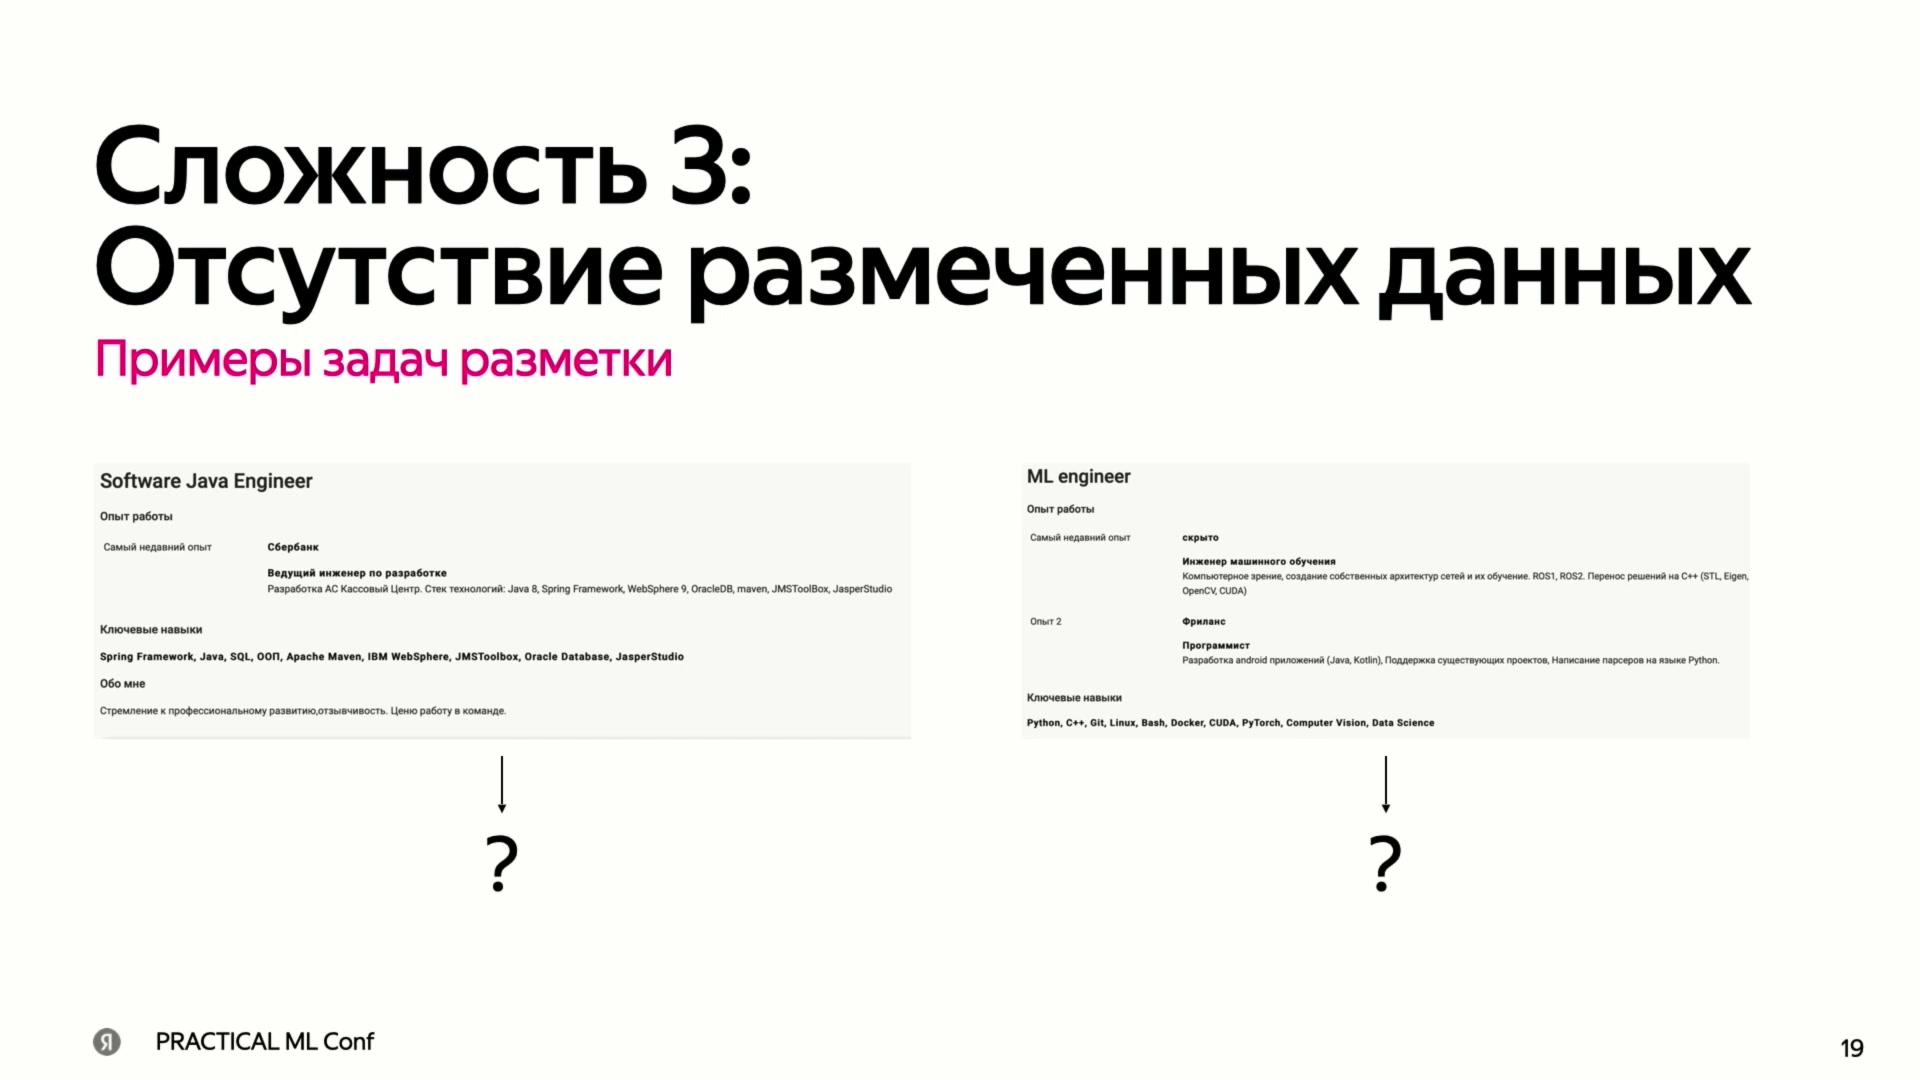
Примеры задач классификации профессий по заголовку, навыкам и обязанностям. Нужна предметная экспертиза, а не только чтение названия позиции.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfМетодолог и DS: подготовка, инструкция, разметка, проверка
Для такой разметки автор выделяет методологов — специалистов, которые разрабатывают и поддерживают процесс на всех его этапах. Они не просто присваивают готовые метки по чужой инструкции: предметные правила формируются и уточняются при их участии вместе со специалистами DS.
Сначала готовят данные. Методолог понимает устройство рынка профессий и помогает DS выбрать содержательные группы для подготовки выборки. Разделение данных на такие группы называется стратификацией. В докладе она приведена как пример задачи, где технической подготовки без понимания профессий недостаточно.
Затем совместно составляют инструкцию для разметки. На этом этапе методолог и DS формулируют правила, по которым объекты будут получать метки. Конкретная инструкция не опубликована, но принцип совместной работы указан прямо: определение задачи нельзя полностью отделить от будущего использования данных моделью.
Во время разметки методолог общается с разметчиками, выясняет, какие случаи вызывают затруднения, и при необходимости корректирует инструкцию. Поэтому разметка не описывается как однократная передача задания с последующим ожиданием готового файла.
Наконец, методолог и DS вместе отвечают за контроль качества. Они выдвигают объяснения обнаруженных проблем, проверяют гипотезы и могут запустить разметку заново. Это обратная связь внутри подготовки данных, а не действие, выполняемое для каждой пользовательской рекомендации. Как именно проверяли качество в кейсе hh.ru, автор дополнительно уточняет в ответах на вопросы.
Доклад · 00:15:31Два пути: размечать объекты по отдельности или сначала сгруппировать
Первый путь начинается с множества вакансий или других объектов. Их передают большому числу методологов, разметчиков или обоим типам специалистов. На выходе получают класс для каждого объекта и используют эти данные для обучения классификатора. Это описание подхода, а не отчёт о конкретном количестве нанятых людей или размеченных вакансий.
Второй путь использует предварительную группировку похожих объектов по их признакам — кластеризацию. Полученные группы называются кластерами. Сначала рассчитывают признаки вакансий, затем группируют их, после чего с результатом работают методологи. Подготовленные классы используются для обучения модели классификации.
На исходной схеме между кластеризацией и классификацией явно стоят методологи. Это существенная часть решения: алгоритм создаёт структуру для работы экспертов, а не автоматически объявляет каждый кластер правильной профессией. В расшифровке есть пропуск части объяснения, поэтому точный способ присвоения меток отдельным объектам восстановить нельзя.
Обе цепочки относятся к подготовке данных и обучению. Кластеризация здесь не показана обязательным шагом обработки каждого нового запроса рекомендаций. Не названы её алгоритм, число кластеров и правила работы с пограничными объектами. Подтверждённый вывод схемы — сокращать часть ручной работы можно предварительной группировкой, сохраняя предметную работу экспертов.
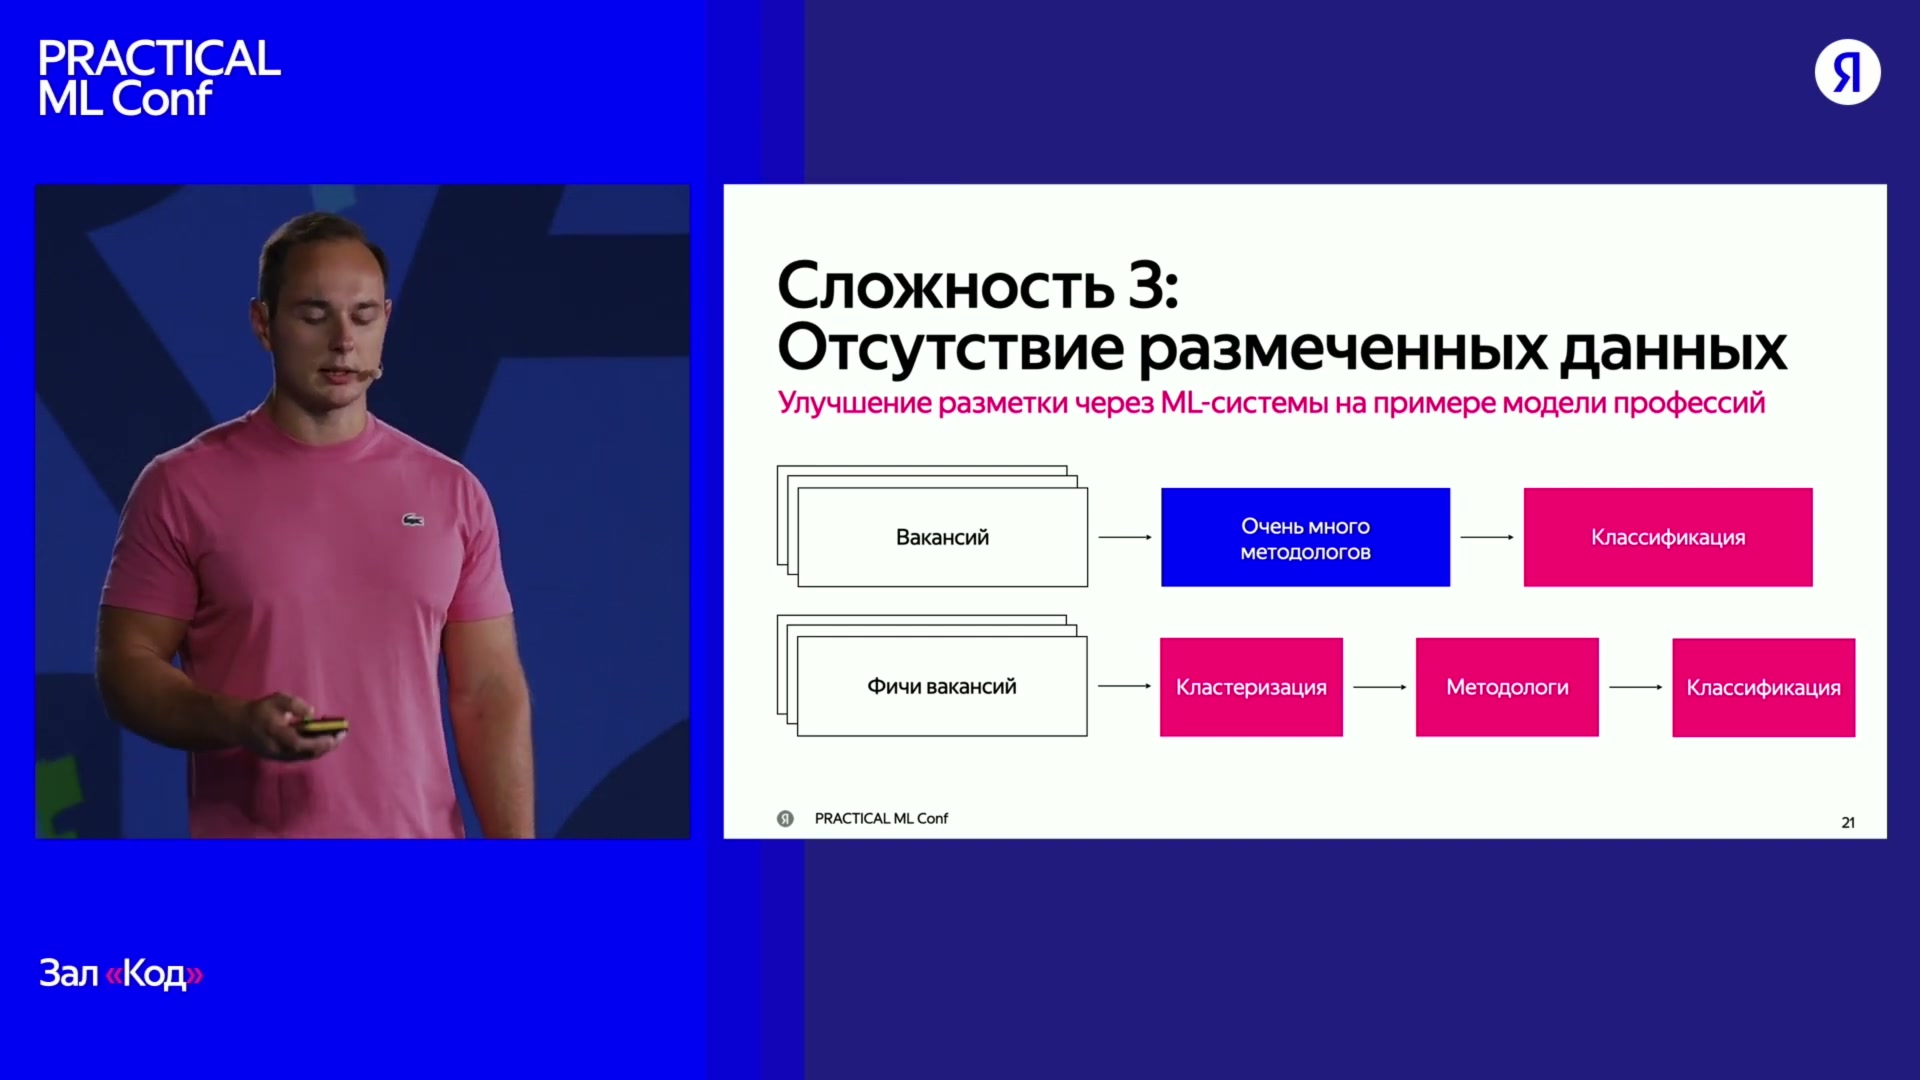
Два пути подготовки разметки: много отдельных объектов → методологи → классификация; либо признаки → кластеризация → методологи → классификация. Выбор зависит от данных и качества кластеров.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfЧто выигрывают и чем платят при использовании кластеризации
У пути без кластеризации есть два преимущества в изложении автора. Он требует меньшего участия DS: данные можно подготовить, передать специалистам и получить разметку. Кроме того, нет дополнительной зависимости от качества кластеризации, поскольку самой группировки в процессе нет.
Обратная сторона — предметные решения сильнее опираются на экспертизу методологов. Вариант с кластеризацией автор называет основанным на данных: алгоритм предварительно очерчивает структуру объектов, и эксперты работают уже в этих рамках. По его оценке, это ускоряет процесс и снижает трудозатраты, потому что часть подготовительной работы сделана автоматически.
Однако предварительная группировка создаёт собственную зависимость: насколько полезны полученные кластеры для предметной разметки. Автор предпочитает этот путь, но не объявляет его обязательным для любой задачи. Выбор зависит от конкретных данных и доступных ресурсов.
В докладе нет численного сравнения стоимости, длительности или качества двух процессов. Поэтому речь идёт о сравнении их устройства и об авторской оценке компромисса, а не об измеренном коэффициенте экономии. Вопрос о проверке самих кластеров остаётся отдельным и возвращается в обсуждении.
Доклад · 00:18:02Почему метрики, разнообразие и разметка нельзя рассматривать отдельно
Итог выступления — не выбор одной универсальной модели. Автор предлагает знать разные подходы и подбирать их к конкретной задаче, вместо того чтобы воспроизводить привычную последовательность действий. В этом кейсе такой выбор потребовал одновременно разобраться с бизнес-целями, устройством выдачи и данными.
Второй вывод касается разметки: большие затраты должны сопровождаться организацией предметной работы и проверкой качества. Третий — метрикам модели нельзя доверять только потому, что они привычны. Но на итоговом слайде сохранена важная оговорка: иногда они всё-таки полезны. Примером в докладе служит Diversity.
Четвёртый вывод связывает всё вместе. Качественная разметка создаёт профессии и категории, необходимые для разнообразных рекомендаций; разнообразие, в свою очередь, оказалось связано с бизнес-эффектами сильнее проверенных точности и полноты. Поэтому работа над данными может помогать проблеме, которая сначала выглядит как чисто алгоритмическая.
Технические детали подхода к прокси-метрикам автор оставляет для отдельной научной работы, на которую ссылается через QR-код в архиве научных публикаций arXiv. Название и точная ссылка по предоставленным материалам не устанавливаются. Это не даёт основания приписывать докладу формальные предположения или результаты другой выбранной наугад статьи.
Общий вывод исходного итогового слайда — проверять связи между частями решения. Последующие ответы на вопросы уточняют, как этот принцип проявляется на практике: в эталонной разметке, словаре навыков, визуальной проверке кластеров и ограничениях отдельных моделей.
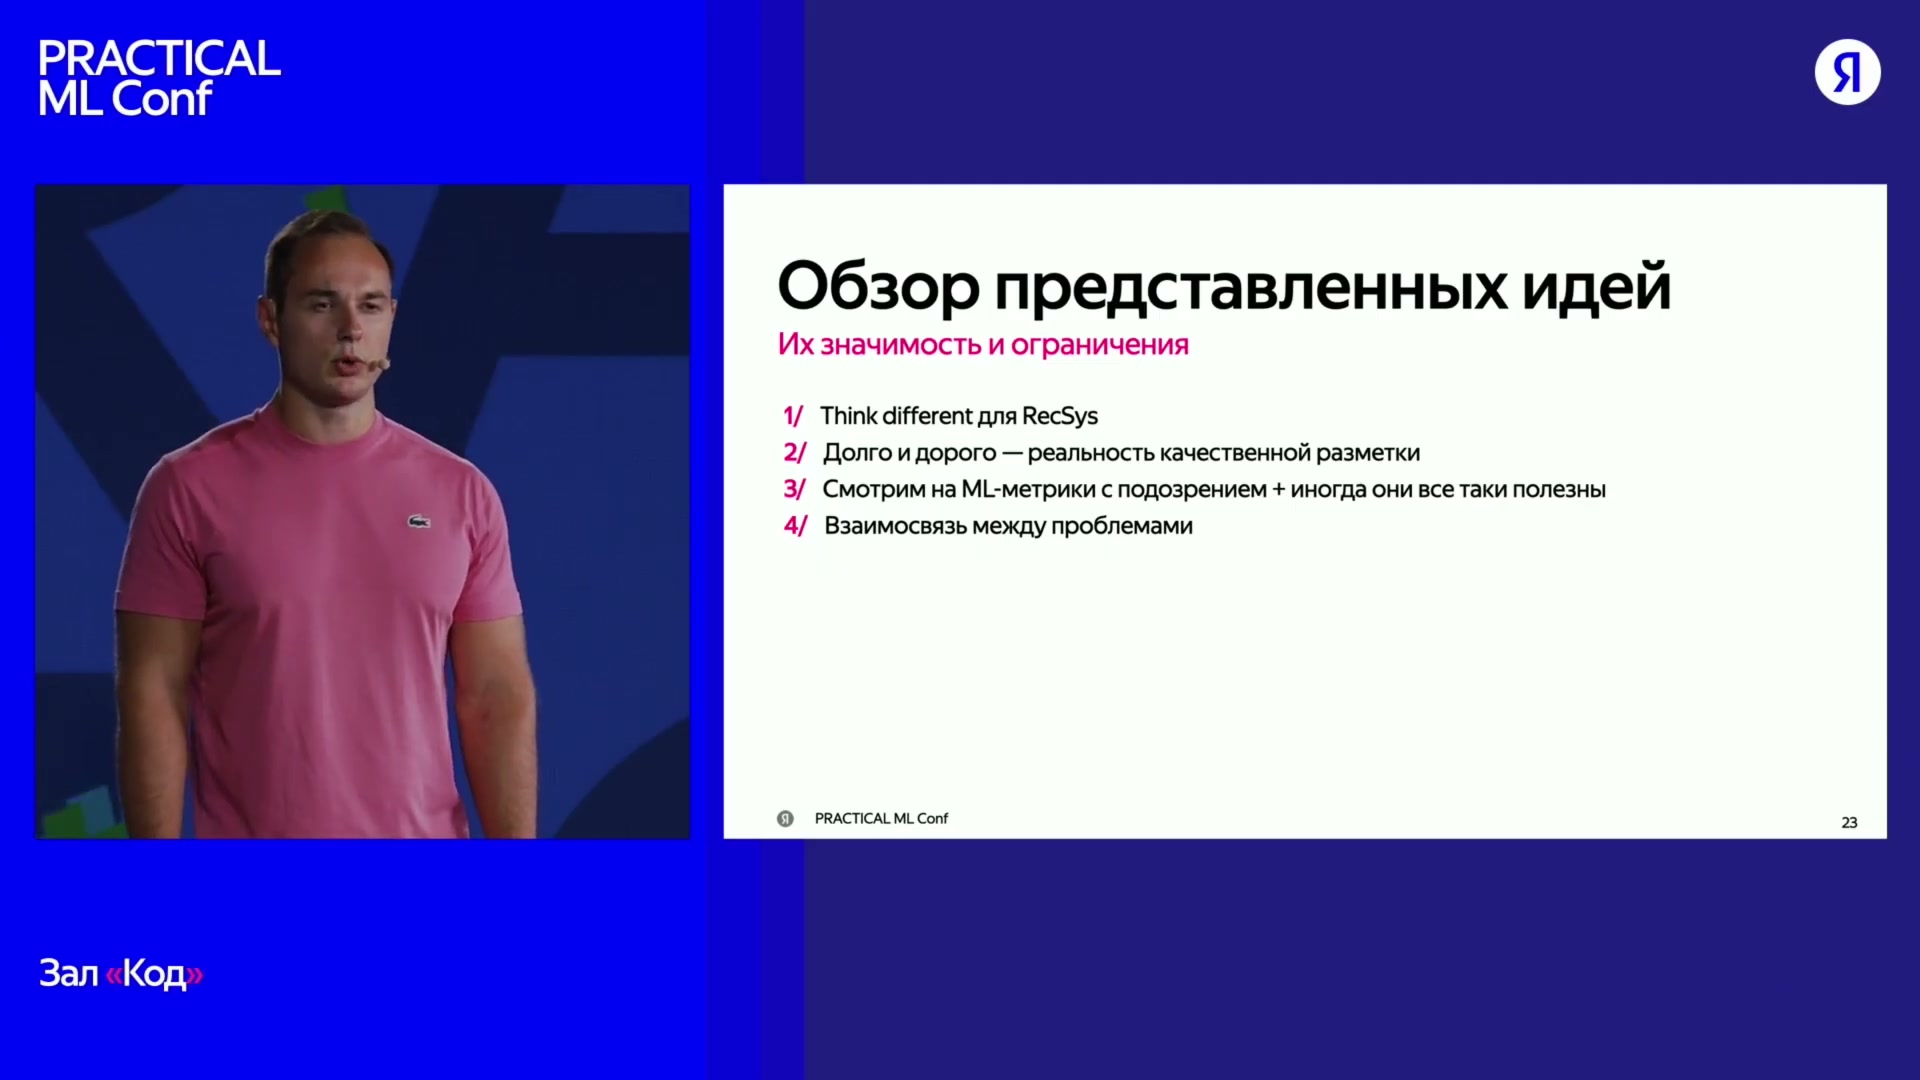
Итоговые идеи доклада: проверять связь ML-метрик с бизнесом, учитывать стоимость разметки и взаимосвязь проблем, подбирать решение под задачу.
Источник: Пётр Чуйков · hh.ru · Practical ML ConfКак проверяли разметку: небольшой внутренний эталон
Первый вопрос после основной части касается качества самой разметки: кто за него отвечает и с чем сравнивают работу разметчиков. Автор снова подчёркивает совместную ответственность методолога и DS. Предметная проверка не отделена от технической оценки данных.
Для проверки команда собрала небольшой набор примеров и разметила его внутренними силами, включая специалистов DS. Такой набор служит внутренним эталоном — материалом, с которым можно сопоставлять разметку. Это не описанный публичный тестовый набор с опубликованными правилами и результатами.
Размер набора, количество независимых оценок одного объекта, разрешение разногласий и численный результат проверки не раскрыты. Завершение ответа и переход к следующему вопросу в расшифровке повреждены. Из них нельзя заключить, что команда в определённый момент отказалась от эталона или перешла на полностью автоматическую проверку. Надёжно установлены сам внутренний набор и совместная работа специалистов.
Доклад · 00:22:16Почему выбор пользователя не равен полезности для работодателя
Следующий вопрос кажется естественным: зачем нужна разметка, если у большого сервиса много пользовательских действий? Здесь такие действия называют онлайн-сигналом — наблюдениями из работающего продукта. Но их количество не отвечает на вопрос, какую полезность они действительно отражают.
Автор приводит пример: пользователю могут нравиться навыки «результативность» и «трудолюбие», хотя работодателю они мало говорят о различиях между кандидатами. Python, напротив, назван дифференцирующим навыком: конкретным умением, которое помогает различать профессиональные профили. Трудолюбие в этом объяснении — желательное общее качество, а не столь же информативный профессиональный признак.
Поэтому успешное предсказание следующего выбранного навыка ещё не означает, что резюме стало эффективнее для работодателя. Наблюдаемое поведение нельзя автоматически принять за эталон этой эффективности. Это не отказ от пользовательских данных, а объяснение, почему они не снимают потребность в предметной оценке и отдельных бизнес-метриках.
В коротком уточнении о навыках собственной команды автор вновь называет Python и библиотеки машинного обучения. Точные названия библиотек в речи не восстанавливаются, но сам пример возвращает к конкретным профессиональным умениям. Он не превращается в формальное описание требований найма.
Доклад · 00:22:54Откуда берутся навыки: белый список и свободный ввод
Рекомендации выбираются из определённого разрешённого множества навыков — белого списка, или whitelist. Это ограничивает набор того, что сама система предлагает пользователю. Однако интерфейс не заставляет человека выбирать только из готовых вариантов.
Пользователь может вписать собственный текст, если предложенные навыки ему не подходят. Автор считает это полезным: люди могут сообщить системе новое знание, которого ещё нет в предложенном наборе. Таким образом, словарь рекомендаций и возможности ручного заполнения — разные вещи.
Из этого ответа не следует, что любой введённый текст автоматически попадает в белый список. Размер словаря, проверка новых формулировок, объединение синонимов и порядок обновления списка не раскрыты. Подтверждено сосуществование ограниченного набора рекомендаций и свободного ввода, а не полностью автоматическое пополнение справочника.
Доклад · 00:23:58Генерация навыков обсуждается как идея, а не как внедрённая замена
Модератор предлагает изменить постановку: не выбирать навыки из списка, а создавать их под конкретное резюме с помощью языковой модели. Языковая модель здесь понимается как инструмент, который по текстовому запросу создаёт текст; в вопросе названы GPT и Яндекс GPT.
В обмене репликами обсуждается последовательность «сгенерировать, затем порекомендовать». Но конец ответа повреждён. По этому фрагменту нельзя установить ни внедрение генерации вместо OvA, ни сравнение качества двух подходов, ни причины окончательного выбора команды.
Статус идеи важен: описанная в основной части система оценивает навыки и смешивает категории. Возможность генерировать новые формулировки не отменяет этого описания. Позже автор действительно подтверждает использование ChatGPT, но в другой роли — как помощника методологов при работе с обязанностями, а не как автономной замены рекомендаций навыков.
Доклад · 00:24:33Отдельная модель уровня позиции: существует, но ещё не в поиске
Вопрос из зала касается уровня позиции или специалиста — seniority — и возможности учитывать такую оценку при подборе объявлений и поиске вакансий. Автор подтверждает существование отдельной модели. Она получает вектор всей вакансии или всего резюме и возвращает одно из трёх значений.
На момент выступления эта модель ещё не используется в поиске. Это прямое ограничение статуса: существование модели не означает, что её оценки уже влияют на поисковую выдачу.
Имя модели в расшифровке повреждено, архитектура и качество не раскрыты. Класс 1 нельзя расшифровывать по привычной шкале уровней без слов автора. Кроме того, вход в виде всей вакансии или резюме относится именно к этой модели; его нельзя переносить на признаки кластеризации, которые уточняются отдельно.
Доклад · 00:25:00Ответ о петле обратной связи ограничен разнообразием
Петля обратной связи, или feedback loop, возникает, когда рекомендации влияют на действия пользователей, а эти действия затем влияют на будущие рекомендации. В вопросе используется именно этот термин, но докладчик и модератор уточняют его здесь как вопрос о пузыре рекомендаций.
Ответ возвращает к категориям: методологи составили их набор для каждой профессии. Для специалиста по Data Science автор называет программирование, машинное обучение и общие нетехнические навыки — soft skills, включая стрессоустойчивость. Внутри каждой категории навыки упорядочиваются, после чего верхние элементы объединяются.
Это дополнительное подтверждение роли методологической структуры в блендере. Но ответ не описывает все возможные петли обратной связи, не задаёт правила исправления смещений в накопленных данных и не доказывает, что такие эффекты полностью устранены. Подтверждён механизм разнообразия в выбранной трактовке вопроса.
Доклад · 00:25:30Почему качество кластеров проверяли глазами
На вопрос о качестве кластеризации автор отвечает, что команда пробовала обычные способы численной оценки. В этой задаче они плохо соответствовали тому качеству группировки, которое было полезно на практике. Поэтому просмотр результатов глазами он называет пока лучшим способом проверки.
Этот ответ важен для сравнения путей разметки. Предварительная группировка может ускорить работу экспертов, но сама тоже нуждается в содержательной проверке. Наличие алгоритмической структуры ещё не означает, что структура пригодна для выделения профессий и подготовки классов.
Конкретные численные метрики, их значения и протокол экспертного просмотра не названы. Неизвестно, какие объекты смотрели и как фиксировали итоговую оценку. Поэтому визуальную проверку нельзя превращать в опубликованный автоматический тест качества. Равно как нельзя расширять локальный опыт до вывода, что численная оценка кластеризации вообще не работает.
Доклад · 00:26:13ChatGPT помогает методологам формулировать обязанности
На вопрос об использовании больших языковых моделей, или LLM, для автоматизации разметки автор отвечает утвердительно, но описывает конкретную ограниченную роль. При работе с обязанностями методологи обращаются к ChatGPT. Например, они могут попросить варианты обязанностей Java-разработчика.
Другое применение — расширять набор формулировок для уже полученных обязанностей. Одно содержание можно выразить разными словами, и модель помогает получить такие варианты. Это работа с текстовыми формулировками, а не подтверждение того, что модель сама определяет все классы профессий.
Автор приводит пример: есть только шесть вариантов написания, и можно попросить по десять синонимичных формулировок для каждой обязанности. Числа 6 и 10 иллюстрируют приём. Они не задают размер всего набора текстов и не означают, что реальный корпус увеличили в десять раз.
В ответе не раскрыты версия ChatGPT, полный запрос, проверка сгенерированных текстов, доля принятых вариантов и измеренное влияние на качество модели. Подтверждена помощь специалистам. Полная автономия разметки и отказ от экспертов не заявлены; статус этого применения нельзя смешивать с более ранней идеей генерировать сами рекомендации навыков.
Доклад · 00:26:40Противоречивые навыки остаются открытым вопросом
Участник спрашивает, как относить к профессии резюме, если в нём указаны противоречивые, взаимно исключающие навыки. Докладчик и модератор обсуждают, какой мог бы быть пример, но убедительного конкретного случая не приводят.
Содержательного решения в ответе нет. Не описаны ни обнаружение таких противоречий, ни их удаление, ни отдельные правила классификации. Этот случай остаётся неразобранным. Поэтому нельзя приписывать системе специальный механизм согласования навыков или делать обратный вывод, что противоречий в данных не бывает.
Доклад · 00:27:29Почему общие навыки нельзя просто удалить
Предпоследний вопрос соединяет две темы: зачем сохранять навыки, которые мало что сообщают работодателю, и зачем вообще отдельное поле навыков, если уже есть заголовок и описание позиции. Автор разделяет эти вопросы, но развёрнуто отвечает только на первый.
По его словам, если удалить общие навыки вроде результативности и аккуратности из белого списка, меньше пользователей будет заканчивать резюме. Тем самым ухудшаются метрики масштаба. Это возвращает к первой бизнес-цели: помощь в завершении резюме имеет самостоятельную ценность, даже если конкретная формулировка недостаточно дифференцирует кандидатов.
Объясняя эту ценность, автор упоминает примерно 700 рублей за резюме в бизнес-модели компании. Реплика сопровождается оговорками «порядка», «по-моему» и «в среднем». Это приблизительный бизнес-ориентир автора, а не опубликованная цена покупки резюме. Способ расчёта суммы не раскрыт.
В результате простое удаление малоинформативных навыков не рассматривается как безусловно полезное изменение. Нужно удерживать обе цели: качество сведений и возможность закончить публикацию. При этом численного эффекта удаления навыков автор не приводит, поэтому реплику нельзя выдавать за полный отчёт контролируемого эксперимента.
Вторая часть вопроса — какую дополнительную пользу даёт поле навыков сверх заголовка и описания — отдельно не разобрана. Подменять отсутствующий ответ общими рассуждениями о поиске или структурированных данных здесь не следует: доклад объясняет конкретный конфликт публикаций и информативности.
Доклад · 00:27:51Возраст и длинный стаж не входят в описанные признаки кластеризации
Последний вопрос касается возраста кандидатов и длинного опыта работы, в том числе в разных областях. Автор отвечает через состав входных данных: возраст и опыт работы как отдельные признаки в рассматриваемую кластеризацию не входят.
Используются навыки, обязанности с последнего места работы и заголовок. Поэтому описанное представление не является обработкой всей трудовой биографии со всеми периодами стажа. При этом содержание профессионального опыта не исчезает полностью: обязанности последней работы явно остаются среди признаков.
Граница ответа важна. Он не описывает все модели hh.ru и не доказывает отсутствие любых косвенных возрастных сигналов. У отдельной модели уровня позиции ранее был назван вектор всей вакансии или резюме; это другой вход, и два описания нельзя смешивать.
При выборе лучшего вопроса докладчик выделяет именно этот — о длинном опыте и том, как его ограничивать. Дополнительного алгоритма он не вводит. Содержательный итог ответа — точное указание того, какие данные используются, вместо предположения, что модель анализирует всё, что есть в резюме.
Доклад · 00:28:36Итог: от содержания резюме к разнообразным рекомендациям навыков
Путь hh.ru начинается с разделения двух целей: помочь человеку опубликовать резюме и повысить полезность навыков для работодателя. Проверка метрик показала, что привычные точность и полнота плохо подходят для предсказания этих бизнес-результатов. Разнообразие оказалось более полезным ориентиром. Для борьбы с узким фокусом оценки отдельных навыков соединили с профессиями и методологически подготовленными категориями.
- 01
Содержание объекта
Система получает заголовок, навыки и обязанности; для описанного представления резюме берутся обязанности с последнего места работы.
- 02
Вектор признаков
Заголовок преобразуется через DSSM, навыки проходят OHE, обязанности — нормализацию. Из этих данных получают векторные представления и признаки.
- 03
Оценки навыков и профессия
Одна ветвь оценивает вероятность следующего выбора каждого навыка, другая определяет профессию по тем же признакам.
- 04
Выбор внутри категорий
Профессиональный контекст задаёт набор категорий, внутри которых отбираются высоко оценённые навыки.
- 05
Смешанный верх списка
Блендер объединяет выбранные навыки разных категорий в рекомендации, не ограничиваясь одной общей сортировкой оценок.
Разметка и обучение происходят вне этой последовательности применения готового решения. Методологи и DS готовят данные, уточняют инструкции и проверяют качество. Предварительная кластеризация может уменьшить часть ручной работы, но требует собственной экспертной проверки; автоматически правильными классами её результаты не становятся.
Оценка решения остаётся отдельной задачей. Proxy score характеризует пригодность метрики, а не прирост публикаций или приглашений. Численный эффект смешивания категорий не раскрыт, положительный итог A/B-теста по повреждённой речи установить нельзя. Формула Diversity, подробности моделей и правила смешивания также неизвестны. Кейс показывает, как согласовать рекомендации, предметную разметку и бизнес-проверку, но не даёт количественного обещания для другого продукта.
Доклад · 00:03:16