Разбор готов
Яндекс Музыка: от фильтра к отдельной системе рекомендаций незнакомого
Слушатель включает «Мою волну», но сегодня хочет не вернуться к любимым песням, а открыть незнакомую музыку. Кажется, достаточно убрать из рекомендаций всё, что он уже слышал. Однако такой фильтр иногда оставляет слишком мало треков, а обычная модель продолжает выбирать осторожно: формально новая музыка не ощущается открытием. Команда Яндекс Музыки изменила и поиск кандидатов, и обучение моделей для настройки «Незнакомое». Разберём, как определяли незнакомство, искали новых исполнителей через любимых, превращали реакции в обучающие пары и согласовывали лёгкое ранжирование с тяжёлым. Затем посмотрим на четыре последовательно внедрённых изменения, их результаты и вопросы, которые остались за пределами основной схемы: новинки, новые пользователи, пассивное слушание и каверы.
Глава полезна разработчикам рекомендательных систем и аналитикам, которым нужно улучшать поиск нового контента, не теряя его соответствия вкусам пользователя. На конкретном каскаде видно, чем отличаются нехватка кандидатов и неверные приоритеты модели, как устроена дистилляция ранжировщика и как читать результаты последовательных A/B-тестов.
Видео · на русском
Как улучшить знакомые подходы для рекомендации незнакомого | Савва Степурин, Яндекс МузыкаСавва Степурин · Опубликовано: 19 декабря 2024 г.
Исходный доклад · Открыть оригинал
Что человек просит, включая «Незнакомое»
Глава основана на докладе Саввы Степурина «Как улучшить знакомые подходы для рекомендации незнакомого» на Practical ML Conf 2024. Автор разбирает развитие конкретной настройки Яндекс Музыки: от фильтра внутри готовой системы до собственного отбора кандидатов и специализированного ранжирования. Описания продукта, внедрений и дальнейших экспериментов относятся к моменту выступления.
«Моя волна» — персонализированный бесконечный поток музыки. В обычном режиме она сочетает то, что человек любит, слушает и отмечает лайками, с чем-то новым. Настройка «Незнакомое» меняет исходный запрос: пользователь сам сообщает, что хочет расширить музыкальный кругозор. Поэтому подходящий для обычной волны баланс знакомого и нового здесь уже не является достаточной целью.
Команда исходит из того, что человек, явно выбравший открытия, готов активнее пользоваться сервисом: внимательнее вслушиваться, переключать треки, ставить лайки. Это продуктовая предпосылка для изменений, а не утверждение, что любой слушатель всегда ведёт себя именно так. Незнакомство при этом определяется по истории в Яндекс Музыке: сервис не заявляет, что знает всю музыку, когда-либо услышанную человеком за его пределами.
Желаемый результат — неожиданная удачная находка, или серендипность (serendipity). В примере автора человек встречает трек, о котором раньше не знал, но который сильно ему нравится. Он ставит лайк, затем переслушивает песню в сервисе или начинает изучать другие записи исполнителя. Важны обе части: неожиданность и личная ценность находки. Простая замена знакомой песни на случайную неизвестную ещё не решает эту задачу.
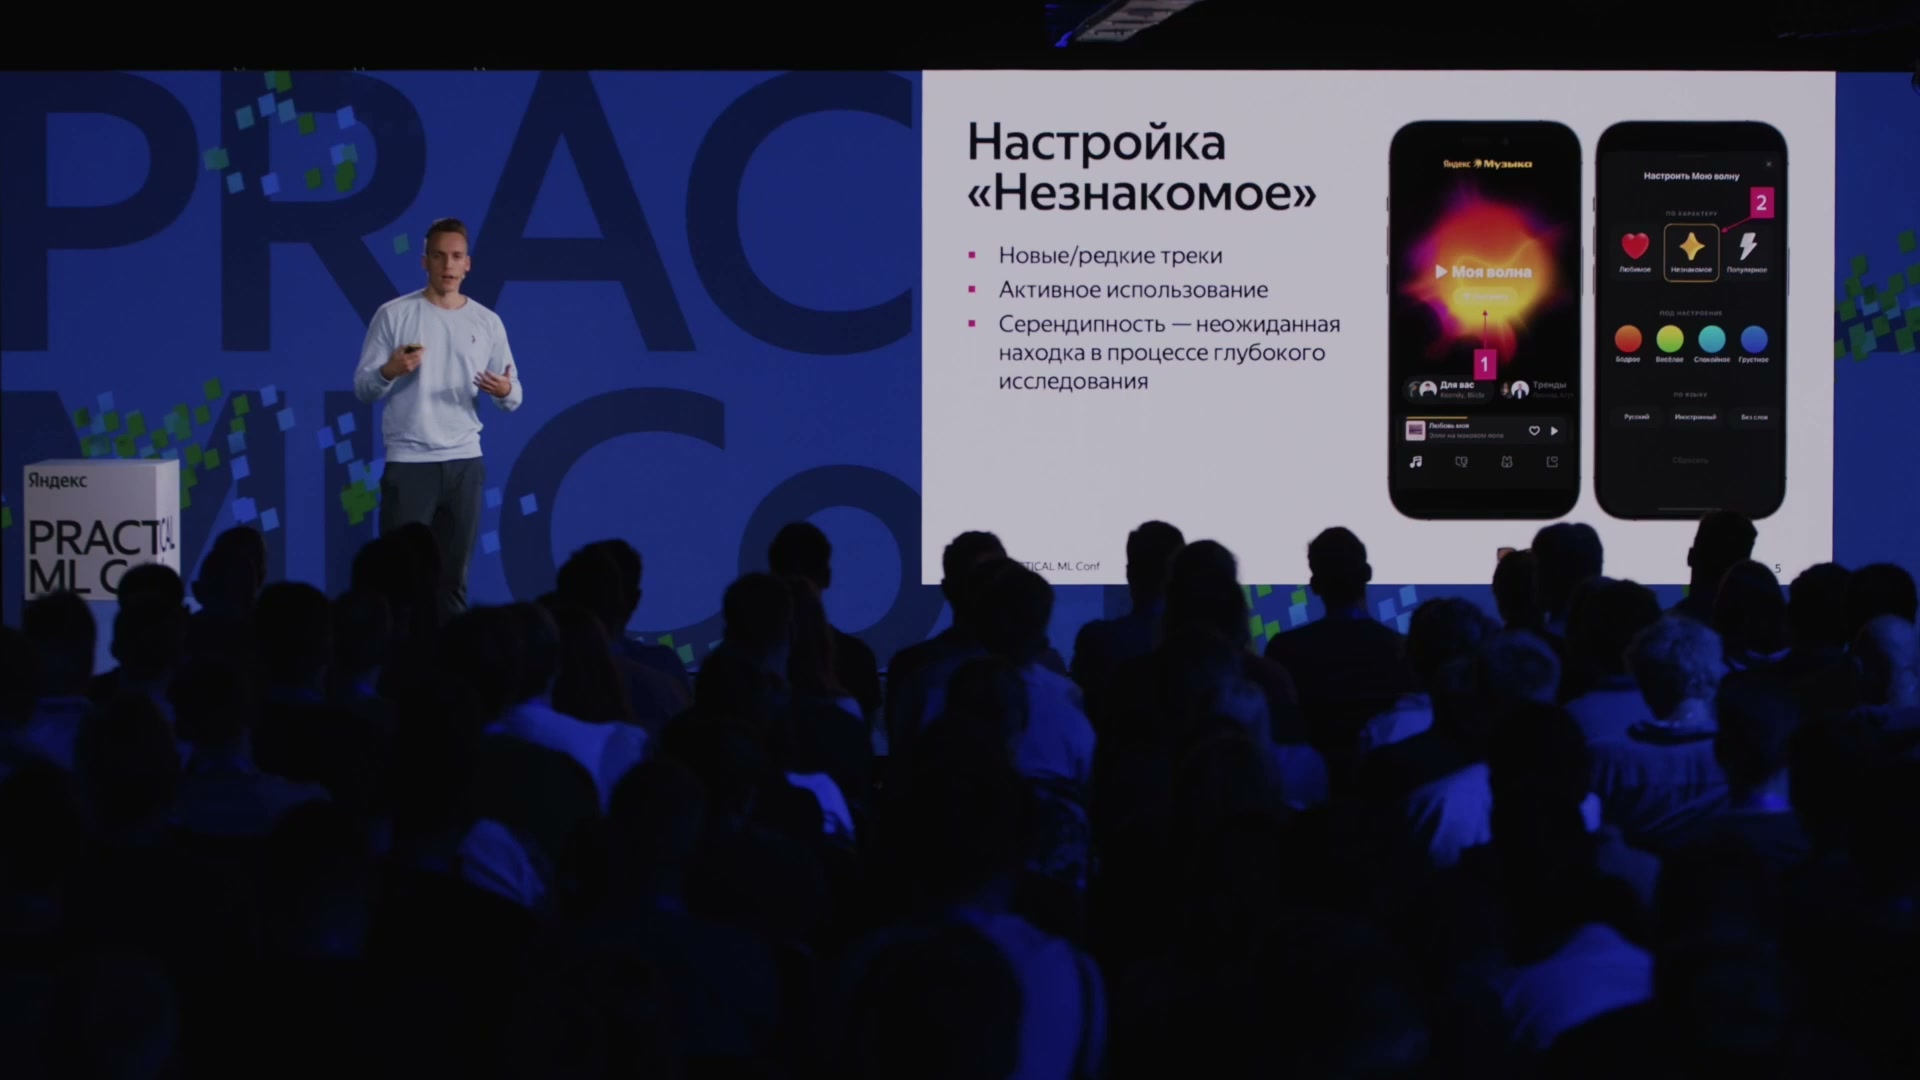
Настройка «Незнакомое» в «Моей волне»: пользователь явно выбирает музыкальные открытия.
Источник: Савва Степурин · Practical ML Conf 2024Пять условий допуска: новый трек ещё не означает новое открытие
Одного отсутствия трека в истории недостаточно. У любимого исполнителя может выйти новая песня: запись новая, но музыкальное направление и сам артист уже хорошо знакомы слушателю. Чтобы «Незнакомое» не свелось к таким рекомендациям, команда ограничивает также знакомство с артистом и альбомом. На исходном слайде условия перечислены следующим образом.
Это правила отбора допустимых объектов, а не показатели качества рекомендаций. Числа 20, 5 и 3 задают ограничения на знакомство; из них нельзя получить долю удачных рекомендаций. Формулировка про альбом содержит именно «хотя бы один», а не требование к каждому альбому. Для появления других треков и альбомов автор не раскрывает более подробный способ подсчёта и временное окно.
Общее определение допускает, что артист уже немного встречался пользователю. Это важно отличать от дополнительного отбора, который появится дальше: там специально ищут похожих исполнителей, которых пользователь ещё вообще не слушал. Таким образом, фильтр описывает границу допустимого, а новый источник кандидатов целенаправленно ищет музыку внутри этой границы.
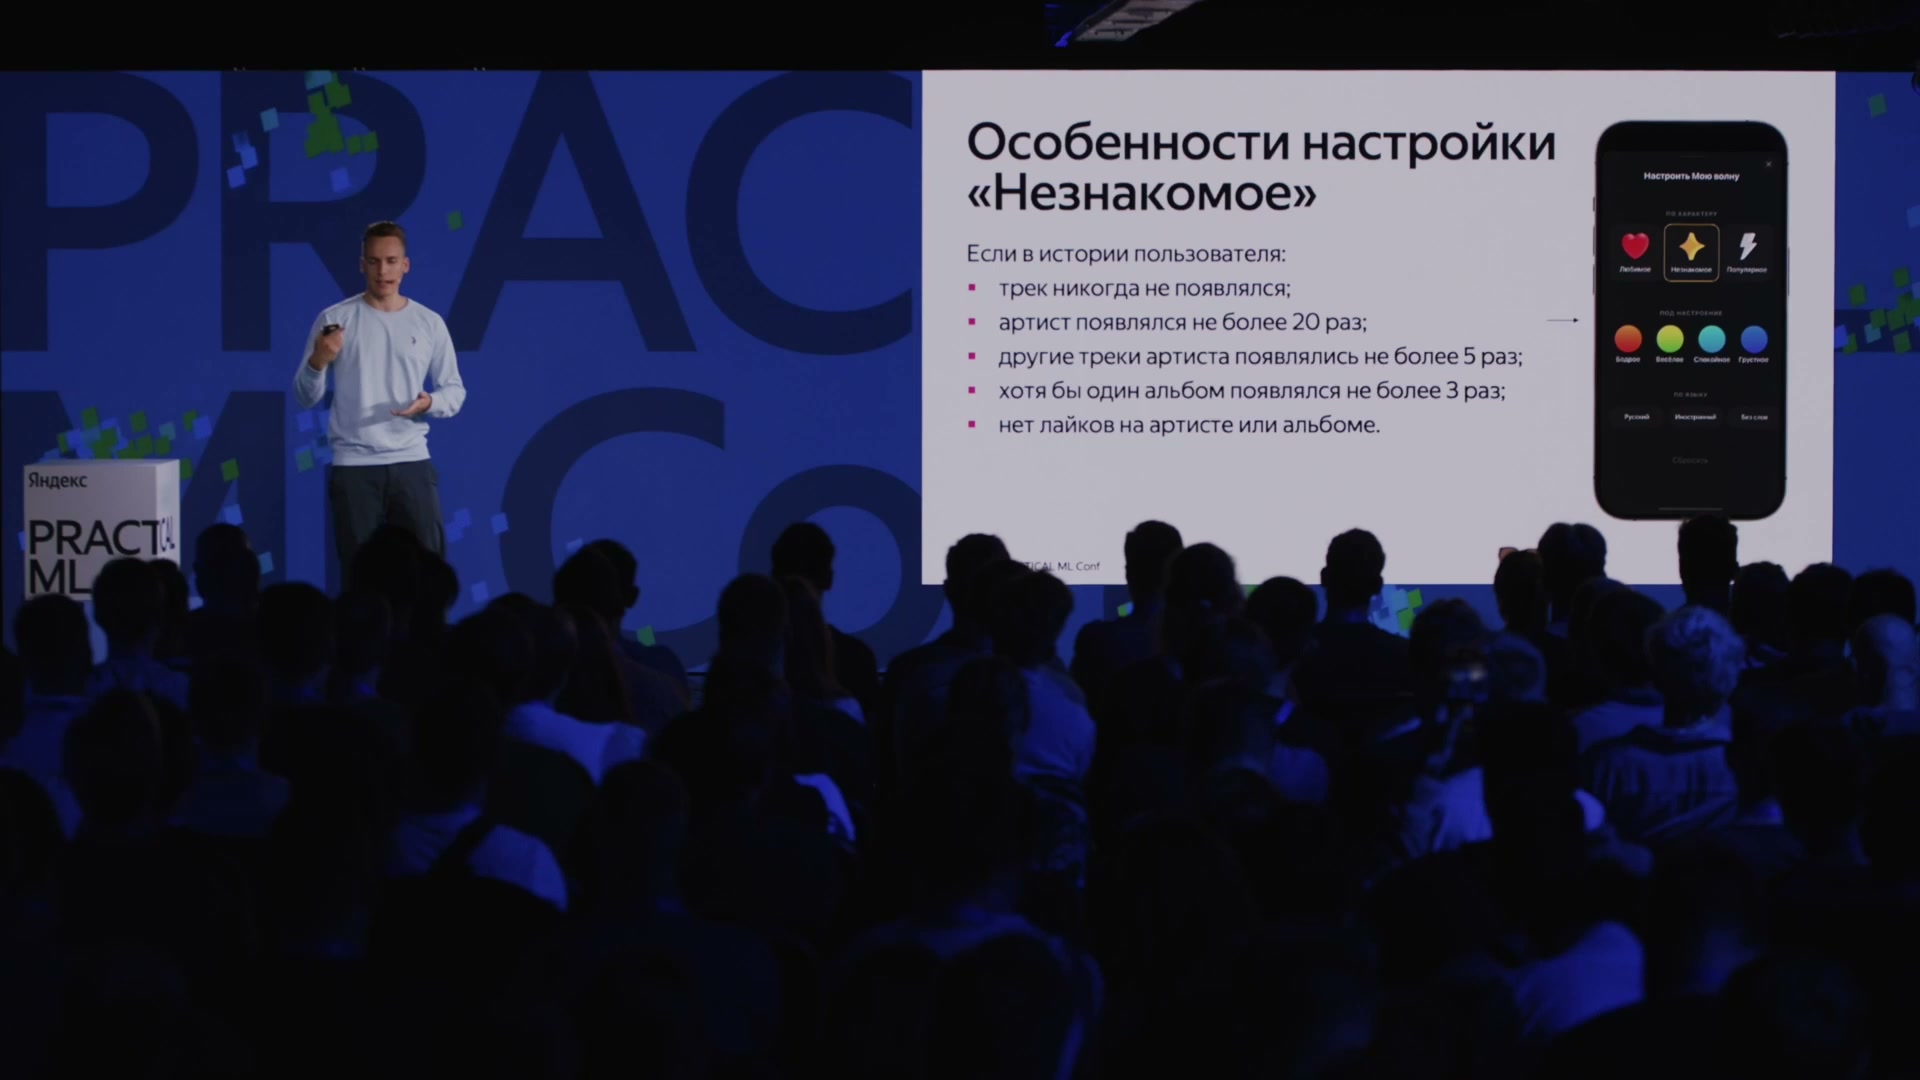
Правила допуска незнакомого трека, артиста и альбома. Это фильтры, а не показатели качества.
Источник: Савва Степурин · Practical ML Conf 2024Как отличить полезное открытие от простого разнообразия
Сначала команда смотрит, расширился ли музыкальный кругозор: увеличилось ли количество уникальных артистов и жанров. Но разнообразие само по себе не отвечает на вопрос, понравилась ли музыка. Можно предложить много разных исполнителей и при этом не попасть во вкус человека. Поэтому рядом с разнообразием нужны показатели реакции на новое.
Такой показатель — лайк при первом прослушивании. В «Незнакомое» один и тот же трек попадает единожды: после прослушивания он уже знаком и повторно в этот режим не возвращается. Если человек сразу отмечает песню лайком, это наблюдаемый сигнал того, что открытие оказалось ценным. Автор использует его как косвенный показатель, или прокси, серендипности. Лайк не измеряет внутреннее чувство напрямую и не описывает все возможные удачные находки.
Ещё один важный показатель — возвращаемость, которую часто называют retention. В этом докладе её смысл конкретен: пользователь слушал настройку «Незнакомое» сегодня и вернулся в неё завтра. Это возвращение именно в режим открытий, а не просто запуск приложения на следующий день. Оно помогает понять, хочет ли человек продолжать такой опыт после отдельной сессии.
Эти измерения отвечают на разные вопросы. Уникальные артисты и жанры характеризуют широту предложенной музыки, лайки — положительную реакцию на первое знакомство, возвращаемость — желание снова воспользоваться настройкой. Точные формулы агрегации, знаменатели долей и окна подсчёта разнообразия в докладе не заданы. Позже в таблице A/B-тестов к ним добавятся доля редких треков и время прослушивания; их не следует смешивать с качеством упорядочивания обучающих пар.
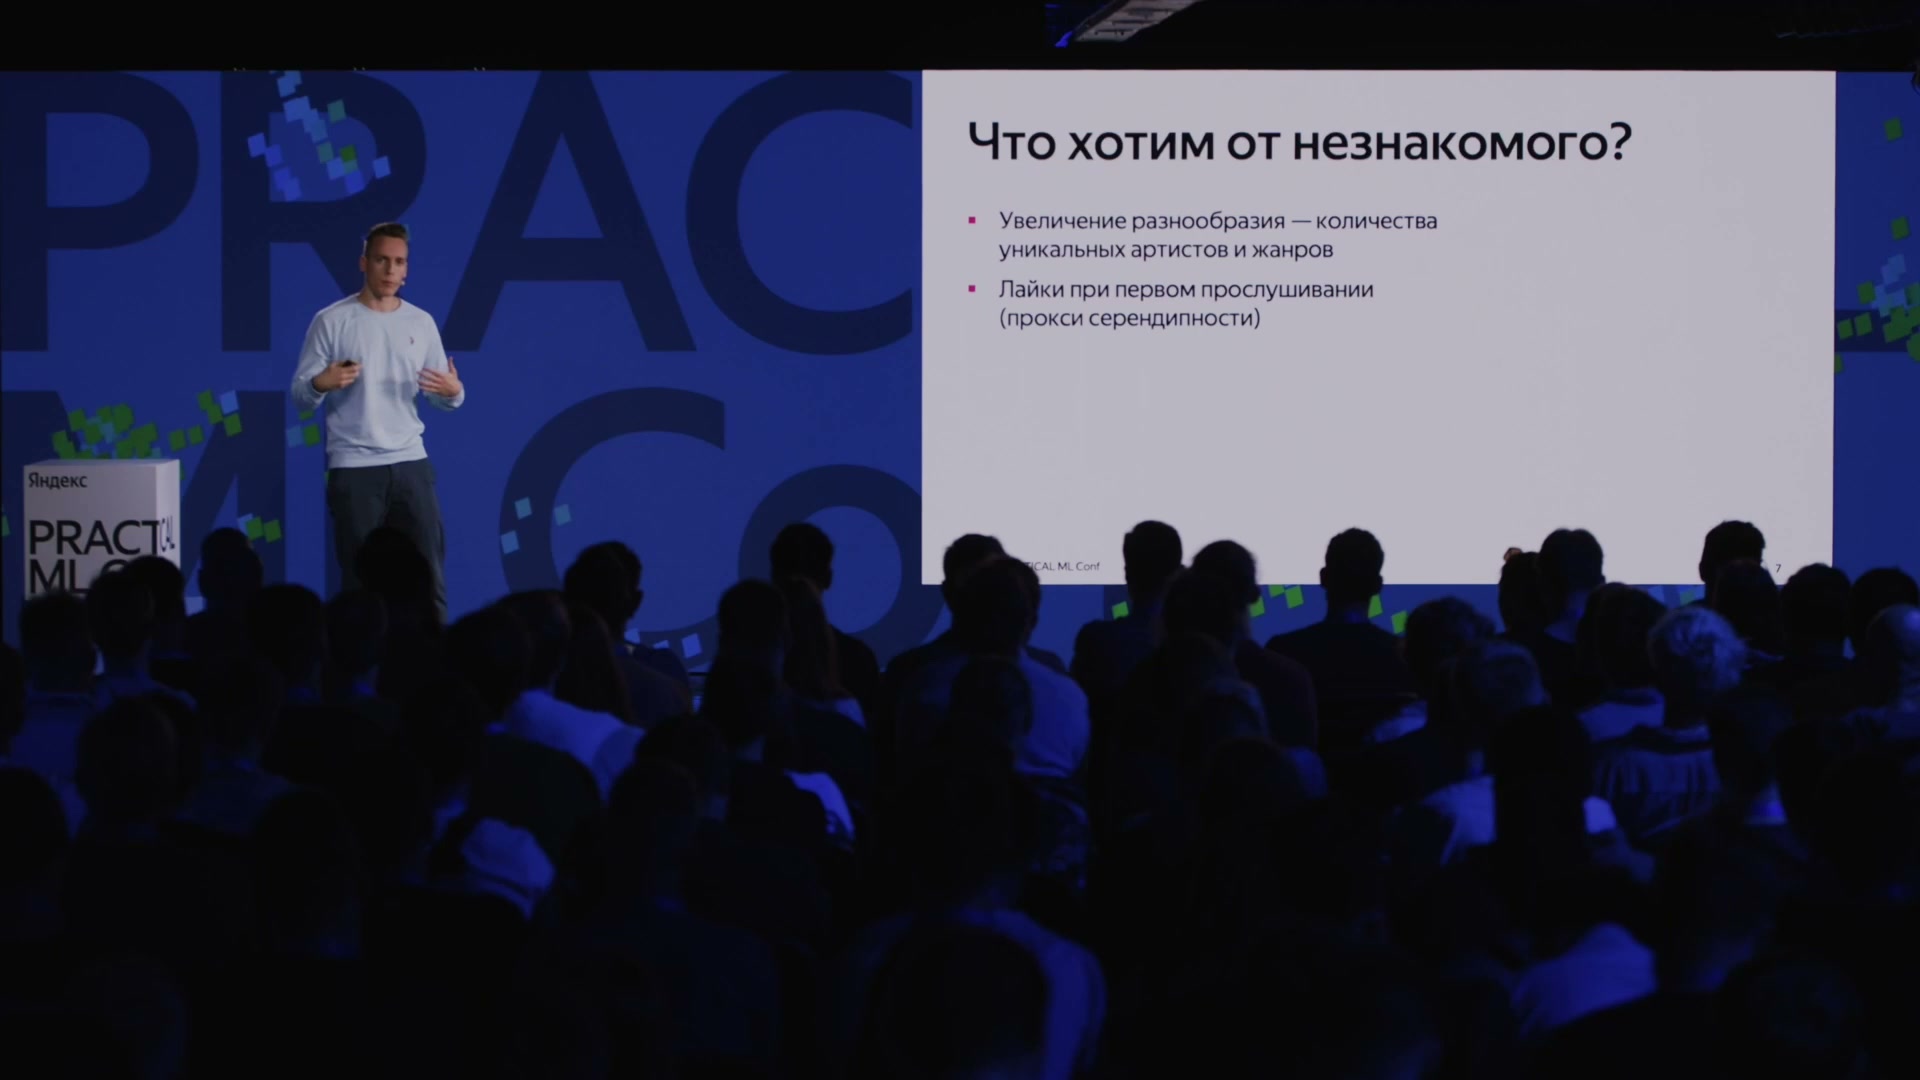
Разнообразие и лайки с первого прослушивания — разные стороны полезного открытия.
Источник: Савва Степурин · Practical ML Conf 2024Как запрос проходит от каталога до короткого списка
После нажатия кнопки «Моя волна» приложение отправляет данные в серверную часть Музыки — бэкенд. Она учитывает подписку пользователя, регион, устройство и сведения о текущей сессии, то есть о происходящем сейчас слушании. Рекомендательная часть добавляет предыдущие сессии и данные, подготовленные заранее вне обработки запроса, например статистики по трекам. Так модель получает и текущую ситуацию, и более длинную историю предпочтений.
Дальше работает многоэтапная система, или каскад. На исходной схеме каталог примерно из 100 млн треков сначала сокращается до порядка 10 тыс. кандидатов — объектов, которые потенциально могут понравиться пользователю. Этот этап ещё не определяет окончательную очередь воспроизведения: он создаёт достаточно небольшой набор для последующей оценки.
Затем лёгкая модель с небольшим количеством признаков оставляет около 3 тыс. наиболее подходящих кандидатов. Тяжёлая модель использует более богатые признаки и упорядочивает эти 3 тыс. треков от наиболее подходящих сейчас до наименее подходящих. Такое упорядочивание называется ранжированием. Из верхней части полученного списка дальше собирают финальную пачку из пяти треков.
Итак, показанный масштаб — примерно 100 млн → 10 тыс. → 3 тыс. → 5. Между 3 тыс. и пятёркой есть две разные операции: тяжёлая модель задаёт порядок, а финальная стадия формирует выдачу. Это пример устройства каскада из доклада, а не утверждение, что каждый запрос всегда проходит через наборы строго одинакового размера.
Автор неформально говорит о возможности ранжировать кандидатов «за буквально полсекунды». Однако измерений задержки по стадиям, распределения времени ответа и условий замера он не приводит. Числа объектов на схеме объясняют разделение работы между моделями, но не дают оснований восстанавливать из них характеристики быстродействия.
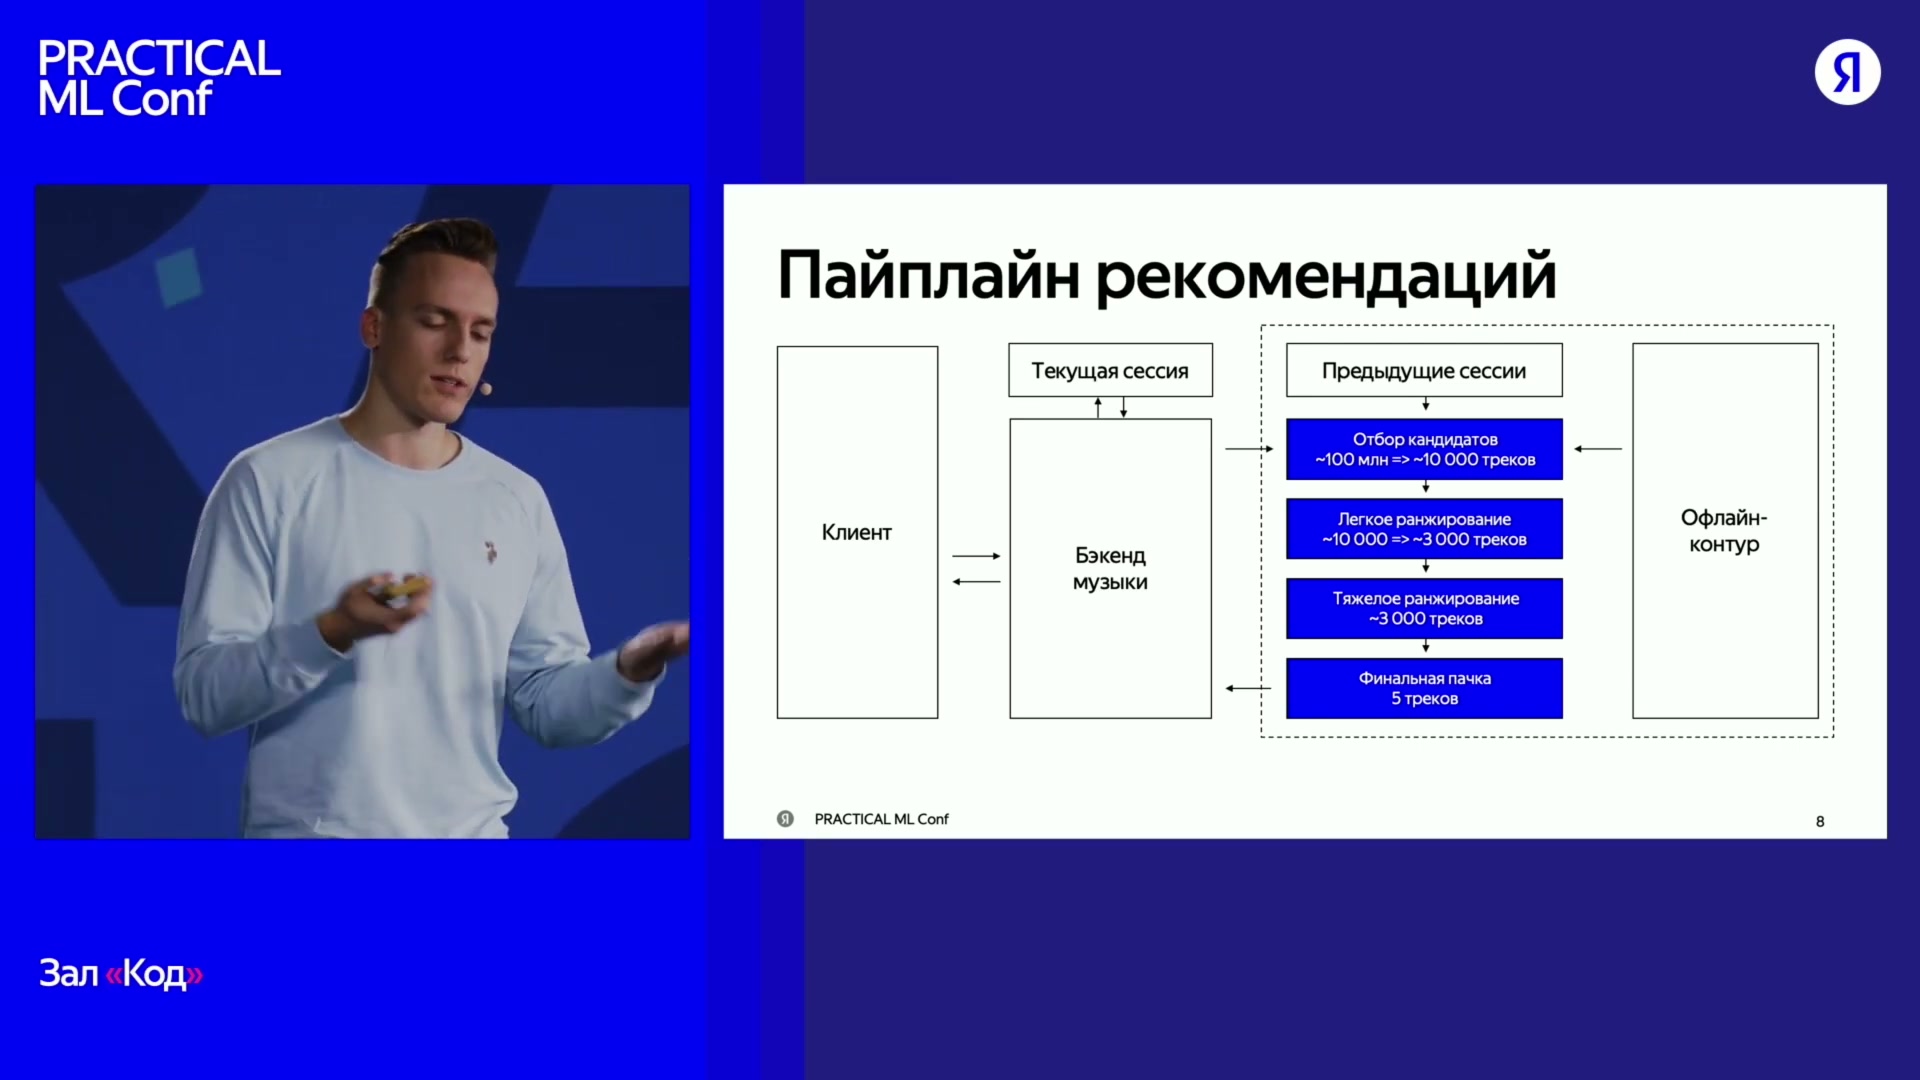
Исходный каскад: каталог около 100 млн треков → 10 тыс. кандидатов → 3 тыс. → 5 рекомендаций.
Источник: Савва Степурин · Practical ML Conf 2024Пятёрка треков — не неизменная очередь
Финальная пачка собирается не только по оценкам тяжёлой модели. Здесь действуют бизнес-правила, то есть ограничения готовой выдачи. Пример автора: в одну пачку из пяти треков не должны попадать два трека одного артиста. Даже если обе записи высоко оценены, короткая последовательность должна сохранять разнообразие. Сформированную пачку возвращают через бэкенд в приложение.
Пользователь не обязан дослушать все пять рекомендаций, прежде чем система учтёт новую реакцию. После активного действия, например лайка на треке, оставшуюся часть пачки отбрасывают. Бэкенд запрашивает новую пятёрку, уже учитывающую последний лайк. Поэтому текущая сессия не просто дополняет старую историю: она может изменить ближайшую выдачу прямо во время слушания.
Это повторное применение обученных моделей с обновлённым контекстом. Новый запрос после лайка не означает, что в этот момент заново обучают CatBoost или выполняют дистилляцию. Обучение определяет, как модели оценивают кандидатов, а изменение контекста позволяет использовать уже выученные зависимости для новой ситуации.
Доклад · 00:06:15Почему фильтр не исправил обычную «Мою волну»
Первоначально режим «Незнакомое» использовал тот же каскад. На стадии отбора добавляли фильтр: трек не должен был встречаться в истории, а артист и альбом не должны были быть слишком знакомыми. Это был естественный способ получить специальный режим без замены уже работающей рекомендательной системы. В целом он работал, но оставлял две разные проблемы.
Первая — иногда фильтр удалял почти всех кандидатов. Общие источники могли хорошо подобрать музыку для обычной волны, но большая её часть оказывалась знакомой конкретному слушателю. После удаления такого контента ранжировщику почти не из чего было выбирать. Улучшать только последнюю модель в этой ситуации недостаточно: она не может вернуть трек, которого нет среди поступивших кандидатов.
Вторая проблема возникала даже при наличии выбора. Ранжирующая модель преимущественно училась на обычной волне, где разумно часто предлагать любимую музыку и осторожно добавлять новое. В режиме открытий этот консервативный выбор мог восприниматься как повторение уже знакомого. Треки формально проходили фильтр, но не давали того ощущения новизны, ради которого человек включал настройку.
Поэтому команда меняет не сам смысл пяти условий, а работу системы вокруг них. Нужен дополнительный способ находить незнакомую музыку и модель, которая лучше понимает реакции в таком режиме. На схеме изменений выделены отбор кандидатов, лёгкое и тяжёлое ранжирование. Финальная стадия формирования пачки остаётся общей. Дальше эти части разбираются по ходу обработки запроса; порядок их фактического внедрения будет отдельно виден в результатах A/B-тестов.
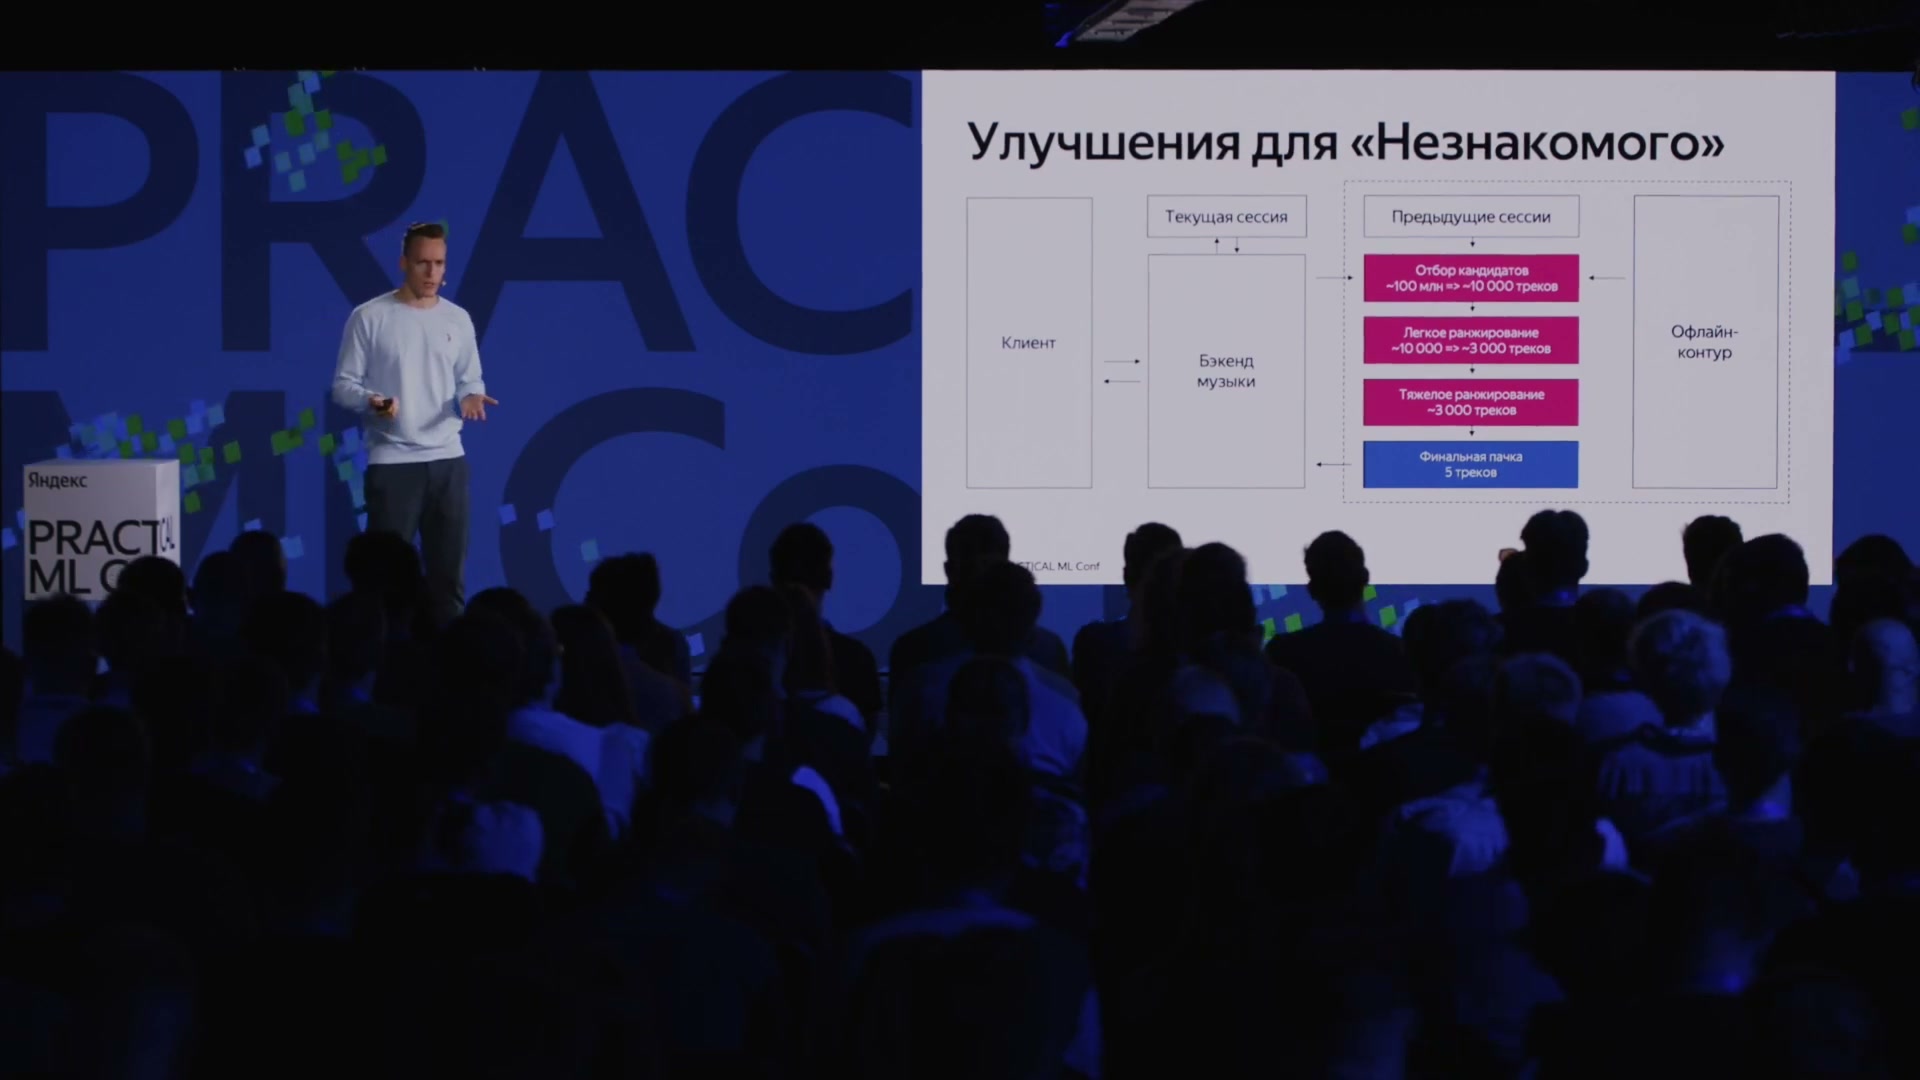
Изменённый отбор, лёгкая и тяжёлая модели; финальная стадия остаётся общей.
Источник: Савва Степурин · Practical ML Conf 2024Четыре общих источника кандидатов и роль истории
Кандидатов не получают одним универсальным способом. Команда берёт некоторое количество треков из нескольких источников и объединяет их в набор порядка 10 тыс. Каждый источник отражает свой взгляд на то, что может понравиться слушателю. Размеры долей каждого источника в докладе не указаны.
Первый источник — наиболее популярные треки сервиса. Логика проста: если музыку выбирают многие, часть таких записей может подойти и конкретному человеку. Популярность не заменяет персонализацию всей системы, но служит одним из способов предложить кандидатов для дальнейшей оценки.
Второй источник — поиск треков, близких к пользовательскому вектору. Векторное представление, или эмбеддинг, — набор чисел, через который модель описывает объект или интересы человека. Автор называет разные способы получать такие представления: матричные разложения взаимодействий, нейросети и аудиомодели. Во время запроса вектор пользователя пересчитывают с учётом текущей сессии, после чего находят близкие векторы треков. Близость используется как сигнал возможного соответствия вкусу; конкретный поисковый индекс и размерности представлений не раскрыты.
Третий источник — сами треки из недавней истории и лайков. Для обычной волны он важен: именно так в кандидаты попадает знакомая музыка, которую человек уже любит. Для «Незнакомого» этот источник прямой выдачи не подходит по определению. На исходном слайде история и лайки перечёркнуты именно в таком качестве, а не как сведения о пользователе вообще.
Четвёртый источник использует эту историю иначе. Берут недавние прослушивания или выбранные лайки и находят другие треки, похожие на них по векторным представлениям. Недавние прослушивания помогают понять текущий интерес, а лайки дают опору на то, что пользователь любит в целом. Исходный понравившийся трек может быть знакомым, но найденные рядом с ним кандидаты — другими записями.
Так становится понятным различие между повторением истории и использованием истории для поиска нового. Однако оставшиеся источники всё равно не обеспечивают наличие незнакомых треков после фильтрации: популярная или очень близкая музыка тоже могла уже встречаться. Требуется источник, в котором незнакомство учитывается при самом построении кандидатов, а не только проверяется в конце.
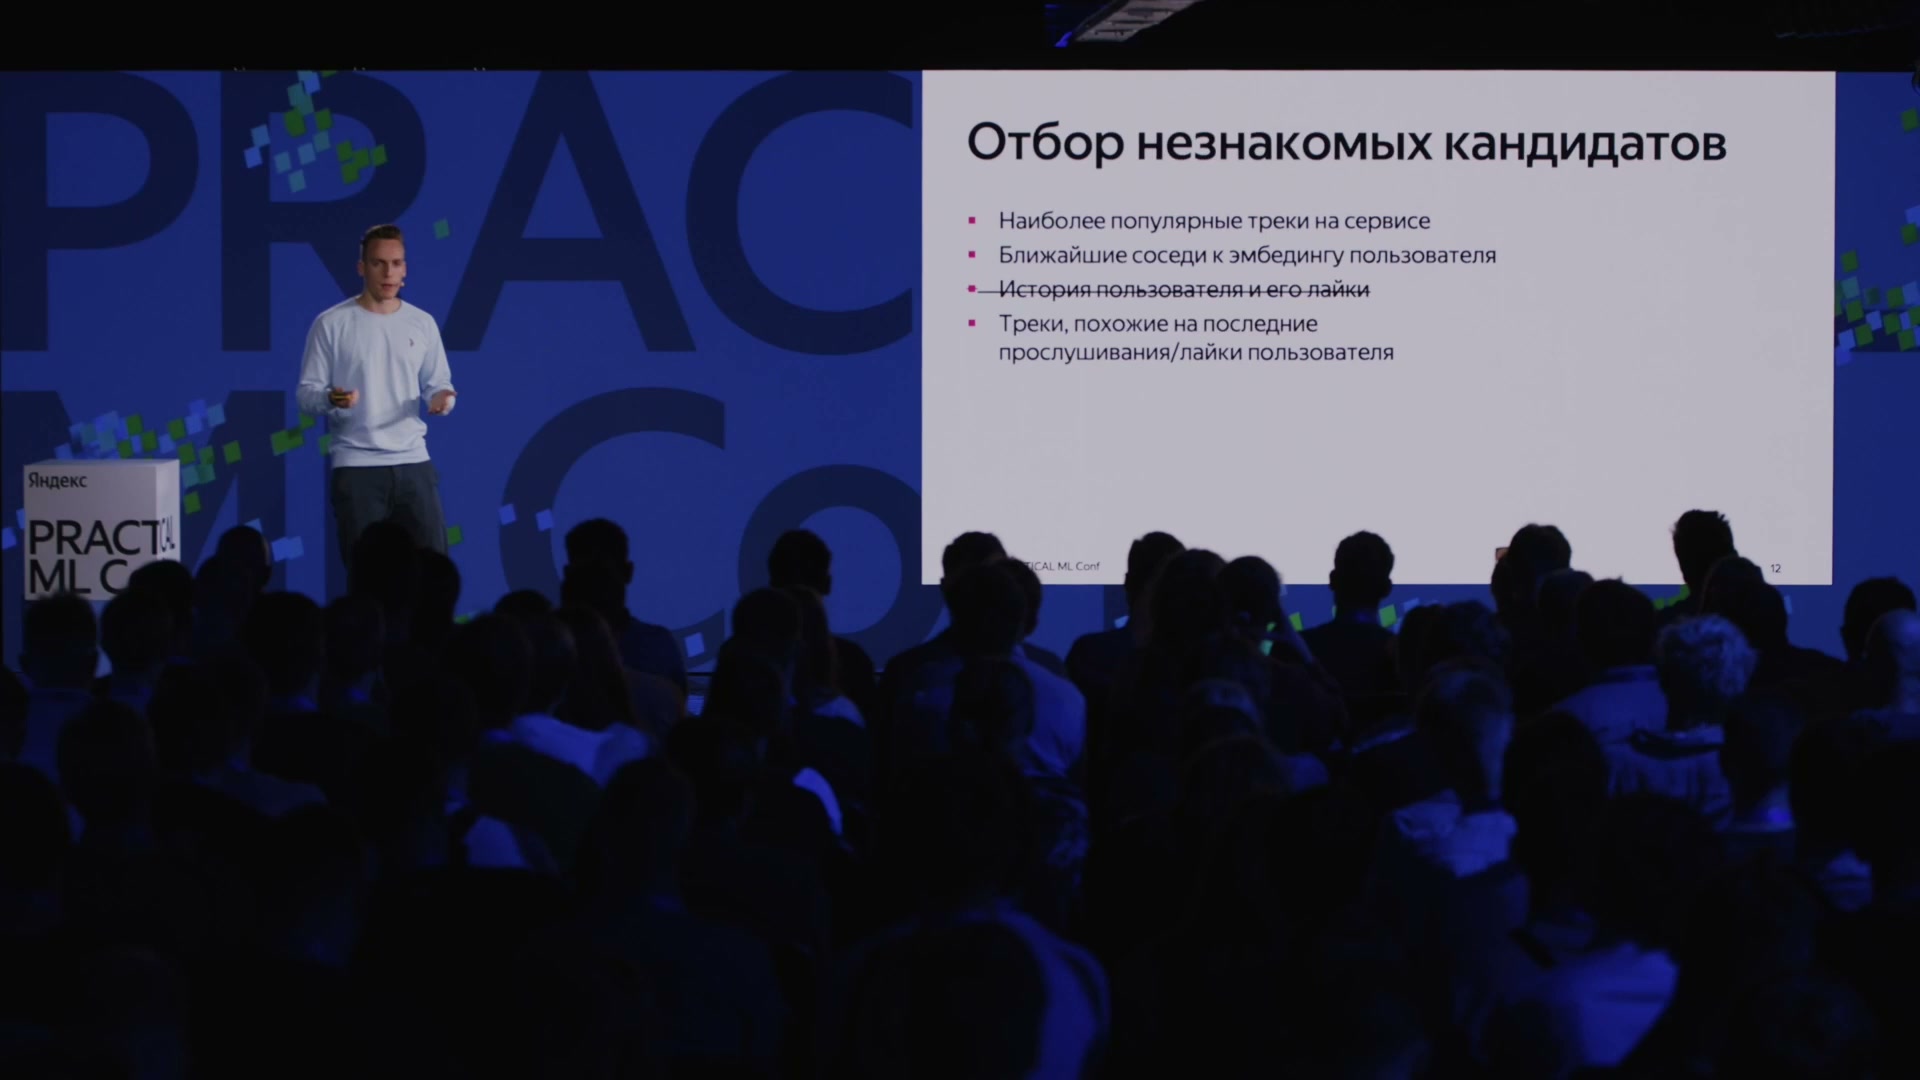
История и лайки напрямую дают знакомые треки: этот источник исключён из отбора незнакомого.
Источник: Савва Степурин · Practical ML Conf 2024От случайного лайка — к похожему, но ещё не слышанному артисту
Дополнительный отбор поднимает поиск с уровня отдельных песен на уровень исполнителей. На каждом запросе берут случайные лайки пользователя; набор исходных лайков каждый раз выбирают заново. Это не один раз закреплённый список любимых песен. Из выбранных треков получают их артистов, а затем ищут похожих исполнителей.
Ключевое ограничение применяется уже при выборе похожего артиста: пользователь не должен был раньше его слышать. От этих незнакомых исполнителей берут наиболее популярные треки и добавляют в кандидаты. Полный путь получается таким: случайный лайк → артист понравившегося трека → похожий неслушанный артист → его популярные записи. На исходной схеме несколько таких путей показаны параллельно.
Здесь знакомая музыка задаёт направление поиска, но не становится результатом. Новый артист должен быть связан со вкусами человека через похожесть, а его записи — давать материал для открытия. Более строгое условие полного незнакомства с выбранным артистом отличает этот источник от общего фильтра, который допускал небольшое число появлений исполнителя в истории.
Треки от ещё не слышанных артистов незнакомы по построению. Автор связывает внедрение этого источника с устранением редких ситуаций, когда почти всё отсеивалось. Но изображённые на схеме три лайка и шесть кандидатов не задают производственную квоту. Не раскрыты также действия при отсутствии лайков или подходящих похожих артистов. Поэтому описанный результат не является обещанием непустого набора при любых будущих данных; отдельная проверка наличия кандидатов будет рассмотрена вместе с экспериментами.
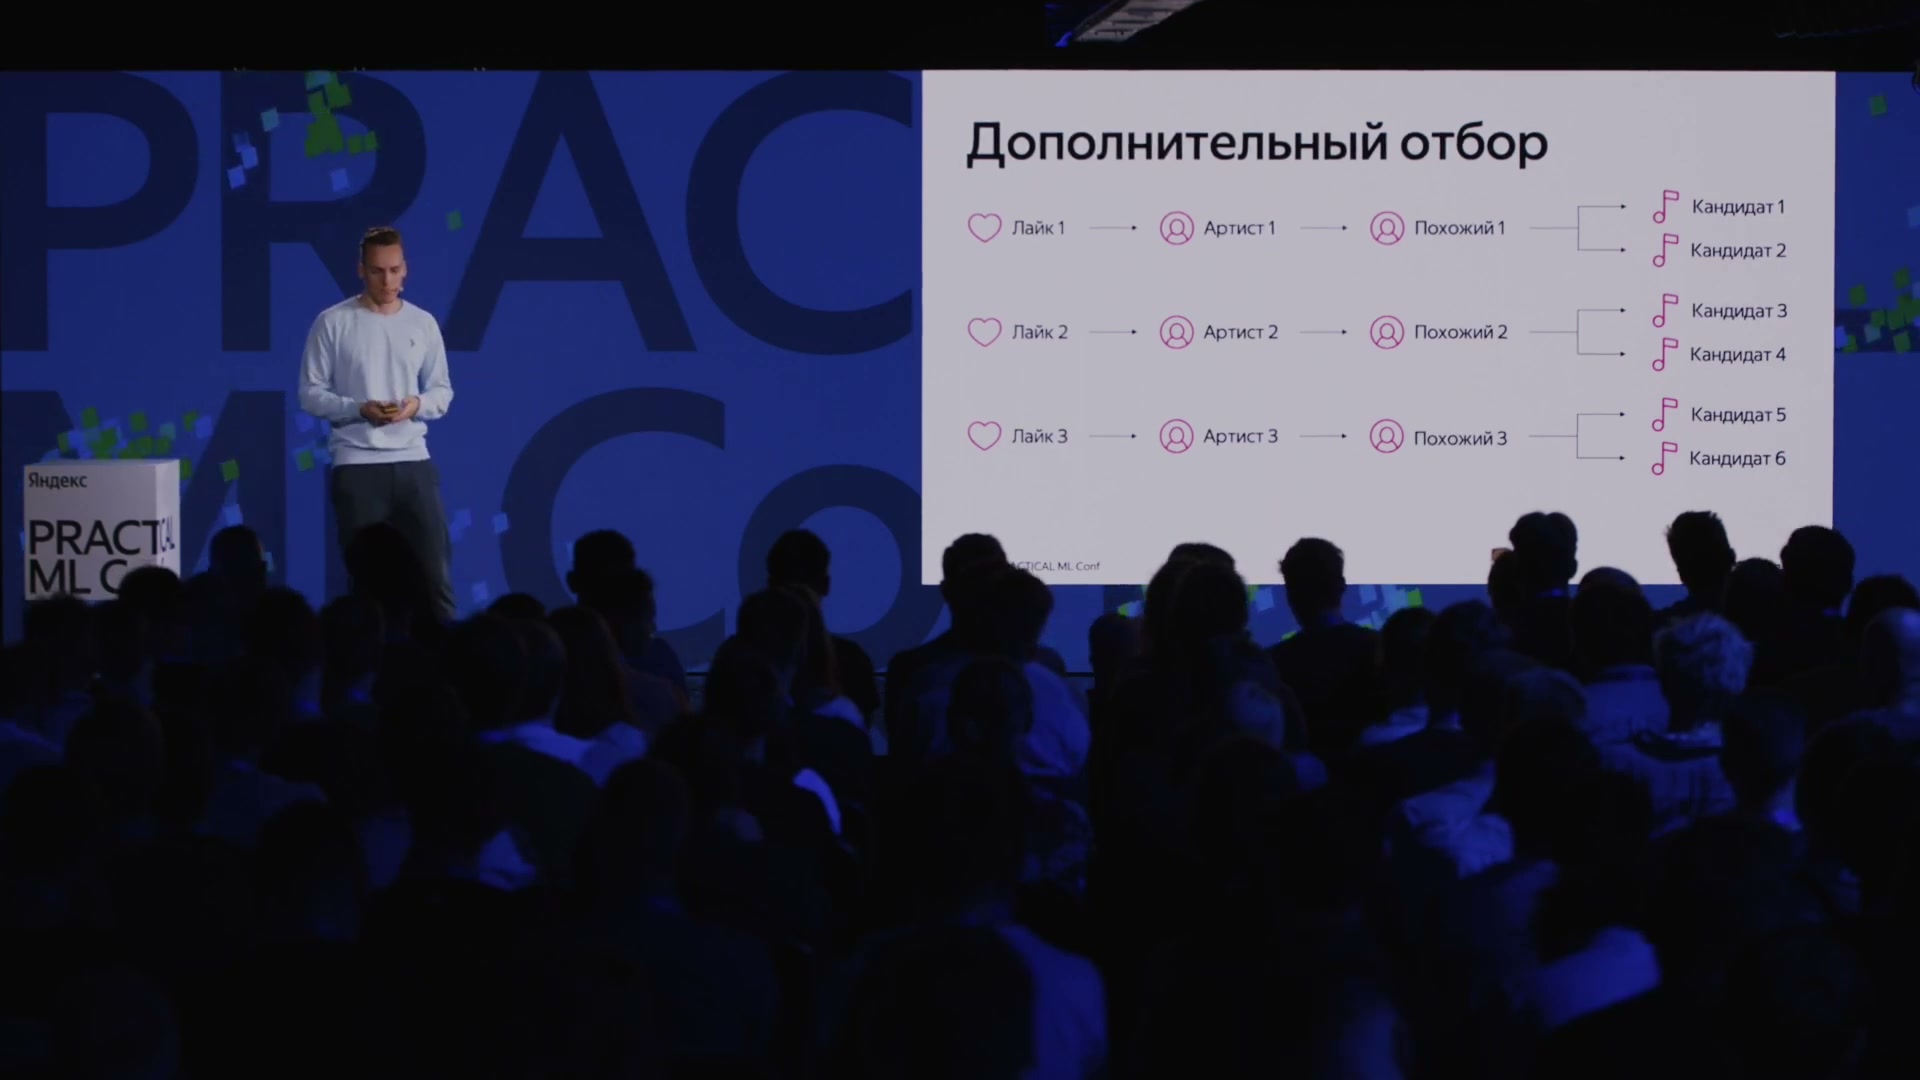
Дополнительный отбор: от лайков через похожих артистов к новым трекам.
Источник: Савва Степурин · Practical ML Conf 2024Чем можно определять похожесть исполнителей
Дополнительный отбор требует способа сравнивать артистов, но доклад не сводит его к одному названному алгоритму. Первый предложенный вариант — разложить матрицу взаимодействий «пользователь—артист», получить векторы исполнителей и искать похожие среди них. Такие представления отражают связи, видимые в поведении слушателей.
Второй вариант — использовать трековые представления, уже подготовленные для других источников кандидатов, и усреднять их внутри артиста. Тогда описание исполнителя получается из описаний его записей. Третий источник — сведения из интернета о том, каких артистов люди считают похожими. Автор приводит это как ещё одну возможность, не описывая конкретный способ сбора таких сведений.
Общий акцент — разнообразие источников похожести. Это перечисление вариантов и направлений работы, а не доказательство, что один из них был единственным внедрённым решением или что все они смешивались в фиксированной пропорции. В частности, из упоминания интернета не следует, что поисковый запрос выполняется при каждом обращении слушателя.
Надёжно раскрыт сам путь отбора: найти связь с любимым артистом, выбрать похожего незнакомого исполнителя и взять его популярные треки. Конкретная модель похожести, её обучающая функция, состав смеси источников и веса этой смеси не приведены. Эти ограничения важны: новый источник кандидатов через артистов нельзя подменять придуманной нейросетевой архитектурой.
Доклад · 00:11:51Обучение начинается с хронологии реакций
Наличие кандидатов решает только первую проблему. Дальше нужно научиться выбирать среди них музыку, на которую человек отреагирует лучше. Для этого собирают хронологию его действий с треками в «Моей волне»: дослушивания, пропуски, лайки и дизлайки. Каждому событию назначают численную цель, которая отражает относительную положительность реакции.
Таблицу можно прокрутить по горизонтали.
Последовательность целей — 3, 3, 1, 5, 0. Автор прямо предупреждает об условности чисел: важно, что лайк имеет больший вес, чем обычное дослушивание, дослушивание — больший, чем явный пропуск, а дизлайк находится внизу. На этом примере объясняется принцип подготовки данных, а не предлагаются готовые коэффициенты для другой системы.
Число у события ещё не является весом обучающей пары. Сначала оно задаёт предпочтительность реакции на отдельный трек. Затем соседние события сравнивают между собой и определяют, какой трек следует поставить выше и насколько важно это сравнение. Такой переход позволяет учить модель относительным предпочтениям, а не требовать от её оценки буквального совпадения с числом 3 или 5.
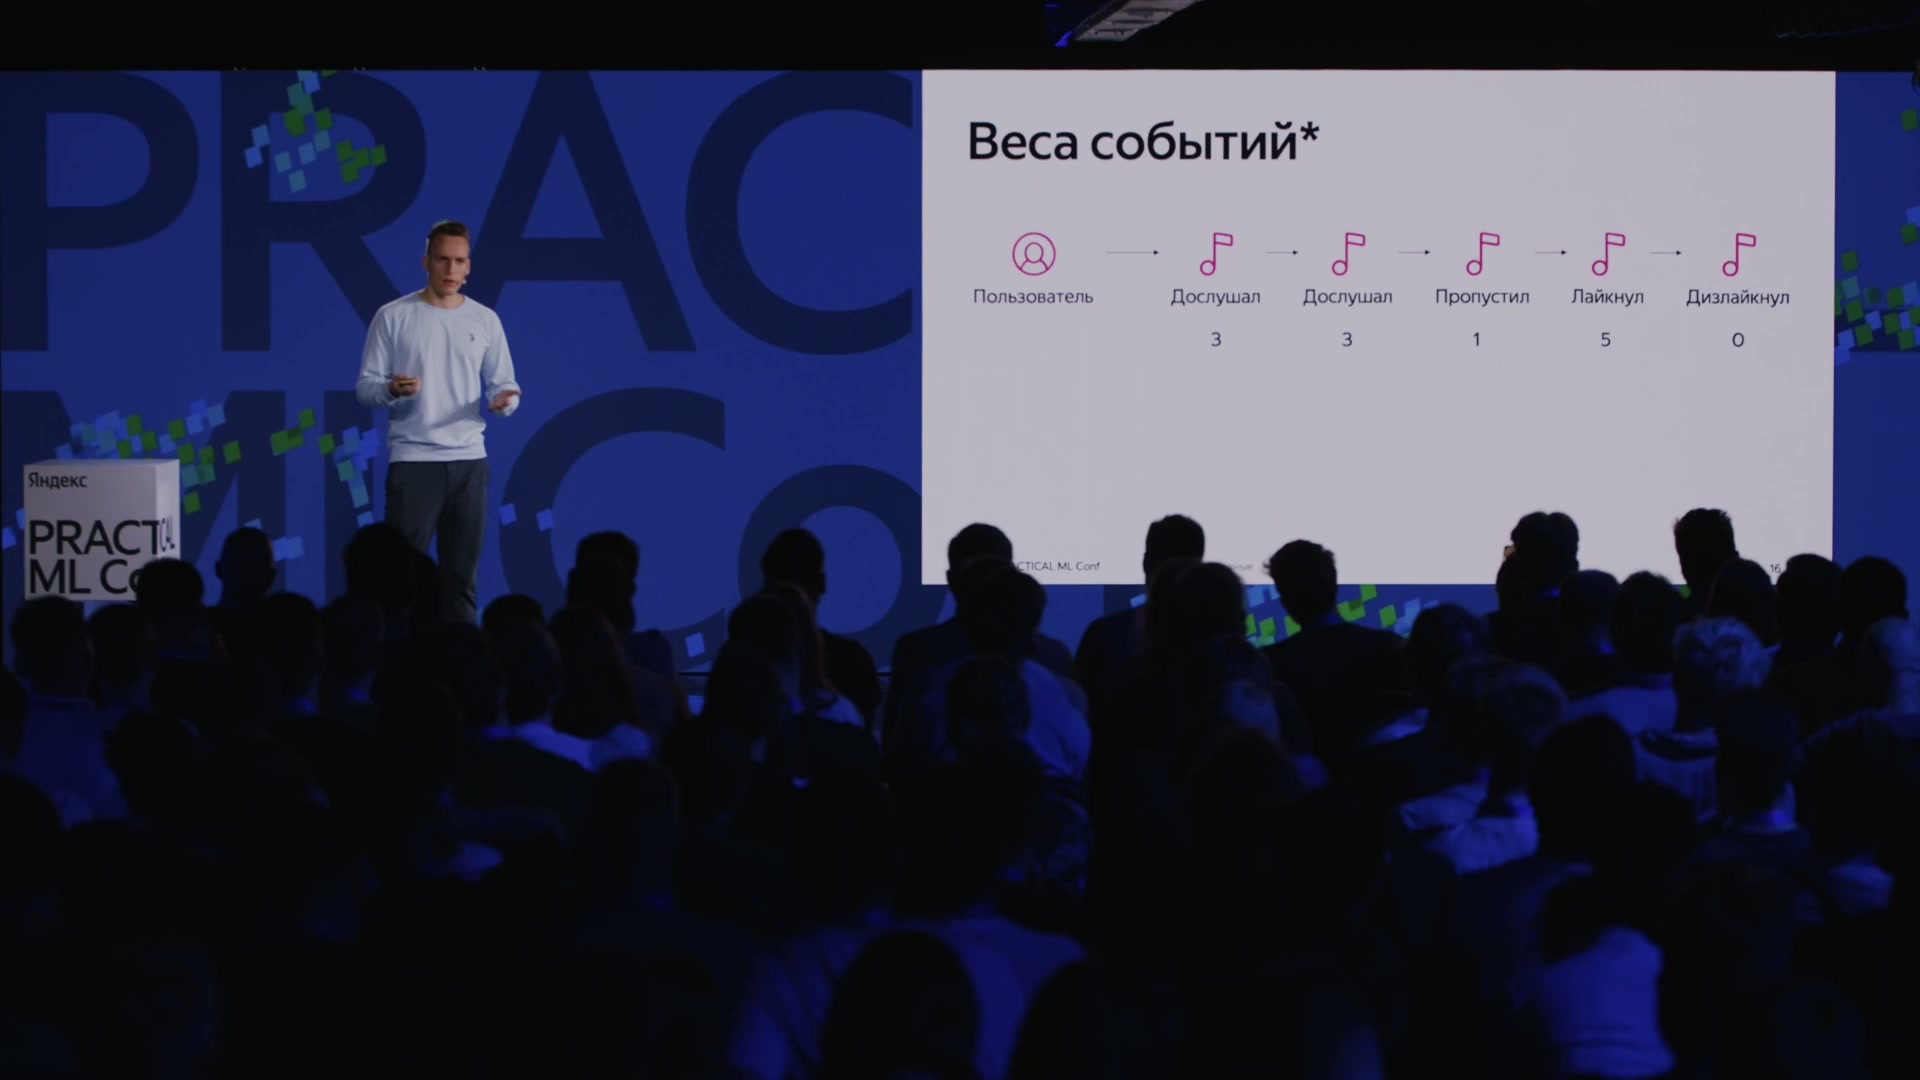
Иллюстративные веса событий: дослушивание 3, пропуск 1, лайк 5, дизлайк 0.
Источник: Савва Степурин · Practical ML Conf 2024Какие пары попадают в обучение и откуда берётся их вес
В обучающий набор попадают только пары последовательных событий одного пользователя с различными целями. В показанной истории два первых дослушивания имеют одинаковую цель 3, поэтому их пара не используется. Следующая пара — второе дослушивание и пропуск — уже даёт предпочтение: один трек получил более положительную реакцию, чем другой. Это не перебор всех сочетаний треков в истории и не добавление случайных отрицательных примеров из каталога.
Обозначим более предпочтительный трек индексом p, а менее предпочтительный — n. Их целевые значения — target_p и target_n. Вес пары w_pn равен модулю разности этих целей. Чем сильнее различаются реакции, тем больший вклад такое сравнение получает в обучении.
Вес пары из исходного примера, 00:14:00. Он определяется различием целей событий, а не временем между ними.
Для пары «дослушал / пропустил» цели равны 3 и 1, поэтому вес — |3 − 1| = 2. Модель должна оценить первый из этих треков выше второго. Следующая по времени пара — «пропустил / лайкнул» — имеет цели 1 и 5. Здесь предпочтителен уже второй трек, а вес равен |1 − 5| = 4. Направление предпочтения не задаётся порядком воспроизведения: его определяет реакция.
Слова «положительный» и «отрицательный» в таком сравнении относительны. Менее предпочтительный трек не обязан иметь дизлайк: пропуск уже проигрывает дослушиванию, а обычное дослушивание — лайку. Ранжировщик учится различать два наблюдавшихся варианта в конкретном контексте, причём более контрастная реакция получает больший вес.
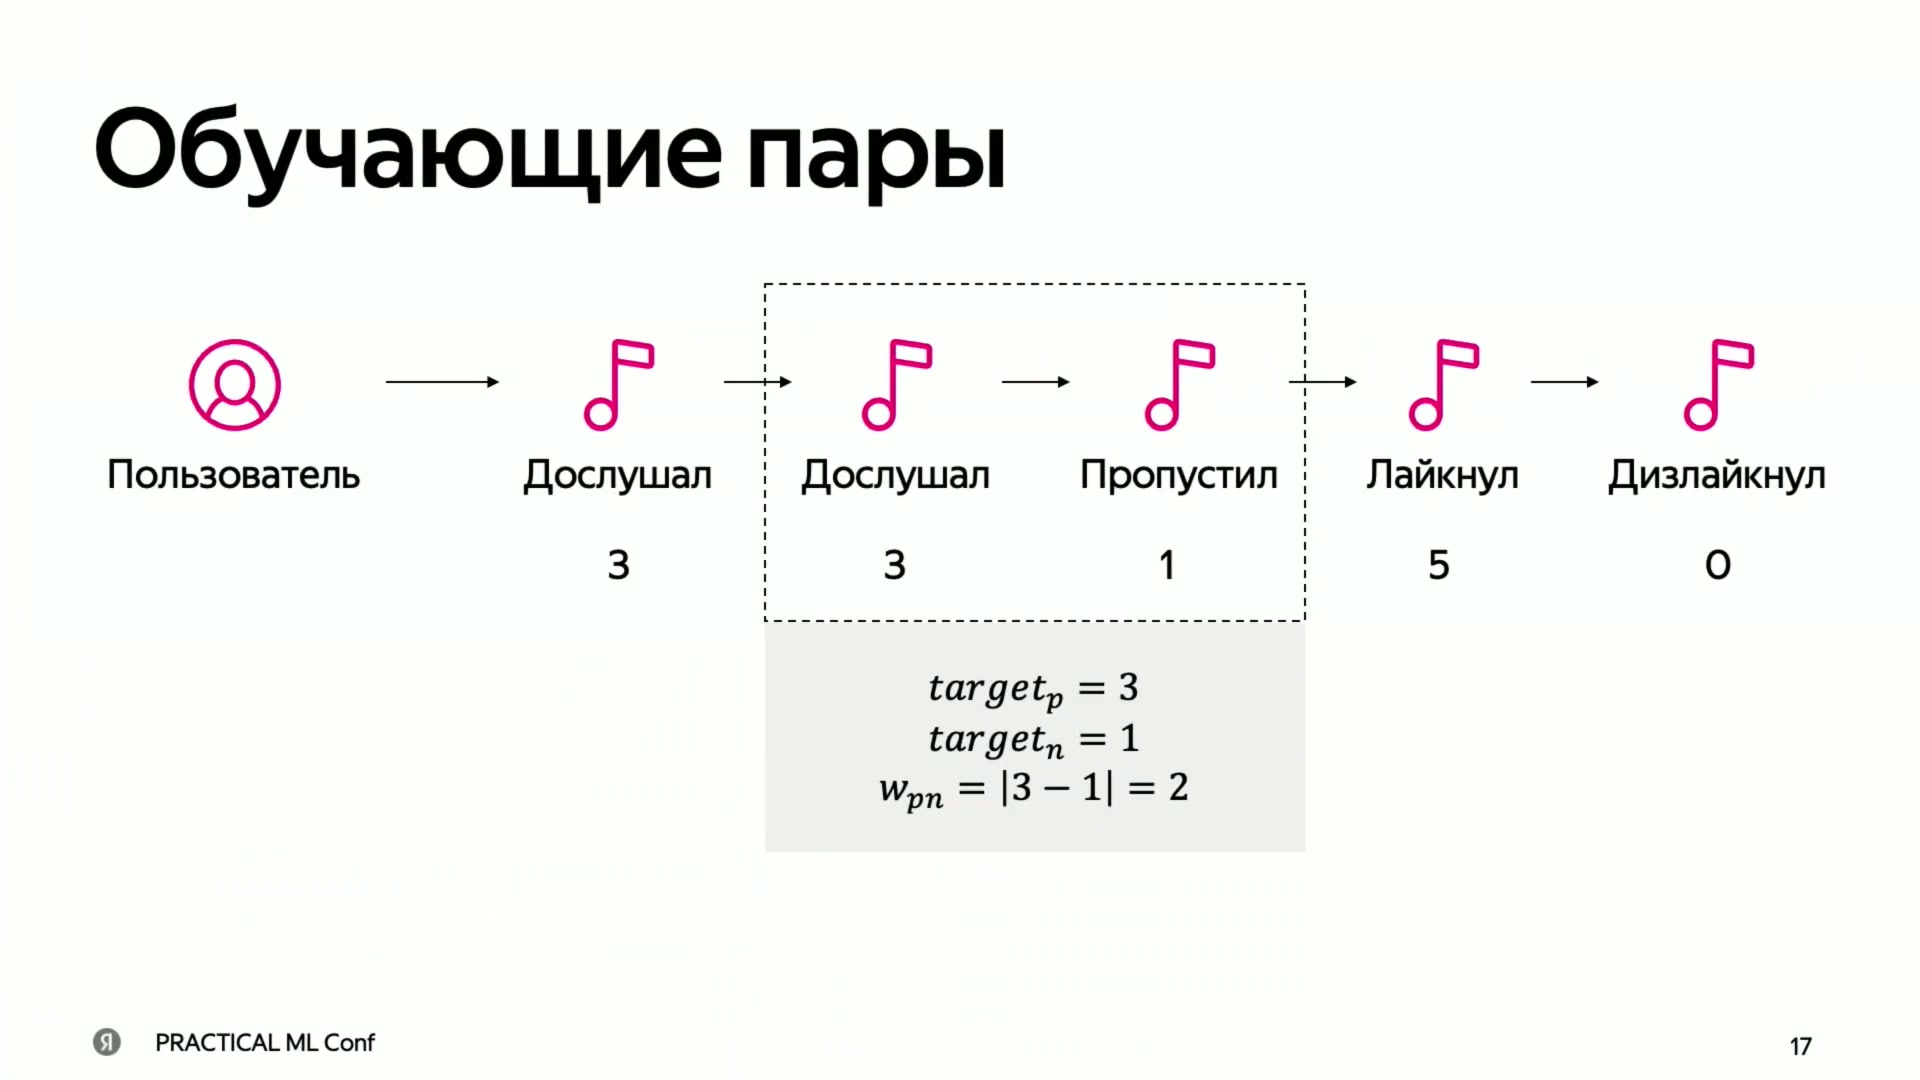
Пример обучающей пары: дослушивание 3 против пропуска 1, вес пары |3−1|=2.
Источник: Савва Степурин · Practical ML Conf 2024Взвешенный RankNet и точность пар — две разные величины
После подготовки пар модель должна выдавать более высокую оценку тому треку, который пользователь предпочёл. Пусть a_p — оценка предпочтительного трека, а a_n — оценка второго. Разность a_p − a_n показывает, совпадает ли порядок модели с наблюдаемой реакцией. Для обучения автор использует взвешенный RankNet — функцию потерь, которая поощряет правильную разницу оценок с учётом важности каждой пары.
Функция потерь для обучения, исходный слайд 00:15:00. Pairs — обучающие пары, w_pn — их веса, σ — сигмоида.
Сигмоида переводит разность оценок в число между нулём и единицей. Затем берут логарифм, умножают на вес пары, суммируют по парам и меняют знак. Когда предпочтительный трек получает большую оценку, вклад пары в потери уменьшается; ошибка на паре с большим весом важнее такой же ошибки на менее значимой паре. Здесь модель обучается относительному порядку, а не напрямую предсказывает долю лайков всей настройки.
Для оценки качества отдельно считают, в какой взвешенной доле пар порядок оказался правильным. Эту величину называют взвешенной точностью пар, или weighted pair accuracy. В отличие от функции потерь, она проверяет сам факт правильного сравнения, а не величину разрыва между оценками.
Офлайн-метрика качества на том же слайде, 00:15:00. Квадратные скобки обозначают индикатор истинности условия.
Индикатор равен единице, когда a_p строго больше a_n, и нулю иначе. При равных оценках пара не засчитывается как правильно упорядоченная. В числителе собираются веса правильных пар, а в знаменателе — веса всех проверяемых пар. Это проверка модели на данных, не измерение поведения пользователей после внедрения. Численного значения этой метрики и её прироста автор здесь не приводит; продуктовый эффект дальше оценивается A/B-тестами.
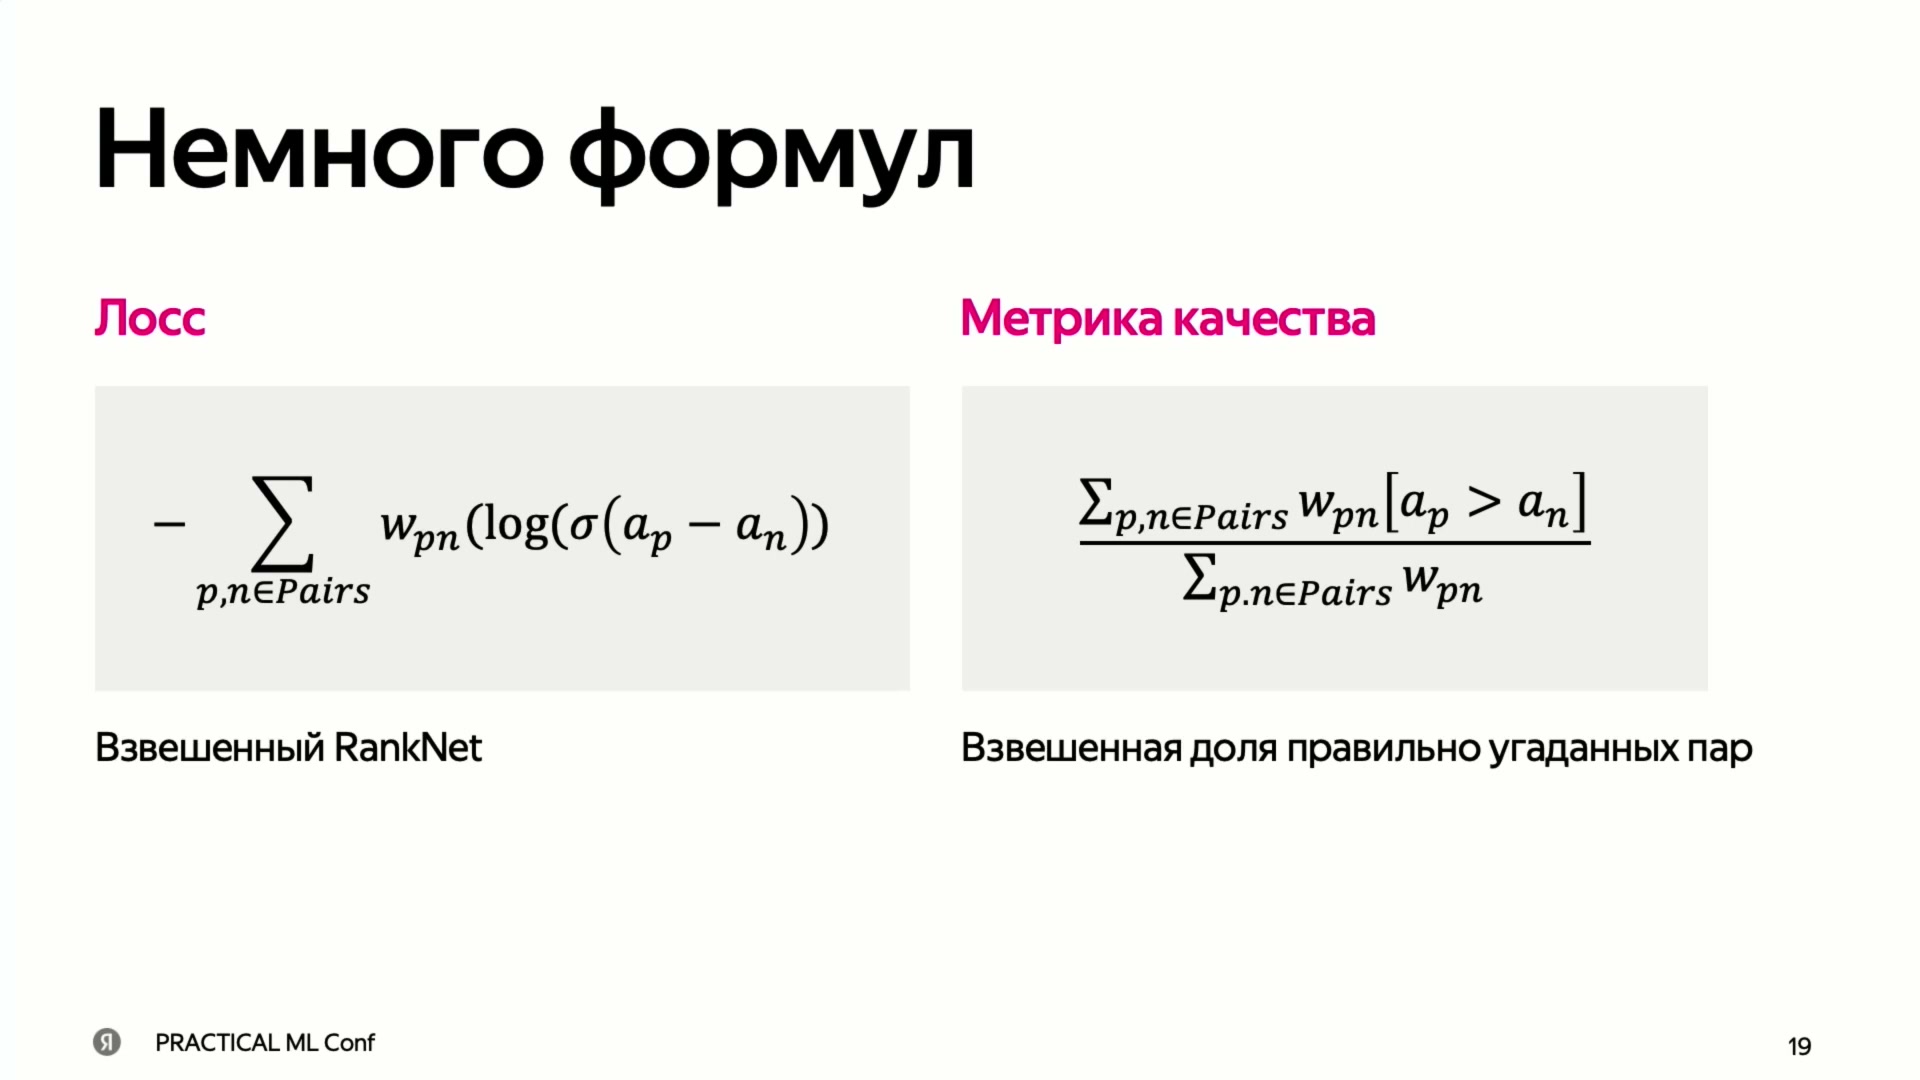
Взвешенный RankNet и взвешенная доля правильно упорядоченных пар — разные формулы.
Источник: Савва Степурин · Practical ML Conf 2024Что получает тяжёлый CatBoost
Тяжёлый ранжировщик в описанной системе — CatBoost, открытая библиотека Яндекса для градиентного бустинга на решающих деревьях. В этой задаче модель из множества деревьев учится упорядочивать треки по подготовленным парам. Автор использует для неё описанную взвешенную функцию потерь. Сложность тяжёлой стадии связана не только с самой моделью, но и с тем, насколько богато описаны пользователь и кандидат.
Первая группа входных признаков — статистики. Они могут относиться к треку, к пользователю или к их взаимодействиям; отдельно названы взаимодействия пользователя с артистом. Такие сведения позволяют оценивать кандидата не изолированно, а на фоне того, как человек слушает музыку и что ему уже известно.
Вторая группа — предсказания других моделей машинного обучения. На вход CatBoost передают выходы нейросетей-трансформеров, моделей на основе матричных разложений и аудиопризнаки, описывающие звучание. Эти модели поставляют дополнительные сигналы, а CatBoost учится использовать их вместе со статистиками. Поэтому наличие трансформеров в системе не означает, что тяжёлая ранжирующая модель в этом докладе сама является трансформером.
При обработке запроса тяжёлая модель оценивает уже сокращённый набор порядка 3 тыс. треков. У неё нет доступа к отброшенным кандидатам как к возможной выдаче: богатые признаки помогают выбирать только среди того, что передала предыдущая стадия. Число деревьев, их глубина, полный перечень статистик, объём обучающих данных и способ разделения данных для проверки в выступлении не раскрыты.
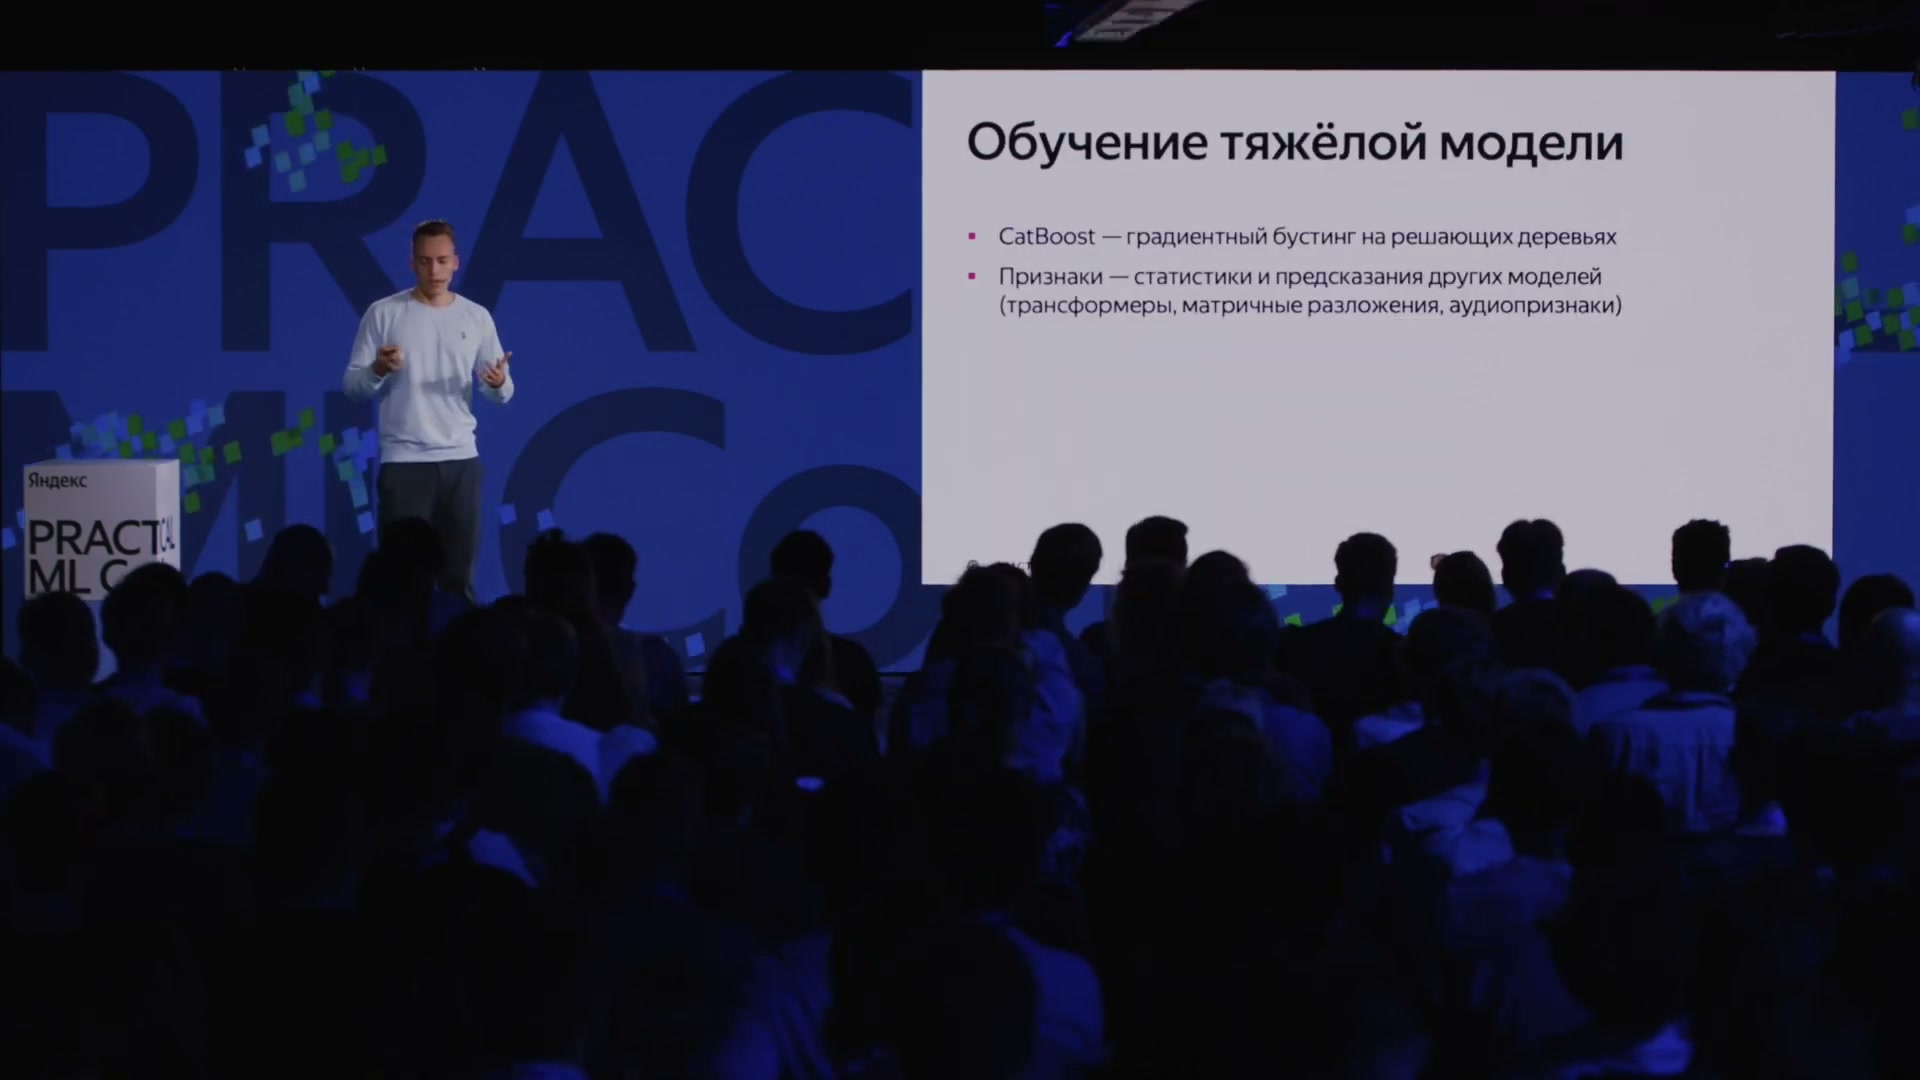
Тяжёлый ранжировщик CatBoost использует статистики и предсказания других моделей.
Источник: Савва Степурин · Practical ML Conf 2024Почему лёгкая модель учится у тяжёлой
Лёгкая модель — тоже CatBoost, но с меньшим количеством деревьев и признаков. Её задача при применении уже: из порядка 10 тыс. кандидатов оставить около 3 тыс. для тяжёлого ранжирования. Она должна быстрее принимать предварительное решение, не выполняя весь объём работы последней модели.
Для обучения берут тот же набор примеров, который используется для тяжёлой модели. Однако лёгкую модель учат воспроизводить уже предсказания тяжёлой, а не просто повторяют исходную постановку по реакциям пользователя. Такое перенесение поведения более сильной модели в меньшую называется дистилляцией. Тяжёлая модель выступает учителем, лёгкая — учеником.
Совпадение обучающего набора здесь не означает совпадения цели. События пользователя задают предпочтения, на которых учится тяжёлый ранжировщик; для лёгкого ориентиром становятся оценки этого ранжировщика на тех же примерах. Так ранняя стадия получает возможность приблизить выбор модели, которой позже предстоит оценить оставленный набор.
В докладе не названа отдельная функция потерь дистилляции. Поэтому нельзя автоматически приписать ученику ровно тот же RankNet, который был показан для обучения по пользовательским предпочтениям. Раскрыты семейство модели, уменьшение числа деревьев и признаков, общий обучающий набор и передача предсказаний учителя. Обучение такой пары моделей происходит отдельно от выдачи пятёрки треков слушателю.
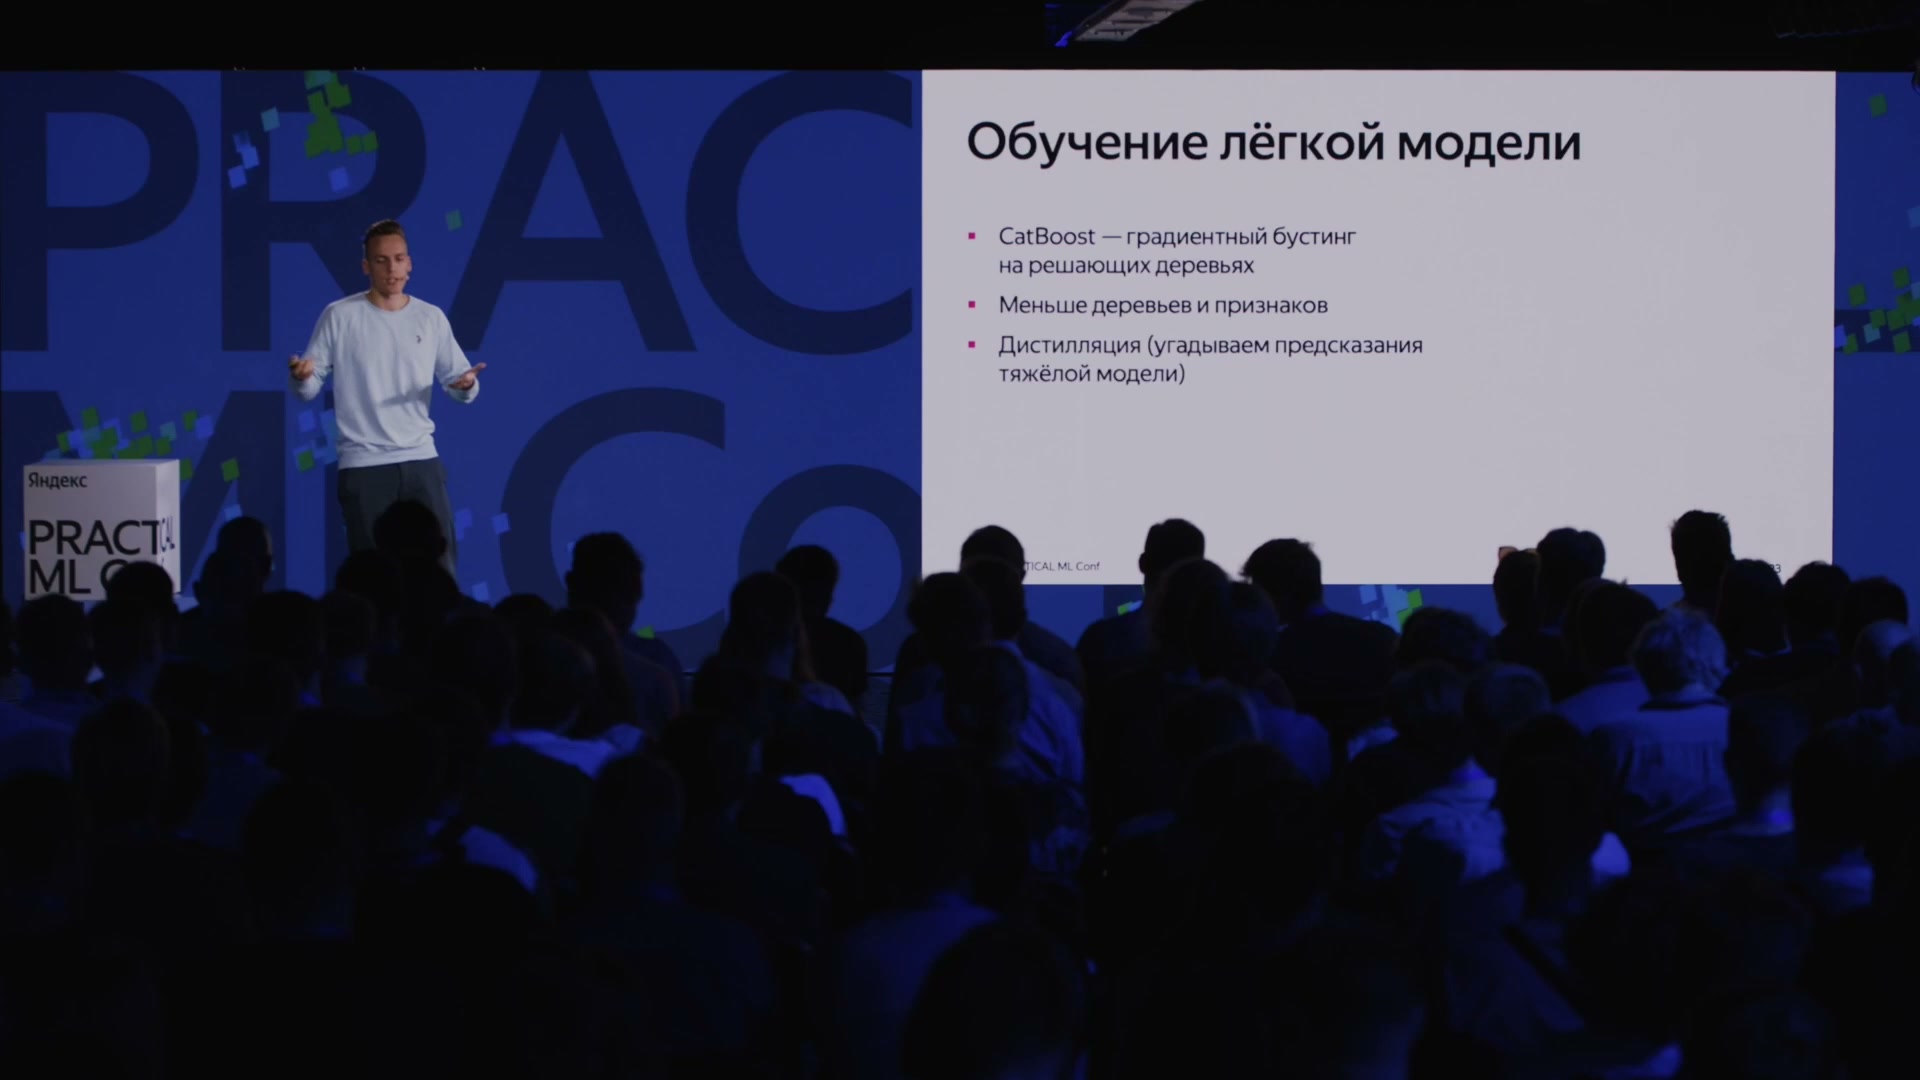
Лёгкий CatBoost: меньше деревьев и признаков, обучение на предсказаниях тяжёлой модели.
Источник: Савва Степурин · Practical ML Conf 2024Специализация без отказа от обычной волны
Чтобы получить ранжировщик для «Незнакомого», команда увеличивает вес обучающих пар из ситуаций, когда пользователь явно включил эту настройку. Такие пары сильнее влияют на обучение. Модель получает больший стимул понимать, как человек реагирует именно на новое: какие направления ему интересны, какие не подходят и от каких предпочтений можно оттолкнуться при следующем открытии.
При этом примеры обычной «Моей волны» не удаляют. Они сохраняют сведения о любимых треках, жанрах и повторных прослушиваниях. Если учиться только на редких встречах с незнакомым, можно потерять полезную опору на общий вкус. Два состояния исходного слайда показывают обе стороны решения: специализацию на незнакомом и сохранение понимания пользовательских предпочтений.
Величину увеличения веса подбирали экспериментально. Автор даёт качественный ориентир: когда примеров взаимодействия с незнакомым контентом меньше, для них стоит пробовать больший вес. Это эвристика выбора экспериментов, а не приведённая математическая зависимость между числом событий и коэффициентом.
Изменяется вклад примеров в обучение отдельной модели, а не только порядок уже готовой выдачи. Поэтому специализация отличается и от фильтра знакомых треков, и от простого повышения оценок каких-то кандидатов при запросе. Фильтр решает, что можно рекомендовать; новое обучение меняет то, как среди допустимых вариантов выбирают наиболее подходящие.
Увеличение веса обучающих пар из режима «Незнакомое».
Источник: Савва Степурин · Practical ML Conf 2024
Специализация на незнакомом сохраняет сигналы общих предпочтений слушателя.
Источник: Савва Степурин · Practical ML Conf 2024Зачем отдельно усиливать лайк
Следующее изменение касается не происхождения пары, а силы положительной реакции: команда увеличивает вес лайка. По словам автора, экспериментировали с увеличением до двух раз. Это верхняя граница названных проб, а не опубликованный окончательный коэффициент; нижняя граница диапазона и выбранное значение в речи не указаны.
Мотивировка возвращает к пользовательскому запросу. Человек сам выбрал режим открытий и допускает, что часть новой музыки ему не подойдёт. Поэтому модель может сильнее ценить удачную находку, отмеченную лайком, а не только стремиться к безопасному дослушиванию. Автор предлагает быть смелее в выборе: искать музыку, которая действительно увлечёт, а не просто не вызовет переключения.
Это не означает, что пропуски и дослушивания перестают существовать в данных. Меняется относительная важность событий для цели обучения. Увеличение веса пар из «Незнакомого» и увеличение веса лайка — два разных вмешательства: первое усиливает нужный контекст, второе — нужную реакцию. Точную формулу их совместного применения автор не раскрывает.
Удачность такого изменения ещё надо проверить по поведению слушателей. Если доля лайков вырастет, но люди перестанут возвращаться в настройку, одно усиление положительного события не будет достаточным результатом. Именно поэтому рядом с лайками в последующих экспериментах рассматриваются возвращаемость и время прослушивания.
Отдельное увеличение веса лайка, чтобы усилить релевантность открытий.
Источник: Савва Степурин · Practical ML Conf 2024Новый учитель требует согласованной лёгкой модели
После обучения тяжёлой модели для «Незнакомого» команда обучает соответствующую лёгкую модель на её предсказаниях. Это та же идея дистилляции, но теперь учитель отражает новые приоритеты режима открытий. При обновлении тяжёлого ранжировщика обновляют и лёгкую модель, чтобы предварительный отбор соответствовал последующему выбору.
Причина проста: даже хороший специализированный ранжировщик не покажет трек, который уже удалён при сокращении 10 тыс. кандидатов до 3 тыс. Если ранняя модель продолжает выбирать слишком консервативно, часть пользы нового учителя теряется ещё до тяжёлой стадии. Согласованный ученик должен оставлять именно те треки, которые представляют интерес для обновлённой модели.
Здесь улучшается состав передаваемого набора, а не заявляется его увеличение. Число около 3 тыс. остаётся ориентиром показанной схемы. Фраза об одновременном переобучении означает согласование моделей; она не описывает одну общую процедуру, в которой параметры обоих CatBoost обновлялись бы единым градиентом.
Также это другой вид отбора, чем переход через похожих артистов. Источник через артистов приносит новые треки в исходный набор. Лёгкая модель выбирает, какие кандидаты из уже собранного набора передать дальше. Оба изменения помогают тяжёлому ранжировщику получить хороший выбор, но действуют на разных стадиях.
Дистилляция лёгкой модели по обновлённой тяжёлой модели для «Незнакомого».
Источник: Савва Степурин · Practical ML Conf 2024Четыре последовательных изменения и меняющаяся база сравнения
Результаты проверяли в A/B-тестах — сравнениях вариантов системы на пользователях. Автор подчёркивает две границы их прочтения. Во-первых, вся показанная таблица относится только к настройке «Незнакомое». Интегральные метрики всей «Моей волны» статистически значимо не изменились; локальные приросты нельзя переносить на всю аудиторию сервиса.
Во-вторых, изменения принимали последовательно. Сначала усилили пары из «Незнакомого», затем вес лайка, далее согласовали лёгкую модель с тяжёлой через дистилляцию и после этого добавили новый отбор через артистов. После принятого шага менялся базовый вариант для следующего сравнения. Поэтому четыре строки описывают последовательные улучшения развивающейся системы, а не четыре замены одного и того же неизменного исходного варианта.
Для колонки редких треков есть отдельное определение: редким здесь считается трек, который на данный момент набрал меньше 100 лайков. Это не порог числа прослушиваний. Кроме того, редкость трека на сервисе и его незнакомство конкретному слушателю — разные свойства. В таблице численно показано количество уникальных артистов; отдельного результата по жанрам на этом слайде нет.
Таблицу можно прокрутить по горизонтали.
Все проценты здесь относительные, не процентные пункты. Общий численный эффект по четырём строкам не вычисляется. Запись «не статистически значимо» означает, что в данном сравнении не обнаружено статистически значимого изменения; она не доказывает ни строго нулевой эффект, ни полную эквивалентность вариантов. Длительность тестов, размеры групп, доверительные интервалы и уровень значимости в докладе не приведены.
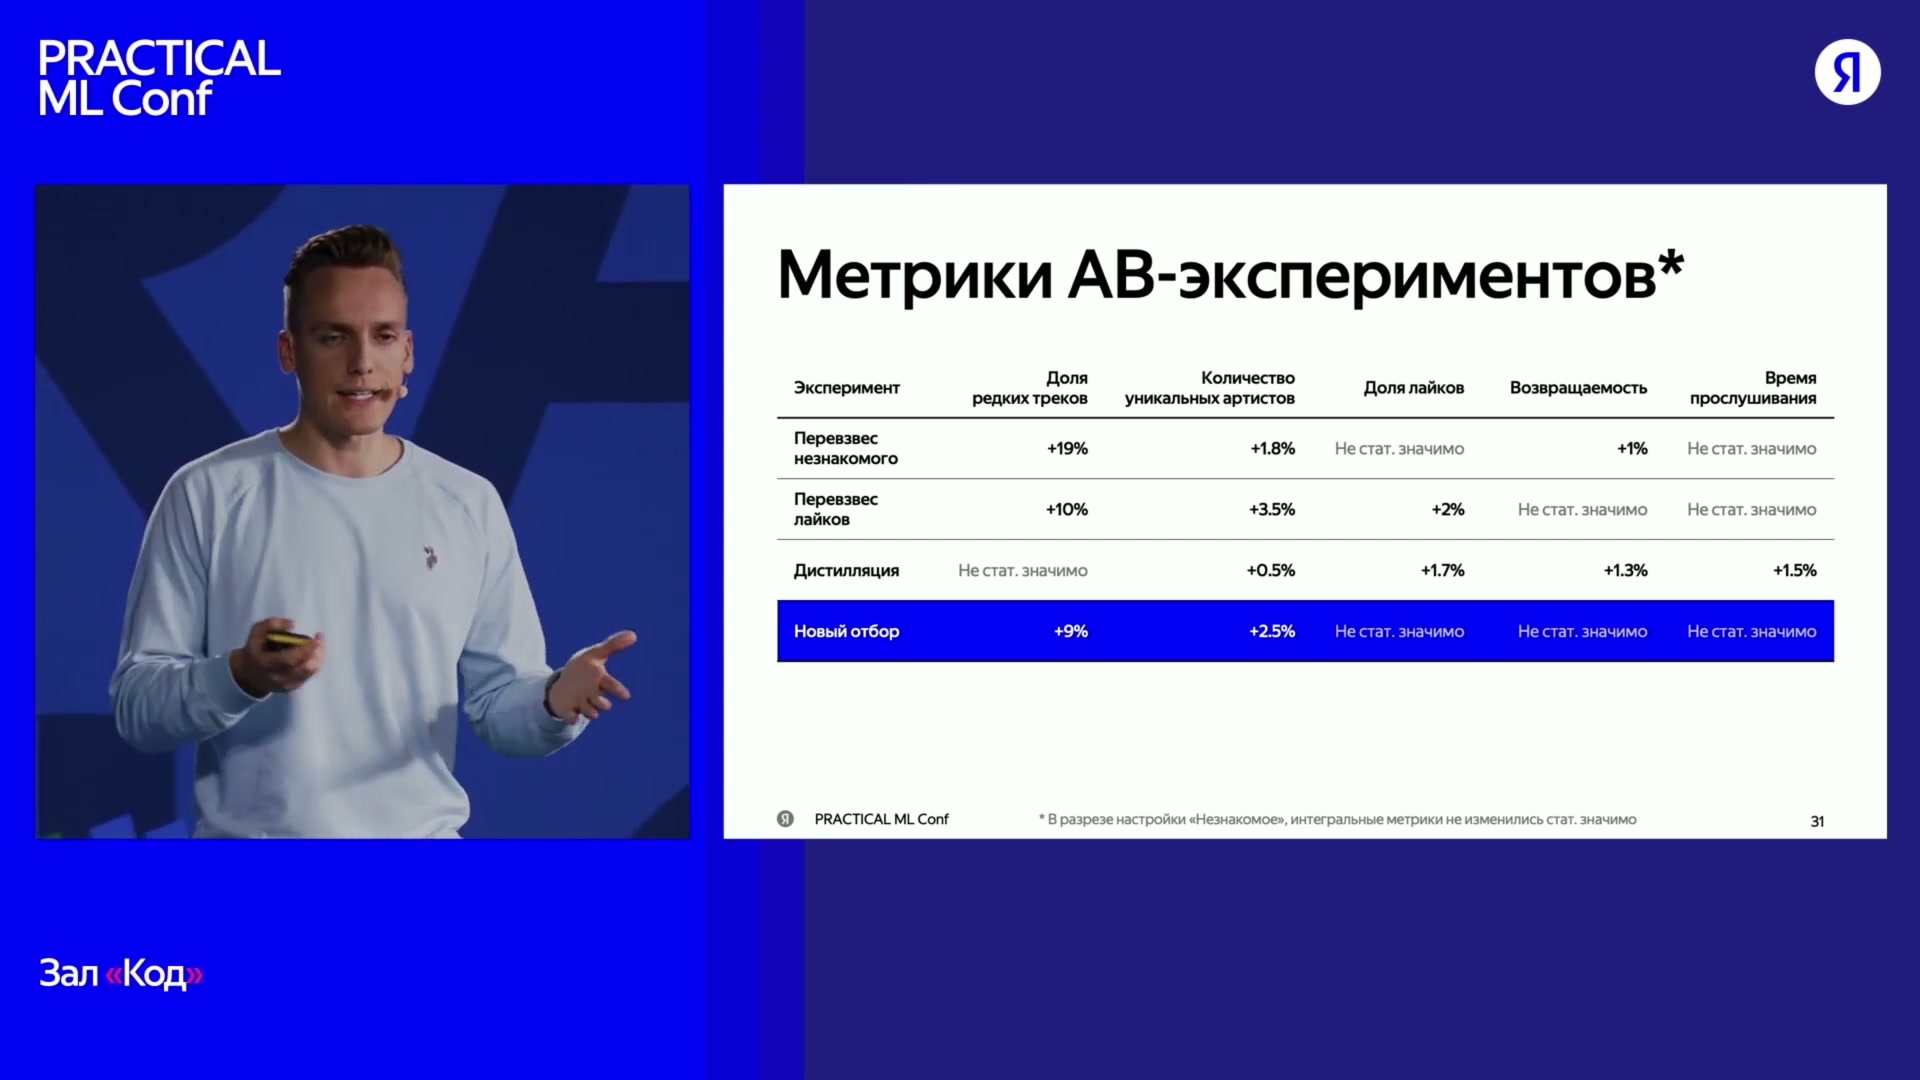
Четыре отдельных A/B-эксперимента. Изменения указаны для режима «Незнакомое»; общие метрики статистически не изменились.
Источник: Савва Степурин · Practical ML Conf 2024Что объясняет каждая строка и зачем отдельно проверяли наличие кандидатов
Увеличение веса пар «Незнакомого» дало больше редких треков и уникальных артистов, а также рост возвращаемости на 1% относительно базы этого шага. Автор связывает результат с тем, что модель лучше поняла редкий контент. Возвращаемость важна для интерпретации: одна лишь доля редких записей могла бы расти и при бесполезной выдаче, а повторное обращение к настройке поддерживает вывод о ценности найденной музыки для пользователя.
Увеличение веса лайка повысило долю лайков на 2% и также расширило разнообразие по показанным метрикам. Для возвращаемости и времени прослушивания значимого изменения не обнаружили. Автор трактует это как поддержку исходной гипотезы: аудитория, которая сама попросила открытия, готова к более смелому выбору. Это вывод через наблюдаемые показатели, а не прямое измерение серендипности и не доказательство отсутствия любого возможного ухудшения.
Дистилляция улучшила сразу несколько показателей реакции: долю лайков на 1,7%, возвращаемость на 1,3% и время прослушивания на 1,5%. Объяснение автора связано с более подходящими кандидатами, которые лёгкая модель стала передавать тяжёлой. У последней появился лучший выбор внутри оставленного набора. Из этих результатов не следует, что число передаваемых треков увеличили сверх показанных 3 тыс.; речь идёт о качестве состава.
Новый отбор через артистов увеличил долю редких треков на 9% и количество уникальных артистов на 2,5%. Изменения доли лайков, возвращаемости и времени прослушивания не оказались статистически значимыми. При этом у источника была ещё одна конкретная задача: устранить редкие ситуации почти полной фильтрации, в которых ранжировщику практически нечего выбирать.
Эту задачу проверяли отдельно от средней продуктовой таблицы. По дополнительным замерам команда сообщила, что такие случаи нехватки кандидатов удалось устранить и треки для «Незнакомого» оставались. Размеры проверяемых выборок, частоты проблемы до и после и подробности измерения не названы. Поэтому это результат наблюдений за описанной системой, а не гарантия для любых будущих запросов, пустой истории или отсутствующих похожих артистов.
В заключительной части результатов автор говорит об общем качественном направлении: больше разнообразия, более редкие подходящие треки, лучшее ощущение открытия и желание возвращаться. Четыре шага сохраняют отдельные результаты, а их численный итог здесь не реконструируется. Важный вывод из таблицы и дополнительных замеров — изменения состава выдачи, пользовательской реакции и наличия кандидатов требуют разных проверок и не сводятся к одной метрике.
Доклад · 00:21:19Какие выводы автор предлагает перенести на другие рекомендации
Первый совет автора относится к наличию выбора: явно добавлять в отбор контент, который пользователь ещё не видел или не слышал. Надежда на то, что общие источники случайно оставят достаточно новых объектов, оказалась слабым местом исходной системы. Специальный источник не отменяет ранжирование — он создаёт материал, с которым оно сможет работать.
Второй совет — смотреть не только на похожесть самих объектов, но и на похожесть их авторов. В музыкальном кейсе это переход от треков к артистам. Автор объясняет его полезность тем, что создателей меньше, чем единиц контента, и на этом уровне легче находить новые направления, связанные со вкусом пользователя. Это качественный аргумент о расширении поиска, а не приведённое измерение экономии времени ответа.
Третий совет — пробовать отдельную модель для рекомендаций незнакомого. В ней стоит сильнее учитывать реакции на новый контент, а важные положительные события использовать для более смелого выбора. В Яндекс Музыке таким событием стал лайк. Сохранение обычной волны в обучении позволяет не терять понимания того, что человеку нравится в целом.
Вместе эти выводы описывают путь данного кейса: сначала обеспечить подходящие новые объекты, затем изменить приоритеты ранжирования и согласовать раннюю модель с поздней. Однако повышенный вес лайка не является универсально верным коэффициентом для любой задачи. Предложенные автором направления в самом докладе проверяются поведением аудитории конкретного режима, а ответы на вопросы показывают, какие случаи требуют другого подхода.
Доклад · 00:24:22Вопросы: перенос в обычную волну и нейросетевое ранжирование
Первый вопрос касается того, используются ли результаты специализированной модели в общей «Моей волне». На момент доклада команда уже начала такие эксперименты. Автор подчёркивает, что у переноса много тонкостей, но не описывает их решение. Доля подмешивания, итоговый эффект и полный запуск на обычной волне не заявлены. Поэтому результаты настройки «Незнакомое» нельзя считать результатами такой интеграции.
Следующий вопрос уточняет роль нейросетей в работающей системе. Трансформеры используются как источники признаков и в отборе кандидатов, а с нейросетевыми моделями ранжирования команда экспериментирует. Описанный в основной части тяжёлый ранжировщик остаётся CatBoost. Это различие между уже используемыми компонентами и исследуемой заменой важно: нейросеть, которая поставляет признак, не тождественна нейросети, которая определяет финальный порядок треков.
Для обоих направлений автор сообщает статус работы, а не ещё один завершённый A/B-результат. Архитектура нейросетевого ранжировщика и конкретные правила объединения режимов в этих ответах не раскрыты.
Доклад · 00:26:25Вопросы: как начинать с новой музыкой и новым слушателем
Вопрос о возможной теме диплома выводит разговор к холодному старту — ситуации, когда об объекте или пользователе ещё мало поведенческих данных. Автор рассказывает о собственном дипломе во время работы в Дзене: как быстро запускать новый контент в рекомендации, чтобы пользу получали и создатели, и пользователи. Он отмечает, что задача актуальна и для Яндекс Музыки. Это конкретный пример направления исследования, а не обещание, что выбранная тема сама по себе обеспечит трудоустройство.
Вопрос о новом альбоме и трендах раскрывает холодный старт трека. Сразу после появления записи ещё нет накопленной обратной связи. В этот момент команда опирается на артиста: старается быстрее донести новинку до людей, которые его слушают. Дополнительно помогают аудиопризнаки, потому что звучание доступно до того, как трек соберёт пользовательские реакции. Отдельный алгоритм выявления вирусных трендов автор здесь не описывает.
Этот ответ относится к продвижению новинок в рекомендациях Музыки в целом. Его нельзя читать как отмену ограничения на знакомых артистов внутри «Незнакомого». Новый релиз любимого исполнителя решает другую пользовательскую задачу, чем поиск ещё не известного музыкального направления.
Для нового пользователя ситуация обратная: почти весь каталог незнаком, но пока неясно, что ему понравится. Поэтому используются отдельные источники кандидатов и модели. При первоначальном знакомстве с сервисом человек выбирает артистов или жанры. Затем система начинает с более популярных треков выбранных направлений и исполнителей. После накопления истории подключаются описанные алгоритмы «Незнакомого».
Таким образом, дополнительный отбор через случайные лайки не объявляется единственным способом начать рекомендации с пустой истории. Для такого слушателя есть отдельный начальный сценарий. Порог, после которого пользователя считают достаточно знакомым системе, в днях, прослушиваниях или лайках не назван.
Доклад · 00:27:12Вопрос о паузах между треками: причина не раскрыта
Один из слушателей спрашивает о ситуации, когда «Моя волна» как будто истощается и приходится ждать следующий трек 3–5 секунд. Эти секунды — наблюдение автора вопроса, а не приведённый докладчиком замер задержки системы. Вопрос касается возможной связи паузы с рекомендациями и действий, которые мог бы предпринять пользователь.
В сохранившейся содержательной части ответа автор советует попробовать настройку «Незнакомое», где должны предлагаться новые треки. Причину паузы, её связь с конкретной стадией каскада и технический способ устранения он не устанавливает. Поэтому этот обмен репликами нельзя превращать ни в объяснение серверной задержки, ни в доказательство того, что новый отбор ускоряет загрузку следующей песни.
Доклад · 00:28:38Вопросы: целый трек, длительность и повторные прослушивания
Слушатель приводит пример песни с ярким припевом и менее интересными остальными частями. Можно ли рекомендовать её на основе конкретного фрагмента? Автор разделяет пользовательские реакции и описание звучания. Реакции учитываются на уровне целого трека: его лайкают, дослушивают или пропускают. Отдельной цели для припева в ответе не описано.
При этом в системе есть аудиопредставления. Автор осторожно допускает, что они могут учитывать характерные фрагменты записи. Это возможность отразить свойства звучания, а не подтверждение отдельного ранжирования частей трека или точного определения, какой припев понравился человеку. Подробной схемы такого анализа в докладе нет.
Другой вопрос сравнивает короткое прослушивание, например пять секунд, с прослушиванием целиком. Автор подтверждает: учитывается, как долго слушали трек, — и в ранжировании, и через признаки. Но точный порог дослушивания и зависимость обучающего веса от числа секунд не раскрыты. Пять секунд в вопросе являются примером, а не объявленной границей между положительным и отрицательным событием.
Наконец, спрашивают, влияет ли число повторов на веса и метрики. По ответу автора, повторные прослушивания учитываются прежде всего в признаках и статистиках. Цель обучения по-прежнему сравнивает, какой из треков больше понравился в конкретный момент. Накопленные сведения помогают понять, было ли дослушивание случайным — например, человек просто отошёл, — или отражало устойчивый интерес.
Повторы здесь дополняют контекст оценки. Правило умножения целевой метки или веса пары на число повторных прослушиваний не описано; отдельной формулы их вклада в продуктовые метрики тоже нет. Поэтому длительность, повторяемость и вид реакции полезно различать: ответ подтверждает наличие дополнительных сигналов, но не заменяет ими показанную схему обучающих пар.
Доклад · 00:29:07Вопросы: фоновое слушание и старые лайки
Полное отсутствие активных действий не обязательно означает неудачные рекомендации. Человек может учиться или заниматься делами, оставив музыку фоном. Автор говорит об отдельных признаках такого состояния: система пытается понять, стоит ли менять музыку или слушателя всё устраивает. Использованное в ответе выражение «пользователь не в сети» обозначает именно отсутствие действий в этом контексте, а не установленную потерю сетевого соединения.
Ответ подтверждает, что пассивное поведение учитывают, но не задаёт отдельного численного множителя для такого прослушивания. Поэтому нельзя восстановить из него правило, по которому любой трек, звучавший фоном, автоматически получает фиксированно меньшую цель. Это ещё один пример того, зачем тяжёлой модели нужны признаки помимо названия события.
Вопрос о старых лайках касается изменения вкуса со временем. По словам автора, лайки хранят за всю историю, а сами отметки на треках пока учитывают примерно равнозначно. Но вместе с ними смотрят на прослушивания: насколько часто человек слушает эту музыку сейчас и как давно к ней возвращался. Старый лайк не исчезает, однако текущая активность даёт дополнительную информацию о его актуальности.
Автор также допускает редкое напоминание о старой любимой песне ради разнообразия или ностальгии. Это ответ об общей работе рекомендаций, а не разрешение повторять знакомый трек в настройке «Незнакомое». Фиксированное окно хранения лайков или формула уменьшения их веса с возрастом в докладе не приведены; описано сочетание сохранённых предпочтений с текущими прослушиваниями.
Доклад · 00:29:53Вопрос о каверах: одного запрета недостаточно
Кавер или ремикс может пройти формальные проверки незнакомства, но восприниматься как вариация уже известной музыки. Поэтому вопрос о множестве таких записей напрямую связан с исходной проблемой: новый объект каталога не всегда даёт новое впечатление. Автор признаёт, что решение этой задачи на момент доклада ещё находится в разработке.
Он называет несколько направлений: разметку примеров, специальные аудиомодели, которые по звучанию распознают связи между треками, а также названия, тексты и различные эвристики. Команда обучает такие модели и экспериментирует. Завершённый механизм фильтрации, подробности обучающих данных, архитектура и численные результаты не представлены.
При этом запретить все каверы и ремиксы — не то же самое, что улучшить рекомендации. Некоторым пользователям такие записи нравятся, и они хотели бы встречать их даже в «Незнакомом». Значит, требуется не только распознать тип связи между песнями, но и понять, подходит ли такой вариант конкретному слушателю.
Этот ответ уточняет границы всей системы: формальные фильтры и специализированный ранжировщик не завершают работу с воспринимаемой новизной. Отдельно остаётся вопрос, насколько похожая версия известной песни является полезным открытием для данного человека.
Доклад · 00:32:00Вопрос о случайном дизлайке: исправление остаётся за пользователем
Слушатель спрашивает, что происходит, если он случайно нажал дизлайк вместо лайка. По описанию на момент выступления дизлайк исключает трек из любой «Моей волны» с любыми настройками. Это не просто уменьшение оценки внутри ранжирования: такая запись больше не должна попадать пользователю в этот поток.
Автор предлагает исправлять ошибку явно: в интерфейсе можно найти список отмеченных дизлайком треков и снять неверную отметку. Система не пытается самостоятельно искать положительное намерение в таком действии. Снятие дизлайка убирает соответствующий запрет и возвращает возможность рекомендовать трек, но не обещает его обязательного появления в ближайшей выдаче.
Такой ответ отделяет правило доступности от обучающего примера. Условный ноль у дизлайка в иллюстрации объяснял силу отрицательной реакции в паре, а здесь обсуждается поведение продукта после явного запрета пользователя. Описанный способ исправления относится к версии сервиса во время доклада, а не является инструкцией по текущему расположению элементов интерфейса.
Доклад · 00:33:17Итог: открытия требуют согласованного отбора и ранжирования
«Незнакомое» выросло из фильтра в специализированный путь внутри рекомендательного каскада. Дополнительный отбор обеспечил новые направления поиска, тяжёлый CatBoost получил другие приоритеты, а лёгкую модель согласовали с ним через дистилляцию. Обучение по парам реакций и предсказаниям учителя происходит отдельно от обработки запроса. При слушании работает следующая последовательность.
- 01
Контекст запроса
Бэкенд учитывает подписку, регион, устройство и текущую сессию. Рекомендательная часть добавляет предыдущие сессии и заранее подготовленные статистики.
- 02
Отбор кандидатов
Общие источники и путь через похожих неслушанных артистов собирают кандидатов с учётом правил незнакомства. Исходные случайные лайки выбираются заново.
- 03
Лёгкая модель
Специализированный CatBoost оставляет около 3 тыс. треков из порядка 10 тыс., подготавливая подходящий набор для следующей стадии.
- 04
Тяжёлая модель
Другой CatBoost упорядочивает оставшиеся треки по статистикам и предсказаниям дополнительных моделей, учитывая предпочтения слушателя.
- 05
Правила и пачка
Из верхней части списка собирают пять треков с бизнес-ограничениями, например без двух песен одного артиста, и возвращают приложению.
- 06
Запрос после действия
После активной реакции, например лайка, остаток пачки отбрасывают и запрашивают новую с обновлённым контекстом.
Порядок модели оценивают взвешенной точностью пар, а пользовательскую пользу — A/B-тестами. В шаге дистилляции возвращаемость выросла на 1,3%, время прослушивания — на 1,5%. Эти относительные изменения относятся только к «Незнакомому». Четыре улучшения внедрялись последовательно с меняющейся базой; общий эффект не вычисляется, интегральные метрики всей волны статистически значимо не изменились.
Дополнительные замеры подтвердили устранение наблюдавшегося дефицита кандидатов, но не дают гарантии для любых будущих случаев. Новые пользователи требуют отдельного начала, а персональная работа с каверами оставалась в разработке. Результат — проверенный путь улучшения конкретного режима, не универсальное решение всех задач музыкальных рекомендаций.
Доклад · 00:04:29