Разбор готов
Северсталь: как современные CV-подходы решают разные промышленные задачи
На производстве компьютерное зрение редко начинается с модной архитектуры. Сначала есть конкретная цена ошибки: оператору приходится пересматривать ложные срабатывания, плотно лежащие куски материала трудно разделить на отдельные объекты, ручная разметка занимает недели, а редкого аварийного дефекта может вообще не оказаться в данных. В статье Олега Карташева эти проблемы разобраны на нескольких независимых проектах «Северстали». Для конвейерной ленты команда экспериментирует с DETR, для плотной сегментации — со StarDist, для анализа и разметки данных — с DINOv2 и Segment Anything, а для редких дефектов — с диффузионной гармонизацией синтетических изображений. Польза этого разбора — не в списке названий моделей. По каждому кейсу видно, с какого ограничения начиналась работа, что не получилось с первого раза, какие изменения потребовались в данных и обучении и какой результат действительно подтверждён источником. Особенно важно не смешивать эти кейсы в одну «супермодель»: это набор разных инструментов для разных узких мест промышленного CV.
Материал полезен ML/CV-инженерам и тимлидам, которые работают с детекцией и сегментацией в промышленности, готовят разметку, сталкиваются с редкими дефектами или выбирают, где современные foundation- и diffusion-модели реально помогают, а где остаются слишком дорогими или недостаточно точными.
Статья · на русском
Новый взгляд на сталь. Тренды компьютерного зрения на службе металлургииОлег Карташев · Опубликовано: 19 декабря 2024 г.
Промышленный CV начинается с проверенных детекторов
Олег Карташев начинает не с новой модели, а с того, что уже работает в промышленности. По его наблюдению, значительная часть производственного Computer Vision по-прежнему строится вокруг хорошо изученных YOLO, Faster R-CNN и Mask R-CNN. В «Северстали» YOLO применяют в задачах производственной безопасности, а Faster R-CNN и Mask R-CNN — при контроле дефектов поверхности плоского проката. Для автора это не устаревшие решения, а рабочий базовый уровень, который действительно доходит до эксплуатации.
При этом вокруг базового уровня быстро меняется инструментарий. В статьях становится больше трансформерных архитектур; появляются foundation-модели — крупные модели общего назначения, которые можно приспосабливать к разным изображениям и задачам; развиваются self-supervised, few-shot, single-shot и zero-shot подходы. Универсальные модели вроде CLIP, DINOv2 и Segment Anything начинают использовать не только как финальный алгоритм, но и как инструменты анализа данных и автоматизации рутинной работы.
Дальше статья показывает несколько таких переносов по отдельности. Это принципиально: DETR, StarDist, DINOv2, Segment Anything и диффузионная гармонизация решают разные проблемы и не являются стадиями одной промышленной системы.
Вступление: промышленный стек и современные методыКонвейерная лента: хорошая полнота оказалась недостаточной
Первый большой кейс связан с контролем дефектов конвейерных лент. Ранние версии решения использовали Faster R-CNN в реализации Detectron2. По описанию автора, модель давала хорошую полноту — то есть находила большую долю нужных дефектов, — но это достигалось ценой более низкой точности. Оператору приходилось просматривать больше кадров с ложными тревогами. Такой режим опасен не только лишней работой: если человек привыкает к большому числу ложных предупреждений, он может начать отклонять их автоматически.
Если когда-либо перейти от подсказки человеку к автоматической остановке конвейера, цена ложного срабатывания станет ещё выше. Но статья не говорит, что такая автоматическая остановка уже была частью описанной системы или что были измерены реальные ложные остановки. Это сформулировано как более жёсткое будущее требование к точности.
Команда пробовала отсеивать ошибки по физическим размерам объектов и использовать цикличность процесса: один и тот же участок ленты возвращается в поле зрения через несколько минут, поэтому предсказания можно сопоставлять между проходами. Эти эвристики не решили проблему. Модель продолжала реагировать на загрязнения, блики и шумовые структуры, похожие на повреждения.
Первый выбранный рисунок показывает узкую область на поверхности ленты, ошибочно принятую за корд — критичный тип дефекта. Вывод из примера: одной высокой полноты детектора недостаточно, если текстура фона регулярно порождает правдоподобные ложные боксы.
На следующем рисунке выделены длинные ребристые участки похожей структуры. Он объясняет источник части ошибок: модель видела локальный паттерн, похожий на повреждение. Вывод здесь не в том, что любой вертикальный рисунок опасен, а в том, что простые фильтры поверх Faster R-CNN не смогли надёжно отделить такие визуальные совпадения от настоящих дефектов.
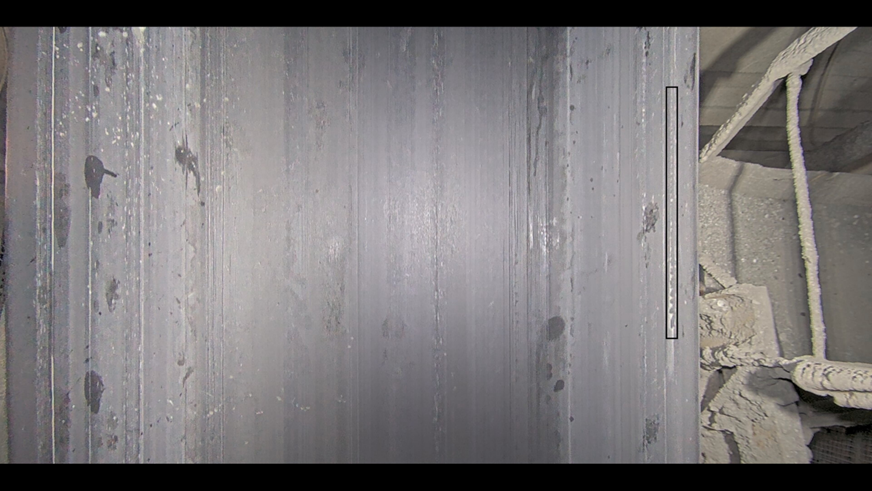
Ложное срабатывание старой модели на повреждение корда. Для этого класса ошибка особенно важна: настоящий дефект требует остановки ленты.
Источник: Северсталь · Олег Карташев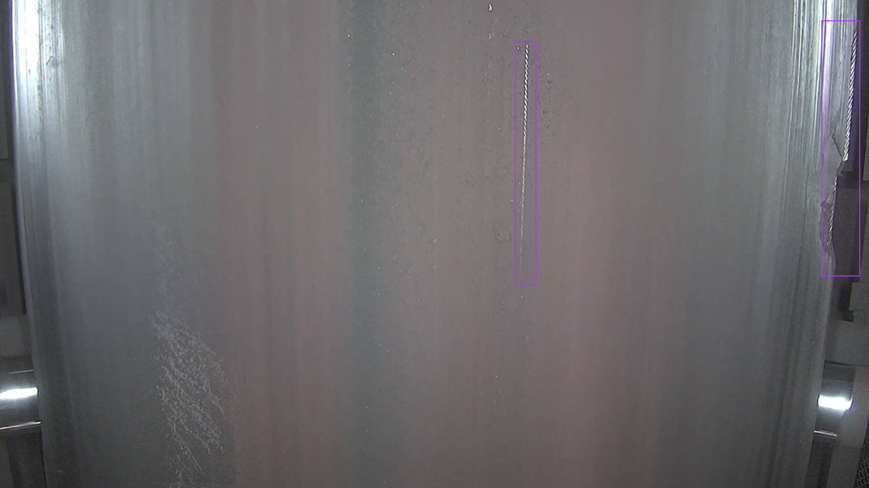
Обучающий пример с ребристой текстурой: сходство таких паттернов с фоном приводило к ложным срабатываниям.
Источник: Северсталь · Олег КарташевПочему попробовали DETR — и где в нём находится венгерское сопоставление
После неудачных внешних фильтров команда решила изменить сам способ детекции и добавить механизм внимания. За основу взяли оригинальный Detection Transformer, DETR. Он рассматривает детекцию как предсказание набора объектов: свёрточная сеть сначала превращает изображение в карту признаков, затем трансформерный энкодер и декодер формируют фиксированный набор предсказаний. Каждое предсказание содержит класс и координаты бокса либо относится к специальному варианту «нет объекта».
Механизм self-attention позволяет строить представления с учётом разных участков изображения и отношений между ними. Это не означает, что отдельная голова внимания обязана всегда соответствовать одному человечески понятному дефекту; карты внимания ниже используются как иллюстрация того, на какие области модель опирается в конкретных примерах.
В исходном тексте статьи венгерский алгоритм упомянут рядом с «фильтрацией и обработкой боксов», что можно прочитать как постобработку инференса. В оригинальной работе DETR это устроено иначе: двудольное венгерское сопоставление входит в set-based функцию потерь при обучении — оно однозначно сопоставляет предсказания объектам разметки перед расчётом loss. Это не отдельная операция обработки кадра после предсказания. Оригинальная работа: https://arxiv.org/abs/2005.12872.
Одна из важных особенностей базового DETR — отсутствие обязательного NMS, то есть процедуры, которая после детектора удаляет перекрывающиеся боксы. Эту архитектурную особенность команда позже использовала как пространство для собственного эксперимента с выходами модели.
Архитектура DETRГотовые веса не помогли: больше 120 часов экспериментов на 2080 Ti
Первая попытка не дала быстрого улучшения. Для старта взяли реализацию и предварительно обученные веса авторов DETR из открытого model zoo Hugging Face. На данных команды качество оказалось заметно хуже Faster R-CNN. Более того, в начале казалось, что обучение почти не идёт: по словам автора, график AP держался около нуля.
Команда продолжила перебирать настройки, и суммарно путь до нормально обучающейся модели занял больше 120 часов на GeForce RTX 2080 Ti. Это важная часть кейса: перенос современной архитектуры в промышленный домен не свёлся к загрузке готового checkpoint и нескольким эпохам дообучения.
На первом графике линия долго растёт на интервале примерно до 120 тысяч шагов, на втором — до примерно 250 тысяч. Однако у приложенных изображений нет подписи оси Y и названия метрики, поэтому по ним нельзя честно утверждать, что конкретное значение AP достигло, например, 49 или 70. Вывод из обоих рисунков уже и надёжнее: обучение было длительным и продолжало заметно меняться далеко не только на первых шагах.
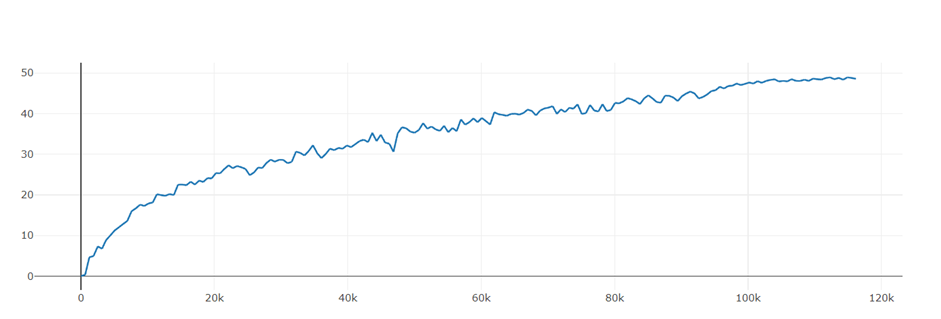
После длительного подбора настроек DETR начал обучаться. Это график из статьи; отдельные подписи осей в исходном рисунке не приведены.
Источник: Северсталь · Олег Карташев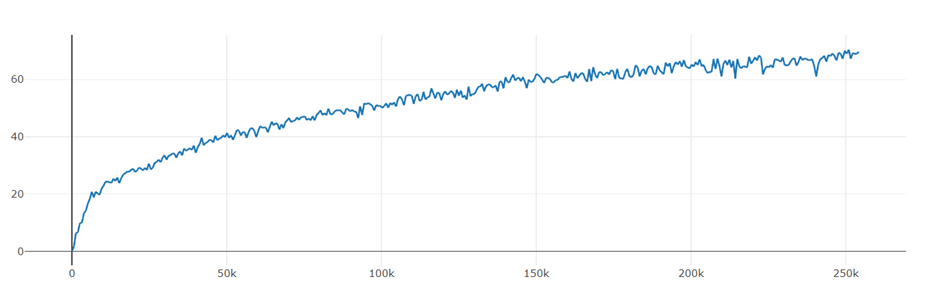
График после дальнейших изменений обучения и данных. Автор связывает улучшение с совокупностью настроек и пересмотром обучающих примеров.
Источник: Северсталь · Олег КарташевСработала не одна настройка: пришлось менять обучение и данные
Сходимость улучшилась после комбинации изменений: подбора размера пакета, learning rate, очень длительного warm-up, отказа от dilated convolutions и собственного предварительного обучения. Для него команда собрала изображения конвейерных лент с разных производств «Северстали», а уже полученные веса использовала как начальную точку финального обучения.
Здесь важно сохранить формулировку источника: речь именно об отказе от dilated convolutions, а не о depthwise convolution. Автор также связывает отказ от dilated convolutions вместе с auxiliary loss с двукратной экономией видеопамяти и двукратным ускорением обучения. В статье не приведена отдельная абляция, поэтому нельзя разложить этот эффект по каждому изменению или вывести универсальную рекомендацию для DETR.
Параллельно переработали данные: убрали лишнюю синтетику и отдельно просмотрели ложные срабатывания. По итогам автор пишет, что удалось обойти их Faster R-CNN ResNet-101 и при этом не потерять в скорости. Численной задержки, FPS или RPS статья не даёт, поэтому сравнение скорости остаётся качественным утверждением команды.
Настройка обучения и подготовка данныхПроверка по классам: DETR выиграл большинство строк, но не все
Сводная таблица по классам позволяет проверить общее утверждение статьи. Ниже сохранены исходные названия вариантов — «DE:TR:» и «Detectron2» — и исходные имена строк. Это F1 по отдельным классам; по этой таблице нельзя отдельно восстановить precision и recall. Для читабельности значения округлены до трёх знаков, сам исходный рисунок при этом остаётся доступен.
Таблицу можно прокрутить по горизонтали.
DE:TR: выше в восьми из десяти показанных строк. Два исключения нужно сохранить отдельно: для cord_F1 у Detectron2 0,818 против 0,800, а для proboyV_F1 — 0,831 против 0,829. Поэтому корректный вывод — улучшение по большинству показанных классов, а не победа новой архитектуры в каждом классе.
Вывод из рисунка важен и методологически: агрегированная формулировка «стало лучше» скрывает разные режимы ошибок. В промышленной задаче критичность классов различается, поэтому поклассовая проверка нужна даже тогда, когда общее направление улучшения выглядит убедительно.
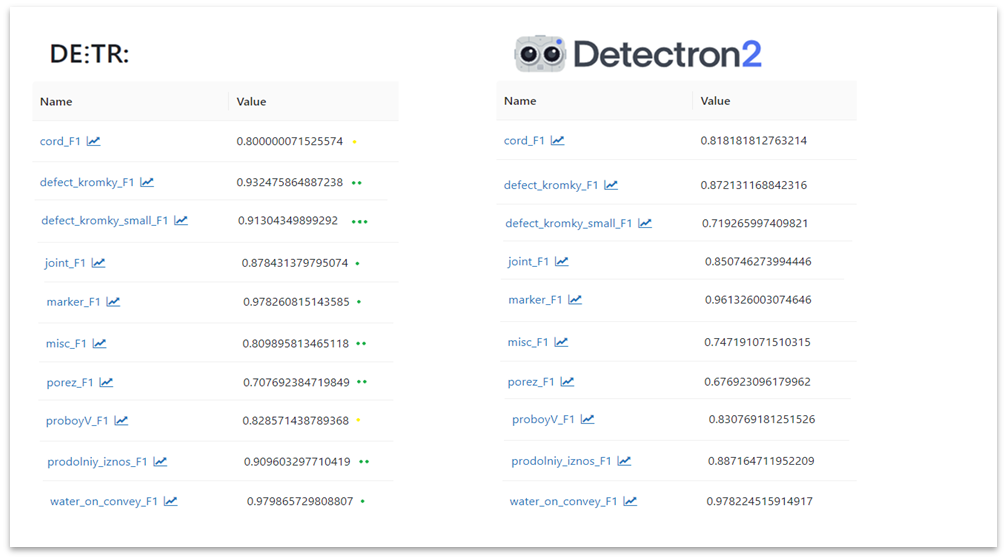
Исходная таблица F1: DE:TR выше в8 из 10строк, но уступает на cord_F1 и proboyV_F1.
Источник: Северсталь · Олег КарташевAttention и объединение боксов: эксперимент команды, а не правило DETR
Автор связывает уменьшение ложноположительных срабатываний с тем, что модель стала лучше отделять настоящие повреждения от похожих текстур. На рисунке с четырьмя query id сверху показаны карты внимания, а снизу — соответствующие области на кадре ленты. Одни запросы концентрируются на узких вертикальных структурах, другой — на горизонтальном участке. Вывод из рисунка: разные объектные запросы действительно могут опираться на разные локальные зоны изображения; сам рисунок не является количественным доказательством уменьшения ошибок.
Дальше команда воспользовалась тем, что в базовом DETR нет обязательного NMS, и добавила собственный этап weighted boxes fusion. Обычный NMS оставляет один из сильно перекрывающихся боксов и подавляет остальные; weighted boxes fusion, напротив, объединяет близкие предсказания. Авторы также решили не отсекать выходы модели заранее по порогу вероятности, а ансамблировать выходы по классам.
Мотивация с классом no-object в статье относится именно к этому эксперименту команды. Из неё не следует универсальное правило, что любой DETR должен сохранять все выходы независимо от no-object или обязательно использовать weighted boxes fusion. Корректнее читать этот фрагмент как попытку использовать доступные выходы модели, чтобы не потерять потенциально полезное предсказание при дополнительной фильтрации.
Есть и терминологическая неоднозначность. В одном месте модель названа «менее чувствительной», при этом «не теряющей в полноте»; позже автор пишет о сохранении «высокой чувствительности» без снижения полноты. Отдельная метрика sensitivity не определена. Поэтому эти слова лучше оставлять качественным описанием поведения и не превращать автоматически в ещё одно численное значение recall.
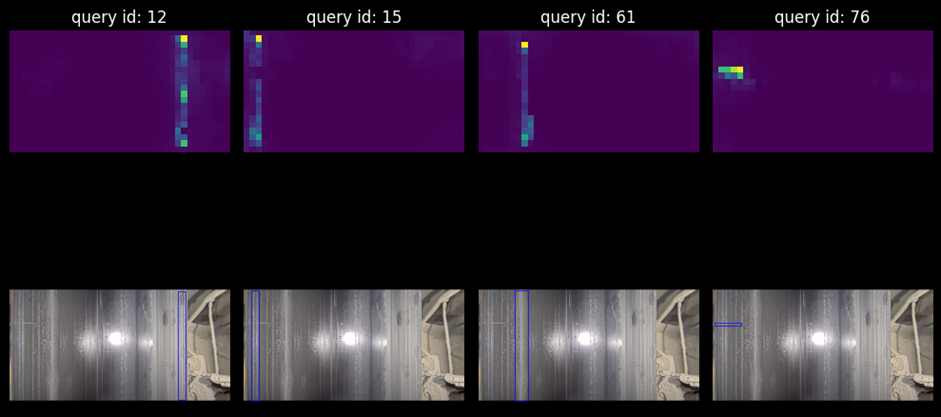
Четыре объектных запроса обращают внимание на разные участки ленты. Рисунок показывает поведение модели, а не отдельную численную оценку качества.
Источник: Северсталь · Олег КарташевОтдельный проект: StarDist для плотно расположенных объектов
Следующий кейс не связан с runtime детектора ленты. Здесь команда переносит в металлургию StarDist — подход, изначально разработанный для сегментации клеток и их ядер на микроскопических изображениях. Проблема похожа геометрически: когда множество объектов лежит вплотную, обычная сегментация может склеить соседние контуры. Автор приводит U-Net++ как пример такого риска. У Mask R-CNN сначала строится бокс, а затем маска внутри него, что в их задаче также могло ухудшать результат.
StarDist описывает объект через расстояния. Поле расстояний помогает разделять уникальные объекты, а набор радиальных расстояний задаёт звёздно-выпуклый контур. В изложении автора радиальная часть также участвует в NMS, чтобы оставить уверенные объекты. Для обучения используются разные представления разметки, а исходную COCO-разметку команда конвертировала в четыре маски: type, instance, dist и stardist.
На выбранном рисунке в каждой строке виден исходный кадр и четыре производных представления. В верхней строке плотные круглые объекты разделены на отдельные области и карты расстояний; в нижней, где целевых объектов практически нет, соответствующие маски пустые. Вывод из рисунка: модель получает не одну бинарную маску, а несколько представлений геометрии и типа объекта.
Для стратифицированного деления датасета команда использовала расстояние Вассерштейна между пиксельными гистограммами классов. Это отдельная операция подготовки данных, а не loss StarDist. Саму модель автор описывает как обучение с пятью функциями потерь, причём их веса заметно влияют на результат; конкретные коэффициенты не приведены. Для извлечения признаков использовали библиотеку timm. SAM упомянут лишь как возможная альтернатива для backbone, а не как сообщённая часть этого решения.
После модели применялось голосование по большинству, чтобы закрывать небольшие «дырки» внутри сегментированных объектов. Постобработка отделена от нейросети и могла выполняться через numba. Автор также сообщает об успешной конвертации в удобные для инференса форматы и работе в half precision без ущерба точности, но не приводит отдельную таблицу скорости или памяти.
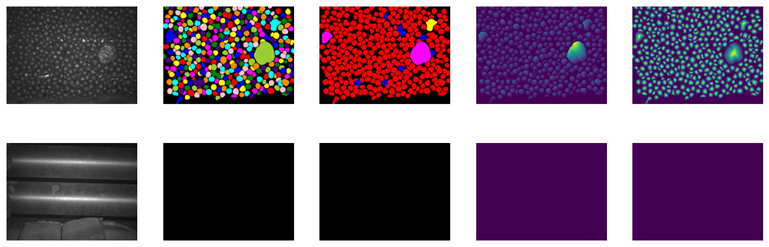
Примеры разных представлений разметки и полей расстояний. Они нужны для обучения StarDist разделять плотно расположенные объекты.
Источник: Северсталь · Олег КарташевDINOv2 помогает не предсказывать, а разбираться в датасете
Следующая задача находится ещё раньше в жизненном цикле модели — нужно понять, из чего вообще состоит датасет. Команда использует Voxel51 для просмотра ground truth и предсказаний, а также для кластеризации изображений по эмбеддингам. В качестве модели представлений здесь выбран DINOv2.
После построения эмбеддингов похожие изображения образуют «островки». Инженер может открыть каждый кластер и решить, нужен ли он в обучении и достаточно ли в нём примеров. В статье названы конкретные находки: отдельный кластер пересвеченных дефектов, небольшой кластер определённого типа повреждения и группа различных вкраплений.
Это пример foundation-модели как диагностического инструмента для данных. Источник не сообщает алгоритм кластеризации, число кластеров или численный прирост качества после такого анализа, поэтому из этого раздела нельзя делать количественный вывод о влиянии DINOv2 на F1.
Анализ датасета с DINOv2Segment Anything сокращает ручную разметку, но не отменяет её
Авторазметка появляется в статье как ответ на очень конкретную рутину: нужно обвести несколько сотен камней на нескольких сотнях изображений. Такую задачу можно отдать human-in-the-loop сервису, попросить эксперта с производства или выполнять силами DS. Во всех трёх вариантах остаются затраты на постановку задачи, проверку результата и ручную работу.
На рисунке с рудой видно, почему задача быстро становится дорогой: кадр почти полностью заполнен камнями разных размеров, формы и взаимного перекрытия. Вывод из изображения: здесь автоматическое получение начальных контуров особенно полезно, потому что ручная работа повторяется для сотен соседних объектов.
Команда использует Segment Anything как помощника разметчика. Сначала датасет можно прогнать через модель и сохранить найденные контуры в COCO или другой формат, совместимый с CVAT. Затем разметку загружают в CVAT v2 и уточняют: добавляют или исключают области, отмечают пропущенные объекты. Segment Anything умеет менять текущую маску по нескольким точкам, поэтому человеку часто не нужно вручную двигать вершины многоугольника.
Режим зависит от плотности сцены. Если целевые объекты занимают почти весь кадр — как руда или окатыши, — автор рекомендует сначала сгенерировать начальную разметку для всего датасета. Если объекты редкие, например люди или отдельные грузы, удобнее начинать с интерактивной разметки с нуля.
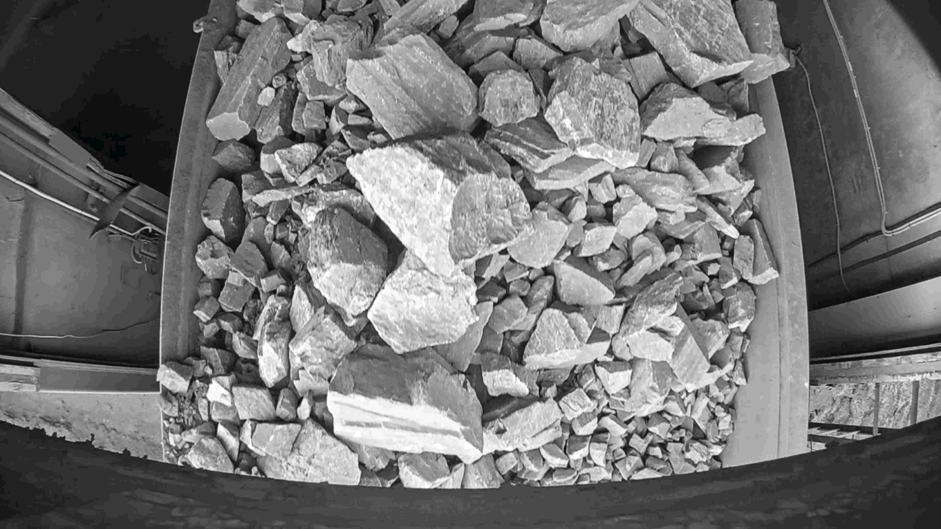
Пример плотного расположения кусков материала: ручная разметка множества объектов требует много времени.
Источник: Северсталь · Олег КарташевПочему Segment Anything не поставили напрямую в промышленный инференс
Сам факт хорошей авторазметки не делает foundation-модель подходящей для рабочего контура. Первая причина у автора — размер и скорость: на карте уровня 2080 Ti обработка одной картинки занимает несколько секунд, тогда как для рассматриваемых задач нужен реалтайм. На производстве GPU может быть слабее, а при редкой частоте кадров иногда выгоднее вообще выполнять модель на CPU.
Вторая причина — доменная точность. Segment Anything не дообучался специально на каждом промышленном дефекте, поэтому ручное исправление авторазметки даёт более надёжный обучающий набор. Третья — контроль данных: DS всё равно должен видеть выбросы и корнер-кейсы, иначе полная автоматизация разметки может скрыть проблемы, которые проявятся уже после запуска модели.
Источник не приводит числовой latency работающей промышленной системы, поэтому «несколько секунд на 2080 Ti» нельзя превращать в точное сравнение с боевым SLA. Здесь важна сама граница применения: SAM ускоряет подготовку разметки, но в описанном кейсе не заменяет специализированную модель реального времени.
Почему SAM не применяют напрямую в реальном времениКогда реального дефекта нет: гармонизация синтетики диффузионной моделью
Ещё один независимый кейс начинается с противоположной проблемы: разметить нечего, потому что нужного изображения нет. Разрыв конвейерной ленты критичен, но команда могла не иметь ни одного примера того, как такой порыв выглядит именно под установленными камерами. Обычный oversampling не создаёт нового визуального разнообразия, а простой copy-paste автор связывает с переобучением.
Идея — взять Stable Diffusion и адаптировать часть, отвечающую за guidance, обучая только её для задачи гармонизации. Сначала дефект грубо вставляют на новое фоновое изображение и передают модели также маску вставленной области. Задача не «нарисовать дефект из текста», а сделать уже вставленный фрагмент визуально согласованным с новым окружением.
Схема на первом рисунке показывает Stable Diffusion с encoder, U-Net и decoder, а также дополнительные обучаемые компоненты для объединения признаков и набор функций потерь. Вывод из схемы: гармонизация добавляет условную обработку исходного изображения и маски к диффузионной основе; это не общая архитектура, объединяющая DETR, StarDist и остальные проекты статьи.
Рабочая последовательность у автора такая: выбрать изображение и маску исходного дефекта; выбрать целевое изображение и новую маску; наивно вставить дефект; пропустить получившийся участок через модель. Если видеопамяти мало, можно обрабатывать только окно 512×512 вокруг нового дефекта, а затем вклеивать гармонизированный фрагмент обратно.
Второй рисунок иллюстрирует именно такую подготовку: рядом показаны кадры ленты и узкая маска области, куда переносится дефект. Вывод из примера: положение нового повреждения задаётся явно маской, а модель отвечает за согласование вставленного фрагмента с фоном, а не за поиск места дефекта в этом изображении.
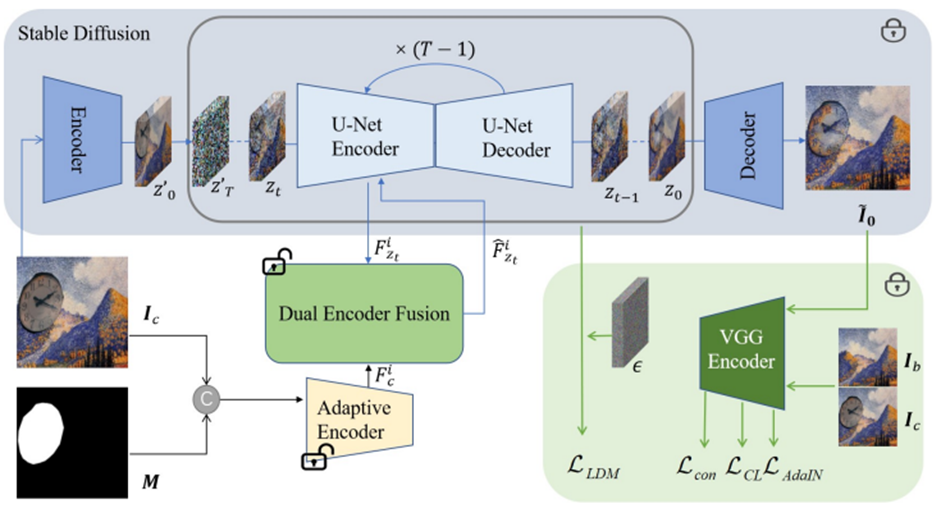
Схема гармонизации из исходной статьи: дополнительная условная ветка согласует вставленный объект и его маску с фоном. Это метод синтеза обучающих изображений.
Источник: Северсталь · Олег Карташев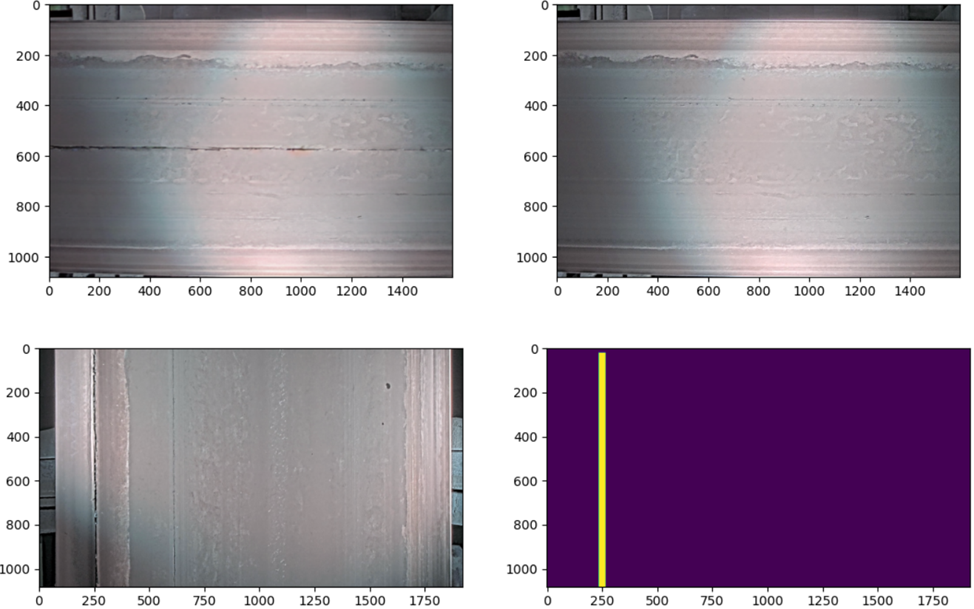
Сверху — результат вставки и согласования дефекта с целевым кадром; снизу — кадр, откуда взят дефект, и его маска.
Источник: Северсталь · Олег КарташевСинтетика проверяется только на реальных данных
Сначала автор показывает качественный пример крупным планом. На рисунке три X-образных повреждения; в тексте прямо уточнено, что синтетический пример находится посередине. Вывод из рисунка ограниченный, но полезный: после гармонизации центральный дефект визуально похож на два реальных. Это иллюстрация правдоподобия, а не измерение качества детектора.
Количественную проверку проводят иначе: тестовый набор состоит только из реальных данных. Автор сравнивает обучение на реальных данных, на синтетике и на смеси. Для чистой синтетики на исходном радаре сравнения есть точки на радаре, но рядом с ними нет числовых подписей, поэтому значения нельзя восстанавливать по положению маркеров.
Таблицу можно прокрутить по горизонтали.
Смесь улучшает все три подписанные метрики относительно обучения только на реальных данных. Для F1 разница между 80,27 и 73,42 равна 6,85 в шкале рисунка; в тексте автор округляет эффект и формулирует его как «25% синтетики добавляет еще 7 пунктов к F1». Это согласованные описания одного результата, а не две разные метрики.
Вывод из радара нужно ограничивать условиями эксперимента: тест — реальный, а смесь содержит 25% синтетики. Размер теста, доверительные интервалы и статистическая значимость не приведены. Числа чисто синтетического варианта также не подписаны, поэтому корректно сохранить только качественный вывод автора: на чистой синтетике результат хуже, чем на реальных данных, а добавление синтетики к реальным оказалось полезным.
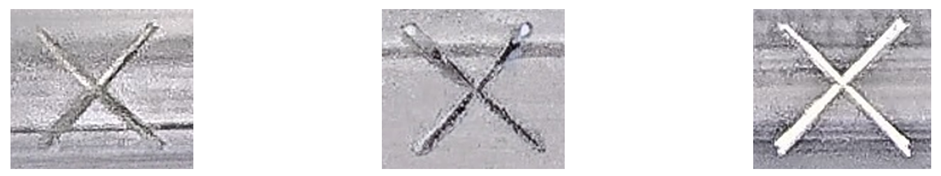
Синтетический дефект находится посередине. Это качественная иллюстрация, отдельно от измерения качества детектора на реальных данных.
Источник: Северсталь · Олег Карташев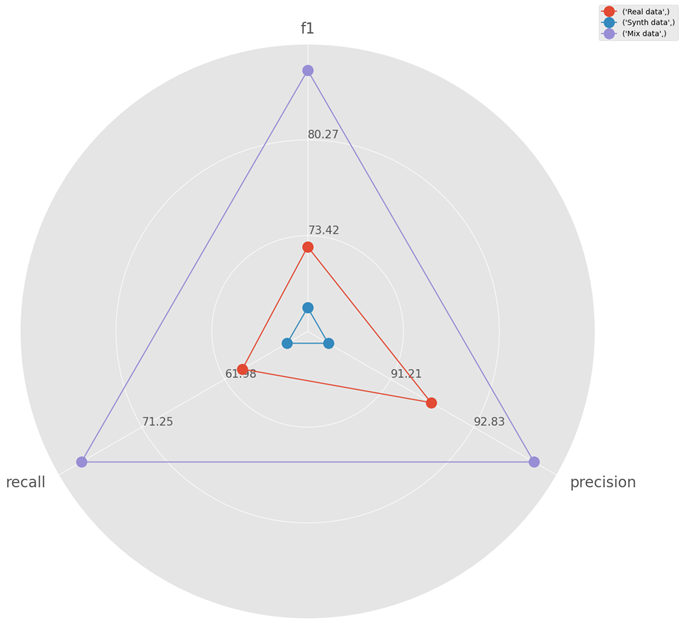
Оценка на реальном тесте: F1 73,42 для реальных обучающих данных и 80,27 для смеси с 25% синтетики. Числа для чистой синтетики не подписаны.
Источник: Северсталь · Олег КарташевГраницы внедрения: что статья действительно показывает
Кейсы объединяет промышленный контекст, но степень готовности у них разная. Для классических YOLO, Faster R-CNN и Mask R-CNN автор прямо говорит о рабочем применении. Для DETR показаны длительное обучение, поклассовые F1 и эксперимент с дополнительным объединением боксов; численной задержки или экономического эффекта нет. Для StarDist сообщаются конвертация и half precision, но нет таблицы производительности. Segment Anything используется прежде всего для разметки, потому что прямой инференс слишком медленный для описанных realtime-задач.
Диффузионная модель решает задачу подготовки данных: создаёт более реалистичные редкие дефекты и оценивается через качество последующей модели на реальном тесте. Это не означает, что diffusion-модель находится в онлайн-контуре детектора конвейера.
Также источник не описывает predictive maintenance в строгом смысле — прогноз будущей поломки, остаточного ресурса или момента обслуживания. Речь идёт о визуальном обнаружении текущих дефектов, уменьшении ложных тревог, сегментации, подготовке разметки и расширении обучающих данных. Называть эти кейсы «предсказательным обслуживанием» без такой оговорки было бы расширением исходника.
В финале упомянута готовая разработка «Северсталь-инфоком» для контроля качества поверхности металлопроката, но статья не связывает её однозначно с DETR, StarDist, Segment Anything или Stable Diffusion. Поэтому её нельзя использовать как доказательство того, что все показанные эксперименты уже объединены и внедрены в один продукт.
Применение современных методов на производствеИтог: современные модели полезны там, где понятно конкретное ограничение
Статья показывает не замену всего промышленного CV одной новой архитектурой, а несколько точечных переносов современных методов. В детекции конвейерной ленты причиной изменения стали ложные срабатывания Faster R-CNN: внешние фильтры не помогли, а DETR потребовал долгого подбора обучения, собственного претрейна и переработки данных. По показанной таблице F1 новая модель лучше Detectron2 в большинстве, но не во всех классах. Эксперимент с weighted boxes fusion — дополнительный приём команды, а не обязательная часть DETR.
- 01
Кадр ленты
Модель получает изображение участка конвейерной ленты, на котором нужно найти дефекты и служебные визуальные объекты.
- 02
Свёрточные признаки
Свёрточная часть превращает изображение в карту признаков, сохраняя информацию о локальных структурах и текстурах.
- 03
Трансформерные предсказания
Энкодер и декодер DETR формируют набор объектных предсказаний: класс или no-object и координаты предполагаемого бокса.
- 04
Объединение выходов по классам
В эксперименте команды выходы дополнительно ансамблируются по классам с weighted boxes fusion вместо раннего отсечения всех слабых вариантов.
- 05
Итоговые боксы
После объединения система возвращает координаты боксов и классы найденных объектов.
Остальные решения относятся к другим этапам. StarDist помогает разделять плотно расположенные объекты и требует собственных масок, лоссов и постобработки. DINOv2 используется для анализа структуры датасета, а Segment Anything — для ускорения разметки с последующей ручной правкой. Диффузионная гармонизация решает дефицит редких дефектов: при тестировании только на реальных данных смесь с 25% синтетики дала около семи пунктов F1. Для DETR-кейса статья описывает получение боксов и классов, но не включает в этот runtime автоматическую остановку оборудования или выдачу команды оператору. Общий урок источника — выбирать современный метод под конкретное ограничение и проверять его на своих данных, не подменяя отдельный измеренный эффект обещанием универсальной промышленной системы.
Итог нескольких промышленных кейсов