Разбор готов
Kandinsky 4.0: данные, видеодиффузия и быстрая версия модели
Нужно получить ролик до 12 секунд в HD 1280×720 по текстовому описанию или стартовой картинке. Для такой задачи мало выбрать сильный трансформер: видеоданные занимают петабайты, длинные последовательности не помещаются в обычное полное внимание, загрузка файлов может оставлять GPU без работы, а десятки шагов диффузии делают генерацию медленной. В Kandinsky 4.0 команда Сбера решала все эти проблемы вместе: строила конвейер данных, выбирала архитектуру MMDiT, меняла схему обучения для HD, ускоряла загрузку и распределённое обучение, а затем дистиллировала модель в быструю Flash-версию. В главе разберём также I2V, генерацию звука и то, как авторы измеряли качество.
Материал полезен ML- и CV-инженерам, которые хотят увидеть полный путь видеогенеративной модели: от отбора данных и распределённого обучения до ускоренного инференса и человеческой оценки. Особенно полезен разбор того, где красивые автоматические метрики перестают быть достаточным ориентиром.
Статья · на русском
Kandinsky 4.0 — новая модель генерации видеоVArkhipkin · Опубликовано: 13 декабря 2024 г.
От Kandinsky Video к мультимедийному семейству
Kandinsky 4.0 продолжает линию Kandinsky 3.0 и первой российской text-to-video модели Kandinsky Video, показанных на AI Journey 2023. Весной 2024 года появились Kandinsky 3.1 с улучшенным качеством изображений и Kandinsky Video 1.1 с улучшенными визуальным качеством и временной связностью кадров. В новом поколении авторы объединяют несколько связанных задач: генерацию видео по тексту, быструю генерацию, продолжение стартовой картинки и генерацию звука по видеоряду. Для основной видеомодели заявлены ролики длительностью до 12 секунд в HD 1280×720 и поддержка разных соотношений сторон.
Предыстория в статье нужна, чтобы объяснить выбор архитектурного направления. Визуальная генерация постепенно смещалась от U-Net-подобных схем к трансформерам: авторы упоминают U-ViT, MAGVIT и MAGVIT-v2, VideoPoet, DiT, W.A.L.T., Latte и MMDiT из Stable Diffusion 3. Затем перечисляются новые видеомодели на основе diffusion transformer: Gen-3, Dream Machine, Open-Sora, Open-Sora-Plan, Mochi-1, Allegro и CogVideoX.
Числа из этого обзора относятся к чужим работам, а не к данным Kandinsky. W.A.L.T. обучалась на 970 млн пар «изображение — текст» и 89 млн пар «видео — текст». Movie Gen описана как 30-миллиардная видеомодель с отдельной 13-миллиардной аудиосистемой. Для Hunyuan Video авторы приводят требование GPU с 80 ГБ памяти для качественного инференса. Эти значения нельзя использовать как размер обучающего корпуса или конфигурацию Kandinsky.
Последние достижения в области мультимедийной генерацииПочему данные хранят отдельно от их метаданных
Видеодатасет здесь — не одна папка с файлами, а система обработки. Сами изображения и видео лежат в S3: объёмы исчисляются петабайтами. Пути к файлам, метаданные, статусы обработки, оценки фильтров и синтетические описания хранятся в SQL-базе. Через неё рабочие процессы получают очередную порцию данных и записывают результаты. Такой разнос позволил авторам масштабировать подготовку на сотни видеокарт и выбирать подмножества датасета по фильтрам для разных стадий обучения.
Общий путь видео состоит из четырёх больших этапов: сначала найти и скачать исходники; затем разрезать видео на сцены и выполнить дешёвую первичную обработку; после этого посчитать более тяжёлые фильтры; наконец, сгенерировать подробные текстовые описания. Изображения проходят похожий путь, но без разбиения на сцены и оценки динамики.
На общей схеме ветка видео подписана как CPU video filters, однако текст следующего этапа прямо описывает подсчёт сценовых метрик множеством GPU-нод. Поэтому подпись рисунка не стоит читать как утверждение, что все фильтры сцен выполняются на CPU: статья сама разделяет ранние дешёвые операции и последующий GPU-этап.
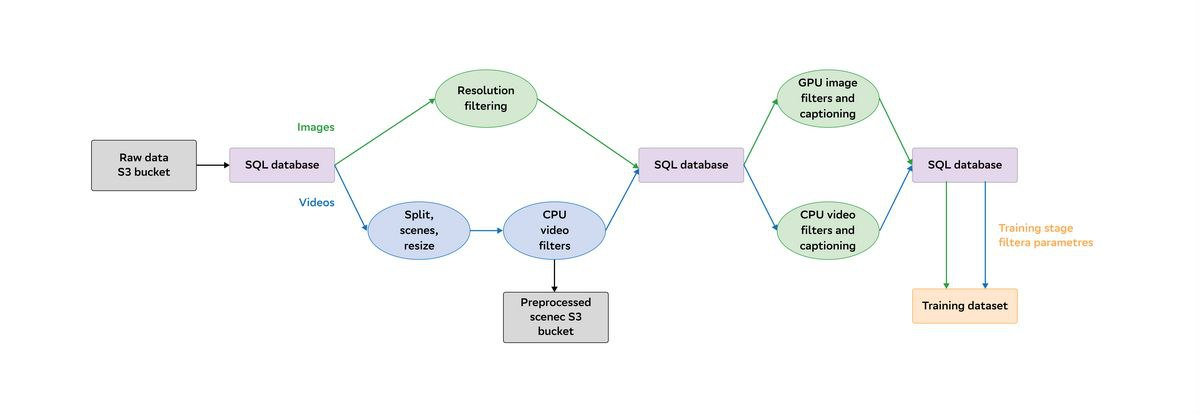
S3 хранит файлы, SQL — статусы и метрики. В тексте фильтрация сцен выполняется на GPU; подпись CPU video filters на схеме не совпадает с этим описанием.
Источник: Оригинальный материалСбор сырых данных и российский культурный код
Обработать весь доступный видеоконтент невозможно по времени и вычислительному бюджету, поэтому отбор начинается ещё до скачивания. В зависимости от источника команда использует разрешение, битрейт, класс контента и пользовательские теги. Уже на этой стадии выполняется первичная дедупликация по метаданным. Данные собирались и автоматически, и вручную.
Ручной сбор понадобился для узких тем и сущностей, которые автоматические источники покрывают плохо: избранных материалов российского и СНГ-фильмофонда, исторических символов и персонажей, мультгероев, редких музыкальных инструментов, старых городов, пейзажей и обрядов. Авторы называют этот набор тем российским культурным кодом. Сначала они определили недопредставленные категории, а затем целенаправленно добирали материал именно по ним.
На примерах видно, зачем понадобилась ручная работа: подпись должна не просто сказать «женщина у окна» или «старое здание», а назвать характерные детали сцены и культурно специфические объекты. Для таких доменов автоматические VLM могли не знать нужных сущностей или видеть их слишком редко в собственном обучении.
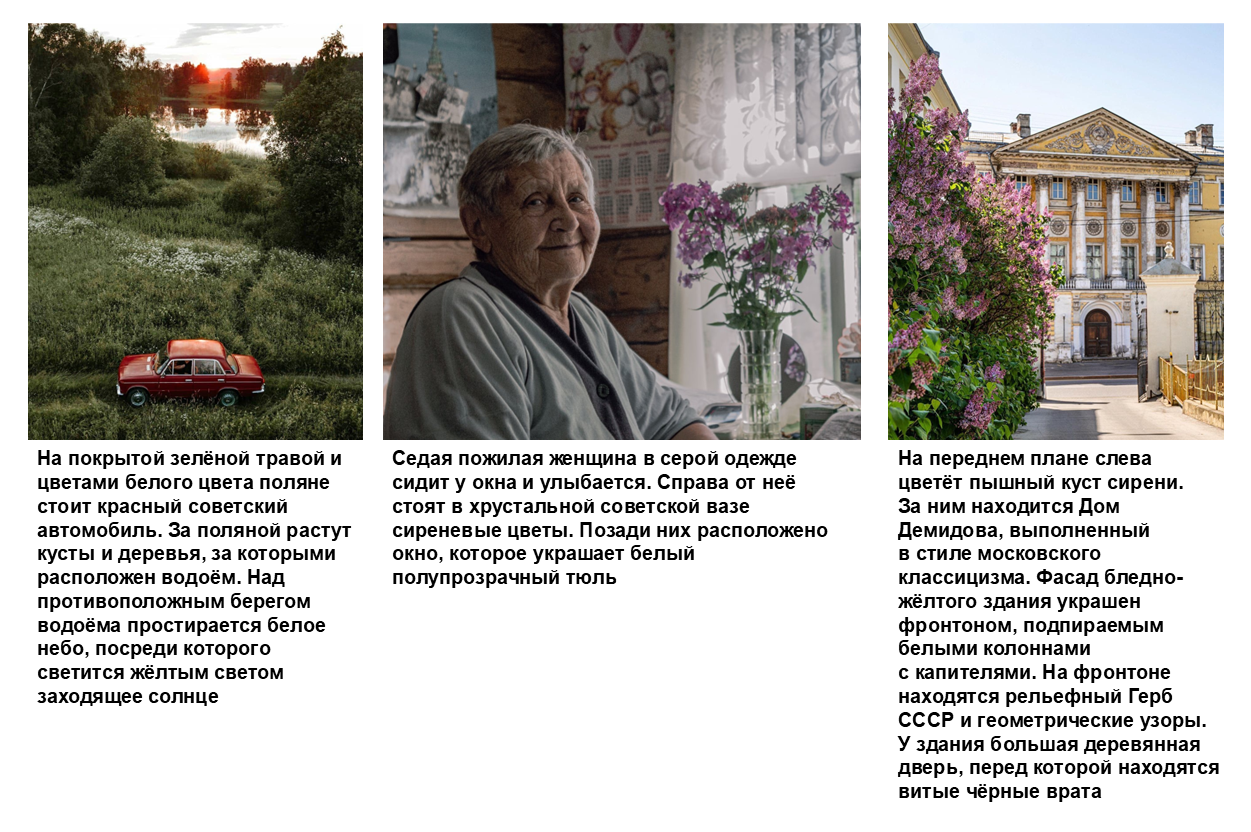
Примеры ручных описаний российского культурного кода, где автоматические модели справлялись хуже.
Источник: Оригинальный материалРазбиение видео на сцены и дедупликация
Сырые ролики делят на сцены библиотекой PySceneDetect. Видео читается последовательно по кадрам, а адаптивные метрики оценивают не только разницу между соседними кадрами, но и то, как эта разница меняется в небольшой окрестности. Сцены короче 2 секунд удаляются, а сцены длиннее минуты дробятся: в обучение идут последовательности примерно от 2 до 60 секунд.
Порог смены сцены подбирали на нескольких тысячах коротких видео, которые анализировали разметчики. Цель — не пропускать реальные переходы, но и не резать один эпизод на слишком короткие куски. Особенно много ложных срабатываний команда наблюдала на динамичных чёрно-белых видео, при мерцании света и в роликах с искусственно повышенным FPS.
Пока файл и так читается покадрово, выполняются дешёвые проверки: оценивается яркость, отбрасываются слишком тёмные и слишком светлые сцены, обрезаются чёрные поля. Слишком высокое разрешение уменьшается до FullHD, FPS выше 30 понижается, а чрезмерный битрейт при необходимости перекодируется. Для каждой сцены вычисляется 64-битный perceptual video hash — короткий отпечаток визуального содержимого для поиска дублей.
При дедупликации проверяется не только полное совпадение hash, но и сцены, отличающиеся на 1–2 бита. В статье индекс назван HNSV. В официальной документации pgvector соответствующий приближённый графовый индекс называется HNSW, а для битовых векторов документирован класс bit_hamming_ops: официальная документация pgvector. Поэтому здесь используем название HNSW. Это уточнение названия структуры, а не дополнительное утверждение о деталях реализации команды.
SQL-база здесь одновременно хранит состояние обработки и играет роль очереди: каждая CPU-нода получает свою порцию исходных видео, а после завершения обновляет статус. Так нарезку и раннюю фильтрацию можно масштабировать на большое число машин без единого последовательного процесса.
Разделение сырых видео на сценыGPU-фильтры и участие разметчиков
После нарезки множество GPU-нод получают сцены через базу и записывают обратно рассчитанные метрики. Если один процесс или одна GPU-нода падает, остальные продолжают работу. Хотя сами сцены лежат в более медленном S3, фоновые загрузчики подкачивают данные заранее, чтобы вычислители не простаивали.
За основу взяли DataProcessingFramework, но загрузку и выполнение фильтров переписали под конкретную задачу. Универсальность стала ниже, зато конвейер лучше использовал ресурсы. На этой стадии измеряются водяные знаки, динамичность, техническое и эстетическое качество, наличие и площадь текста, а также семантическая и визуальная сложность кадра.
Фильтры расположены так, чтобы очевидно плохой пример прекращал путь как можно раньше. Например, статичная сцена или видео с большим количеством текста может быть отброшено сразу после соответствующей проверки, не запуская остальные модели. Для изображений схема похожа, только метрика динамики не нужна.
Люди участвовали не только в финальной оценке модели, но и в настройке самого отбора данных. Несколько тысяч видео разметили по интенсивности движения. Это позволило заменить дорогую оценку динамики через оптический поток более лёгким методом, который, по словам авторов, имел сопоставимую корреляцию с человеческими оценками. Такая формулировка говорит о сравнении сигналов, но не доказывает причинно, что более лёгкий фильтр сам по себе улучшил итоговую генерацию.
Обработка и фильтрация сценСинтетические описания и ручная разметка сложных доменов
Реальные подписи из интернета обычно слишком короткие или неточные для обучения text-to-video. Поэтому для изображений и видео команда генерирует новые подробные описания с помощью визуально-языковых моделей — VLM. Авторы подчёркивают, что качество caption напрямую влияет на динамику обучения и итоговое поведение видеомодели, поэтому модель-аннотатор приходится выбирать отдельно.
Для сравнения captioning-моделей команда сделала собственную шкалу и тестовый набор. Описание одного и того же видео оценивали несколько людей, после чего ответы агрегировали методом Dawid–Skene. Название метода происходит из работы A. P. Dawid и A. M. Skene 1979 года «Maximum Likelihood Estimation of Observer Error-Rates Using the EM Algorithm»: Dawid и Skene, 1979. Статья Kandinsky не указывает, какой программной реализацией этого метода пользовалась команда.
Для российского и постсоветского культурного кода VLM оказалось недостаточно: нужные сущности могли отсутствовать в её обучении или встречаться редко. Поэтому такие подписи составляли вручную, обычно на 200–650 символов, отдельно подчёркивая ключевые объекты и признаки домена.
Генерация синтетических описанийЧетыре модели Kandinsky 4.0
Kandinsky 4.0 в статье — не одна сеть, а семейство из четырёх моделей. T2V генерирует видео по тексту, T2V Flash решает ту же задачу быстрее, I2V продолжает стартовую картинку, а V2A создаёт звуковое сопровождение по видеоряду. Дальше важно не смешивать их обучение и оценки: например, V2A имеет собственный набор данных и отдельный SBS-тест.
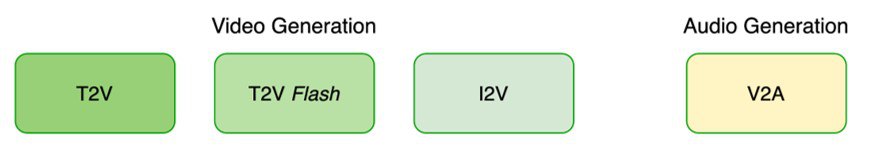
Три модели видео — T2V, T2V Flash, I2V — и отдельная V2A для звука.
Источник: Оригинальный материалT2V: зачем нужна латентная диффузия
Основная видеомодель работает не прямо с пикселями, а со сжатыми представлениями — латентами. Такой подход называется латентной диффузией. Отдельный вариационный автокодировщик, VAE, сжимает видео; текстовый энкодер превращает промпт в числовые представления; основная диффузионная сеть получает зашумлённый видеолатент и учится восстанавливать добавленный шум.
На иллюстрации латентного конвейера внутри центральной ветки написано CogVideoX-DiT. Эту подпись нельзя переносить на собственный генератор Kandinsky: из CogVideoX здесь заимствован VAE, а архитектуру основной сети авторы дальше выбирают отдельно и описывают как MMDiT.
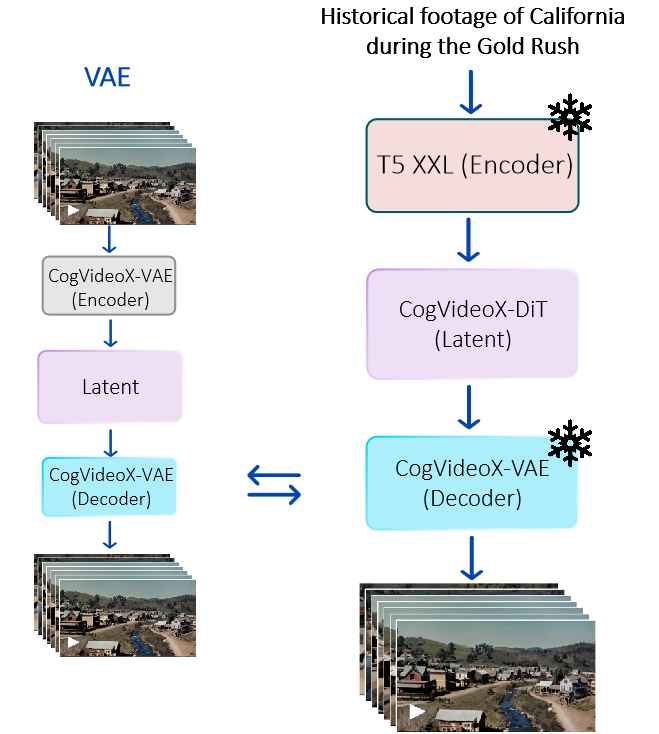
Иллюстрация латентной диффузии с подписями CogVideoX. Kandinsky заимствует VAE, а собственный генератор использует MMDiT; CogVideoX-DiT на рисунке не является точным названием этого генератора.
Источник: Оригинальный материалПочему выбрали MMDiT и как устроено внимание
UNet-подобные варианты команда отбросила в начале из-за проблем с масштабированием. Дальше сравнивали четыре трансформерные схемы: DiT с перекрёстным вниманием (cross-attention), где текст подключается к визуальным признакам отдельным механизмом; WALT-подобный DiT с отдельной обработкой пространства и времени; DiT с причинным вниманием (causal attention); и MMDiT из Stable Diffusion 3.
Два варианта оказались неудачными именно как видеомодели. Causal DiT и WALT-like DiT лучше выглядели в картиночном домене, но их видео напоминали анимированные изображения: отдельный кадр мог быть хорошим, а настоящей временной динамики не хватало. DiT с cross-attention и MMDiT на низких разрешениях показывали примерно одинаковое качество. MMDiT выбрали потому, что без отдельного cross-attention-блока она требовала меньше памяти для активаций.
В MMDiT текстовые и визуальные токены проходят совместное self-attention — механизм, в котором элементы одной объединённой последовательности могут учитывать друг друга. Время шага диффузии влияет на блоки через adaptive LayerNorm. Позицию визуальных токенов задаёт трёхмерное вращательное позиционное кодирование RoPE 3D, которое добавляется непосредственно перед attention.
Ранние версии использовали разные веса для текстовых и визуальных токенов в attention и feed-forward. Позже параметры сделали общими. Это уменьшило размер модели, а заметного замедления сходимости авторы не увидели.
Полное внимание на HD-видео слишком дорого: каждый визуальный токен должен взаимодействовать со всеми остальными. Поэтому команда чередует локальную сетку внимания и глобальную сетку, вдохновляясь block attention и grid attention из MaxViT. В 480p на этапе обучения использовали полное внимание, а при переходе к HD — local/global-блоки.
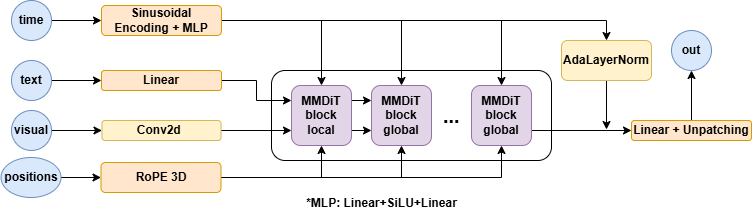
Собственная архитектура Kandinsky: текст, видеолатенты и время, RoPE 3D и чередование локальных и глобальных MMDiT-блоков.
Источник: Оригинальный материал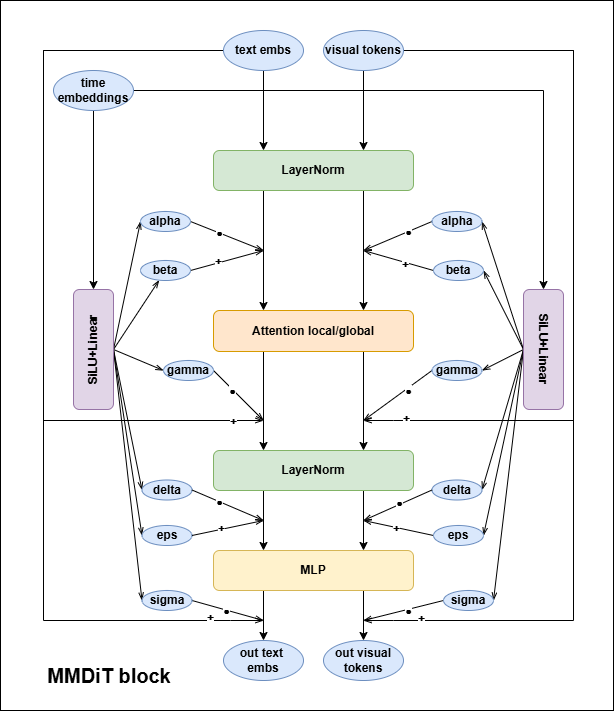
MMDiT: текст и визуальные токены обрабатываются совместным вниманием с адаптивной нормализацией по времени.
Источник: Оригинальный материал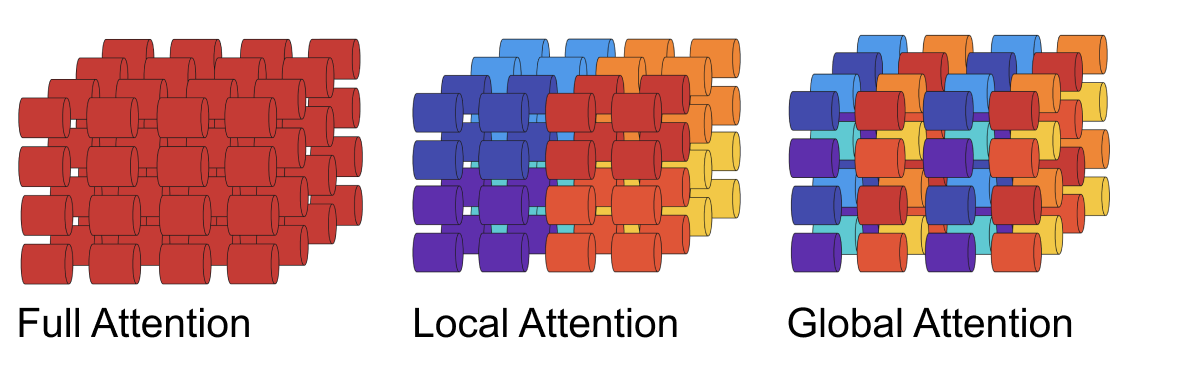
Полное, локальное и глобальное внимание. Для HD чередуют два последних вида.
Источник: Оригинальный материалОбучение T2V: от 480p к HD
Учебная задача стандартна для диффузии: к латентному представлению видео добавляют шум, а модель предсказывает этот шум. В одном обучении смешиваются пакеты видео разной длины и изображения. В выборке есть разные соотношения сторон, поэтому модель учится работать не только с одним фиксированным форматом. С некоторой вероятностью текстовое условие убирают полностью. Это даёт безусловный прогноз, который затем используется в classifier-free guidance — приёме, где условный и безусловный прогнозы смешивают, чтобы сильнее следовать промпту.
Разрешение повышали постепенно. На 480p сеть обучали с полным вниманием. В HD перешли на чередование local и global attention и одновременно изменили расписание шума через timestep shifting: середина диффузионного процесса получает относительно больше шагов, чем края. Авторы связывают это с более детальными результатами на высоком разрешении и применяют сдвиг как на обучении, так и при HD-генерации.
В статье не сообщается полный размер T2V-датасета, число GPU, использованных для всего обучения, стоимость обучения или общий training FLOPs. Эти величины нельзя восстанавливать из размеров культурного поднабора, времён Flash или числа параметров модели.
Kandinsky 4.0 T2V / ОбучениеКак не оставить GPU ждать данные
Даже закодированный набор данных оказался больше всего доступного горячего NFS. Поэтому данные идут каскадом: S3 → NFS-буфер и очередь → параллельная загрузка и подготовка → RAM-буферы по соотношению сторон → VRAM. После чтения видео в оперативную память его копия на NFS удаляется. Эта схема относится к обучению, а не к обработке пользовательского запроса.
Для каждого соотношения сторон есть свой RAM-буфер. Он наполняется, пока суммарное число латентных кадров не достигнет 25; после этого из буфера формируется пакет для модели. Благодаря нескольким независимым очередям обучение обычно может взять уже готовый пакет, не дожидаясь нужного формата с S3 или NFS.
Вторая проблема появилась при data parallelism, включая FSDP. Если одна GPU получила короткое видео, а другая длинное, первая заканчивает вычисления раньше, но всё равно ждёт синхронизации. Команда отказалась от требования складывать в батч только ролики одинаковой длины и стала склеивать разные видео вдоль времени так, чтобы итоговый временной объём пакета на всех GPU совпадал. По данным авторов, это увеличило пропускную способность обучения в 2,6 раза по числу обработанных видео.
Дополнительно применялись FSDP, Activation Checkpointing и Flash Attention. FSDP распределяет параметры и состояния между устройствами, checkpointing экономит память ценой повторного пересчёта части активаций, а Flash Attention ускоряет и удешевляет по памяти само внимание. Для генерации, уже после обучения, использовался Tensor Parallelism; в конфигурации авторов он давал примерно 4-кратное ускорение. Эти 2,6× и ~4× относятся к разным стадиям и не складываются в один общий коэффициент.
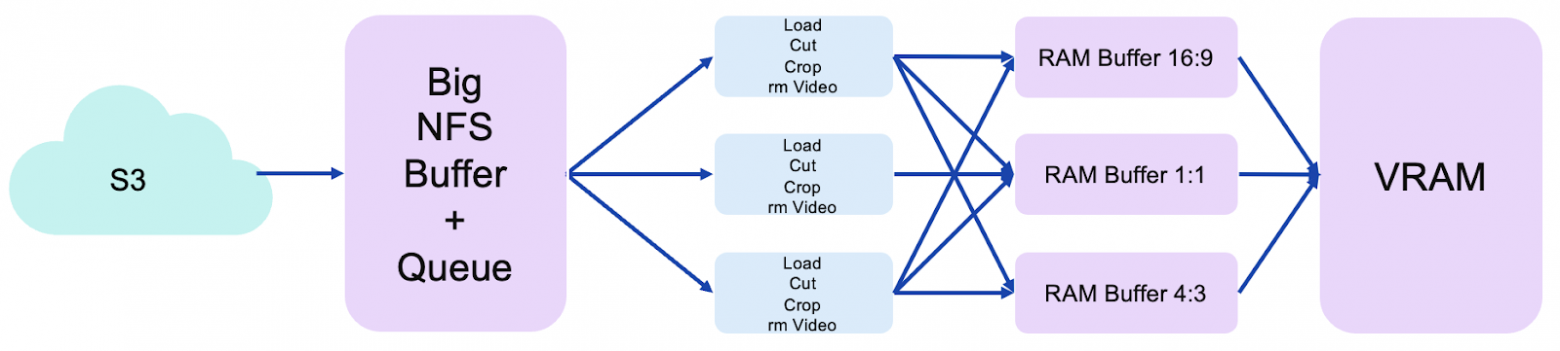
Данные обучения проходят S3 → NFS и очередь → RAM-буферы по соотношению сторон → GPU. Это не путь пользовательского запроса.
Источник: Оригинальный материалЧто отслеживали во время обучения
Большой трансформер может обучаться нестабильно, поэтому команда логировала нормы весов и градиентов, scale-фактор в attention и активации. Параллельно автоматически считались CLIP, FID, UMTFVD, UMTScore, GenEval, VBench и validation loss отдельно для изображений и видео.
Авторы называют валидационным набором случайно выбранные изображения и видео из обучающего набора. Из публикации неясно, исключались ли конкретно эти примеры из фактического потока оптимизации. Поэтому его нельзя уверенно называть независимым holdout, но также нельзя по одному этому описанию объявлять доказанную утечку.
Практический вывод статьи важен: на ранних стадиях внешние автоматические метрики помогали выбирать архитектуру, но позже, особенно на высоком разрешении, почти перестали меняться. На поздних стадиях наиболее информативными для команды оказались validation losses. Это наблюдение авторов для данного обучения, а не универсальное правило о бесполезности CLIP, FID или VBench.
Kandinsky 4.0 T2V / ОбучениеT2V Flash: дистилляция через LADD
Полная T2V-модель требует 50 шагов обратной диффузии. При classifier-free guidance на каждом шаге MMDiT вычисляет условный и безусловный прогнозы, поэтому в статье это описано как 50 проходов с batch size 2. Для видео такая цена особенно заметна, и команда строит отдельную быструю модель через Latent Adversarial Diffusion Distillation — LADD.
Идея LADD — превратить дистилляцию в состязательное обучение. Модель-ученик (student) учится за малое число шагов выдавать латент, который дискриминатор принимает за настоящий. В роли основы дискриминатора используется предобученная диффузионная сеть: её backbone заморожен, обучаются только дискриминативные головы. Голова похожа на упрощённую часть MMDiT и видит не только визуальные признаки, но и текстовое условие и уровень шума t, поэтому может учитывать соответствие промпту.
Стабилизировать GAN-подобную схему оказалось сложно. Авторы отказались от Wasserstein loss, который в их постановке потребовал бы дополнительной регуляризации вроде R1, и взяли среднеквадратичную ошибку (MSE) из Flash Diffusion.
Потеря студента: его результат должен получить от дискриминатора цель 1.
Потеря дискриминатора: реальный латент получает цель 1, сгенерированный — 0.
В исходной публикации подписи у этих двух изображений переставлены: формула с целью 1 для выхода student подписана как loss дискриминатора, а формула real→1/fake→0 — как loss генератора. По самим выражениям роли однозначны, поэтому здесь они названы по функции, а не по ошибочной подписи.
Ещё одно ограничение — память. Student на 5B параметров и дискриминатор примерно на 2,5B не помещались вместе при обучении на 12-секундных HD-видео. Поэтому процессы разделили: чётные работали со student, нечётные — с discriminator. Данные передаются от одной группы к другой, а градиент возвращается обратно.
Рисунки с GenCom/DiscCom и двумя train loops показывают идею обмена данными и градиентами, но это именно сокращённый псевдокод. В нём опущены детали синхронизации и есть неоднозначные повторные имена переменных, поэтому его нельзя копировать как готовую исполняемую программу.
Таблицу можно прокрутить по горизонтали.
Позже в SBS-разделе авторы характеризуют Flash как примерно в 25 раз более быструю, но точная конфигурация базы для этого заявленного ускорения не раскрыта. Поэтому 25× нельзя пытаться вывести из четырёх времён выше и нельзя смешивать однокарточные и восьмикарточные режимы.
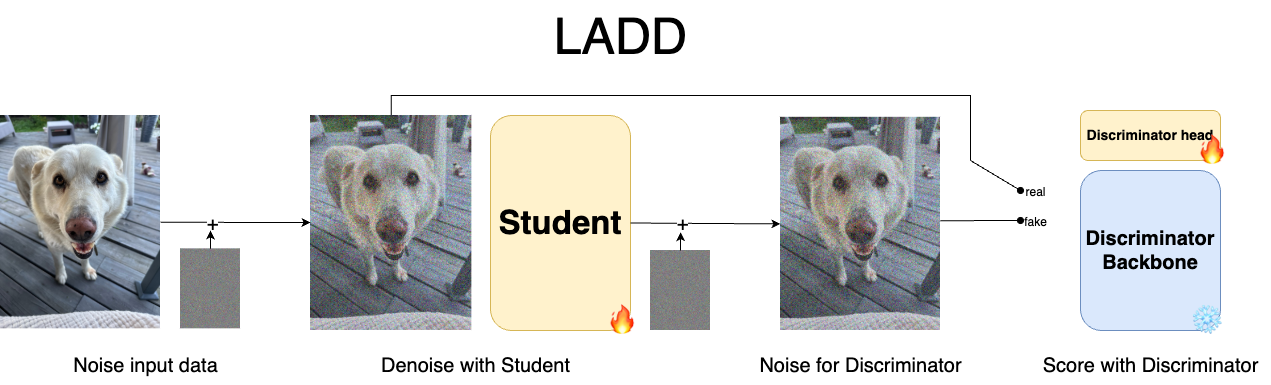
LADD обучает студента и дискриминативные головы при замороженном backbone дискриминатора.
Источник: Оригинальный материал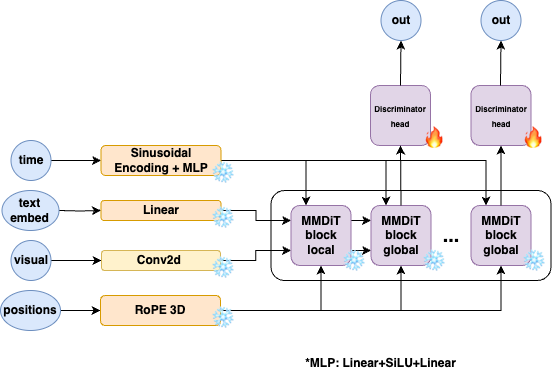
Замороженные блоки и обучаемые головы дискриминатора; текст и сила шума участвуют в оценке.
Источник: Оригинальный материал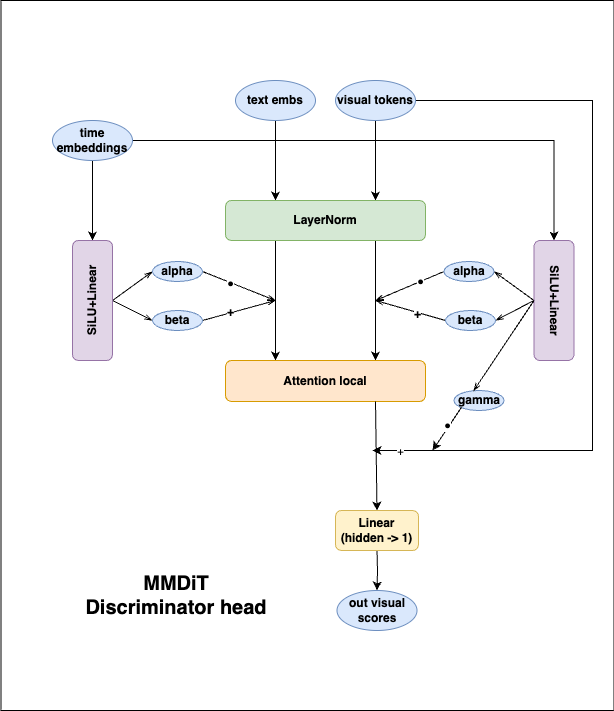
Дискриминативная голова — упрощённая часть MMDiT-блока.
Источник: Оригинальный материал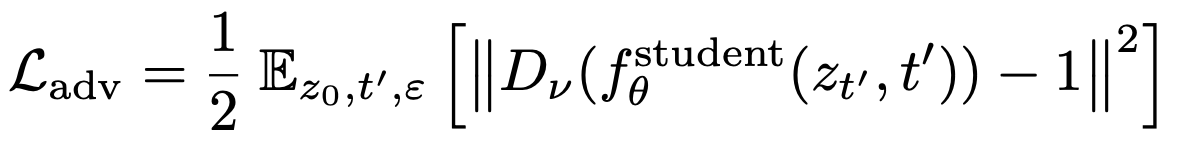
Видимая формула L_adv с целью 1 относится к генератору; подпись «для дискриминатора» в исходной статье перепутана.
Источник: Оригинальный материал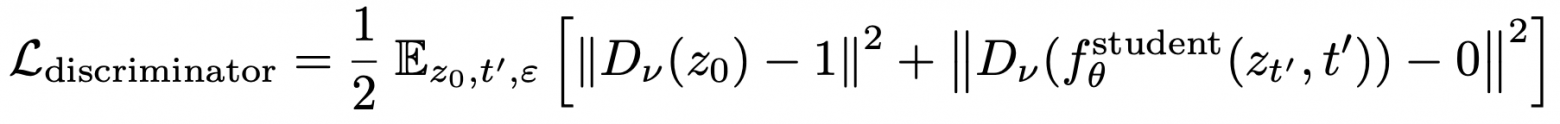
Видимая L_discriminator: реальные данные 1, сгенерированные 0; подпись «для генератора» в исходной статье перепутана.
Источник: Оригинальный материал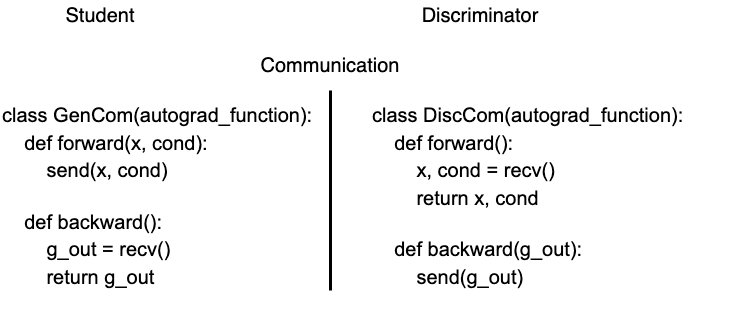
Псевдокод обмена данными и градиентами между процессами, а не полная исполняемая программа.
Источник: Оригинальный материал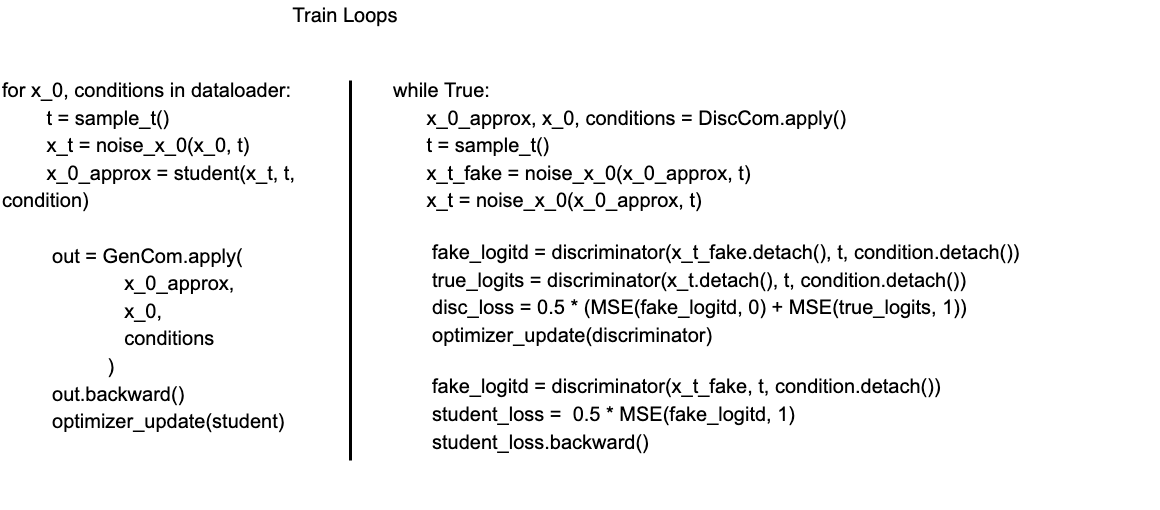
Псевдокод двух циклов оптимизации иллюстрирует разделение процессов; он не задаёт весь рабочий код и коммуникацию.
Источник: Оригинальный материалI2V: отдельный шум для первого кадра
Image-to-video использует ту же основную архитектуру, но меняет условие обучения. Помимо текста и видео модели дают первый кадр. Для первого латентного кадра выбираются собственный шум и собственная степень зашумления, независимые от остальных кадров. Поскольку уровень шума теперь различается, параметры scale и shift в adaptive LayerNorm вычисляются отдельно для первого кадра и для остальной последовательности.
При генерации схема меняется ещё сильнее: первый латент заменяется латентным представлением пользовательской картинки и остаётся чистым, без зашумления. Диффузионный процесс восстанавливает только последующие кадры. На исходной иллюстрации это третья схема: фиксированный первый кадр поступает в MMDiT как условие, а остальная последовательность начинается с шума.
У такого способа есть явное ограничение. Первый кадр обычного обучающего видео распределён не так же, как произвольная отдельная картинка, которую пользователь подаст на вход. Авторы связывают это несоответствие распределений с иногда нестабильными генерациями. Это их объяснение наблюдаемого поведения, а не отдельно проведённый причинный эксперимент.
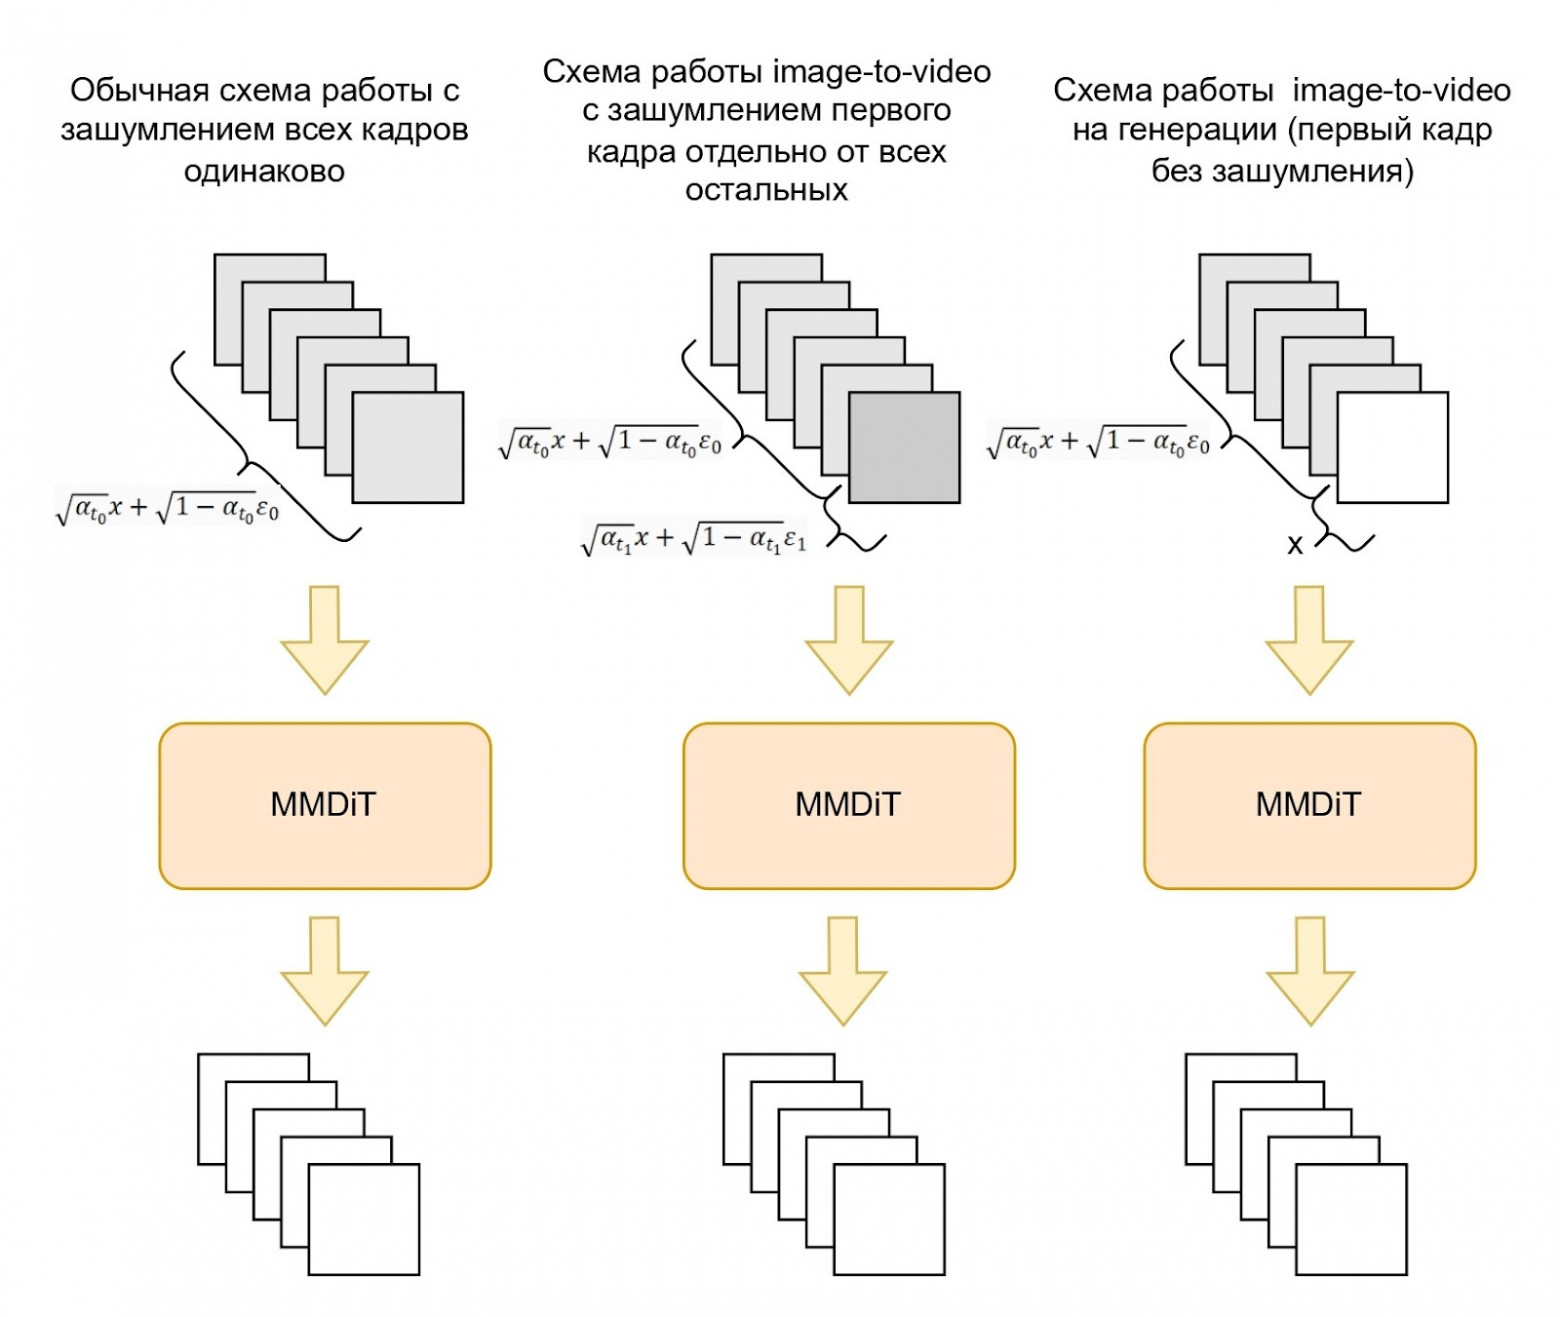
I2V: первый кадр зашумляется отдельно при обучении, а при генерации заданный первый латентный кадр остаётся без шума.
Источник: Оригинальный материалV2A: как из видео получается звук
V2A — отдельная модель для звука, синхронного видеоряду. Визуальный путь начинается с CogVLM2-Video. Каждый кадр проходит CLIP ViT, который делит изображение на патчи и строит семантические признаки. Адаптер уточняет их с учётом временной динамики, а временные метки T0, T1, … связывают признаки с моментами видео.
Visual language decoder выдаёт представления патчей, после чего temporal pooling усредняет их внутри каждого кадра и формирует последовательность признаков FE0, FE1, … . На схеме визуальное условие имеет форму 1×96×2048. Это размерность показанного тензора на рисунке, а не заявленный универсальный предел архитектуры.
Текстовая ветвь использует ту же мультимодальную модель: текст токенизируется и проходит через visual language decoder как текстовый контекст с временными метками. На схеме его размер — 1×100×2048. Далее и текст, и видео входят в U-Net, адаптированный из Riffusion-подобной генерации спектрограмм.
Чтобы состыковать CogVLM2-Video с предварительно обученной аудиомоделью, 2048-мерные представления проецируются в 768-мерное пространство. После каждого self-attention добавлен Video Cross-Attention, который обращается к признакам кадров; к ним также добавляется позиционное кодирование для синхронизации по времени. U-Net генерирует спектрограмму, а вокодер превращает её в звуковой сигнал.
Данные V2A готовили на основе общего видеоконвейера, но старались исключить неприятные звуки и человеческую речь, включая закадровый голос. Целью на этой стадии были в основном диегетические звуки — то, что существует внутри самой сцены. Финальную модель дополнительно дообучали на вручную отобранном чистом наборе. Поэтому упоминание закадровой озвучки в продуктовой схеме FusionBrain ниже не означает, что речь генерирует именно эта V2A.
Этот тест нельзя смешивать с T2V SBS ниже: здесь 2000 видео и бинарный итог 1101 против 899, тогда как видеогенеративные сравнения имеют по 125K отдельных оценок и 17 базовых критериев.
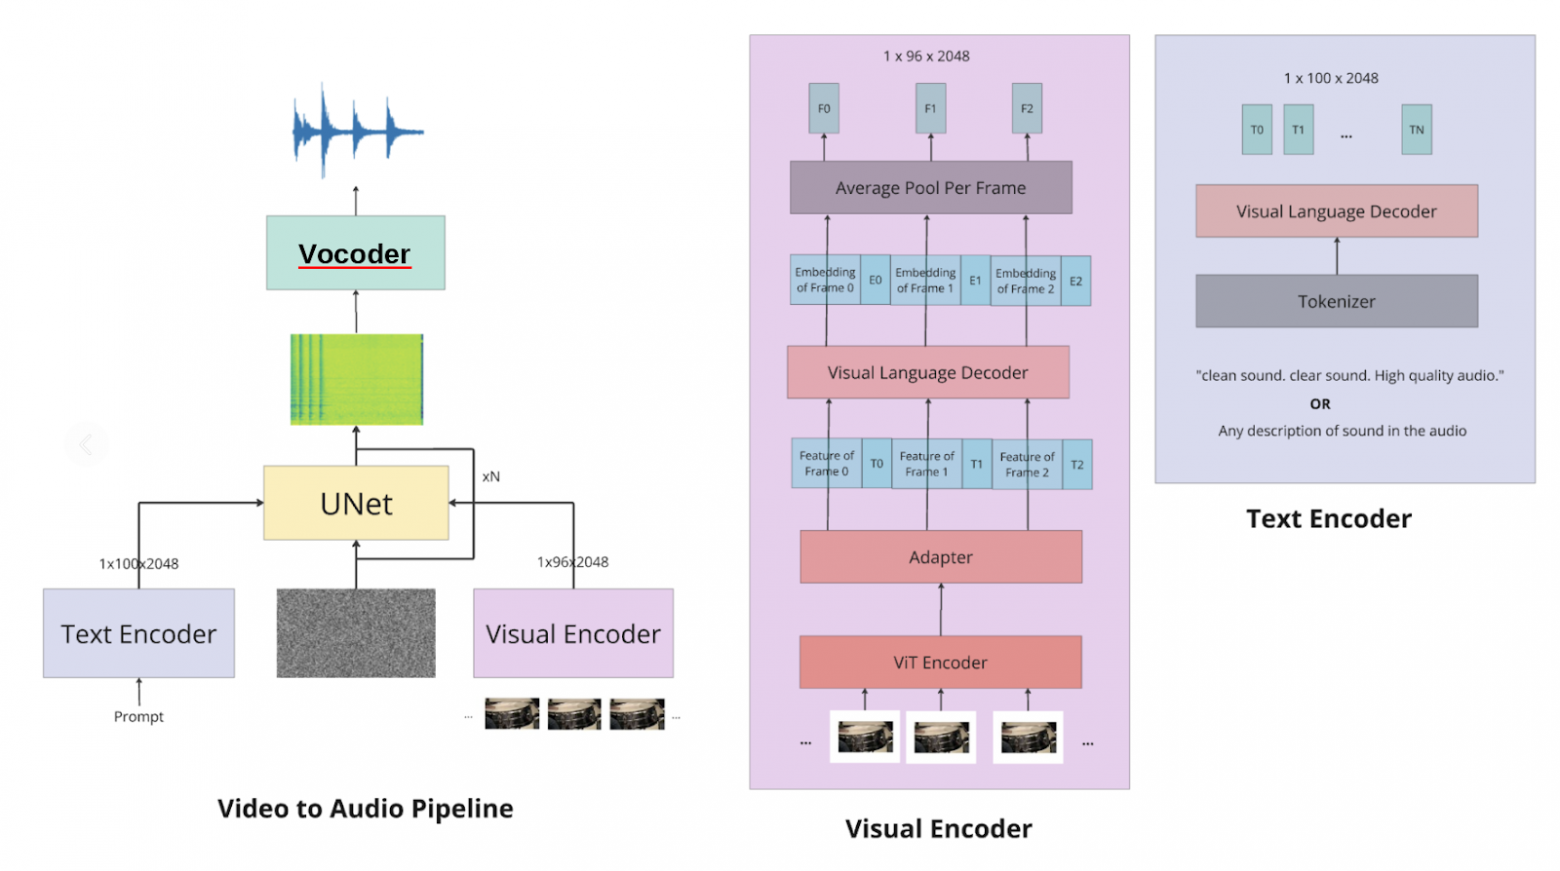
V2A: визуальные и текстовые представления CogVLM2-Video → U-Net → спектрограмма → вокодер.
Источник: Оригинальный материалАвтоматическая оценка: не один VBench, а набор проверок
Авторы берут VBench как основу, но для ряда аспектов меняют или полностью переписывают методику, потому что исходные варианты показались им недостаточно устойчивыми. Поэтому эти таблицы лучше читать как внутреннюю модифицированную оценку на задачах VBench, а не как обычное копирование публичного leaderboard.
Чтобы уменьшить зависимость от случайного seed, по каждому промпту генерируют 5 вариантов в 480p и 3 варианта в HD. Дальше разные аспекты качества проверяются разными процедурами: динамика, действие человека, наличие объектов, цвет и расположение, соответствие промпту, размытие, техническое качество, эстетика и стиль.
Таблицу можно прокрутить по горизонтали.
Авторы формулируют два вывода по Dynamic Degree: короткие промпты заметно ухудшают динамичность генераций, а Kandinsky 4.0 в HD становится динамичнее своей 480p-версии. Первая формулировка относится к их общей интерпретации набора экспериментов; отдельные строки таблицы не дают права превращать её в математическое правило для каждой модели.
Таблицу можно прокрутить по горизонтали.
Human Action проверяет, выполнил ли человек действие, явно заданное в промпте. Авторы считают качество Kandinsky сопоставимым с ведущими открытыми моделями в 480p и HD. Таблица при этом показывает конкретные различия, например 98,20% у Kandinsky 480p против 98,60% у CogVideoX-5B и 99,33% у Kandinsky HD.
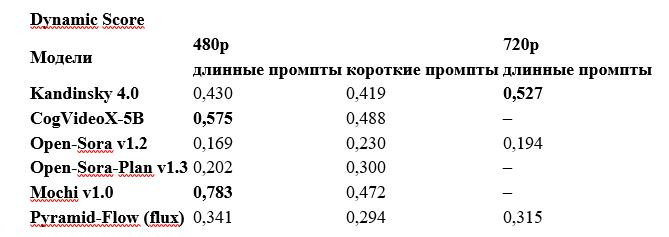
Dynamic Score для длинных и коротких промптов в 480p и 720p. Прочерк — отсутствие опубликованного значения.
Источник: Оригинальный материалОбъекты, цвет, расположение и соответствие промпту
Detection Score разделён на четыре задачи. Для Object Class объект должен присутствовать минимум в 75% кадров. Для Color те же 75% кадров должны одновременно содержать объект нужного цвета. Для Multiple Objects оба объекта нужны минимум в 40% кадров. Для Spatial Relationship в 40% кадров должны присутствовать оба объекта и выполняться заданное пространственное отношение.
Таблицу можно прокрутить по горизонтали.
В 480p Kandinsky по Object Class уступает Open-Sora-Plan и Open-Sora; по Multiple Objects показывает максимальное значение в таблице; по Color делит 0,842 с Open-Sora-Plan и уступает Open-Sora; по Spatial Relationship уступает Mochi. В HD среди моделей с опубликованными числами Kandinsky слабее по Object Class, но выше Open-Sora и Pyramid-Flow по Multiple Objects, Color и Spatial Relationship.
Prompt Consistency устроен иначе. LLaVA-NeXT-Video-34B создаёт по 5 описаний каждого сгенерированного видео. Исходный промпт и каждый caption переводятся в векторы, затем считается косинусная близость. Статья говорит только о «лучшей модели из MTEB» и не называет конкретный энкодер, поэтому его нельзя восстанавливать по догадке.
Рядом с разделом Prompt Consistency в статье опубликована декоративная фотография автомобиля, а не таблица с числовыми результатами этой метрики. Поэтому сохраняем именно текстовые выводы авторов. Для 480p они сообщают, что Kandinsky 4.0 значительно опережает Open-Sora v1.2 и Mochi-1.0 и показывает лучшие результаты относительно прочих рассмотренных SOTA open-source моделей. Для HD авторы отмечают прирост в среднем по исследуемым метрикам. Без опубликованных чисел нельзя добавлять конкретные значения или ранги по отдельным конкурентам.
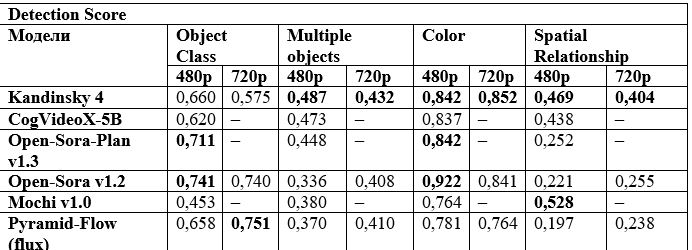
Detection Score: изменённая методика VBench, 75% кадров для объекта/цвета и 40% для двух объектов/пространственной связи.
Источник: Оригинальный материалРазмытие: как считать и как не ошибиться с процентами
Размытие оценивают через CPBD. В статье используется величина 1 − CPBD для каждого кадра, затем значения усредняются по видео. Интервал разбивается на пять бакетов: [0; 0,2) — no blur, [0,2; 0,4) — small blur, [0,4; 0,6) — mid blur, [0,6; 0,8) — high blur, [0,8; 1,0] — very high blur.
Таблицу можно прокрутить по горизонтали.
Для Kandinsky 480p доля no blur + small blur равна 8,9% + 65,5% = 74,4%. Для ближайшего по этому суммарному показателю Pyramid-Flow — 11,0% + 51,3% = 62,3%. Разница составляет 12,1 процентного пункта. В исходном тексте сказано «на 12,1% выше», но арифметически это именно разность долей в процентных пунктах, а не относительный рост на 12,1%.
В HD авторы подчёркивают, что Kandinsky избегает тяжёлых уровней размытия лучше Open-Sora v1.2 и Pyramid-Flow. При этом конкретные значения таблицы лучше сохранять, а не заменять общим заявлением: у Pyramid-Flow, например, выше доля полностью резких видео, но у Kandinsky значительно больше доля small blur и ниже тяжёлые бакеты.
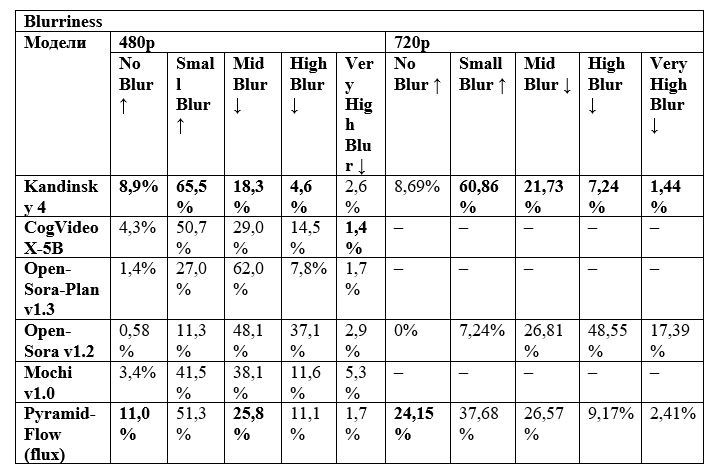
Доли уровней размытия: две первые категории 480p Kandinsky 74,4%, Pyramid-Flow 62,3%. Разность — 12,1 процентного пункта.
Источник: Оригинальный материалТехническое и эстетическое качество
Technical quality измеряется Q-Align — моделями автоматической оценки визуального качества. Эта проверка пытается отражать артефакты, искажения и другие проблемы изображения и видео. В таблицах рядом со средними стоят значения после символа ±, но статья не объясняет, что именно это за величина. Поэтому их нужно сохранять буквально и не называть стандартным отклонением, стандартной ошибкой или доверительным интервалом.
Таблицу можно прокрутить по горизонтали.
Картина неодинакова по столбцам. В 480p Kandinsky сильна по Overall consistency, уступая Pyramid-Flow, но её Human Action ниже CogVideoX, Open-Sora-Plan, Open-Sora и Pyramid-Flow. Авторы предполагают, что это может быть связано с неестественной анатомией. В HD Overall consistency у Kandinsky 0,896 — выше Open-Sora v1.2 с 0,849, но ниже Pyramid-Flow с 0,923. По Human Action Kandinsky 0,852 ниже Open-Sora 0,877 и Pyramid-Flow 0,922. Авторы также предполагают влияние большей длины роликов Kandinsky HD; это объяснение, а не доказанная причина.
Эстетическое качество оценивается двумя разными семействами моделей — LAION-aesthetic v2.5 и Q-Align. Их столбцы нельзя смешивать в одну общую метрику красоты.
Таблицу можно прокрутить по горизонтали.
По LAION Overall в 480p Kandinsky имеет максимальное значение 0,535 среди показанных моделей, но по Q-Align Overall Pyramid-Flow выше: 0,727 против 0,626. В HD у Kandinsky очень высок LAION Human Action — 0,860, однако Q-Align Overall и Q-Align Human Action снова выше у Pyramid-Flow. Поэтому корректный вывод — сильное эстетическое качество в ряде срезов, а не лидерство по всем показателям.
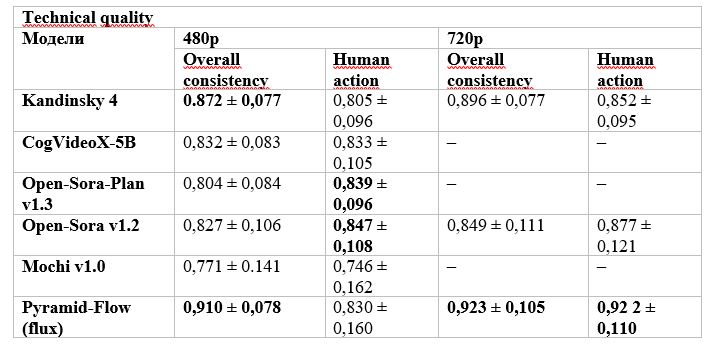
Техническое качество Q-align и слабые стороны Human Action/HD. Символы ± сохранены без догадки о доверительном интервале.
Источник: Оригинальный материал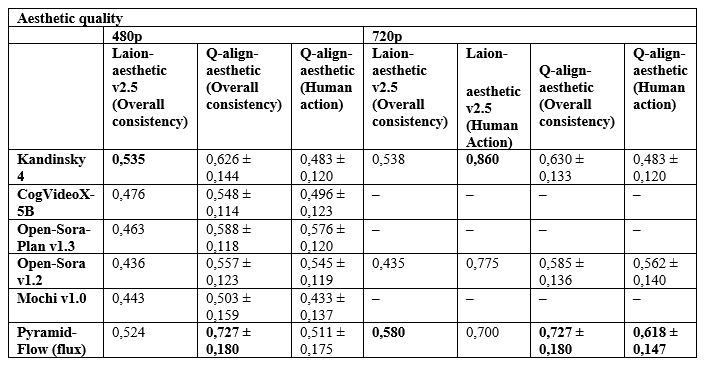
Эстетические оценки LAION и Q-align — разные показатели; Kandinsky не занимает первое место во всех категориях.
Источник: Оригинальный материалСтили: почему исходный CLIP заменили ранжированием
Оригинальный подход VBench сравнивал кадры со стилевым промптом через CLIP ViT-B/32 и косинусную близость. Авторы Kandinsky посчитали такие результаты близкими к шуму. Вместо этого они используют CLIP LAION и на каждом кадре ранжируют набор стилевых промптов: если нужный стиль стоит на первом месте, кадр получает 1.
Таблицу можно прокрутить по горизонтали.
Авторы выделяют oil painting, surrealism и watercolor как сильные стороны Kandinsky 4.0 и отмечают слабость в pixel art и Hokusai/Ukiyo; остальные категории описывают как паритет. Сырые числа показывают, что Kandinsky не максимальна, например, в Van Gogh, animated и cyberpunk. Поскольку отдельная процедура проверки статистической значимости для этих заявлений не раскрыта, лучше сохранять и значения, и осторожную авторскую интерпретацию.
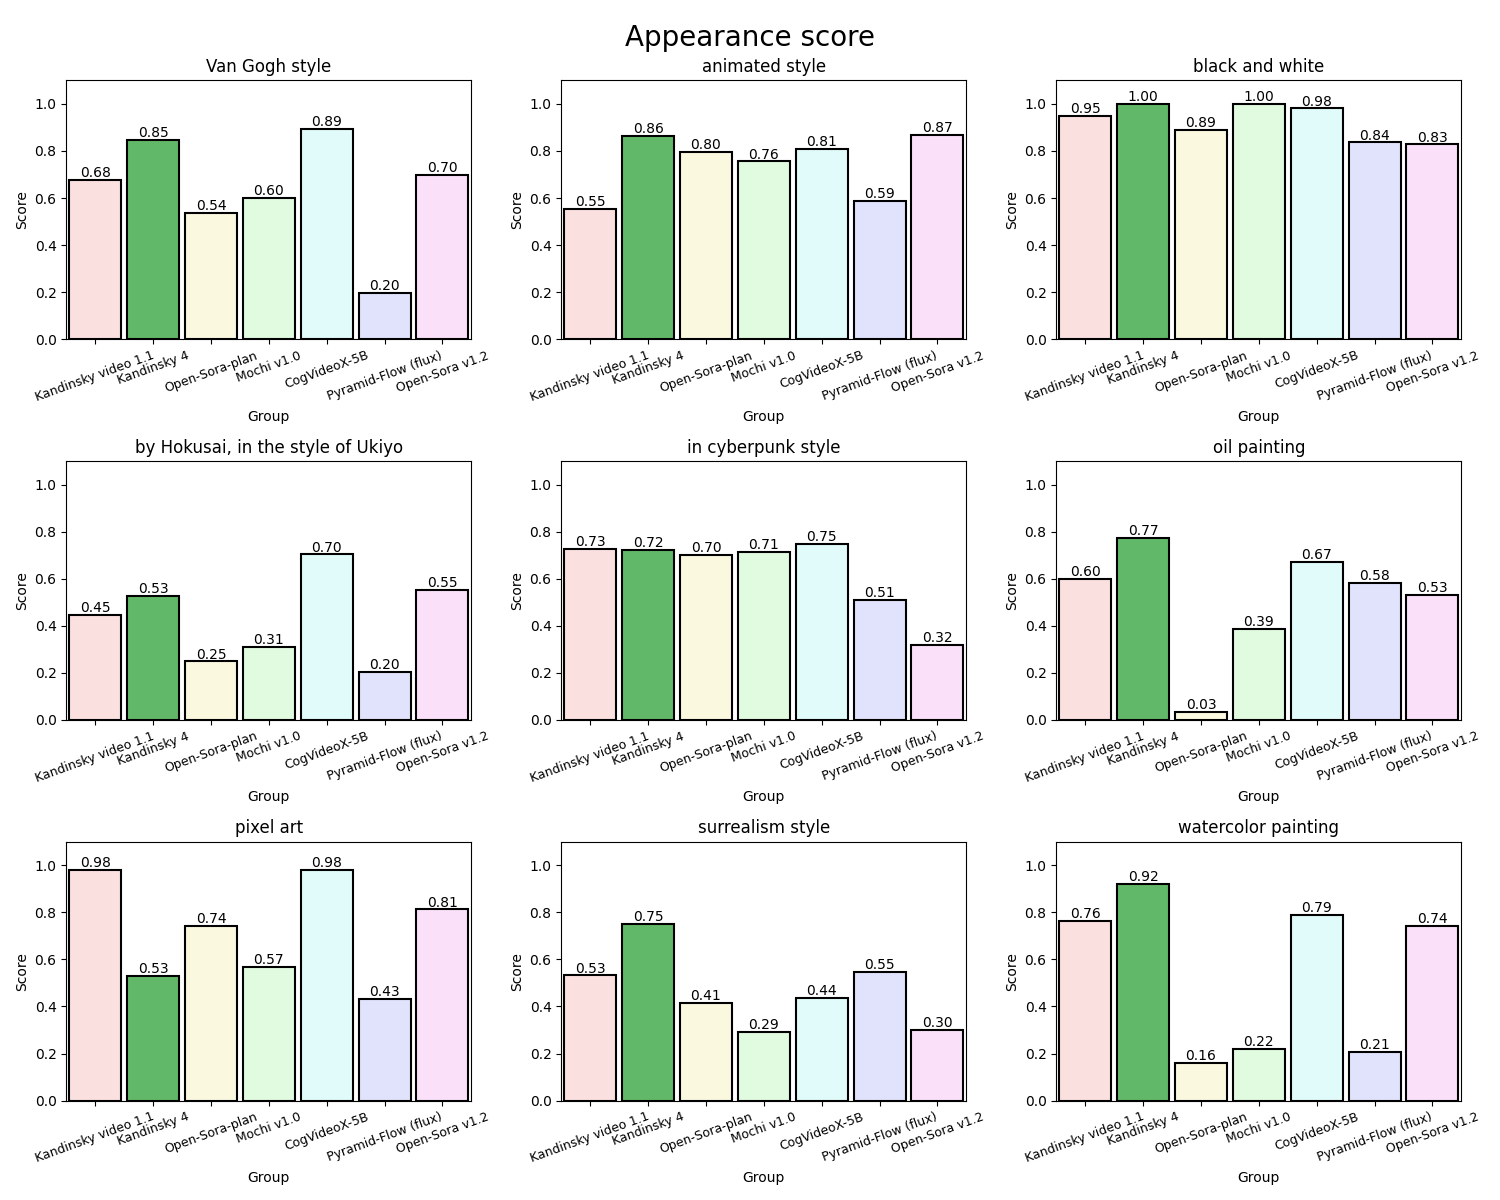
Стилевые оценки CLIP LAION по ранжированию промптов вместо шумного исходного CLIP-подхода.
Источник: Оригинальный материалSide-by-Side: как люди сравнивали видео
Автоматических метрик для генеративного видео недостаточно, поэтому команда проводит Side-by-Side — слепое попарное сравнение. Видео генерируются по корзине из 2000 промптов, сбалансированных по категориям. Каждую пару оценивают 5 разметчиков. Всего есть 17 базовых критериев, которые затем объединяются в три группы: следование промпту, визуальное качество, динамика и реалистичность движения.
В базовых критериях разметчик мог сначала ответить «Одинаково». После этого его всё равно просили выбрать один вариант. На детальных графиках такие forced-choice случаи отмечены светлым цветом и подписью unconf. Поэтому итоговые доли предпочтений нельзя считать долей изначально уверенных голосов.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
Первое сравнение даёт Kandinsky 4 HD общий win rate 0,63 против CogVideoX-1.5. По трём агрегатам — 0,55 по следованию промпту, 0,70 по визуальному качеству и 0,65 по движению. Авторы дополнительно пишут, что на уровне всех 17 базовых критериев не было ни одного, где CogVideoX-1.5 оказался лучше. Детальные графики разбивают агрегаты на отдельные критерии, но здесь не восстанавливаем численные значения отдельных столбцов без их явного чтения.
Для Flash важно не перепутать сторону: именно Flash получает overall 0,42, а полная 480p-модель — 0,58. По трём группам у Flash 0,46, 0,40 и 0,40. Так видно цену ускорения: качество снижается, хотя авторы считают разрыв умеренным на фоне заявленного примерно 25-кратного ускорения. По детальным критериям дополнительные числа без явных значений на графиках не добавляем.
Kandinsky 4 HD против Kandinsky Video 1.1 выигрывает в среднем и особенно по динамике: 0,56 overall и 0,65 по движению. При этом визуальное качество у новой модели — 0,47, то есть ниже 0,53 предыдущего поколения. Авторы объясняют это архитектурой Video 1.1, которая строила опорные кадры через T2I Kandinsky 3.0. Это объяснение совместимо с результатом, но не является отдельным причинным экспериментом.
Последнее сравнение противопоставляет чистый T2V и двухшаговый путь Kandinsky 3.1 T2I → Kandinsky 4 I2V. Сторона T2V имеет 0,47 overall, 0,51 по промпту, 0,40 по визуалу и ровно 0,50 по движению. I2V заметно выигрывает по визуальному качеству — 0,60 — благодаря сильному стартовому изображению; по движению получается ничья. Это конкретный способ подготовки первого кадра, а не доказательство превосходства любого I2V над любым T2V.
Детализация SBS устроена одинаково: шесть базовых критериев относятся к следованию промпту, семь — к визуальному качеству, четыре — к динамике и реалистичности движений. Эти отдельные оценки объясняют три агрегата в обзорных графиках; численные значения отдельных столбцов не выводятся из агрегатов и потому не восстанавливаются по ним.
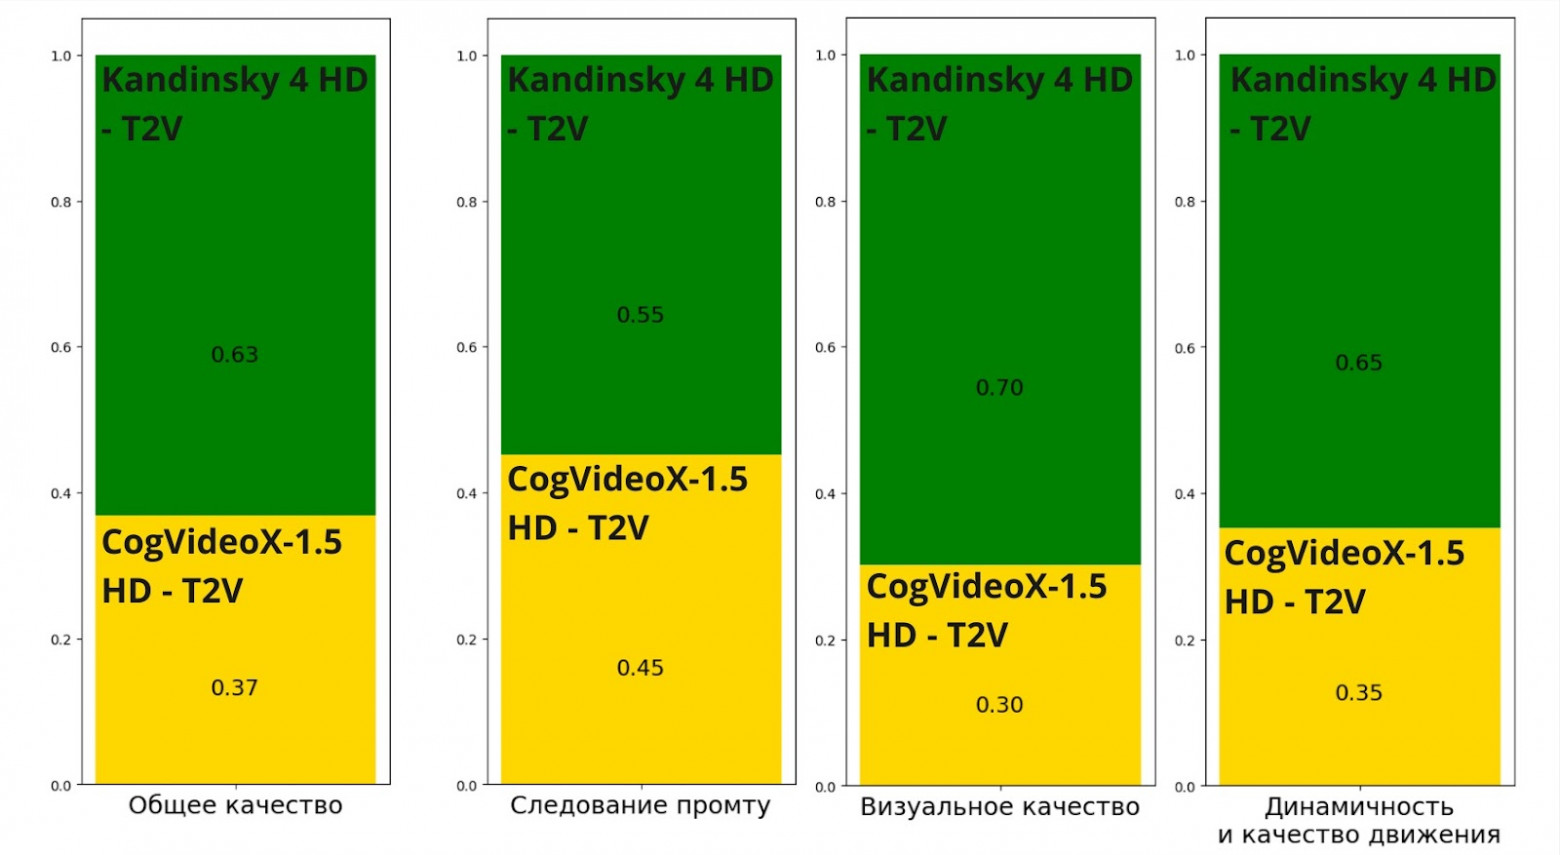
SBS Kandinsky HD против CogVideoX-1.5: предпочтения Kandinsky 0,63 / 0,55 / 0,70 / 0,65.
Источник: Оригинальный материал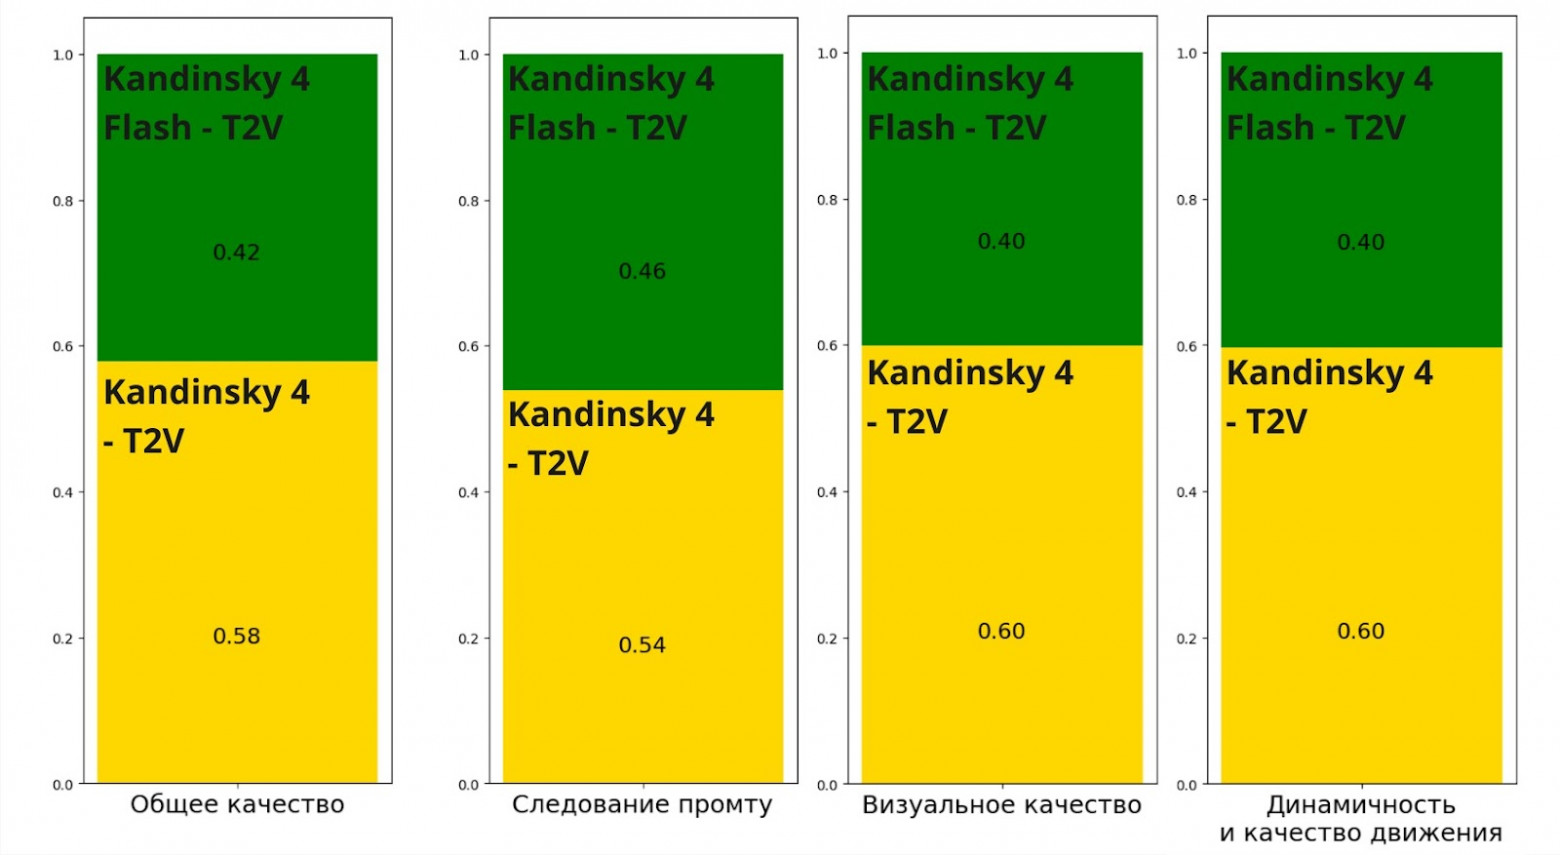
SBS Flash против полной 480p: предпочтения Flash 0,42 / 0,46 / 0,40 / 0,40. Ускорение сопровождается снижением качества.
Источник: Оригинальный материал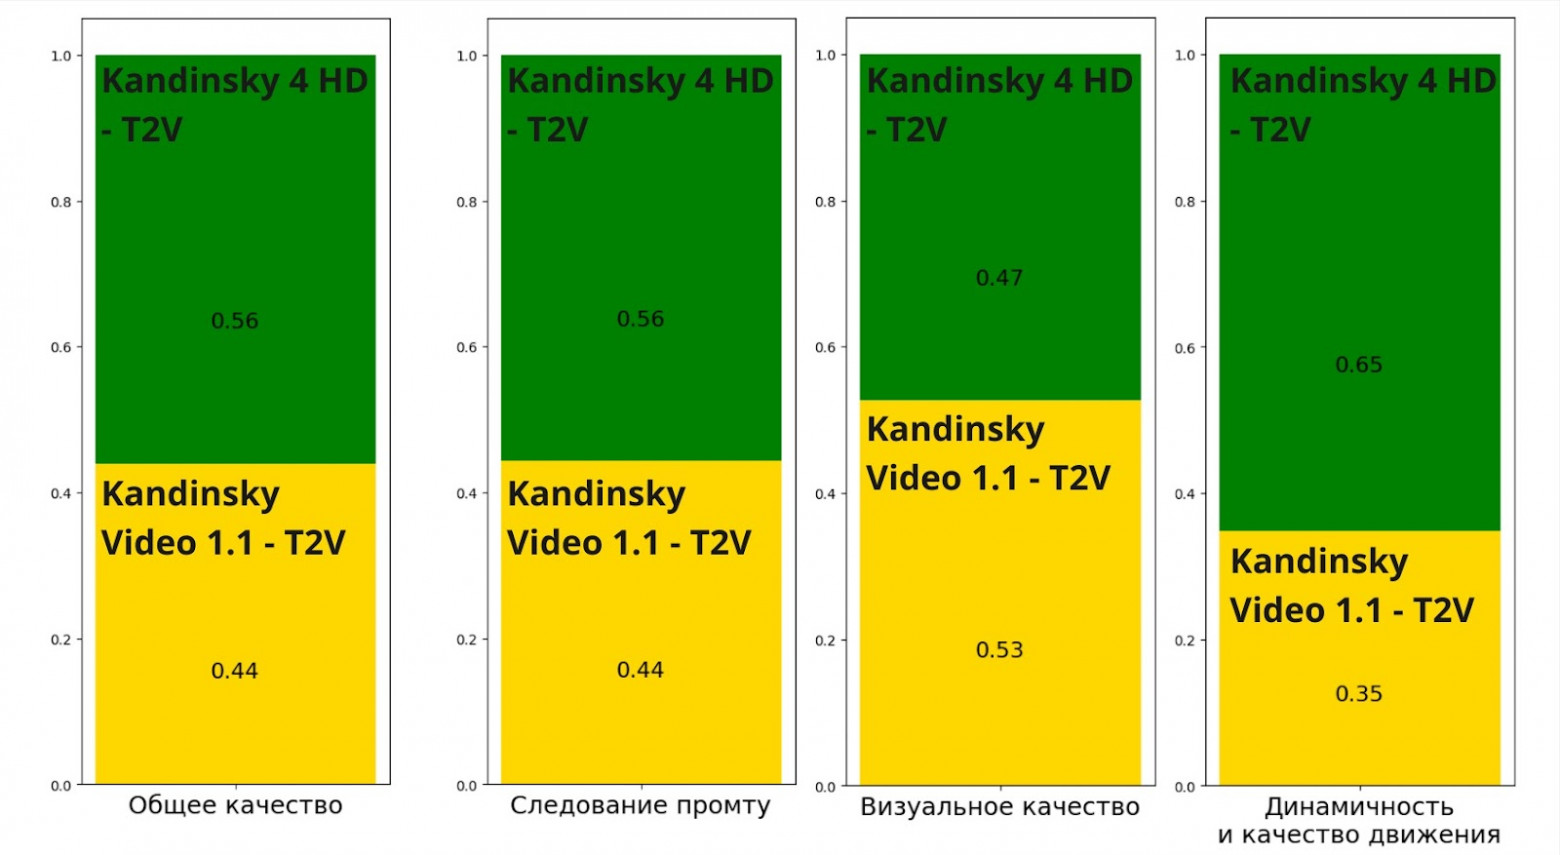
SBS Kandinsky HD против Video 1.1: предпочтения нового 0,56 / 0,56 / 0,47 / 0,65; визуальное качество немного уступает.
Источник: Оригинальный материал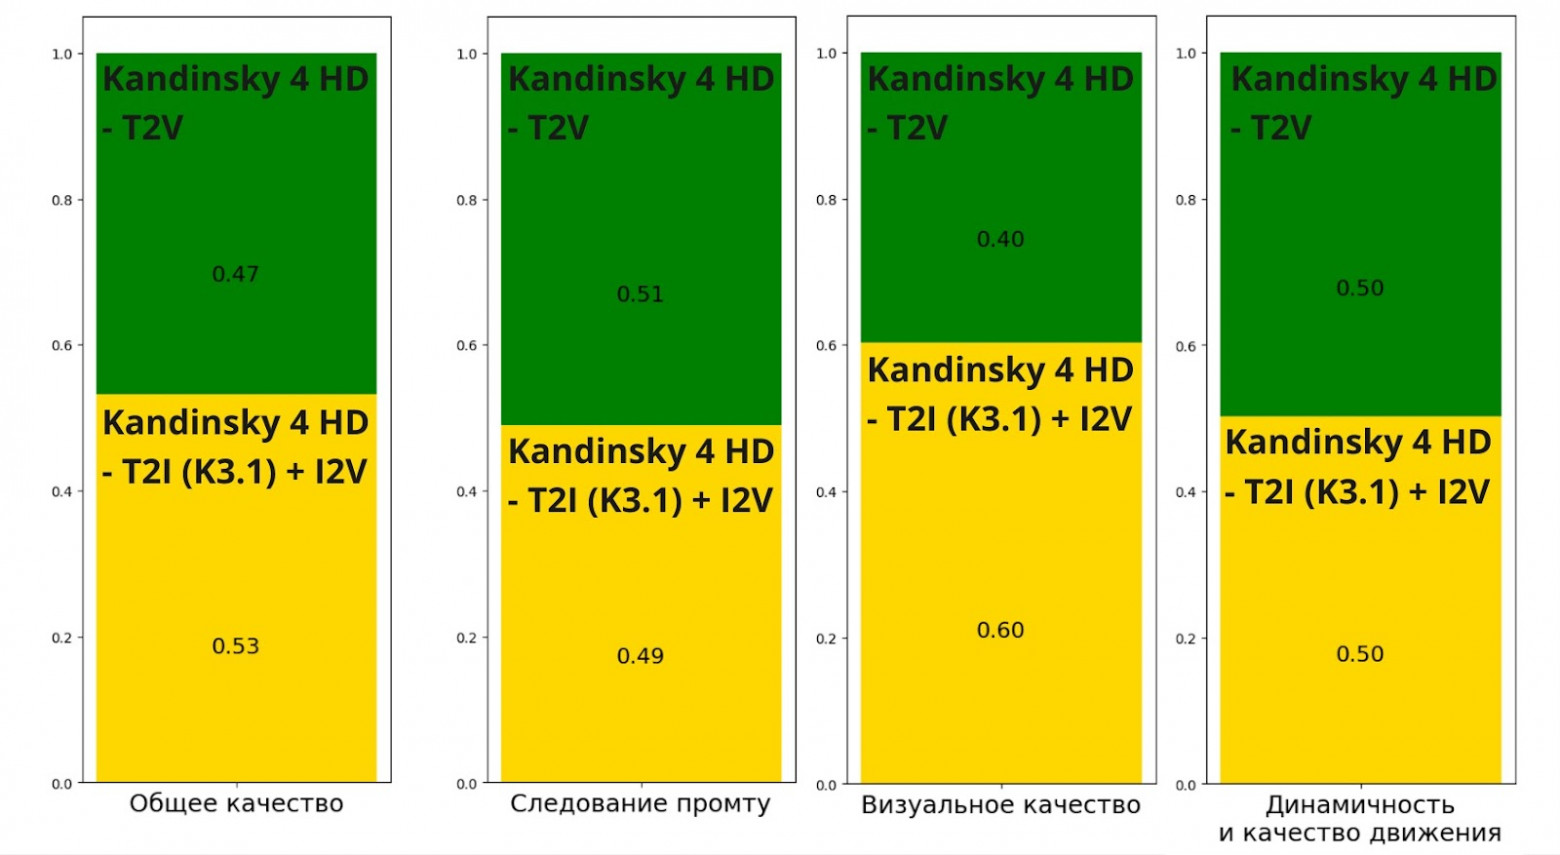
SBS T2V против I2V со стартом от Kandinsky 3.1: предпочтения T2V 0,47 / 0,51 / 0,40 / 0,50. Это конкретный способ подготовки стартовой картинки.
Источник: Оригинальный материалЧто было развернуто на момент публикации
На дату публикации, 13 декабря 2024 года, авторы сообщали о развёртывании на fusionbrain.ai трёх видеомодулей: T2V, T2V Flash и I2V. Первыми доступ получили представители креативных индустрий — художники, дизайнеры, кинематографисты и блогеры. Это историческое состояние релиза 2024 года; оно не описывает автоматически текущую доступность сервиса.
Продуктовая цепочка в заключении шире одной V2A. Сначала GigaChat MAX формирует концепцию, сценарий и текст озвучки; затем Kandinsky строит визуальные сцены; после этого отдельные модели добавляют музыку и закадровый голос, в тексте упомянуты Kandinsky T2I2V и SymFormer. Это важно отделять от V2A выше: её обучающий набор специально очищался от человеческой речи, поэтому продуктовый voice-over нельзя приписывать V2A.
ЗаключениеИтог: как готовая Kandinsky превращает условие в видео
Kandinsky 4.0 выросла из четырёх задач: собрать и очистить видеокорпус, выбрать масштабируемую архитектуру, обучить её в HD и сократить дорогую многошаговую генерацию. Для основной T2V команда выбрала MMDiT с совместной обработкой текста и визуальных токенов; для HD полное внимание заменили чередованием локального и глобального. Flash получили LADD-дистилляцией.
- 01
Условие
Пользователь задаёт текст. В I2V к нему добавляется стартовая картинка, задающая первый кадр видео.
- 02
Представления
Текст преобразуется T5 в векторы, а видео и стартовое изображение представлены в сжатом латентном пространстве VAE.
- 03
Удаление шума
MMDiT постепенно восстанавливает видеолатенты с учётом текста, времени и позиций. Flash решает ту же задачу быстрее после дистилляции.
- 04
Особенность I2V
При генерации первый латент из заданной картинки остаётся чистым и фиксированным; шум удаляется из остальных кадров.
- 05
Видео и звук
VAE декодирует латенты в кадры. При необходимости V2A анализирует видео, строит спектрограмму и через вокодер получает звук.
Качество проверяли модифицированным VBench и Side-by-Side сравнениями. Kandinsky 4 HD выиграла общий SBS у CogVideoX-1.5 с долей предпочтений 0,63; новая версия также превзошла Kandinsky Video 1.1 по динамике движения. Flash была быстрее, но уступила полной 480p-модели по общему качеству: 0,42 против 0,58. У I2V со стартом от Kandinsky 3.1 главным преимуществом оказался визуал.
Границы результата существенны. Авторы не раскрывают полный размер собственного датасета, стоимость полного обучения и смысл значений после знака ± в части таблиц. Для I2V отмечено несовпадение распределений обычных изображений и первых кадров обучающих видео, поэтому возможны нестабильные генерации. V2A обучалась без человеческой речи и предназначалась главным образом для диегетических звуков. Публичное развёртывание трёх видеомодулей и ранний доступ к FusionBrain описывают состояние на 13 декабря 2024 года, а не текущую доступность.
Заключение