Разбор готов
Реклама по последовательности событий вместо тысяч агрегатов
Представим учебный пример, которого нет в статье Meta: вчера человек смотрел материалы о ремонте, сегодня заинтересовался детской мебелью, а затем кликнул по объявлению дивана. Если сохранить только агрегаты вроде «на какие объявления нажимал за последние дни» и «какие страницы посещал», можно потерять и порядок этих действий, и то, какие признаки встретились вместе в одном событии. Прежняя рекламная система Meta опиралась на DLRM и тысячи вручную сконструированных сигналов. Новая система переносит центр тяжести на последовательности событий: стандартизирует их через EBF, строит представление каждого события с учётом времени и затем обрабатывает историю последовательной моделью, одновременно меняя форматы данных и инфраструктуру.
Материал полезен инженерам и аналитикам рекомендательных систем, которые хотят понять, зачем переходить от агрегированных признаков к истории событий и какие вычислительные проблемы появляются после такого перехода. Особенно полезна связка между устройством модели, переменной длиной истории и системными оптимизациями, необходимыми для промышленного ранжирования рекламы.
Статья · на английском
Sequence learning: A paradigm shift for personalized ads recommendationsSri Reddy, Habiya Beg, Arnold Overwijk, Sean O’Byrne · Опубликовано: 19 ноября 2024 г.
Почему агрегаты DLRM стали ограничением
Исходная система не была простой. Deep Learning Recommendation Model, или DLRM, хорошо работает с разреженными категориальными признаками: например, с идентификаторами страниц, объявлений и других сущностей, число возможных значений которых может доходить до миллиардов. Для таких признаков модель учит плотные векторные представления — эмбеддинги — и затем объединяет множество сигналов в итоговое предсказание. Именно эта способность сделала DLRM основой персонализированной рекламы Meta.
Чтобы использовать десятки тысяч признаков, прежняя система агрегировала действия человека по разным источникам, временным окнам и правилам. В статье приведены примеры: список объявлений, по которым человек кликал за последние N дней, или страницы Facebook с числом посещений за последние M дней. На исходной схеме встречаются окна «30 дней» и «2 недели», но это примеры старых агрегатов, а не заданные длины новой последовательности.
Проблема усиливается тем, что интересы и намерения человека меняются. Если важная динамика сначала свёрнута в вручную выбранные агрегаты, последующая нейросеть уже не может восстановить всю потерянную структуру. Поэтому Meta меняет не только набор признаков, а сам способ представления пользовательского опыта.
The limits of DLRMs for ads recommendationsПереход к событиям потребовал перестроить всю систему
Во вступлении статьи Meta описывает две взаимосвязанные перемены. Первая — обучение непосредственно по событиям взаимодействия и конверсии (event-based learning) вместо опоры на традиционные вручную сконструированные агрегаты. Вторая — обучение по последовательностям (learning from sequences): модель читает события в их порядке, а не получает только уже сведённый набор признаков.
Такой переход оказался системным. Последовательность событий имеет другую форму и другую стоимость, поэтому понадобился полный пересмотр хранения данных, входных форматов и архитектуры модели. Авторы отдельно называют новую инфраструктуру, ориентированную на историю человека, оптимизации обучения и применения последовательных моделей, а также совместное проектирование модели и системы ради эффективного масштабирования. Иными словами, замена агрегатов на последовательности не сводится к тому, чтобы поставить новый нейросетевой блок поверх старого конвейера.
A paradigm shift with learning from sequences for recommendation systemsEBF: хранить поток, длину истории и содержание события
Основной вход новой модели Meta называет event-based features, или EBF. По смыслу это стандартизированное представление событий: вместо множества разрозненных агрегатов система работает с последовательностями, где каждое событие остаётся отдельным объектом. EBF нужны, чтобы неоднородные источники можно было одинаково подавать в последовательную модель и постепенно расширять без новой ручной схемы агрегирования для каждого случая.
Поэтому событие здесь — не просто идентификатор. До построения его векторного представления сохраняются атрибуты, относящиеся именно к этому событию, и информация о времени. Meta подчёркивает, что EBF представляет событие как единый согласованный объект. Последовательности EBF становятся основными входами рекомендательной модели и заменяют прежние разреженные агрегированные признаки.
Event-based featuresОт атрибутов события к истории, зависящей от объявления
Сначала работает модель события. Для каждого атрибута она учит собственное векторное представление, а затем линейным преобразованием сжимает набор атрибутов в один вектор содержания события. Отдельно кодируется временная метка: она помогает передать давность события и его положение во времени. Сочетание сжатого представления атрибутов и временного кодирования даёт итоговый вектор события. Так последовательность EBF превращается в последовательность числовых представлений.
Авторы сравнивают этот шаг с тем, как языковая модель представляет слова векторами, но подчёркивают отличие масштаба: пространство EBF во много порядков больше естественного языка, потому что события приходят из разных потоков и содержат миллионы сущностей. Статья не сообщает размер этих векторов, формулу временного кодирования или параметры линейного сжатия.
Словесный вывод из исходной схемы такой. Слева показана прежняя логика: сырые события сначала превращаются в вручную выбранные агрегаты, их эмбеддинги объединяются, и уже это сжатое представление получает DLRM. Справа разные события — например, органический показ, лайк страницы, рекламный показ или конверсия — сохраняют собственные атрибуты: темы, бренд, текст, изображения, видео, сведения об объявлении и другие поля, если они есть у данного типа события. На схеме модель события помечена как неперсонализированная: она строит представление самого события, а выше к нему добавляются позиционная и временная информация и работает персонализированная последовательная модель. Поэтому рисунок показывает перенос места, где история сжимается: новая модель получает гораздо больше структуры исходных событий.
Дальше последовательная модель обобщает историю человека. Важная деталь: она формирует заранее заданное число представлений, которые привязаны к объявлению, ранжируемому сейчас. Практический смысл в том, что одна и та же история может быть прочитана по-разному для разных рекламных кандидатов, вместо того чтобы всегда сворачиваться в один и тот же универсальный вектор пользователя.
По статье, такие техники, как multi-headed attention pooling, уменьшают сложность именно указанного модуля self-attention с O(N²) до O(MN). N — максимальная длина последовательности, M — настраиваемый параметр. Это не утверждение о сложности всей модели или всего запроса.
Значение M в статье не приведено. Не раскрыты и точная схема вычисления итоговой оценки объявления, число слоёв, число голов внимания, размер скрытого представления или другие параметры архитектуры. Поэтому из материала можно уверенно восстановить общую структуру модели, но нельзя достроить её точную конфигурацию.
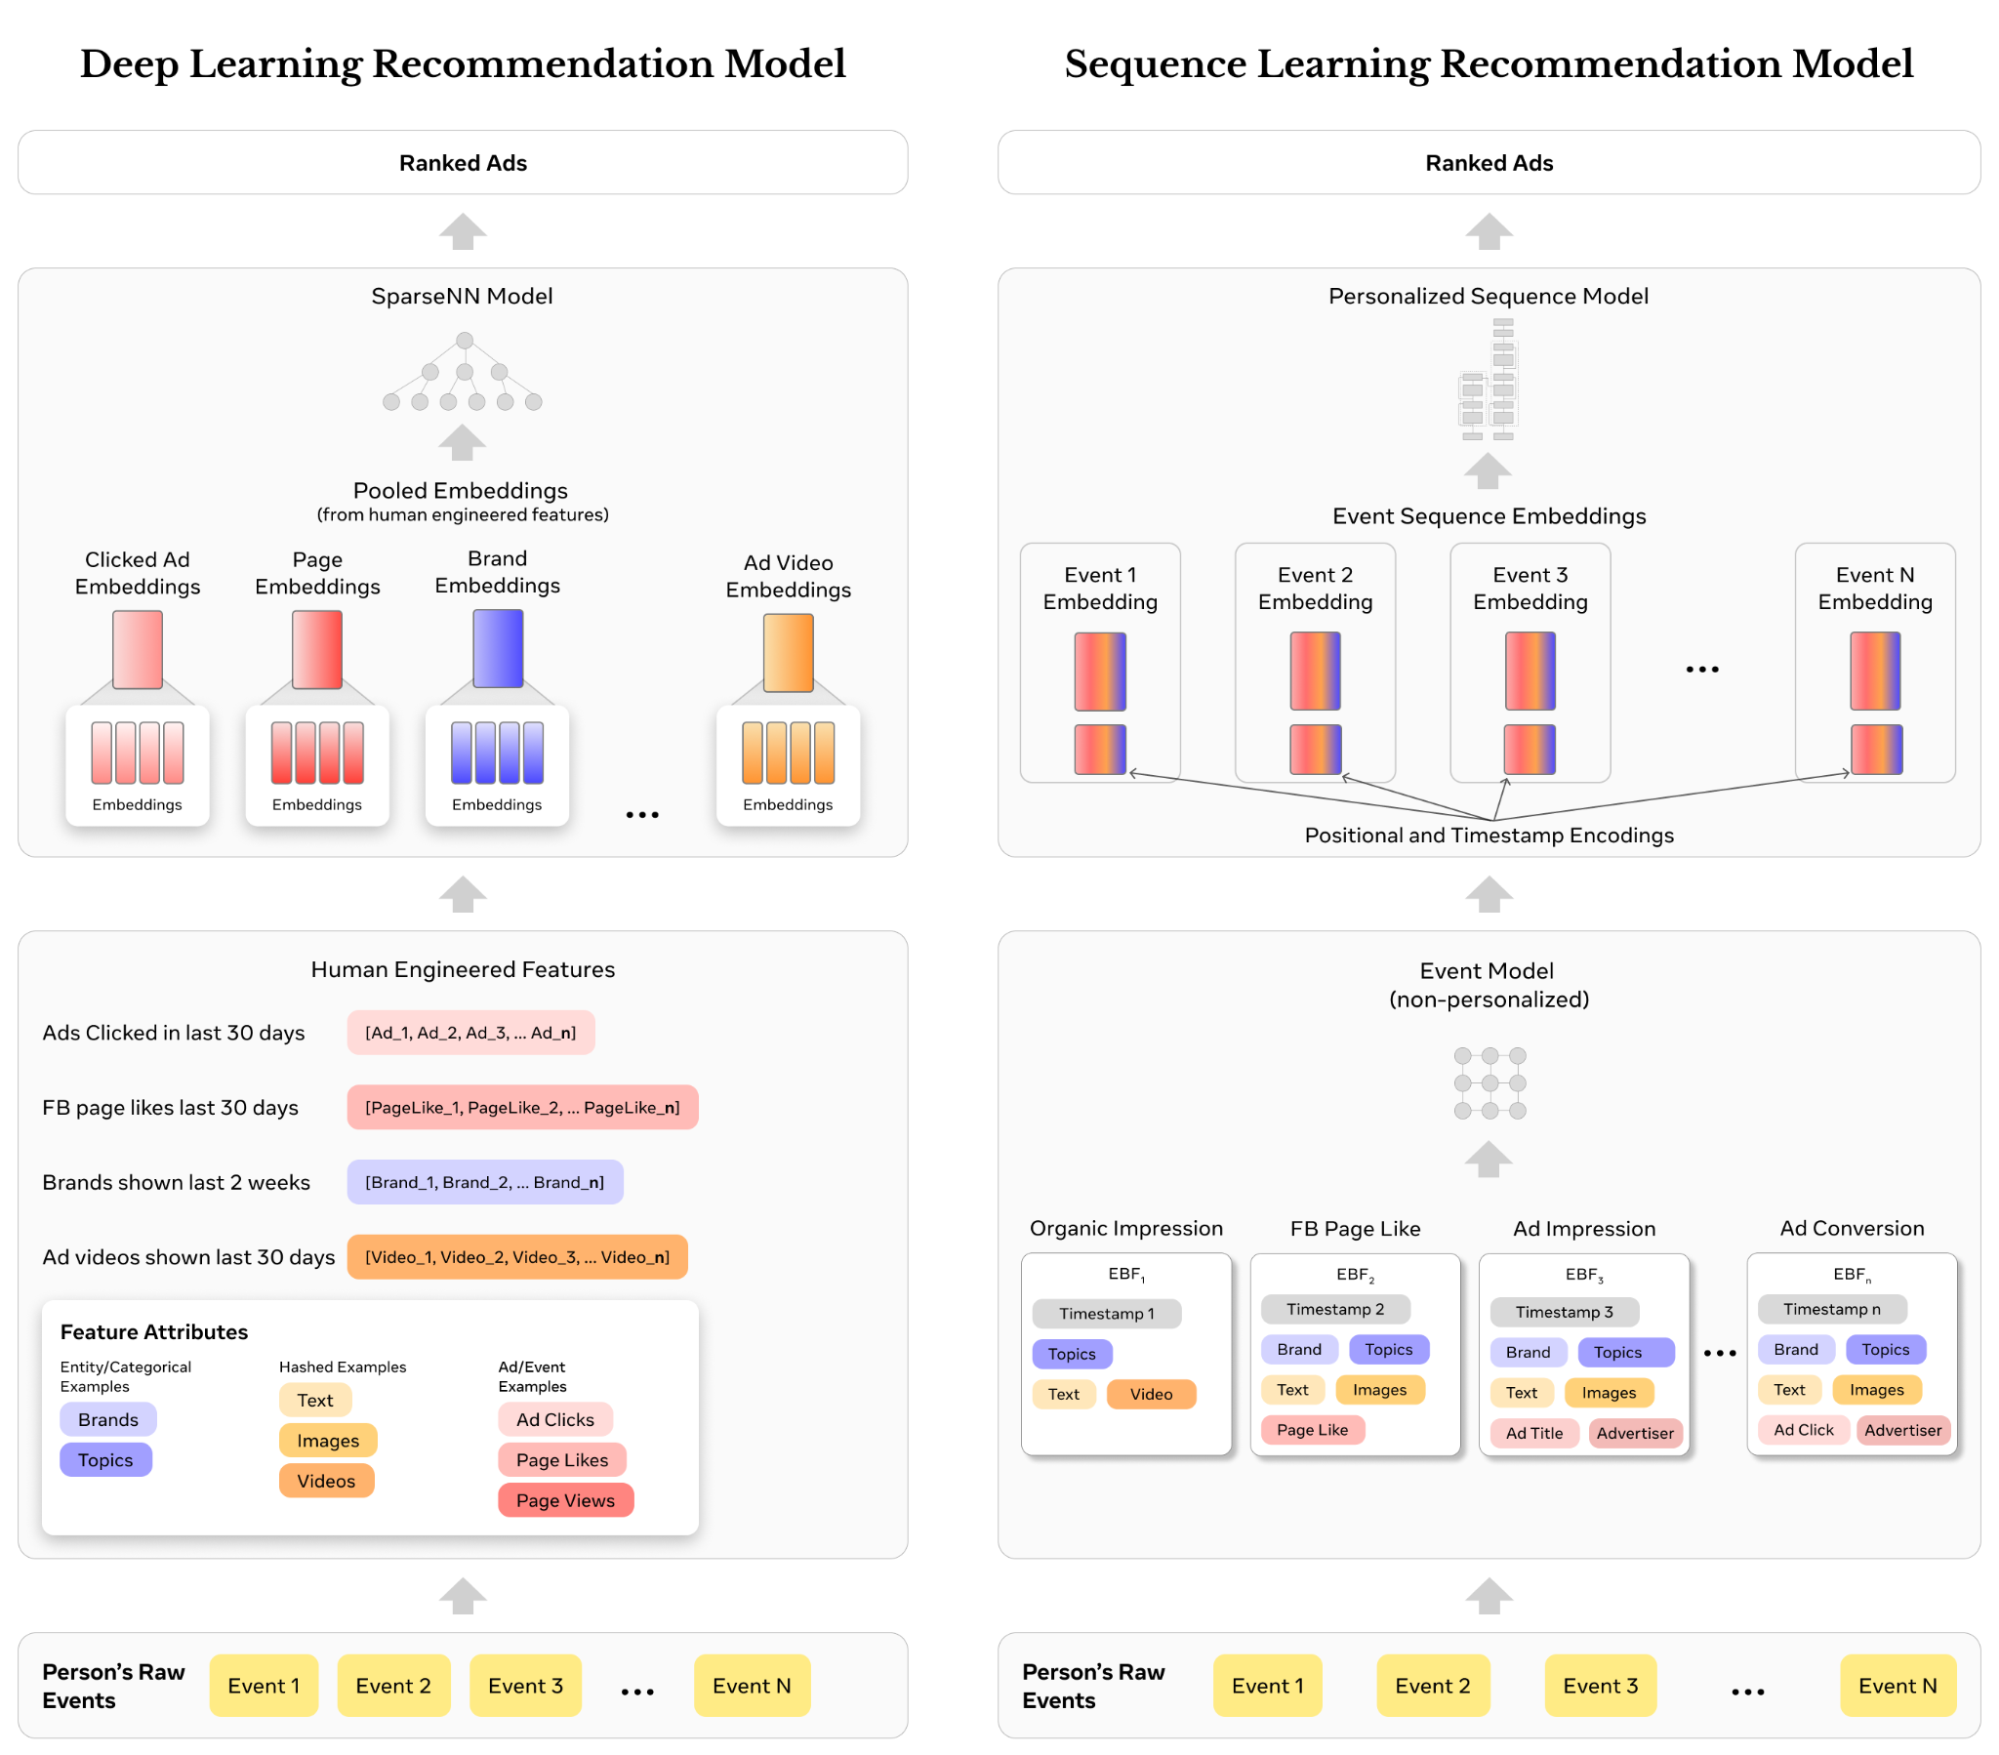
Слева агрегаты действий и объединённые векторы DLRM; справа атрибуты каждого события, позиция и время сохраняются до модели последовательности. Числа 30 дней и 2 недели здесь примеры старых признаков, не размеры новой истории.
Источник: Оригинальный материалПосле смены представления главной задачей стало масштабирование
Когда система перешла от разреженных агрегатов к последовательностям событий, Meta выделила два направления масштабирования. Первое — сделать саму последовательную архитектуру достаточно быстрой и эффективной для работающей рекламной системы. Второе — дать ей читать более длинные истории и более богатое содержание каждого события. Эти задачи связаны: чем меньше информации сворачивается заранее, тем больше потенциально получает модель и тем тяжелее становятся вычисления и обмен данными.
Scaling the new sequence learning paradigmПеременная длина истории: unpooled и jagged tensors
Для более полного моделирования последовательности Meta разработала собственную Transformer-архитектуру со сложными схемами кодирования признаков. Она должна была упростить эксперименты с современными методами последовательного моделирования, но одновременно соответствовать требованиям работающей системы. В статье не называется отдельное имя этой архитектуры и не приводятся её размеры. Инженерное ограничение сформулировано через запрос: рекламная система должна ранжировать тысячи объявлений за несколько сотен миллисекунд. Это требование к системе, а не опубликованный замер задержки новой модели до и после изменений.
Старая инфраструктура была хорошо оптимизирована под фиксированные векторы, полученные после простого объединения, например суммирования или усреднения. Новая архитектура переходит к неагрегированным, или unpooled, эмбеддингам, чтобы учить взаимодействия между отдельными признаками до того, как они потеряются при сведении в один вектор. Цена этого решения — переменная длина данных: у разных людей разное число событий.
Такие последовательности представлены как jagged tensors — тензоры, где строки фактически имеют разную длину. Длинные переменные последовательности и unpooled embeddings увеличивают объём вычислений и коммуникаций и делают этот объём менее равномерным от примера к примеру. Поэтому поддержка jagged-формата становится частью архитектуры системы, а не мелкой деталью хранения.
Важная граница результата: Meta связывает новую систему с более эффективной инфраструктурой, но статья не сообщает процент снижения вычислительной стоимости, памяти или задержки. Поэтому здесь корректно говорить только о направлении инженерного улучшения и перечисленных механизмах, а не о конкретном проценте экономии ресурсов.
Scaling sequence learning architecturesКак сделать историю длиннее и само событие богаче
После того как последовательность стала основным входом, ценность можно наращивать двумя разными способами: давать модели больше событий из прошлого и сохранять больше смысла внутри каждого события. В статье эти направления разделены, и используемые для них способы квантизации тоже различаются.
Таблицу можно прокрутить по горизонтали.
Квантизация с несколькими уровнями точности в части про длинные истории и специальная векторная квантизация в части про богатые атрибуты — не одно и то же утверждение. Первая техника названа как способ эффективнее масштабировать длину последовательности, вторая — как способ компактнее кодировать векторные атрибуты событий. Value-based sampling тоже перечислен среди техник для увеличения длины, но статья не раскрывает ни критерий value, ни правило отбора событий.
Scaling with longer, richer sequencesЧто уже получено, а что Meta оставляет на будущее
В финальном разделе авторы пишут, что подход с последовательностями событий широко принят в рекламных системах Meta и связывают его с улучшением релевантности и производительности рекламы, более эффективной инфраструктурой и ускорением исследовательского цикла. Во вступлении также сказано, что после запуска выросла точность предсказаний рекламы; численный бизнес-результат там сформулирован как 2–4% больше конверсий на отдельных сегментах.
Это число нужно читать буквально: 2–4% больше конверсий именно на отдельных сегментах. Речь не обо всём рекламном трафике Meta, не об абсолютных процентных пунктах и не о другой метрике. Статья не раскрывает размер и длительность эксперимента, доверительные интервалы или полный перечень сегментов. Для инфраструктуры численный процент экономии также не опубликован.
Поэтому 100X нельзя описывать как уже достигнутое масштабирование. Точно так же линейное внимание, модели пространства состояний и оптимизация KV cache в этой статье — планы «going forward», а не детали развернутой системы. Материал не называет конкретный протокол применения модели, тип GPU, размеры сети или отдельное имя архитектуры, и эти пробелы лучше сохранить, чем заполнять предположениями.
The impact and future of sequence learningИтог: как история событий превращается в ранжирование рекламы
Путь Meta начинается не с замены DLRM «более современной сетью», а с изменения того, что вообще получает модель. Прежние агрегаты удобно сводили огромный поток действий в признаки, но при этом теряли порядок событий, совместность атрибутов и требовали множества ручных вариантов. EBF сохраняет структуру каждого события, а последовательная модель получает возможность читать одну и ту же историю с учётом конкретного рекламного кандидата.
- 01
История в формате EBF
Система получает последовательности событий по нужным потокам. В каждом событии сохраняются его атрибуты и временная информация; статья не задаёт одну общую длину для всех потоков.
- 02
Векторы событий
Модель события строит эмбеддинги атрибутов, линейно сжимает их в представление события и объединяет его с кодированием времени.
- 03
История с учётом кандидата
Последовательная модель обобщает векторы событий в представления, привязанные к объявлению, которое сейчас нужно ранжировать. Значение параметра M и точная внутренняя конфигурация не раскрыты.
- 04
Оценка объявления
Полученное персонализированное представление используется для ранжирования кандидата. Формулу итоговой оценки статья не публикует, поэтому точный путь вычисления оценки достраивать нельзя.
- 05
Ранжированный список
Запрос в целом должен упорядочить тысячи объявлений за несколько сотен миллисекунд. Полный путь обработки запроса и распределение вычислений между компонентами источник не описывает.
Обучение и инфраструктурная подготовка находятся вне этого процесса запроса. Для историй переменной длины Meta добавляет поддержку jagged tensors в PyTorch, оптимизированные ядра GPU и Jagged Flash Attention; для масштабирования длины истории использует квантизацию с несколькими уровнями точности и value-based sampling, а для богатых векторных атрибутов — отдельную векторную квантизацию.
После запуска Meta сообщает о 2–4% большем числе конверсий на отдельных сегментах и качественно — о более эффективной инфраструктуре, без процента экономии. Следующие шаги ещё впереди: 100-кратное дальнейшее увеличение последовательностей, линейное внимание, модели пространства состояний, оптимизация KV cache и дальнейшее мультимодальное обогащение.
The impact and future of sequence learning