Разбор готов
ARGUS в Яндексе: как масштабировали рекомендательные трансформеры
В Яндекс Музыке нужно выбирать подходящие треки из огромного каталога за жёстко ограниченное время, учитывать меняющиеся интересы и при этом использовать длинную историю слушателя. Рекомендательные трансформеры долго оставались сравнительно небольшими и часто обучались только по положительным действиям пользователя. Команда Яндекса решила проверить идею, похожую на масштабирование языковых моделей: дать модели гораздо больше данных и ёмкости, но одновременно сделать задачу предварительного обучения более общей. Так появился ARGUS — подход, который моделирует не только следующий объект, но и реакцию пользователя. В разборе проследим весь путь: от многостадийной рекомендательной системы и ограничений SASRec до двух задач ARGUS, упрощённой архитектуры, ускорения обучения, экспериментов от 3,2 млн до 1,007 млрд параметров и результатов внедрения.
Материал полезен ML-инженерам и исследователям рекомендательных систем, которые работают с последовательностями действий, двухбашенными моделями, отбором кандидатов или ранжированием. На одном промышленном примере видно, почему для масштабирования недостаточно просто увеличить трансформер: приходится одновременно менять обучающую задачу, способ обработки истории и процедуру дообучения под рабочий ранкер.
Статья · на русском
ARGUS: как масштабировать рекомендательные трансформерыКирилл Хрыльченко · Опубликовано: 20 июня 2025 г.
Где трансформер находится в рекомендательной системе
Задача рекомендаций выглядит просто только на уровне формулировки: для каждого пользователя нужно выбрать объекты, которые ему понравятся. В реальной системе каталог может содержать миллионы или миллиарды объектов, интересы пользователей меняются, взаимодействия разрежены, а само понятие «понравилось» приходится определять через разные сигналы. У Яндекса есть триллионы обезличенных взаимодействий и много неструктурированных данных об объектах — названия, описания, изображения, аудио. Поэтому модели должны не только запоминать ID, но и уметь кодировать пользователя и объект по содержанию, в том числе для новых объектов и пользователей с небольшой историей.
Из-за ограничений по задержке и вычислительным ресурсам рекомендации строятся в несколько стадий. Сначала быстрые модели отбирают из всего каталога сравнительно небольшой набор кандидатов — обычно сотни или тысячи объектов. Затем более тяжёлые модели ранжируют уже этот набор. Такое разделение принципиально: архитектура, которая подходит для ранжирования небольшого списка, может оказаться слишком дорогой для поиска по всему каталогу.
Для отбора кандидатов удобна двухбашенная модель: одна нейросеть строит вектор пользователя, другая — вектор объекта, а совместимость измеряется скалярным произведением. Векторы объектов можно регулярно считать заранее — например, ежедневно. Для большого каталога по ним строят индекс приближённого поиска, например HNSW. Построение и быстрое обновление такого индекса само по себе является тяжёлой офлайновой операцией, зато во время пользовательского запроса достаточно получить вектор пользователя и найти ближайшие объекты.
Для ранжирования можно использовать те же векторы либо более выразительную модель с ранним связыванием, которая совместно обрабатывает пользователя и конкретный объект. Такая модель способна выучить более сложные зависимости, но её приходится пересчитывать для каждого кандидата: факторизации вычислений, как у двух башен, уже нет. В Яндексе используются оба семейства архитектур, но автор отмечает, что двухбашенные модели применяются чаще: они дешевле и подходят сразу к нескольким стадиям рекомендательной системы.
Пользовательский вектор в современных моделях строят из последовательности событий с помощью трансформера. До ARGUS команда обычно обучала двухбашенную модель в два этапа: сначала контрастивно сближала пользователя с понравившимися объектами и отдаляла от случайных, затем дообучала под конкретную задачу. Для ранжирования такой задачей могло быть попарное сравнение двух показанных объектов с разным фидбеком.
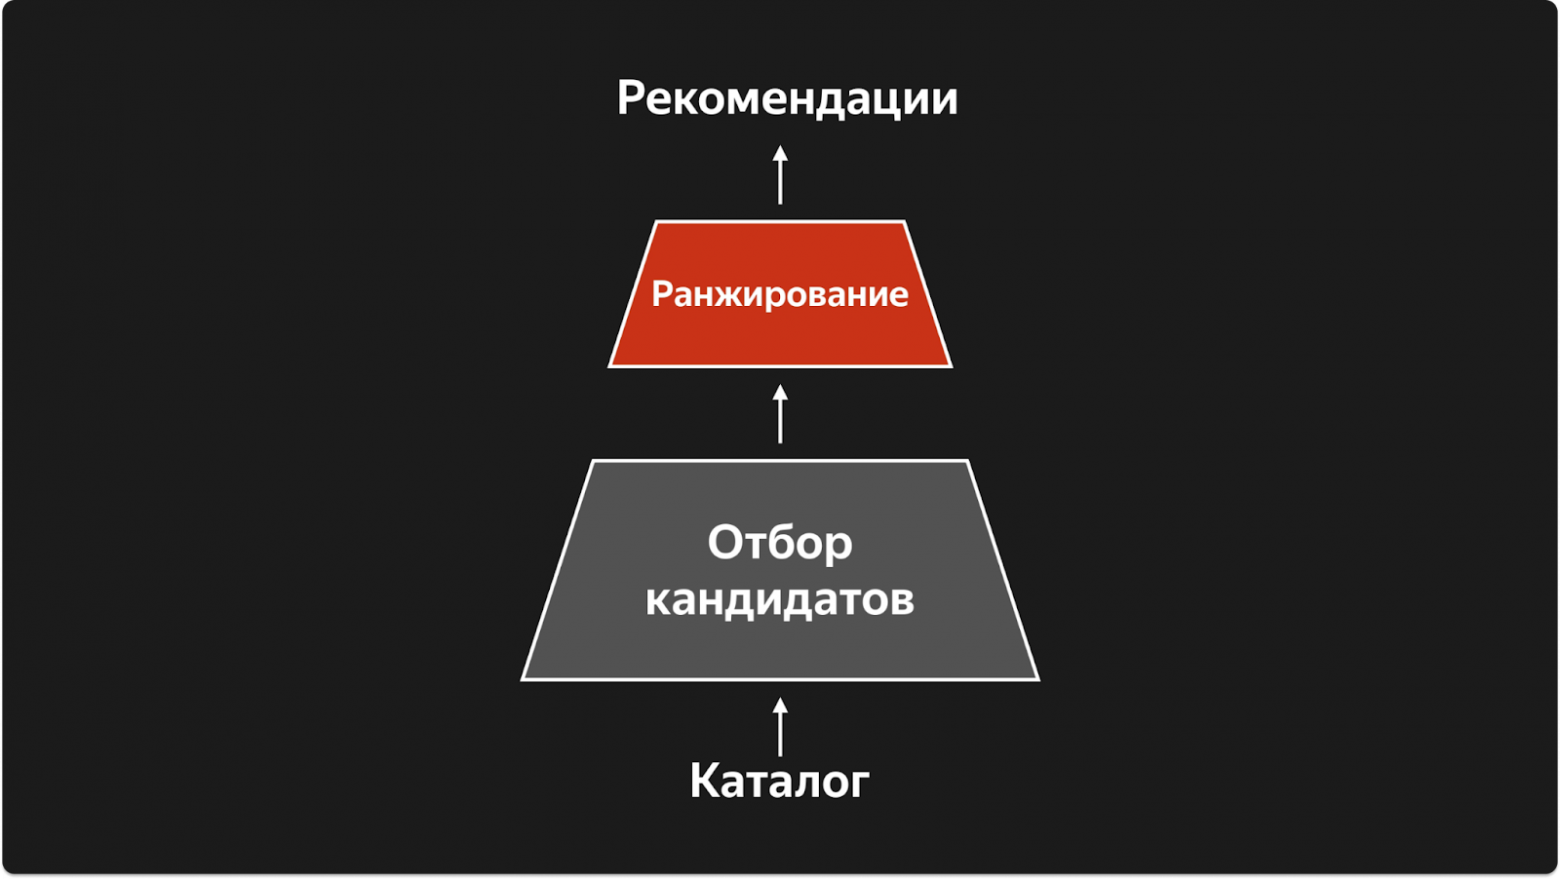
Схема многостадийной рекомендательной системы: каталог сначала сужается отбором кандидатов, затем кандидаты ранжируются.
Источник: Кирилл Хрыльченко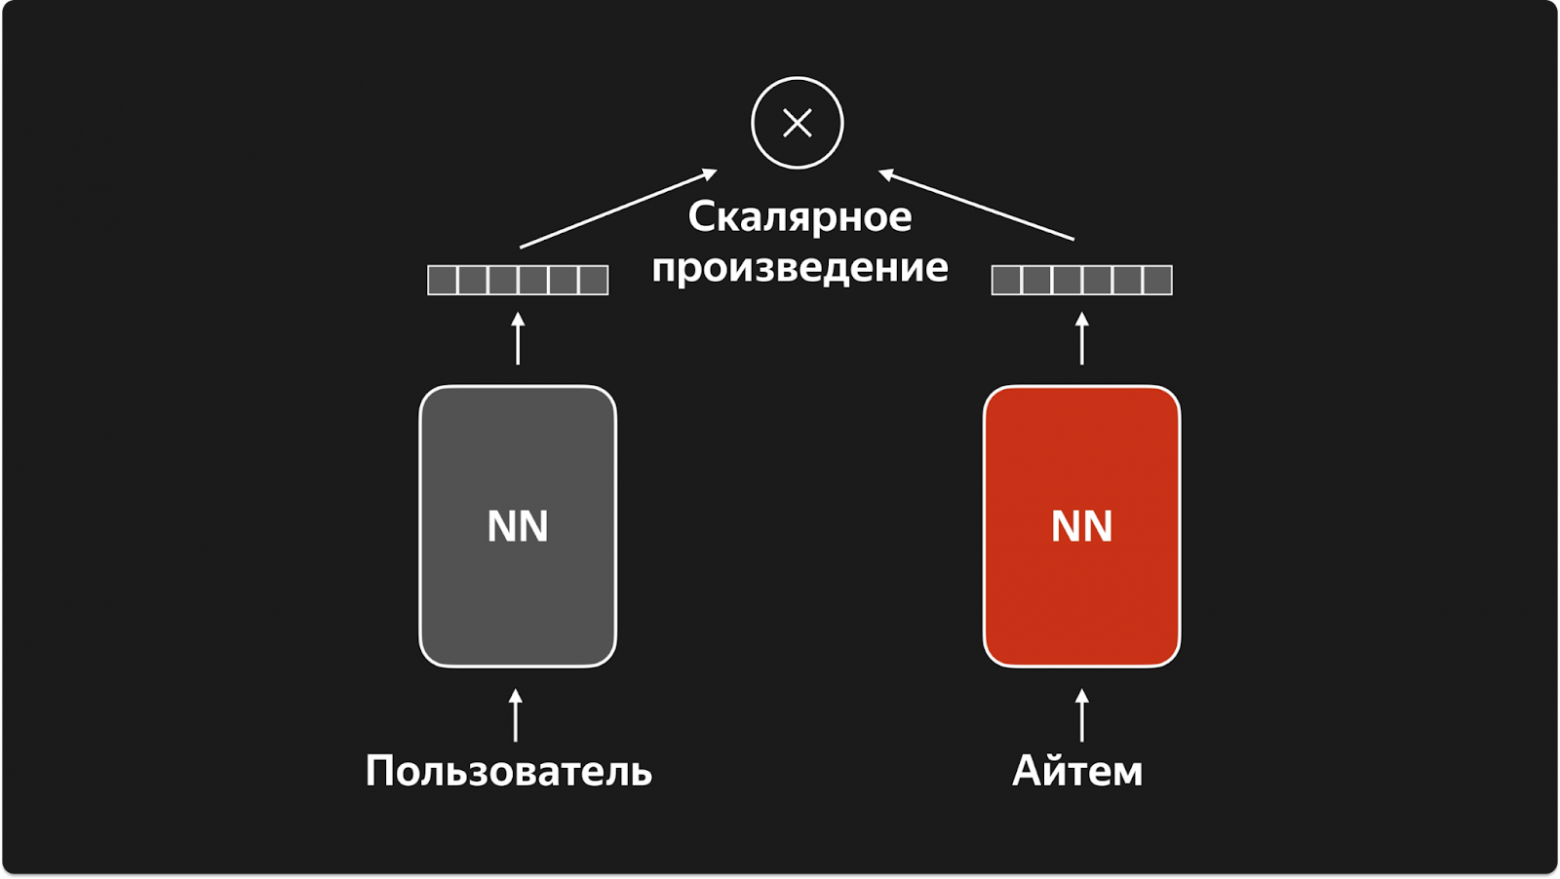
Двухбашенная модель: отдельные нейросети кодируют пользователя и объект, после чего два вектора сравниваются скалярным произведением.
Источник: Кирилл Хрыльченко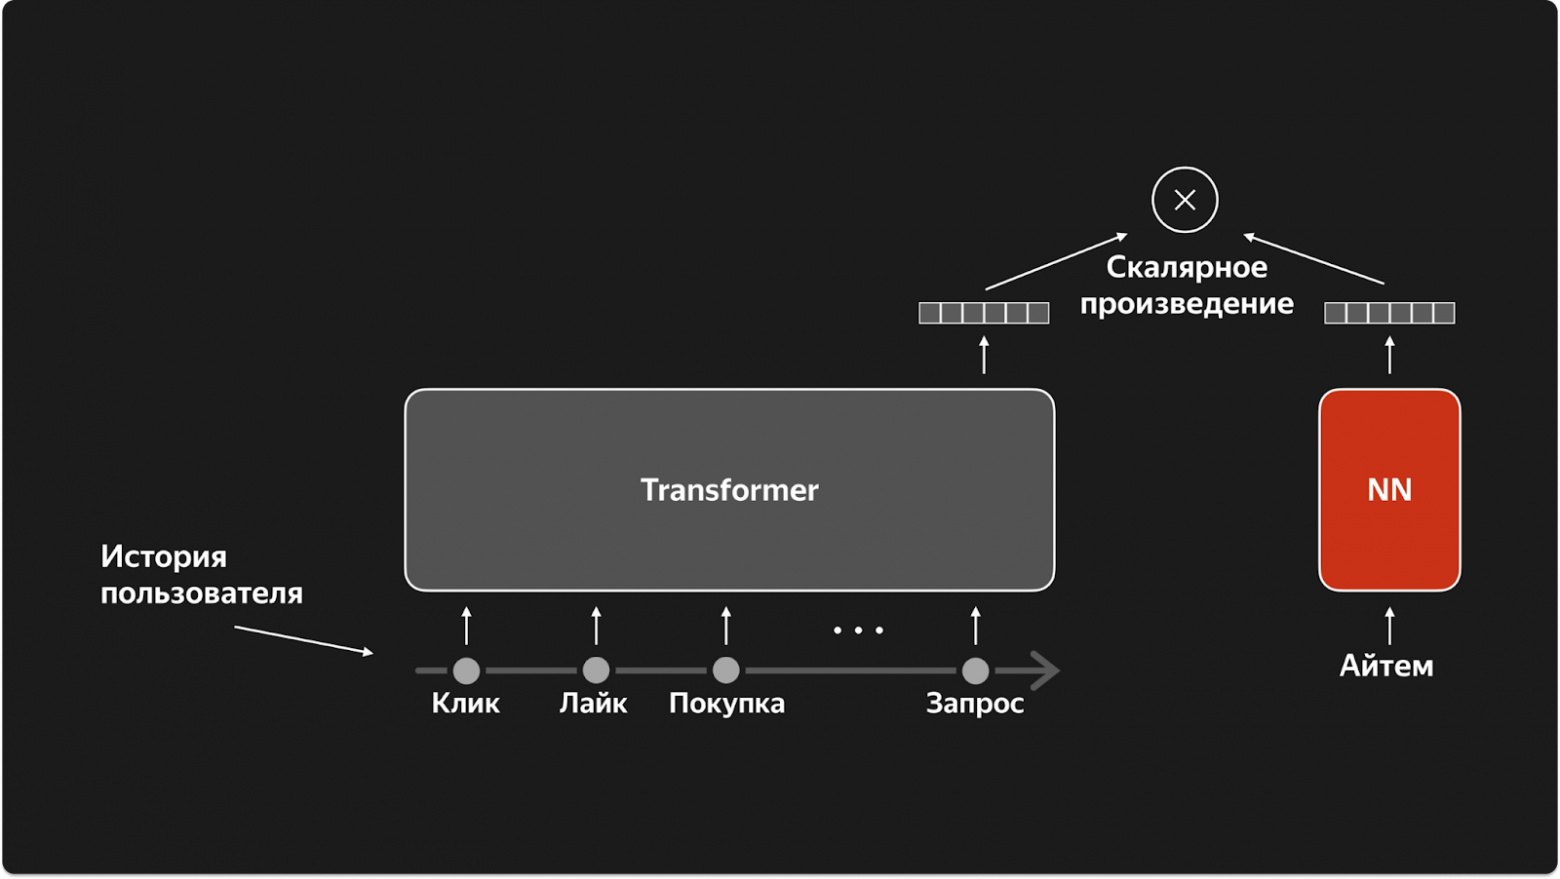
Пользовательская башня на трансформере получает историю событий — клики, лайки, покупки и другие действия; объектная башня остаётся независимой.
Источник: Кирилл ХрыльченкоЧто именно можно масштабировать
Вопрос команды был не просто «сделать модель больше», а понять, по каким осям рекомендации вообще способны масштабироваться. В статье выделены четыре независимых направления: матрицы эмбеддингов для категориальных признаков, объём контекста, размер обучающего набора и ёмкость самого энкодера. Большие данные и огромные таблицы эмбеддингов в индустрии уже давно существуют. Гораздо менее очевидным оставалось, есть ли смысл резко увеличивать длину истории и трансформер, который её обрабатывает.
Таблицу можно прокрутить по горизонтали.
Поэтому ключевая гипотеза ARGUS звучит так: если данные и огромные таблицы признаков уже есть, то следующий скачок может прийти от сочетания гораздо более длинной истории, более крупного энкодера и более общей задачи обучения. Простое увеличение числа слоёв без изменения постановки эту гипотезу ещё не проверяет.
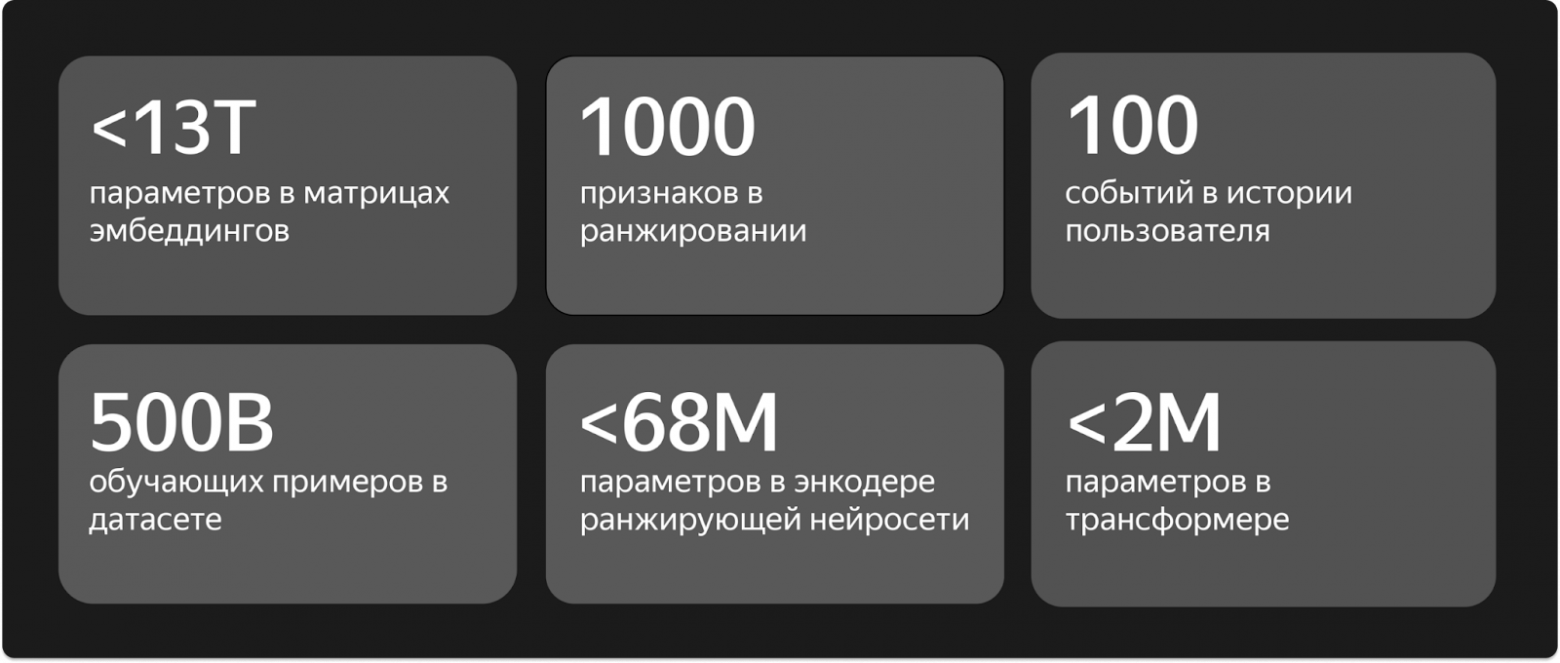
Слайд с масштабами разных частей рекомендательной системы: <13T параметров эмбеддингов, 1000 признаков ранжирования, 100 событий истории, 500B примеров, <68M параметров энкодера ранжирования и <2M параметров трансформера.
Источник: Кирилл ХрыльченкоПочему HSTU стал важной точкой отсчёта
На момент февраля 2024 года длинная история и большой энкодер оставались открытым вопросом. В статье инженеров Meta «Actions speak louder than words» была предложена архитектура HSTU и генеративная постановка для рекомендаций. Авторы работали с историей длиной до 8 тысяч событий и датасетом на 100 млрд примеров — заметно больше типичных последовательных моделей того времени.
Но даже самая крупная упомянутая конфигурация энкодера HSTU имела 176 млн параметров. Автор ARGUS подчёркивает, что по меркам современных языковых моделей это всё ещё небольшой масштаб, и отдельно отмечает, что из последующих публикаций ему неясно, была ли именно крупнейшая конфигурация внедрена. Для команды Яндекса это стало поводом проверить более радикальный рост энкодера и выяснить, продолжает ли качество рекомендаций расти после сотен миллионов параметров.
«Масштабирование рексистем», абзацы про HSTU и вопросы перед созданием ARGUSИз LLM взяли не архитектурный трюк, а принцип задачи обучения
После обзора работ по масштабированию команда сформулировала три условия, при которых рост нейросети имеет шанс давать устойчивый эффект: очень много данных, достаточно выразительная архитектура и максимально общая фундаментальная задача обучения. В рекомендациях первые два условия достижимы: есть триллионы взаимодействий и можно использовать трансформеры. Значит, основной вопрос — чему именно учить модель.
В качестве интуиции автор проводит аналогию с предварительно обученной языковой моделью. Если просто задать ей вопрос, она может воспроизвести наиболее типичный ответ из обучающих данных; промпт вроде «представь, что ты хороший специалист в области X» помогает получить более подходящее поведение. Объяснение автора состоит в том, что модель в процессе сжатия большого массива данных учит не только конкретные ответы, но и более общие закономерности. Для рекомендаций похожая цель означает: не только повторять действия прежней системы, но и построить модель пользователя, чтобы уметь отличать удачный показ от неудачного.
Эту логику автор описывает через обучение с подкреплением. Рекомендательная система выступает агентом, рекомендация — действием, пользователи и их поведение — окружением, распределение вероятностей по объектам — политикой, а положительная реакция — наградой. Награда может быть и сильно отложенной: в качестве примеров источник приводит подписку через месяц или покупку через несколько недель. Прошлая система, которая выбирала показы и тем самым создала обучающие логи, задаёт правила прошлой выдачи. Новая модель должна одновременно уметь имитировать эти правила, понимать предпочтения пользователя и на этой основе корректировать решения.
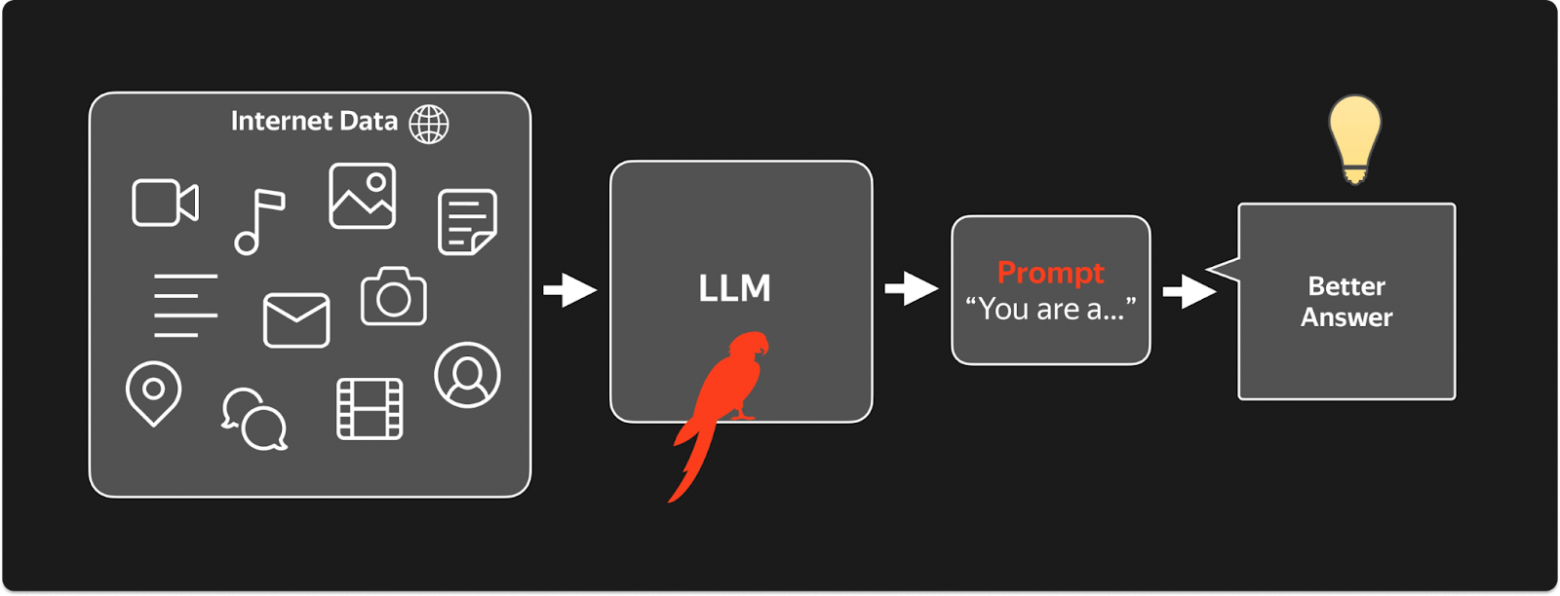
Авторская аналогия: данные интернета обучают LLM, а дополнительный контекст запроса помогает получить более подходящий ответ.
Источник: Кирилл Хрыльченко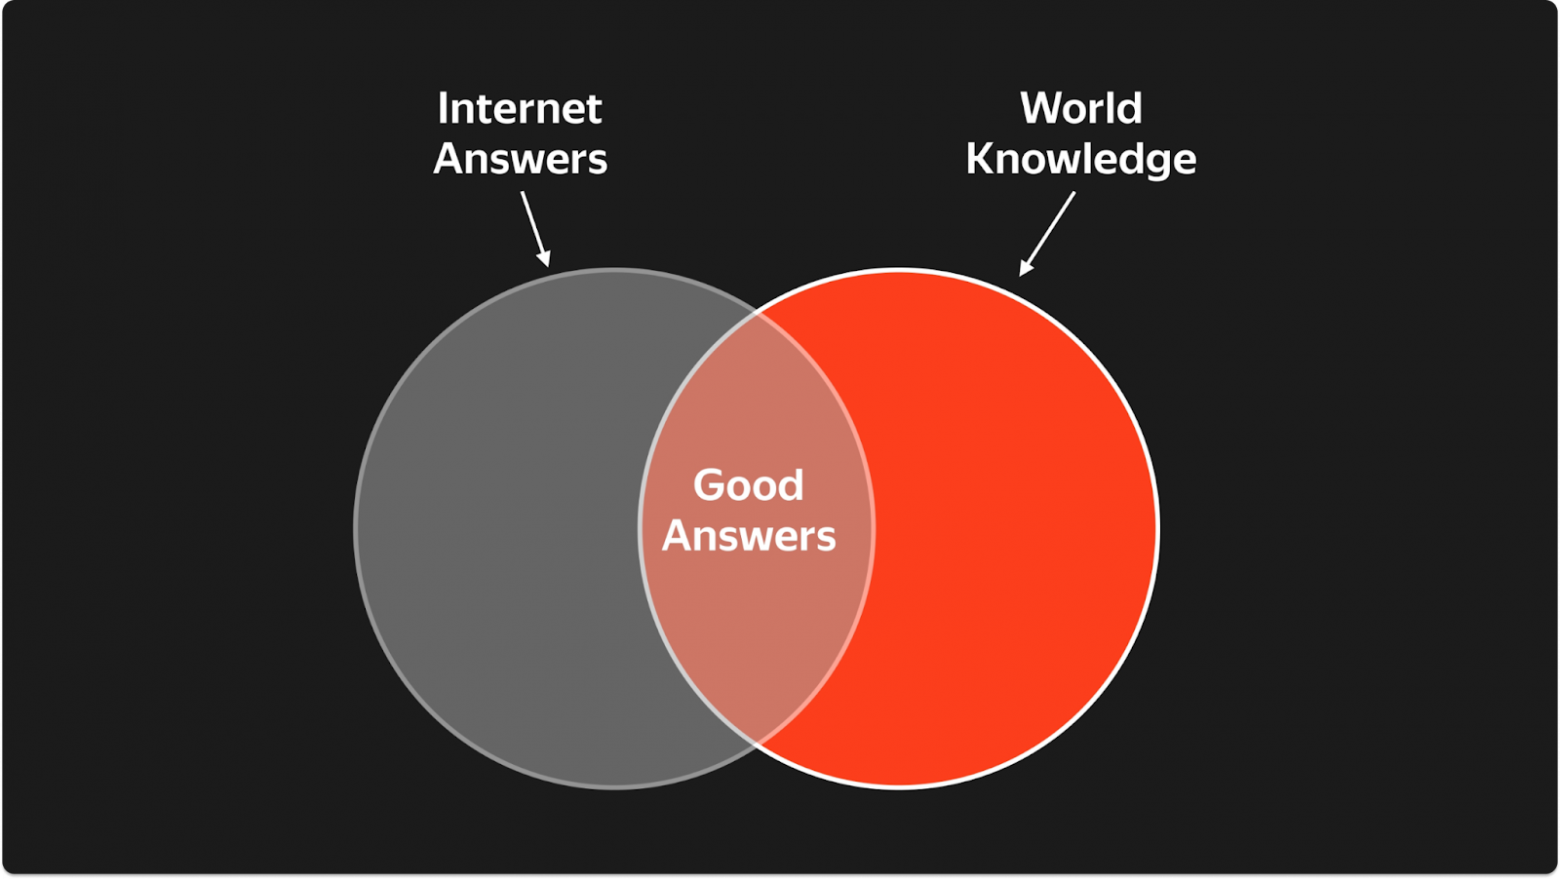
Диаграмма автора связывает хорошие ответы с пересечением наблюдавшихся ответов и более общих знаний модели.
Источник: Кирилл Хрыльченко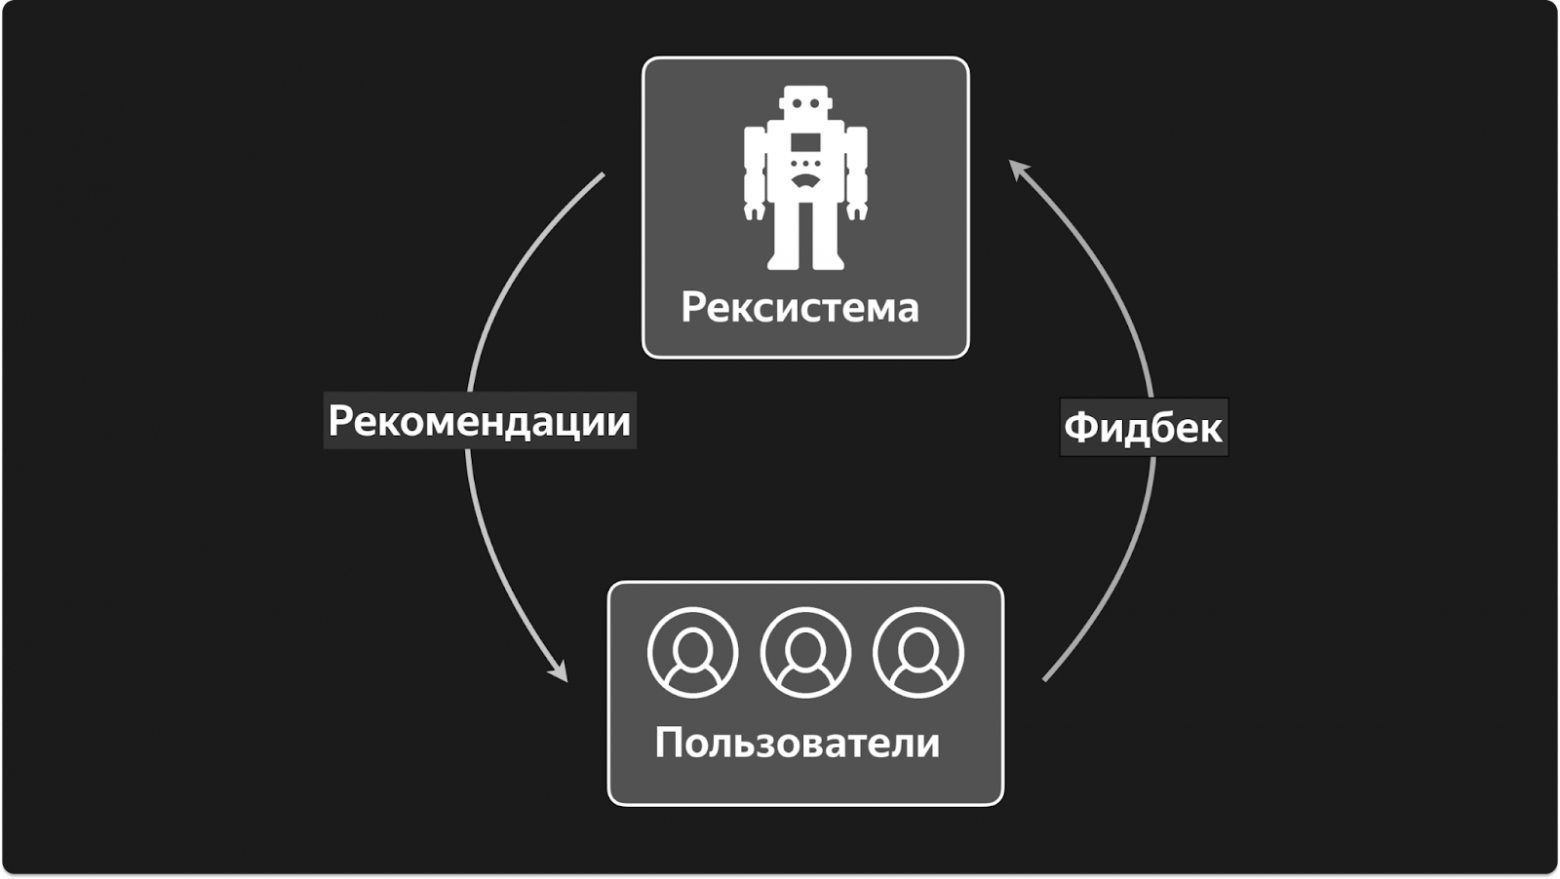
Рекомендательная система формирует рекомендации, пользователи дают обратную связь, а следующий цикл использует этот сигнал.
Источник: Кирилл ХрыльченкоПочему обычного next item prediction команде оказалось мало
Классическая последовательная постановка, яркий пример которой — SASRec, берёт историю положительных действий и учит модель предсказывать следующий положительный объект. Если история состоит из покупок, задача сводится к предсказанию следующей покупки. Это прямой аналог next token prediction, только вместо слов — объекты каталога.
Для цели ARGUS такой постановки не хватает двух вещей. Во-первых, модель не видит полной картины прошлых показов: в последовательности остаются в основном успешные взаимодействия, поэтому трудно понять, что вообще могла предложить действовавшая тогда рекомендательная система. Во-вторых, отрицательная реакция пользователя в значительной степени теряется. Модель учится по тому, что произошло успешно, но не получает явной задачи моделировать, что человеку не понравилось.
Важно, что это не утверждение о бесполезности SASRec. В источнике критика относится к конкретной цели: научить большую модель одновременно воспроизводить поведение прошлой выдачи и строить более полное представление о предпочтениях пользователя. Для этого история и обучающие цели должны быть богаче.
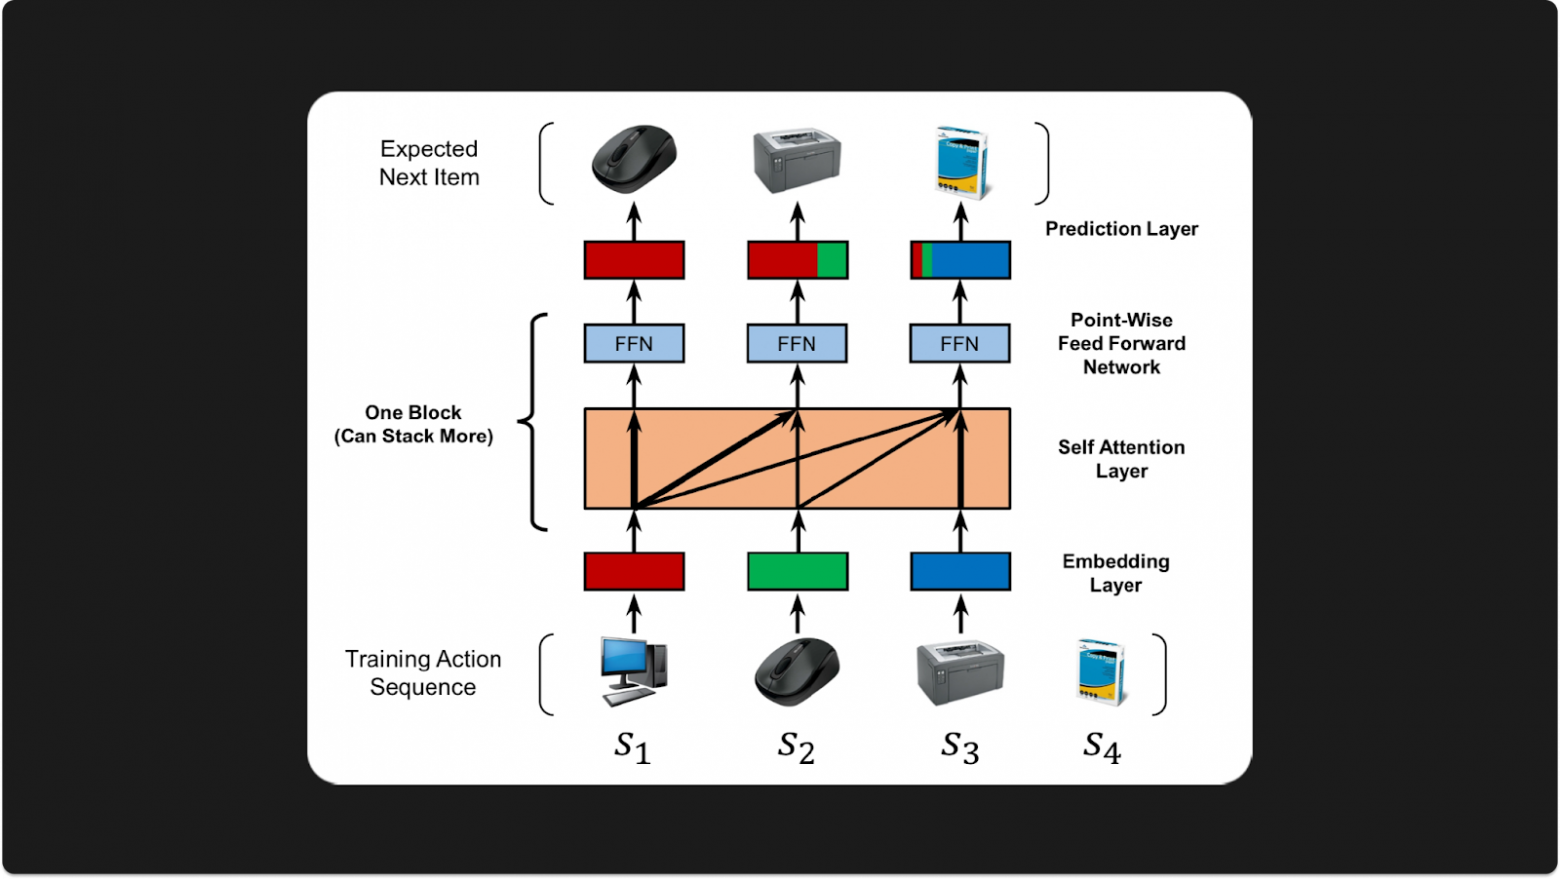
SASRec-подобная постановка: последовательность прошлых действий используется для предсказания следующего объекта.
Источник: Кирилл ХрыльченкоИстория ARGUS: контекст, объект и реакция
ARGUS расшифровывается как AutoRegressive Generative User Sequential modeling. Вместо последовательности только понравившихся объектов модель получает полную анонимизированную историю пользователя. Каждое взаимодействие представляется тройкой «контекст — объект — реакция». Контекст описывает условия события: время, устройство, страницу продукта, настройки «Моей волны» и другие доступные признаки. Объект — например, музыкальный трек. Реакция — то, как пользователь отреагировал: лайк, покупка, доля прослушивания и другие сигналы.
Такой формат важен по двум причинам. Отрицательные взаимодействия больше не исчезают из истории, а контекст позволяет различать действия, возникшие из рекомендации, и органические действия пользователя. На этой общей последовательности ARGUS решает две задачи одновременно: предсказывает следующий объект и предсказывает фидбек на конкретный объект.
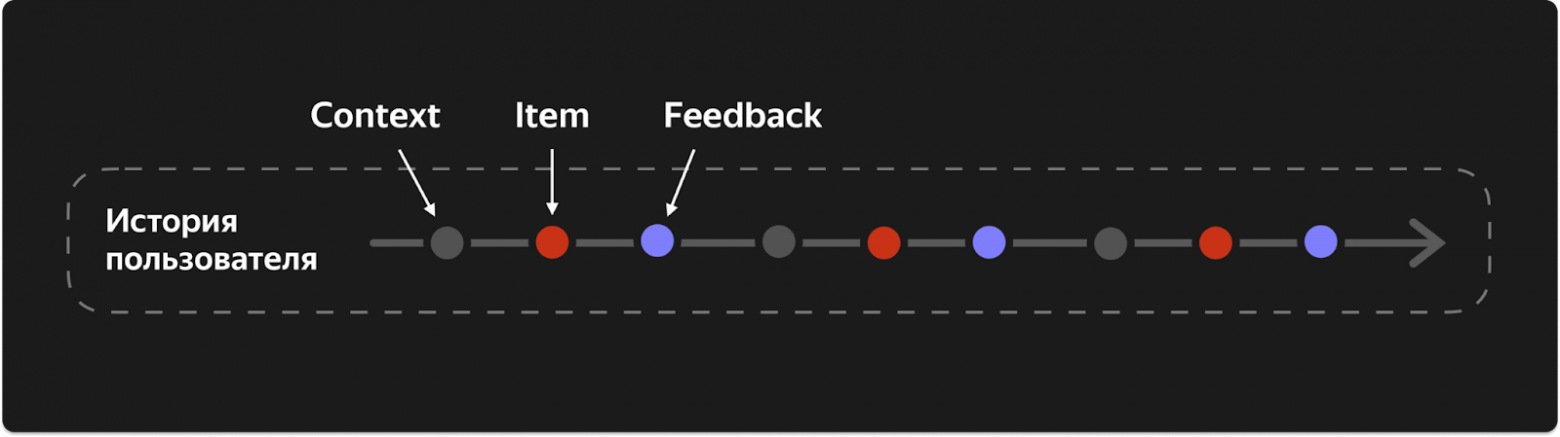
История ARGUS состоит из повторяющихся сущностей Context, Item и Feedback.
Источник: Кирилл ХрыльченкоПервая задача: какой объект появится следующим
Первая цель сохраняет название Next Item Prediction, но отличается от SASRec. Модель оценивает вероятность P(item | history, context): какой объект станет следующим взаимодействием при известной прошлой истории и текущем контексте. Если в данных есть только рекомендательный трафик, такая задача учит воспроизводить правила прошлой выдачи. Если присутствует и органический трафик — например, пользователь сам открыл библиотеку или пришёл из поиска, — модель дополнительно получает сигнал о предпочтениях, который не определяется прошлой рекомендательной системой.
ARGUS предсказывает не только положительные события. В задачу попадают и взаимодействия с отрицательным исходом, а текущий контекст помогает понять, где именно произошло событие и было ли оно рекомендацией. По описанию автора, контекст также уменьшает шум в задаче. Для музыки это особенно существенно: настроение и текущая ситуация могут менять то, что один и тот же пользователь хочет услышать.
Техническая сложность здесь — огромный каталог. Если представить каждый объект отдельным классом, полный softmax потребовал бы вычислить оценки для миллионов или миллиардов классов. Поэтому команда использует sampled softmax: положительный объект сравнивается только с выбранным набором отрицательных. В источнике указана смесь отрицательных объектов из того же пакета примеров и равномерно выбранных объектов, поправка LogQ на вероятность попадания объекта в выборку, а также обучаемая температура, которую ограничивают диапазоном [0.01, 100].
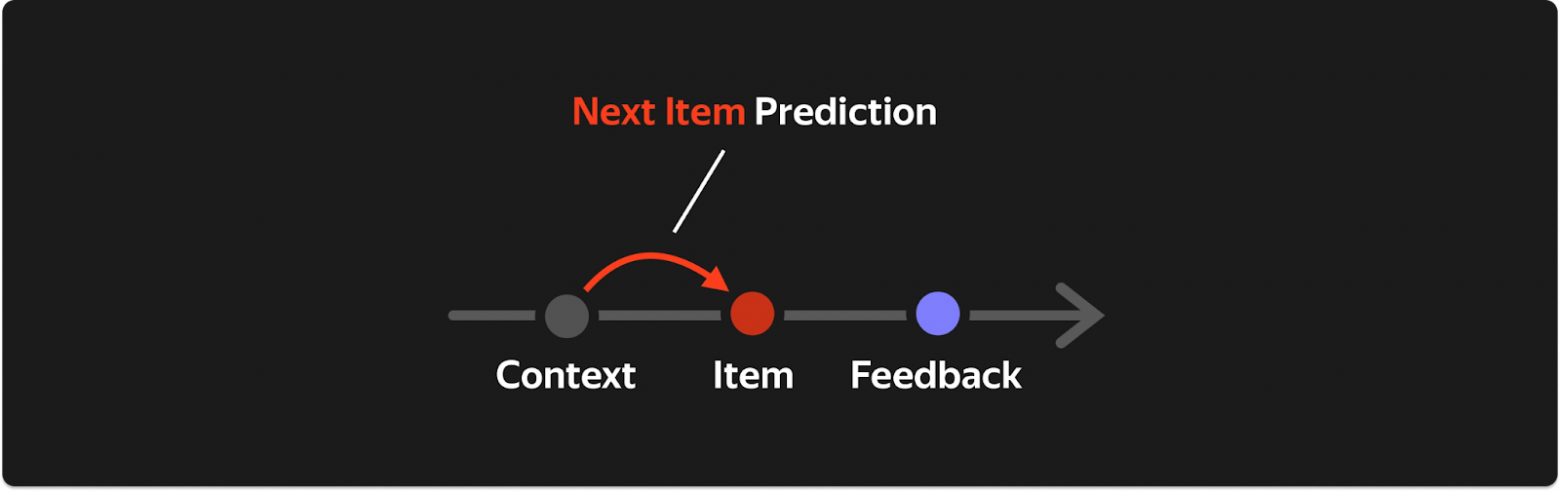
Next Item Prediction: по истории и текущему контексту предсказывается следующий объект.
Источник: Кирилл ХрыльченкоВторая задача: как пользователь отреагирует
Feedback Prediction отвечает на другой вопрос: P(feedback | history, context, item). Модель уже знает историю, текущий контекст и конкретный объект и должна предсказать реакцию пользователя. Эта цель почти не учит имитировать прошлую рекомендательную систему; её роль — построить более содержательную модель интересов пользователя.
Фидбек может состоять сразу из нескольких сигналов. Источник приводит лайк, дизлайк, добавление в плейлист и долю прослушивания. ARGUS разлагает их на отдельные функции потерь: для бинарного события подходит бинарная кросс-энтропия, для других величин можно использовать другую классификацию или регрессию.
Сигналы имеют разную частоту: долгое прослушивание встречается заметно чаще лайка. По наблюдению команды, совместное обучение не мешало модели осваивать все цели; наоборот, частый сигнал помогал моделировать редкий. Автор связывает это с переносом знаний между задачами и отмечает, что с ростом модели ей становилось проще одновременно решать несколько задач без конфликтов.
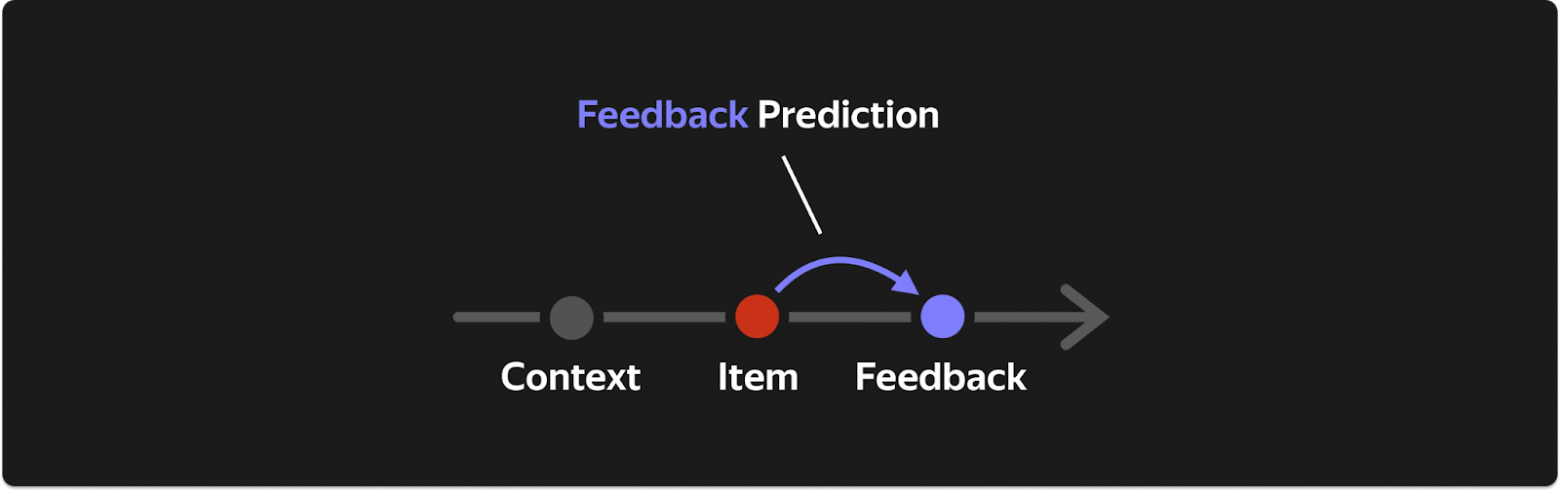
Feedback Prediction: после известного объекта модель предсказывает реакцию пользователя.
Источник: Кирилл ХрыльченкоОдин трансформер, две головы и отличие от SASRec и HSTU
Полная схема ARGUS строится на одной последовательности троек. Трансформер обрабатывает историю, после чего из скрытого состояния контекста модель предсказывает следующий объект, а из состояния объекта — будущую реакцию пользователя. На схеме это две отдельные головы над общей последовательностью: Next Item Prediction обучается sampled softmax, Feedback Prediction — набором классификационных или регрессионных целей.
С SASRec различие становится особенно наглядным. SASRec моделирует P(item | history, positive feedback): история фактически состоит из положительных объектов. ARGUS отдельно моделирует P(item | history, context) и P(positive feedback | history, context, item), поэтому явно разделяет вопрос «что могла показать система» и вопрос «что понравится пользователю».
С HSTU различие другое. В описанной в источнике работе HSTU для отбора кандидатов и ранжирования учатся две отдельные модели. Кандидатная модель содержит полную историю, но функция потерь учитывает только положительные взаимодействия: на отрицательных событиях loss не считается. Ранжирующая постановка ближе к Feedback Prediction. ARGUS делает обе задачи полнее и обучает их одновременно в одном трансформере.
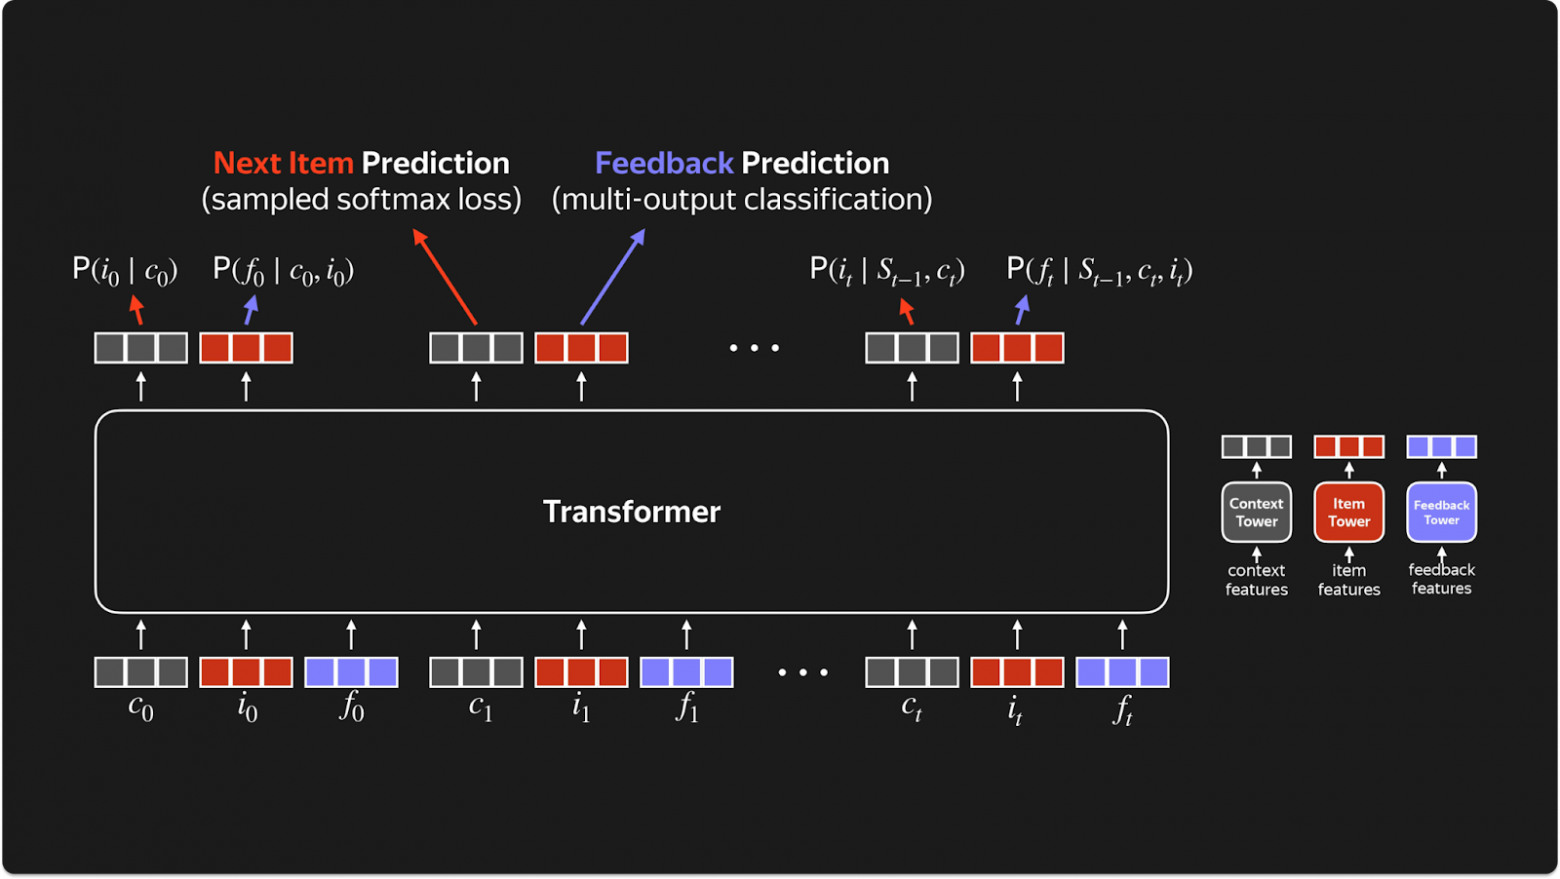
Общий трансформер получает представления context, item и feedback; сверху работают головы Next Item Prediction и Feedback Prediction.
Источник: Кирилл Хрыльченко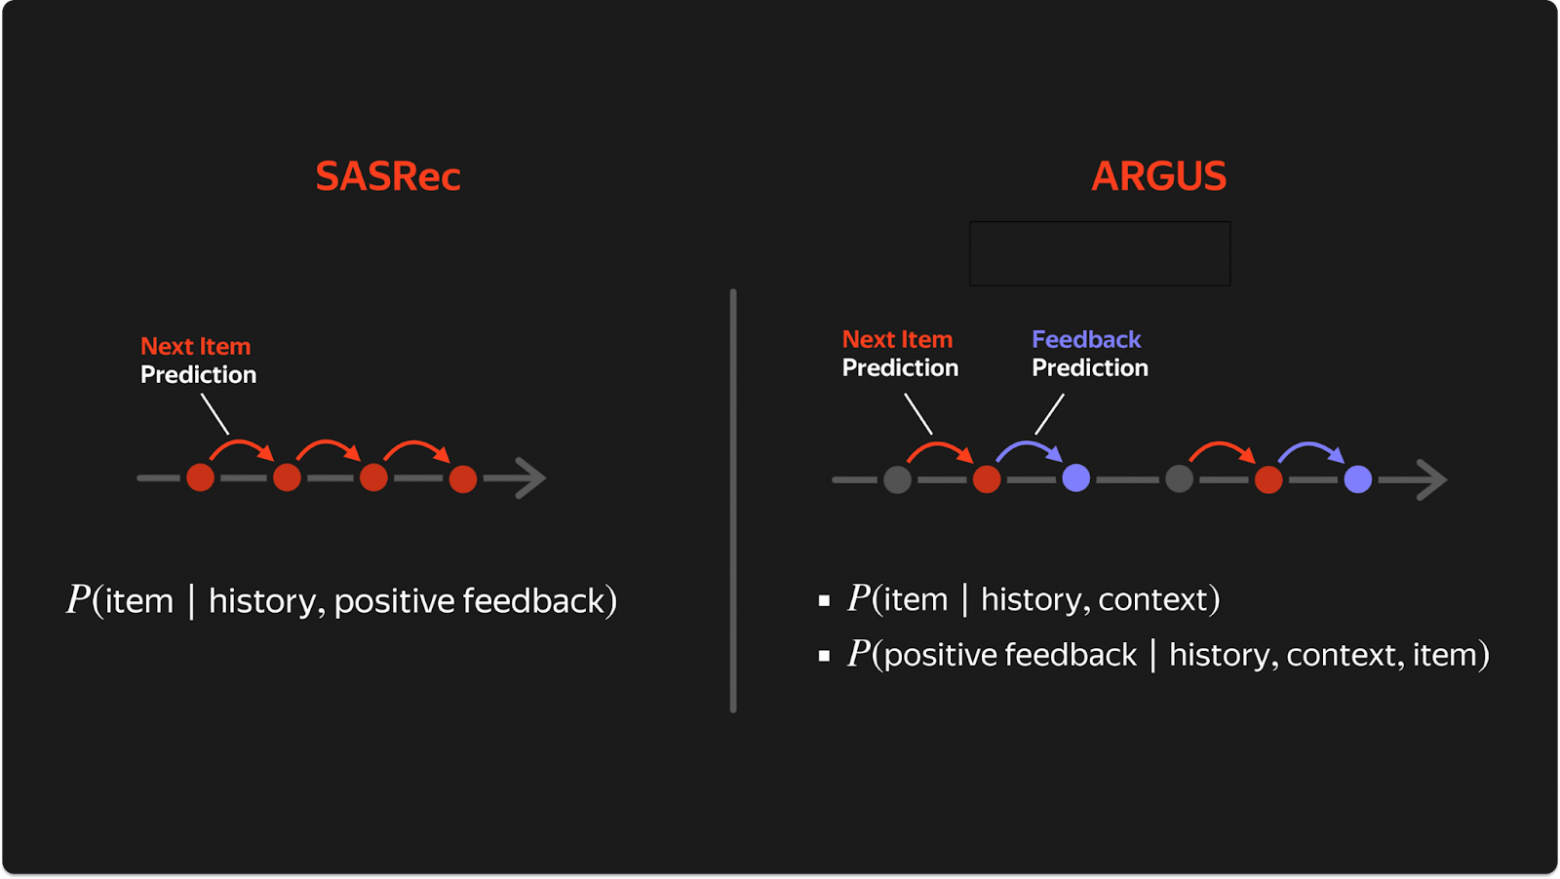
Сравнение постановок: SASRec предсказывает следующий положительный объект, ARGUS разделяет предсказание объекта и пользовательской реакции.
Источник: Кирилл ХрыльченкоПочему полную схему пришлось упростить
Полная токенизация ARGUS дорого обходится по длине последовательности: одно взаимодействие превращается сразу в три токена. Для 8192 последних прослушиваний это почти 25 тысяч токенов. В Яндекс Музыке у активных пользователей могут быть тысячи и десятки тысяч событий, поэтому трёхкратное увеличение истории заметно замедляет обучение. Автор отдельно замечает, что при предобучении LLM средний контекст часто существенно короче максимального и может измеряться сотнями токенов, поэтому прямое сравнение только максимальных контекстных окон вводит в заблуждение.
Команда сделала Simplified ARGUS: тройка «контекст — объект — реакция» сворачивается в один входной вектор, но обе обучающие цели сохраняются. Для предсказания следующего объекта берут скрытое состояние предыдущей тройки, добавляют вектор текущего контекста, сжимают результат полносвязной сетью MLP и применяют sampled softmax. Для предсказания реакции туда же добавляют вектор текущего объекта и отдельной MLP получают целевые величины.
Упрощение делает модель менее чувствительной к конкретному целевому объекту и контексту внутри самого трансформера — в терминах источника, менее target-aware и context-aware. Но практический выигрыш оказался существенным: эта версия ускорила обучение примерно в три раза, сохранив работоспособность двух основных задач.
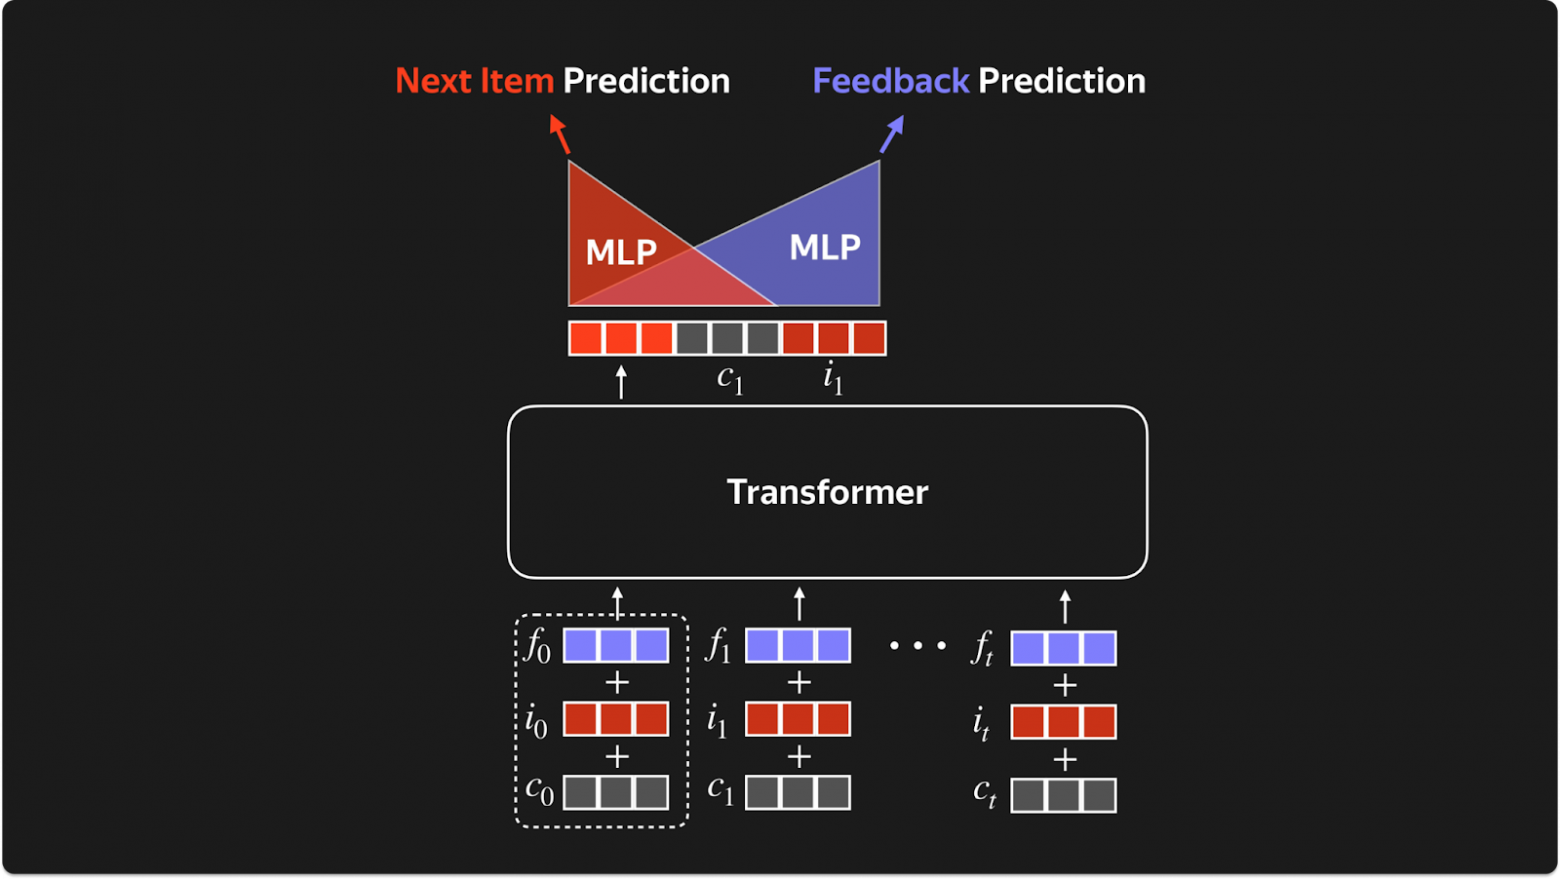
Simplified ARGUS складывает представления контекста, объекта и фидбека в один входной шаг и сохраняет две выходные задачи.
Источник: Кирилл ХрыльченкоПочему ARGUS не стали сразу ставить в работающую систему «как есть»
Предобученная модель уже имеет две полезные головы: Next Item Prediction можно использовать для отбора кандидатов, а Feedback Prediction — для ранжирования. Но первое внедрение команда сознательно сделала иначе. Целью было проверить очень большую модель при умеренной стоимости эксплуатации, поэтому выбрали офлайновую двухбашенную схему: раз в день заранее пересчитывать векторы пользователей и объектов, а во время работы системы оставлять только дешёвое скалярное произведение. Полная предобученная версия ARGUS предполагает доступ к событиям пользователя вплоть до текущего момента и потому естественнее подходит для работы в рантайме.
У прямого использования NIP была ещё одна неопределённость. Эта голова предсказывает все будущие взаимодействия, тогда как традиционный генератор кандидатов обычно обучают только на будущих положительных действиях. Автор допускает, что предсказание всех взаимодействий может быть даже правильнее: сам факт того, что объект дорос до рекомендации, уже содержит информацию о решении предыдущего ранжирования. Но для первого внедрения команда не хотела одновременно проверять и эту гипотезу.
Feedback Prediction тоже не совпадал с текущей задачей финального ранжирования. Предобучение использовало поточечные цели — будет лайк или нет, какая доля трека будет прослушана. Финальный стек Яндекс Музыки обучался на попарном ранжировании: нужно правильно упорядочить объекты, показанные рядом и получившие разный фидбек. Поэтому ARGUS дообучили именно на попарную цель, чтобы его выход стал сильным признаком для существующего финального ранкера.
«Внедрение ARGUS», причины отказа от прямого использования двух голов и выбор офлайнового двухбашенного ранжированияКак авторегрессивное обучение убрало повторные прогоны трансформера
Предыдущее контрастивное предобучение было гибким, но дорогим. Если у пользователя было n положительных действий, из него формировали примерно n обучающих примеров, и трансформер фактически прогонялся n раз. Такой формат позволял свободно собирать пары «пользователь — объект», менять формат истории, кодировать вместе с пользователем контекст и, например, использовать историю с лагом в один день, но вычислительно работал медленно.
ARGUS обучается авторегрессивно: один прогон трансформера даёт обучающий сигнал сразу на всех событиях последовательности. Именно это ускорение позволило при тех же ресурсах перейти к существенно более крупным энкодерам.
Похожий трюк команда перенесла и на дообучение. Раньше при impression-level-подходе для каждого показа или каждой пары объектов пользовательская история обрабатывалась заново. В новой процедуре трансформер с причинной маской один раз проходит длинную историю и выдаёт пользовательские состояния для всех моментов времени. Затем по таймстемпам к нужным состояниям присоединяются показанные объекты, считаются скалярные произведения и все члены функции потерь. Автор оценивает выигрыш относительно многократных прогонов как десятки, сотни и в некоторых случаях даже тысячи раз.
При обучении эмулируется задержка пользовательской истории в один день. После обучения текущим представлением пользователя становится состояние, соответствующее последнему доступному событию, а для объектов используется тот же энкодер, которым кодировались показы при обучении. В офлайновой схеме эти векторы затем пересчитываются ежедневно.
Фраза «вся история за год за один прогон» имеет ограничение. На практике есть максимальная длина последовательности, поэтому история пользователя может быть разбита на несколько чанков. На предобучении чанки не пересекаются. На дообучении дополнительно задаются минимальная длина истории и максимальное число показов рекомендаций внутри одного обучающего примера.
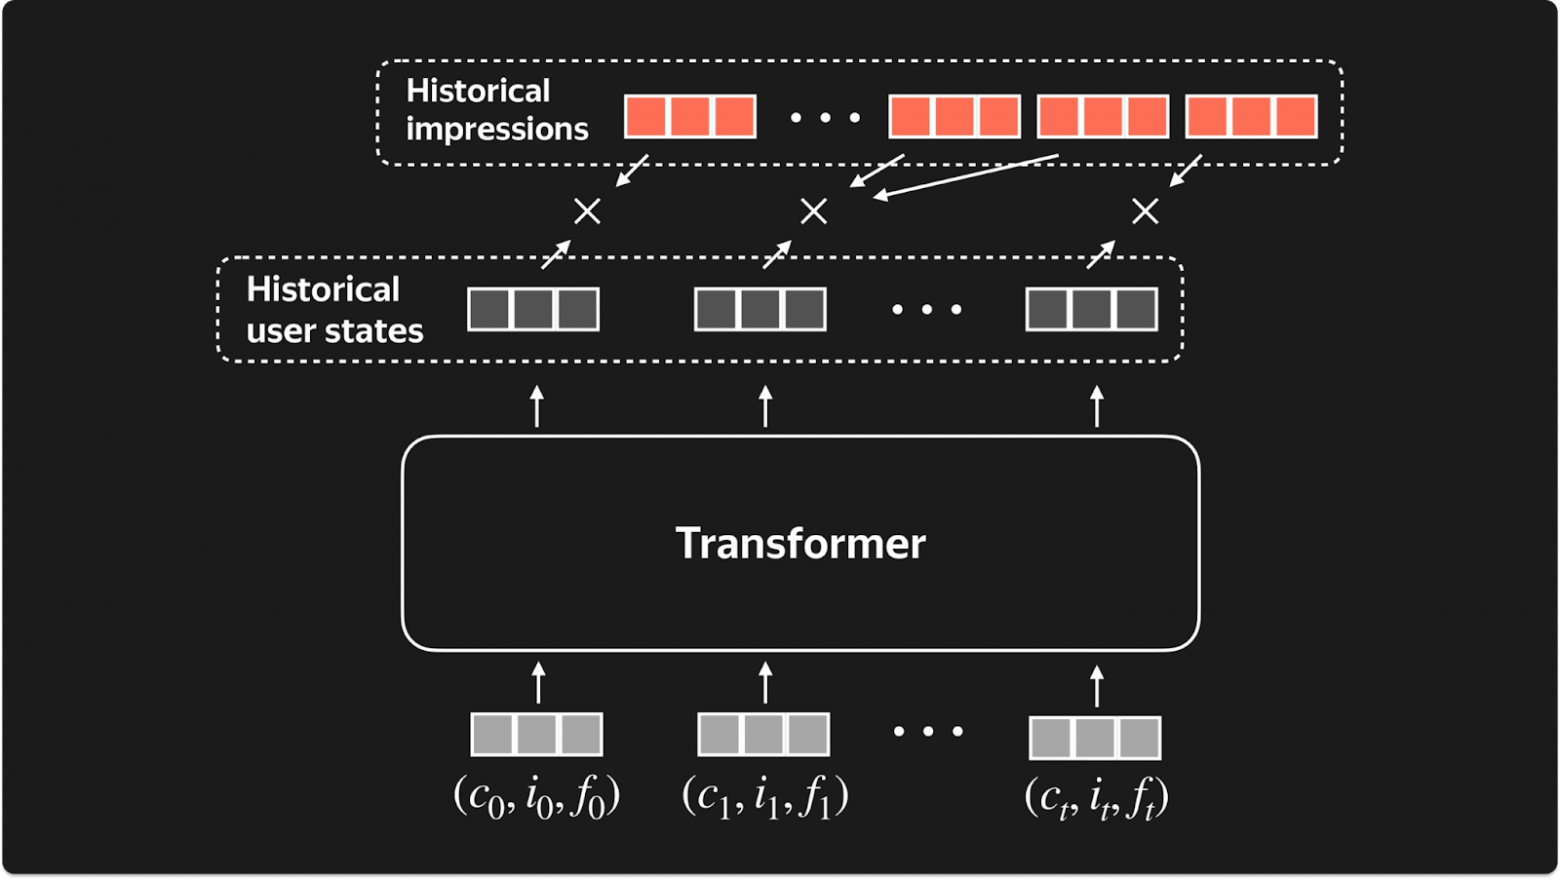
Один проход трансформера строит состояния пользователя для длинной истории, после чего к ним по времени сопоставляются исторические показы.
Источник: Кирилл ХрыльченкоДанные Яндекс Музыки и условия офлайн-оценки
Первой площадкой для масштабирования стала Яндекс Музыка. Команда собрала датасет более чем из 300 млрд прослушиваний миллионов пользователей — по словам автора, в десятки или даже сотни раз больше прежних обучающих наборов. Для каждого события контекст указывает, рекомендательное оно или органическое; для рекомендаций фиксируется поверхность, а для «Моей волны» — её настройки. Объектом является трек, а фидбеком — наличие лайка и доля прослушивания.
Для кодирования трека самым важным признаком назван item ID. Используется техника unified embeddings: для объекта берутся три хэша размерности 512k. Матрица этих эмбеддингов в описанных экспериментах зафиксирована и содержит 130 млн параметров. Это важно при интерпретации масштабирования: в следующем эксперименте меняется размер последовательного энкодера, а не эта матрица.
Разделение на обучение и тест сделано по времени: офлайн-качество проверяют на следующей неделе после обучающего периода, то есть используют global temporal split. История пользователя может заходить далеко в прошлое, но функция потерь на тесте считается только по событиям тестовой недели. Для предварительного обучения смотрят значения функций потерь Next Item Prediction и Feedback Prediction — меньше означает лучше.
После дообучения используется PairAccuracy — доля пар объектов, которые модель расположила в правильном порядке. Пары дополнительно перевзвешиваются по силе различия фидбека: например, «лайк против скипа» весит больше, чем «прослушивание против скипа». Сценарий внедрения — добавить признак ARGUS в финальный ранкер Яндекс Музыки, которым в этом эксперименте является градиентный бустинг. Поэтому команда измеряет относительный прирост PairAccuracy финального ранкера при добавлении нового признака по сравнению с тем же ранкером без него.
«Результаты», описание датасета, признаков, temporal split и метрикМасштабирование от 3,2 млн до 1,007 млрд параметров
Для проверки масштабирования команда выбрала четыре конфигурации обычного трансформера: Mini, Small, Medium и Large. Размер энкодера вырос с 3,2 млн до 1,007 млрд параметров. Отдельно проверили HSTU на 176 млн параметров — крупнейшую конфигурацию, упомянутую в «Actions speak louder than words».
Таблицу можно прокрутить по горизонтали.
По всем четырём размерам обычного трансформера увеличение энкодера улучшало показанные функции потерь и прирост Pairwise Accuracy. Large на 1,007 млрд параметров получил 0.4372 по Next Item Prediction, 0.5631 по Consumption, 0.5436 по Engagement и +2.66% Pairwise Accuracy. Значения в скобках рядом с loss переписаны со слайда; источник не раскрывает здесь отдельную формулу этих процентов, поэтому их не следует самостоятельно трактовать как иной тип метрики.
HSTU на 176 млн параметров не показал преимущества над обычным трансформером в этом сравнении: его результаты близки к Medium на 126 млн параметров. На графике для четырёх трансформерных конфигураций зависимость качества от логарифма размера выглядит примерно линейной. Автор называет это scaling law, но наблюдение построено всего по четырём точкам и не означает доказанный универсальный закон для любых размеров и доменов.
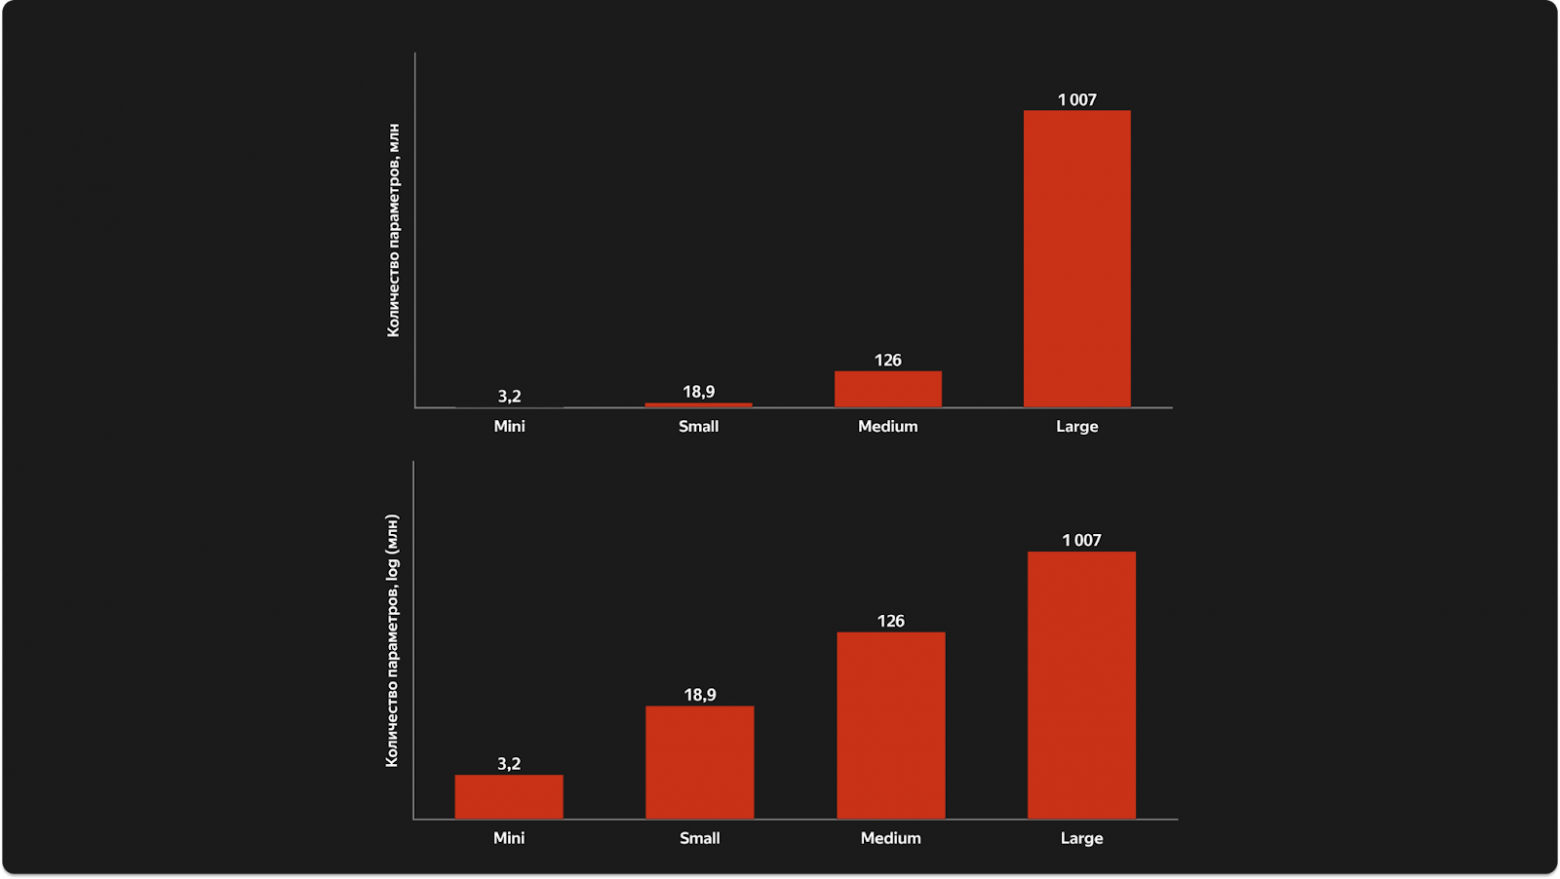
Размеры четырёх трансформеров: Mini 3,2 млн, Small 18,9 млн, Medium 126 млн и Large 1 007 млн параметров.
Источник: Кирилл Хрыльченко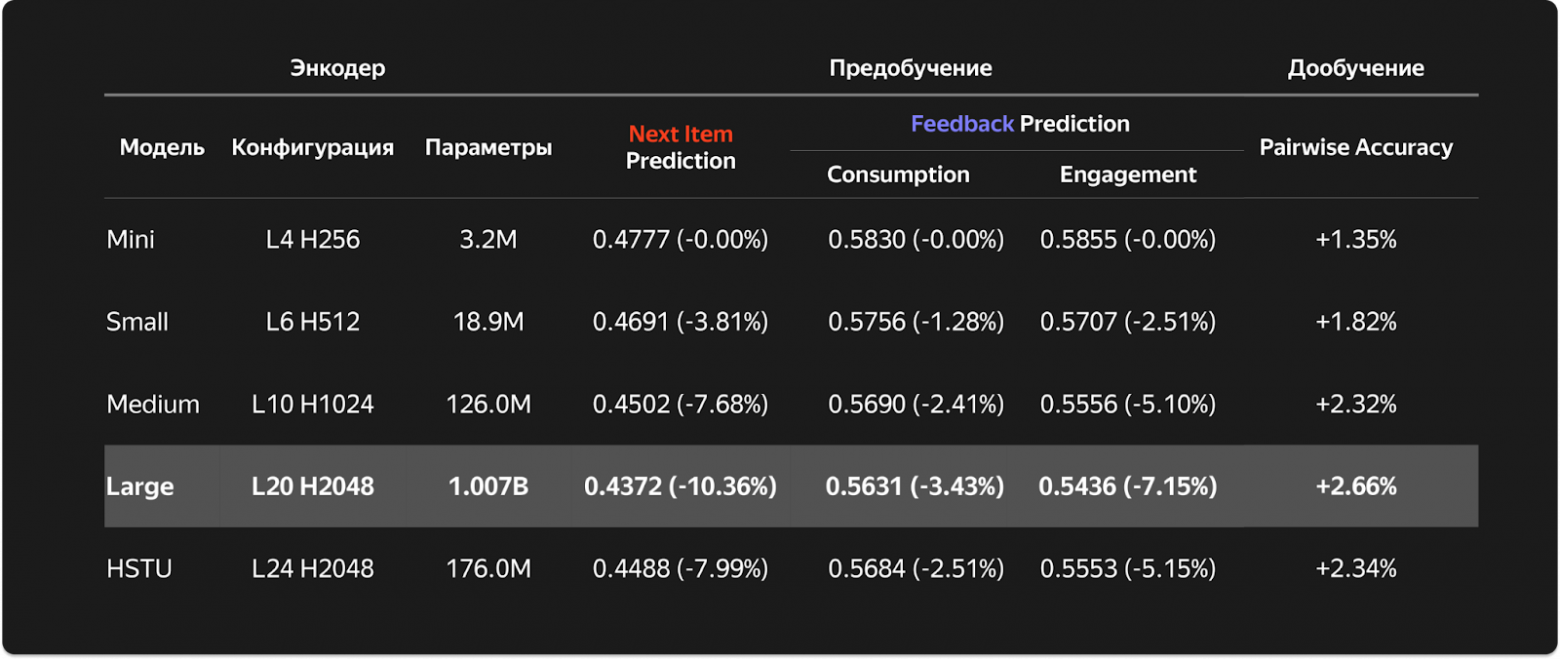
Точная таблица scaling-эксперимента: конфигурации Mini–Large и HSTU, функции потерь предварительного обучения и прирост Pairwise Accuracy после дообучения.
Источник: Кирилл Хрыльченко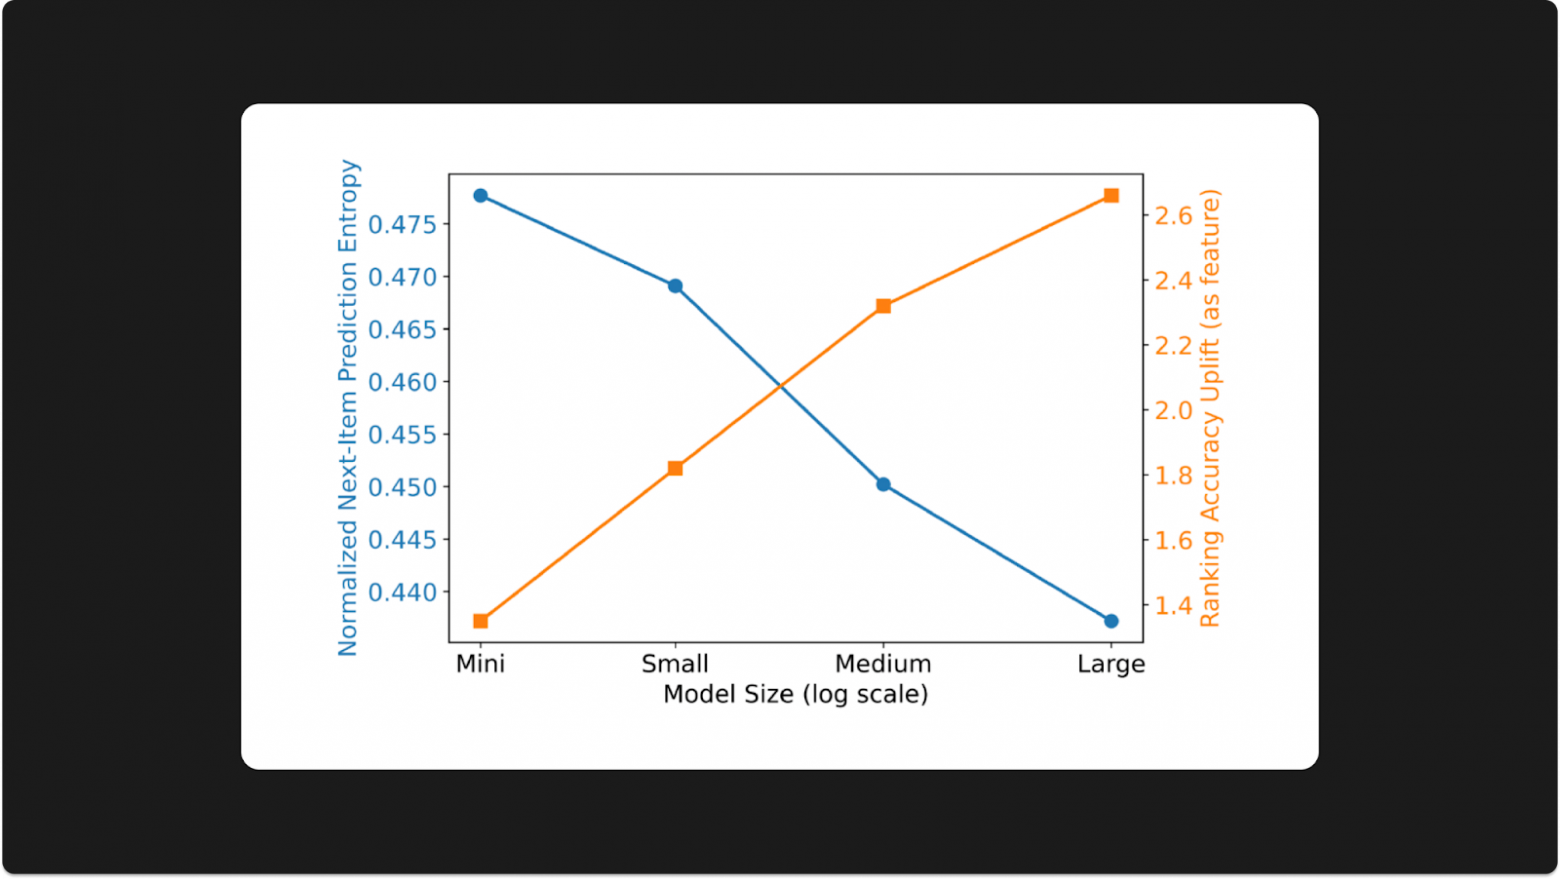
При переходе Mini → Large нормализованная Next-Item Prediction Entropy снижается, а Ranking Accuracy Uplift растёт; точные числа берутся из таблицы, а не считываются с графика.
Источник: Кирилл ХрыльченкоЧто нельзя выбросить из обучения
После основного эксперимента команда проверила отдельные составляющие процедуры. Первый ablation отвечает на вопрос, можно ли отказаться от предварительного обучения. При его отсутствии прирост Pairwise Accuracy финального ранкера составляет +1.17%; с предварительным обучением — +2.32%. Слайд формулирует вывод прямо: «Нельзя убрать предобучение».
Второй эксперимент уменьшает длительность дообучения. На слайде условия подписаны как «1 неделя» и «1 год»: для недели показано +0.63% Pairwise Accuracy, для года — +2.32%. Источник не даёт в этом месте дополнительной расшифровки того, как именно определяется эта длительность, поэтому сохраняем условия буквально.
Третий эксперимент масштабирует саму историю. При длине 512 прирост Pairwise Accuracy равен +1.01%, при 2048 — +2.32%, при 8192 — +2.77%. Ранее модели команды использовали максимум примерно 1,5–2 тысячи событий; здесь впервые удалось заметно выйти за этот диапазон.
Эти три проверки уточняют основной результат. Рост энкодера не заменяет предварительное обучение, сокращение показанного периода дообучения резко уменьшает итоговый прирост, а увеличение длины истории продолжает давать улучшение по крайней мере до 8192 позиций в проверенном диапазоне.
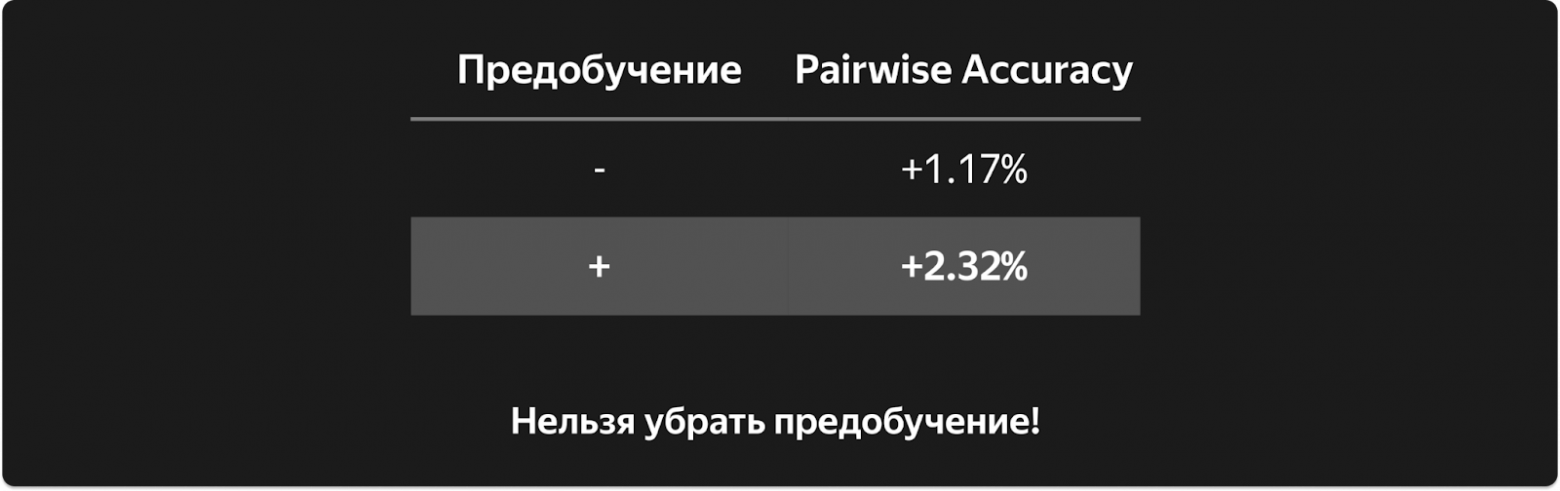
Проверено по оригинальному рисунку: без предварительного обучения Pairwise Accuracy +1.17%, с ним +2.32%; подпись слайда — «Нельзя убрать предобучение!».
Источник: Кирилл Хрыльченко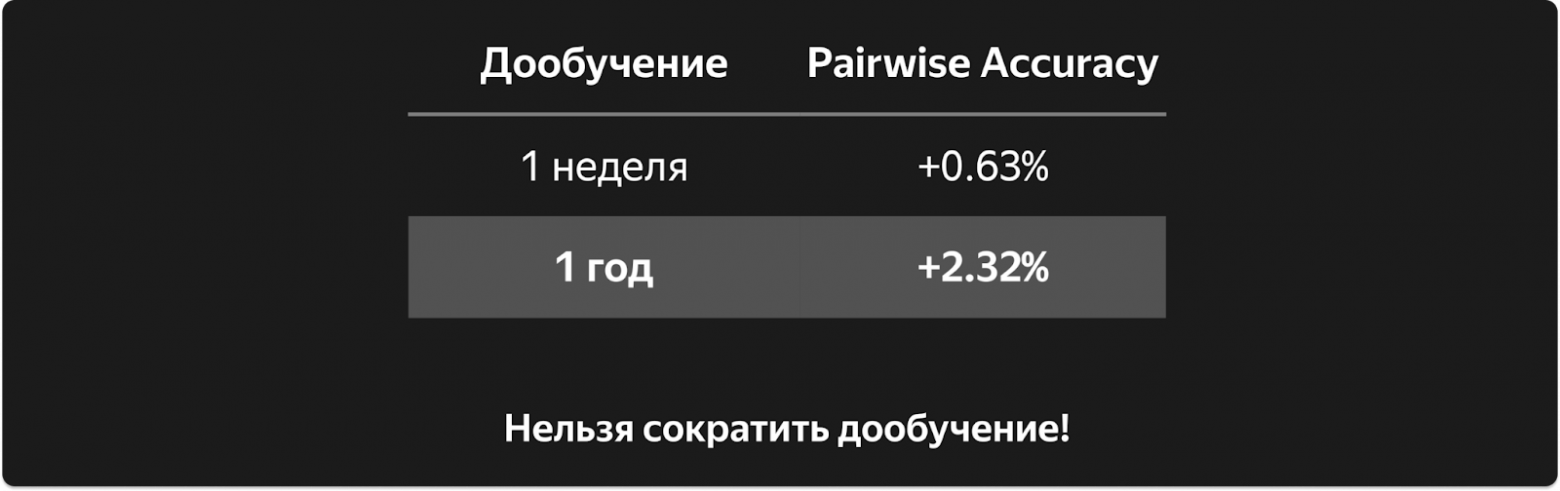
Проверено по оригинальному рисунку: «1 неделя» дообучения соответствует +0.63% Pairwise Accuracy, «1 год» — +2.32%; подпись — «Нельзя сократить дообучение!».
Источник: Кирилл Хрыльченко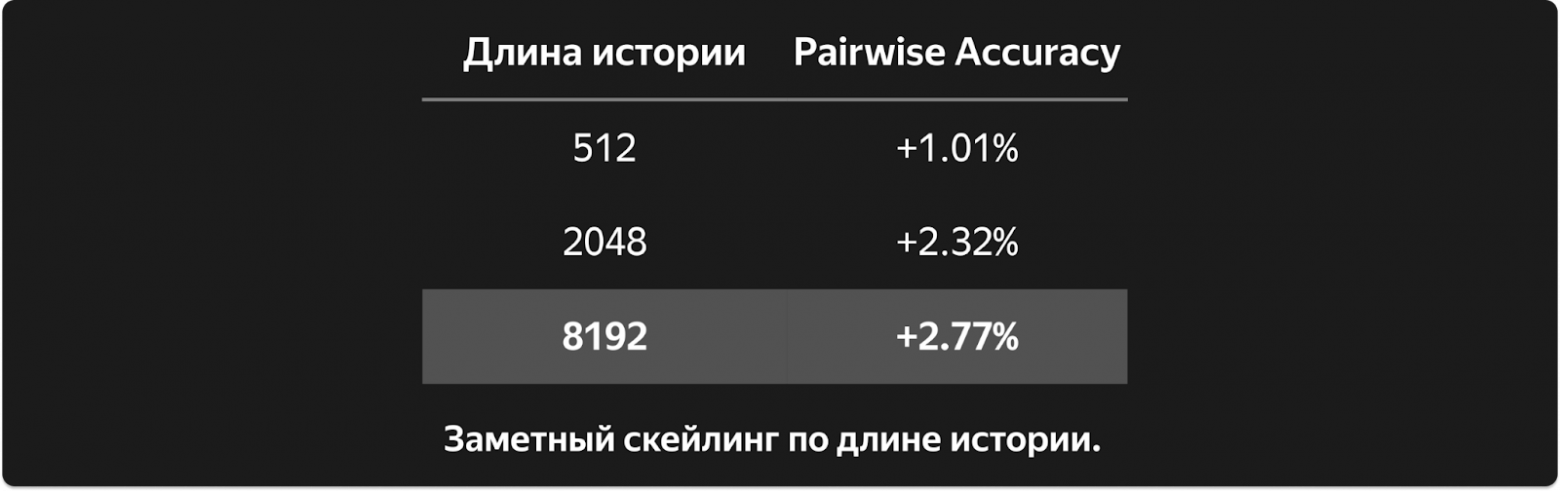
Проверено по оригинальному рисунку: длина истории 512 → +1.01%, 2048 → +2.32%, 8192 → +2.77% Pairwise Accuracy.
Источник: Кирилл ХрыльченкоКак менялись музыкальные трансформеры до ARGUS
Команда Яндекс Музыки и рекомендательная команда развивали музыкальные трансформеры около трёх лет. На эволюционном слайде видно, что ARGUS появился не вместо одного фиксированного базового решения, а после нескольких поколений с разными сигналами и режимами применения.
Первые три версии были офлайновыми: пользовательские и объектные векторы пересчитывались ежедневно, пользовательские загружались в key-value-хранилище, а объектные держались в памяти сервиса. Некоторые модели применялись не только для ранжирования, но и для отбора кандидатов; в этом случае рядом находился HNSW-индекс. Real-time V1 перенёс логику Offline V3 в режим с небольшой задержкой пользовательской истории.
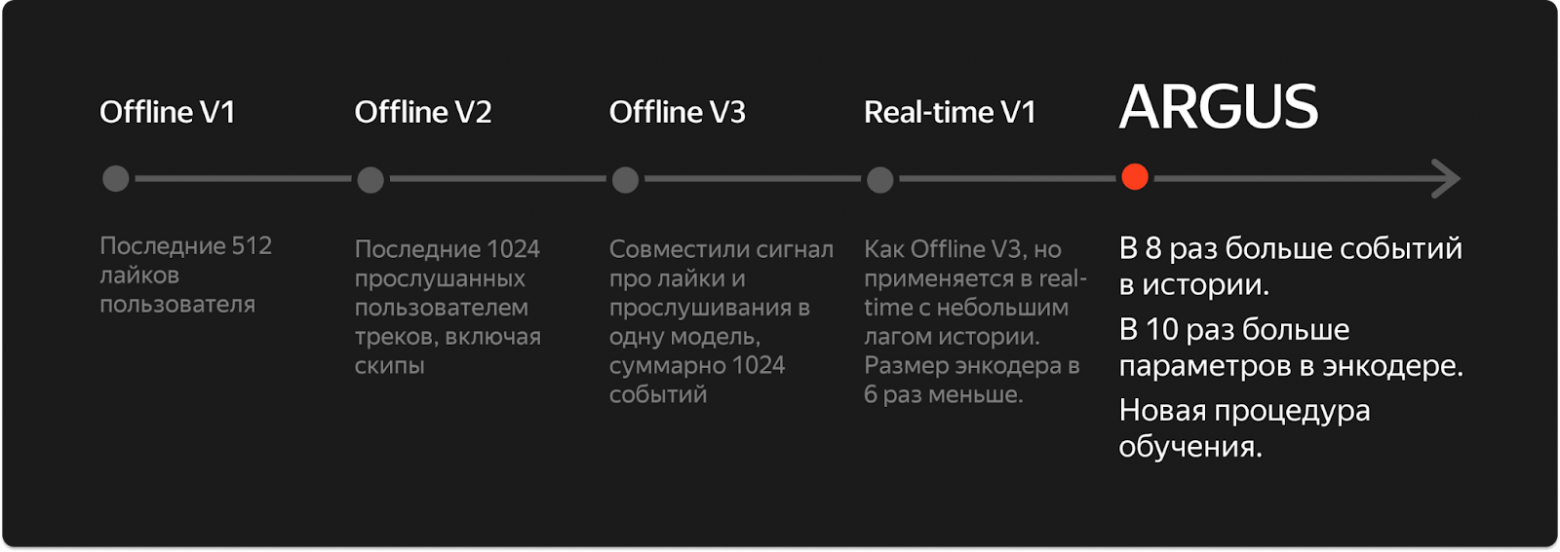
Проверено по оригинальному рисунку: эволюция Offline V1 → Offline V2 → Offline V3 → Real-time V1 → ARGUS с переходом от 512 лайков к 1024 смешанным событиям и затем к существенно более длинной истории.
Источник: Кирилл ХрыльченкоЧто дали последовательные внедрения в «Моей волне»
Следующий слайд позволяет сравнить конфигурации и продуктовые метрики каждого поколения. TLT в источнике расшифровывается как суммарное время прослушивания, а Like Likelihood — как вероятность лайка при включении рекомендации. Это разные метрики, поэтому их значения нельзя складывать или превращать в одну оценку качества.
Таблицу можно прокрутить по горизонтали.
Важно не смешивать исследовательское масштабирование с показанным внедрением. В основном эксперименте команда обучила Large-энкодер на 1,007 млрд параметров, но строка рабочего Offline V4 (ARGUS) на figure-34 соответствует Medium-конфигурации L10 H1024 с 126,0 млн параметров и историей 8192. Автор при этом пишет, что первый ARGUS дал примерно такой же прирост метрик, как все предыдущие внедрения вместе; это качественное сравнение автора, а не предложение арифметически сложить проценты из таблицы.
В тексте статьи значения для «Незнакомого» округлены до +12% TLT и +10% вероятности лайка; оригинальный слайд даёт более точные +12.69% и +10.42%, поэтому в таблице сохранены именно числа со слайда. Для +11.78% источник даёт на рисунке только формулировку «вероятность лайка при первом включении исполнителя» — дополнительного определения этой метрики в тексте нет.
Для музыкальных сценариев в Станциях автор описывает +0,75% к суммарному времени, которое пользователи проводят с активной колонкой; на figure-35 этот результат подписан как +0.75% времени в Алисе, интегрально. Там финальный ранкер является нейросетью, поэтому вместо одного скалярного признака из ARGUS ему удалось передавать полноценные векторы пользователя и объекта. По словам автора, это увеличило прирост качества ещё в 1,5–2 раза по сравнению с вариантом, где использовался один скаляр.
ARGUS также внедрили в Маркет — не только как ранжирующий признак, но и как генератор кандидатов — и в Лавку. Яндекс Музыка вместе с рекомендательной службой Портала адаптировала офлайновый ARGUS к работе в рантайме. Для этих поздних внедрений статья сообщает о положительных изменениях ключевых метрик, но конкретные значения не приводит.
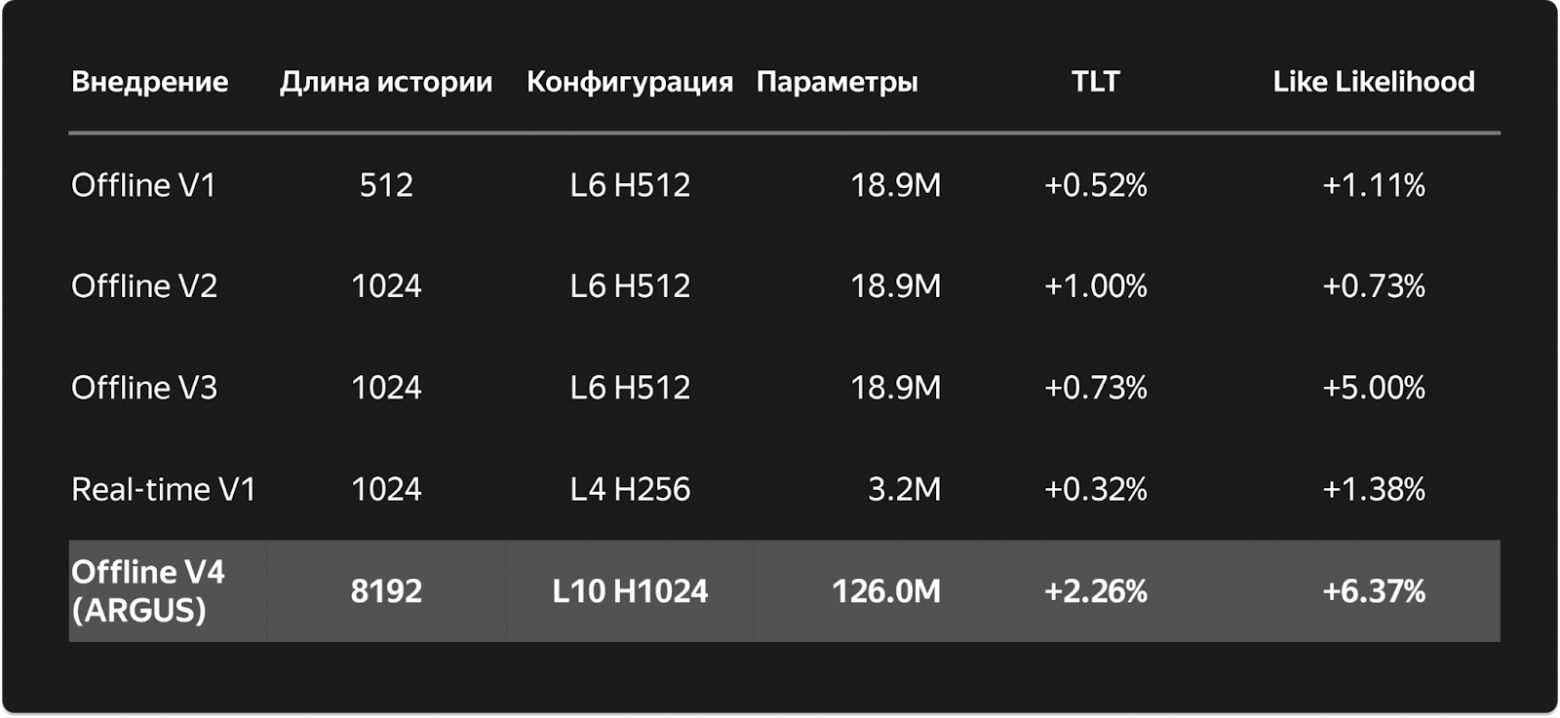
Проверено по оригинальному рисунку: Offline V4 (ARGUS) — история 8192, L10 H1024, 126.0M параметров, +2.26% TLT и +6.37% Like Likelihood; на том же слайде приведены четыре предыдущих внедрения.
Источник: Кирилл Хрыльченко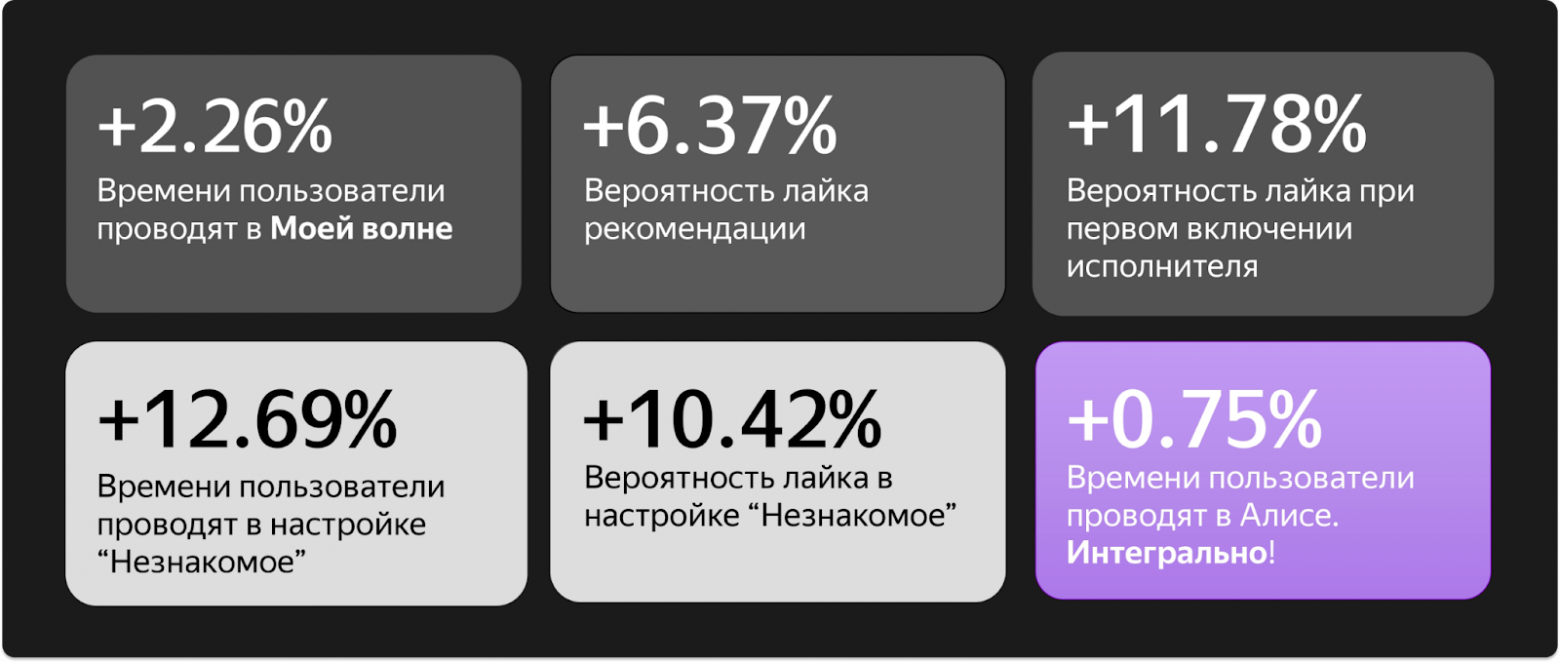
Проверено по оригинальному рисунку: +2.26% времени в «Моей волне», +6.37% вероятности лайка рекомендации, +11.78% вероятности лайка при первом включении исполнителя, +12.69% времени и +10.42% вероятности лайка в «Незнакомом», +0.75% времени в Алисе.
Источник: Кирилл ХрыльченкоГраницы полученного результата
ARGUS не делает длинную историю бесплатной. Полная схема с отдельными токенами контекста, объекта и реакции увеличивала последовательность примерно втрое, поэтому для масштабных экспериментов её упростили до одного вектора на взаимодействие. Команда получила примерно трёхкратное ускорение, но модель стала менее напрямую чувствительной к текущему контексту и целевому объекту внутри трансформера.
Первое внедрение также не является прямой проверкой обеих предобученных голов в рантайме. Модель специально преобразовали в офлайновую двухбашенную схему и дообучили на попарную задачу существующего ранкера. Поэтому результаты Offline V4 нельзя автоматически переносить на сценарий, где NIP напрямую генерирует кандидатов, а FP самостоятельно заменяет финальное ранжирование.
Даже одно-проходное обучение не означает неограниченный контекст: длинная пользовательская история разбивается на чанки. На дообучении дополнительно ограничиваются минимальная длина истории и максимальное число показов в одном примере. Scaling law показан на четырёх размерах обычного трансформера; сравнение HSTU относится к одной выбранной конфигурации и не доказывает универсального превосходства одной архитектуры.
Наконец, на слайдах не приведены длительности A/B-тестов, размеры выборок или доверительные интервалы для продуктовых эффектов. Формула процентов в скобках у loss-метрик figure-28 отдельно не раскрыта. На эволюционном figure-33 ARGUS описан как имеющий «в 10 раз больше параметров в энкодере», тогда как figure-34 отдельно даёт абсолютные размеры 126.0M, 18.9M и 3.2M для разных поколений; источник не указывает базовую версию для этого отношения, поэтому эти сведения не пересчитываются и не примиряются искусственно.
Ограничения из «Simplified ARGUS», «Внедрение ARGUS», результатов и figures 28, 33–35Итог: что именно изменил ARGUS
Путь команды начался с обычных двухбашенных трансформеров: офлайновые версии использовали сначала лайки, затем прослушивания и скипы, потом объединили сигналы, а Real-time V1 перенёс похожую модель в работу с небольшой задержкой истории. ARGUS изменил уже саму процедуру обучения: полная история стала последовательностью контекста, объекта и реакции, появились две совместные цели, а авторегрессивное обучение позволило масштабировать энкодер и длину истории. В экспериментах энкодеры выросли от 3,2 млн до 1,007 млрд параметров, но показанное продуктовое внедрение Offline V4 (ARGUS) использует L10 H1024 на 126,0 млн параметров и историю 8192.
- 01
Обновить историю
Раз в день система получает доступную историю пользователя для построения текущего представления.
- 02
Построить вектор пользователя
Пользовательская башня превращает историю в актуальный вектор.
- 03
Закодировать треки
Объектная башня заранее строит векторы треков, поэтому тяжёлые вычисления не повторяются для каждого запроса.
- 04
Сравнить пару
Для пользователя и трека считается скалярное произведение — численный признак их соответствия.
- 05
Передать в ранкер
Финальный ранкер получает ARGUS-признак вместе с другими сигналами и определяет порядок кандидатов.
На слайде внедрения Offline V4 (ARGUS) дал +2,26% TLT и +6,37% Like Likelihood в «Моей волне». Для «Незнакомого» показаны +12,69% времени и +10,42% вероятности лайка; для Алисы — +0,75% времени. При этом масштабирование до 1,007 млрд — экспериментальная точка, а не показанная версия внедрения. Полная трёхтокенная схема была упрощена ради скорости, история всё равно ограничивается чанками, а scaling law наблюдается лишь на четырёх размерах трансформера. Для Маркета, Лавки и рантайм-адаптации статья сообщает о приростах, но точных чисел не раскрывает.
Суммарно: «ARGUS», «Внедрение ARGUS», «Результаты» и «Итоги внедрения»