Разбор готов
Как Anthropic построила многоагентную систему Research
Исследовательский запрос редко раскладывается в заранее известную последовательность действий. Пока система ищет информацию, появляются новые источники и направления, часть гипотез отпадает, а часть требует отдельной проверки. В Claude Research Anthropic решает эту проблему не одним длинным агентом, а системой, где ведущий агент планирует исследование и поручает независимые направления нескольким подагентам. Они ищут параллельно, возвращают сжатые результаты, после чего отдельный CitationAgent связывает утверждения итогового ответа с конкретными местами в источниках. Статья показывает не только эту архитектуру, но и то, какие проблемы возникли при переходе от прототипа к работающему продукту: плохое делегирование, лишние вызовы инструментов, нестабильные траектории, восстановление после сбоев, трассировка и безопасное обновление долгоживущих агентов.
Материал полезен инженерам, которые строят агентов с поиском и инструментами и хотят понять, когда параллельные подагенты действительно оправданы. На примере Anthropic видно, как связаны декомпозиция запроса, бюджет вычислений, промпты, выбор инструментов, оценка качества и эксплуатация состояния в долгих агентных задачах.
Статья · на английском
How we built our multi-agent research systemAnthropic Engineering · Опубликовано: 13 июня 2025 г.
Почему исследование нельзя свести к фиксированному конвейеру
Исследовательская задача меняется по мере поиска. Нельзя заранее перечислить все необходимые шаги: найденный факт может открыть новое направление, опровергнуть первоначальную гипотезу или потребовать перейти к другому источнику. Поэтому Anthropic рассматривает Research как долгую последовательность решений, где модель сама выбирает следующий шаг на основании промежуточных результатов.
Авторы противопоставляют это линейному одношаговому конвейеру. Для открытого поиска нужна возможность останавливаться, менять направление и исследовать побочные связи. Из этого требования и вырастает агентная архитектура: модель не только формирует ответ, но и многократно решает, что делать дальше.
Benefits of a multi-agent systemЗачем разделять исследование между подагентами
Anthropic описывает поиск как сжатие: из большого корпуса нужно извлечь небольшой набор действительно полезных сведений. Подагенты помогают делать это параллельно. Каждый получает собственное контекстное окно, исследует отдельный аспект и возвращает ведущему агенту уже отобранные факты, а не всю историю поиска.
Отдельные контексты дают и другое преимущество — разделение ответственности. У подагентов могут различаться инструменты, промпты и поисковые траектории. Это уменьшает зависимость всего ответа от одного раннего решения ведущего агента и позволяет независимо проверить несколько направлений.
The essence of search is compressionГде статья показывает выигрыш, а где только стоимость
На внутреннем наборе исследовательских задач Anthropic сравнила одного агента на Claude Opus 4 с системой, где Claude Opus 4 был ведущим агентом, а Claude Sonnet 4 — подагентами. Вариант с несколькими агентами показал результат на 90,2% выше. В статье приводится пример широкого запроса про членов советов директоров компаний IT-сектора S&P 500: разделение поиска между подагентами помогло найти ответ, тогда как последовательный поиск одного агента не справился. Полная структура проверки, размер набора и доверительные интервалы не опубликованы, поэтому 90,2% нельзя трактовать как точность продукта.
Таблицу можно прокрутить по горизонтали.
Авторы также отмечают, что в их анализе переход на Claude Sonnet 4 дал больший выигрыш, чем удвоение token budget Claude Sonnet 3.7. Одновременно они подчёркивают экономическое ограничение: multi-agent подход имеет смысл прежде всего там, где ценность задачи оправдывает значительно больший расход токенов и где работу действительно можно распараллелить.
Our internal evaluations show that multi-agent research systems excel especially for breadth-first queriesАрхитектура orchestrator-worker
Research построен по схеме «координатор — исполнители» (orchestrator-worker). Ведущий агент анализирует запрос, определяет стратегию и создаёт специализированных подагентов. Те исследуют разные части задачи параллельно и возвращают результаты координатору, который собирает итоговую картину.
На первой схеме показан именно этот уровень архитектуры: пользовательский запрос приходит ведущему агенту, тот распределяет направления поиска, а подагенты одновременно исследуют их. В примере на схеме они ищут разные аспекты рынка AI-agent компаний 2025 года и возвращают списки компаний для последующего объединения.
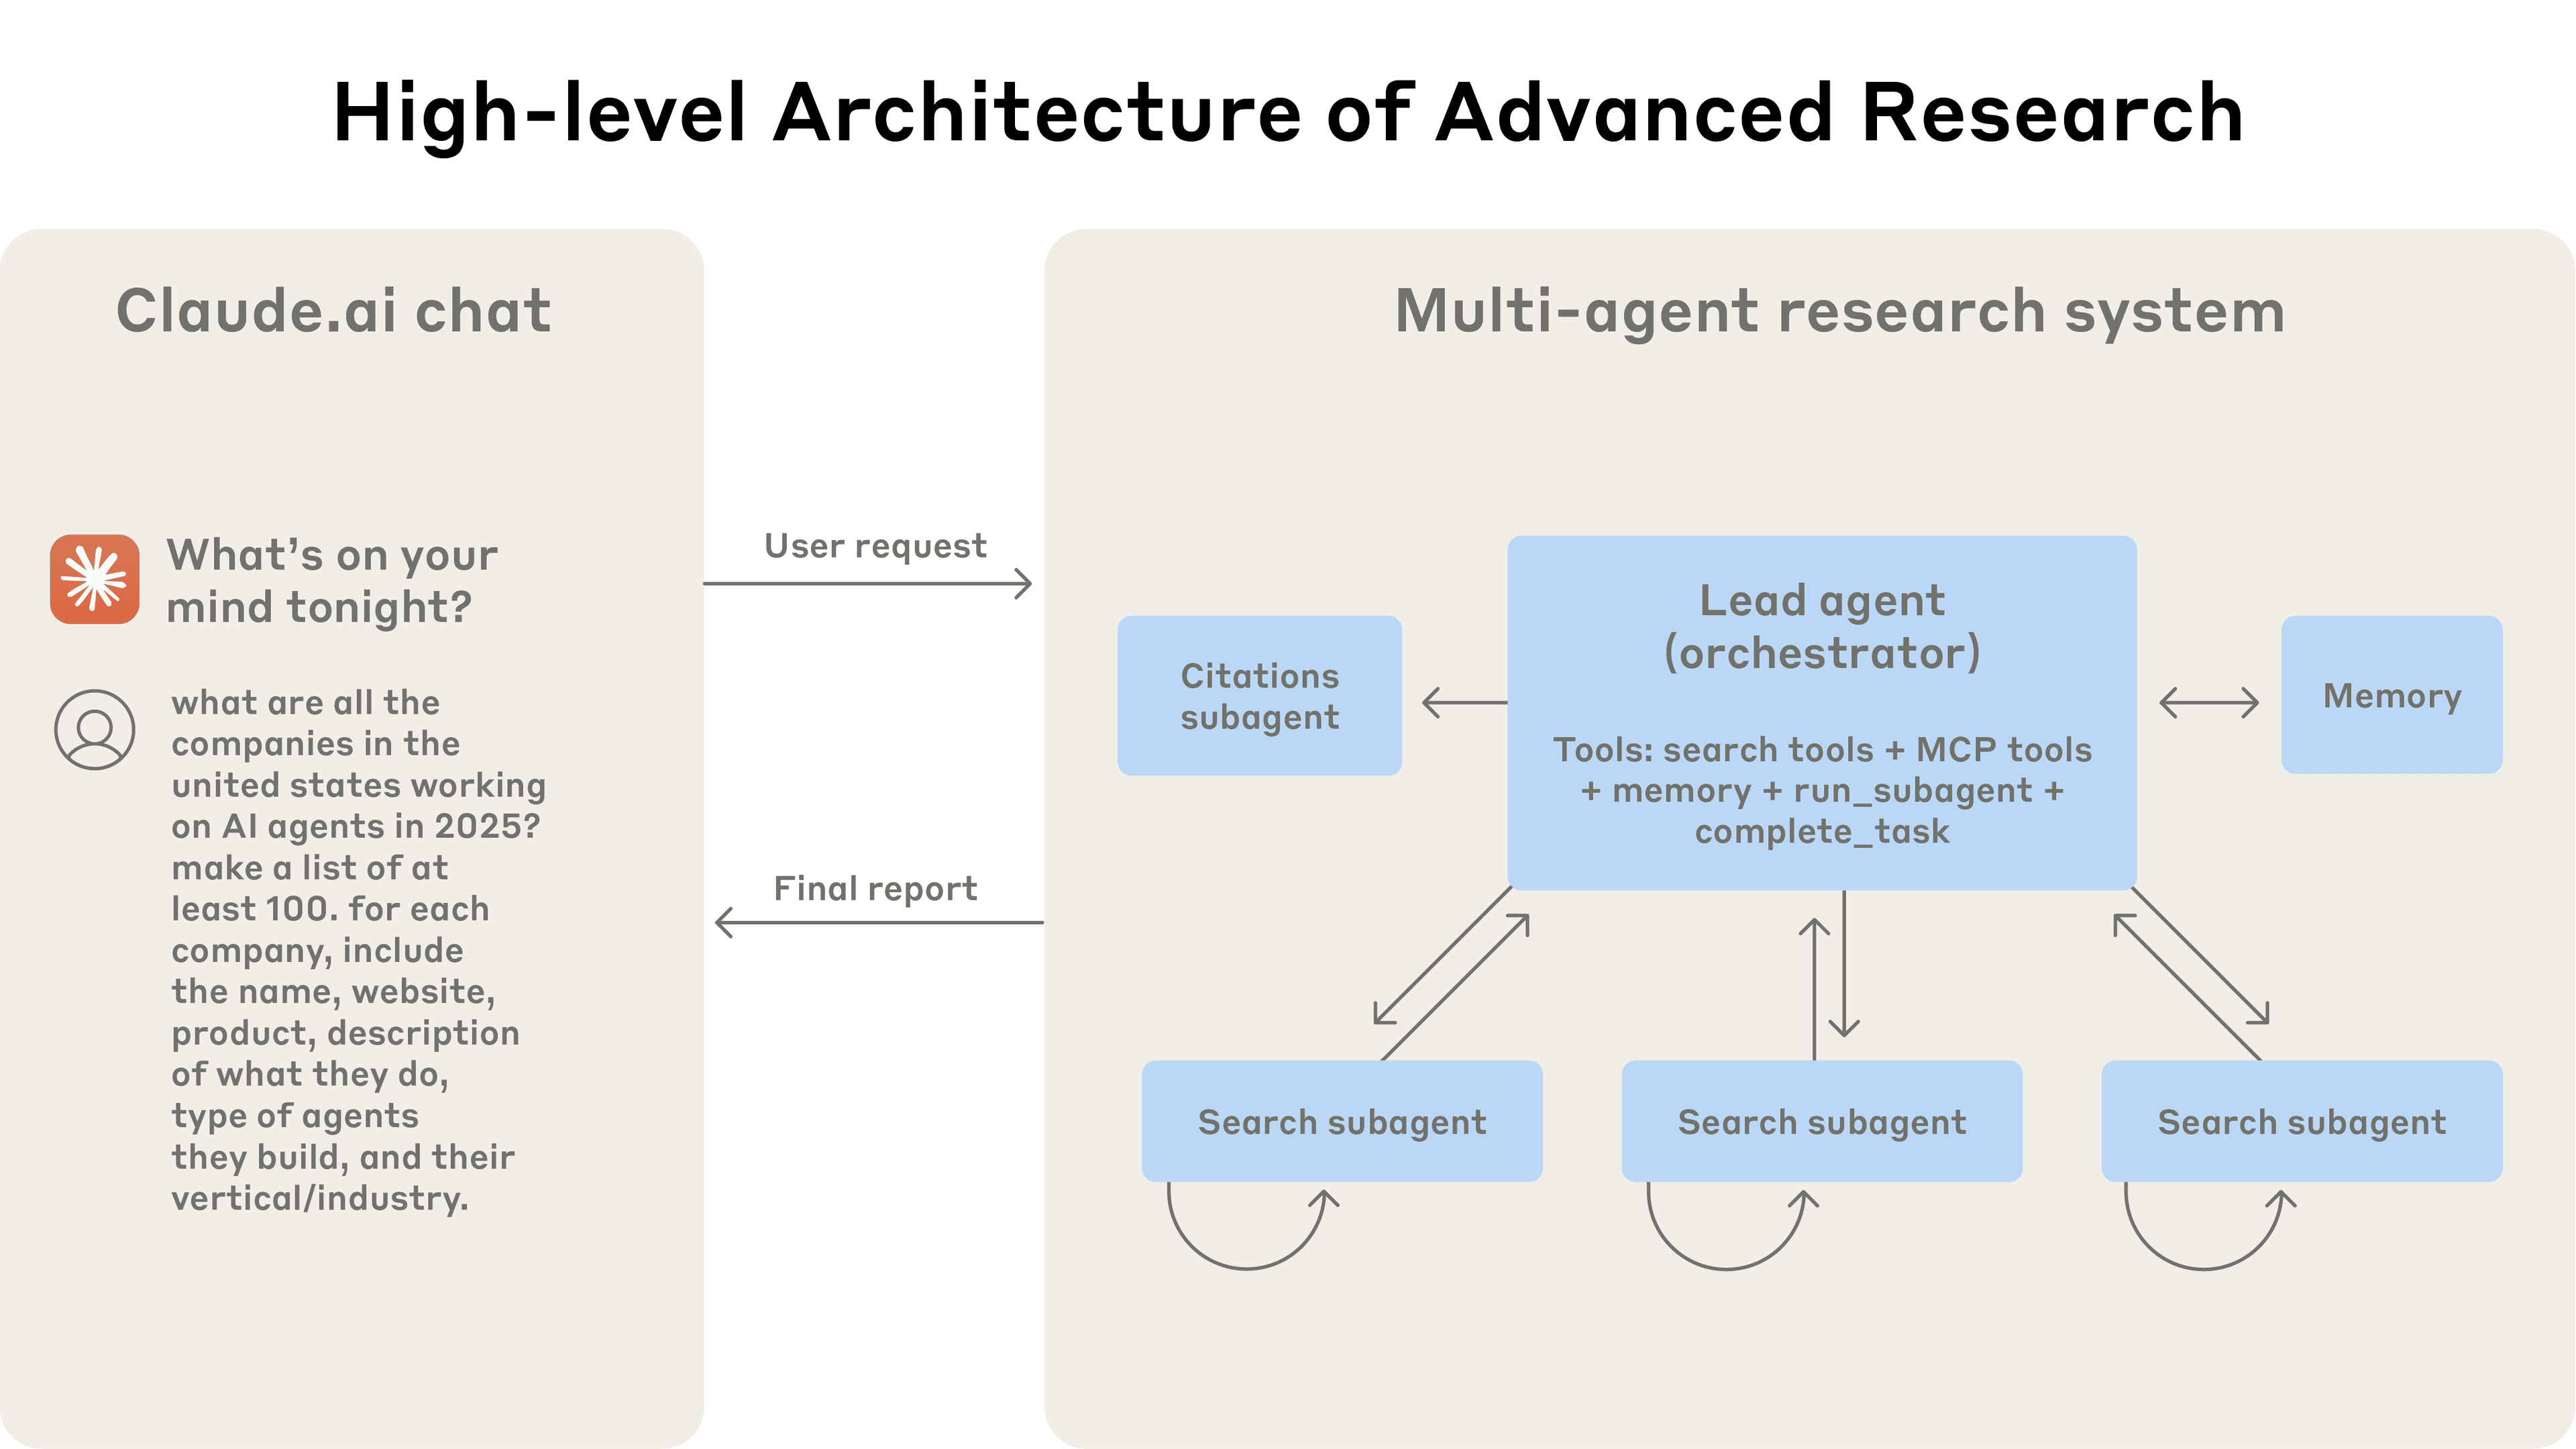
Архитектура Research: ведущий агент делит задачу на независимые направления и затем объединяет результаты.
Источник: Оригинальная иллюстрация AnthropicПочему это не просто статическое извлечение документов
В статье Anthropic противопоставляет свою систему статическому поиску фрагментов по исходному запросу. В Research поиск многошаговый: система смотрит на уже найденное, уточняет запросы, меняет направление и продолжает исследование, пока не сочтёт информации достаточной.
Это сравнение описывает конкретную архитектурную мотивацию авторов, а не доказательство превосходства multi-agent системы над любым вариантом RAG. В статье нет отдельного контролируемого benchmark, который бы сравнивал Research со всеми возможными многошаговыми или агентными вариантами RAG.
Traditional approaches using Retrieval Augmented Generation (RAG) use static retrieval.Как проходит один пользовательский запрос
Вторая схема раскрывает полный процесс. После пользовательского запроса создаётся LeadResearcher. Он продумывает стратегию и сохраняет план в Memory. Причина практическая: если контекст превысит 200 тысяч токенов и будет усечён, система должна сохранить исходный план и не потерять направление исследования.
- 01
План
LeadResearcher выбирает стратегию и сохраняет её в Memory.
- 02
Делегирование
Ведущий агент создаёт специализированных подагентов с конкретными исследовательскими задачами.
- 03
Независимый поиск
Подагенты используют инструменты, оценивают результаты и уточняют дальнейшие запросы.
- 04
Синтез
LeadResearcher собирает результаты и решает, достаточно ли информации или нужен ещё один раунд.
- 05
Проверка ссылок
После завершения исследования CitationAgent находит в документах конкретные места, которые подтверждают утверждения отчёта.
CitationAgent здесь выполняет отдельную роль и не является ещё одним поисковым подагентом. Он получает уже собранные документы и готовый исследовательский отчёт, после чего связывает утверждения с конкретными местами источников. Статья описывает это как механизм атрибуции, но не утверждает, что он полностью исключает неподтверждённые выводы.
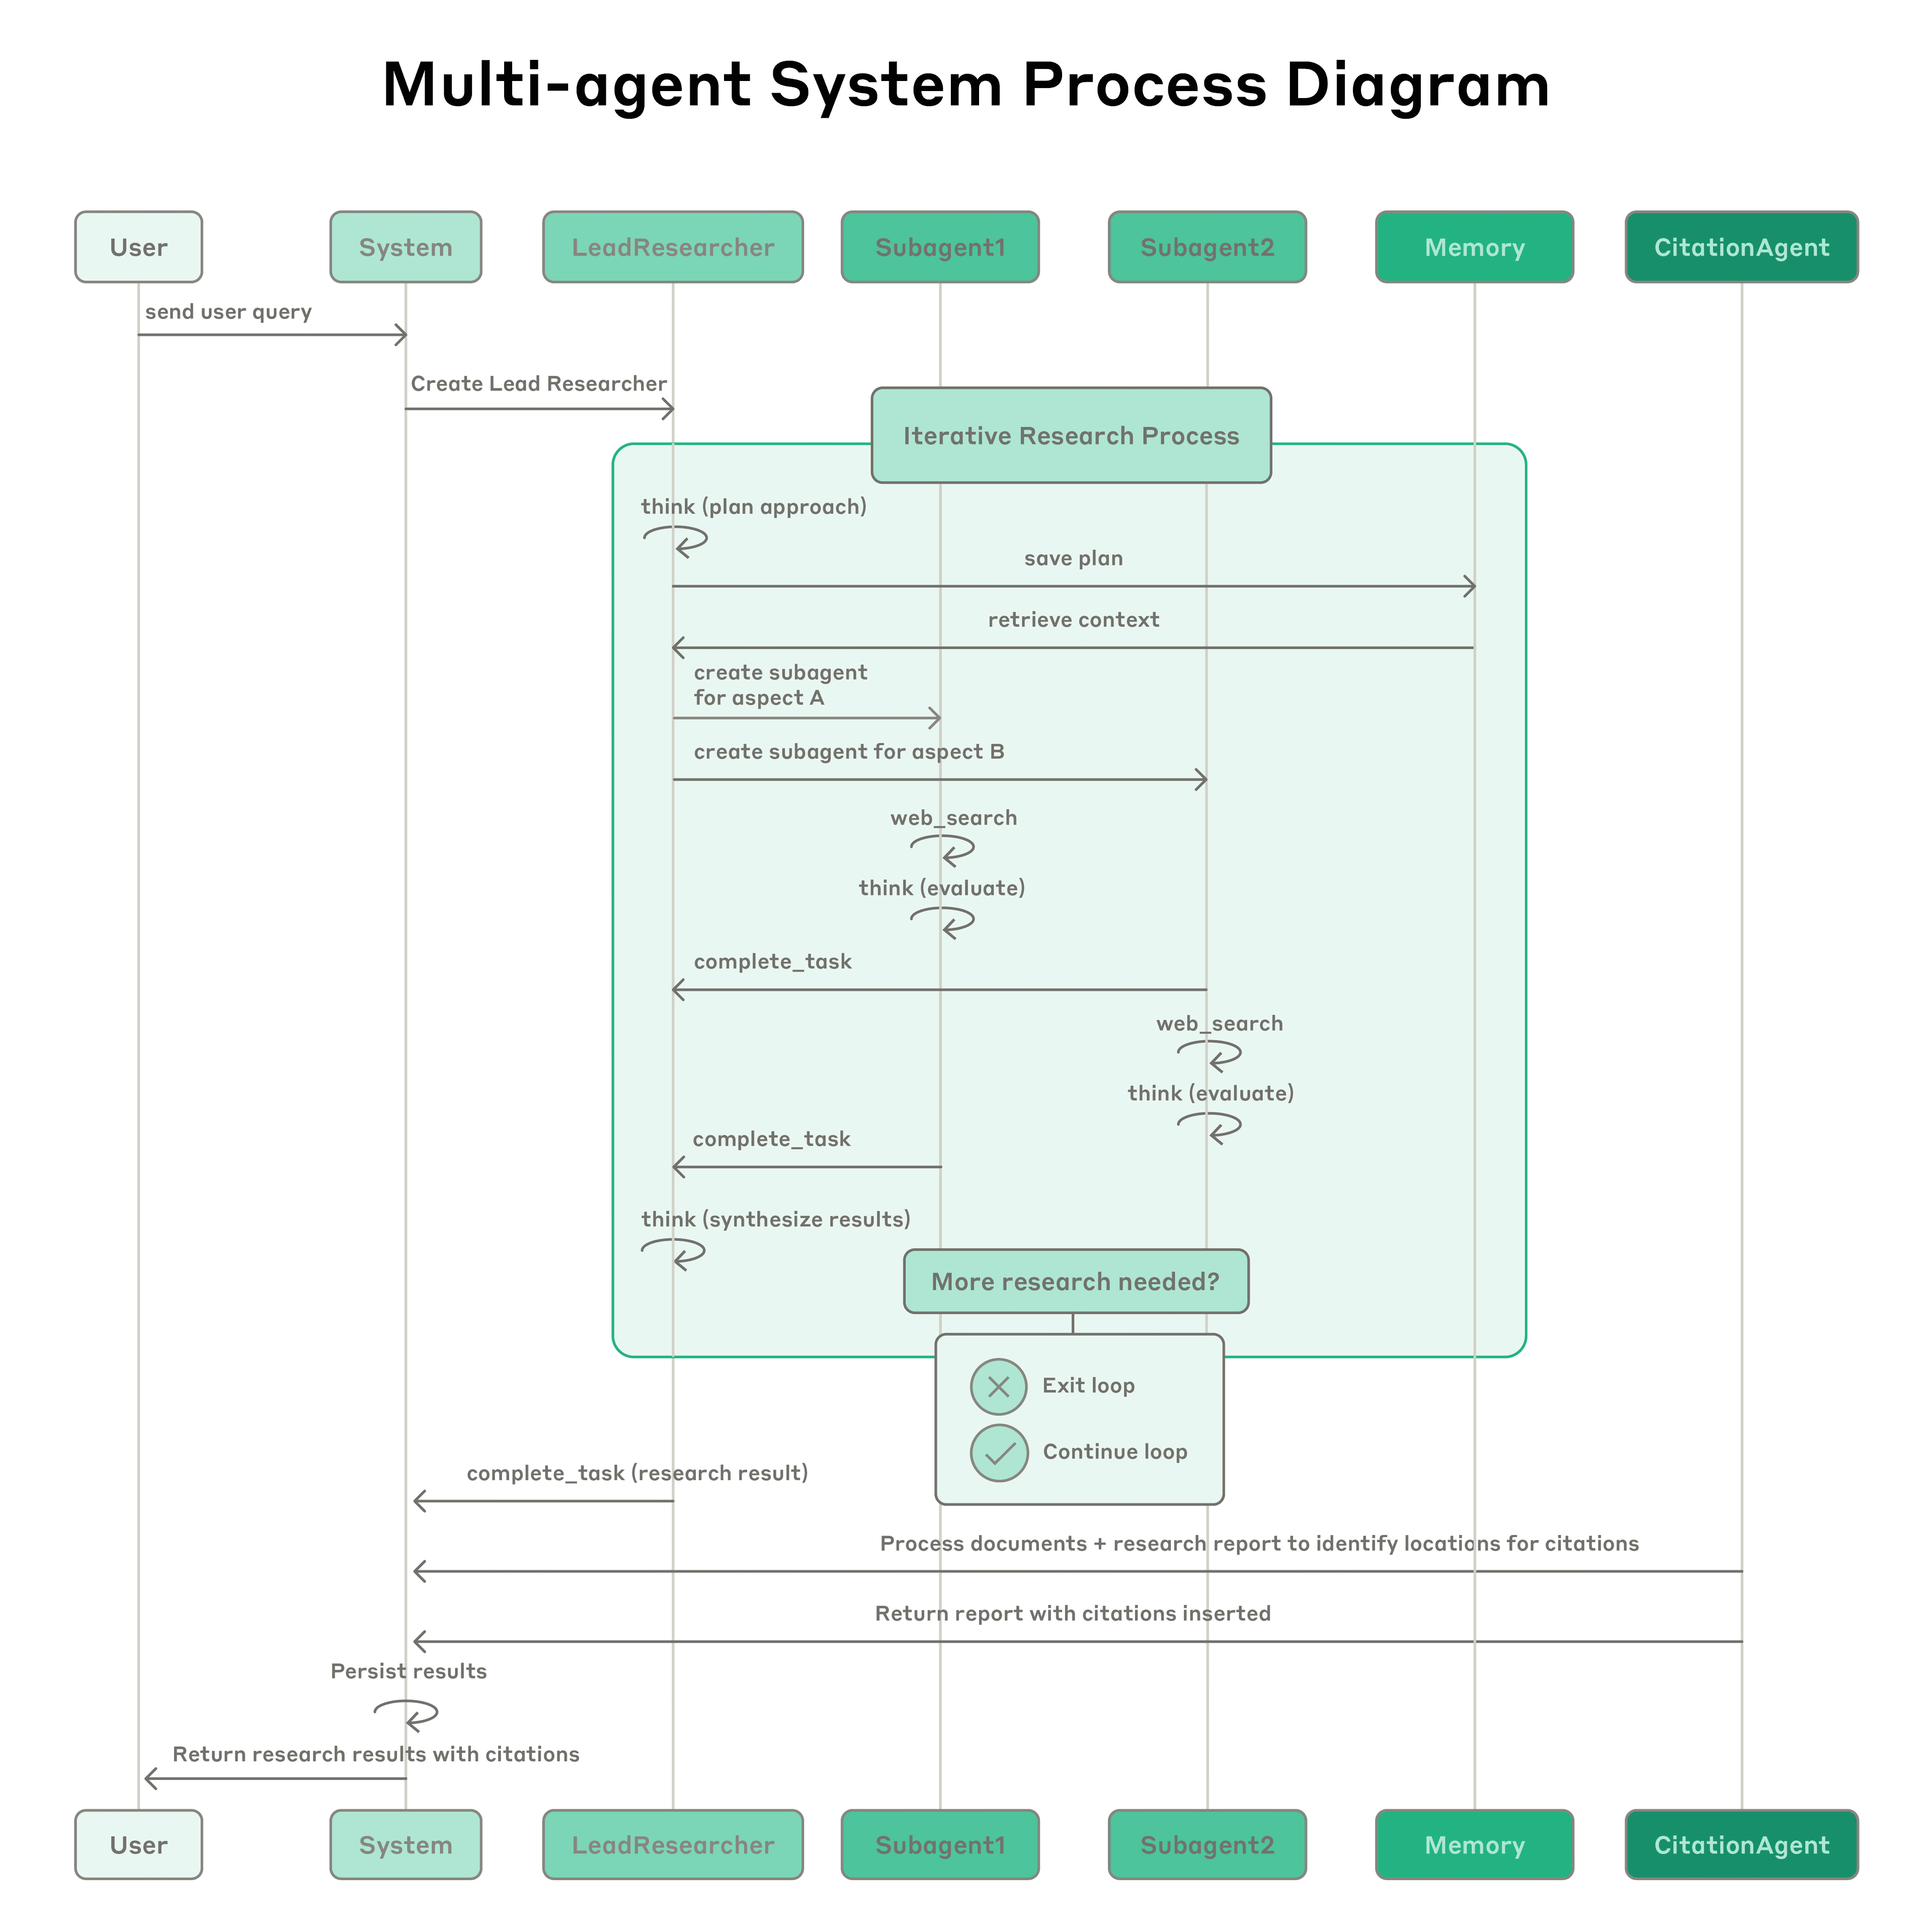
Оригинальный процесс: план и память, параллельный поиск подагентов, сбор результатов и отдельная проверка цитат.
Источник: Оригинальная иллюстрация AnthropicСначала посмотреть, как агент реально работает
Промпты стали одним из главных рычагов управления системой, потому что ранние версии вели себя неожиданно: могли создать 50 подагентов для простого запроса, бесконечно искать несуществующий источник или засорять взаимодействие лишними обновлениями.
Чтобы понимать такие ошибки, команда запускала в Console симуляции с теми же промптами и инструментами, что использовались системой, и просматривала траекторию шаг за шагом. Так становилось видно, например, что агент уже собрал достаточно данных, но продолжает искать, формулирует чрезмерно длинные поисковые запросы или выбирает неправильный инструмент.
Think like your agents.Как научить ведущего агента делегировать
Недостаточно сказать подагенту «исследуй дефицит полупроводников». По опыту Anthropic, хорошее поручение должно задавать цель, ожидаемый формат результата, рекомендуемые инструменты и источники, а также границы задачи. Иначе несколько агентов легко выполняют одно и то же или оставляют важные области без внимания.
Авторы приводят конкретный сбой: при расплывчатом поручении один подагент ушёл в автомобильный дефицит чипов 2021 года, а два других дублировали друг друга, исследуя цепочки поставок 2025 года. Ошибка возникла не из-за отсутствия поисковой способности, а из-за плохо сформулированного разделения труда.
Teach the orchestrator how to delegate.Бюджет усилий должен зависеть от сложности запроса
Модели плохо оценивают, сколько работы действительно требуется запросу, поэтому Anthropic явно записала в промпты ориентиры бюджета. Для простого поиска факта предлагается один агент и 3–10 вызовов инструментов; для прямого сравнения — 2–4 подагента примерно по 10–15 вызовов каждый; для сложного исследования — более 10 подагентов с чётко разделёнными обязанностями.
Эти значения следует читать как рабочие эвристики конкретной системы, а не как универсальные оптимумы. Их назначение — не дать простому вопросу поглотить непропорционально много ресурсов и одновременно разрешить широкому исследованию действительно расширять вычислительный бюджет.
Scale effort to query complexity.Правильный инструмент иногда важнее дополнительного рассуждения
Инструмент должен соответствовать месту, где находится информация. Если нужный контекст доступен только в Slack, поиск по открытому вебу не исправит ошибочный выбор канала. С MCP эта проблема усиливается: модель может впервые увидеть внешний инструмент только по его описанию, и неясная формулировка легко отправляет агента по неправильной траектории.
Anthropic добавила явные правила выбора: сначала посмотреть на доступные инструменты, сопоставить их с намерением пользователя, веб использовать для широкого внешнего поиска, а специализированный инструмент предпочитать универсальному там, где он точнее соответствует задаче. Поэтому описание инструмента становится частью поведения системы, а не просто документацией API.
Tool design and selection are critical.Как агенты помогли улучшать сами инструменты
Команда обнаружила, что Claude 4 способен разбирать собственные агентные сбои и предлагать правки промптов. На этой идее появился отдельный tool-testing agent: ему давали проблемный MCP-инструмент, он многократно пытался им пользоваться и затем переписывал описание так, чтобы будущие агенты реже ошибались.
После тестирования инструмента десятки раз новое описание сократило время выполнения задачи для будущих агентов на 40%, потому что они избегали значительной части прежних ошибок. Статья не раскрывает размер benchmark, распределение времени и доверительные интервалы, поэтому это локальный результат улучшения tool ergonomics, а не универсальный эффект переписывания descriptions.
Let agents improve themselvesСтратегия поиска, размышление и два уровня параллелизма
Anthropic учит агентов начинать с коротких широких запросов, оценивать пространство источников и только затем сужать поиск. Это исправляет естественную тенденцию сразу задавать длинный специфичный запрос, который может вернуть слишком мало результатов. Ведущий агент использует extended thinking, чтобы спланировать подход, подобрать инструменты, оценить сложность и распределить роли; подагенты после ответов инструментов используют interleaved thinking, чтобы оценить качество найденного и закрыть пробелы.
Отдельно команда распараллелила выполнение на двух уровнях: ведущий агент запускает примерно 3–5 подагентов одновременно, а каждый подагент может параллельно использовать 3 и более инструментов. По данным Anthropic, на сложных запросах эти изменения сокращали время исследования до 90%. Формулировка «до 90%» не означает типичное ускорение любого запроса, а статья не публикует полный протокол замера.
Start wide, then narrow down. / Guide the thinking process. / Parallel tool calling transforms speed and performance.Как оценивать систему без единственной правильной траектории
Для multi-agent системы нельзя надёжно задать единственную правильную последовательность действий. Два удачных запуска могут обратиться к разным источникам, сделать разное число вызовов и всё равно прийти к одному полезному ответу. Поэтому Anthropic предлагает оценивать прежде всего достигнутый результат и разумность процесса, а не точное совпадение со заранее выписанной траекторией.
На ранней стадии команда начала примерно с 20 запросов, отражавших реальные сценарии. Авторы объясняют, что при больших эффектах даже малая выборка помогает быстро заметить ошибочное направление: в качестве иллюстрации приводится ситуация, где изменение промпта могло поднять success rate с 30% до 80%. Это аргумент в пользу раннего eval-loop, а не утверждение, что двадцати запросов достаточно для финальной статистической оценки.
Effective evaluation of agentsLLM-judge масштабирует проверку, но не заменяет людей
Исследовательский ответ трудно оценить точным программным правилом, поэтому Anthropic использовала LLM-judge. Один промпт оценивал фактическую точность, соответствие цитат утверждениям, полноту, качество источников и разумность использования инструментов, выдавая оценки от 0 до 1 и итоговый pass/fail. Авторы пробовали несколько отдельных judges, но в их системе один вызов оказался наиболее согласованным с человеческими оценками и позволил проверять сотни результатов.
Ручная проверка всё равно оставалась необходимой. Люди обнаружили, например, что ранние агенты систематически предпочитали хорошо оптимизированные под поисковики контент-фермы более авторитетным, но хуже ранжирующимся академическим PDF и личным профессиональным страницам. После этого в промпты добавили отдельные эвристики качества источников.
LLM-as-judge evaluation scales when done well. / Human evaluation catches what automation misses.Долгоживущие агенты: восстановление после ошибок и трассировка
Агент может долго работать и накапливать состояние через множество вызовов инструментов. Если в середине такого процесса произойдёт сбой, полный перезапуск дорог и меняет пользовательский опыт. Anthropic поэтому строила выполнение так, чтобы агент мог продолжить с места ошибки: модель получает информацию о проблемном инструменте и пытается адаптироваться, а детерминированная часть системы добавляет повторные попытки и регулярные checkpoints.
Недетерминированность усложняет отладку: жалоба «агент не нашёл очевидную информацию» ещё не объясняет причину. Команда добавила полную production tracing и стала наблюдать паттерны решений и структуру взаимодействия агентов. При этом статья отдельно подчёркивает, что такая высокоуровневая наблюдаемость не требует просмотра содержания отдельных пользовательских разговоров.
Agents are stateful and errors compound. / Debugging benefits from new approaches.Rainbow deployments и пределы синхронной координации
Агентная система состоит из связанных промптов, инструментов и логики исполнения, причём во время выпуска новой версии часть запросов уже находится в середине длинного процесса. Anthropic использует rainbow deployments: старая и новая версии некоторое время работают одновременно, а трафик переводится постепенно. Это снижает риск того, что обновление кода или промпта сломает уже запущенного агента.
Текущий Lead Researcher при этом ожидает завершения набора подагентов синхронно. Такой контракт упрощает согласование состояния, но создаёт барьер: ведущий агент не может направлять подагента во время работы, подагенты не координируются между собой, а один медленный исполнитель задерживает весь раунд. Асинхронная схема потенциально дала бы больше параллелизма, но потребовала бы решать координацию результатов, согласованность состояния и распространение ошибок. В статье это направление обозначено как будущий компромисс, а не как уже доказанное улучшение.
Deployment needs careful coordination. / Synchronous execution creates bottlenecks.Какие задачи пользователи решают через Research
После основного заключения статья показывает третью иллюстрацию — карту наиболее частых категорий использования Research на диаграмме Clio. Крупнейшая указанная категория — разработка программных систем в специализированных областях, 10%. Далее идут создание и оптимизация профессионального или технического контента — 8%, стратегии роста бизнеса и выручки — 8%, академические исследования и образовательные материалы — 7%, поиск и проверка информации о людях, местах или организациях — 5%.
Эти проценты показывают категории использования в анализе Anthropic, но статья рядом с рисунком не приводит размер выборки, временной период или полную процедуру категоризации. Поэтому эта иллюстрация полезна для понимания спектра задач, а не как универсальная статистика всего рынка или всех пользователей Claude.
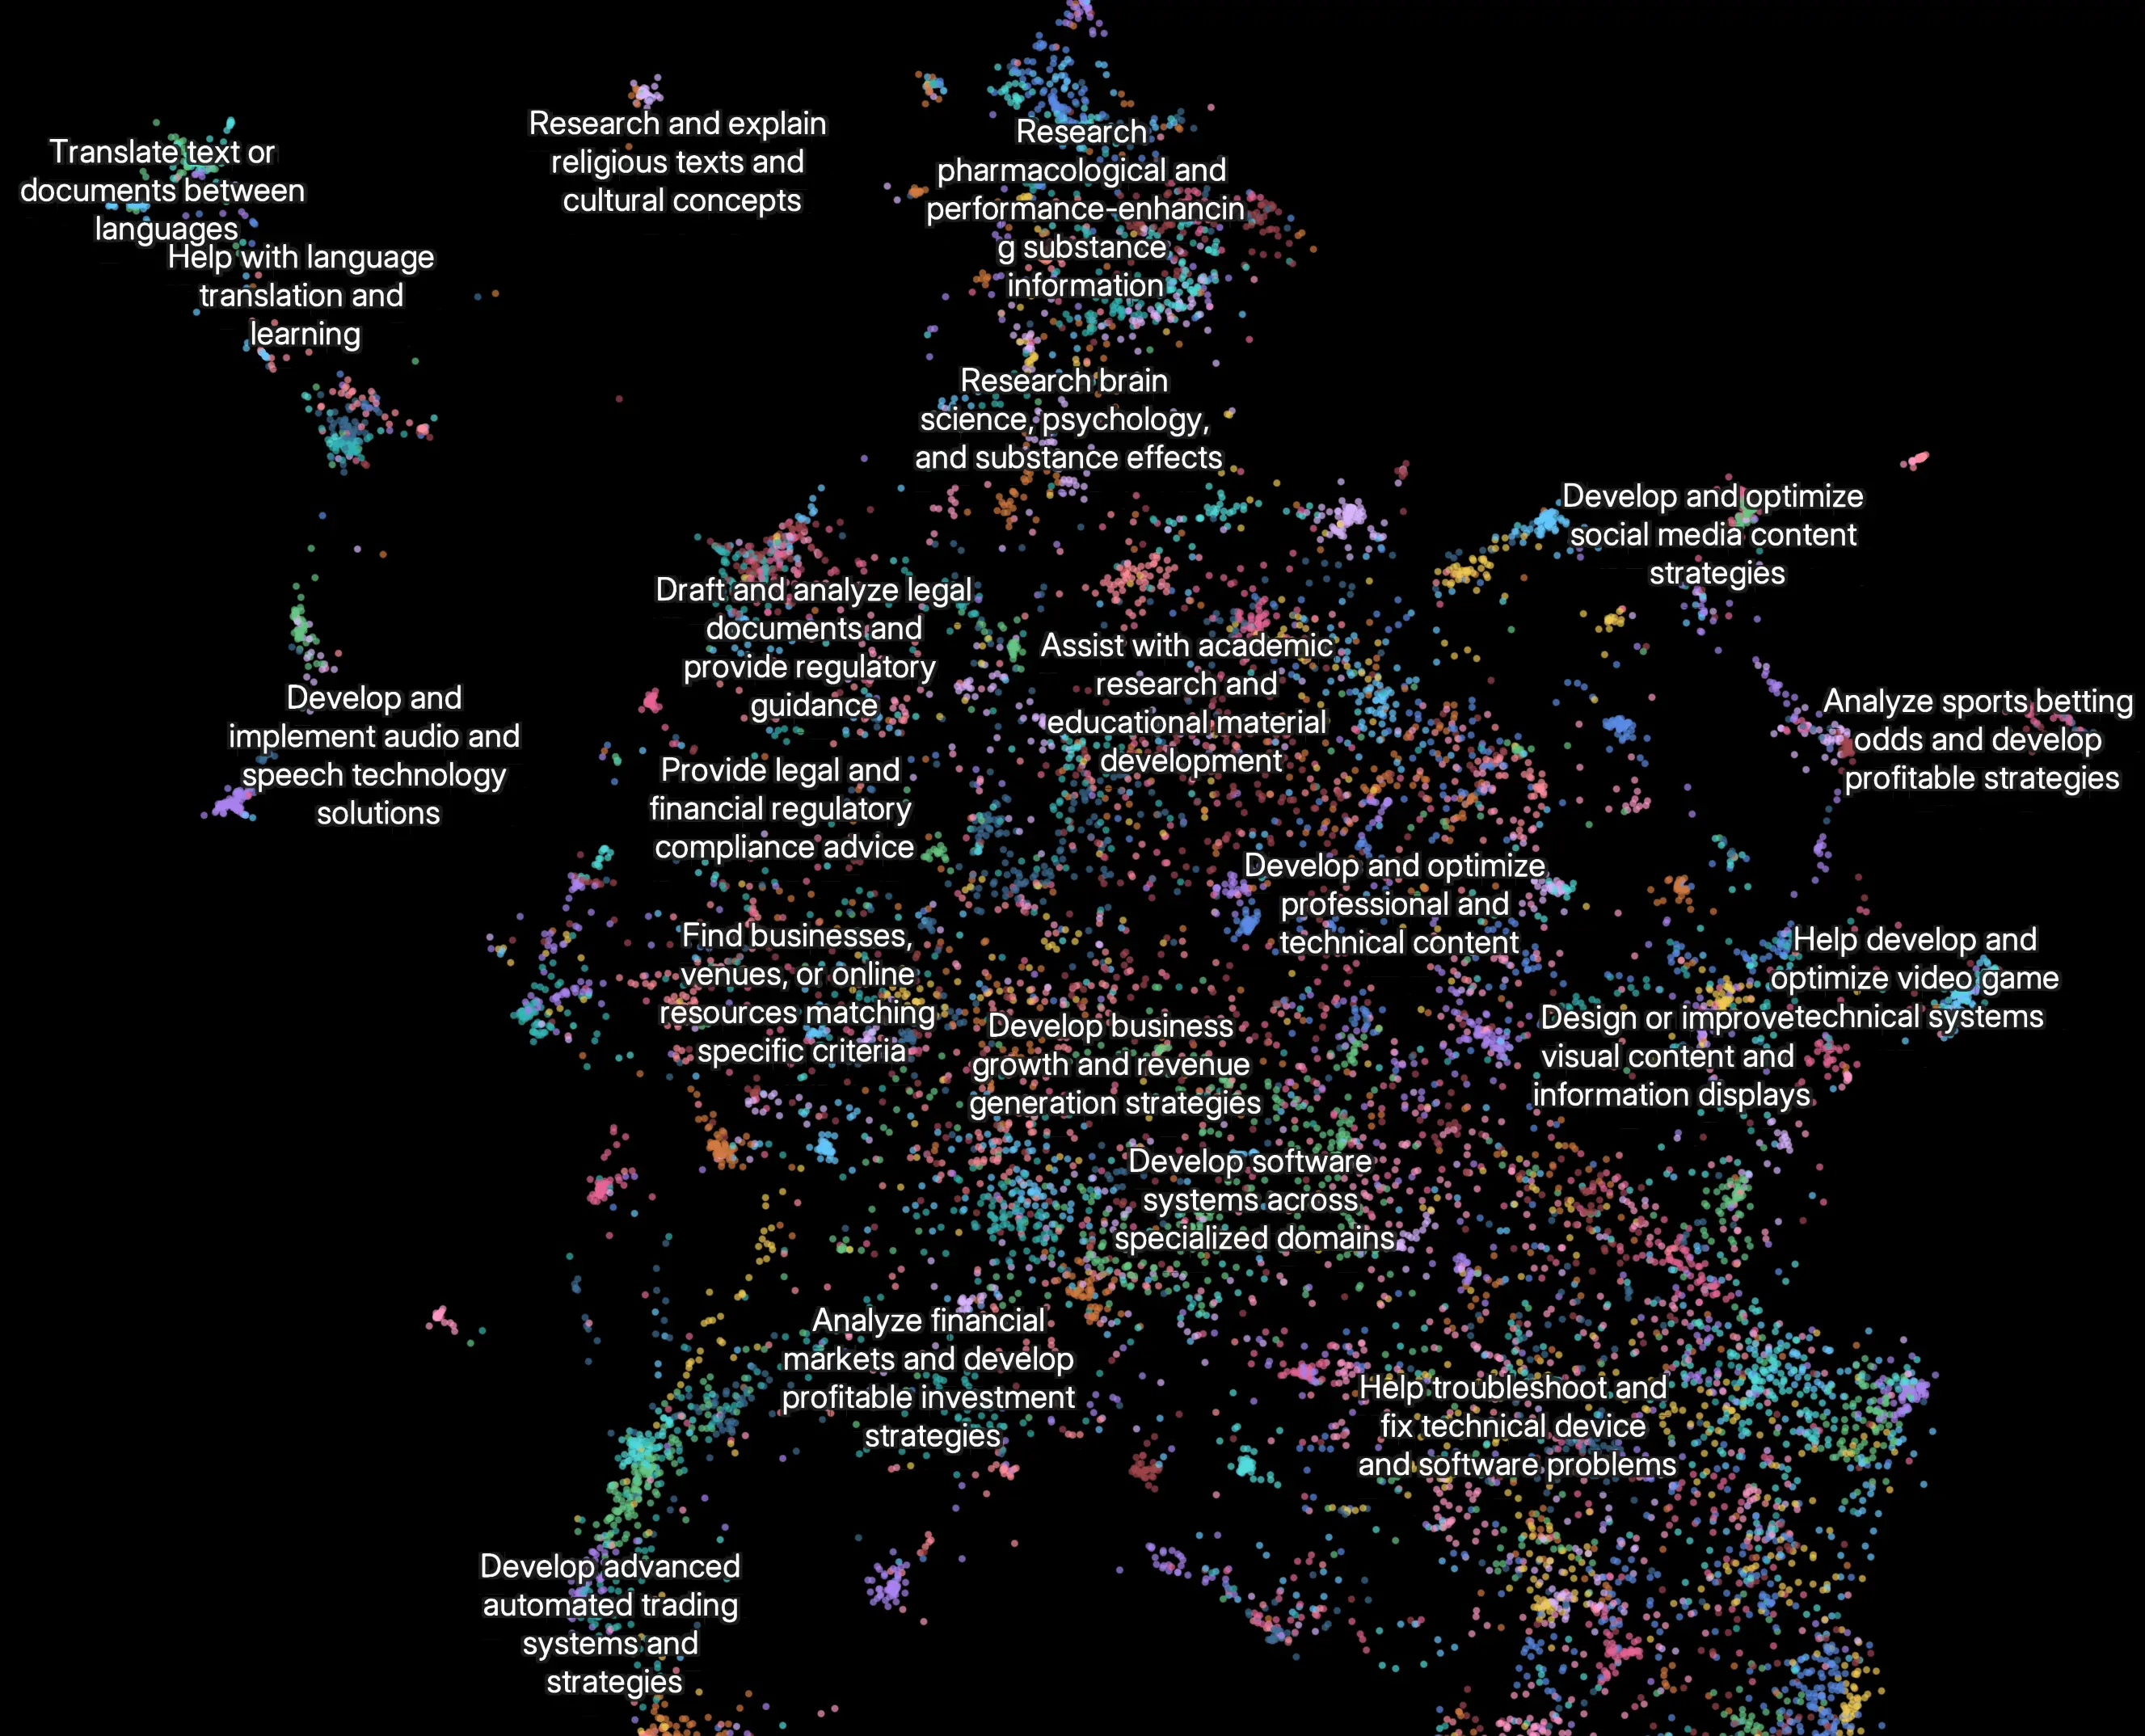
Категории использования Research в анализе Anthropic; проценты относятся к описанной авторами выборке, а не ко всем пользователям Claude.
Источник: Оригинальная иллюстрация AnthropicДополнение: оценивать изменяющих состояние агентов по конечному результату
В дополнении Anthropic выходит за пределы Research, где агент преимущественно ищет и читает информацию и обсуждает агентов, которые меняют постоянное состояние среды. Для таких задач каждое действие влияет на следующие шаги, поэтому пошаговое сравнение с одной эталонной траекторией становится особенно хрупким.
Рекомендация авторов — оценивать конечное состояние: достиг ли агент нужного результата, даже если пришёл к нему другим путём. Для длинных процессов можно добавить промежуточные checkpoints с ожидаемыми изменениями состояния. Это общий совет для state-mutating agents; статья не утверждает, что весь этот механизм является частью текущего Research.
End-state evaluation of agents that mutate state over many turns.Дополнение: как переживать очень длинные диалоги
Для разговоров на сотни ходов обычного контекстного окна становится недостаточно. Anthropic описывает паттерн, где агент суммирует завершённую фазу, сохраняет существенные сведения во внешнюю память и затем продолжает работу уже с более компактным контекстом.
При приближении к пределу контекста можно создавать свежих подагентов с чистыми окнами и передавать им необходимое состояние через аккуратный handoff. Сохранённый план затем извлекается из Memory, а не должен всё время находиться в активной истории. Дополнение формулирует это как общий паттерн для долгоживущих агентов; часть идеи с сохранением research plan явно присутствует и в workflow Research.
Long-horizon conversation management.Дополнение: не передавать большие результаты через цепочку пересказов
Последний совет в дополнении касается потери информации при многоступенчатой передаче. Вместо того чтобы заставлять подагента пересказывать весь результат координатору, специализированный агент может сохранить большой артефакт во внешней системе и вернуть только лёгкую ссылку на него.
Такой подход уменьшает копирование больших данных через историю диалога и снижает риск, что координатор исказит специализированный результат. Авторы особенно отмечают структурированные артефакты вроде кода, отчётов и визуализаций. Это рекомендация по проектированию multi-agent систем в целом; из текста нельзя делать вывод, что именно файловая схема используется как обязательная часть текущего Research.
Subagent output to a filesystem to minimize the ‘game of telephone.’Итог: от открытого поиска к надёжной многоагентной системе
Research у Anthropic начинается не с идеи «добавить побольше агентов», а из-за особенностей самой задачи. В открытом исследовании следующий шаг зависит от уже найденного, а независимые направления выгодно проверять одновременно. Поэтому ведущий агент превращает запрос в набор ограниченных поручений, а подагенты работают в отдельных контекстах и возвращают сжатые результаты. Это расширяет доступный вычислительный бюджет, но не бесплатно: система с несколькими агентами расходует существенно больше токенов и требует явных правил делегирования, остановки, выбора инструментов и бюджета усилий. После поисковой части отдельный CitationAgent связывает утверждения итогового отчёта с конкретными местами документов.
- 01
Понять запрос
LeadResearcher определяет сложность задачи, стратегию и сохраняет план в Memory.
- 02
Разделить направления
Независимые части исследования получают специализированные подагенты с конкретными границами и форматом результата.
- 03
Искать параллельно
Подагенты вызывают подходящие инструменты, оценивают найденное и уточняют следующие запросы.
- 04
Собрать и продолжить
Ведущий агент объединяет результаты и при необходимости запускает новый раунд исследования.
- 05
Привязать источники
CitationAgent находит в собранных документах места, подтверждающие утверждения итогового ответа.
Качество здесь проверяется не одной метрикой и не совпадением с фиксированной траекторией. Anthropic сочетает небольшие ранние eval-наборы, LLM-judge и ручное тестирование, потому что люди замечают сбои и смещения, которые автоматическая оценка пропускает. Работа системы после запуска столь же важна: долгие агенты должны переживать ошибки через retries и checkpoints, оставлять трассы для отладки и не ломаться при обновлении, для чего используются rainbow deployments. Текущая синхронная координация упрощает состояние, но ограничивает взаимодействие во время выполнения. Численные результаты статьи относятся только к описанным условиям: 90,2% — к внутреннему сравнению одной конфигурации, 95% и 80% — к анализу вариации BrowseComp, а 4× и 15× — к расходу токенов. Дополнение расширяет выводы на другие классы агентов. Его советы не следует автоматически считать описанием уже внедрённых компонентов Research.
Conclusion