Разбор готов
Wildberries: как WildBERT перешёл от офлайн-рекомендаций к nearline
Главная страница маркетплейса должна одновременно помнить устойчивые интересы человека и быстро реагировать на то, что он делает прямо сейчас. У Wildberries эту задачу решает семейство моделей WildBERT. Долгое время основная офлайн-модель опиралась прежде всего на историю заказов и хорошо описывала долгосрочные предпочтения, но свежие события попадали в рекомендации с задержкой до суток. Команда поэтому развивала две линии одновременно: ускоряла проверку гипотез для офлайн-BERT и строила реактивный контур обновления рекомендаций с задержкой в считанные секунды. В этой главе разберём путь целиком: как сократили словарь товаров и обучали модель с отрицательными примерами из пакета, как устроили Head-to-Head-эксперименты через Airflow, какие изменения последовательностей, функции потерь, разнообразия и пользовательских признаков дали рост метрик, почему часть идей не сработала и как появился nearline. Главная практическая польза — увидеть, как в большой рекомендательной системе связываются данные, обучение, эксперименты и асинхронное обновление кандидатов, не смешивая задержку подготовки модели с задержкой пользовательского запроса.
Материал полезен ML- и RecSys-инженерам, которые работают с последовательными моделями рекомендаций, ускоряют цикл A/B-экспериментов или строят обновление персонализации по свежим событиям. Здесь особенно хорошо видно, где заканчивается обучение модели и начинается промышленный контур доставки новых кандидатов в выдачу.
Статья · на русском
Трансформеры для персональных рекомендаций на маркетплейсе: от гипотез до A/B-тестированияИван Ващенко · Опубликовано: 4 декабря 2025 г.
WildBERT — концепция для нескольких процессов рекомендаций
WildBERT основан на архитектуре BERT, но в материале это не одна фиксированная модель. Команда использует общую концепцию в нескольких процессах: Item-to-Item-подборках, кандидатной модели офлайн-выдачи, доранжировании, построении User-to-Item-векторов и реактивном источнике онлайн-выдачи. Основная часть истории посвящена офлайн-модели, потому что именно на ней к моменту публикации проверили больше всего гипотез.
Такое различие важно для всей главы. Ни один результат ниже нельзя автоматически переносить на все проявления WildBERT: в разных процессах отличаются входные сигналы, временной горизонт и роль модели в выдаче.
Фрагмент статьи: WildBERT — концепция для нескольких процессов рекомендацийИсходная офлайн-модель: надёжные заказы, длинная история и лаг свежести
Основная офлайн-модель обучается на совершённых заказах. Для команды это самый надёжный и наименее шумный сигнал о предпочтениях. Временной горизонт большой — примерно год, а векторное представление пользователя расширенное. За эту устойчивость приходится платить свежестью: между новыми событиями и фактическим обновлением рекомендаций лаг может доходить до суток.
В материале такую долгосрочную модель называют Long-State. Её задача — удерживать устойчивый профиль интересов, а не мгновенно повторять последнее действие пользователя. Позже именно это различие станет причиной появления отдельного nearline-контура.
Фрагмент статьи: Исходная офлайн-модель: надёжные заказы, длинная история и лаг свежестиДесятки миллионов товаров: словарь сократили до 5 млн
Активный товарный словарь Wildberries насчитывает десятки миллионов позиций. Хранить отдельные обучаемые представления и полный набор отрицательных примеров для всего каталога слишком дорого, поэтому словарь сначала сократили до 5 млн наиболее релевантных товаров.
Даже 5 млн объектов — слишком много для сравнения каждого положительного примера со всеми остальными. Поэтому в исходном обучении использовали отрицательные примеры из того же пакета данных: положительные товары других пользователей внутри batch становились случайными отрицательными примерами для текущего пользователя. Этот приём в источнике называется In-Batch Random Negative Sampling.
На выдаче отдельно действовала фиксированная квота на категорию: она ограничивала число товаров одного типа, чтобы одна категория не заняла почти весь список. Позже и выбор отрицательных примеров, и механизм разнообразия были переработаны.
Фрагмент статьи: Десятки миллионов товаров: словарь сократили до 5 млнСтарый офлайн-конвейер: несколько стадий и накопление лага
До перехода к более быстрому экспериментальному циклу изменения проходили через стандартную цепочку: обучение базовой модели, дообучение, применение дообученной модели, реранкер и бизнес-правила. На исходной схеме под стадиями указаны лаги: два дня у обучения базовой модели и по одному дню у следующих трёх этапов; у бизнес-правил лаг не указан.
Эти подписи нельзя читать как задержку обработки одного запроса пользователя. Схема показывает цикл подготовки и обновления рекомендаций: модель заранее обучается и применяется, затем результат проходит следующие стадии. Пользовательский запрос не ждёт последовательного завершения всех этих шагов.
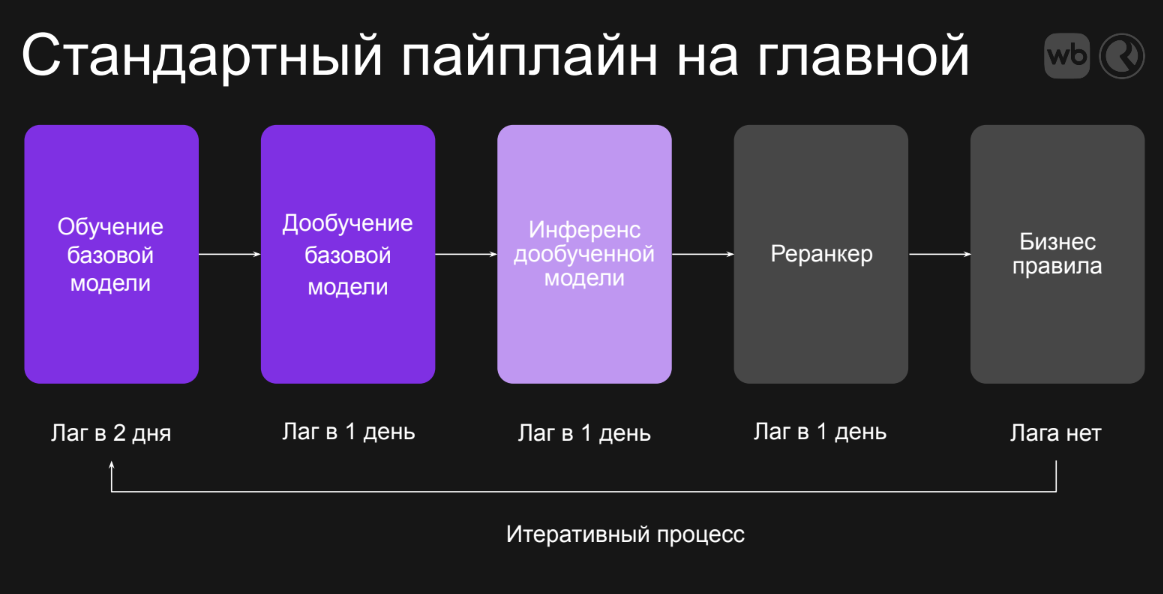
Схема подготовки офлайн-рекомендаций. Указанные лаги относятся к стадиям этого контура, а не ко времени обработки одного запроса.
Источник: Wildberries · Трансформеры в рекомендацияхHead-to-Head: сравнивать две версии BERT на одинаковых данных
Чтобы быстрее проверять идеи, команда перешла к Head-to-Head, или H2H. Здесь нет отдельной чистой контрольной группы: между собой сравниваются рабочая базовая офлайн-BERT из продакшена и её изменённая версия. Обе обучаются на одинаковых репрезентативных данных, поэтому эксперимент отвечает на узкий вопрос: какая из двух версий BERT лучше в одинаковых условиях.
Цикл идёт по дням. Сначала запускается обучение, затем обе модели дообучаются на свежих данных, после чего выполняется их инференс. В обычном продакшен-конвейере дальше есть реранкер и другие модели, но для H2H отдельный реранкер убирают, чтобы экономить ресурсы и время. Бизнес-правила, например фильтрация недоступных товаров, сохраняются.
Контур полуавтоматизирован в Airflow. По словам автора, это позволяет запускать до трёх параллельных A/B-тестов в неделю. Офлайн-метрики остаются предварительным фильтром для явно слабых идей, но решение принимают по эксперименту на реальном трафике после прокраса метрик.
На схеме H2H показаны обучение, дообучение и инференс сравниваемых моделей перед бизнес-правилами. Как и предыдущая схема, это подготовка экспериментальной выдачи, а не последовательность операций внутри одного HTTP-запроса.
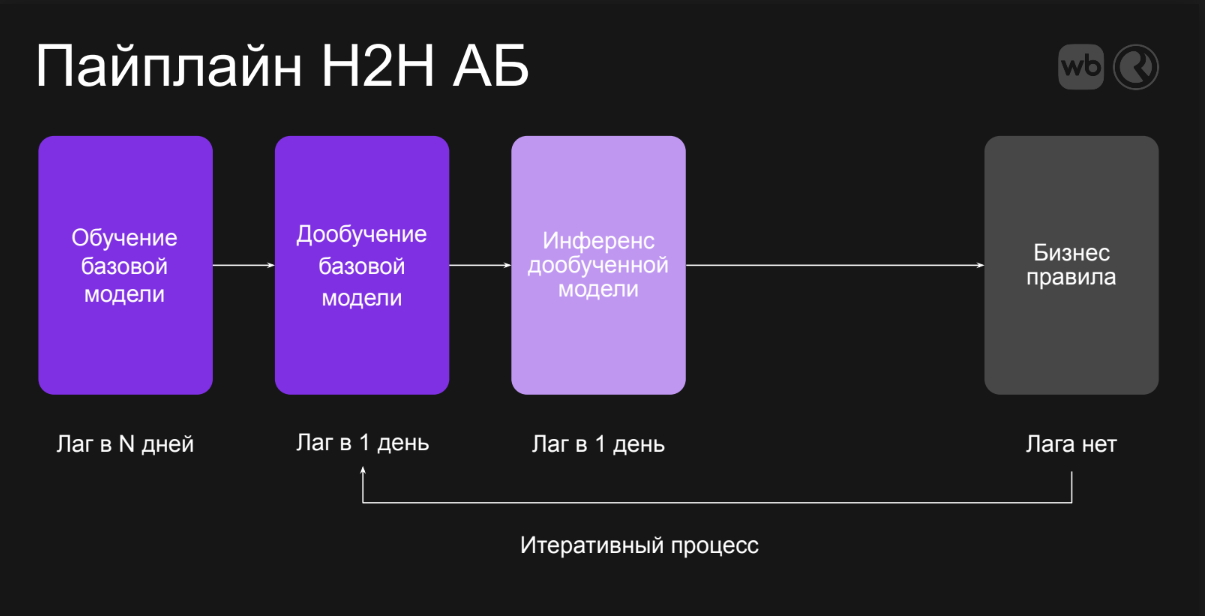
В H2H сравниваются рабочая базовая BERT-модель и изменённая версия на одинаковых данных. Схема показывает итерации подготовки, а не онлайн-запрос.
Источник: Wildberries · Трансформеры в рекомендацияхПоследовательности и функция потерь стали ближе к реальному поведению
Первое крупное изменение затронуло историю пользователя. Раньше последовательность в основном описывала сам факт заказа. Затем в неё добавили разные состояния заказа: товар может быть выкуплен, отменён или всё ещё находиться в пути. За счёт этого модель видит не только факт намерения купить, но и дальнейший исход события.
Изменилась и цель маскирования. В последовательности скрывают только те события, которые связаны с конечной продажей товара. Это более узкий обучающий сигнал, чем маскирование любого действия. При этом источник не утверждает, что вся функция потерь напрямую оптимизирует деньги.
Вместо случайных отрицательных примеров команда перешла к сложным отрицательным примерам, или hard negatives: это товары, которые труднее отличить от положительного. Дополнительно в функцию потерь добавили компоненту, отвечающую за разнообразие рекомендаций. Формула этой компоненты и способ поиска hard negatives в статье не раскрыты.
Фрагмент статьи: Последовательности и функция потерь стали ближе к реальному поведениюДообучение сократило лаг, а разнообразие перестало быть жёсткой квотой
Регулярное дообучение на свежих отложенных датах уменьшило разрыв между событиями, которые модель успела увидеть, и рекомендациями, которые получает пользователь. Автор сравнивает прежний лаг около двух дней с новым значением не более суток.
Одновременно команда отказалась от одинаковой фиксированной квоты для каждой категории как единственного механизма разнообразия. Вместо неё внутри категорий применили экспоненциальное затухание оценок: у доминирующей категории следующие товары получают всё меньший вес, поэтому другим категориям проще попасть в список. Автор связывает рост разнообразия с ростом конверсии.
Фрагмент статьи: Дообучение сократило лаг, а разнообразие перестало быть жёсткой квотойМодель получила признаки пользователя, а не только историю покупок
Следующее изменение — новая модальность входа. Если раньше модель знала пользователя главным образом по его действиям с товарами, то теперь в представление добавили признаки вроде возраста, пола и географии. Они дополняют историю покупок и помогают различать пользователей с похожими последовательностями, но разным контекстом.
В H2H автор отдельно сообщает два результата: hard negatives дали около +2% GMV на главной странице, а пользовательские признаки — почти +3% GMV. GMV здесь — валовой объём продаж, то есть объём товарооборота по этой метрике; это не выручка и не прибыль Wildberries. Эти два эффекта получены для разных гипотез и не образуют один суммарный прирост.
Переход от обычных Item ID к Semantic ID автор упоминает как дальнейшее направление. В планах не только семантические идентификаторы товаров, но и попытка сделать офлайн-оценку более семантической. В описанный текущий результат этот переход не входит.
Фрагмент статьи: Модель получила признаки пользователя, а не только историю покупокЧто не сработало: клики, свежие заказы и цена
Первая неудачная идея — добавить в длинную историю только «качественные» клики: например, переходы к фотографии или отзыву после открытия карточки товара. Такой сигнал казался надёжнее обычного клика, но офлайн-модель стала вести себя слишком похоже на краткосрочный источник. Улучшение кликовых сигналов частично каннибализировало метрики онлайн-источников, то есть Long-State начал конкурировать с тем контуром, который должен был отвечать за свежий интерес.
Вторая идея — чаще маскировать самые свежие заказы. Команда ожидала, что модель лучше поймёт актуальное состояние интересов. Эксперимент прироста не дал; более того, модель стала чаще рекомендовать товары, которые пользователь уже покупал.
В статье описан и отдельный эксперимент с ценой: более дорогим покупкам давали больший вес через логарифм в функции потерь. Средний чек вырос, но конверсия снизилась примерно пропорционально, поэтому общего выигрыша по GMV не получилось. Автор подчёркивает, что неудачные идеи команда может повторно проверять в другой постановке.
Фрагмент статьи: Что не сработало: клики, свежие заказы и ценаNearline нужен для свежего интереса, а не для замены Long-State
К 2025 году команда запустила BERT в режиме обновления с небольшой задержкой — nearline. Его смысл не в том, чтобы отправлять модель на каждый пользовательский запрос, а в том, чтобы асинхронно пересчитывать персонализацию после свежих действий.
Таблицу можно прокрутить по горизонтали.
Таким образом, nearline — не просто более быстрая копия офлайн-модели. Он использует более короткую историю и больше типов действий, чтобы описывать актуальное состояние. Long-State при этом остаётся источником долгосрочного контекста и далее участвует в формировании онлайновых рекомендаций.
Фрагмент статьи: Nearline нужен для свежего интереса, а не для замены Long-StateАсинхронный контур: Kafka → Go → Triton → HNSW → хранилище
- 01
Событие попадает в Kafka
Поток действий пользователя поступает в Kafka. Новое событие или накопившаяся серия событий становится триггером следующего обновления.
- 02
Go-сервис собирает пакет
Consumer на Go получает взаимодействия, собирает их в batch и подготавливает вход модели. В этом же сервисе хранятся необходимые маппинги.
- 03
Triton применяет модель
Подготовленный пакет через балансировщик отправляется на один или несколько Triton inference server. На выходе получается эмбеддинг текущего состояния пользователя.
- 04
HNSW ищет кандидатов
По полученному вектору выполняется приближённый поиск ближайших соседей. HNSW возвращает товары-кандидаты, близкие к состоянию пользователя.
- 05
Результат сохраняется
Сформированный результат обновления записывается в хранилище, откуда его может использовать дальнейшая выдача.
- 06
Следующее событие запускает цикл заново
Контур работает непрерывно и пересчитывает nearline-рекомендации по мере поступления новых действий.
Важная граница: это асинхронное обновление состояния и кандидатов. Пользовательский HTTP-запрос не обязан ожидать прохождения Kafka, Go, Triton и HNSW; система заранее обновляет подготовленный результат.
В тексте сказано, что после HNSW сформированный список кандидатов сохраняется в key-value хранилище, названное User Vector Storage. На схеме стрелка к этому хранилищу подписана как Updated user vectors. Материал не даёт точной спецификации формата записи, поэтому корректнее фиксировать сам факт обновления хранилища и не додумывать, лежат ли там только векторы, только кандидаты или составная структура.
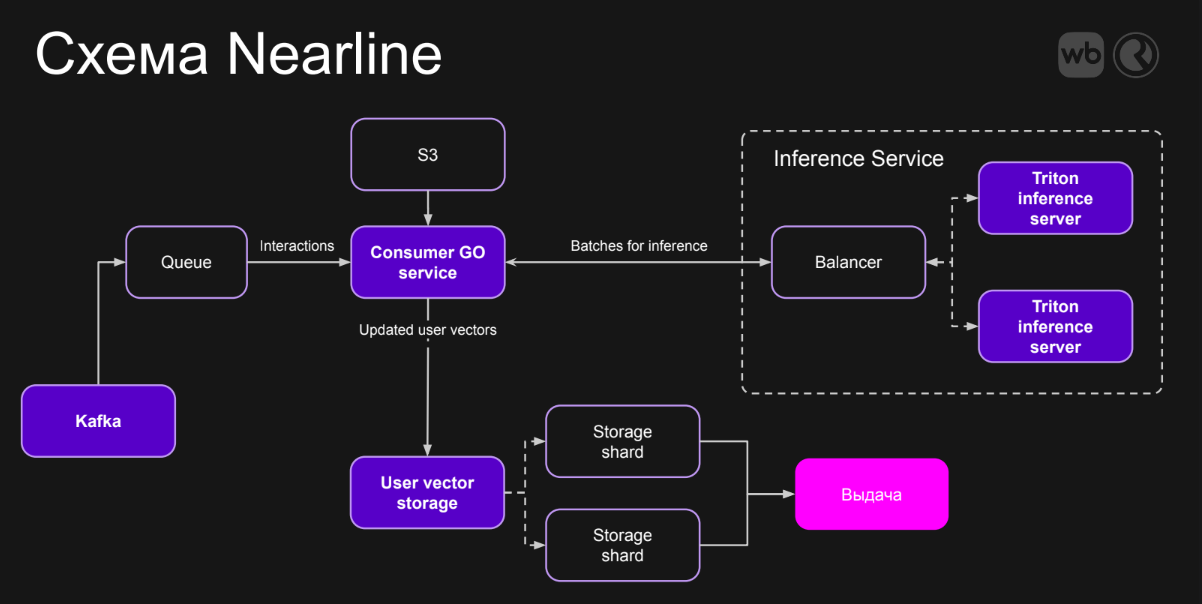
События запускают обновление рекомендаций через Go-сервис и Triton. В тексте после HNSW сохраняются кандидаты; на рисунке также отмечены обновлённые пользовательские векторы.
Источник: Wildberries · Трансформеры в рекомендацияхNearline A/B: сначала просело разнообразие, затем его пришлось расширить
После запуска nearline команда заменила им часть офлайн-выдачи в A/B-тесте. Первая версия показала небольшую просадку разнообразия: свежий краткосрочный интерес мог слишком сильно сузить список вокруг похожих товаров. Проблему исправляли расширением пула категорий, доступных пользователю.
На слайде с результатами отдельно указаны +3,1% GMV главной страницы для варианта, где часть офлайн-выдачи заменена реактивным nearline, и +3,5% при повышении разнообразия на этапе инференса. Это два разных изменения. Их нельзя складывать в +6,6%, а GMV нельзя трактовать как выручку или прибыль компании.
Таблицу можно прокрутить по горизонтали.
Для этих сравнений в материале не опубликованы численные p95, размер выборки, доверительные интервалы или полная схема статистического дизайна A/B. Поэтому таблица сохраняет только те базы и эффекты, которые прямо названы в источнике.
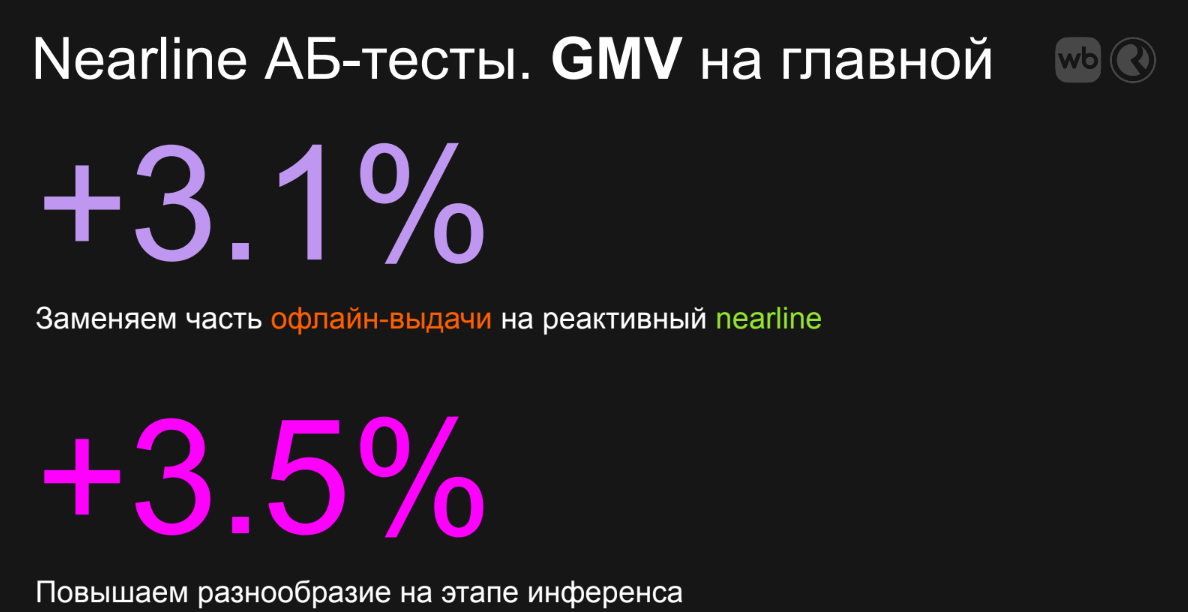
Исходный слайд: +3,1% при замене части офлайн-выдачи на nearline; +3,5% при повышении разнообразия во время применения модели. Это разные указанные изменения, их эффекты не складываются.
Источник: Wildberries · Трансформеры в рекомендацияхLong-State и nearline уже приходится комбинировать
Nearline не отменяет долгосрочную модель. Автор прямо отмечает, что онлайн-BERT получает не только краткосрочное состояние пользователя, но и некоторую информацию от офлайн-модели — фактически Long-State. Поэтому задача команды смещается от выбора «офлайн или онлайн» к поиску правильного способа их сочетания.
Текущее поведение nearline автор описывает как «клики после кликов»: модель хорошо реагирует на недавние клики и оптимизируется на последующие клики. Следующая продуктовая цель — сделать так, чтобы эти цепочки чаще заканчивались покупкой. В источнике это именно план, а не уже измеренный результат.
Фрагмент статьи: Long-State и nearline уже приходится комбинироватьЧто команда планирует дальше
Первое направление — довести инфраструктуру A/B-тестирования nearline и перенести на неё идею быстрого H2H, учитывая отличия реактивной архитектуры. Второе — проверить в nearline те улучшения, которые уже сработали в офлайне, не предполагая, что они перенесутся один в один.
Третье направление — ускорить поиск ближайших соседей и доставку рекомендаций до пользователя. Четвёртое — экспериментально подобрать сочетание Long-State и nearline. Пятое — сменить целевое поведение с «кликов после кликов» на «покупки после кликов». Параллельно команда экспериментирует с HSTU-подобными моделями.
Отдельно ранее был обозначен переход к Semantic ID и более семантическим офлайн-метрикам. Все эти пункты остаются планами или экспериментальными направлениями; их нельзя приписывать уже внедрённой версии системы.
Фрагмент статьи: Что команда планирует дальшеИтог: от долгого офлайна к двум временным масштабам рекомендаций
WildBERT прошёл путь от большой офлайн-модели на заказах к системе, где долгосрочный Long-State дополняется реактивным nearline. Сначала команда уменьшила товарный словарь до 5 млн позиций, использовала отрицательные примеры из пакета и ограничивала категории квотами. Затем H2H и Airflow ускорили проверку изменений: рабочую BERT стали напрямую сравнивать с новой версией на одинаковых данных. Дальше улучшили последовательности, маскирование, сложные отрицательные примеры, разнообразие, свежесть дообучения и признаки пользователя.
- 01
Kafka
Новое действие пользователя попадает в поток событий и запускает очередное обновление.
- 02
Go-сервис и пакет действий
Сервис собирает действия в пакет и готовит вход для модели.
- 03
Triton и вектор
Модель вычисляет новое векторное представление текущего состояния пользователя.
- 04
HNSW
По вектору выполняется приближённый поиск товаров-кандидатов.
- 05
Хранилище
Результат обновления сохраняется для последующей выдачи; точный формат записи источник не специфицирует.
- 06
Выдача
Готовые nearline-кандидаты могут использоваться без запуска всей цепочки внутри пользовательского запроса.
Обучение происходит отдельно от этого контура. Офлайн-модель использует длинную историю заказов, а nearline обучается на более широком наборе взаимодействий и коротком горизонте в несколько недель. Схемы обучения и дообучения поэтому нельзя трактовать как обработку пользовательского запроса.
Опубликованные эффекты относятся к разным тестам: около +2% GMV для сложные отрицательные примеры, почти +3% для признаков пользователя, +3,1% GMV главной при замене части офлайна на nearline и +3,5% при повышении разнообразия. GMV — валовой объём продаж, не выручка и не прибыль компании; эффекты не складываются. Численные p95, выборки и доверительные интервалы не опубликованы.
Дальше команда планирует перенести быстрые эксперименты в nearline, переиспытать офлайн-улучшения, ускорить ANN-поиск и доставку, лучше объединить Long-State с краткосрочным состоянием, перейти от кликов к покупкам как целевому продолжению поведения и экспериментировать с Semantic ID и HSTU-подобными моделями.
Фрагмент статьи: Итог: от долгого офлайна к двум временным масштабам рекомендаций