Разбор готов
МТС Web Services: RAG-помощник для второй линии поддержки
Вторая линия поддержки МТС Web Services разбирает сложные инциденты: связывает симптомы с сервисами, ищет первопричины и передаёт разработчикам проблемы, которые упираются в код или архитектуру. Для такой команды документация — часть времени решения инцидента, но Confluence и Jira со временем накопили неполные, неоднородно организованные инструкции, а одна и та же проблема могла называться по-разному. Владимир Дробот описывает путь от самого дешёвого прототипа с выгрузкой Confluence в MWS GPT до рабочего RAG-помощника, который ищет материалы по смыслу и возвращает ответ вместе с источниками. Важная часть истории — не только сама схема поиска, но и то, что не сработало: дополнительные LLM-вызовы для переписывания запроса и переранжирования документов оказались слишком дорогими по времени относительно небольшого качественного выигрыша. Статья также честно фиксирует границу результата: количественного улучшения SLA или MTTR автор не показывает, а качество помощника по-прежнему ограничено качеством базы знаний и требует участия человека.
Материал полезен инженерам поддержки, SRE и ML/LLM-инженерам, которые хотят встроить поиск по внутренним знаниям в ежедневную работу. Здесь особенно хорошо видны постепенный переход от файлового прототипа к RAG, доменная нормализация запросов, роль ручной проверки и практическая цена усложнений, которые выглядят разумно на схеме, но не дают достаточного выигрыша в реальной команде.
Статья · на русском
RAG-помощник для команды саппорта своими рукамиВладимир Дробот · Опубликовано: 1 декабря 2025 г.
Вторая линия: инциденты, SLA и поиск корня проблемы
Команда Владимира Дробота — вторая линия поддержки кластера рекламных технологий МТС Web Services. Она разбирает сложные инциденты, ищет первопричины и передаёт разработчикам те проблемы, которые упираются в код или архитектуру. В обязанности поддержки также входят мониторинг, эскалация, взаимодействие с клиентами и другими командами, postmortem и постановка задач на устранение дефектов и доработку.
Главную эксплуатационную рамку автор формулирует через SLA: инциденты нужно решать вовремя и качественно. Поэтому документация здесь не самоцель. Она должна сокращать путь от симптома к понятной инструкции, а специалист должен уметь проверить найденное решение и связать наблюдаемую проблему с конкретным сервисом.
ПроблемаПочему обычный поиск по базе знаний перестал помогать
В идеальном состоянии сотрудники помнят ключевые кейсы, а документация полна и аккуратно организована. В описанной команде библиотека была неполной, структура росла непоследовательно, а на отдельный рефакторинг знаний постоянно не хватало времени. Проблема усиливается в распределённой системе: симптом на входе может быть следствием сбоя в сервисе, который находится далеко по цепочке обработки.
Один и тот же класс проблемы может быть записан как «увеличение времени обработки», «увеличение задержек доставки», «увеличение latency» или «рост очереди сообщений». Буквальный поиск заставляет сотрудника угадывать формулировку автора инструкции. Отсюда и постановка задачи: находить материал не только по совпадению слов, но и по смыслу.
ПроблемаПервый прототип: MWS GPT и выгрузка Confluence в файл
Самый дешёвый первый шаг не требовал отдельного RAG-сервиса. Корпоративный MWS GPT уже давал веб-интерфейс к нескольким LLM и позволял прикладывать текстовые файлы. Команда написала простой Python-скрипт, выгрузила пространство Confluence через REST API и сложила статьи в JSON с идентификатором страницы, заголовком и текстом.
{
  "id": "123456789",
  "title": "Заголовок страницы на Confluence",
  "body": "Содержимое страницы"
}
Промпт требовал отвечать только по содержимому статей, не добавлять отсутствующие сведения, при нескольких релевантных статьях использовать их совместно, а при отсутствии ответа явно говорить, что релевантной информации нет. В конце ответа нужно было давать URL страницы Confluence. Это важная часть дизайна: ответ LLM не должен лишать специалиста возможности открыть первоисточник и проверить детали.
MWS GPT с загрузкой базы знаний файломПочему файловый вариант не стал рабочей системой
Автор не объявляет этот путь бесполезным. Он остаётся удобным, когда к запросу нужно приложить небольшой контекст: например, попросить построить SQL по описанию схемы или разобрать часть лога. Но для постоянно обновляемых Confluence и Jira команде нужен сервис, который сам поддерживает индекс и не перекладывает обновление знаний на каждого сотрудника.
MWS GPT с загрузкой базы знаний файломПереход к RAG: сначала найти, потом сгенерировать ответ
После положительного опыта с веб-прототипом команда перешла к OpenAI-совместимому API MWS GPT и выбрала RAG — поиск материалов перед генерацией ответа. Идея проста: прежде чем просить языковую модель ответить на вопрос, система находит во внутренних знаниях подходящие материалы и добавляет их к запросу. Поэтому модель получает сведения об инструкциях и инцидентах, которых не было в её исходном обучении.
Исходная схема RAG показывает только эту логическую связь: пользовательский вопрос дополняется найденными системой документами и затем отправляется LLM. Из неё нельзя вывести конкретную модель, базу данных или способ измерения близости — эти детали схема не называет.
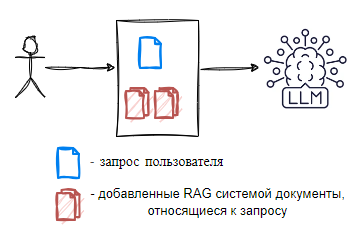
RAG добавляет к вопросу найденные документы. Схема объясняет роль контекста, а не конкретную модель или базу данных.
Источник: Владимир Дробот · МТС Web ServicesКак Confluence и Jira превращаются в поисковый индекс
Документы очищаются от HTML и делятся на фрагменты по 2000–3000 символов с перекрытием 150–200 символов. Каждый фрагмент переводится моделью в числовое представление — эмбеддинг. В базе вместе с ним хранятся ID страницы, пространство Confluence или проект Jira, URL, текст фрагмента и время последнего обновления. Эти размеры — настройки системы авторов, а не универсальный рецепт выбора фрагмента для RAG.
Confluence и Jira проверяются инкрементально раз в 30 минут. Новые и изменённые страницы обновляются, удалённые помечаются как is_deleted. Изменения отдельных фрагментов внутри документа отдельно не отслеживаются: если документ изменился, команда для простоты пересчитывает его целиком.
На схеме подготовки документов видна только последовательность Jira/Confluence → документы → фрагменты → Embedding Model → Embeddings → Vector DB. Название embedding-модели и производитель векторной базы в статье и на схеме не указаны, поэтому подставлять конкретные технологии нельзя.
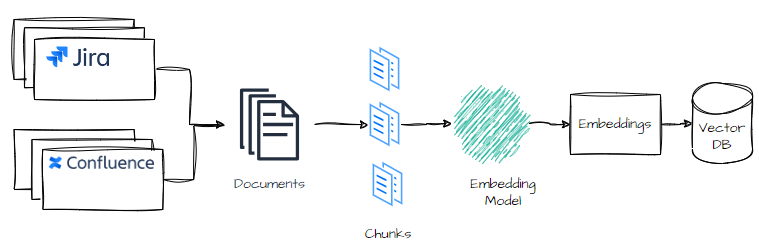
Документы разбиваются на фрагменты, преобразуются в векторы и помещаются в Vector DB. Имена моделей и производителя БД на схеме не указаны.
Источник: Владимир Дробот · МТС Web ServicesРабочий запрос: от вопроса сотрудника до ответа с источниками
- 01
Выбрать вопрос и источник знаний
Пользователь вводит запрос и указывает, где искать информацию — в нужных пространствах Confluence или проектах Jira.
- 02
Построить вектор запроса
Текст вопроса преобразуется в эмбеддинг, то есть числовое представление его смысла.
- 03
Найти близкие материалы
По вектору запроса система ищет наиболее близкие документы или их фрагменты в векторной базе.
- 04
Передать контекст LLM
Найденные материалы добавляются к исходному вопросу и в текстовом виде передаются языковой модели.
- 05
Вернуть ответ и документы
Пользователь получает сгенерированный ответ вместе со списком источников и показанной системой релевантностью.
Логику запроса и представление результатов вынесли в отдельное веб-приложение. С точки зрения безопасности помощника разместили внутри контура МТС. Автор уточняет, что используемые Confluence и Jira не содержали секретных сведений или персональных данных, но бизнес всё равно опасался передачи документов во внешние модели. MWS GPT предоставлял внутренний OpenAI-совместимый API к LLM и embedding-моделям, развёрнутым во внутренней сети.
Итоговая схема работы системыЧто видит сотрудник: ответ, ссылки и управляемые настройки
Интерфейс не скрывает происхождение ответа. На демонстрационном экране можно выбрать источник данных и базу знаний, увидеть список источников под ответом и открыть расширенные настройки. Это поддерживает исходную идею проекта: сотрудник получает быстрый ответ, но сохраняет возможность перейти к документу и перепроверить его.
В интерфейсе помощника показан конкретный демонстрационный ответ от 13 октября 2025 года, подписанный моделью cotype-pro-2_128k_030325. Это свидетельство конфигурации именно этого примера, а не название единственной или постоянной продовой LLM. Отображённая «Уверенность: 5/5» — самооценка сервиса в интерфейсе, а не независимая метрика точности ответа. Наличие ссылок на источники полезнее для проверки содержания, чем само это число.
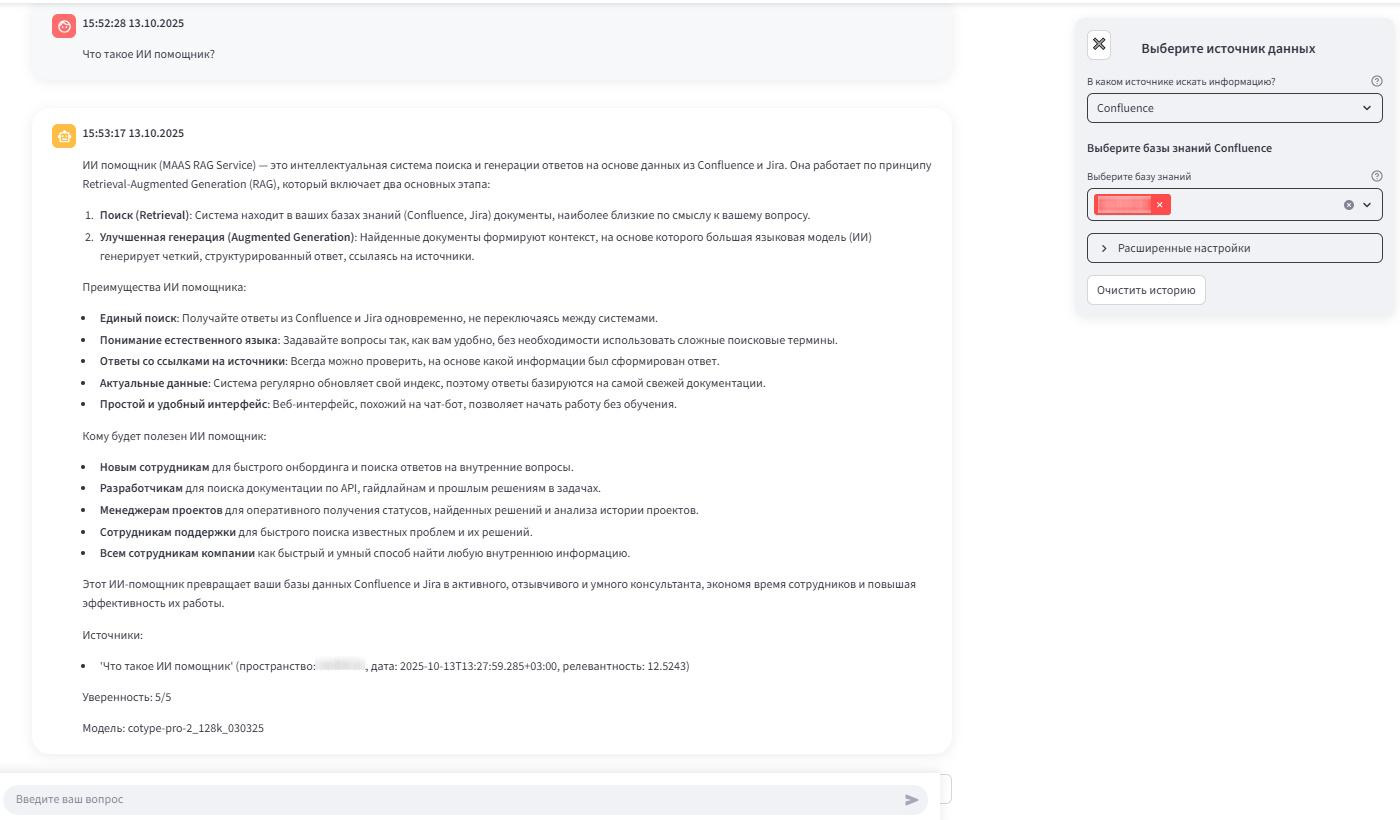
На примере показаны выбор Confluence, база знаний, ссылки на источники и настройки. Ответ подписан cotype-pro-2_128k_030325; отображённая уверенность 5/5 не является независимым измерением качества.
Источник: Владимир Дробот · МТС Web ServicesДо доверия системе человек ищет решение параллельно
Надёжной проверкой качества в своей постановке команда считала экспертное мнение. Для тестирования собрали список запросов и эталонных ответов; в эталонах были ссылки на статьи или тикеты Jira. Эти пары стали тест-кейсами, по которым проверяли изменения системы.
Пока результатам помощника не доверяли достаточно, сотрудников просили обращаться к нему параллельно с обычным поиском. Если ответ оказывался некачественным, создавали задачу на доработку. Это важнее идеи «замены оператора»: на раннем этапе RAG добавлялся к существующему процессу и сравнивался с тем, как специалист решал ту же задачу сам.
Настройка и тестированиеДоменный словарь: когда «постмортем» и postmortem должны означать одно
Семантический поиск тоже ошибался на языке конкретной команды. Embedding-модель не всегда правильно связывала жаргон, транслитерацию терминов и внутренние сокращения. Автор приводит простой пример: запросы «как провести постмортем» и «как провести postmortem» могли выдавать разные страницы.
Вместо обязательного дополнительного вызова LLM команда составила словарь взаимозаменяемых слов и аббревиатур и стала обогащать запрос перед поиском. Тогда «как провести постмортем» превращается в «как провести постмортем postmortem». Приём полезен именно как доменная нормализация: система явно добавляет варианты, которые команда считает эквивалентными. Размер словаря, способ его пополнения и количественный эффект такого расширения в статье не раскрыты.
Настройка и тестированиеДва разумных усложнения, которые не стали настройками по умолчанию
Таблицу можно прокрутить по горизонтали.
Source-6 показывает максимальный путь, когда включены все экспериментальные шаги: словарь терминов, LLM-оптимизация запроса, перевод в embedding, векторный поиск, LLM-переранжирование и финальная генерация. Эту схему нельзя читать как default-путь каждого продового запроса. По статье два LLM-усложнения оставлены как опции именно потому, что дали небольшой качественный выигрыш ценой дополнительного времени.
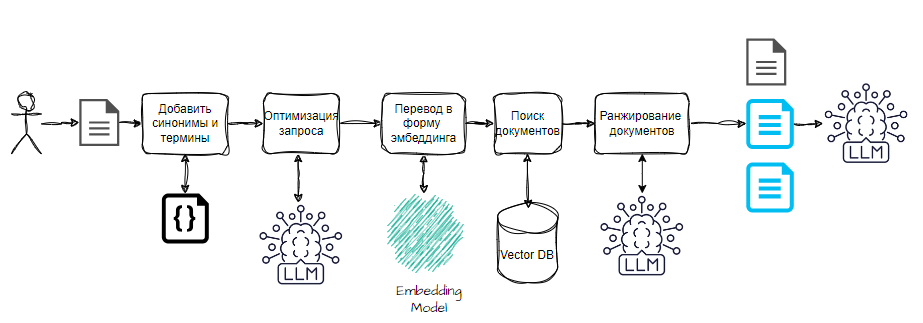
Полная схема включает словарь синонимов, оптимизацию запроса и LLM-ранжирование. Последние два усложнения, по статье, выключены по умолчанию из-за малого выигрыша и дополнительного времени.
Источник: Владимир Дробот · МТС Web ServicesАвтотесты: полезный регрессионный сигнал с неоднозначной метрикой
Когда основные проблемы были устранены, ранее подготовленные тест-кейсы запустили автоматически. В статье метрика описана как нормализованное векторное расстояние между эмбеддингом запроса и эмбеддингом полученного ответа. Значение лежит от 0 до 1: 0 автор называет полным совпадением, 1 — полным несовпадением. Абсолютного порога приемлемого качества команда не знает, поэтому использует значения на эталонных запросах как ориентир и отслеживает изменения после модификаций.
Здесь важно не улучшать методику задним числом. Ранее эталонные ответы содержат ссылки на правильные статьи и Jira, но сам автоматический прокси описан именно как расстояние «запрос — полученный ответ», а не как сходство с эталонным ответом. Кроме того, рядом сказано, что ближе к 0 — лучше, а затем — что при падении метрики нужно разбираться. Эти формулировки внутренне неоднозначны, поэтому из статьи нельзя вывести ни формулу качества, ни порог, ни направление тревоги точнее, чем это сформулировал автор.
Автотесты запускаются как с параметрами по умолчанию, так и с расширенными. Это позволяет хотя бы сравнивать варианты настроек на одном наборе запросов, даже если сам прокси не является полноценной оценкой правильности ответа.
Автоматическое тестированиеЧто изменилось в работе команды после запуска
К моменту статьи система несколько месяцев активно использовалась. Автор сообщает, что семантический поиск помогает быстрее находить связанные материалы в Jira и Confluence и что сотрудники дают хорошие отзывы. Но это качественная оценка: число пользователей, объём запросов, контрольная группа и измеренное сокращение времени поиска не приведены.
Обратная связь встроена в тот же интерфейс: после ответа сотрудник может оценить его и оставить комментарий. Такие сигналы используют не только для настройки поиска, но и для самой базы знаний: плохой ответ может показать, что проблема находится в документации, а не только в модели.
Отдельный вывод автора — современные LLM и инструменты разработки позволили команде довести помощника до рабочего использования без профильной специализации в ИИ. Статья при этом не раскрывает состав проектной команды, трудозатраты или долю времени, которую разработка занимала относительно ежедневной поддержки.
Что мы в итоге поняли / Качественное улучшение работы командыRAG изменил не только поиск, но и привычку документировать
После внедрения команда стала чаще писать знания так, чтобы их было удобно находить через ИИ-помощника. Сложная иерархия страниц, полезная для ручной навигации, потеряла часть прежней важности. В приоритет вышли короткие инструкции и заметки, которые проще обнаружить семантическим поиском.
Это не доказательство того, что иерархия документации больше не нужна вообще. Это наблюдение конкретной команды: сотруднику меньше приходится запоминать, где именно лежит материал. Одновременно качество ответа становится ещё сильнее зависимым от того, насколько сами документы актуальны, непротиворечивы и достаточно полны.
Изменение подходов к документированиюГраница результата: нет измеренного SLA/MTTR uplift и нет замены инженера
Несмотря на положительную обратную связь, статья не показывает количественного эффекта на SLA. Автор прямо пишет, что сокращение времени поиска или ответа пока трудно измерить: SLA решения инцидентов в целом редко нарушается, а стандартные задачи не всегда требуют поиска по базе. Отдельная MTTR-метрика в материале не приведена, поэтому утверждать её снижение нельзя.
RAG-помощник остаётся инструментом сотрудника. Если по теме мало документации, ответ будет неполным или сведётся к общим рассуждениям LLM. Если в базе одновременно лежат устаревшая и актуальная инструкции, система тоже может сбить пользователя с толку. В этом есть побочный полезный эффект: работа с помощником выявляет пробелы и противоречия и тем самым мотивирует чистить базу знаний.
Реальные ограничение и их преодолениеСледующий шаг: ближе к исходному обращению пользователя
Дальнейший план — расширять использование помощника внутри команды и постепенно переходить к обработке оригинальных запросов пользователя, чтобы получать рекомендации по решению ещё до первоначального анализа со стороны сотрудника. В статье это именно направление развития. Нельзя превращать его в уже работающую автономную обработку инцидентов или утверждать, что человек исключён из контура.
Планы на будущееИтог: как работает помощник и где заканчиваются выводы статьи
История МТС Web Services начинается не с выбора модели, а с операционной боли второй линии: нужная инструкция может существовать, но сотруднику приходится угадывать её место и формулировку. Файловый прототип в MWS GPT подтвердил, что ответы по внутренней базе полезны, после чего команда вынесла поиск и генерацию в отдельный RAG-помощник. Его рабочий путь остаётся относительно коротким и не требует LLM-переранжирования на каждом запросе.
- 01
Вопрос
Сотрудник формулирует проблему обычными словами и выбирает доступные источники Confluence или Jira.
- 02
Представление запроса
Система превращает текст в эмбеддинг; доменный словарь может заранее добавить известные эквивалентные термины.
- 03
Поиск
Векторная база возвращает близкие по смыслу фрагменты документов из разрешённых источников.
- 04
Генерация
Найденные материалы добавляются к запросу, после чего LLM формирует ответ на их основе.
- 05
Проверка источников
Помощник показывает документы и релевантность, чтобы сотрудник мог открыть первоисточник и проверить ответ.
Отдельно от этого пути работает обслуживание знаний: Confluence и Jira сканируются каждые 30 минут, изменённые документы переиндексируются, а удалённые помечаются. Качество сначала проверяли экспертными тест-кейсами и параллельным обычным поиском, затем добавили автоматический векторный прокси, методика которого в статье описана неоднозначно. За несколько месяцев команда получила положительную качественную обратную связь и изменила подход к документации, но не измерила убедительный эффект на SLA или MTTR. Следующий шаг — работать ближе к исходным обращениям пользователей — остаётся планом, а не уже достигнутой автономностью.
Итоговая схема работы системы / Что мы в итоге поняли / Планы на будущее