Разбор готов
От сценарного чат-бота к агентам для ипотечного страхования
Домклик начинал с двух отдельных способов отвечать клиенту. В канале «Чат» сценарный бот распознавал тему запроса, предлагал подходящий сценарий и передавал дальнейший диалог сценарному движку; если автоматизация не справлялась, оставался оператор. Параллельно поиск по сайту находил релевантные статьи и использовал GigaChat Max, чтобы их суммаризировать и ранжировать. Когда команда перешла к ИИ-агентам, она не выбросила эти системы, а последовательно связала их: сначала поиск подходящей тематики, затем поиск ответа по статьям, специализированные агенты, инструменты, память и защитные проверки. В ней показан путь от сценариев к собственной среде исполнения агентов, а затем конкретный сценарий ипотечного страхования, где агент не только отвечает текстом, но и участвует в обработке документов. При этом источник не даёт A/B-теста бизнес-эффекта: доля успешно выполненных задач и прямая экономия не приведены. Поэтому ниже отдельно разобраны архитектурные решения, эксплуатационные показатели, инженерные сбои и границы того, что действительно подтверждено статьёй.
Разбор полезен инженерам и ML/LLM-разработчикам, которые строят корпоративных агентов поверх существующих сценариев, RAG и внутренних API. Особенно полезны части про разделение памяти, LLM API Gateway, MCP, собственный runtime, мультиагентную маршрутизацию, обработку страховых документов и стоимость защитного слоя.
Статья · на русском
ИИ-агенты на рынке недвижимости: эволюцияАлина (Quvele) · Опубликовано: 25 ноября 2025 г.
Исходная система: сценарный бот как первая линия
Первая версия решала задачу поддержки через заранее известные сценарии. Клиент мог спросить про ипотеку, покупку или сдачу недвижимости. Бот распознавал намерение, вёл диалог по заданному сценарию, мог выполнить предусмотренное сценарием действие — в статье приведена запись на сделку — и при необходимости переключал разговор на оператора.
Технически запрос сначала превращался в вектор, после чего система искала похожие вопросы в векторной базе. Кандидатов повторно ранжировала Gemma 2. Пользователю показывался список наиболее релевантных сценариев; после выбора управление переходило к сценарному движку. Важная граница этой архитектуры: языковая модель помогала выбрать путь, но дальнейшая логика оставалась заранее описанной.
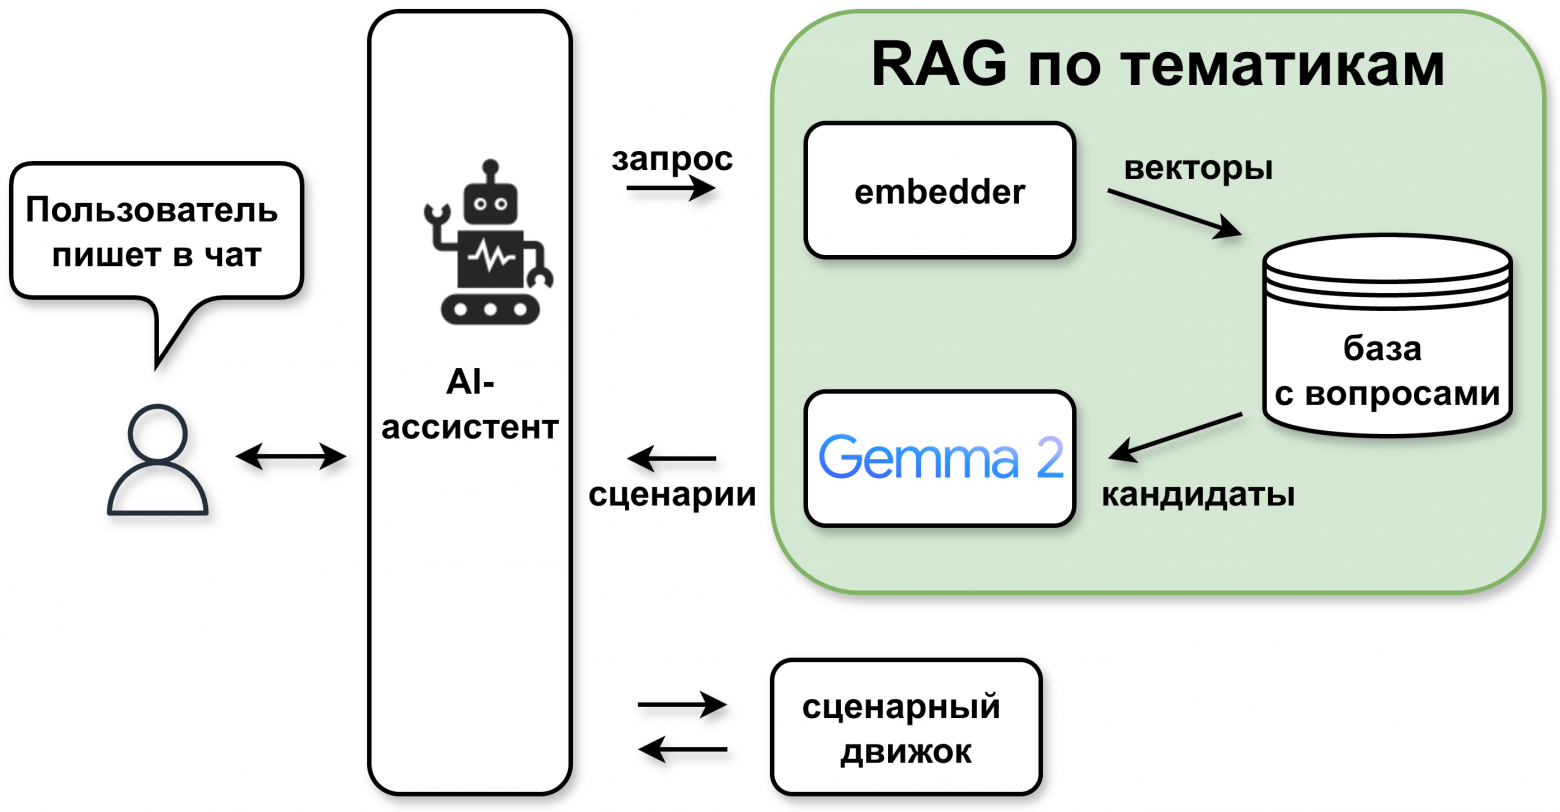
Gemma 2 ранжирует найденные вопросы; после выбора сценария диалог ведёт сценарный движок.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Параллельная ветка: поиск ответа по статьям
Отдельно от чат-бота существовал поиск по сайту. Пользователь формулировал поисковый запрос, система векторизовала его и находила релевантные статьи в векторном хранилище. Найденные материалы передавались GigaChat Max: по статье модель использовалась для суммаризации и ранжирования, после чего клиент получал структурированный ответ с полезными материалами.
Получились два разных контура с общей идеей семантического поиска: один искал подходящую тему и приводил к сценарию, другой искал знания в статьях. Следующий шаг команды состоял не в замене одного контура другим, а в их последовательном объединении.
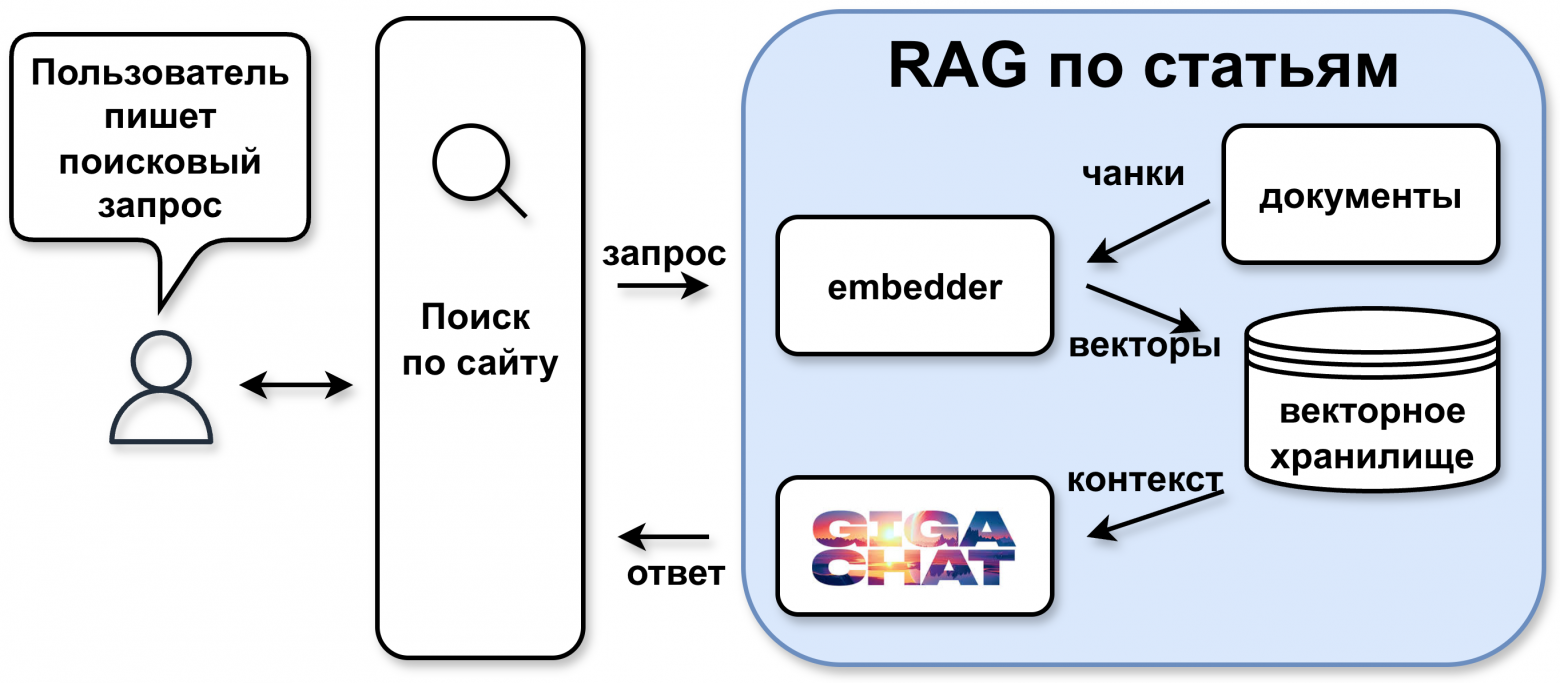
Векторный поиск возвращает статьи, GigaChat Max помогает подготовить ответ.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Первый агент: два RAG и оператор как запасной путь
Поиск ответа с опорой на найденные документы называют RAG. Модель получает внешние сведения вместе с запросом, вместо того чтобы полагаться только на собственные знания. В I квартале, по формулировке статьи, команда получила задачу сделать ИИ-агента. Команда объединила чат-бот и умный поиск. Запрос сначала проходит через RAG, который определяет подходящую тематику или сценарий. Если подходящего интента нет, система пытается найти ответ в статьях. Если и этот путь не даёт ответа, диалог уходит оператору. На другой схеме этот же переход развивается дальше: выбранный сценарий может вызвать специализированного агента, а результат снова возвращается в общий ответ.
Таблицу можно прокрутить по горизонтали.
Автор называет новую систему агентом из-за нескольких свойств: у неё есть роль помощника Домклик, предметная специализация, возможность самой выбирать путь обработки запроса, выполнять многошаговые задачи и учитывать историю. На этой стадии память описана как последние 50 сообщений переписки. Это именно сообщения текущего контекста, а не те 50 диалогов, которые позже появляются в описании долгосрочной эпизодической памяти.
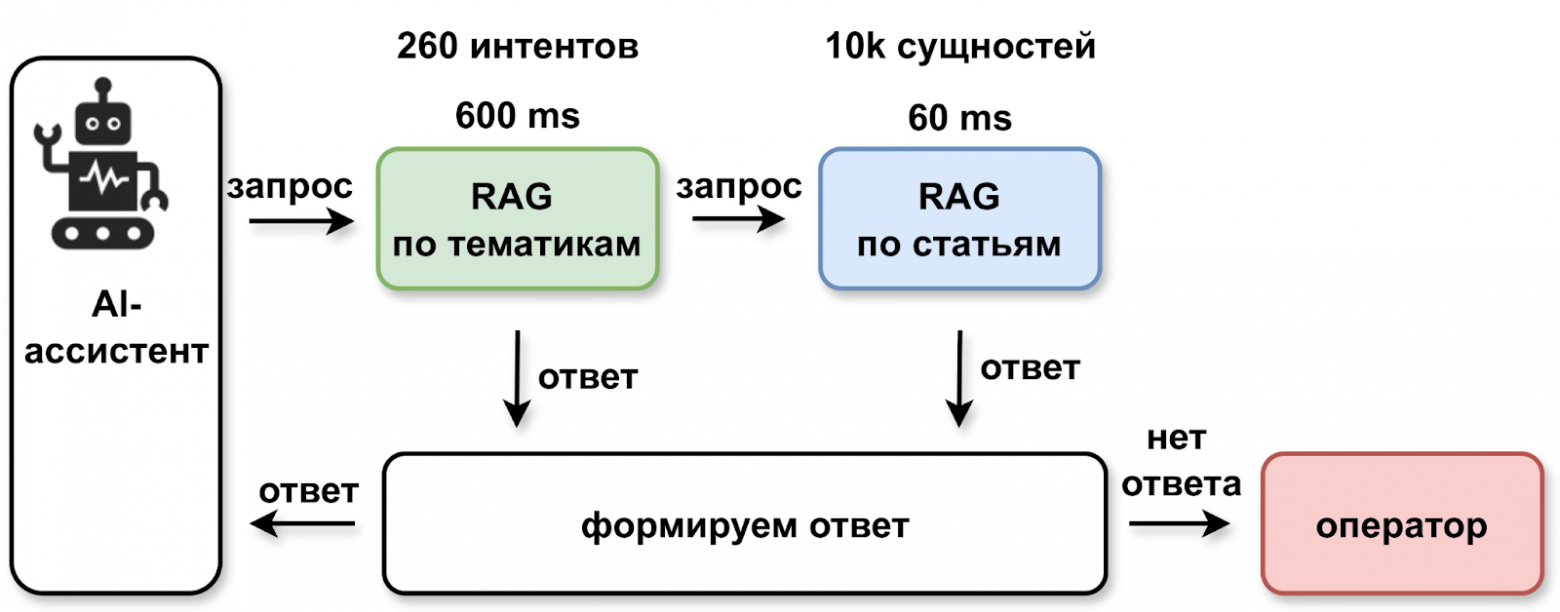
На исходной схеме 260 интентов и 600 мс для RAG по темам, 10 тысяч сущностей и 60 мс для RAG по статьям. Условия замера и статистика задержки не раскрыты; это не SLA и не время полного ответа.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»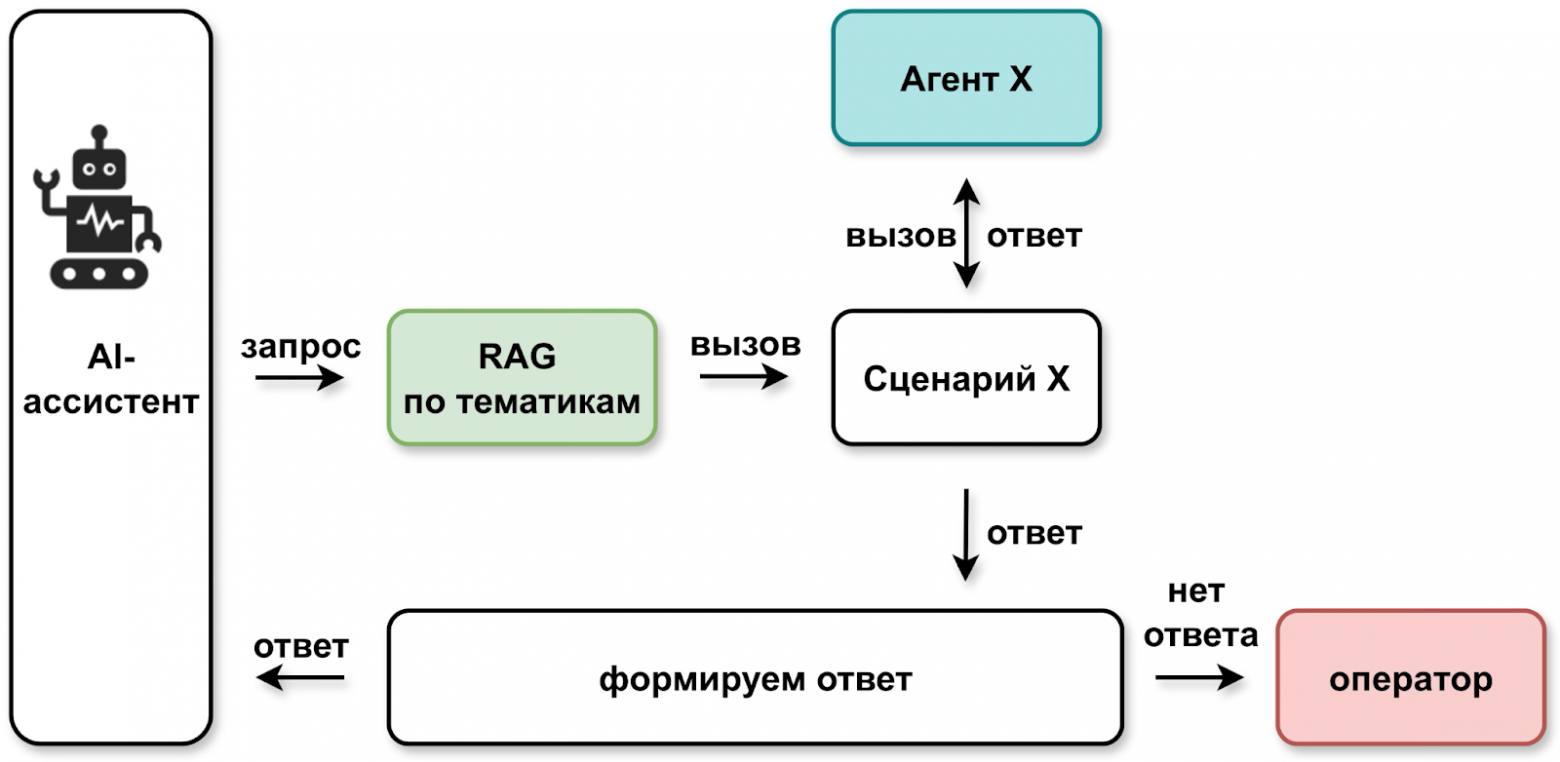
Оркестратор выбирает сценарий или специализированного агента; при отсутствии ответа остаётся оператор.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Что помешало просто наращивать одного агента
Недетерминированность автор прямо называет актуальной проблемой. Приведённые в статье инструкции вроде запрета упоминать имена или отказа объяснять причины отказа — это примеры управления поведением конкретной системы, а не доказательство полной детерминированности и не универсальная схема безопасности. Совокупность этих ограничений и привела команду к вопросу о платформе: общие функции нужно было вынести из отдельных агентов.
Эволюция чат-бота до агента-консультантаОбщий доступ к моделям через LLM API Gateway
Поскольку в системе используется несколько языковых моделей, агентам нужен единый слой доступа к ним. LLM API Gateway отделяет логику агента от конкретного провайдера модели. Через шлюз можно маршрутизировать запросы по типу или сложности, ограничивать расход запросов и токенов, собирать статистику обращений и ошибок, а также кешировать запросы.
Основой шлюза команда выбрала LiteLLM. В статье отдельно отмечено, что фреймворк написан на Python и его можно расширять; команда добавила поддержку function calling под специфический контракт API GigaChat Max. Gemma 2 и GigaChat Max названы примерами используемых моделей, но источник не утверждает, что этим исчерпывается весь набор LLM в платформе.
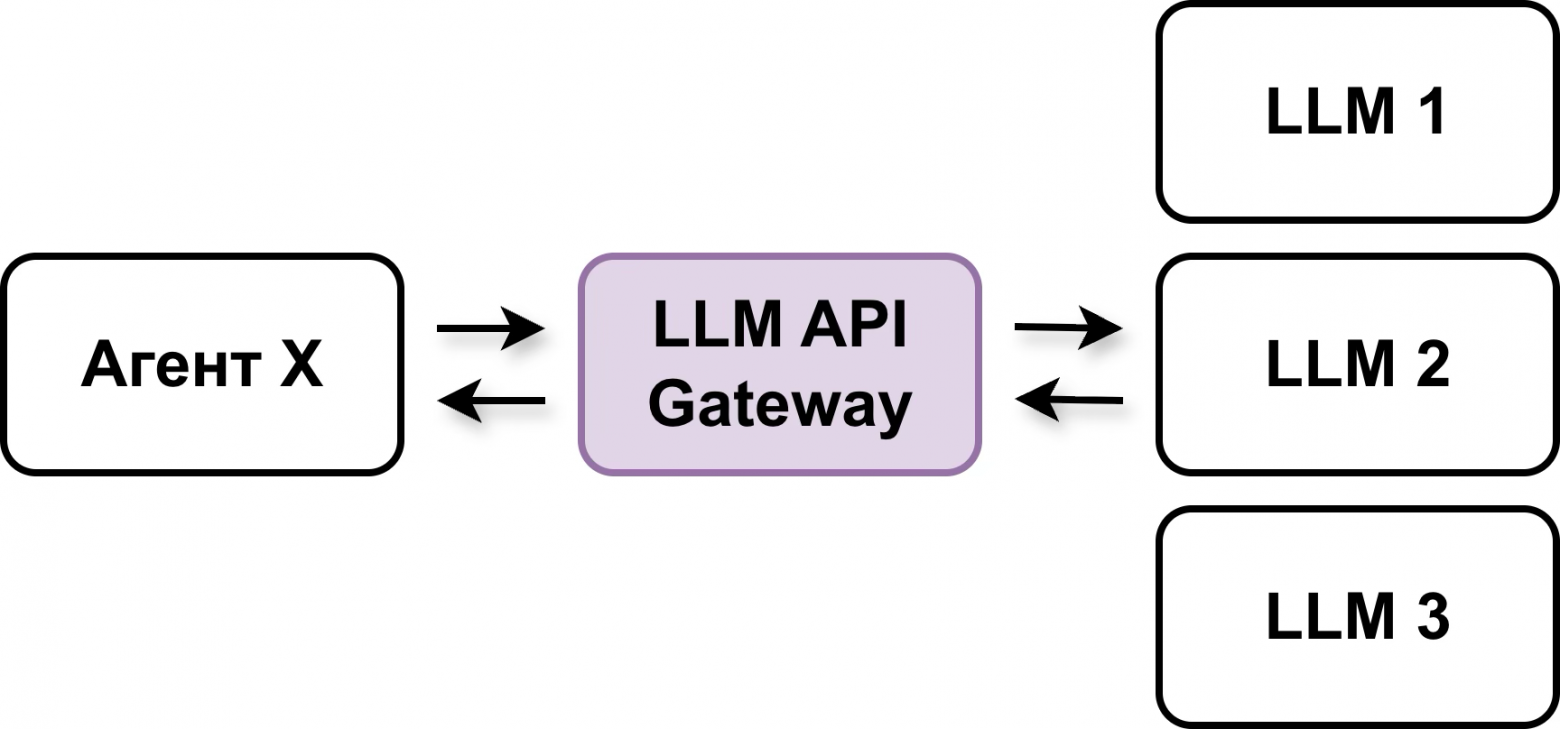
LLM API Gateway отделяет агента от конкретных моделей.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»MCP как слой инструментов
Агенту нужны не только ответы модели, но и действия: вызовы API, обращения к данным и запуск операций. MCP (Model Context Protocol) задаёт общий способ подключения таких инструментов к модели. Команда использует этот контур с клиентом и сервером между агентом и корпоративным API. В ранней версии готовых MCP-серверов для внутренних API не было, поэтому этот слой появлялся постепенно.
Позже статья возвращается к схемам инструментов и показывает, почему эта нормализация важна: сложные конструкции JSON Schema и большие числовые идентификаторы становились источником непредсказуемых ошибок.
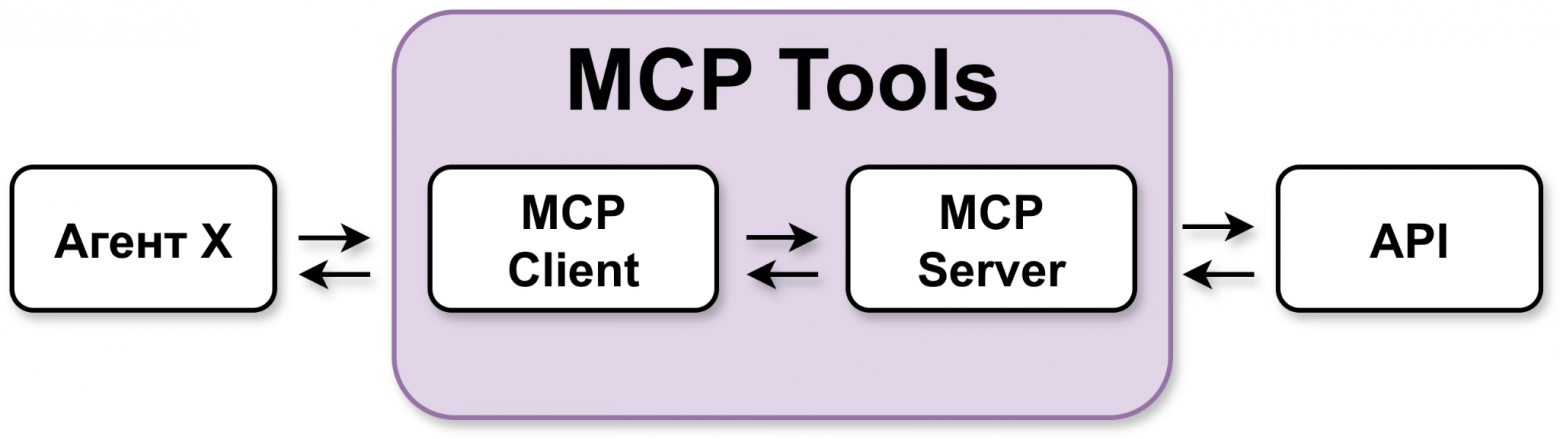
MCP Client и Server связывают агента с API; приватные параметры не должны попадать в контекст модели.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Память и знания: разные данные для разных горизонтов
Память разделена по назначению. Краткосрочный контекст текущей сессии хранится в Redis. Долгосрочная память состоит из семантической и эпизодической частей. Семантическая память — это знания компании, доступные через RAG. Эпизодическая память хранит историю взаимодействий клиента с агентом.
Эпизоды не только сохраняются, но и векторизуются, чтобы по ним можно было искать. Автор отдельно пишет о просмотре последних 50 диалогов и анализе конкретных прошлых случаев. Это другое окно, чем последние 50 сообщений в раннем описании контекста: статья использует два числа для двух разных уровней памяти.
Для семантической памяти документы режутся на фрагменты сплиттером LangChain, превращаются в эмбеддинги моделью E5 и индексируются в OpenSearch. Оригинальная схема индексирования показывает отдельный API, broker, Document Pipeline и Embedder перед векторным хранилищем, а на стороне получения знаний — API, через который контекст запрашивает агент или LLM. Размер фрагментов, top-k и метрики качества поиска в статье не приведены.
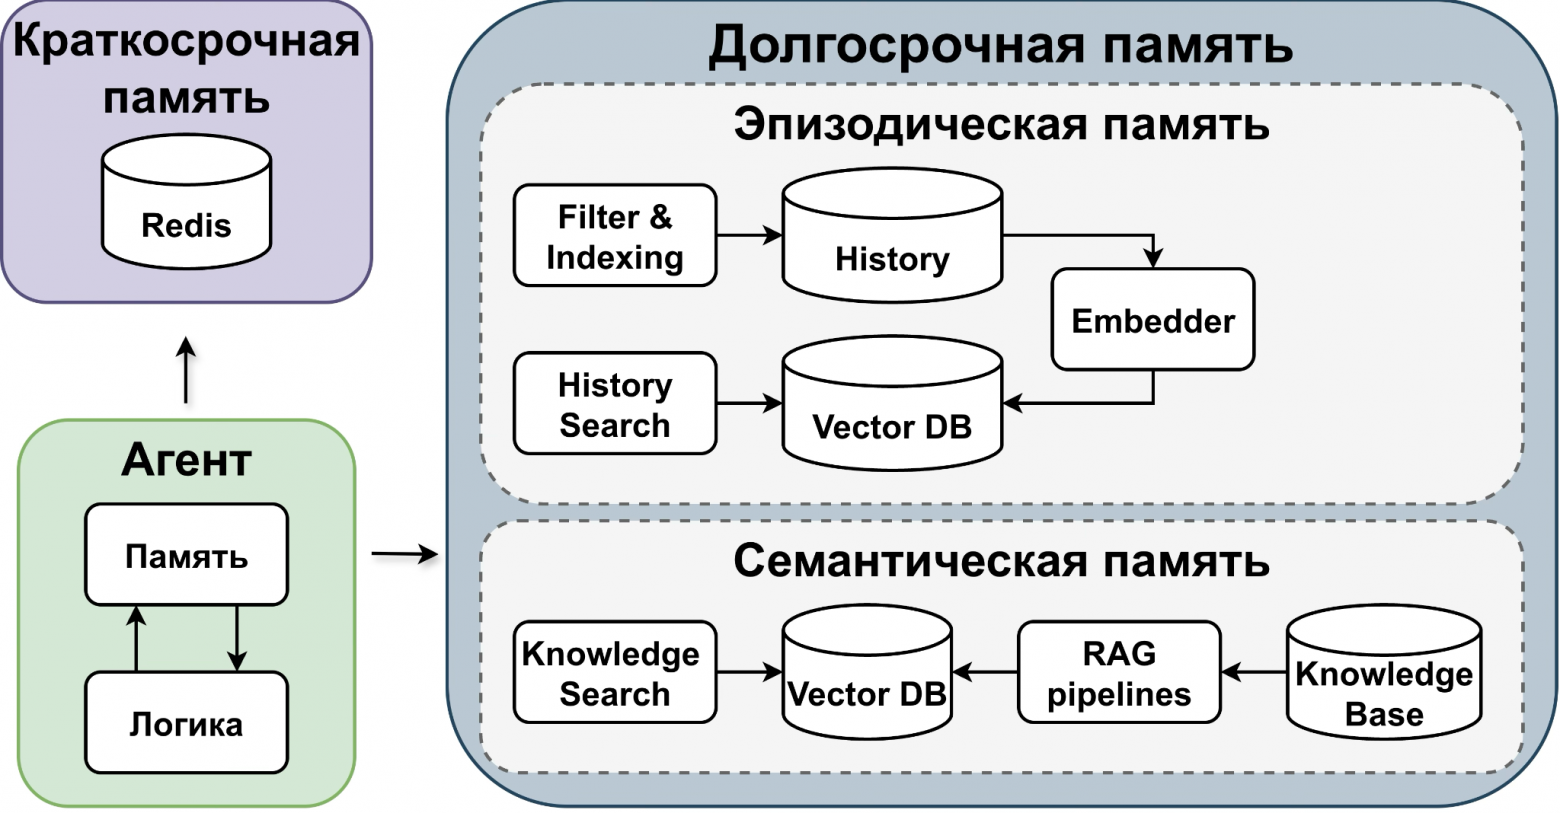
Redis хранит текущую сессию, эпизодическая память — историю взаимодействий, семантическая — знания компании.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»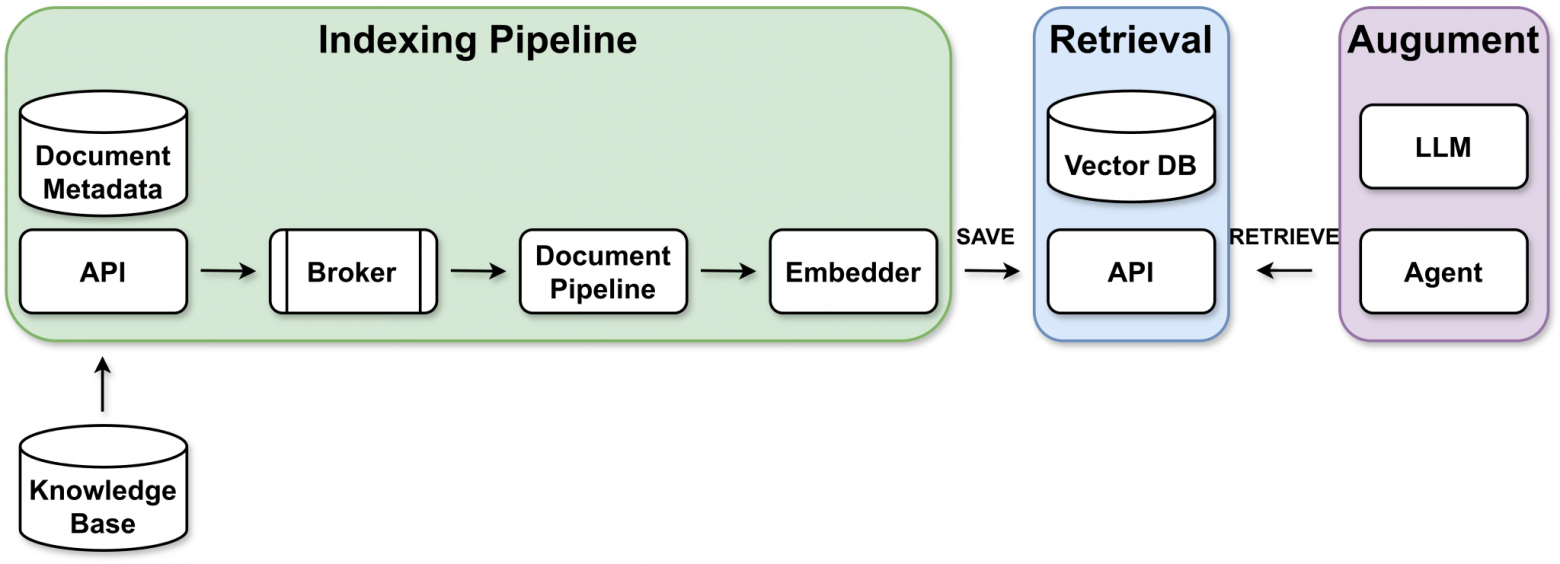
Документы проходят через Document Pipeline и Embedder, результаты сохраняются в векторное хранилище.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Межагентное общение и собственный граф состояний
Когда специализированных агентов становится несколько, нужен протокол общения между ними. Команда рассматривала Agent Communication Protocol от IBM и A2A от Google. В статье критериями названы поддержка REST, карточки агентов и простота реализации. Автор также пишет, что оба проекта были объединены под эгидой Linux Foundation.
Для выполнения многошаговой логики используется координатор, который направляет работу узкоспециализированным агентам. NetworkX здесь не готовая агентная платформа: это основа собственного графа и работы со структурой состояний. Поверх неё команда строит свой конструктор агентов, управление состоянием и сохранение промежуточного состояния (checkpoint) в базе данных, чтобы выполнение можно было остановить и продолжить.
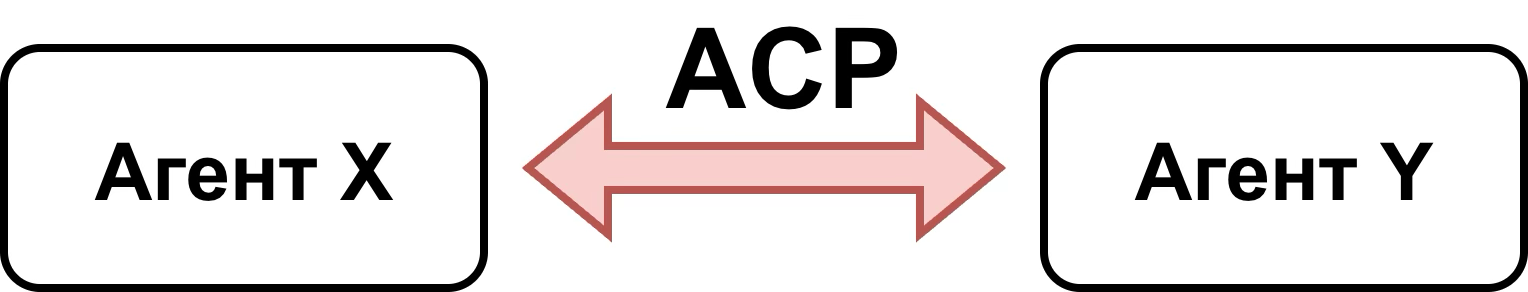
На схеме показан ACP. В статье также обсуждается A2A; это описание выбора команды, а не спецификация всех современных протоколов.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»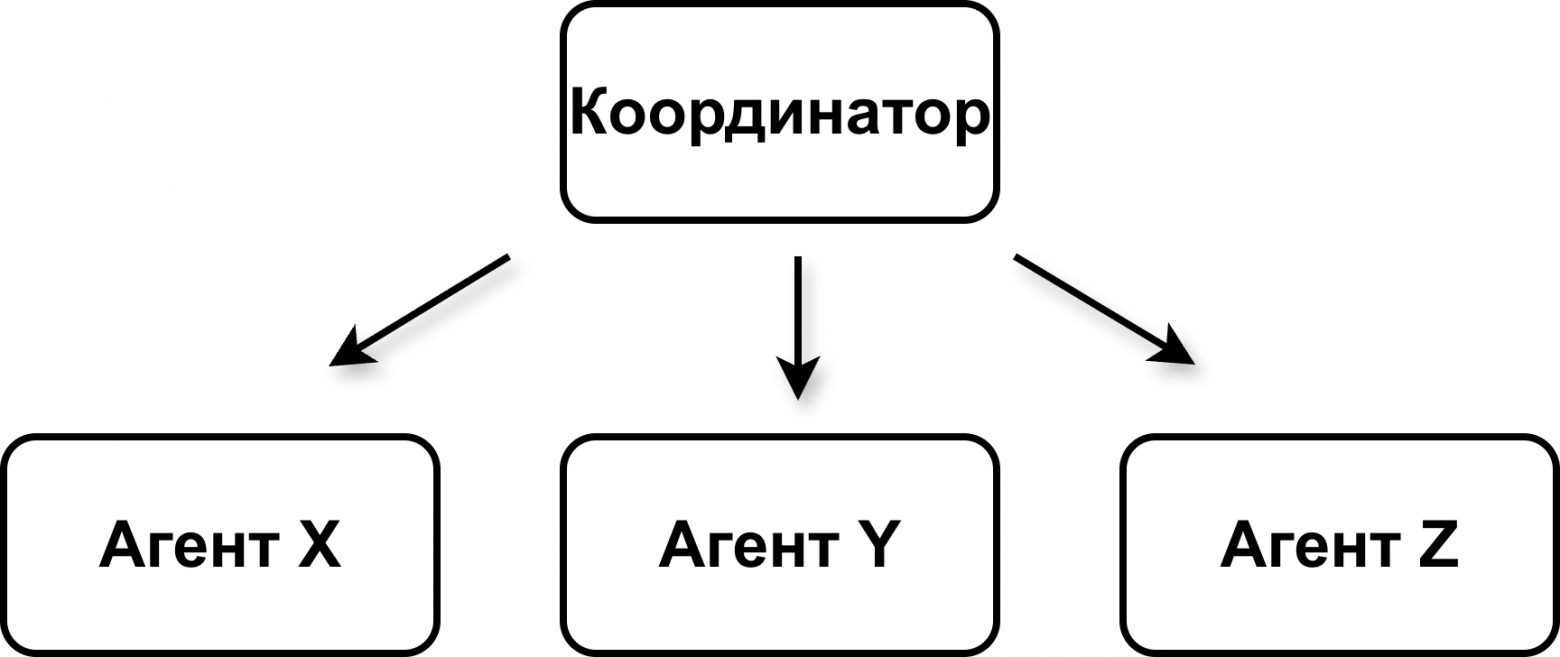
Координатор направляет работу специализированным агентам; граф состояний команда строит на NetworkX.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Agent Runtime: отделить исполнение от моделей, инструментов и знаний
Центр платформы — Agent Runtime, среда исполнения множества агентов. Автор описывает для каждого агента изолированное пространство и связывает это с удобством масштабирования. Исходная схема уточняет устройство: Agent API принимает запрос, брокер сообщений отделяет API от исполнителя, а экземпляры агента показаны как отдельные группы контейнеров (pod). Численных нагрузочных тестов или гарантии «любой нагрузки» статья не приводит.
Runtime обращается к LLM API Gateway, MCP Tools и RAG. Защитный слой расположен на пути от шлюза к LLM. Для синхронного взаимодействия с клиентом при потенциально долгой работе модели статья называет паттерн RPC over RabbitMQ. В схеме RabbitMQ выступает брокером между Agent API и исполнителями. Конкретные таймауты, время полного ответа и статистика очередей не опубликованы.
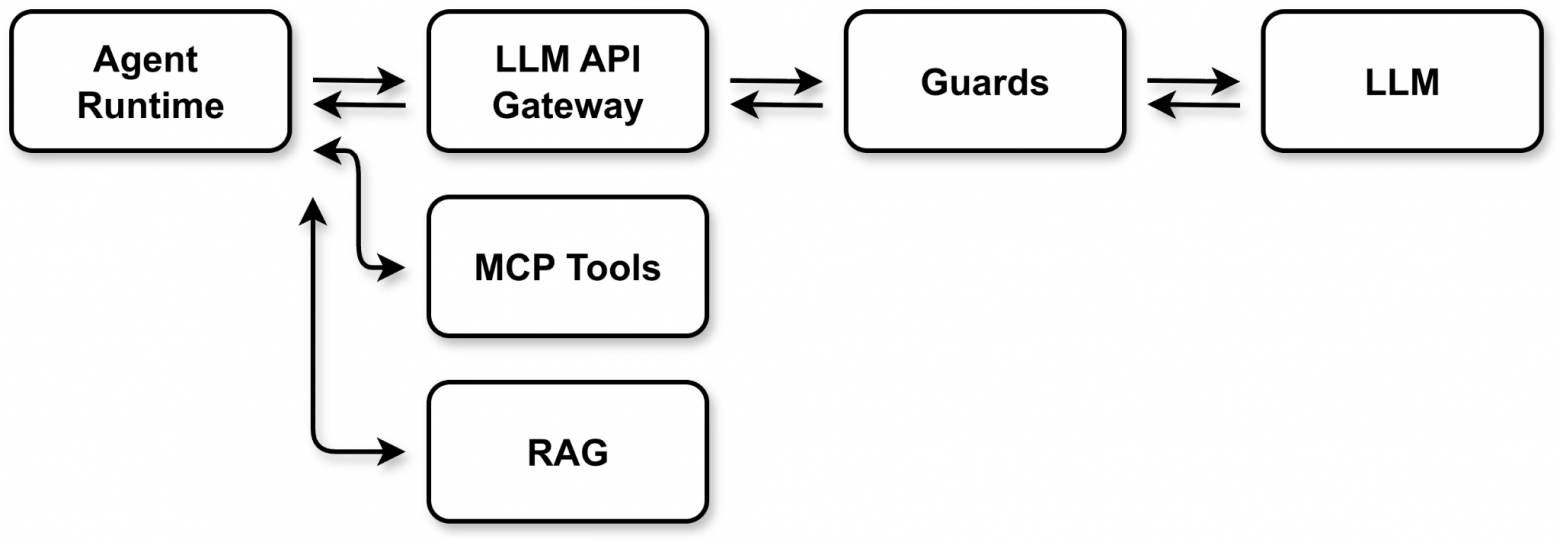
Agent Runtime обращается к шлюзу моделей, MCP Tools и RAG; защитный слой расположен перед LLM.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»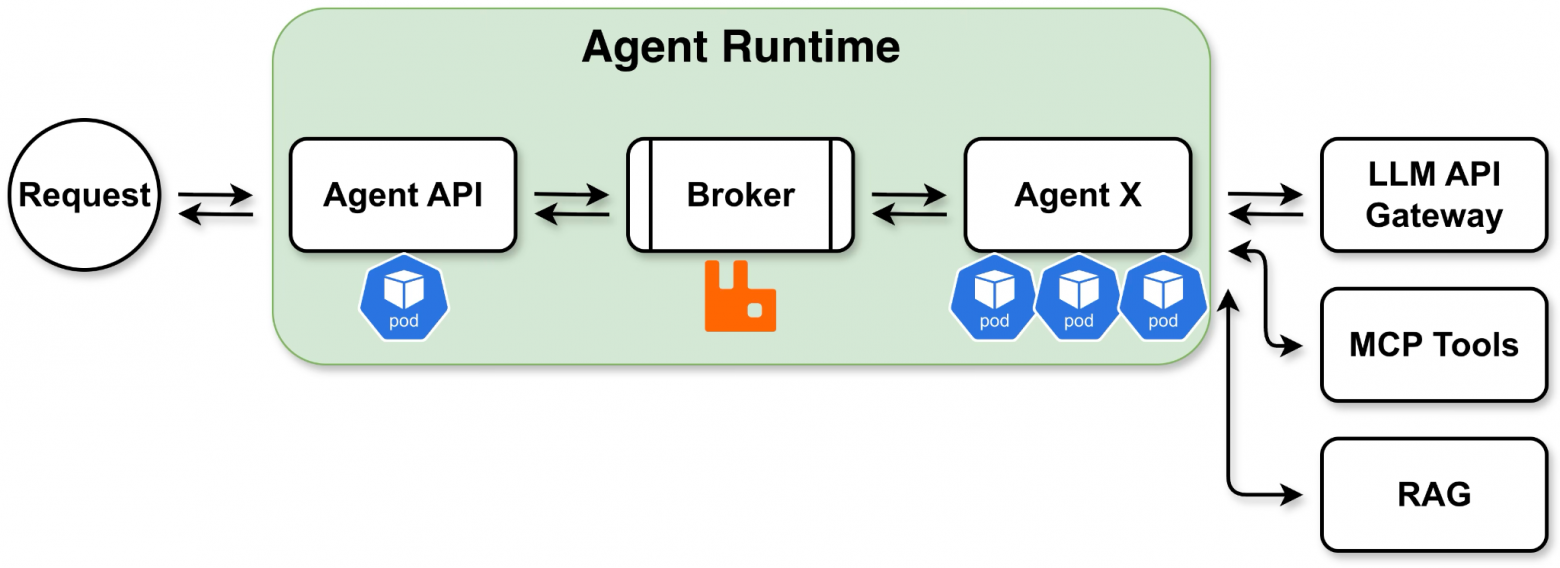
Agent API и агенты разделены брокером RabbitMQ; на схеме показаны отдельные pod. Численных гарантий масштабирования нет.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Почему n8n не закрывал задачу платформы
В обзоре готовых решений n8n рассматривается прежде всего как конструктор автоматизации бизнес-процессов на основе нод. Его сильная сторона в формулировке статьи — возможность собирать конвейеры высокой сложности.
Для агентной платформы команда увидела другой компромисс: мониторинг агентов, специализированные RAG-ноды и другие AI-компоненты пришлось бы реализовывать самостоятельно. Поэтому автор считает n8n более подходящим для точечного добавления ИИ-функций в общие процессы, чем для роли основы всей агентной платформы. Это оценка команды в контексте её требований, а не универсальное сравнение инструментов.
n8n: инструмент для автоматизации процессовЧто давал Dify и где всё равно требовалась доработка
Dify в статье, наоборот, описан как платформа с сильным фокусом на ИИ. Автор утверждает, что 80% её функциональности направлено на агентскую автоматизацию; методика этой доли не приводится, поэтому число нужно читать как характеристику автора, а не как измеренный отраслевой показатель.
К готовым возможностям отнесены версионирование промптов, единый интерфейс к нескольким провайдерам моделей, мониторинг расхода токенов и инструменты RAG. Но для сложных прототипов часть возможностей может быть избыточной, а корпоративные API и внутренние модели — в статье в качестве примера назван GigaChat — всё равно требуют интеграций. Именно этот объём доработок снижал для команды преимущество решения «из коробки».
Dify: платформа, ориентированная на ИИПочему команда выбрала собственную платформу
В начале обзора перечислены n8n, Dify и Langflow. Для Langflow отдельного разбора дальше в тексте нет, поэтому сравнивать его по возможностям с двумя другими системами по этой статье нельзя. Команда формулирует решение через свои вопросы: как часто делаются прототипы, кто будет менять логику, насколько сложны вычисления и конвейеры и существует ли инструмент, удобный одновременно инженерам и бизнесу. Статья также отмечает, что у готовых платформ свои среды исполнения, которые нужно отдельно изучать, а сами решения написаны на разных языках; это учитывалось при оценке стоимости самостоятельных доработок.
Статья фиксирует выбор в пользу собственной платформы, но не публикует результаты Quality Gate, сравнение стоимости владения или нагрузочный эксперимент против n8n, Dify и Langflow. Поэтому вывод относится к требованиям Домклик, а не доказывает превосходство собственного runtime вообще.
Критерии выбора и наше решениеСтрахование: координатор и три специализированные роли
Конкретным примером становится работа с вопросами ипотечного страхования. Пользователь уже имеет ипотеку и может спросить, какая страховка ему нужна, нужно ли продлевать полис, пожаловаться на нестандартную ситуацию или перейти к практическому действию.
В центре находится агент-координатор: он классифицирует запрос и направляет его нужной специализации. Это прикладная версия общей мультиагентной схемы с координатором, а не набор независимых чат-ботов.
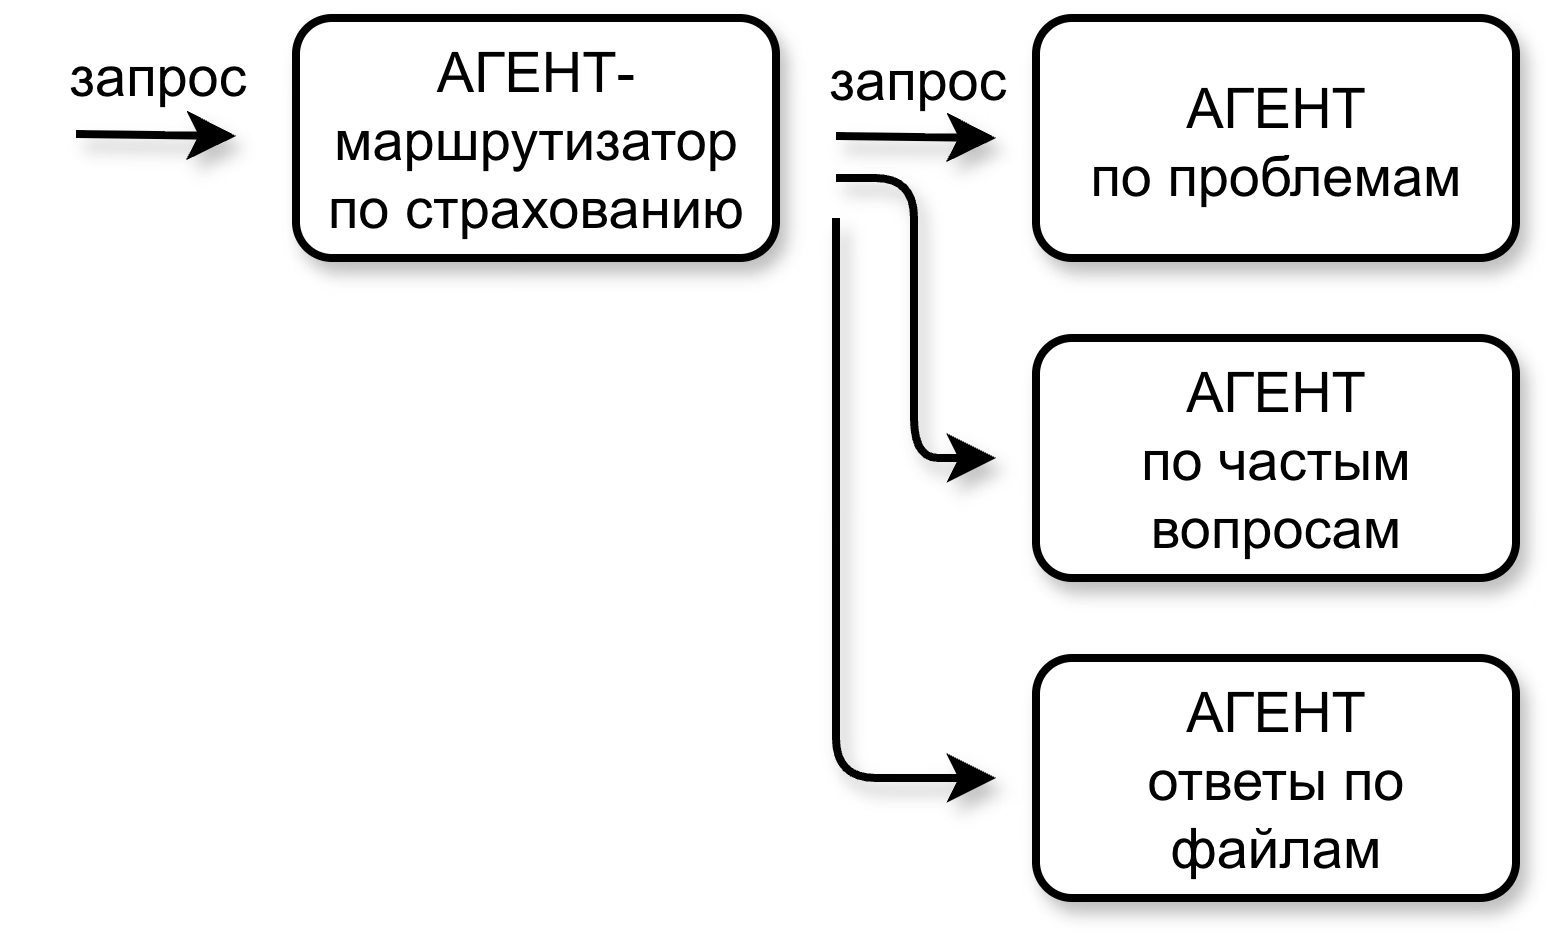
Маршрутизатор направляет запрос агенту по проблемам, консультациям или файлам.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Полис как многошаговая задача: от файла до услуги
- 01
Классифицировать документ
OCR-классификация определяет, что загружено: полис, чек, квитанция или другой тип документа.
- 02
Извлечь данные
Из документов извлекаются значимые поля, в статье названы сумма, ФИО и даты.
- 03
Сверить с контекстом
Агент проверяет соответствие документа сделке и клиенту, корректность суммы и полноту пакета.
- 04
Дособрать пакет
Если чего-то не хватает, агент просит пользователя загрузить недостающие документы.
- 05
Завершить услугу
После успешной проверки агент формирует пакет и отправляет его в банк.
В технологическом контуре статья называет OCR-классификацию, VLM для распознавания документов, Qwen 2.5 Vision 7B для анализа изображений и текста и vLLM для инференса. На проверенной схеме после извлечения данных агент обработки полиса может вызывать внешний сервис через MCP и писать результаты в долгосрочную память.
Таблицу можно прокрутить по горизонтали.
Формулировки «30 тыс. файлов в день» и «примерно 60 RPM» сохранены одновременно, потому что именно так их связывает источник. Статья не объясняет окно, на котором получено 60 RPM, поэтому не следует пытаться самостоятельно привести эти значения к единой средней нагрузке или объявлять одно из них ошибочным.
MVP имеет два входных маршрута. Текстовый запрос проходит через RAG по тематикам и сценарный движок к агенту консультаций или проблем. Документ проходит через обработку файла и свой сценарий к агенту полиса. Агент по файлам фиксирует промежуточные действия в долгосрочной памяти, поэтому другой агент может сообщить клиенту статус процесса, даже если тот занимает заметное время.
Долгосрочная память далее раскрывается как обычный надёжный сервис состояния: синхронный API для чтения, асинхронный API для обновления, событийная модель, PostgreSQL и индексирование по идентификатору клиента и идентификатору события. Этот дизайн нужен для отслеживаемости процесса; отдельной метрики качества памяти источник не приводит.
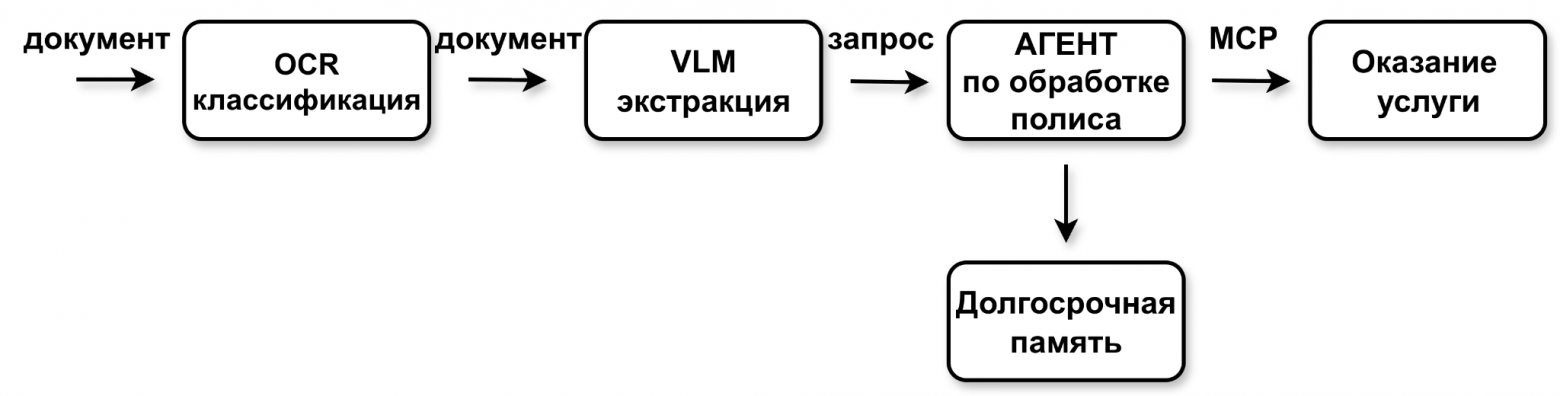
После OCR-классификации и извлечения данных агент проверяет полис, обращается к инструментам и сохраняет результаты в долгосрочной памяти.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»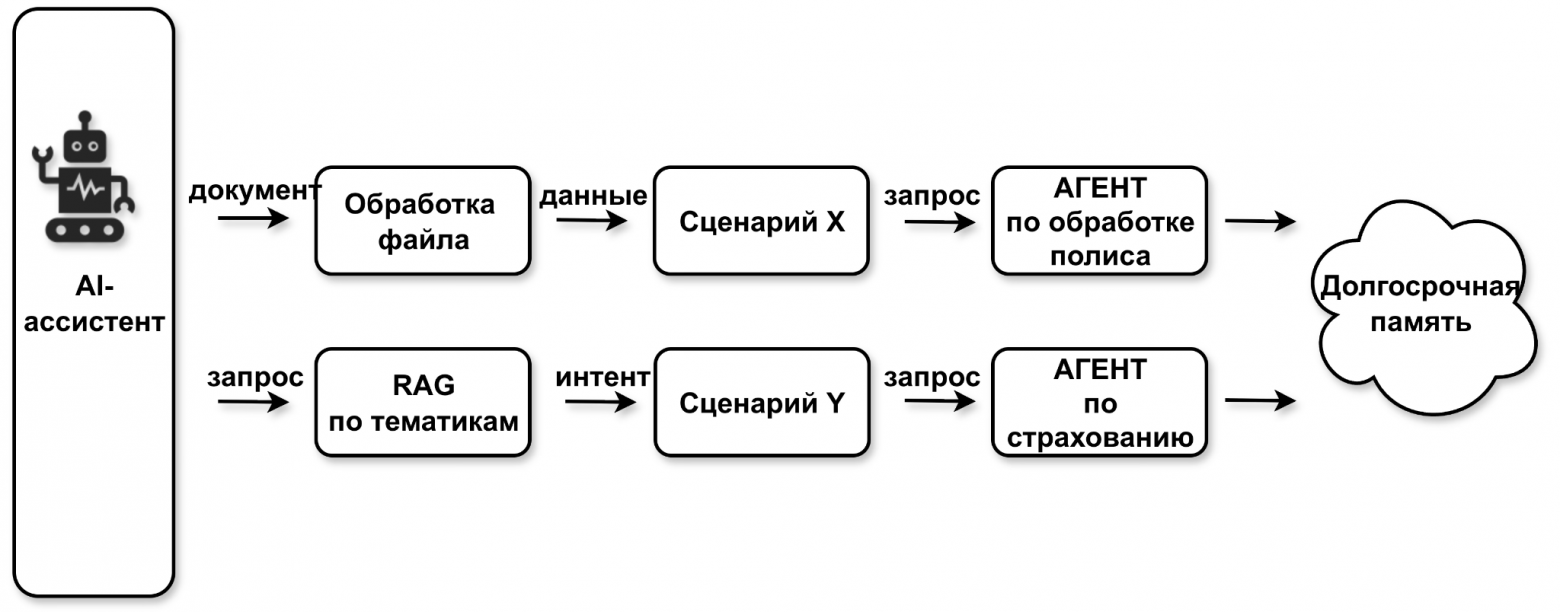
Документ и текстовый запрос идут разными путями, но используют общую долгосрочную память.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Как автор предлагает выбирать модель и оценивать агента
Выбор языковой модели и оценка готового агента — разные задачи. Для LLM автор выделяет качественный русский язык и работу с изображениями: машинный перевод запросов может исказить смысл бизнес-коммуникации. Также важны скорость и стабильность выполнения, вызов внешних инструментов, подходящий способ развёртывания и возможность дообучения. Модель должна сохранять нужные сведения из длинного диалога и следовать инструкциям и сценариям.
Главная методическая оговорка самого источника: хороший текстовый ответ ещё не означает, что задача пользователя решена. Но статья не сообщает task-success, точность вызовов инструментов, hallucination rate или A/B-метрики страхового сценария. Шутка о том, что агента «штрафуют» за ошибки и он «копит на Мальдивы», служит метафорой дисциплины и бизнес-правил. Никакой RL-, reward-model- или штрафной схемы обучения из неё выводить нельзя.
Критерии выбора языковой модели для корпоративных ИИ-агентовДва практических источника недетерминированных ошибок
Первый нюанс связан с большими числовыми идентификаторами. Если ID передавать инструменту как число и оно выходит за безопасную точность представления IEEE-754, часть значения может потеряться. Рекомендация статьи — передавать такие ID строками. Иначе агент может сформировать формально корректный вызов, который никогда не найдёт нужный объект.
Второй нюанс — сложные схемы инструментов. Автор советует избегать $ref, $def, anyOf, default и слишком неопределённых объектов вроде аргумента dict без описанных полей. Чем сложнее и неоднозначнее контракт, тем выше риск нестабильного tool calling. Практический вывод команды — делать схемы максимально простыми, плоскими и однозначными.
Нюансы работыЗащита как отдельный слой, а не один фильтр
В безопасности статья выделяет четыре угрозы: инъекции инструкций, уход разговора за пределы недвижимости и ипотеки, галлюцинации и утечки персональных данных. Галлюцинации, по статье, нужно выявлять не только на тестировании, но и во время реального диалога. Команда пишет, что существующие фреймворки не соответствовали её требованиям, прежде всего из-за поддержки русского языка, поэтому был собран собственный защитный контур.
Защита имеет измеренную цену: статья сообщает об увеличении времени ответа в среднем на 500 миллисекунд и росте потребления токенов как минимум в 2 раза из-за служебных промптов. При этом не указаны исходная задержка, размер и состав выборки, модель, распределение latency или точная база сравнения. Эти числа нельзя превращать в универсальный overhead для других систем.
Отдельный компромисс — цензор должен пропускать обычные вежливые формулировки и не вырезать важный контекст. В качестве следующего шага команда недавно протестировала Qwen3Guard и планирует перейти на неё. Для теста названо время отклика около 100 миллисекунд и экономичное использование ресурсов, но переход ещё описан как план: это не характеристика уже работающего production-контура.
Guardrails размещаются как минимум в двух местах. На пути LLM API Gateway → LLM проверяются промпты и ответы. Во втором месте документы проверяются ещё до индексации в RAG, чтобы конфиденциальная или нежелательная информация не попала в векторную базу и затем не вернулась клиенту через поиск.
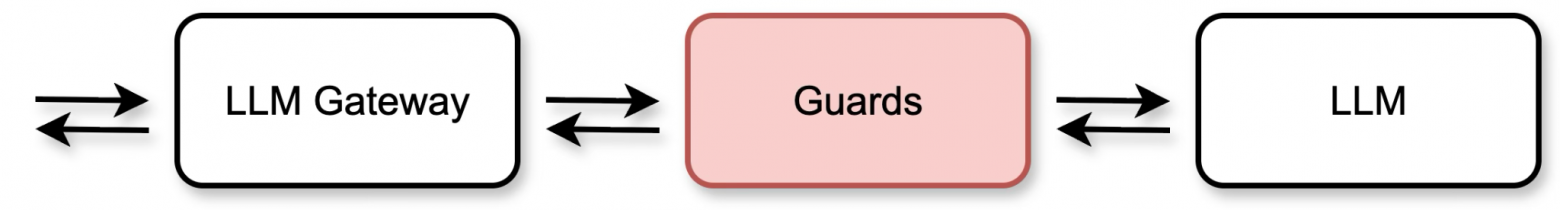
Guards фильтрует запросы и ответы между шлюзом и LLM.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»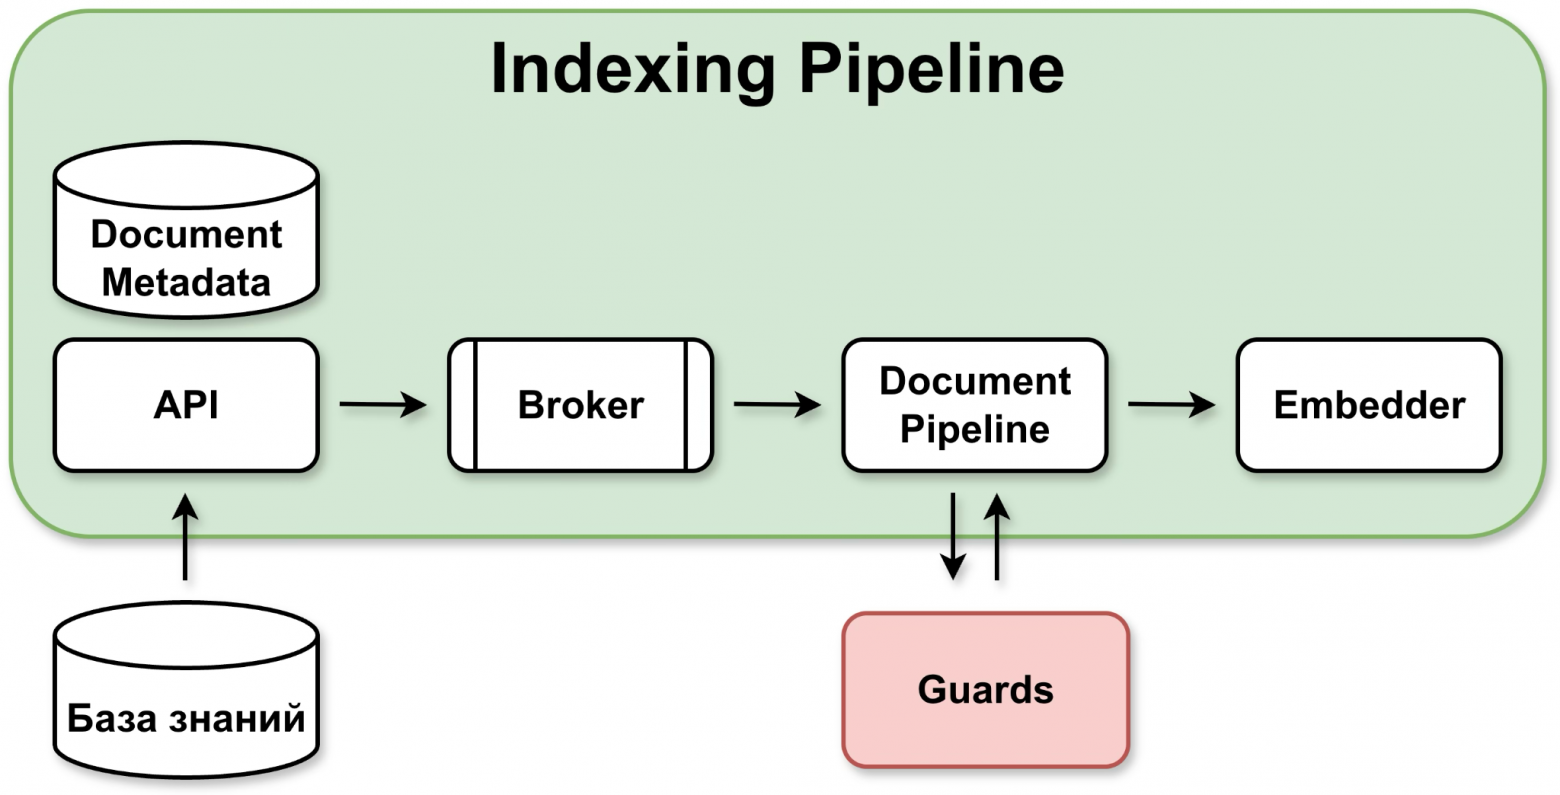
Проверка документов до векторизации помогает не переносить нежелательные сведения в базу знаний.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»Итог: агентная система выросла из существующих сценариев
Домклик пришёл к агентной платформе постепенно: сценарный бот и поиск по статьям уже умели помогать клиентам, но не закрывали многошаговые задачи. Команда связала их с общими сервисами моделей, инструментов, знаний, памяти и защиты. В страховании это позволило описать целый процесс работы с полисом, а не только генерацию ответа. При этом консультация и обработка файла остаются разными маршрутами.
- 01
Принять обращение
Текст проходит через определение темы и сценарный движок к консультанту или агенту по проблемам. Загруженный документ направляется в файловую ветку.
- 02
Определить документы
OCR-классификация различает полис, чек и квитанцию. Это даёт агенту понимание состава поступившего пакета.
- 03
Извлечь сведения
Мультимодальная модель помогает получить сумму, ФИО и даты. В этом контуре названы Qwen 2.5 Vision 7B и vLLM.
- 04
Проверить соответствие
Агент сверяет сведения со сделкой и клиентом, проверяет сумму и полноту пакета, используя необходимые корпоративные инструменты.
- 05
Запросить недостающее
Если документов недостаточно, агент просит их дозагрузить. Промежуточные действия сохраняются в долгосрочной памяти, чтобы консультант мог сообщить статус.
- 06
Завершить услугу
После успешной проверки агент формирует пакет и отправляет его в банк. Для вопросов без автоматического ответа сохраняется обращение к оператору.
Качество предлагается проверять по успешному выполнению задачи, корректности вызовов инструментов, безопасности, времени и затратам токенов. Значений этих метрик для страхового агента статья не публикует. Известны эксплуатационные показатели документного конвейера: до 30 тысяч файлов в день, обработка за 3–30 секунд в зависимости от очереди и загрузка GPU до 95%. Условия измерения раскрыты не полностью.
Защитный слой добавляет в среднем 500 мс и как минимум удваивает расход токенов. Переход на протестированную Qwen3Guard остаётся планом. Практический результат материала — связная архитектура и конкретный сценарий автоматизации; обещать доказанную экономию денег или безошибочную работу по этим данным нельзя.
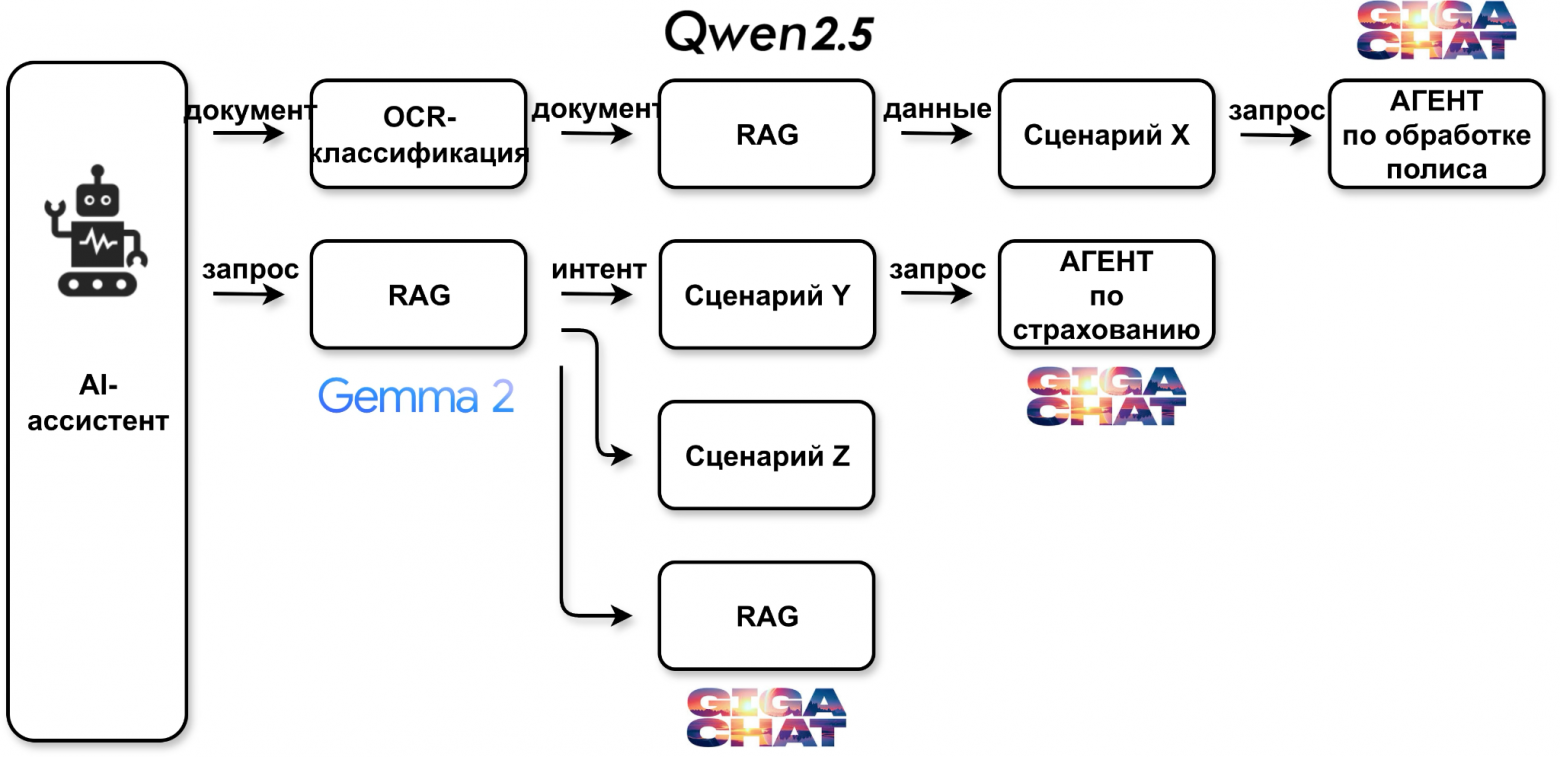
Обработка документов с Qwen 2.5, маршрутизация интентов с Gemma 2 и ответы с GigaChat составляют несколько связанных сценариев, а не одну монолитную модель.
Источник: Домклик · «ИИ-агенты на рынке недвижимости: эволюция»