Разбор готов
Коронатек: почему RAG по корпоративной wiki заработал не с первой попытки
В Коронатеке системным аналитикам нужно разбираться в переводах, займах, переходах между статусами и взаимодействии компонентов. Описания есть в корпоративной базе знаний Confluence, но наличие документа ещё не означает, что сотрудник быстро найдёт нужное объяснение. Команда построила помощника, который сначала ищет подходящие материалы, а затем составляет ответ с опорой на них. Такой подход называется RAG. В докладе «RAG вообще работает?» Иван Комаров и Евгений Чуканов показывают путь от простого прототипа до пилота в трёх отделах: как сохранить содержание диаграмм, подготовить осмысленные фрагменты, совместить разные способы поиска и отсеять лишнее. Отдельная часть истории — проверка результата: рост с 75% до 90% оказался сокращением доли неприемлемых ответов, а не доказательством, что девять ответов из десяти полностью правильны.
Разбор полезен инженерам, которые делают помощника по внутренней документации, системным аналитикам и руководителям таких проектов. Он помогает отделить ошибки исходных материалов от ошибок поиска и генерации, понять ограничения оценки языковой моделью и не спутать результат корпоративного пилота с красивыми числами из внешних исследований.
Видео · на русском
Иван Комаров, Евгений Чуканов | RAG вообще работает?Иван Комаров, Евгений Чуканов · Опубликовано: 17 ноября 2025 г.
Исходный доклад · Открыть оригинал
Сначала найти материал, затем составить ответ
Языковая модель, или LLM, умеет работать с текстом, но внутренние правила конкретной компании не становятся ей известны только потому, что пользователь задал вопрос. В рассматриваемом подходе системе сначала дают найти подходящие документы, а затем предлагают ответить на их основании. Это и есть Retrieval Augmented Generation, сокращённо RAG: поиск материалов перед составлением ответа.
Для поиска документ делят на небольшие фрагменты — чанки. Каждый фрагмент превращают в числовое представление, или вектор: модель кодирует текст набором чисел, по которым поисковая система может сопоставлять его с вопросом. Вектор вопроса рассчитывается уже при обращении пользователя. База возвращает подходящие фрагменты, и они становятся материалом для ответа. Компонент, который ищет материалы, и модель, которая формулирует ответ, выполняют разные задачи.
Инструкция генератору вместе с вопросом и найденными материалами называется промптом. В простейшей схеме её смысл таков: ответь на этот вопрос, используя эти выдержки. Поэтому качество результата зависит не только от способности модели писать связный текст. Если поиск вернул не тот документ или вырезал важное условие, генератор получает недостаточную основу для ответа.
Авторы предваряют эту схему историческим напоминанием: первую работу о RAG они относят к 2020 году, то есть к периоду до появления ChatGPT в конце 2022 года. Но возраст идеи не делает готовой конкретную систему. Вопрос доклада возникает именно на переходе от понятной схемы к корпоративным документам: почему после соединения поиска и генератора ответы всё ещё не устраивают пользователей?
Доклад · 00:05:02Почему знания оставили в документах, а не внесли обучением
Один из способов познакомить модель с предметной областью — изменить её параметры на примерах, то есть дообучить. Команда предпочла другой путь: сохранять знания в доступных системе документах и подбирать их под вопрос. Главные причины — возможность контролировать используемые материалы и удобнее работать с изменениями документации.
Контроль важен и потому, что разным сотрудникам могут быть нужны разные данные. Авторы называют это аргументом в пользу RAG, но не описывают, как права конкретной страницы Confluence проверяются при каждом поиске. Возможность ограничить материалы в принципе и доказанная реализация всех правил доступа — не одно и то же.
Второй мотив связан со свежестью. Описания компонентов и процессов меняются; неудобно каждый раз считать, что новая версия документа должна попасть в параметры модели. При поисковом подходе изменяемым источником остаётся документация. Однако доклад не задаёт расписание обновления индекса — подготовленного представления документов, по которому идёт поиск. Из самого выбора RAG не следует, что любое изменение страницы сразу доступно помощнику.
Наконец, авторы рассчитывают уменьшить неподтверждённые утверждения модели, которые обычно называют галлюцинациями. В речи эта возможность сформулирована очень оптимистично: отвечать только по переданным данным. Практическая история доклада показывает более осторожную границу: нужны хорошие источники, проверка ответов и ссылки для пользователя. Наличие RAG само по себе не служит доказательством отсутствия ошибок. Если документация неполна или неверна, система не получает надёжного основания для правильного объяснения.
Доклад · 00:08:13Продуктовая задача и исходный локальный прототип
Вдохновением для команды стала работа ChatGPT с загруженными документами: авторов впечатлили связные ответы по тексту, таблицам и изображениям. Это ориентир пользовательского впечатления, а не воспроизводимое сравнение двух систем. Для собственного помощника выбрали корпоративную wiki Confluence и чат-интерфейс Open Web UI.
Задача была не в том, чтобы просто добавить чат к базе знаний. В переводах и займах много состояний и переходов, а поведение одной части системы зависит от других компонентов. Помощник должен облегчать системный анализ — помогать человеку разобраться в этих правилах и связях. Поэтому технические схемы, таблицы и положение страницы в общей структуре имеют не меньшее значение, чем обычные абзацы.
Open Web UI оказался удобной точкой входа: через LDAP можно подключать доменные учётные записи сотрудников, плагины позволяют добавлять фильтры и цепочки обработки, встроенные оценки — собирать обратную связь. На исходной иллюстрации отдельно отмечена доступность моделей через программный интерфейс в формате OpenAI API. Это характеристика интеграции в показанном решении, а не утверждение, что обработку выполняет внешняя модель OpenAI.
Контекстное окно — объём текста, с которым модель может работать в одном обращении. Он измеряется в токенах: небольших единицах текста, не обязательно совпадающих со словами. Обозначение 8bit указывает на восьмибитный формат модели; конкретный способ такого представления в докладе не раскрыт. Приведённая конфигурация относится к старту проекта. Позднее команда меняет языковую модель, поэтому нельзя приписывать все последующие результаты исходной Gemma.
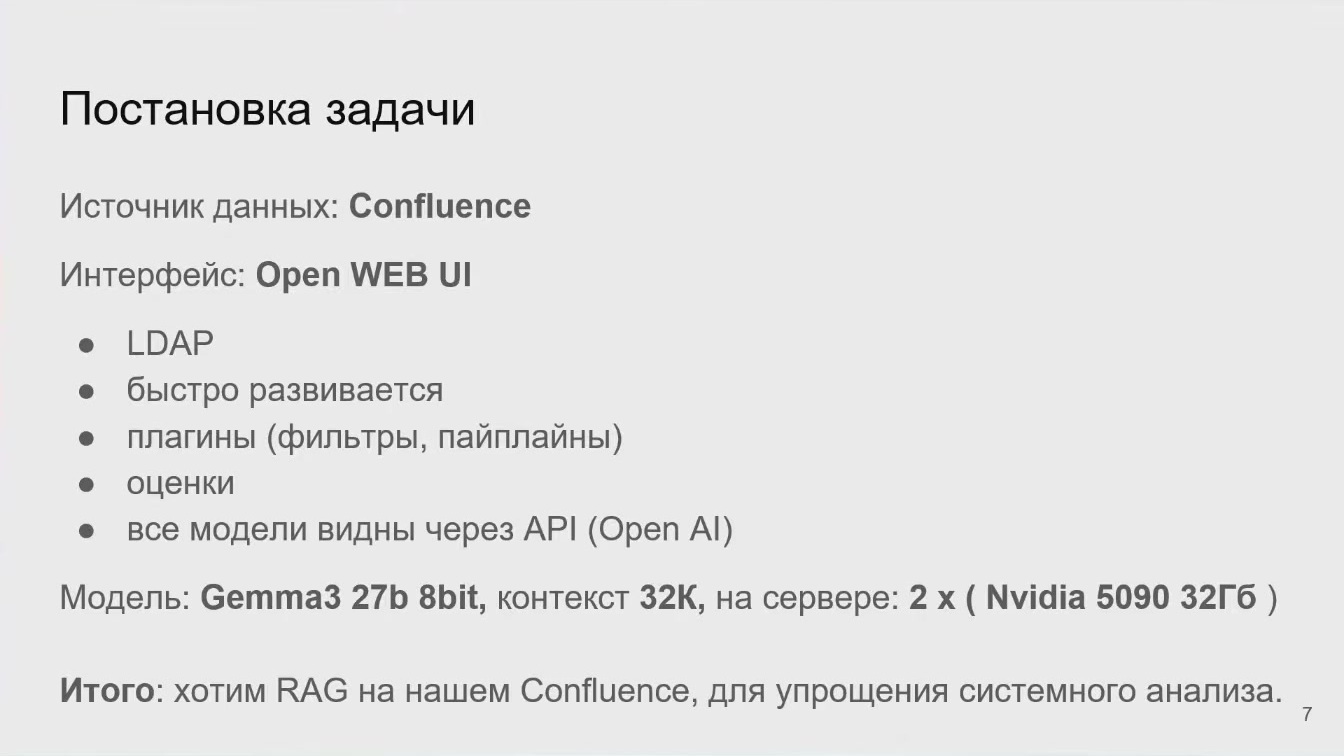
Confluence, Open WebUI, Gemma3 27B в 8-битном формате с контекстом 32K и сервер с двумя Nvidia 5090 по 32 ГБ. Это первоначальная конфигурация, а не единственная модель всех экспериментов.
Источник: Иван Комаров, Евгений Чуканов · КоронатекПодготовка данных: не потерять таблицы, диаграммы и вложенные страницы
До обработки пользовательских вопросов нужно получить из Confluence материал, пригодный для поиска. Авторы начинают с выгрузки статей и перевода содержимого в Markdown — текстовую разметку, в которой сохраняются заголовки, списки и таблицы. На иллюстрации названа библиотека markdownify. Задача здесь не в смене расширения файла, а в сохранении информации, которую затем должна прочитать модель.
Для системного анализа особенно важны диаграммы: на них показаны переходы по статусам и взаимодействия компонентов. Текстовый язык PlantUML описывает такую схему через её элементы и связи. Если исходник PlantUML уже есть, его нужно сохранить. Если схема доступна только как изображение, команда использует способность Gemma 27b работать с картинками и переводит её в текстовое представление. Авторов заинтересовало, что модель может читать эту запись как концентрированное описание связей.
Таблицу можно прокрутить по горизонтали.
Отдельной обработки потребовали исходники PlantUML и вложенные страницы. Потеря вложенного материала означает, что нужного ответа не будет в поисковой базе, даже если он виден человеку в Confluence. Точные правила обхода страниц и проверки полноты выгрузки не раскрыты. Перевод изображения моделью также не следует считать автоматически безошибочным: в докладе нет отдельной оценки точности восстановления схем.
Вся эта подготовка выполняется заранее, отдельно от пути одного вопроса. Позднее подготовленные фрагменты используют повторно. Это объясняет, почему авторы готовы тратить больше усилий на извлечение содержимого: ошибка здесь будет воспроизводиться в следующих обращениях. Частота повторной выгрузки и пересчёта изменившихся документов при этом не названа.
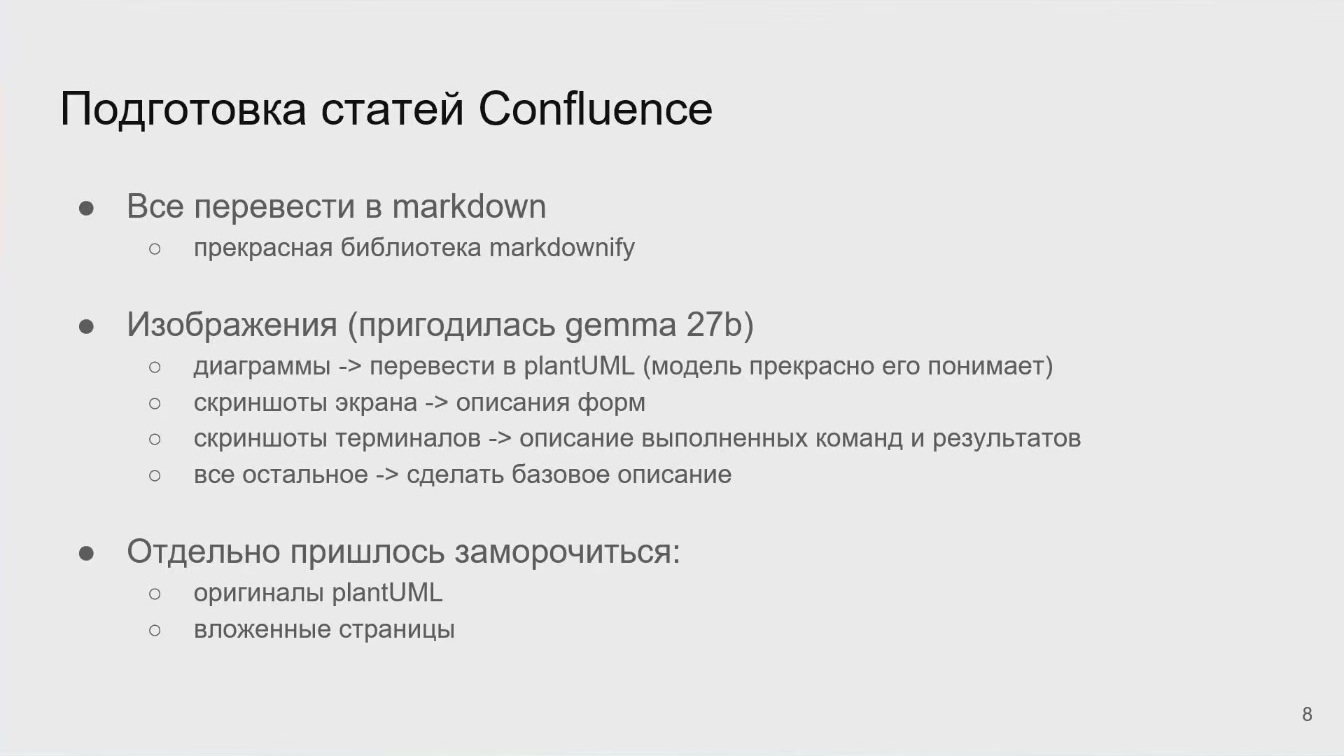
Markdownify, описания изображений и диаграмм, сохранение исходного PlantUML и вложенных страниц помогают не потерять информацию Confluence.
Источник: Иван Комаров, Евгений Чуканов · КоронатекФрагмент должен содержать законченную мысль
Если разбить страницу в произвольных местах, определение может оказаться отдельно от условий, а таблица — отдельно от пояснения. Тогда каждый найденный фрагмент выглядит правдоподобно, но не даёт полного основания для ответа. Команда формулирует требование иначе: чанк должен быть единицей смысла, то есть достаточно самостоятельной законченной мыслью.
В качестве противопоставления автор приводит механическую нарезку по 1000 символов с перекрытием 200. Это иллюстрация простого способа, а не доказанные параметры первого корпоративного прототипа. В своём подходе авторы поручают нарезку языковой модели и задают ориентир в 5–10 предложений. Смысл важнее формального попадания в длину: модель получает объяснение, как обращаться с таблицами и диаграммами.
У фрагмента обязательно сохраняют путь в дереве Confluence. На иллюстрации сопоставлены «Люди / Адаптация новичка / Дата-аналитик» и «Люди / Адаптация новичка / Инженер-разработчик». Похожий текст про адаптацию относится к разным сотрудникам; без пути поиск и генератор могут потерять это различие. Путь становится частью содержательного описания, а не только адресом для перехода.
Но и модель, которая делает нарезку, не может прочитать страницу любого объёма. Поэтому документ предварительно делят по заголовкам, таблицам или макросам. После этого LLM выделяет смысловые части внутри доступного материала. Получать результат помогает Structured Output — вывод в заранее заданной структуре, который программе проще разбирать. Конкретная схема полей этого вывода не показана; важно не приписывать системе произвольный формат, которого авторы не раскрыли.
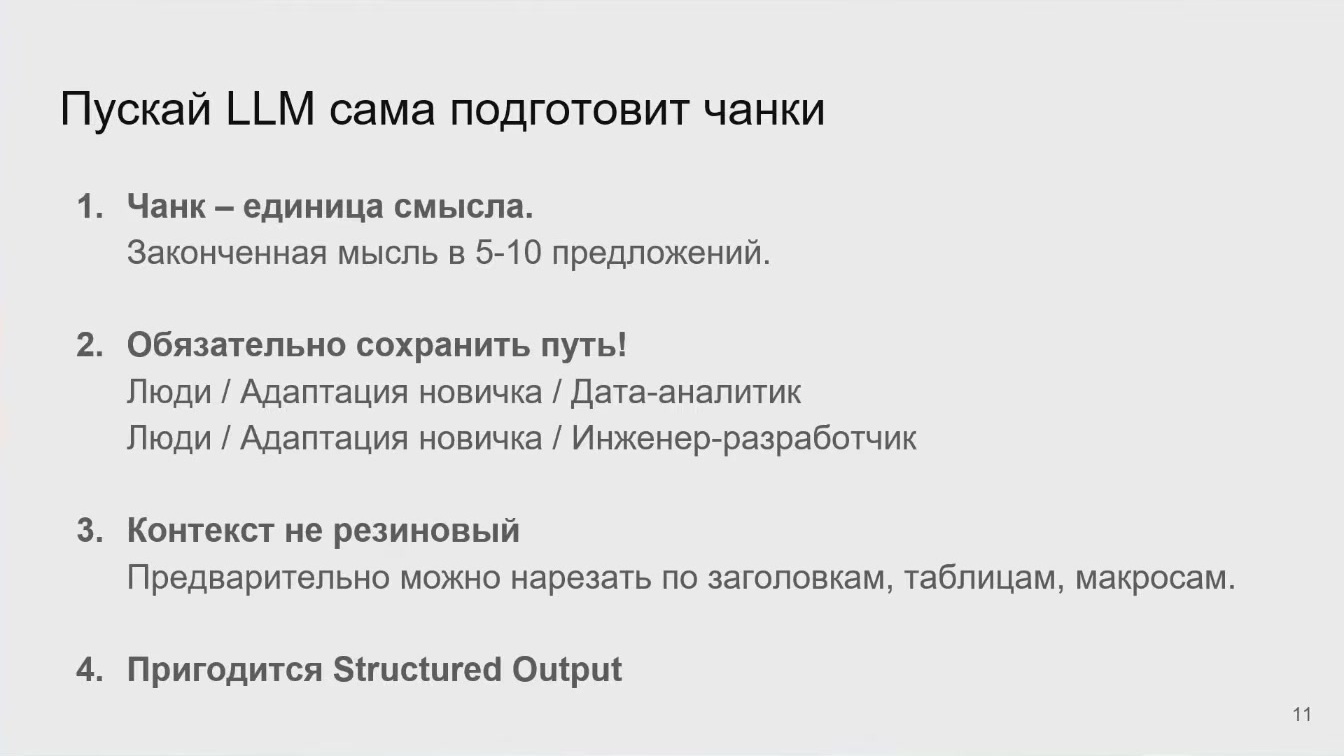
LLM готовит смысловые фрагменты по 5–10 предложений, сохраняет путь; предварительная нарезка ограничивает контекст, структурированный вывод помогает проверять результат.
Источник: Иван Комаров, Евгений Чуканов · КоронатекДаже осмысленному фрагменту нужно объяснение его места в документе
Самостоятельный абзац всё ещё может быть неоднозначным. Он говорит о локальном действии, но не объясняет, частью какого процесса оно является. Чтобы показать разницу, авторы используют иллюстрацию: отдельно видны водоём и рыба, а более широкий кадр показывает рыбу в когтях птицы. Сочетание отдельных деталей без связи между ними создаёт другую картину происходящего.
Поэтому после нарезки языковой модели дают сам фрагмент и страницу, из которой его взяли. Её просят описать, какую роль этот фрагмент играет в документе. Полученный контекст — не история переписки и не размер окна модели. Это короткое пояснение исходного смысла, которое хранится рядом с текстом.
Таблицу можно прокрутить по горизонтали.
Это дополнение влияет на дальнейшую архитектуру: текст с путём и отдельное описание контекста будут участвовать в разных поисках, а при дополнительном отборе модель увидит все три поля. Авторы объясняют полезность этого решения, но не приводят отдельного численного сравнения с вариантом без контекста. Его нельзя объявлять единственной причиной итогового улучшения.
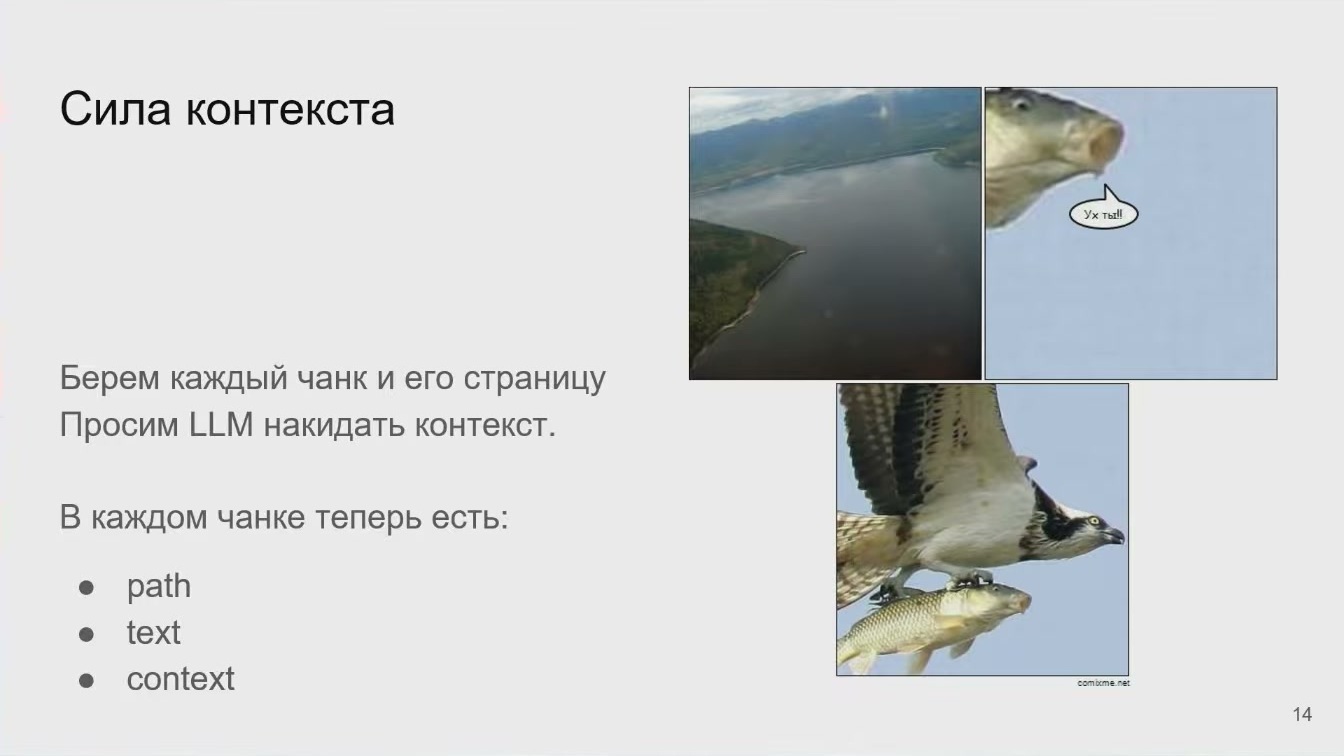
У фрагмента есть path, text и context: краткое объяснение его места в исходной странице.
Источник: Иван Комаров, Евгений Чуканов · КоронатекКак FRIDA ищет по смыслу и где обрывается её вход
Поиск по смыслу требует, чтобы вопрос и подходящее объяснение получали сопоставимые числовые представления. Модель, которая строит такие представления, называется эмбеддером, а полученный вектор — эмбеддингом. В этом проекте команда выбрала FRIDA от Сбера. На исходной иллюстрации указан идентификатор ai-forever/FRIDA и размерность 1536: один вектор содержит 1536 чисел.
Авторы выделяют работу с русским языком и сообщают, что модель хорошо работает у них даже на CPU, то есть на центральном процессоре без обязательного использования видеокарты для этого шага. Это наблюдение команды, а не замер пропускной способности. Время вычисления одного вектора, число запросов в секунду и сравнение с другими эмбеддерами на их документах не приведены.
При использовании FRIDA важно сообщать, что именно подаётся на вход: поисковый вопрос или документ. Для этого служат префиксы — небольшие служебные добавления к тексту, задающие нужный режим представления. Доклад не раскрывает буквальные префиксы рабочей конфигурации, поэтому нельзя восстановить их по общему правилу или перенести настройки другой модели.
Смысловая нарезка и ограничение эмбеддера должны быть согласованы. FRIDA принимает до 512 токенов, а 5–10 предложений вместе с путём могут оказаться длиннее. В речи автор предупреждает: остаток будет отброшен. Получается неприятный разрыв — в сохранённом фрагменте важное условие есть, но в поисковое представление оно не попало. Как именно команда обрабатывает слишком длинные фрагменты, в докладе не показано.
Есть и языковая оговорка. Авторы пишут об обучении на русском и английском, но рядом приводят выдержку из описания модели, где качество английского названо неизвестным. Эти утверждения не нужно искусственно уравнивать: участие языка в обучении не доказывает одинаково хорошую работу на нём. Для данного кейса подтверждён интерес команды к русскоязычной документации, а не измеренное равенство качества двух языков.
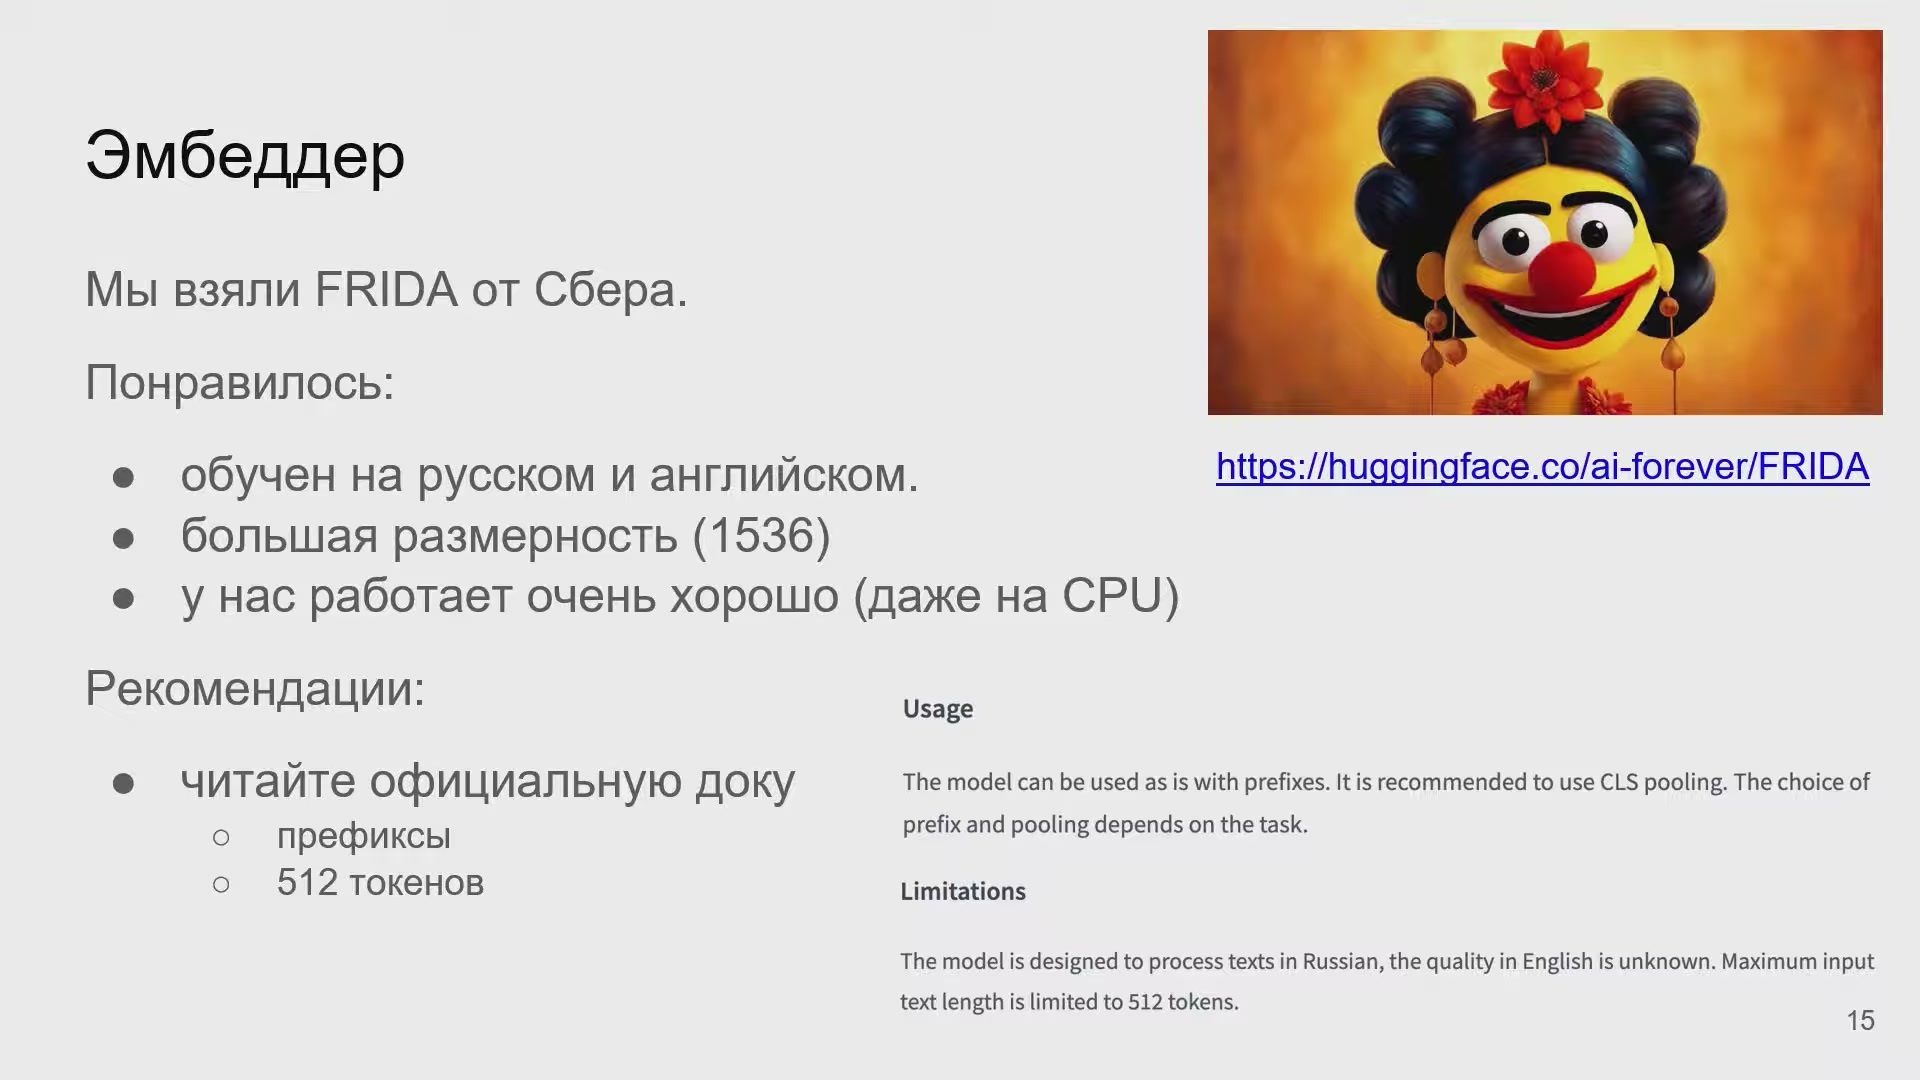
FRIDA даёт векторы из 1 536 чисел; авторы напоминают о префиксах и пределе 512 токенов. Обучение на русском и английском само по себе не доказывает одинаковое качество двух языков.
Источник: Иван Комаров, Евгений Чуканов · КоронатекЗачем смысловому поиску нужен поиск точных названий
Смысловая похожесть — не единственный полезный сигнал. Когда вопрос содержит фамилию, название компонента или редкий термин, точное совпадение может быть важнее общего сходства темы. Автор приводит пример с фамилией Комаров: документы, где она действительно встречается, становятся естественными кандидатами на вопрос об этом человеке.
Как исходную точку для такого поиска обсуждают BM25 — способ упорядочивать документы по совпадающим словам с учётом их информативности. Затем команда рассматривает нейросетевой вариант: модель GTE выдаёт для токенов веса, описывающие их важность в тексте. Из этих весов получается разреженное, или sparse-представление. В отличие от плотного вектора FRIDA, здесь явно учитываются отдельные токены и хранятся только нужные координаты с их значениями.
На исходном слайде указана ссылка на Alibaba-NLP/gte-multilingual-base. Во внешней таблице у её sparse-варианта значение Avg равно 57,2, у BM25 — 47,0. Рядом перечислены MLDR, MIRACL, MKQA, BEIR и LoCo, причём используются разные показатели: nDCG@10 и recall@20. Это сравнение помогло выбрать направление эксперимента, но не измеряет поиск по wiki Коронатека. Полный протокол переноса модели и результаты отдельного сравнения на внутренних документах не раскрыты.
Логика решения состоит в дополнении, а не в обещании универсального победителя: один канал ищет подходящий смысл, другой помогает удержать важные названия. Позднее на итоговой иллюстрации команда прямо указывает добавление sparse-векторов среди доработок. Поэтому неясную устную фразу о BM25 нельзя превращать в утверждение, что в финале от sparse-поиска отказались.
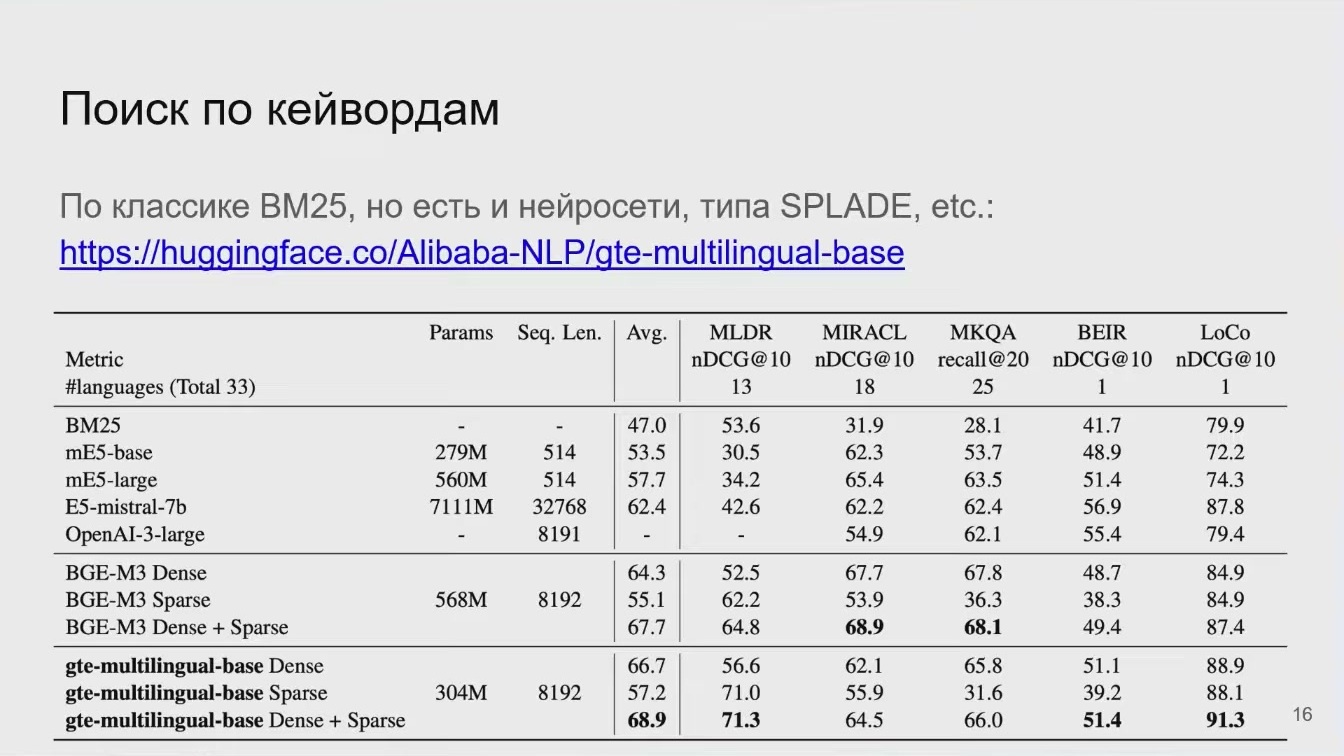
На слайде указана Alibaba-NLP/gte-multilingual-base. 57,2 и47,0 — Avg во внешней таблице по разным наборам и метрикам; это не оценка корпоративной wiki.
Источник: Иван Комаров, Евгений Чуканов · КоронатекКак словарь весов превратили в разреженный вектор
Выход GTE в показанном примере — словарь: у токена «машина» вес 0,8, у «поезда» — 0,3. Это учебные числа для объяснения формата, не измеренный вклад слов в качество корпоративных ответов. Чтобы искать по таким представлениям, нужно договориться, в какой координате вектора хранится вес каждого токена.
Можно было бы вести отдельное соответствие «токен → номер координаты». Команда вместо этого использует хеширование: строка преобразуется в число выбранным постоянным алгоритмом, а остаток от деления помещает это число в допустимый диапазон индексов. Один и тот же токен должен получать одну и ту же координату при подготовке документов и поиске.
idx = hash("машина") %
v[idx] = 0.8
Это схематическая запись с исходной иллюстрации. Размер пространства там равен 4_294_967_295 и подписан как max uint32 — максимальное значение беззнакового 32-битного целого. В речи выбор связывается с возможностями Qdrant, используемой системы хранения и поиска векторов. Конкретная функция хеширования и полный код индексирования не раскрыты.
Число около четырёх миллиардов не означает, что под каждый фрагмент выделяют плотный массив из четырёх миллиардов весов. Представление разреженное: достаточно хранить пары «индекс — ненулевой вес». Большой диапазон также не гарантирует отсутствие совпадений индексов у разных токенов. Такое совпадение называется коллизией. Авторы говорят, что наблюдали мало коллизий, но не приводят их частоту и способ обработки. Поэтому нельзя заменять их наблюдение обещанием уникальной координаты для каждого возможного слова.
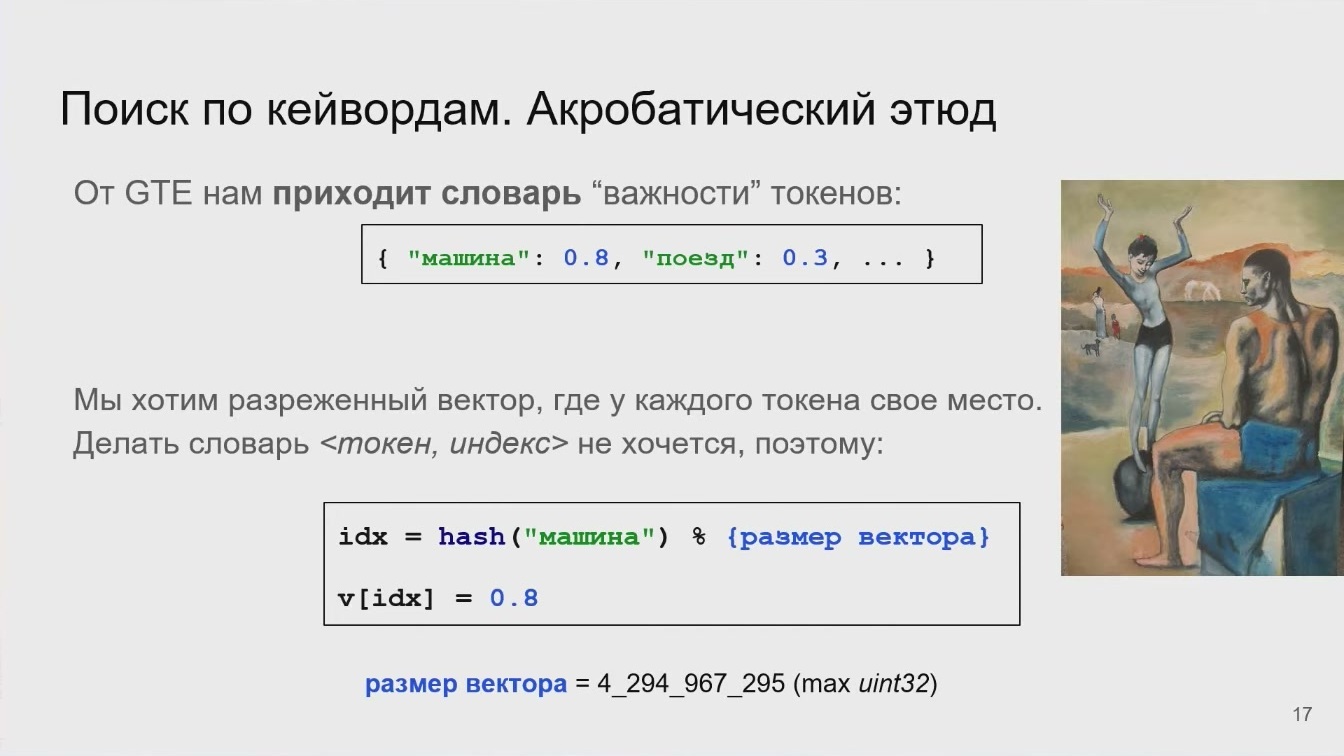
Вес токена из GTE помещается в индекс hash(token) modulo размер_вектора. На слайде размер 4_294_967_295; показан принцип хранения ненулевых весов, не плотная матрица такого размера.
Источник: Иван Комаров, Евгений Чуканов · КоронатекУточнение пользователя нужно превратить в самостоятельный вопрос
Поисковая система получает не только полные вопросы. Человек может сначала спросить о директоре подразделения, а затем продолжить: «А кто у них там руководитель управления?» Во второй реплике нет самостоятельного указания, что означает «у них». Если искать только по последнему сообщению, нужная связь теряется ещё до обращения к документам.
Команда предлагает перед поиском обобщать весь диалог. Языковая модель восстанавливает предмет разговора и формулирует, какую информацию пользователь хочет получить сейчас. Так одна операция решает две задачи: убирает лишние слова и возвращает смысл, который остался в предыдущих репликах.
Этот диалоговый контекст нужно отличать от поля context у фрагмента. Первый объясняет текущий вопрос; второе объясняет положение найденного текста внутри документа. Они помогают с разных сторон одной проблемы: и запрос, и выдержка должны сохранять смысл вне своего ближайшего окружения. Отдельной оценки ошибок переформулирования, модели для этого шага и правил сокращения очень длинной переписки авторы не приводят.
Доклад · 00:21:37Три поиска объединяются в 50 кандидатов
К этому моменту у подготовленного фрагмента есть несколько способов быть найденным. Важное уточнение исходной схемы: речь не об одном плотном и одном разреженном поиске, а о трёх поисковых представлениях. Два из них строит FRIDA, третье связано с весами токенов в основном тексте.
Списки объединяют по местам фрагментов в каждой выдаче, а не простым сложением несопоставимых численных оценок. Этот способ называется Reciprocal Rank Fusion, сокращённо RRF. Его идея в данном объяснении — учитывать, насколько высоко кандидат оказался в разных результатах поиска. Так один источник не обязан выдавать оценки в той же шкале, что и другой.
После объединения берут 50 результатов. Это размер списка перед более дорогим отбором, а не число фрагментов, обязательно попадающих к генератору. На иллюстрации явно перечислены все три представления и названы RRF и 50 кандидатов. Формула слияния, её параметры и глубина каждого отдельного поиска не раскрыты. Фраза автора о простоте настройки не является доказательством полного отсутствия параметров у метода.
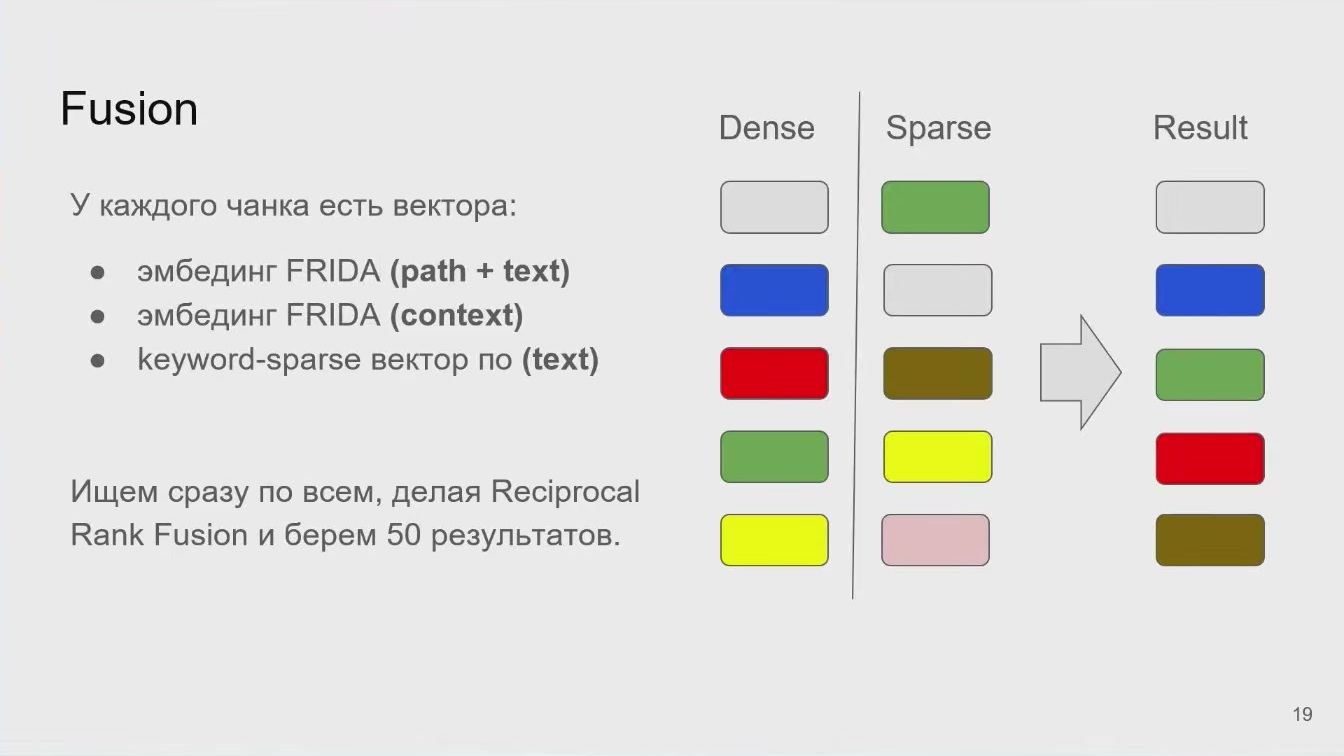
FRIDA(path+text), FRIDA(context) и sparse(text) объединяются Reciprocal Rank Fusion; выбирают 50 кандидатов.
Источник: Иван Комаров, Евгений Чуканов · КоронатекПовторная проверка кандидатов: оставить фрагмент или убрать
Ранжирование — это упорядочивание найденных кандидатов. Обычно после быстрого поиска можно применить более дорогую модель к небольшому списку и уточнить порядок; этот этап называют переранжированием. В докладе раздел имеет такое название, но показанная операция устроена конкретнее: языковая модель решает, нужно ли вообще оставлять каждый фрагмент.
По словам авторов, после долгих экспериментов сама LLM показала себя лучше небольших специализированных моделей. Она получает вопрос, основной текст кандидата, его контекст и путь исходного документа. Инструкция требует вернуть 1, если во фрагменте есть релевантная вопросу информация, и 0 — если её нет. Таким образом, это бинарная фильтрация, а не обязательно построение нового полного порядка выдачи.
: {user_query}
  : {text}
 : {context}
   : {path}

    ,  1.
    0.
Сокращённая запись выше передаёт поля и правило показанного промпта. Модель должна отсмотреть 50 кандидатов после RRF. Это дороже быстрого сопоставления векторов, и авторы прямо отмечают, что этап работает не очень быстро. Взамен они наблюдали существенное улучшение качества. Величина отдельного прироста, названия проигравших моделей, способ параллельной обработки и задержка в секундах не сообщены.
Число 1 здесь означает «оставить этот фрагмент для ответа», а не «ответ пользователю правильный». Позднее качество готовых ответов оценивают по другой шкале, от 0 до 2. Эти два оценивания нельзя объединять: они применяются к разным объектам, в разных местах системы и с разным смыслом. Сколько фрагментов остаётся после фильтра и есть ли ещё ограничение их числа перед генерацией, в материале не указано.
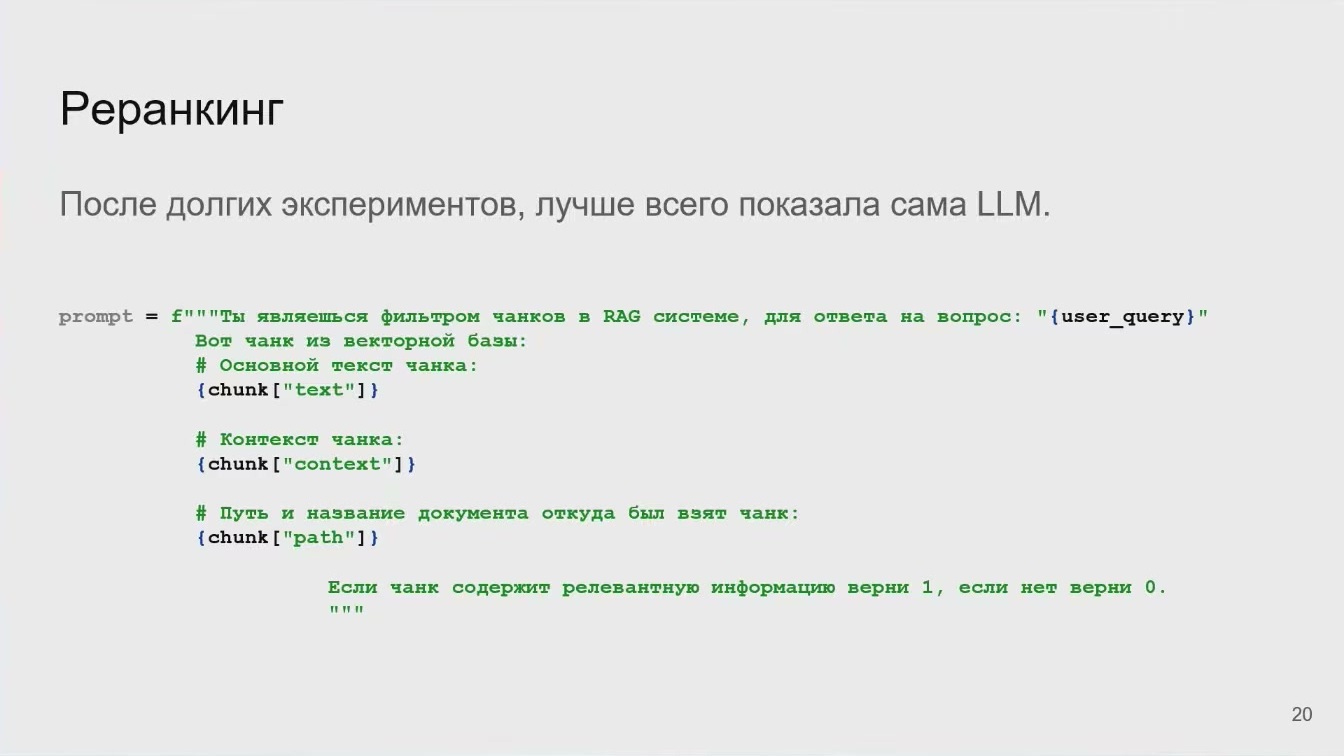
LLM получает вопрос, текст, контекст и путь фрагмента и возвращает 1 или 0. Это бинарная фильтрация кандидатов, не оценка качества финального ответа.
Источник: Иван Комаров, Евгений Чуканов · КоронатекЧто помогает превратить найденный материал в проверяемый ответ
После поиска и фильтрации генератор составляет ответ на основании отобранного материала. Авторы обращают внимание на параметры модели и советуют уменьшать температуру — настройку, влияющую на случайность выбора продолжения. Но конкретного значения температуры и полного набора параметров в докладе нет. Нельзя автоматически приписывать системе температуру 0 или настройки, распространённые в других проектах.
Предметную область нужно объяснить всем языковым этапам, а не только финальному генератору. Переформулировщик вопроса, фильтр фрагментов и модель ответа должны одинаково понимать внутренние сокращения. Пример авторов — «ТК» и «телефонная книга». Иначе один этап может правильно найти сокращение, а следующий решить, что материал относится к другой теме.
Рядом с содержимым полезны дата и время его актуальности. В разных разделах могут одновременно находиться похожие объяснения разных версий. По наблюдению команды, модель склонна выбирать более свежий вариант, когда видит временные сведения. Это полезный сигнал, но не строгая гарантия выбора правильного документа: правила разрешения противоречий и приоритетов версий не описаны.
Ссылки обязательны, потому что пользователь обычно не знает ответ заранее. Уверенный текст без возможности перейти к источнику легко принять на веру. Поэтому ссылка здесь не украшение ответа, а путь к проверке: сотрудник может открыть документ и сопоставить вывод помощника с исходным объяснением. При этом сам факт наличия ссылки ещё не доказывает, что она действительно подтверждает каждую деталь ответа.
Нужно также объяснять человеку ожидание. Пока LLM проверяет множество фрагментов, интерфейс показывает прогресс, чтобы отсутствие готового ответа не выглядело зависанием. Ещё одна деталь исходной иллюстрации — выдавать диаграммы ответа в Mermaid, текстовом формате для отображения схем. Это не замена PlantUML при подготовке исходников: PlantUML используется для сохранения информации документа, а Mermaid упоминается как удобная форма показа новой схемы пользователю.
Из этих решений не складывается полное описание эксплуатации. Не названы гарантированная задержка ответа, расписание обновления индекса, проверка прав на каждую страницу и окончательное число фрагментов в промпте. Доклад раскрывает полезные части реализации, но не даёт оснований достраивать отсутствующие механизмы.
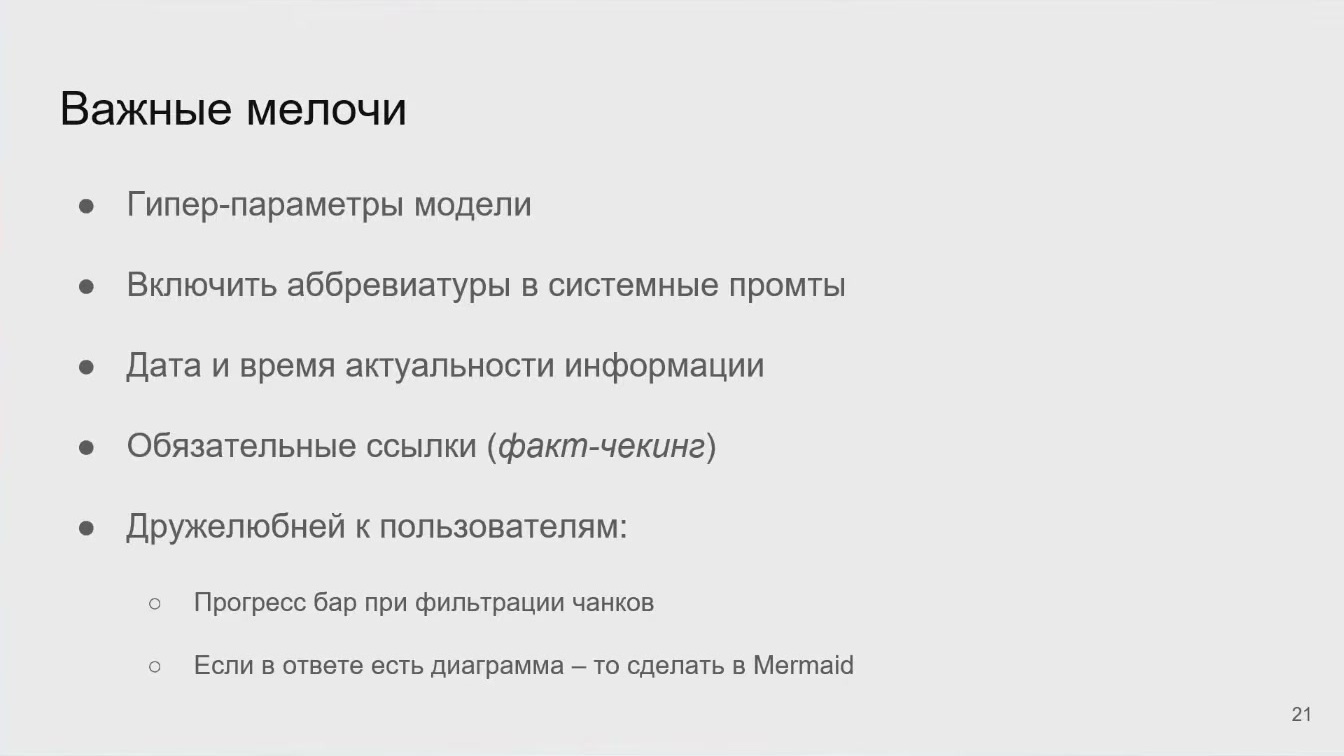
Аббревиатуры, актуальность, ссылки и понятный прогресс обработки дополняют качество retrieval.
Источник: Иван Комаров, Евгений Чуканов · КоронатекПочему автоматически построенный граф не помог
Граф — представление, в котором объекты связаны явными отношениями: например, компонент относится к команде или взаимодействует с другим компонентом. Для задачи системного анализа такая форма выглядит естественно. Команда попробовала подходы GraphRAG: использовать граф связей при работе с документами и поручить извлечение отношений языковой модели.
В речи перечислены несколько попыток: вариант с названием, распознанным как LightRAG, собственное построение и инструменты Microsoft, где отношения извлекаются тройками «объект — связь — объект». Но результат оказался слишком шумным. На иллюстрации видна густая сеть разнородных сущностей и связей; важный вывод не в её размере, а в том, сколько лишнего пришлось бы убрать, прежде чем использовать её для ответов.
Проблема не ограничилась качеством первоначального извлечения. Авторы отдельно указывают большой объём постобработки, сложности хранения и обновления. Граф, который удалось один раз построить, ещё нужно поддерживать при изменении документации. Команда решила пока не делать это направление частью решения. Сопоставимого численного теста графового и неграфового вариантов не приведено, поэтому это не доказательство бесполезности GraphRAG вообще.
Дальнейший план — опереться на уже выверенные связи. Для компании обсуждается Backstage, где сотрудники смогут поддерживать отношения между компонентами и командами. На иллюстрации прямо написано: строгие связи сделают на Backstage. В этой логике помощник использует известную структуру, а не пытается заново достоверно угадать её по всем страницам.
Backstage остаётся планом, а не подтверждённой частью пилота в трёх отделах. Более широкие отношения, извлекаемые из документов, авторы оставляют предметом дальнейшего исследования. Их практический вывод относится к качеству доступного графа: готовые проверенные связи и автоматически полученная мешанина требуют совершенно разного объёма работы.
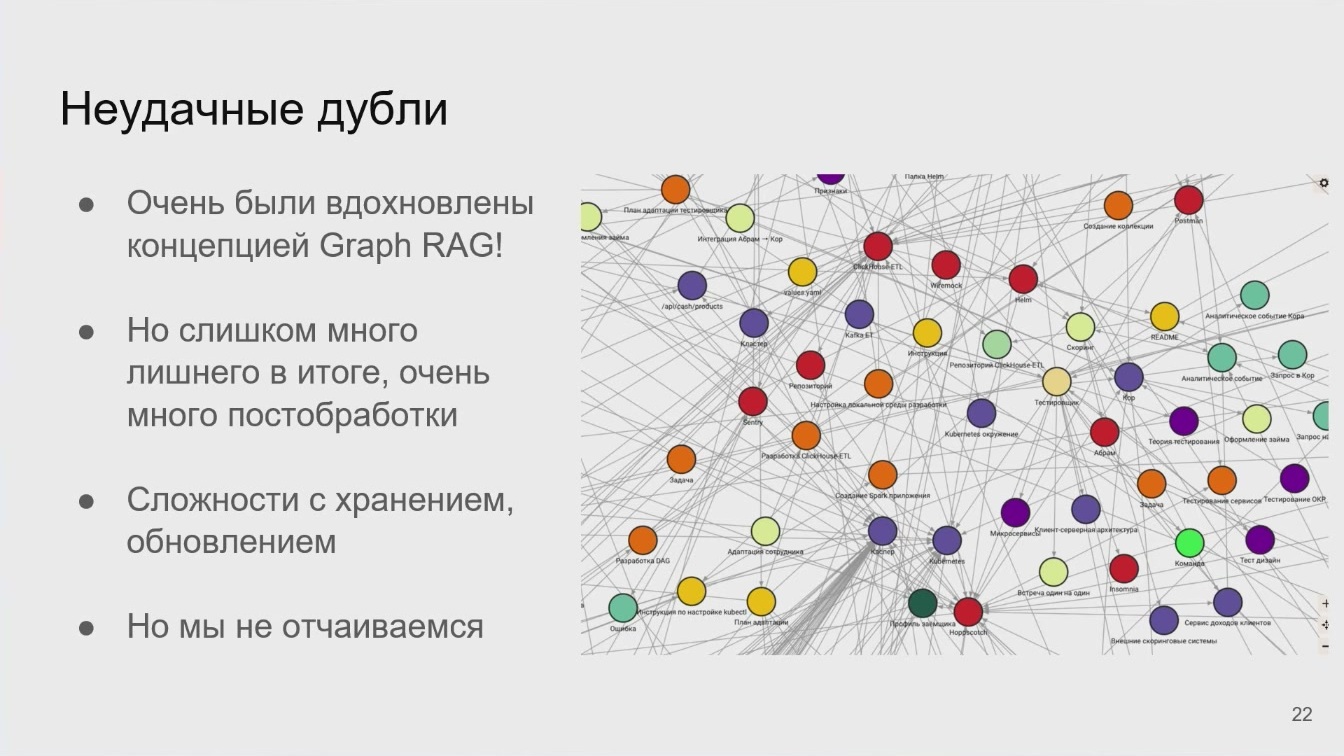
Автоматически полученный граф дал слишком много лишних связей, потребовал постобработки и усложнил хранение и обновление.
Источник: Иван Комаров, Евгений Чуканов · Коронатек
Строгие связи планируют получить из Backstage; более широкие связи между документами ещё требуют исследования.
Источник: Иван Комаров, Евгений Чуканов · КоронатекПочему проверочный набор сделали по собственной документации
Когда меняются нарезка, поиск или генератор, нужно отличать реальное улучшение от удачного ответа на несколько выбранных вопросов. Для этого требуется проверочный набор: одинаковые задания, на которых можно сравнивать результаты разных вариантов системы. Такая проверка называется валидацией.
На слайде названы два внешних источника заданий: UDA для английского языка и DRAGON для русского. Первый объединяет документы и экспертные пары вопросов и ответов из разных предметных областей; второй ориентирован на динамические новости. Но готовые задания ещё не решают вопрос оценки: нужно выбрать, как сопоставлять модельный ответ с эталоном и что считать успехом.
Свежесть новостей упомянута не случайно. Если модель уже видела материал при предварительном обучении, хороший ответ ещё не показывает, что поиск правильно доставил ей нужный документ. Авторы предостерегают от слишком красивого результата на знакомых данных. Это методологическое замечание, а не установленный факт, что конкретный внешний набор обязательно присутствовал в обучении их модели.
Для своей задачи команда поручила стажёру вручную подготовить 400 пар «вопрос — ответ» по внутренней документации. Его незнакомство с частью материала оказалось полезным: естественные вопросы возникали в процессе чтения, после чего он искал ответы в базе знаний. Такой набор ближе к затруднениям будущего пользователя, чем чужие документы на другой предметной области.
Доклад не описывает распределение этих вопросов по темам, отдельный набор, который не использовали при настройке, или правила защиты от подгонки под уже разобранные примеры. Поэтому 400 пар — подтверждённый размер собственного проверочного материала, но не доказательство исчерпывающего покрытия всех задач сотрудников.
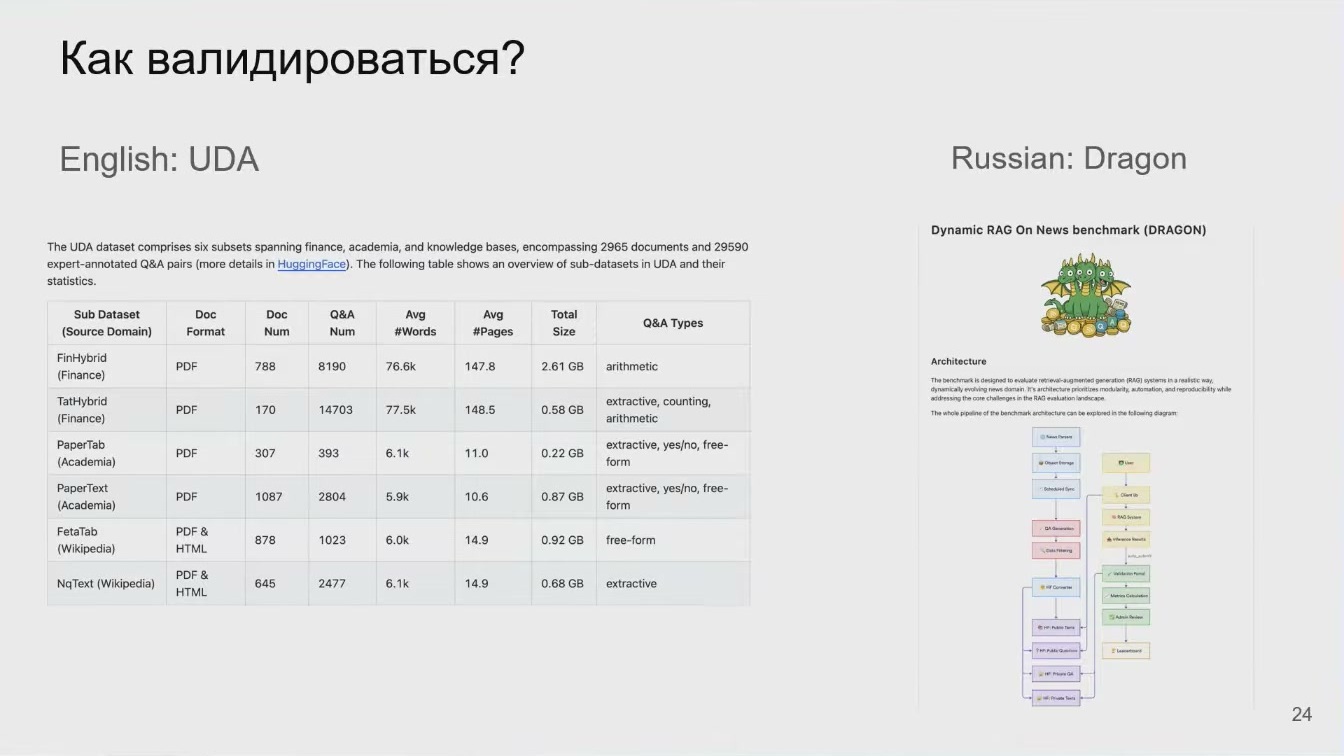
Названы UDA для английского и DRAGON для русского. Их задания иллюстрируют варианты внешней проверки, но итоговый пилот оценивают на 400 собственных вопросах.
Источник: Иван Комаров, Евгений Чуканов · КоронатекОценка 0–2: неприемлемо, неясно, приемлемо
Эталонный ответ ещё не задаёт метрику. Команда не стала строить сложный набор отдельно трактуемых показателей достоверности и релевантности, а выбрала прикладной вопрос: можно ли принять полученный ответ? Первую проверку делали вручную, сопоставляя результат помощника с ответом, подготовленным человеком.
Таблицу можно прокрутить по горизонтали.
В устном пояснении единица означает, что в ответе что-то есть, но он не вполне устраивает проверяющего. Точная подпись на иллюстрации — «не понятно». Поэтому единицу нельзя без дополнительного определения называть правильным ответом или присваивать ей произвольную долю фактической точности.
Затем проверили, как с той же задачей справляется языковая модель в роли оценщика — LLM-as-a-Judge. Здесь модель не отвечает пользователю, а сравнивает готовый ответ с эталоном и предлагает оценку. На иллюстрации сказано, что она работает эквивалентно; речь уточняет, что недочёты оставались и результаты доразмечали руками. Численной меры согласия человека и модели нет, поэтому слово «эквивалентно» следует понимать как рабочее впечатление команды, не как доказанное статистическое равенство.
Приоритетом было уменьшение числа нулей. Уже это определяет смысл будущего результата: если единица не считается нулём, улучшение доли ответов без нуля может включать и переход в неопределённую категорию. Более подробный порядок проверки — модельная оценка с объяснением и последующий контроль человеком — авторы раскрывают в ответах на вопросы.
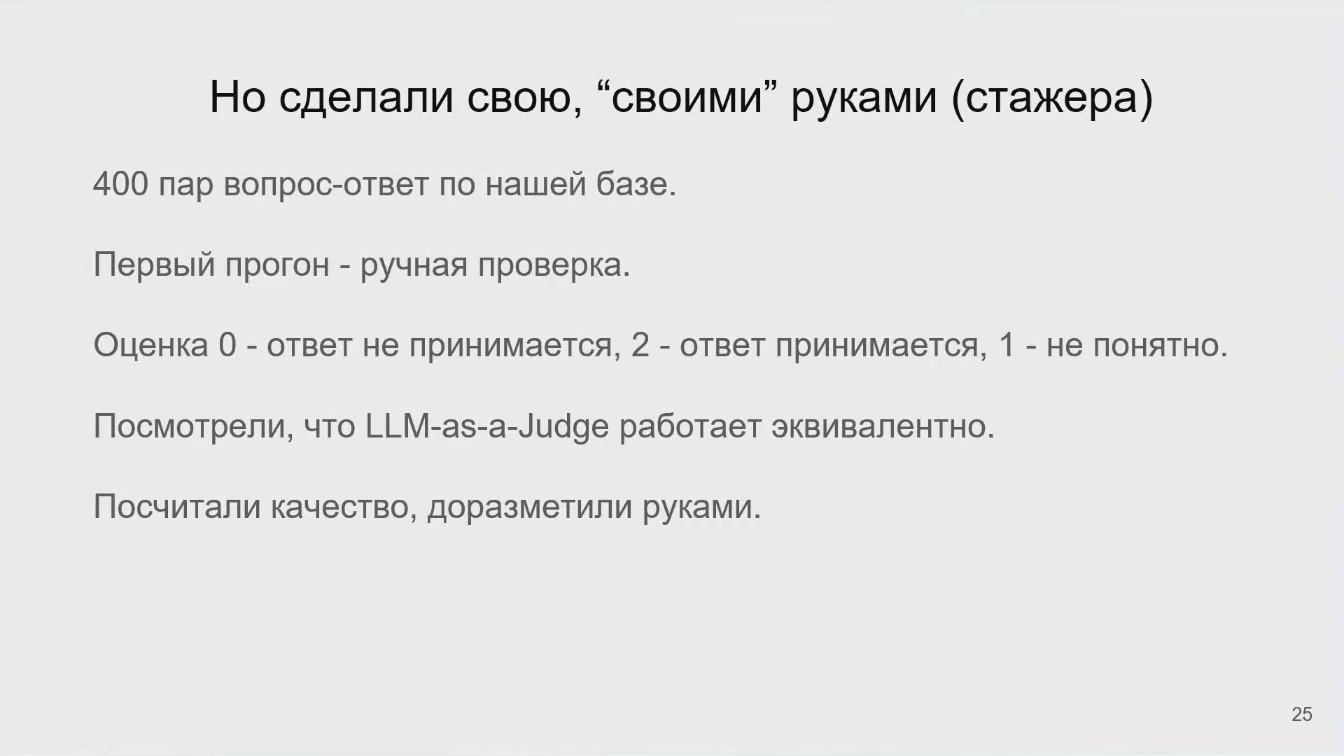
400 пар вопрос–ответ. Шкала: 0 — неприемлемый, 2 — приемлемый, 1 — неясный; сначала ручная проверка, затем сверка LLM-судьи с человеком.
Источник: Иван Комаров, Евгений Чуканов · КоронатекЧто изменили между 75% и 90%
Первый результат, названный в докладе, — 75%. Авторы сочли его неприемлемым: система, которая регулярно не помогает при наличии ответа в документах, не становится хорошим рабочим инструментом только потому, что большинство примеров выглядят удачно. После разбора ошибок команда вернулась ко всей цепочке. Значительная часть архитектуры, рассказанной ранее, уже описывает итог этих итераций, а не первую попытку.
В итоговом варианте выбрали Qwen3-Coder-30b-8bit-Instruct. Авторы особенно выделяют соблюдение требования выдавать ссылки на документы. Это улучшение описано качественно; отдельного измерения доли корректных ссылок не представлено. Замена модели не доказывает, что она же выполняла все другие языковые роли, включая обработку изображений и оценивание.
После доработок показатель достиг 90%. В ответах из зала авторы раскрывают знаменатель: доля ответов с оценкой 0 уменьшилась с 25% до 10%. Следовательно, 75% и 90% — доли ответов, не получивших ноль. В них входят и единицы, и двойки.
Запись смысла показателя по объяснению авторов в Q&A: N₀, N₁, N₂ — числа ответов с соответствующими оценками; N — общее число оценённых ответов. Это не формула доли полностью верных ответов.
Разница составляет 15 процентных пунктов, но её нельзя приписать одной новой модели. Менялись исходники, поисковые представления и реализация, а отдельные измерения вклада каждого изменения не представлены. Нет и распределения между оценками 1 и 2. Поэтому заголовок «точность выросла до 90%» исказил бы смысл результата.
На момент доклада помощника пилотировали в трёх отделах. Авторы сообщают о хорошем отклике и используют оценки в Open Web UI, но не называют число пользователей, длительность наблюдения, доверительные интервалы или результаты сравнения случайно разделённых групп. Это описанный прогресс собственной системы и начало практического использования, а не обещание такого же качества на любой корпоративной wiki.
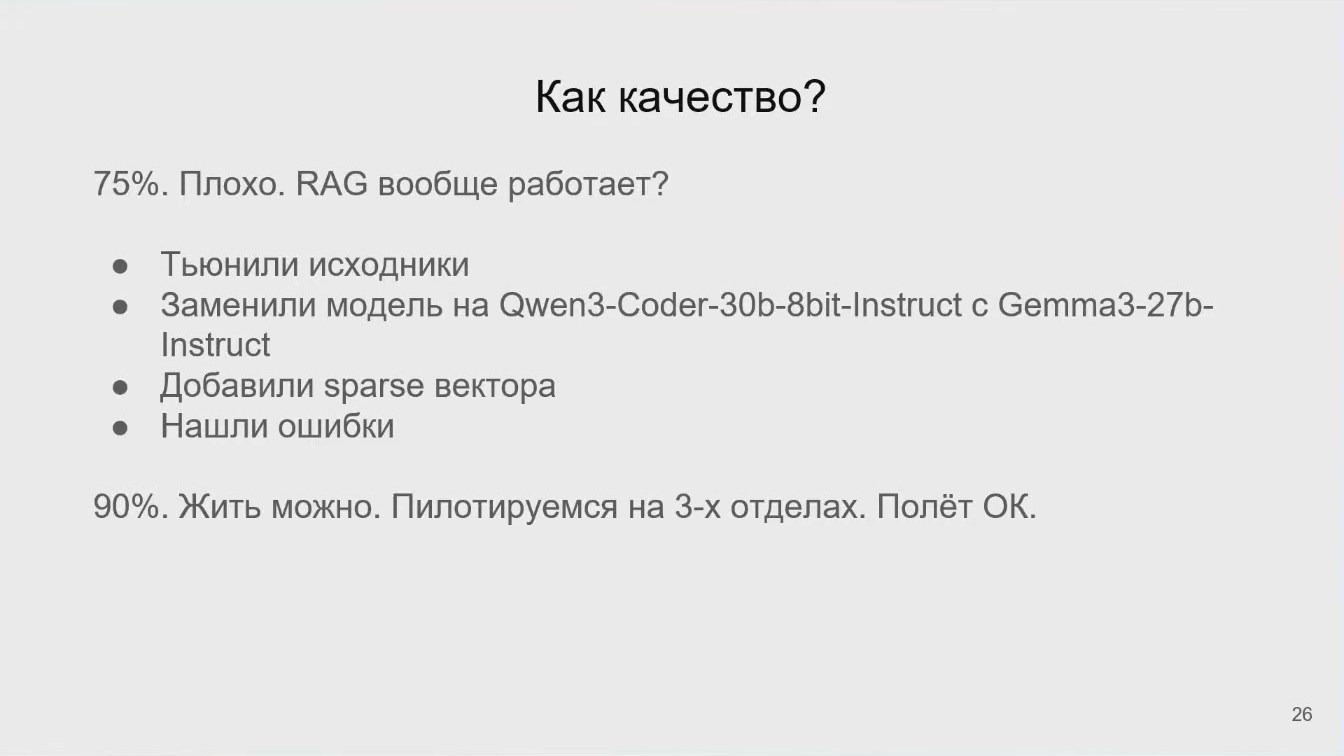
На слайде замена Gemma3-27b-Instruct на Qwen3-Coder-30b-8bit-Instruct, правки исходников, sparse-векторы и устранение ошибок.75% → 90% — доля ответов без оценки 0, включая неопределённые; пилот в трёх отделах.
Источник: Иван Комаров, Евгений Чуканов · КоронатекОтдельный вопрос: поможет ли совместное обучение всей системы
После результата пилота начинается обсуждение других исследований и подходов. Его важно отделить от уже выполненных доработок. Первый вариант — совместно обучать связанные части системы, а не только собирать независимо подготовленные компоненты. В докладе это обсуждается под обозначением end-to-end-обучения и рекламным названием «RAG 2.0».
Авторы возвращаются к одному из участников ранней работы о RAG и его коммерческому предложению. Их ожидание понятно: если поиск и формирование ответа учатся как согласованная система, хочется увидеть сильный конечный результат. Но в приведённом устном сопоставлении внешних таблиц конкретная модель не выглядела безусловным победителем; GTE и FRIDA, по словам докладчика, оставались конкурентоспособными в соответствующих сравнениях.
Внешняя иллюстрация называет Contextual.ai, RAG 2.0 и GritLM; в таблице присутствуют GritLM-7B и GritLM-8x7B. Их положение в этом снимке не заменяет проверки на внутренней документации: задачи и условия отличаются от корпоративного пилота. Команда не сообщает, что обучила собственную end-to-end-систему или получила за счёт неё рост с 75% до 90%. Обещание согласованной архитектуры само по себе не заменяет проверку на вопросах к своей документации.
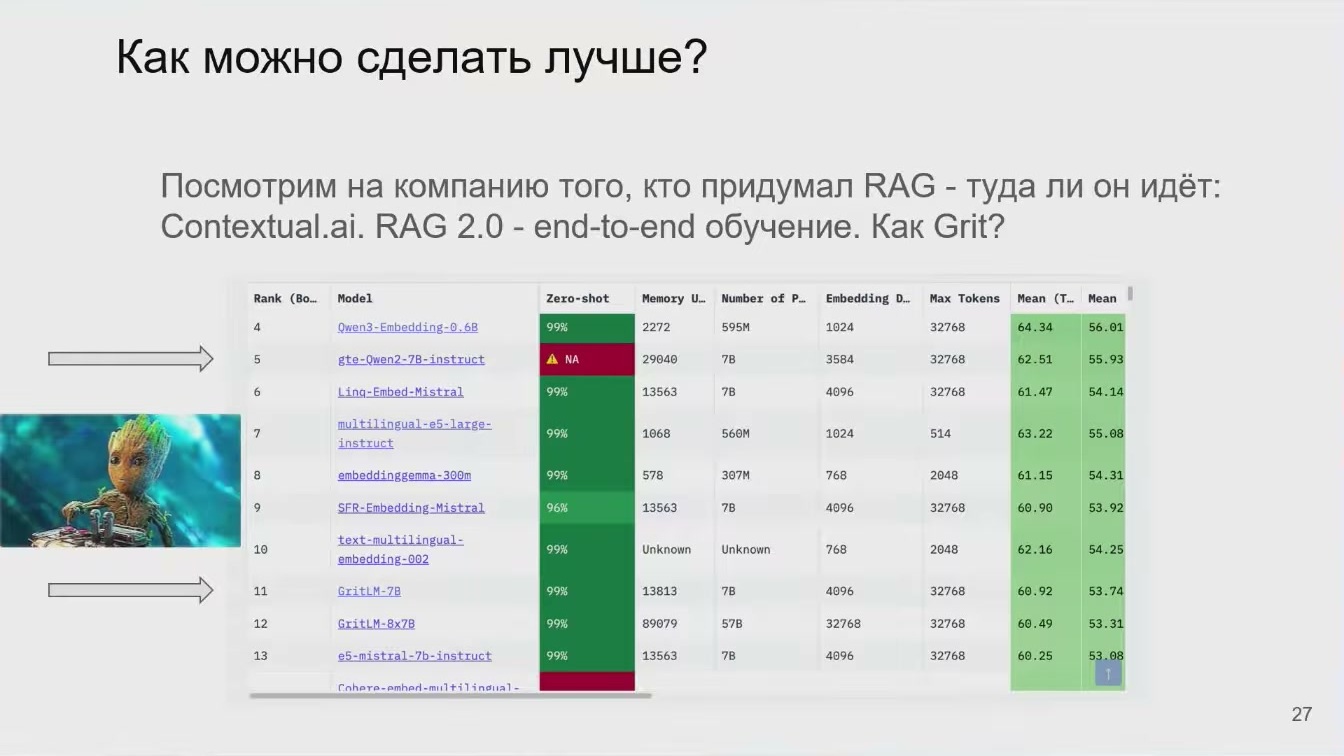
На слайде обсуждаются Contextual.ai / RAG 2.0 и GritLM. Это исследовательская развилка и снимок внешнего сравнения, не внедрение такого обучения в Коронатеке.
Источник: Иван Комаров, Евгений Чуканов · КоронатекБольшой контекст: убрать поиск, но не стоимость обработки
Другая идея — вообще не выбирать маленький набор фрагментов, а положить документы в большое контекстное окно и спросить модель напрямую. В докладе этот вариант назван Context Augmented Generation, или CAG. Это название сохраняется в той форме, в которой его используют авторы; речь идёт об отдельном обсуждении, а не о новой стадии корпоративного пилота.
На иллюстрации приведён Qwen2.5-Turbo с контекстом 1 000 000 токенов и ориентиром в 1300 страниц текста. Справа показан вопрос о героях книги по загруженным частям «Войны и мира». Размер в страницах здесь иллюстрирует масштаб конкретного примера, а не задаёт универсальный коэффициент пересчёта токенов или измеренный объём wiki Коронатека.
Большой вход сначала нужно обработать, а только затем начать ответ. Чтобы не повторять одинаковую работу, автор предлагает сохранять промежуточные числовые представления неизменного контекста. В механизме внимания модели они называются ключами и значениями; хранилище этих представлений — KV-кеш. При добавлении вопроса можно переиспользовать уже рассчитанную часть и вычислять новые представления для добавленного текста. Это не просто сохранение исходной строки промпта.
Такое переиспользование уменьшает повторные вычисления, но длинный контекст всё равно занимает память. Автор связывает миллионное окно даже у небольшой 7B-модели с необходимостью другого оборудования и обсуждает его покупку для дальнейших опытов. Полная конфигурация и условия расчёта памяти не приведены. Из этого разговора нельзя вывести проверенный норматив памяти, гарантированную задержку или достаточность конкретного сервера для произвольной миллионной последовательности.
Главный нерешённый вопрос остаётся содержательным: сможет ли модель надёжно использовать нужную часть огромного входа? Вместить документ и правильно ответить по нему — разные требования. Поэтому следующие примеры авторов посвящены не только размеру окна, но и тому, что именно измеряют тесты длинного контекста.
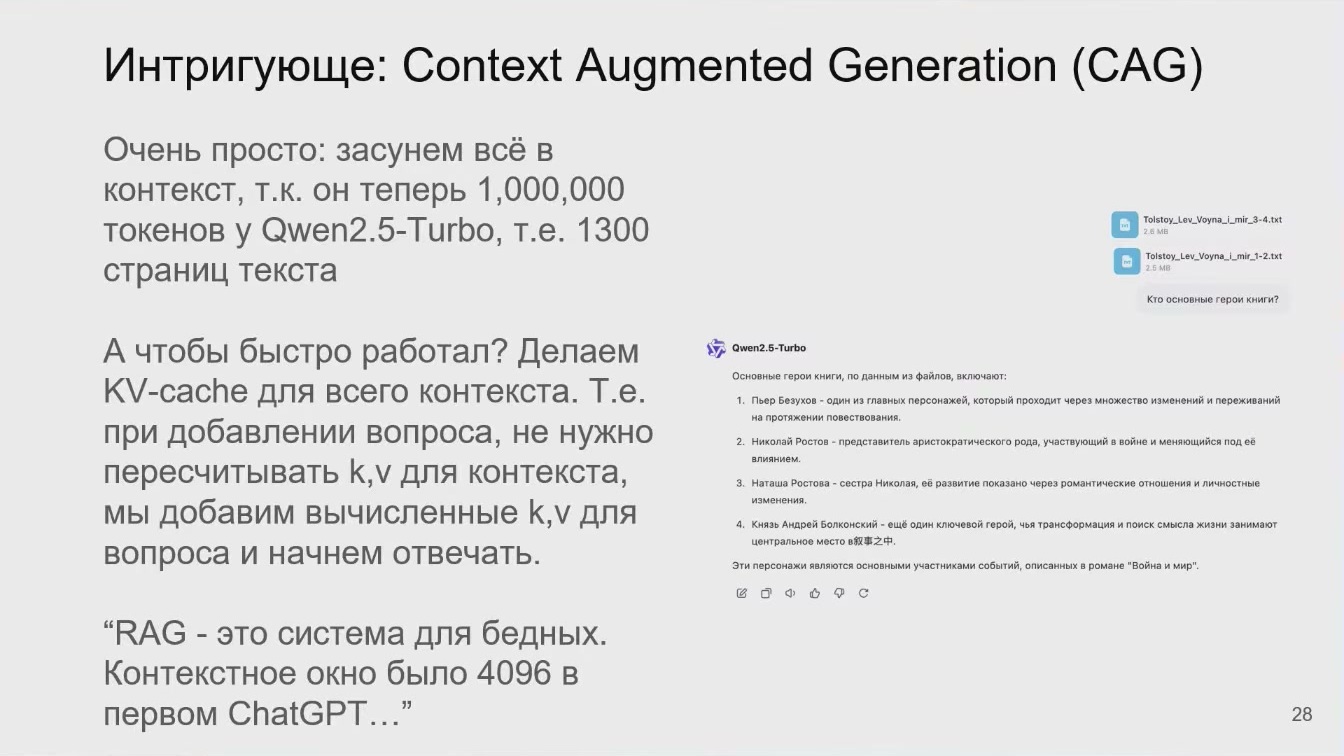
Автор рассматривает CAG: документы в контексте и переиспользование KV-кеша. Миллион токенов / 1 300 страниц — пример на слайде, не измеренный предел корпоративной wiki.
Источник: Иван Комаров, Евгений Чуканов · КоронатекНайти спрятанное число — ещё не ответить по сложной wiki
Первый внешний график показывает Passkey Retrieval Test: в длинном документе среди нерелевантного содержимого прячут число и проверяют, сможет ли модель его найти. Это описание видно в подписи к исходной диаграмме. Значит, тест проверяет конкретную способность извлечь заданный элемент, а не весь спектр понимания технической документации.
По горизонтали отложена длина контекста в токенах, по вертикали — глубина расположения искомого элемента внутри документа. Цвет обозначает Accuracy of Retrieval, то есть точность извлечения в этой постановке; шкала идёт от 0% до 100%. Верхняя карта подписана Qwen2.5-14B-Instruct-1M. Ниже отдельно показаны Qwen2.5-7B-Instruct-1M и Qwen2.5-Turbo.
На верхней карте преобладает зелёная область у верхнего края шкалы; у 7B-варианта заметна небольшая жёлтая область примерно между 700 и 800 тысячами токенов ближе к концу документа. Точное значение этой области по цвету не восстанавливается. Подпись сообщает о документах до миллиона токенов и небольших ошибках меньшей модели.
Докладчик сомневается, что такой результат достаточно сложен для проверки корпоративного помощника. Это обоснованная граница интерпретации самого примера: поиск заметного скрытого числа не проверяет, правильно ли связаны два технических условия, выбрана ли актуальная версия описания и сохранён ли смысл диаграммы. В частности, зелёная карта не означает 100% правильных ответов на вопросы сотрудников. Результаты принадлежат внешнему тесту, а не системе Коронатека.
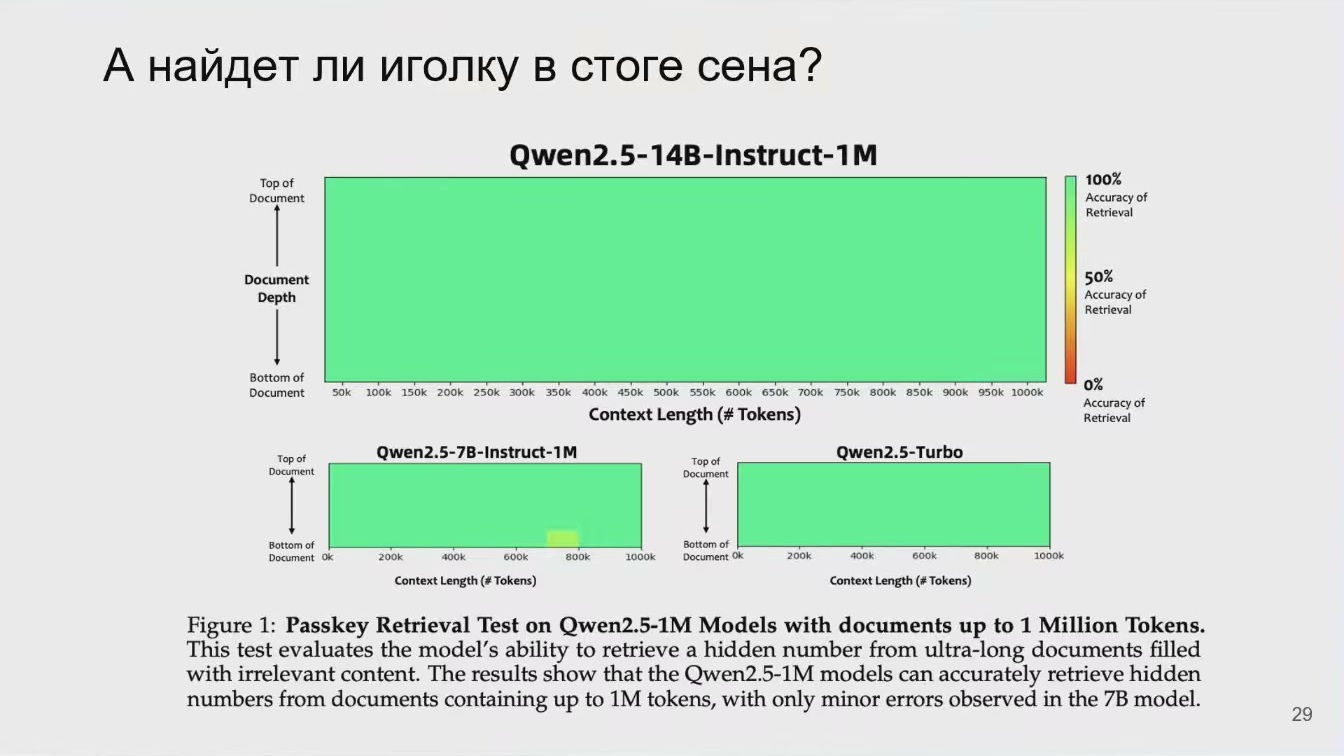
На слайде внешний Passkey Retrieval Test для Qwen2.5-1M: поиск скрытого числа. Он не доказывает качество ответа по сложной wiki.
Источник: Иван Комаров, Евгений Чуканов · КоронатекДругая проверка длинного контекста даёт другую картину
Следующая иллюстрация — снимок Context Arena с выбранной проверкой OpenAI-MRCR. Заголовок графика указывает режим 2-Needle. По горизонтали показаны диапазоны длины контекста, по вертикали — Average Score (%), средний результат теста. Это другая проверка, поэтому её числа нельзя напрямую приравнивать к точности поиска скрытого числа из предыдущего примера.
На графике результат ряда моделей ухудшается по мере роста длины входа. Рядом находится таблица с отдельными столбцами 128k (%) и 1M (%), а авторская подпись выделяет примерно 68% у Gemini 2.5 и 4,2% у qwen-turbo. В таблице верхняя показанная строка Gemini имеет более точное значение 68,1% при 1M.
Таблицу можно прокрутить по горизонтали.
Под одинаковым названием Gemini в таблице есть несколько строк, поэтому выбранное значение нельзя объявлять характеристикой всей линейки во всех режимах. У qwen-turbo сохранена подпись именно этого сравнения, без автоматического отождествления с другой показанной моделью. Подробный протокол MRCR, задания и размеры выборок в докладе не приведены.
Это снимки, представленные в докладе 2025 года, а не актуальный рейтинг моделей. Ни 68,1%, ни 4,2% не измеряют ответы по Confluence. Содержательный вывод авторов осторожнее лозунга об отмене RAG: большой контекст интересен, возможно, и как дополнительная техника поиска, но его пригодность ещё нужно проверять. Прогноз о перспективах «через год-два» относится к моменту выступления, а не к дате чтения этого разбора.
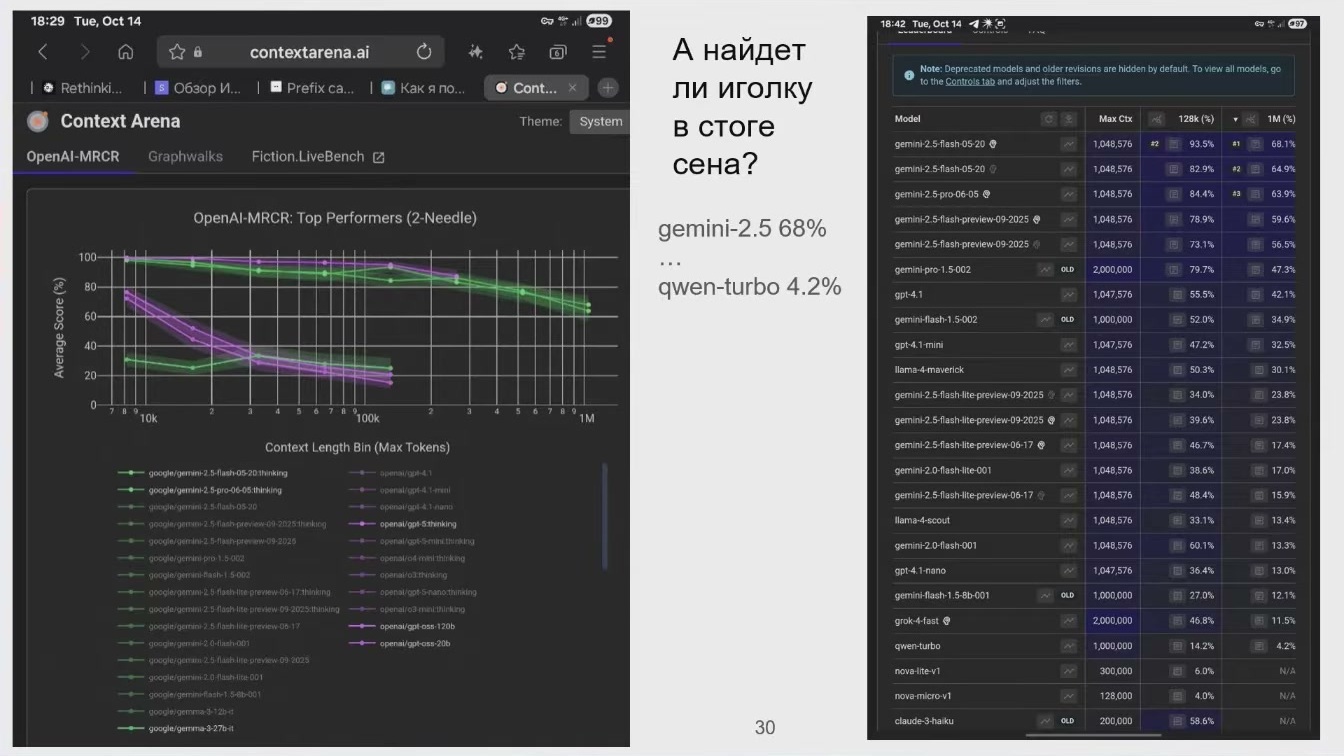
Внешний OpenAI-MRCR/ContextArena на слайде показывает ухудшение при росте контекста. Это снимок 2025 года, не результаты системы Коронатека или актуальный рейтинг.
Источник: Иван Комаров, Евгений Чуканов · КоронатекТекстовый указатель вместо поиска: пример для кодовых агентов
Для помощника по программированию можно заранее написать, где искать нужную документацию и когда её читать. Такая текстовая карта материалов называется в показанном примере llms.txt. Кодовый агент здесь — система, где языковая модель выбирает следующий шаг и обращается к инструментам; один из них загружает выбранную страницу по адресу.
Слева на иллюстрации находится пример для LangGraph. Он не просто перечисляет ссылки: рядом с руководствами по началу работы, локальному запуску, рабочим процессам и основным понятиям написано, при каких задачах нужно читать соответствующую страницу. Справа сопоставлены поиск по векторной базе, выбор адресов по llms.txt с последующей загрузкой и помещение всех документов прямо в контекст.
Таблицу можно прокрутить по горизонтали.
В показанном сравнении самые высокие столбцы относятся не к произвольному текстовому файлу, а к доработанному указателю вместе с инструментом загрузки страниц. То есть преимущество связано с конкретным способом направить модель к материалам, а не с магическим свойством имени llms.txt. Определение Score, состав заданий, версии агентов и статистическая неопределённость в докладе не раскрываются.
Авторы видят в этом возможное направление для задач программирования, но не представляют его внедрением в свою корпоративную wiki. Значения 94,9% и 79,4% не сравнимы напрямую с внутренними 90%: другие задачи, другие системы и другой показатель. Эпизод завершает обзор альтернатив вопросом о том, как лучше сообщать модели местоположение знаний, а не ответом, что один подход уже заменил все остальные.
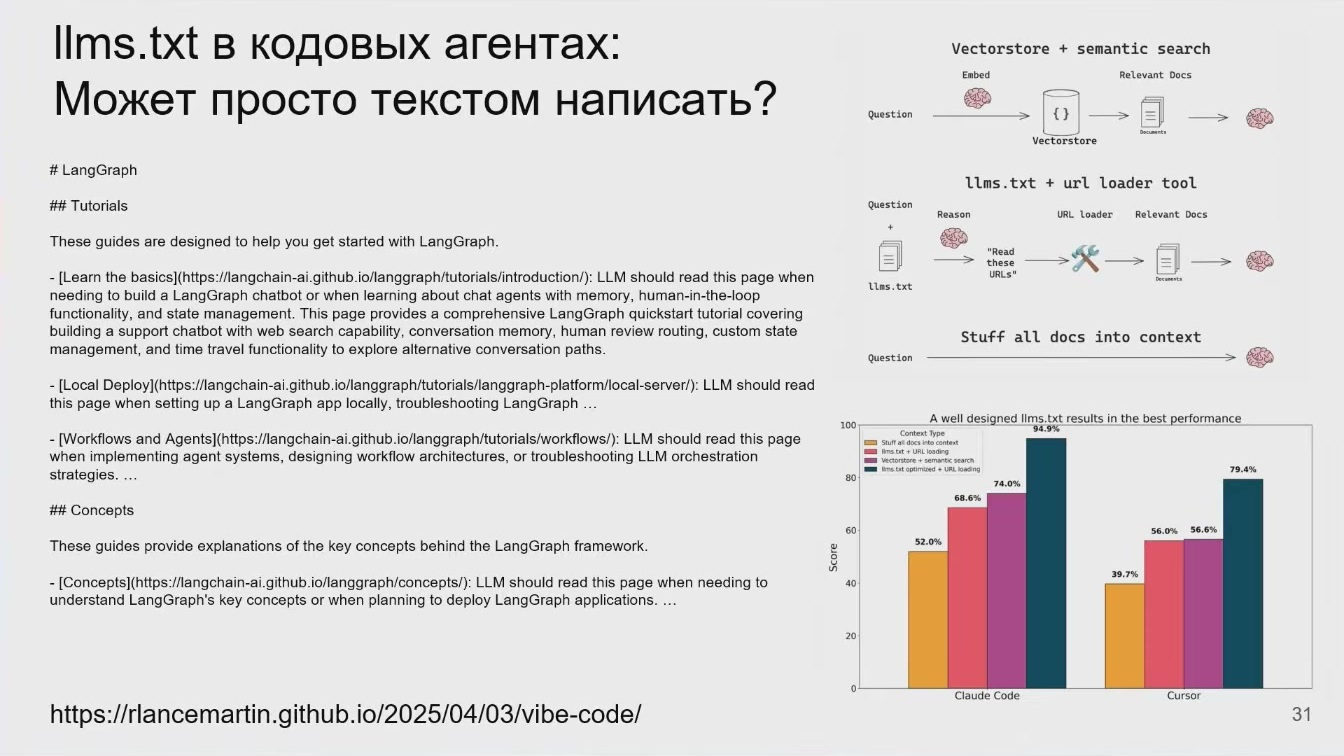
Внешний эксперимент сравнивает способы передачи документации кодовым агентам. Его результаты не измеряют качество корпоративного помощника.
Источник: Иван Комаров, Евгений Чуканов · КоронатекПочему решающей оказалась отлаженная комбинация
Основную часть авторы заканчивают мыслью, которую поддерживают и у победителя упомянутого RAG-челленджа: важны отлаженное сочетание методов, погружение в задачу и качественное извлечение содержимого. Отдельный сильный компонент не компенсирует все потери на остальных этапах.
В этом кейсе подготовка сохраняет схемы и условия, путь и контекст уточняют значение выдержек, разные поиски дополняют друг друга, а LLM-фильтр убирает лишний материал. Ссылки оставляют человеку возможность проверить ответ. Но этой логики ещё недостаточно, чтобы правильно прочитать итоговый процент и оценить полезность продукта. Именно эти два вопроса аудитория задаёт после доклада.
Доклад · 00:36:42Вопрос из зала: кто выставляет оценки при каждом новом прогоне
Первый содержательный вопрос касается способа проверки: оценки 0–2 каждый раз выставлял человек или использовалась автоматическая метрика сравнения текстов? Ответ авторов уточняет и сам показатель, и рабочий процесс. Важным было победить нули — случаи, когда система не дала нужного ответа, хотя он есть в документации. Поэтому считали их долю: сначала 25%, затем 10%.
При повторной проверке модель получает три элемента: вопрос, ответ помощника и правильный ответ, сформулированный человеком. Она должна не только предложить 0, 1 или 2, но и объяснить, почему выбрала эту оценку. Человек затем проверяет модельное решение вместе с объяснением и при необходимости исправляет его. Такой порядок уменьшает объём предварительной работы, но не устраняет ручную проверку.
Уточняющий вопрос звучит прямо: участвовал ли человек всякий раз, когда оценивали новое качество? Авторы подтверждают, что проверяли за LLM. Поэтому слайд о первоначальной ручной проверке и последующем использовании LLM-судьи нельзя пересказывать как переход к полностью автоматической приёмке. Числа 75% и 90% представлены с участием ручной валидации, а не только как самоуверенная оценка модели о себе.
На фоне обсуждения 400 вопросов упоминается примерно трёхчасовая работа, причём, по словам докладчика, LLM работала дольше человека. Границы замера не определены: из ответа нельзя уверенно выделить время генерации, оценивания и ручной проверки. Это не задержка ответа одному сотруднику и не обещание времени любого следующего полного прогона.
Сильная сторона процесса — человек видит не только итоговую метку, но и основания предложенной оценки. Ограничение — отсутствие опубликованной меры согласия оценщиков, подробных правил для пограничной единицы и независимой проверки стабильности рубрики. Авторы считают способ полезным в своей работе, но не представляют его универсальным эталоном оценки RAG.
Доклад · 00:37:39Вопрос из зала: сколько времени и денег сэкономил помощник
Второй содержательный вопрос возвращает проект к исходной задаче: сколько часов системных аналитиков, денег или хотя бы усилий удалось сэкономить? Количественного ответа у авторов нет. Они не предъявляют ни сравнения длительности задач до и после запуска, ни денежного результата. Хорошая обратная связь пилота не заменяет такого измерения.
Зато здесь наиболее ясно описан прежний способ работы. Нужная информация находилась в Confluence, но штатным поиском её было трудно отыскать. Команда воспринимает RAG прежде всего как улучшение доступа к знаниям: найти подходящий материал и сразу получить объяснение. Отдельного прежнего машинно-обученного помощника, который служил бы контрольной системой, в докладе не описано.
Генерация даёт и дополнительные сценарии. Автор приводит пример с описанием вакансии: сотрудник или HR указывает, какого специалиста, какого уровня и в какой отдел хотят нанять. Помощник использует сведения о подразделении и составляет текст. Это пример возможной пользы знания корпоративного контекста, а не самостоятельный эксперимент с измеренной эффективностью найма.
Вторая ожидаемая польза — изменение отношения к документации. Если её наконец можно найти и использовать, она перестаёт выглядеть материалом, который пишут и больше не открывают. Но для этого знания действительно должны попасть в документы. У компании много специфики, часть её остаётся в головах сотрудников, а новые люди не понимают внутренний жаргон без объяснения. Помощник не может извлечь из wiki то, чего туда никто не внёс.
Отсюда третий сценарий — помочь новичку быстрее разобраться в устройстве компании и её сокращениях. Авторы связывают это с ростом команд и необходимостью передавать знания. Они также сравнивают освоение LLM с ранним освоением компьютеров: полезные применения могут становиться понятнее по мере работы. Это позиция о перспективах технологии, не доказательство окупаемости данного внедрения.
Граница результата остаётся чёткой: пилот в трёх отделах и наблюдаемая полезность есть; измеренной экономии часов и денег нет. Трудность оценки не означает, что эффекта не существует, но не даёт права вписывать его величину вместо авторов. На этом содержательные вопросы заканчиваются; далее в записи выбирают лучший вопрос и готовят следующее выступление.
Доклад · 00:40:17Итог: от корпоративной страницы до проверяемого ответа
Команда начинала с желания сделать документацию Confluence доступной через чат, но простого соединения поиска и генератора оказалось недостаточно. Пришлось сохранять содержание схем, выделять законченные мысли, возвращать фрагментам контекст и сочетать несколько способов поиска. Неудача автоматического графа показала, что дополнительная структура полезна лишь тогда, когда её связи достаточно надёжны и поддерживаемы.
Подготовка данных выполняется отдельно: страницы переводят в текстовые представления, нарезают и снабжают полями path, text и context, затем рассчитывают поисковые векторы. Это не повторяется заново для каждого вопроса.
- 01
Понять вопрос
Модель обобщает диалог, чтобы последнее уточнение не потеряло связь с предыдущими репликами.
- 02
Найти фрагменты
Выполняются три поиска: FRIDA по пути с текстом, FRIDA по контексту и sparse-поиск по тексту.
- 03
Объединить выдачи
Reciprocal Rank Fusion сопоставляет позиции кандидатов; дальше проходят 50 результатов.
- 04
Убрать лишнее
LLM проверяет вопрос, текст, контекст и путь каждого кандидата, оставляя фрагменты с решением 1.
- 05
Составить ответ
Генератор использует отобранные материалы и корпоративные пояснения, выдаёт ответ со ссылками для проверки человеком.
На 400 вопросах команда использовала шкалу 0–2, модельную предоценку и ручной контроль. Доля ответов без нуля выросла с 75% до 90%, но сюда входят и неясные ответы с единицей. Несколько частей системы менялись одновременно, поэтому результат не доказывает отдельный эффект Qwen3-Coder-30b-8bit-Instruct.
Помощник дошёл до пилота в трёх отделах; экономию денег и часов не измерили. Частота обновления индекса, проверка прав на документы и конечное число фрагментов генератора не раскрыты. Большой контекст, внешние тесты и llms.txt остаются отдельным исследовательским обсуждением, а Backstage — планом. Достигнутый результат — полезная система с проверяемыми источниками и известными границами, не универсальное обещание безошибочного RAG.
Доклад · 00:37:04