Разбор готов
Uber Eats: как homefeed перешёл от статистических признаков к последовательностям и listwise-архитектуре
Главная лента Uber Eats должна быстро выбрать из доступных ресторанов и магазинов те, которые лучше подходят человеку именно сейчас. По мере роста каталога и числа сигналов прежней модели, основанной в основном на агрегированной статистике, стало не хватать информации о последовательности недавних действий. Uber сначала добавил к DeepCVR вторую ветвь с трансформером, который читает историю кликов и заказов с учётом конкретного магазина-кандидата. Затем команда сократила задержку признаков с дней до нескольких секунд через UserContext и единый механизм вычисления признаков для обучения и работающего сервиса. Но гибрид по-прежнему оценивал по одной паре пользователь–магазин за проход и содержал две параллельные архитектурные ветви. Следующий этап — transformer-centered модель, которая оценивает сразу список магазинов. Разбор последовательно проходит этот путь, а затем показывает, какие изменения потребовались в обучении и инфраструктуре и какие части generative recommendation Uber всё ещё описывает как направление развития, а не как завершённую замену всей системы.
Материал полезен инженерам и специалистам по рекомендательным системам, которые хотят увидеть не отдельный новый слой нейросети, а связь между качеством последовательных признаков, свежестью данных, устройством обучения и ограничениями промышленного инференса. Особенно полезен пример того, как target-aware трансформер сначала встраивается в существующий ранжировщик, а затем архитектура меняется ради более эффективной оценки нескольких кандидатов.
Статья · на английском
Next-Gen Restaurant Recommendation with Generative Modeling and Real-Time FeaturesYicheng Chen, Peng Chen, Nikat Patel, Sanjeev Suresh, Bo Ling · Опубликовано: 16 апреля 2026 г.
Homefeed как задача персонализированного выбора
Homefeed — одна из главных точек входа в Uber Eats. Пользователь открывает приложение не только с заранее выбранным рестораном: лента должна помочь обнаружить подходящий вариант среди большого числа предложений. Для магазинов и ресторанов эта же поверхность определяет, получат ли они видимость перед потенциальным покупателем.
Задача усложняется вместе с каталогом. В ленте появляются не только рестораны, но и продукты, алкоголь и розничные товары. Модель должна объединять множество сигналов — от поведения человека до географического контекста — и выдавать релевантный порядок для конкретной сессии.
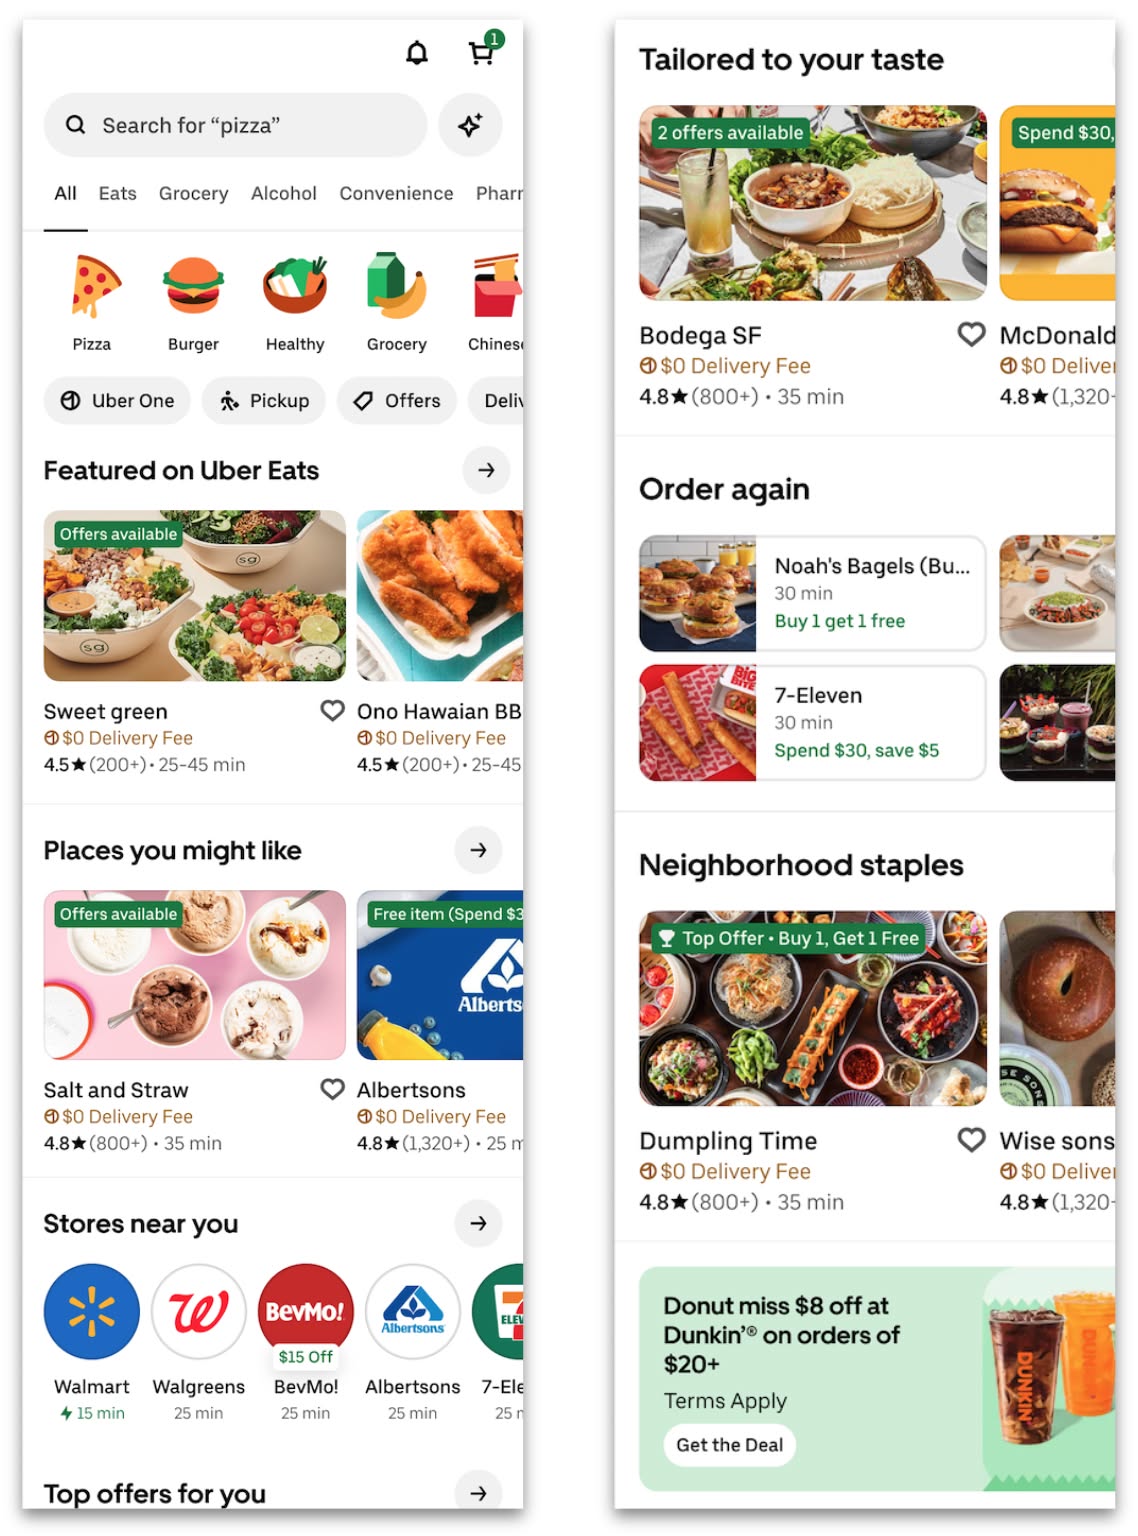
Главная лента Uber Eats показывает рестораны, магазины и предложения с учётом пользователя и контекста.
Источник: Иллюстрация из блога UberС чего начинала система: DeepCVR и агрегированные признаки
В прежней системе homefeed модель DeepCVR в основном использовала агрегированную статистику и признаки, подготовленные инженерами. Такие признаки могут хорошо описывать устойчивые свойства: например, общую историю поведения пользователя или характеристики магазина. Uber пишет, что этот подход давал рабочий базовый уровень качества.
Ограничение проявляется, когда важен порядок событий. Сводная статистика может показать, что человек часто взаимодействовал с некоторой категорией, но хуже отвечает на вопрос, что происходило несколько действий назад и изменился ли интерес прямо в текущей сессии. Именно этот хронологический контекст стал причиной добавления последовательной модели.
From Statistics-Based Features to User Behavioral Sequence Features; фрагмент про aggregate statistics and hand-crafted featuresДве ветви: DCNv2 сохраняет статистику, трансформер читает историю
Первый крупный шаг не был полной заменой DeepCVR. Uber построил гибрид из двух путей. Ветвь на базе DCNv2 продолжила обрабатывать разреженные категориальные признаки и плотные числовые статистики — то есть информацию, для которой табличная рекомендательная модель уже подходила.
Параллельно появилась последовательная ветвь. В неё передаётся хронологический журнал действий пользователя, среди которых источник прямо называет клики и заказы. Несколько голов self-attention позволяют позициям истории взаимодействовать друг с другом и дают модели возможность учитывать временные зависимости, а не только итоговые счётчики.
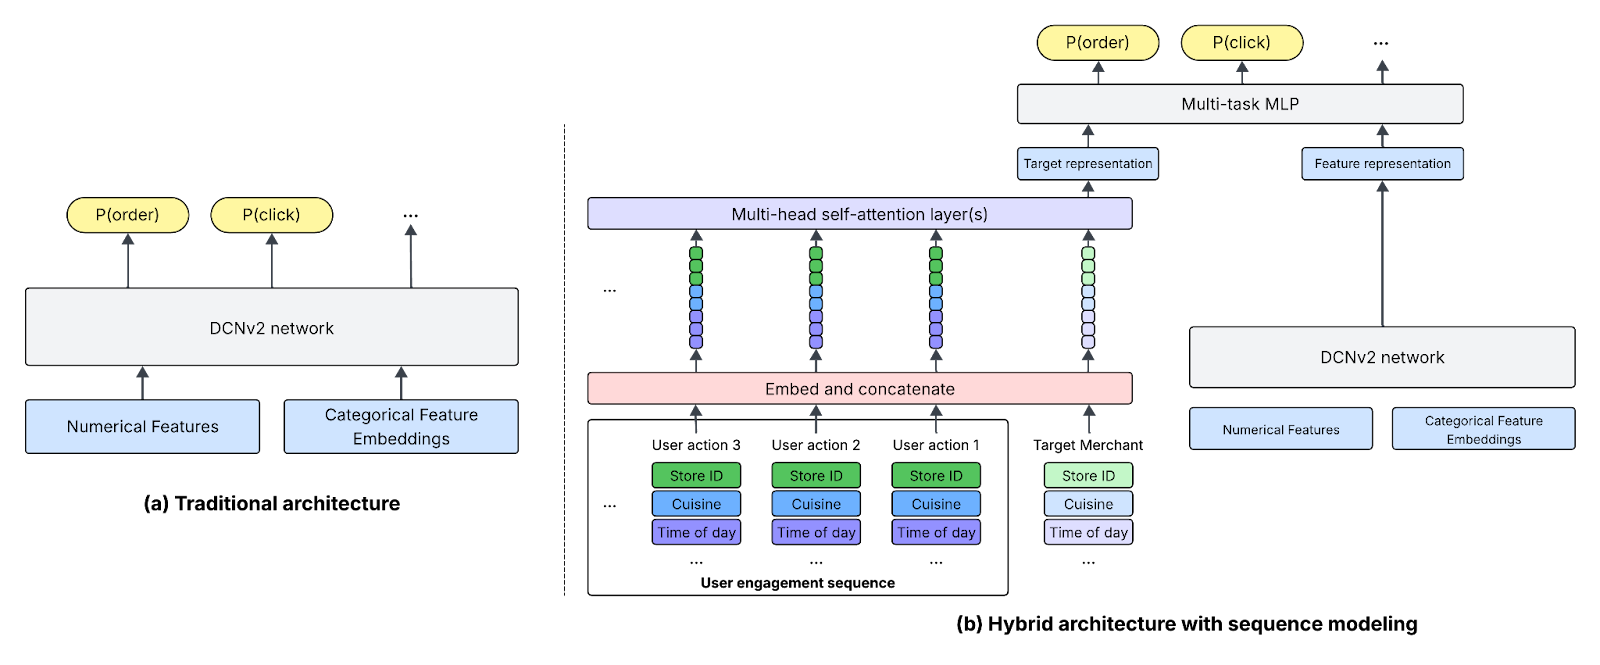
Гибрид сохраняет ветку DCNv2 для обычных признаков и добавляет обработку последовательности действий трансформером.
Источник: Иллюстрация из блога UberИстория читается относительно конкретного магазина
Последовательность в этой модели не кодируется один раз независимо от того, что сейчас нужно оценить. Uber использует target-aware подход: к истории добавляется целевой магазин, для которого вычисляется оценка.
Интуитивно это позволяет модели задавать более конкретный вопрос: какие из прошлых действий важны именно при сравнении пользователя с этим магазином? Один и тот же эпизод истории может иметь разную ценность для разных кандидатов. Авторы связывают этот принцип с идеями DIN и BST.
Target-Aware Sequence Modeling; фрагмент append the target store to the sequenceКак последовательная ветвь встраивается обратно в DeepCVR
На выходе трансформер формирует плотное векторное представление истории пользователя относительно текущего магазина. Этот вектор не используется как самостоятельный окончательный ранжировщик: его присоединяют к остальным признакам основной DeepCVR.
Поэтому корректнее говорить о расширении существующей системы последовательными признаками. Традиционная ветвь и трансформер работают параллельно, а затем их информация объединяется. Такая архитектура позволяет постепенно добавить моделирование поведения, не выбрасывая сразу уже накопленные табличные признаки.
Integration and Scaling; фрагмент про dense sequence embedding и append to the feature vector of the main DeepCVR modelПочему хорошей модели недостаточно, если признаки устарели
Следующее ограничение находилось уже не внутри нейросети. Раньше значительная часть признаков рассчитывалась пакетными офлайн-задачами. Между действием пользователя и появлением обновлённого признака могло пройти 24 часа или больше.
Для homefeed это особенно неприятно: человек может несколько минут назад искать или заказывать определённую еду, а модель всё ещё видеть состояние вчерашнего дня. Последовательная архитектура имеет ограниченную пользу, если входная история сама приходит слишком поздно.
From Batch-Processed to Near-Real-Time Features; фрагмент про 24-hour or longer lagUserContext: история действий с задержкой в секунды
Uber использовал внутреннюю Next Personalization Platform. Её компонент UserContext хранит event-sourced историю: вместо одного заранее материализованного снимка система сохраняет последовательность событий, из которой можно получить актуальный контекст пользователя.
После этого признаки можно вычислять практически по текущей истории, а не ждать следующего большого пакетного пересчёта. По словам авторов, задержка данных сократилась с дней до нескольких секунд. Благодаря этому действия из текущей сессии успевают повлиять на последующие рекомендации.
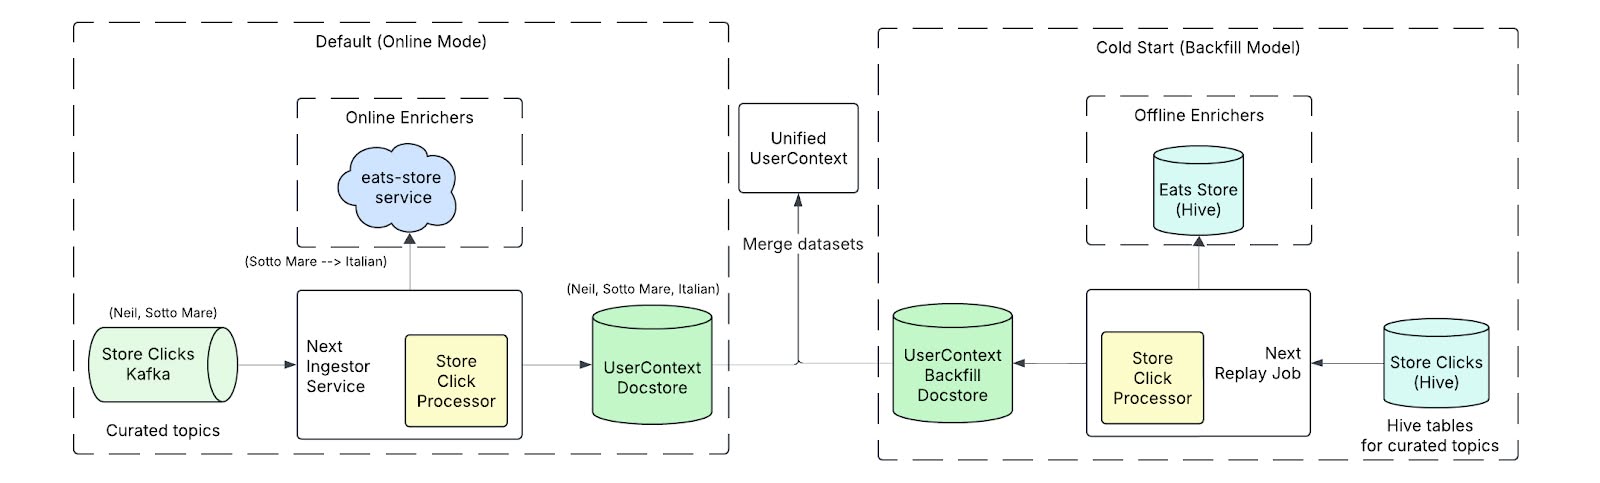
Свежие события приходят из Kafka в онлайн-хранилище UserContext; отдельный путь восстанавливает историю при холодном старте.
Источник: Иллюстрация из блога UberОдинаковые признаки в обучении и в работающем сервисе
Свежесть создаёт новую инженерную проблему: нельзя допустить, чтобы при обучении признак вычислялся одним способом, а в работающем сервисе — другим. Для этого Uber описывает FeatureExtractors — чистые Java-функции, которые онлайн вызывает Feature Store.
При подготовке обучающих данных Spark восстанавливает UserContext в том виде, каким он был в исторический момент соответствующего запроса, и запускает те же FeatureExtractors. Такой исторический пересчёт, или backfill, позволяет получить признаки так, как если бы модель действительно обслуживала пользователя в тот момент, и уменьшает training-serving skew.
Одной общей реализации недостаточно: Uber также выборочно логирует вычисленные онлайн-признаки и сравнивает их с повторным офлайн-расчётом. Это даёт постоянную проверку того, что два контура не начали расходиться после изменений.
абзац про FeatureExtractors, online Feature Store, Apache Spark reconstruction at past inference timestamps и sampled feature loggingЧто даёт свежесть и чего источник не измеряет
Авторы подчёркивают, что переход к секундам особенно важен для пользователей с холодным стартом, у которых накоплено мало долгосрочной истории. В такой ситуации несколько свежих действий составляют большую долю всей доступной информации и могут быстрее показать текущий интерес.
При этом статья не приводит отдельной численной метрики улучшения cold start. Из источника можно утверждать сокращение задержки признаков и возможность учитывать недавние действия, но нельзя выводить из этого конкретный прирост CTR, CVR или числа заказов.
абзац We have now reduced the data lag from days to a few seconds; фрагмент про cold-start usersПочему гибрид всё ещё оказался промежуточным решением
Гибрид лучше использует историю, но сохраняет два системных ограничения. Во-первых, он остаётся pointwise: один проход модели вычисляет оценку одной пары пользователь–магазин. Если нужно оценить много кандидатов, работа повторяется для каждого магазина.
Во-вторых, внутри остаются две отдельные ветви: традиционная DLRM/DCNv2 и последовательный трансформер. Это означает дополнительную сложность архитектуры и ограничивает возможность превратить последовательную модель в общую основу всей системы.
From a Discriminative Model to a Generative Model; фрагмент про single user:store pair и dual-path systemTransformer-centered архитектура: следующая стадия эволюции
Следующее направление — убрать параллельную DCNv2-ветвь и сделать трансформер основной вычислительной частью модели. Обычные, не последовательные признаки при этом не исчезают. Их преобразуют и добавляют к признакам целевого токена до входа в трансформер.
Figure-18 следует читать как архитектуру направления развития к transformer-centered GenRec. Статья описывает этот переход как новую архитектуру и основу дальнейшего движения, но не сообщает, какая доля трафика уже переведена на неё и заменён ли ею весь homefeed. Поэтому схема не доказывает полный production rollout во всех регионах и поверхностях.
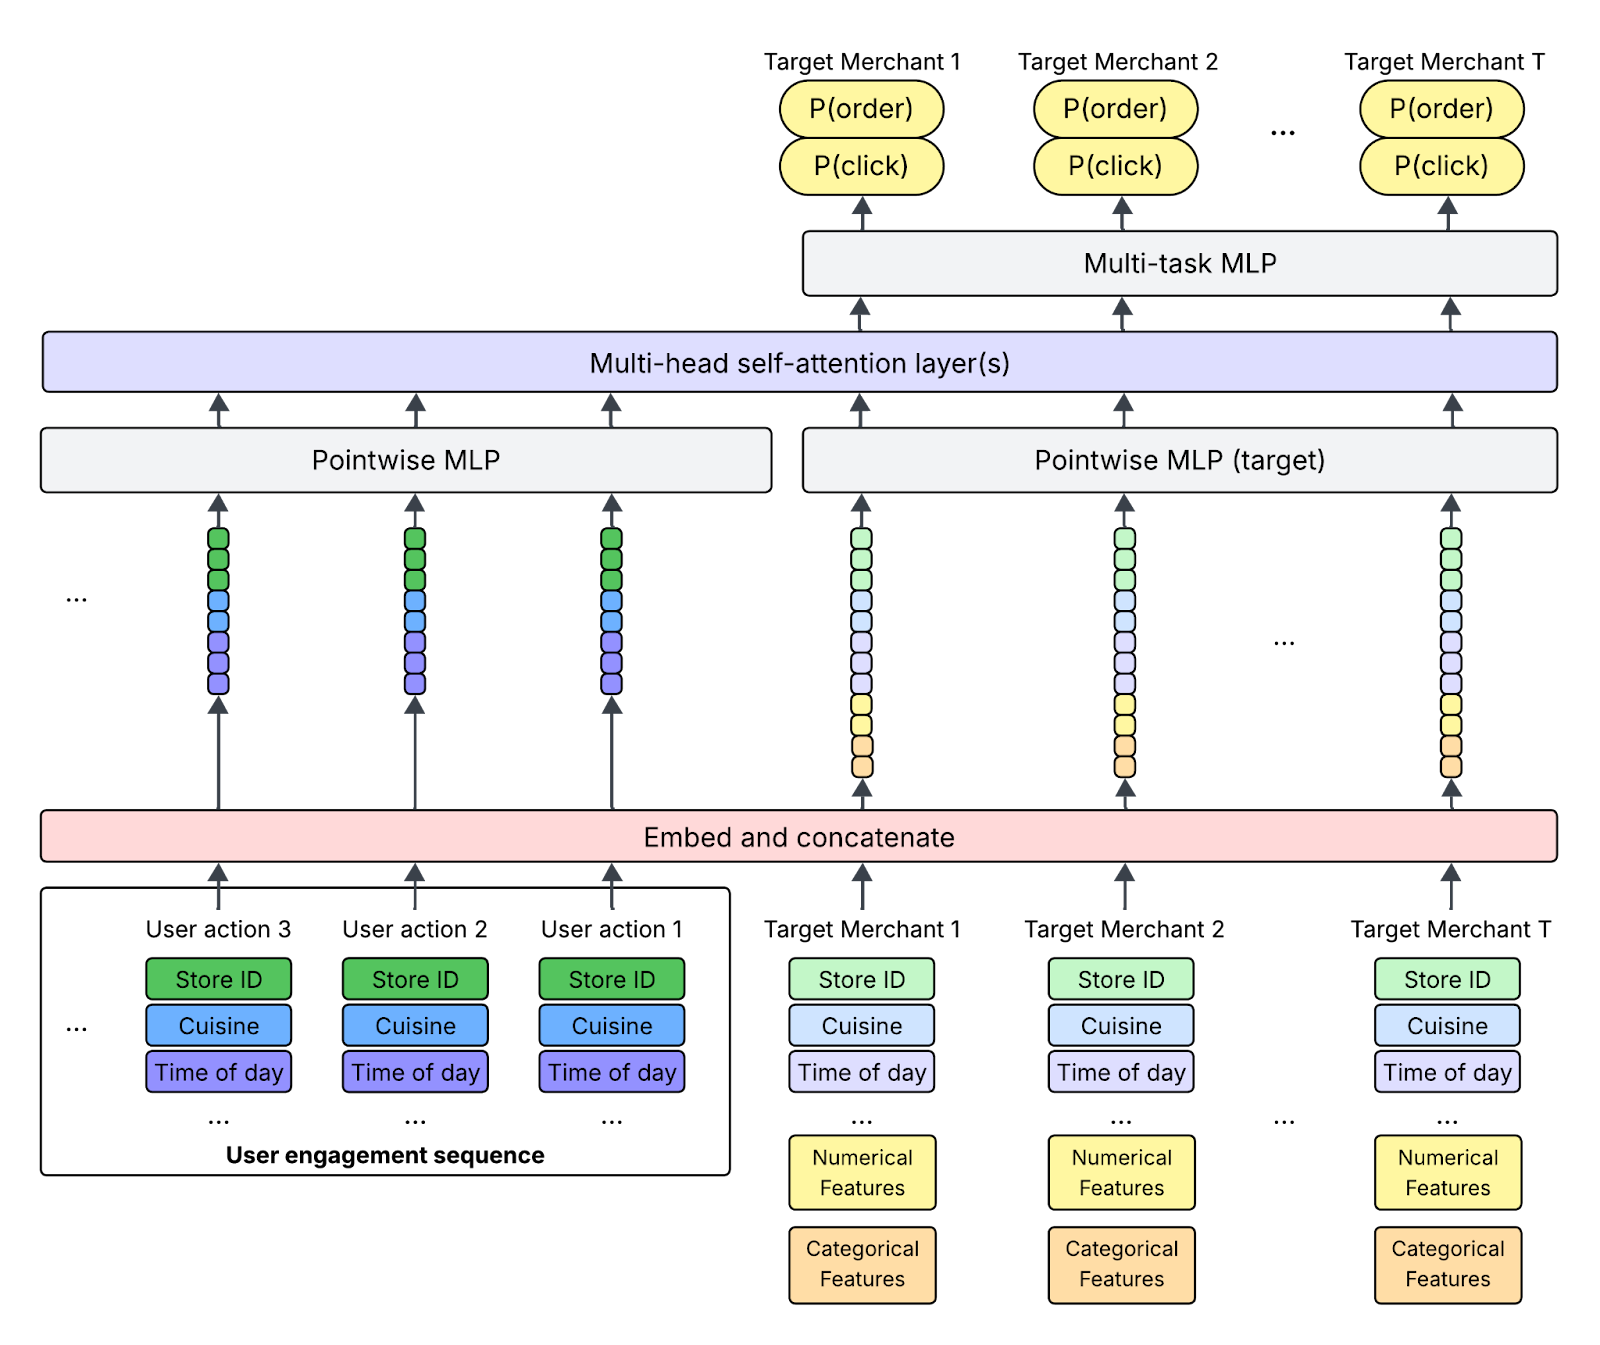
Схема следующего этапа: кандидаты и контекст обрабатываются совместно; статья не даёт точного охвата продакшен-трафика.
Источник: Иллюстрация из блога UberОт одной пары к оценке списка за один проход
Главное вычислительное изменение — переход от pointwise к listwise scoring. Вместо одного магазина модель получает массив кандидатов одной сессии и вычисляет оценки для всего списка в одном forward pass.
Авторы оценивают сложность на один магазин примерно как 1/T от прежней схемы, где T — число одновременно оцениваемых target stores. Это не означает, что end-to-end задержка автоматически уменьшается ровно в T раз: речь идёт о сложности на один кандидат внутри описанной модели.
Важно и другое ограничение интерпретации: здесь listwise GenRec не описан как автогрессивная генерация идентификаторов ресторанов. Входом остаётся набор candidate stores, а модель выдаёт их оценки. Источник не даёт оснований добавлять semantic IDs, генерацию ID или decoder, которых в статье нет.
From Pointwise to Listwise Parallelism; фрагмент про array of candidate stores и complexity per store roughly 1/TЧто пришлось изменить в обучении
Для более сложных последовательных моделей Uber перешёл с Keras/TensorFlow на PyTorch v2. Авторы объясняют это большей гибкостью для новых архитектур.
Дополнительно команда внедрила multi-hash embeddings и обучение в смешанной точности BF16. Для первого изменения источник сообщает о существенном улучшении пропускной способности, для BF16 — о дополнительном заметном ускорении. Точных процентов нет.
Общий смысл оптимизаций — позволить увеличивать модели, сохраняя время обучения сопоставимым с предыдущей базовой системой. Источник не раскрывает размер моделей, число GPU, длительность одного обучения или точный выигрыш каждого изменения.
ML System Optimization → Training EfficiencyONNX и TensorRT: тяжёлую подготовку убрали из запуска сервиса
Раньше оптимизированное представление модели создавалось на лету. Конвертация ONNX в TensorRT во время запуска могла занимать 10–60 секунд и одновременно конкурировать с рабочими задачами за GPU.
Uber перенёс эту операцию в отдельный офлайн-конвейер: ONNX-to-TensorRT выполняется заранее, а готовый артефакт упаковывается с учётом оборудования, на котором будет запускаться. Авторы сообщают, что таким способом cold-start latency удалось приблизить к нулю и сделать поведение запуска более воспроизводимым на разных GPU.
Эти 10–60 секунд относятся именно к стартовой конвертации модели. Их нельзя трактовать как прежнюю задержку выдачи одной рекомендации пользователю.
ML System Optimization → Reliable ServingCPU готовит признаки, GPU занимается моделью
Ещё один предел производительности возник из-за смешивания разнородной работы. Подготовка признаков сильно нагружает CPU, тогда как основная нейросетевая математика должна эффективно занимать GPU. Если обе части тесно связаны внутри одного ресурса, дорогой ускоритель может простаивать в ожидании подготовки входа.
Uber разделил эти задачи: preprocessing выполняется на выделенных CPU-ресурсах, а GPU сосредоточены на высокоскоростном инференсе модели. По данным авторов, такая топология дала до двузначного улучшения throughput на узел при минимальной дополнительной задержке.
Точный процент, QPS и аппаратная конфигурация в статье не приведены. Поэтому корректно сохранять формулировку up to double digit throughput improvement, а не превращать её в конкретные 10%, 20% или двукратное ускорение.
ML System Optimization → CPU/GPU Disaggregation InfrastructureЧто описано как внедрённое, а где охват остаётся неопределённым
Такое разделение важно, потому что заключение статьи говорит о переходе к listwise GenRec, а разделы выше одновременно используют формулировки про движение к fully GenRec paradigm. Без дополнительных данных нельзя превращать это в утверждение, что один конкретный GenRec уже обслуживает весь Uber Eats.
сопоставление From Statistics-Based Features..., Near-Real-Time Features, ML System Optimization, From a Discriminative Model... и Next StepsТри задачи, которые Uber оставляет открытыми
Первая задача — более длинная история. Текущая система хорошо использует ближайший и недавний контекст через последовательности средней длины, но привычки формируются месяцами и годами. Uber хочет перейти к account life sequence learning, чтобы различать временное желание и устойчивое предпочтение.
Вторая задача — персонализировать не только отдельные магазины, но всю двумерную страницу. Homefeed состоит из каруселей и блоков, поэтому локально лучший порядок внутри одного списка не обязательно создаёт лучший общий экран. Future direction — совместно учитывать расположение, разнообразие и визуальный поток всей страницы.
Третья задача связана с физическим миром и несколькими целями одновременно. Рекомендация ресторана обязана учитывать радиус доставки и местоположение. Кроме того, системе нужно сочетать привычное повторение любимых мест с открытием новых. В статье это обозначено как продолжающаяся инженерная работа, а не как окончательно решённая часть GenRec.
Next Steps; Account life sequence learning, 2-D whole page personalization, Integrating generative recommenders with real-world constraintsКакие результаты можно переносить в выводы, а какие данные отсутствуют
В статье нет численных CVR, CTR, GMV, числа заказов, retention, результатов A/B-теста, размера выборки или доверительных интервалов. Нет также точного T, размера трансформера, длины последовательности, функции потерь, negative sampling или полного списка событий. Без этих данных нельзя численно оценить влияние системы на бизнес или восстановить полный рецепт обучения модели.
From Batch-Processed to Near-Real-Time Features; From Pointwise to Listwise Parallelism; ML System OptimizationИтог: путь от вчерашней статистики к свежей последовательной модели
История Uber Eats начинается не с попытки сразу построить полностью генеративную рекомендательную систему, а с конкретного ограничения DeepCVR. Агрегированные признаки хорошо сохраняли устойчивую информацию, но плохо передавали порядок недавних действий. Поэтому Uber добавил target-aware трансформер, который рассматривает историю относительно магазина, оцениваемого прямо сейчас. Затем стало ясно, что последовательная модель мало помогает, если сами признаки приходят на сутки позже. UserContext перенёс их в near-real-time режим, а общий FeatureExtractor для online и исторического Spark-пересчёта помог сохранить одинаковую логику обучения и работающего сервиса.
- 01
Актуальный контекст
Сервис получает историю действий пользователя из UserContext и другие признаки, доступные на момент запроса.
- 02
Признаки кандидата
Для оцениваемого магазина формируются его признаки и контекст пары пользователь–магазин.
- 03
Последовательная обработка
Target-aware трансформер связывает магазин с релевантными событиями пользовательской истории.
- 04
Оценка кандидатов
В работающей гибридной версии представление истории объединяется с признаками DCNv2, после чего модель оценивает конкретную пару пользователь–магазин.
- 05
Ранжирование homefeed
Полученные оценки используются для выбора порядка доступных магазинов в ленте.
Инфраструктуру пришлось менять вместе с моделью: PyTorch v2, BF16 и multi-hash embeddings ускоряют обучение; ONNX-to-TensorRT теперь выполняется заранее, что убрало прежние 10–60 секунд стартовой конвертации; раздельные CPU и GPU дали до двузначного прироста throughput на узел. При этом источник не сообщает CVR, CTR или GMV uplift и не раскрывает полный охват transformer-centered GenRec. Длинная история аккаунта, двумерная персонализация страницы и совмещение рекомендаций с физическими ограничениями доставки остаются следующими задачами.
Conclusion вместе с ключевыми результатами разделов Hybrid Approach, Near-Real-Time Features, Listwise Parallelism и ML System Optimization