Разбор готов
Ozon: от товара к предложению — как учитывать цену и доставку в истории ранжирования
В поиске маркетплейса один и тот же товар может сегодня стоить 10 000 ₽ и ехать неделю, а завтра — стоить 5 000 ₽ и приезжать на следующий день. В старой схеме Ozon цена и срок доставки уже были признаками ранжирования, но основная поведенческая история — показы, клики, корзины и заказы — продолжала копиться на уровне item_id, то есть смешивала разные состояния товара. Из-за этого выдача могла недооценивать скидку, ускорившуюся доставку или новую карточку: старые действия покупателей перевешивали текущие условия. Команда изменила единицу накопления статистики: ввела offer_id для конкретного сочетания товара, ценового сегмента и сегмента доставки, а затем матрицу W для аккуратного переноса истории между состояниями и аналогами. Ниже разберём исходные агрегаты, почему отдельные признаки цены и доставки не решали проблему, правила бинов, перенос статистики, два сценария холодного старта, ежедневный Spark-конвейер и то, как автор разделяет локальные метрики новинок и глобальные результаты A/B-тестов.
Материал полезен инженерам машинного обучения и поиска, которые работают с ранжированием, поведенческими агрегатами и холодным стартом. На примере Ozon хорошо видно, что качество может ограничивать не только модель, но и то, к какой сущности привязана история: если контекст меняется быстрее, чем накапливаются события, отдельная отдельный признак не всегда исправляет устаревшие агрегаты.
Статья · на русском
От товара к предложению: как Ozon учитывает цену и доставку в ранжированииСтанислав Ким · Опубликовано: 28 февраля 2026 г.
Почему выгодное предложение могло оставаться далеко в выдаче
Автор начинает с нового робота-пылесоса: продавец ставит цену примерно на 20% ниже конкурентов и обеспечивает доставку «завтра», но товар всё равно остаётся глубоко в поиске. Причина не в том, что система не знает цену или срок доставки. У новой карточки нет накопленной истории продаж, кликов и других действий, тогда как у более дорогих конкурентов такая история уже есть.
Из этого команда формулирует смену объекта ранжирования: смотреть не только на товар как на постоянную карточку с прошлым, а на конкретное предложение в текущих условиях. Это важно для скидок, ускорения логистики и новых товаров, где сегодняшнее состояние может сильно отличаться от того, на котором накоплена история.
Оригинальная обложка статьи Ozon.
Источник: Иллюстрация из статьи Ozon TechКак другим компаниям помогали новым товарам без истории
Новый товар ещё не накопил просмотров, кликов и заказов — это и есть холодный старт. Автор сравнивает несколько индустриальных решений. Amazon ещё в 2016 году выделяла холодный старт как проблему поиска, а в работе Treating Cold Start in Product Search by Priors 2020 года предлагала оценивать начальные поведенческие сигналы по атрибутам товара. Для Alibaba автор приводит AliBoost и сообщает, что этот подход помогает новым товарам получать начальную видимость. Для eBay описан более прямой механизм: новый листинг временно получает дополнительную видимость на короткое время.
Ozon, по словам автора, тоже использует атрибутивные сигналы и рекламные механизмы. Но в этой работе команда идёт в другую сторону: не только компенсирует нехватку данных для новой карточки, а меняет сущность, на которой хранится поведенческая статистика.
Раздел «Не только наша проблема: cold start в индустрии»; строки 25–38, включая Amazon, AliBoost, eBay и фрагмент «Нужно изменить сам объект, на котором живёт статистика».Старая схема: вся история живёт на item_id
Исторически в поиске Ozon показы, клики, добавления в корзину и заказы агрегировались по item_id — уникальному идентификатору товара, который автор приравнивает к SKU. Цена и срок доставки существовали отдельно как признаки модели, но не входили в ключ, по которому собиралась история.
Пример в статье — популярные кроссовки. Полгода они стоили 10 000 ₽ и продавались вяло, поэтому система накопила слабые поведенческие сигналы. Затем продавец снижает цену до 5 000 ₽. Значение цены в признаках обновляется сразу, но исторические агрегаты по тому же item_id продолжают в основном описывать старое, дорогое состояние.
Автор выделяет три следствия: скидка слишком медленно отражается в накопленной статистике; новинка с нулём заказов проигрывает старому товару с большой историей; быстрая и медленная доставка одного товара смешиваются в одном наборе агрегатов. Общая причина одна — история привязана к товару вообще, а не к его актуальному состоянию.
Раздел «Исторический контекст: жизнь на одном item_id» и «Три системные боли»; строки 39–53.От событий к признакам: товарные и query-item агрегаты
Исходными данными служат первичные события: показ, клик, добавление в избранное, добавление в корзину и заказ. Модель не получает последовательность всех отдельных событий напрямую. Из них заранее считаются агрегаты за скользящие окна — например, сколько кликов объект набрал за последние N дней.
Статья различает два независимых семейства признаков. Товарные агрегаты собирают поведение по товару целиком и отвечают на вопрос о его общей популярности. Парные агрегаты «запрос + товар» собирают действия для конкретного поискового запроса и конкретного товара и описывают, насколько именно этот товар подходит этому запросу.
Из абсолютных счётчиков можно получить производные метрики. Пример автора — CTR как отношение кликов к показам. Поэтому ошибка на уровне ключа агрегации распространяется дальше: если в исходных показах и кликах смешаны разные условия продажи, производный CTR тоже становится усреднением разных состояний.
Раздел «На что опирается поиск: от первичных событий к фичам модели»; строки 54–61.Почему цена и доставка как отдельные признаки не исправляли историю
Ключевой аргумент статьи состоит не в том, что ранжирование раньше игнорировало цену. Наоборот, цена и срок доставки уже были признаками модели. Проблема возникала потому, что сильные исторические признаки продолжали считаться по item_id и тем самым объединяли периоды высокой и низкой цены, быстрой и медленной доставки.
В результате модель могла одновременно видеть актуальную цену 5 000 ₽ и исторический CTR, большую часть которого товар заработал при цене 10 000 ₽. То же касается парных признаков: конверсия по запросу «кроссовки недорого» не должна смешивать поведение товара в разных ценовых сегментах. Поэтому команда меняет не только набор признаков, а уровень их агрегации.
Продолжение раздела «На что опирается поиск», фрагменты «CTR — это функция от первичных счётчиков» и «недостаточно просто добавить цену и доставку как отдельные фичи»; строки 61–66.offer_id: идентификатор текущего состояния предложения
Если item_id отвечает на вопрос «что продаём?», offer_id должен различать, «как продаём это прямо сейчас». Для каждого товара команда определяет ценовой сегмент price_bin и сегмент скорости доставки delivery_bin, а затем объединяет item_id, price_bin и delivery_bin в новый идентификатор.
Когда цена или доставка переводят товар в другой бин, меняется и offer_id. Одни и те же кроссовки за 10 000 ₽ и за 5 000 ₽ остаются одним товаром, но для поведенческой статистики становятся двумя разными предложениями. Так старое состояние больше не обязано полностью определять оценку нового.
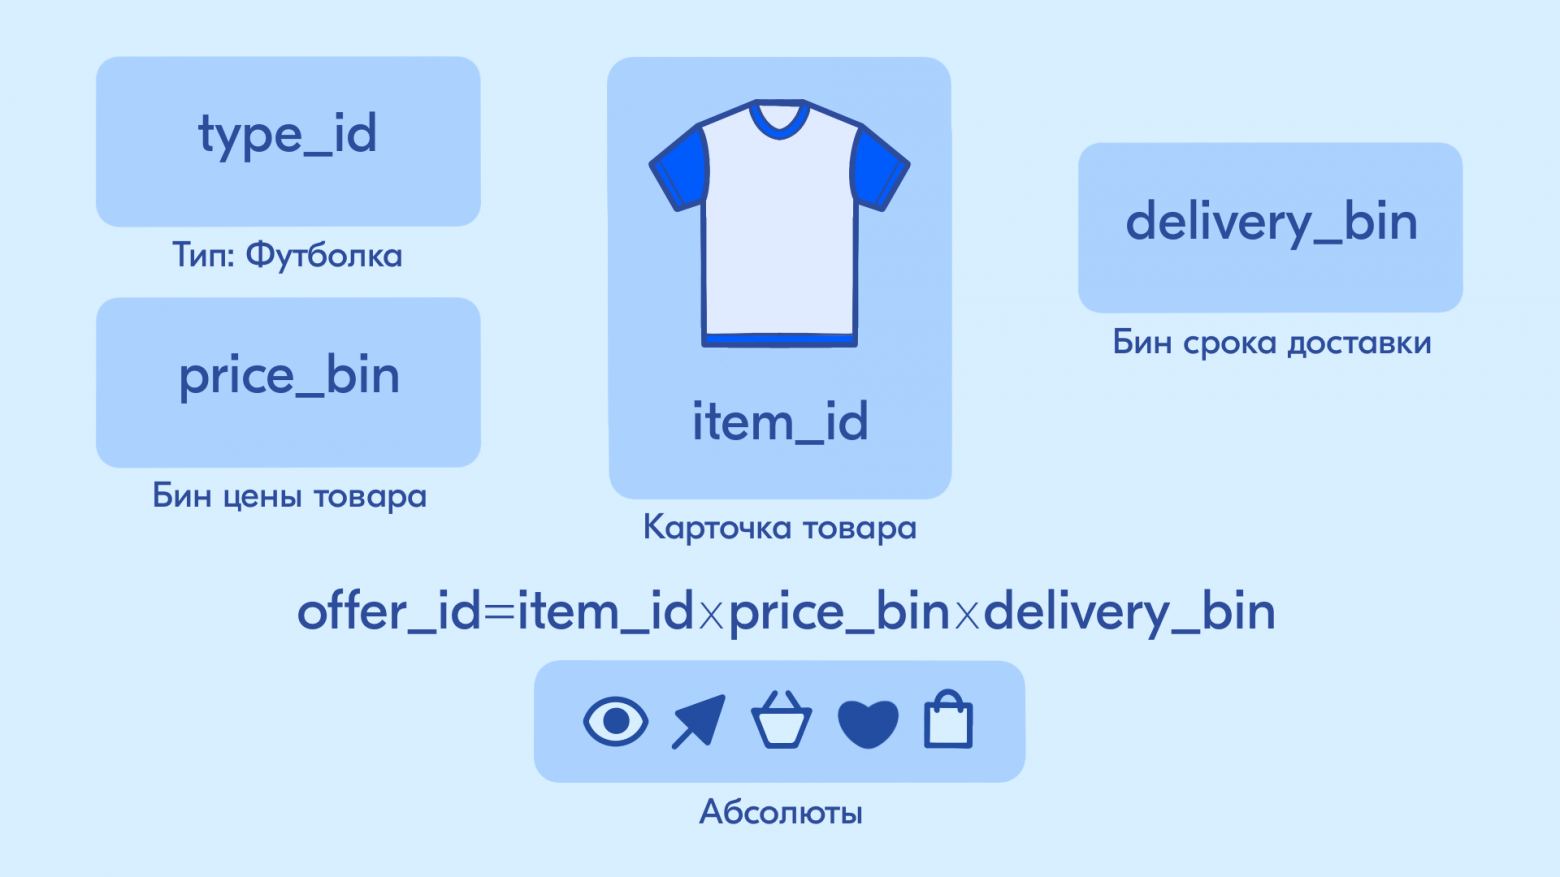
Ozon определяет предложение через товар, ценовой сегмент и срок доставки.
Источник: Иллюстрация из статьи Ozon TechКак строятся price_bin и delivery_bin
Ценовые границы считаются отдельно для каждого типа товара. Команда берёт товары этого типа за 28 дней, вычисляет девять децильных порогов и получает десять сегментов. price_bin = 0 соответствует самым дешёвым 10% внутри типа, price_bin = 9 — самым дорогим.
Для срока доставки используется та же идея: delivery_bin принимает значения от 0 до 9, где 0 — самые быстрые предложения внутри типа, а 9 — самые медленные. В статье не раскрывается более детальная географическая или пользовательская схема расчёта срока доставки, поэтому её не стоит достраивать.
Комбинация 10 ценовых и 10 логистических сегментов даёт теоретически 100 состояний одного товара. На практике, по словам автора, у большинства товаров за жизненный цикл активны только 2–5 состояний.
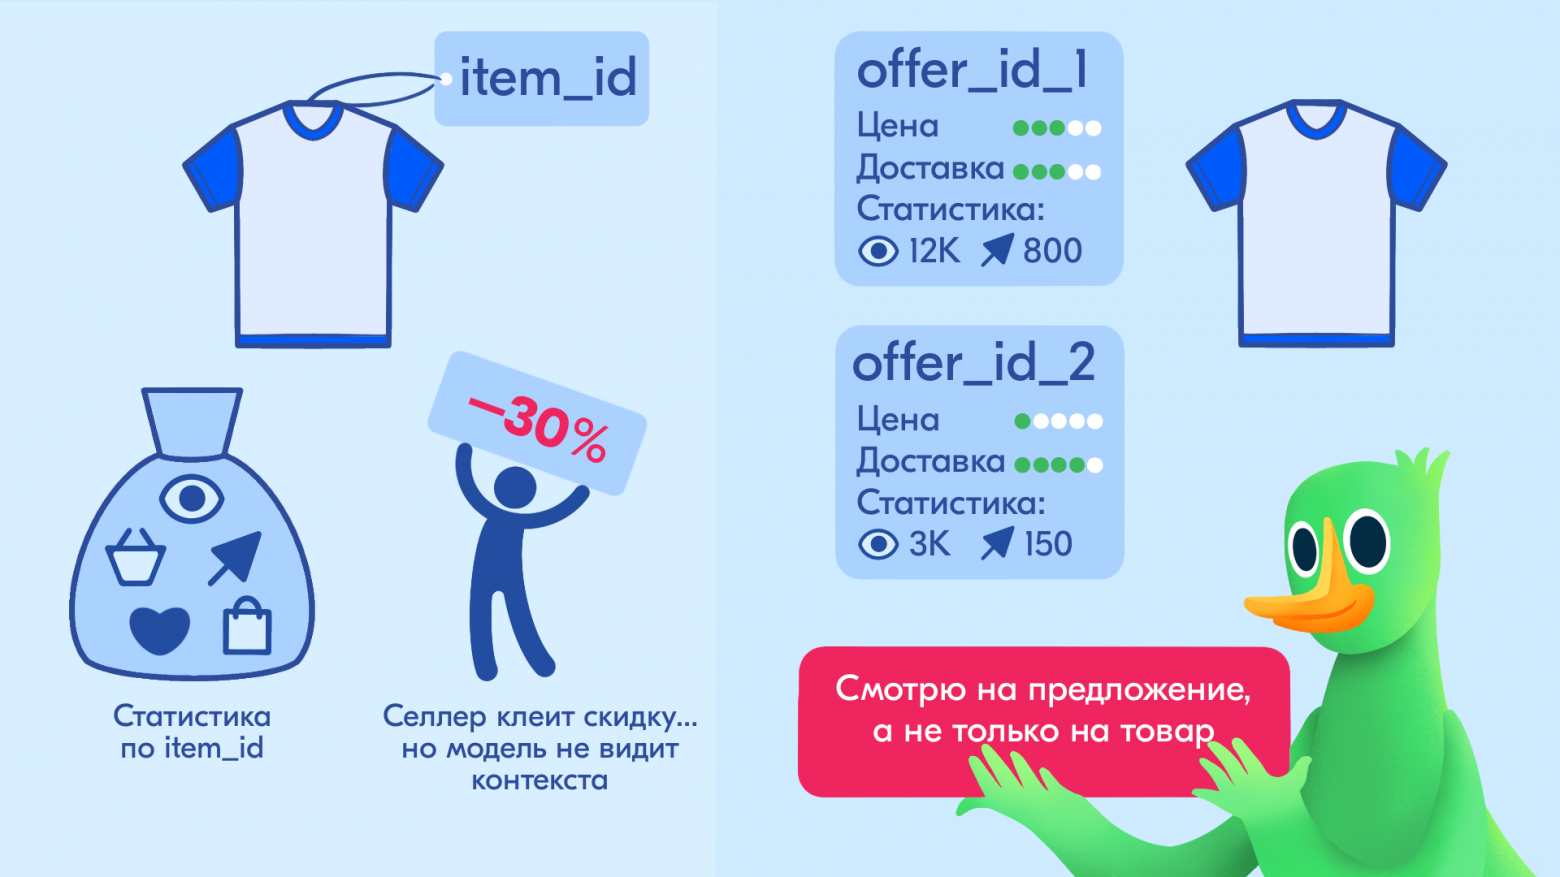
После изменения цены или доставки история больше не смешивается без учёта условий предложения.
Источник: Иллюстрация из статьи Ozon TechМатрица W: как переносить историю, не обнуляя её и не копируя целиком
Смена offer_id создаёт новую проблему. Полностью обнулить историю — значит снова получить холодный старт. Перенести 100% старых агрегатов — значит оставить прежний шлейф и фактически отменить разделение состояний. Поэтому команда вводит матрицу близости W размером 100 × 100: для перехода из одного сочетания price_bin и delivery_bin в другое она задаёт, какую долю прошлой статистики считать релевантной.
Автор объясняет веса на примерах. Сдвиг примерно на один ценовой бин после небольшого изменения цены может сохранить около 90% статистики. Скачок на три бина — около 30%. Переход из самого дорогого сегмента 9 в самый дешёвый 0 получает вес, близкий к нулю. Это иллюстративные значения из текста, а не опубликованная полная таблица коэффициентов.
Переносятся пять видов агрегатов: просмотры, клики, добавления в избранное, добавления в корзину и заказы. После взвешенного суммирования значения могут стать дробными — например, 3,7 клика или 0,4 заказа. Автор прямо допускает такие величины как признаки модели.
W получают эмпирически, анализируя, как изменения цены и доставки связаны с поведением пользователей; коэффициенты затухания названы настраиваемыми. В описанной системе матрица единая. Статья не раскрывает функцию оптимизации, датасет для подбора W или точную процедуру обновления, поэтому эти детали нельзя восстанавливать по общим знаниям.
Раздел «Идея 2. Матрица W — шеринг истории между состояниями»; строки 98–119, включая примеры близких, дальних и чужих состояний и описание пяти метрик.Cold start 1: тот же продукт у нового продавца
Матрица W используется не только между состояниями одного товара. В Ozon есть механизм матчинга, который может определить, что карточки разных продавцов соответствуют одному и тому же продукту. Такие карточки объединяются в группу, и история может переноситься между предложениями внутри неё.
Таблицу можно прокрутить по горизонтали.
В старой схеме продавец В начинал бы с пустых собственных агрегатов. В новой матрица W позволяет взять взвешенную статистику продавцов А и Б из той же группы и соседних состояний. Это не делает их историю идентичной истории новичка: перенос ограничивается весами, зависящими от близости состояний.
Автор отдельно предупреждает, что матчинг одинакового продукта — только один из способов формировать группы аналогов. Другие механизмы в этой статье не раскрываются.
Раздел «Для новинок — киллер-фича» и «Сценарий 1: одинаковый товар от разных продавцов»; строки 120–142.Cold start 2: принципиально новый товар без точного дубля
Второй случай сложнее: появляется новая модель робота-пылесоса, которой нет у других продавцов, поэтому точный матч не найден. Собственной истории тоже нет.
Тогда автор предлагает опираться на соседей по категории. В категории «Робот-пылесос» уже есть товары в близких ценовых бинах и с похожими сроками доставки. W переносит новинке не всю их историю, а взвешенную часть, релевантную текущему состоянию. Так исходные агрегаты отражают ожидания пользователей от товаров похожей цены и доставки, а не остаются нулевыми.
При этом статья не описывает алгоритм выбора таких соседей, размер группы аналогов или способ распределения веса между несколькими товарами. Из источника можно утверждать только сам принцип переноса.
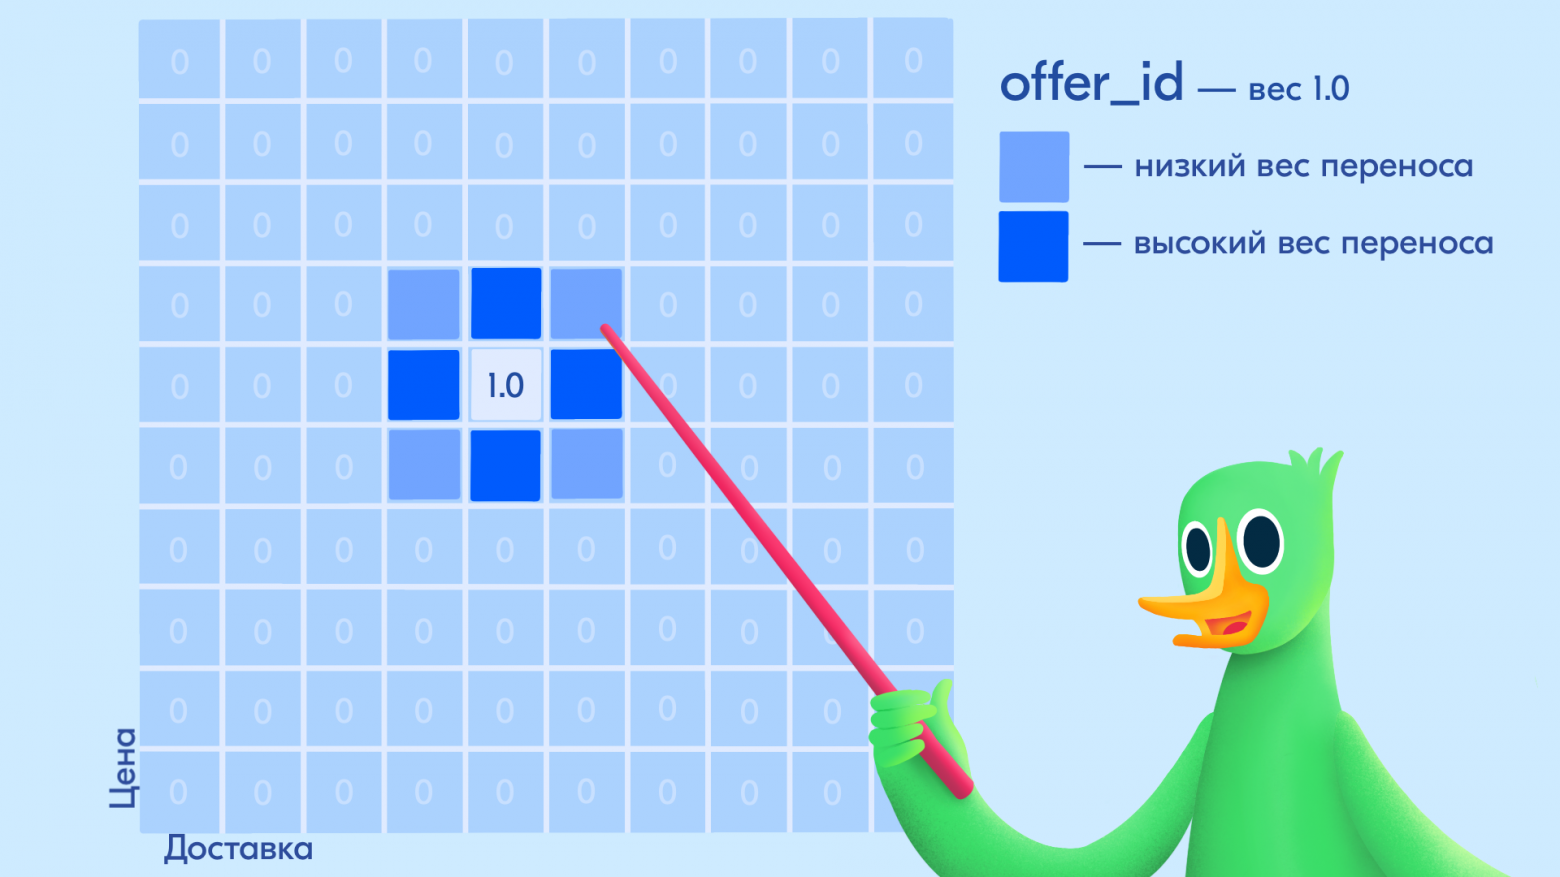
Чем ближе старое и новое состояния, тем больше исторического сигнала переносится.
Источник: Иллюстрация из статьи Ozon TechSpark Init: полный пересчёт примерно раз в 28 дней
Вся механика встроена в ежедневный Spark-конвейер. Тяжёлый режим Init запускается примерно раз в 28 дней. Он заново считает децильные пороги цен и сроков доставки по каждому типу товара на скользящем 28-дневном окне, обновляет границы бинов, полностью пересчитывает offer_id и поведенческую статистику.
В тот же цикл подхватываются новые товары, в том числе ещё не имеющие собственной истории, — через статистику аналогов. После Init у системы появляется новая согласованная система координат для всего ассортимента.
Раздел «Жизненный цикл offer_id: Init и Update» и подраздел «Init-дни: большая стирка раз в 28 дней»; строки 147–160.Spark Update и сглаживание: свежесть без ежедневных скачков
В остальные дни работает более лёгкий Update: система учитывает товары, появившиеся за сутки, обновляет статистику активных offer_id и инкрементально добавляет свежие поведенческие события. Init периодически меняет сами границы системы координат, а Update поддерживает статистику между такими пересчётами.
Но пересчёт децилей может сдвигать товар между соседними бинами даже из-за небольшого рыночного шума. Чтобы предложение не меняло состояние при каждом таком колебании, автор описывает сглаживание: если расчёт предлагает сдвиг всего на один бин, товар остаётся на месте; если сдвиг составляет два бина или больше, за один цикл товар перемещается только на один шаг.
Так система реагирует на устойчивые изменения цены и доставки постепенно, а не переносит статистику между состояниями из-за каждого небольшого движения границы.
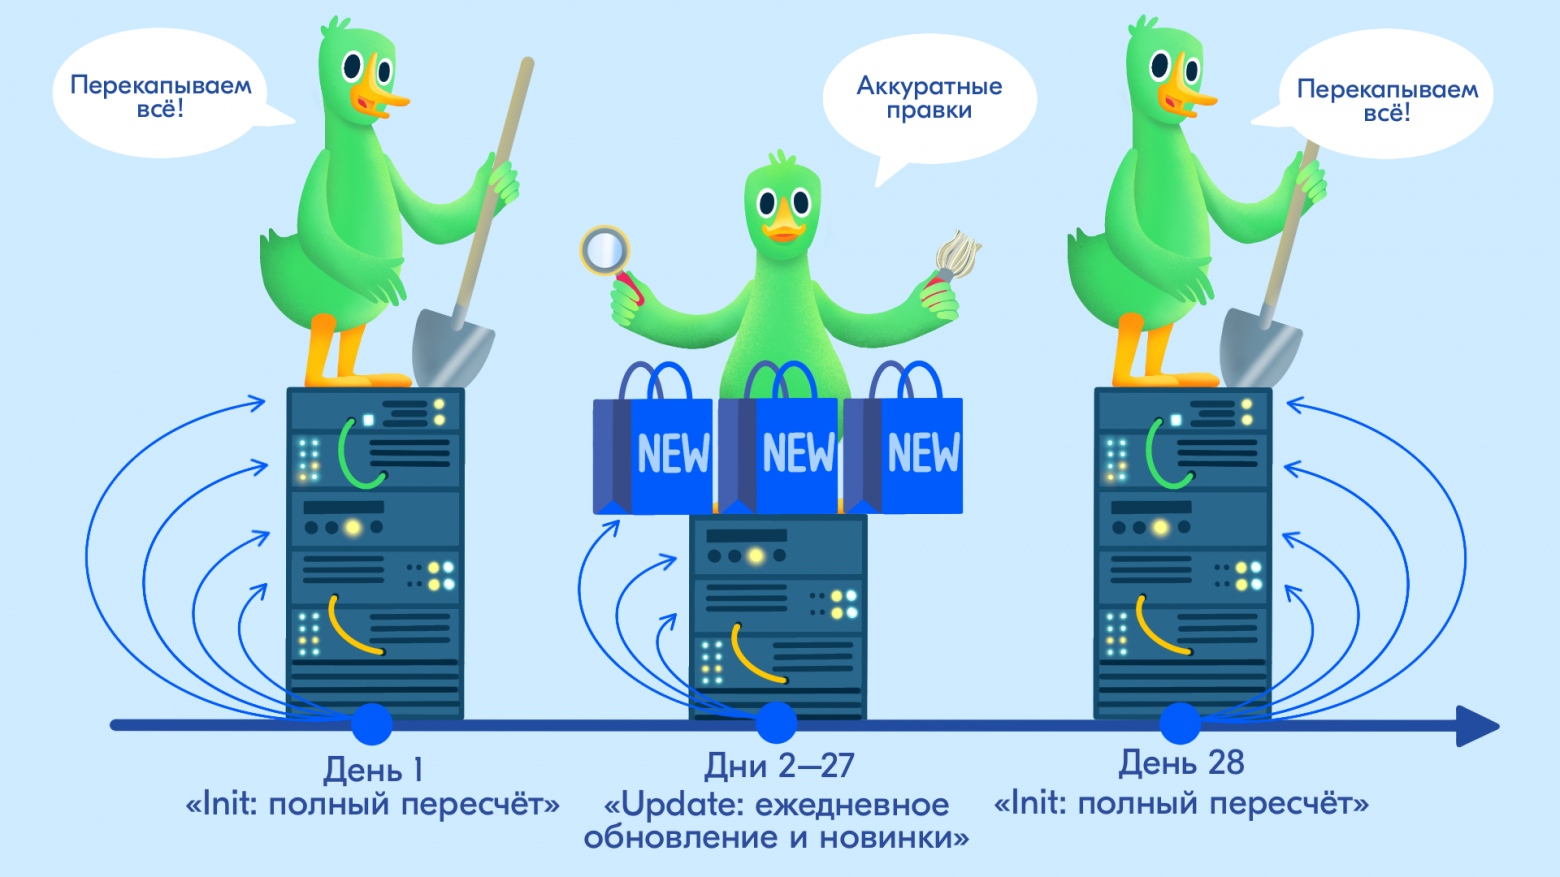
Пороговые значения периодически пересчитываются полностью, а между этими пересчётами статистика обновляется ежедневно.
Источник: Иллюстрация из статьи Ozon TechЧто именно меняется для ранжирования — и чего статья не раскрывает
После перехода к offer_id модель получает поведенческие признаки, рассчитанные для более конкретного состояния предложения, а не только для item_id. Именно это позволяет отдельно описывать историю товара при разных ценах и доставке и переносить релевантную часть старых событий через W.
При этом источник не называет класс ранжирующей модели, функцию потерь, схему её обучения, полный набор остальных признаков или устройство онлайн-сервиса. Поэтому корректный вывод из статьи архитектурный: команда изменила уровень агрегации статистики и способ переноса истории. Приписывать решению конкретный CatBoost, нейросеть или отдельный новый learning-to-rank алгоритм нельзя.
Раздел «На что опирается поиск...»; строки 55–66, и финальный инженерный вывод «не нужно изобретать новый сложный алгоритм... правильно выбрать уровень агрегации»; строки 220–225.Как отдельно проверяли новинки
Перед A/B-тестированием команда провела отдельный ретроспективный анализ. В выборку попали товары, которые находились в индексе менее двух недель. Затем среди них оставили только объекты, у которых уже была хотя бы какая-то активность — просмотры, клики или заказы — и для этой группы посчитали baseline старой системы.
Для товаров, добавленных в последнюю неделю, автор говорит о ещё более сильном эффекте по прохождению до корзины и заказа, но точные числа не приводит. Среднее время до первого взаимодействия практически не изменилось. Автор интерпретирует это как большее число валидных возможностей быть увиденными, а не как искусственное безусловное поднятие каждой новинки в топ.
Важно не расширять этот результат на абсолютно нулевой cold start: сама ретроспективная выборка требовала хотя бы одного вида активности. Механика W умеет задавать стартовую историю товару без собственных событий, но отдельной численной оценки именно для полностью нулевых объектов статья не даёт.
Раздел «Новинки против старожилов: как offer_id решил проблему холодного старта», подразделы «Что мы замерили до запуска» и «Что стало после внедрения»; строки 178–194.Отдельная группа метрик: доля новинок в активности маркетплейса
Это другой уровень измерения, чем рост заказов или просмотров внутри группы новых товаров. В источнике значения записаны со знаком процента; он не называет их процентными пунктами. Здесь сохранена исходная запись без предположения о том, относительное ли это изменение или изменение в процентных пунктах.
Продолжение раздела о новинках, фрагмент «Параллельно с этим выросла доля новинок в общих метриках маркетплейса»; строки 195–201.Глобальные метрики: два последовательных A/B-теста
Эти показатели нельзя смешивать с ретроспективной выборкой новинок и с ростом доли новинок в общих действиях. Статья не сообщает длительность тестов, размер выборки и статистическую неопределённость результата. Она также не раскрывает, чем различались два последовательных эксперимента. Поэтому известно лишь направление и размер опубликованных изменений, а судить об устойчивости эффекта по статье нельзя.
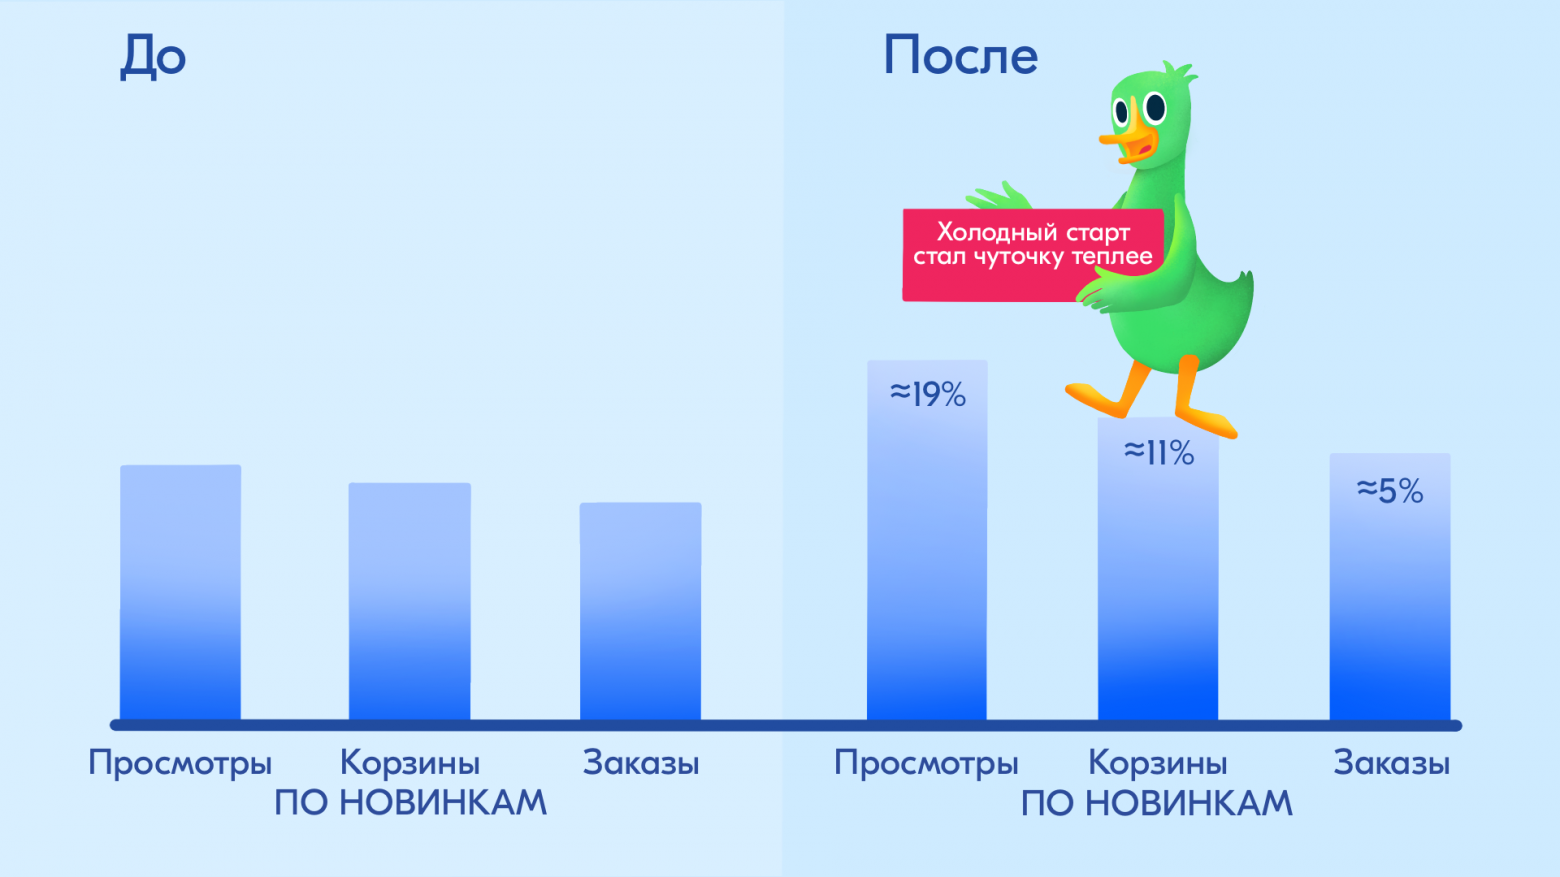
В статье показаны изменения активности новых товаров после включения признаков на основе offer_id; условия сравнения описаны в тексте.
Источник: Иллюстрация из статьи Ozon TechИтог: история должна соответствовать текущему предложению
Путь Ozon начинается не с новой архитектуры ранжирующей модели, а с проверки того, что именно описывает накопленная история. При старом item_id показы, клики, корзины и заказы разных ценовых и логистических состояний смешивались, поэтому актуальная цена могла конфликтовать с сильным историческим сигналом. offer_id разделил один товар на состояния по price_bin и delivery_bin, а матрица W позволила переносить между ними только релевантную часть прошлого. Та же логика дала стартовый сигнал новому продавцу знакомого продукта и новой модели через аналоги.
- 01
1. Собрать события
Показы, клики, избранное, корзины и заказы поступают в статистику.
- 02
2. Обновить систему бинов
Init примерно раз в 28 дней пересчитывает границы цены и доставки; ежедневный Update добавляет новые товары и события.
- 03
3. Определить offer_id
Состояние задаётся item_id, price_bin и delivery_bin; сглаживание отсекает мелкие переходы.
- 04
4. Перенести релевантную историю
W взвешивает историю прежних состояний и, при холодном старте, аналогов.
- 05
5. Сформировать признаки для ранжирования
Товарные и query-item агрегаты описывают конкретный контекст предложения.
Оценка разбита на уровни. Для товаров моложе двух недель, у которых уже была активность, после включения offer_id автор сообщает +5% к заказам, +11% к добавлениям в корзину и +19% к просмотрам. Отдельно выросла доля новинок: +3,6% для заказов, +4,9% для корзин и +4,4% для просмотров. На уровне бизнеса два последовательных A/B-теста дали +0,4% к конверсии из поисковой сессии в заказ и +0,9% к среднему GMV на пользователя. Статья не раскрывает архитектуру ранжировщика, детали построения W, выбор аналогов, размер и длительность экспериментов, статистическую значимость и стоимость Spark-пересчётов. Поэтому главный вывод — правильно выбрать единицу истории и аккуратно переносить сигнал между меняющимися состояниями.
Итоговые разделы «Новинки против старожилов...» и «Итоги для бизнеса, селлеров и планы на будущее»; строки 178–225.