Разбор готов
Авито: трансформерная персонализация в двухбашенной рекомендательной модели
На главной Авито нужно быстро подобрать объявления из огромного каталога под текущий интерес конкретного покупателя. В прежней системе за это отвечали несколько источников кандидатов, ранжирующая модель и правила финальной выдачи, а пользовательский вектор user2vec строился как взвешенная сумма векторов уже просмотренных объявлений. Такой подход был быстрым, но плохо выражал нелинейные связи между интересами, не учитывал порядок действий явно и вообще не использовал поисковые запросы. В разборе проследим, как команда перешла к двухбашенной модели, где отдельная башня кодирует объявления, а трансформер строит представление пользователя по истории объявлений и поисков; как устроены признаки, обучающие примеры, отрицательные объекты, функция потерь, масштаб обучения и работа модели в продукте; и какие эффекты авторы получили в двух сценариях применения.
Материал полезен специалистам по данным, ML-инженерам и MLOps и продакт-менеджерам, которые работают с рекомендациями на большом каталоге. Здесь можно увидеть полный путь от ограничений простого пользовательского вектора до обучения двухбашенной модели и её подключения одновременно к отбору кандидатов и к ранжированию.
Статья · на русском
Как мы улучшили рекомендации для пользователей Авито с помощью трансформенной персонализацииАлександр Михеев · Опубликовано: 27 февраля 2026 г.
Откуда начинали: кандидаты, ранжирование и user2vec
Предыдущая версия рекомендаций была каскадом из трёх этапов. Сначала специализированные модели быстро отбирали объявления-кандидаты. Затем рекомендательная ранжирующая модель упорядочивала их по релевантности, используя оценки источников кандидатов и кликовые признаки — например, популярность объявления и интерес пользователя к категории. После этого правила итоговой выдачи смешивали категории: для каждого места в ленте категория случайно выбиралась с весом, зависящим от предсказанного интереса пользователя, а внутри выбранной категории ставилось самое релевантное по оценке ранжировщика объявление.
Среди основных нейросетевых источников были item2vec и user2vec. item2vec строила векторные представления объявлений: объекты, с которыми человек взаимодействовал в одной сессии, получали близкие векторы, поэтому система могла находить похожие объявления. user2vec представляла пользователя взвешенной суммой векторов объявлений из истории; вес старых действий уменьшался со временем. Это решение работало быстро, но фактически сводило интерес к линейной комбинации уже увиденных объектов.
Новая основа: две башни и трансформер для истории
Новая модель должна была сохранить быстрый поиск кандидатов, но лучше описывать пользователя. Для этого команда выбрала двухбашенную архитектуру: одна модель превращает параметры объявления в векторное представление, или эмбеддинг, а вторая строит эмбеддинг пользователя по последовательности его действий. В пользовательской башне применяется трансформер — модель, которая связывает элементы последовательности между собой и поэтому может учитывать контекст и порядок событий.
Эмбеддинги объявлений можно вычислять отдельно и складывать в быстрое хранилище, тогда как пользовательское представление строится по актуальной истории. Релевантность пары определяется скалярным произведением — суммой попарных произведений координат двух векторов. Чем больше значение, тем ближе пользователь и объявление в выученном пространстве модели.
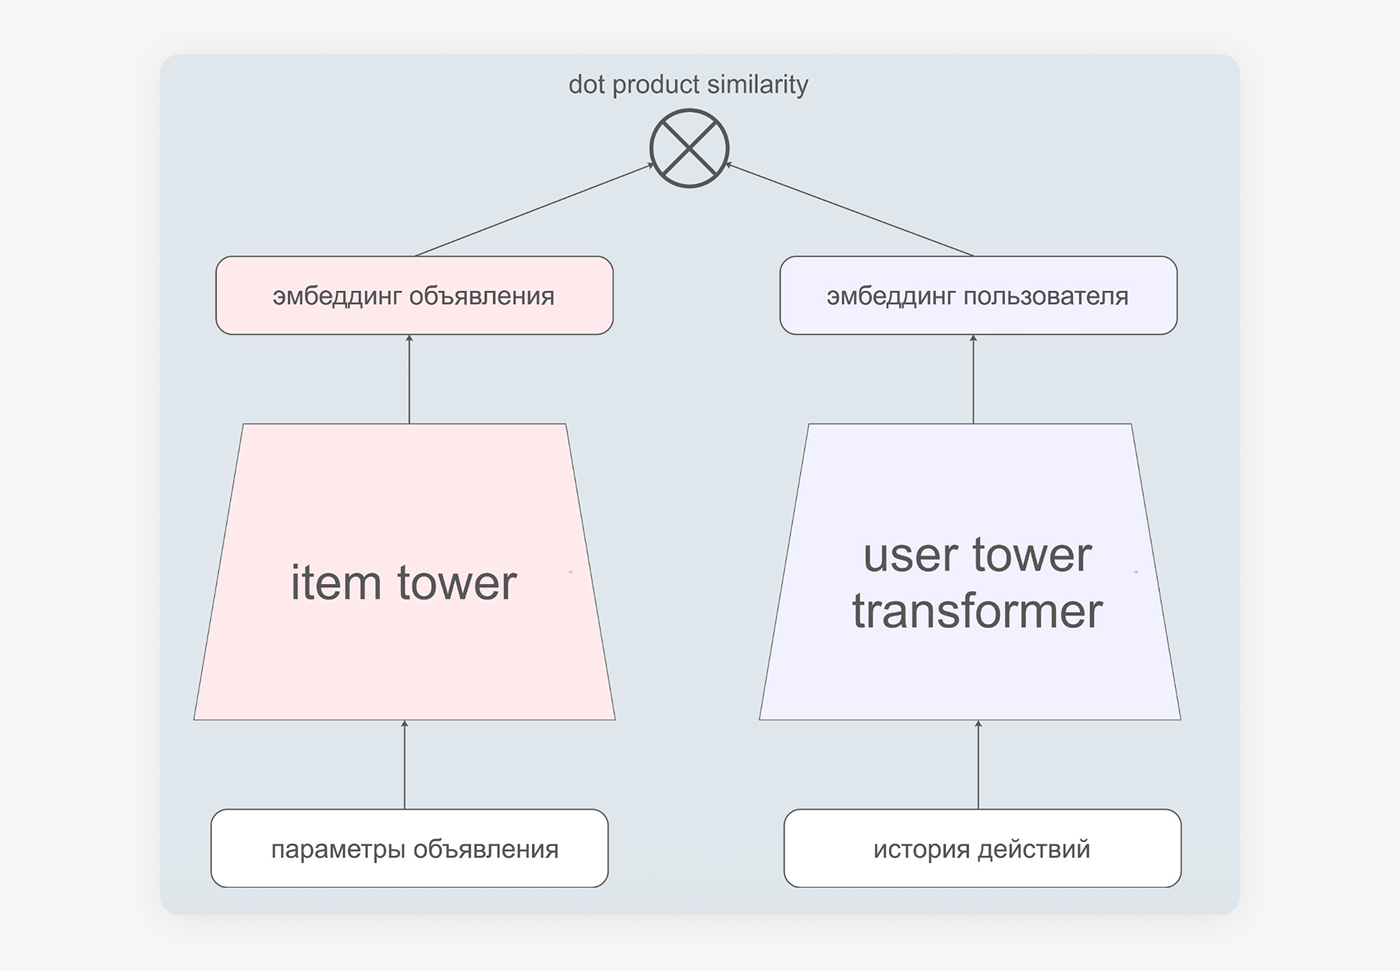
Две башни: параметры объявления превращаются в эмбеддинг объекта, история действий — в эмбеддинг пользователя через transformer; сверху показано сравнение скалярным произведением.
Источник: Александр МихеевКакие данные модель должна уместить в одно представление
Масштаб данных задаёт требования к архитектуре. В датасете — сотни миллионов объявлений, а каждый день система видит сотни миллионов поисковых запросов и пользовательских действий: клики, просмотры, добавления в избранное и другие активности. Действия разделили на два больших типа: поисковые запросы и взаимодействия с объявлениями. Каждый такой объект нужно сначала превратить в вектор, а уже затем передать в пользовательский трансформер.
Таблицу можно прокрутить по горизонтали.
Инфомодель в статье — это набор категорийных характеристик объявлений в виде пар «ключ — значение»: например, «тип объекта — квартира» или «марка — Жигули». Команда оставляет 10 000 самых популярных таких характеристик, каждой сопоставляет эмбеддинг, а затем агрегирует их тем же способом, что и токены текста.
Группы получили разные размерности эмбеддингов: последовательные признаки содержат больше информации, чем простой бинарный флаг, поэтому для них можно выделить более ёмкое представление. Внутри каждой группы использовалась одна общая матрица nn.Embedding со сквозной индексацией всех признаков группы. Например, в категорийной матрице рядом находятся строки для ID категории, ID локации и других категорийных признаков. По словам автора, это избавляло от лишнего перебора признаков внутри прямого прохода модели и ускоряло обучение.
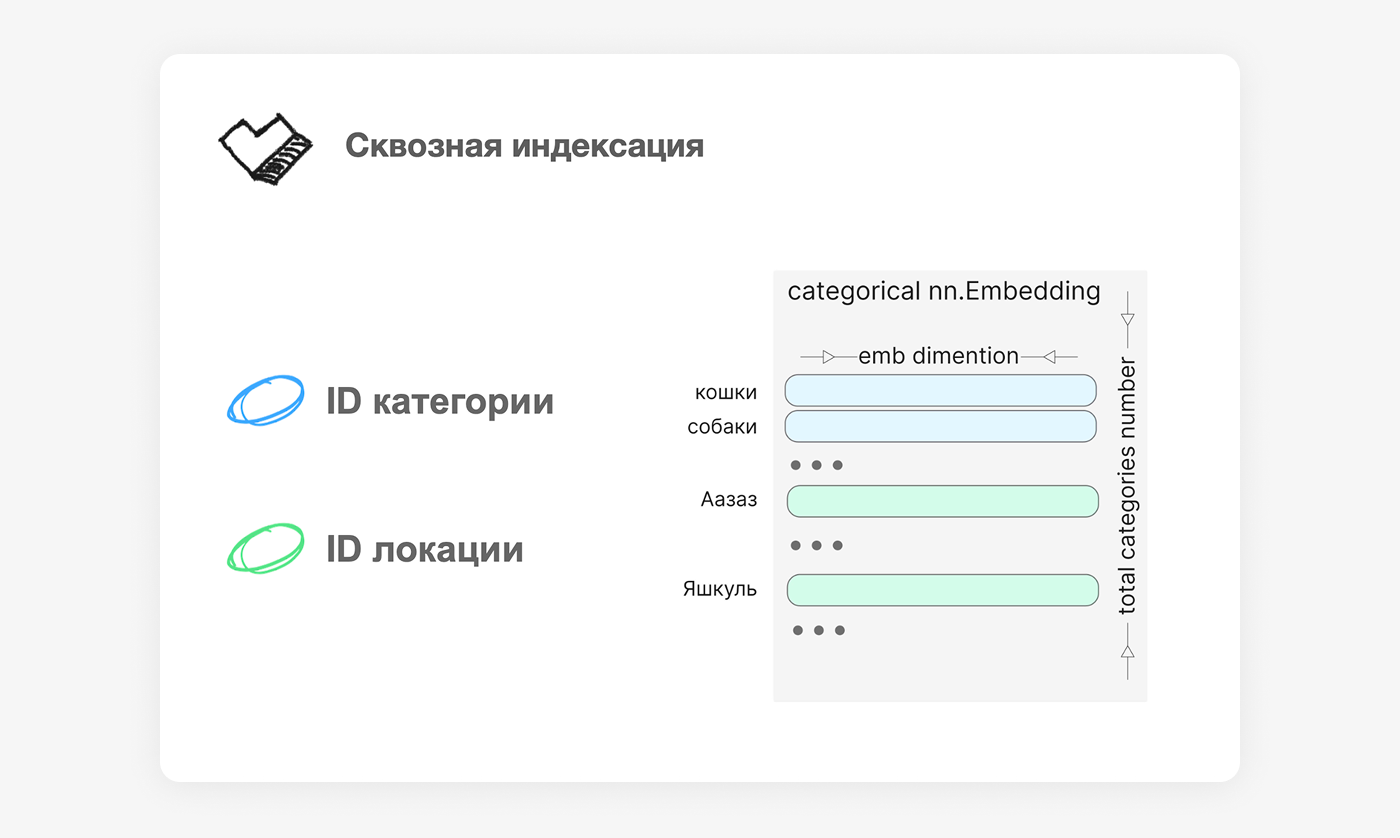
Сквозная индексация категорийных признаков в одной nn.Embedding: на схеме вместе размещены значения ID категории и ID локации.
Источник: Александр МихеевЧисла и текст: как не потерять слишком много информации
Числовые признаки кодировали векторами той же размерности, что и категорийные, чтобы их вклад не уменьшался только из-за меньшего числа координат. Самый простой вариант — разбить диапазон на интервалы, или бины, и назначить каждому бину один эмбеддинг. Но тогда любые два значения внутри одного интервала становятся для модели неразличимыми.
Команда привязала эмбеддинги не к самим бинам, а к их границам. Для конкретного числа берутся векторы двух соседних границ и складываются с весами, пропорциональными близости значения к каждой границе. Так представление меняется плавно внутри интервала. На рисунке значение 2,75 между границами 2 и 3 кодируется как 0,25 от эмбеддинга границы 2 плюс 0,75 от эмбеддинга границы 3.
Текстовые признаки обрабатывались проще: текст разбивается на токены, каждому токену сопоставляется обучаемый эмбеддинг, а представление всей последовательности получается суммой этих токенных векторов. В эту группу входят заголовок и описание объявления, а для поиска — текст запроса.
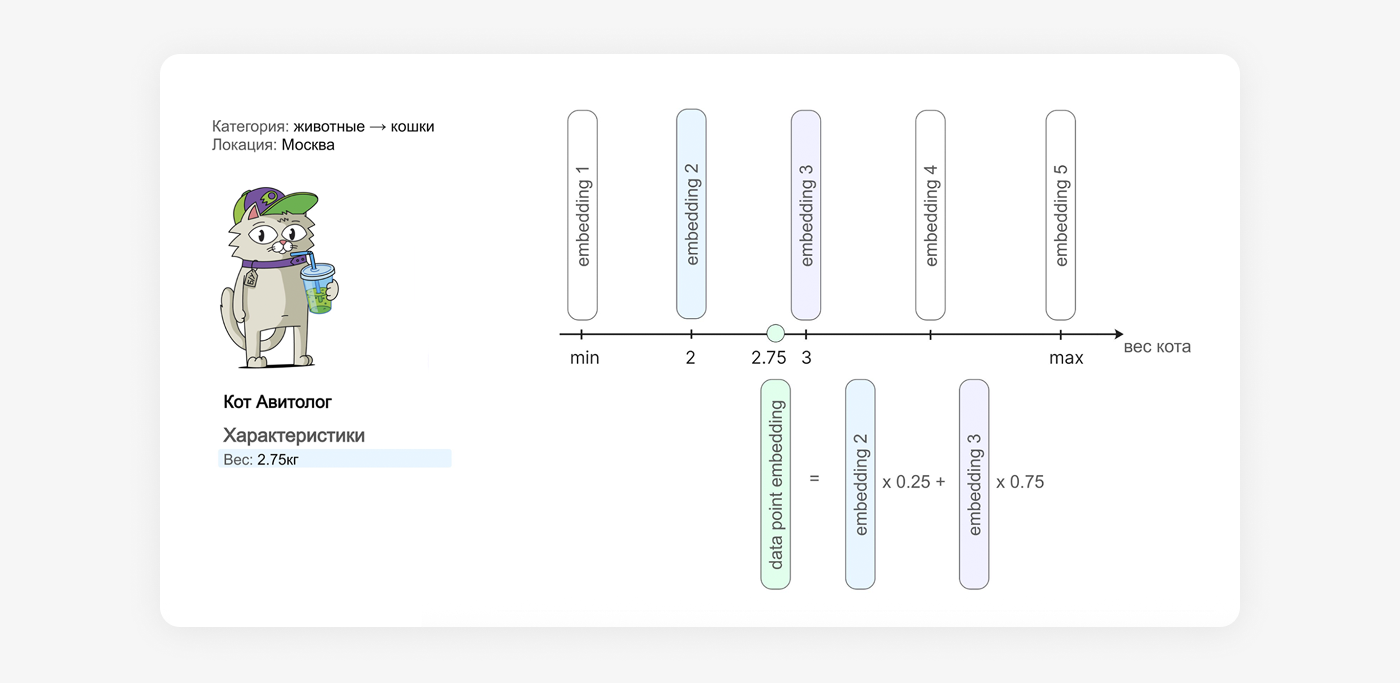
Интерполяция числового признака между границами: значение 2,75 кодируется как embedding 2 × 0,25 + embedding 3 × 0,75.
Источник: Александр Михеев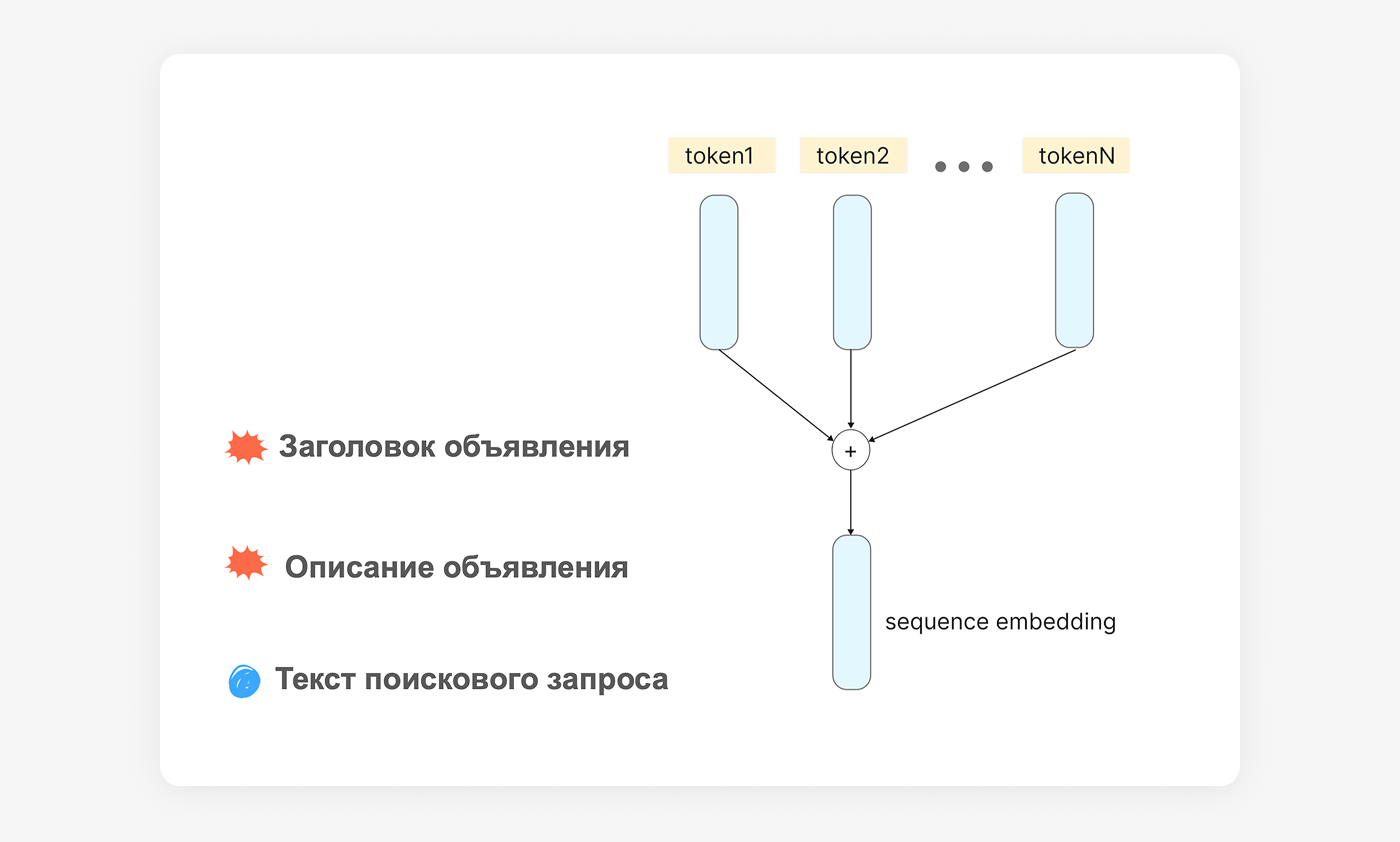
Текст заголовка, описания или поиска разбивается на токены; их эмбеддинги суммируются в один sequence embedding.
Источник: Александр МихеевКак собирали обучающие примеры без слишком лёгкой подсказки
Один обучающий пример связывает историю пользователя с объявлением, на котором произошло целевое действие. Команда хотела одновременно моделировать краткосрочный интерес — например, продолжить недавний интерес к животным похожими объявлениями — и более устойчивые предпочтения. Поэтому между последним событием, которое модель видит в истории, и целевым объявлением вводился случайный временной отступ от нескольких минут до нескольких дней.
Так модель не может опираться только на самый локальный контекст: часть примеров требует использовать недавние действия, а часть — более старые сигналы. В источнике этот приём также связывается со снижением переобучения на локальный контекст и с более реалистичной постановкой задачи.
Есть и защита от прямой утечки целевого действия. Если события из той же сессии привели к взаимодействию с целевым объявлением, их удаляют из истории. В примере с покупкой телефона из входа убираются просмотр этого телефона, добавление его в избранное и другие действия той же сессии, которые слишком прямо подсказывали бы ответ.
В пакет обучения входят два основных блока: целевое объявление и история пользователя. Историю делят на две подпоследовательности — действия с объявлениями и поисковые запросы, потому что их кодируют разными энкодерами. Чтобы после такого разделения не потерять исходный порядок событий, каждому элементу передают его индекс в первоначальной общей истории.
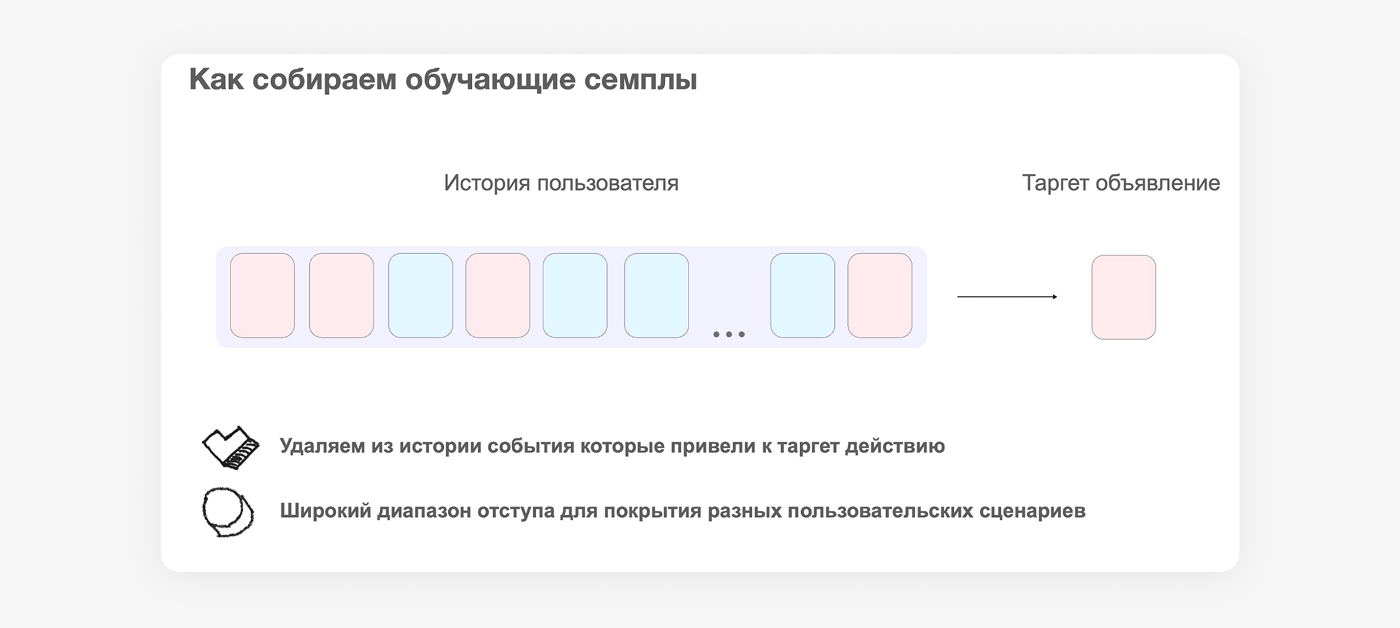
История пользователя отделена от целевого объявления; схема подчёркивает удаление событий, приведших к цели, и широкий временной отступ между историей и целевым действием.
Источник: Александр МихеевКак из разных групп признаков получается вектор объявления или поиска
Сначала эмбеддинги отдельных признаков внутри одной группы объединяются конкатенацией — векторы просто ставятся друг за другом. Получившийся вектор проходит через DCN, Deep Cross Network. Эта сеть специально строит взаимодействия между признаками: первый слой создаёт попарные комбинации, следующий может учитывать взаимодействия более высокого порядка.
После обработки каждой группы их представления снова конкатенируются и проходят ещё через один DCN. Затем отдельный энкодер уменьшает размерность и формирует конечный эмбеддинг объявления или поискового запроса. В итоге и объявления, и запросы представлены компактными векторами, которые уже можно складывать в пользовательскую последовательность.
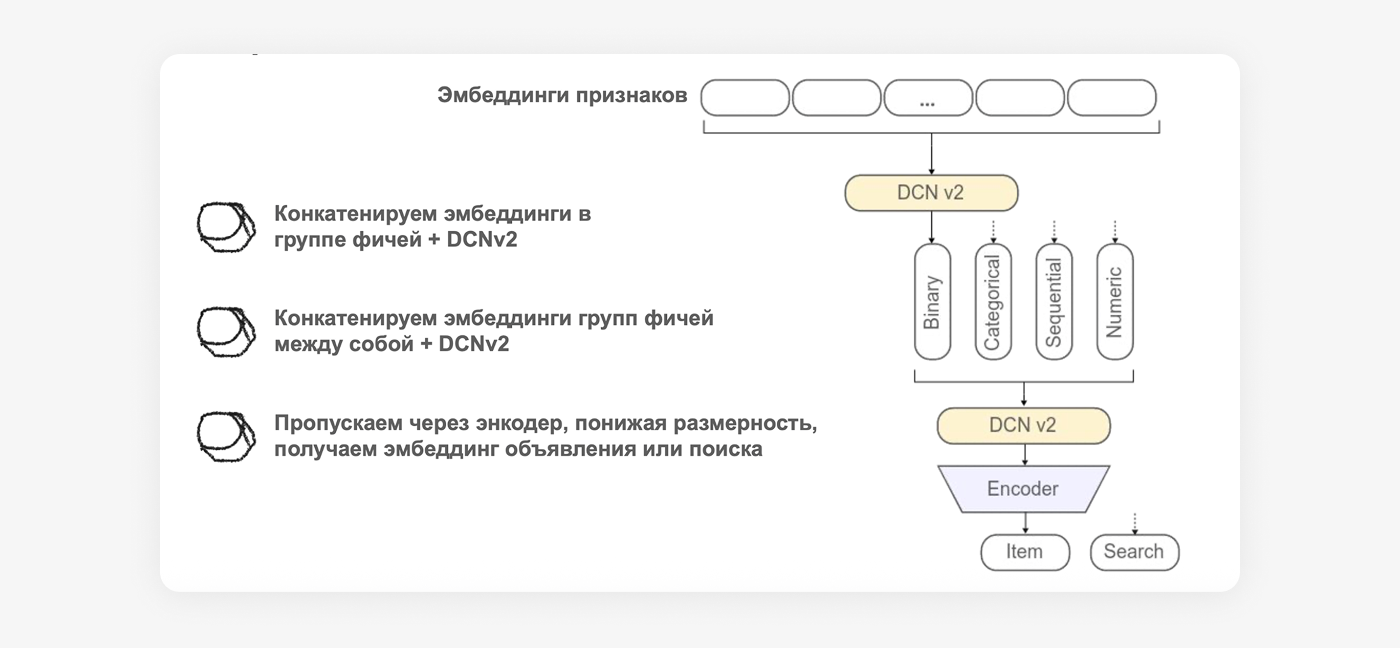
Эмбеддинги признаков проходят DCNv2 внутри групп, затем группы объединяются, снова проходят DCNv2 и энкодер формирует представление Item или Search.
Источник: Александр МихеевТрансформер пользователя и проблема одного CLS-вектора
В пользовательскую часть поступают две подпоследовательности: эмбеддинги действий с объявлениями и эмбеддинги поисков. К ним добавляется информация об исходных позициях событий. Позиционные эмбеддинги сообщают трансформеру, где событие находилось в общей истории, поэтому после раздельного кодирования объявлений и поисков порядок всё равно можно восстановить.
Первоначально профиль пользователя представлялся через CLS-эмбеддинг — специальный вектор, который должен собрать информацию из всей последовательности. Авторы заметили асимметрию: один пользовательский вектор обязан сжать существенно больше информации, чем вектор одного объявления, хотя их размерность одинакова.
Чтобы увеличить информационную ёмкость профиля, пользователя стали кодировать несколькими эмбеддингами. Каждый из них отдельно сравнивается с эмбеддингом объявления скалярным произведением, а полученные значения затем агрегируются в одну итоговую оценку. Точное число пользовательских эмбеддингов и способ агрегации в источнике не раскрыты.
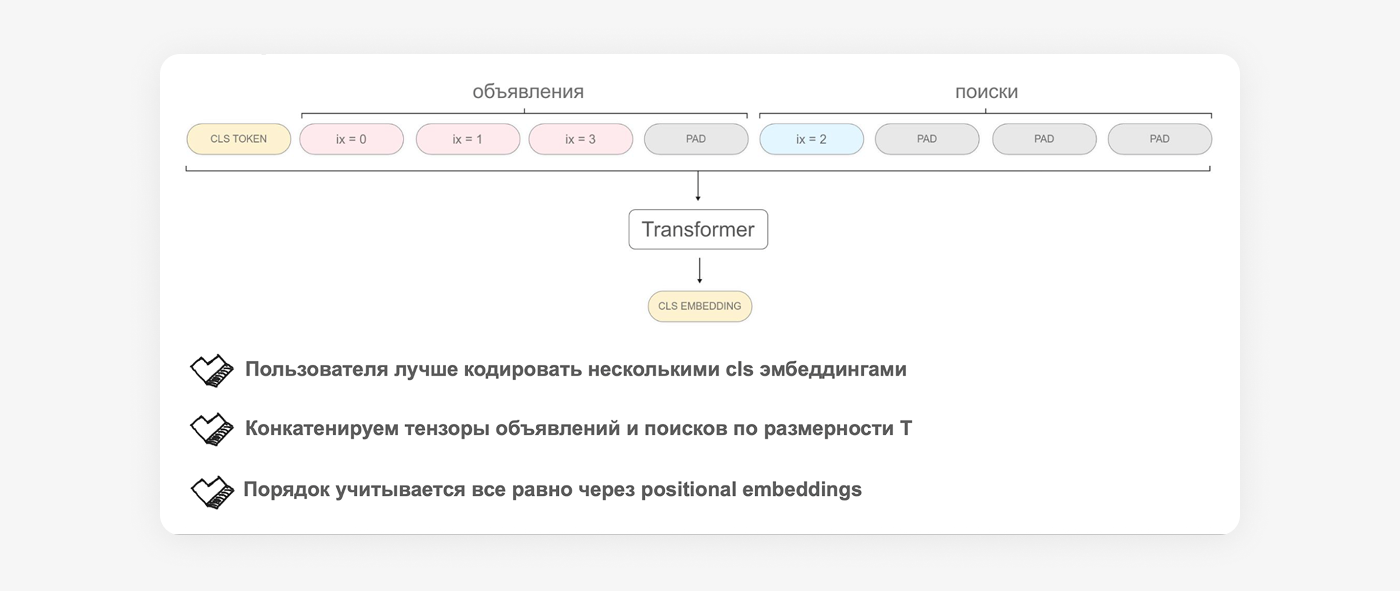
Объявления и поиски собираются в общую последовательность для трансформера; исходные индексы ix сохраняют порядок, служебный CLS используется для пользовательского представления.
Источник: Александр МихеевОбучение близости: позитивы, негативы и выбор InfoNCE
Учебная цель проста по смыслу: релевантные пользователю объявления должны иметь большое скалярное произведение с его профилем, нерелевантные — меньшее. Целевое объявление, которое идёт вместе с историей, становится положительным примером. Объявления других пользователей в том же пакете используются как отрицательные примеры.
Команда увидела, что качество растёт при увеличении числа отрицательных примеров. Поэтому к объектам из текущего пакета добавили случайные объявления из общей базы. Авторы называют этот вариант рациональным с точки зрения расхода RAM и GPU-памяти; кроме того, модель стала чаще видеть объявления, которые редко встречаются в историях действий пользователей.
После построения матрицы пользовательских и объектных эмбеддингов их перемножение даёт матрицу оценок. Главная диагональ соответствует правильным парам «пользователь — целевое объявление» и должна расти; остальные элементы считаются отрицательными и должны уменьшаться.
Таблицу можно прокрутить по горизонтали.
Отдельно команда экспериментировала с обменом отрицательными примерами между пакетами, чтобы ещё расширить их пул. Источник не приводит численного разрыва качества между SigLIP и InfoNCE, поэтому здесь важно сохранить только направление результата: вычислительная скорость указанного сравнения была одинаковой, а качество немного лучше у InfoNCE.
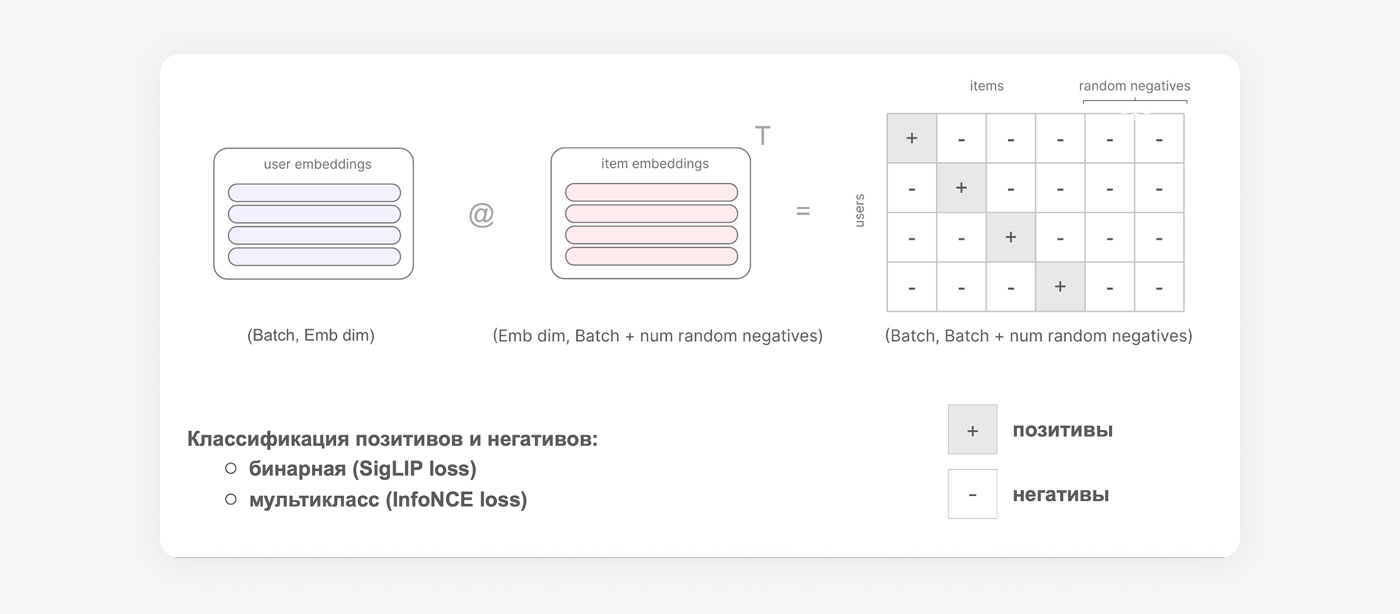
Матрица скалярных произведений: позитивы находятся на диагонали, остальные элементы и дополнительные random negatives служат отрицательными примерами; снизу указаны SigLIP и InfoNCE.
Источник: Александр МихеевМасштаб обучения: пакет вырос вместе с числом GPU
Изначально модель обучали на конфигурации из четырёх видеокарт; в источнике рядом с этой конфигурацией указано 80 ГБ. Эффективный размер пакета, суммарный по всем GPU, составлял около 30 000 примеров. Позже обучение перенесли на один сервер с восемью GPU и увеличили эффективный пакет примерно до 130 000 примеров.
На каждой GPU дополнительно использовалось около 16 000 отрицательных примеров. Это согласуется с общей логикой экспериментов: больший пул негативов давал модели более содержательную задачу различения подходящих и неподходящих объявлений. За два месяца датасет насчитывал порядка 10 млрд обучающих примеров.
Таблицу можно прокрутить по горизонтали.
Как модель работает в продукте: кэш, история и ANN-индекс
Подготовка данных и применение модели реализованы через Aqueduct — фреймворк, который распределяет этапы обработки между отдельными процессами. Предобработка выполняется на CPU, а на каждом инференс-сервере для нейросетевого вычисления используется одна видеокарта. Сам инференс разделён на две независимые по смыслу части: построение эмбеддингов объявлений и построение актуального эмбеддинга пользователя.
Объектная башня получает параметры нового или обновлённого объявления, строит его эмбеддинг и сохраняет результат в Redis-кэше. Пользовательская башня работает во время запроса: получает историю пользователя уже в виде эмбеддингов объявлений из Redis, добавляет параметры его поисков и формирует актуальное представление пользователя.
ANN означает приближённый поиск ближайших соседей: вместо полного сравнения пользовательского вектора со всем каталогом индекс быстро ищет близкие векторы. В статье назван Sphinx, но не раскрыты конкретный алгоритм индекса, его настройки, полнота поиска или задержка.
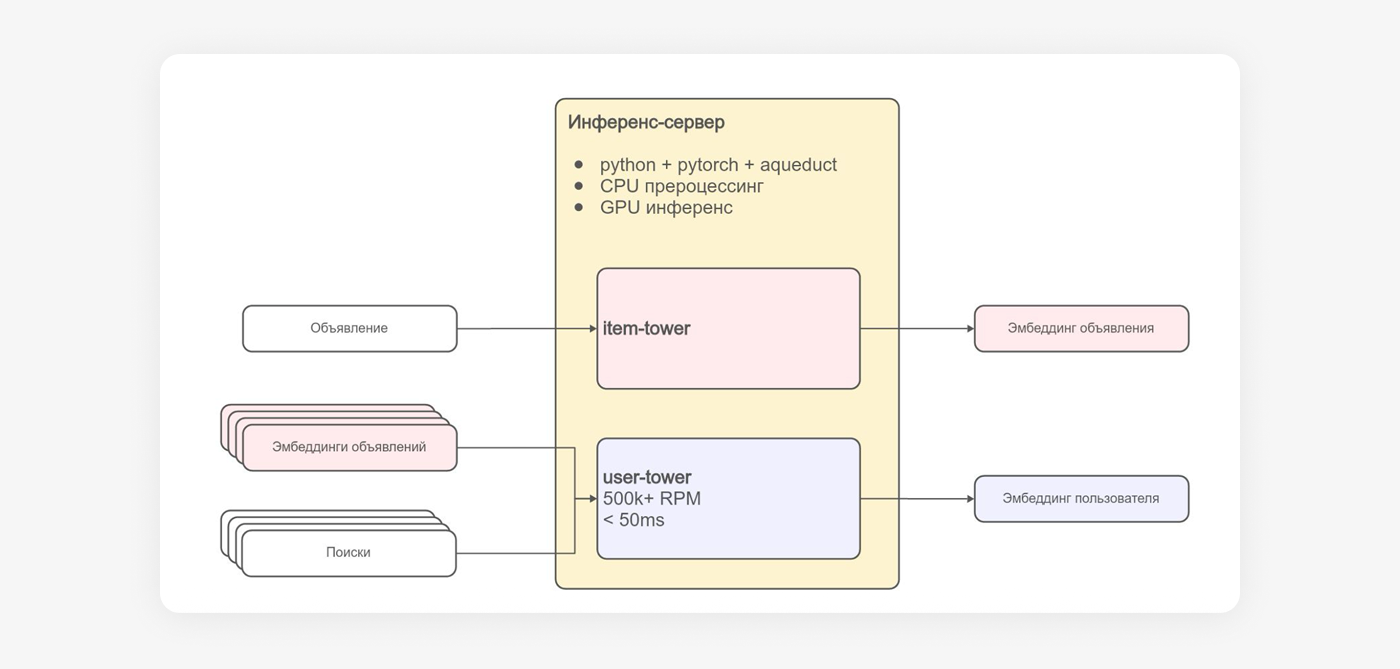
Инференс-сервер с Aqueduct: CPU-предобработка и GPU-инференс, отдельные item-tower и user-tower; пользовательская часть получает кэшированные эмбеддинги объявлений и поиски.
Источник: Александр МихеевДва способа применения и результаты
Одну и ту же идею команда использовала в двух местах каскада. В первом сценарии пользовательский эмбеддинг отправляется в ANN-индекс Sphinx, который возвращает объявления с большим скалярным произведением: они становятся кандидатами для дальнейшего ранжирования. Во втором сценарии кандидаты приходят и из других источников; для каждого из Redis берётся эмбеддинг, вычисляется его скалярное произведение с пользовательским профилем, а это число добавляется как отдельный признак в рекомендательную ранжирующую модель.
Таблицу можно прокрутить по горизонтали.
SHAP-анализ здесь используется как способ оценить вклад признаков в предсказание ранжировщика; источник сообщает, что скалярное произведение новой модели стало признаком с наибольшей важностью по этому анализу. Это не отдельная пользовательская метрика и не заменяет сообщённый эффект на целевых действиях.
Статья не раскрывает точное определение «целевого действия покупателей», длительность и размер проверки результата, доверительные интервалы или единицу рандомизации. Поэтому значения +2,3%, +1,1% и +8,1% следует читать именно как опубликованные авторами изменения метрики в названных сценариях, не превращая их в процентные пункты и не перенося на другие категории.
Раздел «Применение модели и результаты»Итог: что именно изменила трансформерная персонализация
Путь команды начался не с замены всего рекомендательного каскада, а с ограничения user2vec: линейная сумма недавних объявлений была быстрой, но не видела поиски, порядок событий и сложные сочетания интересов. Новая двухбашенная модель сохранила удобное разделение пользователя и объявления, но сделала пользовательскую сторону последовательной. До запуска отдельно готовятся признаки, обучающие пары с временным отступом и очисткой событий той же сессии, отрицательные примеры и веса модели; обучение масштабировали до восьми GPU и эффективного пакета около 130 000 примеров. Это подготовка модели, а не шаги, которые повторяются для каждого запроса пользователя.
- 01
Обновить объявления
Новые и изменённые объявления проходят объектную башню; их эмбеддинги сохраняются в Redis и отправляются в ANN-индекс Sphinx.
- 02
Собрать историю
Во время запроса система получает действия пользователя и поиски, сохраняя информацию об их исходном порядке.
- 03
Построить профиль
Трансформер кодирует историю в несколько пользовательских эмбеддингов, которые содержат контекст последовательности.
- 04
Найти или оценить объявления
Скалярные произведения используются либо для поиска ближайших кандидатов в Sphinx, либо как дополнительный признак для уже собранных кандидатов.
- 05
Передать дальше по каскаду
Найденные кандидаты попадают в существующее ранжирование и правила итоговой выдачи; новая модель не отменяет остальные источники и финальную логику.
В опубликованных результатах мультикатегорийный вариант как признак ранжирования дал +2,3% целевых действий покупателей на главной странице, а модель для «Личных вещей» как источник кандидатов — +1,1% на главной и +8,1% внутри категории. При этом статья не даёт полного протокола проверки результата: не названы точное определение целевого действия, длительность, выборка и доверительные интервалы. Не раскрыты также число пользовательских эмбеддингов, способ агрегации их оценок и настройки ANN-индекса. Поэтому главный подтверждённый вывод кейса — конкретная архитектура, обучение и два успешных сценария применения в системе Авито, а не универсальная гарантия такого же прироста для другого каталога.
Итог по разделам «Предыдущая версия системы рекомендаций», «Архитектура модели», «Работа модели в проде» и «Применение модели и результаты»