Разбор готов
Spotify Wrapped Archive: как подготовили 1,4 миллиарда персональных историй
Spotify Wrapped обычно подводит итог года в цифрах и подборках. В Wrapped Archive команда решила сделать следующий шаг: найти в истории слушателя несколько дней, которые действительно выделялись, и превратить каждый такой день в короткую персональную историю. Задача быстро перестала быть только задачей генерации текста. Для примерно 350 млн подходящих пользователей нужно было выбрать до пяти событий, подготовить около 1,4 млрд отчётов до общего запуска Wrapped, сохранить их без конфликтов при массовой записи и проверить качество там, где сплошная ручная проверка невозможна. Решение разделили на несколько контуров: распределённый расчёт особенных дней, предварительную генерацию через очередь сообщений, отдельное хранилище готовых отчётов и систему оценки с возможностью точечного повторного запуска. Ниже разберём весь путь: от эвристик выбора дня и устройства промпта до дистилляции модели, конкурентных записей, предмасштабирования, LLM-as-a-judge и исправления реального бага во временных зонах.
Материал полезен ML/LLM-инженерам и backend/data-инженерам, которые строят массовую генерацию персонализированного контента: здесь показано, как связать подготовку данных, промпты, обучение более дешёвой модели, batch-предгенерацию, надёжное хранение, нагрузочное тестирование и QA перед единым высоконагруженным запуском.
Статья · на английском
Inside the Archive: The Tech Behind Your 2025 Wrapped HighlightsYoshnee Raveendran · Опубликовано: 12 марта 2026 г.
Как из года прослушиваний выбрать несколько дней, о которых стоит рассказать
Для каждого подходящего пользователя Wrapped Archive выбирал до пяти примечательных дней за 2025 год. Языковая модель появлялась позже: сначала нужно было сократить годовую историю до небольшого набора событий, у которых есть понятный повод для рассказа. Готовый отчёт должен был быть творческим, но опираться только на реальные данные о прослушивании.
Часть кандидатов находилась прямыми статистическими правилами. Biggest Music Listening Day и Biggest Podcast Listening Day брали дни с максимальным временем прослушивания музыки или подкастов. Biggest Discovery Day искал день с наибольшим числом впервые услышанных артистов. Biggest Top Artist Day выделял день, когда слушатель особенно долго слушал одного любимого артиста, а Biggest Top Genre Day — день, когда один жанр сильнее всего доминировал в прослушивании.
Другие эвристики требовали сравнения с обычным поведением человека. Most Nostalgic Day искал всплески старого каталога и «возвратных» сессий, Most Unusual Listening Day — сильнейшее отклонение от привычного вкусового профиля. Дополнительно использовались календарные якоря вроде дня рождения и Нового года. Кандидатов ранжировали по двум соображениям: насколько сильным был статистический сигнал и насколько из события получалась содержательная история. Так сотни миллионов событий сводились к максимум пяти дням. Пример с тем, что самый музыкальный день пользователя совпал со свадьбой, в статье приведён как удачное совпадение результата, а не как отдельный входной признак.
How we taught an algorithm to spot your big dayСнимок пользователя, очередь сообщений и готовый архив
После выбора особенных дней распределённый конвейер данных собирал для каждого пользователя снимок: сами дни и ту часть истории прослушивания, которая понадобится дальнейшей генерации. Этот снимок сохранялся в объектное хранилище. На этом заканчивается расчёт признаков для истории и начинается отдельный контур предварительной генерации.
- 01
Расчёт особенных дней
Распределённый конвейер агрегирует историю слушателя и выбирает до пяти кандидатов.
- 02
Снимок пользователя
Выбранные дни и связанные данные сохраняются в объектное хранилище.
- 03
Публикация заданий
Publish Pipeline читает снимки, собирает payload и публикует задания в Pub/Sub.
- 04
Предварительная генерация
Report Generation Service получает сообщения, формирует промпт и вызывает языковую модель.
- 05
Сохранение результата
Готовый отчёт записывается в архивное хранилище, откуда его позже может прочитать сервис выдачи.
Важно разделить этот путь и пользовательский запрос. Когда человек позже открывает Wrapped Archive, Client Archive UI обращается к Archive Storage/Serving Service, а тот читает уже подготовленный отчёт из хранилища. На схеме языковая модель находится в контуре предгенерации, а не на пути чтения пользователем. Отдельно из основного хранилища отчёты выгружаются в Evaluation Data Warehouse: это база для массовой проверки качества и последующего повторного выпуска проблемных отчётов.
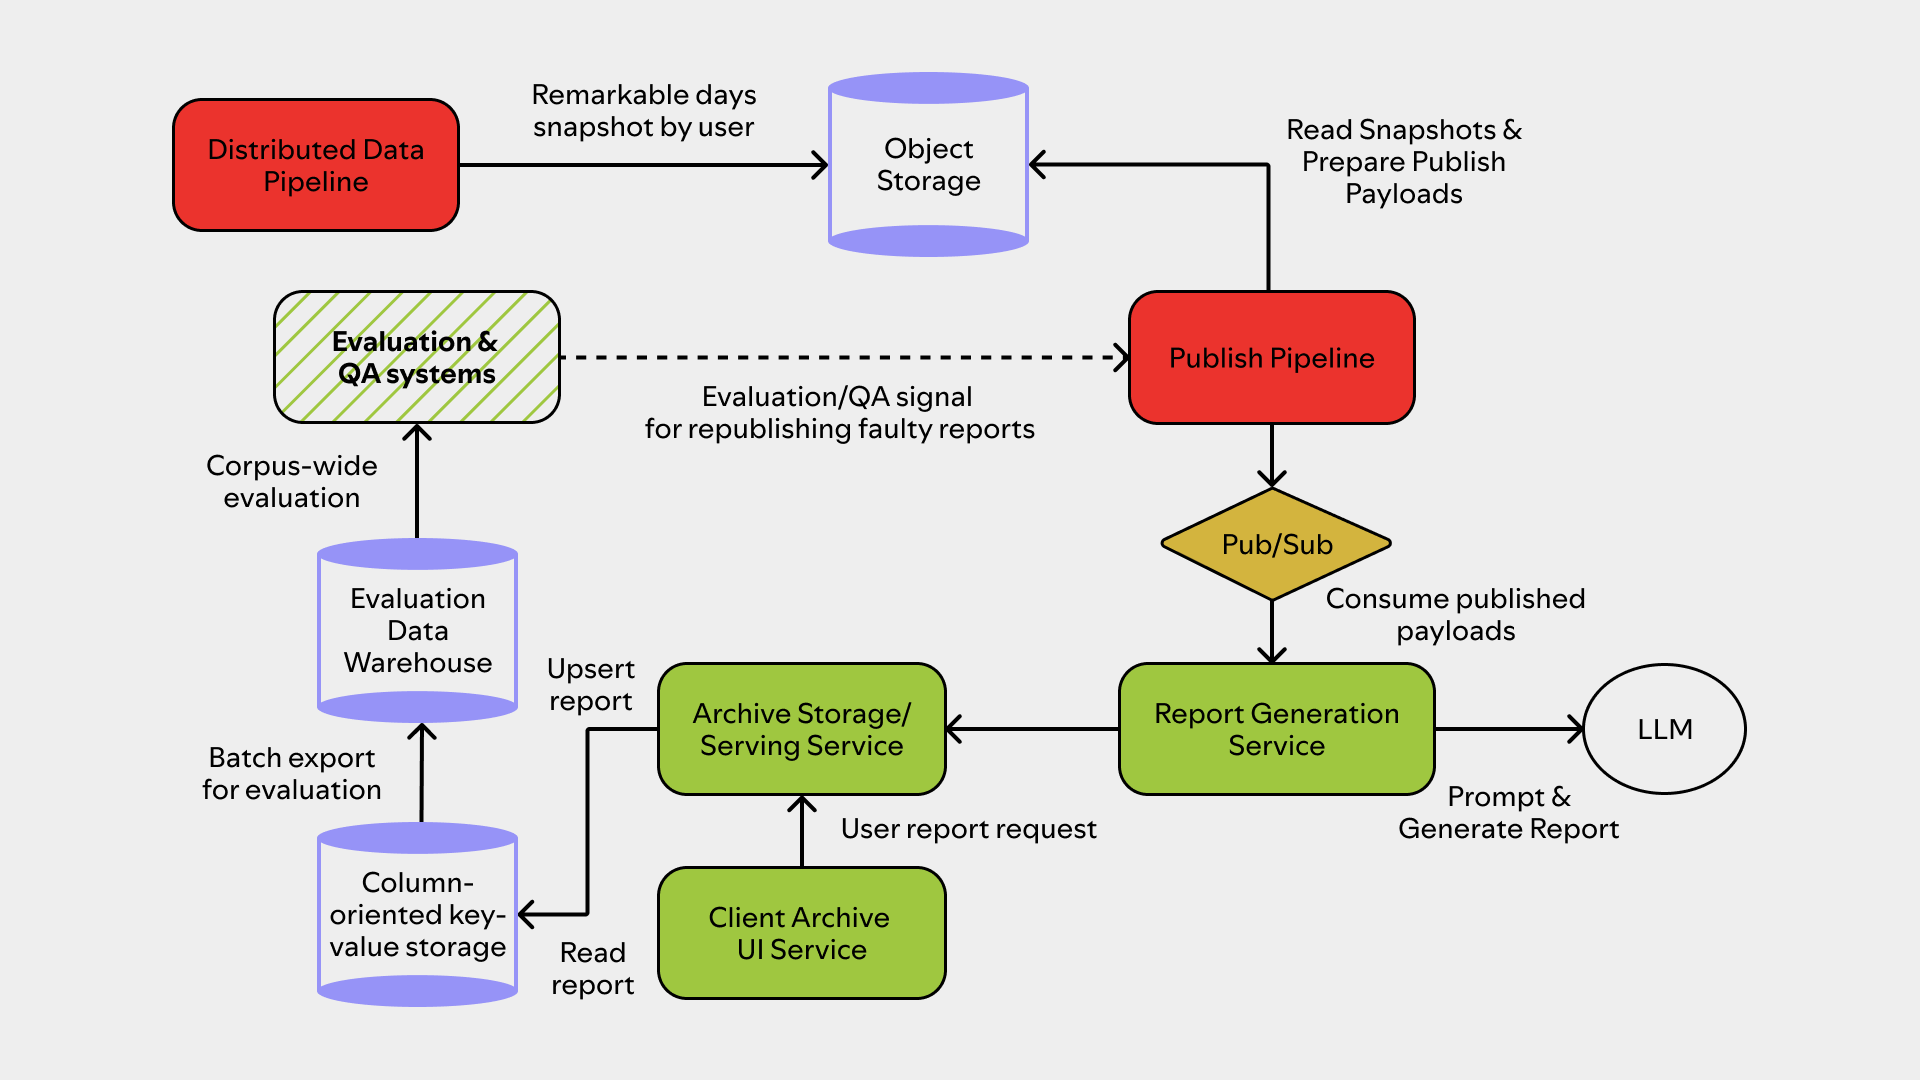
Общая схема Wrapped Archive: исходные данные превращаются в особенные дни слушателя; отчёты готовятся заранее и сохраняются для выдачи после запуска Wrapped.
Источник: Spotify Engineering · Wrapped ArchiveСистемный промпт задаёт границы истории
Промпты команда дорабатывала ежедневно больше трёх месяцев. Причина понятна: история должна одновременно быть живой, эмоциональной и устойчивой к массовому запуску. Поэтому вход модели разделили на два слоя. Первый, системный промпт, задавал постоянные правила — своего рода договор о том, что модель имеет право делать.
Первое правило — опора на данные: каждое наблюдение в тексте должно прослеживаться до реального поведения слушателя. Второе — единый тон: остроумный, искренний и ненавязчиво игривый. Третье — безопасность по умолчанию: не строить истории вокруг наркотиков, алкоголя, секса, насилия или оскорбительной лексики. То есть требования к безопасности встроены в генерацию заранее, а не оставлены только как фильтр после ответа.
Prompt engineering for consistency at scaleПользовательский промпт убирает неоднозначность, а проверка замыкает цикл
Второй слой — данные конкретной генерации. В промпт передавали подробные логи прослушивания за выбранный день, заранее посчитанный блок статистики, общие данные Wrapped пользователя, категорию особенного дня, предыдущие уже созданные отчёты и страну пользователя. Статистику считали вне модели, потому что числовые расчёты не хотели оставлять на LLM. Страна использовалась для правописания и словаря.
Особенно важен контекст предыдущих отчётов. У одного слушателя могло быть несколько историй, и более ранние тексты передавались дальше, чтобы следующая генерация не повторяла те же формулировки и сюжетные ходы. Поэтому качество набора из пяти историй зависело не только от каждого отдельного ответа, но и от согласованности между ними.
Промпт не считался однажды написанной инструкцией. Команда сравнивала версии на прототипе и пограничных случаях, запускала LLM-as-a-judge на выборках и добавляла ручное ревью. Замечания по креативности, технической корректности и безопасности возвращались в следующую версию промпта. В этой системе генерация и оценка развивались вместе.
Prompt engineering for consistency at scaleПочему пришлось переносить поведение сильной модели в более дешёвую
На этапе прототипирования более мощные модели давали подходящее качество, но стоимость меняет смысл решения, когда впереди больше миллиарда генераций. Команда поэтому построила дистилляцию: сильная модель сначала создавала качественные эталонные ответы, а люди отбирали и тщательно проверяли набор примеров, который фиксировал нужный голос, ограничения и стилевые нюансы.
На этом «золотом» наборе дообучили меньшую и более быструю производственную модель. Идея проста: дорогую модель использовать там, где создаются хорошие образцы поведения, а массовый выпуск поручить модели, которая дешевле в применении. Статья не раскрывает ни названия этих моделей, ни их размеры, поэтому из неё нельзя восстановить конкретную конфигурацию обучения.
Shrinking the model, amplifying the storyDPO добавляет сигнал человеческих предпочтений
После дообучения на эталонных ответах команда добавила Direct Preference Optimization, или DPO. Вместо ещё одного набора «правильных текстов» здесь модели показывают предпочтение между вариантами: какой ответ люди считают лучше при сравнении. Эти предпочтения собирались через человеческие A/B-сравнения.
Набор предпочтений был относительно небольшим, но специально составленным и тщательно отобранным. По формулировке авторов, этого оказалось достаточно, чтобы производственная модель достигла сильного паритета по предпочтениям с исходным базовым вариантом. В статье нет численного win rate, размера preference dataset или порога паритета, поэтому результат стоит понимать именно как заявленное качественное сравнение, а не как скрытую процентную метрику.
Shrinking the model, amplifying the storyКак прогнать 1,4 миллиарда отчётов до дня запуска
Масштаб определил эксплуатационную стратегию. В статье указано около 350 млн подходящих пользователей, до пяти отчётов на человека и примерно 1,4 млрд отчётов суммарно. Каждый отчёт требовал отдельного вызова дообученной модели. Чтобы закончить до запуска Wrapped, системе нужно было несколько дней поддерживать тысячи запросов в секунду при строгих ограничениях на задержку.
Исходя из доступной мощности, команда решила провести первоначальную генерацию одним большим batch. После вычисления remarkable days пользовательский снимок публиковался в Pub/Sub. Для одного пользователя отчёты генерировались по одному: предыдущая история могла войти в контекст следующей и уменьшить повторения. Это семантическая последовательность внутри набора пользователя, а не пользовательский онлайн-запрос.
Наблюдаемость была частью самого запуска. Дашборды показывали прогресс генерации, надёжность системы и ожидаемое время завершения. Движок работал непрерывно четыре дня. После первого прохода команда отдельно искала пропущенные отчёты, несогласованности данных и другие проблемы, а затем повторно генерировала только затронутые результаты.
Running the generation engineКак схема хранения убрала гонки при конкурентных записях
К концу предгенерации более миллиарда отчётов уже лежали в хранилище. Для такой записи использовалась распределённая колоночная key-value база: у каждого пользователя была одна строка с ключом по его идентификатору. Внутри этой строки нужно было отмечать, какие из его особенных дней уже получили готовый отчёт.
Наивная схема — хранить один сериализованный список завершённых дней — заставила бы каждую запись сначала прочитать список, изменить его и записать обратно. Если два обновления пришли почти одновременно, одно могло затереть другое. Поэтому завершение каждого дня вынесли в отдельную ячейку: дата стала column qualifier в выделенном семействе колонок. Например, 15 марта кодируется как 20250315, а 22 июня — как 20250622. Записи разных дней затрагивают разные ячейки одной строки и не требуют блокировок или read-modify-write общего значения.
Полный текст отчёта хранился отдельно по пользователю и дате. Порядок записи был намеренно односторонним: сначала сохраняется содержимое отчёта, и только после успешной записи появляется лёгкая метаданные-отметка «этот день завершён». Поэтому интерфейс не увидит признак готовности раньше самого содержимого.
В статье одновременно описаны две гарантии: генерация отчётов одного пользователя идёт последовательно, чтобы учитывать предыдущие тексты, а слой хранения рассчитан на независимые конкурентные записи до пяти отчётов. Источник не раскрывает внутренний планировщик между этими этапами; инженерный смысл раздела в том, что корректность хранилища не зависит от идеальной сериализации всех записей.
Designing for parallelism and persistenceПочему реактивного автомасштабирования перед Wrapped недостаточно
Wrapped запускается глобально в один момент. До старта сервис может быть почти без нагрузки, а через секунду получить миллионы запросов. Обычное автомасштабирование реагирует уже на наблюдаемую нагрузку, поэтому для такого скачка оно запаздывает. Команда готовила ёмкость заранее.
За несколько часов до запуска увеличили число compute pods и мощность узлов базы данных, а также заранее согласовали доступную пропускную способность с провайдером модели. Только после завершения этого предмасштабирования, но ещё до прихода пользователей, во всех географических регионах запустили синтетическую нагрузку.
Синтетические запросы прогревали connection pools и кеши вычислительных сервисов. На стороне хранения они помогали заранее распределить tablet assignments и прогреть block caches. Тест шёл достаточно долго, чтобы захватить критическое окно старта. Смысл был не в измерении красивого пикового QPS, а в том, чтобы реальный запуск начался уже на разогретой инфраструктуре. Точных размеров кластера, числа запросов и имени провайдера статья не приводит.
Built for the big bangКак проверять качество, когда вручную нельзя прочитать миллиард текстов
Авторы объясняют масштаб проблемы гипотетикой: даже если бы доля сбоев была всего 0,1%, на таком объёме это означало бы миллионы неудачных историй. Это иллюстрация последствий малой доли ошибок, а не измеренный частота сбоев системы. Сплошная ручная проверка в любом случае невозможна, поэтому понадобился автоматизированный контур оценки.
Сгенерированные отчёты выгружались в отдельное аналитическое хранилище, рассчитанное на выборочные запросы и анализ всего корпуса. Более крупные модели выступали судьями — LLM-as-a-judge — и оценивали отчёты по четырём направлениям: точность относительно данных, безопасность, тон и формат.
Чтобы не потерять экономию от дистилляции, дорогое оценивание не запускали по всем 1,4 млрд текстов. Вместо этого взяли большую случайную выборку примерно из 165 тысяч отчётов. На каждый отчёт применяли несколько небольших проверок с отдельными правилами, а не один гигантский промпт. Это позволяло распараллелить оценку и, по наблюдению команды, уменьшало недетерминированность.
От judge требовали сначала сформулировать объяснение, а затем итоговую оценку; авторы связывают этот порядок с более стабильными результатами. Дополнительно команда сделала инструменты для сравнения версий промпта бок о бок и структурированного логирования, чтобы специалисты по бренду и дизайну могли участвовать в настройке. Конкретные judge-модели, пороги и численный прирост согласованности в статье не названы.
Who judges the judge?Timezone-баг показал, зачем QA должен вести обратно к исходным данным
Оценка не заканчивалась выставлением балла. Модельные проверки и точечное ручное ревью находили проблемные отчёты, после чего SQL-запросы и регулярные выражения искали по корпусу структурно похожие случаи. Затронутые отчёты можно было пакетно удалить, обновить защитные правила и снова запустить их генерацию.
Хороший пример — Biggest Discovery Day. Некоторые отчёты уверенно праздновали неправильное число открытых артистов. На поверхности это было похоже на ошибку генерации, но исходная эвристика тоже была правильной. Причина находилась выше: тонкий баг с часовыми поясами в предыдущий этап-конвейере данных иногда выбирал неправильный день как главный день открытий. Получив неверный, но внутренне согласованный вход, модель добросовестно написала убедительную историю о нём.
Поскольку у отчётов сохранялись идентификаторы и полные метаданные, команда смогла проследить ошибку до источника, оценить её распространённость по корпусу, исправить конвейер, массово удалить затронутые результаты и безопасно переиграть только их. Статья не сообщает, насколько часто встречался этот баг, поэтому его нельзя связывать с гипотетическими 0,1% из раздела о масштабе QA.
Catching what slips throughЧто оказалось сложнее самого вызова LLM
Первый вывод команды касается промпта: больше инструкций не обязательно означает лучше. Когда ограничений становилось слишком много, тексты теряли креативность. Второй вывод — промпт нельзя масштабировать отдельно от оценки. На миллиардном объёме редкие ошибки перестают быть редкими в абсолютных числах, поэтому правила генерации и проверки должны развиваться вместе.
Третий вывод — часть проблем конкурентности лучше решать схемой данных, а не координацией процессов. Отдельные column qualifiers для дней убрали необходимость в общем read-modify-write. Четвёртый — изоляция пути хранения и выдачи ограничивает последствия неисправности: генеративный конвейер можно чинить и переигрывать отдельно от чтения уже готовых отчётов.
Авторы также отмечают, что AI coding assistants ускоряли прототипирование, создание тестовой обвязки, разбор пограничных случаев и рефакторинг, но основу работы составляла инженерная экспертиза. Их итоговый тезис шире модели: при таком масштабе вызов LLM — относительно простая часть. Сложнее заранее спланировать мощность, стоимость и запуск, обеспечить повторную обработку после ошибок и выстроить контур безопасности.
Границы результата тоже важны. Материал не называет используемые frontier-, production- или judge-модели, конкретную key-value базу, облако или провайдера модели; не раскрывает размер gold- и DPO-наборов, точные QA-пороги, фактическую общую долю ошибок или частоту timezone-багов. Поэтому архитектурные принципы можно изучать подробно, но недостающие параметры нельзя восстанавливать догадками.
Lessons in scale, safety, and storytellingИтог: пользователь читает готовую историю, а тяжёлая работа происходит заранее
Wrapped Archive отделяет момент чтения истории от всей тяжёлой подготовки. Когда пользователь открывает продукт, система не запускает новую генерацию: нужный текст уже создан и сохранён. Поэтому путь обработки запроса короткий и не зависит от доступности языковой модели в этот момент.
- 01
Открытие Archive
Пользователь открывает Wrapped Archive, и Client Archive UI отправляет запрос на получение отчёта.
- 02
Обращение к сервису архива
Client Archive UI обращается к Archive Storage/Serving Service.
- 03
Чтение готового отчёта
Archive Storage/Serving Service читает ранее сохранённый отчёт из column-oriented key-value хранилища по пользователю и дате.
- 04
Возврат текста
Сервис возвращает готовый текст в интерфейс без новой генерации.
Всё остальное происходит заранее и отдельно от обработки пользовательского запроса. Сначала распределённый конвейер выбирает до пяти примечательных дней и сохраняет снимок пользователя. Затем Publish Pipeline читает эти снимки, отправляет задания через Pub/Sub, а Report Generation Service создаёт отчёты. Для одного пользователя они генерируются последовательно, чтобы более ранние тексты помогали избегать повторов; содержимое отчёта записывается раньше метаданных о завершении дня.
Производственную модель готовят ещё раньше: сильная модель создаёт эталонные ответы, меньшую модель дообучают на проверенном наборе, затем добавляют DPO по человеческим предпочтениям. На масштабе примерно 350 млн подходящих пользователей было подготовлено около 1,4 млрд отчётов, а основной прогон занял четыре дня. Перед глобальным запуском инфраструктуру заранее масштабировали и прогревали синтетической нагрузкой.
Контроль качества тоже вынесен в отдельный контур. Примерно 165 тыс. случайно выбранных отчётов проверяли более крупные модели по точности, безопасности, тону и формату. Найденные классы ошибок можно было искать по корпусу и переигрывать выборочно. Так обнаружили баг часовых поясов: на предыдущем этапе данных иногда выбирался неверный Biggest Discovery Day, и модель правдоподобно описывала ошибочный вход. Статья не раскрывает названия моделей, базы или провайдера и не сообщает измеренную общую частоту сбоев.
Lessons in scale, safety, and storytelling