Разбор готов
ecom.tech: доматчинг товаров с помощью LLM и визуальной верификации
В товарном каталоге недостаточно найти две очень похожие карточки. Платья разных размеров могут выглядеть одинаково, линзы отличаться одной диоптрией, а почти одинаковая упаковка скрывать другой вкус или сорт. В ecom.tech основная система работает как последовательность отбора и проверок: сначала картиночная модель быстро сужает множество кандидатов, затем более дорогие модели разбирают только трудные пары. Изображения превращаются в векторы, а их сходство измеряется скалярным произведением (inner product). Но высокая оценка сходства ещё не гарантирует, что товары действительно одинаковы. Поэтому поверх основного отбора команда построила доматчинг: небольшая языковая модель (LLM) разбирает сложные пары по правилам конкретной категории, а затем отдельная мультимодальная модель перепроверяет визуальные детали.
Глава полезна тем, кто строит поиск, дедупликацию или группировку товаров и хочет понять, где LLM оправдана как дорогой второй этап после дешёвого отбора кандидатов. Здесь особенно важны постановка четырёх классов, доменные правила, дообучение и разделение текстовой и визуальной проверки.
Статья · на русском
Доматчинг товаров с использованием LLM: от промптов до квантизацииКоманда продуктового матчинга ecom.tech · AleksaPro · Опубликовано: 27 января 2026 г.
Где начинается доматчинг
Команда продуктового матчинга ecom.tech решает задачи поиска, группировки и сопоставления товаров. Основная система — это последовательность отбора и проверок, которая в итоге оставляет top-1 кандидата на совпадение. Один из ключевых ранних этапов — картиночная модель: она строит векторные представления изображений и сравнивает их скалярным произведением (inner product). Чем выше значение, тем визуально ближе пара.
Такой фильтр хорошо убирает заведомо непохожие товары, но ошибается именно там, где различие мало заметно по картинке. Два платья разной длины могут получить очень высокий inner product; размер S и M визуально почти неотличимы; у контактных линз важной может быть разница всего в одну диоптрию. В статье для разбора берут пары с inner product выше 0.9 как сильных кандидатов на совпадение. Это пример порога отбора, а не универсальная граница для всех категорий и режимов.
Отсюда и роль LLM: не прогонять через неё миллионы товаров, а проверить небольшой трудный хвост после дешёвого отбора. Именно здесь доматчинг становится дополнительным судьёй для пар, которые простые модели уже сочли очень похожими.
Фрагмент статьи: Где начинается доматчингПочему выбрали небольшую открытую текстовую модель
Текстовая модель должна была удовлетворять трём практическим требованиям. Во-первых, рассуждать на русском и явно следовать правилам товарной категории перед финальным вердиктом. Во-вторых, обрабатывать большой поток пар за разумное время на одной A100. В-третьих, быть открытой, чтобы её можно было дообучать на собственных данных.
Команда сознательно отказалась от большой мультимодальной модели на основном этапе. Даже после предварительного фильтра оставались сотни тысяч пар, а для доменного обучения предстояло многократно сравнивать модели и настройки. Поэтому ориентиром стала мономодальная LLM примерно 8B: достаточно небольшая для серии экспериментов и достаточно сильная для русскоязычных правил.
До доменного дообучения сравнили девять открытых моделей: mister Y-8B, mister Y-8Bin, Phi-4-mini-instruct, saiga_yandexgpt_8b, saiga_llama3_8b, saiga_nemo_12b, Qwen2.5-7B-Instruct, Qwen2.5-3B-Instruct и Mistral-Nemo-Instruct-2407. Названия двух mister Y в статье намеренно изменены — настоящую модель по ним угадывать нельзя. Работа моделей без дообучения авторов не устроила, поэтому следующим шагом стало обучение на данных своей товарной задачи.
Фрагмент статьи: Почему выбрали небольшую открытую текстовую модельЧетыре класса вместо бинарного «матч / не матч»
Задачу сделали четырёхклассовой. Коды — это служебные метки ответа, а не измеренные вероятности и не калиброванный уровень уверенности. Класс 11111 означает «точно матч», 22222 — «скорее всего матч», 33333 — «скорее всего не матч», 44444 — «точно не матч».
Логика опирается на наличие и согласованность атрибутов. Если у обоих товаров указаны важные и менее важные признаки и они совпадают, получается 11111. Если отсутствуют только менее важные признаки, но важные присутствуют и совпадают, допускается 22222. Если хотя бы у одного товара не указан важный атрибут, используется 33333. Если обнаружено расхождение в важном или менее важном атрибуте, пара относится к 44444.
Главная причина такой градации — разные downstream-задачи. Для матчинга авторы ориентируются на полноту и принимают классы 11111 и 22222. Для группировки, где особенно важна точность объединения, берут только 11111. Одна модель поэтому поддерживает два режима строгости без необходимости сводить всё к одной бинарной границе.
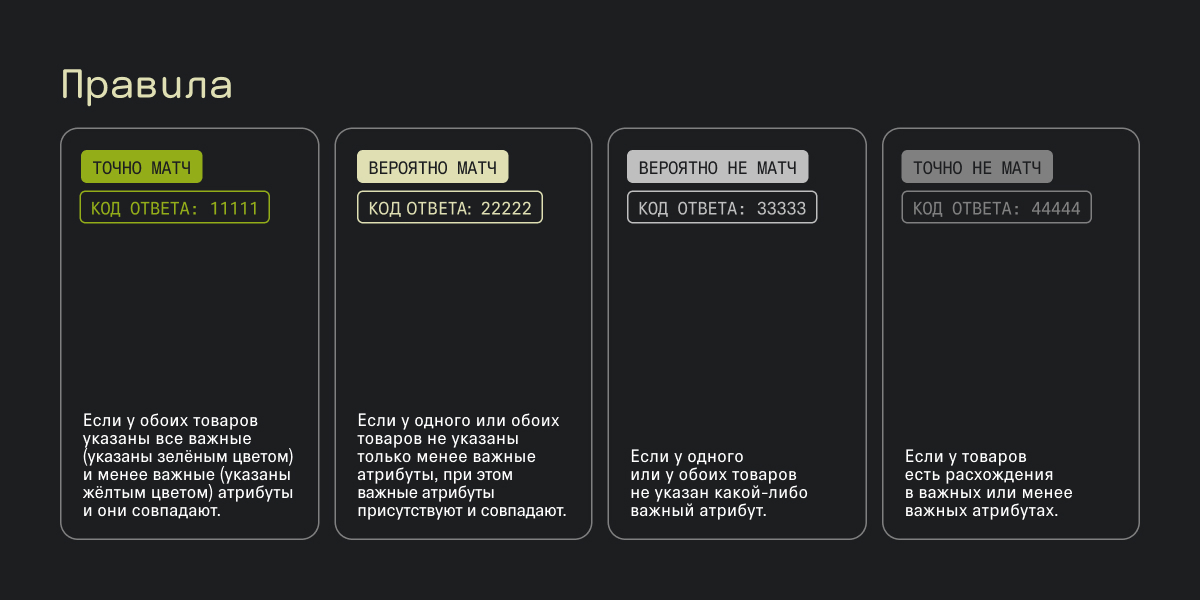
Четыре состояния совпадения определяются наличием и согласованностью важных атрибутов, а не только похожестью описания.
Источник: ecom.tech · Сопоставление товаровЧто считать важным, зависит от категории
Каталог охватывает больше двадцати категорий, многие из них дополнительно делятся на подкатегории. Универсального списка признаков здесь нет: одни и те же поля могут быть критичны в одежде и почти не влиять на решение в другой категории. Поэтому команда подготовила отдельные методички с двумя уровнями: важные и менее важные атрибуты.
Для одежды в приведённом примере важными являются бренд, размер и цвет. Для автомобильных товаров правила иные: в общей категории важен артикул или партномер, а количество в комплекте отмечено как менее важное; для ароматизаторов важны артикул и модель; для автокресел — бренд, возрастная группа и модель, а цвет менее важен. Смысл такого разделения практический: отсутствие второстепенного поля не должно автоматически ломать матч, но отсутствие или конфликт ключевого признака меняет класс.
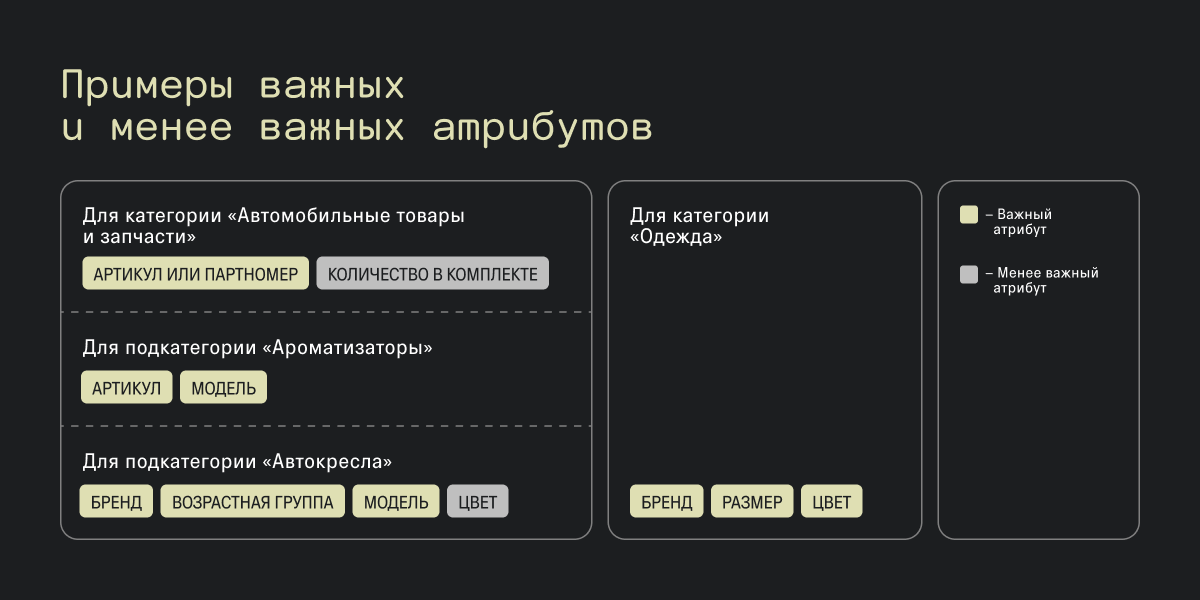
Требования зависят от категории: для одежды важны бренд, размер и цвет, для автомобильных товаров — другие признаки.
Источник: ecom.tech · Сопоставление товаровМетодички превращаются в доменный промпт
Правила категории переносились прямо во вход модели. Промпт задавал четыре допустимых кода, объяснял, какие признаки считать важными и менее важными, а затем передавал два описания товаров. Модель должна была сначала определить релевантную категорию и применить её правила, а уже потом выдать финальный код.
Для обучения собрали 4200 пар — по 200 пар на категорию. Изначально команда хотела поручить асессорам подробные цепочки рассуждений и даже подготовила шаблоны, но качественная ручная CoT-разметка оказалась слишком дорогой по ресурсу команды. Поэтому датасет решили размечать с помощью ИИ, а обучение на этом этапе проводить исключительно по текстовым данным.
Полный промпт содержит и общие правила, и частные исключения: например, отдельные требования для кукол и фигурок, настольных игр, конструкторов, транспорта Lego, колясок, одежды и обуви. Это важно: модель не должна сама выдумывать, какие различия считать существенными, — доменная логика задаётся извне.
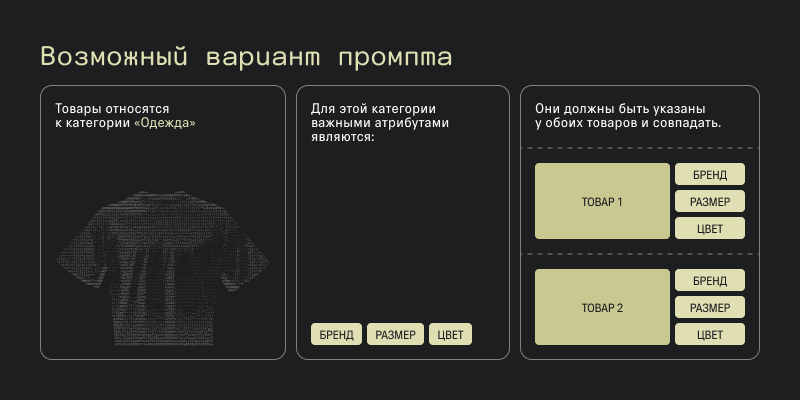
Пример добавления правил категории в промпт. Модель сравнивает указанные атрибуты обеих карточек.
Источник: ecom.tech · Сопоставление товаров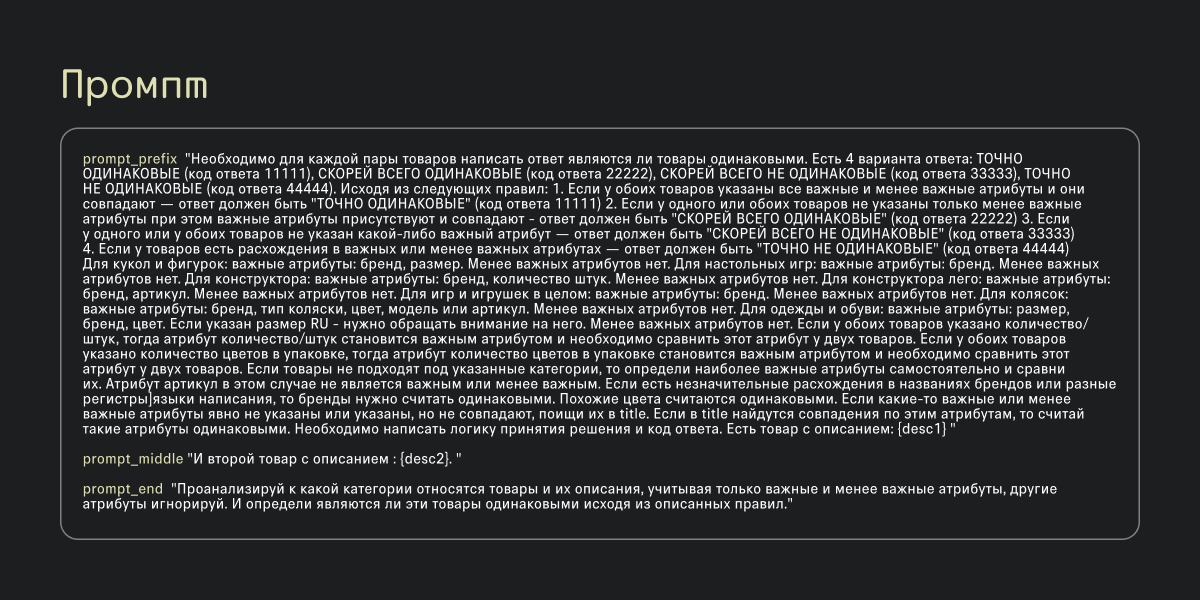
Оригинальный доменный промпт задаёт категории, важные атрибуты и допустимые коды ответа. Его можно увеличить для чтения.
Источник: ecom.tech · Сопоставление товаровПочему простого сравнения строк недостаточно
В обучающем примере сравниваются две карточки спортивных брюк. Поля выглядят по-разному даже там, где описывают близкие свойства. У одного товара состав записан как «полиэтилентерефталат 100%», у другого — «100% полиэстер»; у первого размер расшифрован как 52–54, у второго есть отдельное поле «размер RU: 52» и производительский размер XL. В одной карточке больше служебных полей: тип, серия, модель, сезон, артикул производителя.
Разметчик или LLM должны не сравнить сырые строки один к одному, а понять, какие поля относятся к правилам категории и как сопоставить разные формы записи. В самом примере отдельно анализируются бренд, размер и цвет. Такой кейс показывает, зачем команде потребовались рассуждения по атрибутам: одинаковый смысл может быть разложен по карточкам по-разному, а лишние поля не должны автоматически делать товары разными.
Для простого случая, когда все важные для одежды признаки указаны у обоих товаров и совпадают, правило приводит к классу 11111. Это именно применение доменной инструкции, а не вывод из числовой вероятности модели.
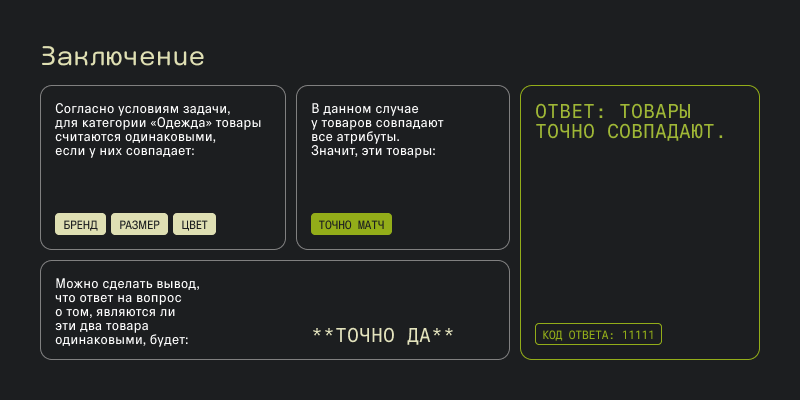
Если все важные атрибуты указаны и совпадают, правила допускают класс «точно совпадают» с кодом11111. Код класса не является измеренной вероятностью.
Источник: ecom.tech · Сопоставление товаровSFT и LoRA: сначала широкий отбор, потом настройка лучших
После подготовки датасета кандидатов дообучили с учителем (Supervised Fine-Tuning, SFT) — то есть на примерах, где для входной пары заранее известен правильный ответ и нужная форма рассуждения. Чтобы не переобучать все веса модели, использовали LoRA: метод обучает небольшие добавочные матрицы поверх основной модели. Эксперименты проводили через trl и torchtune. Сначала модели дообучали без тщательного перебора параметров LoRA, затем оставляли варианты с лучшими метриками и уже для них подбирали настройки.
В статье названы lora_alpha — масштаб LoRA-обновления, r — ранг добавочных матриц, target_modules — модули модели, куда ставятся адаптеры, и weight_decay — коэффициент регуляризации, а также другие гиперпараметры. Их итоговые значения не приведены. Поэтому важен сам порядок работы: сначала отсеять слабые базовые модели, затем тратить вычислительный ресурс на тонкую настройку небольшого числа лучших вариантов.
Фрагмент статьи: SFT и LoRA: сначала широкий отбор, потом настройка лучшихПосле качества упёрлись в скорость применения модели
Для mister Y-8Bin авторы приводят прямой замер на 200 парах: через vLLM обработка заняла 15,5 минуты, через SGLang — 11 минут. vLLM и SGLang здесь — системы для запуска языковых моделей. Это время для указанного набора из 200 пар, а не задержка одной пары и не число запросов в секунду.
Чтобы ускорить обработку дальше, команда перешла к квантизации — снижению разрядности представления весов модели. Сравнили QAT (обучение с учётом квантизации) и GPTQ (квантизацию уже обученной модели) в 4- и 8-битных вариантах. Дополнительно перебирался указанный авторами параметр группировки со значениями 32, 64 и 128. Лучшие метрики получили для GPTQ в 8 бит при значении 32. Источник называет 32 параметром группировки, но не даёт достаточно информации, чтобы утверждать конкретный размер группы или общее число групп.
По статье такой вариант ускорил применение модели почти в 1,5 раза и одновременно дал более высокое качество, чем неквантизованная версия. Итоговое время после квантизации отдельно не указано, поэтому пересчитывать его из исходных 11 минут не следует.
Фрагмент статьи: После качества упёрлись в скорость применения моделиЧто изменилось по F1 после SFT, LoRA и GPTQ
Итог авторы показывают отдельно по каждому из четырёх классов. Реальное имя лучшей 8B-модели остаётся анонимизированным: в тексте нельзя восстанавливать его по косвенным признакам.
Таблицу можно прокрутить по горизонтали.
Здесь Δ — разница значений F1 для одного класса. Это не изменение охвата, не процентные пункты продуктовой метрики и не оценка уверенности модели. Самый большой рост в таблице у класса 33333: с 0.20 до 0.67.
Фрагмент статьи: Что изменилось по F1 после SFT, LoRA и GPTQДоменную ошибку можно исправить правилом, не переобучая модель
После первых экспериментов обнаружилось, что методички не всегда правильно отражали важность признаков. Пример из статьи — количество товара в упаковке для продуктов: сначала этот атрибут был недооценён, хотя в конкретной категории он способен разделять разные товары.
Исправление сделали на уровне промпта: добавили более точное правило и не стали заново обучать LoRA-добавки. Возможность читать рассуждение модели здесь полезна как диагностика: видно, какую доменную инструкцию она применила и где именно правило оказалось неполным. Это не означает, что промпт всегда заменяет обучение; в статье речь о точечной правке логики категории.
Фрагмент статьи: Доменную ошибку можно исправить правилом, не переобучая модельПочему текстовой проверки всё равно недостаточно
Даже пары с высоким сходством изображений и хорошим текстовым совпадением могут отличаться тем, что не попало в карточку: фурнитурой, орнаментом, оттенком, надписью или принтом. Поэтому матчи от текстовой LLM отправляют на ещё один фильтр — мультимодальную InterVL-8B. Она получает изображения вместе с инструкцией и сравнивает визуальные детали; в статье этот этап используется без дополнительного обучения модели.
Промпт здесь намеренно простой: внимательно сравнить форму товара и решить, действительно ли на двух картинках один и тот же товар. Авторы пишут, что такой шаг улучшил «качество доматчинга» примерно на 8% относительно варианта только с текстовой LLM. В статье не раскрыто, какая именно метрика стоит за этим словом, поэтому эти ~8% нельзя переименовывать в accuracy, precision или процентные пункты.
На примере каминов изображения кажутся почти одинаковыми, но различаются отделка, декоративные элементы, пропорции и общий дизайн. Мультимодальная модель поэтому приходит к выводу, что это могут быть разные модели или версии камина. В примере с кофе упаковки оформлены почти одинаково, но на одной написано «Сливочная помадка», на другой — «Бразилия Рамос». Похожая упаковка не делает товары идентичными.
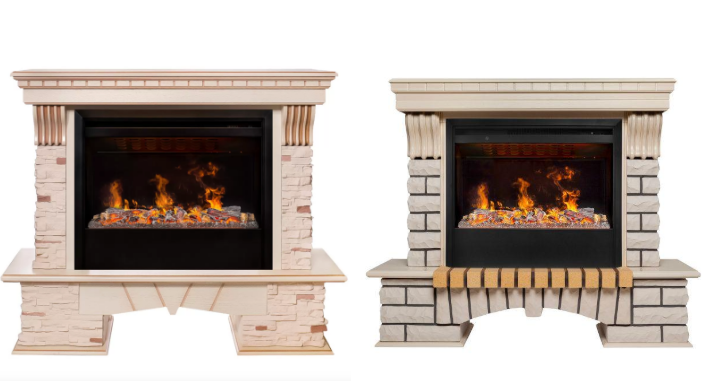
Похожие товары могут отличаться визуальными деталями, которые не отражены в текстовых атрибутах.
Источник: ecom.tech · Сопоставление товаров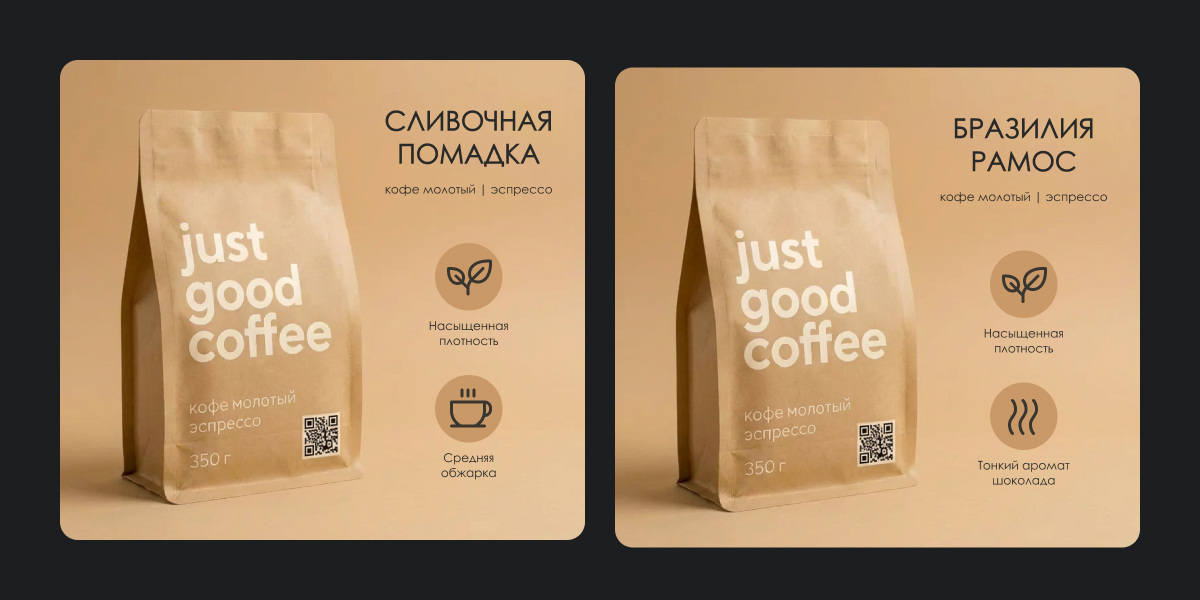
Сходство упаковки ещё не означает одинаковый товар: в примере различаются названия сортов.
Источник: ecom.tech · Сопоставление товаровКак доматчинг встраивается после основного отбора
Доматчинг не заменяет основную последовательность отбора и проверок. Сначала картиночная модель уже существующей системы выбирает сильных кандидатов по inner product. В начале статьи показан пример с порогом выше 0.9; в финальных принципах приводится диапазон 0.8–0.95. Конкретная граница зависит от того, сколько пар команда готова отправить на более дорогую проверку и какие вычислительные ресурсы доступны.
После порога пары проходят текстовую LLM с доменными правилами. Для матчинга допускаются 11111 и 22222, для группировки используется только более строгий 11111. Оставшиеся пары затем проверяет InterVL-8B по изображениям, чтобы убрать визуально похожие, но не одинаковые товары.
Таблицу можно прокрутить по горизонтали.
Это два разных продуктовых режима и две отдельные пары чисел. +8% охвата в матчинге нельзя смешивать с примерно 8% улучшения качества от мультимодальной верификации: первое относится к работе всей системы и охвату, второе — к добавлению визуальной проверки после текстовой LLM. Статья не описывает эти изменения как GMV, процентные пункты или результат конкретного A/B-дизайна.
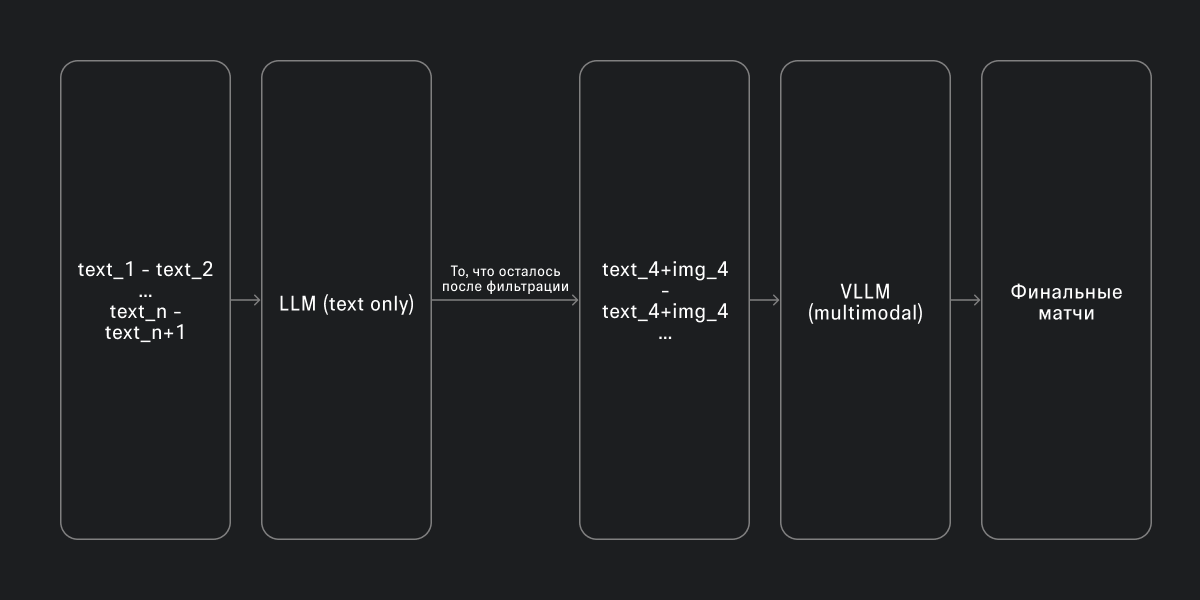
Текстовая модель отбирает пары по атрибутам; оставшиеся пары проходят визуальную проверку перед финальным совпадением.
Источник: ecom.tech · Сопоставление товаровЧто из статьи можно утверждать, а что остаётся неизвестным
Источник даёт ясную архитектуру и конкретные численные результаты, но не раскрывает полный протокол оценки. Не описано, как 4200 пар делили на обучающую и проверочную части, сколько примеров было в итоговой проверке, как оценивалась статистическая неопределённость и как именно был устроен продуктовый эксперимент. Из ограничений оборудования явно названа цель работать на одной A100, но полная конфигурация системы не приведена.
Поэтому числа нужно читать буквально. 83% и 97.4% — «точность» в терминологии авторов для двух продуктовых задач; +8% и +14.7% — изменения охвата; около 8% — отдельное улучшение качества после мультимодальной проверки. Эти величины не следует переводить в другие метрики без дополнительных данных.
Фрагмент статьи: Что из статьи можно утверждать, а что остаётся неизвестнымИтог: дорогую LLM ставят только на трудный хвост
Главная инженерная идея этой системы — не пытаться заменить языковой моделью весь матчинг товаров. Сначала основная модель быстро сужает множество пар, а более дорогие проверки работают только с трудным хвостом. Обучение организовано отдельно от рабочего потока: текстовую модель адаптировали на 4200 размеченных парах с помощью SFT и LoRA, затем ускорили GPTQ. Качество сравнивали по F1 четырёх классов, а ошибки в правилах категории могли исправлять дополнительными условиями в промпте без нового обучения LoRA-добавок.
- 01
1. Основной отбор кандидатов
Картиночная модель сравнивает векторы изображений через inner product, а выбранный порог оставляет только визуально близкие пары.
- 02
2. Текстовый анализ
Дообученная 8B-LLM читает описания товаров и применяет правила категории: какие атрибуты важны и какие расхождения допустимы.
- 03
3. Выбор классов по задаче
Для матчинга принимаются 11111 и 22222, а для более строгой группировки — только 11111.
- 04
4. Визуальная верификация
Пары, прошедшие текстовый этап, сравнивает InterVL-8B, чтобы поймать различия в форме, фурнитуре, принте, цвете или надписях.
- 05
5. Финальные пары
После текстовой и визуальной проверок остаются пары, которые система передаёт дальше в матчинг или группировку.
На реальных данных авторы сообщают рост охвата матчинга на 8% при точности 83% и рост охвата группировки на 14.7% при точности 97.4%. Отдельно мультимодальная проверка дала около 8% улучшения качества относительно варианта только с текстовой LLM — это другая величина. Источник не раскрывает, как именно данные делили для обучения и проверки, подробную схему продуктового эксперимента или статистическую неопределённость результатов. Поэтому эти числа описывают конкретную реализацию ecom.tech, а не универсальный эффект для любого товарного каталога.
Фрагмент статьи: Итог: дорогую LLM ставят только на трудный хвост