Разбор готов
Семь направлений развития рекомендаций по итогам 2025 года
Чтобы выбрать для человека следующий ролик, товар или трек, рекомендательная система должна сократить огромный каталог до небольшой подходящей выдачи. Обычно это делает каскад моделей: одни быстро отбирают кандидатов, другие подробнее оценивают их и определяют порядок. Но ранние этапы ограничивают поздние, несколько целей трудно согласовать, а оборудование используется не полностью. В докладе «Главные тренды рекомендательных систем» на ML Global Recap 2025, 23 декабря 2025 года, Николай Савушкин из Яндекс R&D объясняет, какие ответы индустрия ищет на эти ограничения: генерацию идентификаторов объектов, более крупные модели, длинную историю действий, общие представления и новые способы ранжирования. Это обзор разных компаний и исследований. Он помогает понять причины изменений и границы опубликованных результатов, а не описывает одну внедрённую систему Яндекса.
Материал полезен ML-инженерам и исследователям, которые знакомы с основами рекомендаций и хотят разобраться, что меняется при переходе от каскада к генеративным моделям. Особенно важны различия между обучением и выдачей, размером модели и стоимостью её работы, промышленным примером и пока открытым исследовательским вопросом.
Видео · на русском
Главные тренды рекомендательных систем / Николай СавушкинНиколай Савушкин · Опубликовано: 23 декабря 2025 г.
Исходный доклад · Открыть оригинал
Почему обзор начинается с разных продуктов и исследовательских площадок
Савушкин представляет службу рекомендательных технологий Яндекса как общую для разных продуктов команду. Она занимается рекомендательными исследованиями, инструментами обучения и внедрения моделей. Её разработки применяются там, где нужна персонализация: спикер называет Поиск, Рекламу и Лавку. Это объясняет широкий взгляд на область: задача не ограничивается одним каталогом или одной пользовательской поверхностью.
Доклад состоит из двух частей. Сначала автор рассказывает, где появляются значимые рекомендательные исследования и чем отличаются посещённые конференции. Затем выделяет семь трендов, для каждого объясняя причину интереса, ожидаемую пользу и примеры компаний. Обзор относится к концу 2025 года; слова о будущем сохраняют смысл прогноза, сделанного в этот момент.
Применение разработок команды в сервисах Яндекса не означает, что все последующие архитектуры уже работают в этих сервисах. В дальнейшем нужно различать собственные наблюдения спикера, чужие промышленные решения и исследовательские идеи. Именно эти различия позволяют читать обзор как объяснение развития отрасли, а не как историю внедрения одной модели.
Доклад · 00:00:03Три группы конференций и разные способы следить за областью
Первая группа — специализированные конференции по информационному поиску, к которым автор относит и RecSys. Вторая — площадки на пересечении информационного поиска с другими областями. Для неё на слайде приведены четыре примера, но в речи они отдельно не перечисляются. Третья — общие ведущие ML-конференции, в частности NeurIPS и ICML.
У каждой группы своя ценность. На специализированной конференции проще найти много работ по рекомендациям. На общей ML-конференции рекомендательный трек может быть небольшим, зато туда авторы часто стремятся отправить особенно заметную работу. Поэтому широта тематической программы и шанс увидеть важную новую идею — не одно и то же.
В этой части Савушкин делится собственным ориентиром для чтения и поездок, а не составляет универсальный рейтинг площадок. Даже у крупной конференции может оказаться немного интересного для узкой рекомендательной задачи. Позже он связывает с NeurIPS работу о генеративном поиске, а с ICML — пример масштабирования рекомендательной модели.
Для планирования публикаций автор также рекомендует ресурс с местами проведения конференций и сроками подачи. Его практическая роль — помочь понять, куда ещё можно успеть отправить работу. Эта организационная часть дополняет выбор того, за какими исследованиями следить.
Доклад · 00:01:21RecSys: научная новизна и цена воспроизводимости
В 2025 году команда приехала на RecSys большим составом, в том числе как слушатели. От неё было две публикации: одно устное выступление и один стенд. Это результат участия в конференции, а не число запущенных рекомендательных моделей.
По описанию автора, воркшопы проходят в первый и последний дни. Основная программа разделена между залом с докладами и небольшим залом с постерами. Такой формат отличается от конференции с множеством одновременно идущих устных секций.
Содержательный акцент RecSys Савушкин видит в научной новизне и воспроизводимости. Говоря об основном треке, он подчёркивает необходимость открытых публичных бенчмарков. Для промышленной команды это существенное ограничение: результат, полученный в работающем сервисе, не всегда можно воспроизвести на доступных всем данных. Поэтому сильный промышленный кейс и удобная для научной проверки работа не обязаны совпадать по форме.
Доклад · 00:02:52CIKM: индустриальный фокус, графы и параллельные секции
CIKM, вторую посещённую конференцию, спикер характеризует как площадку с большим количеством работ о графовых нейросетях и очень заметным рекомендательным направлением. По его впечатлению, там регулярно появляются интересные промышленные исследования и менее жёстко трактуется новизна публикации.
Иллюстрация — InterFormer от Meta. По словам Савушкина, работа была опубликована примерно за год до представления на этой конференции, но всё равно попала в программу. Здесь InterFormer нужен как пример публикационной практики. Ни устройство модели, ни её продуктовый эффект в этом фрагменте не разбираются.
Организация создаёт другой компромисс для посетителя: устные доклады идут во многих комнатах одновременно, поэтому приходится выбирать между секциями и переходить из зала в зал. Постерная сессия небольшая, воркшопам отведён один день. Рекомендация автора следить за этой площадкой основана на её индустриальном содержании, а не на утверждении, что такой формат лучше для любой исследовательской задачи.
Доклад · 00:03:54Семь трендов — авторская группировка, а не единая архитектура
Перед технической частью Савушкин задаёт границы обзора. Он сам группирует работы в семь направлений и объясняет, почему считает каждое из них заметным. Это не формальная классификация всей области. Для подробного разбора любого направления потребовалось бы отдельное выступление.
Основной интерес автора — промышленные исследования: что компании пробуют в работающих сервисах, проверяют экспериментами и внедряют. Но такое общее описание не даёт одинакового статуса каждой упомянутой публикации. Например, исток генеративного поиска дальше показан через академический бенчмарк, а универсальный помощник из вопросов и ответов остаётся прогнозом.
Семь направлений затрагивают разные уровни системы. Одни меняют способ получения рекомендаций целиком, другие — размер и вход модели, третьи объединяют знания нескольких продуктов. Развитие ранжирования и отбора кандидатов может происходить внутри сохраняющегося каскада. Поэтому перечисленные решения не нужно соединять в одну последовательность обязательных стадий.
Доклад · 00:05:07End2End-модели: какие ограничения накопились у каскада
У системы есть много объектов и функция, которая оценивает, насколько каждый из них подходит пользователю. Применить самую сложную функцию ко всему каталогу слишком дорого. Поэтому сначала работают быстрые методы отбора, затем более тяжёлые модели обрабатывают всё меньшие наборы кандидатов.
На слайде показана типичная последовательность: каталог документов, отбор кандидатов, предварительное ранжирование, основное ранжирование и переранжирование. «Документ» здесь означает объект рекомендации, а не обязательно текст. Такая организация делает задачу вычислительно выполнимой, но связывает возможности поздней модели с результатами ранней. Объект, потерянный при отборе, уже не попадёт на подробную оценку.
Есть и другие ограничения. Разнесённые по сервисам этапы плохо используют оборудование. Несколько целей приходится согласовывать на всём пути: автор приводит клики и конверсии, лайки и прослушивания. Даже хороший отдельный ранжировщик не решает проблему, если его цели расходятся с целями предыдущего отбора.
End2End-подход рассматривается как попытка уменьшить эти разрывы. Важен не сам ярлык «одна модель», а возможность согласовать выбор объектов и оптимизацию системы. Сравнение с отставанием рекомендаций от NLP, компьютерного зрения и обработки речи выражает оценку спикера; количественного рейтинга областей на слайде нет. Именно 2025 год спикер выделяет как время появления известных ему работ о таком переходе в реальных продуктах.
Рисунок 1. Каскад снизу вверх: Documents → Candidate-Generation → Pre-Ranking → Ranking → Re-Ranking. По мере сокращения списка обработка усложняется, но каждая стадия ограничивает следующую. Это схема мотивации End2End, а не архитектура конкретного запуска Яндекса.
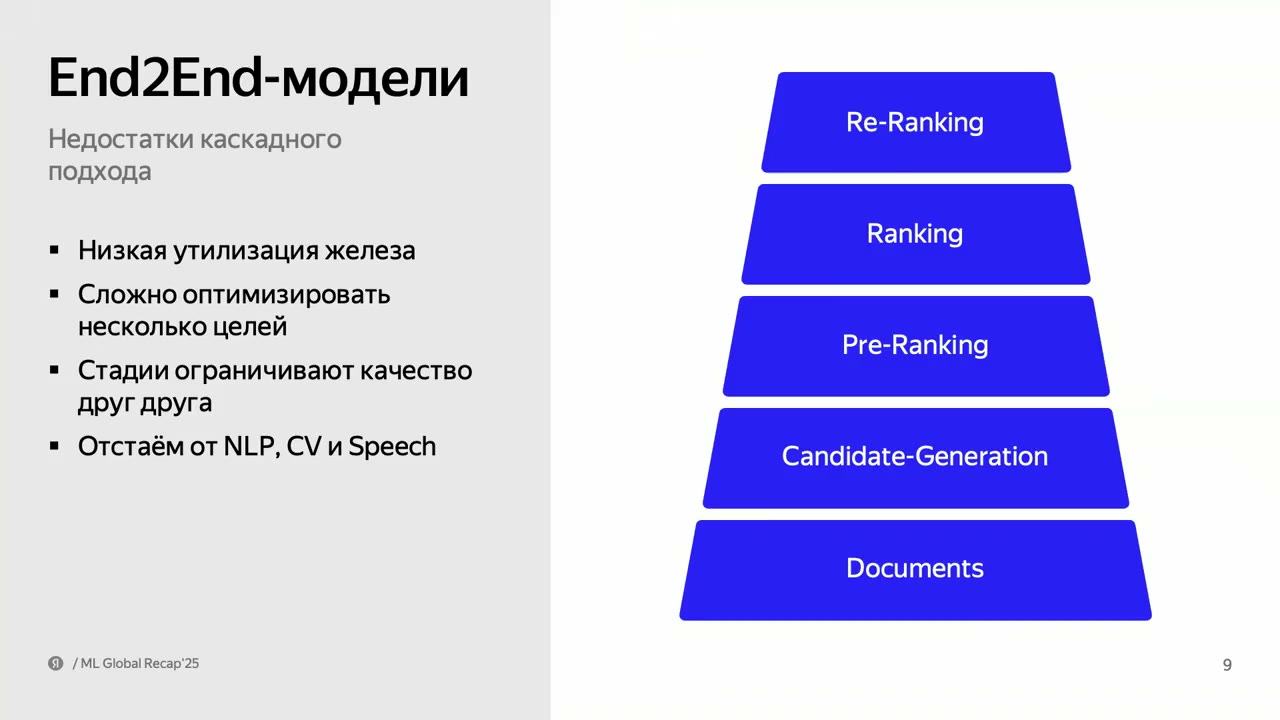
Стадии каскада ограничивают друг друга; отдельные модели усложняют совместную оптимизацию целей и использование оборудования.
Источник: Николай Савушкин · ЯндексГенерировать не оценку всех объектов, а код следующего
Исследовательскую предпосылку спикер связывает с работой Google/DeepMind Recommender Systems with Generative Retrieval, представленной на NeurIPS в 2023 году. Её ключевой для обзора ход — представить объекты каталога короткими последовательностями кодов, которые модель умеет предсказывать.
Такой составной код называется семантическим идентификатором, или Semantic ID. Идею автор объясняет через иерархию: все видео, затем видео о животных, затем о котиках, затем смешные видео о котиках. Номера переходов от общего к частному можно читать как токены. Это пояснение принципа, а не требование вручную разметить весь каталог именно такими категориями.
После этого входом становится последовательность кодов объектов из истории, а выходом — код следующего объекта. В схеме двунаправленный Transformer Encoder обрабатывает историю, а Transformer Decoder генерирует продолжение. Получается задача преобразования одной последовательности в другую, а не непосредственной оценки каждого из миллиардов возможных объектов.
Таблицу можно прокрутить по горизонтали.
На выходе декодера для Item 64 показаны t_5, t_25, t_55 и служебное завершение <EOS>; <BOS> обозначает начало декодирования. Числа внутри кода не задают размер кодбука, а три позиции на этой иллюстрации не устанавливают длину кода для всех генеративных рекомендателей.
В изложении Савушкина исходная работа проверяла идею на академическом бенчмарке. Промышленный переход к действительно крупной системе стал следующим шагом. Его оговорка существенна: до новых работ он не видел опубликованного подтверждения такой адаптации, а не доказал отсутствие непубличных разработок.
Рисунок 2. Recommender Systems with Generative Retrieval: энкодер читает токены пользователя и его истории, декодер выдаёт семантический код следующего объекта. На примере Item 64 видно, что модель генерирует составной идентификатор.
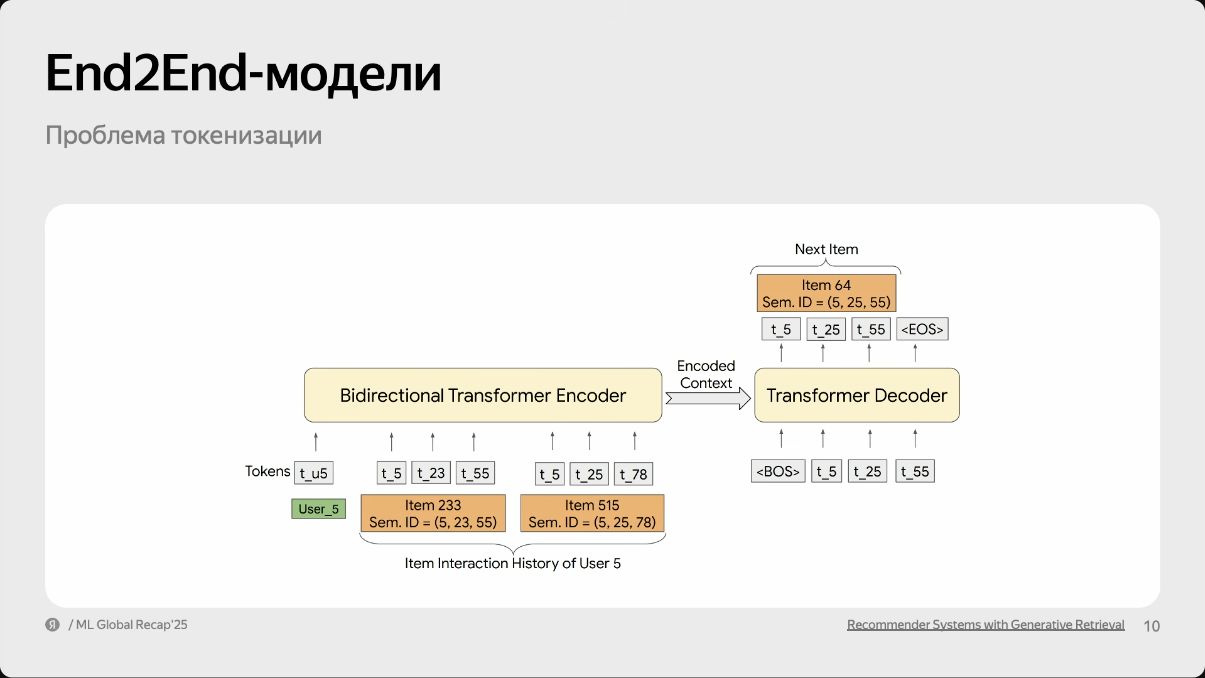
Слайд 10: история объектов кодируется как токены, decoder генерирует код следующего объекта. На слайде прямо указана работа Recommender Systems with Generative Retrieval, 2023.
Источник: Николай Савушкин · ЯндексOneRec: промышленный пример Kuaishou и два этапа обучения
Промышленный пример — OneRec компании Kuaishou, показанный по OneRec Technical Report. Савушкин сравнивает этот китайский видеосервис с TikTok и приводит ориентир около 400 млн ежедневных активных пользователей. Этот масштаб относится к компании: он не является эффектом OneRec и не характеризует аудиторию Яндекса.
В верхней части схемы находится прежний каскад CascadedRec. Он опирается на данные пользователей, объектов и логи рекомендаций, множество правил и моделей. Возле стадий подписаны порядки величин: около 10^8 объектов перед Retrieval, около 10^4 перед Pre-rank и около 10^3 перед Rank. Они иллюстрируют сужение набора кандидатов, а не число параметров или запросов в секунду.
Ниже показана OneRec в форме «энкодер–декодер». Энкодер получает описание пользователя через историю событий; на схеме подготовки входа также видны User Info и Context Info. Декодер генерирует рекомендательные токены. Полученные коды через Mapping сопоставляются с Video ID, то есть с конкретными роликами.
Модель сначала учится повторять поведение системы, которая создала логи. Это поведение называют логирующей политикой: она определяла, какие объекты попадали пользователю. На слайде предварительная цель обозначена NTP — предсказание следующего токена. Такой этап даёт модели исходную способность генерировать выдачу по накопленным примерам.
Таблицу можно прокрутить по горизонтали.
На втором этапе модель согласуют с целями рекомендации через обучение с подкреплением. Reward System оценивает, насколько объект должен понравиться пользователю, и её оценки участвуют в оптимизации. На оригинальной схеме указано ECPO. Численная величина награды, её точное устройство и параметры выборки вариантов в докладе не раскрываются.
Схема различает Train Phase и Infer Phase, а также отмечает Online Learning. Из этого не следует, что обработка каждого запроса включает обновление весов. Для выдачи применяют обученную модель; периодичность её обновления здесь не задана. Необязательный Select с участием Reward System — операция выбора, а не синоним переобучения.
По словам спикера, такую генеративную систему запустили в зрелом рекомендательном продукте Kuaishou. Это прямое заявление о промышленном применении. Однако в обзоре нет численного прироста качества, размера эксперимента или стоимости обслуживания OneRec, поэтому сам запуск нельзя превратить в конкретный измеренный эффект.
Рисунок 3. OneRec Technical Report: сверху — многоэтапный CascadedRec, снизу — энкодер–декодер, генерация кодов и Reward System. NTP и ECPO относятся к разным этапам обучения; сопоставление кодов с роликами относится к получению рекомендаций. Пример принадлежит Kuaishou.
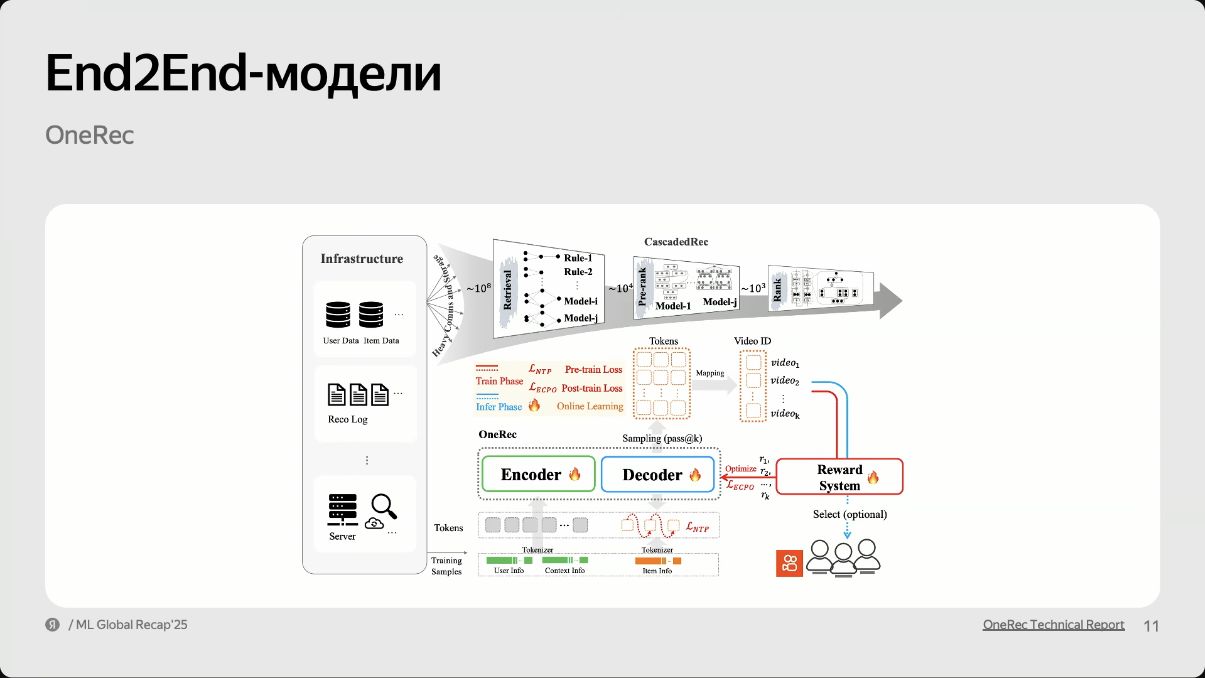
Слайд 11 из OneRec Technical Report. Предобучение по логам и последующая работа с наградой отделены от инференса; это пример Kuaishou, не архитектура Яндекса.
Источник: Николай Савушкин · ЯндексКакие ещё генеративные системы вошли в обзор
После OneRec автор показывает подборку публикаций о генеративных End2End-рекомендателях 2025 года. Он характеризует её как известные ему примеры внедрения в реальные продукты. Подробно устройство решения обсуждалось у OneRec; для остальных слайд фиксирует названия и компании, но не воспроизводит отдельные эксперименты.
Вывод Савушкина относится к составу этой подборки: все перечисленные здесь промышленные End2End-публикации пришли от китайских компаний. Это наблюдение о доступных ему работах на конец 2025 года, а не утверждение, что за пределами Китая никто не занимался генеративными рекомендациями.
Одинаковое место в обзоре не делает модели одинаковыми. Нельзя переносить на OneLoc, EGA или GPR устройство Reward System из OneRec, а на все версии технического отчёта — одну экспериментальную конфигурацию. Здесь важно само расширение направления от одного примера к нескольким компаниям.
Рисунок 4. Подборка End2End-работ: семейства Kuaishou, EGA у Meituan и GPR у Tencent. Список показывает широту направления, но не является таблицей качества или одинакового эффекта внедрения.
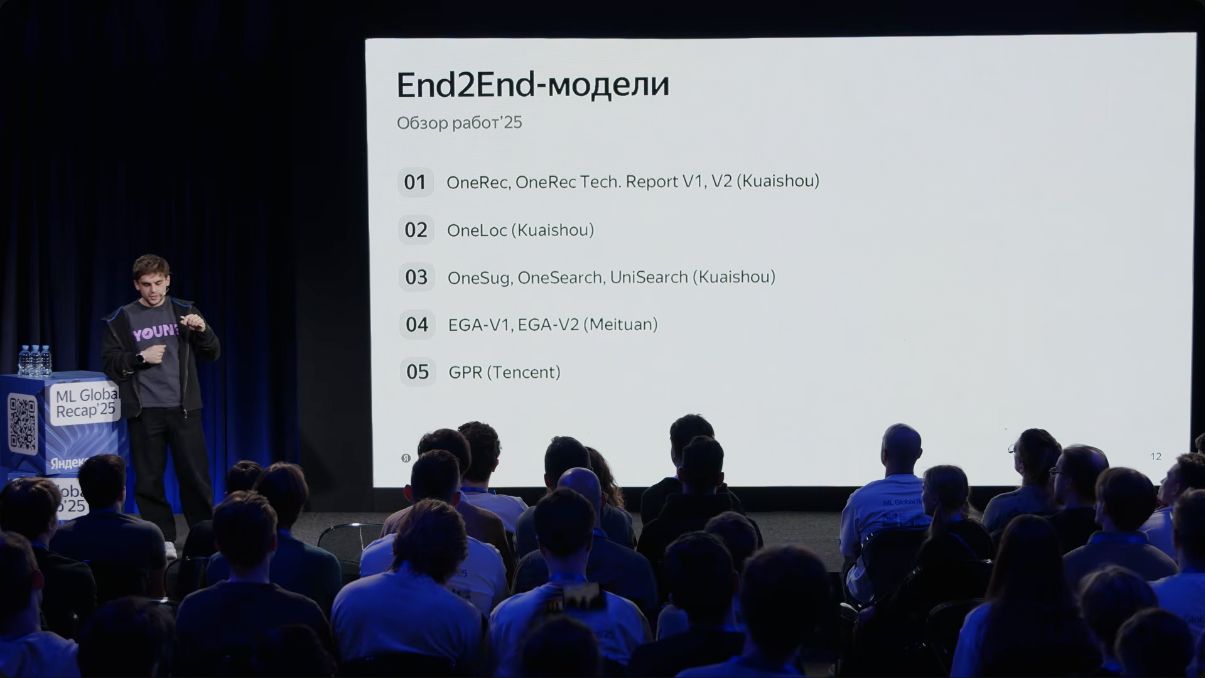
Слайд 12: OneRec/OneLoc/OneSug/OneSearch/UniSearch у Kuaishou, EGA у Meituan и GPR у Tencent. Это список обзора, не отдельные измеренные результаты Яндекса.
Источник: Николай Савушкин · ЯндексРекомендации как отдельная модальность языковой модели
Если объект уже представлен токенами, следующий шаг — научить большую языковую модель работать и с этими токенами. В таком подходе рекомендации становятся ещё одной модальностью: наряду с текстом, изображениями или речью модель обрабатывает обозначения рекомендуемых объектов.
Пользовательский смысл идеи прост. Задачу можно описать обычными словами, а ответ получить не только как набор объектов, но и как объяснение выбора. Савушкин обсуждает эти возможности как направление изменения взаимодействия с рекомендательным продуктом. Он не утверждает, что все перечисленные модели уже реализуют каждую из этих возможностей одинаковым способом.
Таблицу можно прокрутить по горизонтали.
Таким образом, статус этой тройки в самом докладе сильнее, чем просто «перспективные исследования»: слайд прямо относит их к промышленным работам с запуском в продукт. При этом ни величины бизнес-эффекта, ни условия трёх отдельных экспериментов здесь не приведены.
Автор отмечает, что работа DeepMind появилась первой из этой тройки, и связывает её с командой, ранее предложившей рекомендательные токены. Общий интерес направления — не только в новом внутреннем устройстве модели, но и в возможности иначе формулировать запрос к рекомендациям.
Рисунок 5. PLUM, OneRec-Think и Align^3GR объединены темой LLM + RecSys и промышленным статусом по докладу. Слайд не сравнивает их качество и не задаёт общий для всех трёх моделей способ обучения.
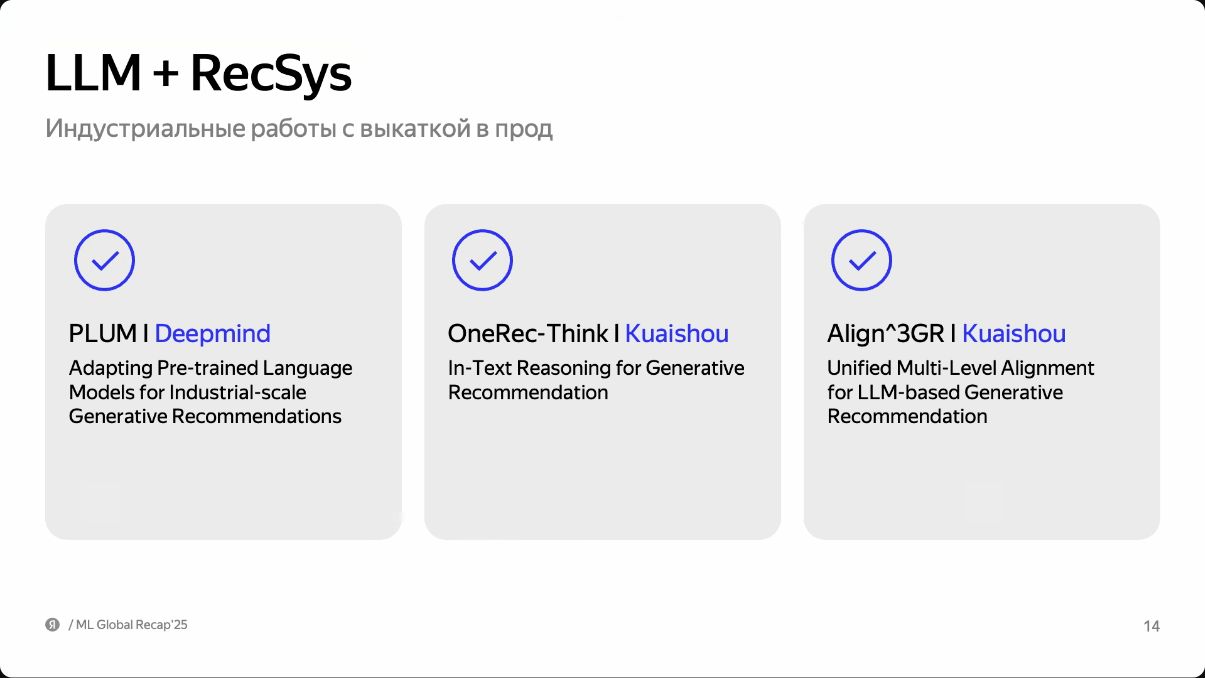
Слайд 14 описывает промышленные работы с LLM: PLUM у DeepMind, OneRec-Think и Align^3GR у Kuaishou. Статус приведён по докладу; численных бизнес-эффектов слайд не показывает.
Источник: Николай Савушкин · ЯндексЧто именно растёт: плотное ядро, вход, данные или таблицы ID
Фраза «модель стала больше» недостаточна для понимания рекомендаций. Увеличить можно вычислительное ядро, объём входной информации, обучающие данные или таблицы представлений отдельных объектов. Эти изменения по-разному влияют на обучение и работу системы.
Таблицу можно прокрутить по горизонтали.
Высокая кардинальность означает, что признак принимает очень много разных значений. Пример автора — идентификаторы видео: в большом сервисе их может быть миллиарды. Если каждому ID соответствует собственный обучаемый вектор, таблица таких векторов становится огромной. Именно эту часть в обзоре называют sparse-частью.
Показательный пример — работа Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations, которую Савушкин связывает с ICML. В его объяснении почти весь упомянутый триллион параметров находится в таблицах эмбеддингов, тогда как собственное трансформероподобное вычислительное ядро содержит порядка 100 млн параметров. Триллион общих параметров не означает триллион параметров плотной нейросети, вычисляемой на каждом запросе.
Такое различие объясняет прежнюю привлекательность расширения sparse-части. По словам автора, оно увеличивает инженерную сложность обучения, но не наращивает вычислительную работу в продакшене так, как увеличение плотного ядра. Это рассуждение об устройстве вычислений, а не обещание нулевой стоимости хранения больших таблиц.
На схеме справа видны входная последовательность, слои эмбеддингов, блоки самовнимания и слой предсказания следующего объекта. Она помогает отделить хранение представлений от их последующей обработки. Числа в рассказе характеризуют обсуждаемый пример, а не собственную модель Яндекса.
Рисунок 6. Четыре оси масштабирования и схема из Actions Speak Louder than Words. Главный вывод — общий счётчик параметров скрывает принципиальную разницу между огромными таблицами ID и плотным вычислительным ядром.
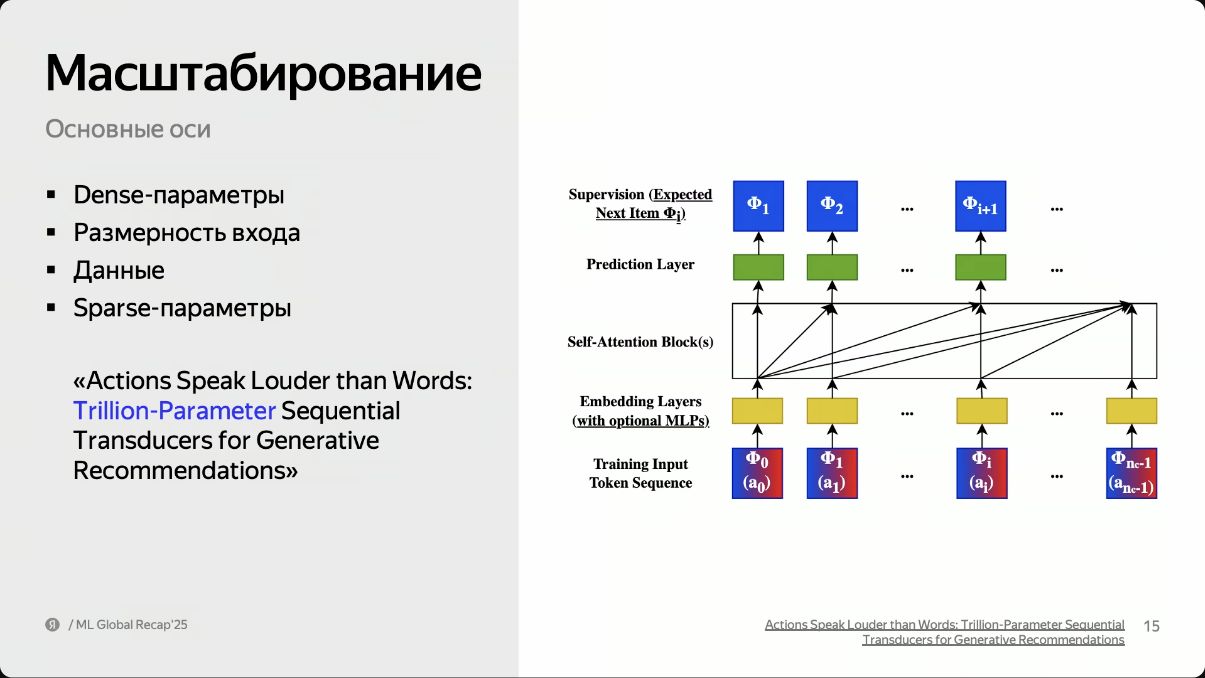
Слайд 15: dense-параметры, размерность входа, данные и sparse-параметры. Триллион параметров в названии работы не равен триллиону параметров плотного вычислительного ядра.
Источник: Николай Савушкин · ЯндексПлотные модели и длинная история: новый масштаб и новые затраты
Сдвиг 2025 года Савушкин видит в том, что компании начинают активнее масштабировать не только таблицы ID, но и плотную часть модели. В обзоре он показывает шесть графиков из разных публикаций: в них меняют параметры, длину последовательности и объём вычислений.
Длинная история пользователя — отдельная часть этого направления. Увеличение числа событий на входе даёт модели больше информации о поведении человека. Это не то же самое, что расширить таблицу эмбеддингов: теперь больше данных нужно обработать внутри самой последовательностной модели.
У роста истории есть вычислительная цена, поэтому длину входа нельзя обсуждать отдельно от размера модели и стоимости её применения. Однако обзор не задаёт конкретного количества событий, окна в днях или способа сжатия старой части истории. Он фиксирует направление масштабирования, а не готовую конфигурацию длинного контекста.
Шесть графиков не образуют единого эксперимента. Автор специально отмечает, что в рекомендациях пока нет общего способа описывать законы масштабирования: компании показывают разные зависимости. Из этого материала нельзя вывести одну универсальную кривую «вычисления — качество» или общий оптимальный размер модели.
Ожидание дальнейшего роста спикер связывает с тем, что рекомендательные датасеты велики и пополняются каждый день. Это мотив продолжать исследование масштабирования. Он не отменяет вопроса, какая часть модели даст больше пользы при ограниченном бюджете; к нему вернутся в конце вопросов и ответов.
Доклад · 00:14:07Фундаментальные модели: общие знания вместо изолированных продуктов
Традиционно рекомендательную модель обучали для конкретного продукта, а иногда и для одного места внутри него. Автор приводит Яндекс Музыку и «Мою волну» как пример такого уровня специализации. Здесь название сервиса иллюстрирует постановку задачи, а не обозначает новый промышленный результат.
Фундаментальная рекомендательная модель должна объединять знания нескольких продуктов или пользовательских поверхностей. Её затем используют в прикладных задачах. В этом фрагменте «фундаментальная» означает прежде всего общую для разных рекомендательных доменов, а не уже универсальную модель, одинаково решающую все задачи текста, изображений и рекомендаций.
На слайде названы три причины такого объединения. Первая — более богатое описание пользователя, которое не ограничено одним контекстом потребления. Вторая — более разнообразный обучающий набор. Третья — возможность повторно использовать модель общего назначения вместо независимой разработки для каждой задачи.
В качестве компаний, сообщивших о внедрении подобных моделей, показаны Pinterest, Meta, Netflix и Tencent. По объяснению спикера, их решения объединяют разные поверхности и продукты, после чего используются в прикладных задачах. Обзор не раскрывает отдельные размеры моделей или показатели качества этих четырёх компаний.
Иллюстративная схема показывает переход от общих представлений к прикладным моделям через последующее обучение. Среди вариантов подписаны дистилляция знаний, совместное использование параметров и обучение представлений. Это возможные способы переноса знаний, а не одна обязательная последовательность, одинаково реализованная у всех компаний.
Рисунок 7. Мотивация фундаментальной модели: больше знаний о пользователе, разнообразнее данные и повторное использование общей основы. Логотипы Pinterest, Meta, Netflix и Tencent обозначают примеры из обзора, а схема показывает идею перехода к прикладным моделям.
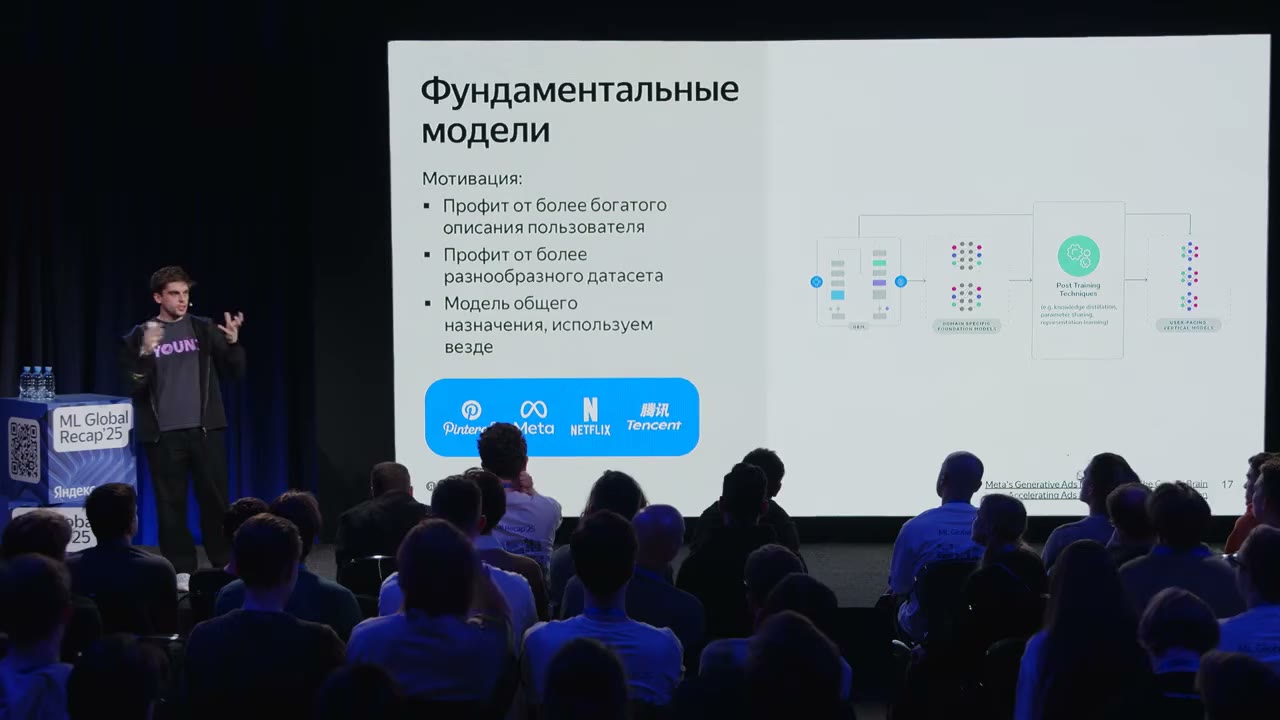
Общие представления пользователя и разнообразные данные мотивируют фундаментальные модели. Перечисленные компании — примеры из обзора, не подтверждение одной общей архитектуры или результатов Яндекса.
Источник: Николай Савушкин · ЯндексПочему готовые мультимодальные векторы недостаточны
Семантические идентификаторы требуют модели, которая представляет содержание объектов в общем пространстве. Такой семантический энкодер нужен, чтобы близкие по содержанию объекты можно было связать при построении кодов. Но его знания могут пригодиться и обычной рекомендательной модели, без полной замены каскада генеративной системой.
Причина интереса — ограниченность отдельных ID. Таблица векторов позволяет выучить представление конкретного объекта, но сам идентификатор не рассказывает, что находится внутри ролика или чем один документ похож на другой. Мультимодальная модель добавляет информацию о содержании и знания о мире.
Однако просто передать готовые мультимодальные векторы в рекомендательную модель оказалось недостаточно. По словам Савушкина, без дообучения такой приём не приносил большого выигрыша ни его команде, ни другим компаниям, судя по их сообщениям. Это качественное наблюдение, без численного сравнения и перечня проверенных энкодеров.
Успешное направление он связывает с дообучением мультимодальных языковых моделей на коллаборативном рекомендательном сигнале — данных о взаимодействиях пользователей с объектами. После этого их специальным образом используют в прикладных рекомендательных задачах. Так представления связываются не только с содержанием, но и с тем, что важно для рекомендации.
Точные функции потерь, названия моделей и способы последующего подключения в этой части не раскрыты. Поэтому основной содержательный результат — необходимость адаптации к рекомендательному сигналу. Неудача простой подстановки векторов включает собственный опыт Яндекса; положительные результаты дообучения автор описывает как более широкий индустриальный тренд.
Это направление отличается от LLM с рекомендательной модальностью. Там меняется то, с какими токенами модель может работать и как человек формулирует запрос. Здесь обсуждается качество представлений содержания и их пригодность для уже существующих рекомендательных задач.
Доклад · 00:16:04Как менялось ранжирование внутри сохраняющегося каскада
Следующее направление не требует немедленно отказываться от многоэтапной системы. Савушкин отдельно переходит к её центральной модели — ранжированию, которое подробно оценивает отобранных кандидатов.
Первый этап развития — ручные признаки и классические модели, например градиентный бустинг. Затем появились нейронные архитектуры, обрабатывающие то же вручную подготовленное признаковое пространство. В этом случае менялась функция обработки признаков, но способ описать пользователя по-прежнему во многом задавался заранее.
Следующий шаг — последовательностные модели. Они получают историю событий и учатся извлекать из неё полезное представление, а не ограничиваются ручной агрегацией прошлого поведения. Это связывает развитие ранжирования с интересом к длинной истории из предыдущего раздела о масштабировании.
Здесь важно различать два значения сквозного обучения. Представление истории может обучаться совместно с ранжировщиком, но вся рекомендательная система при этом остаётся каскадной. Это не тот же переход, что генерация выдачи в End2End-системе OneRec.
Доклад · 00:17:42Attention-ranking: история и ручные признаки встречаются в одной модели
Современный для обзора шаг — объединить два источника информации: ручные признаки и сырую историю событий. Вместо двух независимых подходов компании формируют общий вход и обрабатывают его механизмом внимания или похожим слоем.
Механизм внимания связывает разные части входа при построении представлений. В данном случае это позволяет рассматривать историю пользователя и подготовленные признаки внутри одной модели. Общая идея важнее выбора единственного стандартного блока: автор подчёркивает разнообразие архитектур.
На слайде перечислены Transformer, HSTU, InterFormer и RankMixer. Это разные варианты моделей в обзорном списке, а не четыре последовательных шага одного ранжировщика. По одному этому перечню нельзя приписать им одинаковое устройство внимания.
Справа приведена схема OneTrans: Unified Feature Interaction and Sequence Modeling with One Transformer in Industrial Recommender. В речи автор связывает её со статьёй TikTok. На схеме отдельно показана подготовка последовательных и непоследовательных признаков, затем общая обработка блоками OneTrans и выход для задачи. В раскрытии блока видны Mix Causal Attention и Mix FFN — компоненты обработки разных частей входа.
Савушкин говорит не о рождении этого направления в 2025 году, а о его массовом распространении. В его подборку входят компании, опубликовавшие соответствующие работы в 2025 году; некоторые представлены несколькими публикациями. Это наблюдение о распространённости подхода, а не численная оценка доли индустрии.
Рисунок 8. Варианты attention-based ranking и архитектура OneTrans: история и непоследовательные признаки входят в общую модель. Справа изображён граф архитектуры, а не график качества с осями или численными результатами TikTok.
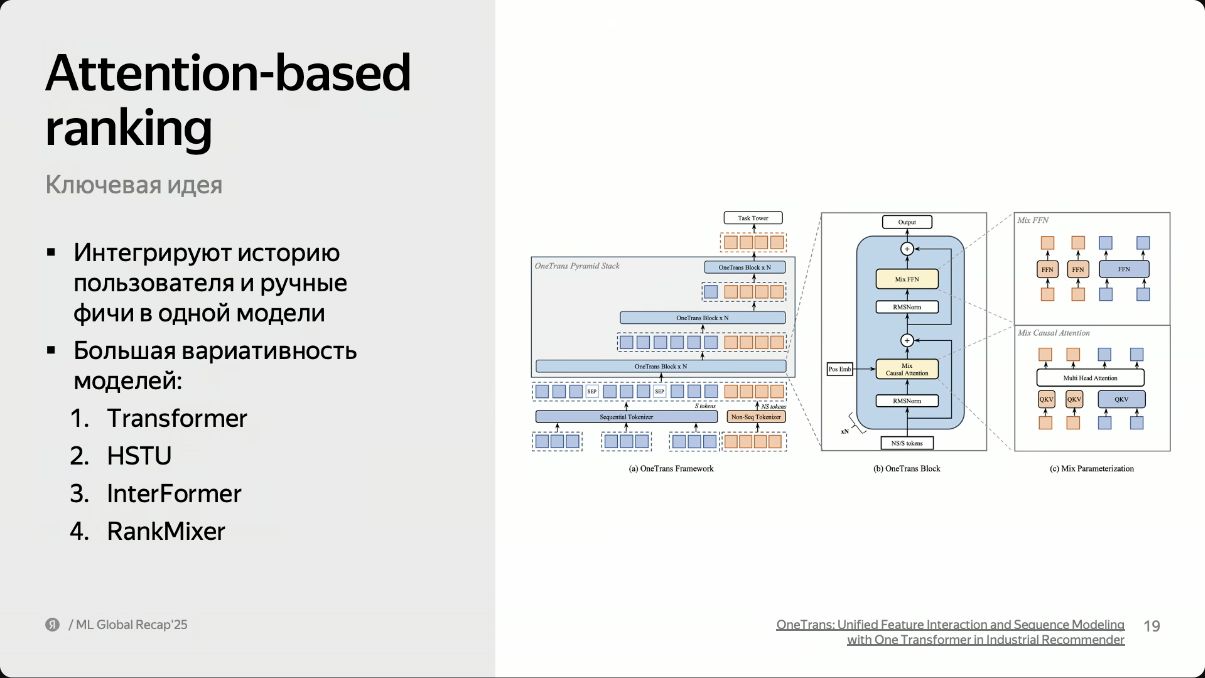
Слайд 19: Transformer, HSTU, InterFormer и RankMixer; справа схема OneTrans. Это граф архитектуры, не численный график качества TikTok.
Источник: Николай Савушкин · ЯндексПочему отбор кандидатов выходит за пределы двух башен
Последний тренд тоже относится к развитию сохраняющегося каскада, но меняет его раннюю стадию — отбор кандидатов. В двухбашенной модели пользователь и объект независимо преобразуются в векторы. Затем простая функция, например косинусная близость или скалярное произведение, оценивает их соответствие.
На слайде названы четыре ограничения. Скалярное произведение слишком просто описывает взаимодействие пользователя и объекта. Генерация кандидатов и правила фильтрации существуют отдельно. Пользовательские и объектные векторы могут относиться к разным версиям модели. Наконец, сложно организовать отбор одновременно для нескольких задач — multi-task retrieval.
Развитие GPU и увеличение доступной высокоскоростной памяти HBM, по объяснению автора, позволяют рассматривать более сложные способы связывания пользователя и документа. То есть меняется не только максимальный размер каталога, но и допустимая сложность функции взаимодействия.
В качестве альтернативных направлений на слайде указаны GPU ANN — приближённый поиск ближайших соседей на GPU, Semantic IDs — семантические идентификаторы, и Multi-vector — представление несколькими векторами. Это набор вариантов поиска и представления объектов, а не единая обязательная архитектура. Сам перенос ANN-поиска на GPU ещё не задаёт новую функцию взаимодействия.
Рисунок 9. Ограничения Two-Tower сопоставлены с направлениями GPU ANN, Semantic IDs и Multi-vector. Слайд объясняет, что именно хотят изменить в отборе кандидатов, но не ранжирует альтернативы по измеренному качеству.
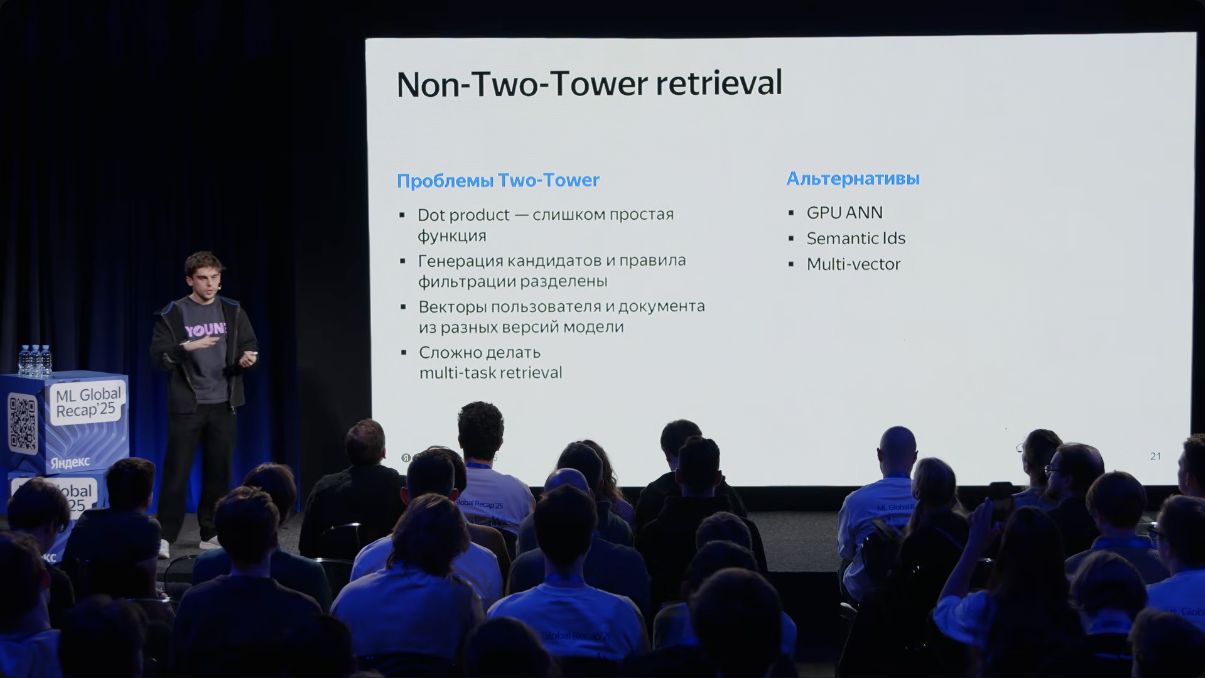
Слайд 21 связывает ограничения dot product и раздельной фильтрации с GPU ANN, Semantic IDs и несколькими векторами объекта.
Источник: Николай Савушкин · ЯндексОбщая обработка на GPU и проблема разных версий векторов
Инженерный аргумент в пользу нового отбора состоит в объединении нескольких операций. На одной видеокарте можно разместить оценивание пар более сложной функцией и фильтрацию по бизнес-правилам. Тогда выбор подходящих объектов и проверка ограничений перестают быть полностью раздельными стадиями.
Второй аргумент касается свежести представлений. Пользовательская часть модели может обновляться, пока в индексе остаются векторы документов, рассчитанные предыдущей версией. Причина, которую называет спикер, — невозможность достаточно часто перестраивать индекс над документами. Сравниваемые векторы в результате оказываются несогласованными по версии.
Савушкин связывает обсуждаемый переход с возможностью избавиться от этого недостатка. Но обзор не задаёт единую реализацию для всех альтернатив: не описаны формат индекса, частота обновления, объём памяти или конкретный способ синхронизации. Нельзя считать, что любой GPU ANN или любой многовекторный метод автоматически устраняет рассогласование.
Объединение скоринга и фильтров на одной GPU также не означает размещение всей рекомендательной системы на одной видеокарте. Здесь рассматривается конкретный участок обработки кандидатов. Задержка ответа, пропускная способность и денежная экономия для него в докладе не измерены.
Доклад · 00:20:40Как соотносятся семь направлений
В конце основной части автор возвращается к списку из семи трендов. Их удобно сопоставить по тому, что именно меняется в системе. Это помогает не путать полную перестройку рекомендаций с улучшением одной части существующего решения.
Связь между направлениями есть, но они не образуют единственный маршрут развития. Семантические коды полезны для генеративных моделей, однако знания о содержании можно использовать и в обычном ранжировании. Общая модель нескольких продуктов не обязана одновременно быть универсальной LLM. А развитие отбора и ранжирования может продолжаться внутри каскада.
Промышленные примеры в этой главе принадлежат разным компаниям. От Яндекса прозвучали сведения о работе команды, опыт неудачной прямой подстановки мультимодальных векторов и, позднее в Q&A, положительное наблюдение о масштабировании собственной модели. Единого численного результата новой End2End-системы Яндекса доклад не сообщает.
Савушкин также обещает после выступления опубликовать в своём Telegram-канале подборки работ 2025 года по каждому направлению. Затем основная часть завершается и начинается обсуждение вопросов: о будущем объединении моделей, данных, стоимости и распределении усилий между частями системы.
Доклад · 00:21:26Q&A: когда появится универсальный рекомендательный помощник
Первый вопрос переносит разговор от устройства рекомендателей к будущему продукта: смогут ли рекомендации объединиться с языковыми и визуальными возможностями так же, как разные задачи уже объединяются в больших мультимодальных моделях?
Ответ связывает два обсуждённых тренда. Фундаментальные рекомендательные модели объединяют разные домены пользователя. LLM + RecSys добавляет способ работать с рекомендациями внутри языковой модели. Их сближение, по мнению Савушкина, ведёт к помощнику, который понимает содержание запроса и личные предпочтения одновременно.
Пример из ответа — сфотографировать элемент одежды и попросить подобрать на маркетплейсе нечто похожее или подходящее по собственному стилю. Здесь фотография задаёт исходный объект, а рекомендательные знания помогают выбирать не просто визуально похожее, а то, что должно понравиться человеку.
Это прогноз, а не показанный рабочий продукт. В декабре 2025 года автор считает такое сближение вероятным в будущем, но не ожидает полноценного результата уже в 2026 году. По его оценке, сначала должны достаточно развиться и фундаментальные рекомендации, и их объединение с LLM. Этот ответ не устанавливает точную дату появления системы.
Доклад · 00:22:04Q&A: где взять данные и как превзойти систему, создавшую логи
Следующий вопрос сравнивает обучение рекомендательной модели с обучением LLM. У языковой модели есть большие текстовые корпуса. Откуда взять достаточно пар входа и выхода для модели, которая получает объекты и генерирует рекомендательные токены?
Ответ — из уже работающих рекомендательных систем. Они постоянно создают большие логи. Савушкин утверждает, что после токенизации дневной набор большой мировой рекомендательной системы может оказаться больше всего обучающего корпуса некоторой актуальной LLM. Он не называет систему, языковую модель или точные объёмы. Поэтому смысл сравнения — масштаб доступных данных, а не конкретная статистика Яндекса.
Уточнение из зала касается более важного методического вопроса. Если новая модель просто перенимает поведение действующего рекомендателя, почему она должна работать лучше? В вопросе это описывается как дистилляция знаний прежней системы.
Спикер снова разделяет обучение на два этапа. На предварительном этапе модель повторяет логирующую политику, то есть способ формирования рекомендаций в прежней системе. На этапе согласования с целями используют обучение с подкреплением, чтобы улучшить поведение относительно исходного.
Таким образом, воспроизведение логов даёт стартовую модель, а улучшение связывается с отдельной оптимизацией. Это объяснение замысла обучения, не гарантия, что любой такой переход даст выигрыш. В ответе не разобраны смещения данных, устройство награды и критерий, который доказывал бы превосходство на каждом новом наборе логов.
Доклад · 00:23:34Q&A: почему больше FLOPs не означает пропорционально больше денег
Третий вопрос касается экономики. В обычной системе быстрый поиск находит кандидатов среди миллионов или миллиардов объектов. В генеративной системе для каждого пользователя нужно применить существенную по размеру модель. Не станет ли такая рекомендация катастрофически дорогой?
Первая часть ответа — различать количество вычислений и их денежную стоимость. FLOPs здесь означает число операций с плавающей точкой на одну рекомендацию. Деньги зависят от реально используемого оборудования и того, насколько полно оно занято полезной работой.
Савушкин возвращается к недостатку каскада: разные стадии разнесены по сервисам, а утилизация оборудования в большой промышленной системе низкая. По его объяснению, более крупная модель может требовать заметно больше операций, но увеличивать расходы не в той же пропорции. Именно поэтому нельзя выводить денежную цену только из числа параметров или FLOPs.
Такой аргумент не равен утверждению, что генеративный вариант обязательно дешевле каскада. В докладе нет численного сравнения оборудования, стоимости одной рекомендации или полной стоимости эксплуатации. Автор объясняет причину возможного расхождения, а не предъявляет универсальный коэффициент экономии.
Вторая часть ответа — ожидание развития оборудования. На конец 2025 года генеративный End2End ещё не описывается как массовый индустриальный стандарт. Спикер предполагает, что дальнейшее удешевление вычислений позволит моделям с сотнями миллионов или примерно миллиардом параметров лучше окупаться через несколько лет. Это прогноз из доклада, а не замер цены конкретной модели.
Доклад · 00:25:21Q&A: что выгоднее масштабировать — пользователя или объект
Последний вопрос разделяет систему на две крупные части. Одна кодирует объекты и участвует в получении семантических токенов. Другая обрабатывает эти объекты в истории пользователя. Что выгоднее увеличивать при ограниченных ресурсах?
В формулировке вопроса отдельно обсуждаются обучение объектного энкодера на промежуточной задаче и последующее преобразование его представлений в дискретные коды. Спикер отвечает, что построение такого энкодера и рекомендательная токенизация — активная область с большим количеством открытых вопросов. Готового правила выбора у него нет.
Дальше он приводит два разных источника наблюдений. Из общения с сотрудниками Snap во время конференционной поездки он узнал об устойчивом росте качества при масштабировании объектного энкодера. Это пересказ профессионального разговора, а не приведённый на слайде опубликованный эксперимент.
Для пользовательской части автор ссылается на публикации Kuaishou и собственный опыт команды по построению такой модели. В обоих случаях он отмечает положительное масштабирование. Собственный опыт относится к Яндексу, но не сопровождается названием модели, величиной прироста, продуктом или заявлением о завершённом промышленном запуске.
Практический вывод ответа ограничен уровнем имеющихся наблюдений: перспектива есть у обеих частей, поэтому исследуют обе. Что важнее при фиксированном бюджете, не установлено. Именно открытым вопросом о распределении вычислений заканчивается содержательная часть доклада.
Доклад · 00:27:36Итог: общий сдвиг и один рабочий пример
Обзор показывает несколько ответов на ограничения каскада: генерацию объектов, масштабирование плотных моделей и истории, объединение знаний продуктов, адаптацию мультимодальных представлений и развитие отдельных стадий. Они могут пересекаться, но не складываются в одну обязательную архитектуру. Для конкретизации рассмотрим работу OneRec компании Kuaishou — одного примера из обзора, а не общей системы всех компаний или Яндекса.
- 01
Вход пользователя
История событий и доступная контекстная информация подготавливаются в токенизированном виде для модели.
- 02
Представление истории
Энкодер обрабатывает описание пользователя и передаёт полученное представление декодеру.
- 03
Генерация вариантов
Декодер выдаёт последовательности рекомендательных токенов, из которых получают варианты объектов.
- 04
Переход к роликам
Сгенерированные коды через показанное на схеме отображение Mapping сопоставляются с конкретными Video ID.
- 05
Выбор выдачи
Система возвращает рекомендации; схема допускает необязательный выбор вариантов с участием Reward System.
Обучение отделено от этих шагов. Сначала NTP учит модель повторять последовательности из логов прежней системы, затем ECPO использует сигнал награды для улучшения поведения. Обновление параметров не является обязательной частью каждого пользовательского запроса.
Оценка результата — отдельный вопрос. Автор сообщает о промышленном запуске OneRec, но обзор не приводит численного эффекта, условий эксперимента или стоимости рекомендации. Размер аудитории Kuaishou не заменяет такие измерения.
Главные открытые вопросы остаются общими: сколько вычислений оправдано качеством, какую длину истории обрабатывать и что выгоднее масштабировать — объектный или пользовательский энкодер. Более высокая вычислительная нагрузка не означает пропорционального роста расходов, однако сама новая архитектура тоже не гарантирует экономии. Доклад даёт направления и промышленные примеры, а не универсальный ответ.
Доклад · 00:06:15