Разбор готов
Авито: модель интересов по категориям для главной ленты
На главной Авито пользователь видит бесконечную персональную ленту объявлений. Даже сильное ранжирование отдельных карточек не гарантирует хорошую ленту целиком: похожие объявления получают близкие оценки и после сортировки могут собираться в длинные однотипные блоки. Команда сначала исправила композицию выдачи простым смешиванием категорий — блендером, а затем заменила ручную формулу интересов небольшой моделью, которая читает последовательность действий пользователя (Transformer Encoder). В материале важен именно путь изменений: почему эвристика уже дала выигрыш, какие ограничения у неё остались, как для новой модели собрали данные и почему после обучения всё равно понадобилось сглаживать предсказания.
Материал полезен тем, кто работает с рекомендательными лентами и хочет увидеть продуктовый путь от независимого ранжирования объектов к управлению разнообразием списка. Здесь есть исходная архитектура, формула эвристического интереса, временная постановка датасета, компактный Transformer Encoder, офлайн-проверка и два разных A/B-теста с разными базами сравнения.
Статья · на русском
Нейросетевая модель интересов пользователя: как мы улучшили разнообразие и релевантность рекомендаций на главной АвитоЯрослав Хныков · Опубликовано: 9 декабря 2025 г.
Главная лента и исходная рекомендательная система
Главная Авито — бесконечная персональная лента объявлений. По данным автора, через неё проходит примерно 50% всех просмотров и 30% общего числа контактов покупателей с продавцами. Эти доли описывают масштаб поверхности, а не эффект новой модели.
Исходная система двухуровневая: сначала отбираются кандидаты, затем они ранжируются. Автор описывает пять генераторов кандидатов: один работает офлайн и реагирует на последние действия с задержкой в несколько часов, четыре работают онлайн и подстраиваются сразу. Финальный порядок задаёт CatBoost с набором признаков от простых счётчиков до оценок трансформерных моделей.
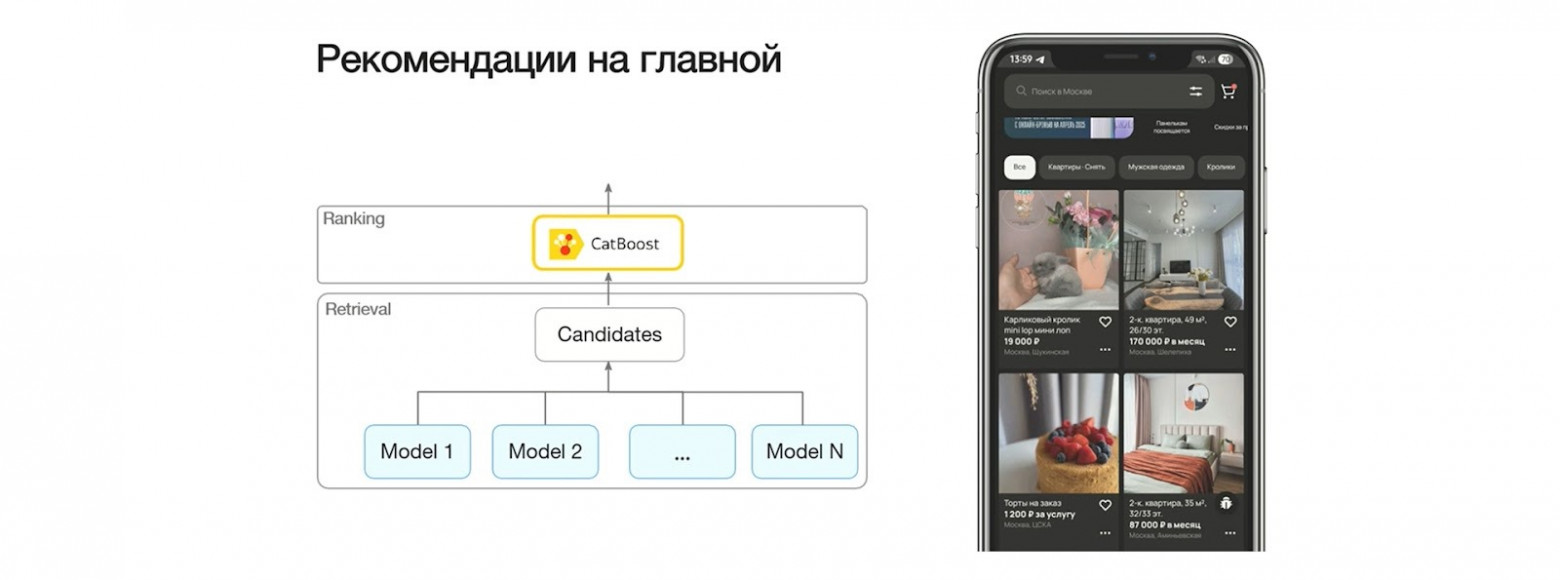
Исходная система: несколько генераторов кандидатов и общий CatBoost-ранжировщик. Хороший порядок отдельных карточек не гарантирует разнообразия всей ленты.
Источник: Ярослав Хныков · АвитоПочему релевантные карточки склеиваются в однотипные блоки
Ранжирующая модель оценивает объявления независимо. Похожие предложения получают близкие оценки, а после сортировки оказываются рядом. При тысячах кандидатов на входе верх выдачи, по словам автора, легко заполняется одной-двумя категориями.
Проблема не сводится к внешнему разнообразию. Второй похожий iPhone после первого даёт небольшую добавочную ценность; другие потенциально релевантные потребности не пробиваются наверх; однообразная лента теряет «интригу». Поэтому команда решила добавить отдельный слой, который меняет композицию готового списка, не заменяя сам ранжировщик.
Рекомендации на главной Авито: как всё устроено и какие возникают проблемыПервый шаг: категорийный блендер после ранжирования
Блендер расположен после CatBoost. Его задача — не заново оценивать объявления, а не дать нескольким категориям склеиться в длинные блоки. Сначала объявления группируются по категориям, при этом внутри каждой категории сохраняется порядок исходного ранжировщика.
- 01
Сгруппировать объявления
Разложить кандидатов по категориям и сохранить внутри каждой категории порядок, который уже задал ранжировщик.
- 02
Получить интересы
Посчитать вес интереса пользователя к каждой категории по его истории.
- 03
Выбрать категорию
Сэмплировать категорию из распределения категорийных интересов.
- 04
Взять лучший объект
Забрать лучшее ещё доступное объявление из выбранной категории и повторять шаги до заполнения ленты.
Распределение интересов можно дополнительно сглаживать: чем сильнее сглаживание, тем больше разнообразия. В статье для этого первого блендера не приведены конкретный вид сглаживания и его численные параметры.
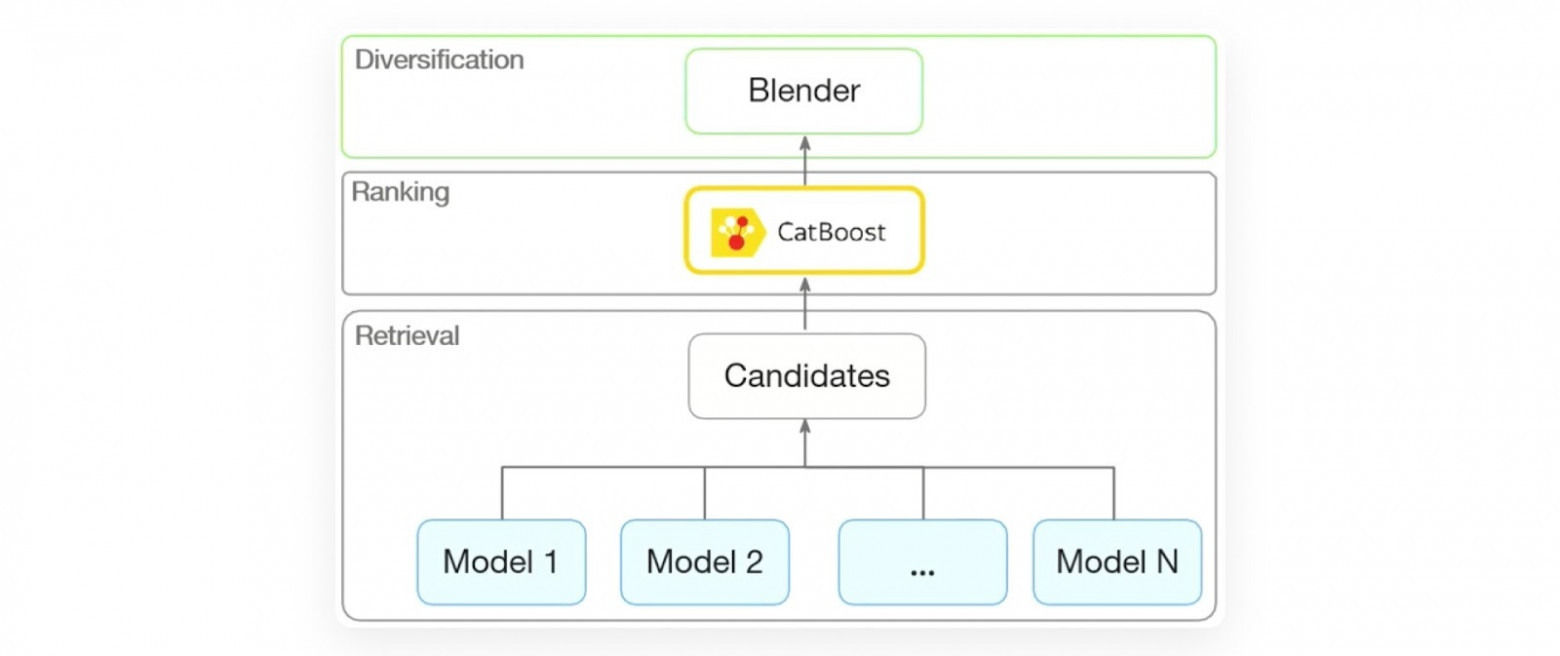
Блендер категорий расположен после ранжирования: он меняет состав и порядок итоговой выдачи с учётом интересов пользователя.
Источник: Ярослав Хныков · Авито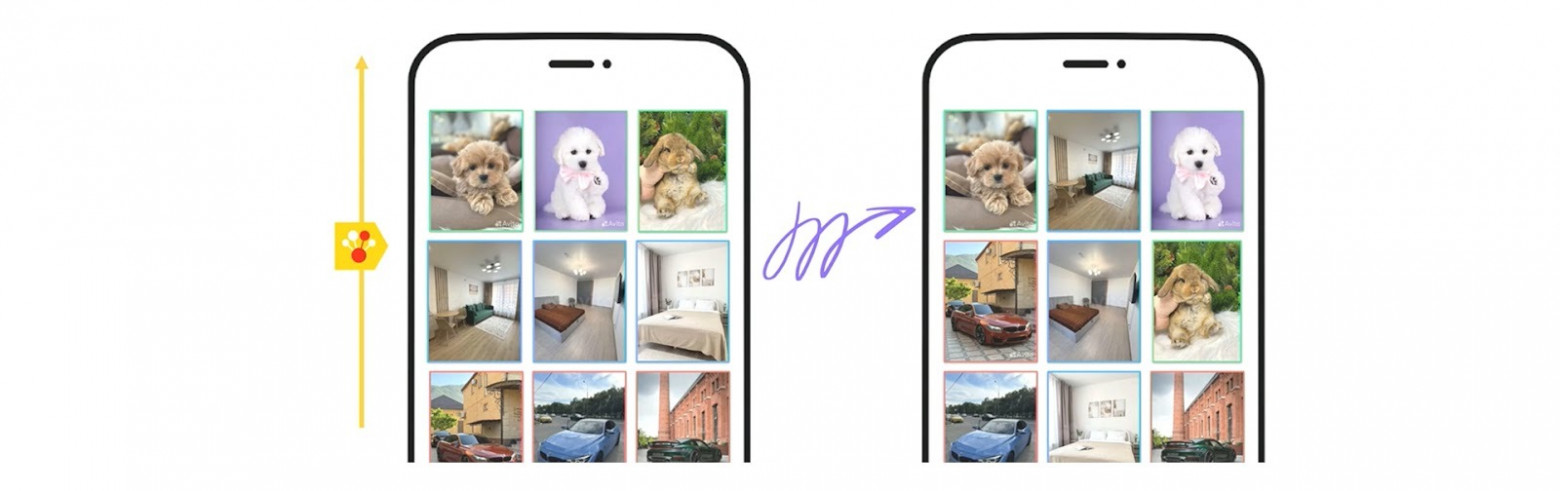
Пример до и после категорийного смешивания. Иллюстрация показывает перемешивание категорий, а не численную оценку A/B.
Источник: Ярослав Хныков · АвитоЭвристический интерес: сила события и затухание по времени
Интерес к категории сначала считали вручную по истории пользователя из онлайн-хранилища. Каждому типу события назначался вес: например, добавление в избранное считалось более сильным сигналом, чем клик. Более свежие события дополнительно получали больший вклад через экспоненциальное затухание.
Формула с оригинального рисунка. Численные веса событий, единица измерения Δt и нижняя численная граница λ в источнике не приведены.
Полученные интересы не являются оценками отдельных объявлений. Они задают распределение, из которого блендер выбирает категорию следующего объекта, а порядок внутри категории по-прежнему приходит от основного ранжировщика.
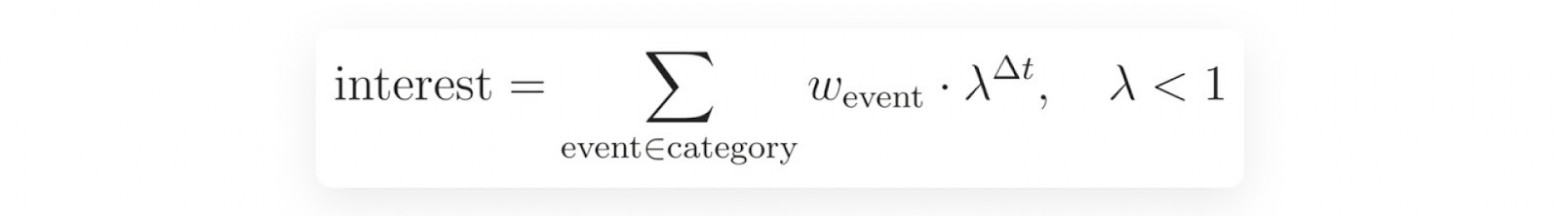
Эвристика суммирует взвешенные события категории с временным затуханием λ^Δt. Значения весов и единица Δt на рисунке не заданы.
Источник: Ярослав Хныков · АвитоПервый A/B-тест: блендер против выдачи без блендера
Первый онлайн-эксперимент сравнивает базовую рекомендательную систему до и после применения категорийного блендера. Это отдельная база сравнения: здесь ещё не оценивается нейросетевая модель интересов.
Автор связывает рост кросс-категорийности с тем, что в верх выдачи чаще попадают менее очевидные, но всё ещё релевантные категории. Для +2,5% он отдельно отмечает масштаб Авито как сотни тысяч дополнительных покупателей в сутки. Размер выборки, длительность теста, доверительные интервалы и единица рандомизации в статье не приведены.
Внедрили блендер категорий на основе интересов пользователяЧетыре ограничения ручной формулы
Первый блендер уже улучшил продуктовые метрики, но его ручная формула интереса стала ограничением дальнейшего развития.
Поиск автор считает более явным сигналом интереса, потому что пользователь сам формулирует потребность в запросе. Чтобы учитывать такой контекст, связи между категориями и другие факторы без роста числа ручных коэффициентов, команда решила предсказывать распределение интересов ML-моделью.
Ограничения формулы интересовДатасет: история до запроса и целевые действия в следующие семь дней
Обучающие примеры привязаны к реальным моментам посещения главной. На вход берётся только история, доступная к этому моменту, что, по формулировке автора, защищает постановку от различных утечек будущей информации.
Целевая величина — распределение по категориям, составленное из пропорций добавлений в избранное и контактных событий в следующие семь дней. Неделя выбрана как компромиссный горизонт: слишком короткое окно хуже захватывает комплементарные категории, слишком длинное сильнее тянет модель к популярному и ослабляет связь с текущей историей.
Просмотры в целевую величину не включают: команда не хочет обучать модель под категории, которые пользователь охотно открывает, но которые автор характеризует как кликбейтные и не обязательно отражающие более сильный интерес.
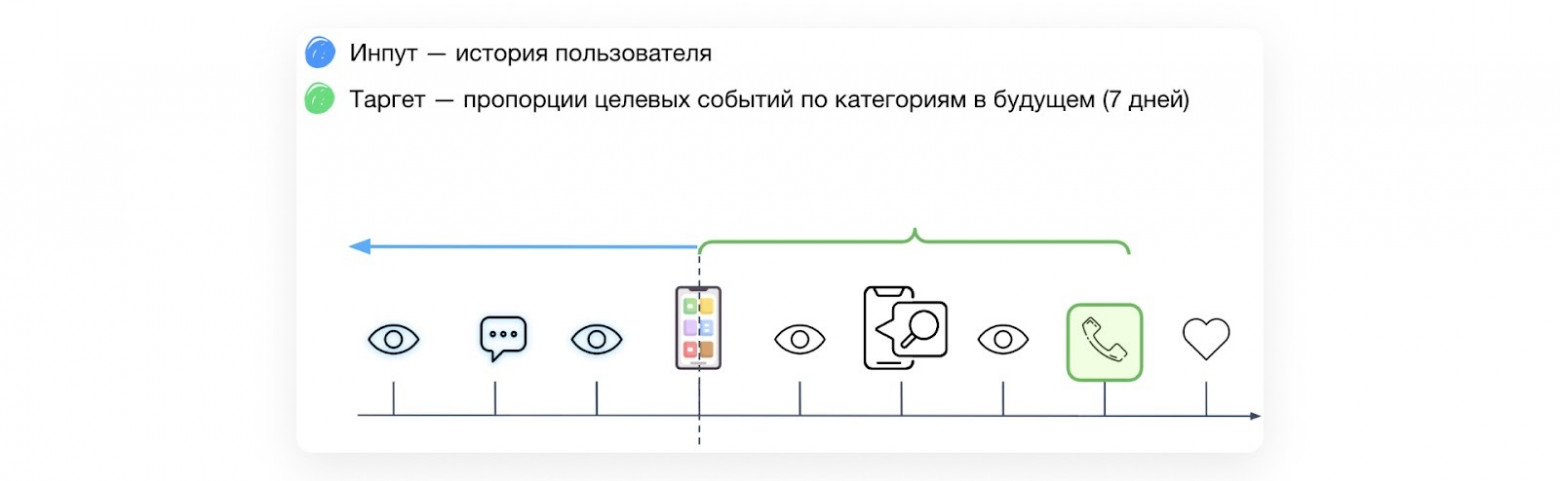
История до запроса служит входом; пропорции целевых действий в следующие семь дней — обучающим распределением категорий.
Источник: Ярослав Хныков · АвитоГенераторные события, первое целевое действие и временной разрыв
Для обобщения модель обучают не только на моментах посещения главной, но и на моментах запроса поисковой выдачи. События, в которых пользователь получает выдачу, автор называет генераторными.
По каждому объявлению оставляют только первое целевое событие. Логика в том, чтобы не превращать повторные очевидные действия в лёгкие цели: если пользователь уже связался с продавцом машины, повторный вход в тот же чат не должен доминировать в обучении.
Разбиение делается по глобальному времени. Оригинальная схема уточняет размеры интервалов: Train — 2 месяца, затем Gap — 2 недели и Val — 2 недели. Разрыв нужен, чтобы не смотреть на валидацию излишне оптимистично.
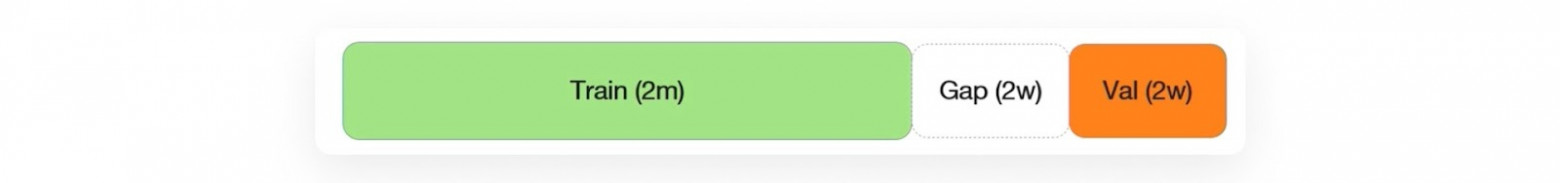
Исходная временная схема: обучение два месяца, разрыв две недели и валидация две недели.
Источник: Ярослав Хныков · АвитоПочему выбрали Transformer Encoder
Команда выбрала Transformer Encoder по трём причинам: к нему удобно добавлять признаки и менять целевые величины; он учитывает последовательный сигнал в истории; небольшой вариант укладывается в требования real-time.
Автор указывает задержку применения небольшого трансформера на CPU в диапазоне 10–20 мс. В статье не приведены percentile, модель CPU, размер пакета или подробная методика измерения, поэтому это число относится только к описанной авторами конфигурации.
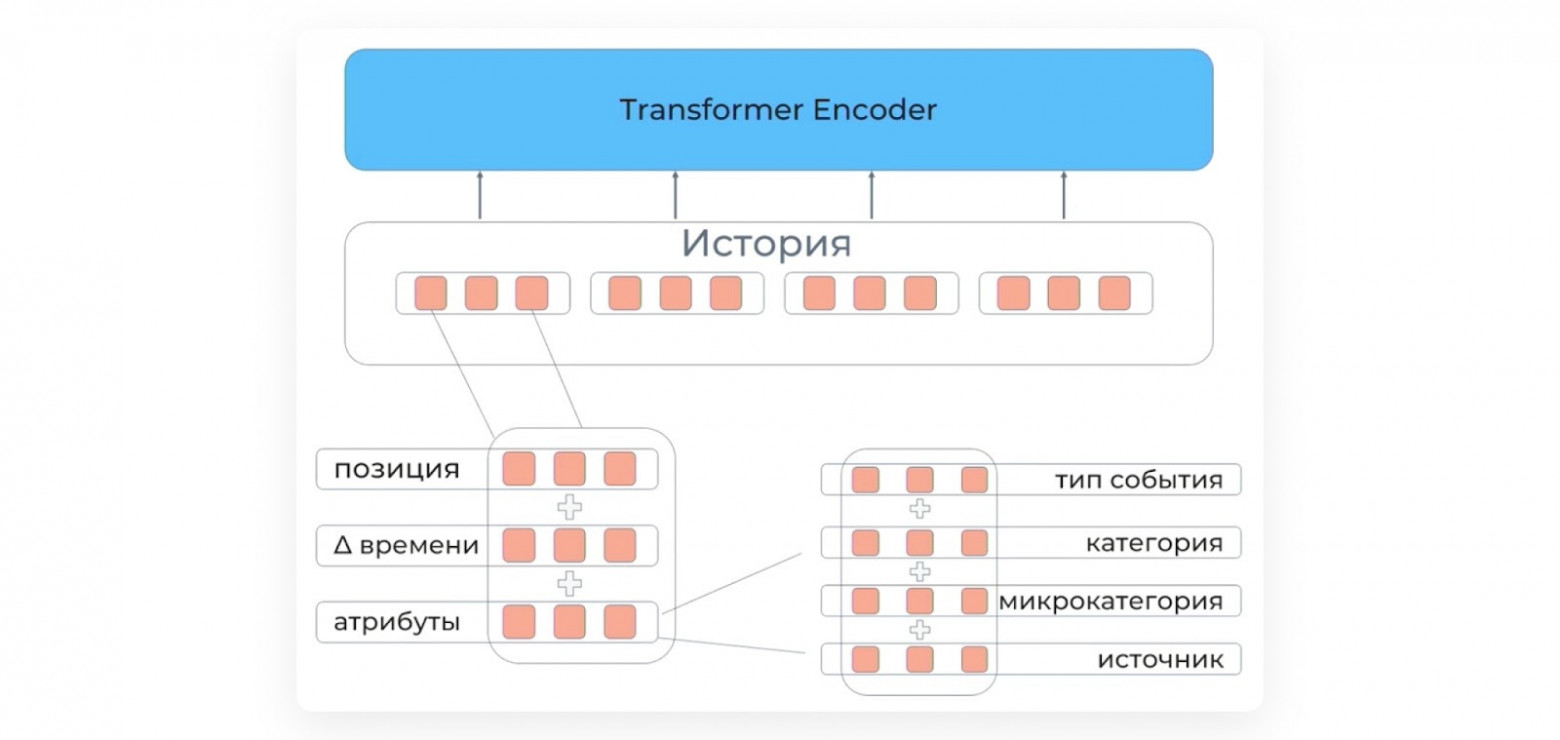
Событие описывается атрибутами, позицией и возрастом. История передаётся Transformer Encoder; отдельные признаки складываются.
Источник: Ярослав Хныков · АвитоКак кодируется событие: атрибуты, позиция и пропуски признаков
У события есть четыре атрибута: тип действия, категория, микрокатегория и источник — например, поиск или рекомендации. Эмбеддинг здесь — обучаемый числовой вектор значения атрибута. Для каждого атрибута используется своя обучаемая таблица эмбеддингов одинаковой размерности, а выбранные векторы складываются.
Во время обучения часть признаков с небольшой вероятностью случайно убирают, чтобы модель была устойчивее к отсутствию некоторых полей на инференсе. Численная вероятность такого feature dropout в статье не указана.
Позиция кодируется обучаемым позиционным эмбеддингом. История идёт от последнего события к первому: автор мотивирует это тем, что свежие события важнее и для них хочется сохранить некоторую инвариантность.
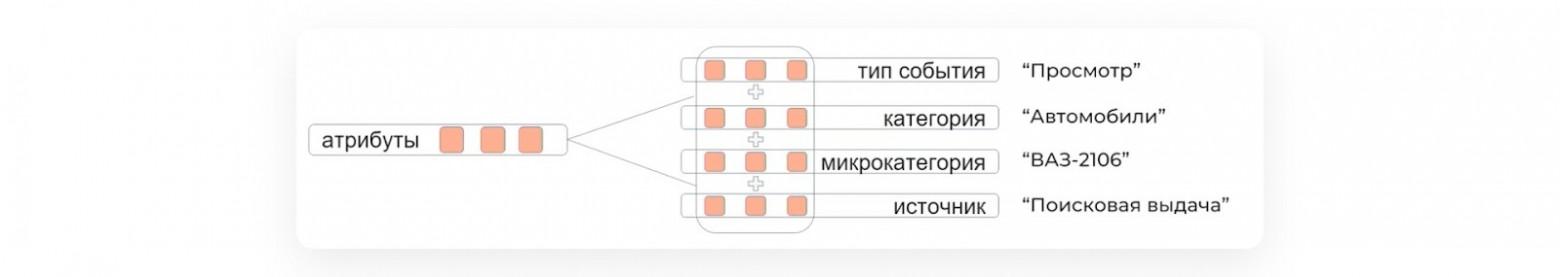
Тип действия, категория, микрокатегория и источник: пример просмотра ВАЗ-2106 из поиска, не обезличенная одинаковая обработка всех событий.
Источник: Ярослав Хныков · АвитоВозраст события как отдельный непрерывный сигнал
Возраст события ΔT измеряется относительно момента запроса и передаётся отдельно от позиции события в последовательности. Значение линейно переводится в диапазон от 1 для текущего момента до −1 для точки два месяца назад.
Преобразование возраста события из статьи. Поведение для событий старше двух месяцев не описано.
После линейного преобразования возраст проходит через небольшой MLP, чтобы модель могла выучить нелинейную функцию затухания, и проецируется в общую размерность. Для полного представления события складываются атрибуты, позиция и возраст; результат нормируется и подаётся в Transformer Encoder.
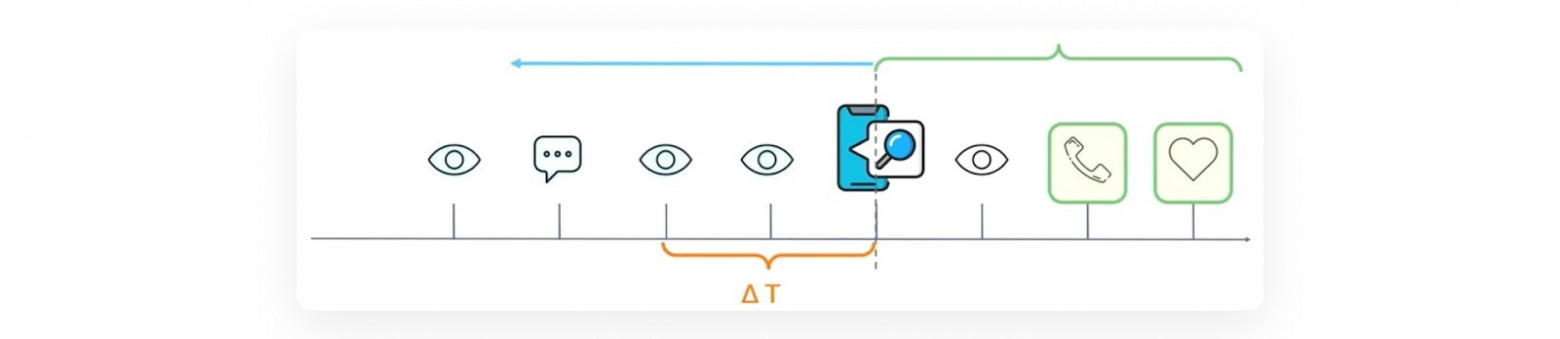
ΔT — давность события относительно момента запроса. Время передаётся отдельно от позиции события в последовательности.
Источник: Ярослав Хныков · АвитоКонфигурация компактной модели
Для ускорения HardSwish источник не называет функцию-альтернативу, железо и методику измерения. Схема показывает двухслойный Transformer Encoder, но не раскрывает отдельный pooling или readout из истории в итоговое распределение категорий; такой механизм не следует угадывать.
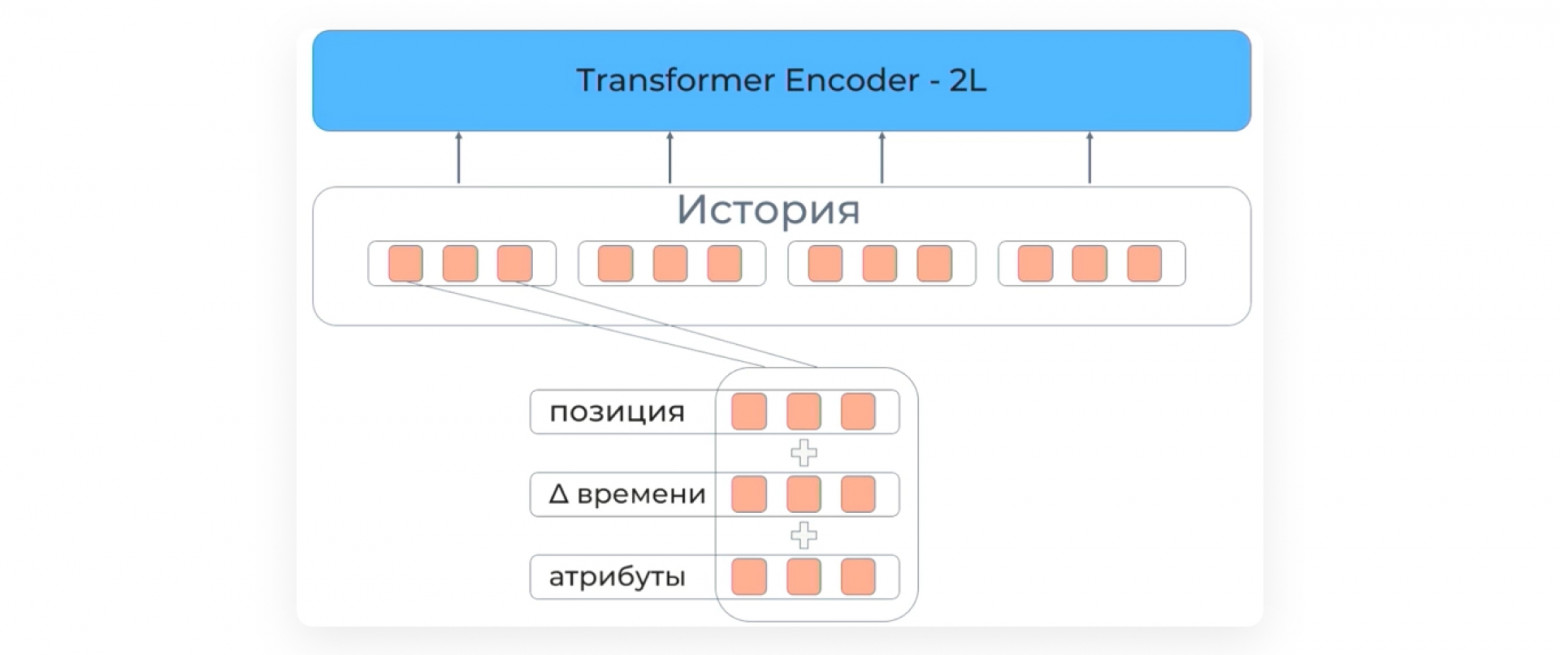
Полное представление события проходит в двухслойный Transformer Encoder. Число слоёв показано на оригинальной схеме.
Источник: Ярослав Хныков · АвитоТретий недостаток: ML-предсказания получились слишком острыми
После перехода от ручной формулы к ML возникла новая проблема. В целевом окне покупатели часто активны лишь в одной-двух категориях, поэтому предсказания модели получаются слишком концентрированными. Если сразу использовать их в блендере, лента снова рискует стать однообразной.
Формула с исходного рисунка. Температура T делит логиты до нормализации; выбранное численное значение T в статье не указано.
Температуру подбирают через имитацию продового трафика, чтобы выровняться по релевантности на реальных пользовательских выдачах. Рисунок показывает само сглаживание распределения, а не таблицу выбранных температур.
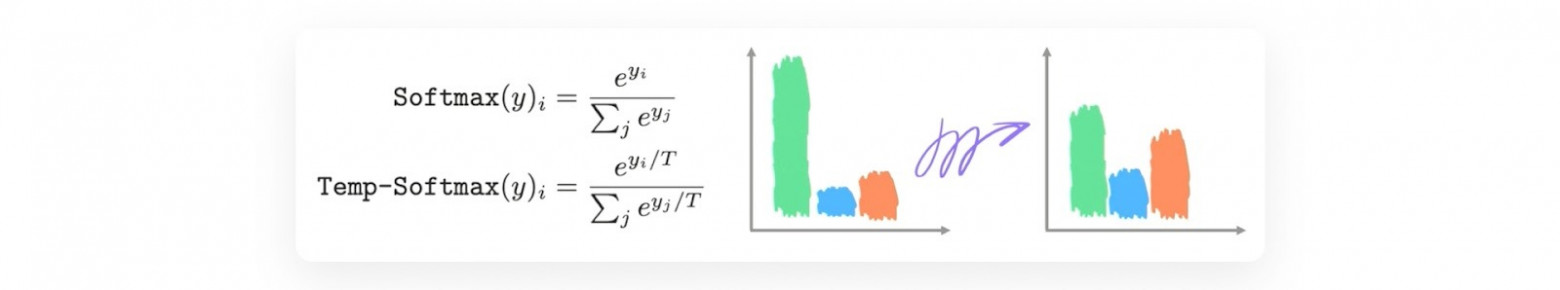
Температурный softmax делит логиты на T перед нормализацией. Рисунок иллюстрирует сглаживание, но не задаёт выбранное численное T.
Источник: Ярослав Хныков · АвитоОфлайн-проверка и качественные связи между категориями
На офлайн-валидации автор сообщает рост метрик ранжирования категорий на 5–7% относительно прежней эвристической формулы. Названия конкретных метрик, абсолютные значения и то, как распределяется прирост внутри диапазона, в статье не приведены.
Качественные примеры показывают то, чего не умела ручная формула. После просмотра микрофона модель добавляет интерес к «Музыкальным инструментам»; после просмотра футбольных бутс в «Обуви» появляется интерес к «Спорту и отдыху».
На этих иллюстрациях значения ручной формулы и выходы ML имеют разные масштабы, поэтому счётчики около 1,0 нельзя читать как вероятности одного общего распределения или напрямую сравнивать с ML-значениями. Это качественные примеры связанных категорий, не отдельный A/B-тест.
Автор также пишет, что модель корректно различает источник события: действия из поиска влияют сильнее, чем действия из рекомендательной ленты.
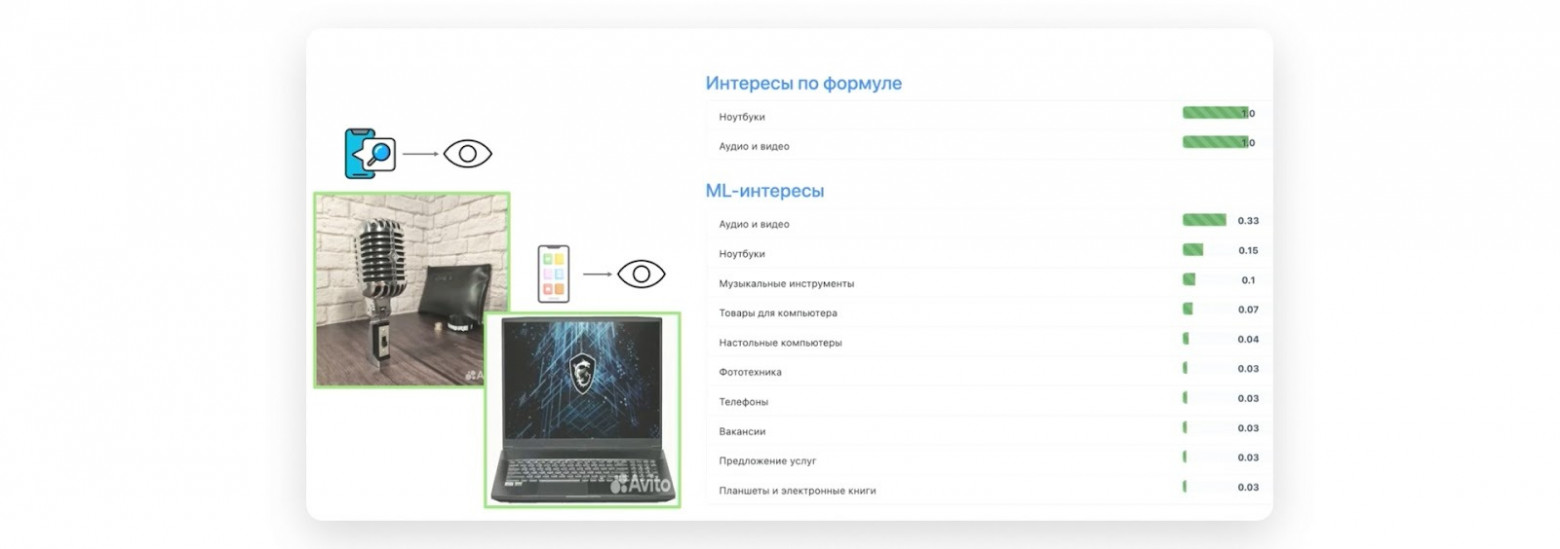
Пример связи микрофона с музыкальными инструментами. Эвристические счётчики и вероятности ML-модели имеют разные масштабы.
Источник: Ярослав Хныков · Авито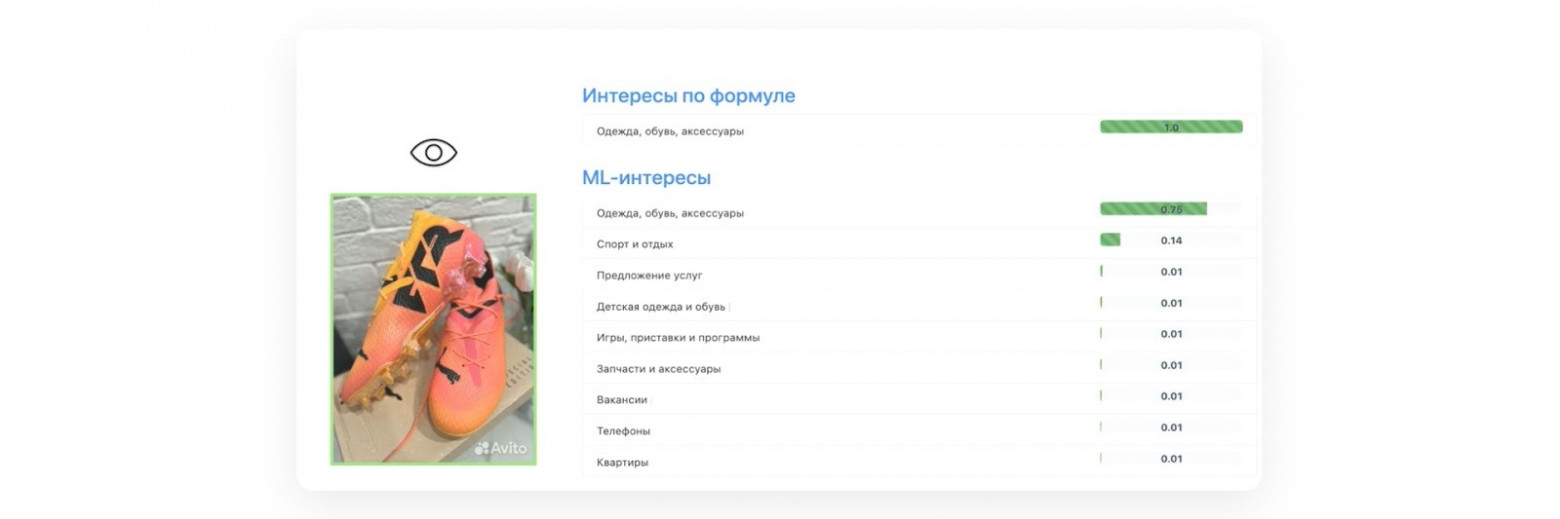
Просмотр футбольных бутс связан не только с обувью, но и со спортом. Это качественный пример распределения, не отдельная метрика качества.
Источник: Ярослав Хныков · АвитоВторой A/B-тест: ML-модель против эвристики
Второй эксперимент имеет другую базу сравнения: новая ML-модель интересов проверяется дополнительно к уже работающей эвристике. Поэтому эти изменения нельзя складывать с +2,5% и +4% первого теста.
Снижение относится именно к скрытиям с указанной причиной, а не к общему числу скрытий рекомендаций. Автор подчёркивает, что это произошло при большем разнообразии, после чего модель была раскатана в продакшен. Как и для первого A/B-теста, статья не даёт длительность, размер выборки, доверительные интервалы и единицу рандомизации.
Что увидели по метрикамИтог: как работает выбранная система
История Авито важна тем, что улучшение появилось не из мгновенной замены всей рекомендательной системы. Сначала команда увидела проблему композиции: хороший ранжировщик независимо оценивал объявления и собирал похожие категории рядом. Простой блендер уже дал продуктовый выигрыш. Затем ограничения ручной формулы интересов стали причиной перехода к компактной последовательной модели, а слишком острые предсказания этой модели потребовали отдельного температурного сглаживания.
- 01
Отбор кандидатов
Несколько генераторов собирают объявления-кандидаты; один работает офлайн с задержкой в несколько часов, остальные реагируют онлайн.
- 02
Ранжирование
CatBoost оценивает кандидатов и задаёт порядок релевантности отдельных объявлений.
- 03
ML-интересы
История пользователя превращается Transformer Encoder в распределение интересов по категориям с учётом типа события, категории, микрокатегории, источника, позиции и возраста.
- 04
Сглаживание
Температурный softmax делает распределение менее острым. При ответе используется температура, выбранная перед запуском.
- 05
Блендер
Категория следующего объявления сэмплируется из сглаженного распределения, а внутри категории берётся лучший оставшийся объект по исходному ранжированию.
- 06
Итоговая лента
Повторение выбора категории и объекта даёт ленту, где релевантные объявления не собираются в длинные однотипные блоки.
Обучение и оценка идут отдельно от этого пути запроса. Датасет строится по истории до генераторного события и целевым действиям следующих семи дней; на исходной временной схеме использованы два месяца обучения, две недели разрыва и две недели валидации. Офлайн автор сообщает +5–7% по неназванным метрикам ранжирования категорий. Онлайн нужно различать два эксперимента: блендер против системы без него дал +2,5% пользователей с контактом и +4% с контактом в новой категории, а ML против эвристики — ещё +1%, +0,6% и −2,5% скрытий именно по причине «несоответствие категории». Эти эффекты относятся к разным базам сравнения и не складываются.
Вся статья кратко