Разбор готов
МаркетAI: от совета о покупке к поиску товаров и быстрому ответу
Покупателю микроволновки нужны не только подходящие карточки: сначала приходится разобраться, какие характеристики важны, а затем понять, чем конкретные модели отличаются друг от друга. МаркетAI объединяет эти задачи в диалоге: объясняет выбор, ищет информацию и товары, составляет сравнения и предлагает идеи подарков. В докладе 2025 года Олег Найдин, отвечавший в Яндекс Маркете за технологии поиска и ассистента, показывает простой прототип такого взаимодействия и разбирает, что мешает превратить его в удобный продукт. Через этот пример видна связь между формой ответа, устройством цепочки моделей, качеством обучающих данных и временем ожидания. Важен не самый длинный граф агентов, а возможность быстро проверять идеи, закреплять полезное поведение и не заставлять покупателя ждать дольше, чем занял бы самостоятельный поиск.
Глава полезна ML-инженерам и разработчикам, которые связывают языковые модели с поиском и программными инструментами, а также продуктовым специалистам, отвечающим за полезность диалогового сервиса. На покупательских сценариях разобраны границы простого прототипа, организация оценки и разметки, дообучение отдельных ролей и компромиссы между гибкостью, качеством и скоростью.
Видео · на русском
Маркет AI: как мы создали AI-ассистента в маркетплейсе / Олег НайдинОлег Найдин · Опубликовано: 4 декабря 2025 г.
Исходный доклад · Открыть оригинал
Две задачи покупателя в одном диалоге
Обычный поиск товаров начинается с запроса, но при незнакомой покупке сам запрос ещё нужно сформулировать. Человек может знать, что ему нужна микроволновка, и не знать, на какие свойства смотреть. Тогда он сначала ищет объяснения в интернете, выделяет критерии, возвращается в маркетплейс и сопоставляет найденные товары с этими критериями. МаркетAI задуман как помощник, который связывает информационную часть выбора с поиском конкретных предложений.
Найдин отсчитывает предысторию идеи от появления ChatGPT 30 ноября 2022 года: диалог стал естественным способом решения задач, которые прежде требовали самостоятельной работы в нескольких интерфейсах. Коллеги из рекламы и монетизации Яндекса искали на хакатоне новые способы монетизации, и одной из веток стал ассистент выбора товаров. В 2024 году над совместными прототипами работали внутри Алисы, а в апреле 2025 года МаркетAI впервые запустился в бете. К моменту выступления автор уже сообщал о выходе из неё.
Ценность продукта поэтому не сводится к умению поддержать разговор. Ассистент должен помочь разобраться, как выбирать, и показать товары, соответствующие обсуждаемым характеристикам. Красивый текст без связи с покупкой решает лишь часть задачи; список карточек без объяснения оставляет покупателю прежнюю работу по сравнению вариантов.
Доклад · 00:01:05Совет, сравнение и подарок требуют разных ответов
В примере с микроволновкой ответ устроен как сочетание совета и конкретного предложения. Сначала покупателю объясняют важные параметры: объём камеры, мощность, внутреннее покрытие и тип управления. Затем показывают карточку товара и описывают его особенности в тех же категориях. Объяснение не висит отдельно от выдачи: по нему можно понять, почему на экране оказался именно такой вариант и какие его свойства имеют значение для выбора.
Сам интерфейс остаётся покупательским, а не превращается в сплошную переписку. На показанном экране рядом с текстом есть изображение товара, цена и другие сведения карточки. Это помогает перейти от общего рассуждения о категории к рассмотрению конкретного предложения.
В сценарии сравнения важна другая связка: таблица характеристик и короткий текстовый вывод. Таблица позволяет сопоставить свойства, но сама по себе не отвечает, какой товар лучше подходит определённой потребности. Ассистент добавляет объяснение: для каких задач и обстоятельств уместен каждый вариант. Именно этот переход от набора характеристик к смыслу выбора автор выделяет как полезную часть ответа.
При выборе подарка цель меняется ещё раз. Покупатель может знать интересы другого человека, но не иметь в виду конкретный товар. Здесь подробный разбор одной модели слишком рано сужает выбор. Поэтому ассистент предлагает разнообразные категории, а внутри них — разные товары под названные интересы. Это сценарий поиска идей: помощник расширяет пространство вариантов, а не изображает уверенность в единственном идеальном подарке.
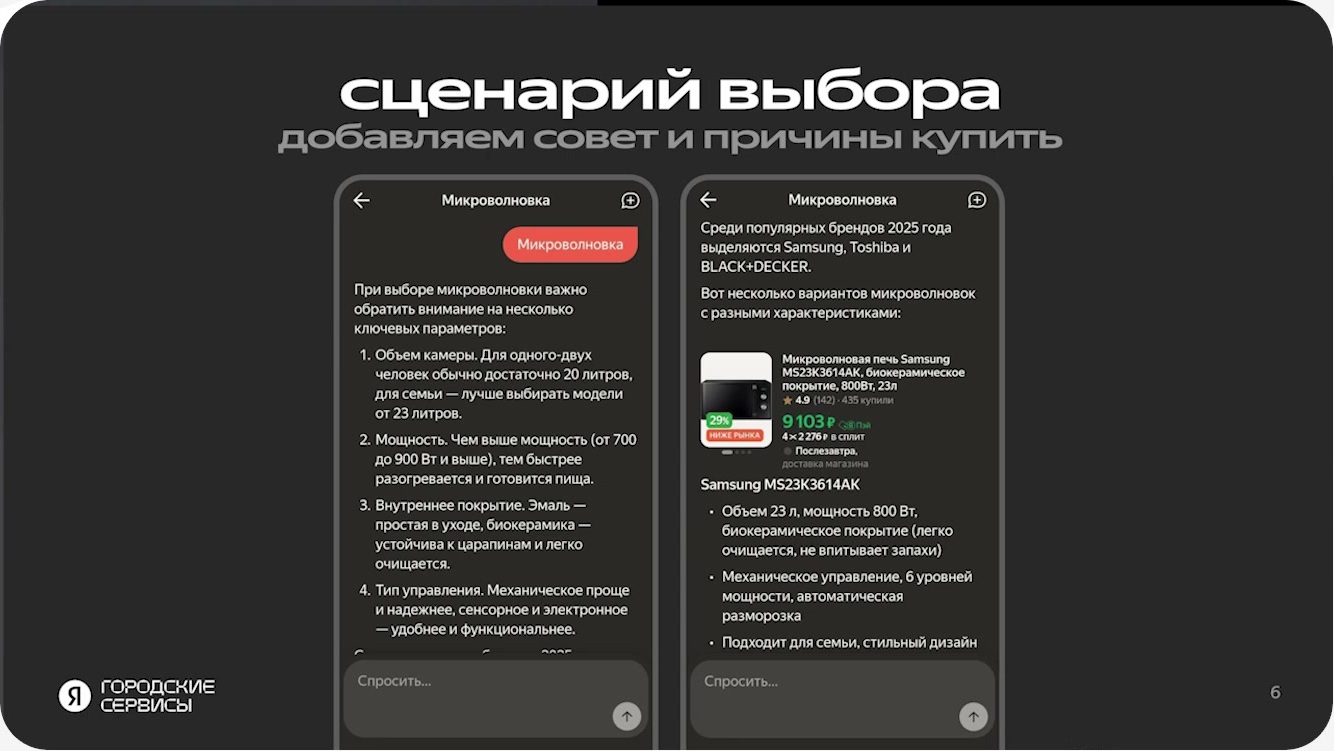
Пример ответа сочетает критерии выбора и карточки товаров.
Источник: Олег Найдин · Яндекс МаркетПростой прототип: рефразер, два поиска и суммаризатор
Для этих сценариев Найдин предлагает начать с базовой схемы, а не с отдельного сложного агента на каждую покупательскую задачу. В ней есть два программных инструмента: поиск информации в интернете и поиск товаров в Маркете. Инструмент здесь означает доступный через API вызов сервиса. Модель не заменяет эти сервисы: она помогает сформулировать обращения к ним и превратить полученные результаты в полезный ответ.
Первую модель автор называет рефразером. На вход она получает диалог, а на выходе формирует поисковые запросы. Это самостоятельная задача: поисковые системы в описанной схеме не умеют непосредственно работать с диалогом. Кроме того, человек не всегда точно выражает потребность. Рефразер должен перевести разговор в форму, с которой уже можно обращаться к поиску.
Из рефразера выходят две группы запросов: за товарами и за информацией. Автор отдельно отмечает, что в каждую поисковую систему отправляют несколько разных запросов, чтобы найти то, что может оказаться полезным покупателю. Это не просто копирование последней реплики в строку поиска. При этом точное число запросов и объём возвращаемой выдачи в докладе не заданы.
Результаты двух поисковых ветвей сходятся у второй модели — суммаризатора. Его задача шире механического сокращения текста: он синтезирует финальный ответ из найденной информации и товаров. Для микроволновки такой ответ связывает объяснение критериев с предложениями, для сравнения — характеристики с выводами, для подарка — идеи категорий с конкретными вариантами.
На схеме данные отделены от исполняющих компонентов: диалог, запросы и ответ показаны белым, поисковые инструменты — серым, языковые модели — жёлтым. Так видны две разные обязанности моделей и место внешнего поиска между ними. Это намеренно упрощённое устройство прототипа, а не полная спецификация работающего МаркетAI: рисунок объясняет поток данных, но не задаёт, например, порядок параллельного выполнения вызовов или обработку их ошибок.
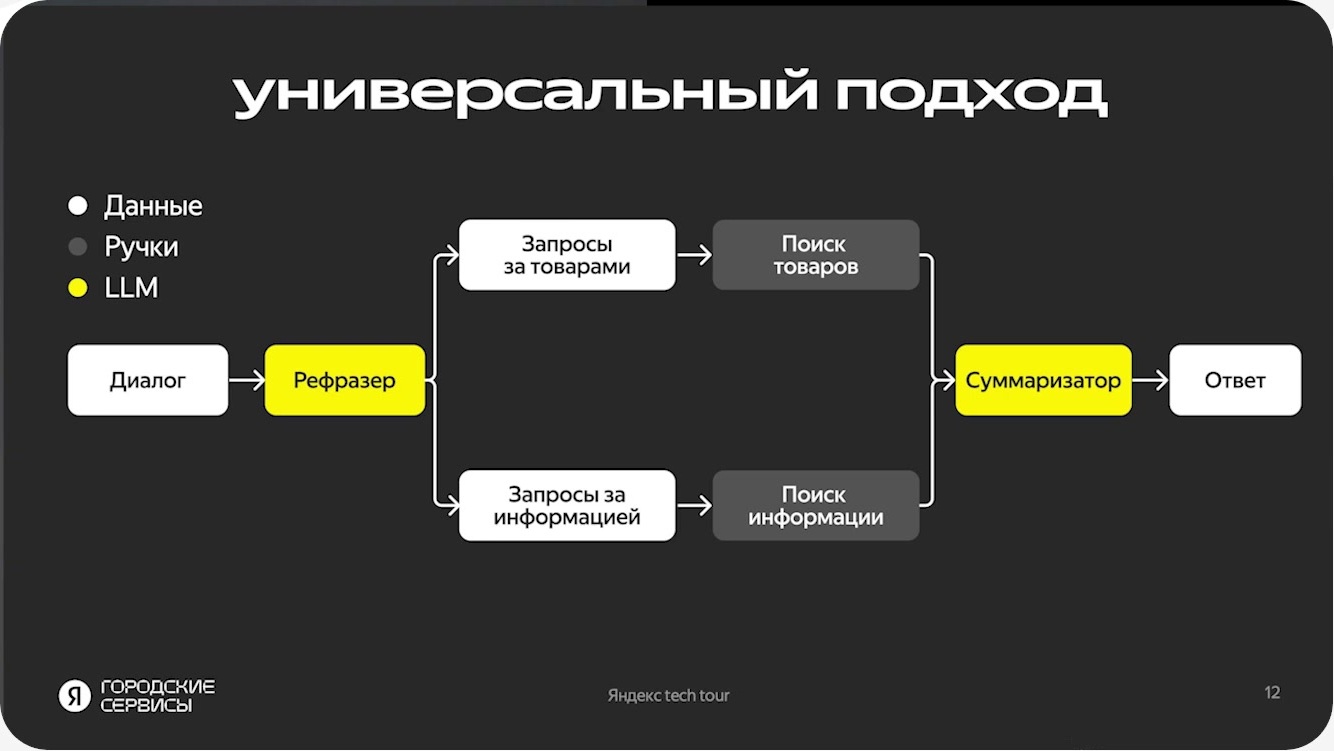
Диалог преобразуется в запросы к поиску товаров и информации; результаты передаются суммаризатору. Это упрощённая схема доклада.
Источник: Олег Найдин · Яндекс МаркетКак расширять помощника, не меняя его основную идею
Базовую схему можно расширять в двух направлениях. Первое — добавлять инструменты для новых потребностей. Чтобы стать не только помощником по выбору, но и более широким ассистентом Маркета, продукту потребуются ответы о статусе заказа, ожидаемом прибытии посылки и балансе Сплита. В выступлении это ближайшие планы, а не перечисление уже запущенных возможностей.
Второе направление — новые инструкции моделям, или промпты, которые меняют работу с имеющимися данными. Например, в результатах интернет-поиска встречаются конкретные модели товаров. Отдельный промпт может извлекать их из текста и тем самым расширять набор рассматриваемых вариантов. Тогда исходный диалог остаётся не единственным местом, из которого появляются названия товаров для дальнейшей работы.
Это разные изменения: новый инструмент открывает доступ к дополнительной функции сервиса, а новый промпт учит использовать уже полученную информацию по-другому. Однако извлечение названия из интернет-текста ещё не объясняет, как оно связывается с карточкой Маркета. Такое сопоставление автор не разбирает, поэтому расширение нельзя считать описанием готового механизма проверки товаров.
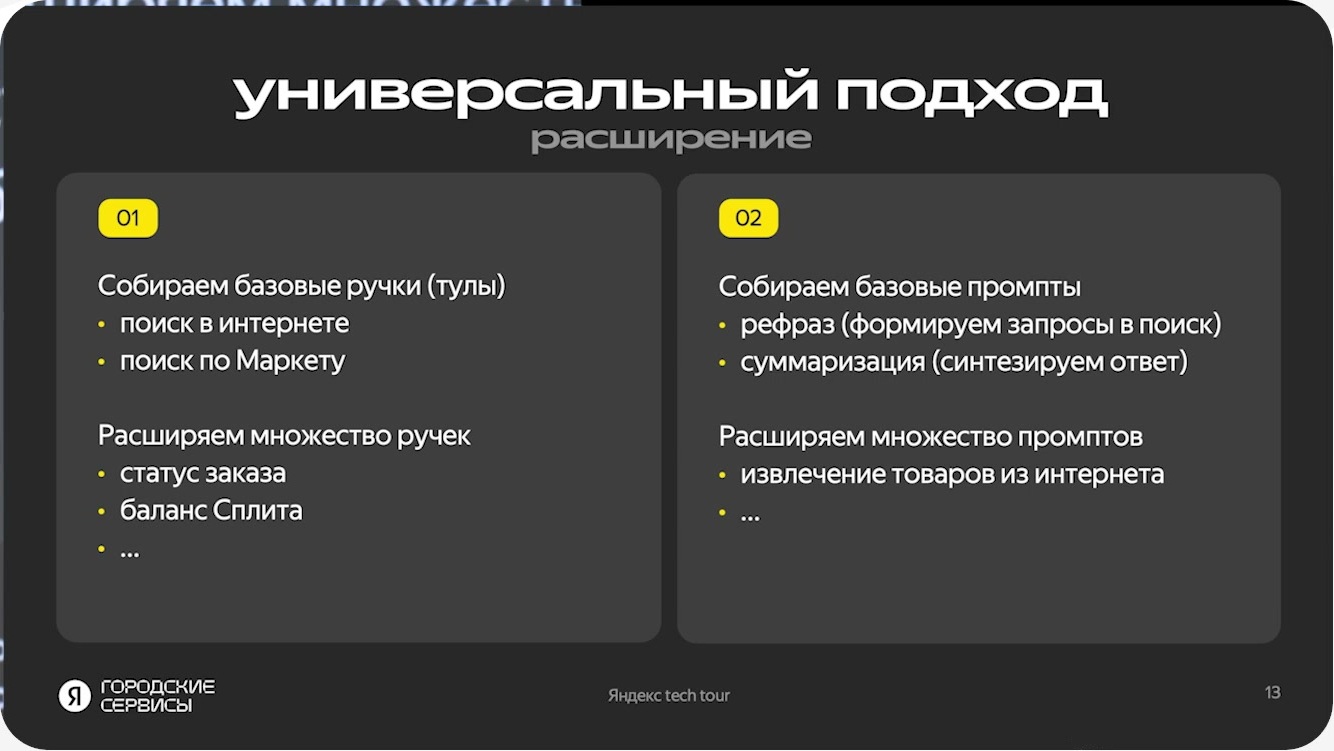
Статус заказа и баланс Сплита показаны как направления расширения, а не доказательство запуска всех возможностей.
Источник: Олег Найдин · Яндекс МаркетКак нащупать MVP и почему удачной демонстрации недостаточно
Когда инструменты и базовые промпты уже доступны, следующий вопрос — не как сразу закончить архитектуру, а какой результат вообще нужен покупателю. Для этого автор предлагает привлекать инженеров и промпт-инженеров к экспериментам, в том числе на хакатонах. Участники пробуют по-разному вызывать инструменты, переставлять шаги и менять инструкции. Так появляется образ минимального полезного продукта — MVP.
Но прототип, на котором удалось получить несколько удачных ответов, ещё не готов к запуску. В докладе переход к продукту описан через четыре ограничения. Они помогают обсуждать не абстрактную «умность» модели, а то, сможет ли человек действительно пользоваться помощником.
Эти ограничения нельзя улучшать независимо друг от друга. Дополнительная модель может сделать ответ содержательнее или удобнее, но одновременно увеличить ожидание. Переписывание цепочки может открыть новый сценарий и отодвинуть запуск. Поэтому дальше Найдин сопоставляет каждое техническое решение с тем, какую именно часть продуктовой задачи оно помогает решить.
Доклад · 00:06:47Почему набор отдельных сценариев перестаёт расти
Выбор микроволновки, сравнение товаров и поиск подарка выглядят разными сценариями. Возникает соблазн для каждого написать собственную последовательность действий, свои инструменты и свой набор промптов. По мысли автора, такой путь плохо масштабируется: расширение продукта превращается в постоянное ручное добавление новых частных решений.
Альтернатива — развивать общие способности, на которых можно строить сценарии. В показанном прототипе такими способностями становятся перевод диалога в поисковые запросы и сборка ответа из найденных данных. Продуктовая вариативность остаётся, но не требует заранее превращать каждую категорию покупки в отдельную программу. Это не отказ от сценариев, а другой способ поддерживать их рост.
Именно поэтому автор связывает продуктовую работу с пониманием технологий. Нужно видеть, какие требования можно выразить через поведение базовой модели, а какие действительно требуют нового инструмента или шага. Хакатоны в этой логике полезны ещё и как способ найти людей, умеющих соединять продуктовый замысел с возможностями моделей, а не только написать удачный промпт.
Доклад · 00:08:51Агенты ускоряют изменения, но могут замедлить ответ
Для разговора о более гибкой сборке Найдин вводит рабочее, а не универсальное определение агента: языковая модель, набор промптов и набор инструментов с описаниями. Мультиагентная система состоит из нескольких таких участников. Они делегируют задачи друг другу, вызывают инструменты и обрабатывают результаты, чтобы совместно довести пользовательскую задачу до ответа.
Сам по себе этот термин не означает, что без специального фреймворка прототип невозможно написать. Универсальную цепочку можно реализовать обычным серверным кодом: вызвать модель, обратиться к поиску, разобрать ответ и передать JSON следующему компоненту. Проблема возникает при частых перестройках. Если захотелось иначе организовать взаимодействия, значительную часть связующего кода приходится писать заново.
Автор иллюстрирует это переходом к другой универсальной схеме, но подробно её не разбирает. Смысл примера — в цене изменения связей между компонентами, а не в доказанном превосходстве одной топологии. Системы сборки агентов полезны тем, что позволяют описывать такие взаимодействия проще и быстрее пробовать варианты поведения.
Быстрые итерации особенно помогают двум первым ограничениям: качеству ответа и удобству интерфейса. Можно добавить агента, который составляет таблицу в конце, или меняет представление товарного блока. Однако каждый такой шаг увеличивает цепочку обработки. В длинной последовательности вызовов LLM суммарное время может расти так, что результат трудно довести до запуска. Гибкость сборки поэтому не равна готовности системы отвечать быстро.
Доклад · 00:09:54Инструменты сборки: исторический срез, а не стек МаркетAI
После обсуждения агентов автор показывает два класса инструментов: high-code, где взаимодействия в основном задают программно, и no/low-code, где значительную часть цепочки собирают из готовых блоков. Его сравнение относится к моменту доклада 2025 года. Это оценки и наблюдения автора, а не актуальный рейтинг возможностей платформ и не перечень компонентов, на которых работает МаркетAI.
Таблицу можно прокрутить по горизонтали.
В этой части обзора важен выбор между быстрым стартом и управляемостью сложного взаимодействия. Найдин отдельно отмечает скорость изменения индустрии: по его словам, три из четырёх показанных high-code решений появились в год выступления. Этот комментарий объясняет исторический контекст списка, но не устанавливает преимущества более нового инструмента.
Таблицу можно прокрутить по горизонтали.
Отдельная перспектива, которую обсуждает автор, — магазины агентских приложений по аналогии с мобильными. Предполагается, что цепочки из промптов и вызовов инструментов можно будет не только быстро собирать, но и распространять. В речи это ожидание будущего развития, а не уже подтверждённый канал распространения МаркетAI. Для дальнейшей логики доклада важнее другое: удобство сборки не освобождает от проверки того, стал ли итоговый ответ лучше.
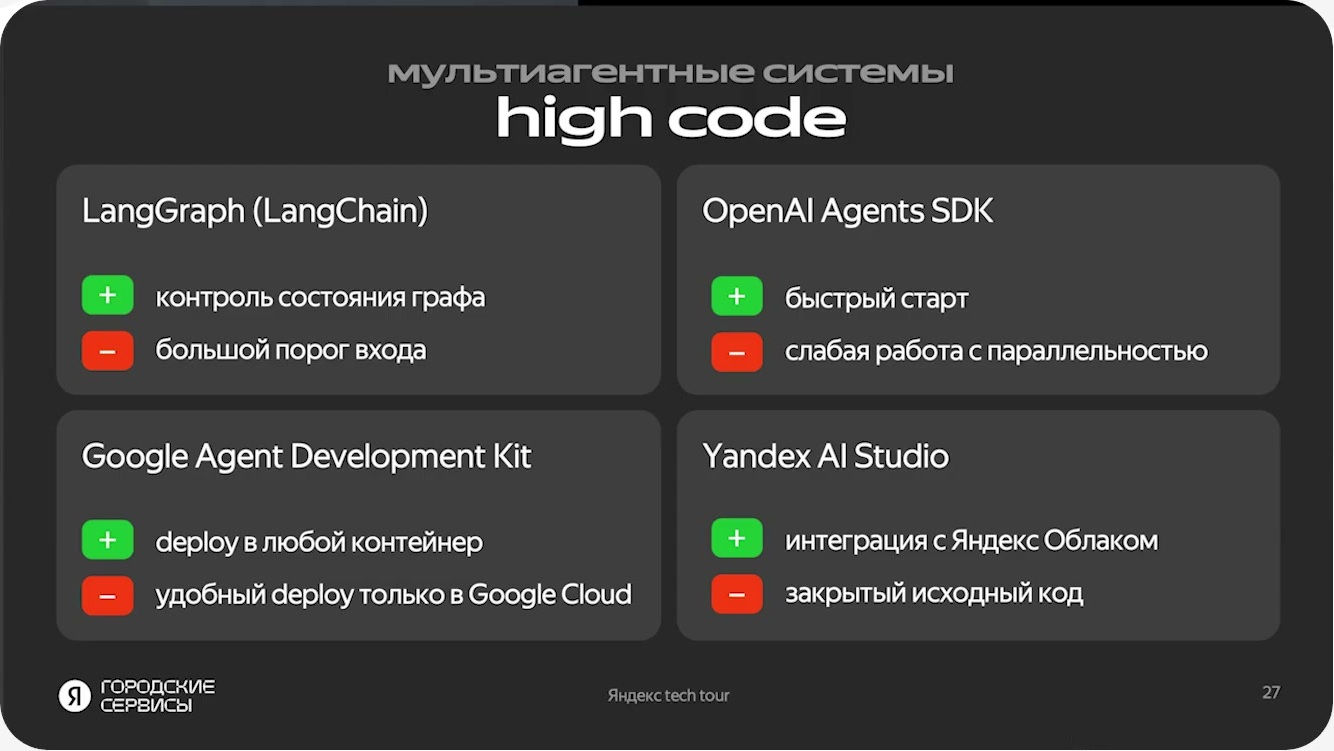
Сравнение LangGraph, OpenAI Agents SDK, Google ADK и Yandex AI Studio отражает мнение автора на момент доклада 2025 года.
Источник: Олег Найдин · Яндекс Маркет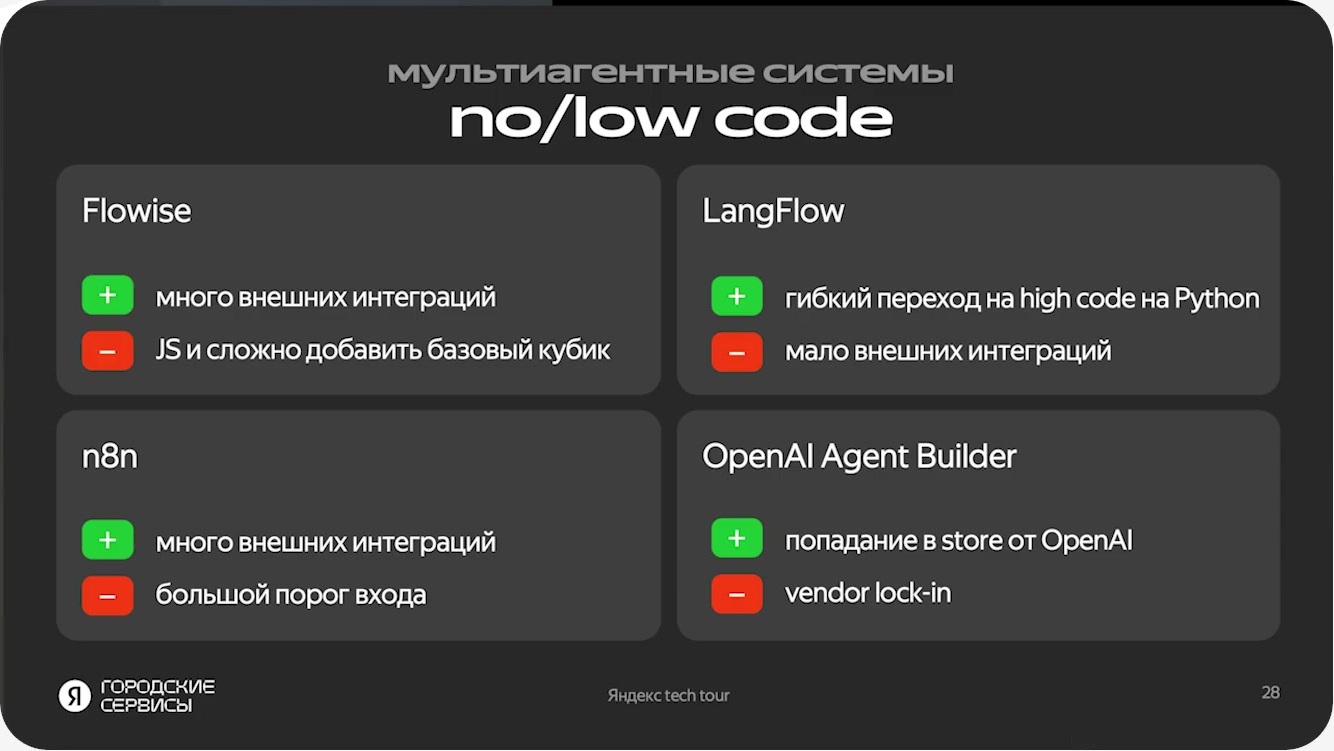
На слайде сравниваются Flowise, LangFlow, n8n и OpenAI Agent Builder; это обзор подходов, а не состав стека МаркетAI.
Источник: Олег Найдин · Яндекс МаркетБез измерения качества быстрые итерации теряют направление
Если цепочку легко перестроить, возникает много вариантов, но ещё не появляется способ выбрать между ними. Найдин предлагает опираться на запросы, похожие на ожидаемый поток будущего ассистента, и на оценки, позволяющие сравнивать ответы. Смысл проверки — после очередного изменения понять, получилась ли успешная итерация, а не просто увидеть ещё одну удачную демонстрацию.
Ручная проверка на нескольких знакомых примерах создаёт риск локального улучшения: команда подстраивает систему под эти примеры и перестаёт замечать остальной поток. В докладе это показано на условных пяти запросах. Речь не о том, что ручная оценка не нужна, а о том, что слишком узкий набор примеров не представляет разнообразие пользовательских задач.
Для сравнения автор допускает оценки людей, автоматические проверки и, возможно, другие языковые модели. Эти средства нужны, чтобы достаточно быстро сопоставлять много вариантов. Но он не задаёт конкретную шкалу, формулу метрики или промпт модели-проверяющего. Поэтому здесь описана организация обратной связи, а не готовая система оценивания с опубликованными результатами.
Проверять нужно и качество содержания, и удобство ответа: помогает ли объяснение выбирать, понятны ли товарные блоки, уместна ли форма результата. Это продолжение исходной продуктовой постановки, а не отдельное соревнование генераторов текста. Такой набор проверок служит ориентиром для развития ассистента; ниже появляется другая задача — подготовить примеры, на которых модель можно обучать.
Доклад · 00:13:57Дообучение: хорошие ответы, SFT и попарные предпочтения
Одних промптов и перестановок агентов может оказаться недостаточно, чтобы добиться нужного поведения в конкретной предметной области. Следующий путь в докладе — дообучение базовой модели под продукт. Автор сразу оговаривает цену: нужны вычисления и способность собирать качественную разметку. Это более трудоёмкая работа, чем изменение инструкции в прототипе. Исходной точкой служит готовая базовая модель общего назначения; автор отмечает, что среди них есть и открытые модели.
Идеальный процесс начинается с инструкции по написанию хороших ответов. По ней тренеры готовят примеры для ассистента, после чего модель учат воспроизводить такое поведение. Этот этап называется SFT — дообучением по образцам желаемых ответов. В учебной последовательности указано написание тысяч ответов. Главный акцент автора — качество: увеличение количества не заменяет соответствия примеров задаче продукта.
Затем появляется отдельная инструкция для SbS, то есть попарного сравнения ответов. Теперь нужно не написать образец, а определить, какой из двух вариантов лучше. На схеме этому соответствует разметка десятков тысяч пар и последующее обучение DPO. В выступлении эта вторая часть обсуждается в разделе об обучении с подкреплением; DPO автор называет своим предпочтительным методом, а не единственно возможным выбором.
Два вида данных несут разный сигнал. Хороший ответ показывает модели, что от неё ожидают. Попарное предпочтение помогает различать более и менее подходящие варианты. При этом тысячи ответов и десятки тысяч пар описывают идеализированный учебный путь, а не раскрытые размеры датасетов МаркетAI. Последовательность SFT и DPO также не доказывает полную историю обучения каждой модели продукта.
Весь этот процесс относится к подготовке модели. Во время обращения покупателя система применяет уже подготовленные модели, вызывает поиск и составляет ответ. Написание примеров, разметка предпочтений и изменение весов не являются шагами, которые нужно заново выполнять для каждого пользовательского запроса.
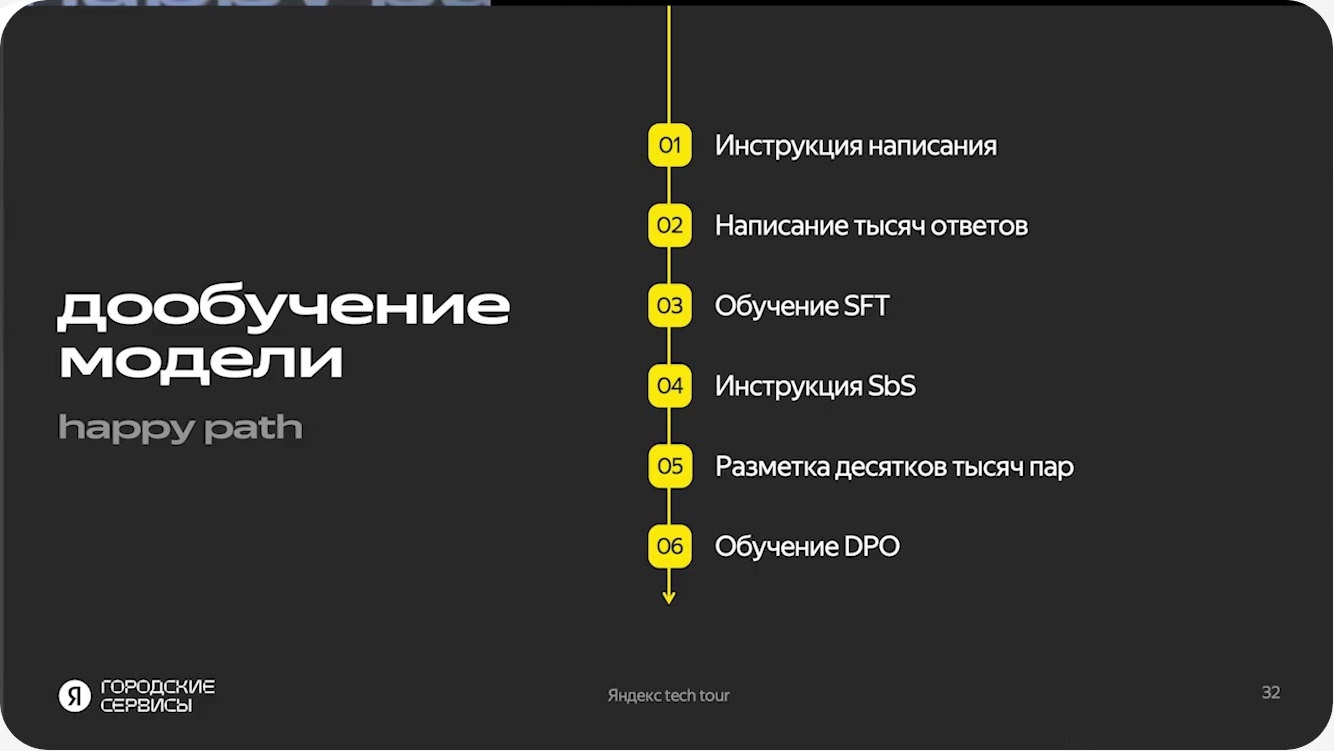
Инструкция, хорошие ответы, SFT, попарная разметка и DPO. Тысячи ответов и десятки тысяч пар здесь описывают учебную схему, не раскрытый датасет продукта.
Источник: Олег Найдин · Яндекс МаркетРеальный путь: инструкции приходится проверять вместе с ответами
Линейная последовательность выглядит убедительно, пока не открыть первые написанные ответы. В реальной работе, которую описывает Найдин, между написанием и обучением появляется проверка. Часть примеров оказывается недостаточно хорошей: подходящие можно оставить, остальные нужно переписать. Образ «половина написана плохо» служит иллюстрацией этой проблемы, а не измеренной долей брака в данных продукта.
Чтобы разделять хорошие и плохие примеры, требуется инструкция фильтрации. Здесь полезна уже проделанная работа над оценкой качества: без понятных критериев трудно объяснить, почему ответ не годится и что именно в нём исправлять. Одной инструкции написания недостаточно, потому что её выполнение ещё не равнозначно приемлемому результату.
На схеме ожидаемого пути повторяются одни и те же действия: написание инструкции, подготовка ответов, инструкция фильтрации, затем новый цикл. Автор дополняет рисунок работой с людьми: нужно улучшать формулировки, разговаривать с тренерами и помогать им писать лучше. Проверка не просто выбрасывает неудачные примеры, а даёт обратную связь для следующей версии инструкции и следующей попытки ответа.
Та же трудность возникает в ветке попарных сравнений. Нужно не только получить много отметок о предпочтении, но и добиться понятного и качественного оценивания. Поэтому подготовка данных не сводится к разовой закупке разметки перед запуском обучения. В центре работы оказываются согласованные критерии хорошего ответа, проверка их применения и повторное исправление неподходящих результатов.
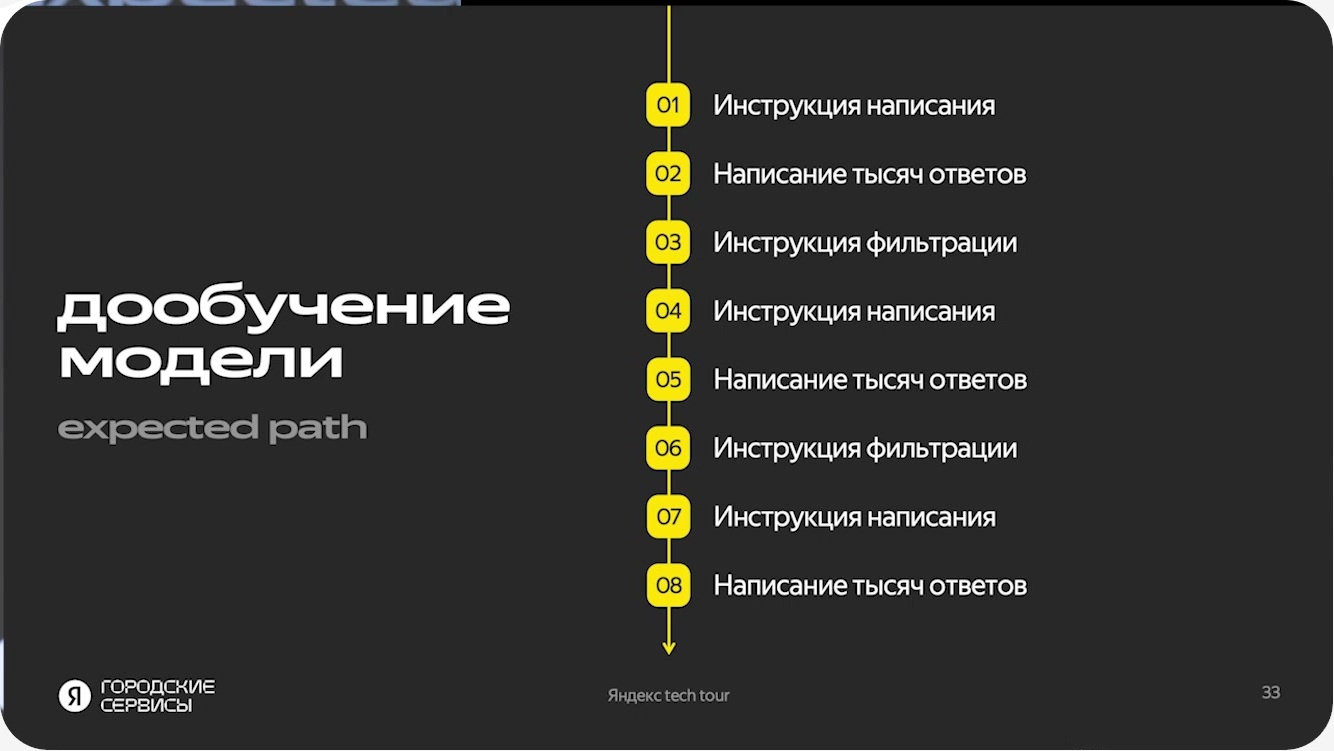
Между написанием и обучением появляются проверка, фильтрация и повторное уточнение инструкции.
Источник: Олег Найдин · Яндекс МаркетКто пишет, кто оценивает и где обучать
У описанного процесса есть три разные ресурсные потребности. Тренеры профессионально пишут ответы для модели. Ассессоры оценивают их качество или сравнивают варианты. Вычислительные ресурсы нужны, чтобы на собранных данных дообучить модель. Эти роли нельзя подменить одним словом «разметка»: создание образца и проверка образца — разные действия.
Для команды без собственной большой разметочной организации автор указывает на крауд-платформы, в том числе платформу Яндекса. На них можно размещать задания, не нанимая исполнителей самостоятельно. Однако описанные ранее инструкции, критерии фильтрации и циклы улучшения от этого не исчезают: внешний способ организации работы не решает сам по себе, какой ответ считать хорошим.
Аналогично рассматриваются облачные сервисы: кроме размещения моделей, они могут предоставлять возможность принести данные и выполнить дообучение на своих вычислениях, в том числе получить адаптер. Конкретный тип адаптера, состав оборудования и бюджет в докладе не названы. Здесь показан способ получить доступ к необходимым ресурсам, а не расчёт стоимости обучения МаркетAI.
Доклад · 00:18:06Модель под роль: не каждому шагу нужна одинаковая мощность
После трудоёмкой подготовки данных возникает естественный вопрос: зачем идти этим путём? Найдин связывает дообучение с двумя выгодами — более точным соответствием задаче продукта и возможностью упростить цепочку обработки. Вместо длинной последовательности общих моделей с промптами можно подготовить модели под конкретные обязанности. Это позиция автора о пользе специализации, а не приведённый в докладе численный эксперимент.
В базовой схеме обязанности заметно различаются. Рефразер читает диалог и формулирует запросы в поиск. Суммаризатор собирает содержательный ответ из результатов поисков. Для первой задачи автор предлагает рассмотреть меньшую модель, а для второй — более сильную. Доменная адаптация означает, что модель дообучают именно под нужную роль и ожидаемый поток запросов.
Таблицу можно прокрутить по горизонтали.
Обозначения 8B и 32B означают восемь и тридцать два миллиарда параметров соответственно. Это размеры приведённых моделей, не значения качества, задержки или расхода памяти сервиса. Автор высказывает предположение, что адаптированный небольшой рефразер может потребовать меньше параметров, чем общая модель с промптами при сопоставимом поведении; измеренного сравнения он не приводит.
Ещё один вариант экономии связан не с ролью, а со сложностью обращения внутри одной роли. Для ответа на «привет» не обязательно использовать ту же модель, что для сложного выбора микроволновки. Автор предлагает обучить два суммаризатора и разделить поток. Это возможность развития, а не подтверждение уже действующего распределения трафика: способ определения сложности, доли обращений и экономия не раскрыты.
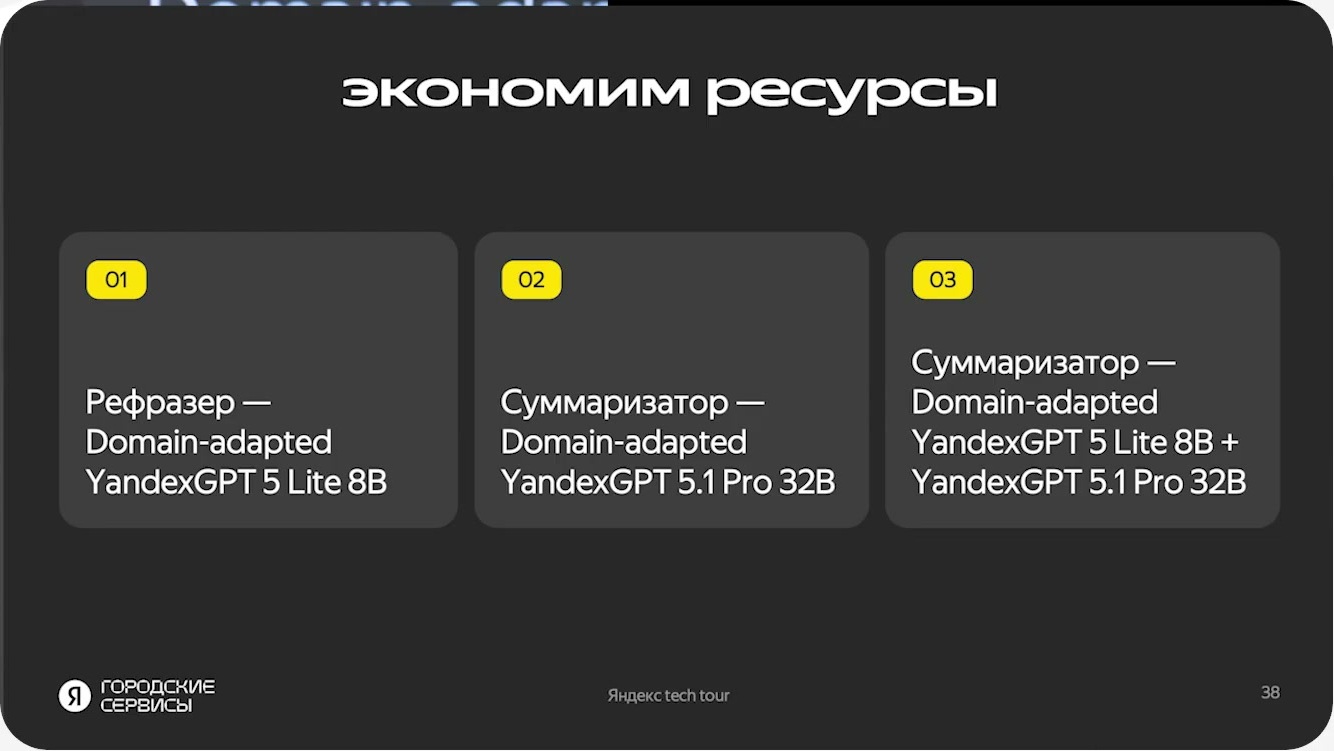
На слайде: адаптированный YandexGPT 5 Lite 8B для рефразера и YandexGPT 5.1 Pro 32B для суммаризатора. Это пример распределения вычислений по ролям.
Источник: Олег Найдин · Яндекс МаркетПочему преимущество специализации не объявлено вечным
Защищая доменную адаптацию, Найдин сам приводит аргументы против её долгосрочной необходимости. Первый — развитие общих моделей. Если они всё лучше следуют сложным инструкциям, разница между отдельным дообучением и хорошим промптом может уменьшаться. Следовательно, тезис о преимуществе специализированной модели не обязан оставаться верным для любого следующего поколения моделей.
Второй аргумент относится к вычислениям. Автор допускает, что их удешевление позволит выполнять большие модели за приемлемое время и на разумном объёме оборудования. Тогда часть мотивации использовать меньшие модели ради скорости тоже может ослабнуть. Это взгляд на возможное развитие технологий, а не прогноз с конкретным сроком и расчётом.
Его практическая позиция привязана к моменту доклада: пока специализация помогает продукту и у команды есть возможности для неё, её имеет смысл использовать. Тем самым дообучение не противопоставляется развитию общих моделей навсегда. Это способ получить нужное поведение при имеющихся условиях, который может потребовать переоценки вместе с этими условиями.
Доклад · 00:21:16Скорость приходится закладывать ещё в прототип
После запуска ассистента радикально перестраивать его становится болезненнее. Поэтому автор возвращается к MVP уже с другой стороны: экспериментальная гибкость нужна, но технические решения, от которых зависит ожидание пользователя, лучше учитывать заранее. Прежде всего это разделение задач между моделями и использование меньших моделей там, где они справляются со своей ролью.
В этой логике ускорение начинается не с настройки отдельного вычислительного приёма, а с устройства самой цепочки. Если каждый новый элемент ответа достигается ещё одним тяжёлым вызовом, удобная сборка прототипа превращается в медленную обработку запроса. Разделение ролей и подготовка моделей дают основу, к которой уже можно добавлять оптимизацию выполнения.
Далее в докладе идут два разных типа изменений. Квантизация и спекулятивное декодирование направлены на выполнение моделей. Стриминг меняет то, когда человек начинает видеть результат. Они отвечают на связанную продуктовую проблему ожидания, но действуют не на одном и том же уровне.
Доклад · 00:22:14Квантизация: уменьшить точность хранения весов
Первая вычислительная мера — квантизация весов. У большой модели много численных параметров, и их хранение с высокой точностью требует памяти. Найдин объясняет идею через более грубое представление этих чисел: точность записи уменьшается, а модель становится компактнее. Цель — снизить расход ресурсов без существенной потери полезного поведения.
В объяснении используется условный переход от нескольких байтов на число к одному байту. Это иллюстрация принципа, а не описание конкретного формата весов МаркетAI. Автор связывает такое сжатие и с ускорением, но не задаёт исходную точность, метод квантизации, оборудование или проверочный набор.
Поэтому сказанное о сжатии и ускорении «в несколько раз» нельзя превращать в результат внедрения или обещание такого же эффекта на любой модели. Для истории ассистента здесь важен дополнительный способ управлять памятью и скоростью. Оценить фактическую экономию ресурсов МаркетAI по этому объяснению нельзя: сравнительных измерений в нём нет.
Доклад · 00:22:49Маленькая модель предлагает продолжение, большая его проверяет
Второй приём — спекулятивное декодирование. Автор рассматривает вариант с небольшой draft-моделью, которая пытается предсказать продолжение за более крупную модель. Большая модель затем проверяет предложенное. За счёт сочетания дешёвой генерации и проверки появляется возможность ускорить получение ответа.
На схеме draft-модель последовательно строит продолжение по контексту, после чего оно поступает основной модели. Над результатом проверки стоят обозначения accept/reject — принять или отклонить. Смысл рисунка в разделении предложения и проверки, а не в замене основной модели другой моделью без контроля.
Найдин сравнивает этот приём с распределением простого и сложного между моделями, но это аналогия. Ранее речь шла о выборе суммаризатора для целого пользовательского обращения. Здесь две модели участвуют в генерации одного ответа: одна предлагает продолжение, другая его проверяет. Эти способы экономии не следует считать одной и той же схемой маршрутизации.
Доклад не задаёт конкретный алгоритм спекулятивного декодирования, долю принятых предложений или коэффициент ускорения. Нарисованные блоки продолжения также не определяют производственный размер такого блока. Представлен общий механизм, который автор предлагает учитывать при работе над скоростью.
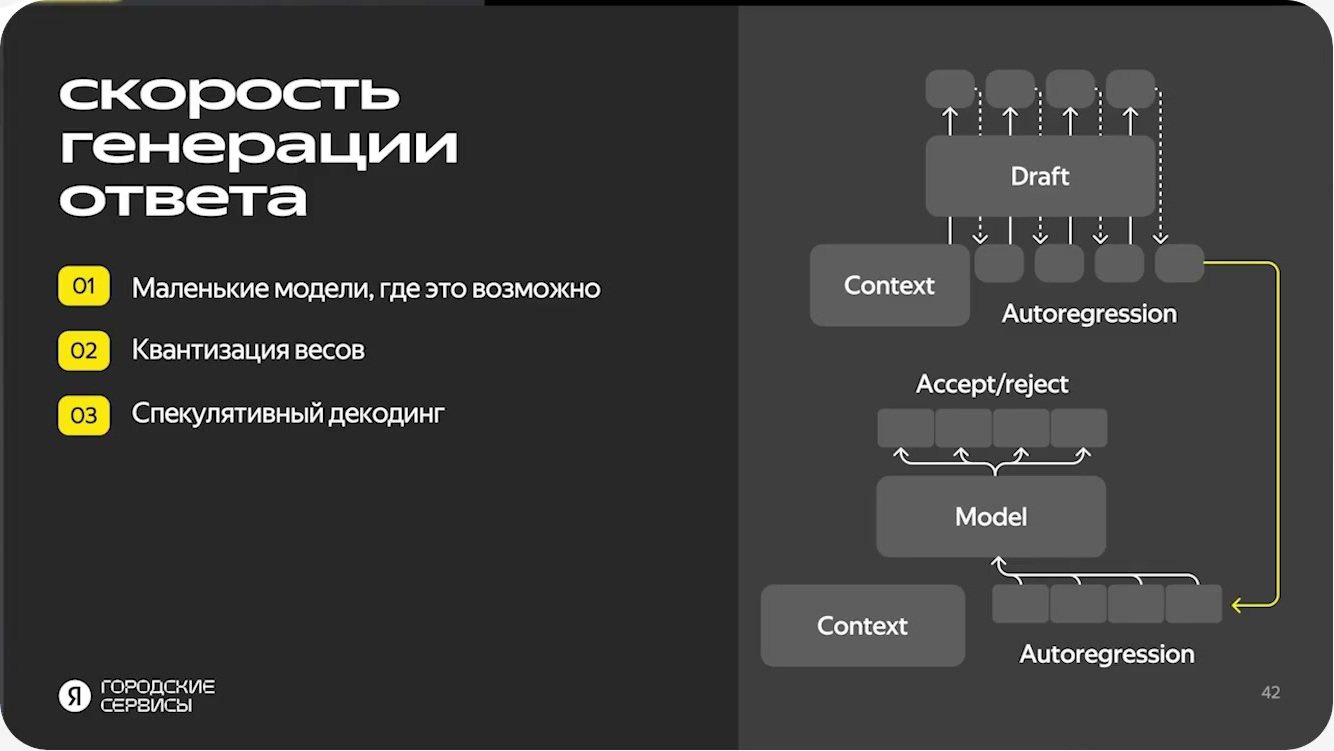
Небольшая draft-модель предлагает продолжение, большая проверяет его. Конкретный коэффициент ускорения не указан.
Источник: Олег Найдин · Яндекс МаркетСтриминг: начать помогать до окончания генерации
Даже при той же длительности генерации ответ можно сделать удобнее для человека. Языковая модель пишет текст последовательно: следующий токен зависит от уже полученного контекста и продолжения. Пользователь тоже читает постепенно. Поэтому не обязательно ждать последнего символа, прежде чем показать первый.
Стриминг финального ответа означает, что текст последней модели начинает поступать на экран по мере появления. Покупатель уже читает объяснение, пока продолжение ещё генерируется. Автор оговаривает условие: если человек читает медленнее, чем приходит текст, оставшаяся генерация может не восприниматься как отдельное ожидание. Это не обещание сократить полное время вычисления ответа до нуля.
Вторая возможность — показывать промежуточные шаги до появления финального текста. Например, интерфейс может сообщать, что ассистент анализирует вопрос, а затем показывать, с какими запросами он обращается к поиску. Так пауза становится понятнее: человек видит, какую работу за него выполняет система.
Найдин связывает эту прозрачность с доверием: пользователь узнаёт действия, которые мог бы сделать самостоятельно. Это объяснение предполагаемой пользы интерфейса, а не опубликованный замер роста доверия. Показ промежуточных действий также не доказывает правильности конечного ответа. Стриминг дополняет работу над содержанием и скоростью, но не заменяет её.
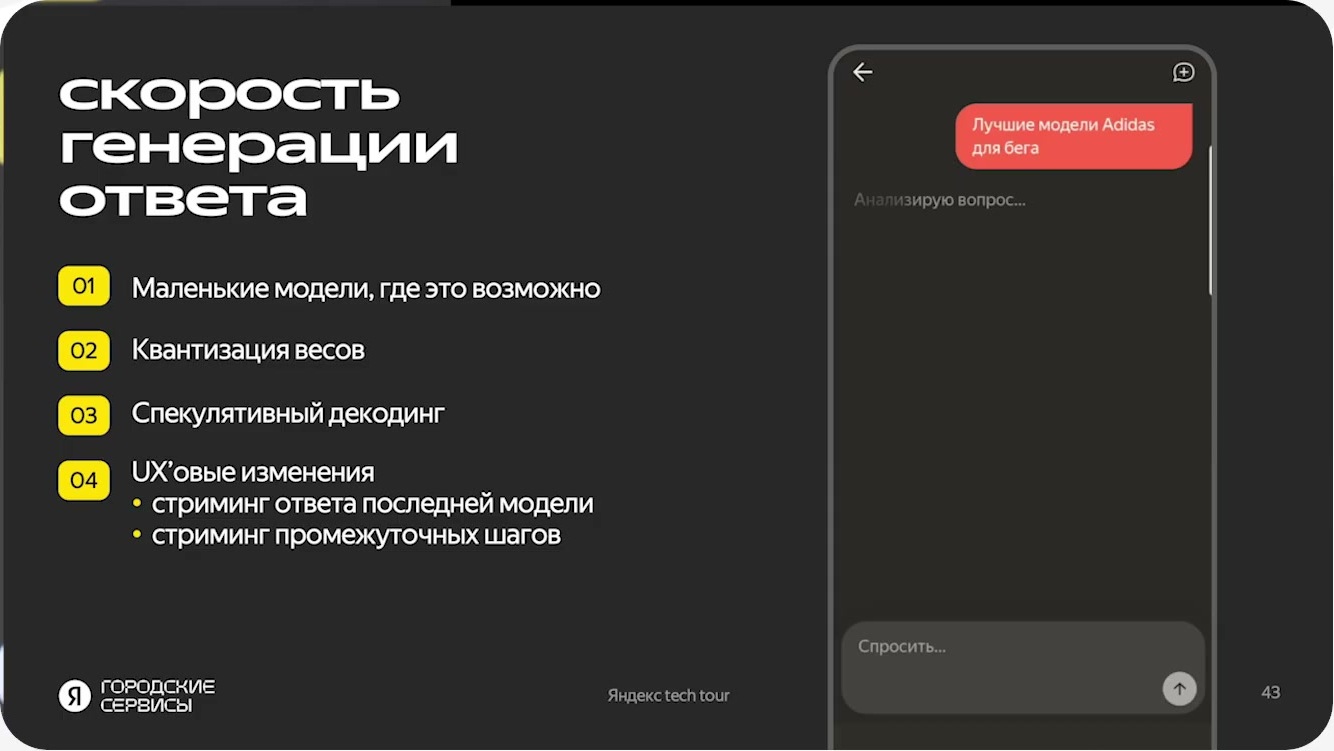
Стриминг финального ответа и промежуточных шагов дополняет выбор меньших моделей, квантизацию и спекулятивное декодирование.
Источник: Олег Найдин · Яндекс МаркетМонолит и отдельные роли: разделять, но не дробить бесконечно
Последний архитектурный вопрос возвращает разговор к исходной схеме. Всю работу можно было бы поручить одному агенту: дать ему поисковые инструменты и длинную инструкцию о том, как формулировать запросы, искать товары и собирать итоговый ответ. В таком варианте разные обязанности оказываются внутри одного большого набора требований.
Автор проводит аналогию с монолитом и микросервисами. Его опасение связано с перегрузкой агента: при изменении одного поведения становится сложнее удерживать остальные. Разделение рефразера и суммаризатора даёт более локальные изменения. Можно отдельно работать над поисковыми формулировками или над сборкой ответа и проще контролировать соответствующую часть.
Однако это не отменяет уже обсуждённую цену длинных цепочек. Если каждое небольшое требование выделять в ещё одного агента, гибкость снова оплачивается временем ответа. Поэтому итоговая рекомендация автора — поддерживать баланс, а не всегда выбирать максимум отдельных компонентов.
Аналогия относится и к разработке, и к обучению, и к применению моделей. Граница между ролями помогает решать, какое поведение менять инструкцией, какое закреплять данными и где использовать более компактную модель. При этом разделение на рисунке не является описанием фактического развёртывания сервисов МаркетAI или доказательством того, что каждому блоку соответствует отдельный сетевой сервис.
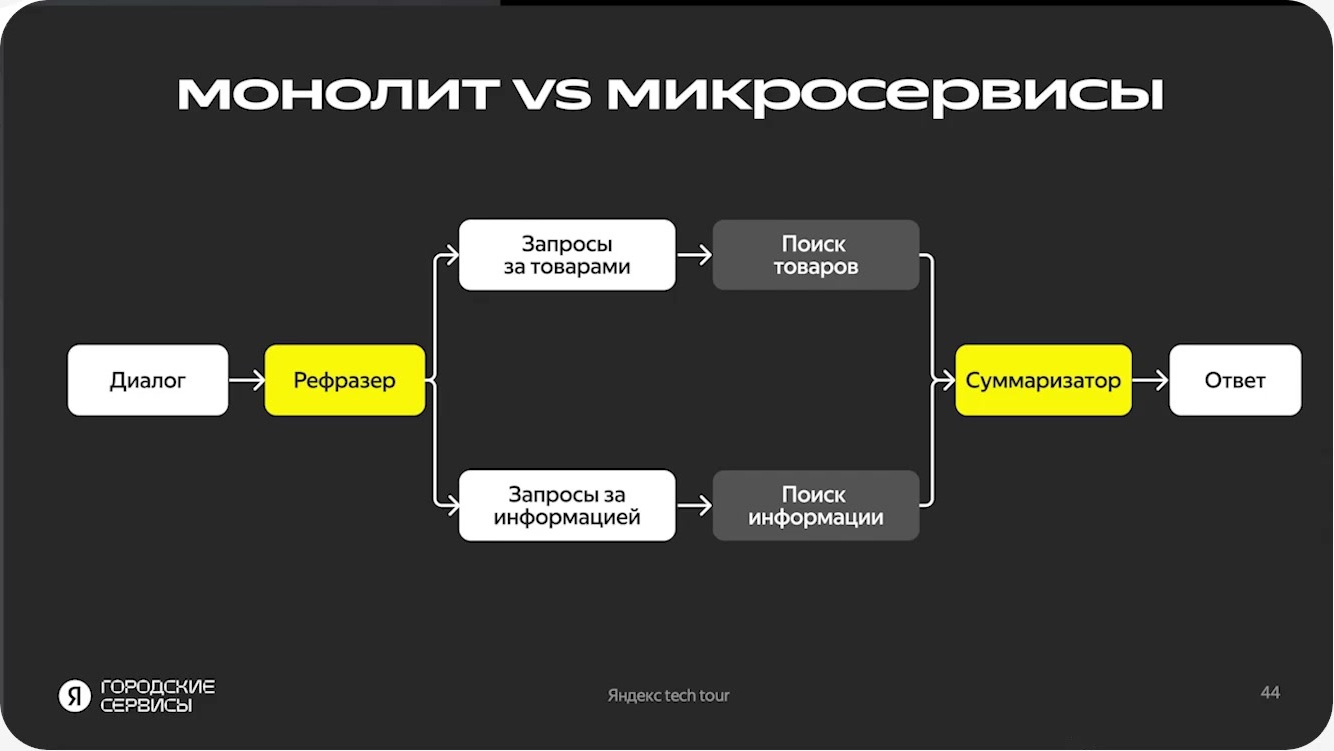
Разделение рефразера, поисковых инструментов и суммаризатора позволяет независимо менять части системы; универсального выбора автор не обещает.
Источник: Олег Найдин · Яндекс МаркетЧто даёт этот путь и где заканчиваются раскрытые детали
Продуктовая история в докладе имеет конкретный результат: МаркетAI прошёл от прототипов к бете и к моменту выступления уже вышел из неё. Показаны сценарии, в которых объяснение выбора связано с конкретными товарами. Техническая часть, в свою очередь, объясняет способы развивать такой помощник, но не раскрывает всю его производственную конфигурацию.
Финальный акцент Найдина — инвестировать в инфраструктуру уже с MVP. Скорость и надёжность для него не вспомогательные инженерные свойства: медленный или неработающий помощник не решает задачу пользователя, даже если отдельная модель умеет писать хорошие ответы. Поэтому выбор границ моделей, оптимизация выполнения и постепенная выдача результата возвращают разговор к продуктовой ценности.
При этом доклад не приводит численных показателей качества, результатов A/B-теста, задержки ответа, стоимости обращения или бюджета обучения. Не раскрыты и состав обучающего корпуса, разделение данных для обучения и проверки, полный набор моделей и инструментов. Поэтому размеры моделей и учебные объёмы разметки нельзя использовать вместо отсутствующих эксплуатационных результатов.
Отдельная граница касается выдуманных товаров и неподтверждённых утверждений. В базовой цепочке есть поиск по Маркету, но само его наличие не доказывает защиту от таких ошибок. Автор не описывает проверку идентификаторов, цены или наличия товара и не задаёт механизм ограничения ответа только проверенными карточками. Это неизвестные детали, а не утверждение об отсутствии защиты в продукте. Аналогично статус заказа и баланс Сплита остаются в рассказе направлениями расширения, а не готовыми составляющими показанного сценария.
Доклад · 00:27:02Итог: как запрос становится покупательским ответом
МаркетAI соединяет две части покупки: понимание критериев и поиск конкретных товаров. Рассмотренный путь начинается с простого прототипа, затем проходит через эксперименты с ответами, оценку, подготовку данных и специализацию моделей. Его цель — сохранить полезность диалога, не превратив каждый новый сценарий в длинную и медленную цепочку.
- 01
Диалог о покупке
Пользователь описывает потребность. Это может быть выбор товара, сравнение вариантов или поиск подарка по интересам другого человека.
- 02
Формирование запросов
Рефразер переводит диалог в несколько запросов за информацией и товарами, помогая доформулировать то, что нужно найти.
- 03
Обращение к поиску
Инструменты ищут информацию в интернете и товары в Маркете. Результаты этих поисковых ветвей становятся материалом для ответа.
- 04
Синтез ответа
Суммаризатор объединяет найденное в объяснение, сравнение или набор идей, связывая текст с рассматриваемыми товарами.
- 05
Представление результата
Покупатель получает текст и товарные блоки. Финальный текст можно выдавать по мере генерации; сообщения о промежуточных действиях показывают раньше.
Развитие этой цепочки требует репрезентативных запросов и сравнения ответов людьми и автоматикой. Дообучение происходит отдельно: тренеры пишут примеры, ассессоры проверяют их и размечают предпочтения, инструкции уточняют, неподходящие ответы переписывают. SFT и DPO относятся к подготовке моделей, а не к обработке каждого обращения.
Автор описывает пользу адаптации по ролям, квантизации и спекулятивного декодирования, но не публикует численных результатов качества, задержки или стоимости. Примеры моделей не являются полной конфигурацией сервиса; механизмы защиты от выдуманных товаров не раскрыты. Заказы и Сплит остаются планами. Главный вывод — развивать содержание ответа, его форму и инфраструктуру вместе, сохраняя баланс между одним перегруженным агентом и чрезмерным дроблением обработки.
Доклад · 00:27:20