Разбор готов
Spotify: NEO и GLIDE — LLM для поиска и рекомендаций по реальному каталогу
Рекомендательная система Spotify уже умеет подстраиваться под историю слушателя, но обычные сигналы — прослушивания, лайки, сохранения и пересылки — лишь косвенно говорят, чего человек хочет сейчас. Естественный язык обещает более прямой способ управления: можно сформулировать цель словами, а модель попробует совместить её с историей поведения. Для реального продукта этого недостаточно. Рекомендация должна указывать на существующий объект каталога, учитывать доступность и продуктовые ограничения, масштабироваться на миллионы объектов и укладываться в требования по стоимости, задержке и надёжности. Статья Spotify Research разбирает два дополняющих подхода. NEO — исследовательский подход, который учит одну LLM совместно работать с языком и сущностями каталога в задачах поиска, рекомендаций, объяснения и понимания пользователя. GLIDE — более узкая рабочая система для генерации кандидатов подкастов, встроенная в существующий рекомендательный стек Spotify. Разбор полезен тем, кто хочет понять не только идею генеративных рекомендаций, но и путь от нового словаря объектов до работающего сервиса, его оценки и ограничений.
Материал полезен ML- и RecSys-инженерам, которые знакомы с базовым отбором кандидатов и ранжированием и хотят понять, как LLM можно связать с большим каталогом, персонализацией и реальными ограничениями продукта.
Статья · на английском
From Models to Products: LLMs for Recommendation at Spotify ScaleEdoardo D’Amico, Marco De Nadai, Mounia Lalmas, Paul Bennett, Praveen Ravichandran · Опубликовано: 3 августа 2026 г.
Почему рекомендациями хочется управлять языком
Для пользователя рекомендации обычно остаются непрозрачными. Он может поставить лайк, дослушать эпизод, сохранить его или переслать, и система со временем подстроится, но все эти действия — косвенные сигналы. Если сегодня хочется сознательно сменить направление и, например, искать другой тип контента, выразить это напрямую трудно. Естественный язык даёт другой интерфейс: пользователь формулирует намерение словами, а модель учитывает эту инструкцию вместе с поведением.
Однако LLM нельзя просто поставить вместо рекомендательной системы. Она должна вернуть реальный объект, который существует в каталоге, доступен конкретному слушателю и соответствует текущей продуктовой цели. Ей также нужно персонализировать ответ по длинной истории, работать с каталогом из миллионов объектов и соблюдать ограничения рабочего сервиса по задержке, стоимости и надёжности. На этом фоне NEO и GLIDE решают разные вопросы: NEO исследует единую многоцелевую модель, а GLIDE проверяет, как такой принцип довести до промышленной рекомендации подкастов.
Opening paragraphs before “Teaching an LLM to speak the catalog”Как научить LLM говорить на языке каталога
Главная проблема — привязка генерации к каталогу. Обычная языковая модель может выдать правдоподобное название эпизода, даже если такого эпизода нет. Для рекомендательной системы нужен не похожий текст, а точная ссылка на существующий объект. Spotify использует Semantic IDs — семантические идентификаторы: короткие последовательности дискретных токенов, полученных из содержания объектов.
В отличие от произвольного номера объекта, такой код несёт структуру: похожие объекты получают похожие последовательности. Благодаря этому у LLM появляется компактный словарь сущностей каталога, с которым можно работать так же последовательно, как с обычными текстовыми токенами. Авторы подчёркивают, что подход рассчитан на каталоги с миллионами объектов.
Схема NEO показывает основной принцип: текстовые токены и токены Semantic ID попадают в один смешанный поток, который читает и продолжает один декодер. На выходе модель может породить идентификатор объекта каталога, естественный язык или их сочетание. Смысл схемы не в свободной генерации названий, а в том, что язык и реальные сущности каталога становятся частями одного интерфейса модели.
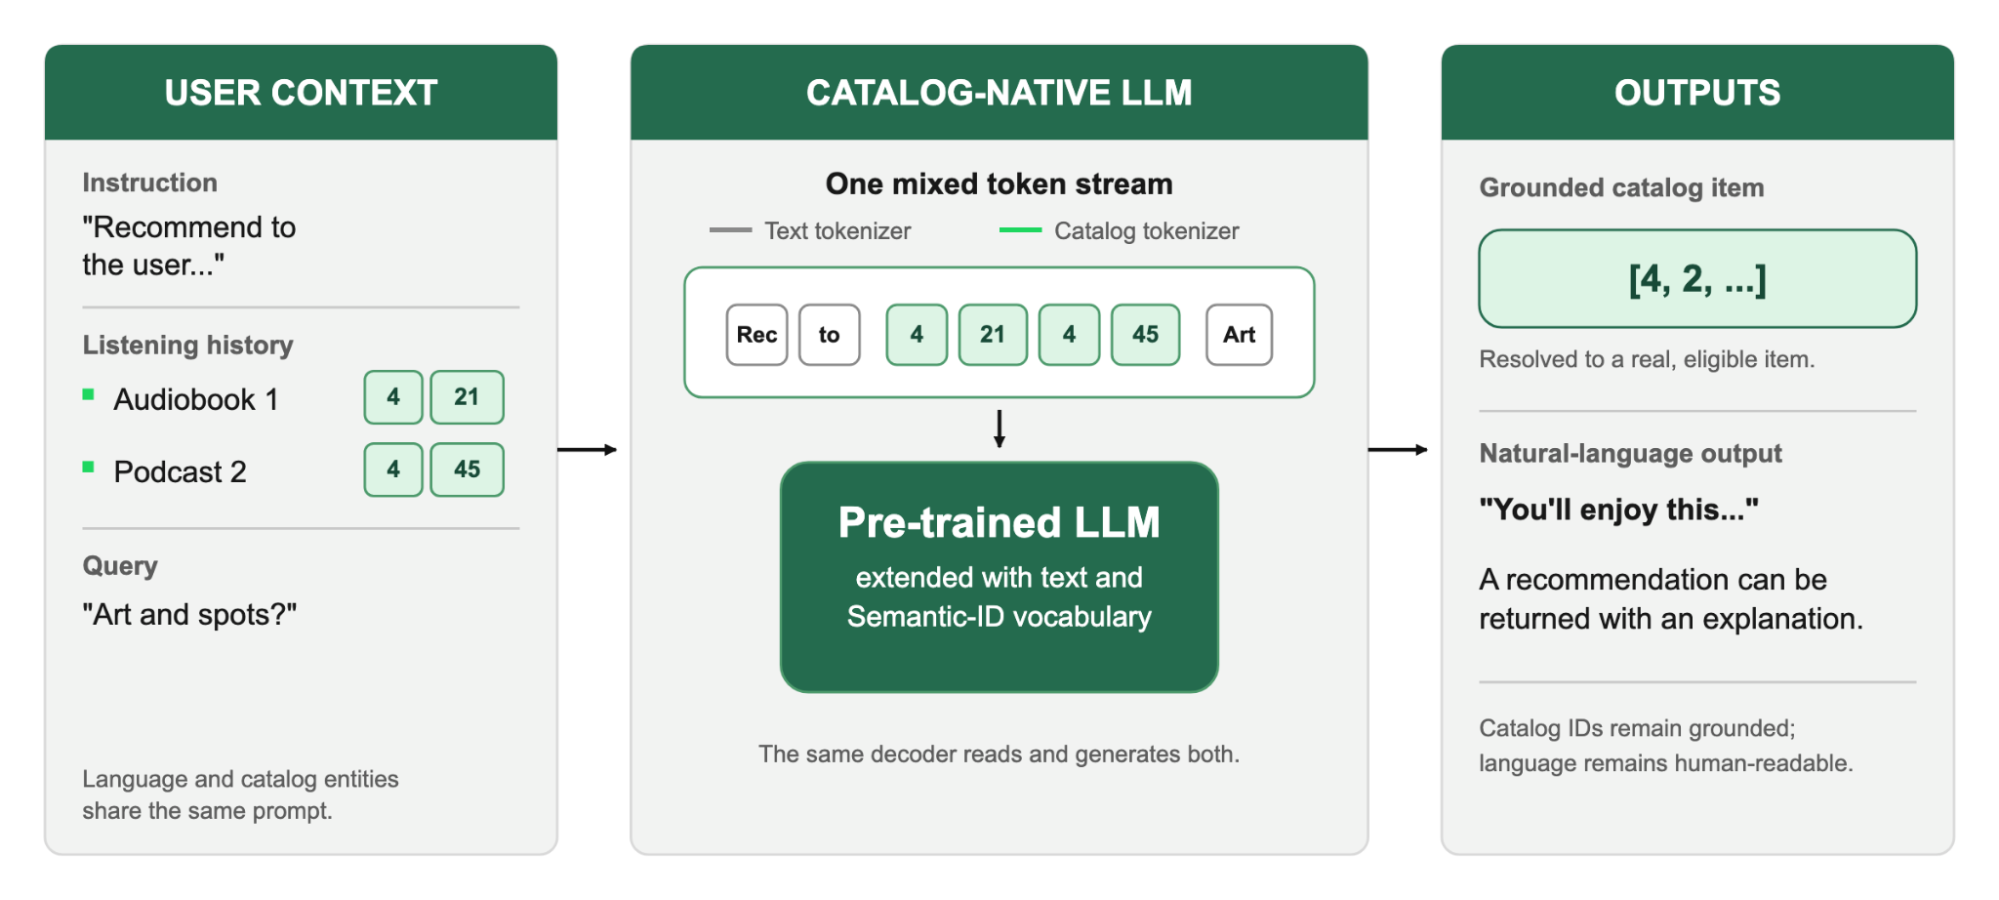
NEO читает текст и семантические коды объектов в одной последовательности и может вернуть объект каталога вместе с объяснением.
Источник: Spotify Research · NEO и GLIDENEO: одна модель для нескольких задач
В традиционной системе поиск, рекомендации, объяснения и построение представления о пользователе часто обслуживаются разными моделями. NEO проверяет более общий вариант: можно ли дать одной LLM общий интерфейс, в котором естественный язык и объекты каталога представлены совместно.
Промпт может содержать текстовую инструкцию, историю пользователя и ссылки на объекты. Выходом могут быть Semantic IDs, обычный текст или смешанный ответ. Инструкция задаёт задачу, тип нужной сущности и формат результата. Поэтому одна и та же модель может искать объект по запросу, рекомендовать эпизод, шоу, аудиокнигу или исполнителя, объяснять рекомендацию и описывать интересы пользователя. В этом смысле NEO управляется языком: меняется инструкция, а не сама модель.
NEO: a unified model for search, recommendation, and reasoningТри стадии обучения NEO
Добавить новые каталожные токены в готовую LLM недостаточно: модель ещё не знает, как они связаны с языком и друг с другом. Поэтому NEO обучается по стадиям. Авторы сравнивают Semantic IDs с новой модальностью: сначала её нужно согласовать с уже существующими языковыми знаниями, а уже затем учить модель решать прикладные задачи.
Таблицу можно прокрутить по горизонтали.
Смысл второй схемы именно в порядке действий. Сначала строится семантический код объекта, затем новые токены аккуратно привязываются к языковому пространству при замороженной основной модели, и только после этого вся сеть обучается многозадачно. Такой порядок нужен, чтобы не пытаться одновременно освоить новый словарь каталога и все прикладные способности.
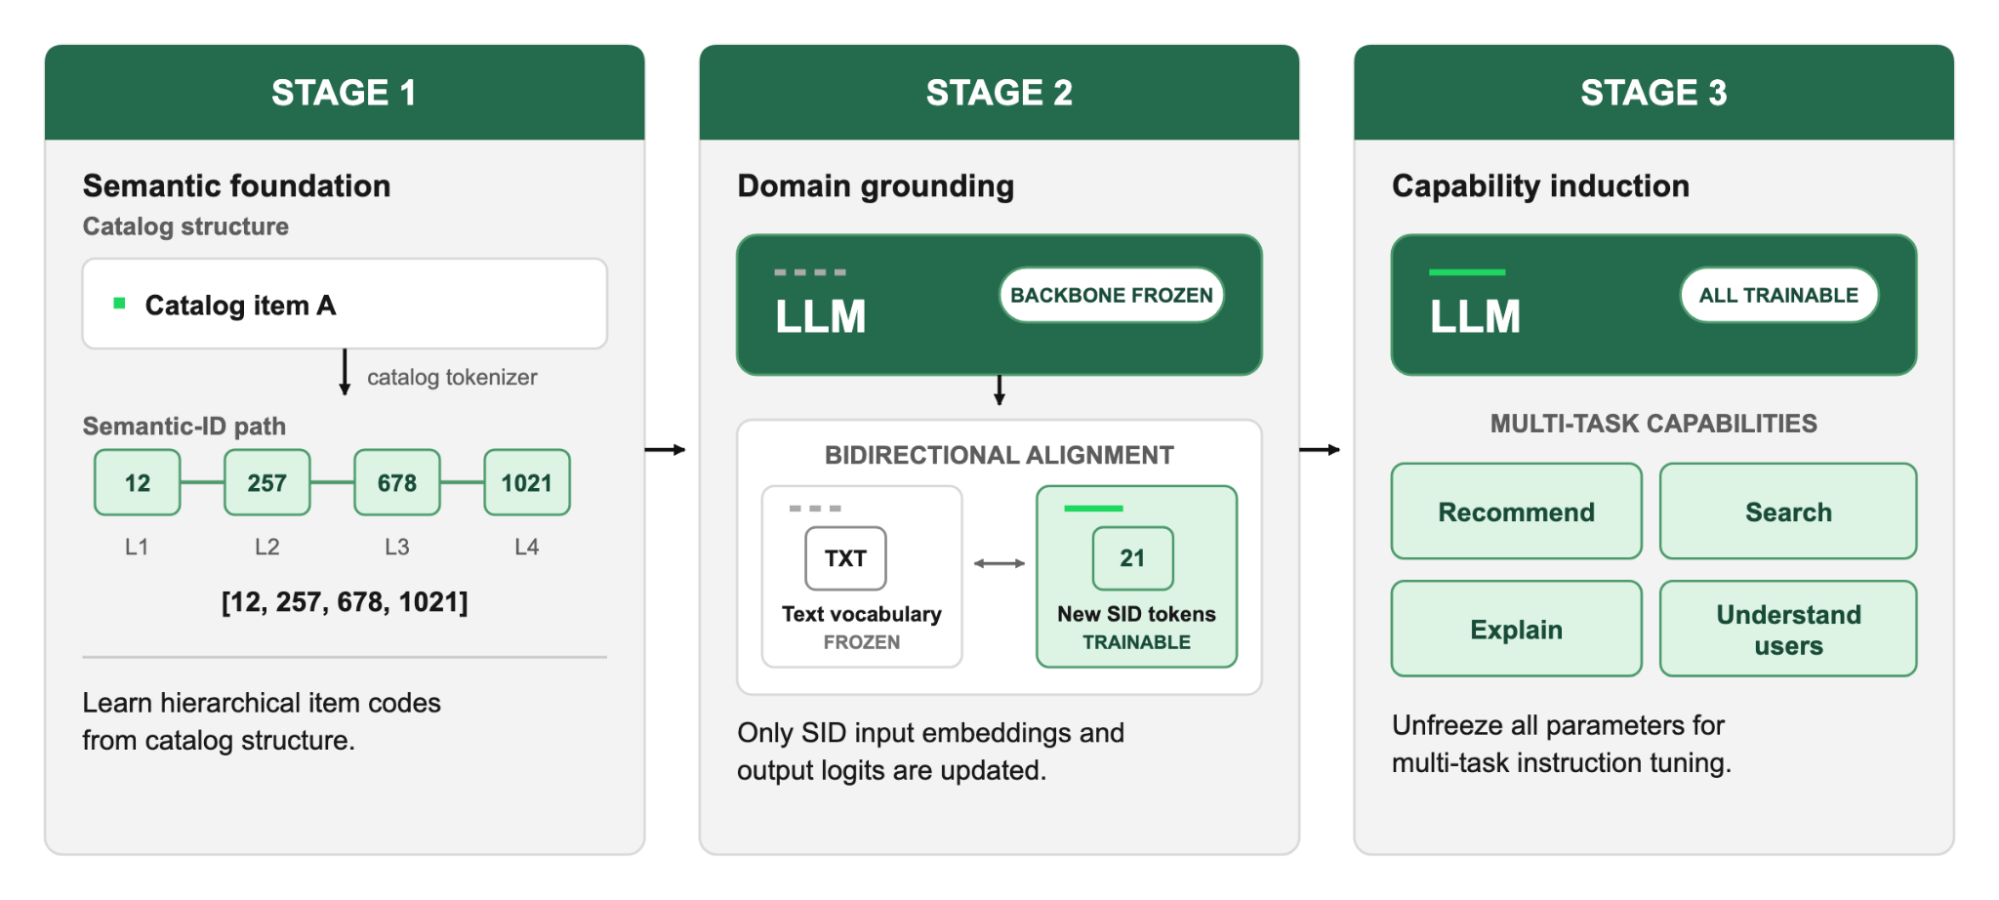
Подготовка NEO: построение иерархических кодов, обучение новых токенов при замороженной базовой модели, затем настройка всей модели под несколько задач.
Источник: Spotify Research · NEO и GLIDEЧто показывает эксперимент NEO
Авторы сообщают результаты на неоднородном каталоге более чем из 10 млн объектов. Семантически структурированные идентификаторы существенно превосходят произвольные item IDs, а отдельная стадия grounding лучше сохраняет языковые способности исходной LLM, чем альтернативные стратегии обучения. В статье нет чисел этих сравнений, поэтому здесь важен именно зафиксированный вывод, а не величина эффекта.
В разделе результатов масштаб NEO описан как более 10 млн объектов и примерно 15 млн пользователей. Один набор весов решает задачи рекомендаций, поиска, объяснения и понимания пользователя. Это результат исследовательского NEO, а не утверждение о том, что Spotify заменил этой моделью весь действующий рекомендательный стек. По формулировке статьи, эта единая модель выполняет перечисленные задачи без обращения к внешним инструментам.
NEO: a unified model for search, recommendation, and reasoning; Results at scaleGLIDE: рабочая задача обнаружения подкастов
GLIDE берёт более узкую задачу: можно ли использовать генеративную работу с Semantic IDs в рабочей системе рекомендаций эпизодов подкастов. В основе — компактная LLM на 1 млрд параметров. В отличие от общего NEO, здесь важна конкретная продуктовая цель и интеграция в существующий стек.
Подкасты создают характерный баланс между привычкой и исследованием. Слушатель возвращается к любимым шоу, но иногда хочет новые темы, форматы или голоса. GLIDE формулирует цель через прослушивания вне привычного круга. Внутри этого режима статья различает знакомый непривычный контент, например шоу, которое слушали раньше, но не недавно, и незнакомый непривычный контент — полностью новое шоу. Полную матрицу всех сочетаний статья не задаёт.
GLIDE: from grounded generation to online podcast discoveryКороткая история, долгосрочный профиль и управляющий токен
GLIDE получает недавнюю историю прослушиваний, компактный долгосрочный контекст и явную цель рекомендации. Недавние события отражают текущий интерес. Стабильные предпочтения берутся из плотного пользовательского вектора уже существующей модели персонализации.
Чтобы не превращать годы прослушиваний в огромный текстовый промпт, этот вектор проецируется в скрытое пространство LLM и добавляется как мягкие токены, то есть soft prompt. Так модель получает долгосрочное состояние пользователя в компактной форме, пригодной для рабочего сервиса.
Отдельно задаётся цель рекомендации. Статья уточняет, что ей соответствует управляющий токен: меняя его, одна и та же GLIDE может смещать генерацию в сторону знакомого или незнакомого открытия контента без обучения отдельных моделей под каждый сценарий.
GLIDE: from grounded generation to online podcast discovery — paragraphs on long-term personalization and language steeringКак GLIDE превращает генерацию в реальные эпизоды
Во время запроса недостаточно получить последовательность токенов. Система собирает промпт, добавляет пользовательский soft prompt, генерирует Semantic IDs кандидатов, разрешает возможные коллизии идентификаторов и сопоставляет коды с объектами каталога. Затем остаются только объекты, прошедшие проверки доступности и ограничения продукта.
После этого реальные эпизоды передаются существующей ранжирующей модели. Это принципиальная граница роли GLIDE: она добавляет новый источник кандидатов, а не заменяет весь ранжирующий стек Spotify.
Третья схема показывает весь рабочий путь целиком: персональные сигналы и цель формируют смешанный промпт, 1B GLIDE генерирует несколько последовательностей Semantic ID, затем коды разрешаются в реальные эпизоды и проходят проверки доступности и ограничения продукта, после чего кандидаты уходят в существующую ранжирующую модель Spotify Home. Смысл схемы — показать, что генерация встроена между пользовательским контекстом и уже существующим ранжированием, а не является самостоятельной финальной выдачей.
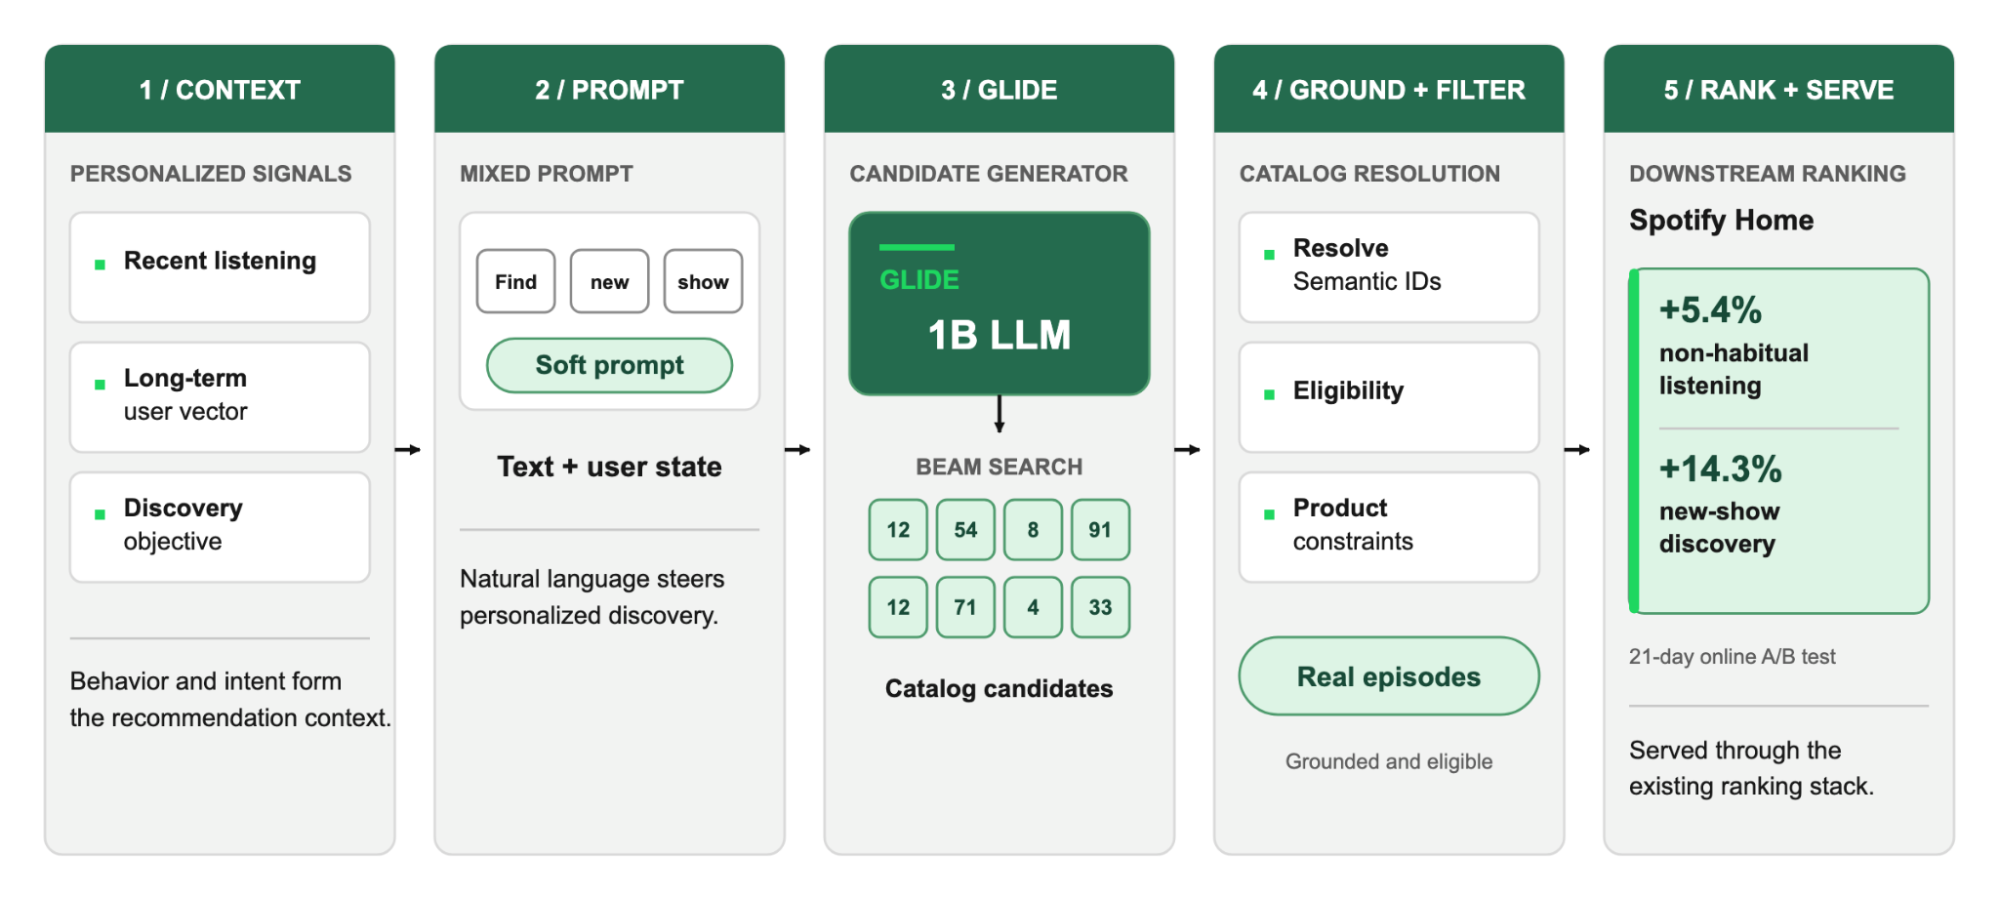
Рабочая система GLIDE и результаты 21-дневного A/B-теста на Spotify Home: +5,4% прослушиваний вне привычного круга и +14,3% открытий новых шоу. Относительные показатели из источника.
Источник: Spotify Research · NEO и GLIDEПочему выбрали beam search
GLIDE использует лучевой поиск, или beam search: вместо одного продолжения модель поддерживает несколько перспективных вариантов последовательности. Для рабочей системы это компромисс между скоростью и качеством поиска кандидатов. По статье, более быстрые альтернативы декодирования дали существенно более низкую точность поиска кандидатов.
Инфраструктуру обслуживания запросов поэтому оптимизировали под широкий beam search, сохранив требования по задержке. Конкретная численная задержка в статье не опубликована; также из этого источника нельзя восстановить детали GPU-конфигурации. Зафиксирован только факт, что система уложилась в производственные ограничения по задержке.
Deploying the model — paragraph beginning “Decoding is another important design choice”Почему одного recall недостаточно
Офлайн-метрики поиска остаются важными, но для рекомендации они не полностью отражают качество. Recall можно повысить, чаще предлагая популярный контент: нужные объекты будут чаще попадать в список, однако это ещё не означает хорошего соответствия индивидуальным интересам. Для GLIDE, которая специально ищет контент вне привычной рутины, такое ограничение особенно важно: воспроизведение ожидаемых или популярных объектов не исчерпывает цель продукта.
Поэтому Spotify сочетает офлайн-метрики с оценкой людьми и языковой моделью-судьёй. Люди обнаруживают устаревшие рекомендации, несоответствие языка и недостаток разнообразия. Языковая модель-судья масштабирует оценку соответствия интересам пользователя. Между несколькими итерациями модели эта оценка выросла с 0,44 до 0,91. Это оценка судьи, а не доля довольных пользователей, не онлайн-конверсия и не результат A/B-теста.
Deploying the model — evaluation paragraphs21-дневный A/B-тест на Spotify Home
GLIDE проверяли как дополнительный источник кандидатов, результаты которого затем проходили существующую ранжирующую модель. В 21-дневном онлайн A/B-тесте на Spotify Home было примерно 20 млн показов на каждую экспериментальную ячейку. Целевые показатели здесь — прослушивания подкастов вне привычного круга (non-habitual podcast listening) и открытие новых шоу (new-show discovery).
Авторы также сообщают, что система соблюдала производственные ограничения по задержке и сохраняла защитные показатели вовлечённости. Численное значение задержки в статье не приведено. Эти результаты относятся к конкретному эксперименту GLIDE на Spotify Home и не являются метриками NEO или доказательством замены всей рекомендательной системы.
Results at scaleОбщие уроки и открытые вопросы
NEO и GLIDE сходятся в нескольких принципах. Языковую модель нужно привязать к реальным сущностям домена, научить новому словарю так, чтобы не потерять исходные языковые способности, дать ей явный способ управления задачей и соединить короткую историю с компактной долгосрочной персонализацией. При этом обслуживание запросов, способ декодирования и оценка качества оказываются не второстепенной инженерией, а частью самого решения.
Авторы рассматривают рекомендации как частный случай более широкой задачи: LLM должна совместно рассуждать о языке, пользователе и структурированных сущностях предметной области. Это направление, а не отдельный доказанный эксперимент за пределами Spotify.
Остаются три открытых вопроса: как оценивать долгосрочное качество рекомендаций вместо одной немедленной релевантности; как языковое управление может выражать более богатые продуктовые цели; как сделать такие системы ещё эффективнее при обслуживании большого трафика. Финальный тезис статьи поэтому не про генерацию текста: ценность LLM здесь связывают со способностью совместно работать с языком, поведением пользователя и реальными объектами каталога.
Results at scale; Looking aheadИтог: от языка к реальному объекту каталога
Статья связывает NEO и GLIDE через одну проблему: LLM должна учитывать язык и поведение пользователя, но возвращать существующий и допустимый объект каталога. NEO исследует общую модель для поиска, рекомендаций, объяснений и понимания пользователя. GLIDE показывает рабочую интеграцию этой идеи в рекомендации подкастов и остаётся дополнительным источником кандидатов перед существующей ранжирующей моделью.
- 01
1. Получение контекста
Система получает недавнюю историю прослушиваний, долгосрочный вектор пользователя и управляющий токен цели рекомендации.
- 02
2. Долгосрочная персонализация
Пользовательский вектор проецируется в скрытое пространство 1B LLM и добавляется к промпту как soft prompt.
- 03
3. Генерация кодов
GLIDE генерирует Semantic IDs кандидатов; для декодирования используется beam search, сохраняющий несколько перспективных продолжений.
- 04
4. Разрешение и фильтры
Коды сопоставляются с реальными эпизодами, после чего применяются проверки доступности и ограничения продукта.
- 05
5. Ранжирование
Допустимые эпизоды передаются существующей ранжирующей модели, которая продолжает формирование выдачи.
Обучение NEO идёт отдельно от обработки запроса GLIDE. Сначала объекты получают иерархические Semantic IDs, затем при замороженной основной LLM новые SID-токены связывают с языком в обе стороны, и только потом все параметры дообучают на нескольких задачах. Один набор весов работает с рекомендациями, поиском, объяснениями и пониманием пользователя; эксперименты охватывают более 10 млн объектов.
Качество GLIDE проверяют не одним recall: популярный контент может повысить его, не улучшив соответствие интересам. Поэтому используют оценки людей и языковую модель-судью; оценка соответствия интересам между итерациями выросла с 0,44 до 0,91, но это не пользовательская метрика. В 21-дневном A/B-тесте на Spotify Home при примерно 20 млн показов на ячейку GLIDE дал +5,4% прослушиваний подкастов вне привычного круга и +14,3% открытия новых шоу при сохранении защитных показателей вовлечённости и ограничений по задержке. Численная задержка не опубликована. Открыты вопросы долгосрочной оценки, более богатых целей и эффективности обслуживания запросов.
Teaching an LLM to speak the catalog; NEO: a unified model for search, recommendation, and reasoning; GLIDE: from grounded generation to online podcast discovery; Deploying the model; Results at scale; Looking ahead